제8장 시뮬레이션과 재표본추출
장 미리보기. 시뮬레이션은 어려운 문제를 풀기 위해 사용하는 계산 집약적인 방법입니다. 시뮬레이션 연구는 물리적 과정을 직접 만들고 실험하여 그 작동 특성을 이해하는 대신 컴퓨터상의 표현에 기반합니다. 즉, 다양한 가상 조건을 입력으로 고려하고 그 결과를 요약합니다. 시뮬레이션을 통해 방대한 수의 가상 조건을 빠르고 저렴하게 검토할 수 있습니다. 8.1절에서는 시뮬레이션을 특히 복잡한 다변량 환경에서 효과적인 유용한 계산 도구로 소개합니다.
8.2절에서 논의하듯이, 분석가들은 복잡한 분포를 요약하는 측도를 계산하는 데 시뮬레이션이 특히 유용하다는 것을 알게 됩니다. 여기에는 손실의 빈도와 심도를 요약하는 측도와 같이 이 책에서 지금까지 언급한 모든 예와 더불어 많은 추가 사례가 포함됩니다. 시뮬레이션은 가설검정에 필요한 복잡한 분포를 계산하는 데에도 사용할 수 있습니다. 또한 시뮬레이션을 사용하여 경험분포로부터 추출할 수도 있습니다. 이 과정을 재표본추출이라고 합니다. 재표본추출을 이용하면 복잡한 모형에서 추정값의 불확실성을 평가할 수 있습니다. 8.3절에서는 추정량의 정밀도를 결정하기 위한 부트스트래핑의 맥락에서 재표본추출을 소개합니다. 교차 검증을 다루는 8.4절에서는 이를 모형 선택과 검증에 사용하는 방법을 보여 줍니다.
8.1 난수 생성
이 절에서는 다음 방법을 배웁니다.
- 균등분포를 따르는 근사적으로 독립인 실현값을 생성하는 방법
- 균등분포를 따르는 실현값을 관심 있는 확률분포의 관측값으로 변환하는 방법
- 기성 난수 생성기를 사용하여 일반적인 분포로부터 시뮬레이션 값을 직접 생성하는 방법
- 일반적인 분포의 시뮬레이션 값을 결합하여 복잡한 분포로부터 시뮬레이션 값을 생성하는 방법
- 공제액이나 꼬리가 긴 계리적 응용에서처럼, 정의역이 특정 관심 영역으로 제한된 분포로부터 시뮬레이션 값을 생성하는 방법
8.1.1 독립 균등 관측값 생성
우리가 고려하는 시뮬레이션(simulations) 주어진 모형 구조를 바탕으로 다양한 가상의 조건과 출력을 컴퓨터로 생성하는 것입니다.은 컴퓨터로 생성됩니다. 이 접근법의 주요 장점은 결과를 재현할 수 있어서 작업을 점검하고 개선할 수 있다는 점입니다. 물론 이는 그 결과가 실제로는 무작위가 아니라는 의미이기도 합니다. 그럼에도 불구하고, 실용적인 목적으로는 결과가 무작위로 보이도록 하는 알고리즘들이 만들어져 왔습니다. 구체적으로, 이러한 알고리즘은 정교한 독립성 검정을 통과하며, 결과가 단일 분포에서 나오도록 설계할 수 있습니다. 이것이 바로 동일하고 독립적으로 분포한다는 우리의 iid(iid) 독립적이고 동일하게 분포된 가정입니다.
이러한 알고리즘이 무엇을 하는지 감을 잡기 위해, 역사적으로 잘 알려진 방법 하나를 살펴보겠습니다.
선형 합동 생성기. 난수열을 생성하려면 시드라고 불리는 시작값 \(B_0\)에서 출발하십시오. 이 값은 재귀 관계식 \[ B_{n+1} = (a B_n + c) \text{ modulo }m, ~~ n=0, 1, 2, \ldots . \] 를 사용하여 갱신됩니다. 이 알고리즘을 선형 합동 생성기(linear congruential generator) 선형 재귀 관계와 초기 시드 값을 사용하여 계산된 의사난수를 산출하는 알고리즘입니다.라고 합니다. \(c=0\)인 경우를 곱셈 합동 생성기라고 하며, 매우 빠른 계산에 특히 유용합니다.
\(a\)와 \(m\)의 예시 값으로, Microsoft의 Visual Basic은 \(m=2^{24}\), \(a=1,140,671,485\), \(c = 12,820,163\)을 사용합니다(https://en.wikipedia.org/wiki/Linear_congruential_generator 참조). 이것은 Microsoft Excel 프로그램의 난수 생성을 뒷받침하는 엔진입니다.
분석가가 사용하는 수열은 \(U_n=B_n/m.\)로 정의됩니다. 분석가는 수열 {\(U_{i}\)}이 구간 (0,1)에서 (근사적으로) 동일하고 독립적인 균등분포를 따른다고 해석할 수 있습니다. 이 알고리즘을 설명하기 위해 다음을 살펴보겠습니다.
예제 8.1.1. 예시 수열. \(m=15\), \(a=3\), \(c=2\), \(B_0=1\)로 두겠습니다. 그러면 다음을 얻습니다.
| 단계 \(n\) | \(B_n\) | \(U_n\) |
|---|---|---|
| 0 | \(B_0=1\) | |
| 1 | \(B_1 =\mod(3 \times 1 +2) = 5\) | \(U_1 = \frac{5}{15}\) |
| 2 | \(B_2 =\mod(3 \times 5 +2) = 2\) | \(U_2 = \frac{2}{15}\) |
| 3 | \(B_3 =\mod(3 \times 2 +2) = 8\) | \(U_3 = \frac{8}{15}\) |
| 4 | \(B_4 =\mod(3 \times 8 +2) = 11\) | \(U_4 = \frac{11}{15}\) |
선형 합동 생성기는 의사 난수 결과를 생성하는 방법 중 하나일 뿐입니다. 이 방법은 이해하기 쉽고 널리 사용됩니다. 선형 합동 생성기에는 분명한 한계가 있으며, 생성된 수열에서 시간에 따른 장기적인 패턴을 감지할 수 있다는 점도 그중 하나입니다(독립성은 함수적 패턴이 전혀 없음을 의미한다고 해석할 수 있음을 상기하십시오). 당연하게도, 이 방법의 몇몇 단점을 보완하는 고급 기법들이 개발되었습니다. R이 생성하는 난수는 이러한 고급 기법을 활용합니다.
컴퓨터로 생성한 무작위 결과는 기계로 생성되며 재현할 수 있다는 사실을 반영하여 의사 난수(pseudo-random numbers) 무작위로 보이지만 공식으로 재현할 수 있는 값입니다.라고 불리기도 합니다. 즉, {\(U_{i}\)}이 i.i.d.인 것처럼 보이더라도 같은 시드 번호(와 같은 알고리즘)를 사용하면 이를 재현할 수 있습니다.
예제 8.1.2. R에서 균등 난수 생성하기. 다음 코드는 runif 명령을 사용하여 R에서 균등 (0,1) 난수 세 개를 생성하는 방법을 보여 줍니다. set.seed() 함수는 초기 시드를 설정합니다. 많은 컴퓨터 패키지에서는 따로 지정하지 않는 한 시스템 시계를 사용하여 초기 시드를 설정합니다.
8.1.2 역변환법
균등 난수 수열을 얻었으면, 다음으로 이를 관심 있는 분포, 예컨대 \(F\)로 변환합니다. 대표적인 기법은 역변환법(inverse transform method) 무작위로 선택된 백분위수를 나타내기 위해 0과 1 사이의 균등 난수를 표본추출한 다음, 시뮬레이션하고자 하는 분포의 누적밀도함수의 역함수를 사용하여 해당 분포로부터의 시뮬레이션 값을 구하는 방법이며, \[ X_i=F^{-1}\left( U_i \right) . \] 로 정의됩니다. 여기서 4.1.1절에서 분포함수의 역함수 \(F^{-1}\)를 소개하고 이를 분위수 함수(quantile function) [0,1] 구간의 백분위수 값을 입력으로 받아 분포에서 그에 대응하는 값을 출력하는 누적밀도함수의 역함수입니다.라고도 불렀음을 상기하십시오. 구체적으로, 이는 \[ F^{-1}(y) = \inf_x ~ \{ F(x) \ge y \} . \] 로 정의됩니다. \(\inf\)은 하한, 즉 최대 하한(greatest lower bound) 지정된 값/원소의 부분집합보다 작거나 같은 값 중 가장 큰 값입니다.을 나타낸다는 점을 상기하십시오. 이는 본질적으로 부등식 \(\{F(x) \ge y\}\)을 만족하는 x의 가장 작은 값입니다. 그 결과, {\(U_i\)}가 \((0,1)\)에서의 균등 분포함수를 따르는 iid이면 수열 {\(X_{i}\)}은 분포함수 \(F\)를 따르는 iid입니다.
역변환 결과는 기저 확률변수가 연속형이든, 이산형이든, 또는 둘의 혼합형이든 사용할 수 있습니다. 이제 그 적용 범위를 보여 주는 일련의 예제를 제시합니다.
예제 8.1.3. 지수 난수 생성. 척도모수가 \(\theta\)인 지수분포에서 관측값을 생성하여 \(F(x) = 1 - e^{-x/\theta}\)이 되도록 하고자 한다고 가정합시다. 역변환을 계산하려면 다음 단계를 사용할 수 있습니다. \[ \begin{aligned} y = F(x) &\Leftrightarrow y = 1-e^{-x/\theta} \\ &\Leftrightarrow -\theta \ln(1-y) = x = F^{-1}(y) . \end{aligned} \] 따라서 \(U\)가 균등 (0,1) 분포를 따르면, \(X = -\theta \ln(1-U)\)는 모수가 \(\theta\)인 지수분포를 따릅니다.
다음 R 코드는 예제 8.1.2에서와 같은 세 개의 균등 난수에서 출발하여 이를 평균이 10인 독립적인 지수분포 확률변수로 변환하는 방법을 보여 줍니다. 또는 R의 rexp 함수를 직접 사용하여 지수분포에서 난수를 생성할 수도 있습니다. 이 루틴에 내장된 알고리즘은 다르기 때문에, 같은 시작 시드 번호를 사용하더라도 개별 실현값은 달라집니다.
세 개의 균등 확률 변량
| Uniform | Exponential 1 | Exponential 2 |
|---|---|---|
| 0.92424 | 25.80219 | 3.25222 |
| 0.53718 | 7.70409 | 8.47652 |
| 0.46920 | 6.33362 | 5.40176 |
예제 8.1.4. 파레토 난수 생성하기. 모수가 \(\alpha\)와 \(\theta\)인 파레토 분포, 즉 \(F(x) = 1 - \left(\frac{\theta}{x+\theta} \right)^{\alpha}\)에서 관측값을 생성하려 한다고 가정합시다. 역변환을 계산하려면 다음 단계를 사용할 수 있습니다. \[ \begin{aligned} y = F(x) &\Leftrightarrow 1-y = \left(\frac{\theta}{x+\theta} \right)^{\alpha} \\ &\Leftrightarrow \left(1-y\right)^{-1/\alpha} = \frac{x+\theta}{\theta} = \frac{x}{\theta} +1 \\ &\Leftrightarrow \theta \left((1-y)^{-1/\alpha} - 1\right) = x = F^{-1}(y) .\end{aligned} \] 따라서 \(X = \theta \left((1-U)^{-1/\alpha} - 1\right)\)는 모수가 \(\alpha\)와 \(\theta\)인 파레토 분포를 따릅니다.
역변환의 정당성. 확률변수 \(X = F^{-1}(U)\)가 분포함수 \(F\)를 갖는 이유는 무엇입니까?
이론 일부 보기
이제 몇 가지 이산형 예를 살펴보겠습니다.
예 8.1.5. 베르누이 난수 생성. 모수가 \(q=0.85\)인 베르누이 분포로부터 확률변수를 시뮬레이션하고자 한다고 가정합니다.
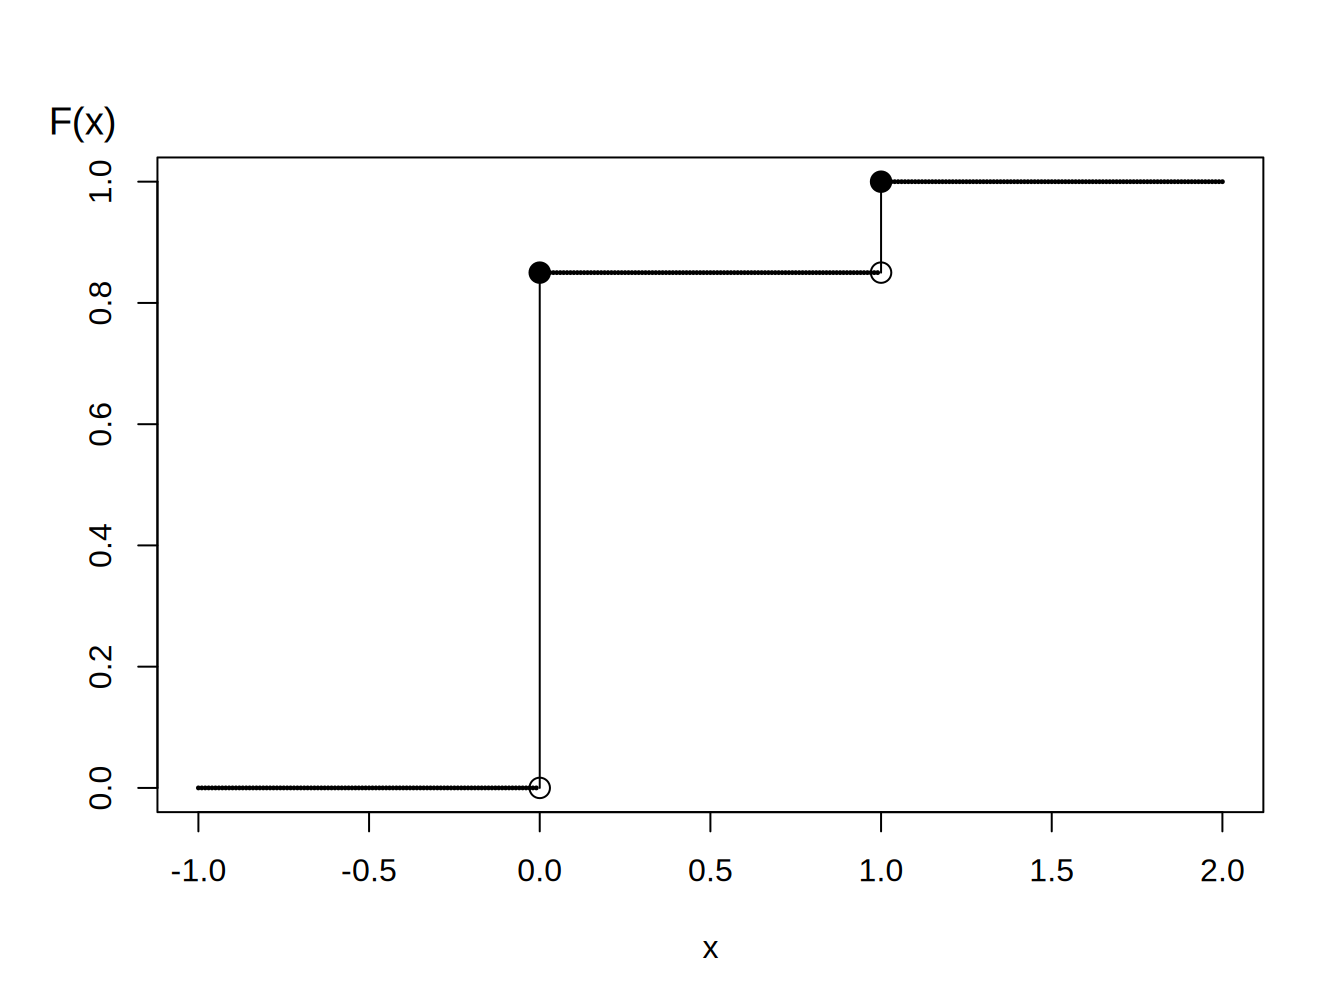
그림 8.1: 이진 확률변수의 분포함수
그림 8.1의 누적분포함수 그래프는 분위수 함수를 \[ \begin{aligned} F^{-1}(y) = \left\{ \begin{array}{cc} 0 & 0<y \leq 0.85 \\ 1 & 0.85 < y \leq 1.0 . \end{array} \right. \end{aligned} \] 와 같이 쓸 수 있음을 보여 줍니다. 따라서 역변환을 이용하여 \[ \begin{aligned} X = \left\{ \begin{array}{cc} 0 & 0<U \leq 0.85 \\ 1 & 0.85 < U \leq 1.0 \end{array} \right. \end{aligned} \] 와 같이 정의할 수 있습니다. 예시로 세 개의 난수를 생성하면 다음을 얻습니다.
세 개의 확률변량
| Uniform | Binary X |
|---|---|
| 0.92424 | 1 |
| 0.53718 | 0 |
| 0.46920 | 0 |
예 8.1.6. 이산분포로부터의 난수 생성. 처음 5년 동안 기계가 고장 나는 시점을 생각해 봅시다. 고장 시점의 분포는 다음과 같이 주어집니다.
이산분포
| Time | 1.0 | 2.0 | 3.0 | 4.0 | 5.0 |
| Probability | 0.1 | 0.2 | 0.1 | 0.4 | 0.2 |
| Distribution Function | 0.1 | 0.3 | 0.4 | 0.8 | 1.0 |
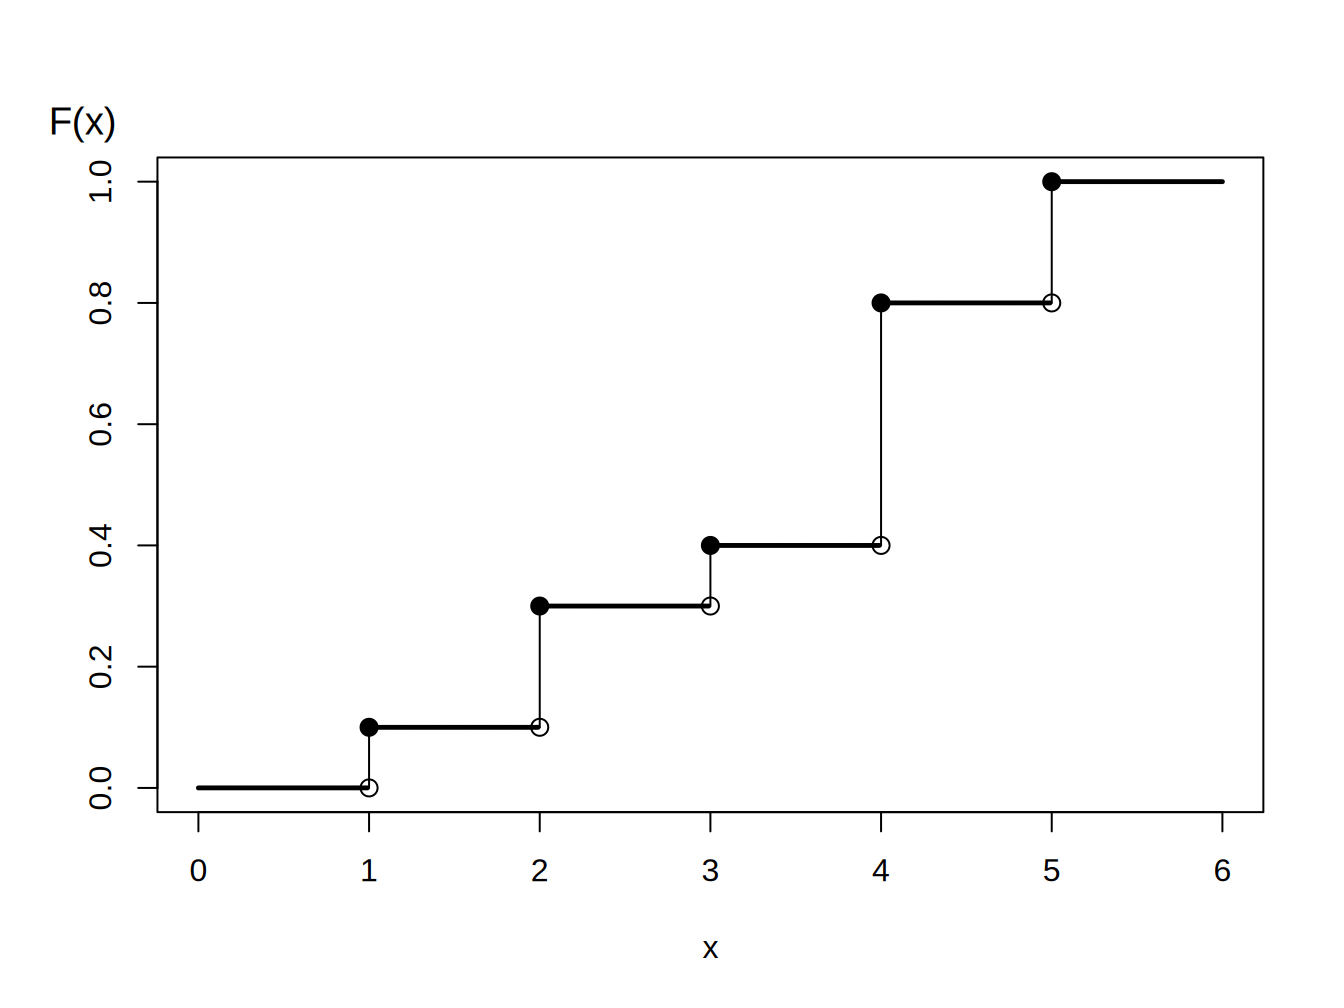
그림 8.2: 이산 확률변수의 분포함수
그림 8.2의 분포함수 그래프를 이용하면, 역변환으로 다음과 같이 정의할 수 있습니다. \[ \small{ \begin{aligned} X = \left\{ \begin{array}{cc} 1 & 0<U \leq 0.1 \\ 2 & 0.1 < U \leq 0.3\\ 3 & 0.3 < U \leq 0.4\\ 4 & 0.4 < U \leq 0.8 \\ 5 & 0.8 < U \leq 1.0 . \end{array} \right. \end{aligned} } \]
일반적인 이산 확률변수의 경우에는 결과들 사이에 순서가 없을 수도 있습니다. 예를 들어, 어떤 사람이 다섯 가지 유형의 생명보험 상품 중 하나를 보유할 수 있으며, 무작위 결과를 생성하기 위해 다음 알고리즘을 사용할 수 있습니다. \[ {\small \begin{aligned} X = \left\{ \begin{array}{cc} \textrm{whole life} & 0<U \leq 0.1 \\ \textrm{endowment} & 0.1 < U \leq 0.3\\ \textrm{term life} & 0.3 < U \leq 0.4\\ \textrm{universal life} & 0.4 < U \leq 0.8 \\ \textrm{variable life} & 0.8 < U \leq 1.0 . \end{array} \right. \end{aligned} } \] 다른 분석가는 다음과 같은 대안적인 절차를 사용할 수도 있습니다. \[ {\small \begin{aligned} X = \left\{ \begin{array}{cc} \textrm{whole life} & 0.9<U<1.0 \\ \textrm{endowment} & 0.7 \leq U < 0.9\\ \textrm{term life} & 0.6 \leq U < 0.7\\ \textrm{universal life} & 0.2 \leq U < 0.6 \\ \textrm{variable life} & 0 \leq U < 0.2 . \end{array} \right. \end{aligned} } \] 두 알고리즘 모두 (장기적으로) \(\Pr(\textrm{whole life})=0.1\) 등과 같이 동일한 확률을 산출합니다. 따라서 어느 쪽도 틀리지 않습니다. 하나의 목표를 달성하는 방법이 둘 이상 있다는 점을 알아 두십시오. 마찬가지로, 순서가 있는 결과(위의 고장 시점 1, 2, 3, 4, 5 등)에 대해서도 대안적인 알고리즘을 사용할 수 있습니다.
8.1.3 기성 난수 생성기
절 8.1.1와 8.1.2에서는 기초로부터 시뮬레이션 값을 생성하는 방법을 보였습니다. 이 접근법은 분석가가 시뮬레이션이 왜 그렇게 잘 작동하는지 이해할 수 있게 해 준다는 점에서 중요합니다. 그러나 시뮬레이션은 매우 널리 사용되므로, 시간을 절약하는 도구로서 패키지들이 개발되어 온 것은 놀라운 일이 아닙니다.
예를 들어, 예 8.1.3에서 rexp 함수를 통해 지수분포를 따르는 확률변량을 생성할 수 있음을 이미 보았습니다. 이 함수를 사용하면 분석가가 균등 확률변량을 생성한 다음 지수분포의 역분포함수로 변환할 필요가 없습니다. 대신 rexp 함수를 사용하여 이 작업을 한 단계로 수행합니다.
표 8.2는 R의 표준 난수 생성기 몇 가지를 요약한 것입니다. 각 함수 이름 앞의 r은 random number generator(난수 생성기)를 가리킵니다. 이 함수들에 대한 추가 문서는 부록 장 20에 있습니다. 파레토 분포에는 actuar 패키지가 필요하다는 점에 유의하십시오.
표 8.2. 난수 생성기(RNG)
\[ {\small \begin{array}{ll|ll} \hline \textbf{Discrete Distributions} & &\textbf{Continuous Distributions} & \\ \textit{Distribution}& \textit{RNG Function}& \textit{Distribution}& \textit{RNG Function}\\ \hline \text{Binomial}& \text{rbinom} &\text{Exponential}& \text{rexp}\\ \text{Poisson} & \text{rpoisson}&\text{Gamma} & \text{rgamma}\\ \text{Negative Binomial}& \text{rnbinom} & \text{Pareto}& \text{actuar::rpareto}\\ & &\text{Normal}& \text{rnorm}\\ & &\text{Weibull}& \text{rweibull}\\ \hline \end{array} } \]
8.1.4 복잡한 분포로부터의 시뮬레이션
분석가는 R과 같은 통계 소프트웨어 프로그램에서 기성 난수 생성기를 여럿 찾을 수 있습니다. 그러나 복잡한 보험계리 응용에서는 기성 생성기가 없는 경우가 많으므로 기초로 돌아가야 합니다.
예를 들어 제7장에서 소개한 총청구액 분포를 생각해 봅시다. 그 장의 7.4.2절에서 총손실 분포를 시뮬레이션하는 방법을 이미 살펴보았습니다. [Example 7.4.2]에서 본 것처럼, 먼저 손실 건수를 시뮬레이션한 다음 개별 손실을 시뮬레이션하는 절차를 따릅니다.
복잡한 분포의 또 다른 예로 다음 예제를 살펴봅시다.
예제 8.1.7. 혼합형 분포로부터 난수 생성하기. 확률 70%로 0의 값을 갖고, 확률 30%로 모수 \(\theta= 10,000\)인 지수분포를 따르는 확률변수를 생각해 봅시다. 보험 응용에서는 보험청구가 발생하지 않을 확률이 70%이고 청구가 발생할 확률이 30%인 상황에 해당할 수 있으며, 청구가 발생하면 그 금액은 지수분포를 따릅니다. 그림 8.3에 나타낸 분포함수는 다음과 같습니다. \[ \begin{aligned} F(y) = \left\{ \begin{array}{cc} 0 & x<0 \\ 1 - 0.3 \exp(-x/10000) & x \ge 0 . \end{array} \right. \end{aligned} \]
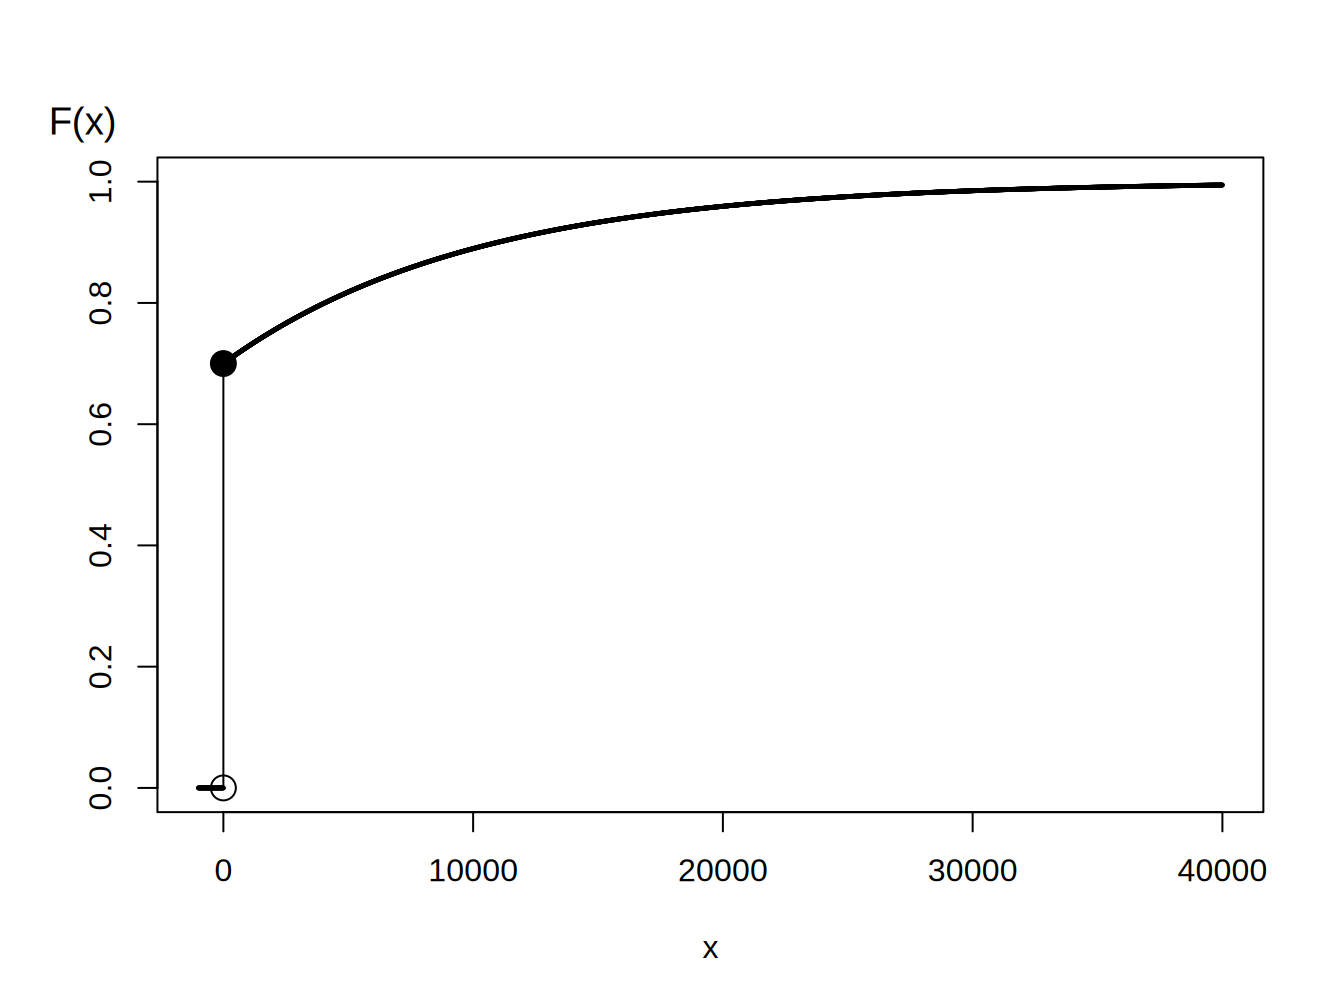
그림 8.3: 혼합형 확률변수의 분포함수
그림 8.3에서 이 분포함수를 갖는 확률변수를 생성하기 위한 역변환이 \[ \begin{aligned} X = F^{-1}(U) = \left\{ \begin{array}{cc} 0 & 0< U \leq 0.7 \\ -1000 \ln (\frac{1-U}{0.3}) & 0.7 < U < 1 . \end{array} \right. \end{aligned} \] 임을 알 수 있습니다. 이산형 및 혼합형 확률변수에서는 분포함수의 그래프를 그려 역함수가 가질 수 있는 값을 시각적으로 파악하는 것이 핵심입니다.
이 혼합형 분포는 3.6절과 4.3.2절에서 소개한 혼합 모형의 특수한 경우로 생각할 수 있습니다. 혼합 모형은 시뮬레이션을 이용하면 간단하게 평가할 수 있습니다. 첫 번째 단계에서는 하위 모집단을 나타내는 변수를 시뮬레이션합니다. 두 번째 단계에서는 해당 하위 모집단에서 시뮬레이션합니다. 이렇게 얻은 변량은 혼합 모형의 한 실현값입니다. 예를 들어 Example 4.3.5를 다시 살펴봅시다.
예제 4.3.5. (계속) 이 문제에서 유형 1 하위 모집단에서 추출한 값은 평균이 200인 지수분포를 따르는 \(X_1\)으로, 유형 2 하위 모집단에서 추출한 값은 모수가 \(\alpha=3\)와 \(\theta=200\)인 파레토 분포를 따르는 \(X_2\)로 표기할 수 있습니다. 여기서 보험계약의 25%는 유형 1이고 75%는 유형 2입니다.
시뮬레이션을 이용하여 연간 손실이 100보다 작을 확률과 평균 손실을 구할 수 있습니다. 예시 코드에서는 기성 난수 생성 함수인 rbinom, rexp, actuar::pareto를 사용합니다.
예제 4.3.5 (계속)의 R 코드 보기
8.1.5 중요도 표본추출
또 다른 중요한 문제 유형에서는 제한된 영역에서 정의된 분포를 사용합니다. 예를 들어 손실에 공제액이 있으면, 그 결과로 생기는 청구는 보험자가 지급하는 금액을 나타내며 공제액보다 작은 금액은 관측되지 않습니다. 이러한 유형의 문제는 제5장에서 자세히 다루었습니다. 또 다른 예로, 매우 큰 청구에 대해서는 분석을 매우 큰 결과로만 한정하고자 할 수 있습니다. 분포의 꼬리에 대한 논의는 13.2절에서 다룹니다. 두 유형의 문제를 모두 다루기 위해, 이제 \(X\in[a,b]\)라는 조건에서 \(X\)에 따라 추출하고자 한다고 가정합니다.
이를 위해 채택-기각 기법(accept-reject mechanism) 확률표본이 미리 지정된 특정 범위 [a, b] 안에 있지 않으면 버리는 표본추출 방법으로, 전통적인 역변환법을 쉽게 사용할 수 없을 때 흔히 사용됩니다.을 사용할 수 있습니다. 분포 \(F\)에서 \(x\)을 추출합니다.
- \(x\in[a,b]\)이면 : 그 값을 유지합니다(“채택”)
- \(x\notin[a,b]\)이면 : 다른 값을 추출합니다(“기각”)
처음에 생성된 \(n\)개의 값 중에서 여기서는 평균적으로 \([F(b)-F(a)]\cdot n\)개의 추출값만 남긴다는 점에 주목하십시오.
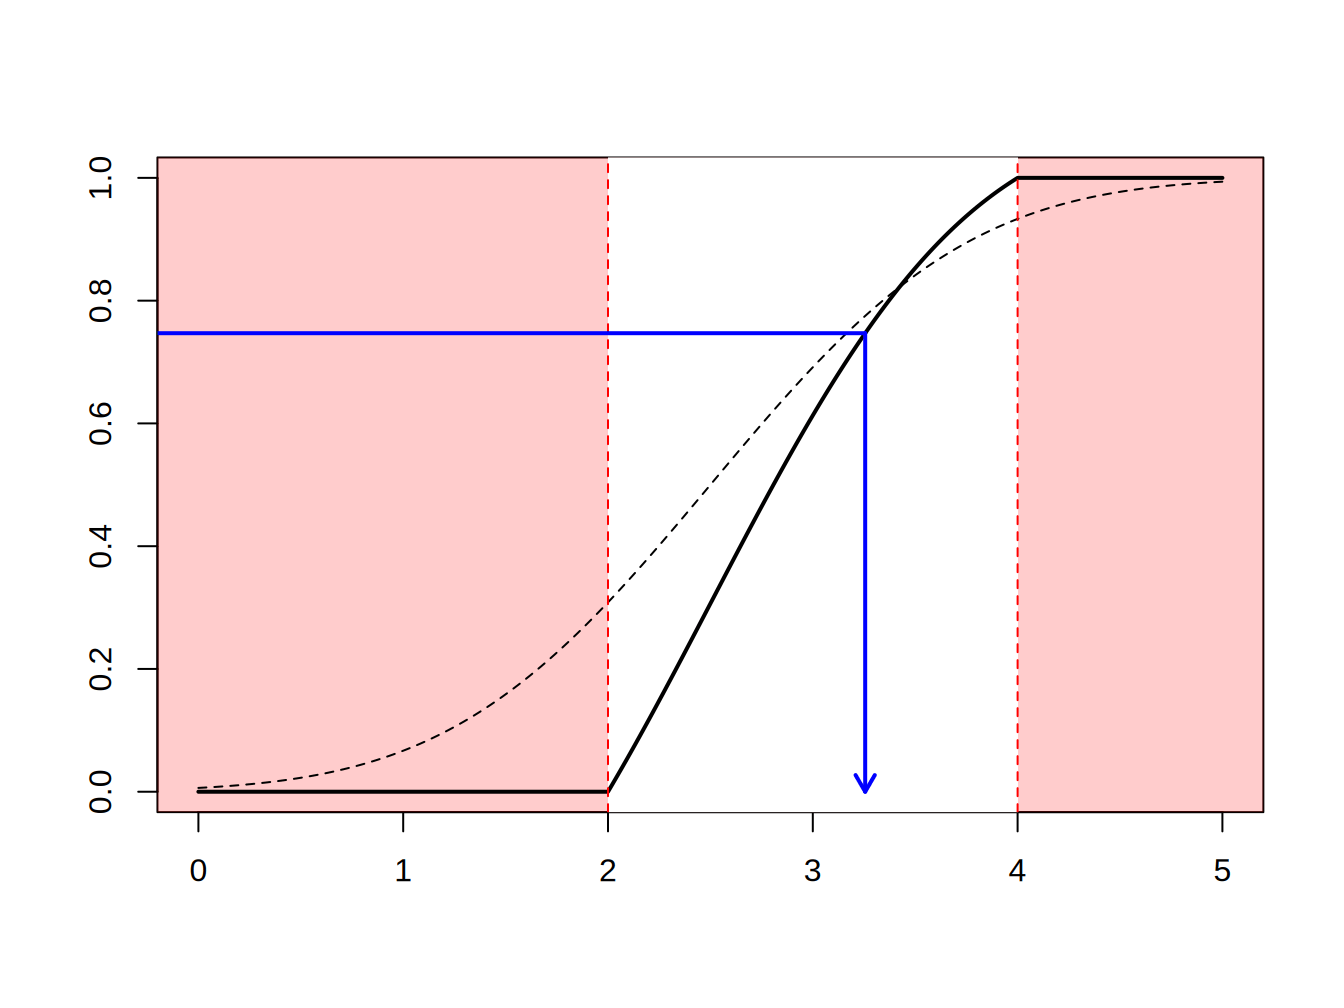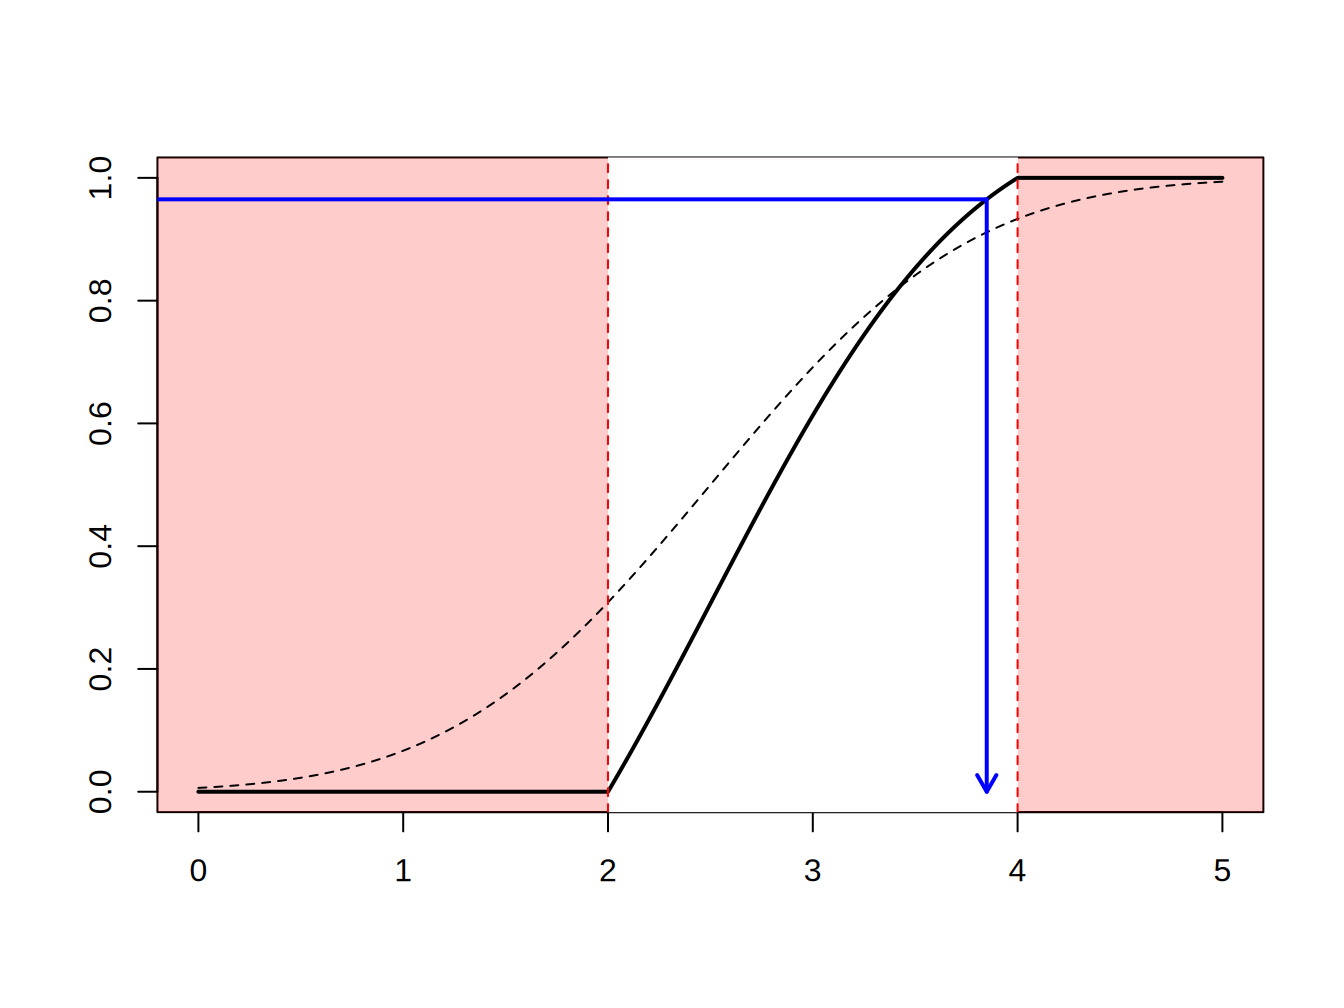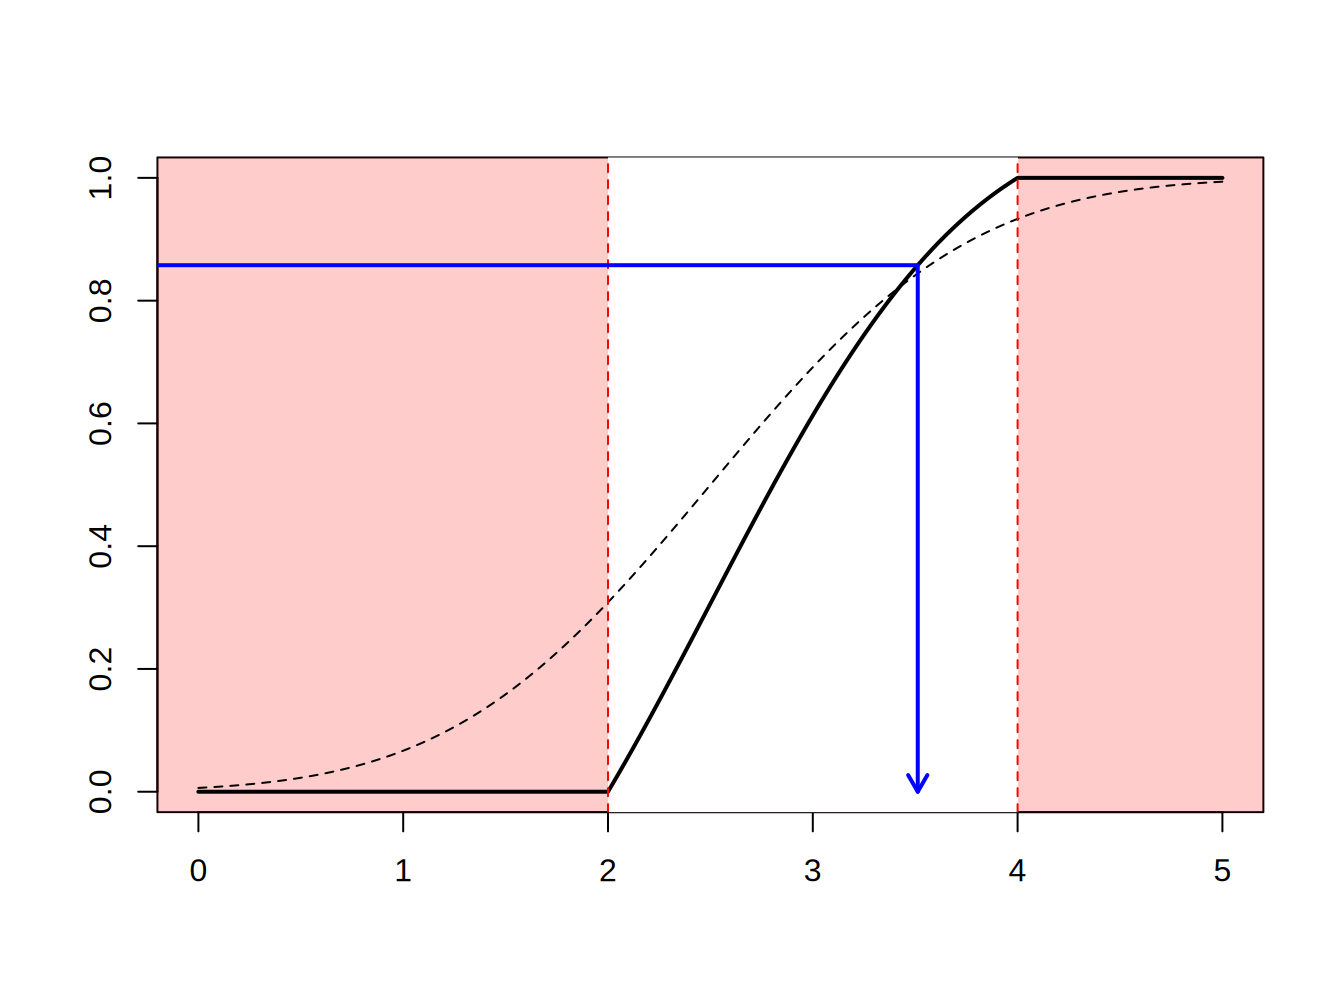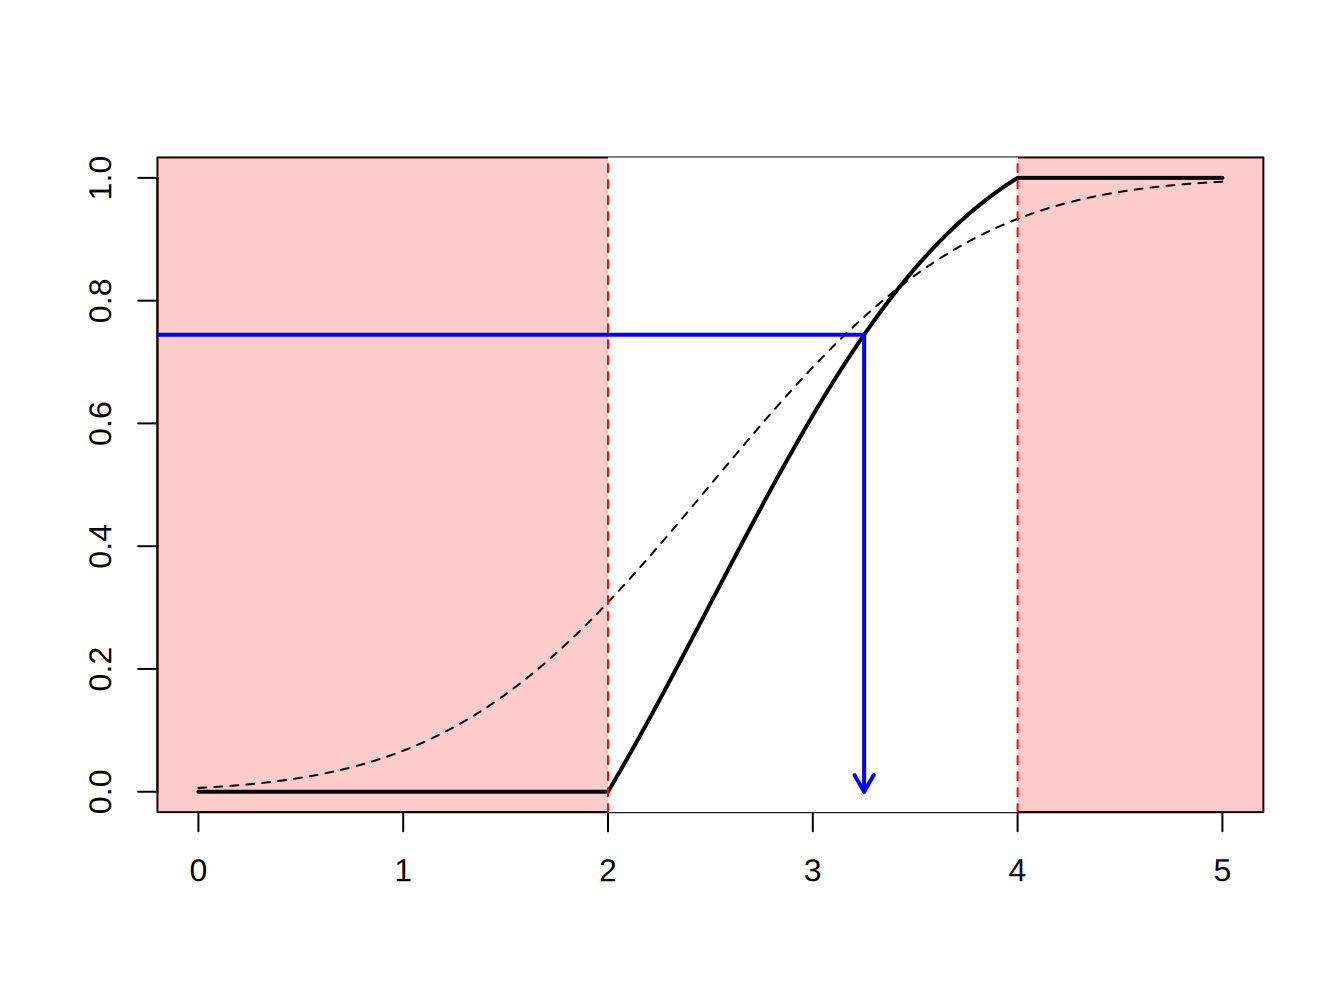
예제 8.1.8. 정규분포로부터의 추출. 평균이 2.5이고 분산이 1인 정규분포 \(N(2.5,1)\)에서 추출하되, \(a = 2\)보다 크고 \(b = 4\)보다 작은 추출값에만 관심이 있다고 가정합시다. 즉, 추출값 중 \(F(4)-F(2) = \Phi(4-2.5)-\Phi(2-2.5)\) = 0.9332 - 0.3085 = 0.6247 비율만 사용할 수 있습니다. 그림 8.4은 일부 추출값은 구간 \((2,4)\) 안에 있고 일부는 밖에 있음을 보여 줍니다.
채택-기각 메커니즘의 R 코드 보기
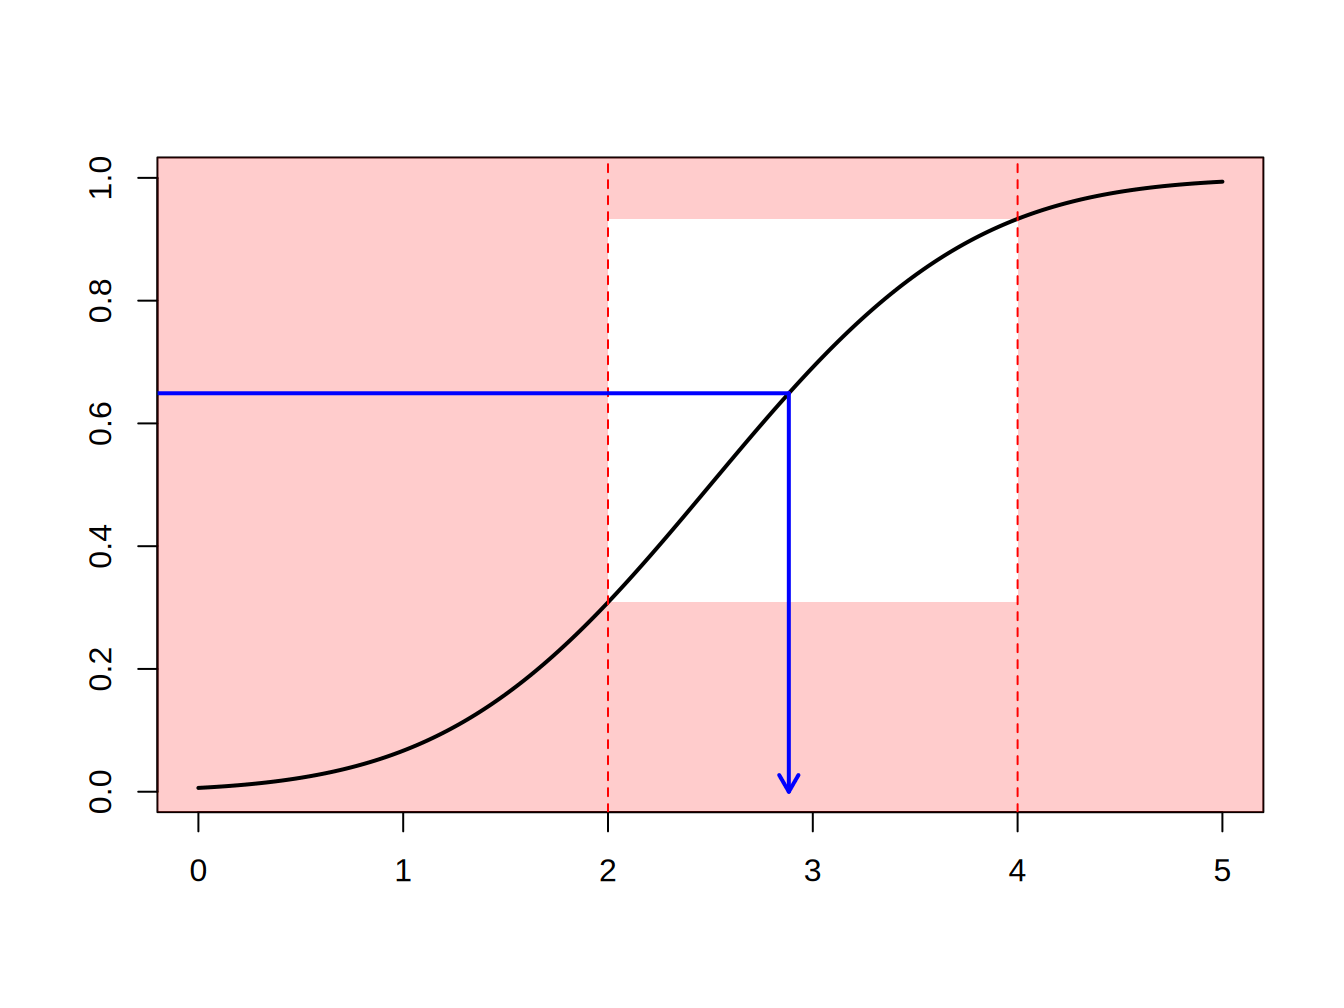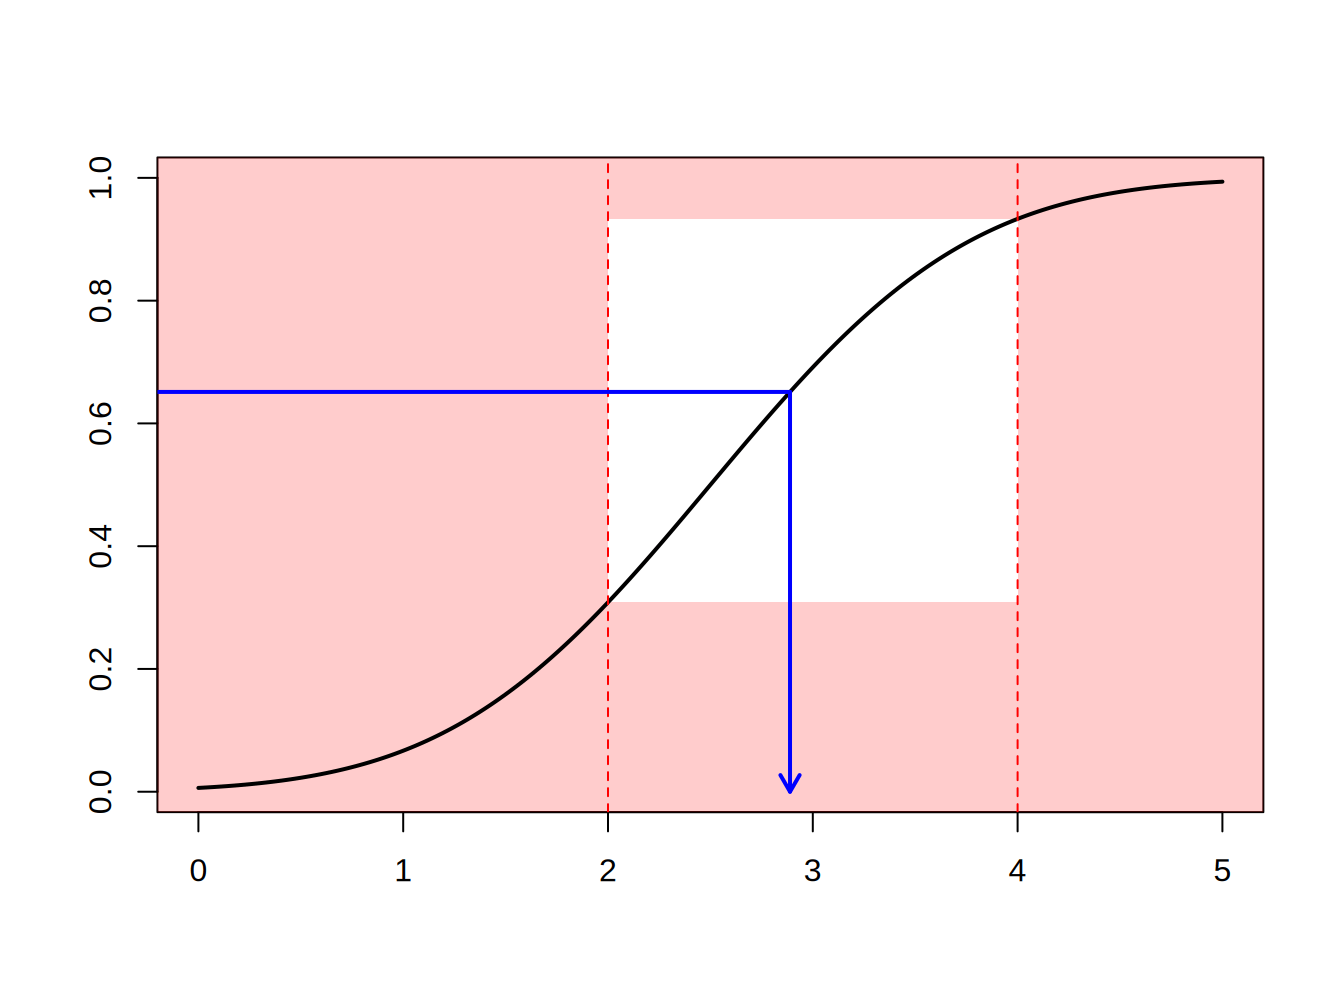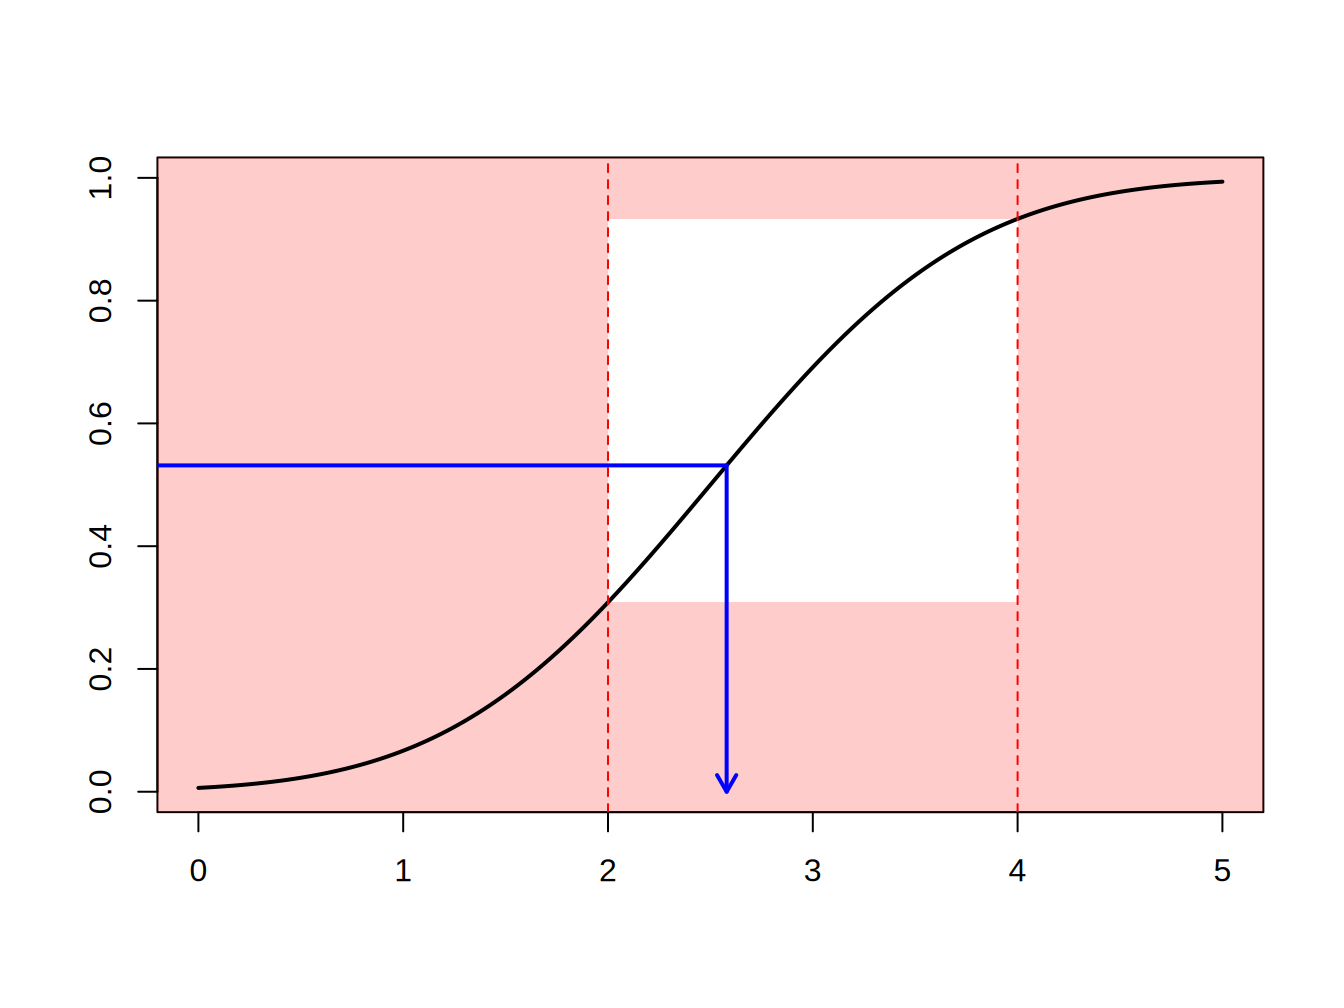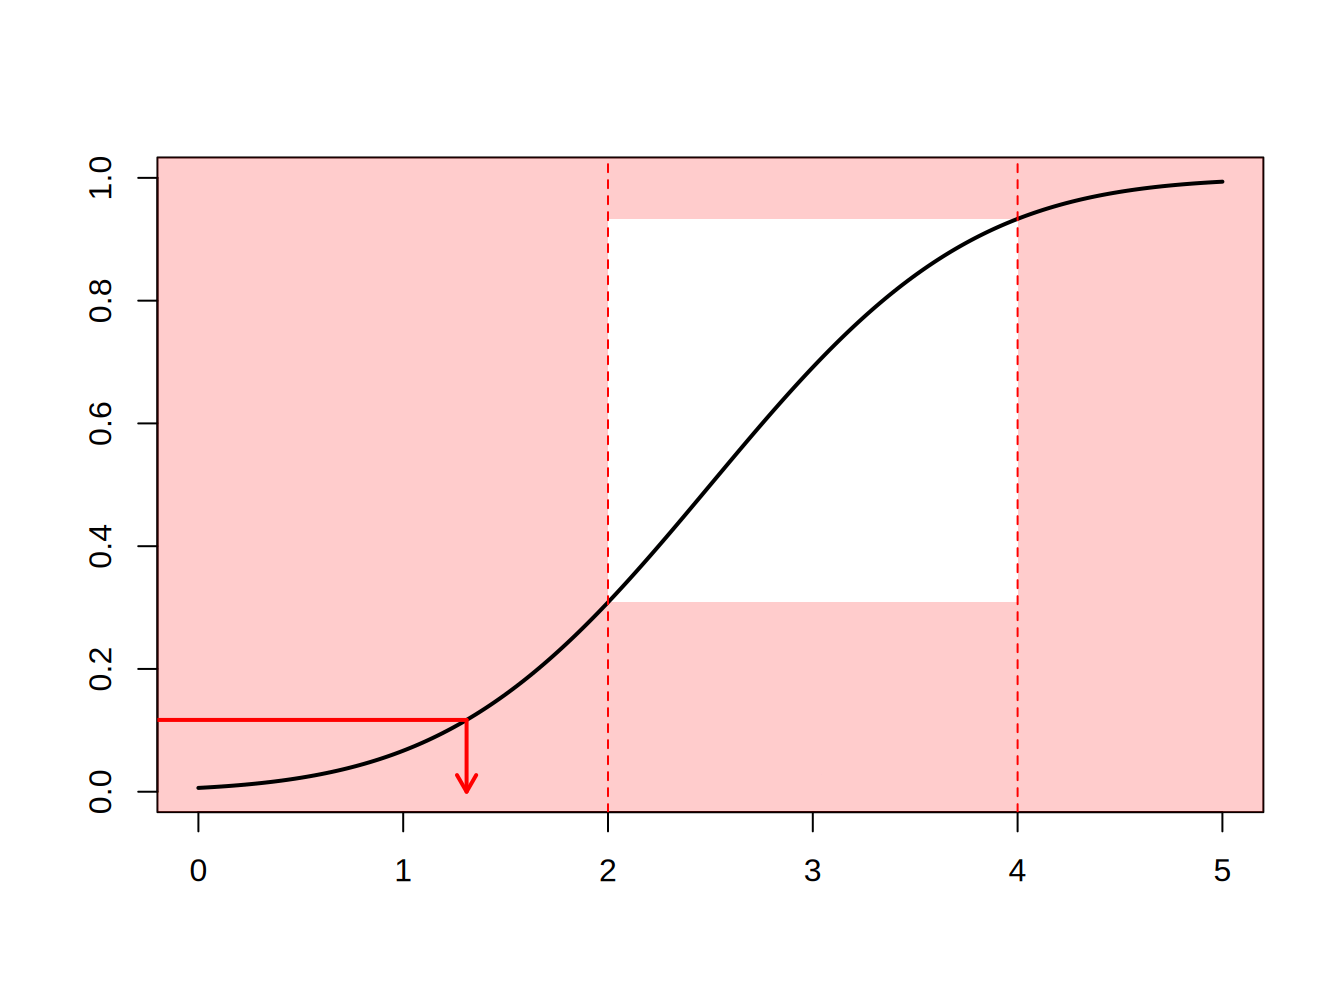
그림 8.4: (2,4) 안팎의 추출값 시연
대신 \[ F^{\star}(x) = \Pr(X \le x | a < X \le b) =\frac{F(x)-F(a)}{F(b)-F(a)}, \ \ \ \text{for } a < x \le b . \] 로 정의되는 조건부 분포 \(F^{\star}\)에 따라 추출할 수 있습니다. 8.1.2절의 역변환 방법을 사용하면 추출값 \[ X^\star=F^{\star-1}\left( U \right) = F^{-1}\left(F(a)+U\cdot[F(b)-F(a)]\right) \] 은 분포 \(F^{\star}\)을 따릅니다. 다른 방식으로 표현하면, \[ \tilde{U} = (1-U)\cdot F(a)+U\cdot F(b) \] 를 정의한 다음 \(F^{-1}(\tilde{U})\)을 사용합니다. 이 접근법에서는 모든 추출값이 유효하게 쓰입니다.
이는 중요도 표본추출 메커니즘(importance sampling mechanism) 관심 영역의 값을 과대표집하거나 관심 영역 밖의 값을 과소표집할 수 있는 표본추출 방법의 한 유형입니다.과 관련지을 수 있습니다. 즉, 관심 있는 양이 있을 것으로 예상되는 영역에서 더 자주 추출합니다. 이 변환은 “측도의 변환”으로 볼 수 있습니다.
역변환 방법을 이용한 중요도 표본추출 R 코드 보기
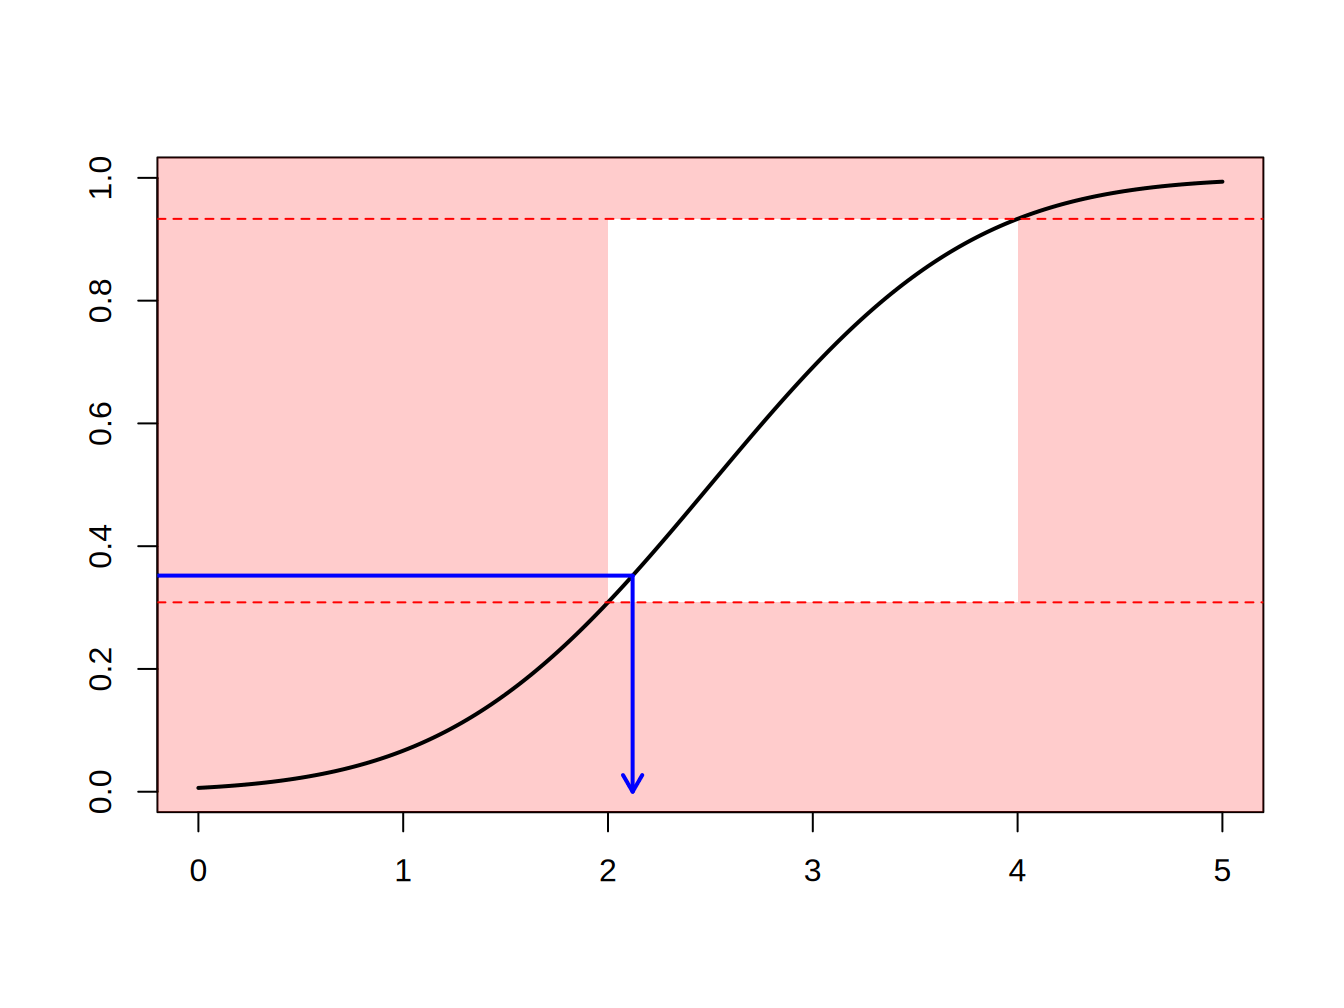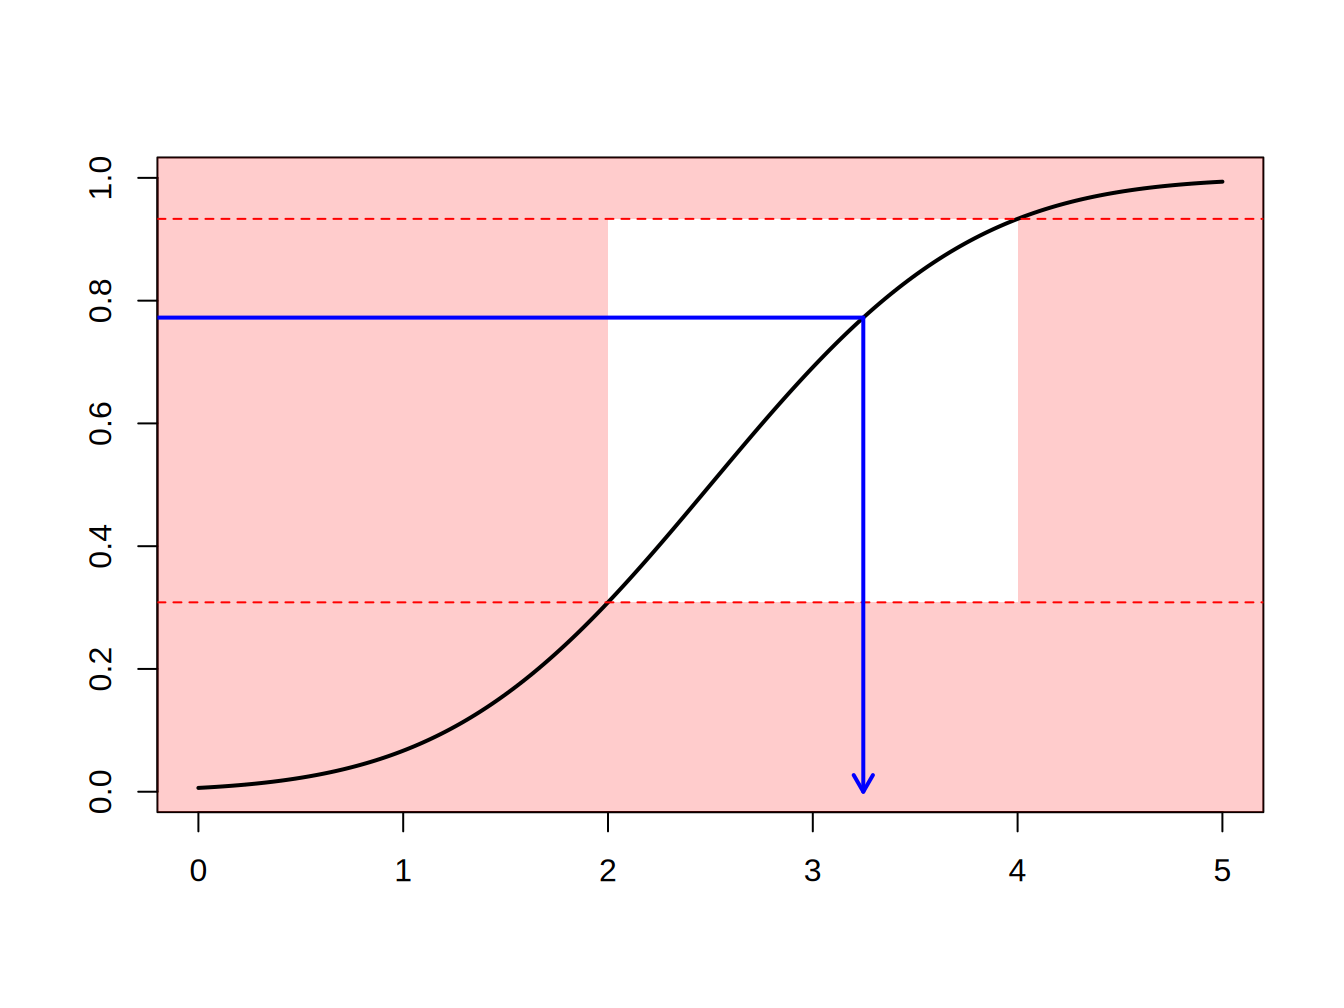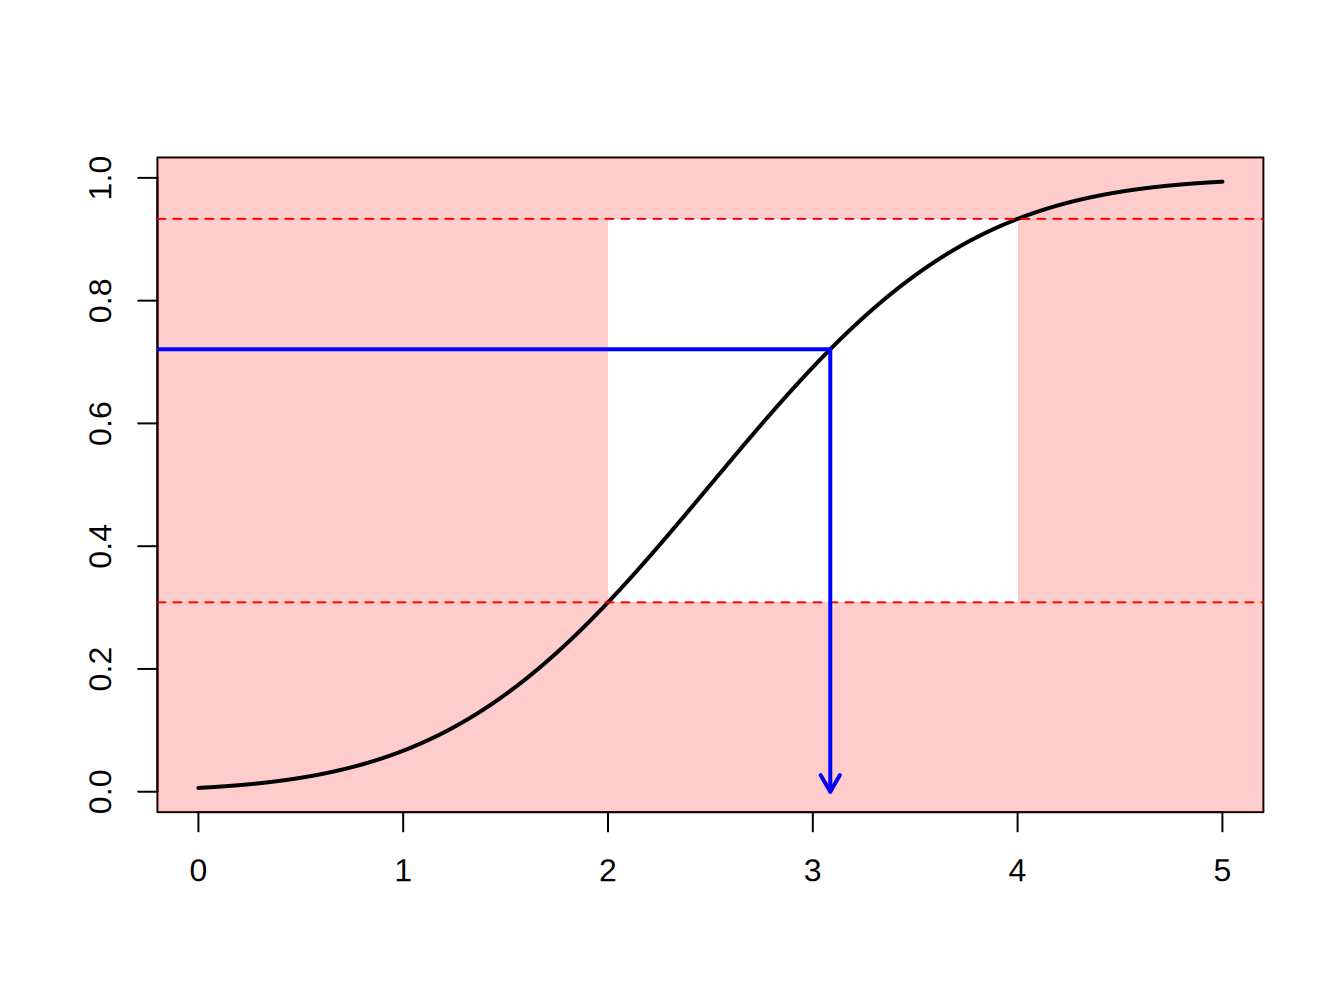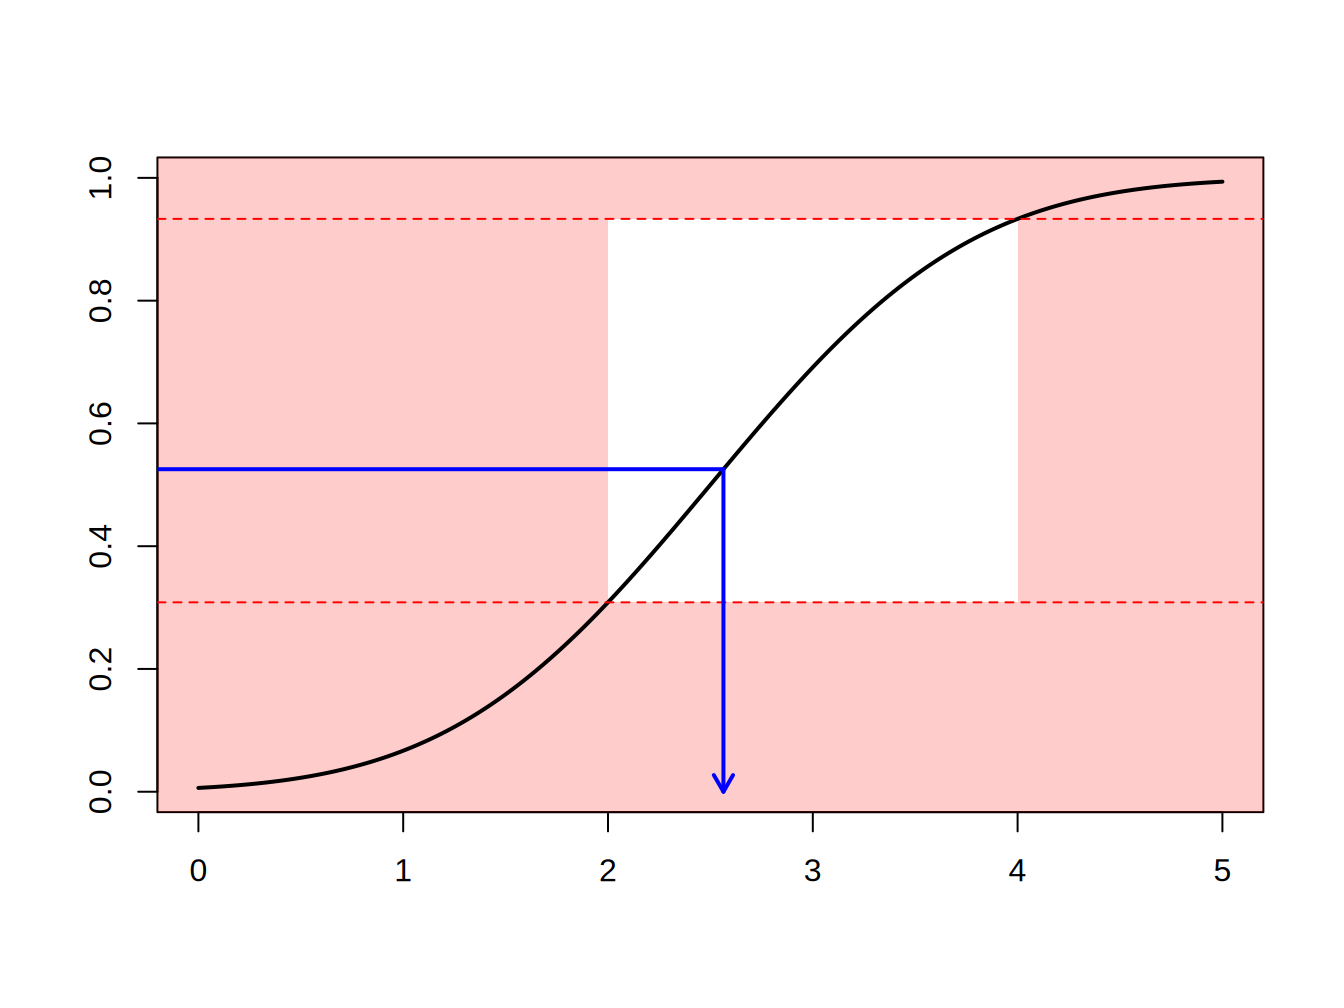
R에서 해당 함수는 qnorm입니다). 그러나 다른 응용에서는 항상 그렇지는 않습니다. 그런 경우에는 단순히 수치적 방법을 사용하여 \(X^\star\)를 방정식 \(F(X^\star) =\tilde{U}\)의 해로 구하면 됩니다. 여기서 \(\tilde{U}=(1-U)\cdot F(a)+U\cdot F(b)\)입니다.
Show R Code for Importance Sampling via Numerical Solutions
8.2 분포 모수의 계산
이 절에서는 다음을 배웁니다.
- 관심 있는 양을 계산하고 계산된 양의 정밀도를 결정하는 방법
- 시뮬레이션 연구에 적절한 반복 횟수를 결정하는 방법
- 가설검정에 필요한 복잡한 분포를 계산하는 방법
8.2.1 모수의 시뮬레이션
모수라는 용어는 알려진 모수적 분포족의 지표 역할을 하는 양이라는 의미로 쓰이기도 합니다. 예를 들어, 일반적으로 평균 \(\mu\)과 표준편차 \(\sigma\)를 정규분포의 모수로 생각합니다. 통계학자들은 분포를 요약하는 임의의 양을 뜻하는 말로도 모수라는 용어를 사용합니다. 이러한 의미에서 모수는 \(\theta(F)\)로 쓸 수 있습니다. 즉, 분포함수 \(F(\cdot)\)를 알면 요약 측도 \(\theta\)를 계산할 수 있습니다.
앞의 소절에서는 관심 있는 분포로부터 독립적인 시뮬레이션 실현값을 생성하는 방법을 배웠습니다. 이러한 실현값으로 경험분포를 구성하고, 필요한 만큼 정밀하게 기저 분포를 근사할 수 있습니다. 이 책에서 더 많은 보험계리적 응용을 소개함에 따라, 시뮬레이션이 매우 다양한 맥락에 적용될 수 있음을 알게 될 것입니다.
이러한 응용의 상당수는 모수 \(\mathrm{E~}[h(X)]\)를 근사하는 문제로 귀결될 수 있으며, 여기서 \(h(\cdot)\)는 어떤 알려진 함수입니다. \(R\)번의 시뮬레이션(반복)을 바탕으로 \(X_1,\ldots,X_R\)를 얻습니다. 이 시뮬레이션 표본으로부터 평균 \[ \overline{h}_R=\frac{1}{R}\sum_{i=1}^{R} h(X_i) \] 를 계산하며, 이를 \(\mathrm{E~}[h(X)]\)의 시뮬레이션 근삿값(추정값)으로 사용합니다. 이 근사의 정밀도를 추정하기 위해 시뮬레이션 분산 \[ s_{h,R}^2 = \frac{1}{R-1} \sum_{i=1}^{R}\left( h(X_i) -\overline{h}_R \right) ^2. \] 를 사용합니다. 독립성으로부터 추정값의 표준오차는 \(s_{h,R}/\sqrt{R}\)입니다. 이 값은 반복 횟수 \(R\)를 늘림으로써 원하는 만큼 작게 만들 수 있습니다.
예제 8.2.1. 포트폴리오 관리. 5.1절에서 우리는 공제금액이 있는 보험계약의 기댓값을 계산하는 방법을 배웠습니다. 닫힌 형태의 식으로는 처리할 수 없는 경우의 예로, 이제 두 가지 위험을 고려합니다. 이는 예제 13.4.6에서 다룰 더 복잡한 예제를 변형한 것입니다.
한 통신 회사의 두 가지 재산 위험을 고려합니다.
- \(X_1\) - 건물로, 평균이 200이고 척도모수가 100인 감마분포를 사용하여 모형화합니다.
- \(X_2\) - 자동차로, 평균이 400이고 척도모수가 200인 감마분포를 사용하여 모형화합니다.
총위험을 \(X = X_1 + X_2.\)로 나타냅니다. 단순화를 위해 이 위험들이 서로 독립이라고 가정합니다.
위험을 관리하기 위해 여러분은 어느 정도의 보험 보장을 구하고자 합니다. 여러분은 예를 들어 \(M\)까지의 소규모 건물 및 자동차 손실 금액은 내부적으로 보유할 의향이 있습니다. \(M\)를 초과하는 확률적 금액은 예산에 예측할 수 없는 영향을 미치므로, 이러한 금액에 대해서는 보험 보장을 구합니다. 수학적으로 표현하면, 여러분이 보유하는 위험은 \(Y_{retained}=\) \(\min(X_1 + X_2,M)\)이고 보험자의 몫은 \(Y_{insurer} = X- Y_{retained}\)입니다.
구체적으로, \(M=\) 400을 사용하고 \(R=\) 1000000번의 시뮬레이션을 수행합니다.
a. 이러한 설정에서 (i) 귀하가 보유하는 금액, (ii) 보험자가 인수하는 금액, (iii) 전체 총액 각각의 기대 청구액과 그에 따른 표준편차를 구하고자 합니다. b. 보험 처리된 청구에 대해 시뮬레이션 근사의 표준오차는 \(s_{h,R}/\sqrt{1000000} =\) 280.86 \(/\sqrt{1000000} =\) 0.281입니다. 이 예제에서는 시뮬레이션이 빠르므로 1000000과 같은 큰 값을 쉽게 선택할 수 있습니다. 그러나 더 복잡한 문제에서는 시뮬레이션 크기가 문제가 될 수 있습니다.
예제 풀이. (a)에 대한 계산 결과는 다음과 같습니다.
                   Retained Insurer  Total
Mean                 365.17  235.01 600.18
Standard Deviation    69.51  280.86 316.36
(b)의 경우, 그림 8.5을 통해 시뮬레이션 횟수가 증가함에 따라 근사가 변화하는 과정을 시각화할 수 있습니다.
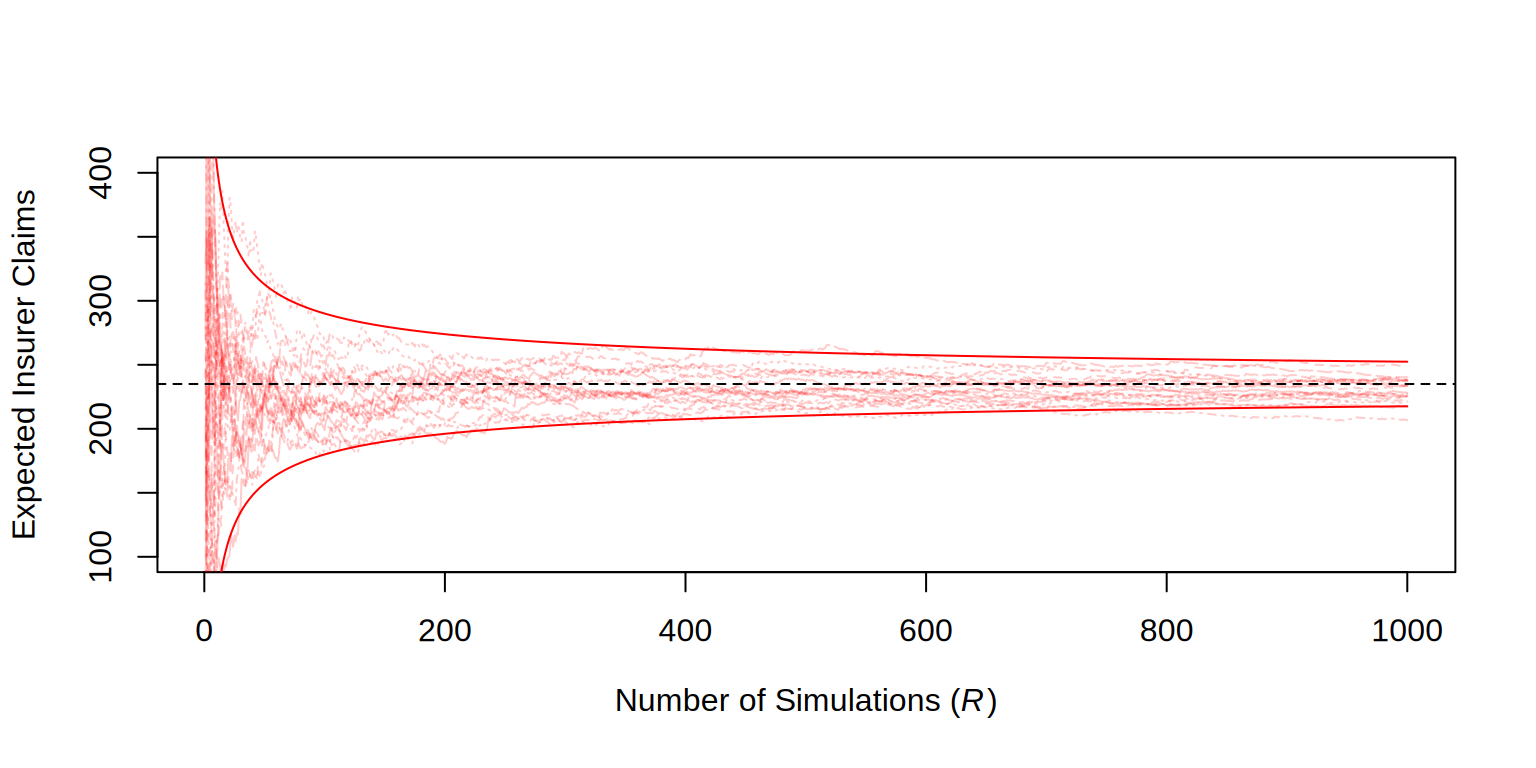
그림 8.5: 시뮬레이션 횟수에 따른 보험자 기대 청구액 추정값
예제 8.2.1의 R 코드 보기
8.2.2 시뮬레이션 횟수 결정
시뮬레이션 값은 몇 개가 적당합니까? 100개입니까? 1,000,000개입니까? 이 질문에 답하기 위해 중심극한정리(central limit theorem) 모집단에서 추출한 크기 n인 확률표본의 표본평균과 표본합은 표본 크기 n이 커짐에 따라 정규곡선으로 수렴합니다.를 사용할 수 있습니다.
결과에 대한 신뢰의 한 가지 기준으로, 95%의 확실성으로 평균의 1% 이내에 들기를 원한다고 가정합시다. 즉, \(\Pr \left( |\overline{h}_R - \mathrm{E~}[h(X)]| \le 0.01 \mathrm{E~}[h(X)] \right) \ge 0.95\)를 원합니다. 중심극한정리에 따르면 추정값은 근사적으로 정규분포를 따르므로, \(0.01 \mathrm{E~}[h(X)]/\sqrt{\mathrm{Var~}[h(X)]/R}) \ge 1.96\)를 만족할 만큼 \(R\)가 충분히 크기를 원합니다. (1.96은 표준정규분포의 97.5번째 백분위수임을 상기하십시오.) \(\mathrm{E~}[h(X)]\)와 \(\mathrm{Var~}[h(X)]\)를 추정값으로 대체하여, \[ \frac{0.01~\overline{h}_R}{s_{h,R}/\sqrt{R}}\geq 1.96 \] 또는 이와 동치인 \[\begin{equation} R \geq 38,416\frac{s_{h,R}^2}{\overline{h}_R^2}. \tag{8.1} \end{equation}\] 가 될 때까지 시뮬레이션을 계속합니다. 이 기준은 근사 정규성을 직접 적용한 것입니다. \(\overline{h}_R\)와 \(s_{h,R}\)는 미리 알려져 있지 않으므로, 사전에 소규모 예비 연구를 수행하거나 절차를 간헐적으로 중단하여 기준이 충족되는지 확인하는 방식으로 추정값을 마련해야 합니다.
예제 8.2.1. 포트폴리오 관리 - 계속. 이 예제에서 평균 보험금 청구액은 235.011이고 이에 대응하는 표준편차는 280.862입니다. 식 (8.1)를 사용하면, 평균의 1% 이내에 들기 위해서는 최소 54.87천 번의 시뮬레이션만 있으면 됩니다. 또한 0.1% 이내에 들기 위해서는 최소 5.49백만 번의 시뮬레이션이 필요합니다.
예제 8.2.2. 근사 방법의 선택. 시뮬레이션의 중요한 응용 중 하나는 \(\mathrm{E~}[h(X)]\)의 근사입니다. 이 예제에서는 \(h(\cdot)\) 함수의 선택과 \(X\)의 분포가 영향을 미칠 수 있음을 보입니다.
다음 질문을 생각해 봅시다. 실수 직선 위에서 \(X\)가 밀도 \(f(x) =\left[\pi(1+x^2)\right]^{-1}\)를 갖는 코시 분포(Cauchy distribution) 두 독립 정규확률변수의 비율의 분포를 나타내는 연속분포로, 분모 분포의 평균이 0인 경우입니다.를 따를 때 \(\Pr[X>2]\)는 얼마입니까? 참값은
\[
\Pr\left[X>2\right] = \int_2^\infty \frac{dx}{\pi(1+x^2)} .
\]
입니다. R의 수치 적분 함수를 사용할 수 있습니다(이 함수는 대체로 이상적분에서도 잘 작동합니다).
이 값은 0.14758와 같습니다.
근사 1. 또는 시뮬레이션 기법을 사용하여 이 값을 근사할 수도 있습니다. 미적분을 통해 코시 분포의 분위수 함수가 \(F^{-1}(y) = \tan \left[\pi(y-0.5) \right]\)임을 확인할 수 있습니다. 그런 다음 시뮬레이션으로 생성한 균등 (0,1) 변량 \(U_1, \ldots, U_R\)을 사용하여 다음 추정량을 구성할 수 있습니다. \[ p_1 = \frac{1}{R}\sum_{i=1}^R \mathrm{I}(F^{-1}(U_i)>2) = \frac{1}{R}\sum_{i=1}^R \mathrm{I}(\tan \left[ \pi(U_i-0.5) \right]>2) . \]
R 코드 보기
백만 번의 시뮬레이션으로 0.14744의 추정값을 얻으며, 표준오차는 0.355(1000으로 나눈 값)입니다. \(p_1\)의 추정 분산은 \(0.127/R\)로 쓸 수 있습니다.
근사 2. \(h(\cdot)\)와 \(F(\cdot)\)를 다르게 선택하면 같은 시뮬레이션 횟수 \(R\)를 사용하더라도 불확실성을 줄일 수 있습니다. 먼저 코시 분포의 대칭성을 이용하여 \(\Pr[X>2]=0.5\cdot\Pr[|X|>2]\)로 쓸 수 있습니다. 이를 이용하여 새로운 추정량을 구성할 수 있습니다. \[ p_2 = \frac{1}{2R}\sum_{i=1}^R \mathrm{I}(|F^{-1}(U_i)|>2) . \]
백만 번의 시뮬레이션으로 0.14748의 추정값을 얻으며, 표준오차는 0.228(1000으로 나눈 값)입니다. \(p_2\)의 추정 분산은 \(0.052/R\)로 쓸 수 있습니다.
근사 3. 그러나 한 단계 더 나아갈 수 있습니다. 간단한 대칭성을 이용하면 이상적분을 정적분으로 쓸 수 있습니다(함수가 대칭이고 실수 직선 위의 적분이 \(1\)와 같으므로). \[ \int_2^\infty \frac{dx}{\pi(1+x^2)}=\frac{1}{2}-\int_0^2\frac{dx}{\pi(1+x^2)} . \] 이 식으로부터 자연스러운 근사는 다음과 같습니다. \[ p_3 = \frac{1}{2}-\frac{1}{R}\sum_{i=1}^R h_3(2U_i), ~~~~~~\text{where}~h_3(x)=\frac{2}{\pi(1+x^2)} . \]
백만 번의 시뮬레이션으로 0.14756의 추정값을 얻으며, 표준오차는 0.169(1000으로 나눈 값)입니다. \(p_3\)의 추정 분산은 \(0.0285/R\)로 쓸 수 있습니다.
근사 4. 마지막으로, 적분에서 변수 변환을 고려할 수도 있습니다. \[ \int_2^\infty \frac{dx}{\pi(1+x^2)}=\int_0^{1/2}\frac{y^{-2}dy}{\pi(1-y^{-2})} . \] 이 식으로부터 자연스러운 근사는 \[ p_4 = \frac{1}{R}\sum_{i=1}^R h_4(U_i/2),~~~~~\text{where}~h_4(x)=\frac{1}{2\pi(1+x^2)} . \] 입니다. 이 식은 앞의 식과 상당히 비슷해 보입니다.
백만 번의 시뮬레이션으로 0.14759의 추정값을 얻으며, 표준오차는 0.01(1000으로 나눈 값)입니다. \(p_4\)의 추정 분산은 \(0.00009/R\)로 쓸 수 있으며, 이는 지금까지 얻은 값보다 훨씬 작습니다!
표 8.1은 \(\Pr[X>2] =\) 0.14758를 근사하기 위한 \(h(\cdot)\)와 \(F(\cdot)\)의 네 가지 선택을 요약합니다. 표준오차는 크게 달라집니다. 따라서 원하는 정확도가 있다면, 시뮬레이션 횟수는 근사하려는 적분을 어떻게 쓰느냐에 크게 좌우됩니다.
표 8.1. 근사를 위한 네 가지 선택의 요약 \(\Pr[X>2]\)
| Estimator | Definition | Support Function | Estimate | Standard Error |
|---|---|---|---|---|
| \(p_1\) | \(\frac{1}{R}\sum_{i=1}^R \mathrm{I}(F^{-1}(U_i)>2)\) | \(~~~~~~F^{-1}(u)=\tan \left( \pi(u-0.5) \right)~~~~~~~\) | 0.147439 | 0.000355 |
| \(p_2\) | \(\frac{1}{2R}\sum_{i=1}^R \mathrm{I}(|F^{-1}(U_i)|>2)\) | \(F^{-1}(u)=\tan \left( \pi(u-0.5) \right)\) | 0.147477 | 0.000228 |
| \(p_3\) | \(\frac{1}{2}-\frac{1}{R}\sum_{i=1}^R h_3(2U_i)\) | \(h_3(x)=\frac{2}{\pi(1+x^2)}\) | 0.147558 | 0.000169 |
| \(p_4\) | \(\frac{1}{R}\sum_{i=1}^R h_4(U_i/2)\) | \(h_4(x)=\frac{1}{2\pi(1+x^2)}\) | 0.147587 | 0.000010 |
8.2.3 시뮬레이션과 통계적 추론
시뮬레이션은 기댓값을 근사하는 데 도움이 될 뿐만 아니라 분포함수의 다른 측면을 계산하는 데에도 유용합니다. 절 8.2.1에서 설명한 바와 같이, 그 논리는 모수 \(\theta(F)\)를 계산하고자 할 때 모수를 계산하는 규칙은 그대로 사용하되 분포함수 \(F(\cdot)\)를 시뮬레이션된 표본으로부터 얻은 경험분포함수로 대체한다는 것입니다. 예를 들어, 분석가는 기댓값뿐만 아니라 복잡한 분포의 분위수를 계산하는 데에도 시뮬레이션을 사용할 수 있습니다.
또한 시뮬레이션은 검정통계량의 분포가 너무 복잡하여 유도하기 어려울 때 매우 유용합니다. 이 경우 시뮬레이션을 사용하여 기준 분포를 근사할 수 있습니다. 이제 절 6.1.2에서 배운 콜모고로프-스미르노프 검정(Kolmogorov-Smirnov test) 데이터 표본이 가정된 연속 확률분포에서 나왔을 수 있는지를 판단하는 데 사용되는 비모수적 통계적 검정을 사용하여 이를 예시하겠습니다.
예제 8.2.3. 분포에 대한 콜모고로프-스미르노프 검정. \(n=100\)개의 관측값 \(\{x_1,\cdots,x_n\}\)이 주어져 있다고 가정합시다. 이 관측값은 분석가가 모르는 사이에 모수가 \(\alpha = 6\)와 \(\theta=2\)인 감마분포로부터 생성된 것입니다. 분석가는 이 데이터가 모수가 1과 0.4인 로그정규분포에서 나왔다고 믿고 있으며, 이 가정을 검정하고자 합니다.
첫 번째 단계는 데이터를 시각화하는 것입니다.
시각화 설정을 위한 R 코드 보기
이 설정에서 그림 8.6는 히스토그램과 경험분포의 그래프를 보여 줍니다. 참고로, 로그정규분포에 따른 빨간 점선을 겹쳐 그렸습니다.
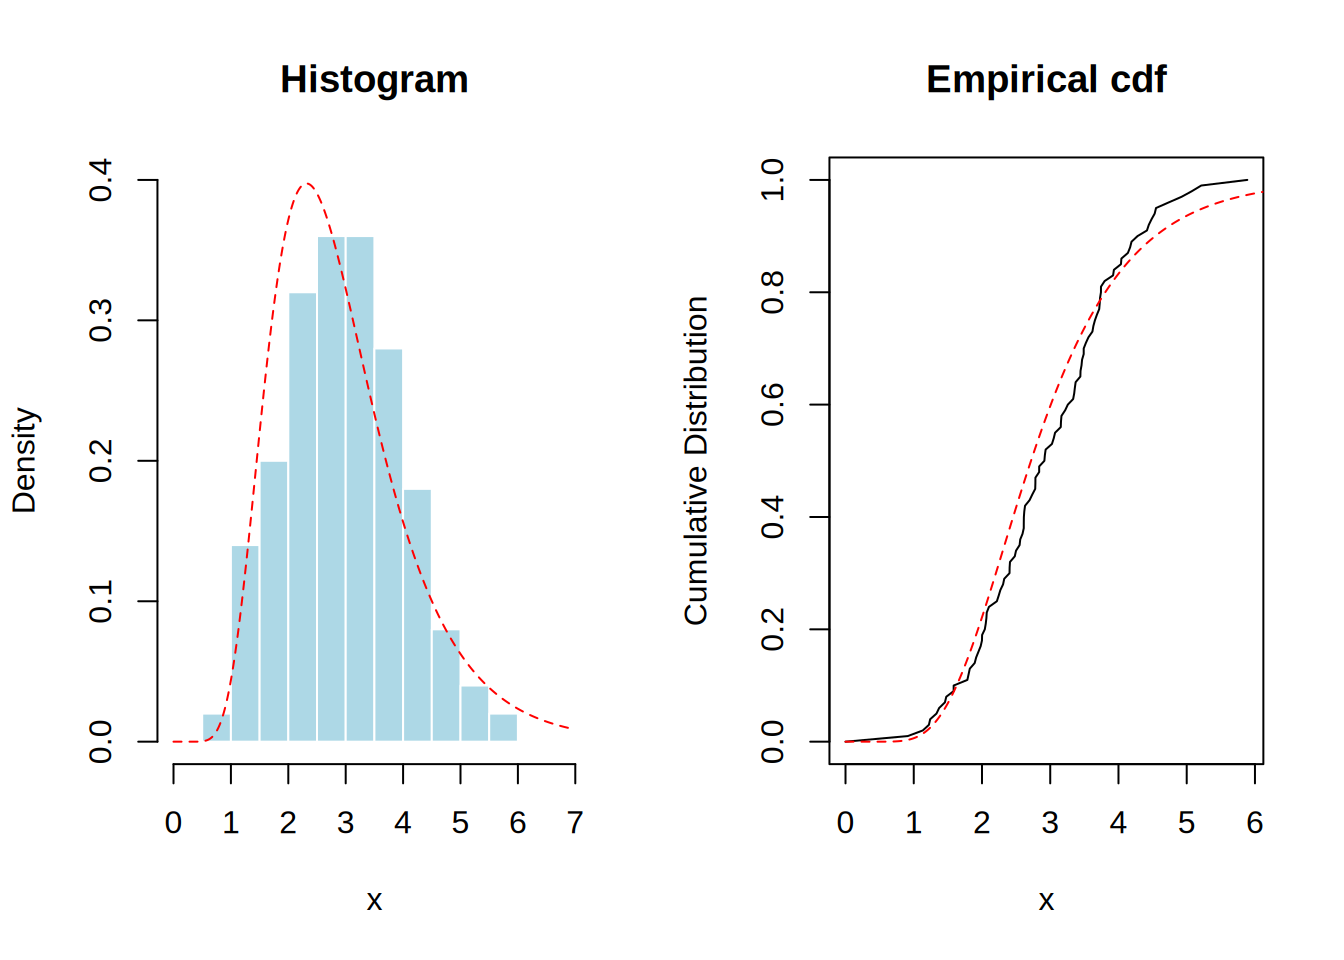
그림 8.6: 콜모고로프-스미르노프 검정에 사용된 데이터의 히스토그램과 경험분포함수. 빨간 점선은 (잘못) 가정된 로그정규분포에 기반한 적합 결과입니다.
그림 8.6을 그리는 R 코드 보기
콜모고로프-스미르노프 통계량은 경험분포와 가정된 분포 사이의 가장 큰 차이와 같다는 점을 상기하십시오. 이는 \(\max_x |F_n(x)-F_0(x)|\)이며, 여기서 \(F_0\)는 가정된 로그정규분포입니다. 이 값은 직접 계산할 수 있습니다.
KS 통계량을 직접 계산하는 R 코드 보기
다행히도 로그정규분포의 경우, R에는 복잡한 프로그래밍 없이 이를 판단할 수 있게 해 주는 내장 검정이 있습니다.
    Asymptotic one-sample Kolmogorov-Smirnov test

data:  x
D = 0.09703666, p-value = 0.303148
alternative hypothesis: two-sided
그러나 보험계리적으로 관심 있는 많은 분포에 대해서는 미리 만들어진 프로그램이 없습니다. 시뮬레이션을 사용하여 검정통계량의 유의성을 검정할 수 있습니다. 구체적으로 \(p\)-값을 계산하기 위해, \(LN(1,0.4)\) 분포에서 (같은 크기의) 확률표본을 수천 개 생성하고 통계량의 분포를 경험적으로 계산해 봅시다.
KS 통계량의 시뮬레이션 분포를 구하는 R 코드 보기
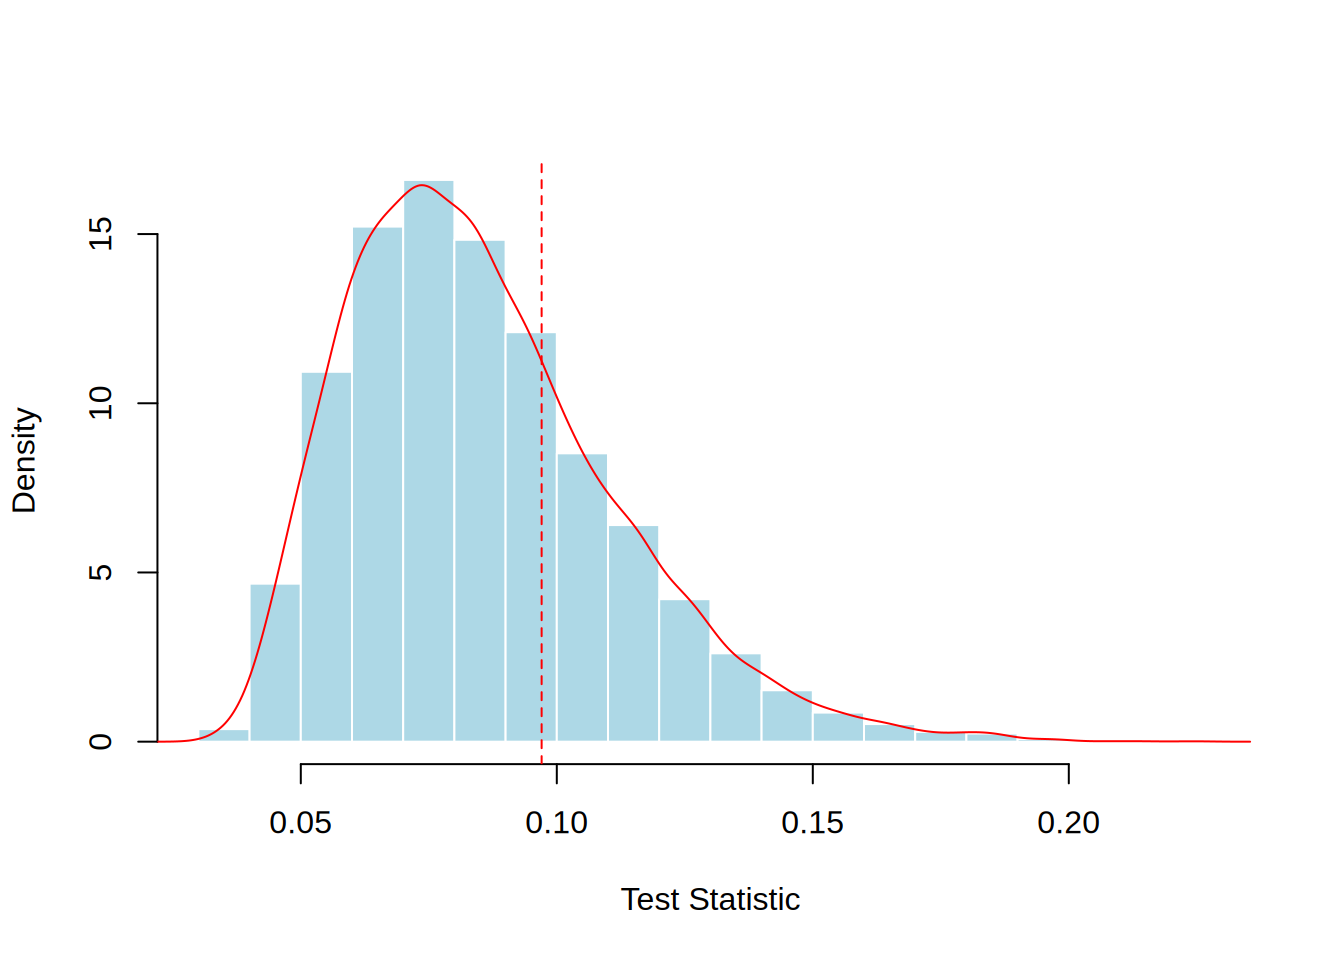
그림 8.7: 콜모고로프-스미르노프 검정통계량의 시뮬레이션 분포. 빨간색 세로 점선은 크기 100인 표본의 검정통계량을 나타냅니다.
10,000개의 확률표본에 기반한 시뮬레이션 분포는 그림 8.7에 요약되어 있습니다. 여기서 통계량은 시나리오의 28.43%에서 경험적 값(0.09704)을 초과했으며, 이론적 \(p\)-값은 0.3031입니다. 시뮬레이션과 이론적 \(p\)-값 모두에서 결론은 같습니다. 즉, 데이터는 로그정규분포라는 가설을 기각할 만한 충분한 증거를 제공하지 않습니다.
시뮬레이션 접근법은 근사에 불과하지만, 각 상황마다 기반 이론의 세부 사항을 전개할 필요 없이 다양한 분포와 검정통계량에 적용됩니다. 시뮬레이션 분포와 p-값을 구하는 절차를 다음과 같이 요약합니다.
- 알려진 분포함수 \(F\)에서 크기 n인 표본, 예컨대 \(X_1, \ldots, X_n\)을 추출하십시오. 관심 있는 통계량을 계산하고, 이를 \(\hat{\theta}(X_1, \ldots, X_n)\)로 표기하십시오. 이를 r번째 반복에 대한 \(\hat{\theta}^r\)이라고 하십시오.
- 이를 \(r=1, \ldots, R\)번 반복하여 통계량의 표본 \(\hat{\theta}^1, \ldots,\hat{\theta}^R\)를 얻으십시오.
- 2단계에서 얻은 통계량의 표본 \(\{\hat{\theta}^1, \ldots,\hat{\theta}^R\}\)로부터 p-값과 같은 관심 있는 요약 측도를 계산하십시오.
8.3 부트스트래핑과 재표본추출
이 절에서는 다음 내용을 배웁니다.
- 관심 있는 통계량에 대한 비모수 부트스트랩 분포를 생성하는 방법
- 부트스트랩 분포를 사용하여 편의, 표준편차, 신뢰구간을 포함한 관심 통계량의 정밀도 추정값을 구하는 방법
- 모수적 분포에 대해 부트스트랩 분석을 수행하는 방법
8.3.1 부트스트랩의 기초
지금까지 소개한 시뮬레이션은 알려진 분포로부터의 표본추출에 기반합니다. 절 8.1에서는 시뮬레이션 기법을 사용하여 알려진 분포로부터 표본을 추출하고 여러 양을 계산하는 방법을 보였습니다. 그러나 통계학은 알려지지 않은 분포에 대한 추론을 제공하는 데 전념하는 학문입니다. 우리는 이 알려지지 않은 모집단 분포에 기반하여 요약 통계량을 수집합니다. 그렇다면 알려지지 않은 분포로부터 어떻게 표본을 추출할 수 있습니까?
당연히 알려지지 않은 분포로부터 추출을 시뮬레이션할 수는 없지만, 관측값으로 이루어진 표본으로부터는 추출할 수 있습니다. 표본이 모집단을 잘 대표한다면, 표본으로부터 시뮬레이션한 추출은 모집단으로부터 시뮬레이션한 추출을 잘 근사할 것입니다. 표본으로부터 표본을 추출하는 과정을 재표본추출(resampling) 또는 부트스트래핑(bootstrapping)이라고 합니다. 부트스트랩(bootstrap) 원래 데이터셋으로부터 복원 표본추출하여 원래와 같은 크기의 추가적인 시뮬레이션 데이터셋을 생성하는 방법이라는 용어는 “자신의 부츠 끈을 잡아당겨 스스로를 끌어올린다(pulling oneself up by one’s bootstraps)”라는 표현에서 유래했습니다@efron1979bootstrap. 재표본추출에서는 원래 표본이 모집단의 역할을 하고, 표본으로부터 얻은 추정값이 실제 모집단 모수의 역할을 합니다.
재표본추출 알고리즘은 이제 표본으로부터 시뮬레이션한 추출을 사용한다는 점을 제외하면 절 8.2.3에서 소개한 것과 같습니다. 일반적으로 원래 표본은 \(\{X_1, \ldots, X_n\}\)로 나타내고, 시뮬레이션한 추출은 \(\{X_1^*, \ldots, X_n^*\}\)로 나타냅니다. 시뮬레이션한 추출이 원래 표본과 같은 가정대로 서로 독립이 되도록 복원추출을 합니다. 또한 각 표본마다 원래 표본 크기와 같은 수인 n개의 시뮬레이션 추출을 사용합니다. 이 절차를 시뮬레이션과 구분하기 위해, 시뮬레이션한 표본의 수는 일반적으로 B(부트스트랩을 뜻함)로 나타냅니다. 이를 명확히 하기 위해 \(\{X_1^{(b)}, \ldots, X_n^{(b)}\}\), \(b=1,\ldots, B\)와 같이 쓸 수도 있습니다.
재표본추출의 기본 방법에는 모형 비의존(model-free) 방법과 모형 기반(model-based) 방법 두 가지가 있으며, 각각 비모수적 방법과 모수적 방법이라고도 합니다. 비모수적 접근법(nonparametric approach) 모집단의 분포에 대해 아무런 가정도 하지 않는 통계적 방법입니다.에서는 모집단의 분포에 대해 아무런 가정도 하지 않습니다. 시뮬레이션한 추출은 경험분포함수 \(F_n(\cdot)\)로부터 나오므로, 각 추출값은 확률 1/n으로 \(\{X_1, \ldots, X_n\}\)에서 나옵니다.
반면 모수적 접근법(parametric approach) 분포나 모형 형태에 대해 사전 가정을 두는 통계적 방법입니다.에서는 분포족 F를 알고 있다고 가정합니다. 원래 표본 \(X_1, \ldots, X_n\)는 그 분포족의 모수, 예컨대 \(\hat{\theta}\)를 추정하는 데 사용됩니다. 그런 다음 \(F(\hat{\theta})\)로부터 시뮬레이션 추출을 합니다. 절 8.3.4에서 이 접근법을 더 자세히 다룹니다.
비모수적 부트스트랩
비모수적 부트스트랩의 아이디어는 그림 8.8에 나타낸 경험누적분포함수 \(F_n\)에 역변환법을 적용하는 것입니다.
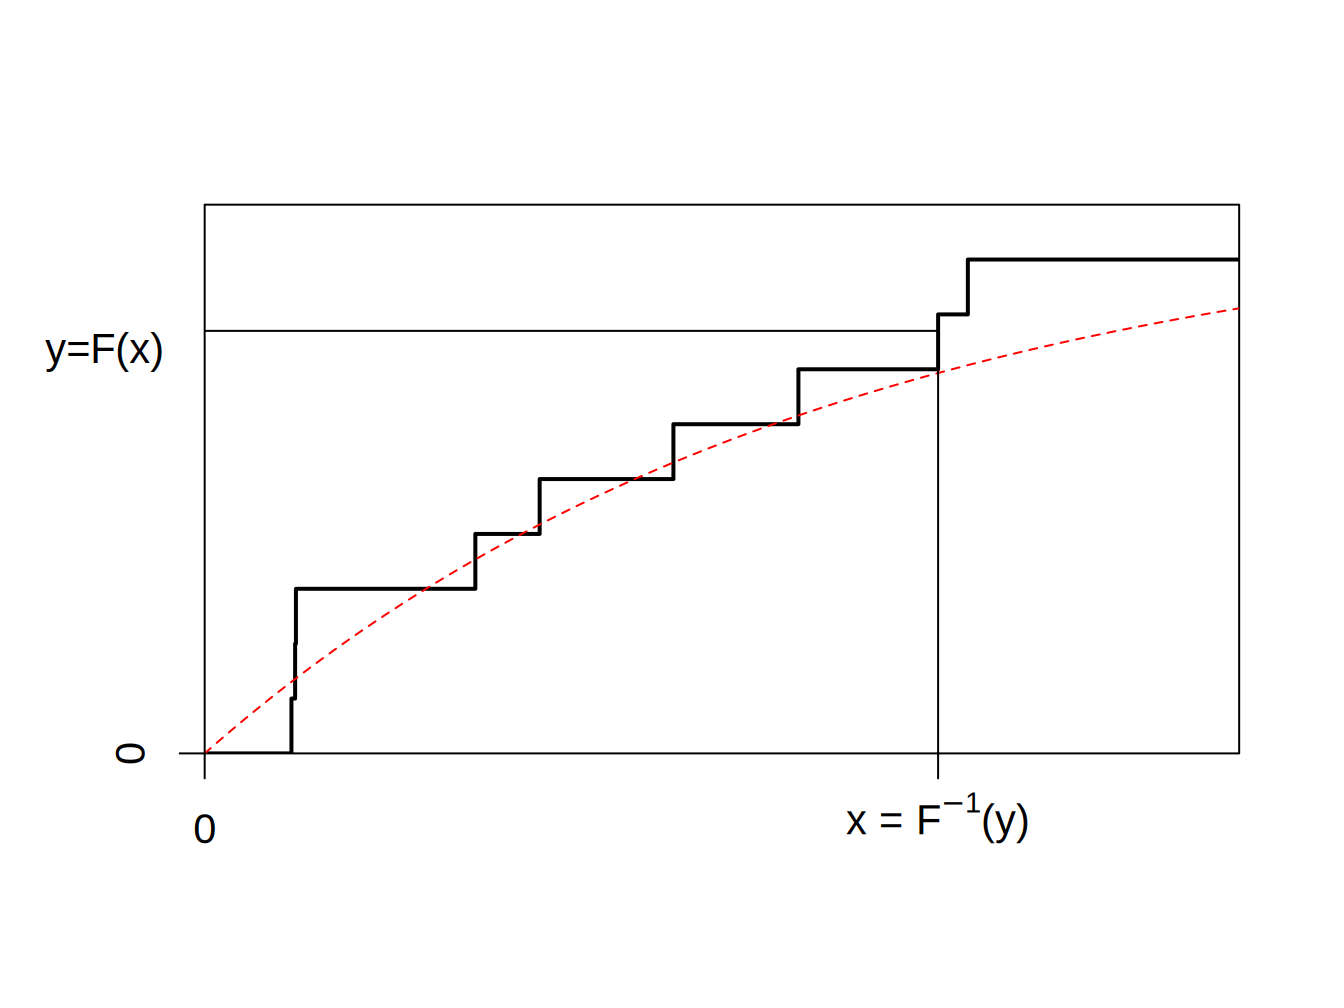
그림 8.8: 경험분포함수의 역함수
\(F_n\)는 계단함수이므로 \(F_n^{-1}\)는 \(\{x_1,\cdots,x_n\}\)에 속하는 값을 가집니다. 더 정확히 말하면, 그림 8.9에 나타낸 것과 같습니다.
- \(y\in(0,1/n)\)이면(확률 \(1/n\)) 가장 작은 값(\(\min\{x_i\}\))을 추출합니다.
- \(y\in(1/n,2/n)\)이면(확률 \(1/n\)) 두 번째로 작은 값을 추출합니다.
- \(\vdots \ \ \vdots \ \ \vdots\)
- \(y\in((n-1)/n,1)\)이면(확률 \(1/n\)) 가장 큰 값(\(\max\{x_i\}\))을 추출합니다.
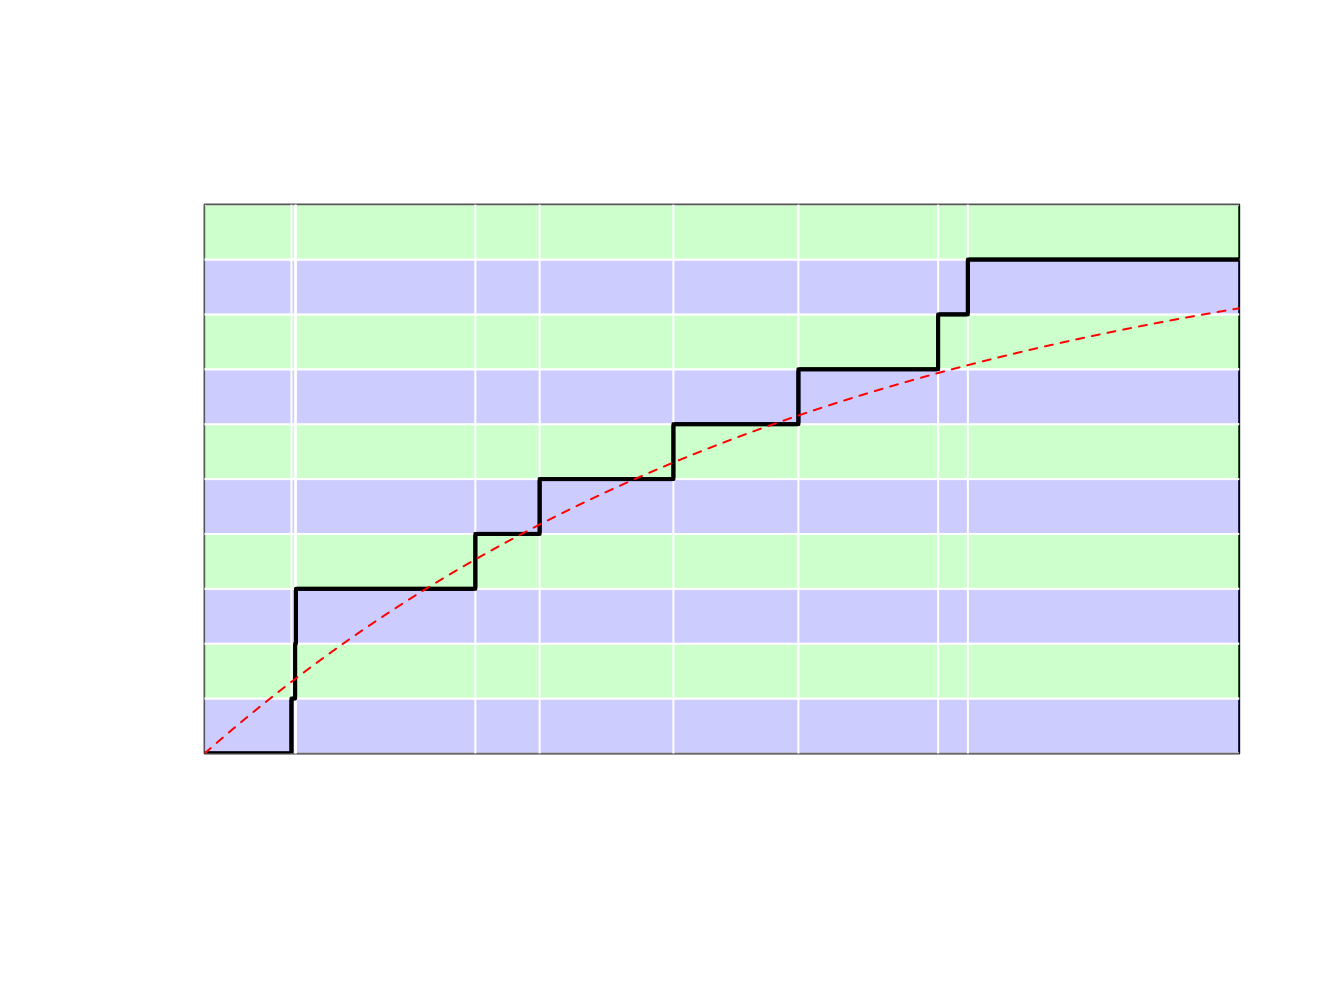
그림 8.9: 경험분포함수의 역함수
\(F_n\)로 역변환 방법을 사용한다는 것은 \(\{x_1,\cdots,x_n\}\)에서 확률 \(1/n\)로 표본추출한다는 것을 의미합니다. 크기 \(B\)인 부트스트랩 표본을 생성한다는 것은 \(\{x_1,\cdots,x_n\}\)에서 확률 \(1/n\)로 복원 표본추출한다는 것을 의미합니다. 다음의 예시 R 코드를 참조하십시오.
부트스트랩 표본 생성 R 코드 보기
[1] 2.6164 5.7394 5.7394 2.6164 2.6164 7.0899 0.8823 5.7394 4.5311 0.8388값 5.7394가 세 번 추출되었음을 확인하십시오.
8.3.2 부트스트랩 정밀도: 편향, 표준편차, 평균제곱오차
비모수적 부트스트랩 절차를 요약하면 다음과 같습니다.
- 표본 \(\{X_1, \ldots, X_n\}\)에서 크기가 n인 표본을 (복원)추출하며, 이를 \(X_1^*, \ldots, X_n^*\)이라 합니다. 시뮬레이션으로 추출한 값들로부터 관심 통계량을 계산하며, 이를 \(\hat{\theta}(X_1^*, \ldots, X_n^*)\)로 표기합니다. b번째 반복에 대해 이를 \(\hat{\theta}_b^*\)이라 합니다.
- 이를 \(b=1, \ldots, B\)번 반복하여 통계량의 표본 \(\hat{\theta}_1^*, \ldots,\hat{\theta}_B^*\)을 얻습니다.
- 2단계에서 얻은 통계량의 표본 \(\{\hat{\theta}_1^*, \ldots, \hat{\theta}_B^*\}\)로부터 관심 요약 측도를 계산합니다.
이 절에서는 세 가지 요약 측도, 즉 편향(bias) 추정량의 기댓값과 추정 대상 모수 사이의 차이입니다. 편향은 더 큰 표본 크기를 관측하더라도 작아지지 않는 추정 오차입니다., 표준편차, 평균제곱오차(MSE)에 초점을 맞춥니다. 표 8.3은 이 세 측도를 요약한 것입니다. 여기서 \(\overline{\hat{\theta^*}}\)는 \(\{\hat{\theta}_1^*, \ldots,\hat{\theta}_B^*\}\)의 평균입니다.
표 8.3. 부트스트랩 요약 측도
\[ {\small \begin{matrix} \begin{array}{l|c|c|c} \hline \textit{Population Measure}& \textit{Population Definition}&\textit{Bootstrap Approximation}&\textit{Bootstrap Symbol}\\ \hline \text{Bias} & \mathrm{E}(\hat{\theta})-\theta&\overline{\hat{\theta^*}}-\hat{\theta}& Bias_{boot}(\hat{\theta}) \\\hline \text{Standard Deviation} & \sqrt{\mathrm{Var}(\hat{\theta})} & \sqrt{\frac{1}{B-1} \sum_{b=1}^{B}\left(\hat{\theta}_b^* -\overline{\hat{\theta^*}} \right) ^2}&s_{boot}(\hat{\theta}) \\\hline \text{Mean Square Error} &\mathrm{E}(\hat{\theta}-\theta)^2 & \frac{1}{B} \sum_{b=1}^{B}\left(\hat{\theta}_b^* -\hat{\theta} \right)^2&MSE_{boot}(\hat{\theta})\\ \hline \end{array}\end{matrix} } \]
예제 8.3.1. 신체상해 청구와 손실제거율. 부트스트랩을 사용하여 추정량의 정밀도를 정량화하는 방법을 보이기 위해, 손실제거율의 비모수적 추정량을 소개했던 [예제 5.3.2]의 신체상해 청구 데이터로 돌아갑니다.
표 8.4는 부트스트랩 추정 결과를 요약한 것입니다. 예를 들어 \(d=14000\)에서 LER의 비모수적 추정값은 0.97678입니다. 이 추정값의 추정 편향은 0.00016이고 표준편차는 0.00687입니다. 응용에 따라서는 추정된 편향을 원래 추정값에 적용하여 편향 보정 추정량(bias-corrected estimator) 추정량이 일정한 방식으로 일관되게 편향되어 있다고 알려져 있으면, 보정 계수를 사용하여 편향을 줄이거나 불편추정량이 되도록 보정할 수 있습니다.을 구하고자 할 수도 있습니다. 이는 다음 예제에서 중점적으로 다룹니다. 이 예시에서는 편향이 작으므로 그러한 보정이 필요하지 않습니다.
LER의 부트스트랩 추정 R 코드 보기
표 8.4. 선택된 공제금액에서의 LER 부트스트랩 추정값
| d | NP Estimate | Bootstrap Bias | Bootstrap SD | Lower Normal 95% CI | Upper Normal 95% CI |
|---|---|---|---|---|---|
| 4000 | 0.54113 | 0.00011 | 0.01237 | 0.51678 | 0.56527 |
| 5000 | 0.64960 | 0.00027 | 0.01412 | 0.62166 | 0.67700 |
| 10500 | 0.93563 | 0.00004 | 0.01017 | 0.91567 | 0.95553 |
| 11500 | 0.95281 | -0.00003 | 0.00941 | 0.93439 | 0.97128 |
| 14000 | 0.97678 | 0.00016 | 0.00687 | 0.96316 | 0.99008 |
| 18500 | 0.99382 | 0.00014 | 0.00331 | 0.98719 | 1.00017 |
부트스트랩 표준편차는 정밀도의 측도를 제공합니다. 표준편차를 응용하는 한 가지 방법으로, 정규근사를 사용하여 신뢰구간을 만들 수 있습니다. 예를 들어 R 함수 boot.ci는 95% 정규 신뢰구간을 산출합니다. 이 신뢰구간은 편향 보정 추정량을 중심으로 하여 부트스트랩 표준편차의 1.95994배의 두 배 길이를 갖는 구간을 만들어 산출합니다(1.95994는 표준정규분포의 97.5번째 분위수입니다). 예를 들어 \(d=14000\)에서 95% 정규 신뢰구간의 하한은 \((0.97678-0.00016)- 1.95994 \times 0.00687\) \(= 0.96316\)입니다. 부트스트랩 신뢰구간에 대해서는 다음 절에서 더 자세히 논의합니다.
예제 8.3.2. \(\log(\mu)\)의 추정. 예를 들어 부트스트랩을 사용하여 추정량의 편향을 정량화할 수 있습니다. 여기서 평균이 \(\mu\)이고 iid(iid) 독립적이고 동일하게 분포된인 표본 \(\mathbf{x}=\{x_1,\cdots,x_n\}\)를 생각해 봅시다.
sample_x <- c(2.46,2.80,3.28,3.86,2.85,3.67,3.37,3.40,5.22,2.55,
              2.79,4.50,3.37,2.88,1.44,2.56,2.00,2.07,2.19,1.77)
관심 대상인 양이 \(\theta=\log(\mu)\)라고 가정합시다. 자연스러운 추정량은 \(\widehat{\theta}_1=\log(\overline{x})\)일 것입니다. 이 추정량은 (젠센 부등식(Jensen inequality) 볼록함수 f(x)에 대하여 f(x의 기댓값) <= f(x)의 기댓값이 성립합니다. 때문에) 편향되어 있지만 점근적으로는 불편입니다. 우리 표본에 대한 추정값은 다음과 같습니다.
[1] 1.08231352부트스트랩 전략을 사용하여 보정을 얻을 수 있습니다. 부트스트랩 표본 \(\mathbf{x}^{\ast}_{b}\)가 주어졌을 때, 그 평균을 \(\overline{x}^{\ast}_{b}\)로 나타내고 다음과 같이 놓습니다.
\[ \widehat{\theta}_2=\frac{1}{B}\sum_{b=1}^B\log(\overline{x}^{\ast}_{b}) . \]
이를 구현하기 위해 다음 코드를 사용하며, 여기서는 R 패키지 boot의 함수 boot를 사용합니다.
부트스트랩 표본 생성을 위한 R 코드 보기
그런 다음 plot(results)와 print(results)를 사용하면 다음을 확인할 수 있습니다.
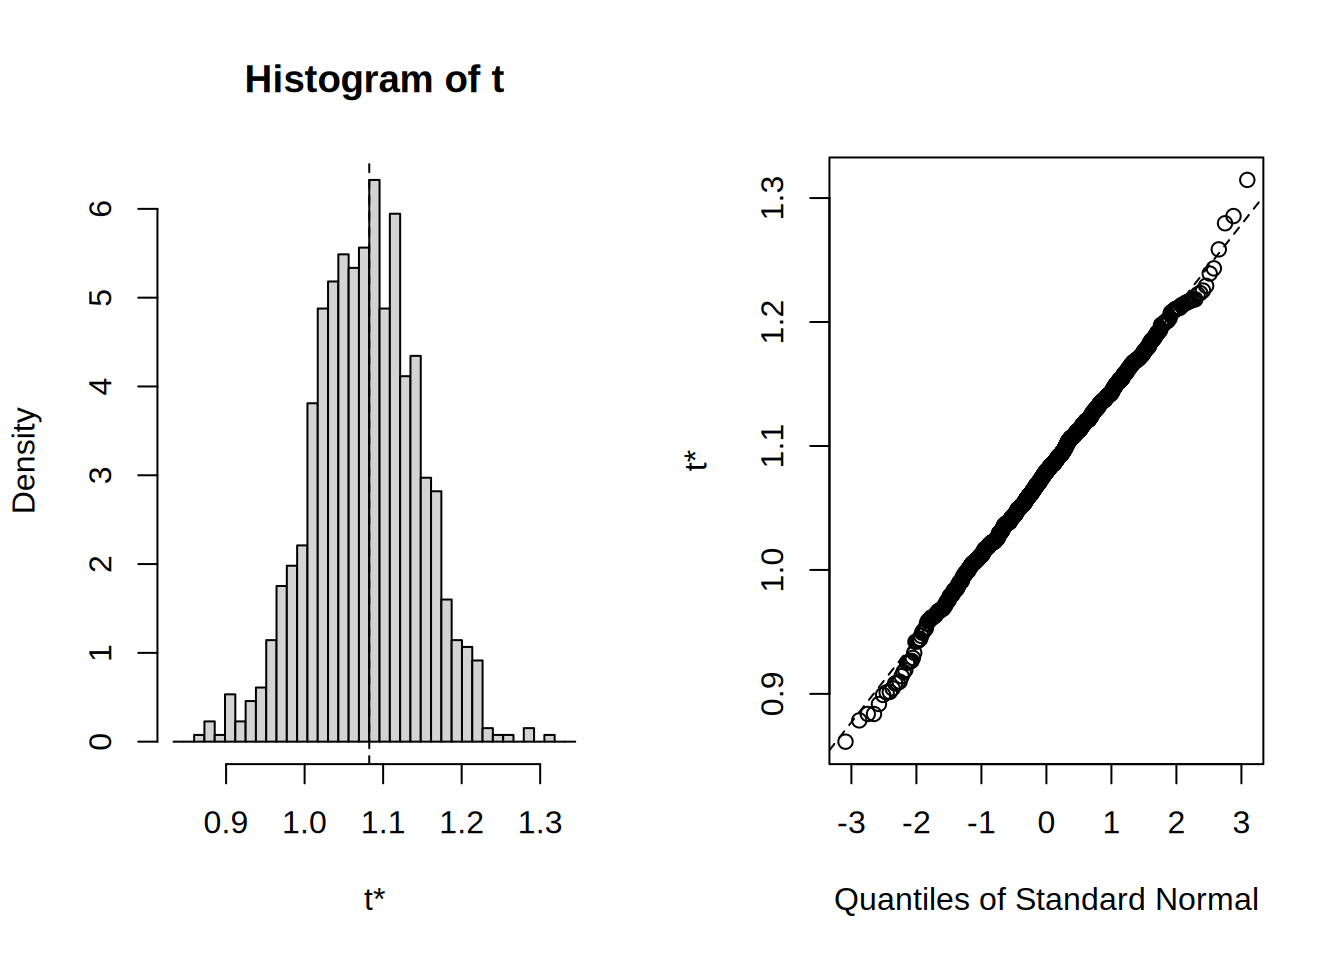
그림 8.10: 부트스트랩 복제값의 분포. 왼쪽 패널은 복제값의 히스토그램입니다. 오른쪽 패널은 부트스트랩 분포를 표준정규분포와 비교하는 분위수-분위수 그림입니다.
ORDINARY NONPARAMETRIC BOOTSTRAP


Call:
boot(data = sample_x, statistic = function(y, indices) {
    log(mean(y[indices]))
}, R = 1000)


Bootstrap Statistics :
      original         bias     std. error
t1* 1.08231352 -0.00438957075 0.0669312212
그 결과 두 개의 추정량, 즉 원 추정량 \(\widehat{\theta}_1=\) 1.082와 부트스트랩 추정량 \(\widehat{\theta}_2=\) 1.087를 얻습니다.
표본 크기가 달라지면 이것은 어떻게 작동합니까? 이제 \(x_i\)들이 형상모수 \(\alpha = 0.25\)와 척도모수 \(\theta = 12\)를 갖는 감마분포에서 생성된다고 가정합시다. 시뮬레이션을 사용하여 표본 크기를 추출하지만, 그다음에는 이를 실현된 관측값 집합인 것처럼 취급합니다. 다음 예시 코드를 참조하십시오.
부트스트랩 표본 생성을 위한 R 코드 보기
비교 결과는 그림 8.11에 요약되어 있습니다. 이 그림은 여러 표본 크기에서 부트스트랩 추정량이 실제 모수 값에 더 가깝다는 것을 보여 줍니다. 두 추정량의 편향은 모두 표본 크기가 커짐에 따라 감소합니다.
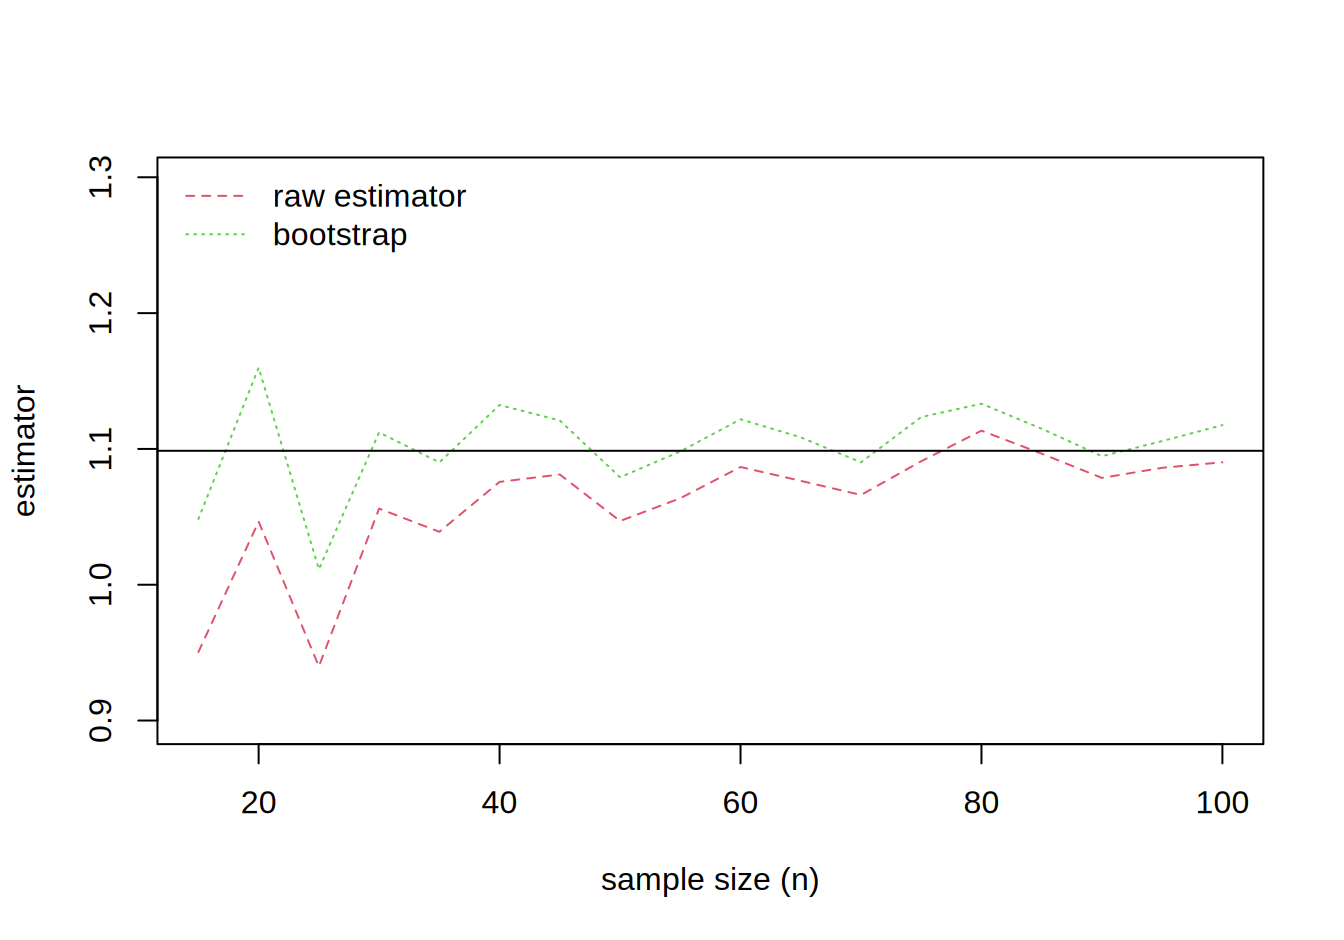
그림 8.11: 추정값의 비교. 모수의 실제 값은 \(\log(3) \approx 1.099\)에 있는 수평 실선으로 표시됩니다.
이 예에서는 성공적이었지만, 편향 조정이 추정량에 추가적인 변동성을 초래하기 때문에 부트스트랩 편향 조정 추정량은 실제로는 일반적으로 사용되지 않는다는 점을 언급해 둡니다. 대신 편향 추정값은 추정값에 편향이 포함되어 있는지 여부에 관한 정보를 제공하며, 이 정보는 추정값의 신뢰성에 관한 추가적인 정보를 줍니다.
8.3.3 신뢰구간
부트스트랩 절차는 추정량 \(\hat{\theta}\)의 복제값 \(\hat{\theta}_1^*, \ldots,\hat{\theta}_B^*\)를 B개 생성합니다. 예제 8.3.1에서는 표준정규근사를 사용하여 관심 모수에 대한 신뢰구간을 구성하는 방법을 살펴보았습니다. 그러나 부트스트래핑을 사용하는 주된 목적이 근사적 정규성 가정에 의존하지 않는 데 있다는 점을 고려하면, 다른 신뢰구간들이 존재한다는 것은 놀라운 일이 아닙니다.
추정량 \(\hat{\theta}\)에 대해 기본 부트스트랩 신뢰구간은 \[\begin{equation} \left(2 \hat{\theta} - q_U, 2 \hat{\theta} - q_L \right) , \tag{8.2} \end{equation}\] 이며, 여기서 \(q_L\)과 \(q_U\)는 부트스트랩 표본 \(\hat{\theta}_1^*, \ldots,\hat{\theta}_B^*\)의 하위 및 상위 2.5% 분위수입니다.
이것이 어디에서 비롯되는지 알아보기 위해, \((q_L, q_U)\)이 \(\hat{\theta}_1^*, \ldots,\hat{\theta}_B^*\)에 대한 95% 구간을 제공한다는 생각에서 출발합시다. 따라서 확률적인 \(\hat{\theta}_b^*\)에 대해 \(q_L \le \hat{\theta}_b^* \le q_U\)일 확률은 95%입니다. 부등식의 방향을 뒤집고 양변에 \(\hat{\theta}\)를 더하면 95% 구간 \[ \hat{\theta} -q_U \le \hat{\theta} - \hat{\theta}_b^* \le \hat{\theta} -q_L . \] 을 얻습니다. 따라서 \(\left( \hat{\theta}-q_U, \hat{\theta} -q_L\right)\)은 \(\hat{\theta} - \hat{\theta}_b^*\)에 대한 95% 구간입니다. 부트스트랩 근사의 아이디어에 따르면 이것은 \(\theta - \hat{\theta}\)에 대한 95% 구간이기도 합니다. 양변에 \(\hat{\theta}\)를 더하면 식 (8.2)의 95% 구간을 얻습니다.
이 밖에도 다양한 부트스트랩 구간을 사용할 수 있습니다. 가장 설명하기 쉬운 것은 백분위수 부트스트랩 구간(percentile bootstrap interval) 부트스트랩 표본마다 다른 표본과 순위를 비교할 수 있는 모수 추정값이 하나 이상 대응하므로, 부트스트랩 표본추출 방식에서 얻은 실제 백분위수 결과를 사용하여 결정한 모수 추정값의 신뢰구간입니다.으로, \(\left(q_L, q_U\right)\)으로 정의됩니다. 그러나 이 구간은 꼬리 부분에서 성능이 나쁠 수 있다는 단점이 있으며, 이는 관심 대상인 일부 보험계리 문제에서 우려가 될 수 있습니다.
예제 8.3.3. 신체상해 청구와 위험측도. 부트스트랩 신뢰구간이 어떻게 작동하는지 알아보기 위해, 예제 8.3.1에서 살펴본 자동차 신체상해 청구로 돌아갑니다. 손실제거율 대신 95번째 백분위수 \(F^{-1}(0.95)\)와 다음과 같이 정의되는 측도 \[ ES_{0.95}[X] = \mathrm{E}[X | X > F^{-1}(0.95)] . \] 를 추정하고자 한다고 가정합시다. 이 측도를 기대부족액(expected shortfall) 평균 위험가치이라고 합니다. 이 정식화에서 이것은 \(X\)가 95번째 백분위수를 초과한다는 조건하에서 \(X\)의 기댓값이며, 때로는 조건부 위험가치라고도 합니다. 13.2절에서는 분위수와 기대부족액이 이른바 위험측도의 가장 중요한 두 가지 예인 이유를 설명합니다. 지금은 이것들을 단순히 우리가 추정하고자 하는 측도로 생각하겠습니다. 백분위수에 대해서는 4.4.1.2절에서 정의한 비모수적 추정량 \(F^{-1}_n(0.95)\)를 사용합니다. 기대부족액에 대해서는 플러그인 원리를 사용하여 비모수적 추정량 \[ ES_{n,0.95}[X] = \frac{\sum_{i=1}^n X_i I[X_i > F^{-1}_n(0.95)]}{\sum_{i=1}^n I[X_i > F^{-1}_n(0.95)]} ~. \] 를 정의합니다. 이 식에서 분모는 95번째 백분위수 \(F^{-1}_n(0.95)\)를 초과하는 관측값의 개수를 셉니다. 분자는 \(F^{-1}_n(0.95)\)를 초과하는 관측값들의 손실을 합산합니다. 표 8.5는 선택된 비율에 대한 추정량을 요약한 것입니다.
분위수 부트스트랩 표본 생성을 위한 R 코드 보기
표 8.5. 선택된 비율에서 분위수의 부트스트랩 추정값
| Fraction | NP Estimate | Bootstrap Bias | Bootstrap SD | Lower Normal 95% CI | Upper Normal 95% CI | Lower Basic 95% CI | Upper Basic 95% CI | Lower Percentile 95% CI | Upper Percentile 95% CI |
|---|---|---|---|---|---|---|---|---|---|
| 0.50 | 6500.00 | -128.02 | 200.36 | 6235.32 | 7020.72 | 6300.00 | 7000.00 | 6000.00 | 6700.00 |
| 0.80 | 9078.40 | 89.51 | 200.27 | 8596.38 | 9381.41 | 8533.20 | 9230.40 | 8926.40 | 9623.60 |
| 0.90 | 11454.00 | 55.95 | 480.66 | 10455.96 | 12340.13 | 10530.49 | 12415.00 | 10493.00 | 12377.51 |
| 0.95 | 13313.40 | 13.59 | 667.74 | 11991.07 | 14608.55 | 11509.70 | 14321.00 | 12305.80 | 15117.10 |
| 0.98 | 16758.72 | 101.46 | 1273.45 | 14161.34 | 19153.19 | 14517.44 | 19326.95 | 14190.49 | 19000.00 |
예를 들어 비율이 0.50일 때, 부트스트랩 시뮬레이션의 하위 및 상위 2.5번째 분위수는 각각 \(q_L=\) 6000와 \(q_u=\) 6700임을 알 수 있습니다. 이들이 백분위수 부트스트랩 신뢰구간을 이룹니다. 비모수적 추정량 6500를 사용하면, 이들로부터 기본 신뢰구간의 하한과 상한이 각각 6300와 7000로 구해집니다. 표 8.5에는 8.3.2절에서 소개한 개념인 편의, 표준편차, 정규 신뢰구간의 부트스트랩 추정값도 나와 있습니다.
표 8.6은 기대부족액에 대한 유사한 계산 결과를 보여 줍니다. 각 경우에 비율이 증가함에 따라 부트스트랩 표준편차가 증가함을 알 수 있습니다. 이는 비율이 증가할수록 분위수를 추정하는 데 사용할 관측값이 적어져 부정확성이 커지기 때문입니다. 신뢰구간도 더 넓어집니다. 흥미롭게도 편향의 추정값에서는 이와 같은 패턴이 나타나지 않는 것으로 보입니다.
ES 부트스트랩 표본 생성을 위한 R 코드 보기
표 8.6. 선택된 위험 수준에서 ES의 부트스트랩 추정값
| Fraction | NP Estimate | Bootstrap Bias | Bootstrap SD | Lower Normal 95% CI | Upper Normal 95% CI | Lower Basic 95% CI | Upper Basic 95% CI | Lower Percentile 95% CI | Upper Percentile 95% CI |
|---|---|---|---|---|---|---|---|---|---|
| 0.50 | 9794.69 | -120.82 | 273.35 | 9379.74 | 10451.27 | 9355.14 | 10448.87 | 9140.51 | 10234.24 |
| 0.80 | 12454.18 | 30.68 | 481.88 | 11479.03 | 13367.96 | 11490.62 | 13378.52 | 11529.84 | 13417.74 |
| 0.90 | 14720.05 | 17.51 | 718.23 | 13294.82 | 16110.25 | 13255.45 | 16040.72 | 13399.38 | 16184.65 |
| 0.95 | 17072.43 | 5.99 | 1103.14 | 14904.31 | 19228.56 | 14924.50 | 19100.88 | 15043.97 | 19220.36 |
| 0.98 | 20140.56 | 73.43 | 1587.64 | 16955.40 | 23178.85 | 16942.36 | 22984.40 | 17296.71 | 23338.75 |
8.3.4 모수적 부트스트랩
비모수적 부트스트랩의 아이디어는 경험적 누적분포함수 \(F_n\)에서 독립 변수를 추출하여 재표본추출하는 것입니다. 이와 대조적으로 모수적 부트스트랩에서는 \(F_{\widehat{\theta}}\)에서 독립 변수를 추출하며, 이때 기저 분포는 감마분포나 로그정규분포와 같은 모수적 분포족에 속한다고 가정합니다. 일반적으로 이 분포의 모수는 표본을 바탕으로 추정하며 \(\hat{\theta}\)로 표기합니다.
예제 8.3.4. 로그정규분포. 다음 데이터셋을 다시 살펴보겠습니다.
sample_x <- c(2.46,2.80,3.28,3.86,2.85,3.67,3.37,3.40,
              5.22,2.55,2.79,4.50,3.37,2.88,1.44,2.56,2.00,2.07,2.19,1.77)
고전적인 (비모수) 부트스트랩은 다음 표본들을 바탕으로 하였습니다.
반면 모수적 부트스트랩에서는 \(x_i\)들의 분포가 특정 분포족에 속한다고 가정해야 합니다. 예를 들어, 다음 코드는 로그정규분포를 사용합니다.
     meanlog         sdlog
  1.0363069735   0.3059343996
 (0.0684090114) (0.0483702729)
그런 다음 그 분포에서 추출합니다.
모수적 부트스트랩 표본에 대한 R 코드 보기
그림 8.12은 변동계수에 대한 부트스트랩 분포를 비교하며, 하나는 비모수적 접근법에 기반하고 다른 하나는 로그정규분포를 가정한 모수적 접근법에 기반합니다.
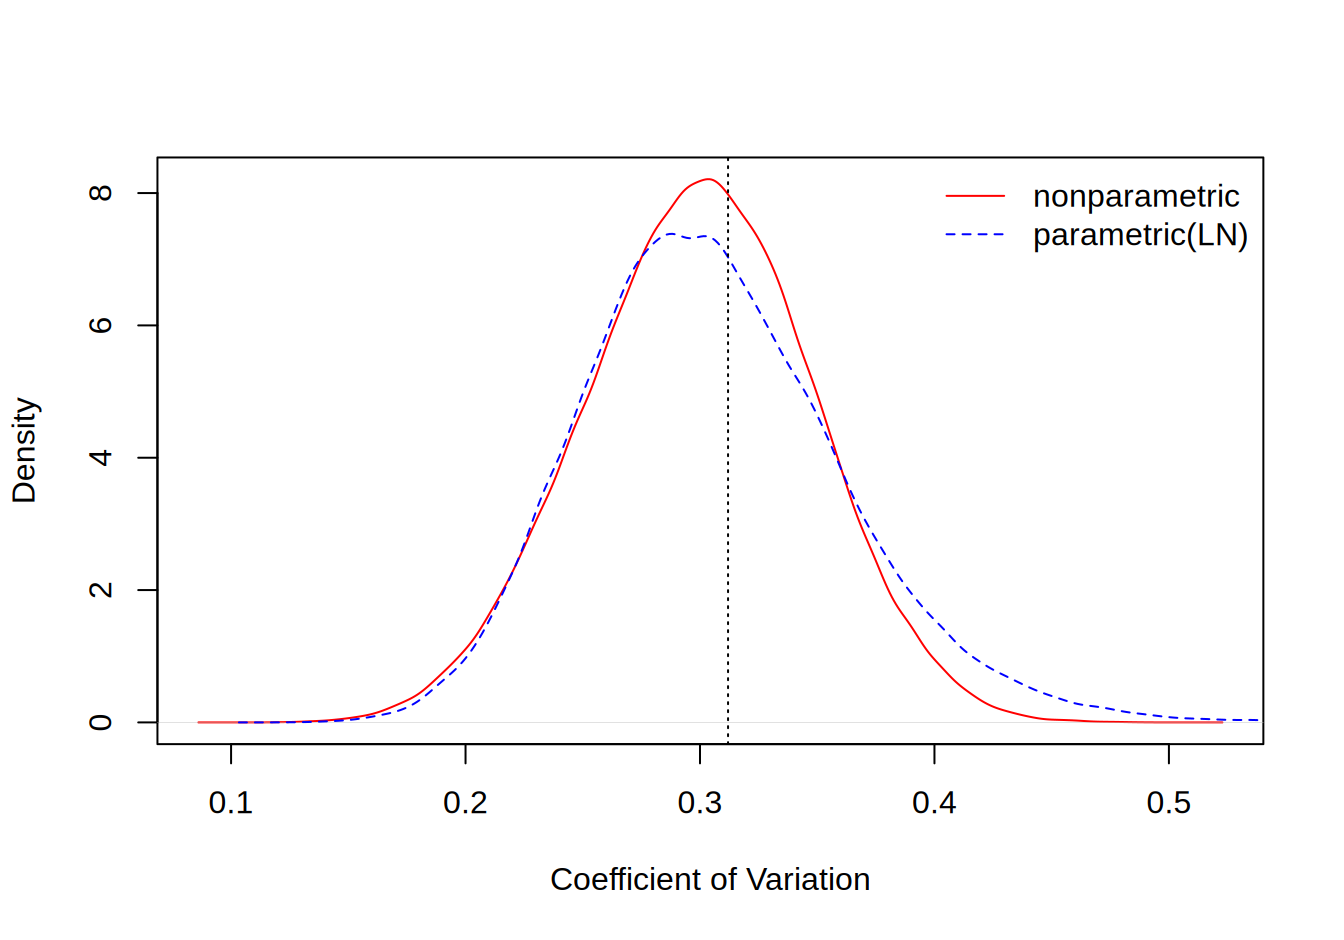
그림 8.12: 변동계수에 대한 비모수 부트스트랩 분포와 모수적 부트스트랩 분포의 비교
예제 8.3.5. 중도절단 관측값의 부트스트래핑. 모수적 부트스트랩은 분포함수의 모수적 추정값에서 시뮬레이션 실현값을 추출합니다. 같은 방식으로, 분포함수의 추정값으로부터 모의 실현값을 추출할 수 있습니다. 한 가지 예로, 4.4.1.3절에서 소개한 분포함수의 평활 추정값으로부터 추출할 수 있습니다. 여기서 다루는 또 다른 특수한 경우는 5.3.3절에서 소개한 카플란-마이어 추정량으로부터 추정값을 추출하는 것입니다. 이러한 방식으로 중도절단된 관측값을 처리할 수 있습니다.
구체적으로, 예제 8.2.1과 8.2.3의 신체상해 데이터로 돌아가되, 이번에는 보험 한도에 의해 중도절단된 17건의 청구를 포함합니다. 예제 4.3.6에서는 이 전체 데이터셋을 사용하여 5.3.3절에서 소개한 생존함수의 카플란-마이어 추정량을 추정하였습니다. 표 8.7은 카플란-마이어 생존함수 추정량으로부터 얻은 분위수의 부트스트랩 추정값을 제시합니다. 여기에는 기본 95% 신뢰구간뿐만 아니라 부트스트랩 정밀도 추정값인 편향과 표준편차도 포함됩니다.
부트스트랩 카플란-마이어 추정값에 대한 R 코드 보기
표 8.7. 선택된 분위점에서의 분위수에 대한 부트스트랩 카플란-마이어 추정값
| Fraction | KM NP Estimate | Bootstrap Bias | Bootstrap SD | Lower Basic 95% CI | Upper Basic 95% CI |
|---|---|---|---|---|---|
| 0.50 | 6500 | 18.77 | 177.38 | 6067 | 6869 |
| 0.80 | 9500 | 167.08 | 429.59 | 8355 | 9949 |
| 0.90 | 12756 | 37.73 | 675.21 | 10812 | 13677 |
| 0.95 | 18500 | Inf | NaN | 12500 | 22300 |
| 0.98 | 25000 | Inf | NaN | -Inf | 27308 |
표 8.7의 결과는 표 8.5의 중도절단되지 않은 부분표본에 대한 결과와 일치합니다. 표 8.7에서는 중도절단으로 인해 큰 분위점에서 분위수를 추정하기 어렵다는 점을 알 수 있습니다. 그러나 중간 크기의 분위점(0.50, 0.80, 0.90)에서는 분위수의 카플란-마이어 비모수(KM NP) 추정값이 표 8.5의 추정값과 일치합니다. 부트스트랩 표준편차는 0.50(중앙값에 해당)에서는 더 작지만 0.80과 0.90 수준에서는 더 큽니다. 표 8.7에 요약된 중도절단 데이터 분석은 표 8.5의 중도절단되지 않은 부분표본 분석보다 더 많은 데이터를 사용하지만, 큰 분위수에 대한 정보를 추출하는 데에는 마찬가지로 어려움이 있습니다.
8.4 모형 선택과 교차 검증
이 절에서는 다음을 학습합니다.
- 교차 검증을 시뮬레이션 기법 및 부트스트랩 방법과 비교하고 대조합니다.
- 모형 선택을 위해 교차 검증 기법을 사용합니다.
- 잭나이프 방법을 교차 검증의 특수한 경우로 설명하고, 편향과 표준오차의 잭나이프 추정값을 계산합니다.
제2장과 6.5절에서 간략히 소개한 교차 검증은 시뮬레이션 결과에 기반한 기법으로, 적절한 모형을 선택하는 데 특히 유용합니다. 이제 교차 검증을 이 장에서 이미 소개한 다른 시뮬레이션 기법들과 비교하고 대조해 보겠습니다.
- 8.1절에서 소개한 시뮬레이션, 즉 몬테카를로 방법을 사용하면 기댓값을 비롯하여 \(p\)-값과 같은 통계적 분포의 여러 요약값을 손쉽게 계산할 수 있습니다.
- 8.3절에서 소개한 부트스트랩 및 기타 재표본추출 방법은 통계량의 정밀도, 즉 변동성에 대한 추정량을 제공합니다.
- 교차 검증은 예측 모형이 실제로 얼마나 정확하게 작동할지를 평가할 때 중요합니다.
서로 겹치는 부분이 있기는 하지만, 그럼에도 각 통계적 방법과 관련된 폭넓은 목표를 생각해 보는 것이 도움이 됩니다.
교차 검증을 논의하기 위해 제2장에서 다룬 모형 검증의 핵심 개념 몇 가지를 상기해 봅시다. 모형을 평가, 즉 검증할 때에는 새로운 데이터, 또는 적어도 모형 적합에 사용되지 않은 데이터에서 측정한 성능을 살펴봅니다. 고전적인 접근법은 표본을 둘로 나누는 것입니다. 한 부분(훈련 데이터셋)은 모형을 적합하는 데 사용하고, 다른 부분(시험 데이터셋)은 검증하는 데 사용합니다. 그러나 이 접근법의 한계는 결과가 분할에 따라 달라진다는 점입니다. 전체 표본은 고정되어 있더라도 훈련 부분표본과 시험 부분표본 사이의 분할은 무작위로 달라집니다. 훈련 표본이 달라지면 모형의 추정 모수도 달라집니다. 모형 모수와 시험 표본이 다르면 검증 통계량도 달라집니다. 두 분석가가 같은 데이터와 같은 모형을 사용하더라도 (서로 다른 무작위 분할에 근거하여) 모형의 타당성에 대해 서로 다른 결론에 도달할 수 있으며, 이는 곤혹스러운 상황입니다.
8.4.1 k-겹 교차 검증
이러한 어려움을 완화하기 위해 4.2.4절에서 소개한 교차 검증 접근법을 사용하는 것이 일반적입니다. 핵심 아이디어는 모형 검증을 위한 기본적인 시험/훈련 접근법을 여러 번 반복하여 데이터의 서로 다른 분할에 걸쳐 평균을 냄으로써 이를 모방하는 것입니다. 주요 장점은 검증 통계량이 특정한 모수적(또는 비모수적) 모형에 얽매이지 않는다는 점입니다. 비모수적 통계량이나 경제적 해석이 가능한 통계량을 사용할 수 있으므로, (가능도비 절차와 달리) 내포되지 않은 모형들을 비교하는 데에도 사용할 수 있습니다.
예제 8.4.1. 위스콘신 재산 기금. 1.3절에서 소개한 2010년 재산 기금 데이터에 대해, 1,377건의 청구 데이터에 감마 분포와 파레토 분포를 적합합니다. 관련 적합도에 대한 자세한 내용은 부록 15.4.4절을 참조하십시오. 이제 6.1.2절에서 소개한 콜모고로프-스미르노프 통계량을 살펴보겠습니다. 전체 데이터셋을 적합했을 때, 콜모고로프-스미르노프 적합도 통계량은 감마분포의 경우 0.2639이고 파레토 분포의 경우 0.0478입니다. 파레토 분포의 값이 더 낮다는 것은 이 분포가 감마 분포보다 더 잘 적합됨을 나타냅니다.
k-겹 교차 검증(k-fold cross-validation) 데이터를 무작위로 k개 그룹으로 나눈 뒤 k개 그룹 각각을 차례로 테스트 데이터셋으로 남겨 두고 나머지 k-1개 그룹을 분포 또는 모형 적합에 사용하며, 이 과정을 총 k번 반복하는 검증 방법의 한 유형입니다.이 어떻게 작동하는지 알아보기 위해, 데이터를 각각 약 \(1377/8 \approx 172\)개의 관측값을 갖는 \(k=8\)개의 그룹, 즉 겹(fold)으로 무작위로 분할합니다. 그런 다음 처음 일곱 개의 겹으로 이루어진 데이터셋(약 \(172 \times 7 = 1,204\)개의 관측값)에 감마 모형과 파레토 모형을 적합하여 추정 모수를 구하고, 이렇게 적합된 모형을 따로 남겨 둔 데이터에 적용하여 콜모고로프-스미르노프 통계량을 구했습니다.
콜모고로프-스미르노프 교차 검증 R 코드 보기
그 결과는 그림 8.13에 나타나 있으며, 가로축의 Fold=1에 해당합니다. 이 과정을 나머지 일곱 개의 겹에 대해서도 반복했습니다. 그림 8.13에 요약된 결과는 파레토 분포가 감마 분포보다 일관되게 더 신뢰할 만한 예측 분포를 제공함을 보여 줍니다.
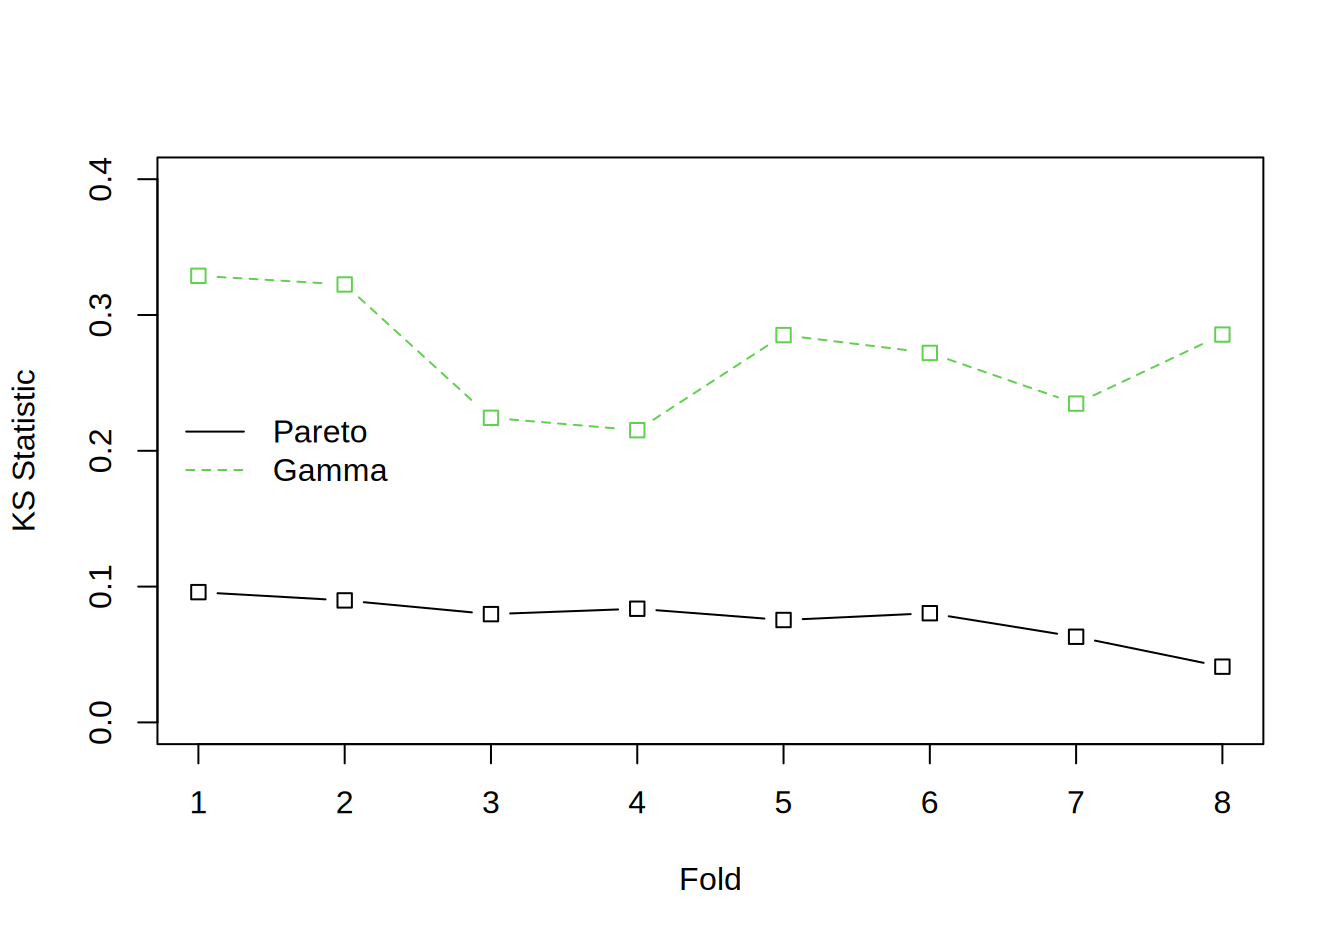
그림 8.13: 재산 기금 청구 데이터에 대한 교차 검증 콜모고로프-스미르노프(KS) 통계량. 검은색 실선은 파레토 분포, 녹색 점선은 감마분포를 나타냅니다. KS 통계량은 무작위로 선택된 데이터의 8개 그룹, 즉 겹 각각에 대해 적합된 분포와 경험분포 사이의 최대 편차를 측정합니다.
8.4.2 하나 남기기 교차 검증
\(k=n\)인 특수한 경우를 하나 남기기 교차 검증(leave-one-out cross validation) k-겹 교차 검증의 특수한 경우로, 각각의 데이터 점이 차례로 유일한 홀드아웃 검정 데이터 점이 되며, 총 n개의 개별 모형을 구축하고 검정하는 방법이라고 합니다. 이 경우는 역사적으로 중요하며, 부트스트랩 기법의 전신인 잭나이프 통계량(jackknife statistics) 추정량을 계산하기 위해 각 관측값을 차례로 제외하고 매번 표본 추정 통계량을 계산한 다음, n개의 개별 추정값을 평균합니다.과 밀접한 관련이 있습니다.
이를 교차 검증의 특수한 경우로 제시하기는 하지만, 명시적으로 정의해 두는 것이 도움이 됩니다. 관심 모수 \(\theta\)에 대한 추정량인 일반적인 통계량 \(\widehat{\theta}=t(\boldsymbol{x})\)를 생각해 봅시다. 잭나이프의 아이디어는 \(n\)개의 값 \(\widehat{\theta}_{-i}=t(\boldsymbol{x}_{-i})\)을 계산하는 것이며, 여기서 \(\boldsymbol{x}_{-i}\)은 \(\boldsymbol{x}\)에서 \(i\)번째 값을 제거한 부분표본입니다. 이 값들의 평균은 다음과 같이 나타냅니다.
\[ \overline{\widehat{\theta}}_{(\cdot)}=\frac{1}{n}\sum_{i=1}^n \widehat{\theta}_{-i} . \]
이 값들을 사용하여 통계량 \(\widehat{\theta}\)의 편의 추정값 \[\begin{equation} Bias_{jack} = (n-1) \left(\overline{\widehat{\theta}}_{(\cdot)} - \widehat{\theta}\right) \tag{8.3} \end{equation}\] 뿐만 아니라 다음과 같은 표준편차 추정값도 구할 수 있습니다. \[\begin{equation} s_{jack} =\sqrt{\frac{n-1}{n}\sum_{i=1}^n \left(\widehat{\theta}_{-i} -\overline{\widehat{\theta}}_{(\cdot)}\right)^2} ~. \tag{8.4} \end{equation}\]
예제 8.4.2. 변동계수. 예를 들어, 다음과 같은 실현값을 갖는 작은 가상 표본 \(\boldsymbol{x}=\{x_1,\ldots,x_n\}\)를 생각해 봅시다.
sample_x <- c(2.46,2.80,3.28,3.86,2.85,3.67,3.37,3.40,
5.22,2.55,2.79,4.50,3.37,2.88,1.44,2.56,2.00,2.07,2.19,1.77)변동계수(coefficient of variation) 표준편차를 분포의 평균으로 나눈 값으로, 평균 단위로 변동성을 측정합니다 \(\theta = CV\) \(= \sqrt{\mathrm{Var~}[X]}/\mathrm{E~}[X]\)에 관심이 있다고 가정합시다.
이 데이터셋에서 변동계수의 추정량은 0.31196입니다. 그러나 이 값은 얼마나 신뢰할 수 있겠습니까? 이 질문에 답하기 위해 편의와 그 표준편차의 잭나이프 추정값을 계산할 수 있습니다. 다음 코드에서 편향의 잭나이프 추정량은 \(Bias_{jack} =\) -0.00627이고 잭나이프 표준편차는 \(s_{jack} =\) 0.01293임을 확인할 수 있습니다.
예제 8.4.2의 R 코드 보기
예제 8.4.3. 신체상해 청구와 손실제거율. 예제 8.3.1에서는 예제 4.1.11의 신체상해 청구 데이터를 사용하여 손실제거율의 편의와 표준편차에 대한 부트스트랩 추정값을 계산하는 방법을 보였습니다. 이제 그 후속으로 잭나이프 통계량을 사용하여 이에 상응하는 값들을 제시합니다.
표 8.8은 잭나이프 추정 결과를 요약한 것입니다. 이 표는 손실제거율 \(\mathrm{E}~[\min(X,d)]/\mathrm{E}~[X]\)의 편의와 표준편차에 대한 잭나이프 추정값이 부트스트랩 방법론의 결과와 대체로 일치함을 보여 줍니다. 또한 표준편차를 사용하여 편의 보정 추정량을 중심으로 하는 정규분포 기반 신뢰구간을 구성할 수 있습니다. 예를 들어, \(d=14000\)에서 LER의 비모수 추정값이 0.97678임을 예제 4.1.11에서 확인하였습니다. 이 추정치의 추정 편향은 0.00010이므로, (잭나이프) 편향 보정 추정량은 0.97688입니다. 95% 신뢰구간은 편향 보정 추정량을 중심으로 잭나이프 표준편차의 1.96배를 양쪽으로 잡아, 그 두 배 길이의 구간을 만들어 구합니다(1.96은 표준정규분포의 97.5번째 분위수의 근삿값입니다).
R 코드 보기
표 8.8. 선택된 공제액에서의 LER 잭나이프 추정값
| d | NP Estimate | Bootstrap Bias | Bootstrap SD | Jackknife Bias | Jackknife SD | Lower Jackknife 95% CI | Upper Jackknife 95% CI |
|---|---|---|---|---|---|---|---|
| 4000 | 0.54113 | 0.00011 | 0.01237 | 0.00031 | 0.00061 | 0.53993 | 0.54233 |
| 5000 | 0.64960 | 0.00027 | 0.01412 | 0.00033 | 0.00068 | 0.64825 | 0.65094 |
| 10500 | 0.93563 | 0.00004 | 0.01017 | 0.00019 | 0.00053 | 0.93460 | 0.93667 |
| 11500 | 0.95281 | -0.00003 | 0.00941 | 0.00016 | 0.00047 | 0.95189 | 0.95373 |
| 14000 | 0.97678 | 0.00016 | 0.00687 | 0.00010 | 0.00034 | 0.97612 | 0.97745 |
| 18500 | 0.99382 | 0.00014 | 0.00331 | 0.00003 | 0.00017 | 0.99350 | 0.99415 |
논의. 한 개 남기기 특수한 경우의 여러 흥미로운 점 중 하나는 추정값을 정확히 재현할 수 있다는 것입니다. 즉, 폴드의 크기가 1에 불과하면 교차 검증으로 인해 추가로 발생하는 불확실성이 없습니다. 이는 분석가들이 서로의 작업을 정확히 재현할 수 있음을 의미하며, 이는 중요한 고려 사항입니다.
잭나이프 통계량은 추정량의 정밀도를 파악하기 위해 개발되었으며, 식 (8.3)와 (8.4)에서 편의와 표준편차의 추정량을 제공합니다. 이는 교차 검증 방법이 아니라 부트스트랩 기법과 연관 지어 온 목표에 해당합니다. 이는 통계 기법이 서로 다른 목표를 달성하는 데 어떻게 사용될 수 있는지를 보여 줍니다.
8.4.3 교차 검증과 부트스트랩
부트스트랩은 통계량의 정밀도, 즉 변동성에 대한 추정량을 제공하는 데 유용합니다. 또한 모형 검증에도 유용하게 쓰일 수 있습니다. 모형 검증을 위한 부트스트랩 접근법은 하나-빼기(leave-one-out) 검증 절차 및 k-겹 검증 절차와 유사합니다.
- \(\{1,\cdots,n\}\)에서 \(n\)개의 인덱스를 (복원) 재표본추출하여 부트스트랩 표본을 만드십시오. 이것이 훈련 표본이 됩니다. 이 표본을 바탕으로 고려 중인 모형을 추정하십시오.
- 시험 표본, 즉 검증 표본은 훈련용으로 선택되지 않은 관측값들로 구성됩니다. (훈련 데이터를 바탕으로) 적합된 모형을 테스트 데이터로 평가하십시오.
이 과정을 여러 번(예를 들어 \(B\)번) 반복하십시오. 결과의 평균을 구하고, 평균 평가 통계량을 바탕으로 모형을 선택하십시오.
예제 8.4.4. 위스콘신 재산 기금. 재산 기금 데이터에 대한 감마 분포와 파레토 분포의 적합도를 살펴본 예제 8.3.1로 돌아갑시다. 이번에도 콜모고로프-스미르노프(KS) 통계량을 사용하여 예측 성능을 비교하지만, 이번에는 부트스트랩 절차를 사용하여 데이터를 훈련 표본과 시험 표본으로 나눕니다. 다음은 예시 코드입니다.
부트스트래핑 검증 절차의 R 코드 보기
\(B=\) 100회의 반복으로 표본추출을 수행했습니다. 파레토 분포의 평균 KS 통계량은 0.058였고, 감마분포의 평균은 0.262였습니다. 이는 앞선 결과와 일치하며, 이 데이터에 대해 파레토 분포가 감마 분포보다 더 나은 모형이라는 또 하나의 증거가 됩니다.
8.5 추가 자료 및 기여자
8.4.2절에서는 잭나이프 통계량을 (하나-빼기) 교차 검증 방법의 응용으로 제시했습니다. 이 내용을 제시하는 또 다른 방법은 역사적 발전 과정을 살펴보는 것입니다. Efron (1982)은 잭나이프 아이디어를 Quenouille (1949)의 것으로 봅니다. 현대적인 컴퓨팅 성능이 널리 보급되기 이전의 이 단순한 시기에도, 잭나이프는 사실상 모든 통계량의 편향과 표준편차를 추정할 수 있는 편리한 도구를 제공했습니다. 또한 이는 1979년 Efron (1979)에서 부트스트랩이 도입되는 계기가 되었습니다(Efron (1992)도 참조하십시오). 부트스트랩은 표준편차를 포함하여 통계량의 불확실성을 이해하는 도구를 제공했습니다.
2장에서 개괄한 이 책의 서술 방식은 분석가들이 채택하는 전략을 따릅니다. 저희는 잭나이프와 부트스트랩을 관심 있는 통계량의 특성을 이해하는 데 도움이 되는 도구로 여깁니다. 또한 교차 검증은 주로 모형 검증에 쓰이는 재표본추출 전략입니다. Efron (1982)에서 언급했듯이, 교차 검증의 역사적 발전 과정은 다소 불분명합니다. 교차 검증은 표본을 절반으로 나눈 뒤, 한쪽 절반으로 훈련한 모형을 사용하여 나머지 절반에서의 성능을 예측하는 매우 단순한 전략에서 비롯된 방법입니다. 교차 검증 방법을 잭나이프 및 부트스트래핑 기법과 비교해 보면, 모두 재표본추출에 기반합니다. 또한 통계적 추론의 문제는 자연스럽게 모형 검증의 문제와 겹치므로, 이 방법들 사이에는 자연스러운 중첩이 존재합니다.
- 더 읽을거리로는, 잭나이프와 부트스트랩에 대한 고전적이면서도 여전히 매우 읽기 쉬운 입문서로 Efron (1982)가 있습니다.
- 다음은 재현성과 무작위성, 그리고 난수 생성기에서 표본 함수로 나아가는 방법에 대해 더 알아볼 수 있는 링크입니다.
기여자
- 퀘벡 대학교 몬트리올 캠퍼스(Université du Quebec á Montreal)의 Arthur Charpentier와 위스콘신 대학교 매디슨 캠퍼스(University of Wisconsin-Madison)의 Edward (Jed) Frees는 이 장 초판의 주 저자입니다.
- 이 장의 검토자로는 Yvonne Chueh와 Brian Hartman이 있습니다.
- 위스콘신 대학교 매디슨 캠퍼스(University of Wisconsin-Madison) 및 호주 국립대학교(Australian National University)의 Edward (Jed) Frees는 이 장 제2판의 저자입니다. 이 장에 대한 의견이나 개선 제안은 jfrees@bus.wisc.edu로 이메일을 보내 주십시오.
- 이 장은 Hirokazu (Iwahiro) Iwasawa의 제안으로부터 많은 도움을 받았습니다.