제3장 빈도 모형화
장 미리보기. 보험회사가 가장 중점을 두는 일은 보험계약에 따라 부담해야 하는 총청구액의 규모를 추정하는 것입니다. 총청구액(Aggregate claims) 일정 기간 동안 관측된 모든 청구액의 합은 보험사고의 빈도와 심도 모두의 영향을 받습니다. 총청구액을 이 두 구성 요소로 분해하는 일은 분석과 요율 산정에 필수적이며, 각 구성 요소는 상당한 주의를 기울일 만한 가치가 있습니다. 이 장에서는 빈도분포, 요약 측도, 모수 추정 기법을 다룹니다.
3.1절에서는 용어를 제시하고 빈도와 심도를 따로 연구하는 이유를 논의합니다. 빈도분포와 측도의 기초는 세 가지 주요 분포인 이항, 포아송, 음이항 분포와 함께 3.2절에서 소개합니다. 이 세 분포는 \((a,b,0)\) 분포족이라고 알려진 분포족에 속하며, 이 분포족의 구별되는 식별 특성 덕분에 확률을 효율적으로 계산할 수 있습니다. 이에 대해서는 3.3절에서 더 자세히 논의합니다. 데이터셋에 분포를 적합할 때는 모수 값을 추정해야 하며, 3.4절에서는 최대가능도 추정 절차를 설명합니다.
보험 데이터셋에서 0이라는 관측값은 특정 사건이 발생하지 않았음을 뜻하며, 이는 흔히 추가로 주의를 기울일 필요가 있습니다. 3.5절에서 더 자세히 설명하듯이, 어떤 데이터셋에서는 연구 대상 사건이 0회 발생하는 것이 불가능할 수 있으며, 또는 사건이 0회인 경우가 다른 사건 건수와는 다른 모형을 따를 수도 있습니다. 어느 경우든 일반적인 건수 모형을 그대로 적합하면 부적절한 추정값을 얻을 수 있습니다. 영절단 기법이나 영수정 기법을 사용하면 분포를 더 적절하게 적합할 수 있습니다.
보험 포트폴리오가 각자 고유한 개별 특성을 지닌 서로 다른 하위 집단들로 구성될 수 있다는 점에 주목하여, 3.6절에서는 포트폴리오 내의 이러한 이질성을 반영할 수 있는 혼합분포와 방법론을 소개합니다. 3.7절에서는 표준적인 빈도분포가 실제 데이터에 잘 적합되는 경우가 많다는 것을 보여 주는 예를 제시합니다. 3.8절에서는 연습문제를 제시하며, 3.9.1절에서는 3.4절에 나타낸 그림에 대한 R 코드로 이 장을 마무리합니다.
3.1 빈도분포
이 절에서는 다음 관점에서 빈도 모형화의 중요성을 요약하는 방법을 배웁니다.
- 계약상의 동기,
- 행동상의 동기,
- 데이터베이스상의 동기,
- 규제/행정상의 동기.
3.1.1 빈도가 심도 정보를 보강하는 방식
기본 용어
이 장에서 손실(ground-up loss라고도 합니다)은 피보험자가 입은 재무적 손실의 금액을 뜻합니다. 청구는 보험사고가 발생했을 때의 보상, 즉 보험자가 지급하는 금액을 나타내는 데 사용합니다. 일부 문헌에서는 손실과 청구액을 같은 뜻으로 사용하지만, 여기서는 공제금액과 보상한도 같은 보험계약 조항이 손실에서 비롯되는 청구액의 크기에 어떤 영향을 미치는지 인식하기 위해 두 용어를 구별하고자 합니다. 빈도(Frequency) 청구 건수를 나타내는 계수형(count) 확률변수는 보험사고가 얼마나 자주 발생하는지를 나타내며, 일반적으로 보험계약 기간 내의 발생 횟수를 말합니다. 여기서는 청구 건수, 즉 사건이 얼마나 자주 발생하는지를 나타내는 건수 확률변수에 초점을 맞춥니다. 심도(Severity) 보험사고 한 건당 지급되는 금액 또는 규모는 보험사고 한 건당 지급액의 금액 또는 크기를 뜻합니다. 장 7에서는 빈도 모형과 심도 모형을 결합한 총합 모형을 살펴봅니다.
빈도의 중요성
1.2절에서 보험 상품의 가격을 설정하는 일이 복잡한 문제일 수 있다는 점을 떠올려 보십시오. 제조업에서는 상품의 원가가 (비교적) 알려져 있습니다. 다른 금융 서비스 분야에서는 시장 가격을 이용할 수 있습니다. 보험에서는 가격 책정을 다음과 같이 일반화할 수 있습니다. 먼저 기대 비용에서 시작하여, 상품의 위험성, 상품 관리에 드는 비용, 그리고 보험자의 이윤/잉여금 몫을 반영하는 “마진”을 더합니다.
보험의 기대 비용은 기대 청구 건수에 청구 건당 금액을 곱한 값, 즉 빈도와 심도를 곱한 값의 기댓값으로 구할 수 있습니다. 청구 건수에 초점을 맞추면 보험자는 손실 발생에 직접 영향을 미치고 그로 인해 청구를 발생시킬 가능성이 있는 요인들을 고려할 수 있습니다.
빈도 정보를 왜 살펴봐야 합니까?
보험사와 정부 기관을 비롯한 여러 이해관계자는 다양한 이유로 빈도 데이터셋을 수집하고 관리합니다.
계약상 이유. 보험계약에서는 보험사고가 발생할 때마다 적용되는 특정 공제액과 보험금 한도가 명시되어 있는 경우가 흔합니다. 이에 따라 생성되는 청구 건수 데이터는 이러한 기준을 충족하는 청구의 수를 나타내므로, 고유한 청구 빈도 척도를 제공합니다. 이를 확장하면, 총 피보험 손실의 모형은 각 보험사고에 대한 공제액과 보험금 한도를 반영해야 합니다.
행동상의 이유. 손실 빈도에 영향을 미치는 요인을 검토할 때는 개인과 기업의 위험 감수 행동과 위험 감소 행동을 고려해야 합니다. 설명(요율) 변수는 사고의 규모를 다루는 모형과 사고가 얼마나 자주 발생하는지를 다루는 모형에 서로 다른 영향을 미칠 수 있습니다.
- 의료 분야에서 개인이 의료 서비스를 이용할지, 그리고 예방 진료와 건강 관리를 통해 의료 이용을 줄일지에 대한 결정은 주로 그 사람의 개인적 특성과 관련이 있습니다. 이용자 1인당 비용은 환자의 건강 상태, 가능한 치료 방법, 그리고 의료 제공자(예: 의사)와 환자의 결정에 따라 결정됩니다. 이러한 요인들과 그것이 총 의료비에 미치는 방식에는 겹치는 부분이 있지만, 의료 이용 빈도와 의료비 심도를 각각 좌우하는 별개의 요인에 주목할 수 있습니다.
- 개인 보험 분야에서는 과거 청구 이력이 중요한 언더라이팅 요인입니다. 피보험자가 계약 전 일정 기간 내에 청구를 한 적이 있는지 여부를 나타내는 지시 변수를 사용하는 것이 일반적입니다. 또한 피보험자가 이전 기간에 발생시킨 청구 건수도 예측력을 가집니다.
- 주택소유자보험에서 잠재적 손실 빈도를 모형화할 때, 보험자는 눈에 보이는 보안 시스템과 같이 주택소유자가 채택한 손실 예방 조치를 고려할 수 있습니다. 이와 별도로, 손실 심도를 모형화할 때 보험자는 수리비와 교체비에 영향을 미치는 요인들을 검토할 것입니다.
데이터베이스. 보험사는 빈도 모형과 심도 모형을 따로 개발하도록 유도하는 별도의 데이터 파일을 보유하고 있을 수 있습니다. 예를 들어, 보험계약자 파일은 보험 계약이 체결될 때 만들어집니다. 이 파일에는 나이, 성별, 과거 청구 경험과 같은 피보험자에 대한 다양한 언더라이팅 정보, 보장 범위, 공제액, 한도와 같은 보험 계약 정보, 그리고 모든 보험 청구 사고가 기록됩니다. “청구” 파일이라고 하는 별도의 파일에는 금액을 포함하여 보험자에 대한 청구의 세부 내용이 기록됩니다. (지급 시점을 기록하는 “지급” 파일이 있을 수도 있지만, 여기서는 다루지 않겠습니다.) 이러한 기록 과정은 보험자가 빈도와 심도를 별개의 과정으로 모형화하는 데까지 이어질 수 있습니다.
규제 및 행정상의 이유. 보험은 위험에 직면한 개인과 기업에 재정적 안정을 제공한다는 점에서 중요하기 때문에, 규제와 감독이 매우 엄격한 산업입니다. 규제 당국은 직무의 일환으로 청구 금액뿐만 아니라 청구 건수의 보고도 정기적으로 요구합니다. 이는 “금액”에 대해 지급액과 발생액처럼 여러 정의가 있을 수 있는 반면, 청구 건수를 보고할 때는 오류의 여지가 더 적기 때문일 수 있습니다. 이러한 지속적인 감독은 보험회사의 재무 안정성을 보장하는 데 도움이 됩니다.
Show Quiz Solution
3.2 기본 빈도분포
이 절에서는 다음 방법을 배웁니다.
- 분포함수와 생존함수처럼 분포를 요약하는 양과 평균, 분산 같은 적률을 구합니다
- 적률생성함수와 확률생성함수를 정의하고 계산합니다
- 세 가지 중요한 빈도분포인 이항분포, 포아송 분포, 음이항 분포 사이의 관계를 기술하고 이해합니다.
이 절에서는 계리 실무에서 건수 데이터를 모형화하는 데 흔히 사용하는 분포들을 소개합니다. 청구 건수 확률변수는 \(N\)로 표기합니다. 이 확률변수는 그 본질상 음이 아닌 정수 값만 가집니다. 따라서 아래의 분포는 모두 음이 아닌 정수의 집합 \(\{0, 1, \ldots \}\)를 받침으로 하는 이산분포입니다.
3.2.1 기초
\(N\)는 \(\{0, 1, \ldots \}\)에서 값을 갖는 이산 확률변수이므로, 그 분포를 완전하게 기술하는 가장 자연스러운 방법은 각 음이 아닌 정숫값을 취할 확률을 명시하는 것입니다. 이로부터 \(N\)의 확률질량함수(pmf)(probability mass function (pmf)) 이산 확률변수가 어떤 값과 정확히 같을 확률을 주는 함수이라는 개념이 나옵니다. 이는 \(p_N(\cdot)\)로 표기하며 다음과 같이 정의합니다. \[ p_N(k)=\Pr(N=k), \quad \hbox{for } k=0,1,\ldots \] \(N\)의 분포를 완전히 기술하는 다른 방법, 곧 다른 특성화도 있습니다. 예를 들어 \(N\)의 분포함수(distribution function) 확률변수가 x 이하일 확률을 x의 함수로 나타낸 것는 \(F_N(x) = \Pr(N \le x)\)로 정의되며 다음과 같이 구합니다. \[ F_N(x)=\begin{cases} \sum\limits_{k=0}^{\lfloor x \rfloor } \Pr(N=k), &x\geq 0;\\ 0, & \hbox{otherwise}. \end{cases} \] 위 식에서 \(\lfloor \cdot \rfloor\)는 바닥 함수를 나타냅니다. 즉 \(\lfloor x \rfloor\)는 \(x\)보다 작거나 같은 정수 중 가장 큰 정수입니다. 이 식을 보면 분포함수를 달리 부를 때 흔히 쓰는 누적분포함수라는 이름이 왜 붙었는지도 알 수 있습니다. 또한 \(S_N(\cdot)\)로 표기하는 \(N\)의 생존함수(survival function) 확률변수가 어떤 수 x보다 큰 값을 가질 확률는 \(F_N(\cdot)\)의 1에 대한 여수, 즉 \(S_N(\cdot)=1-F_N(\cdot)\)로 정의됩니다. 분명히 이것 역시 \(N\)의 분포에 대한 또 하나의 특성화입니다.
분포를 완전히 기술하기보다는 분포의 특정한 측면을 수량화하는 데 관심을 두는 경우가 많습니다. 이는 특히 분포를 서로 비교할 때 유용합니다. 분포의 위치 중심이 그러한 측면 가운데 하나이며, 이를 수량화하는 데 흔히 쓰는 척도는 여러 가지가 있습니다. 이 가운데 가장 널리 쓰이는 것은 평균(mean) 평균입니다. \(\mu_N\)로 표기하는 \(N\)의 평균2은 다음과 같이 정의됩니다.
분포의 또 다른 기본적인 측면은 산포이며, 문헌에서 연구된 다양한 산포 척도 가운데 가장 널리 쓰이는 것은 표준편차(standard deviation) 분산의 제곱근입니다. 이를 정의하기 위해, 먼저 \(\mu_N\)가 유한할 때 \(\mathrm{Var}[N]\)로 표기하는 \(N\)의 분산(variance) 확률변수 x의 2차 중심적률로, 변수와 그 평균 사이의 편차 제곱의 기댓값을 측정합니다을 \(\mathrm{Var}[N]=\mathrm{E}{[(N-\mu_N)^2]}\)로 정의합니다. 확률변수 기댓값의 기본 성질에 따라 \(\mathrm{Var}[N]=\mathrm{E}[N^2]-[\mathrm{E}(N)]^2\)임을 알 수 있습니다. \(\sigma_N\)로 표기하는 \(N\)의 표준편차는 \(\mathrm{Var}[N]\)의 제곱근으로 정의됩니다. \(\mathrm{Var}[N]\)는 평균으로부터의 편차 제곱의 평균이라는 정의상 음이 아니므로, 표준편차는 잘 정의됩니다. \(\mathrm{Var}[N]\)는 \(\sigma_N^2\)로 표기합니다. 이 두 척도는 \([0,\infty]\)에서 값을 취한다는 점에 유의하십시오.
3.2.2 적률생성함수와 확률생성함수
이제 계수 변수를 다룰 때 유용한 두 가지 생성함수를 소개합니다. 이산 확률변수에 대해 \(N\)의 적률생성함수(mgf)(moment generating function (mgf)) 확률변수 n의 mgf는 exp(tn)의 기댓값을 t의 함수로 나타낸 것으로 정의됩니다.은 \(M_N(\cdot)\)로 표기하며, 다음과 같이 정의됩니다. \[ M_N(t) = \mathrm{E}~{[e^{tN}]} = \sum^{\infty}_{k=0} ~e^{tk}~ p_N(k), \quad t\in \mathbb{R}. \] \(M_N(\cdot)\)는 음이 아닌 확률변수(\(e^{tN}\))의 기댓값이므로 잘 정의되지만, \(\infty\)의 값을 가질 수도 있다는 점에 유의합니다. 계수 확률변수의 경우 \(M_N(\cdot)\)는 \(M_N(0)=1\)인 \((-\infty,0]\)에서 유한한 값을 가진다는 점에 유의하십시오. 다음 정리는 그 이름이 붙은 이유를 압축적으로 보여 주며, 그 증명은 Billingsley (2008)(285-6쪽)에서 찾아볼 수 있습니다.
정리 3.1.
\(N\)를 어떤 \(t^\ast>0\)에 대해 \(\mathrm{E}~{[e^{t^\ast N}]}\)가 유한한 계수 확률변수라고 합시다. 그러면 다음이 성립합니다.
- \(N\)의 모든 적률은 유한합니다. 즉, \[ \mathrm{E}{[N^r]}<\infty, \quad r > 0. \]
- mgf를 사용하여 다음과 같이 적률을 생성할 수 있습니다. \[ \left.\frac{{\rm d}^m}{{\rm d}t^m} M_N(t)\right\vert_{t=0}=\mathrm{E}[N^m], \quad m\geq 1. \]
- mgf \(M_N(\cdot)\)는 분포를 특징짓습니다. 다시 말해, 분포를 유일하게 결정합니다.
mgf가 도구로서 매우 유용한 또 다른 이유는, \(0\)의 근방에서 mgf가 존재하는 두 독립 확률변수 \(X\)와 \(Y\)에 대해, 작은 \(t\)에서 \(X+Y\)의 mgf가 각각의 mgf의 곱, 즉 \(M_{X+Y}(t) = M_{X}(t)M_{Y}(t)\)이 된다는 것입니다.
mgf와 관련된 생성함수로 확률생성함수(pgf)(probability generating function (pgf)) 확률변수 n에 대해, 그 pgf는 s의 함수로서 s^n의 기댓값으로 정의됩니다가 있으며, 이는 음이 아닌 정수 값을 가지는 확률변수에 유용한 도구입니다. 확률변수 \(N\)에 대해 그 pgf를 \(P_N(\cdot)\)로 표기하며, 다음과 같이 정의합니다3. \[ P_N(s)=\mathrm{E}~{[s^N]}, \quad s\geq 0. \]
mgf \(M_N(\cdot)\)가 \((-\infty,t^\ast)\)에서 존재하면 \[ P_N(s)=M_N(\log(s)), \quad s<e^{t^\ast}. \] 임을 쉽게 알 수 있습니다. 또한 pgf가 \(s^\ast>1\)인 구간 \([0,s^\ast)\)에서 존재하면 mgf \(M_N(\cdot)\)는 \((-\infty,\log(s^\ast))\)에서 존재하며, 따라서 정리 3.1에 의해 \(N\)의 분포를 유일하게 결정합니다. (다시 한번 말씀드리면, 이 책 전체에서 log는 밑이 10인 (상용)로그나 다른 형태가 아닌 자연로그를 뜻합니다.) pgf에 대한 다음 결과는 정리 3.1의 유사물이며, 특히 그 이름이 붙은 이유를 정당화합니다.
정리 3.2.
\(N\)를 어떤 \(s^\ast>1\)에 대해 \(\mathrm{E}~{(s^{\ast})^N}\)가 유한한 계수 확률변수라고 합시다. 그러면 다음이 성립합니다.
- \(N\)의 모든 적률은 유한합니다. 즉, \[ \mathrm{E}~{N^r}<\infty, \quad r\geq 0. \]
- \(N\)의 \(pmf\)는 pgf로부터 다음과 같이 유도할 수 있습니다. \[ p_N(m)=\begin{cases} P_N(0), &m=0;\cr &\cr \left(\frac{1}{m!}\right) \left.\frac{{\rm d}^m}{{\rm d}s^m} P_N(s)\right\vert_{s=0}\;, &m\geq 1.\cr \end{cases} \]
- \(N\)의 계승적률은 다음과 같이 유도할 수 있습니다. \[ \left.\frac{{\rm d}^m}{{\rm d}s^m} P_N(s)\right\vert_{s=1}=\mathrm{E}~{\prod\limits_{i=0}^{m-1} (N-i)}, \quad m\geq 1. \]
- pgf \(P_N(\cdot)\)는 분포를 특징짓습니다. 다시 말해, 분포를 유일하게 결정합니다.
3.2.3 중요한 빈도분포
이 소절에서는 통계학에서 사용되는 세 가지 중요한 빈도분포, 즉 이항분포, 포아송 분포, 음이항 분포를 살펴봅니다. 이하에서 위험은 보험이 보장하는 단위를 의미합니다. 위험은 개인, 건물, 회사 또는 보험 보장이 제공되는 기타 식별 대상이 될 수 있습니다. 맥락을 위해, 위험별로 또는 다른 방식으로 층화된 청구 건수를 담고 있는 보험 데이터 세트를 떠올려 보십시오. 앞서 언급한 분포들은 공교롭게도 보험 실무에서 가장 흔히 사용되는 분포이기도 하며, 그 이유 중 일부는 아래에서 언급합니다.
- 이러한 분포들은 많은 보험 데이터가 발생하는 실제 과정을 잘 근사하는 자연스러운 확률 실험으로부터 착안할 수 있습니다. 따라서 당연하게도, 이 분포들은 함께 관심 대상인 많은 보험 데이터 세트에 합리적인 적합을 제공합니다. 특정 분포가 데이터 세트에 적절한지는 이 장의 뒷부분에서 논의하는 바와 같이 표준적인 통계적 방법론을 사용하여 판단할 수 있습니다.
- 이 분포들은 우리가 관심을 두는 더 많은 실제 상황을 한층 더 잘 근사하거나 잘 반영하는 다른 분포들을 생성하기에 충분히 풍부한 기반을 제공합니다.
- 이 세 분포는 모수가 하나이거나 두 개인 분포입니다. 데이터에 적합할 때 모수에는 특정한 값이 할당됩니다. 모수를 고유한 확률분포를 갖는 확률변수(또는 확률벡터)로 취급하면 이 분포들의 집합을 볼록 껍질(convex hulls) 점들의 집합 x의 볼록 껍질은 x를 포함하는 가장 작은 볼록 집합입니다로 확장할 수 있으며, 이렇게 확장된 분포 집합은 더 큰 유연성을 제공합니다. 이러한 확장으로 더 잘 다룰 수 있는 간단한 예로는 서로 다른 여러 위험 등급(risk classes) 각 동질 집단의 특성에 따라 동일한 보장에 대해 서로 다른 보험료를 산정하는 것.에 속하는 피보험자들이 발생시킨 청구들의 포트폴리오가 있습니다.
- 보험 데이터에서는 0, 즉 위험별 청구 건수 0이 미미하게 나타나거나 지나치게 많이 나타나는 경우를 관찰할 수 있습니다. 데이터에 적합할 때, 표준적인 형태의 빈도분포는 이러한 발생을 합리적으로 반영하지 못하는 경우가 많습니다. 그러나 위의 세 분포를 자연스럽게 수정하면 이러한 현상을 잘 수용하여 더 나은 적합을 제공할 수 있습니다.
- 보험에서는 지급된 총청구액에 관심이 있으며, 그 분포는 적합된 빈도분포를 심도 분포와 복합하여 얻어집니다. 이 세 분포는 그 결과로 얻어지는 총 심도 분포를 다루기 쉽게 해 주는 성질을 갖고 있습니다.
이항분포
먼저 이진 결과(binary outcomes) 단위가 오직 두 가지 상태만 취할 수 있으며, 그 상태를 전통적으로 0과 1로 표기하는 결과를 갖는 동일하고 독립적인 실험들의 임의의 유한 수열로부터 발생하는 이항분포부터 살펴보겠습니다. 이러한 실험 중 가장 대표적인 것은 결과가 앞면 또는 뒷면인 (편향되었거나 편향되지 않은) 동전 던지기 실험입니다. 따라서 \(N\)가 확률 \(q\)로 앞면이 나오는 동일한 동전으로 시행한 \(m\)번의 독립적인 동전 던지기 실험의 수열에서 나온 앞면의 개수를 나타낸다면, \(N\)의 분포를 모수가 \((m,q)\)인 이항분포(binomial distribution) 어떤 확률변수가 모두 “성공”할 확률이 q로 동일한 독립 확률시행을 고정된 횟수 m번 시행했을 때의 “성공” 횟수라면, 그 확률변수는 (모수가 m과 q인) 이항분포를 따릅니다.이라고 하며, 여기서 \(m\)은 양의 정수이고 \(q\in[0,1]\)입니다. \(q=0\)(또는 \(q=1\))일 때 이 분포는 확률 \(1\)로 \(N=0\)(또는 \(N=m\))인 퇴화분포가 된다는 점에 유의하십시오. 분명히, \(q\in(0,1)\)일 때 그 받침은 \(\{0,1,\ldots,m\}\)과 같으며 pmf는 다음과 같이 주어집니다. 4
\[ p_k= {m \choose k} q^k (1-q)^{m-k}, \quad k=0,\ldots,m. \] 여기서 \[{m \choose k} = \frac{m!}{k!(m-k)!}\]
이 분포가 이러한 이름을 갖게 된 이유는 pmf가 \((q +(1-q))^m\)의 이항 전개에서 나타나는 항들 가운데에서 값을 취하기 때문입니다. 이러한 사실로부터 이항분포의 pgf에 대한 다음 표현식을 얻습니다. \[ \begin{array}{ll} P_N(z) &= \sum_{k=0}^m z^k {m \choose k} q^k (1-q)^{m-k} \\ &= \sum_{k=0}^m {m \choose k} (zq)^k (1-q)^{m-k} \\ &= (qz+(1-q))^m = (1+q(z-1))^m. \end{array} \] 위의 pgf 표현식은 이항분포가 베르누이 분포의 m-합성곱(m-convolution) m개의 독립 확률변수의 합이라는 사실을 확인해 준다는 점에 유의하십시오. 여기서 베르누이 분포는 \(m=1\)이고 pgf가 \((1+q(z-1))\)인 이항분포입니다. “m-합성곱”이란 \(N\)를 \(N_1,\ldots,N_m\)의 합으로 쓸 수 있다는 뜻입니다. 여기서 \(N_i\)은 iid(iid) 독립적이고 동일하게 분포된 베르누이 변량입니다. 또한 이항분포의 mgf는 \((1+q(e^t-1))^m\)로 주어진다는 점에 유의하십시오.
이항분포의 평균과 분산은 몇 가지 서로 다른 방법으로 구할 수 있습니다. 이항분포가 베르누이 분포의 \(m\)-합성곱이라는 핵심 성질을 강조하기 위해, 아래에서는 이 성질을 이용하여 적률을 유도합니다. 먼저 모수가 \(q\)인 베르누이 분포는 \(1\)과 \(0\)에 각각 \(q\)과 \(1-q\)의 확률을 부여한다는 점을 살펴봅시다. 따라서 그 평균은 \(q\)(\(=0\times (1-q) + 1\times q\))이며, \(N^2=N\)가 확률 \(1\)로 성립하므로 원점 2차 적률이 평균과 같다는 점에 유의하십시오. 이 두 사실을 이용하면 분산이 \(q(1-q)\)과 같음을 알 수 있습니다. 이제 모수가 \(m\)과 \(q\)인 이항분포로 넘어가서, 이 분포가 베르누이 분포의 \(m\)-합성곱이라는 사실을 이용하여 \(N\)를 \(N_1,\ldots,N_m\)의 합으로 씁니다. 여기서 \(N_i\)은 위와 같이 iid 베르누이 변량입니다. 이제 베르누이의 적률과 기댓값의 선형성을 이용하면
\[
\mathrm{E}[{N}]=\mathrm{E}\left[{\sum_{i=1}^m N_i}\right] = \sum_{i=1}^m ~\mathrm{E}[N_i] = mq.
\]
임을 알 수 있습니다. 또한 독립 확률변수 합의 분산은 각 분산의 합이라는 사실을 이용하면 다음을 알 수 있습니다.
\[
\mathrm{Var}[{N}]=\mathrm{Var}~\left[{\sum_{i=1}^m N_i}\right]=\sum_{i=1}^m \mathrm{Var}[{N_i}] = mq(1-q).
\]
위 적률의 다른 유도 방법은 연습문제에서 제시합니다. 특히 응용의 관점에서 중요한 관측값 하나는 \(q=0\)가 아닌 한 평균이 분산보다 크다는 것입니다.
포아송 분포
이항분포 다음으로, 포아송 분포(Poisson distribution) 사건이 알려진 일정한 비율로, 그리고 마지막 사건 이후 경과한 시간과 무관하게 발생할 때, 고정된 시간 또는 공간 구간에서 주어진 횟수의 사건이 발생할 확률을 나타내는 이산 확률분포(프랑스의 박식가 시메옹 드니 포아송(Simeon Denis Poisson)의 이름을 딴 것)는 아마도 이산분포 중에서 가장 잘 알려진 분포일 것입니다. 이는 부분적으로, 어떤 유형의 사건이 발생하는 비율이 일정하다면 일정 기간 동안 그 사건이 무작위로 발생하는 횟수의 분포로서 포아송 분포가 자연스럽게 나타나기 때문입니다. 또한 포아송 분포는 \(m\rightarrow \infty\) 및 \(mq\rightarrow \lambda\)인 이항분포의 점근적 극한으로서도 나타납니다.
포아송 분포는 보통 \(\lambda\)로 표기되는 단일 모수로 매개화되며, 이 모수는 \((0,\infty)\)에서 값을 가집니다. 포아송 분포의 pmf는 \[ p_k = \frac{e^{-\lambda}\lambda^k}{k!}, k=0,1,\ldots \] 로 주어집니다. 각 항이 명백히 음이 아니므로 위 식이 pmf를 정의함을 쉽게 확인할 수 있으며, 그 합이 1이라는 것은 \(e^\lambda\)의 무한 테일러 급수 전개로부터 따라 나옵니다. 더 일반적으로, 포아송 분포의 pgf \(P_N(\cdot)\)을 다음과 같이 유도할 수 있습니다: \[ P_N(z)= \sum_{k=0}^\infty p_k z^k = \sum_{k=0}^\infty \frac{e^{-\lambda}\lambda^kz^k}{k!} = e^{-\lambda} e^{\lambda z} = e^{\lambda(z-1)}, \forall z\in\mathbb{R}. \] 위 결과로부터 mgf를 다음과 같이 유도합니다: \[ M_N(t)=P_N(e^t)=e^{\lambda(e^t-1)}, t\in \mathbb{R}. \] 평균을 유도하기 위해, 포아송 분포에 대해 다음이 성립함에 주목합니다. \[ kp_k=\begin{cases} 0, &k=0 \cr \lambda~p_{k-1}, &k\geq1 . \end{cases} \] 이는 쉽게 확인할 수 있습니다. 특히, 이는 다음을 의미합니다. \[ \mathrm{E}[{N}]=\sum_{k\geq 0} k~p_k =\lambda\sum_{k\geq 1} p_{k-1} = \lambda\sum_{j\geq 0} p_{j} =\lambda. \] 실제로 더 일반적으로, 위 결과의 일반화를 이용하거나 정리 3.1을 이용하면 다음을 알 수 있습니다. \[ \mathrm{E}{\prod\limits_{i=0}^{m-1} (N-i)}=\left.\frac{{\rm d}^m}{{\rm d}s^m} P_N(s)\right\vert_{s=1}=\lambda^m, \quad m\geq 1. \] 이는 특히 다음을 의미합니다. \[ \mathrm{Var}[{N}]=\mathrm{E}[{N^2}]-[\mathrm{E}({N})]^2 = \mathrm{E}~[N(N-1)]+\mathrm{E}[N]-(\mathrm{E}[{N]})^2=\lambda^2+\lambda-\lambda^2=\lambda. \] 흥미롭게도 포아송 분포에서는 \(\mathrm{Var}[N]=\mathrm{E}[N]\)임에 유의하십시오.
음이항 분포
세 번째로 중요한 계수 분포는 음이항 분포(negative binomial distribution) 이진 결과를 갖는 실험을 독립적으로 반복할 때 r번째 실패를 관찰할 때까지의 성공 횟수입니다. 이항분포는 결과가 두 가지인 실험을 \(m\)번 독립적으로 반복할 때 성공 횟수의 분포로서 나타났음을 상기하십시오. 대신 이진 결과를 갖는 실험을 독립적으로 반복할 때 \(r\)번째 실패를 관측할 때까지의 성공 횟수를 고려하면, 그 분포는 음이항 분포가 됩니다. \(r=1\)인 특수한 경우가 기하분포입니다. 그러나 \(r\)이 정수가 아닐 때는 위의 확률실험을 적용할 수 없습니다. 이하에서는 이 분포를 보다 일반적으로 동기화하기 위해 모수 \(r\)이 임의의 양의 실수가 되도록 허용합니다. 이 분포의 이름을 설명하기 위해 이항급수를 상기합시다. 즉 \[ (1+x)^s= 1 + s x + \frac{s(s-1)}{2!}x^2 + \ldots..., \quad s\in\mathbb{R}; \vert x \vert<1. \] 일반화된 이항계수 \({s \choose k}\)을 \[ {s \choose k}=\frac{s(s-1)\cdots(s-k+1)}{k!}, \] 로 정의하면 \[ (1+x)^s= \sum_{k=0}^{\infty} {s \choose k} x^k, \quad s\in\mathbb{R}; \vert x \vert<1. \] 이 됩니다. \(s=-r\)로 두면 위 식으로부터 \[ (1-x)^{-r}= 1 + r x + \frac{(r+1)r}{2!}x^2 + \ldots...= \sum_{k=0}^\infty {r+k-1 \choose k} x^k, \quad r\in\mathbb{R}; \vert x \vert<1. \] 을 얻음을 알 수 있습니다. 이는 \(r>0\) 및 \(\beta\geq0\)에 대해 \(p_k\)을 \[ p_k = {r+k-1 \choose k} \left(\frac{1}{1+\beta}\right)^r \left(\frac{\beta}{1+\beta}\right)^k, \quad k=0,1,\ldots \] 로 정의하면 유효한 pmf가 정의됨을 의미합니다. 이렇게 정의된 분포를 \(r>0\), \(\beta\geq 0\)인 모수 \((r,\beta)\)를 갖는 음이항 분포라고 합니다. 또한 이항급수로부터 이 분포의 pgf가 \[ \begin{aligned} P_N(z) &= (1-\beta(z-1))^{-r}, \quad \vert z \vert < 1+\frac{1}{\beta}, \beta\geq0. \end{aligned} \] 로 주어짐을 알 수 있습니다. 위 결과는 mgf가 \[ \begin{aligned} M_N(t) &= (1-\beta(e^t-1))^{-r}, \quad t < \log\left(1+\frac{1}{\beta}\right), \beta\geq0. \end{aligned} \] 로 주어짐을 의미합니다. 정리 3.1을 이용하여 다음과 같이 적률을 유도합니다: \[\begin{eqnarray*} \mathrm{E}[N]&=&M'(0)= \left. r\beta e^t (1-\beta(e^t-1))^{-r-1}\right\vert_{t=0}=r\beta;\\ \mathrm{E}[N^2]&=&M''(0)= \left.\left[ r\beta e^t (1-\beta(e^t-1))^{-r-1} + r(r+1)\beta^2 e^{2t} (1-\beta(e^t-1))^{-r-2}\right]\right\vert_{t=0}\\ &=&r\beta(1+\beta)+r^2\beta^2;\\ \hbox{and }\mathrm{Var}[N]&=&\mathrm{E}{[N^2]}-(\mathrm{E}[{N}])^2=r\beta(1+\beta)+r^2\beta^2-r^2\beta^2=r\beta(1+\beta) \end{eqnarray*}\] \(\beta>0\)일 때 \(\mathrm{Var}[N] >\mathrm{E}[N]\)임에 주목합니다. 다시 말해, 이 분포는 (포아송 분포에 비해) 과대산포(overdispersed) 주어진 통계 모형에 근거하여 기대되는 것보다 데이터 집합에 더 큰 변동성(통계적 산포)이 존재하는 것입니다. 마찬가지로, \(q>0\)일 때 이항분포는 (포아송 분포에 비해) 과소산포(underdispersed) 데이터의 변동이 예측보다 작았습니다이라고 합니다.
마지막으로, 포아송 분포가 음이항 분포의 극한으로도 나타난다는 것을 살펴봅니다. 이를 보이기 위해, \(r\)이 무한대로 갈 때 \(r\beta_r\)이 \(\lambda>0\)에 수렴하도록 \(\beta_r\)을 잡습니다. 그러면 모수 \((r,\beta_r)\)를 갖는 음이항 분포의 mgf가 \[ \lim_{r\rightarrow 0} (1-\beta_r(e^t-1))^{-r}=\exp\{\lambda(e^t-1)\}, \] 를 만족함을 알 수 있으며, 위 식의 우변은 모수 \(\lambda\)를 갖는 포아송 분포의 mgf입니다.5
Show Quiz Solution
3.3 (a, b, 0) 클래스
이 절에서는 다음 방법을 배웁니다.
- (a,b,0) 빈도분포 클래스를 정의합니다
- 이 분포족의 근간을 이루는 재귀 관계의 중요성을 논의합니다.
- 이 일반적인 분포족이 이항분포, 포아송 분포, 음이항 분포 각각으로 축소되는 조건을 파악합니다.
앞 절에서는 세 가지 분포, 즉 이항분포, 포아송 분포, 음이항 분포를 살펴보았습니다. 포아송의 경우 평균을 유도하기 위해 \[ kp_k=\lambda p_{k-1}, \quad k\geq 1, \] 라는 사실을 이용하였으며, 이는 \[ \frac{p_k}{p_{k-1}}=\frac{\lambda}{k}, \quad k\geq 1. \] 로 동치 표현할 수 있습니다. 흥미롭게도 이항분포에 대해서는 \[ \frac{p_k}{p_{k-1}}=\frac{-q}{1-q}+\left(\frac{(m+1)q}{1-q}\right)\frac{1}{k}, \quad k=1,\ldots,m, \] , 음이항 분포에 대해서는 \[ \frac{p_k}{p_{k-1}}=\frac{\beta}{1+\beta}+\left(\frac{(r-1)\beta}{1+\beta}\right)\frac{1}{k}, \quad k\geq 1. \] 임을 마찬가지로 보일 수 있습니다. 위 관계는 모두 \[\begin{equation} \frac{p_k}{p_{k-1}}=a+\frac{b}{k}, \quad k\geq 1; \tag{3.1} \end{equation}\] 꼴이며, 이로부터 이 일반적으로 보이는 점화 관계를 만족하는 다른 분포가 있는지 하는 의문이 생깁니다. 좌변의 비, 즉 두 확률의 비는 음이 아님에 유의하십시오.
이론 일부 보기
위의 전개로부터 점화식 (3.1)가 이 세 분포를 하나로 묶을 뿐만 아니라 이들을 특징짓기도 한다는 것을 알 수 있습니다. 이러한 이유로 계리 문헌에서는 이 세 분포를 통틀어 (a,b,0) 클래스((a,b,0) class) 분포라고 부르며, 여기서 \(0\)은 점화식의 시작점을 가리킵니다. 확률의 합이 1이어야 하므로 \(p_0\)의 값은 \((a,b)\)에 의해 정해진다는 점에 유의하십시오. 물론 \(p_k\)에 대한 점화식으로서 (3.1)는 중복을 없애 pmf 계산을 효율적으로 만듭니다. 뒤에서는 빈도분포가 \((a,b,0)\) 분포족에 속하는 복합분포의 경우에도 그러하다는 것을 보게 될 것이며, 이 사실이 이 세 분포를 이러한 관점에서 살펴보는 더 중요한 동기입니다.
예제 3.3.1. 어떤 이산 확률분포가 다음 성질을 가집니다. \[ \begin{aligned} p_k&=c\left( 1+\frac{2}{k}\right) p_{k-1} \:\:\: k=1,2,3,\ldots\\ p_1&= \frac{9}{256} \end{aligned} \] 이 이산 확률변수의 기댓값을 구하십시오.
예제 풀이 보기
Show Quiz Solution
3.4 빈도분포의 추정
이 절에서는 다음 방법을 배웁니다.
- 이산분포에서 얻은 관측값 표본에 대한 가능도를 정의하십시오
- 이산분포에서 얻은 관측값 확률표본에 대한 최대가능도 추정량을 정의하십시오
- 이항분포, 포아송 분포, 음이항 분포에 대한 최대가능도 추정량을 계산합니다
3.4.1 모수 추정
3.2절에서는 보험에서 발생하는 다양한 유형의 건수 데이터를 모형화하는 데 중요한 세 가지 분포를 소개했습니다. 이제 분포를 적합하고자 하는 계수 데이터 집합이 있고, 이 \((a,b,0)\) 분포 중 하나가 다른 분포보다 더 적절하다고 판단했다고 가정해 봅시다. 이들 각각은 모수가 허용 가능한 어떤 값이든 취하도록 하면 하나의 분포족을 이루므로, 주어진 데이터에 대해 모수의 최적 값을 결정하는 과제가 남습니다. 이는 통계적 점추정 문제이며, 모수적 추론 문제에서는 최대가능도라는 통계적 추론 패러다임이 대개 효율적인 추정량을 제공합니다. 이 절에서는 이 패러다임을 설명하고 최대가능도 추정량을 유도합니다.
pmf가 \(p_\theta\)인 분포로부터 독립이고 동일하게 분포된(iid) 확률변수 \(X_1,X_2,\ldots,X_n\)을 관측한다고 가정합시다. 여기서 \(\theta\)는 모수 벡터이며 모수 공간 \(\Theta\subseteq \mathbb{R}^d\)에 속하는 미지의 값입니다. 예를 들어 포아송 분포의 경우 모수가 하나이므로 \(d=1\)이고
\[
p_\theta(x)=e^{-\theta}\frac{\theta^x}{x!}, \quad x=0,1,\ldots,
\]
여기서 \(\theta > 0\)입니다. 이항분포의 경우
\[
p_\theta(x)= {m \choose x} q^x(1-q)^{m-x}, \quad x=0,1,\ldots,m.
\]
입니다. 일부 응용에서는 \(m\)를 모수로 보고 \(d=2\)로 두어 \(\theta=(m,q)\in \{0,1,2,\ldots\}\times[0,1]\)이 되도록 할 수 있습니다.
관측값이 앞서 제시한 확률표본 \(X_1,X_2,\ldots,X_n\)의 관측값인 \(x_1,\ldots,x_n\)이라고 가정합시다. 이 경우 \(p_\theta\)로부터 이 표본을 관측할 확률은 \[ \prod_{i=1}^n p_\theta(x_i). \] 과 같습니다. \(L(\theta)\)로 표기하는 위 식을 \(\theta\)의 함수로 볼 때 이를 가능도라고 합니다. 이를 모수 벡터의 함수로 보고 있음을 강조하기 위해 데이터에 대한 의존성을 표기에서 생략했다는 점에 유의하십시오. 예를 들어 포아송 분포의 경우 \[ L(\lambda)=e^{-n\lambda} \lambda^{\sum_{i=1}^n x_i} \left(\prod_{i=1}^n x_i!\right)^{-1}. \] 입니다. 이항분포의 경우 \[ L(m,q)=\left(\prod_{i=1}^n {m \choose x_i}\right) q^{\sum_{i=1}^n x_i} (1-q)^{nm-\sum_{i=1}^n x_i} . \] 입니다. \(\theta\)에 대한 최대가능도 추정량(mle)(maximum likelihood estimator (mle)) 데이터를 관찰할 확률이 가장 커지는 모수의 가능한 값는 가능도를 최대화하는 임의의 값이며, 어떤 의미에서 mle는 관측된 관측값을 가장 잘 설명하는 모수 값의 집합을 선택합니다. 부록 17.2.2절에서는 최대가능도 추정의 기초를 검토하며, 부록 19장에서 더 자세한 수학적 내용을 다룹니다.
특수한 경우: 세 개의 베르누이 결과. 예시를 위해, 값이 \(0,1,0\)인 베르누이 분포(\(m=1\)인 이항분포)로부터 얻은 크기 \(n=3\)의 표본을 생각해 봅시다. 이 경우 가능도가 \[ L(q)=q(1-q)^2, \] 과 같음을 쉽게 확인할 수 있으며, 가능도의 그래프는 그림 3.1에 제시되어 있습니다. 그래프에서 보듯이 가능도의 최댓값은 \(4/27\)이고 \(q=1/3\)에서 달성되므로, 주어진 표본에 대한 \(q\)의 최대가능도 추정값은 \(1/3\)입니다. 이 경우 대수적 방법을 이용하여 \[ q(1-q)^2=\left(q-\frac{1}{3}\right)^2\left(q-\frac{4}{3}\right)+\frac{4}{27}, \] 임을 보이고, (구간 \([0,1]\)에서 첫째 항이 양수가 아니라는 사실을 이용하여) 최댓값이 \(4/27\)이며 \(q=1/3\)에서 달성된다고 결론지을 수 있습니다.
그러나 분명히 알 수 있듯이, 대수를 이용하여 mle를 유도하는 이 방법은 일반화되지 않습니다. 일반적으로 mle를 유도할 때는 미적분을 이용합니다. 다만 일부 가능도의 경우, 특히 가능도에 국소 극값(local extrema) 주어진 범위 내에서 함수가 갖는 최댓값과 최솟값이 많을 때는 다른 최적화 방법을 이용해야 할 수도 있다는 점에 유의하십시오. 이와 동치로 가능도의 로그6 \(L(\cdot)\)(\(l(\cdot)\)로 표기)를 최대화하고, 그 1계 도함수7 \(l'(\cdot)\)의 영점 집합을 살펴보는 것이 관례입니다. 위 가능도의 경우 \(l(q)=\log(q)+2\log(1-q)\)이고 \[ l'(q)=\frac{\rm d}{{\rm d}q}l(q)=\frac{1}{q}-\frac{2}{1-q}. \] 입니다. \(l'(\cdot)\)의 유일한 영점은 \(1/3\)이며, \(l''(\cdot)\)이 음수이므로 \(1/3\)이 가능도의 유일한 최대화점이고 따라서 최대가능도 추정값입니다.
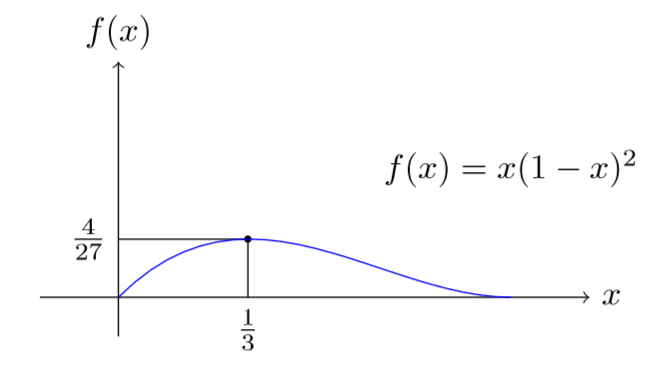
그림 3.1: 베르누이로부터의 \((0,1,0)\) \(3\)-표본의 가능도
3.4.2 빈도분포의 MLE
이하에서는 \((a,b,0)\) 부류의 세 구성원에 대한 최대가능도 추정량(mle)을 유도합니다. 먼저 위의 논의를 요약합니다. pmf가 \(p_\theta\)인 분포로부터 iid, 즉 독립이고 동일하게 분포된 확률변수 \(X_1,X_2,\ldots,X_n\)을 관측하는 설정에서(여기서 \(\theta\)는 \(\Theta\subseteq \mathbb{R}^d\)에 속하는 미지의 값을 취함), \(\Theta\) 위의 함수인 가능도 \(L(\cdot)\)는 \[ L(\theta)=\prod_{i=1}^n p_\theta(x_i), \] 로 정의되며, 여기서 \(x_1,\ldots,x_n\)은 관측값입니다. \(\hat{\theta}_{\rm MLE}\)로 표기하는 \(\theta\)의 mle는 관측값을 \(L(\cdot)\)의 최대화점 집합의 한 원소, 즉 \[ \{\theta \vert L(\theta)=\max_{\eta\in\Theta}L(\eta)\}. \] 로 대응시키는 함수입니다. 이러한 의존성이 명시적으로 드러나지는 않지만, 위 집합은 관측값의 함수라는 점에 유의하십시오. 우리가 다루는 세 분포의 경우, 그리고 상당히 일반적으로, 위 집합은 (표본 크기가 커짐에 따라) 1로 수렴하는 확률로 단일원소 집합이 됩니다. 다시 말해, 흔히 사용되는 많은 분포에 대해 표본 크기가 클 때 가능도 추정값은 높은 확률로 유일하게 정의됩니다.
이하에서는 모수 값은 알려져 있지 않지만, 고려 중인 분포로부터 \(n\)개의 iid 확률변수 \(X_1,X_2,\ldots,X_n\)을 관측했다고 가정합니다. 또한 \(x_1,x_2,\ldots,x_n\)은 관측값을 나타냅니다. 계수 자료, 그리고 일반적으로 이산분포에서 얻은 자료의 경우, 가능도를 \[ L(\theta)=\prod_{k\geq 0} \left(p_\theta(k)\right)^{m_k}, \] 로 달리 나타낼 수도 있다는 점에 주목합니다. 여기서 \(m_k\)는 \(k\)와 같은 관측값의 개수입니다. 수학적으로 \[ m_k= \left\vert \{i\vert x_i=k, 1\leq i \leq n\} \right\vert=\sum_{i= 1}^n I(x_i=k), \quad k\geq 0. \] 입니다. 이 변환은 자료를 모두 보존하면서 간결한 방식으로 정리한다는 점에 유의하십시오. \(n\)이 클 때 이 변환은 충분성의 의미에서 자료의 압축으로 이어집니다. 아래에서는 mle를 \(\{m_k\}_{k\geq 1}\)로 나타낸 식도 함께 제시합니다.
특수한 경우: 포아송 분포. 이 경우 앞에서 언급했듯이 가능도는
\[
L(\lambda)=\left(\prod_{i=1}^n x_i!\right)^{-1}e^{-n\lambda}\lambda^{\sum_{i=1}^n x_i} .
\]
로 주어집니다. 로그를 취하면 로그가능도는
\[
l(\lambda)= -\sum_{i=1}^n \log(x_i!) -n\lambda +\log(\lambda) \cdot \sum_{i=1}^n x_i .
\]
입니다. 도함수를 구하면
\[
l'(\lambda)= -n +\frac{1}{\lambda}\sum_{i=1}^n x_i.
\]
를 얻습니다. \(l''(\lambda)\)를 계산할 때, \(\sum_{i=1}^n x_i>0\)이면 \(l''< 0\)입니다. 따라서 최댓값은 아래에 제시한 표본평균 \(\overline{x}\)에서 얻어집니다. \(\sum_{i=1}^n x_i=0\)일 때는 가능도가 감소함수이므로 최댓값은 가능한 가장 작은 모수 값에서 얻어지며, 그 결과 최대가능도 추정값은 0이 됩니다. 따라서 다음을 얻습니다.
\[
\overline{x} = \hat{\lambda}_{\rm MLE} = \frac{1}{n}\sum_{i=1}^n x_i.
\]
표본평균은
\[
\overline{x} = \frac{1}{n} \sum_{k\geq 1} k \cdot m_k ~.
\]
로도 계산할 수 있다는 점에 유의하십시오. 주목할 만한 점은 포아송의 경우, 기저 분포가 포아송일 때 \(\hat{\lambda}_{\rm MLE}\)의 정확한 분포를 닫힌 형태로 얻을 수 있다는 것입니다. 이 분포는 척도가 조정된 포아송입니다. 이는 독립인 포아송 확률변수들의 합 역시 포아송이기 때문입니다. 물론 표본 크기가 클 때는 통상적인 중심극한정리(CLT)(Central Limit Theorem (CLT)) 어떤 상황에서는 독립 확률변수들을 더할 때, 원래 변수들 자체가 정규분포를 따르지 않더라도 적절히 정규화한 그 합은 정규분포에 가까워지는 경향이 있습니다.를 사용하여 정규근사를 유도할 수 있습니다. 후자의 근사는 기저 분포가 유한한 2차 적률을 갖는 임의의 분포인 경우에도 성립한다는 점에 유의하십시오.
특수한 경우: \(m\)이 알려진 이항분포. 포아송 분포의 경우와 달리, 이항분포의 경우에는 모수 공간이 \(2\)차원입니다. 따라서 최적화 문제가 조금 더 어렵습니다. 먼저 \(m\)이 알려져 있다고 보는 경우를 다룹니다. 이는 보험 응용에서는 현실적인 가정이 아니지만, 확률이 알려지지 않은 \(m\)개의 iid 이진 결과를 관측하는 상황에서는 적절합니다.
먼저 가능도가 \[ L(m,q)= \left(\prod_{i=1}^n {m \choose x_i}\right) q^{\sum_{i=1}^n x_i} (1-q)^{nm-\sum_{i=1}^n x_i} . \] 로 주어진다는 점을 살펴봅니다. 로그를 취하면 로그가능도는 \[ \begin{array}{ll} l(m,q) &= \sum_{i=1}^n \log\left({m \choose x_i}\right) + \left({\sum_{i=1}^n x_i}\right)\log(q) \\ & \ \ \ + \left({nm-\sum_{i=1}^n x_i}\right)\log(1-q) \\ &= \sum_{i=1}^n \log\left({m \choose x_i}\right) + n \overline{x}\log(q) + n\left({m- \overline{x}}\right)\log(1-q) , \end{array} \] 이며, 여기서 \(\overline{x} = n^{-1} \sum_{i=1}^n x_i\)입니다. \(m\)이 알려져 있다고 가정했으므로, \(q\)에 대해 \(l(m,q)\)을 최대화하려면 1계 미분을 구하여 0과 같다고 놓아야 합니다. \[ \frac{{\rm d}l(m,q)}{{\rm d}q}=\frac{n\overline{x}}{q}-\frac{n\left({m- \overline{x}}\right)}{1-q}=0, \] 이로부터 다음이 성립합니다. \[ \hat{q}_{MLE}=\frac{\overline{x}}{m}. \]
특수한 경우: \(m\)이 알려지지 않은 이항분포. \(m\)은 음이 아닌 정수 값만 취하므로, 최적값을 찾는 데 다변수 미적분을 사용할 수 없다는 점에 유의하십시오. 그럼에도 불구하고 일변수 미적분을 사용하여 다음을 보일 수 있습니다. \[\begin{equation} \hat{q}_{MLE}\times \hat{m}_{MLE} = \overline{x}. \tag{3.2} \end{equation}\]
식 (3.2)의 검증 보기
식 (3.2)에 의해, 위 내용은 문제를 \[\begin{equation} L\left(m,\frac{\overline{x}}{m} \right). \tag{3.3} \end{equation}\] 의 최대화 값인 \(\hat{m}_{\rm MLE}\)을 찾는 것으로 축소합니다. \(\max\limits_{1\leq i \leq n}x_i\)보다 작은 \(m\) 값에 대해서는 가능도가 0이 되므로 \(\hat{m}_{\rm MLE}\geq \max_{1\leq i \leq n}x_i\)임에 유의하십시오.
이항분포에 대한 포아송 근사에 관한 기술적 참고 사항
아래 그림 3.2에서는 크기가 \(5\)인 서로 다른 세 표본에 대해 \(L\left(m,\overline{x}/m\right)\)의 그래프를 나타냅니다. 이 세 표본은 표본 최댓값만 서로 다릅니다. 첫 번째 표본 \((2,2,2,4,5)\)는 표본분산에 대한 표본평균의 비가 \(1\)보다 크고(\(1.875\)), 두 번째 표본 \((2,2,2,4,6)\)는 그 비가 \(1.25\)로 \(1\)에 더 가까우며, 세 번째 표본 \((2,2,2,4,7)\)는 그 비가 \(1\)보다 작습니다(\(0.885\)). 그림 3.2에서 보듯이, 이 세 표본에 대해 \(\hat{m}_{\rm MLE}\)는 각각 \(7\), \(18\), \(\infty\)입니다. \(m\)가 무한대로 갈 때 \(L\left(m,\overline{x}/m\right)\)의 극한값은 다음과 같다는 점에 유의하십시오. \[\begin{equation} \left(\prod_{i=1}^n x_i! \right)^{-1} \exp\left(-n \overline{x}~\right) \left(~\overline{x}~\right)^{n\overline{x}}. \tag{3.4} \end{equation}\] 또한 그림 3.2은 \(m\)의 mle가 로버스트(robust) 가정에서 벗어남으로 인해 발생하는 결과의 오류에 강건한하지 않음을, 즉 데이터 집합의 작은 비율에서의 변화가 추정량에 큰 변화를 일으킬 수 있음을 보여 준다는 점에 유의하십시오.
위의 논의로부터 다음과 같은 간단한 알고리즘을 얻을 수 있습니다.
- 1단계. 표본평균이 표본분산보다 작거나 같으면 \(\hat{m}_{MLE}=\infty\)로 둡니다. mle가 제시하는 분포는 \(\hat{\lambda}=\overline{x}\)인 포아송 분포입니다.
- 2단계. 표본평균이 표본분산보다 크면, \(L(m,\overline{x}/m)\)가 (3.4)에 주어진 포아송 가능도 값에 가까워질 때까지 표본 최댓값 이상인 \(m\) 값들에 대해 \(L(m,\overline{x}/m)\)를 계산합니다. 계산된 값들 가운데 \(L(m,\overline{x}/m)\)의 최댓값에 대응하는 \(m\)의 값이 \(\hat{m}_{MLE}\)입니다.
기저 분포가 모수 \((m,q)\)(단, \(q>0\))인 이항분포라면, 표본 크기가 클 때 \(\hat{m}_{MLE}\)는 \(m\)와 같다는 점에 주목합니다. 또한 \(\hat{q}_{MLE}\)는 점근적으로 정규분포를 따르며 확률 1로 \(q\)에 수렴합니다.
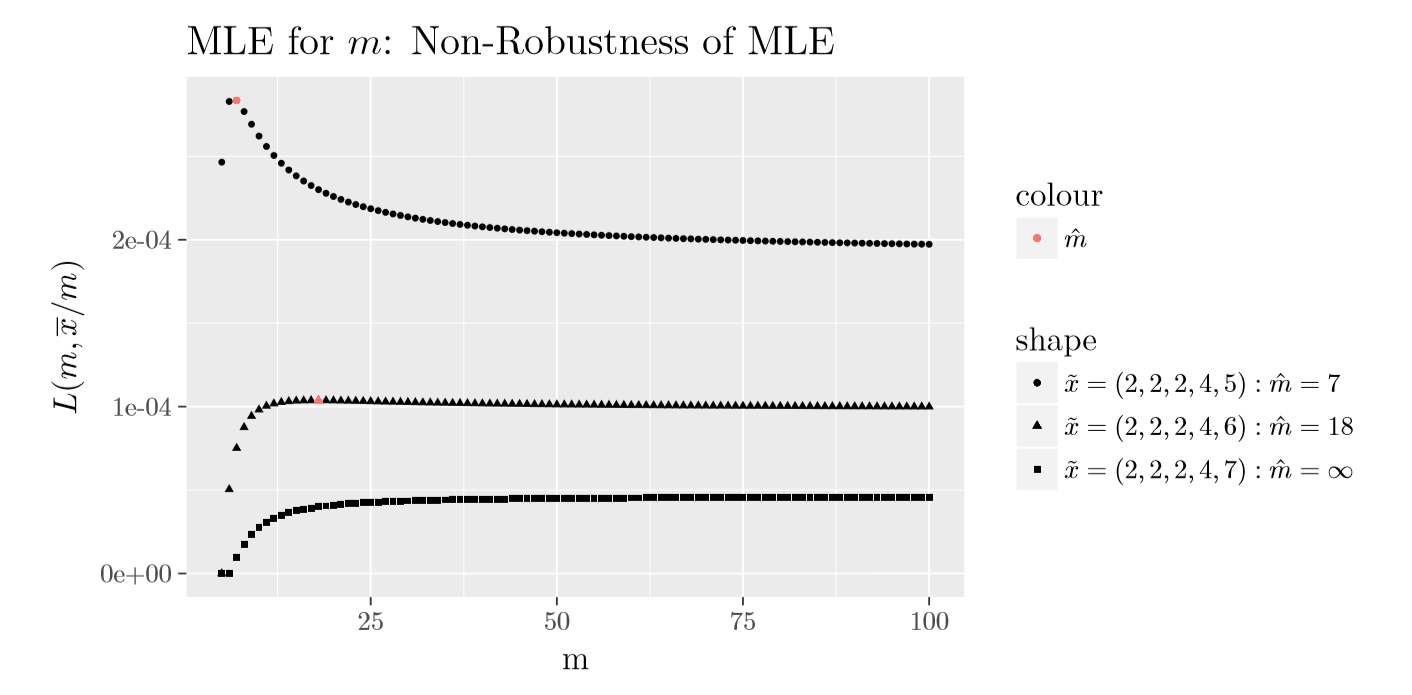
그림 3.2: 이항분포에 대한 \(L(m,\bar{x}/m)\)의 그래프
특수한 경우: 음이항 분포. 음이항 분포의 경우는 모수가 두 개이고 mle를 닫힌 형태로 구할 수 없다는 점에서 이항분포의 경우와 비슷합니다. 둘 사이의 차이점은, 양의 정숫값을 취하는 이항분포의 모수 \(m\)와 달리 음이항분포의 모수 \(r\)는 임의의 양의 실숫값을 취할 수 있다는 것입니다. 이 때문에 최적화 문제가 조금 더 복잡해집니다. 먼저 가능도를 다음과 같은 형태로 표현할 수 있다는 점부터 살펴봅니다.
\[
L(r,\beta)=\left(\prod_{i=1}^n {r+x_i-1 \choose x_i}{r+x_i-1 \choose x_i}\right) (1+\beta)^{-n(r+\overline{x})} \beta^{n\overline{x}}.
\]
위 식으로부터 로그가능도는 다음과 같이 주어지며
\[
l(r,\beta)=\sum_{i=1}^n \log{r+x_i-1 \choose x_i} -n(r+\overline{x}) \log(1+\beta) +n\overline{x}\log\beta,
\]
따라서 다음이 성립합니다.
\[
\frac{\delta}{\delta\beta} l(r,\beta) = -\frac{n(r+\overline{x})}{1+\beta} + \frac{n\overline{x}}{\beta}.
\]
위 식을 0으로 두면 다음을 얻습니다.
\[
\hat{r}_{MLE}\times \hat{\beta}_{MLE} = \overline{x}.
\]
이로써 2차원 최적화 문제가 1차원 문제로 축소됩니다. 즉, \(r\)에 대해
\[
l(r,\overline{x}/r)=\sum_{i=1}^n \log{r+x_i-1 \choose x_i} -n(r+\overline{x}) \log(1+\overline{x}/r) +n\overline{x}\log(\overline{x}/r),
\]
를 최대화해야 하며, 이를 최대화하는 \(r\)가 그 mle이고 \(\hat{\beta}_{MLE}=\overline{x}/\hat{r}_{MLE}\)입니다. Levin, Reeds, et al. (1977)에서는 표본분산이 표본평균보다 크면 \(l(r,\overline{x}/r)\)를 최대화하는 \(r>0\)가 유일하게 존재하며, 따라서 \(r\)와 \(\beta\)에 대한 mle도 유일하게 존재함을 보였습니다. 또한 이들은 \(\hat{\sigma}^2\leq \overline{x}\)이면 음이항 가능도가 \(\hat{\lambda}=\overline{x}\)인 포아송 가능도보다 항상 작거나 같음을 보였습니다. 다시 말해, 포아송 분포가 데이터에 더 잘 적합합니다. \(\hat{\sigma}^2>\hat{\mu}\)인 경우에 이러한 보장이 있으므로, \(l(r,\overline{x}/r)\)를 최대화하는 데 적당한 알고리즘을 사용할 수 있습니다. 가능도를 계산하는 다른 방법을 위해 다음에 주목합니다.
\[
\begin{array}{ll}
l(r,\overline{x}/r)&=\sum_{i=1}^n \sum_{j=1}^{x_i}\log(r-1+j) - \sum_{i=1}^n\log(x_i!) \\
& \ \ \ - n(r+\overline{x}) \log(r+\overline{x}) + nr\log(r) + n\overline{x}\log(\overline{x}),
\end{array}
\]
이로부터 다음을 얻습니다.
\[
\left(\frac{1}{n}\right)\frac{\delta}{\delta r}l(r,\overline{x}/r)=\frac{1}{n}\sum_{i=1}^n \sum_{j=1}^{x_i}\frac{1}{r-1+j} - \log(r+\overline{x}) + \log(r).
\]
위 식들에서 이중합을 포함하는 항의 경우, \(x_i=0\)이면 안쪽 합이 0이 된다는 점에 주목합니다. \(r\)에 대한 최대가능도 추정값은 마지막 식의 근이며, 근 찾기 알고리즘을 사용하여 이를 계산할 수 있습니다. 또한 다음이 성립합니다.
\[
\left(\frac{1}{n}\right)\frac{\delta^2}{\delta r^2}l(r,\overline{x}/r)=\frac{\overline{x}}{r(r+\overline{x})}-\frac{1}{n}\sum_{i=1}^n \sum_{j=1}^{x_i}\frac{1}{(r-1+j)^2}.
\]
간단하면서도 빠르게 수렴하는 반복적 근 찾기 알고리즘으로 뉴턴 방법(Newton’s method) 실숫값 함수의 근에 대해 점점 더 나은 근사를 차례로 생성하는 근 찾기 알고리즘이 있으며, 덧붙이자면 바빌로니아인들이 제곱근을 계산하는 데 이 방법을 사용했다고 알려져 있습니다. 이 방법에서는 근의 초기 근사를 선택한 후, 수렴할 때까지 근에 대한 새로운 근사를 차례로 생성합니다. 뉴턴 방법을 우리 문제에 적용하면 다음 알고리즘을 얻습니다.
i단계. 근사해 하나를 고르고, 이를 \(r_0\)라고 합니다. \(k\)를 \(0\)로 둡니다.
ii단계. \(r_{k+1}\)를 다음과 같이 정의합니다.
\[
r_{k+1}= r_k - \frac{\frac{1}{n}\sum_{i=1}^n \sum_{j=1}^{x_i}\frac{1}{r_k-1+j} - \log(r_k+\overline{x}) + \log(r_k)}{\frac{\overline{x}}{r_k(r_k+\overline{x})}-\frac{1}{n}\sum_{i=1}^n \sum_{j=1}^{x_i}\frac{1}{(r_k-1+j)^2}}
\]
단계 iii. \(r_{k+1}\sim r_k\)이면 \(r_{k+1}\)을 최대가능도 추정값으로 보고합니다. 그렇지 않으면 \(k\)을 \(1\)만큼 증가시키고 단계 ii를 반복합니다.
예를 들어, 모수가 \(r=10\)와 \(\beta=5\)인 음이항분포로부터 \(41, 49, 40, 27, 23\)의 \(5\)개 관측값 표본을 모의실험으로 생성하였습니다. \[ r\beta=\hat{\mu} \quad \hbox{and} \quad r\beta(1+\beta)=\hat{\sigma}^2 \] 이 되도록 \(r\)의 시작값을 선택합니다. 여기서 \(\hat{\mu}\)는 추정 평균을 나타내고 \(\hat{\sigma}^2\)는 추정 분산입니다. 이에 따라 \(r\)의 시작값은 \(23.14286\)이 됩니다. 뉴턴 방법에 의한 \(r\)의 반복값은 다음과 같습니다. \[ 21.39627, 21.60287, 21.60647, 21.60647; \] 위에서 볼 수 있는 빠른 수렴은 뉴턴 방법의 전형적인 특징입니다. 따라서 이 예에서는 \(\hat{r}_{MLE} \sim 21.60647\)이고 \(\hat{\beta}_{MLE} = 1.66616\)입니다.
뉴턴 방법의 R 구현 보기 - r에 대한 음이항 MLE
\((a,b,0)\) 분포족에 대한 MLE(MLE) 최대가능도 추정값 논의를 요약하기 위해, 아래 그림 3.3에서는 표 3.1에 주어진 크기 \(5\)인 세 표본에 대해 포아송 가능도의 최댓값, 이항분포에 대한 \(L(m,\overline{x}/m)\), 음이항분포에 대한 \(L(r,\overline{x}/r)\)를 그래프로 나타냅니다. 이 자료는 표본평균과 표본분산 사이의 세 가지 대소 관계를 모두 포괄하도록 구성되었습니다. 그림 3.3에서 볼 수 있고 이론으로도 뒷받침되듯이, \(\hat{\mu}<\hat{\sigma}^2\)이면 음이항분포가 더 높은 최대가능도 값을 주고, \(\hat{\mu}=\hat{\sigma}^2\)이면 포아송분포가 가장 높은 가능도 값을 가지며, 마지막으로 \(\hat{\mu}>\hat{\sigma}^2\)인 경우에는 이항분포가 다른 분포들보다 더 잘 적합합니다. 따라서 빈도 자료를 \((a,b,0)\) 분포로 적합하기 전에 \(\hat{\mu}\)와 \(\hat{\sigma}^2\)의 대소 관계를 살펴보는 것부터 시작하는 것이 가장 좋습니다. 포아송분포가 음이항분포와 이항분포의 경계에 있다는 점을 다시 한번 강조합니다. 따라서 \(\hat{\mu}\geq\hat{\sigma}^2\)(각각 \(\hat{\mu}\leq\hat{\sigma}^2\))인 경우 포아송분포가 음이항분포(각각 이항분포)보다 더 잘 적합하며, 이는 \(\hat{r}=\infty\)(각각 \(\hat{m}=\infty\))로 나타납니다.
표 3.1. 크기 5인 세 표본
\[ \small{ \begin{array}{c|c|c} \hline \text{Data} & \text{Mean }(\hat{\mu}) & \text{Variance }(\hat{\sigma}^2) \\ \hline (2,3,6,8,9) & 5.60 & 7.44 \\ (2,5,6,8,9) & 6 & 6\\ (4,7,8,10,11) & 8 & 6\\\hline \end{array} } \]
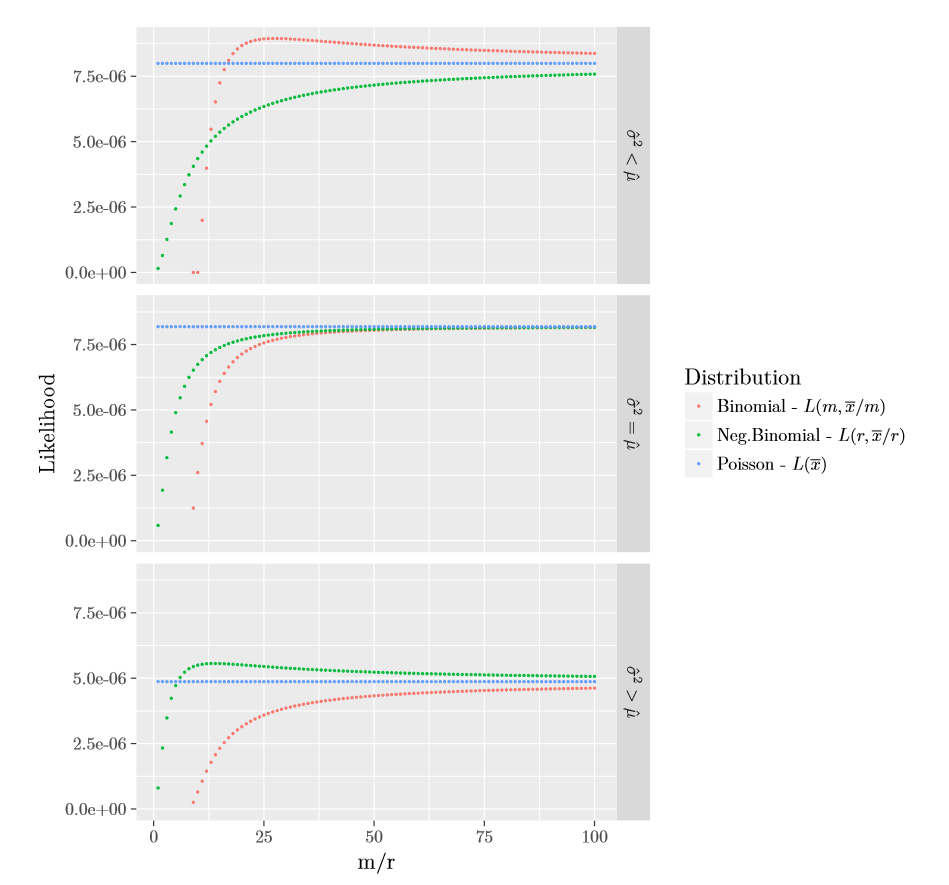
그림 3.3: \((a,b,0)\) 부분 최대화된 가능도의 그래프
Show Quiz Solution
3.5 기타 빈도분포
이 절에서는 다음 방법을 배웁니다.
- (a,b,1) 빈도분포족을 정의하고 이 분포족의 바탕이 되는 재귀 관계의 중요성 논의하기
- 이항분포, 포아송 분포, 음이항 분포의 영절단 버전과 수정 버전을 해석하십시오
- 재귀 관계를 이용하여 확률 계산하기
앞 절에서는 음이 아닌 정수 집합에 포함되는 받침을 갖는 세 가지 분포를 논의하였으며, 이 분포들은 많은 보험 응용에 잘 부합합니다. 또한 일반적으로 모수를 연령, 성별, 지리적 위치(지역) 등과 같이 (보험자에게) 알려진 설명변수(explanatory variables) 회귀에서 설명변수는 다른 변수를 “설명”한다고 여겨지는 변수입니다.의 함수로 둠으로써, 이러한 분포들을 사용하여 이 변수들의 관점에서 청구 확률을 설명할 수 있습니다. 이러한 모형을 연구하는 통계학 분야를 회귀분석(regression analysis) 변수 간의 관계를 추정하기 위한 일련의 통계적 절차이라고 합니다. 이는 계리적으로 중요한 주제이지만 이 책에서는 다루지 않습니다(Frees (2009) 참조).
분명히 이 밖에도 무수히 많은 계수 분포가 있으며, 더 중요한 점은 위의 분포들만으로는 모든 실무적 필요를 충족하지 못한다는 것입니다. 특히 일부 보험 자료의 한 가지 특징은 0인 계수의 비율이 다른 계수들의 비율과 어긋나서 위의 분포들로는 설명하기 어려울 수 있다는 점입니다. 다음에서는 다른 계수들에 대한 상대적 확률의 배정과 관계없이 0인 계수에 임의의 확률을 부여할 수 있도록 위의 분포들을 수정합니다. 자연스럽게 동질적(homogeneous) 기대 손실 빈도와 심도가 대략 동일한 익스포저 단위들. 부분집합들로 구성된 자료 집합의 또 다른 특징은, 위의 분포들이 각 부분집합에는 잘 적합하더라도 자료 집합 전체에는 잘 적합하지 못할 수 있다는 점입니다. 이후에는 특히 이러한 자료 집합에 부합할 수 있도록 \((a,b,0)\) 분포들을 자연스럽게 확장합니다.
3.5.1 영절단 또는 영수정
특정 기간에 발생한 자동차 청구 데이터베이스에 나타나는 자동차 보험계약을 살펴본다고 가정합시다. 이 기간 동안 이 보험계약들에서 발생한 청구 건수를 연구하려 한다면, 분포는 개수 변수가 값 0을 취할 확률로 0을 부여해야 함이 분명합니다. 다시 말해, 청구 데이터베이스에 있는 계약들의 계수 데이터로 관심을 제한함으로써, 우리는 어떤 의미에서 전체 계약의 계수 데이터를 영절단한 것입니다. 개인 보험 종목(자동차 보험 등)에서는 보험계약자가 향후 보험료가 인상될 수 있다는 우려 때문에 첫 번째 청구를 보고하지 않으려 할 수 있으며, 이러한 행동은 영 계수의 비율을 부풀립니다. 후자와 같은 예는 영 계수의 비율을 수정합니다. 흥미롭게도, 앞서 살펴본 세 분포를 자연스럽게 수정하면 보험에서 발생하는 영수정/영절단 데이터 세트에 잘 적합할 수 있습니다.
아래에서 제시하는 바와 같이, 우리는 0이 아닌 계수에 부여된 상대 확률은 유지하면서 \((a,b,0)\) 클래스가 영 계수에 부여하는 확률을 수정합니다. 이것이 영수정입니다. \((a,b,0)\) 분포족이 점화식 (3.1)을 만족하므로, 0이 아닌 개수의 상대적 확률을 유지한다는 것은 \(k\geq 2\)에 대해 점화식 (3.1)이 성립함을 의미한다는 점에 유의하십시오. 이로부터 다음과 같은 분포족이 정의됩니다.
정의. 어떤 상수 \(a\)와 \(b\)에 대해 확률 \(p_k\)가 \[\begin{equation} \frac{p_k}{p_{k-1}}=a+\frac{b}{k},\quad k\geq 2. \tag{3.5} \end{equation}\] 를 만족하면 그 계수 분포는 \((a, b, 1)\) 클래스에 속합니다. 점화식이 \(p_0\)가 아니라 \(p_1\)에서 시작하므로, 이 \((a,b,0)\) 분포의 상위 클래스를 (a,b,1)((a,b,1)) 어떤 상수 a와 b 및 k>=2에 대해 확률이 p_k/p_{k-1}=a+b/k를 만족하는 계수 분포(으)로 부른다는 점에 유의하십시오. 이 클래스를 이해하기 위해, \((a,b,0)\) 클래스의 \(a\)와 \(b\)에 대한 각각의 유효한 값의 쌍은 고유한 확률 벡터 \(\{p_k\}_{k\geq 0}\)에 대응한다는 점을 상기하십시오. 이제 \(\tilde{p}_0\in[0,1)\)를 임의로 선택하여 \[ \tilde{p}_k= \frac{1-\tilde{p}_0}{1-p_0}\cdot p_k, \quad k\geq 1, \] 로 주어지는 확률 벡터 \(\{\tilde{p}_k\}_{k\geq 0}\)를 살펴보면, \(\{p_k\}_{k\geq 0}\)와 \(\{\tilde{p}_k\}_{k\geq 0}\)에 따른 양의 값에 대한 상대 확률이 같으므로 \(\{\tilde{p}_k\}_{k\geq 0}\)가 점화식 (3.5)를 만족함을 알 수 있습니다. 이는 특히 \((a,b,1)\) 분포의 클래스가 \((a,b,0)\)의 클래스보다 엄밀하게 더 넓다는 것을 보여 줍니다.
위에서 우리는 유효한 \((a,b,0)\) 분포로 이어지는 \(a\)와 \(b\)의 값의 쌍에서 출발하여, 이 \((a,b,0)\) 분포에 대응하는 \((a,b,1)\) 분포들을 살펴보았습니다. 이제 \((a,b,1)\) 클래스가 \((a,b,0)\) 클래스보다 \(a\)와 \(b\)에 대해 더 큰 허용 가능한 분포의 집합을 허용한다는 것을 논증하겠습니다. 3.3절에서 \(a<0\)인 경우에는 점화식 (3.1)가 \(k=1\)에서 시작한다는 사실을 사용하지 않았다는 점을 떠올려 보십시오. 따라서 \(a<0\)인 쌍 \((a,b)\) 가운데 \((a,b,0)\) 분포족에 허용되는 쌍의 집합은 \((a,b,1)\) 분포족에 허용되는 쌍의 집합과 동일합니다. \(a=0\)인 쌍에 대해서도 같은 결론을 쉽게 얻을 수 있습니다. \(a>0\)인 경우, \((a,b,0)\) 클래스에 대한 제약 조건 \(a+b>0\) 대신 이제 \((a,b,1)\) 클래스에 대해서는 더 약한 제약 조건 \(a+b/2>0\)를 갖습니다. 3.3절에서 사용한 모수화 \(b=(r-1)a\)를 따르면, 이제 \(r>0\) 대신 더 약한 제약 조건인 \(r>-1\)를 얻습니다. 특히, \((a,b,0)\) 분포를 영수정하면 \((a,b,1)\) 클래스의 분포가 되지만, 그 역방향으로는 이 결론이 성립하지 않음을 알 수 있습니다.
영 계수에 0의 확률을 부여하도록 계수 분포 \(F\)를 영수정하는 것을 \(F\)의 영 절단(zero truncation) 계수가 0일 확률을 0으로 부여하도록 계수 분포를 영 수정한 것(이)라고 합니다. 따라서 확률 \(\{p_k\}_{k\geq 0}\)의 영절단 버전은 다음과 같이 주어집니다. \[ \tilde{p}_k=\begin{cases} 0, & k=0;\\ \frac{p_k}{1-p_0}, & k\geq 1. \end{cases} \]
특히, \(\{p^M_k\}_{k\geq 0}\)로 표기되는 계수 분포 \(\{p_k^T\}_{k\geq 0}\)의 영수정은 \(0\)에서의 퇴화분포(degenerate distribution) 단 하나의 값만을 취하는 결정론적 분포와 \(\{p^T_k\}_{k\geq 0}\)로 표기되는 \(\{p_k\}_{k\geq 0}\)의 영절단의 볼록 결합(convex combination) 모든 계수가 음이 아니고 그 합이 1인 점들의 선형결합(으)로 쓸 수 있습니다. 즉, 다음이 성립합니다. \[ p^M_k= p^M_0 \cdot \delta_{0}(k) + (1-p^M_0) \cdot p^T_k, \quad k\geq 0. \]
예제 3.5.1. 영절단/영수정 포아송. 모수가 \(\lambda=2\)인 포아송 분포를 생각해 보십시오. 일반적인(수정되지 않은) 버전, 절단된 버전, 그리고 \((p_0^M=0.6)\)인 수정된 버전에 대해 \(p_k, k=0,1,2,3\)를 계산하십시오.
예제 풀이 보기
Show Quiz Solution
3.6 혼합분포
이 절에서는 다음 방법을 배웁니다.
- 혼합 요소가 유한한 개수의 하위 집단에 기반할 때 혼합분포를 정의합니다
- 혼합 비율과 각 하위 집단의 분포에 대한 정보로부터 혼합분포의 확률을 계산합니다
- 혼합 요소가 연속형일 때 혼합분포를 정의합니다
많은 응용에서 기저 모집단은 자연스럽게 정의되는 하위 집단들로 구성되며, 각 하위 집단 내에는 어느 정도의 동질성이 있습니다. 이러한 경우에는 개별 하위 집단을 모형화하고, 이를 바탕으로 상향식으로 전체 모집단을 모형화하는 것이 편리합니다. 아래에서 보겠지만, 이 접근법은 미적인 매력을 넘어 표준 모수적 분포로 다룰 수 있는 응용의 범위도 넓혀 줍니다.
\(k\)를 모집단에서 정의된 하위 집단의 개수라 하고, \(F_i\)를 \(i\)번째 하위 집단에서 추출한 관측값의 분포라 합시다. \(\alpha_i\)를 \(i\)번째 하위 집단에 속하는 모집단의 비율이라 하고 \(\sum_{i=1}^k \alpha_i=1\)이라 하면, 모집단에서 무작위로 선택한 관측값의 분포는 \(F\)로 나타내며 \[\begin{equation} F(x)=\sum_{i=1}^k \alpha_i \cdot F_i(x). \tag{3.6} \end{equation}\] 으로 주어집니다. 위 식은 전확률의 법칙을 직접 적용한 것으로 볼 수 있습니다. 예를 들어, 운전 경력이 5년 이하인 운전자와 5년을 초과하는 운전자의 두 하위 집단으로 크게 나뉜 운전자 모집단을 생각해 봅시다. \(\alpha\)을 경력이 \(5\)년 미만인 운전자의 비율이라 하고, \(F_{\leq 5}\)와 \(F_{> 5}\)를 각각 각 집단에 속한 운전자의 연간 청구 건수의 분포라 합시다. 그러면 무작위로 선택한 운전자의 청구 건수 분포는 다음과 같이 주어집니다. \[ \alpha\cdot F_{\leq 5}(x) + (1-\alpha)F_{> 5}(x). \]
혼합분포(mixture distribution) 다른 확률변수들의 모음으로부터 다음과 같이 도출되는 확률변수의 확률분포: 먼저 주어진 선택 확률에 따라 모음에서 확률변수 하나를 무작위로 선택한 다음, 선택된 확률변수의 값을 실현합니다의 또 다른 정의는 다음과 같습니다. \(N_i\)를 분포가 \(F_i\)인 확률변수라 합시다(\(i=1,\ldots, k\)). \(I\)를 각각 확률 \(\alpha_1,\ldots,\alpha_k\)로 값 \(1,2,\ldots,k\)을 취하는 확률변수라 합시다. 그러면 확률변수 \(N_I\)는 식 (3.6)8로 주어지는 분포를 가집니다.
(3.6)에서 분포함수가 구성 분포함수들의 볼록 결합임을 알 수 있습니다. 확률질량함수, 생존함수, 원적률, 기댓값은 모두 분포함수의 선형 사상이므로 이 결과는 이들에게로 쉽게 확장됩니다. 그러나 분산과 같은 중심적률이나 위험률 함수와 같은 조건부 측도에 대해서는 이것이 성립하지 않는다는 점에 유의합니다. 분산의 경우 \[\begin{equation} \mathrm{Var}{[N_I]}=\mathrm{E}[{\mathrm{Var}[{N_I\vert I}]]} + \mathrm{Var}[{\mathrm{E}[{N_I|I}}]]=\sum_{i=1}^k \alpha_i \mathrm{Var}[{N_i}] + \mathrm{Var}[{\mathrm{E}[{N_I|I}}]] . \tag{3.7} \end{equation}\] 로부터 쉽게 알 수 있습니다. 부록 18장에서 이 중요한 식에 대한 추가적인 배경을 제공합니다.
예제 3.6.1. 계리사 시험 문제. 어느 마을에서 한 개인이 1년 동안 걸리는 감기 횟수는 그 개인의 나이와 흡연 여부에 따라 달라지는 포아송 분포를 따릅니다. 모집단의 분포와 평균 감기 횟수는 다음과 같습니다.
표 3.2. 모집단의 분포와 평균 감기 횟수
\[ \small{ \begin{array}{l|c|c} \hline & \text{Proportion of population} & \text{Mean number of colds}\\\hline \text{Children} & 0.3 & 3\\ \text{Adult Non-Smokers} & 0.6 & 1\\ \text{Adult Smokers} & 0.1 & 4\\\hline \end{array} } \]
- 무작위로 뽑은 사람이 1년에 감기에 3번 걸릴 확률을 계산하십시오.
- 1년에 감기에 정확히 3번 걸린 사람이 성인 흡연자일 조건부 확률을 계산하십시오.
예제 풀이 보기
위의 예에서 하위 집단의 수 \(k\)는 3이었습니다. 일반적으로 \(k\)는 임의의 자연수가 될 수 있지만, \(k\)가 클 때에는 모형화 관점에서 다음과 같은 무한히 많은 하위 집단 접근법을 취하는 것이 간결합니다. 이 접근법의 동기를 설명하기 위해, \(i\)번째 하위 집단의 성분 분포 \(F_i\)가 \(G_{\tilde{\theta_i}}\)로 주어진다고 합시다. 여기서 \(G_\cdot\)는 모수 공간이 \(\Theta\subseteq \mathbb{R}^d\)인 모수적 분포족입니다. 이 가정하에서, 모집단에서 무작위로 추출한 관측값의 분포함수 \(F\)는 식 (3.6)과 유사하게
\[
F(x)=\sum_{i=1}^k \alpha_i G_{\tilde{\theta_i}}(x),\quad \forall x\in\mathbb{R} ,
\]
로 주어집니다. 또는 다음과 같이 쓸 수도 있습니다.
\[
F(x)=\mathrm{E}[{G_{\tilde{\vartheta}}(x)}],\quad \forall x\in\mathbb{R},
\]
여기서 \(\tilde{\vartheta}\)는 \(i=1,\ldots,k\)에 대해 확률 \(\alpha_i\)로 값 \(\tilde{\theta_i}\)를 취합니다. 위 식으로부터 \(k\)가 클 때 \(\tilde{\vartheta}\)를 연속형 확률변수로 취급하여 위의 내용을 모형화할 수 있음이 분명해집니다.
이 접근법을 설명하기 위해, 개별 운전자의 청구 건수 분포가 포아송 분포를 따르는 운전자 모집단이 있다고 가정합시다. 각 사람은 자신만의 (개인적인) 기대 청구 건수 \(\lambda\)를 가지며, 우량 운전자는 작은 값을, 그 밖의 운전자는 큰 값을 가집니다. 모집단에는 \(\lambda\)의 분포가 존재합니다. 이 분포를 모형화하는 데 널리 쓰이고 편리한 선택은 모수 \((\alpha, \theta)\)를 갖는 감마분포입니다(감마분포는 4.2.1절에서 정식으로 소개합니다). 이러한 설정하에서, 무작위로 선택된 운전자의 청구 건수 \(N\)의 분포는 모수가 \((r=\alpha,\beta=\theta)\)인 음이항 분포가 됨을 알 수 있습니다. 이는 여러 방법으로 보일 수 있지만, 간단한 논증은 다음과 같습니다: \[ \begin{array}{ll} \Pr(N=k)&= \int_0^\infty \frac{e^{-\lambda}\lambda^k}{k!} \frac{\lambda^{\alpha-1}e^{-\lambda/\theta}}{\Gamma{(\alpha)}\theta^{\alpha}} d\lambda = \frac{1}{k!\Gamma(\alpha)\theta^\alpha}\int_0^\infty \lambda^{\alpha+k-1}e^{-\lambda(1+1/\theta)}~d\lambda \\ &=\frac{\Gamma{(\alpha+k)}}{k!\Gamma(\alpha)\theta^\alpha(1+1/\theta)^{\alpha+k}} \\ &={\alpha+k-1 \choose k}\left(\frac{1}{1+\theta}\right)^\alpha\left(\frac{\theta}{1+\theta}\right)^k, \quad k=0,1,\ldots \end{array} \] 위의 유도 과정에서 다음 사실이 암묵적으로 사용되었음에 유의하십시오. \[ f_{N\vert\Lambda=\lambda}(N=k)=\frac{e^{-\lambda}\lambda^k}{k!}, \quad k\geq 0; \quad \hbox{and} \quad f_{\Lambda}(\lambda)= \frac{\lambda^{\alpha-1}e^{-\lambda/\theta}}{\Gamma{(\alpha)}\theta^{\alpha}}, \quad \lambda>0. \]
모수적 분포족의 혼합을 고려함으로써 그 분포족의 풍부함을 늘릴 수 있습니다. 이렇게 분포를 확장하면, 혼합 분포족은 처음에 출발한 모수적 분포족보다 더 많은 응용에 잘 부합할 수 있게 됩니다. 혼합 모형화는 보험 응용에서 중요한 모형화 기법이며, 이후의 장들에서 이 모형화 기법의 더 많은 측면을 다룰 것입니다.
예제 3.6.2. \(N|\Lambda \sim\) 포아송\((\Lambda)\)이고 \(\Lambda \sim\)가 평균이 1이고 분산이 2인 감마 분포를 따른다고 가정합시다. \(N=1\)일 확률을 구하십시오.
예제 풀이 보기
Show Quiz Solution
3.7 실제 데이터 예제
이 절에서는 다음을 배웁니다.
- 적합된 분포를 경험적 데이터와 비교하여 적합의 적절성을 평가합니다
앞에서 우리는 세 가지 기본 빈도분포와 함께, 영수정/절단을 통한 확장 및 이들 분포의 혼합을 통한 확장을 살펴보았습니다. 그럼에도 불구하고 이러한 분포족은 여전히 모수적이며, 따라서 가능한 모든 빈도분포의 집합(즉, 음이 아닌 정수 위의 분포들의 집합)의 작은 부분집합에 불과합니다. 따라서 미지의 모수를 추정하는 방법을 논의하였더라도, 실제 기저 분포가 모형화에 사용된 분포족과 크게 동떨어져 있다면 적합된 분포가 기저 분포를 잘 나타낸다는 보장은 없습니다.
위에서 살펴본 분포족은 비교적 좁은 범위에 속하지만, 실제 사례를 통해 이 분포들이 보험 목적에 상당히 잘 부합한다는 몇 가지 근거를 제시합니다.
\(1993\)에 싱가포르의 한 주요 보험회사가 보유한 \(n=7,483\)건의 자동차 보험계약 포트폴리오에서 보험계약자당 자동차 사고의 분포는 표 3.3에 제시된 바와 같았습니다.
표 3.3. 싱가포르 자동차 사고 데이터
\[ \small{ \begin{array}{l|c|c|c|c|c|c} \hline \text{Count }(k) & 0 & 1 & 2 & 3 & 4 & \text{Total}\\ \hline \text{No. of Policies with }k\text{ accidents }(m_k) & 6,996 & 455 & 28 & 4 & 0 & 7,483\\ \hline \end{array} } \] 포아송 분포를 적합하면, 포아송 평균 \(\lambda\)에 대한 mle는 표본평균이며, 이는 \[ \overline{N} = \frac{0\cdot 6996 + 1 \cdot 455 + 2 \cdot 28 + 3 \cdot 4 + 4 \cdot 0}{7483} = 0.06989. \] 로 주어집니다. 이제 포아송(\(\hat{\lambda}_{MLE}\))을 적합된 분포로 사용하면, 적합된 건수와 관측된 건수를 표로 비교한 결과는 아래 표 3.4와 같습니다. 여기서 \(\hat{p}_k\)는 적합된 포아송 분포하에서 추정된 확률을 나타냅니다.
표 3.4. 관측 건수와 적합 건수의 비교: 싱가포르 자동차 데이터
\[ \small{ \begin{array}{c|r|r} \hline \text{Count} & \text{Observed} & \text{Fitted Counts}\\ (k) & (m_k) & \text{Using Poisson }(n\hat{p}_k)\\ \hline 0 & 6,996 & 6,977.86 \\ 1 & 455 & 487.70 \\ 2 & 28 & 17.04 \\ 3 & 4 & 0.40 \\ \geq 4 & 0 & 0.01\\ \hline \text{Total} & 7,483 & 7,483.00\\ \hline \end{array} } \] 위의 표 비교를 보면 적합이 상당히 합리적인 것으로 보이며, 이는 포아송 분포가 기저 분포를 잘 나타내는 모형임을 시사합니다. 그럼에도 불구하고, 이러한 표 비교는 기저 분포가 실제로 포아송이라는 가설에 대한 통계적 검정에는 미치지 못한다는 점을 짚어 둘 필요가 있습니다. 6.1.2절에서는 이러한 목적을 위한 적합도 통계량으로 피어슨 카이제곱 통계량을 제시합니다.
3.8 연습문제
이론 연습문제
연습문제 3.1. \(F_N(\cdot)\)와 \(S_N(\cdot)\)를 사용하여 \(p_N(\cdot)\)에 대한 식을 유도하십시오.
연습문제 3.2. 중심 위치의 척도는 이동, 즉 위치 변환에 대해 동변이어야 합니다. 다시 말해, \(N_1\)와 \(N_2\)가 어떤 상수 \(c\)에 대해 \(N_1+c\)가 \(N_2\)와 같은 분포를 갖는 두 확률변수라면, \(N_2\)와 \(N_1\)의 중심 위치 척도의 차이는 \(c\)와 같아야 합니다. 평균이 이 성질을 만족함을 보이십시오.
연습문제 3.3. 산포의 척도는 이동에 대해 불변이어야 하고 척도에 대해 동변이어야 합니다. 다음을 수행하여 표준편차가 이러한 성질을 만족함을 보이십시오.
- 확률변수 \(N\)에 대해, 임의의 상수 \(c\)에 대하여 그 표준편차가 \(N+c\)의 표준편차와 같음을 보이십시오.
- 확률변수 \(N\)에 대해, 임의의 양의 상수 \(c\)에 대하여 그 표준편차가 \(cN\)의 표준편차의 \(1/c\)배와 같음을 보이십시오.
연습문제 3.4. \(N\)를 확률질량함수가 \[ p_N(k)= \begin{cases} \left(\frac{6}{\pi^2}\right)\left(\frac{1}{k^{2}}\right), & k\geq 1;\\ 0, &\hbox{otherwise}. \end{cases} \] 로 주어지는 확률변수라고 합시다. \(N\)의 평균이 \(\infty\)임을 보이십시오.
연습문제 3.5. \(N\)를 유한한 2차 적률을 갖는 확률변수라고 합시다. 미적분을 사용하지 않고, \[ \psi(x)=\mathrm{E}{(N-x)^2}. \quad x\in\mathbb{R} \] 로 정의된 함수 \(\psi(\cdot)\)가 \(\mu_N\)에서 최소가 됨을 보이십시오. 또한 도함수를 사용하여 이 사실을 증명하십시오. 최솟값이 \(N\)의 분산과 같다는 결론을 도출하십시오.
연습문제 3.6. 아래에 제시된 방법을 사용하여 \((a,b,0)\) 분포의 처음 두 중심적률을 유도하십시오.
- 이항분포에 대해서는 pmf만을 사용하여, 다음으로 mgf를, 그리고 pgf를 사용하여 적률을 유도하십시오.
- 포아송 분포에 대해서는 mgf만을 사용하여 적률을 유도하십시오.
- 음이항 분포에 대해서는 pmf만을 사용하여, 그리고 다음으로 pgf를 사용하여 적률을 유도하십시오.
연습문제 3.7. \(N_1\)와 \(N_2\)를 각각 평균이 \(\lambda_1\)와 \(\lambda_2\)인 서로 독립인 두 포아송 확률변수라고 합시다. \(N_1+N_2\)가 주어졌을 때 \(N_1\)의 조건부 분포를 밝히십시오.
연습문제 3.8. (MLE의 비유일성) \([0,1]\)에서 값을 취하는 모수 \(p\)로 색인되는 다음의 모수적 분포족 밀도 \[ f_p(x)=p\cdot\phi(x+2)+(1-p)\cdot\phi(x-2), \quad x\in\mathbb{R}, \] 를 고려하십시오. 여기서 \(\phi(\cdot)\)는 표준정규 밀도를 나타냅니다.
- 모든 \(p\in[0,1]\)에 대해 위의 \(f_p(\cdot)\)가 유효한 밀도함수임을 보이십시오.
- \(f_p(\cdot)\)의 평균과 분산을 \(p\)로 나타낸 식을 구하십시오.
- \(x\)로 이루어진 크기가 1인 표본을 생각해 봅시다. \(x\)가 \(0\)와 같을 때 \(p\)에 대한 최대가능도 추정값의 집합이 \([0,1]\)와 같음을 보이고, 그렇지 않은 경우에는 mle가 유일함을 보이십시오.
연습문제 3.9. 유효한 \((a,b,0)\) 분포를 만들어 내는 \((a,b)\) 값에 해당하는 평면 위의 영역을 그래프로 그리십시오. \((a,b,1)\) 분포에 대해서도 같은 작업을 하십시오.
연습문제 3.10. (계산 복잡도) \((a,b,0)\) 분포족에 대해, 점화 관계를 사용하여 \(n\)개의 확률 \(p_0\ldots p_{n-1}\)를 계산하는 데 필요한 기본 수학 연산(덧셈, 뺄셈, 곱셈, 나눗셈)의 수를 세십시오. \(r\)가 정수가 아닌 음이항 분포에 대해서도 이러한 연산의 수를 세십시오. 무엇을 관찰할 수 있습니까?
연습문제 3.11. 3.3절의 전개를 이용하여, 점화식 (3.1)이 이항분포, 포아송 분포, 음이항 분포를 하나로 묶을 뿐만 아니라 이들 분포의 특성을 규정한다는 것을 엄밀하게 보이십시오.
연습문제 3.12. 보험계리사 시험 문제. 다음이 주어져 있습니다.
- \(p_k\)는 \(k=0,1,2,\ldots\)에 대해 청구 건수가 \(k\)와 같을 확률을 나타냅니다.
- \(\frac{p_n}{p_m}=\frac{m!}{n!}, m\ge 0, n\ge 0\)
\(p_0^M=0.1\)인 대응하는 영수정 청구 건수 분포를 사용하여 \(p_1^M\)를 계산하십시오.
실무 중심 연습문제
연습문제 3.13. 싱가포르 자동차 사고. 이 연습문제에서는 3.7절에서 소개한 실제 데이터 예제를 R을 이용하여 재현하고 확장합니다.
- a. 청구 건수인 변수
Clm_Count를 다루기 위해CASdatasets패키지에서sgautonb데이터를 불러오십시오. 이 패키지에 대한 설명은 22.6절을 참조하십시오. 평균 청구 건수가 0임을 확인하십시오. - b. 적합된 포아송 분포를 계산하고 표 3.2을 재현하십시오.
| Claim Count | Empirical Percentile | Poisson Perc |
|---|---|---|
| 6996 | 0.9349 | 0.9325 |
| 455 | 0.9957 | 0.9977 |
| 28 | 0.9995 | 0.9999 |
| 4 | 1.0000 | 1.0000 |
- c. 음이항 분포에 대한 최대가능도 추정값을 계산하십시오. 이를 수행하는 한 가지 방법은 음의 로그가능도함수를 만들고
R함수optim을 사용하여 최소화하는 것입니다. 이렇게 얻은 최대가능도 추정값을 사용하여 적합된 분포를 만들고, 이 대안 분포를 (b)의 표에 추가하십시오.
(c)에서 더 복잡한 음이항 분포가 더 단순한 포아송 분포와 거의 같은 적합 결과를 낸다는 것을 알게 됩니다. 이 분석 결과에 따라 분석가는 일반적으로 더 단순한 포아송 분포를 선호할 것입니다.
연습문제 3.13 풀이
연습문제 3.14. 기업 출장. 이 연습문제는 [연습문제 1.1]에서 소개한 데이터 세트를 바탕으로 하며, 이번에는 빈도 모델링에 초점을 맞춥니다. 기업 출장의 경우 청구 건수가 충분하므로 별도의 빈도 모형을 고려할 수 있습니다. 청구 빈도를 보면 2006-2021년 기간 동안 2107건의 청구가 있었으며, 이는 연간 131.69건에 해당합니다. 연간 청구 건수를 전체 기간에 대해 포아송 분포나 음이항 분포와 같은 단일 분포로 적합할 수 있다고 가정할 수 있습니다. 또 다른 방법은 이전 연도에 비해 청구 건수가 증가한 2009년부터 분포를 적합하는 것입니다. 세 번째 방법은 부분적으로 코로나19 유행으로 인해 청구 건수가 크게 변동한 2019 언더라이팅 연도 이후의 경험을 제외하는 것입니다. 이 연습문제에서는 첫 번째 방법을 따릅니다.
- a. 모든 청구에 포아송 분포와 음이항 분포를 적합하십시오.
- b. 연습문제 3.13의 (c)에서 소개한 전략을 사용하여 모든 청구에 음이항 분포를 적합하십시오.
- c. 결과를 확인하려면
fitdistrplus패키지의fitdist함수를 음이항(nbinom) 옵션과 함께 사용하십시오. - d.
R의ecdf함수를 사용하여 경험적 누적 확률을 구하십시오. 경험적 백분위수를 포아송 분포 및 음이항 분포에서의 백분위수와 비교하는 표를 작성하십시오.
(d)에서 두 적합된 분포가 모두 잘 맞았으며 어느 쪽도 다른 쪽보다 우수하지 않았음을 알 수 있습니다.
연습문제 3.14 풀이
3.9 추가 자료 및 기여자
부록 챕터 17에서는 모수적 분포족의 모수 추정에 관한 최대가능도 이론을 전반적으로 소개합니다. 부록 챕터 19에서는 보다 구체적인 예를 제시하고 일부 개념을 확장합니다.
R 코딩을 더 연습하고 싶다면 자매 과정인 LDA 단기 과정을 방문하십시오. 특히 빈도 모델링 장을 참조하십시오.
기여자
- 아이오와 대학교의 N.D. Shyamalkumar와 템플 대학교의 Krupa Viswanathan이 이 장의 초판과 제2판의 주 저자입니다. 이 장에 대한 의견과 개선 제안은 shyamal-kumar@uiowa.edu로 이메일을 보내 주십시오.
- 이 장의 검토자는 다음과 같습니다: Chunsheng Ban, Paul Johnson, Hirokazu (Iwahiro) Iwasawa, Dalia Khalil, Tatjana Miljkovic, Rajesh Sahasrabuddhe, Michelle Xia.
\(\mu_N\)는 오로지 확률변수의 분포만의 함수이지만, 편의상 \(F_N\)나 \(p_N\) 대신 확률변수 \(N\)를 첨자로 붙였습니다. \[ \mu_N=\sum_{k=0}^\infty k~p_N(k). \] \(\mu_N\)는 확률변수 \(N\)의 기댓값, 즉 \(\mu_N=\mathrm{E}[N]\)입니다. 이로부터 일반적인 척도의 한 부류인 분포의 적률(moments) r차 적률은 확률변수를 r제곱한 값의 평균입니다.이 나옵니다. \(r> 0\)에 대해 \(N\)의 \(r\)차 원적률은 \(\mathrm{E}{[N^r]}\)로 정의하며 \(\mu_N'(r)\)로 표기합니다. 여기서 프라임 \(\prime\)는 미분을 나타내는 것이 아닙니다. 오히려 이는 4.1.1절에서 소개할 중심적률과 원적률을 구별하기 위해 흔히 사용하는 표기법입니다. \(r>0\)에 대해 다음이 성립합니다.
\[ \mu_N'(r)= \mathrm{E}{[N^r]}= \sum_{k=0}^\infty k^r~p_N(k). \] \(\Pr(N\in\{0, 1, \ldots \})=1\)이므로 \(\mu_N'(\cdot)\)는 \([0,\infty]\)에서 값을 취하는, 잘 정의된 비감소함수입니다. 또한 \(\mu_N=\mu_N'(1)\)임에 유의하십시오. 이하에서 적률을 언급할 때는 따로 밝히지 않는 한 그 적률이 유한하다고 암묵적으로 가정합니다.↩︎\(0^0 = 1\)↩︎
이하에서는 \(N\)에 대한 언급을 생략하고, pmf를 함수 \(p_N(\cdot)\) 대신 수열 \(\{p_k\}_{k\geq 0}\)로 나타냅니다.↩︎
\(L(\cdot)\)의 최대화점 집합은 \(L(\cdot)\)의 임의의 순증가함수의 최대화점 집합과 같으며, 따라서 \(l(\cdot)\)의 최대화점 집합과도 같습니다.↩︎
\(l(\cdot)\)를 다룰 때의 작은 이점은 \(L(\cdot)\)의 상수항이 \(L'(\cdot)\)에는 나타나지만 \(l'(\cdot)\)에는 나타나지 않는다는 것입니다.↩︎
특히 이는 구성 분포에 대해 존재할 수 있는 효율적인 시뮬레이션 기법을 활용하여 혼합분포로부터 시뮬레이션하는 방법을 제시합니다.↩︎