제5장 청구 심도 모형화
장 미리보기. 제4장에서는 손실의 확률적 크기를 모형화하기 위해 연속분포와 혼합분포를 사용하는 방법을 살펴보았습니다. 손실 위험은 흔히 보험계약자(피보험자)와 보험자가 분담합니다. 위험 분담은 여러 비용 분담 형태 가운데, 보험자가 손실을 분담하기 전에 피보험자가 자기 부담으로 지급하는 공제액의 형태, 손실에 대한 피보험자의 책임을 일정 금액으로 제한하는 한도의 형태, 또는 피보험자가 자신의 비용 몫을 부담한 후 보험자가 보상할 책임을 지는 손실의 일정 비율의 형태를 취할 수 있습니다. 5.1.1절부터 5.1.3절까지에서는 보험계약의 공제액 특성, 한도형 보험, 공동보험 비용 분담 약정을 소개합니다. 5.1.4절에서는 보험회사가 재보험자로부터 보장을 확보하여 기초가 되는 피보험 위험의 일부를 어떻게 이전하는지 살펴봅니다. 5.2절에서는 그룹화된 데이터, 중도절단 데이터, 절단 데이터를 포함한 수정된 데이터에 대한 모수적 추정 방법을 다룹니다. 5.3절에서는 수정된 데이터에 오자이브 추정량, 플러그인 원리, 카플란-마이어 곱한계 추정량, 넬슨-알렌 추정량과 같은 비모수적 추정 도구를 적용합니다.
5.1 보장 수정
이 절에서는 다음 방법을 배웁니다:
- 보험계약의 공제액 특성, 한도형 보험, 공동보험 계수 설명하기.
- 다양한 계약 수정하에서 피보험자에게 발생한 손실과 보험자의 지급 청구액 간의 차이를 설명하십시오.
- 여러 보험계약에서 보험자의 지급 청구액에 대한 분포함수와 원적률을 유도하십시오.
- 공제액 부과로 인한 보험자의 기대 지급액 감소율 계산하기.
- 보험회사를 위한 보험 메커니즘(재보험) 설명하기.
- 재보험 계약에서 원보험자가 보유하는 금액의 원적률 계산하기.
이 절에서는 보장 수정, 즉 a) 공제액, b) 보상한도, c) 공동보험, d) 인플레이션이 보험자의 비용에 미치는 영향을 평가합니다.
5.1.1 보험 공제액
일반 공제액 보험에서 피보험자(보험계약자)는 보험자가 지급을 시작하기 전에 보험 청구 금액 중 고정된 금액을 부담하기로 동의합니다. 이처럼 자기 부담으로 지급하는 고정 비용을 공제액이라고 하며, 흔히 \(d\)로 표기합니다. 손실이 \(d\)를 초과하면 보험자는 손실 X에서 공제액 \(d\)을 뺀 금액을 보상할 책임을 집니다. 약정에 따라 공제액은 보장되는 각 손실에 적용될 수도 있고, 정해진 급부 기간(예: 1개월, 1년 등) 동안의 총손실에 적용될 수도 있습니다.
공제액은 다수의 소액 청구, 이러한 청구를 처리하는 데 드는 비용, 그리고 보험 가입으로 인해 발생할 수 있는 도덕적 해이(moral hazard) 손실에 대한 결과를 충분히 부담하지 않을 경우 피보험자가 위험을 추구할 가능성이 커지는 상황를 제거함으로써 보험계약자의 보험료를 낮춥니다. 도덕적 해이는 피보험자가 보험자가 비용을 부담하리라는 것을 알고 더 많은 위험을 감수하여, 보장 대상 위험으로 인한 손실 가능성을 높일 때 발생합니다(예: 충돌 보험에 가입한 보험계약자는 난폭하게 운전하도록 부추겨질 수 있습니다). 공제액이 클수록 피보험자가 보험계약에 대해 지급하는 보험료는 줄어듭니다.
\(X\)은 피보험자에게 발생한 손실을, \(Y\)는 보험자의 지급 청구액을 나타낸다고 합시다. 보험계약자에게 지급되는 급부와 관련하여 손실당 지급액과 지급당 지급액이라는 두 변수를 구분합니다. \(Y^{L}\) 또는 \((X-d)_+\)로 표기하는 손실당 지급액(payment per loss) 손실이 발생했을 때 보험자가 지급하는 금액(0일 수 있음) 변수는 \(d\)보다 작은 \(X\)의 값을 0으로 두므로 좌측 중도절단(left censored) 임계값 d 미만의 값은 무시되지 않고 0으로 변환됩니다.입니다. 이 변수는 다음과 같이 정의됩니다. \[ Y^{L} = \left( X - d \right)_{+} = \left\{ \begin{array}{cc} 0 & X \le d, \\ X - d & X > d \end{array} \right. . \] \(Y^{L}\)는 \(d\) 미만의 값을 무시하지 않고 모든 손실을 \(d\)만큼 이동시키므로 흔히 좌측 중도절단 및 이동 변수라고 부릅니다.
반면, \(Y^{P}\)로 표기하는 지급건당 지급액(payment per payment) 지급이 필요하고 그 금액이 0보다 큰 경우에 보험자가 지급하는 금액 변수는 지급이 있을 때에만 정의됩니다. 구체적으로, \(Y^P\)는 사건 \(\{X >d\}\)에서 \(X-d\)와 같으며, 이를 \(Y^P = X-d | X>d\)로 표기합니다. 이를 표현하는 또 다른 방법으로 흔히 사용되는 것은 \[ Y^{P} = \left\{ \begin{matrix} \text{Undefined} & X \le d \\ X - d & X > d . \end{matrix} \right. \] 입니다. 여기서 \(Y^{P}\)는 흔히 좌측 절단(left truncated) 임계값 d 미만의 값은 보고되지 않으며 알 수 없습니다. 및 이동된 변수 또는 초과손실 변수라고 불리는데, 이는 \(d\)보다 작은 청구는 보고되지 않고 \(d\)를 초과하는 값은 \(d\)만큼 이동되기 때문입니다.
\(X\)의 분포가 연속이더라도 \(Y^{L}\)의 분포는 이산 성분과 연속 성분이 혼합된 형태입니다. 분포의 이산 부분은 \(Y = 0\)에 집중되어 있고(\(X \le d\)일 때), 연속 부분은 구간 \(Y > 0\)에 걸쳐 분포합니다(\(X > d\)일 때). 이산 부분의 경우, 지급이 이루어지지 않을 확률은 손실이 공제액 미만일 확률이며, 즉 \[\Pr\left( Y^{L} = 0 \right) = \Pr\left( X \le d \right) = F_{X}\left( d \right).\]입니다. 분포의 연속 부분에 대해 변환 \(Y^{L} = X - d\)를 사용하면 \(Y^{L}\)의 pdf를 \[ f_{Y^{L}}\left( y \right) = \left\{ \begin{matrix} F_{X}\left( d \right) & y = 0 \\ f_{X}\left( y + d \right) & y > 0 . \end{matrix} \right. \] 와 같이 구할 수 있습니다. 지급건당 지급 변수는 손실이 공제액을 초과한다는 조건(\(X > d\)) 하에서의 손실건당 지급 변수임을 알 수 있으며, 즉 \(Y^{P} = \left. \ Y^{L} \right|X > d\)입니다. 또는 이를 \(Y^P = (X - d)|X > d\)로 표현할 수 있으며, 즉 \(Y^P\)는 손실이 공제액을 초과한다는 조건 하에서 공제액을 초과하는 손실입니다. 따라서 \(Y^{P}\)의 pdf는 \(y > 0\)에 대해 \[ f_{Y^{P}}\left( y \right) = \frac{f_{X}\left( y + d \right)}{1 - F_{X}\left( d \right)}, \] 로 주어집니다. 이에 따라 \(Y^{L}\)와 \(Y^{P}\)의 분포함수는 \(y > 0\)에 대해 각각 \[ F_{Y^{L}}\left( y \right) = \left\{ \begin{matrix} F_{X}\left( d \right) & y = 0 \\ F_{X}\left( y + d \right) & y > 0, \\ \end{matrix} \right. \] 및 \[ F_{Y^{P}}\left( y \right) = \frac{F_{X}\left( y + d \right) - F_{X}\left( d \right)}{1 - F_{X}\left( d \right)}, \] 로 주어집니다.
\(Y^{L}\)와 \(Y^{P}\)의 원적률은 \(X\)의 pdf를 사용하여 다음과 같이 각각 \[\mathrm{E}\left\lbrack \left( Y^{L} \right)^{k} \right\rbrack = \int_{d}^{\infty}\left( x - d \right)^{k}f_{X}\left( x \right)dx ,\] 및 \[ \mathrm{E}\left\lbrack \left( Y^{P} \right)^{k} \right\rbrack = \frac{\int_{d}^{\infty}\left( x - d \right)^{k}f_{X}\left( x \right) dx }{{1 - F}_{X}\left( d \right)} = \frac{\mathrm{E}\left\lbrack \left( Y^{L} \right)^{k} \right\rbrack}{{1 - F}_{X}\left( d \right)}, \] 로 직접 구할 수 있습니다. \(k=1\)의 경우, 생존함수를 사용하여 \(\mathrm{E}(Y^L)\)를 \[ \mathrm{E}(Y^L) = \int_d^{\infty} [1-F_X(x)] ~dx . \] 와 같이 계산할 수 있습니다. 이는 \(\mathrm{E}(Y^L)\)의 초기 정의에서 출발하여 부분적분을 사용하면 쉽게 증명할 수 있습니다.
보험계약에 부과되는 공제액 \(d\)는 보험자가 지급을 하기 전에 본인이 부담해야 하는 손실 금액임을 살펴보았습니다. 보험계약에 부과되는 공제액 \(d\)는 보험자의 지급액을 감소시킵니다. 손실제거율(LER)(loss elimination ratio (LER)) 공제액으로 인해 보험자의 기대 지급액이 감소하는 비율(%)은 공제액을 부과한 결과로 나타나는 보험자의 기대지급액의 감소 비율입니다. 이는 \[ LER = \frac{\mathrm{E}\left( X \right) - \mathrm{E}\left( Y^{L} \right)}{\mathrm{E}\left( X \right)}. \] 로 정의됩니다. 이보다 조금 덜 일반적인 유형의 보험계약 공제액으로 프랜차이즈 공제액이 있습니다. 프랜차이즈 공제액(franchise deductible) 보험자는 공제액 미만의 손실에는 아무것도 지급하지 않지만, 공제액을 초과하는 손실에는 전액을 지급합니다.은 손실이 공제액 \(d\)를 초과할 때 손실 전액을 보험자가 보상한다는 점을 제외하면 일반 공제액과 같은 방식으로 보험계약에 적용됩니다. 손실건당 지급 변수와 지급건당 지급 변수는 각각 \[ Y^{L} = \left\{ \begin{matrix} 0 & X \le d, \\ X & X > d, \\ \end{matrix} \right. \] 및 \[ Y^{P} = \left\{ \begin{matrix} \text{Undefined} & X \le d, \\ X & X > d, \\ \end{matrix} \right. \] 로 정의됩니다.
예제 5.1.1. 보험계리사 시험 문제. 청구 심도 분포는 평균이 1000인 지수분포입니다. 보험회사는 각 청구에 대해 공제액 100을 초과하는 금액을 지급합니다. 지급액이 0일 가능성을 포함하여, 청구 한 건에 대해 보험회사가 지급하는 금액의 분산을 계산하십시오.
예제 풀이 보기
아마도 더 간단한 풀이 방법은 \(X\)와 \(Y^{P}\) 사이의 관계를 활용하는 것입니다. \(X\)가 평균이 1000인 지수분포를 따르면, 지수분포의 무기억성으로 인해 \(Y^{P}\) 역시 같은 평균을 갖는 지수분포를 따릅니다. 따라서 \(E\left( Y^{P} \right)\)=1000이고 \[ E\left\lbrack \left( Y^{P} \right)^{2} \right\rbrack = 2 \times 1000^{2}. \] 입니다. \(Y^{L}\)와 \(Y^{P}\) 사이의 관계를 이용하면 \[ E\left( Y^{L} \right) = \ E\left( Y^{P} \right)S_{X}\left( 100 \right){= 1000e}^{- \frac{100}{1000}} \] \[ E\left\lbrack \left( Y^{L} \right)^{2} \right\rbrack = E\left\lbrack \left( Y^{P} \right)^{2} \right\rbrack S_{X}\left( 100 \right) = 2 \times 1000^{2}e^{- \frac{100}{1000}}. \] 를 얻습니다. \(X\)와 \(Y^P\) 사이의 관계는 균등분포나 파레토 분포를 다룰 때에도 사용할 수 있습니다. \(X\)가 구간 \(\left(0,\theta\right)\)에서 균등분포를 따르면 \(Y^P\)는 구간 \(\left(0,\theta-d\right)\)에서 균등분포를 따르고, \(X\)가 모수 \(\alpha\)와 \(\theta\)를 갖는 파레토 분포를 따르면 \(Y^P\)는 모수 \(\alpha\)와 \(\theta+d\)를 갖는 파레토 분포를 따른다는 것을 쉽게 보일 수 있습니다.
예제 5.1.2. 보험계리사 시험 문제. 어떤 보험에 대하여:
- 손실은 다음과 같은 밀도함수를 갖습니다. \[ f_{X}\left( x \right) = \left\{ \begin{matrix} 0.02x & 0 < x < 10, \\ 0 & \text{elsewhere.} \\ \end{matrix} \right. \]
- 이 보험은 손실당 4의 일반 공제액이 있습니다.
- \(Y^{P}\)는 지급건당 청구 지급액 확률변수입니다.
\(\mathrm{E}\left( Y^{P} \right)\)를 계산하십시오.
예제 풀이 보기
예제 5.1.3. 계리사 시험 문제. 다음이 주어져 있습니다.
- 손실은 모든 연도에서 평균이 같은 지수분포를 따릅니다.
- 올해의 손실제거율은 70%입니다.
- 내년의 일반 공제액은 현재 공제액의 4/3입니다.
내년의 손실제거율을 계산하십시오.
예제 풀이 보기
5.1.2 보상한도
한도가 있는 보험에서 보험자는 실제 손실 \(X\)을 보장 한도까지 보상할 책임을 집니다. 이 고정된 보장 한도(limit of coverage) 보상한도, 즉 하나의 손실에 대한 보험자의 계약상 최대 재정적 의무를 보상한도라고 하며, 흔히 \(u\)로 나타냅니다. 손실이 보상한도를 초과하면 그 차액 \(X - u\)은 보험계약자가 부담해야 합니다. 보상한도가 높을수록 피보험자에게 지급되는 보험금이 많아지지만, 그만큼 보험료도 높아집니다.
\(X\)은 피보험자에게 발생한 손실을, \(Y\)은 보험자의 지급 청구액을 나타낸다고 합시다. 변수 \(Y\)를 제한 손실 변수라고 하며, \(X \land u\)로 나타냅니다. \(u\)보다 큰 값이 \(u\)와 같게 설정되므로, 이는 우측 중도절단 변수(right censored variable) 임계값 u를 초과하는 값은 무시되지 않고 u로 변환됩니다.입니다. 제한 손실 확률변수 \(Y\)는 다음과 같이 정의됩니다. \[ Y = X \land u = \left\{ \begin{matrix} X & X \le u \\ u & X > u. \\ \end{matrix} \right. \] 한도가 있는 보험에서는 보험자가 항상 지급을 하므로 \(Y^{L}\)와 \(Y^{P}\)를 구분할 필요가 없음을 알 수 있습니다.
\(\left(X-u\right)_+ \text{ and } \left(X\land u\right)\)의 정의를 이용하면, 보장 수정이 전혀 없을 때의 기대 지급액 \(X\)이 공제액 \(u\)가 있을 때의 기대 지급액과 한도 \(u\)가 있을 때의 기대 지급액의 합과 같다는 것을 쉽게 알 수 있습니다. 즉, \({X=\left(X-u\right)}_++ \left(X\land u\right)\)입니다.
\(X\)의 분포가 연속이더라도, \(Y\)의 분포는 이산 성분과 연속 성분이 혼합된 형태입니다. 분포의 이산 부분은 \(Y = u\)에 집중되어 있고(\(X > u\)인 경우), 연속 부분은 구간 \(Y < u\)에 걸쳐 분포합니다(\(X \le u\)인 경우). 이산 부분에서 지급되는 보험금이 \(u\)일 확률은 손실이 보상한도 \(u\)를 초과할 확률입니다. 즉, \[ \Pr \left( Y = u \right) = \Pr \left( X > u \right) = {1 - F}_{X}\left( u \right). \] 분포의 연속 부분에서는 \(Y = X\)이므로, \(Y\)의 pdf는 다음과 같습니다. \[ f_{Y}\left( y \right) = \left\{ \begin{matrix} f_{X}\left( y \right) & 0 < y < u \\ 1 - F_{X}\left( u \right) & y = u. \\ \end{matrix} \right. \] 따라서 \(Y\)의 분포함수는 다음과 같습니다. \[ F_{Y}\left( y \right) = \left\{ \begin{matrix} F_{X}\left( x \right) & 0 < y < u \\ 1 & y \geq u. \\ \end{matrix} \right. \] \(Y\)의 원적률은 \(X\)의 pdf를 이용하여 다음과 같이 직접 구할 수 있습니다. \[ \mathrm{E}\left( Y^{k} \right) = \mathrm{E}\left\lbrack \left( X \land u \right)^{k} \right\rbrack = \int_{0}^{u}x^{k}f_{X}\left( x \right)dx + \int_{u}^{\infty}{u^{k}f_{X}\left( x \right)} dx \\ = \int_{0}^{u}x^{k}f_{X}\left( x \right)dx + u^{k}\left\lbrack {1 - F}_{X}\left( u \right) \right\rbrack . \] 생존함수를 이용한 다른 표현은 다음과 같습니다. \[ \mathrm{E}\left[ \left( X \land u \right)^{k} \right] = \int_{0}^{u} k x^{k-1} \left[1 - F_{X}(x) \right] dx . \] 특히 \(k=1\)인 경우, 이는 다음과 같습니다. \[ \mathrm{E}\left( Y \right) = \mathrm{E}\left( X \land u \right) = \int_{0}^{u} [1-F_{X}(x) ]dx . \] 이는 \(\mathrm{E}\left( Y \right)\)의 처음 정의에서 출발하여 부분적분을 이용하면 쉽게 증명할 수 있습니다. 또는 이 제한 기댓값 결과에 대한 다음 근거를 참고하십시오.
제한 기댓값 결과의 근거 보기
예제 5.1.4. 계리사 시험 문제. 단체보험(group insurance) 개별 보험에 비해 낮은 관리 비용의 이점을 누리기 위해 집단에 제공되는 보험 보험계약에서 보험자는 소규모 회사의 직원들이 한 해 동안 지출한 의료비의 100%를 총 최대 100만 달러까지 지급하기로 약정합니다. 발생한 청구서 총액 \(X\)는 pdf \[ f_{X}\left( x \right) = \left\{ \begin{matrix} \frac{x\left( 4 - x \right)}{9} & 0 < x < 3 \\ 0 & \text{elsewhere.} \\ \end{matrix} \right. \] 을 가지며, 여기서 \(x\)는 백만 단위로 측정됩니다. 이 보험계약에 따라 보험자가 지급할 것으로 기대되는 총액을 백만 달러 단위로 계산하십시오.
예제 풀이 보기
5.1.3 공동보험과 인플레이션
절 5.1.1에서 살펴본 바와 같이, 보험계약자가 보유하는 손실 금액은 공제액 \(d\)까지의 손실일 수 있습니다. 보유 손실은 청구액의 일정 비율일 수도 있습니다. 흔히 공동보험 계수라고 불리는 비율 \(\alpha\)는 보험회사가 보상해야 하는 청구액의 비율입니다. 보험계약에 일반 공제액과 보상한도가 적용되는 경우, 공동보험은 일반 공제액과 보상한도를 적용한 후 보험자가 보장해야 하는 청구의 비율을 의미합니다. 손실당 지급 변수 \(Y^{L}\)는 \[ Y^{L} = \left\{ \begin{matrix} 0 & X \le d, \\ \alpha\left( X - d \right) & d < X \le u, \\ \alpha\left( u - d \right) & X > u. \\ \end{matrix} \right. \] 로 정의됩니다. 이 경우 보험자가 지급하는 최대 금액은 \(\alpha\left( u - d \right)\)이며, \(u\)는 최대 보상 손실입니다.
절 5.1.2에서 손실에 공제액 \(d\)와 한도 \(u\)가 모두 적용될 때 손실당 변수 \(Y^L\)를 \(Y^L=\left(X\land u\right)-\left(X\land d\right)\)로 표현할 수 있음을 살펴보았습니다. 공동보험이 적용되면 이는 \(Y^L\)이 되며, \(Y^L=\alpha\left[(X\land u)-(X\land d)\right]\)로 표현할 수 있습니다.
\(Y^{L}\)의 \(k\)차 원적률은 \[ \mathrm{E}\left\lbrack \left( Y^{L} \right)^{k} \right\rbrack = \int_{d}^{u}\left\lbrack \alpha\left( x - d \right) \right\rbrack^{k}f_{X}\left( x \right)dx + \left\lbrack \alpha\left( u - d \right) \right\rbrack^{k} [1-F_{X}\left( u \right)] . \] 로 주어집니다. \(X\)에 증가계수(growth factor) 인플레이션의 영향을 반영하기 위해 분포에 적용하는 곱셈 인자로, 일반적으로 (1+rate)입니다. \(\left( 1 + r \right)\)를 적용하면 인플레이션이 반영된 손실 확률변수 \(\left( 1 + r \right)X\)가 됩니다(사전에 정해진 \(d\)와 \(u\)는 변하지 않습니다). 그 결과 얻어지는 손실당 변수는 \[ Y^{L} = \left\{ \begin{matrix} 0 & X \le \frac{d}{1 + r} \\ \alpha\left\lbrack \left( 1 + r \right)X - d \right\rbrack & \frac{d}{1 + r} < X \le \frac{u}{1 + r} \\ \alpha\left( u - d \right) & X > \frac{u}{1 + r}. \\ \end{matrix} \right. \] 로 쓸 수 있습니다. \(Y^{L}\)의 1차 및 2차 적률은 각각 \[ \mathrm{E}\left( Y^{L} \right) = \alpha\left( 1 + r \right)\left\lbrack \mathrm{E}\left( X \land \frac{u}{1 + r} \right) - \mathrm{E}\left( X \land \frac{d}{1 + r} \right) \right\rbrack, \] 와 \[ \begin{array}{ll} \mathrm{E}\left\lbrack \left( Y^{L} \right)^{2} \right\rbrack &= \alpha^{2}\left( 1 + r \right)^{2} \left\{ \mathrm{E}\left\lbrack \left( X \land \frac{u}{1 + r} \right)^{2} \right\rbrack - \mathrm{E}\left\lbrack \left( X \land \frac{d}{1 + r} \right)^{2} \right\rbrack \right. \\ & \left. \ \ \ \ \ \ \ \ \ - 2\left( \frac{d}{1 + r} \right)\left\lbrack \mathrm{E}\left( X \land \frac{u}{1 + r} \right) - \mathrm{E}\left( X \land \frac{d}{1 + r} \right) \right\rbrack \right\} , \end{array} \] 로 표현할 수 있습니다.
\(Y^{L}\)의 1차 및 2차 적률에 대해 제시된 공식은 일반적인 공식입니다. 완전 보장에서는 \(\alpha = 1\), \(r = 0\), \(u = \infty\), \(d = 0\)이며 \(\mathrm{E}\left( Y^{L} \right)\)는 \(\mathrm{E}\left( X \right)\)으로 단순화됩니다. 일반 공제액만 적용되는 경우 \(\alpha = 1\), \(r = 0\), \(u = \infty\)이며 \(\mathrm{E}\left( Y^{L} \right)\)은 \(\mathrm{E}\left( X \right) - \mathrm{E}\left( X \land d \right)\)로 단순화됩니다. 보상한도만 적용되는 경우 \(\alpha = 1\), \(r = 0\), \(d = 0\)이며 \(\mathrm{E}\left( Y^{L} \right)\)는 \(\mathrm{E}\left( X \land u \right)\)로 단순화됩니다.
예제 5.1.5. 계리사 시험 문제. 2006년 건강보험 보험계약의 전체 손실 확률변수는 평균이 1000인 지수분포를 따르는 확률변수 \(X\)로 모형화됩니다. 한 보험계약은 일반 공제액 100을 초과하는 손실을 지급하며, 연간 최대 지급액은 500입니다. 기초 손실 확률변수는 2007년에 5% 더 커질 것으로 예상되지만, 2007년 보험은 2006년과 동일한 공제액과 최대 지급액을 가집니다. 2006년에서 2007년까지 지급 건당 기대 비용의 증가율을 구하십시오.
예제 풀이 보기
5.1.4 재보험
5.1.1절에서는 보험계약의 공제액 특성을 소개했습니다. 이 특성에서는 피보험자가 보험료를 대가로 보험자로부터 보장을 확보함으로써 위험의 일부를 이전하는 계약상의 약정이 존재합니다. 그 보험 하에서 피보험자는 공제액까지의 모든 손실을 부담해야 하며, 보험자는 공제액을 초과하는 금액(있는 경우)만을 지급합니다. 이제 보험회사를 위한 보험 메커니즘인 재보험(reinsurance) 원보험자가 자신의 손실 및/또는 손해 사정 비용의 일부를 보장해 줄 재보험자로부터 보험을 구입하는 거래을 소개합니다. 재보험은 보험자가 재보험료를 대가로 다른 보험자(재보험자라고 함)로부터 보장을 확보함으로써 기초가 되는 피보험 위험의 일부를 이전하는 계약상의 약정입니다. 재보험은 원 피보험자, 보험자(흔히 출재사(cedent) 재보험자에게 위험을 전가하는 당사자 또는 cedant라고 함), 재보험자라는 세 당사자 간의 관계를 수반하지만, 재보험 계약의 당사자는 원보험자와 재보험자뿐입니다. 원 피보험자와 재보험자 사이에는 아무런 계약상의 합의가 없습니다. 재보험 계약에는 여러 가지 유형이 있지만, 일반적인 형태는 초과손해액 보장(excess of loss coverage) 보험자가 지정된 금액까지의 모든 청구를 지급하고, 명시된 재보험 공제액을 초과하는 청구는 재보험자가 지급하는 계약입니다. 이러한 계약에서 원보험자는 원보험자의 총지급액이 정해진 재보험 공제액에 도달할 때까지 피보험자에게 필요한 모든 지급을 해야 합니다. 그 후 재보험자는 재보험 공제액을 초과하는 손실의 지급에 대해서만 책임을 집니다. 재보험 계약에서 원보험자가 보유하는 최대 금액(재보험 공제액)을 보유액(retention) 재보험 계약에서 원보험자가 지급하는 최대 금액이라고 합니다.
재보험 약정은 재무 자원이 제한된 보험자가 잠재적 손실의 영향을 줄이고 보험회사를 대재해 손실로부터 보호하면서, 보험 인수 능력을 늘리고 더 큰 보험 보장에 대한 고객의 요청을 충족할 수 있게 해 줍니다. 재보험은 또한 원보험자가 대형 재보험회사의 언더라이팅 기술, 전문성, 그리고 복잡한 청구 파일의 능숙한 처리 역량으로부터 혜택을 얻을 수 있게 해 줍니다.
예제 5.1.6. 계리사 시험 문제. 어떤 포트폴리오에서 발생하는 손실은 \(\alpha=5\)와 \(\theta=3,600\)인 2모수 파레토 분포를 따릅니다. 재보험 약정이 체결되었으며, 이에 따라 (a) 재보험자는 \(u=5,000\)까지의 손실의 15%와 5,000을 초과하는 모든 금액을 인수하고 (b) 보험자는 나머지 손실을 지급합니다.
- 재보험자와 보험자의 지급액에 대한 확률변수를 포트폴리오 손실인 \(X\)의 함수로 나타내십시오. b) 보험자가 단일 청구에 대해 지급하는 평균 금액을 계산하십시오. c) 상한이 \(u = \infty\)이라고 가정하여, 보험자가 단일 청구에 대해 지급하는 금액의 표준편차에 대한 상계를 계산하십시오(15% 공동부담은 유지합니다).
예제 풀이 보기
재보험에 대한 추가 논의는 13.4절에서 다룹니다.
Show Quiz Solution
5.2 수정된 데이터를 이용한 모수적 추정
이 절에서는 다음을 학습합니다.
- 그룹화된 데이터, 중도절단 데이터, 절단 데이터를 설명하십시오
- 그룹화된 데이터, 중도절단 데이터, 절단 데이터를 바탕으로 모수적 분포를 추정하십시오
기본 이론과 많은 응용은 4장에서 살펴본 바와 같이 “완전하고” “수정되지 않은” 개별 관측값에 기반합니다. 5.1.1절에서는 두 가지 흔한 제약, 즉 중도절단과 절단으로 인해 “수정된” 관측값의 개념을 소개했습니다. 예를 들어, 보험 공제액은 (왼쪽에서) 절단된 데이터를 만들어 내고, 보험 한도는 (오른쪽에서) 중도절단된 데이터를 만들어 낸다고 생각하는 것이 일반적입니다. 이 관점은 원보험자(보험을 판매하는 쪽)의 관점입니다. 또 다른 관점은 13장에서 더 자세히 다룰 재보험자(보험회사의 보험자)의 관점입니다. 재보험자는 일정 금액보다 작은 청구에 대해서는 청구가 존재한다는 사실만 알 뿐 그 금액은 관측하지 못할 수 있으며, 이는 왼쪽 중도절단의 한 예입니다. 따라서 이 절에서는 가능한 대안 전반을 모두 다룹니다. 구체적으로, 이 절에서는 개별적이고 완전하며 수정되지 않은 데이터에 대한 세 가지 대안, 즉 그룹 단위로만 얻을 수 있는 구간 중도절단 데이터, 제한되거나 중도절단된 데이터, 그리고 절단으로 인해 관측되지 않을 수 있는 데이터에 대한 모수적 추정 방법을 다룹니다.
5.2.1 그룹화된 데이터를 이용한 모수적 추정
분포 \(F(\cdot)\)에서 관측된 크기 \(n\)의 표본을 생각해 봅시다. 다만 그룹 단위로 관측되어, 각 관측값의 정확한 값은 알지 못하고 그 관측값이 속한 그룹만 압니다. 이를 그룹화된 데이터 또는 구간 중도절단 데이터라고 합니다. 예를 들어, 연속된 두 해의 연간 직원 기록을 살펴본다고 합시다. 첫해에는 고용되어 있었으나 둘째 해에는 고용되어 있지 않은 사람들은 그해 중 어느 시점에 퇴사한 것입니다. 정확한 퇴사일(개별 데이터)이 있다면 그들이 회사에 재직한 기간을 계산할 수 있습니다. 퇴사일이 없다면(그룹화된 데이터), 그들이 1년 길이의 구간 중 어느 시점에 퇴사했다는 사실만 알 수 있습니다.
이 아이디어를 공식화하여, 경계 \(c_0 < c_1< \cdots < c_k\)로 구분되는 \(k\)개의 그룹 또는 구간이 있다고 가정합시다. 각 관측값에 대해 우리는 정확한 값이 아니라 그 관측값이 속한 구간(예: \((c_{j-1}, c_j)\))만 관측합니다. 따라서 우리는 각 구간에 속한 관측값의 개수만 알 수 있습니다. 상수 \(\{c_0 < c_1 < \cdots < c_k\}\)는 \(F(\cdot)\)의 정의역에 대한 하나의 분할을 이룹니다. 그러면 관측값 \(X_i\)가 \(j\)번째 구간에 속할 확률은 다음과 같습니다. \[\Pr\left(X _i \in (c_{j-1}, c_j]\right) = F(c_j) - F(c_{j-1}).\]
관측값 하나에 대응하는 확률질량함수는 \[ \begin{aligned} f(x) &= \begin{cases} F(c_1) - F(c_{0}) & \text{if }\ x \in (c_{0}, c_1]\\ \vdots & \vdots \\ F(c_k) - F(c_{k-1}) & \text{if }\ x \in (c_{k-1}, c_k]\\ \end{cases} \\ &= \prod_{j=1}^k \left\{F(c_j) - F(c_{j-1})\right\}^{I(x \in (c_{j-1}, c_j])} \end{aligned} \] 입니다. 이제 \(j\)번째 구간에 속하는 관측값의 개수를 \(n_j\)로 정의합니다(\((c_{j-1}, c_j]\)). 따라서 (모수 \(\theta\)에 대한) 가능도함수(likelihood function) 관측된 데이터가 주어졌을 때 모형 모수의 그럴듯함을 나타내는 함수.는 \[ \begin{aligned} L(\theta) = \prod_{j=1}^n f(x_i) = \prod_{j=1}^k \left\{F(c_j) - F(c_{j-1})\right\}^{n_j} \end{aligned} \] 이고, 로그가능도함수는 \[ \begin{aligned} l(\theta) = \log L(\theta) = \log \prod_{j=1}^n f(x_i) = \sum_{j=1}^k n_j \log \left\{F(c_j) - F(c_{j-1})\right\} \end{aligned} \] 입니다. 그러면 가능도함수를 최대화하면(또는 동등하게 로그가능도함수를 최대화하면) 그룹화된 데이터에 대한 최대가능도 추정값을 얻습니다.
예제 5.2.1. 계리사 시험 문제. 다음이 주어져 있습니다.
- 손실은 평균이 \(\theta\)인 지수분포를 따릅니다. (ii) 손실 20건으로 이루어진 확률표본은 다음과 같이 분포합니다. \[ {\small \begin{array}{l|c} \hline \text{Loss Range} & \text{Frequency} \\ \hline [0,1000] & 7 \\ (1000,2000] & 6 \\ (2000,\infty) & 7 \\ \hline \end{array} } \] \(\theta\)의 최대가능도 추정값을 계산하십시오.
예제 풀이 보기
5.2.2 중도절단된 데이터
중도절단은 관측값의 제한된 값만을 기록할 때 발생합니다. 가장 흔한 형태는 우측 중도절단으로, 이 경우 “참” 종속변수와 중도절단 값 중 더 작은 값을 기록합니다. 기호로 나타내면, \(X\)가 보험사고로 인한 손실이나 사건 발생까지의 시간과 같은 관심 결과를 나타낸다고 합시다. \(C_U\)는 중도절단 금액을 나타낸다고 합시다. 오른쪽 중도절단 관측값의 경우 \(X_U^{\ast}= \min(X, C_U) = X \wedge C_U\)을 기록합니다. 또한 중도절단이 발생했는지 여부도 기록합니다. \(\delta_U= I(X \le C_U)\)를 중도절단이 발생하면 0, 발생하지 않으면 1인 이진 변수라고 합시다. 즉, \(\delta_U\)는 \(X\)가 중도절단되지 않았는지 여부를 나타냅니다.
5.1.2절에서 본 예에서 \(C_U\)은 보험계약 보장의 상한을 나타낼 수 있습니다(해당 절에서는 상한으로 \(u\)를 사용했습니다). 손실이 금액 \(C_U\)를 초과할 수 있지만, 보험자는 지급액으로 \(C_U\)만을 기록하고 있을 뿐 실제 손실 \(X\)의 금액은 기록하고 있지 않습니다.
마찬가지로 좌측 중도절단의 경우, 관심 변수와 중도절단 변수 중 더 큰 값을 기록합니다. 중도절단 금액을 \(C_L\)로 나타낸다면, 중도절단 지시변수 \(\delta_L= I(X > C_L)\)와 함께 \(X_L^{\ast}= \max(X, C_L)\)를 기록합니다.
예로서, 5.1.4절에서 재보험(보험자를 위한 보험)을 간략히 소개했으며, 더 자세한 내용은 13장에서 다룹니다. 재보험자가 \(C_L\)보다 큰 보험자 손실을 보상한다고 가정합시다. 이는 재보험자가 \(C_L\)를 초과하는 \(X_L^{\ast}\)의 초과분을 책임진다는 의미입니다. 기호로 나타내면, 재보험자의 손실은 \(Y = X_L^{\ast} - C_L\)입니다. 이를 확인하기 위해 먼저 보험계약자의 손실이 \(X < C_L\)인 경우를 생각해 봅시다. 이 경우 보험자가 청구액 전체를 지급하며 \(Y =C_L- C_L=0\)이므로 재보험자에게는 손실이 없습니다. 반대로 손실이 \(X \ge C_L\)이면, \(Y = X-C_L\)는 재보험자의 보유 청구액을 나타냅니다. 달리 말하면, 손실이 발생했을 때 재보험자는 그 손실이 한도 \(C_L\)를 초과하면 실제 금액을 기록하고, 그렇지 않으면 \(0\)의 손실이 있었다는 사실만을 기록합니다.
5.2.3 절단 데이터
중도절단된 관측값은 제한된 형태이기는 하지만 연구를 위해 기록됩니다. 이와 달리 절단된 결과는 결측 자료의 한 유형입니다. 관측값을 얻을 수 있는지 여부가 결과에 따라 달라질 때 그 결과는 절단될 가능성이 있습니다.
보험에서는 금액이 \[ \begin{aligned} Y &= \left\{ \begin{array}{cl} \text{we do not observe }X & X \le C_L \\ X & X > C_L \end{array} \right. \end{aligned} . \] 일 때 관측값이 \(C_L\)에서 왼쪽 절단되는 경우가 흔합니다. 다시 말해, \(X\)가 임계값 \(C_L\)보다 작으면 관측되지 않습니다.
5.1.1절에서 본 예에서 \(C_L\)는 보험계약의 공제액을 나타낼 수 있습니다(해당 절에서는 공제액으로 \(d\)를 사용했습니다). 보험 손실이 공제액보다 작으면 보험자는 그 손실을 전혀 관측하거나 기록하지 않을 수 있습니다. 손실이 공제액을 초과하면 초과분 \(X-C_L\)가 보험자가 보상하는 청구액입니다. 5.1.1절에서는 지급 건당 손실을 \[ Y^{P} = \left\{ \begin{matrix} \text{Undefined} & X \le d \\ X - d & X > d \end{matrix} \right. , \] 로 정의하여, 손실이 공제액을 초과하면 초과 금액 \(X-d\)를 기록하도록 했습니다. 이는 보험자가 지급할 금액을 고려할 때 매우 중요합니다. 그러나 이 절의 추정 목적에서는 \(C_L=d\)와 같은 알려진 상수를 빼는지 여부가 거의 중요하지 않습니다. 따라서 절단 변수 \(Y\)에 대해서는 더 간단한 관례를 따라 \(d\)를 빼지 않습니다.
마찬가지로 우측 절단 자료의 경우, \(X\)가 임계값 \(C_U\)를 초과하면 관측되지 않습니다. 이 경우 금액은 다음과 같습니다. \[ \begin{aligned} Y &= \left\{ \begin{array}{cl} X & X \le C_U \\ \text{we do not observe }X & X > C_U. \end{array} \right. \end{aligned} \]
오른쪽 절단의 고전적인 예로는 별까지의 거리를 나타내는 척도인 \(X\)가 있습니다. 거리가 일정 수준 \(C_U\)를 넘으면 그 별은 더 이상 관측할 수 없습니다.
그림 5.1은 절단된 관측값과 중도절단된 관측값을 비교합니다.
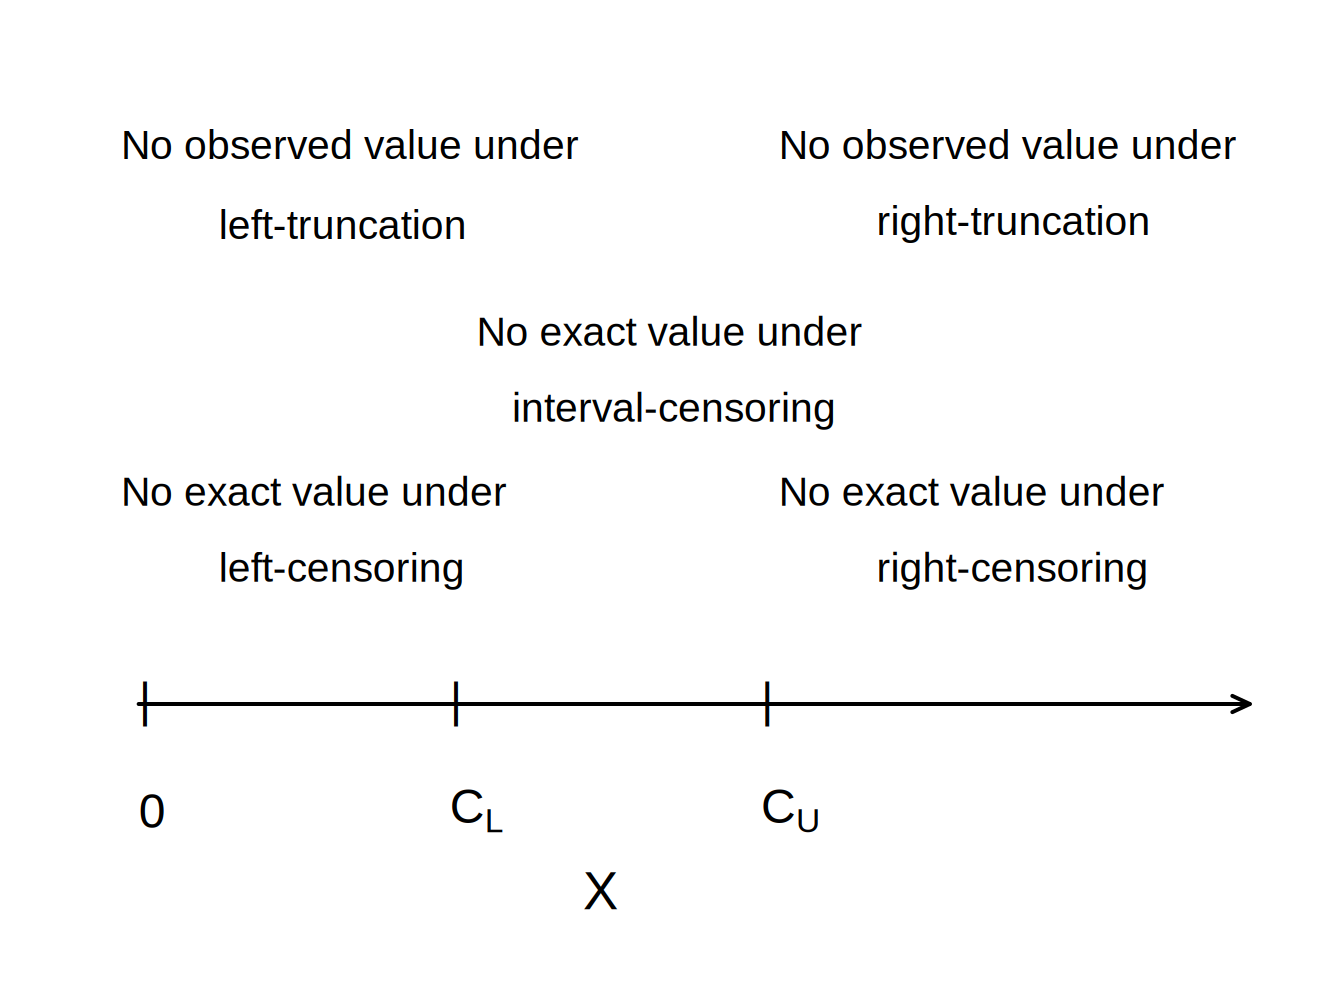
그림 5.1: 중도절단과 절단
사망률 연구 예제 보기
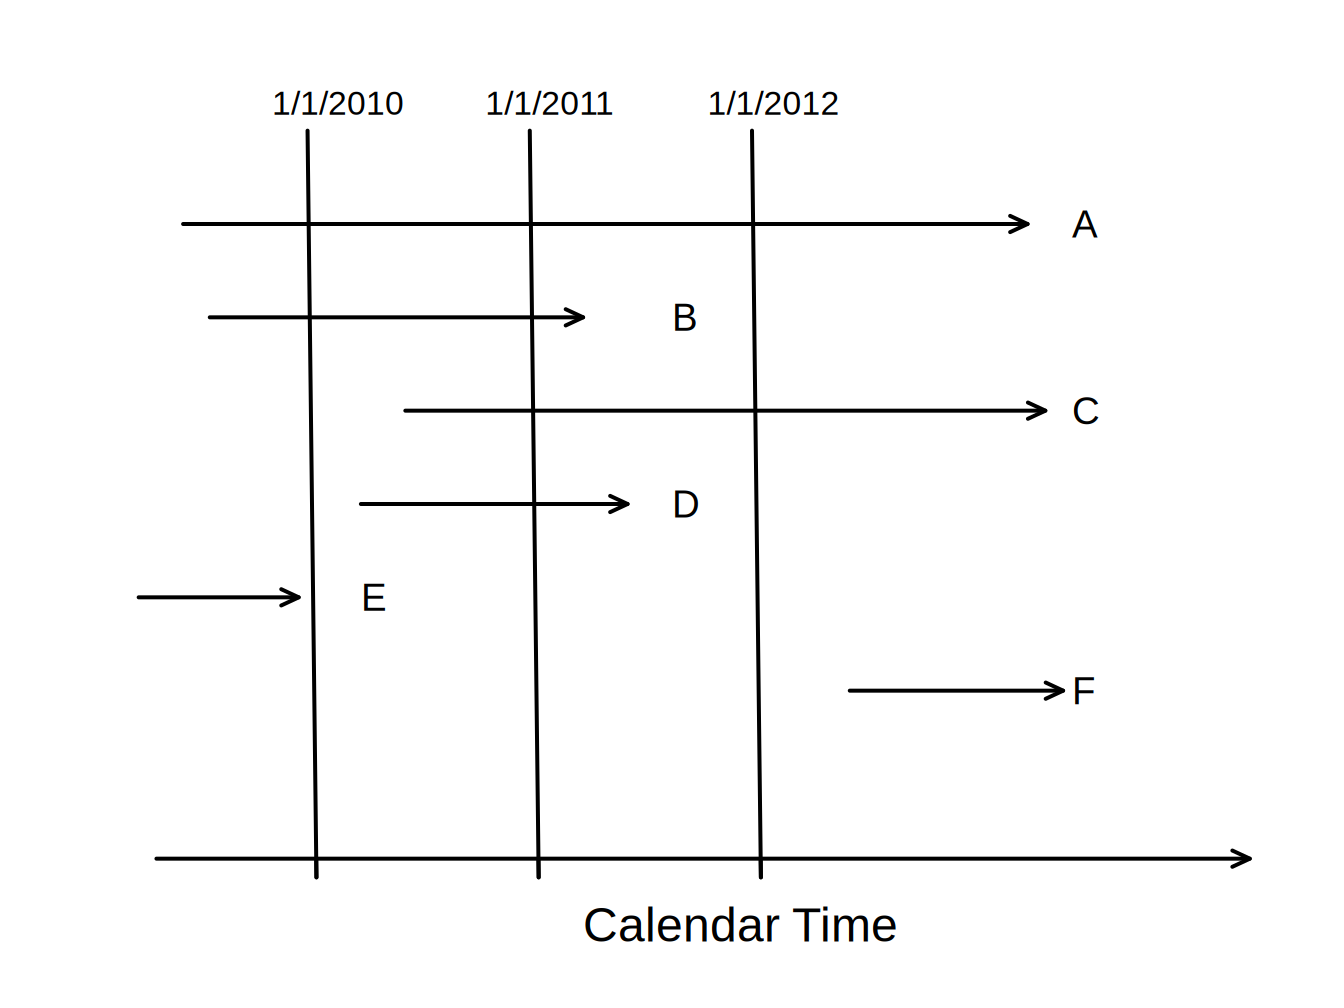
요약하면, 결과 \(X\)와 상수 \(C_L\), \(C_U\)에 대해 다음과 같습니다.
| Limitation Type | Limited Variable | Recording Information |
|---|---|---|
| 오른쪽 중도절단 | \(X_U^{\ast}= \min(X, C_U)\) | \(\delta_U= I(X \le C_U)\) 왼쪽 중도절단 \(X_L^{\ast}= \max(X, C_L)\) \(\delta_L= I(X > C_L)\) 구간 중도절단 |
| 오른쪽 절단 | \(X\) | \(X \le C_U\)이면 \(X\)를 관측 왼쪽 절단 \(X\) \(X > C_L\)이면 \(X\)를 관측 |
5.2.4 중도절단 데이터와 절단 데이터를 이용한 모수적 추정
단순화를 위해 중도절단 양은 확률적이지 않으며 결과 \(X\)는 연속형이라고 가정합니다. 먼저 \(X_U^{\ast}= \min(X, C_U)\)와 중도절단 지시변수 \(\delta= I(X \le C_U)\)를 기록하는 오른쪽 중도절단 데이터의 경우를 생각해 봅시다. 중도절단이 발생하여 \(\delta=0\)이면 \(X > C_U\)이고 가능도는 \(\Pr(X > C_U) = 1-F(C_U)\)입니다. 중도절단이 발생하지 않아 \(\delta=1\)이면 \(X \le C_U\)이고 가능도는 \(f(x)\)입니다. 요약하면 단일 관측값의 가능도는 \[ \begin{aligned} \left\{ \begin{array}{ll} 1-F(C_U) & \text{if }\delta=0 \\ f(x) & \text{if } \delta = 1 \end{array} \right. = \left\{ f(x)\right\}^{\delta} \left\{1-F(C_U)\right\}^{1-\delta} . \end{aligned} \] 입니다. 우변의 식을 사용하면 가능도를 더 간결하게 나타낼 수 있습니다. 이제 크기가 \(n\)인 iid 표본에 대해, 잠재적 중도절단 시점이 \(\{ C_{U1}, \ldots,C_{Un} \}\)일 때 가능도는 \[ L(\theta) = \prod_{i=1}^n \left\{ f(x_i)\right\}^{\delta_i} \left\{1-F(C_{Ui})\right\}^{1-\delta_i} = \prod_{\delta_i=1} f(x_i) \prod_{\delta_i=0} \{1-F(C_{Ui})\}, \] 입니다. 여기서 “\(\prod_{\delta_i=1}\)” 표기는 중도절단되지 않은 관측값들에 대해 곱을 취한다는 뜻이며, “\(\prod_{\delta_i=0}\)”도 마찬가지입니다.
한편, 절단 데이터는 가능도 추론에서 조건부 확률을 통해 다룹니다. 구체적으로, 변수가 관측될 확률로 나누어 가능도 기여분을 조정합니다. 요약하면, 여섯 가지 유형의 결과에 대해 가능도함수에 대한 기여분은 다음과 같습니다.
\[
{\small
\begin{array}{lc}
\hline
\text{Outcome} & \text{Likelihood Contribution} \\
\hline
\text{exact value} & f(x) \\
\text{right-censoring} & 1-F(C_U) \\
\text{left-censoring} & F(C_L) \\
\text{right-truncation} & f(x)/F(C_U) \\
\text{left-truncation} & f(x)/(1-F(C_L)) \\
\text{interval-censoring} & F(C_U)-F(C_L) \\
\hline
\end{array}
}
\]
알려진 결과와 중도절단 데이터에 대해 가능도는
\[
L(\theta) = \prod_{E} f(x_i) \prod_{R} \{1-F(C_{Ui})\} \prod_{L}
F(C_{Li}) \prod_{I} (F(C_{Ui})-F(C_{Li})),
\]
이며, 여기서 “\(\prod_{E}\)”는 정확한 값(Exact)을 갖는 관측값들에 대한 곱이고, 우측(\(R\)ight) 중도절단, 좌측(\(L\)eft) 중도절단
및 구간(\(I\)nterval) 중도절단에 대해서도 마찬가지입니다.
오른쪽 중도절단 및 왼쪽 절단 데이터의 경우 가능도는 \[ L(\theta) = \prod_{E} \frac{f(x_i)}{1-F(C_{Li})} \prod_{R} \frac{1-F(C_{Ui})}{1-F(C_{Li})}, \] 이며, 다른 조합에 대해서도 마찬가지입니다. 더 깊이 이해하기 위해 다음을 살펴보십시오.
특수한 경우 보기 - 지수분포
예제 5.2.2. 계리사 시험 문제. 다음이 주어져 있습니다.
- 손실 표본은 600 700 900입니다. (ii) 500 이하의 손실에 대해서는 아무런 정보가 없습니다. (iii) 손실은 평균이 \(\theta\)인 지수분포를 따른다고 가정합니다.
\(\theta\)의 최대가능도 추정값을 계산하십시오.
예제 풀이 보기
예제 5.2.3. 계리사 시험 문제. 확률표본에 대해 다음 정보가 주어져 있습니다.
- 표본 크기는 5입니다. (ii) 표본은 \(\tau=2\)인 와이블 분포에서 추출되었습니다. (iii) 표본 관측값 중 두 개는 50을 초과하는 것으로 알려져 있으며, 나머지 세 관측값은 20, 30, 45입니다.
\(\theta\)의 최대가능도 추정값을 계산하십시오.
예제 풀이 보기
5.3 수정된 데이터를 이용한 비모수적 추정
이 절에서는 다음을 학습합니다.
- 오자이브를 이용하여 그룹화된 데이터의 분포함수를 추정합니다.
- 플러그인 원리를 이용하여 손실제거율의 비모수적 추정량을 구성합니다.
- 중도절단이 있을 때 분포함수를 추정하기 위해 카플란-마이어 곱한계 추정량과 넬슨-앨런 추정량을 적용합니다.
- 곱한계 추정량의 분산을 추정하기 위해 그린우드 공식을 적용합니다.
비모수적 추정량은 유용한 기준을 제공하므로, 그룹화된 데이터, 중도절단 데이터, 절단 데이터에 대한 추정 절차를 이해하는 것이 도움이 됩니다.
5.3.1 그룹화된 데이터
5.2.1절에서 보았듯이, 관측값은 그룹화될 수 있습니다(구간 중도절단이라고도 합니다). 즉, \(j=1, \ldots, k\)에 대해 \((c_{j-1}, c_j]\) 형태의 \(k\)개 구간 중 하나에 속한다는 사실만 관측한다는 의미입니다. 경계에서 경험분포함수는 통상적인 방식으로 정의됩니다. \[ F_n(c_j) = \frac{\text{number of observations } \le c_j}{n}. \]
오자이브 추정량. \(x \in (c_{j-1}, c_j)\)의 다른 값에 대해서는 오자이브 추정량(ogive estimator) 그룹화된 데이터가 있을 때 분포함수에 대한 비모수적 추정량.으로 분포함수를 추정할 수 있습니다. 이 추정량은 \(F_n(c_{j-1})\)과 \(F_n(c_j)\) 사이를 선형 보간합니다. 즉, 경계 \(F_n(c_{j-1})\)과 \(F_n(c_j)\)에서의 값을 직선으로 연결합니다. 이는 형식적으로 다음과 같이 나타낼 수 있습니다. \[F_n(x) = \frac{c_j-x}{c_j-c_{j-1}} F_n(c_{j-1}) + \frac{x-c_{j-1}}{c_j-c_{j-1}} F_n(c_j) \ \ \ \text{for } c_{j-1} \le x < c_j\]
이에 대응하는 밀도는 다음과 같습니다. \[ f_n(x) = F^{\prime}_n(x) = \frac{F_n(c_j)-F_n(c_{j-1})}{c_j - c_{j-1}} \ \ \ \text{for } c_{j-1} < x < c_j . \]
예제 5.3.1. 보험계리사 시험 문제. 100건의 청구에 대한 청구 규모에 관하여 다음 정보가 주어져 있습니다. \[ {\small \begin{array}{r|c} \hline \text{Claim Size} & \text{Number of Claims} \\ \hline 0 - 1,000 & 16 \\ 1,000 - 3,000 & 22 \\ 3,000 - 5,000 & 25 \\ 5,000 - 10,000 & 18 \\ 10,000 - 25,000 & 10 \\ 25,000 - 50,000 & 5 \\ 50,000 - 100,000 & 3 \\ \text{over } 100,000 & 1 \\ \hline \end{array} } \] 오자이브를 이용하여, 임의로 선택한 청구가 2000과 6000 사이에 있을 확률의 추정값을 계산하십시오.
예제 풀이 보기
5.3.2 플러그인 원리
어떤 양의 비모수적 추정량을 구성하는 한 가지 방법은 유추 원리 또는 플러그인 원리(plug-in principle) 추정의 플러그인 원리 또는 유추 원리는 모수가 모집단에서 갖는 것과 동일한 성질을 표본에서 갖는 표본 통계량으로 모집단 모수를 추정할 것을 제안합니다.를 사용하는 것으로, 이는 알려지지 않은 cdf(cdf) 누적분포함수 \(F\)을 경험 cdf \(F_n\)와 같은 알려진 추정값으로 대체하는 것입니다. 따라서 일반적인 함수 g에 대해 \(\mathrm{E}~[\mathrm{g}(X)]=\mathrm{E}_F~[\mathrm{g}(X)]\)을 추정하려는 경우, 비모수적 추정량을 \(\mathrm{E}_{F_n}~[\mathrm{g}(X)]=n^{-1}\sum_{i=1}^n \mathrm{g}(X_i)\)로 정의합니다.
이것이 어떻게 작동하는지 보기 위해, g의 특수한 경우로서 지급건당 손실 확률변수 \(Y = (X-d)_+\)과 4.4.1절에서 소개한 손실제거율을 고려합니다. 고정된 공제액 \(d\)에 대해 이를 \[ LER(d) = \frac{\mathrm{E~}[X - (X-d)_+]}{\mathrm{E~}[X]} =\frac{\mathrm{E~}[\min(X,d)]}{\mathrm{E~}[X]} , \] 로 나타낼 수 있습니다.
예제 5.3.2. 신체상해 청구와 손실제거율
Derrig, Ostaszewski, and Rempala (2001)의 보스턴 지역 종결된 자동차보험 청구 432건의 표본을 사용합니다. 손실은 자동차 사고로 인한 신체상해에 대한 지급액으로 기록됩니다. 손실에는 공제액이 적용되지 않지만, 데이터에 함께 수록된 다양한 최대 보장 금액에 의해 제한됩니다. 432건 중 17건(\(\approx\) 4%)만이 이러한 보험 한도의 적용을 받은 것으로 나타났으므로, 이 예시에서는 이 데이터를 무시합니다.
평균 지급 손실액은 미국 달러로 6906입니다. 그림 5.3은 분포의 다른 측면을 보여 줍니다. 구체적으로, 왼쪽 패널은 경험분포함수를 보여 주고, 오른쪽 패널은 비모수적 밀도 그림을 제시합니다.
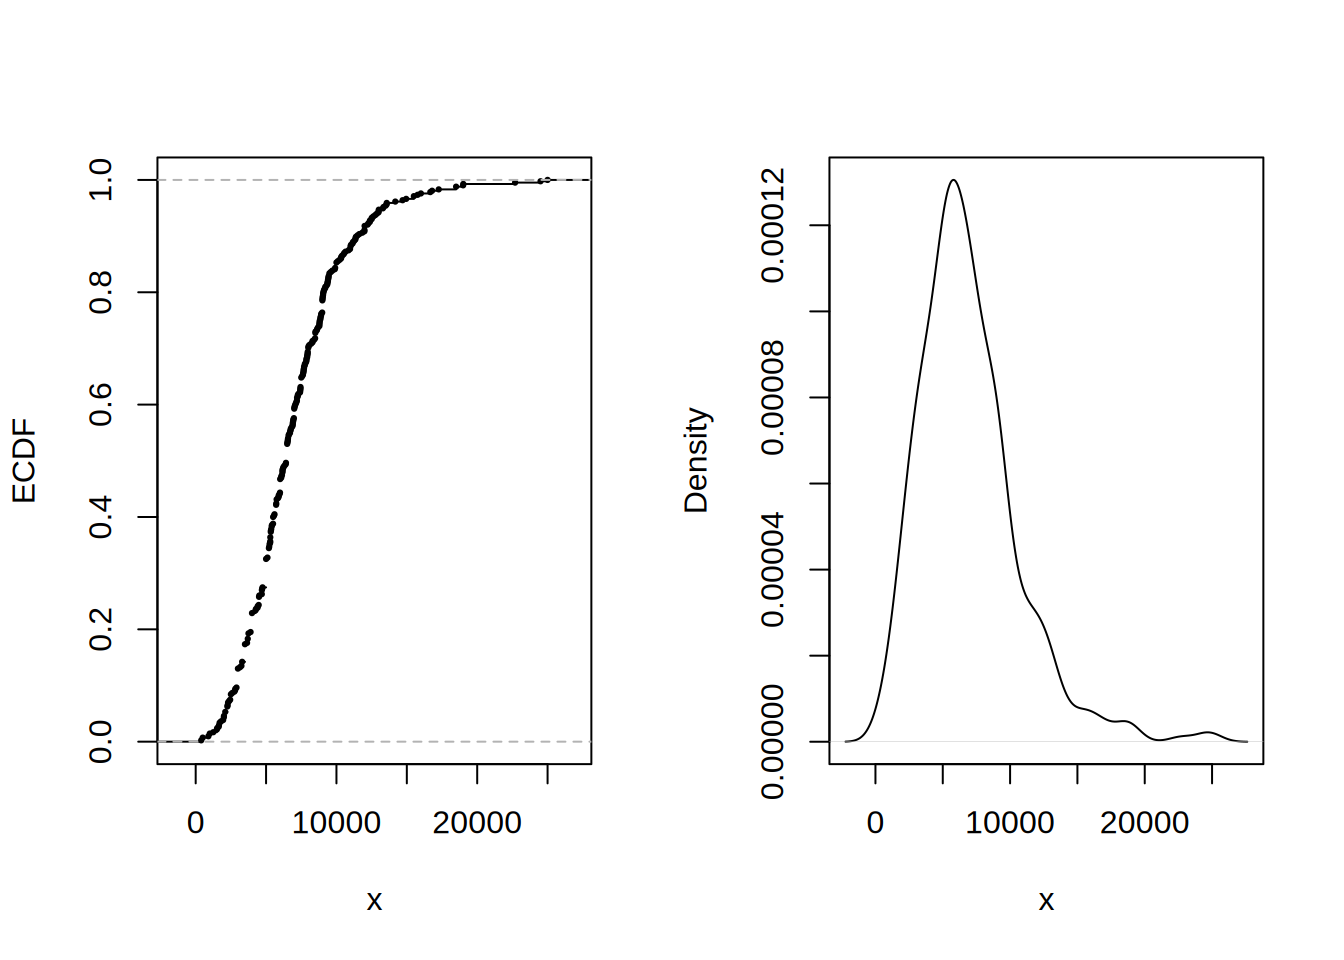
그림 5.3: 신체상해 청구. 왼쪽 패널은 경험분포함수를 보여 줍니다. 오른쪽 패널은 비모수적 밀도 그림을 제시합니다.
신체상해 손실의 영향은 한도를 부과하거나 재보험 계약을 구매함으로써 완화할 수 있습니다(10.3절 참조). 이러한 위험 완화 수단의 영향을 정량화하기 위해, 4.4.1절에서 소개한 손실제거율(LER)을 계산하는 것이 일반적입니다. 분포함수는 알려져 있지 않으므로 어떤 방식으로든 추정해야 합니다. 플러그인 원리를 이용하면 비모수적 추정량을 다음과 같이 정의할 수 있습니다. \[ LER_n(d) = \frac{n^{-1} \sum_{i=1}^n \min(X_i,d)}{n^{-1} \sum_{i=1}^n X_i} = \frac{\sum_{i=1}^n \min(X_i,d)}{\sum_{i=1}^n X_i} . \]
그림 5.4는 다양한 \(d\) 값에 대한 추정량 \(LER_n(d)\)을 보여 줍니다. 예를 들어 \(d=1,000\)에서 \(LER_n(1000) \approx\) 0.1442입니다. 따라서 한도를 1,000으로 부과하면 기대 보유 청구액이 공제액이 0일 때의 기대 청구액에 비해 14.42퍼센트 낮아집니다.
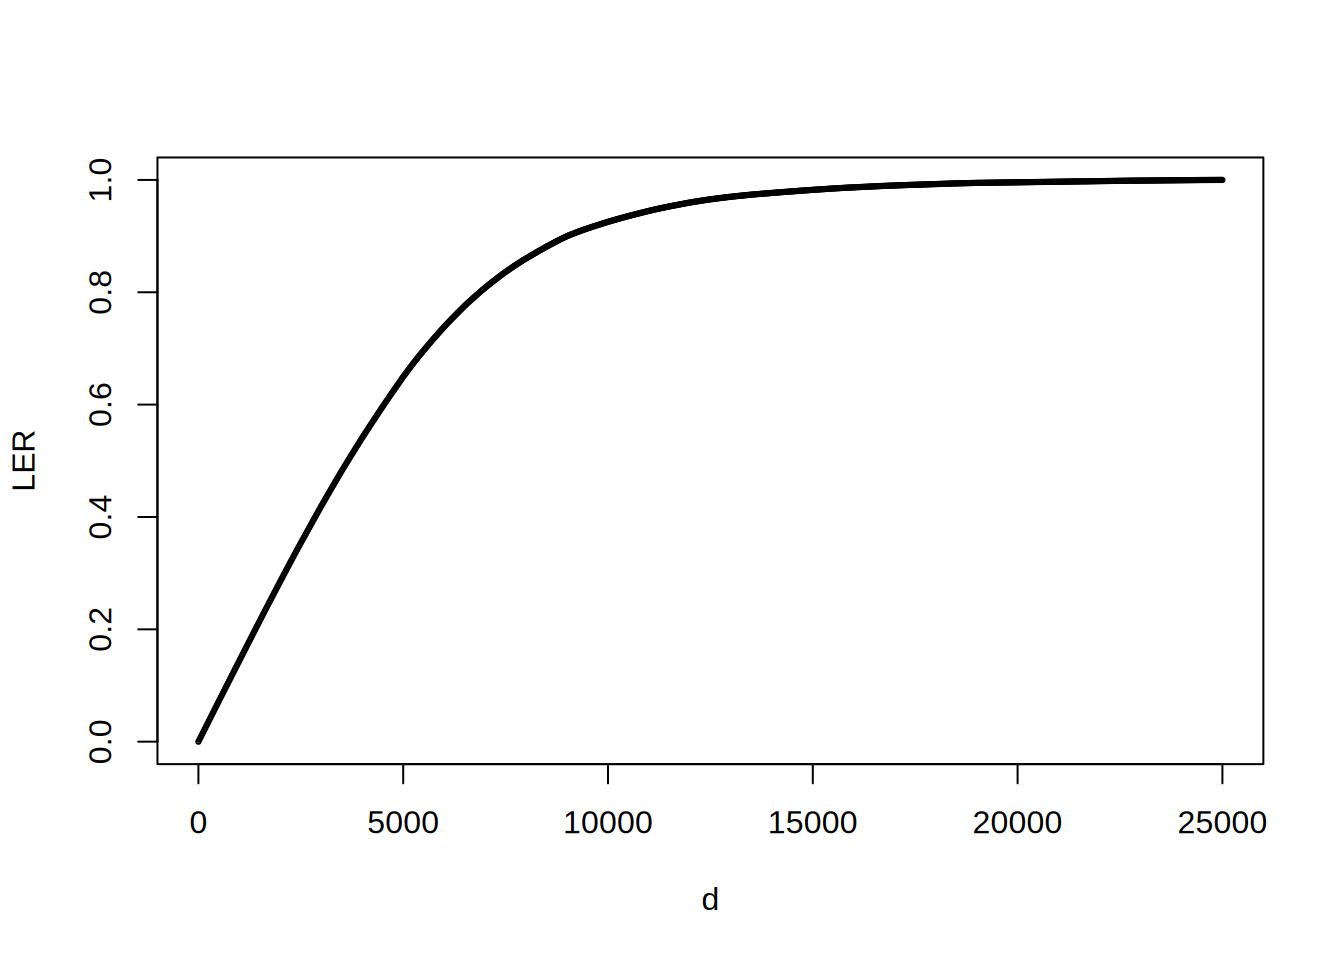
그림 5.4: 신체상해 청구에 대한 LER. 이 그림은 손실제거율(LER)을 공제액 \(d\)의 함수로 나타냅니다.
5.3.3 오른쪽 중도절단 경험분포함수
분포의 모수적 형태에 의존하지 않는 비모수적 방법으로 모수 추정량을 보정하는 것이 유용할 수 있습니다. (Kaplan and Meier 1958)에 의한 곱한계 추정량(product-limit estimator) 불완전한 데이터가 있을 때 생존함수에 대한 비모수적 추정량으로, 카플란-마이어 추정량이라고도 합니다.은 중도절단이 있는 경우의 분포함수 추정량으로 잘 알려져 있습니다.
카플란-마이어 곱한계 추정량의 동기. 곱한계 추정량이 중도절단된 관측값에 대해 왜 그토록 잘 작동하는지 설명하기 위해, 먼저 중도절단이 없는 “일반적인” 경우로 돌아가 봅시다. 이 경우 경험분포함수 \(F_n(x)\)는 분포함수 \(F(x)\)의 불편 추정량입니다. 이는 \(F_n(x)\)이 각각 불편인 지시변수들의 평균이기 때문입니다. 즉, \(\mathrm{E~} [I(X_i \le x)] = \Pr(X_i \le x) = F(x)\)입니다.
이제 확률적 결과가 어떤 한계값, 예컨대 \(C_U\)에 의해 우측 중도절단되어 둘 중 작은 값인 \(X^* = \min(X, C_U)\)을 기록한다고 가정합시다. \(C_U\)보다 작은 \(x\) 값에 대해서는, 중도절단 한계에 도달하기 전까지 지시변수가 여전히 분포함수의 불편추정량을 제공합니다. 즉, \(x < C_U\)에 대해 \(I(X^* \le x) = I(X \le x)\)이므로 \(\mathrm{E~} [I(X^* \le x)] = F(x)\)입니다. 같은 방식으로 \(\mathrm{E~} [I(X^* > x)] = 1 -F(x) = S(x)\)입니다. 그러나 \(x>C_U\)에 대해서는 \(I(X^* \le x)\)이 일반적으로 \(F(x)\)의 불편추정량이 아닙니다.
대안으로, 서로 다른 중도절단 한계를 갖는 두 개의 확률변수를 생각해 봅시다. 예시로, \(X_1^* = \min(X_1, 5)\)과 \(X_2^* = \min(X_2, 10)\)를 관측한다고 가정합시다. 여기서 \(X_1\)과 \(X_2\)는 같은 분포에서 독립적으로 추출된 값입니다. \(x \le 5\)에 대해서는 경험분포함수 \(F_2(x)\)이 \(F(x)\)의 불편추정량입니다. 그러나 \(5 < x \le 10\)에 대해서는 중도절단 제약 때문에 첫 번째 관측값을 분포함수에 사용할 수 없습니다. 대신 (Kaplan and Meier 1958)가 개발한 전략은 \(S_2(5)\)을 \(S(5)\)의 추정량으로 사용한 다음, 두 번째 관측값을 사용하여 시점 5까지 생존했다는 조건하의 생존함수 \(\Pr(X > x | X >5) = \frac{S(x)}{S(5)}\)를 추정하는 것입니다. 구체적으로, \(5 < x \le 10\)에 대해 생존함수의 추정량은 다음과 같습니다. \[ \hat{S}(x) = S_2(5) \times I(X_2^* > x ) . \]
카플란-마이어 곱한계 추정량. 이 아이디어를 확장하여, 각 관측값 \(i\)에 대해 \(u_i\)을 상한 중도절단 한계라고 합시다(중도절단이 없으면 \(=\infty\)). 따라서 기록되는 값은 중도절단이 없는 경우 \(x_i\)이고 중도절단이 있는 경우 \(u_i\)입니다. \(t_{1} <\cdots< t_{k}\)을 중도절단되지 않은 손실이 발생하는 \(k\)개의 서로 다른 점이라 하고, \(s_j\)를 \(t_{j}\)에서 중도절단되지 않은 손실 \(x_i\)의 개수라고 합시다. 이에 대응하는 위험집합(risk set) 특정 시점에서 활성 상태인(중도절단되지 않은) 관측값의 수.은 \(t_{j}\)보다 작은 값에서 활성 상태인(중도절단되지 않은) 관측값의 개수이며, \(R_j = \sum_{i=1}^n I(x_i \geq t_{j}) + \sum_{i=1}^n I(u_i \geq t_{j})\)로 나타냅니다.
이 표기법을 사용하면 분포함수의 곱한계 추정량은 \[\begin{equation} \hat{F}(x) = \left\{ \begin{array}{ll} 0 & x<t_{1} \\ 1-\prod_{j:t_{j} \le x}\left( 1-\frac{s_j}{R_{j}}\right) & x \geq t_{1} \end{array} \right. . \tag{5.2} \end{equation}\] 입니다. 예를 들어 \(x\)이 중도절단되지 않은 손실 중 가장 작은 값보다 작으면 \(x<t_1\)이고 \(\hat{F}(x) =0\)입니다. 또 다른 예로, \(x\)가 중도절단되지 않은 손실 중 두 번째와 세 번째로 작은 값 사이에 있으면 \(x \in (t_2,t_3]\)이고 \(\hat{F}(x) = 1 - \left(1- \frac{s_1}{R_{1}}\right)\left(1- \frac{s_2}{R_{2}}\right)\)입니다.
늘 그렇듯이, 이에 대응하는 생존함수의 추정값은 \(\hat{S}(x) = 1 - \hat{F}(x)\)입니다.
예제 5.3.3. 계리사 시험 문제. 다음은 10건의 지급액 표본입니다: \[ \begin{array}{cccccccccc} 4 &4 &5+ &5+ &5+ &8 &10+ &10+ &12 &15 \\ \end{array} \] 여기서 \(+\)는 손실이 보상한도를 초과했음을 나타냅니다.
카플란-마이어 곱한계 추정량을 사용하여 한 보험계약의 손실이 11을 초과할 확률 \(\hat{S}(11)\)를 계산하십시오.
예제 풀이 보기
예제 5.3.4. 신체상해 청구. 예제 5.1.11에서 소개한 Derrig, Ostaszewski, and Rempala (2001)의 보스턴 자동차 신체상해 청구 데이터를 다시 살펴봅니다. 그 예제에서는 보상한도에 의해 중도절단된 17건의 청구를 제외했습니다. 이제 전체 데이터셋을 포함하고 카플란-마이어 곱한계를 사용하여 생존함수를 추정합니다. 이는 그림 5.5에 나와 있습니다.
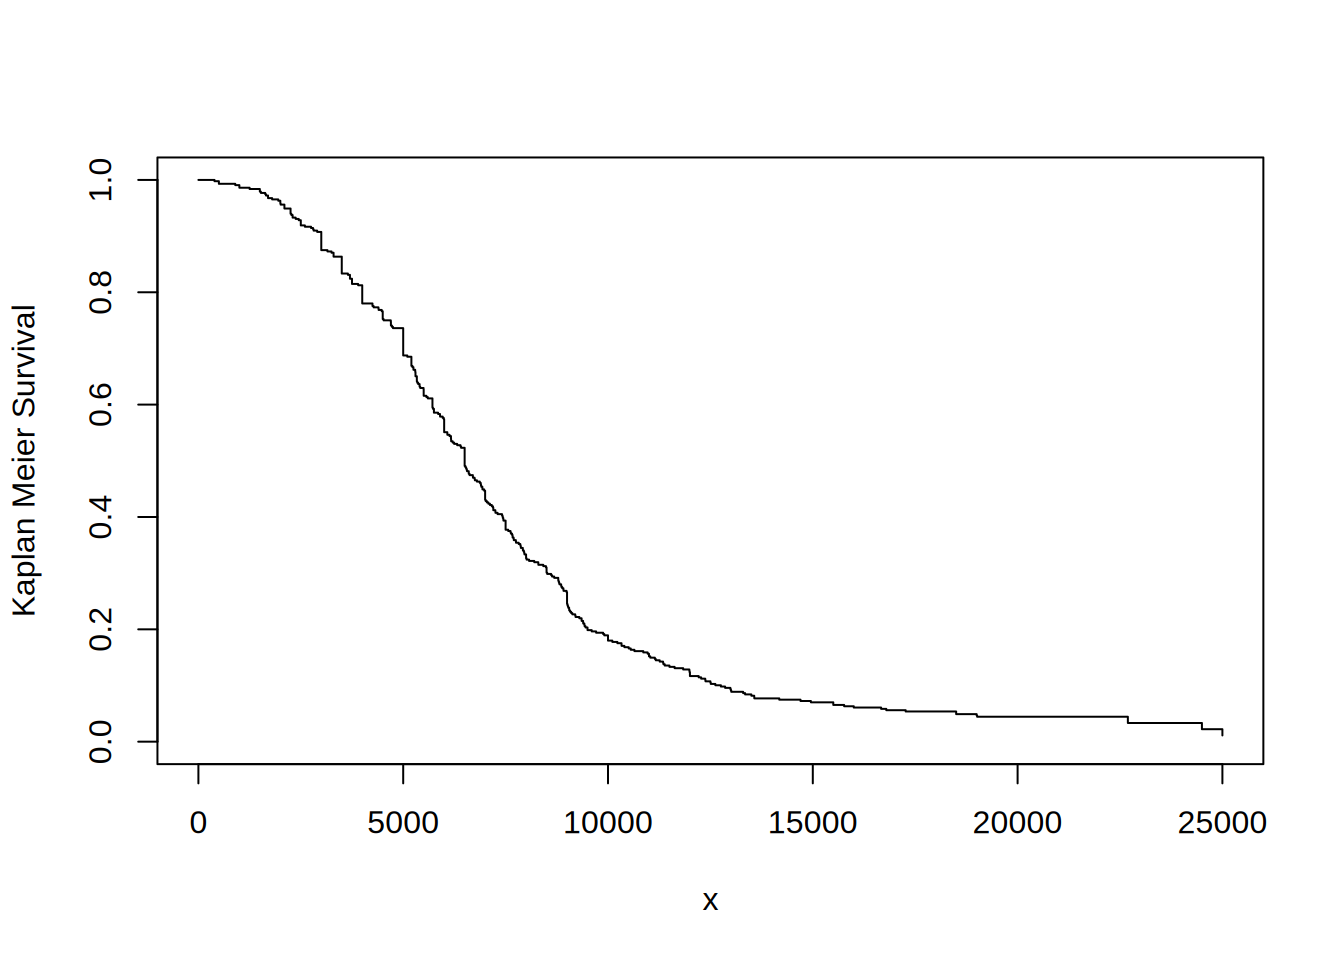
그림 5.5: 신체상해 청구에 대한 생존함수의 카플란-마이어 추정값
R 코드 보기
오른쪽 중도절단, 왼쪽 절단 경험분포함수. 이제 오른쪽 중도절단에 더하여 왼쪽 절단 데이터도 허용하도록 틀을 확장합니다. 앞에서와 마찬가지로 각 관측값 \(i\)에 대하여 \(u_i\)를 상한 중도절단 한계(중도절단이 없으면 \(=\infty\))라고 합시다. 또한 \(d_i\)를 하한 절단 한계(절단이 없으면 0)라고 합시다. 따라서 기록된 값은 (\(d_i\)보다 큰 경우) 중도절단이 없으면 \(x_i\)이고 중도절단이 있으면 \(u_i\)입니다. \(t_{1} <\cdots< t_{k}\)를 관심 사건이 발생하는 \(k\)개의 서로 다른 점이라 하고, \(s_j\)를 시점 \(t_{j}\)에서 기록된 사건 \(x_i\)의 수라고 합시다. 이에 대응하는 위험집합은 \[ R_j = \sum_{i=1}^n I(x_i \geq t_{j}) + \sum_{i=1}^n I(u_i \geq t_{j}) - \sum_{i=1}^n I(d_i \geq t_{j}). \] 입니다. 위험집합을 이렇게 새로 정의하면 분포함수의 곱한계 추정량은 식 (5.2)와 같습니다.
그린우드 공식. (Greenwood 1926)은 곱한계 추정량의 추정 분산 공식을
\[
\widehat{Var}(\hat{F}(x)) = (1-\hat{F}(x))^{2} \sum _{j:t_{j} \le x} \dfrac{s_j}{R_{j}(R_{j}-s_j)}.
\]
로 유도했습니다. 늘 그렇듯이 추정 분산의 제곱근을 표준오차라고 부르며, 이는 신뢰구간과 가설검정에서 일상적으로 사용되는 양입니다. 이를 계산하기 위해 R의 survfit 메서드는 생존 데이터 객체를 받아 생존함수의 카플란-마이어 추정값과 신뢰구간을 담은 새 객체를 생성합니다. 생존곡선의 추정값을 구성할 때는 기본적으로 카플란-마이어 방법(type='kaplan-meier')이 사용됩니다. 그 결과로 얻는 이산 생존함수는 관측된 사건 발생 시점(퇴원일) \(t_j\)에서 점질량을 가지며, 해당 기간까지 생존했다는 조건하에서 사건이 발생할 확률은 그 기간에 관측된 사건 수 \(s_j\)를 사건 발생 기간 직전에 노출된, 즉 ‘위험에 처한’ 대상자 수 \(R_j\)로 나눈 값으로 추정됩니다.
대안적 추정량. survfit 메서드에서는 두 가지 대안적 추정 방식도 사용할 수 있습니다. 대안 방식(type='fh2')은 본질적으로 같은 기간에 발생한 여러 사건이 임의의 순서로 발생한다고 가정하여 동점을 처리합니다. 또 다른 대안 방식(type='fleming-harrington')은 누적 위험률 함수의 넬슨-알렌(Nelson-Aalen) 불완전한 데이터가 있을 때 누적 위험률 함수에 대한 비모수적 추정량.((Aalen 1978) 참조) 추정값을 사용하여 생존함수의 추정값을 얻습니다. 누적 위험률 추정값 \(\hat{H}(x)\)는 0에서 시작하여, 관측된 각 사건 발생 기간 \(t_j\)마다 사건 수 \(s_j\)를 위험에 처한 수 \(R_j\)로 나눈 값만큼 증가합니다. 위와 같은 표기법을 사용하면 분포함수의 넬슨-알렌 추정량은
\[
\begin{aligned}
\hat{F}_{NA}(x) &=
\left\{
\begin{array}{ll}
0 & x<t_{1} \\
1- \exp \left(-\sum_{j:t_{j} \le x}\frac{s_j}{R_j} \right) & x \geq t_{1}
\end{array}
\right. .\end{aligned}
\]
입니다. 위 식은 누적 위험률 함수의 넬슨-알렌 추정량
\[
\hat{H}(x)=\sum_{j:t_j\le x} \frac{s_j}{R_j}
\]
와 생존함수와 누적 위험률 함수 사이의 관계 \(\hat{S}_{NA}(x)=e^{-\hat{H}(x)}\)에서 도출된 결과임에 유의하십시오.
예제 5.3.5. 계리사 시험 문제. 어떤 생존 연구의 관측값 \(i\)에 대하여:
- \(d_i\)는 좌측 절단점입니다
- \(x_i\)는 우측 중도절단되지 않은 경우의 관측값입니다
- \(u_i\)는 우측 중도절단된 경우의 관측값입니다
다음이 주어져 있습니다: \[ {\small \begin{array}{c|cccccccccc} \hline \text{Observation } (i) & 1 & 2 & 3 & 4 & 5 & 6 & 7 & 8 & 9 & 10\\ \hline d_i & 0 & 0 & 0 & 0 & 0 & 0 & 0 & 1.3 & 1.5 & 1.6\\ x_i & 0.9 & - & 1.5 & - & - & 1.7 & - & 2.1 & 2.1 & - \\ u_i & - & 1.2 & - & 1.5 & 1.6 & - & 1.7 & - & - & 2.3 \\ \hline \end{array} } \] 카플란-마이어 곱한계 추정값 \(\hat{S}(1.6)\)를 계산하십시오.
예제 풀이 보기
예제 5.3.6. 보험계리사 시험 문제 - 계속.
- 넬슨-알렌 추정량을 사용하여 보험증권의 손실이 11을 초과할 확률 \(\hat{S}_{NA}(11)\)을 계산하십시오. b) 곱한계 추정값 \(\hat{S}(11)\)의 분산에 대한 그린우드 근사를 계산하십시오.
예제 풀이 보기
Show Quiz Solution
5.4 추가 자료 및 기여자
기여자
- 카이로 아메리칸 대학교의 Zeinab Amin이 이 장의 주 저자입니다. 이 장에 대한 의견과 개선 제안은 zeinabha@aucegypt.edu로 이메일을 보내 주십시오.
- 위스콘신 대학교 매디슨의 Edward W. (Jed) Frees와 Lisa Gao는 이 책 초판의 4장에 실렸던, 수정된 데이터를 이용한 추정에 관한 절들의 주 저자입니다.
- 이 장의 검토자는 다음과 같습니다: Vytaras Brazauskas, Yvonne Chueh, Eren Dodd, Hirokazu (Iwahiro) Iwasawa, Joseph Kim, Andrew Kwon-Nakamura, Jiandong Ren, Di (Cindy) Xu.
추가 읽을거리 및 참고문헌
R 코딩을 더 연습하고 싶다면 자매 과정인 LDA 단기 과정을 방문하십시오. 특히 모형 선택 및 추정 장을 참고하십시오.