제16장 종속성의 정량화
장 미리보기. 의존성 모델링은 통계 모형을 사용하여 확률변수 사이의 의존 구조를 기술하며, 이를 통해 데이터셋에 있는 변수 사이의 관계를 이해할 수 있습니다. 이 장에서는 다변량 분포의 종속성 또는 연관성을 모델링하고 정량화하는 기법을 독자에게 소개합니다. 절 16.1에서는 변수 사이의 종속성을 모델링하기 위한 기본 측도를 자세히 설명합니다.
절 16.2에서는 코퓰라를 사용하여 종속성을 모델링하는 접근법을 소개하며, 절 16.3에서는 실제 예시를 통해 이를 보강합니다. 코퓰라 족의 유형과 코퓰라 함수의 기본 성질은 절 16.4에서 설명합니다. 이 장은 절 16.6에서 의존성 모델링 연구가 왜 중요한지를 설명하며 마무리합니다.
16.1 스칼라 연관성의 고전적 측도
이 절에서는 다음 방법을 배웁니다.
- 피어슨 방법을 사용하여 상관계수를 추정하는 방법
- 스피어만, 켄달과 같은 순위 기반 측도를 사용하여 상관계수를 추정하는 방법
- 꼬리 종속성을 측정하는 방법
이 장에서는 Frees and Valdez (1998)에서 소개되었고 현재 copula 패키지에서 바로 사용할 수 있는, 표본 크기가 (\(n = 1500\))인 보험 데이터셋의 처음 두 변수인 손실액과 비용을 살펴봅니다.
- \({\tt LOSS}\), 보험 서비스 오피스(Insurance Services Office, Inc., ISO)의 일반 배상책임 청구
- \({\tt ALAE}\), 개별 청구의 정산에 구체적으로 귀속되는 비용(예: 변호사 수임료, 청구 조사 비용)
우리는 \({\tt LOSS}\)의 분포가 \({\tt ALAE}\)의 분포에 종속되는지, 아니면 둘이 통계적으로 독립인지 알고자 합니다. 손실액과 비용 사이의 관계를 시각화하기 위해 그림 16.1의 산점도를 달러 척도와 로그 달러 척도로 작성하였습니다. 왼쪽 패널에서는 두 변수 사이에 어떤 관계가 있는지 알아보기 어렵습니다. 오른쪽 패널처럼 로그 척도로 보면 둘의 종속성이 더 뚜렷하게 드러납니다. 이 절에서는 변수 사이의 종속성을 모델링하기 위한 기본 측도를 자세히 설명합니다.
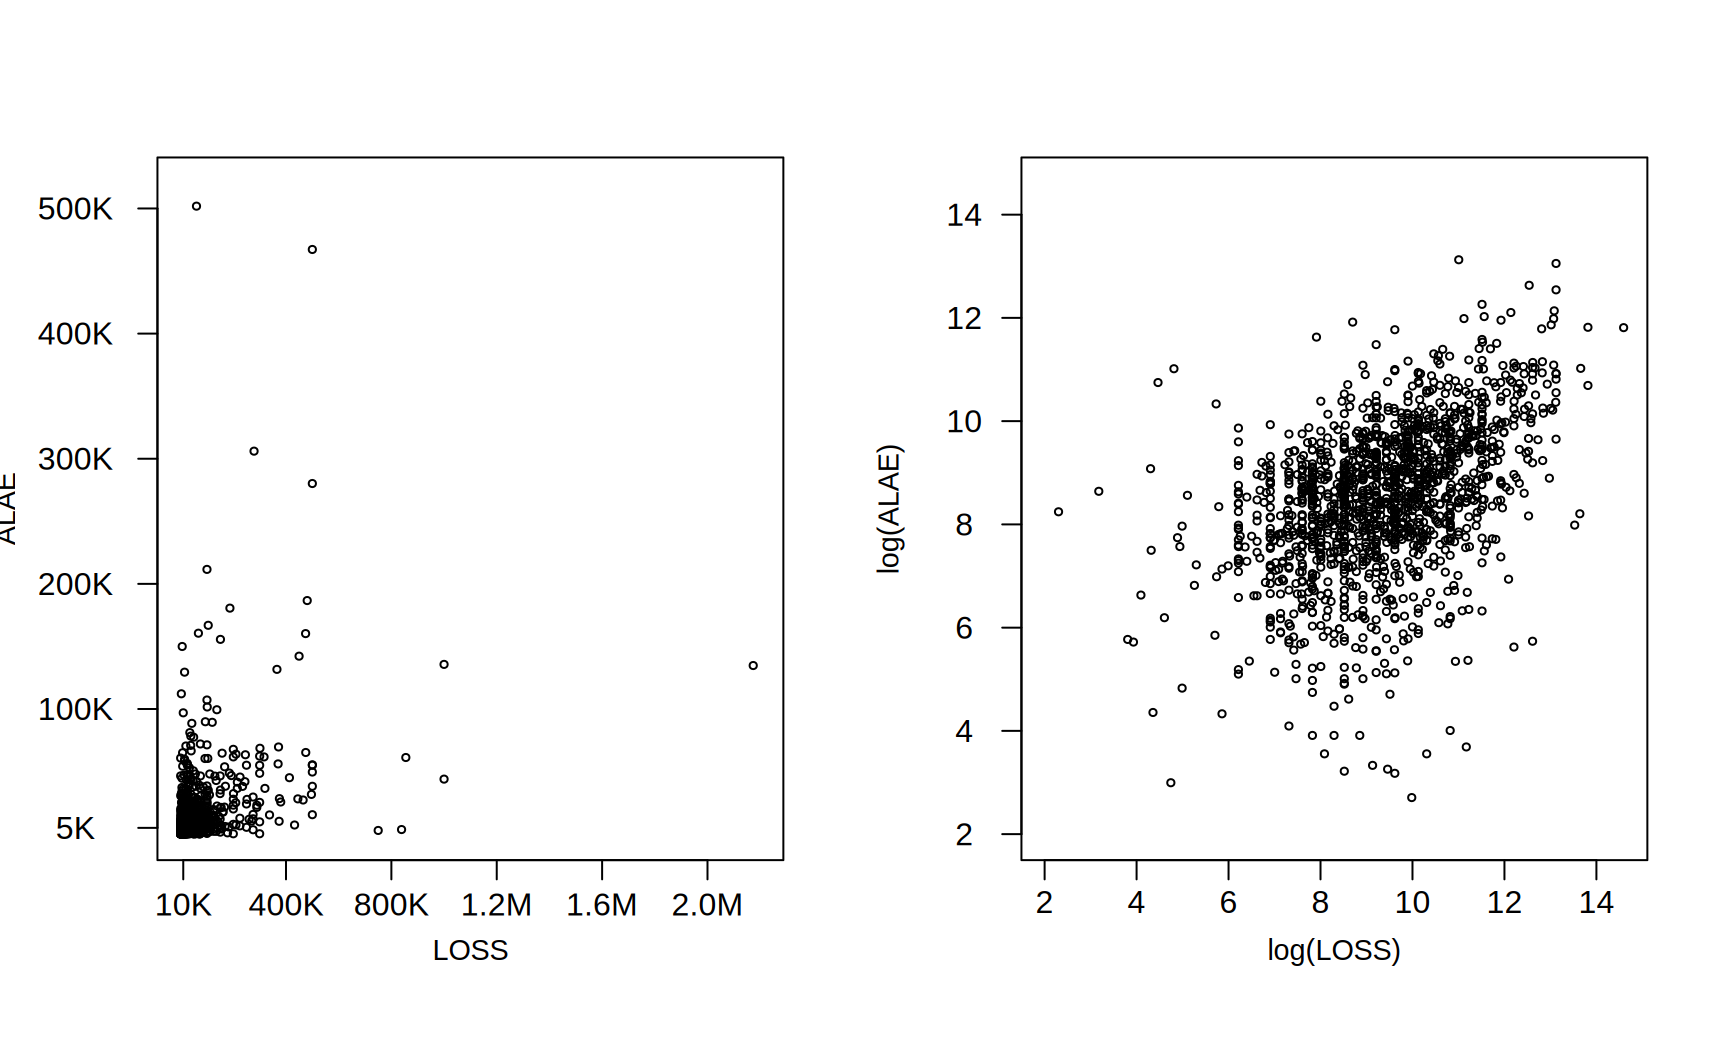
그림 16.1: LOSS와 ALAE의 산점도
손실액 대 비용 산점도를 위한 R 코드
16.1.1 양적 변수에 대한 연관성 측도
이 절에서는 결합분포함수 \(F(\cdot)\)를 갖는 확률변수 쌍 \((X,Y)\)와 확률표본 \((X_i,Y_i), i=1, \ldots, n\)을 고려합니다. 연속형의 경우, \(F(\cdot)\)이 주변 밀도함수를 갖는 절대연속인 주변분포를 갖는다고 가정합니다.
피어슨 상관계수
표본 공분산 함수 \(\widehat{Cov}(X,Y) = \frac{1}{n} \sum_{i=1}^n (X_i - \bar{X})(Y_i - \bar{Y})\)를 정의합니다. 여기서 \(\bar{X}\)와 \(\bar{Y}\)는 각각 \(X\)와 \(Y\)의 표본평균입니다. 그러면 적률(피어슨) 상관계수(product-moment (Pearson) correlation) 피어슨 상관계수, 즉 두 변수 간의 선형 상관관계를 나타내는 척도는 \[ r = \frac{\widehat{Cov}(X,Y)}{\sqrt{\widehat{Cov}(X,X)\widehat{Cov}(Y,Y)}} = \frac{\widehat{Cov}(X,Y)}{\sqrt{\widehat{Var}(X)}\sqrt{\widehat{Var}(Y)}}. \] 로 쓸 수 있습니다. 상관 통계량 \(r\)는 확률변수 사이의 선형 연관성을 포착하는 데 널리 사용됩니다. 이는 공분산을 표준편차의 곱으로 나눈 값으로 정의되는 상관 모수 \(\rho\)의 (비모수적) 추정량입니다.
이 통계량에는 몇 가지 중요한 특징이 있습니다. 회귀 추정량과 달리 이 통계량은 확률변수에 대해 대칭이므로, \(X\)과 \(Y\) 사이의 상관계수는 \(Y\)과 \(X\) 사이의 상관계수와 같습니다. 이 통계량은 확률변수의 선형변환에 대해 (부호 변화를 제외하면) 변하지 않으므로, 해석에 도움이 되도록 확률변수에 값을 곱하거나 상수를 더할 수 있습니다. 이 통계량의 범위는 \([-1,1]\)이며, 이는 \(X\)이나 \(Y\)의 분포에 의존하지 않습니다.
또한 독립인 경우 상관계수 \(r\)는 0입니다. 그러나 상관계수가 0이라고 해서 일반적으로 독립을 의미하지는 않는다는 것은 잘 알려져 있으며, 한 가지 예외는 정규분포를 따르는 확률변수의 경우입니다. 상관 통계량 \(r\)는 이변량 정규분포의 연관성 모수에 대한 (최대가능도) 추정량이기도 합니다. 따라서 정규분포를 따르는 자료의 경우 상관 통계량 \(r\)를 사용하여 독립성을 평가할 수 있습니다. 잘 알려진 이 통계량에 대한 추가적인 해석은 Lee Rodgers and Nicewander (1998)에서 흥미롭게 살펴볼 수 있습니다.
R의 cor() 함수를 사용하고 pearson 방법을 선택하면 피어슨 상관계수(Pearson correlation) 두 변수 간의 선형 상관관계를 나타내는 척도 통계량 \(r\)를 구할 수 있습니다. 아래에서는 그림 16.1의 데이터셋에서 백만 달러 단위의 \({\tt LOSS}\) 요율 변수와 달러 단위의 \({\tt ALAE}\) 금액 변수를 사용하여 이를 보여 줍니다.
피어슨 상관 통계량에 대한 R 코드
위의 R 출력 결과에서 \(r=0.4\)이며, 이는 \({\tt LOSS}\)과 \({\tt ALAE}\) 사이에 양의 연관성이 있음을 나타냅니다. 이는 청구의 손실 금액이 증가할수록 비용도 증가할 것으로 예상된다는 의미입니다.
16.1.2 순위 기반 측도
스피어만의 로
피어슨 상관계수에는 자료의 비선형 변환에 대해 불변이 아니라는 단점이 있습니다. 예를 들어 \(X\)과 \(\log Y\) 사이의 상관계수는 \(X\)과 \(Y\) 사이의 상관계수와 상당히 다를 수 있습니다. 위의 피어슨 상관 통계량에 대한 R 코드에서 볼 수 있듯이, 로그 달러 단위의 \({\tt ALAE}\) 변수와 달러 단위의 \({\tt LOSS}\) 금액 변수 사이의 상관 통계량 \(r\)는 \(0.33\)이며, 이는 달러 단위의 \({\tt ALAE}\) 변수와 달러 단위의 \({\tt LOSS}\) 금액 변수 사이의 상관계수를 계산했을 때의 \(0.4\)과 비교됩니다. 이러한 한계는 대안적인 통계량을 고려하는 한 가지 이유입니다.
대안적인 상관 측도는 자료의 순위에 기반합니다. \(R(X_j)\)가 표본 \(X_1, \ldots, X_n\)에서 \(X_j\)의 순위를 나타낸다고 하고, \(R(Y_j)\)에 대해서도 마찬가지로 정의합니다. \(R(X) = \left(R(X_1), \ldots, R(X_n)\right)'\)가 순위 벡터를 나타낸다고 하고, \(R(Y)\)에 대해서도 마찬가지로 정의합니다. 예를 들어 \(n=3\)이고 \(X=(24, 13, 109)\)이면 \(R(X)=(2,1,3)\)입니다. 순위 통계량에 대한 포괄적인 소개는 예를 들어 Hettmansperger (1984)에서 찾을 수 있습니다. 또한 순위를 사용하여 경험분포함수를 구할 수 있으며, 경험분포함수에 대한 자세한 내용은 4.4.1절을 참조하십시오.
이를 이용하면 Spearman (1904)의 상관 측도는 단순히 순위에 대해 계산한 적률상관계수입니다:
\[
r_S = \frac{\widehat{Cov}(R(X),R(Y))}{\sqrt{\widehat{Cov}(R(X),R(X))\widehat{Cov}(R(Y),R(Y))}}
= \frac{\widehat{Cov}(R(X),R(Y))}{(n^2-1)/12} .
\]
R의 cor() 함수를 사용하고 spearman 방법을 선택하면 스피어만 상관 통계량 \(r_S\)를 구할 수 있습니다. 아래에서 \({\tt LOSS}\) 변수와 \({\tt ALAE}\) 변수 사이의 스피어만 상관계수는 \(0.45\)입니다.
스피어만 상관 통계량에 대한 R 코드
스피어만 상관 통계량은 순증가 변환에 대해 불변임을 보일 수 있습니다. 위의 스피어만 상관 통계량에 대한 R 코드에서, 로그 달러 단위의 \({\tt ALAE}\) 변수와 달러 단위의 \({\tt LOSS}\) 금액 변수 사이에서 \(r_S=0.45\)입니다.
예제 16.1.1. 직접 계산하기. 다음과 같은 여섯 개의 관측값이 주어져 있습니다: \[ \small{ \begin{array}{|c|c|c|} \hline \textbf{Observation} & x \textbf{ value} & y \textbf{ value}\\ \hline 1 & 15 & 19 \\ \hline 2 & 9 & 7 \\ \hline 3 & 5 & 13 \\ \hline 4 & 3 & 15 \\ \hline 5 & 21 & 17 \\ \hline 6 & 12 & 11 \\ \hline \end{array} } \] 표본 스피어만의 \(\rho\)를 계산하십시오.
예제 풀이 보기
켄달의 타우
순위를 사용하는 또 다른 측도는 일치성이라는 개념에 기반합니다. 관측값 쌍 \((X,Y)\)에서 \(X\) 값이 더 큰 관측값이 \(Y\) 값도 더 크면(작으면) 그 쌍을 일치(concordant) 관측값 쌍 (x,y)에서 x 값이 더 큰 관측값이 y 값도 더 클 경우, 그 쌍은 일치(concordant)한다고 합니다(불일치(discordant) 관측값 쌍 (x,y)에서 x 값이 더 큰 관측값이 y 값은 더 작을 경우, 그 쌍은 불일치(discordant)한다고 합니다)이라고 합니다. 그러면 \(\Pr(concordance) = \Pr[ (X_1-X_2)(Y_1-Y_2) >0 ]\), \(\Pr(discordance) = \Pr[ (X_1-X_2)(Y_1-Y_2) <0 ]\), \(\Pr(tie) = \Pr[ (X_1-X_2)(Y_1-Y_2) =0 ]\), 그리고 \[ \begin{array}{rl} \tau(X,Y) &= \Pr(concordance) - \Pr(discordance) \\ & = 2\Pr(concordance) - 1 + \Pr(tie). \end{array} \] 입니다. 따라서 모집단 모수인 켄달의 타우 \(\tau=\tau(X,Y)\)는 변수들의 실제 값과 관계없이 한 변수의 값이 클수록 다른 변수의 값도 대체로 큰지를 측정합니다.
이를 추정하기 위해, 곱 \(sgn(X_j-X_i)sgn(Y_j-Y_i)\)이 1이면 쌍 \((X_i,Y_i)\)와 \((X_j,Y_j)\)을 일치한다고 하고, 곱이 -1이면 불일치한다고 합니다. 여기서 \(sgn(x)=1,0,-1\)는 각각 \(x>0\), \(x=0\), \(x<0\)일 때의 값입니다. 이를 이용하면 켄달의 타우(Kendall’s tau) 로 알려진 Maurice G. Kendall (1938)의 (통계적) 연관성 측도를 \[ \begin{array}{rl} \hat{\tau} &= \frac{2}{n(n-1)} \sum_{i<j} ~sgn(X_j-X_i) \times sgn(Y_j-Y_i)\\ &= \frac{2}{n(n-1)} \sum_{i<j} ~sgn(R(X_j)-R(X_i)) \times sgn(R(Y_j)-R(Y_i)) . \end{array} \] 와 같이 나타낼 수 있습니다. 흥미롭게도 Hougaard (2000)의 137쪽에서는 이 통계량의 최초 발견을 Fechner (1897)의 공으로 돌리면서, 켄달의 발견은 독립적으로 이루어졌으며 원래의 연구보다 더 완전했다고 언급합니다.
R의 cor() 함수에서 kendall 방법을 선택하면 켄달의 타우를 구할 수 있습니다. 아래에서 달러 단위의 \({\tt LOSS}\) 변수와 달러 단위의 \({\tt ALAE}\) 변수 사이에서 \(\hat{\tau}=0.32\)입니다. 데이터에 동순위가 있을 때, cor() 함수는 M. G. Kendall (1945)이 제안한 켄달의 tau_b를 계산합니다.
켄달의 타우를 위한 R 코드
또한 켄달의 타우가 순증가 변환에 대해 불변임을 보이기 위해, 로그 달러 단위의 \({\tt ALAE}\) 변수와 달러 단위의 \({\tt LOSS}\) 금액 변수 사이에서 \(\hat{\tau}=0.32\)임을 확인할 수 있습니다.
예제 16.1.2. 손으로 계산하기. 다음 여섯 개의 관측값이 주어졌습니다: \[ \small{ \begin{array}{|c|c|c|} \hline \textbf{Observation} & x \textbf{ value} & y \textbf{ value}\\ \hline 1 & 15 & 19 \\ \hline 2 & 9 & 7 \\ \hline 3 & 5 & 13 \\ \hline 4 & 3 & 15 \\ \hline 5 & 21 & 17 \\ \hline 6 & 12 & 11 \\ \hline \end{array} } \] 표본 켄달의 \(\tau\)를 계산하십시오.
예제 풀이 보기
16.1.3 꼬리 의존 계수
꼬리 의존성은 두 변수의 분포 꼬리에서 두 변수 사이의 의존성 강도를 측정하는 통계적 개념입니다. 구체적으로 꼬리 의존성은 특정 임계값을 넘어서는 두 변수의 극단값 사이의 상관관계나 의존성, 즉 이변량 분포의 왼쪽 아래 사분면이나 오른쪽 위 사분면 모서리에서의 의존성을 측정합니다. 꼬리 의존성은 금융, 경제, 위험 관리의 여러 분야에서 필수적입니다. 예를 들어 금융 붕괴, 자연재해, 팬데믹과 같은 극단적 사건을 분석할 때 꼬리 의존성이 중요합니다. 이러한 상황에서 꼬리 의존은 결합 극단 사건이 발생할 가능도를 파악하고 관련 위험을 관리하기 위한 전략을 수립하는 데 도움이 될 수 있습니다.
그림 16.2에서는 예를 통해 꼬리 의존성의 개념을 보여 줍니다. 이 그림은 켄달의 타우(Kendall’s Tau)가 0.7인, 무작위로 생성한 두 변수를 보여 줍니다. 그림 16.2의 왼쪽에서는 변수(\(X\)와 \(Y\))를 이변량 정규분포로 시뮬레이션했고, 오른쪽에서는 이변량 \(t\)-분포로 생성했습니다. 양쪽 모두 켄달의 타우가 0.7이지만, 각 패널의 오른쪽 위 사분면(점선 위쪽)에는 차이가 있습니다. 왼쪽 패널에서는 오른쪽 위 사분면의 값(\(X\)와 \(Y\)의 위쪽 꼬리)이 독립인 반면, 오른쪽 패널에서는 위쪽 꼬리의 값들이 상관된 것으로 보입니다(오른쪽 패널의 오른쪽 위 모서리에는 점이 4개 있습니다). 이는 그림 16.2의 왼쪽 패널보다 오른쪽 패널에서 \(X\)가 높은 임계값(예: 그림의 점선)을 넘을 때 \(Y\)도 같은 임계값 위에서 발생할 확률이 더 높다는 것을 시사합니다.
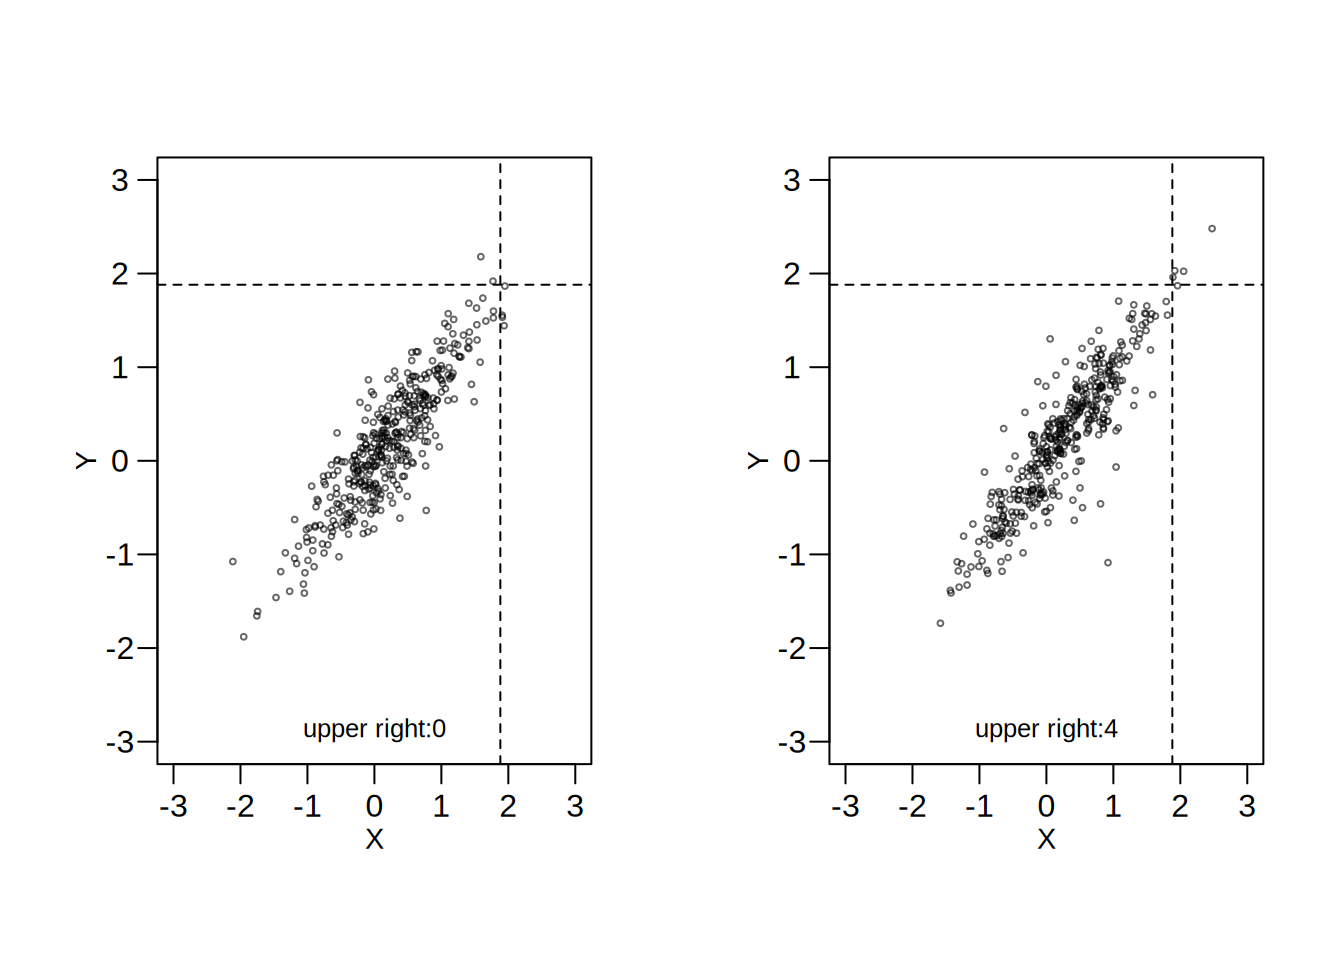
그림 16.2: 왼쪽 패널: \(X\)와 \(Y\)의 위쪽 꼬리는 독립입니다. 오른쪽 패널: \(X\)와 \(Y\)의 위쪽 꼬리는 의존적인 것으로 보입니다.
확률변수 쌍 \((X,Y)\)를 생각해 봅시다. Joe (1997)에 제시된 정의에 따르면, \(\lambda_{\text{up}}\)로 표기하는 위쪽 꼬리 의존 계수는 다음과 같습니다.
\[ \lambda_\text{up} {=} \lim _{u \rightarrow 1^-} \mathrm{Pr}\left\{X>F_X^{-1}(u) \mid Y>F_Y^{-1}(u)\right\}, \] 단, 이는 극한이 존재하는 경우입니다. 여기서 \(F_X^{-1}(u)\)와 \(F_Y^{-1}(u)\)는 수준 \(u\)에서의 \(X\)와 \(Y\)의 분위수를 나타냅니다. 그러면 \(\lambda_\text{up}\in(0,1]\)일 때 \(X\)와 \(Y\)는 위쪽 꼬리 의존이라 하고, \(\lambda_\text{up}=0\)일 때 위쪽 꼬리 독립이라 합니다. 위쪽 꼬리 의존 조건은 한 변수가 극단적으로 높은 값에 도달할 때 다른 변수도 극단적으로 높은 값에 도달한다는 것을 나타냅니다. 반면에 위쪽 꼬리 독립은 두 변수의 극단값이 서로 관련이 없다는 것을 시사합니다. 마찬가지로 하단 꼬리 의존 계수 \(\lambda_{\text{lo}}\)는 다음과 같이 정의됩니다: \[ \lambda_{\text{lo}} {=} \lim _{u \rightarrow 0^+} \mathrm{Pr}\left\{X \leq F_X^{-1}(u) \mid Y \leq F_Y^{-1}(u)\right\} . \] \(R(X_j)\)과 \(R(Y_j)\)가 각각 \(X_j\)와 \(Y_j\)의 순위를 나타낸다고 합시다(\(j=1,\ldots, n\)). Schmidt (2005)에 따르면 \(\lambda_\text{up}\)와 \(\lambda_\text{lo}\)의 비모수 추정량은 다음과 같습니다. \[ \hat{\lambda}_{\text{lo}}=\frac{1}{k} \sum_{j=1}^n I\left\{R(X_j)\leq k, R(Y_j) \leq k\right\}, \] 및 \[ \begin{aligned} \hat{\lambda}_{\text{up}} & =\frac{1}{k} \sum_{j=1}^n I\left\{R(X_j)>n-k, R(Y_j)>n-k\right\}, \end{aligned} \] 여기서 \(k \in {1, . . .,n}\)는 임계 순위이자 분석가가 선택하는 모수이며, \(k=k(n) \rightarrow \infty \text { and } k / n \rightarrow 0 \text { as } n \rightarrow \infty \text {, }\)입니다. 여기서 \(n\)은 표본 크기이고, \(I\{\cdot\}\)는 조건이 충족되면 1, 그렇지 않으면 0의 값을 가집니다.
그림 16.3은 \({\tt LOSS}\) 변수와 \({\tt ALAE}\) 변수의 순위에 대한 산점도를 보여 줍니다. R에서 FRAPO 패키지의 tdc() 함수를 사용하면 상단 및 하단 꼬리 의존 계수를 구할 수 있습니다. 아래 결과에서 \(k=75\)(\(n=1500\)임에 유의하십시오)일 때 \({\tt LOSS}\) 변수와 \({\tt ALAE}\) 변수 사이에서 \(\hat{\lambda}_{\text{up}}=0.39\)이고 \(\hat{\lambda}_{\text{lo}}=0.13\)입니다. 이 결과는 손실 변수와 비용 변수가 위쪽 꼬리에서 더 강하게 의존하는 것으로 보인다는 것을 의미합니다.
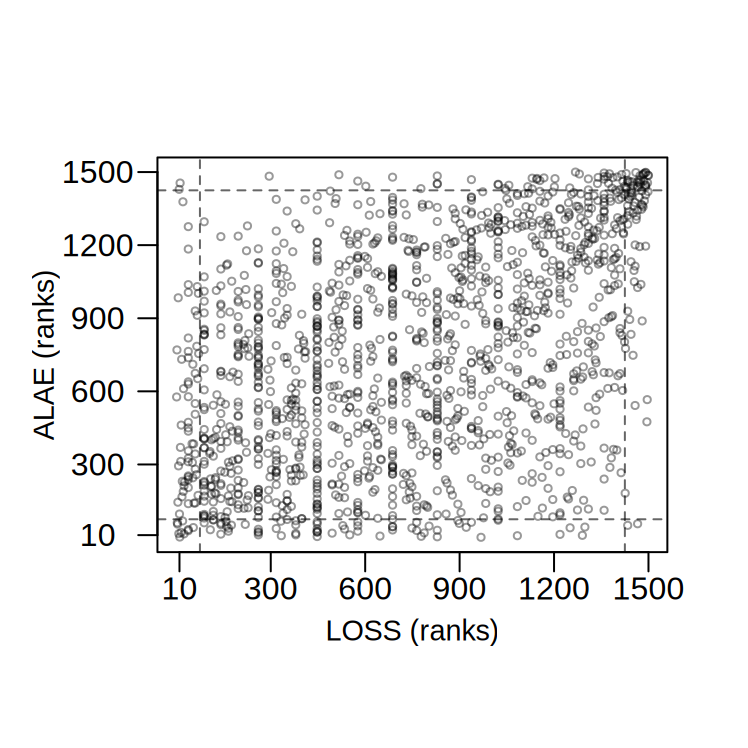
그림 16.3: LOSS와 ALAE의 순위 산점도
꼬리 의존 계수를 위한 R 코드
Show Quiz Solution
16.2 코퓰라 소개
이 절에서는 다음을 배웁니다.
- 다변량 분포함수를 코퓰라 함수로 기술합니다.
16.2.1 코퓰라의 정의
코퓰라는 변수 간의 의존성을 명시적으로 표현하므로, 보험을 비롯한 여러 분야에서 다변량 결과 간의 의존성을 모형화하는 데 널리 사용됩니다. 두 변수 \(Y_1\)와 \(Y_2\)에 대한 결합 누적분포함수(\(cdf\))는 다음과 같다는 것을 상기하십시오. \[ {F}(y_1, y_2)= {\Pr}(Y_1 \leq y_1, Y_2 \leq y_2) . \] \(p\)차원의 다변량인 경우에는 다음과 같습니다. \[ {F}(y_1,\ldots, y_p)= {\Pr}(Y_1 \leq y_1,\ldots ,Y_p \leq y_p) . \] 결합분포는 주변분포와 변수들이 서로 어떻게 관련되어 있는지를 모두 고려합니다. 그러나 결합분포는 이 의존성을 암묵적으로 표현합니다. 코퓰라는 변수들의 결합분포를 따로따로 조정할 수 있는 개별 구성 요소(주변분포와 코퓰라)로 분해할 수 있게 해 주는 다른 방법을 제공합니다.
코퓰라(copula) 주변분포가 균등분포인 다변량 분포함수는 균등 주변분포를 갖는 다변량 분포함수입니다. 구체적으로, \(\{U_1, \ldots, U_p\}\)를 \((0,1)\) 위의 \(p\)개의 균등 확률변수라고 합시다. 이들의 분포함수 \[{C}(u_1, \ldots, u_p) = \Pr(U_1 \leq u_1, \ldots, U_p \leq u_p),\]
는 코퓰라입니다. 우리는 단순히 균등분포를 따르는 데이터에 국한되지 않는 응용에 코퓰라를 활용하고자 합니다. 따라서 임의의 주변분포함수 \({F}_1(y_1)\),…,\({F}_p(y_p)\)를 고려합니다. 그러면 코퓰라를 사용하여 다변량 분포함수를 \[\begin{equation} {F}(y_1, \ldots, y_p)= {C}({F}_1(y_1), \ldots, {F}_p(y_p)). \tag{16.1} \end{equation}\] 와 같이 정의할 수 있습니다. 여기서 \(F\)는 다변량 분포함수이며, 코퓰라 함수의 결괏값은 확률과 관련되므로 \([0,1]\) 범위로 제한됩니다. Sklar (1959)는 \(any\) 다변량 분포함수 \(F\)가 식 (16.1)의 형태로, 즉 코퓰라 표현을 사용하여 쓰일 수 있음을 보였습니다.
또한 Sklar는 주변분포가 연속이면 코퓰라 표현이 유일하게 존재함을 보였습니다. 그러므로 결합분포함수 대신 코퓰라를 사용할 수 있습니다. 유효한 것으로 간주되려면 코퓰라는 유효한 결합 누적분포함수가 갖추어야 할 요건을 충족해야 합니다. 이 장에서는 연속형 변수를 이용한 코퓰라 모형화에 초점을 맞춥니다. 밀도 \[ c(u_1, \ldots, u_p)=\frac{\partial^p}{\partial_{u_p}\ldots \partial_{u_1}}C(u_1, \ldots, u_p), \] 가 존재하면 코퓰라 \(C\)는 절대연속이라고 합니다. 이산형의 경우에 대해서는 Joe (2014)와 Genest and Nešlohva (2007)를 참고하십시오. \(p=2\)인 이변량의 경우, 코퓰라와 두 확률변수의 분포함수를 각각 \[ {C}(u_1, \, u_2) = \Pr(U_1 \leq u_1, \, U_2 \leq u_2) \] 및 \[ {F}(y_1, \, y_2)= {C}({F}_1(y_1), {F}_p(y_2)). \] 로 쓸 수 있습니다. 이변량 코퓰라의 한 예로 곱 코퓰라가 있는데, 두 변수 \(Y_1\)와 \(Y_2\)의 독립성이라는 성질을 포착하므로 독립 코퓰라라고도 부릅니다. 이 코퓰라(분포함수)는 \[ {F}(y_1, \, y_2)= {C}({F}_1(y_1), {F}_p(y_2))={F}_1(y_1){F}_p(y_2)=u_1u_2=\Pi(u). \] 입니다. 그림 16.4에는 독립 코퓰라의 분포함수와 독립 코퓰라에서 생성한 관측값의 산점도가 함께 제시되어 있습니다. 산점도는 두 성분 \(U_1\)와 \(U_2\) 사이에 상관관계가 없음을 보여 줍니다.
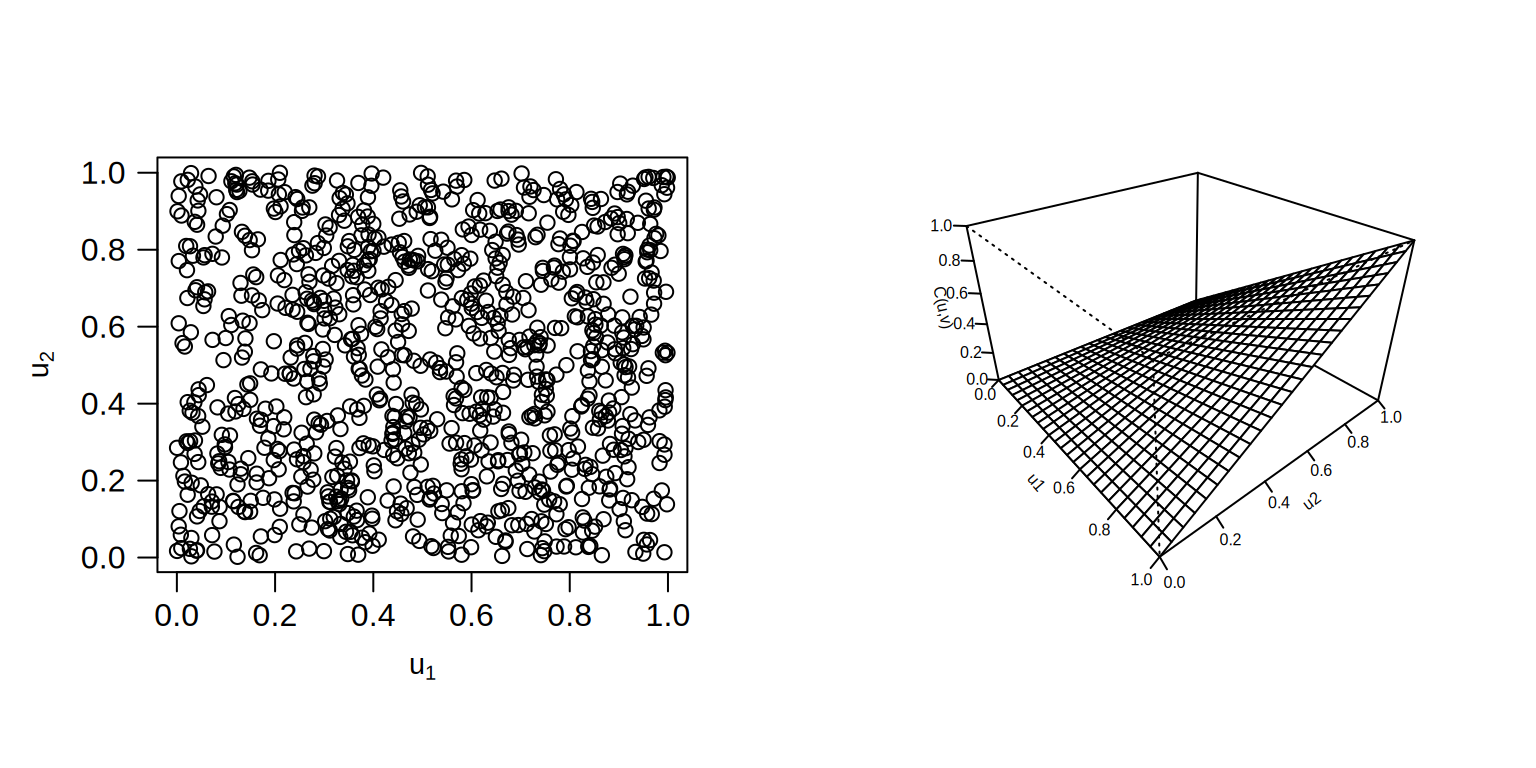
그림 16.4: 독립 코퓰라. 왼쪽: 독립 코퓰라에서 생성한 관측값의 산점도. 오른쪽: 독립 코퓰라의 분포함수 그래프.
독립 코퓰라 그래프를 위한 R 코드
자주 활용되는 또 다른 유형의 코퓰라로 Frank 코퓰라 (Frank 1979)가 있습니다. 이 코퓰라는 양의 의존성과 음의 의존성을 모두 나타낼 수 있으며 해석적 구조가 간단합니다. 이 코퓰라(분포함수)는
\[\begin{equation} {C}(u_1,u_2) = \frac{1}{\gamma} \log \left( 1+ \frac{ (\exp(\gamma u_1) -1)(\exp(\gamma u_2) -1)} {\exp(\gamma) -1} \right). \tag{16.2} \end{equation}\]
이는 단위 정사각형 \([0,1]^2.\) 위에서 정의역을 갖는 이변량 분포함수입니다. 여기서 \(\gamma\)는 의존 모수로, 의존성의 범위가 모수 \(\gamma\)에 의해 조절됩니다. \(\gamma\)가 커질수록 양의 연관성이 커집니다. 앞으로 살펴보겠지만, 이 양의 연관성은 스피어만의 로(Spearman’s rho) (\(\rho_S\))와 켄달의 타우(\(\tau\))로 요약할 수 있습니다.
그림 16.5에서 Frank 코퓰라로부터 생성한 데이터의 산점도를 볼 수 있습니다. \(\gamma\) 값이 변함에 따라 성분 \(U_1\)와 \(U_2\)가 양 또는 음의 의존 관계를 갖게 됨을 관찰할 수 있습니다. \(\theta\)가 0에 가까워지면 (16.2)는 독립 코퓰라로 변환됩니다. 또한 그림 16.6는 \(\gamma=12\)일 때 Frank 코퓰라의 분포함수와 밀도함수를 보여 줍니다. 16.4절에서는 흔히 사용되는 Frank 코퓰라 이외의 코퓰라 함수를 살펴보겠습니다.
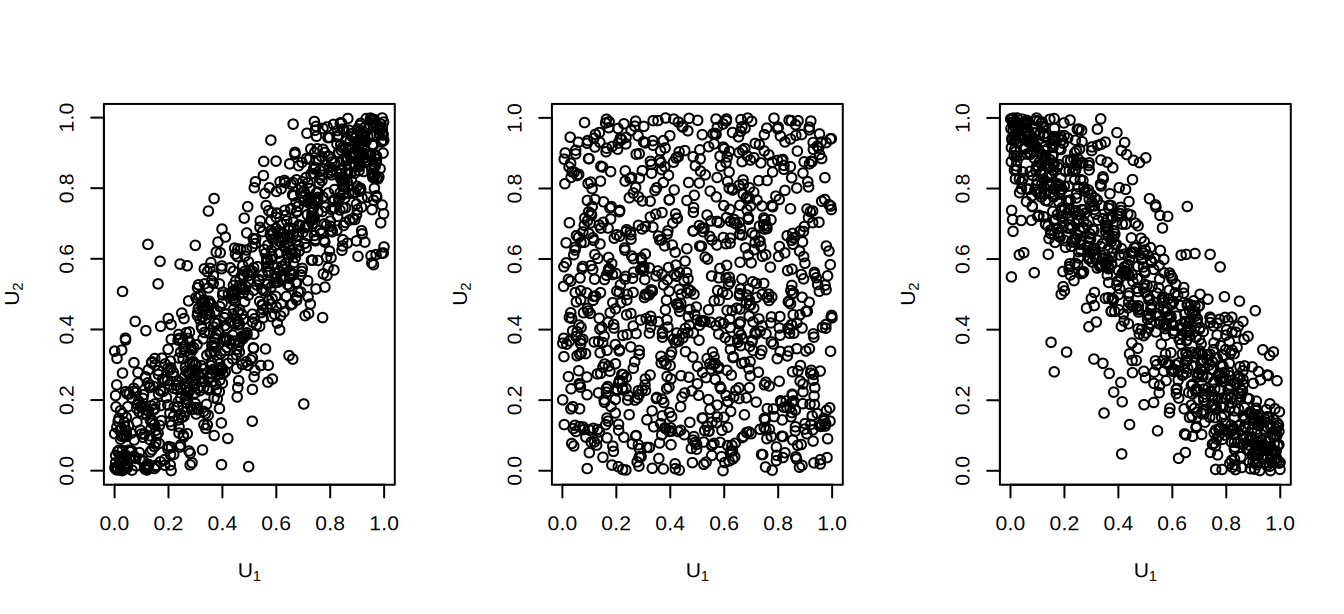
그림 16.5: Frank 코퓰라에서 생성한 관측값의 산점도. \(\gamma=12\)(왼쪽), \(\gamma=0\)(가운데), \(\gamma=-12\)(오른쪽).
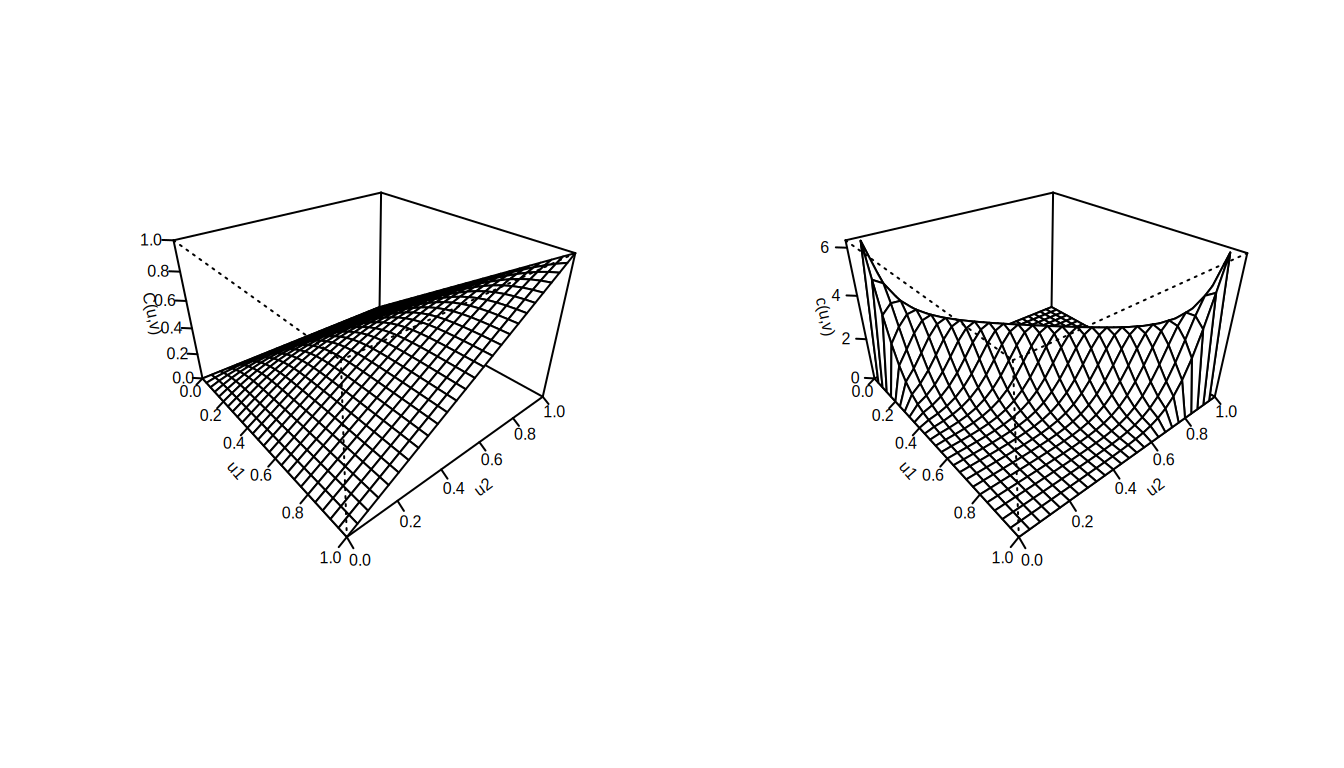
그림 16.6: 왼쪽: Frank 코퓰라의 분포함수 그래프(\(\gamma=12\)). 오른쪽: Frank 코퓰라의 밀도함수 그래프(\(\gamma=12\)).
Frank 코퓰라 그래프를 위한 R 코드
예제 16.2.1. 코퓰라 표현 예제
척도모수가 \(\theta=10\)이고 형상모수가 \(\alpha=1.6\)인 파레토 분포를 따르는 변수 \(X\)가 있다고 가정합니다. 또한 \(Y\)를 평균이 8인 지수 변수라고 합시다. \(F_{X,Y}(7.2, 4.1)\)를 \(C(u,v)\)의 형태로 나타내십시오.
참고: \(F_{X,Y}(x,y)\)는 결합분포함수이고 \(C(u,v)\)는 \(X\)와 \(Y\)를 연결하는 코퓰라입니다.
예제 풀이 보기
16.2.2 Sklar 정리
Sklar (1959)에서 Sklar는 코퓰라가 확률변수 집단의 의존 구조를 어떻게 포착할 수 있는지 보여 주었습니다. 이 원리는 이후 Sklar 정리로 불리게 되었으며 코퓰라 이론의 초석이 되고 있습니다. 연속 다변량 분포에 대해 코퓰라를 이용한 의존성 모델링을 하면 일변량 주변분포의 모델링과 의존 구조의 모델링을 분리할 수 있으며, 이때 코퓰라가 의존 구조를 나타낼 수 있습니다.
주변 누적분포함수가 \(F_1, \ldots, F_p\)인 \(p\)변량 분포 \(F\)에 대해, \(F\)와 연관된 코퓰라는 \(U(0,1)\) 주변분포를 갖는 분포함수 \(C: [0,1]^p \rightarrow [0,1]\)로서 다음을 만족합니다: \[\begin{equation} {F}\left(\mathbf{y}\right)= {C}\left({F}_1\left(y_1\right), \ldots, {F}_p\left(y_p\right)\right), \quad \mathbf{y}=\{y_1 \ldots y_p\} \in \mathbb{R}^p. \tag{16.3} \end{equation}\] \(F\)가 일변량 주변분포 \(F_1, \ldots, F_p\)와 분위수 함수 \(F_1^{-1}, \ldots, F_p^{-1}\)를 갖는 연속 \(p\)변량 분포함수이면, \[ C\left(\mathbf{u}\right) =F\left(F_1^{-1}\left(u_1\right), \ldots, F_p^{-1}\left(u_p\right)\right), \quad \mathbf{u} \in [0,1]^p , \] 가 유일한 선택입니다.
그 역도 성립합니다. \(C\)가 코퓰라이고 \(F_1, \ldots, F_p\)가 일변량 누적분포함수이면, (16.3)로 정의되는 함수 \(F\)는 주변 누적분포함수가 \(F_1, \ldots, F_p\)인 결합 누적분포함수입니다.
스클라 정리의 증명
Sklar 정리의 첫 번째 부분에 따르면, 알려지지 않은 유일한 기저 코퓰라가 존재하며, 이는 이용 가능한 데이터로부터 추정할 수 있습니다. 주변분포와 코퓰라를 추정한 후에는 일반적으로 (16.3)를 사용해 이들을 결합하여 추정된 다변량 분포함수를 얻습니다. 또한 스클라 정리의 두 번째 부분을 이용하면 지정된 일변량 주변분포를 갖는 유연한 다변량 분포함수를 구성할 수 있습니다. 이러한 함수는 가격 결정 모형과 같은 더 복잡한 모형에서 유용합니다.
Show Quiz Solution
16.3 코퓰라를 이용한 응용
이 절에서는 다음을 배웁니다:
- 확률변수 간의 의존 구조를 발견하는 방법
- 코퓰라 함수를 이용한 의존성 모형화
이 절에서는 통계 프로그램 R을 사용하여 보험 손실 및 비용 데이터를 분석합니다. 데이터 세트는 그림 16.1에 시각화되어 있습니다. 모형 적합 과정은 두 변수 \({\tt LOSS}\)와 \({\tt ALAE}\) 각각의 주변 모형화로 시작합니다. 그런 다음 이러한 주변 결과들의 결합분포를 모형화합니다.
16.3.1 주변 모형
결합 모형화를 진행하기 전에 먼저 손실과 비용의 주변분포(marginal distributions) 확률변수 모임의 부분집합에 포함된 변수들의 확률분포를 살펴봅니다. 히스토그램을 보면 \({\tt LOSS}\)와 \({\tt ALAE}\) 모두 오른쪽으로 치우쳐 있고 꼬리가 두꺼운(fat-tailed) 두꺼운 꼬리 분포는 정규분포나 지수분포에 비해 큰 왜도 또는 첨도를 보이는 확률분포입니다임을 알 수 있습니다. 이러한 특징 때문에 손실과 비용의 주변분포 모두에 대해 \[ F(y)=1- \left( \frac{\theta}{y+ \theta} \right) ^{\alpha}. \] 형태의 분포함수를 갖는 파레토 분포를 고려합니다. 여기서 \(\theta\)는 척도모수이고 \(\alpha\)는 형상모수입니다. 이 분포에 대한 자세한 내용은 20.2절에서 다룹니다.
손실과 비용의 주변분포는 최대가능도 방법을 사용하여 적합합니다. 구체적으로는 R VGAM 패키지의 vglm 함수를 사용합니다. 먼저 \({\tt ALAE}\)의 주변분포를 적합합니다. 모수는 표 16.6에 요약되어 있습니다.
ALAE의 파레토 적합을 위한 R 코드
이 절차를 반복하여 \({\tt LOSS}\) 변수의 주변분포를 적합합니다. 손실 변수 역시 오른쪽으로 치우치고 꼬리가 두꺼운 데이터로 보이므로, 이 주변분포도 (모수는 다르지만) 파레토 분포로 모형화합니다.
LOSS의 파레토 적합을 위한 R 코드
표 16.6. LGPIF 데이터로부터 얻은 파레토 최대가능도 적합 모수 요약
\[ {\small \begin{matrix} \begin{array}{l|r|r} \hline & \text{Shape } \hat{\theta} &\text{Scale } \hat{\alpha} \\ \hline \text{ALAE} & 15133.60360 & 2.22304 \\ \text{LOSS} & 16228.14797 & 1.23766 \\ \hline \end{array} \end{matrix}} \] \({\tt LOSS}\)와 \({\tt ALAE}\) 변수의 적합된 분포를 시각화하려면 추정된 모수를 사용하여 해당 분포함수와 밀도함수를 그리면 됩니다. 주변 모형 선택에 대한 자세한 내용은 6장을 참조하십시오.
16.3.2 확률적분변환
시뮬레이션을 공부할 때 8.1.2절에서 역변환법(inverse transform method) 무작위로 선택된 백분위수를 나타내기 위해 0과 1 사이의 균등 난수를 표본추출한 다음, 시뮬레이션하고자 하는 분포의 누적밀도함수의 역함수를 사용하여 해당 분포로부터의 시뮬레이션 값을 구하는 방법에 대해 배웠습니다. 이는 분포의 역함수, 즉 \(X = F^{-1}(U)\)를 통해 \(U(0,1)\) 확률변수를 분포함수 \(F\)를 갖는 확률변수 \(X\)로 대응시키는 방법입니다. 확률 적분 변환(probability integral transformation) 모든 연속형 변수는 그 분포함수를 통해 균등 확률변수로 변환될 수 있습니다은 그 반대 방향으로 진행하며, \(F(X) = U\)임을 말해 줍니다. 역변환 결과는 기저 확률변수가 연속형이든, 이산형이든, 둘의 혼합형이든 성립하지만, 확률적분변환은 주로 분포가 연속형일 때 유용합니다. 이 장에서는 바로 이 경우에 초점을 맞춥니다.
확률적분변환은 두 가지 목적으로 사용합니다. (1) 분포함수를 올바르게 지정했는지 확인하기 위한 진단 목적과 (2) 식 (16.1)의 코퓰라 함수에 대한 입력으로서의 목적입니다.
첫 번째 목적을 위해, 파레토 분포가 주변분포를 모형화하는 데 적절한 분포인지 확인할 수 있습니다. 적합된 파레토 분포가 주어지면, 변수 \({\tt ALAE}\)는 \([0,1]\)에서 균등분포를 따르는 변수 \(u_1\)로 변환됩니다: \[ u_1 = \hat{F}_{1}(ALAE) = 1 - \left( \frac{\hat{\theta}}{\hat{\theta}+ALAE} \right)^{\hat{\alpha}}. \]
\({\tt ALAE}\) 변수에 확률적분변환을 적용한 후, 변환된 \({\tt ALAE}\)의 히스토그램을 그림 16.7에 나타냅니다. 이 그림은 균등분포에서 기대되는 모습에 상당히 가까워 보이며, 이는 파레토 분포가 합리적인 설정임을 시사합니다.
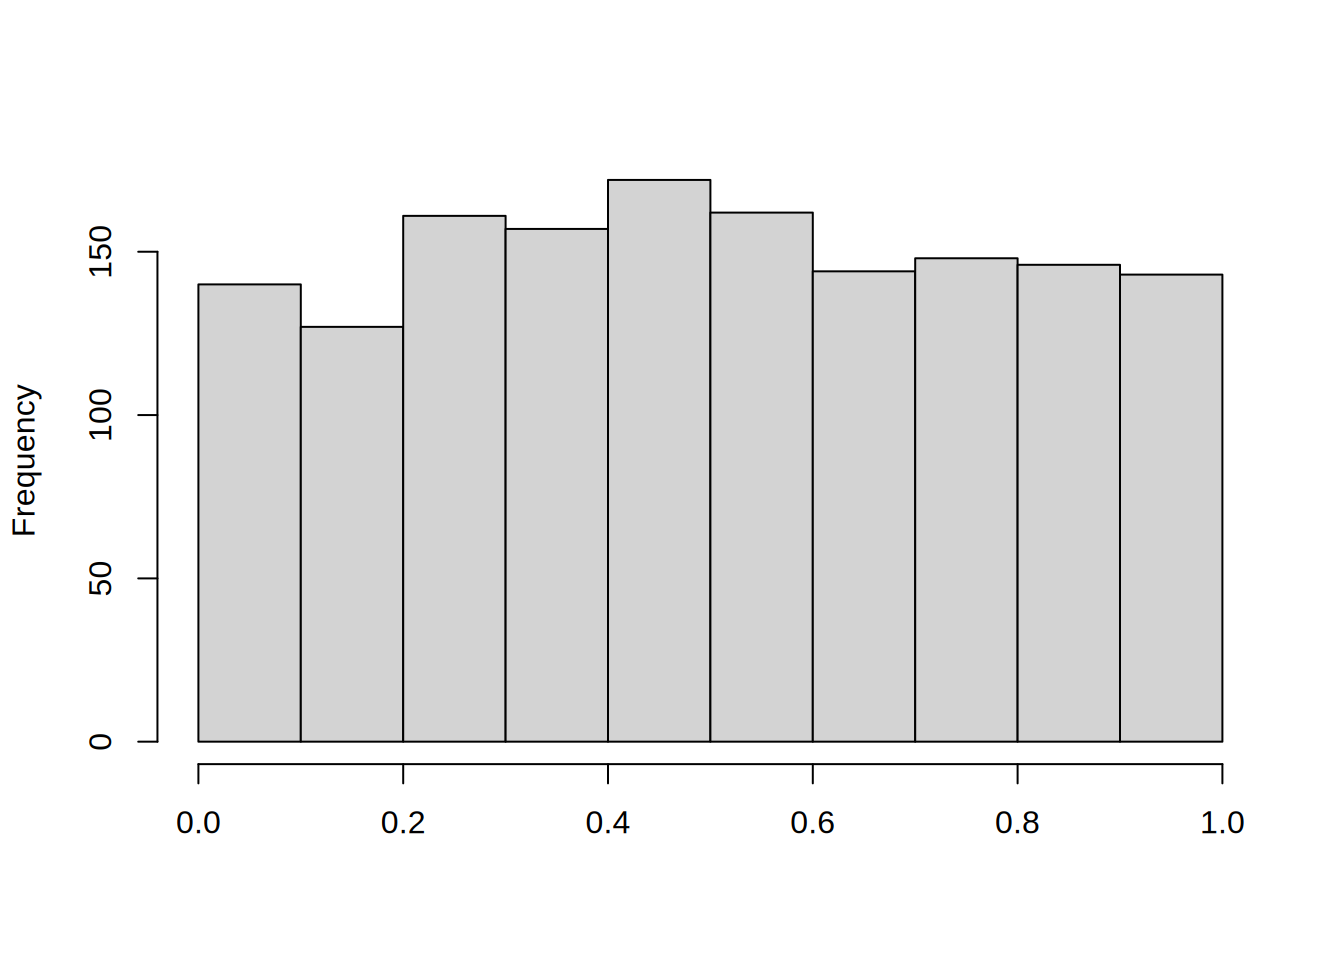
그림 16.7: 변환된 ALAE의 히스토그램
같은 방식으로 변수 \({\tt LOSS}\) 또한 \([0,1]\)에서 균등분포를 따르는 변수 \(u_2\)로 변환됩니다. 그림 16.8의 왼쪽 패널은 변환된 \({\tt ALAE}\)의 히스토그램을 보여 주며, 이는 다시 한번 파레토 분포 설정을 뒷받침합니다. 데이터를 바라보는 또 다른 방법으로, 변수 \(u_2\)를 표준정규분포의 분위수 함수를 이용하여 정규 점수로 변환할 수 있습니다. 그림 16.8에서 볼 수 있듯이, 변수 \({\tt LOSS}\)의 정규 점수는 주변적으로 근사적인 표준정규분포를 따릅니다. 분석가들은 근사적 정규성의 패턴을 찾는 데 익숙하므로 이 그림은 유용합니다(그림에서 이러한 패턴이 뚜렷하게 나타나는 것으로 보입니다). 그 논리는 다음과 같습니다. 파레토 분포가 올바르게 설정되었다면 변환된 손실 \(u_2\)는 근사적으로 정규분포를 따라야 하며, 정규 점수 \(\Phi^{-1}(u_2)\) 역시 근사적으로 정규분포를 따라야 합니다. (여기서 \(\Phi\)는 누적 표준정규분포함수입니다.)
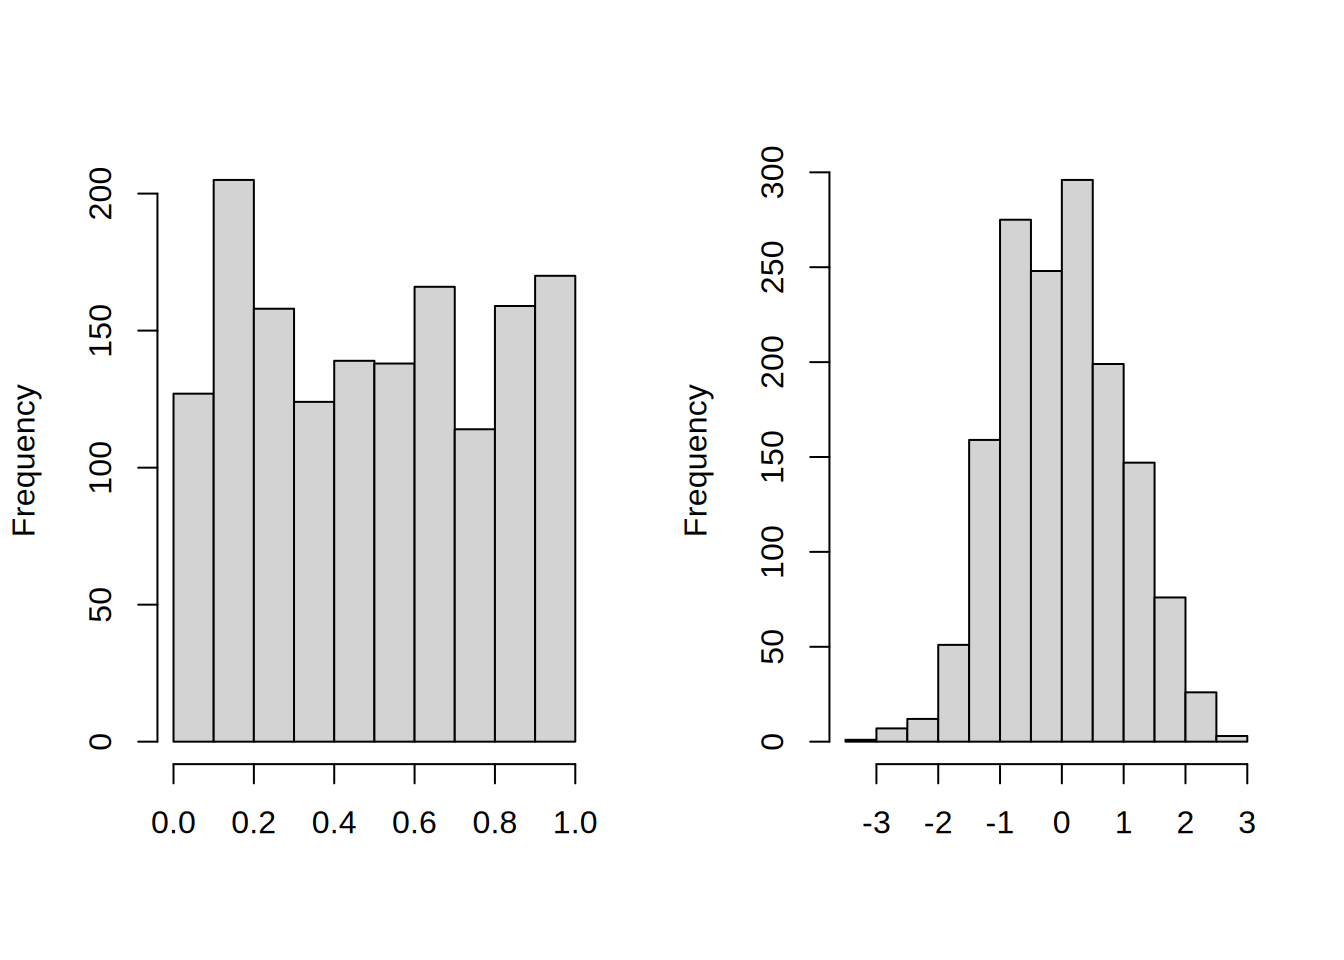
그림 16.8: 변환된 손실의 히스토그램. 왼쪽 패널은 확률적분변환된 손실의 분포를 보여 줍니다. 오른쪽 패널은 이에 대응하는 정규 점수의 분포를 보여 줍니다.
변환된 변수의 히스토그램을 위한 R 코드
16.3.3 코퓰라 함수를 이용한 결합 모형화
손실과 비용을 결합하여 모형화하기 전에, 그림 16.9에 변환된 변수 \((U_1, U_2)\)의 산점도와 정규 점수의 산점도를 그립니다. 왼쪽 패널은 \(U_1\) 대 \(U_2\)의 그래프이며, 여기서 \(U_1 = \hat{F}_1(ALAE)\)이고 \(U_2=\hat{F}_2(LOSS)\)입니다). 그런 다음 역표준정규분포함수 \(\Phi^{-1}(\cdot)\), 즉 R의 qnorm을 사용하여 각각을 변환함으로써 정규 점수를 얻습니다. 그림 16.1에서와 같이, 왼쪽 패널에서는 패턴을 파악하기 어렵습니다. 그러나 척도를 재조정하면 오른쪽 패널에서 패턴이 뚜렷하게 드러납니다. 정규 점수와 코퓰라 모형화에서의 응용에 대해 더 자세히 알아보려면 Joe (2014)를 참조하십시오.
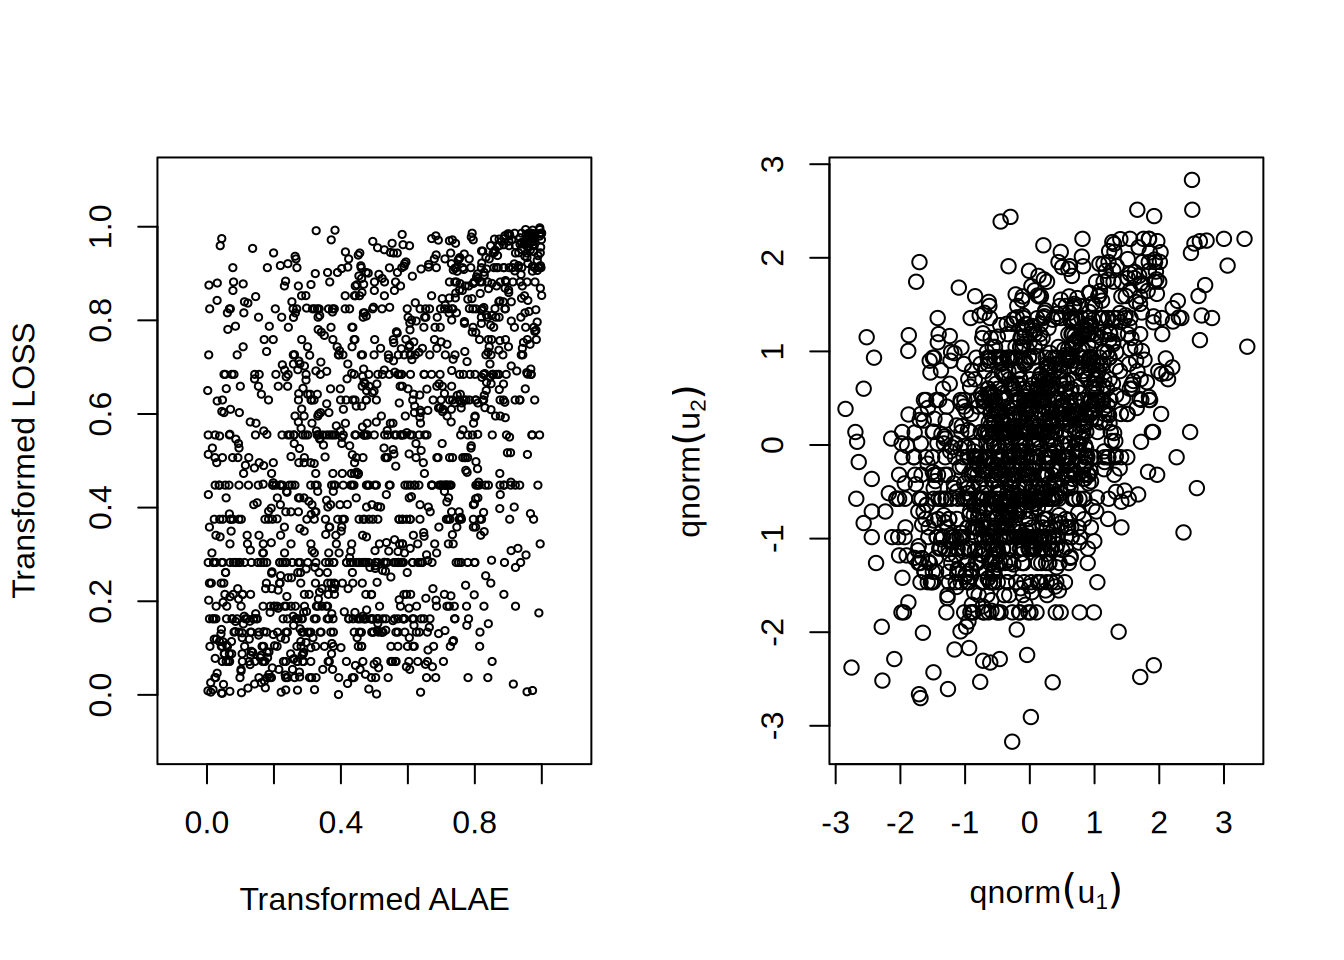
그림 16.9: 왼쪽: 변환된 변수의 산점도. 오른쪽: 정규 점수의 산점도
산점도와 상관계수를 위한 R 코드
그림 16.1의 오른쪽 패널은 이 두 확률변수 사이에 양의 의존성이 있음을 보여 줍니다. 이는 예를 들어 스피어만의 로를 사용하여 요약할 수 있으며, 그 값은 0.451로 나타납니다. 16.1.2절에서 배운 것처럼, 이 통계량은 각 순위를 통해 두 변수의 순서에만 의존합니다. 따라서 이 통계량은 (1) 그림 16.1의 원래 데이터, (2) 그림 16.9의 왼쪽 패널에 있는 균등 척도로 변환된 데이터, (3) 그림 16.9의 오른쪽 패널에 있는 정규 점수에 대해 모두 동일합니다.
다음 단계는 코퓰라 모수의 추정값을 계산하는 것입니다. 한 가지 방법은 전통적인 최대가능도를 사용하여 모든 모수를 동시에 결정하는 것인데, 이는 계산상 부담이 클 수 있습니다. 우리의 간단한 예에서도 이는 다섯 개의 모수, 즉 주변 \({\tt ALAE}\) 분포에 대한 두 개, 주변 \({\tt LOSS}\) 분포에 대한 두 개, 그리고 코퓰라에 대한 한 개에 대해 (로그) 가능도함수를 최대화하는 것을 의미합니다. 널리 쓰이는 대안인 주변분포 추론(inference for margins, IFM) 접근법은 코퓰라를 결정할 때 적합된 주변분포 \(u_1\)와 \(u_2\)를 단순히 입력값으로 사용하는 것입니다. 여기서는 이 접근법을 사용합니다. 다음 코드에서 적합된 코퓰라 모수가 \(\hat{\gamma} = 3.114\)이 됨을 확인할 수 있습니다.
Frank 코퓰라를 이용한 IFM 적합 R 코드
적합된 Frank 코퓰라를 시각화하기 위해 그림 16.10에 분포함수와 밀도함수의 투시도를 그렸습니다.
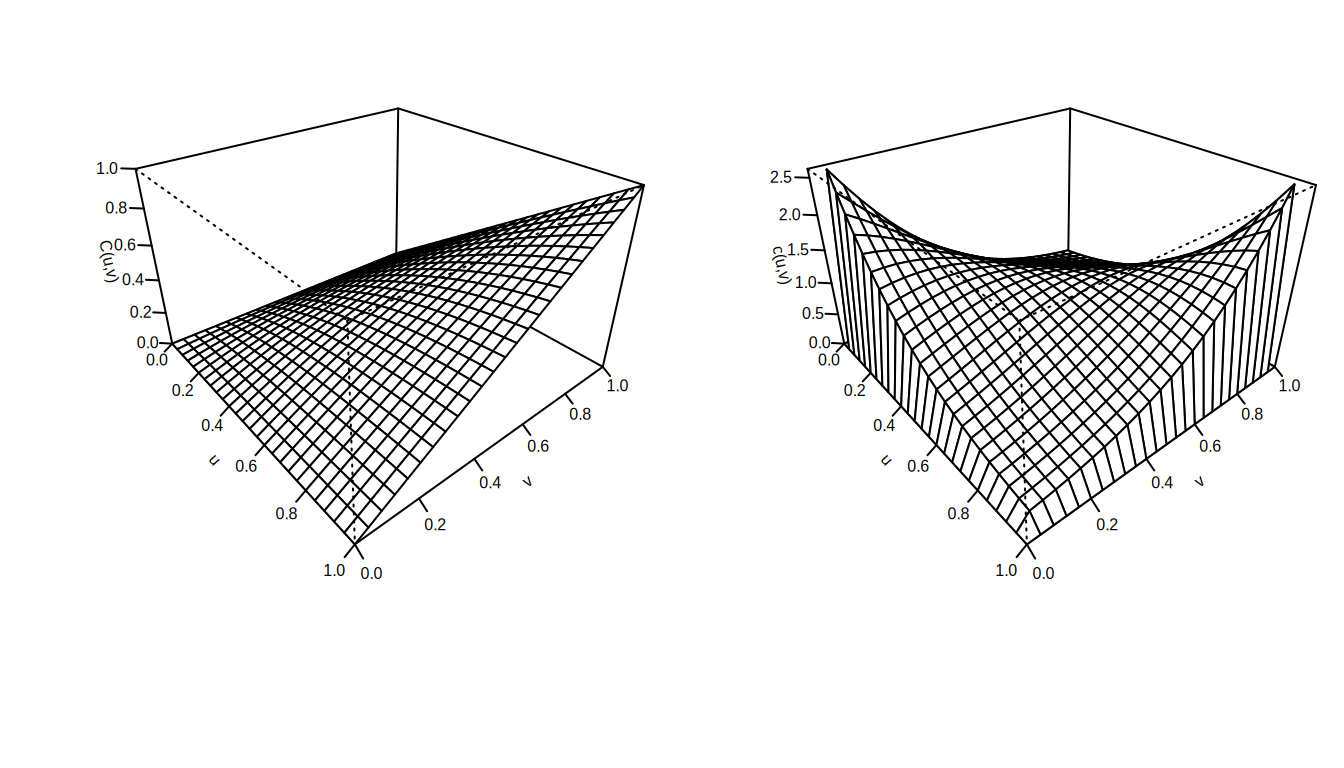
그림 16.10: Frank 코퓰라. 왼쪽: Frank 코퓰라의 분포함수 그림. 오른쪽: Frank 코퓰라의 밀도함수 그림
Frank 코퓰라 그림 R 코드
손실과 비용 데이터를 바탕으로 적합한 Frank 코퓰라를 이용하면, 손실이 특정 임계값을 초과할 때의 예상 비용을 추정할 수 있습니다. 예를 들어, 데이터에 따르면 손실이 \(\$200,000\)를 초과할 때의 평균 비용은 \(\$58,807\)입니다. 그러나 적합한 Frank 코퓰라를 적용하면, 손실이 \(\$200,000\)를 초과할 때의 예상 비용은 \(\$26,767\)입니다. 이는 Frank 코퓰라가 정확한 추정치를 제공하지 못하며 이 데이터셋에 적합하지 않을 수 있음을 시사합니다. 이제 다른 유형의 코퓰라를 살펴보겠습니다.
적합한 Frank 코퓰라를 이용하여 비용의 기대 수준을 계산하는 R 코드
16.4 코퓰라의 유형
이 절에서는 다음을 배웁니다.
- 정규 코퓰라, \(t\)를 포함한 타원형 코퓰라의 기본 유형을 정의합니다.
- 아르키메데스 코퓰라의 기본 유형을 정의합니다.
문헌에는 여러 코퓰라족이 소개되어 있습니다. 코퓰라족 가운데 대표적인 두 가지는 아르키메데스 코퓰라와 타원형 코퓰라입니다.
16.4.1 정규(가우스) 코퓰라
우리는 식 (16.2)의 Frank 코퓰라로 연구를 시작했습니다. 이 코퓰라는 양의 의존성과 음의 의존성을 모두 포착할 수 있고, 이해하기 쉬운 해석적 형태를 가지기 때문입니다. 그러나 \(p>2\)인 다변량의 경우로 확장하기는 쉽지 않으므로 다른 대안을 찾아봅니다. 특히 정규분포, 즉 가우스 분포는 1887년 가우스를 시작으로 오랜 세월 동안 실증 연구에 사용되어 왔습니다. 따라서 다변량 종속성을 이해하기 위한 기준으로 이 분포를 살펴보는 것은 자연스러운 일입니다.
다변량 정규분포에 대해서는 각각 평균이 0이고 표준편차가 1인 \(p\)개의 정규 확률변수를 생각하십시오. 이들의 종속성은 대각 원소가 1인 상관 행렬(correlation matrix) 변수 간의 상관계수를 보여 주는 표 \(\boldsymbol \Sigma\)에 의해 결정됩니다. \(i\)번째 행과 \(j\)번째 열에 있는 수를 \(\boldsymbol \Sigma_{ij}\)라고 하면, 이는 \(i\)번째 정규 확률변수와 \(j\)번째 정규 확률변수 사이의 상관계수를 나타냅니다. 이 확률변수들의 모임은 확률밀도함수가 \[\begin{equation} \phi_N (\mathbf{z})= \frac{1}{(2 \pi)^{p/2}\sqrt{\det \boldsymbol \Sigma}} \exp\left( -\frac{1}{2} \mathbf{z}^{\prime} \boldsymbol \Sigma^{-1}\mathbf{z}\right). \tag{16.4} \end{equation}\] 인 다변량 정규분포를 따릅니다. 이에 대응하는 코퓰라 형태를 유도하려면 식 (16.1)에서 출발하여 정규변수를 사용해 이를 계산하고 약간의 미적분 과정을 거치면 됩니다. 그 대신 정의로서 간단히 제시하면, 정규(가우스) 코퓰라 밀도함수는 다음과 같습니다. \[ c_N(u_1, \ldots, u_p) = \phi_N \left(\Phi^{-1}(u_1), \ldots, \Phi^{-1}(u_p) \right) \prod_{j=1}^p \frac{1}{\phi(\Phi^{-1}(u_j))}. \] 여기서 \(\Phi\)와 \(\phi\)는 각각 표준정규분포의 분포함수와 밀도함수를 나타냅니다. 일반적인 확률밀도함수 \(\phi_N\)와 달리, 코퓰라 밀도함수의 정의역은 초입방체 \([0,1]^p\)입니다. 비교를 위해 그림 16.11에서 이 두 밀도함수를 비교합니다.
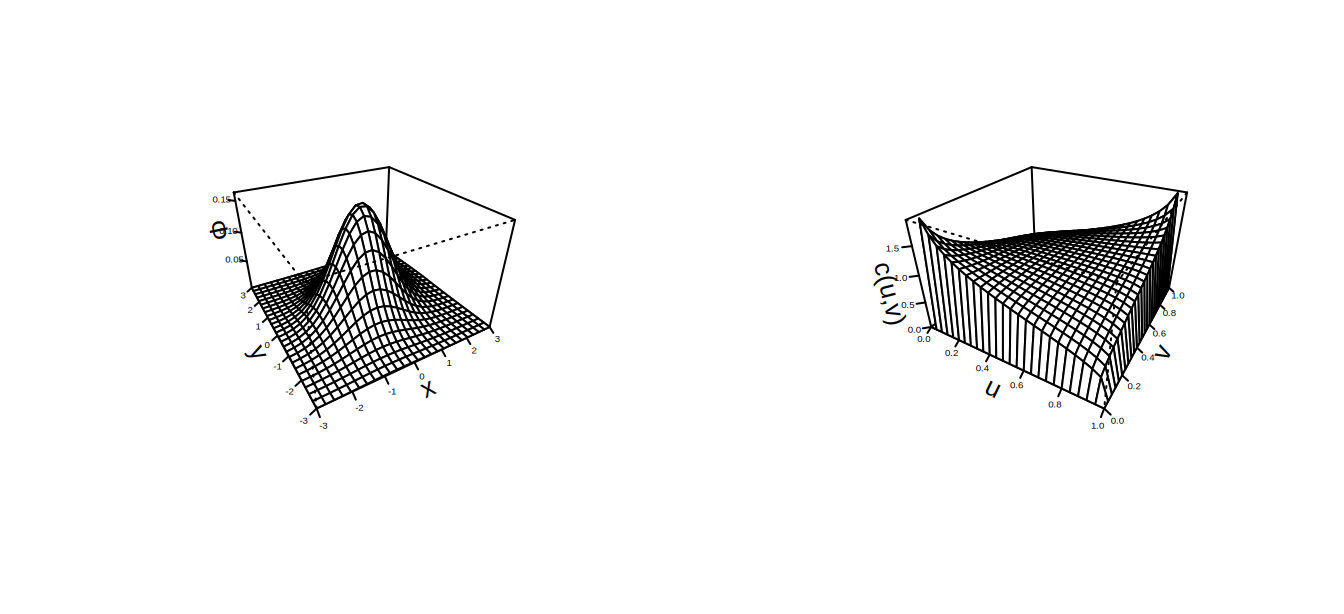
그림 16.11: 이변량 정규 확률밀도함수 그래프. 왼쪽 패널은 전통적인 이변량 정규 확률밀도함수입니다. 오른쪽 그래프는 정규분포에 대한 코퓰라 밀도의 그래프입니다.
정규 pdf와 정규 코퓰라 pdf 그래프를 위한 R 코드
16.4.2 t- 코퓰라와 타원형 코퓰라
실무에서 널리 쓰이는 또 다른 코퓰라는 \(t\)- 코퓰라입니다. \(t\)- 코퓰라와 정규 코퓰라는 모두 타원형 코퓰라라고 알려진 족의 특수한 경우이므로, 먼저 이 일반적인 족을 소개한 다음 \(t\)- 코퓰라의 경우로 좁혀 살펴봅니다.
정규분포와 \(t\)- 분포는 대칭 분포의 예입니다. 더 일반적으로, 타원형 분포(elliptical distributions) 다변량 정규분포를 일반화하는 광범위한 확률분포 족에 속하는 모든 구성원는 대칭이면서 다변량일 수 있는 분포족입니다. 요약하면, 타원형 분포는 대칭인 다변량 분포의 한 유형입니다. 다변량 정규분포와 다변량 \(t\)- 분포는 타원형 분포의 특수한 유형입니다.
타원형 코퓰라(Elliptical copulas) 타원형 분포의 코퓰라 타원형 분포로부터 구성됩니다. 이 코퓰라는 스클라 정리에 의해 (다변량) 타원형 분포를 일변량 타원형 주변분포들로 분해합니다. 타원형 코퓰라의 성질은 대응하는 타원형 분포의 성질로부터 얻을 수 있습니다. 예를 들어 Hofert et al. (2018)을 참조하십시오.
일반적으로, \(p\)차원 확률변수 벡터의 밀도가 \(\mathbf{z} \in R^p\)에 대해 \[ h_E (\mathbf{z})= \frac{k_p}{\sqrt{\det \boldsymbol \Sigma}} g_p \left( \frac{1}{2} (\mathbf{z}- \boldsymbol \mu)^{\prime} \boldsymbol \Sigma^{-1}(\mathbf{z}- \boldsymbol \mu) \right) , \] 로 쓰일 수 있으면 이 벡터는 타원형 분포를 가집니다. 여기서 \(k_p\)은 밀도의 적분값이 1이 되도록 정해지는 상수입니다. 함수 \(g_p(\cdot)\)는 서로 다른 분포를 만들어 내는 데 사용할 수 있으므로 생성자라고 부릅니다. 표 16.7은 계리 실무에서 사용되는 몇 가지 선택을 요약합니다. \(g_p(x) = \exp(-x)\)을 선택하면 식 (16.4)의 정규 pdf가 나옵니다. \(g_p(x) = \exp(-(1+2x/r)^{-(p+r)/2})\)을 선택하면 자유도가 \(r\)인 다변량 \(t\)- 분포가 나오며, 그 pdf는 다음과 같습니다 \[ h_{t_r} (\mathbf{z})= \frac{k_p}{\sqrt{\det \boldsymbol \Sigma}} \exp\left[- \left( 1+ \frac{(\mathbf{z}- \boldsymbol \mu)^{\prime} \boldsymbol \Sigma^{-1}(\mathbf{z}- \boldsymbol \mu)}{r} \right)^{-(p+r)/2}\right] . \]
표 16.7. 주요 타원형 분포의 생성자 함수(\(g_p(\cdot)\))
\[ \small\begin{array}{lc} \hline & Generator \\ Distribution & g_p(x) \\ \hline \text{Normal distribution} & e^{-x}\\ t-\text{distribution with }r \text{ degrees of freedom} & (1+2x/r)^{-(p+r)/2}\\ \text{Cauchy} & (1+2x)^{-(p+1)/2}\\ \text{Logistic} & e^{-x}/(1+e^{-x})^2\\ \text{Exponential power} & \exp(-rx^s)\\ \hline \end{array} \]
타원형 분포를 사용하여 코퓰라를 생성할 수 있습니다. 코퓰라는 주로 관계를 다루므로, \(\mu = \mathbf{0}\)이고 \(\boldsymbol \Sigma\)가 상관행렬인 경우로 고찰 범위를 한정할 수 있습니다. 이러한 제약 아래에서 다변량 타원형 코퓰라의 주변분포들은 모두 같습니다. 이 주변 분포함수를 \(H\)으로 나타내고, 대응하는 밀도를 \(h\)로 나타냅니다. 이 주변밀도는 \(h(z) = k_1 g_1(z^2/2).\)입니다. 예를 들어 정규분포의 경우 \(H(\cdot)=\Phi(\cdot)\)이고 \(h(\cdot)=\phi(\cdot)\)입니다.
이제 단위 입방체 \([0,1]^p\)에서 정의되는 함수인 타원형 코퓰라의 pdf를 다음과 같이 정의할 준비가 되었습니다
\[ {c}_E(u_1, \ldots, u_p) = h_E \left(H^{-1}(u_1), \ldots, H^{-1}(u_p) \right) \prod_{j=1}^p \frac{1}{h(H^{-1}(u_j))}. \]
앞서 언급했듯이, 대부분의 실증 연구는 정규 코퓰라와 \(t\)-코퓰라에 초점을 둡니다. 구체적으로, \(t\)-코퓰라는 특히 금융 위험 분석 응용에서 이변량 분포의 꼬리에서 나타나는 의존성을 모형화하는 데 유용합니다. 연관 모수가 같은 \(t\)-코퓰라라도 자유도 모수를 바꾸면 서로 다른 꼬리 의존 구조를 보입니다. \(t\)-코퓰라에 대한 자세한 내용은 Joe (2014)와 Hofert et al. (2018)을 참조하십시오.
정규 코퓰라와 \(t\) 코퓰라를 적합할 때에도 적합한 Frank 코퓰라에서와 같은 접근법을 사용했습니다. 아래 R 코드는 정규 코퓰라와 \(t\) 코퓰라를 적합하고, 손실이 \(\$200,000\)을 초과할 때의 기대 비용 수준을 추정합니다. 결과에 따르면, 적합된 정규 코퓰라를 사용하여 추정한 손실이 \(\$200,000\)을 초과할 때의 비용은 \(\$35,411\)입니다. 그러나 이는 손실 및 비용 데이터에서 얻은 평균 비용 \(\$58,807\)과 비교하면 좋은 적합이 아닙니다. 손실이 \(\$200,000\)을 초과할 때 적합된 \(t\) 코퓰라는 비용을 \(\$47,354\)으로 추정하므로, 정규 코퓰라보다 더 나은 적합입니다.
적합된 정규 코퓰라와 t 코퓰라를 사용하여 기대 비용 수준을 계산하는 R 코드
16.4.3 아르키메데스 코퓰라
이 코퓰라 부류 역시 생성자 함수로부터 구성됩니다. 아르키메데스 코퓰라에서는 \(g(\cdot)\)가 정의역이 [0,1]이고 치역이 \([0, \infty)\)인 볼록 감소함수이며 \(g(0)=0\)를 만족한다고 가정합니다. \(g\)의 역함수를 \(g^{-1}\)로 나타냅니다. 그러면 다음 함수는
\[ C_g(u_1, \ldots, u_p) = g^{-1} \left(g(u_1)+ \cdots + g(u_p) \right) \]
아르키메데스 코퓰라 분포함수라고 합니다.
이변량의 경우인 \(p=2\)에서 아르키메데스 코퓰라 함수는 다음 함수로 쓸 수 있습니다.
\[ C_{g}(u_1, \, u_2) = g^{-1} \left(g(u_1) + g(u_2) \right). \]
아르키메데스 코퓰라의 중요한 특수한 경우로는 Frank 코퓰라, Clayton/Cook-Johnson 코퓰라, Gumbel/Hougaard 코퓰라가 있습니다. 각 코퓰라 부류는 서로 다른 생성자 함수로부터 도출됩니다. 또 다른 유용한 특수한 경우로, 16.2절과 16.3절에서 설명한 Frank 코퓰라를 상기하십시오. 예시로, 이제 Clayton 코퓰라와 Gumbel/Hougaard 코퓰라의 명시적 표현식을 제시합니다.
Clayton 코퓰라
\(p=2\)에 대해, 모수가 \(\gamma \in [-1,\infty)\)인 Clayton 코퓰라는 다음과 같이 정의됩니다.
\[ C_{\gamma}^C(u)=\max\{u_1^{-\gamma}+u_2^{-\gamma}-1,0\}^{1/\gamma}, \quad u \in [0,1]^2. \]
이는 단위 정사각형 \([0,1]^2.\) 위에서 정의된 이변량 분포함수입니다. Frank 코퓰라와 마찬가지로 종속성의 범위는 모수 \(\gamma\)로 조절됩니다.
Gumbel-Hougaard 코퓰라
Gumbel-Hougaard 코퓰라는 \(\gamma \in [1,\infty)\)로 모수화되며 다음과 같이 정의됩니다.
\[ C_{\gamma}^{GH}(u)=\exp\left(-\left(\sum_{i=1}^2 (-\log u_i)^{\gamma}\right)^{1/\gamma}\right), \quad u\in[0,1]^2. \]
아르키메데스 코퓰라에 대한 자세한 내용은 Joe (2014), Frees and Valdez (1998), Genest and Mackay (1986)을 참조하십시오.
Clayton 코퓰라와 Gumbel-Hougaard 코퓰라를 적합할 때에도 Frank 코퓰라를 적합할 때와 같은 방법을 사용했습니다. 아래의 R 코드는 이 두 코퓰라를 적합하고 \(\$200,000\)보다 큰 손실에 대한 기대 비용 수준을 구합니다. 분석 결과, 적합된 Clayton 코퓰라를 사용하면 \(\$200,000\)를 초과하는 손실에 대한 추정 비용이 \(\$14,209\)이고, 적합된 Gumbel-Hougaard 코퓰라는 \(\$58,554\)를 예측합니다. 고려한 모든 코퓰라 유형 중에서 이 데이터에 가장 잘 적합하는 것은 Gumbel-Hougaard 코퓰라입니다. 적합도 검정에 대한 자세한 내용은 Hofert et al. (2018)를 참조하십시오.
적합된 Clayton 코퓰라와 Gumbel-Hougaard 코퓰라를 사용하여 기대 비용 수준을 계산하는 R 코드
Show Quiz Solution
16.5 코퓰라의 성질
이 절에서는 다음을 배웁니다.
- 종속성의 정도가 변함에 따라 코퓰라 분포함수를 제한하는 경계를 해석합니다
- 여러 코퓰라에 대한 연관성 측도를 계산하고 그 성질을 해석합니다
- 여러 코퓰라의 꼬리 종속성을 해석합니다
선택할 수 있는 코퓰라가 많으므로, 분석가는 이러한 대안들이 어떻게 작동하는지 일반적인 특징을 이해해 두는 것이 도움이 됩니다.
16.5.1 연관성의 경계
모든 분포함수는 아래로는 0, 위로는 1로 유계입니다. 다변량 상황에서는 추가적인 유형의 한계를 사용할 수 있습니다. 이러한 한계는 종속성을 연구할 때 유용합니다. 즉, 분석가가 변수들이 극단적으로 종속되어 있다고 생각할 때, 종속성과 관계없이 넘어설 수 없는 한계를 사용할 수 있습니다. 의존성 모델링에서 가장 널리 사용되는 경계는 Fréchet-Höeffding 경계로 알려져 있으며, 다음과 같습니다.
\[ \max( u_1 +\cdots+ u_p - p +1, 0) \leq C(u_1, \ldots, u_p) \leq \min (u_1, \ldots,u_p). \]
이 식의 우변을 확인하려면 다음에 주목하십시오.
\[ C(u_1,\ldots, u_p) = \Pr(U_1 \leq u_1, \ldots, U_p \leq u_p) \leq \Pr(U_j \leq u_j), \]
여기서 \(j=1,\ldots,p\)입니다. 이 한계는 \(U_1 = \cdots = U_p\)일 때 달성됩니다. \(p=2\)일 때 좌변을 확인하려면 \(U_2=1-U_1\)를 고려하십시오. 이 경우 \(1-u_2 < u_1\)이면 다음이 성립합니다.
\[ \Pr(U_1 \leq u_1, U_2 \leq u_2) = \Pr ( 1-u_2 \leq U_1 < u_1) =u_1+u_2-1. \] 추가적인 논의는 예를 들어 Nelson (1997)를 참조하십시오.
이러한 한계가 종속성 개념과 어떻게 관련되는지 알아보기 위해 \(p=2\)인 경우를 고려하십시오. 기준으로서, 먼저 곱 코퓰라 \(C(u_1,u_2)=u_1 \cdot u_2\)는 확률변수들 사이의 독립을 가정한 결과라는 점에 주목하십시오. 이제 위의 논의로부터, 하한은 두 확률변수가 완전한 음의 관계에 있을 때(\(U_2=1-U_1\)) 달성됨을 알 수 있습니다. 또한 상한은 두 확률변수가 완전한 양의 관계에 있을 때(\(U_2=U_1\)) 달성됨이 분명합니다. 이를 강조하기 위해, 두 확률변수에 대한 프레셰-회프딩 한계(Frechet-Hoeffding bounds) 다변량 분포함수의 한계를 그림 16.12에 나타냈습니다.
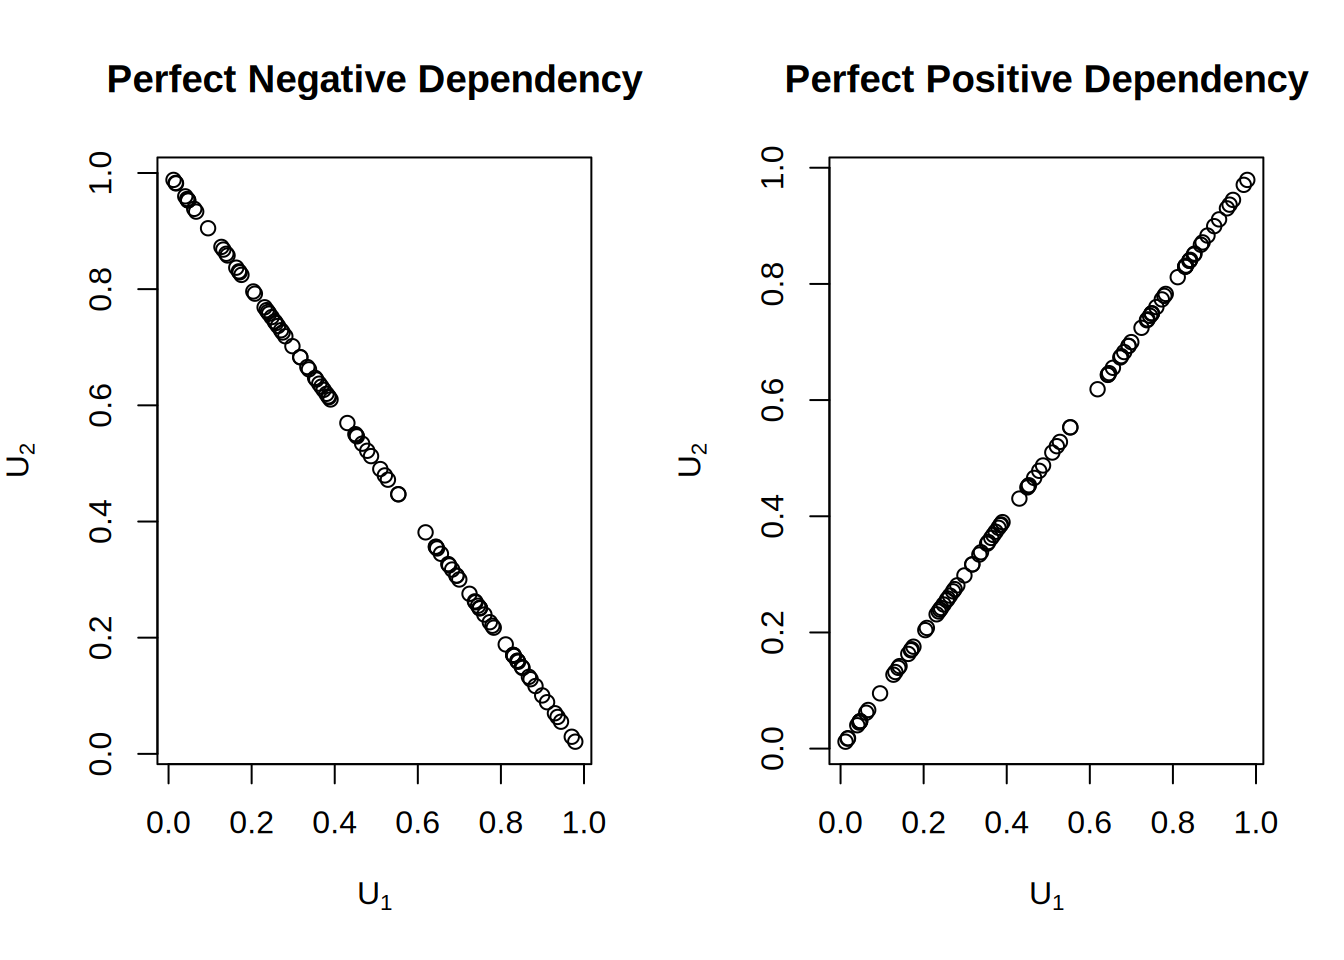
그림 16.12: 완전한 양의 종속성 및 완전한 음의 종속성 그래프
두 확률변수에 대한 Fréchet-Höeffding 한계의 R 코드
Fréchet-Höeffding 하한을 \(W\), 상한을 \(M\)으로 둡시다. 즉, \(W=\max(u_1+\cdots+u_p-p+1, 0)\)이고 \(M=\min(u_1,\ldots,u_p)\)입니다. \(W\)는 \(p=2\)인 경우에만 코퓰라인 반면, \(M\)는 모든 \(p\geq2\)에 대해 코퓰라라는 점에 유의해야 합니다. 2차원에서 \(W=\max(u_1+u_2-1, 0)\)는 반단조 코퓰라로 알려져 있습니다. 이는 두 변수 사이의 역관계, 즉 완전한 음의 관계에 있는 두 확률변수를 포착합니다. 한편, 2차원에서 \(M=\min(u_1,u_2)\)는 공단조 코퓰라로 알려져 있습니다. 이는 한 변수가 다른 변수와 순증가함수로 관련되는 두 변수 사이의 관계, 즉 완전한 양의 종속 관계에 있는 두 확률변수를 포착합니다. 공단조 코퓰라는 다변량의 경우로 확장할 수 있습니다. 그러나 반단조 코퓰라는 확장할 수 없는데, 각 쌍이 직접적인 역관계를 갖는 세 개 이상의 변수는 존재할 수 없기 때문입니다.
예제 16.5.1. 가능한 최댓값 예제
척도모수가 \(\theta=10\)이고 형상모수가 \(\alpha=1.6\)인 파레토 분포를 따르는 변수 \(X\)가 있다고 가정합시다. 또한 \(Y\)를 평균값이 8인 지수 변수라고 합시다. \(F_{X,Y}(x,y)\)를 결합분포함수라고 합시다. \(F_{X,Y}(7.2,4.1)\)의 가능한 최댓값은 얼마입니까?
예제 풀이 보기
16.5.2 연관성 측도
스피어만의 로와 켄달의 타우의 경험적 버전은 각각 16.1.2절에서 소개되었습니다. 이 표현식들의 흥미로운 점은 이러한 연관성 요약 측도가 각 변수의 순위에만 기반한다는 것입니다. 따라서 어떠한 순증가 변환도 이러한 연관성 측도에 영향을 주지 않습니다. 구체적으로, 두 확률변수 \(Y_1\)와 \(Y_2\)를 고려하고, m\(_1\)와 m\(_2\)를 순증가 함수라고 합시다. 그러면 스피어만의 로나 켄달의 타우로 측정한 \(m_1(Y_1)\)와 \(m_2(Y_2)\) 사이의 연관성은 m\(_1\)와 m\(_2\)의 선택과 관계없이 변하지 않습니다. 예를 들어, 이로 인해 분석가는 달러, 유로, 또는 로그 달러를 고려하더라도 본질적으로 동일한 의존성을 유지할 수 있습니다. 16.1절에서 살펴본 바와 같이, 피어슨의 상관 측도는 그렇지 않습니다.
Schweizer, Wolff, et al. (1981)는 각 변수가 측정되는 척도와 관계없이 \(Y_1\)와 \(Y_2\)가 “함께 움직이는” 방식이 코퓰라에 의해 포착된다는 의미에서 코퓰라가 모든 의존성을 설명한다는 것을 입증했습니다. 또한 이들은 두 가지 표준 비모수적 연관성 측도(의 모집단 버전)가 오직 코퓰라 함수만으로 표현될 수 있음을 보였습니다. 스피어만 상관계수는 \[\begin{equation} \rho_S = 12 \int_0^1 \int_0^1 \left\{C(u,v) - uv \right\} du dv. \tag{16.5} \end{equation}\] 로 주어집니다. 켄달의 타우는 \[ \tau= 4 \int_0^1 \int_0^1 C(u,v)~dC(u,v) - 1 . \] 로 주어집니다. 이 식들에서는 \(Y_1\)와 \(Y_2\)가 결합 연속분포함수를 가진다고 가정합니다.
예제. 손실 대 비용. 앞서 16.3절에서 rho 함수로 계산한 스피어만의 상관계수가 0.452임을 확인했습니다. 그런 다음 이 데이터에 Frank 코퓰라를 적합하고, 의존성 모수를 \(\hat{\gamma} = 3.114\)로 추정했습니다. 대안으로, 다음 코드는 식 (16.5)의 경험적 버전을 사용하는 방법을 보여줍니다. 이 경우 스피어만 상관계수는 0.462로, 표본 스피어만 상관계수인 0.452에 가깝습니다.
Frank 코퓰라를 이용한 스피어만 상관을 위한 R 코드
16.5.3 꼬리 종속성
16.1.3절에서 논의한 바와 같이, 연관성이 가장 강한 분포의 부분을 구별하는 것이 유용한 응용 사례들이 있습니다. 예를 들어, 보험에서는 가장 큰 손실들 사이의 연관성, 즉 데이터의 오른쪽 꼬리에서의 연관성을 이해하는 것이 도움이 됩니다. 이 소절에서는 상단 꼬리 의존성과 하단 꼬리 의존성을 코퓰라를 이용하여 정의합니다.
이러한 유형의 의존성을 포착하기 위해 \[ R(z) = \frac{\Pr(U_1 >z, U_2 > z)}{1-z} =\Pr(U_1 > z | U_2 > z) =\frac{1 - 2z + C(z,z)}{1-z} . \] 로 정의되는 오른쪽 꼬리 집중 함수를 사용합니다. 기준으로서, 독립성 하에서 \(R(z)\)는 \(z\)와 같게 됩니다. Joe (1997)는 \(R = \lim_{z \rightarrow 1} R(z)\)에 대해 “상측 꼬리 의존 모수”라는 용어를 사용합니다.
같은 방식으로, 왼쪽 꼬리 집중 함수를 하단 꼬리 의존 모수 \(L = \lim_{z \rightarrow 0} L(z)\)와 함께 \[ L(z) = \frac{\Pr(U_1 \leq z, U_2 \leq z)}{z}=\Pr(U_1 \leq z | U_2 \leq z) =\frac{ C(z,z)}{z}, \] 로 정의할 수 있습니다. 꼬리 의존성(tail dependency) 분포의 꼬리에서 나타나는 공동 움직임의 척도 집중 함수는 두 확률변수가 동시에 극단값을 가질 확률을 포착합니다.
주어진 코퓰라가 꼬리 의존성을 얼마나 잘 포착할 수 있는지 살펴보는 것은 흥미로운 일입니다. 이를 위해 네 가지 유형의 코퓰라, 즉 정규, Frank, Gumbel, \(t\)- 코퓰라에 대해 왼쪽 및 오른쪽 꼬리 집중 함수를 계산합니다. 이 네 코퓰라의 집중 함수 값에 대한 결과는 표 16.8에 요약되어 있습니다. Gary G. Venter (2002)에서와 같이, 그림 16.13의 꼬리 의존성 그림에서 \(z\leq 0.5\)에 대해서는 \(L(z)\)를, \(z>0.5\)에 대해서는 \(R(z)\)를 나타냅니다. 꼬리 의존성 그림은 Frank 코퓰라와 정규 코퓰라는 모두 꼬리 의존성을 보이지 않는 반면, \(t\)- 코퓰라와 Gumbel 코퓰라는 꼬리 의존성을 보인다는 의미로 해석됩니다. \(t\)- 코퓰라는 상단 꼬리와 하단 꼬리를 대칭적으로 다룹니다.
표 16.8. 네 가지 코퓰라의 꼬리 의존 모수
\[ {\small \begin{matrix} \begin{array}{l|rr} \hline \text{Copula} & \text{Lower} & \text{Upper} \\ \hline \text{Frank} & 0 & 0 \\ \text{Gumbel} & 0 & 0.74 \\ \text{Normal} & 0 & 0 \\ t- & 0.10 & 0.10 \\ \hline \end{array} \end{matrix}} \]
여러 코퓰라에 대한 꼬리 코퓰라 함수의 R 코드
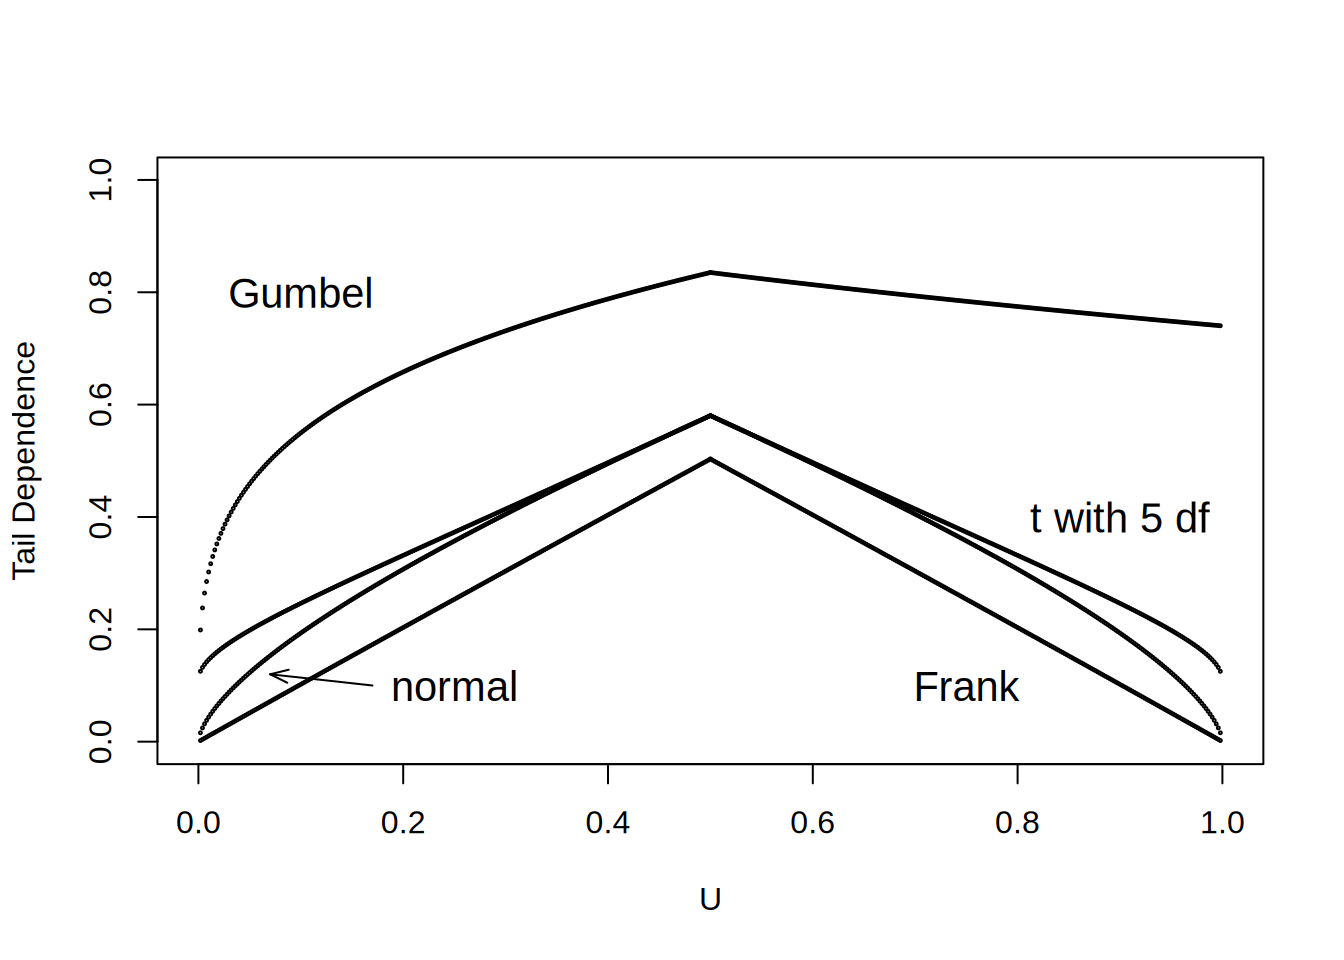
그림 16.13: 꼬리 의존성 그림
여러 코퓰라에 대한 꼬리 의존성 그림의 R 코드
예제 16.5.2. 하단 꼬리 의존 계수 예제
이변량 분포함수 \(C(u,v)=uv\). 이 코퓰라의 하단 꼬리 의존 계수는 무엇입니까?
예제 풀이 보기
Show Quiz Solution
16.6 의존성 모델링의 중요성
이 절에서는 다음을 학습합니다.
- 의존성 모델링의 중요성을 설명하십시오
- 회귀 응용에서 코퓰라의 중요성을 설명합니다
16.6.1 의존성 모델링은 왜 중요합니까?
의존성 모델링은 데이터셋에 있는 변수 간의 관계를 정의함으로써 의존 구조를 이해할 수 있게 해 주기 때문에 중요합니다. 보험에서 의존성 모델링을 무시하면 가격 책정에는 영향을 미치지 않을 수 있으나, 손실을 보전하는 데 필요한 자본을 잘못 추정하게 될 수 있습니다. 예를 들어, 절 16.3 에서 \({\tt LOSS}\)와 \({\tt ALAE}\) 사이에 양의 관계가 있었음을 확인할 수 있습니다. 이는 큰 손실이 발생하면 비용 또한 클 것으로 예상된다는 뜻이며, 이 관계를 무시하면 준비금을 잘못 추정할 수 있습니다.
의존성 모델링의 중요성을 보여 주기 위해, 재산 위험과 배상책임 위험이 독립이라고 가정했던 포트폴리오 관리 Example 13.4.6를 다시 참조하십시오. 이제 네 가지 사업 부문이 가우스 코퓰라를 통해 서로 의존하도록 하여 의존성을 반영합니다. 표 16.9에서는 의존성이 기댓값에는 영향을 미치지 않지만 포트폴리오 분위수(\(VaR_q\))에는 영향을 미친다는 것을 보여 줍니다. 예를 들어, 회사가 기술적으로 지급불능 상태가 되지 않음을 \(99\%\)의 확실성으로 보장하는 데 필요한 자본의 양인 총위험에 대한 \(VaR_{0.99}\)는 의존성을 반영할 때 더 높습니다. 이로 인해 의존성을 무시하면 더 적은 자본이 배분되며, 예상치 못한 지급여력 문제가 발생할 수 있습니다.
표 16.9. 포트폴리오 기댓값 및 분위수 결과(\(VaR_q\))
\[ {\small \begin{matrix} \begin{array}{l|rrrr} \hline \text{Independent} &\text{Expected} & VaR_{0.9} & VaR_{0.95} & VaR_{0.99} \\ &\text{Value} & & & \\ \hline \text{Retained} & 269 & 300 & 300 & 300 \\ \text{Insurer} & 2,274 & 4,400 & 6,173 & 11,859 \\ \text{Total} & 2,543 & 4,675 & 6,464 & 12,159 \\ \hline \text{Gaussian Copula}&\text{Expected}& VaR_{0.9} & VaR_{0.95} & VaR_{0.99} \\ &\text{Value} & & & \\ \hline \text{Retained} & 269 & 300 & 300 & 300 \\ \text{Insurer} & 2,340 & 4,988 & 7,339 & 14,905 \\ \text{Total} & 2,609 & 5,288 & 7,639 & 15,205 \\ \hline \end{array} \end{matrix}} \]
가우스 코퓰라를 이용한 시뮬레이션 R 코드
의존성 모델링을 수행하는 방법은 다양하지만, 코퓰라는 여러 보험계리 응용 분야에서 효과적입니다. 각 코퓰라 함수는 그 함수 형태와 의존성 모수에 따라 고유한 의존 구조를 포착한다는 점을 강조해야 합니다. 따라서 코퓰라의 한계와 성질을 이해하지 않은 채 코퓰라를 사용하면 편향되고 통계적으로 잘못된 결과를 얻을 수 있습니다. 적절한 코퓰라를 선택하는 데에는 많은 노력이 들기 때문에, 도움이 될 만한 일반적인 조언을 몇 가지 소개합니다.
데이터를 분석할 때 진단적 분석과 탐색적 분석은 데이터의 의존 구조에 대한 통찰을 제공하며, 이는 적합한 코퓰라 함수를 결정하는 데 도움이 됩니다. 특히 아르키메데스 코퓰라의 경우, 의존 구조를 이해하면 적절한 코퓰라 함수의 유형을 좁힐 수 있습니다. 예를 들어 Gumbel-Hougaard 코퓰라는 음의 의존성에 적합하지 않지만, Frank 코퓰라는 데이터에 나타나는 세 가지 서로 다른 유형의 의존성을 효과적으로 포착할 수 있습니다.
연구자는 데이터의 상단 꼬리 의존성과 하단 꼬리 의존성을 포착하기 위해 정규 코퓰라나 Frank 코퓰라 함수에 의존할 수 없습니다. 대신 자유도가 낮은 \(t\) 코퓰라는 양쪽 꼬리 모두에 잘 작동합니다. Gumbel-Hougaard 코퓰라는 어느 정도의 상단 꼬리 의존성을 보이지만 하단 꼬리 의존성은 적거나 없는 반면, Clayton 코퓰라는 강한 하단 꼬리 의존성을 나타냅니다.
16.6.2 코퓰라 회귀
회귀 연구에서 반응변수는 일군의 설명변수에 의해 결정됩니다. 이는 반응변수와 설명변수 사이의 관계를 이해하기 위해 흔히 가장 먼저 사용되는 통계적 방법 중 하나입니다. 그러나 선형모형과 일반화선형모형은 반응변수의 분포 선택에 제약을 가할 수 있으며, 이는 실제 데이터 상황에서 제한적일 수 있습니다. 예를 들어 보험금 청구액과 금융자산 수익률은 일반적으로 꼬리가 두껍고 비대칭인 분포를 보이며, 극단값이 나타날 가능성이 있어 정규성을 따르지 않을 수 있습니다.
회귀에서 코퓰라를 활용하는 방법은 보험계리학 분야에서 주목받고 있습니다. 코퓰라 회귀는 의존 구조를 주변분포의 선택과 분리하므로, 보험계리 응용 분야에서 분포를 더 유연하게 선택할 수 있게 해 줍니다. 주변분포의 모수와 코퓰라 분포의 모수는 따로 추정할 수도 있고 함께 추정할 수도 있습니다. 모수 추정에는 최대가능도 방법이 효과적인 경우가 많습니다. 그러나 코퓰라 회귀의 모수 추정에는 주변분포 추론 방법(IFM)이 흔히 사용됩니다. 코퓰라 함수는 주변분포를 보존하며, 공변량이 주어졌을 때 종속변수의 조건부 평균을 사용하여 예측합니다. 코퓰라 회귀에 대한 자세한 예시는 Krämer et al. (2013), Parsa and Klugman (2011);를 참조하십시오.
Show Quiz Solution
16.7 추가 자료 및 기여자
기여자
- 위스콘신 대학교 매디슨의 Edward (Jed) Frees와 Nii-Armah Okine, 그리고 Mimar Sinan 대학교의 Emine Selin Sarıdaş가 이 장 초판의 주 저자입니다.
- 이 장의 검토자는 Runhuan Feng, Fei Huang, Himchan Jeong, Min Ji, Toby White입니다.
- Appalachian State University의 Nii-Armah Okine과 Mimar Sinan University의 Emine Selin Sarıdaş가 이 장 제2판의 주 저자입니다. 이 장에 대한 의견과 개선 제안은 okinean@appstate.edu 및 selin.saridas@msgsu.edu.tr로 이메일을 보내 주십시오.
- 이 장의 검토자로는 Mélina Mailhot이 있습니다.
TS 16.A. 스칼라 연관성의 기타 고전적 측도
TS 16.A.1. 블롬크비스트의 베타
Blomqvist (1950)는 오늘날 블롬크비스트의 베타(Blomqvist’s beta) 로 알려진 종속성 측도를 개발하였으며, 이는 중앙값 일치 계수 및 중앙 상관계수라고도 불립니다. 분포함수를 사용하면 이 모수는 다음과 같이 나타낼 수 있습니다.
\[\begin{equation*} \beta_B = 4F\left(F^{-1}_X(1/2),F^{-1}_Y(1/2) \right) - 1. \end{equation*}\]
즉, 먼저 각 주변분포를 그 중앙값(각각 \(F^{-1}_X(1/2)\)와 \(F^{-1}_Y(1/2)\))에서 평가합니다. 그런 다음, 이변량 분포함수를 두 중앙값에서 평가합니다. 재조정(4를 곱하고 1을 뺌)을 거치면 이 계수의 범위는 \([-1,1]\)이 되며, 독립일 때 0이 됩니다.
스피어만의 로 및 켄달의 타우와 마찬가지로, 순위에 기반한 추정량을 쉽게 제시할 수 있습니다. 먼저 \(\beta_B = 4C(1/2,1/2)-1 = 2\Pr((U_1-1/2)(U_2-1/2))-1\)로 쓰며, 여기서 \(U_1, U_2\)는 균등 확률변수입니다. 그런 다음, 다음과 같이 정의합니다.
\[ \hat{\beta}_B = \frac{2}{n} \sum_{i=1}^n I\left( (R(X_{i})-\frac{n+1}{2})(R(Y_{i})-\frac{n+1}{2}) \ge 0 \right)-1 . \]
자세한 내용은 예를 들어 Joe (2014)의 57쪽 또는 Hougaard (2000)의 135쪽을 참조하십시오.
블롬크비스트의 모수는 분포의 중심에 기반하므로 데이터가 중도절단된 경우에 특히 유용합니다. 이러한 경우에는 분포의 극단 부분에 있는 정보를 항상 신뢰할 수 있는 것은 아닙니다. 이것은 연관성 측도의 선택에 어떤 영향을 미칩니까? 첫째, 연관성 측도는 이변량 분포함수에 기반한다는 점을 상기하십시오. 따라서 분포함수의 좋은 근사를 알고 있다면, 연관성 측도의 계산은 원칙적으로 간단합니다. 둘째, 중도절단 데이터의 경우 일변량 카플란-마이어 분포함수 추정량의 이변량 확장을 사용할 수 있습니다. 예를 들어, Dabrowska (1988)에서 소개된 버전은 매력적입니다. 그러나 데이터 범위의 상단에 대량의 데이터가 나타나는 경우가 있기 때문에, 이 추정량을 비롯한 이변량 분포함수의 추정량들은 신뢰할 수 없습니다. 이는 스피어만의 로나 켄달의 타우에 기반한 추정 분포함수의 요약 측도를 신뢰할 수 없을 수 있다는 것을 의미합니다. 이러한 상황에서는 블롬크비스트의 베타가 분포의 중심에 초점을 맞추므로 더 나은 선택으로 보입니다. Hougaard (2000)의 14장에서 추가적인 논의를 제공합니다.
R의 copula 라이브러리에 있는 betan() 함수를 사용하여 블롬크비스트의 베타를 구할 수 있습니다. 아래에서 백만 달러 단위의 \({\tt Coverage}\) 요율 변수와 달러 단위의 \({\tt Claim}\) 금액 변수 사이에서 \(\beta_B=0.3\)입니다.
블롬크비스트의 베타를 위한 R 코드
또한 블롬크비스트의 베타가 순증가 변환에 대해 불변임을 보이기 위해, 로그 백만 달러 단위의 \({\tt Coverage}\) 요율 변수와 달러 단위의 \({\tt Claim}\) 금액 변수 사이에서 \(\beta_B=0.3\)입니다.
TS 16.A.2. 동순위를 갖는 스피어만 상관계수를 이용한 비모수적 접근법
첫 번째 변수에 대해, \(s\)번째 행에 있는 관측값들의 평균 순위는 다음과 같습니다.
\[\begin{equation*} r_{1s} = n_{m_1\bullet}+ \cdots+ n_{s-1,\bullet}+ \frac{1}{2} \left(1+ n_{s\bullet}\right) \end{equation*}\]
마찬가지로 \(r_{2t} = \frac{1}{2} \left[(n_{\bullet m_1}+ \cdots+ n_{\bullet,s-1}+1)+ (n_{\bullet m_1}+ \cdots+ n_{\bullet s})\right]\)입니다. 이를 이용하면 동순위를 갖는 스피어만의 로는 다음과 같습니다.
\[\begin{equation*} \hat{\rho}_S = \frac{\sum_{s=m_1}^{m_2} \sum_{t=m_1}^{m_2} n_{st}(r_{1s} - \bar{r})(r_{2t} - \bar{r})} {\left[\sum_{s=m_1}^{m_2}n_{s \bullet}(r_{1s} - \bar{r})^2 \sum_{t=m_1}^{m_2} n_{\bullet t}(r_{2t} - \bar{r})^2 \right]^2} \end{equation*}\]
여기서 평균 순위는 \(\bar{r} = (n+1)/2\)입니다.
특수한 경우: 이진 데이터에 대한 증명을 보려면 클릭하십시오.
R의 cor() 함수에서 spearman 방법을 선택하면 동순위 보정 스피어만 상관 통계량 \(r_S\)를 구할 수 있습니다. 아래로부터 \(\hat{\rho}_S=-0.09\)입니다.