제6장 모형 선택
장 미리보기. 모형 선택은 통계적 모형화의 근본적인 측면입니다. 이 장에서는 모형 비교와 진단을 위한 도구를 포함하여 모형 선택 과정을 요약합니다. 이 장에서는 설명변수를 무시한 결과변수의 주변분포에 기반한 모형 선택용 비모수적 도구에 더하여, 모형 선택이 반복적인 과정이라는 생각을 강조합니다. 이 과정에서 모형은 추론에 사용되기 전에 순환적으로 (재)구성되고 적절성을 검정받습니다. 개요를 살펴본 후, 다음에 기반한 모형 선택(model selection) 데이터를 이용하여 후보 모형 집합에서 통계 모형을 선택하는 과정. 과정을 설명합니다.
- 표본 내(in-sample) 분석 및 모형 개발에 사용하는 데이터셋으로, 훈련 데이터셋이라고도 합니다. 데이터셋 또는 훈련 데이터셋,
- 표본 외(out-of-sample) 모형 검증에 사용하는 데이터셋으로, 테스트 데이터셋이라고도 합니다. 데이터셋 또는 검정 데이터셋, 그리고
- 이 두 접근법을 결합한 방법으로서 교차 검증(cross-validation) 데이터 표본을 부분표본들로 분할하고, 각 부분표본을 차례로 표본 외 데이터셋으로 삼아 분할을 구성하는 모형 검증 절차.이라고 알려진 방법.
여기서는 주로 연속분포에서 나온 데이터에 초점을 맞추지만, 같은 과정을 이산형 데이터나 이산분포와 연속분포가 혼합된 형태에서 나온 데이터에도 사용할 수 있습니다.
이 장에서는 다음을 배웁니다.
- 모수적 적합이 비모수적 적합에서 벗어난 정도를 요약하는 측도를 구합니다
- 반복적인 모형 선택 및 설정 과정을 설명합니다
- 모수적 모형을 선택하는 데 필요한 단계를 개략적으로 제시합니다
- 표본 외 모형 검증의 장점과 비교하여, 순전히 표본 내 데이터에만 기반한 모형 선택의 함정을 설명합니다
6.1 모형 선택과 진단을 위한 도구
절 4.1.1에서는 기저 분포에 대해 어떠한 모수적 형태도 가정하지 않는 비모수적 추정량을 소개했습니다. 그러나 많은 계리 응용에서 분석가는 설명이 쉽고, 회귀 설정에서 설명변수를 포함하는 것처럼 더 복잡한 상황으로 쉽게 확장할 수 있다는 이유로 분포의 모수적 적합을 사용하고자 합니다. 모수적 분포를 적합할 때, 어떤 분석가는 손실 데이터 집합을 나타내기 위해 감마분포를 사용하려 할 수 있습니다. 그러나 다른 분석가는 파레토 분포를 사용하는 것을 선호할 수 있습니다. 어떤 모형을 선택할지 어떻게 결정합니까?
비모수적 도구는 모수적 모형의 선택을 뒷받침하는 데 사용할 수 있습니다. 본질적으로 이 접근법은 적합된 모수적 모형에서 선택한 요약 측도를 계산하고, 이를 비모수적 모형에서의 대응하는 값과 비교하는 것입니다. 비모수적 모형은 특정 분포를 가정하지 않으며 단지 데이터의 함수일 뿐이므로, 모수적 분포/모형이 데이터를 얼마나 잘 나타내는지 평가하는 기준으로 사용됩니다. 또한 표본 크기가 커지면 경험분포는 (대수의 강법칙에 의해) 기저 모집단 분포로 거의 확실하게 수렴합니다. 따라서 경험분포는 모집단을 잘 대리합니다. 모수적 추정량과 비모수적 추정량을 비교하면 분석가가 모수적 모형의 결함을 알아차릴 수 있으며, 때로는 모수적 설정을 개선할 방법을 찾을 수도 있습니다. 모형의 타당성을 평가하기 위한 절차를 모형 진단(model diagnostics) 모형의 타당성을 평가하는 절차이라고 합니다.
6.1.1 분포의 그래프 비교
우리는 이미 비교 목적으로 그래프를 겹쳐 그리는 기법을 살펴보았습니다. 이 기법의 적용을 보강하기 위해, 그림 6.1은 절 1.3에서 소개한 재산 기금 데이터의 로그 청구에 대해 경험분포를 두 개의 모수적 적합된 분포와 비교합니다. 왼쪽 패널은 청구액 분포의 분포함수를 보여 줍니다. “S자 모양” 곡선을 이루는 점들은 각 관측값에서의 경험분포함수를 나타냅니다. 굵은 파란색 곡선은 적합된 감마분포에 대응하는 값을, 연한 보라색 곡선은 적합된 파레토 분포에 대응하는 값을 나타냅니다. 파레토 분포가 감마분포보다 경험분포함수에 훨씬 더 가까우므로, 이는 이 데이터셋에 대해 파레토 분포가 더 나은 모형이라는 증거가 됩니다. 오른쪽 패널은 밀도함수에 대해 비슷한 정보를 제공하며, 일관된 결론을 보여 줍니다. (오직) 이 그림들만을 근거로 한다면, 분석가에게는 파레토 분포가 분명한 선택입니다.
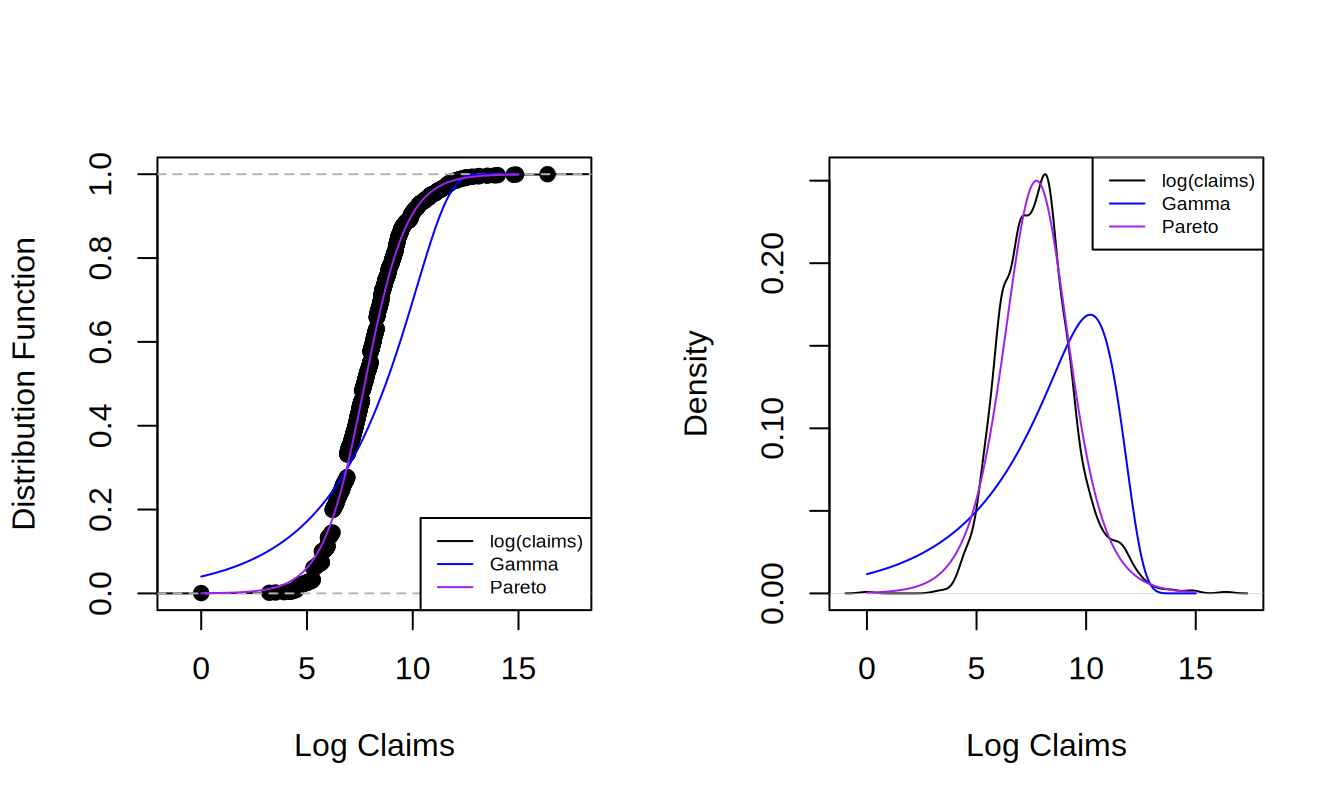
그림 6.1: 비모수적 분포함수 및 밀도함수와 적합된 모수적 분포함수 및 밀도함수의 비교. 왼쪽 패널은 분포함수를 비교하며, 점은 경험분포에, 굵은 파란색 곡선은 적합된 감마분포에, 연한 보라색 곡선은 적합된 파레토 분포에 대응합니다. 오른쪽 패널은 이 세 분포를 확률밀도함수로 요약하여 비교합니다.
두 적합된 모형의 적절성을 비교하는 또 다른 방법으로 확률-확률(pp) 그림(probability-probability (pp) plot) 두 모형을 누적확률을 통해 비교하는 그림.을 고려해 보십시오. \(pp\) 그림은 두 모형에서의 누적확률을 비교합니다. 여기서의 목적상, 이 두 모형은 비모수적 경험분포함수와 모수적 적합된 모형입니다. 그림 6.2는 재산 기금 데이터에 대한 \(pp\) 그림을 보여 줍니다. 왼쪽은 적합된 감마분포, 오른쪽은 적합된 파레토 분포이며, 둘 다 데이터의 동일한 경험분포함수와 비교됩니다. 직선은 비교 대상인 두 분포가 같음을 나타내므로, 점들이 직선에 가까울수록 바람직합니다. 앞서 살펴본 예에서와 같이, 파레토 분포가 감마분포보다 경험분포에 훨씬 더 가까우며, 이는 파레토 분포가 더 나은 모형이라는 추가적인 증거가 됩니다.
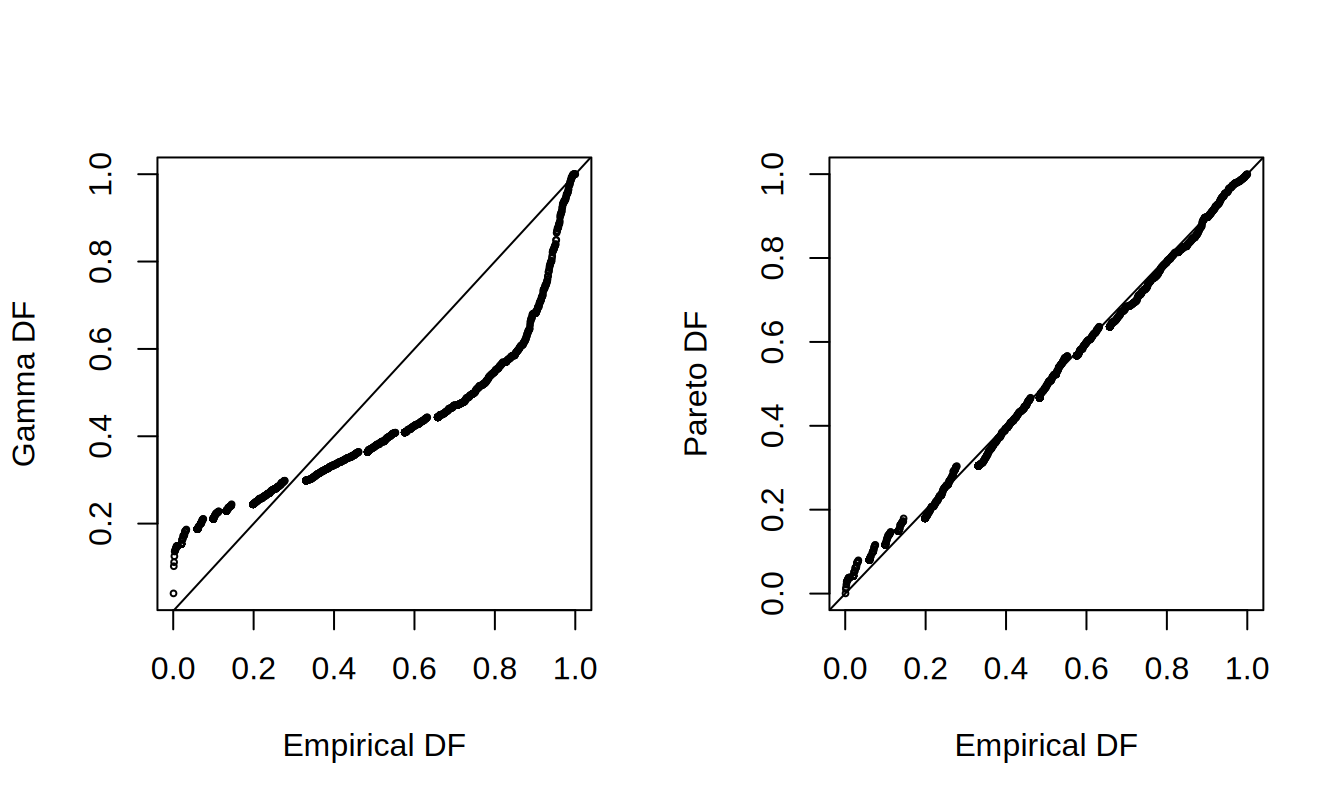
그림 6.2: 확률-확률(\(pp\)) 그림. 가로축은 각 관측값에서의 경험분포함수를 나타냅니다. 왼쪽 패널에서는 이에 대응하는 감마분포의 분포함수가 세로축에 표시됩니다. 오른쪽 패널은 적합된 파레토 분포를 보여 줍니다. \(y=x\) 직선이 겹쳐 그려져 있습니다.
\(pp\) 그림이 유용한 이유 중 하나는 인위적인 척도 조정이 필요하지 않다는 점입니다. 예를 들어 그림 6.1에서 밀도를 겹쳐 그릴 때는 데이터를 더 잘 시각화하기 위해 로그 척도로 바꾸어야 했습니다. 또한 \(pp\) 그림은 결과변수가 둘 이상인 다변량 상황에서도 사용할 수 있다는 점에 유의하십시오. 그러나 \(pp\) 그림의 한계는 누적 분포함수를 그리기 때문에, 적합된 모수적 분포가 어디에서 부족한지 파악하기 어려울 때가 있다는 것입니다. 그 대안으로, 그림 6.3에서 보이는 것처럼 분위수-분위수(qq) 그림(quantile-quantile (qq) plot) 두 모형을 분위수를 통해 비교하는 그림.을 사용하는 것이 일반적입니다.
\(qq\) 그림은 두 적합된 모형을 그 분위수를 통해 비교합니다. \(pp\) 그림에서와 마찬가지로, 비모수적 모형을 모수적 적합된 모형과 비교합니다. 분위수는 용도에 따라 데이터셋의 각 점에서 구할 수도 있고, 격자(예: \(0, 0.001, 0.002, \ldots, 0.999, 1.000\)) 위에서 구할 수도 있습니다. 그림 6.3에서는 앞서 언급한 격자의 각 점에 대해 수평축에 경험분위수를, 수직축에 이에 대응하는 적합된 모수적 분위수를 나타냅니다(위쪽 두 패널은 감마, 아래쪽 두 패널은 파레토). 적합된 분포가 어디에서 부족한지 확인할 수 있도록 왼쪽 패널에서는 분위수를 원래 척도로, 오른쪽 패널에서는 로그 척도로 그렸습니다. 직선은 경험분포와 적합된 분포가 같은 경우를 나타냅니다. 이 플롯들에서도 파레토가 감마보다 전반적으로 더 잘 적합함을 다시 확인할 수 있습니다. 또한 오른쪽 아래 패널을 보면 파레토 분포는 큰 청구액에 대해서는 잘 맞지만, 작은 청구액에 대해서는 적합이 더 나쁩니다.
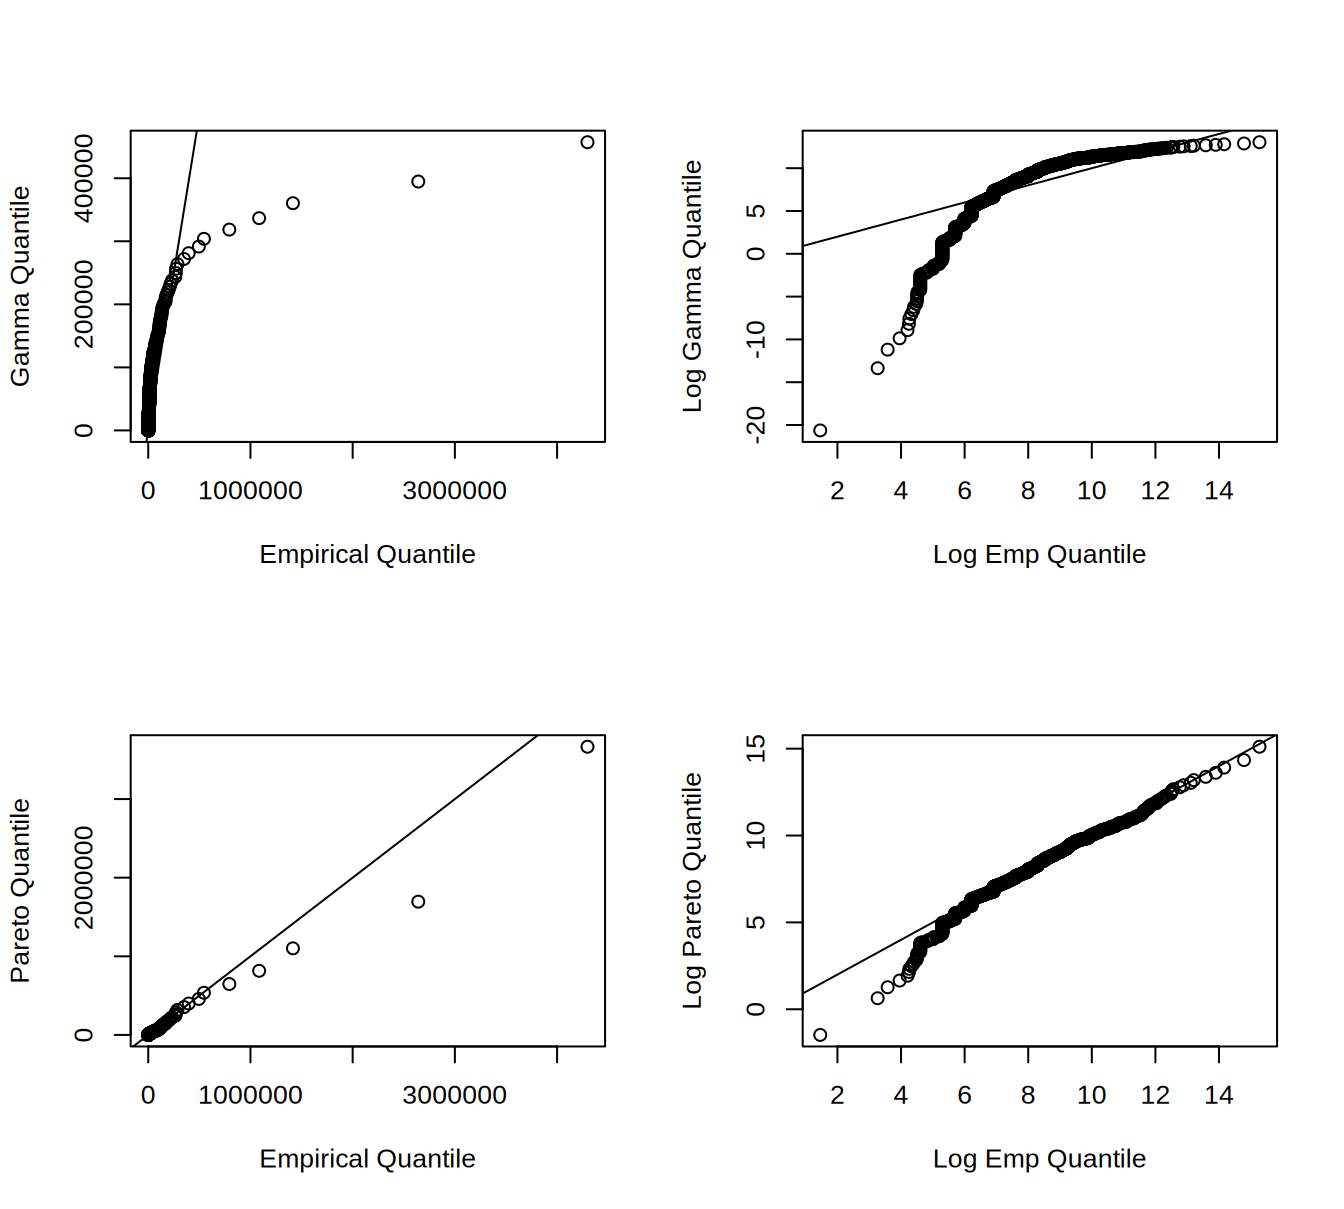
그림 6.3: 분위수-분위수(\(qq\)) 그림. 수평축은 각 관측값에서의 경험분위수를 나타냅니다. 오른쪽 패널은 로그 척도로 그렸습니다. 세로축은 적합된 분포의 분위수를 나타냅니다. 감마 분위수는 위쪽 패널에, 파레토 분위수는 아래쪽 패널에 있습니다.
예제 6.1.1. 보험계리사 시험 문제. 그림 6.4은 적합된 분포를 표본과 비교한 \(pp\) 플롯입니다.
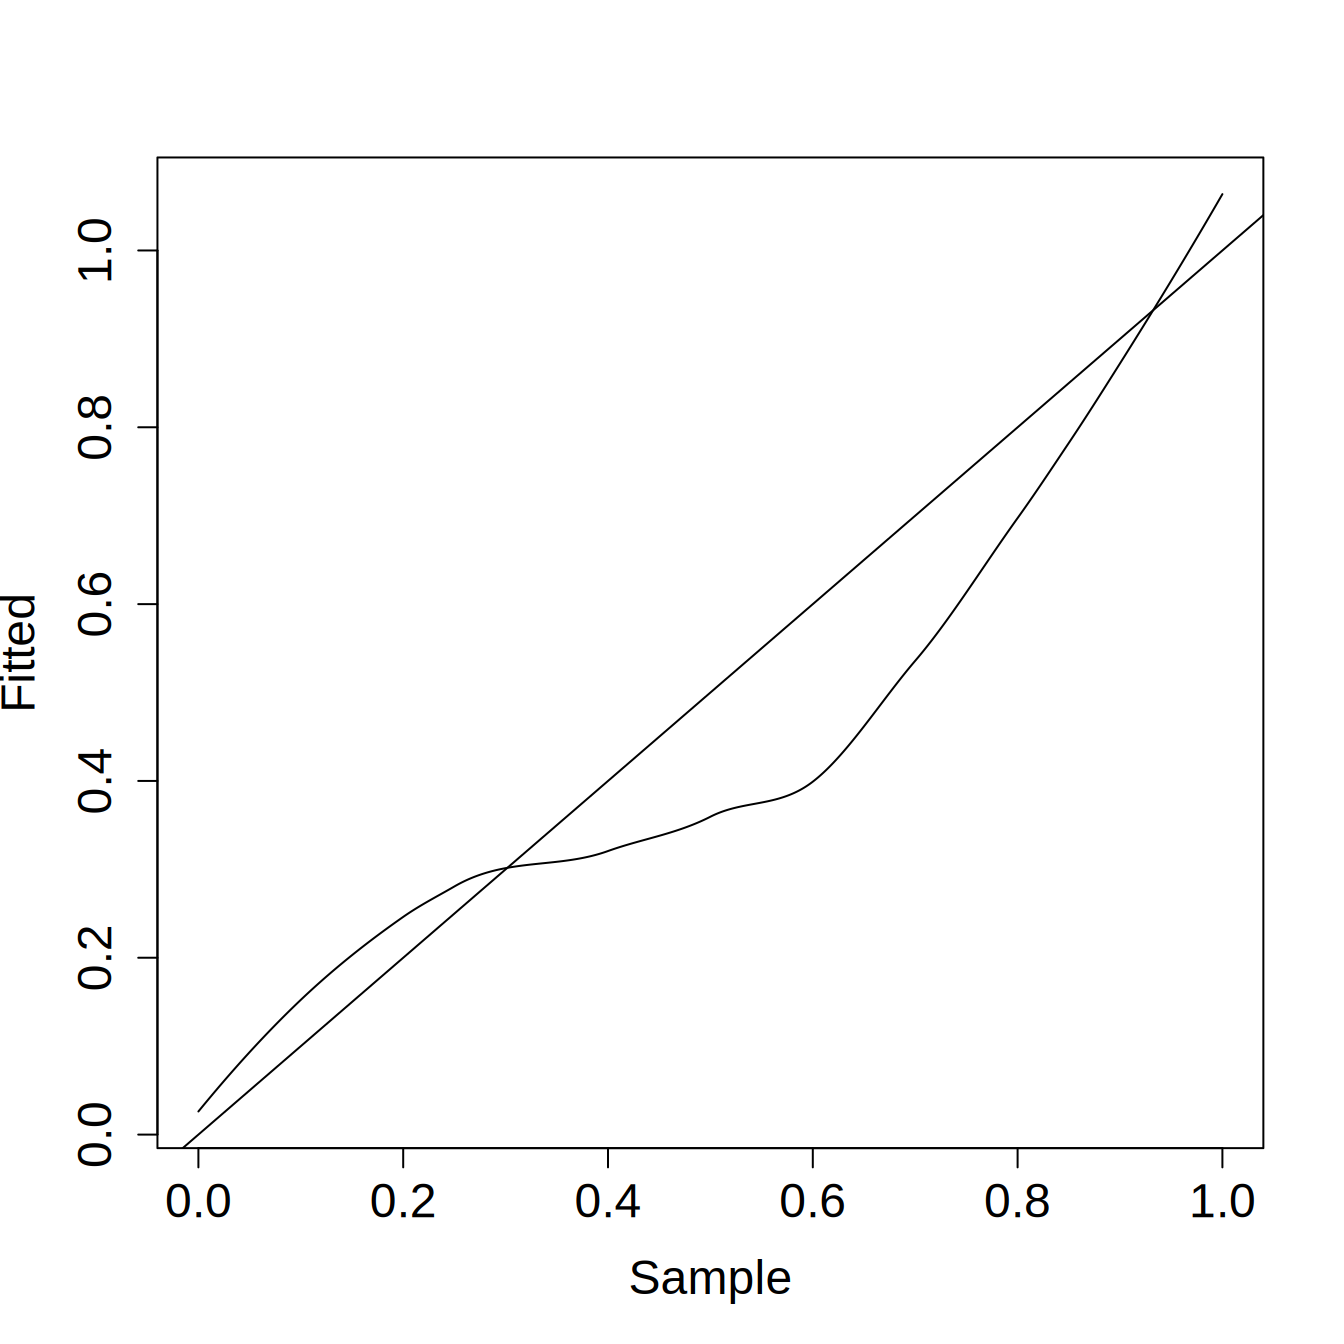
그림 6.4: 예제 6.1.1 플롯
왼쪽 꼬리, 오른쪽 꼬리, 중앙값 부근의 확률 측면에서 두 분포를 비교하여 설명하십시오.
예제 풀이 보기
6.1.2 분포의 통계적 비교
모형을 선택할 때에는 앞서 제시한 그래프를 그려 보는 것이 도움이 됩니다. 그러나 결과를 보고할 때에는 모형의 적합도를 요약하는 몇 가지 통계량으로 그래프를 보완하는 것이 효과적일 수 있습니다. 표 6.1은 흔히 사용되는 세 가지 적합도 통계량(goodness of fit statistics) 통계 모형이 데이터에 얼마나 잘 적합하는지를 평가하는 데 사용하는 척도로, 일반적으로 관측값과 모형하의 기댓값 사이의 차이를 요약하여 나타냅니다.을 제시합니다. 이 표에서 \(F_n\)은 경험분포, \(F\)은 적합된 분포 또는 가설 분포이며, \(F_i^* = F(x_i)\)입니다.
표 6.1. 세 가지 적합도 통계량
\[ {\small \begin{matrix} \begin{array}{l|cc} \hline \text{Statistic} & \text{Definition} & \text{Computational Expression} \\ \hline \text{Kolmogorov-} & \max_x |F_n(x) - F(x)| & \max(D^+, D^-) \text{ where } \\ ~~~\text{Smirnov} && D^+ = \max_{i=1, \ldots, n} \left|\frac{i}{n} - F_i^*\right| \\ && D^- = \max_{i=1, \ldots, n} \left| F_i^* - \frac{i-1}{n} \right| \\ \text{Cramer-von Mises} & n \int (F_n(x) - F(x))^2 f(x) dx & \frac{1}{12n} + \sum_{i=1}^n \left(F_i^* - (2i-1)/n\right)^2 \\ \text{Anderson-Darling} & n \int \frac{(F_n(x) - F(x))^2}{F(x)(1-F(x))} f(x) dx & -n-\frac{1}{n} \sum_{i=1}^n (2i-1) \log\left(F_i^*(1-F_{n+1-i})\right)^2 \\ \hline \end{array} \\ \end{matrix} } \]
콜모고로프-스미르노프 통계량(Kolmogorov-Smirnov statistic)은 적합된 분포함수와 경험분포함수 사이의 최대 절대 차이입니다. 크라메르-폰 미제스 통계량(Cramer-von Mises statistic)은 개별 점에서의 차이를 비교하는 대신, 전체 값의 범위에 걸쳐 경험분포함수와 적합된 분포함수의 차이를 적분합니다. 앤더슨-달링 통계량(Anderson-Darling statistic) 역시 값의 범위에 걸쳐 이 차이를 적분하지만, 분산의 역수로 가중을 둡니다. 따라서 이 통계량은 분포의 꼬리 부분(즉, \(F(x)\) 또는 \(1-F(x)=S(x)\)가 작을 때)에 더 큰 비중을 둡니다.
예제 6.1.2. 계리사 시험 문제 (변형). 청구 지급액의 표본은 다음과 같습니다: \[ \begin{array}{ccccc} 29 & 64 & 90 & 135 & 182 \\ \end{array} \] 콜모고로프-스미르노프 검정통계량의 값을 계산하여 경험 청구분포를 평균이 \(100\)인 지수분포와 비교하십시오.
예제 풀이 보기
피어슨 카이제곱 검정
이 절에서는 또 다른 적합도 검정인 피어슨 카이제곱 검정을 소개합니다. 이 검정은 이산분포가 이산 데이터에 잘 적합하는지 검정하는 데 사용할 수 있습니다. 입문 수리통계학 수준에서 피어슨 카이제곱 검정(Pearson’s chi-square test) 범주형 데이터 집합에 적용하여, 집합 간에 관찰된 차이가 우연히 발생했을 가능성이 얼마나 되는지를 평가하는 통계적 검정에 대해 더 자세히 알고 싶은 독자는 Hogg, Tanis, and Zimmerman (2015)의 9.1절을 참고하시기 바랍니다.
피어슨 카이제곱 검정의 적용을 예시하기 위해 절 3.7에서 소개한 예제를 사용합니다. \(1993\)에 싱가포르의 한 주요 보험회사가 보유한 \(n=7,483\)의 자동차 보험계약으로 구성된 포트폴리오에서 보험계약자당 자동차 사고 수의 분포는 표 6.2에 주어진 것과 같았습니다.
표 6.2. 싱가포르 자동차 사고 데이터
\[ \small{ \begin{array}{l|c|c|c|c|c|c} \hline \text{Count }(k) & 0 & 1 & 2 & 3 & 4 & \text{Total}\\ \hline \text{No. of Policies with }k\text{ accidents }(m_k) & 6,996 & 455 & 28 & 4 & 0 & 7,483\\ \hline \end{array} } \]
포아송 분포를 적합하는 경우, 포아송 평균인 \(\lambda\)의 mle는 표본평균이며 다음과 같이 주어집니다. \[ \overline{N} = \frac{0\cdot 6996 + 1 \cdot 455 + 2 \cdot 28 + 3 \cdot 4 + 4 \cdot 0}{7483} = 0.06989. \] 이제 포아송(\(\hat{\lambda}_{MLE}\))을 적합된 분포로 사용하면, 적합된 빈도와 관측된 빈도를 표로 비교한 결과는 표 6.3과 같습니다. 여기서 \(\hat{p}_k\)는 적합된 포아송 분포하에서 추정된 확률을 나타냅니다.
표 6.3. 관측 빈도와 적합 빈도의 비교: 싱가포르 자동차 데이터
\[ \small{ \begin{array}{c|r|r} \hline \text{Count} & \text{Observed} & \text{Fitted Counts}\\ (k) & (m_k) & \text{Using Poisson }(n\hat{p}_k)\\ \hline 0 & 6,996 & 6,977.86 \\ 1 & 455 & 487.70 \\ 2 & 28 & 17.04 \\ 3 & 4 & 0.40 \\ \geq 4 & 0 & 0.01\\ \hline \text{Total} & 7,483 & 7,483.00\\ \hline \end{array} } \]
적합이 타당해 보이기는 하지만, 피어슨 카이제곱 통계량은 기저 분포가 포아송이라는 가설을 검정하는 데 사용할 수 있는 적합도 측도입니다. 이 통계량을 설명하기 위해, 크기가 \(n\)인 데이터셋이 \(k\)개의 셀로 묶여 있고, \(k=1\ldots,K\)에 대해 \(m_k/n\)과 \(\hat{p}_k\)가 각각 관측값이 \(k\)번째 셀에 속할 관측 확률과 추정 확률이라고 가정합시다. 그러면 피어슨 카이제곱 검정통계량은 다음과 같이 주어집니다.
\[
\sum_{k=1}^K\frac{\left( m_k-n\widehat{p}_k \right) ^{2}}{n\widehat{p}_k}.
\]
위 통계량의 근거는 \(p_k\), \(k=1,\ldots,K\)가 실제 셀 확률일 때
\[
\sum_{k=1}^K\frac{\left( m_k-n{p}_k \right) ^{2}}{n{p}_k}
\]
가 자유도 \(K-1\)인 극한 카이제곱 분포(chi-square distribution) 자유도가 k인 카이제곱 분포는 k개의 독립 표준정규 확률변수의 제곱합의 분포입니다를 따른다는 사실에서 비롯됩니다. 이제 \(m_k\), \(k=1,\ldots,K\)로 나타내는 요약 데이터만 이용할 수 있다고 가정합시다. 더 나아가, \(p_k\)들이 \(s\)개 모수의 함수라면, \(p_k\)들을 효율적으로 추정된 임의의 확률 \(\widehat{p}_k\)들로 대체하더라도 이 통계량은 여전히 극한 카이제곱 분포를 따르지만, 자유도는 \(K-1-s\)가 됩니다. 이러한 효율적 추정값은 예를 들어 (다항 가능도(multinomial likelihood) 다항분포는 k면 주사위를 n번 굴렸을 때 나오는 횟수의 확률을 모형화합니다를 이용한) mle 방법을 사용하거나, 위의 피어슨 카이제곱 통계량을 최소화하는 \(s\)개의 모수를 추정하여 구할 수 있습니다. 예를 들어, 아래의 R 코드는 후자의 방법으로 \(\lambda\)의 추정값을 계산하며, 그 결과 추정값은 \(0.06623153\)으로, 전체 데이터를 사용한 \(\lambda\)의 mle와 가깝지만 다릅니다:
m  <- c(6996,455,28,4,0);
op <- m/sum(m);
g  <- function(lam){ sum( (op-c(dpois(0:3,lam),1-ppois(3,lam)) )^2) };
optim( sum(op*(0:4)), g, method="Brent", lower=0, upper=10)$par
전체 데이터를 사용하여 확률을 추정하면, 점근분포는 모수가 \(K-1\)인 카이제곱 분포와 \(K-1-s\)인 카이제곱 분포의 중간에 위치합니다. 실무에서는 이러한 미묘한 차이를 무시하고 극한 카이제곱 분포의 자유도가 \(K-1-s\)라고 가정하는 것이 일반적입니다. 흥미롭게도, 이 실용적인 간편법은 포아송 분포의 경우 상당히 잘 작동합니다.
싱가포르 자동차 데이터의 경우, 전체 데이터에 기반한 \({\lambda}\)의 mle를 사용하면 피어슨 카이제곱 통계량은 \(41.98\)입니다. 자유도가 \(5-1-1=3\)인 카이제곱 극한분포를 사용하면, \(41.98\)이라는 값은 꼬리 부분의 아주 먼 곳에 있음을 알 수 있습니다(\(99\)번째 백분위수가 \(12\)보다 작습니다). 따라서 포아송 분포는 이 데이터에 적절하게 적합하지 않는다고 결론지을 수 있습니다.
앞에서는 위의 표 요약에 주어진 구간을 그대로 사용하였습니다. 실제로는 카이제곱 분포가 통계량의 유한 표본 분포를 잘 근사하도록 구간을 어떻게 정의할 것인가가 중요한 문제입니다. 경험적 규칙으로는 구간 전부는 아니더라도 적어도 \(80\%\)의 구간에서 기대도수가 \(5\)보다 크도록 구간을 정의합니다. 또한 구간의 수가 많을수록 검정력이 높아지는 것이 분명하므로, 각 구간에 최소 5개의 관측값이 있도록 하면서 구간의 수를 최대화하는 것이 간단한 경험적 규칙입니다.
6.2 반복적 모형 선택
모형을 개발할 때 우리는 개선된 모형을 수립하기 위해 데이터를 그래프로 살펴보고, 모형 구조에 대한 가설을 세우고, 데이터를 후보 모형과 비교합니다. Box (1980)는 이를 반복적 과정으로 설명하며, 이는 그림 6.5에 나와 있습니다.
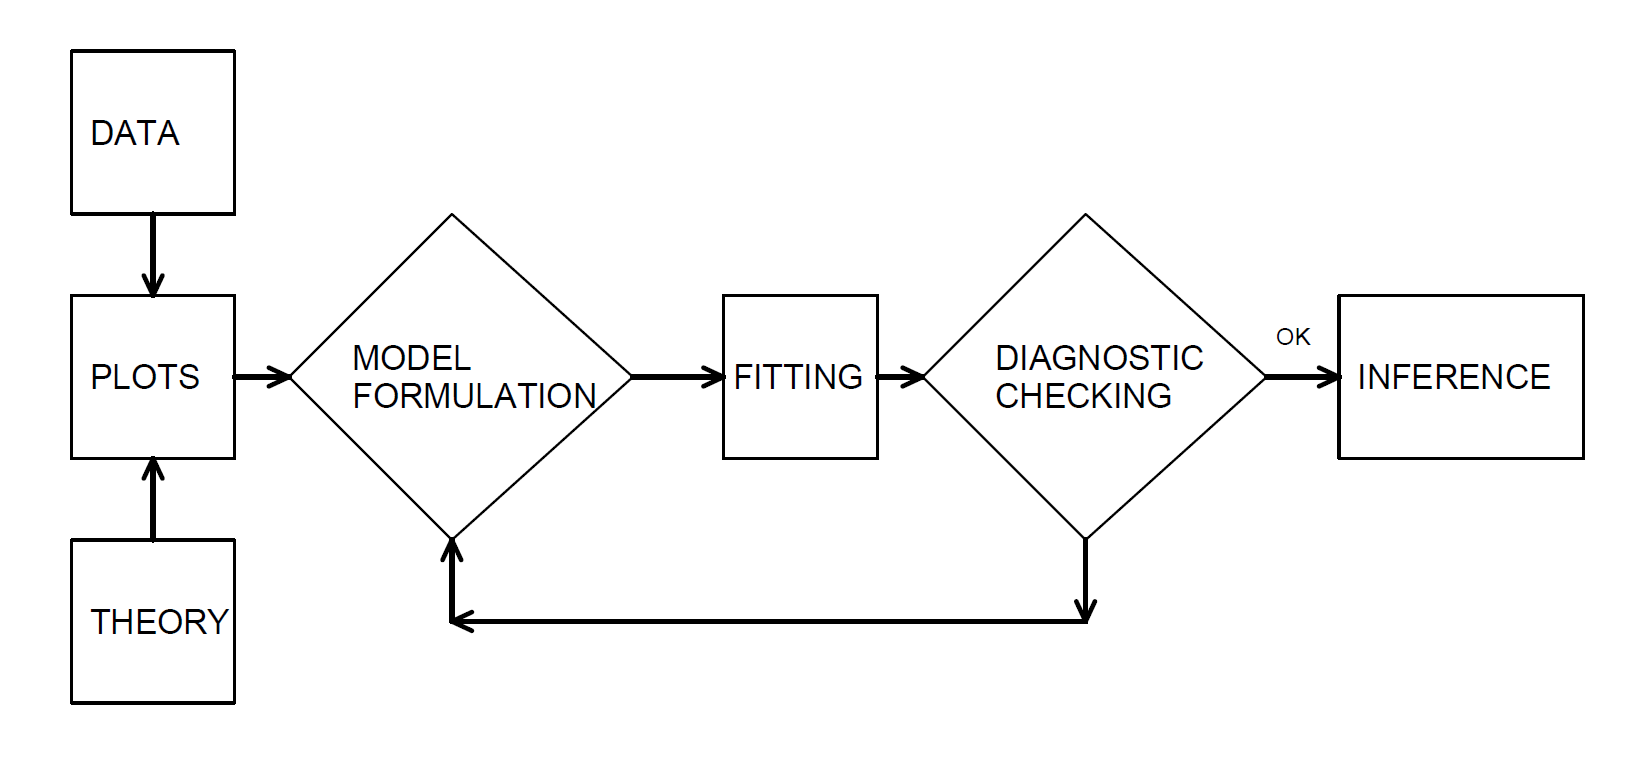
그림 6.5: 반복적 모형 설정 과정
이 반복적 과정은 데이터 집합을 나타낼 모형을 설정하는 작업을 체계화하는 데 유용한 방법을 제공합니다.
- 첫 번째 단계인 모형 수립 단계는 데이터를 그래프로 살펴보고, 경제 이론이나 업계 관행 등에서 얻은 관계에 대한 사전 지식을 활용하여 수행합니다.
- 반복의 두 번째 단계는 설정된 모형의 가정에 기초한 적합입니다. 모형을 타당하게 사용하려면 이러한 가정이 데이터와 부합해야 합니다.
- 세 번째 단계는 진단 검토입니다. 추가적인 추론을 하기 전에 데이터와 모형이 서로 부합해야 합니다. 진단 검토는 모형 수립의 중요한 부분입니다. 진단 검토를 통해 이전 단계에서 저지른 실수를 발견하고 이를 바로잡을 방법을 찾을 수 있습니다.
반복적 과정은 데이터 분석을 제대로 수행하는 데 필요한 역량도 강조합니다. 첫째, 정보를 수치로 요약하고 그래프로 나타내려는 자세가 필요합니다. 둘째, 모형의 성질에 대한 이해를 키우는 것이 중요합니다. 데이터 집합을 확률 모형에 맞추려면 그 모형이 어떻게 작동하는지 이해해야 합니다. 셋째, 데이터의 양상에 기초하여 일반적인 관계를 추론하는 데에는 모형의 이론적 성질도 중요합니다.
6.3 훈련 데이터셋에 기초한 모형 선택
2.2절에서 소개한 바와 같이, 모형 적합에 사용하는 데이터셋을 훈련 데이터셋 또는 표본 내 데이터셋이라고 부르는 것이 일반적입니다. 모형 선택에 사용할 수 있는 기법은 결과 \(X\)가 이산형인지, 연속형인지, 아니면 둘이 혼합된 형태인지에 따라 달라지지만, 원리는 동일합니다.
그래프 및 기타 기본 요약 측도. 4.4.1절에서 요약한 바와 같이, 먼저 데이터를 그래프와 특정 모수적 형태에 의존하지 않는 통계량으로 요약하십시오. 구체적으로, 경험분포함수와 경험밀도함수를 모두 그래프로 그려 보는 것이 좋습니다. 특히 0을 많이 포함하고 치우쳐 있을 수 있는 손실 데이터의 경우, 적절한 척도(예: 로그 척도)를 결정하는 데 어려움이 있을 수 있습니다. 이산형 데이터의 경우에는 표가 선호되는 경우가 많습니다. 평균과 분산 같은 표본 적률과 함께 최솟값, 최댓값, 중앙값을 포함한 주요 분위수를 구하십시오. 이산형 데이터의 경우에는 최빈값(가장 자주 나타나는 값)이 대개 유용합니다.
이러한 요약 결과와 업계 관행에 대한 이해를 바탕으로 하나 이상의 후보 모수적 모형을 떠올릴 수 있을 것입니다. 일반적으로 더 단순한 모수적 모형(예를 들어 모수가 2개인 감마 분포보다 모수가 1개인 지수 분포)부터 시작하여 모형화 과정에 점차 복잡성을 더해 가십시오.
후보 모수적 모형을 수치적으로, 그리고 그래프로 비판적으로 평가하십시오. 그래프에는 6.1절에서 소개한 \(pp\) 플롯과 \(qq\) 플롯 같은 도구를 활용하십시오. 수치적 평가에서는 모수의 통계적 유의성을 검토하고, 추가 정보를 제공하지 않는 모수는 제거하도록 하십시오. 모수의 통계적 유의성 외에도 다음과 같은 모형 비교 도구를 사용할 수 있습니다.
가능도비 검정. 모형 적합을 비교할 때 한 모형이 다른 모형의 부분집합이라면 가능도비 검정을 사용할 수 있습니다. 가능도비 검정의 일반적인 접근법은 부록 절 17.4.3와 19.1에 설명되어 있습니다.
적합도 통계량. 일반적으로 모형들은 서로의 진부분집합이 아니며, 이 경우 전반적인 적합도 통계량이 모형 비교에 도움이 됩니다. 정보 기준은 적합도 통계량의 한 유형입니다. 가장 널리 사용되는 예는 아카이케 정보 기준(AIC)과 (슈바르츠) 베이즈 정보 기준(BIC)입니다. 이들은 다변량 상황으로 쉽게 일반화할 수 있기 때문에 널리 인용됩니다. 부록 17.4.4절에 이들 통계량이 요약되어 있습니다.
적절한 분포를 선택할 때는 6.1.2절에 요약된, 모수적 적합을 비모수적 대안과 비교하는 통계량이 모형 비교에 유용합니다. 이산 데이터의 경우에는 더 직관적이고 설명하기도 간단하므로 일반적으로 적합도 통계량이 선호됩니다.
6.4 테스트 데이터셋에 기반한 모형 선택
모형 검증(Model validation) 제안된 모형이 적절한지 확인하는 과정. 2.2절에서 소개한 이것은 특히 조사의 목적에 비추어 볼 때, 제안된 모형이 적절한지를 테스트 데이터셋 또는 표본 외 데이터셋을 바탕으로 확인하는 과정입니다. 훈련 데이터 또는 표본 내 데이터만을 바탕으로 한 모형 선택 과정은 데이터 스누핑(data-snooping) 관심 있는 사전 가설 없이 하나의 데이터셋에 모형을 반복적으로 적합하는 것., 즉 하나의 데이터 집합에 매우 많은 모형을 적합하는 일에 취약할 수 있으므로 모형 검증은 중요합니다. 많은 수의 모형을 살펴보다 보면 데이터를 과적합하고 우리가 표현하는 모형의 자연적 변동을 과소평가할 수 있습니다.
표본 내 데이터만을 바탕으로 모형을 선택하는 것은 예측 추론(predictive inference) 예측 추론은 과거의 데이터 관측값을 이용하여 미래의 관측값을 예측하는 과정입니다.라는 목표에도 부합하지 않습니다. 특히 보험계리 응용에서 우리의 목표는 현재 가지고 있는 데이터셋이 아니라 새로운 경험에 대해 진술하는 것입니다. 예를 들어, 한 해의 청구 경험을 사용하여 다음 해의 보험계약 가격을 책정하는 데 사용할 수 있는 모형을 개발합니다. 비유하자면, 훈련 데이터셋은 다음 해 테스트 데이터셋의 행태를 예측하는 데 사용되는 한 해의 경험이라고 생각할 수 있습니다.
우리는 표본 외 검증이라고 알려진 기법을 사용하여 이러한 비판에 대응할 수 있습니다. 이상적인 상황은 두 개의 데이터 집합, 즉 훈련(모형 개발)을 위한 집합과 테스트(모형 검증)를 위한 집합을 모두 사용할 수 있는 경우입니다. 먼저 첫 번째 데이터셋에서 하나 또는 여러 개의 모형을 개발하는데, 이를 후보 모형이라고 부릅니다. 그런 다음 두 번째 데이터 집합에서 후보 모형들의 상대적 성능을 측정할 수 있습니다. 이렇게 하면 모형을 검증하는 데 사용되는 데이터가 모형을 수립하는 데 사용된 절차의 영향을 받지 않습니다.
데이터의 무작위 분할. 안타깝게도 연구자가 두 개의 데이터 집합을 확보할 수 있는 경우는 드뭅니다. 2.2절에서 언급했듯이, 데이터셋을 각각 훈련 부분표본과 테스트 부분표본으로 분할하여 검증 과정을 수행할 수 있습니다. 그림 6.6은 이러한 데이터 분할을 보여 줍니다.
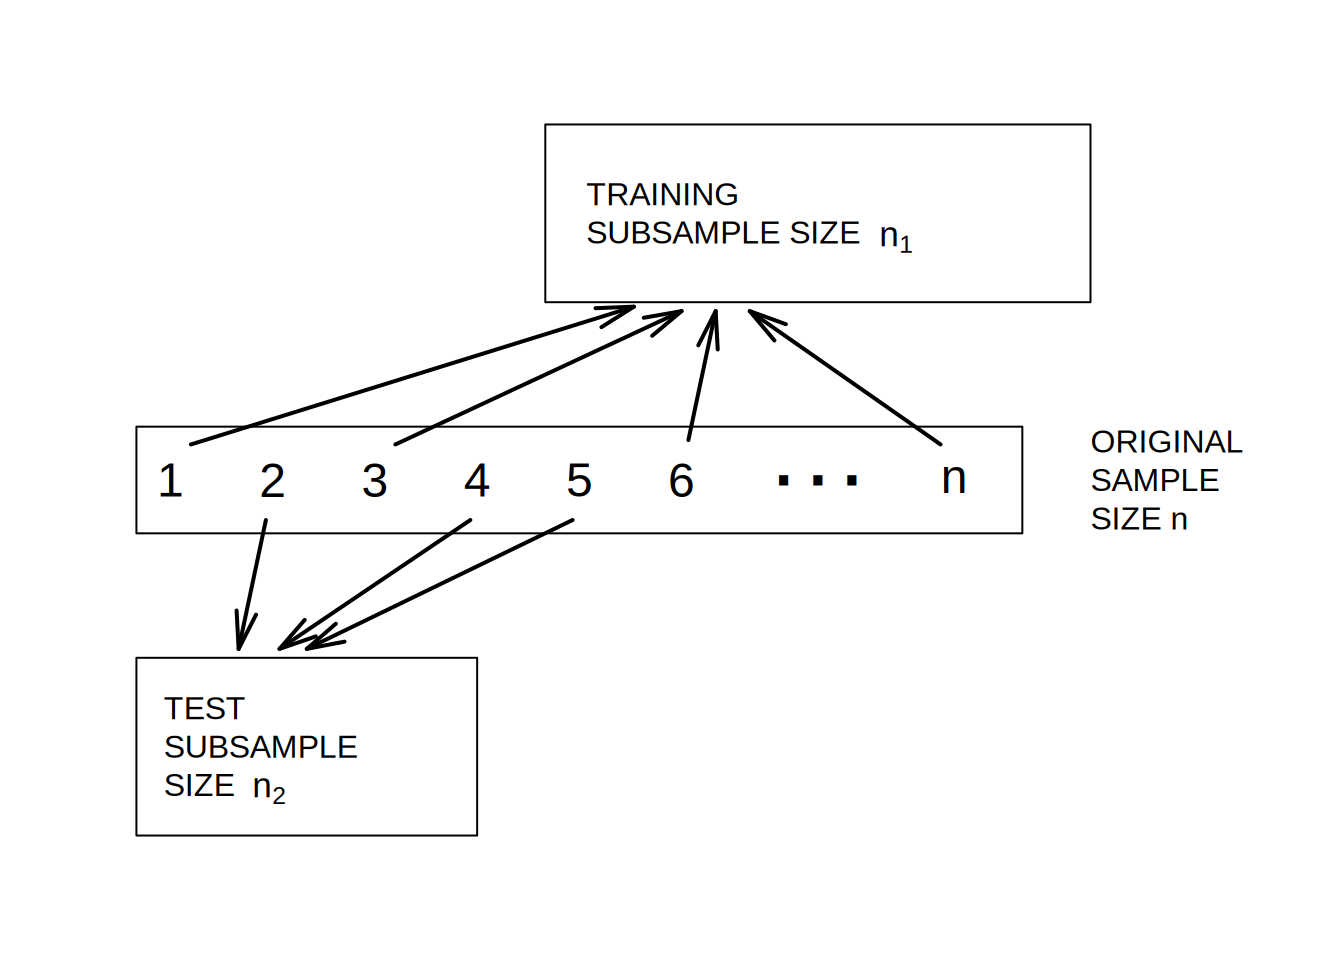
그림 6.6: 모형 검증. 데이터셋을 두 개의 부분표본으로 무작위 분할합니다.
연구자마다 권장하는 배분 비율이 다릅니다. Snee (1977)은 표본 크기가 어느 정도 크지 않다면 데이터 분할을 하지 말 것을 제안합니다. Picard and Berk (1990)의 지침에 따르면 추정해야 할 모수의 수가 많을수록 모형 개발을 위한 훈련 부분표본에 더 큰 비율의 관측값이 필요합니다.
분포 선택. 그렇지만 지금까지 우리의 초점은 추가적인 설명 변수나 입력 변수 \(x_1, \ldots, x_k\) 없이 계리 모형화에 사용할 수 있는 데이터셋의 분포를 선택하는 데 있었습니다. 이처럼 더 근본적인 문제에서도 모형 검증 접근법은 유용합니다. 모든 추론을 표본 내 데이터에만 근거하면 필요 이상으로 복잡한 모형을 선택하는 경향이 생깁니다. 예를 들어, 모수가 두 개인 파레토 분포만으로 충분한데도 모수가 네 개인 GB2(제2종 일반화 베타) 분포를 선택할 수 있습니다. 부록 17.4.4절에서 소개한 AIC(AIC) 통계 모형이 관측값 집합에 얼마나 잘 적합하는지를 나타내는 적합도 척도.와 BIC(BIC) 베이즈 정보 기준 같은 정보 기준은 모형 복잡도에 대한 벌점을 포함하므로 과적합을 방지해 주지만, 검정 표본을 사용하는 것 역시 간결한 모형을 얻는 데 도움이 될 수 있습니다. 흔히 알베르트 아인슈타인이 했다고 전해지는 말처럼, 우리는 “가능한 한 가장 단순한 모형을 사용하되, 그보다 더 단순하게 하지는 말아야” 합니다.
예제 6.4.1. 위스콘신 재산 기금. 1.3절의 2010년 재산 기금 데이터에 대해, 표본 외 예측을 바탕으로 심도 분포를 선택해 볼 수 있습니다. 구체적으로, 1,000개의 관측값을 무작위로 선택하여 훈련 데이터로 삼고, 나머지 377건의 청구를 사용하여 각각 감마 분포와 파레토 분포에 기반한 두 모형을 검증할 수 있습니다. 설명을 위해, 훈련 데이터로 적합한 모형을 사용하여 훈련 데이터셋과 검정 데이터셋 각각에 대한 콜모고로프-스미르노프 통계량을 비교합니다.
콜모고로프-스미르노프 모형 검증 R 코드 보기
모형 검증 통계량. 잠재적인 설명 변수 또는 입력 변수를 무시하고 결과 변수 또는 출력 변수의 주변분포를 비교하기 위해 앞서 소개한 비모수적 도구 외에도, 모형 검증 절차의 수립을 뒷받침하는 문헌의 상당수는 입력-출력 문제로 생각할 수 있는 회귀 모형과 분류 모형에 기반합니다(James et al. (2013)). 즉, \[y = \mathrm{g}\left(x_1, \ldots, x_k\right).\]와 같은 함수를 통해 출력 또는 결과 \(y\)와 관련된 여러 입력 변수 또는 예측 변수 \(x_1, \ldots, x_k\)가 있습니다. 모형 선택을 위해서는 훈련 표본을 사용하여 \(\mathrm{g}\)의 추정값, 예컨대 \(\hat{\mathrm{g}}\)를 구한 다음, \[\begin{equation} \frac{1}{n}\sum_i \mathrm{d}(y_i,\hat{\mathrm{g}}\left(x_{i1}, \ldots, x_{ik}\right) ) . \tag{6.1} \end{equation}\] 형태의 기준을 사용하여 관측된 결과와 예측값 사이의 평균 거리를 보정합니다. 여기서 “d”는 어떤 거리 척도이며, 합 \(i\)는 검정 데이터에 대해 취합니다. 함수 \(\mathrm{g}\)는 해석적 형태를 갖지 않을 수 있으며, 앞서 2.4절에서 소개한 여러 유형의 알고리즘과 모형을 사용하여 각 관측값에 대해 추정할 수 있습니다. 많은 회귀 응용에서는 \(\mathrm{d}(y_i,\mathrm{g}) = (y_i-\mathrm{g})^2\) 형태의 제곱 유클리드 거리를 사용하는 것이 일반적이며, 이 경우 식 (6.1)의 기준을 평균제곱오차(\(MSE\))라고 합니다. 예제 2.3.1은 선형모형에서 시뮬레이션한 데이터를 사용하여 MSE의 제곱근인 평균제곱근오차(Rmse)를 사용합니다. 식 (6.1)에서 알 수 있듯이, 훈련 데이터에서 MSE를 최소화하는 것은 최대가능도 기준 및 최소제곱 기준과 동등하므로, MSE 기준은 분산이 일정한 정규분포하의 선형모형에서 가장 잘 작동합니다. 데이터 분석과 선형회귀에서는 MSE 기준이 더 효과적으로 작동하도록 결과 변수의 변환을 고려할 수 있습니다. 계리 응용에서는 손실 데이터가 치우친 특성을 지니기 때문에 유클리드 거리 \(\mathrm{d}(y_i,\mathrm{g}) = |y_i-\mathrm{g}|\) 아래의 평균절대오차(\(MAE\))가 선호될 수 있습니다. 오른쪽으로 치우친 결과의 경우, \(y\)의 큰 이상값이 척도에 큰 영향을 미칠 수 있을 때에는 검증 통계량이 올바른 모형을 골라내기 위해 더 큰 표본 크기가 필요할 수 있습니다.
예제 2.3.1에 이어, 예제 6.4.2부터 6.4.4까지에서는 시뮬레이션 데이터를 사용하여, 각각 정규분포와 로그정규분포 및 감마분포를 포함한 오른쪽으로 치우친 분포에서 나온 결과에 대해 분포와 입력 변수를 선택하는 데 있어 부록 장 17.4.4의 AIC 정보 기준을 표본 외 MSE 및 MAE 기준과 비교합니다. 오른쪽으로 치우친 분포의 경우, AIC 정보 기준은 올바른 분포 형태와 평균 구조(입력 변수)를 선택하는 데 일관되게 작동하는 것으로 보이는 반면, 표본 외 MSE와 MAE는 감마분포에서 나온 결과처럼 오른쪽으로 치우친 결과에 대해서는 비교적 큰 표본 크기에서도 작동하지 않을 수 있음을 발견합니다. 따라서 데이터 분석에서 흔히 사용되는 모형 검증 통계량은 표본 외 예측의 평균 절대 오차를 나타내는 MAE와 같은 특정 비용 함수를 최소화하는 데에만 효과가 있을 수 있으며, 기저의 데이터 생성 메커니즘을 올바르게 선택한다는 것을 반드시 보장하지는 않습니다.
예제 6.4.2. 정규 결과에 대한 표본 내 AIC와 표본 외 MSE. 예제 2.3.1은 6개 수준을 갖는 단일 범주형 변수에 따라 달라질 수 있는 청구 집합이 있다고 가정합니다. 표본 내 과적합을 보여 주기 위해, 이 예제는 6개 수준 중 2개 수준이 나머지 수준과 다른 공통 평균을 공유한다고도 가정합니다. 예제 2.3.1의 경우 청구액은 분산이 일정한 선형모형에서 생성되었으며, 이에 대해 표본 내 AIC와 표본 외 Rmse는 다음 절에서 소개할 교차 검증 절차에서 일관된 결과를 제공합니다. 여기서는 동일한 데이터 생성 메커니즘을 사용하여 표본 내 AIC의 성능을 표본 내 및 표본 외 Rmse 기준과 비교할 수 있습니다. 구체적으로, 총 200개의 표본을 생성하고 이를 훈련 데이터셋과 테스트 데이터셋으로 균등하게 나눕니다. 표 6.2에서 2수준 모형은 표본 내 AIC와 표본 외 MSE 기준 모두에 의해 올바르게 선택되었지만, 표본 내 MSE는 6수준의 과적합된 모형을 선호한다는 것을 확인할 수 있습니다. 따라서 모형 과적합에 대한 우려 때문에, 더 복잡한 모형을 선호하는 MSE 및 MAE 기준과 같은 표본 내 거리 측도는 사용하지 않습니다.
| Community Rating | Two Levels | Six Levels | |
|---|---|---|---|
| Rmse - Train | 1.186 | 1.016 | 0.990 |
| Rmse - Test | 1.081 | 0.958 | 1.012 |
| AIC - Train | 321.935 | 293.028 | 295.694 |
예제 6.4.2의 R 코드 보기
예제 6.4.3. 오른쪽으로 치우친 결과에 대한 MSE와 MAE - 로그정규 청구. 청구 모형화에서는 MSE 및 MAE 유형의 기준이 오른쪽으로 치우친 데이터에 대해 어떻게 작동하는지 궁금할 수 있습니다. 동일한 데이터 생성 절차를 사용하여, 앞 예제의 정규 결과에 지수를 취함으로써 로그정규 청구액을 생성할 수 있습니다. 로그정규 청구액을 요율 산정과 청구 분석에 흔히 사용되는 로그정규 회귀와 감마 회귀로 적합합니다. 결과는 각각 표 6.3와 표 6.4에 요약되어 있습니다. 이 특정한 데이터 생성 메커니즘의 경우, 표본 내 AIC 기준과 비교할 때 표본 외 Rmse와 MAE가 올바른 분포 형태와 평균 구조를 선택하려면 더 큰 표본 크기가 필요함을 확인할 수 있습니다. AIC 기준은 표본 크기가 200일 때 올바른 모형을 골라낼 수 있지만, 표본 외 MSE와 MAE는 그렇지 못합니다. 따라서 오른쪽으로 치우친 결과의 경우, 특히 표본 크기가 비교적 작을 때에는 큰 청구 금액에 민감할 수 있는 모형 검증 통계량을 사용할 때 주의를 기울여야 합니다.
| Community Rating | Two Levels | Six Levels | |
|---|---|---|---|
| Rmse - Train | 4.365 | 4.185 | 4.192 |
| Rmse - Test | 3.881 | 3.686 | 3.679 |
| MAE - Train | 2.077 | 1.821 | 1.807 |
| MAE - Test | 2.166 | 2.056 | 2.073 |
| AIC - Train | 1800.716 | 1681.550 | 1686.142 |
| Community Rating | Two Levels | Six Levels | |
|---|---|---|---|
| Rmse - Train | 4.634 | 4.572 | 4.572 |
| Rmse - Test | 4.298 | 4.232 | 4.235 |
| MAE - Train | 1.862 | 1.815 | 1.817 |
| MAE - Test | 2.127 | 2.123 | 2.128 |
| AIC - Train | 1906.398 | 1789.312 | 1795.662 |
예제 6.4.3의 R 코드 보기
예제 6.4.4. 오른쪽으로 치우친 결과에 대한 MSE와 MAE - 감마 청구. 오른쪽으로 치우친 결과에 대해, 요율 산정과 청구 분석에 널리 사용되는 또 다른 손실 심도 분포인 감마분포에서 MSE 및 MAE 유형의 측도가 어떻게 작동하는지 연구하는 데 관심을 가질 수 있습니다. 여기서는 로그 연결 함수를 갖는 감마 회귀를 바탕으로 유사한 평균 구조를 사용하여 청구 금액을 생성합니다. 데이터를 로그정규 회귀와 감마 회귀로 적합합니다. 결과는 각각 표 6.5와 표 6.6에 요약되어 있습니다. 감마 결과의 경우, 표 6.6은 총 1000개의 표본을 사용하더라도 표본 외 MSE 및 MAE 기준이 올바른 분포 형태나 평균 구조를 선택하지 못함을 보여 줍니다. 감마 형상모수를 바꾸어 보면, 표본 외 MSE 및 MAE 기준이 특정 설정에서는 분포 형태나 평균 구조를 올바르게 선택하는 데 작동함을 볼 수 있지만, 오른쪽으로 치우친 감마 결과에 대해서는 이러한 모형 검증 통계량의 성능이 서로 다른 모수 값과 표본 크기에 걸쳐 일관되지 않은 것으로 보입니다. 이번에도 AIC 기준은 200이라는 더 작은 표본 크기에서도 감마분포에서 생성된 데이터에 대해 올바른 분포와 평균 구조를 선택하는 데 일관되게 작동하는 것으로 보입니다.
| Community Rating | Two Levels | Six Levels | |
|---|---|---|---|
| Rmse - Train | 1.083 | 0.763 | 0.760 |
| Rmse - Test | 1.128 | 0.815 | 0.812 |
| MAE - Train | 0.800 | 0.535 | 0.529 |
| MAE - Test | 0.830 | 0.565 | 0.566 |
| AIC - Train | 1212.218 | 864.776 | 868.794 |
| Community Rating | Two Levels | Six Levels | |
|---|---|---|---|
| Rmse - Train | 1.553 | 1.476 | 1.475 |
| Rmse - Test | 1.594 | 1.523 | 1.522 |
| MAE - Train | 1.121 | 1.226 | 1.227 |
| MAE - Test | 1.138 | 1.253 | 1.253 |
| AIC - Train | 1249.211 | 852.292 | 856.850 |
예제 6.4.4의 R 코드 보기
6.5 교차 검증에 기반한 모형 선택
표본 외 검증은 예측 모형화에서 가장 신뢰받는 표준이지만, 항상 실행 가능한 것은 아닙니다. 주된 이유는 표본 크기가 제한되어 있고, 식 (6.1)의 표본 외 모형 선택 기준이 데이터의 무작위 분할에 의존하기 때문입니다. 이는 서로 다른 분석가들이 같은 데이터셋과 같은 모형화 접근법을 사용하더라도 서로 다른 모형을 선택할 수 있다는 것을 의미합니다. 계리 분야의 응용에서는 매우 큰 결과가 나올 가능성이 높은 치우친 데이터셋을 다루며 큰 결과가 모수 추정값에 큰 영향을 미칠 수 있으므로, 이러한 일이 일어날 가능성이 높습니다.
교차 검증 절차. 대안으로, 다음과 같이 교차 검증을 사용할 수 있습니다.
- 이 절차는 먼저 무작위 방식을 사용하여 데이터를 폴드라고 부르는 거의 같은 크기의 \(K\)개 부분집합으로 분할하는 것으로 시작하며, 분석가들은 보통 5~10개를 사용합니다.
- 다음으로, 처음 \(K\)-1 부분표본을 사용하여 모형 모수를 추정합니다. 그런 다음, \(K\)번째 부분표본의 결과값을 “예측”하고 식 (6.1)와 같은 측도를 사용하여 적합 정도를 요약합니다.
- 이제 \(K\)개의 부분표본을 각각 차례로 제외하면서 이 과정을 반복하고, 표본 외 통계량으로 요약합니다. 그리하여 이 \(K\)개의 통계량을 보통 평균을 내어 요약함으로써 비교에 사용할 하나의 전체 통계량을 얻습니다.
여러 후보 모형에 대해 이 단계들을 반복하고, 전체 교차 검증 통계량이 가장 낮은 모형을 선택하십시오.
예제 2.3.1에서는 분산이 일정한 선형모형에서 생성된 청구 결과 데이터에 대해, MSE 기준이 k-폴드 교차 검증과 함께 올바른 평균 구조를 선택하는 데 작동하는 것으로 보임을 확인했습니다. 그러나 예제 6.4.3과 6.4.4에서 보듯이, 오른쪽으로 치우친 청구 분포에서는 표본 외 MSE 및 MAE 기준이 분포 형태와 평균 구조를 선택하는 데 일관된 성능을 보이지 않는 것으로 보입니다. 따라서 표본 외 예측 대신 k-폴드 교차 검증을 사용하여, 로그 연결 함수를 사용한 로그정규 회귀 및 감마 회귀에 기반한 오른쪽으로 치우친 분포에서 MSE 및 MAE 유형의 기준이 효과가 있는지 살펴볼 수 있습니다.
예제 6.5.1. 오른쪽으로 치우친 결과값에서의 교차 검증 - 로그정규 청구 로그정규 청구에 대해, 예제 6.4.3의 데이터 생성 방식을 사용하여 총 100개의 표본을 생성하고, 예제 2.3.1의 k-폴드 교차 검증 절차를 사용하여 분포 형태와 평균 구조를 선택합니다. 교차 검증을 사용하면, 총 100개의 표본만으로도 AIC와 표본 외 MSE 및 MAE가 모두 올바른 분포와 평균 구조를 가진 모형을 선택하는 데 효과가 있는 것으로 보입니다.
| Community Rating | Two Levels | Six Levels | |
|---|---|---|---|
| Rmse - Fold 1 | 1.808 | 1.750 | 1.891 |
| Rmse - Fold 2 | 2.145 | 1.773 | 1.813 |
| Rmse - Fold 3 | 3.461 | 3.335 | 3.333 |
| Rmse - Fold 4 | 1.425 | 1.723 | 1.865 |
| Rmse - Fold 5 | 4.848 | 4.450 | 4.454 |
| Rmse - Average | 2.738 | 2.606 | 2.671 |
| MAE - Fold 1 | 1.341 | 1.408 | 1.502 |
| MAE - Fold 2 | 1.881 | 1.264 | 1.255 |
| MAE - Fold 3 | 2.037 | 2.142 | 2.146 |
| MAE - Fold 4 | 1.225 | 1.345 | 1.476 |
| MAE - Fold 5 | 2.421 | 2.022 | 2.051 |
| MAE - Average | 1.781 | 1.636 | 1.686 |
| AIC - Average | 286.257 | 266.223 | 271.200 |
| Community Rating | Two Levels | Six Levels | |
|---|---|---|---|
| Rmse - Fold 1 | 2.557 | 2.642 | 2.677 |
| Rmse - Fold 2 | 1.930 | 1.999 | 2.005 |
| Rmse - Fold 3 | 4.088 | 4.155 | 4.187 |
| Rmse - Fold 4 | 1.181 | 1.273 | 1.318 |
| Rmse - Fold 5 | 5.232 | 5.262 | 5.286 |
| Rmse - Average | 2.998 | 3.066 | 3.095 |
| MAE - Fold 1 | 1.929 | 2.069 | 2.114 |
| MAE - Fold 2 | 1.060 | 1.116 | 1.124 |
| MAE - Fold 3 | 2.488 | 2.660 | 2.725 |
| MAE - Fold 4 | 0.887 | 0.949 | 0.999 |
| MAE - Fold 5 | 2.251 | 2.312 | 2.345 |
| MAE - Average | 1.723 | 1.821 | 1.861 |
| AIC - Average | 299.063 | 281.455 | 282.816 |
예제 6.5.1의 R 코드 보기
예제 6.5.2. 오른쪽으로 치우친 결과값에서의 교차 검증 - 감마 청구 감마 청구에 대해, 예제 6.4.4의 데이터 생성 방식을 사용하여 총 100개의 표본을 생성하고, \(k\)-폴드 교차 검증 절차를 사용하여 분포 형태와 평균 구조를 선택합니다. 교차 검증을 사용하면, 표본 내 AIC는 올바른 분포와 평균 구조를 가진 모형을 선택하는 데 효과가 있는 것으로 보이는 반면, 표본 외 MSE 및 MAE는 표본 크기를 1000으로 늘린 후에도 분포 형태나 평균 구조를 올바르게 선택하지 못하는 것으로 보입니다.
| Community Rating | Two Levels | Six Levels | |
|---|---|---|---|
| Rmse - Fold 1 | 1.080 | 0.794 | 0.799 |
| Rmse - Fold 2 | 0.953 | 0.639 | 0.639 |
| Rmse - Fold 3 | 1.354 | 0.914 | 0.916 |
| Rmse - Fold 4 | 1.097 | 0.725 | 0.727 |
| Rmse - Fold 5 | 1.171 | 0.695 | 0.695 |
| Rmse - Average | 1.131 | 0.753 | 0.755 |
| MAE - Fold 1 | 0.837 | 0.579 | 0.583 |
| MAE - Fold 2 | 0.755 | 0.473 | 0.474 |
| MAE - Fold 3 | 0.952 | 0.600 | 0.602 |
| MAE - Fold 4 | 0.852 | 0.523 | 0.525 |
| MAE - Fold 5 | 0.897 | 0.503 | 0.507 |
| MAE - Average | 0.859 | 0.536 | 0.538 |
| AIC - Average | 1980.018 | 1381.321 | 1388.351 |
| Community Rating | Two Levels | Six Levels | |
|---|---|---|---|
| Rmse - Fold 1 | 1.455 | 1.620 | 1.620 |
| Rmse - Fold 2 | 1.347 | 1.543 | 1.543 |
| Rmse - Fold 3 | 1.865 | 2.006 | 2.005 |
| Rmse - Fold 4 | 1.558 | 1.738 | 1.738 |
| Rmse - Fold 5 | 1.690 | 1.838 | 1.838 |
| Rmse - Average | 1.583 | 1.749 | 1.749 |
| MAE - Fold 1 | 1.003 | 1.223 | 1.223 |
| MAE - Fold 2 | 0.975 | 1.195 | 1.195 |
| MAE - Fold 3 | 1.301 | 1.478 | 1.479 |
| MAE - Fold 4 | 1.118 | 1.342 | 1.342 |
| MAE - Fold 5 | 1.228 | 1.420 | 1.420 |
| MAE - Average | 1.125 | 1.332 | 1.332 |
| AIC - Average | 2047.108 | 1349.855 | 1357.246 |
예제 6.5.2의 R 코드 보기
교차 검증은 표본 외 모형 검증 과정의 예측적 성격을 유지하면서도, 데이터를 재사용하기 때문에 확률표본에 대해 더 안정적이므로 널리 사용됩니다. 또한, 8장의 예제 8.4.1에서는 위스콘신 재산 기금(Wisconsin Property Fund) 데이터를 사용하여 콜모고로프-스미르노프 적합도 통계량에 기반한 감마 모형과 파레토 모형의 k-폴드 교차 검증을 수행합니다. 단일 관측치 제외(leave-one-out) 교차 검증과 부트스트랩을 포함한 재표본추출 절차에 관한 추가 정보와 예제는 8장에서도 찾아볼 수 있습니다.
6.6 수정된 데이터에 대한 모형 선택
지금까지는 수정되지 않은 데이터를 사용한 모형 선택에 대해 논의하였습니다. 그룹화, 중도절단, 절단 데이터를 포함한 수정된 데이터에 대해서는 5장에서 분포 함수의 모수적 추정과 비모수적 추정을 배웠습니다. 모형 선택을 위해 6.1절의 도구들을 수정된 데이터의 경우로 확장할 수 있습니다.
분포 선택의 경우, 6.1절에서 소개한 비모수적 도구들은 추정된 모수적 분포 함수와 비모수적 분포 함수에 기반하므로, 두 유형의 추정량이 모두 존재하는 수정된 데이터로 확장할 수 있습니다.
그래프를 이용한 비교의 경우, 앞서 소개한 \(pp\) 플롯과 \(qq\) 플롯은 5.2절의 모수적 추정치를 5.3절의 확률 함수 또는 분포 함수의 비모수적 추정치에 대해 그림으로써 수정된 데이터에 대해서도 작성할 수 있습니다. 예를 들어, R의 qqPlotCensored 함수와 qqtrunc 함수는 각각 중도절단(왼쪽 또는 오른쪽) 데이터와 절단 데이터에 대한 \(qq\) 플롯을 생성하며, probPlot 함수는 오른쪽 중도절단 데이터와 수정되지 않은 데이터에 대해 더 다양한 분포를 선택하여 \(pp\) 플롯과 \(qq\) 플롯을 모두 생성합니다. 누적 위험 플롯과 같은 추가적인 그래프 도구는 R 패키지 GofCens에서 사용할 수 있습니다.
예제 6.6.1. 신체상해 청구와 \(qq\)-플롯. 예제 5.3.2의 Boston 자동차 신체상해 청구 데이터에 대해, 오른쪽 중도절단을 포함한 전체 데이터셋을 사용하고, \(qq\)-플롯을 이용하여 로그정규분포, 정규분포, 지수분포로부터 추정된 분위수를 비모수적 카플란-마이어 방법으로 얻은 분위수와 비교합니다. 그림 6.7의 \(qq\)-플롯을 보면, 로그정규분포가 정규분포 및 지수분포에 기반한 경우보다 중도절단 데이터에 훨씬 더 잘 적합하는 것으로 보입니다.
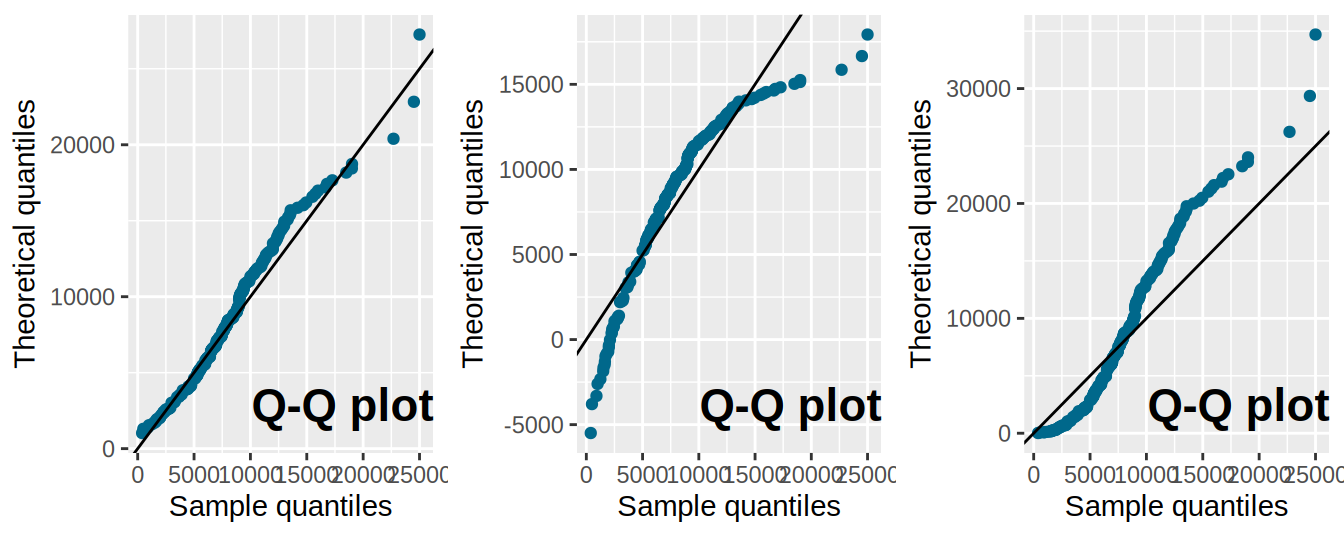
그림 6.7: 신체상해 청구에 대한 분위수-분위수(\(qq\)) 플롯. 가로축은 각 관측값에서의 경험분위수를 나타냅니다. 세로축은 적합된 분포로부터 얻은 분위수를 나타냅니다. 로그정규 분위수는 왼쪽 패널에, 정규 분위수는 가운데 패널에, 지수 분위수는 오른쪽 패널에 있습니다.
R 코드 보기
그래프 도구 외에도, 분포함수의 모수적 추정값과 비모수적 추정값에 기반하여 수정된 데이터로부터 적합한 모형들을 통계적으로 비교하기 위해 절 6.1.2의 도구를 사용할 수 있습니다. 예를 들어, R 패키지 GofCens는 오른쪽 중도절단 데이터와 수정되지 않은 데이터 모두에 대해 6.1.2절의 세 가지 적합도 통계량을 계산하는 함수를 제공합니다. 한편, R 패키지 truncgof는 왼쪽 절단 데이터에 대해 세 가지 적합도 통계량을 계산하는 함수를 제공합니다.
예제 6.6.2. 신체상해 청구와 적합도 통계량. 오른쪽 중도절단이 있는 Boston 자동차 신체상해 청구 데이터에 대해, 적합도 통계량을 사용하여 적합된 로그정규분포, 정규분포, 지수분포를 평가할 수 있습니다. 콜모고로프-스미르노프, 크라머-폰 미제스, 앤더슨-달링 통계량에서 로그정규분포는 정규분포 및 지수분포보다 훨씬 낮은 값을 제공합니다. 적합도 통계량으로부터 얻은 결론은 \(qq\) 플롯이 보여 준 결론과 일치합니다.
| Kolmogorov-Smirnov | Cramer-von Mises | Anderson-Darling | |
|---|---|---|---|
| Lognormal | 1.994 | 0.305 | 1.770 |
| Normal | 3.096 | 1.335 | 9.437 |
| Exponential | 4.811 | 4.065 | 21.659 |
R 코드 보기
분포 형태를 선택하는 것 외에도, 앞서 수정된 데이터에 대해 소개한 가능도함수에 기반한 가능도 기준으로 적합한 모형에 대해 가능도비 검정, 그리고 절 6.3의 AIC를 포함한 정보 기준과 같은 모형 비교 척도를 구할 수 있습니다. 수정된 데이터에 대해, R의 survreg 함수와 flexsurvreg 함수는 최대가능도 추정에 기반하여 중도절단 및/또는 절단 결과에 대한 모수적 회귀 모형을 적합하므로, 표본 내 모형 비교를 위해 가능도비 검정과 AIC 같은 정보 기준을 사용할 수 있습니다. 중도절단 데이터와 절단 데이터에 대해, 이 함수들은 잔차도 출력하므로 절 6.2에서 소개한 반복적 모형 선택 절차를 위한 MSE와 MAE 같은 모형 검증 통계량을 계산할 수 있습니다.
Show Quiz Solution
6.7 추가 자료 및 기여자
기여자
- Northern Illinois University의 Lei (Larry) Hua와 Michelle Xia가 이 장 제2판의 주 저자입니다.
- 위스콘신 대학교 매디슨의 Edward (Jed) Frees와 Lisa Gao가 이 장 초판의 주 저자입니다.
- 이 장의 검토자는 다음과 같습니다: Vytaras Brazauskas, Yvonne Chueh, Eren Dodd, Hirokazu (Iwahiro) Iwasawa, Joseph Kim, Andrew Kwon-Nakamura, Jiandong Ren, Di (Cindy) Xu.
추가 읽을거리 및 참고문헌
R 코딩을 더 연습하고 싶다면 자매 과정인 LDA 단기 과정을 방문하십시오. 특히 모형 선택 및 추정 장을 참고하십시오.