제7장 총손실 모형
장 미리보기. 이 장에서는 보험계약 포트폴리오에서 발생하는 총(전체) 청구액을 기술하기 위한 확률모형을 소개합니다. 표준적인 두 가지 모형화 접근법인 개별위험모형과 집합적 위험 모형을 제시합니다. 나아가 특수한 경우에 대한 정확한 방법, 재귀, 시뮬레이션을 포함하여 총청구액의 분포를 계산하기 위한 전략을 논의합니다. 마지막으로 공제금액, 공동보험, 인플레이션과 같은 개별 보험증권의 수정이 빈도 분포와 심도 분포에 미치는 영향, 그리고 이를 통해 총손실 분포에 미치는 영향을 살펴봅니다.
7.1 서론
이 절에서는 다음을 배웁니다.
- 보험 시스템의 총청구액 개념
- 총손실을 기술하는 여러 가지 방법
- 총청구액에 대한 여러 모형의 해석
이 장의 목적은 일정한 기간 동안 보험 시스템에서 발생하는 총청구액을 기술하는 확률모형을 구축하는 것입니다. 보험 시스템은 단일 보험증권, 단체보험계약, 사업 부문 또는 보험자의 전체 보유계약일 수 있습니다. 이 장에서 총청구액(aggregate claims) 일정 기간 동안 관측된 모든 청구액의 합은 보험계약 포트폴리오에서 발생하는 청구의 건수 또는 금액을 의미합니다. 그러나 이 모형화 체계는 일반적인 상황에도 쉽게 적용할 수 있습니다.
\(n\)개의 개별 계약으로 구성된 보험 포트폴리오를 고려하고, \(S\)가 주어진 기간 동안 포트폴리오의 총손실을 나타낸다고 합시다. 총손실 \(S\)를 모형화하는 접근법에는 개별위험모형과 집합적 위험 모형의 두 가지가 있습니다. 개별위험모형(individual risk model) 개별 계약 각각의 손실을 고려하는 총손실 모델링 방식입니다.은 각 개별 계약에서 발생하는 손실을 강조하며 총손실을 다음과 같이 나타냅니다. \[ S_n=X_1 +X_2 +\cdots+X_n, \] 여기서 \(X_i~(i=1,\ldots,n)\)는 \(i\)번째 계약에서 발생하는 손실 금액으로 해석됩니다. \(n\)은 포트폴리오에 포함된 계약의 수를 나타내므로 확률변수가 아니라 고정된 수라는 점을 강조할 필요가 있습니다. 개별위험모형에서는 일반적으로 \(X_{i}\)들이 서로 독립이라고 가정합니다. 보장(coverage) 보험 보장이란 보험계약에 의해 개인이나 단체에 대해 보장되는 위험 또는 책임의 양입니다.과 익스포저(exposure) 보험료를 결정하기 위해 요율이 적용되는 요율 단위의 척도. 예를 들어, 익스포저는 단위당 기준(예: 하나의 계약으로 자동차 보험에 가입한 가족의 익스포저는 자동차 2대일 수 있습니다) 또는 가치 $1,000당 기준(예: 주택소유자보험)으로 측정될 수 있습니다. 같은 계약 특성이 서로 다르기 때문에 \(X_{i}\)들이 반드시 동일하게 분포된 것은 아닙니다. 각 \(X_i\)의 분포가 갖는 주목할 만한 특징은 청구가 발생하지 않는 사건에 대응하는 0에서의 확률질량입니다.
집합적 위험 모형(collective risk model) 총손실을 빈도분포와 심도 분포로 표현하는 총손실 모형화 접근법.은 총손실을 빈도분포와 심도 분포로 나타냅니다: \[ S_N=X_1 +X_2 + \cdots + X_N . \] 여기서는 손실 건수 또는 지급 건수를 나타낼 수 있는 확률적인 청구 건수 \(N\)를 생각합니다. 이와 대조적으로, 개별위험모형에서는 고정된 계약 수 \(n\)을 사용합니다. \(X_1, X_2, \ldots, X_N\)는 각 손실의 금액을 나타내는 것으로 생각합니다. 각 손실은 하나의 고유한 계약에 대응할 수도 있고 그렇지 않을 수도 있습니다. 예를 들어, 하나의 계약에서 여러 건의 청구가 발생할 수 있습니다. \(X_i=0\)이면 청구가 발생하지 않은 것이므로 \(X_i>0\)를 생각하는 것이 자연스럽습니다. 일반적으로 \(N=n\)이 주어졌을 때 \(X_{1},X_{2},\ldots ,X_{n}\)는 iid(iid) 독립적이고 동일하게 분포된 확률변수라고 가정합니다. \(N\)의 분포는 빈도분포(frequency distribution) 집합적 위험 모형에서 발생하는 확률적인 청구 건수입니다.라고 하며, \(X\)의 공통 분포는 심도 분포(severity distribution) 집합적 위험 모형에서 각 손실의 확률적으로 분포된 금액입니다.라고 합니다. 나아가 \(N\)과 \(X\)는 서로 독립이라고 가정합니다. 집합적 위험 모형을 사용하면 총손실을 빈도(\(N\)) 과정과 심도(\(X\)) 모형으로 분해할 수 있습니다. 이러한 유연성 덕분에 분석가는 이 두 개의 개별 구성 요소에 대해 각각 논할 수 있습니다. 예를 들어, 언더라이팅 기준 완화로 인한 판매 증가는 손실 빈도를 높일 수 있지만 심도에는 영향을 주지 않을 수 있습니다. 마찬가지로, 인플레이션(inflation) 인플레이션은 일정 기간에 걸쳐 재화와 서비스의 일반 물가 수준이 지속적으로 상승하는 현상입니다.이나 기타 경제적 요인은 심도에는 영향을 줄 수 있지만 빈도에는 영향을 주지 않을 수 있습니다.
이 장의 나머지 부분은 다음과 같이 구성됩니다: 절 7.2와 절 7.3에서는 각각 개별위험모형과 집합적 위험 모형에 대해 자세히 설명합니다. 절 7.4에서는 총청구액의 분포를 계산하는 방법을 제시합니다. 절 7.5에서는 보장 수정이 총손실에 미치는 영향을 논의합니다. 기술적인 내용은 절 7.6에 요약되어 있습니다.
Show Quiz Solution
7.2 개별위험모형
이 절에서는 다음을 배웁니다.
- 개별위험모형의 수학적 표현
- 생명보험 및 손해보험에 대한 개별위험모형의 응용
- 개별위험모형의 적률, 생성함수, 분포함수를 계산하는 방법
7.2.1 적률과 분포
앞서 언급한 바와 같이, 개별위험모형에서는 \(X_i\)를 \(i\)번째 계약에서 발생한 손실로 생각하고, \[ S_n=X_1 +X_2 +\cdots+X_n , \] 를 포트폴리오 또는 계약 집단에 속한 모든 계약에서 발생한 총손실로 해석합니다. 여기서 \(X_i\)들은 반드시 동일하게 분포된 것은 아니며, 다음이 성립합니다. \[ {\rm E}(S_n) = \sum_{i=1}^{n} {\rm E}(X_i)~. \]
\(X_i\)에 대한 독립성 가정(이는 모든 \(i \neq j\)에 대해 \(\mathrm{Cov}\left( X_i, X_j \right) = 0\)임을 함의합니다) 하에서, \[ \begin{aligned} {\rm Var}(S_n) &= \sum_{i=1}^{n} {\rm Var}(X_i) \\ P_{S_n}(z) &= \prod_{i=1}^{n}P_{X_i}(z) \\ M_{S_n}(t) &= \prod_{i=1}^{n}M_{X_i}(t), \end{aligned} \] 임을 추가로 보일 수 있습니다. 여기서 \(P_{S_n}(\cdot)\)와 \(M_{S_n}(\cdot)\)은 각각 \(S_n\)의 확률생성함수(pgf)와 적률생성함수(mgf)입니다. 각 \(X_i\)의 분포는 0에서 확률질량을 가지며, 이는 \(i\)번째 계약에서 청구가 발생하지 않는 사건에 해당합니다. 분포에 0에서의 질량을 반영하는 한 가지 방법은 다음과 같은 2부분 구조를 사용하는 것입니다: \[ \begin{aligned} X_i = I_i\times B_i = \left\{\begin{array}{ll} 0~, & \text{if }~ I_i=0 \\ B_i~, & \text{if }~ I_i=1 . \end{array} \right. \end{aligned} \] 여기서 \(I_i\)는 \(i\)번째 계약에서 손실이 발생하는지 여부를 나타내는 베르누이 변수이고, \(B_i\)는 음이 아닌 받침(support) 어떤 분포를 따르는 확률변수가 가질 수 있는 모든 결과의 집합입니다. 예를 들어, 지수분포를 따르는 확률변수 x의 받침은 x>0입니다.을 갖는 확률변수로서 손실이 발생했을 때 해당 계약의 손실액을 나타냅니다. \(I_1 ,\ldots,I_n ,B_1 ,\ldots,B_n\)이 서로 독립이라고 가정합니다. \({\rm Pr} (I_i =1)=q_i\), \(\mu_i={\rm E}(B_i)\), \(\sigma_i^2={\rm Var}(B_i)\)로 표기합니다. \[ \begin{aligned} \mathrm{E}(S_n)& =\sum_{i=1}^n ~q_i ~\mu _i \\ \mathrm{Var}(S_n) & =\sum_{i=1}^n \left( q_i \sigma _i^2+q_i (1-q_i)\mu_i^2 \right)\\ P_{S_n}(z) & =\prod_{i=1}^n \left( 1-q_i+q_i P_{B_i}(z) \right)\\ M_{S_n}(t) & =\prod_{i=1}^n \left( 1-q_i+q_i M_{B_i}(t) \right) . \end{aligned} \] 임을 보일 수 있습니다(자세한 내용은 7.6절의 기술 부록 7.A.1을 참조하십시오). 위 모형의 특수한 경우는 \(B_i\)가 \(\mu_i=b_i\)이고 \(\sigma^2_i=0\)인 퇴화분포를 따르는 경우입니다. 한 가지 예로 정기생명보험(term life insurance) 정기 생명보험계약은 피보험자의 사망이 5년이나 10년과 같은 정해진 기간 내에, 또는 정해진 나이 이전에 발생한 경우에만 보험금이 지급됩니다. 또는 순수생존보험(pure endowment) 순수 생존보험은 보험기간 말에 피보험자가 생존해 있는 경우 보험금이 지급되는 보험계약입니다. 피보험자가 사망한 경우에는 급부 형태로 지급되는 것이 없습니다. 보험이 있으며, 여기서 \(b_i\)는 \(i\)번째 계약의 보험금액을 나타냅니다.
각 계약의 손실에 있는 0에서의 확률질량을 다루는 또 다른 방법은 집합적 위험 모형에서처럼 이를 포트폴리오 수준에서 총계로 고려하는 것입니다. 여기서 총손실은 \(S_{N} = X_1 + \cdots + X_N\)이며, \(N\)은 전체 계약 집단에서 발생한 0이 아닌 청구의 건수를 나타내는 확률변수입니다. 따라서 포트폴리오의 모든 계약이 이 합에 나타나지는 않을 수 있으며, \(N=0\)일 때 \(S_N=0\)입니다. 집합적 위험 모형은 다음 절에서 자세히 논의합니다.
예제 7.2.1. 계리사 시험 문제. 한 보험회사가 다음과 같이 화재보험계약 300건을 판매했습니다:
\[
{\small
\begin{matrix}
\begin{array}{c c c} \hline
\text{Number of} & \text{Policy} & \text{Probability of}\\
\text{Policies} & \text{Maximum} & \text{Claim Per Policy}\\
& (M_i) & (q_i) \\ \hline
100 & 400 & 0.05\\
200 & 300 & 0.06\\ \hline
\end{array}
\end{matrix}
}
\]
다음이 주어져 있습니다:
(i) 각 증권의 청구액 \(X_i\)는 \(0\)과 증권 최대 보상액 \(M_i\) 사이에서 균등분포를 따릅니다.
(ii) 증권당 2건 이상의 청구가 발생할 확률은 \(0\)입니다.
(iii) 청구 발생은 서로 독립입니다.
총청구액의 평균 \(\mathrm{E~}(S_{300})\)와 분산 \(\mathrm{Var~}(S_{300})\)를 계산하십시오. 모든 청구액이 증권 최대 보상액과 같다면 이 결과는 어떻게 달라지겠습니까?
예제 풀이 보기
예제 7.2.1. 계속.
이제 청구가 발생하면 모든 사람이 증권 최대 보상액 \(M_i\)를 받는다고 가정합시다. 기대 총손실 \(\mathrm{E~}(\tilde{S})\)와 총손실의 분산 \(\mathrm{Var~}(\tilde{S})\)는 얼마입니까?
예제 풀이 보기
개별위험모형은 청구 빈도에도 사용할 수 있습니다. \(X_i\)이 \(i\)번째 계약에서 발생한 청구 건수를 나타낸다면, \(S_n\)은 포트폴리오 전체의 총 청구 건수로 해석됩니다. 이 경우에도 청구가 전혀 발생하지 않는 계약에 대해 0에서 확률질량이 존재하므로, 위의 두 부분 구조가 그대로 적용됩니다. \(X_i\)가 \(k=0,1,\ldots\)에 대해 \(p_{ik} = \Pr(X_i=k)\)로 표기되는 pmf(pmf) 확률질량함수를 갖는 \((a,b,0)\) 부류에 속한다고 가정합니다(3.3절 참조). \(X_i^{T}\)이 \(k=1,2,\ldots\)에 대해 pmf \(p_{ik}^T=p_{ik}/(1-p_{i0})\)을 갖는, \((a,b,1)\) 부류에 속하는 관련 영절단 분포를 나타낸다고 합시다(3.5.1절 참조). 두 분포의 확률생성함수 사이의 관계(자세한 내용은 절 7.6의 기술 부록 7.A.2 참조)를 이용하면: \[ \begin{aligned} P_{X_i}(z) = p_{i0} +(1-p_{i0}) P_{X_i^{T}}(z), \end{aligned} \] \(q_i={\rm Pr}(I_i=1)={\rm Pr}(X_i>0)=1-p_{i0}\) 및 \(B_i=X_i^T\)로 \(X_i=I_i\times B_i\)와 같이 쓸 수 있습니다. 이 경우 \(I_i\) 변수가 \(q_i = \Pr(I_i=1)\)로 0에서의 수정된 확률질량을 담당하고, \(B_i=X_i^T\)가 0이 아닌 이산 빈도 부분을 담당하므로 영수정 분포가 됨에 유의하십시오. 영절단 분포와 영수정 분포의 관계는 3.5.1절을 참조하십시오.
예제 7.2.2. 한 보험회사가 서로 독립인 주택소유자보험 보험계약 100건으로 이루어진 포트폴리오를 판매하였으며, 각 보험계약의 청구 빈도는 다음과 같이 영수정 포아송 분포를 따릅니다.
\[
{\small
\begin{matrix}
\begin{array}{cccc} \hline
\text{Type of} & \text{Number of} & \text{Probability of} & \lambda \\
\text{Policy} & \text{Policies} & \text{At Least 1 Claim} & \\ \hline
\text{Low-risk} & 40 & 0.03 & 1 \\
\text{High-risk} & 60 & 0.05 & 2 \\ \hline
\end{array}
\end{matrix}
}
\]
포트폴리오 전체의 청구 빈도에 대한 기댓값과 분산을 구하십시오.
예제 풀이 보기
7.2.2 총손실 분포
총손실의 분포를 파악하기 위해, 중심극한정리(central limit theorem) 일정한 조건이 주어지면, 각각 유한한 평균과 분산을 갖는 독립 확률변수를 매우 많이 반복한 것의 산술평균은 기저 분포와 관계없이 근사적으로 정규분포를 따릅니다.를 이용하여 \(n\)이 클 때 \(S_n\)의 분포를 근사할 수 있습니다. \(\mu_{S_n}={\rm E}(S_n)\) 및 \(\sigma^2_{S_n}={\rm Var}(S_n)\)로 표기하고, cdf(cdf) 누적분포함수 \(\Phi\)를 갖는 표준정규 확률변수 \(Z\sim N(0,1)\)를 둡니다. 그러면 \(S_n\)의 cdf는 다음과 같이 근사할 수 있습니다. \[ \begin{aligned} F_{S_n}(s) &= {\rm Pr}({S_n}\le s) = \Pr \left( \frac{S_n - \mu_{S_n}}{\sigma_{S_n}} \le \frac{s-\mu_{S_n}}{\sigma_{S_n}} \right) \\ &\approx \Pr\left( Z \le \frac{s-\mu_{S_n}}{\sigma_{S_n}} \right) = \Phi \left(\frac{s-\mu_{S_n}}{\sigma_{S_n}}\right) . \end{aligned} \]
예제 7.2.3. 계리사 시험 문제 - 후속. 앞의 예제 7.2.1에서와 같이 한 보험회사가 화재보험계약 300건을 판매했으며, 청구액 \(X_i\)는 0과 보험계약 최대 한도 \(M_i\) 사이에서 균등하게 분포되어 있습니다. 정규근사를 이용하여 총청구액 \(S_{300}\)가 \(\$3,500\)을 초과할 확률을 계산하십시오.
예제 풀이 보기
\(n\)이 작을 때에는 \(S_n\)의 분포가 치우쳐 있을 가능성이 높으므로, 정규근사는 좋지 않은 선택이 됩니다. 총손실 분포를 살펴보기 위해 기본 원리로 돌아갑시다. 구체적으로, 이 분포는 재귀적으로 유도할 수 있습니다. \(S_k=X_1 + \cdots + X_k, k=1,\ldots,n\)로 정의합니다.
\(k=1\)에 대해: \[ F_{S_1}(s) = {\rm Pr}(S_1\le s) = {\rm Pr}(X_1\le s) = F_{X_1}(s). \] \(k=2,\ldots,n\)에 대해: \[ \begin{aligned} F_{S_k}(s)&={\Pr}(X_1+\cdots+X_k\le s) ={\Pr}(S_{k-1}+X_k\le s) \\ &={\rm E}_{X_k}\left[{\rm Pr}(S_{k-1}\le s-X_k|X_k)\right]= {\rm E}_{X_k}\left[F_{S_{k-1}}(s-X_k)\right] . \end{aligned} \]
특수한 경우는 \(X_i\)들이 동일하게 분포된 경우입니다. \(F_X(x)={\Pr}(X\le x)\)를 \(X_i, ~i=1,\ldots,n\)의 공통 분포라고 합시다. \[ F^{*n}_X(x)={\Pr}(X_1+\cdots+X_n\le x) , \] 를 \(F_X\)의 \(n\)중 합성곱(convolution) 확률분포의 합성곱은 독립 확률변수들의 합에 대응하는 분포입니다.으로 정의합니다. 보다 일반적으로, \(F_X^{\ast n}\)는 재귀적으로 계산할 수 있습니다. 재귀는 \(F_X^{\ast 1} \left(x \right) =F_X(x)\)를 이용하여 \(k=1\)에서 시작합니다. 다음으로, \(k=2\)에 대해 다음이 성립합니다. \[\begin{eqnarray*} F_X^{\ast 2} \left(x \right) &=& \Pr(X_1 + X_2 \le x) = \mathrm{E}_{X_2} \left[ \Pr(X_1 \le x - X_2|X_2) \right] \\ &=& \mathrm{E}_{X_2} \left[ F(x - X_2) \right] \\ &=&\left\{\begin{array}{ll} \int_{0}^{x} F(x-y) f(y) dy & \text{for continuous } X_i \text{'s} \\ \sum_{y \le x} F(x-y) f(y) & \text{for discrete } X_i \text{'s} \\ \end{array}\right. \end{eqnarray*}\] \(F(0) = 0\)임을 상기하십시오.
마찬가지로 \(k=n\)에 대해서는 \(S_n = X_1 + X_2 + \cdots + X_n\)이고
\[\begin{eqnarray*}
F^{\ast n}\left(x\right) &=& \Pr(S_n \le x) = \Pr(S_{n-1} + X_n \le x)\\
&=&\mathrm{E}_{X_n} \left[ \Pr(S_{n-1} \le x - X_n|X_n) \right] \\
&=&\mathrm{E}_X \left[ F^{\ast(n-1)}(x - X) \right] \\
&=&
\left\{\begin{array}{ll}
\int_{0}^{x} F^{\ast(n-1)}(x-y)f(y)dy & \text{for continuous } X_i \text{'s} \\
\sum_{y \le x} F^{\ast(n-1)}(x-y)f(y) & \text{for discrete } X_i \text{'s} \\
\end{array}\right.
\end{eqnarray*}\]
\(X_i\)들이 독립이고 같은 분포족에 속할 때, \(S_n\)가 닫힌 형태를 갖는 몇 가지 간단한 경우가 있습니다. 이러한 경우에는 \(\Pr(S_n \le x)\)를 쉽게 계산할 수 있습니다. 이 성질을 합성곱에 대해 닫혀 있음이라고 하며, 이는 독립 확률변수들의 합의 분포가 구성 변수들의 분포와 같은 분포족에 속하되 모수만 다르다는 뜻입니다. 표 7.1에 몇 가지 예가 있습니다.
표 7.1. 닫힌 형태의 부분합 분포
\[ {\small \begin{matrix} \begin{array}{l|l|l} \hline \text{Distribution of } X_i & \text{Abbreviation} & \text{Distribution of } S_n \\ \hline \text{Normal with mean } \mu_i \text{ and variance } \sigma_i^2 & N(\mu_i,\sigma_i^2) & N\left(\sum_{i=1}^{n}\mu_i,~\sum_{i=1}^{n}\sigma_i^2\right) \\ \text{Exponential with mean } \theta & Exp(\theta) & Gam(n,\theta)\\ \text{Gamma with shape } \alpha_i \text{ and scale } \theta & Gam(\alpha_i,\theta) & Gam\left(\sum_{i=1}^n\alpha_i,\theta\right) \\ \text{Poisson with mean (and variance) } \lambda_i & Poi(\lambda_i)& Poi\left(\sum_{i=1}^{n}\lambda_i\right)\\ \text{Binomial with } m_i \text{ trials and } q \text{ success probability} & Bin(m_i, q)& Bin\left(\sum_{i=1}^n m_i, q\right)\\ \text{Geometric with mean } \beta & Geo(\beta) & NB(\beta,n)\\ \text{Negative binomial with mean } r_i \beta~& NB(\beta,r_i)& NB\left(\beta,\sum_{i=1}^n r_i\right)\\ ~ ~ ~ \text{ and variance } ~r_i \beta (1+\beta) & & \\ \hline \end{array} \end{matrix} } \]
예제 7.2.4. 감마분포. \(X_1,\ldots,X_n\)가 \(X_i \sim Gam(\alpha_i, \theta)\)인 독립 확률변수라고 가정합니다. \(X_i\)의 mgf는 \(M_{X_i}(t) = (1 - \theta t)^{- \alpha_i}\)입니다. 따라서 합 \(S_n = X_1 + \cdots + X_n\)의 mgf는 \[ \begin{aligned} M_{S_n}(t) &= \prod_{i=1}^n M_{X_i}(t) ~~~~ \text{from the independence of } X_i \text{'s} \\ &= \prod_{i=1}^n (1 - \theta t)^{- \alpha_i} = (1-\theta t)^{-\sum_{i=1}^n \alpha_i }~ , \end{aligned} \] 이며, 이는 모수가 \((\sum_{i=1}^n \alpha_i, \theta)\)인 감마 확률변수의 mgf입니다. 따라서 \(S_n \sim Gam(\sum_{i=1}^n \alpha_i, \theta)\)입니다.
예제 7.2.5. 음이항 분포. \(X_1,\ldots, X_n\)이 \(X_i \sim NB(\beta, r_i)\)인 독립 확률변수라고 가정합니다. \(X_i\)의 pgf는 \(P_{X_i}(z) = \left[1-\beta(z-1) \right]^{-r_i}\)입니다. 따라서 합 \(S_n =X_1+\cdots+X_n\)의 pgf는 \[ \begin{aligned} P_{S_n}(z) &= \mathrm{E~}\left[ z^{S_n} \right] \\ &= \mathrm{E~}\left[z^{X_1}\right] \cdots \mathrm{E~}\left[z^{X_n}\right] ~~~~ \text{from the independence of } X_i \text{'s} \\ &= \prod_{i=1}^n P_{X_i}(z) = \prod_{i=1}^n \left[1-\beta(z-1) \right]^{-r_i} = \left[1-\beta(z-1) \right]^{-\sum_{i=1}^n r_i} ~, \end{aligned} \] 이며, 이는 모수가 \((\beta, \sum_{i=1}^n r_i)\)인 음이항 확률변수의 pgf입니다. 따라서 \(S_n \sim NB(\beta, \sum_{i=1}^n r_i)\)입니다.
예제 7.2.6. 보험계리사 시험 문제(변형). 4인 가족의 각 구성원의 연간 병원 방문 횟수는 평균이 1.5인 기하분포를 따릅니다. 가족 구성원들의 연간 방문 횟수는 서로 독립입니다. 어떤 보험은 가족당 4번째 방문부터 병원 방문 1회당 100을 지급합니다. 이 가족이 올해 보험금을 받지 못할 확률을 계산하십시오.
예제 풀이 보기
Show Quiz Solution
7.3 집합적 위험 모형
이 절에서는 다음을 배웁니다.
- 집합적 위험 모형의 수학적 표현
- 집합적 위험 모형의 적률, 생성함수, 분포함수를 계산하는 방법
- 스톱로스 보험에서 집합적 위험 모형의 응용
- 집합적 위험 모형의 특수한 경우로서의 트위디 복합 포아송 분포
7.3.1 적률과 분포
집합적 위험 모형 \(S_N=X_1+\cdots+X_N\)에서 \(\{X_i\}\)는 iid이며 \(N\)와 독립입니다. 모든 \(i\)에 대해 \(\mu = {\rm E}\left( X_{i}\right)\), \(\sigma ^{2} = {\rm Var}\left(X_{i}\right)\)이라고 합시다. 따라서 \(N\)이 주어졌을 때 합의 기댓값은 기댓값의 합이고 합의 분산은 분산의 합이므로 \[ \begin{aligned} {\rm E}(S|N) &= {\rm E}(X_1 + \cdots + X_N|N) = \mu N \\ {\rm Var}(S|N) &= {\rm Var}(X_1 + \cdots + X_N|N) = \sigma^2 N . \end{aligned} \] 가 성립합니다. 부록 절 18.2의 반복 기댓값의 법칙(law of iterated expectations) 확률변수의 기댓값을 조건부 성분으로 분해한 것입니다. 구체적으로, 확률변수 x와 y에 대해 e(x) = e[e(x|y)]입니다.을 이용하면 총손실의 평균은 \[ {\rm E}(S_N)={\rm E}_N[{\rm E}_S(S|N)] = {\rm E}_N(N\mu) = \mu ~{\rm E}(N). \] 입니다. 부록 절 18.2의 전분산의 법칙(law of total variance) 확률변수의 분산을 조건부 성분으로 분해하는 것입니다. 구체적으로, 동일한 확률공간 위의 확률변수 x와 y에 대해 var(x) = e[var(y|x)] + var[e(x|y)]가 성립합니다.을 이용하면 총손실의 분산은 다음과 같습니다. \[ \begin{aligned} {\rm Var}(S_N) &= {\rm E}_N[{\rm Var}(S_N|N)] + {\rm Var}_N[{\rm E}(S_N|N)] \\ &= \mathrm{E}_N \left[ \sigma^2 N \right] + \mathrm{Var}_N\left[ \mu N \right] \\ &=\sigma^2~{\rm E}[N] + \mu^2~ {\rm Var}[N] . \end{aligned} \]
특수한 경우: 포아송 분포를 따르는 빈도. \(N \sim Poi (\lambda)\)이면 다음이 성립합니다. \[ \begin{aligned} \mathrm{E}(N) &= \mathrm{Var}(N) = \lambda\\ \mathrm{E}(S_N) &= \lambda ~\mathrm{E}(X)\\ \mathrm{Var}(S_N) &= \lambda (\sigma^2 + \mu^2) = \lambda ~\mathrm{E} (X^2) . \end{aligned} \]
예제 7.3.1. 보험계리사 시험 문제. 사고 건수는 평균이 12인 포아송 분포를 따릅니다. 각 사고는 각각 1/2, 1/3, 1/6의 확률로 1명, 2명 또는 3명의 청구인을 발생시킵니다.
전체 청구인 수의 분산을 계산하십시오.
예제 풀이 보기
일반적으로 \(S_N\)의 적률은 적률생성함수(mgf)로부터 유도할 수 있습니다. \(X_i\)들은 iid이므로 \(X\)의 mgf를 \(M_{X}(t) = \mathrm{E~}(e^{tX})\)로 표기합니다. 반복 기댓값의 법칙을 이용하면 \(S_N\)의 mgf는 \[ \begin{aligned} M_{S_N}(t) &= \mathrm{E}(e^{t S_N})=\mathrm{E}_N[~\mathrm{E}(e^{tS_N}|N)~]\\ &= \mathrm{E}_N \left[ ~\mathrm{E}\left( e^{t(X_1+\cdots+X_N)}\right) ~\right] = \mathrm{E}_N \left[ \mathrm{E}(e^{tX_1})\cdots\mathrm{E}(e^{tX_N}) \right] ~~~~ \text{since } X_i \text{'s are independent} \\ &= \mathrm{E}_N[~(M_{X}(t))^N~] . \end{aligned} \] 입니다. 이제 \(N\)의 확률생성함수(pgf)가 \(P_N(z) = \mathrm{E}(z^N)\)임을 상기하십시오. \(M_{X}(t)=z\)로 표기합니다. 이를 위의 \(S_N\)의 mgf 식에 대입하면 다음이 성립함을 보일 수 있습니다. \[ \begin{aligned} M_{S_N}(t) = \mathrm{E~}(z^N) = P_{N}(z) = P_{N}[M_{X}(t)]. \end{aligned} \]
마찬가지로 \(S_N\)가 이산형이면 \(S_N\)의 pgf가 \[ \begin{aligned} P_{S_N}(z) = P_{N}[P_{X}(z)] . \end{aligned} \] 임을 보일 수 있습니다. \(\mathrm{E}(S_N) = M_{S_N}'(0)\)를 구하기 위해 연쇄 법칙 \[ M_{S_N}'(t) = \frac{\partial}{\partial t} P_{N}(M_{X}(t)) = P_{N}'(M_{X}(t)) M_{X}'(t)\\ \] 을 사용하고 \(M_{X}(0) = 1, M_{X}'(0) = \mathrm{E}(X) = \mu, P_{N}'(1) = \mathrm{E}(N)\)임을 상기합니다. 따라서 \[ \begin{aligned} \mathrm{E}(S_N) = M_{S_N}'(0) = P_{N}'(M_{X}(0)) M_{X}'(0) = \mu {\rm E}(N) . \end{aligned} \] 입니다. 마찬가지로 관계식 \(\mathrm{E}(S_N^2) = M_{S_N}''(0)\)을 이용하면 다음을 얻을 수 있습니다. \[\mathrm{Var}(S_N) = \sigma^2 \mathrm{E}(N) + \mu^2 \mathrm{Var}(N).\]
특수한 경우. 포아송 빈도. \(N \sim Poi (\lambda)\)라고 합시다. 따라서 \(N\)의 pgf는 \(P_N (z) = e^{\lambda(z-1)}\)이고 \(S_N\)의 mgf는 \[ \begin{aligned} M_{S_N}(t) &= P_N[M_X(t)] = e^{\lambda(M_{X}(t) - 1)}. \end{aligned} \] 입니다. 도함수를 구하면 \[ \begin{aligned} M_{S_N}'(t) &= e^{\lambda(M_{X}(t) - 1)}~ \lambda~ M_{X}'(t) = M_{S_N}(t) ~\lambda ~M_{X}'(t)\\ M_{S_N}''(t) &= M_{S_N}(t) ~\lambda~ M_{X}''(t) + [~M_{S_N}(t)~\lambda~ M_{X}'(t)~] ~\lambda~ M_{X}'(t) . \end{aligned} \] 가 됩니다. 이를 \(t=0\)에서 계산하면 \[ \begin{aligned} \mathrm{E}(S_N) &= M_{S_N}'(0) = \lambda \mathrm{E}(X) = \lambda \mu \end{aligned} \] 이 되고 \[ \begin{aligned} M_{S_N}''(0) &= \lambda \mathrm{E}(X^2) + \lambda^2 \mu^2\\ \Rightarrow \mathrm{Var}(S_N) &= \lambda \mathrm{E}(X^2) + \lambda^2 \mu^2 - (\lambda \mu)^2 = \lambda~ \mathrm{E}(X^2). \end{aligned} \]
예제 7.3.2. 보험계리사 시험 문제. 여러분은 현금 상금을 주는 텔레비전 퀴즈 쇼의 프로듀서입니다. 상금의 수 \(N\)와 상금액 \(X\)는 다음과 같은 분포를 따릅니다.
\[
{\small
\begin{matrix}
\begin{array}{ccccc}\hline
n & \Pr(N=n) & & x & \Pr(X=x)\\ \hline
1 & 0.8 & & 0 & 0.2 \\
2 & 0.2 & & 100 & 0.7 \\
& & & 1000 & 0.1\\\hline
\end{array}
\end{matrix}
}
\]
상금 예산은 총 현금 상금의 기댓값에 총 현금 상금의 표준편차를 더한 값과 같습니다. 예산을 계산하십시오.
예제 풀이 보기
\(S_N\)의 분포를 복합분포(compound distribution) 확률변수가 모수화되어 있고, 그 자체로 확률변수인 모수를 하나 이상 포함하면 그 확률변수는 복합분포를 따릅니다. 예를 들어, 트위디 분포는 복합분포입니다.라고 하며, 다음과 같이 \(F_X\)의 합성곱을 바탕으로 유도할 수 있습니다. \[ \begin{aligned} F_{S_N}(s) &= \Pr \left(X_1 + \cdots + X_N \le s \right) \\ &= \mathrm{E} \left[ \Pr \left(X_1 + \cdots + X_N \le s|N=n \right) \right]\\ &= \mathrm{E} \left[ F_{X}^{\ast N}(s) \right] \\ &= p_0 + \sum_{n=1}^{\infty }p_n F_{X}^{\ast n}(s) . \end{aligned} \]
예제 7.3.3. 계리사 시험 문제. 한 기간 동안의 청구 건수는 평균이 \(4\)인 기하분포를 따릅니다. 각 청구의 금액 \(X\)는 \(\Pr(X=x) = 0.25, \ x=1,2,3,4\), 즉 \(\{1,2,3,4\}\) 위의 이산 균등분포를 따릅니다. 청구 건수와 청구액은 서로 독립입니다. \(S_N\)이 해당 기간의 총청구액을 나타낸다고 합시다. \(F_{S_N}(3)\)를 계산하십시오.
예제 풀이 보기
예제 7.3.4. 합성곱 방법을 이용한 총손실 분포 계산. 절 1.3에서 소개되었으며 부록 절 22.1에서 이용할 수 있는 위스콘신 재산 기금 데이터를 생각해 봅시다. 구체적으로, 청구 빈도는 변수 Freq로, 청구 금액은 BCClaim으로 주어지는 건물 및 내용물 청구를 살펴봅니다. 빈도에는 포아송 분포를, 심도에는 감마분포를 가정합니다. 다음 R 코드 블록은 데이터를 불러오는 방법을 보여 주고 이전 장들에서 다룬 모수 추정을 복습합니다.
데이터 불러오기 및 모수 추정을 위한 R 코드
모수 추정값이 준비되었으므로, 이제 합성곱 방법을 사용하여 \(S=X_1+X_2+\cdots+X_N\)의 분포를 계산할 수 있습니다. 그림 7.1는 총손실 분포를 요약합니다. 다음 코드 블록은 그 계산 과정을 보여 줍니다.
합성곱 방법을 사용하여 총손실 분포를 계산하는 R 코드
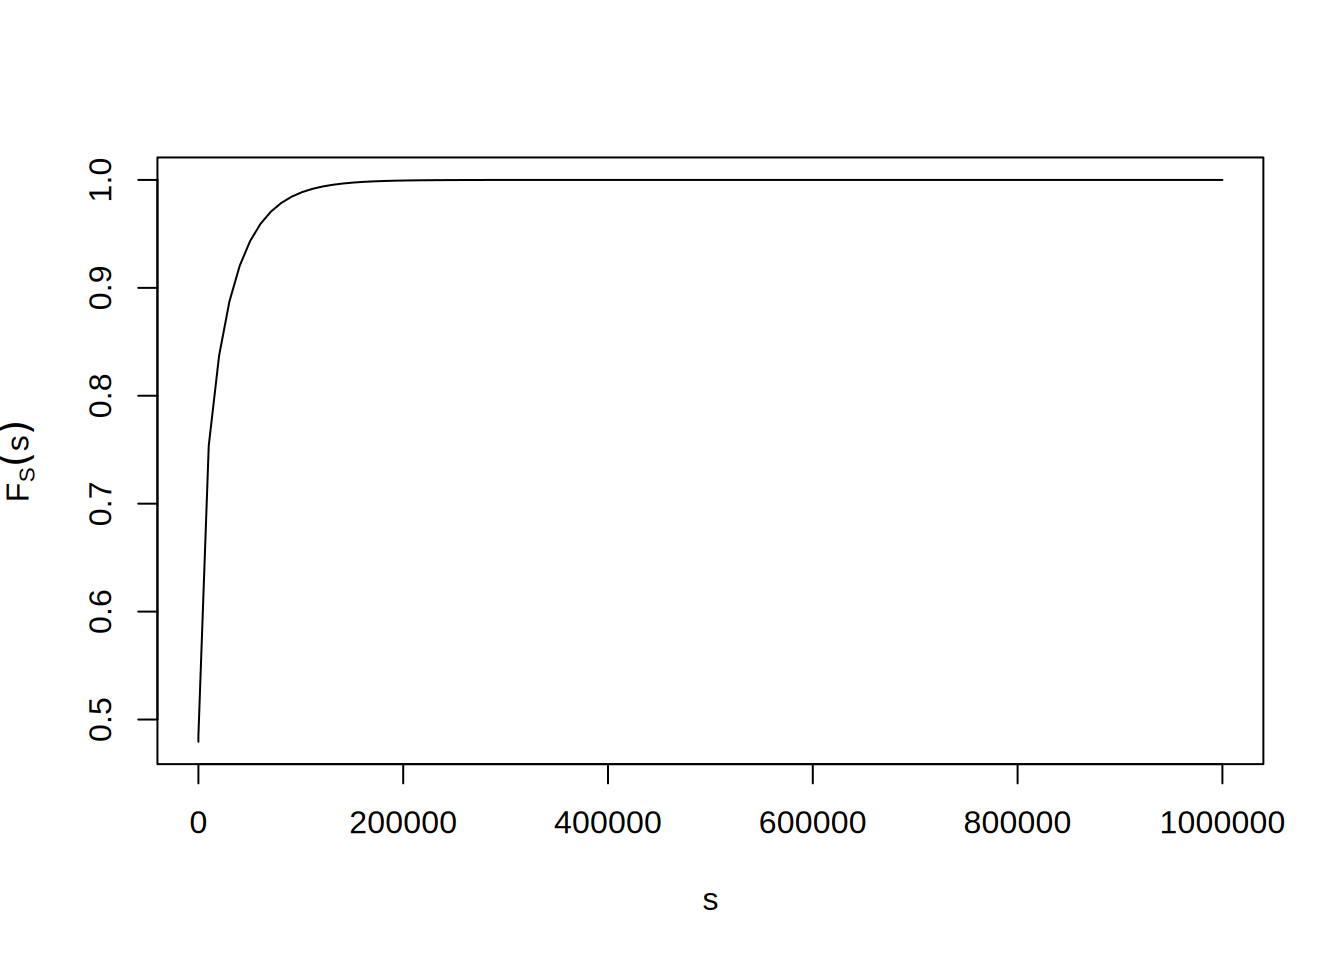
그림 7.1: 위스콘신 재산 기금 건물 및 손실 청구의 총손실 분포
\(\mathrm{E}(N)\)와 \(\mathrm{Var}(N)\)을 알고 있을 때, 개별위험모형에서와 같이 일종의 중심극한정리를 사용하여 \(S_N\)의 분포를 근사할 수도 있습니다. 즉, \(\frac{S_N - \mathrm{E}(S_N)}{\sqrt{\mathrm{Var}(S_N)}}\)는 근사적으로 표준정규분포 \(N(0,1)\)를 따릅니다. 이러한 유형의 중심극한정리에 따르면, \(\mathrm{E}[N]\)가 충분히 클 때 근사가 잘 작동합니다.
예제 7.3.5. 계리사 시험 문제. 다음이 주어져 있습니다: \[ {\small \begin{matrix} \begin{array}{ c | c c } \hline & \text{Mean} & \text{Standard Deviation}\\ \hline \text{Number of Claims} & 8 & 3\\ \text{Individual Losses} & 10,000 & 3,937\\ \hline \end{array} \end{matrix} } \] 기준으로서, 정규근사를 사용하여 총손실이 기대손실의 150\(\%\)를 초과할 확률을 구하십시오.
예제 풀이 보기
예제 7.3.6. 계리사 시험 문제. 65세 이상인 개인에 대해 다음이 주어져 있습니다:
- 약국 청구 건수는 평균이 27인 포아송 확률변수입니다.
- 각 약국 청구의 금액은 5와 97 사이에서 균등분포를 따릅니다.
- 청구 금액과 청구 건수는 서로 독립입니다.
정규근사를 사용하여 이 개인의 총청구액이 \(2000\)를 초과할 확률을 추정하십시오.
예제 풀이 보기
7.3.2 스톱로스 보험
5.1절에서 다룬 개별 보험계약 수준의 보장 수정을 떠올려 보십시오. 공제액(deductible) 공제액은 계약에 명시된 모수입니다. 일반적으로 공제액 미만의 손실은 보험계약자가 부담하고, 공제액을 초과하는 손실은 보험자가 책임집니다(보험가입한도와 공동보험 조건이 적용됩니다). \(d\)가 적용되는 총손실 \(S_N\)에 대한 보험을 순 스톱로스 보험이라고 합니다. 총손실 중 공제액을 초과하는 금액의 기댓값 \[\begin{eqnarray*} \mathrm{E}[(S_N-d)_+] \end{eqnarray*}\] 를 순 스톱로스 보험료라고 합니다.
순 스톱로스 보험료를 계산하면 다음과 같습니다. \[\begin{eqnarray*} \mathrm{E}(S_N-d)_+ &=& \left\{\begin{array}{ll} \int_{d}^{\infty}(s-d) f_{S_N}(s) ds& \text{for continuous } S_N\\ \sum_{s>d}(s-d) f_{S_N}(s) & \text{for discrete } S_N\\ \end{array}\right.\\ &=& \mathrm{E}(S_N) - \mathrm{E}(S_N\wedge d)\\ \end{eqnarray*}\]
예제 7.3.7. 계리사 시험 문제. 어떤 주에 초과 근무가 필요한 프로젝트의 수는 \(\beta=2\)인 기하분포를 따릅니다. 각 프로젝트에 대해, 그 주의 초과 근무 시간 수 \(X\)의 분포는 다음과 같습니다.
\[
{\small
\begin{matrix}
\begin{array}{ccc} \hline
x & & f(x)\\ \hline
5 & & 0.2 \\
10 & & 0.3 \\
20 & & 0.5\\ \hline
\end{array}
\end{matrix}
}
\]
프로젝트의 수와 초과 근무 시간 수는 서로 독립입니다. 그 주에 15시간을 초과하는 초과 근무 시간에 대해서는 수당을 받습니다. 그 주에 수당을 받게 될 초과 근무 시간 수의 기댓값을 계산하십시오.
예제 풀이 보기
순 스톱로스 보험료의 재귀적 계산. 이산형의 경우 이는 \[ \begin{aligned} \mathrm{E}\left[ \left( S_N-(j+1)h \right) _{+} \right]=\mathrm{E}\left[ ( S_N-jh )_{+} \right] -h \left[ 1-F_{S_N}(jh) \right] . \end{aligned} \] 와 같이 재귀적으로 계산할 수 있습니다. 이때 \(S_N\)의 받침이 \(h\) 단위로 등간격이라고 가정합니다.
순 스톱로스 보험료 재귀식의 유도 보기
예제 7.3.8. 계리사 시험 문제 - 계속. 이 문제의 목표는 \(\mathrm{E~}(S_N-15)_+\)를 계산하는 것이었음을 떠올려 보십시오. \(S_N\)의 받침이 5 단위로 등간격이므로, 위의 식을 \(h=5\) 간격으로 적용하여 이 문제를 재귀적으로도 풀 수 있다는 점에 유의하십시오.
1단계:
\[ \begin{aligned} \mathrm{E~}(S_N-5)_+ &= \mathrm{E}(S_N) - 5 [1-\Pr(S_N \le 0) ]\\ %\Pr (S_N\geq 5) \\ &= 28 - 5 \left(1 - \frac{1}{3}\right) = \frac{74}{3}=24.6667 . \end{aligned} \]2단계:
\[ \begin{aligned} \mathrm{E~}(S_N-10)_+ &= \mathrm{E~}(S_N-5)_+ - 5 [1-\Pr(S_N \le 5)]\\ %\Pr (S_N\ge 10) \\ &= \frac{74}{3} - 5\left( 1 - \frac{1}{3} - \frac{0.4}{9}\right) = 21.555 . \end{aligned} \]3단계: \[ \begin{aligned} \mathrm{E~}(S_N-15)_+ &= \mathrm{E~}(S_N-10)_+ - 5 [1-\Pr(S_N \le 10)] \\ %\Pr (S_N\ge 15) \\ &= \mathrm{E~}(S_N-10)_+ - 5\Pr (S_N\ge 15) \\ &= 21.555 - 5 (0.5496) = 18.807 . \end{aligned} \]
7.3.3 닫힌 형태의 분포
청구 빈도 분포와 심도 분포의 조합 가운데 몇 가지는 총손실의 분포를 쉽게 계산할 수 있게 해 줍니다. 이 절에서는 몇 가지 간단한 예를 제시합니다. 이러한 예들은 계산상 편리하지만, 일반적으로 실무에 사용하기에는 너무 단순합니다.
예제 7.3.9. 기하 빈도, 지수 심도. 기하 빈도분포와 지수 심도 분포를 가정하면 총손실 분포를 닫힌 형태로 표현할 수 있습니다.
청구 건수 \(N\)는 평균이 \(\mathrm{E}(N)=\beta\)인 기하분포를 따르고, 청구액 \(X\)는 \(\mathrm{E}(X)=\theta\)인 지수분포를 따른다고 가정합니다. \(N\)의 pgf와 \(X\)의 mgf는 다음과 같음을 상기하십시오. \[ \begin{aligned} P_N (z) &=\frac{1}{1- \beta (z-1)}\\ M_{X}(t) &=\frac{1}{1-\theta t} . \end{aligned} \] 따라서 총손실 \(S_N\)의 mgf는 두 가지 방식으로 표현할 수 있습니다(자세한 내용은 기술 부록 7.A.3을 참조하십시오) \[\begin{eqnarray} M_{S_N}(t) &=& P_N [M_{X}(t)] = \frac{1}{1 - \beta \left( \frac{1}{1-\theta t} - 1\right)} \nonumber\\ &=& 1+ \frac{\beta}{1+\beta} \left([1-\theta(1+\beta)t]^{-1}-1 \right) \tag{7.1}\\ &=& \frac{1}{1+\beta}(1) +\frac{\beta}{1+\beta} \left( \frac{1}{1-\theta (1+\beta)t}\right). \tag{7.2} \end{eqnarray}\]
(7.1)로부터, \(S_N\)는 \(S_N=X^{*}_1+\cdots+X^{*}_{N^{*}}\)의 복합분포와 동등함을 알 수 있습니다. 여기서 \(N^{*}\)는 평균이 \(\beta/(1+\beta)\)인 베르누이 분포를 따르고 \(X^{*}\)는 평균이 \(\theta(1+\beta)\)인 지수분포를 따릅니다. 이를 확인하기 위해 \(S\)의 mgf를 살펴봅니다. \[ \begin{aligned} M_{S_N}(t) = P_N [M_{X}(t)] = P_{N^{*}} [M_{X^{*}}(t)], \end{aligned} \] 여기서 \[ \begin{aligned} P_{N^*} (z) &=1+ \frac{\beta}{1+ \beta} (z-1),\\ M_{X^*} (t) &=\frac{1}{1- {{\theta(1+\beta)}} t}. \end{aligned} \] (7.2)로부터, \(S_N\)는 0과 \(X^{*}\)의 2점 혼합과도 동등함을 알 수 있습니다. 구체적으로, \[ \begin{array}{cl} S_N &= \left\{ \begin{array}{cl} 0 & {\rm with~ probability ~Pr}(N^*=0) = 1/(1+\beta) \\ Y^{*} & {\rm with~ probability ~Pr}(N^*=1) = \beta/(1+\beta) . \end{array} \right. \end{array} \] \(S_N\)의 분포함수는 다음과 같습니다. \[\begin{eqnarray*} \Pr(S_N=0) &=& \frac{1}{1+\beta}\\ \Pr(S_N>s) &=& \Pr(X^*>s) =\frac{\beta}{1+\beta} \exp\left( -\frac{s}{ \theta (1+\beta)}\right) \end{eqnarray*}\] \(s>0\)에 대한 pdf(pdf) 확률밀도함수는 다음과 같습니다. \[\begin{eqnarray*} f_{S_N}(s) = \frac{\beta}{\theta (1+\beta)^2}\exp\left( -\frac{s}{ \theta (1+\beta)}\right) . \end{eqnarray*}\]
예제 7.3.10. 지수 심도. 지수 심도와 임의의 빈도분포를 갖는 집합적 위험 모형을 고려합니다. \(X_i\sim Exp(\theta)\)이면, iid 지수 확률변수의 합 \(S_n=X_1+\cdots+X_n\)는 감마분포, 즉 \(S_n\sim Gam(n,\theta)\)를 따른다는 것을 상기하십시오. 이 분포의 cdf는 다음과 같습니다. \[\begin{eqnarray*} F_{X}^{\ast n}(s) &=& \Pr (S_n \le s) = \int_{0}^{s} \frac{1}{\Gamma(n)\theta^n}s^{n-1}\exp\left(-\frac{s}{\theta}\right) ds\\ &=& 1-\sum_{j=0}^{n-1}\frac{1}{j!}\left( \frac{s}{\theta}\right)^j e^{-s/\theta } . \end{eqnarray*}\] 마지막 등식은 부분적분을 \(n-1\)번 적용하여 유도합니다.
총손실 분포에 대해서는 아래 둘째 줄에서 합의 순서를 바꾸어 \[ \begin{array}{ll} F_{S}\left(s\right) &= p_{0}+\sum_{n=1}^{\infty }p_n F_{X}^{\ast n}\left(s\right)\\ &= 1 - \sum_{n=1}^{\infty }p_n \sum_{j=0}^{n-1}\frac{1}{j!} \left( \frac{s}{\theta}\right)^j e^{-s/\theta }\\ &= 1-e^{-s/\theta}\sum_{j=0}^{\infty} \frac{1}{j!} \left( \frac{s}{\theta} \right)^j \overline{P}_j \end{array} \] 를 얻을 수 있습니다. 여기서 \(\overline{P}_j =p_{j+1}+p_{j+2}+\cdots = \Pr (N>j)\)는 청구 건수 분포의 “생존함수”입니다.
7.3.4 트위디 분포
이 절에서는 청구 건수가 포아송 분포를 따르고 청구 금액이 감마분포를 따르는 특정한 복합분포를 살펴봅니다. 이러한 설정은 트위디 분포(Tweedie distribution) 감마 확률변수들의 포아송 합으로 이루어진 복합분포입니다. 0에서의 이산 확률질량과 연속적인 양의 성분을 함께 수용할 수 있으므로, 보험 총청구액을 모델링하는 데 적합합니다.라고 알려진 분포로 이어집니다. 트위디 분포는 0에서 질량 확률을 가지며, 양의 값에 대해서는 연속 성분을 가집니다. 이러한 특징 때문에 트위디 분포는 보험 청구 모형화에 널리 사용되며, 여기서 0의 질량은 청구가 없는 경우로, 양의 성분은 청구 금액으로 해석됩니다.
구체적으로, 집합적 위험 모형 \(S_N=X_1+\cdots+X_N\)를 고려합니다. \(N\)이 평균이 \(\lambda\)인 포아송 분포를 따르고, 각 \(X_i\)가 형상모수(shape parameter) 분포를 단순히 이동시키거나(위치모수처럼) 늘리거나 줄이는(척도모수처럼) 것이 아니라 분포의 형태에 영향을 주는 모수적 분포의 수치 모수. \(\alpha\)와 척도모수(scale parameter) 분포의 위치나 형태를 바꾸지 않고 분포를 늘리거나 줄이는 모수적 분포의 수치 모수. 척도모수가 클수록 분포는 더 넓게 퍼집니다. 척도모수는 비율 모수의 역수이기도 합니다. 예를 들어, 정규분포의 척도모수는 . \(\gamma\)를 갖는 감마분포를 따른다고 가정합니다. 트위디 분포는 감마 변수들의 포아송 합으로 유도됩니다. \(S_N\)의 분포를 이해하기 위해, 먼저 0에서의 질량 확률을 살펴봅니다. 총손실은 청구가 발생하지 않았을 때 0이 됩니다. 즉, \[ {\rm Pr}(S_N=0)= {\rm Pr}(N=0)=e^{-\lambda}. \] 또한 \(N=n\)이 주어졌을 때의 \(S_N\), 즉 \(S_n=X_1+\cdots+X_n\)로 표기되는 것은 형상모수가 \(n\alpha\)이고 척도모수가 \(\gamma\)인 감마분포를 따른다는 점에 유의하십시오. 따라서 \(s>0\)에 대해 트위디 분포의 밀도는 \[ \begin{aligned} f_{S_N}(s)&=\sum_{n=1}^{\infty} p_n f_{S_n}(s)\\ &=\sum_{n=1}^{\infty}e^{-\lambda}\frac{(\lambda)^n}{n!}\frac{\gamma^{na}}{\Gamma(n\alpha)}s^{n\alpha-1}e^{-s\gamma} . \end{aligned} \] 와 같이 계산할 수 있습니다. 따라서 트위디 분포는 0과 양의 값을 갖는 분포의 혼합으로 생각할 수 있으며, 이 때문에 보험 청구를 모형화하고 순보험료를 계산하는 데 편리한 도구가 됩니다. 트위디 복합 포아송 모형의 평균과 분산은 다음과 같습니다. \[ {\rm E} (S_N)=\lambda\frac{\alpha}{\gamma}~~~~{\rm and}~~~~{\rm Var} (S_N)=\lambda\frac{\alpha(1+\alpha)}{\gamma^2}. \]
또 다른 중요한 특징으로, 트위디 분포는 일반화선형모형(generalized linear models) 흔히 약어 GLM으로 알려져 있습니다. 종속변수가 선형 지수족에 속하는 선형회귀 모형의 확장입니다. GLM은 선형, 이진, 계수, 꼬리가 긴 회귀를 모두 특수한 경우로 포함합니다.에서 확률적 성분을 기술하는 데 사용되는 모형의 한 부류인 지수분산(exponential dispersion) 자연 지수족을 일반화한 분포의 집합으로, 일반화선형모형에서도 중요한 역할을 합니다. 모형의 특수한 경우입니다. 이를 확인하기 위해 다음과 같은 재모수화를 고려합니다: \[\begin{equation*} \lambda=\frac{\mu^{2-p}}{\phi(2-p)},~~~~\alpha=\frac{2-p}{p-1},~~~~\frac{1}{\gamma}=\phi(p-1)\mu^{p-1} . \end{equation*}\] 위의 관계를 이용하면 \(S_N\)의 분포가 \[ f_{S_N}(s)=\exp\left[\frac{1}{\phi}\left(\frac{-s}{(p-1)\mu^{p-1}}-\frac{\mu^{2-p}}{2-p}\right)+C(s;\phi)\right] \] 임을 보일 수 있으며, 여기서 \[ C(s;\phi)=\left\{\begin{array}{ll} \displaystyle 0 & {\rm if}~ s=0 \\ \displaystyle \log \sum\limits_{n \ge 1} \left\{\frac{(1/\phi)^{1/(p-1)}s^{(2-p)/(p-1)}}{(2-p)(p-1)^{(2-p)/(p-1)}}\right\}^{n}\frac{1}{n!~\Gamma[n(2-p)/(p-1)]s} & {\rm if}~ s>0 . \end{array}\right. \] 입니다. 따라서 \(S_N\)의 분포는 모수가 \(\mu\), \(\phi\), \(1 < p < 2\)인 지수족(exponential family) 일반화선형모형에서 기저의 반응변수를 모형화하는 데 실용적인 모수적 분포의 족. 이 족은 다른 많은 분포와 더불어 정규, 베르누이, 포아송, 트위디 분포를 특수한 경우로 포함합니다.에 속하며, 다음이 성립합니다. \[ {\rm E} (S_N)=\mu~~~~{\rm and}~~~~{\rm Var} (S_N)=\phi\mu^{p}. \] 이를 통해 트위디 분포를 일반화 선형모형과 함께 사용하여 청구를 모형화할 수 있습니다. 트위디 모형의 두 가지 극한의 경우도 언급할 가치가 있습니다. \(p\rightarrow 1\)는 포아송 분포가 되고 \(p\rightarrow 2\)는 감마분포가 됩니다. 따라서 트위디 모형은 감마분포와 포아송 분포 사이의 상황을 포괄하며, 이는 트위디 모형이 감마 확률변수들의 포아송 합이라는 점에서 직관적으로 타당합니다.
Show Quiz Solution
7.4 총청구액 분포의 계산
이 절에서는 다음을 배웁니다.
- 총청구액 분포를 계산하는 재귀적 방법
- 총청구액 분포를 계산하는 시뮬레이션 접근법
총손실의 분포를 계산하는 것은 어렵지만 중요한 문제입니다. 앞서 보았듯이, 개별위험모형과 집합적 위험 모형 모두에서 분포를 계산하려면 흔히 \(n\)중 합성곱을 계산해야 합니다. 문제를 다루기 쉽게 만드는 한 가지 전략은 계산하기 쉬운 분포를 사용하여 총손실 분포를 근사하는 것입니다. 예를 들어, 정규분포는 중심극한정리에 근거한 자연스러운 선택이며, 이때 정규분포의 모수는 적률을 일치시켜 추정할 수 있습니다. 이 접근법에는 장점과 한계가 있습니다. 주된 장점은 계산이 쉽다는 것입니다. 단점은 다음과 같습니다. 첫째, 근사 오차의 크기와 방향을 알 수 없습니다. 둘째, 근사가 0에서의 질량점과 같은 총손실의 몇 가지 특수한 특징을 포착하지 못할 수 있습니다.
이 절에서는 총손실의 분포를 계산하는 두 가지 실용적인 접근법인 재귀적 방법과 시뮬레이션을 논의합니다.
7.4.1 재귀적 방법
재귀적 방법은 빈도 구성요소 \(N\)가 \((a,b,0)\) 또는 \((a,b,1)\) 계열에 속하고(3.3절 및 3.5.1절 참조) 심도 구성요소 \(X\)가 이산분포를 따르는 복합모형에 적용됩니다. 연속형 \(X\)의 경우에는 먼저 심도 분포를 이산화하는 것이 일반적이며, 그 후에 재귀적 방법을 적용할 수 있습니다.
\(N\)가 \((a,b,1)\) 계열에 속하여 \(p_{k}=\left( a+\frac{b}{k} \right) p_{k-1}, k = 2,3,\ldots\)이라고 가정합니다. 또한 \(X\)의 받침이 \(\{0,1,\ldots,m\}\)으로 이산적이고 유한하다고 가정합니다. 그러면 \(S_N\)의 확률함수는 다음과 같습니다. \[ \begin{aligned} f_{S_N}(s)&=\Pr (S_N=s) \\ &=\frac{1}{1-af_{X}(0)}\left\{ \left[ p_1 -(a+b)p_{0}\right] f_X (s)+\sum_{x=1}^{s\wedge m}\left( a+\frac{bx}{s} \right) f_X (x)f_{S_N}(s-x)\right\}. \end{aligned} \] \(N\)가 \((a,b,0)\) 계열에 속하면 \(p_1=(a+b)p_0\)이므로 \[ f_{S_N}(s)=\frac{1}{1-af_X (0)}\left\{ \sum_{x=1}^{s\wedge m}\left( a+\frac{bx }{s}\right) f_X (x)f_{S_N}(s-x)\right\}. \] 특수한 경우: 포아송 빈도. \(N \sim Poi(\lambda)\)이면 \(a=0\)이고 \(b=\lambda\)이므로 다음이 성립합니다. \[ f_{S_N}(s)=\frac{\lambda }{s}\left\{ \sum_{x=1}^{s \wedge m} x f_X (x) f_{S_N} (s-x)\right\} . \]
예제 7.4.1. 계리사 시험 문제. 한 기간 동안의 청구 건수 \(N\)는 평균이 4인 기하분포를 따릅니다. 각 청구의 금액 \(X\)는 \(x = 1,2,3,4\)에 대해 \({\rm Pr} (X = x) = 0.25\)를 따릅니다. 청구 건수와 청구 금액은 서로 독립입니다. \(S_N\)는 해당 기간의 총청구액입니다. \(F_{S_N}(3)\)를 계산하십시오.
예제 풀이 보기
예제 7.4.2. 합성곱 방법을 이용한 총손실 분포 계산 - 계속. 이 예제는 예제 7.3.4의 연속으로, 이번에는 재귀적 방법을 사용하여 총손실 분포를 계산합니다. 이를 위해서는 심도 금액을 이산화해야 하며, 이 예시에서는 청구액을 천 단위로 반올림합니다. 다음 코드 블록이 계산 과정을 보여 줍니다.
재귀적 방법을 사용하여 총손실 분포를 계산하는 R 코드
7.4.2 시뮬레이션
총손실의 분포는 몬테카를로 시뮬레이션(Monte Carlo simulation) 다양한 유형의 불확실성이 미치는 영향을 시뮬레이션하는 컴퓨터 기반 통계 모형입니다.을 사용하여 평가할 수 있습니다. 시뮬레이션 절차에 대한 폭넓은 소개는 8장에서 확인할 수 있습니다. 총손실의 경우, 확률표본을 사용하여 \(S_N\)의 경험분포를 계산할 수 있다는 것이 기본 아이디어입니다. 총손실의 기댓값과 분산도 시뮬레이션 값의 표본평균과 표본분산을 사용하여 추정할 수 있습니다.
이제 총손실 모형에 대한 시뮬레이션 절차를 요약합니다. \(R\)을 생성된 총손실 확률표본의 크기라고 합시다.
개별위험모형: \(S_n=X_1+\cdots+X_n\)
- \(j=1,\ldots,R\)을 카운터라고 합시다. 먼저 \(j=1\)로 설정합니다.
- \(i=1,\ldots,n\)에 대해 각 개별 손실 실현값 \(x_{ij}\)을 생성합니다. 예를 들어, 이는 역변환법(8.1.2절)을 사용하여 수행할 수 있습니다.
- 총손실 \(s_j = x_{1j} + \cdots + x_{nj}\)을 계산합니다.
- \(j=2,\ldots,R\)에 대해 위의 두 단계를 반복하여 \(S_n\)의 크기 \(R\) 표본, 즉 \(\{s_1,\ldots,s_R\}\)을 얻습니다.
집합적 위험 모형: \(S_N=X_1+\cdots+X_N\)
- \(j=1, \ldots, R\)을 카운터라고 합시다. 먼저 \(j=1\)로 설정합니다.
- 빈도분포 \(N\)로부터 청구 건수 \(n_j\)을 생성합니다.
- \(n_j\)이 주어지면, 심도 분포 \(X\)로부터 각 청구의 금액을 독립적으로 생성하고 이를 \(x_{1j},\ldots,x_{n_j j}\)로 표기합니다.
- 총손실 \(s_j = x_{1j} + \cdots + x_{n_j j}\)을 계산합니다.
- \(j=2,\ldots,R\)에 대해 위의 세 단계를 반복하여 \(S_N\)의 크기 \(R\) 표본, 즉 \(\{s_1,\ldots, s_R\}\)을 얻습니다.
\(S\)의 확률표본이 주어지면, 경험분포는 \[ \hat{F}_S(s)=\frac{1}{R}\sum_{j=1}^{R}I(s_j\le s), \] 로 계산할 수 있으며, 여기서 \(I(\cdot)\)은 지시함수입니다. 표본 크기가 \(R\rightarrow \infty\)일 때 경험분포(empirical distribution) 경험분포는 확률변수의 기저 분포에 대한 비모수적 추정치입니다. 데이터 관측값을 직접 사용하여 분포를 구성하며, 크기가 n인 표본에서 관측된 각 데이터 점은 확률 1/n을 갖습니다. \(\hat{F}_S(s)\)은 거의 확실하게 \({F}_S(s)\)로 수렴하다(converge) 확률변수열 x_1,…, x_n이 n이 갈 때 어떤 다른 분포에 접근하는 확률적 수렴의 한 유형입니다.합니다.
위 절차는 빈도분포와 심도 분포의 모수 값을 포함한 확률분포가 알려져 있다고 가정합니다. 실제로는 먼저 이러한 분포를 가정하고, 데이터로부터 모수를 추정한 다음, 다양한 모형 검증 도구를 사용하여 모형 적합의 품질을 평가해야 합니다(6장 참조). 예를 들어, 집합적 위험 모형의 가정은 2단계 추정을 시사하는데, 이는 청구 건수 데이터로부터 청구 건수 \(N\)에 대한 모형을 하나 구축하고, 청구 금액 데이터로부터 청구 심도 \(X\)에 대한 또 다른 모형을 구축하는 방식입니다.
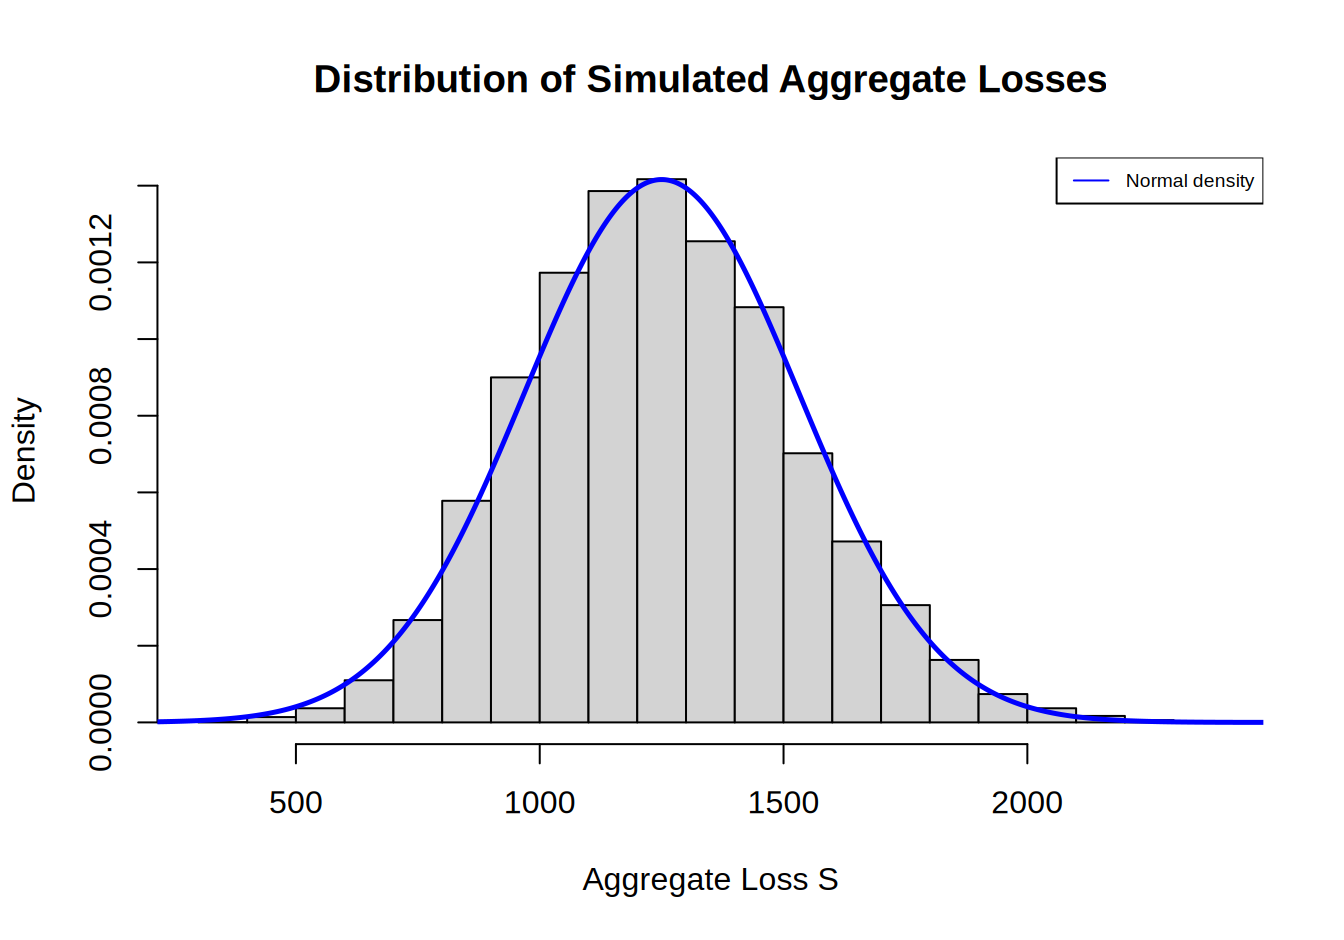
예제 7.4.3. 개인의 청구 빈도 \(N\)이 평균 \(\lambda=25\)인 포아송 분포를 따르고 청구 심도 \(X\)가 구간 \((5,95)\)에서 균등분포를 따르는 예제 7.3.6을 상기하십시오. 10,000개 관측값의 시뮬레이션 표본을 사용하여 총손실 \(S_N\)의 평균과 분산을 추정하십시오. 또한 시뮬레이션 표본을 사용하여 이 개인의 총청구액이 2,000을 초과할 확률을 추정하고, 예제 7.3.6의 정규근사 추정값과 비교하십시오.
예제 풀이 보기
Show Quiz Solution
7.5 보장 수정의 효과
이 절에서는 다음을 평가하는 방법을 배웁니다.
- 익스포저 변화가 총청구액을 구성하는 청구 건수에 미치는 영향
- 발생당 공제액이 청구 빈도에 미치는 영향
- 보장 수정이 총손실에 미치는 효과
7.5.1 익스포저가 빈도에 미치는 영향
이 절에서는 청구 건수에 대한 개별위험모형을 다룹니다. 개별위험모형은 고정된 개수 \(n\)의 계약과 독립적인 손실 확률변수 \(X_i\)로 구성된다는 점을 상기하십시오. \(n\)개의 보험계약으로 이루어진 집단에서 발생하는 청구 건수 \[ S=X_1+\cdots+X_n , \] 를 생각해 봅시다. 여기서 \(X_i\)는 보험계약 \(i\)에서 발생하는 청구 건수를 나타내며 iid라고 가정합니다. 이 경우 보험계약을 익스포저 기준으로 사용하면 포트폴리오의 익스포저는 \(n\)입니다. 10.4절에서는 다른 익스포저 기준을 소개합니다. \(S\)의 pgf는 다음과 같습니다. \[ \begin{aligned} P_{S}(z)&={\rm E}(z^S)={\rm E}\left(z^{\sum_{i=1}^nX_i}\right)\\ &=\prod_{i=1}^n{\rm E}(z^{X_i})=[P_X(z)]^n . \end{aligned} \]
특수한 경우: 포아송. \(X_i\sim Poi(\lambda)\)이면 그 pgf는 \(P_X(z)=e^{\lambda(z-1)}\)입니다. 그러면 \(S\)의 pgf는 \[ P_{S}(z)=[e^{\lambda(z-1)}]^n=e^{n\lambda(z-1)}. \] 입니다. 따라서 \(S\sim Poi(n\lambda)\)입니다. 즉, 각각의 평균이 \(\lambda\)인 \(n\)개의 독립인 포아송 확률변수의 합은 평균이 \(n\lambda\)인 포아송 분포를 따릅니다.
특수한 경우: 음이항. \(X_i\sim NB(\beta,r)\)이면 그 pgf는 \(P_X(z)=[1-\beta(z-1)]^{-r}\)입니다. 그러면 \(S\)의 pgf는 \[ P_{S}(z)=[[1-\beta(z-1)]^{-r}]^n=[1-\beta(z-1)]^{-nr}. \] 입니다. 따라서 \(S\sim NB(\beta,nr)\)입니다.
예제 7.5.1. 각 차량의 청구 건수가 평균이 \(\lambda\)인 포아송 분포를 따른다고 가정합니다. 각 가구에서 관측된 청구 건수에 관한 다음 자료가 주어졌을 때, \(\lambda\)의 MLE(MLE) 최대가능도 추정값를 계산하십시오.
\[
{\small
\begin{matrix}
\begin{array}{c|c|c}
\hline
\text{Household ID} & \text{Number of vehicles} & \text{Number of claims} \\
\hline
1 & 2 & 0 \\
2 & 1 & 2 \\
3 & 3 & 2 \\
4 & 1 & 0 \\
5 & 1 & 1 \\
\hline
\end{array}
\end{matrix}
}
\]
예제 풀이 보기
포트폴리오의 익스포저가 \(n_1\)에서 \(n_2\)로 변하면, 총청구액을 구성하는 청구 건수 사이에 다음과 같은 관계를 세울 수 있습니다. \[ P_{S_{n_2}}(z)=[P_X(z)]^{n_2}=[P_X(z)^{n_1}]^{n_2/n_1}=P_{S_{n_1}}(z)^{n_2/n_1}. \]
7.5.2 공제액이 청구 빈도에 미치는 영향
이 절에서는 공제액이 청구 빈도에 미치는 효과를 살펴봅니다. 직관적으로, 보험 공제액이 부과되면 공제액 수준보다 낮은 손실은 청구로 이어지지 않을 수 있으므로 접수되는 청구가 줄어듭니다. 피보험자가 청구를 제기하더라도, 청구가 거절되거나 손실 금액이 최종적으로 공제액 미만으로 판정될 수 있으므로 보험에서 지급이 이루어지지 않을 수 있습니다. \(N^L\)는 손실 건수(즉, 공제액이 없을 때의 청구 건수)를 나타내고, \(N^P\)는 공제액 \(d\)가 부과될 때의 지급 건수를 나타낸다고 합시다. 우리의 목표는 \(N^L\)의 분포가 주어졌을 때 \(N^P\)의 분포를 구하는 것입니다. 아래에서는 \(N^L\)와 \(N^P\) 사이의 관계를 총위험모형 체계 안에서 세울 수 있음을 보입니다.
공제액이 변경되면 보험계약자의 청구 행동이 달라지는 경우가 있다는 점에 유의하십시오. 여기서는 그렇지 않다고 가정합니다. 즉, 공제액이 변경되어도 빈도와 심도에 대한 손실의 기저 분포는 변하지 않는다고 가정합니다.
손실의 수가 \(N^L\)일 때, 이에 대응하는 손실액을 \(X_1,X_2\ldots,X_{N^L}\)라고 합시다. \(j=1,\ldots,N^L\)에 대해 다음을 정의합니다. \[\begin{eqnarray*} I_j&=& \left \{ \begin{array}{cc} 1 & \text{if} ~X_j>d\\ 0 & \text{otherwise}\\ \end{array} \right.. \end{eqnarray*}\]
그러면 \[ N^P=I_1+I_2+\cdots+I_{N^L}, \] 가 성립합니다. 즉, 총 지급 건수는 공제액 수준을 초과하는 손실의 수와 같습니다. \(I_j\)들이 성공 확률이 \(v=\Pr(X>d)\)인 독립 베르누이 확률변수이므로, 이러한 변수 고정된 개수의 합은 이항 확률변수가 됩니다. 따라서 \(N^L\)가 주어졌을 때 \(N^P\)는 이항분포를 따릅니다. 즉, \(N^P | N^L \sim Bin(N^L, v)\)이며, 여기서 \(v=\Pr(X>d)\)입니다. 이로부터 \[ \begin{aligned} \mathrm{E}\left(z^{N^P}|N^L\right)&= \left[ 1+v(z-1)\right]^{N^L} \end{aligned} \] 가 성립합니다. 따라서 \(N^P\)의 pgf는 \[ \begin{aligned} P_{N^P}(z)&= \mathrm{E}_{N^P}\left(z^{N^P}\right)=\mathrm{E}_{N^L}\left[\mathrm{E}_{N^P}\left(z^{N^P}|N^L\right)\right]\\ &= \mathrm{E}_{N^L}\left[(1+v(z-1))^{N^L}\right]\\ &= P_{N^L}\left(1+v(z-1)\right) . \end{aligned} \] 입니다. 그러므로 \(N^P\)의 pgf는 새로운 인수 \(z^* = 1+v(z-1)\)에서 계산한 \(N^L\)의 pgf로 쓸 수 있습니다. 즉, \(P_{N^P}(z)=P_{N^L}(z^*)\)입니다.
특수한 경우:
\(N^L\sim Poi (\lambda)\). \(N^L\)의 pgf는 \(P_{N^L}=e^{\lambda(z-1)}\)입니다. 따라서 \(N^P\)의 pgf는 다음과 같습니다. \[ \begin{aligned} P_{N^P}(z) &= e^{ \lambda(1+v(z-1)-1)} \\ &= e^{\lambda v(z-1)} , \end{aligned} \]
그러므로 \(N^P \sim Poi(\lambda v)\)입니다. 이는 지급 건수가 손실 건수와 같은 분포를 따르되, 기대 지급 건수가 \(\lambda v = \lambda \Pr(X>d)\)와 같다는 것을 의미합니다.\(N^L \sim NB(\beta, r)\). \(N^L\)의 pgf는 \(P_{N^{L}}\left( z\right) =\left[ 1-\beta \left( z-1\right)\right]^{-r}\)입니다. 따라서 \(N^P\)의 pgf는 \[\begin{aligned} P_{N^P}(z)&= \left( 1-\beta (1+v(z-1)-1)\right)^{-r}\\ &= \left( 1-\beta v(z-1)\right)^{-r}, \end{aligned}\] 입니다. 그러므로 \(N^P \sim NB(\beta v, r)\)입니다. 이는 지급 건수가 손실 건수와 같은 분포를 따르되, 모수가 \(\beta v\)와 \(r\)라는 것을 의미합니다.
예제 7.5.2. 손실 금액이 \(X_i\sim Pareto(\alpha=4,\ \theta=150)\)라고 가정합니다. 손실 빈도는 \(N^L\sim Poi(\lambda)\)이고, 공제액 수준 \(d_1=30\)에서 지급 빈도분포는 \(N^{P}_1\sim Poi(0.4)\)라고 주어져 있습니다. 공제액 수준이 \(d_2=100\)일 때 지급 빈도 \(N^{P}_2\)의 분포를 구하십시오.
예제 풀이 보기
예제 7.5.3. 후속 문제. 이번에는 대신 손실 빈도가 \(N^L \sim NB(\beta,\ r)\)이고, 공제액 \(d_1=30\)에 대해 지급 빈도 \(N^{P}_1\)가 평균이 \(0.4\)인 음이항 분포를 따른다고 가정합시다. 공제액 \(d_2=100\)에 대한 지급 빈도 \(N^{P}_2\)의 평균을 구하십시오.
예제 풀이 보기
다음으로, \(N^L\)가 영수정 분포인 더 일반적인 경우를 살펴봅니다. 영수정 분포는 수정되지 않은 분포를 이용하여 정의할 수 있다는 점을 상기하십시오(3.5.1절에서 보인 바와 같습니다). 즉, \[ \begin{aligned} p_k^M = c~p_k^0, {~\rm for~} k=1,2,3,\ldots, {~\rm with~}c = \frac{1-p_0^M}{1-p_0^0}, \end{aligned} \] 여기서 \(p^0_k\)는 수정되지 않은 분포의 pmf입니다. \(p_0^M=0\)인 경우, 이를 영절단 분포, 또는 \(ZT\)라고 부릅니다. \(p_0^M\)의 그 밖의 임의의 값에 대해서는 이것이 영수정 분포, 즉 \(ZM\) 분포입니다. 수정된 분포의 pgf는 수정되지 않은 분포의 pgf \(P^0(z)\)를 이용하여 \[ \begin{aligned} P^M(z) &= 1-c+c~P^0(z), \end{aligned} \] 로 나타냅니다. \(N^L\)가 영수정 분포를 따를 때, \(N^P\)의 분포는 앞에서와 같은 관계식 \(P_{N^P}(z)=P_{N^L}\left(1+v(z-1)\right)\)를 이용하여 구합니다.
특수한 경우:
\(N^{L}\)는 모수가 \(\lambda\)와 \(p_0^{M}\)인 ZM-포아송 확률변수입니다. \(N^L\)의 pgf는 \[ P_{N^{L}}(z)=1-\cfrac{1-p_0^{M}}{1-e^{-\lambda}}+\cfrac{1-p_0^{M}}{1-e^{-\lambda}}\left( e^{\lambda(z-1)} \right). \] 입니다. 따라서 \(N^P\)의 pgf는 \[ P_{N^{P}}(z)=1-\cfrac{1-p_0^{M}}{1-e^{-\lambda}}+\cfrac{1-p_0^{M}}{1-e^{-\lambda}}\left( e^{\lambda v(z-1)} \right). \] 입니다. 그러므로 지급 건수 역시 모수가 \(\lambda v\)와 \(p_0^{M}\)인 ZM-포아송 분포를 따릅니다. 0에서의 확률은 \({\rm Pr}(N^P=0) = P_{N^P}(0)\)를 이용하여 계산할 수 있습니다.
\(N^{L}\)는 모수가 \(\beta\), \(r\), \(p_0^{M}\)인 ZM-음이항 확률변수입니다. \(N^L\)의 pgf는 \[ P_{N^{L}}(z)=1-\cfrac{1-p_0^{M}}{1-(1+\beta)^{-r}}+\cfrac{1-p_0^{M}}{1-(1+\beta)^{-r}}\left[ 1-\beta \left( z-1\right)\right]^{-r}. \] 입니다. 따라서 \(N^P\)의 pgf는 \[ P_{N^{P}}(z)=1-\cfrac{1-p_0^{M}}{1-(1+\beta)^{-r}}+\cfrac{1-p_0^{M}}{1-(1+\beta)^{-r}}\left[ 1-\beta v\left( z-1\right)\right]^{-r}. \] 입니다. 그러므로 지급 건수 역시 모수가 \(\beta v\), \(r\), \(p_0^{M}\)인 ZM-음이항 분포를 따릅니다. 마찬가지로, 0에서의 확률은 \({\rm Pr}(N^P=0) = P_{N^P}(0)\)를 이용하여 계산할 수 있습니다.
예제 7.5.4. 총손실은 다음과 같이 모형화됩니다.
(i) 손실 건수는 \(\lambda=3\)이고 \(p_0^M = 0.5\)인 영수정 포아송 분포를 따릅니다.
(ii) 각 손실액은 \(\alpha=3, \theta=50, \gamma=1\)인 Burr 분포를 따릅니다.
(iii) 각 손실에 \(d=30\)의 공제액이 적용됩니다.
(iv) 손실 건수와 손실액은 서로 독립입니다.
\(\mathrm{E}(N^P)\)와 \(\mathrm{Var}(N^P)\)를 계산하십시오.
예제 풀이 보기
7.5.3 보험계약 수정이 총청구액에 미치는 영향
이 절에서는 공제액의 변화가 보험 포트폴리오의 총지급액에 어떤 영향을 미치는지 살펴봅니다. 보험금 한도(policy limits) 보상한도는 보험 증권이 보장하는 최대 금액입니다.(\(u\)), 공동보험(coinsurance) 공동보험은 피보험자와 보험자가 보상 대상 손실을 분담하는 약정입니다. 일반적으로 공동보험 모수가 명시되어 있다는 것은 양 당사자가 손실의 일정 비율(예: 50%)을 각각 부담한다는 의미입니다.(\(\alpha\)), 인플레이션(\(r\))의 존재는 보험자가 지급하는 지급 빈도의 기저 분포에 영향을 미치지 않는다고 가정합니다. 앞 절에서와 마찬가지로, 공제액의 변화가 빈도와 심도 모두에 대해 손실의 기저 분포에 영향을 미치지 않는다고 추가로 가정합니다.
손실 건수를 나타내는 기호 \(N^L\)를 상기하십시오. 원손실(ground-up loss) 보험 증권상의 조정이 이루어지기 전(즉, 공동보험, 공제액, 보상한도 중 하나 이상에 따른 차감이 적용되기 전)에 입은 손실의 총액입니다. 금액이 \(X\)이고 보험계약 공제액이 \(d\)일 때, 지급 건수를 \(N^P\)로 나타냅니다(앞 절 7.5.2에서 정의한 바와 같습니다). 또한 손실 기준(per-loss basis) 보험 증권의 변경(예: 공제액)으로 인해 발생한 모든 손실이 지급으로 이어지지는 않습니다. 손실당 기준은 발생한 모든 손실을 고려합니다.의 지급액을 \[\begin{eqnarray*} Y^{L}&=\left\{ \begin{array}{ll} 0 ~, & \text{if } ~X<\cfrac{d}{1+r} \\ \alpha[(1+r)X-d]~, & \text{if } ~\cfrac{d}{1+r}\le X<\cfrac{u}{1+r} \\ \alpha(u-d)~, & \text{if } ~X \ge \cfrac{u}{1+r}\\ \end{array} \right., \end{eqnarray*}\] 로, 지급 기준(per-payment basis) 보험 증권의 변경(예: 공제액)으로 인해 발생한 모든 손실이 지급으로 이어지지는 않습니다. 지급당 기준은 피보험자에게 어느 정도의 지급이 이루어지는 손실만을 고려합니다.의 지급액을 \[\begin{eqnarray*} Y^{P}&=\left\{ \begin{array}{ll} {\rm undefined} ~, & \text{if }~ X<\cfrac{d}{1+r} \\ \alpha[(1+r)X-d]~, & \text{if }~ \cfrac{d}{1+r}\le X<\cfrac{u}{1+r} \\ \alpha(u-d)~, & \text{if } ~ X \ge \cfrac{u}{1+r} .\\ \end{array} \right.. \end{eqnarray*}\] 로 정의합니다. 위에서 \(r\), \(u\), \(\alpha\)는 각각 인플레이션율, 보상한도, 공동보험을 나타냅니다. 따라서 총비용(지급액)은 손실 기준 또는 지급 기준으로 다음과 같이 나타낼 수 있습니다. \[ \begin{aligned} S &= Y^L_1 + \cdots + Y^L_{N^L} \\ &=Y^P_1 + \cdots + Y^P_{N^P} ~. \end{aligned} \] (5.1절에서 손실 기준과 지급 기준을 도입할 때, 손실을 보험 지급액, 즉 청구액과 구별하기 위해 다른 문자 \(Y\)를 사용했다는 점을 상기하십시오. 여기서는 기호를 간단히 하기 위해 문자 \(X\)를 사용합니다.)
이제 집합적 위험 모형에 관한 기본 사항을 적용할 준비가 되었습니다. 예를 들어 다음과 같습니다. \[ \begin{aligned} {\rm E}(S) &= {\rm E}\left(N^L\right) {\rm E}\left(X^L\right) = {\rm E}\left(N^P\right) {\rm E}\left(Y^P\right)\\ {\rm Var}(S) &= {\rm E}\left(N^L\right) {\rm Var}\left(Y^L\right) + \left[{\rm E}\left(Y^L\right)\right]^2 {\rm Var}(N^L) \\ &= {\rm E}\left(N^P\right) {\rm Var}\left(Y^P\right) + \left[{\rm E}\left(Y^P\right)\right]^2 {\rm Var}(N^P)\\ M_S(z)&=P_{N^L}\left[M_{Y^L}(z)\right]=P_{N^P}\left[M_{Y^P}(z)\right] . \end{aligned} \]
예제 7.5.5. 계리사 시험 문제. 어떤 단체 치과 보험의 청구 건수는 평균이 300이고 분산이 800인 음이항 분포를 따릅니다. 원손실 심도는 다음 표와 같습니다.
\[
{\small
\begin{matrix}
\begin{array}{ c | c }
\hline
\text{Severity} & \text{Probability}\\ \hline
40 & 0.25\\
80 & 0.25\\
120 & 0.25\\
200 & 0.25\\
\hline
\end{array}
\end{matrix}
}
\]
빈도는 변하지 않고 심도는 50% 증가할 것으로 예상합니다. 청구 건당 100의 공제액을 부과하기로 합니다. 이러한 변경 후 지급되는 총청구액의 기댓값 \(S\)을 계산하십시오.
예제 풀이 보기
예제 7.5.6. 후속 문제. 지급되는 총청구액 \(\mathrm{Var~}(S)\)의 분산은 얼마입니까?
예제 풀이 보기
대안적 방법: 지급당 기준 사용. 앞에서는 기대 손실 건수에 손실당 기대 지급액을 곱하여 기대 총청구액 지급액을 계산했습니다. 기대 지급 건수에 지급당 기대 지급액을 곱해도 된다는 점을 상기하십시오. 이 경우 \[S=X_1^P + \cdots + X_{N_P}^P \] 입니다. 지급이 발생할 확률은 \[\Pr(1.5X \ge 100)=\Pr(X \ge 66.\bar{6})=\frac{3}{4} .\] 입니다. 따라서 지급 건수 \(N^P\)는 평균이 \[\mathrm{E}(N^P) = \mathrm{E}(N^L)~\Pr(1.5X \geq 100) = 300 \left(\frac{3}{4} \right)=225 .\] 인 음이항 분포를 따릅니다(7.5.2절의 음이항 특수한 경우를 참조하십시오). 지급당 비용은 \[\begin{eqnarray*} X^P &=& \left\{ \begin{array}{ll} \text{undefined}~, & \text{if }~ 1.5x<100 \\ 1.5x-100~, & \text{if } ~ 1.5x\ge 100\\ \end{array} \right. \end{eqnarray*}\] 입니다. 이것의 기댓값은 \[ \mathrm{E}(X^P)=\frac{\mathrm{E}(X^L)}{\Pr(1.5X > 100)}=\frac{75}{(3/4)}=100 . \] 입니다. 따라서 앞에서와 같이 기대 총손실은 다음과 같습니다. \[ \mathrm{E}(S)=\mathrm{E}(X^P) ~ \mathrm{E}(N^P) = 100(225)=22,500 . \]
예제 7.5.7. 계리사 시험 문제. 어떤 회사가 차량 군을 보험에 가입시킵니다. 총손실은 복합 포아송 분포를 따릅니다. 기대 손실 건수는 20입니다. 손실 금액은 차량 종류와 관계없이 \(\theta=200\)인 지수분포를 따릅니다. 보험 비용을 줄이기 위해 다음 두 가지 변경을 하려고 합니다.
(i) 특정 종류의 차량은 보험에 가입시키지 않습니다. 이로 인해 손실 빈도가 20\(\%\) 감소할 것으로 추정됩니다.
(ii) 손실당 100의 공제액을 부과합니다.
변경 이후 보험자가 지급하는 기대 총지급액을 계산하십시오.
예제 풀이 보기
대안적 방법: 지급당 기준 사용. 지급당 기준을 사용하여 변경 이후의 기대 총지급액을 구할 수도 있습니다. 공제액이 100일 때 지급이 발생할 확률은 \(\Pr(X > 100) = e^{-100/200}\)입니다. 지급당 심도에 대해서는 원래 예제의 \(\mathrm{E}(X^L)\)에 대한 식을 대입하면 \[ \begin{aligned} \mathrm{E} (X^P) = \frac{\mathrm{E} (X^L)}{\Pr(X > 100)} = \frac{200 - 200(1-e^{-100/200})}{e^{-100/200}} = 200 \end{aligned} \] 를 얻습니다. 이는 놀라운 일이 아닙니다. 지수분포는 무기억성(memoryless) 무기억성(memoryless property)이란 주어진 확률분포가 그 이력 및 이미 경과한 시간과 무관하다는 것을 의미합니다. 구체적으로, 확률변수 x는 pr(x > s+t | x >= s) = pr(x > t)일 때 무기억성을 가집니다. 이것이 x > s+t와 x >= s가 독립 사건이라는 뜻은 아니라는 점에 유의하십시오.이므로, 100을 초과하여 지급되는 기대 청구액은 여전히 평균이 200인 지수분포를 따른다는 점을 상기하십시오.
이제 지급 빈도 \[ \mathrm{E} (N^P) = \mathrm{E}(N^L)~\Pr(X>100) = 16 ~e^{-100/200} = 9.7. \] 를 살펴봅니다. 이를 종합하면 지급당 기준을 사용해도 앞에서 손실당 기준으로 구한 것과 같은 답을 얻습니다. \[ \mathrm{E}(S) = \mathrm{E} (X^P)~ \mathrm{E} (N^P)= 200(9.7) = 1,941. \]
Show Quiz Solution
7.6 추가 자료 및 기여자
기여자
- 위스콘신 대학교 매디슨의 Peng Shi와 Lisa Gao는 이 장 초판의 주 저자입니다.
- 위스콘신 대학교 매디슨의 Peng Shi는 이 장 제2판의 저자입니다. 이 장에 대한 의견이나 개선 제안은 pshi@bus.wisc.edu로 이메일을 보내 주십시오.
- 이 장의 검토자는 다음과 같습니다: Himchan Jeong, Vytaras Brazauskas, Mark Maxwell, Jiadong Ren, Sherly Paola Alfonso Sanchez, Di (Cindy) Xu.
추가 읽을거리 및 참고문헌
R 코딩을 더 연습하고 싶다면 자매 과정인 LDA Short Course를 방문하십시오. 특히 총손실 모형 장을 참고하십시오.
TS 7.A.1. 개별위험모형의 성질
개별위험모형에서 총손실의 기댓값은 \[ \begin{aligned} \mathrm{E}(S_n) &=\sum_{i=1}^n ~ \mathrm{E}(X_i) = \sum_{i=1}^n ~ \mathrm{E}(I_i \times B_i) = \sum_{i=1}^n ~ \mathrm{E}(I_i) ~~ \mathrm{E}(B_i) ~~~~ \text{from independence of } I_i \text{'s and } B_i \text{'s} \\ &= \sum_{i=1}^n \Pr(I_i=1) ~ \mu_i ~~~~ \text{since } E(I_i) \text{ is the probability } I_i \text{ is 1} \\ &= \sum_{i=1}^n ~ q_i ~ \mu_i . \end{aligned} \] 입니다. 개별위험모형에서 총손실의 분산은 \[ \begin{aligned} \mathrm{Var}(S_n) &= \sum_{i=1}^n \mathrm{Var}(X_i) ~~~~ \text{from independence of } X_i \text{'s} \\ &= \sum_{i=1}^n ~ \left( ~ \mathrm{E}\left[ \mathrm{Var}(X_i | I_i) \right] + \mathrm{Var}\left[ \mathrm{E}(X_i|I_i) \right] ~ \right) ~~~~ \text{from conditional variance formulas} \\ &= \sum_{i=1}^n \left( q_i ~ \sigma_i^2 ~ + ~ q_i ~ (1-q_i) ~ \mu_i^2 \right) . \end{aligned} \] 입니다. 이를 확인하려면 \[ \begin{aligned} \mathrm{E}\left[ \mathrm{Var}(X_i | I_i) \right] &= \mathrm{Var}(X_i|I_i=0) ~ \Pr(I_i=0) + \mathrm{Var}(X_i|I_i=1) ~ \Pr(I_i=1) \\ &= q_i ~ \sigma_i^2 + (1-q_i) ~ (0) = q_i ~ \sigma_i^2, \end{aligned} \] 이고, \(I_i=0\)일 때(확률 \(\Pr(I_i=0) = 1-q_i\)) \(\mathrm{E}(X_i|I_i) = 0\)이고 \(I_i=1\)일 때(확률 \(\Pr(I_i=1)= q_i\)) \(\mathrm{E}(X_i|I_i) = \mu_i\)이므로 베르누이 분산의 간편 공식을 사용하면 \[ \begin{aligned} \mathrm{Var}\left[ \mathrm{E}(X_i|I_i) \right] &= q_i ~ (1-q_i) ~ \mu_i^2~, \end{aligned} \] 임에 주목하십시오.
개별위험모형에서 총손실의 확률생성함수는 \[ \begin{aligned} P_{S_n}(z) &= \prod_{i=1}^n ~ P_{X_i}(z) ~~~~ \text{from the independence of } X_i \text{'s} \\ &= \prod_{i=1}^n ~ \mathrm{E}(z^{~X_i}) = \prod_{i=1}^n ~ \mathrm{E}(z^{~I_i \times B_i}) = \prod_{i=1}^n ~\mathrm{E} \left[ \mathrm{E}(z^{~I_i \times B_i} | I_i) \right] ~~~~ \text{from law of iterated expectations} \\ &= \prod_{i=1}^n \left[ ~ E\left(z^{~I_i \times B_i} | I_i=0\right) ~ \Pr(I_i=0) + E\left(z^{~I_i \times B_i} | I_i=1\right) ~ \Pr(I_i=1) ~ \right] \\ &= \prod_{i=1}^n ~ \left[ ~ (1) ~ (1-q_i) + P_{B_i}(z) ~ q_i ~ \right] = \prod_{i=1}^n \left(~ 1-q_i + q_i ~ P_{B_i}(z) ~\right) \end{aligned} \] 입니다. 마지막으로, 개별위험모형에서 총손실의 적률생성함수는 다음과 같습니다. \[ \begin{aligned} M_{S_n}(t) &= \prod_{i=1}^n ~ M_{X_i}(t) ~~~~ \text{from the independence of } X_i \text{'s} \\ &= \prod_{i=1}^n ~ \mathrm{E}(e^{t~X_i}) = \prod_{i=1}^n ~ \mathrm{E}\left(e^{~t~(I_i \times B_i)} \right) \\ & = \prod_{i=1}^n ~ \mathrm{E} \left[ \mathrm{E} \left( e^{~t~(I_i \times B_i)} | I_i \right) \right] ~~~~ \text{from law of iterated expectations} \\ &= \prod_{i=1}^n ~ \left[~ \mathrm{E}\left(e^{~t~(I_i \times B_i)} | I_i=0 \right) ~ \Pr(I_i=0) + \mathrm{E}\left( e^{~t~(I_i \times B_i)} | I_i=1 \right) ~ \Pr(I_i=1) ~\right] \\ &= \prod_{i=1}^n ~ \left[ ~ (1) ~ (1-q_i) + M_{B_i}(t) ~ q_i ~ \right] = \prod_{i=1}^n \left(~ 1-q_i + q_i ~ M_{B_i}(t) ~\right) . \end{aligned} \]
TS 7.A.2. \(X_i\)와 \(X_i^T\)의 확률생성함수 사이의 관계
\(X_i\)가 \(k=0,1,\ldots\)에 대해 pmf \(p_{ik} = \Pr(X_i = k)\)를 갖는 \((a,b,0)\) 부류에 속하고, \(X_i^T\)가 \(k=1,2,\ldots\)에 대해 pmf \(p_{ik}^T = p_{ik}/(1-p_{i0})\)를 갖는 \((a,b,1)\) 부류의 대응하는 영절단 분포라고 합시다. 그러면 \(X_i\)의 pgf와 \(X_i^T\)의 pgf 사이의 관계는 다음과 같이 나타납니다. \[ \begin{aligned} P_{X_i}(z) &= \mathrm{E~}(z^{X_i}) = \mathrm{E}\left[ \mathrm{E}\left( z^{X_i} | X_i \right) \right] ~~~~ \text{from law of iterated expectations} \\ &= \mathrm{E}\left( z^{X_i} | X_i=0 \right)~ \Pr(X_i=0) + \mathrm{E}\left( z^{X_i} | X_i>0 \right) ~ \Pr(X_i>0) \\ &= (1)~ p_{i0} + \mathrm{E}(z^{X_i^T}) ~ (1-p_{i0}) ~~~~ \text{since } (X_i | X_i>0) \text{ is zero-truncated r.v. } X_i^T \\ &= p_{i0} +(1-p_{i0}) P_{X_i^{T}}(z) . \end{aligned} \]
TS 7.A.3. 예제 7.3.9에서 총손실 \(S_N\)의 적률생성함수
\(N\sim Geo(\beta)\) 및 \(X\sim Exp(\theta)\)에 대해 \[ \begin{aligned} P_N (z) &=\frac{1}{1- \beta (z-1)}\\ M_{X}(t) &=\frac{1}{1-\theta t} . \end{aligned} \] 를 얻습니다. 따라서 총손실 \(S_N\)의 mgf는 \[ \begin{aligned} M_{S_N}(t) &= P_N [M_{X}(t)] = \frac{1}{1 - \beta \left( \frac{1}{1-\theta t} - 1\right)} \\ &= \frac{1}{1 - \beta \left( \frac{\theta t}{1-\theta t} \right)} + 1 - 1 = 1+ \frac{\beta \left( \frac{\theta t}{1-\theta t} \right)}{1 - \beta \left( \frac{\theta t}{1-\theta t} \right)} \\ &= 1 + \frac{\beta \theta t}{(1-\theta t) - \beta \theta t} = 1+ \frac{\beta \theta t}{1-\theta t (1+\beta)} \cdot \frac{1+\beta}{1+\beta} \\ &= 1 + \frac{\beta}{1+\beta} \left[ \frac{\theta (1+\beta) t}{1-\theta(1+\beta)t} \right] \\ &= 1 + \frac{\beta}{1+\beta} \left[ \frac{1}{1-\theta(1+\beta)t} - 1 \right], \\ \end{aligned} \] 이며, 이로부터 (7.1) 식을 얻습니다. mgf의 다른 표현 (7.2)을 구하기 위해 방금 멈춘 곳에서 이어 가겠습니다. \[ \begin{aligned} M_{S_N}(t) &= 1 + \frac{\beta}{1+\beta} \left[ \frac{\theta (1+\beta) t}{1-\theta(1+\beta)t} \right] \\ &= \frac{1+\beta}{1+\beta} + \frac{\beta}{1+\beta} \left[ \frac{\theta (1+\beta) t}{1-\theta(1+\beta)t} \right] \\ &= \frac{1}{1+\beta} + \frac{\beta}{1+\beta} + \frac{\beta}{1+\beta} \left[ \frac{\theta (1+\beta) t}{1-\theta(1+\beta)t} \right] \\ &= \frac{1}{1+\beta} + \frac{\beta}{1+\beta}\left[1 + \frac{\theta (1+\beta) t}{1-\theta (1+\beta)t} \right] \\ &= \frac{1}{1+\beta} +\frac{\beta}{1+\beta} \left[ \frac{1}{1-\theta (1+\beta)t}\right] . \end{aligned} \]