제1장 손실 데이터와 보험 활동
장 미리보기. 이 책은 독자에게 보험 데이터를 분석하는 방법을 소개합니다. 1.1절에서는 보험 산업에서 데이터 활용이 왜 중요한지를 논의하는 것으로 시작합니다. 1.2절에서는 보험 데이터를 분석하는 목적을 전반적으로 개관하며, 이는 1.3절의 사례 연구에서 한층 보강됩니다. 당연히 개관에서 요약한 폭넓은 목표와 사례 연구 적용 사이에는 큰 간극이 있으며, 이 간극은 본문의 나머지 부분에서 다루는 데이터 분석 방법과 기법을 통해 메워집니다.
1.1 데이터 기반 보험 활동
이 절에서는 다음을 배웁니다.
- 소비자와 경제에 대한 보험의 중요성을 요약합니다
- 보험 활동을 관리하는 데 데이터가 하는 역할을 설명합니다
- 일반적인 보험계약의 타임라인과 관련된 데이터 생성 사건을 식별하십시오
1.1.1 보험의 본질과 중요성
이 책은 보험 맥락에서 데이터를 활용하여 의사 결정을 내리는 과정을 소개합니다. 이 책은 독자가 보험에 익숙하다고 가정하지 않으며, 필요에 따라 보험 개념을 소개합니다. 보험은 보험료라고 하는 일정 금액을, 보험사고가 발생하면 상대방에게 보상하겠다는 약속과 교환하는 것입니다.
보험을 처음 접한다면, 임차하고 있는 아파트나 주택의 내용물을 보장하는 보험계약(세입자 보험(renters insurance) 임차인보험(renters insurance)은 임차한 아파트나 주택 내의 물품을 보장하는 보험계약입니다.이라고 합니다)이나 본인 또는 친구가 소유한 건물의 내용물과 재산을 보장하는 보험계약(주택소유자보험(homeowners insurance) 주택소유자보험은 본인이나 지인이 소유한 건물의 내부 물품과 재산을 보장하는 보험계약입니다.이라고 합니다)을 떠올리는 것이 아마 가장 쉬울 것입니다. 또 다른 흔한 예로는 자동차 보험(automobile insurance) 본인 차량의 손해와 사고에 관련된 다른 차량의 손해는 물론, 사고로 부상당한 사람들의 의료 비용까지 보장하는 보험계약.이 있습니다. 사고가 발생하면 이 보험계약은 본인 차량의 손해, 사고에 연루된 다른 차량의 손해뿐 아니라 사고로 부상당한 사람들의 의료비용까지 보장할 수 있습니다.
보험의 본질을 생각하는 한 가지 방법은 누가 보험을 구매하는지를 살펴보는 것입니다. 임차인 보험, 주택 소유자 보험, 자동차 보험은 개인에게 발행되는 보험 증권이라는 점에서 개인보험(personal insurance) 개인이 가입한 보험의 예입니다. 기업도 자사 재산에 대한 보장과 같은 보험을 구매하며, 이를 기업 보험(commercial insurance) 이라고 합니다. 판매자인 보험회사는 보험자라고도 합니다. 보험회사조차도 보험이 필요하며, 이를 재보험(reinsurance) 보험자가 구입하는 보험이라고 합니다.
보험의 본질을 생각하는 또 다른 방법은 보장되는 위험의 유형을 살펴보는 것입니다. 미국에서는 임차인 보험이나 주택 소유자 보험과 같은 보험 증권을 재산보험(property insurance) 재산보험은 부동산이나 동산의 손실 또는 손해로부터 피보험자를 보호하는 보험계약입니다. 손실 원인은 화재, 낙뢰, 영업 중단, 임대료 손실, 유리 파손, 토네이도, 폭풍, 우박, 수해, 폭발, 폭동, 소요, 비, 항공기나 차량에 의한 손해 등일 수 있습니다.이라고 하는 반면, 자동차 보험처럼 사람의 의료적 손해를 보장하는 보험 증권은 상해 보험(casualty insurance) 상해보험(casualty insurance)은 과실에 의한 작위와 부작위를 보장하는 배상책임보험의 한 형태입니다. 산재보험, 전문직 과실책임(errors and omissions), 신원보증, 범죄, 유리, 보일러 및 각종 의료과실 보장 등이 그 예입니다.이라고 합니다. 그 밖의 국가에서는 이 둘을 생명보험(life insurance) 생명보험은 피보험자가 사망하면 보험자가 보험금을 지급하기로 약속하는 계약입니다. 보험금을 받는 사람을 수익자라고 합니다.과 구별하기 위해 모두 손해보험(non-life) 손해보험은 보험금 지급이 지정된 피보험자의 사망(또는 생존)에 근거하지 않는 모든 유형의 보험입니다. 자동차보험, 주택소유자보험 등이 그 예입니다. 재산 및 상해보험(property and casualty) 또는 일반보험이라고도 합니다. 또는 일반보험이라고 합니다.
생명보험과 손해보험은 모두 세계 경제의 중요한 구성 요소입니다. The Organization for Economic Cooperation and Development (OECD) (2021)는 2020년 OECD(경제협력개발기구) 회원국의 원수보험료가 생명보험 2,520,220, 손해보험 2,704,799였던 것으로 추정하며, 이 수치의 단위는 백만 미국 달러입니다. 이 합계는 OECD 국내총생산(GDP)의 9.447%에 해당합니다. 예를 들어, 보험료는 룩셈부르크에서 GDP의 30.9%, 중화 타이베이에서 GDP의 17.0%를 차지했으며(조사 대상 중 가장 높은 두 곳), 미국에서는 GDP의 12.5%를 차지했습니다. 생명보험과 손해보험은 모두 중요한 경제 활동입니다.
보험은 많은 사람의 경제적 생계에 영향을 미치며, 거의 어떤 척도로 보더라도 보험은 주요한 경제 활동입니다. 앞서 언급했듯이, 전 세계적으로 2020년 보험료는 GDP의 약 9.5%를 차지했습니다. 개인 차원에서 보면, 주택을 소유한 거의 모든 사람이 화재, 우박, 또는 기타 재난이 발생할 경우에 대비하여 자신을 보호하기 위해 보험에 가입되어 있습니다. 거의 모든 국가에서 자동차를 운전하는 사람에게 보험 가입을 의무화하고 있습니다. 요컨대, 보험은 국가 경제와 개인의 삶에서 중요한 역할을 합니다.
1.1.2 왜 데이터 기반인가?
보험은 데이터 기반 산업입니다. 모든 주요 기업 및 조직과 마찬가지로, 보험사는 직원에게 급여를 얼마나 지급할지, 직원을 몇 명 유지할지, 서비스와 상품을 어떻게 마케팅할지, 재무 동향을 어떻게 예측할지 등을 결정하려 할 때 데이터를 활용합니다. 이는 보험 산업에만 국한되지 않는 일반적인 활동 영역에 해당합니다. 각 산업마다 고유한 데이터의 특성과 요구가 있지만, 데이터의 수집, 분석 및 활용은 인터넷 대기업에서 소규모 사업체에 이르기까지, 그리고 공공 기관과 정부 기관에 이르기까지 모두가 공유하는 활동이며, 보험 산업에만 국한된 것이 아닙니다. 이 책에서 소개하는 데이터 수집 및 분석 방법과 도구가 모든 분야에 유용하다는 것을 알게 될 것입니다.
어떤 데이터 기반 산업에서든, 데이터로부터 정보를 도출하고 추출하는 일은 매우 중요합니다. 데이터에 기반한 비즈니스 의사결정은 비즈니스 애널리틱스, 비즈니스 인텔리전스, 데이터 과학 등으로 설명되어 왔습니다. 이러한 용어들은 때로는 혼용되기도 하고, 때로는 서로 구별되는 응용 분야를 가리키기도 합니다. 비즈니스 인텔리전스는 주로 데이터베이스와 데이터 웨어하우스를 통해 데이터를 수집하는 과정에 초점을 맞추는 반면, 비즈니스 애널리틱스는 데이터의 통계적 분석을 위한 도구와 방법을 활용합니다. 비즈니스 응용을 강조하는 이 두 용어와 달리, 데이터 과학이라는 용어는 여러 과학 분야에 걸친 보다 폭넓은 데이터 관련 응용을 포괄할 수 있습니다. 이 책에서는 데이터를 활용하여 의사결정을 내리는 과정을 가리키는 용어로 분석(analytics) 분석(analytics)은 데이터를 사용하여 의사 결정을 내리는 과정입니다.을 사용합니다. 이 과정에는 데이터 수집, 불확실성의 개념과 모형에 대한 이해, 일반적인 추론, 그리고 결과 전달이 포함됩니다. 2장에서는 데이터 분석을 더 자세히 설명합니다.
이 책에서는 방법을 소개할 때 보험계약상의 의무에서 발생하거나 이와 관련된 손실 데이터에 초점을 맞춥니다. 예를 들어 세입자 보험 계약에 따른 아파트 손해액, 운전 중 사고로 다치게 한 사람에게 보상하는 데 필요한 금액 등이 이에 해당할 수 있습니다. 이러한 지급을 보험금 청구(insurance claim) 보험금 청구는 보험 계약이 보상하는 상해, 손실 또는 손해가 발생했을 때 보험자가 제공하는 보상입니다.이라고 부릅니다. 이러한 초점을 통해 일반적으로 적용 가능한 통계 도구와 기법을 소개하고 직접 활용할 수 있습니다.
1.1.3 보험 프로세스
보험의 성격을 생각하는 또 다른 방법은 보험 기간(term) 보험계약의 존속 기간이라고 하는 보험계약의 기간에 따라 구분하는 것입니다. 이 책은 단기 보험계약에 초점을 맞춥니다. 단기란 보험 보장이 일반적으로 1년 또는 6개월 동안 제공되는 계약을 의미합니다. 대부분의 손해보험 상업 계약과 개인 계약은 1년 단위이므로, 이를 기본 기간으로 삼습니다. 중요한 예외로는 흔히 6개월 단위인 미국의 자동차 보험 증권이 있습니다.
이와 대조적으로, 생명보험은 일반적으로 여러 해에 걸친 계약을 기본으로 하는 장기 계약으로 간주됩니다. 예를 들어 25세인 사람이 피보험자 사망 시 보험금을 지급하는 종신보험에 가입하고 그 사람이 100세가 되어서야 사망한다면, 해당 계약은 75년 동안 유지됩니다.
생명보험 상품과 손해보험 상품 사이에는 또 다른 중요한 차이점이 있습니다. 생명보험에서는 보험금액이 계약 조항에 명시되어 있는 경우가 많습니다. 이와 대조적으로, 대부분의 손해보험 계약은 사고 이전에는 알 수 없는 보험 손실에 대한 보상을 규정합니다. (보상 금액에는 대개 한도가 설정됩니다.) 여러 해에 걸쳐 이어지는 생명보험 보험계약에서는 화폐의 시간 가치가 중요한 역할을 합니다. 손해보험 계약에서는 확률적인 보상 금액이 우선적으로 중요합니다.
생명보험과 손해보험 모두에서 청구 빈도는 매우 중요합니다. 많은 생명보험 보험계약에서 보험사고(예: 사망)는 단 한 번만 발생합니다. 이와 달리, 자동차보험과 같은 손해보험에서는 개인(특히 젊은 남성 운전자)이 1년 동안 두 번 이상 사고를 당하는 일이 흔합니다. 따라서 우리의 모형은 이러한 관측값을 반영해야 하며, 이에 생명보험을 공부할 때에도 접할 수 있는 다양한 빈도 모형을 소개합니다.
단기 보험의 경우 확률 모형의 틀은 간단합니다. 단일 기간 모형을 생각합니다(기간의 길이, 예컨대 1년은 상황에 따라 정해집니다).
- 기간 초에 피보험자는 계약 당사자 양측이 합의한, 이미 알려진 보험료를 보험자에게 지급합니다.
- 기간 말에 보험자는 (다변량일 수도 있는) 확률적 손실에 대해 피보험자에게 보상합니다.
이 틀은 앞으로 진행하면서 발전시켜 나갈 것입니다. 하지만 먼저 이 틀을 데이터가 어떻게 발생할 수 있는지에 대한 관심사와 통합하는 데 초점을 맞춥니다. 보험자의 관점에서 보면 계약은 1년짜리일 수 있지만 갱신되는 경향이 있습니다. 게다가 한 해 동안 발생한 청구에서 비롯된 지급은 1년을 훨씬 넘어서까지 이어질 수 있습니다. 보험회사의 운영에서 발생하는 데이터를 기술하는 한 가지 방법은 시간축에 따른 세분화된 접근법을 사용하는 것입니다. 프로세스 접근법은 보험계약 기간 동안 발생하는 사건들과 그 성격, 즉 확률적인지 계획된 것인지, 손실 사건(청구)인지 계약 변경 사건인지 등에 대한 전체적인 관점을 제공합니다. 이러한 미시적 관점에서 우리는 계약이 존속하는 여러 단계에서 계약에 어떤 일이 일어나는지 생각해 볼 수 있습니다.
그림 1.1는 전형적인 보험계약의 시간축을 보여 줍니다. 계약 기간 전체에 걸쳐 회사는 1.2절에서 설명하는 보험료 수납 및 평가와 같은 사건을 정기적으로 처리합니다. 이러한 사건은 시간축에 x로 표시되어 있습니다. 비정기적이고 예상치 못한 사건도 발생합니다. 예를 들어, \(\mathrm{t}_2\)와 \(\mathrm{t}_4\)는 보험 청구 사건을 나타냅니다(생명보험과 같은 일부 계약은 청구가 단 한 번만 있을 수 있습니다). 시점 \(\mathrm{t}_3\)와 \(\mathrm{t}_5\)는 보험계약자가 공제액(deductible) 공제액은 계약에 명시된 모수입니다. 일반적으로 공제액 미만의 손실은 보험계약자가 부담하고, 공제액을 초과하는 손실은 보험자가 책임집니다(보험가입한도와 공동보험 조건이 적용됩니다).의 선택이나 보장 금액과 같은 특정 계약 사항을 변경하고자 하는 사건을 나타냅니다. 회사의 관점에서는 계약 개시(도착, 시점 \(\mathrm{t}_1\))와 계약 종료(이탈, 시점 \(\mathrm{t}_6\))조차 불확실한 사건으로 생각할 수 있습니다. (또는 목적에 따라서는 이러한 사건을 조건으로 두고 확실한 것으로 취급할 수도 있습니다.)
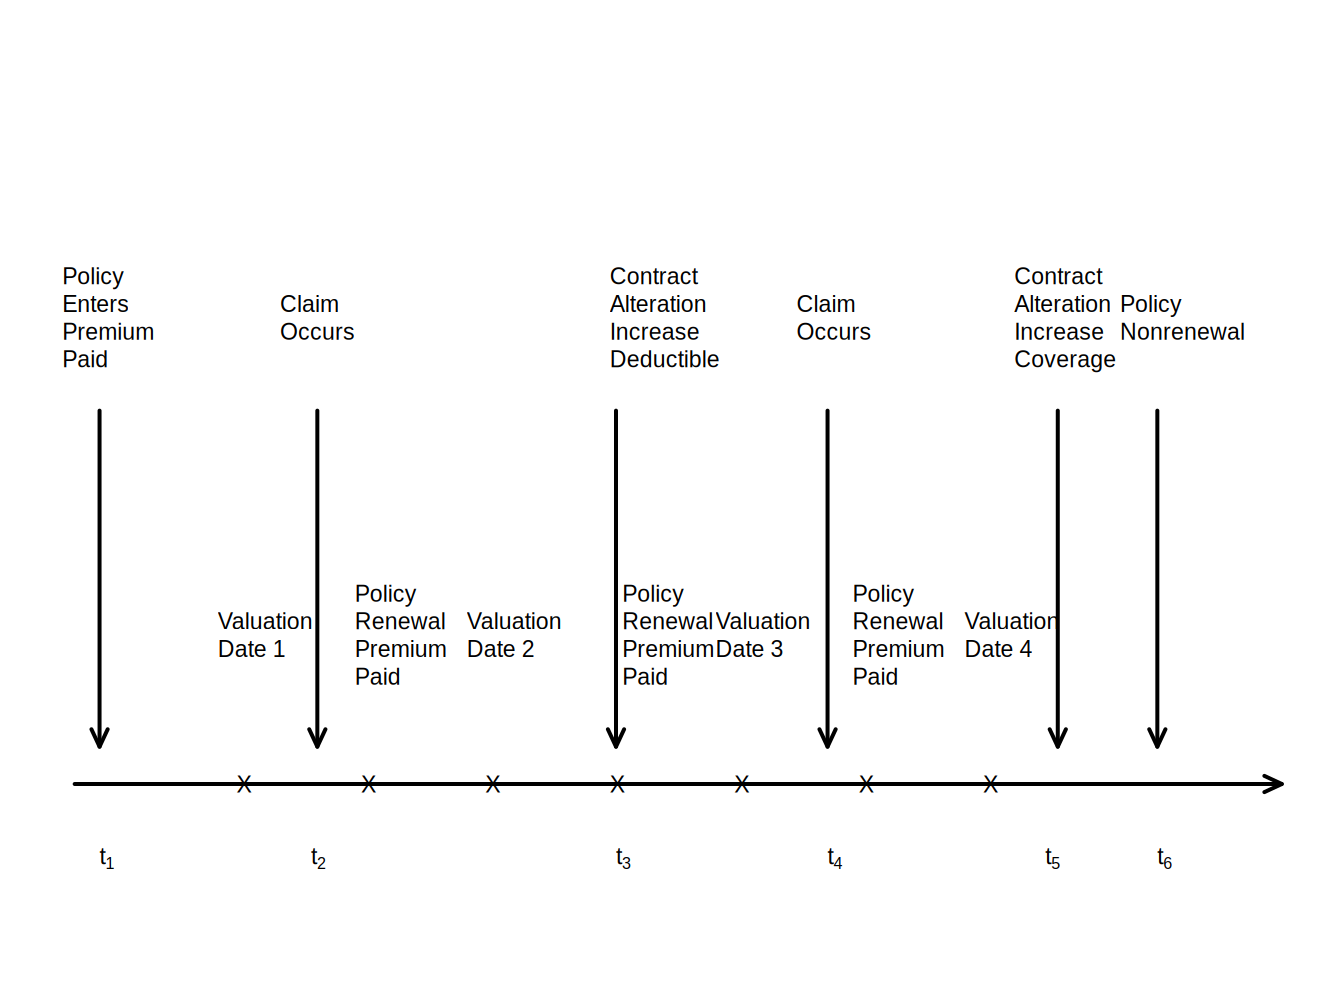
그림 1.1: 일반적인 보험계약의 타임라인. 화살표는 무작위 사건의 발생을 표시합니다. 각 x는 일반적으로 확률적이지 않은, 예정된 사건의 시점을 나타냅니다.
Show Quiz Solution
1.2 보험회사의 운영
이 절에서는 다음을 배웁니다.
- 보험회사의 다섯 가지 주요 운영 영역을 설명합니다.
- 각 운영 영역에서 데이터의 역할과 분석 기회를 파악합니다.
보험 데이터를 갖추었다면 최종 목표는 데이터를 활용해 의사결정을 내리는 것입니다. 데이터를 분석하고 외삽하는 방법은 이후 장에서 더 자세히 배울 것입니다. 우선 왜 분석을 하려는지부터 생각해 봅시다. 여기서는 (피보험자가 아닌) 보험회사의 관점을 취하여, 돈을 들여오고, 지급하고, 비용을 관리하며, 의무를 이행하기에 충분한 자금을 확보하는 방법을 소개합니다. 광고, 마케팅, 인적자원 관리와 같은 일반적인 경영 활동보다는 보험 고유의 업무에 중점을 둡니다.
구체적으로, 많은 보험회사에서는 세부적인 보험 프로세스를 더 큰 운영 단위로 묶는 것이 관례이며, 많은 회사가 이러한 기능 영역을 이용해 직원의 활동과 책임 영역을 구분합니다. 계리사, 그 밖의 재무 분석가, 보험 규제 당국은 이러한 단위 안에서 일하며 다음과 같은 활동에 데이터를 활용합니다.
- 보험 개시. 이 단계에서 회사는 위험을 인수할지 여부를 결정하고(언더라이팅(underwriting) 언더라이팅은 회사가 위험을 인수할지 여부를 결정하는 과정입니다. 단계) 적절한 보험료(또는 요율)를 책정합니다. 보험 분석의 계리적 뿌리는 요율 산정에 있으며, 여기서 분석가는 적절한 위험에 대한 적절한 가격을 결정하고자 합니다.
- 보험 갱신. 많은 계약, 특히 일반보험 계약은 6개월이나 1년과 같이 기간이 비교적 짧습니다. 이러한 계약은 갱신될 것이라는 암묵적인 기대가 있지만, 보험자는 보장을 거절하거나 보험료를 조정할 기회를 가집니다. 분석은 수익성 있는 고객을 유지하는 것이 목표인 이 계약 갱신 단계에서도 활용됩니다.
- 보험금 청구 관리. 분석은 오래전부터 (1) 보험금 청구 사기의 탐지 및 예방, (2) 청구 처리 비용에 대한 적절한 지원 규모 파악을 포함한 청구 비용 관리, 그리고 (3) 재보험 및 보유를 위한 초과 레이어의 이해에 활용되어 왔습니다.
- 지급준비금 산정. 분석 도구는 경영진에게 미래 의무에 대한 적절한 추정치를 제공하고 그 추정치의 불확실성을 정량화하는 데 사용됩니다.
- 지급여력과 자본 배분. 필요한 자본의 규모를 결정하고 여러 대안 투자 간에 자본을 배분하는 방법을 정하는 것 또한 중요한 분석 활동입니다. 회사는 의무가 실현될 것으로 예상되는 시점에 이를 이행할 수 있도록 충분한 현금 흐름을 확보하기 위해 얼마만큼의 자본이 필요한지 알아야 합니다(지급여력). 이는 회사 경영진뿐 아니라 고객, 회사 주주, 규제 당국, 나아가 일반 대중에게도 관련된 중요한 문제입니다. 자본이 얼마나 필요한가의 문제와 관련된 것으로, 일반적으로 투자자의 수익을 극대화하기 위해 서로 다른 재무 프로젝트에 자본을 어떻게 배분할 것인가의 문제가 있습니다. 이 문제는 여러 수준에서 제기될 수 있지만, 보험회사는 일반적으로 회사 내의 여러 사업 부문과 모회사의 여러 자회사에 자본을 어떻게 배분할지에 관심을 둡니다.
데이터는 지급여력과 자본 배분의 핵심 요소이지만, 지역 및 세계 경제 체제, 금융 투자 환경, 그리고 당시 규제 환경에 따른 상당히 구체적인 요건 등 다른 요소들도 중요합니다. 이러한 요소들을 다루려면 상당한 배경지식이 필요하므로, 이 책에서는 지급여력, 자본 배분, 규제 문제를 다루지 않습니다.
그럼에도 불구하고, 모든 운영 함수에 걸쳐 보험 산업의 분석은 소수의 분석가가 스스로 해낼 수 있는 작업이 아니라는 점을 강조합니다. 이를 위해서는 보험자가 정보기술, 마케팅, 언더라이팅, 계리 함수에 상당한 투자를 해야 합니다. 이러한 영역이 데이터 분석의 주된 최종 목표에 해당하므로, 이어지는 하위 절에서 각 운영 단위에 대한 추가적인 배경을 설명합니다.
1.2.1 보험 개시
보험 상품의 가격을 설정하는 일은 난해한 문제일 수 있습니다. 이는 제조업과 같은 다른 산업과 대조적입니다. 그러한 산업에서는 제품의 원가가 (비교적) 알려져 있으며, 이것이 시장 수요 가격을 평가하는 기준이 됩니다. 마찬가지로 금융 서비스의 다른 분야에서는 시장 가격을 이용할 수 있으며, 이것이 상품의 시장 일관적 가격 구조의 토대가 됩니다. 그러나 많은 보험 종목에서는 상품의 원가가 불확실하고 시장 가격을 이용할 수 없습니다. 확률적 비용의 기댓값은 가격 산정의 합리적인 출발점입니다. (재무학을 공부했다면 기댓값이 위험 중립적인 보험자에게 최적 가격이라는 사실을 기억할 것입니다.) 보험 가격 산정에서는 전통적으로 기대 비용에서 출발해 왔습니다. 그런 다음 보험자는 상품의 위험성, 상품 관리에 드는 비용, 회사의 이익/잉여금에 대한 충당분을 반영하기 위해 여기에 마진을 더합니다.
기대 비용을 가격 산정의 토대로 사용하는 방식은 일부 보험 종목에서 널리 쓰입니다. 여기에는 자동차 보험과 주택소유자보험이 포함됩니다. 이러한 종목에서 애널리틱스는 상품의 기대 비용 계산을 더 정밀하게 만들어 시장을 더욱 정교하게 하는 역할을 해 왔습니다. 소비자의 인터넷 이용 가능성이 높아진 것 역시 가격 투명성을 촉진했습니다. 오늘날의 시장에서 소비자는 수많은 보험자로부터 경쟁 견적을 손쉽게 받아 볼 수 있습니다. 보험자는 위험 분류(risk classification) 위험 분류는 보험 계약자를 범주, 즉 등급으로 묶는 과정으로, 각 등급에 속한 피보험자는 같은 등급의 다른 피보험자와 유사한 위험 특성을 갖습니다. 체계를 정교화하여 시장 점유율을 높이고자 하며, 이를 통해 상품 가격을 더 잘 근사하고 크림 스키밍 언더라이팅 전략을 가능하게 합니다(“크림 스키밍”은 보험자가 가장 우량한 위험만을 인수할 때 쓰이는 표현입니다). 여러 조사(예: Earnix (2013))에 따르면 가격 산정은 보험자들 사이에서 애널리틱스가 가장 흔히 활용되는 분야입니다.
위험을 동질적인 범주로 분류하고 보험계약자를 이 범주에 배정하는 과정인 언더라이팅은 요율 산정의 핵심에 있습니다. 한 등급(범주) 안의 보험계약자들은 비슷한 위험 특성을 가지므로 동일한 보험 가격이 부과됩니다. 이것이 보험수리적으로 공정한 보험료의 개념입니다. 즉, 식별 가능한 위험 요인으로 보험계약자들을 구분할 수 있는 경우에만 서로 다른 요율을 부과하는 것이 공정합니다. 자동차 보험 요율 산정을 다룬 초기 논문인 Two Studies in Automobile Insurance Ratemaking (Bailey and LeRoy 1960)는 보험 산업이 분석적 방법을 받아들이는 데 촉매 역할을 했습니다. 이 논문은 분류 요율 산정 문제를 다룹니다. 이 논문은 다섯 개의 용도 등급이 네 개의 실적 요율 등급과 교차 분류된 자동차 보험의 사례를 설명합니다. 당시에는 용도 등급과 실적 요율 등급이 보험료에 기여하는 정도가 서로 독립적으로 결정되었습니다. 서로 다른 분류 변수들의 상호작용 효과를 고려하는 것은 더 어려운 문제입니다.
위험을 처음 인수할 때, 보험자는 계약 지급액을 조정하는 계약 모수를 부과하여 자신의 의무를 관리할 수 있습니다. 4장에서는 공동보험(coinsurance) 공동보험은 피보험자와 보험자가 보상 대상 손실을 분담하는 약정입니다. 일반적으로 공동보험 모수가 명시되어 있다는 것은 양 당사자가 손실의 일정 비율(예: 50%)을 각각 부담한다는 의미입니다., 공제액, 보험 상한액(policy upper limits) 을 비롯한 일반적인 조정 방식을 설명합니다.
1.2.2 보험 갱신
보험은 금융 서비스의 한 유형이며, 많은 서비스 계약과 마찬가지로 보험 보장은 흔히 제한된 기간에 대해 합의되고 그 기간이 끝나면 보장 약정이 종료됩니다. 특히 일반보험의 경우 보장의 필요성이 계속되므로, 기존 계약이 기간 만료에 이르면 유사한 보장을 제공하는 새로운 계약을 발행하려는 노력이 이루어집니다. 이를 보험계약 갱신이라고 합니다. 갱신 문제는 정기(한시) 생명보험과 같은 생명보험에서도 발생할 수 있습니다. 한편 종신연금과 같은 다른 계약은 피보험자의 사망과 함께 종료되므로 갱신 가능성 문제는 해당되지 않습니다.
법적 제한이 없다면, 갱신 시 보험자는 다음과 같은 기회를 가집니다.
- 해당 위험의 언더라이팅을 수락하거나 거절합니다.
- 경우에 따라 위험을 새로 분류하면서 새로운 보험료를 결정합니다.
갱신 시점의 위험 분류와 요율 산정은 두 가지 유형의 정보에 기반합니다. 첫째, 최초 단계에서 보험자는 의사 결정의 근거로 삼을 수 있는 많은 요율 변수를 활용할 수 있습니다. 성별처럼 변할 가능성이 낮은 변수가 많은 반면, 나이처럼 변할 가능성이 높은 변수도 있으며, 신용 점수처럼 변할 수도 있고 변하지 않을 수도 있는 변수도 있습니다. 둘째, 최초 단계와 달리 갱신 시점에는 보험자가 보험계약자의 손실 경험 이력을 활용할 수 있으며, 이 이력은 요율 변수로는 얻을 수 없는 보험계약자에 관한 통찰을 제공할 수 있습니다. 청구 이력으로 보험료를 조정하는 것을 경험요율이라고 하며, 때로는 실적요율이라고도 합니다.
경험요율 방법은 소급적으로 적용되거나 전망적으로 적용됩니다. 소급적 방법에서는 (보험자에게) 유리한 경험이 나타난 경우 보험료의 일부를 보험계약자에게 환급합니다. 소급 보험료(Retrospective premiums) 최초 보험료 납입액에 대한 조정으로 결정되는 실제 손실 경험을 바탕으로 보험계약의 비용을 결정하는 과정입니다.는 생명보험 계약에서 흔히 볼 수 있습니다(미국에서는 보험계약자가 배당금(dividends) 배당금은 피보험자가 납입한 보험료의 일부를 보험자의 잉여금에서 환급하는 것입니다.을 받고, 영국에서는 보너스를 받으며, 이스라엘의 정기 생명보험 보장에서는 이익을 배분받습니다). 일반보험에서는 전망적 방법이 더 일반적이며, 이 경우 유리한 보험 경험은 더 낮은 갱신 보험료를 통해 보상됩니다.
청구 이력은 보험계약자의 위험 성향에 관한 정보를 제공할 수 있습니다. 예를 들어, 개인 보험 종목에서는 지난 3년 동안 청구가 발생했는지 여부를 나타내는 변수를 사용하는 것이 일반적입니다. 또 다른 예로, 근로자 재해보상보험과 같은 기업 보험 종목에서는 지난 3년 동안 보험계약자의 평균 청구 빈도나 심도를 살펴볼 수 있습니다. 청구 이력은 다른 방법으로는 (보험자에게) 드러나지 않는 보험계약자에 관한 정보를 밝혀 줄 수 있습니다.
1.2.3 청구 및 상품 관리
일부 유형의 보험에서는 보험사고에 대한 청구를 지급하는 과정이 비교적 간단합니다. 예를 들어, 생명보험에서는 계약에 규정된 보험금을 지급하는 데 간단한 사망 증명서만 있으면 됩니다. 그러나 재산 및 상해 보험과 같은 손해보험 분야에서는 그 과정이 훨씬 더 복잡할 수 있습니다. 자동차 사고와 같은 비교적 단순한 보험사고를 생각해 보십시오. 이 경우 어느 당사자에게 과실이 있는지를 판단해야 하는 경우가 많으며, 그다음에는 피보험 여부와 관계없이 사고에 관련된 모든 차량과 사람의 피해를 평가해야 합니다. 나아가 피해를 평가하는 데 발생한 비용도 산정해야 하는 등의 일이 따릅니다. 보장 여부와 법적 책임을 판단하고 청구를 정산하는 절차를 청구 사정(claims adjustment) 청구 사정(claims adjustment)은 보장 여부와 법적 책임을 판단하고 청구를 처리하는 과정입니다.라고 합니다.
보험 관리자들은 청구 관리의 비효율로 인해 손실되는 금액을 뜻하는 말로 청구 누수(claims leakage) 보험금 누수는 보험금 청구 관리의 비효율로 인해 손실되는 금액을 나타냅니다.라는 표현을 사용하기도 합니다. 애널리틱스가 청구 절차 관리에 도움을 줄 수 있는 방법은 많습니다. Gorman and Swenson (2013)를 참조하십시오. 역사적으로 가장 중요한 것은 사기 탐지였습니다. 청구 사정 절차에는 정보 비대칭을 줄이는 일이 포함됩니다(청구인은 무슨 일이 일어났는지 알고 있지만, 회사는 일어난 일의 일부만 알고 있습니다). 사기를 줄이는 것은 청구 관리 절차의 중요한 부분입니다.
사기 탐지는 청구 관리의 한 측면에 불과합니다. 더 넓게 보면, 청구 관리는 다음과 같은 구성 요소로 이루어져 있다고 생각할 수 있습니다.
- 청구 분류(트리아지). 의료계에서와 마찬가지로, 고비용 청구(의료계에서는 환자)를 조기에 식별하고 적절히 처리하면 비용을 크게 절감할 수 있습니다. 예를 들어, 산재보험에서 보험회사는 높은 의료비와 긴 지급 기간의 위험이 있는 청구를 조기에 식별하고자 합니다. 이러한 사례에 조기에 개입하면 보험자는 청구 처리, 의료적 치료, 그리고 더 이른 업무 복귀를 통한 전체 비용을 더 잘 통제할 수 있습니다.
- 보험금 청구 처리. 목표는 분석을 활용하여 지급액이 적을 것으로 예상되는 일상적인 상황을 식별하는 것입니다. 더 복잡한 상황에서는 잠재적 지급액이 큰 청구를 적절히 처리하기 위해 더 숙련된 손해사정인과 법률 지원이 필요할 수 있습니다.
- 손해사정 의사결정. 복잡한 청구가 식별되어 손해사정인(adjuster) 손해사정인은 청구를 조사하고 손해 추정액과 가입된 보험계약을 근거로 처리 방안을 권고하는 사람입니다.에게 배정되면, 이후의 의사결정 과정을 돕기 위한 분석 기반 절차를 마련할 수 있습니다. 이러한 절차는 손해사정인이 보험자의 미래 부채에 대한 추정치인 개별 추산 준비금(case reserve)을 산정하는 데에도 도움이 될 수 있습니다. 이는 1.2.4절에서 설명하는 보험자의 지급준비금에 대한 중요한 입력값입니다.
피보험자의 손해에 대한 보상 외에도, 보험자는 또 다른 수익 유출원인 비용에도 관심을 기울여야 합니다. 손해 사정 비용(Loss adjustment expenses) 손해 사정 비용은 청구를 처리하는 데 직접 귀속되는 보험자의 비용입니다. 예를 들어 청구 비용을 평가하는 손해사정인의 비용이나, 청구에 대한 보험자의 법적 의무를 처리하는 데 관여하는 변호사의 비용이 이에 해당합니다.은 보험자가 청구를 관리하는 데 드는 비용의 일부입니다. 분석은 청구 처리와 직접 관련된 비용(배분된(allocated) 배분 손해 사정 비용(allocated loss adjustment expenses)은 ALAE라는 약어로도 불리며, 청구 처리에 직접 귀속될 수 있는 비용입니다. 손해사정인의 비용이 그 예입니다.)뿐만 아니라 청구 과정을 감독하는 데 드는 일반 직원의 시간(미배분된(unallocated) 비배분 손해 사정 비용은 보험금 청구 해결에 간접적으로만 귀속될 수 있는 비용입니다. 예를 들어, 보험금 청구 담당 직원을 지원하는 사무실의 비용이 이에 해당합니다.)을 줄이는 데에도 활용될 수 있습니다. 보험 산업은 금융 서비스 부문의 다른 분야에 비해 운영 비용이 높습니다.
청구 지급 외에도 보험회사가 데이터를 사용하여 상품을 관리하는 방법은 많습니다. 언더라이팅, 즉 최초 인수 단계와 갱신 단계에서의 위험 분류에 분석이 필요하다는 점은 이미 논의하였습니다. 보험자는 또한 어떤 보험계약자가 계약 갱신을 선택하는지에 관심을 가지며, 다른 상품과 마찬가지로 고객 충성도를 모니터링합니다.
분석은 보험자가 인수한 위험의 포트폴리오, 즉 위험의 집합을 관리하는 데에도 활용될 수 있습니다. 13장에서 설명한 바와 같이, 피보험자와 계약이 체결된 후에도 보험자는 재보험 계약을 맺음으로써 순 부담 의무를 조정할 수 있습니다. 이러한 유형의 계약은 보험자의 보험자인 재보험자와 맺는 것입니다. 개인이나 다른 회사와 마찬가지로, 보험회사가 이례적인 사건으로부터 보호받기 위해 자사의 위험 포트폴리오에 대해 보험을 구매하는 것은 흔한 일입니다.
1.2.4 지급준비금 산정
보험을 경제의 다른 부문과 구별하는 중요한 특징은 대가가 교환되는 시점입니다. 제조업에서는 일반적으로 거래 시점에 상품 대금이 지급됩니다. 이와 달리 보험에서는 고객으로부터 돈을 받는 시점이 급부나 서비스보다 앞서며, 급부나 서비스는 보험사고가 발생하는 경우 나중에 제공됩니다. 이로 인해 이미 약정한 의무와 관련된 미래의 의무를 이행하고, 회사가 약속을 이행할 수 있다는 피보험자의 신뢰를 얻기 위해 부의 저장고를 보유할 필요가 생깁니다. 이 부의 저장고의 규모와 그 적정성을 확보하는 일의 중요성은 보험 산업의 주요 관심사입니다.
미지급 청구에 대비하여 자금을 적립하는 것을 지급준비금 산정(loss reserving) 지급준비금은 아직 실현되지 않은 보험금 청구에 대해 보험자가 지급할 것으로 예상하는 금액을 나타내는 부채 추정치입니다. 여기에는 발생했으나 아직 보고되지 않은 손실(IBNR)과, 보고되었으나 아직 지급되지 않은 청구(reported but not settled의 약어인 RBNS로 알려져 있습니다)가 포함됩니다.이라고 하며, 일부 관할 지역에서는 준비금을 책임준비금(technical provisions)이라고도 합니다. 그림 1.1에서 회사가 재무 상태를 정리하는 여러 시점을 살펴보았으며, 이러한 시점을 평가일(valuation dates) 이라고 합니다. 평가일 이전에 발생한 청구는 이미 지급되었거나, 지급 중이거나, 곧 지급될 예정이며, 이러한 평가일 이후에 발생할 청구는 알려져 있지 않습니다. 회사는 재무 건전성을 판단할 때 이러한 미지급 부채를 추정해야 합니다. 지급준비금을 정확하게 산정하는 것은 여러 가지 이유로 보험자에게 중요합니다.
- 지급준비금은 보험자가 고객에게 지급해야 할 것으로 예상되는 청구액을 나타냅니다. 준비금 산정이 과소하게 이루어지면 청구 부채를 이행하지 못하는 결과를 초래할 수 있습니다. 반대로, 준비금을 과도하게 적립한 보험자는 잉여금을 보수적으로 추정하게 되어 실제보다 더 취약한 재무 상태를 보여 줄 수 있습니다.
- 준비금은 계약의 가격 책정에 활용될 수 있는 보험의 미지급 비용에 대한 추정치를 제공합니다.
- 지급준비금 산정은 법률과 규정에 따라 요구됩니다. 대중은 보험회사의 재무 건전성과 지급여력에 큰 관심을 가지고 있습니다.
- 감독 당국 외에도 보험회사 경영진, 투자자, 고객과 같은 다른 이해관계자들이 회사의 지급준비금에 따라 의사결정을 내립니다. 감독 당국과 고객은 미지급 청구에 대한 보수적인 추정치를 선호하는 반면, 경영진과 투자자는 회사의 실제 재무 건전성을 나타내기 위해 보다 편향되지 않은 추정치를 추구합니다.
지급준비금 산정은 생명보험과 일반보험(손해보험 또는 비생명보험이라고도 합니다) 사이에 실질적인 차이가 있는 주제입니다. 생명보험에서는 지급액이 계약에 명시되어 있으므로 심도(손해액)가 불확실성의 원천이 되지 않는 경우가 많습니다. 피보험자의 사망률에 의해 결정되는 빈도는 고려해야 할 사항입니다. 그러나 생명보험계약은 정산까지 오랜 시간이 걸리기 때문에, 계약 체결일부터 지급일까지로 측정되는 화폐의 시간 가치에 대한 불확실성이 빈도에 대한 우려보다 더 클 수 있습니다. 예를 들어, 20세에 생명보험 계약을 구입한 피보험자의 경우, 피보험자가 80세 생일을 맞이하는 60년 후에도 계약이 여전히 유지되고 있는 것은 드문 일이 아닙니다. 생명보험의 준비금 산정에 대한 입문 자료로는 예를 들어 Bowers et al. (1986) 또는 Dickson, Hardy, and Waters (2013)를 참고하십시오. 이와 대조적으로, 대부분의 손해보험 종목에서는 심도가 불확실성의 주요 원천이며 계약 기간이 더 짧은 경향이 있습니다.
Show Quiz Solution
1.3 사례 연구: 위스콘신 재산 기금
이 절에서는 위스콘신 재산 기금을 사례 연구로 사용합니다. 다음 방법을 배웁니다:
- 데이터 생성 사건이 보험 분석가가 관심을 갖는 데이터를 어떻게 만들어 낼 수 있는지 설명하기
- 각 변수에 대해 관련 요약 통계량 산출하기
- 이러한 요약 통계량이 보험회사의 주요 운영 영역 각각에서 어떻게 활용될 수 있는지 설명하기
위스콘신 보험감독청이 운영하는 보험 풀인 지방정부 재산보험 기금(LGPIF)을 살펴봄으로써, 여기서 다루는 데이터의 종류와 우리가 달성하고자 하는 목표를 설명해 봅시다. LGPIF는 카운티, 시, 타운, 빌리지, 학군, 도서관 위원회를 포함한 지방정부 기관에 재산보험을 제공하기 위해 설립되었습니다. 이 기금은 정부 건물, 학교, 도서관, 자동차와 같은 지방정부 재산을 보험 대상으로 합니다. 이 기금은 홍수, 지진, 마모, 극한 기온, 곰팡이, 전쟁, 핵반응, 그리고 직원의 횡령이나 절도로 인한 손해를 제외한 모든 재산 손해를 보장합니다.
이 기금은 매년 약 2,500만 달러의 보험료를 납부하고 약 750억 달러의 보험 보장을 받는 천 개 이상의 지방정부 기관을 보장합니다. 주정부 건물은 보장 대상이 아닙니다. LGPIF는 별도의 예산 책임을 지며, 불확실한 보험 가능 사건이 예산에 미치는 영향을 완화하기 위해 보험이 필요한 지방정부 기관을 위한 것입니다. 위스콘신주는 1911년부터 지방정부 재산에 대한 보장을 제공해 왔으며, 이에 따라 풍부한 과거 데이터가 축적되어 있습니다.
이 예시에서는 건물 및 내용물 보장에서 발생한 청구로 고찰 범위를 제한하며, 지방 기관이 소유한 자동차 및 특수 장비(예: 제설기)에서 발생한 청구는 고려하지 않습니다. 또한 의무가 완전히 이행되어 종결된 보험금 청구만을 고려합니다.
1.3.1 기금 보험금 청구 변수: 빈도와 심도
근본적으로 보험회사는 보험사고가 발생했을 때 보험계약자에게 보상하겠다는 약속의 대가로 보험료를 받습니다. 손해 보상(Indemnification) 보상(indemnification)은 보험자가 제공하는 보상입니다.은 보험증권이 보장하는 상해, 손실 또는 손해가 발생했을 때 보험자가 제공하는 보상입니다. 이러한 보상을 보험금 청구라고도 합니다. 심도라고 하는 지급액의 규모는 보험자의 핵심적인 재무 지출입니다.
고객에게 지급하는 금액 측면에서 보면, 보험자에게 100짜리 청구 열 건과 1,000짜리 청구 한 건은 차이가 없습니다. 그럼에도 보험자는 청구가 얼마나 자주 발생하는지, 즉 청구의 빈도를 연구하는 것이 일반적입니다. 빈도는 비용 측면에서 중요할 뿐만 아니라, 보험사고가 한 번 발생할 때마다 지급되는 금액을 제한하기 위해 설정되는 계약상의 모수(뒤에서 설명할 공제액 및 보험 한도 등)에도 영향을 미칩니다. 빈도는 보험 규제 당국이 일상적으로 감시하며, 보험자의 전체 보상 의무를 결정하는 핵심 요인이 될 수 있습니다. 우리는 빈도와 심도를 이해하고, 모형화하고, 관리하고자 하는 두 가지 주요 청구 변수로 다룰 것입니다.
예를 들어, 2010년에 재산 기금에는 총 1,377건의 청구를 경험한 보험계약자 1,110명이 있었습니다. 표 1.1는 그 분포를 보여 줍니다. 보험계약자의 거의 3분의 2(0.637)는 청구가 한 건도 없었고, 추가로 18.8%는 청구가 한 건뿐이었습니다. 나머지 17.5%(=1 - 0.637 - 0.188)는 청구가 두 건 이상이었으며, 청구 건수가 가장 많은 보험계약자는 239건의 청구를 기록했습니다. 이 표본의 평균 청구 건수는 1.24(=1377/1110)였습니다.
| Number | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 or more | Sum |
| Policies | 707 | 209 | 86 | 40 | 18 | 12 | 9 | 4 | 6 | 19 | 1110 |
| Claims | 0 | 209 | 172 | 120 | 72 | 60 | 54 | 28 | 48 | 614 | 1377 |
| Proportion | 0.637 | 0.188 | 0.077 | 0.036 | 0.016 | 0.011 | 0.008 | 0.004 | 0.005 | 0.017 | 1 |
빈도 표를 위한 R 코드
심도 분포에 대해서는 1,377건의 청구 표본의 분포를 살펴보는 것이 일반적인 접근법입니다. 그러나 청구가 있는 보험계약자들의 평균 청구액 분포를 살펴보는 것도 또 다른 일반적인 접근법입니다. 2010년 표본에는 이러한 보험계약자가 403명(=1110-707) 있었습니다. 이 보험계약자 중 청구가 한 건인 209명의 경우, 평균 청구액은 그들이 경험한 유일한 청구액과 같습니다. 빈도가 가장 높은 보험계약자의 경우, 평균 청구액은 개별적으로 보고된 239건의 청구 사건에 대한 평균입니다.
표 1.2은 청구를 제기한 보험계약자 403명의 평균 심도에 대한 표본 분포를 요약한 것으로, 평균 청구액이 56,330임을 보여 줍니다(모든 금액은 미국 달러 기준입니다). 그러나 평균은 분포에 대해 제한된 정보만을 제공합니다. 요약 통계량에서는 더 많은 정보를 얻을 수 있으며, 이를 통해 12,920,000에 달하는 매우 큰 청구가 있음을 알 수 있습니다. 그림 1.2는 표본 청구의 분포에 대한 추가 정보를 제공하는데, 이 하나의 대형 청구가 분포를 지배하고 있어 히스토그램이 그다지 유용하지 않음을 보여 줍니다. 이 대형 청구를 제거하더라도 분포가 오른쪽으로 치우쳐 있음을 알 수 있습니다. 일반적으로 받아들여지는 기법은 특히 그래프를 그릴 때 청구를 로그 단위로 다루는 것이며, 오른쪽 패널의 해당 그림은 훨씬 해석하기 쉽습니다.
| Minimum | First Quartile | Median | Mean | Third Quartile | Maximum |
|---|---|---|---|---|---|
| 167 | 2,226 | 4,951 | 56,332 | 11,900 | 12,922,218 |
평균 심도 분포를 위한 R 코드
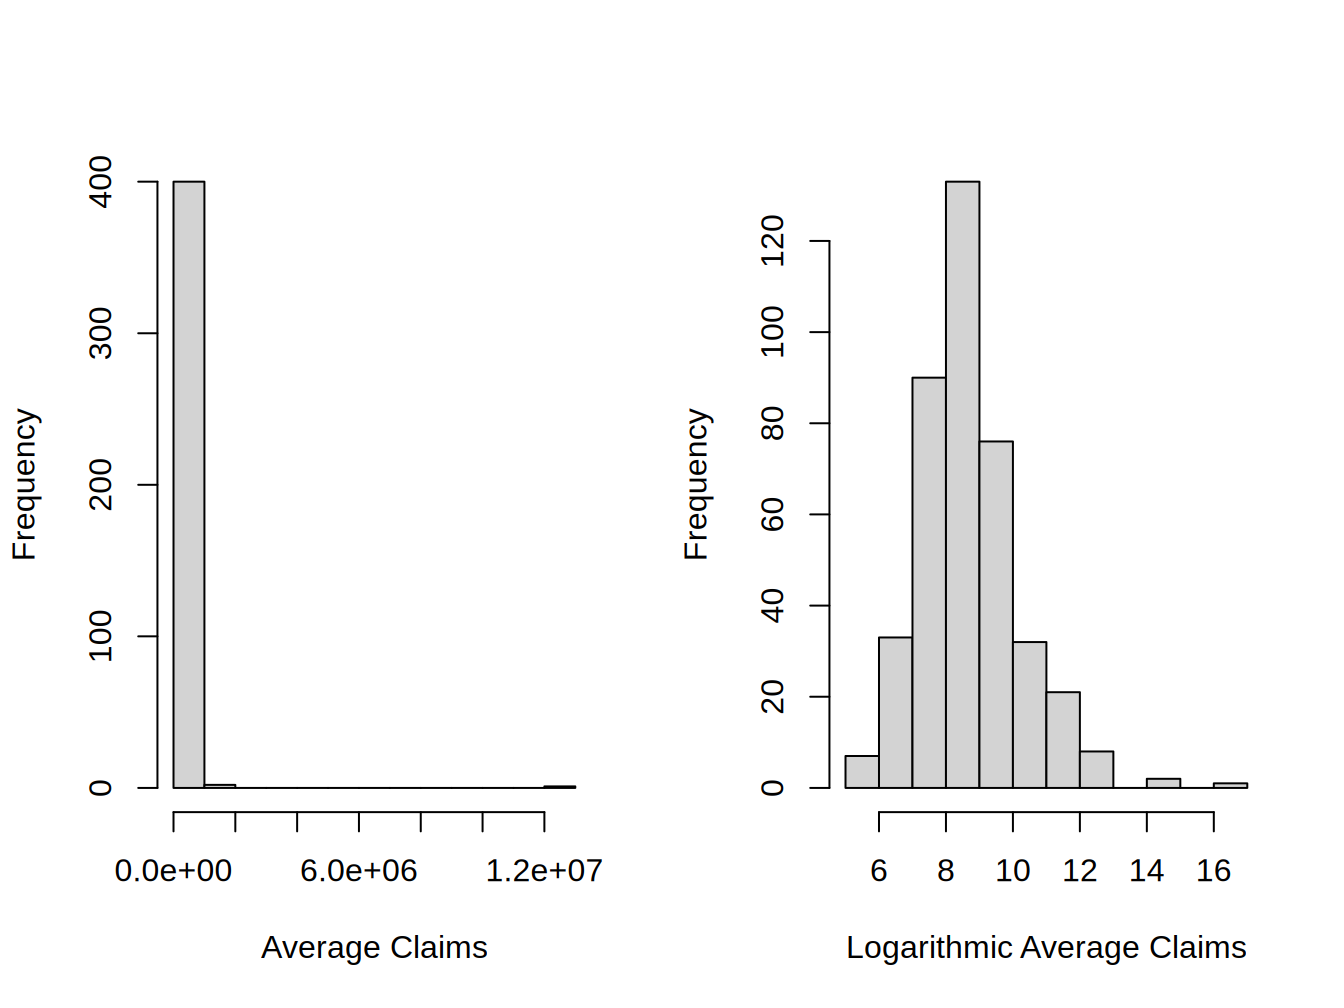
그림 1.2: 양의 평균 심도의 분포
심도 분포 표와 그림을 위한 R 코드
1.3.2 기금 요율 변수
두 가지 결과 변수인 빈도와 심도를 나타내고 관리하기 위한 모형을 개발하는 것이 이 책 앞부분 장들의 핵심입니다. 그러나 계리사와 기타 금융 분석가들이 이러한 모형을 사용할 때는 외부 변수라는 맥락 속에서 사용합니다. 일반적인 통계 용어로는 이를 설명 변수 또는 예측 변수라고 부를 수 있으며, 통계학, 경제학, 심리학 및 기타 분야에서는 이 밖에도 많은 이름으로 불립니다. 이 책은 보험에 초점을 두므로, 보험 요율과 보험료를 정하는 데 유용하다는 점에서 이를 요율 변수(rating variables) 요율 변수는 보험 가격 산정 공식의 구성 요소입니다. 여기에는 수치형 변수(가액, 매출, 면적 등)와 분류형 변수(소재지, 차량 유형, 점유 유형 등)가 포함될 수 있습니다.라고 부릅니다.
앞에서 우리는 1,110명의 보험계약자 표본에서 얻은 관측값을 살펴보았는데, 이는 많아 보일 수 있습니다. 그러나 앞으로 다룰 응용 사례에서 보게 되듯이, 0이 압도적으로 많고 청구가 치우친 성질을 띠기 때문에 계리사는 대개 더 많은 데이터를 갈망합니다. 여기서 우리가 채택하는 일반적인 접근법 하나는 여러 해의 결과를 살펴봄으로써 표본 크기를 늘리는 것입니다. 이 전략의 장점과 한계는 나중에 논의하겠지만, 지금 시점에서는 이 방법이 어떻게 작동하는지 독자에게 보여 드리고자 할 뿐입니다.
구체적으로, 표 1.3는 이제 2006년부터 2010년까지(양 끝 포함) 5년간의 데이터에 걸친 보험 계약을 고려한다는 것을 보여 줍니다. 데이터가 2006년부터 시작하는 이유는 2005년에 청구 코드 체계가 바뀌어 그 이전 연도와 비교하는 것이 도움이 되지 않기 때문입니다. 미결 청구의 영향을 줄이기 위해 2011년 이전의 보험연도를 고려합니다. 미결 청구란 분석 시점에 해당 청구에 대한 의무가 모두 알려져 있지 않은 청구를 뜻합니다. 자동차 사고나 작업장에서 사람이 입은 상해와 같은 일부 청구의 경우, 비용이 완전히 알려지기까지 수년이 걸릴 수 있습니다.
| Year | Average Frequency | Average Severity | Average | Number of Policyholders |
|---|---|---|---|---|
| 2006 | 0.951 | 9,695 | 32,498,186 | 1,154 |
| 2007 | 1.167 | 6,544 | 35,275,949 | 1,138 |
| 2008 | 0.974 | 5,311 | 37,267,485 | 1,125 |
| 2009 | 1.219 | 4,572 | 40,355,382 | 1,112 |
| 2010 | 1.241 | 20,452 | 41,242,070 | 1,110 |
보험계약자별 청구 요약을 위한 R 코드
표 1.3는 평균 청구액이 시간에 따라 변동하며, 특히 2010년의 값이 높다는 것을 보여 줍니다(앞에서 보았듯이 이는 단 한 건의 대형 청구 때문입니다)1. 전체 보험계약자 수는 꾸준히 감소하고 있으며, 반대로 보장은 꾸준히 증가하고 있습니다. 보장 변수는 재산 및 내용물에 대한 보장 금액입니다. 대략적으로 말해, 이를 보험자가 지급할 수 있는 최대 금액으로 생각할 수 있습니다. 당장의 목적상, 보장은 우리의 첫 번째 요율 변수입니다. 다른 조건이 동일하다면, 보장이 더 큰 보험계약자일수록 청구도 더 클 것으로 예상할 수 있습니다. 앞으로 진행하면서 이 막연한 생각을 훨씬 더 정밀하게 다듬고, 이러한 예상을 데이터로 뒷받침할 것입니다.
2006-2010년 데이터를 다른 관점에서 살펴보기 위해, 표 1.4는 우리의 두 결과 변수인 빈도와 청구 금액의 분포를 요약합니다. 두 경우 모두 평균이 중앙값을 초과하므로, 두 분포가 오른쪽으로 치우쳐 있음을 시사합니다. 또한 이 표는 연속형 요율 변수인 보장과 공제액을 요약합니다. 이 표는 이들 변수 역시 오른쪽으로 치우친 분포를 가진다는 점도 시사합니다.
| Minimum | Median | Average | Maximum | |
|---|---|---|---|---|
| Claim Frequency | 0 | 0 | 1.109 | 263 |
| Claim Severity | 0 | 0 | 9,292 | 12,922,218 |
| Deductible | 500 | 1,000 | 3,365 | 100,000 |
| Coverage (000’s) | 8.937 | 11,354 | 37,281 | 2,444,797 |
청구 빈도와 심도, 공제액, 보장 요약을 위한 R 코드
표 1.5는 이 장에서 고려하는 요율 변수를 설명합니다. 이들이 청구 결과와 자연스럽게 관련될 수 있다고 여러분이 생각하는 변수이기를 바랍니다. 이 변수들에 대해서는 Frees, Lee, and Yang (2016b)에서 더 자세히 알아볼 수 있습니다. 왜도를 처리하기 위해 이후로는 보장과 공제액의 로그 변환에 초점을 맞춥니다.
표 1.5. 요율 변수에 대한 설명
\[{\small \begin{matrix} \begin{array}{ l | l} \hline Variable & Description \\ \hline \text{EntityType} & \text{Categorical variable that is one of six types: (Village, City,} \\ & ~~~~ \text{County, Misc, School, or Town)} \\ \text{LnCoverage} & \text{Total building and content coverage, in logarithmic millions of dollars}\\ \text{LnDeduct} & \text{Deductible, in logarithmic dollars} \\ \text{AlarmCredit} & \text{Categorical variable that is one of four types: (0, 5, 10, or 15)} \\ & ~~~~ \text{for automatic smoke alarms in main rooms} \\ \text{NoClaimCredit} & \text{Binary variable to indicate no claims in the past two years} \\ \text{Fire5 } & \text{Binary variable to indicate the fire class is below 5} \\ & ~~~~ \text{(The range of fire class is 1 to 10)} \\ \hline \end{array} \end{matrix}}\]
경보 할인(alarm credit) 변수에서 0은 주요 실내 공간 어디에도 자동 화재경보기가 없음을 의미합니다. 마찬가지로 5는 주요 실내 공간 중 일부에 화재경보기가 있음을, 10은 주요 실내 공간 모두에 화재경보기가 있음을 의미합니다. 15 수준에서는 경찰, 소방서 또는 보안 업체가 시설을 하루 24시간, 주 7일 감시합니다. 화재 요율 등급도 이와 비슷한 유형의 점수입니다. 이 등급은 지역사회와 지역이 화재에 얼마나 대비되어 있는지를 반영합니다. 주로 지역 소방서와 급수 시설에 초점을 맞추지만, 지역의 점수에 영향을 미치는 다른 요인들도 있습니다. 이 요율 등급은 구조가 도착하기 전에 화재가 심각한 피해를 입힐 가능성이 얼마나 되는지를 판단하는 데 사용되며, 1이 가장 좋고 10이 가장 나쁩니다.
연속형이 아닌 요율 변수와 청구 간의 관계를 파악하기 위해, 표 1.6은 청구 결과를 이러한 범주형 변수와 연관 짓습니다. 표 1.6는 기관 유형에 따라 청구 빈도와 평균 심도에 상당한 차이가 있음을 시사합니다. 또한 \({\tt Fire5}\) 변수에서는 빈도와 심도가 더 높고, \({\tt NoClaimCredit}\) 변수에서는 그 반대임을 보여 줍니다. \({\tt Fire5}\) 변수에 대한 관계는 직관에 반하는데, 공공 보호 수준이 더 좋은 지역(보호 코드가 5 이하인 경우)의 보험계약자는 청구액이 더 낮을 것으로 예상되기 때문입니다. 물론 이 관계에 영향을 미치는 다른 변수들도 있습니다. 이후의 다변량 회귀 분석에서는 이러한 배경 변수들이 고려되며, 그 결과 \({\tt Fire5}\) 변수에 대해 직관적이고 납득할 만한 (음의) 부호를 얻게 됨을 보게 될 것입니다.
| Number of Policies | Claim Frequency | Average Severity | |
|---|---|---|---|
| Village | 1,341 | 0.452 | 10,645 |
| City | 793 | 1.941 | 16,924 |
| County | 328 | 4.899 | 15,453 |
| Misc | 609 | 0.186 | 43,036 |
| School | 1,597 | 1.434 | 64,346 |
| Town | 971 | 0.103 | 19,831 |
| Fire5–No | 2,508 | 0.502 | 13,935 |
| Fire5–Yes | 3,131 | 1.596 | 41,421 |
| NoClaimCredit–No | 3,786 | 1.501 | 31,365 |
| NoClaimCredit–Yes | 1,853 | 0.31 | 30,499 |
| Total | 5,639 | 1.109 | 31,206 |
기관 유형, 화재 등급, 무사고 할인별 청구 요약을 위한 R 코드
표 1.7와 1.8은 경보 할인별 청구 경험을 보여 줍니다. 이는 변수를 개별적으로 살펴보는 것이 얼마나 어려운지를 잘 보여 줍니다. 예를 들어 전체 기관의 실적을 살펴보면, 경보 할인이 없는 보험계약자가 가장 높은 경보 할인(15%, 소방서 또는 보안 업체의 24시간 연중무휴 감시)을 받는 보험계약자보다 평균적으로 빈도와 심도가 더 낮다는 것을 알 수 있습니다. 특히 기관 유형이 학교(School)인 경우를 살펴보면, 경보 할인이 없을 때 빈도는 0.422, 심도는 25,523인 반면, 가장 높은 경보 수준에서는 각각 2.008과 85,140입니다. 이는 단순히 청구가 더 많은 기관일수록 경보 시스템을 갖추고 있을 가능성이 높다는 것을 의미할 수도 있습니다. 요약표는 다변량 효과를 검토하지 않습니다. 예를 들어 표 1.6은 청구에 영향을 미치는 규모(보장 금액으로 측정)의 효과를 무시합니다.
| AC0 Claim Frequency | AC0 Avg. Severity | AC0 Num. Policies | AC5 Claim Frequency | AC5 Avg. Severity | AC5 Num. Policies | |
|---|---|---|---|---|---|---|
| Village | 0.326 | 11,078 | 829 | 0.278 | 8,086 | 54 |
| City | 0.893 | 7,576 | 244 | 2.077 | 4,150 | 13 |
| County | 2.14 | 16,013 | 50 | 0 | 0 | 1 |
| Misc | 0.117 | 15,122 | 386 | 0.278 | 13,064 | 18 |
| School | 0.422 | 25,523 | 294 | 0.41 | 14,575 | 122 |
| Town | 0.083 | 25,257 | 808 | 0.194 | 3,937 | 31 |
| Total | 0.318 | 15,118 | 2611 | 0.431 | 10,762 | 239 |
| AC10 Claim Frequency | AC10 Avg. Severity | AC10 Num. Policies | AC15 Claim Frequency | AC15 Avg. Severity | AC15 Num. Policies | |
|---|---|---|---|---|---|---|
| Village | 0.5 | 8,792 | 50 | 0.725 | 10,544 | 408 |
| City | 1.258 | 8,625 | 31 | 2.485 | 20,470 | 505 |
| County | 2.125 | 11,688 | 8 | 5.513 | 15,476 | 269 |
| Misc | 0.077 | 3,923 | 26 | 0.341 | 87,021 | 179 |
| School | 0.488 | 11,597 | 168 | 2.008 | 85,140 | 1013 |
| Town | 0.091 | 2,338 | 44 | 0.261 | 9,490 | 88 |
| Total | 0.517 | 10,194 | 327 | 2.093 | 41,458 | 2462 |
기관 유형, 화재 등급, 무사고 할인별 청구 요약을 위한 R 코드
건수 데이터의 모델링에 대해서는 3장에서, 심도 데이터에 대해서는 4장과 7장에서 더 자세히 배울 것입니다.
1.3.3 기금 운영
지금까지 기금의 두 결과 변수, 즉 청구 건수를 나타내는 계수형 변수와 청구 금액을 나타내는 연속형 변수의 분포를 살펴보았습니다. 또한 연속형 요율 변수(로그 보장), 이산형 양적 변수(로그 공제액), 두 개의 이진 요율 변수(무청구 할인 및 화재 등급), 두 개의 범주형 요율 변수(기관 유형 및 경보 할인)를 소개했습니다. 이후 장에서는 이러한 변수의 분포와 그 관계를 분석하고 모형화하는 방법을 설명합니다. 이러한 기술적 세부 사항으로 들어가기 전에, 먼저 우리가 어디로 나아가고자 하는지 생각해 봅시다. 일반보험 보험회사의 기능 영역은 1.2절에서 설명하였습니다. 이제 이러한 영역이 재산 기금의 맥락에서 어떻게 적용될 수 있는지 살펴보겠습니다.
보험 개시
이 기금은 정부가 후원하는 기금이므로 우량 위험을 선별하거나 불량 위험을 회피하는 것에 대해 걱정할 필요가 없습니다. 기금은 자격을 갖춘 지방 정부 기관의 보장 신청을 거절할 수 없습니다. 언더라이팅을 할 필요가 없다면, 보험료를 얼마나 부과해야 하겠습니까?
가장 최근 경험인 2010년을 살펴볼 수 있는데, 이 해의 기금 총청구액은 약 2,816만 USD(\(=1377 \text{ claims} \times 20452 \text{ average severity}\))였습니다. 이를 1,110명의 보험계약자로 나누면 24,370( \(\approx\) 28,160,000/1110)의 요율이 산출됩니다. 그러나 2010년은 좋지 않은 해였습니다. 같은 방법을 사용하더라도 2009년 데이터를 기준으로 하면 보험료는 훨씬 낮아집니다. 이러한 보험료의 변동은 지역 재산 관리자들이 예산에 반영할 수 있는 안정적인 부과금을 제공한다는 기금의 주된 목적에 어긋납니다.
모든 보험계약자에게 단일 가격을 적용하는 것은 편리하지만 공정하다고 보기는 어렵습니다. 예를 들어, 표 1.6에 따르면 학교는 다른 기관보다 총청구액이 높으므로 더 많은 보험료를 내야 합니다. 그러나 단순히 기관별로 계산하는 것도 옳지 않습니다. 예를 들어, 표 1.7와 1.8에서 보았듯이, 이 전략을 사용했다면 15% 경보 할인(최고 수준의 경보 시스템을 갖춘 우량 행동에 대한 할인)을 받는 기관이 실제로는 더 많은 보험료를 내게 되었을 것입니다.
따라서 적절한 부과 요율을 고려하기 위한 데이터는 갖추고 있지만, 분석을 더 깊이 진행해야 합니다. 이 주제는 보험료 산정의 기초를 다루는 제10장에서 더 자세히 살펴보겠습니다. 적절한 위험의 선택은 위험 분류를 다루는 제11장에서 소개합니다.
보험 갱신
재산보험은 일반적으로 1년 계약이지만, 표 1.3는 보험계약자들이 갱신하는 경향이 있음을 보여 주며, 이는 일반보험의 전형적인 특징입니다. 갱신하는 보험계약자의 경우 요율 변수 외에도 청구 이력이 있으며, 이 청구 이력은 향후 청구를 잘 예측하는 변수가 될 수 있습니다. 예를 들어, 표 1.6을 보면 최근 2년간 청구가 없었던 보험계약자는 사고가 한 번 이상 있었던 보험계약자보다 청구 빈도가 훨씬 낮았습니다(0.310 대 1.501). 예측 빈도가 낮으면 일반적으로 보험료도 낮아집니다. 이러한 이유로 보험회사가 요율 산정에 \({\tt NoClaimCredit}\)와 같은 변수를 사용하는 것이 일반적입니다. 이 주제는 경험요율을 다루는 제12장과 제15장에서 더 자세히 살펴보겠습니다.
청구 관리
물론 2010년 경험의 핵심은 그해 청구액의 거의 절반에 달하는 1,200만 USD 이상의 대형 청구였습니다. 이를 예방하거나 완화할 방법이 있었을까요? 기금이 이처럼 규모가 크고 이례적인 사건에 대비한 보장을 구매할 방법이 있을까요? 앞서 언급한 2010년 경험의 또 다른 이례적인 특징은 한 보험계약자의 청구 빈도가 매우 높았다는 점(239건)입니다. 그해 청구가 1,377건에 불과했다는 점을 고려하면, 단일 보험계약자가 전체 청구의 17.4 %를 차지했다는 의미입니다. 데이터의 이러한 극단적인 특징은 제13장의 주제인 청구 관리의 기회를 시사합니다.
지급준비금 산정
이 사례 연구에서는 종결된(미결의 반대) 청구의 1년 결과만 살펴봅니다. 그러나 다른 많은 보험 종목과 마찬가지로 화재, 우박 등 건물에 발생한 보험사고로 인한 채무는 즉시 확정되지 않으며 시간이 지나면서 진전될 수 있습니다. 신체 상해가 발생하는 종목을 포함한 다른 보험 종목은 진전되는 데 훨씬 더 오랜 시간이 걸립니다. 제14장에서는 이러한 문제와 함께, 보험회사가 채무를 이행하기 위해 얼마를 적립해야 하는지 결정하는 분야인 지급준비금 산정을 소개합니다.
Show Quiz Solution
1.4 연습문제
이 연습문제에서는 R 코드와 같은 통계 소프트웨어를 사용하여 데이터를 다루게 됩니다. R 코드를 연습하고 싶다면 손해 데이터 분석 단기 과정의 첫 번째 장을 방문하십시오. 또 다른 학습 방법으로, 저희 온라인 버전 R 코드 사이트에서 ‘R’ 코드를 실행하는 연습을 할 수도 있습니다.
연습문제 1.1. 기업 출장. 대학은 공식적인 대학 업무로 출장하는 교직원과 학생이 캠퍼스나 주 근무지를 떠나 있는 동안 겪는 다양한 사고와 사건을 보장하기 위해 기업 출장 보험에 가입합니다. 이 폭넓은 보장에는 의료 및 후송, 개인 재산 손실, 정치적 사유 및 기상 관련 사유로 인한 긴급 철수 등이 포함됩니다. 이 데이터는 호주국립대학교(ANU)의 경험을 나타내며, 추가적인 세부 사항은 ANU의 기업 출장 보험 약관에서 확인할 수 있습니다. 이 보험 종목에 대해서는 ANU의 보험자인 Chubb Travel에서도 더 자세히 알아볼 수 있습니다. 제공된 데이터는 보험자인 Chubb이 관리하며, 2022년 7월 29일에 접근하였습니다. 데이터는 부록 22.2절에서 얻을 수 있습니다.
a. 청구 빈도. 출장 데이터의 이력은 길고 안정적입니다. 이 보장은 2006년 11월 1일에 시작되었습니다. 표 1.9는 2015년부터 2019년까지(양 끝 연도 포함)의 청구 건수를 보여 줍니다. 전체 기간에 대해 이와 비슷한 청구 빈도 표를 작성하십시오. COVID 팬데믹 전후의 이례적인 빈도에 대해 논평하십시오.
| 2015 | 2016 | 2017 | 2018 | 2019 |
|---|---|---|---|---|
| 158 | 154 | 139 | 205 | 274 |
b. 영(0) 청구 조정. 이 데이터 세트에는 2107건의 발생 청구가 있습니다. 이 청구 중 269건은 0이며, 추가로 3건은 발생 청구액이 10 미만입니다. 분석에서는 이러한 청구를 제외합니다. 발생 청구액이 10 미만인 청구를 제외하고 (a) 부분의 분석을 다시 수행하십시오.
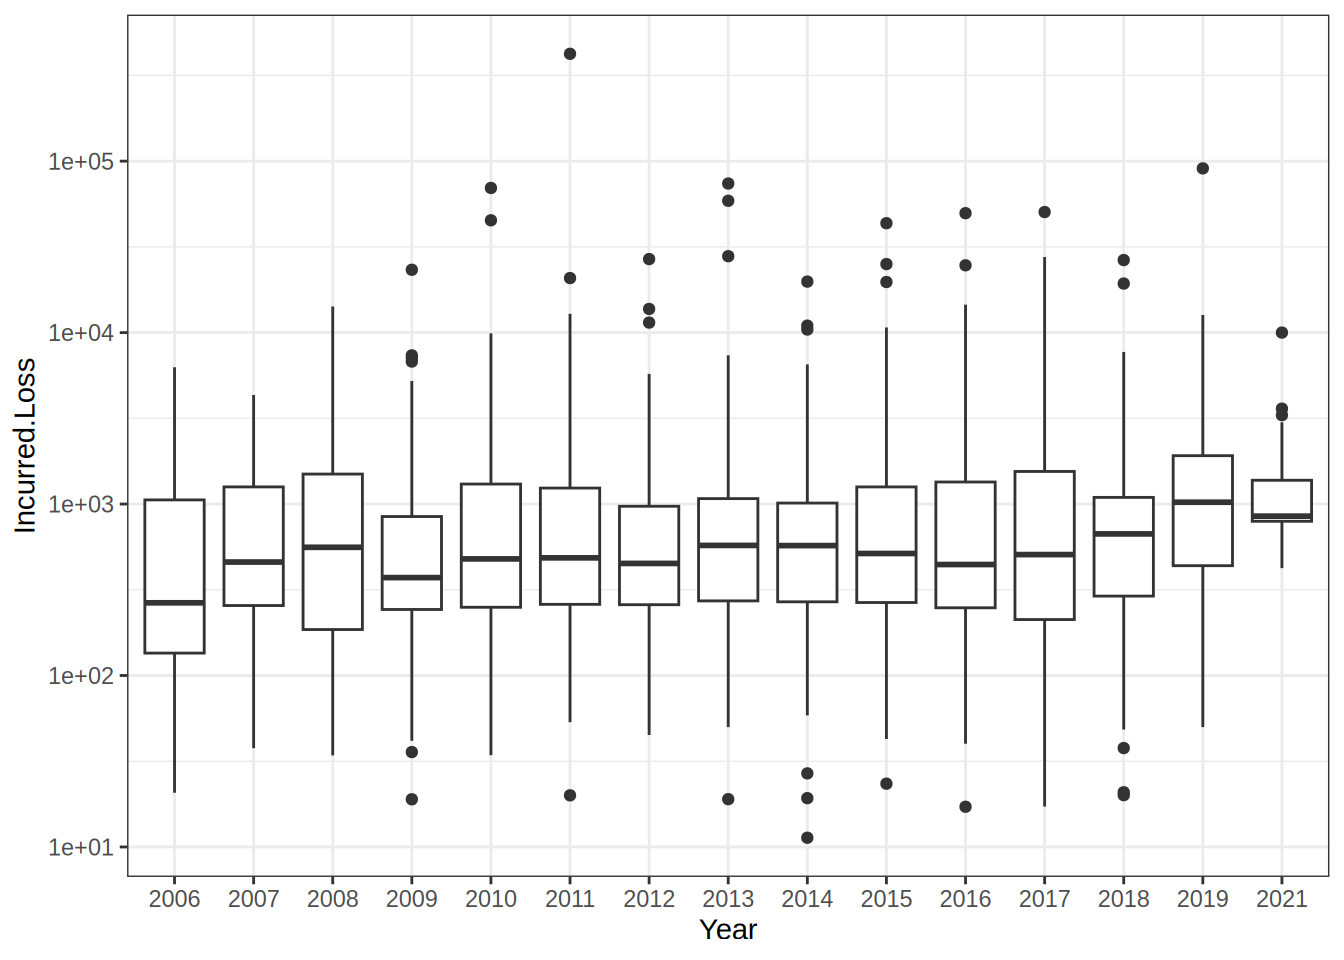
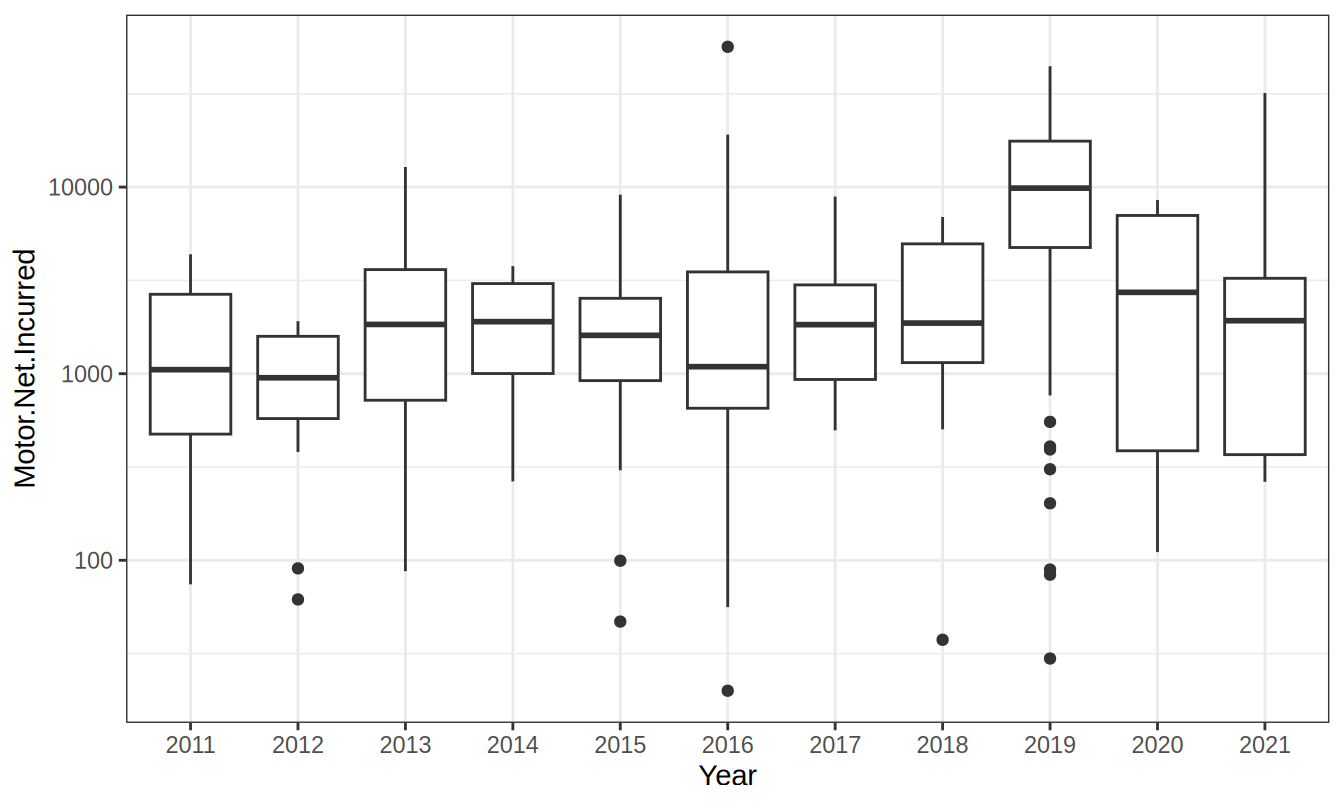
c. 시간에 따른 손실 분포. 사용 가능한 모든 연도를 포함한 데이터셋에는 1835건의 발생 손해가 있습니다(단, 10 미만의 청구는 제외). 그림 1.3은 2015년부터 2019년까지(양 끝 연도 포함)의 기간 동안 발생 손해의 분포가 안정적임을 보여 줍니다. 전체 기간에 대해 이와 비슷한 그림을 작성하십시오.
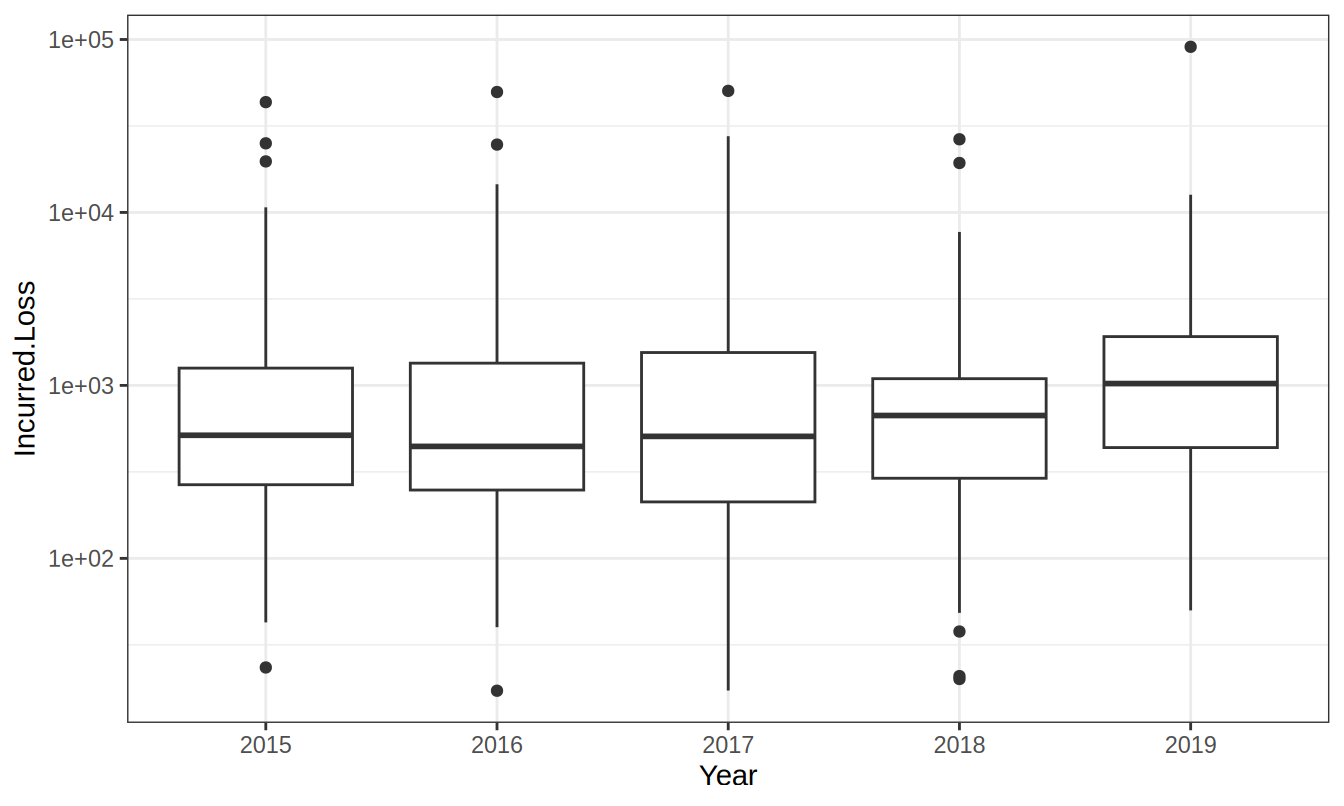
그림 1.3: 연도별 출장 손해 분포
d. 요약 통계량. 그래프와 더불어 여러 요약 통계량을 제시하는 것도 도움이 될 수 있습니다. 2015년부터 2019년까지의 5년 기간에 대해 요약 통계량을 작성하십시오.
출장 청구 연습문제 풀이
연습문제 1.2. 단체 상해. 단체 상해 보험은 업무 중 발생한 사고로 인한 부상이나 사망에 대해 재정적 보호를 제공합니다. 단체 상해 보험은 사고로 인한 사망이나 부상에 대해 보험 보장과 배상책임보험 보호를 제공합니다. 이 보험은 학생과 ANU의 자원봉사자를 보장하며, ANU 직원은 “산재보상(workers’ compensation)”이라는 별도의 제도를 통해 보장받습니다.
보험 기간에 대한 1,000,000, 비정기 항공편에 대한 600,000 등 여러 한도가 적용됩니다. 우리가 고려하는 데이터에서는 이러한 한도에 도달한 경우가 없었습니다. 이 보장의 경우, 주간 급여에는 “7일 자기부담금(excess)”이 있지만 일반 급여에는 없습니다. 저희에게 제공된 데이터베이스 문서와 저희가 제공하는 데이터에는 자기부담금이 적용되었는지 여부가 나타나 있지 않으며, 저희가 가진 것은 지급 청구액뿐입니다. 이 보험 종목의 규모가 비교적 작기 때문에, 이 종목에 대해서는 공제액의 효과를 무시합니다.
우리에게 제공된 데이터는 보험자인 Chubb이 관리합니다. 이 데이터는 언더라이팅 연도 2007년부터 시작되며, 2022년 7월 29일에 접근하였습니다. 부록 절 22.3로 가면 데이터를 얻을 수 있습니다.
a. 청구 빈도. 이 데이터 세트에는 148건의 발생 청구가 있습니다. 이 청구 중 35건은 0이며, 추가로 0건은 발생 청구액이 10 미만입니다. 우리는 분석에서 이러한 청구를 제외합니다. 표 1.11은 2015년부터 2019년까지(양 끝 포함)의 청구 건수를 보여 줍니다. 10 미만인 청구를 제외하고, 전체 기간에 대해 이와 비슷한 청구 빈도 표를 작성하십시오.
| 2015 | 2016 | 2017 | 2018 | 2019 |
|---|---|---|---|---|
| 4 | 7 | 16 | 11 | 9 |
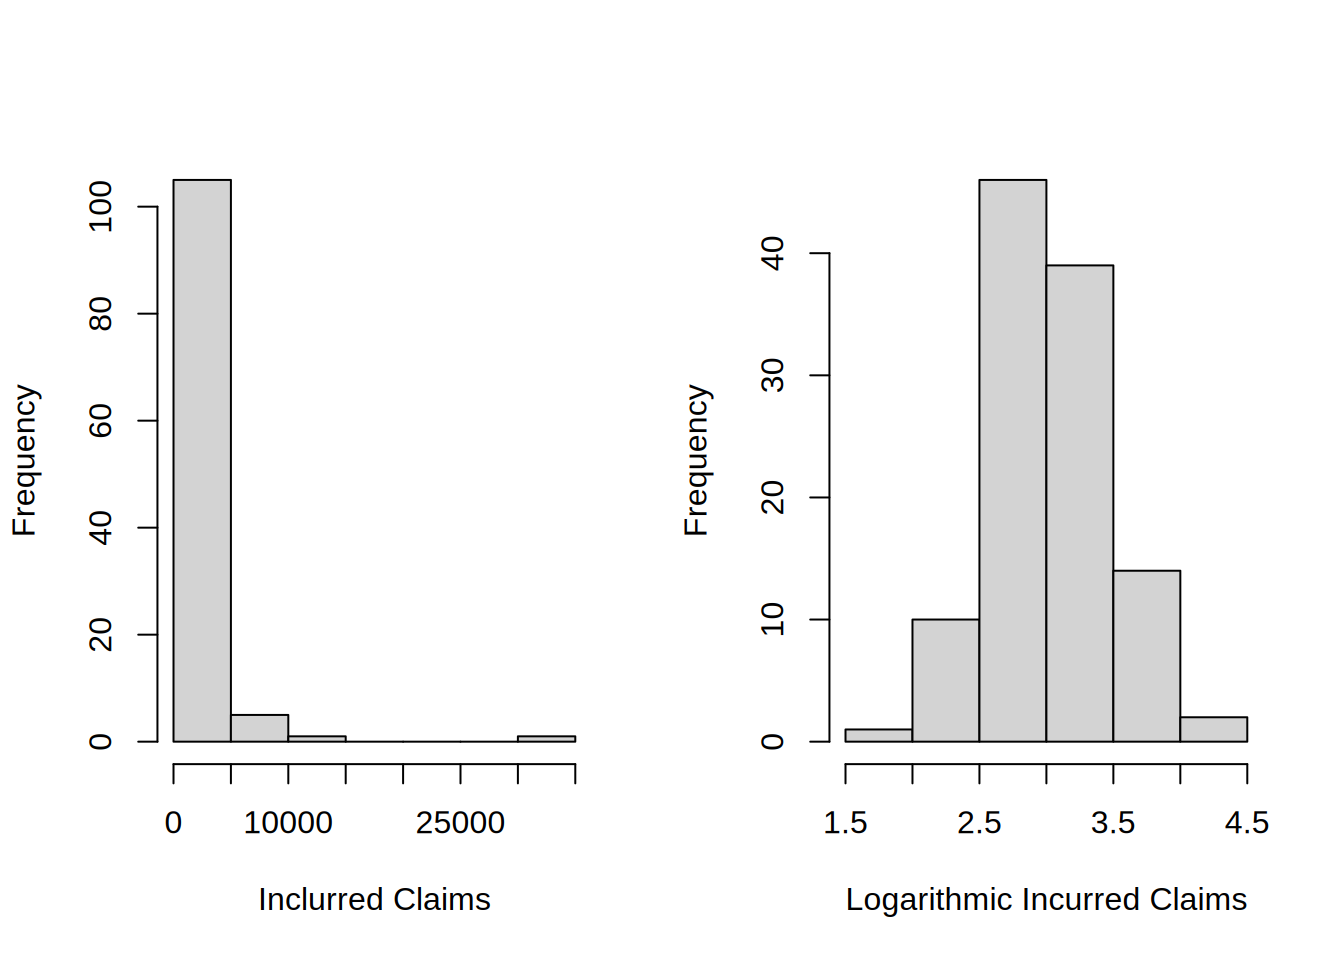
b. 청구 심도 분포의 왜도. 그림 1.4의 왼쪽 패널은 발생 청구의 히스토그램을 보여 주며, 이 분포가 오른쪽으로 치우쳐 있음을 드러냅니다. 오른쪽 패널은 같은 청구를 로그(밑 10) 척도로 보여 주며, 이 그림은 로그 변환이 분포를 대칭화할 수 있음을 보여 줍니다. 이 그림들은 2015-2019년 데이터에 대한 것입니다. 사용 가능한 모든 연도의 발생 청구를 사용하여(여전히 10 미만인 청구는 제외하고) 이 작업을 재현하십시오.
c. 요약 통계량. 사용 가능한 모든 연도를 사용하여(여전히 10 미만인 청구는 제외하고) 청구와 로그 청구 모두에 대한 요약 통계량을 산출하십시오. 청구와 로그 청구 각각에 대해 평균과 중앙값의 관계를 논하고, 이를 (b)에서 관찰한 분포의 대칭성과 연관 지으십시오.
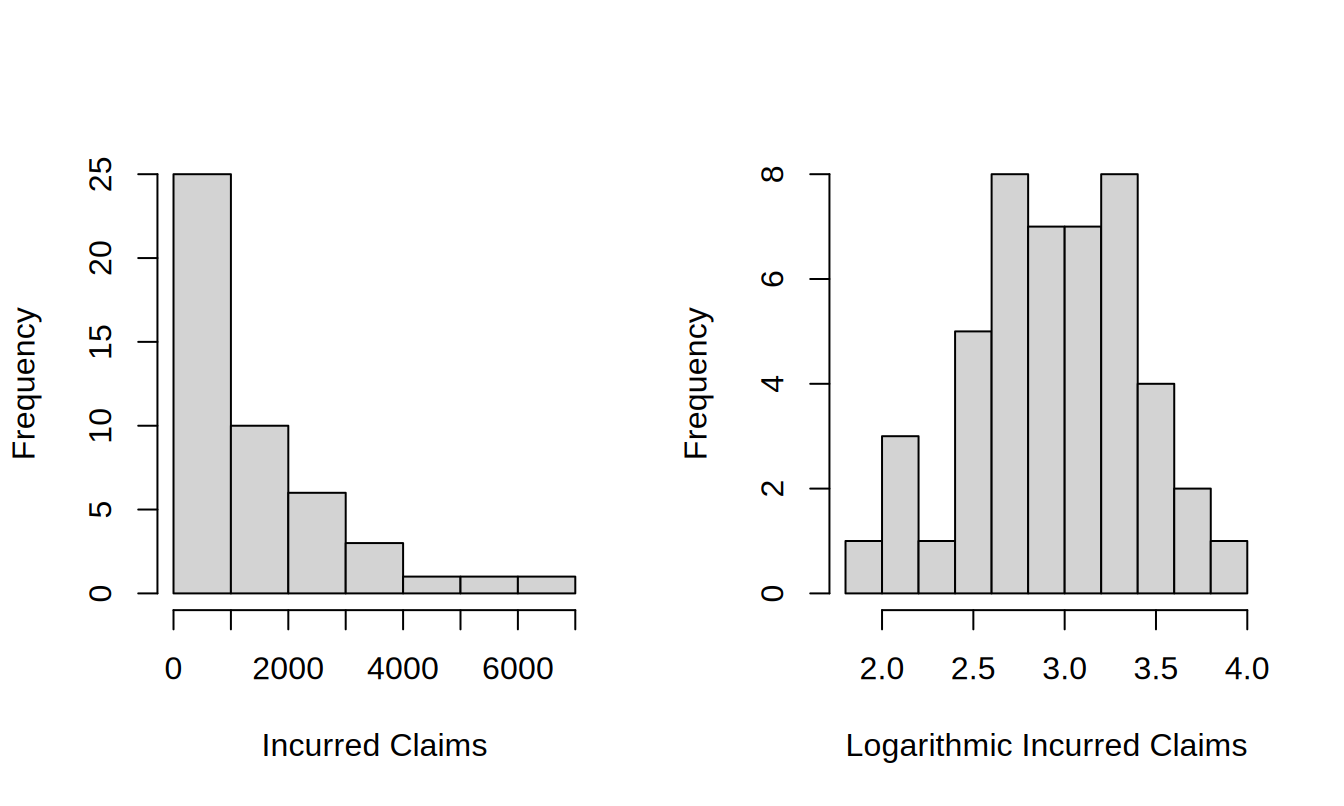
그림 1.4: 2015-2019년 발생 청구의 분포
d. 시간에 따른 손실 분포. 112건의 발생 손실이 있습니다. 그림 1.5은 2015년부터 2019년까지(양 끝 포함)의 기간 동안 발생 손실이 안정적임을 보여 줍니다. 전체 기간에 대해 이와 비슷한 그림을 작성하고 분포의 안정성을 논하십시오.
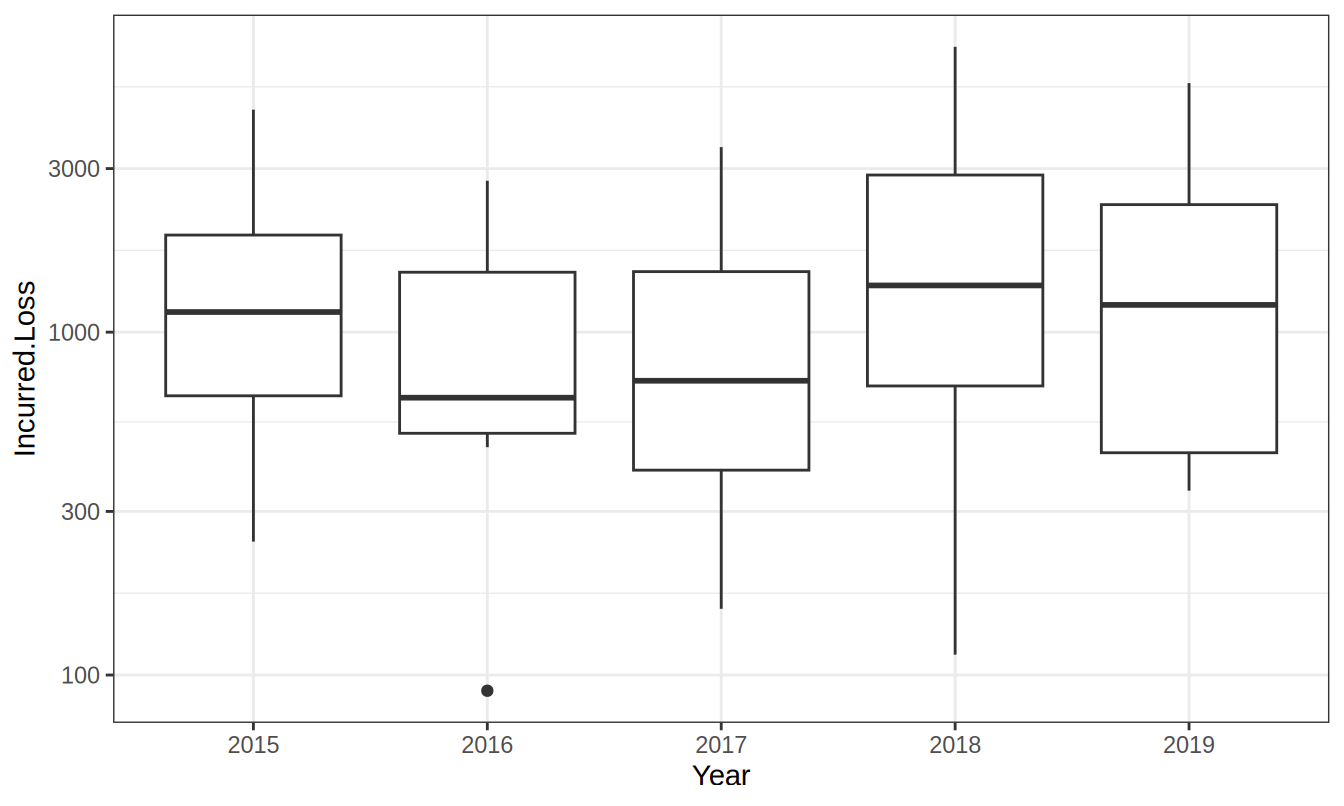
그림 1.5: 연도별 단체 상해 손실의 분포
GPA 청구 연습문제 풀이
연습문제 1.3. 자동차. 이 보험은 승용차, 밴, 유틸리티 차량, 오토바이를 포함한 ANU의 차량을 보장합니다. 이 보장은 두 부분으로 구성되는데, 하나는 피보험 차량의 종합 손해에 대한 것이고 다른 하나는 법적 배상책임에 대한 것입니다. 손실 또는 손해에 대한 종합 보장은 본질적으로 피보험 차량의 시장 가치로 한도가 정해집니다. 법적 배상책임의 경우, 하나의 사고 또는 하나의 근본 원인으로 인한 일련의 사고에서 발생하는 모든 청구에 대해 5천만 달러의 상한이 있습니다. 또한 차량이 위험물 운송에 사용되는 경우에는 (5천만보다 낮은) 별도의 상한이 있습니다.
확보한 데이터에는 보험자(Vero Insurance Limited)가 지급한 금액이 포함되어 있으며, 이것이 초기 분석의 초점입니다. 또한 데이터에는 공제액(데이터 파일에서는 “excess”라고 부름)도 포함되어 있으며, 이는 뒷부분에서 살펴봅니다.
저희에게 제공된 데이터는 보험자인 Vero Insurance Limited가 관리하고 있습니다. 이 데이터는 2012 언더라이팅 연도부터 시작되며, 2022년 8월 8일에 접근하였습니다. 데이터는 부록 22.4절에서 확인할 수 있습니다.
a. 0 값 조정. 이 데이터 세트에서 다음을 확인하십시오.
- 발생 청구가 318건 있습니다.
- 이 청구 중 0인 청구가 50건이고,
- 발생 청구액이 10 미만인 청구가 추가로 0건 있습니다.
분석에서 이러한 청구를 제거하여 발생 청구가 268건이 되도록 하십시오.
b. 청구 빈도. 전체 기간에 대한 청구 건수를 보여 주는 표를 작성하십시오.
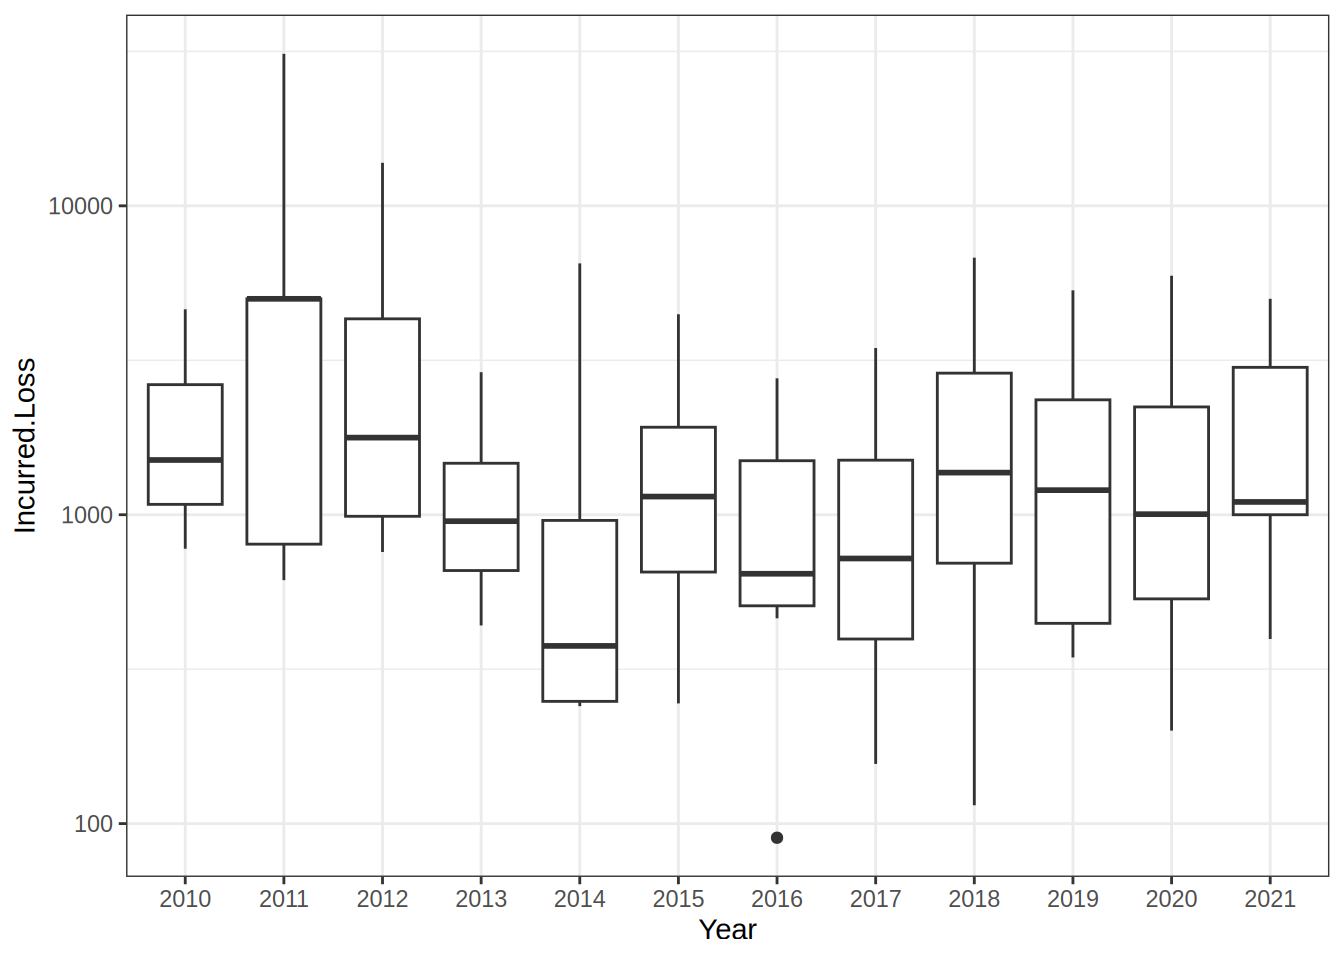
c. 시간에 따른 손실 분포. 시간에 따른 자동차 지급액의 분포를 보여 주는 그림을 작성하고, 분포의 안정성에 대해 논하십시오.
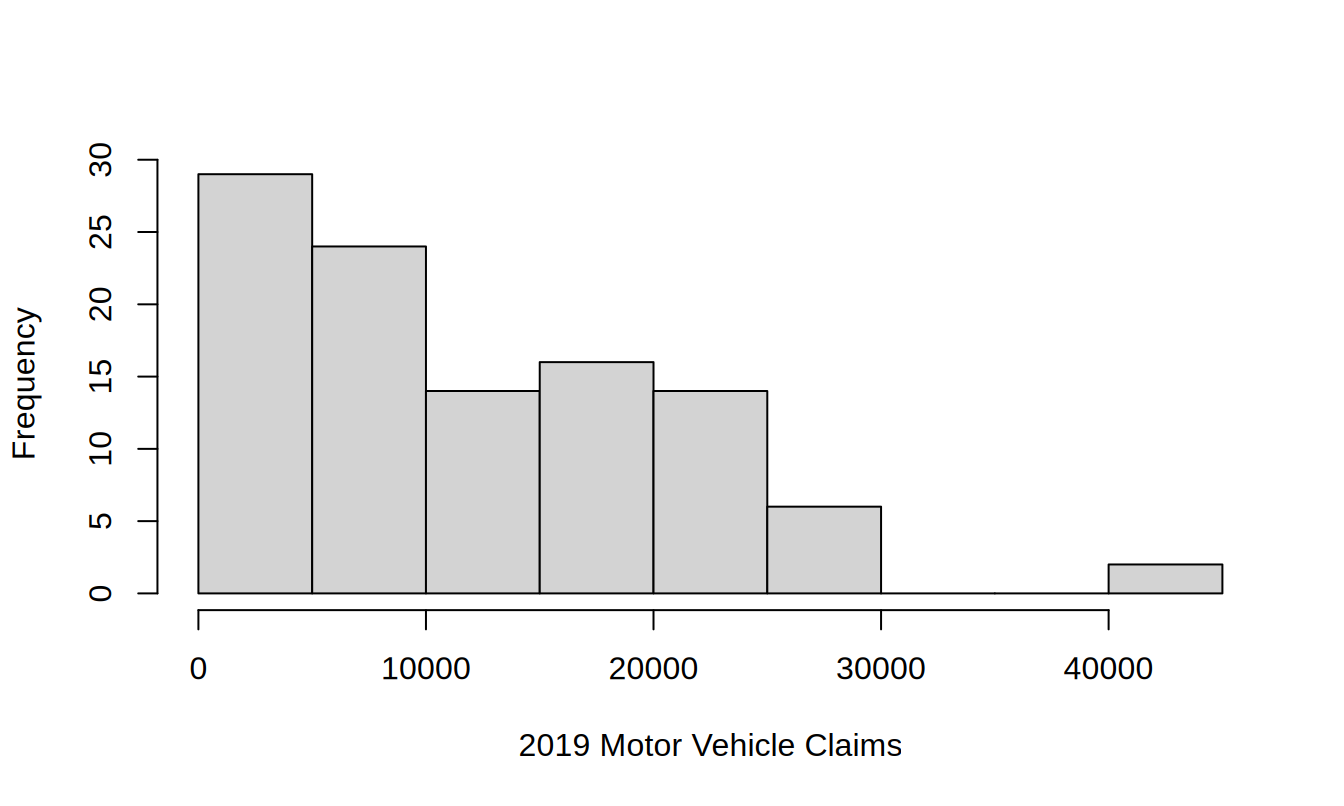
d. 2019년. 앞 단계의 분석에서 2019년의 특이한 측면을 발견하였을 수 있습니다. 그해 ANU는 우박을 동반한 폭풍으로 광범위한 피해를 입었으며, 이로 인해 청구 빈도와 심도가 모두 증가하였습니다. 해당 연도의 지급 청구액에 대한 히스토그램을 작성하십시오.
e. 공제액. 별도로 명시되지 않는 한, 각 사고 또는 하나의 원인에서 비롯된 일련의 사고에 대해 ANU는 피보험 차량 각각에 대한 공제액을 부담합니다. 데이터셋에서 표준 공제액(또는 자기부담금)은 1000입니다. 그러나 데이터셋을 대략 살펴보기만 해도 차량별로, 그리고 시간에 따라 매우 큰 차이가 있음을 알 수 있습니다. 각 연도별로 자기부담금이 0인 청구, 자기부담금이 0보다 크고 1000 미만인 청구, 자기부담금이 1000인 청구, 자기부담금이 1000을 초과하는 청구의 청구 건수를 보여 주는 표 1.13를 재현하십시오.
| UW.Year | Num 0 | Num 0-1000 | Num = 1000 | Num >1000 | Total |
|---|---|---|---|---|---|
| 2011 | 1 | 1 | 7 | 0 | 9 |
| 2012 | 1 | 2 | 13 | 0 | 16 |
| 2013 | 4 | 1 | 22 | 0 | 27 |
| 2014 | 0 | 0 | 11 | 0 | 11 |
| 2015 | 1 | 1 | 14 | 0 | 16 |
| 2016 | 6 | 1 | 19 | 0 | 26 |
| 2017 | 16 | 0 | 4 | 1 | 21 |
| 2018 | 19 | 0 | 1 | 0 | 20 |
| 2019 | 99 | 0 | 6 | 0 | 105 |
| 2020 | 5 | 0 | 0 | 0 | 5 |
| 2021 | 10 | 0 | 0 | 0 | 10 |
(공제액. 관심 있는 독자는 심도와 빈도 모두에서 이 공제액을 반영하도록 저희의 분석을 확장해 보시기를 권합니다.)
자동차 청구 연습문제 풀이
1.5 추가 자료 및 기여자
R 코딩을 추가로 연습하고 싶다면 자매 과정인 LDA 단기 과정을 방문하십시오. 특히 손해 데이터 분석 입문 장을 참조하십시오.
기여자
- 위스콘신 대학교 매디슨 캠퍼스 및 호주 국립대학교의 Edward (Jed) Frees는 이 장의 초판과 제2판의 주 저자입니다. 장에 대한 의견과 개선 제안은 jfrees@bus.wisc.edu로 이메일을 보내 주십시오.
- 이 장의 검토자는 다음과 같습니다: Yair Babad, Chunsheng Ban, Aaron Bruhn, Gordon Enderle, Hirokazu (Iwahiro) Iwasawa, Dalia Khalil, Bell Ouelega, Michelle Xia.
이 책은 계리사와 기타 금융 위험 분석가에게 가장 관련성이 높은 손해 데이터 분석 도구를 소개합니다. 또한 여러분에게 새로운 보험 용어도 많이 소개하였습니다. 더 많은 용어는 NAIC Glossary (2018)에서 찾을 수 있습니다.

이 저작물은 크리에이티브 커먼즈 저작자표시 4.0 국제 라이선스에 따라 이용할 수 있습니다.