제9장 베이즈 통계와 모델링
장 미리보기. 지금까지 이 책에서는 다양한 손실 분포 모수를 추정하기 위해 거의 전적으로 빈도주의(frequentist) 빈도주의 확률에 기반한 통계적 추론의 한 유형으로, 확률을 빈도와 동등한 개념으로 다루며 데이터에서 관측된 결과의 빈도나 비율을 강조하는 방식으로 표본 데이터로부터 결론을 도출합니다. 접근법에 초점을 맞추었습니다. 이 장에서는 방향을 바꾸어 다른 패러다임인 베이즈주의를 논의합니다. 이 두 접근법이 서로 다른 것은 베이지안(Bayesian) 모형 모수와 데이터를 모두 확률변수로 보는 통계적 추론의 한 유형. 통계학자와 빈도주의 통계학자가 불확실성의 원천에 대해 견해를 달리하기 때문입니다. 베이즈 통계는 관측된 데이터 표본이 고정되어 있고 모형 모수가 확률적이라고 가정하는 반면, 빈도주의는 그 반대로 봅니다(즉, 표본 데이터가 확률적이며, 모형 모수는 고정되어 있으나 알려져 있지 않습니다).
이 장에서는 특히 손해 데이터 분석에 초점을 맞추어 베이즈 통계와 모델링을 소개합니다. 먼저 9.1절에서 베이즈 통계의 기초를 설명합니다. 베이즈 통계를 빈도주의와 비교하고, 이 패러다임의 역사적 배경을 소개합니다. 또한 베이즈 통계의 핵심 구성 요소 역할을 하는 중요한 베이즈 정리를 소개합니다. 이어서 이를 바탕으로 절 9.2에서는 베이즈 통계의 주요 구성 요소인 사후분포, 가능도함수, 사전분포를 소개합니다. 9.3절에서는 대수적 편의를 위해 사전분포를 선택하여 사후분포에 대한 닫힌 형태의 표현식이 도출되는 간단한 사례들을 제시합니다. 문헌에서는 이를 켤레 분포족이라고 부릅니다. 9.4절은 닫힌 형태의 표현식을 얻을 수 없어 수치 적분이 필요한 경우를 다룹니다. 구체적으로, 영향력 있는 두 가지 마르코프 연쇄 몬테카를로 샘플러인 깁스 샘플러와 메트로폴리스–헤이스팅스 알고리즘을 논의합니다. 또한 이러한 방법으로 얻은 연쇄를 해석하는 방법(즉, 마르코프 연쇄 진단)도 논의합니다. 마지막으로, 이 장의 마지막 절인 9.5절에서는 이용 가능한 주요 컴퓨팅 자원을 설명하고 손해 데이터 맥락에서 예시를 제시합니다.
9.1 베이즈 통계에 대한 친절한 입문
9.1절에서는 다음을 배웁니다.
- 빈도주의 접근법의 대안으로서 베이즈주의를 정성적으로 설명합니다.
- 베이즈 통계의 역사적 배경을 제시합니다.
- 베이즈 정리를 사용하여 조건부 확률을 구합니다.
- 베이즈 통계의 기초를 이해합니다.
9.1.1 베이즈 통계 대 빈도주의 통계
고전적인 빈도주의 통계는 빈도주의 확률에 기반합니다. 빈도주의 확률이란 어떤 사건의 확률을 반복 가능한 수많은 시행에서 그 사건이 나타나는 상대도수(또는 성향)의 극한으로 정의하는 확률 해석입니다. 빈도주의 통계는 수집될 수 있었던 수많은 가상의 데이터셋 중 하나인 표본으로부터 결론을 도출합니다. 따라서 불확실성은 표본과 관련된 표본추출 오차에서 비롯되며, 모형 모수와 여러 관심 대상의 양은 고정되어 있습니다(다만 실험자에게는 알려져 있지 않습니다).
예제 9.1.1. 동전 던지기. 동전 던지기라는 간단한 경우를 생각해 보면, 공정한 동전을 여러 번 던질 때 약 50%의 확률로 앞면이 나올 것으로 기대합니다. 그러나 동전을 몇 번만 던진다면, 순전히 우연에 의해 다른 표본을 볼 수도 있습니다. 실제로 모두 앞면이 관측될 확률은 0이 아닙니다(표본이 매우 크더라도 마찬가지입니다). 그림 9.1는 iid인 다섯 번의 던지기로 이루어진 표본 100개에서 관측된 앞면의 수를 보여 줍니다. 이 특정 예에서는 모든 던지기가 앞면인 표본이 6개 관측됩니다.9
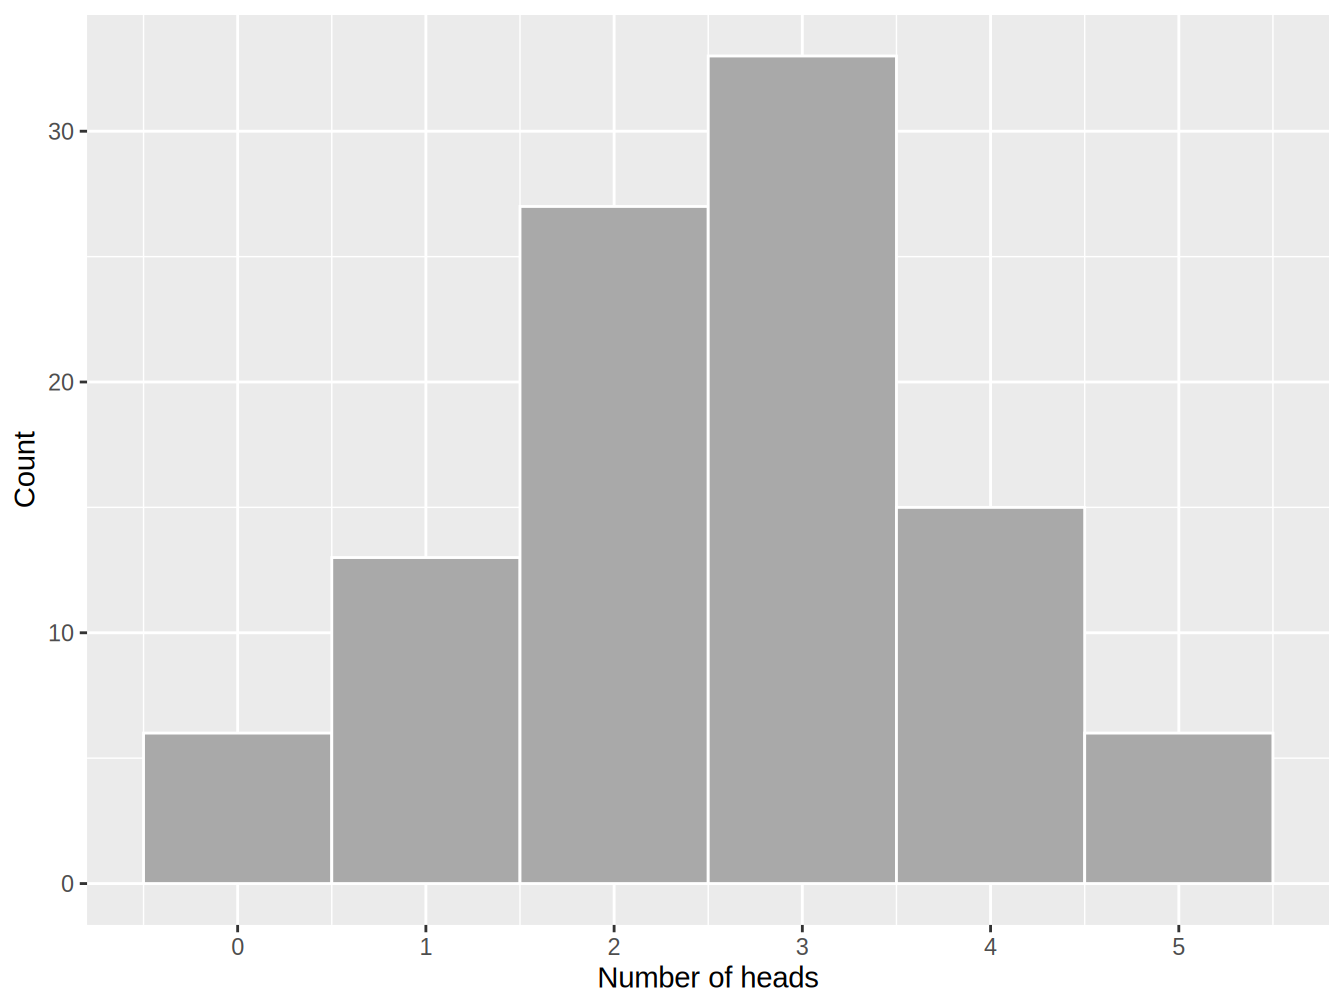
그림 9.1: 데이터 점 다섯 개로 이루어진 표본에서 앞면이 나온 횟수의 도수 히스토그램
그러나 동전이 공정하다면, 표본 크기가 커질수록 앞면의 상대도수는 50%에 가까워져야 합니다. 그림 9.2은 던지는 횟수가 늘어나면 앞면의 상대도수가 0.5, 즉 동전을 한 번 던질 때 앞면이 나올 확률에 가까워진다는 것을 보여 줍니다. 다시 말해, 표본 크기를 늘리면 그 결과로 얻는 모수 추정값의 불확실성이 줄어들며, 실험자가 실험을 무한히 반복할 수 있다고 가정하면 극한에서 확률 0.5에 도달하게 됩니다.
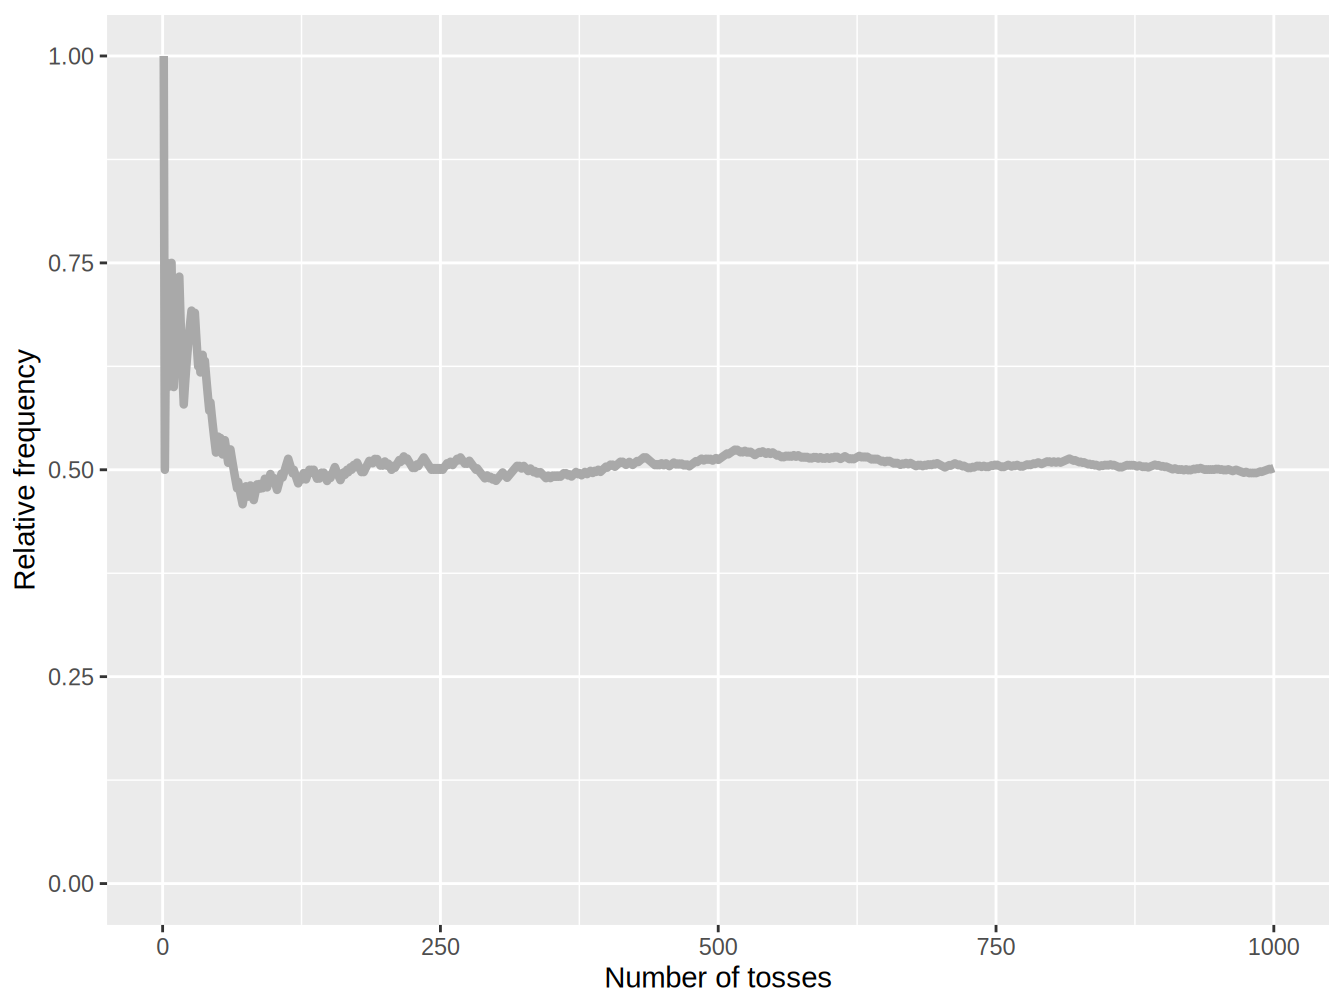
그림 9.2: 표본 크기 증가에 따른 앞면의 누적 상대도수
베이지안은 이를 다르게 봅니다. 이들은 확률을 어떤 관심 대상 양에 대한 확신의 정도로 해석합니다. 이러한 확률을 구하기 위해 베이지안은 해당 양에 대한 사전 지식을 활용하며, 이는 데이터를 고려하기 전에 가지고 있던 믿음을 표현한 것입니다. 그런 다음 데이터가 수집됨에 따라 세상에 대한 지식이 갱신되며, 이를 통해 새로운 정보를 일관된 방식으로 반영할 수 있습니다. 그 결과로 얻는 분포를 사후분포라고 하며, 이는 사전분포와 데이터 양쪽의 정보를 요약합니다.
베이즈 통계와 모델링의 맥락에서 이러한 확률 해석은 모형 모수를 확률변수로 가정한다는 것을 의미하며, 이는 모형 모수를 고정된 값으로 보는 빈도주의 접근법과 다릅니다. 사전분포에서 출발하여, 가능도함수로 요약된 데이터를 사용해 사전분포를 갱신하고 모수의 사후분포를 만듭니다(사후분포(posterior distribution) 사후분포는 베이즈 추론을 통해 사전 정보와 관측 데이터를 반영한 후 갱신된 모수의 확률분포입니다., 가능도함수(likelihood function) 관측된 데이터가 주어졌을 때 모형 모수의 그럴듯함을 나타내는 함수., 사전분포(prior distribution) 추가 데이터를 관측하기 전에 부여되는 확률분포에 대한 자세한 내용은 절 9.2을 참조하십시오). 관측된 데이터 표본의 크기가 커질수록 사후분포에 대한 사전분포의 영향력은 약해집니다. 즉, 새로운 정보가 들어올수록 사전 정보의 중요성은 점점 줄어듭니다.
예제 9.1.1. 동전 던지기(계속). 이제 앞의 동전 던지기 실험을 베이지안 관점에서 다시 살펴보겠습니다. 먼저 (공정하지 않을 수도 있는) 동전이 하나 있고, 앞면이 나올 확률을 알고자 한다고 가정합시다. 이 예제에서는 이 확률을 \(q\)로 나타냅니다. 베이지안 패러다임에 따라 이 모수는 확률적입니다. 앞면이 관측될 확률과 연관된 확률변수를 \(Q\)로 나타낸다고 가정합시다. 단순화를 위해 조사 대상인 특정 동전에 대한 사전 정보가 없다고 가정합니다.10 다시 표본이 iid인 다섯 번의 던지기로만 이루어져 있다고 가정하면, 앞면이 \(x\)번 관측될 확률은 \(m=5\)인 이항분포로 주어지며 \[ p_{X|Q=q}(x) = \mathrm{Pr}(X = x \, | \, Q = q) = \binom{5}{x} q^x (1-q)^{5-x}, \quad x \in \{0,1,...,5\}, \] 이고, 여기서 \(0 \leq q \leq 1\)입니다. 이는 모수 \(q\)에 대해 명시적으로 조건화함으로써 이 확률이 해당 모수에 의존한다는 사실을 강조합니다(지금까지 이 책에서 사용한 표기법과 달리, 이 장에서는 연구 대상인 확률변수를 나타내기 위해 여러 pdf와 pmf에 아래 첨자를 붙인다는 점에 유의하십시오. 이 추가 표기법을 통해 같은 문제에서 서로 다른 확률변수의 pdf와 pmf를 함께 다룰 수 있습니다).
이 다섯 번의 던지기에 대한 표본을 생성해 봅시다.
set.seed(1)
nbheads <- c(1)
num_flips <- 5
coin <- c('heads', 'tails')
flips <- sample(coin, size = 5, replace = TRUE)
nbheads <- sum(flips=="heads")
cat('Number of heads:',nbheads)
Number of heads: 3이 시뮬레이션을 바탕으로 앞면 세 번과 뒷면 두 번을 포함하는 데이터 표본을 얻습니다. 따라서 베이즈 통계를 사용하면 \[ f_{Q|X=3}(q) \, \propto \, q^3 (1-q)^{2}, \] 임을 보일 수 있으며, 여기서 \(\propto\)는 비례함을 뜻합니다(이 식을 얻으려면 절 9.2에서 소개할 몇 가지 도구가 필요하다는 점에 유의하십시오).11 그림 9.3는 이 pdf를 나타내며, 데이터 점 다섯 개로 이루어진 이 표본에 근거한 모수 \(q\)에 대한 불확실성을 보여 줍니다. 이 예제에서 불확실성이 상당히 크다는 것을 알 수 있으며, 이는 데이터 점을 다섯 개만 사용한 데 따른 결과입니다. 실제로 이 다섯 개의 관측값을 바탕으로 하면 확률이 \(\frac{3}{5}=0.6\)에 가까워야 한다고 주장할 수도 있습니다. 이 베이즈 분석은 0.6일 가능성이 높지만 그 불확실성 또한 매우 크다는 것을 보여 주는데, 이는 빈도주의 접근법에서는 바로 얻을 수 없는 결론입니다.
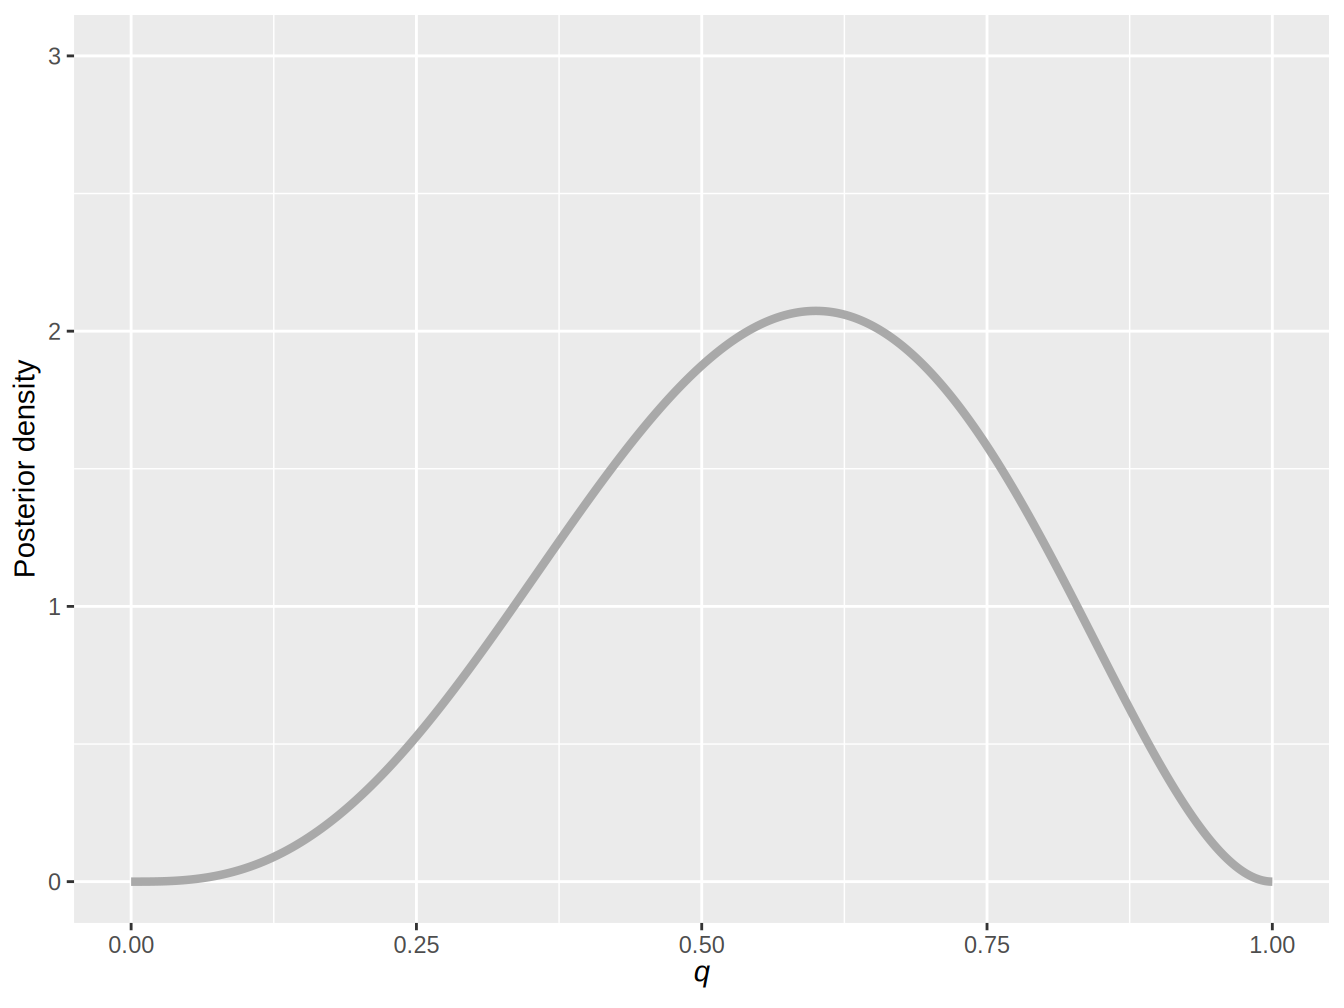
그림 9.3: 다섯 개의 데이터 점으로 이루어진 표본에 대한 모수 \(q\)의 사후 확률밀도함수
그림 9.4는 그림 9.2를 베이즈 관점에서 본 대응물을 보여 줍니다. 즉, 그림 9.2에서 사용한 것과 동일한 표본에 대해 모수 \(q\)의 사후밀도가 표본 크기의 함수로서 어떻게 변화하는지를 볼 수 있습니다. 더 많은 증거를 얻을수록 사후밀도는 0.5 주변에 더 집중되며, 이는 위의 시뮬레이션에서 공정한 동전을 사용했기 때문입니다. 그러나 표본 크기가 1,000이더라도 여전히 어느 정도의 모수 불확실성이 남아 있습니다.
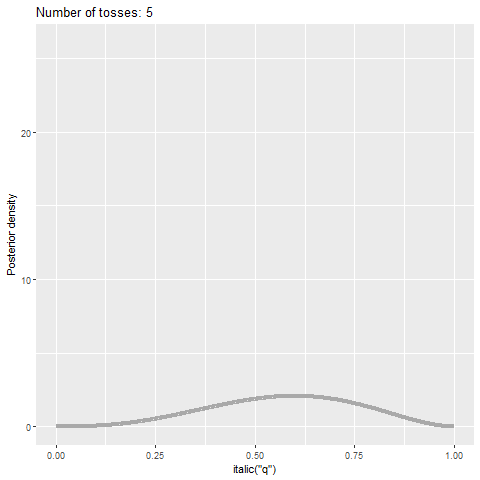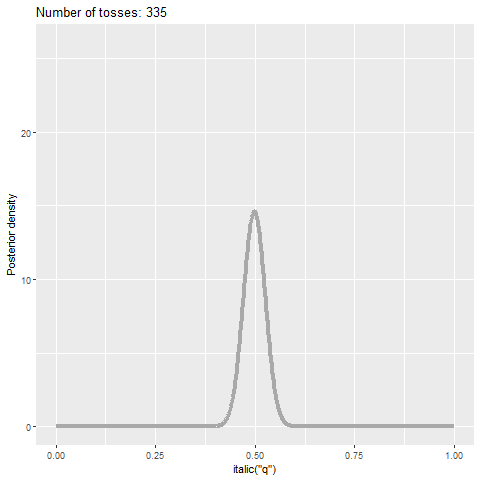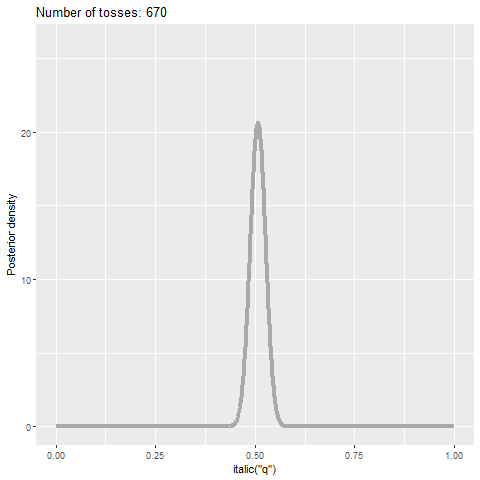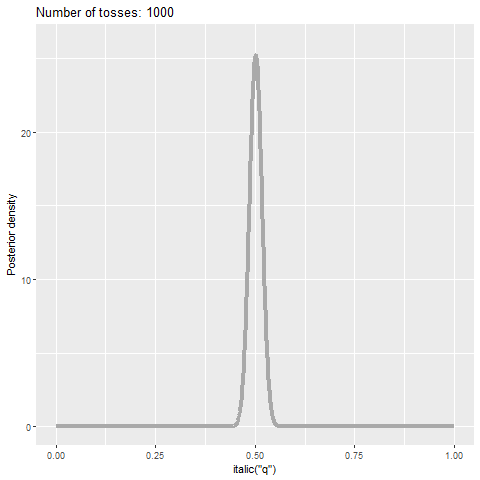
그림 9.4: 표본 크기에 따른 모수 \(q\)의 사후 확률밀도함수
그렇다면 왜 베이지안이 되어야 합니까? 베이지안 접근법에는 실제로 여러 가지 장점이 있습니다. 첫째, 이 접근법을 사용하면 데이터가 주어졌을 때 모수의 전체 조건부 분포를 기술할 수 있으며, 모수에 관한 확률 진술을 문자 그대로 확률로 해석할 수 있는 형태로 제시할 수 있습니다. 둘째, 모수 추정을 위한 통일된 접근법을 제공합니다. 최소제곱법(least squares) 선형회귀에서 모수를 추정하는 기법입니다. 과결정 시스템의 근사해를 구하는 회귀분석의 표준적인 접근법입니다. 이 기법에서는 각 관측값과 그에 대응하는 설명변수의 선형결합 사이의 차이 제곱합을 최소화하는 모수를 구합니다.과 같은 일부 비베이지안 방법은 분산 성분을 추정하기 위해 별도의 접근법을 필요로 합니다. 이와 달리 베이지안 방법에서는 모든 모수를 비슷한 방식으로 다룰 수 있습니다. 셋째, 실험자가 다른 출처에서 얻은 사전 정보를 데이터와 일관된 방식으로 결합할 수 있게 해 줍니다.12
베이지안이 되는 데 단점은 없습니까? 물론 있습니다. 베이지안 접근법에는 많은 장점이 있지만 단점이 없는 것은 아닙니다. 첫째, 계산 부담이 매우 큰 경향이 있습니다(즉, 베이지안 방법은 특히 고차원 문제나 대규모 데이터셋을 다룰 때 복잡한 계산을 요구하는 경우가 많습니다). 예를 들어 복잡한 모형은 닫힌 형태의 해가 없어 특수한 계산 기법이 필요할 수 있으며, 이는 시간이 많이 걸릴 수 있습니다. 둘째, 사전분포—모수에 대한 우리의 초기 믿음과 지식—를 선택하는 데 어느 정도 주관성이 개입되며, 이로 인해 최종적으로 서로 다른 결과가 나올 수 있습니다. 셋째, 베이즈 분석은 비전문가에게 효과적으로 전달하기 어려운 결과를 내는 경우가 많습니다.
이러한 단점에도 불구하고 베이지안 접근법은 여러 보험계리 문제에 대해 여전히 강력하고 유연한 방법입니다.
베이즈 통계를 받아들이려면 베이즈주의자가 되어야 합니까? 아닙니다. 이는 사안별로 결정할 수 있습니다. 모수에 대한 사전 지식이나 믿음이 있을 때, 추정값의 불확실성을 명시적으로 정량화해야 할 때, 데이터가 제한적일 때, 복잡한 모형을 위한 유연한 틀이 필요할 때, 또는 불확실성하의 의사결정이 분석의 핵심 측면일 때 베이지안 연구를 고려하십시오.
진정한 베이지안이 되고 싶지 않더라도 일부 방법의 유용성은 여전히 인정할 수 있습니다. 실제로 인공지능과 머신러닝 분야의 일부 현대적 통계 도구는 베이즈 기법에 크게 의존합니다(몇 가지만 예를 들면 베이즈 신경망, 가우스 과정, 베이즈 분류기 등이 있습니다).
9.1.2 간략한 역사
흥미롭게도, 베이즈 통계의 탄생이 보험과 밀접하게 관련되어 있다고 주장하는 사람들도 있습니다. 예를 들어 Cowles (2013)를 참조하십시오. 구체적으로 말하면, 1만 채가 넘는 가옥과 약 100개의 교회를 파괴한 1666년 런던 대화재는 오늘날 우리가 알고 있는 보험이 등장하는 계기가 되었습니다. 얼마 지나지 않아 1680년대에 잉글랜드에서 최초의 본격적인 화재보험회사가 등장했습니다. 18세기로 접어들 무렵에는 보험이라는 개념이 잉글랜드에 깊이 자리 잡았고 그 이용이 급증하고 있었습니다. 예를 들어 Haueter (2017)을 참조하십시오. 그러나 위험을 이해하는 데 꼭 필요한 통계 모형과 방법이 부족했기 때문에 일부 보험회사는 파산에 이르렀습니다.
영국의 통계학자이자 철학자이며 장로교 목사였던 토머스 베이즈는 보험회사들이 제기한 이러한 중요한 통계적 질문 중 일부에 몰두했습니다. 그 결실이 바로 그의 사후인 1763년에 출간된 기념비적 논문 우연의 원리에 관한 한 문제를 해결하기 위한 시론(Essay towards solving a problem in the doctrine of chances)에 담긴 베이즈의 확률 이론입니다. 이 논문은 오늘날 우리가 베이즈 통계라고 부르는 것의 토대를 마련했습니다.
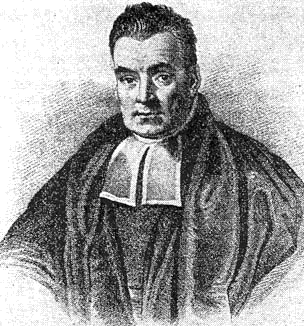
그림 9.5: O’Donnell (1936)에서 토머스 베이즈로 지목된, 신원 미상의 장로교 성직자의 초상화
토머스 베이즈의 연구는 프랑스의 저명한 학자이자 박식가인 피에르시몽 라플라스가 1700년대 후반과 1800년대 초반에 확률의 베이즈 해석을 발전시키고 대중화하는 데에도 도움이 되었습니다. 라플라스는 또한 베이즈의 논문을 넘어서 그의 체계를 일반화했습니다. 라플라스의 노력은 많은 이들에게 이어졌으며, 베이즈적 사고는 브루노 데 피네티, 해럴드 제프리스, 데니스 린들리, 레너드 지미 새비지와 같은 통계학자들의 도움으로 수년에 걸쳐 계속 발전했습니다.
오늘날 베이즈 통계와 모델링은 지난 30년간 이루어진 계산 능력의 향상 덕분에 과학 분야에서 널리 사용되고 있습니다. 더 구체적으로는 보험계리학과 손실 모델링 또한 베이즈 방법론이 성장하는 토양이 되어 왔습니다. 그러므로 베이즈 통계는 어떤 의미에서 모든 것이 시작된 보험으로 다시 돌아오는 셈입니다.
9.1.3 베이즈 규칙
이 소절에서는 사건의 조건부 확률을 계산하는 데 베이즈 규칙이 어떻게 적용되는지 소개합니다.
조건부 확률. 조건부 확률의 개념은 두 개(또는 그 이상)의 사건이 일어날 확률 사이의 관계를 다룹니다. 가장 단순한 형태로 말하면, 조건부 확률에 관심을 둔다는 것은 결국 다음 질문에 답하는 것입니다. 사건 \(B\)가 일어났다는 사실이 주어졌을 때, 이는 \(A\)가 일어날 확률에 어떤 영향을 미치는가? 이 질문에 답하기 위해 조건부 확률의 개념을 다음과 같이 형식적으로 정의할 수 있습니다. \[ \Pr\left(A \, \middle| \, B\right) = \frac{\Pr(A \cap B)}{\Pr(B)}. \] 이것이 제대로 정의되려면 \(\Pr(B)\)가 0보다 크다고 가정해야 합니다. 즉, 사건 \(B\)가 불가능한 사건이 아니어야 합니다. 간단히 말해, 조건부 확률은 \(B\)를 새로운 확률 공간으로 삼은 다음, \(B\) 안에 있는 \(A\)의 부분(즉, \(A \cap B\))만을 고려합니다.
예제 9.1.2. 보험계리사 시험 문제. 한 보험회사는 확장 건강보험에는 가입했지만 장기 장애보험에는 가입하지 않은 보험계약자의 40%가 내년에 계약을 갱신하고, 장기 장애보험에는 가입했지만 확장 건강보험에는 가입하지 않은 보험계약자의 70%가 내년에 계약을 갱신할 것으로 추정합니다. 이 회사는 또한 두 보험에 모두 가입한 고객의 50%가 내년에 적어도 하나의 보험을 갱신할 것으로 추정합니다. 회사 기록에 따르면 고객의 65%가 확장 건강보험에, 40%가 장기 장애보험에 가입해 있으며, 10%는 두 보험에 모두 가입해 있습니다. 위의 자료를 이용하여 내년에 적어도 하나의 보험을 갱신할 보험계약자의 비율을 계산하십시오.13
예제 풀이 보기
독립. 두 사건이 서로 관련이 없을 때, 두 사건은 독립(independent) 한 변수에 대해 주어진 조건부 정보가 다른 변수에 관해 아무런 정보도 제공하지 않으면 두 변수는 독립입니다.이라고 합니다. 구체적으로, \[ \Pr(A \cap B) = \Pr(A) \, \Pr(B). \] 이면 \(A\)와 \(B\)는 독립입니다. 확률이 양수인 사건에 대해서는 \(A\)와 \(B\) 사이의 독립이 \[ \Pr(A\,|\, B) = \Pr(A) \quad \text{and} \quad \Pr(B\,|\, A) = \Pr(B), \] 와도 동치이며, 이는 사건 \(B\)의 발생이 \(A\)의 발생에 영향을 미치지 않고 그 역도 마찬가지라는 뜻입니다.
베이즈 규칙. 직관적으로 말해, 베이즈 규칙(Bayes’ rule) 은 베이즈적 사고를 실제로 적용하는 메커니즘을 제공합니다. 베이즈 규칙을 이용하면 가능도에서 얻은 데이터와 사전 분포를 결합하여 사후 확률을 구함으로써 우리의 정보를 갱신할 수 있습니다.
명제 9.1.1. 사건에 대한 베이즈 규칙. 사건 \(A\)와 \(B\)에 대해, \(B\)가 주어졌을 때 사건 \(A\)의 사후 확률은 \[ \Pr(A\,|\,B) = \frac{\Pr(B\, |\, A) \Pr(A)}{\Pr(B)}, \] 를 따르며, 여기서 전확률 법칙을 이용하면 다음을 구할 수 있습니다.
\[ \Pr(B) = \Pr(A) \Pr(B \, | \, A) + \Pr(A^{\text{c}}) \Pr(B \, |\, A^{\text{c}}). \] 다시 말하지만, 이는 사건 \(B\)가 가능한 경우(즉, \(\Pr(B) > 0\))에만 성립한다는 점에 유의하십시오.14
이론 일부 보기
간단히 말해, \(B\)이 주어졌을 때 사건 \(A\)의 사후 확률은 고정된 \(A\)이 주어졌을 때 \(B\)의 가능도(\(\Pr(B\, |\, A)\)로 대신 나타냅니다)와 \(A\)를 관측할 사전 확률을 결합한 다음, 확률의 합이 1이 되도록 사건 \(B\)의 주변 확률로 나누어 얻습니다.
예제 9.1.3. 보험계리사 시험 문제. 한 자동차 보험회사는 모든 연령대의 운전자를 보험에 가입시킵니다. 한 보험계리사가 몇몇 연령대별 사고 발생 확률과 함께 각 연령대가 이 회사의 피보험 운전자 중 차지하는 비율의 추정치를 다음과 같이 정리했습니다. \[ \small{ \begin{matrix} \begin{array}{c|c|c} \hline \text{Age of Driver} & \text{Probability of Accident} & \text{Portion of Company's } \\ & & \text{Insured Drivers} \\\hline \text{16-20} & 0.06 & 0.08 \\\hline \text{21-30} & 0.03 & 0.15 \\\hline \text{31-65} & 0.02 & 0.49 \\\hline \text{66-99} & 0.04 & 0.28 \\\hline \end{array} \end{matrix} } \]
이 회사가 보험에 가입시킨 운전자 중 무작위로 선택한 한 명이 사고를 냈습니다. 이 운전자의 나이가 16-20세였을 확률을 계산하십시오.15
예제 풀이 보기
9.1.4 베이즈 정리의 입문 예제
위 예제는 학술적 맥락에서 베이즈 정리를 사용하는 방법을 보여 줍니다. 그러나 이 책의 초점은 데이터 분석입니다. 따라서 실제 데이터를 사용해서도 베이즈 정리를 설명하고자 합니다. 이 입문 예제에서는 3장에서 이미 사용한 R 패키지 CASdatasets의 싱가포르 자동차 데이터 sgautonb를 사용합니다.
이 데이터셋에는 자동차 사고 건수와 몇 가지 위험 요인(즉, 피보험 차량의 유형, 차량의 연식, 보험계약자의 성별, 일곱 개 범주로 묶은 보험계약자의 나이)에 관한 정보가 들어 있습니다.16
예제 9.1.4. 싱가포르 보험 데이터. 모집단 중 고령층을 대상으로 하는 한 신규 보험회사는 계약자의 20%가 65세 이상일 것으로 추정합니다. 이 보험회사에서 일하는 보험계리사들은 새 회사의 사고 발생을 이해하는 데 싱가포르 보험 데이터셋이 신뢰할 만하다고 판단합니다. 이 정보를 바탕으로, 사고를 (최소) 한 번 낸 운전자 중 무작위로 선택한 한 명이 65세 이상일 확률을 구하십시오.
예제 풀이 보기
다음 절에서는 베이즈 규칙의 개념을 확장하여, 사건 대신 확률변수가 관련된 약간 더 일반적인 경우에 적용합니다.
9.2 베이즈 통계의 구성 요소
9.2절에서는 다음 방법을 학습합니다:
- 베이즈 통계의 주요 구성 요소, 즉 사후분포, 가능도함수, 사전분포를 설명합니다.
- 실무에서 사용되는 여러 종류의 사전분포를 요약합니다.
앞의 명제 9.1.1은 사건에 대한 베이즈 규칙의 기본적인 경우를 다룹니다. 이 형태의 베이즈 규칙은 베이즈 통계의 기초를 이해하는 데 유용하지만, 우리의 목적을 달성하려면 이를 약간 더 일반화한 형태가 필요합니다. 구체적으로, 명제 9.1.1을 확률변수의 경우로 일반화해야 합니다.
먼저 이산 확률변수의 경우를 살펴봅시다. \(X\)과 \(Y\)가 모두 이산 확률변수이며, \[ p_{X,Y}(x,y) = \Pr(X=x \,\text{ and }\, Y=y) \] 의 결합 확률질량함수(pmf)가 다음과 같고 \(X\)과 \(Y\)의 주변분포가 각각 다음과 같다고 가정합니다: \[ p_X(x)= \Pr(X=x) = \sum_k p_{X,Y}(x,k) \quad \text{and} \quad p_Y(y)= \Pr(Y=y) = \sum_k p_{X,Y}(k,y), \] 명제 9.1.1의 결과를 사용하고 사건 \(A\)를 \(\{Y=y\}\)로, \(B\)를 \(\{X=x\}\)로 두면 \[ p_{Y|X=x}(y)= \frac{p_{X|Y=y}(x)\, p_Y(y)}{p_X(x)}, \] 를 얻습니다. 여기서 \(p_{Y|X=x}(y) = \Pr\left( Y = y \, \middle|\, X = x\right)\)는 \(X\)가 \(x\)와 같다는 조건에서 \(Y\)의 조건부 pmf입니다. 전확률 법칙 \[ p_X(x)= \sum_k p_{X,Y}(x,k) = \sum_k p_{X|Y=k}(x) \, p_Y(k), \] 을 사용하면 위의 분모를 다시 써서 다음과 같은 형태의 베이즈 규칙을 얻을 수 있습니다. \[ p_{Y|X=x}(y) = \frac{p_{X|Y=y}(x)\, p_Y(y)}{\sum_k p_{X|Y=k}(x) \, p_Y(k)}. \] 확률질량함수를 확률밀도함수로, 합을 적분으로 바꾸면 연속형 확률변수에 대해서도 비슷한 베이즈 규칙을 얻을 수 있습니다.
명제 9.2.1. 연속형 확률변수에 대한 베이즈 규칙. 두 연속형 확률변수 \(X\)와 \(Y\)에 대해, \(X=x\)가 주어졌을 때 \(Y\)의 조건부 확률밀도함수는 \[ f_{Y|X=x}(y) = \frac{f_{X|Y=y}(x)\, f_Y(y)}{f_X(x)}, \] 를 따릅니다. 여기서 \(X\)와 \(Y\)의 주변분포는 각각 다음과 같습니다. \[ f_X(x)=\int_{-\infty}^{\infty} \! f_{X,Y}(x,u) \, du \quad \text{and} \quad f_Y(y)=\int_{-\infty}^{\infty} \! f_{X,Y}(u,y) \, du, \] 이산 확률변수의 경우와 마찬가지로, 전확률 법칙을 이용하여 위 식의 분모를 \[ f_{X}(x) = \int_{-\infty}^{\infty} \! f_{X,Y}(x,u) \, du = \int_{-\infty}^{\infty} \! f_{X|Y=u}(x) \, f_Y (u) \, du \] 로 바꿀 수 있습니다.
이론 일부 보기
모수는 연속형 확률변수이고 관측값은 이산 확률변수로 표현되는 경우, 또는 그 반대의 경우를 다루기 위해 베이즈 규칙의 이산형 정의와 연속형 정의를 함께 사용할 수 있다는 점에 유의하십시오.
9.2.1 사후분포
베이즈 패러다임에서는 모형 모수를 확률변수로 가정합니다. 즉, (이산 또는 연속) 확률변수에 대한 베이즈 규칙을 적용하여 새로운 데이터를 이용해 모수에 대한 사전 지식을 갱신할 수 있습니다. 이는 실제로 9.1.1절에서 사용한 과정과 유사합니다.
우선은 확률변수 \(\Theta\)와 연관된 미지의 모형 모수 \(\theta\) 하나만 고려합시다.17 또한 확률변수들의 모음 \[ \mathbf{X} = (X_1, X_2, ..., X_n). \]의 실현값인 \(n\)개의 관측값 \[ \mathbf{x} = (x_1, x_2, ..., x_n), \] 를 고려합니다. 명제 9.2.1에서 \(Y\)를 \(\Theta\)로, \(X\)를 \(\mathbf{X}\)로 바꾸면 \[ f_{\Theta|\mathbf{X}=\mathbf{x}}(\theta) = \frac{f_{\mathbf{X}|\Theta=\theta}(\mathbf{x})\, f_{\Theta}(\theta)}{f_{\mathbf{X}}(\mathbf{x})}, \] 을 얻습니다. 이는 새로운 관측값 \(\mathbf{x}\)에 근거하여 분포를 갱신한 후의 모형 모수의 사후분포를 나타내며, 여기서
- \(f_{\mathbf{X}|\Theta=\theta}(\mathbf{x})\)는 가능도함수로, 모수 \(\theta\)의 값이 주어졌다고 가정할 때 관측값의 조건부 결합 pdf라고도 하며,
- \(f_{\Theta}(\theta)\)는 사전 정보를 나타내는 모수의 비조건부 pdf이고,
- \(f_{\mathbf{X}}(\mathbf{x})\)은 주변가능도로, \(\theta\)에 대해 상수인 항이며 사후밀도의 적분값이 1이 되도록 합니다.
다시 말해, 베이즈 규칙은 관측값 \(\mathbf{x}\)를 고려하여 모수의 사전분포를 사후분포로 갱신하는 방법을 제공합니다.
관측값이 주어지면 주변가능도는 상수라는 점에 유의하십시오. 주변가능도는 \(\theta\)에 의존하지 않으며 pdf의 전체적인 형태에 영향을 미치지 않습니다. 단지 밀도의 적분값이 1이 되도록 적절한 척도를 제공할 뿐입니다. 이러한 이유로, 대신 비례 관계를 사용하여 사후분포를 나타내는 것이 일반적입니다. \[ f_{\Theta|\mathbf{X}=\mathbf{x}}(\theta) \propto \underbrace{f_{\mathbf{X}|\Theta=\theta}(\mathbf{x})}_{\text{Likelihood}} \, \, \underbrace{\vphantom{f_{\mathbf{X}|\Theta=\theta}(\mathbf{x})}f_{\Theta}(\theta)}_{\text{Prior}}. \]
예제 9.2.1. Meyers (1994)에서 착안한 문제. 한 자동차 보험이 자동차 보험계약에 대해 다음과 같은 (독립적인) 청구액을 지급합니다. \[ 1050, \quad\quad 1250, \quad\quad 1550, \quad\quad 2600, \quad\quad 5350, \quad\quad 10200. \] 1회 지급액은 \(\theta = 1000\)이고 \(\alpha\)를 모르는 단일모수 파레토 분포를 따르며, \[ f_{X_i|A=\alpha}(x_i) = \frac{\alpha \, 1000^{\alpha}}{x_i^{\alpha+1}}, \quad x_i \in \mathbb{R}_+. \] 입니다. \(\alpha\)의 사전분포는 형상모수 2, 척도모수 1인 감마분포로 주어지고, 그 pdf는 \[ f_{A}(\alpha) = \alpha\,e^{-\alpha}, \quad \alpha \in \mathbb{R}_+. \] 라고 가정합니다. 모수 \(\alpha\)의 사후분포를 구하십시오.
예제 풀이 보기
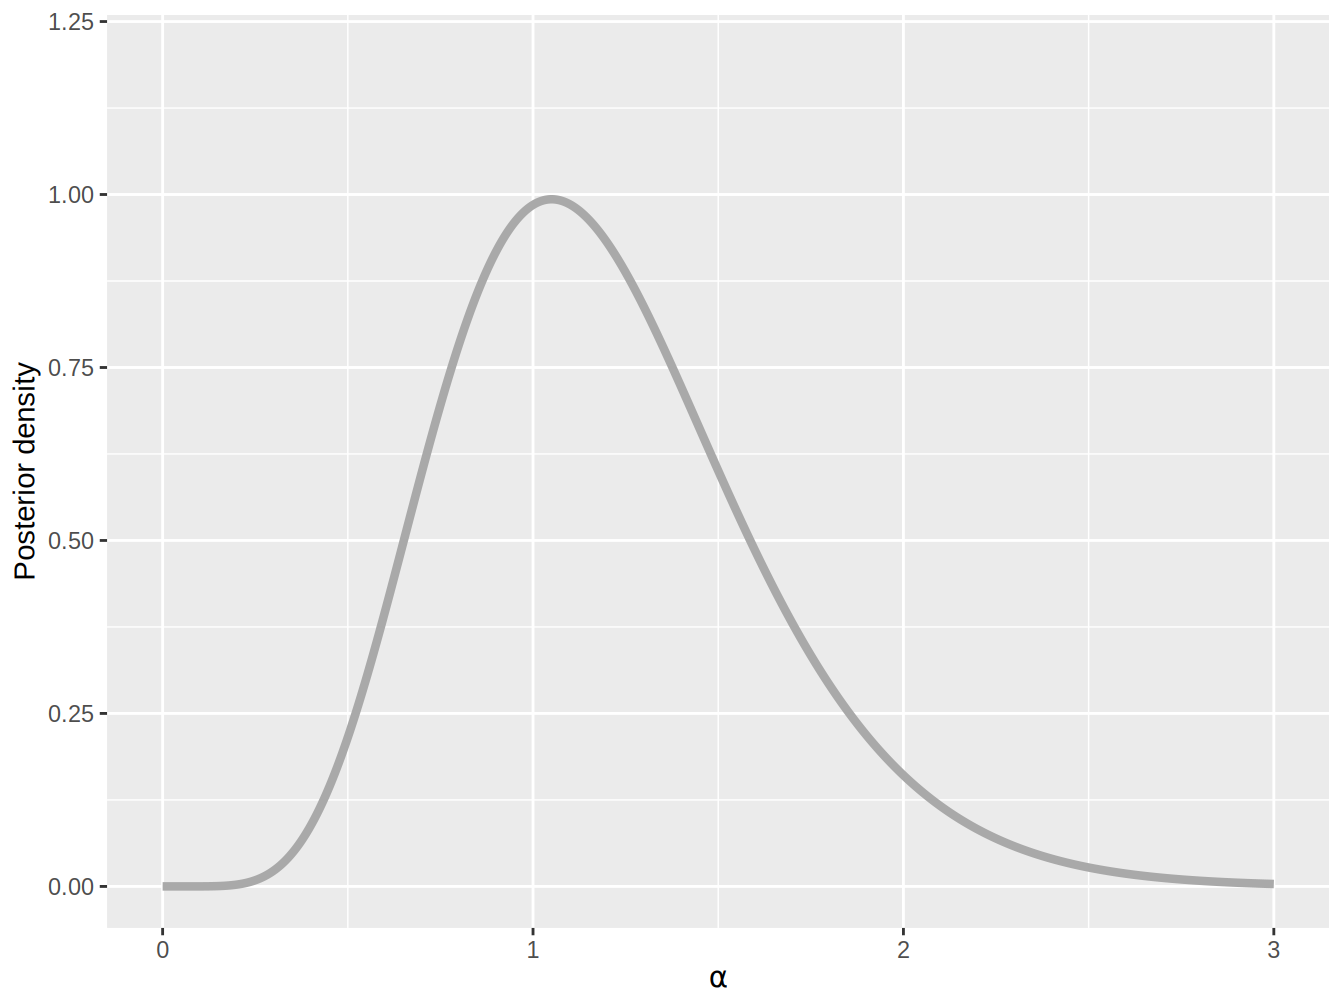
위의 논의는 연속형 확률변수를 다루었지만, 확률밀도함수를 확률질량함수로 바꾸면 이산 확률변수에도 같은 논리를 적용할 수 있습니다.
예제 9.2.2. 동전 던지기 다시 보기. (독립적인) 다섯 번의 던지기 중 앞면이 세 번 관측되었다고 가정합니다. 각 던지기에서 앞면이 관측될 확률은 \(q\)이고 뒷면이 관측될 확률은 \(1-q\)입니다. 구간 \([0,1]\)에서의 균등 사전분포를 가정하여 \(q\)의 사후분포를 구하십시오.
예제 풀이 보기
이어지는 하위 절에서는 사후분포를 구성하는 데 사용되는 두 가지 주요 구성 요소인 가능도함수와 사전분포에 대해 더 자세히 논의하겠습니다.
9.2.2 가능도함수
가능도함수는 통계학의 기본 개념입니다. 가능도 함수는 관측된 데이터를 바탕으로 통계 모형의 모수를 추정하는 데 사용됩니다. 앞선 장들에서 언급했듯이, 가능도함수는 최대가능도 추정량을 구하는 데 사용할 수 있습니다. 베이즈 통계에서 가능도함수는 증거(또는 데이터)를 바탕으로 사전분포를 갱신하는 데 사용됩니다.
위에서 그리고 17장에서 설명했듯이, 가능도함수는 모형 모수가 주어졌을 때 관측 데이터의 조건부 결합 pdf 또는 pmf로 정의됩니다. 다시 말해, 가능도 함수는 특정 모수 값이 주어졌을 때 데이터를 관측할 확률입니다.
수학적으로 가능도함수는 \(f_{\mathbf{X}|\Theta=\theta}(x)\)(연속형 확률변수의 경우) 또는 \(p_{\mathbf{X}|\Theta=\theta}(x)\)(이산 확률변수의 경우)로 표기합니다. 이 책 전반에서 가능도함수에 \(L(\theta|\mathbf{x})\)라는 표기도 사용되었으며, 이 장에서는 두 표기를 혼용한다는 점에 유의하십시오.
특수한 경우: 독립이며 동일하게 분포된 관측값. 많은 문제와 실제 응용에서 관측값이 iid라고 가정하는 경우가 많습니다. 그렇다면 가능도함수를 다음과 같이 쉽게 쓸 수 있습니다.
\[ f_{\mathbf{X}|\Theta=\theta}(\mathbf{x}) = \prod_{i=1}^n f_{X_i|\Theta=\theta}(x_i) \quad \text{ or } \quad p_{\mathbf{X}|\Theta=\theta}(\mathbf{x}) = \prod_{i=1}^n p_{X_i|\Theta=\theta}(x_i). \]
9.2.3 사전분포
베이지안 패러다임에서 사전분포는 데이터를 관측하기 전에 미지의 모수에 대해 우리가 가진 지식이나 믿음을 나타냅니다. 사전분포는 모수 값에 대한 불확실성을 표현하는 확률분포입니다. 사전분포는 일반적으로 확률분포족을 선택하고 그 모수에 구체적인 값을 지정하는 방식으로 정합니다.
사전분포의 선택은 주관적이며, 외부 정보나 선행 연구에 근거하는 경우가 많습니다. 어떤 경우에는 모수에 대한 사전 지식이나 가정을 최소한으로만 나타내는 무정보 사전분포를 사용할 수 있습니다. 또 다른 경우에는 외부 출처에 근거한 사전 지식이나 가정을 반영하는 정보적 사전분포와 약정보 사전분포를 사용할 수 있습니다. 사전분포는 신중하게 선택해야 하며, 서로 다른 사전 가정에 대해 결과가 얼마나 강건한지 평가하기 위해 민감도 분석을 수행할 수 있습니다.
왜 중요한가? 사전분포의 선택은 베이즈 분석의 결과에 상당한 영향을 미칠 수 있습니다. 사전분포가 다르면 사후분포도 달라질 수 있습니다. 사후분포란 데이터를 관측한 후 모수에 대해 갱신된 확률분포를 말합니다. 따라서 모수에 대한 우리의 사전 지식이나 믿음을 반영하는 사전분포를 선택하는 것이 중요합니다.
정보적 사전분포와 약정보 사전분포
정보적(Informative) 통계학에서 정보적 사전분포는 새로운 데이터를 관측하기 전에 모수에 대한 특정 정보나 믿음을 반영하도록 의도적으로 선택한 사전 확률분포입니다. 및 약정보적(weakly informative) 약정보 사전분포는 최종 추론에 큰 영향을 미치지 않으면서 모수에 대한 일반적인 제약이나 모호한 믿음을 도입하는 사전 확률분포입니다. 사전분포는 통계 모형에 반영된 사전 지식이나 믿음의 양을 나타내는 데 쓰이는 용어입니다. 정보적 사전분포는 모형의 모수에 대한 상당한 사전 지식을 담고 있는 반면, 약정보 사전분포는 적당한 수준의 사전 지식을 담고 있습니다.
정보적 사전분포는 모형 모수에 대해 강력하고 어쩌면 주관적일 수도 있는 사전 정보가 있을 때 유용하며, 이는 사후분포를 제약하고 추론을 개선하는 데 도움이 될 수 있습니다. 예를 들어 보험금 청구 분석 연구에서는 이전 청구 연구의 결과와 같은 기존 지식을 반영하기 위해 정보적 사전분포를 사용할 수 있습니다.
반면 약정보 사전분포는 사전 지식이 어느 정도 있기는 하지만 많지 않을 때, 또는 데이터가 분석을 주도하도록 하는 것이 목표일 때 사용합니다. 약정보 사전분포는 사후분포에 약한 영향만 미치도록 설계되며, 대칭성이나 척도 불변성 같은 원칙에 따라 선택되는 경우가 많습니다.
전반적으로 사전분포의 선택은 당면한 구체적인 문제와 활용 가능한 사전 지식이나 믿음에 따라 달라집니다. 정보적 사전분포는 사전 정보를 활용할 수 있을 때 유용하며, 사후분포의 정밀도를 높일 수 있습니다. 이와 달리 약정보 사전분포는 데이터가 분석을 주도하도록 하고 강한 사전 가정을 부과하지 않는 것이 목표일 때 유용합니다.
예제 9.2.3. 계리사 시험 문제. 다음이 주어져 있습니다.
- 연간 청구 빈도는 평균이 \(\lambda\)인 포아송 분포를 따릅니다.
- \(\lambda\)의 사전분포는 다음과 같은 확률밀도함수(pdf)를 가집니다. \[ f_{\Lambda}(\lambda) = (0.3) \frac{1}{6} e^{-\frac{\lambda}{6}} + (0.7) \frac{1}{12} e^{-\frac{\lambda}{12}}, \quad \text{where } \lambda > 0. \]
한 피보험자에게서 1차 연도에 청구 10건이 관측되었습니다. \(\lambda\)의 사후분포의 기댓값을 계산하십시오.18
예제 풀이 보기
무정보 사전분포
무정보적(noninformative) 무정보 사전분포는 모수에 대한 특정 정보나 강한 믿음을 반영하지 않도록 의도적으로 설계된 사전 확률분포입니다. 사전분포를 사용하면 약정보 사전분포의 개념을 극단까지 밀고 나갈 수 있습니다. 무정보 사전분포란 사전 믿음이나 가정에 지나치게 좌우되지 않고 데이터가 사후분포에 더 결정적인 영향을 미치도록 의도적으로 선택한 사전분포입니다.
무정보 사전분포는 예를 들어 평탄 사전분포처럼 다양한 형태를 취할 수 있습니다. 평탄 사전분포는 추가적인 정보나 가정 없이 가능한 모든 모수 값에 동일한 확률을 부여합니다.
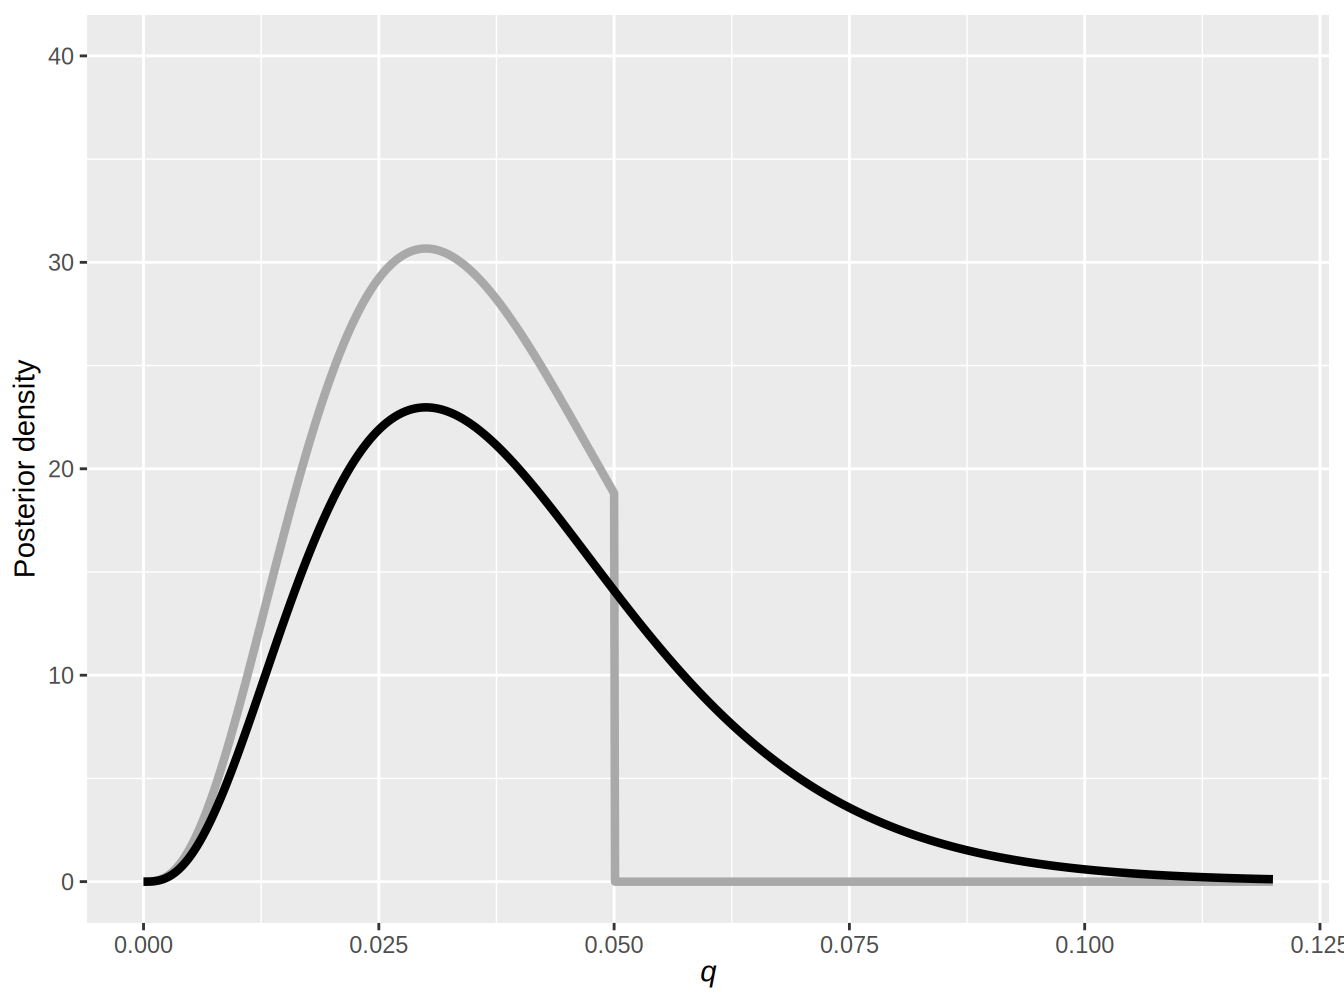
예제 9.2.4. 정보적 사전분포 대 무정보 사전분포. 정보적 사전분포와 무정보 사전분포가 청구 빈도 분석에 미치는 영향을 조사하고자 합니다. 각 보험계약의 청구 빈도가 확률 \(q\)인 베르누이 확률변수를 따라 \[ q_{X_i|Q=q}(x_i) = q^{x_i} (1-q)^{1-x_i}, \quad x_i \in \{0,1\}, \] 이고 \(q \in [0,1]\)라고 가정하고, 다음 두 가지 사전분포를 고려하십시오:
- 정보적: 과거 경험에 비추어 청구 확률이 일반적으로 5% 미만임을 알고 있으므로, \([0,0.05]\)에서의 균등분포를 사용하는 것이 타당합니다.
- 무정보: 사후분포가 사전 가정의 영향을 받기를 원하지 않으므로, 단순히 \(q\)의 정의역인 \([0,1]\)에서의 균등분포를 선택합니다.
싱가포르 보험 데이터셋의 처음 100행을 사용하여(이 데이터셋에 대한 자세한 내용은 예제 9.1.4를 참조하십시오), 두 사전 가정 각각에 대해 두 사후분포와 확률 \(q\)의 사후 기댓값을 구하십시오.
예제 풀이 보기
부적절한 사전분포
부적절(improper) 비정칙 사전분포(improper prior)는 전체 모수 공간에서 적분한 값이 유한하지 않은 사전 확률분포입니다. 사전분포란 적절한 확률분포가 아닌 사전분포, 즉 전체 모수 공간에 걸쳐 적분(또는 합)한 값이 1이 되지 않는 사전분포를 말합니다. 부적절한 사전분포는 베이지안 분석에 사용될 수 있지만, 부적절한 사후분포로 이어질 수 있으므로 신중하게 다루어야 합니다.
부적절한 사전분포는 일반적으로 관심 모수에 대한 사전 정보가 거의 또는 전혀 없을 때 사용되며(실제로 일부 무정보 사전분포는 부적절합니다), 매우 퍼져 있거나 어느 쪽에도 치우치지 않은 사전 믿음을 나타내는 것으로 볼 수 있습니다. 예를 들어, 무한 구간에서의 균등분포는 흔히 선택되는 부적절한 사전분포입니다.
예제 9.2.5. 부적절한 사전분포, 적절한 사후분포. 확률변수들의 모음 \(\mathbf{X} = (X_1,X_2, ..., X_n)\)의 실현값인 크기 \(n\)의 확률표본 \(\mathbf{x}\)을 가정합시다. 또한 각 확률변수 \(X_i\)는 독립이며 평균 \(\mu\), 분산 1인 정규분포를 따른다고 가정합니다: \[ f_{X_i|M=\mu}(x_i) = \frac{1}{\sqrt{2\pi}} \exp\left( - \frac{1}{2} \left( x_i -\mu\right)^2 \right), \quad x_i \in \mathbb{R}, \] 여기서 \(\mu\)는 (확률적) 모수입니다. \(\mu\)의 사전분포가 부적절(improper)하며 \(f_M(\mu) \propto 1\)로 주어진다고 가정할 때, 그 사후분포를 구하십시오. 여기서 \(\mu \in \mathbb{R}\)입니다.
예제 풀이 보기
부적절한 사전분포를 다룰 때는 특별한 주의가 필요합니다. 실제로 예제 9.2.5에서처럼 사후분포를 닫힌 형태로 유도하고 그것이 적절함을 보일 수 있다면 우려할 필요가 없습니다. 반면에 사후분포를 닫힌 형태로 구할 수 없는 경우에는 사후분포가 적절하다는 보장이 없으므로 각별한 주의가 필요합니다.
사전분포의 선택
베이즈 통계학에서 사전분포를 선택하는 일은 관심 모수에 대한 실험자의 사전 신념, 지식 또는 가정을 반영하는 매우 중요한 단계입니다. 사전분포를 선택하는 방법에는 여러 가지가 있습니다.
- 정보적 사전분포는 일반적으로 실험자의 주관적 신념, 지식 또는 경험에 기반합니다. 예를 들어, 어떤 모수가 특정 범위 안에 있을 가능성이 높다는 주관적 신념을 가질 수 있으며, 이 신념을 정보적 사전분포로 정형화합니다.
- 무정보 사전분포는 정보를 최소한으로 담도록 선택되며, 모수에 대한 사전 정보를 거의 또는 전혀 나타내지 않습니다. 예를 들어, 균등 사전분포는 특정 모수 값에 대한 사전 선호가 없음을 나타내는 무정보 사전분포로 흔히 사용됩니다.
- 경험적 베이즈 사전분포는 데이터 자체에 의존하며, 경험적 정보를 베이즈 방법론과 결합합니다. 이는 관측된 데이터를 사용하여 사전분포의 초모수를 추정함으로써 사전분포를 정하는 방식으로 수행할 수 있습니다.
- 전문가 의견 도출에 의존하는 사전분포는 사전분포를 정하기 위해 해당 분야 전문가의 의견을 구하는 것을 포함합니다. 예를 들어, 실험자가 당면한 문제에 대해 추가적인 지식을 가지고 있어 모수에 대한 자신의 신념을 나타내는 사전분포를 사용할 수 있습니다.
사전분포 민감도 분석
사전분포 민감도 분석은 베이즈 모형화 과정에서 중요한 단계입니다. 이는 서로 다른 사전 가정이 통계 분석 결과에 미치는 영향을 검토하고 평가하는 것을 말합니다. 다시 말해, 이러한 분석은 베이즈 추론에서 도출된 결론이 사전분포의 선택에 대해 강건한지를 확인하는 것을 목표로 합니다. 그럴듯한 여러 사전분포를 탐색함으로써, 실험자는 사전분포의 선택이 최종 결과에 얼마나 영향을 미치는지, 그리고 서로 다른 사전 가정하에서도 그 결론이 일관되게 유지되는지에 대한 통찰을 얻을 수 있습니다.
예를 들어, 사전분포는 사후 추정값에 상당한 영향을 미쳐 서로 다른 결론으로 이어질 수 있습니다. 이들 중 일부는 주관적이거나(즉, 정보적 사전분포) 전문가 지식에 기반할 수 있으며, 이러한 가정의 영향을 평가하는 것은 분석의 투명성과 객관성을 높입니다.
9.3 켤레 분포족
9.3절에서는 다음 내용을 학습합니다.
- 켤레 분포족의 세 가지 구체적인 부류를 설명합니다.
- 켤레 분포를 사용하여 모수의 사후분포를 구합니다.
- 켤레 분포족 모형의 장단점을 이해합니다.
베이즈 통계학에서 사후분포가 사전분포와 같은 분포에서 나오는 경우, 그 사전분포와 사후분포를 켤레 분포(conjugate distributions) 사후분포와 사전분포가 같은 분포족에 속하게 되는 분포입니다.라고 합니다. 일반적으로 사후분포와 사전분포는 비슷한 형태를 가지지만 모수는 서로 다르다는 점에 유의하십시오.
그런데 왜일까요? 켤레 분포족이 역사적으로 그토록 널리 사용되어 온 이유는 크게 두 가지입니다.
- 계산 측면에서 사용하기 쉽습니다. 대부분의 켤레 분포족에서는 사후분포를 닫힌 형태로 구할 수 있으므로, 컴퓨팅 자원을 이용할 수 없더라도 이 부류의 모형을 쉽게 사용할 수 있습니다.
- 해석하기 쉬운 경향이 있습니다. 사후분포는 데이터와 사전분포 사이의 절충입니다. 사전분포와 사후분포가 같은 분포족에 속하되—모수만 다르므로—데이터가 우리의 초기 가정을 어떻게 바꾸었는지 이해하고 정량화할 수 있습니다.
9.3.1 베타–이항 켤레 분포족
이 책에서 살펴보는 첫 번째 켤레 분포족은 베타-이항 족입니다. \(\mathbf{X} = (X_1, X_2, ... X_m)\)이 \[ X_i = \begin{cases} 1 & \text{if success} \\ 0 & \text{if failure} \end{cases} , \] 을 만족하는 iid 베르누이 확률변수의 표본이고, 각각의 확률이 \(q\)와 \(1-q\)라고 합시다. 또한 실현된 성공 횟수의 합을 \(x = \sum_{i=1}^m x_i\)로 정의합시다.
기초 확률론으로부터 \(X = \sum_{i=1}^m X_i\)은 예제 9.1.1의 동전 던지기 경우와 마찬가지로 \([0,1]\)에서 미지의 성공 확률 \(q\)을 갖는 이항분포(즉, \(m\)번의 베르누이 시행에서의 성공 횟수 \(x\))를 따르며, 가능도함수는 \[ p_{\mathbf{X}|Q=q}(\mathbf{x}) = \binom{m}{x} q^x (1-q)^{m-x}, \quad x \in \{0,1,...,m\}, \] 로 주어진다는 것을 알 수 있습니다. 여기서 \(x = \sum_{i=1}^m x_i\)입니다. 후자는 우리의 증거를 나타냅니다. 그런 다음, 이를 통상적인 켤레 사전분포인 모수 \(a\)와 \(b\)를 갖는 베타분포와 결합합니다. 베타분포의 pdf는 다음과 같이 주어집니다. \[ f_{Q}(q) = \frac{\Gamma(a+b)}{\Gamma(a)\Gamma(b)} q^{a-1} (1-q)^{b-1}, \quad q \in [0,1], \] 여기서 \(a\)와 \(b\)는 베타분포의 형상모수입니다.19
이제 사전분포(베타)와 가능도함수(이항)를 결합하여 사후분포를 얻을 수 있습니다.
명제 9.3.1. 베타-이항 켤레 분포족. 각각 성공 확률이 \(q\)인 \(m\)개의 iid 베르누이 실험 \((X_1,X_2,...,X_m)\)으로 이루어진 표본을 생각해 봅시다. 나아가 성공 확률과 연관된 확률변수 \(Q\)가 형상모수 \(a\)와 \(b\)를 갖는 베타 사전분포를 따른다고 가정합니다. 따라서 \(Q\)의 사후분포는 \[ f_{Q|\mathbf{X}=\mathbf{x}}(q) = \frac{\Gamma(a+b+m)}{\Gamma(a+x)\Gamma(b+m-x)} q^{a+x-1} (1-q)^{b+m-x-1}, \] 로 주어지며, 여기서 \(x = \sum_{i=1}^m x_i\)이고, 이는 형상모수 \(a+x\)와 \(b+m-x\)를 갖는 베타분포입니다.
이론 일부 보기
모수 대 초모수. 이러한 맥락에서 \(a\)와 \(b\)를 초모수(hyperparameters) 초모수는 사전분포의 분포를 정의하는 모수입니다., 즉 사전분포의 모수라고 부릅니다. 이는 기저 모형의 모수(즉, 베타–이항족에서의 \(q\))와는 다릅니다. 초모수는 일반적으로 실험자가 가정하고 결정하는 반면, 베이즈 맥락에서 기저 모형 모수는 확률적입니다.
예제 9.3.1. 보험계리사 시험 문제. 다음이 주어져 있습니다.
한 보험계약자의 \(i\)년도 연간 청구 건수는 다음 pmf를 갖는 이항분포를 따릅니다. \[ p_{X_i|Q=q}(x_i) = \binom{2}{x} q^{x_i} (1-q)^{2-x_i}, \quad x_i \in \{ 0, 1, 2\}. \]
사전분포는 \[ f_Q(q) = 4 q^3, \quad q \in [0,1]. \] 입니다. 이 보험계약자는 1년도와 2년도에 각각 한 건의 청구가 있었습니다. 3년도의 기대 청구 건수에 대한 베이지안 추정값을 계산하십시오.20
예제 풀이 보기
예제 9.3.2. 베타 사전분포가 사후분포에 미치는 영향. 서로 다른 베타 초모수가 사후분포에 미치는 영향을 살펴보고자 합니다. 각 보험증권의 청구 빈도가 확률 \(q\)를 갖는 베르누이 확률변수를 따라 \[ p_{X_i|Q=q}(x_i) = q^{x_i} (1-q)^{1-x_i}, \quad x_i \in \{0,1\}, \] 이라고 가정하고(여기서 \(q \in [0,1]\)), 다음 두 가지 초모수 집합을 생각해 봅시다.
- 집합 1: \(a = 1\) 및 \(b=10\).
- 집합 2: \(a = 2\) 및 \(b=2\).
그림 9.8은 이 두 사전분포의 pdf를 보여 줍니다. 첫 번째 사전분포는 \(\frac{1}{11}\)이라는 작은 사전 평균 빈도를 가정하는 반면, 두 번째 사전분포의 평균은 \(\frac{1}{2}\)입니다.
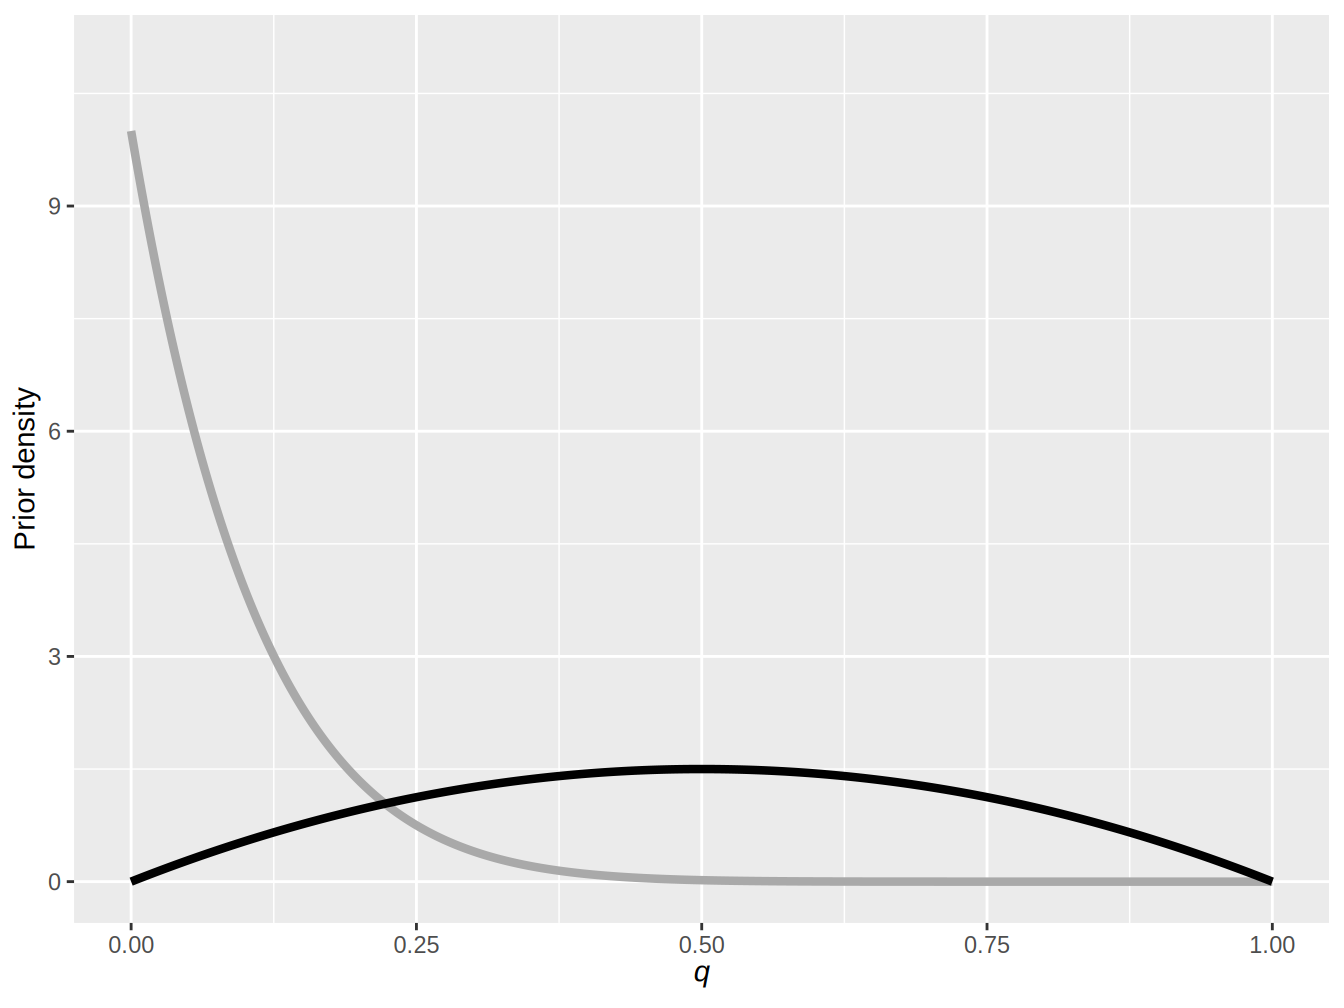
그림 9.8: 베타 사전밀도: \(a=1\) 및 \(b=10\) (회색), 그리고 \(a=2\) 및 \(b=2\) (검은색)
싱가포르 보험 데이터셋의 처음 100행을 다시 사용하여(이 데이터셋에 대한 자세한 내용은 예제 9.1.4를 참고하십시오) 두 사후분포를 구하십시오.
예제 풀이 보기
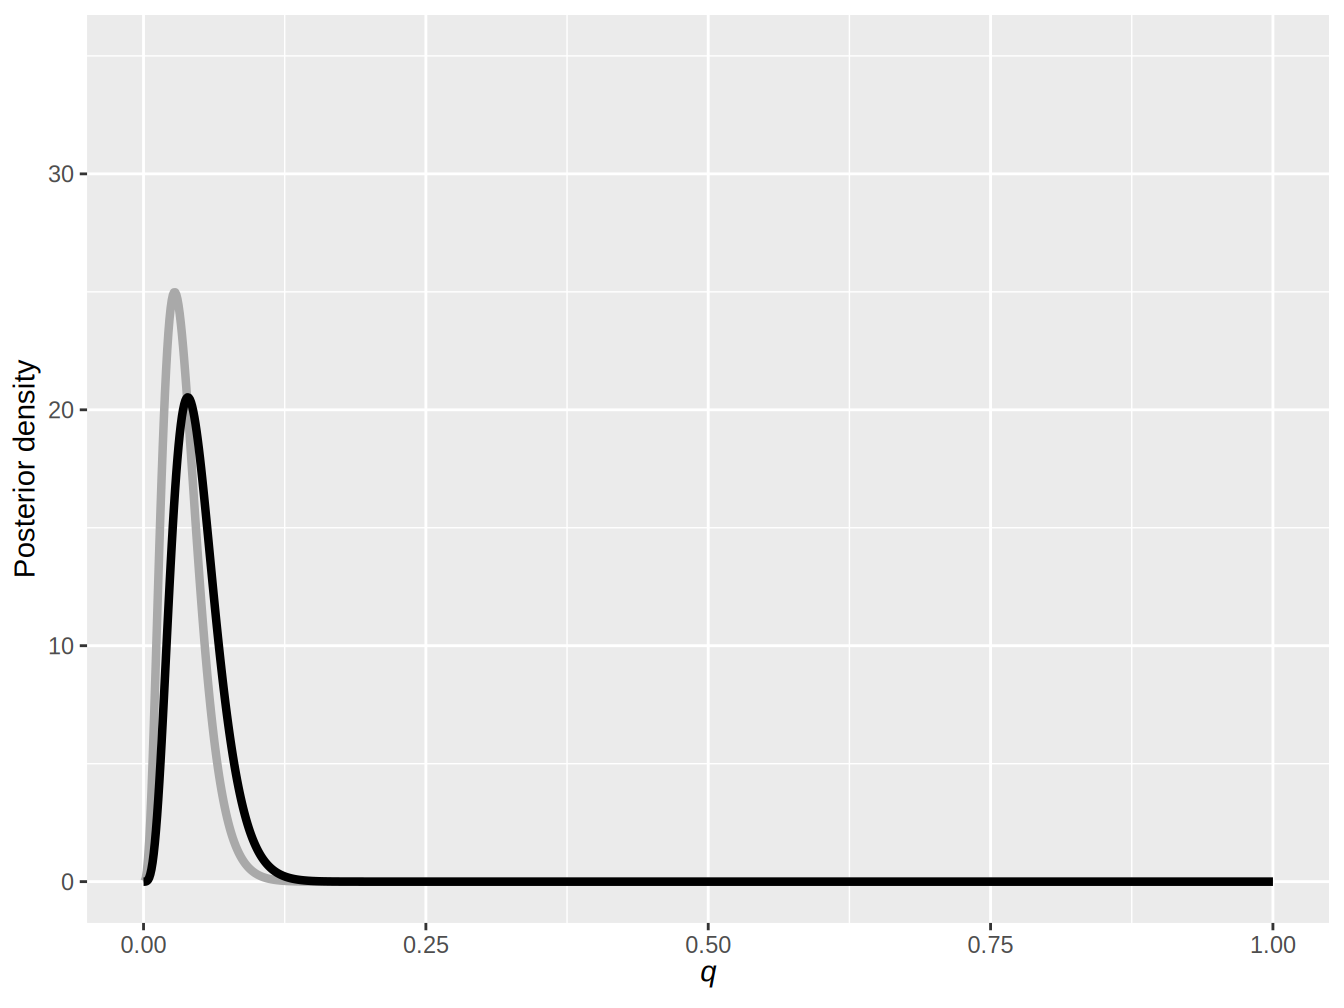
사전분포(및 그 초모수)는 사후분포에 분명히 영향을 미칩니다. 베타 사전분포에 대한 일반적인 경험 법칙으로, \(a\)가 클수록 \(q\)의 큰 값에 더 많은 가중치를 두고, \(b\)가 클수록 \(q\)의 작은 값에 더 많은 가중치를 둡니다.
9.3.2 감마-포아송 켤레 분포족
이제 두 번째 켤레 분포족인 감마-포아송 족을 소개합니다. \(\mathbf{X} = (X_1, X_2, ..., X_n)\)을 \[ p_{X_i|\Lambda=\lambda}(x_i) = \frac{\lambda^{x_i}\, e^{-\lambda}}{x_i!}, \quad x_i \in \mathbb{R}_+ . \] 를 만족하는 iid 포아송 확률변수의 표본이라고 합시다. 그러면 이 표본과 관련된 가능도함수는 \[ f_{\mathbf{X}|\Lambda=\lambda}(\mathbf{x}) = \prod_{i=1}^n p_{X_i|\Lambda=\lambda}(x_i) = \prod_{i=1}^n \frac{\lambda^{x_i}\, e^{-\lambda}}{x_i!} = \frac{\lambda^x \, e^{-n\lambda}}{\prod_{i=1}^n x_i !} \propto \lambda^x \, e^{-n\lambda}, \] 로 주어지며, 여기서 \(x = \sum_{i=1}^n x_i\)입니다. \(\lambda\)의 함수로서 이 가능도함수의 형태는 감마분포를 연상시키며, 이는 이 분포가 켤레 사전분포의 좋은 후보가 될 수 있음을 시사합니다. 실제로 사전분포를 형태 초모수 \(\alpha\)와 척도 초모수 \(\theta\)를 갖는 감마분포라고 하면, \[ f_{\Lambda}(\lambda) = \frac{1}{\Gamma(\alpha)\theta^{\alpha}} \lambda^{\alpha-1} \, e^{-\frac{\lambda}{\theta}}, \quad \lambda \in \mathbb{R}_+, \] \(\lambda\)의 사후분포 역시 감마분포임을 보일 수 있습니다.
명제 9.3.2. 감마-포아송 켤레 분포족. 각각 비율 모수가 \(\lambda\)인 \(n\)개의 iid 포아송 실험 \((X_1,X_2,...,X_n)\)으로 이루어진 표본을 생각해 봅시다. 또한 비율과 관련된 확률변수 \(\Lambda\)가 형태 초모수 \(\alpha\)와 척도 초모수 \(\theta\)를 갖는 감마분포를 사전분포로 갖는다고 가정합시다. 따라서 \(\Lambda\)의 사후분포는 \[ f_{\Lambda|\mathbf{X}=\mathbf{x}}(\lambda) = \frac{1}{\Gamma(\alpha+x)\left(\frac{\theta}{n\theta+1} \right)^{\alpha+x}} \lambda^{\alpha+x-1} \, e^{-\frac{\lambda\,(n\theta+1)}{\theta}}, \] 로 주어지며, 여기서 \(x = \sum_{i=1}^n x_i\)이고, 이는 형상모수 \(\alpha+x\)와 척도모수 \(\tfrac{\theta}{n\theta+1}\)를 갖는 감마분포입니다.
이론 일부 보기
예제 9.3.3. 보험계리사 시험 문제. 다음이 주어져 있습니다:
- 임의의 피보험자가 한 달 동안 발생시키는 청구 건수는 평균이 \(\lambda\)인 포아송 분포를 따릅니다.
- 서로 다른 피보험자의 청구 빈도는 iid입니다.
- 사전분포는 다음 pdf를 갖는 감마분포입니다: \[ f_{\Lambda}(\lambda) = \frac{(100\lambda)^6}{120\lambda}e^{-100\lambda}, \quad \lambda \in \mathbb{R}_+. \]
- 매월 청구 건수는 다음과 같이 분포합니다: \[ \small{ \begin{matrix} \begin{array}{c|c|c} \hline \text{Month} & \text{Number of Insured} & \text{Number of Claims} \\ \hline \text{1} & 100 & 6 \\\hline \text{2} & 150 & 8 \\\hline \text{3} & 200 & 11 \\\hline \text{4} & 300 & ? \\\hline \end{array} \end{matrix} } \]
4월차의 기대 청구 건수를 계산하십시오.
예제 풀이 보기
9.3.3 정규-정규 켤레 분포족
마지막 켤레 분포족은 정규-정규 족입니다. \(\mathbf{X}=(X_1,X_2,...,X_n)\)을 \[ f_{X_i|M=\mu}(x_i) = \frac{1}{\sqrt{2\pi\sigma^2}}\exp\left( - \frac{1}{2} \frac{(x_i-\mu)^2}{\sigma^2} \right), \quad x_i \in \mathbb{R}. \] 을 만족하는 iid 정규 확률변수의 표본이라고 합시다. 또한 \(\mu\)에 초점을 맞추기 위해, 분석 전반에 걸쳐 분산 모수 \(\sigma^2\)는 알려져 있다고 가정하겠습니다.21 따라서 이 표본과 관련된 가능도함수는 다음과 같이 주어집니다. \[\begin{align*} f_{\mathbf{X}|M=\mu}(\mathbf{x}) =&\, \prod_{i=1}^n f_{X_i|M=\mu}(x_i) \\ =&\, \left( \frac{1}{\sqrt{2\pi\sigma^2}} \right)^n \exp\left( - \frac{1}{2} \sum_{i=1}^n \frac{(x_i-\mu)^2}{\sigma^2} \right) \\ \propto&\, \exp\left( - \frac{1}{2} \sum_{i=1}^n \frac{(x_i-\mu)^2}{\sigma^2} \right). \end{align*}\]
가능도 구조와 잘 맞는 매우 자연스러운 사전분포는 당연하게도 정규분포입니다. \(\mu\)에 대한 사전분포가 \[ f_{M}(\mu) = \frac{1}{\sqrt{2\pi \tau^2}} \exp\left( -\frac{1}{2} \frac{(\mu-\theta)^2}{\tau^2} \right), \] 로 주어진다고 가정합시다. 여기서 \(\theta\)는 평균 모수이고 \(\tau^2\)는 분산 모수입니다. 그러면 \(\mu\)의 사후분포 역시 정규분포로 주어진다는 것을 쉽게 보일 수 있습니다.
명제 9.3.3. 정규-정규 켤레 분포족. 크기가 \(n\)인 iid 정규 표본 \((X_1,X_2,...,X_n)\)를 고려하십시오. 각 표본은 평균 모수 \(\mu\)와 알려진 분산 모수 \(\sigma^2\)를 갖습니다. 또한 평균과 관련된 확률변수 \(M\)가 평균 초모수 \(\theta\)와 분산 초모수 \(\tau^2\)를 갖는 정규분포를 사전분포로 갖는다고 가정합시다. 따라서 \(M\)의 사후분포는 \[ f_{M|\mathbf{X}=\mathbf{x}}(\mu) = \frac{1}{\sqrt{2\pi\left( \frac{\tau^2\sigma^2}{n\tau^2 +\sigma^2} \right)} } \exp\left( - \frac{1}{2} \frac{ \left( \mu - \left( \frac{x}{n} \frac{\tau^2}{n\tau^2 +\sigma^2} + \theta \frac{\sigma^2}{n\tau^2 +\sigma^2} \right) \right)^2 }{ \frac{\tau^2\sigma^2}{n\tau^2 +\sigma^2} } \right), \] 로 주어지며, 여기서 \(x = \sum_{i=1}^n x_i\)입니다. 이는 평균 모수가 \[ \frac{x}{n} \frac{n\tau^2}{n\tau^2 +\sigma^2} + \theta \frac{\sigma^2}{n\tau^2 +\sigma^2} \] 이고 분산 모수가 다음과 같은 정규분포입니다. \[ \frac{\tau^2\sigma^2}{n\tau^2 +\sigma^2}. \]
이론 일부 보기
정규-정규 켤레 분포족에서 사전분포의 초모수와 사후분포의 모수는 다음과 같이 해석할 수 있습니다.
- 사전분포의 경우, \(\theta\)는 평균 모수의 사전적 값을 나타내며, \(\tau^2\)는 그 사전 평균의 정밀도(precision) 정밀도(precision)는 분산의 역수이며, 사전분포나 사후분포의 불확실성 또는 변동성의 정도를 정량화하는 데 흔히 사용됩니다.와 관련이 있습니다(즉, 값이 클수록 사전 평균의 정밀도가 낮아지며, 그 반대도 마찬가지입니다).
- 사후분포에서 새로운 평균 모수는 사전 평균 모수 \(\theta\)와 표본평균 \(\tfrac{x}{n}\)의 가중평균입니다. 새로운 분산 모수는 사전 변동성 \(\tau^2\)와 데이터의 변동성 \(\sigma^2\)에 의해 결정됩니다.
예제 9.3.4. 정규 사전분포가 사후분포에 미치는 영향. 소규모 보험계약 포트폴리오에 대해 다음과 같은 자동차 청구가 관측되었다고 가정합시다. \[ 1050, \quad\quad 1250, \quad\quad 1550, \quad\quad 2600, \quad\quad 5350, \quad\quad 10200. \] 또한 청구액의 로그가 모수 \(\mu\)와 \(\sigma^2 = 1\)를 갖는 정규분포를 따른다고 가정합시다. \(\theta = 7\)인 정규 사전분포에 대해 평균 모수 \(\mu\)의 사후분포를 구하십시오. \(\tau^2\)의 여러 값, 즉 \(\tau^2 = 0.1\), \(\tau^2 = 1\), \(\tau^2 = 10\)를 고려하십시오. 그림 9.10은 이 세 사전분포의 pdf를 보여 줍니다.
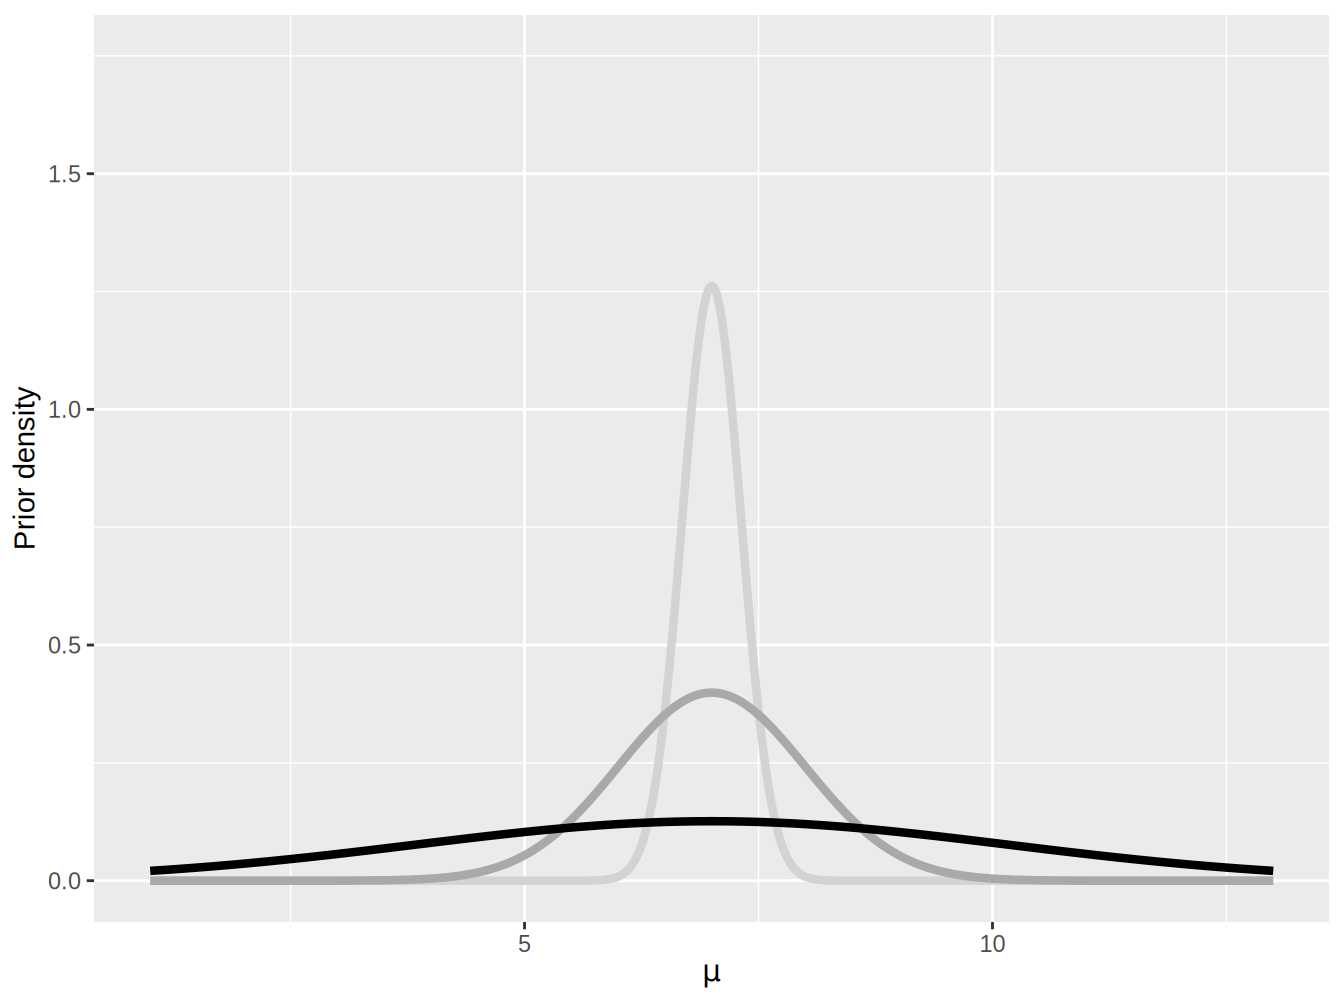
그림 9.10: 정규 사전밀도: \(\tau^2 = 0.1\) (연회색), \(\tau^2=1\) (회색), \(\tau^2 = 10\) (검은색)
예제 풀이 보기
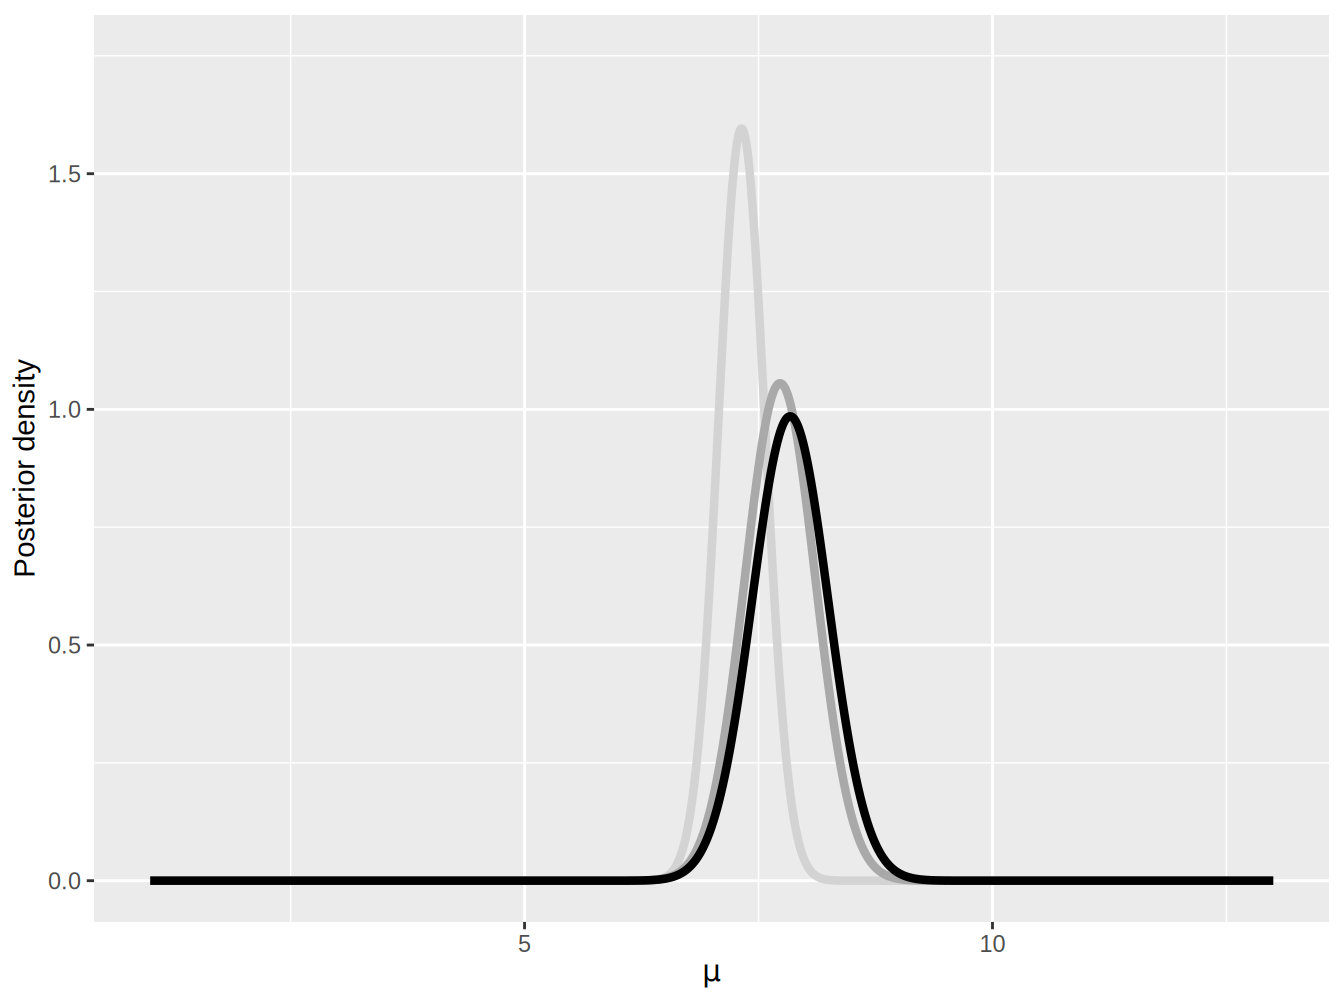
흥미롭게도, 예제 9.3.4에서 보듯이 사전분포는 최종 사후분포에 어느 정도 영향을 미칠 수 있습니다. 평균에 대한 사전 가정이 매우 정밀한 경우, 몇 개의 데이터 점만으로는 사전분포와 사후분포 사이에 큰 차이가 생기지 않습니다(그림 9.10과 9.11의 연회색 곡선을 참조하십시오). 반면에 사전분포가 매우 부정밀한 경우에는 데이터가 스스로 말하게 되며, 사후분포는 사전분포와 상당히 다를 수 있습니다.
9.3.4 켤레 분포족 모형에 대한 비판
켤레 분포족 모형은 해석이 쉽고 계산이 간단하다는 등의 장점이 있지만, 다음과 같은 몇 가지 한계도 있습니다.
- 켤레 분포족은 연구 대상 데이터를 정확하게 모형화하는 능력보다는 수학적 편리성 때문에 선택되는 경우가 많습니다. 이로 인해 모형이 지나치게 단순해지고 실제 현상을 모형화하는 데 필요한 유연성이 부족해질 수 있습니다.
- 켤레 분포족 모형은 사전분포의 선택에 의존하며, 켤레가 아닐 수도 있는 사전분포를 다르게 선택하면 매우 다른 사후분포가 도출될 수 있습니다.
- 켤레 분포족 모형은 좁은 범위의 문제에만 적용할 수 있으므로 실제 응용에서의 유용성이 제한됩니다.
켤레 분포족 모형에는 한계가 있지만, 특정 상황, 특히 모형의 가정이 잘 이해되어 있고 데이터가 비교적 단순한 경우에는 여전히 유용할 수 있다는 점에 유의해야 합니다.
9.4 사후 시뮬레이션
9.4절에서는 다음 방법을 배웁니다.
- 베이즈 통계학의 표준 계산 도구를 사용합니다.
- 마르코프 연쇄의 수렴을 진단합니다.
9.4.1 마르코프 연쇄 몬테카를로 방법 소개
때로는 켤레 분포족 모형을 사용하는 것이 당면한 문제에 적합하지 않아 더 복잡한 사전분포를 선택해야 합니다. 또 다른 상황에서는 복잡한 모형에 많은 모수가 포함되어 사후분포를 다루기 어려워집니다. 이러한 경우 일반적으로 모수의 사후분포는 닫힌 형태의 해를 갖지 않으므로 수치적 방법을 통해 추정해야 합니다.
모수의 사후분포로부터 표본을 생성하는 일반적인 방법은 정상분포, 즉 마르코프 연쇄가 전이확률이 더 이상 시간에 따라 변하지 않는 상태에 도달했을 때 변하지 않고 유지되는 확률분포가 관심 대상인 사후분포와 일치하는 마르코프 연쇄를 만드는 것입니다. 이러한 마르코프 연쇄 기반 방법은 문헌에서 마르코프 연쇄 몬테카를로(MCMC) 방법으로 알려져 있습니다. 이 절에서는 이러한 방법과 그 용도를 간략히 개관합니다. 이러한 방법의 이론을 자세히 다루려면 마르코프 연쇄와 그 이론에 대한 깊은 이해가 필요하므로, 여기서는 그 이론을 많이 다루지 않을 것입니다.22 대신 보험 및 손실 모형화에서의 응용에 초점을 맞춥니다. 구체적으로, 다음 두 소절에서는 가장 일반적인 두 가지 MCMC 방법, 즉 Gelfand and Smith (1990)의 깁스 샘플러(Gibbs sampler) 깁스 샘플러(Gibbs sampler)는 복잡한 확률분포로부터 표본을 시뮬레이션하는 데 사용되는 통계학의 반복 알고리즘입니다. 깁스 표집기는 다른 변수들을 고정한 채 한 번에 하나의 변수씩 갱신하는 방식으로 다변량 분포에서 표본을 추출할 수 있으므로, 베이즈 분석에서 특히 유용합니다.와 Hastings (1970) 및 Metropolis et al. (1953)의 메트로폴리스–헤이스팅스 알고리즘(Metropolis–Hastings algorithm) 메트로폴리스–헤이스팅스 알고리즘은 새로운 표본을 제안하고 이를 채택할지 결정하는 방식으로 복잡한 분포에서 표본을 생성하는 방법이며, 이 덕분에 베이즈 분석과 복잡한 모형화에 유용합니다.을 소개합니다.
9.4.2 깁스 샘플러
앞서 언급했듯이, 때로는 켤레 분포족을 사용할 수 없습니다. 모수 공간이 큰 다른 경우에는 주변 가능도 \(f_{\mathbf{X}}(\mathbf{x})\)(정규화 상수라고도 함)를 구하기가 매우 어려울 수 있습니다. 즉, 모형 모수가 \(\pmb{\theta} = [\, \theta_1 \quad ... \theta_2 \quad ... \quad \theta_k \,]\)로 주어지고 모수의 개수가 \(k\)라고 가정하면, 주변 가능도는 다음과 같이 주어집니다.
\[ f_{\mathbf{X}}(\mathbf{x}) = \int \int ... \int f_{\mathbf{X}|\pmb{\Theta} = \pmb{\theta}} (\mathbf{x}) f_{\pmb{\Theta}}(\pmb{\theta}) \, d\theta_1 \,d\theta_2 \,... \,d\theta_k \]
일반적인 구적법 기반 규칙을 사용하더라도 계산하기 어려우며, 특히 \(k\)가 클 때 그렇습니다.
다행히 매우 완화된 정칙 조건하에서는, 다른 모든 모수를 고정한 채 각 모수를 하나씩 순차적으로 표본추출함으로써 모수의 결합 추정값에 대한 표본을 얻을 수 있습니다. 이를 위해서는 다른 모든 모수(및 데이터)가 주어졌을 때 임의의 한 모수의 조건부 분포를 알아야 합니다. 이러한 분포를 완전 조건부 분포라고 합니다. 즉,
\[ f_{\Theta_i \,|\, \mathbf{X} = \mathbf{x}, \, \pmb{\Theta}_{\backslash i} = \pmb{\theta}_{\backslash i}} (\theta_i), \]
모수 \(\theta_i\)에 대한 것이며, 여기서 \(\pmb{\theta}_{\backslash i}\)는 \(i^{\text{th}}\)번째 모수를 제외한 모든 모수를 나타내고, \(\pmb{\Theta}_{\backslash i}\)는 이 모수 집합에 대응하는 확률변수입니다.
완전 조건부 분포는 깁스 표본추출의 중요한 구성 요소입니다. 실제로 다른 모든 모수의 값이 주어졌을 때 각 모수의 조건부 분포를 닫힌 형태로 얻을 수 있다면, 각 모수에 대한 표본을 생성할 수 있습니다. 구체적으로, 임의의 시작값 집합 \(\pmb{\theta}^{(0)}_{\vphantom{2}} = [ \, {\theta}_1^{(0)} \quad {\theta}_2^{(0)} \quad ... \quad {\theta}_k^{(0)} \, ]\)에서 출발하여 \(m = 1, 2, ..., M\)에 대해 다음 단계를 수행함으로써 각 모수에 대한 표본을 생성할 수 있습니다.
- \(f_{\Theta_1^{\vphantom{(m)}} \, |\, \mathbf{X} = \mathbf{x}, \, \Theta_2^{\vphantom{(m)}} = \, \theta_2^{(m-1)}, \,..., \, \Theta_k^{\vphantom{(m)}} = \, \theta_k^{(m-1)}} (\theta_1)\)에서 \(\theta^{(m)}_1\)를 추출합니다.
- \(f_{\Theta_2^{\vphantom{(m)}} \, |\, \mathbf{X} = \mathbf{x}, \, \Theta_1^{\vphantom{(m)}} = \, \theta_1^{(m)}, \, \Theta_3^{\vphantom{(m)}} = \,\theta_3^{(m-1)}, \,..., \, \Theta_k^{\vphantom{(m)}} = \,\theta_k^{(m-1)}} (\theta_2)\)에서 \(\theta^{(m)}_2\)를 추출합니다.
- \(f_{\Theta_3^{\vphantom{(m)}} \, |\, \mathbf{X} = \mathbf{x}, \, \Theta_1^{\vphantom{(m)}} =\, \theta_1^{(m)}, \, \Theta_2^{\vphantom{(m)}} =\, \theta_2^{(m)}, \, \Theta_4^{\vphantom{(m)}} = \,\theta_4^{(m-1)}, \,..., \, \Theta_k^{\vphantom{(m)}} =\, \theta_k^{(m-1)}} (\theta_3)\)에서 \(\theta^{(m)}_3\)을 추출합니다.
\(~~\vdots\)
\(k\). \(f_{\Theta_k^{\vphantom{(m)}} \, |\, \mathbf{X} = \mathbf{x}, \, \Theta_1^{\vphantom{(m)}} =\, \theta_1^{(m)}, \,..., \, \Theta_{k-1}^{\vphantom{(m)}} = \,\theta_{k-1}^{(m)}} (\theta_k)\)에서 \(\theta^{(m)}_k\)을 추출합니다.
표본은 특히 초기에 초깃값 \(\pmb{\theta}^{(0)}_{\vphantom{2}}\)에 의존하며, 샘플러가 정상분포에 도달하기까지 시간이 걸릴 수 있습니다. 이러한 이유로 실무에서는 분석이 초기 모수의 선택에 영향을 받지 않도록 처음 \(M^*\)번의 반복을 버립니다. 이처럼 표본을 버리는 초기 구간을 번인(burn-in) 구간이라고 합니다.
나머지 표본, 즉 남은 \(M-M^*\)번의 반복은 사후분포와 관심 있는 각종 양을 추정하는 데 사용합니다.
베이지안 선형회귀에의 적용
통계학에서 가장 단순한 형태의 선형회귀는 스칼라 반응변수와 설명변수 사이의 관계를 모형화하는 방법입니다. 이 장에서는 전자를 \(i \in \{1, ..., n\}\)에 대해 \(x_i\)로, 후자를 \(i \in \{1,...,n\}\)에 대해 \(z_{i}\)으로 나타냅니다. 수학적으로 이 관계는 다음과 같이 쓸 수 있습니다.
\[ x_i = \alpha + \beta z_{i} + \varepsilon_i, \]
여기서 \(\varepsilon_i\)는 선형 관계에 오차가 생길 가능성을 반영하는 교란항입니다. 이 오차항은 일반적으로 평균이 0이고 분산이 \(\sigma^2\)인 정규분포를 따른다고 가정합니다.
일반적으로 계수 \(\alpha\)와 \(\beta\)는 알려져 있지 않으므로 추정해야 합니다. 실험자는 베이즈 통계를 이용하여 \(\sigma^2\)의 사후분포와 함께 모수 \(\alpha\)와 \(\beta\)의 사후분포를 구할 수 있습니다. 이 소절의 나머지 부분에서는 깁스 표본추출을 선형회귀에 적용하는 구체적인 사례를 살펴봅니다.
먼저 모수 값이 주어졌을 때의 조건부 가능도함수를 계산합니다. \[\begin{align*} f_{\mathbf{X}\,|\,A=\alpha,\, B=\beta,\,\Sigma^2=\sigma^2}(\mathbf{x})=&\, \prod_{i=1}^n \frac{1}{\sqrt{2\pi\sigma^2}} \exp\left( - \frac{\left( x_i - \alpha -\beta z_{i} \right)^{2}}{2 \sigma^2} \right) \\ =&\, \left( 2 \pi \sigma^2 \right)^{-\tfrac{n}{2}} \exp\left(- \frac{\sum_{i=1}^n \left( x_i - \alpha - \beta z_{i} \right)^{2}}{2 \sigma^2} \right), \end{align*}\] 이것이 사후분포를 구성하는 첫 번째 구성 요소입니다.
다음으로 사전분포가 필요한데, 이는 정보적, 약한 정보적, 또는 비정보적 사전분포일 수 있습니다. 이 적용에서는 각 모수의 완전 조건부 분포를 닫힌 형태로 얻을 수 있게 해 주는 사전분포를 선택합니다. 구체적으로 \(\alpha\)와 \(\beta\)에는 정규분포를, \(\sigma^2\)에는 형상모수가 \(\tfrac{n_{\sigma}}{2}\)이고 척도모수가 \(\tfrac{\theta_{\sigma}}{2}\)인 역감마분포를 사용합니다. 여기서 \[\begin{align*} f_{A}(\alpha) =&\, \frac{1}{\sqrt{2\pi \tau_{\alpha}^2\vphantom{2\pi \tau_{\beta}^2} }} \exp\left( - \frac{1}{2} \frac{(\alpha-\theta_{\alpha})^2}{\tau_{\alpha}^2 } \right), \\ f_{B}(\beta) =&\, \frac{1}{\sqrt{2\pi \tau_{\beta}^2 }} \exp\left( - \frac{1}{2} \frac{(\beta-\theta_{\beta})^2}{\tau_{\beta}^2 } \right), \\ f_{\Sigma^2}(\sigma^2) =&\, \frac{(\theta_{\sigma}/2)^{n_{\sigma}/2}}{\Gamma(n_{\sigma}/2)} \left( \frac{1}{\sigma^2} \right)^{n_{\sigma}/2+1} \exp\left( - \frac{\theta_{\sigma}/2}{\sigma^2} \right). \end{align*}\]
명제 9.4.1. 베이지안 선형회귀 모수의 완전 조건부 분포. \[ x_i = \alpha + \beta z_{i} + \varepsilon_i, \] 를 만족하는 \(n\)개의 관측값 \(\mathbf{x} = (x_1,...,x_n)\)로 이루어진 표본을 생각합시다. 여기서 \(\varepsilon_i\)는 평균이 0이고 분산이 \(\sigma^2\)인 정규분포를 따릅니다. 모수 \(\alpha\), \(\beta\), \(\sigma^2\)의 완전 조건부 분포는 다음 식으로 주어집니다. \[\begin{align*} A\sim&\, \text{Normal}\left( \frac{1}{n} \left(\sum_{i=1}^n x_i - \beta z_i \right) \frac{n \tau_{\alpha}^2}{n\tau_{\alpha}^2 + \sigma^2} + \theta_{\alpha} \frac{\sigma^2}{n\tau_{\alpha}^2+\sigma^2}, \frac{\tau_{\alpha}^2\sigma^2}{n\tau_{\alpha}^2+\sigma^2} \right), \\ B\sim&\, \text{Normal}\left( \frac{1}{n}\left( \sum_{i=1}^n z_i\left( x_i - \alpha \right) \right) \frac{n \tau_{\beta}^2}{\tau_{\beta}^2\sum_{i=1}^n z_i^2 + \sigma^2} + \theta_{\beta} \frac{\sigma^2}{\tau_{\beta}^2\sum_{i=1}^n z_i^2 +\sigma^2}, \frac{\tau_{\beta}^2\sigma^2}{\tau_{\beta}^2 \sum_{i=1}^n z_i^2 +\sigma^2} \right)\!, \\ \Sigma^2\sim &\, \text{Inverse Gamma}\left( \frac{n_{\sigma}+n}{2}, \frac{\theta_{\sigma} + \sum_{i=1}^n \left( y_i - \alpha - \beta z_{i} \right)^{2}}{2} \right), \end{align*}\]
각각 위에서 언급한 사전분포를 가정합니다.
이론 일부 보기
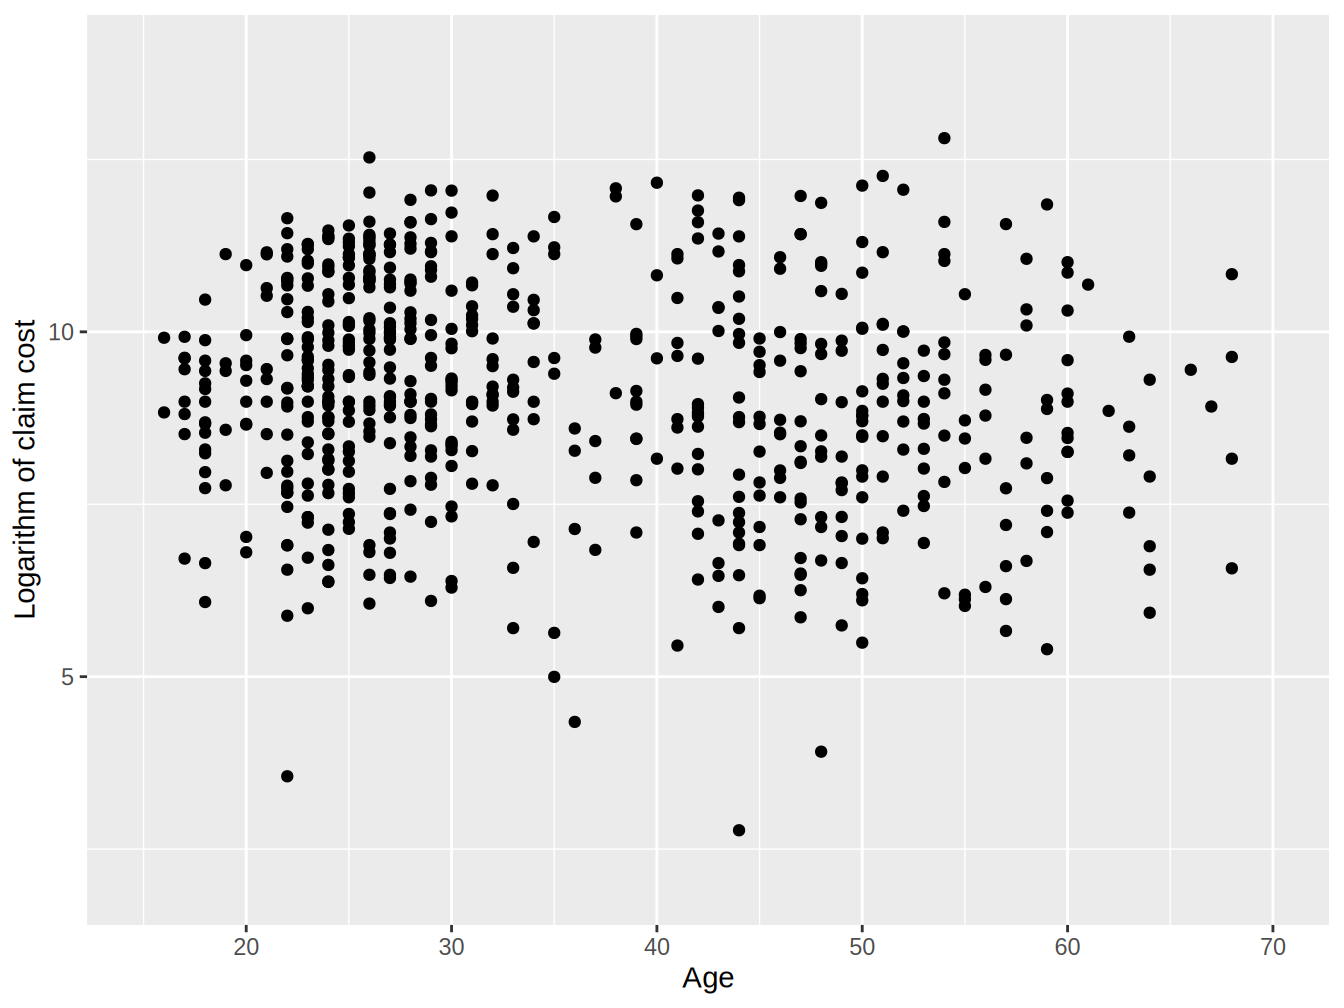
이제 실제 데이터에 깁스 샘플러를 적용합니다. 이 예제에서는 R 패키지 insuranceData의 dataOhlsson에서 가져온, 스웨덴 보험회사 Wasa의 오토바이 보험 데이터를 사용합니다. 자세한 내용은 Wolny-Dominiak and Trzesiok (2014)을 참조하십시오.
이 데이터셋에는 오토바이 사고 건수, 청구 비용, 그리고 몇 가지 위험 요인(예: 운전자의 나이, 차량의 연식, 지리적 구역)에 관한 정보가 담겨 있습니다.
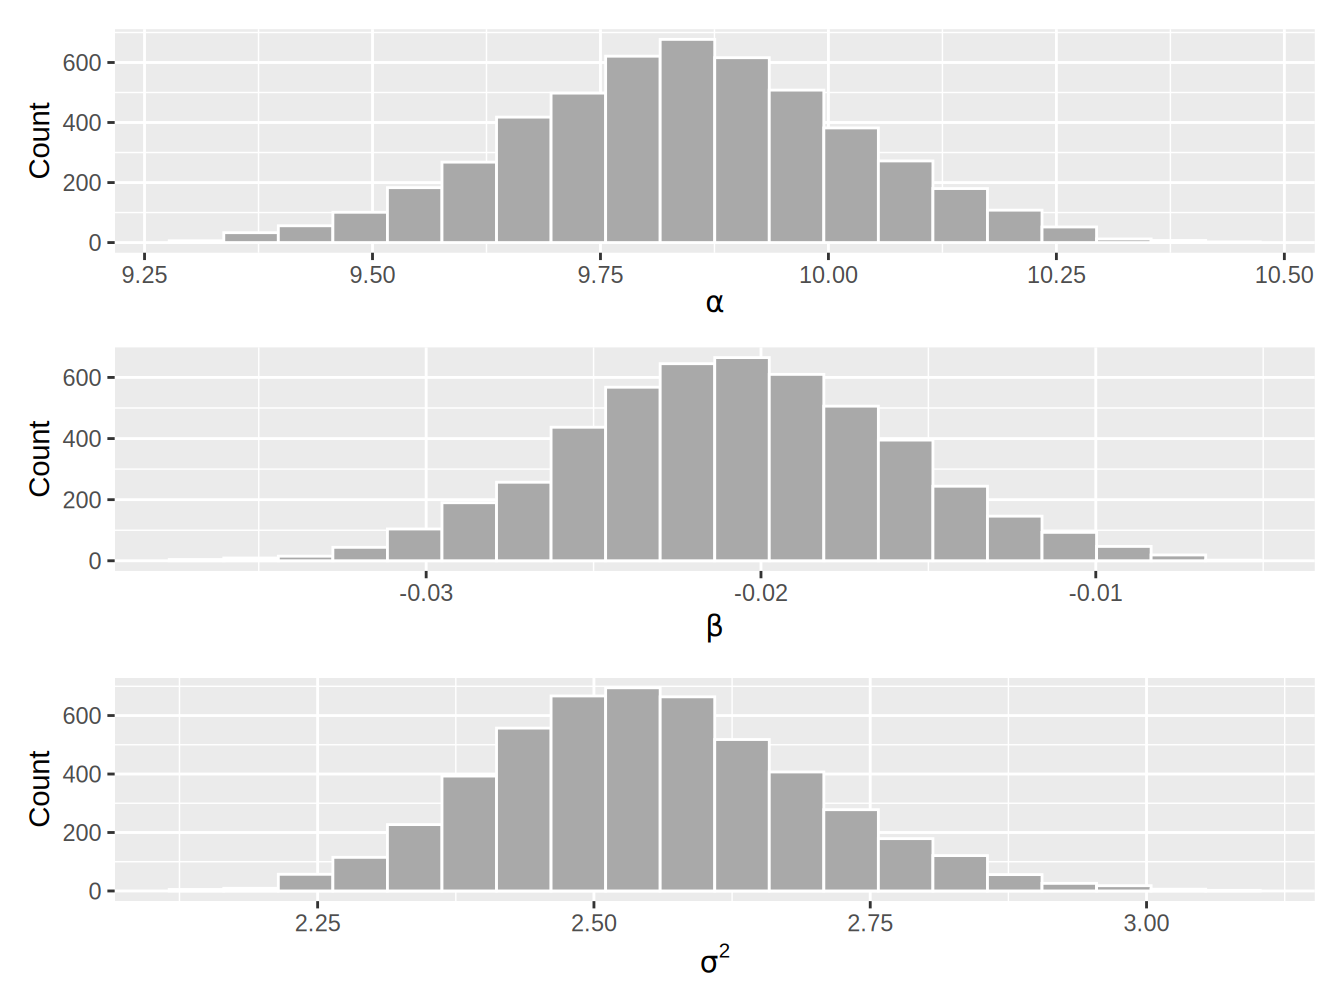
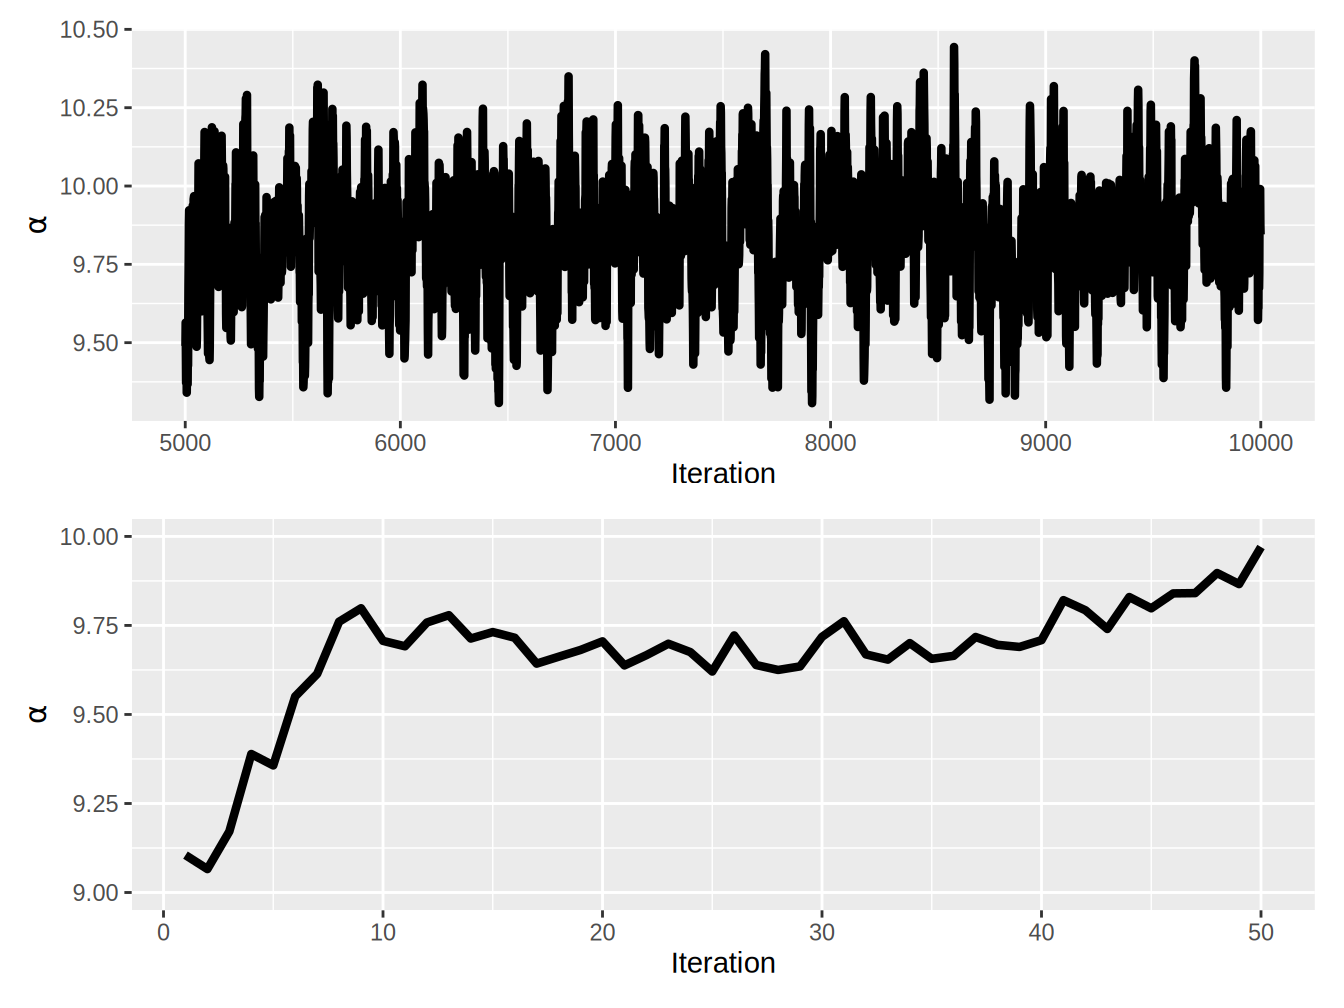
예제 9.4.1. 베이지안 선형회귀. 운전자의 나이와 청구 비용(의 로그) 사이의 관계를 파악하려고 합니다. \(x_i\)를 \(i^{\text{th}}\) 청구 비용의 로그라 하고, \(z_i\)를 \(i^{\text{th}}\) 청구와 관련된 나이라 합시다. 또한 두 양 사이에 다음과 같은 선형 관계를 가정합니다. \[ x_i = \alpha + \beta z_{i} + \varepsilon_i, \] 여기서 \(\varepsilon_i\)는 평균이 0이고 분산이 \(\sigma^2\)인 정규분포를 따릅니다. 깁스 샘플러를 사용하여 세 모수 \(\alpha\), \(\beta\), \(\sigma^2\)의 사후밀도를 구하십시오.
예제 풀이 보기
9.4.3 메트로폴리스–헤이스팅스 알고리즘
깁스 표본추출은 모형의 각 모수에 대한 완전 조건부 분포를 구할 수 있고 그 분포가 흔히 쓰이는 형태일 때 잘 작동합니다. 안타깝게도 이것이 항상 가능한 것은 아니며, 이 경우 모수의 사후분포를 구하기 위해 다른 계산 도구에 의존해야 합니다. 깁스 방법의 단점을 보완하는 매우 널리 쓰이는 방법 중 하나는 메트로폴리스–헤이스팅스 샘플러입니다.
첫 번째 모형 모수의 현재 값이 \(\theta_1^{(0)}\)라고 가정합시다. 이제 이 현재 값으로부터 이 모수의 새로운 값을 구하고자 합니다. 이를 위해 후보(또는 제안) 밀도 \(q\left( \theta_1^* \,\middle|\, \theta_1^{(0)} \right)\)로부터 이 모수의 새로운 값 \(\theta^*_1\)를 제안합니다. 이 제안은 모수의 사후분포와 아무런 관련이 없으므로 모든 후보를 최종 표본에 남겨서는 안 됩니다—관심 대상인 사후분포를 대표하는 표본만 채택합니다. 후보를 채택할지 기각할지 결정하기 위해 \[ \alpha\left(\theta_1^{(0)},\theta_1^*\right) = \frac{h\left(\theta_1^*\vphantom{\theta_1^{(1)}}\right) q\left( \theta_1^{(0)} \,\middle|\,\theta_1^* \right)}{h\left(\theta_1^{(1)}\right) q\left( \theta_1^* \,\middle|\, \theta_1^{(0)} \right)} \] 를 사용하여 이른바 채택 비율 \(\alpha\left( \theta_1^{(0)}, \theta_1^* \right)\)를 계산합니다. 여기서 \[ h(\theta_1) = f_{\mathbf{X}\,|\,\Theta_1 = \,\theta_1, \, \pmb{\Theta}_{\backslash1}=\,\pmb{\theta}_{\backslash1}}(\mathbf{x}) \, f_{\Theta_1,\pmb{\Theta}_{\backslash1}}\left(\theta_1,\pmb{\theta}_{\backslash1}\right) \] 이고 \(\pmb{\theta}_{\backslash 1}\)는 첫 번째 모수를 제외한 모든 모수를 나타냅니다. 그런 다음 제안된 값 \(\theta_1^*\)를 확률 \(\alpha\left( \theta_1^{(0)}, \theta_1^* \right)\)로 채택하고 확률 \(1-\alpha\left( \theta_1^{(0)}, \theta_1^* \right)\)로 기각합니다. 구체적으로, \[ \theta_1^{(1)} = \left\{ \begin{array}{ll} \theta_1^* & \text{with probability }\,\alpha\left(\theta_1^{(0)},\theta_1^*\right) \\ \theta_1^{(0)} &\text{with probability }\,1-\alpha\left(\theta_1^{(0)},\theta_1^*\right) \end{array} \right. \] 체인에서 모수 \(\pmb{\theta}_{\backslash i}\)를 가장 최근 값으로 대체하면서 나머지 모든 모수에 대해 같은 과정을 반복하여 \(\theta_2^{(1)}\)부터 \(\theta_k^{(1)}\)까지 구할 수 있습니다. 모든 값을 갱신하고 나면, 깁스 샘플러에서 사용한 반복 과정과 마찬가지로 \(\{2,3,...,M\}\)의 모든 \(m\)에 대해 이 과정을 반복할 수 있습니다.23
특수한 경우: 대칭 제안분포. 제안분포가 대칭이면 \[ q\left( \theta_i^{(m)} \,\middle|\,\theta_i^* \right) = q\left( \theta_i^* \,\middle|\,\theta_i^{(m)} \right), \] 이므로 해당 항들이 상쇄되어 \[ \alpha\left(\theta_i^{(m)},\theta_1^*\right) = \frac{h\left(\theta_i^*\vphantom{\theta_1^{(1)}}\right)}{h\left(\theta_i^{(m)}\right) }. \] 만 남습니다. 이 특수한 경우를 메트로폴리스 알고리즘이라고 합니다.
일반적으로 말해 메트로폴리스–헤이스팅스 샘플러는 실험자가 각 모수에 대해 제안분포를 선택해야 하므로 많은 미세 조정이 필요합니다. 일반적인 접근법은 이전 값을 중심으로 하는 정규 제안분포를 가정하는 것입니다. 즉, 단계 \(m\)에서 \[ \Theta_i^* \sim \text{Normal}\left( \theta_i^{(m-1)} , \delta_i^2 \right), \] 이며, 여기서 \(\delta_i^2\)는 \(i^{\text{th}}\) 모수의 제안분포의 분산입니다.
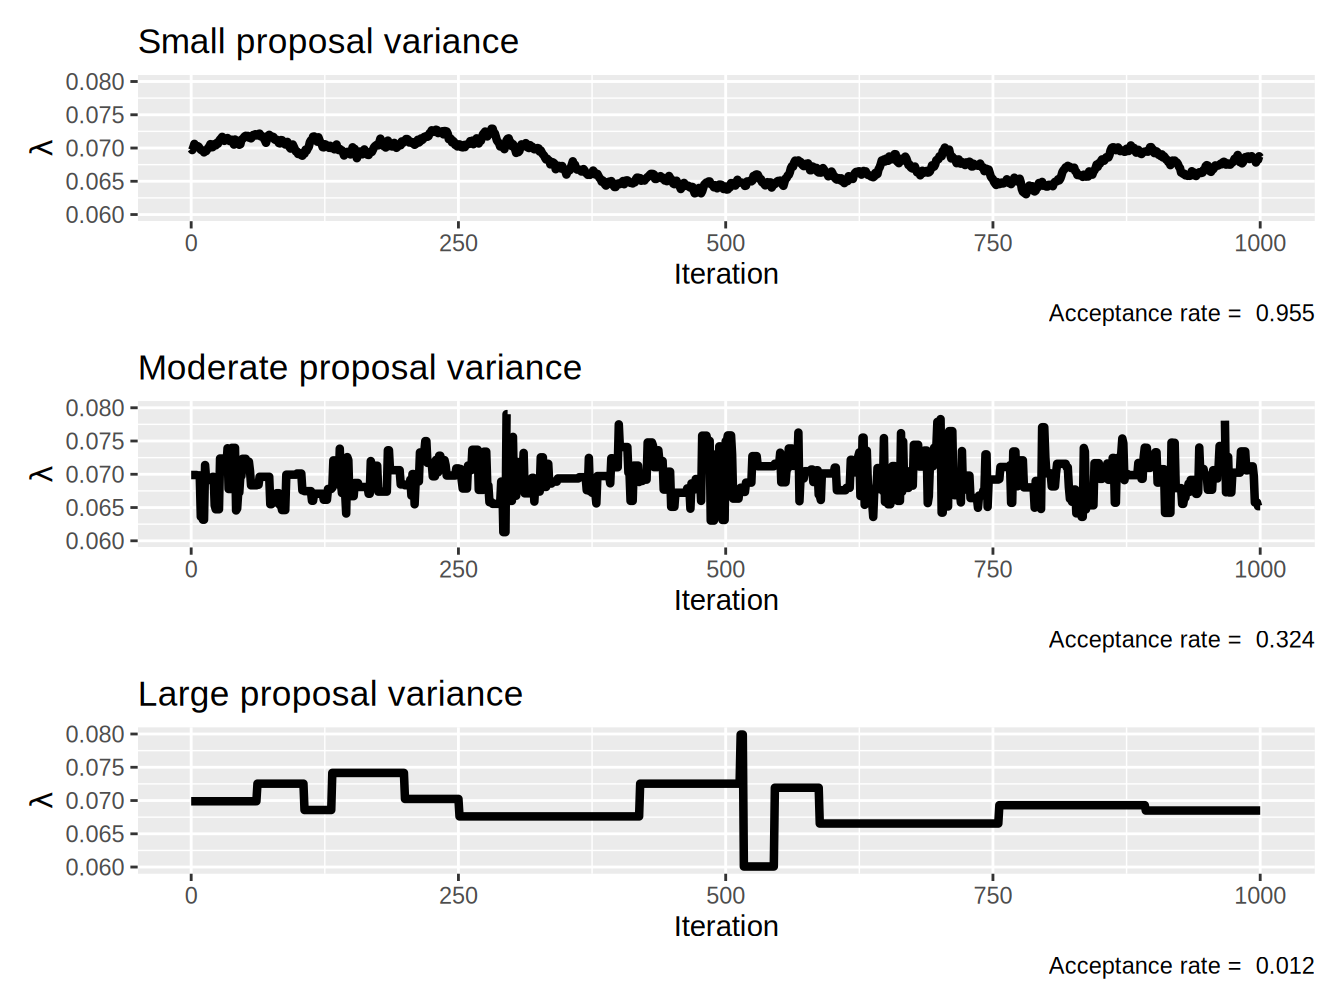
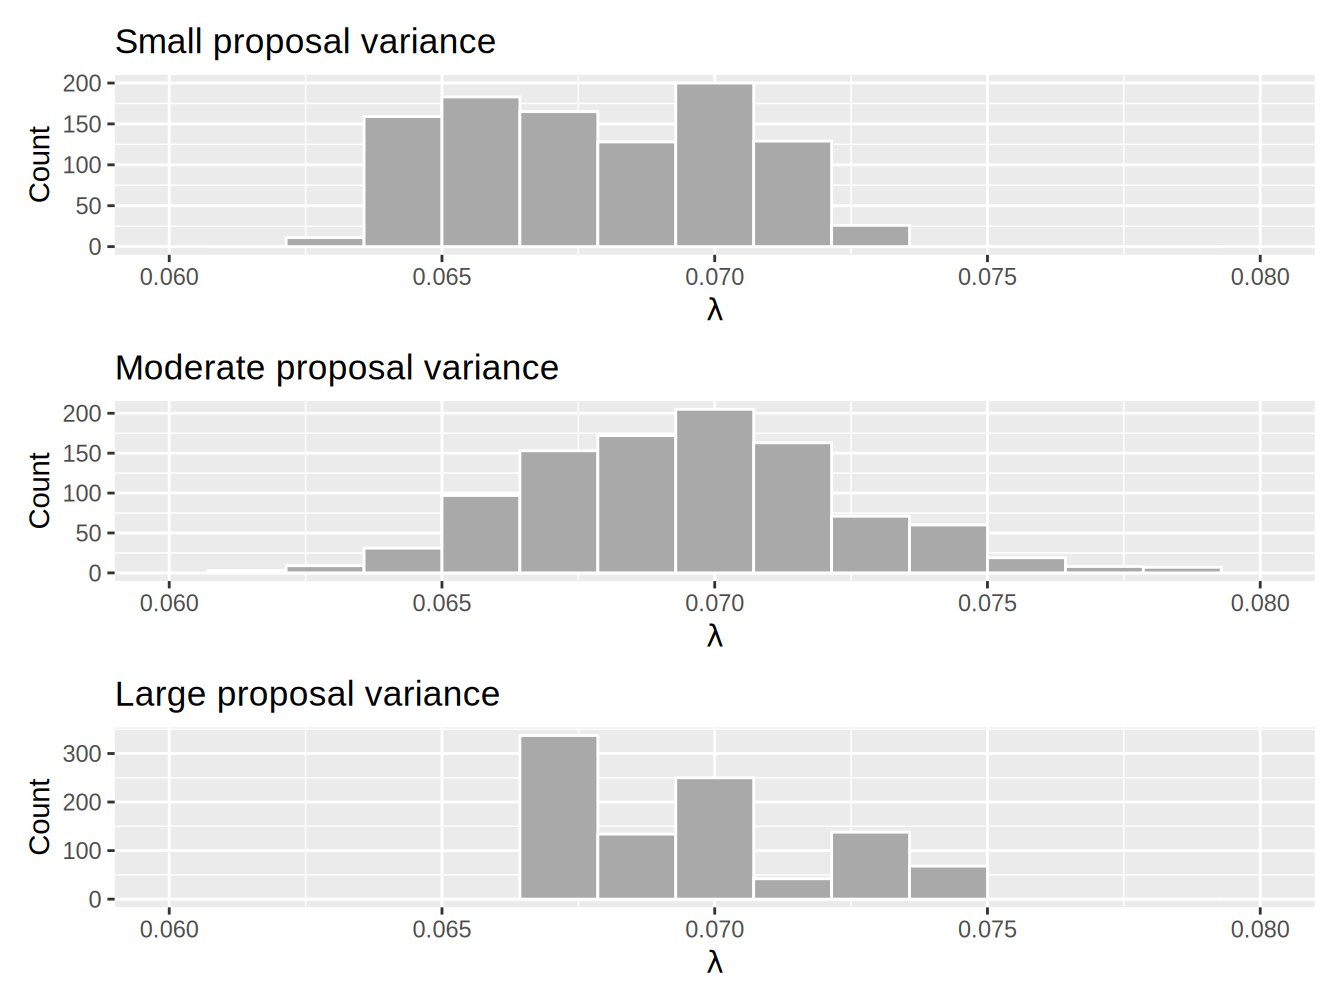
예제 9.4.2. 제안밀도가 채택률에 미치는 영향. 각 보험계약자의 청구 건수(빈도)가 \[ p_{N_i\,|\,\Lambda=\lambda}(n_i) = \frac{\lambda^{n_i}e^{-\lambda}}{n_i!}, \] 을 만족하는 포아송 확률변수로 분포한다고 가정합니다. 여기서 \(n_i\)는 \(i^{\text{th}}\) 보험계약자와 관련된 청구 건수입니다. 또한 \([0,\infty]\)에 대해 무정보 평평한 사전분포를 가정합니다. 즉, \[ f_{\Lambda}(\lambda) \propto 1, \quad \lambda \in [0,\infty]. \] 입니다. 싱가포르 보험 데이터(Singapore Insurance Data)의 청구 건수 데이터를 가정하고 메트로폴리스–헤이스팅스 샘플러를 1,000회 반복하여 모수의 사후분포를 구하십시오(자세한 내용은 예제 9.1.4를 참조하십시오). 실험에서 제안분산 \(\delta\)로 작은 값(\(1\times 10^{-7}\)), 중간 값(\(1\times 10^{-4}\)), 큰 값(\(1 \times 10^{-1}\))을 갖는 정규 제안분포를 사용하고 그 차이에 대해 논하십시오.
예제 풀이 보기
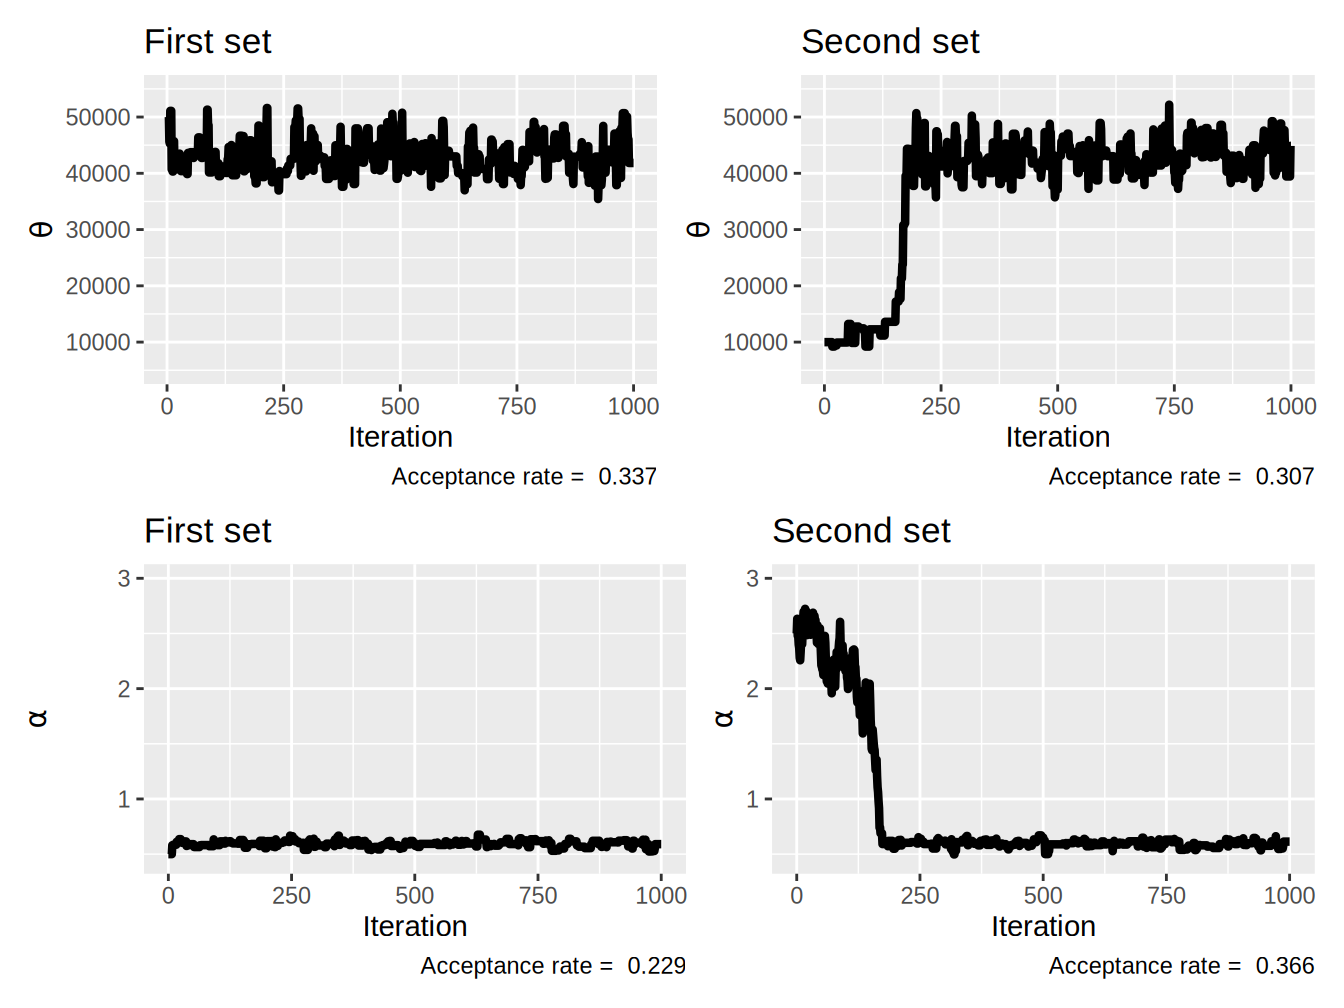
예제 9.4.3. 초기 모수의 영향. 예제 9.4.1에서 사용한 Wasa의 오토바이 보험 데이터를 고려합니다. 오토바이 손실의 청구액을 감마분포로 모형화하고자 합니다. 즉, \[ f_{X_i\,|\,\Theta = \theta,\, A = \alpha}(x_i) = \frac{1}{\theta^{\alpha}\Gamma(\alpha)} x_i^{\alpha-1} e^{-\frac{x_i}{\theta}}, \] 이며, 여기서 \(x_i\)는 \(i^{\text{th}}\) 청구액입니다. \(\theta\)와 \(\alpha\)의 사전분포가 모두 무정보이며 평평하다고 가정합니다. 즉, \[ f_{\Theta , A}( \theta,\alpha) \propto 1, \quad \theta \in [0,\infty], \quad \alpha \in [0,\infty]. \] 입니다. 메트로폴리스–헤이스팅스 샘플러를 1,000회 반복하여 모수의 사후분포를 구하십시오. \(\theta\)에 대해서는 제안분산 \(5 \times 10^7\), \(\alpha\)에 대해서는 \(1 \times 10^{-2}\)인 정규 제안분포를 사용하고, 메트로폴리스–헤이스팅스 샘플러를 시작할 때 \(\theta^{(0)} = 50,000\)과 \(\alpha^{(0)} = 0.5\)를 사용하십시오. \(\theta^{(0)} = 10,000\)과 \(\alpha^{(0)} = 2.5\)로 실험을 다시 수행하십시오.
예제 풀이 보기
다음 소절에서는 MCMC 방법으로 생성한 마르코프 연쇄의 수렴을 진단하는 몇 가지 방법과 지표를 살펴봅니다.
9.4.4 마르코프 연쇄 진단
MCMC 기법에는 다양한 조정 모수가 있으며, 이들은 모두 이러한 방법으로 생성한 마르코프 연쇄의 수렴에 영향을 미칩니다. 이러한 선택(예: 반복 횟수, 번인 길이, 제안분포)이 연쇄에 미치는 영향을 이해하기 위해 연쇄의 수렴을 분석하는 몇 가지 방법을 소개합니다.
트레이스 플롯과 자기상관 검토
트레이스 플롯. MCMC 연쇄가 사후분포로 수렴했는지 평가하는 가장 기초적인 도구는 트레이스 플롯입니다. 앞서 언급했듯이 트레이스 플롯은 표본의 수열을 반복 횟수의 함수로 나타내며, 표본값을 \(y\)축에, 반복 횟수를 \(x\)축에 둡니다. 연쇄가 수렴했다면 트레이스 플롯은 참 사후분포 주위에서 털이 많은 애벌레처럼 보이는 안정적인 표본 수열을 보여야 합니다. 그러나 연쇄가 아직 수렴하지 않았다면 트레이스 플롯은 여전히 변하고 있거나 아직 안정적인 패턴에 자리 잡지 못한 것으로 보이는 표본 수열을 보일 수 있습니다.
트레이스 플롯은 수렴 평가 외에도 혼합 불량이나 자기상관과 같은 MCMC 알고리즘의 잠재적 문제를 진단하는 데에도 사용할 수 있습니다. 예를 들어 트레이스 플롯에서 오랫동안 변화가 없다가 갑자기 도약하는 모습이 나타난다면, 이는 혼합이 불량함을 나타내며 MCMC 알고리즘을 조정하거나 다른 방법을 사용해야 함을 시사할 수 있습니다.
시차 1 자기상관. 도움이 될 수 있는 또 다른 양은 시차 1 자기상관, 즉 주어진 연쇄에서 연속된 표본 사이의 상관입니다. \[ \mathrm{Cov}\left[ \theta_i^{(m)}, \theta_i^{(m-1)} \right]. \] 자기상관이 너무 높으면 연쇄가 잘 혼합되지 않고 사후분포에서 효과적으로 표본추출을 하지 못하고 있음을 나타낼 수 있다는 점에 유의하십시오. 이는 수렴 불량, 실행 시간 증가, MCMC 알고리즘으로 얻은 추정값의 정밀도 저하로 이어질 수 있습니다.
트레이스 플롯을 검토하고 자기상관계수를 계산하는 것 외에도, 얻은 연쇄가 신뢰할 만하고 수렴했는지 평가하기 위해 더 형식적인 다른 도구를 사용할 수 있습니다.
병렬 연쇄 비교
Gelman–Rubin 통계량 수렴을 평가하는 또 다른 방법은 서로 다른 시작점에서 여러 연쇄를 병렬로 실행하고 그 거동이 비슷한지 확인하는 것입니다. 트레이스 플롯을 비교하는 것 외에도 통계적 검정, 즉 Gelman and Rubin (1992)의 Gelman–Rubin 검정을 사용하여 연쇄를 비교할 수 있습니다. 이 검정은 연쇄 내 분산과 연쇄 간 분산을 비교합니다. 통계량을 계산하려면 적은 수의 연쇄(예: \(R\))를 생성해야 하며, 각 연쇄는 번인 이후 \(M-M^*\)회 반복합니다.
연쇄가 수렴했다면 연쇄 내 분산은 연쇄 간 분산과 비슷해야 합니다. 관심 모수를 \(\theta_i\)라고 하면 연쇄 내 분산은 \[ W = \frac{1}{R(M-M^*-1)} \sum_{r=1}^R \sum_{m=M^*+1}^{M} \left( \theta_{i,r}^{(m)} - \overline{\theta}_{i,r} \right)^2 , \] 이며, 여기서 \(\theta_{i,r}^{(m)}\)는 \(r^{\text{th}}\) 연쇄에서 \(\theta_i\)의 \(m^{\text{th}}\) 추출값이고 \(\overline{\theta}_{i,r}\)는 \(r^{\text{th}}\) 연쇄에 대한 \(\theta_i\)의 표본평균입니다. 연쇄 간 분산은 \[ B = \frac{M-M^*}{R-1} \sum_{r=1}^R \left( \overline{\theta}_{i,r} - \overline{\theta}_{i} \right), \] 로 주어지며, 여기서 \(\overline{\theta}_{i}\)는 모든 연쇄에서 얻은 \(\theta_i\)의 전체 표본평균입니다. Gelman–Rubin 통계량은 \[ \sqrt{\left( \frac{M-M^*-1}{M-M^*} + \frac{R+1}{R(M-M^*)} \frac{B}{W} \right) \frac{\text{df}}{\text{df}-2} }, \] 이며, 여기서 \(\text{df}\)은 사후분포를 근사하는 스튜던트 \(t\)분포의 자유도입니다. 연쇄가 수렴했다면 이 통계량은 1에 가까운 값을 산출해야 합니다. 반면 통계량 값이 1.1 또는 1.2보다 크면 연쇄가 수렴하지 않았을 수 있음을 나타내며, 연쇄가 잘 혼합되지 않는 이유를 규명하기 위해 추가 분석이 필요할 수 있습니다.
유효 표본 크기 계산
유효 표본 크기. 유효 표본 크기(ESS)는 MCMC 체인에서 얻은 독립 표본의 수를 나타내는 척도입니다. MCMC 체인에서는 각 표본이 직전 표본과 상관되어 있다는 점을 떠올리십시오. 그 결과 유효한 독립 표본의 수는 보통 MCMC 알고리즘이 생성한 전체 표본 수보다 훨씬 적습니다. ESS는 이러한 상관을 고려하여, 체인 안의 상관된 표본들과 동등한 독립 표본의 수에 대한 추정값을 제공합니다.
일반적으로 유효 표본 크기가 클수록 MCMC 알고리즘이 더 많은 독립 표본을 생성했으며 사후분포를 정확하게 표집했을 가능성이 더 높다는 것을 뜻합니다. 반면 유효 표본 크기가 작다면 신뢰할 수 있는 사후 추정값을 얻기 위해 MCMC 알고리즘을 추가로 조정하거나 최적화해야 할 수 있음을 시사합니다.
R 패키지 mcmcse의 함수 multiESS는 Vats, Flegal, and Jones (2019)에 설명된 대로 다변량 마르코프 연쇄의 ESS를 계산하는 함수입니다. 이 패키지에는 지정된 상대 허용 수준에 필요한 최소 ESS의 추정값도 포함되어 있습니다(함수 minESS 참조).
이제 이러한 여러 진단 방법을 예제에 적용해 봅시다.
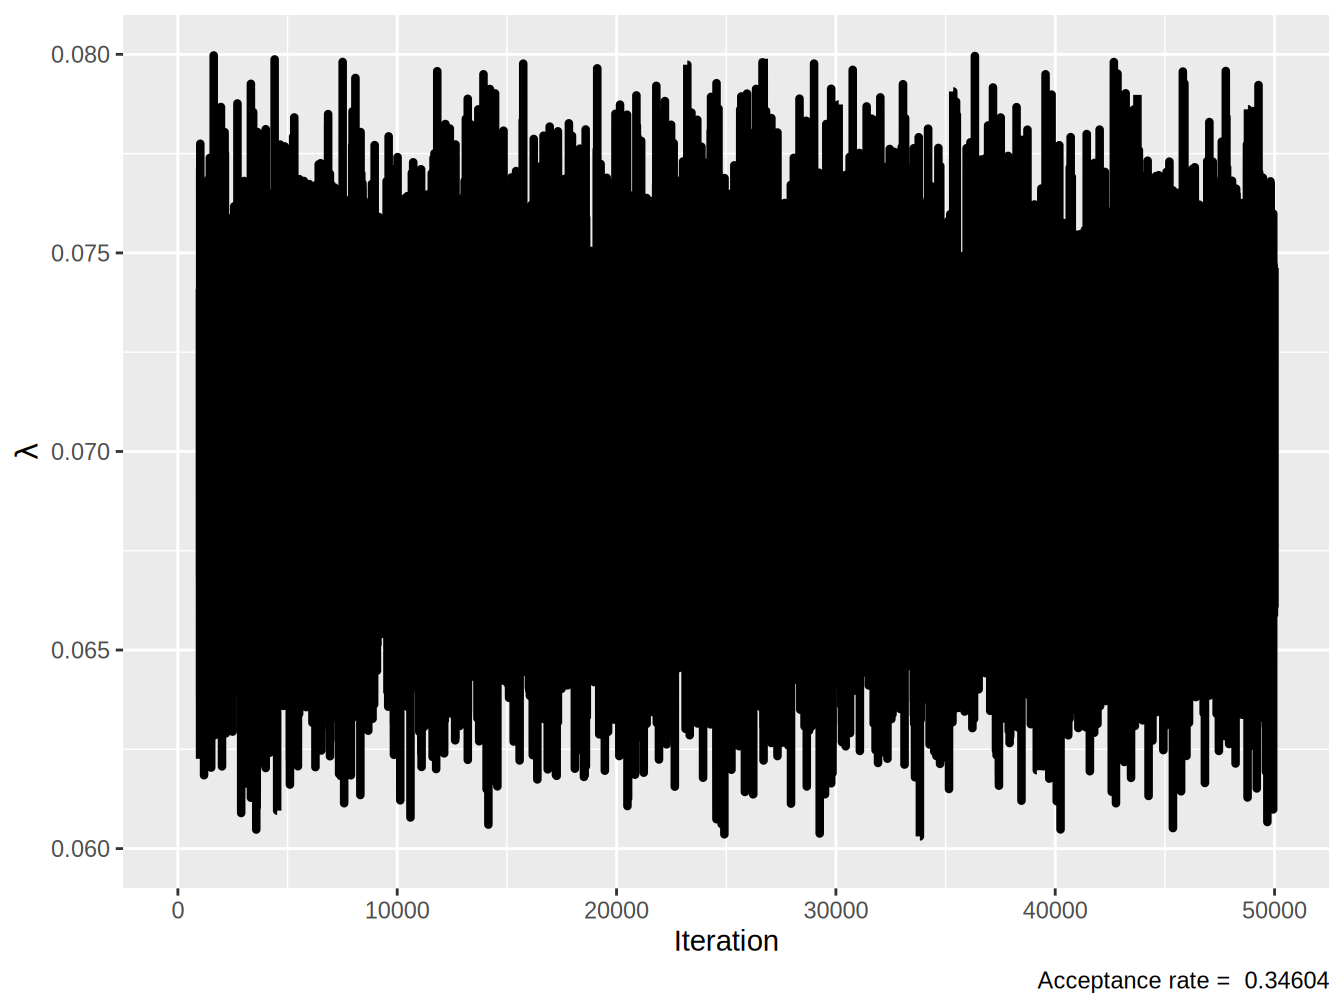
예제 9.4.4. 마르코프 연쇄 진단. 예제 9.4.2의 설정을 고려하십시오. 51,000회 반복으로 이루어진 연쇄와 1,000회의 번인을 사용하여 위에서 언급한 여러 마르코프 연쇄 진단 지표를 계산하십시오.
예제 풀이 보기
9.5 실제 베이즈 통계
9.5절에서는 다음 방법을 배웁니다.
- 베이즈 통계와 모델링에 사용할 수 있는 주요 컴퓨팅 자원을 설명하기
- 그중 하나를 손실 데이터에 적용하기
최종 사용자에게 다행스럽게도 이러한 방법 중 일부는 R에서 바로 사용할 수 있어 접근성이 상당히 좋습니다. 베이즈 통계에서 널리 쓰이는 컴퓨팅 자원 몇 가지를 아래에 소개합니다.
- 스타니스와프 울람(Stanislaw Ulam)을 기리기 위해 이름 붙여진
RSTAN은 베이즈 통계 모델링과 추론을 위해 널리 사용되는 확률적 프로그래밍 언어인 STAN의 R 구현입니다. 매우 유연하며 사용자가 복잡한 통계 모형을 정의할 수 있게 해 줍니다. nimble은 Numerical Inference for Bayesian and Likelihood Estimation(베이즈 및 가능도 추정을 위한 수치적 추론)의 약자로, 통계 계산과 계층적 모델링을 위해 설계된 R 패키지입니다.nimble은 사용자가 복잡한 통계 모형을 쉽게 정의할 수 있게 해 주는 고수준 프로그래밍 언어를 제공합니다.R2OpenBUGS를 사용하면 R 사용자가 베이즈 데이터 분석을 위한 고전적이고 널리 쓰이는 소프트웨어 패키지인 OpenBUGS를 사용할 수 있습니다. 이 패키지는 깁스 표본추출과 같은 MCMC 기법을 사용하여 사후분포에서 표본을 얻습니다.rjags는 JAGS(Just Another Gibbs Sampler, 또 하나의 깁스 샘플러) 프로그램의 R 구현입니다. 이는 BUGS의 확장으로 개발된 오픈 소스 소프트웨어입니다. 이는 BUGS 언어를 위한 플랫폼 독립적인 엔진을 제공하여, 다양한 환경에서 BUGS 모형을 사용할 수 있게 합니다. BUGS와 마찬가지로JAGS도 MCMC 표본추출 기법을 통한 베이즈 분석에 사용됩니다.
이어지는 내용에서는 손실 데이터의 맥락에서 nimble 패키지를 사용하겠습니다.
예제 9.5.1. nimble 패키지. 예제 9.4.2의 설정과 비슷하게, 각 보험계약자의 청구 건수(빈도)가
\[
p_{N_i\,|\,\Lambda=\lambda}(n_i) = \frac{\lambda^{n_i}e^{-\lambda}}{n_i!},
\]
를 만족하는 포아송 확률변수로 분포한다고 가정합시다. 여기서 \(n_i\)는 \(i^{\text{th}}\) 보험계약자와 관련된 청구 건수입니다. 그러나 앞의 예제와 달리, 형상모수가 2이고 척도모수가 5인 역감마 사전분포를 가정합시다.24
nimble 패키지를 사용하여 51,000회 반복의 체인과 1,000회의 번인(burn-in)을 생성함으로써 모수의 사후분포를 구하십시오.
예제 풀이 보기
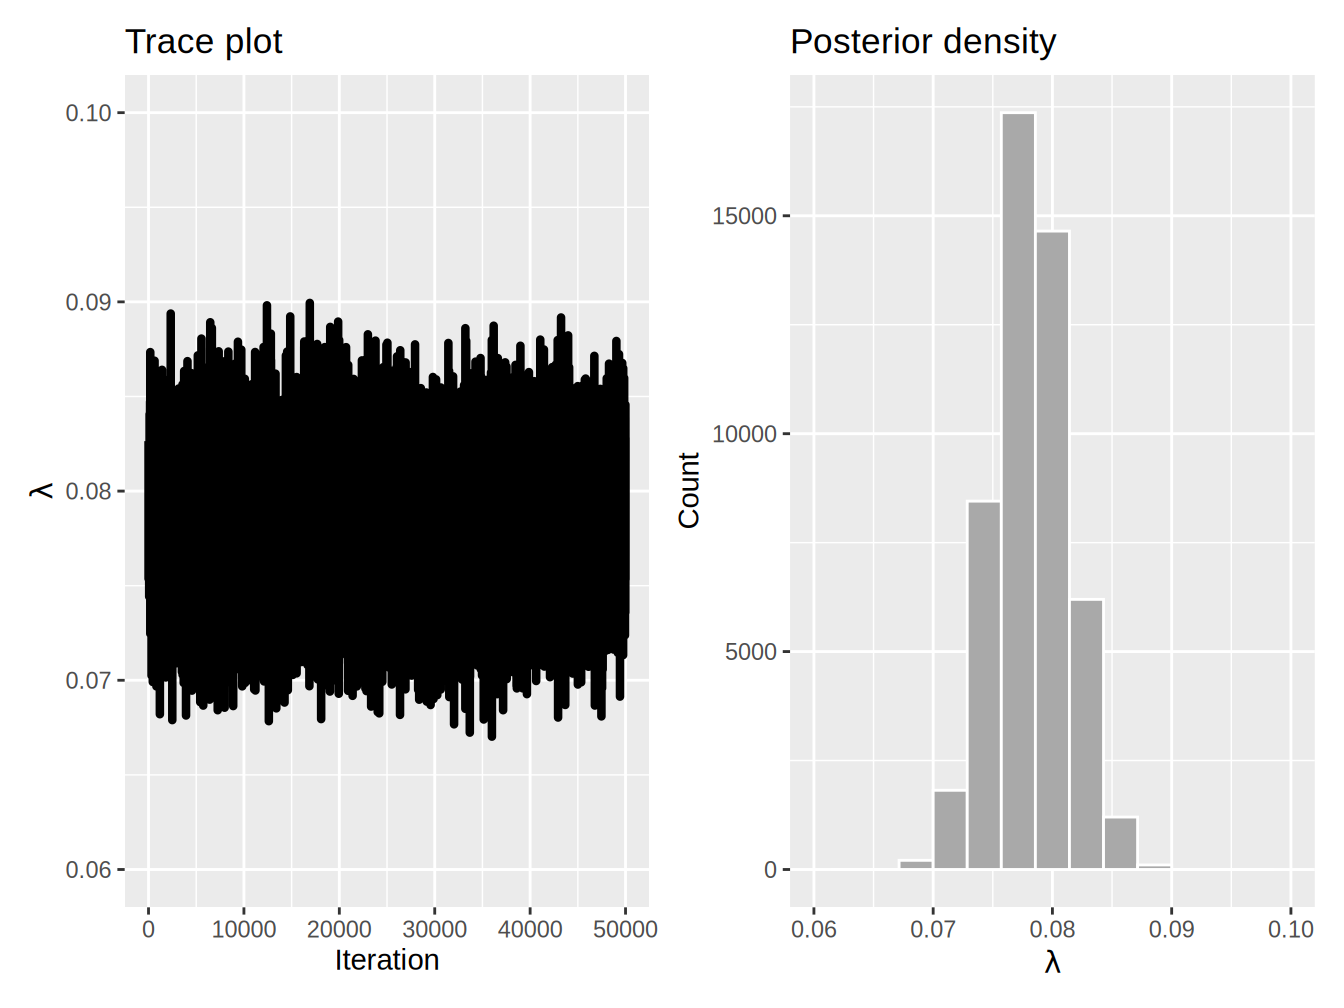
이 간단한 예시는 방대한 코드를 작성할 필요 없이 R 패키지를 활용하여 MCMC 체인을 생성하는 일이 얼마나 간단한지를 보여 줍니다. nimble 패키지에 대한 자세한 내용은 Valpine et al. (2017)을 참조하십시오.
9.6 추가 자료 및 기여자
베이즈 통계와 MCMC 기법을 다룬 훌륭한 책이 많이 있습니다. 관심 있는 독자는 이러한 주제에 대한 심화된 논의를 위해 Bernardo and Smith (2009)와 Robert and Casella (1999)을 참조하십시오.
지난 40년 동안 보험계리학 분야의 많은 학술 논문이 베이즈 통계와 MCMC 기법을 활용해 왔습니다. 예를 들어 Heckman and Meyers (1983), Meyers and Schenker (1983), Cairns (2000), Cairns, Blake, and Dowd (2006), Hartman and Heaton (2011), Bermúdez and Karlis (2011), Hartman and Groendyke (2013), Fellingham, Kottas, and Hartman (2015), Bignozzi and Tsanakas (2016), Bégin (2019), Huang and Meng (2020), Bégin (2021), Cheung et al. (2021), Bégin (2023)을 참고하십시오.
기여자
- 사이먼 프레이저 대학교(Simon Fraser University)의 Jean-François Bégin은 이 장 초판의 주 저자입니다. 이 장에 대한 의견 및 개선 제안은 이메일 jbegin@sfu.ca로 보내 주십시오.
- 이 장의 검토자는 Brian Hartman, Chun Yong, Margie Rosenberg, Gary Dean입니다.
각 동전 던지기는 베르누이 확률변수로 볼 수 있으며, 이는 그 합이 모수 \(q=0.5\)와 \(m=5\)를 갖는 이항분포를 따른다는 의미입니다. 자세한 내용은 20.1장을 참조하십시오.↩︎
구체적으로, 사전분포로는 \([0,1]\) 위의 균등분포를 사용합니다. 절 9.2.3에서 설명한 바와 같이, 이러한 유형의 사전분포를 무정보 사전분포라고 합니다.↩︎
손실 모형화 분야와 넓게는 보험계리학 분야에서도 사전 정보를 데이터와 결합해 온 풍부한 역사가 있으며, 이를 신뢰도라고 합니다. 기술적으로 말하면, 신뢰도 이론의 주된 과제는 베이지안 예측 밀도의 평균에 대한 최적 선형 근사를 찾는 데 있습니다. 이러한 이유로 신뢰도 이론은 선형 필터링, 그리고 더 넓은 분야인 베이즈 통계와 많은 결과를 공유합니다. 신뢰도 이론을 이용한 경험요율에 관한 자세한 내용은 12장을 참조하십시오.↩︎
이 문제는 Be An Actuary 웹사이트의 문제를 각색한 것입니다. 자세한 내용은 여기를 참조하십시오.↩︎
전확률 법칙에 따르면, 사건 \(B\)의 전체 확률은 서로 다른 조건에서 \(B\)가 발생할 확률을 각 조건의 확률로 가중하여 합한 값과 같습니다. 서로 다른 조건이 두 가지뿐인 경우(\(A\)와 \(A^{\text{c}}\)라고 합시다)에는 이 두 조건만 고려하면 됩니다. 그러나 일반적으로는 표본 공간을 두 사건으로만 나눌 수 없다면 더 많은 경우를 고려해야 합니다.↩︎
이 문제는 미국계리사회의 Exam P 표본 문제(Sample Questions)에서 가져온 것입니다. 자세한 내용은 여기를 참고하십시오.↩︎
이 데이터는 싱가포르의 손해보험사들로 구성된 단체인 싱가포르 일반보험협회(General Insurance Association of Singapore)에서 제공한 것입니다. 이 데이터에는 \(n=7{,}483\)건의 자동차 보험계약에 대한 자동차 사고 건수와 함께 여러 범주형 설명변수와 각 계약의 익스포저가 포함되어 있습니다.↩︎
간결함을 위해 여기서의 유도에서는 모수 하나만 고려합니다. 나중에 두 개 이상의 모수가 있는 경우도 고려할 것이며, 이러한 확장이 우리의 결과와 유도의 대부분을 바꾸지 않는다는 점에 유의하십시오.↩︎
이 문제는 미국계리사회 Exam C 표본 문제 중 표본 문제 184를 변형한 것입니다.↩︎
여기서는 베타분포의 정의역이 \([0,1]\)라고 가정하며, 이는 \(\theta = 1\)임을 의미합니다. 자세한 내용은 20장을 참조하십시오.↩︎
이 문제는 미국계리사회 Exam C 표본 문제 중 표본 문제 5입니다.↩︎
\(\sigma^2\)가 알려져 있지 않은 정규분포에 대한 켤레 분포족도 유도할 수 있습니다. 단순화를 위해, 이 책에서는 분산 모수가 알려진 경우에만 초점을 맞추겠습니다.↩︎
깁스 샘플러는 보다 일반적인 메트로폴리스–헤이스팅스 알고리즘의 특수한 경우로 볼 수 있습니다. 구체적으로, 깁스 방법에서는 모든 제안이 자동으로 채택됩니다. 즉, \(\alpha\left(\theta_1^{(0)},\theta_1^*\right)=1\)입니다.↩︎
역감마 사전분포를 포아송 분포와 결합하면 일반적으로 닫힌 형태의 사후밀도가 도출되지 않으므로, MCMC 방법을 사용해야 한다는 점에 유의하십시오.↩︎