제4장 손실 심도 모형화
장 미리보기. 총손실(aggregate losses) 총청구액, 즉 해당 기간에 관찰된 청구의 총액을 모형화하는 전통적인 손실 분포 접근법은 손실 건수에는 빈도분포를, 손실 크기에는 심도 분포를 각각 따로 적합하는 것에서 시작합니다. 추정된 총손실 분포는 손실 빈도분포와 손실 심도 분포를 합성곱으로 결합한 것입니다. 흔히 계수분포 또는 빈도분포라고 부르는 이산분포는 3장에서 운전자의 사고 건수나 보험자에게 접수된 청구 건수와 같은 사건의 수를 기술하는 데 사용되었습니다. 수명, 자산 가치, 손실, 청구 금액은 보통 연속형 확률변수로 모형화하며, 따라서 흔히 손실 분포 또는 심도 분포라고 부르는 연속분포를 사용하여 모형화합니다. 혼합분포(mixture distribution) 연속형 또는 이산형일 수 있는 다른 분포들의 가중평균는 더 단순한 분포들의 가중 결합으로, 배상책임보험(liability insurance) 타인에 대한 법적 배상책임으로 인한 손실을 피보험자에게 보상하는 보험에서 두 가지 이상의 청구 유형(빈번하게 발생하는 소액 청구와 비교적 드물게 발생하는 고액 청구)을 모형화하는 경우처럼 이질적인 모집단에서 관찰되는 현상을 모형화하는 데 사용됩니다. 이 장에서는 확률적인 손실 규모를 모형화하기 위해 연속분포와 혼합분포를 사용하는 방법을 살펴봅니다.
4.1절부터 4.3절까지는 연속형 모형을 특징짓는 주요 속성과 기존 분포로부터 새로운 분포를 만드는 방법을 제시합니다. 4.4.1절에서는 손실 분포를 추정하는 몇 가지 주요 비모수적 방법, 즉 적률 및 백분위수 기반 방법, 경험적 방법, 밀도 추정 방법을 설명합니다. 4.4.2절에서는 적률법과 백분위수 대응법을 포함한 모수적 추정 방법을 다루고, 최대가능도 방법에 대한 이해를 심화합니다. 7장에서는 3장의 빈도분포와 이 장의 개념을 결합하여 전체 포트폴리오에 대한 총손실을 기술할 것입니다.
4.1 기본적인 분포적 양
이 절에서는 다음과 같은 몇 가지 기본적인 분포적 양을 정의하는 방법을 배웁니다.
- 적률,
- 적률생성함수,
- 백분위수
4.1.1 적률과 적률생성함수
\(X\)를 확률밀도함수(pdf) \(f_{X}\left( x \right)\)와 분포함수 \(F_{X}\left( x \right)\)를 갖는 연속형 확률변수(continuous random variable) 지정된 정의역에서 무한히 많은 값을 가질 수 있는 확률변수라고 합시다. \(X\)의 k차 raw moment(raw moment) 확률변수 x의 k차 적률은 x^k의 평균(기댓값)입니다.는 \(\mu_{k}^{\prime}\)로 표기하며, 존재하는 경우 \(X\)의 k제곱의 기댓값(expected value) 평균입니다. 1차 원적률 \(\mu_{1}^{\prime}\)는 \(X\)의 평균이며 보통 \(\mu\)로 표기합니다. \(\mu_{k}^{\prime}\)에 대한 공식은 \[ \mu_{k}^{\prime} = \mathrm{E}\left( X^{k} \right) = \int_{0}^{\infty}{x^{k}f_{X}\left( x \right)dx } . \] 와 같습니다. 여기서 적률에 사용하는 표기법은 3.2.1절에서 사용한 표기법과 다르다는 점에 유의하십시오. 보험계리적 현상이 음수인 경우는 드물기 때문에 확률변수 \(X\)의 받침은 음이 아니라고 가정합니다. 예를 들어, 간단한 부분적분을 통해 음이 아닌 변수의 원적률은 \(S_X(x) = 1-F_{X}(x)\)로 표기하는 생존함수에 기반한 \[ \mu_{k}^{\prime} = \int_{0}^{\infty}{k~x^{k-1}\left[1- F_{X}(x) \right]dx }, \] 를 사용하여 계산할 수도 있음을 보일 수 있습니다. 이 공식은 \(k=1\)일 때 특히 유용합니다. 5.1.2절에서는 이 접근법을 더 자세히 논의합니다.
\(X\)의 k차 중심적률(central moment) 확률변수 x의 k차 중심적률은 (x-x의 평균)^k의 기댓값입니다.은 \(\mu_{k}\)로 표기하며, \(X\)의 평균 \(\mu\)로부터의 편차의 k제곱의 기댓값입니다. \(\mu_{k}\)에 대한 공식은 \[ \mu_{k} = \mathrm{E}\left\lbrack {(X - \mu)}^{k} \right\rbrack = \int_{0}^{\infty}{\left( x - \mu \right)^{k}f_{X}\left( x \right) dx }. \] 와 같습니다. 2차 중심적률 \(\mu_{2}\)는 \(X\)의 분산(variance) 확률변수 x의 2차 중심적률로, 변수와 그 평균 사이의 편차 제곱의 기댓값을 측정합니다을 정의하며, \(\sigma^{2}\)로 표기합니다. 분산의 제곱근은 표준편차(standard deviation) 분산의 제곱근 \(\sigma\)입니다.
고전적인 관점에서 분포의 형태를 더 자세히 특징짓는 요소로는 대칭의 정도와 정규분포에 비해 얼마나 평평한지가 있습니다. 3차 중심적률과 표준편차의 세제곱의 비 \(\left( \mu_{3} / \sigma^{3} \right)\)는 대칭성의 척도인 왜도(skewness) 분포의 대칭성을 나타내는 척도로, 3차 중심적률/표준편차^3 계수를 정의합니다. 왜도 계수가 양수이면 분포가 오른쪽으로 치우쳐 있음(양의 왜도)을 나타냅니다. 4차 중심적률과 표준편차의 네제곱의 비 \(\left(\mu_{4} / \sigma^{4} \right)\)는 첨도(kurtosis) 분포의 뾰족한 정도를 나타내는 척도로, 4차 중심적률/표준편차^4 계수를 정의합니다. 정규분포의 첨도 계수는 3입니다. 첨도 계수가 3보다 큰 분포는 정규분포보다 꼬리가 두껍고, 첨도 계수가 3보다 작은 분포는 꼬리가 얇고 더 평평합니다. 절 13.2에서는 보험 및 계리적 관점에서 분포의 꼬리를 설명합니다.
예제 4.1.1. 계리사 시험 문제. rv(rv) 확률변수 \(X\)가 평균이 8이고 왜도가 1인 감마분포를 따른다고 가정합니다. \(X\)의 분산을 구하십시오. (힌트: 감마분포는 절 4.2.1에서 다룹니다.)
예제 풀이 보기
\(M_{X}(t)\)로 표기하는 적률생성함수(mgf)(moment generating function (mgf)) 확률변수 n의 mgf는 exp(tn)의 기댓값을 t의 함수로 나타낸 것으로 정의됩니다.는 \(X\)의 분포를 유일하게 특징짓습니다. 서로 다른 두 분포가 같은 적률을 가지면서도 여전히 다를 수는 있지만, 적률생성함수의 경우에는 그렇지 않습니다. 즉, 두 확률변수의 적률생성함수가 같으면 두 확률변수의 분포도 같습니다. 적률생성함수는 기댓값이 존재하는 모든 \(t\)에 대해 \[ M_{X}(t) = \mathrm{E}\left( e^{tX} \right) = \int_{0}^{\infty}{e^{\text{tx}}f_{X}\left( x \right) dx } \] 로 주어집니다. mgf는 0에서의 k계 도함수가 \(X\)의 k차 원적률과 같은 실함수입니다. 이를 기호로 나타내면 다음과 같습니다. \[ \left.\frac{d^k}{dt^k} M_{X}(t)\right|_{t=0} = \mathrm{E}\left( X^{k} \right) . \]
예제 4.1.2. 계리사 시험 문제. 확률변수 \(X\)는 평균이 \(\frac{1}{b}\)인 지수분포를 따릅니다. \(M_{X}\left( - b^{2} \right) = 0.2\)임이 밝혀졌습니다. \(b\)를 구하십시오. (힌트: 지수분포는 감마분포의 특수한 경우이며, 감마분포는 절 4.2.1에서 다룹니다.)
예제 풀이 보기
예제 4.1.3. 계리사 시험 문제. \(X_{1}, \ldots, X_{n}\)이 독립(independent) 한 변수에 대해 주어진 조건부 정보가 다른 변수에 관해 아무런 정보도 제공하지 않으면 두 변수는 독립입니다. 확률변수이고, \(X_i\)가 모수 \(\alpha_{i}\)와 \(\theta\)를 갖는 감마분포를 따른다고 합시다. \(S = \sum_{i = 1}^{n}X_{i}\)의 분포, 평균 \(\mathrm{E}(S)\), 분산 \(\mathrm{Var}(S)\)을 구하십시오.
예제 풀이 보기
적률생성함수를 이용하여 확률생성함수 \[ P_{X}(z) = \mathrm{E}\left( z^{X} \right) = M_{X}\left( \log z \right) . \] 를 계산할 수도 있습니다. 3.2.2절에서 소개한 바와 같이, 확률생성함수는 이산 확률변수에 대해 더 유용합니다.
4.1.2 분위수
분위수는 \(X\)의 분포의 특성을 기술하는 데에도 사용할 수 있습니다. \(X\)의 분포가 연속일 때, 주어진 비율 \(0 \le p \le 1\)에 대응하는 분위수는 방정식 \[ F_{X}\left( \pi_{p} \right) = p . \] 의 해입니다. 예를 들어, 분포의 중간점인 \(\pi_{0.5}\)는 중앙값(median) 분포의 50번째 백분위수, 즉 분포의 절반이 그 아래에 놓이는 중앙값입니다. 백분위수(percentile) 확률변수 x의 p번째 백분위수는 그 값을 초과하지 않을 확률이 p%가 되는 가장 작은 값 x_p입니다.는 분위수의 한 종류이며, \(100p\) 백분위수는 자료의 \(100 \times p\) 퍼센트가 그 값보다 작게 되는 수입니다.
예제 4.1.4. 계리사 시험 문제. \(X\)를 밀도함수가 \(x > 0\)에 대해 \(f_{X}\left( x \right) = \theta e^{- \theta x}\)이고 그 밖에서는 0인 연속형 확률변수라고 합시다. 이 분포의 중앙값이 \(\frac{1}{3}\)일 때, \(\theta\)를 구하십시오.
예제 풀이 보기
4.4.1.2절에서는 분위수의 정의를 이산형, 연속형, 또는 이들의 혼합형 분포까지 포함하도록 확장합니다.
Show Quiz Solution
4.2 손실 심도 모형화를 위한 연속분포
이 절에서는 다음 네 가지 기본 심도 분포를 정의하고 적용하는 방법을 배웁니다.
- 감마분포,
- 파레토분포,
- 와이블분포,
- 제2종 일반화 베타분포.
4.2.1 감마분포
손실을 모형화하는 전통적인 접근법은 빈도와 청구 심도에 대해 각각 별도의 모형을 적합하는 것임을 상기하십시오. 빈도와 심도를 따로 모형화할 때, 계리사들은 흔히 청구 건수에는 포아송 분포(3.2.3절에서 소개)를, 심도 모형화에는 감마분포를 사용합니다. 최근 인기를 얻고 있는 손실 모형화의 대안적 접근법은 순보험료(평균 청구 비용)에 대한 단일 모형을 만드는 것입니다.
연속형 변수 \(X\)의 확률밀도함수가 \[ f_{X}\left( x \right) = \frac{\left( x/ \theta \right)^{\alpha}}{x~ \Gamma\left( \alpha \right)}\exp \left( -x/ \theta \right) \ \ \ \text{for } x > 0 . \] 로 주어지면, 이 변수는 형상모수 \(\alpha\)와 척도모수 \(\theta\)를 갖는 감마분포를 따른다고 합니다. \(\alpha > 0,\ \theta > 0\)임에 유의하십시오.
그림 4.1의 두 패널은 척도모수와 형상모수가 감마 밀도함수에 미치는 영향을 보여 줍니다.
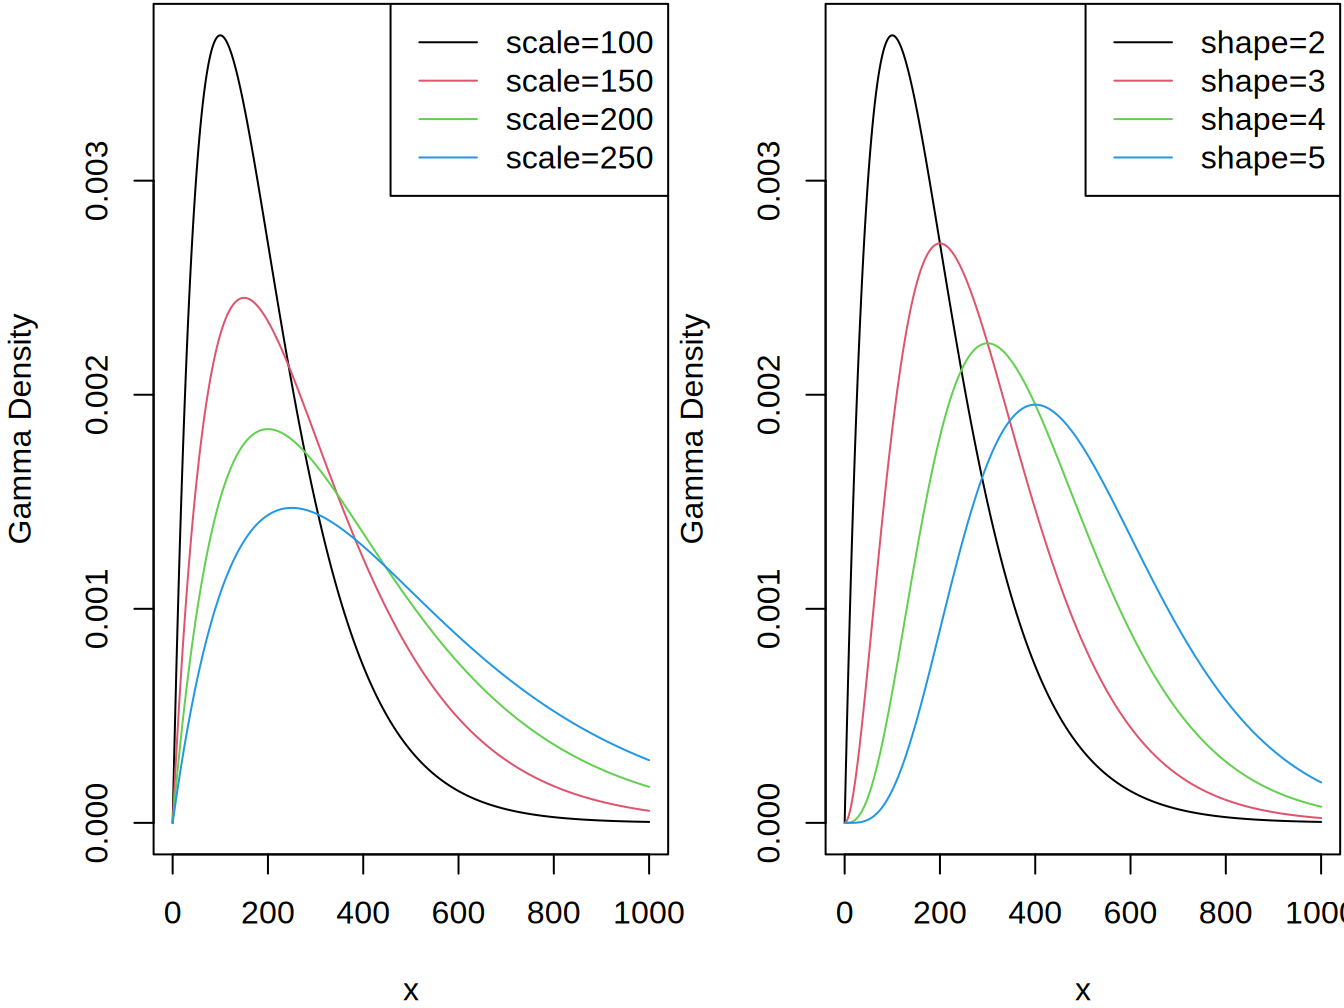
그림 4.1: 감마 밀도. 왼쪽 패널은 shape=2이고 척도를 변화시킨 것입니다. 오른쪽 패널은 scale=100이고 형상을 변화시킨 것입니다.
감마 밀도 그래프를 위한 R 코드
\(\alpha = 1\)이면 감마분포는 지수분포(exponential distribution) 비율 모수로 정의되는 단일 모수 연속 확률분포로 축소되고, \(\alpha = \frac{n}{2}\)이고 \(\theta = 2\)이면 감마분포는 자유도가 \(n\)인 카이제곱 분포(chi-square distribution) 관측 데이터가 이론적 분포에 얼마나 잘 맞는지 적합도를 판단하는 카이제곱 검정에 흔히 사용되는 분포로 축소됩니다. 17.4.1절에서 살펴보겠지만, 카이제곱 분포는 통계적 가설검정에서 광범위하게 사용됩니다.
감마 모형의 분포함수는 \(\Gamma\left(\alpha; \frac{x}{\theta} \right)\)로 표기되는 불완전 감마함수이며, 다음과 같이 정의됩니다. \[ F_{X}\left( x \right) = \Gamma\left( \alpha; \frac{x}{\theta} \right) = \frac{1}{\Gamma\left( \alpha \right)}\int_{0}^{x /\theta}t^{\alpha - 1}e^{- t}~dt , \] 여기서 \(\alpha > 0,\ \theta > 0\)입니다. \(\alpha\)가 정수이면 이는 \(\Gamma\left( \alpha; \frac{x}{\theta} \right) = 1 - e^{-x/\theta}\sum_{k = 0}^{\alpha-1}\frac{(x/\theta)^k}{k!}\)로 쓸 수 있습니다.
임의의 양수 \(k\)에 대해 감마분포를 따르는 확률변수의 \(k\)차 원적률은 다음과 같습니다. \[ \mathrm{E}\left( X^{k} \right) = \theta^{k} \frac{\Gamma\left( \alpha + k \right)}{\Gamma\left( \alpha \right)} . \] 평균과 분산은 각각 \(\mathrm{E}\left( X \right) = \alpha\theta\)와 \(\mathrm{Var}\left( X \right) = \alpha\theta^{2}\)입니다.
양수인 \(k\)에 대해 모든 적률이 존재하므로 감마분포는 얇은 꼬리 분포(light tailed distribution) 기준이 되는 지수분포보다 꼬리가 얇은 분포로 간주되며, 심각한 손실의 가능도를 현실적으로 평가하지 못하기 때문에 위험 자산을 모형화하는 데에는 적합하지 않을 수 있습니다.
4.2.2 파레토 분포
이탈리아 경제학자 빌프레도 파레토(Vilfredo Pareto, 1843-1923)의 이름을 딴 파레토 분포(Pareto distribution) 꼬리가 두껍고 양의 왜도를 갖는 2모수 분포는 경제와 금융 분야에서 다양하게 응용됩니다. 이 분포는 양의 왜도를 가지는 두꺼운 꼬리 분포이므로 소득, 고위험 보험 청구, 대형 재해 손실의 심도를 모형화하는 데 적합합니다. 0으로 천천히 감소하는 파레토 분포의 생존함수는 모집단의 적은 비율이 전체 부의 큰 부분을 보유하는 소득 분포를 설명하는 데 처음 사용되었습니다. 극단적인 보험 청구의 경우, 심도 분포의 꼬리(임계값을 초과하는 손실)는 일반화 파레토 분포를 사용하여 모형화할 수 있습니다.
연속형 변수 \(X\)의 pdf(pdf) 확률밀도함수가 \[\begin{equation} f_{X}\left( x \right) = \frac{\alpha\theta^{\alpha}}{\left( x + \theta \right)^{\alpha + 1}} \ \ \ x > 0, \ \alpha > 0, \ \theta > 0. \tag{4.1} \end{equation}\] 로 주어지면, 이 변수는 형상모수 \(\alpha\)와 척도모수 \(\theta\)를 갖는 (2모수) 파레토 분포를 따른다고 합니다. 그림 4.2의 두 패널은 척도모수와 형상모수가 파레토 밀도함수에 미치는 영향을 보여 줍니다. 파레토 분포에는 부록 절 20.2에 제시된 1모수 버전을 비롯하여 다른 형태의 정식화도 있습니다. 이후 파레토 분포라고 하면 식 (4.1)의 pdf로 주어진 버전을 의미합니다.
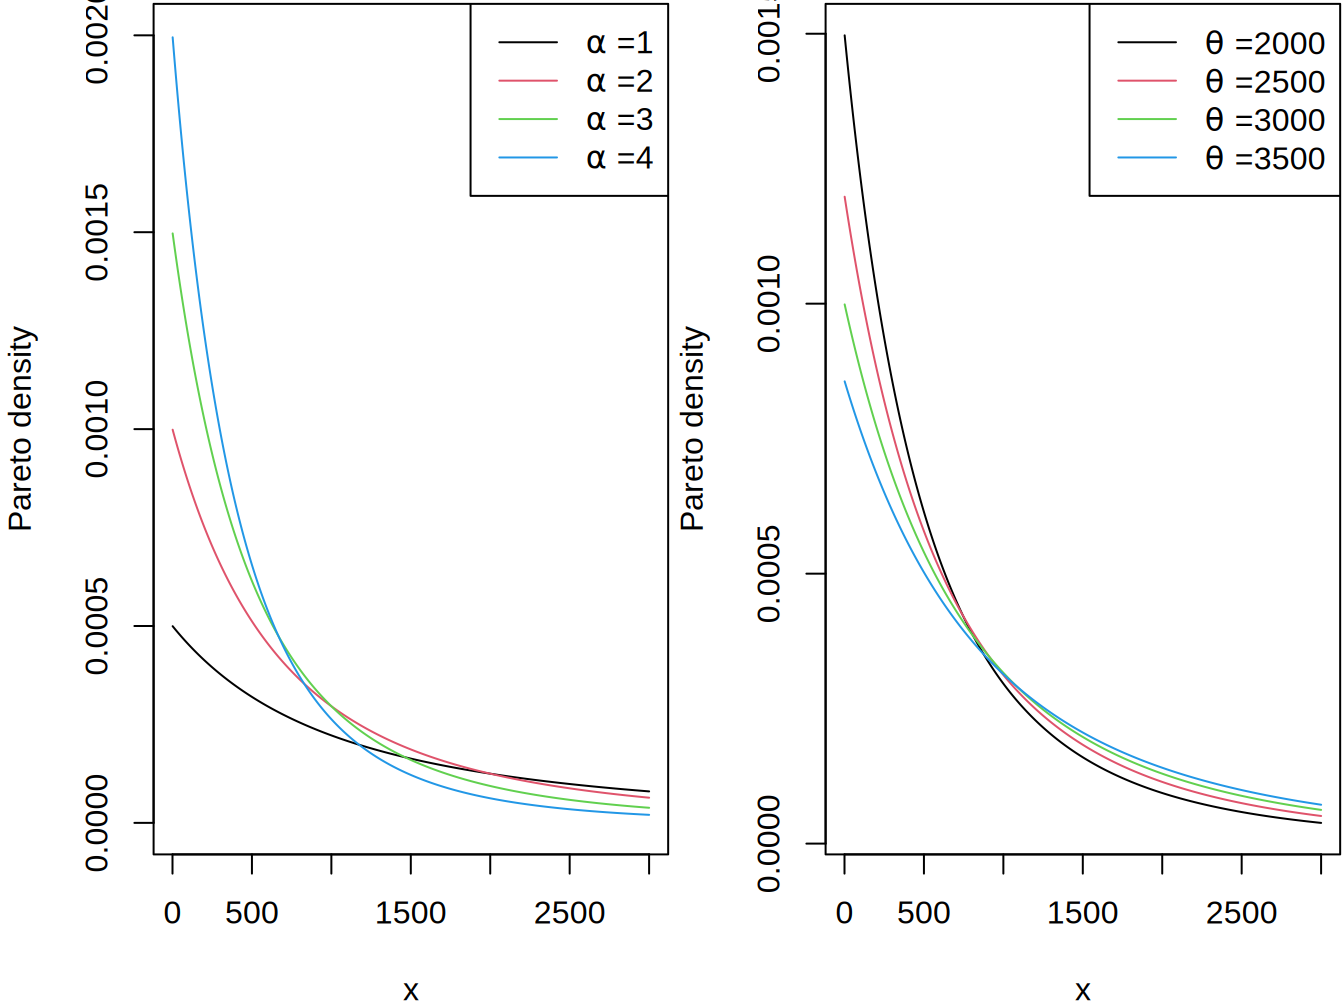
그림 4.2: 파레토 밀도. 왼쪽 패널은 scale=2000이고 형태모수를 변화시킨 경우입니다. 오른쪽 패널은 shape=3이고 척도모수를 변화시킨 경우입니다.
파레토 밀도 그래프를 위한 R 코드
파레토 분포의 분포함수는 다음과 같습니다. \[ F_{X}\left( x \right) = 1 - \left( \frac{\theta}{x + \theta} \right)^{\alpha} \ \ \ x > 0,\ \alpha > 0,\ \theta > 0. \] 파레토 분포의 위험률 함수(hazard function) 확률밀도함수와 생존함수의 비율 f(x)/s(x)로, 짧은 시간 구간 내의 순간 확률을 나타냅니다.가 \(x\)에 대한 감소함수임을 쉽게 알 수 있으며, 이는 이 분포가 두꺼운 꼬리를 가진다는 또 다른 증거입니다. 다시 모집단의 소득에 비유하면, 위험률 함수가 시간에 따라 감소할 때 모집단은 점점 감소하는 비율로 소멸하며, 그 결과 분포의 꼬리가 더 두꺼워집니다. 위험률 함수는 꼬리 분포에 관한 정보를 드러내며, 생존분석에서 데이터 분포를 모형화하는 데 자주 사용됩니다. 위험률 함수는 관심 사건이 매우 짧은 시간 구간 내에 발생할 순간적인 가능성으로 정의됩니다.
파레토 분포를 따르는 확률변수의 \(k\)차 원적률은 \(\alpha > k\)일 때, 그리고 그때에만 존재합니다. \(k\)가 양의 정수이면 다음이 성립합니다. \[ \mathrm{E}\left( X^{k} \right) = \frac{\theta^{k}~ k!}{\left( \alpha - 1 \right)\cdots\left( \alpha - k \right)} \ \ \ \alpha > k. \] 평균과 분산은 각각 \[\mathrm{E}\left( X \right) = \frac{\theta}{\alpha - 1} \ \ \ \text{for } \alpha > 1\] 및 \[\mathrm{Var}\left( X \right) = \frac{\alpha\theta^{2}}{\left( \alpha - 1 \right)^{2}\left( \alpha - 2 \right)} \ \ \ \text{for } \alpha > 2,\]입니다.
예제 4.2.1. 어떤 보험 포트폴리오의 청구 규모는 평균과 분산이 각각 40과 1800인 파레토 분포를 따릅니다. 다음을 구하십시오.
- 형태모수와 척도모수. b. 이 분포의 95번째 백분위수.
예제 풀이 보기
4.2.3 와이블 분포
스웨덴 물리학자 왈로디 와이블(Waloddi Weibull, 1887-1979)의 이름을 딴 와이블 분포(Weibull distribution) 형상모수에 따라 위험률 함수가 증가하거나 감소할 수 있는, 모수가 2개인 양의 왜도를 갖는 연속분포는 신뢰성, 수명 데이터 분석, 일기 예보 및 일반보험 청구에 널리 사용됩니다. 보험 연구에서는 절단 데이터가 자주 발생합니다. 와이블 분포는 지진 발생 간격뿐만 아니라 자동차 보험에 대한 초과손해액 특약을 모형화하는 데에도 사용되어 왔습니다.
연속형 변수 \(X\)의 pdf가 \[ f_{X}\left( x \right) = \frac{\alpha}{\theta}\left( \frac{x}{\theta} \right)^{\alpha - 1} \exp \left(- \left( \frac{x}{\theta} \right)^{\alpha}\right) \ \ \ x > 0,\ \alpha > 0,\ \theta > 0. \] 로 주어지면, 이 변수는 형상모수 \(\alpha\)와 척도모수 \(\theta\)를 갖는 와이블 분포를 따른다고 합니다. 그림 4.3의 두 패널은 척도모수와 형상모수가 와이블 밀도함수에 미치는 영향을 보여 줍니다.
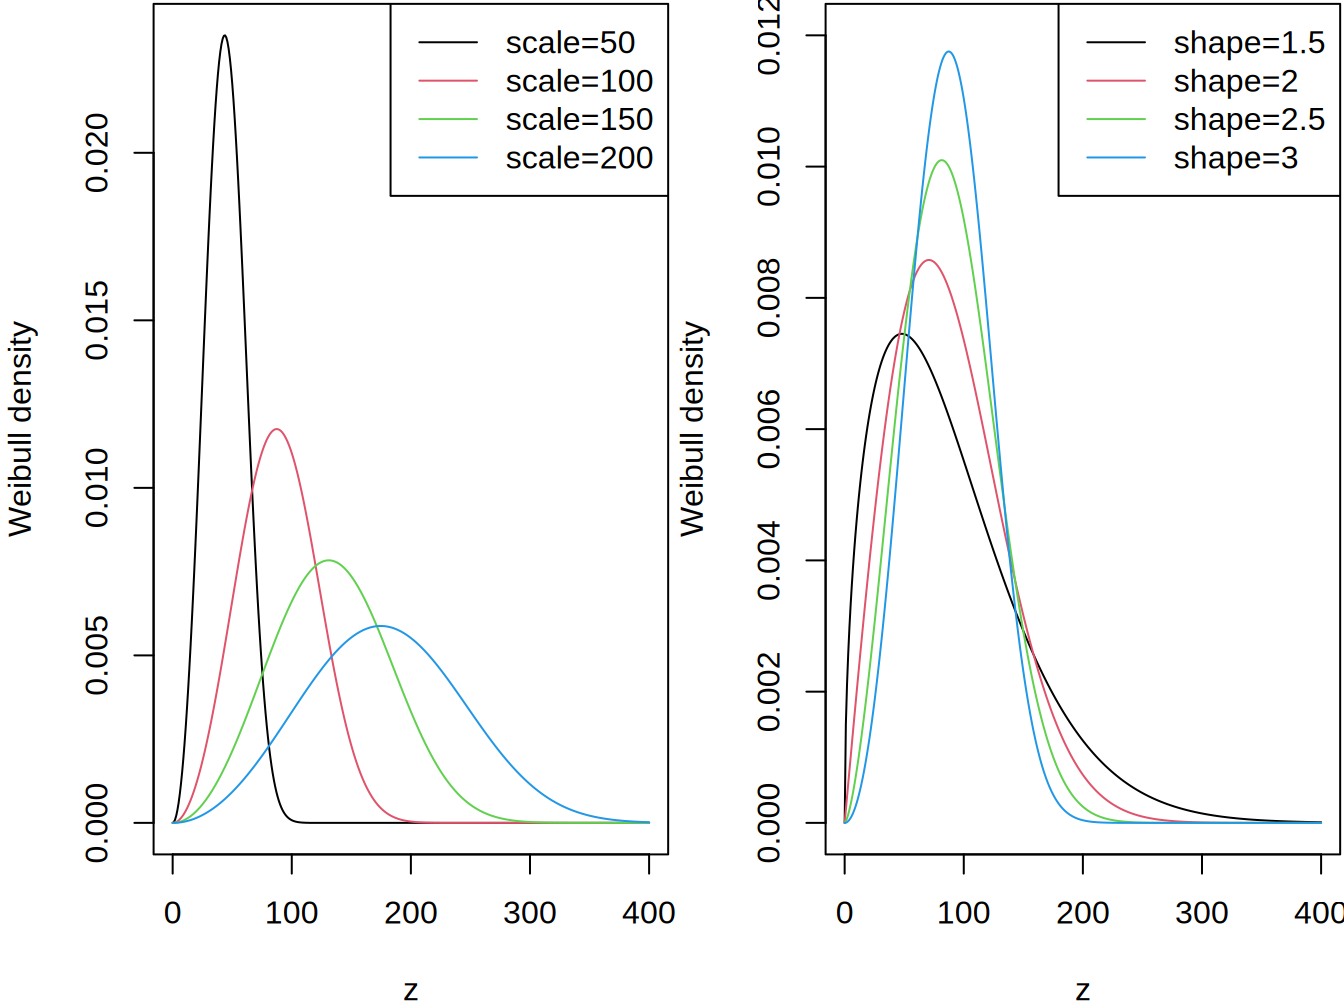
그림 4.3: 와이블 밀도. 왼쪽 패널은 shape=3이고 척도가 변하는 경우입니다. 오른쪽 패널은 scale=100이고 형상이 변하는 경우입니다.
와이블 밀도 그래프를 위한 R 코드
와이블 분포의 분포함수는 \[ F_{X}\left( x \right) = 1 - \exp\left(- \left( \frac{x}{\theta} \right)^{\alpha}~\right) \ \ \ x > 0,\ \alpha > 0,\ \theta > 0. \] 로 주어집니다. 형상모수 \(\alpha\)가 와이블 분포의 위험률 함수의 형태를 결정한다는 것을 쉽게 알 수 있습니다. 위험률 함수는 \(\alpha < 1\)일 때 감소함수(두꺼운 꼬리 분포)이고, \(\alpha = 1\)일 때 상수이며, \(\alpha > 1\)일 때 증가함수(얇은 꼬리 분포)입니다. 위험률 함수의 이러한 특성 때문에 와이블 분포는 일기 예보, 전기 및 산업 공학, 보험 모형화, 금융 위험 분석 등 매우 다양한 현상에 적합한 모형이 됩니다.
와이블 분포를 따르는 확률변수의 \(k\)차 원적률은 \[ \mathrm{E}\left( X^{k} \right) = \theta^{k}~\Gamma\left( 1 + \frac{k}{\alpha} \right) . \] 로 주어집니다. 평균과 분산은 각각 \[ \mathrm{E}\left( X \right) = \theta~\Gamma\left( 1 + \frac{1}{\alpha} \right) \] 및 \[ \mathrm{Var}(X)= \theta^{2}\left( \Gamma\left( 1 + \frac{2}{\alpha} \right) - \left\lbrack \Gamma\left( 1 + \frac{1}{\alpha} \right) \right\rbrack ^{2}\right), \] 로 주어집니다.
예제 4.2.2. 진단 시점부터의 AIDS 환자 수명(개월 단위)의 확률분포가 형상모수 1.2, 척도모수 33.33인 와이블 분포로 기술된다고 가정합시다.
- 이 모집단에서 무작위로 선택한 사람이 최소 12개월 이상 생존할 확률을 구하십시오. b. 이 모집단에서 환자 10명의 확률표본을 추출합니다. 진단 후 1년 이내에 사망하는 환자가 최대 2명일 확률은 얼마입니까? c. 수명 분포의 99번째 백분위수를 구하십시오.
예제 풀이 보기
4.2.4 제2종 일반화 베타분포
제2종 일반화 베타분포(Generalized Beta Distribution of the Second Kind) 여러 일반적인 분포를 포괄하는 유연한 4모수 분포(GB2)는 G. Venter (1983)가 보험 손실 모형화의 맥락에서, 그리고 McDonald (1984)가 소득 및 부의 분포로서 도입하였습니다. 이는 양의 방향으로 치우친 분포뿐만 아니라 음의 방향으로 치우친 분포도 모형화할 수 있는, 매우 유연한 4모수 분포입니다.
연속형 변수 \(X\)의 pdf가 \[\begin{equation} f_{X}\left( x \right) = \frac{(x/\theta)^{\alpha_2/\sigma}}{x \sigma~\mathrm{B}\left( \alpha_1,\alpha_2\right)\left\lbrack 1 + \left( x/\theta \right)^{1/\sigma} \right\rbrack^{\alpha_1 + \alpha_2}} \ \ \ \text{for } x > 0, \tag{4.2} \end{equation}\] \(\sigma,\theta,\alpha_1,\alpha_2 > 0\)로 주어지면, 이 변수는 모수 \(\sigma\), \(\theta\), \(\alpha_1\), \(\alpha_2\)를 갖는 GB2 분포를 따른다고 합니다. 여기서 베타함수 \(\mathrm{B}\left( \alpha_1,\alpha_2 \right)\)는 다음과 같이 정의됩니다. \[ \mathrm{B}\left( \alpha_1,\alpha_2\right) = \int_{0}^{1}{t^{\alpha_1 - 1}\left( 1 - t \right)^{\alpha_2 - 1}}~ dt. \]
GB2는 꼬리가 가벼운 데이터뿐만 아니라 꼬리가 두꺼운 데이터에 대한 모형도 제공합니다. 이 분포는 지수, 감마, 와이블, 버, 로맥스, F, 카이제곱, 레일리, 로그정규, 로그로지스틱 분포를 특수한 경우 또는 극한의 경우로 포함합니다. 예를 들어, 모수를 \(\sigma = \alpha_1 = \alpha_2 = 1\)로 설정하면 GB2는 로그로지스틱 분포가 됩니다. \(\sigma = 1\)이고 \(\alpha_2 \rightarrow \infty\)이면 감마분포가 되고, \(\alpha = 1\)이고 \(\alpha_2 \rightarrow \infty\)이면 와이블 분포가 됩니다.
GB2 확률변수는 다음과 같이 구성할 수 있습니다. \(G_1\)와 \(G_2\)가 독립 확률변수이고, \(G_i\)가 형상모수 \(\alpha_i\)와 척도모수 1을 갖는 감마분포를 따른다고 가정합시다. 그러면 확률변수 \(X = \theta \left(\frac{G_1}{G_2}\right)^{\sigma}\)이 식 (4.2)에 요약된 pdf를 갖는 GB2 분포를 따름을 보일 수 있습니다. 이 이론적 결과는 몇 가지 시사점을 가집니다. 예를 들어, 적률이 존재할 때 GB2 분포를 따르는 확률변수의 \(k\)차 원적률은 \[ \mathrm{E}\left( X^{k} \right) = \frac{\theta^{k}~\mathrm{B}\left( \alpha_1 +k \sigma,\alpha_2 - k \sigma \right)}{\mathrm{B}\left( \alpha_1,\alpha_2 \right)}, \ \ \ k > 0. \] 로 주어짐을 보일 수 있습니다. 절 4.3.1.1에서 설명하겠지만, GB2는 \(F\)-분포와도 관련이 있으며, 이 결과는 시뮬레이션과 잔차 분석에 유용하게 쓰일 수 있습니다.
GB2는 초기에는 소득 데이터에 적용되었으며, 최근에는 꼬리가 긴 청구 데이터를 모형화하는 데 사용되어 왔습니다(절 13.2에서는 “긴 꼬리”라는 표현의 다양한 해석을 설명합니다). GB2는 의료보험 청구 데이터뿐만 아니라 다양한 유형의 자동차 보험 청구, 화재 손실의 심도를 모형화하는 데에도 사용되어 왔습니다.
Show Quiz Solution
4.3 새로운 분포를 만드는 방법
이 절에서는 다음을 배웁니다:
- 분포들 사이의 연관성 이해하기
- 어떤 분포가 다른 대안에 비해 언제 선호되는지에 대한 통찰 얻기
- 새로운 분포를 만들기 위한 기초 마련하기
4.3.1 확률변수의 함수와 그 분포
절 4.2에서는 몇 가지 기본적인 알려진 분포를 다루었습니다. 이 절에서는 기존의 분포로부터 새로운 모수적 확률분포를 만드는 방법을 논의합니다. 구체적으로, \(X\)를 알려진 pdf \(f_{X}(x)\)와 분포함수 \(F_{X}(x)\)를 갖는 연속형 확률변수라고 합시다. 우리는 \(Y = g\left( X \right)\)의 분포에 관심이 있으며, 여기서 \(g(X)\)는 새로운 확률변수 \(Y\)를 정의하는 일대일 변환(transformation) 한 분포를 다른 분포로 바꾸는 함수 또는 방법입니다. 이 절에서는 새로운 분포족을 만들기 위해 다음 기법들을 적용합니다: (a) 상수 곱하기, (b) 거듭제곱하기, (c) 지수화, (d) 혼합.
상수 곱하기
청구 데이터가 시간에 따른 변화를 보인다면 이러한 변환은 인플레이션을 조정하는 데 유용할 수 있습니다. 인플레이션 수준이 양수이면 청구 비용이 상승하고 있는 것이고, 음수이면 비용이 하락하고 있는 것입니다. 인플레이션을 조정하기 위해 비용 \(X\)에 1+ 인플레이션율을 곱합니다(음의 인플레이션은 디플레이션입니다). 청구 비용에 대한 통화의 영향을 반영하기 위해, 기준 통화에서 상대 통화로의 환전을 적용하는 변환도 사용합니다.
변환 \(Y = cX\)를 생각해 봅시다. 여기서 \(c > 0\)이면, \(Y\)의 분포함수는 \[ F_{Y}\left( y \right) = \Pr\left( Y \le y \right) = \Pr\left( cX \le y \right) = \Pr\left( X \le \frac{y}{c} \right) = F_{X}\left( \frac{y}{c} \right). \] 로 주어집니다. 미분의 연쇄 법칙을 사용하면, 관심 대상인 pdf \(f_{Y}(y)\)는 \[ f_{Y}\left( y \right) = \frac{1}{c}f_{X}\left( \frac{y}{c} \right). \] 로 쓸 수 있습니다. \(X\)가 어떤 모수적 분포(parametric distributions) 고정된 모수 집합으로 정의되는 확률분포의 집합에 속한다고 가정하고, 척도를 조정한 버전 \(Y\ = \ cX\), \(c\ > \ 0\)를 정의합니다. \(Y\)가 같은 분포 집합에 속하면, 그 분포를 척도 분포(scale distribution) 모든 값에 상수를 곱해도 척도모수만 바뀌고 같은 분포족에 속하는 성질을 갖는 분포라고 합니다. 척도 분포에 속하는 분포에 상수 \(c\) (\(c > 0\))를 곱하면, 이 척도 분포의 척도모수는 다음 두 조건을 만족합니다:
- 모수는 \(c\)를 곱한 값으로 바뀝니다.
- 다른 모든 모수는 변하지 않습니다.
예제 4.3.1. 계리사 시험 문제. Eiffel 자동차 보험의 손실은 유로화로 표시되며 \(\mu = 8\), \(\sigma = 2\)인 로그정규분포를 따릅니다. 1유로 \(=\) 1.3달러일 때, Eiffel의 달러 기준 손실 분포를 나타내는 로그정규 모수의 집합을 구하십시오.
예제 풀이 보기
예제 4.3.2. 계리사 시험 문제. 감마분포가 척도 분포임을 보이십시오.
예제 풀이 보기
예제와 같은 방법을 사용하면, 절 4.2에서 소개한 다른 분포들도 척도 분포임을 보일 수 있습니다. 보험계리 모형화에서 척도 분포를 다루는 것은 인플레이션의 효과를 반영하고 통화 단위의 변화를 수용할 수 있게 해 주므로 매우 편리합니다.
4.3.1.1 거듭제곱하기
절 4.2.3에서 우리는 신뢰성 데이터(reliability data) 고장 난 개체의 고장 시간과 아직 작동 중인 개체의 작동 시간으로 구성된 데이터셋를 적합하는 데 있어 와이블 분포의 유연성에 대해 이야기했습니다. 와이블 분포의 기원을 살펴보면, 와이블은 지수분포의 거듭제곱 변환(power transformation) 확률변수를 거듭제곱하는 변환 유형임을 알 수 있습니다. 이는 확률변수를 거듭제곱하는, 또 다른 유형의 변환을 적용한 것입니다.
변환 \(Y = X^{\tau}\)를 생각해 봅시다. 여기서 \(\tau > 0\)이면, \(Y\)의 분포함수는 \[ F_{Y}\left( y \right) = \Pr\left( Y \le y \right) = \Pr\left( X^{\tau} \le y \right) = \Pr\left( X \le y^{1/ \tau} \right) = F_{X}\left( y^{1/ \tau} \right). \] 로 주어집니다. 따라서 관심 대상인 pdf \(f_{Y}(y)\)는 \[ f_{Y}(y) = \frac{1}{\tau} y^{(1/ \tau) - 1} f_{X}\left( y^{1/ \tau} \right). \] 로 쓸 수 있습니다. 한편 \(\tau < 0\)이면, \(Y\)의 분포함수는 \[ F_{Y}\left( y \right) = \Pr\left( Y \le y \right) = \Pr\left( X^{\tau} \le y \right) = \Pr\left( X \geq y^{1/ \tau} \right) = 1 - F_{X}\left( y^{1/ \tau} \right), \] 로 주어지며 \[ f_{Y}(y) = \left| \frac{1}{\tau} \right|{y^{(1/ \tau) - 1}f}_{X}\left( y^{1/ \tau} \right). \]
예제 4.3.3. \(X\)가 평균이 \(\theta\)인 지수분포를 따른다고 가정하고, 변환된 변수 \(Y = X^{\tau}\)를 고려합시다. \(\tau\)가 양수일 때 \(Y\)가 와이블 분포를 따름을 보이고, 그 와이블 분포의 모수를 구하십시오.
예제 풀이 보기
특수한 경우. GB2와 \(F\)-분포의 관계. 상수를 곱하거나 거듭제곱하는 것과 같은 변환을 사용하여 GB2 분포가 응용통계학에서 널리 쓰이는 분포인 \(F\)-분포와 관련되어 있음을 확인할 수 있습니다.
GB2와 F-분포의 관계
지수변환
정규분포는 매우 다양한 응용 분야에서 널리 쓰이는 모형이며, 표본 크기가 클 때에는 다른 모형에 대한 근사분포로 사용될 수 있습니다. 확률변수 \(X\)이 평균이 \(\mu\)이고 분산이 \(\sigma^{2}\)인 정규분포를 따르면, \(Y = e^{X}\)는 모수가 \(\mu\)와 \(\sigma^{2}\)인 로그정규분포(lognormal distribution) 확률변수의 자연로그가 같은 모수 값을 갖는 정규분포를 따르는, 꼬리가 두껍고 양의 왜도를 갖는 2-모수 연속분포를 따릅니다. 로그정규 확률변수는 하한이 0이고, 양의 왜도를 가지며, 긴 오른쪽 꼬리를 가집니다. 로그정규분포는 주가와 같은 금융자산의 분포를 설명하는 데 흔히 사용됩니다. 또한 자동차보험뿐만 아니라 건강보험의 청구액을 적합하는 데에도 사용됩니다. 이는 지수변환을 포함하는 또 다른 유형의 변환의 예입니다.
일반적으로 변환 \(Y = e^{X}\)를 생각해 봅시다. 그러면 \(Y\)의 분포함수는 \[ F_{Y}\left( y \right) = \Pr\left( Y \le y \right) = \Pr\left( e^{X} \le y \right) = \Pr\left( X \le \log y \right) = F_{X}\left( \log y \right). \] 로 주어집니다. 도함수를 구하면, 관심 대상인 pdf \(f_{Y}(y)\)는 \[ f_{Y}(y) = \frac{1}{y}f_{X}\left( \log y \right). \] 로 쓸 수 있음을 알 수 있습니다. 중요한 특수한 경우로서, \(X\)가 평균이 \(\mu\)이고 분산이 \(\sigma^2\)인 정규분포를 따른다고 가정합시다. 그러면 \(Y = e^X\)의 분포는 \[ f_{Y}(y) = \frac{1}{y}f_{X}\left( \log y \right) = \frac{1}{y \sigma \sqrt{2 \pi}} \exp \left\{-\frac{1}{2}\left(\frac{ \log y - \mu}{\sigma}\right)^2\right\}. \] 입니다. 이를 로그정규 분포라고 합니다.
예제 4.3.4. 계리사 시험 문제. \(X\)가 구간 \((0,\ c)\)에서 균등분포를 따른다고 가정하고 \(Y = e^{X}\)로 정의합니다. \(Y\)의 분포를 구하십시오.
예제 풀이 보기
4.3.2 심도에 대한 혼합분포
혼합분포는 이질적 모집단(heterogeneous population) 하위 모집단이 서로 구별되는 개별 분포로 표현되는 데이터셋에서 추출된 데이터를 모형화하는 유용한 방법입니다. 이 모집단은 서로 다른 분포를 갖는 여러 하위 모집단으로 나뉘어 있다고 생각할 수 있습니다.
유한 혼합
2점 혼합
근본 현상이 다양하여 실제로 최빈값이 서로 다른 두 하위 모집단을 나타내는 두 현상으로 설명될 수 있다면, 2점 혼합 확률변수 \(X\)를 구성할 수 있습니다. 확률변수 \(X_{1}\)와 \(X_{2}\)의 pdf가 각각 \(f_{X_{1}}\left( x \right)\)와 \(f_{X_{2}}\left( x \right)\)일 때, \(X\)의 pdf는 구성 요소 pdf \(f_{X_{1}}\left( x \right)\)와 \(f_{X_{2}}\left( x \right)\)의 가중평균입니다. \(X\)의 pdf와 분포함수는 각각 \[ f_{X}\left( x \right) = af_{X_{1}}\left( x \right) + \left( 1 - a \right)f_{X_{2}}\left( x \right), \] 및 \[ F_{X}\left( x \right) = aF_{X_{1}}\left( x \right) + \left( 1 - a \right)F_{X_{2}}\left( x \right), \]
로 주어지며(단, \(0 < a <1\)), 여기서 혼합 모수(mixing parameters) 혼합에서 각 하위 모집단에 주어지는 비율 가중치 \(a\)와 \((1 - a)\)는 각각 두 하위 모집단에 속하는 데이터 점의 비율을 나타냅니다. 이러한 가중평균은 분포와 관련된 여러 다른 양에도 적용할 수 있습니다. \(X\)의 k차 원적률과 적률생성함수는 각각 \(\mathrm{E}\left( X^{k} \right) = a\mathrm{E}\left( X_{1}^{K} \right) + \left( 1 - a \right)\mathrm{E}\left( X_{2}^{k} \right)\), \[ M_{X}(t) = aM_{X_{1}}(t) + \left( 1 - a \right)M_{X_{2}}(t), \] 입니다.
예제 4.3.5. 계리사 시험 문제. 어떤 보험계약 집합은 두 가지 유형으로 구성됩니다. 보험계약의 25%는 유형 1이고 75%는 유형 2입니다. 유형 1 보험계약의 연간 손실 금액은 평균이 200인 지수분포를 따르고, 유형 2 보험계약의 연간 손실 금액은 모수가 \(\alpha=3\) 및 \(\theta=200\)인 파레토 분포를 따릅니다. 두 유형의 증권 전체에서 무작위로 선택한 증권에 대해, 연간 손실이 100 미만일 확률을 구하고 평균 손실을 구하십시오.
예제 풀이 보기
k점 혼합
유한 혼합분포의 경우, 관심 확률변수 \(X\)는 확률 \(p_{i}\)로 동질적인 하위 모집단 \(i\)에서 추출되며, 여기서 \(i = 1,2,\ldots,k\)이고 \(k\)는 혼합에서 처음에 지정한 하위 모집단의 개수입니다. 혼합 모수 \(p_{i}\)는 하위 모집단 \(i\)에서 나온 관측값의 비율을 나타냅니다. \(k\)개의 서로 다른 하위 모집단에서 생성된 확률변수 \(X\)를 생각해 봅시다. 여기서 하위 모집단 \(i\)는 연속분포 \(f_{X_{i}}\left( x \right)\)로 모형화됩니다. \(X\)의 확률분포는 \[f_{X}\left( x \right) = \sum_{i = 1}^{k}{p_{i}f_{X_{i}}\left( x \right)},\] 로 주어지며, 여기서 \(0 < p_{i} < 1\)이고 \(\sum_{i = 1}^{k} p_{i} = 1\)입니다.
이 모형은 흔히 유한 혼합(finite mixture) 하위 모집단의 수 k가 유한한 혼합분포 또는 \(k\)점 혼합이라고 합니다. \(k\)점 혼합의 분포함수, \(r\)차 원적률, 적률생성함수는 각각 \[ F_{X}\left( x \right) = \sum_{i = 1}^{k}{p_{i}F_{X_{i}}\left( x \right)}, \] \[ \mathrm{E}\left( X^{r} \right) = \sum_{i = 1}^{k}{p_{i}\mathrm{E}\left( X_{i}^{r} \right)}, \ \ \ \text{and} \] \[ M_{X}(t) = \sum_{i = 1}^{k}{p_{i}M_{X_{i}}(t)}, \] 와 같습니다.
예제 4.3.6. 계리사 시험 문제. \(Y_{1}\)는 혼합 가중치가 \(a\)와 \((1 - a)\)인 \(X_{1}\)와 \(X_{2}\)의 혼합입니다. \(Y_{2}\)는 혼합 가중치가 \(b\)와 \((1 - b)\)인 \(X_{3}\)와 \(X_{4}\)의 혼합입니다. \(Z\)는 혼합 가중치가 \(c\)와 \((1 - c)\)인 \(Y_{1}\)와 \(Y_{2}\)의 혼합입니다.
\(Z\)가 \(X_{1}\), \(X_{2}\), \(X_{3}\), \(X_{4}\)의 혼합임을 보이고, 혼합 가중치를 구하십시오.
예제 풀이 보기
연속 혼합
하위 모집단의 수가 매우 많은(\(k\)가 무한대로 가는) 혼합을 흔히 연속 혼합(continuous mixture) 하위 모집단의 수가 무한하며, 혼합 모수 자체가 연속분포를 따르는 혼합분포이라고 합니다. 연속 혼합에서 하위 모집단은 이산적인 혼합 모수가 아니라 연속형 변수 \(\Theta\)에 의해 구분되며, 여기서 \(\Theta\)는 유한 혼합에서 \(p_{i}\)의 역할을 합니다. 모수 \(\Theta\)에 의존하는 분포를 갖는 확률변수 \(X\)를 생각해 봅시다. 여기서 \(\Theta\) 자체도 연속형 확률변수입니다. 이러한 설정으로부터 \(X\)에 대한 다음 모형을 얻습니다. \[ f_{X}\left( x \right) = \int_{-\infty}^{\infty}{f_{X}\left(x \left| \theta \right. \right)g_{\Theta}( \theta )} d \theta , \] 여기서 \(f_{X}\left( x | \theta \right)\)은 \(\Theta=\theta\)의 특정 값에서 \(X\)의 조건부 분포(conditional distribution) 조건을 만족하는 하위 모집단에 적용되는 확률분포이고, \(g_{\Theta}\left( \theta \right)\)는 미지의 모수 \(\theta\)에 대한 확률적 진술입니다. 베이지안 맥락(9장에서 설명할 예정입니다)에서는 이를 \(\Theta\)의 사전분포(prior distribution) 추가 데이터를 관측하기 전에 부여되는 확률분포(분석에 사용될 사전 정보 또는 전문가 의견)라고 합니다.
연속 혼합의 분포함수, \(k\)차 원적률, 적률생성함수는 각각 다음과 같습니다. \[ F_{X}\left( x \right) = \int_{-\infty}^{\infty}{F_{X}\left(x \left| \theta \right. \right) g_{\Theta}(\theta)} d \theta, \] \[ \mathrm{E}\left( X^{k} \right) = \int_{-\infty}^{\infty}{\mathrm{E}\left( X^{k}\left| \theta \right. \right)g_{\Theta}(\theta)}d \theta, \] \[ M_{X}(t) = \mathrm{E}\left( e^{t X} \right) = \int_{-\infty}^{\infty}{\mathrm{E}\left( e^{ tx}\left| \theta \right. \right)g_{\Theta}(\theta)}d \theta, \]
혼합분포의 \(k\)차 원적률은 \[ \mathrm{E}\left( X^{k} \right) = \int_{-\infty}^{\infty}{\mathrm{E}\left( X^{k}\left| \theta \right. \right)g_{\Theta}(\theta)}d\theta ~=~ \mathrm{E}\left\lbrack \mathrm{E}\left( X^{k}\left| \Theta \right. \right) \right\rbrack . \] 로 다시 쓸 수 있습니다. 반복 기댓값의 법칙(부록 18장 참조)을 이용하면 \(X\)의 평균과 분산을 \[ \mathrm{E}\left( X \right) = \mathrm{E}\left\lbrack \mathrm{E}\left( X\left| \Theta \right. \right) \right\rbrack \] 및 \[ \mathrm{Var}\left( X \right) = \mathrm{E}\left\lbrack \mathrm{Var}\left( X\left| \Theta \right. \right) \right\rbrack + \mathrm{Var}\left\lbrack \mathrm{E}\left( X\left| \Theta \right. \right) \right\rbrack . \]
예제 4.3.7. 보험계리사 시험 문제. \(X\)는 평균이 \(\Lambda\)이고 분산이 1인 정규분포를 따릅니다. \(\Lambda\)는 평균이 1이고 분산이 1인 정규분포를 따릅니다. \(X\)의 평균과 분산을 구하십시오.
예제 풀이 보기
예제 4.3.8. 보험계리사 시험 문제. 청구 크기 \(X\)는 각 보험계약자에 대해 구간 \(\left(\Theta,\Theta+10\right)\)에서 균등분포를 따릅니다. \(\Theta\)는 평균이 5인 지수분포에 따라 보험계약자마다 다릅니다. \(X\)의 무조건부 분포(unconditional distribution) 부과된 다른 어떤 조건과도 무관한 확률분포, 평균, 분산을 구하십시오.
예제 풀이 보기
Show Quiz Solution
4.4 손실 분포의 추정
이 절에서는 다음을 학습합니다.
- 모수적 분포를 참조하지 않고 적률, 분위수, 분포를 추정합니다
- 모수적 분포를 참조하지 않고 데이터를 그래프로 요약합니다
- 적률법, 백분위수 대응법, 최대가능도 추정을 사용하여 여러 분포의 모수를 추정합니다.
4.4.1 비모수적 추정
빈도에 관한 3.4절과 심도에 관한 4.1절에서는 평균, 분산, 분위수/백분위수 등을 계산하여 분포를 요약하는 방법을 배웠습니다. 데이터셋을 이용하여 이러한 요약 측도를 근사하는 한 가지 전략은 다음과 같습니다.
- 빈도에 대해서는 음이항분포, 심도에 대해서는 감마분포와 같이 분포의 모수적 형태를 가정하고, ii. 그 분포의 모수를 추정한 다음, iii. 추정된 모수를 갖는 분포를 사용하여 원하는 요약 측도를 계산합니다.
이것이 모수적(parametric) 데이터를 추출한 모집단에 대해 분포 가정을 세우며, 그 성질은 모수를 사용하여 정의됩니다. 접근법입니다. 또 다른 전략은 모수적 모형을 참조하지 않고 관측값으로부터 원하는 요약 측도를 직접 추정하는 것입니다. 당연하게도, 이를 비모수적(nonparametric) 데이터를 추출한 모집단에 대해 어떠한 분포 가정도 하지 않습니다. 접근법이라고 합니다.
가장 기본적인 유형의 표본추출 방식(sampling scheme) 데이터를 모집단으로부터 어떻게 얻는지, 그리고 어떤 데이터가 관측되는지에 관한 것입니다.부터 생각해 봅시다. 관측값은 확률변수 집합 \(X_1, \ldots, X_n\)의 실현값이며, 이 확률변수들은 미지의 모집단 분포 \(F(\cdot)\)에서 iid(iid) 독립적이고 동일하게 분포된로 추출되었다고 가정합니다. 이를 달리 말하면 \(X_1, \ldots, X_n\)가 \(F(\cdot)\)에서 (복원) 추출한 확률표본이라는 것입니다. 이제 분포를 요약하는 여러 중요한 측도의 비모수적 추정량을 설명합니다.
4.4.1.1 적률 추정량
빈도에 대한 적률은 3.2.2절에서, 심도에 대한 적률은 4.1.1절에서 정의하는 방법을 배웠습니다. 특히 \(k\)차 적률 \(\mathrm{E~}[X^k] = \mu^{\prime}_k\)은 \(k\)를 다르게 선택함에 따라 분포의 여러 측면을 요약합니다. 여기서 \(\mu^{\prime}_k\)은 그에 대응하는 비모수적 추정량인 \(k\)차 표본 적률 \[ \frac{1}{n} \sum_{i=1}^n X_i^k , \] 과 구별하기 위해 \(k\)차 모집단 적률이라고 부르기도 합니다. 이론적으로 반드시 그럴 필요는 없지만, 일반적인 응용에서 \(k\)는 양의 정수입니다. 모집단 평균 \(\mu\)에 대한 표본 추정량을 표본평균이라고 하며, 확률변수 위에 막대를 붙여 나타냅니다: \[ \overline{X} =\frac{1}{n} \sum_{i=1}^n X_i . \] \(k\)차 중심적률 \(\mu_k\)의 비모수적 추정량, 즉 표본 추정량은 \[ \frac{1}{n} \sum_{i=1}^n \left(X_i - \overline{X}\right)^k . \] 입니다. \(n^{-1}\sum_{i=1}^n \left(X_i - \overline{X}\right)^2\)와 같은 분산의 표본적률 추정량의 성질은 광범위하게 연구되었지만, 이것이 가능한 유일한 추정량은 아닙니다. 가장 널리 쓰이는 형태는 유효 표본 크기를 하나 줄인 것이며, 따라서 다음과 같이 정의합니다. \[ s^2 = \frac{1}{n-1} \sum_{i=1}^n \left(X_i - \overline{X}\right)^2. \] 보험 응용에서 흔히 그렇듯 표본 크기 \(n\)이 클 때에는 \(n\) 대신 \(n-1\)로 나누는 것이 거의 차이를 만들지 않습니다. 표본분산 추정량 \(s^2\)은 \(\mathrm{E~} [s^2] = \sigma^2\)이라는 의미에서 불편(unbiased) 편향이 없는 추정량, 즉 추정량의 기댓값이 추정 대상 모수와 같은 추정량입니다.이며, 이는 특히 분석 결과를 해석할 때 바람직한 성질입니다.
경험분포함수
지금까지 \(k\)차 적률 \(\mathrm{E~} [X^k]\)의 비모수적 추정량을 계산하는 방법을 살펴보았습니다. 같은 방식으로, 임의의 알려진 함수 \(\mathrm{g}(\cdot)\)에 대해 \(n^{-1}\sum_{i=1}^n \mathrm{g}(X_i)\)를 사용하여 \(\mathrm{E~} [\mathrm{g}(X)]\)를 추정할 수 있습니다.
이제 고정된 \(x\)에 대해 함수 \(\mathrm{g}(X) = I(X \le x)\)를 생각해 봅시다. 여기서 표기 \(I(\cdot)\)는 지시함수(indicator) 두 개의 그룹만을 갖는 범주형 변수입니다. 수치값은 보통 어떤 속성이 있음을 나타낼 때 1, 그렇지 않을 때 0으로 둡니다. 이진 변수의 다른 이름입니다. 함수로, 사건 \((\cdot)\)가 참이면 1을, 그렇지 않으면 0을 반환합니다. 이제 확률변수 \(\mathrm{g}(X)\)는 베르누이 분포(\(n=1\)인 이항분포)를 따른다는 점에 유의하십시오. 이 분포를 이용하면 평균과 분산 같은 양을 쉽게 계산할 수 있습니다. 예를 들어, \(\mathrm{g}(\cdot)\)를 이와 같이 선택하면 기댓값은 \(\mathrm{E~} [I(X \le x)] = \Pr(X \le x) = F(x)\), 즉 \(x\)에서 평가한 분포함수입니다. 분포함수의 비모수적 추정량을 다음과 같이 정의합니다.
\[
\begin{aligned}
F_n(x)
&= \frac{1}{n} \sum_{i=1}^n I\left(X_i \le x\right) \\
&= \frac{\text{number of observations less than or equal to }x}{n} .
\end{aligned}
\]
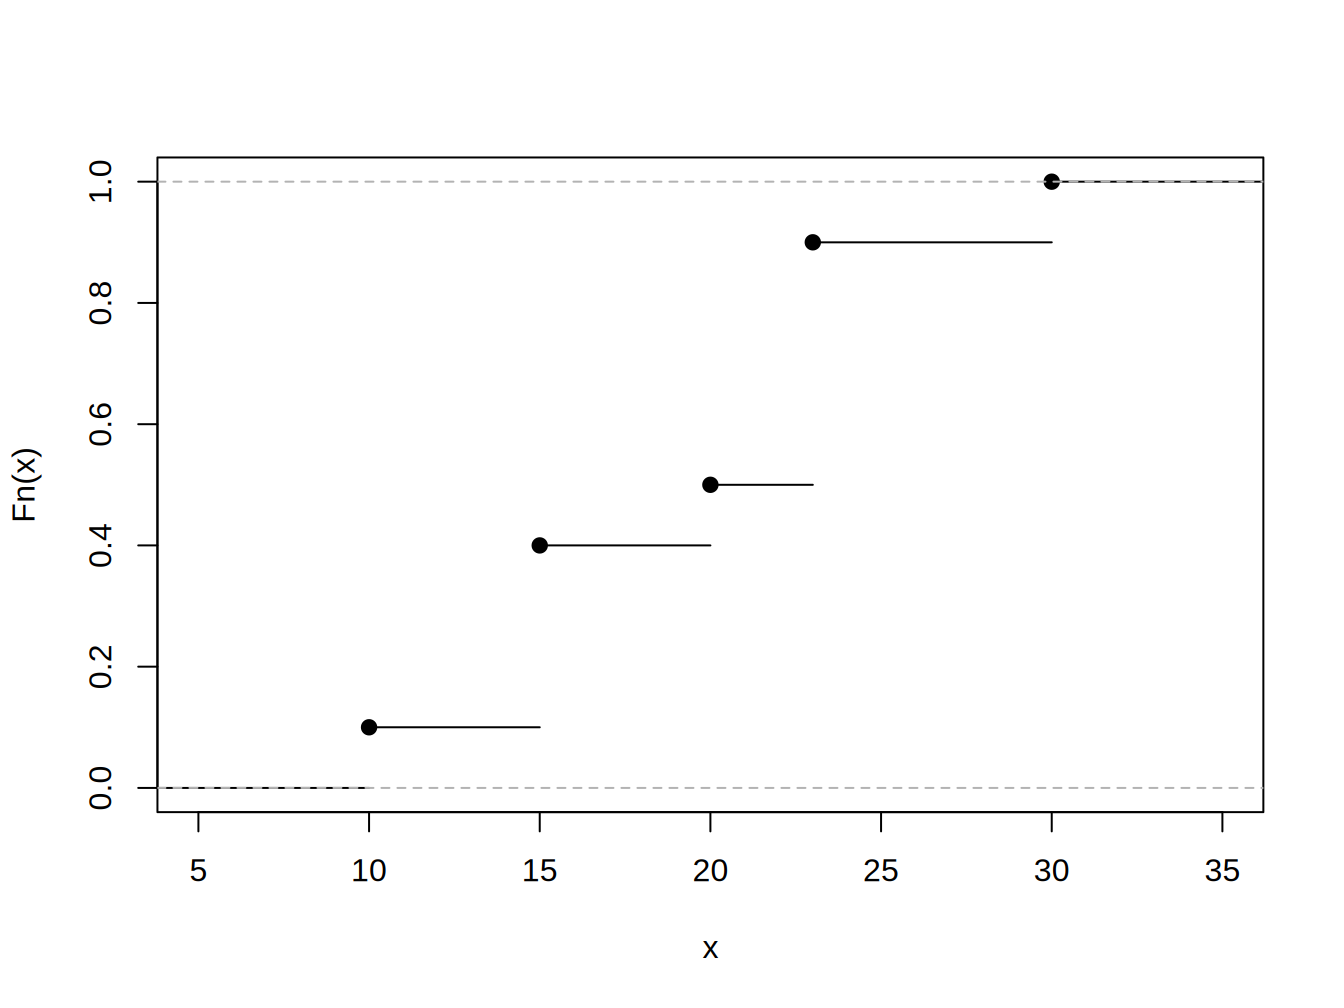
\(F_n(\cdot)\)은 관측값에만 근거하며 분포에 대해 모수적 분포족을 가정하지 않으므로 비모수적이며, 경험분포함수(empirical distribution function) 경험분포는 확률변수의 기저 분포에 대한 비모수적 추정입니다. 데이터 관측값을 직접 사용하여 분포를 구성하며, 크기가 n인 표본에서 관측된 각 데이터 점은 1/n의 확률을 갖습니다.라고도 합니다. 이는 경험누적분포함수라고도 하며, R에서는 ecdf(.) 함수를 사용하여 계산할 수 있습니다.
예제 4.4.1. 장난감 데이터 세트. 예시를 위해, \(n=10\)개의 관측값으로 이루어진 가상의, 즉 “장난감” 데이터 세트를 생각해 봅시다. 경험분포함수를 구하십시오.
\[ {\small \begin{array}{c|cccccccccc} \hline i &1&2&3&4&5&6&7&8&9&10 \\ X_i& 10 &15 &15 &15 &20 &23 &23 &23 &23 &30\\ \hline \end{array} } \]
예제 풀이 보기
4.4.1.2 사분위수, 백분위수 및 분위수
중앙값 중앙값(median) 분포의 50번째 백분위수, 즉 분포의 절반이 그 아래에 놓이는 중앙값은 4.1.2절에서 이미 살펴보았습니다. 중앙값은 데이터 집합의 약 절반이 그 값보다 작은(또는 큰) 수입니다. 제1사분위수(first quartile) 제25백분위수로, 데이터의 약 25%가 그보다 작은 값이 되는 수입니다.는 데이터의 약 25%가 그보다 작은 수이고, 제3사분위수(third quartile) 제75백분위수로, 데이터의 약 75%가 그보다 작은 값이 되는 수입니다.는 데이터의 약 75%가 그보다 작은 수입니다. \(100p\) 백분위수(percentile) 100p번째 백분위수는 데이터의 100p퍼센트가 그 아래에 있게 되는 수입니다.는 데이터의 \(100 \times p\)퍼센트가 그보다 작은 수입니다.
이 개념을 일반화하기 위해, 연속일 수도 있고 아닐 수도 있는 분포함수 \(F(\cdot)\)를 생각하고, \(q\)를 \(0<q<1\)를 만족하는 비율이라 합시다. 분위수(quantile) q번째 분위수는 분포함수의 값이 q와 같아지는 점(들), 즉 누적분포함수의 역함수입니다. \(q_F\)를 \(F(q_F) \approx q\)를 만족하는 수로 정의하고자 합니다. \(q = 0.5\)일 때 \(q_F\)는 중앙값이고, \(q = 0.25\)일 때 \(q_F\)는 제1사분위수이며, 나머지도 마찬가지입니다. 같은 방식으로, \(q = 0, 0.01, 0.02, \ldots, 0.99, 1.00\)일 때 얻어지는 \(q_F\)는 백분위수입니다. 따라서 분위수는 중앙값, 사분위수, 백분위수의 개념을 일반화한 것입니다.
엄밀하게 말하면, 주어진 \(0<q<1\)에 대해 \(q\)분위수 \(q_F\)를 \[\begin{equation} F(q_F-) \le q \le F(q_F) \tag{4.3} \end{equation}\] 를 만족하는 임의의 수로 정의합니다. 여기서 \(F(x-)\)라는 표기는 함수 \(F(\cdot)\)를 좌극한으로 평가한다는 의미입니다.
이 정의를 더 잘 이해하기 위해 몇 가지 특수한 경우를 살펴봅시다. 먼저, 그림 4.5에 나타낸 것처럼 \(X\)가 연속형 확률변수여서 분포함수 \(F(\cdot)\)에 도약점이 없는 경우를 고려합시다. 이 그림에는 몇 가지 비율 \(q_1\), \(q_2\), \(q_3\)가 그에 대응하는 분위수 \(q_{F,1}\), \(q_{F,2}\), \(q_{F,3}\)와 함께 표시되어 있습니다. 각 경우에 \(F(q_F-)= F(q_F)\)이므로 분위수가 유일하게 존재함을 알 수 있습니다. 임의의 \(0<q<1\)에서 분포함수의 유일한 역함수를 구할 수 있으므로, \(q_F= F^{-1}(q)\)라고 쓸 수 있습니다.
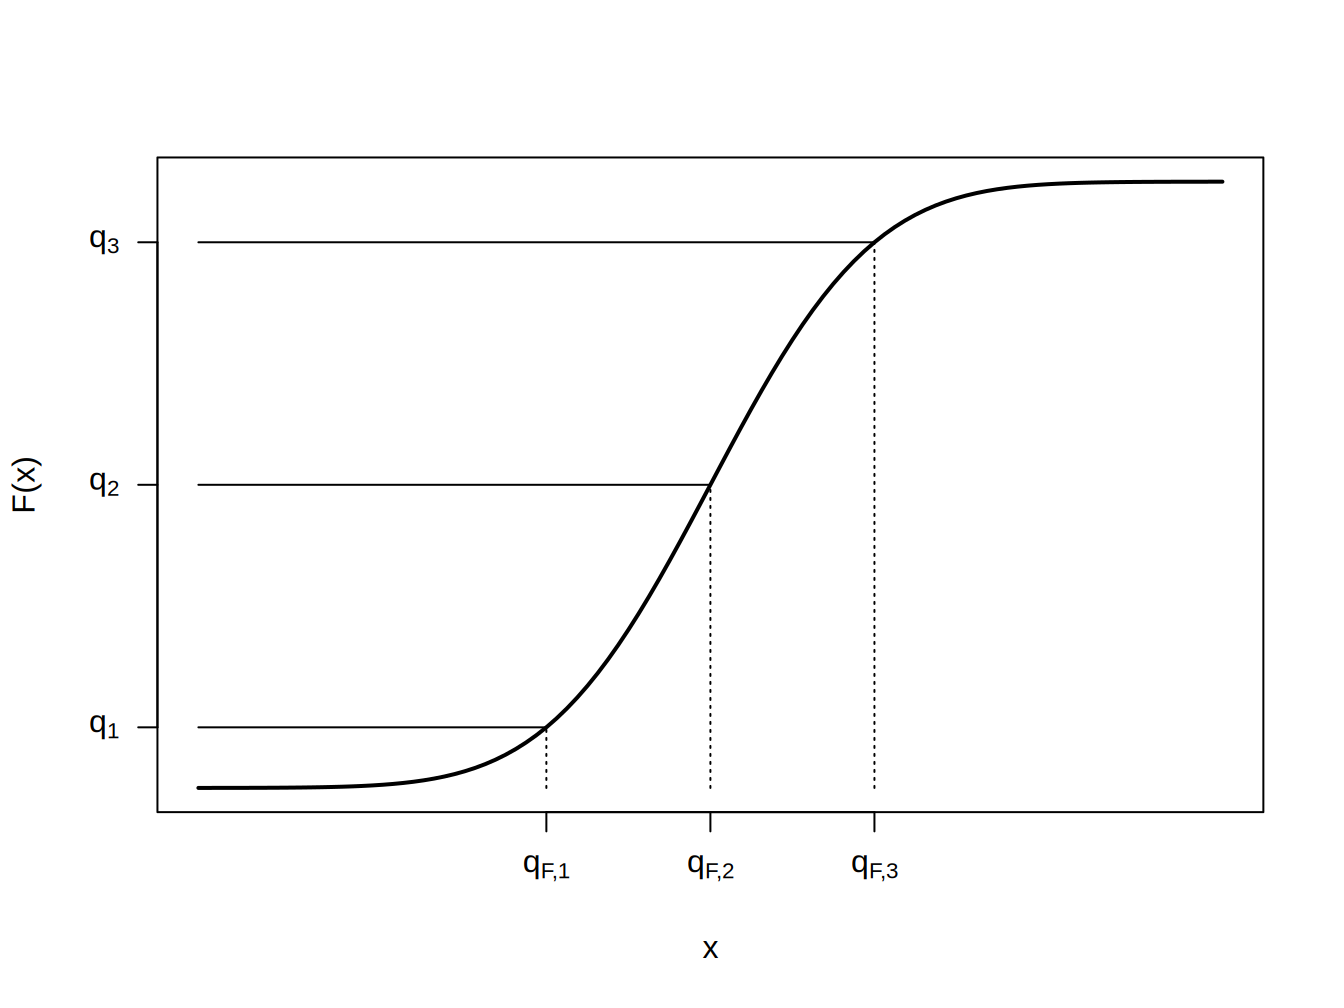
그림 4.5: 연속형 분위수의 경우
그림 4.6은 분포함수의 세 가지 경우를 보여 줍니다. 왼쪽 패널은 방금 논의한 연속형 경우에 해당합니다. 가운데 패널은 그림 4.4의 경험분포함수에서 이미 본 것과 비슷한 도약점을 보여 줍니다. 이 패널에 표시된 \(q\) 값에 대해서는 여전히 분위수 \(q_F\)의 값이 유일합니다. \(F(q_F-) \le q \le F(q_F)\)를 만족하는 \(q\) 값은 많지만, 특정한 \(q\) 값에 대해 식 (4.3)의 해는 하나뿐입니다. 오른쪽 패널은 식 (4.3)을 만족하는 \(q_F\)가 구간을 이루기 때문에, 표시된 \(q\)에 대해 분위수를 유일하게 정할 수 없는 상황을 나타냅니다.
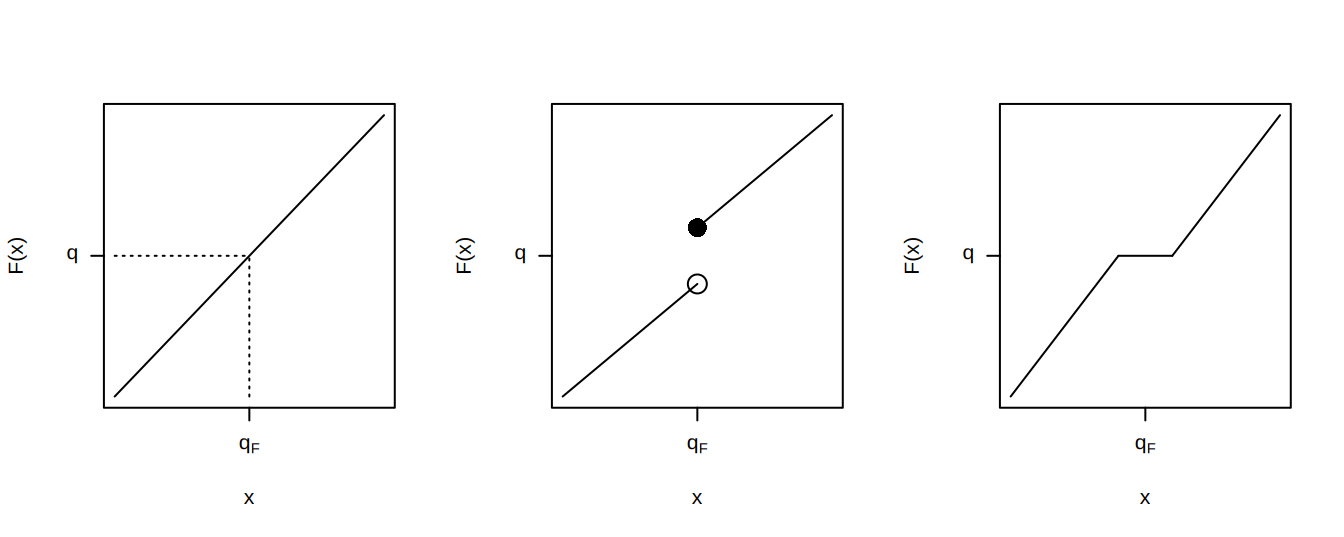
그림 4.6: 분위수의 세 가지 경우
예제 4.4.2. 장난감 데이터 집합: 계속. 20번째, 50번째, 95번째 백분위수에 해당하는 분위수를 구하십시오.
예제 풀이 보기
데이터 관측값 사이의 가중평균을 취함으로써, 평활 경험분위수는 그림 4.6의 오른쪽 패널과 같은 경우를 다룰 수 있습니다. \(q\)번째 평활 경험분위수(smoothed empirical quantile) 두 경험분위수, 즉 두 데이터 점 사이를 선형 보간하여 얻은 분위수.는 \[ \hat{\pi}_q = (1-h) X_{(j)} + h X_{(j+1)} \] 로 정의되며, 여기서 \(j=\lfloor(n+1)q\rfloor\), \(h=(n+1)q-j\), \(X_{(1)}, \ldots, X_{(n)}\)은 \(X_1, \ldots, X_n\)에 대응하는 순서화된 값(순서통계량이라고 합니다)입니다. (괄호 \(\lfloor \cdot\rfloor\)은 최대 정수값을 나타내는 바닥 함수임을 상기하십시오.) \(\hat{\pi}_q\)은 단순히 \(X_{(j)}\)과 \(X_{(j+1)}\) 사이의 선형 보간이라는 점에 유의하십시오.
예제 4.4.3. 장난감 데이터 세트: 계속. 50번째 및 20번째 평활 백분위수를 구하십시오.
예제 풀이 보기
4.4.1.3 밀도 추정량
이산형 변수. 확률변수가 이산형인 경우, 확률질량함수 \(f(x) = \Pr(X=x)\)를 추정하는 것은 간단합니다. 단순히 표본평균을 사용하며, 이는 \[ f_n(x) = \frac{1}{n} \sum_{i=1}^n I(X_i = x), \] 으로 정의되고 \(x\)과 같은 표본의 비율입니다.
그룹 내 연속형 변수. 연속형 확률변수의 경우, \(F(\cdot)\)의 정의역이 상수 \(\{c_0 < c_1 < \cdots < c_k\}\)에 의해 \(j=1, \ldots, k\)에 대해 \([c_{j-1}, c_j)\) 형태의 구간들로 분할되는 이산화된 정식화를 고려하십시오. 따라서 데이터 관측값은 그것이 속하는 구간에 따라 “그룹화”됩니다. 그러면 경험적 질량함수의 기본 정의를 사용하거나, \[ f_n(x) = \frac{n_j}{n \times (c_j - c_{j-1})} \ \ \ \ \ \ c_{j-1} \le x < c_j, \] 과 같은 변형을 사용할 수 있으며, 여기서 \(n_j\)는 구간 \([c_{j-1}, c_j)\)에 속하는 관측값(\(X_i\))의 개수입니다.
연속형 변수(그룹화되지 않은 경우). 이 개념을 개별 데이터를 관측하는 경우로 확장하면, 언제나 임의의 그룹을 만들어 이 공식을 사용할 수 있다는 점에 유의하십시오. 보다 형식적으로, \(b>0\)을 대역폭(bandwidth) 계단의 폭과 평활화 정도를 결정하는 작은 양의 상수.라고 하는 작은 양의 상수라 하고, 밀도 추정량을 다음과 같이 정의합니다. \[\begin{equation} f_n(x) = \frac{1}{2nb} \sum_{i=1}^n I(x-b < X_i \le x + b) \tag{4.4} \end{equation}\]
이론 일부 보기
보다 일반적으로, \(x\)에서 pdf(pdf) 확률밀도함수의 커널 밀도 추정량(kernel density estimator) 확률변수의 밀도함수에 대한 비모수적 추정량.을 \[\begin{equation} f_n(x) = \frac{1}{nb} \sum_{i=1}^n w\left(\frac{x-X_i}{b}\right) , \tag{4.5} \end{equation}\] 로 정의하며, 여기서 \(w\)는 0을 중심으로 하는 확률밀도함수입니다. 식 (4.4)은 \(w(x) = \frac{1}{2}I(-1 < x \le 1)\)인 커널 밀도 추정량의 특수한 경우이며, 이는 균등 커널이라고도 한다는 점에 유의하십시오. 그 밖에 널리 쓰이는 선택지는 표 4.1에 나와 있습니다.
표 4.1. 널리 쓰이는 커널 선택
\[ {\small \begin{matrix} \begin{array}{l|cc} \hline \text{Kernel} & w(x) \\ \hline \text{Uniform } & \frac{1}{2}I(-1 < x \le 1) \\ \text{Triangle} & (1-|x|)\times I(|x| \le 1) \\ \text{Epanechnikov} & \frac{3}{4}(1-x^2) \times I(|x| \le 1) \\ \text{Gaussian} & \phi(x) \\ \hline \end{array}\end{matrix} } \]
여기서 \(\phi(\cdot)\)는 표준정규 밀도함수입니다. 다음 예제에서 보듯이, 대역폭 \(b\)의 선택에는 국소적인 분포 특성을 맞추는 것과 변동성을 줄이는 것 사이의 편향-분산 상충관계(bias-variance tradeoff) 모형의 단순성(과소적합, 높은 편향)과 유연성(과적합, 높은 분산) 사이의 상충 관계.가 따릅니다.
예제 4.4.4. 재산 기금. 그림 4.7는 2010년 로그 재산 청구액의 히스토그램(회색 음영 직사각형)을 보여 줍니다. (파란색) 굵은 곡선은 가우스 커널 밀도를 나타내며, 여기서 대역폭은 이 데이터의 표본 크기와 변동성에 기반한 임시 규칙을 사용하여 자동으로 선택되었습니다. 이 데이터셋의 경우 대역폭은 \(b=0.3255\)로 나타났습니다. 비교를 위해 (빨간색) 점선 곡선은 대역폭이 0.1인 밀도 추정량을 나타내고, 초록색 매끄러운 곡선은 대역폭 1을 사용합니다. 예상대로 더 작은 대역폭(0.1)은 더 적은 데이터에 대해 국소 평균을 취한다는 것을 의미하므로 국소 평균을 더 잘 파악할 수 있지만, 그 대가로 변동성이 커집니다. 반대로 더 큰 대역폭(1)은 국소적 요동을 평활화하여 더 매끄러운 곡선을 만들지만, 국소 평균의 섭동을 놓칠 수 있습니다. 보험계리 응용에서는 주로 데이터에 대한 시각적 인상을 빠르게 얻기 위해 커널 밀도 추정량을 사용합니다. 이러한 관점에서 대역폭 선택에는 기본 임시 규칙을 그대로 사용하면 되며, 당면한 상황에 따라 이를 변경할 수 있다는 점을 알아 두면 됩니다.
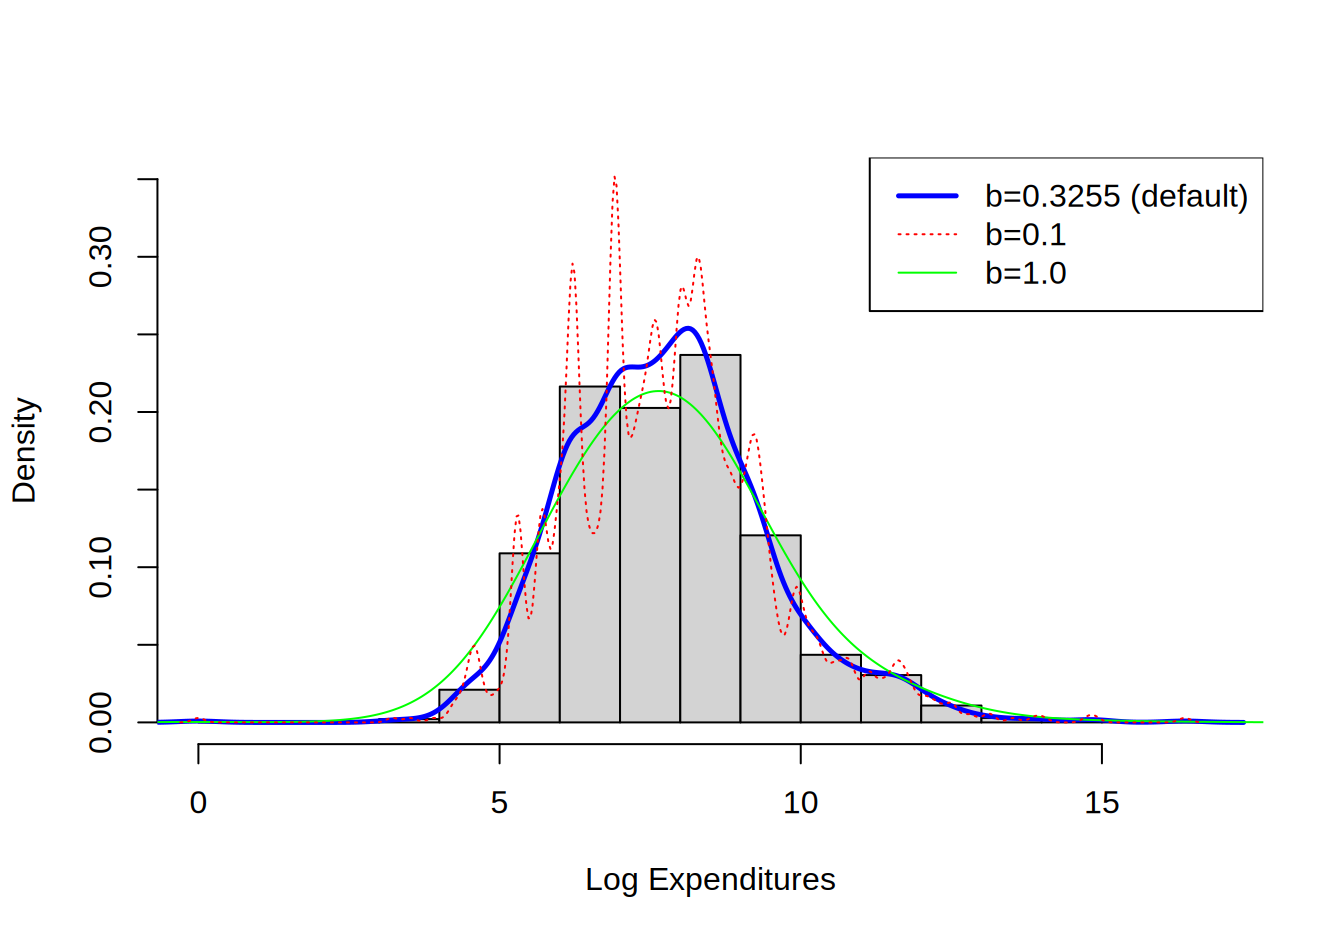
그림 4.7: 커널 밀도 추정량을 겹쳐 그린 로그 재산 청구액의 히스토그램
R 코드 보기
커널 추정량과 같은 비모수 밀도 추정량은 실무에서 일상적으로 사용됩니다. 이 개념은 경험분포함수의 매끄러운 버전을 제공하도록 확장할 수도 있습니다. 커널 밀도 추정량의 정의가 주어지면 분포함수의 커널 추정량은 \[ \begin{aligned} \tilde{F}_n(x) = \frac{1}{n} \sum_{i=1}^n W\left(\frac{x-X_i}{b}\right).\end{aligned} \] 로 구할 수 있으며, 여기서 \(W\)는 커널 밀도 \(w\)에 대응하는 분포함수입니다. 예를 들어 균등 커널의 경우 \(w(y) = \frac{1}{2}I(-1 < y \le 1)\)이므로 \[ \begin{aligned} W(y) = \begin{cases} 0 & y<-1\\ \frac{y+1}{2}& -1 \le y < 1 \\ 1 & y \ge 1 \\ \end{cases}\end{aligned} . \]
예제 4.4.5. 보험계리사 시험 문제. 질병 발병부터 사망까지의 시간을 추정하기 위해 다섯 명을 연구합니다. 사망까지의 시간은 다음과 같습니다: \[ \begin{array}{ccccc} 2 & 3 & 3 & 3 & 7 \\ \end{array} \] 대역폭 \(2\)인 삼각 커널을 사용하여 2.5에서의 밀도함수 추정값을 계산하십시오.
예제 풀이 보기
4.4.2 모수적 추정
절 4.2에서는 보험 응용에서 흔히 사용되는 모수적 분포에 초점을 맞추었습니다. 그러나 응용 작업에 유용하려면 이러한 분포는 모수에 “현실적인” 값을 사용해야 합니다. 이 절에서는 모수를 추정하는 세 가지 방법인 적률법, 백분위수 대응법, 최대가능도 추정을 다룹니다.
적률법
적률법(method of moments) 모수적 적률을 경험적 표본 적률로 근사하여 모집단 모수를 추정하는 것.에서는 절 4.4.1.1에서 설명한 경험적률을 사용하여 모수적 분포의 적률을 근사합니다. 그런 다음 대수적으로 풀어 모수 추정값을 구할 수 있습니다.
예제 4.4.6. 재산 기금. 2010년 재산 기금에는 \(n=1,377\)건의 개별 청구(단위: 천 달러)가 있으며 \[ m_1 = \frac{1}{n} \sum_{i=1}^n X_i = 26.62259 \ \ \ \ \text{and} \ \ \ \ m_2 = \frac{1}{n} \sum_{i=1}^n X_i^2 = 136154.6 . \] 적률법을 사용하여 감마 분포와 파레토 분포의 모수를 적합하십시오.
예제 풀이 보기
위 예제에서 알 수 있듯이, 적률법에는 유연성이 있습니다. 예를 들어, 1차와 2차 적률 대신 2차와 3차 적률을 일치시킬 수도 있었으며, 그 경우 다른 추정량이 얻어집니다. 또한 각 문제에 대해 해가 존재한다는 보장이 없습니다. 중도절단되거나 절단된 데이터의 경우, 일부 문제에서는 적률을 일치시키는 것이 가능하지만 일반적으로는 더 어려운 상황입니다. 마지막으로, 적률이 존재하지 않거나 무한한 분포에 대해서는 적률법을 사용할 수 없습니다. 대안으로 백분위수 대응 기법을 사용할 수 있습니다.
백분위수 대응
백분위수 대응법(percentile matching) 경험분위수를 사용하여 모수적 백분위수를 근사함으로써 모집단 모수를 추정하는 것.에서는 4.4.1.2절에서 설명한 경험분위수 또는 경험 백분위수를 사용하여 모수적 분포의 분위수 또는 백분위수를 근사합니다.
예제 4.4.7. 재산 기금. 2010년 재산 기금에 대해 분위수 일치를 예시합니다. 특히 파레토 분포는 분위수에 대한 닫힌 형태의 해가 있기 때문에 직관적으로 매력적입니다. 파레토 분포의 분포함수가 \[ F(x) = 1 - \left(\frac{\theta}{x+\theta}\right)^{\alpha}. \] 임을 상기하십시오. 간단한 대수 계산으로 분율 \(q\), \(0<q<1\)에 대해 분위수를 \[ F^{-1}(q) = \theta \left( (1-q)^{-1/\alpha} -1 \right) , \] 로 나타낼 수 있음을 알 수 있습니다.
25번째와 95번째 경험분위수를 사용하여 파레토 분포 모수의 추정값을 구하십시오.
예제 풀이 보기
예제 4.4.8. 계리사 시험 문제. 다음이 주어져 있습니다.
- 손실은 누적분포함수가 \[ F(x) = \frac{\left(x/\theta\right)^{\gamma}}{1+\left(x/\theta\right)^{\gamma}} \] 인 로그로지스틱 분포를 따릅니다. (ii) 손실 표본은 다음과 같습니다. \[ \begin{array}{ccccccccccc} 10 &35 &80 &86 &90 &120 &158 &180 &200 &210 &1500 \\ \end{array} \]
40번째와 80번째 평활 경험 백분위수 추정값을 사용하여 백분위수 대응으로 \(\theta\)의 추정값을 계산하십시오.
예제 풀이 보기
적률법과 마찬가지로, 백분위수 대응은 선택한 백분위수에 따라 추정량이 달라질 수 있다는 점에서 지나치게 유연하다고 할 수 있습니다. 예를 들어, 어떤 계리사는 25번째와 95번째 백분위수를 사용하여 추정하는 반면, 다른 계리사는 20번째와 80번째 백분위수를 사용할 수 있습니다. 일반적으로 추정된 모수는 서로 다르며, 어느 한쪽을 다른 쪽보다 선호할 만한 설득력 있는 이유는 없습니다. 또한 적률법과 마찬가지로, 백분위수 대응은 특정 상황에서 쉽게 적용할 수 있고 직관적인 근거를 갖는 기법을 제공한다는 점에서 매력적입니다. 대부분의 계리 응용에서는 최대가능도 추정량을 사용하지만, 적률법이나 백분위수 대응과 같은 대안적 접근법을 사용할 수 있으면 편리할 수 있습니다.
4.4.2.1 완전 데이터에 대한 최대가능도 추정량
기초적인 수준에서, 분석가가 분포함수 \(F_X\)를 갖는 분포로부터 얻은 확률표본 \(X_1, \ldots, X_n\)을 가지고 있다고 가정합니다(간결함을 위해 때때로 아래첨자 \(X\)를 생략합니다). 일반적인 관례에 따라, \(F\)의 모수 집합을 나타내기 위해 벡터 \(\boldsymbol \theta\)를 사용합니다. 이 기본적인 표본 추출 방식은 부록 17.1.1절에서 다룹니다. 이 표본추출 방식은 기본적이지만, 실무에서 일상적으로 사용되는 더 복잡한 방식을 이해하는 기초를 제공하므로 기본을 확실히 익히는 것이 중요합니다.
분포로부터 추출하기 전에, 확률변수 \(X_i\)로 요약되는 잠재적 결과를 고려합니다(여기서 \(i\)는 1, 2, …, \(n\)입니다). 추출한 후에는 \(x_i\)를 관측합니다. 표기상, 확률변수에는 로마자 대문자를, 실현값에는 소문자를 사용합니다. 이러한 설정은 이미 3.4절에서 살펴보았으며, 그곳에서는 표본 \(\{x_1, \ldots, x_n\}\)를 추출할 “가능도”를 정량화하기 위해 \(\Pr(X_1 =x_1, \ldots, X_n=x_n)\)를 사용했습니다. 연속형 데이터의 경우에는 결합확률 대신 결합 확률밀도함수를 사용합니다. 독립성 가정하에서 결합 pdf는 pdf들의 곱으로 쓸 수 있습니다. 따라서 가능도를 \[\begin{equation} L(\boldsymbol \theta) = \prod_{i=1}^n f(x_i) . \tag{4.6} \end{equation}\] 로 정의합니다. 표기에서 알 수 있듯이, 데이터 \(\{x_1, \ldots, x_n\}\)를 고정한 채 이를 \(\boldsymbol \theta\)에 있는 모수들의 함수로 간주한다는 점에 유의하십시오. 최대가능도 추정량은 \(L(\boldsymbol \theta)\)를 최대화하는 \(\boldsymbol \theta\)의 모수값입니다.
미적분학에서 알 수 있듯이, 함수를 최대화하는 것은 그 함수의 로그를 최대화하는 것과 같은 결과를 냅니다(로그가 단조함수이기 때문입니다). 같은 결과를 얻으므로 계산을 쉽게 하기 위해 \[\begin{equation} l(\boldsymbol \theta) = \log L(\boldsymbol \theta) = \sum_{i=1}^n \log f(x_i) . \tag{4.7} \end{equation}\] 로 표기되는 로그가능도를 고려하는 것이 일반적입니다. 부록 17.2.2절에서는 최대가능도 추정의 기초를 다루며, 더 자세한 수학적 내용은 부록 19장에서 다룹니다.
예제 4.4.9. 계리사 시험 문제. 다음 다섯 개의 관측값이 주어집니다: 521, 658, 702, 819, 1217. 다음 분포함수를 갖는 단일모수 파레토 분포를 사용합니다: \[ F(x) = 1- \left(\frac{500}{x}\right)^{\alpha}, ~~~~ x>500 . \] \(n=5\)일 때, 로그가능도함수는 다음과 같습니다. \[ l(\alpha) = \sum_{i=1}^5 \log f(x_i;\alpha ) = 5 \alpha \log 500 + 5 \log \alpha -(\alpha+1) \sum_{i=1}^5 \log x_i. \]
그림 4.8은 모수 \(\alpha\)의 함수로서 로그가능도를 보여 줍니다.
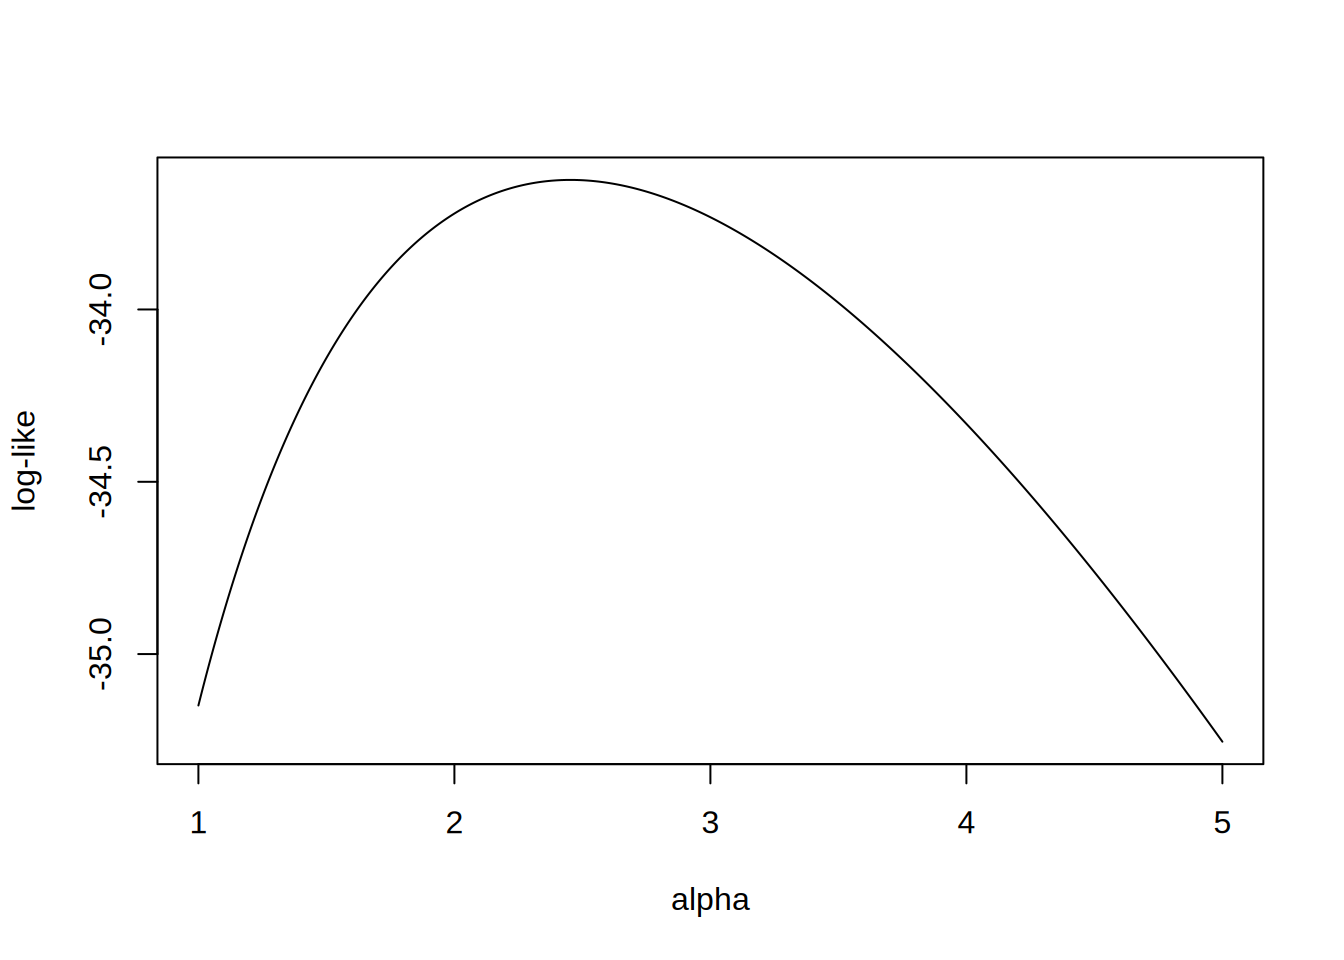
그림 4.8: 단일 모수 파레토 분포의 로그가능도
도함수를 구하여 0으로 놓으면 로그가능도의 최댓값을 구할 수 있습니다. 그러면
\[
\begin{array}{ll}
\frac{ \partial}{\partial \alpha } l(\alpha ) &= 5 \log 500 + 5 / \alpha - \sum_{i=1}^5 \log x_i
=_{set} 0 \Rightarrow \\
\hat{\alpha}_{MLE} &= \frac{5}{\sum_{i=1}^5 \log x_i - 5 \log 500 } = 2.453 .
\end{array}
\]
을 얻습니다. 물론 최적화를 손으로 계산하는 것이 실용적이지 않은 문제도 많습니다. 다행히 R 함수 optim과 같이 사용할 수 있는 통계 루틴이 많이 있습니다.
최적화를 위한 R 코드
이 코드는 최대가능도 추정량이 \(\alpha_{MLE} =\) 2.453125이라는 우리의 손 계산 결과를 확인해 줍니다.
계리사가 최대가능도를 사용하여 일련의 청구 데이터에 모수적 분포 모형을 적합하는 방법을 보여 주는 몇 가지 추가 예제를 제시합니다.
예제 4.4.10. 계리사 시험 문제. 다음 청구액의 확률표본을 고려하십시오: 8000 10000 12000 15000. 청구액이 모수 \(\theta\)를 갖는 역지수분포를 따른다고 가정합니다. \(\theta\)에 대한 최대가능도 추정량을 계산하십시오.
예제 풀이 보기
예제 4.4.11. 계리사 시험 문제. 크기가 6인 확률표본이 모수 \(\mu\)와 \(\sigma\)를 갖는 로그정규분포에서 추출되었습니다. 표본값은 다음과 같습니다. \[ 200 \ \ \ 3000 \ \ \ 8000 \ \ \ 60000 \ \ \ 60000 \ \ \ 160000. \] \(\mu\)와 \(\sigma\)에 대한 최대가능도 추정량을 계산하십시오.
예제 풀이 보기
두 후속 질문은 이전 과정에서 보았을 수도 있는 대표본 성질에 기반합니다. 부록 19장에서는 가능도함수의 정의를 복습하고, 그 성질을 소개하며, 최대가능도 추정량을 복습하고, 그 대표본 성질을 모형에 모수가 여러 개 있는 경우로 확장하며, 최대가능도 추정량에 기반한 통계적 추론을 복습합니다. 이 예제들의 풀이에서는 모형 모수의 최대가능도 추정량의 점근 분산을 유도합니다. 이 모수들의 함수의 점근 분산을 유도하기 위해 델타 방법을 사용합니다.
예제 4.4.10 - 후속 질문. 예제 4.4.10을 참조하십시오.
- 최대가능도 추정량의 분산을 근사하십시오. b. \(\theta\)에 대한 근사 95% 신뢰구간을 구하십시오. c. \(\Pr \left( X \le 9,000 \right).\)에 대한 근사 95% 신뢰구간을 구하십시오.
예제 풀이 보기
예제 4.4.11 - 후속. 예제 4.4.11을 참조하십시오.
- 최대가능도 추정량의 공분산 행렬(covariance matrix) (i,j)번째 원소가 i번째 확률변수와 j번째 확률변수 사이의 공분산을 나타내는 행렬을 추정하십시오. b. \(\mu\)와 \(\sigma\)에 대한 근사 95% 신뢰구간을 구하십시오. c. 로그정규분포의 평균에 대한 근사 95% 신뢰구간을 구하십시오.
예제 풀이 보기
예제 4.4.12. 위스콘신 재산 기금. 최대가능도 추정량이 실제 데이터에서 어떻게 작동하는지 살펴보기 위해, 1.3절에서 소개한 2010년 청구 데이터로 돌아갑니다.
다음 코드 조각은 지수, 감마, 파레토, 로그정규, \(GB2\) 모형을 적합하는 방법을 보여 줍니다. 일관성을 위해 이 코드는 R 패키지 VGAM을 사용합니다. 이 약어는 Vector Generalized Linear and Additive Models(벡터 일반화 선형 및 가법 모형)를 뜻합니다. 이름에서 알 수 있듯이 이 패키지는 이러한 모형을 적합하는 것보다 훨씬 많은 일을 할 수 있지만, 우리의 목적에는 이것으로 충분합니다. 유일한 예외는 보험 분야 외에서는 널리 사용되지 않는 \(GB2\) 밀도입니다. 그러나 이 밀도를 직접 코드로 작성하고 범용 최적화 함수인 optim을 사용하여 최대가능도 추정량을 계산할 수 있습니다.
예제 풀이 보기
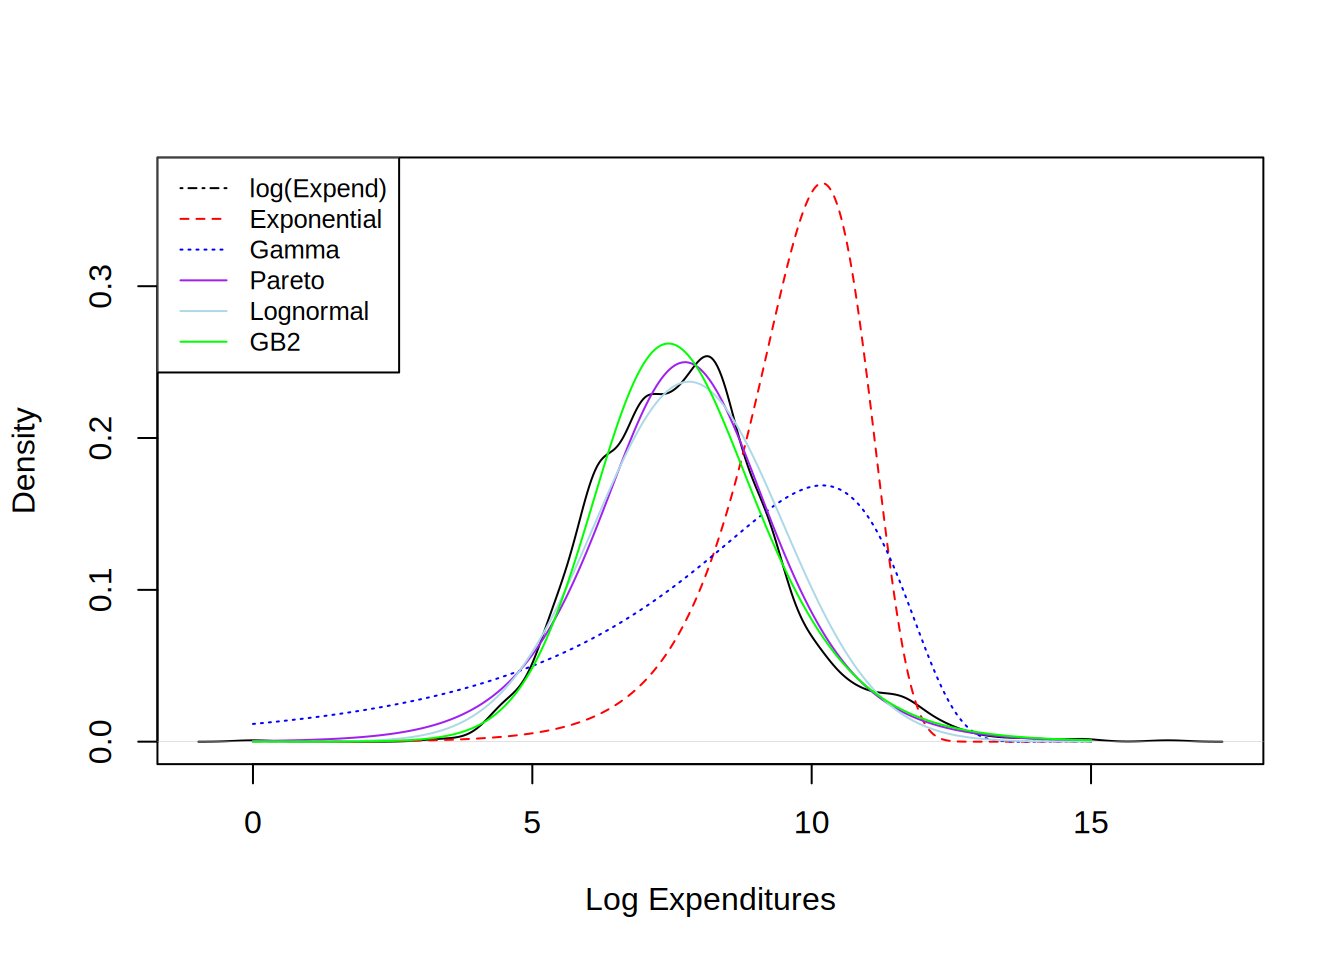
그림 4.9: 위스콘신 재산 기금의 밀도 비교
적합 결과는 그림 4.9에 요약되어 있습니다. 여기서 검은색 “longdash” 곡선은 실제 데이터의 밀도 추정량(4.4.1.3절에서 소개함)이며, 나머지 곡선은 모수를 최대가능도로 계산한 모수적 곡선입니다. 지수분포 적합을 나타내는 빨간색 파선과 감마분포 적합을 나타내는 파란색 점선은 적합도가 좋지 않음을 알 수 있습니다. 나머지 곡선인 파레토, 로그정규, GB2는 모두 실제 데이터에 상당히 잘 적합하는 것으로 보입니다. 6장에서는 모형 선택의 원리를 더 자세히 설명합니다.
시작값
일반적으로 최대가능도는 데이터를 더 효율적으로 활용하므로 모수 추정에 선호되는 기법입니다. (효율성의 정확한 정의는 부록 장 19을 참조하십시오.) 그러나 적률법과 백분위수 대응법은 해석하기가 더 쉬워 계리사나 분석가가 다른 사람에게 절차를 설명하기 좋으므로 유용합니다. 또한 최대가능도를 위한 수치적 추정 절차(예: R에서 수행하는 경우)는 반복적이며, 재귀 과정을 시작하려면 시작값이 필요합니다. 많은 문제는 시작값 선택에 영향을 크게 받지 않지만, 일부 복잡한 상황에서는 (알려지지 않은) 최적값에 가까운 시작값을 갖는 것이 중요할 수 있습니다. 적률법과 백분위수 대응법은 큰 계산 부담 없이 바람직한 추정값을 산출할 수 있으므로, 최대가능도를 계산하기 위한 시작값으로 사용할 수 있습니다.
Show Quiz Solution
4.5 실무 중심 연습문제
연습문제 4.1. 기업 출장 이 연습문제는 연습문제 1.1에서 소개한 데이터 세트를 바탕으로 하며, 이번에는 심도 모형화에 초점을 둡니다. 연습문제 3.14에서와 같이, 2006-2021년 기간의 데이터를 적합하되 청구액은 10(호주 달러) 이상인 것으로 제한합니다.
- a.
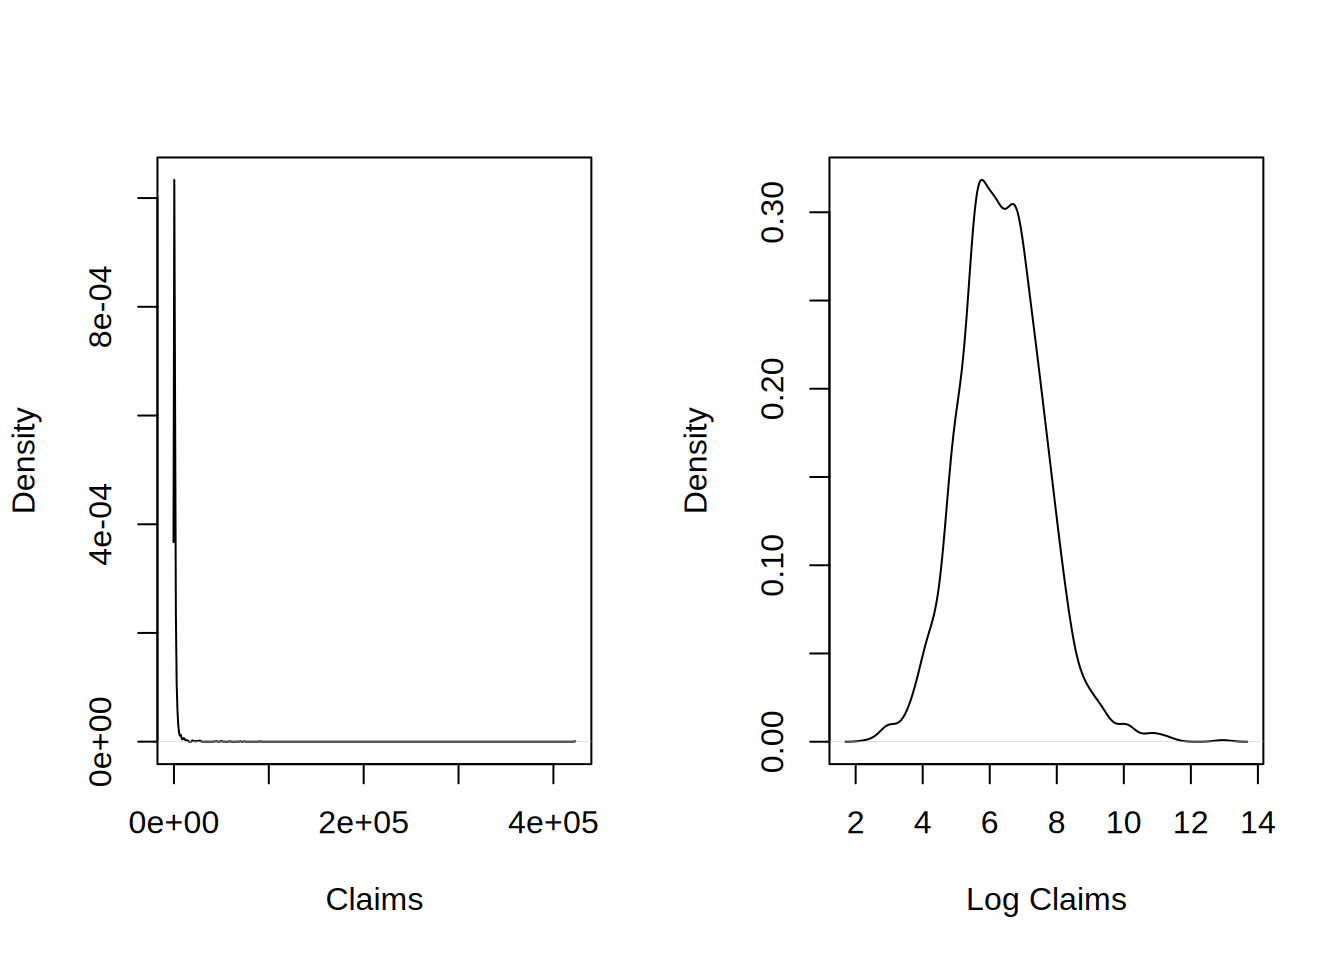
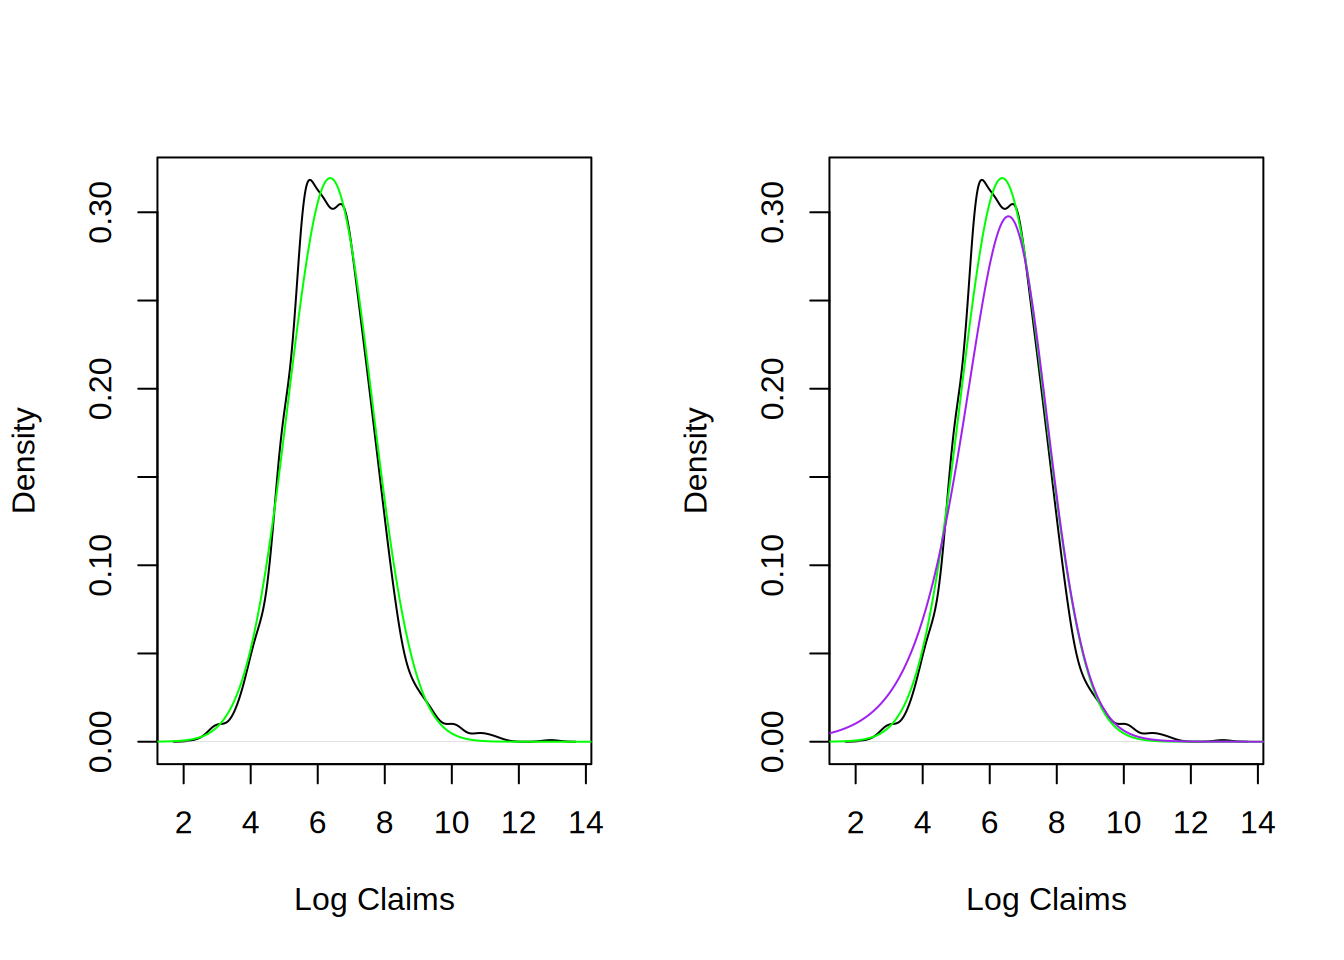
R함수density를 사용하여 데이터 범위에 걸쳐 원래 척도와 로그 척도 모두에서 청구액의 비모수 밀도 추정값을 제시하십시오. 이 그림을 사용하여 로그 척도에서 그림이 더 해석하기 쉽다는 것을 확인하십시오. - b. 로그 청구액에 정규분포를 적합하고, 적합된 분포를 비모수(경험) 분포와 비교하십시오. 이 비교를 로그정규분포가 이 데이터를 나타내기에 매우 좋은 후보라는 의미로 해석하십시오.
- c. 대안으로, 최대가능도를 사용하여 청구 데이터에 파레토 분포를 적합하십시오. 결과를 검증하기 위해 두 가지 방법으로 수행하십시오. 기본적인 접근법은 로그 가능도함수를 만든 뒤 (함수
optim을 사용하여) 이를 최소화하는 것입니다. 두 번째 방법은VGAM패키지의vglm함수를 사용하는 것입니다. - d. 우리는 \(X\)을 파레토 분포로 적합했지만 \(Y=\ln(X)\)을 그리고자 합니다. 4.3.1.3절에서 \(F_Y(y) = F_X(e^y)\)과 \(f_Y(y) = e^y f_X(e^y)\)임을 보았습니다. 이 변환을 사용하여 (b)의 그림에 파레토 분포를 추가하십시오.
이 분석을 통해 로그정규분포와 파레토 분포가 데이터에 거의 비슷하게 적합되며, 로그정규분포가 약간 더 낫다는 것을 알 수 있습니다.
연습문제 4.1 풀이
연습문제 4.2. 위스콘신 재산 기금. 연습문제 4.1에서 보인 기법을 사용하여 예제 4.4.12에서 소개한 실제 데이터 예제를 재현하십시오.
연습문제 4.3. 단체 상해보험. 이 연습문제는 연습문제 1.2에서 소개한 데이터 세트를 바탕으로 합니다. 이용 가능한 모든 연도의 발생 청구액을 사용하며, 여전히 10 미만인 청구액은 제외합니다.
손실에 분포를 적합할 수 있습니다. 그림 4.10에 요약된 분석은 발생 손실에 감마분포, 파레토 분포, 로그정규분포를 최대가능도로 적합한 결과를 보여 줍니다. 이 그림은 로그정규분포가 가장 잘 적합되는 것으로 보인다는 것을 시사합니다.
연습문제 4.1과 4.2의 개요에 따라 이 데이터를 최대가능도로 적합하고, 결과를 요약하는 그림을 재현하십시오.
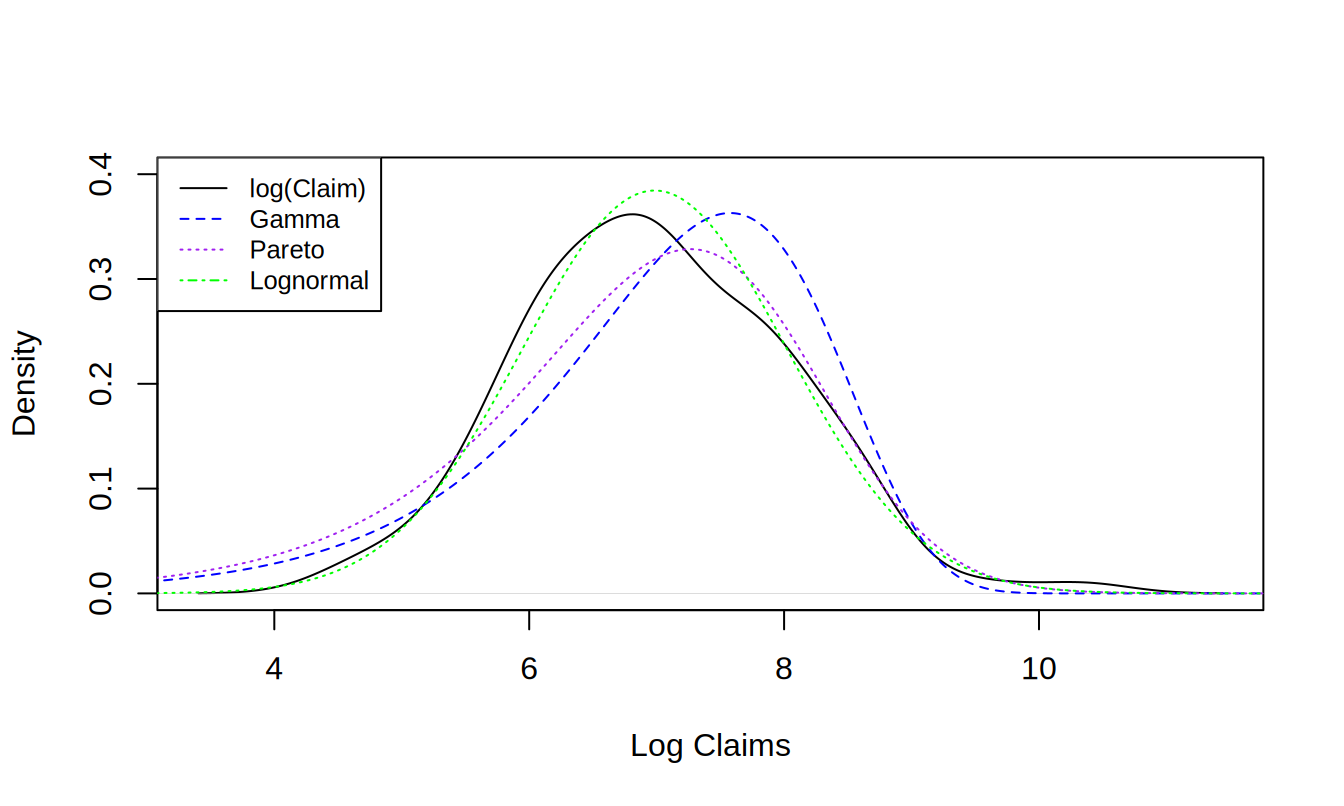
그림 4.10: 적합된 분포를 겹쳐 그린 단체 상해 손실 분포
연습문제 4.3 풀이
4.6 추가 자료 및 기여자
기여자
- 카이로 아메리칸 대학교의 Zeinab Amin은 이 장의 초판과 제2판의 주 저자입니다. 위스콘신 대학교 매디슨의 Edward (Jed) Frees와 Lisa Gao는 이 책 초판의 4장에 실렸던 비모수적 추정 관련 절들의 주 저자입니다. 이 장에 대한 의견이나 개선 제안은 zeinabha@aucegypt.edu로 이메일을 보내 주십시오.
- Hirokazu (Iwahiro) Iwasawa가 많은 유익한 의견을 주었습니다 iwahiro@bb.mbn.or.jp.
- 그 밖의 이 장의 검토자로는 Rob Erhardt, Samuel Kolins, Tatjana Miljkovic, Michelle Xia, Jorge Yslas가 있습니다.