접미사 오토마톤
접미사 오토마톤은 문자열과 관련된 많은 문제를 풀 수 있게 해 주는 강력한 자료 구조입니다.
예를 들어, 한 문자열 안에서 다른 문자열이 나타나는 모든 위치를 찾거나, 주어진 문자열의 서로 다른 부분 문자열의 개수를 셀 수 있습니다. 두 작업 모두 접미사 오토마톤을 이용하면 선형 시간에 해결할 수 있습니다.
직관적으로, 접미사 오토마톤은 주어진 문자열의 모든 부분 문자열을 압축한 형태로 이해할 수 있습니다. 놀라운 점은 접미사 오토마톤이 이 모든 정보를 매우 압축된 형태로 담고 있다는 것입니다. 길이가 $n$인 문자열에 대해 접미사 오토마톤은 $O(n)$의 메모리만 필요로 합니다. 게다가 (알파벳의 크기 $k$를 상수로 간주하면) $O(n)$ 시간에 구축할 수도 있으며, 그렇지 않으면 메모리와 시간 복잡도는 모두 $O(n \log k)$가 됩니다.
접미사 오토마톤 크기의 선형성은 1983년 Blumer 등이 처음 발견하였고, 1985년에 Crochemore와 Blumer가 최초의 선형 구축 알고리즘을 발표하였습니다.
접미사 오토마톤의 정의
주어진 문자열 $s$에 대한 접미사 오토마톤은 문자열 $s$의 모든 접미사를 받아들이는 최소 DFA(결정적 유한 오토마톤 / 결정적 유한 상태 기계)입니다.
다시 말하면 다음과 같습니다:
- 접미사 오토마톤은 방향이 있는 비순환 그래프입니다. 정점을 상태라고 부르고, 간선을 상태 사이의 전이라고 부릅니다.
- 상태 중 하나인 $t_0$은 초기 상태이며, 그래프의 시작점(source)이어야 합니다(다른 모든 상태는 $t_0$에서 도달할 수 있습니다).
- 각 전이에는 어떤 문자가 레이블로 붙어 있습니다. 한 상태에서 나가는 모든 전이는 서로 다른 레이블을 가져야 합니다.
- 하나 이상의 상태가 종료 상태로 표시됩니다. 초기 상태 $t_0$에서 출발하여 전이를 따라 종료 상태까지 이동하면, 지나온 전이들의 레이블은 문자열 $s$의 접미사 중 하나를 이루어야 합니다. $s$의 모든 접미사는 각각 $t_0$에서 종료 상태까지 가는 경로로 표현될 수 있어야 합니다.
- 접미사 오토마톤은 위에서 설명한 조건을 만족하는 모든 오토마톤 중에서 정점의 개수가 가장 적습니다.
부분 문자열 성질
접미사 오토마톤의 가장 단순하면서도 가장 중요한 성질은 문자열 $s$의 모든 부분 문자열에 대한 정보를 담고 있다는 것입니다. 초기 상태 $t_0$에서 시작하는 임의의 경로에 대해 전이의 레이블을 차례로 적으면 $s$의 부분 문자열이 됩니다. 그리고 반대로 $s$의 모든 부분 문자열은 $t_0$에서 시작하는 어떤 경로에 대응됩니다.
설명을 간단히 하기 위해, 부분 문자열이 그 경로($t_0$에서 시작하고 레이블이 그 부분 문자열을 이루는 경로)에 대응한다고 하겠습니다. 그리고 반대로 임의의 경로는 그 레이블들이 이루는 문자열에 대응한다고 하겠습니다.
하나의 상태로 이어지는 경로는 하나일 수도 있고 여러 개일 수도 있습니다. 따라서 상태는 이 경로들에 대응하는 문자열들의 집합에 대응한다고 하겠습니다.
구축된 접미사 오토마톤의 예시
여기서는 몇 가지 간단한 문자열에 대한 접미사 오토마톤의 예시를 보여 드리겠습니다.
초기 상태는 파란색으로, 종료 상태는 초록색으로 표시하겠습니다.
문자열 $s =~ \text{""}$의 경우:

문자열 $s =~ \text{"a"}$의 경우:
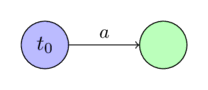
문자열 $s =~ \text{"aa"}$의 경우:
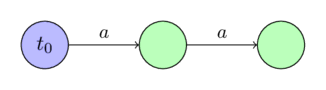
문자열 $s =~ \text{"ab"}$의 경우:
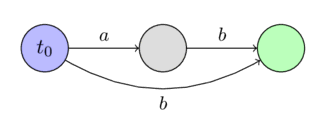
문자열 $s =~ \text{"aba"}$의 경우:
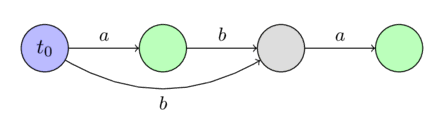
문자열 $s =~ \text{"abb"}$의 경우:
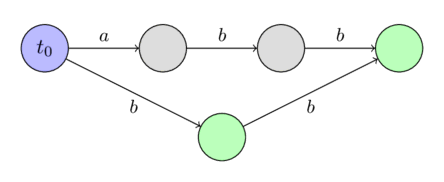
문자열 $s =~ \text{"abbb"}$의 경우:
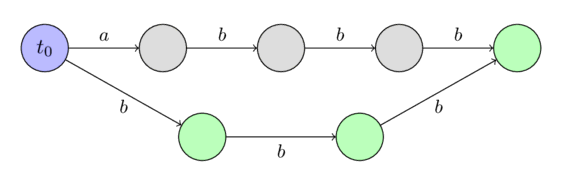
선형 시간 구성
접미사 오토마톤을 선형 시간에 구성하는 알고리즘을 설명하기 전에, 구성 과정을 이해하는 데 매우 중요한 몇 가지 새로운 개념과 간단한 증명을 소개해야 합니다.
끝 위치 $endpos$
문자열 $s$의 비어 있지 않은 임의의 부분 문자열 $t$를 생각해 봅시다. 문자열 $s$에서 $t$의 출현이 끝나는 모든 위치의 집합을 $endpos(t)$로 나타내겠습니다. 예를 들어, 문자열 $\text{"abcbc"}$에 대해 $endpos(\text{"bc"}) = \{2, 4\}$입니다.
두 부분 문자열 $t_1$과 $t_2$의 끝 위치 집합이 일치할 때, 즉 $endpos(t_1) = endpos(t_2)$일 때, 두 부분 문자열을 $endpos$-동치라고 부르겠습니다. 따라서 문자열 $s$의 비어 있지 않은 모든 부분 문자열은 $endpos$ 집합에 따라 여러 개의 동치류로 나눌 수 있습니다.
접미사 오토마톤에서 $endpos$-동치인 부분 문자열들은 같은 상태에 대응한다는 사실이 밝혀져 있습니다. 다시 말해, 접미사 오토마톤의 상태 수는 모든 부분 문자열의 동치류 개수에 초기 상태 하나를 더한 것과 같습니다. 접미사 오토마톤의 각 상태는 같은 $endpos$ 값을 갖는 하나 이상의 부분 문자열에 대응합니다.
이후에 이 가정을 사용하여 구성 알고리즘을 설명하겠습니다. 그러면 최소성을 제외한 접미사 오토마톤의 모든 필수 성질이 만족된다는 것을 확인하게 됩니다. 그리고 최소성은 Nerode 정리로부터 도출됩니다(이 글에서는 증명하지 않습니다).
$endpos$ 값에 관하여 몇 가지 중요한 관찰을 할 수 있습니다:
보조정리 1: 비어 있지 않은 두 부분 문자열 $u$와 $w$($length(u) \le length(w)$)가 $endpos$-동치일 필요충분조건은 문자열 $u$가 $s$에서 오직 $w$의 접미사 형태로만 나타나는 것입니다.
증명은 자명합니다. $u$와 $w$의 $endpos$ 값이 같다면, $u$는 $w$의 접미사이며 $s$에서 오직 $w$의 접미사 형태로만 나타납니다. 그리고 $u$가 $w$의 접미사이면서 $s$에서 오직 접미사 형태로만 나타난다면, 정의에 의해 $endpos$ 값은 같습니다.
보조정리 2: 비어 있지 않은 두 부분 문자열 $u$와 $w$를 생각해 봅시다($length(u) \le length(w)$). 그러면 이들의 $endpos$ 집합은 전혀 겹치지 않거나, $endpos(w)$가 $endpos(u)$의 부분집합입니다. 그리고 어느 쪽인지는 $u$가 $w$의 접미사인지 아닌지에 따라 결정됩니다.
증명: 집합 $endpos(u)$와 $endpos(w)$에 공통 원소가 적어도 하나 있다면, 문자열 $u$와 $w$는 모두 그 위치에서 끝납니다. 즉, $u$는 $w$의 접미사입니다. 그런데 그렇다면 $w$가 나타나는 모든 위치에서 부분 문자열 $u$도 함께 나타나므로, $endpos(w)$는 $endpos(u)$의 부분집합입니다.
보조정리 3: $endpos$-동치류 하나를 생각해 봅시다. 이 동치류에 속한 모든 부분 문자열을 길이의 내림차순으로 정렬합니다. 그러면 정렬된 수열에서 각 부분 문자열은 바로 앞의 문자열보다 길이가 1 짧으며, 동시에 바로 앞 문자열의 접미사가 됩니다. 다시 말해, 같은 동치류 안에서 더 짧은 부분 문자열은 실제로 더 긴 부분 문자열의 접미사이며, 그 길이는 어떤 구간 $[x; y]$의 가능한 모든 값을 가집니다.
증명: 어떤 $endpos$-동치류 하나를 고정합니다. 이 동치류에 문자열이 하나뿐이라면 보조정리는 자명하게 성립합니다. 이제 동치류에 속한 문자열의 개수가 둘 이상이라고 합시다.
보조정리 1에 따르면, 서로 다른 두 $endpos$-동치 문자열은 항상 짧은 쪽이 긴 쪽의 진접미사인 관계에 있습니다. 따라서 동치류 안에 길이가 같은 두 문자열이 존재할 수 없습니다.
동치류에서 가장 긴 문자열을 $w$로, 가장 짧은 문자열을 $u$로 나타냅시다. 보조정리 1에 따르면, 문자열 $u$는 문자열 $w$의 진접미사입니다. 이제 길이가 구간 $[length(u); length(w)]$에 속하는 $w$의 임의의 접미사를 생각해 봅시다. 이 접미사 역시 같은 동치류에 속한다는 것을 쉽게 알 수 있습니다. 이 접미사는 문자열 $s$에서 오직 $w$의 접미사 형태로만 나타날 수 있기 때문입니다(더 짧은 접미사 $u$조차 $s$에서 오직 $w$의 접미사 형태로만 나타나기 때문입니다). 따라서 보조정리 1에 따라, 이 접미사는 문자열 $w$와 $endpos$-동치입니다.
접미사 링크 $link$
오토마톤에서 어떤 상태 $v \ne t_0$를 생각해 봅시다. 알다시피, 상태 $v$는 $endpos$ 값이 같은 문자열들의 동치류에 대응합니다. 그리고 이 문자열 중 가장 긴 것을 $w$로 나타내면, 나머지 문자열은 모두 $w$의 접미사입니다.
또한 문자열 $w$의 접미사를 길이의 내림차순으로 살펴볼 때, 처음 몇 개의 접미사는 모두 이 동치류에 속하고, 나머지 접미사(적어도 하나, 즉 빈 접미사는 존재합니다)는 다른 동치류에 속한다는 것도 알고 있습니다. 그러한 접미사 중 가장 긴 것을 $t$로 나타내고, 그것으로 향하는 접미사 링크를 만듭니다.
다시 말해, 접미사 링크 $link(v)$는 다른 $endpos$-동치류에 속하는 $w$의 가장 긴 접미사에 대응하는 상태로 이어집니다.
여기서 초기 상태 $t_0$는 자기 자신만의 동치류(빈 문자열만 포함)에 대응한다고 가정하며, 편의상 $endpos(t_0) = \{-1, 0, \dots, length(s)-1\}$로 정합니다.
보조정리 4: 접미사 링크는 $t_0$을 루트로 하는 트리를 이룹니다.
증명: $v \ne t_0$인 임의의 상태를 생각해 봅시다. 접미사 링크 $link(v)$는 길이가 엄격히 더 짧은 문자열에 대응하는 상태로 이어집니다(이는 접미사 링크의 정의와 보조정리 3에서 도출됩니다). 따라서 접미사 링크를 따라 이동하다 보면 언젠가는 빈 문자열에 대응하는 초기 상태 $t_0$에 도달하게 됩니다.
보조정리 5: 집합 $endpos$를 사용하여 트리를 구성하면(부모 노드의 집합이 모든 자식의 집합을 부분집합으로 포함한다는 규칙에 따라), 그 구조는 접미사 링크의 트리와 일치합니다.
증명: 집합 $endpos$를 사용하여 트리를 구성할 수 있다는 사실은 보조정리 2(임의의 두 집합은 서로 교차하지 않거나 한쪽이 다른 쪽에 포함된다는 것)에서 바로 도출됩니다.
이제 $v \ne t_0$인 임의의 상태와 그 접미사 링크 $link(v)$를 생각해 봅시다. 접미사 링크의 정의와 보조정리 2로부터 다음이 성립합니다.
이는 앞의 보조정리와 함께 다음 주장을 증명합니다: 접미사 링크의 트리는 본질적으로 집합 $endpos$의 트리입니다.
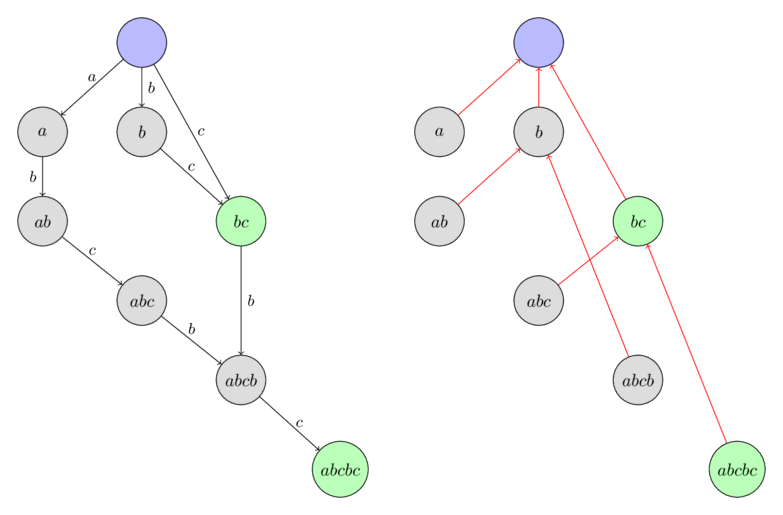
다음은 문자열 $\text{"abcbc"}$에 대해 구성한 접미사 오토마톤에서 접미사 링크 트리의 예시입니다. 각 노드에는 해당 동치류에서 가장 긴 부분 문자열이 레이블로 붙어 있습니다.
요약
알고리즘 자체로 넘어가기 전에, 지금까지 쌓은 지식을 요약하고 몇 가지 보조 표기법을 도입하겠습니다.
- 문자열 $s$의 부분 문자열들은 끝 위치 $endpos$에 따라 동치류로 분할할 수 있습니다.
- 접미사 오토마톤은 초기 상태 $t_0$과, 각 $endpos$-동치류마다 하나씩의 상태로 구성됩니다.
- 각 상태 $v$에는 하나 또는 여러 개의 부분 문자열이 대응합니다. 그러한 문자열 중 가장 긴 것을 $longest(v)$로, 그 길이를 $len(v)$로 나타냅니다. 그러한 부분 문자열 중 가장 짧은 것을 $shortest(v)$로, 그 길이를 $minlen(v)$로 나타냅니다. 그러면 이 상태에 대응하는 모든 문자열은 문자열 $longest(v)$의 서로 다른 접미사이며, 구간 $[minlen(v); len(v)]$ 안의 가능한 모든 길이를 가집니다.
- $v \ne t_0$인 각 상태에 대해 접미사 링크는 문자열 $longest(v)$의 접미사 중 길이가 $minlen(v) - 1$인 접미사에 대응하는 상태로 이어지는 링크로 정의됩니다. 접미사 링크는 $t_0$을 루트로 하는 트리를 이루며, 동시에 이 트리는 집합 $endpos$ 사이의 포함 관계를 나타냅니다.
- $v \ne t_0$에 대해 $minlen(v)$는 접미사 링크 $link(v)$를 사용하여 다음과 같이 표현할 수 있습니다.
- 임의의 상태 $v_0$에서 시작하여 접미사 링크를 따라가면 언젠가는 초기 상태 $t_0$에 도달합니다. 이 경우 서로 겹치지 않는 구간 $[minlen(v_i); len(v_i)]$들의 수열을 얻게 되며, 이들의 합집합은 연속 구간 $[0; len(v_0)]$을 이룹니다.
알고리즘
이제 알고리즘 자체로 넘어갈 수 있습니다. 이 알고리즘은 온라인 알고리즘입니다. 즉, 문자열의 문자를 하나씩 추가하면서 각 단계마다 오토마톤을 그에 맞게 수정합니다.
메모리 사용량을 선형으로 유지하기 위해, 각 상태에는 $len$, $link$ 값과 전이 목록만 저장합니다. 종료 상태에는 표시를 하지 않습니다(다만 접미사 오토마톤을 구성한 뒤 이러한 표시를 어떻게 붙이는지는 나중에 보이겠습니다).
처음에 오토마톤은 단일 상태 $t_0$으로 구성되며, 이 상태의 인덱스는 $0$입니다(나머지 상태들은 인덱스 $1, 2, \dots$를 받습니다). 편의상 이 상태에 $len = 0$과 $link = -1$을 할당합니다($-1$은 존재하지 않는 가상의 상태입니다).
이제 전체 과제는 현재 문자열의 끝에 문자 $c$를 하나 추가하는 과정을 구현하는 것으로 귀결됩니다. 이 과정을 설명해 봅시다:
- 문자 $c$를 추가하기 전의 전체 문자열에 대응하는 상태를 $last$라고 합시다. (처음에는 $last = 0$으로 설정하며, 알고리즘의 마지막 단계에서 $last$를 그에 맞게 변경합니다.)
- 새로운 상태 $cur$를 만들고, $len(cur) = len(last) + 1$을 할당합니다. 이 시점에서는 $link(cur)$의 값을 알 수 없습니다.
- 이제 다음 절차를 수행합니다: 상태 $last$에서 시작합니다. 문자 $c$를 통한 전이가 없는 동안, 상태 $cur$로의 전이를 추가하고 접미사 링크를 따라갑니다. 어느 시점에서 문자 $c$를 통한 전이가 이미 존재하면, 멈추고 이 상태를 $p$로 표기합니다.
- 그러한 상태 $p$를 찾지 못했다면 가상의 상태 $-1$에 도달한 것이므로, 단순히 $link(cur) = 0$을 할당하고 종료하면 됩니다.
- 이제 문자 $c$를 통한 전이가 존재하는 상태 $p$를 찾았다고 가정합시다. 그 전이가 향하는 상태를 $q$로 표기하겠습니다.
- 이제 두 가지 경우가 있습니다. $len(p) + 1 = len(q)$이거나, 그렇지 않은 경우입니다.
- $len(p) + 1 = len(q)$이면, 단순히 $link(cur) = q$를 할당하고 종료하면 됩니다.
-
그렇지 않은 경우는 조금 더 복잡합니다. 상태 $q$를 복제해야 합니다: 새로운 상태 $clone$을 만들고, $len$ 값을 제외한 $q$의 모든 데이터(접미사 링크와 전이)를 복사합니다. $len(clone) = len(p) + 1$을 할당합니다.
복제한 후에는 $cur$에서 $clone$으로, 그리고 $q$에서도 clone으로 접미사 링크를 연결합니다.
마지막으로 상태 $p$에서부터 접미사 링크를 따라 거슬러 올라가면서, $c$를 통해 상태 $q$로 가는 전이가 있는 동안 그 전이들을 모두 상태 $clone$으로 다시 연결해야 합니다.
-
세 가지 경우 중 어느 경우든, 절차를 완료한 후에는 $last$ 값을 상태 $cur$로 갱신합니다.
어떤 상태가 종료 상태이고 어떤 상태가 그렇지 않은지도 알고 싶다면, 전체 문자열 $s$에 대한 완전한 접미사 오토마톤을 구성한 후에 모든 종료 상태를 찾을 수 있습니다. 이를 위해 전체 문자열에 대응하는 상태(변수 $last$에 저장된 상태)를 가져와서, 초기 상태에 도달할 때까지 그 접미사 링크를 따라갑니다. 방문한 모든 상태를 종료 상태로 표시합니다. 이렇게 하면 문자열 $s$의 모든 접미사에 대응하는 상태들, 즉 정확히 종료 상태들만 표시된다는 것을 쉽게 이해할 수 있습니다.
다음 절에서는 각 단계를 자세히 살펴보고 그 정당성을 보이겠습니다.
여기서는 $s$의 각 문자마다 새로운 상태를 하나 또는 두 개만 만들기 때문에, 접미사 오토마톤이 선형 개수의 상태를 가진다는 점만 짚어 두겠습니다.
전이 개수의 선형성, 그리고 일반적으로 알고리즘 실행 시간의 선형성은 덜 명확하며, 이들은 정당성을 증명한 후에 증명하겠습니다.
정당성
-
$len(p) + 1 = len(q)$이면 전이 $(p, q)$를 연속적이라고 부르겠습니다. 그렇지 않은 경우, 즉 $len(p) + 1 < len(q)$일 때 그 전이를 비연속적이라고 부르겠습니다.
알고리즘 설명에서 볼 수 있듯이, 연속 전이와 비연속 전이는 알고리즘에서 서로 다른 경우로 이어집니다. 연속 전이는 고정되어 있으며, 다시는 바뀌지 않습니다. 반면 비연속 전이는 문자열에 새로운 글자가 추가될 때 바뀔 수 있습니다(전이 간선의 끝점이 바뀔 수 있습니다).
-
모호함을 피하기 위해, 현재 문자 $c$를 추가하기 전에 접미사 오토마톤이 만들어져 있던 문자열을 $s$로 나타내겠습니다.
-
알고리즘은 전체 문자열 $s + c$에 대응할 새로운 상태 $cur$를 만드는 것으로 시작합니다. 새로운 상태를 만들어야 하는 이유는 분명합니다. 새로운 문자와 함께 새로운 동치류가 생기기 때문입니다.
-
새로운 상태를 만든 후, 전체 문자열 $s$에 대응하는 상태에서 시작하여 접미사 링크를 따라 순회합니다. 각 상태에 대해 새로운 상태 $cur$로 가는 문자 $c$의 전이를 추가하려고 시도합니다. 이렇게 하여 $s$의 각 접미사에 문자 $c$를 덧붙입니다. 하지만 이 새로운 전이들은 이미 존재하는 전이와 충돌하지 않는 경우에만 추가할 수 있습니다. 따라서 $c$의 전이가 이미 존재하는 것을 발견하는 즉시 멈춰야 합니다.
-
가장 간단한 경우는 가상 상태 $-1$에 도달한 경우입니다. 이는 $s$의 모든 접미사에 $c$의 전이를 추가했다는 뜻입니다. 또한 이는 문자 $c$가 이전에 문자열 $s$에 나타난 적이 없다는 뜻이기도 합니다. 따라서 $cur$의 접미사 링크는 상태 $0$으로 이어져야 합니다.
-
두 번째 경우는 이미 존재하는 전이 $(p, q)$를 만난 경우입니다. 이는 오토마톤에 이미 존재하는 문자열 $x + c$($x$는 $s$의 접미사)를 오토마톤에 추가하려 했다는 뜻입니다(문자열 $x + c$는 이미 $s$의 부분 문자열로 나타납니다). 문자열 $s$에 대한 오토마톤이 올바르게 만들어졌다고 가정하므로, 여기에서 새로운 전이를 추가해서는 안 됩니다.
하지만 한 가지 어려움이 있습니다. 상태 $cur$의 접미사 링크는 어느 상태로 이어져야 합니까? 가장 긴 문자열이 정확히 $x + c$인 상태로 접미사 링크를 만들어야 합니다. 즉, 이 상태의 $len$은 $len(p) + 1$이어야 합니다. 하지만 그러한 상태가 아직 존재하지 않을 수도 있습니다. 즉, $len(q) > len(p) + 1$일 수 있습니다. 이 경우 상태 $q$를 분할하여 그러한 상태를 만들어야 합니다.
-
전이 $(p, q)$가 연속 전이로 밝혀지면 $len(q) = len(p) + 1$입니다. 이 경우에는 모든 것이 간단합니다. $cur$의 접미사 링크를 상태 $q$로 향하게 합니다.
-
그렇지 않으면 전이는 비연속 전이입니다. 즉, $len(q) > len(p) + 1$입니다. 이는 상태 $q$가 길이가 $len(p) + 1$인 $s + c$의 접미사뿐만 아니라 $s$의 더 긴 부분 문자열에도 대응한다는 뜻입니다. 상태 $q$를 두 개의 하위 상태로 분할하여 첫 번째 상태의 길이가 $len(p) + 1$이 되도록 하는 것 외에는 방법이 없습니다.
상태는 어떻게 분할할 수 있습니까? 상태 $q$를 복제하여 상태 $clone$을 얻고, $len(clone) = len(p) + 1$로 설정합니다. $q$를 거쳐 가는 경로를 바꾸고 싶지 않으므로 $q$의 모든 전이를 $clone$으로 복사합니다. 또한 $clone$의 접미사 링크는 $q$의 접미사 링크가 가리키던 상태를 가리키도록 설정하고, $q$의 접미사 링크는 $clone$을 가리키도록 설정합니다.
그리고 상태를 분할한 뒤에는 $cur$의 접미사 링크가 $clone$을 가리키도록 설정합니다.
마지막 단계에서는 $q$로 향하는 전이 중 일부를 $clone$으로 향하도록 바꿉니다. 어떤 전이를 바꿔야 합니까? 문자열 $w + c$($w$는 $p$의 가장 긴 문자열)의 모든 접미사에 해당하는 전이만 바꾸면 충분합니다. 즉, 정점 $p$에서 출발하여 가상 상태 $-1$에 도달하거나 $q$가 아닌 다른 상태로 향하는 전이를 만날 때까지 접미사 링크를 따라 계속 이동해야 합니다.
선형 연산 횟수
먼저 알파벳의 크기가 상수라고 바로 가정합니다. 그렇지 않다면 선형 시간 복잡도를 논할 수 없습니다. 한 정점에서 나가는 전이 목록은 균형 트리에 저장하며, 이렇게 하면 키 탐색 연산과 키 추가를 빠르게 수행할 수 있습니다. 따라서 알파벳의 크기를 $k$라고 하면, 알고리즘의 점근적 동작은 $O(n)$ 메모리에 $O(n \log k)$가 됩니다. 그러나 알파벳이 충분히 작다면 균형 트리를 쓰지 않는 대신 메모리를 희생하여, 각 정점의 전이를 길이 $k$의 배열(키로 빠르게 탐색하기 위함)과 동적 리스트(존재하는 모든 키를 빠르게 순회하기 위함)로 저장할 수 있습니다. 이렇게 하면 알고리즘의 시간 복잡도는 $O(n)$이 되지만, 그 대가로 메모리 복잡도는 $O(n k)$가 됩니다.
그러므로 알파벳의 크기를 상수로 간주합니다. 즉, 문자로 전이를 탐색하는 연산, 전이를 추가하는 연산, 다음 전이를 탐색하는 연산을 모두 $O(1)$에 수행할 수 있습니다.
알고리즘의 모든 부분을 살펴보면, 선형 복잡도가 자명하지 않은 곳이 세 군데 있습니다:
- 첫 번째는 상태 $last$에서 출발하여 접미사 링크를 따라가며 문자 $c$에 대한 전이를 추가하는 부분입니다.
- 두 번째는 상태 $q$를 새 상태 $clone$으로 복제할 때 전이를 복사하는 부분입니다.
- 세 번째는 $q$로 향하는 전이를 $clone$으로 향하도록 바꾸는 부분입니다.
접미사 오토마톤의 크기(상태 수와 전이 수 모두)가 선형이라는 사실을 이용합니다. (상태 수가 선형이라는 증명은 알고리즘 자체이며, 상태 수가 선형이라는 증명은 아래에서 알고리즘 구현 이후에 제시합니다.)
따라서 첫 번째와 두 번째 부분의 전체 복잡도는 자명합니다. 결국 각 연산은 오토마톤에 분할 상환으로 새 전이를 하나만 추가하기 때문입니다.
남은 것은 원래 $q$를 가리키던 전이를 $clone$으로 향하도록 바꾸는 세 번째 부분의 전체 복잡도를 추정하는 일입니다. $v = longest(p)$라고 합시다. 이는 문자열 $s$의 접미사이며, 반복할 때마다 그 길이가 줄어듭니다. 따라서 문자열 $s$의 접미사로서 $v$의 위치는 반복할 때마다 단조 증가합니다. 이때 루프의 첫 번째 반복 전에 해당 문자열 $v$가 $last$로부터 깊이 $k$($k \ge 2$)에 있었다면(깊이는 접미사 링크의 개수로 셉니다), 마지막 반복 후에 문자열 $v + c$는 $cur$(새로운 $last$ 값이 됩니다)에서 출발하는 경로상의 $2$번째 접미사 링크가 됩니다.
따라서 이 루프를 한 번 반복할 때마다 현재 문자열의 접미사로서 문자열 $longest(link(link(last))$의 위치가 단조 증가합니다. 따라서 이 사이클은 $n$번을 초과하여 반복될 수 없으며, 이것이 증명하고자 한 내용입니다.
구현
먼저 특정 전이에 관한 모든 정보($len$, $link$, 전이 목록)를 저장할 자료 구조를 설명합니다. 필요하다면 여기에 종료 플래그나 그 밖의 정보를 추가할 수 있습니다. 전이 목록은 $map$ 형태로 저장합니다. 이렇게 하면 문자열 전체를 처리하는 데 총 $O(n)$ 메모리와 $O(n \log k)$ 시간을 달성할 수 있습니다.
struct state {
    int len, link;
    map<char, int> next;
};
접미사 오토마톤 자체는 이러한 $state$ 구조체의 배열에 저장됩니다. 현재 크기 $sz$와 함께, 현재 시점의 문자열 전체에 대응하는 상태인 변수 $last$도 저장합니다.
const int MAXLEN = 100000;
state st[MAXLEN * 2];
int sz, last;
접미사 오토마톤을 초기화하는 함수(상태가 하나뿐인 접미사 오토마톤을 만드는 함수)를 제시합니다.
void sa_init() {
    st[0].len = 0;
    st[0].link = -1;
    sz++;
    last = 0;
}
마지막으로 주 함수의 구현을 제시합니다. 이 함수는 현재 문자열의 끝에 다음 문자를 추가하고, 그에 따라 오토마톤을 다시 구성합니다.
void sa_extend(char c) {
    int cur = sz++;
    st[cur].len = st[last].len + 1;
    int p = last;
    while (p != -1 && !st[p].next.count(c)) {
        st[p].next[c] = cur;
        p = st[p].link;
    }
    if (p == -1) {
        st[cur].link = 0;
    } else {
        int q = st[p].next[c];
        if (st[p].len + 1 == st[q].len) {
            st[cur].link = q;
        } else {
            int clone = sz++;
            st[clone].len = st[p].len + 1;
            st[clone].next = st[q].next;
            st[clone].link = st[q].link;
            while (p != -1 && st[p].next[c] == q) {
                st[p].next[c] = clone;
                p = st[p].link;
            }
            st[q].link = st[cur].link = clone;
        }
    }
    last = cur;
}
앞서 언급했듯이 메모리를 희생하면($O(n k)$, 여기서 $k$는 알파벳의 크기입니다), 알파벳 크기 $k$가 얼마이든 오토마톤의 구성 시간을 $O(n)$으로 만들 수 있습니다. 다만 이를 위해서는 각 상태마다 크기 $k$의 배열(해당 문자의 전이로 빠르게 이동하기 위함)을 저장해야 하며, 추가로 모든 전이의 리스트(전이들을 빠르게 순회하기 위함)도 저장해야 합니다.
추가 성질
상태의 개수
길이 $n$인 문자열 $s$의 접미사 오토마톤에서 상태의 개수는 $2n - 1$을 넘지 않습니다($n \ge 2$일 때).
증명은 구성 알고리즘 그 자체입니다. 처음에 오토마톤은 상태 하나로 이루어져 있고, 첫 번째와 두 번째 반복에서는 상태가 하나씩만 생성되며, 나머지 $n-2$번의 단계에서는 각각 최대 $2$개의 상태가 생성되기 때문입니다.
그러나 이 추정은 알고리즘을 모르더라도 보일 수 있습니다. 상태의 개수는 서로 다른 $endpos$ 집합의 개수와 같다는 사실을 떠올려 봅시다. 또한 이 $endpos$ 집합들은 트리를 이룹니다(부모 정점의 집합은 모든 자식의 집합을 포함합니다). 이 트리를 생각하고 약간 변형해 봅시다. 자식이 하나뿐인 내부 정점이 있는 한(이는 자식의 집합에 부모 집합의 위치 중 적어도 하나가 빠져 있다는 뜻입니다), 빠진 위치들의 집합을 갖는 새로운 자식을 만듭니다. 결국 각 내부 정점의 차수가 1보다 크고 리프의 개수가 $n$을 넘지 않는 트리를 얻게 됩니다. 따라서 이러한 트리의 정점은 $2n - 1$개를 넘지 않습니다.
이 상태 개수의 상한은 모든 $n$에 대해 실제로 달성될 수 있습니다. 가능한 문자열은 다음과 같습니다:
세 번째 반복부터 매 반복마다 알고리즘은 상태 하나를 분할하게 되며, 그 결과 정확히 $2n - 1$개의 상태가 생깁니다.
전이의 개수
길이 $n$인 문자열 $s$의 접미사 오토마톤에서 전이의 개수는 $3n - 4$를 넘지 않습니다($n \ge 3$일 때).
이를 증명해 봅시다:
먼저 연속 전이의 개수를 추정해 봅시다. 오토마톤에서 상태 $t_0$에서 시작하는 가장 긴 경로들로 이루어진 신장 트리를 생각해 봅시다. 이 골격은 연속 간선들로만 이루어지므로, 그 개수는 상태의 개수보다 적습니다. 즉, $2n - 2$를 넘지 않습니다.
이제 비연속 전이의 개수를 추정해 봅시다. 현재 비연속 전이를 문자 $c$에 대한 $(p, q)$라고 합시다. 이에 대응하는 문자열 $u + c + w$를 취합니다. 여기서 문자열 $u$는 초기 상태에서 $p$까지의 가장 긴 경로에 대응하고, $w$는 $q$에서 임의의 종료 상태까지의 가장 긴 경로에 대응합니다. 한편으로, 이러한 문자열 $u + c + w$는 비연속 전이마다 모두 서로 다릅니다(문자열 $u$와 $w$는 연속 전이로만 이루어지기 때문입니다). 다른 한편으로, 이러한 각 문자열 $u + c + w$는 종료 상태의 정의에 의해 전체 문자열 $s$의 접미사가 됩니다. $s$의 비어 있지 않은 접미사는 $n$개뿐이고, 문자열 $u + c + w$ 중 어느 것도 $s$가 될 수 없으므로(전체 문자열은 연속 전이만으로 이루어지기 때문입니다), 비연속 전이의 총 개수는 $n - 1$을 넘지 않습니다.
이 두 추정을 결합하면 $3n - 3$이라는 상한을 얻습니다. 그러나 상태 수의 최댓값은 테스트 케이스 $\text{"abbb\dots bbb"}$에서만 달성될 수 있고 이 경우의 전이 수는 분명히 $3n - 3$보다 적으므로, 접미사 오토마톤의 전이 수에 대해 더 엄밀한 상한인 $3n - 4$를 얻습니다.
이 상한은 다음 문자열로도 달성될 수 있습니다:
응용
여기서는 접미사 오토마톤을 사용하여 풀 수 있는 몇 가지 문제를 살펴봅니다. 단순화를 위해 알파벳 크기 $k$가 상수라고 가정하며, 이에 따라 문자를 추가하는 연산과 탐색의 복잡도를 상수로 간주할 수 있습니다.
등장 여부 확인
텍스트 $T$와 여러 패턴 $P$가 주어집니다. 문자열 $P$가 $T$의 부분 문자열로 등장하는지 여부를 확인해야 합니다.
텍스트 $T$의 접미사 오토마톤을 $O(length(T))$ 시간에 구축합니다. 패턴 $P$가 $T$에 등장하는지 확인하려면, $t_0$에서 시작하여 $P$의 문자에 따라 전이를 따라갑니다. 어느 시점에서 전이가 존재하지 않으면, 패턴 $P$는 $T$의 부분 문자열로 등장하지 않습니다. 이런 방식으로 문자열 $P$ 전체를 처리할 수 있다면, 그 문자열은 $T$에 등장합니다.
이 과정이 각 문자열 $P$마다 $O(length(P))$ 시간이 걸린다는 것은 분명합니다. 또한 이 알고리즘은 실제로 텍스트에 등장하는 $P$의 가장 긴 접두사의 길이를 찾아냅니다.
서로 다른 부분 문자열의 개수
문자열 $S$가 주어집니다. 서로 다른 부분 문자열의 개수를 계산하고자 합니다.
문자열 $S$에 대한 접미사 오토마톤을 구축합시다.
$S$의 각 부분 문자열은 오토마톤의 어떤 경로에 대응합니다. 따라서 서로 다른 부분 문자열의 개수는 오토마톤에서 $t_0$에서 시작하는 서로 다른 경로의 개수와 같습니다.
접미사 오토마톤이 방향 비순환 그래프라는 점을 고려하면, 서로 다른 경로의 개수는 동적 계획법을 사용하여 계산할 수 있습니다.
구체적으로, 상태 $v$에서 시작하는 경로의 개수(길이가 0인 경로 포함)를 $d[v]$라고 합시다. 그러면 다음과 같은 재귀식을 얻습니다:
즉, $d[v]$는 $v$의 모든 전이의 끝점에 대한 답의 합으로 나타낼 수 있습니다.
서로 다른 부분 문자열의 개수는 $d[t_0] - 1$의 값입니다(빈 부분 문자열은 세지 않기 때문입니다).
전체 시간 복잡도: $O(length(S))$
또는, 각 상태 $v$가 길이 $[minlen(v),len(v)]$의 부분 문자열에 대응한다는 사실을 활용할 수 있습니다. 따라서 $minlen(v) = 1 + len(link(v))$이므로, 상태 $v$에서의 서로 다른 부분 문자열의 총개수는 $len(v) - minlen(v) + 1 = len(v) - (1 + len(link(v))) + 1 = len(v) - len(link(v))$입니다.
이는 아래에 간결하게 나타나 있습니다:
long long get_diff_strings(){
    long long tot = 0;
    for(int i = 1; i < sz; i++) {
        tot += st[i].len - st[st[i].link].len;
    }
    return tot;
}
이 방법 역시 $O(length(S))$이지만, 추가 공간과 재귀 호출이 필요하지 않으므로 실제로는 더 빠르게 동작합니다.
서로 다른 모든 부분 문자열의 길이의 총합
문자열 $S$가 주어집니다. 이 문자열의 서로 다른 모든 부분 문자열의 길이 합을 구하려고 합니다.
풀이는 앞의 문제와 비슷하지만, 이번에는 동적 계획법 부분에서 두 가지 값을 고려해야 합니다. 서로 다른 부분 문자열의 개수 $d[v]$와 그 길이의 합 $ans[v]$입니다.
$d[v]$를 계산하는 방법은 앞의 문제에서 이미 설명했습니다. $ans[v]$ 값은 다음 재귀식으로 계산할 수 있습니다.
인접한 각 정점 $w$의 답을 가져와 여기에 $d[w]$를 더합니다(상태 $v$에서 시작하면 모든 부분 문자열이 한 글자씩 길어지기 때문입니다).
이 문제 역시 $O(length(S))$ 시간에 계산할 수 있습니다.
또는 각 상태 $v$가 길이 $[minlen(v),len(v)]$의 부분 문자열에 대응한다는 사실을 다시 한번 활용할 수도 있습니다. $minlen(v) = 1 + len(link(v))$이고 등차수열의 합 공식 $S_n = n \cdot \frac{a_1+a_n}{2}$($S_n$은 $n$개 항의 합, $a_1$은 첫째 항, $a_n$은 마지막 항을 나타냅니다)를 이용하면, 한 상태에 속한 부분 문자열의 길이 합을 상수 시간에 계산할 수 있습니다. 그런 다음 오토마톤의 각 상태 $v \neq t_0$에 대해 이 합들을 모두 더합니다. 아래 코드가 이 방법을 보여 줍니다.
long long get_tot_len_diff_substings() {
    long long tot = 0;
    for(int i = 1; i < sz; i++) {
        long long shortest = st[st[i].link].len + 1;
        long long longest = st[i].len;

        long long num_strings = longest - shortest + 1;
        long long cur = num_strings * (longest + shortest) / 2;
        tot += cur;
    }
    return tot;
}
이 방법은 $O(length(S))$ 시간에 동작하지만, 무작위 문자열로 실험해 보면 메모이제이션을 사용한 동적 계획법 버전보다 20배 빠르게 동작합니다. 추가 공간이 필요 없고 재귀도 사용하지 않습니다.
사전순으로 $k$번째 부분 문자열
문자열 $S$가 주어집니다. 여러 개의 쿼리에 답해야 합니다. 주어진 각 수 $K_i$에 대해, 모든 부분 문자열을 사전순으로 정렬한 목록에서 $K_i$번째 문자열을 찾아야 합니다.
이 문제의 풀이는 앞의 두 문제의 아이디어에 기반합니다. 사전순으로 $k$번째 부분 문자열은 접미사 오토마톤에서 사전순으로 $k$번째 경로에 대응합니다. 따라서 각 상태에서 출발하는 경로의 수를 센 뒤에는, 오토마톤의 루트에서 출발하여 $k$번째 경로를 쉽게 찾을 수 있습니다.
전처리에 $O(length(S))$ 시간이 걸리고, 각 쿼리마다 $O(length(ans) \cdot k)$ 시간이 걸립니다(여기서 $ans$는 쿼리의 답이고 $k$는 알파벳의 크기입니다).
가장 작은 순환 이동
문자열 $S$가 주어집니다. 사전순으로 가장 작은 순환 이동을 찾고자 합니다.
문자열 $S + S$에 대한 접미사 오토마톤을 만듭니다. 그러면 이 오토마톤은 문자열 $S$의 모든 순환 이동을 경로로서 포함하게 됩니다.
따라서 문제는 길이가 $length(S)$인 경로 중 사전순으로 가장 작은 경로를 찾는 문제로 바뀌며, 이는 간단하게 해결할 수 있습니다. 초기 상태에서 시작하여 가장 작은 문자의 전이를 탐욕적으로 따라가면 됩니다.
전체 시간 복잡도는 $O(length(S))$입니다.
등장 횟수
텍스트 $T$가 주어집니다. 여러 개의 쿼리에 답해야 합니다. 주어진 각 패턴 $P$에 대해 문자열 $P$가 문자열 $T$에 부분 문자열로 몇 번 나타나는지 구해야 합니다.
텍스트 $T$에 대한 접미사 오토마톤을 구성합니다.
다음으로 아래와 같은 전처리를 수행합니다: 오토마톤의 각 상태 $v$에 대해 집합 $endpos(v)$의 크기와 같은 수 $cnt[v]$를 계산합니다. 실제로 같은 상태 $v$에 대응하는 모든 문자열은 텍스트 $T$에 같은 횟수만큼 나타나며, 그 횟수는 집합 $endpos$에 있는 위치의 개수와 같습니다.
그러나 집합 $endpos$를 명시적으로 구성할 수는 없으므로, 그 크기 $cnt$만 고려합니다.
이를 계산하기 위해 다음과 같이 진행합니다. 각 상태에 대해, 그 상태가 복제로 생성되지 않았다면(그리고 초기 상태 $t_0$가 아니라면) $cnt = 1$로 초기화합니다. 그런 다음 모든 상태를 길이 $len$의 내림차순으로 순회하면서, 현재 값 $cnt[v]$를 접미사 링크에 더합니다:
이렇게 하면 각 상태에 대해 올바른 값을 얻습니다.
이것이 왜 올바릅니까? 복제를 통하지 않고 얻은 상태의 총 개수는 정확히 $length(T)$개이며, 그중 처음 $i$개는 처음 $i$개의 문자를 추가했을 때 나타났습니다. 따라서 이러한 각 상태에 대해 그 상태가 처리된 시점에 대응하는 위치를 셉니다. 그러므로 처음에는 이러한 각 상태에 대해 $cnt = 1$이고, 나머지 모든 상태에 대해서는 $cnt = 0$입니다.
그런 다음 각 $v$에 대해 다음 연산을 적용합니다: $cnt[link(v)] \text{ += } cnt[v]$. 이것의 의미는, 문자열 $v$가 $cnt[v]$번 나타난다면 그 모든 접미사도 정확히 같은 끝 위치에서 나타나므로 역시 $cnt[v]$번 나타난다는 것입니다.
이 과정에서 왜 중복하여 세지 않습니까(즉, 어떤 위치를 두 번 세지 않습니까)? 한 상태의 위치를 오직 하나의 다른 상태에만 더하기 때문에, 한 상태가 자신의 위치를 서로 다른 두 가지 방법으로 다른 상태에 두 번 전달하는 일은 일어날 수 없습니다.
따라서 오토마톤의 모든 상태에 대해 $cnt$ 값을 $O(length(T))$ 시간에 계산할 수 있습니다.
그 후에는 패턴에 대응하는 상태 $t$가 존재한다면 값 $cnt[t]$를 조회하는 것만으로 쿼리에 답할 수 있습니다. 그렇지 않으면 $0$으로 답합니다. 쿼리 하나에 답하는 데 $O(length(P))$ 시간이 걸립니다.
첫 번째 등장 위치
텍스트 $T$와 여러 개의 쿼리가 주어집니다. 각 쿼리 문자열 $P$에 대해 문자열 $T$에서 $P$가 처음 등장하는 위치($P$의 시작 위치)를 찾고자 합니다.
다시 접미사 오토마톤을 구성합니다. 추가로 오토마톤의 모든 상태에 대해 위치 $firstpos$를 미리 계산합니다. 즉, 각 상태 $v$에 대해 첫 번째 등장의 끝 위치 $firstpos[v]$를 찾고자 합니다. 다시 말해, 각 집합 $endpos$의 최소 원소를 미리 찾고자 합니다(모든 집합 $endpos$를 명시적으로 유지할 수 없는 것은 자명하기 때문입니다).
이러한 위치 $firstpos$를 유지하기 위해 함수 sa_extend()를 확장합니다. 새로운 상태 $cur$를 생성할 때 다음과 같이 설정합니다:
그리고 정점 $q$를 $clone$으로 복제할 때 다음과 같이 설정합니다:
(값이 될 수 있는 유일한 다른 후보는 $firstpos(cur)$인데, 이는 확실히 너무 크기 때문입니다)
따라서 쿼리의 답은 단순히 $firstpos(t) - length(P) + 1$이며, 여기서 $t$는 문자열 $P$에 대응하는 상태입니다. 쿼리에 답하는 데에는 이번에도 $O(length(P))$ 시간만 걸립니다.
모든 출현 위치
이번에는 문자열 $T$에서 나타나는 모든 출현 위치를 출력해야 합니다.
이번에도 텍스트 $T$에 대한 접미사 오토마톤을 구성합니다. 앞의 문제와 마찬가지로 모든 상태에 대해 위치 $firstpos$를 계산합니다.
$t$가 쿼리 문자열 $P$에 대응하는 상태라면, $firstpos(t)$가 답의 일부임은 분명합니다. 이로써 $P$를 포함하는 오토마톤의 상태는 고려하였습니다. 그 밖에 어떤 상태들을 더 고려해야 하겠습니까? $P$를 접미사로 가지는 문자열에 대응하는 모든 상태입니다. 다시 말해 접미사 링크를 따라 상태 $t$에 도달할 수 있는 모든 상태를 찾아야 합니다.
따라서 이 문제를 풀려면 각 상태마다 그 상태로 향하는 접미사 참조의 목록을 저장해야 합니다. 그러면 쿼리의 답에는 상태 $t$에서 시작하여 접미사 참조만을 사용하는 DFS / BFS로 찾을 수 있는 각 상태의 $firstpos$가 모두 포함됩니다.
전체적으로 전처리에 $O(length (T))$가 필요하고 각 요청마다 $O(length(P) + answer(P))$가 필요합니다. 여기서 $answer(P)$는 답의 크기입니다.
먼저 패턴의 각 문자를 따라 오토마톤을 내려가며 시작 노드를 찾는데, 여기에 $O(length(P))$가 필요합니다. 그다음 위의 탐색을 수행하는데, 이는 $O(answer(P))$ 시간에 동작합니다. 같은 상태를 두 번 방문하지 않기 때문입니다(각 상태에서 나가는 접미사 링크는 하나뿐이므로, 같은 상태로 이어지는 서로 다른 두 경로가 존재할 수 없습니다).
다만 서로 다른 두 상태가 같은 $firstpos$ 값을 가질 수 있다는 점만 고려하면 됩니다. 이는 한 상태가 다른 상태를 복제하여 얻어진 경우에 발생합니다. 그러나 각 상태는 최대 하나의 복제본만 가질 수 있으므로, 이것이 복잡도를 망치지는 않습니다.
더 나아가 복제된 상태의 위치를 출력하지 않으면 중복된 위치도 없앨 수 있습니다. 실제로 복제된 상태가 도달할 수 있는 상태는 원래 상태에서도 도달할 수 있습니다. 따라서 각 상태에 대해 is_cloned 플래그를 기억해 두면, 복제된 상태는 간단히 무시하고 나머지 모든 상태에 대해서만 $firstpos$를 출력하면 됩니다.
다음은 몇 가지 구현 스케치입니다:
struct state {
    ...
    bool is_clone;
    int first_pos;
    vector<int> inv_link;
};

// after constructing the automaton
for (int v = 1; v < sz; v++) {
    st[st[v].link].inv_link.push_back(v);
}

// output all positions of occurrences
void output_all_occurrences(int v, int P_length) {
    if (!st[v].is_clone)
        cout << st[v].first_pos - P_length + 1 << endl;
    for (int u : st[v].inv_link)
        output_all_occurrences(u, P_length);
}
나타나지 않는 가장 짧은 문자열
문자열 $S$와 특정 알파벳이 주어집니다. $S$에 나타나지 않는 가장 짧은 길이의 문자열을 찾아야 합니다.
문자열 $S$에 대해 만든 접미사 오토마톤 위에서 동적 계획법을 적용합니다.
$d[v]$를 노드 $v$에 대한 답이라고 합시다. 즉, 부분 문자열의 일부를 이미 처리하여 현재 상태 $v$에 있으며, 존재하지 않는 전이를 찾기 위해 추가해야 하는 문자의 최소 개수를 구하려는 것입니다. $d[v]$를 계산하는 것은 매우 간단합니다. 알파벳 중 적어도 한 문자에 대해 전이가 없다면 $d[v] = 1$입니다. 그렇지 않으면 문자 하나로는 충분하지 않으므로, 모든 전이의 답 중 최솟값을 취해야 합니다:
문제의 답은 $d[t_0]$이 되며, 계산된 배열 $d[]$를 이용해 실제 문자열을 복원할 수 있습니다.
두 문자열의 최장 공통 부분 문자열
두 문자열 $S$와 $T$가 주어집니다. 최장 공통 부분 문자열, 즉 $S$와 $T$ 모두에 부분 문자열로 나타나는 문자열 $X$를 찾아야 합니다.
문자열 $S$에 대한 접미사 오토마톤을 구성합니다.
이제 문자열 $T$를 가져와 각 접두사에 대해 그 접두사의 접미사 중 $S$에 나타나는 가장 긴 것을 찾습니다. 다시 말해, 문자열 $T$의 각 위치에 대해 그 위치에서 끝나는 $S$와 $T$의 최장 공통 부분 문자열을 찾고자 합니다.
이를 위해 현재 상태 $v$와 현재 길이 $l$이라는 두 변수를 사용합니다. 이 두 변수는 현재 매칭되는 부분, 즉 그 길이와 그에 대응하는 상태를 나타냅니다.
처음에는 $v = t_0$이고 $l = 0$입니다. 즉, 매칭되는 부분이 비어 있습니다.
이제 문자 $T[i]$를 추가하고 그에 대한 답을 다시 계산하는 방법을 설명하겠습니다.
- $v$에서 문자 $T[i]$로의 전이가 있다면, 단순히 그 전이를 따라가고 $l$을 1 증가시킵니다.
- 그러한 전이가 없다면 현재 매칭되는 부분을 줄여야 하며, 이는 접미사 링크를 따라가야 함을 의미합니다: $v = link(v)$. 동시에 현재 길이도 줄여야 합니다. 접미사 링크를 거치고 나면 대응하는 가장 긴 문자열이 부분 문자열인 상태에 도달하므로, 당연히 $l = len(v)$로 대입해야 합니다.
- 여전히 필요한 문자로의 전이가 없다면, 전이를 찾거나 가상의 상태 $-1$에 도달할 때까지 다시 접미사 링크를 따라가고 $l$을 줄이는 과정을 반복합니다(가상의 상태에 도달했다는 것은 기호 $T[i]$가 $S$에 전혀 나타나지 않는다는 뜻이므로, $v = l = 0$으로 대입합니다).
문제의 답은 모든 $l$ 값 중 최댓값이 됩니다.
한 번의 이동에서 $l$을 1 증가시키거나, 접미사 링크를 여러 번 거치되 매번 $l$ 값을 줄이게 되므로, 이 부분의 복잡도는 $O(length(T))$입니다.
구현:
string lcs (string S, string T) {
    sa_init();
    for (int i = 0; i < S.size(); i++)
        sa_extend(S[i]);

    int v = 0, l = 0, best = 0, bestpos = 0;
    for (int i = 0; i < T.size(); i++) {
        while (v && !st[v].next.count(T[i])) {
            v = st[v].link ;
            l = st[v].len;
        }
        if (st[v].next.count(T[i])) {
            v = st [v].next[T[i]];
            l++;
        }
        if (l > best) {
            best = l;
            bestpos = i;
        }
    }
    return T.substr(bestpos - best + 1, best);
}
여러 문자열의 최장 공통 부분 문자열
$k$개의 문자열 $S_i$가 주어집니다. 최장 공통 부분 문자열, 즉 각 문자열 $S_i$에 모두 부분 문자열로 나타나는 문자열 $X$를 찾아야 합니다.
모든 문자열을 하나의 큰 문자열 $T$로 이어 붙이되, 각 문자열 사이를 특수 문자 $D_i$(문자열마다 하나씩)로 구분합니다:
그런 다음 문자열 $T$에 대한 접미사 오토마톤을 구성합니다.
이제 오토마톤에서 모든 문자열 $S_i$에 포함된 문자열을 찾아야 하며, 이는 추가한 특수 문자를 이용하여 할 수 있습니다. 어떤 부분 문자열이 문자열 $S_j$에 포함되어 있다면, 접미사 오토마톤에는 이 부분 문자열에서 시작하여 문자 $D_j$를 포함하고 다른 문자 $D_1, \dots, D_{j-1}, D_{j+1}, \dots, D_k$는 포함하지 않는 경로가 존재한다는 점에 주목하십시오.
따라서 오토마톤의 각 상태와 각 기호 $D_i$에 대해 그러한 경로가 존재하는지를 알려 주는 도달 가능성을 계산해야 합니다. 이는 DFS 또는 BFS와 동적 계획법으로 쉽게 계산할 수 있습니다. 그 후 문제의 답은 모든 특수 문자로 향하는 경로가 존재하는 상태 $v$에 대한 문자열 $longest(v)$가 됩니다.