교차하는 선분 쌍 찾기
평면 위에 $n$개의 선분이 주어집니다. 이 중 적어도 두 선분이 서로 교차하는지 확인해야 합니다. 교차한다면 교차하는 선분 쌍을 출력하십시오. 답이 여러 개일 때는 그중 아무것이나 선택하면 충분합니다.
단순한 풀이 알고리즘은 $O(n^2)$에 모든 선분 쌍을 순회하면서 각 쌍이 교차하는지 확인하는 것입니다. 이 글에서는 스위프 라인 알고리즘을 기반으로 $O(n \log n)$ 시간에 동작하는 알고리즘을 설명합니다.
알고리즘
머릿속으로 수직선 $x = -\infty$를 그리고, 이 직선을 오른쪽으로 옮겨 나가기 시작합시다. 이 직선은 움직이는 동안 선분들과 만나게 되며, 선분이 직선과 교차할 때마다 정확히 한 점에서 교차합니다(수직인 선분은 없다고 가정합니다).
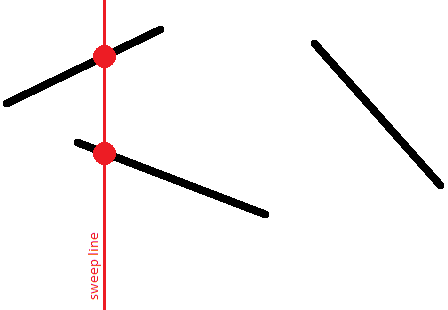
따라서 각 선분은 어느 시점에 스위프 라인 위에 점으로 나타나고, 직선이 움직임에 따라 이 점도 움직이며, 마지막으로 어느 시점에 직선에서 사라집니다.
우리가 관심을 두는 것은 수직 방향에서의 선분들의 상대적인 순서입니다. 즉, 주어진 시점에 스위프 라인과 교차하는 선분들의 목록을 저장하며, 이 목록의 선분들은 스위프 라인 위에서의 $y$좌표를 기준으로 정렬됩니다.
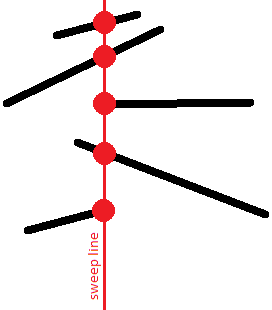
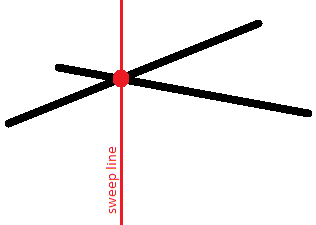
이 순서가 중요한 이유는 교차하는 선분들이 적어도 한 시점에서는 같은 $y$좌표를 가지기 때문입니다:
핵심 명제를 정리하면 다음과 같습니다:
- 교차하는 쌍을 찾으려면 스위프 라인의 각 고정된 위치에서 인접한 선분들만 고려하면 충분합니다.
- 스위프 라인을 가능한 모든 실수 위치 $(-\infty \ldots +\infty)$에서 고려할 필요는 없으며, 새로운 선분이 나타나거나 기존 선분이 사라지는 위치에서만 고려하면 충분합니다. 다시 말해, 선분 끝점들의 x좌표와 같은 위치로만 한정하면 충분합니다.
- 새로운 선분이 나타나면, 이전 스위프 라인에서 얻은 목록의 알맞은 위치에 이 선분을 삽입하기만 하면 됩니다. 이때 추가된 선분과 목록에서 바로 위와 아래에 있는 이웃의 교차 여부만 확인하면 됩니다.
- 선분이 사라지면 현재 목록에서 이 선분을 제거하기만 하면 됩니다. 그 후에는 목록에서 위쪽 이웃과 아래쪽 이웃이 교차하는지 확인해야 합니다.
- 목록 내 선분의 순서에는 앞서 설명한 것 외의 다른 변화가 없습니다. 다른 교차 확인은 필요하지 않습니다.
이 명제들이 참임을 이해하려면 다음 사항들로 충분합니다:
- 서로 교차하지 않는 두 선분은 상대적인 순서가 절대 바뀌지 않습니다.
실제로 한 선분이 처음에는 다른 선분보다 위에 있다가 나중에 아래로 내려갔다면, 그 두 시점 사이에 두 선분의 교차가 있었던 것입니다. - 교차하지 않는 두 선분은 같은 $y$좌표를 가질 수도 없습니다.
- 이로부터 선분이 나타나는 순간 큐에서 이 선분의 위치를 찾을 수 있으며, 이후에는 큐에서 이 선분의 위치를 다시 조정할 필요가 없다는 것을 알 수 있습니다: 큐 안의 다른 선분들에 대한 이 선분의 순서는 바뀌지 않습니다.
- 교차하는 두 선분은 교점에 도달하는 순간 큐에서 서로 이웃하게 됩니다.
- 따라서 교차하는 선분 쌍을 찾으려면, 스위프 라인이 움직이는 동안 한 번이라도 서로 이웃했던 모든 선분 쌍에 대해, 그리고 오직 그러한 쌍에 대해서만 교차 여부를 확인하면 충분합니다.
선분을 추가할 때는 추가된 선분과 그 위아래 이웃을, 선분을 제거할 때는 그 위아래 이웃(제거 후 서로 이웃이 되는 선분들)을 확인하기만 하면 된다는 것을 쉽게 알 수 있습니다. - 스위프 라인의 고정된 위치에서는 이 x좌표에서 시작하는 모든 선분을 먼저 추가하고, 이곳에서 끝나는 모든 선분은 그다음에야 제거해야 한다는 점에 유의하십시오.
이렇게 하면 정점에서 일어나는 선분 교차, 즉 두 선분이 공통 정점을 가지는 경우를 놓치지 않습니다. - 실제로 수직 선분은 알고리즘의 정확성에 영향을 주지 않는다는 점에 유의하십시오.
이러한 선분은 나타나는 시점과 사라지는 시점이 같다는 점에서 구별됩니다. 그러나 앞의 설명에 따라 모든 선분이 먼저 큐에 추가되고 그 다음에야 삭제된다는 것을 알 수 있습니다. 따라서 수직 선분이 그 순간 열려 있는 다른 어떤 선분(수직 선분 포함)과 교차한다면, 그 교차는 검출됩니다.
수직 선분은 큐의 어느 위치에 놓아야 합니까? 수직 선분에는 하나의 특정한 $y$좌표가 없고, $y$좌표를 따라 하나의 구간 전체에 걸쳐 있기 때문입니다. 그러나 이 구간의 어떤 좌표든 $y$좌표로 취할 수 있다는 것은 쉽게 알 수 있습니다.
따라서 전체 알고리즘은 선분 쌍의 교차 검사를 $2n$번 이하로 수행하고, 선분 큐에 대한 연산을 $O(n)$번 수행합니다(각 선분이 나타나고 사라지는 시점마다 $O(1)$번의 연산).
따라서 알고리즘의 최종적인 점근적 동작은 $O(n \log n)$입니다.
구현
설명한 알고리즘의 전체 구현은 다음과 같습니다:
const double EPS = 1E-9;

struct pt {
    double x, y;
};

struct seg {
    pt p, q;
    int id;

    double get_y(double x) const {
        if (abs(p.x - q.x) < EPS)
            return p.y;
        return p.y + (q.y - p.y) * (x - p.x) / (q.x - p.x);
    }
};

bool intersect1d(double l1, double r1, double l2, double r2) {
    if (l1 > r1)
        swap(l1, r1);
    if (l2 > r2)
        swap(l2, r2);
    return max(l1, l2) <= min(r1, r2) + EPS;
}

int vec(const pt& a, const pt& b, const pt& c) {
    double s = (b.x - a.x) * (c.y - a.y) - (b.y - a.y) * (c.x - a.x);
    return abs(s) < EPS ? 0 : s > 0 ? +1 : -1;
}

bool intersect(const seg& a, const seg& b)
{
    return intersect1d(a.p.x, a.q.x, b.p.x, b.q.x) &&
           intersect1d(a.p.y, a.q.y, b.p.y, b.q.y) &&
           vec(a.p, a.q, b.p) * vec(a.p, a.q, b.q) <= 0 &&
           vec(b.p, b.q, a.p) * vec(b.p, b.q, a.q) <= 0;
}

bool operator<(const seg& a, const seg& b)
{
    double x = max(min(a.p.x, a.q.x), min(b.p.x, b.q.x));
    return a.get_y(x) < b.get_y(x) - EPS;
}

struct event {
    double x;
    int tp, id;

    event() {}
    event(double x, int tp, int id) : x(x), tp(tp), id(id) {}

    bool operator<(const event& e) const {
        if (abs(x - e.x) > EPS)
            return x < e.x;
        return tp > e.tp;
    }
};

set<seg> s;
vector<set<seg>::iterator> where;

set<seg>::iterator prev(set<seg>::iterator it) {
    return it == s.begin() ? s.end() : --it;
}

set<seg>::iterator next(set<seg>::iterator it) {
    return ++it;
}

pair<int, int> solve(const vector<seg>& a) {
    int n = (int)a.size();
    vector<event> e;
    for (int i = 0; i < n; ++i) {
        e.push_back(event(min(a[i].p.x, a[i].q.x), +1, i));
        e.push_back(event(max(a[i].p.x, a[i].q.x), -1, i));
    }
    sort(e.begin(), e.end());

    s.clear();
    where.resize(a.size());
    for (size_t i = 0; i < e.size(); ++i) {
        int id = e[i].id;
        if (e[i].tp == +1) {
            set<seg>::iterator nxt = s.lower_bound(a[id]), prv = prev(nxt);
            if (nxt != s.end() && intersect(*nxt, a[id]))
                return make_pair(nxt->id, id);
            if (prv != s.end() && intersect(*prv, a[id]))
                return make_pair(prv->id, id);
            where[id] = s.insert(nxt, a[id]);
        } else {
            set<seg>::iterator nxt = next(where[id]), prv = prev(where[id]);
            if (nxt != s.end() && prv != s.end() && intersect(*nxt, *prv))
                return make_pair(prv->id, nxt->id);
            s.erase(where[id]);
        }
    }

    return make_pair(-1, -1);
}
여기서 주 함수는 solve()이며, 교차하는 선분이 있으면 그 선분들을 반환하고 교차가 없으면 $(-1, -1)$을 반환합니다.
두 선분의 교차 여부는 삼각형의 부호 있는 넓이에 기반한 알고리즘을 사용하는 intersect () 함수로 검사합니다.
선분 큐는 set<event> 타입의 전역 변수 s입니다. 큐에서 각 선분의 위치를 가리키는 반복자(큐에서 선분을 편리하게 제거하기 위한 것)는 전역 배열 where에 저장됩니다.
또한 이전 원소와 다음 원소에 대한 반복자(해당 원소가 없으면 end())를 반환하는 두 보조 함수 prev()와 next()를 도입합니다.
상수 EPS는 두 실수를 비교할 때의 오차를 나타냅니다(주로 두 선분의 교차 여부를 검사할 때 사용됩니다).