헤비-라이트 분할
헤비-라이트 분할은 트리 위의 쿼리로 귀결되는 많은 문제를 효과적으로 해결할 수 있게 해 주는 상당히 범용적인 기법입니다.
설명
임의의 루트를 가지며 $n$개의 정점으로 이루어진 트리 $G$가 있다고 합시다.
이 트리 분할의 핵심은 임의의 $v$에서 최대 $\log n$개의 경로만 거쳐 루트 정점에 도달할 수 있도록 트리를 여러 개의 경로로 나누는 것입니다. 또한 이 경로들 중 어느 것도 다른 경로와 겹치지 않아야 합니다.
임의의 트리에 대해 이러한 분할을 찾을 수 있다면, “$a$에서 $b$까지의 경로 위에서 무언가를 계산하라” 형태의 특정 단일 쿼리를 ”$k^{th}$ 경로의 구간 $[l, r]$ 위에서 무언가를 계산하라” 유형의 여러 쿼리로 환원할 수 있다는 것은 분명합니다.
구성 알고리즘
각 정점 $v$에 대해 서브트리의 크기 $s(v)$, 즉 정점 $v$ 자신을 포함하여 $v$의 서브트리에 속한 정점의 개수를 계산합니다.
다음으로, 정점 $v$의 자식으로 이어지는 모든 간선을 살펴봅시다. 간선이 다음을 만족하는 정점 $c$로 이어지면 그 간선을 무거운 간선이라고 부릅니다:
나머지 모든 간선은 가벼운 간선이라고 부릅니다.
한 정점에서 아래로 뻗어 나가는 무거운 간선은 최대 하나뿐이라는 것은 자명합니다. 그렇지 않다면 정점 $v$는 크기가 $\ge \frac{s(v)}{2}$인 자식을 적어도 두 개 가지게 되고, 따라서 $v$의 서브트리 크기가 $s(v) \ge 1 + 2 \frac{s(v)}{2} > s(v)$로 너무 커져 모순이 발생하기 때문입니다.
이제 트리를 서로소인 경로들로 분할하겠습니다. 아래로 내려가는 무거운 간선이 하나도 없는 모든 정점을 살펴봅시다. 이러한 각 정점에서 트리의 루트에 도달하거나 가벼운 간선을 지날 때까지 위로 올라갑니다. 그 결과, 0개 이상의 무거운 간선과 하나의 가벼운 간선으로 이루어진 여러 경로를 얻게 됩니다. 루트에서 끝나는 경로는 예외로, 가벼운 간선을 가지지 않습니다. 이러한 경로를 무거운 경로라고 부르겠습니다. 이것이 바로 헤비-라이트 분할에서 원하는 경로입니다.
정당성 증명
먼저, 알고리즘으로 얻은 무거운 경로들은 서로소라는 점에 주목합니다. 실제로 두 경로가 공통 간선을 가진다면 한 정점에서 무거운 간선이 두 개 나온다는 뜻이 되는데, 이는 불가능합니다.
둘째로, 트리의 루트에서 임의의 정점까지 내려가는 동안 거쳐 가는 무거운 경로가 $\log n$번보다 많이 바뀌지 않는다는 것을 보이겠습니다. 가벼운 간선을 따라 내려가면 현재 서브트리의 크기가 절반 이하로 줄어듭니다:
따라서 서브트리의 크기가 1로 줄어들기 전까지 최대 $\log n$개의 가벼운 간선만 지날 수 있습니다.
한 무거운 경로에서 다른 무거운 경로로는 가벼운 간선을 통해서만 이동할 수 있으므로(루트에서 시작하는 경로를 제외한 각 무거운 경로에는 가벼운 간선이 하나씩 있습니다), 루트에서 임의의 정점까지의 경로를 따라가는 동안 무거운 경로를 $\log n$번보다 많이 바꿀 수 없으며, 이로써 원하는 결과가 증명됩니다.
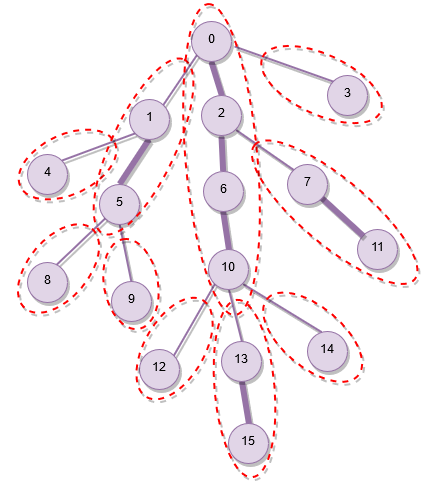
다음 그림은 예시 트리의 분할을 보여 줍니다. 무거운 간선은 가벼운 간선보다 굵게 표시되어 있습니다. 무거운 경로는 점선 경계로 표시되어 있습니다.
예제 문제
문제를 풀 때는 헤비-라이트 분할을 (간선이 서로소인 경로가 아니라) 정점이 서로소인 경로의 집합으로 보는 것이 더 편리할 때가 있습니다. 이렇게 하려면 각 무거운 경로의 마지막 간선이 가벼운 간선일 경우 그 간선을 제외하기만 하면 됩니다. 그러면 어떤 성질도 깨지지 않으면서, 이제 각 정점은 정확히 하나의 무거운 경로에 속하게 됩니다.
아래에서는 헤비-라이트 분할을 이용해 풀 수 있는 몇 가지 전형적인 문제를 살펴보겠습니다.
특히 경로 위 수들의 합 문제는 더 간단한 기법으로도 풀 수 있는 문제의 예이므로 따로 눈여겨볼 만합니다.
두 정점 사이 경로 위의 최댓값
트리가 주어지고, 각 정점에는 값이 할당되어 있습니다. $(a, b)$ 형태의 쿼리가 주어집니다. 여기서 $a$와 $b$는 트리의 두 정점이며, 정점 $a$와 $b$ 사이 경로 위의 최댓값을 구해야 합니다.
먼저 트리의 헤비-라이트 분할을 미리 구성합니다. 각 무거운 경로마다 세그먼트 트리를 구성하는데, 이를 통해 지정된 무거운 경로의 지정된 구간에서 할당된 값이 최대인 정점을 $\mathcal{O}(\log n)$에 찾을 수 있습니다. 헤비-라이트 분할에서 무거운 경로의 개수는 최대 $n - 1$개에 이를 수 있지만, 모든 경로의 크기 합은 $\mathcal{O}(n)$으로 제한되므로 세그먼트 트리들의 전체 크기 역시 선형입니다.
쿼리 $(a, b)$에 답하기 위해, 원하는 아무 방법으로 $a$와 $b$의 최소 공통 조상을 구하여 이를 $l$이라 합니다. 이제 문제는 두 쿼리 $(a, l)$과 $(b, l)$로 축소되었으며, 각각에 대해 다음과 같이 할 수 있습니다. 더 아래쪽 정점이 속한 무거운 경로를 찾아 이 경로에 쿼리를 수행하고, 이 경로의 맨 위로 이동한 뒤, 다시 현재 어느 무거운 경로에 있는지 확인하여 그 경로에 쿼리를 수행하는 과정을 $l$을 포함하는 경로에 도달할 때까지 반복합니다.
예를 들어 $a$와 $l$이 같은 무거운 경로 위에 있는 경우에는 주의해야 합니다. 이때는 이 경로에 대한 최댓값 쿼리를 접두사가 아니라 $a$와 $l$ 사이의 내부 구간에 대해 수행해야 합니다.
부분 쿼리 $(a, l)$과 $(b, l)$에 답하려면 각각 $\mathcal{O}(\log n)$개의 무거운 경로를 거쳐야 하고, 각 경로마다 경로의 일부 구간에 대해 최댓값 쿼리를 수행하며, 이는 다시 세그먼트 트리에서 $\mathcal{O}(\log n)$번의 연산을 필요로 합니다. 따라서 쿼리 $(a, b)$ 하나에 $\mathcal{O}(\log^2 n)$의 시간이 걸립니다.
각 무거운 경로에 대해 모든 접두사의 최댓값을 추가로 계산하여 저장해 두면, 조상 $l$에 도달할 때의 최대 한 번을 제외하고는 모든 최댓값 쿼리가 접두사에 대한 것이므로 $\mathcal{O}(\log n)$ 풀이를 얻을 수 있습니다.
두 정점 사이 경로 위 수들의 합
트리가 주어지고, 각 정점에는 값이 할당되어 있습니다. $(a, b)$ 형태의 쿼리가 주어집니다. 여기서 $a$와 $b$는 트리의 두 정점이며, 정점 $a$와 $b$ 사이 경로 위 값들의 합을 구해야 합니다. 이 문제의 변형으로, 하나 이상의 정점에 할당된 수를 변경하는 갱신 연산이 추가로 주어지는 경우도 있습니다.
이 문제는 앞의 최댓값 문제와 마찬가지로 헤비-라이트 분할을 이용하여 무거운 경로 위에 세그먼트 트리를 구축하는 방식으로 풀 수 있습니다. 갱신이 없다면 대신 누적 합을 사용할 수 있습니다. 하지만 이 문제는 더 간단한 기법으로도 풀 수 있습니다.
갱신이 없다면 binary lifting으로 두 정점의 LCA를 찾는 것과 동시에 두 정점 사이 경로 위의 합을 구할 수 있습니다. 이를 위해 전처리 과정에서 각 정점의 $2^k$번째 조상과 함께 그 조상까지의 경로 위 합도 저장해야 합니다.
이 문제에는 근본적으로 다른 접근법도 있습니다. 트리의 오일러 투어를 고려하여 그 위에 세그먼트 트리를 구성하는 것입니다. 이 알고리즘은 비슷한 문제에 대한 글에서 다룹니다. 마찬가지로 갱신이 없다면 누적 합을 저장하는 것으로 충분하며 세그먼트 트리는 필요하지 않습니다.
두 방법 모두 쿼리 하나에 $\mathcal{O}(\log n)$이 걸리는 비교적 간단한 풀이를 제공합니다.
두 정점 사이 경로의 간선 다시 칠하기
트리가 주어지고, 각 간선은 처음에 흰색으로 칠해져 있습니다. $(a, b, c)$ 형태의 갱신이 주어집니다. 여기서 $a$와 $b$는 두 정점이고 $c$는 색이며, 이는 $a$에서 $b$로 가는 경로 위의 모든 간선을 색 $c$로 다시 칠해야 함을 뜻합니다. 모든 다시 칠하기가 끝난 후, 각 색의 간선이 몇 개가 되었는지 보고해야 합니다.
앞의 문제들과 마찬가지로, 헤비-라이트 분할을 적용하고 각 무거운 경로마다 세그먼트 트리를 만들기만 하면 됩니다.
경로 $(a, b)$에 대한 각 다시 칠하기는 두 갱신 $(a, l)$과 $(b, l)$로 바뀝니다. 여기서 $l$은 정점 $a$와 $b$의 최소 공통 조상입니다.
경로 하나당 $\mathcal{O}(\log n)$이 걸리고 경로가 $\mathcal{O}(\log n)$개이므로, 갱신 한 번의 복잡도는 $\mathcal{O}(\log^2 n)$입니다.
구현
위에서 설명한 방법의 일부를 수정하면 효율을 잃지 않으면서 구현을 더 쉽게 할 수 있습니다.
- 무거운 간선의 정의를 서브트리가 가장 큰 자식으로 향하는 간선으로 바꿀 수 있으며, 크기가 같으면 임의로 하나를 고릅니다. 이렇게 하면 일부 가벼운 간선이 무거운 간선으로 바뀔 수 있습니다. 즉 몇몇 무거운 경로가 합쳐져 하나의 경로가 될 수 있지만, 모든 무거운 경로는 여전히 서로소입니다. 또한 가벼운 간선을 따라 내려가면 서브트리의 크기가 절반 이하로 줄어든다는 점도 여전히 보장됩니다.
- 무거운 경로마다 세그먼트 트리를 따로 만드는 대신, 세그먼트 트리 하나를 두고 각 무거운 경로에 서로소인 구간을 할당하여 사용할 수 있습니다.
- 앞에서 쿼리에 답하려면 LCA를 계산해야 한다고 언급했습니다. LCA를 따로 계산할 수도 있지만, 쿼리에 답하는 과정에 LCA 계산을 통합하는 것도 가능합니다.
헤비-라이트 분할을 수행하려면 다음과 같이 합니다.
vector<int> parent, depth, heavy, head, pos;
int cur_pos;

int dfs(int v, vector<vector<int>> const& adj) {
    int size = 1;
    int max_c_size = 0;
    for (int c : adj[v]) {
        if (c != parent[v]) {
            parent[c] = v, depth[c] = depth[v] + 1;
            int c_size = dfs(c, adj);
            size += c_size;
            if (c_size > max_c_size)
                max_c_size = c_size, heavy[v] = c;
        }
    }
    return size;
}

void decompose(int v, int h, vector<vector<int>> const& adj) {
    head[v] = h, pos[v] = cur_pos++;
    if (heavy[v] != -1)
        decompose(heavy[v], h, adj);
    for (int c : adj[v]) {
        if (c != parent[v] && c != heavy[v])
            decompose(c, c, adj);
    }
}

void init(vector<vector<int>> const& adj) {
    int n = adj.size();
    parent = vector<int>(n);
    depth = vector<int>(n);
    heavy = vector<int>(n, -1);
    head = vector<int>(n);
    pos = vector<int>(n);
    cur_pos = 0;

    dfs(0, adj);
    decompose(0, 0, adj);
}
트리의 인접 리스트를 init 함수에 전달해야 하며, 분할은 정점 0을 루트로 가정하고 수행됩니다.
dfs 함수는 모든 정점 v에 대해 v에서 나가는 무거운 간선의 반대쪽 끝에 있는 자식인 heavy[v]를 계산하는 데 사용됩니다. 또한 dfs는 각 정점의 부모와 깊이도 저장하며, 이는 나중에 쿼리를 처리할 때 유용하게 쓰입니다.
decompose 함수는 각 정점 v에 head[v]와 pos[v] 값을 할당합니다. 이 값은 각각 v가 속한 무거운 경로의 머리, 그리고 모든 정점을 포괄하는 단일 세그먼트 트리에서 v의 위치입니다.
경로에 대한 쿼리, 예를 들어 앞에서 설명한 최댓값 쿼리에 답하려면 다음과 같이 할 수 있습니다.
int query(int a, int b) {
    int res = segment_tree_query(pos[a], pos[a]);
    for (; head[a] != head[b]; b = parent[head[b]]) {
        if (depth[head[a]] > depth[head[b]])
            swap(a, b);
        int cur_heavy_path_max = segment_tree_query(pos[head[b]], pos[b]);
        res = max(res, cur_heavy_path_max);
    }
    if (depth[a] > depth[b])
        swap(a, b);
    int last_heavy_path_max = segment_tree_query(pos[a], pos[b]);
    res = max(res, last_heavy_path_max);
    return res;
}