센트로이드 분할
사전 지식: 깊이 우선 탐색(DFS), 분할 정복, 트리.
소개
센트로이드 분할은 트리에서 사용하는 분할 정복 기법입니다. 특정 성질을 만족하는 경로의 개수 세기, 거리 구하기, 트리 경로에 대한 쿼리 처리 등 트리의 경로와 관련된 다양한 문제를 해결하는 데 사용됩니다.
핵심 아이디어는 트리의 센트로이드를 찾아 트리를 재귀적으로 분할하는 것입니다. 이 특별한 정점을 제거하면 트리가 여러 컴포넌트로 나뉘며, 각 컴포넌트는 원래 트리 정점 수의 절반 이하만 포함합니다. 이로써 재귀 깊이가 로그 수준으로 보장되어 효율적인 알고리즘을 얻을 수 있습니다.
센트로이드의 성질과 정의
먼저 센트로이드가 무엇인지 알아봅시다. 트리의 센트로이드란 제거했을 때 $\frac{N}{2}$개보다 많은 정점을 가진 서브트리가 남지 않는 정점이며, 여기서 $N$은 트리의 전체 정점 수입니다.
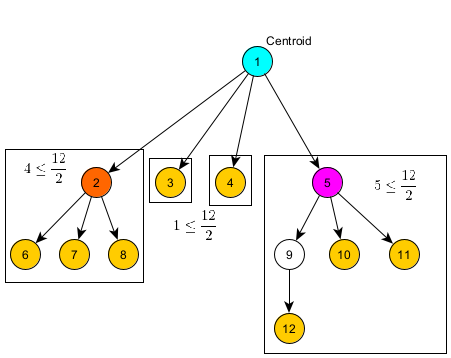
정점이 $N$개인 임의의 트리에는 센트로이드가 한 개 또는 두 개 존재합니다. 센트로이드가 두 개라면 두 센트로이드는 또한 반드시 인접해야 합니다.
존재성과 유일성
정리: 모든 트리는 적어도 한 개, 많아야 두 개의 센트로이드를 가집니다. 센트로이드가 두 개라면 두 센트로이드는 반드시 인접해야 합니다.
증명
존재성: 임의의 정점에서 시작하여 가장 큰 서브트리를 가진 자식으로 계속 이동합니다. $\frac{N}{2}$개보다 많은 정점을 가진 자식이 없으면 멈춥니다. 이 시점에서 현재 정점 $v$는 센트로이드입니다. 그 이유는 (1) 어떤 자식의 서브트리도 $\frac{N}{2}$개보다 많은 정점을 포함하지 않으며(정지 조건에 의해), (2) "부모 쪽"($v$가 자식이었을 때 $v$의 서브트리를 제외한 모든 정점)은 많아야 $\frac{N}{2}$개의 정점을 포함하기 때문입니다(그렇지 않았다면 부모에서 $v$로 이동하지 않았을 것입니다).
이 과정이 항상 종료된다는 것은 쉽게 알 수 있으며, 따라서 적어도 하나의 센트로이드가 존재함이 증명됩니다.
유일성: 두 센트로이드 $u$와 $v$가 있다고 가정합시다. 둘 사이의 경로를 생각해 봅시다. $u$를 제거하면 정점 $v$는 많아야 $\frac{N}{2}$개의 정점을 가진 컴포넌트에 속해야 합니다. 마찬가지로 $v$를 제거하면 정점 $u$는 많아야 $\frac{N}{2}$개의 정점을 가진 컴포넌트에 속해야 합니다. 이는 $u$와 $v$가 인접한 경우에만 가능합니다. 그렇지 않다면 둘 중 하나를 제거했을 때 다른 하나는 $\frac{N}{2}$개보다 많은 정점을 가진 컴포넌트에 속하게 됩니다. 이는 두 센트로이드가 모두 많아야 $\frac{N}{2}$개의 정점을 가진 컴포넌트에 속한다는 처음의 명제와 모순됩니다. 더 나아가 두 센트로이드가 존재한다면 이들은 트리를 각각 정확히 $\frac{N}{2}$개의 정점을 가진 두 컴포넌트로 나누어야 하며, 이는 $N$이 짝수일 때에만 가능합니다.
센트로이드 분할의 성질과 정의
따라서 트리를 "분할"한다는 것은 본질적으로 센트로이드를 재귀적으로 찾고, 센트로이드의 컴포넌트를 기준으로 트리를 서브트리들로 나누는 것을 의미합니다. 이처럼 트리를 컴포넌트들로 재귀적으로 분할하면 다음과 같은 고유한 성질들이 생깁니다.
- 분할 깊이: 각 단계마다 컴포넌트 크기가 적어도 절반으로 줄어들기 때문에 깊이는 $O(\log N)$입니다.
- 경로 커버리지: 트리의 모든 경로는 분해 과정에서 어떤 컴포넌트의 센트로이드를 지납니다.
분해 깊이
정리: 임의의 트리에 센트로이드 분할을 적용할 때의 깊이, 즉 단계 수는 $O(\log N)$입니다.
증명
원래 트리의 임의의 정점 $v$를 생각해 봅시다. 분해 과정에서 $v$가 컴포넌트에 몇 번 속할 수 있는지 추적합니다.
첫 번째 레벨에서 $v$는 크기가 $N$인 컴포넌트에 속합니다. 이 컴포넌트의 센트로이드를 제거하면, $v$는 (균형 성질에 의해) 크기가 최대 $\frac{N}{2}$인 컴포넌트에 속하게 됩니다.
두 번째 레벨에서 $v$는 크기가 최대 $\frac{N}{2}$인 컴포넌트에 속합니다. 이 컴포넌트의 센트로이드를 제거하면 $v$는 크기가 최대 $\frac{N}{4}$인 컴포넌트에 속하게 됩니다.
이 패턴을 계속하면, $k$번째 레벨에서 $v$는 크기가 최대 $\frac{N}{2^{k-1}}$인 컴포넌트에 속합니다.
분해는 컴포넌트의 크기가 1이 되면 멈춥니다. 이는 $\frac{N}{2^{k-1}} \leq 1$일 때 일어나며, 이로부터 $k \leq \log_2 N + 1$을 얻습니다.
따라서 센트로이드 분할 트리의 최대 깊이는 $O(\log N)$입니다.
따름정리: 각 정점은 최대 $O(\log N)$개 수준의 분할에만 참여하고 각 수준에서 각 정점을 한 번씩 처리하므로, 센트로이드 분할을 사용하는 알고리즘의 시간 복잡도는 일반적으로 정점 하나가 수준 하나에서 하는 작업량에 $O(\log N)$을 곱한 꼴이 됩니다.
경로 커버리지
정리: 원래 트리의 모든 경로는 분해 과정에서 어떤 컴포넌트의 센트로이드를 지납니다.
증명
원래 트리에서 정점 $u$에서 정점 $v$로 가는 임의의 경로 $P$를 생각해 봅시다. 이 경로가 분해 과정에서 선택된 센트로이드 중 적어도 하나를 지난다는 것을 보여야 합니다.
이를 분해 과정에 대한 귀납법으로 증명합니다.
기저 사례: 분해의 첫 번째 레벨에서 전체 트리의 센트로이드 $c_1$을 선택합니다. 경로 $P$가 $c_1$을 지난다면 증명이 끝납니다.
귀납 단계: 경로 $P$가 $c_1$을 지나지 않는다고 가정합시다. $c_1$을 제거하면 트리는 여러 컴포넌트로 나뉩니다. $P$는 연결된 경로이므로, $c_1$을 제거한 뒤 $u$와 $v$는 모두 같은 컴포넌트 $C$에 속해야 합니다(그렇지 않다면 $P$가 둘을 연결하기 위해 $c_1$을 지나야 하므로 가정에 모순됩니다).
이제 컴포넌트 $C$를 재귀적으로 분해합니다. 컴포넌트 $C$에 귀납 가정을 적용하면, ($C$에 완전히 포함된) 경로 $P$는 $C$의 분해 과정에서 어떤 컴포넌트의 센트로이드를 반드시 지납니다.
이 과정은 $P$가 지나는 센트로이드를 찾을 때까지 계속됩니다. 각 레벨에서 $P$를 포함하는 컴포넌트는 (균형 성질에 의해) 엄격하게 작아지고 결국 하나의 간선이나 정점으로 줄어들기 때문에, 이 과정은 반드시 종료됩니다.
따름정리: 이 성질은 센트로이드 분할 알고리즘이 올바르게 동작하기 위한 기본 조건입니다. 이 성질 덕분에 각 센트로이드를 지나는 모든 경로를 처리하면, 트리에서 가능한 모든 경로를 분해의 어느 한 단계에서 정확히 한 번씩 다루게 됩니다. 센트로이드 분할로 경로 관련 문제를 효율적으로 풀 수 있는 이유가 바로 이것입니다. 모든 경로는 처음으로 센트로이드를 만나는 수준에서 정확히 한 번만 고려됩니다.
센트로이드 찾기
트리의 센트로이드를 효율적으로 찾는 방법은 다음과 같습니다.
- 깊이 우선 탐색(DFS)을 사용하여 모든 정점의 서브트리 크기를 계산합니다
- 임의의 정점에서 시작합니다
- 서브트리에 $\frac{N}{2}$개보다 많은 정점이 포함된 자식 $v$를 찾습니다
- $v$로 이동한 뒤 3단계를 반복합니다
- 그러한 자식이 없으면 현재 정점이 센트로이드입니다
시간 복잡도: $O(N)$입니다.
공간 복잡도: $O(N)$입니다.
알고리즘 설명
센트로이드 분할을 사용할 때의 일반적인 흐름은 다음과 같습니다.
- 현재 트리/컴포넌트의 센트로이드를 찾습니다
- 이 센트로이드를 지나는 모든 경로를 처리하고 필요한 계산을 수행합니다
- 센트로이드를 제거합니다(사용됨으로 표시합니다)
- 그 결과로 생긴 각 서브트리를 재귀적으로 분해합니다
이렇게 하면 센트로이드 트리가 만들어집니다. 이 트리의 각 노드는 분해의 어느 한 단계에서 찾은 센트로이드를 나타냅니다. 즉, 어떤 센트로이드(임의의 노드)의 부모는 그 센트로이드를 포함하는 더 큰 컴포넌트에서 찾은 센트로이드입니다. 앞에서 증명했듯이 이 트리의 높이는 $O(\log N)$입니다.
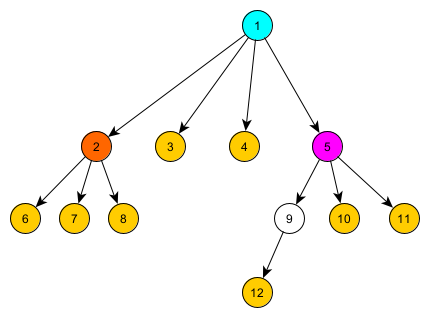
예를 들어, 위 그림은 센트로이드 트리를 보여 줍니다. 트리의 각 단계에 있는 각 노드는 해당 컴포넌트의 센트로이드입니다(예를 들어 루트는 전체 트리의 센트로이드이고, 루트의 가장 왼쪽 자식은 루트의 가장 왼쪽 서브트리의 센트로이드인 식입니다).
구현
다음은 센트로이드 분할로 트리에서 길이가 정확히 $K$인 모든 경로의 수 세기라는 특정 문제를 해결하는 구현입니다.
이 문제에서는 $N$개의 정점으로 이루어진 트리가 주어지며, 간선이 정확히 $K$개인 경로가 몇 개인지 세어야 합니다. 경로는 서로 다른 두 정점으로 정의됩니다.
const int MAXN = 1e5;
vector<int> adj[MAXN];
bool removed[MAXN];
int subtree_size[MAXN];
int K;  // Target path length
long long answer = 0;  // Count of paths with length K

int get_subtree_size(int v, int p = -1) {
    subtree_size[v] = 1;
    for (int u : adj[v]) {
        if (u == p || removed[u]) continue;
        subtree_size[v] += get_subtree_size(u, v);
    }
    return subtree_size[v];
}

int get_centroid(int v, int tree_size, int p = -1) {
    for (int u : adj[v]) {
        if (u == p || removed[u]) continue;
        if (subtree_size[u] * 2 > tree_size)
            return get_centroid(u, tree_size, v);
    }
    return v;
}

void get_distances(int v, int p, int dist, vector<int>& distances) {
    if (dist > K) return;
    distances.push_back(dist);
    for (int u : adj[v]) {
        if (u == p || removed[u]) continue;
        get_distances(u, v, dist + 1, distances);
    }
}

void process_centroid(int centroid) {
    unordered_map<int, int> all_distances;
    all_distances[0] = 1;

    for (int u : adj[centroid]) {
        if (removed[u])
            continue;

        vector<int> current_distances;
        get_distances(u, centroid, 1, current_distances);

        for (int d : current_distances) {
            if (K - d >= 0) {
                answer += (all_distances[K - d] ? all_distances[K - d] : 0);
            }
        }

        for (int d : current_distances) {
            if (all_distances.find(d) == all_distances.end())
                all_distances[d] = 0;
            all_distances[d]++;
        }
    }
}

void decompose(int v) {
    int tree_size = get_subtree_size(v);
    int centroid = get_centroid(v, tree_size);

    process_centroid(centroid);

    removed[centroid] = true;

    for (int u : adj[centroid]) {
        if (!removed[u]) {
            decompose(u);
        }
    }
}
이 템플릿은 센트로이드 분할을 이용하는 여러 문제를 풀 수 있도록 변형할 수 있습니다. 이 경우에는 길이가 $K$인 모든 경로의 개수를 세는 문제를 풉니다. 전략은 다음과 같습니다. 각 센트로이드에 대해 서로 다른 서브트리에 있으면서 거리 $d_1$과 $d_2$의 합이 $K$가 되는 정점 쌍을 찾아, 그 센트로이드를 지나는 경로의 개수를 셉니다(즉, 센트로이드를 지나는 경로는 한 서브트리에서 센트로이드와의 거리가 $d_1$인 정점과 다른 서브트리에서 거리가 $d_2$인 정점으로 이루어지며, 이때 $d_1 + d_2 = K$입니다). 코드는 현재 서브트리의 각 거리 $d$에 대해 앞서 처리한 서브트리들에서 거리가 $K - d$인 정점이 몇 개인지 셉니다. 이 최적화는 불필요한 재귀를 피하기 위해 $K$를 넘는 거리를 건너뜁니다.
센트로이드 트리 구성하기
센트로이드 트리 구조를 명시적으로 구성해야 한다면(쿼리에 답할 때 유용합니다) 다음과 같이 합니다.
int centroid_parent[MAXN];

int decompose(int v, int p = -1) {
    int tree_size = get_subtree_size(v);
    int centroid = get_centroid(v, tree_size);

    centroid_parent[centroid] = p;
    removed[centroid] = true;

    for (int u : adj[centroid]) {
        if (!removed[u]) {
            decompose(u, centroid);
        }
    }

    return centroid;
}
연습 문제
- CSES - Finding a Centroid [난이도: 쉬움]
- CSES - Fixed-Length Paths II [난이도: 쉬움]
- Codeforces - Xenia and Tree [난이도: 보통]
- Codeforces - Digit Tree [난이도: 보통]
- OJ - Race [난이도: 보통]
- SPOJ - QTREE5 [난이도: 어려움]