LCA(최소 공통 조상)를 구하여 RMQ(구간 최솟값 쿼리) 풀기
배열 A[0..N-1]이 주어집니다. [L, R] 형태의 각 쿼리마다 배열 A에서 위치 L부터 위치 R까지의 최솟값을 구하려고 합니다. 이 과정에서 배열 A는 변하지 않는다고 가정합니다. 즉, 이 글은 정적 RMQ 문제의 해법을 설명합니다.
다음은 점근적으로 최적인 해법에 대한 설명입니다. 이 해법은 RMQ 문제의 다른 해법들과 매우 달라서 그들과 확연히 구별됩니다. 이 해법은 RMQ 문제를 LCA 문제로 환원한 다음, Farach-Colton과 Bender 알고리즘을 사용합니다. 이 알고리즘은 LCA 문제를 다시 특수한 형태의 RMQ 문제로 환원하여 해결합니다.
알고리즘
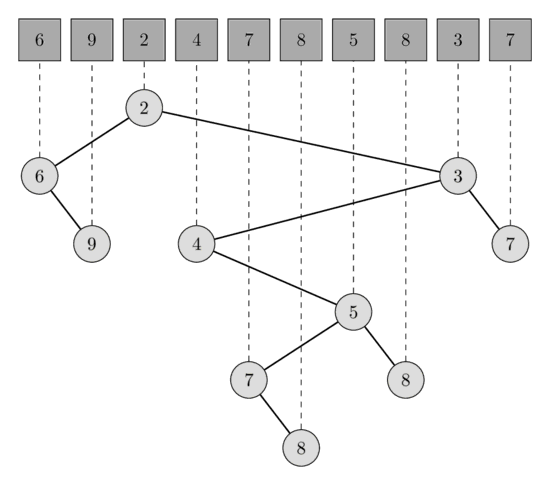
배열 A로부터 데카르트 트리를 구성합니다. 배열 A의 데카르트 트리는 최소 힙 성질(부모 노드의 값이 자식 노드의 값보다 작거나 같아야 함)을 가지는 이진 트리로, 트리를 중위 순회하면 배열 A에 있는 순서와 같은 순서로 노드를 방문합니다.
다시 말해, 데카르트 트리는 재귀적인 자료 구조입니다. 배열 A는 세 부분으로 나뉩니다. 최솟값 앞까지의 배열의 접두사, 최솟값, 그리고 나머지 접미사입니다. 트리의 루트는 배열 A의 최솟값 원소에 대응하는 노드가 되고, 왼쪽 서브트리는 접두사의 데카르트 트리가 되며, 오른쪽 서브트리는 접미사의 데카르트 트리가 됩니다.
다음 그림에서 길이가 10인 배열 하나와 그에 대응하는 데카르트 트리를 볼 수 있습니다.
구간 최솟값 쿼리 [l, r]은 최소 공통 조상 쿼리 [l', r']과 동치입니다. 여기서 l'은 원소 A[l]에 대응하는 노드이고 r'은 원소 A[r]에 대응하는 노드입니다. 실제로 구간에서 가장 작은 원소에 대응하는 노드는 구간 내 모든 노드의 조상이어야 하므로, l'과 r'의 조상이기도 합니다. 이는 최소 힙 성질로부터 자동으로 따라 나옵니다. 또한 이 노드는 가장 낮은 조상이어야 합니다. 그렇지 않다면 l'과 r'이 모두 왼쪽 서브트리 또는 모두 오른쪽 서브트리에 있게 되는데, 그러한 경우에는 최솟값이 구간 안에 있지조차 않게 되므로 모순이 발생하기 때문입니다.
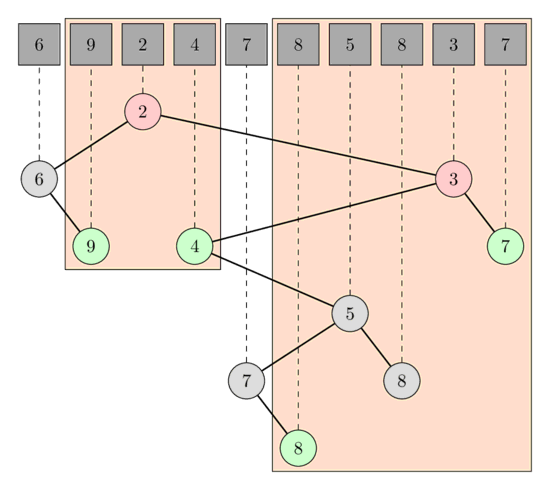
다음 그림에서 RMQ 쿼리 [1, 3]과 [5, 9]에 대한 LCA 쿼리를 볼 수 있습니다. 첫 번째 쿼리에서 노드 A[1]과 A[3]의 LCA는 값이 2인 A[2]에 대응하는 노드이고, 두 번째 쿼리에서 A[5]와 A[9]의 LCA는 값이 3인 A[8]에 대응하는 노드입니다.
이러한 트리는 $O(N)$ 시간에 만들 수 있으며, Farach-Colton과 Bender 알고리즘은 트리를 $O(N)$에 전처리하고 LCA를 $O(1)$에 구할 수 있습니다.
데카르트 트리의 구성
원소를 하나씩 차례로 추가하여 데카르트 트리를 만듭니다. 각 단계에서 지금까지 처리한 모든 원소에 대한 올바른 데카르트 트리를 유지합니다. 원소 s[i]를 추가할 때 트리의 가장 오른쪽 경로(루트에서 시작하여 오른쪽 자식을 반복해서 따라가는 경로)에 있는 노드들만 바뀔 수 있다는 것은 쉽게 알 수 있습니다. s[i]보다 크거나 같은 값 중 가장 작은 값을 가진 노드의 서브트리는 s[i]의 왼쪽 서브트리가 되고, s[i]를 루트로 하는 트리는 s[i]보다 작은 값 중 가장 큰 값을 가진 노드의 새로운 오른쪽 서브트리가 됩니다.
이는 가장 오른쪽 노드들의 인덱스를 저장하는 스택을 사용하여 구현할 수 있습니다.
vector<int> parent(n, -1);
stack<int> s;
for (int i = 0; i < n; i++) {
    int last = -1;
    while (!s.empty() && A[s.top()] >= A[i]) {
        last = s.top();
        s.pop();
    }
    if (!s.empty())
        parent[i] = s.top();
    if (last >= 0)
        parent[last] = i;
    s.push(i);
}