펜윅 트리
$f$를 어떤 군 연산(항등원소와 역원소를 갖는 집합 위에서 정의된 결합 법칙을 만족하는 이항 함수)이라 하고, $A$를 길이가 $N$인 정수 배열이라 합시다. $f$의 중위 표기를 $*$로 나타냅니다. 즉, 임의의 정수 $x,y$에 대해 $f(x,y) = x*y$입니다. (이 연산은 결합법칙을 만족하므로, 중위 표기를 사용할 때 $f$의 적용 순서를 나타내는 괄호는 생략하겠습니다.)
펜윅 트리는 다음과 같은 자료 구조입니다.
- 주어진 구간 $[l, r]$에서 함수 $f$의 값(즉, $A_l * A_{l+1} * \dots * A_r$)을 $O(\log N)$ 시간에 계산합니다
- $A$의 원소 값을 $O(\log N)$ 시간에 갱신합니다
- $O(N)$ 메모리를 필요로 합니다($A$에 필요한 양과 같습니다)
- 사용과 구현이 쉬우며, 특히 다차원 배열의 경우에 그렇습니다
펜윅 트리의 가장 흔한 활용은 구간의 합을 계산하는 것입니다. 예를 들어, 정수 집합 위의 덧셈을 군 연산으로 사용하는 경우, 즉 $f(x,y) = x + y$인 경우를 생각해 봅시다. 이 경우 이항 연산 $*$는 $+$이므로 $A_l * A_{l+1} * \dots * A_r = A_l + A_{l+1} + \dots + A_{r}$입니다.
펜윅 트리는 이진 인덱스 트리(Binary Indexed Tree, BIT)라고도 불립니다. 이 자료 구조는 "A new data structure for cumulative frequency tables"라는 제목의 논문(Peter M. Fenwick, 1994)에서 처음 소개되었습니다.
설명
개요
간단히 하기 위해, 함수 $f$가 정수 위에서 $f(x,y) = x + y$로 정의된다고 가정하겠습니다.
정수 배열 $A[0 \dots N-1]$이 주어졌다고 합시다. (0부터 시작하는 인덱스를 사용한다는 점에 유의하십시오.) 펜윅 트리는 단지 배열 $T[0 \dots N-1]$일 뿐이며, 각 원소는 어떤 구간 $[g(i), i]$에 있는 $A$의 원소들의 합과 같습니다.
여기서 $g$는 $0 \le g(i) \le i$를 만족하는 어떤 함수입니다. $g$는 이어지는 몇 단락에서 정의하겠습니다.
이 자료 구조를 트리라고 부르는 이유는 트리 형태로 멋지게 표현할 수 있기 때문입니다. 다만 노드와 간선으로 이루어진 실제 트리를 모델링할 필요는 없습니다. 모든 쿼리를 처리하려면 배열 $T$만 유지하면 됩니다.
참고: 여기에서 소개하는 펜윅 트리는 0부터 시작하는 인덱스를 사용합니다. 많은 사람들이 1부터 시작하는 인덱스를 사용하는 버전의 펜윅 트리를 사용합니다. 따라서 구현 절에서 1부터 시작하는 인덱스를 사용하는 대체 구현도 확인할 수 있습니다. 두 버전은 시간 복잡도와 메모리 복잡도 면에서 동등합니다.
이제 앞에서 언급한 두 연산에 대한 의사 코드를 작성할 수 있습니다. 아래에서는 구간 $[0, r]$에 있는 $A$의 원소들의 합을 구하고, 어떤 원소 $A_i$를 갱신(증가)합니다.
def sum(int r):
    res = 0
    while (r >= 0):
        res += t[r]
        r = g(r) - 1
    return res

def increase(int i, int delta):
    for all j with g(j) <= i <= j:
        t[j] += delta
함수 sum은 다음과 같이 동작합니다.
- 먼저, 구간 $[g(r), r]$의 합(즉, $T[r]$)을
result에 더합니다. - 그다음, 구간 $[g(g(r)-1), g(r)-1]$로 "점프"하여 이 구간의 합을
result에 더합니다. - 이 과정은 $[0, g(g( \dots g(r)-1 \dots -1)-1)]$에서 $[g(-1), -1]$로 "점프"할 때까지 계속됩니다. 이 지점에서
sum함수는 점프를 멈춥니다.
함수 increase도 같은 방식으로 동작하지만, 인덱스가 증가하는 방향으로 "점프"합니다.
- 조건 $g(j) \le i \le j$를 만족하는 $[g(j), j]$ 꼴의 각 구간의 합이
delta만큼 증가합니다. 즉,t[j] += delta입니다. 따라서 $A_i$가 속하는 구간에 대응하는 $T$의 모든 원소가 갱신됩니다.
sum과 increase의 복잡도는 모두 함수 $g$에 따라 달라집니다. 모든 $i$에 대해 $0 \le g(i) \le i$를 만족하도록 함수 $g$를 고르는 방법은 여러 가지가 있습니다. 예를 들어 함수 $g(i) = i$도 가능하며, 이 경우 $T = A$가 됩니다(이때는 합 쿼리가 느립니다). 함수 $g(i) = 0$을 택할 수도 있습니다. 이는 누적 합 배열에 해당합니다(이때는 구간 $[0, i]$의 합을 구하는 데 상수 시간만 걸리지만, 갱신이 느립니다). 펜윅 트리 알고리즘의 영리한 점은 두 연산을 모두 $O(\log N)$ 시간에 처리할 수 있도록 함수 $g$를 특별하게 정의하여 사용한다는 것입니다.
$g(i)$의 정의
$g(i)$의 계산은 다음과 같은 간단한 연산으로 정의됩니다: $i$의 이진 표현에서 끝에 연속으로 있는 $1$ 비트를 모두 $0$ 비트로 바꿉니다.
다시 말해, $i$의 이진 표현에서 최하위 자리가 $0$이면 $g(i) = i$입니다. 그렇지 않으면 최하위 자리가 $1$이며, 이 $1$과 그 뒤에 연속으로 이어지는 다른 모든 $1$들을 뒤집습니다.
예를 들면 다음과 같습니다.
위에서 설명한 자명하지 않은 연산은 비트 연산을 사용하여 간단하게 구현할 수 있습니다:
여기서 $\&$는 비트 AND 연산자입니다. 이 방법이 위에서 설명한 연산과 같은 일을 한다는 것은 어렵지 않게 확인할 수 있습니다.
이제 $g(j) \le i \le j$를 만족하는 모든 $j$를 순회하는 방법만 찾으면 됩니다.
$i$에서 시작하여 마지막으로 설정되지 않은 비트를 뒤집어 나가면 그러한 $j$를 모두 찾을 수 있다는 것은 쉽게 알 수 있습니다. 이 연산을 $h(j)$라고 부르겠습니다. 예를 들어 $i = 10$인 경우는 다음과 같습니다:
예상할 수 있듯이, $h$ 역시 비트 연산을 사용하여 간단하게 수행할 수 있습니다:
여기서 $|$는 비트 OR 연산자입니다.
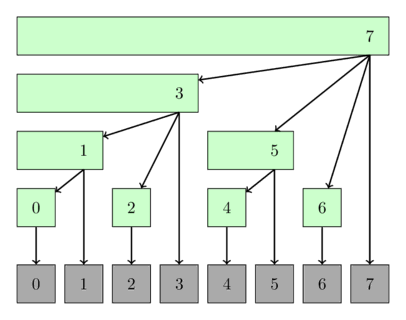
다음 그림은 펜윅 트리를 트리로 해석할 수 있는 한 가지 방법을 보여 줍니다. 트리의 각 노드는 해당 노드가 담당하는 구간을 나타냅니다.
구현
1차원 배열에서 합 구하기
여기서는 합 쿼리와 단일 원소 갱신을 위한 펜윅 트리의 구현을 소개합니다.
일반적인 펜윅 트리는 sum(int r)을 사용하여 $[0, r]$ 형태의 합 쿼리에만 답할 수 있지만, 두 합 $[0, r]$과 $[0, l-1]$을 계산하여 빼면 $[l, r]$ 형태의 다른 쿼리에도 답할 수 있습니다. 이는 sum(int l, int r) 메서드에서 처리합니다.
또한 이 구현은 두 가지 생성자를 지원합니다. 0으로 초기화된 펜윅 트리를 생성할 수도 있고, 기존 배열을 펜윅 형태로 변환할 수도 있습니다.
struct FenwickTree {
    vector<int> bit;  // binary indexed tree
    int n;

    FenwickTree(int n) {
        this->n = n;
        bit.assign(n, 0);
    }

    FenwickTree(vector<int> const &a) : FenwickTree(a.size()) {
        for (size_t i = 0; i < a.size(); i++)
            add(i, a[i]);
    }

    int sum(int r) {
        int ret = 0;
        for (; r >= 0; r = (r & (r + 1)) - 1)
            ret += bit[r];
        return ret;
    }

    int sum(int l, int r) {
        return sum(r) - sum(l - 1);
    }

    void add(int idx, int delta) {
        for (; idx < n; idx = idx | (idx + 1))
            bit[idx] += delta;
    }
};
선형 구성
위의 구현은 $O(N \log N)$ 시간이 필요합니다. 이를 $O(N)$ 시간으로 개선할 수 있습니다.
핵심 아이디어는, 인덱스 $i$에 있는 수 $a[i]$가 $bit[i]$에 저장된 구간에 기여하고, 인덱스 $i | (i + 1)$이 기여하는 모든 구간에도 기여한다는 것입니다. 따라서 수를 순서대로 더해 나가면 현재 합을 다음 구간으로 넘겨주기만 하면 되며, 그 합은 다시 그다음 구간으로 넘겨지는 식으로 계속 이어집니다.
FenwickTree(vector<int> const &a) : FenwickTree(a.size()){
    for (int i = 0; i < n; i++) {
        bit[i] += a[i];
        int r = i | (i + 1);
        if (r < n) bit[r] += bit[i];
    }
}
1차원 배열에서 $[0, r]$의 최솟값 구하기
펜윅 트리는 $[0, r]$ 형태의 쿼리에만 답할 수 있으므로, 펜윅 트리를 사용하여 구간 $[l, r]$의 최솟값을 구하는 쉬운 방법이 없다는 것은 자명합니다. 또한 값을 update할 때마다 새 값은 현재 값보다 작아야 합니다. 두 가지 중요한 제약은 모두 $min$ 연산이 정수 집합과 함께 군을 이루지 못하기 때문에 생깁니다. 역원소가 존재하지 않기 때문입니다.
struct FenwickTreeMin {
    vector<int> bit;
    int n;
    const int INF = (int)1e9;

    FenwickTreeMin(int n) {
        this->n = n;
        bit.assign(n, INF);
    }

    FenwickTreeMin(vector<int> a) : FenwickTreeMin(a.size()) {
        for (size_t i = 0; i < a.size(); i++)
            update(i, a[i]);
    }

    int getmin(int r) {
        int ret = INF;
        for (; r >= 0; r = (r & (r + 1)) - 1)
            ret = min(ret, bit[r]);
        return ret;
    }

    void update(int idx, int val) {
        for (; idx < n; idx = idx | (idx + 1))
            bit[idx] = min(bit[idx], val);
    }
};
참고: 임의의 최솟값 구간 쿼리와 임의의 갱신을 처리할 수 있는 펜윅 트리를 구현하는 것도 가능합니다. 논문 Binary Indexed Tree를 이용한 효율적인 구간 최솟값 쿼리(Efficient Range Minimum Queries using Binary Indexed Trees)에서 그러한 접근 방식을 설명합니다. 그러나 하나의 트리로는 배열의 모든 원소 값을 저장하기에 충분하지 않으므로, 이 방법을 사용하려면 데이터에 대해 구조가 약간 다른 두 번째 이진 인덱스 트리를 유지해야 합니다. 또한 구현도 일반적인 합 구현에 비해 훨씬 어렵습니다.
2차원 배열에서 합 구하기
앞서 말했듯이, 다차원 배열에 대한 펜윅 트리는 매우 쉽게 구현할 수 있습니다.
struct FenwickTree2D {
    vector<vector<int>> bit;
    int n, m;

    // init(...) { ... }

    int sum(int x, int y) {
        int ret = 0;
        for (int i = x; i >= 0; i = (i & (i + 1)) - 1)
            for (int j = y; j >= 0; j = (j & (j + 1)) - 1)
                ret += bit[i][j];
        return ret;
    }

    void add(int x, int y, int delta) {
        for (int i = x; i < n; i = i | (i + 1))
            for (int j = y; j < m; j = j | (j + 1))
                bit[i][j] += delta;
    }
};
1-기반 인덱싱 방식
이 방식에서는 $T[]$와 $g()$에 대한 요구 사항과 정의를 약간 변경합니다. $T[i]$가 $[g(i)+1; i]$의 합을 저장하도록 합니다. 이렇게 하면 구현이 약간 바뀌며, $g(i)$에 대해서도 비슷하게 깔끔한 정의를 얻을 수 있습니다:
def sum(int r):
    res = 0
    while (r > 0):
        res += t[r]
        r = g(r)
    return res

def increase(int i, int delta):
    for all j with g(j) < i <= j:
        t[j] += delta
$g(i)$의 계산은 다음과 같이 정의됩니다: $i$의 이진 표현에서 마지막으로 설정된 $1$ 비트를 반전시키는 것입니다.
마지막 켜진 비트는 $i ~\&~ (-i)$를 사용하여 추출할 수 있으므로, 이 연산은 다음과 같이 표현할 수 있습니다:
그리고 $A[j]$를 갱신하려면 수열 $i,~ h(i),~ h(h(i)),~ \dots$에 있는 모든 값 $T[j]$를 변경해야 한다는 것은 어렵지 않게 알 수 있습니다. 여기서 $h(i)$는 다음과 같이 정의됩니다:
보시다시피, 이 방식의 주요 장점은 이진 연산들이 서로 매우 잘 보완한다는 것입니다.
다음 구현은 다른 구현들과 같은 방식으로 사용할 수 있지만, 내부적으로는 1-기반 인덱싱을 사용합니다.
struct FenwickTreeOneBasedIndexing {
    vector<int> bit;  // binary indexed tree
    int n;

    FenwickTreeOneBasedIndexing(int n) {
        this->n = n + 1;
        bit.assign(n + 1, 0);
    }

    FenwickTreeOneBasedIndexing(vector<int> a)
        : FenwickTreeOneBasedIndexing(a.size()) {
        for (size_t i = 0; i < a.size(); i++)
            add(i, a[i]);
    }

    int sum(int idx) {
        int ret = 0;
        for (++idx; idx > 0; idx -= idx & -idx)
            ret += bit[idx];
        return ret;
    }

    int sum(int l, int r) {
        return sum(r) - sum(l - 1);
    }

    void add(int idx, int delta) {
        for (++idx; idx < n; idx += idx & -idx)
            bit[idx] += delta;
    }
};
구간 연산
펜윅 트리는 다음과 같은 구간 연산을 지원할 수 있습니다:
- 점 갱신과 구간 쿼리
- 구간 갱신과 점 쿼리
- 구간 갱신과 구간 쿼리
1. 점 갱신과 구간 쿼리
이것은 위에서 설명한 평범한 펜윅 트리일 뿐입니다.
2. 구간 갱신과 점 쿼리
간단한 기법을 사용하면 반대 연산, 즉 구간의 값을 증가시키고 단일 값을 질의하는 연산도 수행할 수 있습니다.
펜윅 트리가 0으로 초기화되어 있다고 합시다. 구간 $[l, r]$의 값을 $x$만큼 증가시키려 한다고 가정합시다. 펜윅 트리에 add(l, x)와 add(r+1, -x)라는 두 번의 점 갱신 연산을 수행합니다.
$A[i]$의 값을 구하려면, 일반적인 구간 합 방법을 사용하여 누적 합을 구하기만 하면 됩니다. 이것이 성립하는 이유를 알아보려면 앞의 증가 연산에만 다시 주목하면 됩니다. $i < l$이면 두 갱신 연산은 쿼리에 아무런 영향을 주지 않으며, 합으로 $0$을 얻습니다. $i \in [l, r]$이면 첫 번째 갱신 연산 덕분에 답으로 $x$를 얻습니다. 그리고 $i > r$이면 두 번째 갱신 연산이 첫 번째 갱신 연산의 효과를 상쇄합니다.
다음 구현은 1부터 시작하는 인덱스를 사용합니다.
void add(int idx, int val) {
    for (++idx; idx < n; idx += idx & -idx)
        bit[idx] += val;
}

void range_add(int l, int r, int val) {
    add(l, val);
    add(r + 1, -val);
}

int point_query(int idx) {
    int ret = 0;
    for (++idx; idx > 0; idx -= idx & -idx)
        ret += bit[idx];
    return ret;
}
참고: 물론 range_add(i, i, val)을 사용하여 단일 점 $A[i]$의 값을 증가시킬 수도 있습니다.
3. 구간 갱신과 구간 쿼리
구간 갱신과 구간 쿼리를 모두 지원하기 위해, 0으로 초기화된 두 개의 BIT, 즉 $B_1[]$과 $B_2[]$를 사용합니다.
구간 $[l, r]$의 값을 $x$만큼 증가시키려 한다고 가정합시다. 앞의 방법과 마찬가지로 $B_1$에 add(B1, l, x)와 add(B1, r+1, -x)라는 두 번의 점 갱신을 수행합니다. 그리고 $B_2$도 갱신합니다. 자세한 내용은 뒤에서 설명합니다.
def range_add(l, r, x):
    add(B1, l, x)
    add(B1, r+1, -x)
    add(B2, l, x*(l-1))
    add(B2, r+1, -x*r)
구간 합은 두 항의 차로 쓸 수 있으며, 첫 번째 항에는 $B_1$을, 두 번째 항에는 $B_2$를 사용합니다. 두 쿼리의 차이가 $[0, i]$에 대한 누적 합을 제공합니다.
마지막 식은 필요한 항과 정확히 같습니다. 따라서 $B_1[i]\times i$를 곱할 때 생기는 여분의 항을 제거하는 데 $B_2$를 사용할 수 있습니다.
$l-1$과 $r$에 대한 누적 합을 계산하고 다시 그 차이를 구하면 임의의 구간 합을 구할 수 있습니다.
def add(b, idx, x):
    while idx <= N:
        b[idx] += x
        idx += idx & -idx

def range_add(l,r,x):
    add(B1, l, x)
    add(B1, r+1, -x)
    add(B2, l, x*(l-1))
    add(B2, r+1, -x*r)

def sum(b, idx):
    total = 0
    while idx > 0:
        total += b[idx]
        idx -= idx & -idx
    return total

def prefix_sum(idx):
    return sum(B1, idx)*idx -  sum(B2, idx)

def range_sum(l, r):
    return prefix_sum(r) - prefix_sum(l-1)
연습 문제
- UVA 12086 - Potentiometers
- LOJ 1112 - Curious Robin Hood
- LOJ 1266 - Points in Rectangle
- Codechef - SPREAD
- SPOJ - CTRICK
- SPOJ - MATSUM
- SPOJ - DQUERY
- SPOJ - NKTEAM
- SPOJ - YODANESS
- SRM 310 - FloatingMedian
- SPOJ - Ada and Behives
- Hackerearth - Counting in Byteland
- DevSkill - Shan and String (archived)
- Codeforces - Little Artem and Time Machine
- Codeforces - Hanoi Factory
- SPOJ - Tulip and Numbers
- SPOJ - SUMSUM
- SPOJ - Sabir and Gifts
- SPOJ - The Permutation Game Again
- SPOJ - Zig when you Zag
- SPOJ - Cryon
- SPOJ - Weird Points
- SPOJ - Its a Murder
- SPOJ - Bored of Suffixes and Prefixes
- SPOJ - Mega Inversions
- Codeforces - Subsequences
- Codeforces - Ball
- GYM - The Kamphaeng Phet's Chedis
- Codeforces - Garlands
- Codeforces - Inversions after Shuffle
- GYM - Cairo Market
- Codeforces - Goodbye Souvenir
- SPOJ - Ada and Species
- Codeforces - Thor
- CSES - Forest Queries II
- Latin American Regionals 2017 - Fundraising