최소 공통 조상 - Farach-Colton과 Bender 알고리즘
$G$를 트리라고 합시다. $(u, v)$ 형태의 모든 쿼리에 대해 노드 $u$와 $v$의 최소 공통 조상을 찾고자 합니다. 즉, $u$에서 루트 노드로 가는 경로 위에 있으면서 $v$에서 루트 노드로 가는 경로 위에도 있는 노드 $w$를 찾고자 하며, 그러한 노드가 여러 개라면 루트 노드에서 가장 멀리 떨어진 노드를 선택합니다. 다시 말해, 구하고자 하는 노드 $w$는 $u$와 $v$의 가장 낮은 조상입니다. 특히 $u$가 $v$의 조상이라면, $u$가 두 노드의 최소 공통 조상입니다.
이 글에서 설명할 알고리즘은 Farach-Colton과 Bender가 개발했습니다. 이 알고리즘은 점근적으로 최적입니다.
알고리즘
LCA 문제를 RMQ 문제로 환원하는 고전적인 방법을 사용합니다. DFS로 트리의 모든 노드를 순회하면서, 방문한 모든 노드와 그 노드들의 높이를 담은 배열을 유지합니다. 두 노드 $u$와 $v$의 LCA는 투어에서 $u$와 $v$가 등장하는 위치 사이에 있는 노드 중 높이가 가장 작은 노드입니다.
다음 그림에서 트리의 가능한 오일러 투어 하나를 볼 수 있으며, 아래 목록에서 방문한 노드들과 그 높이를 볼 수 있습니다.
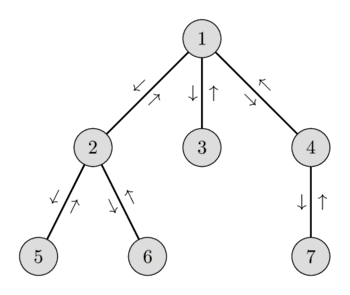
이 환원에 대해서는 최소 공통 조상 글에서 더 자세히 읽을 수 있습니다. 그 글에서는 구간의 최솟값을 제곱근 분할로 $O(\sqrt{N})$에 구하거나 세그먼트 트리를 사용하여 $O(\log N)$에 구했습니다. 이 글에서는 전처리에 여전히 $O(N)$ 시간만 들이면서 주어진 구간 최솟값 쿼리를 $O(1)$ 시간에 해결하는 방법을 살펴봅니다.
환원된 RMQ 문제는 매우 특수하다는 점에 주목하십시오: 배열에서 인접한 두 원소는 정확히 1만큼 차이가 납니다(배열의 원소는 순회 순서대로 방문한 노드들의 높이에 불과하며, 자손으로 내려가면 다음 원소가 1 커지고, 조상으로 되돌아가면 다음 원소가 1 작아지기 때문입니다). Farach-Colton과 Bender 알고리즘은 바로 이 특수한 RMQ 문제에 대한 해법을 제시합니다.
구간 최솟값 쿼리를 수행하려는 배열을 $A$로 나타냅시다. 그리고 $N$을 $A$의 크기라고 합시다.
$O(N \log N)$ 전처리와 쿼리당 $O(1)$로 RMQ 문제를 해결하는 데 사용할 수 있는 간단한 자료 구조가 있습니다: 바로 희소 테이블입니다. 각 원소 $T[i][j]$가 구간 $[i, i + 2^j - 1]$에서 $A$의 최솟값과 같은 테이블 $T$를 만듭니다. 당연히 $0 \leq j \leq \lceil \log N \rceil$이므로, 희소 테이블의 크기는 $O(N \log N)$이 됩니다. $T[i][j] = \min(T[i][j-1], T[i+2^{j-1}][j-1])$임을 이용하면 테이블을 $O(N \log N)$에 쉽게 만들 수 있습니다.
이 자료 구조를 사용하여 RMQ 쿼리에 어떻게 $O(1)$에 답할 수 있겠습니까? 받은 쿼리를 $[l, r]$이라고 하면, 답은 $\min(T[l][\text{sz}], T[r-2^{\text{sz}}+1][\text{sz}])$이며, 여기서 $\text{sz}$는 $2^{\text{sz}}$가 구간 길이 $r-l+1$보다 크지 않은 가장 큰 지수입니다. 실제로 구간 $[l, r]$을 길이가 $2^{\text{sz}}$인 두 구간, 즉 $l$에서 시작하는 구간과 $r$에서 끝나는 구간으로 덮을 수 있습니다. 이 두 구간은 겹치지만, 이것이 계산에 방해가 되지는 않습니다. 쿼리당 $O(1)$의 시간 복잡도를 실제로 달성하려면, $1$부터 $N$까지 가능한 모든 길이에 대해 $\text{sz}$ 값을 알아야 합니다. 하지만 이는 쉽게 미리 계산할 수 있습니다.
이제 전처리의 복잡도를 $O(N)$으로 낮추고자 합니다.
배열 $A$를 크기가 $K = 0.5 \log N$인 블록들로 나눕니다. 여기서 $\log$는 밑이 2인 로그입니다. 각 블록에 대해 최솟값 원소를 계산하여 배열 $B$에 저장합니다. $B$의 크기는 $\frac{N}{K}$입니다. 배열 $B$로 희소 테이블(sparse table)을 구성합니다. 이 희소 테이블의 크기와 시간 복잡도는 다음과 같습니다:
이제 각 블록 내부의 구간 최솟값 쿼리에 빠르게 답하는 방법만 알아내면 됩니다. 실제로 주어진 구간 최솟값 쿼리가 $[l, r]$이고 $l$과 $r$이 서로 다른 블록에 있다면, 답은 다음 세 값 중 최솟값입니다: $l$이 속한 블록에서 $l$부터 시작하는 접미사의 최솟값, $r$이 속한 블록에서 $r$로 끝나는 접두사의 최솟값, 그리고 그 사이에 있는 블록들의 최솟값입니다. 사이에 있는 블록들의 최솟값은 희소 테이블을 사용하여 $O(1)$에 구할 수 있습니다. 따라서 블록 내부의 구간 최솟값 쿼리만 남습니다.
여기서 배열의 성질을 활용합니다. 배열의 값은 트리에서의 높이 값일 뿐이므로, 인접한 값끼리는 항상 정확히 1만큼 차이 난다는 점을 기억하십시오. 블록의 첫 번째 원소를 제거하고 블록의 나머지 모든 원소에서 그 값을 빼면, 모든 블록을 $+1$과 $-1$로 이루어진 길이 $K - 1$의 수열로 식별할 수 있습니다. 이 블록들은 매우 작기 때문에 나타날 수 있는 서로 다른 수열은 몇 개 되지 않습니다. 가능한 수열의 개수는 다음과 같습니다:
따라서 서로 다른 블록의 개수는 $O(\sqrt{N})$이며, 그러므로 서로 다른 모든 블록에 대해 블록 내부의 구간 최솟값 쿼리 결과를 $O(\sqrt{N} K^2) = O(\sqrt{N} \log^2(N)) = O(N)$ 시간에 미리 계산할 수 있습니다. 구현할 때는 블록을 길이 $K-1$의 비트마스크(표준 int에 들어갑니다)로 나타내고, 최솟값의 인덱스를 크기가 $O(\sqrt{N} \log^2(N))$인 배열 $\text{block}[\text{mask}][l][r]$에 저장할 수 있습니다.
이렇게 해서 각 블록 내부의 구간 최솟값 쿼리와 여러 블록에 걸친 구간 최솟값 쿼리를 모두 $O(N)$에 미리 계산하는 방법을 알아보았습니다. 이러한 전처리를 통해 미리 계산된 값을 최대 네 개까지 사용하여 각 쿼리에 $O(1)$에 답할 수 있습니다: l을 포함하는 블록의 최솟값, r을 포함하는 블록의 최솟값, 그리고 그 사이에 있는 블록들 중 겹치는 두 구간의 최솟값입니다.
구현
int n;
vector<vector<int>> adj;

int block_size, block_cnt;
vector<int> first_visit;
vector<int> euler_tour;
vector<int> height;
vector<int> log_2;
vector<vector<int>> st;
vector<vector<vector<int>>> blocks;
vector<int> block_mask;

void dfs(int v, int p, int h) {
    first_visit[v] = euler_tour.size();
    euler_tour.push_back(v);
    height[v] = h;

    for (int u : adj[v]) {
        if (u == p)
            continue;
        dfs(u, v, h + 1);
        euler_tour.push_back(v);
    }
}

int min_by_h(int i, int j) {
    return height[euler_tour[i]] < height[euler_tour[j]] ? i : j;
}

void precompute_lca(int root) {
    // get euler tour & indices of first occurrences
    first_visit.assign(n, -1);
    height.assign(n, 0);
    euler_tour.reserve(2 * n);
    dfs(root, -1, 0);

    // precompute all log values
    int m = euler_tour.size();
    log_2.reserve(m + 1);
    log_2.push_back(-1);
    for (int i = 1; i <= m; i++)
        log_2.push_back(log_2[i / 2] + 1);

    block_size = max(1, log_2[m] / 2);
    block_cnt = (m + block_size - 1) / block_size;

    // precompute minimum of each block and build sparse table
    st.assign(block_cnt, vector<int>(log_2[block_cnt] + 1));
    for (int i = 0, j = 0, b = 0; i < m; i++, j++) {
        if (j == block_size)
            j = 0, b++;
        if (j == 0 || min_by_h(i, st[b][0]) == i)
            st[b][0] = i;
    }
    for (int l = 1; l <= log_2[block_cnt]; l++) {
        for (int i = 0; i < block_cnt; i++) {
            int ni = i + (1 << (l - 1));
            if (ni >= block_cnt)
                st[i][l] = st[i][l-1];
            else
                st[i][l] = min_by_h(st[i][l-1], st[ni][l-1]);
        }
    }

    // precompute mask for each block
    block_mask.assign(block_cnt, 0);
    for (int i = 0, j = 0, b = 0; i < m; i++, j++) {
        if (j == block_size)
            j = 0, b++;
        if (j > 0 && (i >= m || min_by_h(i - 1, i) == i - 1))
            block_mask[b] += 1 << (j - 1);
    }

    // precompute RMQ for each unique block
    int possibilities = 1 << (block_size - 1);
    blocks.resize(possibilities);
    for (int b = 0; b < block_cnt; b++) {
        int mask = block_mask[b];
        if (!blocks[mask].empty())
            continue;
        blocks[mask].assign(block_size, vector<int>(block_size));
        for (int l = 0; l < block_size; l++) {
            blocks[mask][l][l] = l;
            for (int r = l + 1; r < block_size; r++) {
                blocks[mask][l][r] = blocks[mask][l][r - 1];
                if (b * block_size + r < m)
                    blocks[mask][l][r] = min_by_h(b * block_size + blocks[mask][l][r],
                            b * block_size + r) - b * block_size;
            }
        }
    }
}

int lca_in_block(int b, int l, int r) {
    return blocks[block_mask[b]][l][r] + b * block_size;
}

int lca(int v, int u) {
    int l = first_visit[v];
    int r = first_visit[u];
    if (l > r)
        swap(l, r);
    int bl = l / block_size;
    int br = r / block_size;
    if (bl == br)
        return euler_tour[lca_in_block(bl, l % block_size, r % block_size)];
    int ans1 = lca_in_block(bl, l % block_size, block_size - 1);
    int ans2 = lca_in_block(br, 0, r % block_size);
    int ans = min_by_h(ans1, ans2);
    if (bl + 1 < br) {
        int l = log_2[br - bl - 1];
        int ans3 = st[bl+1][l];
        int ans4 = st[br - (1 << l)][l];
        ans = min_by_h(ans, min_by_h(ans3, ans4));
    }
    return euler_tour[ans];
}