서로소 집합 유니온
이 글에서는 서로소 집합 유니온(Disjoint Set Union), 줄여서 DSU라고 부르는 자료 구조를 다룹니다. 두 가지 주요 연산의 이름을 따서 유니온 파인드(Union Find)라고도 자주 부릅니다.
이 자료 구조는 다음과 같은 기능을 제공합니다. 여러 개의 원소가 주어지며, 각 원소는 저마다 별개의 집합을 이룹니다. DSU는 임의의 두 집합을 합치는 연산을 제공하며, 특정 원소가 어느 집합에 속하는지 알려 줄 수 있습니다. 고전적인 버전에서는 세 번째 연산도 제공하는데, 이 연산은 새 원소로 집합을 만듭니다.
따라서 이 자료 구조의 기본 인터페이스는 다음 세 가지 연산으로만 이루어집니다.
make_set(v)- 새 원소v하나로 이루어진 새 집합을 만듭니다union_sets(a, b)- 지정한 두 집합(원소a가 속한 집합과 원소b가 속한 집합)을 합칩니다find_set(v)- 원소v가 속한 집합의 대표(리더라고도 합니다)를 반환합니다. 이 대표는 해당 집합의 원소 중 하나입니다. 대표는 자료 구조가 각 집합에서 스스로 선택하며, 시간이 지나면서, 즉union_sets를 호출한 뒤에 바뀔 수 있습니다. 이 대표를 이용하면 두 원소가 같은 집합에 속하는지 확인할 수 있습니다.find_set(a) == find_set(b)이면a와b는 정확히 같은 집합에 속합니다. 그렇지 않으면 두 원소는 서로 다른 집합에 속합니다.
뒤에서 더 자세히 설명하겠지만, 이 자료 구조를 사용하면 각 연산을 평균적으로 거의 $O(1)$ 시간에 수행할 수 있습니다.
또한 하위 절 중 하나에서는 DSU의 다른 구조를 설명합니다. 이 구조는 평균 복잡도가 $O(\log n)$으로 더 느리지만, 일반적인 DSU 구조보다 더 강력할 수 있습니다.
효율적인 자료 구조 만들기
집합은 트리 형태로 저장하며, 각 트리가 하나의 집합에 대응합니다. 그리고 트리의 루트가 그 집합의 대표/리더가 됩니다.
다음 그림에서 이러한 트리가 어떻게 표현되는지 볼 수 있습니다.
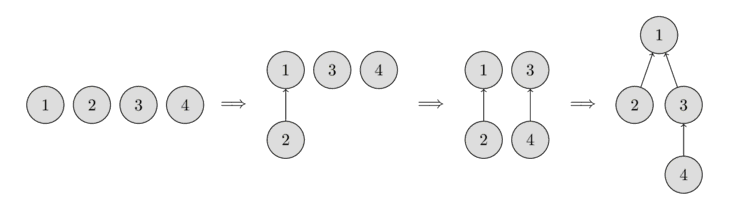
처음에는 모든 원소가 각각 하나의 집합이므로, 각 정점이 저마다 하나의 트리를 이룹니다. 그다음 원소 1이 속한 집합과 원소 2가 속한 집합을 합칩니다. 그다음 원소 3이 속한 집합과 원소 4가 속한 집합을 합칩니다. 그리고 마지막 단계에서는 원소 1이 속한 집합과 원소 3이 속한 집합을 합칩니다.
구현 측면에서 보면, 트리에서 바로 위 조상에 대한 참조를 저장하는 배열 parent를 관리해야 합니다.
단순한 구현
이제 서로소 집합 유니온 자료 구조의 첫 번째 구현을 작성할 수 있습니다. 처음에는 꽤 비효율적이지만, 이후 두 가지 최적화를 적용하여 각 함수 호출이 거의 상수 시간에 수행되도록 개선할 수 있습니다.
앞서 말했듯이, 원소들의 집합에 대한 모든 정보는 배열 parent에 저장합니다.
새 집합을 만들려면(make_set(v) 연산) 정점 v를 루트로 하는 트리를 만들기만 하면 됩니다. 즉, v는 자기 자신의 조상이 됩니다.
두 집합을 합치려면(union_sets(a, b) 연산) 먼저 a가 속한 집합의 대표와 b가 속한 집합의 대표를 찾습니다. 두 대표가 같다면 집합이 이미 합쳐져 있으므로 할 일이 없습니다. 그렇지 않다면 한 대표를 다른 대표의 부모로 지정하기만 하면 되며, 이렇게 하여 두 트리가 합쳐집니다.
마지막으로 대표를 찾는 함수(find_set(v) 연산)의 구현입니다. 정점 v에서 루트, 즉 조상을 가리키는 참조가 자기 자신을 가리키는 정점에 도달할 때까지 조상을 따라 올라가기만 하면 됩니다. 이 연산은 재귀로 쉽게 구현할 수 있습니다.
void make_set(int v) {
    parent[v] = v;
}

int find_set(int v) {
    if (v == parent[v])
        return v;
    return find_set(parent[v]);
}

void union_sets(int a, int b) {
    a = find_set(a);
    b = find_set(b);
    if (a != b)
        parent[b] = a;
}
하지만 이 구현은 비효율적입니다. 트리가 긴 사슬로 퇴화하는 예시를 쉽게 만들 수 있습니다. 그런 경우 find_set(v)를 한 번 호출할 때마다 $O(n)$ 시간이 걸릴 수 있습니다.
이는 우리가 원하는 복잡도(거의 상수 시간)와는 거리가 멉니다. 따라서 작업 속도를 크게 높여 주는 두 가지 최적화를 살펴보겠습니다.
경로 압축 최적화
이 최적화는 find_set의 속도를 높이기 위해 고안되었습니다.
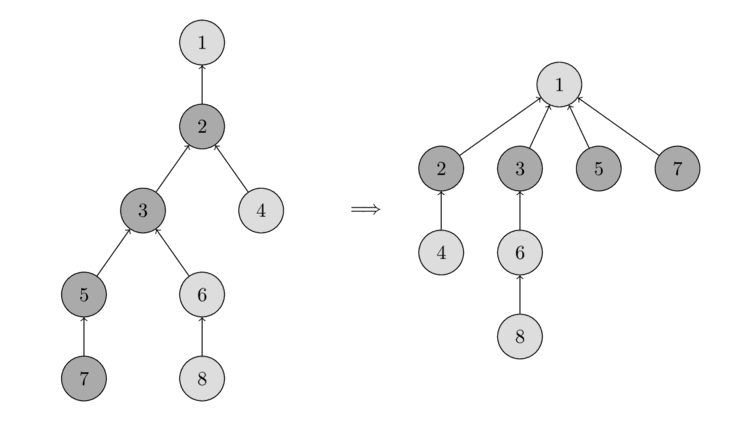
어떤 정점 v에 대해 find_set(v)를 호출하면, 실제로는 v와 실제 대표 p 사이의 경로에서 방문하는 모든 정점의 대표 p를 찾게 됩니다. 요령은 방문한 각 정점의 부모를 곧바로 p로 설정하여 그 모든 노드의 경로를 짧게 만드는 것입니다.
다음 그림에서 이 연산을 확인할 수 있습니다. 왼쪽에는 트리가 있고, 오른쪽에는 find_set(7)을 호출한 뒤 압축된 트리가 있습니다. 이 호출로 방문한 노드 7, 5, 3, 2의 경로가 짧아집니다.
find_set의 새로운 구현은 다음과 같습니다.
int find_set(int v) {
    if (v == parent[v])
        return v;
    return parent[v] = find_set(parent[v]);
}
이 간단한 구현은 의도한 대로 동작합니다. 먼저 집합의 대표(루트 정점)를 찾고, 그다음 스택이 풀리는 과정에서 방문한 노드들을 대표에 직접 연결합니다.
연산을 이렇게 간단히 수정하는 것만으로도 호출당 평균 $O(\log n)$의 시간 복잡도를 달성합니다(여기서는 증명을 생략합니다). 이를 훨씬 더 빠르게 만들어 주는 두 번째 수정이 있습니다.
크기에 의한 합치기 / 랭크에 의한 합치기
이 최적화에서는 union_set 연산을 변경합니다. 정확히 말하면, 어느 트리를 다른 트리에 연결할지를 변경합니다. 단순한 구현에서는 항상 두 번째 트리를 첫 번째 트리에 연결했습니다. 실제로 이렇게 하면 길이가 $O(n)$인 사슬을 포함하는 트리가 생길 수 있습니다. 이 최적화에서는 어느 트리를 연결할지 매우 신중하게 선택하여 이를 방지합니다.
사용할 수 있는 휴리스틱은 여러 가지가 있습니다. 가장 많이 쓰이는 방법은 다음 두 가지입니다. 첫 번째 방법에서는 트리의 크기를 랭크로 사용하고, 두 번째 방법에서는 트리의 깊이(더 정확히는 트리 깊이의 상한입니다. 경로 압축을 적용하면 깊이가 작아지기 때문입니다)를 사용합니다.
두 방법 모두 최적화의 본질은 같습니다. 랭크가 낮은 트리를 랭크가 높은 트리에 연결합니다.
다음은 크기에 의한 합치기의 구현입니다:
void make_set(int v) {
    parent[v] = v;
    size[v] = 1;
}

void union_sets(int a, int b) {
    a = find_set(a);
    b = find_set(b);
    if (a != b) {
        if (size[a] < size[b])
            swap(a, b);
        parent[b] = a;
        size[a] += size[b];
    }
}
그리고 다음은 트리의 깊이를 기준으로 한 랭크에 의한 합치기의 구현입니다:
void make_set(int v) {
    parent[v] = v;
    rank[v] = 0;
}

void union_sets(int a, int b) {
    a = find_set(a);
    b = find_set(b);
    if (a != b) {
        if (rank[a] < rank[b])
            swap(a, b);
        parent[b] = a;
        if (rank[a] == rank[b])
            rank[a]++;
    }
}
시간 복잡도
앞서 언급했듯이 두 최적화, 즉 경로 압축과 크기에 의한 합치기 / 랭크에 의한 합치기를 함께 사용하면 쿼리를 거의 상수 시간에 처리할 수 있습니다. 최종 분할 상환 시간 복잡도는 $O(\alpha(n))$임이 밝혀져 있으며, 여기서 $\alpha(n)$은 매우 느리게 증가하는 역 아커만 함수입니다. 실제로 이 함수는 매우 느리게 증가하여, 현실적인 모든 $n$(대략 $n < 10^{600}$)에 대해 $4$를 넘지 않습니다.
분할 상환 복잡도는 여러 연산으로 이루어진 연산 열 전체에 걸쳐 평가한 연산당 총 시간입니다. 핵심은 개별 연산이 분할 상환 시간보다 훨씬 느려지는 것은 허용하면서, 연산 열 전체의 총 시간을 보장하는 것입니다. 예를 들어 우리의 경우 한 번의 호출은 최악의 경우 $O(\log n)$이 걸릴 수 있지만, 이러한 호출을 $m$번 연달아 수행하면 평균 시간은 $O(\alpha(n))$이 됩니다.
이 시간 복잡도에 대한 증명은 상당히 길고 복잡하므로 여기서는 제시하지 않습니다.
또한 크기에 의한 합치기 / 랭크에 의한 합치기는 사용하되 경로 압축은 사용하지 않는 DSU는 쿼리당 $O(\log n)$ 시간에 동작한다는 점도 언급할 만합니다.
인덱스 기준 연결 / 동전 던지기 연결
랭크에 의한 합치기와 크기에 의한 합치기는 모두 각 집합마다 추가 데이터를 저장하고, 매 합치기 연산마다 이 값들을 유지해야 합니다. 합치기 연산을 조금 더 단순하게 만드는 무작위 알고리즘도 있는데, 바로 인덱스 기준 연결입니다.
각 집합에 인덱스라고 부르는 무작위 값을 할당하고, 인덱스가 더 작은 집합을 인덱스가 더 큰 집합에 붙입니다. 큰 집합이 작은 집합보다 더 큰 인덱스를 가질 가능성이 높으므로, 이 연산은 크기에 의한 합치기와 밀접한 관련이 있습니다. 실제로 이 연산이 크기에 의한 합치기와 같은 시간 복잡도를 가진다는 것을 증명할 수 있습니다. 하지만 실제로는 크기에 의한 합치기보다 약간 느립니다.
복잡도에 대한 증명과 더 많은 합치기 기법은 여기에서 찾을 수 있습니다.
void make_set(int v) {
    parent[v] = v;
    index[v] = rand();
}

void union_sets(int a, int b) {
    a = find_set(a);
    b = find_set(b);
    if (a != b) {
        if (index[a] < index[b])
            swap(a, b);
        parent[b] = a;
    }
}
어느 집합을 다른 집합에 붙일지 단순히 동전을 던져 결정해도 같은 복잡도를 가진다는 것은 흔한 오해입니다. 하지만 이는 사실이 아닙니다. 위에 링크된 논문은 동전 던지기 연결을 경로 압축과 결합하면 복잡도가 $\Omega\left(n \frac{\log n}{\log \log n}\right)$이라고 추측합니다. 그리고 벤치마크에서는 크기에 의한 합치기/랭크에 의한 합치기나 인덱스에 의한 연결보다 훨씬 나쁜 성능을 보입니다.
void union_sets(int a, int b) {
    a = find_set(a);
    b = find_set(b);
    if (a != b) {
        if (rand() % 2)
            swap(a, b);
        parent[b] = a;
    }
}
응용과 다양한 개선
이 절에서는 이 자료 구조의 여러 응용을 살펴보며, 간단한 사용법과 자료 구조에 대한 몇 가지 개선을 모두 다룹니다.
그래프의 연결 요소
이는 DSU의 명백한 응용 중 하나입니다.
문제를 형식적으로 정의하면 다음과 같습니다: 처음에는 빈 그래프가 주어집니다. 정점과 무방향 간선을 추가하고, $(a, b)$ 형태의 쿼리, 즉 "정점 $a$와 $b$가 그래프의 같은 연결 요소에 속합니까?"에 답해야 합니다.
여기서는 자료 구조를 바로 적용할 수 있으며, 정점이나 간선의 추가와 쿼리를 평균적으로 거의 상수 시간에 처리하는 풀이를 얻을 수 있습니다.
이 응용은 최소 신장 트리를 찾는 Kruskal 알고리즘에서 거의 같은 문제가 등장하기 때문에 상당히 중요합니다. DSU를 사용하면 $O(m \log n + n^2)$ 복잡도를 $O(m \log n)$으로 개선할 수 있습니다.
이미지에서 연결 요소 찾기
DSU의 응용 중 하나는 다음과 같은 문제입니다: $n \times m$ 픽셀 크기의 이미지가 있습니다. 처음에는 모든 픽셀이 흰색이지만, 이후 몇 개의 검은 픽셀이 그려집니다. 최종 이미지에서 각 흰색 연결 요소의 크기를 구하려고 합니다.
해법은 간단합니다. 이미지의 모든 흰색 픽셀을 순회하면서 각 칸의 네 이웃을 살펴보고, 이웃이 흰색이면 union_sets를 호출합니다. 따라서 이미지 픽셀에 대응하는 $n m$개의 노드를 가진 DSU가 만들어집니다. DSU에서 만들어진 트리들이 바로 구하고자 하는 연결 요소입니다.
이 문제는 DFS나 BFS로도 풀 수 있지만, 여기서 설명한 방법에는 장점이 있습니다: 행렬을 한 행씩 $O(\min(n, m))$ 메모리로 처리할 수 있습니다(즉, 한 행을 처리하는 데에는 이전 행과 현재 행만 필요하고, 한 행의 원소들에 대해 구성한 DSU만 있으면 됩니다).
각 집합에 추가 정보 저장하기
DSU를 사용하면 집합에 추가 정보를 쉽게 저장할 수 있습니다.
간단한 예로 집합의 크기가 있습니다: 크기를 저장하는 방법은 이미 크기에 의한 합치기 절에서 설명했습니다(이 정보는 집합의 현재 대표가 저장했습니다).
같은 방식으로, 즉 대표 노드에 저장함으로써 집합에 관한 다른 어떤 정보도 저장할 수 있습니다.
구간을 따라 점프 압축하기 / 오프라인으로 부분 배열 칠하기
DSU의 흔한 응용 중 하나는 다음과 같습니다: 정점들의 집합이 있고, 각 정점에는 다른 정점으로 나가는 간선이 하나씩 있습니다. DSU를 사용하면 주어진 시작점에서 모든 간선을 따라갔을 때 도달하는 끝점을 거의 상수 시간에 찾을 수 있습니다.
이 응용의 좋은 예가 부분 배열 칠하기 문제입니다. 길이가 $L$인 구간이 있고, 각 원소는 처음에 색 0을 가지고 있습니다. 각 쿼리 $(l, r, c)$마다 부분 배열 $[l, r]$을 색 $c$로 다시 칠해야 합니다. 마지막에는 각 칸의 최종 색을 구하려고 합니다. 모든 쿼리를 미리 알고 있다고 가정합니다. 즉, 이 문제는 오프라인 문제입니다.
해법으로, 각 칸마다 다음으로 칠해지지 않은 칸에 대한 링크를 저장하는 DSU를 만들 수 있습니다. 따라서 처음에는 각 칸이 자기 자신을 가리킵니다. 요청된 구간 하나를 다시 칠하고 나면, 그 구간의 모든 칸은 구간 바로 다음 칸을 가리키게 됩니다.
이제 이 문제를 풀기 위해 쿼리를 역순으로, 즉 마지막 쿼리부터 첫 쿼리까지 살펴봅니다. 이렇게 하면 쿼리를 실행할 때 부분 배열 $[l, r]$에서 아직 칠해지지 않은 칸만 정확히 칠하면 됩니다. 나머지 칸들은 이미 최종 색을 가지고 있습니다. 칠해지지 않은 모든 칸을 빠르게 순회하기 위해 DSU를 사용합니다. 구간 안에서 가장 왼쪽의 칠해지지 않은 칸을 찾아 다시 칠하고, 포인터를 이용해 오른쪽의 다음 빈 칸으로 이동합니다.
여기서는 경로 압축을 적용한 DSU는 사용할 수 있지만, 랭크에 의한 합치기 / 크기에 의한 합치기는 사용할 수 없습니다(병합 후 누가 대표가 되는지가 중요하기 때문입니다). 따라서 복잡도는 합치기 한 번당 $O(\log n)$이 됩니다(이 역시 꽤 빠릅니다).
구현:
for (int i = 0; i <= L; i++) {
    make_set(i);
}

for (int i = m-1; i >= 0; i--) {
    int l = query[i].l;
    int r = query[i].r;
    int c = query[i].c;
    for (int v = find_set(l); v <= r; v = find_set(v)) {
        answer[v] = c;
        parent[v] = v + 1;
    }
}
최적화 방법이 있습니다: 다음으로 칠해지지 않은 칸을 추가 배열 end[]에 저장하면 랭크에 의한 합치기 / 크기에 의한 합치기를 사용할 수 있습니다. 그러면 휴리스틱에 따라 두 집합을 하나로 합칠 수 있으며, $O(\alpha(n))$에 해를 얻을 수 있습니다.
대표 원소까지의 거리 유지하기
DSU의 특정 응용에서는 때때로 정점과 그 정점이 속한 집합의 대표 원소 사이의 거리(즉, 트리에서 현재 노드부터 트리의 루트까지의 경로 길이)를 유지해야 합니다.
경로 압축을 사용하지 않는다면 거리는 단순히 재귀 호출의 횟수입니다. 하지만 이 방법은 비효율적입니다.
그러나 각 노드에 대해 부모까지의 거리를 추가 정보로 저장하면 경로 압축을 할 수 있습니다.
구현에서는 parent[]에 쌍(pair)의 배열을 사용하는 것이 편리하며, 이제 find_set 함수는 집합의 대표 원소와 그 대표 원소까지의 거리라는 두 개의 수를 반환합니다.
void make_set(int v) {
    parent[v] = make_pair(v, 0);
    rank[v] = 0;
}

pair<int, int> find_set(int v) {
    if (v != parent[v].first) {
        int len = parent[v].second;
        parent[v] = find_set(parent[v].first);
        parent[v].second += len;
    }
    return parent[v];
}

void union_sets(int a, int b) {
    a = find_set(a).first;
    b = find_set(b).first;
    if (a != b) {
        if (rank[a] < rank[b])
            swap(a, b);
        parent[b] = make_pair(a, 1);
        if (rank[a] == rank[b])
            rank[a]++;
    }
}
경로 길이의 홀짝성 유지하기 / 온라인으로 이분 그래프 여부 확인하기
리더까지의 경로 길이를 계산하는 것과 같은 방식으로, 리더까지의 경로 길이의 홀짝성을 유지할 수 있습니다. 이 응용을 왜 별도의 단락에서 다룰까요?
경로의 홀짝성을 저장해야 하는 특이한 요구 사항은 다음 문제에서 나타납니다: 처음에 빈 그래프가 주어지고, 간선이 추가될 수 있으며, "이 정점을 포함하는 연결 요소가 이분 그래프인가?" 형태의 쿼리에 답해야 합니다.
이 문제를 해결하기 위해 연결 요소를 저장하는 DSU를 만들고, 각 정점에 대해 대표 원소까지의 경로의 홀짝성을 저장합니다. 따라서 간선을 추가했을 때 이분 그래프 성질이 깨지는지 여부를 빠르게 확인할 수 있습니다: 즉, 간선의 양 끝점이 같은 연결 요소에 있고 리더까지의 경로 길이의 홀짝성이 같다면, 이 간선을 추가하면 길이가 홀수인 사이클이 생기고 해당 연결 요소는 이분 그래프 성질을 잃게 됩니다.
유일한 어려움은 union_find 메서드에서 홀짝성을 계산하는 것입니다.
두 연결 요소를 하나로 잇는 간선 $(a, b)$를 추가하면, 한 트리를 다른 트리에 붙일 때 홀짝성을 조정해야 합니다.
다른 집합에 붙게 될 집합의 리더에 부여할 홀짝성을 계산하는 공식을 유도해 봅시다. 정점 $a$에서 그 리더 $A$까지의 경로 길이의 홀짝성을 $x$, 정점 $b$에서 그 리더 $B$까지의 경로 길이의 홀짝성을 $y$, 합친 후 $B$에 부여해야 하는 원하는 홀짝성을 $t$라고 합시다. 이 경로는 세 부분으로 이루어집니다: $B$에서 $b$까지, 하나의 간선으로 연결되어 있으므로 홀짝성이 $1$인 $b$에서 $a$까지, 그리고 $a$에서 $A$까지입니다. 따라서 다음 공식을 얻습니다($\oplus$는 XOR 연산을 나타냅니다):
따라서 합치기를 몇 번 수행하든 관계없이 간선의 홀짝성은 한 리더에서 다른 리더로 전달됩니다.
홀짝성을 지원하는 DSU의 구현을 제시합니다. 이전 절과 마찬가지로 조상과 홀짝성을 저장하기 위해 쌍을 사용합니다. 또한 각 집합에 대해 그 집합이 여전히 이분 그래프인지 여부를 배열 bipartite[]에 저장합니다.
void make_set(int v) {
    parent[v] = make_pair(v, 0);
    rank[v] = 0;
    bipartite[v] = true;
}

pair<int, int> find_set(int v) {
    if (v != parent[v].first) {
        int parity = parent[v].second;
        parent[v] = find_set(parent[v].first);
        parent[v].second ^= parity;
    }
    return parent[v];
}

void add_edge(int a, int b) {
    pair<int, int> pa = find_set(a);
    a = pa.first;
    int x = pa.second;

    pair<int, int> pb = find_set(b);
    b = pb.first;
    int y = pb.second;

    if (a == b) {
        if (x == y)
            bipartite[a] = false;
    } else {
        if (rank[a] < rank[b])
            swap (a, b);
        parent[b] = make_pair(a, x^y^1);
        bipartite[a] &= bipartite[b];
        if (rank[a] == rank[b])
            ++rank[a];
    }
}

bool is_bipartite(int v) {
    return bipartite[find_set(v).first];
}
평균 $O(\alpha(n))$의 오프라인 RMQ(구간 최솟값 쿼리) / Arpa의 트릭
배열 a[]가 주어지며, 배열의 주어진 구간들에서 최솟값을 계산해야 합니다.
DSU로 이 문제를 해결하는 아이디어는 다음과 같습니다: 배열을 순회하면서 i번째 원소에 있을 때 R == i인 모든 쿼리 (L, R)에 답합니다. 이를 효율적으로 하기 위해 처음 i개의 원소를 사용하여 다음 구조를 갖는 DSU를 유지합니다: 어떤 원소의 부모는 그 원소의 오른쪽에 있는 다음으로 더 작은 원소입니다. 그러면 이 구조를 사용하여 쿼리의 답은 L의 오른쪽에 있는 가장 작은 수인 a[find_set(L)]이 됩니다.
이 방법은 당연히 오프라인에서만, 즉 모든 쿼리를 미리 알고 있을 때만 동작합니다.
경로 압축을 적용할 수 있다는 것은 쉽게 알 수 있습니다. 또한 실제 리더를 별도의 배열에 저장한다면 랭크에 의한 합치기(Union by rank)도 사용할 수 있습니다.
struct Query {
    int L, R, idx;
};

vector<int> answer;
vector<vector<Query>> container;
container[i]에는 R == i인 모든 쿼리가 들어 있습니다.
stack<int> s;
for (int i = 0; i < n; i++) {
    while (!s.empty() && a[s.top()] > a[i]) {
        parent[s.top()] = i;
        s.pop();
    }
    s.push(i);
    for (Query q : container[i]) {
        answer[q.idx] = a[find_set(q.L)];
    }
}
오늘날 이 알고리즘은 Arpa's trick으로 알려져 있습니다. 이 이름은 이 기법을 독자적으로 발견하고 널리 알린 AmirReza Poorakhavan의 이름을 딴 것입니다. 다만 이 알고리즘은 그가 발견하기 전에도 이미 존재했습니다.
평균 $O(\alpha(n))$에 구하는 오프라인 LCA(트리에서의 최소 공통 조상)
LCA를 구하는 알고리즘은 최소 공통 조상 - Tarjan의 오프라인 알고리즘 문서에서 다룹니다. 이 알고리즘은 단순하다는 점에서 LCA를 구하는 다른 알고리즘들보다 유리합니다(특히 Farach-Colton과 Bender의 알고리즘과 같은 최적 알고리즘과 비교하면 더욱 그렇습니다).
DSU를 집합 리스트로 명시적으로 저장하기 / 다양한 자료 구조를 병합할 때 이 아이디어의 응용
DSU를 저장하는 다른 방법 중 하나는 각 집합을 원소들의 명시적으로 저장된 리스트 형태로 보관하는 것입니다. 동시에 각 원소는 자신이 속한 집합의 대표에 대한 참조도 저장합니다.
언뜻 보기에 이는 비효율적인 자료 구조처럼 보입니다. 두 집합을 합칠 때 한 리스트를 다른 리스트의 끝에 붙여야 하고, 두 리스트 중 한 리스트의 모든 원소에 대해 리더 정보를 갱신해야 하기 때문입니다.
그러나 가중치 휴리스틱(크기에 의한 합치기(Union by size)와 유사함)을 사용하면 점근적 복잡도를 크게 줄일 수 있음이 밝혀졌습니다. $n$개의 원소에 대해 $m$개의 쿼리를 수행하는 데 $O(m + n \log n)$이 걸립니다.
가중치 휴리스틱이란 항상 두 집합 중 작은 집합을 큰 집합에 추가한다는 것을 의미합니다. 한 집합을 다른 집합에 추가하는 것은 union_sets에서 쉽게 구현할 수 있으며, 추가되는 집합의 크기에 비례하는 시간이 걸립니다. 그리고 이러한 저장 방식에서는 find_set에서 리더를 찾는 데 $O(1)$이 걸립니다.
$m$개의 쿼리를 실행하는 데 드는 시간 복잡도 $O(m + n \log n)$을 증명해 봅시다. 임의의 원소 $x$를 고정하고, 병합 연산 union_sets에서 이 원소가 몇 번 건드려지는지 세어 보겠습니다. 원소 $x$가 처음 건드려질 때, 새 집합의 크기는 최소 $2$입니다. 두 번째로 건드려질 때는 작은 집합이 큰 집합에 추가되므로, 결과 집합의 크기는 최소 $4$가 됩니다. 이런 식으로 계속됩니다. 이는 $x$가 최대 $\log n$번의 병합 연산에서만 이동될 수 있음을 의미합니다. 따라서 모든 정점에 대해 합하면 $O(n \log n)$이 되고, 여기에 각 요청마다 $O(1)$이 더해집니다.
구현은 다음과 같습니다.
vector<int> lst[MAXN];
int parent[MAXN];

void make_set(int v) {
    lst[v] = vector<int>(1, v);
    parent[v] = v;
}

int find_set(int v) {
    return parent[v];
}

void union_sets(int a, int b) {
    a = find_set(a);
    b = find_set(b);
    if (a != b) {
        if (lst[a].size() < lst[b].size())
            swap(a, b);
        while (!lst[b].empty()) {
            int v = lst[b].back();
            lst[b].pop_back();
            parent[v] = a;
            lst[a].push_back (v);
        }
    }
}
작은 부분을 큰 부분에 추가하는 이 아이디어는 DSU와 전혀 관계없는 많은 풀이에서도 사용할 수 있습니다.
예를 들어 다음 문제를 생각해 봅시다. 트리가 주어지고, 각 리프에는 수가 하나씩 할당되어 있습니다(같은 수가 서로 다른 리프에 여러 번 나타날 수 있습니다). 트리의 모든 노드에 대해 그 서브트리에 있는 서로 다른 수의 개수를 구하고자 합니다.
같은 아이디어를 이 문제에 적용하면 다음과 같은 풀이를 얻을 수 있습니다. 정수 집합에 대한 포인터를 반환하는 DFS를 구현합니다. 이 집합은 해당 서브트리에 있는 수들의 목록입니다. 그런 다음 현재 노드에 대한 답을 구하기 위해(물론 리프가 아닌 경우에 한합니다) 해당 노드의 모든 자식에 대해 DFS를 호출하고, 반환받은 집합들을 모두 하나로 합칩니다. 그 결과로 얻은 집합의 크기가 현재 노드에 대한 답이 됩니다. 여러 집합을 효율적으로 합치려면 앞에서 설명한 방법을 그대로 적용하면 됩니다. 즉, 작은 집합을 큰 집합에 추가하는 방식으로 집합들을 합칩니다. 결국 $O(n \log^2 n)$ 풀이를 얻게 되지만, 여기서는 흔히 쓰는 정당화 방식에 주의가 필요합니다. 어떤 수를 담은 집합은 이동할 때마다 크기가 두 배가 되므로 그 수는 집합에 $O(\log n)$번만 추가된다고 말하고 싶어지지만, 집합이 서로 다른 수를 담고 있을 때는 이것이 성립하지 않습니다. 크기가 $k$인 집합을 더 큰 집합에 합쳐도 결과가 원래보다 전혀 커지지 않을 수 있으므로, 두 배가 되는 것은 아무것도 없습니다. 그 대신 셀 수 있는 것은 삽입 시도 횟수입니다. 중복된 값이라도 탐색 비용은 여전히 들기 때문입니다. 서브트리의 집합이 갖는 원소 수는 그 서브트리의 정점 수를 넘지 않으며, 서로 다른 수가 가장 많은 자식에 합치는 비용은 서브트리가 가장 큰 자식에 합치는 비용보다 크지 않습니다. 이 규칙에 대해서는 두 배 논증이 값이 아닌 정점에 적용되어 실제로 성립합니다. 합쳐진 서브트리는 작은 쪽 서브트리의 최소 두 배이므로, 한 정점이 작은 쪽 서브트리에 속하는 횟수는 최대 $O(\log n)$번입니다. 따라서 삽입은 $O(n \log n)$번이 되고, 각 삽입은 set에서 $O(\log n)$의 비용이 듭니다.
명시적인 트리 구조를 유지하며 DSU 저장하기 / 평균 $O(\alpha(n))$의 온라인 브리지 찾기
DSU의 가장 강력한 응용 중 하나는 압축된 트리와 압축되지 않은 트리 형태로 모두 저장할 수 있다는 점입니다. 압축된 형태는 트리를 합치거나 두 정점이 같은 트리에 있는지 확인하는 데 사용할 수 있고, 압축되지 않은 형태는 예를 들어 주어진 두 정점 사이의 경로를 찾거나 트리 구조를 다른 방식으로 순회하는 데 사용할 수 있습니다.
구현에서 이는 압축된 조상 배열 parent[]에 더해 압축되지 않은 조상 배열 real_parent[]도 유지해야 한다는 뜻입니다. 이 추가 배열을 유지해도 복잡도가 나빠지지 않는다는 것은 자명합니다. 이 배열은 두 트리를 합칠 때만, 그것도 단 하나의 원소에서만 변경되기 때문입니다.
한편 실제로 적용할 때에는 두 루트 노드가 아닌 지정된 간선을 사용하여 트리를 연결해야 하는 경우가 많습니다. 이는 트리 중 하나의 루트를 바꾸는 것(간선의 끝점을 트리의 새 루트로 만드는 것) 외에는 다른 방법이 없다는 뜻입니다.
언뜻 보기에는 이 루트 변경이 매우 비용이 크고 시간 복잡도를 크게 악화시킬 것처럼 보입니다. 실제로 정점 $v$를 트리의 루트로 만들려면 그 정점에서 기존 루트까지 올라가면서 해당 경로 위의 모든 노드에 대해 parent[]와 real_parent[]의 방향을 바꿔야 합니다.
하지만 실제로는 그렇게 나쁘지 않습니다. 앞 절들의 아이디어와 마찬가지로 두 트리 중 작은 쪽의 루트만 바꾸면 되며, 평균 $O(\log n)$을 얻을 수 있습니다.
자세한 내용(시간 복잡도의 증명 포함)은 온라인으로 브리지 찾기 글에서 확인할 수 있습니다.
역사적 회고
DSU 자료 구조는 오래전부터 알려져 왔습니다.
이 자료 구조를 트리의 숲 형태로 저장하는 방식은 1964년 Galler와 Fisher가 처음 기술한 것으로 보이지만(Galler, Fisher, "An Improved Equivalence Algorithm), 이 알고리즘의 시간 복잡도에 대한 완전한 분석은 훨씬 나중에 이루어졌습니다.
경로 압축과 랭크에 의한 합치기(Union by rank) 최적화는 McIlroy와 Morris가 개발했으며, 이들과 독립적으로 Tritter도 개발했습니다.
Hopcroft와 Ullman은 1973년에 시간 복잡도 $O(\log^\star n)$을 보였습니다(Hopcroft, Ullman "Set-merging algorithms", 즉 집합 병합 알고리즘). 여기서 $\log^\star$는 반복 로그입니다(느리게 증가하는 함수이지만, 역 아커만 함수만큼 느리지는 않습니다).
$O(\alpha(n))$이라는 평가는 1975년에 처음 제시되었습니다(Tarjan "Efficiency of a Good But Not Linear Set Union Algorithm", 즉 좋지만 선형이 아닌 집합 합치기 알고리즘의 효율성). 이후 1985년에 그는 Leeuwen과 함께 여러 가지 랭크 휴리스틱과 경로 압축 방식에 대한 다양한 복잡도 분석을 발표했습니다(Tarjan, Leeuwen "Worst-case Analysis of Set Union Algorithms", 즉 집합 합치기 알고리즘의 최악의 경우 분석).
마지막으로 1989년에 Fredman과 Sachs는 채택된 계산 모델에서 서로소 집합 유니온 문제를 푸는 어떤 알고리즘이든 평균적으로 최소 $O(\alpha(n))$ 시간이 걸린다는 것을 증명했습니다(Fredman, Saks, "The cell probe complexity of dynamic data structures", 즉 동적 자료 구조의 셀 프로브 복잡도).