위상 정렬
정점 $n$개와 간선 $m$개로 이루어진 방향 그래프가 주어집니다. 모든 간선이 인덱스가 작은 정점에서 인덱스가 큰 정점으로 향하도록 하는 정점의 순서를 찾아야 합니다.
다시 말해, 그래프의 모든 간선이 정의하는 순서에 부합하는 정점의 순열(위상 순서)을 찾고자 합니다.
다음은 주어진 그래프 하나와 그 위상 순서입니다:
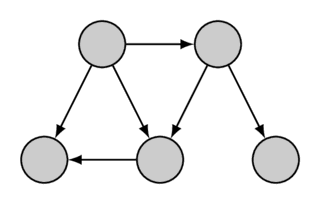
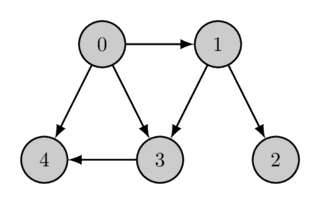
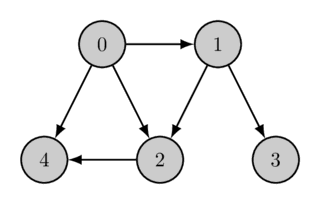
위상 순서는 유일하지 않을 수 있습니다(예를 들어, $a$에서 $b$로 가는 경로와 $a$에서 $c$로 가는 경로는 존재하지만 $b$에서 $c$로 가는 경로나 $c$에서 $b$로 가는 경로는 존재하지 않는 세 정점 $a$, $b$, $c$가 있는 경우입니다). 예시 그래프에도 위상 순서가 여러 개 있으며, 두 번째 위상 순서는 다음과 같습니다:
위상 순서가 아예 존재하지 않을 수도 있습니다. 위상 순서는 방향 그래프에 사이클이 없을 때에만 존재합니다. 그렇지 않으면 모순이 생깁니다. 정점 $a$와 $b$를 포함하는 사이클이 있다면, $a$는 $b$보다 작은 인덱스를 가져야 하고($a$에서 $b$에 도달할 수 있으므로) 동시에 더 큰 인덱스도 가져야 합니다($b$에서 $a$에 도달할 수 있으므로). 이 글에서 설명하는 알고리즘은 모든 비순환 방향 그래프에 위상 순서가 적어도 하나 존재한다는 것을 구성적으로 보여 주기도 합니다.
위상 정렬이 등장하는 대표적인 문제는 다음과 같습니다. 값을 알 수 없는 변수 $n$개가 있습니다. 일부 변수들에 대해서는 한 변수가 다른 변수보다 작다는 사실을 알고 있습니다. 이 제약 조건들이 서로 모순되는지 확인하고, 모순되지 않는다면 변수들을 오름차순으로 출력해야 합니다(가능한 답이 여러 개라면 그중 아무것이나 출력합니다). 이것이 바로 정점 $n$개로 이루어진 그래프의 위상 순서를 찾는 문제라는 것을 쉽게 알 수 있습니다.
알고리즘
이 문제를 풀기 위해 깊이 우선 탐색을 사용하겠습니다.
그래프에 사이클이 없다고 가정합시다. 깊이 우선 탐색은 무엇을 합니까?
어떤 정점 $v$에서 시작하면, DFS는 $v$에서 나가는 모든 간선을 따라 탐색하려고 합니다. 끝점이 이미 이전에 방문된 간선에서는 멈추고, 나머지 간선들을 따라 탐색하며 그 끝점에서 재귀적으로 탐색을 계속합니다.
따라서 함수 호출 $\text{dfs}(v)$가 끝나는 시점에는 $v$에서 도달할 수 있는 모든 정점이 직접(간선 하나를 통해) 또는 간접적으로 탐색에 의해 방문된 상태입니다.
$\text{dfs}(v)$를 마칠 때 정점 $v$를 리스트에 추가합시다. 도달할 수 있는 모든 정점은 이미 방문되었으므로, $v$를 추가하는 시점에 그 정점들은 이미 리스트에 들어 있습니다. 한 번 또는 여러 번의 깊이 우선 탐색을 실행하여 그래프의 모든 정점에 대해 이 작업을 수행합시다. 그래프의 모든 방향 간선 $v \rightarrow u$에 대해, $u$는 $v$에서 도달할 수 있으므로 이 리스트에서 $u$가 $v$보다 먼저 나타납니다. 따라서 이 리스트의 정점들에 $n-1, n-2, \dots, 1, 0$을 차례로 붙이기만 하면 그래프의 위상 순서를 얻게 됩니다. 다시 말해, 이 리스트는 위상 순서를 뒤집은 것입니다.
이러한 설명은 DFS 알고리즘의 탈출 시각 관점에서도 제시할 수 있습니다. 정점 $v$의 탈출 시각은 함수 호출 $\text{dfs}(v)$가 끝난 시각입니다(시각에는 $0$부터 $n-1$까지 번호를 매길 수 있습니다). 임의의 정점 $v$의 탈출 시각은 그 정점에서 도달할 수 있는 모든 정점의 탈출 시각보다 항상 크다는 것을 쉽게 이해할 수 있습니다(그러한 정점들은 $\text{dfs}(v)$ 호출 이전이나 호출 도중에 방문되었기 때문입니다). 따라서 원하는 위상 순서는 정점들을 탈출 시각의 내림차순으로 나열한 것입니다.
구현
다음은 그래프에 사이클이 없다고, 즉 원하는 위상 정렬 순서가 존재한다고 가정한 구현입니다. 필요하다면 깊이 우선 탐색 글에 설명된 대로 그래프에 사이클이 없는지 쉽게 확인할 수 있습니다.
int n; // number of vertices
vector<vector<int>> adj; // adjacency list of graph
vector<bool> visited;
vector<int> ans;

void dfs(int v) {
    visited[v] = true;
    for (int u : adj[v]) {
        if (!visited[u]) {
            dfs(u);
        }
    }
    ans.push_back(v);
}

void topological_sort() {
    visited.assign(n, false);
    ans.clear();
    for (int i = 0; i < n; ++i) {
        if (!visited[i]) {
            dfs(i);
        }
    }
    reverse(ans.begin(), ans.end());
}
이 풀이의 주 함수는 topological_sort이며, 이 함수는 DFS 변수를 초기화하고 DFS를 실행한 뒤 벡터 ans에 답을 받습니다. 그래프에 사이클이 있는 경우에도 topological_sort의 결과는 어느 정도 의미를 가진다는 점에 주목할 만합니다. 정점 $u$가 정점 $v$에서 도달 가능하지만 그 역은 성립하지 않는다면, 결과 배열에서 정점 $v$가 항상 먼저 나옵니다. 제시된 구현의 이러한 성질은 사이클이 있는 방향 그래프에서 강한 연결 요소와 그 위상 정렬을 구하기 위해 Kosaraju 알고리즘에서 사용됩니다.
연습 문제
- SPOJ TOPOSORT - Topological Sorting [difficulty: easy]
- UVA 10305 - Ordering Tasks [difficulty: easy]
- UVA 124 - Following Orders [difficulty: easy]
- UVA 200 - Rare Order [difficulty: easy]
- Codeforces 510C - Fox and Names [difficulty: easy]
- SPOJ RPLA - Answer the boss!
- CSES - Course Schedule
- CSES - Longest Flight Route
- CSES - Game Routes