에라토스테네스의 체
에라토스테네스의 체는 $O(n \log \log n)$번의 연산으로 구간 $[1;n]$에 있는 모든 소수를 찾는 알고리즘입니다.
알고리즘은 매우 간단합니다. 먼저 2부터 $n$까지의 모든 수를 적습니다. 2가 가장 작은 소수이므로 2의 모든 진배수를 합성수로 표시합니다. 수 $x$의 진배수란 $x$보다 크면서 $x$로 나누어떨어지는 수를 말합니다. 그다음 아직 합성수로 표시되지 않은 다음 수를 찾습니다. 이 경우에는 3입니다. 이는 3이 소수라는 뜻이므로, 3의 모든 진배수를 합성수로 표시합니다. 표시되지 않은 다음 수는 5이며, 이것이 다음 소수이므로 5의 모든 진배수를 표시합니다. 그리고 나열된 모든 수를 처리할 때까지 이 과정을 계속합니다.
다음 그림에서 구간 $[1; 16]$의 모든 소수를 구하는 알고리즘의 시각화를 볼 수 있습니다. 그림에서 보듯이, 같은 수를 여러 번 합성수로 표시하는 경우가 상당히 많습니다.
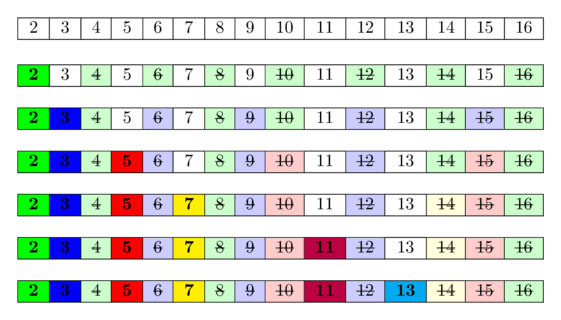
이 알고리즘의 기본 아이디어는 다음과 같습니다. 어떤 수가 자신보다 작은 어떤 소수로도 나누어떨어지지 않으면 그 수는 소수입니다. 소수를 차례대로 순회하므로, 소수 중 적어도 하나로 나누어떨어지는 모든 수는 이미 나누어떨어지는 수로 표시되어 있습니다. 따라서 어떤 칸에 도달했을 때 그 칸이 표시되어 있지 않다면, 그 수는 더 작은 어떤 소수로도 나누어떨어지지 않으므로 반드시 소수입니다.
구현
int n;
vector<bool> is_prime(n+1, true);
is_prime[0] = is_prime[1] = false;
for (int i = 2; i <= n; i++) {
    if (is_prime[i] && (long long)i * i <= n) {
        for (int j = i * i; j <= n; j += i)
            is_prime[j] = false;
    }
}
이 코드는 먼저 0과 1을 제외한 모든 수를 소수 후보로 표시한 다음, 합성수를 걸러 내는 과정을 시작합니다. 이를 위해 $2$부터 $n$까지의 모든 수를 순회합니다. 현재 수 $i$가 소수이면, $i^2$부터 시작하여 $i$의 배수인 모든 수를 합성수로 표시합니다. 이는 이미 단순한 구현 방식을 개선한 최적화이며, $i$의 배수 중 이보다 작은 수들은 모두 $i$보다 작은 소인수를 반드시 가지므로 이미 앞에서 모두 걸러졌기 때문에 이렇게 해도 됩니다. $i^2$는 int 타입에서 쉽게 오버플로가 발생할 수 있으므로, 두 번째 중첩 루프에 들어가기 전에 long long 타입을 사용하여 추가로 확인합니다.
이렇게 구현하면 알고리즘은 (당연히) $O(n)$의 메모리를 사용하며 $O(n \log \log n)$번의 연산을 수행합니다(다음 절 참고).
점근적 분석
소수의 분포에 대해 아무것도 모르더라도 실행 시간이 $O(n \log n)$임은 쉽게 증명할 수 있습니다. is_prime 검사를 무시하면 내부 루프는 $i = 2, 3, 4, \dots$에 대해 (최대) $n/i$번 실행되므로, 내부 루프의 총 연산 횟수는 $n(1/2 + 1/3 + 1/4 + \cdots)$와 같은 조화합이 되고, 이는 $O(n \log n)$으로 제한됩니다.
알고리즘의 실행 시간이 $O(n \log \log n)$임을 증명해 봅시다. 알고리즘은 내부 루프에서 모든 소수 $p \le n$에 대해 $\frac{n}{p}$번의 연산을 수행합니다. 따라서 다음 식의 값을 구해야 합니다:
잘 알려진 두 가지 사실을 떠올려 봅시다.
- $n$ 이하인 소수의 개수는 대략 $\frac n {\ln n}$입니다.
- $k$번째 소수는 대략 $k \ln k$와 같습니다(이는 앞의 사실에서 도출됩니다).
따라서 합을 다음과 같이 쓸 수 있습니다:
여기서 첫 번째 소수인 2를 합에서 따로 떼어 냈는데, 근삿값 $k \ln k$에서 $k = 1$이면 값이 $0$이 되어 0으로 나누는 문제가 생기기 때문입니다.
이제 같은 함수를 $k$에 대해 $2$부터 $\frac n {\ln n}$까지 적분하여 이 합의 값을 구해 봅시다(실제로 이 합은 직사각형 방법을 이용한 적분의 근삿값에 해당하므로 이러한 근사가 가능합니다):
피적분 함수의 부정적분은 $\ln \ln k$입니다. 치환을 사용하고 낮은 차수의 항을 제거하면 다음 결과를 얻습니다.
이제 원래의 합으로 돌아가면, 그 근사적인 평가를 다음과 같이 얻습니다.
더 엄밀한 증명(상수 배 이내로 정확한, 더 정밀한 평가를 제공하는 증명)은 Hardy & Wright가 저술한 책 "An Introduction to the Theory of Numbers"(349쪽)에서 찾을 수 있습니다.
에라토스테네스의 체의 다양한 최적화
이 알고리즘의 가장 큰 약점은 단일 원소만을 조작하면서 메모리를 여러 번 "훑고 지나간다"는 점입니다. 이는 캐시 친화적이지 않습니다. 그리고 그 때문에 $O(n \log \log n)$에 숨겨진 상수가 비교적 큽니다.
게다가 큰 $n$에 대해서는 소비되는 메모리가 병목이 됩니다.
아래에 제시된 방법들을 사용하면 수행되는 연산의 양을 줄일 수 있을 뿐만 아니라 소비되는 메모리도 눈에 띄게 줄일 수 있습니다.
제곱근까지만 체로 거르기
자명하게도, $n$까지의 모든 소수를 찾으려면 $n$의 제곱근을 넘지 않는 소수들로만 체로 거르는 작업을 수행하는 것으로 충분합니다.
int n;
vector<bool> is_prime(n+1, true);
is_prime[0] = is_prime[1] = false;
for (int i = 2; i * i <= n; i++) {
    if (is_prime[i]) {
        for (int j = i * i; j <= n; j += i)
            is_prime[j] = false;
    }
}
이러한 최적화는 복잡도에 영향을 주지 않지만(실제로 위에 제시된 증명을 반복하면 $n \ln \ln \sqrt n + o(n)$이라는 평가를 얻으며, 이는 로그의 성질에 따라 점근적으로 동일합니다), 연산 횟수는 눈에 띄게 줄어듭니다.
홀수로만 체로 거르기
($2$를 제외한) 모든 짝수는 합성수이므로, 짝수를 검사하는 일을 아예 그만둘 수 있습니다. 대신 홀수만을 다루어야 합니다.
첫째, 이를 통해 필요한 메모리를 절반으로 줄일 수 있습니다. 둘째, 알고리즘이 수행하는 연산 횟수가 대략 절반으로 줄어듭니다.
메모리 사용량과 연산 속도
에라토스테네스의 체의 이 두 구현은 vector<bool> 자료 구조를 사용하여 $n$비트의 메모리를 사용한다는 점에 주목해야 합니다. vector<bool>은 일련의 bool을 저장하는 일반적인 컨테이너가 아닙니다(대부분의 컴퓨터 아키텍처에서 bool 하나는 1바이트의 메모리를 차지합니다). 이는 vector<T>의 메모리 최적화 특수화로, $\frac{N}{8}$바이트의 메모리만을 소비합니다.
현대 프로세서 아키텍처는 보통 비트에 직접 접근할 수 없기 때문에 비트보다 바이트를 훨씬 더 효율적으로 다룹니다. 따라서 내부적으로 vector<bool>은 비트를 커다란 연속 메모리에 저장하고, 몇 바이트 단위의 블록으로 메모리에 접근하며, 비트 마스킹이나 비트 시프트 같은 비트 연산으로 비트를 추출하거나 설정합니다.
그 때문에 vector<bool>로 비트를 읽거나 쓸 때는 일정한 오버헤드가 있으며, vector<char>(각 항목마다 1바이트를 사용하므로 메모리 양이 8배입니다)를 사용하는 편이 더 빠른 경우가 꽤 많습니다.
하지만 에라토스테네스의 체의 단순한 구현에서는 vector<bool>을 사용하는 것이 더 빠릅니다. 데이터를 캐시에 얼마나 빨리 적재할 수 있는지에 따라 성능이 제한되므로, 메모리를 적게 사용하는 것이 큰 이점이 됩니다. 벤치마크(링크)에 따르면 vector<bool>을 사용하는 것이 vector<char>를 사용하는 것보다 1.4배에서 1.7배 빠릅니다.
같은 고려 사항이 bitset에도 적용됩니다. 이 역시 vector<bool>과 비슷하게 비트를 효율적으로 저장하는 방법이므로 $\frac{N}{8}$바이트의 메모리만 차지하지만, 원소에 접근하는 속도는 조금 느립니다. 위의 벤치마크에서 bitset은 vector<bool>보다 약간 낮은 성능을 보입니다. bitset의 또 다른 단점은 컴파일 시점에 크기를 알아야 한다는 것입니다.
구간 분할 체
"제곱근까지 체로 거르기" 최적화로부터 전체 배열 is_prime[1...n]을 항상 유지할 필요가 없다는 사실이 도출됩니다. 체로 거르기 위해서는 $n$의 제곱근까지의 소수, 즉 prime[1... sqrt(n)]만 유지하고, 전체 범위를 블록으로 나눈 뒤 각 블록을 따로 체로 거르는 것으로 충분합니다.
블록의 크기를 결정하는 상수를 $s$라고 하면, 블록은 모두 $\lceil {\frac n s} \rceil$개가 되고, 블록 $k$($k = 0 ... \lfloor {\frac n s} \rfloor$)는 구간 $[ks; ks + s - 1]$의 수들을 포함합니다. 블록을 차례대로 처리할 수 있습니다. 즉, 모든 블록 $k$에 대해 모든 소수($1$부터 $\sqrt n$까지)를 순회하며 이 소수들을 사용해 체로 거릅니다. 처음 몇 개의 수를 처리할 때는 전략을 약간 수정해야 한다는 점에 주목할 필요가 있습니다. 첫째, $[1; \sqrt n]$에 속하는 모든 소수는 자기 자신을 제거해서는 안 되고, 둘째, 수 $0$과 $1$은 소수가 아닌 수로 표시되어야 합니다. 마지막 블록을 처리할 때는 필요한 마지막 수 $n$이 반드시 블록의 끝에 위치하지는 않는다는 점을 잊어서는 안 됩니다.
앞서 논의한 바와 같이, 에라토스테네스의 체의 일반적인 구현은 데이터를 CPU 캐시에 얼마나 빠르게 불러올 수 있는지에 따라 속도가 제한됩니다. 소수가 될 수 있는 수들의 범위 $[1; n]$을 더 작은 블록으로 나누면 여러 블록을 동시에 메모리에 유지할 필요가 전혀 없으며, 모든 연산이 훨씬 더 캐시 친화적이 됩니다. 이제 더 이상 캐시 속도에 제한받지 않으므로 vector<bool>을 vector<char>로 바꿀 수 있으며, 프로세서가 바이트 단위로 읽기와 쓰기를 직접 처리할 수 있고 개별 비트를 추출하기 위해 비트 연산에 의존할 필요가 없으므로 추가적인 성능 향상을 얻을 수 있습니다. 벤치마크(링크)에 따르면, 이 상황에서는 vector<char>를 사용하는 것이 vector<bool>을 사용하는 것보다 약 3배 빠릅니다. 주의할 점이 있습니다. 이 수치는 아키텍처, 컴파일러, 최적화 수준에 따라 달라질 수 있습니다.
다음은 블록 체를 사용하여 $n$ 이하인 소수의 개수를 세는 구현입니다.
int count_primes(int n) {
    const int S = 10000;

    vector<int> primes;
    int nsqrt = sqrt(n);
    vector<char> is_prime(nsqrt + 2, true);
    for (int i = 2; i <= nsqrt; i++) {
        if (is_prime[i]) {
            primes.push_back(i);
            for (int j = i * i; j <= nsqrt; j += i)
                is_prime[j] = false;
        }
    }

    int result = 0;
    vector<char> block(S);
    for (int k = 0; k * S <= n; k++) {
        fill(block.begin(), block.end(), true);
        int start = k * S;
        for (int p : primes) {
            int start_idx = (start + p - 1) / p;
            int j = max(start_idx, p) * p - start;
            for (; j < S; j += p)
                block[j] = false;
        }
        if (k == 0)
            block[0] = block[1] = false;
        for (int i = 0; i < S && start + i <= n; i++) {
            if (block[i])
                result++;
        }
    }
    return result;
}
블록 체의 실행 시간은 (블록의 크기가 매우 작지 않은 한) 일반적인 에라토스테네스의 체와 같지만, 필요한 메모리는 $O(\sqrt{n} + S)$로 줄어들고 캐시 효율도 더 좋아집니다. 반면에 각 블록과 $[1; \sqrt{n}]$에 속하는 소수의 모든 쌍마다 나눗셈이 한 번씩 발생하며, 이는 블록 크기가 작을수록 훨씬 더 나빠집니다. 따라서 상수 $S$를 선택할 때 균형을 유지하는 것이 필요합니다. 블록 크기가 $10^4$에서 $10^5$ 사이일 때 가장 좋은 결과를 얻었습니다.
범위 내의 소수 찾기
때로는 크기가 작은(예: $R - L + 1 \approx 1e7$) 범위 $[L,R]$에 있는 모든 소수를 찾아야 하는데, 이때 $R$은 매우 클 수 있습니다(예: $1e12$).
이러한 문제를 해결하기 위해 구간 체(Segmented sieve)의 아이디어를 사용할 수 있습니다. $\sqrt R$까지의 모든 소수를 미리 생성하고, 그 소수들을 사용하여 구간 $[L, R]$에 있는 모든 합성수를 표시합니다.
vector<char> segmented_sieve(long long L, long long R) {
    // generate all primes up to sqrt(R)
    long long lim = sqrt(R);
    vector<char> mark(lim + 1, false);
    vector<long long> primes;
    for (long long i = 2; i <= lim; ++i) {
        if (!mark[i]) {
            primes.emplace_back(i);
            for (long long j = i * i; j <= lim; j += i)
                mark[j] = true;
        }
    }

    vector<char> isPrime(R - L + 1, true);
    for (long long i : primes)
        for (long long j = max(i, (L + i - 1) / i) * i; j <= R; j += i)
            isPrime[j - L] = false;
    for (long long x = L; x <= min(R, 1LL); x++)
        isPrime[x - L] = false;
    return isPrime;
}
모든 소수를 미리 생성하지 않는 것도 가능합니다.
vector<char> segmented_sieve_no_pre_gen(long long L, long long R) {
    vector<char> isPrime(R - L + 1, true);
    long long lim = sqrt(R);
    for (long long i = 2; i <= lim; ++i)
        for (long long j = max(i, (L + i - 1) / i) * i; j <= R; j += i)
            isPrime[j - L] = false;
    for (long long x = L; x <= min(R, 1LL); x++)
        isPrime[x - L] = false;
    return isPrime;
}
당연히 복잡도는 더 나빠지며, $O((R - L + 1) \log (R) + \sqrt R)$입니다. 그러나 실제로는 여전히 매우 빠르게 실행됩니다.
선형 시간 변형
알고리즘을 선형 시간 복잡도만 갖도록 수정할 수 있습니다. 이 방법은 선형 체 글에 설명되어 있습니다. 그러나 이 알고리즘에도 나름의 약점이 있습니다.
연습 문제
- Leetcode - Four Divisors
- Leetcode - Count Primes
- Leetcode - Closest Prime Numbers in Range
- SPOJ - Printing Some Primes
- SPOJ - A Conjecture of Paul Erdos
- SPOJ - Primal Fear
- SPOJ - Primes Triangle (I)
- Codeforces - Almost Prime
- Codeforces - Sherlock And His Girlfriend
- SPOJ - Namit in Trouble
- SPOJ - Bazinga!
- Project Euler - Prime pair connection
- SPOJ - N-Factorful
- SPOJ - Binary Sequence of Prime Numbers
- UVA 11353 - A Different Kind of Sorting
- SPOJ - Prime Generator
- SPOJ - Printing some primes (hard)
- Codeforces - Nodbach Problem
- Codeforces - Colliders