가장 가까운 두 점 찾기
문제 설명
평면 위에 $n$개의 점이 주어집니다. 각 점 $p_i$는 좌표 $(x_i,y_i)$로 정의됩니다. 이 점들 중에서 서로 간의 거리가 최소가 되는 두 점을 찾아야 합니다:
거리로는 일반적인 유클리드 거리를 사용합니다:
모든 쌍을 순회하며 각 쌍의 거리를 계산하는 자명한 알고리즘은 $O(n^2)$에 동작합니다.
아래에서는 $O(n \log n)$ 시간에 동작하는 알고리즘을 설명합니다. 이 알고리즘은 1975년 Shamos와 Hoey가 제안했습니다. (출처: Kleinberg & Tardos의 Algorithm Design 5장 Notes, 여기도 참고하십시오) Preparata와 Shamos는 이 알고리즘이 결정 트리 모델에서 최적임도 보였습니다.
알고리즘
알고리즘은 분할 정복 알고리즘의 일반적인 틀에 따라 구성합니다. 즉, 알고리즘을 점들의 집합을 전달받는 재귀 함수로 설계합니다. 이 재귀 함수는 집합을 절반으로 나누고, 각 절반에 대해 자기 자신을 재귀적으로 호출한 뒤, 답을 합치기 위한 몇 가지 연산을 수행합니다. 합치기 연산은 최적해의 한 점은 한쪽 절반에, 다른 한 점은 다른 쪽 절반에 속하는 경우를 찾아내는 것입니다(이 경우 각 절반에 대한 재귀 호출은 이 쌍을 각자 따로 찾아낼 수 없습니다). 분할 정복 알고리즘이 늘 그렇듯, 주된 어려움은 병합 단계를 효율적으로 구현하는 데 있습니다. 재귀 함수에 $n$개의 점으로 이루어진 집합이 전달될 때 병합 단계가 $O(n)$ 이내로 동작해야 하며, 그러면 전체 알고리즘의 점근적 복잡도 $T(n)$은 다음 방정식으로부터 구할 수 있습니다:
잘 알려져 있듯이, 이 방정식의 해는 $T(n) = O(n \log n).$입니다.
그러면 이제 알고리즘을 구성해 봅시다. 이후에 병합 단계를 효율적으로 구현하기 위해, 점들의 집합을 $x$좌표에 따라 두 부분집합으로 나눕니다. 사실상 점들의 집합을 거의 같은 크기의 두 부분집합으로 나누는 수직선을 하나 긋는 것입니다. 이러한 분할은 다음과 같이 하는 것이 편리합니다. 점들을 수의 쌍으로 보고 표준적인 방식으로 정렬합니다. 즉:
그런 다음 정렬 후 가운데 점 $p_m (m = \lfloor n/2 \rfloor)$을 잡고, 그 앞의 모든 점과 $p_m$ 자신은 첫 번째 절반에, 그 뒤의 모든 점은 두 번째 절반에 배정합니다:
이제 집합 $A_1$과 $A_2$ 각각에 대해 재귀적으로 호출하여, 각 절반에 대한 답 $h_1$과 $h_2$를 구합니다. 그리고 그중 더 좋은 값을 취합니다: $h = \min(h_1, h_2)$.
이제 병합 단계를 수행해야 합니다. 즉, 두 점 사이의 거리가 $h$보다 작으면서 한 점은 $A_1$에, 다른 한 점은 $A_2$에 속하는 점의 쌍을 찾으려 합니다. 수직선으로부터의 거리가 $h$보다 작은 점들만 고려하면 충분하다는 것은 자명합니다. 즉, 이 단계에서 고려하는 점들의 집합 $B$는 다음과 같습니다:
집합 $B$의 각 점에 대해, 그 점과의 거리가 $h$보다 작은 점들을 찾으려 합니다. 예를 들어, $y$좌표의 차이가 $h$ 이하인 점들만 고려하면 충분합니다. 더 나아가, $y$좌표가 현재 점의 $y$좌표보다 큰 점들은 고려할 필요가 없습니다. 따라서 각 점 $p_i$에 대해 고려할 점들의 집합 $C(p_i)$를 다음과 같이 정의합니다:
집합 $B$의 점들을 $y$좌표로 정렬해 두면 $C(p_i)$를 매우 쉽게 찾을 수 있습니다. 이는 점 $p_i$ 바로 앞에 연속해서 놓인 몇 개의 점들입니다.
따라서 새 표기법으로 나타내면 병합 단계는 다음과 같습니다. 집합 $B$를 만들고, 그 안의 점들을 $y$좌표로 정렬한 뒤, 각 점 $p_i \in B$에 대해 모든 점 $p_j \in C(p_i)$를 살펴보고, 각 쌍 $(p_i,p_j)$에 대해 거리를 계산하여 현재까지의 최선의 거리와 비교합니다.
언뜻 보기에는 이 알고리즘도 여전히 최적이 아닌 것 같습니다. 집합 $C(p_i)$의 크기가 $n$ 정도가 될 것처럼 보이므로 원하는 점근적 복잡도를 얻을 수 없을 것 같습니다. 그러나 놀랍게도, 각 집합 $C(p_i)$의 크기가 $O(1)$인 양이라는 것, 즉 점들 자체와 관계없이 어떤 작은 상수를 넘지 않는다는 것을 증명할 수 있습니다. 이 사실에 대한 증명은 다음 절에서 제시합니다.
마지막으로, 위 알고리즘에 포함된 정렬에 주목합시다. 첫째는 쌍 $(x, y)$ 기준의 정렬이고, 둘째는 집합 $B$의 원소를 $y$ 기준으로 정렬하는 것입니다. 사실 재귀 함수 안에 있는 이 두 정렬은 모두 제거할 수 있습니다(그렇지 않으면 병합 단계에서 $O(n)$ 추정치에 도달할 수 없고, 알고리즘의 전체 점근적 복잡도는 $O(n \log^2 n)$이 됩니다). 첫 번째 정렬은 쉽게 없앨 수 있습니다. 재귀를 시작하기 전에 이 정렬을 수행하면 충분합니다. 결국 재귀 안에서 원소 자체는 바뀌지 않으므로 다시 정렬할 필요가 없습니다. 두 번째 정렬은 수행하기가 조금 더 어려워서, 미리 수행해 두는 방식은 통하지 않습니다. 그러나 마찬가지로 분할 정복 원리로 동작하는 병합 정렬을 떠올리면, 이 정렬을 재귀 안에 간단히 끼워 넣을 수 있습니다. 재귀가 어떤 점들의 집합(기억하듯이 쌍 $(x, y)$ 기준으로 정렬된 집합)을 받아서, 같은 집합을 $y$좌표 기준으로 정렬하여 반환하도록 합시다. 이를 위해서는 재귀 호출이 반환한 두 결과를 ($O(n)$에) 병합하기만 하면 됩니다. 그러면 $y$좌표 기준으로 정렬된 집합을 얻습니다.
점근적 복잡도 평가
위 알고리즘이 실제로 $O(n \log n)$에 실행됨을 보이려면 다음 사실을 증명해야 합니다: $|C(p_i)| = O(1)$.
그러면 어떤 점 $p_i$를 생각해 봅시다. 집합 $C(p_i)$는 $y$좌표가 구간 $[y_i-h; y_i]$에 놓이는 점들의 집합이며, 더 나아가 $x$ 좌표 방향으로 보면 점 $p_i$ 자신과 집합 $C(p_i)$의 모든 점은 폭이 $2h$인 띠 안에 놓인다는 것을 떠올리십시오. 다시 말해, 우리가 고려하는 점 $p_i$와 $C(p_i)$는 크기가 $2h \times h$인 직사각형 안에 놓입니다.
우리의 과제는 이 직사각형 $2h \times h$ 안에 놓일 수 있는 점의 최대 개수를 추정하는 것이며, 이로써 집합 $C(p_i)$의 최대 크기를 추정합니다. 이때 평가하면서 중복된 점이 있을 수 있다는 사실을 잊어서는 안 됩니다.
$h$는 집합 $A_1$과 $A_2$에 대한 두 재귀 호출의 결과로부터 얻은 값임을 기억하십시오. 여기서 $A_1$은 분할선의 왼쪽에 있는 점들과 분할선 위의 점 일부를 포함하고, $A_2$는 분할선 위의 나머지 점들과 분할선 오른쪽의 점들을 포함합니다. $A_1$에서 고른 임의의 점 쌍, 그리고 $A_2$에서 고른 임의의 점 쌍에 대해 거리는 $h$보다 작을 수 없습니다. 그렇지 않다면 재귀 함수가 잘못 동작했다는 뜻이 됩니다.
직사각형 $2h \times h$ 안의 점의 최대 개수를 추정하기 위해 이를 두 개의 정사각형 $h \times h$로 나눕니다. 첫 번째 정사각형은 모든 점 $C(p_i) \cap A_1$을 포함하고, 두 번째 정사각형은 나머지 모든 점, 즉 $C(p_i) \cap A_2$를 포함합니다. 위의 고찰로부터 이 정사각형 각각에서 임의의 두 점 사이의 거리는 적어도 $h$임을 알 수 있습니다.
각 정사각형 안에 점이 많아야 네 개 있음을 보이겠습니다. 예를 들어 다음과 같이 할 수 있습니다. 정사각형을 변의 길이가 $h/2$인 $4$개의 작은 정사각형으로 나눕니다. 그러면 각 작은 정사각형 안에는 점이 하나보다 많을 수 없습니다(대각선조차 $h / \sqrt{2}$로 $h$보다 작기 때문입니다). 따라서 정사각형 전체에는 점이 $4$개보다 많을 수 없습니다.
이로써 직사각형 $2h \times h$ 안에는 점이 $4 \cdot 2 = 8$개보다 많을 수 없음을 증명했으며, 따라서 요구한 대로 집합 $C(p_i)$의 크기는 $7$을 넘을 수 없습니다.
구현
점(좌표와 번호)을 저장하는 자료 구조와 두 종류의 정렬에 필요한 비교 연산자를 도입합니다:
struct pt {
    int x, y, id;
};

struct cmp_x {
    bool operator()(const pt & a, const pt & b) const {
        return a.x < b.x || (a.x == b.x && a.y < b.y);
    }
};

struct cmp_y {
    bool operator()(const pt & a, const pt & b) const {
        return a.y < b.y;
    }
};

int n;
vector<pt> a;
재귀를 편리하게 구현하기 위해, 두 점 사이의 거리를 계산하고 그것이 현재 답보다 나은지 확인하는 보조 함수 upd_ans()를 도입합니다:
double mindist;
pair<int, int> best_pair;

void upd_ans(const pt & a, const pt & b) {
    double dist = sqrt((a.x - b.x)*(a.x - b.x) + (a.y - b.y)*(a.y - b.y));
    if (dist < mindist) {
        mindist = dist;
        best_pair = {a.id, b.id};
    }
}
마지막으로 재귀 자체의 구현입니다. 이 함수를 호출하기 전에 배열 $a[]$가 이미 $x$좌표 기준으로 정렬되어 있다고 가정합니다. 재귀에는 두 포인터 $l, r$만 넘기며, 이는 $a[l \ldots r)$에 대한 답을 찾아야 함을 나타냅니다. $r$과 $l$ 사이의 거리가 너무 작으면 재귀를 멈추고, 자명한 알고리즘으로 가장 가까운 쌍을 찾은 다음 부분 배열을 $y$좌표 기준으로 정렬해야 합니다.
재귀 호출에서 받은 두 점 집합을 ($y$좌표 기준으로 정렬된) 하나로 병합하기 위해 표준 STL $merge()$ 함수를 사용하고, 보조 버퍼 $t[]$(모든 재귀 호출이 공유하는 하나)를 만듭니다. (inplace_merge ()는 일반적으로 선형 시간에 동작하지 않으므로 사용하는 것이 실용적이지 않습니다.)
마지막으로, 집합 $B$도 같은 배열 $t$에 저장합니다.
vector<pt> t;

void rec(int l, int r) {
    if (r - l <= 3) {
        for (int i = l; i < r; ++i) {
            for (int j = i + 1; j < r; ++j) {
                upd_ans(a[i], a[j]);
            }
        }
        sort(a.begin() + l, a.begin() + r, cmp_y());
        return;
    }

    int m = (l + r) >> 1;
    int midx = a[m].x;
    rec(l, m);
    rec(m, r);

    merge(a.begin() + l, a.begin() + m, a.begin() + m, a.begin() + r, t.begin(), cmp_y());
    copy(t.begin(), t.begin() + r - l, a.begin() + l);

    int tsz = 0;
    for (int i = l; i < r; ++i) {
        if (abs(a[i].x - midx) < mindist) {
            for (int j = tsz - 1; j >= 0 && a[i].y - t[j].y < mindist; --j)
                upd_ans(a[i], t[j]);
            t[tsz++] = a[i];
        }
    }
}
참고로 모든 좌표가 정수라면 재귀 과정에서 분수 값으로 넘어갈 필요가 없으며, $mindist$에는 최소 거리의 제곱을 저장하면 됩니다.
메인 프로그램에서는 재귀를 다음과 같이 호출해야 합니다.
t.resize(n);
sort(a.begin(), a.end(), cmp_x());
mindist = 1E20;
rec(0, n);
선형 시간 무작위 알고리즘
선형 기대 시간을 갖는 무작위 알고리즘
1976년에 Rabin이 처음 제안한 다른 방법은 실행 시간을 휴리스틱하게 개선하려는 매우 단순한 아이디어에서 출발합니다. 평면을 $d \times d$ 크기의 정사각형 격자로 나누면, 같은 블록이나 인접한 블록에 있는 점들 사이의 거리만 검사하면 됩니다(모든 정사각형이 서로 떨어져 있는 경우는 예외이지만, 이런 경우는 설계상 피할 것입니다). 그 밖의 쌍은 모두 같은 정사각형 안의 두 점보다 거리가 더 크기 때문입니다.
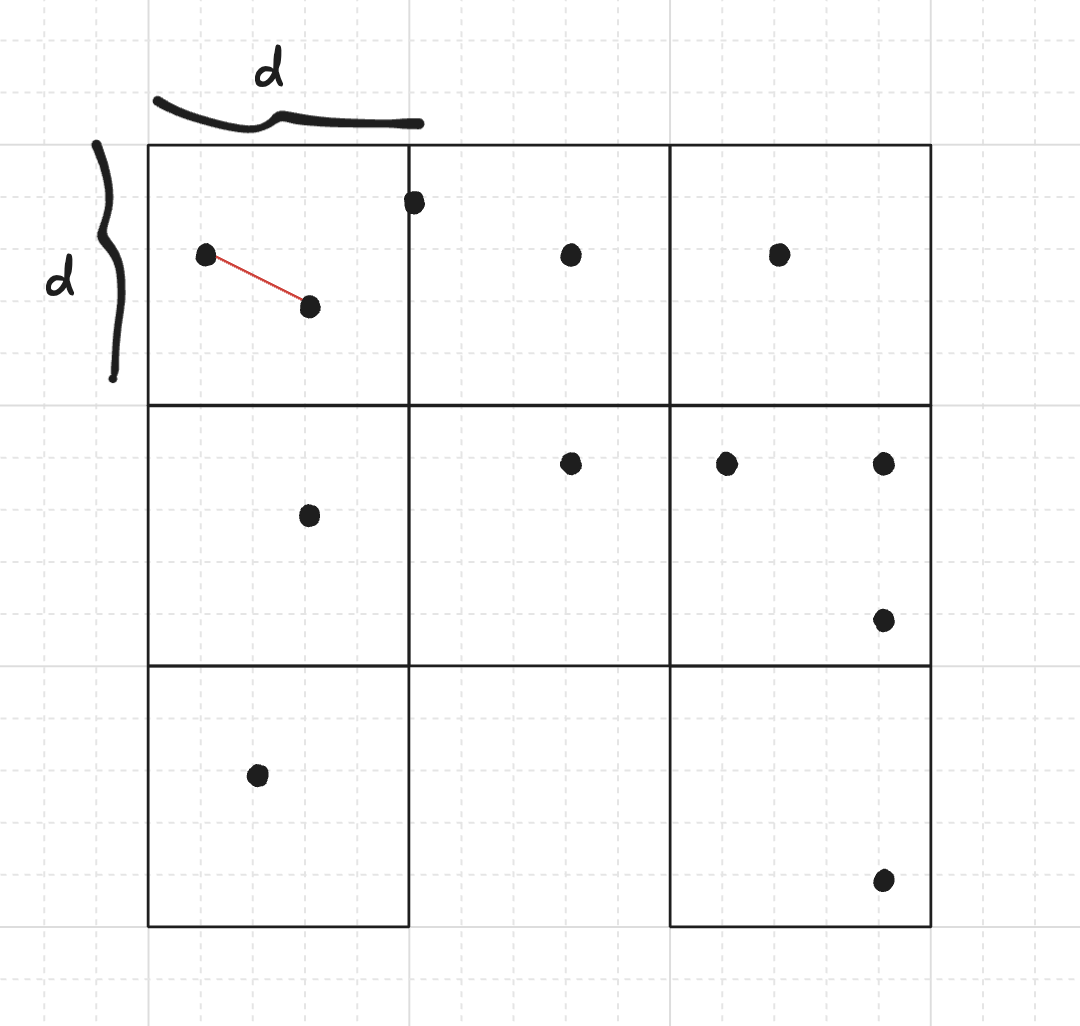
점을 하나 이상 포함하는 정사각형만 고려하겠습니다. 남은 $k$개의 정사각형 각각에 들어 있는 점의 개수를 $n_1, n_2, \dots, n_k$로 나타냅니다. 적어도 두 점이 같은 정사각형이나 인접한 정사각형에 있고 중복된 점이 없다고 가정하면, 시간 복잡도는 $\Theta\!\left(\sum\limits_{i=1}^k n_i^2\right)$입니다. 해시 테이블을 사용하면 기대 선형 시간 안에 중복된 점을 찾을 수 있으며, 중복된 점이 있다면 그 쌍이 답입니다.
증명
$n_i$개의 점을 포함하는 $i$번째 정사각형 내부의 쌍의 개수는 $\Theta(n_i^2)$입니다. $i$번째 정사각형이 $j$번째 정사각형과 인접해 있다면, $n_i n_j \le \max(n_i, n_j)^2 \le n_i^2 + n_j^2$번의 거리 비교도 추가로 수행합니다. 각 정사각형에 인접한 정사각형은 최대 $8$개이므로, 전체 비교 횟수의 합은 $\Theta(\sum_{i=1}^{k} n_i^2)$로 제한됩니다. $\quad \blacksquare$
이제 $\Theta\!\left(\sum\limits_{i=1}^k n_i^2\right)$가 최소가 되도록 $d$를 어떻게 정할지 결정해야 합니다.
d 선택하기
$d$는 최소 거리 $d$의 근삿값이어야 합니다. Richard Lipton은 $n$개의 거리를 무작위로 샘플링한 뒤, 그중 가장 작은 거리를 $d$의 근삿값으로 삼아 $d$로 선택하는 방법을 제안했습니다. 이제 이 알고리즘의 기대 실행 시간이 선형임을 증명하겠습니다.
증명
$d$를 특정 값, 예컨대 $x$로 선택했을 때 점들이 정사각형에 배치된 상태를 생각해 봅시다. $d$를 거리 샘플링의 결과로 얻어지는 확률 변수로 간주합니다. $d=x$로 선택했을 때 특정 배치의 비용 추정치를 $C(x) := \sum_{i=1}^{k(x)} n_i(x)^2$로 정의합시다. 이제 $C(x) = \lambda(x) \, n$이 되도록 $\lambda(x)$를 정의합시다. 이러한 선택 $x$가 $n$개의 독립적인 거리 샘플링에서 살아남을 확률은 얼마입니까? 샘플링된 쌍 중 단 하나라도 거리가 $x$보다 작으면, 이 배치는 더 작은 $d$로 대체됩니다. 정사각형 내부에서는 약 $1/16$의 쌍이 더 작은 거리를 만들어 냅니다(모든 정사각형 안에 네 개의 작은 정사각형이 있다고 생각하십시오. 비둘기집 원리에 따라 적어도 하나의 작은 정사각형에는 $n_i/4$개의 점이 있습니다). 따라서 최종 $d$를 더 작게 만드는 쌍은 약 $\sum_{i=1}^{k} {n_i/4 \choose 2} \approx \sum_{i=1}^{k} \frac{1}{16} {n_i \choose 2}$개입니다. 이는 대략 $\frac{1}{32} \sum_{i=1}^{k} n_i^2 = \frac{1}{32} \lambda(x) n$입니다. 한편, 샘플링될 수 있는 쌍은 약 $\frac{1}{2} n^2$개입니다. 따라서 거리가 $x$보다 작은 쌍을 샘플링할 확률은 (대략) 적어도 다음과 같습니다.
그러므로 $n$번의 시행 동안 그러한 쌍이 적어도 하나 선택될(따라서 더 작은 $d$를 찾을) 확률은 다음과 같습니다.
(임의의 실수 $x$에 대해 $(1 + x)^n \le e^{xn}$이 성립한다는 사실을 사용했습니다. 베르누이 부등식을 참고하십시오.)
$\lambda(x)$가 커질수록 이 값이 지수적으로 $1$에 가까워진다는 점에 주목하십시오. 이는 잘못 선택된 $d$에 대해서는 $\lambda$가 작을 것임을 시사합니다.
지금까지 $\Pr(d \le x) \ge 1 - e^{-\lambda(x)/16}$임을, 다시 말해 $\Pr(d \ge x) \le e^{-\lambda(x)/16}$임을 보였습니다. 기댓값을 추정하려면 $\Pr(\lambda(d) \ge \text{something})$을 알아야 합니다. $\lambda(d) \ge \lambda(x) \iff d \ge x$라는 점에 주목합니다. 정사각형을 작게 만들면 각 정사각형에 들어 있는 점의 개수가 줄어들기만 하고(점들이 다른 정사각형으로 나뉘고), 그에 따라 제곱의 합도 계속 줄어들기 때문입니다. 따라서,
($E[X] = \int_0^{+\infty} \Pr(X \ge x) \, \mathrm{d}x$라는 사실을 사용했습니다. Stackexchange proof를 참고하십시오.)
마지막으로 $\mathbb{E}[C(d)] = \mathbb{E}[\lambda(d) \, n] \le 16n$이며, 기대 실행 시간은 상수 계수가 적당한 $O(n)$입니다. $\quad \blacksquare$
알고리즘 구현
이 알고리즘은 구현하기 쉬우면서도 실제 성능이 좋다는 장점이 있습니다. 먼저 거리 $n$개를 표본으로 뽑고, 그중 최솟값을 $d$로 정합니다. 다음으로 2차원 좌표를 점의 벡터에 대응시키는 해시 테이블을 사용하여 점들을 "블록"에 넣습니다. 마지막으로 같은 블록에 있는 쌍과 인접한 블록에 있는 쌍 사이의 거리만 계산하면 됩니다. 해시 테이블 연산의 기대 시간 비용은 $O(1)$이므로, 이 알고리즘은 상수가 커지기는 해도 $O(n)$의 기대 시간 비용을 유지합니다.
Library Checker에 제출한 이 코드를 확인하십시오.
#include <bits/stdc++.h>
using namespace std;


using ll = long long;
using ld = long double;


struct pt {
    ll x, y;
    pt() {}
    pt(ll x_, ll y_) : x(x_), y(y_) {}
    void read() {
        cin >> x >> y;
    }
};

bool operator==(const pt& a, const pt& b) {
    return a.x == b.x and a.y == b.y;
}


struct CustomHashPoint {
    size_t operator()(const pt& p) const {
        static const uint64_t C = chrono::steady_clock::now().time_since_epoch().count();
        return C ^ ((p.x << 32) ^ p.y);
    }
};


ll dist2(pt a, pt b) {
    ll dx = a.x - b.x;
    ll dy = a.y - b.y;
    return dx*dx + dy*dy;
}


pair<int,int> closest_pair_of_points(vector<pt> P) {
    int n = int(P.size());
    assert(n >= 2);

    // if there is a duplicated point, we have the solution
    unordered_map<pt,int,CustomHashPoint> previous;
    for (int i = 0; i < int(P.size()); ++i) {
        auto it = previous.find(P[i]);
        if (it != previous.end()) {
            return {it->second, i};
        }
        previous[P[i]] = i;
    }

    unordered_map<pt,vector<int>,CustomHashPoint> grid;
    grid.reserve(n);

    mt19937 rd(chrono::system_clock::now().time_since_epoch().count());
    uniform_int_distribution<int> dis(0, n-1);

    ll d2 = dist2(P[0], P[1]);
    pair<int,int> closest = {0, 1};

    auto candidate_closest = [&](int i, int j) -> void {
        ll ab2 = dist2(P[i], P[j]);
        if (ab2 < d2) {
            d2 = ab2;
            closest = {i, j};
        }
    };

    for (int i = 0; i < n; ++i) {
        int j = dis(rd);
        int k = dis(rd);
        while (j == k) k = dis(rd);
        candidate_closest(j, k);
    }

    ll d = ll( sqrt(ld(d2)) + 1 );

    for (int i = 0; i < n; ++i) {
        grid[{P[i].x/d, P[i].y/d}].push_back(i);
    }

    // same block
    for (const auto& it : grid) {
        int k = int(it.second.size());
        for (int i = 0; i < k; ++i) {
            for (int j = i+1; j < k; ++j) {
                candidate_closest(it.second[i], it.second[j]);
            }
        }
    }

    // adjacent blocks
    for (const auto& it : grid) {
        auto coord = it.first;
        for (int dx = 0; dx <= 1; ++dx) {
            for (int dy = -1; dy <= 1; ++dy) {
                if (dx == 0 and dy == 0) continue;
                pt neighbour = pt(
                    coord.x  + dx,
                    coord.y + dy
                );
                for (int i : it.second) {
                    if (not grid.count(neighbour)) continue;
                    for (int j : grid.at(neighbour)) {
                        candidate_closest(i, j);
                    }
                }
            }
        }
    }

    return closest;
}
기대 선형 시간에 동작하는 또 다른 무작위 알고리즘
이제 덜 실용적이지만 기대 선형 시간에 동작한다는 것을 보이기가 매우 쉬운 다른 무작위 알고리즘을 소개합니다.
- 점 $n$개를 무작위로 섞습니다
- $\delta := \operatorname{dist}(p_1, p_2)$로 둡니다
- 평면을 한 변의 길이가 $\delta/2$인 정사각형들로 분할합니다
- $i = 1,2,\dots,n$에 대해:
- $p_i$에 해당하는 정사각형을 찾습니다
- 평면을 분할하는 정사각형 격자에서 현재 정사각형으로부터 두 칸 이내에 있는 정사각형 $25$개를 순회합니다
- 그 정사각형들 안의 어떤 $p_j$가 $\operatorname{dist}(p_j, p_i) < \delta$를 만족하면,
- $\delta := \operatorname{dist}(p_j, p_i)$로 두고 분할과 정사각형들을 다시 계산합니다
- 점 $p_1, \dots, p_i$를 해당하는 정사각형에 저장합니다
- 그렇지 않으면 $p_i$를 해당하는 정사각형에 저장합니다
- $\delta$를 출력합니다
어느 시점에서든 거리가 $\delta$인 쌍을 이미 하나 가지고 있으므로 거리가 $\delta$보다 작은 새로운 쌍만 찾으면 된다는 사실에서 정당성이 따라 나옵니다. 각 정사각형의 한 변의 길이가 $\delta/2$이므로 후보 쌍은 최대 $2$칸 떨어져 있을 수 있고, 따라서 주어진 점에 대해 주변 정사각형 $25$개에 있는 후보를 확인합니다. 그보다 더 멀리 떨어진 정사각형에 있는 점과의 거리는 항상 $\delta$보다 큽니다.
이 알고리즘은 모든 것을 여러 번 다시 계산하기 때문에 느려 보일 수 있지만, 전체 기대 비용이 선형임을 보일 수 있습니다.
증명
점 $p_i$가 $\delta$의 변경과 자료 구조의 재계산을 일으키면 $1$, 그렇지 않으면 $0$인 확률 변수를 $X_i$라고 합시다. $i$번째 단계에서는 처음 $i$개의 점만 고려하므로, 비용이 $O(n + \sum_{i=1}^{n} i X_i)$임을 쉽게 보일 수 있습니다. 그런데 $\Pr(X_i = 1) \le \frac{2}{i}$임이 밝혀집니다. $i$번째 단계에서 $\delta$는 $\{p_1,\dots,p_i\}$에서 가장 가까운 쌍의 거리이고, $\Pr(X_i = 1)$은 $p_i$가 가장 가까운 쌍에 속할 확률입니다. 이는 가능한 $i(i-1)$개의 쌍 중 $2(i-1)$개의 쌍에서만 일어나므로(모든 거리가 서로 다르다고 가정할 때), 앞서 점들을 균등하게 섞었기 때문에 그 확률은 최대 $\frac{2(i-1)}{i(i-1)} = \frac{2}{i}$입니다.
따라서 기대 비용은 다음과 같음을 알 수 있습니다.
일반화: 둘레가 최소인 삼각형 찾기
위에서 설명한 알고리즘은 흥미롭게도 다음 문제로 일반화됩니다. 주어진 점들의 집합에서 서로 다른 세 점을 골라, 그 점들 사이의 쌍별 거리의 합이 최소가 되도록 하는 문제입니다.
실제로 이 문제를 풀기 위한 알고리즘은 그대로입니다. 수직선으로 영역을 두 절반으로 나누고, 두 절반에 대해 재귀적으로 해를 구한 뒤, 찾은 둘레들 중 최솟값 $minper$를 고르고, 두께가 $minper / 2$인 띠를 만든 다음, 답을 개선할 수 있는 모든 삼각형을 순회합니다. (둘레가 $\le minper$인 삼각형은 가장 긴 변이 $\le minper / 2$라는 점에 유의하십시오.)