세그먼트 트리
세그먼트 트리는 배열 구간에 대한 정보를 트리 형태로 저장하는 자료 구조입니다. 이를 이용하면 배열에 대한 구간 쿼리에 효율적으로 답할 수 있으면서도, 배열을 빠르게 수정할 수 있을 만큼 유연합니다. 예를 들어 연속한 배열 원소 $a[l \dots r)$의 합을 구하거나, 그러한 구간의 최솟값을 $O(\log n)$ 시간에 찾을 수 있습니다. 세그먼트 트리는 이러한 쿼리에 답하는 사이사이에 원소 하나를 교체하거나, 부분 구간 전체의 원소를 변경하여(예: 모든 원소 $a[l \dots r)$에 임의의 값을 대입하거나, 부분 구간의 모든 원소에 값을 더하는 것) 배열을 수정할 수 있게 해 줍니다.
일반적으로 세그먼트 트리는 매우 유연한 자료 구조이며, 이를 이용해 매우 많은 문제를 풀 수 있습니다. 또한 더 복잡한 연산을 적용하고 더 복잡한 쿼리에 답하는 것도 가능합니다(세그먼트 트리의 고급 버전 참조). 특히 세그먼트 트리는 더 높은 차원으로 쉽게 일반화할 수 있습니다. 예를 들어 2차원 세그먼트 트리를 사용하면 주어진 행렬의 어떤 부분 직사각형에 대한 합 쿼리나 최솟값 쿼리에 단 $O(\log^2 n)$ 시간에 답할 수 있습니다.
세그먼트 트리의 중요한 성질 중 하나는 선형 크기의 메모리만 필요하다는 것입니다. 표준 세그먼트 트리는 크기가 $n$인 배열을 다루기 위해 $4n$개의 정점이 필요합니다.
세그먼트 트리의 가장 단순한 형태
쉽게 시작하기 위해 가장 단순한 형태의 세그먼트 트리를 살펴보겠습니다. 우리는 합 쿼리에 효율적으로 답하고자 합니다. 우리 과제의 형식적인 정의는 다음과 같습니다. 배열 $a[0 \dots n-1]$이 주어졌을 때, 세그먼트 트리는 인덱스 $l$과 $r$ 사이 원소들의 합을 구할 수 있어야 하며(즉, 합 $\sum_{i=l}^r a[i]$를 계산), 배열 원소의 값 변경도 처리할 수 있어야 합니다(즉, $a[i] = x$ 형태의 대입을 수행). 세그먼트 트리는 두 쿼리를 모두 $O(\log n)$ 시간에 처리할 수 있어야 합니다.
이는 더 단순한 접근법들보다 개선된 것입니다. 단순한 배열 구현, 즉 그냥 평범한 배열을 사용하는 방식은 원소를 $O(1)$에 갱신할 수 있지만, 합 쿼리 하나를 계산하는 데 $O(n)$이 필요합니다. 그리고 미리 계산한 누적 합은 합 쿼리를 $O(1)$에 계산할 수 있지만, 배열 원소 하나를 갱신하려면 누적 합을 $O(n)$번 변경해야 합니다.
세그먼트 트리의 구조
배열 구간을 다룰 때는 분할 정복 접근법을 사용할 수 있습니다. 먼저 전체 배열 원소의 합, 즉 구간 $a[0 \dots n-1]$의 합을 계산하여 저장합니다. 그런 다음 배열을 두 절반 $a[0 \dots (n-1)/2]$와 $a[(n+1)/2 \dots n-1]$로 나누고, 각 절반의 합을 계산하여 저장합니다. 이 두 절반은 각각 다시 절반으로 나뉘며, 모든 구간의 크기가 $1$이 될 때까지 이를 반복합니다.
이 구간들은 이진 트리를 이룬다고 볼 수 있습니다. 이 트리의 루트는 구간 $a[0 \dots n-1]$이고, (리프 정점을 제외한) 각 정점은 정확히 두 개의 자식 정점을 가집니다. 대부분의 구현에서는 트리를 명시적으로 구성하지 않지만, 이 자료 구조를 "세그먼트 트리"라고 부르는 이유가 바로 이것입니다(구현 참조).
다음은 배열 $a = [1, 3, -2, 8, -7]$에 대한 세그먼트 트리를 시각적으로 나타낸 것입니다:
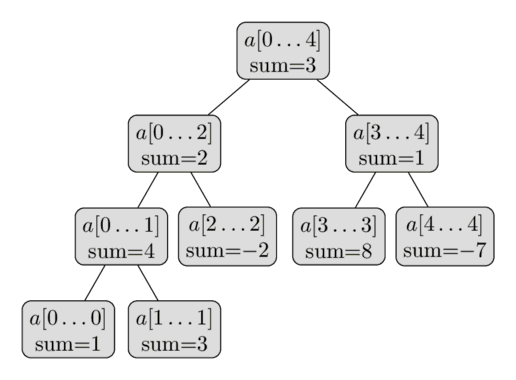
이 자료 구조에 대한 짧은 설명만으로도 세그먼트 트리에는 선형 개수의 정점만 필요하다는 결론을 내릴 수 있습니다. 트리의 첫 번째 레벨에는 노드가 하나(루트) 있고, 두 번째 레벨에는 정점이 두 개, 세 번째 레벨에는 정점이 네 개 있으며, 이는 정점의 수가 $n$에 도달할 때까지 계속됩니다. 따라서 최악의 경우 정점의 수는 합 $1 + 2 + 4 + \dots + 2^{\lceil\log_2 n\rceil} \lt 2^{\lceil\log_2 n\rceil + 1} \lt 4n$으로 추정할 수 있습니다.
$n$이 2의 거듭제곱이 아닐 때에는 세그먼트 트리의 모든 레벨이 완전히 채워지지는 않는다는 점에 주목할 필요가 있습니다. 그림에서 이러한 현상을 확인할 수 있습니다. 지금은 이 사실을 잊어도 되지만, 나중에 구현할 때 중요해집니다.
세그먼트 트리의 높이는 $O(\log n)$입니다. 루트에서 리프로 내려갈 때 구간의 크기가 대략 절반씩 줄어들기 때문입니다.
구성
세그먼트 트리를 구성하기 전에 다음을 정해야 합니다:
- 세그먼트 트리의 각 노드에 저장되는 값. 예를 들어 합 세그먼트 트리에서는 노드가 자신의 구간 $[l, r]$에 속한 원소들의 합을 저장합니다.
- 세그먼트 트리에서 두 형제 노드를 병합하는 병합 연산. 예를 들어 합 세그먼트 트리에서는 구간 $a[l_1 \dots r_1]$과 $a[l_2 \dots r_2]$에 대응하는 두 노드의 값을 더하여, 구간 $a[l_1 \dots r_2]$에 대응하는 노드로 병합합니다.
어떤 정점에 대응하는 구간이 원래 배열의 값 하나만을 포함한다면, 그 정점을 "리프 정점"이라고 한다는 점에 유의하십시오. 리프 정점은 세그먼트 트리의 가장 아래 레벨에 있습니다. 리프 정점의 값은 (대응하는) 원소 $a[i]$와 같습니다.
이제 세그먼트 트리를 구성하기 위해, 가장 아래 레벨(리프 정점들)에서 시작하여 각 정점에 해당하는 값을 할당합니다. 이 값들을 바탕으로 merge 함수를 사용하여 바로 위 레벨의 값들을 계산할 수 있습니다. 그리고 그 값들을 바탕으로 다시 그 위 레벨의 값들을 계산할 수 있으며, 루트 정점에 도달할 때까지 이 과정을 반복합니다.
이 연산은 반대 방향, 즉 루트 정점에서 리프 정점 방향으로 재귀적으로 기술하는 것이 편리합니다. 생성 절차를 리프 정점이 아닌 정점에서 호출하면 다음을 수행합니다:
- 두 자식 정점의 값을 재귀적으로 구성합니다
- 계산된 자식들의 값을 병합합니다.
구성은 루트 정점에서 시작하며, 따라서 세그먼트 트리 전체를 계산할 수 있습니다.
병합 연산이 상수 시간이라고 가정하면 이 구성의 시간 복잡도는 $O(n)$입니다(병합 연산은 $n-1$번 호출되며, 이는 세그먼트 트리의 내부 노드 개수와 같습니다).
합 쿼리
우선은 합 쿼리에 답해 보겠습니다. 입력으로 두 정수 $l$과 $r$이 주어지며, 구간 $a[l \dots r)$의 합을 $O(\log n)$ 시간에 계산해야 합니다.
이를 위해 세그먼트 트리를 순회하면서 미리 계산해 둔 구간의 합을 사용합니다. 현재 구간 $a[tl \dots tr)$을 담당하는 정점에 있다고 가정합시다. 가능한 경우는 세 가지입니다: 1. $[tl \dots tr)$이 $[l \dots r)$에 완전히 포함되는 경우: 이 경우 이 구간의 합은 반드시 최종 답의 일부가 되므로, 이 합을 반환합니다. 2. $[tl \dots tr)$이 $[l \dots r)$을 부분적으로 덮는 경우: 이 경우 이 정점의 합을 그대로 포함할 수 없으므로 왼쪽 자식과 오른쪽 자식을 모두 탐색해야 합니다. 먼저 왼쪽 자식($[tl \dots tm)$)으로 가서 이 정점에 대한 부분 답(즉, 쿼리 구간과 왼쪽 자식 구간의 교집합에 속한 값들의 합)을 계산하고, 이어서 오른쪽 자식($[tm \dots tr)$)으로 가서 그 정점을 이용해 부분 답을 계산한 뒤, 두 답을 더하여 합칩니다. 3. $[tl \dots tr)$과 $[l \dots r)$ 사이에 교집합이 없는 경우: 이 구간은 합에 기여하지 않으므로 0을 반환합니다.
즉, 합 쿼리의 처리는 구간끼리 완전히 겹치거나 전혀 겹치지 않는 경우를 만날 때까지 왼쪽 자식과 오른쪽 자식에 대해 자기 자신을 재귀적으로 호출하는 함수입니다.
다시 말해, 쿼리 계산은 트리의 필요한 모든 가지로 퍼져 나가는 트리 순회이며, 트리에 미리 계산해 둔 구간들의 합 값을 사용합니다.
당연히 순회는 세그먼트 트리의 루트 정점에서 시작합니다.
이 과정은 다음 그림에 나타나 있습니다. 이번에도 배열 $a = [1, 3, -2, 8, -7]$을 사용하며, 여기서는 합 $\sum_{i=2}^4 a[i]$를 계산하려고 합니다. 색칠된 정점들을 방문하게 되며, 초록색 정점들에 미리 계산된 값을 사용합니다. 그 결과 $-2 + 1 = -1$을 얻습니다.
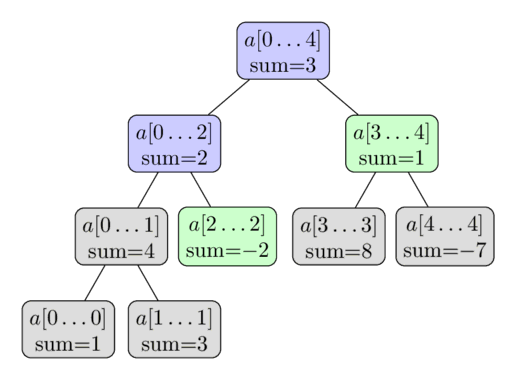
이 알고리즘의 복잡도는 왜 $O(\log n)$입니까? 이 복잡도를 보이기 위해 트리의 각 레벨을 살펴봅니다. 살펴보면 각 레벨에서 방문하는 정점은 네 개를 넘지 않습니다. 그리고 트리의 높이가 $O(\log n)$이므로, 원하는 실행 시간을 얻습니다.
이 명제(각 레벨마다 최대 네 개의 정점)가 참임은 귀납법으로 보일 수 있습니다. 첫 번째 레벨에서는 루트 정점 하나만 방문하므로, 여기서는 네 개보다 적은 정점을 방문합니다. 이제 임의의 레벨을 살펴봅시다. 귀납법의 가정에 의해, 최대 네 개의 정점을 방문합니다. 최대 두 개의 정점만 방문한다면, 다음 레벨에서는 최대 네 개의 정점을 방문합니다. 각 정점은 최대 두 번의 재귀 호출만 일으킬 수 있으므로 이는 자명합니다. 그러므로 현재 레벨에서 세 개 또는 네 개의 정점을 방문한다고 가정합시다. 그 정점들 가운데 중간에 있는 정점들을 더 자세히 분석하겠습니다. 합 쿼리는 연속된 부분 배열의 합을 구하므로, 중간에 방문한 정점들에 대응하는 구간은 합 쿼리의 구간에 완전히 포함된다는 것을 알 수 있습니다. 따라서 이 정점들은 재귀 호출을 전혀 하지 않습니다. 그러므로 가장 왼쪽 정점과 가장 오른쪽 정점만이 재귀 호출을 할 가능성이 있습니다. 그리고 이 정점들은 최대 네 번의 재귀 호출만 만들어 내므로, 다음 레벨도 이 명제를 만족합니다. 한 가지는 쿼리의 왼쪽 경계로 다가가고, 다른 가지는 오른쪽 경계로 다가간다고 말할 수 있습니다.
따라서 전체적으로 최대 $4 \log n$개의 정점을 방문하며, 이는 $O(\log n)$의 실행 시간과 같습니다.
결론적으로, 쿼리는 입력 구간을 여러 개의 부분 구간으로 나누는 방식으로 동작하며, 이 부분 구간들의 합은 모두 이미 미리 계산되어 트리에 저장되어 있습니다. 그리고 쿼리 구간이 정점 구간과 일치할 때마다 분할을 멈춘다면, 이러한 구간은 $O(\log n)$개만 필요하며, 바로 이 점이 세그먼트 트리를 효율적으로 만듭니다.
갱신 쿼리
이제 배열의 특정 원소를 수정하려고 합니다. 예를 들어 대입 $a[i] = x$를 수행한다고 합시다. 그리고 수정된 새 배열에 대응하도록 세그먼트 트리를 다시 구성해야 합니다.
이 쿼리는 합 쿼리보다 쉽습니다. 세그먼트 트리의 각 레벨은 배열의 분할을 이룹니다. 따라서 원소 $a[i]$는 각 레벨에서 단 하나의 구간에만 기여합니다. 그러므로 $O(\log n)$개의 정점만 갱신하면 됩니다.
갱신 요청을 재귀 함수로 구현할 수 있다는 것은 쉽게 알 수 있습니다. 이 함수는 현재 트리 정점을 전달받아, 두 자식 정점 중 하나(자신의 구간에 $a[i]$를 포함하는 정점)로 자기 자신을 재귀적으로 호출하고, 그 후 build 메서드에서와 비슷한 방식으로(즉, 두 자식의 합으로) 자신의 합 값을 다시 계산합니다.
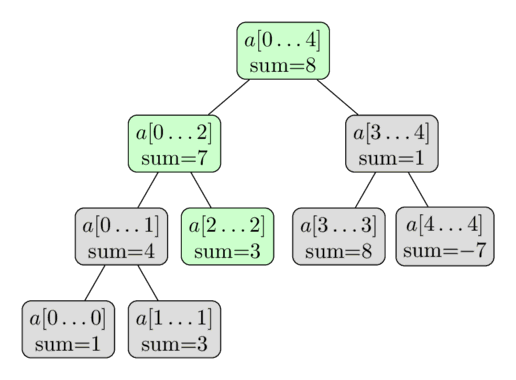
다시 같은 배열을 사용한 시각화를 살펴봅시다. 여기서는 갱신 $a[2] = 3$을 수행합니다. 초록색 정점은 방문하여 갱신하는 정점입니다.
구현
가장 중요하게 고려할 점은 세그먼트 트리를 어떻게 저장하느냐입니다. 물론 $\text{Vertex}$ 구조체를 정의하고, 구간의 경계와 그 합, 그리고 추가로 자식 정점을 가리키는 포인터까지 저장하는 객체를 생성할 수도 있습니다. 하지만 이렇게 하면 포인터 형태로 많은 중복 정보를 저장해야 합니다. 여기서는 암시적 자료 구조를 사용하는 간단한 기법으로 이를 훨씬 더 효율적으로 만들겠습니다: 합만 배열에 저장하는 것입니다. (이진 힙에도 비슷한 방법이 사용됩니다). 루트 정점의 합은 인덱스 1에, 그 두 자식 정점의 합은 인덱스 2와 3에, 그 두 정점의 자식들의 합은 인덱스 4부터 7까지에 저장하는 식으로 계속됩니다. 1-인덱싱을 사용하면 편리하게도 인덱스 $i$에 있는 정점의 왼쪽 자식은 인덱스 $2i$에, 오른쪽 자식은 인덱스 $2i + 1$에 저장됩니다. 마찬가지로, 인덱스 $i$에 있는 정점의 부모는 $i/2$(정수 나눗셈)에 저장됩니다.
이렇게 하면 구현이 훨씬 간단해집니다. 트리의 구조를 메모리에 저장할 필요가 없습니다. 구조는 암시적으로 정의됩니다. 모든 구간의 합을 담는 배열 하나만 있으면 됩니다.
앞서 언급했듯이, 최대 $4n$개의 정점을 저장해야 합니다. 이보다 적을 수도 있지만, 편의상 항상 크기가 $4n$인 배열을 할당합니다. 합 배열에는 실제 트리의 어떤 정점에도 대응하지 않는 원소가 일부 있겠지만, 이것이 구현을 복잡하게 만들지는 않습니다.
따라서 세그먼트 트리는 단순히 입력 크기 $n$의 네 배 크기를 갖는 배열 $t[]$로 저장합니다:
int n, t[4*MAXN];
주어진 배열 $a[]$로부터 세그먼트 트리를 구성하는 절차는 다음과 같습니다: 이는 매개변수로 $a[]$(입력 배열), $v$(현재 정점의 인덱스), 그리고 현재 구간의 경계 $tl$과 $tr$을 받는 재귀 함수입니다. 메인 프로그램에서 이 함수는 루트 정점의 매개변수인 $v = 1$, $tl = 0$, $tr = n$으로 호출됩니다.
void build(int a[], int v, int tl, int tr) {
    if (tr - tl == 1) {
        t[v] = a[tl];
    } else {
        int tm = (tl + tr) / 2;
        build(a, v*2, tl, tm);
        build(a, v*2+1, tm, tr);
        t[v] = t[v*2] + t[v*2+1];
    }
}
또한 합 쿼리에 답하는 함수도 재귀 함수이며, 매개변수로 현재 정점/구간에 대한 정보(즉, 인덱스 $v$와 경계 $tl$, $tr$)와 쿼리의 경계에 대한 정보인 $l$과 $r$을 받습니다. 코드를 단순화하기 위해 이 함수는 재귀 호출이 하나만 필요한 경우에도 항상 두 번의 재귀 호출을 수행합니다 - 이 경우 불필요한 재귀 호출에서는 $l > r$이 되며, 이는 함수 시작 부분에 추가 검사를 두어 쉽게 걸러낼 수 있습니다.
int sum(int v, int tl, int tr, int l, int r) {
    if (r <= tl || tr <= l) return 0;  // no overlap
    if (l <= tl && tr <= r) return t[v];  // nested segment

    int tm = (tl + tr) / 2;
    // partial overlap
    return sum(v * 2, tl, tm, l, r)
            + sum(v * 2 + 1, tm, tr, l, r);
}
마지막으로 갱신 쿼리입니다. 이 함수 역시 현재 정점/구간에 대한 정보를 받으며, 추가로 갱신 쿼리의 매개변수(즉, 원소의 위치와 새 값)도 받습니다.
void update(int v, int tl, int tr, int pos, int new_val) {
    if (tr - tl == 1) {
        t[v] = new_val;
    } else {
        int tm = (tl + tr) / 2;
        if (pos < tm)
            update(v*2, tl, tm, pos, new_val);
        else
            update(v*2+1, tm, tr, pos, new_val);
        t[v] = t[v*2] + t[v*2+1];
    }
}
메모리 효율적인 구현
대부분의 사람들은 이전 절의 구현을 사용합니다. 배열 t를 살펴보면 트리 노드의 번호가 BFS 순회(레벨 순서 순회)의 순서를 따른다는 것을 알 수 있습니다. 이 순회를 사용하면 정점 $v$의 자식은 각각 $2v$와 $2v + 1$입니다. 그러나 $n$이 2의 거듭제곱이 아니면 이 방법은 일부 인덱스를 건너뛰게 되어 배열 t의 일부가 사용되지 않은 채로 남습니다. $n$개의 원소로 이루어진 배열의 세그먼트 트리에는 $2n - 1$개의 정점만 필요한데도, 메모리 사용량의 상한은 $4n$입니다.
그러나 이를 줄일 수 있습니다. 트리의 정점 번호를 오일러 투어 순회(전위 순회) 순서로 다시 매기고, 이 정점들을 모두 나란히 배치합니다.
인덱스 $v$에 있는 정점을 살펴봅시다. 이 정점이 구간 $[l, r]$을 담당한다고 하고, $mid = \dfrac{l + r}{2}$라고 합시다. 왼쪽 자식의 인덱스가 $v + 1$이 된다는 것은 자명합니다. 왼쪽 자식은 구간 $[l, mid]$를 담당하므로, 왼쪽 자식의 서브트리에는 총 $2 * (mid - l + 1) - 1$개의 정점이 있습니다. 따라서 $v$의 오른쪽 자식의 인덱스를 계산할 수 있습니다. 그 인덱스는 $v + 2 * (mid - l + 1)$입니다. 이렇게 번호를 매기면 필요한 메모리를 $2n$으로 줄일 수 있습니다.
세그먼트 트리의 고급 버전
세그먼트 트리는 매우 유연한 자료 구조이며, 여러 다양한 방향으로 변형하고 확장할 수 있습니다. 아래에서 이들을 분류해 봅시다.
더 복잡한 쿼리
세그먼트 트리가 다른 쿼리를 계산하도록(예: 합 대신 최솟값/최댓값 계산) 바꾸는 것은 꽤 쉬울 수도 있지만, 매우 까다로울 수도 있습니다.
최댓값 찾기
위에서 설명한 문제의 조건을 조금 바꿔 봅시다. 이제 합을 쿼리하는 대신 최댓값 쿼리를 수행합니다.
트리는 위에서 설명한 트리와 정확히 같은 구조를 가집니다. $\text{build}$ 함수와 $\text{update}$ 함수에서 $t[v]$를 계산하는 방식만 바꾸면 됩니다. 이제 $t[v]$는 해당 구간의 최댓값을 저장합니다. 또한 $\text{sum}$ 함수의 반환값 계산 방식도 바꿔야 합니다(합산을 최댓값으로 대체).
물론 이 문제는 최댓값 대신 최솟값을 계산하도록 쉽게 바꿀 수 있습니다.
이 문제의 구현을 보여 드리는 대신, 다음 절에서 이 문제의 더 복잡한 버전에 대한 구현을 제시하겠습니다.
최댓값과 그 등장 횟수 찾기
이 작업은 이전 작업과 매우 비슷합니다. 최댓값을 찾는 것에 더해, 최댓값이 등장하는 횟수도 구해야 합니다.
이 문제를 풀기 위해 트리의 각 정점에 수의 쌍을 저장합니다. 최댓값에 더해 해당 구간에서 최댓값이 등장하는 횟수도 저장합니다. 자식 정점에 저장된 쌍의 정보를 이용하면 $t[v]$에 저장할 올바른 쌍을 여전히 상수 시간에 구할 수 있습니다. 이러한 두 쌍을 합치는 작업은 트리를 만들 때, 최댓값 쿼리에 답할 때, 수정을 수행할 때 모두 사용하는 연산이므로 별도의 함수로 작성해야 합니다.
pair<int, int> t[4*MAXN];

pair<int, int> combine(pair<int, int> a, pair<int, int> b) {
    if (a.first > b.first)
        return a;
    if (b.first > a.first)
        return b;
    return make_pair(a.first, a.second + b.second);
}

void build(int a[], int v, int tl, int tr) {
    if (tr - tl == 1) {
        t[v] = make_pair(a[tl], 1);
    } else {
        int tm = (tl + tr) / 2;
        build(a, v*2, tl, tm);
        build(a, v*2+1, tm, tr);
        t[v] = combine(t[v*2], t[v*2+1]);
    }
}

pair<int, int> get_max(int v, int tl, int tr, int l, int r) {
    if (r <= tl || tr <= l)
        return make_pair(-INF, 0);
    if (l <= tl && tr <= r)
        return t[v];
    int tm = (tl + tr) / 2;
    return combine(get_max(v*2, tl, tm, l, r),
                   get_max(v*2+1, tm, tr, l, r));
}

void update(int v, int tl, int tr, int pos, int new_val) {
    if (tr - tl == 1) {
        t[v] = make_pair(new_val, 1);
    } else {
        int tm = (tl + tr) / 2;
        if (pos < tm)
            update(v*2, tl, tm, pos, new_val);
        else
            update(v*2+1, tm, tr, pos, new_val);
        t[v] = combine(t[v*2], t[v*2+1]);
    }
}
최대공약수 / 최소공배수 계산
이 문제에서는 배열의 주어진 구간에 속한 모든 수의 GCD / LCM을 계산하려고 합니다.
세그먼트 트리의 이 흥미로운 변형은 앞서 합 / 최솟값 / 최댓값 쿼리를 위해 유도한 세그먼트 트리와 정확히 같은 방식으로 풀 수 있습니다: 트리의 각 정점에 해당 정점의 GCD / LCM을 저장하면 충분합니다. 두 정점을 합치려면 두 정점의 GCD / LCM을 계산하면 됩니다.
0의 개수 세기, $k$번째 0 찾기
이 문제에서는 주어진 구간에 있는 0의 개수를 구하고, 추가로 두 번째 함수를 사용하여 $k$번째 0의 인덱스를 찾으려고 합니다.
이번에도 트리에 저장하는 값을 조금 바꿔야 합니다: 이번에는 각 구간에 있는 0의 개수를 $t[]$에 저장합니다. $\text{build}$, $\text{update}$, $\text{count_zero}$ 함수를 구현하는 방법은 꽤 명확하며, 합 쿼리 문제의 아이디어를 그대로 사용하면 됩니다. 이로써 문제의 첫 번째 부분을 해결했습니다.
이제 배열 $a[]$에서 $k$번째 0을 찾는 문제를 해결하는 방법을 알아봅시다. 이를 위해 루트 정점에서 시작하여 세그먼트 트리를 내려가며, 어느 구간에 $k$번째 0이 있는지에 따라 매번 왼쪽 자식이나 오른쪽 자식으로 이동합니다. 어느 자식으로 가야 하는지 결정하려면 왼쪽 정점에 해당하는 구간에 나타나는 0의 개수를 보는 것으로 충분합니다. 미리 계산해 둔 이 개수가 $k$ 이상이면 왼쪽 자식으로 내려가야 하고, 그렇지 않으면 오른쪽 자식으로 내려가야 합니다. 오른쪽 자식을 선택한 경우에는 $k$에서 왼쪽 자식의 0의 개수를 빼야 한다는 점에 유의하십시오.
구현에서는 $a[]$에 0이 $k$개보다 적게 있는 특수한 경우를 -1을 반환하여 처리할 수 있습니다.
int find_kth(int v, int tl, int tr, int k) {
    if (k > t[v])
        return -1;
    if (tr - tl == 1)
        return tl;
    int tm = (tl + tr) / 2;
    if (t[v*2] >= k)
        return find_kth(v*2, tl, tm, k);
    else
        return find_kth(v*2+1, tm, tr, k - t[v*2]);
}
주어진 합을 갖는 배열 접두사 찾기
문제는 다음과 같습니다: 주어진 값 $x$에 대해 배열 $a[]$의 처음 $i$개 원소의 합이 $x$ 이상이 되는 가장 작은 인덱스 $i$를 빠르게 찾아야 합니다(배열 $a[]$에는 음이 아닌 값만 들어 있다고 가정합니다).
이 작업은 세그먼트 트리로 접두사의 합을 계산하면서 이진 탐색을 사용하여 해결할 수 있습니다. 하지만 이렇게 하면 $O(\log^2 n)$ 풀이가 됩니다.
대신 이전 절과 같은 아이디어를 사용하여 트리를 내려가며 위치를 찾을 수 있습니다: 왼쪽 자식의 합에 따라 매번 왼쪽이나 오른쪽으로 이동하는 것입니다. 따라서 $O(\log n)$ 시간에 답을 찾을 수 있습니다.
주어진 값보다 큰 첫 번째 원소 찾기
문제는 다음과 같습니다: 주어진 값 $x$와 구간 $a[l \dots r)$에 대해, 구간 $a[l \dots r)$ 안에서 $a[i]$가 $x$보다 큰 가장 작은 $i$를 찾아야 합니다.
이 작업은 세그먼트 트리에서 최대 접두사 쿼리에 대한 이진 탐색을 사용하여 해결할 수 있습니다. 하지만 이렇게 하면 $O(\log^2 n)$ 풀이가 됩니다.
대신 이전 절들과 같은 아이디어를 사용하여 트리를 내려가며 위치를 찾을 수 있습니다: 왼쪽 자식의 최댓값에 따라 매번 왼쪽이나 오른쪽으로 이동하는 것입니다. 따라서 $O(\log n)$ 시간에 답을 찾을 수 있습니다.
int get_first(int v, int tl, int tr, int l, int r, int x) {
    if (r <= tl || tr <= l) return -1;
    if(t[v] <= x) return -1;

    if (tr - tl == 1) return tl;

    int tm = tl + (tr-tl)/2;
    int left = get_first(2*v, tl, tm, l, r, x);
    if(left != -1) return left;
    return get_first(2*v+1, tm, tr, l ,r, x);
}
최대 합을 갖는 부분 구간 찾기
여기서도 각 쿼리마다 구간 $a[l \dots r)$이 주어지며, 이번에는 $l \le l^\prime$이고 $r^\prime \le r$이면서 이 구간에 속한 원소의 합이 최대가 되는 부분 구간 $a[l^\prime \dots r^\prime)$을 찾아야 합니다. 이전과 마찬가지로 배열의 개별 원소를 수정할 수도 있어야 합니다. 배열의 원소는 음수일 수 있으며, 최적의 부분 구간은 비어 있을 수도 있습니다(예: 모든 원소가 음수인 경우).
이 문제는 세그먼트 트리를 자명하지 않은 방식으로 활용하는 문제입니다. 이번에는 각 정점마다 네 개의 값을 저장합니다: 구간의 합, 최대 누적 합, 최대 접미사 합, 그리고 그 안에서 합이 최대인 부분 구간의 합입니다. 다시 말해, 세그먼트 트리의 각 구간마다 그 구간의 답이 미리 계산되어 있고, 그 구간의 왼쪽 경계와 오른쪽 경계에 닿는 구간들의 답도 미리 계산되어 있습니다.
이러한 데이터를 가진 트리는 어떻게 구축할 수 있습니까? 이번에도 재귀적인 방식으로 계산합니다. 먼저 왼쪽 자식과 오른쪽 자식에 대해 네 가지 값을 모두 계산한 다음, 이를 결합하여 현재 정점의 네 가지 값을 얻습니다. 현재 정점의 답은 다음 중 하나라는 점에 유의하십시오:
- 왼쪽 자식의 답: 최적의 부분 구간이 왼쪽 자식의 구간 안에 완전히 놓여 있는 경우입니다
- 오른쪽 자식의 답: 최적의 부분 구간이 오른쪽 자식의 구간 안에 완전히 놓여 있는 경우입니다
- 왼쪽 자식의 최대 접미사 합과 오른쪽 자식의 최대 누적 합을 더한 값이며, 이는 최적의 부분 구간이 두 자식 모두와 교차한다는 뜻입니다.
따라서 현재 정점의 답은 이 세 값 중 최댓값입니다. 최대 접두사 합과 최대 접미사 합을 계산하는 것은 이보다 더 쉽습니다. 다음은 $\text{combine}$ 함수의 구현입니다. 이 함수는 왼쪽 자식과 오른쪽 자식의 데이터만 받아서 현재 정점의 데이터를 반환합니다.
struct data {
    int sum, pref, suff, ans;
};

data combine(data l, data r) {
    data res;
    res.sum = l.sum + r.sum;
    res.pref = max(l.pref, l.sum + r.pref);
    res.suff = max(r.suff, r.sum + l.suff);
    res.ans = max(max(l.ans, r.ans), l.suff + r.pref);
    return res;
}
$\text{combine}$ 함수를 사용하면 세그먼트 트리를 쉽게 구축할 수 있습니다. 앞의 구현들과 완전히 같은 방식으로 구현할 수 있습니다. 리프 정점을 초기화하기 위해 보조 함수 $\text{make_data}$를 추가로 만듭니다. 이 함수는 단일 값의 정보를 담은 $\text{data}$ 객체를 반환합니다.
data make_data(int val) {
    data res;
    res.sum = val;
    res.pref = res.suff = res.ans = max(0, val);
    return res;
}

void build(int a[], int v, int tl, int tr) {
    if (tr - tl == 1) {
        t[v] = make_data(a[tl]);
    } else {
        int tm = (tl + tr) / 2;
        build(a, v*2, tl, tm);
        build(a, v*2+1, tm, tr);
        t[v] = combine(t[v*2], t[v*2+1]);
    }
}

void update(int v, int tl, int tr, int pos, int new_val) {
    if (tr - tl == 1) {
        t[v] = make_data(new_val);
    } else {
        int tm = (tl + tr) / 2;
        if (pos < tm)
            update(v*2, tl, tm, pos, new_val);
        else
            update(v*2+1, tm, tr, pos, new_val);
        t[v] = combine(t[v*2], t[v*2+1]);
    }
}
이제 쿼리의 답을 계산하는 방법만 남았습니다. 쿼리에 답하려면 앞에서와 같이 트리를 따라 내려가면서 쿼리를 세그먼트 트리의 구간들과 일치하는 여러 부분 구간으로 나누고, 각 부분 구간의 답을 결합하여 쿼리에 대한 하나의 답을 만듭니다. 그러면 이 작업이 단순한 세그먼트 트리에서의 작업과 완전히 같다는 것을 알 수 있습니다. 다만 값을 더하거나 최솟값 또는 최댓값을 구하는 대신 $\text{combine}$ 함수를 사용한다는 점만 다릅니다.
data query(int v, int tl, int tr, int l, int r) {
    if (r <= tl || tr <= l)
        return make_data(0);
    if (l <= tl && tr <= r)
        return t[v];
    int tm = (tl + tr) / 2;
    return combine(query(v*2, tl, tm, l, r),
                   query(v*2+1, tm, tr, l, r));
}
각 정점에 부분 배열 전체 저장하기
이 하위 절은 다른 절들과 성격이 달라 따로 다룹니다. 세그먼트 트리의 각 정점에 해당 구간에 대한 정보를 압축된 형태(합, 최솟값, 최댓값, ...)로 저장하는 대신, 구간의 모든 원소를 저장하기 때문입니다. 따라서 세그먼트 트리의 루트는 배열의 모든 원소를 저장하고, 왼쪽 자식 정점은 배열의 앞쪽 절반을, 오른쪽 정점은 뒤쪽 절반을 저장하는 식입니다.
이 기법의 가장 단순한 활용에서는 원소들을 정렬된 순서로 저장합니다. 더 복잡한 형태에서는 원소들을 리스트가 아닌 더 발전된 자료 구조(집합, 맵, ...)에 저장합니다. 하지만 이러한 방법들에는 모두 공통점이 있습니다. 각 정점에 선형 크기의 메모리(즉, 해당 구간의 길이에 비례하는 메모리)가 필요하다는 점입니다.
이러한 세그먼트 트리를 살펴볼 때 가장 먼저 자연스럽게 떠오르는 질문은 메모리 사용량에 관한 것입니다. 직관적으로는 $O(n^2)$ 메모리가 필요할 것처럼 보일 수 있지만, 실제로는 트리 전체에 $O(n \log n)$ 메모리만 필요합니다. 왜 그렇습니까? 아주 간단합니다. 배열의 각 원소는 $O(\log n)$개의 구간에만 속하기 때문입니다(트리의 높이가 $O(\log n)$이라는 점을 기억하십시오).
따라서 이러한 세그먼트 트리는 겉보기에는 메모리를 많이 쓸 것 같지만, 실제로는 일반적인 세그먼트 트리보다 메모리를 조금 더 사용할 뿐입니다.
아래에서 이 자료 구조의 몇 가지 대표적인 활용을 설명합니다. 이러한 세그먼트 트리가 2차원 자료 구조와 비슷하다는 점은 주목할 만합니다(실제로 이것은 2차원 자료 구조이지만, 기능이 상당히 제한적입니다).
지정된 수보다 크거나 같은 가장 작은 수를 찾습니다. 수정 쿼리는 없습니다.
다음 형태의 쿼리에 답하려고 합니다. 주어진 세 수 $(l, r, x)$에 대해 구간 $a[l \dots r)$에서 $x$보다 크거나 같은 최소의 수를 찾아야 합니다.
세그먼트 트리를 구성합니다. 앞에서 설명한 것처럼, 각 정점에는 해당 구간에 나타나는 모든 수를 정렬한 리스트를 저장합니다. 이러한 세그먼트 트리를 어떻게 하면 최대한 효율적으로 구축할 수 있겠습니까? 언제나처럼 이 문제에 재귀적으로 접근합니다. 왼쪽 자식과 오른쪽 자식의 리스트가 이미 구성되어 있다고 하고, 현재 정점의 리스트를 만들고자 합니다. 이렇게 보면 이 연산은 이제 자명하며 선형 시간에 수행할 수 있습니다. 두 정렬된 리스트를 하나로 합치기만 하면 되며, 이는 두 포인터로 두 리스트를 순회하여 할 수 있습니다. C++ STL에는 이 알고리즘의 구현이 이미 있습니다.
세그먼트 트리의 이러한 구조와 병합 정렬 알고리즘과의 유사성 때문에, 이 자료 구조는 흔히 "병합 정렬 트리(Merge Sort Tree)"라고도 불립니다.
vector<int> t[4*MAXN];

void build(int a[], int v, int tl, int tr) {
    if (tr - tl == 1) {
        t[v] = vector<int>(1, a[tl]);
    } else {
        int tm = (tl + tr) / 2;
        build(a, v*2, tl, tm);
        build(a, v*2+1, tm, tr);
        merge(t[v*2].begin(), t[v*2].end(), t[v*2+1].begin(), t[v*2+1].end(),
              back_inserter(t[v]));
    }
}
이런 방식으로 구성한 세그먼트 트리가 $O(n \log n)$의 메모리를 필요로 한다는 것은 이미 알고 있습니다. 그리고 이 구현 덕분에 구축 역시 $O(n \log n)$ 시간이 걸립니다. 결국 각 리스트는 그 크기에 대해 선형 시간에 구성되기 때문입니다.
이제 쿼리에 대한 답을 생각해 봅시다. 일반적인 세그먼트 트리에서처럼 트리를 따라 내려가면서 구간 $a[l \dots r)$을 여러 개의 부분 구간(최대 $O(\log n)$개의 조각)으로 나눕니다. 전체 쿼리의 답이 각 부분 쿼리의 답 중 최솟값이라는 것은 분명합니다. 따라서 이제 트리의 어떤 정점에 대응하는 그러한 부분 구간 하나에 대한 쿼리에 어떻게 답하는지만 이해하면 됩니다.
세그먼트 트리의 어떤 정점에 있으며, 쿼리의 답, 즉 주어진 수 $x$보다 크거나 같은 최소의 수를 계산하려고 합니다. 정점은 원소의 리스트를 정렬된 순서로 담고 있으므로, 이 리스트에서 단순히 이진 탐색을 수행하여 $x$보다 크거나 같은 첫 번째 수를 반환하면 됩니다.
따라서 트리의 한 구간에서 쿼리에 답하는 데 $O(\log n)$ 시간이 걸리고, 전체 쿼리는 $O(\log^2 n)$에 처리됩니다.
int query(int v, int tl, int tr, int l, int r, int x) {
    if (r <= tl || tr <= l)
        return INF;
    if (l <= tl && tr <= r) {
        vector<int>::iterator pos = lower_bound(t[v].begin(), t[v].end(), x);
        if (pos != t[v].end())
            return *pos;
        return INF;
    }
    int tm = (tl + tr) / 2;
    return min(query(v*2, tl, tm, l, r, x),
               query(v*2+1, tm, tr, l, r, x));
}
상수 $\text{INF}$는 배열의 모든 수보다 큰 어떤 큰 수와 같습니다. 이 값이 사용되었다는 것은 구간에 $x$보다 크거나 같은 수가 없다는 뜻입니다. 이는 "주어진 구간에 답이 없음"을 의미합니다.
지정된 수보다 크거나 같은 가장 작은 수를 찾습니다. 수정 쿼리가 있는 경우입니다.
이 문제는 앞의 문제와 비슷합니다. 앞의 방법에는 쿼리에 답하는 사이에 배열을 수정할 수 없다는 단점이 있었습니다. 이제 바로 그것을 하려고 합니다. 수정 쿼리는 대입 $a[i] = y$를 수행합니다.
해법은 앞 문제의 해법과 비슷하지만, 세그먼트 트리의 각 정점에 리스트 대신 수를 빠르게 검색하고, 삭제하고, 새로 삽입할 수 있는 균형 잡힌 리스트를 저장합니다. 배열에 같은 수가 반복해서 들어 있을 수 있으므로, 최적의 선택은 자료 구조 $\text{multiset}$입니다.
이러한 세그먼트 트리의 구축은 앞 문제와 거의 같은 방식으로 이루어지며, 다만 이제는 정렬된 리스트가 아니라 $\text{multiset}$들을 합쳐야 합니다. 그 결과 구축 시간은 $O(n \log^2 n)$이 됩니다(일반적으로 두 레드-블랙 트리의 병합은 선형 시간에 할 수 있지만, C++ STL은 이 시간 복잡도를 보장하지 않습니다).
쿼리 함수인 $\text{query}$도 거의 동일하며, 다만 이제는 대신 $\text{multiset}$ 함수의 $\text{lower_bound}$ 함수를 호출해야 합니다($\text{std::lower_bound}$는 임의 접근 반복자와 함께 사용할 때만 $O(\log n)$ 시간에 동작합니다).
마지막으로 수정 요청입니다. 이를 처리하려면 트리를 따라 내려가면서, 영향을 받는 원소를 포함하는 해당 구간들의 $\text{multiset}$을 모두 수정해야 합니다. 이 원소의 이전 값을 삭제하고(단, 하나만 삭제합니다) 새 값을 삽입하기만 하면 됩니다.
void update(int v, int tl, int tr, int pos, int new_val) {
    t[v].erase(t[v].find(a[pos]));
    t[v].insert(new_val);
    if (tl != tr) {
        int tm = (tl + tr) / 2;
        if (pos < tm)
            update(v*2, tl, tm, pos, new_val);
        else
            update(v*2+1, tm, tr, pos, new_val);
    } else {
        a[pos] = new_val;
    }
}
이 수정 쿼리를 처리하는 데에도 $O(\log^2 n)$ 시간이 걸립니다.
주어진 수보다 크거나 같은 가장 작은 수를 찾습니다. "fractional cascading"을 이용한 가속입니다.
문제 설정은 같습니다. 구간에서 $x$보다 크거나 같은 최소의 수를 찾고자 하지만, 이번에는 $O(\log n)$ 시간에 찾고자 합니다. "fractional cascading" 기법을 사용하여 시간 복잡도를 개선하겠습니다.
Fractional cascading은 동시에 수행되는 여러 이진 탐색의 실행 시간을 개선할 수 있게 해 주는 간단한 기법입니다. 탐색 쿼리에 대한 이전의 접근 방식은 작업을 여러 하위 작업으로 나누고, 각 하위 작업을 이진 탐색으로 해결하는 것이었습니다. Fractional cascading을 사용하면 이 모든 이진 탐색을 단 하나의 이진 탐색으로 대체할 수 있습니다.
Fractional cascading의 가장 단순하고 명확한 예는 다음 문제입니다: 정렬된 수의 리스트가 $k$개 있고, 각 리스트에서 주어진 수보다 크거나 같은 첫 번째 수를 찾아야 합니다.
각 리스트마다 이진 탐색을 수행하는 대신, 모든 리스트를 하나의 큰 정렬된 리스트로 병합할 수 있습니다. 또한 각 원소 $y$에 대해, $k$개의 리스트 각각에서 $y$를 탐색한 결과의 리스트를 저장합니다. 따라서 $x$보다 크거나 같은 가장 작은 수를 찾고 싶다면 단 한 번의 이진 탐색만 수행하면 되고, 인덱스 리스트로부터 각 리스트에서의 가장 작은 수를 결정할 수 있습니다. 하지만 이 접근 방식은 $O(n \cdot k)$($n$은 합쳐진 리스트의 길이)가 필요하며, 이는 상당히 비효율적일 수 있습니다.
Fractional cascading은 $k$개의 입력 리스트로부터 $k$개의 새 리스트를 만들어 이 메모리 복잡도를 $O(n)$ 메모리로 줄이는데, 이때 각 리스트는 대응하는 리스트와 함께 다음 새 리스트의 원소를 하나 걸러 하나씩 추가로 포함합니다. 이 구조를 사용하면 원래 리스트에서의 원소의 인덱스와 다음 새 리스트에서의 원소의 인덱스, 이렇게 두 개의 인덱스만 저장하면 됩니다. 따라서 이 접근 방식은 $O(n)$ 메모리만 사용하면서도 여전히 단 한 번의 이진 탐색으로 쿼리에 답할 수 있습니다.
하지만 우리의 응용에서는 fractional cascading의 모든 기능이 필요하지는 않습니다. 우리의 세그먼트 트리에서 정점은 왼쪽 서브트리 또는 오른쪽 서브트리에 나타나는 모든 원소의 정렬된 리스트를 담게 됩니다(병합 정렬 트리에서와 같이). 이 정렬된 리스트에 더해, 각 원소마다 두 개의 위치를 저장합니다. 원소 $y$에 대해, 왼쪽 자식의 정렬된 리스트에서 $i$번째 원소가 $y$보다 크거나 같게 되는 가장 작은 인덱스 $i$를 저장합니다. 그리고 오른쪽 자식의 정렬된 리스트에서 $j$번째 원소가 $y$보다 크거나 같게 되는 가장 작은 인덱스 $j$를 저장합니다. 이 값들은 트리를 구축할 때 병합 단계와 병행하여 계산할 수 있습니다.
이것이 어떻게 쿼리의 속도를 높이겠습니까?
기억하십시오, 일반적인 풀이에서는 모든 노드에서 이진 탐색을 수행했습니다. 하지만 이 수정을 통해 하나를 제외한 모든 이분 탐색을 피할 수 있습니다.
쿼리에 답하려면 루트 노드에서 이진 탐색을 한 번만 수행하면 됩니다. 이를 통해 전체 배열에서 $y \ge x$인 가장 작은 원소를 얻을 수 있으며, 동시에 두 개의 위치도 얻을 수 있습니다. 하나는 왼쪽 서브트리에서 $x$ 이상인 가장 작은 원소의 인덱스이고, 다른 하나는 오른쪽 서브트리에서 가장 작은 원소 $y$의 인덱스입니다. 배열에는 $x$와 $y$ 사이의 원소가 없으므로 $\ge y$는 $\ge x$와 같다는 점에 주목하십시오. 일반적인 병합 정렬 트리 풀이에서는 이 인덱스들을 이진 탐색으로 계산하지만, 미리 계산해 둔 값을 이용하면 $O(1)$에 바로 찾을 수 있습니다. 그리고 쿼리 구간을 덮는 모든 노드를 방문할 때까지 이 과정을 반복할 수 있습니다.
정리하면, 평소와 같이 쿼리 하나를 처리하는 동안 $O(\log n)$개의 노드를 방문합니다. 루트 노드에서는 이진 탐색을 수행하고, 나머지 모든 노드에서는 상수 시간의 작업만 수행합니다. 즉, 쿼리 하나에 답하는 복잡도는 $O(\log n)$입니다.
하지만 이 방법은 이미 많은 메모리($O(n \log n)$)를 사용하는 일반적인 병합 정렬 트리보다 메모리를 세 배 더 사용한다는 점에 유의하십시오.
수정 쿼리가 필요 없는 문제에는 이 기법을 간단히 적용할 수 있습니다. 두 위치는 단순한 정수이며, 정렬된 두 수열을 병합할 때 개수를 세어 쉽게 계산할 수 있습니다.
수정 쿼리까지 허용하는 것도 가능하지만, 그렇게 하면 코드 전체가 복잡해집니다. 정수 대신 정렬된 배열을 multiset으로 저장해야 하고, 인덱스 대신 반복자(iterator)를 저장해야 합니다. 또한 수정 쿼리를 처리할 때 올바른 반복자를 증가시키거나 감소시키도록 매우 신중하게 작업해야 합니다.
그 밖의 가능한 변형
이 기법은 완전히 새로운 부류의 응용 가능성을 시사합니다. 각 정점에 벡터($\text{vector}$)나 $\text{multiset}$을 저장하는 대신 다른 자료 구조를 사용할 수 있습니다: 다른 세그먼트 트리(더 높은 차원으로의 일반화에서 어느 정도 다룹니다), 펜윅 트리, 데카르트 트리 등입니다.
구간 갱신 (지연 전파)
앞 절들의 모든 문제에서 다룬 수정 쿼리는 각각 배열의 원소 하나에만 영향을 주었습니다. 하지만 세그먼트 트리를 사용하면 연속된 원소로 이루어진 구간 전체에 수정 쿼리를 적용할 수 있으며, 그 쿼리도 똑같이 $O(\log n)$ 시간에 수행할 수 있습니다.
구간에 대한 덧셈
가장 단순한 형태의 문제부터 살펴보겠습니다. 수정 쿼리는 구간 $a[l \dots r)$의 모든 수에 수 $x$를 더해야 합니다. 답해야 하는 두 번째 쿼리는 단순히 $a[i]$의 값을 묻습니다.
덧셈 쿼리를 효율적으로 처리하기 위해, 세그먼트 트리의 각 정점에 해당 구간의 모든 수에 얼마를 더해야 하는지를 저장합니다. 예를 들어 "배열 전체 $a[0 \dots n-1]$에 3을 더하라"는 쿼리가 들어오면, 트리의 루트에 수 3을 기록합니다. 일반적으로는 쿼리 구간을 분할하는 여러 구간에 이 수를 기록해야 합니다. 따라서 $O(n)$개의 값을 모두 바꿀 필요 없이 $O(\log n)$개만 바꾸면 됩니다.
이제 배열의 특정 항목의 현재 값을 묻는 쿼리가 들어오면, 트리를 따라 내려가면서 도중에 만나는 모든 값을 더하기만 하면 됩니다.
void build(int a[], int v, int tl, int tr) {
    if (tr - tl == 1) {
        t[v] = a[tl];
    } else {
        int tm = (tl + tr) / 2;
        build(a, v*2, tl, tm);
        build(a, v*2+1, tm, tr);
        t[v] = 0;
    }
}

void update(int v, int tl, int tr, int l, int r, int add) {
    if (r <= tl || tr <= l)
        return;
    if (l <= tl && tr <= r) {
        t[v] += add;
    } else {
        int tm = (tl + tr) / 2;
        update(v*2, tl, tm, l, r, add);
        update(v*2+1, tm, tr, l, r, add);
    }
}

int get(int v, int tl, int tr, int pos) {
    if (tr - tl == 1)
        return t[v];
    int tm = (tl + tr) / 2;
    if (pos < tm)
        return t[v] + get(v*2, tl, tm, pos);
    else
        return t[v] + get(v*2+1, tm, tr, pos);
}
구간에 대한 대입
이제 수정 쿼리가 특정 구간 $a[l \dots r)$의 각 원소에 어떤 값 $p$를 대입하라고 요구한다고 가정합시다. 두 번째 쿼리로는 이번에도 배열의 값 $a[i]$를 읽는 쿼리를 생각하겠습니다.
이 수정 쿼리를 전체 구간에 대해 수행하려면 세그먼트 트리의 각 정점에 해당 구간이 전부 같은 값으로 덮여 있는지 여부를 저장해야 합니다. 이렇게 하면 "지연(lazy)" 업데이트를 할 수 있습니다. 쿼리 구간을 덮는 트리의 모든 구간을 변경하는 대신 일부만 변경하고 나머지는 그대로 둡니다. 표시된 정점은 해당 구간의 모든 원소에 그 값이 할당되었음을 의미하며, 실제로는 전체 서브트리도 이 값만을 담고 있어야 합니다. 어떤 의미에서 우리는 게으르게 행동하여 그 모든 정점에 새 값을 기록하는 일을 미루는 것입니다. 이 번거로운 작업은 필요할 때 나중에 할 수 있습니다.
따라서 수정 쿼리가 실행된 후에는 트리의 일부가 무의미해집니다. 즉, 일부 수정 사항이 트리 안에 반영되지 않은 채로 남습니다.
예를 들어 "전체 배열 $a[0 \dots n-1]$에 어떤 수를 할당하라"는 수정 쿼리가 실행되면 세그먼트 트리에서는 단 하나의 변경만 이루어집니다. 그 수가 트리의 루트에 놓이고 이 정점이 표시됩니다. 실제로는 그 수가 트리 전체에 놓여야 하지만, 나머지 구간은 변경되지 않은 채로 남습니다.
이제 두 번째 수정 쿼리가 배열의 앞쪽 절반 $a[0 \dots n/2]$에 다른 어떤 수를 할당하라고 한다고 가정합시다. 이 쿼리를 처리하려면 루트 정점의 왼쪽 자식 전체에 있는 각 원소에 그 수를 할당해야 합니다. 하지만 이를 수행하기 전에 먼저 루트 정점을 정리해야 합니다. 여기서 미묘한 점은 배열의 오른쪽 절반에는 여전히 첫 번째 쿼리의 값이 할당되어 있어야 하는데, 현재로서는 오른쪽 절반에 대한 정보가 전혀 저장되어 있지 않다는 것입니다.
이를 해결하는 방법은 루트의 정보를 자식들에게 전달(push)하는 것입니다. 즉, 트리의 루트에 어떤 수가 할당되어 있었다면 왼쪽과 오른쪽 자식 정점에 이 수를 할당하고 루트의 표시를 제거합니다. 그 후에는 필요한 정보를 잃지 않고 왼쪽 자식에 새 값을 할당할 수 있습니다.
요약하면 다음과 같습니다. 어떤 쿼리(수정 쿼리든 읽기 쿼리든)이든 트리를 따라 내려가는 동안에는 항상 현재 정점의 정보를 두 자식 모두에게 전달해야 합니다. 이는 트리를 내려갈 때 지연된 수정 사항을 적용하되, 정확히 필요한 만큼만 적용하는 것으로 이해할 수 있습니다(그래야 $O(\log n)$의 복잡도가 나빠지지 않습니다).
구현을 위해서는 현재 정점을 받아 그 정점의 정보를 두 자식 모두에게 전달하는 $\text{push}$ 함수를 만들어야 합니다. 이 함수는 쿼리 함수의 시작 부분에서 호출합니다(단, 리프에서는 호출하지 않습니다. 리프에서는 더 이상 정보를 전달할 필요가 없기 때문입니다).
void push(int v) {
    if (marked[v]) {
        t[v*2] = t[v*2+1] = t[v];
        marked[v*2] = marked[v*2+1] = true;
        marked[v] = false;
    }
}

void update(int v, int tl, int tr, int l, int r, int new_val) {
    if (r <= tl || tr <= l)
        return;
    if (l <= tl && tr <= r) {
        t[v] = new_val;
        marked[v] = true;
    } else {
        push(v);
        int tm = (tl + tr) / 2;
        update(v*2, tl, tm, l, r, new_val);
        update(v*2+1, tm, tr, l, r, new_val);
    }
}

int get(int v, int tl, int tr, int pos) {
    if (tr - tl == 1) {
        return t[v];
    }
    push(v);
    int tm = (tl + tr) / 2;
    if (pos < tm)
        return get(v*2, tl, tm, pos);
    else
        return get(v*2+1, tm, tr, pos);
}
참고: $\text{get}$ 함수는 다른 방식으로도 구현할 수 있습니다. 지연 업데이트를 하지 않고, $marked[v]$가 참이면 즉시 값 $t[v]$를 반환하는 것입니다.
구간에 더하기, 최댓값 쿼리
이제 수정 쿼리는 어떤 범위의 모든 원소에 수를 더하는 것이고, 읽기 쿼리는 어떤 범위의 최댓값을 구하는 것입니다.
따라서 세그먼트 트리의 각 정점마다 해당 부분 구간의 최댓값을 저장해야 합니다. 흥미로운 부분은 수정 요청을 처리하는 동안 이 값들을 어떻게 다시 계산하느냐입니다.
이를 위해 각 정점마다 추가 값을 하나 저장합니다. 이 값에는 아직 자식 정점들에게 전파하지 않은 더할 값들을 저장합니다. 자식 정점으로 이동하기 전에 $\text{push}$를 호출하여 그 값을 두 자식 모두에게 전파합니다. 이 작업은 갱신 함수 $\text{update}$와 쿼리 함수 $\text{query}$ 모두에서 수행해야 합니다.
void build(int a[], int v, int tl, int tr) {
    if (tr - tl == 1) {
        t[v] = a[tl];
    } else {
        int tm = (tl + tr) / 2;
        build(a, v*2, tl, tm);
        build(a, v*2+1, tm, tr);
        t[v] = max(t[v*2], t[v*2 + 1]);
    }
}

void push(int v) {
    t[v*2] += lazy[v];
    lazy[v*2] += lazy[v];
    t[v*2+1] += lazy[v];
    lazy[v*2+1] += lazy[v];
    lazy[v] = 0;
}

void update(int v, int tl, int tr, int l, int r, int addend) {
    if (r <= tl || tr <= l)
        return;
    if (l <= tl && tr <= r) {
        t[v] += addend;
        lazy[v] += addend;
    } else {
        push(v);
        int tm = (tl + tr) / 2;
        update(v*2, tl, tm, l, r, addend);
        update(v*2+1, tm, tr, l, r, addend);
        t[v] = max(t[v*2], t[v*2+1]);
    }
}

int query(int v, int tl, int tr, int l, int r) {
    if (r <= tl || tr <= l)
        return -INF;
    if (l <= tl && tr <= r)
        return t[v];
    push(v);
    int tm = (tl + tr) / 2;
    return max(query(v*2, tl, tm, l, r),
               query(v*2+1, tm, tr, l, r));
}
고차원으로의 일반화
세그먼트 트리는 꽤 자연스럽게 고차원으로 일반화할 수 있습니다. 1차원의 경우 배열의 인덱스를 구간들로 나누었다면, 2차원에서는 첫 번째 인덱스에 대해 일반적인 세그먼트 트리를 만들고, 각 구간마다 두 번째 인덱스에 대해 일반적인 세그먼트 트리를 구축합니다.
간단한 2D 세그먼트 트리
행렬 $a[0 \dots n-1, 0 \dots m-1]$이 주어지고, 어떤 부분 행렬 $a[x_1 \dots x_2, y_1 \dots y_2]$의 합(또는 최솟값/최댓값)을 구하는 동시에 개별 행렬 원소의 수정(즉, $a[x][y] = p$ 형태의 쿼리)도 수행해야 합니다.
따라서 2D 세그먼트 트리를 구성합니다. 먼저 첫 번째 좌표($x$)에 대한 세그먼트 트리를 만들고, 그다음 두 번째 좌표($y$)에 대한 세그먼트 트리를 만듭니다.
구성 과정을 더 쉽게 이해하려면 잠시 행렬이 2차원이라는 사실을 잊고 첫 번째 좌표만 남겨 두어도 됩니다. 첫 번째 좌표만 사용하여 평범한 1차원 세그먼트 트리를 구성합니다. 그러나 구간마다 수 하나를 저장하는 대신 세그먼트 트리 전체를 저장합니다. 즉, 이 시점에서 두 번째 좌표도 있다는 사실을 다시 떠올립니다. 다만 이 시점에서는 첫 번째 좌표가 이미 어떤 구간 $[l \dots r)$로 고정되어 있으므로, 실제로는 $a[l \dots r, 0 \dots m-1]$ 형태의 띠를 다루게 되고 이 띠에 대해 세그먼트 트리를 구성합니다.
다음은 2D 세그먼트 트리를 구성하는 구현입니다. 이 구현은 실제로 두 개의 독립된 블록으로 이루어져 있습니다. 하나는 $x$ 좌표를 따라 세그먼트 트리를 구성하는 부분($\text{build}_x$)이고, 다른 하나는 $y$ 좌표를 따라 구성하는 부분($\text{build}_y$)입니다. $\text{build}_y$의 리프 노드에서는 두 가지 경우를 구분해야 합니다. 첫 번째 좌표의 현재 구간 $[tlx \dots trx]$의 길이가 1인 경우와 1보다 큰 경우입니다. 첫 번째 경우에는 행렬에서 해당 값을 그대로 가져오면 되고, 두 번째 경우에는 $x$ 좌표 기준으로 왼쪽 자식과 오른쪽 자식에 해당하는 두 세그먼트 트리의 값을 합치면 됩니다.
void build_y(int vx, int lx, int rx, int vy, int ly, int ry) {
    if (ry - ly == 1) {
        if (rx - lx == 1)
            t[vx][vy] = a[lx][ly];
        else
            t[vx][vy] = t[vx*2][vy] + t[vx*2+1][vy];
    } else {
        int my = (ly + ry) / 2;
        build_y(vx, lx, rx, vy*2, ly, my);
        build_y(vx, lx, rx, vy*2+1, my, ry);
        t[vx][vy] = t[vx][vy*2] + t[vx][vy*2+1];
    }
}

void build_x(int vx, int lx, int rx) {
    if (rx - lx > 1) {
        int mx = (lx + rx) / 2;
        build_x(vx*2, lx, mx);
        build_x(vx*2+1, mx, rx);
    }
    build_y(vx, lx, rx, 1, 0, m);
}
이러한 세그먼트 트리도 여전히 선형 크기의 메모리를 사용하지만, 상수가 더 커서 $16 n m$입니다. 앞서 설명한 $\text{build}_x$ 과정 역시 선형 시간에 동작한다는 것은 분명합니다.
이제 쿼리 처리로 넘어갑니다. 2차원 쿼리에도 같은 원리로 답합니다. 먼저 첫 번째 좌표를 기준으로 쿼리를 나누고, 도달한 각 정점마다 그에 대응하는 두 번째 좌표의 세그먼트 트리를 호출합니다.
int sum_y(int vx, int vy, int tly, int try_, int ly, int ry) {
    if (ry <= tly || try_ <= ly)
        return 0;
    if (ly <= tly && try_ <= ry)
        return t[vx][vy];
    int tmy = (tly + try_) / 2;
    return sum_y(vx, vy*2, tly, tmy, ly, ry)
         + sum_y(vx, vy*2+1, tmy, try_, ly, ry);
}

int sum_x(int vx, int tlx, int trx, int lx, int rx, int ly, int ry) {
    if (rx <= tlx || trx <= lx)
        return 0;
    if (lx <= tlx && trx <= rx)
        return sum_y(vx, 1, 0, m, ly, ry);
    int tmx = (tlx + trx) / 2;
    return sum_x(vx*2, tlx, tmx, lx, rx, ly, ry)
         + sum_x(vx*2+1, tmx, trx, lx, rx, ly, ry);
}
이 함수는 먼저 첫 번째 좌표의 트리를 따라 내려가면서, 트리에서 지나가는 각 정점마다 두 번째 좌표에 대응하는 세그먼트 트리에 쿼리를 수행하므로 $O(\log n \log m)$ 시간에 동작합니다.
마지막으로 수정 쿼리를 살펴봅니다. 어떤 원소의 값이 $a[x][y] = p$로 바뀌었을 때 이에 맞추어 세그먼트 트리를 수정하는 방법을 알아보겠습니다. 변경은 첫 번째 세그먼트 트리에서 좌표 $x$를 포함하는 정점에서만 일어나고(이러한 정점은 $O(\log n)$개입니다), 그 정점들에 대응하는 세그먼트 트리에서도 좌표 $y$를 포함하는 정점에서만 일어난다는 것(이러한 정점은 $O(\log m)$개입니다)은 분명합니다. 따라서 구현은 1차원의 경우와 크게 다르지 않으며, 다만 먼저 첫 번째 좌표를 따라 내려간 다음 두 번째 좌표를 따라 내려간다는 점만 다릅니다.
void update_y(int vx, int lx, int rx, int vy, int ly, int ry, int x, int y, int new_val) {
    if (ry - ly == 1) {
        if (rx - lx == 1)
            t[vx][vy] = new_val;
        else
            t[vx][vy] = t[vx*2][vy] + t[vx*2+1][vy];
    } else {
        int my = (ly + ry) / 2;
        if (y <= my)
            update_y(vx, lx, rx, vy*2, ly, my, x, y, new_val);
        else
            update_y(vx, lx, rx, vy*2+1, my, ry, x, y, new_val);
        t[vx][vy] = t[vx][vy*2] + t[vx][vy*2+1];
    }
}

void update_x(int vx, int lx, int rx, int x, int y, int new_val) {
    if (rx - lx > 1) {
        int mx = (lx + rx) / 2;
        if (x <= mx)
            update_x(vx*2, lx, mx, x, y, new_val);
        else
            update_x(vx*2+1, mx, rx, x, y, new_val);
    }
    update_y(vx, lx, rx, 1, 0, m, x, y, new_val);
}
2D 세그먼트 트리의 압축
다음과 같은 문제를 생각해 봅시다. 평면 위에 좌표 $(x_i, y_i)$로 주어진 점이 $n$개 있고, "직사각형 $((x_1, y_1), (x_2, y_2))$ 안에 있는 점의 개수 세기" 형태의 쿼리가 주어집니다. 이러한 문제에서 원소가 $O(n^2)$개인 2차원 세그먼트 트리를 구성하는 것은 지나치게 낭비라는 것이 분명합니다. 이 메모리의 대부분은 낭비됩니다. 각 점은 첫 번째 좌표에 대한 트리에서 $O(\log n)$개의 구간에만 속할 수 있으므로, 두 번째 좌표에 대한 모든 트리 구간의 "유용한" 크기를 합해도 $O(n \log n)$이기 때문입니다.
그래서 다음과 같이 진행합니다. 첫 번째 좌표에 대한 세그먼트 트리의 각 정점에, 첫 번째 좌표의 현재 구간에 나타나는 두 번째 좌표들만으로 구성한 세그먼트 트리를 저장합니다. 다시 말해, 인덱스가 $vx$이고 경계가 $tlx$와 $trx$인 어떤 정점 안에 세그먼트 트리를 구성할 때, 구간 $x \in [tlx, trx]$에 속하는 점들만 고려하고 그 점들만으로 세그먼트 트리를 구성합니다.
이렇게 하면 두 번째 좌표에 대한 각 세그먼트 트리가 꼭 필요한 만큼의 메모리만 차지하게 됩니다. 그 결과 전체 메모리 사용량은 $O(n \log n)$으로 줄어듭니다. 여전히 $O(\log^2 n)$ 시간에 쿼리에 답할 수 있으며, 두 번째 좌표에 대해 이진 탐색을 수행하기만 하면 되는데, 이는 복잡도를 악화시키지 않습니다.
그러나 이 구조에서는 수정 쿼리가 불가능합니다. 실제로 새로운 점이 생기면 두 번째 좌표에 대한 어떤 세그먼트 트리의 중간에 새 원소를 추가해야 하는데, 이는 효율적으로 할 수 없습니다.
끝으로, 이렇게 압축한 2차원 세그먼트 트리는 1차원 세그먼트 트리의 변형과 사실상 동일해진다는 점을 짚어 둡니다(각 정점에 부분 배열 전체 저장하기 참고). 특히 2차원 세그먼트 트리는 트리의 각 정점에 부분 배열을 저장하는 방식의 특수한 경우일 뿐입니다. 따라서 어떤 쿼리를 수행할 수 없어서 2차원 세그먼트 트리를 포기해야 한다면, 중첩된 세그먼트 트리를 데카르트 트리처럼 더 강력한 자료 구조로 바꾸어 보는 것이 좋습니다.
값의 이력 보존하기 (퍼시스턴트 세그먼트 트리)
퍼시스턴트 자료 구조는 수정할 때마다 이전 상태를 기억하는 자료 구조입니다. 따라서 이 자료 구조에서 원하는 버전 어디에든 접근하여 그 버전에 쿼리를 실행할 수 있습니다.
세그먼트 트리는 시간과 메모리 사용량 양쪽 모두에서 효율적으로 퍼시스턴트 자료 구조로 바꿀 수 있는 자료 구조입니다. 수정할 때마다 트리 전체를 복사하는 일은 피하고 싶으며, 구간 쿼리에 답하는 데 드는 $O(\log n)$ 시간 성능도 잃고 싶지 않습니다.
사실 세그먼트 트리에 대한 모든 변경 요청은 루트에서 시작하는 경로 위에 있는 $O(\log n)$개 정점의 데이터만 바꿉니다. 따라서 세그먼트 트리를 포인터로 저장한다면(즉, 각 정점이 왼쪽 자식 정점과 오른쪽 자식 정점을 가리키는 포인터를 저장한다면), 수정 쿼리를 수행할 때 기존 정점을 변경하는 대신 새 정점을 만들기만 하면 됩니다. 수정 쿼리의 영향을 받지 않는 정점은 포인터가 이전 정점을 가리키게 하여 계속 사용할 수 있습니다. 따라서 수정 쿼리 하나마다 세그먼트 트리의 새 루트 정점을 포함하여 $O(\log n)$개의 새 정점이 만들어지며, 이전 루트 정점을 루트로 하는 트리의 이전 버전 전체는 그대로 유지됩니다.
가장 간단한 세그먼트 트리, 즉 합을 묻는 쿼리와 단일 원소 수정 쿼리만 있는 경우의 구현 예시를 들어 봅시다.
struct Vertex {
    Vertex *l, *r;
    int sum;

    Vertex(int val) : l(nullptr), r(nullptr), sum(val) {}
    Vertex(Vertex *l, Vertex *r) : l(l), r(r), sum(0) {
        if (l) sum += l->sum;
        if (r) sum += r->sum;
    }
};

Vertex* build(int a[], int tl, int tr) {
    if (tr - tl == 1)
        return new Vertex(a[tl]);
    int tm = (tl + tr) / 2;
    return new Vertex(build(a, tl, tm), build(a, tm, tr));
}

int get_sum(Vertex* v, int tl, int tr, int l, int r) {
    if (r <= tl || tr <= l)
        return 0;
    if (l <= tl && tr <= r)
        return v->sum;
    int tm = (tl + tr) / 2;
    return get_sum(v->l, tl, tm, l, r)
         + get_sum(v->r, tm, tr, l, r);
}

Vertex* update(Vertex* v, int tl, int tr, int pos, int new_val) {
    if (tr - tl == 1)
        return new Vertex(new_val);
    int tm = (tl + tr) / 2;
    if (pos < tm)
        return new Vertex(update(v->l, tl, tm, pos, new_val), v->r);
    else
        return new Vertex(v->l, update(v->r, tm, tr, pos, new_val));
}
세그먼트 트리를 수정할 때마다 새 루트 정점을 얻게 됩니다. 세그먼트 트리의 서로 다른 두 버전 사이를 빠르게 오가려면 이 루트들을 배열에 저장해야 합니다. 세그먼트 트리의 특정 버전을 사용하려면 해당하는 루트 정점으로 쿼리를 호출하기만 하면 됩니다.
위에서 설명한 방법을 사용하면 거의 모든 세그먼트 트리를 퍼시스턴트 자료 구조로 바꿀 수 있습니다.
구간에서 $k$번째로 작은 수 찾기
이번에는 "구간 $a[l \dots r)$에서 $k$번째로 작은 원소는 무엇인가" 형태의 쿼리에 답해야 합니다. 이 쿼리는 이진 탐색과 병합 정렬 트리를 사용하여 답할 수 있지만, 단일 쿼리의 시간 복잡도는 $O(\log^3 n)$이 됩니다. 여기서는 퍼시스턴트 세그먼트 트리를 사용해 같은 작업을 $O(\log n)$에 해내겠습니다.
먼저 더 간단한 문제의 풀이를 살펴보겠습니다. 원소가 $0 \le a[i] \lt n$으로 제한된 배열만 고려합니다. 또한 배열 $a$의 어떤 접두사에서 $k$번째로 작은 원소만 찾으려 합니다. 여기서 세운 아이디어는 나중에 제한이 없는 배열과 제한이 없는 구간 쿼리로 매우 쉽게 확장할 수 있습니다. $a$에는 1-based 인덱싱을 사용한다는 점에 유의하십시오.
등장하는 모든 수의 개수를 세는 세그먼트 트리를 사용합니다. 즉, 세그먼트 트리에 배열의 히스토그램을 저장합니다. 따라서 리프 정점은 값 $0$, $1$, $\dots$, $n-1$이 배열에 각각 몇 번 나타나는지를 저장하고, 나머지 정점은 어떤 범위에 속하는 수가 배열에 몇 개 있는지를 저장합니다. 다시 말해, 배열의 히스토그램에 대해 합 쿼리를 수행하는 일반적인 세그먼트 트리를 만듭니다. 하지만 가능한 모든 접두사마다 세그먼트 트리를 하나씩, 모두 $n$개 만드는 대신, 같은 정보를 담는 퍼시스턴트 세그먼트 트리 하나를 만듭니다. $root_0$이 가리키는 빈 세그먼트 트리(모든 개수가 $0$)에서 시작하여 원소 $a[1]$, $a[2]$, $\dots$, $a[n]$을 하나씩 차례로 추가합니다. 수정할 때마다 새 루트 정점을 얻게 되는데, 배열 $a$의 처음 $i$개 원소를 삽입한 뒤의 세그먼트 트리의 루트를 $root_i$라고 부릅시다. $root_i$를 루트로 하는 세그먼트 트리는 접두사 $a[1 \dots i]$의 히스토그램을 담습니다. 이 세그먼트 트리를 사용하면 0의 개수 세기, $k$번째 0 찾기에서 설명한 것과 같은 기법으로 $k$번째 원소의 위치를 $O(\log n)$ 시간에 찾을 수 있습니다.
이제 제한이 없는 버전의 문제로 넘어가겠습니다.
먼저 쿼리에 대한 제한부터 살펴보겠습니다. 이 쿼리들을 $a$의 접두사에 대해서만 수행하는 대신, 임의의 구간 $a[l \dots r)$에 대해 수행하려고 합니다. 이를 위해서는 구간 $a[l \dots r)$에 있는 원소들의 히스토그램을 나타내는 세그먼트 트리가 필요합니다. 이러한 세그먼트 트리는 $root_{r}$을 루트로 하는 세그먼트 트리와 $root_{l-1}$을 루트로 하는 세그먼트 트리의 차이일 뿐이라는 것을 쉽게 알 수 있습니다. 즉, $[l \dots r)$ 세그먼트 트리의 모든 정점은 $root_{r}$ 트리의 정점에서 $root_{l-1}$ 트리의 정점을 빼서 계산할 수 있습니다.
$\text{find_kth}$ 함수를 구현할 때는 두 개의 정점 포인터를 전달하고, 현재 구간의 개수/합을 두 정점의 개수/합의 차이로 계산하여 이를 처리할 수 있습니다.
다음은 수정된 $\text{build}$, $\text{update}$, $\text{find_kth}$ 함수입니다.
Vertex* build(int tl, int tr) {
    if (tr - tl == 1)
        return new Vertex(0);
    int tm = (tl + tr) / 2;
    return new Vertex(build(tl, tm), build(tm, tr));
}

Vertex* update(Vertex* v, int tl, int tr, int pos) {
    if (tr - tl == 1)
        return new Vertex(v->sum+1);
    int tm = (tl + tr) / 2;
    if (pos < tm)
        return new Vertex(update(v->l, tl, tm, pos), v->r);
    else
        return new Vertex(v->l, update(v->r, tm, tr, pos));
}

int find_kth(Vertex* vl, Vertex *vr, int tl, int tr, int k) {
    if (tr - tl == 1)
        return tl;
    int tm = (tl + tr) / 2, left_count = vr->l->sum - vl->l->sum;
    if (left_count >= k)
        return find_kth(vl->l, vr->l, tl, tm, k);
    return find_kth(vl->r, vr->r, tm, tr, k-left_count);
}
앞에서 이미 설명했듯이, 초기 세그먼트 트리의 루트뿐만 아니라 각 업데이트 이후의 모든 루트도 저장해야 합니다. 다음은 [0, MAX_VALUE] 범위의 원소를 가진 벡터 a에 대해 영속 세그먼트 트리를 구축하는 코드입니다.
int tl = 0, tr = MAX_VALUE + 1;
std::vector<Vertex*> roots;
roots.push_back(build(tl, tr));
for (int i = 0; i < a.size(); i++) {
    roots.push_back(update(roots.back(), tl, tr, a[i]));
}

// find the 5th smallest number from the subarray [a[2], a[3], ..., a[19]]
int result = find_kth(roots[2], roots[20], tl, tr, 5);
이제 배열 원소에 대한 제한을 살펴보겠습니다. 실제로 인덱스 압축을 통해 어떤 배열이든 이러한 배열로 변환할 수 있습니다. 배열에서 가장 작은 원소에는 값 0이, 두 번째로 작은 원소에는 값 1이 할당되며, 이런 식으로 계속됩니다. 값을 인덱스로, 또 인덱스를 값으로 $O(\log n)$ 시간에 변환하는 조회 테이블은 (예를 들어 $\text{map}$을 사용하여) 쉽게 만들 수 있습니다.
동적 세그먼트 트리
(모양이 동적이고 노드가 보통 동적으로 할당되기 때문에 이렇게 불립니다. 암시적 세그먼트 트리 또는 희소 세그먼트 트리라고도 합니다.)
앞에서는 원래의 세그먼트 트리를 구축할 수 있는 경우를 살펴보았습니다. 하지만 원래 배열이 어떤 기본 원소로 채워져 있는데, 그 크기 때문에 트리를 미리 완전히 구축할 수 없다면 어떻게 해야 합니까?
이 문제는 세그먼트 트리를 지연 방식으로(점진적으로) 생성하여 해결할 수 있습니다. 처음에는 루트만 생성하고, 다른 정점들은 필요할 때만 생성합니다. 이 경우에는 포인터 기반 구현을 사용합니다(정점의 자식으로 이동하기 전에 자식이 생성되어 있는지 확인하고, 생성되어 있지 않으면 생성합니다). 각 쿼리의 복잡도는 여전히 $O(\log n)$에 불과하며, 이는 대부분의 사용 사례에서 충분히 작습니다(예: $\log_2 10^9 \approx 30$).
이 구현에는 두 가지 쿼리가 있습니다. 하나는 특정 위치에 값을 더하는 것이고(처음에는 모든 값이 $0$입니다), 다른 하나는 구간 내 모든 값의 합을 계산하는 것입니다. Vertex(0, n)이 암시적 트리의 루트 정점이 됩니다.
struct Vertex {
    int left, right;
    int sum = 0;
    Vertex *left_child = nullptr, *right_child = nullptr;

    Vertex(int lb, int rb) {
        left = lb;
        right = rb;
    }

    void extend() {
        if (!left_child && left + 1 < right) {
            int t = (left + right) / 2;
            left_child = new Vertex(left, t);
            right_child = new Vertex(t, right);
        }
    }

    void add(int k, int x) {
        extend();
        sum += x;
        if (left_child) {
            if (k < left_child->right)
                left_child->add(k, x);
            else
                right_child->add(k, x);
        }
    }

    int get_sum(int lq, int rq) {
        if (lq <= left && right <= rq)
            return sum;
        if (max(left, lq) >= min(right, rq))
            return 0;
        extend();
        return left_child->get_sum(lq, rq) + right_child->get_sum(lq, rq);
    }
};
물론 이 아이디어는 다양한 방식으로 확장할 수 있습니다. 예를 들어 지연 전파를 통해 구간 갱신을 지원하도록 추가할 수 있습니다.
연습 문제
- SPOJ - KQUERY [영속 세그먼트 트리 / 병합 정렬 트리]
- Codeforces - Xenia and Bit Operations
- UVA 11402 - Ahoy, Pirates!
- SPOJ - GSS3
- Codeforces - Sereja And Brackets
- Codeforces - Distinct Characters Queries
- Codeforces - Knight Tournament [입문자용]
- Codeforces - Ant colony
- Codeforces - Drazil and Park
- Codeforces - Circular RMQ
- Codeforces - Lucky Array
- Codeforces - The Child and Sequence
- Codeforces - DZY Loves Fibonacci Numbers [지연 전파]
- Codeforces - Alphabet Permutations
- Codeforces - Eyes Closed
- Codeforces - Kefa and Watch
- Codeforces - A Simple Task
- Codeforces - SUM and REPLACE
- Codeforces - XOR on Segment [지연 전파]
- Codeforces - Please, another Queries on Array? [지연 전파]
- COCI - Deda [x보다 작거나 같은 마지막 원소 / 이진 탐색]
- Codeforces - The Untended Antiquity [2D]
- CSES - Hotel Queries
- CSES - Polynomial Queries
- CSES - Range Updates and Sums