최소 신장 트리 - Prim 알고리즘
정점 $n$개와 간선 $m$개로 이루어진 가중치가 있는 무방향 그래프 $G$가 주어집니다. 이 그래프에서 모든 정점을 연결하면서 가중치가 가장 작은(즉, 간선 가중치의 합이 최소인) 신장 트리를 찾고자 합니다. 신장 트리란 어떤 정점에서든 다른 모든 정점으로 정확히 하나의 단순 경로를 통해 도달할 수 있는 간선의 집합입니다. 가중치가 가장 작은 신장 트리를 최소 신장 트리라고 합니다.
왼쪽 그림에서는 가중치가 있는 무방향 그래프를, 오른쪽 그림에서는 그에 대응하는 최소 신장 트리를 볼 수 있습니다.
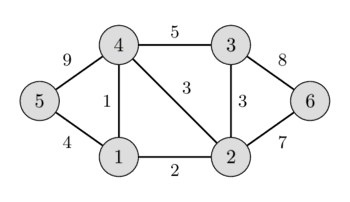
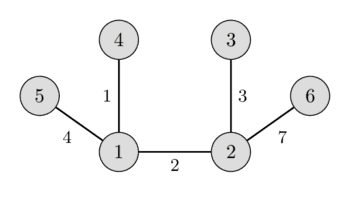
모든 신장 트리는 반드시 $n-1$개의 간선을 포함한다는 것을 쉽게 알 수 있습니다.
이 문제는 여러 문제에서 매우 자연스럽게 등장합니다. 예를 들어 다음 문제를 생각해 봅시다. 도시가 $n$개 있고, 각 도시 쌍마다 두 도시 사이에 도로를 건설하는 비용이 주어집니다(또는 두 도시 사이에 도로를 건설하는 것이 물리적으로 불가능하다는 것을 알고 있습니다). 모든 도시에서 다른 모든 도시로 이동할 수 있도록 도로를 건설해야 하며, 모든 도로를 건설하는 비용이 최소가 되어야 합니다.
Prim 알고리즘
이 알고리즘은 원래 1930년에 체코의 수학자 Vojtěch Jarník이 발견했습니다. 그러나 이 알고리즘은 1957년에 이를 재발견하여 다시 발표한 미국의 수학자 Robert Clay Prim의 이름을 따서 주로 Prim 알고리즘으로 알려져 있습니다. 또한 Edsger Dijkstra가 1959년에 이 알고리즘을 발표했습니다.
알고리즘 설명
여기서는 알고리즘을 가장 단순한 형태로 설명합니다. 최소 신장 트리는 간선을 한 번에 하나씩 추가하며 점진적으로 만들어집니다. 처음에 신장 트리는 (임의로 선택한) 정점 하나로만 이루어져 있습니다. 그런 다음 이 정점에서 나가는 간선 중 가중치가 최소인 간선을 선택하여 신장 트리에 추가합니다. 그러면 신장 트리는 이미 정점 두 개로 이루어지게 됩니다. 이제 한쪽 끝은 이미 선택된 정점(즉, 이미 신장 트리에 속한 정점)에 있고 다른 쪽 끝은 선택되지 않은 정점에 있는 간선 중 가중치가 최소인 간선을 선택하여 추가합니다. 이런 식으로 계속합니다. 즉, 매번 선택된 정점 하나와 선택되지 않은 정점 하나를 잇는 간선 중 가중치가 최소인 간선을 선택하여 추가합니다. 신장 트리가 모든 정점을 포함할 때까지(또는 동등하게 간선이 $n - 1$개가 될 때까지) 이 과정을 반복합니다.
결국 이렇게 구성된 신장 트리는 최소가 됩니다. 그래프가 처음부터 연결되어 있지 않았다면 신장 트리가 존재하지 않으므로, 선택된 간선의 수는 $n - 1$보다 작게 됩니다.
증명
그래프 $G$가 연결되어 있다고, 즉 답이 존재한다고 합시다. Prim 알고리즘으로 찾은 결과 그래프를 $T$로, 최소 신장 트리를 $S$로 나타냅니다. 당연히 $T$는 실제로 신장 트리이며 $G$의 부분 그래프입니다. $S$와 $T$의 가중치가 같다는 것만 보이면 됩니다.
알고리즘에서 $S$에 속하지 않는 간선을 $T$에 처음으로 추가하는 시점을 생각해 봅시다. 이 간선을 $e$로, 그 양 끝을 $a$와 $b$로, 이미 선택된 정점의 집합을 $V$로 나타냅시다($a \in V$이고 $b \notin V$이거나, 그 반대입니다).
최소 신장 트리 $S$에서 정점 $a$와 $b$는 어떤 경로 $P$로 연결되어 있습니다. 이 경로 위에서 한쪽 끝은 $V$에 속하고 다른 쪽 끝은 그렇지 않은 간선 $f$를 찾을 수 있으며, 이때 $f$의 두 끝 중 하나만 $V$에 있습니다. 알고리즘이 $f$ 대신 $e$를 선택했으므로, $f$의 가중치는 $e$의 가중치보다 크거나 같습니다.
최소 신장 트리 $S$에 간선 $e$를 추가하고 간선 $f$를 제거합니다. $e$를 추가하면 사이클이 하나 생기는데, $f$도 그 유일한 사이클에 속해 있었으므로 $f$를 제거하면 결과 그래프에는 다시 사이클이 없습니다. 그리고 사이클에서 간선 하나만 제거했으므로 결과 그래프는 여전히 연결되어 있습니다.
$e$의 가중치가 $f$의 가중치보다 크지 않았으므로 결과 신장 트리의 총 가중치는 더 커질 수 없고, $S$가 최소 신장 트리였으므로 더 작아질 수도 없습니다. 즉, 간선 $f$를 $e$로 교체하여 또 다른 최소 신장 트리를 만든 것입니다. 그리고 $e$의 가중치는 $f$의 가중치와 같아야 합니다.
따라서 Prim 알고리즘에서 고르는 모든 간선은 임의의 최소 신장 트리의 간선들과 가중치가 같으며, 이는 Prim 알고리즘이 실제로 최소 신장 트리를 만든다는 것을 의미합니다.
구현
알고리즘의 복잡도는 적절한 간선들 가운데 다음 최소 간선을 어떻게 찾는지에 따라 달라집니다. 여러 가지 접근 방식이 있으며, 방식에 따라 복잡도와 구현이 달라집니다.
단순한 구현: $O(n m)$과 $O(n^2 + m \log n)$
가능한 모든 간선을 순회하며 간선을 찾으면, 가중치가 최소인 간선을 찾는 데 $O(m)$ 시간이 걸립니다. 전체 복잡도는 $O(n m)$이 됩니다. 최악의 경우 이는 $O(n^3)$으로, 매우 느립니다.
이미 선택된 각 정점에서 간선을 하나씩만 살펴보면 이 알고리즘을 개선할 수 있습니다. 예를 들어 각 정점에서 나가는 간선들을 가중치 오름차순으로 정렬하고, 첫 번째 유효한 간선(즉, 선택되지 않은 정점으로 가는 간선)을 가리키는 포인터를 저장할 수 있습니다. 그런 다음 최소 간선을 찾아 선택한 뒤 포인터들을 갱신합니다. 이렇게 하면 복잡도는 $O(n^2 + m)$이 되고, 간선 정렬에 $O(m \log n)$이 추가로 들어 최악의 경우 복잡도는 $O(n^2 \log n)$이 됩니다.
아래에서는 조금씩 다른 두 알고리즘을 살펴봅니다. 하나는 밀집 그래프용이고 다른 하나는 희소 그래프용이며, 둘 다 더 나은 복잡도를 가집니다.
밀집 그래프: $O(n^2)$
이 문제에 다른 각도에서 접근합니다. 아직 선택되지 않은 모든 정점에 대해, 이미 선택된 정점으로 가는 최소 간선을 저장합니다.
그러면 각 단계에서는 이 최소 가중치 간선들만 살펴보면 되므로 복잡도는 $O(n)$입니다.
간선을 추가한 후에는 일부 최소 간선 포인터를 다시 계산해야 합니다. 가중치는 감소할 수만 있다는 점에 유의하십시오. 즉, 아직 선택되지 않은 각 정점의 최소 가중치 간선은 그대로이거나, 새로 선택된 정점으로 가는 간선으로 갱신됩니다. 따라서 이 단계도 $O(n)$에 수행할 수 있습니다.
이렇게 해서 복잡도가 $O(n^2)$인 Prim 알고리즘을 얻었습니다.
특히 이 구현은 유클리드 최소 신장 트리 문제에 매우 편리합니다. 평면 위에 $n$개의 점이 있고 각 점 쌍 사이의 거리는 두 점 사이의 유클리드 거리이며, 이 완전 그래프의 최소 신장 트리를 찾고자 합니다. 이 문제는 앞서 설명한 알고리즘으로 $O(n^2)$ 시간과 $O(n)$ 메모리에 풀 수 있으며, 이는 Kruskal 알고리즘으로는 불가능합니다.
int n;
vector<vector<int>> adj; // adjacency matrix of graph
const int INF = 1000000000; // weight INF means there is no edge

struct Edge {
    int w = INF, to = -1;
};

void prim() {
    int total_weight = 0;
    vector<bool> selected(n, false);
    vector<Edge> min_e(n);
    min_e[0].w = 0;

    for (int i=0; i<n; ++i) {
        int v = -1;
        for (int j = 0; j < n; ++j) {
            if (!selected[j] && (v == -1 || min_e[j].w < min_e[v].w))
                v = j;
        }

        if (min_e[v].w == INF) {
            cout << "No MST!" << endl;
            exit(0);
        }

        selected[v] = true;
        total_weight += min_e[v].w;
        if (min_e[v].to != -1)
            cout << v << " " << min_e[v].to << endl;

        for (int to = 0; to < n; ++to) {
            if (adj[v][to] < min_e[to].w)
                min_e[to] = {adj[v][to], v};
        }
    }

    cout << total_weight << endl;
}
크기가 $n \times n$인 인접 행렬 adj[][]에는 간선의 가중치가 저장되며, 두 정점 사이에 간선이 없으면 가중치 INF를 사용합니다. 이 알고리즘은 배열 두 개를 사용합니다. 하나는 이미 선택한 정점이 무엇인지 나타내는 플래그 selected[]이고, 다른 하나는 아직 선택되지 않은 각 정점에 대해 선택된 정점으로 이어지는 최소 가중치 간선을 저장하는 배열 min_e[]입니다(가중치와 끝 정점을 저장합니다). 이 알고리즘은 $n$단계를 수행합니다. 각 반복에서 간선 가중치가 가장 작은 정점을 선택하고, 나머지 모든 정점의 min_e[]를 갱신합니다.
희소 그래프: $O(m \log n)$
위에서 설명한 알고리즘에서 최솟값을 찾는 연산과 일부 값을 수정하는 연산은 집합 연산으로 해석할 수 있습니다. 이 두 가지 고전적인 연산은 여러 자료 구조에서 지원됩니다. C++의 set(레드-블랙 트리로 구현됩니다)이 그 예입니다.
주된 알고리즘은 그대로이지만, 이제 최소 간선을 $O(\log n)$ 시간에 찾을 수 있습니다. 반면에 포인터를 다시 계산하는 데는 이제 $O(n \log n)$ 시간이 걸리며, 이는 이전 알고리즘보다 나쁩니다.
하지만 전체적으로 갱신은 $O(m)$번만 하면 되고 최소 간선 탐색은 $O(n)$번 수행한다는 점을 고려하면, 전체 복잡도는 $O(m \log n)$이 됩니다. 희소 그래프에서는 이것이 위의 알고리즘보다 낫지만, 밀집 그래프에서는 더 느립니다.
const int INF = 1000000000;

struct Edge {
    int w = INF, to = -1;
    bool operator<(Edge const& other) const {
        return make_pair(w, to) < make_pair(other.w, other.to);
    }
};

int n;
vector<vector<Edge>> adj;

void prim() {
    int total_weight = 0;
    vector<Edge> min_e(n);
    min_e[0].w = 0;
    set<Edge> q;
    q.insert({0, 0});
    vector<bool> selected(n, false);
    for (int i = 0; i < n; ++i) {
        if (q.empty()) {
            cout << "No MST!" << endl;
            exit(0);
        }

        int v = q.begin()->to;
        selected[v] = true;
        total_weight += q.begin()->w;
        q.erase(q.begin());

        if (min_e[v].to != -1)
            cout << v << " " << min_e[v].to << endl;

        for (Edge e : adj[v]) {
            if (!selected[e.to] && e.w < min_e[e.to].w) {
                q.erase({min_e[e.to].w, e.to});
                min_e[e.to] = {e.w, v};
                q.insert({e.w, e.to});
            }
        }
    }

    cout << total_weight << endl;
}
여기서 그래프는 인접 리스트 adj[]로 표현하며, adj[v]에는 정점 v의 모든 간선이 (가중치와 대상 정점의 쌍 형태로) 들어 있습니다. min_e[v]에는 정점 v에서 이미 선택된 정점으로 이어지는 가장 작은 간선의 가중치가 (역시 가중치와 대상 정점의 쌍 형태로) 저장됩니다. 또한 큐 q에는 아직 선택되지 않은 모든 정점이 가중치 min_e의 오름차순으로 들어 있습니다. 이 알고리즘은 n단계를 수행하며, 각 단계에서 가중치 min_e가 가장 작은 정점 v를 (큐의 맨 앞에서 꺼내어) 선택한 다음, 이 정점에서 나가는 모든 간선을 살펴보며 min_e의 값을 갱신합니다(갱신할 때는 큐 q에서 기존 간선을 제거하고 새 간선을 넣어야 합니다).