정수 인수분해
이 글에서는 정수를 인수분해하는 여러 알고리즘을 소개합니다. 각 알고리즘은 입력에 따라 빠를 수도 있고, 정도의 차이는 있지만 느릴 수도 있습니다.
인수분해하려는 수가 실제로는 소수라면 대부분의 알고리즘이 매우 느리게 동작한다는 점에 유의하십시오. 이는 페르마, Pollard의 p-1, Pollard의 rho 인수분해 알고리즘에서 특히 그렇습니다. 따라서 수를 인수분해하기 전에 확률적(또는 빠른 결정론적) 소수 판정을 먼저 수행하는 것이 가장 합리적입니다.
시행 나눗셈
이는 소인수분해를 구하는 가장 기본적인 알고리즘입니다.
가능한 모든 약수 $d$로 나누어 봅니다. 합성수 $n$의 소인수가 모두 $\sqrt{n}$보다 클 수는 없다는 것을 알 수 있습니다. 따라서 $2 \le d \le \sqrt{n}$인 약수만 확인하면 되며, 이렇게 하면 $O(\sqrt{n})$에 소인수분해를 구할 수 있습니다. (이는 의사 다항 시간입니다. 즉, 입력값에 대해서는 다항 시간이지만 입력의 비트 수에 대해서는 지수 시간입니다.)
가장 작은 약수는 반드시 소수입니다. 찾은 인수를 나누어 제거하고 이 과정을 계속합니다. $[2; \sqrt{n}]$ 범위에서 약수를 하나도 찾지 못한다면 그 수 자체가 소수입니다.
vector<long long> trial_division1(long long n) {
    vector<long long> factorization;
    for (long long d = 2; d * d <= n; d++) {
        while (n % d == 0) {
            factorization.push_back(d);
            n /= d;
        }
    }
    if (n > 1)
        factorization.push_back(n);
    return factorization;
}
휠 인수분해
이는 시행 나눗셈을 최적화한 방법입니다. 수가 2로 나누어떨어지지 않는다는 것을 알고 나면 다른 짝수는 확인할 필요가 없습니다. 그러면 확인해야 할 수가 $50\%$만 남습니다. 2를 인수로 모두 나누어 홀수를 얻은 뒤에는 3부터 시작하여 홀수만 세면 됩니다.
vector<long long> trial_division2(long long n) {
    vector<long long> factorization;
    while (n % 2 == 0) {
        factorization.push_back(2);
        n /= 2;
    }
    for (long long d = 3; d * d <= n; d += 2) {
        while (n % d == 0) {
            factorization.push_back(d);
            n /= d;
        }
    }
    if (n > 1)
        factorization.push_back(n);
    return factorization;
}
이 방법은 더 확장할 수 있습니다. 수가 3으로 나누어떨어지지 않는다면 이후 계산에서 3의 다른 배수도 모두 무시할 수 있습니다. 따라서 $5, 7, 11, 13, 17, 19, 23, \dots$만 확인하면 됩니다. 남은 수들에서 규칙을 발견할 수 있습니다. $d \bmod 6 = 1$인 수와 $d \bmod 6 = 5$인 수를 모두 확인해야 합니다. 그러면 확인해야 할 수가 $33.3\%$만 남습니다. 먼저 소수 2와 3을 인수로 나누어 제거한 뒤, 5부터 시작하여 $6$으로 나눈 나머지가 $1$과 $5$인 수만 세는 방식으로 이를 구현할 수 있습니다.
다음은 소수 2, 3, 5에 대한 구현입니다. 건너뛰는 간격을 배열에 저장해 두면 편리합니다.
vector<long long> trial_division3(long long n) {
    vector<long long> factorization;
    for (int d : {2, 3, 5}) {
        while (n % d == 0) {
            factorization.push_back(d);
            n /= d;
        }
    }
    static array<int, 8> increments = {4, 2, 4, 2, 4, 6, 2, 6};
    int i = 0;
    for (long long d = 7; d * d <= n; d += increments[i++]) {
        while (n % d == 0) {
            factorization.push_back(d);
            n /= d;
        }
        if (i == 8)
            i = 0;
    }
    if (n > 1)
        factorization.push_back(n);
    return factorization;
}
이 방법을 계속 확장하여 더 많은 소수를 포함하면 더 나은 비율을 얻을 수 있지만, 건너뛰기 목록은 더 커집니다.
미리 계산한 소수
휠 인수분해 방법을 끝없이 확장하면 확인할 수로 소수만 남게 됩니다. 이를 확인하는 좋은 방법은 에라토스테네스의 체로 $\sqrt{n}$까지의 모든 소수를 미리 계산해 두고 하나씩 확인하는 것입니다.
vector<long long> primes;

vector<long long> trial_division4(long long n) {
    vector<long long> factorization;
    for (long long d : primes) {
        if (d * d > n)
            break;
        while (n % d == 0) {
            factorization.push_back(d);
            n /= d;
        }
    }
    if (n > 1)
        factorization.push_back(n);
    return factorization;
}
페르마 인수분해 방법
홀수 합성수 $n = p \cdot q$는 두 제곱수의 차 $n = a^2 - b^2$으로 나타낼 수 있습니다:
페르마 인수분해법은 첫 번째 제곱수 $a^2$을 추측한 뒤 나머지 부분인 $b^2 = a^2 - n$ 역시 제곱수인지 확인하는 방식으로 이 사실을 활용하려고 합니다. 제곱수라면 $n$의 인수 $a - b$와 $a + b$를 찾은 것입니다.
int fermat(int n) {
    int a = ceil(sqrt(n));
    int b2 = a*a - n;
    int b = round(sqrt(b2));
    while (b * b != b2) {
        a = a + 1;
        b2 = a*a - n;
        b = round(sqrt(b2));
    }
    return a - b;
}
이 인수분해법은 두 인수 $p$와 $q$의 차이가 작다면 매우 빠를 수 있습니다. 이 알고리즘은 $O(|p - q|)$ 시간에 동작합니다. 하지만 실제로는 이 방법이 거의 사용되지 않습니다. 인수들이 서로 멀리 떨어질수록 극도로 느려지기 때문입니다.
그렇지만 이 접근법에는 여전히 많은 최적화 방법이 있습니다. 제곱수 $a^2$을 고정된 작은 수를 법으로 하여 살펴보면, 특정 값 $a$는 제곱수 $a^2 - n$을 만들어 낼 수 없으므로 확인할 필요가 없다는 것을 알 수 있습니다.
Pollard의 $p - 1$ 방법
수 $n$이 작은 $\mathrm{B}$에 대해 $p - 1$이 $\mathrm{B}$-powersmooth인 소인수 $p$를 적어도 하나 가질 가능성은 매우 높습니다. 정수 $m$을 나누는 모든 소수 거듭제곱이 $\mathrm{B}$ 이하이면 $m$을 $\mathrm{B}$-powersmooth라고 합니다. 형식적으로, $\mathrm{B} \geqslant 1$이라 하고 $m$을 임의의 양의 정수라고 합시다. $m$의 소인수분해가 $m = \prod {q_i}^{e_i}$라고 가정합시다. 여기서 각 $q_i$는 소수이고 $e_i \geqslant 1$입니다. 이때 모든 $i$에 대해 ${q_i}^{e_i} \leqslant \mathrm{B}$이면 $m$은 $\mathrm{B}$-powersmooth입니다. 예를 들어 $4817191$의 소인수분해는 $1303 \cdot 3697$입니다. 그리고 $1303 - 1 = 2 \cdot 3 \cdot 7 \cdot 31$이고 $3697 - 1 = 2^4 \cdot 3 \cdot 7 \cdot 11$이므로, 값 $1303 - 1$과 $3697 - 1$은 각각 $31$-powersmooth와 $16$-powersmooth입니다. 1974년 John Pollard는 합성수로부터 $p-1$이 $\mathrm{B}$-powersmooth인 인수 $p$를 추출하는 방법을 고안했습니다.
이 아이디어는 페르마의 소정리에서 비롯됩니다. $n$의 인수분해를 $n = p \cdot q$라고 합시다. 이 정리에 따르면 $a$가 $p$와 서로소일 때 다음 명제가 성립합니다:
이는 또한 다음을 의미합니다
따라서 $p - 1 ~|~ M$을 만족하는 임의의 $M$에 대해 $a^M \equiv 1$임을 알 수 있습니다. 이는 $a^M - 1 = p \cdot r$임을 의미하며, 그 결과 $p ~|~ \gcd(a^M - 1, n)$도 성립합니다.
따라서 $n$의 인수 $p$에 대해 $p - 1$이 $M$을 나눈다면, 유클리드 알고리즘을 사용하여 인수를 추출할 수 있습니다.
모든 $\mathrm{B}$-powersmooth 수의 배수가 되는 가장 작은 $M$이 $\text{lcm}(1,~2~,3~,4~,~\dots,~B)$라는 것은 자명합니다. 또는 다음과 같이 나타낼 수도 있습니다:
$n$의 모든 소인수 $p$에 대해 $p-1$이 $M$을 나눈다면, $\gcd(a^M - 1, n)$은 그냥 $n$이 된다는 점에 유의하십시오. 이 경우에는 인수를 얻지 못합니다. 따라서 $M$을 계산하는 동안 $\gcd$를 여러 번 수행해 보겠습니다.
작은 $\mathrm{B}$에 대해 $p-1$이 $\mathrm{B}$-powersmooth가 되는 인수 $p$를 갖지 않는 합성수도 있습니다. 예를 들어, 합성수 $100~000~000~000~000~493 = 763~013 \cdot 131~059~365~961$의 경우, $p-1$의 값은 각각 $190~753$-powersmooth와 $1~092~161~383$-powersmooth입니다. 이 수를 인수분해하려면 $B \geq 190~753$을 선택해야 합니다.
다음 구현에서는 $\mathrm{B} = 10$에서 시작하여 매 반복마다 $\mathrm{B}$를 증가시킵니다.
long long pollards_p_minus_1(long long n) {
    int B = 10;
    long long g = 1;
    while (B <= 1000000 && g < n) {
        long long a = 2 + rand() %  (n - 3);
        g = gcd(a, n);
        if (g > 1)
            return g;

        // compute a^M
        for (int p : primes) {
            if (p >= B)
                continue;
            long long p_power = 1;
            while (p_power * p <= B)
                p_power *= p;
            a = power(a, p_power, n);

            g = gcd(a - 1, n);
            if (g > 1 && g < n)
                return g;
        }
        B *= 2;
    }
    return 1;
}
이것은 확률적 알고리즘이라는 점에 유의하십시오. 그 결과, 알고리즘이 인수를 전혀 찾지 못할 가능성도 있습니다.
복잡도는 반복당 $O(B \log B \log^2 n)$입니다.
Pollard의 rho 알고리즘
Pollard의 Rho 알고리즘은 John Pollard가 고안한 또 다른 인수분해 알고리즘입니다.
어떤 수의 소인수분해를 $n = p q$라고 합시다. 이 알고리즘은 의사 난수 수열 $\{x_i\} = \{x_0,~f(x_0),~f(f(x_0)),~\dots\}$를 살펴봅니다. 여기서 $f$는 다항 함수이며, 보통 $c = 1$인 $f(x) = (x^2 + c) \bmod n$을 선택합니다.
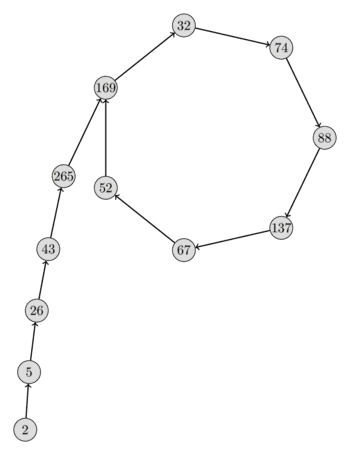
이 경우 우리는 수열 $\{x_i\}$ 자체에는 관심이 없습니다. 우리가 더 관심을 두는 것은 수열 $\{x_i \bmod p\}$입니다. $f$는 다항 함수이고 모든 값이 $[0;~p)$ 범위 안에 있으므로, 이 수열은 결국 루프로 수렴하게 됩니다. 실제로 생일 역설에 따르면 반복이 시작되기까지의 원소 개수의 기댓값은 $O(\sqrt{p})$입니다. $p$가 $\sqrt{n}$보다 작다면, 반복은 $O(\sqrt[4]{n})$ 안에 시작될 가능성이 높습니다.
다음은 $n = 2206637$, $p = 317$, $x_0 = 2$, $f(x) = x^2 + 1$일 때의 수열 $\{x_i \bmod p\}$를 시각화한 것입니다. 수열의 모양을 보면 이 알고리즘이 왜 Pollard의 $\rho$ 알고리즘이라고 불리는지 매우 분명하게 알 수 있습니다.
하지만 아직 해결되지 않은 질문이 남아 있습니다. 수 $p$ 자체를 알지도 못하는 상태에서 수열 $\{x_i \bmod p\}$의 성질을 어떻게 우리에게 유리하게 활용할 수 있겠습니까?
사실 이는 꽤 쉽습니다. 수열 $\{x_i \bmod p\}_{i \le j}$에 사이클이 존재하는 것은 $x_s \equiv x_t \bmod p$를 만족하는 두 인덱스 $s, t \le j$가 존재하는 것과 동치입니다. 이 방정식은 $x_s - x_t \equiv 0 \bmod p$로 다시 쓸 수 있으며, 이는 $p ~|~ \gcd(x_s - x_t, n)$과 같습니다.
따라서 $g = \gcd(x_s - x_t, n) > 1$을 만족하는 두 인덱스 $s$와 $t$를 찾으면, 사이클을 찾은 것이며 동시에 $n$의 인수 $g$도 찾은 것입니다. $g = n$일 수도 있습니다. 이 경우에는 자명하지 않은 인수를 찾지 못한 것이므로, 다른 매개변수(다른 시작값 $x_0$, 다항 함수 $f$의 다른 상수 $c$)로 알고리즘을 다시 수행해야 합니다.
사이클을 찾기 위해 일반적인 사이클 탐지 알고리즘 중 어느 것이든 사용할 수 있습니다.
Floyd의 사이클 탐지 알고리즘
이 알고리즘은 수열 위를 서로 다른 속도로 이동하는 두 포인터를 사용하여 사이클을 찾습니다. 매 반복마다 첫 번째 포인터는 한 원소씩 전진하고, 두 번째 포인터는 두 원소씩 전진합니다. 이 아이디어를 이용하면, 사이클이 존재할 경우 루프를 도는 동안 어느 시점에 두 번째 포인터가 한 바퀴 돌아 첫 번째 포인터와 만나게 된다는 것을 쉽게 알 수 있습니다. 사이클의 길이가 $\lambda$이고 사이클이 시작되는 첫 인덱스가 $\mu$라면, 알고리즘은 $O(\lambda + \mu)$ 시간에 동작합니다.
이 알고리즘은 거북이(느린 포인터)와 토끼(빠른 포인터)가 경주를 벌이는 이야기에서 이름을 따 거북이와 토끼 알고리즘이라고도 불립니다.
실제로 이 알고리즘을 사용하면 매개변수 $\lambda$와 $\mu$도 구할 수 있습니다(이때에도 $O(\lambda + \mu)$ 시간과 $O(1)$ 공간이 듭니다). 사이클이 감지되면 알고리즘은 'True'를 반환합니다. 수열에 사이클이 없으면 함수는 끝없이 루프를 돕니다. 그러나 Pollard의 Rho 알고리즘을 사용하면 이를 막을 수 있습니다.
function floyd(f, x0):
    tortoise = x0
    hare = f(x0)
    while tortoise != hare:
        tortoise = f(tortoise)
        hare = f(f(hare))
    return true
구현
먼저 Floyd의 사이클 탐지 알고리즘을 사용한 구현입니다. 이 알고리즘은 일반적으로 $O(\sqrt[4]{n} \log(n))$ 시간에 동작합니다.
long long mult(long long a, long long b, long long mod) {
    return (__int128)a * b % mod;
}

long long f(long long x, long long c, long long mod) {
    return (mult(x, x, mod) + c) % mod;
}

long long rho(long long n, long long x0=2, long long c=1) {
    long long x = x0;
    long long y = x0;
    long long g = 1;
    while (g == 1) {
        x = f(x, c, n);
        y = f(y, c, n);
        y = f(y, c, n);
        g = gcd(abs(x - y), n);
    }
    return g;
}
다음 표는 $n = 2206637$, $x_0 = 2$, $c = 1$일 때 알고리즘이 진행되는 동안의 $x$와 $y$ 값을 보여 줍니다.
이 구현은 128비트 정수를 위한 GCC의 타입 __int128을 사용하여 $\le 10^{18}$인 두 정수를 오버플로 없이 곱하는 함수 mult를 사용합니다. GCC를 사용할 수 없다면 이진 거듭제곱과 비슷한 아이디어를 사용할 수 있습니다.
long long mult(long long a, long long b, long long mod) {
    long long result = 0;
    while (b) {
        if (b & 1)
            result = (result + a) % mod;
        a = (a + a) % mod;
        b >>= 1;
    }
    return result;
}
또는 몽고메리 곱셈을 구현할 수도 있습니다.
앞서 말했듯이 $n$이 합성수인데 알고리즘이 $n$을 인수로 반환한다면, 다른 매개변수 $x_0$와 $c$로 이 과정을 반복해야 합니다. 예를 들어 $x_0 = c = 1$을 선택하면 $25 = 5 \cdot 5$를 인수분해하지 못합니다. 알고리즘은 $25$를 반환합니다. 그러나 $x_0 = 1$, $c = 2$를 선택하면 인수분해할 수 있습니다.
Brent의 알고리즘
Brent는 두 개의 포인터를 사용하여 Floyd와 비슷한 방법을 구현합니다. 차이점은 포인터를 각각 한 칸과 두 칸씩 전진시키는 대신 2의 거듭제곱만큼 전진시킨다는 것입니다. $2^i$가 $\lambda$와 $\mu$보다 커지는 즉시 사이클을 찾게 됩니다.
function brent(f, x0):
    tortoise = x0
    hare = f(x0)
    l = 1
    while tortoise != hare:
        tortoise = hare
        repeat l times:
            hare = f(hare)
            if tortoise == hare:
                return true
        l *= 2
    return true
Brent의 알고리즘도 선형 시간에 동작하지만, 함수 $f$를 더 적게 계산하므로 일반적으로 Floyd의 알고리즘보다 빠릅니다.
구현
Brent의 알고리즘을 단순하게 구현한 것은 $k < \frac{3 \cdot l}{2}$일 때 항 $x_l - x_k$를 생략하여 더 빠르게 만들 수 있습니다. 또한 매 단계마다 $\gcd$ 계산을 수행하는 대신, 항들을 곱해 두었다가 몇 단계마다 한 번씩만 실제로 $\gcd$를 확인하고, 지나쳤다면 되돌아갑니다.
long long brent(long long n, long long x0=2, long long c=1) {
    long long x = x0;
    long long g = 1;
    long long q = 1;
    long long xs, y;

    int m = 128;
    int l = 1;
    while (g == 1) {
        y = x;
        for (int i = 1; i < l; i++)
            x = f(x, c, n);
        int k = 0;
        while (k < l && g == 1) {
            xs = x;
            for (int i = 0; i < m && i < l - k; i++) {
                x = f(x, c, n);
                q = mult(q, abs(y - x), n);
            }
            g = gcd(q, n);
            k += m;
        }
        l *= 2;
    }
    if (g == n) {
        do {
            xs = f(xs, c, n);
            g = gcd(abs(xs - y), n);
        } while (g == 1);
    }
    return g;
}
작은 소수에 대한 시행 나눗셈과 Brent 버전의 Pollard rho 알고리즘을 결합하면 매우 강력한 인수분해 알고리즘이 됩니다.