두 번째로 좋은 최소 신장 트리
최소 신장 트리 $T$는 주어진 그래프 $G$의 모든 정점을 잇는 트리로, 가능한 모든 신장 트리 중에서 간선 가중치의 합이 최소인 트리입니다. 두 번째로 좋은 MST $T'$는 그래프 $G$에서 만들 수 있는 모든 신장 트리 가운데 간선 가중치의 합이 두 번째로 작은 신장 트리입니다.
관찰
그래프 $G$의 최소 신장 트리를 $T$라고 합시다. 두 번째로 좋은 최소 신장 트리는 $T$에서 간선 하나만 교체한 것이라는 사실을 관찰할 수 있습니다. (이 명제의 증명은 여기의 문제 23-1을 참고하십시오.)
따라서 $T$에 속하지 않는 간선 $e_{new}$를 찾아 $T$에 속한 간선 하나(이를 $e_{old}$라고 합시다)와 교체하되, 새 그래프 $T' = (T \cup \{e_{new}\}) \setminus \{e_{old}\}$가 신장 트리이면서 가중치 차이($e_{new} - e_{old}$)가 최소가 되도록 해야 합니다.
Kruskal 알고리즘 사용하기
먼저 Kruskal 알고리즘으로 MST를 구한 뒤, 거기서 간선 하나를 제거하고 다른 간선으로 교체해 보면 됩니다.
- 간선을 $O(E \log E)$에 정렬한 뒤, Kruskal로 $O(E)$에 MST를 구합니다.
- MST에 속한 각 간선(MST에는 $V-1$개의 간선이 있습니다)에 대해, 그 간선이 선택되지 않도록 간선 목록에서 일시적으로 제외합니다.
- 그런 다음 남은 간선들로 다시 $O(E)$에 MST를 구해 봅니다.
- MST의 모든 간선에 대해 이 과정을 수행하고, 그중 가장 좋은 결과를 택합니다.
참고: 3단계에서는 간선을 다시 정렬할 필요가 없습니다.
따라서 전체 시간 복잡도는 $O(E \log V + E + V E)$ = $O(V E)$가 됩니다.
최소 공통 조상(LCA) 문제로 모델링하기
앞의 방법에서는 MST의 간선 하나를 제거하는 모든 경우를 시도했습니다. 여기서는 정확히 그 반대로 합니다. MST에 아직 속하지 않은 모든 간선을 추가해 봅니다.
- 간선을 $O(E \log E)$에 정렬한 뒤, Kruskal로 $O(E)$에 MST를 구합니다.
- MST에 아직 속하지 않은 각 간선 $e$에 대해, 이를 MST에 일시적으로 추가하여 사이클을 만듭니다. 이 사이클은 LCA를 지나갑니다.
- 간선 $e$의 양 끝 노드에서 부모를 따라 LCA까지 올라가며, 사이클에서 $e$가 아닌 간선 중 가중치가 최대인 간선 $k$를 찾습니다.
- $k$를 일시적으로 제거하여 새로운 신장 트리를 만듭니다.
- 가중치 차이 $\delta = weight(e) - weight(k)$를 계산하고, 이를 바뀐 간선과 함께 기억해 둡니다.
- 다른 모든 간선에 대해 2단계를 반복하고, MST와의 가중치 차이가 가장 작은 신장 트리를 반환합니다.
이 알고리즘의 시간 복잡도는 알고리즘의 2단계에서 최대 가중치 간선인 $k$들을 어떻게 계산하느냐에 달려 있습니다. 이를 $O(E \log V)$에 효율적으로 계산하는 한 가지 방법은 문제를 최소 공통 조상(LCA) 문제로 변환하는 것입니다.
MST에 루트를 정하여 LCA를 전처리하고, 각 노드에서 조상까지의 경로에 있는 최대 간선 가중치도 함께 계산합니다. 이는 LCA를 위한 이진 리프팅을 사용하여 수행할 수 있습니다.
이 방법의 최종 시간 복잡도는 $O(E \log V)$입니다.
예를 들면 다음과 같습니다:
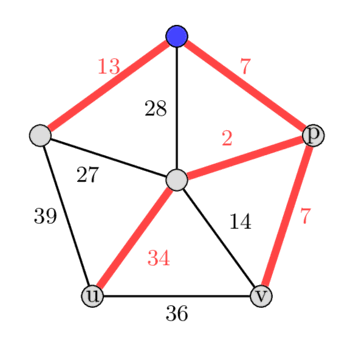
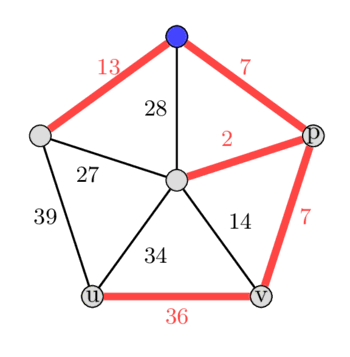
*그림에서 왼쪽은 MST이고 오른쪽은 두 번째로 좋은 MST입니다.*
주어진 그래프에서 MST의 루트를 맨 위의 파란색 정점으로 정하고, MST에 속하지 않은 간선을 선택해 나가면서 알고리즘을 실행한다고 가정합시다. 처음 선택한 간선을 가중치가 36인 간선 $(u, v)$라고 합시다. 이 간선을 트리에 추가하면 36 - 7 - 2 - 34 사이클이 만들어집니다.
이제 $\text{LCA}(u, v) = p$를 구하여 이 사이클에서 가중치가 최대인 간선을 찾습니다. $u$에서 $p$까지의 경로와 $v$에서 $p$까지의 경로에서 가중치가 최대인 간선을 계산합니다. 참고: 경우에 따라 $\text{LCA}(u, v)$가 $u$ 또는 $v$와 같을 수도 있습니다. 이 예시에서는 가중치가 34인 간선이 사이클에서 가중치가 최대인 간선이 됩니다. 이 간선을 제거하면 가중치 차이가 2밖에 나지 않는 새로운 신장 트리를 얻습니다.
처음 MST에 속하지 않은 나머지 모든 간선에 대해서도 같은 작업을 하고 나면, 이 신장 트리가 전체에서도 두 번째로 좋은 신장 트리였음을 알 수 있습니다. 가중치가 14인 간선을 선택하면 트리의 가중치가 7 증가하고, 가중치가 27인 간선을 선택하면 14 증가하며, 가중치가 28인 간선을 선택하면 21 증가하고, 가중치가 39인 간선을 선택하면 5 증가합니다.
구현
struct edge {
    int s, e, w, id;
    bool operator<(const struct edge& other) { return w < other.w; }
};
typedef struct edge Edge;

const int N = 2e5 + 5;
long long res = 0, ans = 1e18;
int n, m, a, b, w, id, l = 21;
vector<Edge> edges;
vector<int> h(N, 0), parent(N, -1), size(N, 0), present(N, 0);
vector<vector<pair<int, int>>> adj(N), dp(N, vector<pair<int, int>>(l));
vector<vector<int>> up(N, vector<int>(l, -1));

pair<int, int> combine(pair<int, int> a, pair<int, int> b) {
    vector<int> v = {a.first, a.second, b.first, b.second};
    int topTwo = -3, topOne = -2;
    for (int c : v) {
        if (c > topOne) {
            topTwo = topOne;
            topOne = c;
        } else if (c > topTwo && c < topOne) {
            topTwo = c;
        }
    }
    return {topOne, topTwo};
}

void dfs(int u, int par, int d) {
    h[u] = 1 + h[par];
    up[u][0] = par;
    dp[u][0] = {d, -1};
    for (auto v : adj[u]) {
        if (v.first != par) {
            dfs(v.first, u, v.second);
        }
    }
}

pair<int, int> lca(int u, int v) {
    pair<int, int> ans = {-2, -3};
    if (h[u] < h[v]) {
        swap(u, v);
    }
    for (int i = l - 1; i >= 0; i--) {
        if (h[u] - h[v] >= (1 << i)) {
            ans = combine(ans, dp[u][i]);
            u = up[u][i];
        }
    }
    if (u == v) {
        return ans;
    }
    for (int i = l - 1; i >= 0; i--) {
        if (up[u][i] != -1 && up[v][i] != -1 && up[u][i] != up[v][i]) {
            ans = combine(ans, combine(dp[u][i], dp[v][i]));
            u = up[u][i];
            v = up[v][i];
        }
    }
    ans = combine(ans, combine(dp[u][0], dp[v][0]));
    return ans;
}

int main(void) {
    cin >> n >> m;
    for (int i = 1; i <= n; i++) {
        parent[i] = i;
        size[i] = 1;
    }
    for (int i = 1; i <= m; i++) {
        cin >> a >> b >> w; // 1-indexed
        edges.push_back({a, b, w, i - 1});
    }
    sort(edges.begin(), edges.end());
    for (int i = 0; i <= m - 1; i++) {
        a = edges[i].s;
        b = edges[i].e;
        w = edges[i].w;
        id = edges[i].id;
        if (unite_set(a, b)) {
            adj[a].emplace_back(b, w);
            adj[b].emplace_back(a, w);
            present[id] = 1;
            res += w;
        }
    }
    dfs(1, 0, 0);
    for (int i = 1; i <= l - 1; i++) {
        for (int j = 1; j <= n; ++j) {
            if (up[j][i - 1] != -1) {
                int v = up[j][i - 1];
                up[j][i] = up[v][i - 1];
                dp[j][i] = combine(dp[j][i - 1], dp[v][i - 1]);
            }
        }
    }
    for (int i = 0; i <= m - 1; i++) {
        id = edges[i].id;
        w = edges[i].w;
        if (!present[id]) {
            auto rem = lca(edges[i].s, edges[i].e);
            if (rem.first != w) {
                if (ans > res + w - rem.first) {
                    ans = res + w - rem.first;
                }
            } else if (rem.second != -1) {
                if (ans > res + w - rem.second) {
                    ans = res + w - rem.second;
                }
            }
        }
    }
    cout << ans << "\n";
    return 0;
}
참고 문헌
- Competitive Programming-3, Steven Halim 저
- web.mit.edu