강한 연결 요소와 응축 그래프
정의
$G=(V,E)$를 정점 집합 $V$와 간선 집합 $E \subseteq V \times V$로 이루어진 방향 그래프라고 합시다. $G$의 정점 개수를 $n=|V|$로, 간선 개수를 $m=|E|$로 나타냅니다. 이 글의 모든 정의는 멀티그래프로 쉽게 확장할 수 있지만, 여기서는 그 부분을 다루지 않습니다.
정점의 부분집합 $C \subseteq V$가 다음 조건을 만족하면 이를 강한 연결 요소라고 합니다:
- 모든 $u,v\in C$에 대하여 $u \neq v$이면 $u$에서 $v$로 가는 경로와 $v$에서 $u$로 가는 경로가 존재하며,
- $C$는 극대입니다. 즉, 위 조건을 위반하지 않고는 어떤 정점도 추가할 수 없습니다.
$G$의 강한 연결 요소들의 집합을 $\text{SCC}(G)$로 나타냅니다. 이 강한 연결 요소들은 서로 겹치지 않으며, 그래프의 모든 정점을 덮습니다. 따라서 집합 $\text{SCC}(G)$는 $V$의 분할입니다.
강한 연결 요소가 강조 표시된 다음 그래프 $G_\text{example}$을 살펴봅시다:
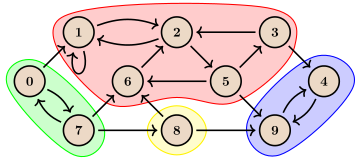
여기서 $\text{SCC}(G_\text{example})=\{\{0,7\},\{1,2,3,5,6\},\{4,9\},\{8\}\}.$입니다. 각 강한 연결 요소 안에서 모든 정점이 서로 도달 가능함을 확인할 수 있습니다.
응축 그래프 $G^{\text{SCC}}=(V^{\text{SCC}}, E^{\text{SCC}})$를 다음과 같이 정의합니다:
- $G^{\text{SCC}}$의 정점은 $G$의 강한 연결 요소들입니다. 즉, $V^{\text{SCC}} = \text{SCC}(G)$이며,
- 응축 그래프의 모든 정점 $C_i,C_j$에 대하여, $C_i$에서 $C_j$로 가는 간선이 존재할 필요충분조건은 $C_i \neq C_j$이고 $G$에서 $a$에서 $b$로 가는 간선이 있는 $a\in C_i$와 $b\in C_j$가 존재하는 것입니다.
$G_\text{example}$의 응축 그래프는 다음과 같습니다:
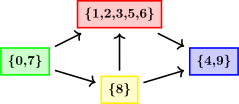
응축 그래프의 가장 중요한 성질은 비순환이라는 것입니다. 실제로 정의에 의해 응축 그래프에는 '자기 루프'가 없으며, 만약 응축 그래프에 두 개 이상의 정점(강한 연결 요소)을 지나는 사이클이 있다면, 도달 가능성에 의해 이 강한 연결 요소들의 합집합 자체가 하나의 강한 연결 요소가 되어야 하므로 모순입니다.
다음 절에서 설명하는 알고리즘은 주어진 그래프의 모든 강한 연결 요소를 찾습니다. 그 후에 응축 그래프를 구성할 수 있습니다.
Kosaraju 알고리즘
알고리즘 설명
여기서 설명하는 알고리즘은 1980년경 Kosaraju와 Sharir가 각각 독립적으로 제안하였습니다. 이 알고리즘은 두 차례의 깊이 우선 탐색에 기반하며, 실행 시간은 $O(n + m)$입니다.
알고리즘의 첫 번째 단계에서는 일련의 깊이 우선 탐색(dfs)을 수행하여 그래프 전체를 방문합니다. 즉, 아직 방문하지 않은 정점이 남아 있는 한, 그중 하나를 골라 그 정점에서 깊이 우선 탐색을 시작합니다. 각 정점에 대해 탈출 시각 $t_\text{out}[v]$를 기록합니다. 이는 정점 $v$에 대한 dfs 실행이 끝나는 '타임스탬프', 즉 $v$에서 도달 가능한 모든 정점을 방문하고 알고리즘이 $v$로 돌아온 시점입니다. 타임스탬프 카운터는 연속된 dfs 호출 사이에 초기화하지 않아야 합니다. 탈출 시각은 이 알고리즘에서 핵심적인 역할을 하며, 이는 다음 정리를 논의할 때 분명해집니다.
먼저, 강한 연결 요소 $C$의 탈출 시각 $t_\text{out}[C]$를 모든 $v \in C.$에 대한 $t_\text{out}[v]$ 값의 최댓값으로 정의합니다. 또한 정리의 증명에서 각 정점 $v\in G$의 진입 시각 $t_{\text{in}}[v]$를 언급할 것입니다. $t_{\text{in}}[v]$ 값은 알고리즘의 첫 번째 단계에서 재귀 함수 dfs가 정점 $v$에 대해 호출되는 '타임스탬프'를 나타냅니다. 강한 연결 요소 $C$에 대해, $t_{\text{in}}[C]$를 모든 $v \in C$에 대한 $t_{\text{in}}[v]$ 값들의 최솟값으로 정의합니다.
정리
$C$와 $C'$가 서로 다른 두 강한 연결 요소이고, 응축 그래프에서 $C$에서 $C'$로 가는 간선이 있다고 합시다. 그러면 $t_\text{out}[C] > t_\text{out}[C']$입니다.
증명
깊이 우선 탐색이 어느 요소에 먼저 도달하는지에 따라 두 가지 경우가 있습니다:
-
경우 1: 요소 $C$에 먼저 도달한 경우입니다(즉, $t_{\text{in}}[C] < t_{\text{in}}[C']$). 이 경우 깊이 우선 탐색은 요소 $C$와 $C'$의 다른 모든 정점이 아직 방문되지 않은 어느 시점에 어떤 정점 $v \in C$를 방문합니다. 응축 그래프에서 $C$에서 $C'$로 가는 간선이 있으므로, $G$에서 $v$로부터 $C$의 다른 모든 정점에 도달할 수 있을 뿐만 아니라 $C'$의 모든 정점에도 도달할 수 있습니다. 즉, 정점 $v$에서 시작된 이
dfs실행은 이후에 요소 $C$와 $C'$의 다른 모든 정점도 방문하게 되므로, 이 정점들은 깊이 우선 탐색 트리에서 $v$의 자손이 됩니다. 이로부터 각 정점 $u \in (C \cup C')\setminus \{v\},$에 대해 $t_\text{out}[v] > t_\text{out}[u]$가 성립합니다. 따라서 $t_\text{out}[C] > t_\text{out}[C']$이며, 이것으로 이 경우의 증명이 끝납니다. -
경우 2: 요소 $C'$에 먼저 도달한 경우입니다(즉, $t_{\text{in}}[C] > t_{\text{in}}[C']$). 이 경우 깊이 우선 탐색은 요소 $C$와 $C'$의 다른 모든 정점이 아직 방문되지 않은 어느 시점에 어떤 정점 $v \in C'$를 방문합니다. 응축 그래프에서 $C$에서 $C'$로 가는 간선이 있으므로, 비순환성에 의해 $C'$에서 $C$로는 도달할 수 없습니다. 따라서 정점 $v$에서 시작된
dfs실행은 $C$의 어떤 정점에도 도달하지 못하지만, $C'$의 모든 정점은 방문합니다. $C$의 정점들은 알고리즘의 이 단계에서 나중에 다른dfs실행에 의해 방문되므로, 실제로 $t_\text{out}[C] > t_\text{out}[C']$가 성립합니다. 이로써 증명이 완료됩니다.
증명한 정리는 강한 연결 요소를 찾는 데 매우 중요합니다. 이 정리에 따르면 응축 그래프의 모든 간선은 $t_\text{out}$ 값이 더 큰 요소에서 더 작은 요소로 향합니다.
모든 정점 $v \in V$를 탈출 시각 $t_\text{out}[v]$의 내림차순으로 정렬하면, 첫 번째 정점 $u$는 응축 그래프에서 들어오는 간선이 없는 "루트" 강한 연결 요소에 속합니다. 이제 이 정점 $u$에서 어떤 탐색을 실행하여, 그 정점이 속한 강한 연결 요소의 모든 정점은 방문하되 다른 정점은 방문하지 않도록 하려고 합니다. 이를 반복하면 모든 강한 연결 요소를 차례로 찾을 수 있습니다: 처음 찾은 요소에 속한 모든 정점을 제거한 다음, 남은 정점 중 $t_\text{out}$ 값이 가장 큰 정점을 찾아 그 정점에서 이 탐색을 실행하고, 이 과정을 계속 반복합니다. 결국 모든 강한 연결 요소를 찾게 됩니다. 원하는 대로 동작하는 탐색 방법을 찾기 위해 다음 정리를 살펴봅시다:
정리
$G$에서 간선의 방향을 뒤집어 얻은 $G$의 전치 그래프를 $G^T$로 나타냅시다. 그러면 $\text{SCC}(G)=\text{SCC}(G^T)$입니다. 또한 $G^T$의 응축 그래프는 $G$의 응축 그래프의 전치입니다.
증명은 생략합니다(어렵지는 않습니다). 이 정리에 따라 $G^T$의 응축 그래프에는 "루트" 요소에서 다른 요소로 가는 간선이 존재하지 않습니다. 따라서 정점 $v$를 포함하는 "루트" 강한 연결 요소 전체를 방문하려면 전치 그래프 $G^T$에서 정점 $v$부터 깊이 우선 탐색을 실행하기만 하면 됩니다! 이 탐색은 정확히 이 강한 연결 요소의 모든 정점만을 방문합니다. 앞서 언급했듯이, 그런 다음 이 정점들을 그래프에서 제거할 수 있습니다. 그다음 $t_\text{out}[v]$ 값이 최대인 다음 정점을 찾고, 그 정점에서 시작하여 전치 그래프에서 탐색을 실행해 다음 강한 연결 요소를 찾습니다. 이를 반복하면 모든 강한 연결 요소를 찾을 수 있습니다.
정리하면, 강한 연결 요소를 찾는 다음 알고리즘을 살펴보았습니다:
-
1단계. $G$에 대해 일련의 깊이 우선 탐색을 수행하면, 탈출 시각 $t_\text{out}$의 오름차순으로 정렬된 정점 리스트(예:
order)를 얻습니다. -
2단계. 전치 그래프 $G^T$를 만들고, 정점들을 역순으로(즉, 탈출 시각의 내림차순으로) 하여 일련의 깊이 우선 탐색을 수행합니다. 각 깊이 우선 탐색은 강한 연결 요소 하나를 만들어 냅니다.
-
3단계(선택 사항). 응축 그래프를 만듭니다.
깊이 우선 탐색을 두 번 수행하므로 이 알고리즘의 실행 시간 복잡도는 $O(n + m)$입니다. 응축 그래프를 만드는 것 역시 $O(n+m).$입니다
끝으로, 여기서 위상 정렬을 언급하는 것이 적절합니다. 1단계에서는 탈출 시각의 오름차순으로 정점을 찾습니다. $G$에 사이클이 없다면, 이는 $G$의 (역순) 위상 정렬에 해당합니다. 2단계에서 알고리즘은 강한 연결 요소를 탈출 시각의 내림차순으로 찾습니다. 따라서 알고리즘은 요소, 즉 응축 그래프의 정점을 응축 그래프의 위상 정렬에 해당하는 순서로 찾습니다.
구현
vector<bool> visited; // keeps track of which vertices are already visited

// runs depth first search starting at vertex v.
// each visited vertex is appended to the output vector when dfs leaves it.
void dfs(int v, vector<vector<int>> const& adj, vector<int> &output) {
    visited[v] = true;
    for (auto u : adj[v])
        if (!visited[u])
            dfs(u, adj, output);
    output.push_back(v);
}

// input: adj -- adjacency list of G
// output: components -- the strongy connected components in G
// output: adj_cond -- adjacency list of G^SCC (by root vertices)
void strongly_connected_components(vector<vector<int>> const& adj,
                                  vector<vector<int>> &components,
                                  vector<vector<int>> &adj_cond) {
    int n = adj.size();
    components.clear(), adj_cond.clear();

    vector<int> order; // will be a sorted list of G's vertices by exit time

    visited.assign(n, false);

    // first series of depth first searches
    for (int i = 0; i < n; i++)
        if (!visited[i])
            dfs(i, adj, order);

    // create adjacency list of G^T
    vector<vector<int>> adj_rev(n);
    for (int v = 0; v < n; v++)
        for (int u : adj[v])
            adj_rev[u].push_back(v);

    visited.assign(n, false);
    reverse(order.begin(), order.end());

    vector<int> roots(n, 0); // gives the root vertex of a vertex's SCC

    // second series of depth first searches
    for (auto v : order)
        if (!visited[v]) {
            std::vector<int> component;
            dfs(v, adj_rev, component);
            components.push_back(component);
            int root = *component.begin();
            for (auto u : component)
                roots[u] = root;
        }

    // add edges to condensation graph
    adj_cond.assign(n, {});
    for (int v = 0; v < n; v++)
        for (auto u : adj[v])
            if (roots[v] != roots[u])
                adj_cond[roots[v]].push_back(roots[u]);
}
함수 dfs는 깊이 우선 탐색을 구현합니다. 이 함수는 인접 리스트와 시작 정점을 입력으로 받습니다. 또한 벡터 output에 대한 참조도 받습니다. 방문한 각 정점은 dfs가 그 정점을 떠날 때 output에 추가됩니다.
함수 dfs를 알고리즘의 1단계와 2단계 모두에서 사용한다는 점에 유의하십시오. 첫 번째 단계에서는 $G$의 인접 리스트를 전달하고, dfs를 연속으로 호출하는 동안 같은 '출력 벡터' order를 계속 전달하여 최종적으로 탈출 시각의 오름차순으로 정렬된 정점 리스트를 얻습니다. 2단계에서는 $G^T$의 인접 리스트를 넘기고, 매 호출마다 빈 '출력 벡터' component를 넘깁니다. 그러면 한 번에 강한 연결 요소를 하나씩 얻습니다.
Tarjan의 강한 연결 요소 알고리즘
알고리즘 설명
여기서 설명하는 알고리즘은 1972년 Tarjan이 처음 제안했습니다. 이 알고리즘은 일련의 DFS 호출을 수행하면서 그 구조에 내재된 정보를 이용해 강한 연결 요소(SCC)를 찾으며, 실행 시간은 $O(n+m)$입니다.
정점에 DFS를 적용할 때는 그 정점의 인접 리스트를 순회하며, 아직 방문하지 않은 정점을 발견하면 그 정점에 재귀적으로 DFS를 적용합니다.
일련의 DFS 호출로 유도되는 트리를 생각해 봅시다. 이 트리를 DFS 트리라고 부르겠습니다. 어떤 SCC에 속한 정점에서 처음으로 DFS를 호출하면, 그 SCC의 모든 정점은 서로 도달 가능하므로 이 호출이 끝나기 전에 모두 방문됩니다. DFS 트리에서 이 첫 번째 정점은 SCC의 다른 모든 정점의 공통 조상이 됩니다. 이 정점을 SCC의 루트로 정의합니다.
정리
SCC의 모든 정점은 DFS 트리의 연결된 부분 그래프를 유도합니다.
증명
앞에서 SCC의 모든 정점에는 공통 조상, 즉 DFS 호출로 처음 방문되는 정점이 있다는 것을 확인했습니다. 정점 $v$와 그 루트인 정점 $r$을 생각해 봅시다. $r$에서 $v$로 가는 경로 위의 모든 정점은 같은 SCC에 속합니다. 이 정점들은 모두 $r$에서 도달 가능하고 모두 $v$에 도달할 수 있으며, 정의에 따라 $v$는 $r$에 도달하므로 이 정점들은 모두 서로 도달 가능합니다. 루트에서 SCC의 다른 모든 정점으로 가는 경로가 모두 같은 SCC에 속하므로, 이렇게 만들어지는 부분 그래프는 연결되어 있습니다.
SCC들은 DFS 트리를 연결된 부분 그래프들로 빈틈없이 나눈다는 점에 유의하십시오.
따라서 알고리즘의 아이디어는 다음과 같습니다.
-
일련의 DFS 호출을 수행하며, 인접 리스트의 정점들에 재귀적으로 DFS를 적용합니다.
-
어떤 정점의 인접 리스트 순회를 마치면, 어떤 방법으로든 그 정점이 루트인지 아닌지 판별할 수 있습니다. 이 방법은 뒤에서 설명하겠습니다.
-
정점이 루트라면, 즉시 그 SCC의 모든 정점을 찾아 할당합니다.
모든 호출이 끝나면 모든 루트가 발견되고, 모든 정점이 어떤 SCC의 일부로 할당되어 있을 것입니다.
이제 이러한 할당 과정을 도입했을 때 DFS가 갖는 성질을 분석해 봅시다.
정리
정점 $v$를 생각하고, 방금 그 정점의 인접 리스트 순회를 마쳤다고 합시다. 그 서브트리에서 아직 할당되지 않은 모든 정점은 같은 SCC에 속합니다.
증명
알고리즘은 SCC의 루트를 발견하면 그 SCC의 정점들을 할당합니다. $v$의 인접 리스트 순회가 끝났으므로 그 서브트리에 대한 모든 DFS 호출이 끝났고, 루트들이 발견되었으며, 그 루트들의 SCC에 속한 정점들은 할당되었습니다. 남아 있는 할당되지 않은 정점들의 루트는 아직 할당 과정이 실행되지 않은 조상이므로, $v$이거나 $v$의 조상입니다. $v$는 모든 정점에서 그 루트로 가는 경로 위에 있고 SCC는 트리의 연결된 부분 그래프를 유도해야 하므로, $v$와 남아 있는 모든 정점은 같은 SCC에 속합니다.
정리
정점 $v$를 생각하고, $v$의 인접 리스트를 순회하며 현재 간선 $(v, u)$를 처리하고 있다고 합시다. $u$가 이미 어떤 DFS 호출에서 방문되었고 아직 할당되지 않은 상태라면, $v$와 $u$는 같은 SCC에 속합니다.
증명
간선의 종류에 따라 여러 경우가 있습니다:
-
트리 간선: 이 간선이 트리 간선이라면, 정점 $u$를 처음으로 발견한 것입니다. 따라서 먼저 $u$에 대해 DFS 호출을 재귀적으로 적용하고, 그 DFS 호출이 끝난 뒤에 $u$를 고려해야 합니다. 정점 $u$가 아직 할당되지 않은 상태라면, $u$의 루트는 $v$이거나 $v$의 조상이므로 두 정점은 같은 SCC에 속해야 합니다.
-
역방향 간선: 더 간단한 경우입니다. $u$가 $v$의 조상이라면 두 정점은 서로 도달할 수 있으므로 정의에 따라 같은 SCC에 속합니다.
-
순방향 간선: 이 간선을 처리하기 전에 $u$의 루트를 찾지 못한 채 끝난 일련의 DFS 호출이 있었고, 이후 $v$로 돌아와 $v$의 DFS 호출이 계속 진행되었습니다. 그러면 $u$의 루트는 아직 할당 과정이 실행되지 않은 조상이므로 $v$이거나 $v$의 조상이며, 따라서 두 정점은 같은 SCC에 속해야 합니다.
-
교차 간선: 마찬가지로 이 간선을 처리하기 전에 $u$의 루트를 찾지 못한 채 끝난 일련의 DFS 호출이 있었고, 이후 $u$와 $v$의 공통 조상으로 돌아왔으며, 그 공통 조상의 DFS 호출이 계속 진행되면서 $v$에 대한 호출로 이어지는 새로운 일련의 DFS 호출을 시작했습니다. 그러면 $u$의 루트는 아직 할당 과정이 실행되지 않은 조상이며, 가능한 후보는 모두 $v$와의 공통 조상입니다. $u$의 루트는 $v$의 조상이므로 $v$에 도달하고, 이제 $v$가 $u$에 도달하므로 두 정점은 같은 SCC에 속해야 합니다.
참고로, 두 정점이 같은 요소에 속할 때 두 정점의 루트는 반드시 두 정점의 공통 조상이어야 합니다.
정리
$v$를 정점이라고 합시다. 다음 명제들은 동치입니다:
- $v$의 서브트리에 있는 어떤 정점이 서브트리 바깥에 있는 할당되지 않은 정점에 도달합니다.
- $v$는 SCC의 루트가 아닙니다.
증명
-
$1. \implies 2.$: $v$의 서브트리에 있는 어떤 정점 $u$가 서브트리 바깥에 있는 할당되지 않은 정점 $w$에 도달한다고 가정합시다. 앞에서 $u$와 $w$가 같은 SCC에 속하며, 그 루트는 반드시 두 정점의 공통 조상이어야 한다는 사실을 보였습니다. 이 공통 조상은 반드시 서브트리 바깥에 있으며, $v$의 조상이기도 합니다. $v$는 루트에서 $u$로 가는 경로 위에 있으므로 같은 SCC에 속해야 하며, 그 SCC의 루트는 $v$가 아닙니다.
-
$\neg 1. \implies \neg 2.$: $v$의 서브트리에 있는 어떤 정점도 서브트리 바깥에 있는 할당되지 않은 정점에 도달하지 않는다고 가정합시다. 이는 $v$의 서브트리에 있는 어떤 정점도 $v$의 조상에 도달하지 않는다는 뜻입니다. 서브트리 바깥의 정점으로 향할 수 있는 간선은 이미 할당된 정점으로 향하는 교차 간선뿐입니다. 이 정점들은 $v$의 조상에 도달할 수 없습니다. 만약 도달한다면 $v$와 같은 SCC에 속하게 되는데, 이들의 SCC는 이미 정해졌으므로 이는 불가능하기 때문입니다. $v$의 서브트리에서 $v$의 어떤 조상에도 도달할 수 없으므로, $v$의 루트는 $v$ 자신이어야 합니다.
이제 정점이 루트인지 아닌지 판별하는 방법을 찾아야 하며, 그 방법이 올바르려면 할당 과정의 성질이 필요합니다. 이를 위해 각 정점 $v \in G$에 대해 진입 시각 $t_{in}[v]$를 정의합니다. 이는 $v$에 대해 DFS가 호출된 '타임스탬프'에 해당합니다. 정의에 따라 루트는 SCC에서 DFS가 가장 먼저 방문하는 정점이므로, 루트의 $t_{in}$ 값은 그 SCC에서 가장 작습니다.
$v$를 정점이라 하고 그 서브트리를 살펴봅시다. $v$의 인접 리스트 순회를 마치는 시점에는 서브트리 밖에서 DFS가 이미 방문한 모든 정점의 $t_{in}$ 값이 더 작습니다. 그 정점들에서는 DFS가 $v$에서 시작되기 전에 먼저 호출되었기 때문입니다.
점유 과정을 생각해 보면, $v$의 서브트리 밖에 있는 아직 점유되지 않은 모든 정점의 $t_{in}$ 값은 $t_{in}[v]$보다 작습니다. 이제 $t_{in}$을 사용하여 루트를 판별하는 방법을 알 수 있습니다. 도달할 수 있는 미점유 정점들의 $t_{in}$ 최솟값을 구하고, 이 정보를 트리 간선을 통해 조상들에게 전파합니다. 이렇게 전파된 값을 $t_{low}$라고 부르겠습니다.
더 엄밀하게는, $t_{low}[v]$를 $v$의 서브트리에 속한 정점이 직접 간선을 통해 도달할 수 있는 $t_{in}$의 최솟값으로 정의합니다. 따라서 $t_{low}[v] < t_{in}[v]$인지 확인하여 정점 $v$가 루트인지 아닌지 판별할 수 있습니다.
마지막으로, 정점을 할당하는 방법은 다른 그래프 탐색 알고리즘을 사용하는 등 여러 가지가 있지만, 간단한 자료 구조를 사용하여 아직 할당되지 않은 정점을 추적하는 것도 가능합니다. 기본 원리부터 이 자료 구조를 결정하기 위해, 자료 구조가 구현해야 하는 메서드를 살펴봅시다. 메서드는 두 가지뿐입니다.
-
정점을 처음 방문하면, 이 정점은 아직 할당되지 않았으므로 단순히 자료 구조에 삽입해야 합니다.
-
루트를 찾으면, 그 서브트리에 남아 있는 할당되지 않은 정점을 모두 찾아 자료 구조에서 제거해야 합니다.
정점 $v$의 인접 리스트를 순회한 직후에는 $v$ 이후에 자료 구조에 들어간 정점이 모두 $v$의 서브트리에 속한다는 점에 주목하면, 제거 연산을 다른 방식으로 설명할 수 있습니다. $v$가 루트라면 $v$ 이후에 삽입되어 남아 있는 정점을 모두 제거해야 합니다. 따라서 제거 연산은 다음과 같이 기술할 수도 있습니다:
- 루트를 찾으면 그 이후에 삽입되어 남아 있는 정점을 모두 찾아 제거해야 합니다.
이제 이를 스택으로 구현할 수 있음을 알 수 있습니다:
-
정점을 처음 방문하면 스택에 push합니다.
-
루트를 찾으면 루트 자신을 pop할 때까지 모든 원소를 pop합니다.
이로써 마침내 알고리즘을 구현할 수 있습니다.
일련의 DFS 호출의 실행 시간 복잡도는 $O(n + m)$입니다. 스택의 경우, 각 노드가 한 번씩만 push되고 pop되므로 복잡도는 분할 상환하면 $O(n)$입니다. 따라서 전체 실행 시간 복잡도는 $O(n + m)$입니다.
덧붙이자면, 루트들은 역위상 순서로 발견됩니다. 이 알고리즘에서 정점이 루트가 되는 것은 서브트리 밖의 미점유 정점으로 향하는 간선이 없을 때입니다. 즉, 도달 가능한 다른 모든 컴포넌트는 그 서브트리 안에 있거나(따라서 그 루트들은 이미 발견되었습니다), 서브트리 밖의 이미 점유된 정점에 연결됩니다(그 루트들 역시 이미 발견되었습니다). 따라서 도달 가능한 모든 컴포넌트는 이미 발견된 상태이며, 이는 컴포넌트들이 응축 그래프의 올바른 역위상 순서로 나타난다는 뜻입니다.
구현
vector<int> st;    // - stack holding the unclaimed vertices
vector<int> roots; // - keeps track of the SCC roots of the vertices
int timer;         // - dfs timestamp counter
vector<int> t_in;  // - keeps track of the dfs timestamp of the vertices
vector<int> t_low; // - keeps track of the lowest t_in of unclaimed vertices
                   // reachable in the subtree

// implements the tarjan algorithm for strongly connected components
void dfs(int v, vector<vector<int>> const &adj, vector<vector<int>> &components) {

  t_low[v] = t_in[v] = timer++;
  st.push_back(v);

  for (auto u : adj[v]) {
    if (t_in[u] == -1) { // tree-edge
      dfs(u, adj, components);
      t_low[v] = min(t_low[v], t_low[u]);
    } else if (roots[u] == -1) { // back-edge, cross-edge or forward-edge to an unclaimed vertex
      t_low[v] = min(t_low[v], t_in[u]);
    }
  }

  if (t_low[v] == t_in[v]) { // vertex is a root
    components.push_back({v}); // initializes a new component with root v
    while (true) {
      int u = st.back();
      st.pop_back();
      roots[u] = v; // claims the vertex
      if (u == v)
        break;
      components.back().push_back(u); // adds vertex u to the component of v
    }
  }
}

// input: adj -- adjacency list of G
// output: components -- the strongy connected components in G
// output: adj_cond -- adjacency list of G^SCC (by root vertices)
void strongly_connected_components(vector<vector<int>> const &adj,
                                   vector<vector<int>> &components,
                                   vector<vector<int>> &adj_cond) {
  components.clear();
  adj_cond.clear();

  int n = adj.size();

  st.clear();
  roots.assign(n, -1);
  timer = 0;
  t_in.assign(n, -1);
  t_low.assign(n, -1);

  // applies the tarjan algorithm to all the vertices
  // adds vertices to the components in reverse topological order
  for (int v = 0; v < n; v++) {
    if (t_in[v] == -1) {
      dfs(v, adj, components);
    }
  }

  // adds edges to the condensation graph
  adj_cond.assign(n, {});
  for (int v = 0; v < n; v++) {
    for (auto u : adj[v])
      if (roots[v] != roots[u])
        adj_cond[roots[v]].push_back(roots[u]);
  }
}
Library Checker에 이 코드로 통과한 제출이 있습니다.
마지막으로 덧붙이자면, 인접 리스트를 순회하는 다른 방법이 있습니다. 현재는 다음과 같이 하고 있습니다:
for (auto u : adj[v]) {
  if (t_in[u] == -1) { // tree-edge
    dfs(u, adj);
    t_low[v] = min(t_low[v], t_low[u]);
  } else if (roots[u] == -1) { // back-edge, cross-edge or forward-edge to an unclaimed vertex
    t_low[v] = min(t_low[v], t_in[u]);
  }
}
대신 다음과 같이 할 수도 있습니다:
for (auto u : adj[v]) {
  if (t_in[u] == -1) // vertex is not visited
    dfs(u, adj);
  if (roots[u] == -1) // vertex has not been claimed
    t_low[v] = min(t_low[v], t_low[u]);
}
$t_{low}$는 정보를 루트까지 전파하는 데 사용되며, t_low[v] = min(t_low[v], t_in[u])를 수행할 때 우리는 $u$와 $v$가 같은 SCC에 속한다는 것을 알고 있습니다. $t_{low}[u]$가 $u$의 루트까지 전파된다면, 루트가 같으므로 $v$를 거쳐서도 전파될 수 있습니다. $t_{low}[u] \leq t_{in}[u]$이므로 이는 어떠한 충돌도 일으키지 않으며, 오히려 $v$의 루트에 대한 경계를 개선할 뿐입니다.
응축 그래프 만들기
응축 그래프의 인접 리스트를 만들 때, 각 요소의 정점 리스트에서 첫 번째 정점을 그 요소의 루트로 선택합니다(이는 임의의 선택입니다). 이 루트 정점이 해당 SCC 전체를 대표합니다. 각 정점 v에 대해 roots[v] 값은 v가 속한 SCC의 루트 정점을 나타냅니다.
이제 응축 그래프는 정점 components(하나의 강한 연결 요소가 응축 그래프의 한 정점에 대응합니다)로 주어지며, 인접 리스트는 강한 연결 요소의 루트 정점만을 사용하여 adj_cond로 주어집니다. $G$에서 어떤 $a\in C$에서 어떤 $b\in C'$로 가는 간선마다 $G^\text{SCC}$에서 $C$에서 $C'$로 가는 간선을 하나씩 생성한다는 점에 주목하십시오($C\neq C'$인 경우). 이는 우리 구현에서 응축 그래프의 두 요소 사이에 다중 간선이 존재할 수 있음을 의미합니다.
참고 문헌
- Thomas Cormen, Charles Leiserson, Ronald Rivest, Clifford Stein. Introduction to Algorithms [2005].
- M. Sharir. 강한 연결성 알고리즘과 데이터 흐름 분석에서의 응용 [1979].
- Robert Tarjan. 깊이 우선 탐색과 선형 그래프 알고리즘 [1972].
연습 문제
- SPOJ - Good Travels
- SPOJ - Lego
- Codechef - Chef and Round Run
- UVA - 11838 - Come and Go
- UVA 247 - Calling Circles
- UVA 13057 - Prove Them All
- UVA 12645 - Water Supply
- UVA 11770 - Lighting Away
- UVA 12926 - Trouble in Terrorist Town
- UVA 11324 - The Largest Clique
- UVA 11709 - Trust groups
- UVA 12745 - Wishmaster
- SPOJ - True Friends
- SPOJ - Capital City
- Codeforces - Scheme
- SPOJ - Ada and Panels
- CSES - Flight Routes Check
- CSES - Planets and Kingdoms
- CSES - Coin Collector
- Codeforces - Checkposts