신경망
MLIR과 현대 컴파일러 기술을 살펴보는 여정에서 우리는 수치 계산을 위한 효율적인 시스템을 구축하는 방법을 탐구했습니다. 이제 이러한 시스템의 가장 중요한 응용 분야 중 하나인 딥러닝으로 관심을 돌려 봅시다. MLIR이 신경망 계산을 어떻게 최적화할 수 있는지 살펴보기 전에, 신경망이 어떻게 작동하는지 기본 원리부터 이해하는 것이 매우 중요합니다.
이 절에서는 순수 Python으로 신경망 라이브러리를 처음부터 구현합니다. 이 구현은 성능보다 명료함을 우선시하지만, MLIR이 제공할 수 있는 최적화를 이해하기 위한 훌륭한 토대가 됩니다. 모든 것을 처음부터 직접 구축함으로써 다음 내용에 대한 깊은 통찰을 얻게 됩니다.
- 신경망의 수학적 기초
- 자동 미분이 학습을 가능하게 하는 방식
- 신경망을 하드웨어 가속에 이상적으로 만드는 계산 패턴
- PyTorch와 TensorFlow 같은 프레임워크가 지금과 같은 구조를 갖게 된 이유
이 시리즈의 후반부에서는 이러한 개념을 활용하여 GPT-2의 NumPy 구현을 이해하고, 그 텐서 연산을 MLIR로 컴파일할 것입니다. 이 스칼라 신경망은 미분과 학습의 기본 메커니즘을 알려 주고, 트랜스포머는 GPU에서 실행하고자 하는 배열 계산을 제공할 것입니다.
이 절의 전체 소스 코드는 참고용으로 별도의 저장소에서 확인할 수 있습니다.
요즘 신경망은 어디에나 있으므로 그것이 왜 유용한지 길게 설명하지는 않겠지만, Jax, PyTorch, TensorFlow 같은 인기 라이브러리를 사용해 보셨다면 이들 덕분에 복잡한 모델을 쉽게 구축하고 학습시킬 수 있다는 것을 아실 것입니다. 이러한 프레임워크가 내부적으로 어떻게 작동하는지 이해하는 것은 매우 값진 일입니다. 이 절에서는 아주 최소한의 신경망 라이브러리를 기본 원리부터 직접 구축하며, 이를 통해 현대 딥러닝을 움직이는 핵심(Core) 메커니즘을 이해할 수 있게 됩니다.
그래디언트와 최적화
신경망 학습의 중심에는 그래디언트라는 개념이 있습니다. 그래디언트를 함수가 가장 가파르게 증가하는 방향을 가리키는 나침반이라고 생각하십시오. 여러 입력을 갖는 함수 에 대해, 그래디언트 는 각 방향으로의 변화율을 담은 벡터입니다.
각 성분 는 다른 모든 입력을 고정한 채 해당 입력을 약간 조정했을 때 함수가 얼마나 변하는지를 알려 줍니다. 이 정보는 신경망 학습에 매우 중요합니다.
신경망 학습에서 우리는 모델의 성능이 얼마나 좋은지를 측정하는 손실 함수 를 최소화하고자 합니다. 매개변수 에는 네트워크의 모든 가중치와 편향이 포함되며, 그 수는 흔히 수천 개에서 수백만 개에 이릅니다. 그래디언트 는 손실을 줄이기 위해 각 매개변수를 어떻게 조정해야 하는지 알려 줍니다.
이것이 바로 경사 하강법이 작동하는 모습입니다. 즉, 그래디언트의 반대 방향으로 (학습률 로 제어되는) 작은 걸음을 반복해서 내디디며, 손실을 최소화하는 매개변수 값을 점진적으로 찾아갑니다.
이러한 그래디언트를 효율적으로 계산하는 것은 매우 중요합니다. 다음과 같은 수치 근사를 사용할 수도 있지만,
여기서 는 작은 수이고 는 방향 의 단위 벡터인데, 이 방식은 느리고 수치적으로 불안정합니다. 대신 우리는 계산 그래프를 따라 연쇄 법칙을 체계적으로 적용하여 정확한 그래디언트를 계산하는 자동 미분을 사용합니다.
연쇄 법칙에 따르면 합성 함수의 도함수는 곱해집니다.
더 높은 차원에서는 이것이 다음과 같이 됩니다:
여기서 는 계산 과정의 중간값입니다. 이것은 역전파의 기초이며, 역전파는 우리의 신경망 라이브러리에서 구현할 것입니다.
신경망 이론
신경망은 본질적으로 일련의 조정 가능한 변환을 통해 입력을 출력으로 매핑하는 방법을 학습하는 함수입니다. 기본 구성 요소는 인공 뉴런이며, 인공 뉴런은 생물학적 뉴런이 정보를 처리하는 방식을 모방합니다:
- 여러 입력 신호()를 받습니다
- 각 입력에는 강도 매개변수()로 가중치가 부여됩니다
- 가중치가 부여된 입력들이 편향 항()과 함께 합산됩니다
- 그 결과가 활성화 함수()를 통과합니다
수학적으로 이 과정은 다음과 같이 기술됩니다:
여기서 는 가중합(흔히 사전 활성화라고 부릅니다)이고, 는 뉴런의 출력(또는 활성화)입니다.
여러 뉴런이 층으로 구성되고, 층들이 쌓여 네트워크를 이룹니다. 완전 연결 순방향 신경망에서는 각 뉴런이 다음 층의 모든 뉴런과 연결됩니다. 층 에 대해 이를 행렬 형태로 간결하게 쓸 수 있습니다:
여기서:
- 는 층 의 가중치 행렬입니다
- 는 이전 층의 활성화 값을 담고 있습니다
- 는 편향 벡터입니다
- 는 각 원소에 활성화 함수를 적용합니다
활성화 함수의 선택은 매우 중요한데, 네트워크가 복잡한 패턴을 학습할 수 있게 하는 비선형성을 도입하기 때문입니다. 비선형성이 없다면 신경망은 층의 개수와 관계없이 선형 모델처럼 동작할 것입니다. 선형 함수의 합성은 여전히 선형 함수이기 때문입니다. 비선형 활성화 함수는 네트워크가 복잡한 함수를 근사하고 데이터 속의 복잡한 관계를 포착할 수 있게 합니다. 비선형 활성화 함수는 모델이 오차로부터 학습하고, 더 다양한 함수를 표현할 수 있는 방식으로 가중치를 조정할 수 있게 합니다. 흔히 선택되는 활성화 함수는 다음과 같습니다:
-
ReLU (Rectified Linear Unit, 정류 선형 유닛):
- 단순하고 계산 효율이 높습니다
- 기울기 소실을 방지하는 데 도움이 됩니다
- 현대 네트워크에서 가장 널리 사용됩니다
-
시그모이드(Sigmoid):
- 값을 [0,1] 범위로 압축합니다
- 역사적으로 널리 쓰였지만 기울기 소실이 일어나기 쉽습니다
- 이진 분류에는 여전히 유용합니다
-
Tanh:
- 시그모이드와 비슷하지만 범위가 [-1,1]입니다
- 시그모이드보다 성능이 더 좋은 경우가 많습니다
- 여전히 기울기 소실 문제를 겪을 수 있습니다
-
SwiGLU:
- GLU(Gated Linear Unit, 게이트 선형 유닛) 계열에서 도입되었습니다.
- 트랜스포머 아키텍처에서 자주 사용됩니다
- 비선형성과 계산 효율 사이의 균형을 제공합니다
SwiGLU는 현대의 많은 네트워크에서 기본 선택지가 되었습니다. 여기서는 GLU 계열을 자세히 다루지 않겠지만, 더 알아보고 싶으시다면 GLU 논문을 읽어 보시기를 권합니다. 우리의 목적에는 ReLU가 더 단순하므로 이를 활성화 함수로 사용하겠습니다.
자동 미분
자동 미분은 신경망 학습을 움직이는 엔진입니다. 도함수를 근사하는 수치 미분이나 수학적 표현식을 조작하는 기호 미분과 달리, 자동 미분은 계산 그래프에서 연산을 추적하여 정확한 도함수를 계산합니다.
우리 구현의 중심은 Value 클래스입니다. 이 클래스는 스칼라 값을 감싸고 그 값에 수행된 연산을 기록합니다:
class Value:
    def __init__(self, data, _children=(), _op="", label=""):
        self.data = data
        self.grad = 0.0
        self.label = label
        self._backward = lambda: None
        self._prev = set(_children)
        self._op = _op
각 연산(덧셈이나 곱셈 등)은 새로운 Value를 만들고, 기울기가 역방향으로 어떻게 흘러야 하는지를 정의합니다. 예를 들어, 덧셈은 다음과 같이 동작합니다:
def __add__(self, other):
    other = other if isinstance(other, Value) else Value(other)
    out = Value(self.data + other.data, (self, other), "+")

    def _backward():
        # The gradient flows equally to both inputs
        self.grad += out.grad
        other.grad += out.grad

    out._backward = _backward
    return out
곱셈의 경우 기울기는 곱의 법칙을 따릅니다. 각 입력의 기울기에 다른 입력의 값이 곱해집니다:
def __mul__(self, other):
    other = other if isinstance(other, Value) else Value(other)
    out = Value(self.data * other.data, (self, other), "*")

    def _backward():
        # Each input's gradient is scaled by the other's value
        self.grad += other.data * out.grad
        other.grad += self.data * out.grad

    out._backward = _backward
    return out
역방향 패스는 backward()를 호출하여 시작하며, 이 메서드는 다음을 수행합니다:
- 계산 그래프를 위상 정렬합니다
- 출력의 기울기를 1.0으로 설정합니다
- 그래프를 따라 기울기를 역방향으로 전파합니다
def backward(self):
    # Sort nodes in topological order
    topo = []
    visited = set()

    def topo_sort(v):
        if v not in visited:
            visited.add(v)
            for child in v._prev:
                topo_sort(child)
            topo.append(v)

    topo_sort(self)

    # Backpropagate gradients
    self.grad = 1
    for v in reversed(topo):
        v._backward()
실제로 동작하는 모습을 보기 위해 relu(a * b + c) 표현식에 대한 간단한 계산 그래프를 만들어 봅시다:
# Create input values
a = Value(2.0, label="a")
b = Value(-3.0, label="b")
c = Value(10.0, label="c")

# Build computation graph
d = a * b
d.label = "d"
e = d + c
e.label = "e"
f = e.relu()
f.label = "f"
이제 각 입력에 대한 출력의 기울기를 계산할 수 있습니다:
print("Gradients after backward pass:")
print(f"a.grad = {a.grad}")
print(f"b.grad = {b.grad}")
print(f"c.grad = {c.grad}")
print(f"d.grad = {d.grad}")
print(f"e.grad = {e.grad}")
print(f"f.grad = {f.grad}")
그 결과로 만들어진 계산 그래프는 그림 1과 같습니다. 각 노드는 값을 나타내고, 간선은 값들이 연산을 통해 어떻게 결합되는지를 보여 줍니다. f.backward()를 호출하면 기울기가 이 그래프를 따라 역방향으로 흐르므로, 각 입력이 최종 출력에 어떤 영향을 미치는지 계산할 수 있습니다.
 그림 1: 연산들이 어떻게 연결되고 기울기가 어떻게 역방향으로 흐르는지를 보여 주는 계산 그래프 시각화.
역전파
역전파는 네트워크 매개변수에 대한 손실 함수의 그래디언트를 효율적으로 계산하여 신경망이 데이터로부터 학습할 수 있게 하는 알고리즘입니다. 역전파는 미적분의 연쇄 법칙을 적용하여 오차 그래디언트를 출력층에서 입력층 방향으로 네트워크를 거슬러 전파합니다.
이 과정은 순방향 패스로 시작하며, 이때 입력 데이터가 네트워크를 통과하여 예측값을 만들어 냅니다. 손실 함수 은 이 예측값과 실제 목표값 사이의 차이를 수치화합니다. 평균 제곱 오차 손실의 경우 이는 다음과 같습니다.
여기서 는 실제값이고 는 예측값입니다.
학습의 목표는 네트워크 매개변수(가중치와 편향)를 조정하여 이 손실을 최소화하는 것입니다. 이를 위해서는 각 매개변수에 대한 손실의 그래디언트를 계산해야 합니다:
이는 층 의 각 가중치 와 편향 에 대해 계산합니다.
역전파는 네트워크를 거꾸로 거슬러 올라가며 이러한 그래디언트를 효율적으로 계산합니다. 출력층 에 대해서는 먼저 오차 항을 계산합니다.
여기서 은 출력 활성화값에 대한 손실의 그래디언트이고, 는 활성화 이전 값 에서 계산한 활성화 함수의 도함수이며, 는 원소별 곱셈을 나타냅니다.
은닉층에 대해서는 오차 항을 재귀적으로 계산합니다.
여기서 는 층 의 가중치 행렬의 전치입니다.
마지막으로, 매개변수에 대한 손실의 그래디언트는 다음과 같습니다:
여기서 는 층 에 있는 뉴런 의 활성화값입니다.
우리 구현에서는 이러한 계산을 Value 클래스와 그 연산들이 자동으로 처리합니다. loss.backward()를 호출하면 그래디언트가 계산되어 각 매개변수의 grad 속성에 저장됩니다.
신경망 구성 요소 만들기
자동 미분 엔진이 준비되었으므로 이제 신경망 구성 요소를 만들 수 있습니다. Module 클래스는 모든 신경망 모듈의 기반 클래스 역할을 합니다.
class Module:
    """Base class for all neural network modules."""

    def zero_grad(self):
        """Sets gradients of all parameters to zero."""
        for p in self.parameters():
            p.grad = 0

    def parameters(self):
        """Returns a list of all parameters in the module."""
        return []
Neuron 클래스는 입력의 가중합에 편향을 더한 값을 계산하고, 선택적으로 비선형 활성화 함수를 적용하는 단일 뉴런을 구현합니다.
class Neuron(Module):
    """A single neuron with multiple inputs and one output."""

    def __init__(self, nin, nonlin=True):
        self.w = [Value(random.uniform(-1, 1)) for _ in range(nin)]
        self.b = Value(0)
        self.nonlin = nonlin

    def __call__(self, x):
        act = sum((wi * xi for wi, xi in zip(self.w, x)), self.b)
        return act.relu() if self.nonlin else act

    def parameters(self):
        return self.w + [self.b]
Layer 클래스는 뉴런들을 묶어 입력을 병렬로 처리합니다.
class Layer(Module):
    """A layer of neurons, where each neuron has the same number of inputs."""

    def __init__(self, nin, nout, **kwargs):
        self.neurons = [Neuron(nin, **kwargs) for _ in range(nout)]

    def __call__(self, x):
        out = [n(x) for n in self.neurons]
        return out[0] if len(out) == 1 else out

    def parameters(self):
        return [p for n in self.neurons for p in n.parameters()]
마지막으로 MLP(다층 퍼셉트론) 클래스는 층들을 결합하여 완전한 네트워크를 구성합니다.
class MLP(Module):
    """Multi-layer perceptron (fully connected feed-forward neural network)."""

    def __init__(self, nin, nouts):
        sz = [nin] + nouts
        self.layers = [
            Layer(sz[i], sz[i + 1], nonlin=i != len(nouts) - 1)
            for i in range(len(nouts))
        ]

    def __call__(self, x):
        for layer in self.layers:
            x = layer(x)
        return x

    def parameters(self):
        return [p for layer in self.layers for p in layer.parameters()]
이러한 모듈식 설계 덕분에 어떤 크기의 네트워크든 쉽게 만들 수 있습니다. 예를 들어, 이진 분류를 위한 작은 네트워크는 다음과 같이 만들 수 있습니다.
# Create a network with:
# - 2 input features
# - 8 neurons in first hidden layer
# - 8 neurons in second hidden layer
# - 1 output neuron
model = MLP(nin=2, nouts=[8, 8, 1])
그림 2는 이 아키텍처를 시각화한 것으로, 뉴런이 층으로 구성되고 층들이 연결되어 완전한 네트워크를 이루는 방식을 보여 줍니다.
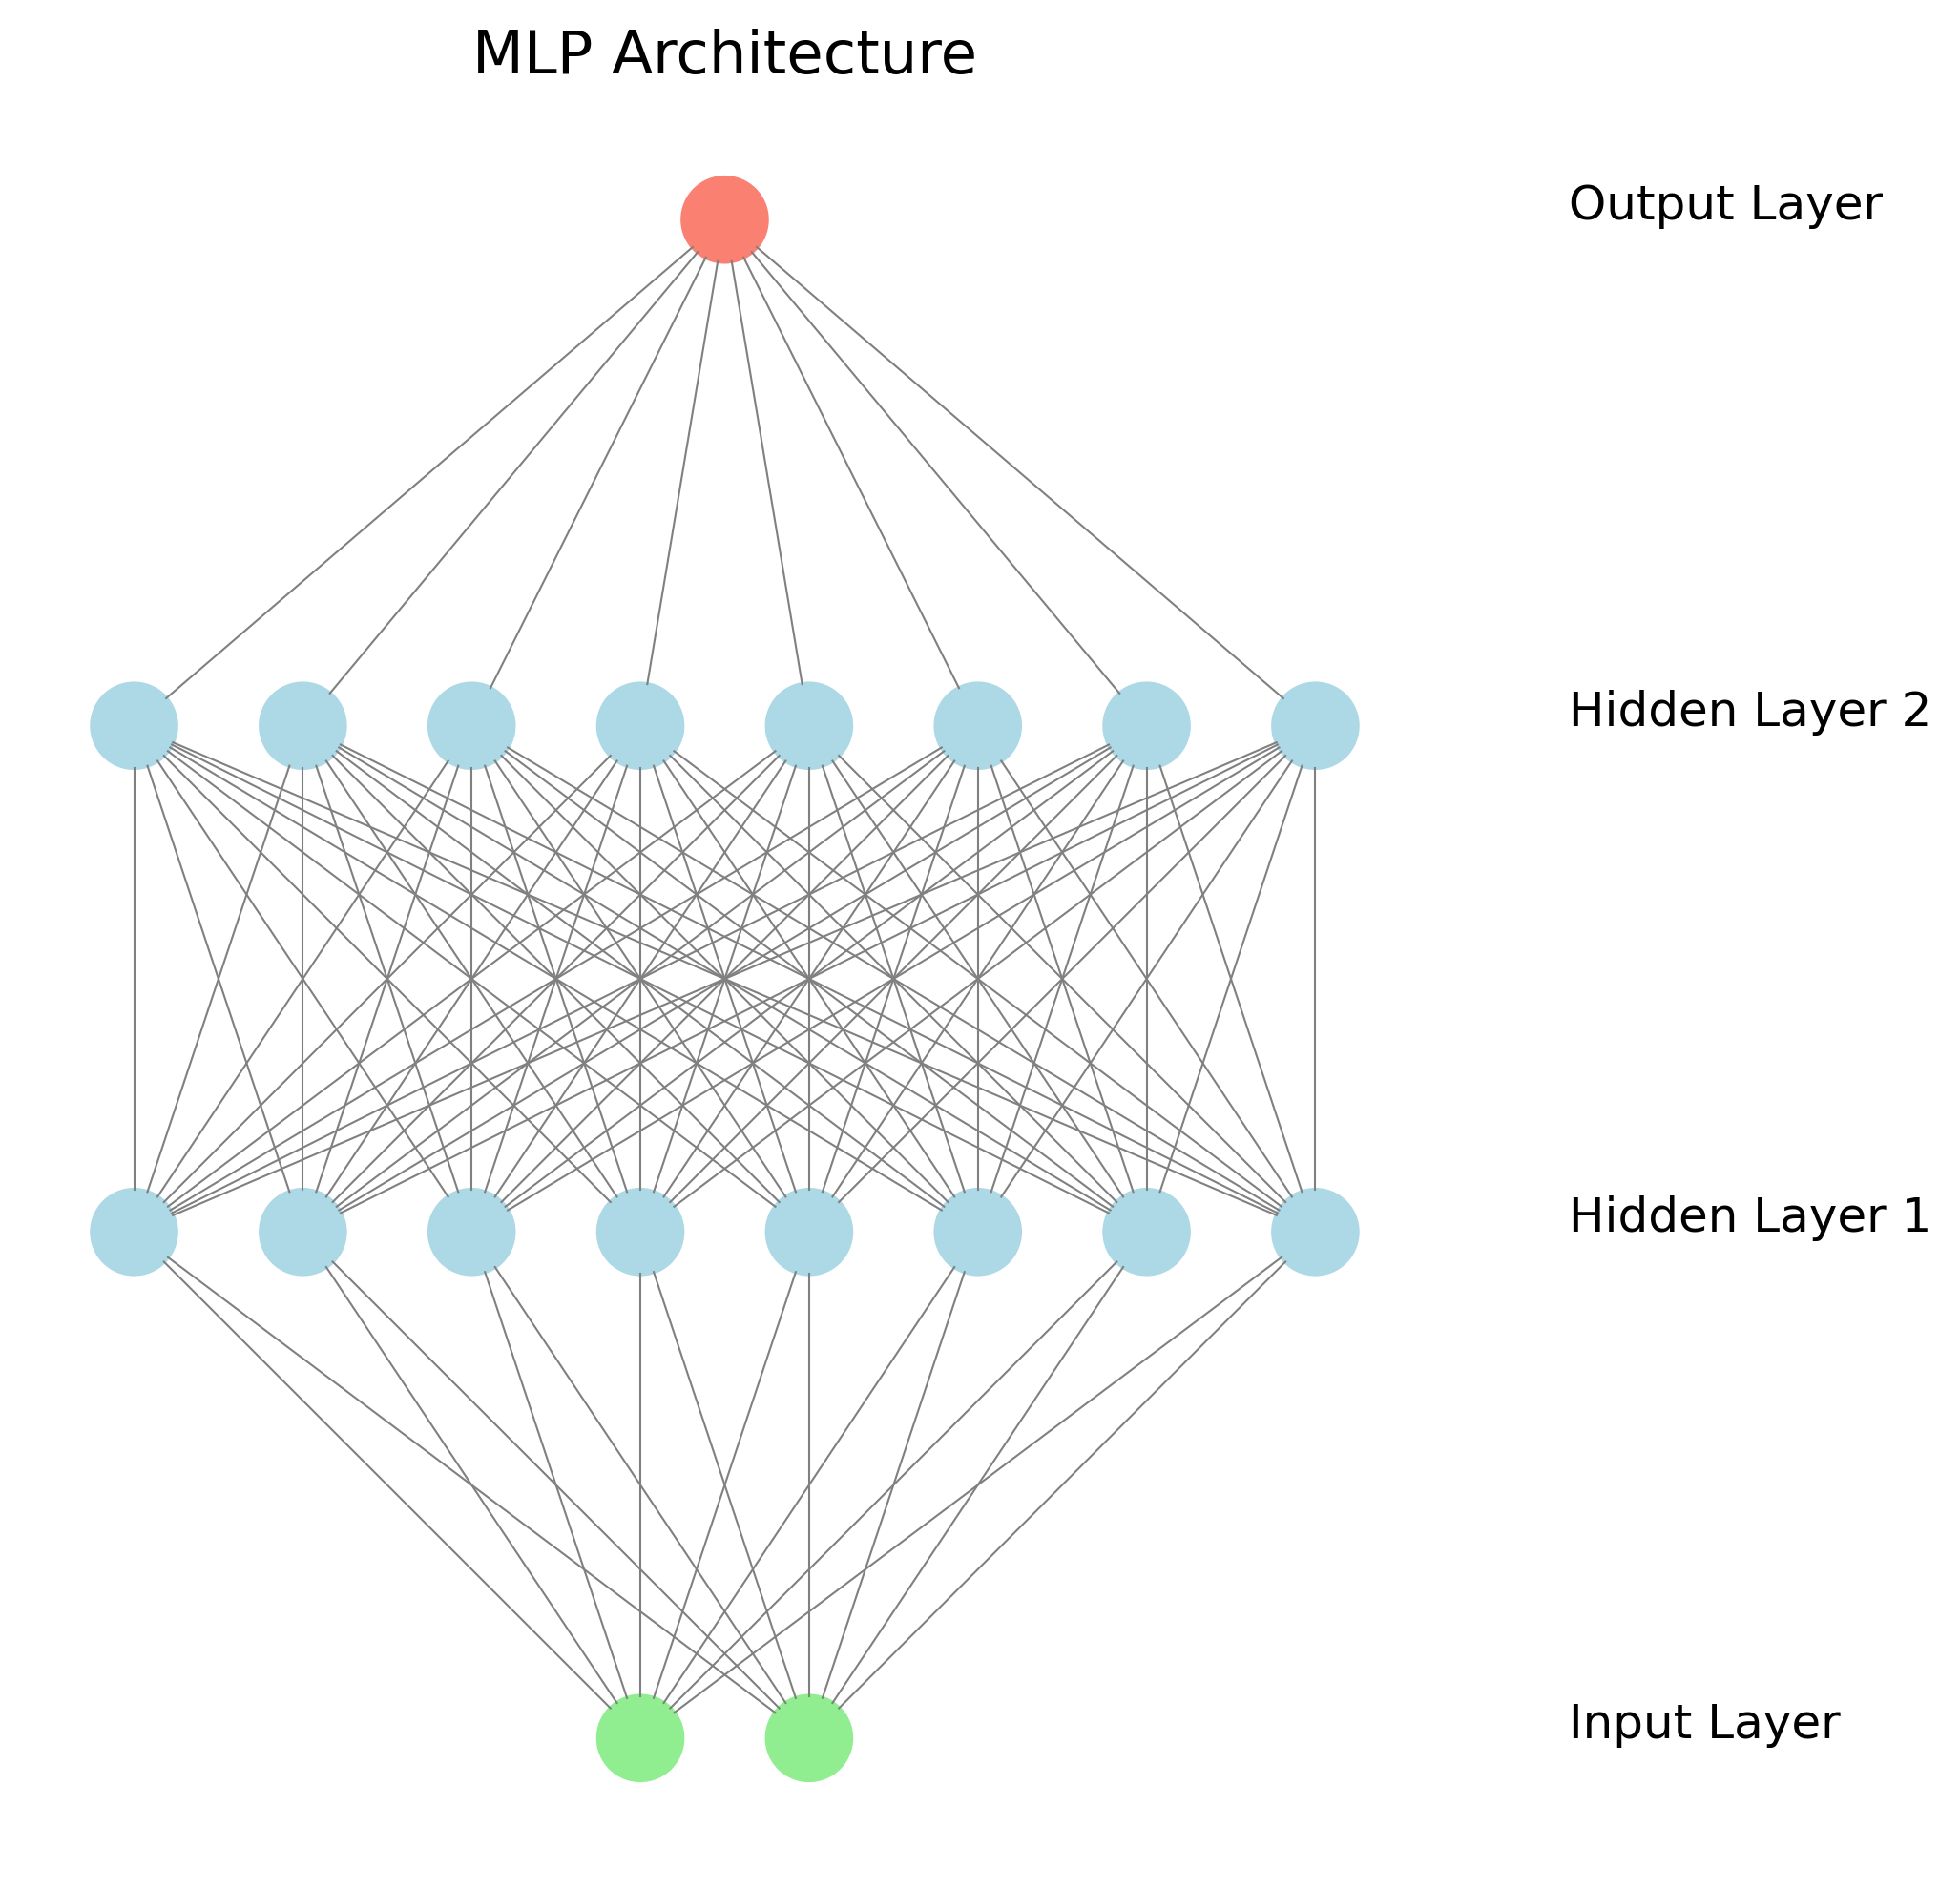 그림 2: 여러 층의 뉴런으로 이루어진 신경망 아키텍처의 시각화.
그림 3에서 보듯이 층을 더 추가하여 더 깊은 네트워크를 만들 수 있습니다. 층이 하나 추가될 때마다 네트워크는 더 복잡한 특징을 학습할 수 있습니다. 앞쪽 층은 일반적으로 단순한 패턴(이미지의 가장자리 등)을 학습하고, 더 깊은 층은 이를 조합하여 더 복잡한 패턴(물체나 개념 등)을 인식합니다.
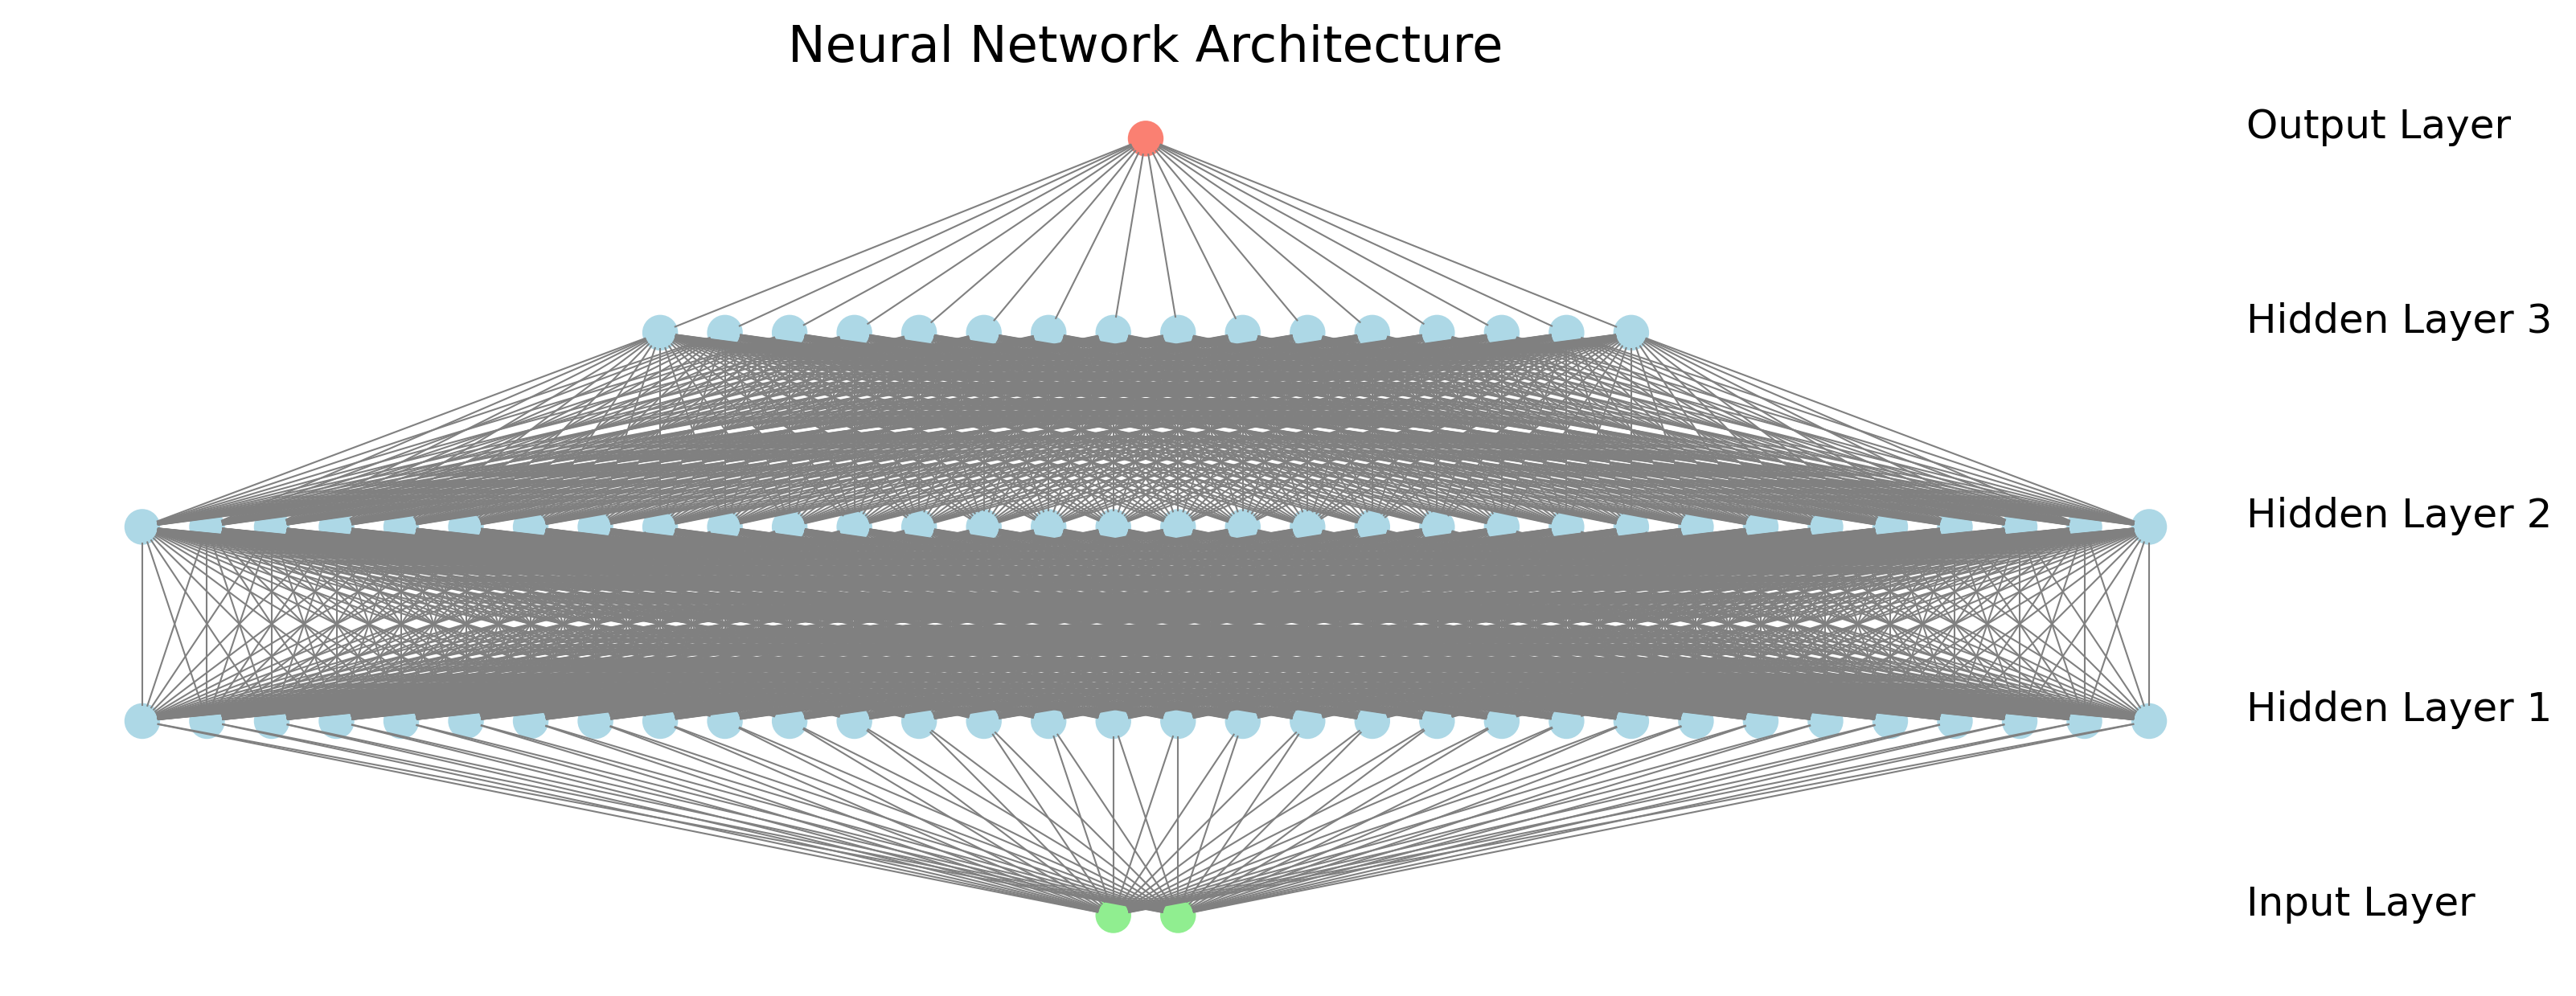 그림 3: 여러 은닉층을 가진 더 깊은 신경망으로, 층을 쌓아 모델 용량을 늘리는 방식을 보여 줍니다.
최적화와 학습
신경망을 학습시키려면 그래디언트를 바탕으로 매개변수를 갱신하는 옵티마이저가 필요합니다. 우리의 SGD(확률적 경사 하강법) 옵티마이저는 놀라울 만큼 단순합니다:
class SGD:
    """
    Stochastic Gradient Descent optimizer.
    """

    def __init__(self, parameters, lr=0.01):
        self.parameters = parameters
        self.lr = lr

    def zero_grad(self):
        """Set all parameter gradients to zero."""
        for p in self.parameters:
            p.grad = 0

    def step(self):
        """
        Updates each parameter as: p = p - lr * p.grad
        """
        for p in self.parameters:
            p.data -= self.lr * p.grad
옵티마이저는 모델 매개변수에 대한 참조를 저장하고, 각 순방향 패스 전에 그래디언트를 0으로 초기화하는 메서드를 제공하며, 다음과 같은 경사 하강법 규칙을 사용하여 매개변수를 갱신합니다:
여기서 는 매개변수를 나타내고, 는 학습률이며, 는 매개변수에 대한 손실 함수의 그래디언트입니다.
Adam이나 RMSProp 같은 더 정교한 옵티마이저는 과거 기울기 정보를 바탕으로 각 매개변수의 학습률을 조정하여 더 나은 수렴 특성을 제공하지만, SGD는 기울기 기반 최적화의 핵심(Core) 원리를 잘 보여 줍니다.
학습 과정은 Trainer 클래스에 캡슐화되어 있으며, 이 클래스는 데이터 배치 처리, 순방향 및 역방향 패스, 매개변수 갱신, 지표 추적을 담당합니다:
import random
import matplotlib.pyplot as plt
from tinynn.engine import Value


class Trainer:
    def __init__(self, model, optimizer, loss_fn=None):
        self.model = model
        self.optimizer = optimizer
        self.loss_fn = loss_fn or self._mse_loss

        # Training history
        self.losses = []
        self.accuracies = []

    def _mse_loss(self, pred, target):
        """Mean squared error loss function."""
        return (pred - target) * (pred - target)

    def train(
        self, X, y, n_epochs=100, batch_size=32, verbose=True, early_stopping=True
    ):
        """
        Train the model on the given dataset.

        Args:
            X: Features (list or numpy array)
            y: Target values (list or numpy array)
            n_epochs: Number of training epochs
            batch_size: Mini-batch size
            verbose: Whether to print progress
            early_stopping: Whether to stop early on perfect accuracy

        Returns:
            Dictionary containing training history
        """
        print("Training neural network...")

        for epoch in range(n_epochs):
            # Track metrics for this epoch
            total_loss = 0.0
            correct = 0

            # Shuffle the data
            indices = list(range(len(X)))
            random.shuffle(indices)

            # Mini-batch training
            for start_idx in range(0, len(X), batch_size):
                end_idx = min(start_idx + batch_size, len(X))
                batch_indices = indices[start_idx:end_idx]

                # Zero gradients
                self.optimizer.zero_grad()

                # Accumulate loss and accuracy over the batch
                batch_loss = Value(0.0)

                for idx in batch_indices:
                    # Convert numpy features to Value objects
                    x_vals = [Value(X[idx][0]), Value(X[idx][1])]

                    # Forward pass
                    pred = self.model(x_vals)
                    pred_value = pred[0] if isinstance(pred, list) else pred

                    # Binary cross-entropy loss with tanh activation
                    target = 1.0 if y[idx] == 1 else -1.0  # Use -1/1 targets for tanh

                    # Calculate loss
                    loss = self.loss_fn(pred_value, target)

                    # Accumulate loss
                    batch_loss = batch_loss + loss

                    # Check accuracy
                    pred_class = 1 if pred_value.data > 0 else 0
                    if pred_class == y[idx]:
                        correct += 1

                # Scale loss by batch size
                batch_loss = batch_loss * (1.0 / len(batch_indices))

                # Backward pass
                batch_loss.backward()

                # Update parameters
                self.optimizer.step()

                # Track total loss
                total_loss += batch_loss.data

            # Record metrics
            avg_loss = total_loss / max(1, (len(X) // batch_size))
            accuracy = correct / len(X)
            self.losses.append(avg_loss)
            self.accuracies.append(accuracy)

            # Print progress every 10 epochs
            if verbose and (epoch + 1) % 10 == 0:
                print(
                    f"Epoch {epoch+1}/{n_epochs}: Loss={avg_loss:.4f}, Accuracy={accuracy:.4f}"
                )

            # Early stopping if we reach perfect accuracy
            if early_stopping and accuracy == 1.0 and avg_loss < 0.01:
                print(f"Early stopping at epoch {epoch+1} with 100% accuracy!")
                break

        print("Training complete!")
        print(f"Final accuracy: {self.accuracies[-1]:.4f}")

        return {"losses": self.losses, "accuracies": self.accuracies}

    def plot_training_progress(self, save_path="output/training_progress.png"):
        """Plot and save the training progress."""
        plt.figure(figsize=(12, 5))

        plt.subplot(1, 2, 1)
        plt.plot(self.losses)
        plt.title("Training Loss")
        plt.xlabel("Epoch")
        plt.ylabel("Loss")

        plt.subplot(1, 2, 2)
        plt.plot(self.accuracies)
        plt.title("Training Accuracy")
        plt.xlabel("Epoch")
        plt.ylabel("Accuracy")

        plt.tight_layout()
        plt.savefig(save_path)
        plt.close()
각 에포크마다 트레이너는 데이터를 섞고, 미니 배치를 처리하고, 손실과 그래디언트를 계산하고, 매개변수를 갱신하며, 손실과 정확도 같은 지표를 추적합니다. 이처럼 구조화된 학습 방식 덕분에 일관된 학습 절차를 유지하면서도 다양한 모델과 데이터셋으로 손쉽게 실험할 수 있습니다.
L2 정규화
정규화 기법은 머신러닝에서 과적합을 방지하는 데 필수적입니다. 과적합이란 모델이 학습 데이터에서는 좋은 성능을 보이지만 처음 보는 데이터에서는 성능이 떨어지는 현상입니다. **가중치 감쇠(weight decay)**라고도 하는 L2 정규화는 신경망에서 가장 흔히 쓰이는 정규화 방법 중 하나입니다.
L2 정규화의 핵심(Core) 아이디어는 큰 가중치를 억제하는 페널티 항을 손실 함수에 추가하는 것입니다:
여기서 는 정규화 강도로, 학습 데이터에 대한 적합과 가중치를 작게 유지하는 것 사이의 균형을 조절하는 하이퍼파라미터입니다.
각 가중치에 대한 이 정규화 항의 그래디언트는 다음과 같습니다:
이는 가중치 업데이트 단계에서 각 가중치가 원래 손실의 그래디언트에 따라 조정될 뿐만 아니라 그 크기에 비례하여 줄어든다는 뜻입니다:
이렇게 하면 데이터가 가중치가 커야 한다는 강력한 근거를 제시하지 않는 한 가중치가 0 쪽으로 밀려나는 효과가 있습니다. 그 결과 과적합 가능성이 더 낮은, 더 단순한 모델이 만들어집니다.
우리 프레임워크에서 L2 정규화를 구현하는 것은 간단합니다. 손실 함수가 정규화 항을 포함하도록 수정하면 됩니다:
def _mse_loss_with_l2(self, pred, target, lambda_reg=0.01):
    """Mean squared error loss function with L2 regularization."""
    # Original MSE loss
    mse_loss = (pred - target) * (pred - target)

    # L2 regularization term
    l2_reg = Value(0.0)
    for p in self.model.parameters():
        l2_reg = l2_reg + p * p
    l2_reg = l2_reg * lambda_reg

    # Combined loss
    return mse_loss + l2_reg
또는 가중치 업데이트 규칙을 수정하여 옵티마이저에서 직접 L2 정규화를 구현할 수도 있습니다:
def step(self, lambda_reg=0.01):
    """Updates each parameter with L2 regularization."""
    for p in self.parameters:
        # L2 regularization: weight decay
        p.data -= self.lr * (p.grad + 2 * lambda_reg * p.data)
L2 정규화에는 다음과 같은 여러 이점이 있습니다:
- 큰 가중치에 페널티를 주어 과적합을 방지하는 데 도움이 됩니다
- 학습 데이터의 노이즈에 대해 모델을 더 견고하게 만듭니다
- 처음 보는 데이터에 대한 일반화 성능을 향상시킬 수 있습니다
- 학습 중 수치적 안정성에 도움이 될 수 있습니다
정규화 강도 는 튜닝이 필요한 하이퍼파라미터입니다. 가 너무 작으면 정규화 효과가 미미하고, 너무 크면 모델이 데이터에 과소적합될 수 있습니다. 일반적으로 의 최적값을 찾는 데에는 교차 검증을 사용합니다.
엔드투엔드 사용 예
라이브러리가 실제로 동작하는 모습을 보여 주기 위해, 간단한 분류 작업인 scikit-learn의 “moons” 데이터셋으로 신경망을 학습시킵니다. 이 데이터셋은 서로 맞물린 두 개의 반원으로 이루어져 있어, 클래스를 분리하려면 비선형 결정 경계가 필요합니다:
from sklearn.datasets import make_moons
import numpy as np
import matplotlib.pyplot as plt

from tinynn.engine import Value
from tinynn.nn import MLP
from tinynn.optim import SGD
from tinynn.trainer import Trainer

# Generate the dataset
X, y = make_moons(n_samples=100, noise=0.1, random_state=42)

# Create a neural network: 2 inputs -> 32 -> 32 -> 16 -> 1 output
model = MLP(nin=2, nouts=[32, 32, 16, 1])

# Create an optimizer
optimizer = SGD(model.parameters(), lr=0.005)

# Create trainer
trainer = Trainer(model, optimizer)

# Train the model
trainer.train(X, y, n_epochs=500, batch_size=10, verbose=True)
학습의 핵심 개념은 다음과 같습니다.
배치 크기(Batch Size): 각 순전파/역전파 패스에서 함께 처리되는 학습 예제의 수를 결정합니다. 배치가 작을수록 기울기 업데이트에 노이즈가 더 많이 생기지만(이는 지역 최솟값에서 벗어나는 데 도움이 될 수 있습니다) 수렴 속도가 더 느립니다. 배치가 클수록 더 안정적으로 업데이트되지만 최적이 아닌 해에 갇힐 수 있습니다.
에포크(Epochs): 학습 데이터셋 전체를 한 번 완전히 거치는 패스입니다. 모델이 효과적으로 학습하려면 여러 에포크가 필요합니다. 최적의 에포크 수는 데이터셋 크기, 모델 복잡도, 최적화 매개변수와 같은 요인에 따라 달라집니다.
학습 손실(Training Loss): 모델의 예측이 실제 값과 얼마나 잘 일치하는지를 측정합니다. 여기서는 평균 제곱 오차(Mean Squared Error, MSE)를 사용합니다.
MSE가 이번 이진 분류 작업에 특히 적합한 이유는 다음과 같습니다.
- 제곱 항 때문에 큰 오차에 큰 페널티를 부여합니다
- 최적화에 유리한 매끄러운 기울기를 제공합니다
- 구현하기 쉽고 이해하기도 쉽습니다
정확도(Accuracy): 올바른 예측의 비율입니다. 정확도는 직관적이지만, 불균형한 데이터셋에서는 오해를 불러일으킬 수 있으므로 다른 지표와 함께 고려해야 합니다.
학습 진행 상황은 그림 4에 나와 있으며, 시간이 지남에 따라 손실은 줄어들고 정확도는 높아지는 것을 확인할 수 있습니다.
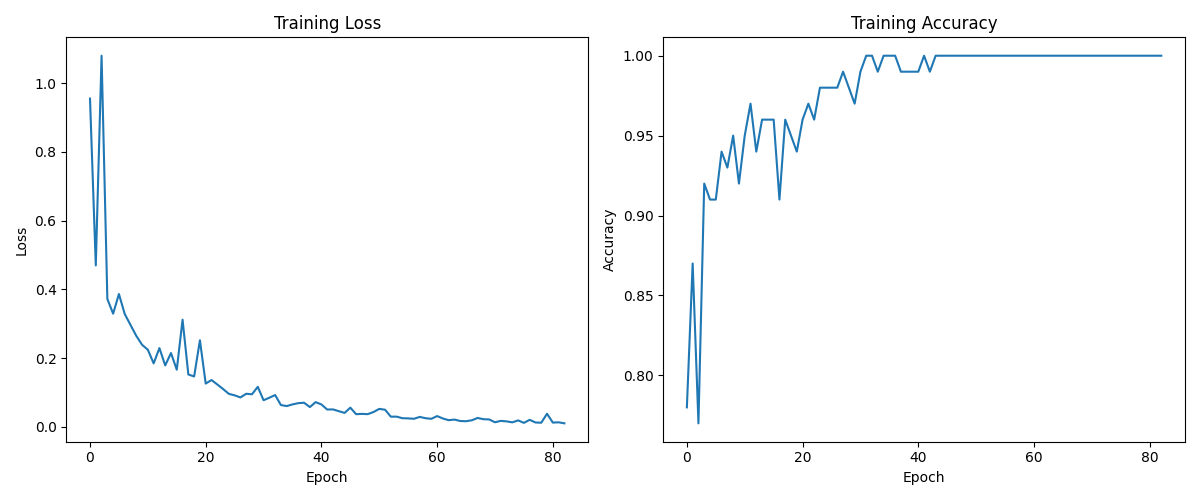 그림 4: 모델이 학습하면서 손실이 줄어들고 정확도가 높아지는 과정을 보여 주는 학습 진행 상황입니다.
그림 5의 결정 경계 시각화에서 볼 수 있듯이, 이 간단한 모델은 두 클래스를 효과적으로 분리하도록 학습합니다.
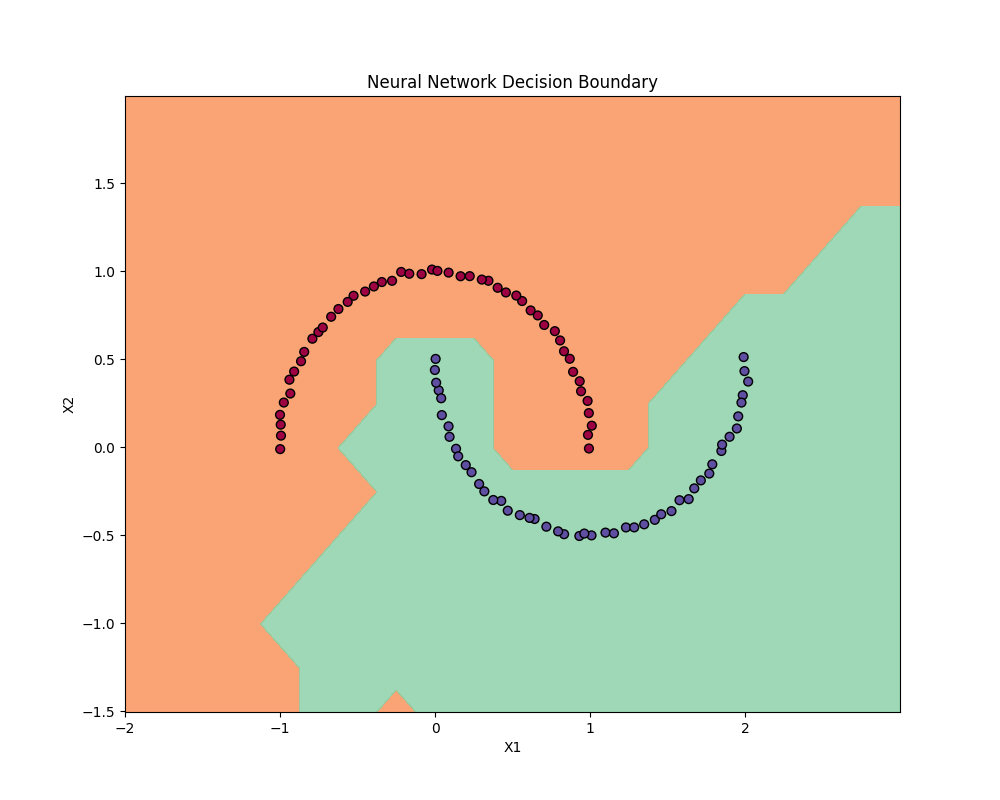 그림 5: 학습된 결정 경계는 모델이 비선형 경계로 두 클래스를 어떻게 분리하는지 보여 줍니다.
최적화 기회
신경망 학습에는 여러 차원에 걸쳐 병렬화할 수 있는 기회가 많습니다. 가장 분명한 것은 배치 병렬성으로, 여러 학습 예제를 네트워크에서 동시에 처리할 수 있습니다. 배치 내의 각 예제는 순방향 패스 동안 독립적으로 계산될 수 있으며, 그 그래디언트는 역전파 동안 병렬로 누적될 수 있습니다. 또한 각 층 안에서는 행렬 곱셈과 원소별 연산을 뉴런과 특징 차원에 걸쳐 병렬화할 수 있으므로, 최신 하드웨어가 활용할 수 있는 풍부한 병렬 계산 계층 구조가 만들어집니다.
이러한 고유의 병렬성 덕분에 최신 GPU는 딥러닝 워크로드에 이상적입니다. 복잡한 제어 흐름을 가진 순차 처리에 최적화된 CPU와 달리, GPU에는 병렬 산술 연산을 위해 특별히 설계된 더 단순한 코어가 수천 개 들어 있습니다. 이 아키텍처는 신경망 계산과 완벽하게 맞아떨어집니다. 행렬 곱셈, 합성곱, 원소별 연산을 모두 이 코어들에 분산할 수 있으므로 CPU 구현에 비해 수십에서 수백 배 빨라집니다. 최신 GPU에는 딥러닝에서 흔히 쓰이는 혼합 정밀도 행렬 연산을 가속하는 전용 텐서 코어도 탑재되어 있습니다.
GPU의 메모리 계층 구조는 딥러닝 성능을 좌우하는 또 하나의 중요한 요소입니다. GPU는 고대역폭 메모리와 정교한 캐싱 메커니즘 덕분에 수많은 처리 코어에 데이터를 효율적으로 공급할 수 있으며, 공유 메모리는 같은 연산을 수행하는 스레드 사이의 빠른 통신을 가능하게 합니다. 이는 딥러닝에서 특히 중요합니다. 딥러닝은 메모리 접근 패턴이 예측 가능하고 규칙적이어서 메모리 하위 시스템을 최적으로 활용할 수 있기 때문입니다. 이러한 메모리 특성은 GPU의 대규모 병렬 처리 능력과 결합하여 GPU를 현대 딥러닝 인프라의 근간으로 만들며, 점점 더 크고 복잡해지는 모델의 학습을 가능하게 합니다. GPU 실행을 다루기 전에, 6부에서 작은 표현식 컴파일러를 만들고 7부에서 트랜스포머 워크로드를 소개하겠습니다.
외부 자료
- 역전파
- PyTorch 신경망
- JAX와 Flax: 간단한 신경망
- 역전파 완전 정복
- 신경망과 역전파에 대한 상세한 입문: micrograd 만들기
- JAX 소개
- Micrograd
- PyTorch를 활용한 딥러닝
- 최적화와 초기화
이전: 4부 - MLIR에서의 선형대수 · 시리즈 목차 · 다음: 6부 - E-그래프로 Python 특수화하기