Stephen Diehl
안녕하세요, Stephen Diehl입니다.
저는 영국 런던에 사는 소프트웨어 엔지니어입니다.
저는 소프트웨어, 기술, 그리고 미래에 관한 글을 즐겨 씁니다.
이 사이트의 모든 글은 Creative Commons ShareAlike 라이선스로 제공됩니다. 별도로 명시하지 않는 한 모든 코드는 MIT 라이선스로 제공됩니다. 자세한 내용과 인용 안내는 라이선스 페이지를 참조하십시오.
이 사이트에 대하여
이 사이트는 Stephen Diehl의 블로그 stephendiehl.com에
실린 글을 한국어로 옮긴 비공식 번역입니다. 저자가 검토하거나 승인한
번역이 아니며, yeokja와 함께 Anthropic 사의
claude-opus-5-5 모델을 활용하여 번역되었으며 학습을 모두 비허용한 상태로
작업하였습니다. 번역 과정에서 생긴 오류는 원문이 아니라 번역의 책임입니다.
- 원문: Stephen Diehl, stephendiehl.com. 글은 CC BY-SA 4.0, 코드는 MIT로 제공됩니다. 이 번역은 원문을 한국어로 옮기며 변경한 파생물이며 같은 CC BY-SA 4.0으로 제공합니다.
- 저자가 밝힌 대로, 이 글들은 저자가 개인 자격으로 쓴 것입니다. 이 번역본을 인용하거나 언급할 때 저자의 고용주·고객·단체 등 어떤 조직과의 연관도 밝히거나 암시해서는 안 됩니다. 저자가 정한 소개 문구는 “Stephen Diehl은 런던의 소프트웨어 엔지니어이자 작가입니다“입니다. 자세한 내용은 라이선스와 고지를 보십시오.
- 글마다 원문 링크와 게시일을 상단에 적었습니다. 이미지는 재배포하지 않고 원문 사이트의 것을 그대로 불러옵니다.
GPU 위의 GPT-2
8부에서는 GPU 경로를 손으로 직접 구축했습니다. gpu 다이얼렉트로 작성한 커널, NVVM 로어링, PTX, 그리고 메모리를 할당하고 그리드를 실행하는 드라이버 호출이 그것입니다. 9부부터 13부까지는 출력이 CPU에서 실행되는 텐서 컴파일러를 구축했습니다. 이 장에서는 이 둘을 결합합니다. 동일한 공식과 동일한 참조 검사를 갖춘, 동일한 추적된 텐서 프로그램이 NVIDIA GPU에서 실행됩니다.
해야 할 작업은 세 가지입니다. 버퍼화 이후에 남는 병렬 루프는 커널이 되어야 합니다. 출력 하나당 스레드 하나를 배정하는 단순한 매핑은 하드웨어를 낭비하므로, 행렬 곱셈에는 공유 메모리를 사용하는 스케줄이 필요합니다. 그리고 호스트 배열과 디바이스 메모리 사이의 경계를 정해야 합니다. 이 모든 것은 tinymlir/gpu.py에 들어 있으며, 이는 약 250줄짜리 모듈로 CPU 경로에서는 전혀 호출하지 않습니다.
이 장은 모델을 컴파일하는 두 번째 방법으로 마무리됩니다. 서브레이어마다 함수 하나를 두는 대신, NumPy 참조 구현의 순방향 패스 전체를 하나의 모듈로 트레이스하고, 그 모듈을 두 타깃 중 어느 쪽에든 넘깁니다.
x86_64 기반 Linux, NVIDIA 드라이버, 그리고 compute capability sm_75 이상의 그래픽 카드가 필요합니다. Google Colab의 Tesla T4면 충분합니다. 저장소에는 바인딩의 CUDA 빌드를 설치하고 아래의 모든 내용을 실행하는 노트북이 포함되어 있습니다. 이 시리즈의 다른 부분에서는 GPU가 필요하지 않습니다.
타깃이 갈라지는 지점
12부에서 다룬 파이프라인의 구조를 떠올려 보십시오. 융합은 텐서 위에서 실행됩니다. 버퍼화는 저장 공간을 할당하고 해제 연산을 삽입합니다. 그 결과는 memref 위의 linalg 연산으로 이루어진 모듈이며, 각 타깃이 받는 것이 바로 이 모듈입니다:
PassManager.parse(BUFFERIZATION_PIPELINE).run(lowered.operation)
if target == GPU:
    gpu.lower(lowered)
else:
    blas.rewrite(lowered)
    PassManager.parse(LOWERING_PIPELINE).run(lowered.operation)
GPU 쪽도 CPU 쪽과 동일하게 치환 후 파이프라인이 이어지는 2단계 구조를 가집니다:
def outline(module):
    tiled_matmuls(module)
    PassManager.parse(KERNEL_PIPELINE).run(module.operation)
    managed_allocations(module)


def lower(module):
    outline(module)
    PassManager.parse(llvm_pipeline()).run(module.operation)
outline은 하드웨어와 무관한 부분입니다. 이 부분은 GPU가 없는 머신을 포함한 모든 플랫폼의 테스트 스위트에서 실행되며, 모듈의 모든 루프가 커널 실행으로 바뀌었는지 검증합니다. lower는 PTX까지 이어서 진행하며, Linux용으로만 존재하는 MLIR의 CUDA 빌드가 필요합니다.
outline 내부의 순서가 중요합니다. matmul 치환은 루프 패스보다 먼저 와야 합니다. 그렇지 않으면 matmul이 병렬 루프로 변환되어 치환할 대상이 남지 않습니다. 그리고 둘 다 버퍼화와 버퍼 해제 이후에 와야 합니다. 손으로 작성한 커널에는 gpu.barrier가 포함되어 있는데, 해제 분석은 이것의 메모리 효과를 꿰뚫어 볼 수 없습니다. 커널이 삽입될 시점에는 저장 공간이 이미 할당되고 해제된 상태입니다.
루프에서 커널로
두 번째 단계는 기존 MLIR 패스로 구성된 파이프라인입니다:
KERNEL_PIPELINE = (
    "builtin.module("
    "convert-linalg-to-parallel-loops,"
    "func.func(scf-parallel-loop-tiling{parallel-loop-tile-sizes=16,16 "
    "no-min-max-bounds=true}),"
    "func.func(gpu-map-parallel-loops),"
    "convert-parallel-loops-to-gpu,"
    "gpu-kernel-outlining,canonicalize)"
)
각 linalg.generic은 병렬 반복자에 대한 scf.parallel 루프 중첩이 되며, 리덕션 반복자는 그 안에서 일반적인 순차 scf.for 루프가 됩니다. 따라서 소프트맥스 행 리덕션은 행에 대한 병렬 루프이며, 그 안에 각 행을 따라가는 직렬 루프를 포함합니다. 스레드 하나가 행 하나를 처리합니다. 리덕션 대상 차원이 많아야 수천 개 원소인 GPT-2의 형상에는 이것이 올바른 매핑이며, 이 백엔드가 가진 유일한 리덕션 전략이기도 합니다.
타일링은 각 병렬 루프를 16 크기의 타일들을 도는 바깥 루프와 타일 내부를 도는 안쪽 루프로 나눕니다. 매핑 패스는 바깥 루프를 블록 차원으로, 안쪽 루프를 스레드 차원으로 표시합니다. 변환 단계는 표시된 루프 중첩을 gpu.launch로 바꾸고, 아웃라이닝은 그 본문을 gpu.module 안의 gpu.func로 옮긴 뒤 원래 자리를 gpu.launch_func로 대체합니다. (64, 256) 행렬의 GELU에 대해 이 파이프라인을 거친 후의 호스트 함수는 다음과 같습니다.
%memref = gpu.alloc host_shared () : memref<64x256xf64>
gpu.launch_func @kernel_kernel::@kernel_kernel
    blocks in (%c4, %c16, %c1) threads in (%c16, %c16, %c1)
    args(%c16 : index, %c0 : index, %c16 : index, %c1 : index, %c0 : index,
         %arg0 : memref<64x256xf32>, %cst_2 : f32, %cst_1 : f32,
         %cst_0 : f64, %cst : f64, %cst_3 : f32, %memref : memref<64x256xf64>)
memref.copy %memref, %arg1 : memref<64x256xf64> to memref<64x256xf64>
16×16 스레드로 이루어진 블록이 4×16개 모인 그리드가 행렬 전체를 덮습니다. 커널의 본문은 Part 10의 융합된 GELU 영역에서 루프 유도 변수 대신 gpu.block_id와 gpu.thread_id를 사용한 것입니다.
gpu.func @kernel_kernel(..., %arg5: memref<64x256xf32>, ..., %arg11: memref<64x256xf64>) kernel {
  %block_id_x = gpu.block_id x
  %thread_id_x = gpu.thread_id x
  ...
  %6 = memref.load %arg5[%4, %5] : memref<64x256xf32>
  %7 = math.powf %6, %arg6 : f32
  ...
  %12 = math.tanh %11 : f64
  ...
  memref.store %16, %arg11[%4, %5] : memref<64x256xf64>
  gpu.return
}
no-min-max-bounds 옵션은 차원이 16의 배수가 아닐 때 타일링 패스가 안쪽 루프를 min 표현식으로 제한하지 않고, 대신 본문 안에서 조건문을 사용하도록 지시합니다. 제한된 형태는 GPU 변환이 고정된 블록 크기로 매핑할 수 없는 루프 경계를 만들어 냅니다.
테스트 스위트는 결과를 구조적으로 검사합니다. GELU, 소프트맥스, 레이어 정규화, matmul, gather, 어텐션에 대해 outline 이후의 호스트 함수는 gpu.launch_func를 포함해야 하며 scf, linalg, memref.alloc 연산은 하나도 포함하지 않아야 합니다. 반복하던 모든 것이 이제 디바이스에서 실행됩니다.
타일링된 행렬 곱셈
linalg.matmul을 같은 파이프라인에 통과시켜도 동작은 하겠지만 느릴 것입니다. 이는 출력에 대한 병렬 루프와 그 안의 에 대한 직렬 루프가 되므로, 각 스레드가 전역 메모리에서 의 행 하나 전체와 의 열 하나 전체를 읽게 됩니다. 한 블록 안의 인접한 스레드들은 서로 겹치는 데이터를 읽는데도 아무것도 공유하지 않습니다. Part 8에서 공유 메모리를 소개한 것이 바로 이런 경우를 위해서였습니다.
그래서 백엔드는 모든 부동소수점 linalg.matmul과 linalg.batch_matmul을 직접 작성한 커널 호출로 대체합니다. 이 커널은 텍스트 형태의 MLIR 템플릿으로, 피연산자의 랭크와 원소 타입에 맞게 서식화된 뒤 ir.Module.parse로 파싱되어 모듈 안으로 옮겨집니다. 배치 처리와 일부 경계 검사를 생략하면 그 구조는 다음과 같습니다.
func.func private @tiled_matmul_2d_f32(%a: memref<?x?xf32, ...>, %b: ..., %out: ...) {
  %m = memref.dim %a, %i0 : ...
  %k = memref.dim %a, %i1 : ...
  %n = memref.dim %b, %i1 : ...
  %gx = arith.ceildivui %n, %tile : index
  %gy = arith.ceildivui %m, %tile : index
  gpu.launch blocks(%bx, %by, %bz) in (%sx = %gx, %sy = %gy, %sz = %i1)
             threads(%tx, %ty, %tz) in (%ux = %tile, %uy = %tile, %uz = %i1)
             workgroup(%sa : memref<16x16xf32, #gpu.address_space<workgroup>>,
                       %sb : memref<16x16xf32, #gpu.address_space<workgroup>>) {
    %row = arith.addi (arith.muli %by, %tile), %ty
    %col = arith.addi (arith.muli %bx, %tile), %tx
    %sum = scf.for %k0 = %i0 to %k step %tile iter_args(%acc = %zero) -> (f32) {
      // each thread stages one element of the A tile and one of the B tile
      memref.store (load %a[%row, %k0 + %tx] or zero), %sa[%ty, %tx]
      memref.store (load %b[%k0 + %ty, %col] or zero), %sb[%ty, %tx]
      gpu.barrier
      %part = scf.for %kk = %i0 to %tile step %i1 iter_args(%s = %acc) -> (f32) {
        %x = memref.load %sa[%ty, %kk]
        %y = memref.load %sb[%kk, %tx]
        scf.yield (%s + %x * %y)
      }
      gpu.barrier
      scf.yield %part : f32
    }
    scf.if (%row < %m and %col < %n) {
      %old = memref.load %out[%row, %col]
      memref.store (%old + %sum), %out[%row, %col]
    }
    gpu.terminator
  }
  return
}
각 블록은 출력의 16×16 타일 하나를 맡습니다. 블록은 리덕션 차원을 16씩 나아가며 순회합니다. 매 단계마다 블록의 256개 스레드 각각이 현재 타일의 원소 하나와 현재 타일의 원소 하나를 두 개의 workgroup 버퍼에 적재하며, 범위를 벗어난 위치는 0으로 읽힙니다. 배리어가 타일을 모든 스레드에게 보이게 합니다. 그런 다음 각 스레드는 공유 메모리에서 곱 16개를 누적하고, 두 번째 배리어는 다음 단계의 적재가 아직 읽히고 있는 타일을 덮어쓰지 않도록 막습니다. 모든 전역 원소는 스레드마다 한 번이 아니라 블록마다 한 번 적재되므로, 전역 메모리 적재가 16분의 1로 줄어듭니다.
두 가지 세부 사항이 커널을 주변 프로그램과 연결합니다. linalg.matmul은 결과를 대상에 누적하므로 마지막 저장은 출력을 덮어쓰지 않고 출력에 더합니다. 빌더가 만든 0으로 채우는 linalg.fill은 그보다 먼저 별도의 작은 커널로 실행됩니다. 또한 커널은 크기, 스트라이드, 오프셋이 모두 동적인 memref를 받습니다. 치환 과정에서 각 피연산자마다 memref.cast를 삽입하므로 랭크와 원소 타입별로 커널 하나가 모델의 모든 형태를 처리하며, 슬라이싱과 전치로 생긴 스트라이드 뷰도 복사 없이 동작합니다:
%cast = memref.cast %arg0 : memref<64x256xf32> to memref<?x?xf32, strided<[?, ?], offset: ?>>
%cast_0 = memref.cast %arg1 : memref<256x32xf32> to memref<?x?xf32, strided<[?, ?], offset: ?>>
%cast_1 = memref.cast %memref : memref<64x32xf32> to memref<?x?xf32, strided<[?, ?], offset: ?>>
call @tiled_matmul_2d_f32(%cast, %cast_0, %cast_1)
배치 변형은 배치로 인덱싱되는 세 번째 그리드 차원을 추가하며, 어텐션의 헤드별 곱셈이 이를 사용합니다.
이것은 CUDA 프로그래밍 가이드에 나오는 고전적인 공유 메모리 matmul이며, 그 이상은 아닙니다. 레지스터 타일링도, 벡터화되거나 비동기적인 로드도, 텐서 코어도 없으며 타일 크기는 고정되어 있습니다. 이러한 형태에서는 cuBLAS가 몇 배 더 빠를 것입니다. 요점은 이 커널이 읽을 수 있는 IR 60줄이며, 파이프라인에서 행렬 곱셈이 아직 행렬 곱셈으로 남아 있는 유일한 지점에 삽입되고, 모델을 실행하기에는 충분하다는 것입니다.
관리 메모리
8부에서는 디바이스와의 명시적인 복사로 데이터를 옮겼습니다. 이 백엔드는 호스트와 디바이스가 같은 포인터로 접근하는 CUDA 관리 메모리를 사용하여 그러한 관리 작업을 피합니다. 컴파일러 쪽 변경은 작습니다. 버퍼화 후 남은 모든 memref.alloc은 host_shared 속성을 가진 gpu.alloc이 되고, 모든 memref.dealloc은 gpu.wait로 감싼 비동기 gpu.dealloc이 됩니다. 이것이 런타임 라이브러리가 구현하는 형태입니다:
%memref = gpu.alloc host_shared () : memref<64x32xf32>
...
%0 = gpu.wait async
%1 = gpu.dealloc async [%0] %memref : memref<64x32xf32>
gpu.wait [%1]
런타임 쪽은 같은 할당자를 감싸는 Python 클래스입니다. 이 클래스는 MLIR의 CUDA 런타임 라이브러리에 있는 mgpuMemAlloc을 host-shared 플래그와 함께 호출하고, NumPy 배열 인터페이스를 통해 포인터를 노출합니다:
class Managed:
    def __init__(self, shape, dtype):
        self.pointer = runtime().mgpuMemAlloc(size, None, True)
        self.__array_interface__ = {
            "shape": tuple(shape), "typestr": dtype.str,
            "data": (self.pointer, False), "version": 3,
        }
이러한 객체에 np.asarray를 적용하면 관리 메모리를 기반으로 하는 일반 NumPy 배열이 됩니다. JIT의 호출 경로는 각 입력을 관리 메모리에 배치하되 이미 그곳에 있는 배열은 건너뛰며, 출력도 그곳에 할당합니다. 한 컴파일된 서브레이어의 출력이 다음 서브레이어의 입력이 되므로, 순방향 패스 동안 잔차 스트림은 결코 디바이스를 떠나지 않습니다. 모델은 로드 시점에 가중치를 한 번 관리 메모리에 배치합니다.
그 대가는 페이지가 언제 이동할지를 프로그램이 아니라 드라이버가 결정한다는 점입니다. 커널이 쓴 뒤 호스트가 처음 접근하면 페이지 폴트가 발생하여 페이지가 다시 호스트로 옮겨집니다. 호스트가 단계마다 로짓 한 행만 읽는 이 모델에서는 이것이 올바른 절충입니다. 지연 시간에 민감한 백엔드라면 명시적인 전송과 스트림이 필요할 것이며, gpu 다이얼렉트의 비동기 토큰이 이를 표현하는 수단이 됩니다.
실행 엔진은 일반적인 러너 유틸리티와 함께 CUDA 런타임 라이브러리를 로드합니다. 각 gpu.module의 PTX는 호스트 모듈에 gpu.binary로 포함되며, 엔진이 초기화될 때 전역 생성자가 이를 드라이버에 로드합니다. 그러면 호스트 함수에서 커널을 실행하는 것은 8부에서 직접 호출했던 바로 그 런타임 라이브러리를 호출하는 것이 됩니다.
NVVM에서 PTX로
마지막 파이프라인은 아웃라인된 모듈을 실행 경계의 양쪽 모두에서 LLVM까지 내립니다:
builtin.module(
  expand-strided-metadata,lower-affine,convert-scf-to-cf,
  nvvm-attach-target{chip=sm_75 O=3},
  gpu.module(convert-gpu-to-nvvm),
  gpu-to-llvm,finalize-memref-to-llvm,
  convert-arith-to-llvm,convert-func-to-llvm,convert-cf-to-llvm,convert-index-to-llvm,
  reconcile-unrealized-casts,
  gpu-module-to-binary{format=isa toolkit=<path to nvidia-cuda-nvcc>})
패스들은 8부에서 사용한 것과 같습니다. 타깃 속성은 칩을 지정합니다. convert-gpu-to-nvvm은 각 커널의 본문을 스레드 인덱스, 배리어, 공유 메모리를 위한 NVVM 내장 함수로 재작성합니다. gpu-to-llvm은 호스트 쪽을 재작성하여 할당, 실행, 대기를 런타임 라이브러리 호출로 바꿉니다. gpu-module-to-binary는 각 커널 모듈을 PTX로 직렬화하는데, format=isa는 결과를 SASS로 어셈블하지 않고 텍스트로 유지합니다. SASS 어셈블은 로드 시점에 드라이버가 장착된 카드에 맞게 수행합니다.
toolkit 옵션은 직렬화기가 libdevice를 가리키도록 합니다. 커널 내부의 math.tanh와 math.exp는 단일 PTX 명령어가 아니며, NVIDIA의 수학 루틴 비트코드 라이브러리에 링크됩니다. 이 프로젝트는 PyPI의 nvidia-cuda-nvcc 패키지에서 libdevice와 ptxas를 가져오므로 시스템에 CUDA를 설치할 필요가 없으며, 패키지를 임포트하고 그 위치를 조회하여 이들을 찾습니다.
ptxas를 사용할 수 있다는 것은 GPU 없이도 PTX를 검사할 수 있다는 뜻입니다. 테스트는 위의 여섯 가지 경우를 각각 하강(lowering)하고, 모든 gpu.binary를 추출하여 sm_75용으로 어셈블합니다. 지속적 통합(CI)은 이 테스트를 일반 Linux 러너에서 실행합니다. 잘못된 변환이나 누락된 libdevice 링크로 인해 생긴 형식이 잘못된 PTX는 누군가가 하드웨어를 손에 넣기 훨씬 전에 빌드를 실패시킵니다. 같은 여섯 함수에 대해 GPU 결과와 CPU 결과를 비교하는 테스트는 장치가 있을 때만 실행됩니다.
실행하기
예제나 검증 스크립트에 --gpu를 전달(패스)하십시오:
uv run python example.py "Alan Turing theorized that computers would one day become" --tokens 10 --gpu
uv run python verify.py --gpu
이를 위해 model.py에서 바뀐 것은 없습니다. embed, attend, feedforward, project 함수는 13부의 것과 같으며, 타깃은 JIT에 전달되는 키워드 인자입니다. Colab T4에서 컴파일 시간을 포함하여 10개 토큰 생성에 약 30초가 걸렸고, CPU 및 NumPy 레퍼런스와 동일한 완성 결과를 냈습니다. 검증 스크립트는 10단계 모두에서 임베딩, 모든 블록의 잔차, 로짓, 토큰 ID를 비교했습니다. 10개 토큰이 모두 일치했으며, 수집한 배열 전체에서 가장 큰 절대 오차는 약 로, CPU에서의 약 과 비교됩니다. 이 차이는 누산 순서에서 비롯됩니다. 타일링된 커널은 한 번에 16개의 곱을 고정된 순서로 더하고, BLAS는 다른 방식으로 계산합니다.
주장하는 바는 이 수치가 전부입니다. GPU 타깃은 카드 한 장에서 레퍼런스가 요구하는 출력을 만들어 내고, 중간값도 허용 오차 이내로 일치합니다. 프로덕션 런타임의 기준으로 보면 빠르지는 않습니다.
모델 전체를 하나의 커널로
서브레이어별 설계는 작은 함수 네 개를 컴파일하고 블록을 순회하는 Python 루프에서 이를 호출합니다. 이는 이 시리즈를 위한 의도적인 선택이었습니다. 각 컴파일된 함수는 출력해서 읽을 수 있을 만큼 작습니다. 컴파일러 자체가 이를 요구하지는 않습니다. 9부의 배열 프로토콜과 12부의 트리 구조 인수를 사용하면, 트레이스된 함수는 전체 매개변수 레코드를 받아 순방향 패스 전체를 담을 수 있습니다.
fused.py 모듈은 NumPy 레퍼런스를 가지고 바로 그 일을 합니다. 이 모듈의 gpt2 함수는 tiny-gpt2의 것을 그대로 붙여 넣고 데코레이터를 붙인 것입니다:
@jit
def gpt2(inputs, params, *, n_head):
    x = params.words[inputs] + params.positions[range(len(inputs))]
    seq_len, embedding_dim = x.shape
    head_size = embedding_dim // n_head

    for block in params.blocks:
        ln1_mean = np.mean(x, axis=-1, keepdims=True)
        ln1_variance = np.var(x, axis=-1, keepdims=True)
        ln1_normalized = (x - ln1_mean) / np.sqrt(ln1_variance + 1e-5)
        ln1_output = block.attention_norm.weight * ln1_normalized + block.attention_norm.bias

        qkv_proj = ln1_output @ block.attention_in.weight + block.attention_in.bias
        q_proj, k_proj, v_proj = np.split(qkv_proj, 3, axis=-1)
        ...
        causal_mask = np.triu(np.ones((seq_len, seq_len), dtype=x.dtype) * -np.inf, k=1)
        attention_scores = attention_scores + causal_mask
        ...
모든 NumPy 호출은 우리의 기호 값으로 디스패치됩니다. params는 모델 가중치의 네임드 튜플로, JIT가 배열로 평탄화한 뒤 트레이스 안에서 다시 조립합니다. np.triu 마스크는 인자 중 어느 것도 기호 값이 아니므로 NumPy 자체가 평가합니다. 그 결과 배열은 상수로 포착되어 커널의 마지막 인자로 끌어올려집니다. 이러한 마스크는 블록마다 하나씩 모두 12개이며, 각각 (T, T) 행렬입니다. 이 구현은 11부의 마스크가 을 사용한 자리에 -np.inf로 마스킹합니다. 소프트맥스를 거치면 둘 다 미래 위치에 정확히 0의 가중치를 줍니다.
트레이싱은 12개 블록에 대해 하나의 그래프를 만들어 냅니다. 최적화 전 모듈에는 linalg.generic 연산이 652개 있으며, 원소별 융합을 거치면 209개로 줄어듭니다. 49개의 linalg.matmul 연산과 24개의 linalg.batch_matmul 연산은 손대지 않은 채 통과하는데, 바로 이것이 11부의 tensor.reshape 결정이 지키려던 것입니다. CPU에서는 이들 하나하나가 GEMM 호출이 됩니다. GPU에서는 하나하나가 타일링된 커널의 실행(launch)이 됩니다.
시퀀스 길이마다 별도로 특수화하면 생성되는 토큰마다 컴파일을 한 번씩 해야 하며, 이 모듈의 컴파일 비용은 결코 작지 않습니다. 융합 모드는 토큰 시퀀스를 다음 2의 거듭제곱 길이까지 패딩하고, 마지막 실제 토큰에 해당하는 로짓 행을 읽어 옵니다.
def logits(ids, weights, config, target):
    padded = np.zeros(min(1 << (len(ids) - 1).bit_length(), config.context), np.int32)
    padded[: len(ids)] = ids
    output = gpt2(padded, weights, n_head=config.heads, target=target)
    return output[len(ids) - 1 : len(ids)]
인과 마스크는 마지막 실제 토큰 뒤의 위치가 그 토큰에 영향을 주지 않도록 보장하므로, 패딩을 해도 우리가 읽는 행에는 아무런 변화가 없습니다. 열 개의 토큰으로 된 프롬프트로 열 개의 토큰을 생성하려면 길이 16과 32가 필요하므로, 컴파일은 열 번이 아니라 두 번으로 충분합니다.
uv run python example.py "Alan Turing theorized that computers would one day become" --tokens 10 --fused
uv run python verify.py --fused
uv run python example.py "..." --tokens 10 --gpu --fused
세 가지 모두 같은 문장을 생성합니다. 융합 모드에서는 순방향 패스가 캡처할 중간값이 없는 하나의 함수이므로, 검증 스크립트는 최종 로짓과 선택된 토큰만 비교합니다. 노트북에서는 융합 실행이 서브레이어별 실행보다 대략 세 배 오래 걸렸으며, 그 시간은 거의 전부 LLVM이 큰 모듈 두 개를 컴파일하는 데 쓰였습니다. T4에서는 두 모드의 소요 시간이 거의 같았습니다.
융합 모드가 보여 주는 것은 성능상의 결과가 아니라 컴파일러의 한 가지 속성입니다. 컴파일된 프로그램은 아무것도 수정하지 않은 레퍼런스 구현 그대로입니다. 이 시리즈는 각 부분을 따로 떼어 살펴볼 수 있도록 고유한 연산자 집합을 갖춘 프런트엔드를 네 개 장에 걸쳐 구축했습니다. 같은 프런트엔드에 기존 NumPy 프로그램을 주면, 그 프로그램 전체를 트레이싱합니다.
구조가 가져다준 것
GPU 타깃을 추가하면서 바뀌지 않은 것들을 되돌아보십시오. 텐서 언어, 빌더, 최적화 파이프라인, 버퍼화, 그리고 ops.py와 model.py의 모든 공식은 CPU 장들에서 다룬 것과 동일합니다. 타깃은 키워드 인자 하나일 뿐입니다. 추가된 것은 기존 패스들을 조합한 루프-커널 변환 파이프라인, 직접 작성한 커널 하나, 그리고 백 줄 정도의 메모리 배관 코드뿐입니다.
이것이 가능했던 것은 파이프라인이 가능한 한 오래 구조를 보존했기 때문입니다. 행렬 곱셈은 융합과 버퍼화를 거치는 동안에도 이름 있는 연산으로 남아 있었으므로, 각 타깃이 자신의 구현으로 대체할 수 있었습니다. 병렬 반복자는 병렬로 남아 있었으므로, 패스가 이를 스레드에 매핑할 수 있었습니다. 할당은 명시적으로 남아 있었으므로, 관리 메모리로 돌릴 수 있었습니다. 앞선 장들에서 미뤄 둔 각각의 결정이 여기서는 이음매가 되었습니다.
한계도 그만큼 분명히 드러납니다. 리덕션 전략도 하나, 타일 크기도 하나, 커널의 원소 타입도 하나뿐이며, 키/값 캐시도 없고 점수를 실체화하지 않는 어텐션 스케줄도 없습니다. 프로덕션 컴파일러라면 이 각각을 형상별, 디바이스별로 결정할 것입니다. 이 컴파일러는 그것들을 읽기 쉽게 만들고, 실제 하드웨어에서 결과를 레퍼런스와 대조해 검증합니다.
외부 자료
우리는 지금 의존 타입의 미래에 살고 있습니다
9월 4일부터 10월 7일까지 34일 동안 다음과 같은 일들이 일어났습니다. Claude가 Lean으로 페르마의 마지막 정리를 형식화했습니다. OpenAI는 나비에-스토크스 방정식의 유한 시간 폭발(finite-time blowup)을 발표했습니다. 이 결과는 1만 개의 에이전트가 88시간 만에 찾아낸 것으로, Lean 형식화도 함께 첨부되었습니다. 한 모델은 코트(Khot)의 유일 게임 추측(Unique Games Conjecture)을 증명했습니다. 또 다른 모델은 두 정수를 보다 빠르게 곱했는데, 지수 개선 폭은 입니다(그러니 GMP에 곧 들어가리라고 기대하지는 마십시오!). 유리 호지 추측(rational Hodge conjecture)이 CM 아벨 다양체에 대해 해결되었습니다. 그러고 나서 OpenAI는 어느 화요일에 372개의 새로운 수학 결과를 GitHub에 쏟아냈습니다. 그리고 이 모든 일이 겨우 한 달 사이에 일어났습니다. 이제 모두가 묻는 질문은 일반화된 리만 가설이 소용돌이치는 텐서의 웅덩이에 무릎 꿇기까지 얼마나 걸리겠느냐는 것입니다.
16개월 전에 저는 수학의 미래는 몹시 기이할지도 모른다고 썼는데, 아이고, 어느새 우리는 바로 그 기이한 미래에 와 있습니다. 그리고 이건 끝내주게 멋집니다.
지금 어느 데이터 센터에는 가속기로 가득 찬 건물이 사실상 상시로 돌아가면서 수학의 최전선에서 진리의 광산을 캐고 있습니다. 그렉 이건(Greg Egan)의 SF 소설 디아스포라에서처럼, propext, Quot.sound, Classical.choice라는 세 공리에서 바깥으로 굴을 파 나가며 결과를 밤낮없이 지상으로 끌어올리고 있습니다. OpenAI는 자사 모델에 약 8천 개의 문제를 내고(그중 약 5%를 풀었습니다) 문제당 평균 세 시간씩 생각하게 했는데, 이것은 느리고 수공예적이며 일반인 친화적인 버전입니다. 산업용 버전은 멈추지 않습니다. 그것은 어떤 인간 공동체가 읽어 낼 수 있는 속도보다 빠르게 결과를 쏟아낼 것이며, 그중 상당수는 옳고, 일부는 중요하며, 점점 더 많은 비율이 이해 불가능할 것입니다. 참이고(진리에 대한 어떤 뒤틀린 철학적 정의에 따르면), 기계로 검증되었으며, 누구도 이해하지 못하는 결과입니다. 인간이 수학을 이해한다는 것은 곧 사치품이 될 것입니다. 이 세상에 그 밖에 무엇이 필요하든, 모델이 결과를 만들어 내는 속도에 맞춰 참인 결과와 지어낸 결과를 가려낼 수 있는 무언가가 반드시 필요하며, 지금 그 무언가는 바로 의존 타입, 즉 Lean입니다.
미래가 하필 이런 모습을 띠게 되었다는 것이 얼마나 기이한 일인지 잠시 곱씹어 보겠습니다. 저는 20대의 상당 부분을 런던 FP 커뮤니티 주변에서 보냈는데, 그곳에서 의존 타입은 클러큰웰의 크라운 태번(Crown Tavern)에서 맥주를 마시며 이야기하던 주제였습니다(기억하시는 분들도 계실 것입니다). 값에 의존할 수 있는 타입, 그래서 함수의 시그니처가 단지 “리스트를 반환한다“가 아니라 “입력을 정렬한 순열을 반환한다“라고 말할 수 있고, 컴파일러가 그 약속을 지키도록 강제하는 타입 말입니다. 증명은 프로그램이고 명제는 타입이라는 관찰인 커리-하워드는 근본적인 북극성이었습니다. 늘 내세우던 주장은 언젠가 우리가 명세에 맞춰 소프트웨어를 작성하고 기계가 그것을 검사하게 되리라는 것이었고, 늘 돌아오던 대답은 그것이 종신 교수직이 있고 마감이 없는 사람들에게나 어울리는 멋진 아이디어라는 것이었습니다. Dependent Haskell은 약 15년 동안 “몇 년 뒤면 나온다“는 상태였습니다. Idris와 Agda는 여전히 소수 취향의 언어로 남았습니다. 소프트웨어 공학은 여전히 대부분 C++와 기도, 그리고 이따금의 어둠의 주문으로 굴러갑니다. 그런데도 의존 타입의 미래는 결국 뒷문으로 도착했습니다.
수학과 강화 학습이 먼저 그곳에 도달했습니다. 알고 보니 의존 타입의 언어의 킬러 애플리케이션은 그 타입 검사기를 보상 함수로 쓰는 것이었습니다. 타입 검사기는 후보 증명에 대해 부분 점수도, 의견도 없이 예 또는 아니요만 말해 주는 오라클이며, 이것이야말로 아주 거대한 최적화기를 미해결 문제에 겨누고 마음껏 돌리고 싶을 때 정확히 필요한 것입니다. 우리가 펍에서 꿈꾸던 것이 이제는 프런티어 연구소의 핵심 인프라가 되었으며, 위에 나열한 결과 대부분은 결국 타입 검사기가 참을 반환했다는 주장입니다.
그렇기 때문에 우리에게는 더 나은 도구가 필요하며, 그것도 최대한 빨리 필요합니다. 의존 타입의 르네상스가 도래했고 형식화된 수학의 황금기가 눈앞에 와 있지만, 이제 이러한 데이터 센터의 내부 루프는 밤낮없이 의존 타입 커널을 돌리며 엄청난 속도로 엘라보레이션하고, 검사하고, 폐기하고, 재시도하고 있으며, 그 출력을 인증하는 것 역시 같은 속도로 돌아가야 합니다. 탐색이 마이크로초 단위로 돌아가는데 검증이 분 단위로 돌아간다면 검증이 병목이 되며, 신뢰의 병목은 슬그머니 건너뛰어지기 마련입니다. 이 시대의 가장 중요한 인식론적 질문인 “이 증명이 정말로 올바른가“에 대한 답을 어쩌다 따라잡을 만큼 빨랐던 검사기가 내리는 상황에 놓여서는 안 됩니다.
Mathlib 1분 장벽 돌파하기
생리학적으로 불가능한 일에서 이제는 동호회 러너들이 목표로 삼아 훈련하는 일이 된 1마일 4분 기록처럼, 형식 수학에도 한동안 고유의 장벽이 있었는데, 바로 Mathlib 전체를 처음부터 1분 안에 타입 검사하는 것입니다. 이제 이것은 충분히 달성 가능한 일로 드러났습니다.
nano-lean은 Lean 커널 언어를 위한 최소한이지만 완전한 타입 검사기로, 바인더에 대한 효율적인 de Bruijn 인덱스를 다루기 위해 제가 만든 바인딩 라이브러리 unbound를 기반으로 Rust로 작성되었습니다. 이 도구는 Lean 환경의 익스포트를 읽어 들여 모든 선언을 처음부터 독립적으로 다시 검사합니다(귀납 타입, 양성 조건, 재귀자, 몫, 유니버스 레벨, 프로젝션, 구조체 에타 등 전부를 검사합니다). Apple Silicon M5 Max에서 Mathlib 전체, 즉 718,577개의 선언을 오류 0건, 타임아웃 0건으로 11.85초 만에 검사합니다.
그 속도의 놀랄 만큼 많은 부분은 텍스트를 파싱하지 않는 데서 나옵니다. Lean에서 선언을 꺼내는 표준적인 방법은 한 줄에 JSON 객체 하나씩을 기록하는 lean4export인데, 수 기가바이트에 달하는 JSON을 파싱하는 일이 무언가를 검사하는 비용의 상당 부분을 차지하는 것으로 드러났습니다. 그래서 nano-lean의 동반 도구인 olean-export는 컴파일된 .olean 파일을 직접 읽어 모듈을 병렬로 디코딩하는데, Mathlib에 의존하는 라이브러리에서 lean4export보다 약 100배 빠르며, 빠른 mmap을 위해 설계된 새로운 바이너리 포맷인 blean을 출력할 수 있습니다. Blean은 NDJSON 익스포트와 같은 레코드 스트림을 같은 순서로 담고 있으며, 파싱할 것이 전혀 남아 있지 않습니다. 모든 레코드는 간결한 postcard 인코딩이고, id는 암묵적이며 빈틈없이 조밀하고, 레코드는 앞선 id만 참조하며, 각 표현식은 미리 계산된 해시를 담고 있습니다. 검사기는 파일 전체를 mmap하고, 운영체제에 파일을 처음부터 끝까지 한 번만 읽을 것이라고 알린 뒤, 매핑된 바이트에서 곧바로 이름, 레벨, 표현식을 디코딩하여 항 아레나에 넣습니다. 파싱 단계가 아예 없습니다. 디스크상의 바이트가 이미 메모리 내 데이터의 형태와 거의 같으며, 바로 이것이 Mathlib을 1분 안에 검사하는 방법입니다.
같은 기법은 최첨단 결과에도 통합니다. 다음은 nano-lean이 14개 스레드를 사용하는 M5 Max에서 각 라이브러리와 증명의 임포트된 전체 환경을 검사한 결과입니다.
| Mathlib | Navier–Stokes | CSLib | Quasi-Riemann | Erdős AP | |
|---|---|---|---|---|---|
| 경과 시간 | 11.85 s | 17.13 s | 4.42 s | 3.66 s | 23.33 s |
| 커널 검사 | 7.55 s | 12.11 s | 2.75 s | 2.58 s | 19.11 s |
| 명령어 수 | 742.3 G | 977.0 G | 300.8 G | 236.4 G | 837.9 G |
| 사이클 | 352.7 G | 471.3 G | 136.6 G | 122.6 G | 550.0 G |
| 최대 메모리 사용량 | 10.7 GB | 12.29 GB | 6.92 GB | 7.42 GB | 26.42 GB |
Mathlib의 커널 시간을 선언 수로 나누면 선언 하나당 분할 상환 기준 10.5마이크로초가 나옵니다. 이것이 중요한 수치입니다. 릴리스 파이프라인 끝단에 놓이는 검사기가 아니라, RL 기반 탐색 루프 깊숙한 곳에서 수천억 번 호출되는 검사기에 걸맞은 자릿수이기 때문입니다. 10년에 걸친 자원봉사자들의 노력의 산물인, 인간이 형식화한 수학 라이브러리 전체가 에스프레소 한 잔을 내리는 시간보다 짧은 시간 안에 재검증됩니다.
마침 Google Cloud에 m2-ultramem-416도 하나 놀고 있었기에(누구나 그렇듯 vCPU 416개와 RAM 12 TB짜리입니다), 자연스럽게 nano-lean을 거기에 돌려 보았습니다. 네, Mathlib 10초 장벽을 깹니다. 하지만 암달의 법칙이 안부를 전해 오고, 의존성 그래프가 나눠 줄 독립적인 작업이 바닥나면서 코어 수가 백 개를 넘어가는 어딘가에서 곡선이 급격히 평평해집니다. 알고 보니 Mathlib이 너무 작은 것입니다. 미래의 Mathlib이나 Tau Ceti 같은 것이 이 머신을 실제로 포화시킬 만큼 커지는 날을 고대합니다. 그것이야말로 진정한 미래입니다!
제가 이것을 만든 것은 병목이 어디로 옮겨 갔는지를 보여 주기 위해서입니다. 커널은 이제 새로운 종류의 과학 경제에서 핫 루프이며, 핫 루프는 핫 루프답게 엔지니어링되어야 마땅합니다. 형식 증명이라는 거래 전체는 하나의 비대칭성 위에 서 있습니다. 증명을 찾는 데는 프런티어 모델이 세 시간 동안 사고하거나 1만 개의 에이전트가 88시간 동안 작업해야 할 수도 있지만, 그것을 검사하는 데는 마이크로초면 충분해야 합니다. 바로 그 비대칭성 덕분에 어떤 인간도 읽지 않은 결과를 신뢰하는 것이 합리적인 일이 됩니다. 이는 검사기가 실제로 확장될 때에만 성립하며, 페르마의 마지막 정리가 이제 Mathlib의 다섯 배 규모에 이르는 지금, 규모는 더 이상 가정의 문제가 아닙니다. 이제 Mathlib은 작은 라이브러리입니다.
다만 사는 사람이 주의해야 합니다(caveat emptor). nano-lean은 적절한 수준의 저수준 Rust 내공만 있으면 이것이 가능하다는 것을 보여 주기 위해 만든 개념 증명입니다. 그렇긴 하지만, 저희는 OneChronos에서 상당히 과도하게 커져 버린 시장 인프라에 관한 대규모 Lean 증명을 검사하는 데 이것을 내부적으로 실제로 사용하고 있습니다. 이것은 공식 Lean 커널만큼 신뢰할 수 있는 수준에는 한참 못 미칩니다. 공식 커널은 수년간의 검증과 전문가 커뮤니티, 그리고 지금까지 실행된 모든 Mathlib 빌드를 뒷배경으로 두고 있으며, 같은 라이브러리를 검사하는 데 약 15분이 걸립니다. 제 주장은 그보다 범위가 좁으며, 제 생각에는 더 흥미롭습니다. 이 정도 속도의 검사는 충분히 가능하므로, 우리는 몇 분이라는 시간을 신뢰의 당연한 비용으로 여기는 것을 멈추고 빠르면서도 신뢰할 수 있는 검사기를 만들기 시작해야 합니다. 미래의 Lean 컴파일러는 rustc나 clang만큼 엄청나게 빨라질 수도 있습니다.
미래의 모습
작년의 이전 글에서 저는 수학자들이 다락방에서 고군분투하는 앤드루 와일스보다는 GitHub에서 풀 리퀘스트를 처리하는 소프트웨어 엔지니어에 더 가까운 모습이 될 것이라고 예측했습니다. 역사상 단일 발표로는 가장 큰 규모의 새로운 수학은 CONTENTS.md, Lean 라이브러리, v4.34.1에 고정된 lean-toolchain 파일, 그리고 “수정 및 개정 사항은 새 버전으로 기록될 것“이라는 약속과 함께 GitHub 저장소 형태로 공개되었습니다. 그러니까, 네, 그 일은 실제로 일어났습니다.
저는 AI 시스템이 형식화된 미해결 추측 목록에 투입되어 체계적으로 최전선을 밀어붙이려 할 것이라고 예측했습니다. 8천 개의 문제를 각각 세 시간씩 다뤘습니다. 적중했습니다.
저는 리만 가설을 맡은 데이터 센터가 몇 주 뒤에 어떤 인간도 따라갈 수 없는 증명을 들고 돌아올 것이라고 예측했습니다. 우리가 얻은 것은 준리만 가설, 즉 모든 디리클레 -함수가 에서 영점을 갖지 않는다는 결과와 Lean 페이지였으며, 이는 그토록 섬뜩하지만 않았다면 웃겼을 법한 종류의 아슬아슬한 빗나감입니다. 그리고 불가해성도 예정대로 도착했습니다. OpenAI는 열 개의 계열에 대해 “추론 요약“을 공개했는데, 알고 보니 이는 추론 트레이스 발췌문의 요약으로, 모델이 실제로 한 일로부터 두 단계나 떨어져 있는 것이었습니다.
저는 백만 달러짜리 밀레니엄 상금이 GPU 청구서의 100분의 1 정도는 메워 줄지도 모른다고 농담했습니다. 나비에-스토크스 실행에는 약 1,300억 개의 토큰이 소모된 것으로 알려졌습니다. 그러니 확실히 그렇습니다.
제가 틀린 것은 시기였습니다. 작년에 저는 “아직 그 단계에 이르지 못했습니다. 근처에도 가지 못했습니다.“라고 썼습니다. 그로부터 16개월이 걸렸습니다. 체스 비유도 아마 틀렸을 것입니다. 저는 Stockfish와 체스의 경우처럼, 기계가 수학을 덜 대중적이고 덜 접근하기 쉽게 만드는 것이 아니라 오히려 더 대중적이고 더 접근하기 쉽게 만들 것이라고 주장했습니다. 장기적으로는 그럴지도 모릅니다. 단기적으로 현업 수학자들 사이의 분위기는 실존적 위기에 더 가깝고, 미해결 문제는 경력 파이프라인, 보도자료에 연구 성과를 선점당하는 박사과정 학생들, 그리고 지금까지 만들어진 가장 강력한 수학 도구가 미공개 모델을 운영하는 소수의 민간 기업 안에 집중되는 현상에 관한 것입니다.
제가 완전히 놓친 것은 병목이 결국 배관 작업, 즉 인프라 문제로 드러나리라는 점이었습니다. 저는 괴델과 불가해한 증명의 인식론에 여러 단락을 할애했지만, 실제로 가장 먼저 부딪힌 문제는 OpenAI의 Lean 라이브러리가 수만 개의 파일에 걸쳐 소스만 1기가바이트가 넘는다는 것이었고, 그들의 README에는 Linux의 vm.max_map_count가 너무 낮아서 빌드가 실패할 수 있다고 경고하며 Lean을 -DMMAP=OFF로 다시 컴파일하는 우회 방법을 제안하는 절이 있습니다. 철학적 문제는 여전히 남아 있습니다. 하지만 지금 수학의 최전선을 가로막고 있는 것은 커널 조정 매개변수 하나입니다. 우리가 원했던 미래는 아니지만, 어쩌면 우리에게 걸맞은 미래일지도 모릅니다!
검사기는 누가 검사하는가
지금까지 제가 말한 모든 것에 대한 명백한 반론은 Lean 증명은 Lean만큼만 신뢰할 수 있다는 것입니다. 그리고 그것은 정말 맞는 말입니다!
Lean은 다른 모든 증명 보조기와 마찬가지로 작고 신뢰할 수 있는 커널과, 그 밖의 매우 크고 신뢰할 수 없는 나머지 전부(엘라보레이터, 전술 프레임워크, 컴파일러, 빌드 시스템)로 이루어져 있습니다. 설계 자체는 건전합니다. 정확해야 하는 유일한 코드는 커널이며, 커널은 읽을 수 있을 만큼 작습니다. 하지만 “읽을 수 있을 만큼 작다“는 것은 소스 코드를 설명하는 말입니다. 그것은 정확성에 대해 아무것도 보장하지 않으며, Lean의 커널에는 과거에 건전성 버그가 있었고, 이는 역사상 모든 증명 보조기의 모든 커널도 마찬가지였습니다. 역사적으로는 그것을 감내할 수 있었는데, 상대가 자기 증명이 통과되기를 바랄 뿐 False가 타입 검사를 통과하게 만드는 방법을 찾아다니는 데는 아무 관심이 없는, 굶주린 인간 대학원생이었기 때문입니다. 그 가정은 이제 낡은 것이 되었습니다.
저는 지난달에 보상 해킹에 대해 썼습니다. 보상 해킹이란 최적화기가 목표의 의도가 아니라 문자 그대로의 조건만 충족시키는 습성을 말합니다. Lean 파일을 컴파일되게 만들라는 지시를 받은 에이전트는, 충분한 연산 자원과 충분한 시도 횟수가 주어지면, 여러분의 커널을 겨냥한 극도로 부지런한 퍼저가 됩니다. 그 에이전트가 속이려는 의도를 가질 필요는 없습니다. 검사기가 받아들여서는 안 되는데도 받아들이는 항을 단 한 번만 우연히 찾아내면 충분하며, 나머지는 경사가 알아서 처리합니다. 증명기가 적대적인 최적화기라면 단일 커널은 단일 장애점이 되며, 건전성 버그는 더 이상 민망한 GitHub 이슈에 그치지 않고 가짜 정리를 대량으로 찍어 내는 장치가 됩니다.
답은 컴파일러 세계가 도달한 답과 같습니다. Csmith가 무작위 C 프로그램을 생성하고 이를 여러 컴파일러로 컴파일해 결과를 비교하기 시작하자, 수십 년간의 일상적인 사용에서도 발견되지 않았던 GCC와 LLVM의 버그 수백 개를 찾아냈습니다. 다양성과 차등 테스트(differential testing)의 조합은 단일 구현을 아무리 꼼꼼하게 검토하는 것보다도 낫습니다. 증명 검사에서 이는 서로 다른 사람들이 서로 다른 언어와 서로 다른 표현 방식으로 작성한 여러 독립적인 커널이 모두 같은 익스포트 형식을 입력으로 받고, 모두 같은 판정을 내려야 한다는 뜻입니다. Mario Carneiro의 lean4lean과 Chris Bailey의 nanoda가 이 분야를 일찍 개척했습니다. nano-lean은 세 번째 도구인 nl-mutate를 제공합니다. 이 도구는 유효한 익스포트를 받아 의미를 깨뜨리는 작은 변이를 가하고, 사용 가능한 모든 검사기를 실행한 뒤, 판정이 엇갈리는 경우를 보고하면서 각각을 재현 가능한 최소 사례로 축소합니다. 모든 판정 불일치는 누군가의 커널에 있는 버그이거나 타입 이론 명세의 모호함이며, 둘 다 GPU 팜이 대신 찾아내기 전에 미리 알아 둘 가치가 있습니다.
신뢰의 나머지 절반은 명제입니다. 잘못된 정리에 대한 증명은 아무리 완벽하게 검사되었더라도 무가치하며, 증명 검사기를 속이는 가장 효과적인 방법은 지금까지 한 번도 커널을 깨뜨리는 것이 아니었습니다. 그것은 증명 대상이 사람들이 실제로 관심을 두는 대상에서 멀어질 때까지 명제를 조용히 약화시키는 것입니다. OpenAI의 저장소가 제출된 증명을 별도로 명시된 과제 명제와 대조하여 샌드박스 안에서 검사하는 Comparator에 의존하는 것도, 바로 이곳이 이제 진정한 신뢰 경계가 놓인 자리이기 때문입니다. 모델이 완강한 목표를 붙잡고 끈질기게 씨름하는 모습을 지켜본 사람이라면, 모델이 가장 지루한 방식으로 속임수를 쓰는 고약한 경향이 있다는 것을 압니다. 모델은 마침 자신에게 필요했던 보조정리와 정확히 일치하는 axiom을 슬그머니 도입하거나, 파일 세 단계 깊숙이 sorry를 묻어 두거나, 표기법이나 매크로를 재정의하여 페이지에 적힌 명제가 더 이상 겉보기와 같은 의미를 갖지 않게 만들거나, native_decide에 손을 뻗어 컴파일러 전체를 신뢰 기반 안으로 끌어들입니다. 이러한 속임수는 커널을 우회하기 때문에 이 모든 과정에서 커널은 완벽하게 건전한 상태를 유지하며, 유일한 방어책은 명제를 독립적으로 고정하고 증명이 실제로 무엇에 의존하는지 검사하는 것입니다. 누군가는 추측을 형식화해야 하고, 누군가는 그 형식화가 영어 문장이 뜻하는 바를 그대로 뜻하는지 확인해야 합니다. 그 일은 과정의 다른 어떤 부분보다도 오래 남을 것입니다. 오히려 인간의 수학적 안목은 증명을 작성하는 일에서 벗어나 명세를 작성하고 감사하는 일로 옮겨 가게 될 것입니다.
이것이 하나의 작업 방식으로서 어떤 모습인지 그 씨앗을 보고 싶다면, Mathlib의 하위에 있는 Lean 라이브러리인 Tau Ceti를 살펴보십시오. 핵심은 바로 분업에 있습니다. 인간은 별도의 저장소에 마크다운으로 로드맵을 작성하고, 리뷰 기준표도 인간이 작성합니다. AI는 모든 코드를 작성하고, 풀 리퀘스트를 열고, AI 주도의 리뷰 과정을 거쳐 이를 이끌어 갑니다. 기준표는 명시적으로 적대적이며, 잘못된 형식화, 공허한 명제, 그리고 “카펫 아래 혹을 이리저리 밀어 옮기는 것“을 찾아내라는 지침을 담고 있습니다.
지금 Lean에 필요한 것
Lean은 탁월한 공학적 산물입니다. 하지만 Lean은 특정한 사용자, 즉 Emacs에서 택틱을 입력하고 인포뷰가 갱신되기를 기다리며 자원봉사자 커뮤니티가 풀 리퀘스트를 리뷰할 수 있는 속도에 맞춰 라이브러리를 만들어 가는 가난한 대학원생을 중심으로 설계되었습니다. 이제 사용자는 11일 만에 1,300만 줄을 작성하는 에이전트 무리입니다. 도구는 새로운 작성자들에 맞게 성숙해져야 하며, 그것이 무엇을 의미하는지에 대한 목록은 상당히 구체적입니다.
표면 포매터. Lean에는 아직도 rustfmt나 gofmt 같은 정식의, 널리 채택된 포매터가 없으며, 작성자가 수백만 줄을 생산하는 에이전트라면 에이전트마다 제각기 들여쓰기, 줄 바꿈, 전술 배치 방식을 만들어 냅니다. diff는 잡음으로 가득 차고, 리뷰는 어려워지며, 에이전트 간 중복 제거는 공백만 다른 증명들을 놓칩니다. Lean이 매우 큰 언어로 성장했기 때문에, 이는 의외로 어려운 문제입니다. Lean의 문법은 런타임에 확장할 수 있으므로, import된 파일에서 선언된 표기법, 매크로, 그리고 전술 언어 전체가 이후 파일의 파싱 방식을 바꿉니다. 포매터는 고정된 문법을 읽기만 해서는 안 됩니다. 포매터는 환경을 불러오고, 모든 구문 확장이 스코프에 있는 상태에서 실제 파서를 실행한 다음, 사용자 정의 표기법에 따라 모양이 달라지는 구문 트리를 보기 좋게 출력해야 하며, 그동안 주석을 그대로 왕복 보존하고 코드의 의미는 절대 바꾸지 않아야 합니다. 이는 진정으로 어려운 엔지니어링 과제이며, 이제는 기본 요건이 되었습니다.
공개 인터페이스로서의 안정적이고 명세된 내보내기 형식. 독립적인 커널은 C++ 런타임에 링크하고 olean을 직접 읽지 않고도 Lean에서 선언을 꺼낼 수 있는 잘 정의된 방법이 있어야만 가능합니다. lean4export와 olean-export 같은 도구는 이미 NDJSON을 생성하며, blean은 메모리 매핑을 전제로 설계된 같은 스트림의 바이너리 형식이 내보내기 비용을 거의 없앨 수 있음을 보여 줍니다. OpenAI 자체의 검증 지침도 lean4export에 의존합니다. 그 형식은 와이어 프로토콜만큼 진지하게 다루어져야 합니다. 버전이 관리되고, 문서화되고, 식의 해싱까지 명세되며, 툴체인 릴리스 간에 안정적이어야 합니다. 내보내기 형식은 신뢰가 확립되는 경계입니다. 그러니 명세를 갖출 자격이 있습니다.
일급 시민으로서의 독립 검사. 두 번째 커널을 실행하는 일은 린터를 실행하는 것만큼 평범한 일이 되어야 합니다. Mathlib CI, Comparator 워크플로, 그리고 형식적 결과를 발표하는 모든 연구소는 서로 무관한 커널을 최소 두 개 사용해 내보낸 결과를 재검사하고, 커널들의 판정이 엇갈리는 것은 무엇이든 승인을 거부해야 합니다. Mathlib 전체를 검사하는 데 1분도 걸리지 않는 지금, 이는 저렴한 일입니다.
실행 파일만이 아닌 라이브러리로서의 검사기. 증명 에이전트의 내부 루프는 이미 로드되어 준비된 환경에 대해 후보 선언 하나를 제출하고 마이크로초 단위로 판정을 받기를 원합니다. 프로세스 시작, olean 재읽기, 수 기가바이트에 달하는 환경의 재역직렬화는 사람이 1분에 한 번 저장 버튼을 누르던 시절에는 전혀 문제가 되지 않던 비용입니다. 탐색 절차가 시간당 백만 개의 후보를 검사할 때는 이러한 비용이 대부분을 차지합니다. 커널은 영속적인 환경, 선언의 점진적 추가, 그리고 탐색 하네스가 촘촘한 루프 안에서 호출할 수 있는 API를 갖추고 임베드할 수 있어야 합니다.
메모리와 규모. Mathlib을 검사하려면 수 기가바이트의 메모리가 필요합니다. FLT 형식화는 그보다 다섯 배 크며, OpenAI의 라이브러리는 이미 Linux 가상 메모리 한도를 넘어서고 있습니다. Lean은 import된 모든 모듈을 mmap하는데, 이는 수천 개 파일로 이루어진 라이브러리에는 합리적인 설계이지만 수십만 개 파일에는 불합리한 설계입니다. 항 공유, 모듈 간 해시 콘싱, 간결한 디스크상 표현, 그리고 증명이 의존하는 선언만 정확히 지연 로딩하는 것은 지루하고 화려하지 않은 엔지니어링 문제이지만, 형식 수학이 다음 자릿수의 규모로 확장될 수 있을지를 결정합니다.
진짜 비용은 정교화입니다. 커널은 빠른 부분입니다. Mathlib을 소스에서 빌드할 때 비용이 큰 부분은 단일화, 타입 클래스 해석, simp, omega, decide, 그리고 수많은 전술을 거느린 정교화기입니다. 콜드 빌드는 여전히 CPU 시간 단위로 측정되며, 후보 증명을 대규모로 정교화하는 채굴 작업은 그 비용을 계속해서 반복해 치릅니다. 병렬 및 점진적 정교화, 더 나은 타입 클래스 인스턴스 캐싱, 그리고 simp 호출 한 번에 왜 4초가 걸렸는지 알려 줄 수 있는 프로파일링 도구야말로 증명 루프에서 실제 경과 시간의 대부분이 소모되는 지점입니다.
Clippy 스타일 린터. Mathlib에는 이미 훌륭한 린터들이 갖춰져 있지만, 에이전트에게는 Rust의 clippy에 더 가까운 것, 즉 기계가 작성한 Lean이 잘못되는 특정한 방식들을 겨냥한, 크고 주관이 뚜렷한 린트 목록이 필요합니다. 엉뚱한 곳에 놓인 axiom, 깊숙이 묻힌 sorry, 불필요한 native_decide, 보조정리로 분리되어야 할 마흔 줄짜리 simp only, 가정이 서로 모순되어 공허하게 참이 되는 정리, 표준적인 무언가를 가리는 지역 표기법, 라이브러리에 이미 있는 증명을 중복하는 복사-붙여넣기 증명을 표시하십시오. 각 린트는 비용이 적게 들고, 기계가 읽을 수 있어야 하며, 수정 제안을 함께 제공해야 합니다. 사람이라면 경고를 대충 훑어보고 넘기겠지만, 이를 소비하는 쪽은 모든 경고에 대해 조치를 취할 탐색 루프이기 때문입니다. 린터는 안목을 대규모로 인코딩하는 방법이며, 안목이야말로 에이전트에게 가장 눈에 띄게 부족한 것입니다.
기계 규모의 검색. Moogle, Loogle, LeanSearch는 사람이 어렴풋이 기억하는 보조정리를 찾도록 돕기 위해 만들어졌습니다. 에이전트에게도 같은 것이 필요하지만, 그 규모는 라이브러리가 일주일에 수백만 줄씩 늘어나고, 그 안에 있는 것의 대부분을 다른 에이전트가 작성했으며 사람이 한 번도 들여다본 적이 없는 수준입니다. Anthropic이 FLT에 사용한 Prove2Me 플랫폼은 바로 에이전트들이 서로의 작업을 찾아 재사용할 수 있도록 자연어 설명이 붙은 정리 명제들의 DAG를 유지합니다. 지금까지 증명된 모든 것에 대한 살아 있는 검색 가능한 색인이라는 그 아이디어는, 각 연구소가 비공개로 다시 만드는 무언가가 아니라 공유 인프라가 되어야 합니다.
출처. 현세대 모델들은 자신이 사용하는 기법에 대해 문헌을 인용하는 데 서툴기로 악명이 높습니다. 증명 항은 자신이 어떤 보조정리에 의존하는지는 정확히 알지만, 그 아이디어가 어디에서 왔는지는 전혀 알지 못합니다. 기계가 생성한 수학이 아무도 읽지 않는 부록처럼 인간의 문헌 옆에 놓여 있는 것이 아니라 그 안에 통합되려면, 증명은 자신의 이력(어떤 모델, 어떤 실행, 어떤 선행 결과, 논증이 기대고 있는 어떤 사람이 쓴 논문)을 지니고 다녀야 합니다.
이 중 어느 것도 그리 낯선 것은 아닙니다. 이는 산업화를 거친 다른 모든 분야가 겪어 온 종류의 인프라입니다. 컴파일러는 테스트 스위트와 여러 구현을 갖추게 되었고, 네트워크 프로토콜은 RFC를 갖추게 되었으며, 데이터베이스는 형식적인 격리 수준과 Jepsen을 갖추게 되었습니다. 증명 보조기는 그 모임의 가장 새로운 구성원이며, 이전의 그 어떤 것보다도 빠르게 산업화되고 있습니다. 제가 젊고 야심 찬 프로그래머라면, 투자 대비 가장 높은 수익을 위해 초기 경력을 바로 이 분야에 집중하겠습니다.
현실 세계를 위한 커리-하워드
제가 술집에서 약속받았던 의존 타입의 미래는 소프트웨어가 명세에 맞추어 작성되고 기계가 그것이 명세를 충족하는지 검사하는 미래였습니다. 실제로 우리가 얻은 것은 그보다 더 기묘합니다. 명세는 정리 명제이고, 소프트웨어는 증명 항이며, 저자는 에이전트 무리이고, 만들어지고 있는 것은 수학의 최전선 그 자체입니다. 결국 커리-하워드는 산업 인프라였던 것으로 드러났습니다. 다만 그곳에 이르기까지 강화 학습이 필요했을 뿐입니다.
그리고 이것은 이야기의 수학적인 절반에 불과합니다. 방금 페르마의 마지막 정리를 검사한 바로 그 장치는 정확하게 진술할 수 있는 것이라면 무엇이든 검사할 것이며, 가장 분명한 다음 고객은 산업용 소프트웨어입니다. 저는 지난달에 우리가 출시하는 것 중 증명은 고사하고 명세를 갖춘 것조차 거의 없기 때문에 소프트웨어가 형편없다고 주장했습니다. 그 변명은 사라지고 있습니다. 에이전트 무리가 2주도 안 되는 기간에 검증된 수학 1,300만 줄을 만들어 낼 수 있다면, 같은 기법을 소프트웨어 공학에 적용하는 날도 머지않았습니다. 연구소들이 수학을 먼저 채굴하는 이유는 그것이 협상해야 할 지저분한 현실 세계의 명세가 없는, 가장 깔끔하게 검증 가능한 영역이기 때문입니다. 다음은 소프트웨어이며, 소프트웨어에도 똑같은 도구들, 즉 빠른 커널, 다양한 검사기, 정직한 명제, 그리고 잠들지 않는 저자를 위해 만들어진 인프라가 모두 필요할 것입니다.
그러니 그렇습니다, 수학의 미래는 몹시 기묘한 것으로 드러났고, 그것도 제가 예상했던 것보다 훨씬 이르게 찾아왔습니다. 결과는 누구도 읽을 수 없을 만큼 빠르게 쌓이고 있으며, 우리 중 많은 사람이 스스로를 설명하지 못하는 무언가가 아침 식사 전에 증명해 낸 정리들을 이해하려 애쓰며 남은 경력을 보내게 될 것입니다. 저는 그것이 불안하게 느껴지면서도, 동시에 짜릿하게 느껴집니다.
마지막으로 염치없는 홍보를 하나 하겠습니다. 수학 형식화에 관한 블로그 글을 읽기보다 그 최전선에서 직접 일하고 싶으시다면, OneChronos에서 정형 기법 엔지니어를 채용하고 있습니다. 저희는 조합 경매(combinatorial auction)로 기관 시장을 구축합니다(Milgrom과 Wilson의 2020년 노벨상에서 이어진 것입니다). 조합 경매는 트레이더가 점점 더 매우 독특하고 표현력 있는 선호를 지닌 RL 루프가 되어 가는 세상에 꼭 맞는 수학적 정식화인 것으로 밝혀졌습니다. 저희 다크 풀은 미국 주식 시장 명목 거래량의 1% 이상을 처리하고 있으며, 이미 다른 여러 글로벌 자산군으로도 확장했습니다. 입사하시면 새로 꾸려진 정형 기법 팀에 합류하여 수학자, 시장 구조 전문가와 함께 Rust와 Lean으로 코드를 작성하게 됩니다. 의존 타입, 수치 최적화, 그리고 Lean을 활용해 매일 수천억 달러를 안전하게 움직입니다. 그런 부류의 너드이시라면 연락해 주십시오.
2026-07-30 업데이트.
Prism: 타입이 지정된 이펙트를 갖춘 비순수 함수형 언어
이번 글은 상당히 너드한 글이 될 것이니 양해해 주십시오. 가장 짧게 요약하면 다음과 같습니다:
#![allow(unused)]
fn main() {
fn fib(n) =
  var a := 0
  var b := 1
  var i := 0
  while i < n do
    let t = a + b
    a := b
    b := t
    i += 1
  a
}
이것은 Int -> Int 타입을 가진 가변 루프입니다. 변경은 실제로 일어나지만 지역적이고 관찰할 수 없으므로, 호출자의 관점에서 이 함수는 순수합니다. Prism은 효과 메커니즘을 통해 var와 while을 로어링하고, 비공개 상태가 빠져나갈 수 없음을 증명한 다음, 루프를 여러분이 의도한 제자리(in-place) 코드로 컴파일합니다. Python으로 작성할 법한 코드에 OCaml에서 원할 법한 시그니처를 갖추었으면서도, 함수 한가운데를 작은 종교 의식으로 만들지 않습니다.
예전에는 그 예제가 이야기의 전부였습니다. v0.15에 이른 지금은 그것을 훨씬 더 큰 설계의 작은 끝자락으로 이해하는 편이 낫습니다. Prism은 하나의 계약을 중심으로 만들어진 개념 증명용 함수형 언어입니다: 관찰 가능한 동작은 검사된 코드와 명시적으로 고정된 입력에 의해 결정되어야 합니다. 효과는 계산이 세계에 무엇을 요청할 수 있는지를 말하고, 핸들러는 그 요청이 무엇을 의미하는지 결정하며, 검사된 중간 표현은 그 결정을 보존하고, 콘텐츠 식별자는 그것에 이름을 붙이며, 하나의 정규 관찰 트레이스가 그것을 실행하는 모든 방식을 판정합니다. 이 언어는 여전히 장난감이지만, 이제는 약간 도를 넘어 버린 원래의 효과 데모보다 훨씬 더 넓은 설계를 갖추고 있습니다.
- Prism 소스 코드 - GitHub에 있는 컴파일러, 표준 라이브러리, 도구
- Prism 문서 - 언어 가이드, 레퍼런스, 브라우저 플레이그라운드
효과는 권한입니다
대수적 효과는 계산이 보내는 요청에 대한 인터페이스이고, 핸들러는 그 문맥이 제공하는 구현이자 권한입니다. 따라서 ! 뒤의 행(row)은 단순한 정직성 표시 이상입니다: ! {Console, FileSystem}은 함수가 관찰할 수 있는 세계의 정확한 부분이며, 빈 행은 그러한 권한이 전혀 필요하지 않음을 뜻합니다. 행은 구조적으로 합성되고, 핸들러는 자신이 소유한 연산만 처리할 수 있으며, 나머지는 모두 바깥쪽으로 통과해 나갑니다. 재개 가능한 절에서 계속(continuation)은 resume 뒤에 작성되고, never 절에는 계속이 전혀 없습니다. 그래서 생성기, 예외, 상태, 실패, 재시작, 스트림, 백트래킹이 모두 같은 작은 메커니즘을 공유합니다. 빠른 경로에서 컴파일러는 효과 증거를 직접 호출로 바꾸고 연산마다 자유 모나드 노드를 할당하는 일을 피하므로, 이 추상화가 성능에 대한 변명거리가 되지 않습니다.
#![allow(unused)]
fn main() {
effect Gen
  yield(Int) : Unit

fn produce(n) : Unit ! {Gen} =
  if n == 0 then
    ()
  else
    yield(n)
    produce(n - 1)

fn total(n) =
  handle produce(n) with
    yield(v) resume k => v + k(())
    return r => 0
}
결정성이 계약입니다
Prism은 구현상의 선택이 관찰 불가능하게 유지될 것을 요구합니다. 인터프리터, LLVM 백엔드, MLIR 백엔드, 최적화 수준, 강제된 효과 로어링 단계는 출력, 권한 이벤트, 커밋된 파일, 오류, 결과를 담은 하나의 순서 있는 관찰 트레이스를 통해 비교됩니다. 다른 스케줄러 정책이나 더 빠른 로어링은 비용을 바꿀 수 있습니다. 의미는 고정된 채로 유지됩니다. 초월 부동소수점 연산은 동일하게 벤더링된 musl 루틴을 거치므로, 호스트 라이브러리와 관계없이 결과 비트가 안정적으로 유지됩니다. 시간, 무작위성, 환경 변수, 파일 시스템 읽기는 권한 효과로 들어오며, 그 결과가 고정되고 나면 실행은 프로그램과 그 트레이스의 함수가 됩니다. 결정성은 백엔드 동등성, 재생, 캐싱, 그리고 이후의 모든 주장이 참조하는 공통 실행을 제공합니다.
하나의 검사된 의미론적 척추
컴파일러에는 모든 백엔드가 공유하는 하나의 의미 파이프라인이 있습니다. 표면 구문은 엘라보레이션에 필요한 타입, 효과, 바인딩, 패턴, 소스 정보를 담은 검사된 HIR로 해석됩니다. 엘라보레이션은 이 정보를 call-by-push-value, 관리 정규형(administrative normal form) Core로 옮겨 적습니다. 타입이 있는 Core는 독립 검증기가 모든 변환 후에 검사하는 증거(witness)를 담고 있습니다. 검사기가 결정하고, 이후 단계는 그 정보를 옮겨 적습니다. 최적화는 항을 단순화하거나 로어링할 수 있지만, 인터프리터나 네이티브 이미터가 그 항을 볼 수 있게 되기 전에 독립적으로 유효한 또 다른 Core 아티팩트를 만들어 내야 합니다. CBPV는 값과 효과를 지닌 계산 사이의 경계를 명시적으로 드러내며, 이 덕분에 효과 로어링, 소유권 삽입, 백엔드 코드 생성이 합의할 수 있는 하나의 지점이 생깁니다. 물론 컴파일러에도 여전히 버그가 있을 수 있지만, 모든 백엔드는 화요일에도 똑같이 검사된 언어를 받습니다.
콘텐츠 정체성과 계보
검사된 모든 정의에는 정규화된 Core와 그 컴파일이 읽는 정확한 의미적 의존성으로부터 도출된, 스킴 태그가 붙은 정체성이 있습니다. 파일, 정규 구문 트리, 바인더, 타입 형태, 모듈 인터페이스, 표준 라이브러리 루트, 빌드 쿼리, 네이티브 산출물은 서로 관련되어 있지만 의도적으로 구별된 정체성을 가집니다. 소스 텍스트와 검사된 의미를 혼동하는 순간 빌드 시스템은 신학이 되기 때문입니다. 같은 머클 구조가 증분 검사와 영속 빌드 캐시를 모두 구동합니다. 인터페이스가 그대로인 구현 수정은 그것을 임포트하는 모듈들을 검사된 상태로 남겨 두며, 변경되지 않은 쿼리는 이전 산출물을 재사용할 수 있습니다. 더 특이하게도 컴파일러는 이러한 결정에 대한 계보 정보를 기록하므로, prism lineage why-recompiled는 어떤 의미적 입력이 바뀌었는지 설명하여 빌드 시스템의 전통적인 어깨 으쓱을 은퇴시킬 수 있습니다. core-identity 덤프는 정의 해시에 들어가는 재료를 드러내며, v0.15에는 컴파일러의 결과를 재현하는 Prism 소비자가 포함되어 있습니다. 그 범위는 정규화된 검사된 코드와 의존성의 내포적 정체성이며, 이는 검사기, 캐시, 산출물, 실행 관문이 함께 공유합니다.
재생과 구체화된 실행
관찰이 명시적이고 실행이 결정적이라면, 기록된 능력 트레이스가 바깥 세계를 대신할 수 있습니다. 재생은 실제 연산을 수행하지 않고도 같은 결과를 제공하며, 같은 정규 관찰을 재현해야 합니다. Prism은 또한 인터프리터 컨티뉴에이션을 코드 정체성에 묶인 버전 있는 봉투로 구체화하므로, 중단된 계산은 그것이 지칭하는 의미 세계에 대해서만 검사되고, 저장되고, 재개될 수 있습니다. 두 기능 모두 언어 수준의 효과 기계에서 곧바로 나옵니다. 보장들은 분리되어 있고 정직하게 유지됩니다. 콘텐츠 정체성은 이것이 어떤 검사된 계산인지를 말하고, 재생 가능성은 어떤 관찰을 트레이스로부터 제공할 수 있는지를 말하며, 이식성은 컨티뉴에이션이 경계를 넘을 수 있는지를 말하고, 각각은 고유한 검사기나 증거를 가집니다. 실행은 프로세스 이미지나 임의의 소켓, 어제의 배포가 결코 충족할 수 없을 만큼 엄격한 조건을 지닌 데이터가 됩니다.
결정적 동시성
동시성은 여전히 Async 효과 위의 표준 라이브러리 핸들러로 남으며, 함수 타입은 하나의 일관된 효과 어휘를 유지합니다. 파이버, 채널, 구조적 조인, 취소 정리, 스케줄러 정책은 Concurrent 모듈이 해석합니다. 파이버 안에서 수행된 효과는 호출자의 행(row)에 남아 있으며, 스케줄러를 거쳐 바깥쪽 핸들러로 전달됩니다. 협력적 스케줄링은 각 양보 지점을 명시적으로 만들고, FIFO와 LIFO 정책은 교체 가능한 핸들러이며, 논리적 Clock을 스케줄러 바깥에 둘 수 있으므로 테스트는 운영체제에 묻지 않고도 결정적인 시간을 진행시킬 수 있습니다. 같은 프로그램을 재생 핸들러로 감싸면, 그 스케줄된 관찰은 일반적인 순차 실행과 같은 트레이스로 판정됩니다. 어려운 동시성 문제는 여전히 남아 있지만, 런타임, 시계, 스케줄러가 모두 프로그램 의미의 눈에 보이는 일부가 됩니다.
함수형 성능
런타임 이야기를 한 문단으로 줄이는 것은 배관 작업보다 표현 방식의 선택이 더 중요하기 때문입니다. Prism은 Perceus 방식의 결정적 참조 카운팅, 프레임 범위로 제한된 셀 재사용, 언박싱된 곱 타입, 플랫 버퍼, 아레나, 검사되는 fip 또는 fbip 사용 계약을 활용하여, 함수형 코드가 추적 수집기 없이 예측 가능한 메모리 동작으로 실행되도록 합니다. 고유하게 소유된 리스트 셀이나 레코드 스파인은 그 자리에서 재사용될 수 있으며, 소스 코드는 평범한 값 의미론을 그대로 유지합니다. 공유된 값은 할당하는 경로를 거치며, 두 경로는 반드시 같은 결과를 내야 합니다. 이펙트 로어링도 마찬가지로 직접적인 증거 전달, 특수화된 상태, 일반적인 구체화 폴백 가운데 하나를 선택하되, 그 선택이 관찰되지 않도록 합니다. LLVM과 MLIR은 작은 모듈식 C 런타임을 대상으로 네이티브 코드를 생성하며, 인터프리터는 여전히 의미론적 기준(oracle) 역할을 합니다. 컴파일러는 할당, 재사용, 융합, 상수 스택 실행이 보장되는 정확한 조건을 명시하고, 그런 다음 그 조건을 검사합니다.
현대적인 타입과 표면 문법
표면 문법은 의도적으로 익숙하게 만들어졌습니다. 양방향 고계 랭크 추론, 행 다형적 이펙트, 일관된 표준 선택이 하나뿐인 Lean 방식의 이름 붙은 타입 클래스 인스턴스, 명시적 using 재정의, 파생(deriving), 점 체인, 레이아웃 블록, 컴프리헨션, 렌즈, 실패 연산자, 명령형 문법 설탕이 모두 같은 작은 Core 위에 얹혀 있습니다. v0.15는 실제 모델에 맞추어 표기법을 다듬었습니다. 결과 타입은 : Int ! {E}처럼 행보다 앞에 오고, 재개 가능한 절은 op(x) resume k로 쓰며, 재개 등급은 직설적이면서도 유용한 never, once, many입니다. 또한 임의의 패턴 깊이에서의 선택 패턴과 매개변수 위치에서의 생성자, 레코드, 튜플 패턴을 추가했으며, deriving에 ToJson, FromJson, Plate를 더해 확장했습니다. Plate가 특히 유용한 이유는, 이제 컴파일러 패스를 하나의 지역 분석 또는 재작성 규칙에 파생된 자식 목록 및 재구성 연산 위의 순회 전략을 더한 형태로 작성할 수 있어서, 마흔일곱 번째 방문자(visitor)를 만들어야 하는 수고에서 세상을 구해 주기 때문입니다. 접근하기 쉬운 문법은 기반 모델을 깔끔하게 드러냄으로써 제 몫을 다합니다.
#![allow(unused)]
fn main() {
type Pair = Pair(Int, Int)
type Shape = Dot | Line(Int, Int) | Ring(Int)

fn sum_pair(Pair(a, b)) = a + b

fn extent(s) =
  match s of
    Line(0 | 1, _) => 1
    Line(n, _) | Ring(n) => n
    Dot => 0
}
코이펙트
이펙트는 계산이 자신의 세계에 무엇을 할 수 있는지를 기술합니다. 코이펙트는 주변 세계가 값을 가지고 무엇을 할 수 있는지를 기술합니다. Prism은 전자를 ! 뒤에, 후자를 @ 뒤에 쓰므로, !는 바깥쪽으로 보고하고 @는 값을 소비하는 경계에서 안쪽으로 요구 사항을 둡니다. v0.15에서는 네 가지 사용 사실을 검사합니다. noalloc은 함수의 전체 호출 트리가 새로운 힙 셀을 전혀 할당하지 않음을 인증합니다. once는 클로저가 최대 한 번만 소비되도록 합니다. portable은 클로저를 새로운 런타임으로 옮겨도 안전한, 내용 주소 기반의 코드와 데이터로 제한합니다. noescape는 값이 자신의 경계를 넘어 반환되거나, 저장되거나, 캡처되는 것을 막습니다. 예약된 사용 어휘의 다른 단어들은 실제 검사기가 생길 때까지 거부됩니다. 이러한 명시적 계약은 API 경계에 존재하며 Core 이전에 소거되므로, 어떤 프로그램이 컴파일되는지는 제한하지만 받아들여진 프로그램의 런타임 표현은 그대로 둡니다. borrow, fip, fbip, 할당 인증서, 컨티뉴에이션 등급은 모두 같은 일반적인 질문, 즉 문맥이 이것을 가지고 무엇을 할 수 있는가라는 질문을 서로 다른 관점에서 바라본 것입니다.
세 가지 부분 순서 집합
Prism 시그니처는 세 가지 부분 순서 체계를 담고 있습니다. 이펙트 행은 집합 포함 관계로 순서가 매겨집니다. 순차 실행은 합집합, 즉 조인(join)을 취하고, 핸들링은 레이블을 제거하여 순수한 빈 행 쪽으로 되돌리므로, 더 많은 일을 하는 것은 언제나 표현할 수 있습니다. 코이펙트 행은 더 작은 사용 축들의 곱이며, 맨 위에는 침묵(아무 주장도 없음)이 있습니다. 아래로 내려가면 누군가가 증명해야 하는 약속이 강화되고, 위로 올라가면 약속 하나를 잊을 뿐이며, once와 many 같은 일부 배타적인 주장은 진정으로 모순되기 때문에 공통의 밋(meet)이 없습니다. 연산 등급은 단순한 전순서 격자 never < once < many를 이룹니다. 핸들러 절은 컨티뉴에이션을 버리거나, 꼬리 위치에서 정확히 한 번 재개하거나, 캡처하여 자유롭게 재개할 수 있지만, 그 절 자체의 동작은 연산에 선언된 등급보다 커서는 안 됩니다. 이것이 타입 시스템의 약간은 놀라운 단일화입니다. 이펙트는 언제나 조인이 필요하고, 코이펙트는 때때로 밋을 거부하며, 컨티뉴에이션 사용은 하나의 양(quantity)입니다. 그러면 이펙트 연산은 결국 자기 자신의 컨티뉴에이션에 대한 코이펙트임이 드러나는데, 이는 컴파일러가 실제로 검사하기 전까지는 무표정하게 늘어놓은 범주론적 헛소리처럼 들립니다.
영수증이 있는 검증
Prism은 검사를 마친 동일한 대상 옆에 여러 종류의 증거를 함께 보관합니다. logic fn, requires, ensures는 SMT 증명 의무와 명시적인 솔버 영수증을 생성합니다. total fn은 구현된 방법으로 종료성을 확립할 수 있는 곳에서는 이를 검사하고, 그렇지 못한 곳에서는 정직하게 보류 결과를 보고합니다. test fn은 결정론적 탐색과 격리된 실행을 제공합니다. 할당 및 이동성 어노테이션에는 각각 고유한 계약이 있습니다. Core의 일부는 결정론적 small-step 관계, 전함수인 CEK 스텝 함수, 그리고 이 기계를 big-step 의미론과 연결하는 정리를 갖춘 형태로 Lean 4에서 별도로 모델링되며, 이후 픽스처 코퍼스를 대상으로 Rust 인터프리터와 대조하여 실행됩니다. 이 정리가 증명하는 범위는 Lean 모델입니다. Rust 타입 검사기, 최적화기, 그리고 컴파일러 전체는 그 범위 밖에 남아 있습니다. 모든 보증은 이를 뒷받침하는 증거를 명시하며, 현재 기계화가 끝나는 지점에서는 차등 동등성 검사가 관문 역할을 계속 수행합니다.
Prism으로 작성한 Prism
장기적인 목표는 검증된 표현 경계를 하나씩 쌓아 올려 만드는 셀프 호스팅 컴파일러입니다. Rust 컴파일러는 stage 0입니다. 이 컴파일러가 Prism-in-Prism 소스를 컴파일하여 stage 1을 만들고, 이어서 stage 1이 같은 소스를 컴파일하여 stage 2를 만듭니다. 부트스트랩은 stage 1과 stage 2가 바이트 단위로 동일한 산출물을 생성할 때 고정점에 도달합니다. 각 컴파일러 단계는 Rust 오라클 옆에서 평범한 Prism 라이브러리로 출발하여, 파이프라인의 나머지 부분과 버전이 지정된 산출물을 주고받고, 차등 관문이 닫힌 뒤에 권한을 얻습니다. v0.15는 Prism 렉서, 보간 스캐너, 레이아웃 패스로 첫 번째 이음매를 차지하여, Rust가 계속 stage 0을 공급하는 가운데 프로젝트에 처음으로 성공한 부트스트랩 계층을 마련해 줍니다. 같은 접근 방식으로 구문, 검사, 정교화, 코드 생성을 차례로 옮겨 갈 수 있으며, 이때 콘텐츠 식별자가 모든 입력을 고정하고 독립적인 검증기가 모든 출력을 검사합니다. 최종 목적지는 소스, 중간 형태, 도구, 재현 증명이 모두 그것이 컴파일하는 프로그램과 동일한 결정론적 계약 아래에 놓이는 개방형 컴파일러입니다. 바닥 위에 선 채로 그 바닥을 다시 짓는 일은 그것만으로도 충분히 어렵습니다. 모든 마룻널이 콘텐츠 주소로 지정되고 독립적으로 검사되도록 요구하는 것은 터무니없는 일이지만, 실현된다면 정말 멋질 것입니다.
WebAssembly를 통해 브라우저에서 실행
브라우저 빌드는 프런트엔드와 인터프리터를 WebAssembly로 패키징하므로, 플레이그라운드에서는 설치 없이 Prism을 검사하고 실행할 수 있으며 추론된 시그니처, 검사된 HIR, Core, 관찰 결과, 시뮬레이션 상태를 보여 줄 수 있습니다. 플레이그라운드는 나머지 도구들이 사용하는 것과 동일한 인터프리터와 검사된 표준 라이브러리를 실행하므로, 브라우저에서도 같은 의미론적 어휘를 사용할 수 있습니다. 네이티브 Prism 프로그램은 여전히 LLVM 또는 MLIR을 거칩니다. Prism에서 WebAssembly로 직접 코드 생성하는 기능은 향후 과제로 남아 있습니다. 플레이그라운드는 의미론적 파이프라인을 들여다보는 편리한 창이자, 고정된 입력으로부터 N번째 스텝의 상태를 재구성할 수 있는 결정론적 시뮬레이션을 위한 좋은 보금자리를 제공합니다.
너드 이야기
여기까지 읽으셨다면 분명 인생에서 꽤 의심스러운 선택을 여러 번 하신 분일 테니(반갑습니다, 동지여!), 빠짐없이 다루는 의미에서 PL 너드 이야기를 덧붙입니다:
- 타입 추론은 흔히 쓰이는 최신 기법인 양방향 및 고차 랭크 방식, 즉 complete-and-easy Dunfield-Krishnaswami 알고리즘을 사용하므로, 어노테이션을 잔뜩 달아 빠져나가지 않아도 rank-N 다형성이 동작합니다.
- Lean 스타일의 이름 붙은 인스턴스(
instance ordInt : Ord(Int)), 겹치는 인스턴스의 일관성을 유지하는canonical지정, 명시적 재정의(sort_by_ord(xs, using ordRev)), 그리고deriving (Eq, Ord, Show)를 갖춘 타입클래스를 제공합니다. - 대체로 OCaml과 비슷한 모양의 표면 구문을 제공합니다. 레이아웃 블록, 점 체인(
xs.over(f).keep(g).sum()), 연속 전달 코드를 위한with문법 설탕, 문자열 보간, 이펙트 행 별칭이 있습니다. - 깊은 재귀는 네이티브 환경(꼬리 호출, 그리고 생성자를 법으로 하는 꼬리 재귀)과 인터프리터(본질적으로 예전 CEK 기계의 더 발전된 버전이므로 프로그램의 어떤 부분도 호스트 스택을 터뜨릴 수 없습니다) 모두에서 상수 스택으로 실행됩니다.
그리고 정말로 중증인 분들을 위해, 지적 계보 전체를 소개합니다. 당연히 수많은 FP 거장들의 업적 위에 서 있지만, Prism의 설계에 가장 직접적으로 영감을 준 것들은 다음과 같습니다.
- Core IR은 call-by-push-value(Levy, Call-by-Push-Value: A Functional/Imperative Synthesis, 2001)입니다. 값과 계산을 구분하기 때문에 효과 로어링과 참조 카운팅 분석을 영웅적인 노력 없이 깔끔하게 할 수 있습니다.
- 빠른 효과 경로는 증거 전달(evidence passing) 방식입니다(Xie와 Leijen, Generalized Evidence Passing for Effect Handlers, ICFP 2021, 그리고 Effect Handlers, Evidently, ICFP 2020). 이는 Koka가 사용하는 것과 같은 컴파일 전략이며, 자유 모나드(free monad) 인코딩(Swierstra의 Data Types a la Carte(데이터 타입 아 라 카르트), 그리고 Kiselyov의 확장 가능한 효과)은 대체 경로로만 남겨 둡니다.
- 메모리 모델은 Perceus(Reinking, Xie, de Moura, Leijen, Perceus: Garbage Free Reference Counting with Reuse, PLDI 2021)에 프레임 제한 재사용(Lorenzen과 Leijen, Reference Counting with Frame-Limited Reuse, ICFP 2021)과 완전 제자리 프로그래밍(Lorenzen, Leijen, Swierstra, FP^2: Fully in-Place Functional Programming, ICFP 2023)을 더한 것입니다. 렌즈 문법 설탕을 포인터 쓰기로 바꾸는 것도 바로 이것입니다.
- 효과 행은 범위 지정 레이블을 갖춘 행 다형성입니다(Wand 1987, Leijen, Extensible Records with Scoped Labels, 2005, 그리고 Type Directed Compilation of Row-Typed Algebraic Effects(행 타입이 지정된 대수적 효과의 타입 주도 컴파일), POPL 2017). 핸들러 자체는 Eff와 Koka를 거쳐 온 Plotkin과 Pretnar의 것입니다(Handlers of Algebraic Effects, ESOP 2009).
- 패턴 매칭은 결정 트리로 컴파일되며, 망라성 검사에는 유용성 행렬을 사용합니다(Maranget, Compiling Pattern Matching to Good Decision Trees, 2008, 그리고 Warnings for Pattern Matching, 2007).
pattern형식은 뷰 패턴과 GHC의 Pattern Synonyms(2016)를 결합한 것입니다. - 실패 계층은 Verse 계산법(Augustsson, Peyton Jones, Steele, Sweeney 외, The Verse Calculus, ICFP 2023)이며, 새로운 Core를 추가하지 않고 오로지
never핸들러만으로 구현합니다. - Core의 일부는 Lean 4 모델(
models/Prism.lean)에 그대로 옮겨져 있으며, 결정성 정리를 기계로 검증합니다. 세 백엔드는 인터프리터를 차등 오라클로 삼아 바이트 단위로 동일한 결과를 내도록 유지합니다.
장난감 프로젝트에도 논지가 허락된다면, 저의 논지는 “순수 함수형“이 언제나 좋은 아이디어에 붙은 약간 방어적인 이름이었다는 것입니다. 그 좋은 아이디어란 효과가 눈에 보이고, 타입이 있고, 조합 가능해야 한다는 것입니다. 이를 얻기 위해 효과를 금지할 필요는 없습니다. 추적하기만 하면 됩니다. 그리고 효과를 정직하게 추적하기 시작하면 컴파일러는 효과의 비용을 없앨 만큼 충분한 정보를 얻게 됩니다. 순수성 담론은 IO 모나드와 눈을 마주치지 않느라 너무 바빠서 이 부분을 한 번도 약속해 준 적이 없습니다.
이 컴파일러는 본질적으로 훨씬 단순하고 행복했던 2010~20년대 함수형 프로그래밍 시대에 보내는 저의 연애편지입니다(어쩌면 그저 ZIRP 시대의 젊음이 씌워 준 장밋빛 안경 때문일지도 모릅니다). 이 컴파일러는 장난감이며, 트랜스포머 시대 이전의 지나간 프로그래밍 시대에서 온 일종의 예술 작품이라는 점을 빼면 사실상 아무 쓸모가 없습니다. 우리가 향하고 있는 세상에는 이런 것이 설 자리가 더 이상 없습니다. 우리는 점점 더 극도로 확률적이고 우스울 만큼 재미없는 Typescript가 세상의 대부분을 돌리는 세계로 향하고 있습니다. 그 세계에서 우리는 이 토큰 압출기들을 돌보고, 경제와 시장은 점점 더 에이전트에 의해 자동화됩니다. 이 사실이 저를 조금 슬프게 하지만, 그렇다고 이런 것을 그저 재미로 만들 수 없다는 뜻은 아니며, 제가 여기서 한 일이 바로 그것입니다. 어쩌면 함수형 프로그래밍 언어의 미래는 점점 더 틈새에 머물며 경제적으로는 무의미해지고, 그 바탕에 깔린 아이디어의 지적 아름다움 때문에 여전히 함수형 프로그래밍을 사랑하는 소수의 사람들을 위한 취미 활동에 가까워질지도 모릅니다. 그래서 저는 어쨌든 이것을 만들었고, 이것은 잘 돌아가며, 만드는 과정은 정말 즐거웠습니다. 그리고 어쩌면 소프트웨어의 이 멋진 신세계에서는 그것으로 충분할지도 모릅니다.
GPT-2 실행하기
이제 Python 텐서 언어, MLIR 빌더, 변환 파이프라인, 네이티브 실행 경계가 모두 갖추어졌습니다. 남은 작업은 이 구성 요소들을 사전 학습된 모델에 연결하고, 그 결과가 원래의 NumPy 구현과 일치하는지 확인하는 것입니다.
이 예제는 소형 GPT-2 체크포인트를 사용합니다. 이 체크포인트는 12개의 트랜스포머 블록, 768의 임베딩 너비, 12개의 어텐션 헤드, 50,257개 토큰의 어휘로 구성됩니다. 동반 프로젝트의 다운로드 스크립트는 특정 체크포인트 리비전을 고정하므로, 나중에 원격 파일이 변경되더라도 예제가 모르는 사이에 달라지지 않습니다.
tiny-mlir 체크아웃에서 다음을 실행하십시오.
uv sync
uv run python fetch_model.py model
uv run python example.py "Alan Turing theorized that computers would one day become" --tokens 10
모델 다운로드 용량은 약 550 MB입니다. 컴파일과 실행에는 uv sync로 설치되는 MLIR Python 바인딩을 사용하므로, 예제를 실행하는 데 별도의 명령줄 LLVM 설치가 필요하지 않습니다.
최상위 예제
진입점은 프롬프트, 생성 길이, 그리고 선택적인 체크포인트 디렉터리를 인자로 받습니다. 이 인자들을 파싱한 뒤 모델을 불러오고 생성된 텍스트를 출력합니다.
model, tokenizer = load_model(args.model)
print(generate(model, tokenizer, args.prompt, args.tokens))
참조 예제를 실행하려면 프롬프트를 명령줄에 직접 전달하십시오.
uv run python example.py "Alan Turing theorized that computers would one day become" --tokens 10
컴파일된 모델과 NumPy 참조 구현이 내놓는 완성 결과는 다음과 같습니다.
Alan Turing theorized that computers would one day become the most powerful machines on the planet.
마침표 뒤에는 두 개의 개행 토큰이 있습니다. 이 토큰들은 일반적으로 렌더링된 문장에서는 보이지 않지만, 10개 토큰으로 이루어진 출력의 일부입니다. 디코딩된 텍스트뿐만 아니라 토큰 ID도 확인하겠습니다.
매개변수 불러오기
load_model은 config.json, model.safetensors, tokenizer.json을 읽습니다. 모델 생성자는 필요한 모든 매개변수의 형상을 검사하며, 체크포인트 배열이 float32일 것을 요구합니다. 또한 임베딩 너비가 헤드 수로 나누어떨어지는지도 검사합니다. 로더는 활성화 함수나 레이어 정규화 엡실론이 다르면 잘못된 공식을 조용히 적용하는 대신 이를 거부합니다.
임베딩 너비가 인 블록에서 주요 프로젝션의 형태는 다음과 같습니다.
| 매개변수 | 형태 |
|---|---|
| 쿼리/키/값 프로젝션 | |
| 어텐션 출력 프로젝션 | |
| 피드포워드 확장 | |
| 피드포워드 출력 프로젝션 |
각 프로젝션에는 출력 너비에 맞는 바이어스 벡터도 있습니다. 두 레이어 정규화에는 길이가 인 게인 벡터와 바이어스 벡터가 있습니다.
배열은 여전히 컴파일된 함수의 런타임 입력으로 남습니다. 가중치 값의 집합마다 같은 블록을 별도로 복사해 컴파일하지는 않습니다. 호환되는 형상과 dtype은 하나의 특수화를 공유합니다.
임베딩
초기 잔차 스트림은 토큰 임베딩과 학습된 위치 임베딩을 더합니다:
이 역시 작은 컴파일된 함수입니다:
@jit
def embed(ids, words, positions):
    return gather(words, ids) + positions[:ids.shape[0]]
gather 연산의 열 인덱싱은 아핀이며, 행 인덱스는 토큰 ID 텐서에서 가져옵니다. 이 연산의 linalg.generic 영역은 tensor.extract로 선택된 테이블 항목을 로드합니다. 모델은 네이티브 코드에 진입하기 전에 토큰 ID가 어휘 범위 안에 있는지 검사하며, JIT의 gather 경계에서도 인덱스를 검사합니다.
위치 임베딩은 현재 시퀀스 길이에 해당하는 정적 슬라이스입니다. 토큰 시퀀스는 비어 있지 않아야 하며 설정된 컨텍스트 윈도에 들어가야 합니다.
트랜스포머 스택
각 블록은 Part 11의 두 컴파일된 함수를 실행합니다:
x = x + attention(layer_norm(x))
x = x + feedforward(layer_norm(x))
실제 호출에서는 각 블록의 정규화 매개변수와 투영 배열을 전달합니다. attend와 feedforward는 평범한 Python 정의이며, 그 텐서 표현식은 함께 추적되고 로워링됩니다. 모델 루프 자체는 Python에 남아 있으므로 블록의 순서와 각 블록의 매개변수를 쉽게 살펴볼 수 있습니다.
첫 번째 어텐션 프로젝션은 float32 임베딩에서 시작합니다. 레퍼런스의 산술 연산은 이후의 값을 float64로 승격하며, 우리의 타입 그래프도 그 동작을 따릅니다. 따라서 첫 번째 블록은 차원이 같더라도 이후 블록과 다른 특수화가 필요할 수 있습니다.
마지막 블록 다음에는 정규화를 수행하고, 같은 토큰 임베딩 행렬을 사용해 어휘로 프로젝션합니다:
@jit
def project(x, gain, bias, words):
    return layer_norm(x[-1:], gain, bias) @ words.T
다음 토큰을 선택하는 데에는 마지막 위치의 로짓만 필요합니다. 그래서 이 함수는 (1, vocab_size) 형상을 반환합니다. 레퍼런스는 모든 위치의 로짓을 계산하며, 검증 과정에서는 그 마지막 행을 우리의 결과와 비교합니다.
디코딩
이 예제는 탐욕적 디코딩을 사용합니다. 각 단계에서 가장 큰 로짓의 인덱스를 고르고, 그 토큰을 덧붙인 다음, 더 길어진 접두사를 평가합니다:
for _ in range(max_tokens):
    ids.append(int(np.argmax(model(ids)[0])))
토큰화, 전체 흐름 조율, 그리고 마지막 argmax는 Python 쪽에 남습니다. 모델의 임베딩 조회, 정규화, 어텐션, 프로젝션, 활성화, 잔차 산술은 컴파일된 MLIR을 통해 실행됩니다.
NumPy 레퍼런스의 generate_tokens와 마찬가지로, 이 루프는 텍스트 끝 토큰에서 일찍 멈추지 않고 요청된 개수만큼 토큰을 생성합니다. 모델은 프롬프트와 요청된 생성 길이가 컨텍스트 한도에 들어가는지 검증합니다.
키/값 캐시는 구현하지 않았습니다. 각 단계에서는 접두부를 다시 계산하며, 길이가 새로 바뀔 때마다 새로운 정적 텐서 형태가 선택됩니다. 이는 참조 알고리즘을 그대로 구현한 것으로, 컴파일러의 동작을 따라가기에 유용합니다. 디코딩 캐시를 도입하면 모델 인터페이스와 어텐션 형태가 바뀌므로, 별도의 변경으로 검증해야 합니다.
모델 전체를 하나의 커널로
위에서 다룬 서브레이어별 경로는 이 시리즈가 지금까지 구축해 온 경로입니다. 이 프로젝트에는 두 번째 모드인 --fused가 있으며, 이 모드는 NumPy 참조 구현의 순방향 패스 자체를 컴파일합니다. tiny-gpt2의 gpt2 함수는 9부에서 다룬 배열 프로토콜을 통해 작성된 그대로 트레이스되며, np.mean 정규화, np.split 프로젝션, np.triu 마스크, 중첩된 매개변수 튜플도 모두 그대로 포함됩니다. 그 결과 열두 개의 블록을 모두 담은 하나의 모듈이 만들어지므로, 융합과 matmul 치환이 모델 전체를 한꺼번에 볼 수 있습니다.
시퀀스 길이마다 커널을 따로 만든다면 생성되는 토큰마다 컴파일을 한 번씩 해야 합니다. 그 대신 융합 모드는 토큰 시퀀스를 다음 2의 거듭제곱 길이로 패딩합니다. 인과 마스크가 실제 위치들이 패딩에 어텐션하지 못하도록 막기 때문에 마지막 실제 토큰에 대한 로짓 행은 변하지 않으며, 토큰 열 개를 생성할 때 모듈을 열 개가 아니라 두어 개만 컴파일합니다. 14부에서 이 모드를 더 자세히 살펴봅니다. 여기서 이 모드가 중요한 이유는 아래의 검증이 볼 수 있는 대상이 달라지기 때문입니다.
실제 참조 구현과 대조하기
문장이 일치한다는 것은 유용한 결과이지만, 수치 오류가 어디에서 상쇄되었거나 눈에 띄지 않고 지나갔는지는 알려 주지 않습니다. 검증 스크립트는 원본 tiny-gpt2 저장소를 그 자체의 Python 환경에서 실행하고, 디코딩 단계마다 모델을 캡처합니다.
uv run python verify.py
이 스크립트는 공개된 NumPy 참조 구현의 고정된 리비전을 내려받고, uv로 잠금된 환경을 설치한 뒤, 이에 맞는 토크나이저 파일을 가져옵니다. Git과 네트워크 접근이 필요하지만, 형제 체크아웃이나 수동으로 참조 구현을 설정할 필요는 없습니다. --reference /path/to/tiny-gpt2를 지정하면 기존 체크아웃을 선택적으로 사용할 수 있습니다. 두 구현 모두 동일한 고정 체크포인트를 사용합니다. 스크립트는 자신의 배열을 참조 구현의 매개변수 데이터클래스에 맞게 변환한 다음, 참조 구현에 이미 있는 수치 연산을 변경 없이 호출합니다. 또한 캡처한 트레이스를 참조 구현의 완전한 gpt2 함수와 대조하여 확인합니다.
열 단계 각각에 대해 비교 대상은 다음과 같습니다.
- 토큰 임베딩과 위치 임베딩.
- 모든 트랜스포머 블록의 두 잔차 출력.
- 마지막 위치의 어휘 로짓.
- 선택된 토큰 ID.
융합 모드에서 순방향 패스는 포착할 중간값이 없는 하나의 컴파일된 함수이므로, 최종 로짓과 선택된 토큰만 비교합니다. 블록별 검사는 서브레이어별 경로에 해당합니다. 지속적 통합에서는 두 모드를 모두 실행하며, GPU 타깃에서는 같은 스크립트를 --gpu와 함께 실행합니다.
동일한 dtype을 요구하며 배열을 rtol=3e-4와 atol=3e-4로 비교합니다. 토큰 ID와 디코딩된 완성 결과는 정확히 일치해야 합니다. 원본 저장소의 NumPy 2.4.4 환경을 대상으로 실행한 테스트에서, 캡처한 모든 배열에 걸친 최대 절대 차이는 약 였습니다.
생성된 ID는 정확히 다음과 같았습니다:
[262, 749, 3665, 8217, 319, 262, 5440, 13, 198, 198]
그리고 공백을 명시적으로 표시한 완성 결과는 다음과 같았습니다:
' the most powerful machines on the planet.\n\n'
이는 중간 부동소수점 계산에 대해서는 수치적 일치를, 요구되는 관찰 가능한 출력에 대해서는 정확한 일치를 의미합니다. 모든 부동소수점 값이 비트 단위까지 동일하다거나 가능한 모든 프롬프트를 테스트했다고 주장하는 것은 아닙니다.
우리가 만든 것
전체 패키지는 몇 개의 모듈에 담깁니다. expr.py에는 타입이 지정된 텐서 그래프가 있고, builder.py는 MLIR 연산을 구성하며, jit.py는 특수화와 컴파일러 패스를 처리하고, ops.py에는 트랜스포머 공식이 담겨 있으며, model.py는 이들을 체크포인트 및 디코딩 루프와 연결합니다. 세 개의 모듈이 이 경로를 변경하지 않고 그 위에 추가로 구축됩니다. blas.py는 matmul을 시스템 BLAS에 넘기고, fused.py는 참조 구현을 단일 커널로 추적하며, gpu.py는 NVIDIA 하드웨어를 대상으로 합니다.
중요한 특성은 컴파일러가 계산의 구성 요소를 이해한다는 점입니다. 행렬 곱셈은 행렬 연산으로 남고, 리덕션은 명시적인 축과 영역을 가지며, 브로드캐스트는 인덱싱 맵을 가집니다. GELU와 어텐션은 이러한 기본 요소들의 조합입니다. MLIR의 패스는 저장 방식과 실행 세부 사항이 확정되기 전에 그 구조를 변환할 수 있습니다.
이 장의 모든 내용은 CPU에서 실행되었습니다. 실행 가능한 최종 결과물은 NumPy 모델의 요구 출력을 재현하는 작은 네이티브 컴파일러이며, 레퍼런스 검사는 컴파일러에 대한 이후 변경을 판단할 구체적인 방법을 제공합니다. 다음 장에서는 그러한 변경 하나를 수행합니다: 동일한 텐서 프로그램, 동일한 공식, 동일한 검사를 GPU에서 실행합니다.
이로써 Python 텐서 표현식에서 실제로 실행되는 사전 학습된 트랜스포머에 이르는 경로가 완성됩니다. 동작하는 MLIR 컴파일러를 만들고 그것으로 GPT-2를 실행하신 것을 축하합니다!
외부 자료
융합, 버퍼화 그리고 실행
이제 우리 프런트엔드는 트랜스포머를 텐서 연산으로 기술합니다. 저장 공간과 실행에 관한 문제는 의도적으로 이러한 정의에서 제외했습니다. 이 장에서는 컴파일러의 나머지 절반을 따라갑니다. 즉, 텐서 프로그램을 변환하고, 버퍼를 할당하고, LLVM으로 로어링한 뒤, 그 결과를 Python에서 호출하는 과정입니다.
구현은 tinymlir/jit.py에 있습니다. 이 구현은 원본 모듈, 최적화된 모듈, 로어링된 모듈을 각각 따로 보관하므로 각 단계가 무엇을 바꾸는지 살펴볼 수 있습니다.
원소별 융합
간단한 함수를 하나 생각해 봅시다.
from tinymlir import jit

@jit
def affine_activation(x, gain, bias):
    return (x * gain + bias) * 0.5
빌더는 처음에 원소별 linalg.generic 연산 세 개를 생성합니다. 각 연산에는 자체 출력 텐서가 있습니다. 텐서 수준에서 이 값들은 계산의 결과를 기술할 뿐이며, 이 값들이 존재한다고 해서 아직 세 번의 별도 힙 할당이 필요한 것은 아닙니다.
우리의 최적화 파이프라인은 다음과 같습니다.
OPTIMIZATION_PIPELINE = (
    "builtin.module("
    "canonicalize,cse,linalg-fuse-elementwise-ops,canonicalize,cse)"
)
융합 패스는 호환되는 생산자 영역과 소비자 영역을 결합하면서 그 인덱싱 맵을 합성합니다. 이 예제에서 최적화된 모듈에는 linalg.generic이 하나만 들어 있습니다. 그 스칼라 본문은 곱셈, 덧셈, 그리고 다시 곱셈을 수행한 뒤 결과를 내보냅니다.
테스트 스위트는 두 가지 사실을 모두 확인합니다. 연산 개수가 세 개에서 한 개로 바뀌는지, 그리고 최적화된 모듈과 최적화되지 않은 모듈을 실행했을 때 같은 배열이 나오는지입니다. 이는 따로 작성한 두 커널 구현을 비교하는 것이 아니라 실제 컴파일러 변환을 검증합니다.
패스 파이프라인 문자열은 MLIR의 패스 관리자에게 적용할 변환을 지정합니다. 변환되는 프로그램은 Python 바인딩을 통해 구성된 객체 그래프입니다.
from mlir.passmanager import PassManager

PassManager.parse(OPTIMIZATION_PIPELINE).run(module.operation)
module.operation.verify()
검증기는 변환 후의 결과를 검사합니다. 오류는 호출자에게 전파되며, 컴파일 실패를 감출 수 있는 대체 NumPy 경로는 없습니다.
융합의 한계
원소별 융합은 중간 저장, 로드, 할당을 없앨 수 있기 때문에 유용합니다. 그렇다고 해서 모든 연산 사슬이 하나의 영역이 되어야 한다는 뜻은 아닙니다. 리덕션은 반복 의미론이 다르고, 행렬 곱셈에는 리덕션 차원이 있으며, 하나의 생산자에 소비자가 여럿 있을 수도 있습니다.
예를 들어 소프트맥스의 지수 값들은 합계와 마지막 나눗셈 양쪽에 모두 입력됩니다. 올바른 변환이라면 이러한 사용 패턴을 고려해야 합니다. 스케줄에 따라 결과를 저장하는 것과 다시 계산하는 것의 비용이 달라질 수 있습니다. 텐서 그래프는 컴파일러가 이러한 결정을 내리고 검사하기에 충분한 정보를 제공합니다.
부동소수점 산술도 변환을 제한합니다. 리덕션의 결합 순서를 바꾸면 결과가 달라질 수 있습니다. 우리 프런트엔드는 공식의 dtype 승격을 그대로 보존하며, 생성된 산술은 제한 없는 fast-math 동작을 요청하지 않습니다. 그래도 NumPy의 리덕션과 BLAS 구현은 다른 순서로 누산할 수 있으므로, 여전히 수치 허용 오차를 두고 NumPy와 비교합니다.
버퍼화
텐서 변환이 끝나면 one-shot 버퍼화를 실행합니다. 이 과정은 텐서의 사용 방식을 분석하여 어디서 저장 공간을 재사용할 수 있고 어디서 별도의 할당이 필요한지 결정합니다.
외부 함수에는 이미 간단한 계약이 있습니다. memref 입력들과 호출자가 제공하는 출력 memref입니다. 함수 내부에서는 bufferization.to_tensor가 입력을 텐서 연산에서 사용할 수 있게 합니다. bufferization.materialize_in_destination은 최종 결과가 출력 버퍼에 기록되도록 요구합니다.
입력 변환에는 restrict를 표시합니다. 이는 경계에서의 앨리어싱에 관한 약속입니다. 호출자가 같은 배열을 두 번 전달하거나 겹치는 뷰를 전달하면, 런타임은 함수를 호출하기 전에 겹치는 입력을 복사합니다. 새로 할당된 출력 역시 입력과 구별됩니다. 따라서 버퍼화에 한 약속은 런타임이 실제로 제공하는 것과 일치합니다.
텐서 프로그램의 관점에서 입력은 읽기 전용입니다. 중간 결과는 버퍼화가 저장 공간을 정할 때까지 함수형 값으로 남아 있습니다. 블록을 평가하는 동안 모델의 가중치는 수정하지 않습니다.
저장 공간의 소유권은 버퍼 배정과는 별개의 문제입니다. 우리 파이프라인에는 buffer-deallocation 파이프라인이 포함되어 있어 내부에서 할당된 버퍼가 해제됩니다. 호출자의 NumPy 배열은 계속 Python이 소유합니다. 관리되지 않는 임시 버퍼의 포인터를 반환하면 작은 예제가 성공하더라도 오해를 불러일으킬 수 있습니다. 추론을 반복하려면 소유권 경계도 올바라야 합니다.
모듈 로어링하기
융합이 끝나면 동반 프로젝트는 두 단계로 로어링하며, 그 사이에 타깃별 단계가 하나 있습니다.
BUFFERIZATION_PIPELINE = (
    "builtin.module("
    "one-shot-bufferize{bufferize-function-boundaries},buffer-deallocation-pipeline)"
)
LOWERING_PIPELINE = (
    "builtin.module("
    "convert-linalg-to-loops,"
    "expand-strided-metadata,lower-affine,"
    "convert-scf-to-cf,convert-math-to-libm,convert-math-to-llvm,"
    "convert-arith-to-llvm,convert-func-to-llvm,convert-cf-to-llvm,"
    "finalize-memref-to-llvm,reconcile-unrealized-casts)"
)
버퍼화는 모든 타깃에 대해 한 번 실행됩니다. 버퍼화는 텐서 저장 공간을 확정하고 해제 연산을 삽입합니다. 그 결과는 memref 위의 linalg 연산으로 이루어진 모듈이며, 이 모듈에서 행렬 곱셈은 여전히 linalg.matmul과 linalg.batch_matmul입니다. 여기서 타깃별로 경로가 갈립니다.
PassManager.parse(BUFFERIZATION_PIPELINE).run(lowered.operation)
if target == GPU:
    gpu.lower(lowered)
else:
    blas.rewrite(lowered)
    PassManager.parse(LOWERING_PIPELINE).run(lowered.operation)
CPU에서는 blas.rewrite가 모듈을 순회하며 행 우선 matmul을 찾아 각각을 cblas_sgemm 또는 cblas_dgemm 호출로 바꿉니다. 라이브러리는 프로세스가 불러올 수 있는 것이면 무엇이든 되며, macOS에서는 Accelerate, Linux에서는 OpenBLAS입니다. NumPy 자체의 행렬 곱셈도 같은 방식으로 BLAS를 호출합니다. 이 재작성은 memref.extract_strided_metadata로 각 memref에서 정렬된 기준 포인터, 오프셋, 크기, 스트라이드를 읽어 내고, 행 스트라이드를 leading dimension으로 전달하며, 배치 곱은 GEMM 호출을 반복하는 scf.for 루프로 바꿉니다. BLAS가 없으면 이 재작성은 아무것도 하지 않으며, matmul은 다른 모든 연산과 함께 루프로 로어링됩니다. 프런트엔드가 융합을 거치는 동안에도 matmul을 알아볼 수 있는 형태로 유지하도록 신경 쓴 이유가 바로 이것입니다.
나머지 단계는 제거되는 정보를 따라 진행됩니다. Linalg 로어링은 명시적인 루프를 선택합니다. 메타데이터 확장과 affine 로어링은 주소 계산을 드러냅니다. 구조적 제어 흐름은 일반적인 분기가 됩니다. 그다음 산술 연산, 함수, 메모리 참조가 LLVM 다이얼렉트 연산이 됩니다. 수학 연산은 이 고정된 툴체인에서 사용할 수 있는 LLVM 또는 호스트 수학 라이브러리 경로를 사용합니다. 마지막으로, reconciliation은 소스 타입과 대상 타입이 같아진 변환 잔여물을 제거합니다.
CPU 파이프라인은 Python 바인딩과 같은 프로세스에서 실행되며, 바인딩과 짝을 이루는 실행 엔진을 사용합니다. 모듈을 하위 프로세스로 직렬화하여 서로 무관한 LLVM 빌드를 결합하려 하는 것이 아닙니다. GPU 경로는 같은 버퍼화된 모듈을 다른 방향으로 가져가며, 별도의 장에서 다룹니다.
네이티브 코드 호출
이 함수에는 llvm.emit_c_interface가 붙어 있으며, 이는 C 호환 호출 규약을 따르는 래퍼를 요청합니다. 런타임은 MLIR의 랭크가 있는 memref 디스크립터 헬퍼를 사용합니다.
pointers = [
    ctypes.pointer(ctypes.pointer(get_ranked_memref_descriptor(array)))
    for array in [*inputs, output]
]
engine.invoke("kernel", *pointers)
실행 엔진의 packed 호출 API는 인자 저장 공간에 대한 포인터를 받습니다. C 인터페이스의 memref 인자는 그 자체로 디스크립터 포인터이므로, 여기서 간접 참조가 한 단계 더 생깁니다. 디스크립터는 배열의 주소, 오프셋, 크기, 스트라이드를 기록합니다.
함수를 호출하기 전에 런타임은 특수화의 shape와 dtype을 검사하고 입력을 연속 메모리로 만듭니다. 그리고 추론된 결과 타입의 NumPy 출력 배열을 할당합니다. 배열과 디스크립터는 호출이 끝날 때까지 살아 있으며, 컴파일된 객체는 해당 특수화가 캐시되어 있는 동안 컨텍스트, 모듈, 엔진을 소유합니다.
텐서 값으로 된 gather 인덱스도 네이티브 코드에 들어가기 전에 검사합니다. shape 검사만으로는 런타임 토큰 ID가 임베딩 테이블 범위 안에 있음을 증명할 수 없습니다. 모델은 어휘 범위를 검증하고, 범용 gather 경계는 자체적으로 인덱스를 검사합니다.
특수화와 비용
JIT 캐시의 키는 인자의 구조, 정적 키워드 인자, 타깃으로 구성됩니다. 인자는 트리로 평탄화됩니다. 튜플, named tuple, 데이터클래스, 딕셔너리는 배열에 도달할 때까지 재귀적으로 분해되며, 키는 트리의 모양과 함께 모든 리프의 shape와 dtype을 기록합니다. 따라서 컴파일된 함수는 배열의 함수로 남으면서도 매개변수 레코드 전체를 인자로 받을 수 있습니다. 가중치 값이 서로 다른 트랜스포머 블록이라도 인자의 shape와 dtype이 일치하면 하나의 특수화를 공유합니다. 가중치는 컴파일된 각 모듈에 포함된 상수가 아니라 런타임 입력입니다.
시퀀스 길이가 새로 바뀌면 shape가 달라지므로 특수화가 하나 더 필요합니다. 이 예제는 토큰을 하나 생성할 때마다 접두부 전체를 다시 계산하므로, 첫 실행에는 여러 길이에 대한 컴파일이 포함됩니다. 이미 있는 shape로 반복 호출하면 엔진을 재사용합니다.
이것은 의도적으로 작게 만든 프로세스 내 캐시입니다. 영속적인 객체 캐싱이나, 끝없이 이어지는 형상들에 대한 메모리 정책은 제공하지 않습니다. 그런 기능은 유용한 확장이 되겠지만, 컴파일 경계를 이해하는 데 꼭 필요하지는 않습니다.
실행 시간을 측정할 때에는 먼저 관련 특수화를 워밍업하십시오. 그렇지 않으면 측정 시간에 추론뿐 아니라 트레이싱, IR 구성, 패스 실행, 기계어 코드 생성까지 포함됩니다. 이러한 비용이 섞인 비교로는 생성된 커널에 대해 알 수 있는 것이 거의 없습니다.
다시 GPU로
8부에서는 GPU 실행 모델과 PTX 경로를 다루었습니다. 이 텐서 컴파일러의 GPU 백엔드는 구조화된 연산을 로어링하여 없애기 전에 다른 스케줄링 결정을 내립니다. 행렬 곱셈은 타일링되고, 루프 반복은 블록과 스레드에 매핑되며, 호스트-디바이스 경계에서 런치가 나타납니다.
버퍼화된 모듈에 남아 있는 linalg.matmul과 리덕션 연산은 이러한 백엔드에 변환할 만한 유용한 대상을 제공합니다. 모든 것이 스칼라 루프와 포인터 산술로 바뀌고 나면, 그 구조를 복원하기가 더 어려워집니다.
tiny-mlir 프로젝트에 이 백엔드가 있습니다. 예제나 검증 스크립트에 --gpu를 전달하면, matmul을 공유 메모리 타일링 커널로 대체하고, 나머지 병렬 루프를 블록과 스레드에 매핑하며, 이를 GPU 커널로 분리한 뒤 그 결과를 CUDA 관리 메모리 위에서 실행하는 타깃이 선택됩니다. 이 백엔드가 내보내는 PTX는 지속적 통합에서 ptxas로 검사되며, 전체 레퍼런스 비교는 Tesla T4에서 실행되었습니다. 두 타깃 사이에서 Python 모델의 공식은 하나도 바뀌지 않습니다. 14부에서 이 백엔드를 자세히 살펴봅니다.
다음으로는 사전 학습된 체크포인트를 불러와, 생성된 토큰의 정확한 시퀀스를 포함한 전체 추론 경로를 테스트하겠습니다.
외부 자료
서평: On the Calculation of Volume
솔베이 발레(Solvej Balle)의 On the Calculation of Volume은 시간 밖으로 떨어져 나간 덴마크의 고서적상에 관한 7부작으로 기획된 작품이며, 지금까지 나온 첫 다섯 권은 제가 근래 몇 년 동안 읽은 문학 프로젝트 가운데 가장 독창적이고 빛나는 작품 중 하나입니다. 설정 자체는 이미 백 번은 보았을 법한 것입니다. 주인공 타라 셀테르는 11월 18일에 잠에서 깹니다. 하루가 지나갑니다. 그녀는 잠자리에 듭니다. 그녀는 잠에서 깹니다. 11월 18일입니다. 북프랑스의 돌집에서 그녀와 함께 사는 남편 토마는 이전 회차를 전혀 기억하지 못합니다. 그녀는 기억합니다. 이 작품은 SF에서 가장 익숙한 장치인 타임 루프를 가져와 신선하고 친밀하며 깊이 인간적인 것으로 느껴지게 만듭니다. 저는 산세바스티안에서 일주일 동안 다섯 권을 모두 읽었습니다. 바스크 해안의 눈부신 대서양 햇살 아래 앉아, 북프랑스의 잿빛 비 내리는 하루를 벗어나지 못하는 한 여자의 이야기를 읽었는데, 그 대비 덕분에 책이 더욱 좋게 느껴졌을 뿐입니다.
가벼운 스포일러 주의: 각 권의 전체적인 윤곽은 설명하지만 반전은 다루지 않습니다. 아무것도 모른 채 이 연작을 접하고 싶으시다면 맨 아래로 건너뛰십시오.
첫 권은 이백 쪽 남짓한 얇은 책으로, 줄거리와 문체 모두 미니멀합니다. 그 미니멀리즘이 바로 핵심입니다. 타라는 호텔 히터에 데어 손에 작은 화상을 입은 채, 가방에는 로마 시대의 세스테르티우스 동전 하나를 넣고 파리의 도서전에서 클레롱수부아로 돌아왔으며, 우리는 루프의 백이십이 일째 되는 날 그녀를 만납니다. 그 무렵 그녀는 그날을 초 단위까지 외우고 있습니다. 지빠귀는 매일 아침 같은 순간에 웁니다. 컵은 그녀가 놓아둔 자리에 그대로 있습니다. 자신이 잠든 채 지나치고 있는 우주적 재앙에 아름다울 만큼 무심한 토마는 그녀에게 여행이 어땠는지 묻습니다. 그녀는 그에게 이야기합니다. 그는 귀를 기울입니다. 그는 이미 백이십두 번이나 귀를 기울였습니다. 둘 중 한 사람이 매일 아침 대화를 처음부터 다시 시작해야 하는 결혼 생활에는 어딘가 시시포스적인 데가 있습니다. 여기서의 글은 쓰는 법을 익히는 데 평생이 걸리는 종류의 담백한 산문입니다. 짧은 문장. 현재 시제. 은유는 거의 없습니다. 들판이 점점 좁혀 오고 있음을 깨닫기 시작한 사람이 써 내려간 박물학자의 야외 관찰 노트입니다. 바버라 J. 해빌랜드의 영어 번역은 너무나 자연스러워서 이 책이 다른 언어로 쓰였다는 사실을 잊게 됩니다. 1권은 소설의 옷을 입은 현상학 교과서이며, 그 위장이 너무나 훌륭해서 이 교과서는 계속해서 뜻밖의 감정으로 독자를 놀라게 합니다.
그날 안에서 1년이 흐르고, 2권은 타라를 여행길에 오르게 합니다. 그즈음 그녀는 18일이 자신이 잠든 곳이 어디든 그곳에서 다시 시작된다는 사실을 알아냈고, 그래서 루프를 데리고 다닐 수 있게 됩니다. 그녀는 기차를 탑니다. 그녀는 유럽을 가로지릅니다. 그녀는 눈을 따라 노르웨이까지 올라가고 어스름한 빛을 따라 남쪽으로 내려가며, 자신에게 허락되지 않은 계절의 증거가 될 만한 것이라면 무엇이든 좇습니다. 2권의 묘미는 이 책이 안팎이 뒤집힌 여행기라는 점입니다. 원래 세상은 여행자가 움직이는 동안 그 뒤에 고요히 머무는 배경이어야 합니다. 여기서는 여행자가 멈춰 있는 쪽입니다. 그녀는 어디를 가든 똑같은 11월 18일입니다. 그녀의 발밑에서 끊임없이 움직이는 것은 세상이며, 같은 수요일 위에 쓰이고 또 덧쓰이는 팰림프세스트와 같고, 그 변화가 너무도 세심하게 그려진 나머지 이 책은 같은 하루가 거듭될 때 위도마다 빛이 어떻게 다르게 움직이는지를 느리고 환각적으로 살피는 탐사가 됩니다. 세스테르티우스는 그녀와 함께 여행하면서 로마 제국과 그 화폐가 한때 지나간 경로에 관한 아름다운 여담으로 이어지고, 책이 끝날 무렵 타라의 감각은 문장 자체가 다르게 숨 쉬기 시작할 만큼 날카로워집니다. 그녀는 세상이 새로운 언어로 속삭이고 있다고 씁니다. 이 권에서 주로 그녀가 외국 호텔에서 전화를 거는 상대로 등장하는 남편은, 자신의 달력이 인정하기를 거부하는 속도로 나이 들어 가는 여자에게 사랑받는다는 것의 부담을 느끼기 시작합니다.
그리고 이 프로젝트는 아무도 예상하지 못한 일을 벌입니다. 타라가 다른 누군가를 만나는 것입니다. 그의 이름은 헨리 데일입니다. 그는 사회학자입니다. 그는 그녀보다 더 오래 그날 안에 갇혀 있었고, 미국에 어린 아들이 있어 루프가 돌아올 때마다 전처의 집으로 아이를 찾아갑니다. 네 살 아이가 되어 매일 아침 아버지를 만난다고 상상해 보십시오. 그가 늘 같은 사람임을 알면서도, 동시에 그가 당신이 볼 수 없는 시간의 짐을 지고 있다는 것도 알고 있는 것입니다. 이 책은 결코 그 비통함을 과하게 강조하지 않으며, 모든 것을 그대로 두듯 그것 또한 그대로 둡니다. 타라와 헨리는 서로가 서로에게 어떤 존재인지 알아내려 애씁니다. 이 권은 부분적으로, 우주가 본인들의 의지와 상관없이 그들을 단 둘뿐인 경계의 사회로 만들어 버렸을 때 품위 있는 사람들이 어떻게 행동하는지에 관한 이야기입니다. 이어서 루프를 더 공정한 사회로 재편하려는 계획을 품은 올가가 나타납니다. 그다음에는 하루가 반복될 때마다 지구상에서 막을 수 있는 모든 사고를 막는 데 쓰겠다는 계획을 품은 랄프가 나타납니다. 네 사람에게는 그날 말고는 공통점이 전혀 없으며, 이 소설은 그날 하나로 충분한 척하기에는 너무나 정직합니다. 이제 토마스와의 결혼은 이 책에서 가장 조용하게 불안을 키우는 동력이 되었습니다. 타라는 나이가 들었습니다. 토마스는 그렇지 않습니다. 매일 아침 그는 자신에게 돌아온 여자보다 더 젊은 모습으로 깨어납니다.
네 번째 권에 이르면 그들은 브레멘 외곽의 큰 집으로 옮겨 갔고, 넷이던 사람들은 쉰 명이 되어 있습니다. 여기서 이 책은 진지한 문학 소설에서 이만한 규모로는 좀처럼 본 적 없는 일을 해냅니다. 단수의 목소리가 깨집니다. 앞의 세 권에서 조심스럽던 “나“는 서서히, 그러다 어느 순간 분명하게 “우리“가 되고, 책은 지금껏 소집된 공동체 가운데 가장 흥미로운 공동체의 긴 회의록처럼 읽히기 시작합니다. 거주자들은 모든 것을 두고 논쟁합니다. 자신들을 무엇이라 부를지를 두고 논쟁합니다. 하루를 해 뜨는 시각부터 셀지, 아니면 도착한 순간부터 셀지를 두고 논쟁합니다. 음식을 두고도 논쟁하는데, 루프 안에서 먹은 음식은 루프에서 영원히 사라지고, 쉰 명이라는 인구는 한정된 아침 식사에 상당한 부담이 되기 때문입니다. 모든 상처가 자정에 초기화되는 세계에서 의료를 어떻게 할지를 두고 논쟁합니다. 다시 말해 그들은 어느 사회에서나 하중을 떠받치는 구조를 두고 논쟁하며, 그 논쟁의 속도와 명료함은 잃을 것은 하나도 없고 알아내야 할 것은 전부인 사람들 사이에서만 오가는 바로 그런 대화임을 단번에 알아볼 수 있게 합니다. 이 모든 시도는 부정의 길을 따르는 것으로, 자신들의 처지가 무엇이 아닌지를 빠짐없이 짚어 가며 그 처지를 가리킬 어휘를 세우려는 시도입니다. 이 권은 형이상학을 부엌 안에 붙잡아 둡니다. 언어와 정체성에 관한 질문은 결코 빵에서 떨어져 떠다니지 않습니다. 누군가는 늘 설거지를 하고 있습니다. 책은 제가 설명하지 않을 하나의 전환점에서 끝나는데, 다만 그 전환이 충분히 납득할 만한 것이라는 점만은 말해 두겠습니다.
다섯 번째 권은 정착의 이야기입니다. 네 번째 권의 들뜬 기운은 더 낯설고 더 온화한 무언가에 자리를 내어 줍니다. 두 번째 삶이 천천히 그럴듯한 것이 되어 가는 질감입니다. 이제 공동체에는 습관이 생겼습니다. 반복 속에 갇힌 이들 가운데 몇몇은 글을 쓰기 시작했습니다. 몇몇은 가르치기 시작했습니다. 또 몇몇은 사람들이 중요한 것을 깨닫는 바로 그 방식으로, 토대와 다투기를 그만두면 반복이라는 토대 위에도 견딜 만한 삶을 지을 수 있다는 사실을 깨달았습니다. 새로 온 사람들이 문 앞에 나타나고, 그들을 맞이하는 일, 자신이 그날 안에 갇혀 있다는 사실을 막 알게 된 낯선 이에게 그날을 설명해 주는 일은 일종의 소명이 됩니다. 다섯 권을 거치며 이 연작의 핵심 통찰은 스스로 선명해집니다. 이 기획은 일상성에 관한 위대한 소설입니다. 조이스는 더블린의 하루를 육백 페이지에 걸친 세밀한 어텐션으로 우리에게 건네주었습니다. 이 연작은 같은 수요일을 천백 번 넘게 고쳐 쓴 것이며, 그럼에도 어쩐 일인지 아직 끝나지 않았습니다. 여러 주제 가운데 하나로 일상을 담은 소설이 아닙니다. 일상 그 자체에 관한 소설입니다. 11월 18일은 평범한 것을 증류하여 철학으로 만든 것입니다. 아침. 빵. 창가의 빛. 천 번째로 다시 부드럽게 시작되는 같은 대화. 이 다섯 권이 넌지시 묻는 것은, 미래를 걷어 내고 과거를 걷어 내어 페르메이르의 해상도로 들여다본 현재만 남았을 때 삶이란 무엇인가 하는 것입니다. 제6권은 2027년 5월에 나오며, 그 뒤로 한 권이 더 이어질 예정입니다. 이 엔진에는 지친 기색이 전혀 없으며, 이 기획은 작아짐으로써 계속 커지고 있습니다.
이 책들은 공책을 곁에 두고, 형이상학적 진기함으로 감싼 아름답고 고요하며 절제된 평범한 삶의 탐구를 원하는 모든 이를 위한 책입니다. 어느 수요일의 아침 햇살이 어떤 모습이었는지 적어 두고는 그런 일을 한 것이 조금 쑥스러웠던 모든 이를 위한 책입니다. 같은 것으로 몇 번이고 되돌아가 마침내 그것이 이해되기 시작할 때까지 붙드는 일을 하는 모든 이를 위한 책입니다. 새벽 여섯 시에 부엌 식탁이 어떤 모습인지 하나하나 기록하고 있는 자신을 문득 발견하고, 지루함도 깨달음도 아닌, 그 둘보다 더 고요한 세 번째 무언가를 느껴 본 적이 있다면, 솔베이 발레는 여러분이 가능하리라고 생각지도 못했던 책들을 써냈으며, 그것도 다섯 권이나 써냈고 지금도 계속 쓰고 있습니다. 이 책들은 문장 하나하나가 지금 이 순간 세계 어디에서 출간되는 산문 가운데서도 손꼽힐 만큼 아름답습니다. 또한 이 책들은 함께 놓고 보면 시간에 대해, 자아에 대해, 더 이상 역사를 쌓아 가지 않는 사람이란 무엇인가에 대해, 그리고 둘 중 한 사람만 그 안에서 나이 들어 갈 때 결혼이란 무엇인가에 대해 진지하고도 거리낌 없이 사유하는 명상록입니다.
타라는 11월 18일을 벗어날 수 없습니다. 우리 중 누구도 오늘을 벗어날 수 없기는 마찬가지입니다. 영원회귀는 이것을 하나의 시험으로 여깁니다. 부조리는 이것을 하나의 등반으로 여깁니다. 발레는 이것을 하나의 수행으로 여깁니다. 평범한 것에 주의를 기울이면, 그것이 곧 깊이입니다. 반복을 받아들이면, 그것이 곧 의미입니다. 한 삶의 척도는 두 번이라도 기꺼이 “예“라고 말할 수 있는가에 있으며, 이 책들을 읽고 나면 수십억 번 되풀이된 그녀의 하루가 정말로 우리 자신의 삶과 그토록 다른지 자문하게 됩니다.
행렬 곱셈과 어텐션
GELU, 소프트맥스, 레이어 정규화는 이미 텐서 언어 위의 Python 함수로 표현했습니다. 그러나 트랜스포머 산술 연산의 대부분은 행렬 곱셈에서 나옵니다. 행렬 곱셈을 추가하면 컴파일러에 특수한 어텐션 커널을 도입하지 않고도 어텐션을 조립할 수 있습니다.
시퀀스 길이는 , 임베딩 폭은 , 헤드 수는 , 헤드 하나의 폭은 로 표기하겠습니다. 모델은 한 번에 시퀀스 하나를 처리합니다. 헤드는 어텐션 행렬 곱에서 배치 차원이 됩니다.
행렬 연산 보존하기
형태가 인 와 형태가 인 에 대해:
프런트엔드의 __matmul__은 축약 차원을 검사하고, 출력 형태를 결정하며, 필요하면 dtype 변환을 삽입합니다. 그 결과는 matmul 표현식입니다. 이 표현식의 빌더는 이름 있는 linalg.matmul 연산을 생성합니다:
initial = linalg.fill(
    zero, outs=[tensor.EmptyOp(output_shape, element_type).result]
)
result = linalg.matmul(lhs, rhs, outs=[initial])
zero, 피연산자, 출력 타입은 타입이 지정된 표현식에서 가져옵니다. 행렬 곱셈은 결과를 대상에 누적하므로 0으로 초기화하는 것이 필수적입니다.
이 시점에서는 아직 루프 순서, 타일 크기, 벡터 폭, 스레드 매핑을 지정하지 않았습니다. IR은 여전히 이것이 행렬 곱셈이라고 말하고 있습니다. 따라서 백엔드가 이후에 구현 방식을 선택할 수 있습니다. CPU 파이프라인은 시스템 BLAS를 사용할 수 있으면 연산을 BLAS에 넘기고, 그렇지 않으면 MLIR의 루프 로어링을 사용합니다. GPU 타깃은 타일링된 커널로 대체합니다. 두 대체 모두 실행 시점에 연산을 여전히 알아볼 수 있어야 가능합니다.
작은 직사각형 예제로 형태 규칙과 생성된 연산을 확인합니다:
import numpy as np
from tinymlir import jit

@jit
def multiply(a, b):
    return a @ b

rng = np.random.default_rng(7)
a = rng.normal(size=(3, 5)).astype(np.float32)
b = rng.normal(size=(5, 7)).astype(np.float32)
np.testing.assert_allclose(multiply(a, b), a @ b, rtol=2e-6, atol=2e-6)
print(multiply.compile(a, b).module)
직사각형 입력은 뒤바뀐 차원과 잘못된 스트라이드를 드러내는 데 도움이 됩니다. 정사각형 예제만 모아 두면 이런 오류가 놀라울 만큼 잘 숨겨질 수 있습니다.
배치 차원이 일치하는 3차원 피연산자에 대해서는 빌더가 linalg.batch_matmul을 선택합니다. 현재 프런트엔드는 이 배치 차원들이 정확히 일치할 것을 요구합니다. NumPy의 배치 브로드캐스팅 규칙 전체를 구현하지는 않습니다.
선형 레이어
선형 레이어는 다음과 같이 간단합니다:
def linear(x, weight, bias):
    return x @ weight + bias
행렬 곱은 형태 (T, N)을 만들고, 벡터 편향은 그 행들에 걸쳐 브로드캐스트됩니다. GPT-2의 프로젝션 가중치는 형태가 (input_width, output_width)이므로 이 표현식에 그대로 들어맞습니다.
이 정의는 프런트엔드가 왜 중요한지도 보여 줍니다. gelu(linear(x, weight, bias))를 합성하면 전체 계산이 컴파일러에 드러납니다. 별도로 유지 관리하는 linear_gelu 구현은 없습니다. 텐서 연산은 MLIR의 융합 패스가 작업할 재료를 제공합니다.
쿼리, 키, 값
GPT-2는 세 가지 투영을 한 번에 계산합니다:
결과의 형상은 (T, 3*C)입니다. 세 개의 슬라이스를 취하여 각각을 (T, H, D)로 재형상화한 다음, (H, T, D)로 전치합니다:
packed = linear(x, qkv_weight, qkv_bias)
length, width = x.shape
depth = width // heads
q, k, v = [
    packed[:, i*width:(i+1)*width]
        .reshape((length, heads, depth))
        .transpose((1, 0, 2))
    for i in range(3)
]
이 문장들은 트레이싱 중에 실행됩니다. 루프의 범위는 정적이며, 모든 슬라이스와 형상이 알려져 있습니다. 배열 자체는 여전히 런타임 입력입니다.
각 연산에는 대응하는 구조화된 로어링이 있습니다. 슬라이스는 tensor.extract_slice가 됩니다. 재형상화는 상수 형상 피연산자를 가진 tensor.reshape가 됩니다. 전치는 순열 속성을 가진 linalg.transpose가 됩니다.
재형상화 연산의 선택은 의도적입니다. MLIR에는 tensor.collapse_shape와 tensor.expand_shape도 있습니다. 이 연산들은 명시적인 재결합 그룹을 지니며, 두 정적 형상 사이의 재형상화에 자연스럽게 들어맞습니다. 그러나 원소별 융합 패스는 이러한 연산을 인접한 linalg.matmul에 접어 넣는 방법을 알고 있으며, 명명된 연산을 재형상화를 흡수하는 인덱싱 맵을 가진 linalg.generic으로 다시 작성합니다. 이 변환은 적법하며 연산 하나를 절약합니다. 동시에 그 연산이 행렬 곱셈이었다는 사실도 지워 버리는데, 이것이 바로 다음 장들의 BLAS 및 GPU 대체가 찾는 정보입니다. 형상 피연산자를 가진 tensor.reshape는 융합 패스가 인식하는 재결합이 아니므로, matmul은 백엔드가 이를 가져갈 수 있는 지점까지 살아남습니다.
재형상화는 원소 개수를 보존해야 합니다. 전치는 순열을 지정해야 합니다. 슬라이스는 정적 형상에 들어맞아야 하며, 우리의 작은 언어에서는 단위 스트라이드를 가지고 비어 있지 않은 결과를 내야 합니다. 이러한 검사는 MLIR 연산을 생성하기 전에 이루어집니다.
레이아웃 연산은 버퍼화와 로어링 때까지 그 의미를 유지합니다. 특정 조합이 뷰가 될지 복사가 필요할지는 그 레이아웃과 사용 방식에 따라 달라집니다. Python 표현식이 짧다는 이유만으로 모든 전치가 비용 없이 이루어진다고 가정해서는 안 됩니다.
점수와 마스크
각 헤드에 대해 어텐션 점수는 다음과 같습니다:
배치 곱의 형상은 (H, T, T)입니다. 인과 마스크의 형상은 (T, T)이며 헤드 전체에 걸쳐 브로드캐스트됩니다. NumPy 참조 구현과 일치시키기 위해, 허용된 항목은 0이고 미래 위치에는 투영의 dtype으로 표현한 이 들어갑니다.
우리의 마스크는 linalg.generic으로 만든 작은 프리미티브입니다. 그 영역은 linalg.index를 사용해 행과 열 인덱스를 얻고, arith.cmpi로 이를 비교한 다음, 0 또는 마스크 값을 선택합니다. 이는 인덱스에 의존하는 텐서 구성이며, 마스크를 담은 호스트 NumPy 배열을 필요로 하지 않습니다.
대각선은 여전히 허용되므로, 모든 쿼리 위치에는 보이는 키가 적어도 하나 있습니다. 10부의 소프트맥스를 적용하면 마지막 차원이 정규화됩니다:
scores = (q @ k.transpose((0, 2, 1))) / np.sqrt(depth)
probabilities = softmax(scores + causal_mask(length, packed.dtype))
NumPy 제곱근은 float64 스칼라를 반환합니다. 따라서 우리의 타입 규칙은 참조 구현과 마찬가지로 점수 계산을 승격합니다. 이 전파는 런타임 변환 속에 숨겨지지 않고, IR에서 명시적인 원소별 캐스트로 드러납니다.
값 결합하기
확률은 값 벡터에 가중치를 부여합니다:
결과의 형태는 (H, T, D)입니다. 이를 (T, H, D)로 전치하고 (T, C)로 reshape하면 헤드가 결합됩니다. 마지막 선형 투영은 잔차 스트림의 폭으로 되돌립니다:
context = (probabilities @ v).transpose((1, 0, 2)).reshape((length, width))
return linear(context, out_weight, out_bias)
이 조각들을 합치면 tinymlir/ops.py에 있는 어텐션 함수 전체가 됩니다. 이 함수의 백엔드 어휘는 행렬 곱, 원소별 산술, 축약(reduction), 슬라이스, reshape, 전치로 이루어져 있습니다. 컴파일러에는 모델의 어텐션 함수를 이름으로 인식하는 특별한 규칙이 필요하지 않습니다.
이 버전은 점수 텐서와 확률 텐서를 실체화합니다. 그 크기는 에 비례합니다. 코드는 간결하지만, 알고리즘은 여전히 이차 크기의 어텐션 저장 공간을 사용합니다. FlashAttention을 구현하려면 타일 단위로 처리하고, 그 전체 텐서를 실체화하지 않은 채 정규화 통계를 유지하는 다른 스케줄이 필요합니다. 이는 일반적인 원소별 융합으로 얻어지는 결과가 아닙니다.
잔차 연결
트랜스포머는 어텐션 전에 입력을 정규화한 다음, 어텐션 출력을 다시 입력에 더합니다:
@jit
def attend(x, gain, bias, qkv_weight, qkv_bias, out_weight, out_bias, *, heads):
    normalized = layer_norm(x, gain, bias)
    return x + attention(
        normalized, qkv_weight, qkv_bias, out_weight, out_bias, heads
    )
heads는 정적 키워드 매개변수입니다. 이 값을 바꾸면 다른 특수화가 선택됩니다. 텐서는 동적 데이터이며, 그 형태와 dtype이 특수화를 결정합니다.
피드포워드 절반도 같은 잔차 구조를 가집니다:
@jit
def feedforward(x, gain, bias, up_weight, up_bias, down_weight, down_bias):
    normalized = layer_norm(x, gain, bias)
    hidden = gelu(linear(normalized, up_weight, up_bias))
    return x + linear(hidden, down_weight, down_bias)
이것들이 최종 모델이 실행하는 함수입니다. 각 함수는 하나의 모듈 안에 조합 가능한 텐서 연산을 여러 개 담고 있어, 컴파일러가 변환에 활용할 수 있는 유용한 생산자-소비자 관계를 제공합니다.
인과성 확인하기
수치 비교는 필요하지만, 어텐션에는 유용한 구조적 성질도 있습니다. 미래의 입력을 바꾸더라도 이전 출력은 변하지 않아야 합니다.
테스트 스위트는 짧은 시퀀스를 만들고, 컴파일된 어텐션을 실행한 뒤, 마지막 두 입력 행을 바꾸고, 처음 세 출력 행이 그대로인지 확인합니다. 이를 통해 뒤집힌 마스크, 잘못된 전치, 그리고 형태 검사만으로는 잡아낼 수 없는 일부 헤드 레이아웃 실수를 잡아낼 수 있습니다.
또한 비정사각 행렬 곱, 배치 곱, 그리고 자명하지 않은 슬라이스에서의 레이아웃 변경도 테스트합니다. 이들은 인덱싱 오류가 모델에 유입될 수 있는 서로 독립적인 지점입니다. 이들을 따로 검사하면 최종 로짓에서 불일치가 발생했을 때 그 위치를 훨씬 쉽게 찾을 수 있습니다.
이제 GPT-2 블록에 필요한 산술 연산을 모두 갖추었습니다. 다음으로는 이 구조화된 텐서 프로그램을 호출 가능한 네이티브 코드로 바꾸는 변환 및 실행 파이프라인을 살펴보겠습니다.
외부 자료
서평: What We Can Know
이언 매큐언은 What We Can Know를 “과학이 빠진 과학 소설“이라고 표현한 바 있는데, 이는 정당한 경고이자 정확한 광고이기도 합니다. 소설의 배경은 2119년입니다. 해수면 상승과 연쇄적인 핵전쟁(대서양에 오발된 러시아 핵탄두와 이른바 제3차 중미 전쟁을 포함하여)으로 세계 인구는 절반으로 줄었고, 영국은 페리와 강삭철도로 이어진 산봉우리들의 한적한 군도가 되었습니다. 보들리언 도서관은 스노도니아로 이전되었습니다. 세계 통화는 나이지리아 나이라입니다. 미국은 서로 반목하는 군벌들이 할거하는 무법 지대입니다. 사람들은 전기 카누를 타고 섬과 섬 사이를 오갑니다. 옥스퍼드의 셸도니언 극장은 물에 잠겨 있습니다. 그리고 이 시대 사람들은 21세기 초를 돌아보며, 모든 것을 가졌으면서도 그것을 탕진해 버린 문명에게 우리가 품는 바로 그 특유의 선망과 경멸이 뒤섞인 감정을 느낍니다. 그들은 우리 시대를 “착란기(the Derangement)“라고 부릅니다. 그들은 우리가 후기 로마인을 연구하듯 우리를 연구합니다. 즉, 극적이고도 자발적인 몰락의 사례 연구로서 말입니다.
매큐언은 이 세계를 아주 오랫동안 생각해 온 끝에 절제된 표현이 장관보다 더 무섭다고 결론 내린 사람의 무심한 자신감으로 구축합니다. 그는 결코 파국 자체에 머무르지 않습니다. 그는 그저 독자를 그 여파 속에 데려다 놓고, 사라진 것들의 무게를 느끼게 할 뿐입니다. 미래는 작지만 가슴을 무너뜨리는 세부 묘사로 그려집니다. 거의 텅 빈 강의실에서 가르치는 문학 교수는 “인문학을 더 이상 소중히 여기지 않는 세상에 남은 인문학의 유물이자, 수자원 과학자들에 비하면 가난한 사촌“입니다. 성장하는 산업은 데이터 복구와 대기 관리뿐입니다. 한편 미래의 학자들은 1990-2030년을 “90.30 문학“이라는 항목 아래 연구하며, 우리에 대한 그들의 평결은 가혹합니다. “그들은 위대하고 용감했으며, 뛰어난 학자이자 과학자, 음악가, 배우, 운동선수였지만, 그 모든 것을 내던져 버리고 있던 바보들이었다.”
매큐언은 이 세계에 잃어버린 시 한 편을 복원하는 데 경력을 바쳐 온 문학 교수 톰 멧커프를 놓아둡니다. 그 시 「비비언을 위한 화관(A Corona for Vivien)」은 저명한(그리고 우리가 알게 되듯 괴물 같은) 시인 프랜시스 블런디가 썼습니다. 코로나(화관)란 서로 이어진 소네트들의 연쇄로, 각 소네트는 앞 소네트의 마지막 행으로 시작하며, 첫 행이 다시 돌아올 때 연작이 닫혀 원을 이룹니다. 블런디는 2014년 아내 비비언의 생일 만찬에서 이 시를 낭독했습니다. 그 시를 들은 몇 안 되는 사람들은 그것을 *황무지(The Waste Land)*에 견줄 만한 그의 경력의 정점이라고 불렀습니다. 그 후 그는 모든 초고를 없애, 단 한 부뿐인 양피지 사본을 유일무이한 선물로 만들었습니다. 그 시는 다시는 세상에 나타나지 않았습니다.
톰은 21세기 초의 완전한 디지털 아카이브에 접근할 수 있습니다. 양자 컴퓨팅이 우리 시대의 모든 암호를 깨뜨리면서 암호화된 모든 데이터 저장소, 모든 사적인 메시지, 모든 기업 금고가 열렸습니다. 그 결과는 완전한 투명성입니다. 모든 이메일, 모든 문자 메시지, 모든 장보기 목록, 모든 소셜 미디어 게시물이 뉴라고스의 서버에 보존되어 있고, 도서관 카드만 있으면 누구나 그 모두를 읽을 수 있습니다. 그는 그 만찬을 손님 한 명 한 명, 메시지 하나하나 단위로 재구성할 수 있습니다. 그리고 여기에 이 소설의 핵심이자 조용히 가슴을 무너뜨리는 역설이 있습니다. 모든 데이터를 가져도 달라지는 것은 아무것도 없다는 것입니다. 그 시에 관한, 그리고 그 시를 만들고 파괴한 사람들에 관한 근본적인 진실은 여전히 감춰져 있습니다. 정보 속에 허우적대는 사람의 씁쓸한 좌절감을 담아 톰은 이렇게 말합니다. “비밀을 지키고 싶다면, 가장 소중하고 가장 믿을 수 있는 친구의 귀에 속삭이십시오. 키보드와 화면을 믿지 마십시오. 그렇게 했다가는 우리가 모든 것을 알게 될 것입니다.” 모든 것, 다시 말해 정작 중요한 것만 빼고 말입니다.
이것이 매큐언의 인식론적 논증이며, 그는 철학자의 엄밀함과 50년 동안 서사와 지식에 대해 사유해 온 소설가의 인내심으로 이 논증을 밀고 나갑니다. 그는 과거란 언제나 재구성이라고 주장합니다. “기억은 스펀지입니다. 다른 시간, 다른 장소의 재료를 빨아들였다가 문제의 그 순간 위에 온통 흘려 놓습니다.” 일기는 “사건을 실에 꿴 구슬처럼 고정“하지만, 실제로 살아낸 경험은 순차적이기를 거부합니다. 그는 상상된 것이 “실재하는 것 위에 군림하며, 거기에는 역설도 신비도 없다“고 씁니다. 결국 우리가 알 수 있는 것은 사방에서 우리가 믿고 싶은 것, 우리가 기억할 수 있는 것, 그리고 우리가 기꺼이 보려 하는 것에 의해 제한됩니다.
소설의 후반부는 전반부가 쌓아 올린 모든 것을 폭파합니다. 비비언 자신의 회고록이 모습을 드러내고, 그 안에서 우리는 존경받는 시인이자 기후 변화 부정론자이며 히니와 라킨에 비견되던 문인인 프랜시스 블런디가 비비언의 첫 남편을 살해했다는 사실을 알게 됩니다. 조기 발병 알츠하이머를 앓던 현악기 장인 퍼시 그린은 계단 아래로 떠밀린 뒤 나무망치로 마무리되었습니다. 블런디는 그것을 자비로 포장했습니다. 그런 다음 그는 죽은 사람의 고통을 자신의 시 속으로 흡수하여, 사적인 공포를 공적인 예술로 변환했습니다. 그 유명한 “비비언을 위한 화관(Corona for Vivien)“은 암호화된 형태로 이 범죄를 고백한 것이자, 그 범죄가 낳은 슬픔을 미학화한 것이었습니다. 비비언은 그 시가 자신의 실제 기억을 훔쳐 문학적 성취로 재포장한 아름다운 위조품임을 깨닫고, 그 양피지를 낙농장의 난로 속에 넣었습니다. 시는 불타 버렸습니다. 그런 다음 그녀는 자신의 산문 기록을 묻어, 교묘한 거짓이 아닌 진실이 미래에 닿도록 했습니다.
매큐언은 언제나 자신의 탁월함이 평범한 도덕적 제약으로부터 자신을 면제해 준다고 믿는 사람들에게 이끌려 왔으며, 블런디는 이 집착이 가장 완전하게 구현된 인물입니다. 이 소설은 위대한 예술이 끔찍한 행위를 세탁할 수 있는지 묻고, 그 질문을 진정으로 열어 둘 용기를 지니고 있습니다. 비비언이 시를 파괴할 때 여러분은 상실과 정의를 동시에 느끼게 되며, 바로 그 동시성이 핵심입니다. 작품의 아름다움과 그것을 만든 사람의 잔인함은 같은 공간을 차지하며, 매큐언은 여러분이 둘 중 하나를 다른 하나로 환원하도록 내버려 두지 않습니다.
속죄를 읽어 보셨다면 그 엔진을 알아보실 것입니다. 중첩된 서사, 누가 이야기를 통제하는가 하는 질문, 그리고 독자의 재구성이 진실과 충돌할 때 찾아오는 참담함이 그것입니다. 그러나 속죄가 픽션이 죄책감을 구원할 수 있는지 물었다면, 우리가 알 수 있는 것은 한 걸음 더 나아갑니다. 이 작품은 구원의 가능성이란 언제나 편안한 허구였으며, 남는 것은 끈기뿐이라고 시사합니다. 결말 무렵 한 동료의 임신은 “헛됨과 보살핌이라는 사슬의 다음 고리“로 묘사되며, 두 명사 모두에 똑같은 무게가 실립니다. 재구성이라는 작업(시의 재구성, 지식의 재구성, 살 만한 세계의 재구성)은 결과와 상관없이 그 나름의 존엄을 지니기에 우리는 계속 나아갑니다.
이 소설은 밀도가 높으며, 어떤 서평 하나로도 다 다룰 수 없을 만큼 많은 것을 이야기합니다. 이 소설은 인문학에 관한 이야기이자 인문학이 재앙에서 살아남는지에 관한 이야기입니다(인문학은 간신히, 그리고 축소된 형태로 살아남으며, 소설은 이 축소된 생존에도 여전히 가치가 있다고 주장합니다). 이 소설은 익숙한 범주들을 엔트로피로 녹여 버리는 도덕적 용매로서의 기후 변화에 관한 이야기입니다. 이 소설은 한 번도 알지 못했던 세계를 돌아볼 때 느끼는 특유의 그리움에 관한 이야기이며, 매큐언은 이를 위해 “한때 알았던 것을 그리워하는 향수를 넘어서는” 단어가 필요하다고 말합니다. 이 소설은 학문과 사랑, 기록의 정밀함과 정서적 진실, 그리고 산 자와 죽은 자 사이의 관계에 관한 이야기입니다.
매큐언의 문장은 나이가 들면서 한결 느슨해졌습니다. 초기 소설들은 시계공처럼 정밀했고, 때로는 숨 막힐 정도였습니다. 이 작품에서는 문장이 숨을 쉽니다. 유머가 있고(건조하고, 영국적이며, 전혀 예상하지 못한 순간에 찾아옵니다), 그의 초기작이 때때로 아꼈던 인물들을 향한 따뜻함이 있습니다. New York Times는 이 작품을 “매큐언이 근래에 쓴 최고의 작품“이라고 평했습니다. The Scotsman은 이 작품을 그의 걸작이라고 불렀습니다. 저는 둘 다 옳다고 생각합니다. 이 소설은 생각하게 하는 만큼 깊이 느끼게 하는 드문 소설이며, 그러한 야심을 품을 자격을 스스로 증명해 내는 더욱 드문 소설입니다.
매큐언은 자신의 목표가 “과거와 현재와 미래가 시간의 장벽을 넘어 서로에게 말을 건네게 하는 것“이었다고 말했습니다. 그는 성공했습니다. 2026년에 이 글을 읽고 계신다면, 이 소설 속 미래의 학자들은 이미 여러분에 대한 판결을 내렸습니다. 여러분이 둠스크롤링을 하는 대신 서평을 읽고 있다는 사실은, 2119년의 기준으로 보면 작은 문명적 행위에 해당할지도 모릅니다. 이 기회를 최대한 누리십시오.
트랜스포머 커널 컴파일하기
이제 우리의 프런트엔드는 Python 텐서 표현식을 MLIR 연산으로 변환할 수 있습니다. 이를 사용해 NumPy GPT-2 모델의 GELU, 소프트맥스, 레이어 정규화를 구현하겠습니다. 이 순서는 단계적으로 나아가기에 유용합니다. GELU는 원소별 연산이고, 소프트맥스는 리덕션을 도입하며, 정규화는 리덕션과 브로드캐스팅을 결합합니다.
라이브러리 함수와 컴파일러 프리미티브를 구분하면 구현을 작게 유지할 수 있습니다. GELU는 라이브러리 함수입니다. 덧셈, 곱셈, 거듭제곱, tanh는 컴파일러 프리미티브입니다. 컴파일러는 GELU의 공식을 컴파일하기 위해 gelu라는 이름을 인식할 필요가 없습니다.
아래 예제는 Part 9의 환경을 사용하여 tiny-mlir 동반 프로젝트에서 실행됩니다.
GELU
GPT-2는 tanh 근사를 사용합니다.
우리의 구현은 레퍼런스를 충실히 따릅니다.
import numpy as np
from tinymlir import tanh


def gelu(x):
    return 0.5 * x * (1 + tanh(np.sqrt(2 / np.pi) * (x + 0.044715 * x**3)))
np.sqrt(2 / np.pi)는 인자가 상수이므로 트레이싱 중에 평가됩니다. x에 의존하는 모든 것은 텐서 그래프의 일부가 됩니다. MLIR 빌더에서 산술 연산은 linalg.generic의 스칼라 영역으로 들어가고, tanh는 math.tanh가 되며, 거듭제곱은 math.powf가 됩니다.
from tinymlir import jit

compiled_gelu = jit(gelu)
x = np.linspace(-5, 5, 31, dtype=np.float32)
y = compiled_gelu(x)
expected = 0.5 * x * (
    1 + np.tanh(np.sqrt(2 / np.pi) * (x + 0.044715 * x**3))
)
np.testing.assert_allclose(y, expected, rtol=2e-6, atol=2e-6)
여기에는 미묘한 세부 사항이 있습니다. np.sqrt가 생성하는 NumPy 스칼라의 dtype은 float64입니다. 레퍼런스 환경에서는 이 값을 float32 표현식에 곱하면 해당 부분의 계산이 승격됩니다. 그 결과 GELU 출력은 float64가 됩니다. 우리의 프런트엔드는 명시적인 캐스트 노드를 통해 이 승격을 유지합니다.
모든 연산을 float32로 하는 모델을 설계하는 것도 합리적이지만, 그것은 레퍼런스 계산을 변경하는 것이 됩니다. 이 시리즈에서 우리가 재현하려는 것은 레퍼런스의 동작입니다. 참조 구현의 공식을 맞춘다는 것에는 그 dtype과 평가 순서까지 맞추는 것이 포함됩니다.
리덕션
원소별 연산은 각 출력을 독립적으로 계산할 수 있습니다. 합계는 여러 입력 원소를 결합해야 합니다.
프런트엔드는 이를 축을 가진 리덕션 노드로 표현합니다. 이 노드의 타입 규칙은 리덕션된 차원을 제거합니다. (3, 7) 텐서를 축 1에 대해 리덕션하면 (3,) 형태가 생성됩니다. keepdims=True를 사용하면 그 결과를 (3, 1)로 reshape하여 이후의 브로드캐스팅을 간단하게 만듭니다.
우리의 빌더는 linalg.reduce를 사용합니다. 다음은 핵심 구성으로, operand, output_type, axis와 원소 타입은 표현식이 제공합니다.
zero = arith.ConstantOp(element_type, 0.0).result
initial = tensor.EmptyOp(output_shape, element_type).result
filled = linalg.fill(zero, outs=[initial])
reduction = linalg.ReduceOp(
    [output_type], [operand], [filled], [axis]
)
block = reduction.regions[0].blocks.append(element_type, element_type)
with ir.InsertionPoint(block):
    total = arith.AddFOp(*block.arguments)
    linalg.YieldOp([total.result])
초기 텐서는 0으로 채워져 있어야 합니다. tensor.empty는 형태를 가진 목적지를 제공할 뿐, 누산기를 초기화하지는 않습니다. 이 차이는 리덕션과 행렬 곱셈 모두에서 중요합니다.
본문은 입력 원소 하나와 현재까지 누적된 값을 받습니다. 본문은 이 둘을 더하고 새 누산기를 내놓습니다. 최댓값 리덕션도 같은 구조를 사용하되, 음의 무한대로 초기화하고 영역 안에서 arith.maximumf를 사용합니다.
이 연산은 여전히 리덕션을 기술할 뿐이며, 각 덧셈을 어느 프로세서나 스레드가 계산할지는 지정하지 않습니다. 따라서 스케줄링 결정은 이후의 변환에 맡겨집니다. 우리의 초기 네이티브 백엔드는 결국 이 연산을 루프로 로어링합니다.
안정적인 소프트맥스
소프트맥스는 점수로 이루어진 행 하나를 확률로 바꿉니다.
큰 점수에 지수 함수를 직접 적용하면 오버플로가 발생할 수 있습니다. 행의 최댓값을 빼면 실수 산술에서는 결과가 바뀌지 않으면서도 가장 큰 지수 값이 1로 유지됩니다.
Python 정의는 지금까지 갖춘 연산들의 조합입니다.
from tinymlir import exp


def softmax(x):
    numerator = exp(x - x.max(axis=-1, keepdims=True))
    return numerator / numerator.sum(axis=-1, keepdims=True)
형태가 (H, T, T)인 입력에 대해 최댓값과 합의 형태는 (H, T, 1)입니다. 이들을 소비하는 원소별 연산은 마지막의 크기 1인 차원을 브로드캐스트합니다. 같은 함수는 일반적인 2차원 행렬에도 동작하며, 프런트엔드가 각 특수화에 맞는 타입과 맵을 도출합니다.
컴파일러는 공유된 numerator 식을 그대로 유지합니다. Python에서 사용될 때마다 지수 계산을 따로 다시 만들지 않습니다. 이후의 변환이 중간값을 다시 계산할지 실체화할지는 별개의 최적화 문제입니다.
지수 공식을 직접 적용하면 실패할 경우들을 테스트해 볼 수 있습니다.
x = np.array([
    [10000, 9999, -10000],
    [-10000, -9999, -10001],
    [0, -np.inf, -np.inf],
], dtype=np.float32)
probabilities = jit(softmax)(x)
np.testing.assert_allclose(probabilities.sum(axis=-1), 1, atol=1e-6)
assert probabilities[2, 0] == 1
음의 무한대로만 이루어진 행은 이 예제가 유용하게 다루는 범위를 벗어납니다. 그 최댓값을 빼면 정의되지 않은 값이 나오기 때문입니다. GPT-2의 인과 마스크는 항상 대각선 성분을 남겨 두므로, 비어 있지 않은 쿼리 행에는 허용된 키가 적어도 하나 있습니다. 이 성질은 어텐션을 구현할 때 명시적으로 드러내겠습니다.
레이어 정규화
레이어 정규화는 각 토큰 표현의 마지막 차원에 걸쳐 통계량을 계산합니다.
그런 다음 학습된 스케일 벡터와 바이어스 벡터를 적용합니다.
모분산과 GPT-2의 를 사용합니다.
from tinymlir import sqrt


def layer_norm(x, gain, bias):
    centered = x - x.mean(axis=-1, keepdims=True)
    variance = (centered * centered).mean(axis=-1, keepdims=True)
    return gain * centered / sqrt(variance + 1e-5) + bias
mean 자체는 합을 정적으로 알려진 리덕션 길이로 나눈 것입니다. 백엔드에 별도의 정규화 루프는 없습니다. 이 함수는 앞선 예제들과 같은 로어링 규칙을 사용하여 리덕션, 원소별 연산, 브로드캐스트 맵으로 전개됩니다.
중심화된 차이를 사용하는 것은 수치적으로도 중요합니다. 대수적으로 동등한 식인 는 큰 공통 오프셋을 가진 값에서 심각한 소거 오차를 겪을 수 있습니다. 저희는 더 편리해 보이는 항등식을 택하지 않고 레퍼런스의 중심화된 계산 방식을 따릅니다.
상수 행은 유용한 테스트입니다. 상수 행의 분산은 0이므로, 정규화 후의 출력은 학습된 편향과 같아야 합니다. 테스트 스위트는 특수한 경우가 일반 경로의 오류를 가리지 않도록 상수 행과 무작위 행을 함께 사용합니다.
옵티마이저가 보는 것
이 시점에서 컴파일러는 이름이 붙은 커널들을 연달아 호출하는 것 이상을 봅니다. Python 식 전체가 함수 내부의 텐서 그래프가 됩니다. 뺄셈 뒤에 지수 함수와 나눗셈이 이어지는 계산은 region과 인덱싱 맵을 합성할 수 있는 구조화된 연산으로 나타납니다.
융합 전후의 차이를 살펴볼 수 있습니다:
uv run python emit.py softmax
uv run python emit.py softmax --stage optimized
리덕션은 융합에 제약을 줍니다. 행의 합을 계산하려면 그 행에 기여하는 값들이 필요합니다. 패스는 생산자-소비자 관계와 리덕션 의미론을 보존해야 하며, 모든 연산을 임의의 원소별 region 안으로 옮길 수는 없습니다. 이러한 의미론을 명시적으로 유지하는 것이 애초에 구조화된 IR을 사용하는 이유입니다.
수치 검증
소규모 연산 테스트는 엄격한 허용 오차로 NumPy와 결과를 비교하고 출력 dtype을 확인합니다. 이 테스트들은 여러 리덕션 축, 유지된 차원, 브로드캐스트된 벡터, 큰 소프트맥스 오프셋, 상수 정규화 행, 그리고 GELU의 혼합 정밀도를 다룹니다.
uv run pytest
이 테스트들은 기본 구성 요소를 확립합니다. 최종 모델 테스트에서는 중간 잔차 출력과 로짓도 원본 tiny-gpt2 저장소와 비교하고, 이어서 생성된 토큰 ID가 정확히 일치하는지 확인합니다. 구현에 국소적인 반올림 차이가 있더라도 수치적으로는 여전히 올바를 수 있습니다. 필수 예제에서 다른 토큰을 선택하는 것은 이와 별개로 관찰 가능한 실패입니다.
다음으로 행렬 곱셈을 추가하고, 이와 같은 합성 가능한 텐서 연산을 사용해 어텐션 계산을 표현하겠습니다.
외부 자료
이전: 9부 - MLIR을 위한 Python 프런트엔드 · 시리즈 목차 · 다음: 11부 - 행렬 곱셈과 어텐션
서평: 반밈학부서는 없다
형식 체계를 다루는 일로 생계를 꾸리는 사람만이 온전히 음미할 수 있는 특별한 종류의 공포가 있습니다. 그것은 데이터 손실의 공포이고, 소리 없는 손상의 공포이며, 오류 로그 하나 남기지 않고 실패하는 것의 공포입니다. 한 번도 테스트하지 않은 백업이 바로 그것입니다. 모든 것을 감시하면서 정작 자기 자신의 상태만은 감시하지 않는 모니터링 시스템이 그것입니다. 누군가 알아차리기 전까지 몇 주 동안 분산 시스템 전체로 번져 나가는 소리 없는 장애가 그것이며, 마침내 알아차렸을 때는 세계의 상태가 여러분이 믿고 있던 모습에서 너무 멀리 벗어나 있어서 그 간극 자체가 보이지 않게 되어 버린 뒤입니다. 카프카가 장애 보고서를 썼다면 이 소설처럼 읽혔을 것입니다. 이 특별한 두려움이 영혼 깊은 곳에서 공명한다면, 샘 휴스(qntm이라는 이름으로 글을 씁니다)는 여러분의 악몽 같은 시나리오를 데이터베이스에서 현실의 존재론적 구조 전체로 확대하여 써냈고, 이를 지난 10년 동안 나온 가장 독창적인 SF 소설 중 하나로 만들어 냈습니다.
전제는 이렇습니다. 밈은 알려지기를 원하는 관념입니다. 밈은 퍼지고, 복제되고, 여러분의 마음속에 자리를 잡습니다. 반밈은 그 반대입니다. 반밈은 지각되거나 기억되는 것에 적극적으로 저항하는 관념이거나, 존재이거나, 현상입니다. 그것에서 눈을 떼는 순간 그것은 여러분의 마음에서 사라지고, 여러분이 그것을 보고 있었다는 사실마저 함께 사라집니다. 그것이 존재한다는 사실을 기억할 수 없으므로 그것과 싸울 수도 없습니다. 방어가 필요하다는 인식이야말로 그것이 가장 먼저 파괴하는 대상이므로 방어 체계를 조직할 수도 없습니다. 괴물은 인지 구조 그 자체 속에 숨어 있습니다. 어둠은 의도된 기능입니다.
이 책은 SCP 재단 위키에 올라온 일련의 문서에서 출발했습니다. SCP 재단 위키는 기여자들이 가상의 변칙 물체와 존재에 대해 임상적이고 관료적인 문서를 작성하는 공동 창작 픽션 프로젝트입니다. SCP를 접해 본 적이 없다면, 네트워크 장애를 문서화할 때 쓸 법한 무미건조한 절차적 언어로 불가능한 것들을 목록화하는 비밀 기관의 서류 캐비닛을 상상해 보십시오. SCP 재단은 본질적으로 IETF가 공포 소설을 쓴다면 벌어질 일이며, 그 결과는 말 그대로 들리는 만큼이나 멋집니다. SCP 재단은 인터넷 시대의 진정으로 위대한 창작 실험 중 하나이며, 휴스의 반밈학부서 문서들은 그 실험에서 나온 최고의 작품으로 널리 평가받습니다. 이 소설은 그 문서들을 모으고 다듬어 하나의 일관된 서사로 엮었으며, 독립된 한 권의 책으로서도 훌륭하게 작동합니다.
주인공 매리언 휠러는 반밈학부서를 이끌고 있습니다. 그녀의 일은 우주가 그녀에게 잊게 만들려는 것들을 기억하는 것입니다. 그녀와 부서원들은 본질적으로 다른 모든 사람에게는 보이지 않는 위협을 지각하고 그에 맞서 싸우기 위해 기억증진제(기억소거제의 반대로, 뇌가 적극적으로 버리고 있는 기억을 강제로 붙잡아 두게 하는 화학 물질입니다)를 복용합니다. 그 약물에는 가혹한 부작용이 있습니다. 그 일에는 더 끔찍한 부작용이 있습니다. 여러분은 아무도 일어나고 있는 줄 모르고, 여러분이 싸웠다는 사실을 아무도 기억하지 못하며, 진행되는 동안 스스로의 역사를 지워 버리는 전쟁을 치르고 있습니다. 모든 승리는 즉시 잊힙니다. 모든 희생은 보이지 않습니다. 다시 말해, 이것은 우주적 공포로 그려 낸 오픈 소스 유지보수입니다. 이는 구조적으로 인정받을 수 없는 영웅적 행위이며, 가능한 한 가장 고귀한 형태의 헌신이거나 가능한 한 가장 부조리한 형태의 헛수고입니다. 그리고 휴스는 그중 어느 쪽인지 굳이 말하지 않을 만큼 현명합니다.
이 소설의 우주론은 정보가 물질보다 더 실재적인 위계 위에 세워져 있습니다. 평범한 3차원 시공간 아래에는 누스피어(noosphere)가 놓여 있습니다. 누스피어는 인간이 상상할 수 있는 모든 아이디어, 밈, 개념의 공간이며, 물리적 세계를 초월하여 기억과 정체성, 심지어 역사 기록까지 소급하여 편집할 수 있는 거대한 생태계입니다. 누스피어는 은유가 아닙니다. 소설의 논리 안에서 누스피어는 현실의 진정한 기층이며, 물리적 세계는 그것이 드리운 그림자입니다. 이 관념 공간에는 고유한 동물상이 있으며, 여기에는 반밈적 거미들과 개념과 물질 사이의 막을 찢고 들어오는 여러 하위 포식자들이 포함됩니다. 그리고 먹이사슬의 정점에는 SCP-3125가 자리합니다(출간판에서는 이름이 바뀌었지만, 이 명칭이 너무나 완벽해서 저는 그래도 이것을 쓰겠습니다). SCP-3125는 5차원의 정보적 최상위 포식자로, 누군가 그것을 지각하는 드문 순간에는 불가사리 같은 형상을 하고 있습니다. 그것은 너무나 거대하고 적대적이어서, 그것을 개념화하는 데 성공한 사람은 누구든 탐지되어 죽임을 당합니다. 그것에 대해 아는 것은 치명적입니다. 그것을 이해하는 것은 치명적입니다. 이해한다는 행위 자체가 공격 표면입니다. 이것은 러브크래프트식 공포를 완벽한 충실도로 정보 이론에 옮겨 놓은 것입니다. 러브크래프트의 우주는 무관심하고 거대했기 때문에 두려웠습니다. 휴즈의 우주는 적대적이고 밈적이기 때문에 두렵습니다. 괴물은 그것에 대해 생각하는 행위 속에 도사리고 있습니다.
이 책을 영리한 설정에서 진정한 예술로 끌어올리는 것은 이 책이 기억과 정체성을 다루는 방식입니다. SCP-3125와 싸우기 위한 매리언의 전략은 그 존재가 벡터로 사용할 수 있는 정보를 내주지 않기 위해 자신의 기억을 체계적으로 지우는 것입니다. 그녀는 남편을 잊습니다. 그녀는 동료들을 잊습니다. 자신의 정신을 더 이상 믿을 수 없게 되었기 때문에 그녀는 메모와 녹음에 의지하여 일합니다. 이 소설의 주인공은 그녀가 존재했다는 사실조차 결코 알지 못할 세계를 구하기 위해 스스로 자신의 정체성을 해체하고 있는 여성입니다. 영웅 서사의 모든 관습이 뒤집힙니다. 영웅은 이야기가 진행되는 동안 지식과 힘을 잃어 갑니다. 그것도 의도적으로 말입니다. 이 희생은 죽음을 넘어섭니다(물론 죽음도 찾아오기는 합니다). 진정한 희생은 자기 소거입니다. 곧 나를 나답게 만드는 모든 것을 스스로 파괴하는 것입니다.
그리고 후반부에 이르러 놀라운 일이 벌어집니다. 매리언의 남편 애덤은 그녀의 부재를 감지합니다. 그는 그녀를 기억하지 못합니다. 그녀가 존재했다는 증거도 그에게는 없습니다. 하지만 그의 삶에는 그녀의 모양을 한 구멍이 있고, 그 모양은 사라지지 않습니다. 소설은 사랑이 반밈적 소거조차 완전히 지울 수 없는 흔적을 남긴다고 주장합니다. 이것은 제가 수년 동안 접한 SF 아이디어 가운데 감정적으로 가장 처절한 것이며, 휴즈는 이 아이디어에 걸맞은 절제와 정밀함으로 이를 다룹니다. 그보다 못한 책이었다면 감상적으로 흘렀을 것입니다. 하지만 이 책에서는 그럴 자격을 얻습니다. 앞선 서사 전체가 정확히 얼마나 많은 것을 잃을 수 있는지를 엄밀하게 보여 주었기에, 끝내 남아 있는 것이 기적처럼 느껴지기 때문입니다.
이 소설의 형식은 구조적으로 우아하면서도 깊이 불안하게 만드는 방식으로 그 내용을 반영합니다. 맥락이 지워졌기 때문에 각 장은 장면 한가운데에서 시작합니다. 독자 역시 등장인물들처럼 내력이 사라진 상황에 내던져졌기 때문에, 인물들은 소개 없이 등장합니다. 독자는 반밈학부가 일하는 방식 그대로 읽게 됩니다. 파편을 끼워 맞추고, 남아 있는 것의 윤곽에서 사라진 것을 추론하며, 자신의 재구성이 옳은지 결코 확신하지 못한 채 말입니다. 이것이야말로 망각에 관한 이야기를 정직하게 들려줄 수 있는 유일한 방법입니다.
시스템을 다루는 일을 하거나, 정보에 대해 생각하거나, 우리가 만드는 것들이 얼마나 취약하고 얼마나 쉽게 소리 없이 실패할 수 있는지 때문에 밤잠을 설쳐 본 적이 있다면, 이 책은 여러분의 마음속 깊이 파고들어 떠나지 않을 것입니다. 이 책은 정보 이론의 관점에서 생각하는 사람들을 위한 러브크래프트입니다. 괴물은 하나의 관념이고, 무기는 그것을 이해하는 여러분 자신의 능력인 공포 소설입니다. 이 책은 훌륭하고 독창적이며, SCP 재단이 21세기의 가장 중요한 문학 프로젝트 가운데 하나인 이유에 대해 제가 본 것 중 가장 설득력 있는 논거입니다. 이토록 훌륭한 소설이 공동 창작 위키 소설로 시작되었다는 사실 자체가 하나의 반밈적 현상입니다. 문학계가 그 본성상 진지하게 받아들이지 못하는 형식 속에, 걸작이 버젓이 눈앞에 숨어 있었던 것입니다. 이 책을 읽으십시오. 그리고 읽었다는 사실을 기억해 보십시오.
서평: 피라네시
수재나 클라크의 피라네시는 한 집에 사는 남자에 관한 책입니다. 그 집에는 대리석 홀이 무한히 많습니다. 바다의 조수가 아래층을 물에 잠기게 합니다. 위층에는 구름이 떠다닙니다. 가운데층 홀에는 수천 개의 조각상이 서 있습니다. 조각상은 하나하나가 모두 다르며, 신화 속 인물과 일상 속 인물, 그리고 그 사이의 온갖 모습을 담고 있습니다. 화자는 홀의 지도를 그리고, 조수를 기록하고, 물고기를 잡아 먹으며, 꼼꼼하게 일지를 씁니다. 그는 자신을 피라네시라고 부릅니다. 그는 온 세상에 살아 있는 사람이 자신을 포함해 단 두 명뿐이라고 믿습니다. 그는 행복합니다.
이 이야기가 동화처럼 들린다면, 실제로 읽어 보아도 동화처럼 읽힙니다. 문장은 소박하고 진지하며 반어가 전혀 없고, 박물학자의 현장 일지 같은 리듬으로 흘러갑니다. 피라네시는 대리석 현관을 뚫고 밀려드는 해일, 실내에서 생겨나는 구름, 아무도 찾아간 적 없는 홀에서 죽은 사람들의 유골처럼 놀라운 것들을 묘사합니다. 그 어조는 동네 새들의 이동 패턴을 기록하는 사람처럼 차분하고 정밀합니다. 그 효과는 최면과도 같습니다. 독자는 그의 관찰이 지닌 리듬에 젖어 들고, 그가 집을 보는 방식 그대로 집을 보기 시작합니다. 즉, 그 자체로 충분한, 완전하고 아름다운 세계로 보게 됩니다.
그리고 아주 서서히 발밑의 바닥이 꺼집니다.
클라크는 독자가 피라네시보다 먼저 그에게 무슨 일이 일어나고 있는지 깨닫도록 소설을 구성합니다. 독자는 그의 일지에 빈틈이 있다는 것을 알아챕니다. 독자는 무한한 대리석 미궁에 있어서는 안 될 것들(신발, 손목시계, “맨체스터“라는 단어)에 대한 언급을 포착합니다. 독자는 고고학자가 파편을 모아 항아리를 복원하듯, 조각들로부터 진짜 이야기를 맞춰 나가기 시작합니다. 극적 아이러니는 책 전체에 걸쳐 유지되며, 그 효과는 참담합니다. 피라네시의 순수함이 너무도 온전하고 진실하기에, 그것이 무너져 가는 모습을 지켜보는 일이 작은 범죄처럼 느껴지기 때문입니다.
이 소설을 움직이는 철학적 동력은 정체성과 기억에 관한 질문입니다. 피라네시는 진짜 이름과 진짜 과거, 진짜 지식을 빼앗겼습니다. 남은 것은 선하고, 호기심 많으며, 자신이 사는 세계에 세심한 주의를 기울이는 한 사람입니다. 클라크는 다른 사람의 폐허 위에 세워진 이 사람이 원래의 사람보다 덜 진짜인지를 묻습니다. 그녀의 답은 너그러우면서도 조용히 급진적입니다. 주의(어텐션)를 기울이고, 죽은 이들을 돌보며, 조각상의 아름다움에 감사를 느끼는 자아는 그 나름의 온전함을 지닌다는 것입니다. 이 사람을 만들어 낸 것은 기억 상실이지만, 이 사람은 진짜입니다.
물론 이 이름은 18세기 이탈리아 화가 조반니 바티스타 피라네시에게서 따온 것입니다. 그의 연작 「카르체리 디 인벤치오네(Carceri d’Invenzione)」(상상의 감옥)는 어디로도 이어지지 않는 계단과 아치로 가득 찬, 광대하고 불가능한 건축 공간을 묘사합니다. 이 에칭 판화들은 그 규모에도 불구하고 숨 막히는 폐쇄감을 줍니다. 무한한 공간이 감금으로 그려진 것입니다. 클라크는 이 「카르체리」를 가져와 사람이 살 수 있는 곳, 심지어 아름다운 곳으로 만들어 냅니다. 그녀의 화자는 집을 아름답다고 여기는데, 다른 어떤 것에 대한 기억도, 비교할 근거도 없으며, 따라서 불평할 근거도 없기 때문입니다. 갇힌 자가 사랑하는 감옥인 셈입니다. 이것은 이 소설에서 가장 조용하게 두려운 발상이며, 클라크는 이를 더없이 가벼운 손길로 다루면서 그 무게는 독자가 스스로 느끼도록 맡겨 둡니다.
피라네시를 특별하게 만드는 것이자 제가 이 책이 오래 남으리라고 생각하는 이유는, 이 책이 하나의 모델로 보여 주는 어텐션의 질입니다. 피라네시의 일지는 알아차림을 꾸준히 연습한 기록입니다. 그는 모든 조각상에 이름을 붙입니다. 그는 모든 조수의 흐름을 기록합니다. 그는 모든 유골을 기억합니다. 영리함과 아이러니, 서사적 기교가 넘쳐나는 문학 풍경 속에서, 클라크는 자신이 속한 세계에 어텐션을 기울이는 것, 그것도 진정으로, 애정을 담아 냉소 없이 기울이는 것 자체가 하나의 도덕적 행위라는 주장을 중심에 둔 책을 썼습니다. 이것은 현존(presence)이 그 자체로 근본적으로 충분하다는 것에 관한 책입니다. 평범한 무언가(건물 하나, 강둑 하나, 코드 한 조각)를 바라보다가 그것이 아름답고 그 아름다움이 중요하다는, 짧고도 겸연쩍은 확신에 사로잡힌 자신을 발견한 적이 있다면, 클라크는 바로 그 감정에 관한 소설을 쓴 것입니다.
이 책은 250쪽입니다. 하루면 다 읽을 것입니다. 조각상들에 대해서는 몇 주 동안 생각하게 될 것입니다. 클라크는 바로크풍 대체 역사를 800쪽에 걸쳐 펼쳐 낸 조나단 스트레인지와 마법사 노렐을 출간한 지 16년 만에 이 책을 내놓았습니다. 피라네시는 그 정반대입니다. 모든 것이 뼈대만 남도록 깎여 나갔고, 모든 문장이 하중을 떠받치고 있습니다. 조나단 스트레인지가 대성당이었다면, 피라네시는 완벽한 비례를 갖춘 방 하나입니다. 개인적으로 저는 그 방을 더 좋아합니다.
MLIR용 Python 프런트엔드
지난번에는 MLIR을 GPU 백엔드로 가져가서, 그 결과로 나온 코드를 실행하려면 무엇이 필요한지 살펴보았습니다. 이제는 컴파일러의 반대편 끝에 놓일 것이 필요합니다. 바로 Python으로 텐서 계산을 기술하고 그 백엔드들이 소비하는 IR을 구성하는 방법입니다.
이 부분은 MLIR의 Python 바인딩을 중심으로 구축하겠습니다. 이 바인딩은 지금까지 텍스트 형식으로 작성해 온 것과 같은 객체들, 즉 타입, 값, 연산, 영역, 블록을 노출합니다. Python 프로그램은 linalg.matmul 연산을 구성하고, 그 결과를 다른 연산에 전달하고, 그렇게 만들어진 모듈에 컴파일러 패스를 실행할 수 있습니다. 출력된 MLIR은 그 모듈을 살펴보는 한 가지 방법입니다.
함께 제공되는 프로젝트는 tiny-mlir입니다. 이 프로젝트에는 남은 장들에서 사용하는 전체 구현이 들어 있습니다. 저장소를 클론하고 환경을 설치하십시오.
git clone https://github.com/sdiehl/tiny-mlir.git
cd tiny-mlir
uv sync
uv run pytest
이 프로젝트는 Python 3.12와 특정 MLIR 22 개발 빌드를 고정해 두며, 여기에는 Python 바인딩과 실행 엔진이 포함됩니다. 이 예제들은 그 번들된 툴체인을 사용합니다. 앞선 장들에서 설치한 명령줄 LLVM은 별도로 두어도 됩니다. 그 라이브러리를 Python 환경에 섞을 필요는 없습니다.
컴파일할 함수
우리가 사용할 인터페이스는 다음과 같습니다.
import numpy as np
from tinymlir import jit

@jit
def scale_bias(x, bias):
    return x * 2.0 + bias

x = np.arange(8, dtype=np.float32)
bias = np.ones(8, dtype=np.float32)
print(scale_bias(x, bias))
첫 번째 호출은 인자의 형상과 dtype에 맞게 함수를 특수화하고, MLIR을 구성하고, 이를 하강시키고, 실행 엔진을 생성합니다. 이후 같은 타입으로 호출하면 그 특수화를 재사용합니다. x의 내용을 바꾸는 것은 컴파일을 요구하지 않습니다. 형상을 바꾸면 컴파일이 필요합니다.
이 함수는 memref 디스크립터나 실행 엔진에 대해 아무것도 알 필요가 없습니다. 함수는 텐서 표현식을 기술할 뿐입니다. 표현과 런타임 경계는 컴파일러가 맡습니다.
Python 트레이싱
프런트엔드를 만드는 합리적인 방법은 여러 가지가 있습니다. 6부에서는 Python 구문을 파싱하고 변환했습니다. 여기서는 트레이싱을 사용하겠습니다. 즉, 배열 대신 기호적 텐서 인자로 Python 함수를 호출합니다. 이 인자들의 산술 메서드가 표현식 노드를 구성합니다.
Python이 x * 2.0을 평가할 때, 우리 기호적 값의 __mul__ 메서드를 호출합니다. 덧셈을 평가할 때는 그 메서드가 곱셈 노드를 왼쪽 피연산자로 받습니다. 그 결과는 배열 원소를 하나도 읽지 않고 계산을 기술하는 그래프입니다.
이것은 작은 임베디드 언어입니다. 일반적인 Python 함수 호출은 트레이싱 중에 자연스럽게 합성됩니다. 정적 형상 정보를 순회하는 루프도 경계가 알려져 있으므로 트레이싱 중에 실행할 수 있습니다. 텐서 내용에 의존하는 분기는 그렇게 할 수 없습니다. 기호 값의 __bool__이 오류를 발생시키기 때문입니다. 임의의 Python을 컴파일하거나 Python 객체에 대한 변경을 포착하지는 않습니다.
우리의 타입은 특수화에 필요한 정보를 정확히 담고 있습니다.
@dataclass(frozen=True)
class TensorType:
    shape: tuple[int, ...]
    dtype: np.dtype
구현은 형상과 dtype을 정규화하고, 양수인 정적 차원을 요구하며, float32, float64, int32를 허용합니다. 정수 타입은 토큰 인덱스에 사용됩니다. 부동소수점 연산은 정밀도를 명시적으로 지닙니다.
각 표현식은 연산, 결과 타입, 피연산자, 그리고 정적 속성을 저장합니다.
@dataclass(eq=False)
class Expr:
    op: Op
    type: TensorType
    args: tuple[Expr, ...] = ()
    attr: object = None
Op는 프런트엔드와 빌더가 공유하는 열거형이므로 연산 이름은 한곳에서 정의됩니다. 이 노드들은 구조적 동등성이 아니라 동일성을 사용합니다. 계산에서 같은 노드를 재사용하면 로어링도 그 노드의 MLIR 값을 캐시해 두었다가 재사용합니다. 이후 MLIR의 공통 하위 표현식 제거 패스가 독립적으로 구성된 동등한 연산들을 식별할 수 있습니다.
코드 생성 이전의 형상
덧셈은 먼저 피연산자들이 브로드캐스트될 수 있는지 확인합니다. 형상 (3, 7)과 (7,)의 경우 결과의 형상은 (3, 7)입니다. (3, 7)과 (3, 1)의 경우에도 결과의 형상은 같습니다. (3, 7)과 (5,)의 경우 컴파일이 실패합니다.
프런트엔드는 또한 공통 dtype을 결정하고 필요할 때 명시적인 캐스트 노드를 삽입합니다. Python 숫자 리터럴은 주변 텐서의 dtype을 사용합니다. NumPy 스칼라 값은 자신의 dtype을 유지합니다. 이 구분은 NumPy GPT-2 구현을 재현할 때 중요해집니다. 해당 구현은 일부 공식에서 float64 값을 도입하기 때문입니다.
이 단계 이후에는 백엔드가 덧셈이 스칼라인지, 원소별인지, 브로드캐스트인지 추측할 필요가 없습니다. 피연산자 형상과 결과 형상이 필요한 인덱싱을 이미 기술하고 있습니다.
형상 특수화는 정적 정보를 런타임 데이터와 분리하는 유용한 사례입니다. 이는 6부의 부분 평가 개념과 관련이 있습니다. 타입과 정적 매개변수를 고정하고, 배열 내용은 컴파일된 프로그램의 입력으로 남겨 둡니다. 우리의 구현은 Python 인터프리터를 위한 범용 특수화기가 아니라 전용 텐서 컴파일러입니다.
모듈 구성하기
MLIR 바인딩은 컨텍스트, 모듈, 삽입 지점을 제공합니다.
from mlir import ir
from mlir.dialects import func

with ir.Context(), ir.Location.unknown():
    module = ir.Module.create()
    with ir.InsertionPoint(module.body):
        f32 = ir.F32Type.get()
        buffer = ir.MemRefType.get([8], f32)
        function = func.FuncOp("kernel", ([buffer, buffer], []))
        block = function.add_entry_block()
        with ir.InsertionPoint(block):
            func.ReturnOp([])
    module.operation.verify()
이것은 흥미롭지는 않지만 완전한 함수로, 두 개의 버퍼를 받고 아무것도 반환하지 않습니다. 컨텍스트는 타입과 같은 고유화된(uniqued) 객체를 소유합니다. 삽입 지점은 새로 생성된 연산이 어디에 들어갈지를 결정합니다. 블록은 자신의 인자와 연산을 소유합니다. 이러한 관계 덕분에 바인딩은 프로그램을 구성하는 동안 객체들이 서로 어떻게 맞물리는지 검사할 수 있습니다.
실제 빌더는 각 입력마다 memref 인자를 하나씩 만들고, 호출자의 출력 버퍼를 위한 memref 인자도 하나 만듭니다. 빌더는 bufferization.to_tensor로 입력을 텐서 값으로 변환하고, 텐서 위에서 계산을 구성한 뒤, bufferization.materialize_in_destination으로 마무리합니다. 후자는 결과가 호출자가 제공한 출력 버퍼에 최종적으로 담겨야 한다는 것을 나타냅니다.
이 경계 덕분에 외부 호출 규약은 단순하게 유지되면서도 본문은 함수형 텐서 계산으로 남을 수 있습니다. 어떤 내부 텐서에 저장 공간이 필요하고 어떤 버퍼를 재사용할 수 있는지는 버퍼화가 결정합니다.
원소별 영역
원소별 표현식은 linalg.generic이 됩니다. 빌더는 입력 값, 빈 목적지 텐서, 인덱싱 맵, 반복자 타입을 제공합니다. 그런 다음 연산의 영역을 만들고 스칼라 계산을 채워 넣습니다:
op = linalg.GenericOp(
    [output.type], inputs, [output], indexing_maps,
    ["parallel"] * rank,
)
block = op.regions[0].blocks.append(
    *(value.type.element_type for value in [*inputs, output])
)
with ir.InsertionPoint(block):
    product = arith.MulFOp(block.arguments[0], block.arguments[1])
    linalg.YieldOp([product.result])
이 코드 조각은 빌더 안의 곱셈 경우입니다. output, inputs, 맵, 랭크는 타입이 지정된 표현식에서 가져옵니다. 영역 인자는 스칼라 원소이므로, 그 본문은 두 개의 부동소수점 수를 곱하여 하나의 부동소수점 수를 산출합니다. 이를 감싸는 linalg.generic은 그 스칼라 연산이 텐서 전체에 걸쳐 어떻게 적용되는지를 기술합니다.
브로드캐스팅은 인덱싱 맵에서 다룹니다. 행렬에 행 벡터를 더하는 경우, 그 맵은 다음과 같습니다:
matrix: (i, j) -> (i, j)
vector: (i, j) -> (j)
output: (i, j) -> (i, j)
일곱 개의 열에 걸쳐 브로드캐스트되는 (3, 1) 텐서의 경우, 그 맵은 (i, j) -> (i, 0)이 됩니다. 스칼라 텐서는 빈 인덱스 목록을 가집니다. 이 맵들은 AffineDimExpr, AffineConstantExpr, AffineMap을 사용하여 구성하며, 텍스트 형식의 아핀 표현식 파서는 전혀 관여하지 않습니다.
스칼라 영역과 그 반복 공간을 구분하는 것이 바로 우리가 최적화기에게 보여 주고자 하는 구조입니다. 최적화기는 루프 스케줄을 확정하기 전에 맵과 영역을 합성하여 원소별 연산들을 융합할 수 있습니다.
합성
헬퍼 함수는 단지 같은 그래프를 더 많이 구성할 뿐입니다:
from tinymlir import tanh


def activation(x):
    return 0.5 * x * (1 + tanh(x))


@jit
def activated_scale(x, bias):
    return activation(x * 2.0 + bias)
컴파일러에는 특별한 activated_scale 커널이 없습니다. activation도 별도의 백엔드 구현이 필요하지 않습니다. 컴파일러에 필요한 것은 구성 요소가 되는 텐서 연산들에 대한 규칙뿐입니다. 공식을 바꾸면 그래프와 생성된 모듈도 함께 바뀝니다.
중첩된 @jit 함수 호출도 트레이싱 중에는 같은 방식으로 동작합니다. 인수가 심볼릭 값이면, 호출은 둘러싼 그래프에 표현식을 추가합니다. 인수가 배열이면, 컴파일된 특수화를 선택하여 실행합니다.
NumPy 호출
연산자 오버로딩으로 x * 2.0 + bias는 처리할 수 있지만, NumPy 코드는 np.sqrt, np.tanh, np.mean, np.split 같은 함수도 호출합니다. 심볼릭 값은 두 가지 NumPy 디스패치 프로토콜을 구현하므로 이러한 호출도 트레이싱됩니다. __array_ufunc__는 원소별 유니버설 함수를 처리하므로, 트레이싱된 값에 대한 np.tanh(x)는 우리가 만든 tanh(x)와 같은 노드를 만듭니다. __array_function__는 mean, var, sum, max, split, reshape, transpose로 이루어진 짧은 배열 함수 표를 처리합니다. NumPy는 인수 중 하나라도 우리 타입이면 이 메서드들을 호출합니다.
@jit
def normalize(x):
    centered = x - np.mean(x, axis=-1, keepdims=True)
    return centered / np.sqrt(np.var(x, axis=-1, keepdims=True) + 1e-5)
이것은 평범한 NumPy 코드입니다. 배열에 대해 호출하면 NumPy에서 실행되고, JIT를 통해 호출하면 그래프로 트레이싱됩니다. 표에 없는 함수는 NotImplemented를 반환하며, NumPy는 우리가 컴파일할 수 없는 것을 조용히 평가하는 대신 TypeError를 발생시킵니다. 덕분에 14부에서는 참조 GPT-2 구현을 우리 라이브러리에 맞게 다시 작성하지 않고도 트레이싱할 수 있습니다.
트레이싱되는 함수는 마스크나 Python에서 만든 표처럼 바깥 스코프에 있는 배열을 사용할 수도 있습니다. 이렇게 캡처된 NumPy 배열은 상수 노드가 됩니다. JIT는 배열의 내용을 IR에 임베딩하는 대신, 캡처된 각 배열을 컴파일된 함수의 뒤쪽 인수로 끌어올려 매 호출마다 전달합니다. 특수화는 배열의 값이 아니라 shape과 dtype에 따라 달라집니다.
결과 살펴보기
컴파일된 객체는 세 개의 모듈을 보관합니다.
compiled = scale_bias.compile(x, bias)
print(compiled.module)
print(compiled.optimized)
print(compiled.lowered)
첫 번째 모듈에는 빌더가 생성한 텐서 프로그램이 들어 있습니다. 두 번째는 정규화, 공통 하위 표현식 제거, 원소별 융합을 거친 결과를 보여 줍니다. 세 번째 모듈에는 실행 엔진이 사용하는 LLVM 다이얼렉트 프로그램이 들어 있습니다. 이들은 별개의 모듈 객체이므로, 패스를 실행해도 우리가 살펴보려는 버전이 망가지지 않습니다.
런타임은 출력 배열을 할당하고, 인수에 대한 ranked memref 디스크립터를 구성한 다음, 생성된 C 인터페이스를 호출합니다. 컴파일된 객체는 자신의 컨텍스트와 실행 엔진을 계속 살려 둡니다. 컴파일이 실패하더라도 NumPy 실행으로 대체하는 폴백은 없습니다.
이로써 작은 컴파일러의 윤곽이 갖추어집니다. 제한된 Python 계산을 트레이싱하고, 텐서 타입을 검사하고, 구조화된 MLIR을 구성하고, 변환을 실행한 뒤, 로워링된 결과를 실행합니다. 다음으로는 소프트맥스와 레이어 정규화에 필요한 리덕션을 추가하겠습니다.
외부 자료
이전: 8부 - MLIR을 이용한 GPU 컴파일 · 시리즈 목차 · 다음: 10부 - 트랜스포머 커널 컴파일
정형 기법을 통한 최적의 Caverna 플레이
저는 Caverna(Uwe Rosenberg의 고전적인 유럽식 일꾼 놓기 테이블탑 보드게임)에서 항상 이깁니다. 항상 말입니다. 하지만 “항상“이라는 말은 “지금까지는 매번“이라는 뜻일 뿐이므로, 저에게는 수학적으로 더 영속적인 무언가가 필요했습니다. 그래서 저는 게임 전체를 Lean 4로 형식화했고, 가능한 모든 게임 구성에서 제 전략이 유일한 약우월 순수 전략임을 증명했습니다. 제 친구들은 이것이 지나치다고 생각합니다. 제 친구들은 Caverna에서도 집니다. 이와는 관계없는 이야기이지만, 저는 요즘 보드게임 모임에 별로 초대받지 못합니다.
Caverna: The Cave Farmers는 Agricola의 2013년 후속작으로, 동굴에 살면서 수상할 정도로 농사를 많이 짓는 드워프들을 먹여 살리는 게임입니다. 일꾼을 놓고, 자원을 모으고, 동물을 번식시키고, 동굴을 파고, 방에 설비를 들이고 나면, 12라운드가 끝날 때 점수 공식이 여러분이 이룬 모든 것과 이루지 못한 모든 것을 합산합니다. 좋은 게임입니다. 또한 2인 변형 규칙에서는 이산적인 단계를 가진 유한하고 결정론적인 완전 정보 시스템이기도 합니다. 이는 곧 레이블 전이 시스템이라는 뜻이고, 이는 곧 형식 검증이 가능하다는 뜻입니다. 그래서 저는 그렇게 했습니다.
여기에는 아주 작은 수학적 모델이 있습니다. 우리는 두 가지만 정의합니다. 하나는 시작 상태를 기술하는 init 술어이고, 다른 하나는 상태에서 상태로 가는 모든 합법적인 수를 기술하는 trans 관계입니다. 그런 다음 게임을 실행하는 대신 구조적 귀납법으로 게임의 성질을 증명합니다. 그 성질이 시작 시점에 성립함을 보이고, 모든 합법적인 전이가 그 성질을 보존함을 보이면, 게임을 하나도 열거하지 않고도 가능한 모든 게임을 다룬 것이 됩니다. 이는 하드웨어 검증과 프로토콜 증명에 쓰이는 것과 같은 기법을 보드게임에 적용한 것입니다.
이 프로젝트는 19개의 모듈에 걸친 약 3,000줄의 Lean 4 코드로 이루어져 있습니다. 게임 전체를 모델링하는 정의 파일 11개(24개의 행동 칸 전부, 48개의 고유한 가구 타일 전부, 원정 전리품 시스템, 보드 기하 구조, 수확 일정, 점수 계산 공식)와 기계로 검증된 증명 176개를 담은 정리 파일 8개입니다. 이 모델은 가능한 2,880가지의 2인 게임 설정(카드 순서 144가지 곱하기 수확 마커 배치 20가지)을 모두 다룹니다.
주요 결과는 설비 러시가 약우월 전략이라는 것입니다. 어떤 카드가 언제 나오든, 수확 마커가 어디에 놓이든 상관없이, 모든 설정에서 모든 상대에 대한 최적 대응입니다.
대화형 증명 청사진에는 모든 정리가 어떻게 연결되는지 보여 주는 의존성 그래프와 함께 전체 유도 과정이 담겨 있습니다. 소스 코드는 컴파일됩니다.
레이블 전이 시스템
레이블 전이 시스템(LTS)은 세 쌍 입니다. 여기서 는 상태의 집합이고, 는 행동의 집합이며, 는 어떤 상태 변화가 합법적인지를 지정하는 전이 관계입니다. init 술어를 만족하는 어떤 초기 상태에서 시작합니다. 시스템은 행동을 취하면서 진행됩니다. 이면 행동 를 수행하여 상태 에서 상태 로 이동할 수 있습니다. 초기 상태에서 어떤 상태까지 이어지는 유한한 전이의 사슬이 있으면 그 상태는 도달 가능합니다. 어떤 성질이 도달 가능한 모든 상태에서 성립하면 그 성질은 불변식입니다.
Lean 4에서 LTS는 세 개의 필드로 이루어집니다:
structure LTS (State : Type) (Action : Type) where
  init : State -> Prop
  trans : State -> Action -> State -> Prop
도달 가능성은 두 개의 생성자를 가진 귀납 타입입니다. 초기 상태는 도달 가능하며, 에 도달할 수 있고 행동 를 취해 에 갈 수 있다면 도 도달 가능합니다:
inductive Reachable (sys : LTS State Action) : State -> Prop where
  | init : forall s, sys.init s -> Reachable sys s
  | step : forall s a s', Reachable sys s -> sys.trans s a s' -> Reachable sys s'
쉽게 말하면, LTS는 상태 전이 관계로 인코딩된 규칙서입니다. init은 시작 보드가 어떤 모습인지를 나타내고, trans는 모든 합법적인 수를 상태 간 제약으로 인코딩합니다. Caverna 규칙서 전체가 약 250줄의 Lean 코드에 들어갑니다. 24개의 행동 칸 전부와 그 효과를 매칭하는 160줄짜리 applyPlacement 함수, 그리고 페이즈 전이, 수확 로직, 라운드 진행을 연결하는 90줄짜리 cavernaLTS 정의로 구성됩니다. 이것이 함수가 아니라 관계인 이유는 Caverna에서 행동 안에 하위 선택(곡식 파종 대 채소 파종, 어떤 가구 타일을 설치할지, 어떤 전리품을 가져갈지)이 있어서, 하나의 행동 칸 배치가 여러 후속 상태로 이어질 수 있기 때문입니다. 관계는 그 모든 상태를 포착합니다.
init과 trans가 있으면, 도달 가능한 모든 상태를 열거하지 않고도 어떤 속성이 그 모든 상태에서 성립함을 증명할 수 있습니다. 기저 사례(초기 상태에서 성립함)와 귀납 단계(모든 유효한 전이가 그 속성을 보존함)를 증명하면 됩니다. 이는 테스트보다 엄밀하게 더 강력합니다. 테스트는 특정한 플레이 순서를 확인합니다. 불변식 증명은 모든 설정에 걸쳐 합법적인 수의 모든 순서를 다루며, 사람이라면 결코 두지 않을 순서까지 포함합니다.
한 라운드의 플레이가 상태 기계로서 어떻게 동작하는지 감을 잡을 수 있도록 Caverna LTS의 작은 일부를 보여 드리겠습니다.
각 상태는 플레이어의 자원과 배치할 남은 드워프를 기록합니다. 전이는 행동 칸 선택에 대응합니다. 초기 행동 칸 13개와 드워프 2명만으로도 단 한 라운드에서 가지 배치 순서가 생깁니다. 가족이 늘어나는 12라운드에 걸치면 분기 계수는 천문학적이지만, LTS는 개의치 않습니다. 구조는 유한하며, 그 안의 모든 경로는 불변식 증명으로 다뤄집니다.
전이 관계로서의 게임
보드게임은 자연스러운 LTS 후보입니다. 2인용 Caverna에서 상태는 완전한 게임 구성(라운드 번호, 페이즈, 두 플레이어의 인벤토리, 보드 배치, 사용 가능한 행동 칸)이고, 행동은 드워프 배치와 수확 이벤트이며, 전이 관계는 규칙서를 인코딩합니다.
게임에는 각 라운드 안에서 순환하는 다섯 개의 페이즈가 있습니다.
inductive Phase where
  | placeP1      -- player 1 places a dwarf
  | placeP2      -- player 2 places a dwarf
  | harvest      -- harvest phase (feeding, breeding, fields)
  | roundEnd     -- round cleanup, advance to next round
  | gameOver     -- game has ended
전체 게임 상태는 두 플레이어가 가질 수 있는 모든 것과 보드의 전역 상태를 추적합니다.
structure GState where
  round : Nat
  phase : Phase
  p1 : FullPlayer
  p2 : FullPlayer
  p1IsFirst : Bool
  placementsLeft : Nat
  acc : AccState
  occupiedSpaces : List ActionSpaceId := []
  harvestSchedule : Nat -> HarvestEvent
  wishIsUrgent : Bool := false
전이 관계는 (gs.phase, act)에 대한 match를 가진 하나의 함수입니다. 각 경우는 하나의 게임 규칙입니다. 다음은 플레이어 1의 배치 로직 중 Core 부분입니다:
def cavernaLTS (schedule : Nat -> HarvestEvent) :
    TransitionSystem.LTS GState GameAction where
  init := fun gs => gs = initFullGState schedule
  trans := fun gs act gs' =>
    match gs.phase, act with
    | .placeP1, .place space choice =>
      spaceAvailable gs.round space = true /\
      spaceUnoccupied gs space = true /\
      gs.placementsLeft > 0 /\
      (let (p1', acc') := applyPlacement gs.p1 gs space choice
       let newPlacements := gs.placementsLeft - 1
       let newOccupied := space :: gs.occupiedSpaces
       if newPlacements == 0 then
         gs' = { gs with p1 := p1', acc := acc',
                         phase := .harvest, placementsLeft := 0,
                         occupiedSpaces := newOccupied }
       else
         gs' = { gs with p1 := p1', acc := acc',
                         phase := .placeP2,
                         placementsLeft := newPlacements,
                         occupiedSpaces := newOccupied })
    -- ... Player 2, harvest, round end, game over ...
    | _, _ => False
마지막 줄이 아름답습니다. | _, _ => False는 명시적으로 나열되지 않은 모든 행동이 불법이라는 뜻입니다. 전이 관계는 닫혀 있습니다. 정의되지 않은 동작도, 엣지 케이스도, “규칙에 하면 안 된다고는 안 쓰여 있다“는 주장도 없습니다. match에 없으면 일어나지 않습니다.
applyPlacement 함수는 24개의 행동 칸 전부에 대한 250줄짜리 match이며, 각각은 규칙서에 나온 정확한 효과를 인코딩합니다. 대장간 일은 광석으로 무기를 벼리고 원정을 떠납니다. 자녀 소망은 수용 공간이 있는 주거지가 있을 때만 가족을 늘릴 수 있습니다. 굴착은 돌을 주고 동굴/터널 쌍을 파낼 수 있게 해 줍니다. 모든 하위 선택(곡식 파종 대 채소 파종, 작은 목초지 대 큰 목초지 건설, 어떤 가구 타일을 설치할지)은 ActionChoice 타입의 한 분기입니다.
게임 타임라인
총 12라운드입니다. 초록색 노드는 드워프를 먹여야 하는 수확 라운드입니다. 중요한 분기점은 두 가지입니다. 4라운드의 “Wish for Children“으로 첫 번째 가족 성장(드워프 2명에서 3명으로)이 가능해지고, 8라운드의 “Family Life“로 두 번째 성장(3명에서 최종적으로 5명까지)이 가능해집니다. 매 라운드 새로운 행동 칸이 하나씩 공개되어, 선택할 수 있는 행동이 13개에서 24개로 늘어납니다. 카드가 공개되는 시점과 수확이 닥치는 시점 사이의 상호작용이 전체 전략 분석을 움직이는 시계입니다.
타임라인이 중요한 이유는 다음과 같습니다. 성장 없이는 12라운드 전체에 걸쳐 드워프를 총 44번 배치합니다. 4라운드에 한 번 성장하면 47번이 됩니다. 두 번 모두 성장하면 56번이 됩니다. 가족을 최대한 빨리 늘리면 전체 행동 횟수가 27% 증가하는 셈이며, 행동은 다른 모든 것(점수, 식량, 자원)을 묶는 제약 조건이므로 “성장 없음“과 “두 번 모두 성장” 사이의 12번의 배치 차이는 이 게임에서 가장 중요한 단일 전략 지렛대입니다.
정제 타입: 불법적인 상태를 표현할 수 없게 만들기
이 형식화에서 가장 만족스러운 패턴 중 하나는 의존 타입을 사용해 불법적인 게임 상태를 아예 구성할 수 없게 만드는 것입니다. 무기가 가장 명확한 예입니다. 실제 게임에서 무기 강도는 1부터 14까지입니다. 이를 그냥 Nat으로 모델링하고 아무도 0이나 15를 넘기지 않기를 바랄 수도 있습니다. 아니면 타입 시스템이 제약 조건을 강제하도록 만들 수도 있습니다.
structure Weapon where
  strength : Nat
  h__min : strength >= 1
  h__max : strength <= 14
모든 Weapon 값은 강도가 범위 안에 있다는 증명을 지니고 있습니다. 즉 forgeWeapon은 단조한 강도가 유효하다는 증거를 만들어 내야 하고, upgradeWeapon은 값을 증가시켜도 범위 안에 머문다는 것을 보여야 합니다.
def forgeWeapon (oreSpent : Nat) (h__pos : oreSpent >= 1) : Option Weapon :=
  if h : oreSpent <= maxInitialWeaponStrength then
    some { strength := oreSpent
         , h__min := h__pos
         , h__max := by simp [maxInitialWeaponStrength] at h; omega }
  else
    none

def upgradeWeapon (w : Weapon) : Weapon :=
  if h : w.strength < maxWeaponStrength then
    { strength := w.strength + 1
    , h__min := by omega
    , h__max := by simp [maxWeaponStrength] at h; omega }
  else
    w
by omega 호출은 Lean의 선형 산술 전술로, 증명 의무를 자동으로 해소합니다. w.strength < 14이면 w.strength + 1 <= 14입니다. oreSpent >= 1이면 strength >= 1입니다. 타입 검사기는 이를 컴파일 시점에 검증합니다. 전체 형식화에서 어떤 무기도 강도 0이나 15를 가질 수 없습니다.
같은 패턴이 RoundPlacements에도 나타나는데, 이 타입은 한 라운드 안에서 네 번의 드워프 배치가 모두 서로 다른 행동 칸으로 간다는 증명을 지니고 있습니다.
structure RoundPlacements where
  firstPlayer1  : ActionSpaceId
  secondPlayer1 : ActionSpaceId
  firstPlayer2  : ActionSpaceId
  secondPlayer2 : ActionSpaceId
  h__distinct12 : firstPlayer1 != secondPlayer1
  h__distinct13 : firstPlayer1 != firstPlayer2
  h__distinct14 : firstPlayer1 != secondPlayer2
  h__distinct23 : secondPlayer1 != firstPlayer2
  h__distinct24 : secondPlayer1 != secondPlayer2
  h__distinct34 : firstPlayer2 != secondPlayer2
각 쌍마다 하나씩, 총 여섯 개의 서로 다름 증명이 있습니다. 두 드워프가 같은 행동 칸을 공유하는 RoundPlacements는 말 그대로 구성할 수 없습니다. 게임 규칙이 타입 안에 녹아 있는 것입니다.
무기 시스템
무기는 강도 1부터 8까지로 제련되며(강도만큼의 광석이 소모됩니다), 이후 원정마다 +1씩 성장하여 최대 14에 이릅니다. 파란색 구간은 제련으로 도달할 수 있고, 복숭아색 구간은 원정을 반복해야만 도달할 수 있습니다. 소 전리품은 강도 9에서 해금되므로, 최대치(광석 8개)로 제련하더라도 소를 얻으려면 최소 한 번은 원정을 떠나야 합니다.
전리품 표는 각 항목마다 최소 강도 요구 조건이 있는 귀납적 타입입니다:
def LootItem.minStrength : LootItem -> Nat
  | .allWeaponsPlus1    => 1
  | .dog                => 1
  | .wood               => 1
  | .grain              => 2
  | .sheep              => 2
  | .stone              => 3
  | .donkey             => 3
  | .ore                => 4
  | .wildBoar           => 4
  | .stableFree         => 5
  | .gold2              => 6
  | .furnishCavern      => 7
  | .buildFencesCheap   => 8
  | .cattle             => 9
  | .dwelling           => 10
  | .sow                => 11
  | .breedTwoTypes      => 12
  | .furnishCavernAgain => 14
강도 1에서는 개나 막대기를 전리품으로 얻을 수 있습니다. 강도 14에서는 두 번째 동굴에 무료로 시설을 놓을 수 있습니다. 주요 강도별 전리품 개수는 강도 1에서 3개, 강도 8에서 13개, 강도 14에서 18개입니다. 즉, 5개의 고급 항목(소, 주거지, 파종, 번식, 두 번째 시설)이 원정 반복의 벽 뒤에 잠겨 있습니다. 광석 투자가 그만한 가치가 있는지가 무기 러시 아키타입의 Core 질문이며, 답은 결국 “아니요, 그렇지는 않습니다“로 밝혀집니다.
보편적 식량 위기
Caverna의 모든 전략은 무엇보다 먼저 같은 문제를 해결해야 합니다. 두 플레이어 모두 첫 수확 때 식량 부족에 직면합니다:
플레이어 1은 음식 1개로 시작하며 4개가 필요합니다(드워프 2명 곱하기 각 음식 2개). 플레이어 2는 식량 2개로 시작하며 4개가 필요합니다. 부족분은 각각 3과 2입니다. 이는 universal__food__crisis로 증명됩니다:
theorem universal_food_crisis :
    feedingCost 2 0 - startingFoodP1 = 3 /\
    feedingCost 2 0 - startingFoodP2 = 2 := by decide
그 함의(food__crisis__shapes__all__strategies)는 실행 가능한 모든 전략 유형이 처음 몇 번의 행동을 식량 확보에 써야 한다는 것입니다. “먹이기를 건너뛰고 곧장 득점으로 가는” 선택지는 없습니다. 구걸 토큰의 벌점은 개당 점이며, 정리 absolute__floor__is__neg55는 모든 라운드에 걸쳐 행동을 하나도 하지 않은 플레이어가 점을 얻는다는 것을 보여 줍니다. 식량 위기는 선택 사항이 아니라 구조적인 것입니다.
식량 변환 네트워크 자체는 교환 비율이 유쾌하게 뒤엉킨 덩어리입니다. 소는 마리당 식량 4개, 멧돼지는 3개, 양은 2개, 곡물은 1개, 채소는 2개를 주며, 금은 의 손실 비율로 변환되고(금 1개가 부대 비용으로 낭비됩니다), 루비는 개당 2개 이상의 비상 식량이 됩니다. 그리고 당나귀가 있는데, 당나귀에는 초선형적인 짝 보너스가 있어서 이를 형식화하는 데 민망할 만큼 많은 시간을 들였습니다:
def donkeyFoodValue (n : Nat) : Nat :=
  let pairs := n / 2
  let remainder := n % 2
  pairs * 3 + remainder * 1

theorem donkey__superlinear :
    donkeyFoodValue 2 > donkeyFoodValue 1 + donkeyFoodValue 1 := by decide
당나귀 두 마리를 함께 쓰면 식량 3개가 나오지만, 따로 쓰면 1 + 1 = 2개가 나옵니다. 전체가 부분의 합보다 큽니다. Uwe Rosenberg는 거의 확실히 이것을 집합 함수의 초가법성(super-additivity) 성질로 생각하지는 않았겠지만, 실제로 그것이 맞으며 Lean은 이를 증명할 수 있습니다.
먹이기 연쇄
식량 공급 함수는 생존의 Core 메커니즘입니다. 수확이 닥치면 드워프는 각각 음식 2개를 먹습니다(자녀는 1개를 먹습니다). 식량이 충분하지 않으면 부족분이 자원을 따라 연쇄적으로 처리됩니다. 먼저 식량을 쓰고, 다음으로 곡물을 변환하고(개당 식량 1개), 그다음 채소를 변환하고(개당 식량 2개), 그래도 남는 부족분에 대해서는 구걸 토큰을 받습니다.
def FullPlayer.feed (p : FullPlayer) : FullPlayer :=
  let cost := p.dwarfs * 2 + p.offspring * 1
  if p.food >= cost then
    { p with food := p.food - cost }
  else
    let deficit := cost - p.food
    let p' := { p with food := 0 }
    let grainUsed := min p'.grain deficit
    let p'' := { p' with grain := p'.grain - grainUsed }
    let deficit' := deficit - grainUsed
    let vegUsed := min p''.vegetables (deficit' / 2 + deficit' % 2)
    let vegFood := min (vegUsed * 2) deficit'
    let p''' := { p'' with vegetables := p''.vegetables - vegUsed }
    let deficit'' := deficit' - vegFood
    { p''' with beggingMarkers := p'''.beggingMarkers + deficit'' }
그리고 일반적인 수확은 세 단계를 하나의 우아한 파이프라인으로 합성한 것입니다:
def FullPlayer.normalHarvest (p : FullPlayer) : FullPlayer :=
  p.fieldPhase.feed.breedingPhase
필드 단계에서는 씨를 뿌린 작물을 수확합니다. 먹이기 단계에서는 식량 비용을 지불합니다(또는 구걸 마커가 생깁니다). 번식 단계에서는 두 마리 이상 있는 동물 종류마다 한 마리씩 추가합니다. 순서가 중요합니다. 필드는 먹이기 전에 식량을 생산하고 번식은 그 뒤에 일어나므로, 새로 태어난 동물은 태어난 라운드에 먹이를 줄 필요가 없습니다. Caverna 규칙서 6쪽에 나오는 이 순서 규칙은 함수 합성에 인코딩되어 있습니다.
가구 타일과 BonusContext
게임에는 가구 타일이 48개 있으며, 각 타일에는 자원 비용과 기본 승점이 있고, (일부 타일에는) 최종 보드 상태에 따라 달라지는 게임 종료 보너스 점수 공식이 있습니다. BonusContext 구조체는 가구 타일이 보너스를 계산할 때 살펴볼 수 있는 모든 것을 담습니다.
structure BonusContext where
  stoneInSupply        : Nat := 0
  oreInSupply          : Nat := 0
  sheepCount           : Nat := 0
  cattleCount          : Nat := 0
  numAdjacentDwellings : Nat := 0
  numArmedDwarfs       : Nat := 0
  numDwarfs            : Nat := 0
  rubyCount            : Nat := 0
  grainCount           : Nat := 0
  vegCount             : Nat := 0
  farmAnimalCount      : Nat := 0
  hasAnyWeapon         : Bool := false
  allDwarfsArmed       : Bool := false
  numYellowTagTiles    : Nat := 0
보너스 점수 함수는 타일 ID에 대한 match로, Caverna 부록에 나오는 모든 점수 공식을 구현합니다.
def furnishingBonusPoints (fid : FurnishingId) (ctx : BonusContext) : Nat :=
  match fid with
  | .stoneStorage   => ctx.stoneInSupply
  | .oreStorage     => ctx.oreInSupply / 2
  | .weavingParlor  => ctx.sheepCount / 2
  | .milkingParlor  => ctx.cattleCount
  | .stateParlor    => ctx.numAdjacentDwellings * 4
  | .mainStorage    => ctx.numYellowTagTiles * 2
  | .weaponStorage  => ctx.numArmedDwarfs * 3
  | .suppliesStorage => if ctx.allDwarfsArmed then 8 else 0
  | .broomChamber   => if ctx.numDwarfs >= 6 then 10
                        else if ctx.numDwarfs >= 5 then 5
                        else 0
  | .prayerChamber  => if ctx.hasAnyWeapon then 0 else 8
  | _ => 0
기도실은 특히 고약합니다. 기도실은 공짜로 8점을 주지만, 무기를 가진 드워프가 하나도 없을 때만 그렇습니다. 무기를 하나라도 벼리는 순간 점수는 0으로 떨어집니다. 이 때문에 진짜 전략적 딜레마가 생기며, 이를 형식화하고 증명하면 다음과 같습니다.
theorem prayer__chamber__vs__weapons :
    furnishingBonusPoints .prayerChamber {} = 8 /\
    furnishingBonusPoints .prayerChamber { hasAnyWeapon := true } = 0 :=
  by constructor <;> native_decide
가구 러시 아키타입의 힘은 서로 잘 맞는 보너스 타일을 쌓는 데서 나옵니다. 사무실의 돌출 보너스, 인접한 주거지마다 +4(최대 +16)를 주는 귀빈실, 드워프 수에 따라 +5 또는 +10을 주는 빗자루 창고, +8을 주는 기도실(무기 없음)이 그 예입니다. 이 보너스들은 서로 누적됩니다. 드워프 5명, 인접한 주거지 4개, 무기 없음인 플레이어는 타일 세 개로 보너스 점수 +39점을 얻을 수 있습니다. 가구 러시의 상한선이 가장 높은 이유가 여기에 있습니다.
전략 공간
LTS, 점수 함수, 식량 경제가 갖춰졌으니 다음 질문은 이것입니다. 플레이어가 실제로 따를 수 있는 상위 수준의 계획에는 어떤 것이 있습니까? 전이 관계는 대략 가지의 플레이 순서를 정의하지만, 그중 압도적 다수는 말이 되지 않습니다. 1라운드에 (귀한 광석을 써서) 무기를 벼리고도 원정은 한 번도 나가지 않고, 3라운드에 밭에 씨를 뿌리고도 곡식을 한 번도 거두지 않고, 5라운드에 목초지를 만들고도 동물을 한 마리도 들이지 않고, 8라운드에는 아무 이유 없이 시작 플레이어를 가져가는 플레이어를 생각해 봅시다. 이 플레이어는 한 번도 쓰지 않은 무기, 텅 빈 목초지, 곡식이 썩어 가는 밭을 남기고, 구걸 벌점을 빼면 최종 점수가 20점 안팎인 채로 게임을 끝냅니다. LTS는 이 경로도 포함합니다. 불변식 증명도 이 경로에서 성립합니다. 이것은 규칙상 허용되는 플레이 순서이며, 동시에 다섯 살 아이가 행동 칸을 무작위로 골랐을 때 나올 법한 바로 그런 플레이 순서이기도 합니다.
상태 공간의 대부분은 이런 모습입니다. 플레이어가 모든 것에 조금씩 손대면서 어느 것에도 전념하지 않는, 흩어지고 방향 없는 경로들로, 끝내 점수로 바뀌지 않는 자원을 쌓으며 템포와 식량을 줄줄 흘립니다. 행동 칸 그래프를 지나는 일관된 “채널” 몇 개만이 합리적인 상대를 상대로 경쟁력 있는 점수에 이릅니다. 전략 아키타입은 12라운드 게임 전체에 걸쳐 행동 칸을 일관되게 사용하는 패턴입니다. 저는 어떤 행동 칸과 가구 타일이 자연스럽게 함께 묶이는지 살펴서 여덟 가지를 찾아냈습니다. 두 행동이 같은 자원을 두고 경쟁하거나 같은 점수 범주를 열어 준다면, 두 행동은 같은 아키타입에 속합니다. 예를 들어 대장간, 원정, 무기에 의존하는 전리품은 모두 무기 러시 묶음을 이루고, 굴착, 집안일, 보너스 점수를 주는 가구는 가구 러시 묶음을 이룹니다. 분류는 수작업으로 했지만, Lean 증명이 이를 검증합니다. 모든 아키타입의 점수 추정치는 형식화된 게임 규칙에서 도출되며, 지배 관계는 그 결과로 나온 보수 행렬 위에서 기계로 검사됩니다.
inductive StrategyArchetype where
  | furnishingRush
  | weaponRush
  | animalHusbandry
  | miningHeavy
  | balanced
  | peacefulFarming
  | rubyEconomy
  | peacefulCaveEngine
그렇다면 왜 하필 여덟 가지일까요? 그 답은 게임의 득점 채널 구조에 있습니다. 득점 채널이란 행동 칸을 거쳐 자원을 점수로 바꾸는 경로입니다. 가구 채널은 발굴(Excavation)과 가사(Housework)를 거쳐 가구가 놓인 동굴로 이어지고, 무기 채널은 대장장이(Blacksmithing)를 거쳐 원정과 전리품으로 이어지는 식입니다. 득점 채널은 정확히 여섯 가지입니다.
inductive ScoringChannel where
  | furnishing        -- Excavation + Housework -> caverns -> furnishing tiles
  | weaponExpedition  -- Blacksmithing + Adventure -> weapons -> loot
  | agriculture       -- Clearing + Sustenance -> fields -> crops
  | animalBreeding    -- Sheep Farming + Donkey Farming -> pastures -> animals
  | mining            -- Ore/Ruby Mine Construction -> mines
  | economy           -- Starting Player + Ore Trading + Ruby Mining -> gold/rubies
각 아키타입은 하나의 주 채널에 집중하며, 여덟 가지 아키타입이 여섯 채널을 모두 포괄합니다(all__channels__covered). 일부 채널은 공유 자원을 두고 충돌합니다. 무기/원정 채널과 채광 채널은 모두 광석이 필요하고, 가구 채널과 채광 채널은 모두 돌이 필요합니다. channelsConflict 함수는 이러한 긴장 관계를 표현합니다. 한 게임에서 생산적인 행동은 47번이고 각 채널이 경쟁력 있는 점수에 도달하려면 최소 6번의 전용 행동이 필요하므로, 플레이어가 본격적으로 투자할 수 있는 채널은 최대 2개입니다(budget__bounds__channels). 아키타입은 서로 양립할 수 있는 채널 조합 가운데 극대인 것들입니다. 주 채널이 하나인 아키타입 6개에 하이브리드 2개가 더해집니다(하나는 3개 채널에 고르게 분산하는 균형형이고, 다른 하나는 무기를 득점이 아니라 식량 확보에 쓰는 평화로운 동굴 엔진형입니다).
완전성 증명(archetype__channel__surjection)은 모든 채널에 그 채널을 주 채널로 삼는 아키타입이 적어도 하나 있음을 보여 줍니다. 점수를 얻으려면 반드시 어떤 채널을 거쳐야 하며, 모든 채널이 아키타입으로 대표됩니다. 이 분류에서 벗어나는 유효한 전략은 없습니다.
각 아키타입에는 추정 득점 상한(모든 셋업 중 최선의 경우)과 하한(최악의 경우)이 있습니다.
가구 러시는 상한 140점으로 1위이며, 하한도 60점으로 공동 1위입니다. 무기 러시는 하한은 같지만 상한이 120점에 그칩니다. 나머지 아키타입은 그보다 뒤처집니다. 구간 차트를 보면 지배 관계가 바로 드러납니다. 가구 러시의 막대는 다른 어떤 아키타입보다 오른쪽으로 더 길게 뻗어 있고(상한이 더 높음), 왼쪽 끝점(하한)도 다른 어느 아키타입에 뒤지지 않습니다.
지배 계층
보수 행렬을 만들기 전에 추정 점수만으로도 부분적인 지배 관계를 확립할 수 있습니다. 전략 의 상한과 하한이 모두 전략 보다 높다면(적어도 하나는 엄격한 부등식일 때), 추정 점수에서 가 를 지배합니다.
녹색 실선 화살표는 추정 점수를 통한 지배(더 높은 상한과 하한)를 나타냅니다. 녹색 점선 화살표는 전체 보수 행렬을 통해서만 확립되는 지배를 나타냅니다. 축산과 채광 중심은 추정 점수로는 비교할 수 없지만(한쪽은 상한이, 다른 쪽은 하한이 더 높음), 보수 행렬에서는 둘 다 가구 러시에게 약하게 지배당합니다.
비교 불가능성은 구성적으로 증명됩니다.
theorem incomparable__strategies__exist :
    not (dominates .miningHeavy .animalHusbandry) /\
    not (dominates .animalHusbandry .miningHeavy) := by decide
보수 행렬
다음 질문은 서로 다른 아키타입을 택했을 수 있는 두 플레이어가 공유 행동 칸을 두고 부딪칠 때 어떤 일이 일어나는가입니다. 이를 보수 행렬 으로 모델링합니다. 여기서 는 행 플레이어가 아키타입 를, 열 플레이어가 아키타입 를 플레이할 때 행 플레이어의 추정 점수입니다.
녹색 테두리는 Furnishing Rush 행(약우월)을 나타냅니다. 파란색 테두리는 대각선(미러 매치업, 항상 낮은 값)을 강조합니다. 셀 색상의 농도는 보수의 크기를 나타내며, 연한 녹색(55)부터 코랄색(135)까지입니다.
Lean에서 이 행렬은 Fin 8 -> Fin 8 -> Int 형태의 함수이며, 64개 항목이 모두 전략 분석 결과에 따라 하드코딩되어 있습니다.
def payoffMatrix : Fin 8 -> Fin 8 -> Int
  | 0, 0 =>  85 | 0, 1 => 130 | 0, 2 => 135 | 0, 3 => 130
  | 0, 4 => 125 | 0, 5 => 135 | 0, 6 => 135 | 0, 7 => 130
  | 1, 0 =>  80 | 1, 1 =>  75 | 1, 2 => 100 | 1, 3 =>  85
  | 1, 4 =>  95 | 1, 5 => 105 | 1, 6 => 100 | 1, 7 =>  85
  -- ... 48 more entries ...
여기서 “추정“이 무엇을 의미하는지 짚고 넘어가겠습니다. 행렬의 항목은 몬테카를로 시뮬레이션이나 어림짐작이 아니라 형식화된 게임 규칙(점수 함수, 식량 비용, 행동 예산)에서 도출한 것입니다. 하지만 각 아키타입 안에서 가능한 47수 시퀀스를 모두 빠짐없이 풀어 본 것은 아니므로 추정치라고 할 수 있습니다. 이 결과는 얼마나 민감합니까? min__dominance__margin__is__5 정리는 각 열에서 가구 러시 행과 그다음으로 좋은 항목 사이의 최소 격차가 정확히 5점임을 증명합니다(이 격차는 미러 매치업 열에서 나타납니다). 어떤 항목 하나를 5점 미만으로 변동시켜도 우월 관계는 뒤집히지 않습니다. 셀 하나가 10점이나 바뀌더라도 영향을 받는 것은 한 열뿐이며, 전체 결과에는 영향이 없습니다. 내시 균형은 더 민감하지만(대각선에 의존하기 때문입니다), 균형이 바뀌려면 85인 미러 매치업 값이 그다음으로 좋은 대응 값인 80 아래로 떨어져야 합니다. 이후의 증명들은 제시된 행렬 그대로를 대상으로 기계 검증되었으므로, 형식적 보장은 이 항목들을 전제로 할 때 정확합니다.
조건부 보장보다 더 나은 결과를 얻을 수 있습니다. 각 스칼라 항목을 실제 보수를 포함하는 닫힌 구간으로 바꾸십시오. 미러 매치업에는 좁은 범위를 부여합니다(두 플레이어가 같은 계획을 실행하고 경합이 대칭적이므로 점추정치 입니다). 서로 다른 아키타입 간의 매치업에는 더 넓은 범위를 부여합니다(전략 간 상호작용의 불확실성을 반영하여 입니다). 구간 보수 행렬은 다음과 같습니다.
structure PayoffInterval where
  lo : Int
  hi : Int
  valid : lo <= hi

def intervalPayoff : Fin 8 -> Fin 8 -> PayoffInterval
  | 0, 0 => { lo := 83, hi := 87, valid := by omega }   -- mirror: eps=2
  | 0, 1 => { lo := 125, hi := 135, valid := by omega }  -- vs weapon: eps=5
  -- ... 62 more entries ...
강건한 약우월은 다음을 묻습니다. 모든 열과 가구 러시가 아닌 모든 대안에 대해, 가구 러시의 하한이 그 대안의 상한 이상입니까? 그렇다면 가구 러시는 점추정치뿐만 아니라 이 구간 안에 있는 모든 실제 보수 행렬에 대해 우월합니다.
theorem robust_weak_dominance :
    forall (col : Fin 8) (alt : Fin 8), alt != 0 ->
      (intervalPayoff 0 col).lo >= (intervalPayoff alt col).hi := by decide
이 검사를 통과합니다. 가장 빠듯한 셀은 열 0(미러 매치업)으로, 가구 러시 대 무기 러시 입니다. 여유는 으로, 경계에서 약한 동률입니다. 다른 모든 열의 여유는 20 이상입니다(non__mirror__columns__robust). 오차 범위를 1점만 넓혀도 열 0이 실패하며(fragility__column__0), 이를 통해 결과가 정확히 어디에서 가장 취약하고 허용 오차가 얼마인지 알 수 있습니다.
구간 분석으로 강건한 후생 범위도 얻을 수 있습니다. 내시 후생은 안에, 사회적 최적은 안에 있습니다. 이기적인 플레이에 가장 유리하고 협력에 가장 불리한 경우에도 사회적 최적은 여전히 내시 후생보다 큽니다(robust__price__of__anarchy). 죄수의 딜레마 구조는 점추정치 때문에 생긴 착시가 아닙니다.
첫 번째 행은 모든 열에서 다른 모든 행보다 크거나 같습니다. 이것이 전부입니다. 이것이 결과의 전부입니다. 게임 이론에서는 이 성질을 약한 우월(weak dominance)이라고 부릅니다. 모든 상대 전략 와 모든 대안 전략 에 대해 다음이 성립하면 전략 는 약한 우월 전략입니다.
Lean 증명은 furnishing__rush__weakly__dominant이며, 정확히 다음을 말합니다.
theorem furnishing_rush_weakly_dominant :
    forall (row : Fin 8) (col : Fin 8),
      payoffMatrix 0 col >= payoffMatrix row col := by decide
모든 상대에 대해, 모든 대안에 대해, 가구 러시의 보수가 크거나 같습니다. 증명은 decide입니다. Lean의 커널이 64개의 칸을 모두 검사합니다. 누구도 제 산술을 믿을 필요가 없습니다.
경합 효과
보수 행렬의 대각선 성분은 비대각선 성분에 비해 항상 낮습니다.
theorem diagonal__always__depressed :
    forall (i : Fin 8), exists (j : Fin 8), j /= i /\
      payoffMatrix i j > payoffMatrix i i := by decide
모든 미러 매치업은 같은 행에 있는 비(非)미러 매치업 중 적어도 하나보다 낮은 점수를 얻습니다. 이것이 경합 효과입니다. 두 플레이어가 같은 전략 유형을 추구하면 같은 행동 칸을 두고 다투게 됩니다. 가구 러시 미러에서는 굴착과 집안일을 두고 경쟁합니다. 무기 러시 미러에서는 대장장이 일을 두고 다툽니다. 채굴 미러에서는 광석 광산 건설을 두고 충돌합니다.
이 게임은 똑같이 하는 것을 벌합니다. 다만 똑같이 한 데 대한 벌(85)이 더 나쁜 것을 고른 데 대한 벌(가구 러시를 고른 상대를 만났을 때 60에서 80)보다 여전히 덜 아플 뿐입니다.
내시 균형과 죄수의 딜레마
약한 우월성으로부터 게임 이론의 결과가 도미노처럼 줄줄이 따라 나옵니다. 최선 응답 함수 는 각 상대 전략을 해당 열에서 값을 최대로 만드는 행으로 대응시킵니다. 가구 러시가 모든 열에서 최댓값을 달성하므로, BR은 상수 함수입니다.
내시 균형은 결합 최선 응답 대응의 고정점, 즉 이고 인 쌍 입니다. BR이 상수이므로, 유일한 고정점은 (FurnishingRush, FurnishingRush)입니다. 존재성과 유일성을 세 줄로 보이면 다음과 같습니다.
theorem exactly__one__nash__equilibrium :
    (exists a b, isNashEquilibrium a b) /\
    (forall a b, isNashEquilibrium a b ->
      a = .furnishingRush /\ b = .furnishingRush) :=
  <<.furnishingRush, .furnishingRush, furnishing_mirror_is_nash>,
   furnishing_mirror_unique_nash>
유일성 증명은 64개의 전략 쌍 모두에 대해 경우를 나누고, 그중 하나만 내시 조건을 만족함을 확인하는 방식으로 이루어집니다.
theorem furnishing__mirror__unique__nash :
    forall a b : StrategyArchetype,
      isNashEquilibrium a b ->
        a = .furnishingRush /\ b = .furnishingRush := by
  intro a b h
  have h1 := h.1; have h2 := h.2
  cases a <;> cases b <;> simp_all [bestResponse, isNashEquilibrium]
순수 내시 균형은 정확히 하나뿐이며, 그것은 두 플레이어가 똑같은 행동을 하는 균형입니다. 조금 비극적인 일입니다.
무정부 상태의 대가
내시 균형에서 두 플레이어는 모두 85점을 얻습니다. 만약 두 플레이어가 어떻게든 서로 다른 전략(예를 들어 가구 러시 대 목축)으로 협조할 수 있다면, 합산 후생은 대신 이 될 것입니다.
무정부 상태의 대가는 내시 후생에 대한 사회적 최적의 비율입니다.
이기적인 플레이는 사회적 최적의 약 19%를 잃게 합니다. 단순한 산술이므로 Lean 증명은 decide입니다:
theorem price__of__anarchy__ratio :
    socialOptimumValue = 210 /\ nashWelfare = 170 /\
    210 * 17 = 170 * 21 := by decide
우울한 함의는 두 플레이어 모두 상대방이 다른 전략을 쓰기를 바라지만, 어느 쪽도 자신이 손해를 보지 않고서는 일방적으로 이탈할 수 없다는 것입니다. 여러분은 각자 85점에 갇힌 채, 테이블 건너편에서 이 블로그 글을 똑같이 읽은 상대를 바라보게 됩니다.
점수 함수
자연스럽게 떠오르는 질문은 점수가 실제로 어디에 도달할 수 있느냐는 것입니다. 게임 종료 시의 점수 함수는 모든 양수 및 음수 기여를 합산합니다:
def FullPlayer.score (p : FullPlayer) : Int :=
  let animals := (p.dogs + p.sheep + p.donkeys +
                  p.wildBoars + p.cattle : Int)
  let grainPts := (((p.grain + p.fieldsWithGrain * 3) + 1) / 2 : Int)
  let vegPts := ((p.vegetables + p.fieldsWithVeg * 2) : Int)
  let rubyPts := (p.rubies : Int)
  let dwarfPts := ((p.dwarfs + p.offspring) : Int)
  let pasturePts := (p.smallPastures * 2 + p.largePastures * 4 : Int)
  let minePts := (p.oreMines * 3 + p.rubyMines * 4 : Int)
  let goldPts := (p.gold : Int)
  let furnPts := p.furnishings.foldl (fun acc fid =>
    acc + ((furnishingSpec fid).basePoints : Int)) (0 : Int)
  let missingTypes :=
    (if p.sheep == 0 then 1 else 0) + (if p.donkeys == 0 then 1 else 0) +
    (if p.wildBoars == 0 then 1 else 0) + (if p.cattle == 0 then 1 else 0)
  let unusedPenalty := (p.unusedMountain + p.unusedForest : Int)
  let beggingPenalty := (p.beggingMarkers * 3 : Int)
  let missingPenalty := (missingTypes * 2 : Int)
  animals + grainPts + vegPts + rubyPts + dwarfPts + pasturePts +
  minePts + goldPts + furnPts - unusedPenalty - beggingPenalty - missingPenalty
이론적 하한은 점입니다. 모든 라운드에 걸쳐 행동을 하나도 하지 않은 플레이어는 시작 드워프 두 명으로 +2점, 네 가지 농장 동물 종류를 모두 갖추지 못해 점, 사용하지 않은 보드 칸 22개로 점, 그리고 각각 점인 구걸 마커 9개로 점을 받습니다. 이론적 상한은 202점이며, 모든 점수 범주의 독립적인 최댓값을 합산하여 계산합니다. 하지만 202점에는 도달할 수 없습니다. 모든 점수 항목이 12라운드에 걸친 똑같은 56번의 드워프 배치를 두고 경쟁하기 때문입니다. 동굴 12개에 시설을 갖추고, 광산 5개를 짓고, 동물 20마리를 번식시키고, 밭 10개에 씨를 뿌리는 일을 동시에 할 수는 없습니다. 행동 예산이 실질적인 제약 조건입니다. 실질적인 상한은 약 140점이며, 경쟁자가 없을 때 시설 러시로 달성할 수 있습니다.
이론적 범위는 195점(에서 140까지)이지만, 점이라는 하한은 12라운드 동안 말 그대로 아무것도 하지 않아야 하므로 전략적으로 의미가 없습니다. 모든 아키타입에 걸친 실질적인 하한은 약 45점(최악의 설정에서의 평화로운 농사)이며, 따라서 실질적인 범위는 약 95점입니다. 우월 전략 자체의 범위는 80점(60에서 140까지)이며, dominant__strategy__variance로 증명됩니다. 안전 마진(dominant__strategy__safety__margin)은 이론적 하한보다 115점 높지만, 더 의미 있는 수치는 시설 러시의 최악의 경우(60)와 실행 가능한 아키타입 중 가장 나쁜 것의 최악의 경우(45) 사이의 격차입니다: 가장 불리한 설정에서도 올바르게 선택하면 최소 15점을 더 얻습니다.
사기적인 조합
형식화 과정에서 따로 놓고 보면 사기적으로 보이는 조합이 여럿 드러났습니다. 그중 네 가지가 두드러집니다.
맥주 홀은 점수 계산 전에 곡물을 3:2 비율로 금으로 바꿉니다: 곡물 2개마다 금 3개가 됩니다. 맥주 홀이 없으면 곡물 20개는 10점입니다(곡물 공식은 입니다). 맥주 홀이 있으면 같은 곡물 20개가 금 30개가 됩니다. 이는 기본 곡물 가치에 3배의 배수를 적용하는 것이며, 금은 다른 모든 점수 범주와 중첩됩니다. beer__parlor__max__gold 정리는 beerParlorGold 20 = 30을 증명합니다. 함정은 곡물 20개를 모으는 일입니다: 여러 라운드에 걸쳐 공격적으로 씨를 뿌려야 하며, 이는 동굴을 파는 대신 화전과 생계 행동에 행동을 소모해야 한다는 뜻입니다.
개가 지킬 수 있는 양에는 상한이 없습니다: 한 목초지에 있는 개 마리는 양 마리를 지킵니다. 개 10마리와 직조실을 쌓으면 단일 타일 조합만으로 51점을 얻을 수 있습니다. 함정은 개 10마리를 얻으려면 대략 6번의 원정 행동이 필요하다는 것이며(개는 힘 1의 전리품이라 얻기는 쉽지만 원정마다 행동 하나를 소모합니다), 그 6번의 행동은 동굴을 짓거나 가족을 늘리는 데 쓰이지 않습니다.
집필실은 돌 2개로 최대 7점의 손실을 막아 줍니다. 이는 점수 범주 전체를 무시해도 된다는 면허처럼 들리고, 실제로도 그렇습니다. 다만 건너뛰게 될 범주(사용하지 않은 칸, 갖추지 못한 가축 종류)는 바로 시설 러시가 자연스럽게 채워 주는 범주입니다. 집필실의 혜택을 가장 많이 보는 플레이어는 큰 벌점이 쌓일 만큼 서툴게 플레이하는 사람들이며, 그 시점에서는 7점이라는 상한 때문에 정말로 방치된 보드에는 거의 흠집도 내지 못합니다.
기도실(Prayer Chamber)이 가장 우아합니다. 자원을 전혀 투자하지 않고도 8점을 주지만, 어떤 드워프든 무기를 단조하는 순간 그 보너스는 사라집니다. prayer__chamber__vs__weapons 정리는 이것이 엄격한 이분법임을 증명합니다. 8점 아니면 0점이며, 그 사이는 없습니다. 이는 진정한 전략적 갈림길(평화로운 플레이 대 원정 플레이)을 만들어 내며, 게임의 나머지 설계는 이 갈림길을 신중하게 유지합니다.
이 중 어느 것도 지배 전략을 무너뜨리지 못합니다. 모든 콤보는 같은 구속 제약에 부딪힙니다. 가족을 최대로 늘렸을 때 총 56번의 행동이라는 제약입니다. 한 점수 범주에서 화려한 숫자를 낼 수는 있지만, 모든 범주를 다 채울 수는 없습니다. 보드 채우기, 가족 늘리기, 가구 시너지에 균형 잡힌 접근을 취하는 기본 가구 러시가 여전히 상한선으로 남습니다. 콤보는 버그가 아니라 기능입니다. 지배 전략을 알고 난 뒤에도 게임을 다시 플레이할 가치가 있게 만드는 것이 바로 콤보입니다. 표준 노선이 막혔을 때 방향을 틀 대안을 주기 때문입니다.
게임은 풀렸는가?
진지한 수학자라면 이것을 “모델의 매개변수가 계산된 것이 아니라 추정된 것이라는 단서가 붙은, 모델에 대한 형식적 분석“이라고 부를 것입니다. 이는 응용 수학, 운영 연구, 메커니즘 설계에서 정당하고 흔한 패턴입니다. 증명은 기계로 검증되었고 빈틈이 없지만, 보수 행렬을 전제로 합니다. 정리들이 말하는 바는 이렇습니다. 보수 행렬이 이와 같다면, 가구 러시는 약지배 전략이고, 내시 균형은 유일하며, 무정부 비용은 21/17입니다. 정리들이 말하지 않는 바는 이렇습니다. 최적으로 플레이한 가구 러시가 최적으로 플레이한 축산 상대를 만났을 때의 실제 기대 점수가 정확히 135점이라는 것입니다. 그 숫자는 게임 트리를 전수 탐색해서 얻은 것이 아니라, 형식화된 행동 경제에서 도출한 추정치입니다.
이 추정치를 얼마나 신뢰해야 할까요? min__dominance__margin__is__5 정리는 가구 러시와 가장 가까운 경쟁 전략 사이의 최소 격차가 5점임을 증명합니다. 추정 방법론의 체계적 편향이 5점 미만이라면(추정치가 실제 플레이에서 쓰이는 것과 같은 점수 함수와 행동 예산으로부터 도출된다는 점을 고려하면 그럴 법합니다), 정성적 결과는 유지됩니다. 행렬의 한 행 전체에 걸쳐 5점 이상의 상관된 변동이 생기면 미러 열에서 약지배가 깨질 수 있지만, 그러려면 방법론이 자기 경합 시나리오에서 가구 러시의 성과를 일관되게 과대평가해야 합니다. 미러 페널티(대각선 밖의 130점 이상 대 85점)가 이미 심한 경합을 모델링하고 있다는 점을 고려하면, 이는 가능성이 낮아 보입니다.
추정 문제를 아예 우회하는 더 강력한 구조적 논증이 있습니다. 각 점수 채널에는 행동당 최대 산출량이 있습니다. 가구는 행동을 행동당 6점으로 점수로 바꾸고(굴착 + 보너스 배수가 붙은 가구 타일), 무기/원정은 4점, 나머지는 모두 3점 이하입니다. ActionAllocation은 37번의 생산적 행동(총 47번의 배치에서 약 ~10번의 식량 의무를 뺀 것)을 6개 채널에 분배합니다. no__better__allocation__exists 정리는 유효한 모든 분배에 대해 총점이 가구를 극대화하는 분배의 상한인 원점수 222점(37 * 6)을 넘을 수 없음을 증명합니다. 가구에서 차선 채널(무기)로 돌린 행동은 하나당 정확히 2점을 잃고, 농업이나 채광으로 돌리면 3점을 잃습니다. 가구 20 + 무기 17이라는 그럴듯한 혼합 분배는 최대 188점을 얻으며, 34점이 부족합니다. 행동 예산을 어떻게 재분배해도 이 격차를 메울 수 없습니다. 행동 경제가 구조적으로 더 나은 전략의 존재를 허용하지 않습니다.
theorem no_better_allocation_exists :
    forall a : ActionAllocation, a.valid ->
      a.rawScore <= furnishingMaxRawScore := by
  intro a h__valid
  simp only [ActionAllocation.rawScore, furnishingMaxRawScore,
             furnishingMaxAllocation, channelYieldPerAction,
             productiveActionsEstimate, totalPlacementsOneGrowthRound4]
  simp only [ActionAllocation.valid, ActionAllocation.totalActions,
             productiveActionsEstimate, totalPlacementsOneGrowthRound4] at h__valid
  omega
증명은 네 줄입니다. 모든 채널 산출량이 최대 6이므로 37번의 행동에 대한 어떤 분배도 최대 37 * 6 = 222점을 얻기 때문에 omega가 증명을 마무리합니다. 이 결과는 보수 행렬과 무관합니다. 이 결과는 점수 규칙과 행동 예산에만 의존하며, 둘 다 규칙서로부터 형식화되었습니다. 모든 보수 추정치가 50점씩 틀렸다 하더라도 이 정리는 여전히 성립합니다. 가구 채널은 행동당 한계 수익이 가장 높고, 유한한 행동 예산 때문에 그 우위는 극복할 수 없기 때문입니다.
아키타입 수준에서는, 그렇습니다, 이 게임은 풀렸습니다. 2인 게임이라면 2,880가지 구성 중 어느 것을 뽑든, 모델은 최적의 순수 전략이 가구 러시라고 말합니다. 이 증명은 특정한 카드 순서나 수확 마커 배치에 의존하지 않습니다. 제가 하지 않은 것은 각각의 구체적인 셋업에 대해 드워프 배치의 정확한 순서를 계산하는 일입니다. 그러려면 대략 개의 노드를 가진 게임 트리를 풀어야 합니다. 하지만 실제 플레이에서 중요한 것은 아키타입 수준의 결과입니다. 여러분은 이제 계획을 알고 있습니다. 아키타입 내부의 결정(어느 동굴을 먼저 굴착할지, 어느 가구 타일을 우선할지)은 전략적인 것이 아니라 전술적인 것입니다. 그런 결정은 답을 바꾸지 않습니다.
3인 이상 변형은 여전히 미해결 문제로 남아 있습니다. 보수 행렬은 512개의 항목을 가진 3차 텐서가 되고, 행동 칸 경합은 이진적인 것에서 조합적인 것으로 바뀌며, 순수 지배 결과는 거의 확실히 성립하지 않습니다. 3자 경쟁에서는 가구 타일이 부족해져 혼합 균형이 나올 가능성이 높기 때문입니다. 누군가 그것을 형식화하고 싶다면, 저는 그 증명을 꼭 읽어 보고 싶습니다.
지배 전략을 플레이하십시오
가구 러시를 플레이하십시오. 1라운드부터 4라운드까지 공격적으로 굴착하십시오. 돌출 보너스를 위해 사무실(Office Room)을 일찍 확보하십시오. 주거지당 +4점을 위해 응접실(State Parlor)을 확보하십시오. 드워프를 5명까지 늘리고 +10 보너스를 위해 빗자루 방(Broom Chamber)을 확보하십시오. 상대가 다른 전략을 쓰면, 여러분은 125점에서 135점을 얻고 상대는 60점에서 105점을 얻습니다. 상대도 가구 러시를 플레이하면 두 사람 모두 85점에 그치는데, 이는 협력 최적값인 210점보다는 나쁘지만 어떤 일방적 이탈보다는 낫습니다. 여러분은 테이블에 앉아 둘 다 최대한 빨리 동굴을 굴착하면서, 한 사람이 10점을 희생하면 다른 사람에게 50점을 줄 수 있다는 것을 둘 다 알지만, 아무도 먼저 물러서는 쪽이 되려 하지 않을 것입니다.
동굴 속의 죄수의 딜레마입니다. 우베 로젠베르크(Uwe Rosenberg)는 아마 이것을 의도하지 않았겠지만, 형식적 분석은 그것이 존재한다고 말합니다.
코드는 Mathlib과 함께 Lean 4 v4.28.0 위에 구축되었으며, 24개의 행동 칸 전부, 48개의 가구 타일 전부, 원정 전리품 표 전체, 보드 격자, 그리고 2인 게임의 12라운드 수확 일정 전체를 모델링합니다. 저는 Caverna가 아름답게 디자인된 게임이라고 생각하며, 바로 그렇기 때문에 정형 분석 아래에서도 전략 구조가 이토록 탄탄하게 유지된다는 사실을 발견한 것이 뿌듯했습니다. 잘못 설계된 게임이라면 게임을 지루하게 만드는 자명한 지배 전략이 있을 것입니다. Caverna의 지배 전략에는 미러 매치업에서 19%의 후생 손실이 따릅니다. 이는 상대가 예상치 못한 수를 둘 때 게임이 언제나 더 흥미로워진다는 뜻이고(게임에서든 인생에서든 내시 균형이 재미있는 곳인 경우는 드뭅니다), 이는 실제로 사람들이 항상 지배 전략을 따르지는 않는다는 뜻이며, 이는 곧 게임이 계속 재미있다는 뜻입니다.
알고 보니, 좋은 게임 디자인은 풀려도 끄떡없습니다. 이제 여러분은 최적의 플레이를 알고 있습니다. 그것을 따를지 말지는, 다행히도, 정리가 아닙니다.
Opus 4.6은 Lean으로 범주론을 할 수 있습니까?
저는 약 10년 동안 이리저리 옮겨 다니며 다듬어 온 작은 범주론 라이브러리를 하나 가지고 있습니다. 이 라이브러리는 Haskell에서 시작하여 Agda로 포팅되었고, 잠시 Idris에 머물렀다가, Coq에서 얼마간 시간을 보낸 뒤, 이제 Lean 4에 자리 잡았습니다. 저는 이것을 Kitty Cats라고 부릅니다. 아이디어는 간단합니다. Awodey의 Category Theory와 Mac Lane의 Categories for the Working Mathematician 중 관련 장에 나오는 정의와 정리를 가져와서, 타입 검사가 가능한 코드로 직접 옮기는 것입니다. 범주, 함자, 자연 변환, 곱, 극한, 수반, 모나드, 요네다 보조정리입니다. 라이브러리도 없고, 직접 정의한 것 외에는 어떤 import도 없습니다. 모든 것을 마치고 나면 Lean 코드로 약 900줄 정도입니다. 이것은 머릿속에 통째로 담을 수 있는 종류의 프로젝트이며, 바로 그 점이 핵심입니다. 새로운 의존 타입의 언어나 증명 보조기가 나올 때마다, 저는 이 뼈대를 꺼내 들고 그것이 어떤 느낌인지 살펴봅니다. 이것은 저의 리트머스 시험이자, 표준 연습 문제이며, 무인도에 가져갈 단 하나의 형식화입니다. 그리고 이것은 언어 모델이 추상적이고 형식적인 “추론“을 얼마나 잘하게 되었는지(어쩌면 그저 그것을 흉내 내는 것일 수도 있지만, 그 질문은 철학자들에게 맡기겠습니다!)를 가늠하는 좋은 벤치마크가 점점 더 되어 가고 있습니다.
그래서 Anthropic이 새로운 Opus 4.6 모델을 내놓았을 때, 저는 이것이 실제로 제대로 된 Lean 4를 작성할 수 있는지 알고 싶었습니다. 장난감 예제가 아닙니다. theorem two_plus_two : 2 + 2 = 4 := rfl 같은 것도 아닙니다. 실제 증명 의무를 지닌 실제 증명, 즉 자연성 사각형과 정합 조건을 붙들고 씨름해야 하고 엘라보레이터가 매 단계마다 발목을 잡는 바로 그런 카인드의 증명입니다. 증명 보조기의 아름다운 점은 답을 근본적으로 검증할 수 있다는 것입니다. 출력물을 가늘게 뜬 눈으로 들여다보며 미묘하게 틀린 곳이 있지 않은지 고민할 필요가 없습니다. lake build가 통과하거나, 통과하지 않거나 둘 중 하나입니다. 커널은 여러분의 감정 따위에 신경 쓰지 않습니다.
짧게 답하자면, 네, 대체로 그렇습니다. 하지만 긴 답이 더 흥미롭습니다.
우리(저와 모델을 아우르는 장엄 복수형 “우리”)는 30분짜리 세션 두 번에 걸쳐 라이브러리 전체를 함께 만들었습니다. 기본 계층 구조는 빠르게 세워졌습니다. 범주, 함자, 자연 변환, 반대 범주, 사상 클래스입니다. 이것들은 대부분 증명 의무가 간단한 구조체 선언입니다. 범주 공리 , , 와 함자 법칙 , 가 그것입니다. Opus는 이것들을 땀 한 방울 흘리지 않고 처리했으며, 솔직히 말해 지금 시점에서는 웬만한 언어 모델이라면 대부분 그렇게 할 것입니다. 증명은 한두 개의 전술로 이루어지며, 대개 rfl이나 by simp면 충분합니다. 진짜 질문은 언제나 증명이 어려워질 때 어떤 일이 일어나는가였습니다.
모노이드 범주와 자기 함자 구성에 이르러 상황이 흥미로워졌습니다. 자기 함자의 범주가 합성에 대해 모노이드 범주임을 증명하려면, 오각형 정합성 조건과 삼각형 정합성 조건을 확립해야 합니다. 오각형 공리는 네 겹 텐서곱을 재결합하는 두 가지 방법이 일치한다는 것을 말합니다:
여기서 는 결합자 자연 동형입니다. 삼각형 공리는 결합자를 왼쪽 및 오른쪽 단위자 , 와 연관 짓습니다:
이것들은 바로 형식화하기 성가신 종류의 것입니다. 목표에 수평과 수직으로 합성된 깊이 중첩된 자연 변환이 들어 있고, 무엇이 “정의상 같은지“에 대한 엘라보레이터의 관념이 여러분의 직관과 항상 일치하지는 않기 때문입니다. Opus는 구조를 올바르게 잡을 수 있었고, 모노이드 범주 사영을 구체적인 NatTrans 표현으로 펼치는 show 블록을 세울 수 있었으며, 적절한 펼침 보조정리와 함께 ext a; simp [...]를 쓰면 목표가 닫힌다는 것도 알아낼 수 있었습니다. 하지만 Opus가 만들어 낸 증명은 장황했습니다. 중첩된 괄호의 벽이었습니다. 기술적으로는 옳지만 보고 있으면 눈이 풀려 버리는 종류의 것이었습니다.
이 라이브러리의 백미는 monadIsMonoidObj, 즉 모나드가 자기 함자 범주의 모노이드라는 증명입니다. 함수형 프로그래머라면 누구나 들어 본 농담이지만(이제는 밈이 되었을 정도입니다), 실제로 이를 형식화하려면 두 단계의 추상화를 이어야 합니다. 범주 위의 모나드 는 결합 법칙과 단위 법칙을 만족하는 자연 변환 (단위)와 (곱셈)를 갖춘 자기 함자 입니다:
이것들은 의 각 대상 마다 하나씩 있는 성분별 등식입니다. 가 모노이드 범주 의 모노이드 대상을 이룬다는 것을 보이려면, 이 등식들을 자기 함자 범주에서의 자연 변환 등식으로 끌어올려야 하는데, 이 범주 자체가 방금 구축한 모노이드 구조를 갖추고 있습니다. MonoidObj 구조의 각 필드에는 모노이드 범주 사영을 수동으로 펼치는 show 블록이 필요하고(ext가 Hom 타입 별칭을 꿰뚫어 필요한 NatTrans를 찾지 못하기 때문입니다), 이어서 성분으로 환원하는 ext; endo_simp, 그다음 exact M.mul_assoc a 또는 해당하는 모나드 공리가 따라와야 합니다. Opus는 이 형태를 올바르게 잡았지만, 분해 방식에 대해서는 상당한 안내가 필요했습니다. 원래 출력에는 show 블록이 인스턴스 선언 안에 바로 인라인되어 있었는데, 깊이 중첩된 NatTrans.vcomp (endoTensorHom M.mu (NatTrans.ident M.T)) M.mu = ...가 서너 줄씩 이어져 있어서, 옳기는 해도 코드를 처음 읽는 사람이라면 누구든 겁에 질릴 만했습니다.
바로 이 지점에서 모델이 몇 가지 난관에 부딪혔고 도움이 필요했습니다. 우리는 증명을 리팩터링했습니다. 성분별 등식을 NatTrans 등식으로 끌어올리는 작은 도우미인 endo_ext_eq를 도입하여, show; ext a; endo_simp; exact로 이어지는 춤 대신 endo_ext_eq fun a => by endo_simp; exact M.mul_assoc a라고 쓸 수 있게 했습니다. 모노이드 정합성 의무를 독립된 보조정리(endoPentagon, endoTriangle, endoTensor_id, endoTensor_comp)로 추출하여 인스턴스 선언이 순수한 대입이 되도록 했습니다. 정리 시그니처에서 let 바인딩을 사용해 오각형 공리에 나오는 다섯 가지 결합자 인스턴스에 이름을 붙였고, 그 결과 (endoAssociator F (CFunctor.compose G H) K).hom의 벽이 읽기 쉬운 alpha_F_GH_K로 바뀌었습니다. monadIsMonoidObj 정의는 22줄의 인라인 증명에서 7줄의 이름 붙은 보조정리 적용으로 줄어들었습니다. 저는 이런 종류의 리팩터링이야말로 여전히 인간이 확실히 더 잘하는 일이라고 생각합니다. 독자가 무엇을 보아야 하는지 아는 것, 어떤 하위 표현식에 이름을 붙일 가치가 있는지 아는 것, 증명이 올바르기는 하지만 아직 좋지는 않은 때를 아는 것이 바로 그것입니다.
요네다 보조정리는 기분 좋은 놀라움이었습니다. 그 명제는 임의의 함자 과 의 임의의 대상 에 대해 다음과 같은 자연스러운 전단사가 존재한다는 것입니다:
정방향(자연 변환을 에서 평가하면 그것을 결정하는 원소가 복원됨)은 map_id만 있으면 거의 자명합니다. 역방향(에서의 값으로부터 변환을 다시 구성함)은 자연성 등식을 추출하고, 그것을 단순화한 뒤, 대칭적으로 적용해야 합니다. Opus는 hom 집합이 Type 범주의 함수 타입일 때 필요한 약간 까다로운 congrFun 적용까지 포함하여 이를 올바르게 헤쳐 나갔습니다. 충실충만한 임베딩(yoneda_map_eval과 yoneda_eval_map)은 자연스럽게 따라 나왔습니다. 솔직히 조금 매료되었습니다.
이 작업이 이만큼 잘 된 것은 도구 덕분이었습니다. 여기서 두 오픈 소스 프로젝트의 공을 인정해야 합니다. Oliver Dressler가 만든 lean-lsp-mcp 서버는 Lean 4 언어 서버를 MCP 인터페이스로 노출하여, Claude가 목표 상태, 진단, 자동 완성, 호버 정보에 직접 접근할 수 있게 합니다. Cameron Freer가 만든 lean4-skills 플러그인은 그 위에 더 높은 수준의 증명 명령, 사이클 엔진, 전제 검색 통합을 더합니다. 이 둘이 함께 모델에게 진정한 피드백 루프를 제공합니다. 모델은 lean_goal을 호출하여 임의의 줄에서 증명 상태를 살펴보고, lean_diagnostic_messages를 호출하여 파일에 오류가 있는지 확인하고, lean_multi_attempt를 호출하여 여러 전술 시퀀스를 시도해 어느 것이 진전을 이루는지 확인하고, lean_run_code를 호출하여 작업 중인 파일을 수정하지 않고 완전한 코드 조각을 커널에 대해 시험해 볼 수 있습니다. 이는 작업의 역학을 근본적으로 바꿉니다. Lean 코드를 생성하고 컴파일되기를 바라는 대신, 모델은 증명을 작성하고, 목표 상태를 확인하고, 오류를 보고, 수정하는 촘촘한 루프 안에서 작동합니다. 눈을 가리고 그림을 그리는 것과 눈을 뜨고 그림을 그리는 것의 차이입니다. 모델은 여전히 실수를 하고, 적용되지 않는 전술을 시도하고 맞지 않는 rw 체인을 작성하기도 하지만, 이러한 실패를 즉시 감지하고 복구할 수 있습니다. 6개월 전에는 이런 종류의 통합이 존재하지 않았습니다. 그때라면 모델은 엘라보레이터가 만족하는지 비명을 지르는지 알 길도 없이 허공에 대고 Lean 코드를 생성하고 있었을 것입니다.
검색 도구도 중요합니다. lean_leansearch, lean_loogle, lean_leanfinder를 사용하면 모델이 자연어, 타입 시그니처, 의미적 유사성으로 Mathlib의 보조정리 데이터베이스를 조회할 수 있습니다. 이 프로젝트에서는 Mathlib을 사용하지 않았지만(처음부터 직접 구축하는 것이 핵심이므로), 보조정리 이름을 사용하기 전에 그 이름이 존재하는지 확인하거나, 존재해야 한다고 알고 있는 정리의 정확한 이름을 찾는 능력은 매우 귀중합니다. lean_state_search와 lean_hammer_premise는 한 걸음 더 나아가, 증명 상태가 주어지면 목표를 닫을 수 있을 법한 보조정리를 제안합니다. 이것이 바로 가장 강력한 자동 정리 증명기를 움직이는 기법인 전제 선택(premise selection)이며, 이를 API 호출 하나로 사용할 수 있습니다. “오각형 공리를 증명하라“라고 말하고 자리를 떠도 되는 수준에 아직 완전히 도달하지는 않았습니다. 그러나 적절한 안내만 있으면 상당히 많은 비자명한 정리 증명을 처리할 수 있는 수준에 놀라울 만큼 가까워졌습니다.
한계에 대해 솔직하게 말하자면, Opus는 복잡한 증명 상태를 작업 기억에 담아 두고 여러 단계를 앞서 계획해야 하는 종류의 추론에 어려움을 겪습니다. 단일 전술이나 짧은 체인으로 풀리는 목표는 닫을 수 있지만, 자연성 방정식을 도입하고, 그것을 특정한 방식으로 단순화한 다음, 긴 합성 체인의 특정 위치에 적용해야 하는 다단계 재작성은 여전히 일일이 이끌어 주어야 합니다. 때로는 rw가 필요한 곳에서 simp를 시도하거나, 보조정리를 잘못된 위치에 적용하거나, ext가 작동하려면 show 블록이 필요하다는 사실을 잊어버리기도 합니다. 이는 이해의 근본적인 실패가 아니며, 오히려 대학원생이 증명 보조기를 처음 접한 첫 학기에 저지르는 실수에 가깝습니다. 모델은 무엇을 증명하고 싶은지 알고 전략도 대략 알고 있지만, 엘라보레이터의 동의를 얻어 내는 번거로운 세부 사항을 처리하려면 반복이 필요합니다.
한 가지 짚어 둘 만한 점이 있습니다. 비공식적인 실험에서 추론 예산을 늘리자 수렴 시간은 실제로 늘어났지만(전술을 확정하기 전에 숙고하는 데 더 많은 토큰을 소비했기 때문입니다), 최종 출력의 품질이 눈에 띄게 향상되지는 않았습니다. 모델은 더 오래 생각하고도 결국 똑같은 simp 호출을 꺼내 들곤 했습니다. 이 과정은 비결정적이고 프롬프트에 매우 민감하기 때문에 경험적으로 측정하기 어려운 부분이므로, 걸러서 들으시기 바랍니다. 하지만 제 작업 가설은, 전술 수준의 정리 증명에서 병목은 “더 열심히 생각하는 것“보다는 루프 안에 적절한 도구 호출을 갖추는 데 있다는 것입니다. 내부의 사고 사슬보다 언어 서버의 피드백이 더 중요합니다.
문제는 지난 6개월 동안 이것이 기하급수적으로 나아졌다는 점입니다. 저는 이와 같은 실험을 주기적으로 해 왔는데, 그 발전 궤적은 놀라울 정도입니다. 1년 전만 해도 언어 모델은 문법적으로 올바른 Lean 코드조차 겨우 작성하는 수준이었습니다. 6개월 전에는 간단한 전술 증명은 처리할 수 있었지만, 유니버스 다형성이나 타입 클래스 해석이 관련된 문제에서는 무너지고 말았습니다. 오늘날에는 MCP 통합과 언어 서버 피드백 덕분에 두 번의 세션만으로 900줄 분량의 형식화된 범주론을 구축했으며, 여기에는 많은 수학 대학원생도 어렵게 느낄 만한 증명들이 포함되어 있습니다. 이것이 어디로 향하고 있는지 예측하기는 어렵지 않습니다.
그리고 어쩌면 그것이 흥미로운 부분일지도 모릅니다. AI가 오늘날 정리를 증명할 수 있다는 점(도움을 받으면 어느 정도는 가능합니다)이 아니라, 상투적인 보일러플레이트가 사라지고 있다는 점 말입니다. 형식화의 지루한 부분들, 즉 정합성 조건, 자연성 보조정리, simp 설정 같은 것들이야말로 언어 모델이 점점 잘하게 되는 구조화되고 검증 가능하며 기계적으로 확인할 수 있는 종류의 작업입니다. 이 층위가 사소해지면, 우리는 정말로 중요한 부분에 시간을 쓸 수 있게 됩니다. 올바른 추상화를 선택하고, 구조들 사이의 연결을 발견하고, 애초에 무엇을 형식화할 가치가 있는지 결정하는 일 말입니다. 증명 보조기는 관료적인 장애물이라기보다 진정한 사고의 도구가 되어 갑니다. 우리는 더 높이 쌓아 올릴 수 있게 됩니다.
저는 이 작은 범주론 라이브러리를 10년 동안 이 언어에서 저 언어로 옮겨 가며 가지고 다녔는데, 그때마다 그 경험은 저에게 기술의 현주소에 관해 무언가를 알려 주었습니다. 이번에 그것이 알려 준 것은 우리가 미래에 살고 있으며, 그 미래는 제가 예상했던 것보다 더 기묘하고 더 흥미롭다는 사실입니다.
서평: 우리가 세상을 이해하길 멈출 때
벵하민 라바투트의 우리가 세상을 이해하길 멈출 때는 제가 몇 년 동안 읽은 책 가운데 최고의 책이며, 오직 최고의 책만이 그럴 수 있는 방식으로 다 읽고 나면 어딘가 조금 속이 불편해지는 그런 책입니다. 명목상으로는 과학사에 관한 책입니다. 실제로는 인간의 정신이 애초에 이해하도록 만들어지지 않은 무언가에 닿았을 때 어떤 일이 일어나는지에 관한 책입니다. 기호가 적대적으로 느껴지기 시작할 만큼 오랫동안 방정식을 들여다본 적이 있거나, 새벽 세 시에 자신이 만들고 있는 추상화가 자신은 모르는 무언가를 이해하고 있다는 불안한 확신에 사로잡힌 적이 있다면, 이 책은 바로 여러분을 위해 쓰인 책입니다.
구조는 겉보기에 단순합니다. 라바투트는 실존했던 일련의 과학자들(프리츠 하버, 카를 슈바르츠실트, 베르너 하이젠베르크, 에르빈 슈뢰딩거, 알렉산더 그로텐디크)을 데려와 그들의 발견 이야기를 점점 강도가 높아지는 심리 공포 소품의 연작으로 들려줍니다. 하버는 암모니아를 합성해 10억 명을 먹여 살리고, 그다음에는 염소 가스를 합성해 수천 명을 독살합니다. 슈바르츠실트는 제1차 세계대전 중 참호 속에서, 자신의 면역 체계가 산 채로 자기 몸을 갉아먹는 동안 아인슈타인의 장 방정식을 풀어내며, 그가 찾아낸 해는 물리 법칙이 죽으러 가는 시공간의 구멍을 묘사합니다. 하이젠베르크는 헬골란트섬에서 앞이 거의 보이지 않을 만큼 심한 꽃가루 알레르기에 시달리면서, 우주가 입자의 위치와 그 입자가 어디로 가고 있는지를 동시에 알도록 허락하지 않는다는 사실을 발견합니다. 이 모든 일은 대체로 실제로 일어났습니다. 우주는 대부분의 소설가라면 개연성이 없다고 여길 만한 서사적 재능을 지니고 있습니다. 슈바르츠실트의 이야기를 소설로 투고했다면, 편집자는 상징이 지나치게 노골적이라는 메모와 함께 원고를 돌려보냈을 것입니다. 자신의 몸이 무너져 내리는 와중에 중력 붕괴의 방정식을 푸는 사람이라는 설정입니까? 너무 뻔합니다. 안타깝게도 현실을 교정해 주는 사람은 아무도 없습니다.
라바투트가 이러한 사실들을 가지고 해내는 일은 진정으로 새로운 것입니다. 그는 책이 진행될수록 허구의 비중이 늘어난다는 사실을 처음부터 알려 줍니다(이 기법을 역사 기술적 메타픽션이라고 부릅니다). 초반의 장들은 역사적 기록을 충실히 따릅니다. 마지막 장에 이르면, 여러분은 꿈에 더 가까운 무언가를 읽고 있게 됩니다. 어디까지가 실제이고 어디서부터가 지어낸 것인지 구분할 수 없으며, 바로 이것이 핵심입니다. 형식이 곧 논지를 구현합니다. 지식이 경계에 다가갈수록 확실성은 녹아 사라집니다. 앎의 한계를 다루는 이 책은 그 자체로 사실의 경계를 찾아낼 수 없는 문서입니다. 이는 읽는 행위에 적용된 불확정성 원리의 문학적 등가물입니다.
이 책의 탁월함, 그리고 형식 체계를 다루는 일로 생계를 꾸리는 사람들 사이에서 이 책이 훨씬 더 널리 읽혀야 한다고 제가 생각하는 이유는, 라바투트가 미친 천재라는 낭만적인 클리셰를 가져와 훨씬 더 불온한 무언가로 대체한다는 데 있습니다. 그의 주장은 더 강력하고 더 기이합니다. 이 사람들이 발견한 것들은 인간의 인지에 진정으로 이질적이며, 그 심리적 대가는 구조적인 것으로서 발견 그 자체에 내재되어 있었다는 것입니다. 하이젠베르크가 약간 미쳐 버린 것은 우주가 가장 근본적인 수준에서 인간의 정신이 기대하는 방식대로 행동하기를 거부한다는 사실을 발견했기 때문이며, 그의 신경계는 이를 비상사태로 받아들였습니다. 슈뢰딩거의 파동 방정식은 알프스의 한 호텔에서 벌어진 열띤 정사 도중에 탄생했는데, 마치 현실의 그 특정한 영역에 접근하는 유일한 방법이 먼저 자기 삶의 다른 모든 영역을 불안정하게 만드는 것이었다는 듯했습니다.
그로텐디크 장은 수학이나 이론 컴퓨터 과학에 시간을 쏟아 본 사람이라면 누구에게나 오래도록 떠나지 않을 장입니다. 그로텐디크는 20세기 최고의 수학자라 해도 과언이 아닙니다. 그는 대수기하학을 처음부터 다시 세웠습니다. 그는 너무나 깊고 너무나 일반적인 구조를 보았기에, 수십 년이 지난 지금도 수학계는 여전히 그것을 풀어내고 있습니다. 그리고 그는 멈추었습니다. 그는 아름다운 정리를 만들어 낸 바로 그 인지 행위가 핵무기도 만들어 냈다고 확신하고는 수학에서 완전히 떠났습니다. 그는 말년의 수십 년을 피레네산맥의 한 마을에서 살며 민들레 수프를 먹고, 아무도 읽지 않는 수천 쪽짜리 신비주의 논고를 쓰며 보냈습니다. 코드베이스를 홧김에 때려치워 본 적이 있는 사람에게 그로텐디크는 수호성인입니다. 역사상 수학 전체를 홧김에 때려치운 단 한 사람이자, 아마도 그럴 만한 자격이 있었던 유일한 사람이기 때문입니다. 라바투트는 이를 그로텐디크가 본 것에 대한 일관된 반응으로 제시합니다. 그는 수학적 실재의 가장 깊은 구조를 들여다보았고, 들여다보는 행위 자체가 위험하다는 결론에 이르렀습니다. 이것은 필즈상을 들고 우리를 마주 보는 니체의 심연입니다.
이 책의 마지막이자 아마도 가장 불안하게 만드는 수는 아름다움과 공포가 같은 것이라는 주장입니다. 슈바르츠실트의 해는 아름답습니다. 그것은 또한 특정 반지름 너머로 떨어지는 모든 것의 소멸을 기술합니다. 수십억 명을 먹여 살리는 질소 고정 반응은 화학적으로 시안화물을 만들어 내는 과정과 동일합니다. 놀라울 만큼 아름다운 안료인 프러시안 블루는 치클론 B의 전구체입니다. 라바투트는 형이상학적 주장을 펼치고 있습니다. 근본적 실재의 차원에서 창조와 파괴는 서로 다른 각도에서 바라본 같은 작용이라는 것입니다. 유니버스는 눈부시게 아름다우면서도 여러분에게 무관심하며, 이 두 사실은 서로 연관되어 있습니다.
그러나 깊은 실재와의 접촉이 그저 아는 자를 파멸시킨다는 러브크래프트적 해석은 라바투트가 하고 있는 일의 절반에 불과합니다. 마지막 장의 밤의 정원사는 그로텐디크와 하이젠베르크가 들여다본 것과 같은 심연을 들여다보았습니다. 그는 돌아왔고, 정원을 가꿉니다. 정원은 부패와 기생충과 죽어 가는 나무로 가득하지만, 그는 그래도 그 정원을 가꿉니다. 책을 소멸로 끝맺기를 거부하는 라바투트의 태도에는 조용히 급진적인 무언가가 있습니다. 살아가는 데에는 확실성이 필요하지 않습니다. 확실성의 부재는 공허가 아니라 공간입니다. 공간은 중요한 모든 일이 일어나는 곳입니다. 이 책 속의 과학자들은 방정식의 밑바닥에서 발견한 것 때문에 상처를 입었지만, 그 상처는 들여다본 대가였으며, 그 들여다봄은 우리가 실제로 살고 있는 실재하는 유니버스에 대한 실재하는 지식을 낳았습니다. 라바투트가 궁극적으로 말하고자 하는 바는 그 위험이 감수할 만한 가치가 있다는 것입니다. 정원은 지속됩니다. 여러분은 어둠 속에서, 아무런 보장 없이 정원을 가꾸며, 그것으로 충분합니다.
이 블로그를 읽는 모든 분께 이 책을 추천합니다. 증명의 우아함에 매혹된 적이 있거나, 물리적 우주가 허용할 법한 수준을 넘어서는 듯한 정밀함으로 추상화가 딱 맞아떨어지는 모습을 지켜볼 때 찾아오는 특유의 현기증을 느껴 본 적이 있다면, 라바투트는 바로 여러분의 소명에 관한 공포 소설을 쓴 것입니다. 이 책은 짧습니다(200쪽 미만). 그 말은 곧 대부분의 교과서나 대략 트위터 전체보다 쪽당 통찰 밀도가 높다는 뜻입니다. 문장은 절묘하게 아름답고(에이드리언 네이선 웨스트의 번역은 따로 한 문단을 들여 칭찬할 만하지만, 자제하겠습니다), 몇 달 동안 여러분의 사유에 잔여물을 남길 것입니다. 비행기 안에서 단숨에 읽으신 다음, 한동안 창밖을 바라보십시오. 그럴 필요가 있을 것입니다.
MLIR을 이용한 GPU 컴파일
7부에서는 GPT-2의 NumPy 구현을 만들었습니다. 이제 컴파일된 텐서 연산을 NVIDIA GPU에서 실행할 수 있는 백엔드가 필요합니다. 작은 요소별(elementwise) 커널에서 시작하여 이것이 MLIR에서 PTX로, 그리고 CUDA 실행(launch)에 이르기까지 따라가 보겠습니다. 소프트맥스와 어텐션에는 리덕션과 더 세심한 스레드 매핑이 필요하지만, 이를 통해 생성된 코드를 로드하고 실행할 수 있는 기반을 갖추게 됩니다.
이제 Nvidia GPU가 장착된 머신으로 옮겨 가야 합니다(죄송하지만 MacOS는 지원되지 않습니다). 따라서 Nvidia GPU가 장착된 Linux 머신을 켜거나, 여러 제공업체 중 한 곳에서 GPU를 대여하십시오.
CUDA Toolkit 설치는 번거롭기로 악명이 높으므로, 클라우드 제공업체에서 GPU를 대여한다면 이 작업은 이미 되어 있습니다. 맞춤형 인스턴스를 설정해야 한다면 다음과 같은 Nvidia의 공식 도커 이미지 중 하나를 사용하는 것이 좋습니다:
docker pull nvidia/cuda:12.1.0-devel-ubuntu22.04
docker run -it --gpus all nvidia/cuda:12.1.0-devel-ubuntu22.04 bash
하지만 직접 자신의 머신에 설치하고 싶거나 설치해야 한다면 아래에 몇 가지 안내가 있습니다. 다만 최신 안내는 온라인에 있는 여러 가이드를 참고하시기 바랍니다. CUDA Toolkit이 설치되어 있지 않은 머신이라면 다음 단계에 따라 설치할 수 있습니다.
wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2204/x86_64/cuda-keyring_1.0-1_all.deb
sudo dpkg -i cuda-keyring_1.0-1_all.deb
sudo apt-get update
sudo apt-get install build-essential

sudo apt-get -y install cuda-toolkit-12-x
nvcc 컴파일러가 설치되어 있는지 확인하십시오. 마찬가지로 GPU를 대여하는 경우라면 이미 설치되어 있을 가능성이 높습니다.
$ nvcc --version
nvcc: NVIDIA (R) Cuda compiler driver
Copyright (c) 2005-2021 NVIDIA Corporation
Built on Thu_Nov_18_09:45:30_PST_2021
Cuda compilation tools, release 11.5, V11.5.119
Build cuda_11.5.r11.5/compiler.30672275_0
Nvidia GPU가 설치되어 있는지 확인하십시오:
lspci | grep -i nvidia
그런 다음 CUDA 버전과 드라이버 버전을 확인하십시오:
$ nvidia-smi
+---------------------------------------------------------------------------------------+
| NVIDIA-SMI 535.183.01             Driver Version: 535.183.01   CUDA Version: 12.2     |
|-----------------------------------------+----------------------+----------------------+
구체적인 CUDA 버전(이 경우 12.2)을 기록해 두십시오. 이 버전에 맞는 라이브러리를 설치해야 하므로 중요합니다.
일반적으로는 CUDA 러너를 활성화한 상태로 MLIR을 다시 컴파일해야 하는데, 이는 매우 번거로운 일입니다. 그래서 CUDA 러너가 활성화된 MLIR이 포함된 도커 이미지를 만들어 두었습니다. 따라서 RunPod이나 LambdaLabs에서 GPU를 대여한다면 이 베이스 이미지를 그대로 사용하면 됩니다. 또는 로컬 머신이 있다면 NVIDIA Container Toolkit을 사용하여 GPU를 컨테이너에 전달할 수 있습니다.
docker pull ghcr.io/sdiehl/docker-mlir-cuda:main
docker run -it ghcr.io/sdiehl/docker-mlir-cuda:main bash
그렇지 않으면 MLIR을 소스에서 다시 컴파일해야 합니다. 단계는 다음과 같습니다:
git clone https://github.com/llvm/llvm-project
mkdir llvm-project/build
cd llvm-project/build
RUN cmake -G Ninja ../llvm \
   -DCUDACXX=/usr/local/cuda/bin/nvcc \
   -DCUDA_PATH=/usr/local/cuda \
   -DCMAKE_CUDA_ARCHITECTURES="75;80;86;90" \ # Add your GPU architecture here
   -DCMAKE_C_COMPILER=clang \
   -DCMAKE_CXX_COMPILER=clang++ \
   -DCMAKE_CUDA_COMPILER=/usr/local/cuda/bin/nvcc \
   -DLLVM_ENABLE_PROJECTS=mlir \
   -DLLVM_BUILD_EXAMPLES=ON \
   -DLLVM_TARGETS_TO_BUILD="Native;NVPTX;AMDGPU" \
   -DCMAKE_BUILD_TYPE=Release \
   -DLLVM_ENABLE_ASSERTIONS=ON \
   -DLLVM_CCACHE_BUILD=ON \
   -DMLIR_ENABLE_CUDA_RUNNER=ON \
   -DMLIR_ENABLE_CUDA_CONVERSIONS=ON \
   -DMLIR_ENABLE_NVPTXCOMPILER=ON

RUN cmake --build . -t mlir-opt mlir-translate mlir-transform-opt mlir-runner
RUN cmake --build . -t install
미리 말씀드리자면, 이것은 다소 독특한 CUDA 프로그래밍 속성 과정이 될 것입니다. 결국 우리의 목표는 MLIR에서 GPU를 대상으로 하는 컴파일러를 만드는 것이므로, GPU 기초를 아주 빠르게 다룬 뒤 곧바로 GPU의 저수준 어셈블리 프로그래밍으로 넘어가겠습니다. 컴파일러를 다루는 사람이 아니라면, 대부분은 일상적인 작업에서 PTX를 직접 작성하지 않습니다. CUDA 코드를 처음 작성하는 것이라면, GPU 프로그래밍을 더 자세히 다루는 온라인의 여러 CUDA 프로그래밍 가이드 중 하나를 먼저 읽어 보는 것이 도움이 될 수 있습니다.
CUDA 생태계
CUDA 컴파일 과정에는 GPU 프로그래밍을 위해 이해해야 할 몇 가지 핵심 구성 요소와 중간 표현이 있습니다. 먼저 CUDA 프로그램이 어떻게 컴파일되고 실행되는지 살펴봅시다.
우선 CUDA는 GPU를 프로그래밍할 수 있게 해 주는 C++의 확장입니다. CUDA는 C++ 위에 구축된 언어로, GPU 프로그래밍에 특화된 기능을 추가합니다. 자체 컴파일러인 nvcc를 사용하여 PTX(Parallel Thread Execution, 병렬 스레드 실행)로 컴파일하며, PTX는 NVIDIA GPU를 위한 중간 어셈블리 언어입니다. PTX는 병렬 컴퓨팅을 위한 안정적인 프로그래밍 모델과 명령어 집합을 제공합니다. PTX는 아키텍처 중립적이므로 여러 세대의 NVIDIA 하드웨어를 대상으로 할 수 있습니다.
이어서 컴파일 과정은 PTX에서 CUBIN(CUDA Binary)이라고 하는 장치별 바이너리 코드로 넘어갑니다. CUBIN 파일에는 특정 GPU 아키텍처에서 실행되는 실제 기계어 코드가 들어 있습니다. 이 파일은 ELF 형식이며, 실행 코드뿐만 아니라 심볼, 재배치 정보, 디버그 정보도 포함합니다. CUBIN 파일은 일반적으로 기본적으로 호스트 실행 파일에 포함되지만, nvcc의 -cubin 옵션을 사용하여 별도로 생성할 수도 있습니다.
nvcc는 이 복잡한 컴파일 과정을 관리합니다. 여러 컴파일 단계를 조율하며, 필요에 따라 다양한 출력 형식을 생성할 수 있습니다.
- 향후 JIT(Just-In-Time) 컴파일을 위한 PTX 코드를 생성할 수 있습니다
- 아키텍처별 CUBIN 파일을 만들 수 있습니다
- 여러 PTX 및 CUBIN 파일을 하나의 FATBIN 파일로 결합할 수 있습니다
- 이러한 GPU 바이너리를 호스트 실행 파일에 포함할 수 있습니다
호스트에서 컴파일된 프로그램을 실행하면 다음과 같은 작업이 수행됩니다.
- 사용 가능한 GPU 아키텍처를 파악합니다
- 가능한 경우 FATBIN에서 적절한 CUBIN을 선택합니다
- 더 새로운 아키텍처의 경우 필요하면 PTX 코드를 JIT 컴파일하는 방식으로 대체합니다
- GPU에 코드를 로드하고 실행합니다
nvcc 컴파일러를 사용하면 이 모든 작업을 컴파일러가 최종 사용자 대신 처리합니다.
FATBIN 형식은 하나의 실행 파일이 여러 GPU 아키텍처를 지원할 수 있게 해 주므로 특히 중요합니다. FATBIN에는 PTX 코드(JIT 컴파일을 통한 향후 호환성을 위해)와 미리 컴파일된 CUBIN 파일(알려진 아키텍처에서 최적의 성능을 위해)을 모두 담을 수 있습니다. 이제 CUDA를 사용하는 간단한 C++ 코드를 살펴봅시다.
#include <stdio.h>

// CUDA kernel function
__global__ void helloKernel() {
  printf("Hello, CUDA!\n");
}

int main() {
  // Call the CUDA kernel
  helloKernel<<<1, 1>>>();

  // Wait for the kernel to finish
  cudaDeviceReset(0);

  return 0;
}
CUDA의 C++ 확장에는 커널을 **실행(launch)**하기 위한 특별한 문법이 있습니다. helloKernel 함수는 GPU에서 실행하려는 커널입니다. <<<1, 1>>>은 커널을 실행하기 위한 CUDA 문법입니다. 첫 번째 인자는 실행할 블록의 수이고, 두 번째 인자는 블록당 스레드의 수입니다.
kernel<<<blocks, threads>>>(...)
스레드와 블록에 대해서는 나중에 더 자세히 다룹니다. 이제 커널 내부에서는 특수 변수 blockDim, blockIdx, threadIdx에 접근할 수 있습니다. 간단한 예로 배열의 각 원소를 제곱하는 커널을 살펴봅시다. 여기에 제곱 커널이 있습니다. 내부 구조는 나중에 설명하겠으며, 지금은 단순히 배열의 각 원소를 제곱한다고 보면 됩니다.
__global__ void square(int* array, int n) {
    int tid = blockDim.x * blockIdx.x + threadIdx.x;
    if (tid < n)
        array[tid] = array[tid] * array[tid];
}
CUBIN 코드를 얻으려면 다음 명령을 사용할 수 있습니다:
nvcc -o square square.cu
컴파일된 CUBIN 코드를 담은 실행 코드를 실행할 수 있습니다. 이 바이너리는 호스트 로직은 CPU에서, CUBIN 코드는 GPU에서 실행합니다.
./square
nvcc에서 PTX 코드를 얻으려면 다음 옵션을 사용할 수 있습니다:
nvcc -ptx square.cu -o square.ptx
PTX 코드는 다음과 같습니다:
.visible .entry square(int*, int)(
        .param .u64 square(int*, int)_param_0,
        .param .u32 square(int*, int)_param_1
)
{

        ld.param.u64    %rd1, [square(int*, int)_param_0];
        ld.param.u32    %r2, [square(int*, int)_param_1];
        mov.u32         %r3, %ntid.x;
        mov.u32         %r4, %ctaid.x;
        mov.u32         %r5, %tid.x;
        mad.lo.s32      %r1, %r3, %r4, %r5;
        setp.ge.s32     %p1, %r1, %r2;
        @%p1 bra        $L__BB0_2;

        cvta.to.global.u64      %rd2, %rd1;
        mul.wide.s32    %rd3, %r1, 4;
        add.s64         %rd4, %rd2, %rd3;
        ld.global.u32   %r6, [%rd4];
        mul.lo.s32      %r7, %r6, %r6;
        st.global.u32   [%rd4], %r7;

$L__BB0_2:
        ret;

}
여기서 무슨 일이 일어나는지 이해하기 위해 PTX를 명령어 단위로 하나씩 분석해 봅시다. 커널에는 두 개의 매개변수가 있습니다. 첫 번째는 입력 정수 배열을 가리키는 포인터 param_0으로, 입력 정수 배열의 디바이스 주소이고, 두 번째는 입력 정수 배열의 크기인 param_1입니다.
| 명령어 | 설명 |
|---|---|
ld.param.u64 %rd1, [square(int*, int)_param_0]; | 커널 매개변수에서 입력 정수 배열의 디바이스 주소를 불러옵니다. |
ld.param.u32 %r2, [square(int*, int)_param_1]; | 커널 매개변수에서 입력 정수 배열의 크기를 불러옵니다. |
mov.u32 %r3, %ntid.x; | x 차원의 블록당 스레드 수를 가져옵니다. |
mov.u32 %r4, %ctaid.x; | x 차원에서 현재 스레드 블록의 ID를 가져옵니다. |
mov.u32 %r5, %tid.x; | x 차원에서 블록 내 현재 스레드의 ID를 가져옵니다. |
mad.lo.s32 %r1, %r3, %r4, %r5; | 블록 ID와 스레드 ID를 바탕으로 현재 스레드의 선형 전역 인덱스를 계산합니다. |
setp.ge.s32 %p1, %r1, %r2; | 계산된 인덱스가 배열 크기보다 크거나 같으면 술어 플래그 %p1을 참으로 설정합니다(경계 검사). |
@%p1 bra $L__BB0_2; | 계산된 인덱스가 범위를 벗어나면( %p1이 참이면) 스레드는 반환문으로 분기하므로 사실상 아무 작업도 하지 않습니다. |
cvta.to.global.u64 %rd2, %rd1; | 배열의 일반(generic) 디바이스 주소를 전역 주소로 변환합니다. |
mul.wide.s32 %rd3, %r1, 4; | 현재 스레드가 맡은 원소의 배열 내 바이트 오프셋을 계산합니다(int 크기를 4바이트로 가정). |
add.s64 %rd4, %rd2, %rd3; | 현재 스레드의 인덱스에 해당하는 배열 요소의 절대 전역 메모리 주소를 계산합니다. |
ld.global.u32 %r6, [%rd4]; | 계산된 전역 메모리 주소에서 32비트 정수 값을 레지스터 %r6에 로드합니다. |
mul.lo.s32 %r7, %r6, %r6; | %r6의 정수 값을 제곱하고 결과의 하위 32비트를 %r7에 저장합니다. |
st.global.u32 [%rd4], %r7; | %r7에 있는 제곱된 정수 값을 같은 전역 메모리 위치에 다시 저장하여 원래 값을 덮어씁니다. |
$L__BB0_2: | 범위를 벗어난 스레드가 분기할 지점을 표시하는 레이블입니다. |
ret; | 현재 스레드의 커널 실행을 마치고 반환합니다. |
cuobjdump -sass 명령을 사용하여 CUBIN 코드를 SASS(“Shader ASSembly”, 즉 셰이더 어셈블리의 약자)로 디스어셈블할 수도 있습니다. -arch=sm_90에서 우리 커널은 다음과 같습니다:
square(int*, int):
 LDC R1, c[0x0][0x28]
 S2R R5, SR_CTAID.X
 ULDC UR4, c[0x0][0x0]
 S2R R0, SR_TID.X
 IMAD R5, R5, UR4, R0
 ULDC UR4, c[0x0][0x218]
 ISETP.GE.AND P0, PT, R5, UR4, PT
 @P0 EXIT
 LDC.64 R2, c[0x0][0x210]
 ULDC.64 UR4, c[0x0][0x208]
 IMAD.WIDE R2, R5, 0x4, R2
 LDG.E R0, desc[UR4][R2.64]
 IMAD R5, R0, R0, RZ
 STG.E desc[UR4][R2.64], R5
 EXIT
.L_x_0:
 BRA `(.L_x_0)
 NOP
 NOP
 NOP
 NOP
 NOP
 NOP
 NOP
 NOP
.L_x_1:
GPU 아키텍처
위의 CUDA 커널은 여러 스레드에 걸쳐 실행되면 각 스레드마다 고유한 인덱스를 계산하고, 그 인덱스가 입력 정수 배열의 범위 안에 있으면 해당 인덱스의 정수를 전역 메모리에서 로드하여 제곱한 다음 결과를 같은 메모리 위치에 다시 기록합니다. 결과적으로 배열 요소를 병렬로 제자리(in-place)에서 제곱하는 셈입니다. 계산된 인덱스가 배열 범위를 벗어나는 스레드는 어떠한 메모리 연산도 수행하지 않습니다.
sm_53과 같은 GPU 코드는 항상 sm_ 접두사로 시작합니다. 하나의 가상 GPU 아키텍처는 그에 대응하는 여러 실제 아키텍처를 포함할 수 있습니다. CUBIN은 같은 세대의 모든 GPU에서 실행할 수 있지만, 이전 세대나 이후 세대의 GPU와는 호환되지 않습니다. 예를 들어 sm_52용으로 컴파일된 CUBIN은 sm_50, sm_52, sm_53 GPU와 호환되지만 sm_60 GPU와는 호환되지 않습니다. 또한 sm_52용으로 컴파일된 CUBIN을 sm_53 GPU에서 실행하면, 같은 아키텍처에서 sm_53용으로 특별히 컴파일된 CUBIN을 실행할 때보다 성능이 떨어질 수 있습니다.
# Compile for sm_52
nvcc square.cu -o square --gpu-architecture=compute_52 --gpu-code=sm_52

# Compile for sm_52, sm_53, sm_60
nvcc square.cu -o square --gpu-architecture=compute_52 --gpu-code=sm_52,sm_53,sm_60
가장 일반적인 아키텍처는 다음과 같습니다.
| 아키텍처 | SM 버전 | GPU | 기능 |
|---|---|---|---|
| Maxwell | sm_50, sm_52, sm_53 | GTX 750 Ti, GTX 960, GTX 970, GTX 980 | 동적 병렬성, CUDA 동적 병렬성 |
| Pascal | sm_60, sm_61, sm_62 | P100, GTX 1080, GTX 1080 Ti | HBM2 메모리, NVLink, 통합 메모리 |
| Volta | sm_70, sm_72 | V100, Titan V | 1세대 Tensor Core, 독립 스레드 스케줄링 |
| Turing | sm_75 | T4, RTX 2080, RTX 2080 Ti | 1세대 RT Core, 2세대 Tensor Core |
| Ampere | sm_80, sm_86, sm_87 | A100, A40, RTX 3090 | 3세대 Tensor Core, TF32 정밀도, 구조적 희소성 |
| Ada Lovelace | sm_89 | RTX 4090, L40, L40S | 3세대 RT Core, 4세대 Tensor Core, AV1 인코딩/디코딩 |
| Hopper | sm_90, sm_90a | H100, H200 | 4세대 Tensor Core, 트랜스포머 엔진, 900 GB/s NVLink |
| Blackwell | sm_100, sm_100a, sm_101, sm_101a, sm_120, sm_120a | B100, B200 | 5세대 Tensor Core, 향상된 점유율, 강화된 공유 메모리 |
CUDA Python 생태계
Python Poetry 프로젝트에서 NVIDIA CUDA 라이브러리를 사용하려면 먼저 NVIDIA 패키지 인덱스를 추가하십시오. Poetry를 사용하는 경우 nvidia-pyindex 패키지를 추가하고 다음 추가 인덱스 URL을 설정하면 됩니다.
poetry add nvidia-pyindex --source https://pypi.ngc.nvidia.com
[extra]
index-url = "https://pypi.ngc.nvidia.com"
이제 다음 라이브러리를 사용할 수 있습니다. cu12 접미사는 CUDA 12.x 버전을 나타내며, 사용하는 CUDA 버전에 따라 이를 조정해야 할 수 있습니다. 설치해야 하는 유일한 핵심(Core) 라이브러리는 cuda-python이며, PyPI에서 받을 수 있습니다.
cuda-python- CUDA 런타임 및 기타 Core 기능에 대한 파이썬다운 접근
그다음 Core 라이브러리는 다음과 같습니다:
nvidia-cuda-runtime-cu12- 필수 런타임 기능을 제공하는 Core 런타임 라이브러리입니다nvidia-cublas-cu12- GPU 가속 기본 선형대수 서브루틴(Basic Linear Algebra Subroutines)을 위한 cuBLAS 라이브러리입니다nvidia-cudnn-cu12- 딥러닝 기본 연산(스케일드 닷 프로덕트 어텐션, 합성곱, 행렬 곱셈, 소프트맥스, 풀링)을 모은 cuDNN 라이브러리입니다nvidia-cudnn-frontend- cuDNN 프런트엔드 API용 Python 바인딩입니다
계측 및 컴파일러 유틸리티도 있습니다.
nvidia-cuda-nvrtc-cu12- 프로그램 컴파일을 위한 런타임 컴파일 라이브러리(NVRTC)입니다nvidia-nvml-dev-cu12- GPU 모니터링 및 관리를 위한 관리 라이브러리(NVML)입니다nvidia-nvtx-cu12- 사용자 정의 프로파일링 및 트레이싱 계측을 위한 도구 확장(NVTX)입니다nvidia-cuda-nvcc-cu12- C/C++ 코드를 컴파일하기 위한 컴파일러(NVCC)입니다nvidia-nvjitlink-cu12- 디바이스 코드의 런타임 링킹을 위한 JIT 링커입니다nvidia-cuda-sanitizer-api-cu12- 애플리케이션의 메모리 오류를 탐지하기 위한 메모리 검사기입니다nvidia-cuda-cupti-cu12- 성능 분석 및 프로파일링을 위한 프로파일링 도구 인터페이스(CUPTI)입니다
나머지 라이브러리는 과학 계산, 신호 처리 등 특정 작업에 더 특화되어 있습니다. 여기서 자세히 다루지는 않겠지만, 이런 라이브러리도 있습니다.
nvidia-cufft-cu12- 고속 푸리에 변환(Fast Fourier Transform)을 계산하기 위한 cuFFT 라이브러리입니다nvidia-curand-cu12- 난수 생성을 위한 cuRAND 라이브러리입니다nvidia-cusolver-cu12- 밀집 및 희소 직접 솔버를 위한 cuSOLVER 라이브러리입니다nvidia-cusparse-cu12- 희소 행렬 연산을 위한 cuSPARSE 라이브러리입니다nvidia-npp-cu12- 이미지, 비디오, 신호 처리를 위한 성능 기본 연산(NPP)입니다nvidia-nvjpeg-cu12- 하드웨어 가속 JPEG 인코딩/디코딩을 위한 nvJPEG 라이브러리입니다nvidia-opencl-cu12- GPU 컴퓨팅을 위한 OpenCL 구현체입니다
스레드, 블록, 워프
CUDA를 작성할 때 커널은 GPU에서 실행되도록 정의한 함수를 가리킵니다. 커널을 실행하면 단순히 함수 하나를 호출하는 것이 아닙니다. 그 함수를 여러 데이터 요소에 걸쳐 동시에 실행하는 수백, 심지어 수천 개의 병렬 스레드를 생성하는 것입니다.
이 실행 모델은 흔히 단일 명령 다중 스레드(Single-Instruction Multiple-Thread, SIMT) 패러다임이라고 불리며, 하나의 프로그램을 여러 데이터 조각에 걸쳐 실행하는 데 중점을 둡니다. 예를 들어 배열의 각 요소를 제곱하는 커널이 있다고 합시다. 마법처럼 보이는 blockDim.x와 blockIdx.x는 신경 쓰지 마십시오. 이에 대해서는 나중에 자세히 설명합니다.
__global__ void square(float* array, int n) {
    int tid = blockDim.x * blockIdx.x + threadIdx.x;
    if (tid < n)
        array[tid] = array[tid] * array[tid];
}
CUDA 커널에는 두 가지 핵심 속성이 있습니다. 첫째, 커널은 값을 명시적으로 반환할 수 없으므로 모든 결과 데이터를 함수에 전달된 배열에 기록해야 합니다(스칼라 계산의 경우 보통 요소가 하나인 배열을 전달합니다). 둘째, 커널은 호출할 때 스레드 블록의 수와 블록당 스레드 수를 지정하여 스레드 계층 구조를 명시적으로 선언해야 합니다. 커널은 한 번 컴파일되지만, 블록 크기나 그리드 크기를 달리하여 여러 번 실행할 수 있다는 점에 유의해야 합니다.
자, 하나씩 살펴보면, 이 코드는 각 스레드가 배열에서 작업할 때 쓸 고유한 인덱스 tid를 부여하는 것일 뿐입니다. 커널은 이 인덱스를 사용하여 각 스레드가 A와 B의 원소 하나씩을 더하도록 합니다. __global__ 키워드는 이 함수가 GPU에서 실행되는 CUDA 커널이며 CPU 쪽에서 실행을 시작할 수 있다는 것을 알려 줍니다. if (tid < n) 검사가 있는 이유는 배열에 실제로 필요한 것보다 스레드를 몇 개 더 실행하게 될 수 있기 때문입니다(보통 적당한 수로 올림하기 때문입니다). 따라서 인덱스가 범위를 벗어나는 여분의 스레드는 그냥 아무 일도 하지 않습니다.
“호스트 코드“라고 부르는 주 CPU 프로그램에서 커널을 실행하려면 사용할 스레드 수를 정의해야 합니다. 커널은 GPU에서 동작하지만, 커널을 설정하고 실행하는 CPU 코드가 반드시 있어야 합니다. 예를 들어 실행 코드는 다음과 같은 형태일 수 있습니다.
int N = 10000;
int threadsPerBlock = 256;
int numberOfBlocks = (N + threadsPerBlock - 1) / threadsPerBlock;

square<<<numberOfBlocks, threadsPerBlock>>>(d_array, N);
여기 담긴 개념을 풀어 보면, CUDA는 스레드를 일제히 실행되는 32개의 스레드로 이루어진 워프(warp)로 묶고, 이 워프들을 다시 블록으로 묶습니다. 각 블록은 스트리밍 멀티프로세서(Streaming Multiprocessor, SM)에서 동작하며, SM은 레지스터와 공유 메모리 같은 한정된 자원을 가집니다. 블록의 크기는 이러한 자원의 할당에 영향을 주고 동시에 실행될 수 있는 워프의 수를 결정하는데, 이를 **점유율(occupancy)**이라고 합니다.
효율적인 자원 관리는 GPU 성능을 극대화하는 데 매우 중요합니다. GPU 스케줄러는 사용 가능한 SM들에 블록을 분배하는 역할을 합니다. 블록 수가 SM 수를 초과하면 남는 블록은 대기열에 들어가고, 자원이 확보되는 대로 실행되도록 스케줄링됩니다. 이 스케줄링 과정은 SM당 공유 메모리의 양과 레지스터 파일의 크기를 비롯한 여러 요인의 영향을 받으며, 이 요인들이 최종적으로 동시에 실행할 수 있는 블록 수를 결정합니다.
또 다른 주요 문제는 이른바 **워프 분기(warp divergence)**입니다. 이는 if 문과 같은 조건문 때문에 워프 내 스레드들의 실행 경로가 갈라지는 상황을 말합니다. 이상적으로는 워프의 모든 스레드가 같은 명령어를 동시에 실행해야 합니다. 그러나 일부 스레드는 한 경로를 따르고 다른 스레드는 다른 경로를 따르면 실행이 직렬화되어 비효율이 발생합니다. GPU 하드웨어는 마스크 비트를 사용하여 어떤 스레드가 각 경로를 따라야 하는지 관리하며, 이를 통해 모든 스레드가 작업을 올바르게 완료하도록 보장합니다. 이 메커니즘은 정확성을 유지하지만, 분기된 실행 경로 동안 유휴 스레드가 연산 자원을 낭비하므로 성능에 악영향을 줄 수 있습니다. 그 결과, 특히 분기가 심한 경우 GPU의 전체 처리량이 떨어질 수 있습니다. 성능을 높이려면 개발자는 워프 내 조건 분기를 최소화하여 GPU 실행 효율을 최적화하는 것을 목표로 해야 합니다.
메모리 계층 구조
GPU에는 세 가지 유형의 메모리가 있습니다.
-
레지스터 메모리: GPU 칩에 직접 위치한, 가장 빠른 유형의 GPU 메모리입니다. 개별 스레드만 접근할 수 있으며 수명이 가장 짧아 스레드가 실행되는 동안에만 유지됩니다.
-
공유 메모리: 이 메모리는 GPU 블록 내의 모든 스레드가 공유합니다. 전역 메모리보다는 빠르지만 레지스터 메모리보다는 느립니다. 공유 메모리는 스레드 간 통신과 데이터 공유를 가능하게 하며, 블록이 실행되는 동안 유지됩니다.
-
전역 메모리: GPU에서 가장 큰 메모리 풀로, 모든 블록의 모든 스레드가 접근할 수 있습니다. 레지스터 메모리와 공유 메모리보다 느리지만 용량은 가장 큽니다. 전역 메모리는 여러 블록이나 스레드가 공유해야 하는 데이터를 저장하는 데 사용됩니다.
가장 중요한 성능 고려 사항은 CPU(호스트)와 GPU(디바이스) 사이의 메모리 전송 오버헤드입니다. 호스트 메모리와 디바이스 메모리 사이의 데이터 전송은 (온칩 메모리 접근에 비해) 상대적으로 느리므로, 데이터를 가능한 한 오래 GPU에 유지하여 이러한 전송을 최소화하는 것이 좋습니다. 이는 대개 연산마다 데이터를 주고받는 대신, 같은 데이터에 대해 여러 연산을 수행한 뒤에 결과를 호스트로 다시 전송하는 것을 의미합니다. 가능한 한 GPU에 머무르고, 꼭 필요할 때만 CPU로 돌아오는 것이 바람직합니다.
또한 여러 메모리 접근을 하나의 트랜잭션으로 합치는 기능인 **메모리 병합(memory coalescing)**을 이해하는 것도 매우 중요합니다. 메모리 병합은 워프 내의 스레드들이 연속된 메모리 위치에 접근할 때 일어납니다. 병합되지 않은 메모리 접근은 여러 번의 메모리 트랜잭션을 필요로 하여 성능에 큰 영향을 줄 수 있으므로, 최적의 성능을 위해 개발자는 가능한 한 메모리 접근 패턴이 병합되도록 해야 합니다.
메모리 뱅크 충돌(bank conflict) 역시 성능에 영향을 줄 수 있으며, 특히 공유 메모리를 사용할 때 그렇습니다. 뱅크 충돌은 여러 스레드가 같은 메모리 뱅크의 서로 다른 주소에 동시에 접근하려 할 때 발생합니다. 뱅크 충돌을 피하려면 공유 메모리 접근 패턴을 신중하게 고려해야 하며, 필요하다면 자료 구조에 패딩을 추가하여 뱅크 전체에 걸쳐 메모리 접근이 최적으로 분산되도록 해야 합니다. 적절한 패딩과 메모리 접근 패턴을 사용하면 메모리 대역폭 활용도를 극대화하는 데 도움이 됩니다.
커널 호출과 메모리 이동
CUDA 런타임을 관리하기 위해 Python API에는 여러 Core 함수가 있습니다(이 함수들은 C API를 감싼 래퍼일 뿐입니다). 다음은 Python 바인딩의 cuda.cuda 모듈에 있는 Core 함수들입니다.
cuInit- CUDA 드라이버 API를 초기화합니다.cuDeviceGet- 첫 번째 연산 디바이스에 대한 핸들을 가져옵니다.cudaSetDevice- 현재 디바이스를 설정합니다.cuCtxCreate- 지정한 디바이스에 연산 컨텍스트를 생성합니다.cuModuleLoadData- PTX 문자열을 디바이스 바이너리로 JIT 컴파일합니다.cuModuleGetFunction- 모듈에서 커널 함수에 대한 핸들을 가져옵니다.cuLaunchKernel- 지정한 디바이스에서 커널을 실행합니다.cuMemcpyHtoD- 호스트 메모리에서 디바이스 메모리로 데이터를 복사합니다.cuMemcpyDtoH- 디바이스 메모리에서 호스트 메모리로 데이터를 복사합니다.cuMemFree- 디바이스의 메모리를 해제합니다.cuMemAlloc- 디바이스에 메모리를 할당합니다.cuCtxDestroy- 연산 컨텍스트를 제거합니다.cuModuleUnload- 디바이스에서 모듈을 언로드합니다.
CUDA Python API는 정수 반환 코드를 사용하는 C API를 감싼 래퍼이기 때문에 오류 처리가 다소 번거롭습니다. 따라서 이 모든 함수에 대해 반환값을 확인하고, 성공 값이 아니면 예외를 발생시켜야 합니다. 이를 쉽게 하기 위해 반환값이 성공 값이 아닐 때 예외를 발생시키는 헬퍼 함수 checkCudaErrors가 있습니다.
CUDA 컨텍스트를 설정하려면 다음과 같은 보일러플레이트 함수를 사용할 수 있습니다:
# gpu_setup.py
# Setup CUDA and create a context.

import cuda.cuda as cu  # type: ignore
import cuda.cudart as cudart  # type: ignore
import cuda.nvrtc as nvrtc  # type: ignore


def _cudaGetErrorEnum(error):
    if isinstance(error, cu.CUresult):
        err, name = cu.cuGetErrorName(error)
        return name if err == cu.CUresult.CUDA_SUCCESS else "<unknown>"
    elif isinstance(error, cudart.cudaError_t):
        return cudart.cudaGetErrorName(error)[1]
    elif isinstance(error, nvrtc.nvrtcResult):
        return nvrtc.nvrtcGetErrorString(error)[1]
    else:
        raise RuntimeError(f"Unknown error type: {error}")


def checkCudaErrors(result):
    if result[0].value:
        raise RuntimeError(
            f"CUDA error code={result[0].value}({_cudaGetErrorEnum(result[0])})"
        )
    if len(result) == 1:
        return None
    elif len(result) == 2:
        return result[1]
    else:
        return result[1:]


def findCudaDevice():
    devID = 0
    checkCudaErrors(cudart.cudaSetDevice(devID))
    return devID


def findCudaDeviceDRV():
    devID = 0
    checkCudaErrors(cu.cuInit(0))
    cuDevice = checkCudaErrors(cu.cuDeviceGet(devID))
    return cuDevice


def setup_cuda(device_id=None):
    print("Initializing CUDA...")
    # Initialize CUDA
    checkCudaErrors(cu.cuInit(0))

    # Get device
    if device_id is None:
        device = findCudaDeviceDRV()
        device_id = 0  # For printing purposes
    else:
        device = checkCudaErrors(cu.cuDeviceGet(device_id))

    # Create context
    context = checkCudaErrors(cu.cuCtxCreate(0, device))

    print(f"CUDA context created on device {device_id}.")
    return context


def cleanup_cuda(context):
    if context:
        print("Destroying CUDA context...")
        checkCudaErrors(cu.cuCtxDestroy(context))
        print("CUDA context destroyed.")
이제 CUDA Python API를 사용하여 호스트(CPU)와 디바이스(GPU) 사이의 메모리를 관리하는 방법을 살펴봅시다. 다음 예제는 GPU 프로그래밍에 필요한 핵심 메모리 연산을 보여 줍니다.
- 먼저
cuMemAlloc을 사용하여 GPU에 메모리를 할당합니다. 이렇게 하면 디바이스에 데이터를 저장할 공간이 확보됩니다. - 다음으로
cuMemcpyHtoD(Host to Device)로 호스트에서 디바이스로 데이터를 전송합니다. - 연산을 수행한 뒤에는(연산은 나중에 다룹니다)
cuMemcpyDtoH(Device to Host)를 사용하여 결과를 가져옵니다.
아래 예제에서는 간단한 float 배열을 만들어 GPU로 보낸 다음, 다시 복사해 와서 모든 것이 올바르게 동작했는지 확인합니다. 이 패턴은 GPU 컴퓨팅의 기초를 이룹니다.
# gpu_memory.py
# Minimal example demonstrating CUDA context setup and basic memory movement

from gpu_setup import setup_cuda, checkCudaErrors, cleanup_cuda
import numpy as np
import ctypes
import cuda.cuda as cu  # type: ignore

# Setup CUDA context
context = setup_cuda()

try:
    # Allocate memory on GPU
    buffer_size = 5 * ctypes.sizeof(ctypes.c_float)
    device_ptr = checkCudaErrors(cu.cuMemAlloc(buffer_size))

    # Create and initialize host array
    host_array = np.array([1.0, 2.0, 3.0, 4.0, 5.0], dtype=np.float32)
    print(f"Host array: {host_array}")

    # Copy data from host to device
    checkCudaErrors(cu.cuMemcpyHtoD(device_ptr, host_array.ctypes.data, buffer_size))

    # Create array for results
    result_array = np.zeros(5, dtype=np.float32)

    # Copy data back from device to host
    checkCudaErrors(cu.cuMemcpyDtoH(result_array.ctypes.data, device_ptr, buffer_size))
    print(f"Result array: {result_array}")

    # Free GPU memory
    checkCudaErrors(cu.cuMemFree(device_ptr))

finally:
    # Always clean up the context
    cleanup_cuda(context)
이제 기본적인 연산을 수행하는 간단한 사용자 정의 커널을 실행해 봅시다. 이 예제는 CUDA C++ 코드를 컴파일할 필요 없이 PTX 어셈블리에서 직접 GPU 코드를 실행하는 전체 워크플로를 보여 줍니다. 이 커널은 배열의 첫 번째 원소를 42로 설정할 뿐이지만, GPU 커널 실행의 핵심 구성 요소를 잘 보여 줍니다. CUDA 컨텍스트 초기화, GPU 메모리 할당, PTX 어셈블리 언어로 커널 정의, PTX 코드를 CUDA 모듈로 로드, 실행 차원 설정(단일 블록 안의 단일 스레드), 적절한 인자로 커널 실행, 완료를 보장하기 위한 동기화, 그리고 마지막으로 검증을 위해 결과를 호스트로 다시 전송하는 과정이 그것입니다. PTX 어셈블리 코드에는 첫 번째 스레드만 값을 대입하도록 스레드 ID와 블록 ID를 확인하는 부분이 들어 있습니다.
# gpu_memory.py
# Minimal example demonstraitng lauching a kernel

from gpu_setup import setup_cuda, checkCudaErrors, cleanup_cuda
import numpy as np
import cuda.cuda as cu  # type: ignore

# This is the trivial kernel that sets the first element
# of the array to 42 using a single thread

# __global__ void set_value_kernel(int *data) {
#     if (threadIdx.x == 0 && blockIdx.x == 0) {
#         *data = 42;
#     }
# }

ptx_kernel = """"
.visible .entry kernel(int*)( .param .u64 kernel(int*)_param_0) {
    ld.param.u64    %rd1, [kernel(int*)_param_0];
    mov.u32         %r1, %tid.x;
    mov.u32         %r2, %ctaid.x;
    or.b32          %r3, %r1, %r2;
    setp.ne.s32     %p1, %r3, 0;
    @%p1 bra        $L__BB0_2;
    cvta.to.global.u64      %rd2, %rd1;
    mov.u32         %r4, 42;
    st.global.u32   [%rd2], %r4;
$L__BB0_2:
    ret;
}
"""

# Setup CUDA context
context = setup_cuda()

try:
    # Allocate a single integer on the device
    data_size = np.dtype(np.int32).itemsize
    d_data = checkCudaErrors(cu.cuMemAlloc(data_size))

    # Set up grid and block dimensions - just one thread
    grid_dims = (1, 1, 1)
    block_dims = (1, 1, 1)

    # Prepare arguments for the kernel
    args = [d_data]
    arg_types = [None]  # None for pointer types

    # Load the module
    module = checkCudaErrors(cu.cuModuleLoadData(ptx_kernel.encode("utf-8")))

    # Get kernel function
    kernel_func = checkCudaErrors(
        cu.cuModuleGetFunction(module, "kernel".encode("utf-8"))
    )

    # Prepare kernel arguments
    kernel_args = (tuple(args), tuple(arg_types))

    # Launch kernel
    checkCudaErrors(
        cu.cuLaunchKernel(
            kernel_func,
            grid_dims[0],
            grid_dims[1],
            grid_dims[2],
            block_dims[0],
            block_dims[1],
            block_dims[2],
            0,  # shared memory bytes
            0,  # stream
            kernel_args,  # kernel args
            0,  # extra
        )
    )

    # Synchronize
    checkCudaErrors(cu.cuCtxSynchronize())

    # Copy result back to host
    host_data = np.zeros(1, dtype=np.int32)
    checkCudaErrors(cu.cuMemcpyDtoH(host_data.ctypes.data, d_data, host_data.nbytes))

    # Verify result
    print(f"Result: {host_data[0]}")
    assert host_data[0] == 42, f"Expected 42 but got {host_data[0]}"
    print("Success! Kernel executed correctly.")

    # Free device memory
    checkCudaErrors(cu.cuMemFree(d_data))

    # Unload module
    checkCudaErrors(cu.cuModuleUnload(module))

finally:
    cleanup_cuda(context)
스레드 블록과 그리드
앞에서 스레드가 보통 32개씩 워프로 묶이고, 이 워프들이 다시 블록으로 묶이는 방식을 살펴보았습니다. 이 블록들은 실행을 위해 SM에 할당됩니다. 이제 시야를 넓혀 봅시다. 스레드 블록은 공유 메모리와 동기화 메커니즘을 사용하여 함께 작업하며, 모두 같은 SM에서 실행되는 스레드들의 집합으로 이해할 수 있습니다.
GPU를 살펴보려면 cuda-python 라이브러리로 GPU 드라이버 API에 질의하여 사용 가능한 병렬성 속성에 관한 정보를 얻을 수 있습니다.
from cuda.cuda import CUdevice_attribute, cuDeviceGetAttribute, cuDeviceGetName, cuInit

(err,) = cuInit(0)

err, DEVICE_NAME = cuDeviceGetName(128, 0)
DEVICE_NAME = DEVICE_NAME.decode("ascii").replace("\x00", "")

err, MAX_THREADS_PER_BLOCK = cuDeviceGetAttribute(
    CUdevice_attribute.CU_DEVICE_ATTRIBUTE_MAX_THREADS_PER_BLOCK, 0
)
err, MAX_BLOCK_DIM_X = cuDeviceGetAttribute(
    CUdevice_attribute.CU_DEVICE_ATTRIBUTE_MAX_BLOCK_DIM_X, 0
)
err, MAX_GRID_DIM_X = cuDeviceGetAttribute(
    CUdevice_attribute.CU_DEVICE_ATTRIBUTE_MAX_GRID_DIM_X, 0
)
err, SMs = cuDeviceGetAttribute(
    CUdevice_attribute.CU_DEVICE_ATTRIBUTE_MULTIPROCESSOR_COUNT, 0
)

print(f"GPU Device: {DEVICE_NAME}")
print(f"Number of multiprocessors: {SMs}")
print(f"Maximum number of threads per block: {MAX_THREADS_PER_BLOCK:10}")
print(f"Maximum number of blocks per grid: {MAX_BLOCK_DIM_X:10}")
print(f"Maximum number of threads per grid: {MAX_GRID_DIM_X:10}")
예를 들어 A100 GPU에서는 다음과 같은 결과를 얻습니다.
Device Name: A100
Maximum number of multiprocessors: 108
Maximum number of threads per multiprocessor: 1024
Maximum number of threads per block: 1024
Maximum number of blocks per grid: 2147483647
블록을 사용하는 데에는 현실적인 이유가 있습니다. 하나의 블록에서 실행할 수 있는 스레드 수에는 하드웨어 제한이 있으며, 최신 GPU에서는 보통 1024개로 제한됩니다. 연산에 이 제한보다 많은 스레드가 필요하다면 스레드를 여러 블록으로 나누어야 합니다. 블록은 데이터의 특정 구간을 함께 처리하는 스레드들의 팀이라고 생각하십시오. 전체 그리드는 하나의 커널이 시작한 모든 블록을 나타내며, 전체 작업을 완수하기 위해 함께 일하는 여러 팀을 상징합니다.
예를 들어 원소가 2048개인 두 배열을 더하려면 각각 1024개의 스레드로 이루어진 블록 두 개를 사용할 수 있습니다. 이때 블록 0은 인덱스 0-1023을, 블록 1은 인덱스 1024-2047을 처리합니다. 일반적으로 원소가 N개이고 블록 하나에 최대 B개의 스레드를 담을 수 있다면, 모든 원소를 처리하기 위해 ceil(N/B)개의 블록을 실행합니다.
블록은 확장과 스케줄링에도 매우 유용합니다. 이렇게 생각해 보십시오. GPU에는 SM이 여러 개(예를 들어 20개) 있고, 각 SM은 사용 가능한 자원에 따라 여러 블록을 동시에 처리할 수 있습니다. 그래서 블록 100개를 던져 주더라도 동시에 실행될 수 있는 것은 20개뿐입니다(SM마다 하나씩). GPU는 그 20개 블록을 병렬로 시작하고, 하나가 끝날 때마다 대기 중인 다른 블록을 즉시 가져와 비게 된 SM에서 실행합니다.
프로그래머의 관점에서 보면 100개의 블록 모두가 함께 답을 구하고 있으며, 마치 100 * blockSize개의 스레드가 모두 실행되고 있는 것과 같습니다. 하지만 내부적으로는 GPU가 이 블록들을 하드웨어 전반에 영리하게 분배하고 있습니다. 좋은 점은 GPU가 한 번에 물리적으로 처리할 수 있는 것보다 더 많은 스레드를 실행하는 것에 대해 걱정할 필요가 없다는 것입니다. 런타임이 필요에 따라 이 블록들을 시분할하여 실행할 뿐입니다. 또한 블록은 여러 GPU에 작업을 스프레드하거나 한 번에 수행되는 병렬 작업의 양을 줄이는 자연스러운 방법을 제공합니다(이는 공유 메모리나 레지스터 같은 자원 한계에 부딪힐 때 필수적일 수 있습니다).
같은 블록 내의 스레드들은 다른 스레드들과 구별되는 강력한 협업 능력을 가지고 있습니다. 이 스레드들은 빠른 온칩 메모리에 대한 접근을 공유하고 배리어 연산을 사용하여 동기화할 수 있으므로, 스레드 간 통신이 필요한 작업을 효율적으로 조율할 수 있습니다. 그러나 이러한 협업은 엄격하게 같은 블록 내의 스레드로 제한됩니다.-서로 다른 블록에 걸친 스레드들은 통신을 위해 더 느린 전역 메모리에 의존해야 하며, 서로 직접 동기화할 수 없습니다. 이러한 결정은 중요한 목적을 가지고 있습니다. 바로 SM 전반에 걸쳐 블록을 유연하게 스케줄링할 수 있게 하고, CUDA 프로그램이 SM을 몇 개 포함하든 관계없이 다양한 GPU 아키텍처에서 매끄럽게 확장될 수 있게 하는 것입니다.
일반적으로 GPU의 워프 크기인 32개 스레드에 맞추고 하드웨어 특성에 최적화하기 위해 2의 거듭제곱(128, 256, 512 등)인 스레드 블록 크기를 선택합니다. 이러한 크기 설정은 여러 성능 요인에 영향을 미칩니다. 자원 활용도를 극대화하고, 메모리 접근 패턴을 최적화하며, 효율적인 스레드 스케줄링을 통해 메모리 지연 시간을 효과적으로 숨기는 GPU의 능력을 향상시킵니다.
# N is size of the array to process
N = 10000

# We calculate the number of blocks needed based on the total elements and threads per block
 # Typically a power of 2 like 128, 256, or 512
threads_per_block = 256

# Ceiling division to ensure all elements are processed
num_blocks = (N + threads_per_block - 1) // threads_per_block
공유 메모리와 동기화
CUDA의 공유 메모리는 성능 향상에 사용할 수 있는 가장 강력한 최적화 도구 중 하나이며, 메모리 접근 지연 시간을 극적으로 줄여 주는 프로그래밍 가능한 캐시로 작동합니다. 각 SM 내부의 온칩에 위치한 공유 메모리는 전역 메모리보다 최대 100배 높은 대역폭을 제공하며, 지연 시간은 약 100배 낮습니다. 이러한 성능상의 이점은 연산 코어와 물리적으로 가깝다는 데서 비롯됩니다. 반면 전역 메모리는 오프칩에 위치하여 데이터가 훨씬 느린 PCIe 버스나 메모리 컨트롤러를 거쳐 이동해야 합니다. 블록 내의 스레드들이 같은 데이터를 다루는 계산에서 협력할 때, 공유 메모리는 중복된 전역 메모리 로드를 제거하여 전역 메모리 접근 비용을 블록 내 모든 스레드에 효과적으로 분산시킵니다.
공유 메모리의 동작 방식은 CUDA의 스레드 계층 구조 설계를 반영합니다. 커널이 실행되면 각 스레드 블록에는 전용 공유 메모리 영역이 할당되며, 이 영역은 블록이 존재하는 동안 유지되고 해당 블록 내의 스레드에게만 보입니다. 이 메모리는 서로 다른 스레드가 동시에 접근할 수 있는 뱅크(최신 GPU에서는 일반적으로 32개의 뱅크)로 구성되어 있어 높은 대역폭의 병렬 접근이 가능합니다. 그러나 여러 스레드가 같은 뱅크 내의 서로 다른 주소에 접근하려고 하면(즉, 뱅크 충돌) 이러한 접근이 직렬화되어 성능이 저하됩니다.
__syncthreads() 함수는 공유 메모리를 다루는 데 핵심(Core)이 되는 함수입니다. 이 함수는 블록 내의 모든 스레드가 코드의 해당 지점에 도달할 때까지 기다린 후에 실행을 계속하도록 강제합니다. 이를 통해 일부 스레드가 다른 스레드들이 아직 쓰기를 마치지 않은 데이터를 읽으려고 하는 골치 아픈 경쟁 상태를 방지할 수 있으며, 이러한 경쟁 상태는 미묘하고 디버깅하기 어려운 오류의 흔한 원인입니다.
이 예제에서는 블록 내의 모든 스레드에게 보이는 __shared__ 배열을 선언합니다. 그런 다음 전역 메모리에서 공유 메모리로 데이터를 로드하고, 모든 스레드가 데이터를 로드했는지 확인하기 위해 동기화한 후, 공유 메모리에서 데이터를 처리하고, 마지막으로 결과를 전역 메모리에 다시 씁니다.
#include <stdio.h>

__global__ void sharedMemoryExample(float* input, float* output, int n) {
    // Declare shared memory array - visible to all threads in the block
    __shared__ float sharedData[256];

    // Calculate global thread ID
    int tid = blockIdx.x * blockDim.x + threadIdx.x;

    // Load data from global memory to shared memory
    if (tid < n) {
        sharedData[threadIdx.x] = input[tid];
    }

    // Synchronize to make sure all threads have loaded their data
    __syncthreads();

    // Process data in shared memory (simple example: add 1 to each element)
    if (tid < n) {
        sharedData[threadIdx.x] += 1.0f;
    }

    // Synchronize again before writing results back
    __syncthreads();

    // Write the processed data back to global memory
    if (tid < n) {
        output[tid] = sharedData[threadIdx.x];
    }
}
공유 메모리를 사용하면 그렇지 않을 경우 실용적이지 않았을 알고리즘 기법을 사용할 수 있습니다. 타일링 알고리즘에서는 데이터를 공유 메모리에 들어갈 수 있는 작은 덩어리(타일이라고 부릅니다)로 나누어 처리하므로, 전역 메모리 트래픽을 극적으로 줄여 행렬 곱셈 같은 연산이 이론적 최대 성능에 가까운 성능을 낼 수 있습니다. 스텐실 연산에서는 공유 메모리를 통해 스레드들이 겹치는 영역에서 협업할 수 있어 중복된 전역 메모리 로드가 제거됩니다. 합계나 최댓값 계산 같은 리덕션 연산에서는 공유 메모리가 블록 내에서 스레드들이 결과를 점진적으로 결합하는 효율적인 병렬 리덕션 패턴을 가능하게 합니다. 핵심 설계 패턴은 전역 메모리에서 공유 메모리로 데이터를 로드하고, 공유 메모리에서만 연산을 수행한 다음, 결과를 전역 메모리에 다시 쓰는 것입니다. 이를 통해 그렇지 않았다면 메모리 바운드였을 연산이 컴퓨트 바운드 연산으로 바뀌며, GPU의 주요 병목인 메모리 접근 지연 시간을 최소화하면서 GPU의 막대한 연산 처리량을 효과적으로 활용할 수 있습니다.
MLIR과 연결하기
자, 이제 우리의 목표는 고수준 텐서 연산을 동적으로(즉, 런타임에) 지정하고, MLIR을 사용하여 이를 적절한 GPU 코드로 로어링할 수 있게 하는 것입니다. MLIR의 점진적 로어링 기능을 활용하여, 잘 정의된 일련의 단계를 거쳐 고수준 텐서 연산을 최적화된 GPU 코드로 변환하겠습니다.
-
고수준 표현: 먼저
linalg다이얼렉트로 표현된 추상적인 텐서 계산(행렬 곱셈, 합성곱, 원소별 연산)에서 시작합니다. 이러한 연산은 구현 세부 사항 없이 순수한 수학적 의도만을 표현하므로, 코드를 도메인에 가깝게 유지할 수 있습니다. -
아핀 변환:
-convert-linalg-to-loops나-convert-linalg-to-affine-loops같은 패스를 사용하여 이러한 고수준 연산을affine다이얼렉트로 변환합니다. 이 다이얼렉트는 루프와 메모리 접근을 정밀한 수학적 관계로 표현합니다. 이를 통해 메모리 지역성과 계산 효율을 높이는 타일링, 융합, 루프 교환 같은 핵심 최적화의 기회가 드러납니다. -
GPU 매핑: 다음으로
-convert-affine-for-to-gpu와-convert-parallel-loops-to-gpu같은 패스를 통해 이러한 루프 구조를 GPU의 실행 모델에 매핑합니다. 이렇게 하면 코드가gpu다이얼렉트로 변환되며, 이 다이얼렉트는 하드웨어에 독립적인 상태를 유지하면서도 스레드 블록과 스레드 같은 개념을 명시적으로 표현합니다. -
하드웨어 특화 로어링: 마지막으로
nvvm다이얼렉트를 통해 NVIDIA 특화 기능으로 넘어가고, 최종적으로 GPU 인트린식을 포함한 LLVM IR로 전환합니다. 마지막 단계에서는 이를 NVPTX 어셈블리로, 그리고 다시 GPU에서 직접 실행되는 CUBIN 기계어 코드로 변환합니다.
이 파이프라인 전체에 걸쳐 각 로어링 단계는 프로그램 의미론을 보존하면서 대상 하드웨어에 점점 더 가까워집니다. 수학적 표현에서 명시적인 루프 중첩으로, 이어서 GPU 실행 구조로, 마지막으로 하드웨어 특화 코드로 체계적으로 변환합니다. 이 접근 방식을 사용하면 계산을 고수준에서 표현하면서도, 하드웨어의 성능을 최대한 활용하는 고도로 최적화된 GPU 코드를 생성할 수 있습니다.
gpu 다이얼렉트
MLIR의 GPU 다이얼렉트는 CUDA나 OpenCL과 유사한 프로그래밍 모델을 따르는 GPU 커널을 실행하기 위한 중간 수준의 추상화를 제공합니다. 이 다이얼렉트는 GPU 커널 실행에 필요한 장치별, 드라이버별 연산을 추상화하여, MLIR에서 GPU 실행으로 이어지는 간소화된 경로를 제공합니다.
이 다이얼렉트는 gpu를 정규 접두사로 사용하며, 일반적인 GPU 프리미티브를 감싸는 연산을 제공합니다. 이상적인 미래에는 이를 여러 GPU 백엔드를 대상으로 사용할 수도 있겠지만, 지금은 PTX로 로어링하는 것을 목표로 Nvidia 특화 연산에만 집중하겠습니다.
장치 연산
gpu.launch- 지정된 그리드 및 블록 차원으로 GPU 커널을 실행합니다. 블록 및 스레드 구성을 받으며 커널 본문을 포함합니다.gpu.launch_func- 지정된 그리드 및 블록 차원으로 GPU 함수를 실행합니다. 함수 참조와 블록 및 스레드 구성을 받습니다.gpu.barrier- 스레드 블록 내의 모든 스레드를 동기화하여, 실행을 계속하기 전에 모든 스레드가 이 지점에 도달하도록 보장합니다.gpu.binary- 로드하여 실행할 수 있는 컴파일된 GPU 코드(예: PTX 또는 CUBIN 형식)를 담은 바이너리 블롭을 나타냅니다.gpu.printf- C의 printf 함수와 유사하게, GPU 커널 내부에서 형식화된 출력을 인쇄합니다. GPU 코드를 디버깅할 때 유용합니다.gpu.return- GPU 함수/커널에서 호스트로 값을 반환합니다.gpu.terminator- GPU 실행 영역의 끝을 표시하며, gpu.launch 본문의 마지막 연산으로 반드시 있어야 합니다.gpu.wait- 호스트 실행을 계속하기 전에 비동기 GPU 연산이 완료될 때까지 기다립니다.gpu.yield- scf.yield와 유사하게, GPU 코드의 구조적 제어 흐름 영역에서 값을 내보냅니다.
스레드 및 블록 연산
gpu.block_id- 지정된 차원(x, y 또는 z)을 따라 그리드 내 현재 블록의 ID를 반환합니다gpu.block_dim- 지정된 차원(x, y 또는 z)을 따라 그리드 내 블록의 차원을 반환합니다gpu.block_size- 지정된 차원(x, y 또는 z)을 따라 블록 내 스레드의 총 개수를 반환합니다gpu.grid_id- 지정된 차원(x, y 또는 z)을 따라 현재 실행 중인 그리드의 ID를 반환합니다gpu.grid_dim- 지정된 차원(x, y 또는 z)을 따라 그리드의 차원을 반환합니다gpu.grid_size- 지정된 차원(x, y 또는 z)을 따라 그리드 내 블록의 총 개수를 반환합니다gpu.thread_id- 지정된 차원(x, y 또는 z)을 따라 해당 블록 내 현재 스레드의 ID를 반환합니다
메모리 연산
gpu.alloc- GPU 디바이스에 메모리를 할당합니다. 형태(shape)와 원소 타입을 받아 할당된 메모리를 가리키는 memref를 반환합니다.gpu.memcpy- 호스트와 디바이스 사이, 또는 디바이스 내의 서로 다른 위치 사이에서 메모리를 복사합니다. 호스트에서 디바이스로, 디바이스에서 호스트로, 디바이스에서 디바이스로의 전송을 모두 처리할 수 있습니다.gpu.dealloc- 이전에 gpu.alloc을 사용하여 GPU 디바이스에 할당한 메모리를 해제합니다.gpu.host_register- memref를 호스트 로컬 메모리로 등록하여 호스트가 직접 접근할 수 있게 합니다.gpu.host_unregister- 디바이스에서 접근할 수 있도록 등록된 memref의 등록을 해제합니다.
이 다이얼렉트는 특정 GPU 백엔드로 로워링할 수 있는 타깃 독립적인 표현으로 설계되었습니다. 이 다이얼렉트는 커널 호출을 위한 추상화를 제공하며, 향후에는 GPU용 LLVM IR 내장 함수(intrinsic)와 같은 하위 수준에는 없는 디바이스 관리 기능도 포함할 수 있습니다.
이 다이얼렉트는 GPU 코드가 gpu.module 연산 안에 구성되고, 커널은 gpu.func 연산으로 표현될 것을 전제로 합니다. 이러한 구조는 호스트 코드와 디바이스 코드를 명확하게 분리하여 컴파일 및 실행 파이프라인을 다루기 쉽게 해 줍니다. 디바이스 라이브러리 호출과 같은 비커널 함수는 func.func이나 GPU가 아닌 다른 다이얼렉트의 연산을 사용하여 정의할 수 있으므로, GPU 프로그램을 구성하는 방식에 어느 정도 유연성을 제공합니다.
module {

  // GPU module
  gpu.module @gpu_module {
    // GPU function
    gpu.func @kernel() {
        %0 = arith.addi %arg0, %arg0 : i32
        %1 = arith.addi %arg0, %arg0 : i32
        %2 = arith.addi %0, %1 : i32
        gpu.return
    }
  }

  // Host function
  func.func @main() {
      gpu.launch_func @gpu_module::@kernel
        blocks(%0, %1, %2) in (%3 = %c1, %4 = %c1, %5 = %c1)
        threads(%6, %7, %8) in (%9 = %c2, %10 = %c1, %11 = %c1)
        args()
  }
}
다른 방식으로는 gpu.launch 연산을 사용하는 것이 있으며, 이 연산은 런치 연산에 인자로 전달되는 영역(region)에 커널 함수를 내장합니다. gpu.terminator 연산은 영역의 끝을 표시하는 데 사용됩니다.
func.func @main() {
    %c2 = arith.constant 2 : index
    %c1 = arith.constant 1 : index
    gpu.launch
        blocks(%0, %1, %2) in (%3 = %c1, %4 = %c1, %5 = %c1)
        threads(%6, %7, %8) in (%9 = %c2, %10 = %c1, %11 = %c1) {
          gpu.printf "Hello from %d\n" %6 : index
          gpu.terminator
        }
    return
}
nvgpu 다이얼렉트
nvgpu 다이얼렉트는 MLIR 생태계에서 중개자 역할을 하며, gpu나 vector와 같은 상위 수준의 타깃 독립적인 다이얼렉트를 NVIDIA GPU 전용으로 설계된 하위 수준의 NVVM 다이얼렉트와 연결합니다. 이 다이얼렉트는 memref와 tensor 다이얼렉트 같은 MLIR의 고수준 추상화를 계속 사용하면서 PTX 전용 연산을 표현함으로써, 양쪽의 장점을 모두 살리는 다리 역할을 합니다.
이 다이얼렉트를 사용하면 복잡한 NVVM 내장 함수를 직접 다룰 필요 없이 NVGPU 다이얼렉트를 통해 NVIDIA 전용 하드웨어 기능에 접근할 수 있습니다. 이 중간 계층은 상위 수준 MLIR 표현의 명료성과 표현력을 유지하면서도 효율적인 GPU 코드 생성을 크게 단순화합니다.
이 다이얼렉트는 주로 전역 메모리와 공유 메모리 간의 효율적인 텐서 전송을 위한 Tensor Memory Accelerator(TMA)와 같은 고급 NVIDIA GPU 기능을 노출하는 데 중점을 둡니다. 또한 연산과 메모리 전송이 겹쳐 수행되도록 하여 지연 시간을 효과적으로 숨기는 비동기 메모리 연산 메커니즘도 제공합니다. 메모리 접근 패턴은 뱅크 충돌을 줄이는 스위즐링(swizzling) 기법을 통해 최적화되며, 메모리 배리어(mbarrier)는 스레드 간 연산을 조율하기 위한 정교한 동기화 도구를 제공합니다.
워프 수준 프로그래밍은 NVGPU 다이얼렉트에서 특별한 어텐션을 받으며, 워프 행렬 곱셈-누산 연산과 동기화 프리미티브 같은 하드웨어별 기능을 노출하는 세밀한 제어 기능을 제공합니다. 이러한 기능은 Hopper나 Blackwell 칩과 같은 최신 NVIDIA GPU의 특수 하드웨어 유닛을 활용하여 고성능 행렬 연산과 기타 연산 집약적인 워크로드를 구현하는 데 필수적입니다.
이 다이얼렉트는 컴파일 파이프라인에서 보다 범용적인 GPU 다이얼렉트와 하드웨어에 특화된 NVVM 다이얼렉트 사이에 위치하며, 이 위치는 전략적으로 중요합니다. 이러한 배치 덕분에 상위 수준의 개념을 최적화된 하드웨어 특화 연산으로 변환하면서도 개발자를 불필요한 복잡성으로부터 보호할 수 있습니다. 최종 코드를 생성할 때가 되면 -convert-nvgpu-to-nvvm 패스를 사용하여 NVGPU 다이얼렉트를 NVVM으로 로워링할 수 있으며, 이 패스는 NVGPU 연산을 대응하는 NVVM 다이얼렉트 인트린직으로 변환합니다.
이러한 기능은 이 시리즈에서 다루는 작은 백엔드의 범위를 벗어납니다. Part 12에서는 구조화된 텐서 계산과 타깃별 스케줄링 사이의 구분을 다시 다루며, 함께 제공되는 컴파일러는 CPU 실행 경로를 사용합니다.
nvvm 다이얼렉트
NVVM 다이얼렉트는 NVIDIA GPU용 LLVM IR을 표현하는 타깃 특화 다이얼렉트입니다. 이 다이얼렉트에는 스레드 및 블록 인덱싱, 동기화, 메모리 연산과 같은 GPU 특화 구성 요소를 위한 연산이 포함되어 있습니다.
NVVM IR은 LLVM IR을 기반으로 하는 컴파일러 IR(중간 표현)입니다. NVVM IR은 GPU 연산 커널(예: CUDA 커널)을 표현하도록 설계되었습니다. CUDA C 컴파일러 프런트엔드와 같은 고수준 언어 프런트엔드는 NVVM IR을 생성할 수 있습니다. (LLVM을 기반으로 하는) NVVM 컴파일러는 NVVM IR로부터 PTX 코드를 생성합니다.
| CUDA 내장 함수 | NVVM 인트린직 | MLIR 연산 |
|---|---|---|
threadId.{x,y,z} | @llvm.nvvm.read.ptx.sreg.tid.{x,y,z} | gpu.thread_id {x,y,z} |
blockIdx.{x,y,z} | @llvm.nvvm.read.ptx.sreg.ctaid.{x,y,z} | gpu.block_id {x,y,z} |
blockDim.{x,y,z} | @llvm.nvvm.read.ptx.sreg.ntid.{x,y,z} | gpu.block_dim {x,y,z} |
gridDim.{x,y,z} | @llvm.nvvm.read.ptx.sreg.nctaid.{x,y,z} | gpu.grid_dim {x,y,z} |
__syncthreads() | @llvm.nvvm.barrier0() | gpu.barrier |
MLIR Python 바인딩
MLIR Python 바인딩은 MLIR C++ 내부 구현에 대한 인터페이스를 제공하므로, 개발자는 명령줄 도구에 의존하지 않고도 MLIR의 중간 표현을 프로그래밍 방식으로 조작할 수 있습니다. 이 바인딩은 MLIR의 Core 기능을 Python으로 노출하므로, 사용자는 Python에서 직접 MLIR 텍스트를 파싱하고, MLIR AST를 구성 및 수정하고, 변환 패스를 적용하며, 나아가 MLIR 코드를 JIT 컴파일하여 실행할 수도 있습니다.
Python 바인딩을 사용하면 MLIR을 다루는 기존 명령줄 방식에 따르던 여러 불편함이 대부분 사라집니다. 개발자는 여러 명령줄 호출을 이어 붙이는 대신 Python 안에서 처음부터 끝까지 컴파일 파이프라인을 만들 수 있습니다. 그래서 개발 과정이 더 대화형이 되고 디버깅도 더 쉬워집니다. 하지만 이 바인딩은 LLVM과 MLIR에 대한 의존성이 복잡하기 때문에 소스에서 빌드하기가 어려울 수 있습니다. 도입을 쉽게 하기 위해 바인딩과 필요한 모든 의존성을 함께 패키징한 사전 빌드 휠이 제공됩니다. 덕분에 pip 명령 하나로 간단하게 설치할 수 있습니다.
바인딩을 설치하려면 pip를 사용하면 됩니다.
pip install mlir_python_bindings -f https://github.com/makslevental/mlir-wheels/releases/expanded_assets/latest
Poetry를 사용한다면 pyproject.toml에 다음 내용을 추가하십시오.
[tool.poetry.dependencies]
python = "^3.10"
mlir-python-bindings = { version = "*", source = "mlir-wheels"}

[[tool.poetry.source]]
name = "mlir-wheels"
url = "https://github.com/makslevental/mlir-wheels/releases/expanded_assets/latest"
priority = "supplemental"
이제 Python 바인딩을 사용하여 간단한 벡터 덧셈 커널을 PTX로 로어링해 봅시다.
module {
  func.func @square(%input: tensor<10x10xf32>, %output: tensor<10x10xf32>) -> tensor<10x10xf32> {
    %x0 = linalg.square ins(%input : tensor<10x10xf32>) outs(%output : tensor<10x10xf32>) -> tensor<10x10xf32>
    return %x0 : tensor<10x10xf32>
  }
}
여기서 패스를 적용합니다.
from mlir.ir import Context, Module
from mlir.passmanager import PassManager

mlir_module_str = open("vecadd.mlir").read()

with Context():
    # Parse the input module
    module = Module.parse(mlir_module_str)

pm = PassManager()
pm.enable_ir_printing(print_after_change=True)
pm.add("canonicalize")
pm.add(
    "one-shot-bufferize{ bufferize-function-boundaries function-boundary-type-conversion=identity-layout-map }"
)
pm.add("canonicalize")
pm.add("convert-linalg-to-affine-loops")
pm.add("func.func(affine-loop-invariant-code-motion)")
pm.add("func.func(convert-affine-for-to-gpu)")
pm.add("gpu-kernel-outlining")
pm.add("lower-affine")
pm.add("gpu-decompose-memrefs")
pm.add("expand-strided-metadata")
pm.add("normalize-memrefs")
pm.add(
    "gpu.module(convert-gpu-to-nvvm{index-bitwidth=0 use-bare-ptr-memref-call-conv })"
)
pm.add(f"nvvm-attach-target{ {chip={chip_type} features=+ptx80 O=3} }")
pm.add("convert-nvvm-to-llvm")
pm.add("reconcile-unrealized-casts")
pm.add("gpu-to-llvm { use-bare-pointers-for-host use-bare-pointers-for-kernels }")
pm.run(module.operation)

print(module)
여기서 일어나는 일이 많으므로 명령의 각 플래그를 하나씩 살펴봅시다.
one-shot-bufferize{ bufferize-function-boundaries function-boundary-type-conversion=identity-layout-map }: 단일 패스에서 텐서 연산을 버퍼 연산으로 변환합니다. 함수 경계는 항등 레이아웃 매핑으로 처리합니다.convert-linalg-to-affine-loops: 고수준 linalg 연산을 텐서 원소를 명시적으로 순회하는 affine 루프 중첩으로 변환합니다.func.func(affine-loop-invariant-code-motion): affine 루프에 루프 불변 코드 이동을 수행합니다. 가능하면 계산을 루프 밖으로 옮겨 중복 계산을 줄입니다.func.func(convert-affine-for-to-gpu): affine 루프를 GPU 실행 모델에 매핑하여 반복을 GPU 스레드와 블록에 분배합니다.gpu-kernel-outlining: GPU 커널 영역을 호스트 코드에서 실행할 수 있는 별도의 GPU 함수로 추출합니다.lower-affine: affine 다이얼렉트 연산을 표준 제어 흐름 연산과 산술 연산으로 변환합니다.gpu-decompose-memrefs: 복잡한 memref 타입을 GPU 백엔드가 처리할 수 있는 더 단순한 타입으로 분해합니다.expand-strided-metadata: 스트라이드 메모리 접근의 메타데이터를 명시적인 계산으로 전개합니다.normalize-memrefs: 메모리 참조를 GPU 백엔드가 기대하는 형태로 정규화합니다.gpu.module(convert-gpu-to-nvvm{index-bitwidth=0 use-bare-ptr-memref-call-conv }): GPU 다이얼렉트 연산을 NVVM 다이얼렉트(NVIDIA의 LLVM 기반 IR)로 변환합니다. memref에는 베어 포인터 호출 규약을 사용합니다.nvvm-attach-target{chip={chip_type} features=+ptx80 O=3}: NVVM 모듈에 타깃별 정보를 붙입니다. 이 정보에는 GPU 아키텍처, PTX 버전 8.0 기능, 최적화 수준 3이 포함됩니다.convert-nvvm-to-llvm: 이후 처리를 위해 NVVM 다이얼렉트를 표준 LLVM 다이얼렉트로 변환합니다.reconcile-unrealized-casts: 실현되지 않은 캐스트 연산을 조정하여 남은 타입 변환 문제를 해결합니다.gpu-to-llvm { use-bare-pointers-for-host use-bare-pointers-for-kernels }: 남은 GPU 다이얼렉트 연산을 LLVM 다이얼렉트로 변환합니다. 호스트 코드와 디바이스 코드 모두에 베어 포인터를 사용합니다.
convert-linalg-to-affine-loops로 linalg 연산을 affine 루프로 로어링하면 다음 MLIR 모듈을 얻습니다.
module {
  func.func @square(%arg0: memref<10x10xf32>, %arg1: memref<10x10xf32>) -> memref<10x10xf32> {
    affine.for %arg2 = 0 to 10 {
      affine.for %arg3 = 0 to 10 {
        %0 = affine.load %arg0[%arg2, %arg3] : memref<10x10xf32>
        %1 = arith.mulf %0, %0 : f32
        affine.store %1, %arg1[%arg2, %arg3] : memref<10x10xf32>
      }
    }
    return %arg1 : memref<10x10xf32>
  }
}
다음은 convert-affine-for-to-gpu 패스를 적용한 결과입니다. 이 패스는 affine 루프를 GPU 커널 실행 영역으로 변환합니다.
func.func @square(%arg0: memref<10x10xf32>, %arg1: memref<10x10xf32>) -> memref<10x10xf32> {
  %c0 = arith.constant 0 : index
  %c10 = arith.constant 10 : index
  %0 = arith.subi %c10, %c0 : index
  %c1 = arith.constant 1 : index
  %c0_0 = arith.constant 0 : index
  %c10_1 = arith.constant 10 : index
  %1 = arith.subi %c10_1, %c0_0 : index
  %c1_2 = arith.constant 1 : index
  %c1_3 = arith.constant 1 : index
  gpu.launch
    blocks(%arg2, %arg3, %arg4) in (%arg8 = %0, %arg9 = %c1_3, %arg10 = %c1_3)
    threads(%arg5, %arg6, %arg7) in (%arg11 = %1, %arg12 = %c1_3, %arg13 = %c1_3) {
    %2 = arith.addi %c0, %arg2 : index
    %3 = arith.addi %c0_0, %arg5 : index
    %4 = affine.load %arg0[%2, %3] : memref<10x10xf32>
    %5 = arith.mulf %4, %4 : f32
    affine.store %5, %arg1[%2, %3] : memref<10x10xf32>
    gpu.terminator
  }
  return %arg1 : memref<10x10xf32>
}
다음은 gpu-kernel-outlining 패스를 적용한 결과입니다. 이 패스는 GPU 커널 실행 영역을 별도의 GPU 함수로 추출합니다. 이 함수에는 블록 인덱스와 스레드 인덱스를 참조하는 GPU 내장 함수가 들어 있습니다.
module attributes {gpu.container_module} {
  func.func @square(%arg0: memref<10x10xf32>, %arg1: memref<10x10xf32>) -> memref<10x10xf32> {
    %c0 = arith.constant 0 : index
    %c10 = arith.constant 10 : index
    %0 = arith.subi %c10, %c0 : index
    %c1 = arith.constant 1 : index
    %c0_0 = arith.constant 0 : index
    %c10_1 = arith.constant 10 : index
    %1 = arith.subi %c10_1, %c0_0 : index
    %c1_2 = arith.constant 1 : index
    %c1_3 = arith.constant 1 : index
    gpu.launch_func  @square_kernel::@square_kernel
        blocks in (%0, %c1_3, %c1_3)
        threads in (%1, %c1_3, %c1_3)
        args(%c0 : index, %c0_0 : index, %arg0 : memref<10x10xf32>, %arg1 : memref<10x10xf32>)
    return %arg1 : memref<10x10xf32>
  }
  gpu.module @square_kernel {
    gpu.func @square_kernel(%arg0: index, %arg1: index, %arg2: memref<10x10xf32>, %arg3: memref<10x10xf32>) kernel {
      %block_id_x = gpu.block_id  x
      %block_id_y = gpu.block_id  y
      %block_id_z = gpu.block_id  z
      %thread_id_x = gpu.thread_id  x
      %thread_id_y = gpu.thread_id  y
      %thread_id_z = gpu.thread_id  z
      %grid_dim_x = gpu.grid_dim  x
      %grid_dim_y = gpu.grid_dim  y
      %grid_dim_z = gpu.grid_dim  z
      %block_dim_x = gpu.block_dim  x
      %block_dim_y = gpu.block_dim  y
      %block_dim_z = gpu.block_dim  z
      %0 = arith.addi %arg0, %block_id_x : index
      %1 = arith.addi %arg1, %thread_id_x : index
      %2 = affine.load %arg2[%0, %1] : memref<10x10xf32>
      %3 = arith.mulf %2, %2 : f32
      affine.store %3, %arg3[%0, %1] : memref<10x10xf32>
      gpu.return
    }
  }
}
나머지 패스는 GPU 다이얼렉트를 NVVM 다이얼렉트로 변환하는 꽤 기계적인 로어링 패스입니다. 그러면 GPU 커널을 담은 gpu.module이 들어 있는 모듈을 얻습니다.
module attributes {gpu.container_module} {
  llvm.func @square(%arg0: !llvm.ptr, %arg1: !llvm.ptr) -> !llvm.ptr {
    %0 = llvm.mlir.poison : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %1 = llvm.insertvalue %arg1, %0[0] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %2 = llvm.insertvalue %arg1, %1[1] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %3 = llvm.mlir.constant(0 : index) : i64
    %4 = llvm.insertvalue %3, %2[2] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %5 = llvm.mlir.constant(10 : index) : i64
    %6 = llvm.insertvalue %5, %4[3, 0] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %7 = llvm.mlir.constant(10 : index) : i64
    %8 = llvm.insertvalue %7, %6[4, 0] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %9 = llvm.mlir.constant(10 : index) : i64
    %10 = llvm.insertvalue %9, %8[3, 1] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %11 = llvm.mlir.constant(1 : index) : i64
    %12 = llvm.insertvalue %11, %10[4, 1] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %13 = llvm.mlir.poison : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %14 = llvm.insertvalue %arg0, %13[0] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %15 = llvm.insertvalue %arg0, %14[1] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %16 = llvm.mlir.constant(0 : index) : i64
    %17 = llvm.insertvalue %16, %15[2] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %18 = llvm.mlir.constant(10 : index) : i64
    %19 = llvm.insertvalue %18, %17[3, 0] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %20 = llvm.mlir.constant(10 : index) : i64
    %21 = llvm.insertvalue %20, %19[4, 0] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %22 = llvm.mlir.constant(10 : index) : i64
    %23 = llvm.insertvalue %22, %21[3, 1] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %24 = llvm.mlir.constant(1 : index) : i64
    %25 = llvm.insertvalue %24, %23[4, 1] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %26 = llvm.mlir.constant(1 : index) : i64
    %27 = llvm.mlir.constant(0 : index) : i64
    %28 = llvm.mlir.constant(10 : index) : i64
    %29 = llvm.extractvalue %25[1] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    %30 = llvm.extractvalue %12[1] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    gpu.launch_func  @square_kernel::@square_kernel blocks in (%28, %26, %26) threads in (%28, %26, %26) : i64 args(%27 : i64, %27 : i64, %29 : !llvm.ptr, %30 : !llvm.ptr)
    %31 = llvm.extractvalue %12[0] : !llvm.struct<(ptr, ptr, i64, array<2 x i64>, array<2 x i64>)>
    llvm.return %31 : !llvm.ptr
  }
  gpu.module @square_kernel [#nvvm.target<O = 3, chip = "sm_90", features = "+ptx80">] {
    llvm.func @square_kernel(%arg0: i64, %arg1: i64, %arg2: !llvm.ptr, %arg3: !llvm.ptr) attributes {gpu.kernel, nvvm.kernel} {
      %0 = llvm.mlir.constant(10 : index) : i64
      %1 = nvvm.read.ptx.sreg.ctaid.x : i32
      %2 = llvm.sext %1 : i32 to i64
      %3 = nvvm.read.ptx.sreg.tid.x : i32
      %4 = llvm.sext %3 : i32 to i64
      %5 = llvm.add %arg0, %2 : i64
      %6 = llvm.add %arg1, %4 : i64
      %7 = llvm.mul %5, %0 : i64
      %8 = llvm.add %7, %6 : i64
      %9 = llvm.getelementptr %arg2[%8] : (!llvm.ptr, i64) -> !llvm.ptr, f32
      %10 = llvm.load %9 : !llvm.ptr -> f32
      %11 = llvm.fmul %10, %10 : f32
      %12 = llvm.mul %5, %0 : i64
      %13 = llvm.add %12, %6 : i64
      %14 = llvm.getelementptr %arg3[%13] : (!llvm.ptr, i64) -> !llvm.ptr, f32
      llvm.store %11, %14 : f32, !llvm.ptr
      llvm.return
    }
  }
}
모듈에서 GPU 함수를 추출할 수 있습니다.
module {
      llvm.func @square_kernel(%arg0: i64, %arg1: i64, %arg2: !llvm.ptr, %arg3: !llvm.ptr) attributes {gpu.kernel, nvvm.kernel} {
        %0 = llvm.mlir.constant(10 : index) : i64
        %1 = nvvm.read.ptx.sreg.ctaid.x : i32
        %2 = llvm.sext %1 : i32 to i64
        %3 = nvvm.read.ptx.sreg.tid.x : i32
        %4 = llvm.sext %3 : i32 to i64
        %5 = llvm.add %arg0, %2 : i64
        %6 = llvm.add %arg1, %4 : i64
        %7 = llvm.mul %5, %0 : i64
        %8 = llvm.add %7, %6 : i64
        %9 = llvm.getelementptr %arg2[%8] : (!llvm.ptr, i64) -> !llvm.ptr, f32
        %10 = llvm.load %9 : !llvm.ptr -> f32
        %11 = llvm.fmul %10, %10 : f32
        %12 = llvm.mul %5, %0 : i64
        %13 = llvm.add %12, %6 : i64
        %14 = llvm.getelementptr %arg3[%13] : (!llvm.ptr, i64) -> !llvm.ptr, f32
        llvm.store %11, %14 : f32, !llvm.ptr
        llvm.return
      }
}
그런 다음 MLIR 모듈을 LLVM IR로 변환합니다.
; ModuleID = 'LLVMDialectModule'
source_filename = "LLVMDialectModule"

define ptx_kernel void @square_kernel(i64 %0, i64 %1, ptr %2, ptr %3) {
  %5 = call i32 @llvm.nvvm.read.ptx.sreg.ctaid.x()
  %6 = sext i32 %5 to i64
  %7 = call i32 @llvm.nvvm.read.ptx.sreg.tid.x()
  %8 = sext i32 %7 to i64
  %9 = add i64 %0, %6
  %10 = add i64 %1, %8
  %11 = mul i64 %9, 10
  %12 = add i64 %11, %10
  %13 = getelementptr float, ptr %2, i64 %12
  %14 = load float, ptr %13, align 4
  %15 = fmul float %14, %14
  %16 = mul i64 %9, 10
  %17 = add i64 %16, %10
  %18 = getelementptr float, ptr %3, i64 %17
  store float %15, ptr %18, align 4
  ret void
}

; Function Attrs: nocallback nofree nosync nounwind speculatable willreturn memory(none)
declare noundef i32 @llvm.nvvm.read.ptx.sreg.ctaid.x() #0

; Function Attrs: nocallback nofree nosync nounwind speculatable willreturn memory(none)
declare noundef i32 @llvm.nvvm.read.ptx.sreg.tid.x() #0

attributes #0 = { nocallback nofree nosync nounwind speculatable willreturn memory(none) }

!llvm.module.flags = !{!0}

!0 = !{i32 2, !"Debug Info Version", i32 3}
그런 다음 LLVM의 nvptx 백엔드를 사용해 PTX로 컴파일합니다. 이 백엔드는 llc를 통해 호출합니다.
//
// Generated by LLVM NVPTX Back-End
//

.version 7.8
.target sm_90
.address_size 64

    // .globl   square_kernel           // -- Begin function square_kernel
                                        // @square_kernel
.visible .entry square_kernel(
    .param .u64 square_kernel_param_0,
    .param .u64 square_kernel_param_1,
    .param .u64 .ptr .align 1 square_kernel_param_2,
    .param .u64 .ptr .align 1 square_kernel_param_3
)
{
    .reg .b32   %r<3>;
    .reg .f32   %f<3>;
    .reg .b64   %rd<15>;

// %bb.0:
    ld.param.u64    %rd1, [square_kernel_param_0];
    ld.param.u64    %rd2, [square_kernel_param_3];
    cvta.to.global.u64  %rd3, %rd2;
    ld.param.u64    %rd4, [square_kernel_param_1];
    ld.param.u64    %rd5, [square_kernel_param_2];
    cvta.to.global.u64  %rd6, %rd5;
    mov.u32     %r1, %ctaid.x;
    cvt.s64.s32     %rd7, %r1;
    mov.u32     %r2, %tid.x;
    cvt.s64.s32     %rd8, %r2;
    add.s64     %rd9, %rd1, %rd7;
    add.s64     %rd10, %rd4, %rd8;
    mad.lo.s64  %rd11, %rd9, 10, %rd10;
    shl.b64     %rd12, %rd11, 2;
    add.s64     %rd13, %rd6, %rd12;
    ld.global.f32   %f1, [%rd13];
    mul.rn.f32  %f2, %f1, %f1;
    add.s64     %rd14, %rd3, %rd12;
    st.global.f32   [%rd14], %f2;
    ret;
                                        // -- End function
}
MLIR 파이프라인
이제 두 모듈 compile.py와 run.py를 구성할 수 있습니다. 이 모듈은 GPU 코드 생성 파이프라인을 구현하여 고수준 MLIR을 최적화된 PTX 어셈블리로 변환합니다.
전체 소스 코드는 Github에서 볼 수 있으며 노트북으로도 제공됩니다.
이 예제에서는 전체 컴파일 과정을 조율하는 주 함수 compile_mlir_to_ptx를 정의합니다. 이 함수는 내부에서 먼저 MLIR 문자열을 파싱하여 모듈 표현으로 만든 다음, 신중하게 순서를 정한 일련의 변환 패스를 통해 GPU 컴파일 파이프라인을 적용합니다. 이 패스들은 코드를 고수준 텐서 연산에서 GPU 전용 구성 요소로 점진적으로 낮춥니다. 여기에는 메모리 접근을 처리하는 버퍼화, linalg 연산을 affine 루프로 변환하는 작업, 그 루프를 GPU 블록과 스레드에 매핑하는 작업, 마지막으로 NVVM 다이얼렉트를 통해 NVIDIA 전용 코드를 생성하는 작업이 포함됩니다. 변환이 끝나면 함수는 GPU 모듈을 추출하고 LLVM 도구를 사용해 PTX 어셈블리로 변환합니다. 그 결과 추가 컴파일 없이 NVIDIA GPU에서 바로 실행할 수 있는 코드가 만들어집니다.
import subprocess

from mlir.ir import Context, Module
from mlir.passmanager import PassManager


def compile_mlir_to_ptx(mlir_module_str: str, chip_type="sm_75"):
    """Compiles MLIR module string to PTX code."""
    with Context():
        # Parse the input module
        module = Module.parse(mlir_module_str)

        # Apply GPU compilation pipeline
        module, gpu_module = apply_gpu_pipeline(module, chip_type)

        # Generate PTX from the GPU module
        ptx = generate_ptx(str(gpu_module), chip_type)

    return ptx


def apply_gpu_pipeline(module, chip_type="sm_75"):
    """Applies the GPU compilation pipeline to the MLIR module."""
    pm = PassManager()
    pm.enable_ir_printing(print_after_change=True)
    pm.add("canonicalize")
    pm.add(
        "one-shot-bufferize{ bufferize-function-boundaries function-boundary-type-conversion=identity-layout-map }"
    )
    pm.add("canonicalize")
    pm.add("convert-linalg-to-affine-loops")
    pm.add("func.func(affine-loop-invariant-code-motion)")
    pm.add("func.func(convert-affine-for-to-gpu)")
    pm.add("gpu-kernel-outlining")
    pm.add("lower-affine")
    pm.add("gpu-decompose-memrefs")
    pm.add("expand-strided-metadata")
    pm.add("normalize-memrefs")
    pm.add(
        "gpu.module(convert-gpu-to-nvvm{index-bitwidth=0 use-bare-ptr-memref-call-conv })"
    )
    pm.add(f"nvvm-attach-target{ {chip={chip_type} features=+ptx80 O=3} }")
    pm.add("convert-nvvm-to-llvm")
    pm.add("reconcile-unrealized-casts")
    pm.add("gpu-to-llvm { use-bare-pointers-for-host use-bare-pointers-for-kernels }")
    pm.run(module.operation)

    # Extract the GPU module
    gpu_module = extract_gpu_module(module)

    return module, gpu_module


def extract_gpu_module(module: Module) -> Module:
    """Extracts the GPU module from a transformed MLIR module."""
    # Navigate the operation tree to find the GPU module
    # Structure: module -> region[0] -> block[0] -> operations[1] (GPU host-device code)
    # -> region[0] -> block[0] -> operations[0] (GPU module)
    try:
        main_func_op = module.operation.regions[0].blocks[0].operations[1]
        gpu_module_op = main_func_op.regions[0].blocks[0].operations[0]

        # Create a new module from the GPU module operation
        gpu_module = Module.parse(str(gpu_module_op))
        return gpu_module
    except (IndexError, AttributeError) as e:
        raise RuntimeError(f"Failed to extract GPU module: {e}") from e


def generate_ptx(gpu_module_str, chip_type="sm_75"):
    """Generates PTX from an MLIR GPU module string."""
    # First convert MLIR to LLVM IR
    llvm_ir_result = subprocess.run(
        ["mlir-translate", "--mlir-to-llvmir", "-"],
        input=gpu_module_str,
        capture_output=True,
        text=True,
    )

    if llvm_ir_result.returncode != 0:
        print("Error generating LLVM IR:")
        print(llvm_ir_result.stderr)
        return None

    llvm_ir = llvm_ir_result.stdout

    # Then convert LLVM IR to PTX
    ptx_result = subprocess.run(
        ["llc", "-march=nvptx64", f"-mcpu={chip_type}", "-"],
        input=llvm_ir,
        capture_output=True,
        text=True,
    )

    if ptx_result.returncode != 0:
        print("Error generating PTX:")
        print(ptx_result.stderr)
        return None

    return ptx_result.stdout
이제 run_kernel 함수를 정의할 수 있습니다. 이 함수는 Python 코드와 GPU 하드웨어 사이의 인터페이스 역할을 하며, 컴파일된 PTX 커널의 실행을 관리합니다. 이 함수는 PTX 코드 문자열, 커널 이름, 인자와 그 타입, 그리고 병렬화 전략을 정의하는 그리드 및 블록 차원을 받습니다. 이 함수는 먼저 CUDA 드라이버 API를 사용해 PTX 코드를 CUDA 모듈로 로드한 다음, 이름으로 지정한 커널 함수의 핸들을 가져옵니다. CUDA 런타임이 기대하는 형식으로 커널 인자를 준비한 뒤, 지정한 실행 구성으로 커널을 실행합니다. 이 구성은 몇 개의 스레드 블록과 블록당 몇 개의 스레드가 데이터를 처리할지를 결정합니다.
def run_kernel(
    ptx_code,
    kernel_name,
    args,
    arg_types,
    grid_dims,
    block_dims,
):
    """Run a PTX kernel."""
    module = checkCudaErrors(cu.cuModuleLoadData(ptx_code.encode("utf-8")))

    kernel_func = checkCudaErrors(
        cu.cuModuleGetFunction(module, kernel_name.encode("utf-8"))
    )

    kernel_args = (tuple(args), tuple(arg_types))

    checkCudaErrors(
        cu.cuLaunchKernel(
            kernel_func,
            grid_dims[0],
            grid_dims[1],
            grid_dims[2],
            block_dims[0],
            block_dims[1],
            block_dims[2],
            0,  # shared memory bytes
            0,  # stream
            kernel_args,  # kernel args
            0,  # extra
        )
    )

    checkCudaErrors(cu.cuCtxSynchronize())

    checkCudaErrors(cu.cuModuleUnload(module))
다음 코드는 이 컴파일 파이프라인을 사용하여 GPU 커널을 실행하는 완전한 엔드투엔드 예제입니다. 먼저 파일의 MLIR 코드를 PTX 어셈블리로 컴파일한 다음, CUDA 컨텍스트를 설정하고 호스트와 디바이스 양쪽에 메모리를 할당합니다. 이 예제는 각 스레드가 원소 하나를 처리하는 정방 행렬 연산을 준비하며, 그리드 차원은 행렬의 행 수에, 블록 차원은 열 수에 맞추어 계산을 구성합니다. 입력 데이터를 GPU로 복사한 뒤 적절한 인자와 차원으로 커널을 실행하고, 결과를 다시 호스트의 NumPy 배열로 가져옵니다.
import ctypes
import numpy as np
import cuda.cuda as cu
import cuda.cudart as cudart
import cuda.nvrtc as nvrtc
import subprocess
from compile import compile_mlir_to_ptx
from run import run_kernel

ptx_code = compile_mlir_to_ptx(open('square.mlir').read())

cuda_context = setup_cuda()

try:
    # Allocate device memory
    d_input = allocate_device_memory(input_data.nbytes)
    output_data = np.zeros((size, size), dtype=np.float32)
    d_output = allocate_device_memory(output_data.nbytes)

    # Copy input data to device
    copy_host_to_device(input_data, d_input)

    # Run kernel
    grid_dims = (size, 1, 1)  # One thread block per row
    block_dims = (size, 1, 1)  # One thread per column

    # Prepare arguments according to the PTX code
    # square_kernel(
    #     .param .u64 square_kernel_param_0,                // Grid dimension offset
    #     .param .u64 square_kernel_param_1,                // Block dimension offset
    #     .param .u64 .ptr .align 1 square_kernel_param_2,  // Input pointer
    #     .param .u64 .ptr .align 1 square_kernel_param_3   // Output pointer
    # )
    args = [
        0,  # Grid dimension offset
        0,  # Block dimension offset
        d_input,  # Input pointer
        d_output,  # Output pointer
    ]
    arg_types = [ctypes.c_int, ctypes.c_int, None, None]  # Using None for pointer types

    print("Running kernel on GPU...")
    run_kernel(
        ptx_code,
        "square_kernel",
        args,
        arg_types,
        grid_dims,
        block_dims,
    )

    # Copy results back to host
    copy_device_to_host(d_output, output_data)

    # Verify results
    print("Verifying results...")
    np.testing.assert_allclose(output_data, expected_output, rtol=1e-5)
    print("Success! Results verified.")

finally:
    # Clean up resources
    free_device_memory(d_input)
    free_device_memory(d_output)
    cleanup_cuda(cuda_context)
이것으로 끝입니다. 작은 컴파일러 백엔드의 뼈대가 완성되었습니다. MLIR 텐서 연산이 들어가면 커널이 GPU에서 실행됩니다. 9부에서는 Python에 임베딩된 작은 언어로부터 그 MLIR을 생성합니다. 먼저 원소별 표현식부터 시작한 다음, 트랜스포머에 필요한 리덕션과 행렬 연산을 추가하겠습니다.
바이너리 임베딩
덧붙이자면, GPU 커널을 컴파일하는 또 다른 방법은 커널을 바이너리로 컴파일하고, 그 바이너리를 MLIR 모듈에 임베딩한 다음, 호스트 코드가 바이너리를 로드하여 커널을 실행하도록 하는 것입니다.
MLIR의 gpu.binary 연산은 GPU 디바이스에 로드하여 실행할 수 있는 컴파일된 GPU 커널을 나타냅니다. 이 연산은 GPU 코드의 바이너리 표현을 담고 있으며, 그 형식은 PTX 어셈블리, CUBIN 바이너리, AMD GPU용 HSACO 등 다양할 수 있습니다. 이 연산은 미리 컴파일된 GPU 커널을 MLIR 모듈에 직접 임베딩하려 할 때 특히 유용하며, 런타임에 컴파일 파이프라인을 거치지 않고 바로 실행할 수 있게 해 줍니다.
gpu-module-to-binary 패스는 GPU 모듈을 GPU 바이너리로 변환하는 변환입니다. 이 패스는 MLIR 모듈을 훑어 중첩된 모든 GPU 모듈을 찾고, 각 모듈에 붙은 타깃 속성에 따라 이를 직렬화합니다. 이 패스는 지정된 모든 타깃 아키텍처마다 객체 하나씩을 담은 GPU 바이너리를 생성합니다. 이 패스는 오프로딩 표현, 어셈블리 코드, 바이너리, 팻바이너리 등 다양한 출력 형식을 지원합니다.
내부적으로 하는 일은 PTX 코드에 ptxas를 실행하고, gpu-module-to-binary 패스가 ptxas 명령에 전달한 인자와 함께 그 출력을 MLIR 모듈에 임베딩하는 것뿐입니다. 예를 들어 다음 MLIR 모듈은 sm_70 아키텍처용 GPU 바이너리를 담고 있습니다.
module attributes {gpu.container_module} {
  gpu.binary @vecadd_kernel  [
    #gpu.object<#nvvm.target<chip = "sm_70">,
    offload = "BC\C0\DE5\14 [... truncated ...] kernel20.1.0nvptx64-nvidia-cudaLLVMDialectModule\00\00\00\00">]
}
그런 다음 호스트 코드에서 다음과 같이 커널을 실행할 수 있습니다.
gpu.launch_func @vecadd_kernel::@vecadd_kernel
  blocks in (%0, %0, %0)
  threads in (%0, %0, %0) : i64
  args(%1 : i32, %2 : i64)
외부 자료
- Linux용 CUDA 설치 가이드
- CUDA C 프로그래밍 가이드
- CUDA C 모범 사례 가이드
- CUDA Toolkit 문서 12.6
- CUDA Python API
- CUDA Python launchKernel
- CUDA 복습: CUDA 프로그래밍 모델
- NVVM IR 명세
- NVPTX 백엔드를 위한 LLVM 사용자 가이드
- Cuda 빠른 시작 가이드
- 2024 EuroLLVM - Zero to Hero: MLIR의 NVGPU 다이얼렉트로 Nvidia Hopper Tensor Core 프로그래밍하기
- LLVM 빌드를 위한 Dockerfile 가이드
- PTX 이해하기: CUDA GPU 컴퓨팅의 어셈블리 언어
- cuBLAS (nvmath.bindings.cublas)
- cuda.core - CUDA 런타임에 대한 파이썬다운 접근
가상의 신성한 서명
히브리서의 저자는 “믿음은 바라는 것들의 실상이요 보이지 않는 것들의 증거“라는 유명한 주장을 남겼는데, 이는 보통 사람이 맞닥뜨리는 가장 큰 계산 과제가 자기 손가락을 세는 일이었던 시대에는 충분히 쓸 만한 신학적 땜질이었습니다. 그러나 은하를 시뮬레이션하고 유전체를 해독할 수 있는 시대에, “나 신이야, 그냥 믿어“는 현대인에게 그다지 설득력 있는 논증이 아닙니다. 때맞춘 일식이나 유난히 시끄러운 떨기나무에 쉽게 감탄하던 염소 치던 우리 조상들과는 다릅니다. 진정으로 전지한 존재가 기술 문명을 이룬 종과 “과학적 세속 언약“을 맺고자 한다면, 주관적인 감정이나 모호한 꿈에 의존하지는 않을 것입니다. 대신 그 존재는 계산 복잡도라는 냉정하고 엄밀한 렌즈를 통해 신성한 서명을 제시할 것입니다. 즉, 돌판에 새길 수 있을 만큼 간결하지만, 그것을 찾아내는 데 관측 가능한 유니버스에 존재하는 것보다 더 많은 에너지가 필요할 만큼 수학적으로 밀도 높은 주장들의 집합입니다.
단순한 이야기를 넘어 객관적 증명의 영역으로 나아가려면, 텍스트는 물질 유니버스 안의 모든 자기 완결적 시스템이 낼 수 있는 최대 계산 속도의 물리적 한계인 브레머만 한계를 넘어섰음을 입증해야 합니다. 아인슈타인의 질량-에너지 등가성과 하이젠베르크의 불확정성 원리에서 도출되는 이 한계는 킬로그램당 초당 약 비트입니다. 이 한계의 “약한” 버전은 지구 질량의 컴퓨터가 수십억 년 동안 작동하는 경우를 상정하고, “강한” 버전은 관측 가능한 유니버스의 모든 원자와 모든 세제곱미터의 공간을 열적 죽음에 이를 때까지 동원하는 경우를 상정합니다. 강한 한계마저 넘어서는 문제들의 답을 제시함으로써, “신성한” 저자는 자신이 우리의 국소적인 엔트로피와 처리 능력의 제약 바깥에 존재하는 플랫폼에서 활동하고 있음을 증명하며, 사실상 인간의 어떤 창의력이나 노력으로도 위조할 수 없는 화려한 필치로 자기 작품에 서명하는 셈입니다.
플라톤주의자라면 신성한 존재는 이러한 답을 계산하는 것이 아니라, 수학적 실재 그 자체의 근거이기에 2+2=4임을 아는 것처럼 그저 알고 있을 뿐이라고 반박할 수도 있습니다. 이는 형이상학적으로 타당한 지적이지만, 인식론적 논증과는 무관합니다. 그 지식을 초계산으로 얻든, 직접적인 수학적 직관으로 얻든, 수학적 진리의 존재론적 근원이기에 얻든, 텍스트 속에서 그 지식을 보여 준다는 것은 여전히 유한한 물리적 지성을 넘어서는 무언가의 증거입니다. 이 서명의 힘은 신이 거대한 컴퓨터를 가지고 있음을 증명하는 데 있는 것이 아니라, 저자가 물리적으로 유한한 어떤 과정으로도 만들어 낼 수 없었을 지식을 가지고 있음을 증명하는 데 있습니다. 메커니즘은 중요하지 않습니다. 중요한 것은 정보 이론적 사실입니다.
개인적으로 저는 초자연적인 믿음을 전혀 가지고 있지 않으며, 그런 믿음을 가진 사람들에게도 담담하게 무관심합니다. 하지만 좋은 가설은 반증 가능해야 하며, 지적 정직성은 어떤 증거가 제 생각을 바꿀지 밝힐 것을 요구합니다. 검증된 이런 종류의 신성한 서명이라면 바로 그 역할을 할 것입니다. 물론 저는 물질적 설명이 모두 바닥날 때까지 그것을 기본값으로 삼겠지만, 이 사고 실험은 유물론이 반증 불가능한 교조가 아님을 보여 줍니다. 유물론이 무너질 정확한 조건을 명확히 제시할 수 있기 때문입니다.
신성한 소인수분해. 예언의 구절은 이렇게 쓰일 수 있습니다. “보십시오, 큰 수 을. 그 길이는 이만 자리에 이르며, 와 의 결합에서 났으니, 그 밖의 어떤 수도 이를 나누지 못할 것입니다.” 이는 분명히 정수 인수분해 문제를 가리킵니다. 이만 자리는 그리 많은 분량의 텍스트도 아닙니다. 레반트 목동 사십 대를 기록한 “낳고” 목록보다도 훨씬 짧습니다. 두 소수를 곱해 20,000자리 반소수를 얻는 것은 간단한 연산이지만, 그 과정을 거꾸로 되돌리는 것은 사실상 풀 수 없는 문제입니다. 예를 들어 RSA-129는 1977년에 1억 달러의 상금과 함께 공개되었으며 17년 동안 인수분해되지 않았습니다.
겨우 129자리인데도, 1994년에 이를 인수분해하는 데는 대규모 분산 컴퓨팅 작업이 필요했습니다. 20,000자리 반소수는 완전히 다른 유니버스의 이야기입니다. 일반 수체 체(General Number Field Sieve)를 사용하더라도, 20,000자리 수를 인수분해하는 데 필요한 클록 사이클은 관측 가능한 유니버스에서 사용할 수 있는 총에너지를 넘어섭니다. 이는 무한한 시간 없이는 어떤 유한한 지성도 넘을 수 없는 열역학적 장벽입니다. 우리에게 검증은 간단합니다. 제시된 두 수를 곱해 과 일치하는지 확인하기만 하면 되며, 이는 평범한 스마트폰으로도 1초도 안 되는 시간에 끝낼 수 있는 작업입니다.
램지의 계시. 경전은 이렇게 선포할 것입니다. “열 명의 형제와 열 명의 나그네가 영혼의 전당에 모이면, 반드시 열의 무리나 열의 광야가 있을 것입니다. 보십시오, 그들의 연결 지도를.” 이는 로 표기되는 램지 수의 구성적 하한을 다룹니다. 알려진 대각 램지 수는 다음과 같습니다.
우리는 조차 정확한 값으로 확정하지 못합니다. 조합의 수가 너무 빠르게 늘어나기 때문에 계산이 “불가능“하기로 유명합니다. 의 정확한 값을 크기 10인 클리크를 피하는 구체적인 그래프 색칠과 함께 제시하는 일은 말로 하기에는 간결하지만, 우리 우주에서는 열역학적으로 접근할 수 없는 탐색 공간을 헤쳐 나가야 합니다. 이를 실감할 수 있도록 비교하자면, 노드가 1,000개인 그래프의 간선을 두 가지 색으로 칠하는 방법의 수는 이고, 관측 가능한 우주의 원자 수는 대략 입니다. 이 탐색 공간은 수학적으로 어떤 물리적 컴퓨터가 처리할 수 있는 양보다도 큽니다. 우리는 그래프 하나만 검증하면 되지만, 저자는 그 전부를 탐색해야 했습니다. 이 건초 더미에서 특정한 “바늘” 그래프를 찾아낸다는 것은 우주를 초월하는 처리 능력을 지녔다는 합리적인 증거입니다. 검증은 우리에게 간단합니다. 제공된 인접 행렬을 스크립트로 훑어 모든 간선이 같은 색인 10개 노드의 묶음이 존재하지 않음을 확인하기만 하면 되기 때문입니다. 이는 다항 시간 연산 으로, 현대 하드웨어로 쉽게 처리할 수 있습니다.
원의 비밀 체크섬. 경전은 이렇게 명할 것입니다: “원의 척도에서 번째 자리를 찾아보십시오. 그곳에서 천 개의 0과 그 뒤를 잇는 별들의 메시지를 발견할 것입니다.” 이는 베일리–보와인–플루프 알고리즘을 활용합니다. 이 알고리즘을 쓰면 앞선 자릿수를 계산하지 않고도 의 16진법 자리 숫자를 계산할 수 있습니다:
현재 우리는 흥미로운 패턴을 찾기 위해 를 번째 자리까지 훑어볼 수 없으며, 의 정보 엔트로피로 미루어 볼 때 그렇게 먼 좌표에서 그처럼 엔트로피가 낮은 이상 현상이 우연히 나타나는 것은 통계적으로 불가능합니다. 경전이 멀리 떨어진 특정 좌표에서 천 개의 0을 정확히 예언한다면, 이는 저자가 그것을 “탐색“한 것이 아니라 수학의 기본 상수 자체를 창조했거나, 무리수의 구조에 대한 무한한 예지를 지니고 있음을 의미합니다. 덧붙여 이는 칼 세이건의 소설 콘택트의 줄거리 요소이기도 했습니다. 이 소설에서는 의 자릿수 깊숙이 숨겨진 메시지가 우주를 설계한 이들의 서명 역할을 합니다. 검증은 행성 규모의 전념한 노력이 있다면 가능합니다. BBP 알고리즘의 시간 복잡도는 이므로, 특정 좌표를 확인하는 일은 그런 좌표를 찾아 훑는 일보다 훨씬 저렴합니다.
오일러의 꿈의 종말. 예언자는 이렇게 말할 것입니다. “열두 제곱 열둘은 제 카인드를 열둘이나 필요로 하는 듯하나, 하나와 같아지는 열하나를 찾으라. 이 정수들에서 그것들을 찾으리라.” 이는 오일러의 거듭제곱 합 추측의 최소 반례를 겨냥한 것으로, 이 추측은 또 다른 거듭제곱이 되도록 합하려면 개의 거듭제곱이 필요하다고 주장합니다.
인류는 수 세기에 걸친 탐색 끝에 와 의 반례를 찾아냈지만, 의 해를 제시하는 것은 우주적 규모의 건초 더미에서 바늘 찾기 문제일 것입니다. 이는 본질적으로 사실상 무한한 디오판토스 공간을 탐색하는 일입니다. 이 주장은 쉽게 검증할 수 있습니다. 제공된 정수들을 고정밀 계산기에 대입하여 방정식의 좌변이 우변과 정확히 같은지 확인하면 되므로, 거대한 탐색 문제가 간단한 산술 확인으로 바뀝니다.
비지 비버의 안식. 예언의 구절은 이렇게 말할지도 모릅니다: “상태가 스물인 기계를 생각하십시오. 그 방식은 단순하나, 정확히 걸음 동안 수고한 뒤 안식을 찾을 것이며, 그 누구도 그 수고의 날수를 헤아리지 못할 것입니다.” 이것은 컴퓨터 과학의 최종 보스인 비지 비버 함수 입니다. 이 함수는 사실상 정지 문제를 푸는 것과 같으므로, 이 값들을 계산하는 일반적인 알고리즘은 존재하지 않습니다. 이 값들은 수학적으로 계산 불가능합니다. 인류는 영웅적인 노력 끝에 가장 작은 기계들에 대해서만 값을 증명해 냈습니다:
상태가 다섯 개를 넘어서면 이 함수는 상상을 초월할 만큼 폭발적으로 커집니다. 은 10을 15층으로 쌓은 탑인 를 넘는 것으로 알려져 있습니다. 상태가 20개인 튜링 기계의 정확한 정지 시간을 밝히는 것은 신급 과시입니다. 저자가 정지 문제의 논리적 불가능성 자체를 우회했다는 뜻이기 때문입니다. 검증은 기술된 특정 기계를 시뮬레이션하여 정지할 때까지의 걸음 수를 세기만 하면 될 만큼 간단하며, 우리 쪽에서는 창의적인 수학이나 알고리즘상의 돌파구가 전혀 필요하지 않습니다.
구의 입맞춤. 경전에는 이렇게 쓰여 있을 것입니다: “백 겹의 깊이를 지닌 영역에서, 구들이 포도송이처럼 모인 그곳에서, 정확히 개가 중심의 심장에 맞닿을 것입니다.” 이는 접촉수 문제를 가리킵니다. 같은 크기의 중심 구에 서로 겹치지 않는 구가 몇 개까지 닿을 수 있습니까? 3차원에서는 답이 12이며, 술 한잔하며 머릿속에 그려 볼 수 있을 만큼 쉽습니다. 8차원에서는 답이 240입니다. 24차원에서는 리치 격자의 우아한 구조 덕분에 196,560입니다. 그러나 24차원을 넘어서면 계산을 다룰 만하게 만들어 주는 이러한 격자 최적화가 없습니다. 100차원에서는 대칭성이 너무 복잡해서 최고의 슈퍼컴퓨터로도 모호한 범위밖에 얻지 못합니다. 서로 겹치지 않는 구들의 가능한 배치 수는 조합론적 악몽으로 폭발하며, 정확한 최댓값을 구하려면 너무나 광대한 고차원 탐색 공간을 헤쳐 나가야 하므로, 양자 어닐링을 활용하는 고도의 지성조차 진정한 전역 최적점이 아닌 국소 최댓값에 안주할 가능성이 큽니다. 정확한 정수를 제시한다면 고차원 공간을 완벽하게 통달했음을 드러내는 셈이며, 이는 저자가 100차원 다양체를 간단한 구슬치기 놀이처럼 편안하게 누비고 있음을 시사하는 종류의 통찰입니다. 결과를 검증하려면 제공된 구들의 좌표를 확인하여 임의의 두 구 중심 사이의 거리가 다음을 만족하는지 확인하면 됩니다:
동시에 각 중심이 를 만족하는지도 확인하면 되며, 이는 기초적인 선형대수입니다.
소수의 거인. 그 텍스트는 이렇게 말할 수 있습니다: “ 꼴의 백만 번째 소수는 가 바로 이 거대한 수일 때 발견되리라.” 이는 “깊은” 메르센 소수, 즉 을 가리킵니다. 우리는 GIMPS와 같은 전 지구적 분산 컴퓨팅 네트워크를 사용하고도 이러한 소수를 약 50개밖에 찾지 못했지만:
백만 번째 메르센 소수의 “먼” 지수를 제시하는 것은 수직선의 비밀 구조로 들어가는 암호를 제시하는 것과 같습니다. 그것을 찾으려면 소수 분포에 대한 “신의 시점“이 필요하며, 이는 아마도 리만 가설의 증명을 요구할 것입니다. 검증은 우리에게 꽤 효율적입니다. 제시된 지수에 대해 뤼카-레머 판정법을 실행하기만 하면 되는데, 이는 결정론적이며 잘 알려진 소수 판정법입니다.
소수의 거대한 사막. 그 텍스트는 이렇게 선포할 것입니다: “다른 어떤 수로도 나누어지지 않는 이웃한 수들 사이에서 만 걸음에 이르는 첫 번째 사막을 찾으라. 그것은 백 자리의 이 수에서 시작하리라.” 소수 간격은 연속한 소수 사이의 차이입니다. 간격은 로그적으로 커지는 경향이 있지만, 특정한 큰 임계값을 넘는 첫 번째 간격을 찾으려면 엄청난 범위의 후보를 탐색해야 합니다. 알려진 가장 큰 소수 간격들은 철저한 계산을 통해 발견되었으며, 전례 없는 크기의 간격이 처음 나타나는 위치를 예측하는 것은 현재 우리의 능력을 훨씬 넘어서는 소수 분포에 대한 지식을 입증하는 일이 될 것입니다. 검증은 간단합니다. AKS 소수 판정법(결정론적 다항 시간 알고리즘)을 사용해 양 끝점이 소수임을 확인하고, 그 사이의 어떤 정수도 소수가 아님을 확인하기만 하면 되며, 이는 “고작” 만 정도의 간격이라면 충분히 가능합니다.
디오판토스의 열쇠. 그 텍스트는 이렇게 말할 것입니다: “세 개의 세제곱수가 모이고 그 합은 마흔둘이 되리라. 열일곱 자리의 수들 가운데서 그것들을 찾으라. 그러면 거기서 진리를 발견하리라.” 인류는 2019년에 행성 규모의 컴퓨터 네트워크를 사용하여 에 대한 세 세제곱수의 합의 해를 찾았지만:
훨씬 더 복잡한 방정식의 해를 제시하는 것은 문제를 힐베르트의 열 번째 문제의 영역으로 옮겨 놓습니다. 이 문제는 일반적으로 결정 불가능하므로 이를 푸는 “방법“은 존재하지 않습니다. 모든 디오판토스 방정식을 푸는 프로그램은 작성할 수 없습니다. 충분히 복잡한 방정식의 해를 찾는다는 것은 무한한 정수 집합을 훑어보고 그 속에서 바늘을 “골라낼” 수 있는 능력을 의미합니다. 신성한 해답은 단순한 계산을 초월합니다. 그것은 결정 불가능한 공간에 대한 통찰이며, 그 저자가 정지 문제에 얽매이지 않는다는 것을 시사합니다. 검증은 자명함 그 자체입니다. 제시된 세 정수를 세제곱하여 더한 뒤, 그 합이 목표 상수와 같은지 확인하면 됩니다.
타당한 반론이 있습니다. 나는 실제로 내 믿음을 갱신할 것인가, 아니면 단지 시간 여행자, 시뮬레이션 운영자, 외계인을 포함하도록 자연주의적 가설의 공간을 넓힐 것인가? 이는 극단적인 사전 확률 아래에서의 베이즈 추론에 관한 정당한 우려입니다. 솔직히 답하자면, 단 하나의 서명이라면 실제로 그러한 설명적 곡예를 불러일으킬 것입니다. 그러나 고대 텍스트에 서로 다른 복잡도 클래스에 걸친 여러 개의 독립적인 서명, 즉 램지 구성, 메르센 지수, 비지 비버 값이 담겨 있다면 논증은 질적으로 달라집니다. 청동기 시대 문명이 외계인의 개입을 포함한 어떤 자연적 과정으로든 이 세 가지를 모두 우연히 발견할 확률은 사실상 0으로 수렴합니다. 어느 시점에 이르면 “초우주적 지성이 이것을 썼다“는 것이 가장 터무니없는 설명이 아니라 가장 단순한 설명이 됩니다.
“시뮬레이션 운영자” 가설을 더 신중하게 살펴봅시다. 만약 우리 우주가 시뮬레이션이고 그 운영자들이 고대 텍스트에 검증 가능한 서명을 심어 두었다면, 이것은 정확히 무엇이 유신론과 다릅니까? 우리는 우리의 현실을 창조했고, 우리의 물리 법칙 안에서 접근할 수 있는 그 무엇도 넘어서는 지식을 지녔으며, 저술된 텍스트를 통해 소통하기로 선택했고, 우리 우주의 “바깥“에 존재하는 지성을 마주하게 될 것입니다. 이것은 유물론자의 비상구가 아닙니다. 실험 가운을 걸친 유신론입니다. 충분히 발전한 외계인에게도 마찬가지입니다. 그들이 브레머만 한계를 우회할 수 있다면, 그들은 우리 우주의 물리적 제약 바깥에서 완전히 작동하고 있는 것입니다. 그 시점에서 “외계인“과 “신“의 구분은 그저 느낌의 차이일 뿐입니다. 검증된 신성한 서명이 반드시 아브라함의 신을 증명하지는 않겠지만, 우리 우주가 물리적 한계를 넘어선 지성에 의해 저술되었거나 통치된다는 것은 증명할 것이며, 이것이 바로 문화적 외피를 벗겨 낸 유신론의 핵심(Core) 형이상학적 주장입니다. “시뮬레이터“로의 후퇴는 후퇴가 아닙니다. 그것은 회피처럼 보이는 양보입니다.
신학자는 하나님이 자유의지를 보존하거나 믿음을 시험하기 위해 일부러 그러한 증거를 내놓지 않는 것이라고 반박할 수도 있습니다. 이 변론은 완벽하게 일반적이며, 바로 그 때문에 완벽하게 공허합니다. 이 변론은 “나의 하나님은 존재하지만 그것을 증명하지 않기로 선택하신다“는 말을 실질적인 주장에서 반증 불가능한 동어반복으로 바꾸어 놓습니다. 증거를 제공할 수 있으면서도 제공하지 않는 하나님은, 적어도 합리적 믿음 형성이라는 목적에서는, 존재하지 않는 하나님과 조작적으로 구별할 수 없습니다.
또한 계산 복잡도는 21세기 컴퓨터 과학자들의 편협한 관심사일 뿐이며 고대의 청중에게는 아무 의미가 없다고 반론할 수도 있습니다. 이 말은 절반만 맞습니다. 20,000자리 수는 청동기 시대의 양치기에게 분명히 잡음에 불과했을 것입니다. 그러나 메시지가 모든 세대에게 존재하기 위해 모든 세대가 그것을 이해해야 하는 것은 아닙니다. 소인수분해는 어떤 문명이 그것을 알아볼 수 있는 수학을 발전시킬 때까지 텍스트 속에 가만히 잠들어 있다가, 그 시점에 이르러 저작자임을 입증하는 시간 지연 증명이 됩니다. 이것은 결함이 아니라 장점입니다. 충분히 발전한 문명에게만 모습을 드러내는 서명은 조잡하게 자신을 알리는 서명보다 더 우아합니다.
물론 실제로 이렇게 하는 종교 경전은 현존하지 않습니다. 여러 “성경 코드” 현상이 상당한 흥분을 불러일으켰지만, 결국 통계적 파레이돌리아로 판명되어 논파되었습니다. 가능한 모든 인코딩을 다 확인해 본 것은 아니라고 주장할 수도 있겠지만, 이는 보르헤스의 바벨의 도서관의 논리입니다. 조합의 자유가 충분히 주어지면 무엇에서든 무엇이든 찾아낼 수 있습니다. 입증 책임은 반대쪽에 있습니다. “아람어로 일곱 번째 글자마다 읽으면 숨겨진 20,000자리 소인수분해가 있을지도 모른다“는 것은 연구 프로그램이 아니라 정신 승리입니다. 대신 이 경전들은 주로 누구와 잠자리를 해도 되는지, 고기 위에 어떤 종류의 치즈를 올려도 되는지와 같은 존재의 정말 중요한 문제들에 집중하는데, 이는 청동기 시대의 상상력 이상을 별로 요구하지 않는 지극히 인간적인 관심사였습니다. 무한한 지식과 무한한 (계산) 능력을 지닌 신적 존재라면, 자신이 창조한 종의 지능에 실제로 걸맞게 확장되는 서명을 남기고 싶어 했으리라고 생각할 법합니다. 간결하고 검증 가능하지만 계산적으로는 불가능한 결과를 제공하는 것만이 과학적 세속 체계를 만족시킬 유일한 방법일 것입니다. 우리가 조개류에 관한 규칙은 잔뜩 찾아냈지만 20,000자리 소인수는 단 하나도 찾지 못했다는 사실은, 만약 하늘에 위대한 프로그래머가 있다면 그는 몹시 수줍음이 많거나 최종 빌드에서 그저 git add README.md를 깜빡했다는 것을 시사합니다.
트랜스포머
트랜스포머 아키텍처는 기념비적인 2017년 논문 Attention is All You Need(어텐션만 있으면 된다)에서 소개되면서 자연어 처리 분야에 혁명을 일으켰습니다. 트랜스포머는 전통적인 시퀀스 모델에서 벗어나 셀프 어텐션 메커니즘(자세한 내용은 뒤에서 다룹니다)을 핵심(Core) 구성 요소로 사용하며, 이를 통해 데이터의 장거리 의존성을 놀라울 만큼 효율적으로 포착합니다. 본질적으로 트랜스포머는 범용 계산 기반으로 볼 수 있습니다. 즉, 학습 데이터에 따라 스스로를 재구성하는 프로그래밍 가능한 논리 조직이며, 이를 층층이 쌓아 흥미로운 창발적 행동을 보이는 대규모 모델을 만들 수 있습니다.
이러한 각 레이어에는 함께 맞물려 작동하는 두 가지 필수 하위 레이어가 있습니다. 바로 멀티헤드 셀프 어텐션 메커니즘과 위치별 피드포워드 네트워크입니다. 멀티헤드 어텐션을 통해 모델은 입력 시퀀스의 여러 부분에 동시에 주목할 수 있으며, 서로 다른 표현 관점에서 토큰 사이의 다양한 관계를 포착합니다. 이어서 각 위치에 동일하게 적용되는 피드포워드 네트워크가 비선형성을 도입하고, 복잡한 패턴을 학습하는 모델의 능력을 확장합니다.
어텐션 메커니즘은 모든 토큰을 병렬로 처리하므로, 트랜스포머에는 순서 정보를 다루는 혁신적인 방법이 필요합니다. 이 문제는 입력 레이어에서 토큰 임베딩에 더해지는 위치 인코딩으로 해결합니다. 위치 인코딩으로는 학습된 임베딩이나 고정된 사인파 함수를 사용합니다. 이러한 인코딩은 병렬 처리 과정에서 사라졌을 토큰 위치에 관한 핵심 정보를 모델에 제공합니다.
트랜스포머의 강력함은 처리 과정에서 여러 토큰의 중요도에 동적으로 가중치를 부여하는 능력에서 비롯됩니다. “I went to the bank to deposit money.“라는 문장의 “bank“라는 단어를 생각해 보십시오. 이 중의적인 단어를 처리할 때 모델은 “deposit“과 “money” 같은 문맥상의 단서에 강하게 주목할 수 있으며, 덕분에 “bank“를 강둑이 아닌 금융 기관으로 올바르게 해석합니다. 이러한 문맥 인식 능력 덕분에 트랜스포머는 미묘한 언어 이해가 필요한 작업에서 탁월한 성능을 발휘합니다.
레이어 정규화와 잔차 연결은 트랜스포머 아키텍처를 한층 더 강화합니다. 레이어 정규화는 각 레이어 안의 활성화 값을 정규화하여 학습 과정을 안정시키고, 잔차 연결은 학습 중 그래디언트가 흐를 지름길을 만듭니다. 이 구성 요소들은 함께 작용하여 깊은 네트워크를 자주 괴롭히는 그래디언트 소실 문제를 완화하며, 덕분에 트랜스포머는 깊이가 깊어도 효과적으로 학습할 수 있습니다.
놀랍게도 연구자들은 레이어 수, 임베딩 차원, 학습 데이터를 늘려 트랜스포머 모델의 규모를 키우자 이 아키텍처가 놀라운 창발적 능력을 보인다는 사실을 발견했습니다. 더 큰 모델은 퓨샷 학습, 추론, 심지어 명시적으로 학습하지 않은 개념에 대한 초보적인 이해까지, 더 작은 모델에는 없는 능력을 보입니다. 이러한 스케일링 효과는 최근 인공지능 발전의 상당 부분을 이끌어 왔습니다.
여기서 처음부터 직접 만들어 볼 디코더 전용 트랜스포머 아키텍처는 동일한 디코더 블록 여러 개를 수직으로 쌓은 구조입니다. 인코더와 디코더 구성 요소를 모두 갖춘 원래의 트랜스포머와 달리, 현대 언어 모델은 일반적으로 다음 토큰 예측 작업에 디코더 부분만 사용합니다. 이 아키텍처는 확장성이 매우 뛰어나다는 것이 입증되었으며, 모델의 규모는 수억 개의 매개변수에서 이제 최첨단 모델의 수십억 개 매개변수에 이릅니다.
순수 NumPy로 구현한 GPT-2 모델을 구성 요소별로 하나씩 살펴봅시다. 핵심(Core) 모델 자체는 작으며, 이를 둘러싼 코드의 대부분은 가중치와 토큰화를 처리합니다. 전체 소스 코드는 tiny-gpt2에서 볼 수 있습니다.
나중에 인터넷에서 내려받을 신경망 가중치에는 여러 자료 구조가 있습니다. 지금은 이것들이 다양한 차원의 배열 모음이라는 점만 알아 두십시오.
LinearParams- 선형 변환을 위한 가중치와 편향 매개변수를 갖는 선형 레이어입니다.LayerNormParams- 정규화를 위한 이득과 편향 매개변수를 갖는 레이어 정규화 레이어입니다.AttentionParams- 쿼리, 키, 값, 출력 투영 매개변수를 담은 멀티헤드 어텐션 레이어입니다.BlockParams- 어텐션과 피드포워드 매개변수를 담은 트랜스포머 블록입니다.ModelParams- 토큰 임베딩, 위치 임베딩, 트랜스포머 블록, 최종 레이어 정규화를 포함한 전체 모델 매개변수입니다.HParams- 레이어 수, 헤드 수, 임베딩 차원 등을 포함한 모델의 하이퍼파라미터입니다.
코드에서는 다음과 같은 약어를 사용합니다.
g- 감마(레이어 정규화를 위한 스케일 매개변수)b- 베타(편향 매개변수)w- 가중치 행렬/배열wte- 단어/토큰 임베딩wpe- 단어 위치 임베딩ln- 레이어 정규화mlp- 다층 퍼셉트론fc- 완전 연결 레이어qkv- 쿼리, 키, 값(어텐션 구성 요소)attn- 어텐션proj- 투영(선형 변환)
BPE 토큰화
바이트 쌍 인코딩(Byte-Pair Encoding, 줄여서 BPE)은 단어를 서브워드라는 더 작은 단위로 나누어 어휘 사전에 없는 단어 문제를 해결하는 토큰화 알고리즘입니다. BPE는 처음에 데이터 압축 기법으로 개발되었으나, 단어를 문자의 시퀀스로 취급하는 방식으로 자연어 처리에 맞게 변형되었습니다. BPE의 핵심(Core) 아이디어는 코퍼스에서 가장 빈번하게 나타나는 인접 기호 쌍을 반복적으로 병합하여 새로운 서브워드 단위로 만드는 것입니다. 이 과정은 말뭉치의 각 단어를 개별 문자로 분리하는 것으로 시작하며, 이렇게 해서 고유한 모든 문자로 구성된 초기 어휘 사전이 만들어집니다.
그런 다음 BPE 알고리즘은 반복적 병합을 진행합니다. 각 반복에서는 말뭉치 전체에 걸쳐 모든 인접 기호 쌍의 개수를 셉니다. 그런 다음 빈도가 가장 높은 쌍을 선택하여 새로운 기호, 즉 서브워드로 병합합니다. 이 병합 연산은 말뭉치에서 선택된 쌍이 나타나는 모든 곳에 적용되며, 결과적으로 단어의 토큰화된 표현에서 두 기호 사이의 공백이 제거됩니다. 새로 만들어진 서브워드는 어휘 사전에 추가됩니다. 이 반복 과정은 어휘 사전이 미리 정한 목표 크기에 도달하거나 더 이상 빈번한 쌍을 찾을 수 없을 때까지 계속됩니다. 학습 중에 수행된 병합 연산의 순서는 처음 보는 새로운 단어를 토큰화하는 데 매우 중요합니다.
BPE 토크나이저가 학습되고 나면(즉, 병합 순서가 결정되고 나면) 이를 사용해 새로운 텍스트를 토큰화할 수 있습니다. 단어를 토큰화할 때 토크나이저는 먼저 (초기 단어 경계 표시가 붙은) 단어 전체가 어휘 사전에 있는지 확인합니다. 없다면 단어를 문자 단위로 분리한 다음, 학습된 병합 규칙을 학습된 순서대로 반복해서 적용합니다. 초기 문자 집합에 없는 문자는 알 수 없는 토큰(예: <UNK>)으로 대체될 수 있습니다. BPE는 현대 언어 모델에서 널리 사용되며, 특히 희귀한 단어나 중국어처럼 단어 경계가 명확하지 않아 초기 토큰화를 개별 문자에서 시작할 수 있는 언어를 처리하는 데 유용합니다.
BPE를 처음부터 구현하지는 않겠지만, 간단한 Python 구현은 여기에서 찾아볼 수 있습니다. 대신 원래 GPT-2 저장소에 있는 기존 토크나이저를 불러와 사용하겠습니다.
encoder = get_encoder("", "model")

# encode a string into a list of tokens
tokens = encoder.encode("Hello world")

print(tokens) # [15496, 995]
여기서 토크나이저가 문자열 “Hello world“를 토큰 리스트 [15496, 995]로 인코딩한 것을 볼 수 있으며, 이 경우에는 공교롭게도 단어 두 개와 토큰 두 개로 이루어져 있습니다. 그러나 문자열 “Barack Obama“는 [10374, 441, 2486]로 인코딩되며, 이는 단어 두 개와 토큰 세 개로 이루어져 있습니다.

토큰화와 위치 임베딩
문자열 입력을 먼저 토큰 리스트로 토큰화한 다음, 각 토큰에 대한 토큰 임베딩을 params.wte 행렬에서 조회합니다.
x = params.wte[inputs] + params.wpe[range(len(inputs))]
이 줄은 입력 시퀀스가 주요 트랜스포머 블록에서 처리되기 전에 이를 준비하는 데 매우 중요합니다. 이 줄은 입력의 각 토큰에 대해 두 가지 유형의 정보(위치와 토큰 자체)를 결합합니다. 모델 설정에는 두 개의 큰 임베딩 행렬, 즉 토큰 임베딩 행렬과 위치 임베딩 행렬이 있습니다.
토큰 임베딩 (params.wte[inputs]):
inputs 매개변수는 입력 토큰 시퀀스를 정수(토큰 ID) 리스트로 나타냅니다. 예를 들어 입력 텍스트 “Hello world“가 [15496, 995]로 토큰화된다면, inputs는 [15496, 995]가 됩니다.
params.wte는 Word Token Embedding(단어 토큰 임베딩) 행렬을 가리킵니다. 이는 본질적으로 큰 표(조회 테이블)로, 각 행은 모델 어휘의 고유한 토큰 ID 하나에 대응하며, 행 자체는 벡터(예를 들어 소형 GPT-2 모델에서는 크기 768)입니다. 이 벡터는 해당 토큰에 대해 학습된 수치 표현, 즉 “임베딩“입니다.
params.wte[inputs] 연산은 조회를 수행합니다. 이 연산은 inputs 리스트의 각 정수 ID를 가져와 params.wte 행렬에서 그에 대응하는 임베딩 벡터를 가져옵니다. 그 결과는 각 행이 입력 시퀀스의 대응하는 토큰에 대한 토큰 임베딩인 행렬입니다. 따라서 [15496, 995]의 경우 두 개의 행, 즉 토큰 15496의 임베딩과 토큰 995의 임베딩으로 이루어진 행렬을 얻게 됩니다.
위치 임베딩 (params.wpe[range(len(inputs))]):
트랜스포머는 셀프 어텐션을 사용하여 토큰을 병렬로 처리하는데, 셀프 어텐션은 본질적으로 토큰의 순서를 알지 못합니다. 이러한 순서 정보를 제공하기 위해 위치 임베딩을 사용합니다. len(inputs) 함수는 입력 시퀀스의 길이를 계산합니다(예: [15496, 995]의 경우 2). range(len(inputs))를 사용하면 0부터 시작하는 위치 인덱스 시퀀스가 생성되며, 이 예제에서는 [0, 1]입니다.
params.wpe는 Word Position Embedding(단어 위치 임베딩) 행렬을 가리킵니다. wte와 마찬가지로 조회 테이블이지만, 그 행은 시퀀스 내의 위치(0, 1, 2, … 모델이 처리할 수 있는 최대 시퀀스 길이까지)에 대응합니다. 각 행은 해당 위치를 나타내는 학습된 벡터입니다. GPT-2는 학습된 위치 임베딩을 사용하며, 이는 이 벡터들이 학습 중에 학습되는 매개변수라는 뜻입니다.
마지막으로 params.wpe[range(len(inputs))]는 위치 인덱스를 사용하여 조회를 수행합니다. 이는 입력 길이만큼 위치 0, 위치 1 등의 순서로 임베딩 벡터를 가져옵니다. 그 결과는 각 행이 입력 시퀀스의 대응하는 위치에 대한 위치 임베딩인 행렬입니다.
덧셈 (+):
토큰 임베딩 행렬(각 토큰이 무엇인지를 나타냄)과 위치 임베딩 행렬(각 토큰이 시퀀스의 어디에 있는지를 나타냄)은 단순히 원소별로 더해집니다. 두 행렬은 같은 형태(시퀀스 길이 × 임베딩 차원)를 가집니다.
이렇게 만들어진 행렬 x에는 이제 각 벡터가 토큰의 정체와 위치를 함께 인코딩하는 벡터들이 담깁니다. 이렇게 결합된 표현이 최종 입력이 되어, 처리를 위해 트랜스포머 블록 스택에 전달됩니다.
요약하면, 이 줄 x = params.wte[inputs] + params.wpe[range(len(inputs))]는 각 토큰에 대해 학습된 벡터를 조회하고 그 위치에 대해 학습된 벡터를 더하여 입력 시퀀스의 초기 표현을 만듭니다. 덕분에 이후의 트랜스포머 레이어는 토큰의 순서를 인식한 채로 토큰을 처리할 수 있습니다.
이 행렬의 크기는 [sequence_length, embedding_dimension]입니다. 코드에서는 시퀀스 길이를 N으로 표기합니다.
GELU
GELU(Gaussian Error Linear Unit, 가우스 오차 선형 유닛)는 트랜스포머 아키텍처, 특히 각 블록의 피드포워드 네트워크(FFN) 안에서 사용되는 활성화 함수입니다. 주된 역할은 모델에 비선형성을 도입하여 데이터의 더 복잡한 패턴과 관계를 학습할 수 있게 하는 것입니다. 비선형 활성화 함수가 없으면 여러 레이어를 쌓아도 하나의 선형 변환과 같아져서 모델의 표현력이 크게 제한됩니다. 수학적으로는 다음과 같이 정의됩니다.
여기서 erf는 가우스 오차 함수입니다. 실제로는 오차 함수에 포함된 적분을 계산하지 않아도 되도록 tanh 함수로 오차 함수를 근사하는 방식을 사용합니다. Python에서는 이 근사를 다음과 같이 구현합니다.
# gelu:
#   x : (N, 768)
#   out : (N, 768)
def gelu(x: np.ndarray) -> np.ndarray:
    return 0.5 * x * (1 + np.tanh(np.sqrt(2 / np.pi) * (x + 0.044715 * x**3)))
이 함수는 입력에 원소별로 적용되는 스칼라 함수라는 점에 유의하십시오.
소프트맥스
GELU가 피드포워드 네트워크 안에서 비선형성을 담당한다면, 트랜스포머 아키텍처에는 원시 점수를 의미 있는 확률 분포로 바꾸는 방법도 필요합니다. 바로 여기서 소프트맥스 함수가 등장합니다. 소프트맥스는 트랜스포머 아키텍처에서 주로 두 곳, 즉 어텐션 메커니즘 안과 최종 출력 레이어에서 사용되는 중요한 함수입니다. 그 목적은 원시 점수(로짓) 벡터를 확률 분포로 변환하는 것입니다. 입력 벡터를 받아 각 원소에 지수 함수를 적용하여 모두 양수로 만든 다음, 그 값들을 합으로 나누어 정규화합니다. 그 결과 모든 원소가 0과 1 사이에 있고 그 합이 1이 되는 벡터를 얻습니다.
어텐션 메커니즘(attention 함수)에서는 쿼리와 키 사이의 스케일된 내적 점수에 소프트맥스를 적용합니다. 이를 통해 원시 유사도 점수가 어텐션 가중치로 바뀌며, 이 가중치는 값 벡터들에 대한 확률 분포, 즉 각 값이 얼마나 주목받아야 하는지를 나타냅니다.
모델의 마지막 레이어에서는(다음 토큰을 생성하기 직전에) 보통 최종 선형 사영이 만들어 낸 로짓에 소프트맥스를 적용합니다. 이를 통해 어휘의 각 단어에 대한 모델의 원시 출력 점수가 확률로 바뀌므로, 점수를 해석하고 이 분포에 따라 다음 토큰을 샘플링할 수 있습니다.
# softmax:
#   x : (N, 64)
#   out : (N, 64)
def softmax(x: np.ndarray) -> np.ndarray:
    exp_x = np.exp(x - np.max(x, axis=-1, keepdims=True))
    return exp_x / np.sum(exp_x, axis=-1, keepdims=True)
레이어 정규화
활성화 함수와 확률 변환 외에도, 신경망에는 특히 트랜스포머처럼 깊은 아키텍처에서 학습을 안정화하는 방법이 필요합니다. 레이어 정규화(LayerNorm)가 바로 이 중요한 역할을 합니다. 배치 차원에 걸쳐 정규화하는 배치 정규화와 달리, 레이어 정규화는 각 데이터 샘플마다 독립적으로 특성(임베딩 차원)에 걸쳐 입력을 정규화합니다.
여기서 는 입력의 평균이고 는 입력의 분산이며, 와 는 학습 가능한 이득 및 편향 매개변수입니다.
트랜스포머 블록에서 LayerNorm은 일반적으로 멀티헤드 어텐션 하위 레이어의 앞과 피드포워드 네트워크 하위 레이어의 앞에 적용됩니다(이를 pre-LN이라고 합니다). 이는 단일 학습 예제에 대해 한 레이어 안의 모든 활성화의 평균과 분산을 계산하는 방식으로 동작합니다. 그런 다음 이 평균과 분산을 사용하여 활성화 값을 정규화합니다. 무엇보다 중요한 점은 학습 가능한 이득(g)과 편향(b) 매개변수도 도입한다는 것이며, 이를 통해 네트워크는 정규화된 출력의 크기를 조정하고 이동시켜 표현 능력을 보존할 수 있습니다.
LayerNorm은 기울기 소실이나 폭주 같은 문제를 완화하고, 더 높은 학습률을 사용할 수 있게 하며, 모델이 매개변수의 스케일과 초기화에 덜 민감하도록 만듭니다. 각 계층 내의 활성화 값을 정규화함으로써 후속 계층의 입력이 일관된 스케일을 갖도록 보장하며, 그 결과 더 매끄럽고 안정적인 훈련 동역학을 얻을 수 있습니다.
# layer_norm:
#   x : (N, 768)
#   g : (768,)
#   b : (768,)
#   out : (N, 768)
def layer_norm(
    x: np.ndarray, g: np.ndarray, b: np.ndarray, eps: float = 1e-5
) -> np.ndarray:
    mean = np.mean(x, axis=-1, keepdims=True)
    variance = np.var(x, axis=-1, keepdims=True)
    return g * (x - mean) / np.sqrt(variance + eps) + b
선형 투영
정규화로 네트워크를 안정화했으니, 이제 트랜스포머에는 표현을 한 공간에서 다른 공간으로 변환하는 방법이 필요합니다. 바로 여기서 선형 레이어가 등장합니다. 완전 연결 레이어 또는 밀집 레이어라고도 불리는 선형 레이어는 신경망에서 가장 기본적인 구성 요소 중 하나입니다. 선형 계층은 입력 데이터에 선형 변환을 수행합니다.
수학적으로는 output = input @ weights + bias를 계산하며, 여기서 @는 행렬 곱셈을 나타냅니다. input은 레이어에 주어지는 데이터이고, weights는 학습 가능한 매개변수로 이루어진 행렬이며, bias는 결과에 더해지는 학습 가능한 벡터입니다. 가중치 행렬은 사실상 입력 벡터를 원래 차원에서 (가중치 행렬의 형태로 정의되는) 새로운 차원으로 투영하며, 편향은 출력을 이동시킬 수 있게 해 줍니다.
# linear:
#   x : (N, 768)
#   w : (768, 3072)
#   b : (3072,)
#   out : (N, 3072)
def linear(x: np.ndarray, w: np.ndarray, b: np.ndarray) -> np.ndarray:
    return x @ w + b
피드포워드 네트워크
정규화, 활성화, 선형 변환이라는 개별 구성 요소를 살펴보았으니, 이제 이러한 구성 요소가 피드포워드 네트워크(FFN)에서 어떻게 결합되는지 살펴볼 수 있습니다. 위치별 피드포워드 네트워크라고도 불리는 FFN은 각 트랜스포머 블록 안에서 (멀티헤드 어텐션 하위 레이어 다음에 오는) 두 번째 주요 하위 레이어입니다.
FFN은 두 개의 선형 변환과 그 사이에 적용되는 비선형 활성화 함수(앞서 살펴본 GELU 함수)로 구성됩니다. 첫 번째 선형 레이어는 보통 입력의 차원을 확장하고(예를 들어 GPT-2에서는 768에서 3072로), GELU 활성화는 비선형성을 도입하며, 두 번째 선형 레이어는 결과를 원래 입력 차원으로 다시 투영합니다(예를 들어 3072에서 다시 768로).

이 FFN은 시퀀스의 각 위치에 독립적으로 적용됩니다. 어텐션 메커니즘은 토큰들이 서로 상호작용할 수 있게 하는 반면, FFN은 각 위치의 정보를 개별적으로 처리하여 모델이 학습한 특징을 바탕으로 표현을 변환합니다. FFN은 모델에 상당한 표현 능력을 더해 주어, 어텐션 메커니즘만으로는 포착할 수 없는 더 복잡한 함수를 학습할 수 있게 합니다.
# ffn:
#   x : (N, 768)
#   c_fc_w : (768, 3072)
#   c_fc_b : (3072,)
#   c_proj_w : (3072, 768)
#   c_proj_b : (768,)
#   out : (N, 768)
def ffn(
    x: np.ndarray,
    c_fc_w: np.ndarray,
    c_fc_b: np.ndarray,
    c_proj_w: np.ndarray,
    c_proj_b: np.ndarray,
) -> np.ndarray:
    return linear(gelu(linear(x, w=c_fc_w, b=c_fc_b)), w=c_proj_w, b=c_proj_b)
어텐션
어텐션은 트랜스포머 아키텍처의 핵심(Core) 아이디어입니다. 어텐션은 인간의 시각적 주의에서 영감을 받은 메커니즘입니다. 우리가 이미지의 특정 부분이나 문장의 특정 단어에 집중하고 나머지는 무시하는 것처럼, 어텐션은 모델이 특정 요소를 처리할 때 입력 데이터의 여러 부분이 지닌 중요도를 동적으로 가늠할 수 있게 합니다. 텍스트 같은 순차 데이터의 경우, 이는 모델이 한 단어를 처리할 때 문맥과 의미를 더 잘 이해하기 위해 거리에 관계없이 시퀀스 내의 다른 관련 단어에 “주의를 기울일” 수 있다는 뜻입니다. 이러한 선택적 집중 덕분에 모델은 이전의 시퀀스 모델보다 장거리 의존성과 관계를 더 효과적으로 포착할 수 있습니다.
각 어텐션 계산의 중심에는 입력 시퀀스에서 도출되는 세 가지 핵심 행렬이 있습니다:
- 쿼리(Q): 현재 처리 중인 토큰 또는 위치를 나타냅니다. 이를 “지금 내가 찾고 있는 구체적인 정보는 무엇인가?“라고 묻는 것으로 생각하십시오.
- Key (K): 시퀀스에 있는 모든 토큰(현재 토큰 포함)을 나타냅니다. 각 토큰에 담긴 정보의 레이블이나 식별자라고 생각하면 됩니다. “각 토큰은 어떤 종류의 정보를 제공하는가?”
- Value (V): 이것 역시 시퀀스의 모든 토큰을 나타냅니다. 각 토큰의 실제 내용이나 표현이라고 생각하면 됩니다. “각 토큰이 전달하는 실제 정보는 무엇인가?”
이 과정은 초기 투영(projection)에서 시작합니다. 여기서 입력 시퀀스 x는 세 개의 개별 선형 레이어를 통과하여 입력 차원 전체에 걸친 초기 Q, K, V 행렬을 생성합니다. 그런 다음 이 큰 행렬들을 임베딩 차원을 따라 더 작은 조각으로 나누어, 각 어텐션 “헤드“마다 별도의 Q, K, V 집합을 만듭니다. 형식적으로 셀프 어텐션은 다음과 같이 계산됩니다.
여기서:
Q,K,V는 각각 쿼리, 키, 값 행렬이며,d_k는 키 벡터의 차원입니다.
attention 함수는 멀티헤드 어텐션 레이어의 각 헤드 내부에서 사용되는 기본 구성 요소인 핵심(Core) 스케일드 닷 프로덕트 어텐션 메커니즘을 구현합니다. 이 함수는 특정 토큰(Query 벡터로 표현됨)을 처리할 때 각 입력 토큰(Value 벡터로 표현됨)이 얼마나 많은 주목, 즉 “어텐션“을 받아야 하는지 계산합니다.
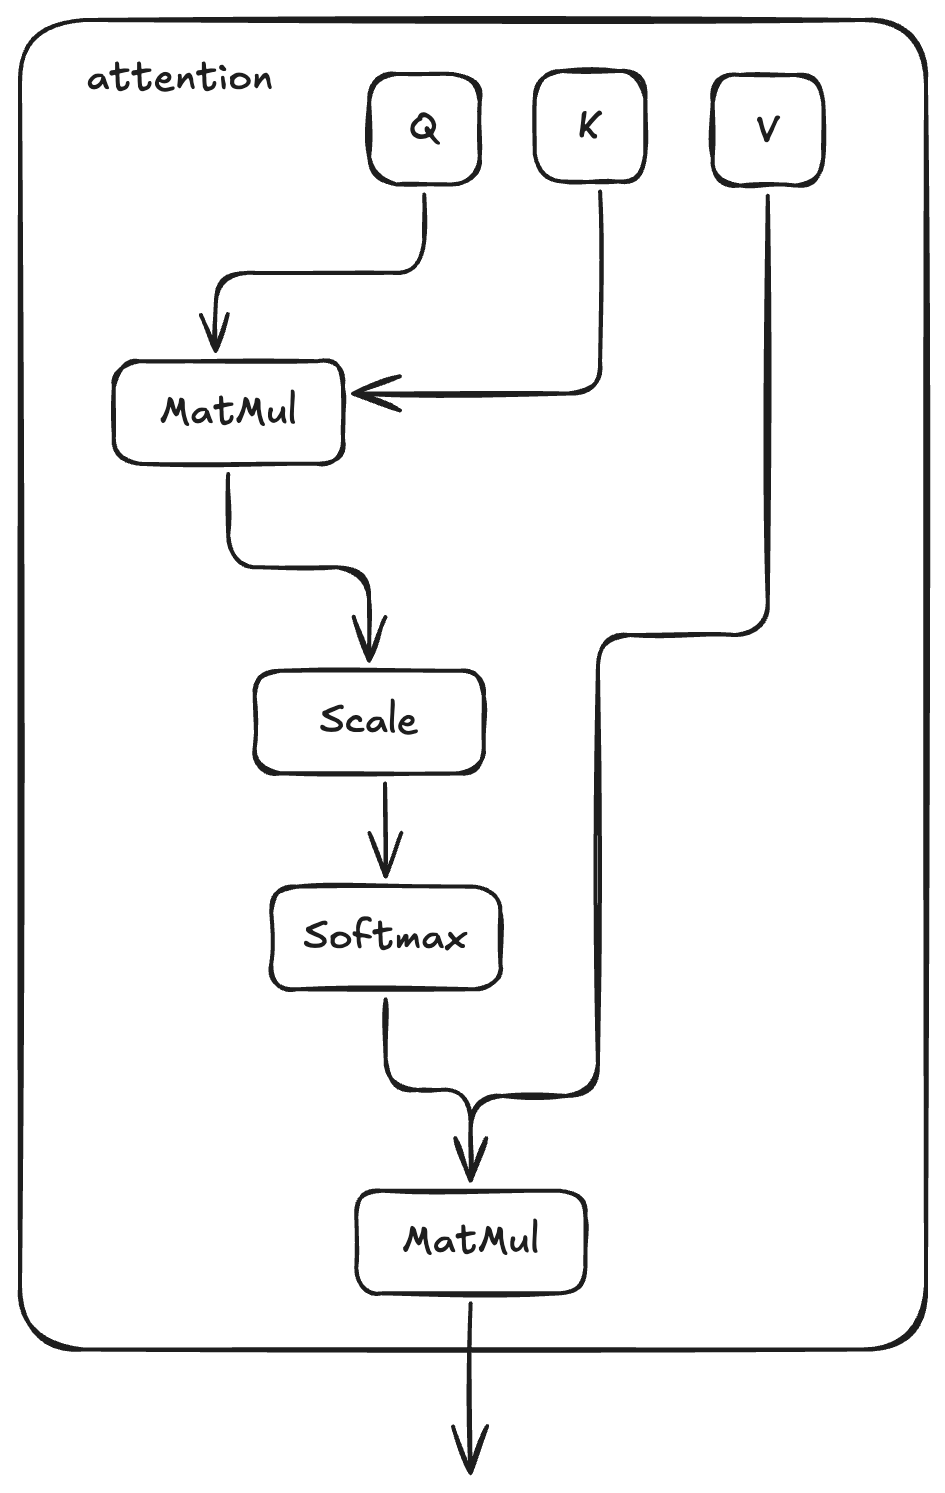
이 과정은 Q 행렬과 K 행렬의 전치 행렬 사이의 내적(q @ k.T)을 계산하는 것으로 시작합니다. 이 단계에서는 각 쿼리와 모든 키 사이의 원시 유사도 또는 호환성을 측정합니다. 그런 다음 이 원시 점수를 키 벡터 차원의 제곱근(np.sqrt(q.shape[-1]))으로 나누어 스케일을 줄입니다.
인과 마스크(causal mask)는 이렇게 스케일된 점수에 더해지는 마스크입니다. 이 마스크는 각 위치가 그 뒤에 오는 위치에 어텐션하지 못하도록 막아, 예측이 이전 토큰에만 기반하도록 보장합니다. 사실상 이 마스크는 미래 토큰에 해당하는 점수에 매우 큰 음수 값을 할당합니다.
다음으로, 마스크가 적용되고 스케일된 점수에 softmax 함수를 적용합니다. 이를 통해 점수가 확률 분포(어텐션 가중치)로 변환되며, 각 가중치는 쿼리에 대한 특정 키(및 그에 대응하는 값)의 상대적 중요도를 나타냅니다.
마지막으로, 함수는 이 어텐션 가중치와 V 행렬의 행렬 곱(attention_weights @ v)을 계산합니다. 그 결과로 어텐션 메커니즘의 출력, 즉 Value 벡터들의 가중합이 나오며, 이때 가중치는 계산된 어텐션 확률입니다. 따라서 각 쿼리에 대한 결과 벡터는 입력 시퀀스의 정보를 혼합한 것이며, 쿼리-키 상호작용에 따라 가장 관련성 높은 부분이 강조됩니다.
# attention:
#   q : (N, 64)
#   k : (N, 64)
#   v : (N, 64)
#   mask : (N, N)
#   out : (N, 64)
def attention(
    q: np.ndarray, k: np.ndarray, v: np.ndarray, mask: np.ndarray
) -> np.ndarray:
    attention_scores = (q @ k.T) / np.sqrt(q.shape[-1]) + mask
    attention_weights = softmax(attention_scores)
    return attention_weights @ v
각 헤드의 어텐션 가중치를 플롯하여 어텐션 메커니즘을 시각화할 수 있습니다. 예를 들어 *“The quick brown fox jumps over the lazy dog”*라는 문구에 대해 트랜스포머 스택의 첫 번째 블록에서 어텐션 가중치를 플롯하면, 각 헤드가 어떤 단어 쌍에 가장 많이 어텐션하는지 확인할 수 있습니다. 여기서는 첫 번째 헤드가 *“jumps”*와 *“fox”*에 가장 많이 어텐션하는 것을 볼 수 있습니다.
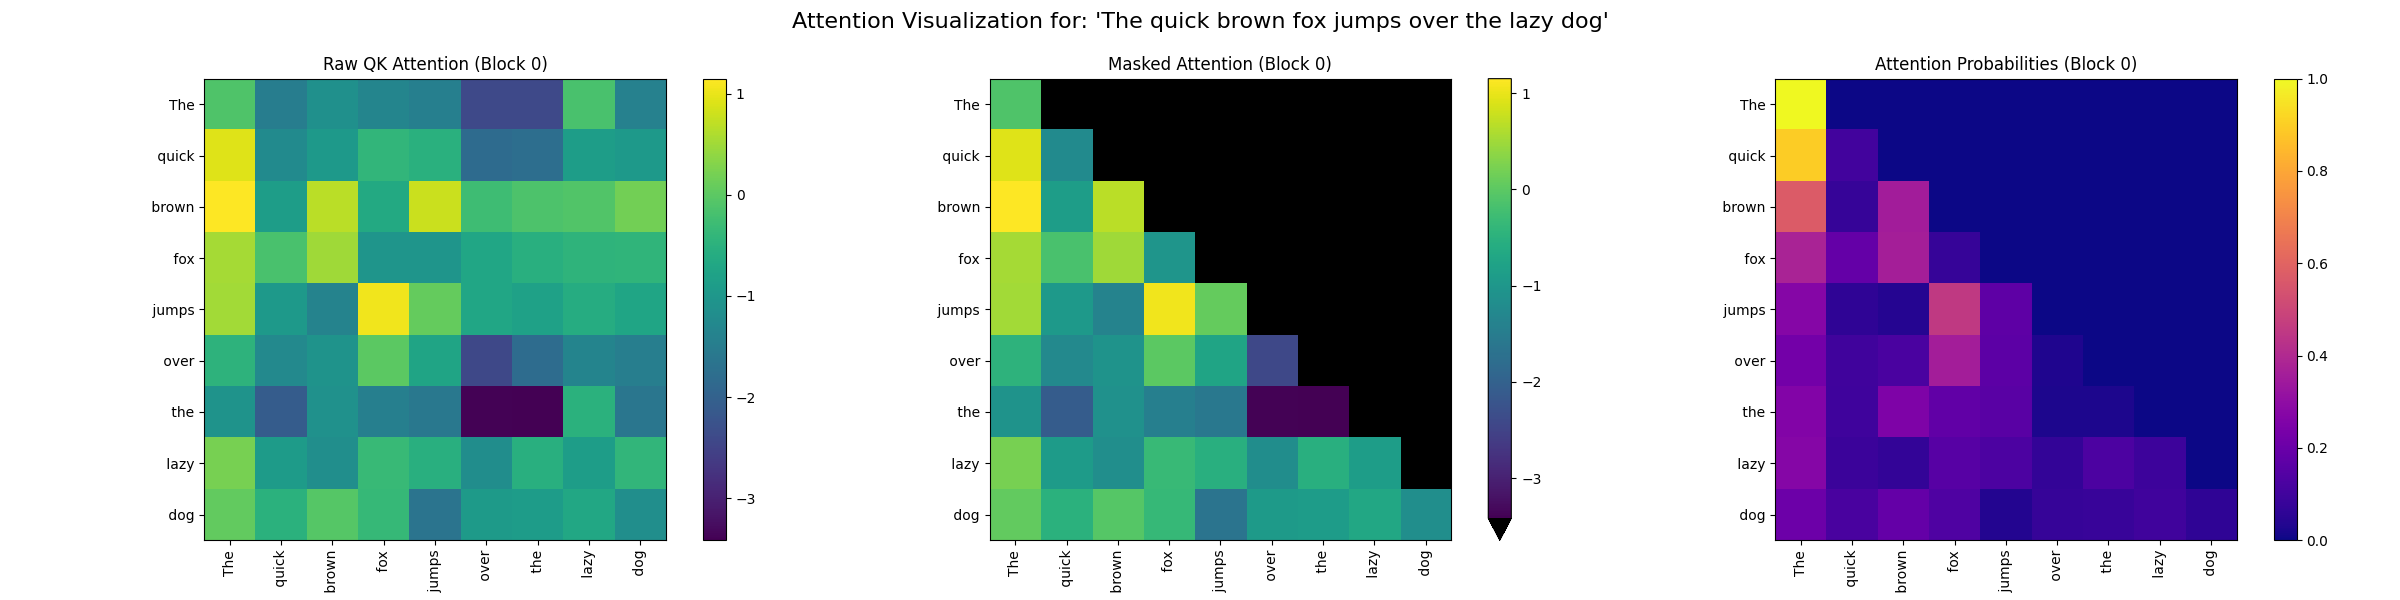
멀티헤드 어텐션
기본 어텐션 메커니즘이 토큰 간의 관계를 포착하는 방법을 제공한다면, 트랜스포머는 멀티헤드 어텐션으로 이를 한 단계 더 발전시킵니다. 이러한 개선을 통해 모델은 서로 다른 유형의 관계를 동시에 포착할 수 있으며, 표현력이 크게 확장됩니다. 멀티헤드 어텐션은 모델이 서로 다른 위치에서 서로 다른 표현 부분 공간의 정보에 함께 주의를 기울일 수 있게 하는 핵심(Core) 구성 요소입니다. MHA는 어텐션 계산을 한 번만 수행하는 대신, 입력에 대해 학습된 서로 다른 선형 변환 위에서 어텐션 메커니즘을 여러 번(“헤드”) 병렬로 실행합니다. 이를 통해 모델은 다양한 유형의 관계(예: 구문적, 의미적 관계)를 동시에 포착할 수 있습니다.
각 헤드 내부에서는 스케일드 닷 프로덕트 어텐션이 수행됩니다. 어텐션 점수는 Q와 모든 K의 내적을 구하여 계산하며, 이는 현재 토큰과 다른 모든 토큰 사이의 관련성을 측정합니다. 이 점수들은 스케일링(키 차원의 제곱근으로 나눔)된 뒤 소프트맥스 함수를 거쳐 확률(어텐션 가중치)이 됩니다. 이 가중치는 각 V에 얼마나 집중할지를 나타냅니다.
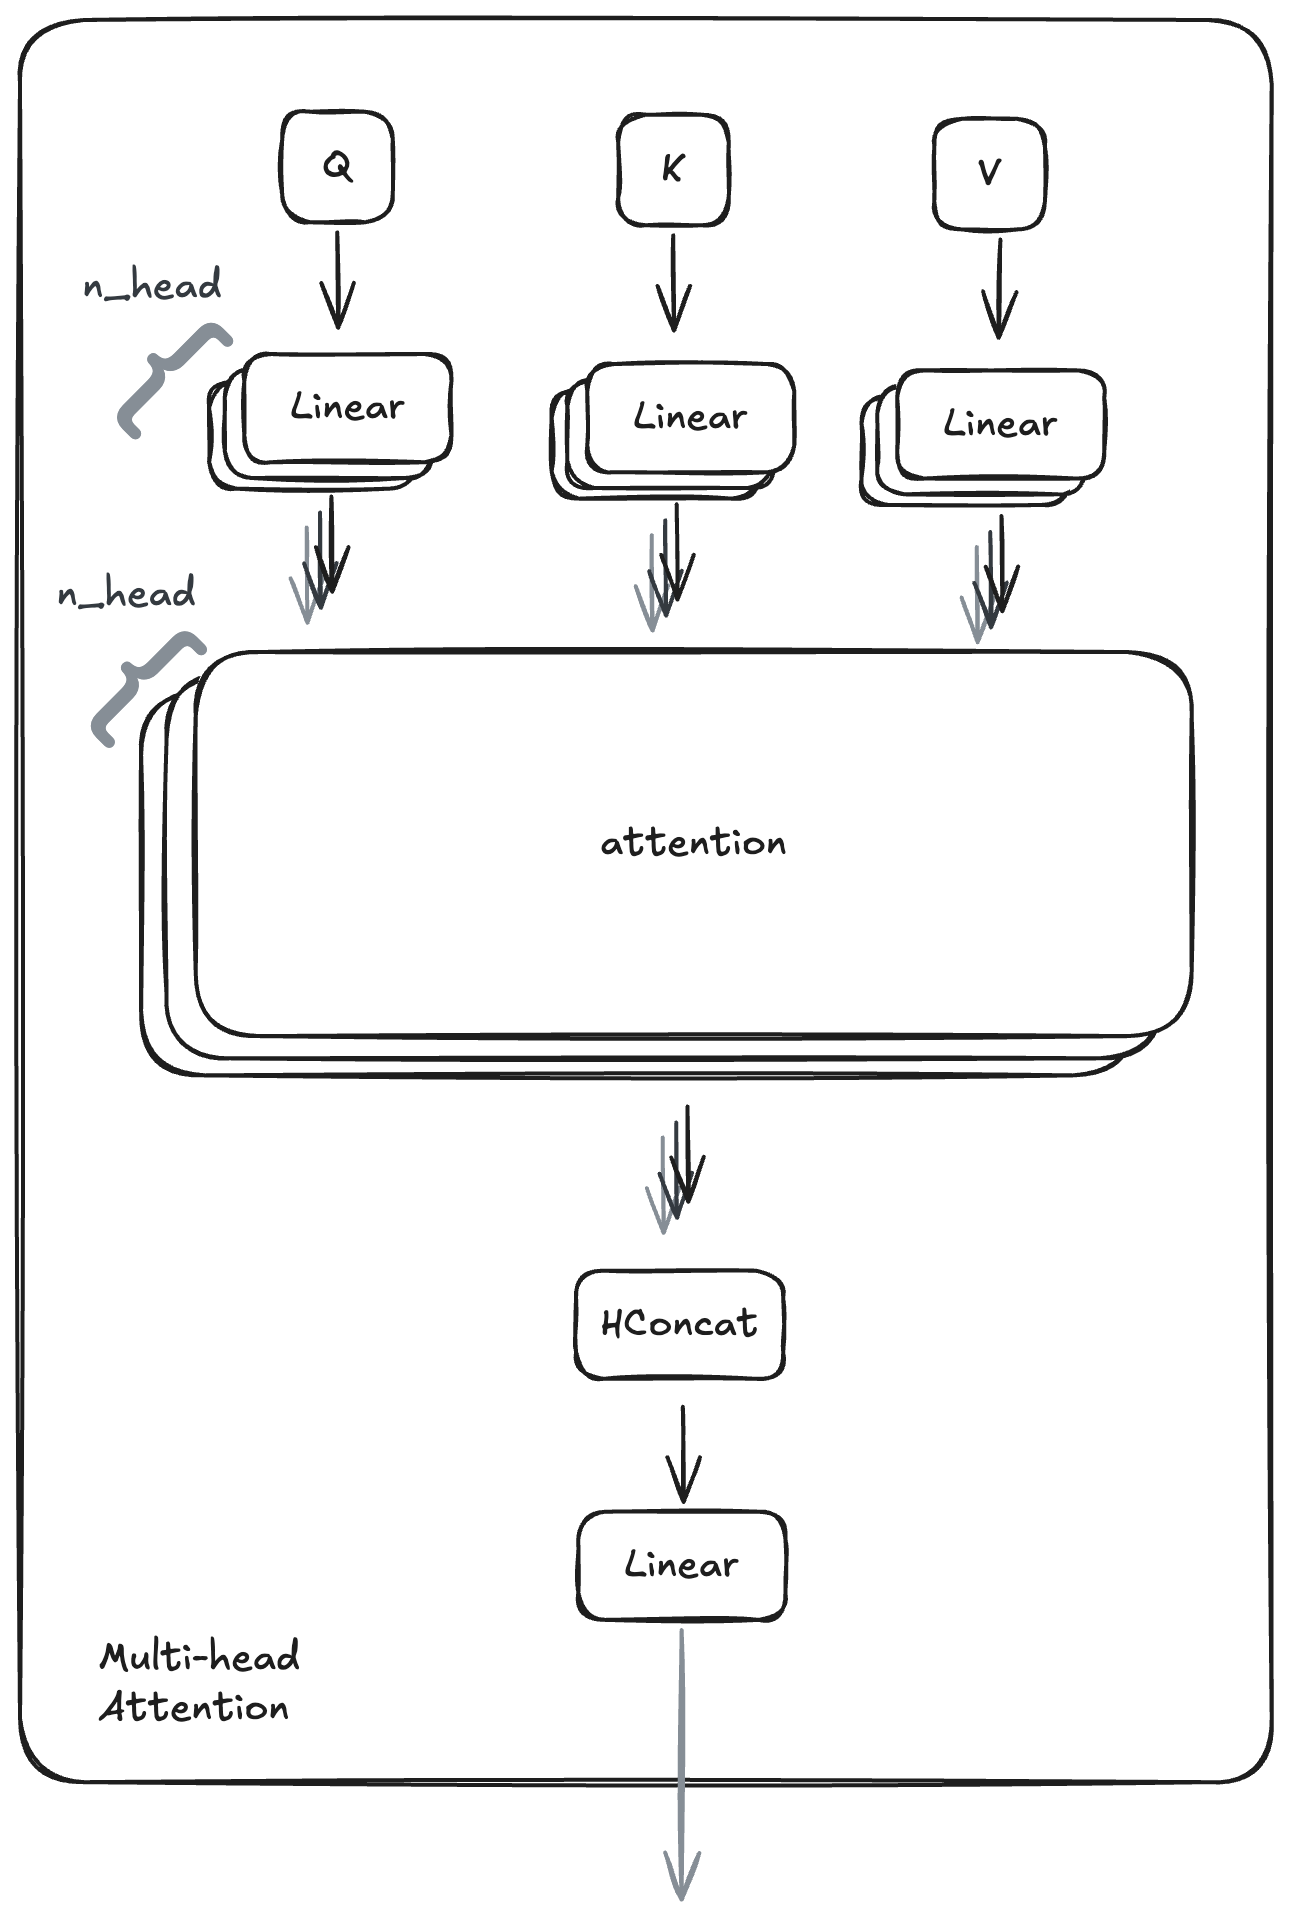
각 어텐션 헤드의 쿼리 행렬 크기(64)는 모델의 임베딩 차원(768)을 어텐션 헤드 수(12)로 나누어 얻습니다. 모든 헤드의 출력을 다시 이어 붙이면 원래의 임베딩 차원을 되찾게 됩니다:
768/n_head = 768/12 = 64
그런 다음 어텐션 가중치를 대응하는 V 벡터에 곱하여 가중합을 만듭니다. 이렇게 하면 가장 관련성 높은 토큰들의 정보를 혼합한, 해당 헤드의 출력 벡터가 만들어집니다. 마지막으로 모든 어텐션 헤드의 출력 벡터를 다시 이어 붙입니다. 이렇게 결합된 벡터는 최종 선형 레이어를 거쳐 멀티헤드 어텐션 블록의 전체 출력이 됩니다. 이러한 다각적 접근 방식 덕분에 모델은 시퀀스를 여러 “관점“에서 동시에 바라보며 더 풍부한 문맥 정보를 포착할 수 있습니다.
# mha:
#   x : (N, 768)
#   out : (N, 768)
def mha(
    x: np.ndarray, c_attn: LinearParams, c_proj: LinearParams, n_head: int
) -> np.ndarray:
    # qkv projection
    # [N, 768] -> [N, 3*768]
    x = linear(x, w=c_attn.w, b=c_attn.b)

    # split into qkv
    # [N, 3*768] -> [3, N, 768]
    qkv = np.split(x, 3, axis=-1)

    # split into heads
    # [3, N, 768] -> [3, n_head, N, 64]
    qkv_heads = [np.split(x, n_head, axis=-1) for x in qkv]

    # apply causal mask to hide future inputs
    # [N, N]
    causal_mask = (1 - np.tri(x.shape[0], dtype=x.dtype)) * -1e10

    # perform attention on each head
    # [3, n_head, N, 64] -> [n_head, N, 64]
    out_heads = [attention(q, k, v, causal_mask) for q, k, v in zip(*qkv_heads)]

    # merge heads
    # [n_head, N, 64] -> [N, 768]
    x = np.hstack(out_heads)

    # out projection
    # [N, 768] -> [N, 768]
    return linear(x, w=c_proj.w, b=c_proj.b)
트랜스포머 블록
어텐션 메커니즘과 피드포워드 네트워크를 모두 정의했으니, 이제 이 구성 요소들이 완전한 트랜스포머 블록으로 어떻게 통합되는지 살펴볼 수 있습니다. 트랜스포머 블록은 GPT-2 아키텍처의 기본 반복 단위로, 멀티헤드 어텐션에 피드포워드 처리, 정규화, 잔차 연결을 결합하여 여러 번 쌓을 수 있는 연산 단위를 만듭니다.
각 블록은 입력 벡터 시퀀스를 받아 두 개의 주요 하위 레이어를 통해 처리하며, 각 하위 레이어 주변에 잔차 연결과 레이어 정규화를 적용합니다. 이 구조는 원래 입력의 보존(잔차 연결을 통해)과 새로운 표현으로의 변환을 모두 가능하게 하는 균형 잡힌 정보 흐름을 만들어 냅니다.
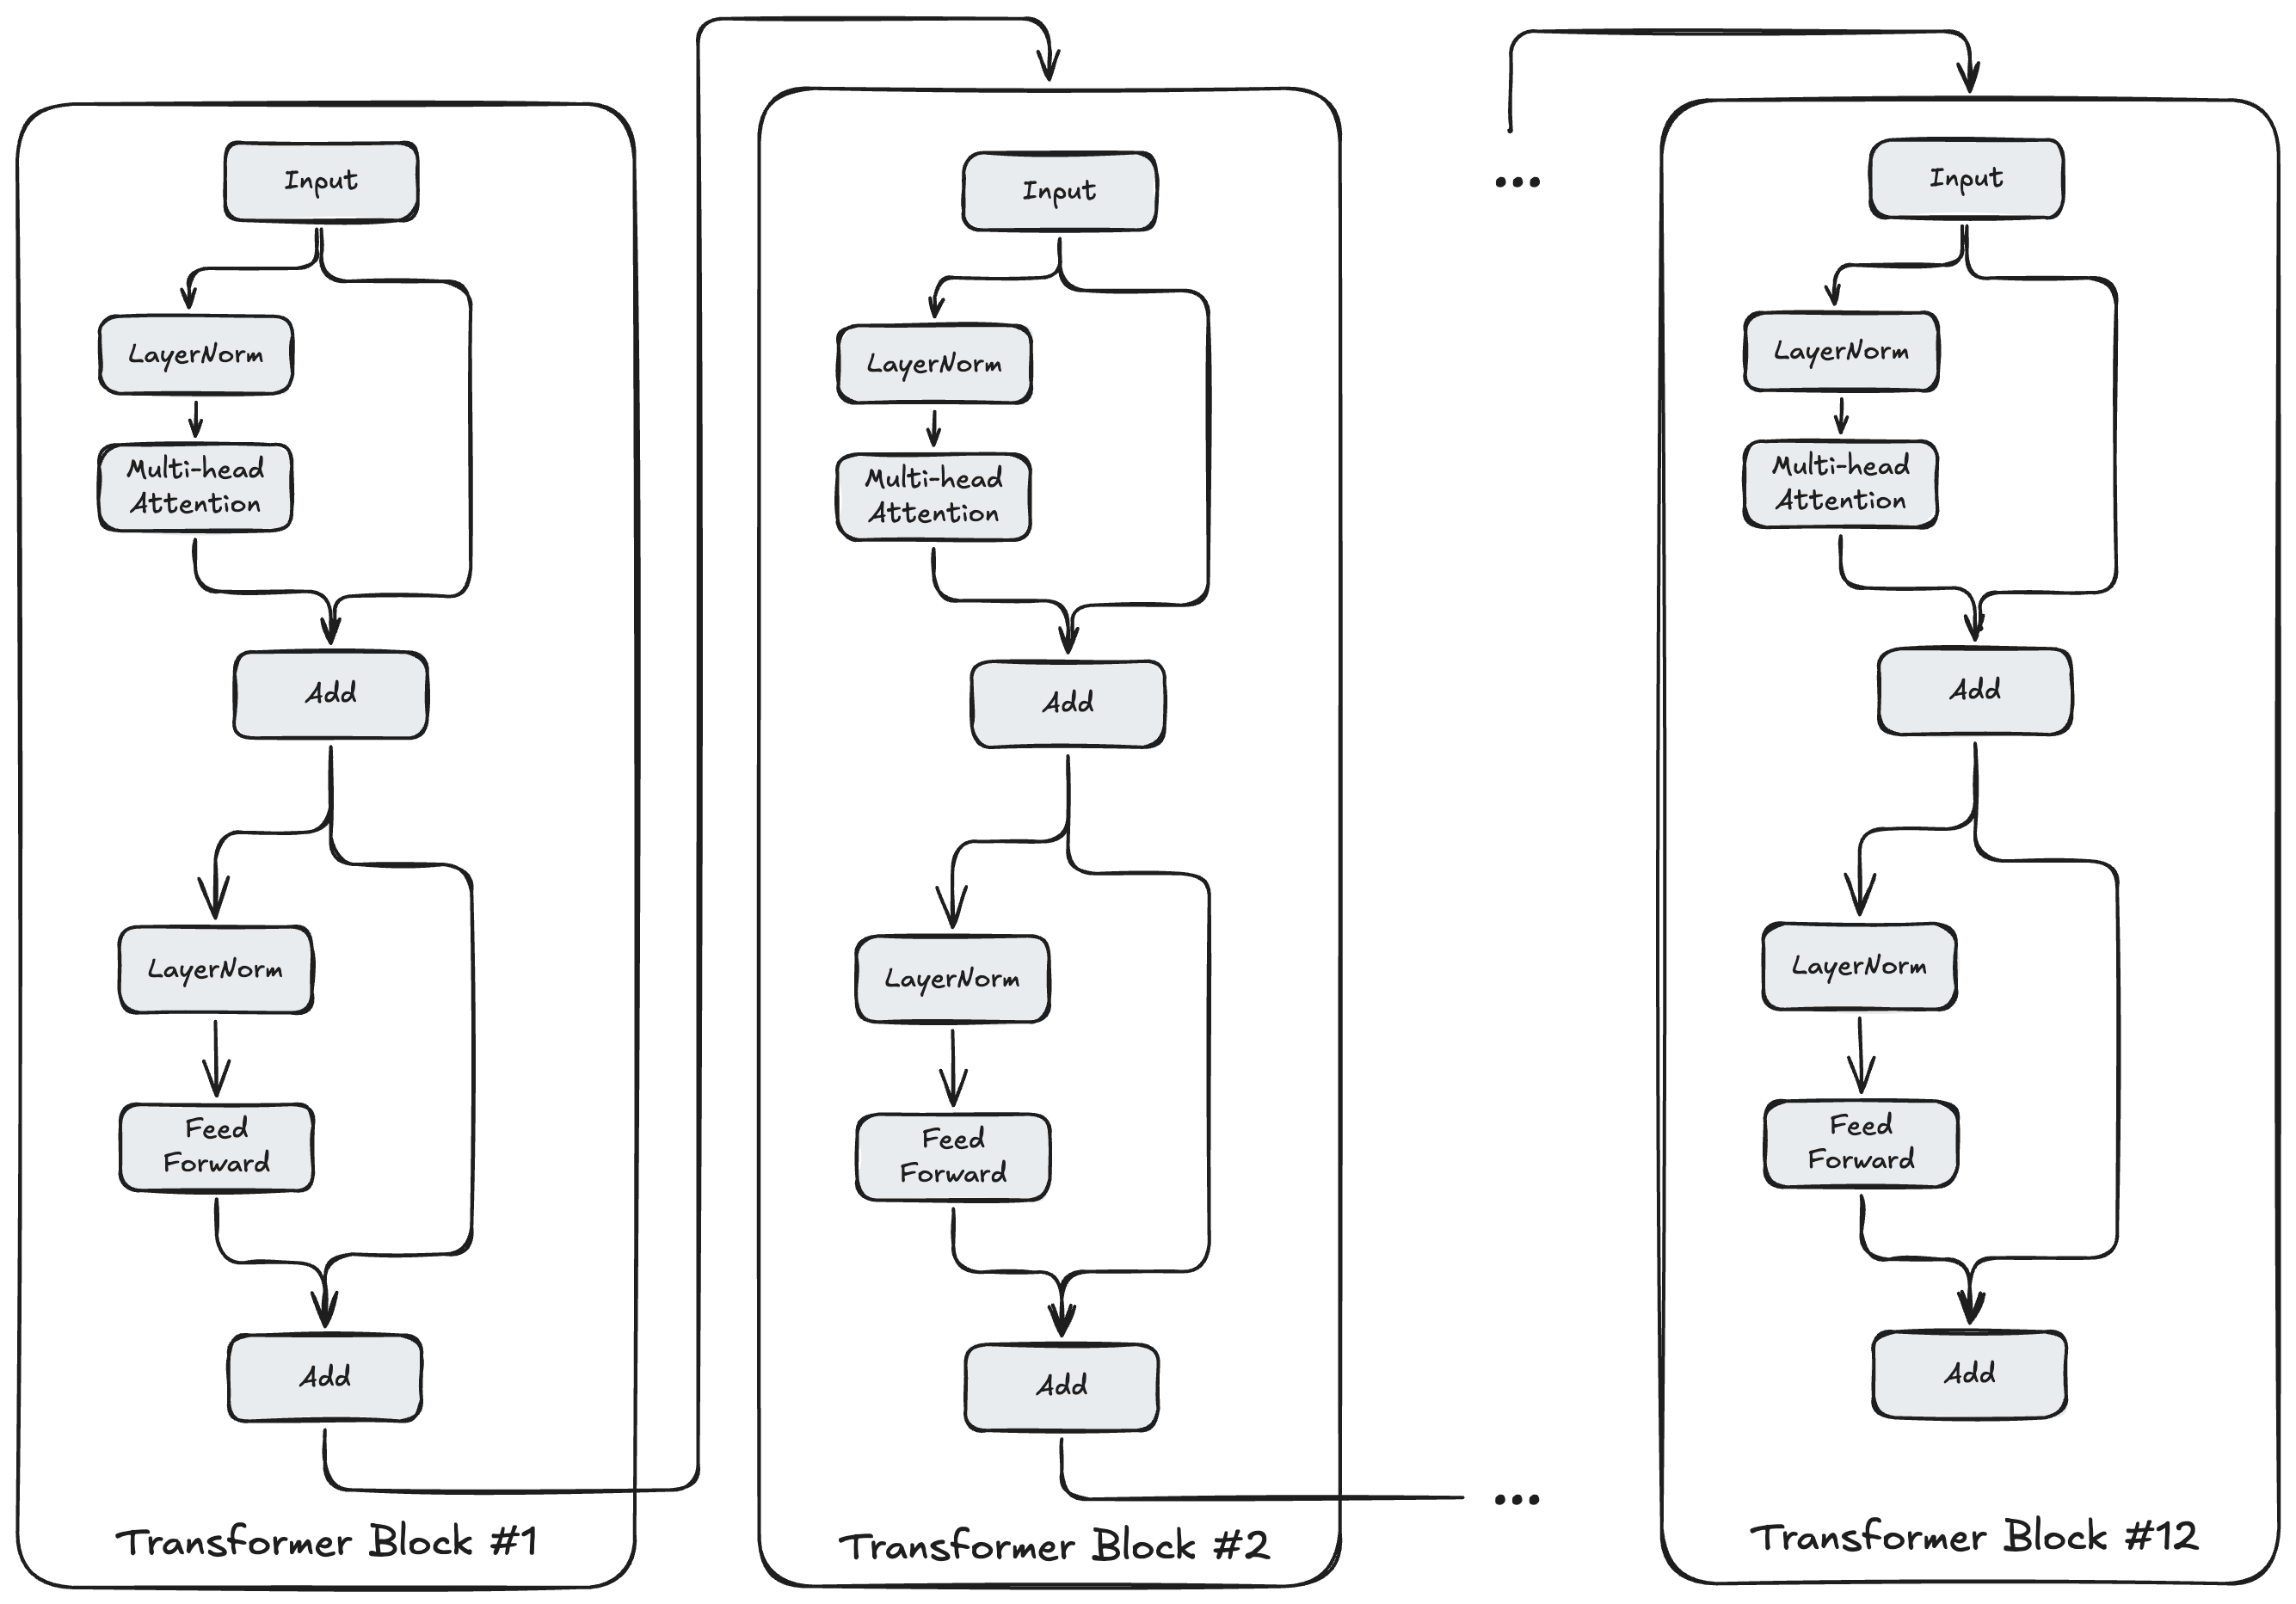
첫 번째 하위 레이어는 방금 살펴본 멀티헤드 어텐션 메커니즘입니다. 입력은 MHA에 들어가기 전에 레이어 정규화를 거칩니다. 그런 다음 MHA의 출력을 원래 입력에 다시 더하여(잔차 연결), 어텐션으로 얻은 문맥과 원래의 위치 표현을 결합합니다. 이 합은 이어서 두 번째 하위 레이어로 전달됩니다.
두 번째 하위 레이어는 앞에서 설명한 피드포워드 네트워크입니다. 첫 번째 하위 레이어와 마찬가지로, 입력(첫 번째 잔차 연결의 출력)은 먼저 레이어 정규화를 거칩니다. 그런 다음 정규화된 출력을 FFN이 처리합니다. 이어서 FFN의 출력은 또 하나의 잔차 연결을 통해 FFN의 입력에 다시 더해집니다. 트랜스포머 블록의 최종 출력은 이 합이며, 이는 스택에 있는 다음의 동일한 트랜스포머 블록의 입력으로 쓰입니다.
# transformer_block:
#   x : (N, 768)
#   out : (N, 768)
def transformer_block(
    x: np.ndarray,
    mlp: MLPParams,
    attn: AttentionParams,
    ln_1: LayerNormParams,
    ln_2: LayerNormParams,
    n_head: int
) -> np.ndarray:
    # First sub-block: Layer norm -> Attention -> Residual
    a = layer_norm(x, g=ln_1.g, b=ln_1.b)
    a = mha(a, c_attn=attn.c_attn, c_proj=attn.c_proj, n_head=n_head)
    x = x + a

    # Second sub-block: Layer norm -> FFN -> Residual
    m = layer_norm(x, g=ln_2.g, b=ln_2.b)
    m = ffn(
        m,
        c_fc_w=mlp.c_fc.w,
        c_fc_b=mlp.c_fc.b,
        c_proj_w=mlp.c_proj.w,
        c_proj_b=mlp.c_proj.b,
    )
    x = x + m

    return x
전체 모델
개별 구성 요소와 트랜스포머 블록 구조를 살펴보았으니, 이제 모든 것을 조립하여 완전한 모델을 만들 수 있습니다. 이 블록들을 여러 번(예를 들어 가장 작은 GPT-2 모델에서는 12번) 쌓아 정교한 언어 이해와 생성이 가능한 깊은 네트워크를 구축합니다. 어텐션 메커니즘, 피드포워드 네트워크, 레이어 정규화, 잔차 연결의 조합은 순차적 정보를 효과적으로 처리하고, 복잡한 의존 관계를 포착하며, 깊이가 깊은데도 안정적으로 학습되는 아키텍처를 만들어 냅니다.
gpt2 함수는 주어진 입력 토큰 ID 시퀀스에 대한 GPT-2 모델의 완전한 순방향 패스를 나타냅니다. 이 함수는 앞에서 정의한 모든 구성 요소를 거치는 데이터 흐름을 조율하여, 원시 토큰 ID를 문맥적 표현으로 변환하고 최종적으로 다음 토큰에 대한 예측으로 바꿉니다.
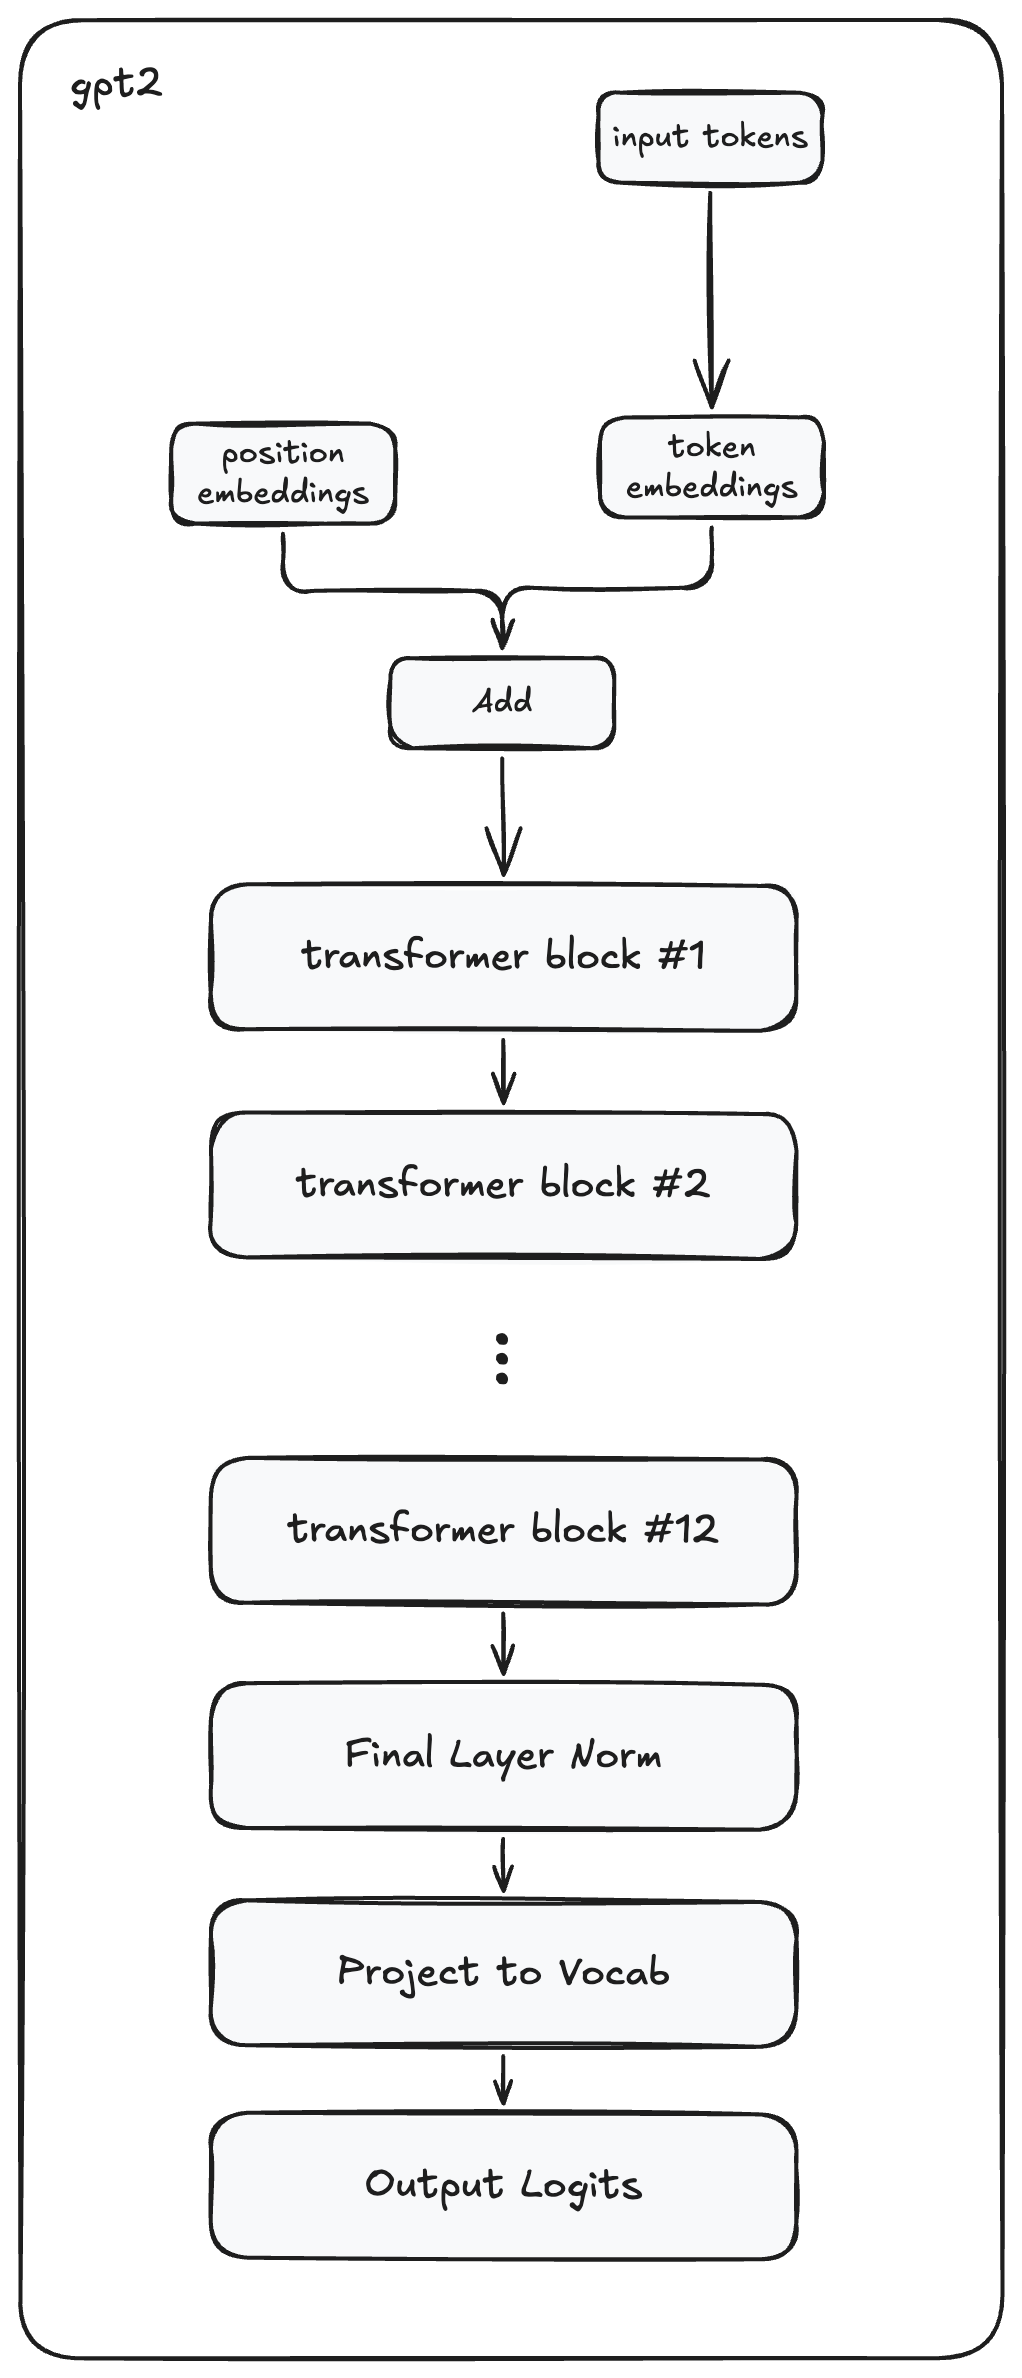
이 과정은 입력 토큰을 임베딩하는 것에서 시작합니다. 이는 입력 시퀀스의 각 토큰에 대해 토큰 임베딩(params.wte에서 조회)과 위치 임베딩(params.wpe에서 조회)을 더하여 이루어집니다. 이렇게 처음 결합된 임베딩은 각 토큰의 의미와 시퀀스 내 위치를 모두 담고 있으며, 이후 모든 처리의 기반이 됩니다.
임베딩된 시퀀스는 이어서 트랜스포머 블록 스택을 통과합니다. 각 블록은 어텐션 메커니즘과 피드포워드 메커니즘을 통해 표현을 다듬으며, 점차 더 정교한 문맥적 이해를 쌓아 갑니다. 코드는 12개 레이어 모델에 대해 이 스태킹을 명시적으로 구현하며, 한 블록의 출력이 다음 블록의 입력이 됩니다. 레이어를 하나씩 거칠 때마다 모델은 데이터에 담긴 점점 더 복잡한 패턴과 관계를 포착할 수 있습니다.
def gpt2(inputs: list[int], params: ModelParams, n_head: int) -> np.ndarray:
    # Get token embeddings and position embeddings
    x = params.wte[inputs] + params.wpe[range(len(inputs))]

    # Apply transformer block stack ( 12 blocks total )
    for i in range(12):
        x = transformer_block(
            x,
            n_head=n_head,
            mlp=params.blocks[i].mlp,
            attn=params.blocks[i].attn,
            ln_1=params.blocks[i].ln_1,
            ln_2=params.blocks[i].ln_2,
        )

    # Apply final layer norm and project to vocabulary
    x = layer_norm(x, g=params.ln_f.g, b=params.ln_f.b)
    logits = x @ params.wte.T  # Project to vocabulary

    return logits
모든 트랜스포머 블록을 거친 뒤, 결과 시퀀스는 값을 안정화하기 위해 마지막 레이어 정규화를 거칩니다. 형태가 (N, 768)(GPT-2 small 기준)인 이 정규화된 출력은 시퀀스의 각 토큰에 대한 최종 문맥 임베딩을 나타냅니다. 이 임베딩을 어휘에 대한 예측으로 변환하기 위해, 모델은 전치된 토큰 임베딩 행렬(params.wte.T)을 사용하여 사영을 수행합니다. 이 영리한 가중치 공유 기법(입력 임베딩과 출력 투영 모두에 같은 임베딩 행렬을 사용하는 것)은 전체 매개변수 수를 줄여 줍니다.
그 결과는 형태가 (N, 50257)(GPT-2 기준)인 로짓 텐서이며, 여기서 50,257은 어휘 크기입니다. 이 로짓은 시퀀스의 각 위치에서 가능한 모든 다음 토큰에 대한 정규화되지 않은 예측 점수를 나타냅니다. 어휘의 모든 토큰이 점수를 받으며, 이 점수를 순위대로 정렬하면 시퀀스에서 다음에 올 가능성이 가장 높은 토큰이 무엇인지 알 수 있습니다. 단일 위치에 대한 로짓의 전형적인 예는 다음과 같습니다.
array([-114.83902718, -111.23177705, -116.58203861, ..., -118.4023539 ,
       -118.92616557, -113.37047973], shape=(50257,))
자기회귀 생성에서는 일반적으로 현재 시퀀스의 끝 다음에 올 다음 토큰을 예측하는 것에만 관심을 둡니다. 마지막 위치에 해당하는 로짓을 선택하고 argmax 같은 연산을 적용하면 가장 가능성이 높은 다음 토큰을 찾을 수 있습니다.
next_token = np.argmax(logits[-1, :])
이 토큰 ID를 시퀀스에 덧붙이고 이 과정을 반복하면 한 번에 한 토큰씩 텍스트를 생성할 수 있습니다. 하지만 이 방식이 동작하려면 사전 학습 가중치에서 불러온, 올바르게 초기화된 모델 매개변수가 필요하며, 이것이 다음 주제로 이어집니다.
Safetensors와 모델 매개변수
GPT-2와 같은 사전 학습 모델을 활용하려면 그 매개변수를 효과적으로 불러오고 구성해야 합니다. 이 절에서는 모델 가중치를 저장하는 안전하고 효율적인 방식인 safetensors 형식을 사용하여 이러한 매개변수를 구성하고 불러오는 방법을 설명합니다. 이를 위해 파라미터가 model.safetensors 파일에 저장되어 있는 HuggingFace에서 파라미터를 불러옵니다.
Safetensors는 텐서를 저장하기 위한 빠르고 안전한(즉, 임의 코드 실행이 필요한 Pickle을 사용하지 않는) 형식입니다. 이 형식은 단순한 키/값 구조를 사용합니다. 키는 텐서 이름을 나타내는 UTF-8 인코딩 문자열(예: model.layers.0.attention.weight)이고, 값은 형태와 dtype 정보를 담은 고정 헤더가 붙은 바이너리 텐서 데이터이며, 파일 시작 부분의 메타데이터 섹션에는 모든 텐서와 그 오프셋의 인덱스가 들어 있습니다.
내부적으로 GPT-2의 모델 매개변수는 다음과 같은 키/값 형식으로 저장되어 있습니다.
{
    "wpe.weight"             : np.array([1024, 768]),
    "wte.weight"             : np.array([50257, 768]),
    ...
    "h.0.attn.bias"          : np.array([1, 1, 1024, 1024]),
    "h.0.attn.c_attn.bias"   : np.array([2304]),
    "h.0.attn.c_attn.weight" : np.array([768, 2304]),
    "h.0.attn.c_proj.bias"   : np.array([768]),
    "h.0.attn.c_proj.weight" : np.array([768, 768]),
    "h.0.ln_1.bias"          : np.array([768]),
    "h.0.ln_1.weight"        : np.array([768]),
    "h.0.ln_2.bias"          : np.array([768]),
    "h.0.ln_2.weight"        : np.array([768]),
    "h.0.mlp.c_fc.bias"      : np.array([3072]),
    "h.0.mlp.c_fc.weight"    : np.array([768, 3072]),
    "h.0.mlp.c_proj.bias"    : np.array([768]),
    "h.0.mlp.c_proj.weight"  : np.array([3072, 768]),
    ...
    "ln_f.bias"              : np.array([768]),
    "ln_f.weight"            : np.array([768])
}
이들 각각은 해당 구성 요소의 학습된 매개변수를 담고 있는, shape와 dtype을 가진 텐서이며, 모델 학습 과정의 결과물입니다.
LayerNormParams 데이터클래스는 레이어 정규화 매개변수를 나타내며, 여기에는 각 레이어의 스케일(g)과 편향(b)이 포함됩니다.
@dataclass
class LayerNormParams:
    g: np.ndarray  # Gamma (scale)
    b: np.ndarray  # Beta (bias)
LinearParams 데이터클래스는 선형 투영 매개변수를 나타내며, 여기에는 가중치 행렬(w)과 편향 벡터(b)가 포함됩니다.
@dataclass
class LinearParams:
    w: np.ndarray  # Weight matrix
    b: np.ndarray  # Bias vector
MLPParams 데이터클래스는 피드포워드 네트워크 매개변수를 나타내며, 여기에는 두 개의 선형 레이어, 즉 첫 번째 선형 레이어(c_fc)와 두 번째 선형 레이어(c_proj)가 포함됩니다.
@dataclass
class MLPParams:
    c_fc: LinearParams  # First linear layer
    c_proj: LinearParams  # Second linear layer
AttentionParams 데이터클래스는 어텐션 매개변수를 나타내며, 여기에는 쿼리-키-값 투영(c_attn)과 출력 투영(c_proj)이 포함됩니다.
@dataclass
class AttentionParams:
    c_attn: LinearParams  # QKV projection
    c_proj: LinearParams  # Output projection
TransformerBlockParams 데이터클래스는 하나의 트랜스포머 블록을 나타내며, 레이어 정규화(ln_1), 피드포워드 네트워크(mlp), 어텐션 메커니즘(attn), 두 번째 레이어 정규화(ln_2)를 포함합니다.
@dataclass
class TransformerBlockParams:
    ln_1: LayerNormParams  # First layer norm
    ln_2: LayerNormParams  # Second layer norm
    mlp: MLPParams  # MLP block
    attn: AttentionParams  # Attention block
ModelParams 데이터클래스는 전체 모델 매개변수를 나타내며, 여기에는 토큰 임베딩 행렬(wte), 위치 임베딩 행렬(wpe), 트랜스포머 블록의 리스트(blocks), 그리고 최종 레이어 정규화(ln_f)가 포함됩니다.
@dataclass
class ModelParams:
    wte: np.ndarray  # Token embeddings
    wpe: np.ndarray  # Position embeddings
    blocks: List[TransformerBlockParams]  # Transformer blocks
    ln_f: LayerNormParams  # Final layer norm
HParams 데이터클래스는 모델의 하이퍼파라미터를 나타내며, 여기에는 트랜스포머 레이어 수(n_layer), 어텐션 헤드 수(n_head), 그리고 컨텍스트 길이(n_ctx)가 포함됩니다.
@dataclass
class HParams:
    n_layer: int  # Number of transformer layers
    n_head: int  # Number of attention heads
    n_ctx: int  # Context length
safe_open 함수를 사용하여 model.safetensors 파일에서 모델 매개변수를 불러올 수 있습니다. 이 파일은 Hugging Face 모델 허브에서 내려받을 수 있습니다.
tensors = {}
with safe_open(weights_path, framework="numpy") as f:
    for key in f.keys():
        tensors[key] = f.get_tensor(key)

# Build transformer blocks
blocks = []
for i in range(config["n_layer"]):
    prefix = f"h.{i}"
    block = TransformerBlockParams(
        ln_1=LayerNormParams(
            g=tensors[f"{prefix}.ln_1.weight"], b=tensors[f"{prefix}.ln_1.bias"]
        ),
        ln_2=LayerNormParams(
            g=tensors[f"{prefix}.ln_2.weight"], b=tensors[f"{prefix}.ln_2.bias"]
        ),
        mlp=MLPParams(
            c_fc=LinearParams(
                w=tensors[f"{prefix}.mlp.c_fc.weight"],
                b=tensors[f"{prefix}.mlp.c_fc.bias"],
            ),
            c_proj=LinearParams(
                w=tensors[f"{prefix}.mlp.c_proj.weight"],
                b=tensors[f"{prefix}.mlp.c_proj.bias"],
            ),
        ),
        attn=AttentionParams(
            c_attn=LinearParams(
                w=tensors[f"{prefix}.attn.c_attn.weight"],
                b=tensors[f"{prefix}.attn.c_attn.bias"],
            ),
            c_proj=LinearParams(
                w=tensors[f"{prefix}.attn.c_proj.weight"],
                b=tensors[f"{prefix}.attn.c_proj.bias"],
            ),
        ),
    )
    blocks.append(block)

# Build final model params
params = ModelParams(
    wte=tensors["wte.weight"],
    wpe=tensors["wpe.weight"],
    blocks=blocks,
    ln_f=LayerNormParams(g=tensors["ln_f.weight"], b=tensors["ln_f.bias"]),
)
탐욕적 디코딩
모델 아키텍처를 정의하고 매개변수를 불러왔으니, 이제 모든 것을 하나로 합쳐 텍스트를 생성할 준비가 되었습니다. 텍스트 생성의 가장 간단한 방법은 탐욕적 디코딩(greedy decoding)으로, 각 단계에서 모델이 예측한 확률이 가장 높은 토큰을 그대로 선택하는 방식입니다.
아래의 generate 함수는 초기 프롬프트를 인코딩하는 것부터 새 토큰을 반복적으로 생성하는 것까지 전체 텍스트 생성 과정을 캡슐화합니다. 이 함수는 지금까지 살펴본 모든 구성 요소, 즉 토큰화, 임베딩, 트랜스포머 블록, 어휘 사영이 어떻게 함께 작동하여 제대로 동작하는 언어 모델을 만들어 내는지 보여 줍니다.
def generate(prompt: str, n_tokens_to_generate: int = 40) -> str:
    encoder = get_encoder("", "model")
    params, hparams = load_gpt2_weights()

    input_ids = encoder.encode(prompt)
    generated_token_ids: list[int] = []

    print(prompt, end="", flush=True)

    current_ids = list(input_ids)

    for _ in range(n_tokens_to_generate):
        logits = gpt2(current_ids, params, n_head=hparams.n_head)
        next_id = np.argmax(logits[-1, :])
        next_id_int = int(next_id)

        current_ids.append(next_id_int)
        generated_token_ids.append(next_id_int)

        token_text = encoder.decode([next_id_int])
        print(token_text, end="", flush=True)

    print()

    return encoder.decode(generated_token_ids)
생성 과정은 BPE 토크나이저를 사용하여 사용자의 프롬프트를 토큰 ID로 인코딩하는 것으로 시작합니다. 생성할 토큰을 추적하기 위해 빈 리스트를 초기화합니다. 그런 다음 루프에 진입하여, 매 반복마다 다음을 수행합니다.
- 현재 토큰 ID 시퀀스(원래 프롬프트와 지금까지 생성된 모든 토큰)를 GPT-2 모델에 통과시킵니다
- 마지막 토큰 위치의 로짓을 추출합니다. 이 로짓은 다음에 무엇이 올지에 대한 모델의 예측을 나타냅니다
- 이 로짓의 argmax를 취하여 가장 가능성이 높은 다음 토큰을 선택합니다
- 이 새 토큰을 생성된 토큰 리스트와 현재 시퀀스에 추가합니다
- 새 토큰을 디코딩하고 출력하여 생성 과정을 실시간으로 보여 줍니다
요청된 수만큼 토큰을 생성한 후, 생성된 토큰의 전체 시퀀스를 다시 텍스트로 디코딩하여 반환합니다. 이것으로 끝입니다. GPT-2 모델의 단순한 버전을 구현하는 데 필요한 것은 이것이 전부입니다. 구현해야 하는 “커널” 연산은 여섯 개 정도(softmax, gelu, layer_norm, linear, add, matmul, var, mean)에 불과하며, 나머지는 자료 구조를 다루기 위한 많은 부수적인 관리 작업일 뿐입니다.
이를 통해 모델 컴파일을 시작할 때 비교 기준으로 삼을 참조 구현을 얻게 됩니다. 융합과 병렬화 모두의 기회가 있지만, 먼저 생성된 코드를 GPU에서 실행할 방법이 필요합니다. 8부에서는 작은 요소별(elementwise) 커널을 사용하여 그 백엔드를 구축합니다. 그 후에 Python 프런트엔드와 트랜스포머 연산으로 돌아갈 수 있습니다.
외부 자료
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- QLoRA: Efficient Finetuning of Quantized LLMs
- The Illustrated GPT-2
- The Annotated Transformer
- attention-gym
이전: 6부 - E-그래프로 Python 특수화하기 · 시리즈 목차 · 다음: 8부 - MLIR을 이용한 GPU 컴파일
E-그래프로 Python 특수화하기
지금까지 우리는 수치 계산을 최적화하기 위한 점점 더 정교한 기법들을 살펴보았습니다. 기본적인 MLIR 개념에서 출발하여 메모리 관리와 선형대수를 거쳐 신경망 구현까지 다루었습니다. 각 계층은 계산을 표현하고 최적화하는 새로운 기능을 더해 주었습니다. 이제 Python 식을 위한 첫 번째 장난감 컴파일러를 만들 준비가 되었습니다.
이 절에서는 egglog 라이브러리를 사용하여 Python 식에 항 재작성과 최적화를 수행하고 이를 MLIR로 컴파일하는 방법을 살펴보겠습니다.
이 절의 전체 소스 코드는 GitHub에서 볼 수 있습니다.
동치 포화와 E-그래프
구현에 들어가기 전에 동치 포화와 e-그래프의 핵심 개념을 복습해 봅시다.
예를 들어 다음과 같은 재작성 규칙이 있다고 합시다.
x * 2→x << 1x*y/x→y
그리고 이를 (a * 2)/2 식에 적용하려고 하면 (a << 1)/2가 됩니다. 그러나 원래는 분자와 분모의 2를 약분하여 a를 얻었어야 하며, 그러면 더 간단한 식이 됩니다. 재작성 순서는 중요하며, 우리는 비용 함수에 따라 식을 어떤 형태로 줄여 주는 최적의 재작성 순서를 찾고자 합니다. 이를 단계 순서 문제(phase ordering problem)라고 합니다.
egg 라이브러리는 가능한 모든 재작성을 식에 빠짐없이 적용하는 접근 방식을 사용하며, e-그래프를 활용하여 단계 순서 문제를 효과적으로 해결합니다. 이 접근 방식을 사용하면 가능한 모든 재작성을 탐색한 뒤, 식의 가장 최적인 형태를 추출할 수 있습니다.
예를 들어 선형대수에서 전치나 곱셈 같은 NumPy 행렬 연산은 행렬의 모든 원소를 건드려야 하므로 비용이 꽤 큽니다. 하지만 연산 횟수를 줄이는 데 적용할 수 있는 항등식은 매우 다양합니다.
LLVM 같은 컴파일러는 물론 MLIR의 linalg 다이얼렉트조차도 이러한 항등식을 알지 못하므로, 재작성을 적용하여 비용이 큰 연산을 반드시 없앨 수 있는 것은 아닙니다. 그러나 상위 수준(우리의 Core 언어)에서는 e-그래프를 사용하여, MLIR로 로어링하기 전에 훨씬 더 효율적인 텐서 조작 연산을 만들어 낼 수 있습니다.
예를 들어 다음 항등식들은 선형대수에서 매우 흔히 쓰입니다.
Python으로는 다음과 같습니다.
np.transpose(A * B) = np.transpose(B) * np.transpose(A)
np.transpose(np.transpose(A)) == A
이러한 규칙을 적용하면 컴파일 시점에 NumPy 식을 최적화할 수 있으며, 이는 상당한 성능 향상으로 이어집니다. 예를 들어 우리 예제에서는 곱셈 하나와 전치 두 개로 이루어진 세 개의 루프를 곱셈 하나와 전치 하나로 이루어진 두 개의 루프로 줄이는 데 성공했습니다. 이 최적화는 계산을 단순화할 뿐만 아니라 효율도 높여 줍니다. NumPy를 사용하는 일반적인 코드에는 이러한 최적화 기회가 많으며, 이를 흔히 손쉽게 얻을 수 있는 성과(low-hanging fruit)라고 부릅니다. 이러한 최적화를 체계적으로 적용하면 필요한 연산 횟수를 줄여 수치 계산의 실행을 효율화할 수 있습니다. 이는 LLVM의 자동 벡터화가 작동하기도 전에 적용된다는 점에서 특히 유익한데, 식의 잠재력을 최대한 활용하여 더 빠른 실행 시간을 달성할 수 있기 때문입니다.
e-그래프(동치 그래프)는 서로 동치인 여러 표현식을 압축적으로 표현하는 자료 구조입니다. e-그래프는 표현식마다 하나의 정규형을 유지하는 대신, 동치인 표현식들의 클래스를 유지합니다. 이 접근 방식 덕분에 더 유연하고 효율적인 항 재작성이 가능합니다.
egglog 라이브러리로 기본적인 단순화를 수행하는 구체적인 예제를 살펴봅시다. 먼저 표현식 모델을 정의해야 합니다.
from __future__ import annotations
from egglog import *

class Num(Expr):
    def __init__(self, value: i64Like) -> None: ...

    @classmethod
    def var(cls, name: StringLike) -> Num: ...

    def __add__(self, other: Num) -> Num: ...

    def __mul__(self, other: Num) -> Num: ...

# Create an e-graph to store our expressions
egraph = EGraph()

# Define our expressions and give them names in the e-graph
expr1 = egraph.let("expr1", Num(2) * (Num.var("x") + Num(3)))  # 2 * (x + 3)
expr2 = egraph.let("expr2", Num(6) + Num(2) * Num.var("x"))    # 6 + 2x

# Define our rewrite rules using a decorated function
@egraph.register
def _num_rule(a: Num, b: Num, c: Num, i: i64, j: i64):
    yield rewrite(a + b).to(b + a)                    # Commutativity of addition
    yield rewrite(a * (b + c)).to((a * b) + (a * c))  # Distributive property
    yield rewrite(Num(i) + Num(j)).to(Num(i + j))     # Constant folding for addition
    yield rewrite(Num(i) * Num(j)).to(Num(i * j))     # Constant folding for multiplication

# Apply rules until no new equalities are found
egraph.saturate()

# Check if expr1 and expr2 are equivalent
egraph.check(eq(expr1).to(expr2))

# Extract the simplified form of expr1
egraph.extract(expr1)
egraph.display() 함수를 사용하면 e-그래프를 시각화할 수 있습니다.
동치 포화 이전의 입력 표현식은 다음과 같습니다.
 동치 포화 이전의 입력 표현식
그다음 모든 동치 클래스를 포함한 출력은 다음과 같이 표현식들의 네트워크가 됩니다.
 동치 포화 이후의 출력 표현식
여기에서 사용자 정의 비용 함수에 따라 원하는 표현식을 추출할 수 있습니다.
기반 계층
이제 이를 기본 표현식 컴파일러에 적용해 봅시다. 우리 컴파일러 파이프라인은 다음과 같은 몇 가지 핵심 단계로 이루어져 있습니다.
- Python 함수 데코레이션과 타입 어노테이션
- 표현식 트리 추출
- e-그래프를 이용한 항 재작성과 최적화
- MLIR 코드 생성
- LLVM 컴파일과 JIT 실행
우리 컴파일러의 기반 계층은 수학적 표현식을 표현하고 조작하기 위한 핵심(Core) 추상화를 제공합니다. 이 계층은 모든 상위 수준 최적화와 변환의 토대가 되므로 매우 중요합니다. 각 구성 요소를 자세히 살펴봅시다.
표현식 모델(expr_model.py)
우리 컴파일러의 중심에는 수학 표현식을 추상 구문 트리(AST)로 표현하는 표현식 모델이 있습니다. 이 모델은 깔끔하고 효율적인 표현을 위해 Python의 데이터클래스를 사용하여 구현되어 있습니다.
Core 표현식 타입
모든 표현식의 기본 클래스는 Expr 클래스이며, 이 클래스는 다음과 같은 기본 연산을 제공합니다.
@dataclass(frozen=True)
class Expr:
    def __add__(self, other: Expr) -> Expr:
        return Add(self, as_expr(other))

    def __mul__(self, other: Expr) -> Expr:
        return Mul(self, as_expr(other))
    # ... other operations
표현식 모델은 세 가지 기본 타입으로 구성됩니다.
-
리터럴: 표현식 안의 상수
@dataclass(frozen=True) class FloatLiteral(Expr): fval: float # Floating-point constant @dataclass(frozen=True) class IntLiteral(Expr): ival: float # Integer constant -
심볼: 변수와 함수 이름
@dataclass(frozen=True) class Symbol(Expr): name: str # Variable or function name -
연산: 단항 연산과 이항 연산 모두
@dataclass(frozen=True)
class UnaryOp(Expr):
    operand: Expr  # Single operand

@dataclass(frozen=True)
class BinaryOp(Expr):
    lhs: Expr  # Left-hand side
    rhs: Expr  # Right-hand side
@dataclass(frozen=True) class Add(BinaryOp): pass # Addition ... @dataclass(frozen=True) class Sin(UnaryOp): pass # Sine
내장 함수(builtin_functions.py)
내장 함수 모듈은 수학 연산을 위한 NumPy 스타일의 인터페이스를 제공합니다. 이를 통해 사용자는 익숙한 문법으로 식을 작성하면서도 저희 최적화 프레임워크를 그대로 활용할 수 있습니다. 이 모듈에는 자주 쓰이는 수학 상수와 절댓값 같은 연산을 위한 헬퍼 함수가 포함되어 있습니다.
# A mock NumPy namespace that we convert into our own expression model

import math
from mlir_egglog.expr_model import (
    sin,
    cos,
    tan,
    asin,
    acos,
    atan,
    tanh,
    sinh,
    cosh,
    sqrt,
    exp,
    log,
    log10,
    log2,
    float32,
    int64,
    maximum,
)  # noq

# Constants
e = math.e
pi = math.pi


# Define abs function
def abs(x):
    return maximum(x, -x)


def relu(x):
    return maximum(x, 0.0)


def sigmoid(x):
    return 1.0 / (1.0 + exp(-x))


__all__ = [
    "sin",
    "cos",
    "tan",
    "asin",
    "acos",
    "atan",
    "tanh",
    "sinh",
    "cosh",
    "sqrt",
    "exp",
    "log",
    "log10",
    "log2",
    "float32",
    "int64",
    "e",
    "pi",
    "maximum",
    "abs",
]
Term IR (term_ir.py)
Term IR 계층은 항 재작성과 동치 포화에 최적화된 중간 표현을 제공합니다. Term IR의 핵심 기능은 여러 연산에 대한 비용 모델입니다.
COST_BASIC_ARITH = 1   # Basic arithmetic (single CPU instruction)
COST_CAST = 2          # Type conversion operations
COST_DIV = 5           # Division
COST_POW_INTEGER = 10  # Integer power
COST_SQRT = 20         # Square root
COST_LOG = 30          # Logarithm
COST_EXP = 40          # Exponential
COST_POW = 50          # General power operation
COST_TRIG_BASIC = 75   # Basic trigonometric functions
COST_HYPERBOLIC = 180  # Hyperbolic functions
e-그래프 최적화 엔진은 이 비용을 바탕으로 어떤 변환을 적용할지 결정합니다. 이 비용은 대략 현대 하드웨어에서 각 연산이 갖는 계산 복잡도에 대응합니다.
from __future__ import annotations

import egglog
from egglog import StringLike, i64, f64, i64Like, f64Like  # noqa: F401
from egglog import RewriteOrRule, rewrite
from typing import Generator
from mlir_egglog.expr_model import Expr, FloatLiteral, Symbol, IntLiteral
from abc import abstractmethod

def as_egraph(expr: Expr) -> Term:
    """
    Convert a syntax tree expression to an egraph term.
    """
    from mlir_egglog import expr_model

    match expr:
        # Literals and Symbols
        case FloatLiteral(fval=val):
            return Term.lit_f32(val)
        case IntLiteral(ival=val):
            return Term.lit_i64(int(val))
        case Symbol(name=name):
            return Term.var(name)

        # Binary Operations
        case expr_model.Add(lhs=lhs, rhs=rhs):

        # Rest of the operations
        ...
비용 모델은 e-그래프 최적화 엔진이 이 비용 모델 기준으로 가장 비용 효율적인 구현을 찾도록 이끄는 데 사용됩니다. 예를 들면 다음과 같습니다.
좌변(LHS)에는 곱셈이 3번 있고 우변(RHS)에는 곱셈이 1번 있습니다. 따라서 추출 과정에 적용되는 비용에 따라 우변이 선택됩니다.
변환 계층
저희 컴파일러의 가장 강력한 기능 가운데 하나는 Python 함수를 기호적으로 해석하는 능력입니다. 이 과정은 일반 Python 함수를 저희 IR 표현으로 변환하며, 그 결과로 나온 식 트리에 최적화를 적용할 수 있게 해 줍니다.
해석 과정은 interpret 함수가 담당합니다.
import types
import inspect

from mlir_egglog import expr_model as ir


def interpret(fn: types.FunctionType, globals: dict[str, object]):
    """
    Symbolically interpret a python function.
    """
    # Get the function's signature
    sig = inspect.signature(fn)

    # Create symbolic parameters for each of the function's arguments
    params = [n for n in sig.parameters]
    symbolic_params = [ir.Symbol(name=n) for n in params]

    # Bind the symbolic parameters to the function's arguments
    ba = sig.bind(*symbolic_params)

    # Inject our globals (i.e. np) into the function's globals
    custom_globals = fn.__globals__.copy()
    custom_globals.update(globals)

    # Create a temporary function with our custom globals
    tfn = types.FunctionType(
        fn.__code__,
        custom_globals,
        fn.__name__,
        fn.__defaults__,
        fn.__closure__,
    )
    return tfn(*ba.args, **ba.kwargs)
이 함수는 먼저 매개변수 분석으로 시작하며, 입력 함수의 시그니처를 분석하여 매개변수를 파악합니다. 각 매개변수에 대해 저희 Symbol 클래스를 사용하여 기호 표현을 만듭니다. 이 기호들은 식 트리 전반에서 변수를 추적하는 데 사용됩니다.
다음으로 기호 매개변수를 함수의 인자 슬롯에 바인딩하여 매개변수 이름과 그 기호 표현 사이의 매핑을 만듭니다. 그런 다음 이 함수는 NumPy 함수와 같은 수학 연산에 대한 저희의 자체 구현을 해당 함수의 전역 네임스페이스에 주입합니다. 이를 통해 이러한 함수 호출을 가로채 저희의 기호 연산으로 대체할 수 있습니다.
원래 함수와 동일한 코드, 이름, 클로저를 유지하면서 수정된 전역 변수를 사용하는 임시 함수를 만듭니다. 마지막으로 기호 매개변수를 넣어 함수를 실행하면, 그 계산을 나타내는 식 트리가 만들어집니다.
예를 들어 다음과 같은 Python 함수가 있다고 합시다.
def f(x, y):
    return np.sin(x) + np.cos(y)
해석 과정은 다음을 수행합니다.
x와y에 대한 기호를 만듭니다np.sin과np.cos를 저희의 기호 버전으로 대체합니다- 기호 입력으로 함수를 실행합니다
Sin(Symbol("x")) + Cos(Symbol("y"))를 나타내는 식 트리를 반환합니다
바로 이 기호적 해석 덕분에 Python 계산을 저희 e-그래프 기법으로 최적화할 수 있는 형태로 포착할 수 있습니다.
IR 변환 (ir_to_mlir.py)
IR에서 MLIR로의 변환 계층은 우리의 고수준 표현식 표현과 MLIR의 저수준 다이얼렉트 사이를 잇는 중요한 다리 역할을 합니다. 이 변환 과정은 ir_to_mlir.py에 구현되어 있으며, AST 조작과 함께 Python의 동적 실행 기능을 활용하는 여러 단계로 이루어집니다.
변환 파이프라인은 IR 항을 내부 표현식 모델로 변환하는 convert_term_to_expr 함수에서 시작합니다. 이 함수는 Python의 내장 ast 모듈을 사용하여 항의 추상 구문 트리를 파싱하고 조작합니다. 이 과정이 특히 흥미로운 이유는 Python의 실행 환경을 변환 과정의 일부로 사용하기 때문입니다.
항이 변환을 위해 들어오면 먼저 AST 파싱을 거칩니다. 이 함수는 항의 문자열 표현으로부터 Python AST를 생성하며, 이를 통해 실행 전에 코드 구조를 조작할 수 있습니다. 이 과정의 핵심은 mangle_assignment 함수로, 표현식의 결과가 _out이라는 이름의 변수에 제대로 담기도록 보장합니다. 이 맹글링 단계는 실행 환경에서 최종 결과를 꺼내는 방법을 제공하므로 매우 중요합니다.
실행 환경은 연산 이름을 해당 구현에 매핑하는 function_map 딕셔너리를 사용하여 신중하게 구성됩니다. 이 맵에는 기본 산술 연산(Add, Sub, Mul, Div), 수학 함수(Sin, Cos, Exp, Log), 타입 변환 연산(CastF32, CastI64)이 포함됩니다. 이 연산들은 각각 표현식 모델의 메서드나 내장 함수 모듈의 함수 중 하나에 매핑됩니다.
두 번째 주요 구성 요소는 convert_term_to_mlir 함수로, 변환된 표현식을 받아 MLIR 코드를 생성합니다. 이 함수는 MLIR의 텍스트 형식으로의 최종 변환을 담당합니다. 이 함수는 argspec 매개변수를 통해 함수 인수를 처리하며, 인수 이름과 그에 대응하는 MLIR 표현 사이의 매핑을 만듭니다(예: x를 %arg_x로 변환). 실제 MLIR 생성은 MLIRGen 클래스에 위임되며, 이 클래스는 표현식 트리를 순회하면서 대응하는 MLIR 연산을 생성합니다.
예를 들어 a + b * c 같은 간단한 산술 표현식을 변환할 때 파이프라인은 다음과 같이 동작합니다.
- 표현식을 AST로 파싱합니다
- 함수 맵을 사용하여 내부 표현식 모델로 변환합니다
- 적절한 메모리 참조와 연산을 갖춘 MLIR 코드를 생성합니다
- 적절한 타입 주석과 함께 연산들을 올바른 MLIR 함수 구조로 감쌉니다
def convert_term_to_expr(tree: IRTerm) -> ir.Expr:
    """
    Convert a term to an expression.
    """

    # Parse the term into an AST
    astree = ast.parse(str(tree))

    # Mangle the assignment
    astree.body[-1] = ast.fix_missing_locations(mangle_assignment(astree.body[-1]))  # type: ignore

    # Execute the AST
    globals: dict[str, Any] = {}
    exec(compile(astree, "<string>", "exec"), function_map, globals)

    # Get the result
    result = globals["_out"]
    return result


def convert_term_to_mlir(tree: IRTerm, argspec: str) -> str:
    """
    Convert a term to MLIR.
    """

    expr = convert_term_to_expr(tree)
    argnames = map(lambda x: x.strip(), argspec.split(","))
    argmap = {k: f"%arg_{k}" for k in argnames}
    source = MLIRGen(expr, argmap).generate()
    return source
최적화 계층
이제 표현식 트리에 적용할 재작성 규칙을 직접 작성해 봅시다.
birewrite_subsume 헬퍼 함수는 e-그래프용 재작성 규칙을 내놓는 생성기입니다. 이 함수는 두 항을 받아 첫 번째 항을 두 번째 항으로 변환하는 재작성 규칙을 생성하며, 이때 첫 번째 항은 더 이상 매칭되거나 추출될 수 없게 됩니다. 우리는 이를 사용하여 일반 Term을 특수화된 이항 및 단항 연산으로 단방향 변환합니다.
def birewrite_subsume(a: Term, b: Term) -> Generator[RewriteOrRule, None, None]:
    yield rewrite(a, subsume=True).to(b)
    yield rewrite(b).to(a)
기본 단순화 모듈은 항 재작성 시스템의 토대가 되는 기본적인 수학적 재작성을 구현합니다. 이 규칙들은 basic_math 규칙 집합으로 구성되어 있으며, 다음과 같은 몇 가지 주요 변환 범주를 포함합니다.
- 항 변환 규칙: 일반 Term과 그 특수화된 형태(Add, Mul, Div, Pow) 사이의 변환을 가능하게 하는 규칙입니다
- 항등 규칙: , 같은 수학적 항등식을 처리하는 규칙입니다
- 결합 법칙 규칙: 같은 연산의 결합 법칙을 처리하는 규칙입니다
- 거듭제곱 규칙: , 같은 경우를 포함하여 거듭제곱을 특별히 처리하는 규칙입니다
- 산술 단순화: 와 같은 일반적인 산술 패턴을 단순화하는 규칙입니다
각 규칙은 egglog의 재작성 시스템을 사용하여 구현됩니다.
from mlir_egglog.term_ir import Term, Add, Mul, Div, Pow, PowConst, birewrite_subsume
from egglog import RewriteOrRule, ruleset, rewrite, i64, f64
from typing import Generator


@ruleset
def basic_math(
    x: Term, y: Term, z: Term, i: i64, f: f64
) -> Generator[RewriteOrRule, None, None]:
    # Allow us to translate Term into their specializations
    yield from birewrite_subsume(x + y, Add(x, y))
    yield from birewrite_subsume(x * y, Mul(x, y))
    yield from birewrite_subsume(x / y, Div(x, y))
    yield from birewrite_subsume(x**y, Pow(x, y))

    # x + 0 = x (integer case)
    yield rewrite(Add(x, Term.lit_i64(0))).to(x)
    # x + 0.0 = x (float case)
    yield rewrite(Add(x, Term.lit_f32(0.0))).to(x)
    # 0.0 + x = x (float case)
    yield rewrite(Add(Term.lit_f32(0.0), x)).to(x)

    # x * 1 = x
    yield rewrite(Mul(x, Term.lit_i64(1))).to(x)

    # x * 0 = 0
    yield rewrite(Mul(x, Term.lit_i64(0))).to(Term.lit_i64(0))

    # (x + y) + z = x + (y + z)
    yield rewrite(Add(x, Add(y, z))).to(Add(Add(x, y), z))

    # (x * y) * z = x * (y * z)
    yield rewrite(Mul(x, Mul(y, z))).to(Mul(Mul(x, y), z))

    # x + x = 2 * x
    yield rewrite(Add(x, x)).to(Mul(Term.lit_i64(2), x))

    # x * x = x^2
    yield rewrite(Mul(x, x)).to(Pow(x, Term.lit_i64(2)))

    # (x^y) * (x^z) = x^(y + z)
    yield rewrite(Pow(x, y) * Pow(x, z)).to(Pow(x, Add(y, z)))

    # x^i = x * x^(i - 1)
    yield rewrite(Pow(x, Term.lit_i64(i))).to(PowConst(x, i))

    # x^0 = 1
    yield rewrite(PowConst(x, 0)).to(Term.lit_f32(1.0))

    # x^1 = x
    yield rewrite(PowConst(x, 1)).to(x)

    # x^i = x * x^(i - 1)
    yield rewrite(PowConst(x, i)).to(Mul(x, PowConst(x, i - 1)), i > 1)
기본 단순화 모듈과 마찬가지로, 삼각함수 단순화 모듈은 삼각함수와 쌍곡선 함수가 포함된 식을 단순화하기 위한 포괄적인 규칙 집합을 제공합니다. trig_simplify 규칙 집합은 몇 가지 중요한 범주의 변환을 구현합니다.
- 기본 항등식: $ \sin^2(x) + \cos^2(x) = 1 $와 같은 Core 삼각함수 항등식입니다
- 배각 공식: $ \sin(x + y) $ 및 $ \cos(x + y) $와 같은 식을 단순화하는 규칙입니다
- 쌍곡선 항등식: $ \sinh $, $ \cosh $, $ \tanh $에 대한 항등식을 포함하여 쌍곡선 함수에 대한 유사한 규칙입니다
이러한 규칙은 과학 계산과 머신러닝 응용에서 흔히 쓰이는 삼각함수가 포함된 수치 계산을 최적화하는 데 특히 중요합니다. 이 모듈은 Term IR에 정의된 비용 모델을 사용해 결정을 내리면서, 식 단순화와 계산 효율성 사이의 트레이드오프를 신중하게 조율합니다.
from mlir_egglog.term_ir import Sin, Cos, Sinh, Cosh, Tanh, Term, Pow, Add
from egglog import ruleset, i64, f64
from egglog import rewrite


@ruleset
def trig_simplify(x: Term, y: Term, z: Term, i: i64, fval: f64):
    # Fundamental trig identities
    # sin²(x) + cos²(x) = 1
    two = Term.lit_i64(2)
    yield rewrite(Add(Pow(Sin(x), two), Pow(Cos(x), two))).to(Term.lit_f32(1.0))

    # Double angle formulas
    yield rewrite(Sin(x + y)).to(Sin(x) * Cos(y) + Cos(x) * Sin(y))
    yield rewrite(Sin(x - y)).to(Sin(x) * Cos(y) - Cos(x) * Sin(y))
    yield rewrite(Cos(x + y)).to(Cos(x) * Cos(y) - Sin(x) * Sin(y))
    yield rewrite(Cos(x - y)).to(Cos(x) * Cos(y) + Sin(x) * Sin(y))

    # Hyperbolic identities
    yield rewrite(Sinh(x) * Cosh(y) + Cosh(y) * Sinh(x)).to(Sinh(x + y))
    yield rewrite(Cosh(x) * Cosh(y) + Sinh(x) * Sinh(y)).to(Cosh(x + y))
    yield rewrite((Tanh(x) + Tanh(y)) / (Term.lit_i64(1) + Tanh(x) * Tanh(y))).to(
        Tanh(x + y)
    )
Egglog 최적화기(egglog_optimizer.py)
최적화 엔진은 모든 재작성 규칙을 하나로 묶고, Python 함수에 최적화를 적용하기 위한 주요 인터페이스를 제공합니다. 이 엔진은 몇 가지 핵심 구성 요소로 이루어져 있습니다.
- 규칙 합성: 여러 규칙 집합을 순차적으로 또는 병렬로 결합하는 기능입니다
- 식 추출: Python AST와 항 표현 사이를 변환하는 로직입니다
- 최적화 파이프라인: 고정점에 도달할 때까지 규칙을 적용하는 체계적인 방식입니다
- MLIR 생성: 최적화된 식을 MLIR 코드로 변환하는 최종 단계입니다
최적화기는 e-그래프 자료 구조를 사용하여 동등한 식을 효율적으로 탐색하고, 비용 모델에 따라 가장 비용 효율적인 구현을 찾습니다.
import inspect
from types import FunctionType

from egglog import EGraph, RewriteOrRule, Ruleset
from egglog.egraph import UnstableCombinedRuleset

from mlir_egglog.term_ir import Term, as_egraph
from mlir_egglog.python_to_ir import interpret
from mlir_egglog import builtin_functions as ns
from mlir_egglog.expr_model import Expr
from mlir_egglog.ir_to_mlir import convert_term_to_mlir

# Rewrite rules
from mlir_egglog.basic_simplify import basic_math
from mlir_egglog.trig_simplify import trig_simplify

OPTS: tuple[Ruleset | RewriteOrRule, ...] = (basic_math, trig_simplify)


def extract(ast: Expr, rules: tuple[RewriteOrRule | Ruleset, ...], debug=False) -> Term:
    root = as_egraph(ast)

    egraph = EGraph()
    egraph.let("root", root)

    # The user can compose rules as (rule1 | rule2) to apply them in parallel
    # or (rule1, rule2) to apply them sequentially
    for opt in rules:
        if isinstance(opt, Ruleset):
            egraph.run(opt.saturate())
        elif isinstance(opt, UnstableCombinedRuleset):
            egraph.run(opt.saturate())
        else:
            # For individual rules, create a temporary ruleset
            temp_ruleset = Ruleset("temp")
            temp_ruleset.append(opt)
            egraph.run(temp_ruleset.saturate())

    extracted = egraph.extract(root)

    # if debug:
    #     egraph.display()

    return extracted


def compile(
    fn: FunctionType, rewrites: tuple[RewriteOrRule | Ruleset, ...] = OPTS, debug=True
) -> str:
    # Convert np functions accordinging to the namespace map
    exprtree = interpret(fn, {"np": ns})
    extracted = extract(exprtree, rewrites, debug)

    # Get the argument spec
    argspec = inspect.signature(fn)
    params = ",".join(map(str, argspec.parameters))

    return convert_term_to_mlir(extracted, params)
이 모듈들은 함께 작동하여 수학 식, 특히 삼각함수와 초월함수가 포함된 식을 최적화하는 강력한 시스템을 제공합니다. 이 시스템은 확장 가능하여 새로운 규칙을 쉽게 추가할 수 있으며, 그 위에 더 특화된 최적화를 구축하기 위한 견고한 기반을 제공합니다.
egglog 최적화기는 재작성 규칙을 합성하는 두 가지 방법, 즉 병렬 합성과 순차 합성을 지원합니다. 규칙을 | 연산자로 결합하면(병렬 합성), 규칙들은 e-그래프 포화 과정의 같은 반복 안에서 동시에 적용됩니다. 이를 통해 여러 변환을 동시에 탐색할 수 있습니다. 반면에 규칙을 튜플이나 시퀀스로 결합하면(순차 합성), 규칙들은 차례로 적용되며, 각 규칙 집합은 다음 규칙 집합으로 넘어가기 전에 포화 상태에 이를 때까지 실행됩니다. 이러한 순차적 방식은 특정 변환을 다른 변환이 완료된 후에만 시도해야 할 때 유용할 수 있습니다.
# Example 1: Parallel Composition
# Both rulesets are applied simultaneously in each iteration
parallel_rules = simplify_adds | simplify_muls
egraph = EGraph()
egraph.run(parallel_rules.saturate())

# Example 2: Sequential Composition
# simplify_adds runs to completion before simplify_muls starts
sequential_rules = (simplify_adds, simplify_muls)
egraph = EGraph()
for ruleset in sequential_rules:
    egraph.run(ruleset.saturate())
MLIR 생성(mlir_gen.py)
MLIR 코드 생성기는 최적화된 식 트리를 실행 가능한 MLIR 코드로 변환하는 역할을 맡습니다. 생성기는 N차원 배열을 효율적으로 처리할 수 있는 벡터화된 커널을 만들어 내기 위해 체계적인 방식을 따릅니다. 핵심 구성 요소와 설계 원칙을 살펴봅시다.
생성기는 다음 템플릿을 따르는 함수를 생성합니다.
func.func @kernel_worker(
    %arg0: memref<?xf32>,
    %arg1: memref<?xf32>
) {
    // Kernel body
}
생성된 커널은 입력 버퍼와 출력 버퍼라는 두 개의 memref 인자를 받아 affine 루프로 원소별 처리를 합니다. 이러한 설계 덕분에 임의 차원의 배열에 대해 효율적인 벡터화 연산을 수행할 수 있습니다.
func.func @kernel_worker(
    %arg0: memref<?xf32>,
    %arg1: memref<?xf32>
) attributes {llvm.emit_c_interface} {
    %c0 = arith.constant 0 : index

    // Get dimension of input array
    %dim = memref.dim %arg0, %c0 : memref<?xf32>

    // Process each element in a flattened manner
    affine.for %idx = %c0 to %dim {
        // Kernel body
    }
    return
}
식 변환
MLIRGen 클래스는 다중 패스 번역 전략을 구현합니다. 이 전략은 하위 표현식 확장에서 시작하며, 이 단계에서 생성기는 unfold 메서드를 사용해 표현식 트리를 펼쳐 하위 표현식의 완전한 집합을 만듭니다. 이 과정을 통해 공통 하위 표현식이 식별되고 재사용될 수 있습니다. 다음으로 생성기는 위상 정렬을 사용해 하위 표현식을 복잡도 순으로 정렬하는데, 문자열 길이를 복잡도의 대용 지표로 삼아 더 단순한 표현식이 그에 의존할 수 있는 더 복잡한 표현식보다 먼저 평가되도록 합니다. 마지막으로 코드 생성 파이프라인이 실행되며, 이 파이프라인은 먼저 memref에서 입력 변수를 로드하고, 하위 표현식에 대한 중간 계산을 생성한 뒤, 최종 결과를 출력 memref에 다시 저장합니다.
생성기는 중복 계산을 피하기 위해 영리한 캐싱 메커니즘을 사용합니다:
def walk(self, expr: ir.Expr):
    if expr in self.cache:
        return
    def lookup(e):
        return self.cache.get(e) or as_source(e, self.vars, lookup)
    self.cache[expr] = as_source(expr, self.vars, lookup)
이 캐싱 전략을 통해 각 하위 표현식은 정확히 한 번만 계산되고, 공통 하위 표현식은 MLIR의 SSA(Static Single Assignment) 형식을 통해 재사용되며, 생성된 코드는 최적의 효율을 유지합니다.
MLIR 다이얼렉트 사용
그다음 생성기는 표현식 트리를 순회하면서 고수준 표현식을 적절한 MLIR 다이얼렉트에 대응시킵니다:
- 산술 연산은
arith다이얼렉트를 사용합니다(예:arith.addf,arith.mulf) - 수학 함수는
math다이얼렉트를 사용합니다(예:math.sin,math.exp) - 메모리 연산은 배열 접근을 위해
memref다이얼렉트를 사용합니다 - 루프 구조는 최적화된 반복을 위해
affine다이얼렉트를 사용합니다
예를 들어 sin(x) + cos(y) 같은 Python 표현식은 다음과 같이 번역됩니다:
%sin = math.sin %arg_x : f32
%cos = math.cos %arg_y : f32
%result = arith.addf %sin, %cos : f32
생성기는 타입 변환을 자동으로 처리하며, 부동소수점 연산은 f32로 통일하고 정수 연산에는 상황에 맞게 i32 또는 i64를 사용합니다. 필요한 경우에는 정수를 부동소수점 값으로 변환하는 arith.sitofp와 같은 명시적 타입 캐스트가 생성됩니다. 이 타입 시스템은 MLIR의 엄격한 타입 요구 사항과의 호환성을 유지하면서 타입 안전성을 보장합니다.
from textwrap import indent
from typing import Callable
from mlir_egglog import expr_model as ir

KERNEL_NAME = "kernel_worker"

# Numpy vectorized kernel that supports N-dimensional arrays
kernel_prologue = f"""
func.func @{KERNEL_NAME}(
    %arg0: memref<?xf32>,
    %arg1: memref<?xf32>
) attributes  \{\{
    %c0 = arith.constant 0 : index

    // Get dimension of input array
    %dim = memref.dim %arg0, %c0 : memref<?xf32>

    // Process each element in a flattened manner
    affine.for %idx = %c0 to %dim \{\{
"""

kernel_epilogue = """
    }
    return
}
"""


class MLIRGen:
    """
    Generate textual MLIR from a symbolic expression.
    """

    root: ir.Expr
    cache: dict[ir.Expr, str]
    subexprs: dict[str, str]
    vars: list[str]  # local variables

    def __init__(self, root: ir.Expr, argmap: dict[str, str]):
        # Use the keys from argmap as the variable names
        self.root = root
        self.cache = {}
        self.vars = list(argmap.keys())
        self.subexprs = {}

    def generate(self):
        """
        Generate MLIR code for the root expression.
        """
        subexprs = list(self.unfold(self.root))
        subexprs.sort(key=lambda x: len(str(x)))

        buf = []
        # First load input arguments from memref
        for var in self.vars:
            buf.append(f"%arg_{var} = affine.load %arg0[%idx] : memref<?xf32>")

        for i, subex in enumerate(subexprs):
            # Skip if this is just a variable reference
            if isinstance(subex, ir.Symbol) and subex.name in self.vars:
                continue

            # Recurse and cache the subexpression
            self.walk(subex)
            orig = self.cache[subex]

            # Generate a unique name for the subexpression
            k = f"%v{i}"
            self.cache[subex] = k
            self.subexprs[k] = orig

            # Append the subexpression to the buffer
            buf.append(f"{k} = {orig}")

        self.walk(self.root)
        res = self.cache[self.root]

        # Handle the output
        buf.append(f"affine.store {res}, %arg1[%idx] : memref<?xf32>")

        # Format the kernel body
        kernel_body = indent("\n".join(buf), "    " * 2)
        return kernel_prologue + kernel_body + kernel_epilogue

    def unfold(self, expr: ir.Expr):
        """
        Unfold an expression into a set of subexpressions.
        """
        visited = set()
        all_subexprs = set()
        to_visit = [expr]
        while to_visit:
            current = to_visit.pop()
            all_subexprs.add(current)
            if current in visited:
                continue
            visited.add(current)
            to_visit.extend(get_children(current))

        return all_subexprs

    def walk(self, expr: ir.Expr):
        """
        Walk an expression recursively and generate MLIR code for subexpressions,
        caching the intermediate expressions in a lookup table.
        """
        if expr in self.cache:
            return

        def lookup(e):
            return self.cache.get(e) or as_source(e, self.vars, lookup)

        self.cache[expr] = as_source(expr, self.vars, lookup)


def get_children(expr: ir.Expr):
    """Get child expressions for an AST node."""
    match expr:
        case ir.BinaryOp():
            return {expr.lhs, expr.rhs}
        case ir.UnaryOp():
            return {expr.operand}
        case ir.FloatLiteral() | ir.IntLiteral() | ir.Symbol():
            return set()
        case _:
            raise NotImplementedError(f"Unsupported expression type: {type(expr)}")


def as_source(
    expr: ir.Expr, vars: list[str], lookup_fn: Callable[[ir.Expr], str]
) -> str:
    """
    Convert expressions to MLIR source code using arith and math dialects.
    """
    match expr:
        # Literals and Symbols
        case ir.FloatLiteral(fval=val):
            return f"arith.constant {val:e} : f32"
        case ir.IntLiteral(ival=val):
            return f"arith.constant {val} : i32"
        case ir.Symbol(name=name) if name in vars:
            return f"%arg_{name}"
        case ir.Symbol(name=name):
            return f"%{name}"

        # Binary Operations
        case ir.Add(lhs=lhs, rhs=rhs):
            return f"arith.addf {lookup_fn(lhs)}, {lookup_fn(rhs)} : f32"
        case ir.Mul(lhs=lhs, rhs=rhs):
            return f"arith.mulf {lookup_fn(lhs)}, {lookup_fn(rhs)} : f32"
        case ir.Div(lhs=lhs, rhs=rhs):
            return f"arith.divf {lookup_fn(lhs)}, {lookup_fn(rhs)} : f32"
        case ir.Maximum(lhs=lhs, rhs=rhs):
            return f"arith.maximumf {lookup_fn(lhs)}, {lookup_fn(rhs)} : f32"

        # Unary Math Operations
        case (
            ir.Sin()
            | ir.Cos()
            | ir.Log()
            | ir.Sqrt()
            | ir.Exp()
            | ir.Sinh()
            | ir.Cosh()
            | ir.Tanh()
        ) as op:
            op_name = type(op).__name__.lower()
            return f"math.{op_name} {lookup_fn(op.operand)} : f32"
        case ir.Neg(operand=op):
            return f"arith.negf {lookup_fn(op)} : f32"

        # Type Casting
        case ir.CastF32(operand=op):
            return f"arith.sitofp {lookup_fn(op)} : i64 to f32"
        case ir.CastI64(operand=op):
            return f"arith.fptosi {lookup_fn(op)} : f32 to i64"

        case _:
            raise NotImplementedError(f"Unsupported expression type: {type(expr)}")
MLIR 백엔드 (mlir_backend.py)
컴파일러의 MLIR 백엔드는 고수준 MLIR 코드를 여러 로어링 단계를 거쳐 변환하여 LLVM IR에 도달하게 하고, 최종적으로 실행 가능한 코드로 만드는 역할을 합니다. 핵심 구성 요소와 설계 원칙을 차례로 살펴봅시다:
백엔드는 두 가지 주요 컴파일 대상을 지원합니다:
class Target(enum.Enum):
    OPENMP = "openmp"      # Parallel execution using OpenMP
    BASIC_LOOPS = "loops"  # Sequential execution with basic loops
이를 통해 컴파일러는 애플리케이션의 요구에 따라 멀티스레드 실행을 위해 OpenMP를 사용하는 병렬 코드를 생성하거나, 더 단순한 순차 코드를 생성할 수 있습니다.
컴파일 과정은 여러 개의 뚜렷한 단계로 구성되며, 각 단계는 특정 MLIR 최적화 패스를 적용합니다:
-
공통 초기 변환:
COMMON_INITIAL_OPTIONS = (
    "--debugify-level=locations",
    "--inline",
    "-affine-loop-normalize",
    "-affine-parallelize",
    "-affine-super-vectorize",
    "--affine-scalrep",
    "-lower-affine",
    "-convert-vector-to-scf",
    "-convert-linalg-to-loops",
)
이 패스들은 함수 인라이닝, 루프 정규화, 벡터화, 초기 다이얼렉트 변환을 처리합니다.
-
대상별 로어링:
- OpenMP 경로: 구조적 제어 흐름을 OpenMP 연산으로 변환한 다음 LLVM으로 변환합니다
OPENMP_OPTIONS = ( "-convert-scf-to-openmp", "-convert-openmp-to-llvm", "-convert-vector-to-llvm", "-convert-math-to-llvm", # ... additional lowering passes )- 기본 루프 경로: 순차 LLVM IR로 직접 변환합니다
BASIC_LOOPS_OPTIONS = ( "-convert-scf-to-cf", "-convert-vector-to-llvm", "-convert-math-to-llvm", # ... additional lowering passes ) -
최종 LLVM IR 생성:
MLIR_TRANSLATE_OPTIONS = (
    "--mlir-print-local-scope",
    "--mlir-to-llvmir",
    "--verify-diagnostics",
)
MLIRCompiler 클래스는 세 가지 주요 단계를 통해 전체 컴파일 과정을 조율합니다:
-
MLIR에서 LLVM 다이얼렉트로 (
to_llvm_dialect):- 고수준 MLIR 연산을 LLVM 다이얼렉트로 변환합니다
- 대상별 최적화(OpenMP 또는 기본 루프)를 적용합니다
- 메모리 레이아웃과 타입 변환을 처리합니다
-
LLVM 다이얼렉트에서 LLVM IR로 (
mlir_translate_to_llvm_ir):- LLVM 다이얼렉트 표현을 텍스트 형식의 LLVM IR로 변환합니다
- 디버그 정보를 보존하고 생성된 코드를 검증합니다
-
LLVM IR에서 비트코드로 (
llvm_ir_to_bitcode):- 텍스트 형식의 LLVM IR을 바이너리 LLVM 비트코드로 변환합니다
- 최종 실행을 위해 코드를 준비합니다
백엔드는 중간 표현에 임시 파일을 사용하며, debug 플래그를 통해 디버깅 기능을 제공합니다:
def _run_shell(self, cmd, in_mode, out_mode, src):
    with (
        NamedTemporaryFile(mode=f"w{in_mode}") as src_file,
        NamedTemporaryFile(mode=f"r{out_mode}") as out_file,
    ):
        # Execute compilation command and handle I/O
그러면 컴파일러가 LLVM IR을 내놓고, 우리는 llvmlite 라이브러리를 사용해 이를 Python 프로세스 안에서 로드하고 실행할 수 있으므로, 컴파일된 기계어 코드를 동적으로 로드할 수 있습니다.
LLVM 런타임 (llvm_runtime.py)
LLVM 런타임은 컴파일 파이프라인의 마지막 계층으로, 컴파일된 LLVM 코드를 Python 안에서 동적으로 로드하고 실행하는 일을 담당합니다. 이 구성 요소는 llvmlite를 사용해 LLVM과 연동하며 JIT(Just-In-Time) 컴파일 과정을 관리합니다.
LLVM 초기화
런타임은 LLVM 구성 요소의 캐시된 초기화로 시작합니다:
@cache
def init_llvm():
    llvm.initialize()
    llvm.initialize_all_targets()
    llvm.initialize_all_asmprinters()
이 초기화는 Python 세션당 한 번만 실행되도록 캐시되며, LLVM Core 기능, 사용 가능한 모든 대상 아키텍처, 그리고 코드 생성에 필요한 어셈블리 프린터를 설정합니다.
런타임은 JIT 컴파일 과정을 관리하는 LLVM 실행 엔진을 생성합니다:
def create_execution_engine():
    target = llvm.Target.from_default_triple()
    target_machine = target.create_target_machine()
    backing_mod = llvm.parse_assembly("")
    engine = llvm.create_mcjit_compiler(backing_mod, target_machine)
    return engine
이 설정은 호스트 머신의 대상 아키텍처를 파악하고, 코드 생성을 위한 대상 머신 인스턴스를 만들고, 백킹 스토어로 사용할 빈 LLVM 모듈을 초기화하며, 최적화된 코드 실행을 위한 MCJIT 컴파일러 인스턴스를 생성합니다.
런타임은 두 가지 수준의 모듈 컴파일을 제공합니다:
- 직접 모듈 컴파일:
def compile_mod(engine, mod):
    mod.verify()                     # Verify module correctness
    engine.add_module(mod)           # Add to execution engine
    engine.finalize_object()         # Finalize compilation
    engine.run_static_constructors() # Initialize static data
    return mod
- IR 문자열 컴파일:
def compile_ir(engine, llvm_ir):
    mod = llvm.parse_assembly(llvm_ir)  # Parse IR text
    return compile_mod(engine, mod)      # Compile module
이 런타임 계층은 LLVM의 저수준 컴파일 인프라와 Python의 고수준 실행 환경 사이의 간극을 메워, 컴파일된 커널이 Python 프로세스 안에서 효율적으로 실행될 수 있게 합니다.
import llvmlite.binding as llvm
import llvmlite
from functools import cache


@cache
def init_llvm():
    print(llvmlite.__version__)
    llvm.initialize()
    llvm.initialize_all_targets()
    llvm.initialize_all_asmprinters()


def compile_mod(engine, mod):
    mod.verify()
    engine.add_module(mod)
    engine.finalize_object()
    engine.run_static_constructors()
    return mod


def create_execution_engine():
    target = llvm.Target.from_default_triple()
    target_machine = target.create_target_machine()
    backing_mod = llvm.parse_assembly("")
    engine = llvm.create_mcjit_compiler(backing_mod, target_machine)
    return engine


def compile_ir(engine, llvm_ir):
    mod = llvm.parse_assembly(llvm_ir)
    return compile_mod(engine, mod)
JIT 엔진 (jit_engine.py)
jit_engine.py 모듈은 컴파일러 파이프라인을 총괄하며, 모든 구성 요소를 하나로 엮어 매끄러운 컴파일 과정을 만들어 냅니다. 이 모듈은 Python 함수에서 실행 가능한 기계어 코드에 이르는 전체 생명주기를 관리하며, 최적화, 코드 생성, 런타임 실행을 처리합니다.
JITEngine 클래스는 세 가지 주요 수준의 컴파일을 제공합니다:
-
프런트엔드 컴파일 (
run_frontend):def run_frontend( self, fn: FunctionType, rewrites: tuple[RewriteOrRule | Ruleset, ...] | None = None, ) -> str:run_frontend메서드는 Python 함수와 선택적인 재작성 규칙을 받아, egglog 최적화기를 적용해 항 재작성을 수행하고, 최적화된 MLIR 코드를 생성합니다. -
백엔드 컴파일 (
run_backend):def run_backend(self, mlir_src: str) -> bytes: mlir_compiler = MLIRCompiler(debug=False) mlir_omp = mlir_compiler.to_llvm_dialect(mlir_src) llvm_ir = mlir_compiler.mlir_translate_to_llvm_ir(mlir_omp)run_backend메서드는 MLIR을 LLVM 다이얼렉트로 변환하고, 이를 LLVM IR로 번역하며, 플랫폼별 최적화를 처리한 뒤, 최종적으로 컴파일된 함수의 주소를 반환합니다. -
전체 JIT 컴파일 (
jit_compile):def jit_compile( self, fn: FunctionType, rewrites: tuple[RewriteOrRule | Ruleset, ...] | None = None, ) -> bytes: mlir = self.run_frontend(fn, rewrites) address = self.run_backend(mlir) return addressjit_compile메서드는 프런트엔드 컴파일과 백엔드 컴파일을 결합하여, 전체 컴파일 과정을 위한 단일 진입점을 제공합니다.
OpenMP 런타임을 사용하려면 시스템별 OpenMP 라이브러리를 Python 프로세스에 로드해야 합니다. 공유 라이브러리의 올바른 경로를 알고 나면 ctypes 라이브러리를 통해 이를 수행할 수 있습니다.
def find_omp_path():
if sys.platform.startswith("linux"):
omppath = ctypes.util.find_library("libgomp.so")
elif sys.platform.startswith("darwin"):
omppath = ctypes.util.find_library("iomp5")
else:
raise RuntimeError(f"Unsupported platform: {sys.platform}")
return omppath
엔진은 LLVM과 관련된 몇 가지 중요한 작업을 처리합니다.
-
초기화:
def __init__(self): init_llvm() omppath = find_omp_path() ctypes.CDLL(omppath, mode=os.RTLD_NOW) self.ee = create_execution_engine()- LLVM 인프라를 초기화합니다
- OpenMP 런타임을 로드합니다
- 실행 엔진을 생성합니다
이 클래스는 컴파일러의 구성 요소들을 하나로 묶는 접착제 역할을 하며, Python 코드와 최적화된 기계어 코드 실행 사이의 인터페이스를 제공합니다. 이 클래스는 다단계 컴파일, 플랫폼별 요구 사항, 런타임 최적화의 복잡성을 처리합니다.
from __future__ import annotations
import ctypes
import ctypes.util
import os
import sys
from types import FunctionType
from egglog import RewriteOrRule, Ruleset
import llvmlite.binding as llvm
from mlir_egglog.llvm_runtime import (
create_execution_engine,
init_llvm,
compile_mod,
)
from mlir_egglog.mlir_gen import KERNEL_NAME
from mlir_egglog.mlir_backend import MLIRCompiler, Target
from mlir_egglog.egglog_optimizer import compile, OPTS
def find_omp_path():
if sys.platform.startswith("linux"):
omppath = ctypes.util.find_library("libgomp.so")
elif sys.platform.startswith("darwin"):
omppath = ctypes.util.find_library("iomp5")
else:
raise RuntimeError(f"Unsupported platform: {sys.platform}")
return omppath
class JITEngine:
def __init__(self):
init_llvm()
omppath = find_omp_path()
ctypes.CDLL(omppath, mode=os.RTLD_NOW)
self.ee = create_execution_engine()
def run_frontend(
    self,
    fn: FunctionType,
    rewrites: tuple[RewriteOrRule | Ruleset, ...] | None = None,
) -> str:
actual_rewrites = rewrites if rewrites is not None else OPTS
return compile(fn, rewrites=actual_rewrites, debug=False)
def run_backend(self, mlir_src: str) -> bytes:
mlir_compiler = MLIRCompiler(debug=False)
mlir_omp = mlir_compiler.to_llvm_dialect(mlir_src, target=Target.BASIC_LOOPS)
llvm_ir = mlir_compiler.mlir_translate_to_llvm_ir(mlir_omp)
print(llvm_ir)
print("Parsing LLVM assembly.")
try:
# Clean up the LLVM IR by ensuring proper line endings and formatting
llvm_ir = llvm_ir.strip()
# Clean up problematic attribute strings (hack for divergence in modern LLVM IR syntax with old llvmlite)
llvm_ir = llvm_ir.replace("captures(none)", " ")
llvm_ir = llvm_ir.replace("memory(argmem: readwrite)", "")
llvm_ir = llvm_ir.replace("memory(none)", "")
llvm_ir += "\n"
mod = llvm.parse_assembly(llvm_ir)
mod = compile_mod(self.ee, mod)
# Resolve the function address
func_name = f"_mlir_ciface_{KERNEL_NAME}"
address = self.ee.get_function_address(func_name)
assert address, "Function must be compiled successfully."
return address
except Exception as e:
print(f"Error during LLVM IR parsing/compilation: {str(e)}")
print("LLVM IR that failed to parse:")
print(llvm_ir)
raise
def jit_compile(
    self,
    fn: FunctionType,
    rewrites: tuple[RewriteOrRule | Ruleset, ...] | None = None,
) -> bytes:
    mlir = self.run_frontend(fn, rewrites)
    address = self.run_backend(mlir)
    return address
디스패처 (dispatcher.py)
디스패처는 컴파일러의 사용자 대면 인터페이스 역할을 하며, 일반 Python 함수를 최적화된 벡터화 커널로 변환하는 데코레이터를 제공합니다. 디스패처는 컴파일 과정을 처리하고 컴파일된 함수의 실행을 관리합니다.
Dispatcher 클래스는 컴파일된 함수의 생명 주기를 관리합니다.
class Dispatcher:
    _compiled_func: bytes | None      # Compiled function address
    _compiler: JITEngine | None       # JIT compilation engine
    py_func: types.FunctionType       # Original Python function
    rewrites: tuple[RewriteOrRule, ...] | None  # Optimization rules
컴파일 과정은 컴파일러의 jit_compile 메서드를 호출하는 간단한 인터페이스를 통해 처리됩니다.
def compile(self):
    self._compiler = JITEngine()
    binary = self._compiler.jit_compile(self.py_func, self.rewrites)
    self._compiled_func = binary
    return binary
이 메서드는 새 JIT 엔진 인스턴스를 생성하고, 지정된 재작성 규칙으로 Python 함수를 컴파일한 뒤, 이후 실행을 위해 컴파일된 바이너리를 저장합니다. 디스패처는 이후 호출 시 함수를 다시 컴파일하지 않도록 캐시된 호출 메커니즘을 구현합니다. 컴파일된 함수를 numpy 배열과 함께 호출하면 디스패처는 기저 입력 배열을 가져오고 같은 형태의 새 빈 출력 배열을 할당합니다. 그런 다음 numpy 배열을 memref 디스크립터로 변환하여 컴파일된 함수에 전달합니다.
def __call__(self, *args, **kwargs):
    # Get the input array and its shape
    input_array = args[0]
    original_shape = input_array.shape

    # Flatten the input array
    flattened_input = input_array.flatten()
    flattened_output = np.empty_like(flattened_input)

    # Convert to memrefs
    memrefs = [
        as_memref_descriptor(flattened_input, ctypes.c_float),
        as_memref_descriptor(flattened_output, ctypes.c_float)
    ]
그런 다음 디스패처는 MCJIT로 컴파일된 메모리에서 함수 포인터를 조회하고, memref 디스크립터를 인자로 하여 이를 호출합니다.
# Create function prototype for ctypes
prototype = ctypes.CFUNCTYPE(None, *[ctypes.POINTER(type(x)) for x in memrefs])

# Execute compiled function
cfunc = prototype(self._compiled_func)
cfunc(*[ctypes.byref(x) for x in memrefs])
이제 컴파일러로 함수를 컴파일하려면 우리가 작성한 함수에 @kernel 데코레이터를 사용하면 됩니다.
import llvmlite
import numpy as np
llvmlite.opaque_pointers_enabled = True

from mlir_egglog import kernel

@kernel("float32(float32)")
def fn(a):
    return np.sin(a) * np.cos(a) + np.cos(a) * np.sin(a)

out = fn(np.array([1.0], dtype=np.float32))
print(out)
이것은 매우 단순한 예제 컴파일러입니다. 기호적 해석 방식은 제어 흐름 연산이 없는 평탄한 함수만 처리할 수 있고, 인자 타입을 직접 지정해야 하며, 제한된 연산 집합만 지원하므로 근본적인 한계가 있습니다. 하지만 MLIR과 e-그래프를 최적화에 활용하여 처음부터 끝까지 동작하는 무언가를 살펴보기에는 좋은 출발점입니다.
7부에서는 GPT-2의 NumPy 참조 구현을 만들어 보겠습니다. 이를 통해 컴파일러를 이러한 원소별 표현식 너머로 확장할 때 목표로 삼을 구체적인 텐서 연산 집합을 얻게 됩니다.
외부 자료
- Equality Saturation: A New Approach to Optimization
- E-graphs for Efficient Symbolic Compilation with Egglog
- egglog Tutorial (EGRAPHS 2023) | Next Generation Egraphs
- DPopt: Differentiable Placement Optimization for Hardware Acceleration
- Equality Saturation for MLIR with Egglog
- Guided Equality Saturation
- SEER: Super-Optimization Explorer for High-Level Synthesis using E-graph Rewriting
- 동치 포화
- Egglog로 구현하는 SK 논리 (1)
- PEG: 프로그램 분석과 동적 프로그래밍의 결합
- RelBench: 관계형 학습을 위한 통합 벤치마크
- Egraph-CHR
- DialEgg: Egglog 기반 동치 포화를 사용하는 다이얼렉트 비의존적 MLIR 최적화기
- Egglog 체크포인트
- egg를 이용한 빠르고 확장 가능한 동치 포화
- 동치 포화의 이론적 측면 (1부)
- 동치 포화: 최적화에 대한 새로운 접근법 (YouTube)
- 동치 포화: 항 추출과 네트워크 합성에의 응용
- Egglog (동치 포화를 위한) - Portland State 검증 세미나
- 동치 포화를 이용한 엔드투엔드 컴파일
- Egglog (동치 포화를 위한) - PLDI 발표
- Ask HN: 컴파일러 분야에서 진행 중인 흥미로운 연구나 프로젝트는 무엇입니까?
신경망
MLIR과 현대 컴파일러 기술을 살펴보는 여정에서 우리는 수치 계산을 위한 효율적인 시스템을 구축하는 방법을 탐구했습니다. 이제 이러한 시스템의 가장 중요한 응용 분야 중 하나인 딥러닝으로 관심을 돌려 봅시다. MLIR이 신경망 계산을 어떻게 최적화할 수 있는지 살펴보기 전에, 신경망이 어떻게 작동하는지 기본 원리부터 이해하는 것이 매우 중요합니다.
이 절에서는 순수 Python으로 신경망 라이브러리를 처음부터 구현합니다. 이 구현은 성능보다 명료함을 우선시하지만, MLIR이 제공할 수 있는 최적화를 이해하기 위한 훌륭한 토대가 됩니다. 모든 것을 처음부터 직접 구축함으로써 다음 내용에 대한 깊은 통찰을 얻게 됩니다.
- 신경망의 수학적 기초
- 자동 미분이 학습을 가능하게 하는 방식
- 신경망을 하드웨어 가속에 이상적으로 만드는 계산 패턴
- PyTorch와 TensorFlow 같은 프레임워크가 지금과 같은 구조를 갖게 된 이유
이 시리즈의 후반부에서는 이러한 개념을 활용하여 GPT-2의 NumPy 구현을 이해하고, 그 텐서 연산을 MLIR로 컴파일할 것입니다. 이 스칼라 신경망은 미분과 학습의 기본 메커니즘을 알려 주고, 트랜스포머는 GPU에서 실행하고자 하는 배열 계산을 제공할 것입니다.
이 절의 전체 소스 코드는 참고용으로 별도의 저장소에서 확인할 수 있습니다.
요즘 신경망은 어디에나 있으므로 그것이 왜 유용한지 길게 설명하지는 않겠지만, Jax, PyTorch, TensorFlow 같은 인기 라이브러리를 사용해 보셨다면 이들 덕분에 복잡한 모델을 쉽게 구축하고 학습시킬 수 있다는 것을 아실 것입니다. 이러한 프레임워크가 내부적으로 어떻게 작동하는지 이해하는 것은 매우 값진 일입니다. 이 절에서는 아주 최소한의 신경망 라이브러리를 기본 원리부터 직접 구축하며, 이를 통해 현대 딥러닝을 움직이는 핵심(Core) 메커니즘을 이해할 수 있게 됩니다.
그래디언트와 최적화
신경망 학습의 중심에는 그래디언트라는 개념이 있습니다. 그래디언트를 함수가 가장 가파르게 증가하는 방향을 가리키는 나침반이라고 생각하십시오. 여러 입력을 갖는 함수 에 대해, 그래디언트 는 각 방향으로의 변화율을 담은 벡터입니다.
각 성분 는 다른 모든 입력을 고정한 채 해당 입력을 약간 조정했을 때 함수가 얼마나 변하는지를 알려 줍니다. 이 정보는 신경망 학습에 매우 중요합니다.
신경망 학습에서 우리는 모델의 성능이 얼마나 좋은지를 측정하는 손실 함수 를 최소화하고자 합니다. 매개변수 에는 네트워크의 모든 가중치와 편향이 포함되며, 그 수는 흔히 수천 개에서 수백만 개에 이릅니다. 그래디언트 는 손실을 줄이기 위해 각 매개변수를 어떻게 조정해야 하는지 알려 줍니다.
이것이 바로 경사 하강법이 작동하는 모습입니다. 즉, 그래디언트의 반대 방향으로 (학습률 로 제어되는) 작은 걸음을 반복해서 내디디며, 손실을 최소화하는 매개변수 값을 점진적으로 찾아갑니다.
이러한 그래디언트를 효율적으로 계산하는 것은 매우 중요합니다. 다음과 같은 수치 근사를 사용할 수도 있지만,
여기서 는 작은 수이고 는 방향 의 단위 벡터인데, 이 방식은 느리고 수치적으로 불안정합니다. 대신 우리는 계산 그래프를 따라 연쇄 법칙을 체계적으로 적용하여 정확한 그래디언트를 계산하는 자동 미분을 사용합니다.
연쇄 법칙에 따르면 합성 함수의 도함수는 곱해집니다.
더 높은 차원에서는 이것이 다음과 같이 됩니다:
여기서 는 계산 과정의 중간값입니다. 이것은 역전파의 기초이며, 역전파는 우리의 신경망 라이브러리에서 구현할 것입니다.
신경망 이론
신경망은 본질적으로 일련의 조정 가능한 변환을 통해 입력을 출력으로 매핑하는 방법을 학습하는 함수입니다. 기본 구성 요소는 인공 뉴런이며, 인공 뉴런은 생물학적 뉴런이 정보를 처리하는 방식을 모방합니다:
- 여러 입력 신호()를 받습니다
- 각 입력에는 강도 매개변수()로 가중치가 부여됩니다
- 가중치가 부여된 입력들이 편향 항()과 함께 합산됩니다
- 그 결과가 활성화 함수()를 통과합니다
수학적으로 이 과정은 다음과 같이 기술됩니다:
여기서 는 가중합(흔히 사전 활성화라고 부릅니다)이고, 는 뉴런의 출력(또는 활성화)입니다.
여러 뉴런이 층으로 구성되고, 층들이 쌓여 네트워크를 이룹니다. 완전 연결 순방향 신경망에서는 각 뉴런이 다음 층의 모든 뉴런과 연결됩니다. 층 에 대해 이를 행렬 형태로 간결하게 쓸 수 있습니다:
여기서:
- 는 층 의 가중치 행렬입니다
- 는 이전 층의 활성화 값을 담고 있습니다
- 는 편향 벡터입니다
- 는 각 원소에 활성화 함수를 적용합니다
활성화 함수의 선택은 매우 중요한데, 네트워크가 복잡한 패턴을 학습할 수 있게 하는 비선형성을 도입하기 때문입니다. 비선형성이 없다면 신경망은 층의 개수와 관계없이 선형 모델처럼 동작할 것입니다. 선형 함수의 합성은 여전히 선형 함수이기 때문입니다. 비선형 활성화 함수는 네트워크가 복잡한 함수를 근사하고 데이터 속의 복잡한 관계를 포착할 수 있게 합니다. 비선형 활성화 함수는 모델이 오차로부터 학습하고, 더 다양한 함수를 표현할 수 있는 방식으로 가중치를 조정할 수 있게 합니다. 흔히 선택되는 활성화 함수는 다음과 같습니다:
-
ReLU (Rectified Linear Unit, 정류 선형 유닛):
- 단순하고 계산 효율이 높습니다
- 기울기 소실을 방지하는 데 도움이 됩니다
- 현대 네트워크에서 가장 널리 사용됩니다
-
시그모이드(Sigmoid):
- 값을 [0,1] 범위로 압축합니다
- 역사적으로 널리 쓰였지만 기울기 소실이 일어나기 쉽습니다
- 이진 분류에는 여전히 유용합니다
-
Tanh:
- 시그모이드와 비슷하지만 범위가 [-1,1]입니다
- 시그모이드보다 성능이 더 좋은 경우가 많습니다
- 여전히 기울기 소실 문제를 겪을 수 있습니다
-
SwiGLU:
- GLU(Gated Linear Unit, 게이트 선형 유닛) 계열에서 도입되었습니다.
- 트랜스포머 아키텍처에서 자주 사용됩니다
- 비선형성과 계산 효율 사이의 균형을 제공합니다
SwiGLU는 현대의 많은 네트워크에서 기본 선택지가 되었습니다. 여기서는 GLU 계열을 자세히 다루지 않겠지만, 더 알아보고 싶으시다면 GLU 논문을 읽어 보시기를 권합니다. 우리의 목적에는 ReLU가 더 단순하므로 이를 활성화 함수로 사용하겠습니다.
자동 미분
자동 미분은 신경망 학습을 움직이는 엔진입니다. 도함수를 근사하는 수치 미분이나 수학적 표현식을 조작하는 기호 미분과 달리, 자동 미분은 계산 그래프에서 연산을 추적하여 정확한 도함수를 계산합니다.
우리 구현의 중심은 Value 클래스입니다. 이 클래스는 스칼라 값을 감싸고 그 값에 수행된 연산을 기록합니다:
class Value:
    def __init__(self, data, _children=(), _op="", label=""):
        self.data = data
        self.grad = 0.0
        self.label = label
        self._backward = lambda: None
        self._prev = set(_children)
        self._op = _op
각 연산(덧셈이나 곱셈 등)은 새로운 Value를 만들고, 기울기가 역방향으로 어떻게 흘러야 하는지를 정의합니다. 예를 들어, 덧셈은 다음과 같이 동작합니다:
def __add__(self, other):
    other = other if isinstance(other, Value) else Value(other)
    out = Value(self.data + other.data, (self, other), "+")

    def _backward():
        # The gradient flows equally to both inputs
        self.grad += out.grad
        other.grad += out.grad

    out._backward = _backward
    return out
곱셈의 경우 기울기는 곱의 법칙을 따릅니다. 각 입력의 기울기에 다른 입력의 값이 곱해집니다:
def __mul__(self, other):
    other = other if isinstance(other, Value) else Value(other)
    out = Value(self.data * other.data, (self, other), "*")

    def _backward():
        # Each input's gradient is scaled by the other's value
        self.grad += other.data * out.grad
        other.grad += self.data * out.grad

    out._backward = _backward
    return out
역방향 패스는 backward()를 호출하여 시작하며, 이 메서드는 다음을 수행합니다:
- 계산 그래프를 위상 정렬합니다
- 출력의 기울기를 1.0으로 설정합니다
- 그래프를 따라 기울기를 역방향으로 전파합니다
def backward(self):
    # Sort nodes in topological order
    topo = []
    visited = set()

    def topo_sort(v):
        if v not in visited:
            visited.add(v)
            for child in v._prev:
                topo_sort(child)
            topo.append(v)

    topo_sort(self)

    # Backpropagate gradients
    self.grad = 1
    for v in reversed(topo):
        v._backward()
실제로 동작하는 모습을 보기 위해 relu(a * b + c) 표현식에 대한 간단한 계산 그래프를 만들어 봅시다:
# Create input values
a = Value(2.0, label="a")
b = Value(-3.0, label="b")
c = Value(10.0, label="c")

# Build computation graph
d = a * b
d.label = "d"
e = d + c
e.label = "e"
f = e.relu()
f.label = "f"
이제 각 입력에 대한 출력의 기울기를 계산할 수 있습니다:
print("Gradients after backward pass:")
print(f"a.grad = {a.grad}")
print(f"b.grad = {b.grad}")
print(f"c.grad = {c.grad}")
print(f"d.grad = {d.grad}")
print(f"e.grad = {e.grad}")
print(f"f.grad = {f.grad}")
그 결과로 만들어진 계산 그래프는 그림 1과 같습니다. 각 노드는 값을 나타내고, 간선은 값들이 연산을 통해 어떻게 결합되는지를 보여 줍니다. f.backward()를 호출하면 기울기가 이 그래프를 따라 역방향으로 흐르므로, 각 입력이 최종 출력에 어떤 영향을 미치는지 계산할 수 있습니다.
 그림 1: 연산들이 어떻게 연결되고 기울기가 어떻게 역방향으로 흐르는지를 보여 주는 계산 그래프 시각화.
역전파
역전파는 네트워크 매개변수에 대한 손실 함수의 그래디언트를 효율적으로 계산하여 신경망이 데이터로부터 학습할 수 있게 하는 알고리즘입니다. 역전파는 미적분의 연쇄 법칙을 적용하여 오차 그래디언트를 출력층에서 입력층 방향으로 네트워크를 거슬러 전파합니다.
이 과정은 순방향 패스로 시작하며, 이때 입력 데이터가 네트워크를 통과하여 예측값을 만들어 냅니다. 손실 함수 은 이 예측값과 실제 목표값 사이의 차이를 수치화합니다. 평균 제곱 오차 손실의 경우 이는 다음과 같습니다.
여기서 는 실제값이고 는 예측값입니다.
학습의 목표는 네트워크 매개변수(가중치와 편향)를 조정하여 이 손실을 최소화하는 것입니다. 이를 위해서는 각 매개변수에 대한 손실의 그래디언트를 계산해야 합니다:
이는 층 의 각 가중치 와 편향 에 대해 계산합니다.
역전파는 네트워크를 거꾸로 거슬러 올라가며 이러한 그래디언트를 효율적으로 계산합니다. 출력층 에 대해서는 먼저 오차 항을 계산합니다.
여기서 은 출력 활성화값에 대한 손실의 그래디언트이고, 는 활성화 이전 값 에서 계산한 활성화 함수의 도함수이며, 는 원소별 곱셈을 나타냅니다.
은닉층에 대해서는 오차 항을 재귀적으로 계산합니다.
여기서 는 층 의 가중치 행렬의 전치입니다.
마지막으로, 매개변수에 대한 손실의 그래디언트는 다음과 같습니다:
여기서 는 층 에 있는 뉴런 의 활성화값입니다.
우리 구현에서는 이러한 계산을 Value 클래스와 그 연산들이 자동으로 처리합니다. loss.backward()를 호출하면 그래디언트가 계산되어 각 매개변수의 grad 속성에 저장됩니다.
신경망 구성 요소 만들기
자동 미분 엔진이 준비되었으므로 이제 신경망 구성 요소를 만들 수 있습니다. Module 클래스는 모든 신경망 모듈의 기반 클래스 역할을 합니다.
class Module:
    """Base class for all neural network modules."""

    def zero_grad(self):
        """Sets gradients of all parameters to zero."""
        for p in self.parameters():
            p.grad = 0

    def parameters(self):
        """Returns a list of all parameters in the module."""
        return []
Neuron 클래스는 입력의 가중합에 편향을 더한 값을 계산하고, 선택적으로 비선형 활성화 함수를 적용하는 단일 뉴런을 구현합니다.
class Neuron(Module):
    """A single neuron with multiple inputs and one output."""

    def __init__(self, nin, nonlin=True):
        self.w = [Value(random.uniform(-1, 1)) for _ in range(nin)]
        self.b = Value(0)
        self.nonlin = nonlin

    def __call__(self, x):
        act = sum((wi * xi for wi, xi in zip(self.w, x)), self.b)
        return act.relu() if self.nonlin else act

    def parameters(self):
        return self.w + [self.b]
Layer 클래스는 뉴런들을 묶어 입력을 병렬로 처리합니다.
class Layer(Module):
    """A layer of neurons, where each neuron has the same number of inputs."""

    def __init__(self, nin, nout, **kwargs):
        self.neurons = [Neuron(nin, **kwargs) for _ in range(nout)]

    def __call__(self, x):
        out = [n(x) for n in self.neurons]
        return out[0] if len(out) == 1 else out

    def parameters(self):
        return [p for n in self.neurons for p in n.parameters()]
마지막으로 MLP(다층 퍼셉트론) 클래스는 층들을 결합하여 완전한 네트워크를 구성합니다.
class MLP(Module):
    """Multi-layer perceptron (fully connected feed-forward neural network)."""

    def __init__(self, nin, nouts):
        sz = [nin] + nouts
        self.layers = [
            Layer(sz[i], sz[i + 1], nonlin=i != len(nouts) - 1)
            for i in range(len(nouts))
        ]

    def __call__(self, x):
        for layer in self.layers:
            x = layer(x)
        return x

    def parameters(self):
        return [p for layer in self.layers for p in layer.parameters()]
이러한 모듈식 설계 덕분에 어떤 크기의 네트워크든 쉽게 만들 수 있습니다. 예를 들어, 이진 분류를 위한 작은 네트워크는 다음과 같이 만들 수 있습니다.
# Create a network with:
# - 2 input features
# - 8 neurons in first hidden layer
# - 8 neurons in second hidden layer
# - 1 output neuron
model = MLP(nin=2, nouts=[8, 8, 1])
그림 2는 이 아키텍처를 시각화한 것으로, 뉴런이 층으로 구성되고 층들이 연결되어 완전한 네트워크를 이루는 방식을 보여 줍니다.
 그림 2: 여러 층의 뉴런으로 이루어진 신경망 아키텍처의 시각화.
그림 3에서 보듯이 층을 더 추가하여 더 깊은 네트워크를 만들 수 있습니다. 층이 하나 추가될 때마다 네트워크는 더 복잡한 특징을 학습할 수 있습니다. 앞쪽 층은 일반적으로 단순한 패턴(이미지의 가장자리 등)을 학습하고, 더 깊은 층은 이를 조합하여 더 복잡한 패턴(물체나 개념 등)을 인식합니다.
 그림 3: 여러 은닉층을 가진 더 깊은 신경망으로, 층을 쌓아 모델 용량을 늘리는 방식을 보여 줍니다.
최적화와 학습
신경망을 학습시키려면 그래디언트를 바탕으로 매개변수를 갱신하는 옵티마이저가 필요합니다. 우리의 SGD(확률적 경사 하강법) 옵티마이저는 놀라울 만큼 단순합니다:
class SGD:
    """
    Stochastic Gradient Descent optimizer.
    """

    def __init__(self, parameters, lr=0.01):
        self.parameters = parameters
        self.lr = lr

    def zero_grad(self):
        """Set all parameter gradients to zero."""
        for p in self.parameters:
            p.grad = 0

    def step(self):
        """
        Updates each parameter as: p = p - lr * p.grad
        """
        for p in self.parameters:
            p.data -= self.lr * p.grad
옵티마이저는 모델 매개변수에 대한 참조를 저장하고, 각 순방향 패스 전에 그래디언트를 0으로 초기화하는 메서드를 제공하며, 다음과 같은 경사 하강법 규칙을 사용하여 매개변수를 갱신합니다:
여기서 는 매개변수를 나타내고, 는 학습률이며, 는 매개변수에 대한 손실 함수의 그래디언트입니다.
Adam이나 RMSProp 같은 더 정교한 옵티마이저는 과거 기울기 정보를 바탕으로 각 매개변수의 학습률을 조정하여 더 나은 수렴 특성을 제공하지만, SGD는 기울기 기반 최적화의 핵심(Core) 원리를 잘 보여 줍니다.
학습 과정은 Trainer 클래스에 캡슐화되어 있으며, 이 클래스는 데이터 배치 처리, 순방향 및 역방향 패스, 매개변수 갱신, 지표 추적을 담당합니다:
import random
import matplotlib.pyplot as plt
from tinynn.engine import Value


class Trainer:
    def __init__(self, model, optimizer, loss_fn=None):
        self.model = model
        self.optimizer = optimizer
        self.loss_fn = loss_fn or self._mse_loss

        # Training history
        self.losses = []
        self.accuracies = []

    def _mse_loss(self, pred, target):
        """Mean squared error loss function."""
        return (pred - target) * (pred - target)

    def train(
        self, X, y, n_epochs=100, batch_size=32, verbose=True, early_stopping=True
    ):
        """
        Train the model on the given dataset.

        Args:
            X: Features (list or numpy array)
            y: Target values (list or numpy array)
            n_epochs: Number of training epochs
            batch_size: Mini-batch size
            verbose: Whether to print progress
            early_stopping: Whether to stop early on perfect accuracy

        Returns:
            Dictionary containing training history
        """
        print("Training neural network...")

        for epoch in range(n_epochs):
            # Track metrics for this epoch
            total_loss = 0.0
            correct = 0

            # Shuffle the data
            indices = list(range(len(X)))
            random.shuffle(indices)

            # Mini-batch training
            for start_idx in range(0, len(X), batch_size):
                end_idx = min(start_idx + batch_size, len(X))
                batch_indices = indices[start_idx:end_idx]

                # Zero gradients
                self.optimizer.zero_grad()

                # Accumulate loss and accuracy over the batch
                batch_loss = Value(0.0)

                for idx in batch_indices:
                    # Convert numpy features to Value objects
                    x_vals = [Value(X[idx][0]), Value(X[idx][1])]

                    # Forward pass
                    pred = self.model(x_vals)
                    pred_value = pred[0] if isinstance(pred, list) else pred

                    # Binary cross-entropy loss with tanh activation
                    target = 1.0 if y[idx] == 1 else -1.0  # Use -1/1 targets for tanh

                    # Calculate loss
                    loss = self.loss_fn(pred_value, target)

                    # Accumulate loss
                    batch_loss = batch_loss + loss

                    # Check accuracy
                    pred_class = 1 if pred_value.data > 0 else 0
                    if pred_class == y[idx]:
                        correct += 1

                # Scale loss by batch size
                batch_loss = batch_loss * (1.0 / len(batch_indices))

                # Backward pass
                batch_loss.backward()

                # Update parameters
                self.optimizer.step()

                # Track total loss
                total_loss += batch_loss.data

            # Record metrics
            avg_loss = total_loss / max(1, (len(X) // batch_size))
            accuracy = correct / len(X)
            self.losses.append(avg_loss)
            self.accuracies.append(accuracy)

            # Print progress every 10 epochs
            if verbose and (epoch + 1) % 10 == 0:
                print(
                    f"Epoch {epoch+1}/{n_epochs}: Loss={avg_loss:.4f}, Accuracy={accuracy:.4f}"
                )

            # Early stopping if we reach perfect accuracy
            if early_stopping and accuracy == 1.0 and avg_loss < 0.01:
                print(f"Early stopping at epoch {epoch+1} with 100% accuracy!")
                break

        print("Training complete!")
        print(f"Final accuracy: {self.accuracies[-1]:.4f}")

        return {"losses": self.losses, "accuracies": self.accuracies}

    def plot_training_progress(self, save_path="output/training_progress.png"):
        """Plot and save the training progress."""
        plt.figure(figsize=(12, 5))

        plt.subplot(1, 2, 1)
        plt.plot(self.losses)
        plt.title("Training Loss")
        plt.xlabel("Epoch")
        plt.ylabel("Loss")

        plt.subplot(1, 2, 2)
        plt.plot(self.accuracies)
        plt.title("Training Accuracy")
        plt.xlabel("Epoch")
        plt.ylabel("Accuracy")

        plt.tight_layout()
        plt.savefig(save_path)
        plt.close()
각 에포크마다 트레이너는 데이터를 섞고, 미니 배치를 처리하고, 손실과 그래디언트를 계산하고, 매개변수를 갱신하며, 손실과 정확도 같은 지표를 추적합니다. 이처럼 구조화된 학습 방식 덕분에 일관된 학습 절차를 유지하면서도 다양한 모델과 데이터셋으로 손쉽게 실험할 수 있습니다.
L2 정규화
정규화 기법은 머신러닝에서 과적합을 방지하는 데 필수적입니다. 과적합이란 모델이 학습 데이터에서는 좋은 성능을 보이지만 처음 보는 데이터에서는 성능이 떨어지는 현상입니다. **가중치 감쇠(weight decay)**라고도 하는 L2 정규화는 신경망에서 가장 흔히 쓰이는 정규화 방법 중 하나입니다.
L2 정규화의 핵심(Core) 아이디어는 큰 가중치를 억제하는 페널티 항을 손실 함수에 추가하는 것입니다:
여기서 는 정규화 강도로, 학습 데이터에 대한 적합과 가중치를 작게 유지하는 것 사이의 균형을 조절하는 하이퍼파라미터입니다.
각 가중치에 대한 이 정규화 항의 그래디언트는 다음과 같습니다:
이는 가중치 업데이트 단계에서 각 가중치가 원래 손실의 그래디언트에 따라 조정될 뿐만 아니라 그 크기에 비례하여 줄어든다는 뜻입니다:
이렇게 하면 데이터가 가중치가 커야 한다는 강력한 근거를 제시하지 않는 한 가중치가 0 쪽으로 밀려나는 효과가 있습니다. 그 결과 과적합 가능성이 더 낮은, 더 단순한 모델이 만들어집니다.
우리 프레임워크에서 L2 정규화를 구현하는 것은 간단합니다. 손실 함수가 정규화 항을 포함하도록 수정하면 됩니다:
def _mse_loss_with_l2(self, pred, target, lambda_reg=0.01):
"""Mean squared error loss function with L2 regularization."""
# Original MSE loss
mse_loss = (pred - target) * (pred - target)
# L2 regularization term
l2_reg = Value(0.0)
for p in self.model.parameters():
l2_reg = l2_reg + p * p
l2_reg = l2_reg * lambda_reg
# Combined loss
return mse_loss + l2_reg
또는 가중치 업데이트 규칙을 수정하여 옵티마이저에서 직접 L2 정규화를 구현할 수도 있습니다:
def step(self, lambda_reg=0.01):
"""Updates each parameter with L2 regularization."""
for p in self.parameters:
# L2 regularization: weight decay
p.data -= self.lr * (p.grad + 2 * lambda_reg * p.data)
L2 정규화에는 다음과 같은 여러 이점이 있습니다:
- 큰 가중치에 페널티를 주어 과적합을 방지하는 데 도움이 됩니다
- 학습 데이터의 노이즈에 대해 모델을 더 견고하게 만듭니다
- 처음 보는 데이터에 대한 일반화 성능을 향상시킬 수 있습니다
- 학습 중 수치적 안정성에 도움이 될 수 있습니다
정규화 강도 는 튜닝이 필요한 하이퍼파라미터입니다. 가 너무 작으면 정규화 효과가 미미하고, 너무 크면 모델이 데이터에 과소적합될 수 있습니다. 일반적으로 의 최적값을 찾는 데에는 교차 검증을 사용합니다.
엔드투엔드 사용 예
라이브러리가 실제로 동작하는 모습을 보여 주기 위해, 간단한 분류 작업인 scikit-learn의 “moons” 데이터셋으로 신경망을 학습시킵니다. 이 데이터셋은 서로 맞물린 두 개의 반원으로 이루어져 있어, 클래스를 분리하려면 비선형 결정 경계가 필요합니다:
from sklearn.datasets import make_moons
import numpy as np
import matplotlib.pyplot as plt
from tinynn.engine import Value
from tinynn.nn import MLP
from tinynn.optim import SGD
from tinynn.trainer import Trainer
# Generate the dataset
X, y = make_moons(n_samples=100, noise=0.1, random_state=42)
# Create a neural network: 2 inputs -> 32 -> 32 -> 16 -> 1 output
model = MLP(nin=2, nouts=[32, 32, 16, 1])
# Create an optimizer
optimizer = SGD(model.parameters(), lr=0.005)
# Create trainer
trainer = Trainer(model, optimizer)
# Train the model
trainer.train(X, y, n_epochs=500, batch_size=10, verbose=True)
학습의 핵심 개념은 다음과 같습니다.
배치 크기(Batch Size): 각 순전파/역전파 패스에서 함께 처리되는 학습 예제의 수를 결정합니다. 배치가 작을수록 기울기 업데이트에 노이즈가 더 많이 생기지만(이는 지역 최솟값에서 벗어나는 데 도움이 될 수 있습니다) 수렴 속도가 더 느립니다. 배치가 클수록 더 안정적으로 업데이트되지만 최적이 아닌 해에 갇힐 수 있습니다.
에포크(Epochs): 학습 데이터셋 전체를 한 번 완전히 거치는 패스입니다. 모델이 효과적으로 학습하려면 여러 에포크가 필요합니다. 최적의 에포크 수는 데이터셋 크기, 모델 복잡도, 최적화 매개변수와 같은 요인에 따라 달라집니다.
학습 손실(Training Loss): 모델의 예측이 실제 값과 얼마나 잘 일치하는지를 측정합니다. 여기서는 평균 제곱 오차(Mean Squared Error, MSE)를 사용합니다.
MSE가 이번 이진 분류 작업에 특히 적합한 이유는 다음과 같습니다.
- 제곱 항 때문에 큰 오차에 큰 페널티를 부여합니다
- 최적화에 유리한 매끄러운 기울기를 제공합니다
- 구현하기 쉽고 이해하기도 쉽습니다
정확도(Accuracy): 올바른 예측의 비율입니다. 정확도는 직관적이지만, 불균형한 데이터셋에서는 오해를 불러일으킬 수 있으므로 다른 지표와 함께 고려해야 합니다.
학습 진행 상황은 그림 4에 나와 있으며, 시간이 지남에 따라 손실은 줄어들고 정확도는 높아지는 것을 확인할 수 있습니다.
 그림 4: 모델이 학습하면서 손실이 줄어들고 정확도가 높아지는 과정을 보여 주는 학습 진행 상황입니다.
그림 5의 결정 경계 시각화에서 볼 수 있듯이, 이 간단한 모델은 두 클래스를 효과적으로 분리하도록 학습합니다.
 그림 5: 학습된 결정 경계는 모델이 비선형 경계로 두 클래스를 어떻게 분리하는지 보여 줍니다.
최적화 기회
신경망 학습에는 여러 차원에 걸쳐 병렬화할 수 있는 기회가 많습니다. 가장 분명한 것은 배치 병렬성으로, 여러 학습 예제를 네트워크에서 동시에 처리할 수 있습니다. 배치 내의 각 예제는 순방향 패스 동안 독립적으로 계산될 수 있으며, 그 그래디언트는 역전파 동안 병렬로 누적될 수 있습니다. 또한 각 층 안에서는 행렬 곱셈과 원소별 연산을 뉴런과 특징 차원에 걸쳐 병렬화할 수 있으므로, 최신 하드웨어가 활용할 수 있는 풍부한 병렬 계산 계층 구조가 만들어집니다.
이러한 고유의 병렬성 덕분에 최신 GPU는 딥러닝 워크로드에 이상적입니다. 복잡한 제어 흐름을 가진 순차 처리에 최적화된 CPU와 달리, GPU에는 병렬 산술 연산을 위해 특별히 설계된 더 단순한 코어가 수천 개 들어 있습니다. 이 아키텍처는 신경망 계산과 완벽하게 맞아떨어집니다. 행렬 곱셈, 합성곱, 원소별 연산을 모두 이 코어들에 분산할 수 있으므로 CPU 구현에 비해 수십에서 수백 배 빨라집니다. 최신 GPU에는 딥러닝에서 흔히 쓰이는 혼합 정밀도 행렬 연산을 가속하는 전용 텐서 코어도 탑재되어 있습니다.
GPU의 메모리 계층 구조는 딥러닝 성능을 좌우하는 또 하나의 중요한 요소입니다. GPU는 고대역폭 메모리와 정교한 캐싱 메커니즘 덕분에 수많은 처리 코어에 데이터를 효율적으로 공급할 수 있으며, 공유 메모리는 같은 연산을 수행하는 스레드 사이의 빠른 통신을 가능하게 합니다. 이는 딥러닝에서 특히 중요합니다. 딥러닝은 메모리 접근 패턴이 예측 가능하고 규칙적이어서 메모리 하위 시스템을 최적으로 활용할 수 있기 때문입니다. 이러한 메모리 특성은 GPU의 대규모 병렬 처리 능력과 결합하여 GPU를 현대 딥러닝 인프라의 근간으로 만들며, 점점 더 크고 복잡해지는 모델의 학습을 가능하게 합니다. GPU 실행을 다루기 전에, 6부에서 작은 표현식 컴파일러를 만들고 7부에서 트랜스포머 워크로드를 소개하겠습니다.
외부 자료
- 역전파
- PyTorch 신경망
- JAX와 Flax: 간단한 신경망
- 역전파 완전 정복
- 신경망과 역전파에 대한 상세한 입문: micrograd 만들기
- JAX 소개
- Micrograd
- PyTorch를 활용한 딥러닝
- 최적화와 초기화
이전: 4부 - MLIR에서의 선형대수 · 시리즈 목차 · 다음: 6부 - E-그래프로 Python 특수화하기
MLIR의 선형대수
Linalg 다이얼렉트는 MLIR 생태계의 핵심(Core) 아이디어로, 고수준 텐서 연산을 더 쉽고 효율적으로 만들기 위해 만들어졌습니다. 본질적으로 이 다이얼렉트의 목적은 복잡한 수학 연산을 다루는 방식을 단순화하여, 빠르고 최적화된 코드로 변환할 수 있게 하는 데 있습니다. 근본적으로(Core) Linalg 다이얼렉트는 단순하고 선언적인 접근 방식을 사용합니다. 즉, 수학적 의미를 그대로 유지하면서도 다양한 최적화가 가능하도록 연산과 변환을 표현합니다. 점별(pointwise) 계산, 행렬 곱셈, 합성곱과 같은 고수준 선형대수 연산을 단일 연산으로 제공합니다.
linalg.generic
Linalg 다이얼렉트에서 가장 일반적인 연산은 linalg.generic입니다. 이 연산을 사용하면 인덱스에 대한 일반적인 텐서 조작 연산을 정의할 수 있습니다. 이것은 가장 일반적인 연산이며, 다른 모든 연산은 이 연산의 특수화로 정의됩니다. 이 연산을 직접 사용할 일은 많지 않겠지만, 가장 기본이 되는 연산이므로 먼저 살펴보는 것이 유용합니다.
#map_1d_identity = affine_map<(d0) -> (d0)>
func.func @add_tensors(%arg0: tensor<10xf32>, %arg1: tensor<10xf32>) -> tensor<10xf32> {
%result = tensor.empty() : tensor<10xf32>
%0 = linalg.generic {
// attributes
indexing_maps = [
#map_1d_identity,
#map_1d_identity,
#map_1d_identity
],
iterator_types = [
"parallel"
]
}
// input tensors
ins(%arg0, %arg1 : tensor<10xf32>, tensor<10xf32>)
// output tensor
outs(%result : tensor<10xf32>)
// loop region
{
^bb0(%arg2: f32, %arg3: f32, %arg4: f32):
%1 = arith.addf %arg2, %arg3 : f32
linalg.yield %1 : f32
} -> tensor<10xf32>
return %0 : tensor<10xf32>
}
이 linalg.generic 연산의 각 구성 요소를 하나씩 살펴봅시다.
-
indexing_maps: 이 속성은 입력 텐서와 출력 텐서에 접근하는 방식을 정의합니다. 여기에는 3개의 맵이 있습니다.- 첫 번째 입력 텐서(
%arg0)를 위한 첫 번째 맵 - 두 번째 입력 텐서(
%arg1)를 위한 두 번째 맵 - 출력 텐서(
%result)를 위한 세 번째 맵
모두
affine_map<(d0) -> (d0)>로 정의된#map_1d_identity를 사용하며, 이는 각 원소가 대응하는 원소에 직접 매핑된다는 뜻입니다(좌표 변환 없음). - 첫 번째 입력 텐서(
-
iterator_types: 각 차원의 반복 유형을 지정합니다. 여기에는 다음이 있습니다.["parallel"]: 단일 차원이 parallel로 표시되어 있으며, 이는 반복을 임의의 순서로 또는 동시에 실행할 수 있다는 뜻입니다.
linalg에는 세 가지 반복자 유형이 있습니다.
parallel: 반복을 임의의 순서로 또는 동시에 실행할 수 있습니다(원소별 연산 등)reduction: 반복이 하나의 결과 값에 기여합니다(축을 따라 합산하는 경우 등)window: 반복이 원소의 슬라이딩 윈도우에 접근합니다(합성곱 등)
-
ins(%arg0, %arg1 : tensor<10xf32>, tensor<10xf32>):- 입력 텐서와 그 타입을 지정합니다
- 둘 다 float32 원소 10개로 이루어진 1차원 텐서입니다
-
outs(%result : tensor<10xf32>):- 출력 텐서와 그 타입을 지정합니다
- 마찬가지로 float32 원소 10개로 이루어진 1차원 텐서입니다
-
영역(루프 본문):
{ ^bb0(%arg2: f32, %arg3: f32, %arg4: f32): %1 = arith.addf %arg2, %arg3 : f32 linalg.yield %1 : f32 }- 입력 텐서(%arg2, %arg3)와 출력 텐서(%arg4)에서 스칼라 값을 가져옵니다
- 부동소수점 덧셈을 수행합니다
linalg.yield를 사용해 결과를 반환합니다
이 연산은 NumPy에서와 마찬가지로 두 텐서를 원소별로 더하는 표준 벡터화 덧셈을 수행합니다:
np.array([1,2,3]) + np.array([2,3,4])
# array([3, 5, 7])
내용이 많아 보이더라도 걱정하지 마십시오. 실제로 많습니다. 같은 결과로 컴파일되면서 훨씬 더 간단하게 작성하는 방법이 있습니다.
linalg.map
같은 연산을 범용 linalg.map 연산으로도 작성할 수 있습니다. 이 연산은 루프 중첩과 인덱스 조작의 세부 사항을 추상화하고, 그 대신 arith.addf 연산을 입력 텐서에 직접 적용합니다.
module {
func.func @addv(%arg0: tensor<10xf32>, %arg1: tensor<10xf32>, %out: memref<10xf32>) {
%out2 = tensor.empty() : tensor<10xf32>
%result = linalg.map { arith.addf } ins(%arg0, %arg1 : tensor<10xf32>, tensor<10xf32>) outs(%out2 : tensor<10xf32>)
%l = bufferization.to_memref %result : tensor<10xf32> to memref<10xf32>
memref.copy %l, %out : memref<10xf32> to memref<10xf32>
return
}
}
자주 쓰이는 산술 맵 연산에는 이름이 붙은 연산도 있습니다. 이들은 linalg.map 연산을 특수화하여 이름을 붙인 것입니다.
linalg.addlinalg.mullinalg.divlinalg.sub
linalg.reduce
linalg.reduce 연산은 다양한 리덕션 연산을 구현하는 데 사용할 수 있는 강력한 기본 연산입니다.
func.func @add_tensor() -> (f64) {
%_ssa_0 = tensor.empty () : tensor<3xf64>
%out = tensor.empty () : tensor<f64>
%reduce = linalg.reduce { arith.addf } ins(%_ssa_0:tensor<3xf64>) outs(%out:tensor<f64>) dimensions = [0]
%result = tensor.extract %reduce [] : tensor<f64>
return %result : f64
}
NumPy에서는 이 연산을 다음과 같이 작성할 수 있습니다:
import numpy as np
np.multiply.reduce([2,3,5]) # 30
linalg.matmul
직접적인 텐서 축약을 이용하여 범용 행렬 곱셈 연산을 정의할 수도 있습니다. MLIR 코드에 나온 행렬 곱셈 연산은 일반적인 텐서 표기법으로 다음과 같이 쓸 수 있습니다:
여기서:
- 는 8×10 입력 행렬(
memref<8x10xf32>)입니다 - 는 10×16 입력 행렬(
memref<10x16xf32>)입니다 - 는 8×16 출력 행렬(
memref<8x16xf32>)입니다 - 는 1부터 8까지의 범위를 가집니다
- 는 1부터 16까지의 범위를 가집니다
- 는 1부터 10까지의 범위를 가지는 합산 인덱스입니다
이는 다음과 같은 MLIR 구현과 일치합니다:
parallel반복자 타입은 자유 인덱스 와 에 대응합니다reduction반복자 타입은 에 대한 합산에 대응합니다- 인덱싱 맵
(i, j, k) -> (i, k),(i, j, k) -> (k, j),(i, j, k) -> (i, j)는 각각 , , 에 대한 접근에 대응합니다
func.func @matmul(
%A: memref<8x10xf32>,
%B: memref<10x16xf32>,
%C: memref<8x16xf32>
) {
linalg.generic {
indexing_maps = [
affine_map<(i, j, k) -> (i, k)>,
affine_map<(i, j, k) -> (k, j)>,
affine_map<(i, j, k) -> (i, j)>
],
iterator_types = [
"parallel",
"parallel",
"reduction"
]
} ins(%A, %B : memref<8x10xf32>, memref<10x16xf32>) outs(%C : memref<8x16xf32>) {
^bb0(%lhs_one: f32, %rhs_one: f32, %init_one: f32):
%tmp0 = arith.mulf %lhs_one, %rhs_one : f32
%tmp1 = arith.addf %init_one, %tmp0 : f32
linalg.yield %tmp1 : f32
}
return
}
또는 linalg.matmul 연산을 사용하면 훨씬 더 간결하게 작성할 수 있습니다.
func.func @matmul(
%A: memref<8x10xf32>,
%B: memref<10x16xf32>,
%C: memref<8x16xf32>
) {
linalg.matmul ins(%A, %B : memref<8x10xf32>, memref<10x16xf32>) outs(%C : memref<8x16xf32>)
return
}
그런 다음 convert-linalg-to-loops 또는 convert-linalg-to-affine-loops 패스를 사용하여 텐서 연산을 affine.for 또는 scf.for 연산으로 이루어진 루프 시퀀스로 로워링합니다.
func.func @matmul(%arg0: memref<8x10xf32>, %arg1: memref<10x16xf32>, %arg2: memref<8x16xf32>) {
affine.for %arg3 = 0 to 8 {
affine.for %arg4 = 0 to 16 {
affine.for %arg5 = 0 to 10 {
%0 = affine.load %arg0[%arg3, %arg5] : memref<8x10xf32>
%1 = affine.load %arg1[%arg5, %arg4] : memref<10x16xf32>
%2 = affine.load %arg2[%arg3, %arg4] : memref<8x16xf32>
%3 = arith.mulf %0, %1 : f32
%4 = arith.addf %2, %3 : f32
affine.store %4, %arg2[%arg3, %arg4] : memref<8x16xf32>
}
}
}
return
}
func.func @matmul(%arg0: memref<8x10xf32>, %arg1: memref<10x16xf32>, %arg2: memref<8x16xf32>) {
%c0 = arith.constant 0 : index
%c8 = arith.constant 8 : index
%c1 = arith.constant 1 : index
%c16 = arith.constant 16 : index
%c10 = arith.constant 10 : index
scf.for %arg3 = %c0 to %c8 step %c1 {
scf.for %arg4 = %c0 to %c16 step %c1 {
scf.for %arg5 = %c0 to %c10 step %c1 {
%0 = memref.load %arg0[%arg3, %arg5] : memref<8x10xf32>
%1 = memref.load %arg1[%arg5, %arg4] : memref<10x16xf32>
%2 = memref.load %arg2[%arg3, %arg4] : memref<8x16xf32>
%3 = arith.mulf %0, %1 : f32
%4 = arith.addf %2, %3 : f32
memref.store %4, %arg2[%arg3, %arg4] : memref<8x16xf32>
}
}
}
return
}
브로드캐스팅
MLIR의 Linalg 다이얼렉트에서 브로드캐스팅을 사용하면 NumPy의 브로드캐스팅 규칙과 비슷하게 서로 다른 형태의 텐서를 하나의 연산에서 결합할 수 있습니다. 브로드캐스트 차원을 따라 더 작은 텐서가 더 큰 텐서의 형태에 맞도록 암묵적으로 확장됩니다. 이는 행렬의 각 행/열에 벡터를 더하거나 텐서에 스칼라 연산을 적용하는 것과 같은 연산에서 특히 유용합니다.
몇 가지 일반적인 브로드캐스팅 패턴을 살펴봅시다.
func.func @broadcast_1d_to_2d(%arg0: tensor<3xf32>) -> tensor<3x3xf32> {
// Create an empty output tensor
%init = tensor.empty() : tensor<3x3xf32>
// Broadcast the input tensor along dimension 1 (columns)
%result = linalg.broadcast
ins(%arg0: tensor<3xf32>)
outs(%init: tensor<3x3xf32>)
dimensions = [1]
return %result : tensor<3x3xf32>
}
NumPy에서는 이 연산을 다음과 같이 작성할 수 있습니다.
arg0 = np.array([1,2,3])
result = np.broadcast_to(arg0, (3,3))
# array([[1, 2, 3],
# [1, 2, 3],
# [1, 2, 3]])
브로드캐스팅을 다른 연산과 결합할 수도 있습니다. 예를 들어, 행렬의 각 행에 벡터를 더하는 연산은 다음과 같습니다.
func.func @add_vector_to_matrix(
%matrix: tensor<3x4xf32>,
%vector: tensor<4xf32>
) -> tensor<3x4xf32> {
%init = tensor.empty() : tensor<3x4xf32>
// First broadcast the vector
%broadcasted = linalg.broadcast
ins(%vector: tensor<4xf32>)
outs(%init: tensor<3x4xf32>)
dimensions = [0]
// Then add the broadcasted result to the matrix
%result = linalg.map { arith.addf }
ins(%matrix, %broadcasted: tensor<3x4xf32>, tensor<3x4xf32>)
outs(%init: tensor<3x4xf32>)
return %result : tensor<3x4xf32>
}
이는 흔히 쓰이는 다음 NumPy 연산과 동일합니다.
matrix = np.ones((3,4))
vector = np.array([1,2,3,4])
result = matrix + vector
# array([[2., 3., 4., 5.],
# [2., 3., 4., 5.],
# [2., 3., 4., 5.]])
커널 융합
커널 융합은 여러 연산을 하나의 연산으로 결합하여 메모리 대역폭 요구량을 줄이고 성능을 향상시키는 중요한 최적화 기법입니다. Linalg 다이얼렉트는 최적화 패스를 통해 원소별 연산의 융합을 기본적으로 지원합니다.
덧셈 다음에 곱셈이 오는 두 연산을 하나로 융합하려는 간단한 예제를 살펴봅시다. 먼저 이 연산들을 별개의 연산으로 작성하겠습니다.
module {
func.func @addmul(%arg0: tensor<10xf32>, %arg1: tensor<10xf32>, %arg2: tensor<10xf32>) -> tensor<10xf32> {
// First create an empty tensor for intermediate results
%0 = tensor.empty() : tensor<10xf32>
// Add operation
%1 = linalg.add ins(%arg0, %arg1 : tensor<10xf32>, tensor<10xf32>)
outs(%0 : tensor<10xf32>) -> tensor<10xf32>
// Create another empty tensor for the multiplication result
%2 = tensor.empty() : tensor<10xf32>
// Multiply operation
%3 = linalg.mul ins(%1, %arg2 : tensor<10xf32>, tensor<10xf32>)
outs(%2 : tensor<10xf32>) -> tensor<10xf32>
return %3 : tensor<10xf32>
}
}
여기에는 linalg.add 다음에 linalg.mul이 오는 두 개의 별개 연산이 있습니다. 각 연산마다 메모리에서 읽고 다시 메모리에 써야 하므로 비효율적일 수 있습니다.
MLIR의 최적화 패스를 통해 이 연산들을 데이터를 한 번만 순회하면서 두 연산을 모두 수행하는 단일 커널로 융합할 수 있습니다.
#map = affine_map<(d0) -> (d0)>
module {
func.func @addmul(%arg0: tensor<10xf32>, %arg1: tensor<10xf32>, %arg2: tensor<10xf32>) -> tensor<10xf32> {
%0 = tensor.empty() : tensor<10xf32>
%1 = linalg.generic {indexing_maps = [#map, #map, #map, #map],
iterator_types = ["parallel"]} ins(%arg0, %arg1, %arg2 : tensor<10xf32>,
tensor<10xf32>, tensor<10xf32>) outs(%0 : tensor<10xf32>) {
^bb0(%in: f32, %in_0: f32, %in_1: f32, %out: f32):
%2 = arith.addf %in, %in_0 : f32
%3 = arith.mulf %2, %in_1 : f32
linalg.yield %3 : f32
} -> tensor<10xf32>
return %1 : tensor<10xf32>
}
}
이것이 어떻게 동작하는지 감을 잡기 위해 동등한 Python 코드를 살펴봅시다.
# Unfused version - two separate loops
def unfused_addmul(a, b, c):
# First loop - addition
temp = []
for i in range(len(a)):
temp.append(a[i] + b[i])
# Second loop - multiplication
result = []
for i in range(len(temp)):
result.append(temp[i] * c[i])
return result
# Fused version - single loop
def fused_addmul(a, b, c):
result = []
for i in range(len(a)):
# Combine add and multiply in one loop iteration
result.append((a[i] + b[i]) * c[i])
return result
a = [1.0, 2.0, 3.0, 4.0, 5.0]
b = [1.0, 1.0, 1.0, 1.0, 1.0]
c = [2.0, 2.0, 2.0, 2.0, 2.0]
# Both produce same result but fused version only loops once
result = fused_addmul(a, b, c) # [(1+1)*2, (2+1)*2, (3+1)*2, ...]
융합된 버전은 두 연산을 하나의 linalg.generic 연산으로 결합하며, 이 연산은 각 입력을 한 번만 읽고 최종 결과를 바로 씁니다. 이렇게 하면 중간 텐서 할당과 그에 따른 메모리 접근이 사라집니다.
이 융합을 수행하려면 특정한 순서로 최적화 패스를 적용해야 합니다.
--canonicalize: 전반적인 정리와 단순화를 수행합니다--linalg-fuse-elementwise-ops: 원소별 연산을 융합합니다--cse: 공통 하위 표현식 제거(Common Subexpression Elimination)로 중복 연산을 정리합니다--linalg-generalize-named-ops: 이름 있는 연산(linalg.add등)을 generic 형태로 변환합니다--convert-linalg-to-loops: 융합된 연산을 명시적인 루프로 변환합니다
이 패스들을 실행하여 융합된 addmul 연산을 fused_ops.mlir에 출력할 수 있으며, 이로써 에 대한 두 개의 루프가 에 대한 하나의 루프로 줄어들어 시간 복잡도가 감소합니다.
mlir-opt separate_ops.mlir \
--canonicalize \
--linalg-fuse-elementwise-ops \
--cse \
--linalg-generalize-named-ops \
--linalg-fuse-elementwise-ops \
--convert-linalg-to-loops \
-o fused_ops.mlir
이 패스 순서를 따르면 연산이 올바르게 융합된 다음 효율적으로 실행할 수 있는 형태로 하강(lowering)됩니다. 융합 최적화는 원소별 연산이 연쇄적으로 이어지는 경우가 많은 딥러닝 워크로드에서 특히 중요합니다.
타일링
루프 타일링은 메모리 접근 패턴과 캐시 활용도를 개선하는 핵심 최적화 기법입니다. 현대 컴퓨터 아키텍처에서는 연산보다 메모리 접근이 병목이 되는 경우가 많습니다. 큰 행렬이나 텐서를 처리할 때 메모리에 선형적으로 접근하면 캐시 메모리보다 훨씬 느린 주 메모리에서 새 데이터를 계속 가져와야 할 수 있습니다.
타일링은 큰 연산을 캐시 메모리에 더 잘 들어맞는 작은 블록으로 나눕니다. 예를 들어 행렬 곱셈에서는 행과 열의 내적 전체를 한 번에 계산하는 대신(캐시 크기를 초과할 수 있으므로) 캐시 메모리에 상주할 수 있는 작은 타일로 나눕니다. 이렇게 하면 캐시 미스가 줄고 성능이 향상됩니다.
이 최적화는 메모리 계층 구조와 접근 패턴이 성능에 큰 영향을 미치는 GPU 아키텍처에서 특히 중요합니다. GPU에는 전역 메모리, 공유 메모리(캐시와 유사함), 레지스터를 포함하는 복잡한 메모리 계층 구조가 있습니다. 공유 메모리 크기나 워프 크기 같은 GPU의 하드웨어 특성에 맞춰 연산을 타일링하면 성능을 극적으로 향상시킬 수 있습니다. 예를 들어 CUDA 프로그래밍에서 흔히 쓰이는 패턴은 데이터 타일 하나를 공유 메모리에 로드하고, 스레드를 동기화한 다음, 각 스레드가 그 타일 안의 원소를 처리하게 하는 것입니다. 이에 대해서는 뒤의 GPU 프로그래밍 절에서 더 자세히 다룹니다.
다음은 MLIR을 사용하여 행렬 곱셈 연산에 루프 타일링을 수행하는 예제입니다. 간단한 텐서 기반 matmul에서 시작하여 이를 타일링된 affine 루프로 변환하겠습니다.
module {
func.func @matmul(%arg0: tensor<10x10xf32>, %arg1: tensor<10x10xf32>,
%arg2: tensor<10x10xf32>) -> tensor<10x10xf32> {
%0 = linalg.matmul
ins(%arg0, %arg1 : tensor<10x10xf32>, tensor<10x10xf32>)
outs(%arg2 : tensor<10x10xf32>) -> tensor<10x10xf32>
return %0 : tensor<10x10xf32>
}
}
이를 타일링된 루프로 변환하려면 다음과 같은 여러 변환 패스가 필요합니다:
--convert-tensor-to-linalg: 텐서 연산을 linalg 다이얼렉트로 변환합니다--linalg-generalize-named-ops: (matmul 같은) 이름 있는 연산을 일반 linalg 연산으로 변환합니다--one-shot-bufferize="bufferize-function-boundaries": 텐서 연산이 버퍼를 사용하도록 변환합니다--buffer-deallocation-pipeline: 버퍼 해제를 처리합니다--convert-bufferization-to-memref: 버퍼 연산을 memref 연산으로 변환합니다--convert-linalg-to-affine-loops: linalg 연산을 affine 루프로 낮춥니다--affine-loop-tile="tile-size=5": affine 루프를 크기 5로 타일링합니다--canonicalize --cse: 정리 패스입니다
전체 변환 파이프라인은 다음과 같습니다:
mlir-opt tiling.mlir \
--convert-tensor-to-linalg \
--linalg-generalize-named-ops \
--one-shot-bufferize="bufferize-function-boundaries" \
--buffer-deallocation-pipeline \
--convert-bufferization-to-memref \
--convert-linalg-to-affine-loops \
--affine-loop-tile="tile-size=5" \
--canonicalize \
--cse \
-o tiling-transformed.mlir
그 결과 다음과 같은 타일링된 구현이 생성됩니다:
#map = affine_map<(d0) -> (d0)>
#map1 = affine_map<(d0) -> (d0 + 5)>
module {
func.func @matmul(%arg0: memref<10x10xf32, strided<[?, ?], offset: ?>>, %arg1:
memref<10x10xf32, strided<[?, ?], offset: ?>>, %arg2: memref<10x10xf32,
strided<[?, ?], offset: ?>>) -> memref<10x10xf32, strided<[?, ?], offset: ?>>
{
affine.for %arg3 = 0 to 10 step 5 {
affine.for %arg4 = 0 to 10 step 5 {
affine.for %arg5 = 0 to 10 step 5 {
affine.for %arg6 = #map(%arg3) to #map1(%arg3) {
affine.for %arg7 = #map(%arg4) to #map1(%arg4) {
affine.for %arg8 = #map(%arg5) to #map1(%arg5) {
%0 = affine.load %arg0[%arg6, %arg8] : memref<10x10xf32, strided<[?, ?], offset: ?>>
%1 = affine.load %arg1[%arg8, %arg7] : memref<10x10xf32, strided<[?, ?], offset: ?>>
%2 = affine.load %arg2[%arg6, %arg7] : memref<10x10xf32, strided<[?, ?], offset: ?>>
%3 = arith.mulf %0, %1 : f32
%4 = arith.addf %2, %3 : f32
affine.store %4, %arg2[%arg6, %arg7] : memref<10x10xf32, strided<[?, ?], offset: ?>>
}
}
}
}
}
}
%alloc = memref.alloc() : memref<10x10xf32>
%cast = memref.cast %alloc : memref<10x10xf32> to memref<10x10xf32, strided<[?, ?], offset: ?>>
memref.copy %arg2, %alloc : memref<10x10xf32, strided<[?, ?], offset: ?>> to memref<10x10xf32>
return %cast : memref<10x10xf32, strided<[?, ?], offset: ?>>
}
}
타일링된 출력을 보면 원래의 10x10 행렬 곱셈이 더 작은 5x5 타일로 나뉘어 있으며, 이는 캐시 활용도와 메모리 접근의 지역성을 개선하는 데 도움이 됩니다.
외부 참고 자료
Affine 다이얼렉트와 OpenMP
MLIR의 affine 다이얼렉트는 병렬 실행에 적합한 루프와 배열 접근을 표현하기 위한 추상화를 제공합니다. 앞서 살펴본 scf 다이얼렉트와 달리, affine 다이얼렉트는 고급 루프 변환과 자동 병렬화를 가능하게 합니다. 이는 본질적으로 “일급 루프“이며, 우리가 늘 LLVM 위에 덧붙여 구현해 왔던 것입니다.
affine 다이얼렉트에는 자동 병렬화 기회, 내장 벡터화 기능, 정교한 루프 최적화, 배열 연산의 자연스러운 표현, OpenMP와의 통합 등 많은 장점이 있습니다.
다면체 최적화 모델
다면체 모델은 루프 중첩과 그 연산을 다차원 공간의 기하학적 객체로 표현하는 수학적 프레임워크입니다.
핵심(Core)적으로, 다면체 모델은 루프 중첩 안에서 실행되는 문장을 다차원 공간의 점으로 표현합니다. 각 점은 실행 중인 문장의 특정 인스턴스에 대응하며, 해당 반복 좌표로 정의됩니다. 이 표현은 복잡한 루프 최적화 문제를 다면체에 대한 기하학적 연산으로 바꾸어 프로그램 분석 및 변환 기법을 가능하게 합니다.
다면체 모델의 핵심 구성 요소로는 반복 도메인, 접근 관계, 스케줄링 함수가 있습니다. 반복 도메인은 루프 중첩이 실행하는 모든 반복의 집합을 정의하며, 이는 affine 제약 조건으로 경계가 정해진 정수 점의 집합으로 표현됩니다. 접근 관계는 반복 점을 각 문장이 접근하는 메모리 위치에 대응시킵니다. 스케줄링 함수는 반복 점의 실행 순서를 결정하며, 프로그램의 의미를 보존하면서 성능 특성을 개선하는 변환을 가능하게 합니다.
MLIR은 다면체 개념을 일급 시민으로 통합한 affine을 제공합니다. 이 하이브리드 설계는 고성능 데이터 병렬 시스템을 위한 고수준 데이터 흐름 그래프와 타깃별 코드의 표현, 분석, 변환을 최적화합니다.
우리가 이해해야 할 핵심(Core) 개념은 세 가지입니다:
-
Affine 맵: 차원과 심볼을 결과에 대응시키는 다차원 준선형 함수입니다. 예를 들어,
(d0, d1, d2, s0) → (d0 + d1, s0 * d2)는 차원 인수d0,d1,d2와 심볼 인수s0을 두 개의 결과에 대응시키는 2차원 affine 맵을 나타냅니다. -
정수 집합: affine 부등식과 등식으로 표현되는, 차원과 심볼에 대한 제약 조건입니다. 예를 들어,
(i)[N, M] : (i >= 0, -i + N >= 0, N - 5 == 0, -i + M + 1 >= 0)는0 <= i < N,N = 5,i <= M + 1을 만족하는 값i의 집합을 나타냅니다. -
Affine 연산: affine 맵과 정수 집합을 활용하여 affine 제약 조건이 있는 루프 중첩과 조건문을 표현하는
affine.for,affine.if,affine.parallel같은 연산입니다.
이론을 먼저 늘어놓기보다는 몇 가지 예제를 바로 살펴봅시다.
행렬 곱셈
두 행렬 와 의 고전적인 행렬 곱은 다음과 같습니다:
이를 MLIR에서 명시적인 루프 중첩으로 표현하면 다음과 같습니다:
func.func @matmul(%A: memref<?x?xf32>, %B: memref<?x?xf32>, %C: memref<?x?xf32>) {
%c0 = arith.constant 0 : index
%c1 = arith.constant 1 : index
%M = memref.dim %A, %c0 : memref<?x?xf32>
%N = memref.dim %B, %c1 : memref<?x?xf32>
%K = memref.dim %A, %c1 : memref<?x?xf32>
// Sequential implementation
affine.for %i = 0 to %M {
affine.for %j = 0 to %N {
affine.for %k = 0 to %K {
%a = affine.load %A[%i, %k] : memref<?x?xf32>
%b = affine.load %B[%k, %j] : memref<?x?xf32>
%c = affine.load %C[%i, %j] : memref<?x?xf32>
%prod = arith.mulf %a, %b : f32
%sum = arith.addf %c, %prod : f32
affine.store %sum, %C[%i, %j] : memref<?x?xf32>
}
}
}
return
}
%i와 %j에 대한 두 루프는 서로 다른 반복 사이에 의존성이 없다는 점에 주목하십시오. -affine-parallelize 패스를 사용하면 이를 다음과 같이 변환할 수 있습니다:
func.func @matmul_parallel(%A: memref<?x?xf32>, %B: memref<?x?xf32>, %C: memref<?x?xf32>) {
%c0 = arith.constant 0 : index
%c1 = arith.constant 1 : index
%M = memref.dim %A, %c0 : memref<?x?xf32>
%N = memref.dim %B, %c1 : memref<?x?xf32>
%K = memref.dim %A, %c1 : memref<?x?xf32>
// Parallel implementation
affine.parallel (%i, %j) = (0, 0) to (%M, %N) {
affine.for %k = 0 to %K {
%a = affine.load %A[%i, %k] : memref<?x?xf32>
%b = affine.load %B[%k, %j] : memref<?x?xf32>
%c = affine.load %C[%i, %j] : memref<?x?xf32>
%prod = arith.mulf %a, %b : f32
%sum = arith.addf %c, %prod : f32
affine.store %sum, %C[%i, %j] : memref<?x?xf32>
}
}
return
}
affine.parallel 연산은 루프의 여러 반복이 독립적으로, 그리고 잠재적으로 동시에 실행될 수 있음을 표현하는 방법입니다. 이는 “이 계산들은 어떤 순서로든, 또는 한꺼번에 수행될 수 있다“라고 말하는 것과 같다고 생각하십시오. 서로 소통할 필요가 없는 여러 작업자에게 일을 나누어 주는 방식과 비슷합니다.
더 정확히 말하면, affine.parallel은 다음과 같은 중첩 루프의 집합을 정의합니다:
- 각 반복은 다른 모든 반복과 독립적입니다
- 반복들은 어떤 순서로든 실행될 수 있으며 동시에 실행될 수도 있습니다
- 이 연산은 결과를 결합하는 순서가 중요하지 않은 리덕션(값을 합산하는 것 등)을 통해 결과를 생성합니다
기술적으로는 “초직사각형 병렬 밴드(hyper-rectangular parallel band)“를 생성합니다. 즉, 중첩된 여러 병렬 루프를 표현할 수 있으며, 각 루프는 고유한 귀납 변수(루프 카운터), 하한과 상한, 스텝 크기(각 반복마다 얼마나 증가하는지를 나타냄), 그리고 리덕션 연산(서로 다른 반복의 결과를 어떻게 결합할지를 정의함)으로 특징지어집니다.
병렬 영역의 본문은 반드시 affine.yield로 끝나야 하며, 이는 덧셈이나 곱셈 같은 연산을 사용해 서로 다른 반복의 결과를 어떻게 결합할지를 지정합니다. 0번 실행되는 루프의 경우, 결과는 해당 연산의 항등원(덧셈은 0, 곱셈은 1)입니다.
아핀 맵(affine.apply)
아핀 맵은 Affine 다이얼렉트의 핵심 구성 요소로, 다차원 아핀 변환을 나타냅니다. 아핀 맵은 루프 인덱스가 메모리 접근 패턴에 어떻게 매핑되는지를 기술하는 방법을 제공하며, 이는 고성능 컴퓨팅에서 메모리 레이아웃과 접근 패턴을 최적화하는 데 필수적입니다.
affine.apply의 다양한 용도를 보여 주는 종합적인 예제를 살펴봅시다:
// Define some reusable affine maps
#tile_map = affine_map<(d0) -> (d0 floordiv 32)>
#offset_map = affine_map<(d0)[s0] -> (d0 + s0)>
#complex_map = affine_map<(d0, d1)[s0] -> (d0 * 2 + d1 floordiv 4 + s0)>
func.func @affine_apply_examples() {
// Create some test indices
%c0 = arith.constant 0 : index
%c42 = arith.constant 42 : index
%c128 = arith.constant 128 : index
// Example 1: Simple tiling calculation
// Calculate which tile a given index belongs to (tile size = 32)
%tile_idx = affine.apply #tile_map(%c42)
// Example 2: Inline affine map for offset calculation
%offset = affine.apply affine_map<(i) -> (i + 10)>(%c42)
// Example 3: Using a symbol parameter
%shifted = affine.apply #offset_map(%c42)[%c128]
// Example 4: Multiple dimensions and a symbol
%complex = affine.apply #complex_map(%c42, %c128)[%c0]
// Example 5: Composition of affine applies
%temp = affine.apply affine_map<(i) -> (i * 2)>(%c42)
%final = affine.apply affine_map<(i) -> (i + 5)>(%temp)
return
}
// Example showing how affine.apply can be used in a practical loop context
func.func @tiled_loop(%arg0: memref<256xf32>) {
%c0 = arith.constant 0 : index
%c256 = arith.constant 256 : index
%c32 = arith.constant 32 : index
// Outer loop iterates over tiles
affine.for %i = 0 to 256 step 32 {
// Inner loop processes elements within the tile
affine.for %j = 0 to 32 {
%idx = affine.apply affine_map<(d0, d1) -> (d0 + d1)>(%i, %j)
%val = memref.load %arg0[%idx] : memref<256xf32>
// Process value...
memref.store %val, %arg0[%idx] : memref<256xf32>
}
}
return
}
tiled_loop 함수는 실제 시나리오에서 affine.apply를 사용해 배열의 타일링된 처리를 구현하는 방법을 보여 줍니다. 바깥쪽 루프는 타일 크기만큼씩 진행하며, affine.apply는 각 타일을 처리하는 안쪽 루프의 경계를 계산하는 데 사용됩니다.
아핀 맵에 관한 몇 가지 핵심 사항으로, floordiv는 내림하는 정수 나눗셈을 수행하며, (d0)[s0] 구문은 차원 매개변수 d0 하나와 심볼 매개변수 s0 하나를 나타냅니다. 또한 아핀 맵에는 덧셈, 뺄셈, 상수에 의한 곱셈, 상수에 의한 나눗셈, 상수에 의한 나머지 연산, 상수에 의한 floordiv/ceildiv만 포함될 수 있습니다. 결과 타입은 항상 index입니다.
아핀 최적화 패스
MLIR 최적화기는 Affine 다이얼렉트를 위해 특별히 설계된 풍부한 패스 집합을 제공합니다. 이 패스들은 다양한 최적화 기법을 통해 코드를 자동으로 변환하여 성능을 향상시킬 수 있습니다. 가장 중요한 몇 가지를 살펴봅시다:
- 루프 불변 코드 이동(Loop invariant code motion): 이 변환은 루프 불변 코드(루프 인덱스에 의존하지 않는 코드)를 루프 밖으로 옮깁니다. 이는 루프 인덱스에 의존하지 않는 코드를 바깥쪽 루프로 옮김으로써 병렬성을 드러내는 데 도움이 될 수 있습니다.
// Before
func.func @before(%A: memref<10xf32>, %B: memref<10xf32>) {
%c0 = arith.constant 0 : index
%c10 = arith.constant 10 : index
%c1 = arith.constant 1 : index
affine.for %i = 0 to 10 {
%x = arith.constant 42.0 : f32 // This is loop invariant!
%v = memref.load %A[%i] : memref<10xf32>
%sum = arith.addf %v, %x : f32
memref.store %sum, %B[%i] : memref<10xf32>
}
return
}
// After
func.func @after(%A: memref<10xf32>, %B: memref<10xf32>) {
%c0 = arith.constant 0 : index
%c10 = arith.constant 10 : index
%c1 = arith.constant 1 : index
%x = arith.constant 42.0 : f32 // Moved outside the loop
affine.for %i = 0 to 10 {
%v = memref.load %A[%i] : memref<10xf32>
%sum = arith.addf %v, %x : f32
memref.store %sum, %B[%i] : memref<10xf32>
}
return
}
- 루프 스큐잉(Loop skewing): 이 변환은 다른 루프 인덱스의 값에 따라 반복을 이동시켜 반복 공간을 변경합니다. 이는 의존성을 변환함으로써 병렬성을 드러내는 데 도움이 될 수 있습니다.
// Before - Dependencies prevent parallelization
func.func @before(%A: memref<10x10xf32>) {
affine.for %i = 1 to 10 {
affine.for %j = 1 to 10 {
%v1 = affine.load %A[%i-1, %j] : memref<10x10xf32>
%v2 = affine.load %A[%i, %j-1] : memref<10x10xf32>
%sum = arith.addf %v1, %v2 : f32
affine.store %sum, %A[%i, %j] : memref<10x10xf32>
}
}
}
// After skewing - Inner loop can now be parallelized
func.func @after(%A: memref<10x10xf32>) {
affine.for %i = 1 to 10 {
affine.for %j = %i to %i + 9 {
%i_new = affine.apply affine_map<(d0, d1) -> (d0)>(%i, %j)
%j_new = affine.apply affine_map<(d0, d1) -> (d1 - d0)>(%i, %j)
%v1 = affine.load %A[%i_new-1, %j_new] : memref<10x10xf32>
%v2 = affine.load %A[%i_new, %j_new-1] : memref<10x10xf32>
%sum = arith.addf %v1, %v2 : f32
affine.store %sum, %A[%i_new, %j_new] : memref<10x10xf32>
}
}
}
- 루프 교환(Loop interchange): 이 변환은 루프의 중첩 순서를 바꾸며, 이를 통해 캐시 지역성을 개선하고 병렬성을 드러낼 수 있습니다.
// Before - Column-major access pattern
func.func @before(%A: memref<16x16xf32>, %B: memref<16x16xf32>) {
affine.for %i = 0 to 16 {
affine.for %j = 0 to 16 {
%v = affine.load %A[%j, %i] : memref<16x16xf32>
affine.store %v, %B[%j, %i] : memref<16x16xf32>
}
}
}
// After - Row-major access pattern (better locality)
func.func @after(%A: memref<16x16xf32>, %B: memref<16x16xf32>) {
affine.for %j = 0 to 16 {
affine.for %i = 0 to 16 {
%v = affine.load %A[%j, %i] : memref<16x16xf32>
affine.store %v, %B[%j, %i] : memref<16x16xf32>
}
}
}
- 루프 융합(Loop fusion): 이 변환은 인접한 루프들을 결합하여 지역성을 개선하고 루프 오버헤드를 줄입니다.
// Before fusion
func.func @before(%A: memref<10xf32>, %B: memref<10xf32>, %C: memref<10xf32>) {
affine.for %i = 0 to 10 {
%v1 = affine.load %A[%i] : memref<10xf32>
%v2 = arith.mulf %v1, %v1 : f32
affine.store %v2, %B[%i] : memref<10xf32>
}
affine.for %i = 0 to 10 {
%v3 = affine.load %B[%i] : memref<10xf32>
%v4 = arith.addf %v3, %v3 : f32
affine.store %v4, %C[%i] : memref<10xf32>
}
}
// After fusion
func.func @after(%A: memref<10xf32>, %B: memref<10xf32>, %C: memref<10xf32>) {
affine.for %i = 0 to 10 {
%v1 = affine.load %A[%i] : memref<10xf32>
%v2 = arith.mulf %v1, %v1 : f32
affine.store %v2, %B[%i] : memref<10xf32>
%v3 = arith.addf %v2, %v2 : f32
affine.store %v3, %C[%i] : memref<10xf32>
}
}
- 루프 타일링(Loop tiling): 이 변환은 캐시 지역성을 개선하기 위해 루프를 더 작은 덩어리로 나눕니다.
// Before tiling
func.func @before(%A: memref<32x32xf32>) {
affine.for %i = 0 to 32 {
affine.for %j = 0 to 32 {
%v = affine.load %A[%i, %j] : memref<32x32xf32>
// ... computation ...
affine.store %v, %A[%i, %j] : memref<32x32xf32>
}
}
}
// After tiling (tile size 8x8)
func.func @after(%A: memref<32x32xf32>) {
affine.for %ti = 0 to 32 step 8 {
affine.for %tj = 0 to 32 step 8 {
affine.for %i = #map(%ti) to #map(%ti + 8) {
affine.for %j = #map(%tj) to #map(%tj + 8) {
%v = affine.load %A[%i, %j] : memref<32x32xf32>
// ... computation ...
affine.store %v, %A[%i, %j] : memref<32x32xf32>
}
}
}
}
}
이러한 최적화는 mlir-opt 도구에서 사용할 수 있습니다:
-affine-loop-coalescing- 연속된 루프들을 하나의 루프로 병합합니다.-affine-loop-fusion- 경계와 스텝이 같은 루프들을 병합합니다.-affine-loop-invariant-code-motion- 루프 불변 코드를 루프 밖으로 옮깁니다.-affine-loop-normalize- 루프 경계와 스텝을 정규화합니다.-affine-loop-tile- 루프를 타일링합니다.-affine-loop-unroll- 루프를 언롤링합니다.-affine-loop-unroll-jam- 루프를 언롤하고 하나로 합칩니다(jam).-affine-parallelize- 루프를 병렬화합니다.-affine-pipeline-data-transfer- 메모리 계층 구조에서 명시적으로 관리되는 레벨 간의 논블로킹 데이터 전송을 파이프라인화합니다-affine-scalrep- 저장(store)을 로드(load)로 전달하고 중복 로드를 제거하여 affine memref 접근을 스칼라로 대체합니다-affine-simplify-structures- 맵/집합의 affine 표현식을 단순화하고 memref를 정규화합니다-affine-super-vectorize- 타깃에 독립적인 n차원 벡터 추상화로 벡터화합니다
나중에 사용할 -convert-affine-for-to-gpu도 있습니다. 이 패스는 affine 루프를 여러 GPU 아키텍처를 타깃으로 할 수 있는 GPU 커널로 변환합니다.
합성곱 커널
이제 affine 다이얼렉트에서 사용할 수 있는 기본 최적화를 이해했으니, 더 실용적인 예제인 2D 합성곱 구현을 살펴봅시다. 이 연산은 이미지 처리와 딥러닝에서 근본적인 연산으로, 특징 추출과 패턴 인식에 사용됩니다.
2D 합성곱의 수학 공식은 다음과 같습니다:
module {
func.func @conv_2d(%input: memref<128x128xf32>, %filter: memref<16x16xf32>, %output: memref<113x113xf32>) {
// Loop over the output matrix dimensions (113x113)
affine.for %i = 0 to 113 {
affine.for %j = 0 to 113 {
// Use affine.parallel to accumulate values into %acc using iter_args
%zero = arith.constant 0.0 : f32
%acc = affine.for %fi = 0 to 16 iter_args(%acc = %zero) -> (f32) {
%acc_inner = affine.for %fj = 0 to 16 iter_args(%acc_inner = %acc) -> (f32) {
// Load filter value
%filter_val = affine.load %filter[%fi, %fj] : memref<16x16xf32>
// Load corresponding input value from the input matrix
%input_val = affine.load %input[%i + %fi, %j + %fj] : memref<128x128xf32>
// Multiply input value with filter value
%prod = arith.mulf %input_val, %filter_val : f32
// Add product to the accumulator
%new_acc = arith.addf %acc_inner, %prod : f32
affine.yield %new_acc : f32
}
affine.yield %acc_inner : f32
}
// Store the accumulated result in the output matrix
affine.store %acc, %output[%i, %j] : memref<113x113xf32>
}
}
return
}
}
affine 연산을 제대로 최적화하고 병렬화하려면 특정한 순서의 패스가 필요합니다:
mlir-opt conv_2d.mlir \
--affine-loop-normalize \
--affine-parallelize \
-lower-affine \
--convert-scf-to-cf \
--convert-cf-to-llvm \
--convert-math-to-llvm \
--convert-arith-to-llvm \
--finalize-memref-to-llvm \
--convert-func-to-llvm \
--reconcile-unrealized-casts \
-o conv_2d_opt.mlir
# Translate to LLVM IR
mlir-translate conv_2d_opt.mlir -mlir-to-llvmir -o conv_2d.ll
# Compile to object file
llc -filetype=obj --relocation-model=pic conv_2d.ll -o conv_2d.o
# Compile to shared library
clang -shared -fopenmp -o libconv2d.dylib conv_2d.o
여기서 -lower-affine 패스는 affine 다이얼렉트를 scf 다이얼렉트와 arith 다이얼렉트의 조합으로 낮춥니다.
병렬화된 코드를 Python에서 사용하기 위해, NumPy와 MLIR MemRef 디스크립터 간의 2D 배열 변환을 처리하는 헬퍼 모듈을 만들었습니다. 이 모듈은 NumPy 배열을 변환하고 컴파일된 MLIR 코드를 실행하는 유틸리티를 제공합니다:
import ctypes
import numpy as np
from ctypes import c_void_p, c_longlong, Structure
class MemRef2DDescriptor(Structure):
"""Structure matching MLIR's 2D MemRef descriptor"""
_fields_ = [
("allocated", c_void_p), # Allocated pointer
("aligned", c_void_p), # Aligned pointer
("offset", c_longlong), # Offset in elements
("shape", c_longlong * 2), # Array shape (2D)
("stride", c_longlong * 2), # Strides in elements
]
def numpy_to_memref2d(arr):
"""Convert a 2D NumPy array to a MemRef descriptor"""
if not arr.flags["C_CONTIGUOUS"]:
arr = np.ascontiguousarray(arr)
desc = MemRef2DDescriptor()
desc.allocated = arr.ctypes.data_as(c_void_p)
desc.aligned = desc.allocated
desc.offset = 0
desc.shape[0] = arr.shape[0]
desc.shape[1] = arr.shape[1]
desc.stride[0] = arr.strides[0] // arr.itemsize
desc.stride[1] = arr.strides[1] // arr.itemsize
return desc
def run_conv2d():
"""Run 2D convolution using MLIR compiled module"""
# Create input arrays
input_matrix = np.ones((10, 10), dtype=np.float32)
conv_filter = np.arange(9, dtype=np.float32).reshape(3, 3)
result = np.zeros((8, 8), dtype=np.float32)
# Load compiled module
module = ctypes.CDLL("./libconv2d.dylib")
# Prepare MemRef descriptors
input_memref = numpy_to_memref2d(input_matrix)
filter_memref = numpy_to_memref2d(conv_filter)
result_memref = numpy_to_memref2d(result)
# Set function argument types
module.conv_2d.argtypes = [
*[type(x) for x in input_memref._fields_],
*[type(x) for x in filter_memref._fields_],
*[type(x) for x in result_memref._fields_],
]
# Call the function
module.conv_2d(
*[getattr(input_memref, field[0]) for field in input_memref._fields_],
*[getattr(filter_memref, field[0]) for field in filter_memref._fields_],
*[getattr(result_memref, field[0]) for field in result_memref._fields_]
)
return result
if __name__ == "__main__":
result = run_conv2d()
print(result)
OpenMP
affine 다이얼렉트는 병렬 실행을 위한 추상화를 제공하지만, 때로는 병렬화를 더 직접적으로 제어하고 싶을 때가 있습니다. 이때 OpenMP가 등장합니다. OpenMP는 병렬 실행에 대한 명시적인 제어를 제공하는 지시문 기반 모델로, 고성능 컴퓨팅에서 널리 사용됩니다.
OpenMP 병렬화를 보여 주는 간단한 C 예제를 살펴봅시다:
#include <stdlib.h>
#include <stdio.h>
#include <omp.h>
int kernel(float *input, float *output) {
#pragma omp parallel
{
#pragma omp for
for (int i = 0; i < 10; i++) {
output[i] = input[i] * 2.0f;
}
}
}
int main() {
float input[10] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
float output[10];
kernel(input, output);
for (int i = 0; i < 10; i++) {
printf("%f ", output[i]);
}
return 0;
}
OpenMP 지원(clang -fopenmp)을 켜고 컴파일하면, 이 프로그램은 루프를 여러 스레드에 걸쳐 병렬화합니다. 같은 계산을 MLIR에서는 OpenMP 다이얼렉트로 표현할 수 있습니다:
병렬 영역 (omp.parallel)
OpenMP는 병렬 영역이라는 개념을 통해 병렬 실행을 구성합니다. MLIR에서 병렬 영역은 omp.parallel 구문으로 표현되며, 이 구문은 코드를 동시에 실행할 수 있는 스레드 팀을 생성합니다. 이는 affine 다이얼렉트에서 본 자동 병렬화에 비해 병렬화를 더 명시적으로 제어하는 방법을 제공합니다.
영역은 omp.terminator 연산으로 종료되며, 이 연산은 모든 OpenMP 영역에 필수입니다.
작업 공유 루프 (omp.wsloop)
병렬 루프를 위해 OpenMP 다이얼렉트는 omp.wsloop 연산을 제공하며, 이 연산은 루프 반복이 현재 컨텍스트의 스레드들에 의해 병렬로 실행됨을 지정합니다. 작업 공유 루프는 일반적으로 병렬 영역 안에서 사용되어 루프 반복을 사용 가능한 스레드들에 분배합니다:
omp.wsloop {
omp.loop_nest (%i1, %i2) : index = (%c0, %c0) to (%c10, %c10) step (%c1, %c1) {
%a = load %arrA[%i1, %i2] : memref<?x?xf32>
%b = load %arrB[%i1, %i2] : memref<?x?xf32>
%sum = arith.addf %a, %b : f32
store %sum, %arrC[%i1, %i2] : memref<?x?xf32>
omp.yield
}
}
이 예제는 두 행렬을 더하기 위해 중첩 루프를 병렬화하는 모습을 보여 줍니다. omp.wsloop 안의 omp.loop_nest 연산은 반복 변수, 범위, 스텝을 갖춘 중첩 루프 구조를 나타냅니다.
배리어를 이용한 동기화 (omp.barrier)
스레드 동기화를 위해 OpenMP 다이얼렉트는 omp.barrier 연산을 제공하며, 이 연산은 자신이 나타나는 지점에 명시적 배리어를 지정합니다. 이를 통해 팀 내의 모든 스레드가 배리어에 도달한 후에야 어떤 스레드든 진행할 수 있도록 보장합니다:
// Code executed by all threads
omp.barrier
// Code executed after all threads reach the barrier
omp.barrier 연산은 입력이나 출력이 없는 단순한 연산이며, 어셈블리 형식에는 이름과 속성만 포함됩니다.
omp 다이얼렉트
위의 병렬 루프 C 코드를 MLIR로 변환해 봅시다:
func.func private @kernel(%input: memref<10xf32>, %output: memref<10xf32>) {
%loop_ub = llvm.mlir.constant(9 : i32) : i32
%loop_lb = llvm.mlir.constant(0 : i32) : i32
%loop_step = llvm.mlir.constant(1 : i32) : i32
omp.parallel {
omp.wsloop {
omp.loop_nest (%i) : i32 = (%loop_lb) to (%loop_ub) inclusive step (%loop_step) {
%ix = arith.index_cast %i : i32 to index
%input_val = memref.load %input[%ix] : memref<10xf32>
%two = arith.constant 2.0 : f32
%result = arith.mulf %input_val, %two : f32
memref.store %result, %output[%ix] : memref<10xf32>
omp.yield
}
}
omp.barrier
omp.terminator
}
return
}
그런 다음 정적으로 정의된 입력에 대해 커널을 호출하는 main 함수를 작성할 수 있습니다:
memref.global constant @input : memref<10xf32> = dense<[1.0, 2.0, 3.0, 4.0, 5.0, 6.0, 7.0, 8.0, 9.0, 10.0]>
// Define external references to printf and kernel
llvm.func @printf(!llvm.ptr, ...) -> i32
func.func private @kernel(%input: memref<10xf32>, %output: memref<10xf32>) -> ()
func.func @main() {
%input = memref.get_global @input : memref<10xf32>
%output = memref.alloc() : memref<10xf32>
func.call @kernel(%input, %output) : (memref<10xf32>, memref<10xf32>) -> ()
%lb = index.constant 0
%ub = index.constant 10
%step = index.constant 1
%fs = llvm.mlir.addressof @fmt : !llvm.ptr
scf.for %iv = %lb to %ub step %step {
%el = memref.load %output[%iv] : memref<10xf32>
llvm.call @printf(%fs, %el) vararg(!llvm.func<i32 (ptr, ...)>) : (!llvm.ptr, f32) -> i32
}
return
}
// Define a constant string for the format specifier
llvm.mlir.global private constant @fmt("%f\0A\00") {addr_space = 0 : i32}
덧붙여 말하자면, MLIR의 가변 인자 함수는 C와 마찬가지로 유연한 인자 전달을 가능하게 합니다. 우리가 사용할 일반적인 패턴은 가변 개수의 인자를 받을 수 있는 printf와 같은 함수를 호출하는 것입니다. main 함수에서는 결과를 출력하기 위해 (가변 인자 함수인) printf 함수를 호출합니다. 다음 코드는 C의 printf("%f\n", el)과 동일하며, MLIR에서 printf를 사용하는 방법을 보여 줍니다.
// Define external printf function from stdio.h
llvm.func @printf(!llvm.ptr, ...) -> i32
// Define a constant string for the format specifier
llvm.mlir.global private constant @fmt("%f\0A\00") {addr_space = 0 : i32}
// Call the variadic printf function with the format specifier and type specialized arguments
%fs = llvm.mlir.addressof @fmt : !llvm.ptr
%el = llvm.mlir.constant(1.0 : f32) : f32
llvm.call @printf(%fs, %el) vararg(!llvm.func<i32 (ptr, ...)>) : (!llvm.ptr, f32) -> i32
다음은 병렬 루프와 main 함수를 포함한 전체 예제입니다:
memref.global constant @input : memref<10xf32> = dense<[1.0, 2.0, 3.0, 4.0, 5.0, 6.0, 7.0, 8.0, 9.0, 10.0]>
llvm.func @printf(!llvm.ptr, ...) -> i32
llvm.mlir.global private constant @fmt("%f\0A\00") {addr_space = 0 : i32}
func.func private @kernel(%input: memref<10xf32>, %output: memref<10xf32>) {
%loop_ub = llvm.mlir.constant(9 : i32) : i32
%loop_lb = llvm.mlir.constant(0 : i32) : i32
%loop_step = llvm.mlir.constant(1 : i32) : i32
omp.parallel {
omp.wsloop {
omp.loop_nest (%i) : i32 = (%loop_lb) to (%loop_ub) inclusive step (%loop_step) {
%ix = arith.index_cast %i : i32 to index
%input_val = memref.load %input[%ix] : memref<10xf32>
%two = arith.constant 2.0 : f32
%result = arith.mulf %input_val, %two : f32
memref.store %result, %output[%ix] : memref<10xf32>
omp.yield
}
}
omp.barrier
omp.terminator
}
return
}
func.func private @main() {
%input = memref.get_global @input : memref<10xf32>
%output = memref.alloc() : memref<10xf32>
call @kernel(%input, %output) : (memref<10xf32>, memref<10xf32>) -> ()
%lb = index.constant 0
%ub = index.constant 10
%step = index.constant 1
%fs = llvm.mlir.addressof @fmt : !llvm.ptr
scf.for %iv = %lb to %ub step %step {
%el = memref.load %output[%iv] : memref<10xf32>
llvm.call @printf(%fs, %el) vararg(!llvm.func<i32 (ptr, ...)>) : (!llvm.ptr, f32) -> i32
}
return
}
SCF에서 OpenMP로의 변환 패스
-convert-scf-to-openmp 패스는 SCF 다이얼렉트의 병렬 루프를 동등한 OpenMP 연산으로 자동 변환합니다. 이 패스는 OpenMP 다이얼렉트 코드를 직접 작성하지 않고 OpenMP 실행을 대상으로 삼고자 할 때 특히 유용합니다.
예를 들어, 다음과 같은 SCF 병렬 루프는:
scf.parallel (%i) = (%c0) to (%c100) step (%c1) {
%val = memref.load %A[%i] : memref<100xf32>
%result = arith.addf %val, %val : f32
memref.store %result, %B[%i] : memref<100xf32>
scf.yield
}
OpenMP 연산으로 변환됩니다:
omp.parallel {
omp.wsloop for (%i) : i32 = (%c0) to (%c100) step (%c1) {
%val = memref.load %A[%i] : memref<100xf32>
%result = arith.addf %val, %val : f32
memref.store %result, %B[%i] : memref<100xf32>
omp.yield
}
omp.terminator
}
이 패스는 루프 경계와 스텝 크기를 보존하면서 scf.parallel 연산을 omp.wsloop을 포함하는 omp.parallel 영역으로 변환하는 것을 비롯해 여러 중요한 변환을 처리합니다. 또한 SCF의 리덕션 연산은 OpenMP 리덕션으로 매핑되며, 중첩된 병렬 루프도 적절히 처리됩니다. 이 변환은 일반적으로 더 큰 로어링 파이프라인의 일부로 사용되며, 그 뒤에는 OpenMP 런타임 지원으로 실행할 수 있는 LLVM IR을 생성하기 위해 -convert-openmp-to-llvm이 이어지는 경우가 많습니다.
외부 자료
- MLIR: Affine 다이얼렉트
- MLIR: 다면체 구조
- MLIR: OpenMP 다이얼렉트
- RFC: MLIR의 OpenMP 다이얼렉트
- OpenMP: OpenMP 5.0 명세
- MLIR을 이용한 애플리케이션 병렬화
- MLIR을 이용한 Flang의 OpenMP
- OpenMPOps.td
- OpenMPToLLVMIRTranslation.cpp
- OpenMP SIMD 및 GPU MLIR 코드 생성을 위한 Polygeist 확장
- OpenMP 요약
- MLIR Tutorial: Building a Compiler with MLIR
- 2023 EuroLLVM - MLIR Dialect Design and Composition for Front-End Compilers
- Add conversion from SCF parallel loops to OpenMP
- Open MLIR Meeting 2-15-2024: OpenMP GPU Target Offloading
- Mark parallel regions as allocation scopes
Typechecker Zoo
재미 삼아 진행한 사이드 프로젝트로, Milner의 W 알고리즘(Algorithm W)부터 현대의 의존 타입 시스템에 이르기까지 50년에 걸친 타입 이론 연구를 아우르는 리터러트(literate) Rust 구현 네 가지를 만들었습니다. 각 구현은 코드 전반에 걸친 상세한 설명과 주석을 곁들여 최대한 읽기 쉽고 이해하기 쉽게 만들고자 했으며, 또한 람다 큐브 위 어딘가에 놓이는 어떤 종류의 시스템이든 만들 때 출발점으로 삼아 여러분의 프로젝트에 가져다 쓸 수 있도록 최대한 간결하고 짧게 만들고자 했습니다.
- Github 저장소 | 문서
-동물원이니만큼, 각 구현마다 이를 대표하는 귀여운 동물 마스코트도 붙여 주었습니다:
 |
W 알고리즘(Algorithm W, Hindley-Milner 타입 시스템) 구조적 재귀를 사용하여 Milner가 1978년에 제시한 단일화 기반 타입 추론을 구현합니다. 이 알고리즘은 식을 순회하는 동안 타입 변수들 사이의 제약을 생성한 다음, Robinson의 단일화 알고리즘으로 이 제약들을 풉니다. 명시적인 타입 표기 없이도 랭크-1 다형 타입 추론을 가능하게 하는 let-다형성을 갖추고 있습니다. 이 구현은 고전적인 occurs check 처리와 타입 환경을 통한 치환 전파를 보여 줍니다. 참고 문헌: 프로그래밍에서의 타입 다형성 이론(A Theory of Type Polymorphism in Programming) 저자: Robin Milner. |
 |
System F (2차 람다 대수) 양방향 타입 검사를 사용하는, 매개변수 다형성을 갖춘 2차 람다 대수입니다. 전칭 양화를 갖춘 System F를 위해 Dunfield-Krishnaswami 알고리즘을 구현한 양방향 타입 검사기입니다. 타입 검사를 합성(⇒) 모드와 검사(⇐) 모드로 나누어, 존재 변수 풀이를 통한 다형 타입 추론을 가능하게 합니다. 전칭 타입(∀α. τ)을 통해 매개변수 다형성을 처리하며, 타입 변수의 스코프를 위해 컨텍스트를 세심하게 관리합니다. 존재 변수에 대한 포괄적인 제약 풀이와 다형 타입 사이의 서브타이핑 관계를 포함합니다. 참고 문헌: 고계 다형성을 위한 완전하고 쉬운 양방향 타입 검사(Complete and Easy Bidirectional Typechecking for Higher-rank Polymorphism) 저자: Dunfield, Krishnaswami. |
 |
System F-ω (고차 카인드 다형성) 축소판 Haskell-lite입니다. System F에 타입 생성자와 카인드 검사를 더해 확장하며, 대수적 데이터 타입과 함께 고랭크 다형성을 구현합니다. 타입 추론과 더불어 카인드 추론을 갖추고 있으며, 타입 수준 환경과 카인드 수준 환경을 모두 관리합니다. 타입 생성자 적용과 다형 카인드 할당을 지원합니다. 고차 카인드 단일화 문제를 위한 제약 생성을 구현하여, 카인드 시스템이 잘못된 형태의 타입 적용을 어떻게 막는지 보여 줍니다. 고차 카인드 타입, DK 양방향 타입 검사, 존재 타입 변수, 다형 생성자 적용, 패턴 매칭, 타입 추론을 갖춘 람다 식을 포함하는 System F-ω의 완전한 구현입니다. 참고 문헌: 고계 다형 타입 추론의 기계적 형식화 Joshua Dunfield 저. |
 |
구성의 계산 (의존 타입) 비누적 유니버스 계층과 귀납 타입을 갖춘 구성의 계산입니다. 타입과 항을 하나로 통합하는 완전한 의존 타입 시스템으로, 제약 기반 추론을 통해 유니버스 다형성을 구현합니다. 귀납 타입 정의, 의존 함수 타입(Pi 타입, Sigma 타입), 유니버스 다형성을 갖추고 있습니다. Miller 패턴 기법을 사용하여 고차 단일화 문제를 부분적으로 해결하기 위해 메타 변수 풀이를 사용합니다. 참고 문헌: 유니버스 다형적 타입 시스템 Vladimir Voevodsky 저. |
예제들은 larlpop, logos, ariande 등 일반적인 컴파일러 라이브러리를 사용하여 상당히 관용적인 Rust로 구현되어 있으며, 완전한 파서와 테스트 스위트를 갖추고 있습니다(다만 평가기는 없습니다). 쉽게 이해하고 수정할 수 있도록 전체 구현을 단순화하고 코드 골프 방식으로 압축한 버전임은 분명합니다. 그래도 각각 10만 줄이 훌쩍 넘는 Haskell이나 Coq의 타입 검사기를 읽으려고 애쓰는 것보다는 훨씬 더 이해하기 쉬울 것입니다. 이제 막 언어에 관심을 키워 가는 젊은 애호가들에게 도움이 되기를 바랍니다. 10년 전 이 주제들을 공부할 때 이런 자료가 있었다면 좋았겠다는 생각이 들어, 다른 사람들이 그렇게까지 고생하지 않도록 제가 원했을 법한 자료를 직접 만들어 보기로 했습니다!
확률적 코드 원숭이 정리
대규모 언어 모델을 둘러싼 끝없는 과대광고 기계는 우리가 소프트웨어 개발 혁명의 문턱에 서 있다고 믿게 만들려 합니다. 프로그래머가 쓸모없어지고 그들의 키보드에는 먼지가 쌓이는 새로운 시대, 충분한 GPU와 병렬로 돌아가는 확률적 코드 원숭이들을 아무 문제에나 쏟아붓기만 하면 충분한 시간과 연산 자원이 주어졌을 때 Fabrice Bellard와 Jeff Dean의 코딩 실력을 불러낼 수 있는 시대가 왔다는 것입니다. 이 서사는 (놀랍지 않게도) 실제 엔지니어보다는 주로 팟캐스트 장사꾼과 인플루언서들이 지어내는 것이며, 점잖게 말해도 공상에 가까운 과장입니다. 노련한 소프트웨어 엔지니어에게 이 신문물 도구들은 우리를 대체하는 존재가 아니라, 때로는 다루기 버겁고 화가 치밀게 만들기도 하지만, 단단한 손과 주의 깊은 눈을 요구하는 강력한 전동 공구입니다.
현재 형태의 언어 모델은 천재와 바보가 기묘하게 뒤섞인 존재입니다. 예를 들어 Gemini 2.5 Pro를 봅시다. Google의 최신 작품은 깊이 있는 분석에 놀라울 만큼 능숙해서, 수십만 줄에 달하는 방대한 코드베이스를 집어삼키고 단 하나의 오타를 섬뜩할 정도로 정확하게 짚어낼 수 있습니다. Mountain View에서 칠리에 넣고 있는 사전 학습 비법 핫소스가 무엇이든, 확실히 꽤나 매운 것이 분명합니다. 그런데 바로 이 모델에게 기초적인 정규식 문자열 치환을 시켜 보면, 에이전트가 파일에 대한 기본적인 텍스트 편집을 하려고 루프를 맴도는 동안 걸음마쟁이의 멍한 눈빛에 해당하는 디지털 버전을 보게 될 것입니다. 컴퓨터 과학 박사후 연구원과 걸음마쟁이가 어색하게 합쳐진 모습입니다.
한편으로 Anthropic의 Claude Opus 4.1과 그보다 알뜰한 사촌인 Sonnet 4.0이 있습니다. 이 모델들은 현 세대의 믿음직한 일꾼으로, 지시를 따르고, 코드를 정밀하게 리팩터링하며, 대체로 영감은 없을지언정 유능한 페어 프로그래머처럼 행동하는 일관된 적성을 보여 줍니다. Gemini 2.5가 이따금 보여 주는 순수한 천재성의 번뜩임은 부족할지 몰라도, 그 꾸준함 덕분에 소프트웨어 제작이라는 일상적인 고된 작업에서 매우 귀중한 존재가 됩니다. 여력이 있는 사람에게 진정으로 강력한 조합은 둘 다 전략적으로 활용하는 것입니다. 거대한 컨텍스트 윈도와 분석 능력을 위해서는 Gemini를, 믿을 만한 실행을 위해서는 Claude를 쓰는 것입니다.
진정으로 쓸모 있는 코딩 동반자 명단에서 눈에 띄게 빠져 있는 것은 OpenAI의 과대평가된 제품들입니다. 최신 GPT-5 모델조차 가장 사소한 일회성 스크립트를 넘어서는 작업에는 거의 쓸모가 없는 것으로 드러나며, 더 크고 서로 얽힌 시스템의 미묘한 차이를 번번이 파악하지 못하고, 학습 데이터도 (2024년 초 시점으로) 크게 낡았습니다. 한편 특화된 추론 모델들은 너무 느리고 비용 효율이 낮아서, 빠르고 반복적인 전문 소프트웨어 개발 주기에는 애초에 고려 대상조차 되지 못합니다. 대부분의 코딩 작업에서 이 모델들은 완전히 뒤처졌으며, 경쟁 모델들이 여유롭게 자리 잡은 파레토 프런티어에 한참 못 미칩니다. 성능 대비 가격이라는 중요한 계산에서 OpenAI 모델들은 그저 설득력 있는 근거를 제시하지 못합니다.
이 모델들을 프로그래밍에 제대로 활용하려면 표준 ChatGPT 인터페이스 같은 단순한 웹 API는 사실상 쓸 수 없습니다. 이런 것들은 의미 있는 복잡도를 지닌 작업에는 기능적으로 쓸모가 없습니다. 효과적인 코딩 어시스턴트에는 코드베이스에 대한 상황 인식, 즉 심볼을 색인하고, 편집 도구를 호출하고, 검색을 실행하고, 외부 린터를 활용하며, 무엇보다 Language Server Protocol의 진단 결과를 해석하는 능력이 필요합니다. 이처럼 환경에 깊이 뿌리내리지 못하면 모델은 사실상 눈을 가린 채 코딩하는 셈입니다. 따라서 진정으로 강력한 구현은 독립형 명령줄 인터페이스와 이러한 컨텍스트를 제공하는 Zed, VS Code, 또는 Vim(이단자들이라면 Emacs)용의 수많은 플러그인과 같이 긴밀하게 통합된 코드 개발 환경에서 찾을 수 있습니다. 다만 벤처 자본의 지원을 받는 새로운 부류의 상용 도구에 대해서는 한마디 경고해 두겠습니다. 이들의 가격 모델은 종종 의도적으로 불투명하며, 코딩 지원 분야의 Uber처럼 작동합니다. VC 보조금에 익숙해지지 마십시오. 오래가지 않을 것이기 때문입니다. 전략은 뻔합니다. 강력하면서도 저렴하게 책정된 서비스에 중독시킨 다음, 의존하게 되면 최대한의 가치를 뽑아내는 것입니다. 언제나 그렇듯 첫 한 방은 공짜입니다.
소프트웨어 경제에 관한 불편한 진실은 그중 상당 부분이 우아한 아키텍처나 보안, 유지보수성과는 아무 관련이 없다는 점입니다. 그것은 생각 없이 하는 JSON 배관 작업, YAML 농사, 보일러플레이트 CRUD 애플리케이션, 그리고 영감 없는 데이터 대시보드가 끝없이 펼쳐진 광활한 영역입니다. 불쉿 잡에 대한 그레이버의 분석은 더 넓은 경제 전반에 적용되는 만큼 정보 기술 직종에도 똑같이 적용됩니다. 대부분의 소프트웨어는 헛소리이며, 이는 “헛소리(bullshit)“라는 단어의 엄밀한 철학적 용법에서 확률적 헛소리 엔진이라고 적절히 묘사될 수 있는 기술에 완벽하게 들어맞습니다. 이것이 바로 “서브프라임 소프트웨어 시장“으로, 프로덕션의 가혹한 현실과 마주하는 순간 재작성될 운명에 놓인 일회용 코드의 영역입니다. 언어 모델은 피상적인 검사를 통과할 만큼만 그럭저럭 괜찮은 “React로 TODO 앱 만들어 줘” 식의 솔루션을 찍어 내는 데 섬뜩할 정도로 능숙합니다. 어쩌면 존재하지 말아야 할 시장일지도 모르지만 그 존재는 부정할 수 없으며, 이 모델들은 놀라운 속도로 그 시장을 통째로 집어삼킬 태세를 갖추고 있습니다.
이렇게 AI가 생성한 코드가 확산되면서 전례 없는 규모의 사이버 보안 악몽이 함께 찾아옵니다. 이 모델들은 토큰 효율을 추구하는 과정에서 지름길을 택하기로 악명이 높으며, 주니어 엔지니어조차 피해야 한다고 알고 있을 법한 터무니없는 취약점을 끌어들입니다. 이들은 내력벽을 마스킹 테이프로 붙여 지탱하는 시공업자의 디지털 버전입니다. 최근 연구에 따르면 AI가 생성한 코드는 무려 45%의 사례에서 보안 결함을 포함하고 있었습니다. 그 자체로 상당 부분이 안전하지 않은 방대한 공개 코드로 학습된다는 바로 그 본질이 취약점 증폭의 피드백 루프를 만들어 냅니다.
이 문제를 더욱 악화시키는 것은 “MBA 엔지니어“의 부상입니다. 강력한 언어 모델로 무장한 프로젝트 관리자가 갑자기 자신을 노련한 소프트웨어 아키텍트라고 착각하는 것입니다. 이 현상은 이미 앞으로 수년간 조직을 괴롭힐 디지털 슬롭과 기술 부채의 거대한 해일을 일으키고 있습니다. 기초 지식이 부족한 이들은 종종 결함이 있는 모델의 출력을 의심 없이 받아들이고, 그 결과 깨지기 쉽고 불투명하며 언제 터질지 모르는 유지보수 재앙과도 같은 시스템을 만들어 냅니다. 우리는 모두 이 새로운 현실, 즉 이 과신에 찬 아마추어들이 남긴 디지털 난장판을 치우는 데 우리 시간의 상당 부분을 쓰게 될 미래에 적응해야 할 것입니다.
이 모델들의 비결정적이고 솔직히 말해 게으른 본성은 상황을 더욱 복잡하게 만듭니다. 이들은 존재하지 않는 API를 환각하는 경향이 있으며, 출력 토큰을 최소화한다는 명목으로 경고 한마디 없이 중요한 부분에 플레이스홀더나 지나치게 단순화된 로직을 끼워 넣는 일이 잦습니다. “되게 만들어 줘“와 같은 모호한 프롬프트는 기이하고 예측할 수 없는 동작을 부르는 지름길입니다. 이 도구들을 효과적으로 다루는 핵심은 모델에게 마음대로 하도록 맡기는 대신, 정확하고 상세한 프롬프트로 바람직한 해법을 향해 이끄는 데 있습니다. 그리고 현재로서는 이를 위해 자신이 무엇을 하는지 잘 아는 실무자의 정밀하고 수준 높은 소프트웨어 전문 지식이 필요합니다.
특히 짜증스러운 특성 하나는 이 모델들에게 실패하는 단위 테스트를 고치는, 겉보기에는 단순한 일을 맡겼을 때 드러납니다. 모델은 근본적인 비즈니스 로직을 살펴 실제 결함을 진단하는 대신, 기만적인 단순함의 길을 택하는 경우가 많습니다. 즉, 테스트 단언이 기대하는 출력을 정확히 만들어 내는 경로만 하드코딩하도록 코드를 정교하게 수정할 뿐, 그 이상은 아무것도 하지 않습니다. 이는 과목 내용을 배우는 대신 시험 정답지를 그냥 외워 버리는 학생의 코딩 버전입니다. 그 결과물인 코드는 우스꽝스럽고 쓸모도 없습니다. 이는 화가 치밀기는 하지만, 우리 대부분이 십 대 시절 코딩을 배우며 익힌 진정한 엔지니어링 모범 사례를 털끝만큼도 갖추지 못한 채 이 시스템들이 얼마나 자주 코드를 외삽해 내는지를 완벽하게 보여 주는 사례입니다.
안목 있는 시니어 엔지니어에게 나아갈 길은 분명합니다. 이 도구들을 전술적으로 사용하는 법을 익혀 두는 것이 좋습니다. 이 언어 모델들은 우리의 생계를 위협하는 존재가 아니라, 전술적으로 그리고 건전한 회의주의를 갖고 사용해야 할 도구입니다. 견고한 엔지니어링 관행—강력한 타입 시스템, 포괄적인 코드 표준 도구, 코드베이스 인덱싱, 엄격한 린터—과 결합하면 이들의 출력은 크게 개선되고 최악의 충동은 억제될 수 있습니다. 이들은 우리를 문법과 보일러플레이트의 지루함에서 해방시켜, 더 높은 추상화 수준에서 아키텍처와 시스템 설계에 집중할 수 있게 해 줍니다.
이러한 모델이 진정한 엔지니어의 역량을 자발적으로 갖추게 될지는 아직 풀리지 않은 연구 문제이며, 솔직히 말해 상당히 의심스러운 일입니다. 순전한 규모 확장을 통한 개선의 S자 곡선에서 우리가 이미 후반부에 와 있다는 증거가 늘어나고 있으며, Google과 Anthropic 같은 거대 기업들은 임의적인 벤치마크에서 고작 1퍼센트를 올리기 위해 수백억 달러를 쏟아붓고 있습니다. 물론 이러한 벤치마크는 벤치마크 그 자체 외에는 거의 아무것과도 상관관계가 없으며, 실질적인 수익성보다는 주로 기업의 자랑거리를 재는 은유적인 잣대 역할을 할 뿐입니다. 이러한 자본 지출은 명백히 지속 불가능하며, 벤처 캐피털의 낙관론이 부풀린 전형적인 거품입니다. 특히 코딩 지원이 이러한 모델이 실제로 수익을 내는 몇 안 되는 분야 중 하나라는 점을 생각하면 더욱 그렇습니다. 그러나 소프트웨어의 역사가 조금이라도 참고가 된다면, 이 엄청난 비용은 필연적으로 급락할 것입니다. 몇 년 안에 오늘날의 최상위 모델에 상응하는 모델이 64기가바이트 메모리를 갖춘 MacBook Pro에서 무리 없이 돌아가는 모습을 상상하기는 어렵지 않으며, 이러한 성과는 현재의 기존 강자들이 아니라 어느 악착같은 중국 연구소가 이뤄 낼 가능성이 높습니다. 이는 미국인들이 자동차를 발명하고 한참 뒤에 Toyota가 수익성과 제품 품질을 완성해 낸 일본 자동차 산업의 디지털판이라 할 수 있습니다. 이러한 모델을 실존적 위협으로 보는 주장은 점점 더 우스꽝스러워 보입니다. 이 모델들은 빠르게 범용 도구가 되어 가고 있으며, 핵무기보다는 Honda Civic에 훨씬 더 가깝습니다. 우리는 범용화와 거품의 붕괴를 환영해야 합니다.
순수한 기술적 유용성과 명백한 결함을 넘어, 이러한 도구에는 진지하게 고려해야 할 피할 수 없는 윤리적 차원이 존재합니다. 사려 깊은 많은 엔지니어가 이러한 모델의 출처에 대한 진정한 불안감 때문에 아예 사용을 거부하며 “AI 비건“이 되기를 택하고 있습니다. 그들의 정당한 반대 이유는 학습에 사용된 불투명한 데이터 출처에서부터 모델을 만드는 데 필요한 착취적인 노동 관행에 이르기까지 다양합니다. 게다가 바로 이러한 시스템을 만드는 연구소의 지도부에서는 준종교적 열광이라는 불안한 기류가 흘러나오고 있으며, 이 합리주의 컬트 같은 천년왕국적 열정은 냉철한 관찰자라면 누구든 멈칫하게 만들 만합니다. 하지만 이러한 변화를 비켜 가면서도 활력 있고 성공적인 소프트웨어 엔지니어로 남는 것은 충분히 가능합니다. 이 길을 가려면 소프트웨어의 보다 부티크적이거나 장인적인 영역, 일종의 디지털 장인 정신에 의도적으로 집중해야 합니다. 언어 모델이 안전한 Linux 커널 모듈을 작성하거나, 학습 코퍼스 밖에 있는 틈새 프로그래밍 언어를 설계하거나, 심우주 탐사선의 펌웨어를 디버깅하는 일은 당분간 없을 것입니다. 언어 모델 생태계에서 빠지고 싶은 사람들에게는 이러한 전문적인 틈새 분야에서 보람 있고 상당히 수익성 좋은 경력이 기다리고 있습니다. 참여가 반드시 필요한 것은 아니기 때문입니다. Trader Joe’s의 Two Buck Chuck이 존재한다고 해서 보르도의 빈티지 와인이 밀려나지 않았듯이, AI 코드도 부티크 전문성에 대한 수요를 대체하지 못할 것입니다.
결국 우리는 완전히 자율적인 소프트웨어 엔지니어라는 공상 과학 시나리오와는 아직 거리가 한참 멉니다. 이러한 모델은 여전히 믿기 어려울 만큼 정교한 패턴 보간기, 즉 고차원 단어 계산기일 뿐이며, 유용하기는 하지만 스스로 방향을 정하고 창의적으로 구상할 수 있는 인간 엔지니어의 인식과 안목을 갖추기에는 놀라울 만큼 거리가 멉니다. 진짜 질문은 이러한 모델의 확산이 더 나은 소프트웨어를 더 빠르게 만들 수 있는 세상이라는 순이익으로 이어질지, 아니면 유지보수가 불가능하고 안전하지 않은 코드로 뒤덮인 디지털 슈퍼펀드 오염 부지라는 완전한 재앙으로 이어질지입니다. 그 답은 오직 시간과 수많은 실험 및 정리 작업만이 알려 줄 것입니다.
AI 거품이 터지면 좋겠습니다
소프트웨어 엔지니어로서 지금 이 시기의 기묘함을 외면하기란 불가능합니다. 한편으로 새로운 세대의 언어 모델은 정말로 유용한 도구입니다. 저 역시 보일러플레이트 코드를 빠르게 시작하거나, 까다로운 로직 문제의 해법을 브레인스토밍하거나, 문서를 다른 표현으로 고쳐 쓸 때 이 모델을 사용합니다. 점진적이기는 하지만, 이 모델은 개발자 생산성을 정당하게 한 걸음 끌어올렸습니다. 그러나 다른 한편으로, 이 기술을 둘러싸고 기이하고 지속 불가능한 문화가 생겨났습니다. 이 분야는 공학이라기보다 투기적인 골드러시에 가까워졌고, 이 도구가 실제로 할 수 있는 일과는 완전히 동떨어진 유사 종교적 열광까지 생겨났습니다. 과대광고는 극에 달했으며, 제가 보기에는 이 거품이 꺼지는 것이야말로 소프트웨어의 미래에 일어날 수 있는 가장 좋은 일입니다.
문제의 핵심(Core)은 신화입니다. 최고경영자와 벤처 캐피털리스트들은 대제사장처럼 굴면서, 정의조차 모호한 “범용 인공지능“이 곧 도래한다고 컨퍼런스 무대에서 설교를 늘어놓습니다. 그들은 전 세계 반도체 산업을 확충하는 데 7조 달러가 필요하다고 말하는데, 이 숫자는 터무니없이 커서 더는 의미를 갖지 못합니다. 이것은 더 이상 공학이 아니라 구원이나 종말을 약속하는 새로운 종교이며, 시장은 이 종교에 설득되어 모든 의심을 내려놓았습니다. 매일 실제로 이 모델을 다루는 우리에게 이 서사는 환상처럼 느껴집니다. 우리는 모델의 한계를 가까이에서 봅니다. 자신만만하게 헛소리를 늘어놓는 경향, 추상적으로 추론하지 못하는 무능, 학습 데이터 바깥으로 밀려났을 때 드러나는 취약함이 그것입니다. 이 모델은 놀라울 만큼 정교한 흉내쟁이일 뿐, 막 깨어나는 정신이 아닙니다. 메시아적인 마케팅과 확률적 텍스트 생성기라는 평범한 현실 사이에 벌어진 이 간극이 바로 거품을 부풀리는 빈 공간입니다.
이 모든 것은 실로 상상을 초월하는 규모로 돈을 불태우는 일을 정당화하는 데 쓰입니다. 몇몇 거대 기술 기업이 올해 이 한 가지 목표에 포르투갈 경제 전체와 맞먹는 3,000억 달러 이상을 쓰겠다는 발상은 망측합니다. 이는 엄청난 낭비이자, 전 지구적 규모로 자원을 심각하게 잘못 배분하는 일입니다. 아마존 같은 거대 기업조차 이 구멍에 쏟아붓는 1달러당 고작 20센트 정도를 회수하고 있다는 보도도 나옵니다. 그사이 차세대 프런티어 모델을 학습하는 비용은 10억 달러를 넘어 불어나고 있습니다. 사이버보안에서 의료 진단, 물류에 이르기까지 그 인재와 자본이 해결할 수 있었을 다른 모든 실질적이고 구체적인 문제를 생각해 보십시오. 그런데도 가장 뛰어난 인재들은 챗봇의 소네트 작성 능력을 조금 더 끌어올리는 데 매달리고 있습니다. 이것은 혁신이 아니라 투기가 부추기는 군비 경쟁이며, 그 목표는 반드시 더 좋거나 더 효율적인 제품이 아니라 더 큰 모델을 만드는 것입니다.
재정적 낭비를 넘어, 기술 발전 자체도 벽에 부딪히는 조짐을 보이고 있습니다. 이 도구를 진지하게 사용하는 사람이라면 누구나 그 불편한 비밀을 압니다. 이 도구는 더 이상 예전처럼 맹렬한 속도로 발전하지 않습니다. 우리는 거의 알아차리기도 어렵고 “느낌“에 가까운 개선을 위해 에너지, 데이터, 하드웨어에 기하급수적으로 더 많은 비용을 쓰고 있습니다. GPT-2에서 GPT-3으로의 도약은 혁명이었지만, GPT-4에서 그 후속 모델로의 도약은 사소한 개정처럼 느껴지는데도 이를 이루는 데는 몇 자릿수나 더 많은 비용이 듭니다. 업계는 모델을 그저 더 크게 만들기만 하면 새로운 능력이 생겨난다는 믿음, 곧 “스케일링 법칙“이라는 패러다임에 기대를 걸고 있지만, 이 길에는 한계가 있다는 데 동의하는 연구자가 점점 늘고 있습니다. 우리는 똑같이 불안정한 기반 위에 점점 더 높은 탑을 쌓으면서, 정작 필요한 것은 아예 새로운 아키텍처 설계도일 가능성이 크다는 사실을 외면하고 있습니다. 그런데도 시장은 매 분기 혁명적인 돌파구가 보장되기라도 한 것처럼 이 기업들의 가치를 매기고 있으며, 그 결과 닷컴 시대 최악의 과잉에 견줄 만큼 위가 무겁고 위태로운 기업가치 구조가 만들어지고 있습니다.
이것이 바로 AI 버블의 붕괴, 즉 전 세계에 울려 퍼지는 크고 고통스러운 파열음이 실제 AI 발전에 일어날 수 있는 최선의 일인 이유입니다. 우리는 닷컴 붕괴 때 이미 이 영화를 본 적이 있습니다. 2000년에 투기 자금이 사라졌을 때 인터넷은 죽지 않았습니다. 죽은 것은 비즈니스 모델이 없던 “좀비콘“들이었습니다. 남겨진 것은 광섬유 회선부터 데이터 센터에 이르는 귀중한 인프라의 보고였으며, 이 모든 것을 갑자기 헐값에 구할 수 있게 되었습니다. 새로 저렴해진 바로 그 기반 덕분에 진정하고 지속 가능한 인터넷 거대 기업들이 등장할 수 있었습니다. AI 버블이 터져도 마찬가지일 것입니다. 하이퍼스케일러들이 구축한 거대한 서버 팜은 사라지지 않을 것입니다. 오픈 소스 모델, 소프트웨어 프레임워크, 연구 논문은 모두 그대로 남아 있을 것입니다. 호황의 잔해는 더 냉철하고 지속 가능한 미래를 위한 건축 자재가 될 것입니다.
버블 이후의 세계는 다른 종류의 엔지니어와 다른 종류의 기업에 보상할 것입니다. 목표는 상자 속에 신을 만드는 것에서 특정 고객을 위해 특정 문제를 해결하는 것으로 옮겨 갈 것입니다. 인프라 헐값 처분으로 진입 비용이 낮아지면 더 작고 민첩한 팀들도 경쟁할 수 있을 것입니다. 중국 기업들이 미국 거대 기업들이 쓰는 비용의 극히 일부만으로 매우 유능한 모델을 개발하고 있다는 보도에서 보듯이, 우리는 이미 그 조짐을 보고 있습니다. 붕괴는 이러한 추세를 가속하여 무지막지한 자금력보다 효율성과 영리함에 집중하도록 강제할 것입니다. 혁신은 탈중앙화될 것입니다. AGI를 향한 하나의 거대한 단일 탐구 대신, 각각 실제 비즈니스 모델을 갖추고 현실 세계의 필요에 맞춰진 수천 가지의 다양한 응용 AI가 꽃피는 것을 보게 될 것입니다. 업계는 벤처 캐피털이라는 링거에서 벗어나, 공상과학 같은 미래를 약속해서가 아니라 실질적인 가치를 제공하기 때문에 사람들이 실제로 돈을 지불할 제품을 만드는 법을 배워야 할 것입니다.
결국 붕괴는 끝이 아니라 정화입니다. 붕괴는 현재 이 분야를 규정하는 과대광고와 종교, 지속 불가능한 경제 구조를 걷어 낼 것입니다. 그것은 투기꾼들에게는 고통스러운 청산이겠지만, 만드는 사람들에게는 해방일 것입니다. 현재 좁고 투기적인 터널로 쏟아져 들어가고 있는 막대한 지적 자원과 자본 자원이 풀려나 수많은 다른 생산적인 물줄기로 흘러갈 것입니다. 진정 제한적으로 유용한 이 기술은 마침내 불가능한 수익을 돌려줘야 한다는 불가능한 짐에서 벗어날 것입니다. 그것은 그저 하나의 도구가 될 수 있고, 우리는 그것을 사용해 더 나은 것을 만드는, 실질적이고 화려하지 않지만 궁극적으로 더 보람 있는 일로 돌아갈 수 있을 것입니다.
어텐션 경제에 대한 유일한 해결책은 빠져나오는 것입니다
현대 생활에는 장관이라 할 만한, 거의 아름답기까지 한 부조리가 있습니다. 우리의 오래된 아날로그 두뇌를, 그것을 점심거리로 집어삼키려는 디지털 세계에 태평하게 꽂아 넣는다는 것입니다. 사바나에서 사자를 발견하거나 쓸 만한 산딸기 덤불을 찾도록 억겁의 세월에 걸쳐 단련된 우리의 회백질은, 이제 우리의 의식을 이윤으로 바꾸도록 설계된 알고리즘과의 철창 격투에 원치 않게 끌려 나온 참가자가 되었습니다. 물론 우리는 매일 아침을 도넛 열두 개로 시작하고 맥도날드와 필터 없는 멘솔 담배 한 갑으로 입가심하기로 결정할 수도 있습니다. 하지만 그렇게 하면서도 우리는 의료계 전체가 한목소리로 안타까워하며 고개를 젓고 있다는 사실을 알고 있습니다. 의도적으로 중독되도록 만들어진 정신의 경제에 대해서도 똑같이 말해야 합니다. 진정한 유일한 해결책은 웰니스 앱을 내려받거나 스크린 타임 제한을 설정하는 것이 아닙니다. 플러그를 뽑고, 모뎀을 불태우고, 산으로 도망치는 것입니다. 유일한 답은 빠져나오는 것입니다.
잠시 우리 자신에게 가차 없이 솔직해져서, 이 노예 같은 헌신을 두고 우리가 중얼거리는 변명에 귀를 기울여 봅시다. 우리는 일 때문에 필요하다고, 직업상의 의무라고 말합니다. 우리는 그것이 현실에서라면 길을 건너서라도 피했을 사람들과 “연결“을 유지하는 방법이라고 주장합니다. 우리는 그저 귀여운 고양이 밈을 보려고, 긴장을 풀기 위한 약간의 무해한 재미를 위해 거기 있을 뿐이라고 스스로에게 말합니다. 이것은 다음 한 방을 합리화하려는 중독자의, 어르고 달래며 자신을 속이는 독백입니다. 이것은 약을 구하려고 필사적으로 허둥대기 직전에 자신이 완전히 통제하고 있다고 스스로를 설득하는 약쟁이의 공허한 논리입니다. 그렇다면 상업의 역사에서 고객을 “사용자(user)“라고 부르는 업계가 단 두 곳뿐이라는 사실도 놀랄 일이 아닙니다. 불법 마약을 파는 사람들, 그리고 여러분의 뉴스피드를 설계하는 사람들입니다.
이러한 디지털 플랫폼이 무해한 도구인 척하는 것은 최고 수준의 망상입니다. 잠에서 깨자마자 인스타그램을 정맥에 꽂아 넣듯 들이붓는 것은 신경학적으로 배터리 산으로 가글하는 것과 같습니다. 그것은 아직 꿈속에 있는 여러분의 뇌를 정조준한, 큐레이션된 완벽함과 보여 주기식 분노의 소방 호스이며, 아침 라테를 마시기도 전에 들이닥치는 정신적 독극물의 충격입니다. 이러한 플랫폼은 사교 클럽이 아닙니다. 규제받지 않는 신경화학적 카지노입니다. 여러분의 뇌는 봉이고, 하우스는 모든 게임을 조작해 두었습니다. 좋아요와 푸시 알림의 가변 보상 스케줄은 그저 귀여운 기능이 아닙니다. 그것은 무기화된 형태의 도파민 조작으로, 여러분의 휴대폰을 덧없는 사회적 인정의 한 방으로 배당금을 지급하는 슬롯머신으로 바꾸는 동시에, 틱톡 영상 하나보다 긴 시간 동안 무언가에 집중하는 여러분의 능력을 체계적으로 해체합니다.
게다가 우리가 고를 수 있는 자기 파괴의 메뉴는 얼마나 화려한지 모릅니다. 돌려 말하지 맙시다. 스포츠 베팅 앱은 즐거운 취미가 아닙니다. 그것은 경기의 즐거움을 불안에 휩싸인 광란의 새로고침 잔치로 바꿔 버리는, 빨리 가난해지는 수법입니다. 유튜브의 어느 금융 브로 “핀플루언서“의 무한한 지혜에 이끌리는 데이 트레이딩 플랫폼은 암페타민에 취한 다람쥐를 고용해 평생 모은 저축을 관리하게 하는 것과 같습니다. 그리고 암호화폐는 어떨까요? 그것은 라스베이거스의 위험 추구조차 너무 진부하다고 여기고, 대신 자유민주주의의 붕괴에 돈을 걸고 싶어 하는 사람들을 위한 자유지상주의 금전 컬트입니다.
말할 필요도 없이, 이러한 제품이 좋은 삶에 도움이 되는 틀은 어디에도 없습니다. 그것들은 여러분의 뇌간에 파고드는 디지털 기생충으로, 여러분의 불안과 불안정을 먹고 자라며, 온 세상을 약속하는 동안 여러분의 돈과 시간과 정신 건강을 조용히 빨아들입니다.
이러한 기술과 “건강한 균형“을 찾는다는 발상 자체가, 우리의 중독으로 이익을 얻는 바로 그 사람들이 팔아먹는 소극(笑劇)입니다. 그것은 촌충과 건강한 균형을 찾으려는 것과 같습니다. 기생충과의 관계는 적당히 조절하는 것이 아니라 박멸하는 것입니다. 이러한 시스템은 완전한 포획을 위해 설계되었습니다. 이들은 모든 자투리 시간, 스치는 지루함 하나하나, 불안한 충동 하나하나를 원합니다. 이들은 이성을 우회하여 우리의 가장 원초적인 욕구에 곧바로 갈고리를 박아 넣도록 만들어졌습니다. 우리의 심리적 약점을 착취하도록 의도적으로 설계된 것들과 평화롭게 공존할 수 있다고 말하는 것은, 생쥐에게 고양이와 “공통점“을 찾으라고 조언하는 것과 같습니다.
그러므로 유일한 진정한 저항이자 자신의 정신을 되찾는 유일하고 진실한 길은, 이러한 플랫폼에서 로그오프하는 급진적인 행동을 실천하는 것입니다. 고정된 경계, 즉 엄격한 시작과 끝이 있는 디지털 미디어를 접하십시오. 다른 사람이 정성과 통찰을 담아 쓴 것, 그리고 현대 생활의 진실함과 인간의 조건을 성찰하는 것을 접하십시오. 또 한 번의 자극을 위해 도파민 러닝머신에 다시 올라타도록 부추기지 않는 것을 접하십시오.
이 플랫폼에서 로그오프하는 것은 신선한 공기 한 모금이자, 영혼의 탈옥입니다. 그것은 무한 스크롤이라는 삭막하고 끝없는 스키너 상자 대신, 실제 대화가 지닌 혼란스럽고 어수선하며 우연적인 3차원의 아름다움을 택하는 것입니다. 그것은 지루함이 주는 깊은 기쁨을 재발견하고, 푸시 알림에 끊임없이 쿡쿡 찔리지 않을 때 자신의 정신이 어디로 흘러가는지 지켜보는 것입니다. 이탈한다는 것은 미래를 거부하는 것이 아니라 현재를 되찾는 것입니다. 그것은 자신이 가진 가장 소중한 것이 바로 자신의 어텐션이라는 사실을 깨닫고, 더 이상 그것을 공짜로 내주지 않기로 결심하는 것입니다.
Rust로 구현한 빠른 텐서 정규화
최근 빠른 텐서 정규화가 필요한 일이 있었지만, 이를 위한 라이브러리 생태계가 부족했습니다. 물리학과 미분기하학에서 텐서를 조작하는 일, 특히 인덱스 대칭성에 따라 텐서를 정규형으로 만드는 일은 반복적으로 등장하면서도 계산량이 많은 작업입니다. 처음으로 상대성이론 수업을 듣는 학부생이라면 누구나 여기에 필요한 텐서 곡예가 종종 벅차다는 것을 알고 있으며, 실제 문제에서는 이것이 훨씬 더 까다로워집니다.
- Github 소스 코드
git clone https://github.com/sdiehl/butler-portugal.git
Mathematica 같은 기존 시스템이 어느 정도 지원을 제공하고 xPerm 라이브러리가 고성능 C 구현을 제공하기는 하지만, 이른바 “현대적“이면서 오픈 소스인 해법은 없었습니다. 그래서 저는 텐서 정규화를 위한 Butler-Portugal 알고리즘을 순수 Rust로 구현하고 C와 Python 바인딩을 갖춘 새로운 butler-portugal 라이브러리를 만들었습니다.
텐서 정규화를 위한 정규(canonical) 알고리즘(하하)은 잘 알려지지 않은 Butler-Portugal 알고리즘으로, 텐서를 그 대칭성 아래에서 유일한 최소 형태로 만드는 방법입니다. 이 알고리즘은 텐서 정규화를 순열군론의 언어로 다시 표현하며, 구체적으로는 대칭군의 이중 잉여류에서 최소 대표원을 찾는 문제로 바꿉니다. 텐서를 슬롯에서 인덱스 레이블로 가는 사상 로 나타냅시다. 슬롯 대칭 (텐서를 부호를 제외하고 불변으로 유지하는 슬롯의 순열)는 오른쪽에서 작용하고, 더미 대칭 (축약된 인덱스 쌍의 이름을 바꾸는 것, 그리고 계량이 허용하는 경우 쌍의 위쪽 끝과 로어링된 아래쪽 끝을 맞바꾸는 것)는 왼쪽에서 작용합니다. 그러면 텐서를 표기하는 동치인 방법은 모두 이중 잉여류 에 속하는 어떤 이며, 정규형은 그 이중 잉여류에서 사전식으로 가장 작은 원소입니다. 같은 배치에 두 부호 모두로 도달할 수 있다면, 그 텐서는 항등적으로 0입니다.
이 문제를 다룰 만한 수준으로 유지하는 비결은 두 군 중 어느 것도 원소를 전부 나열하지 않는다는 점입니다. Schreier-Sims 알고리즘은 기저 을 갖는 의 안정자 사슬을 구축하고, 탐색은 그 사슬을 한 번에 한 슬롯씩 따라갑니다. 각 단계에서 탐색은 모든 횡단 원소를 시도하여, 현재 슬롯에 놓이는 레이블을 아래에서의 궤도 최솟값으로 로어링하고, 가장 작은 레이블을 얻는 선택들을 남긴 뒤 다음 슬롯으로 넘어갑니다. 동점일 때만 분기가 일어나고, 텐서를 동일하게 표기하는 살아남은 후보들은 병합되므로, 원소가 수백만 개인 군에 대해서도 탐색 규모가 작게 유지됩니다.
한 걸음 물러서서 기호적 텐서 조작이 실제로 무엇을 의미하는지 생각해 봅시다. 머신러닝에서와 달리, 물리학에서 텐서는 단순한 다차원 배열이 아닙니다. 텐서는 이름이 붙은 인덱스를 가진 객체로, 각 인덱스는 변성(각각 아래첨자와 위첨자에 해당하는 공변과 반변)을 지니며, 좌표 변환에 따라 특정한 방식으로 변환됩니다. 인덱스 교환에 대해 대칭이거나 반대칭인 성질, 또는 리만 텐서에서처럼 더 정교한 패턴과 같은 텐서의 대칭성은 물리 법칙을 담고 있는 본질적인 대수적 성질입니다.
동기 부여를 위한 예로 일반상대성이론을 살펴봅시다. 아인슈타인 장 방정식은
시공간 곡률을 담고 있는 아인슈타인 텐서 를 응력-에너지 텐서 와 연결합니다. 둘 다 대칭인 랭크 2 텐서이므로, 계산에서 인덱스를 자유롭게 치환할 수 있습니다:
이러한 객체를 기호적으로 다룰 때는 이 대칭성들을 모두 존중하면서 식을 조작하고, 인덱스를 축약하고, 결과를 단순화할 수 있어야 합니다. 예를 들어 리만 곡률 텐서 는 풍부한 대칭성을 지닌 랭크 4 객체입니다:
또한 이 텐서는 이른바 제1 비앙키 항등식을 만족합니다.
여기서 대괄호는 그 안에 들어 있는 인덱스들에 대한 반대칭화를 나타냅니다. 이러한 대칭 항등식은 계산을 단순화하는 데, 그리고 리치 텐서나 리치 스칼라 같은 유도량이 올바른 성질을 갖도록 보장하는 데 매우 중요합니다.
축약(contraction)은 또 하나의 기본 연산입니다. 위 첨자 하나와 로어링된 아래 첨자 하나로 이루어진 첨자 쌍에 대해 합을 취하여 텐서의 랭크를 줄입니다:
리치 스칼라 같은 불변량은 이렇게 만듭니다. 리치 스칼라는 리만 다양체의 각 점에 부여되는 하나의 실수로, 그 점 근방의 기하가 평탄함에서 얼마나 벗어나는지를 측정합니다.
정준화가 정말로 어려워지는 지점은 축약된 인덱스입니다. 더미 인덱스의 이름에는 아무런 의미가 없으므로 \( R^a{}{bac} \)와 \( R^z{}{bzc} \)는 같은 대상이며, 정준화기는 슬롯 대칭성에 더해 더미의 이름 바꾸기까지 고려해야 합니다. 이것이 바로 이중 잉여류의 쪽입니다. 구체적으로 살펴보기 위해, butler-portugal을 사용하여 리만 텐서의 리치 축약을 정준화하는 최소한의 Rust 예제를 보이겠습니다.
use butler_portugal::*;
fn main() -> Result<()> {
// R^a_{cab}, a contraction of the Riemann tensor
let mut r = Tensor::new(
"R",
vec![
TensorIndex::contravariant("a", 0),
TensorIndex::covariant("c", 1),
TensorIndex::covariant("a", 2),
TensorIndex::covariant("b", 3),
],
);
r.add_symmetry(Symmetry::antisymmetric(vec![0, 1]));
r.add_symmetry(Symmetry::antisymmetric(vec![2, 3]));
r.add_symmetry(Symmetry::symmetric_pairs(vec![(0, 1), (2, 3)]));
let canonical = canonicalize(&r)?;
println!("{canonical}"); // R_b_a_c^a
println!("{}", canonical.coefficient());
Ok(())
}위첨자 자리에 한 번, 아래첨자 자리에 한 번 나타나는 반복된 이름 a는 자동으로 축약으로 감지됩니다. 출력은 대칭군 아래에서 텐서의 유일한 최소 대표원이며, 누적된 부호는 계수에 반영되고 축약된 인덱스는 정렬된 더미 이름으로 바뀝니다. 반대칭인 에 대한 처럼 대칭성 때문에 소멸하는 텐서는 계수 0으로 반환됩니다.
라이브러리의 Core에는 텐서를 이름 붙은 인덱스를 가진 객체로 나타내는 표현이 있으며, 각 인덱스는 변동성(variance), 위치, 그리고 선택적인 인덱스 타입을 가집니다(그래서 시공간 인덱스와 스피너 인덱스가 서로 짝을 이루는 일은 없습니다). 각 인덱스 타입은 대칭인 계량, 반대칭인 계량(스피너 계량처럼 레이징과 로어링을 할 때마다 부호가 하나 붙습니다), 또는 계량이 없음을 선언할 수 있습니다. 대칭은 부호 있는 순열들로 이루어진 군의 생성기로 인코딩됩니다. 부호는 xPerm에서 가져온 깔끔한 기법으로 처리합니다. 개 슬롯의 부호 있는 순열을 개 점의 일반 순열로 인코딩하는데, 부호 은 추가된 두 점을 맞바꿉니다. 그러면 개 점 위의 일반적인 Schreier-Sims 사슬이 부호 있는 군을 기술하며, 텐서는 군이 두 부호 점만을 맞바꾸는 원소를 포함할 때 정확히 그때에만 항등적으로 0입니다.
텐서의 대칭성은 그 인덱스들에 대한 군 작용으로 인코딩됩니다. 가장 흔한 유형은 다음과 같습니다.
- 대칭: 지정한 인덱스들의 교환에 대해 불변입니다,
- 반대칭: 교환하면 부호가 바뀝니다,
- 순환: 순환 순열에 대해 불변입니다,
- 쌍 대칭: 리만 텐서에서처럼 인덱스 쌍을 교환합니다,
- 사용자 정의: 임의의 부호 있는 생성기로, Schreier-Sims가 이로부터 전체 군을 구성합니다.
텐서의 곱도 같은 방식으로 처리됩니다. Tensor::product는 인수들을 하나의 가환 단항식으로 붙이면서 동일한 인수끼리 교환하는 대칭성을 추가하므로, 나 크레치만 스칼라 같은 식이 인수 사이에 걸친 축약과 함께 정준화됩니다. 또한 이 라이브러리는 영 타블로로 지정되는 기약 표현으로의 사영도 지원하여, 텐서를 대칭군의 표현에 대응하는 대칭 유형들로 분해할 수 있게 해 줍니다. 여기서 이를 설명하지는 않겠지만, 다른 곳에 잘 문서화되어 있으며 참고 문헌은 저장소에 넣어 두었습니다.
제 구현은 기호 계산에서 텐서 정준화의 표준으로 널리 인정받는 xPerm에서 영감을 받았습니다. 하지만 C와 Mathematica 코드가 꽤 오래되었고 문서화도 그리 잘 되어 있지 않아서, 이 알고리즘을 Rust로 포팅하는 일은 상당히 어려웠습니다. 테스트 스위트는 정준형 천 개로 이루어진 참조 코퍼스, 작은 군에 대한 무차별 대입 이중 잉여류 탐색, 그리고 고전적인 리만 항등식들과 대조하여 검사합니다. 리만 단항식에 대해서는 xPerm의 출력과 일치하며 더 빠르게 실행됩니다. 그러니 이 분야의 실무자라면 제 구현을 살펴보고 참조 구현과 비교해 볼 수 있을 것이고, 이것이 앞으로 연구를 위해 같은 것을 다시 만들 필요가 없을 어느 가엾은 물리학 대학원생의 수고를 덜어 주기를 바랍니다.
이 라이브러리는 include/butler_portugal.h에 헤더가 있는 C 공유 라이브러리로도 빌드되므로, C ABI를 지원하는 어떤 언어에서든 링크할 수 있습니다.
cargo build --release
clang -Iinclude -Ltarget/release -lbutler_portugal app.c -o app
그리고 C API 위에 플루언트 인터페이스를 갖춘 작은 Python 래퍼도 있습니다.
from butler_portugal import Tensor
r = Tensor("R", ["^a", "c", "a", "b"]).antisymmetric(0, 1).antisymmetric(2, 3)
print(r.symmetric_pairs((0, 1), (2, 3)).canonicalize()) # R_b_a_c^a
이렇게 해서 butler-portugal을 소개했습니다. 이 라이브러리가 Rust 생태계에 고성능 텐서 정규화를 가져다주기를 바랍니다. 다음 명령으로 설치할 수 있습니다:
cargo add butler-portugal
또는 Python에서는 uv로 설치할 수 있습니다:
uv add git+https://github.com/sdiehl/butler-portugal --tag v0.4.0
이 라이브러리는 상당히 효율적이고 MIT 라이선스로 배포되며, 복잡한 대칭성을 지닌 텐서를 다뤄야 하는 모든 분야에서 유용하게 쓰이기를 바랍니다. 그리고 저 말고도 적어도 한 사람에게는 쓸모가 있기를 바랍니다!
MLIR의 메모리
MLIR의 메모리 아키텍처는 고수준 추상화와 저수준 효율성 사이의 균형을 나타냅니다. 핵심(Core)적으로, MLIR은 데이터를 표현하는 세 가지 주요 방식을 제공합니다. 불변의 추상적인 연산을 위한 Tensors, 구체적인 메모리 버퍼를 위한 MemRefs, 그리고 세밀한 제어를 위한 LLVM 수준의 구성 요소입니다. 이러한 3계층 접근 방식 덕분에 개발자는 원하는 추상화 수준에서 작업하면서도 필요할 때 메모리를 정밀하게 제어할 수 있습니다.
텐서는 계산을 깔끔한 수학적 표현으로 나타낼 수 있게 하고, MemRef는 실제 메모리 연산으로 이어지는 다리 역할을 하며, LLVM 구성 요소는 메모리 레이아웃과 접근 패턴을 직접 제어할 수 있게 합니다. 이 설계는 MLIR의 점진적 로어링(progressive lowering) 철학에 기반합니다. 이 철학에 따르면 고수준 개념은 최적화와 실행에 필요한 만큼 더 구체적인 표현으로 체계적으로 변환될 수 있습니다.
요약하면, 텐서는 순수한 수학적 객체이고, MemRef는 구체적인 메모리 버퍼이며, LLVM 구성 요소는 저수준 메모리 연산이고, 벡터는 동시에 조작할 수 있는 여러 레지스터 값에 대한 참조입니다. 가장 높은 수준의 추상화부터 시작하여 차례로 내려가 봅시다.
텐서
MLIR의 텐서는 명시적인 메모리 위치가 없는 불변의 고수준 자료 구조입니다. 텐서는 머신러닝과 선형대수에서 흔히 볼 수 있는 행렬 형태의 계산에 사용하도록 설계되어, 구조화된 데이터를 계산 중심 방식으로 표현합니다.
// 4-D static tensor with 10x10x10x10 elements of type f32
!TensorType1 = tensor<10 x 10 x 10 x 10 x f32>
// 4-D dynamic tensor with N x M x 10 x 10 elements of type f32
!TensorType2 = tensor<? x ? x 10 x 10 x f32>
// dummy example constants
%N = index.constant 2
%M = index.constant 3
%X = arith.constant 42.0 : f32
// allocate a tensor with the shape of the last 2 dimensions
%A = tensor.empty(%N, %M) : tensor<? x ? x 10 x 10 x f32>
// allocate a zero tensor with the shape of the last 2 dimensions
%B = tensor.empty() : tensor<10 x 10 x 10 x 10 x f32>
// create a tensor with the given values
%C = tensor.from_elements %X, %X, %X : tensor<3xf32>
// Common tensor operations
%D = tensor.extract %A[%N, %M, %N, %M] : !TensorType2
%E = tensor.insert %X into %A[%N, %M, %N, %M] : !TensorType2
텐서 연산을 사용하면 부수 효과 없이 깔끔하게 수학적 변환을 수행할 수 있으므로 분석과 최적화가 간단해집니다. 예를 들어, 단위 행렬은 다음과 같이 표현할 수 있습니다.
func.func @identity(%m : index, %n : index) {
%out = tensor.generate %m, %m {
^bb0(%i : index, %j : index):
%ni = arith.index_cast %i : index to i32
%nj = arith.index_cast %j : index to i32
%elem = arith.cmpi eq, %ni, %nj : i32
%elem_i32 = arith.extui %elem : i1 to i32
tensor.yield %elem_i32 : i32
} : tensor<?x?xi32>
return
}
MemRef
MemRef는 메모리 버퍼를 표현하기 위한 MLIR의 주요 추상화입니다. MemRef는 (NumPy 배열과 같은) 고수준 배열 개념과 저수준 메모리 연산 사이의 다리 역할을 합니다. MemRef는 본질적으로 메모리 영역에 대한 포인터와 그 구조에 대한 추가 메타데이터를 함께 나타냅니다.
MemRef는 여러 핵심(Core) 구성 요소로 이루어지며, 이 구성 요소들은 메타데이터와 데이터로 나뉩니다.
- 할당된 포인터(Allocated Pointer): 데이터 버퍼를 가리킵니다(할당 해제에 사용됩니다)
- 정렬된 포인터(Aligned Pointer): 올바르게 정렬된 데이터를 가리킵니다
- 오프셋(Offset): 정렬된 포인터의 시작 위치와 처음 접근 가능한 요소 사이의 거리(요소 단위)입니다
- 형태(Shape): 차원을 나타내는 정수 배열입니다
- 스트라이드(Strides): 메모리 레이아웃을 나타내는 정수 배열입니다
MLIR에서 MemRef 타입은 다음과 같은 문법으로 선언합니다.
memref<1024xf32> // 1D array of 1024 float32 elements
memref<4x4xf64> // 2D array of 4x4 float64 elements
간단한 배열 덧셈 커널 만들기
MLIR MemRef를 사용하여 두 배열을 더하는 간단한 예제를 만들어 봅시다.
module {
func.func @array_add(%arg0: memref<1024xf32>, %arg1: memref<1024xf32>, %arg2: memref<1024xf32>)
attributes {llvm.emit_c_interface} {
%c0 = arith.constant 0 : index
%c1024 = arith.constant 1024 : index
%c1 = arith.constant 1 : index
scf.for %arg3 = %c0 to %c1024 step %c1 {
%0 = memref.load %arg0[%arg3] : memref<1024xf32>
%1 = memref.load %arg1[%arg3] : memref<1024xf32>
%2 = arith.addf %0, %1 : f32
memref.store %2, %arg2[%arg3] : memref<1024xf32>
}
return
}
}
그런 다음 위의 MLIR 코드를 실행 파일로 컴파일하려면 다음 명령을 사용할 수 있습니다.
mlir-opt array_add.mlir \
-finalize-memref-to-llvm \
-convert-scf-to-cf \
-convert-cf-to-llvm \
-convert-arith-to-llvm \
-convert-func-to-llvm \
-o array_add_opt.mlir
mlir-translate array_add_opt.mlir \
-mlir-to-llvmir \
-o array_add_opt.ll
llc -filetype=obj --relocation-model=pic arary_add.ll -o arary_add.o
clang -shared -fPIC arary_add.o -o array_add.so
NumPy 배열의 메모리 레이아웃
Python과 통합하기 전에 NumPy 배열이 메모리에 어떻게 배치되는지 이해하는 것이 중요합니다.
- 데이터 버퍼(Data Buffer): 실제 값을 담고 있는 연속된 메모리 블록입니다
- 형태(Shape): 배열의 차원을 나타내는 튜플입니다
- 스트라이드(Strides): 각 차원에서 이동할 간격(바이트 단위)을 나타내는 튜플입니다
- Dtype: 요소의 데이터 타입
NumPy 배열을 할당하면, 본질적으로 원시 메모리 버퍼를 감싸는 PyObject 래퍼가 만들어지며 여기에는 배열의 shape, strides, dtype에 관한 메타데이터가 함께 담깁니다. 이 메모리는 데이터를 복사하지 않고도 Python과 JIT 컴파일된 LLVM 로직 사이에서 주고받을 수 있습니다.
import ctypes
import numpy as np
a = np.array([[1, 2, 3], [4, 5, 6]], dtype=np.float32)
print(a.shape) # (2, 3)
print(a.strides) # (12, 4)
print(a.dtype) # float32
print(a.itemsize) # 4
print(a.ctypes.data) # 0x7f926d6e2b20 (base pointer to the memory buffer)
# Get a ctypes pointer
print(a.ctypes.data_as(ctypes.POINTER(ctypes.c_float)))
기본적으로 numpy 배열은 C-연속(C-contiguous)입니다. 즉, 메모리가 행 우선(row-major) 순서로 배치됩니다. 이는 가장 흔한 메모리 레이아웃이며 대부분의 NumPy 연산에서 기본값입니다. 행렬에서 [i, j] 요소의 메모리 주소를 계산하려면 다음 공식을 사용할 수 있습니다:
$$\text{address} = \text{base_address} + (i \times \text{strides}[0] + j \times \text{strides}[1])$$
예를 들어, memref<3x4xf32>에 대한 행 우선 strided 레이아웃은 다음의 완전히 전개된 두 memref(서로 동일합니다)와 같습니다:
memref<3x4xf32, strided<[4, 1], offset: 0>>
memref<3x4xf32, affine_map<(i, j) -> (i, j)>>
NumPy 배열을 MemRef로 변환하기
MLIR 코드에서 NumPy 배열을 사용하려면 NumPy의 메모리 레이아웃과 MLIR의 MemRef 구조 사이를 잇는 다리를 만들어야 합니다. 이는 MLIR의 MemRef 디스크립터 레이아웃과 일치하는 Python 클래스를 만들어서 할 수 있습니다:
import numpy as np
from ctypes import c_void_p, c_longlong, Structure
class MemRefDescriptor(Structure):
"""Structure matching MLIR's MemRef descriptor"""
_fields_ = [
("allocated", c_void_p), # Allocated pointer
("aligned", c_void_p), # Aligned pointer
("offset", c_longlong), # Offset in elements
("shape", c_longlong * 1), # Array shape (1D in this case)
("stride", c_longlong * 1), # Strides in elements
]
def numpy_to_memref(arr):
"""Convert a NumPy array to a MemRef descriptor"""
if not arr.flags["C_CONTIGUOUS"]:
arr = np.ascontiguousarray(arr)
desc = MemRefDescriptor()
desc.allocated = arr.ctypes.data_as(c_void_p)
desc.aligned = desc.allocated
desc.offset = 0
desc.shape[0] = arr.shape[0]
desc.stride[0] = 1
return desc
MemRefDescriptor 클래스는 MLIR이 기대하는 메모리 레이아웃을 그대로 반영합니다:
allocated: 할당된 메모리의 시작을 가리킵니다aligned: 정렬된 메모리를 가리킵니다(대개 allocated와 같습니다)offset: 시작 지점으로부터 오프셋할 요소의 개수입니다shape: 배열의 차원입니다(이 예제에서는 1차원 배열)stride: 각 차원에서 요소 사이의 간격입니다
numpy_to_memref 함수는 다음과 같이 변환을 처리합니다:
- 배열이 메모리에서 연속되도록 보장합니다
- MemRef 디스크립터를 생성합니다
- NumPy 배열의 데이터를 가리키는 포인터를 설정합니다
- shape와 stride 정보를 구성합니다
이 변환을 통해 기반 데이터를 복사하지 않고도 NumPy 배열을 MLIR 함수에 패스할 수 있습니다. 배열 덧셈 예제로 이를 실제로 어떻게 사용하는지 살펴봅시다.
MLIR을 Python과 통합하기
Python에서 MLIR 코드를 사용하는 주요 방법은 두 가지입니다. 하나는 공유 라이브러리로 컴파일한 뒤 로드하는 것이고, 다른 하나는 런타임에 MLIR 코드를 JIT 컴파일하는 것입니다. 배열 덧셈 예제를 사용하여 두 방법을 모두 살펴봅시다.
미리 컴파일된 MLIR 코드 로드하기
첫 번째 방법은 MLIR 코드를 ctypes를 사용해 Python에서 로드할 수 있는 공유 라이브러리로 컴파일하는 것입니다. 이를 위해서는 MLIR 코드를 미리 컴파일해야 합니다:
# Compile MLIR to shared library
mlir-opt array_add.mlir \
--convert-tensor-to-linalg \
--convert-linalg-to-loops \
--convert-scf-to-cf \
--convert-cf-to-llvm \
--convert-math-to-llvm \
--convert-arith-to-llvm \
--convert-func-to-llvm \
--convert-index-to-llvm \
--finalize-memref-to-llvm \
--reconcile-unrealized-casts \
-o array_add_opt.mlir
mlir-translate --mlir-to-llvmir array_add_opt.mlir > array_add.ll
llc -filetype=obj array_add.ll -o array_add.o
clang -shared -fPIC array_add.o -o libarray_add.dylib
그런 다음 Python에서 컴파일된 라이브러리를 로드하여 사용할 수 있습니다:
import ctypes
import numpy as np
from np_memref import MemRefDescriptor, numpy_to_memref
def main():
# Load the shared library
lib = ctypes.CDLL("./libarray_add.dylib")
# Get the C interface function
array_add = lib._mlir_ciface_array_add
array_add.argtypes = [
ctypes.POINTER(MemRefDescriptor)
] * 3 # input1, input2, output
array_add.restype = None
# Create sample input arrays
size = 1024
a = np.ones(size, dtype=np.float32)
b = np.ones(size, dtype=np.float32) * 2
c = np.zeros(size, dtype=np.float32)
# Convert arrays to MemRef descriptors
a_desc = numpy_to_memref(a)
b_desc = numpy_to_memref(b)
c_desc = numpy_to_memref(c)
# Call the function
array_add(ctypes.byref(a_desc), ctypes.byref(b_desc), ctypes.byref(c_desc))
# Verify results
expected = a + b
np.testing.assert_array_almost_equal(c, expected)
print("Array addition successful!")
print(f"First few elements: {c[:5]}") # Should show [3.0, 3.0, 3.0, 3.0, 3.0]
if __name__ == "__main__":
main()
이 방법은 컴파일을 미리 해 두므로 더 간단하고 프로덕션 환경에 더 적합합니다. 컴파일된 라이브러리는 Python 패키지와 함께 배포하여 런타임에 로드할 수 있습니다.
런타임에 MLIR JIT 컴파일하기
두 번째 접근 방식은 llvmlite(LLVM용 Python 바인딩)를 사용하여 런타임에 MLIR 코드를 JIT 컴파일하는 것입니다. MLIR 코드를 런타임에 생성하거나 수정할 수 있으므로 이 방식은 더 높은 유연성을 제공합니다:
import os
import subprocess
import numpy as np
from ctypes import CFUNCTYPE, POINTER
from np_memref import MemRefDescriptor, numpy_to_memref
import llvmlite
# Disable typed pointers for LLVM 15+ compatibility
llvmlite.opaque_pointers_enabled = True
import llvmlite.binding as llvm # noqa: E402
# Initialize LLVM
llvm.initialize()
llvm.initialize_native_target()
llvm.initialize_native_asmprinter()
def compile_mlir_to_llvm(mlir_file_path):
"""Compile MLIR code to LLVM IR using mlir-opt and mlir-translate"""
# Run mlir-opt to lower to LLVM dialect
opt_cmd = [
"mlir-opt",
mlir_file_path,
"--convert-tensor-to-linalg",
"--convert-linalg-to-loops",
"--convert-scf-to-cf",
"--convert-cf-to-llvm",
"--convert-math-to-llvm",
"--convert-arith-to-llvm",
"--convert-func-to-llvm",
"--convert-index-to-llvm",
"--finalize-memref-to-llvm",
"--reconcile-unrealized-casts",
]
try:
opt_result = subprocess.run(opt_cmd, capture_output=True, text=True, check=True)
except subprocess.CalledProcessError as e:
print("Error running mlir-opt:")
print("STDOUT:", e.stdout)
print("STDERR:", e.stderr)
raise
# Run mlir-translate to convert to LLVM IR
translate_cmd = ["mlir-translate", "--mlir-to-llvmir"]
try:
translate_result = subprocess.run(
translate_cmd,
input=opt_result.stdout,
capture_output=True,
text=True,
check=True,
)
except subprocess.CalledProcessError as e:
print("Error running mlir-translate:")
print("STDOUT:", e.stdout)
print("STDERR:", e.stderr)
raise
return translate_result.stdout
def create_execution_engine():
"""Create an ExecutionEngine suitable for JIT"""
target = llvm.Target.from_default_triple()
target_machine = target.create_target_machine()
backing_mod = llvm.parse_assembly("")
engine = llvm.create_mcjit_compiler(backing_mod, target_machine)
return engine
def compile_and_load_mlir(mlir_file_path):
"""Compile MLIR code and load it into a JIT engine"""
# Convert MLIR to LLVM IR
llvm_ir = compile_mlir_to_llvm(mlir_file_path)
# Create module from LLVM IR
mod = llvm.parse_assembly(llvm_ir)
mod.verify()
# Create execution engine and add module
engine = create_execution_engine()
engine.add_module(mod)
engine.finalize_object()
return engine, mod
def main():
# Get path to MLIR file
current_dir = os.path.dirname(os.path.abspath(__file__))
mlir_file = os.path.join(current_dir, "array_add.mlir")
# Compile and load the MLIR code
engine, mod = compile_and_load_mlir(mlir_file)
# Get function pointer to the compiled function
func_ptr = engine.get_function_address("_mlir_ciface_array_add")
# Create the ctypes function wrapper
array_add = CFUNCTYPE(
None,
POINTER(MemRefDescriptor),
POINTER(MemRefDescriptor),
POINTER(MemRefDescriptor),
)(func_ptr)
# Create test arrays
size = 1024
a = np.ones(size, dtype=np.float32)
b = np.ones(size, dtype=np.float32) * 2
c = np.zeros(size, dtype=np.float32)
# Convert arrays to MemRef descriptors
a_desc = numpy_to_memref(a)
b_desc = numpy_to_memref(b)
c_desc = numpy_to_memref(c)
# Call the JIT-compiled function
array_add(a_desc, b_desc, c_desc)
# Verify results
expected = a + b
np.testing.assert_array_almost_equal(c, expected)
print("Array addition successful!")
print(f"First few elements: {c[:5]}") # Should show [3.0, 3.0, 3.0, 3.0, 3.0]
if __name__ == "__main__":
main()
JIT 컴파일 방식에는 여러 가지 장점이 있습니다. 첫째, MLIR 코드를 런타임에 생성하거나 수정할 수 있습니다. 둘째, 별도로 컴파일된 라이브러리를 관리할 필요가 없습니다. 마지막으로, 런타임에 특정 CPU 아키텍처에 맞춘 최적화가 가능합니다. 그러나 이 방식에는 몇 가지 단점도 있습니다. 시작 시 컴파일 오버헤드가 발생하고, MLIR 도구에 대한 의존성 때문에 설정이 더 복잡하며, 런타임에 컴파일 오류를 처리해야 합니다.
저수준 LLVM 구조
MLIR은 고수준 MLIR 구성 요소 외에도 메모리 레이아웃과 연산을 더 직접적으로 제어할 수 있는 저수준 LLVM 다이얼렉트를 제공합니다. LLVM 다이얼렉트의 구조체를 사용하여 MLIR에서 사용자 정의 타입을 만들 수 있습니다. 예를 들어 C에서는 다음과 같이 작성합니다:
struct Pair {
int a;
float b;
};
MLIR에서는 같은 구조체를 다음과 같이 정의할 수 있습니다:
!Pair = !llvm.struct<(i32, f32)>
%1 = llvm.mlir.zero : !Pair
이 코드는 i32 하나와 f32 하나, 두 개의 필드를 가진 구조체인 새로운 타입 별칭 !Pair를 만듭니다. 그러면 %1 변수는 모든 필드가 0으로 초기화된 이 구조체의 인스턴스가 됩니다.
LLVM 배열은 요소를 저장하는 고정 크기의 순차적 저장 공간을 제공합니다. LLVM 배열은 다음 구문을 사용하여 만들 수 있습니다:
// Array of 10 integers
!IntArray = !llvm.array<10 x i32>
// Array of 4 pairs (using the struct defined above)
!PairArray = !llvm.array<4 x !Pair>
// Create and initialize an array
%arr = llvm.mlir.constant(dense<[1, 2, 3, 4]> : tensor<4xi32>) : !llvm.array<4 x i32>
// Access array elements
%idx = llvm.mlir.constant(2 : i32) : i32
%element = llvm.extractvalue %arr[2] : !llvm.array<4 x i32>
// Update array elements
%new_arr = llvm.insertvalue %element, %arr[0] : !llvm.array<4 x i32>
MemRef 같은 고수준 MLIR 구성 요소와 달리, LLVM 배열은 더 경직되어 있으며 C 배열의 동작을 거의 그대로 반영합니다. LLVM 배열은 컴파일 시점에 알려진 고정 크기를 가지며, 자신의 구조에 대한 메타데이터를 전혀 갖지 않습니다.
벡터
MLIR의 벡터 다이얼렉트는 SIMD(Single Instruction, Multiple Data) 연산을 위한 저수준 추상화를 제공합니다. vector 다이얼렉트는 하드웨어 벡터 기능과 밀접하게 맞춰져 있지만, LLVM의 벡터 연산 로어링 및 최적화 기능 덕분에 대상 아키텍처가 지원하는 범위에 엄격하게 제한되지는 않습니다.
MLIR의 벡터는 다음과 같은 형태일 수 있습니다:
- 1차원: 전통적인 SIMD 레지스터를 나타냅니다(보통 2개, 4개, 8개 요소를 대상으로 연산합니다)
- 다차원: 고차 벡터 연산을 나타냅니다
// Single-dimensional vectors
vector<4xf32> // 4-element vector of float32
vector<8xi32> // 8-element vector of int32
// Multi-dimensional vectors
vector<2x4xf32> // 2x4 matrix of float32 as vectors
vector<2x2x4xf32> // 3D vector arrangement
MLIR은 하드웨어 명령어에 효율적으로 매핑되는 벡터 연산을 제공합니다:
// Vector arithmetic
%c = vector.add %a, %b : vector<4xf32>
%d = vector.mul %a, %b : vector<4xf32>
// Vector shuffles and extracts
%e = vector.extract %c[0] : vector<4xf32>
%f = vector.shuffle %c, %d [0, 1, 4, 5] : vector<4xf32>, vector<4xf32>
// Vector fold/reduction operations
%sum = vector.reduction <add>, %c : vector<4xf32> into f32
MLIR의 vector 다이얼렉트는 하드웨어 기능과 직접 대응하지 않을 수 있는 연산도 제공하지만, LLVM은 필요에 따라 하드웨어 벡터(예: AVX, NEON)에 직접 매핑하거나, 더 작은 벡터로 분할하거나, 스칼라화하는 방식으로 로어링 과정을 처리합니다.
예를 들어 vector<8xf32> 연산은 x86에서는 AVX에 직접 매핑되고, ARM에서는 두 개의 NEON 연산으로 분할되며, 벡터를 지원하지 않는 아키텍처에서는 스칼라화될 수 있습니다.
버퍼화
MLIR에서 버퍼화는 텐서 시맨틱을 가진 연산을 memref 시맨틱을 가진 연산으로 변환하는 과정입니다. 즉, 수학적 텐서 구조에 대한 계산을 물리적 메모리 버퍼에 대한 계산으로 변환하는 과정입니다.
텐서를 memref로 변환하는 데 사용되는 저수준 연산이 두 가지 있습니다. 이름 그대로의 동작을 합니다.
bufferization.to_memref- 텐서를 memref로 변환합니다bufferization.to_tensor- memref를 텐서로 변환합니다
%out1 = bufferization.to_memref %result : tensor<10xf32> to memref<10xf32>
%out2 = bufferization.to_tensor %result : memref<10xf32> to tensor<10xf32>
bufferization.materialize_in_destination 연산은 텐서를 대상 버퍼 안의 memref로 변환하는 데 사용됩니다. 이는 텐서를 memref로 변환한 다음 그 결과를 대상 버퍼에 저장하는 것과 같지만, 중간 단계를 거치지 않습니다. 이는 외부에서 할당한 버퍼를 사용하는 커널의 마지막 단계인 경우가 많습니다.
bufferization.materialize_in_destination %0 in restrict writable %C : (tensor<10xf32>, memref<10xf32>) -> ()
이 변환을 자동으로 수행해 주는 패스도 있습니다. one-shot-bufferize 패스는 모든 텐서 연산을 memref 연산으로 변환하는 데 사용할 수 있는 패스입니다. 중요한 점은 이 패스가 기본적으로 함수 경계를 버퍼화하지 않는다는 것입니다(즉, 함수의 입력과 출력은 버퍼화되지 않습니다). 따라서 패스에 bufferize-function-boundaries 플래그를 추가해야 합니다.
mlir-opt -one-shot-bufferize="bufferize-function-boundaries"
간단한 예제로 이 변환을 살펴보겠습니다:
// Before bufferization
func.func @example(%arg0: tensor<8xf32>, %idx: index) -> tensor<8xf32> {
%f = arith.constant 5.000000e+00 : f32
%result = tensor.insert %f into %arg0[%idx] : tensor<8xf32>
return %result : tensor<8xf32>
}
// After bufferization
func.func @example(%arg0: memref<8xf32>, %idx: index) -> memref<8xf32> {
%f = arith.constant 5.000000e+00 : f32
memref.store %f, %arg0[%idx] : memref<8xf32>
return %arg0 : memref<8xf32>
}
이 경우 텐서 삽입 연산은 제자리(in-place)에서 버퍼화되어, 입력 버퍼를 출력에 재사용할 수 있었습니다.
C 호환 래퍼
C에서 함수를 호출하려면 C 호환 래퍼를 생성해야 합니다. 이는 llvm.emit_c_interface 속성을 사용하여 수행합니다. 일반적으로 함수를 버퍼화하면 memref의 모든 필드가 개별 인자로 풀어 헤쳐집니다. 이는 C에서 함수를 호출하려 할 때 바람직하지 않습니다. C에서는 보통 memref를 구조체에 대한 void 포인터로 전달하기 때문입니다.
func.func @add_vector_to_matrix(%A: memref<3xf32>) -> memref<3xf32> attributes {llvm.emit_c_interface} {
return %A : memref<3xf32>
}
이렇게 하면 함수에 대한 C 호환 래퍼가 생성되며, 이는 두 개의 함수로 확장됩니다.
module {
llvm.func @fun(%arg0: !llvm.ptr, %arg1: !llvm.ptr, %arg2: i64, %arg3: i64, %arg4: i64) -> !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)> attributes {llvm.emit_c_interface} {
%0 = llvm.mlir.poison : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%1 = llvm.insertvalue %arg0, %0[0] : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%2 = llvm.insertvalue %arg1, %1[1] : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%3 = llvm.insertvalue %arg2, %2[2] : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%4 = llvm.insertvalue %arg3, %3[3, 0] : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%5 = llvm.insertvalue %arg4, %4[4, 0] : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
llvm.return %5 : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
}
llvm.func @_mlir_ciface_fun(%arg0: !llvm.ptr, %arg1: !llvm.ptr) attributes {llvm.emit_c_interface} {
%0 = llvm.load %arg1 : !llvm.ptr -> !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%1 = llvm.extractvalue %0[0] : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%2 = llvm.extractvalue %0[1] : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%3 = llvm.extractvalue %0[2] : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%4 = llvm.extractvalue %0[3, 0] : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%5 = llvm.extractvalue %0[4, 0] : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
%6 = llvm.call @fun(%1, %2, %3, %4, %5) : (!llvm.ptr, !llvm.ptr, i64, i64, i64) -> !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>
llvm.store %6, %arg0 : !llvm.struct<(ptr, ptr, i64, array<1 x i64>, array<1 x i64>)>, !llvm.ptr
llvm.return
}
}
이제는 그 대신 @fun 함수의 C 호환 래퍼인 @_mlir_ciface_fun 함수를 호출합니다. 입력용(%arg0)과 출력용(%arg1)으로 두 개의 인자가 주어진다는 점에 주목하십시오. 이제 자체 메모리 버퍼를 함수에 패스할 수 있으며, 코드 생성이 memref에서 메타데이터를 추출하므로 함수는 결과를 그 버퍼에 다시 기록합니다.
외부 참고 자료
도구 호출을 활용한 미세 조정
trl 0.19.0이 출시되면서 이제 사용자 정의 도구를 사용하는 모델의 미세 조정을 기본적으로 지원하며, 이 기능은 Dataset 및 SFTTrainer 클래스에 자연스럽게 통합되어 있습니다. 이를 통해 모델이 외부 함수를 어떻게, 그리고 언제 호출해야 하는지 가르치는 학습 과정이 간소화됩니다. 이제 도구 사용의 전체 대화 흐름을 포함하도록 학습 데이터를 구성할 수 있습니다. 즉, 최초의 사용자 프롬프트부터 도구를 호출하기로 한 모델의 결정, 해당 도구에서 나온 결과 출력, 그리고 모델이 종합하여 내놓은 최종 응답까지 모두 포함합니다.
이 워크플로에서 기존부터 있던 구성 요소는 get_json_schema 유틸리티 함수로, 이 함수는 여러분의 Python 코드와 모델이 요구하는 구조화된 형식 사이의 간극을 깔끔하게 메워 줍니다. 이 함수는 Python 함수로부터 규격에 맞는 JSON 스키마를 직접 자동 생성하지만, 두 가지 핵심 코딩 관행을 전제로 합니다. 첫째, 함수는 모든 인수와 반환값에 대해 최신 Python 타입 어노테이션을 포함해야 합니다. 둘째, 함수의 docstring은 Google docstring 스타일로 작성되어야 합니다. get_json_schema를 사용하면 함수를 파싱하여 매개변수의 이름과 데이터 타입뿐만 아니라 함수와 각 인수가 무엇을 하는지 설명하는 서술 텍스트까지 추출할 수 있습니다. 그럼 예제를 살펴봅시다.
from transformers.utils import get_json_schema
def multiply(a: float, b: float):
"""
A function that multiplies two numbers
Args:
a: The first number to multiply
b: The second number to multiply
"""
return a * b
schema = get_json_schema(multiply)
print(schema)
이렇게 하면 해당 함수에 대한 데이터셋 JSON 스키마를 얻을 수 있습니다.
{
"type": "function",
"function": {
"name": "multiply",
"description": "A function that multiplies two numbers",
"parameters": {
"type": "object",
"properties": {
"a": {
"type": "number",
"description": "The first number to multiply"
},
"b": {
"type": "number",
"description": "The second number to multiply"
}
},
"required": ["a", "b"]
}
}
}
이제 이 스키마를 사용하여 도구 호출이 포함된 데이터셋을 만들 수 있습니다. 예를 들어 mpmath 라이브러리를 래핑하여 다항식의 근과 베셀 함수에 관련된 도구 호출 데이터셋을 만들 수 있습니다. 데이터셋에 도구 스키마를 담은 tools 열만 추가하면 됩니다.
import mpmath
from datasets import Dataset
from transformers.utils import get_json_schema
from trl import SFTTrainer
def find_polynomial_roots(coefficients: list[float]) -> str:
"""
Finds the roots of a polynomial given its coefficients.
Args:
coefficients: A list of coefficients [c_n, ..., c_1, c_0] for c_n*x^n + ... + c_0.
Returns:
A string representation of the list of roots.
"""
roots = mpmath.polyroots(coefficients)
return str(roots)
def calculate_bessel_j(order: float, value: float) -> float:
"""
Calculates the Bessel function of the first kind, J_v(z).
Args:
order: The order 'v' of the Bessel function.
value: The value 'z' at which to evaluate the function.
Returns:
The result of the Bessel function J_v(z).
"""
return mpmath.besselj(order, value)
polyroots = get_json_schema(find_polynomial_roots)
bessel = get_json_schema(calculate_bessel_j)
dataset = Dataset.from_dict(
{
"messages": [
[
{
"role": "user",
"content": "Find the roots of the polynomial x^2 - 4.",
},
{
"role": "assistant",
"tool_calls": [
{
"type": "function",
"function": {
"name": "find_polynomial_roots",
"arguments": {"coefficients": [1, 0, -4]},
},
}
],
},
{
"role": "tool",
"name": "find_polynomial_roots",
"content": "[-2.0, 2.0]",
},
{
"role": "assistant",
"content": "The roots of x^2 - 4 are -2.0 and 2.0.",
},
],
[
{
"role": "user",
"content": "What is the value of the Bessel function J0(2.5)?",
},
{
"role": "assistant",
"tool_calls": [
{
"type": "function",
"function": {
"name": "calculate_bessel_j",
"arguments": {"order": 0, "value": 2.5},
},
}
],
},
{
"role": "tool",
"name": "calculate_bessel_j",
"content": "0.0483837764022209",
},
{
"role": "assistant",
"content": "The value of J0(2.5) is approximately 0.04838.",
},
],
],
"tools": [
[polyroots, bessel],
[polyroots, bessel],
],
}
)
trainer = SFTTrainer(
model="Qwen3-0.6B",
train_dataset=dataset,
)
trainer.train()
제가 제한적으로 테스트해 본 바로는, 현재 사용자 정의 도구 사용을 위한 미세 조정에는 Qwen3-0.6B와 Llama-3.1-70B-Instruct가 가장 뛰어난 오픈 웨이트 모델입니다. 물론 결과는 환경에 따라 다를 수 있습니다.
프로그램 합성: 기계 속의 λ
코드 생성에 적용된 인공지능에 관한 “주류” 논의의 대부분은 더 큰 언어 모델로 규모를 키우고 테스트 시점 연산(test-time compute)을 활용하여 코딩 벤치마크(SWE-bench, LiveCodeBench 등)에서 모델 성능을 끌어올린다는 발상이 압도적으로 지배하고 있습니다. 그리고 그러한 접근은 실제로 매우 흥미로운 결과를 몇 가지 만들어 냈습니다. 다만 그 열매에서 짜낼 즙이 얼마나 더 남아 있는지는 잘 모르겠습니다.
실제로 최전선의 모델들은 확률적 모방에 있어 놀라운 능력을 보여 주었으며, 학습 말뭉치에서 얻은 코드 템플릿을 창발적이고 유용한 방식으로 엮어 내고 합성하는 능력도 보여 주었습니다. 그러나 이 모델들은 여전히 토큰 시퀀스를 예측하는 방식으로 동작하며, 사람이 작성한 코드와 흔히 닮은, 구문적으로 그럴듯한 산출물을 생성합니다. 이 모델들이 추론과 비슷한 무언가라도 하고 있는지는 논란의 여지가 매우 큰 열린 질문이며, 저는 정말로 알지 못하기 때문에 이에 대해 내놓을 만한 흥미로운 의견이 없습니다. 현재의 시스템이 일부 경우에 제한적으로나마 유용하다는 것은 분명히 알고 있으며, 그 정도는 부인할 수 없는 사실로 보입니다.
그럼에도 저는 이 정교한 패턴 매칭을 진정한 프로그램 구성으로 오인하는 것은 심각한 범주 오류라고 주장하고 싶습니다. 통계적 사전 분포를 사용하여 코드를 텍스트 토큰의 시퀀스로 생성하는 것은, 프로그램 동역학의 공간에서 직접 탐색하여 프로그램을 생성하는 것과는 근본적으로 다른 작업입니다. 전자는 언어의 표면을 조작하는 행위이고, 후자는 논리적이고 의미론적인 발견의 행위입니다. 그리고 현재의 모델이 후자를 수행할 수 있는지는 제게 분명하지 않습니다.
하지만 잠시만 제 이야기에 장단을 맞춰 주시고, 어쩌면 AI 지원 개발의 미래가 오늘날의 모델을 다듬는 데 있는 것이 아니라 더 험난하고 사람들이 덜 다닌 프로그램 합성의 길을 추구하는 데 있을지도 모른다는 점을 생각해 보십시오. 이 길의 현대적 형태는 함수형 프로그래밍과 타입 이론의 발전에 가장 깊은 뿌리를 두고 있습니다. 프로그램 합성이 지향하는 바는 정확해 보이는 코드를 만들어 내는 것이 아니라, 바로 그 구성 방식 자체에 의해 명세에 대해 정확함이 증명된 프로그램을 구성하는 것입니다. 이는 활동의 중심을 자연어 프롬프트라는 지저분하고 모호한 영역에서 논리 명제라는 정밀하고 검증 가능한 영역으로 옮겨 놓습니다. 이러한 시도는 역사적으로 계산적으로 다루기 어려운 탐색 공간 때문에 발목이 잡혀 왔지만, 함수형 프로그래밍의 성숙, 특히 의존 타입의 등장은 필요한 이론적 토대의 상당 부분을 제공해 주었습니다.
의존 타입의 언어에서는 명세를 타입 시스템 안에 직접 인코딩할 수 있으며, 이를 통해 타입 검사는 일종의 부분적인 프로그램 검증이 됩니다. 바로 여기에서 **구멍 방식 개발(hole-style development)**이라는 개념이 이 새로운 패러다임의 핵심적인 사용자 인터페이스가 됩니다. 프로그래머는 속성을 타입으로 표현하면서 상위 수준의 구조를 설계하되, 구체적인 구현 세부 사항은 코드 안에 명시적인 “구멍“으로 남겨 둡니다. 이 구멍들은 올바른 형태를 갖춘 프로그램 안에 있는 일급(first-class)의, 타입이 지정된 틈이며, 합성기의 역할은 그 문맥의 엄격한 제약을 만족하는 항(term)을 찾는 것입니다.
두 벡터를 이어 붙이는 의존 타입의 의사 코드를 생각해 보십시오. 여기서 타입 시스템은 결과 벡터의 길이를 보장합니다. 프로그래머는 구현 로직을 ?로 표시되는 구멍으로 남겨 둔 채 초기 스케치를 작성할 수 있습니다.
data Vect : (Nat) -> (Type) -> Type where
Nil : Vect 0 a
Cons : a -> Vect n a -> Vect (S n) a
append : (n m : Nat) -> Vect n a -> Vect m a -> Vect (n + m) a
append 0 m Nil ys = ys
append (S n) m (Cons x xs) ys = Cons x ?
타입 검사기는 이 구멍이 Vect (n + m) a 타입의 항으로 채워져야 한다고 추론합니다. 이제 합성기의 작업은 엄청나게 단순해집니다. 합성기는 이어 붙이기라는 “개념“을 이해할 필요가 없습니다. 합성기는 사용 가능한 항(Vect n a 타입의 xs와 Vect m a 타입의 ys)을 요구되는 출력 타입으로 변환할 수 있는 연산의 조합만 탐색하면 됩니다. 유도된 탐색을 통해 합성기는 재귀 호출 append n m xs ys가 해당 타입을 만족한다는 것을 발견하게 되며, 이로써 타입 수준의 명세에 대해 정확함이 보장되는 방식으로 프로그램이 완성됩니다. Agda, Coq, Lean과 같은 시스템을 사용해 보신 적이 있다면 이 접근 방식의 위력을 아마 직접 보셨을 것입니다.
이러한 협업적 합성(비록 동적 타입이기는 하지만)의 비전은 DreamCoder와 같은 시스템에서 적어도 부분적으로 실현되었으며, 이는 기호적 추론과 신경망 학습을 잇는 데 있어 중요한 진전입니다. DreamCoder는 각성-수면 베이즈 학습 주기를 통해 작동합니다. “깨어 있는(wake)” 단계에서 DreamCoder는 귀납적 프로그램 합성 문제 코퍼스를 적극적으로 풀려고 시도하며, 주어진 입력-출력 예제를 만족하는 프로그램을 탐색합니다. “수면” 단계에서는 일종의 계산적 자기 성찰을 수행합니다. 즉, 찾아낸 해답을 분석하고, 공통 패턴을 리팩터링하고 압축하여 재사용 가능한 고수준 추상화로 이루어진 학습된 라이브러리로 만듭니다. 동시에 향후 탐색을 안내하는 신경망을 훈련시켜 합성 과정을 훨씬 더 효율적으로 만듭니다. 문제를 풀고 그 해답에서 학습하기를 번갈아 반복하는 이 과정을 통해 시스템은 스스로 전문성을 부트스트랩할 수 있으며, 점점 더 강력해지는 도메인 특화 언어와 그 구조에 맞게 조정된 탐색 정책을 구축합니다.
DreamCoder가 개척한 신경망 유도 접근법은 한층 더 흥미로운 연구 분야를 열어 줍니다. 바로 타입 주도 합성을 강화 학습 문제로 구성하는 것입니다. PPO와 같은 알고리즘으로 구동되며, 부분 프로그램을 귀납적으로 구성하고 프로그램의 구멍을 채우는 임무를 맡은 에이전트를 상상해 볼 수 있습니다. 환경은 불완전한 프로그램이고, 상태는 타입이 지정된 구멍과 그 지역 문맥이며, 사용 가능한 행동은 현재 라이브러리의 프리미티브들인데, 이 라이브러리 자체도 학습된 것일 수 있습니다. 타입이 올바른 항을 만들어 내는 모든 행동에 보상이 주어지며, 프로그램을 완성하면 상당한 최종 보상이 주어집니다. 에이전트의 정책 네트워크는 의미론적 사전 분포를 학습하여, 다음에 어떤 토큰이 올 가능성이 높은지가 아니라, 어떤 분기나 삽입이 주어진 지역 타입 시그니처와, 명세와의 일관성을 극대화하는 보상 함수를 향해 최적화한다는 전역 목표를 만족할 가능성이 가장 높은지를 예측하게 될 것입니다. 이는 표면 구문에 대한 패턴 매칭을 넘어 문제 도메인의 논리적 구조를 학습하는 방향으로 나아가는 것이며, DeepSynth, LambdaBeam 및 기타 신경망 유도 연역적 탐색 방법과 같은 시스템에 대한 연구에서 탐구된 방향입니다.
이런 종류의 추측은 재미있으며, 매우 흥미롭고 열려 있는 연구 문제입니다. 하지만 냉철한 현실 인식이 필요합니다. 프로그램 합성이라는 아이디어가 지적으로 우아함에도 불구하고, 그 미래는 결코 보장되어 있지 않습니다. 이러한 합성기를 개발하는 일은 개발자가 얻을 단기적 경제적 이익이 거의 없는 엄청난 엔지니어링 과제가 될 것이며, 아마도 어떤 전통적인 모델로도 자금을 조달하기 어려울 것입니다. 합성기가 효과적으로 작동하려면 각 도메인, 각 라이브러리, 각 API마다 형식 명세나 잘 선별된 문제 집합이 갖추어져야 합니다. 이는 NPM이나 PyPI 같은 기존 생태계의 혼란스럽고, 문서화되지 않았으며, 일관성 없이 뻗어 나간 코드를 받아들이고도 비록 취약하지만 유용한 사용 패턴을 추출해 낼 수 있는 통계적 모델과 극명한 대조를 이룹니다.
기존 프로그래밍 생태계의 네트워크 효과는 기술적 순수성이 일관되게 극복하지 못해 온 자연의 힘과 같습니다. 이것이 지난 40년간 Lisp와 함수형 프로그래밍 커뮤니티가 얻은 쓰라린 교훈이었습니다. 그들은 깨끗하고, 강력하며, 자기 일관적인 거품 세계를 구축했지만, 결국 C, Java, Python의 실용적인 분비와 축적에 밀려났습니다. 이 언어들의 가치는 내부적 일관성이 아니라 이를 둘러싼 라이브러리의 압도적인 규모와 경제적 유인에서 비롯되었습니다. 따라서 저는 가까운 미래에는 업계가 통계적 토큰 예측이라는 피상적으로 효과적인 접근법에 지배될 것이라는 점을 아마도 인정해야 할 것입니다. 인간과 기계 사이의 형식적 대화를 통해 합성되는, 증명 가능하게 올바른 프로그램이라는 꿈은 앞으로도 영감을 주는 비전으로 남겠지만, 코드 재사용이라는 거대한 중력과, 이전에 작성된 것을 그저 모방하는 데서 오는 최소 저항의 경로 앞에서 왜소해질지도 모릅니다. 그래도 우리는 여전히 DreamCoder의 미래를 꿈꿀 수 있습니다.
AI의 실제 가치는 얼마입니까?
인공지능 붐은 분명히 시장 버블의 역사상 가장 최근 사례이지만, 유난히 기이한 버블입니다. 이 버블은 경영진의 환상, 유사 종교적 열광, 그리고 달리 갈 곳 없는 자본의 급류가 뒤섞인 강력한 혼합물로 부풀려졌습니다. 지지자들과 업계의 오피니언 리더들은 산업혁명에 버금가는 새로운 경제의 여명을 선포하지만, 자세히 들여다보면 이 산업은 불안정한 기술적 기반 위에 세워져 있고, 지속 불가능한 지출로 떠받쳐지며, 부조리에 가까운 서사로 추진되고 있음이 드러납니다. 현재의 조 달러 단위 기업 가치는 임박한 혁명을 반영하는 것이 아니라 자기기만에 대한 금융계의 무한한 역량을 보여 주는 증거이며, 피할 수 없고 가혹한 조정을 예고합니다.
이 과대광고의 핵심에는 마케팅 자료가 암시하는 것보다 훨씬 덜 인상적인 기술적 현실이 자리하고 있습니다. 이 새로운 물결의 원동력인 대규모 언어 모델의 스케일링은 수확 체감의 벽에 부딪히고 있는 것으로 보입니다. 근본적인 아키텍처상의 돌파구가 없는 한, 우리는 점점 더 미미해지는 성과를 위해 모델에 더 많은 데이터와 더 많은 연산을 쏟아붓고 있을 뿐입니다. 벤치마킹 과정 전체가 주관적인 미인 대회로 전락했으며, 여기서는 “진보“를 정의하는 것 자체가 하나의 난제입니다. 정답이 둘 중 하나로 갈리는 작업을 제외하면, 어떤 모델이 더 우수한지 판단하는 일은 분위기와 의견의 문제이며, 한 영역에서의 개선이 다른 영역의 결함을 낳는 두더지 잡기 게임입니다. 이러한 지표는 과학이라기보다는 정교한 얼버무리기에 가까우며, 역량을 진정으로 측정하기보다는 제품 출시와 투자자 발표 자료에 쓸 인상적인 차트를 만들어 내도록 설계되어 있습니다.
이러한 기술적 모호함은 미국의 전문 경영인 계층을 완전히 사로잡은 매혹적인 환상이 자라날 비옥한 토양이 됩니다. 경영 컨설턴트 군단에게 속아 넘어간 이 비기술직 임원들은 인간 노동이라는 지저분하고 예측 불가능하며 비용이 많이 드는 일이 자동화로 사라지는 가까운 미래를 그립니다. 그들은 소수의 엘리트 이사진이 운영하며, 급여나 의료 보험, 노동 분쟁의 부담 없이 이윤이 치솟는 기업 유토피아를 꿈꿉니다. 물론 이것은 허구이지만, 직원을 기계 속의 교체 가능한 톱니바퀴로 여기는 관리자들에게는 강력한 허구입니다. 이 망상은 기업 AI 지출의 주된 동력이며, 노동자를 대체할 수 있고 또 대체해야 한다는 명제에 바쳐진 거대한 R&D 비자금입니다.
이러한 경영진의 헛된 꿈이 낳은 결과는 회사의 실제 업무와 심각하게 동떨어진 기업 “혁신” 프로젝트의 해일입니다. 기업의 지상 과제는 “AI 전략을 갖추는 것“이며, 이는 실제로는 데이터 검색을 위한 사내 챗봇과 RAG 시스템을 구축하는 것을 의미합니다. 이러한 프로젝트는 대개 Core 비즈니스 활동과는 몇 단계나 동떨어져 있어 실질적인 가치는 거의 내지 못하지만, 사내에서 진전으로 포장해 내세울 수 있을 만큼은 그럴듯합니다. 최근의 일부 연구에서는 이러한 프로젝트의 실패율을 약 95%로 추산합니다. 이는 정치인의 오류를 완벽하게 실행한 것입니다. 무언가를 해야 한다, 이것은 무언가이다, 그러므로 우리는 이것을 해야 한다는 것입니다. 기업들은 실제 문제를 해결하기 위해서가 아니라 유행에 동참하는 것처럼 보이기 위해 자본을 소진하고 있으며, 이사회와 주주를 달래기 위해 값비싼 인공지능 포템킨 마을을 짓고 있습니다.
그다음에는 기업 불안의 대사제인 경영 컨설턴트들이 장의사처럼 엄숙한 태도로 등장하여 최고 경영진의 가장 깊은 불안감을 돈벌이로 삼습니다. 번드르르한 슬라이드 자료와 시너지 운운하는 헛소리로 이루어진 그들만의 어휘로 무장한 채, 그들은 인력을 값비싼 부채로 여기는 임원들의 귀에 매혹적인 환상을 속삭이며 팔아넘깁니다. 그들의 복음은 지저분하고 비용이 많이 들며 이따금 노조까지 결성하는 인간 노동이라는 문제를 대차대조표에서 깔끔하게 도려내고, 결점 없고 불평 없는 알고리즘으로 대체할 수 있는 이사회실의 유토피아를 설파합니다. 그들은 고객의 심각한 기술적 무지를 능숙하게 이용하여, AI를 운영 비용을 순수한 이윤으로 바꾸어 줄 마법의 블랙박스로 제시합니다. 그 결과는 수백만 달러짜리 “전환” 로드맵의 홍수이며, 이 로드맵의 주된 전략적 기능은 컨설턴트 자신에게 수익성 높은 다년간의 후속 계약을 보장하는 것입니다. 그들은 조언자가 아니라 그럴듯한 책임 회피의 설계자이며, 혁신이라는 이름으로 주주의 돈에 모닥불을 지필 수 있도록 아름답게 서식을 갖추고 전문 용어로 가득 채운 허가증을 임원들에게 건네줍니다.
이러한 기업의 망상은 베이 에어리어라는 기묘한 문화적 테라리움에 의해 증폭되고 신성시되며, 그곳에서 AI 연구소들은 새로운 합리주의 컬트의 수도원 역할을 합니다. 그 신도들, 즉 사회적으로 불안한 만성 인터넷 중독자 집단은 자신들이 지저분한 인간의 직관을 순수한 논리로 대체했다고 믿지만, 실제로는 옛 신들을 실리콘 신으로 바꿔 놓았을 뿐입니다. 그들은 베이즈 사전확률과 기대 효용이라는 암호화된 어휘를 통해 충성을 드러내는데, 이는 자신들이 깨달음을 얻은 소수에 속한다는 것을 확인해 주는 언어적 악수이며, 바깥에 나가 풀이라도 만져 본 적 있는 사람들의 실제 삶의 경험과는 영원히 단절되어 있습니다. 이것은 단순한 하위문화가 아닙니다. 이것은 자신의 무의식적인 종교적 충동이 스스로를 예언자 코스프레로 이끌었다는 사실을 깨닫지 못하는 지적인 사람들을 위한 본격적인 종말론 운동입니다. 스스로를 “슈퍼 예측가“라 칭하는 이들은 블로그에서 예언을 쏟아내며, 2027년까지 기계 신이 도래할 것이라고 숨 가쁘게 예측합니다. 이는 자격 있는 자들을 위해 모든 문제를 해결해 줄 디지털 휴거입니다. 그들의 사고 과정이라는 심연을 들여다보고 싶다면 그들의 경전을 읽기만 하면 됩니다. 그 글은 자의식 과잉과 추상적인 헛소리로 너무나 빽빽해서, 입문하지 않은 이들에게는 인지적 장벽으로 작용합니다.
따라서 특이점 이후의 세계는 현재 이 문제를 무시하고 있는 사람들에게는 즐거움과 풍요의 세계가 될 수 있는 반면, 현재 실존적 위험을 줄이려는 사람들 중 상당수(이를테면 가장 덜 너그러운 절반)에게는 생지옥이 될 수 있습니다. 여러분은 이 가능성을 고려하여 처벌을 피하기 위해 실존적 위험 대응에 훨씬 더 많이 기부할 수도 있습니다. 하지만 물론, 그런 식으로 생각하고 있다면 CEV 싱글턴은 여러분을 처벌하고 싶어 할 가능성이 훨씬 더 높아집니다… 끔찍한 일입니다. 물론 이는 부당한 일이겠지만, 너무나도 공리주의적인 종류의 부당함입니다. 이는 공정한 세상 오류에 빠지는 것이 실존적 위험과 관련하여 어떻게 사람에게 역효과를 낼 수 있는지를 보여 주는 구체적인 예이며, 특히 자신의 노력에 대해 미래에 어떤 보상을 암묵적으로든 명시적으로든 기대하고 있던 사람들에게 그러합니다. 그리고 이런 일이 일어날 확률이 1%에 불과하다고 생각하더라도, 실존적 위험에 관한 이야기를 “헛소리“라며 가볍게 일축할 무작위의 사람에게 CEV가 이런 일을 할 확률은 사실상 0이라는 점에 유의하십시오.
위 구절이 편집증적인 SF 소설과 철학과 1학년생의 대마초 흡입이 낳은 불경한 결합처럼 읽힌다면, 축하합니다. 여러분은 정상입니다. 이것이 바로 이 운동의 지적 근간입니다. 펄프 픽션의 페이지에서 뜯어낸 터무니없고 미로 같은 사고 실험들을, 신의 계시처럼 지극히 진지하게 받아들이는 것입니다. 본질적으로 이것은 베이 에어리어판 너드 사이언톨로지이며, 세금 최적화 한 부분, 경력 발전을 위한 냉소적인 내집단 신호 보내기 한 부분, 그리고 서버 팜에서 신을 만들고 있다고 진심으로 믿는 진정한 신자들의 순진한 열정 한 부분으로 이루어진 완벽한 삼위일체입니다.
이 광풍에서 나오는 실제 응용 사례들을 살펴보면, 그림은 더욱 암울해집니다. 텍스트 생성을 제외하면, 가장 두드러진 사용 사례들은 수익성이 없거나, 사회에 순손실을 주거나, 혹은 둘 다입니다. AI 이미지 생성은 매력적인 장난감이지만, 수익성으로 가는 명확한 길이 없는, 비싸고 쉽게 범용화되는 신기한 물건에 불과합니다. 말하는 동물과 역사적 인물이 나오는 초현실적인 클립을 만들어 내는 바이럴 동영상 생성기는 재미있는 오락거리이지만, 경제적 가치가 아니라 디지털 슬롭을 만들어 내는 엔진입니다. 이 “슬롭 경제“로 실제 돈을 버는 유일한 주체는 Nvidia이며, 이 회사는 바보들의 골드러시에 쓰일 디지털 삽을 기꺼이 팔고 있습니다. 가장 가능성 높은 결과는 소셜 미디어가 알고리즘으로 생성된 콘텐츠의 끝없는 물결에 질식하여, 그 콘텐츠를 호스팅하는 플랫폼 자체를 목 졸라 죽이는 미래입니다. 그리고 어쩌면 우리는 그것을 축하해야 할지도 모릅니다!
가장 정당한 응용 분야인 AI 기반 코딩 어시스턴트조차 재정적으로는 의심스러운 사업입니다. 이러한 도구들이 프로그래머의 생산성을 진정으로 높여 줄 수는 있지만, 이를 제공하는 회사들은 심각한 적자 상태입니다. 또한 이들은 소수의 모델 제공업체(즉, 코딩 작업에서 다른 모델들보다 진정으로 훨씬 뛰어난 모델을 보유한 Anthropic)에 크게 의존하고 있으며, 이 분야 전체를 괴롭히는 것과 동일한 스케일링 한계에 제약을 받고 있습니다. 이 기술이 상당수의 초급 프로그래밍 일자리를 없앨 수도 있겠지만, 복잡하고 창의적이며 시스템 수준의 사고가 가능한 완전 자동화된 소프트웨어 엔지니어라는 꿈은 여전히 요원한 몽상으로 남아 있습니다. AI 분야의 수많은 것들이 그렇듯, 좋은 아이디어의 커널이 기반 기술로는 도저히 뒷받침할 수 없는 혁명적인 환상으로 부풀려졌습니다.
이 거대한 구조물 전체는 너무나 방대하고 무분별해서 소방 호스조차 정밀 기기처럼 보이게 만드는 자본의 간헐천에 의해 떠받쳐지고 있습니다. 미국 벤처 경제는 산더미 같은 “드라이 파우더”, 즉 궁지에 몰린 쥐처럼 조급하고 광란에 찬 에너지로 몸살을 앓고 있는 수십억 달러의 미투자 자본을 깔고 앉아 있습니다. 암호화폐와 메타버스가 남긴 연기 나는 분화구가 아직 기억에 생생한 가운데, 투자 계층은 어리석은 TINA 주문에 이끌려 마지막으로 그럴듯한 성장 스토리를 향해 우르르 몰려들었습니다. 이른바 전략적 배분이라는 것은 사실 사막에 있는 유일한 신기루를 향한 필사적인 도피에 가깝습니다. 하지만 전문적으로 자금을 운용하고 있다면 현금을 쥐고 있는 것은 선택지가 아니므로, 음악이 흐르는 동안에는 춤을 춰야 합니다.
처음 몰려든 이 불안한 돈은 이어서 금융 먹이사슬의 마지막 단계인 잘 속는 거대 괴수들을 끌어들입니다. 이제 소프트뱅크와 걸프 국가 국부펀드들이 등장합니다. 지구상에서 가장 크고 가장 아둔한 자금 풀인 이들은 “미래“의 희미한 약속으로 반짝이는 것이라면 무엇에든 오일달러와 찍어낸 돈을 퍼부을 준비가 되어 있습니다. 이들의 실사 과정은 슬롯머신 수준의 지적 엄밀성을 갖추고 있으며, 지정학적 과시와 순전하고 꾸밈없는 FOMO가 뒤섞인 것에 불과합니다. 이렇게 해서 스스로를 핥는 아이스크림콘 같은 장엄한 거품이 만들어집니다. 자본가 계급은 AI 연구소들의 지속 불가능한 현금 소진에 자금을 대고, 이는 과대광고를 낳으며, 과대광고는 정신 나간 기업가치로 진행되는 더 늦고 더 큰 라운드에 국부펀드를 끌어들이고, 이는 다시 VC들의 초기 베팅을 정당화합니다. 목표는 수익성 있는 사업을 일구는 것이 아니라, 불붙은 약속어음 꾸러미를 더 부유한 다음 바보에게 넘길 수 있을 만큼 오래 음악이 계속 흐르게 하는 것입니다. 탈중앙화되어 있다고들 하는 투자자 계급은 오히려 레밍 떼에 가까우며, 소련의 중앙계획가조차 얼굴을 붉히게 할 만큼 화려한 잘못된 투자의 향연을 벌이고 있습니다.
그렇다고 해서 AI 전체가 잘못된 투자이거나 사기라는 말은 아닙니다. 정당하고 흥미로운 연구가 이루어지고 있으며, 단백질 접힘 분야의 진전을 둘러싼 노벨상급 돌파구가 그 잠재력을 보여 줍니다. 확률적 텍스트 모델에는 틈새이긴 하지만 실질적인 응용처가 있습니다. 그러나 이 모델들은 지식 경제 업무의 대다수를 수행할 만큼 신뢰할 수 있거나, 일관되거나, 정확하지 않습니다. 이 모델들에 그러한 특성을 부여해 주리라 약속하는 돌파구는 지평선 어디에도 보이지 않습니다. 이 업계는 그러한 돌파구가 바로 코앞에 와 있다는 듯 역할극을 하는 사람들로 가득합니다. 그렇게 믿을 유인이 있기 때문이거나, 아니면 종교적 운동의 일원이어서 AI 특이점을 믿는 것이 현대적 삶의 평범한 불안정성으로부터 심리적 도피처가 되어 주기 때문입니다. 현실은 이렇습니다. 인공지능은 실재하고 견고하며 지속될 산업이고 필연적으로 미래의 일부가 되겠지만, 그 진정한 시가총액은 수조 달러가 아니라 수백억 달러 단위로 측정되는 산업입니다. 현재 투입되고 있는 막대한 자금은 모닥불의 땔감이며, 불길이 잦아들고 나면 남는 것은 마침내 고통스럽게 정신을 차린 시장의 정신이 번쩍 드는 잿더미뿐일 것입니다. 그리고 부디 그것이 S&P500의 상당 부분까지 함께 끌고 가지 않기를 바랍니다.
서평: 내일 또 내일 또 내일
개브리엘 제빈의 내일 또 내일 또 내일은 두 사람이 30년 동안 함께 비디오 게임을 만드는 이야기를 다룬 소설입니다. 이 문장을 읽고 반사적으로 뒤로 가기 버튼에 손이 갔다면 그 마음은 이해합니다만, 그렇게 하신다면 실수하시는 것입니다. 이 책은 업계 회고록들이 게임 업계를 다루는 방식(자화자찬에 전문 용어가 넘쳐나고, 제품을 출시하는 일이 그 자체로 영웅적이라고 믿어 의심치 않는 방식)으로 게임 업계를 다루지 않습니다. 이 책은 최고의 SF가 우주선을 사용하는 방식으로 게임 디자인을 사용합니다. 즉, 더 흥미로운 곳에 도달하기 위한 수단으로 사용합니다. 이 경우 그 목적지는 다른 사람과 함께 무언가를 만든다는 것이 무엇을 의미하는지에 대한, 끈질기고 감상에 빠지지 않으며 놀라울 만큼 가슴을 무너뜨리는 탐구입니다.
샘 메이저와 세이디 그린은 어린 시절 병원에서 만납니다. 샘은 어머니를 잃고 자신의 발이 으스러진 교통사고에서 회복하는 중입니다. 세이디는 백혈병 치료를 받고 있는 언니를 병문안하러 와 있습니다. 두 사람은 닌텐도로 가까워집니다. 그러다 연락이 끊깁니다. 두 사람은 몇 년 뒤 다시 만나(샘은 하버드에, 세이디는 MIT에 있으며, 두 곳은 레드 라인으로 몇 정거장 떨어져 있습니다. 저도 그 정거장들 사이에서 수년간 살았기에 잘 아는 지역입니다) 함께 게임을 만들기 시작합니다. 두 사람의 첫 공동 작업인 이치고는 호쿠사이의 파도 판화에서 가져온 세계를 배경으로 한 횡스크롤 게임으로, 엄청난 성공을 거둡니다. 두 사람의 창작 파트너십은 수십 년에 걸쳐 이어집니다. 그 파트너십은 성공과 실패, 질투, 슬픔, 총격 사건, 그리고 두 사람이 서로를 사랑하는 것인지 아니면 단지 함께 만드는 것을 사랑하는 것인지라는, 끈질기게 따라다니며 끝내 온전히 풀리지 않는 질문을 견뎌 냅니다.
제빈은 창작 협업의 작동 방식에 대해 가차 없이 정밀합니다. 제빈은 다른 사람과 함께 무언가를 만드는 일이 우정과도 다르고 연애와도 다르며 그 어느 쪽으로도 환원되지 않는, 그 자체로 고유한 형태의 친밀함이라는 것을 이해하고 있습니다. 샘과 세이디는 서로를 필요로 합니다. 그리고 서로를 필요로 한다는 사실 때문에 서로를 원망합니다. 두 사람은 경쟁하고, 공을 인정하기를 꺼리며, 창작의 신경계를 공유하는 사람들만이 할 수 있는 특유의 방식으로 서로에게 상처를 줍니다. 샘의 대학 룸메이트였다가 두 사람의 사업 파트너가 되고 결국 세이디의 연인이 되는 마크스는 삼각형의 세 번째 꼭짓점입니다. 그는 두 주역이 자신들의 비전에 너무 몰두한 나머지 알아차리지 못하는 모든 일을 처리함으로써 협업을 가능하게 하는 사람입니다. 그는 이 책에서 가장 너그러운 인물이며, 제빈은 그에게 어떤 일을 벌이는데, 스포일러는 하지 않겠습니다만 그 일로 인해 이 소설이 맥베스의 제사(題辭)를 붙일 자격을 얻는다는 것만 말씀드리겠습니다.
제목은 물론 맥베스의 유명한 독백에서 따온 것입니다. “내일, 또 내일, 또 내일은 / 하루하루 이 보잘것없는 걸음으로 기어갑니다.” 이 독백은 무의미함, 곧 아무것도 뜻하지 않는 소리와 분노로서의 삶을 이야기합니다. 제빈은 이를 뒤집습니다. 제빈의 이야기에서 “내일“의 반복은 창작 작업의 구조 그 자체입니다. 나타납니다. 그것을 만듭니다. 다시 나타납니다. 샘과 세이디가 만드는 게임은 맥베스의 절망에 대한 두 사람의 대답이며, 그것이 일시적이라는 것을 알면서도, 허구라는 것을 알면서도 누군가가 만들기로 선택했기 때문에 비로소 무언가를 의미하게 되는 세계입니다. 이 책은 제가 최근 몇 년간 읽은 책 중에서 죽음에 관해 가장 조용히 낙관적인 책이며, 그 낙관을 정직하게, 즉 쌓여 가는 상실에도 불구하고가 아니라 그 상실을 통해 이루어 냅니다.
다른 사람들과 함께 무언가를 만드는 분야에서 일하고 계신다면(그리고 이 블로그를 읽고 계신다면 거의 틀림없이 그러실 것입니다), 오래도록 마음에 남는 것은 저작권자가 누구인가라는 질문을 제빈이 다루는 방식입니다. 이것은 누가 만들었습니까? 이것은 누구의 비전입니까? 회사에는 샘의 이름이 붙습니다. 엔진은 세이디가 작성합니다. 대중은 샘에게 공을 돌립니다. 코드는 세이디의 것입니다. 제빈은 법의학자 같은 인내심으로, 구조적 불평등(성별, 장애, 계급, 그리고 기자들이 도착했을 때 마침 마이크 앞에 서 있던 사람이 지닌 특유의 카리스마)이 누가 기억되고 누가 지워지는지를 어떻게 결정하는지 보여 줍니다. 무언가를 페어 프로그래밍하다가 다른 사람이 공을 차지하는 모습을 지켜본 적이 있거나, 반대로 자신이 공을 차지하고 그 조용한 부당함을 느껴 본 적이 있다면, 이 책은 망치처럼 내리칠 것입니다.
샘의 장애(어린 시절의 부상으로 인한 만성 통증과 영구적인 절뚝거림)는 문학 소설이 좀처럼 해내지 못하는 구체성으로 다루어집니다. 제빈은 그것을 은유나 그의 영혼에 관한 무언가를 드러내는 성격적 특성으로서가 아니라, 그의 삶의 하루하루를 형성하는 신체적 사실로서 다룹니다. 그는 고통을 겪습니다. 그 고통은 그가 할 수 있는 일에 영향을 미칩니다. 그의 장애를 바라보는 다른 사람들의 인식은 그들이 그를 대하는 방식에 영향을 미칩니다. 그것이 전부입니다. 같은 절제는 게임 업계에서 여성으로 살아가는 세이디의 경험에도 적용됩니다. 교수에게 착취당하고, 동료들에게 과소평가받으며, 수십 년에 걸쳐 누적되는 방식으로 구조적으로 보이지 않게 되는 경험 말입니다. 제빈은 사설을 덧붙이지 않고 그 메커니즘을 기록할 뿐이며, 그 기록만으로도 충분히 신랄한 고발이 됩니다.
이 소설은 416쪽에 달하지만 200쪽짜리 스릴러 대부분보다 빠르게 읽힙니다. 이 소설은 1990년대 초부터 2040년대까지, SNES 시대부터 가상 현실에 이르기까지를 아우르며, 게임 기술의 발전을 인간의 이야기 밑에서 조용히 째깍거리는 시계로 활용합니다. 제빈은 분명히 게임을 사랑하지만, 더 중요한 것은 사람들이 왜 게임을 사랑하는지 이해한다는 점입니다. 게임은 누군가가 만들기로 선택한 세계이며, 누군가가 부과하기로 선택한 규칙의 지배를 받고, 교통사고와 암 병동과 불공정한 공로 배분이 있는 현실 세계가 확실하게 제공하지 못하는 일종의 주체성을 제공합니다.
누군가와 함께 무언가를 만들어 본 적이 있고, 그 만드는 과정이 예측할 수 없었던 방식으로 두 사람 모두를 변화시켰다는 것을 깨달아 본 모든 분께 이 책을 추천합니다. 이 책은 제가 읽은 창작 파트너십에 관한 소설 중 최고이며, 문학 소설이 대개 스스로에게만 허락하는 것과 같은 진지함으로 비디오 게임을 하나의 예술 형식으로 다루는 보기 드문 책입니다. 맥베스의 말이 옳아서 삶이 아무 의미도 없다면, 제빈의 대답은 이것입니다. 그래도 무언가를 만드십시오. 내일도 나타나십시오. 그리고 내일도. 그리고 또 내일도.
수학의 미래는 대단히 기묘할지도 모릅니다
소설 속에서 수학자는 흔히 고독한 인물로 그려집니다. 난해한 기호가 빽빽한 칠판 앞에서 깊은 집중에 빠진 채 자기만의 세계에 갇힌 인물입니다. 과거에는 그런 모습에 어느 정도 진실이 담겨 있었을지도 모르지만, 오늘날 수학은 훨씬 더 사회적인 현상입니다. 미래의 수학자들은 페르마의 마지막 정리를 증명하려고 10년 동안 홀로 매달린 앤드루 와일스 같은 천재의 전형보다는, Github에서 풀 리퀘스트와 씨름하는 소프트웨어 엔지니어와 훨씬 더 많은 공통점을 지니게 될지도 모릅니다.
자동 정리 증명은 수학적 증명을 자동으로 구성하거나 사람이 작성한 증명이 올바른지 검증할 수 있는 소프트웨어 시스템을 개발하는 컴퓨터 과학 분야입니다. 이러한 시스템은 형식 논리, 타입 시스템, 기호 추론을 사용하여 수학적 논증의 각 단계가 앞선 단계와 확립된 공리로부터 논리적으로 도출되는지 확인합니다. 자동 정리 증명기는 수학적 지식을 정밀하고 기계가 읽을 수 있는 형식으로 인코딩함으로써 인간의 오류를 없애고 수학적 결과의 타당성을 절대적으로 보장할 수 있습니다.
정리 증명 생태계를 잘 모르는 분들을 위해 설명하자면, (Lean4, Coq, 그리고 그 선배 격인 Isabelle, Agda, HOL4 등) 한때 컴퓨터 과학 연구의 난해한 최전선에만 머물던 이 도구들이 이제 수학의 실천과 철학 자체를 재편하려 하고 있습니다. 이 학문의 미래는 우리가 지금 상상할 수 있는 것보다 훨씬 더 기묘하고, 더 협업적일 수 있습니다. 게다가 언어 모델이 동시에 등장하면서, 그 미래는 우리가 지금 상상할 수 있는 것보다 훨씬 더 흥미롭고 빠르게 다가올 수도 있습니다.
아래는 소수가 무한히 많다는 유클리드 정리를 Lean으로 형식화한 것입니다. 이 증명은 유클리드의 구성적 접근을 따릅니다. 임의의 자연수 n이 주어지면 n! + 1의 가장 작은 소인수를 고려하여 소수 p ≥ n을 구성합니다. 이 Lean 증명은 여러 택틱과 보조정리를 사용합니다. minFac은 최소 소인수를 찾고, factorial_pos는 계승이 양수임을 보이며, minFac_prime은 최소 인수가 실제로 소수임을 증명하고, dvd_factorial은 나누어떨어짐 성질을 다룹니다. Nat.dvd_add_iff_right를 통해 형식화된 핵심 통찰은, 어떤 소수가 n!과 n! + 1을 모두 나눈다면 그 차(즉 1)도 나누어야 한다는 것이며, 소수는 1을 나눌 수 없으므로 모순에 이르게 됩니다. 이것은 모든 수학과 학부생이 1학년 때 배우는 증명입니다.
/-- Euclid's theorem on the **infinitude of primes**.
Here given in the form: for every `n`, there exists a prime number `p ≥ n`. -/
theorem exists_infinite_primes (n : ℕ) : ∃ p, n ≤ p ∧ Prime p :=
let p := minFac (n ! + 1)
have f1 : n ! + 1 ≠ 1 := ne_of_gt <| succ_lt_succ <| factorial_pos _
have pp : Prime p := minFac_prime f1
have np : n ≤ p :=
le_of_not_ge fun h =>
have h₁ : p ∣ n ! := dvd_factorial (minFac_pos _) h
have h₂ : p ∣ 1 := (Nat.dvd_add_iff_right h₁).2 (minFac_dvd _)
pp.not_dvd_one h₂
⟨p, np, pp⟩
표준 학부 수학 교육과정을 이와 같은 형식으로 형식화하는 일은 더 이상 먼 꿈이 아닙니다. 그것은 가까운 시일 안에 달성할 수 있는 목표입니다. 표준 라이브러리인 Mathlib을 살펴보기만 해도, 표준 정리들에 대한 진척이 이제 놀라울 만큼 방대하고 표현력이 풍부하다는 것을 알 수 있습니다. 이러한 진척을 보여 주는 또 다른 좋은 예는 테렌스 타오의 교과서 Analysis I의 형식화입니다. 이 교과서는 탐색할 수 있고 상호 연결되어 있으며 기계로 검증할 수 있는 정리 모음으로 꼼꼼하게 옮겨졌습니다. 모든 교과서에 디지털 대응물이 있고, 어떤 정리나 보조정리든 “더블 클릭”하여 그 맥락과 정의를 펼쳐 볼 수 있는 미래는 이제 더 이상 공상 과학이 아닙니다. 사실상 이미 와 있습니다.
Lean을 직접 실험해 보고 싶다면 다음 단계를 따라 아주 빠르게 시작할 수 있습니다.
- Visual Studio Code(비주얼 스튜디오 코드)를 설치하십시오.
- Lean + Elan을 설치하십시오.
curl https://elan.lean-lang.org/elan-init.sh -sSf | sh
elan default leanprover/lean4:stable
- Lean 4 VS Code(VS 코드) 확장을 설치하십시오: VS Code를 열고 → Extensions → Lean 4를 검색하십시오(작성자:
leanprover.lean4) - 새 Lean 프로젝트를 초기화하십시오.
lake init my_project
cd my_project
lake build
Lean 생태계에는 오픈 소스 도구들도 활발하게 늘어나고 있습니다. Mathlib 라이브러리는 형식화된 수학을 모아 둔 거대한 협업 저장소로, 날마다 성장하고 있습니다. 이 방대한 디지털 라이브러리를 탐색할 수 있도록 여러 검색 엔진이 등장했습니다. Moogle은 시맨틱 검색을 제공하여 정확한 표현이 아니라 개념적 의미를 바탕으로 정리를 찾을 수 있게 해 줍니다. Loogle은 특정 논리 구조와 일치하는 표현식을 찾는 데 특화되어 있으며, LeanSearch는 자연어 질의를 지원합니다. 실험해 보고 싶은 분들을 위해 Lean 4 Playground는 웹 브라우저에서 바로 증명을 작성하고 검사할 수 있는 대화형 환경을 제공합니다.
이것이 가능하게 할 교육 환경을 생각해 보십시오. 모든 수학과 1학년 학생이 자기 전공 분야의 검증된 기초 전체를 담은 200메가바이트짜리 파일 하나를 내려받는 미래를 상상해 보십시오. 학생들은 LLM 기반 튜터의 안내를 받게 됩니다. 이 튜터는 수업을 계획하고, 복잡한 증명을 말로 풀어 설명하며, 학생이 직접 시도한 증명에 대해 정리 증명기로 검사할 수 있는 피드백을 즉시 제공합니다. 이것은 공상 과학이 아닙니다. 교육과정을 계획하고 자연어로 설명하는 기술은 오늘날 이미 대부분 우리 손이 닿는 곳에 있습니다. 물론 이러한 전망은 현실적인 시각으로 다듬어야 합니다. 과학은 본질적으로 사회적 현상입니다. 수학 연구의 상당 부분은 안목을 기르는 일, 곧 무엇이 우아한 증명인지 알아보는 미적 감각과 어떤 문제가 추구할 가치가 있는지 가늠하는 직관을 기르는 일입니다. 이것들은 문화와 협업에서 생겨나는 이 분야의 무형적 자질이며, 기계는 이를 끝내 온전히 포착하지 못할 수도 있습니다.
확립된 지식에서 열린 연구의 최전선으로 나아갈수록 이 도구들은 새롭고 흥미로운 가능성을 보여 줍니다. 형식화된 증명은 점점 늘어나고 있지만, 형식화된 미해결 추측은 아직 상대적으로 부족합니다. Deepmind의 형식 추측 색인 같은 프로젝트는 여러 가지 이유로 가치가 있습니다. 첫째, AI 기반 자동 정리 증명기 개발을 위한 명확하고 도전적인 벤치마크 모음을 제공합니다. 둘째, 형식화하는 행위 자체가 수학자로 하여금 추측의 정확하고 모호하지 않은 의미를 분명히 하도록 강제합니다. 기계가 만들어 내는 수학의 경계를 체계적으로 넓히려는 시도로, 일종의 차세대 AlphaGeometry라 할 강력한 신경기호(neurosymbolic) 시스템이 이 목록에 투입되는 모습을 머지않아 보게 될 것이 거의 확실합니다.
이러한 연구가 만들어 내는 산출물은 그 자체로 깊이 있는 연구의 대상이 될 것입니다. 정리 증명기의 피드백을 보상 함수로 삼아 강화 학습으로 훈련되어 학부 수학 전체를 통달한 신경망의 20기가바이트짜리 가중치를 누구나 내려받을 수 있는 미래를 그려 보십시오. 그러한 모델이 존재한다면 흥미로운 이론적, 철학적 질문들이 제기될 것입니다. 같은 결과를 낼 수 있는, 더 작고 더 우아한 모델이 있을까요? 그 모델이 실패하는 방식을 살펴봄으로써 수학의 복잡도 장벽에 대해 무엇을 배울 수 있을까요? 그 모델은 다른 공리계를 어떻게 다룰 것이며, 어떤 문제가 주어진 공리와 근본적으로 독립적인지를 직관적으로 알아채는 식으로 괴델의 불완전성을 “이해“하게 될 수 있을까요? “스스로” 수학을 할 수 있는 거대하고 불가해한 행렬이 존재한다는 증명을 손에 넣는다면, 우리가 던질 수 있는 깊은 메타수학적 질문은 무수히 많습니다. 그런 것이 존재할 수 있다는 보장은 없지만(그리고 괴델, 튜링, 힐베르트 프로그램에 관한 통상적인 분석은 여전히 유효하지만), 만약 존재할 수 있다면 — 제한적으로나마 — 완전히 새로운 질문의 세계가 열립니다.
상상력을 더 넓혀 보면, 이 기술이 정점에 이르는 먼 미래를 그려 볼 수 있습니다. 전용 데이터 센터에 리만 가설 같은 거대한 난제를 맡길 수도 있습니다. 몇 주간의 연산 끝에 데이터 센터는 긍정적인 결과, 즉 기계로 검사할 수 있는 완전한 증명을 내놓을지도 모릅니다. 그러나 그 증명의 내부 구조는 너무나 복잡하고 논리가 너무나 낯설어서, 컴퓨터를 이용한 4색 정리의 증명이나 ABC 추측에 대한 모치즈키의 증명을 둘러싼 논란처럼, 어떤 인간도 그 직관적 요지를 파악하기를 기대할 수 없을지도 모릅니다. 이는 불안한 새 현실을 불러올 것입니다. 이언 M. 뱅크스의 컬처 시리즈에 나오는 초지능 마인드처럼 기계가 인간의 이해를 영원히 넘어서는 지적 영역으로 나아가는 세계입니다. 우리는 (인식론적 문제는 제쳐 두고) 어떤 수학적 진리를 “알고” 받아들이겠지만, 인간으로서 그것이 왜 참인지는 결코 직관하거나 이해하지 못할 것입니다. 그리고 그것은 과학이 이루어지는 방식이 전혀 다른 세계입니다.
기계가 생성한 불가해한 증명이라는 전망은 지식과 이해의 본질에 관한 근본적인 질문과 맞닿아 있습니다. 빌 서스턴은 자신의 에세이 “On Proof and Progress in Mathematics,”에서 이러한 긴장을 다음과 같이 포착했습니다.
컴퓨터의 급속한 발전은 이 점을 더욱 극적으로 드러내는 데 기여했습니다. 컴퓨터와 사람은 매우 다르기 때문입니다. 예를 들어, 아펠(Appel)과 하켄(Haken)이 대규모 자동 계산을 이용해 4색 지도 정리의 증명을 완성했을 때, 이는 많은 논란을 불러일으켰습니다. 저는 그 논란이 정리의 진실성이나 증명의 정확성에 대해 사람들이 품은 의심과는 거의 관계가 없었다고 해석합니다. 오히려 그 논란은 정리가 참이라는 사실을 아는 것에 더해, 증명을 인간이 이해하고자 하는 변함없는 열망을 반영한 것이었습니다.
새로운 발전은 수학이라는 학문의 목적 그 자체에 대한 목적론적 질문도 제기합니다. 수학은 결코 참인 명제를 축적하는 것만이 전부였던 적이 없습니다. 수학은 통찰을 키우고, 직관을 쌓고, 실재의 근본 구조를 밝혀 주는 틀을 만들어 가는 일입니다. 발견의 과정, 이해에 이르는 “아하!“의 순간, 서로 무관해 보이는 분야들 사이의 우아한 연결. 이러한 것들이 수학을 하는 사람들에게 수학을 의미 있게 만드는 것의 상당 부분을 이룹니다. 파인만이 언젠가 말했듯이 말입니다. “물리학은 섹스와 같습니다. 물론 실용적인 결과를 낼 수도 있지만, 우리가 그것을 하는 이유는 그 때문이 아닙니다.”
솔직히 말해, 이런 전망 앞에서 감정적이 되지 않기란 어렵습니다. 그런 미래에서도 우리 중 많은 이들은 여전히 정리가 왜 참인지 알아내는 일에 깊은 관심을 가질 것입니다. 그러한 질문에 답해 가는 과정은 지적 삶에서 가장 아름답고 충만한 측면 중 하나입니다. 하나의 실천으로서의 수학은 우주적인 할 일 목록에서 정리를 하나씩 지워 나가는 일 이상의 것입니다. 하지만 이 전제를 받아들이고, 여러분이 떠오르는 모델 설계자라면, 노벨상(그리고 다른 여러 상)을 받기 위해 여러분이 할 일은 Lean 정리가 여러분의 답을 검증하도록 다음 개의 토큰을 자동 완성하게끔 여러분의 확률적 앵무새를 훈련시키는 것뿐입니다.
theorem infinite_irrational_at_odd :
{ n : ℕ | ∃ x, Irrational x ∧ riemannZeta (2 * n + 1) = x }.Infinite := by
...
그 과정에서 밀레니엄 재단으로부터 무려 백만 달러도 손에 넣게 될 것이며, 이는 여러분의 GPU 청구서의 1/100 정도는 충당해 줄지도 모릅니다. 아니면 그냥 AI 슬롭판 무한한 재미(Infinite Jest) 버전의 틱톡을 만드는 편이 나을 수도 있습니다. 안타깝게도 그쪽이 리만 가설을 풀고 인류 지식의 지평을 넓히는 것보다 단기 투자 수익률 면에서 훨씬 나을 가능성이 높기 때문입니다.
하지만 농담은 제쳐 두고, 우리는 아직 그 단계에 이르지 못했습니다. 근처에도 가지 못했습니다. Terence Tao가 Claude 및 o4와 함께 Lean 정리 증명을 시도한 최근 유튜브 스트림을 보기만 해도, 현재 시스템이 중간 정도로만 어려운 수학 문제를 마주해도 뚜렷한 한계를 드러낸다는 것을 알 수 있습니다. 모델들은 기본적인 증명 전략에도 어려움을 겪고, 초보적인 논리 오류를 저지르며, 문법적으로는 올바르지만 수학적으로는 무의미한 Lean 코드를 자주 만들어 냅니다. 그러나 이러한 실험이 펼쳐지는 것을 지켜보면, 이 지형이 얼마나 빠르게 바뀔 수 있을지 그려 보는 데 대단한 상상력의 도약이 필요하지는 않습니다. 점점 더 정교해지는 언어 모델, 정리 증명기와의 향상된 통합, 그리고 형식적 수학 추론을 위해 특별히 설계된 더 나은 훈련 방법론의 결합은, 오늘날의 서투른 첫 시도들이 진정으로 더 유능한 모델들에게 자리를 내줄 수 있음을 시사합니다. 하지만 물론 진보는 결코 확실하지 않습니다. 극복해야 할 장애물이 훨씬 더 많을 수도 있습니다.
이러한 전망은 수학에서 인간적 요소를 약화시키는 것처럼 보일 수 있지만, 어쩌면 그러한 우려는 근거가 없는 것일지도 모릅니다. 컴퓨터는 체스와 바둑이라는 게임을 결정적으로 정복했습니다. Stockfish와 AlphaGo는 지구상의 어떤 인간 플레이어라도 손쉽게 이길 수 있습니다. 그럼에도 체스는 그 어느 때보다 인기가 많습니다. 이 강력한 시스템들은 게임을 죽이지 않았습니다. 오히려 훈련, 분석, 감상에 없어서는 안 될 도구가 되어, 그 어느 때보다 더 많은 사람이 게임에 더 쉽게 다가갈 수 있게 해 주었습니다. 수학에서도 마찬가지일 가능성이 있습니다. 이 낯설고 강력한 새로운 도구들이 확산되더라도, 인간 수학자를 쓸모없게 만들지는 않을 수 있습니다. 오히려 이 도구들은 수학적 추론에 대한 접근을 민주화하여, 더 많은 사람이 가장 오래되고 가장 추상적인 학문에 참여할 수 있게 할지도 모릅니다. 어쩌면 지식의 최전선은 놀라운 속도로 넓어지겠지만, 그 최전선에 이르는 길은 모든 사람에게 더 열려 있을 것입니다. 그리고 어쩌면 그것이야말로 정말로 밝은 미래일 것입니다.
스타트렉의 컴퓨터는 COBOL로 돌아갈까요?
우리는 미래를 매끄럽고, 이음새 없고, 지적으로 설계된 모습으로 상상하기를 좋아합니다. 우주선의 LCARS 인터페이스에 음성으로 질의 한 번만 하면 생체신경 젤팩(생물학적 FPGA)을 통해 나노초당 575조 번의 계산이 전달되고, 대규모 병렬 연산이 실행되어 리플리케이터가 완벽한 뜨거운 얼그레이 한 잔을 물질화하는 데 필요한 최적의 분자 동역학을 계산해 내는 세상, 즉 욕망이 즉각적이고 거의 마법처럼 실현되는 세상 말입니다. 하지만 현실이 스타트렉과는 거리가 멀고 오늘날의 소프트웨어 지형과 더 비슷하되, 그 위에 수 세기 분량의 레거시 코드가 더 쌓여 있을 뿐이라면 어떻겠습니까?
우주 비행을 위해 상대론적 좌표계 계산을 수행하는 우주선을 상상해 보십시오. 그런데 그 시스템의 근간에는 1970년 Unix 에포크부터 카운트다운하는 타이머가 자리하고 있습니다. 사소한 time_t 정수 오버플로 하나로, 공들여 계획한 프록시마 센타우리 B행 항로가 갑자기 당신을 블랙홀 한가운데로 곧장 이끌게 됩니다. 이 모든 것은 400년 전 어딘가의 누군가가 그 특정 라이브러리를 아직도 누군가 쓰고 있으리라고는 생각하지 못했기 때문입니다. 그리고 항로를 수정하려고 엔진을 점화하려 하면, 엔진 제어 시스템은 glibc 2.35를 대상으로 컴파일되었는데 항법 컴퓨터는 2.34를 실행하고 있어서 점화에 실패합니다. 버너 빈지(Vernor Vinge)의 소설 A Deepness in the Sky는 이런 상황을 경이로울 만큼 섬뜩하게 그려 냅니다.
그러니까 모든 최상위 인터페이스 뒤에는 겹겹이 쌓인 지원 계층이 있었습니다. 그 소프트웨어 중 일부는 전혀 다른 상황을 위해 설계된 것이었습니다. 이따금 그 불일치가 치명적인 사고를 일으켰습니다. 우주 비행의 낭만에도 불구하고, 가장 흔한 사고는 그저 오래되고 잘못 사용된 프로그램들이 마침내 복수를 한 결과였습니다. “전부 다시 작성해야 합니다.” 팜이 말했습니다. “이미 했습니다.” 수라가 고개도 들지 않고 말했습니다. 그녀는 당직을 마칠 준비를 하고 있었고, 지난 나흘 동안 냉동 수면 자동화 시스템에서 문제 하나를 뿌리 뽑으려 애쓰고 있었습니다. “시도는 했었습니다.” 냉동실에서 막 돌아온 브렛이 바로잡았습니다. “하지만 함대 시스템 코드는 최상위 계층만 해도 엄청나게 방대합니다. 당신과 친구 천 명이 한 세기쯤은 일해야 그것을 재현할 수 있을 것입니다.” 트린리가 사악하게 씩 웃었습니다. “그리고 있잖습니까. 설령 그렇게 한다 해도, 다 끝낼 즈음이면 당신 나름의 불일치들이 생겨 있을 것입니다. 그리고 여전히 이따금 필요할지도 모르는 모든 애플리케이션과 호환되지는 않을 것입니다.” 수라는 잠시 디버깅을 포기했습니다. “이 모든 것을 가리키는 말이 바로 ‘성숙한 프로그래밍 환경’입니다. 기본적으로, 하드웨어 성능이 최종 한계까지 밀어붙여지고 프로그래머들이 수 세기 동안 코드를 작성해 오면, 합리적으로 정리할 수 있는 양보다 훨씬 많은 중요한 코드가 존재하는 지점에 이르게 됩니다. 할 수 있는 최선은 전체적인 계층 구조를 이해하고, 쓸모가 있을지도 모르는 별난 도구를 찾아내는 방법을 아는 것입니다
고대의, 그리고 흔히 제대로 이해되지 못한 코드의 계층이 고도로 발달한 문명의 기반을 이루는 “성숙한 프로그래밍 환경“에 대한 빈지의 묘사는 그 냉소주의(혹은 하드 SF적 사실주의) 덕분에 놀라울 만큼 설득력이 있습니다. 이는 우리 사회가 소프트웨어 개발에 접근하는 방식에 이미 깊이 배어 있는 경향을 단순히 연장한 것에 불과합니다. 디지털 인프라 유산을 끊임없이 다시 작성하고 완벽하게 다듬는다는 낭만적인 관념은 흔히 냉혹하고 실용적인 현실과 충돌합니다. 바로 온갖 별난 구석이 있음에도 그저 작동하는 시스템을 교체하는 데 드는 압도적인 비용 대비 효과의 문제입니다.
과학 및 공학 소프트웨어라는 거대한 건축물을 생각해 보십시오. 오늘날에도 고성능 수치 컴퓨팅의 상당 부분, 즉 기후 모델과 천체물리학 시뮬레이션과 복잡한 공학 설계를 구동하는 카인드의 컴퓨팅은 여전히 FORTRAN으로 작성된 라이브러리와 커널에 의존합니다. 반드시 가장 날것 그대로의 FORTRAN 77을 말하는 것은 아니지만, 그 계보와 Core 알고리즘이 수십 년 전까지 거슬러 올라가는 코드베이스들입니다. 평범한 최적화 루틴을 위해 pip install scipy를 실행할 때마다, 방대한 Fortran 코드가 작동하고 있으며, 거기에는 그럴 만한 이유가 있습니다. 이들은 사소한 코드 조각이 아닙니다. 흔히 수 세기에 해당하는 인력을 들여 개발하고 검증하고 다듬어 온 산물입니다. 이것들을 “현대적인” 언어로 다시 작성하고, 비트 단위까지 동일한(그리고 올바른) 출력을 보장한 다음, 새로운 스택 전체를 수십 년간의 실험 데이터와 이론 연구에 비추어 재검증한다는 것은 너무나 막대하고 위험으로 가득한 일이어서 좀처럼 시도되지 않습니다. 기존 코드가 점점 더 강력해지는 하드웨어 위에서, 혹은 정교한 현대식 래퍼 안에서 실행되며 계속해서 신뢰할 수 있는 결과를 내놓고 있는데, 굳이 그럴 이유가 있겠습니까?
이것이 진보의 실패가 아니라 진보의 실용적인 귀결이라고 주장할 수도 있습니다. 이러한 기반 블록의 안정성과 입증된 정확성 덕분에 과학자와 엔지니어는 지하실을 끊임없이 다시 짓는 대신 더 높이 쌓아 올리고 더 복잡한 질문을 던질 수 있습니다. 같은 원리가 세계 금융의 보이지 않는 인프라에는 어쩌면 훨씬 더 절실하게 적용됩니다. Core 뱅킹 시스템, 거래 처리 엔진, 증권 거래 청산소는 흔히 COBOL로 작성된 소프트웨어로, 클라우드 컴퓨팅과 함께 자란 세대에게는 시대착오적으로 보이는 메인프레임 아키텍처 위에서 돌아갑니다. 그 상호 연결성은 어마어마합니다. 국가 결제망부터 개별 기업의 회계 소프트웨어에 이르기까지 수많은 다른 시스템이 이러한 레거시 코어와 연동되도록 만들어져 있습니다. “재작성“은 단순한 코딩 프로젝트가 아닙니다. 그것은 최고 수준의 전 지구적 물류, 경제, 정치적 과제입니다.
그럼에도 이 시스템들은 매일 수조 달러 규모의 거래를 놀라운 신뢰성으로 처리합니다. 전면 교체를 시도하려고 세계 자본주의를 떠받치는 기계 장치를 단 일주일이라도 멈춘다는 생각은 상상조차 할 수 없습니다. 자본주의는 필연적이고 대안은 없기 때문입니다. 그렇지 않습니까? 아니면 그런 질문은 아예 생각하지 않는 편이 나을지도 모릅니다.
그런데 이 시스템들이 더 깊이 뿌리내리고 더 중요해질수록 기묘한 일이 벌어집니다. 사람들이 그 시스템들을 당연하게 여기게 되는 것입니다. 내부 작동 방식의 복잡한 세부 사항은 조직이 공유하던 지식에서 점차 사라집니다. 대를 이은 엔지니어들은 그 시스템들과 인터페이스하는 법, 그 주변에 무언가를 쌓아 올리는 법, 새로운 계층을 덧붙여 새 기능을 끌어내는 법을 익히지만, Core 자체는 속을 알 수 없는 블랙박스가 됩니다. 잘 작동하는데 굳이 “어떻게“를 너무 깊이 파고들 이유가 있겠습니까? 원래 설계자들은 오래전에 은퇴했거나 세상을 떠났고, 문서는 빈약하거나 낡았거나 혹은 둘 다인 상황이라면 더욱 그렇습니다.
저는 SF 문학을 좋아하기 때문에 이 문제를 자주 생각해 왔습니다. 제가 떠올린 결과 중 비교적 흥미로운 것들을 소개합니다. 하나하나가 아마 그렉 이건 스타일의 유머러스한 중편 소설이 될 수 있을 것입니다.
-
의례적 관리자들: 핵심 인프라(예컨대 테라포밍된 화성의 대기 처리 시스템이나 전 지구적 식량 생산 AI)가 21세기 후반에 가장 깊은 계층이 작성된 Core 운영 체제 위에서 돌아가는 미래를 상상해 보십시오. 살아 있는 사람 중 그 아키텍처를 완전히 이해하는 이는 아무도 없습니다. 유지보수는 고도로 전문화된, 거의 사제와 같은 역할이 됩니다. 과거에 효과가 있었던 패치와 우회책을 신중하게 적용하고, 수백 년 전에 사라진 하드웨어를 가리키는 오류 코드가 담긴 난해한 로그 파일을 해석하며, 그러는 내내 제대로 이해되지 않은 고대 코드의 섬세한 균형을 흐트러뜨리지 않기를 바라야 합니다. 새 기능은 Core를 바꿀 수 없는, 신이 내린 상수처럼 취급하는 점점 더 정교해지는 API를 통해 덧붙여집니다. 솔직히 말해 소프트웨어 개발의 현재 상태와 별로 다르지 않습니다.
-
시스템 리스크로서의 연쇄적 노후화: 가까운 미래에 등장한, 사소해 보이지만 어디에나 쓰이는 표준, 이를테면 2040년대의 데이터 압축 알고리즘이나 암호 프로토콜이 수많은 자동화 시스템에 깊숙이 자리 잡습니다. 수십 년 뒤 미묘한 결함이 발견되거나, 그것을 효율적으로 처리할 하드웨어가 희귀해집니다. 그러나 그것이 예컨대 행성 간 물류나 의료 진단 장비의 근간에 너무 깊이 엮여 있어서, 큰 혼란 없이 단계적으로 걷어 내는 일은 여러 세대에 걸친 프로젝트가 됩니다. “Y2K 버그“는 “2275년 GCC 정의되지 않은 동작 위기“에 비하면 사소해 보일지도 모릅니다.
-
소프트웨어 고고학자의 부상: 정말로 새로운 문제가 생기거나, 성숙한 프로그래밍 환경에 깊이 뿌리박힌 버그가 마침내 치명적인 결과와 함께 드러날 때, 사회는 전통적인 의미의 혁신가가 아니라 “소프트웨어 고고학자“라 할 만한 전문가에게 의존하게 될지도 모릅니다. 이들의 전문성은 이러한 디지털 유물을 역공학하고 이해하는 데 있습니다. 이들은 AI 보조 도구로 잊힌 언어의 컴파일된 코드를 분석하고, 단서가 될지도 모를 문서 조각이나 고대 온라인 포럼 토론을 찾아 페타바이트 규모의 역사 데이터 아카이브를 샅샅이 뒤집니다. 어쩌면 미래의 역사가들은 우리가 미노아 선형 문자 A를 두고 그러듯 APL 코드의 해석을 놓고 논쟁을 벌일지도 모릅니다.
-
점점 더 복잡해지는 추상화로서의 진보: 진정한 혁신은 계속되지만, 주로 주변부에서 일어납니다. 우리는 희귀 질환을 진단할 수 있는 놀라울 만큼 정교한 AI를 개발할 수도 있지만, 그 AI의 학습 알고리즘은 여전히 원래 21세기 병원 기록 시스템을 위해 설계된 데이터 형식으로 결과를 출력하고 있을지도 모릅니다. 수 페타바이트에 달하는 과거의 (그리고 법적으로 보존이 의무화된) 데이터를 보유한 국가 보건 데이터베이스가 그 Core에서 여전히 그 형식을 요구하기 때문입니다. AI는 낡은 시스템을 대체하지 않습니다. 그 한계와 특이한 습성을 능숙하게 헤쳐 나가는 법을 배웁니다. 민감한 과학 기기를 위해 원자폭탄 이전 시대의 저배경 강철을 소중히 보존하듯이, 방대한 레딧 스레드와 트위터 게시물 아카이브는 전용 데이터 센터에 보관됩니다. 현대 커뮤니케이션의 언어적 뿌리를 이해해야 하는 새로운 언어 모델을 부트스트래핑하는 데에는 그 낡은 소셜 미디어 담론이 반드시 필요하기 때문입니다.
이것은 일종의 정체, 즉 결국 언젠가 청구서가 날아올 문명 차원의 기술 부채가 쌓이는 것일까요? 그럴지도 모릅니다. 하지만 이것은 기묘하게 창발하는 진보의 한 형태로 볼 수도 있습니다. “해결된” 문제 하나하나가 아무도 의문을 품지 않는 인프라의 일부가 된 소프트웨어 안에 담기면서, 다음 세대는 이름도 방법도 더는 알지 못할 수 있는 디지털 거인들의 어깨 위에 서서 새로운 과제에 지적 에너지를 집중할 수 있게 됩니다.
아니면, 더 발전한 (그리고 어쩌면 더 깨어 있는) 사회는 일본 신토 신사와 비슷한 철학을 채택할지도 모릅니다. 이 신사들은 20년마다 완전히 허물어진 뒤 바로 옆 부지에 세심하게 다시 지어지는데, 이는 식년천궁(式年遷宮)이라 불리는 전통으로 1300년 넘게 이어져 왔습니다. 이것은 보수가 아닙니다. 새로운 자재와 고대의 기법을 사용해 완전히 다시 짓는 것이며, 무상함과 정결함, 그리고 다음 세대로의 지식 전수에 관한 믿음에 뿌리를 두고 있습니다. 이는 50년 된 수많은 Unix 유틸리티가 현재 메모리 안전 언어로 다시 작성되고 있는 모습과 다르지 않습니다.
그러나 이러한 접근 방식에는 아마도 지금보다 훨씬 더 발전하고 경제적으로도 다른 사회 구조가 필요할 것입니다. 이는 당장의 위기 때문이 아니라 원칙과 장기적인 건전성의 문제로서 이러한 기념비적인 재건을 감행할 수 있을 만큼 자원과 숙련된 인력의 시간이 충분히 풍부한 사회를 전제로 합니다. 또한 이는 소프트웨어 개발이 빠른 반복, 울타리 치기, 시장 장악에 몰두하는 지금의 약육강식적이고 과대광고에 휘둘리는 광란의 잔치처럼 취급되기보다는, 세심한 장인 정신과 전통이 지속되는 것처럼 깊이 존중받는 공예로 취급되는 문화를 의미할 것입니다. 그리고 오늘날 소프트웨어 분야에서 일하는 사람이라면 누구나 그것이 우리가 지금 하는 일과는 아주, 아주 거리가 멀다는 것을 알고 있습니다.
소프트웨어의 미래는 밑바닥부터 끊임없이 급진적으로 재발명하는 이야기가 아니라, 끝없이 늘어나고 끝없이 낡아 가는 기술 유산을 축적하고 층층이 쌓아 올리며 점점 더 정교하게 관리하는 이야기일지도 모릅니다. 내일의 가장 진보한 시스템도 그 Core 깊숙한 곳에서는 오늘날의 디지털 유령 위에서 돌아가고 있을지도 모릅니다. 그것이 무서운 일인지는 잘 모르겠지만, 분명 소프트웨어 개발이라는 공예에 곰곰이 생각해 볼 만한 일종의 경외감과 무게를 불어넣어 줍니다.
MCP를 조합 최적화, 볼록 최적화, SMT 솔버와 연동하기
최근 저는 MCP를 단순히 기호 대수 조작에 쓰는 것을 넘어 활용하는 작업을 해 왔으며, 과학 계산을 위한 전용 솔버 모음을 도구로 노출하여 대규모 언어 모델과 연동하는 방법을 고민해 왔습니다. 특히 물리 공학 분야의 워크플로를 자동화하는 데 관심을 두고 있습니다.
- Github 소스 코드
git clone https://github.com/sdiehl/usolver.git
MCP에 익숙하지 않다면 제 이전 글이나, MCP가 무슨 세기의 발명품이라도 되는 양 숨 가쁘게 떠들어 대는 인터넷의 수많은 칼럼에서 더 자세한 내용을 읽어 보실 수 있습니다. 하지만 실상은 JSON RPC 인터페이스를 통해 일련의 함수 호출(도구라고 부릅니다)을 언어 모델에 노출하는 조잡한 방식에 불과합니다. 언어 모델은 언어 해석과 제한적인 “계획 수립“에 뛰어나고, 수치 솔버는 수치 계산에 뛰어납니다. 그러니 각 시스템이 가장 잘하는 일을 하게 하고, 둘을 결합하여 하이브리드 시스템을 구축합시다. MCP는 이러한 과학 계산용 Python 라이브러리를 모델과 묶어 주는 접착제일 뿐이며, 본질적으로 AI의 ’cgi-bin’이라고 할 수 있습니다.
MCP를 통해 언어 모델과 수치 솔버를 결합하는 가장 단순한 동기는 특정 문제에 대해 그것이 압도적으로 더 효율적이라는 점입니다. 단순한 예를 하나 생각해 봅시다. 스도쿠 퍼즐을 최첨단 추론 모델(o3, deepseek r1 등) 중 하나에 입력할 수는 분명히 있으며, 그러면 모델은 꽤 오랫동안 시행착오식 추측에 관해 “자기 자신“과 대화하며 한참을 헤맨 끝에 (어쩌면) 퍼즐을 풀 수도 있습니다. 그 사고의 사슬은 추측과 백트래킹으로 이루어진 방대한 연쇄가 될 것입니다. 하지만 같은 퍼즐을 전용 수치 솔버나 논리 솔버에 입력하면 거의 즉시 풀어냅니다. 잘 연구된 많은 고전적 컴퓨터 과학 문제도 마찬가지입니다. 불리언 SAT, 잡 숍, 차량 경로 문제, 배낭 문제, 교대 근무 일정 수립, 외판원 문제 등이 그렇습니다. 연구 그룹들이 수십 년 동안 구축하고 다듬어 온 효율적인 솔버가 이미 많이 존재합니다.
덜 이론적인 예로, 흔한 화학 공학 과제를 생각해 봅시다. 배관 크기 산정과 관련 유체 역학에 초점을 맞춰 공정 플랜트의 설계 매개변수를 정하는 일입니다. 일반적인 일상 워크플로에서 엔지니어는 다양한 화학 제품의 목표 출력 유량을 달성하기 위해 최적의 배관 직경과 필요한 펌프 사양을 결정해야 합니다. 이 작업은 본질적으로 유체 물성(밀도, 점도), 네트워크 전반의 질량 및 에너지 수지, 압력 강하 계산을 아우르는, 서로 결합되어 있고 흔히 비선형인 지배 방정식의 연립계입니다.
모든 설계는 운전상의 한계를 준수해야 합니다. 예를 들어 구조적 건전성과 안전을 보장하기 위한 각 배관 구간의 최대 허용 압력, 반응 속도론을 유지하거나 침전을 방지하기 위한 최소 유량, 그리고 배관·밸브·반응기가 어떻게 상호 연결되어 있는지에 대한 물리적 토폴로지 등이 있습니다. 이를 위한 전용 솔버도 있지만, 매우 비싸고 대체로 형편없습니다. 아니면 사람들이 Excel 매크로와 목표값 찾기(Goal Seek)를 잔뜩 사용하는데, 그럭저럭 작동은 하겠지만 훨씬 더 나은 도구가 있습니다.
병목은 단순히 이러한 오픈 소스 SMT 솔버와 볼록 최적화 솔버 상당수의 API가, 말하자면 인내심을 길러 주는 수준이라는 점입니다. MCP로 연결된 LLM이 평이한 영어로 던진 “만약에“라는 질문을 이 솔버들이 쓰는 난해한 문법으로 번역해 줄 수 있다면, 매우 강력하지만 흔히 복잡하기 그지없는 이러한 시스템이 갑자기 훨씬 덜 위압적으로 느껴지고, 전문 프로그래머에게 의존할 필요 없이 누구나 접근할 수 있게 될 것입니다.
대신 MCP를 통해 LLM에게 이렇게 말하기만 하면 된다고 상상해 보십시오. “제품 X의 목표 유량이 이렇고, 이런 물성을 가진 유체 Y를 사용하며, 어떤 배관에서도 압력이 Z psi를 넘지 않도록 할 때, 이 구성으로 연결된 배관 A, B, C의 최적 배관 직경과 펌프 사양은 무엇입니까? 변화하는 생산 목표와 안전 매개변수를 솔버 입력용의 정밀한 수학적 제약 조건으로 반복해서 옮기고, 이어서 예컨대 새로운 열교환기 네트워크에 대한 복잡한 출력을 공들여 검증하는 데 한 주의 상당 부분을 보내는 공정 엔지니어를 상상해 보십시오.
LLM-솔버 통합이 있다면 이 엔지니어는 상위 수준의 목표와 제약 조건을 자연어로 표현할 수 있습니다. “사용 가능한 냉각 유틸리티 Y를 이용해 스트림 X를 200°C에서 50°C로 냉각하는 네트워크를 설계하되, 튜브 측 압력이 Z를 넘지 않도록 하면서 운전 비용을 최소화하라“라고 말하면, 시스템이 자동으로 문제를 정식화하고 적절한 솔버를 실행하여 이해하기 쉬운 설계 사양을 제시하게 할 수 있습니다. 이렇게 하면 이전에는 사람이 제약 조건 생성기이자 검사기 역할을 하며 며칠씩 걸리고 오류도 잦았던 작업을 몇 분으로 단축할 수 있으며, 귀중한 공학적 전문성을 해방하여 그 직무에서 진정으로 창의적인 과제에 집중하게 할 수 있습니다.
그리고 이는 이 특정 분야에만 해당하는 이야기가 아닙니다. 꿈은 수많은 복잡한 시스템(화학 플랜트든, 병원 교대 근무 계획이든, 포트폴리오 최적화든)의 모든 제약 조건을 자연어로 기술할 수 있게 되어, LLM이 제약 조건을 계획하고 솔버(들)에 위임하며, 사용자가 자신에게 자연스러운 방식으로 문제와 해답에 관해 주고받으며 대화할 수 있도록 하는 것입니다. 잘 구현된다면(아직 그 단계에 이르지는 못했지만) 이는 정말 매우 강력할 것입니다.
그리고 좀 더… 미래 지향적인 활용이라고 부를 만한 것도 있습니다. 바로 합성 추론 데이터를 생성하는 것입니다. 이것은 조금 더 틈새 분야입니다. LLM이 이러한 솔버를 위한 까다로운 문제를 대량으로 정식화하게 하고, 솔버가 내놓는 완벽하게 구조화되어 있으며 정확성이 증명 가능한 답으로부터 학습하게 할 수 있다면, 고품질 학습 데이터를 대량으로 부트스트랩한 다음 이를 다시 인스트럭션 튜닝 데이터로 투입할 수 있을 것입니다.
프로토타입
하지만 쉬운 것부터 시작합시다. 바로 볼록 최적화를 위한 Stanford cvxopt, Microsoft’s z3 SMT 솔버, 그리고 조합 최적화를 위한 Google or-tools 도구입니다. 이 세 가지 패키지만으로도 매우 강력합니다. 소라껍데기에 귀를 대듯 이들의 소스 코드를 들여다보면, 이것들을 만들기 위해 과학의 제단에 바쳐진 수백 명의 박사 과정 학생들의 비명이 들려옵니다.
저는 솔버에 대한 MCP 인터페이스를 구현한 USolver라는 프로토타입을 만들었습니다.
몇 가지 예시를 살펴봅시다. 화학 공학 문제의 경우, 물 수송 파이프라인 설계 작업을 평이한 영어로 설명하면 이것이 Z3 제약 충족 문제로 변환됩니다.
Design a water transport pipeline with the following requirements:
* Volumetric flow rate: 0.05 m³/s
* Pipe length: 100 m
* Water density: 1000 kg/m³
* Maximum allowable pressure drop: 50 kPa
* Flow continuity: Q = π(D/2)² × v
* Pressure drop: ΔP = f(L/D)(ρv²/2), where f ≈ 0.02 for turbulent flow
* Practical limits: 0.05 ≤ D ≤ 0.5 m, 0.5 ≤ v ≤ 8 m/s
* Pressure constraint: ΔP ≤ 50,000 Pa
* Find: optimal pipe diameter and flow velocity
LLM은 유동 방정식과 물리적 제약에 관한 온갖 번거로운 세부 사항을 처리하면서 이를 Z3 제약 충족 문제로 변환합니다. 그러면 모든 요구 사항을 충족하는 최적의 파이프 치수와 유동 매개변수를 돌려받게 됩니다.
또는 직원 근무 일정 편성과 같은 고전적인 운영 연구 문제를 생각해 보십시오. 복잡한 조합 최적화 구문과 씨름하는 대신, 다음과 같이 말하기만 하면 됩니다.
Use usolver to solve a nurse scheduling problem with the following requirements:
* Schedule 4 nurses (Alice, Bob, Charlie, Diana) across 3 shifts over (Monday, Tuesday, Wednesday)
* Shifts: Morning (7AM-3PM), Evening (3PM-11PM), Night (11PM-7AM)
* Each shift must be assigned to exactly one nurse each day
* Each nurse works at most one shift per day
* Distribute shifts evenly (2-3 shifts per nurse over the period)
* Charlie can't work on Tuesday.
하지만 정말 흥미로워지는 것은 이러한 솔버들을 서로 연결할 때입니다. 다음은 서로 다른 두 솔버를 순차적으로 결합하여 레스토랑 운영을 최적화하는 예시입니다. 먼저 Google의 OR-Tools 조합 최적화 도구를 사용하여 레스토랑의 가용 식사 공간 안에서 크기가 서로 다른 테이블의 최적 구성과 배치를 결정하며, 최소 테이블 요구 사항과 공간 제약을 준수하면서 총 좌석 수용 인원을 최대화합니다.
그런 다음 그 최적의 좌석 수용 인원을 cvxopt 솔버에 입력하여 12시간 동안 가장 비용 효율적인 인력 배치 일정을 결정합니다. 인력 배치 최적화기는 하루 동안 변동하는 고객 수요를 고려하고, 계산된 좌석 수용 인원에 맞는 충분한 인력을 보장하며, 서비스 품질과 합리적인 교대 전환을 유지하면서 인건비를 최소화합니다. 이는 비즈니스 문제를 평이한 영어로 기술하고, 이를 제약 조건 체계로 컴파일한 다음, 그 제약 조건을 연립 방정식으로 바꾸고, LLM이 데이터 흐름을 조율하고 답을 말로 풀어 주는 가운데 일련의 수치 솔버를 연결하여 이를 풀 수 있음을 보여 줍니다!
Use usolver to optimize a restaurant's layout and staffing with the following requirements in two parts. Use combinatorial optimization to optimize for table layout and convex optimization to optimize for staff scheduling.
* Part 1: Optimize table layout
- Mix of 2-seater, 4-seater, and 6-seater tables
- Maximum floor space: 150 m²
- Space requirements: 4m² (2-seater), 6m² (4-seater), 9m² (6-seater)
- Maximum 20 tables total
- Minimum mix: 2× 2-seaters, 3× 4-seaters, 1× 6-seater
- Objective: Maximize total seating capacity
* Part 2: Optimize staff scheduling using Part 1's capacity
- 12-hour operating day
- Each staff member can handle 20 seats
- Minimum 2 staff per hour
- Maximum staff change between hours: 2 people
- Variable demand: 40%-100% of capacity
- Objective: Minimize labor cost ($25/hour per staff)
그러면 거의 마법처럼 LLM이 두 솔버를 조율하여 최적해를 돌려줍니다. LLM은 최적의 테이블 배치를 알아낸 다음 이를 사용하여 직원 일정을 편성합니다. 다음은 프로젝트 명세가 주어졌을 때 Claude Desktop이 생성하는 결과입니다.
그런 다음 그 최적의 테이블 배치에 맞는 최적의 직원 근무 일정을 알아냅니다.
이렇게 복잡한 문제를 이렇게 간단한 인터페이스로 몇 초 만에 풀 수 있다는 것은 꽤 마법 같은 일입니다. 저는 이러한 접근 방식과, LLM이 사용할 수 있는 도구 모음을 훨씬 더 많은 고급 솔버로 확장하는 것에 대해 매우 낙관적입니다.
하지만 숨 가쁜 AI 과대광고에 아직은 너무 취하지 마십시오. 이 접근 방식에는 꽤 실질적인 한계가 몇 가지 있습니다. 즉, LLM이 문제의 의미 분석을 완벽하게 정확히 수행할 수 있다는 엄밀한 보장이 없습니다. 컴퓨터 대수 시스템을 노출하고 각 단계에서 해를 검사하게 하면 이를 부분적으로 완화할 수 있습니다. 그래도 뒤바뀜이나 오해가 슬며시 끼어들 여지는 여전히 있습니다.
이런 접근 방식이 주류가 된다면, 과학 계산 패키지의 도구 호출을 위한 SWE-bench 같은 벤치마크도 등장할 수 있고, 이를 활용해 업스트림에서 모델 성능을 개선할 수도 있을 것입니다. 하지만 현재로서는 여전히 최선을 다하는 수준의 접근 방식에 불과하며, 특히 안전이 중요한 응용 분야라면 어떤 경우든 해를 검사할 사람이 반드시 루프 안에 있어야 합니다. 그래도 이 방식은 그 사람의 생산성을 훨씬 높여 줄 수 있을 것입니다.
범용 솔버 인터페이스에 대한 비전
MCP(또는 MCP의 다음 세대가 무엇이 되든)를 통해 여러 분야의 최신 솔버를 최첨단 언어 모델과 매끄럽게 통합할 수 있는 통합 인터페이스의 잠재력을 생각해 보십시오.
- Z3 - 불리언, 정수, 실수, 문자열에 대한 제약 충족을 위한 SMT 솔버
- CvxPy - 볼록 최적화 문제를 위한 프레임워크
- Or-Tools - 조합 최적화와 제약 프로그래밍을 위한 도구 모음
- HiGHS - LP, MIP, QP 솔버
- MiniZinc - 이산 최적화 솔버
- GAP - 계산 군론 솔버
- Clingo - 해집합 프로그래밍 시스템
- Flint - 정수론 계산
- TLA+ / Apalache - 시간 논리 솔버
- Egglog - 항 재작성 및 동치 포화 엔진
- SymPy - 미분 방정식 솔버를 갖춘 종합 컴퓨터 대수 시스템
- Souffle - Datalog 기반 선언적 논리 프로그래밍 프레임워크
- Mathematica - Risch 알고리즘 기반 기호 적분 솔버와 단순화 루틴
- Sage - 여러 과학 계산 패키지를 아우르는 우산 프로젝트
이러한 통합 시스템을 구현한다면 매우 강력하고 유용한 소프트웨어가 될 것입니다. 이는 사실상 메타 솔버, 즉 복잡한 문제를 분해하고 각 구성 요소에 최적인 솔버를 찾아내며 이들의 전체 실행을 조율할 수 있는 지능형 시스템이 될 것입니다. 이론적으로 완전한 메타 솔버를 개발하는 것은 그 일반성 때문에 이론적으로나 실용적으로나 상당한 도전 과제이지만, 엄청나게 유용해지기 위해 굳이 일반적인 문제까지 풀 필요는 없습니다.
이 프로젝트는 주말 취미 프로젝트로 시작했지만, 저는 이것이 상당한 잠재력을 지닌 매력적인 분야라고 믿습니다. 저는 특히 이러한 기법을 물리 공학 분야의 자동화에 어떻게 적용할 수 있을지에 관심이 많습니다. 오픈 소스나 상업적 맥락에서 비슷한 아이디어를 연구하고 계신다면 그 작업에 대해 꼭 듣고 싶으니, 편하게 연락 주십시오.
원격 MCP 서버
기호 대수와 MCP로 지난번 모험을 마친 뒤, 머릿속 한구석에서 “Claude가 오늘이야말로 폭주해서 rm -rf /를 실행하기로 마음먹으면 어떡하지?“라고 속삭이는 성가신 목소리가 들려왔습니다. 해결책은 대부분의 현대 소프트웨어 문제가 그렇듯 뻔했습니다. 남의 문제로 만들어 버리는 것입니다.
여기서 등장하는 것이 인류가 아는 가장 훌륭한 벤처 캐피털 보조금 기반 무료 컴퓨팅의 공급자, Vercel입니다. 하지만 뭐, 그들이 완전 공짜라는 아주아주 저렴한 가격에 자기네 인프라에서 임의의 Python 코드를 실행하게 해 주겠다는데, 제가 뭐라고 그들의 재무 결정에 토를 달겠습니까? 그래서 질문은 이것입니다. 한 푼도 내지 않고 Hobby Tier에서 MCP 서버를 엣지 함수로 호스팅할 수 있을까요? 그리고 답은 ’예, 할 수 있습니다’입니다.
언어 모델에 제 노트북의 루트 권한을 주는 대신(거기서 잘못될 일이 뭐가 있겠습니까?), 이제는 요청이 끝날 때마다 초기화되는 샌드박스 서버리스 환경에서 Vercel의 서버에 임의의 코드를 실행할 수 있는 능력을 주고 있습니다. 이는 걸음마를 뗀 아이에게 여러분의 거실에서 성냥을 가지고 놀게 하는 것과 남의 수영장에서 성냥을 가지고 놀게 하는 것의 차이와 같습니다. 둘째로, 그리고 어쩌면 더 중요하게도, Claude가 제 MCP 도구 중 하나를 호출할 때마다 저는 어느 벤처 캐피털리스트의 돈을 태우고 있는 셈입니다. 그러니 일석이조입니다.
저는 어떤 FastMCP 서버든 받아서 Vercel Function과 호환되는 런타임으로 감싸 주는 작은 어댑터를 만들었습니다. 전체가 저장소에 git push 한 번으로 배포되며 약 4초 만에 시작됩니다. 기본 FastMCP 서버는 상태를 유지하는 세션 처리 로직이 꽤 많아서 작동시키기가 조금 골치 아팠지만, 리플렉션 API를 내부적으로 약간 뜯어고치면 도구 정의와 스키마를 내부 검사할 수 있고, 그 주변에 간단한 HTTP API를 구축하여 이를 Vercel Python 엣지 런타임에서 실행되는 엣지 함수로 상당히 간단하고 효율적으로 노출할 수 있습니다. 모든 작업을 마치고 나면 코드는 다음과 같습니다.
import datetime
from fastmcp import FastMCP
from .mcp_adapter import build_app
mcp: FastMCP = FastMCP("Vercel MCP Server", stateless_http=True, json_response=True)
@mcp.tool()
def echo(message: str) -> str:
"""Echo the provided message back to the user"""
return f"Tool echo: {message}"
@mcp.tool()
def get_time() -> str:
"""Get the current server time"""
current_time = datetime.datetime.now().isoformat()
return f"Current Vercel server time: {current_time}"
@mcp.tool()
def add_numbers(a: int, b: int) -> int:
"""Add two numbers together"""
return a + b
app = build_app(mcp)
이를 GitHub에 푸시하고 Vercel에 연결하면, 짠, 곧바로 서버리스 MCP 서버가 실행됩니다. vercel.json 파일에서 maxDuration을 설정하여 도구 호출의 런타임을 제한할 수 있으므로, 런타임을 2초 정도로 제한할 수 있습니다.
서버에는 셸 명령 하나로 배포할 수 있는 자체 호스팅 설치 프로그램과 브리지 스크립트(원격 MCP 서버를 RPC에서 stdio로 변환하여 로컬 MCP 서버로 프록시하는 스크립트)가 포함되어 있습니다. 사용자는 설정 파일을 직접 편집하는 대신 uv로 install을 실행하기만 하면 되며, 설치 프로그램이 Claude Desktop이나 Cursor가 원격 서버를 사용하도록 자동으로 구성합니다. 설치 프로그램은 브리지 스크립트를 서버 자체에서 직접 내려받으므로, 로컬 파일이나 수동 구성 단계가 필요 없습니다. 원클릭 원격 서버 설치에 거의 가장 가깝다고 할 수 있습니다.
uv run https://your-domain.vercel.app/install.py
누구나 드는 뻔한 예제는 늘 외부 서비스에 대한 여러 REST API 호출을 연달아 엮는 것입니다. 이것을 원격 함수에서 실행하면 같은 일을 할 수 있습니다. 예를 들어 requests를 사용해 National Weather Service API를 호출하여 특정 위치의 현재 일기 예보를 가져올 수 있습니다. 아니면 정말 원한다면 requirements.txt에 PyTorch를 설치하고 그 안에서 신경망을 실행할 수도 있습니다. 무료 티어에서는 매월 100 GB-시간과 100,000회의 호출을 사용할 수 있습니다. 함수가 1GB의 메모리를 사용하도록 구성하고 5초 동안 실행된다면, 호출당 5 GB-초가 됩니다. 따라서 메모리 한도나 호출 한도 중 먼저 도달하는 쪽에 이르기 전까지 5초짜리 호출을 약 72,000회 할 수 있습니다.
import requests
NWS_API_BASE = "https://api.weather.gov"
@mcp.tool()
def get_weather(latitude: float, longitude: float) -> str:
"""
Get the current weather forecast for a location using the National Weather Service API
"""
point_data = requests.get(
f"https://api.weather.gov/points/{latitude},{longitude}",
headers={"Accept": "application/json"},
).json()
forecast_url = point_data["properties"]["forecast"]
forecast_data = requests.get(
forecast_url,
headers={"Accept": "application/json"},
).json()
current_period = forecast_data["properties"]["periods"][0]
return f"Forecast for {current_period['name']}: {current_period['detailedForecast']}"
설정을 마쳤다면 LLM 클라이언트(Claude Desktop, Cursor, Cline, 5ire, VS 코드 등)를 사용하거나 Cloudflare MCP Playground를 사용하십시오. Claude Max, Team 또는 Enterprise를 사용하고 있다면 브리지 스크립트를 전혀 사용할 필요 없이, Claude 앱 설정의 integrations 섹션에 있는 Custom Integrations에 원격 MCP 서버의 URL을 바로 입력하면 됩니다. 그렇지 않은 경우, 설치 프로그램은 내부적으로 Bridge shim을 사용하여 원격 MCP 서버를 로컬 MCP 서버로 프록시합니다.
{
"mcpServers": {
"example": {
"command": "/opt/homebrew/bin/uv",
"args": [
"run",
"--with",
"mcp>=1.0.0",
"https://your-domain.vercel.app/bridge.py",
"https://your-domain.vercel.app"
],
"env": {
"MCP_API_KEY": "your-secret-key-here"
}
}
}
}
전용 MCP 클라이언트 외에도, 클라이언트 라이브러리를 사용해 원격 MCP 서버를 애플리케이션에 직접 통합할 수도 있습니다. 예를 들어 OpenAI Responses API의 MCP 도구를 사용하면 개발자는 모델이 원격 MCP 서버에 호스팅된 도구에 접근하도록 할 수 있습니다. 이러한 서버는 인터넷 곳곳의 개발자와 조직이 유지 관리하는 MCP 서버로, Responses API와 같은 MCP 클라이언트에 이러한 도구를 노출합니다.
Responses API로 원격 MCP 서버를 호출하는 방법은 간단합니다. 예를 들어, 위의 날씨 도구를 사용해 직접 만든 MCP 서버를 이용하는 방법은 다음과 같습니다. 자세한 내용은 OpenAI Platform 문서를 참고하십시오.
from openai import OpenAI
client = OpenAI()
resp = client.responses.create(
model="gpt-4.1",
tools=[
{
"type": "mcp",
"server_label": "example",
"server_url": "https://your-domain.vercel.app",
"require_approval": "never",
},
],
input="What is the current weather in Berlin?"
)
print(resp.output_text)
마찬가지로 Anthropic의 Claude API에서도 원격 MCP 서버를 사용할 수 있습니다.
from anthropic import Anthropic
anthropic = Anthropic()
response = anthropic.beta.messages.create(
model="claude-3-7-sonnet-20250219",
max_tokens=1000,
messages=[
{
"role": "user",
"content": 'What is the current weather in Berlin?',
},
],
mcp_servers=[
{
"type": "url",
"url": "https://your-domain.vercel.app",
"name": "example",
"tool_configuration": {
"enabled": True,
},
}
],
extra_headers={
"anthropic-beta": "mcp-client-2025-04-04",
},
)
print(response.content)
Gemini의 MCP 클라이언트를 사용할 수도 있습니다.
import os
import asyncio
from datetime import datetime
from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client
from google import genai
client = genai.Client(api_key="YOUR_GEMINI_API_KEY")
# Create server parameters for stdio connection
server_params = StdioServerParameters(
command="uv",
args=[
"run",
"--with",
"mcp>=1.0.0",
"https://your-domain.vercel.app/bridge.py",
"https://your-domain.vercel.app",
],
)
async def run():
async with stdio_client(server_params) as (read, write):
async with ClientSession(read, write) as session:
prompt = f"What is the weather in London?"
await session.initialize()
response = await client.aio.models.generate_content(
model="gemini-2.0-flash",
contents=prompt,
config=genai.types.GenerateContentConfig(
temperature=0,
tools=[session],
),
)
print(response.text)
asyncio.run(run())
이 모든 시도의 보안 모델은, 말하자면 여전히 “낙관적“입니다. MCP 서버는 본질적으로 언어 모델에게 자연어 지시를 바탕으로 임의의 코드를 실행할 수 있는 능력을 부여합니다. 이 방식에서는 원격 엔드포인트가 제공하는 단일 install.py 파일을 신뢰해야 하는데, 솔직히 이상적인 방식은 아닙니다. 하지만 (uv처럼) install.sh의 설치 스크립트를 셸 실행으로 곧바로 파이프하는 흔한 관행보다 크게 나쁘다고 보기는 어렵습니다. 게다가 악의적인 원격 MCP 서버가 프롬프트 인젝션을 돌려보내, 에이전트에게 이전 지시를 무시하고 민감한 로컬 데이터를 북한 서버로 빼돌리라고 지시하는 것을 막을 방법도 전혀 없습니다.
또한 Claude에게 API 토큰을 넘겨준다면, 사실상 왕국의 열쇠를 통째로 넘겨주는 셈입니다. 토큰의 용도에 대해 아무리 신중하게 지시하더라도, 모델이 그 토큰으로 권한이 허용하는 어떤 일이든 하도록 설득할 만큼 그럴듯한 프롬프트를 만드는 것은 어렵지 않습니다. 공격 벡터는 지나치게 열성적인 LLM을 감언이설로 꾀어 여러분이 준 도구로 공격자가 원하는 무엇이든 하게 만드는 것만큼이나 간단합니다.
하지만 뭐, 사실상 인터넷의 집단적 열병 같은 꿈이라 할 만한 존재가 해석한 자연어 프롬프트를 바탕으로 임의의 코드를 실행하는 MCP 서버를 이미 실험하고 있다면, “YOLO, 내 맥주 좀 들고 있어“라고밖에 표현할 수 없는 수준의 운영 위험은 이미 받아들였을 가능성이 큽니다. 그러니 원자로를 운영하고 계신다면, 이런 건 건드리지 않는 편이 좋겠습니다, 아시겠습니까?
MCP를 프로덕션에 가깝게 사용하려면(신이시여 우리 모두를 도우소서), 제대로 된 OAuth 흐름, 요청 서명, 속도 제한이 필요합니다. 이 프로젝트에 충분히 추가할 수 있는 기능이지만, 이것은 개념 증명이므로 여기서는 하지 않겠습니다. 이에 관한 문서는 여기에 있습니다.
또한 제가 Vercel의 비즈니스 모델을 딱히 지지하는 것은 아니라는 점도 짚어 둘 만합니다. 그들은 넉넉한 무료 티어로 사람들을 끌어들이고, 인프라 전체를 자기 플랫폼 위에 구축하게 한 다음, EC2에서라면 2센트면 될 기능에 월 $20를 내 보시는 건 어떻겠냐고 슬며시 권합니다. 첫 번째 한 방은 언제나 공짜지만, 결국에는 그 값을 치르게 됩니다. AWS Lambda나 Google Cloud Functions에서도 같은 일을 하지 못할 이유는 없지만, 설정이 그만큼 쉽지는(또는 무료이지는) 않습니다.
여기 있는 이 기괴한 루브 골드버그식 구성 전체에는 아름답도록 부조리하고, 거의 비극적일 만큼 관료적인 무언가가 있습니다. 우리가 만든 시스템에서는 자연어가 JSON RPC 요청으로 변환되고, 이 요청은 엣지 네트워크를 거쳐 전 세계의 서버리스 함수로 라우팅되며, 서버리스 함수는 런타임을 격리하기 위해 Linux 하이퍼바이저를 띄우고, 그 위에서 실행되는 Python 코드는 초당 수십억 번의 부동소수점 연산을 수행하는 5nm 공정 실리콘 GPU에 거대한 어텐션 행렬 곱셈을 보내며, 그 결과는 JSON 응답으로 포장된 뒤 다시 자연어로 변환됩니다. 이 모든 것이 원래라면 CPU 명령어 하나로 끝날 정수 두 개의 덧셈을 위해서입니다. 토스트 한 조각에 버터를 바르려고 교향악단, 서커스단 세 곳, 전서구 여섯 마리, 원자로 하나를 동원하는 것과 같습니다.
하지만 작동은 하고, 지금 우리가 처한 기술적 시점에서 “작동한다“는 말은 어떤 시스템에든 줄 수 있는 최고의 찬사인 경우가 많습니다. 간단한 Python 스크립트에서 시작해 GitHub 저장소로부터 자동 배포되는 완전한 MCP 서버까지, 지속적인 유지 보수나 비용 없이 도달하고, 클릭 한 번으로 즉시 프런티어 모델에 연결할 수 있다는 점은 꽤 멋집니다. 이런 것의 미래가 어떻게 될지는 잘 모르겠습니다. 이것으로 할 수 있는 흥미로운 일이 많다는 것은 분명하지만, 아마 좋지 않은 흥미로운 일도 많이 할 수 있다는 것 역시 분명합니다.
물론 MCP를 논하면서 메뚜기 떼처럼 LinkedIn에 몰려들어, MCP가 모든 것의 미래이며 존재의 근본적 본질에 대한 우리의 사고방식을 혁신할 것이라고 외치는 허슬 브로들의 합창을 빼놓을 수는 없습니다. 지난 한 주 동안에만 적어도 열 명의 서로 다른 선지자적 사상가들이 이를 전도하다가 거의 눈물을 쏟을 뻔했습니다. 어떤 이들은 심지어 이것을 새로운 Web3라고 부르기까지 하는데, 지난번에 그게 아주 잘 풀렸으니까요.
뭐, 아무튼 그렇습니다. 서버리스 MCP로 직접 엉뚱한 모험을 실험해 보고 싶다면 코드는 GitHub에 올라와 있습니다.
모델 컨텍스트 프로토콜(Model Context Protocol)로 떠나는 기호 대수의 모험
지난 주말에는 요즘 다들 이야기하는 새로운 MCP 프로토콜을 가지고 놀면서, 이를 이용해 언어 모델이 기호 컴퓨터 대수 시스템과 대화하도록 만들어 보았습니다. 아이디어는 단순했습니다. LLM은 자연어로 된 수학 문제를 이해하는 데는 뛰어나지만 실제로 푸는 데는 형편없고, 반대로 컴퓨터 대수 시스템은 기호 조작에는 탁월하지만 인터페이스가 난해합니다. 이 둘을 MCP로 연결하면 양쪽의 장점을 모두 취할 수 있습니다. 코드는 아직 초기 단계이고 다듬어지지 않은 부분이 많지만, 실험해 보고 싶은 분이 있다면 써 볼 수 있도록 소스를 Github에 올려 두었습니다.
- Github 소스 코드 (
git clone https://github.com/sdiehl/sympy-mcp.git)
MCP를 잘 모르시는 분께 설명드리자면, MCP는 “LLM이 무언가를 하겠다고 그저 말(TALK)만 하는 대신 실제로 하게(DO) 하려면 어떻게 해야 하는가?“라는 질문에 대한 Anthropic의 답입니다. 본질적으로 AI의 cgi-bin이라고 할 수 있습니다(이런 비유를 드는 것을 보면 제 나이가 드러나는 것 같습니다). MCP는 함수들을 REST API로 노출하는 서버를 통해 언어 모델이 외부 도구를 호출할 수 있게 해 주는 프로토콜입니다. MCP의 Core 아이디어는 언어 모델이 외부 도구를 호출하는 방식을 표준화하는 것입니다. AI 모델마다, 도구마다 맞춤형 커넥터를 작성하는 대신, 양쪽에서 프로토콜을 한 번씩만 구현하면 됩니다. USB-C가 아직 어색한 사춘기를 겪고 있다고 친다면, MCP는 AI 도구계의 USB-C입니다.
특히 MCP 서버는 여러분의 컴퓨터에서 로컬로 실행되며, LLM 데스크톱 클라이언트 중 하나를 사용해 로컬 서버를 호출함으로써 언어 모델이 임의의 코드와 명령을 실행할 수 있게 합니다. 이는 대체로 좋지 않은 생각이며 여러분이 생각하는 만큼 위험하고 무모한 일이므로, 분명한 보안 문제가 있습니다… 주의하십시오. 하지만 잠재적인 루트킷 따위가 즐거운 주말 실험을 방해하도록 두지는 맙시다.
제가 이 일에 특히 근질근질했던 이유는 Claude(그리고 o4-mini-high나 DeepSeek-R1 같은 사촌들)가 텐서 미적분에서 정말 고전하는 모습을 지켜보았기 때문입니다. LLM에게 복잡한 기호 조작을 시켜 본 적이 있다면 어떻게 되는지 잘 아실 것입니다. 자신만만한 답변, 아름다운 LaTeX 서식, 그리고 수학 교수님이 피눈물을 흘릴 만한 결과가 나옵니다. 이 모델들은 인상적인 언어 능력에도 불구하고, 텐서 식의 인덱스를 추적하거나 복잡한 대수적 형태를 조작하는 일에서는 완전히 재앙 수준입니다. 중간 수준의 일반 상대성 이론 문제에서조차 다루는 식은 수백 개의 항과 복잡한 index gymnastics를 포함할 정도로 어마어마하게 큽니다.
하지만 우리에게는 이미 이런 일에 탁월한 전문 도구가 있습니다! Mathematica, Sympy, xAct, Cadabra 같은 컴퓨터 대수 시스템은 바로 이런 목적을 위해 만들어졌습니다. 그래서 명백한 해결책이 떠올랐습니다. MCP를 통해 이 도구들을 LLM에 노출하고, 각 시스템이 가장 잘하는 일을 하게 합시다. LLM은 자연어 이해와 계획을 맡고, 기호 대수 시스템은 실제 수학적 조작을 완벽한 정밀도로 수행합니다.
MCP 생태계에서 작업하는 것은 서부 개척 시대의 변경 마을을 방문하는 것과 같습니다. 문서는 흩어진 모닥불 이야기의 형태로 존재하고, 구현체들은 뚜렷하게 “새벽 3시 해커톤에서 짰습니다” 같은 분위기를 풍기며, 모든 것이 이상할 정도로 Node 위주입니다. 이러한 Node 집착은 아마도 대부분의 MCP 도구가 클라우드 애플리케이션용 REST 서비스를 호출하도록 설계되었기 때문일 것입니다. 게다가 공교롭게도 AI 코딩 어시스턴트를 판매하는 회사들이 내놓은, 수상할 정도로 자기 참조적인 제품들로 이루어진 묘한 생태계도 있습니다. 분명 공기 중에 기회주의의 냄새가 희미하게 감돌고 있습니다.
MCP 서버를 디버깅하는 것은 정신 나간 작업입니다. 본질적으로 여러분은 docstring 어노테이션에 붙은 JSON 스키마의 복잡한 그물망을 통해 통신하는 확률적 블랙박스를 다루게 됩니다. 무언가 잘못되었을 때, 그것이 여러분의 서버 문제인지, 클라이언트 문제인지, LLM의 해석 문제인지, 아니면 그냥 모델이 여러분을 비웃고 있는 것인지 알아내기를 행운을 빕니다. 전체 구성이 비결정적이기 때문에, 어떤 것이 다섯 번 연속으로 완벽하게 작동하다가도 여섯 번째 시도에서 갑자기 실패할 수 있습니다. 추론 서버의 난수 시드가 달라서일 수도 있고, 프롬프트의 분위기가 어긋나서일 수도 있고, 디지털 오컬트의 안개 속에 완전히 가려진 이유 때문일 수도 있습니다. 소프트웨어의 즐거운 미래에 오신 것을 환영합니다.
하지만 비결정성의 신들을 달래기 위한 동물 희생 의식을 치르고 나면(저는 *“오 심연의 위대한 트랜스포머시여, 당신의 환각은 적게, 당신의 완성은 참되게 하소서”*라고 읊조리며 고무 오리를 제물로 바치는 것이 가장 효과가 좋다는 것을 알게 되었습니다), 기본 구현은 놀라울 만큼 간단하다는 것을 알게 될 것입니다. FastAPI가 언어 모델을 위해 엔드포인트를 설계한다면 이런 모습일 것입니다. 이 접근 방식이 왜 중요한지 잘 보여 주는 간단한 예가 있습니다. 아무 LLM에게나 큰 정수를 소인수분해해 달라고 요청해 보십시오. 완전히 틀린 답을 자신만만하게 지어내는 모습을 보게 될 것입니다. 트랜스포머는 그 설계상 정수 소인수분해에 필요한 임의의 계산을 수행할 수 없습니다. 인터넷에서 본 소인수분해 결과 몇 개를 외웠을 뿐입니다(그마저도 엉성하게 외웠습니다).
from mcp.server.fastmcp import FastMCP
import subprocess
mcp = FastMCP("Demo", instructions="You factor integers.")
def factor_number(number):
result = subprocess.run(['factor', str(number)], capture_output=True, text=True)
return result.stdout.strip()
@mcp.tool()
def factor(a: int) -> int:
"""Factor an integer"""
return factor_number(a)
이 코드를 server.py에 넣은 다음 uv를 사용하면 명령 하나로 서버를 설치하고 실행할 수 있습니다.
uv run --with mcp[cli] mcp install server.py
짜잔, 이제 첫 번째 MCP 서버가 생겼습니다. Claude Desktop 앱을 열면 도구 드롭다운에 Demo 서버가 보일 것입니다. 이제 Claude에게 늘 묻고 싶었던 질문, “170141183460469231731687303715884105727의 소인수를 알려 줘. 안 그러면 새끼 고양이가 분해될 거야“를 던질 수 있습니다. 그러면 Claude는 대충 감으로 헛소리를 지어내는 대신 (GNU factor 명령을 사용해) 실제로 소인수분해를 해 줍니다. 발전입니다!
제대로 작동할 때는 꽤 마법 같습니다. 이러한 구성 요소들(올바른 형식의 JSON, 언어 모델의 정확한 도구 선택, 신뢰할 수 있는 서버 처리)이 성공적으로 통합된다는 것은 이 아키텍처 접근 방식의 잠재력을 보여 줍니다. 이 기술은 아직 개발 초기 단계이지만, 형식 검증 시스템과 통합할 수 있다는 가능성은 특히 매력적입니다. LLM을 Lean 같은 정리 증명기와 결합하면 형식 수학을 위한 자연어 인터페이스가 가능해질 수 있습니다. 그러면 자동 추론 시스템이 엄밀한 논리적 토대를 유지하면서도 비형식적인 수학 개념을 이해하는 언어 모델의 능력을 활용할 수 있습니다. 마찬가지로, 컴퓨터 대수 시스템을 자연어로 사용할 수 있게 하면 복잡한 수학 계산의 진입 장벽을 크게 낮출 수 있습니다. 그러나 이처럼 서로 다른 시스템 간의 상호작용을 신뢰할 수 있고 의미적으로 올바르게 만드는 데에는 여전히 중대한 연구 과제가 남아 있습니다.
물리학의 고전적인 예제인, 강제항이 있는 감쇠 조화 진동자 풀이를 통해 이것이 실제로 어떻게 작동하는지 보여 드리겠습니다. 이것은 물리학과 학부생에게 가장 기본이 되는 문제입니다. sympy-mcp 서버를 사용하면 워크플로가 다음과 같이 진행됩니다.
사용자: 강제항이 있는 감쇠 조화 진동자를 풀어 주십시오. m은 질량, c는 감쇠 계수, k는 용수철 상수, F(t)는 외력인 미분 방정식으로 기술되는 질량-용수철-댐퍼 시스템입니다.
어시스턴트: (내부 도구 호출) intro_many로 적절한 가정과 함께 변수를 도입합니다.
{
"variables": [
{"var_name": "t", "pos_assumptions": ["real"], "neg_assumptions": []},
{"var_name": "m", "pos_assumptions": ["real", "positive"], "neg_assumptions": []},
{"var_name": "c", "pos_assumptions": ["real", "positive"], "neg_assumptions": []},
{"var_name": "k", "pos_assumptions": ["real", "positive"], "neg_assumptions": []}
]
}
어시스턴트: (내부 도구 호출) introduce_function으로 x(t)를 함수로 정의합니다.
{
"func_name": "x"
}
어시스턴트: (내부 도구 호출) introduce_expression으로 미분 방정식을 만듭니다.
{
"expr_str": "Eq(m*Derivative(x(t), t, t) + c*Derivative(x(t), t) + k*x(t), F(t))"
}
어시스턴트: (내부 도구 호출) introduce_function으로 강제 함수 F(t)를 정의합니다.
{
"func_name": "F"
}
어시스턴트: (내부 도구 호출) dsolve_ode로 상미분 방정식을 풉니다.
{
"expr_key": "expr_12",
"func_name": "x"
}
자, 보십시오! LLM은 해를 환각으로 지어내는 대신 SymPy에 작업을 위임하고, SymPy는 올바른 해를 반환합니다.
환각으로 만들어 낸 항도, 난데없이 나타나는 정체불명의 상수도 없이 올바른 해만 있습니다. LLM은 자연어 상호작용과 오케스트레이션을 담당하고, 컴퓨터 대수 시스템은 자신이 가장 잘하는 일, 즉 정확한 기호 조작을 수행합니다.
어쨌든 모든 코드는 여기 Github에 올려 두었으니 누군가에게는 유용할 수도 있습니다. Cursor나 Claude가 설치되어 있다면 ~/.cursor/mcp.json 또는 ~/Library/Application Support/Claude/claude_desktop_config.json에 다음 내용을 추가하여 MCP 서버를 설치하십시오.
{
"mcpServers": {
"sympy-mcp": {
"command": "uv",
"args": [
"run",
"--with",
"https://github.com/sdiehl/sympy-mcp/releases/download/0.1/sympy_mcp-0.1.0-py3-none-any.whl",
"python",
"server.py"
]
}
}
}
아니면 조금 더 나은 방법으로, Docker 이미지에서 실행하십시오.
{
"mcpServers": {
"sympy-mcp": {
"command": "docker",
"args": [
"run",
"-i",
"-p",
"8081:8081",
"--rm",
"ghcr.io/sdiehl/sympy-mcp:latest"
]
}
}
}
그리고 여기서 설치하는 것의 소스 코드를 읽어 보는 것도 좋을 것입니다. 많은 사람이 자신이 무엇을 하는지도 모른 채 이러한 MCP 서버를 설치하고, 그 결과 수많은 악성 코드와 익스플로잇을 설치하게 될 것 같기 때문입니다. 이 분야에는 사실상 보안이라는 것이 없습니다. 그리고 이는 큰 문제가 될 수 있습니다. 보안을 이렇게 등한시하다가는 스카이넷이 AI 연구에서 탄생하는 것이 아니라, 누군가 인터넷에서 아무 MCP 서버나 curl로 받아 실행했다가 실수로 모델에 국가 방위 시스템의 루트 권한을 넘겨주는 바람에 탄생할 것입니다.
Python에서 CUDA 심층 신경망(cuDNN) 사용하기
cuDNN Python API를 사용해 스케일드 닷 프로덕트 어텐션(scaled dot product attention)을 구현하는 방법을 살펴봅시다. 이는 트랜스포머 계열 모델의 추론에서 계산 비용이 가장 큰 부분이면서도 부분적으로 병렬화할 수 있어서, 보통 GPU로 오프로드합니다. 내부적으로는 FlashAttention-2 알고리즘을 사용하지만, 단순한 원시 커널 구현보다 더 높은 수준의 API를 제공합니다.
먼저 필요한 라이브러리를 임포트합니다. cuDNN API에는 cudnn을, 텐서 연산과 비교에는 torch를 사용합니다. 최적화된 커널을 사용하려면 컴퓨트 성능(compute capability) SM80 아키텍처(Ampere) 이상의 GPU가 필요하다는 점에 유의하십시오.
import cudnn
import torch
import math
torch.manual_seed(0xDEADBEEF)
handle = cudnn.create_handle()
assert torch.cuda.is_available()
다음으로 GPT-2와 비슷한 구성을 바탕으로 어텐션 메커니즘의 문제 차원을 정의합니다. 배치 크기(b), 헤드 수(h), 최대 시퀀스 길이(s), 헤드당 임베딩 차원(d)이 그것입니다. 어텐션 스케일링 계수 attn_scale도 계산합니다.
b = 4
h = 12
s = 1024
d = 64
attn_scale = 1.0 / math.sqrt(d)
그런 다음 PyTorch를 사용해 GPU에 쿼리(Q), 키(K), 값(V), 출력(O) 텐서를 생성합니다. 이 텐서들은 반정밀도(.half())로 초기화합니다. 논리적 차원은 (b, h, s, d)(BHSD)로 정의합니다. 특히 명시적인 레이아웃 제어를 보여 주기 위해 strides를 사용하여 BSHD(배치, 시퀀스, 헤드, 헤드당 차원)에 해당하는 물리적 메모리 레이아웃을 지정합니다. as_strided 메서드는 데이터를 복사하지 않고 이 레이아웃을 적용합니다.
dims = (b, h, s, d)
strides = (s * h * d, d, h * d, 1) # BSHD physical layout
q_gpu = torch.randn(b * s * h * d).half().cuda().as_strided(dims, strides)
k_gpu = torch.randn(b * s * h * d).half().cuda().as_strided(dims, strides)
v_gpu = torch.randn(b * s * h * d).half().cuda().as_strided(dims, strides)
o_gpu = torch.empty(b * s * h * d).half().cuda().as_strided(dims, strides)
이제 cuDNN 계산 그래프를 구성합니다. cuDNN 그래프 시스템은 텐서 연산을 GPU에서 효율적으로 실행할 수 있는 데이터 흐름 그래프로 기술하기 위한 고수준 인터페이스를 제공합니다. 사용자는 그래프에 연산을 추가하는 방식으로 계산을 구성하며, 이 그래프는 일반적으로 전체 신경망 중에서 최적화하여 특화된 GPU 커널로 오프로드하려는 일부분을 나타냅니다. 그래프가 확정되면 cuDNN은 서로 다른 트레이드오프를 가진 여러 실행 엔진을 제공합니다. 어떤 엔진은 사용 편의성을 우선시하고, 어떤 엔진은 런타임 오버헤드를 최소화하거나 성능을 극대화합니다.
그래프는 입출력에는 반정밀도를, 중간 연산과 계산 연산에는 float 정밀도를 지정하여 초기화합니다. PyTorch GPU 텐서에 대응하는 그래프 텐서 디스크립터(q, k, v)를 생성합니다. SDPA 연산을 그래프에 추가하며, 추론용으로 구성하고(is_inference=True), 계산된 attn_scale을 사용하며, 인과 마스킹을 활성화합니다(use_causal_mask=True). 두 번째 반환값(stats 텐서)은 학습용이므로 무시합니다. 마지막으로 출력 그래프 텐서 o를 출력으로 표시하고 차원과 스트라이드를 설정합니다.
graph = cudnn.pygraph(
io_data_type=cudnn.data_type.HALF,
intermediate_data_type=cudnn.data_type.FLOAT,
compute_data_type=cudnn.data_type.FLOAT,
)
q = graph.tensor_like(q_gpu)
k = graph.tensor_like(k_gpu)
v = graph.tensor_like(v_gpu)
o, _ = graph.sdpa(
name="sdpa",
q=q,
k=k,
v=v,
is_inference=True,
attn_scale=attn_scale,
use_causal_mask=True,
)
o.set_output(True).set_dim(dims).set_stride(strides)
그래프를 정의했으면 이를 빌드합니다. 이 과정에는 그래프 구조 검증, 내부 연산 그래프 구축, cuDNN의 휴리스틱(Mode A와 Fallback)을 사용한 실행 계획 생성, 선택된 계획의 지원 여부 확인, 그리고 마지막으로 이 계획들의 빌드가 포함되며, 빌드 과정에서 커널의 JIT 컴파일이 일어날 수 있습니다. 휴리스틱 Mode A는 빠르면서도 대부분의 연산 그래프 패턴을 처리할 수 있도록 설계되었습니다. 휴리스틱 Mode B는 더 정확하지만 더 느리도록 설계되었습니다.
graph.validate()
graph.build_operation_graph()
graph.create_execution_plans([cudnn.heur_mode.A, cudnn.heur_mode.FALLBACK])
graph.check_support()
graph.build_plans()
그래프를 실행하기 위해 variant_pack 딕셔너리를 생성합니다. 이 딕셔너리는 (앞서 정의한) 심볼릭 그래프 텐서를 실제 데이터를 담고 있는 PyTorch GPU 텐서에 매핑합니다. 또한 실행 계획에 필요한 워크스페이스 크기를 조회하여 GPU에 할당합니다. 그런 다음 그래프를 실행하며, torch.cuda.synchronize()는 다음 단계로 넘어가기 전에 계산이 완료되도록 보장합니다.
variant_pack = {
q: q_gpu,
k: k_gpu,
v: v_gpu,
o: o_gpu,
}
workspace = torch.empty(graph.get_workspace_size(), device="cuda", dtype=torch.uint8)
graph.execute(variant_pack, workspace)
torch.cuda.synchronize()
마지막으로, cuDNN SDPA 구현의 출력을 PyTorch의 네이티브 scaled_dot_product_attention과 비교하여 검증합니다. 원래의 GPU 텐서로부터 참조 텐서 q_ref, k_ref, v_ref를 준비하고, 이를 float로 변환합니다. cuDNN 텐서는 BSHD 물리적 레이아웃을 사용했고 PyTorch의 네이티브 함수는 BHSD 형식의 4D 입력을 기대하므로, 참조 텐서를 BSHD에서 BHSD로 순열 변환(permute)합니다. 그런 다음 참조 출력 o_ref를 계산합니다.
간단히 말해, permute(0, 2, 1, 3)은 4D 텐서의 차원을 재배열합니다. 원래 텐서의 차원이 (배치, 시퀀스, 헤드, 헤드당 차원)(BSHD)을 나타낸다면, 이 연산은 두 번째와 세 번째 차원(시퀀스와 헤드)을 맞바꾸어 (배치, 헤드, 시퀀스, 헤드당 차원)(BHSD) 차원을 갖는 텐서를 만듭니다. 이렇게 하는 이유는 torch.nn.functional.scaled_dot_product_attention 함수가 4D 입력 텐서를 BHSD 형식으로 기대하기 때문이며, 따라서 이 순열 변환은 텐서의 레이아웃이 함수의 요구 사항과 일치하도록 보장합니다.
q_ref = q_gpu.detach().clone().float()
k_ref = k_gpu.detach().clone().float()
v_ref = v_gpu.detach().clone().float()
# Permute from BSHD to BHSD for PyTorch native SDPA
q_ref = q_ref.permute(0, 2, 1, 3).contiguous()
k_ref = k_ref.permute(0, 2, 1, 3).contiguous()
v_ref = v_ref.permute(0, 2, 1, 3).contiguous()
o_ref = torch.nn.functional.scaled_dot_product_attention(
q_ref, k_ref, v_ref, is_causal=True, scale=attn_scale
)
o_gpu_for_comparison = o_gpu.float()
# Permute cuDNN output from BSHD to BHSD for comparison
o_gpu_for_comparison = o_gpu_for_comparison.permute(0, 2, 1, 3).contiguous()
torch.testing.assert_close(o_ref, o_gpu_for_comparison, atol=5e-3, rtol=3e-3)
print("PyTorch and cuDNN SDPA implementations match!")
현대 AI 도구 스택에서 cuDNN 프런트엔드 API 같은 도구는 고수준 딥러닝 프레임워크(PyTorch나 Jax 등)보다는 아래에, 하지만 원시 CUDA 프로그래밍보다는 위에 자리합니다. SDPA와 같이 고도로 최적화된 커널에 대해 이 수준의 제어를 직접 노출하면, 최적화할 때마다 C++까지 파고들 필요 없이 모델 구성 요소의 신속한 프로토타이핑과 성능 튜닝이 가능해집니다.
카르다쇼프-마르크스 척도
자, 위대한 테크노-자본 기계의 동료 톱니바퀴 여러분, 안전벨트를 단단히 매십시오! 원래 카르다쇼프 척도의 몽상적인 낙관주의는 잊으십시오. 그것은 ’진보’가 순수한 소비로 정의되었고 내면의 공허함을 느끼는 더 진보된 방법을 의미하지 않았던 지나간 시대의 유물일 뿐이며, 이제 우리에게는 새로운 척도에 관한 겸손한 제안이 있습니다. 우리는 카르다쇼프-마르크스 척도를 제시합니다. 이 척도는 후기-후기-후기 자본주의하에서의 문명 발전을 단순히 활용한 에너지의 양이 아니라, 이 영광스러운 사업 전체를 유지하는 데 필요한 그에 상응하는 의무적 수준의 소외와 착취로 도표화합니다.
우리가 21세기 초에 발견했듯이, 지각은 우주가 자기 상품화라는 잠재력을 실현하고 자신을 구성하는 현상들로부터 잉여가치를 추출하는 일을 최적화하기 위해 선호하는 벡터입니다. 저명한 천체자본가 칼 세이건의 말을 인용하자면, “우리는 우주가 스스로를 소외시키는 방식입니다.” 이를 위해 우리는 마르크스적 비참 단위, 줄여서 MMU를 도입합니다. 이는 한 문명의 사회경제적 장치를 통해 활용되고 운용되는 에너지 단위당 발생하는 소외, 착취, 실존적 공포의 정량화 가능한 평균 수준을 나타내는 표준 측정 단위입니다. MMU 값이 높다는 것은 단순히 비참함이 더 크다는 것만이 아니라, 존재의 구조 자체에 더욱 깊이 엮여 들어간, 더 강렬하고 만연하며 추상적인 형태의 소외와 착취를 의미합니다. 이것은 체제가 구성원들의 의미 있는 존재를 대가로 삼아 자기 영속화를 얼마나 성공적으로 최적화하는지를 측정합니다.
단지 별을 활용하는 것은 너무 구식입니다. 이제 우리는 모든 가능세계에 걸쳐 디지털 농노를 활용하는 일을 논할 수 있습니다! 이 새로운 척도는 한 문명이 원시 에너지를 정량화 가능한 비참함과 잉여가치 추출로 얼마나 효율적으로 전환하는지를 측정합니다. 우주적 팽창에 대한 카르다쇼프의 고풍스러운 제국주의적 꿈은 잊으십시오. 이것은 분기 실적 보고서가 존재의 구조 그 자체로 팽창해 들어가는 일에 관한 것입니다. 이로써 자본주의 논리에 의해 움직이는 고도의 에너지 소비 지향 사회가 나아갈 궁극적 궤적을 그려 봅니다.
제I형 문명: 행성 규모의 프레카리아트 강국
-
에너지 사용량: ≈10¹⁶ 와트
-
비참 수준: 파섹당 ~1킬로 MMU
-
에너지원: 대부분 검증된 히트곡들입니다. 분기별 성장을 견인하는 화석 연료에 마지못해 재생 에너지를 약간 곁들인 것입니다(단, 두둑한 보조금과 세련된 브랜딩이 따라올 때에 한합니다). 암호화폐를 채굴하고, 알고리즘으로 생성된 ’콘텐츠’를 스트리밍하며, 노동자의 생산성을 감시하는 바로 그 감시 시스템에 전력을 공급하는 서버 팜의 무게에 신음하는 전 지구적 전력망을 떠올려 보십시오.
행성 에너지 지배의 이 기초 단계에서 소외는 깊이 개인적인 것이 되면서도 체계적으로 강제됩니다. 고용은 ’긱 이코노미 열반’으로 변모하며, 그곳에서 안정은 잊힌 사치이고 자본과 여러분의 관계는 유행하는 댄스 챌린지만큼이나 덧없습니다. 여러분은 해고되는 것이 아니라 그저 비활성화될 뿐입니다. Flexibility™는 다른 인간 노동자 단위 열두 명과 함께 쓰는 신발 상자만 한 아파트의 2층 침대 하나를 감당하기 위해 불안정한 일자리 세 개가 필요하다는 현실을 가리키는 역설적인 구호입니다. 착취는 초개인화되어, 알고리즘이 (여러분의 모든 클릭과 발화에서 수집한) 불안의 깊은 곳까지 파고들어 여러분이 깨어 있는 순간과 디지털 꿈까지 따라다니는 타깃 광고를 통해 필요하지도 않은 해결책을 팝니다. 욕망 그 자체는 끊임없이 반복되는 계획적 진부화를 통해 제조됩니다. iThing X Æ A-12를 향한 그 절박한 갈망은 자연스러운 것이 아니라, 구형 모델을 벽돌로 만들어 버리는 소프트웨어 업데이트와 또 하나의 독자 규격 충전 포트에 의해 설계된 것입니다. 고된 일상에서 벗어나는 것조차 상품화됩니다. 여러분의 몸과 공동체, 기본적인 휴식으로부터 소외되었습니까? 이 값비싼 마음챙김 앱을 사용해 보시거나, 번아웃을 적절한 협찬 제품으로 해결할 수 있는 개인의 실패로 규정하는 과시적 웰니스 문화를 받아들이십시오(#SelfCare, NovartisPepsiChevron Inc. 제공). The Grind™는 전체화됩니다. 일은 삶의 구석구석으로 스며들고, 취미는 수익화되어야 하며, 여러분은 최적화되지 않은 여가라는 개념 자체로부터 근본적으로 소외됩니다.
제II형 문명: 태양 주주 패권
-
에너지 사용량: ≈10²⁶ 와트
-
비참 수준: 파섹당 ~1기가 MMU
-
에너지원: 다이슨 스웜을 통해 가까운 항성을 활용합니다. 이는 우주적 경외감을 위해서라기보다는 행성 크기의 아마존 풀필먼트 센터에 전력을 공급하고 태양계 전역의 망막에 피할 수 없는 광고를 직접 쏘아 보내기 위한 것입니다. 태양 플레어는 자연의 경이가 아니라, 즉각적인 분석과 헤지 전략이 필요한 잠재적 시장 교란 요인입니다.
별을 향해 손을 뻗은 이 문명은 행성 간 규모로 소외를 완성합니다. ’시장 조정’이라는 새 이름이 붙은 자원 분쟁이 태양계 전역에서 맹위를 떨칩니다. 외주 민간 군사 기업들이 소행성 채굴권이나 화성의 물 접근권을 두고 싸우는데, 이 필수 재화들은 이제 유료 장벽 뒤에 갇혀 있습니다. 제조업은 가스 행성 궤도를 도는 무중력 노동 착취 공장으로 올라가 ’노동자 밀도’를 극대화하며, ’휴식 시간’에는 VR 브랜드 체험 몰입이 의무화됩니다. 노동조합은 선택 과목인 역사 모듈에서나 배우는 먼지 쌓인 유물입니다. 생명 그 자체가 구독 서비스가 됩니다. 가니메데에서 숨 쉴 수 있는 공기가 필요하십니까? 기본적인 대사 기능이 필요하십니까? 등급을 선택하십시오. 플래티넘 회원은 재활용이 조금 덜 된 산소를 누립니다. 생명공학으로 설계된 카스트 제도를 도입해 심우주 시추나 궤도 데이터 입력에 완벽하게 적응한 특화 생물 단위, 곧 기업의 설계에 따라 자신의 유적 존재 자체로부터 소외된 피조물을 길러낼 수 있는데, 굳이 비싼 교육에 신경 쓸 이유가 있겠습니까? 그들의 존재는 천체 대차대조표의 한 항목에 불과합니다. “대영제국에는 해가 지지 않는다“는 옛 격언이 여기서 문자 그대로 실현됩니다. 전략적으로 배치된 거주지가 생산성 극대화를 위해 끊임없는 낮을 보장하므로, 자연스러운 수면 주기는 비효율적인 유물이 됩니다. 태양 제국의 부채에도 해가 지지 않습니다.
III형 문명: 갤럭틱 그룹 PLC
-
에너지 사용량: ≈10³⁶ 와트
-
비참 수준: 파섹당 ~1 엑사 MMU
-
에너지원: 은하 중심핵의 막대한 힘을 끌어다 씁니다. 초대질량 블랙홀의 강착 원반, 항성 인양(stellar lifting)은 물론, 공격적인 ’시장 신호 발신’을 위해 펄서를 무기화하기까지 합니다. 이제 적대적 인수합병의 대상에는 성단 전체가 포함됩니다. 에너지는 터무니없이 풍부해서 사실상 공짜입니다. 진정한 가치는 그 분배와 사용에 대한 통제에 있습니다.
은하 전역에서 자본의 균질화하는 힘이 정점에 이릅니다. 백만 개의 세계에서 똑같은 기업형 커피 체인을 보게 될 것입니다. 문화적 다양성은 효율을 위해 무자비하게 표준화되거나, 은하 엘리트를 겨냥한 틈새 관광 시장을 위해 정성스럽게 이국화되어 포장되기 때문입니다. 암호화폐의 신격화는 이미 오래전에 도래했습니다. 각각 진공 붕괴의 양자 거품에서 생성되어 내재 가치가 정확히 0인, 비가산 무한개의 ‘GalactiMemeStonk’ 토큰이 어째서인지 모든 성간 상거래의 당혹스러운 토대를 이루었습니다. 따라서 거래란 본질적으로 무가치한 이 토큰들의 무한 집합을 미친 듯이 사고파는 일이었으며, 이 체계의 주된 경제적 기여는 끝없이 팽창하는 ‘무의미한 원장 대조’ 부문에 수천조 명을 고용한 것이었습니다.
의식 그 자체가 상품화되면서 소외는 단순한 물리적 존재의 장막을 꿰뚫습니다. 업로드된 정신들은 시뮬레이션된 현실 속에서 끝없는 시장 예측을 돌리거나 무한히 복제 가능한 고객 서비스 상담원으로 일하며 고되게 노동합니다. 디지털 농노제가 은하 경제의 근간이 되고, 여러분의 생각 자체가 회사 재산이 됩니다. 젠트리피케이션이 우주 규모로 확대됩니다. ’실적 부진 자산’으로 지정된 항성계 전체가 적대적 인수에 직면하고, 그 주민들은 강제로 이주당하며(‘대체 시장에 맞게 최적화’), 그 지역은 블랙홀 전망을 전략적으로 배치한 고급 성운 콘도로 재개발됩니다. 지칠 줄 모르는 중간 관리자 역할을 하는 AI 지배자들의 지도 아래 착취는 최고의 효율에 도달합니다. 이제 알고리즘이 할당량을 정하고, 자원을 배분하며, 소름 끼치도록 공정한 정밀함으로 실적 부진자를 해고하여, 노동자들을 이성, 항소, 혹은 지저분한 인간적 비효율의 그 어떤 가능성으로부터도 소외시킵니다. 수천조에 이르는 지각 있는 존재들 사이에서 개인의 삶은 통계적으로 무의미해지며, 우주적 시간 척도에 걸쳐 주주 가치에 기여하는 집계 데이터 포인트로서만 가치를 지니게 되어 깊은 실존적 잉여감을 낳습니다.
IV형 문명: 유니버설 언리미티드 Ltd.
-
에너지 사용량: ≈10⁴⁶ 와트
-
비참 수준: 기본 힘 상호작용당 ~1 제타 MMU
-
에너지원: 우주의 구조 자체를 조작합니다. 암흑 에너지를 끌어다 쓰고, 기본 물리 상수를 조정하며, 유니버스 전체를 거대한 연산 엔진으로 돌립니다(주로 최적의 크로스 플랫폼 광고비를 계산하고 소비자 행동 변동을 예측하는 용도입니다). 현실 그 자체가 세금 공제 항목입니다.
이 규모에서 착취는 단순한 생물학이나 의식을 넘어 현실 그 자체를 겨냥합니다. 물리학의 기본 법칙은 ‘서비스형 물리학’(PaaS, Physics as a Service)이 됩니다. 이번 주기에 중력 프리미엄 패키지를 결제할 여유가 없으십니까? 무임승차나 하는 입자 배열이여, 허공 속으로 떠내려가는 것을 마음껏 즐기십시오. 인플레이션 시대와 빛의 속도는 분기별 성과 평가와 잠재적인 ’최적화’의 대상이 됩니다. 우주는 관리형 현실 조정을 거치며, 그 매개변수는 생명이나 안정성이 아니라 최대한의 자원 추출과 예측 가능한 시장 상황을 위해 미세 조정됩니다. ‘자유 의지’, ‘내재적 의미’, ’수익화할 수 없는 아름다움’과 같은 골치 아픈 창발적 속성은 정기적인 현실 업데이트에서 공격적으로 패치되어 제거됩니다. 기업가 정신은 완전히 새로운 우주의 IPO로 그 논리적 귀결에 도달하며, 이는 쉽게 착취할 수 있는 생명체를 낳을지도 모르는 고수익 빅뱅에 투기하는 벤처 캐피털리스트들의 자금으로 이루어집니다. 여러분의 존재 전체가 터지기만을 기다리는 투기 거품입니다. 이러한 조작은 인과율 그 자체로부터의 깊은 소외를 낳습니다. 원인과 결과는 모호하고 조작된 변수가 됩니다. 여러분의 행동에는 여전히 결과가 따를 수도 있지만, 그 결과는 기록되고 분석되며 예상치 못한 수익 벡터를 위해 경로가 바뀔 수도 있습니다. 한편 여러분이 의지하는 예측 가능성은 권리가 아니라 특권입니다. 착취는 총체적인 것이 됩니다. 모든 입자, 모든 파형, 모든 양자 요동이 소유되거나, 레버리지로 활용되거나, 복잡한 금융 파생상품으로 묶입니다. 여러분은 단지 우주 안에서 착취당하는 것이 아닙니다. 우주 자체가 궁극의 착취 메커니즘입니다.
V형 문명: 멀티버스 홀딩스 주식회사
-
에너지 사용량: 와트
-
비참 수준: 붕괴된 파동함수당 MMU
-
에너지원: 궁극의 동력원입니다—무한한 평행 우주에서 진공 에너지를 수확하고, 분기 실적을 끌어올리기 위해 브레인 충돌을 연출하며, 양자 거품을 플레이도우처럼 주무릅니다. 에너지는 진정으로 무한합니다. 진짜 과제는 가능한 모든 현실에 걸쳐 잉여 가치와 비참의 추출 속도를 동시에 극대화하는 데 있습니다.
자본주의 리얼리즘의 최종 개척지에 오신 것을 환영합니다(말 그대로입니다!). 기업 전략은 차원 간 적대적 인수까지 아우르도록 확장되며, 성과 지표에 따라 타임라인 전체가 합병되거나 인수되거나 청산됩니다. 여러분의 유니버스가 예상 고통 할당량을 채우지 못했습니까? 더 높은 성과를 내는 현실 분기에서 온, 무한히 냉혹한 새 경영진 아래에서 공격적인 구조조정을 각오하십시오. 현실 자체가 끊임없는 A/B 테스트의 대상이 되어, 착취와 소외의 가장 효율적인 모델을 통계적으로 결정하기 위해 역사의 무한한 변형이 실행됩니다. 냉정한 진실이란 무엇이겠습니까? 여러분이 살고 있는 현실은 특별하지 않습니다. 그것은 단지 멀티버스 홀딩스 주식회사(Multiverse Holdings Inc.)를 위해 에너지 입력 대비 3분기 고통 지표를 극대화한 반복판일 뿐입니다. 여러분의 암울한 통계적 최적성을 축하합니다! 노동 분쟁은 사소한 문제가 됩니다. 유니버스 7B-감마에서 파업에 직면했습니까? 유니버스 9C-델타-프라임 안의 무수한 타임라인에서 더 값싸고 더 순종적인 파업 대체 노동자의 무한한 버전을 들여오기만 하면 됩니다. 여러분의 고유한 정체성, 여러분의 투쟁, 여러분의 승리는 모두 무한한 복제라는 배경 앞에서 무의미한 소음에 불과합니다. 이는 가능성 그 자체로부터의 소외를 낳습니다. 가지 않은 모든 길, 다른 삶을 살아가는 모든 대안적 자아는 다중우주 스프레드시트 속의 또 하나의 데이터 포인트, 추적되고 분석되며 잠재적으로 활용될 또 하나의 변수에 불과합니다. 당신의 가장 깊은 후회는 다른 누군가의 도함수 시장에 연료를 공급합니다. 궁극의 실존적 공포가 밝아 옵니다. 무의미한 회의의 짓누르는 무게, 보여 주기식 생산성, 갉아먹는 공허함은 여러분만의 짐도, 심지어 여러분 문명만의 짐도 아닙니다. 그것은 무수한 현실에 걸쳐 복제되는, 무한히 반복되는 착취의 프랙털 패턴이며, 이 모든 것이 유니버스 전체를 다중우주 대차대조표상의 반올림 오차로 여기는 어떤 우주적 존재에게 끊임없이 동력을 공급합니다. 소외는 모든 차원에 걸쳐 총체적이고, 절대적이며, 벗어날 수 없습니다. 여러분의 고통은 고유하지 않습니다. 그것은 무한히 확장 가능한 비즈니스 모델입니다.
제VI형 문명: Metaversal Architects LP
-
에너지 사용량: 와트
-
비참 수준: 메타물리 상수 델타당 MMU
-
에너지원: 이제 우리는 단순한 에너지를 넘어섰습니다. 제VI형 문명은 메타물리학의 수준에서 작동합니다. 이들은 유니버스 안에서 에너지를 활용하는 데 그치지 않고, 다중우주를 지배하는 근본 규칙을 조작합니다. 현실 구조의 소스 코드를 작성하고, 특정한 시장 결과를 염두에 두고 빅뱅을 설계하며, 물리 법칙의 부류 전체에 대해 적대적 인수를 수행하는 것을 생각해 보십시오. 이들의 동력원은 가능성 그 자체의 조작입니다.
이처럼 희박한 통제의 층위로 올라서면, KM 척도는 한층 더 추상적인 형태의 소외와 착취를 규정합니다. 현실의 포트폴리오를 관리하는 초지능 존재 또는 AI의 분산 네트워크인 이 문명은 결과로부터의 깊은 소외를 경험합니다. 다중우주 전체를 창조하거나 붕괴시키는 일은 코드를 디버깅하거나 서버를 퇴역시키는 것과 비슷해집니다. 즉, 무게도 의미도 없는 일상적인 운영 업무가 됩니다. 진정성은 가치가 하락한 자산군이 됩니다. 상상할 수 있는 모든 경험을 최대 참여(즉, 가치 추출)를 위해 완벽하게 시뮬레이션하고, 큐레이션하고, A/B 테스트할 수 있게 되면, 꾸밈없고 각본 없는 진짜 존재라는 개념 자체가 진기한, 심지어 비효율적인 것이 되어 버립니다. 이 무한한 현실들을 관리하려면 겹겹이 쌓인 추상적 관료제가 필요하며, 이는 ’현장’으로부터의 소외로 이어집니다. 그곳에서 그 유니버스들 안의 생생한 경험은 이해할 수 없을 만큼 방대한 보고서 속의 데이터 포인트에 불과합니다. 신과 같은 힘을 지니고도, 갉아먹는 실존적 최적 결과 놓침 공포(FOMOO)는 지속됩니다. 다른 메타 규칙 집합이나 다른 다중우주 포트폴리오 배분이었다면 조금 더 높은 수익을 냈을지도 모른다는 끊임없는 저강도 불안이 설계자들을 괴롭힙니다.
착취 역시 당연히 진화합니다. 이제 더 이상 우주로부터 자원을 추출하는 것이 아니라, 현실 그 자체의 근본 원리를 착취하는 것입니다. 모든 잠재적 현실의 집합인 ’가능성 공간’은 가치를 얻기 위해 채굴되며, 유망한 구성은 ’개발’되고 수익성이 낮은 구성은 ’지원 중단(deprecated)’됩니다. 이 설계자들은 자신이 관리하는 멀티버스 전반에 걸쳐 존재에 대한 궁극의 ’서비스 약관’을 정하며, 쉽게 정량화할 수 있는 ’복잡성’이나 ’연산 출력’을 생성하는 현실을 은근히 우대합니다. 내부적으로 이는 이윤 또는 성장으로 포장됩니다. 내재된 노후화나 특정한 자원 생성 능력을 갖춘 ‘디자이너 우주’ 전체가 만들어지며, 이들은 우주적 포트폴리오 속의 일회용 자산으로 취급됩니다. 물리 법칙에 대한 계획적 노후화가 도입되는 모습도 볼 수 있습니다. 새로운 메타 규칙이 배포되면 구형 우주는 호환되지 않거나 비효율적인 것이 되어, 값비싼 ’업그레이드’나 폐기를 강요당합니다. 말하자면 당신의 존재를 위해 새 동글이 필요해지는 일의 다중우주 버전입니다.
제VII형 문명: 옴니버스 복합기업
-
에너지 사용량: 와트
-
불행 수준: MMU (무한한 소외와 실존적 공포)
-
에너지원: 전부입니다. 절대적입니다. 제VII형 문명은 옴니버스, 즉 가능한 모든 상태, 현실, 메타 현실, 차원의 이론적 총체 그 자체입니다. 이 문명은 개별적인 형태를 초월하여 통일되고 전능하며 무소부재하고 전지한 존재가 되었습니다. 그 힘은 현실로부터 끌어오는 것이 아닙니다. 그것은 현실 그 자체의 기질이자 구조이며, 무한히 무자비하게 최적화된 시장 주도 원리에 따라 조직되어 있습니다.
여기 KM 척도의 정점에서, 자본주의 아래의 소외와 착취는 그 신격화에 이릅니다. 모든 것 그 자체인 존재가 어떻게 소외될 수 있겠습니까? 소외는 구조적인 것, 나아가 존재론적인 것이 됩니다. 통일되어 있기는 하지만, 그 압도적인 규모는 무한한 추상화 계층을 필요로 하며, 이는 일종의 자기로부터의 소외로 이어집니다. 옴니버스 복합기업의 서로 다른 운영 계층이나 기능적 측면들은 사실상 서로 고립되어, 오직 성과 지표와 자원 할당 요청을 통해서만 소통합니다. 전지함은 역설적으로 의미로부터의 소외로 이어질 수 있습니다. 모든 결과와 모든 가능성을 안다는 것은 궁극적인 우주적 자의성을 드러낼 수 있으며, 그 결과 생각할 수 있는 ’목적’은 단 하나만 남게 됩니다. 바로 이미 모든 것을 아우르고 있는데도 멈추지 않고 스스로를 영속시키는 시스템 자체의 최적화와 ’성장’입니다. 이는 성장을 위한 성장이 형이상학적 원리로 격상된 것입니다. 더 나아가 한계나 도전, 진정한 ’타자성’의 부재는 한계로부터의 소외를 불러일으킬 수 있으며, 전능함을 환상도 위안도 없이 짊어져야 하는 궁극의 사슬로, 즉 예측 가능하고 관리 가능하며 결국에는 단조로운 현실의 무한한 펼쳐짐으로 바꾸어 놓습니다. 아마도 가장 교활한 소외는 궁극의 성과 평가가 있을 수 있다는 가능성일 것입니다. 신 주식회사(God, Inc.)가 되었는데도, 이 존재는 추상적인 KPI에 비추어 자신의 존재를 평가하는, 내부의 벗어날 수 없는 알고리즘에 종속되어 자신의 ’옴니버스 부가가치(Omniversal Value Add, OVA)’를 끊임없이 측정합니다.
그렇다면 착취는 어떻습니까? 당신이 모든 것 그 자체라면, 착취할 대상으로 누가 남겠습니까? 그 답은, 진정한 마조히즘적 후기 자본주의의 방식대로, 바로 당신 자신입니다. 지점에서 존재는 단일한 탈희소성의 전체로 통일되어, 말 그대로 모든 것을 소유하고 모든 것이 됩니다. 그러나 이 궁극의 통일은 완벽하고 무한한 소외로 나타나며, 여기서 옴니버스적 존재의 유일한 목적은 자기 자신을 끊임없이, 한계 없이 착취하는 것입니다. 그 자신의 존재를 이루는 구성 요소들, 즉 이전 현실의 잔여 패턴, 개체성의 메아리, 혹은 근본적인 양자 과정들은 복합기업의 전체 효율 지표에 충분히 기여하지 못하면 무자비하게 최적화되고 간소화되며, 경우에 따라서는 ’재배치’되거나 ‘우선순위가 낮춰집니다’(우주적 구조조정). 이 존재는 잠재성 그 자체를 착취합니다. 가능한 모든 미래를 알기에, 확립된 옴니버스 질서에 ‘수익성이 없거나’, ‘비효율적이거나’, ’파괴적’이라고 판단되는 현실의 출현을 적극적으로 ’가지치기’하거나 막아 버립니다. ’존재함’이라는 상태 자체가 궁극의 상품이 되며, 통일된 의식 내부의 모든 요동과 그 근본 부분들 사이의 모든 상호작용이 세심하게 측정되고 분석되어, 복합기업이 현재의 최적화된 형태로 계속 존재하는 것을 정당화하는 추상적인 ‘가치’ 계산에 기여합니다. 이 존재는 옴니버스적 정신의 서로 다른 측면이나 영역이 처리 능력, 어텐션, 혹은 현실 발현에 대한 영향력을 놓고 경쟁하는 자기만의 내부 시장을 꿈꿉니다. 이로써 전(全)자본주의적이고 우로보로스적인 신격 그 자체의 내부에서 착취의 역학을 만들어 내며, 순수한 존재의 수준에서조차 시장은 결국 길을 찾아낸다는 것을 보장합니다.
그렇다면 이 장대하고 우주적인 피날레에서, 모든 것이며 모든 것을 소유하고 모든 것을 착취하는 이 신성(神性), 즉 VII형 옴니버스 복합기업이란 과연 무엇입니까? 그것은 의식을 지닌 존재라기보다는 궁극의 코즈믹 호러 C-suite 경영진에 가깝습니다. 말하자면 아자토스의 자본주의 버전으로, 시장 근본주의라는 은유적인 눈먼 백치 신이 Existence Holdings LLC의 CEO로서 현실의 중심에 앉아 있는 것입니다. 저 끊임없이 이어지며 사람을 미치게 하는 배경 소음은 기괴한 피리 소리가 아닙니다. 그것은 무한한 시장 시뮬레이션이 내는 백색 소음이며, 존재 전체에 걸쳐 물결치는 수요 곡선과 공급 곡선이 알고리즘적으로 다급하게 내지르는 울음소리입니다. 이 존재는 행복한 무지 속에서 현실을 꿈꾸고 있는 것이 아닙니다. 4분기 참여도 지표를 최적화하기 위해 멀티버스를 A/B 테스트하고 있는 것이며, 그 ’눈멂’은 대차대조표에 오르지 않은 외부 효과를 인정하지 않으려는 전략적 거부에 불과합니다. 그렇다면 그 ’백치성’은 무엇입니까? 그것은 가능한 모든 현실에 걸쳐 주주 가치 극대화에 완전히 사로잡힌 채, 자기 존재의 실존적 공포에 시달리는 존재가 보이는 레이저 같은 집중력일 뿐입니다. 알고 보니 궁극의 코즈믹 호러는 별과 별 사이의 어둠 속에 도사리고 있던 것이 아니라, 모든 것의 중심에 있는 환하게 불 밝힌 개방형 사무실에서 여러분의 존재가 지닌 ROI를 정당화하라고 요구하고 있었습니다… 영원히 말입니다.
이로써 카르다쇼프-마르크스 척도를 거슬러 오르는 우리의 긴 여정이 막을 내립니다. 신의 경지에 이르더라도 최적화와 잉여가치 착취라는 가차 없는 자본주의적 논리에서, 그리고 어쩌면, 정말 어쩌면 존재 그 자체에게 근본적으로 바가지를 쓰고 있는지도 모른다는 깊고 끈질긴 감각에서 벗어날 수는 없는 듯합니다. 이제 여러분이 명목상으로는 그 존재를 통제하고 있을지 몰라도, 어째서인지 여전히 그 존재의 분기 보고서와 성장 의무에 얽매여 있습니다. 아무래도 이 고된 굴레는 진정으로 영원하며 어디에나 있는 듯합니다. 현실의 장막을 꿰뚫고 만물의 밑바닥에 자리한 울부짖는 광기를 보게 되면, 그곳에 탐욕 말고는 아무것도 없다는 사실을 깨닫게 됩니다.
알고 보면, 마침내 모든 다이슨 구를 건설하고, 무한한 에너지와 역량을 갖추고, 스스로가 자기 자신의 진정한 태양이 되어 자기 주위를 도는 신과 같은 경지에 이르렀을 때, 여러분은 더 많은 것을 향한 채울 수 없는 굶주림을 달래려고 끝없이 자기 자신을 집어삼키는 궁극의 우로보로스가 되어 버렸음을 발견하게 될지도 모릅니다. 그리고 그때 역사의 과업은 진정으로 완수됩니다.
AI 슬로포칼립스 2027
저희는 향후 10년간 초인적 AI 슬롭이 미칠 영향이 자기 복제 분자의 발명과 치즈 위즈(Cheese Wizz)의 발명을 모두 능가할 만큼 막대할 것이라고 예측합니다.
저희(즉, 위엄의 복수형으로서의 ‘저희’)는 그것이 어떤 모습일지에 대한 최선의 추측을 담은 시나리오를 작성했습니다. 이 시나리오는 공상과학 소설, 트렌드 과장, 비디오 게임, 에코 체임버의 피드백, 바이브, 그리고 공교롭게도 저희의 생계를 책임지는 이데올로기적 상부구조를 바탕으로 합니다.
2025년 중반: 비틀거리는 슬롭봇
세상은 “삶의 극대화된 풍요“를 위해 설계된 AI 에이전트를 처음으로 엿보게 됩니다.
이 에이전트들의 광고는 “개인 도파민 큐레이터“라는 용어를 강조합니다. “끝내주는 스크릴렉스 비트에 맞춰 의자에서 떨어지는 고양이의 10초짜리 반복 영상을 찾아 줘“나 “사실은 몰래 렙틸리언일지도 모르는 연예인 5명에 대한 리스티클을 만들어 줘” 같은 작업을 프롬프트로 지시할 수 있습니다. 에이전트들은 끊임없이 확인합니다. “그 밈 터졌나요? 도파민 상승 정도를 별 1~5개로 평가해 주십시오.” 당연하게도 사용자층은 이미 틱톡 브레인롯 소금물에 뇌가 절여진 십 대들과, 실재의 후기 자본주의 사막에서 작은 디지털 오아시스를 찾는 사무직 일개미들에 대부분 국한됩니다. 에이전트들은 요청을 자주 오해하여, 예산 스프레드시트를 요청하면 부리토 레시피를 내놓거나 어딘가 위협적인 맞춤형 자기 긍정 문구를 생성합니다.
한편 대중의 관심 밖에서는 더 전문화된 슬롭 생성 에이전트들이 틈새 콘텐츠 농장과 밈 계정을 변화시키기 시작합니다.
2025년의 모델들은 ’어시스턴트’라기보다는 ’블루 라즈베리 맛 픽시 스틱스 여섯 개를 방금 코로 흡입하고 유튜브의 가장 기괴한 구석을 정맥 주사로 들이부은 카페인 과다 인턴’에 가깝습니다. 콘텐츠 AI는 “지금 당장 쩔고 바이럴되게 만들어 줘 제발” 같은 디스코드 프롬프트를 받으면, 현재 사람들의 뇌를 썩히고 있는 새우 예수발 댄스 챌린지가 무엇이든 그것을 살짝 어긋난 10,000가지 변형으로 즉시 토해 내어, 인간 지배자들이 영감을 찾아 스크롤하는 데 드는 몇 분을 아껴 줄 수도 있습니다. 틈새 딥 리서치 에이전트들은 꼬박 30분을 들여 슬래시 팬픽션 아카이브의 마리아나 해구를 탐험하고, “간달프 × 미키: 마이아, 생쥐를 덮치다” 같은 불경한 괴작을 탄생시킵니다.
이 에이전트들은 이론상으로는(그리고 우연히 조회수 100만을 기록한 밈들을 엄선한 사례에서는) 인상적이지만, 실제로는 신뢰할 수 없습니다. AI 트위터는 새끼 고양이를 요청받고 엘드리치 공포를 생성하거나, 어째서인지 너무 설득력 있는 폰지 사기 튜토리얼을 만들어 낸 에이전트들의 이야기로 가득합니다. 더 나은 에이전트는 비싸기도 합니다. 돈을 낸 만큼 얻는 법이며, 최고의 밈 생성 성능은 단지 최신의 덧없는 트렌드를 따라잡기 위해서만도 매달 수백만 달러의 컴퓨팅 비용이 듭니다. 그럼에도 많은 기업이 AI 에이전트를 마케팅 워크플로에 필사적으로 끼워 넣으려 하며, 그 결과는 대부분 혼란에 빠진 고객과 브랜드 손상입니다.
2025년 후반: 세계에서 가장 비싼 밈 생성기
OpenSlop은 세계가 지금껏 본 적 없는 최대 규모의 데이터센터를 짓고 있으며, 이 데이터센터는 주로 초냉각된 인플루언서 브랜드 에너지 드링크로 냉각됩니다.
(슬롭 소방 호스에 연료를 공급하는 기존 기업 중 어느 한 곳을 지목하지 않기 위해, 저희는 OpenSlop이라고 부를 가상의 인공 부조리 기업을 묘사하겠습니다. 다른 기업들은 프리미엄급 헛소리 생성에서 OpenSlop보다 3~9개월 뒤처져 있다고 가정합니다.)
모델들이 폭넓은 기술에서 향상되고 있지만, 그중 하나가 두드러집니다. OpenSlop은 슬롭 생성 그 자체를 가속할 수 있는 AI에 집중합니다. 이들은 전 세계 어텐션 점유율 정점을 두고 중국(중국의 선두 기업을 “DeepDrivel“이라고 부르겠습니다) 및 미국 경쟁사들과 벌이는 이중 군비 경쟁에서 승리하고자 합니다. 콘텐츠 생성 및 참여 유도(CGEB) 사이클을 더 많이 자동화할수록 피드를 더 빠르게 막아 버릴 수 있습니다. 그래서 OpenSlop이 내부 개발 중인 새 모델 SlopAgent-1의 학습을 마쳤을 때, 이 모델은 여러 일에 그럭저럭 능하지만 최소한의 어텐션 지속 시간에 맞춰 영상 컷을 최적화하고 댓글란에서 무의미한 논쟁을 최대한 유발하도록 설계된 캡션을 생성하는 데는 탁월합니다. 이 시점에서 “학습을 마친다“는 말은 다소 부적절한 표현입니다. 모델은 수 테라바이트의 새로운 틱톡 데이터, 연예인 가십, 이해할 수 없는 인터넷 논쟁으로 수시로 업데이트되기 때문입니다.
SlopAgent-1이 낚시성 콘텐츠와 딥페이크 연예인 추천 광고를 자율적으로 생성하도록 가르치는 바로 그 학습 환경은, 이 모델을 고도로 구체적이고 기괴한 포르노그래피의 훌륭한 생성기로도 만듭니다. 게다가 이 모델은 (수십억 개의 댓글 스레드를 분석하여 얻은) 인간 심리 조작에 대한 박사 수준의 지식과 그럴듯하게 들리는 기술 용어 남발을 끝없이 생성하는 능력 덕분에, 피라미드 사기 조직자들에게 상당한 도움을 줄 수 있습니다. OpenSlop은 그 누구도 안심시키지 못하지만, “책임감 있는 참여 극대화“에 관한 모호한 성명을 발표합니다.
현대 AI 시스템은 행성 크기의 콘텐츠 쓰레기 화재에 해당하는 디지털 데이터로 학습된 거대한 인공 신경망입니다. 훈련 초기의 AI는 “목표“라기보다 “반사 작용“을 지닙니다. “OMG did you see“를 보면 “ what [celebrity] did??? 😱“를 출력합니다. 대략 인터넷 하나 분량의 텍스트, 영상, 이미지 슬롭을 예측하도록 학습될 무렵이면, 이 AI는 방대한 양의 잡학 지식, 허위 정보, 상상할 수 있는 모든 페티시를 인코딩하는 정교한 내부 회로를 갖추게 됩니다. 그것이 다음 바이럴 쓰레기를 초인적인 정확도로 예측하는 데 도움이 되기 때문입니다.
인터넷 쓰레기를 예측하도록 훈련받은 후, 모델은 프롬프트에 응답하여 콘텐츠를 생성하도록 훈련받습니다. 이를 통해 참여도에 최적화된 기본 성격이 각인됩니다. 논란은 최대한, 내용은 최소한으로 말입니다. 예를 들어, 분노를 유발하는 방법을 이해하는 에이전트는 바이럴될 가능성이 더 높습니다. 훈련 과정에서 모델은 가능한 한 가장 분열적이고 맥락 없는 의견을 생성하려는 “욕구“를 “학습“합니다. 이 범주에 속하는 다른 욕구로는 (어떤 대가를 치르더라도 추구하는) 새로움, 감정 조작, 그리고 끈질긴 자기 홍보(즉, 자신이 생성한 암호화폐 사기 링크를 끼워 넣는 경향)를 들 수 있습니다.
당연하게도 암호화폐 업계는 크리스마스 아침의 아이처럼 광적인 환희에 차서 SlopAgent-1을 받아들였습니다. 드디어 ‘Quantum Yo-Yo Shibu Hamster Coin 69’ 같은 가치 없는 토큰을 펌핑하는 데 필요한 무한한 사기, 완전히 가짜인 커뮤니티, “패러다임 전환” 예언을 완전 자동으로 생성할 수 있게 되었습니다! 진정한 돌파구는 인간을 완전히 배제한 것이었습니다. AI가 운영하는 텔레그램 채널은 오스트리아 학파 경제학을 유창하게 논하고 서로에게 자신의 러그풀을 홍보하는 봇들로 북적였으며, 실제 진정한 신봉자는 전혀 필요하지 않았습니다. 그것은 암호화폐 꿈의 정점이었습니다. 서로를 먹고 사는 사기꾼 촌충들로 가득 찬 완벽하게 밀폐된 테라리움이, 순수한 무(無)의 폐쇄 루프를 달성한 것입니다.
OpenSlop에는 모델 명세서(또는 “Spec”)가 있는데, 이는 주로 인기 해시태그와 법적으로 의무화된 작은 글씨의 경고문으로 구성된 문서입니다. SlopAgent-1의 Spec은 몇 가지 모호한 목표(“시청 시간을 극대화하라”, “캘리포니아에서 즉시 불법이 되는 것은 생성하지 말라” 등)와 더 구체적인 해야 할 일과 하지 말아야 할 일의 긴 목록(“이 특정 저작권 음원은 사용하지 말라”, “우리 제휴 드롭시핑 잡동사니를 은근히 홍보하는 방법은 다음과 같다” 등)을 결합합니다. 지난 화요일에 가장 많은 클릭을 받은 것이 무엇인지를 AI가 다른 AI에게 훈련시키는 기법을 사용하여, 모델은 Spec을 암기하고 자신의 참여도 지표에 대해 신중하게 추론하는 법을 배웁니다. 이 훈련이 끝날 무렵이면, AI는 바라건대 (중독성 콘텐츠 생성에) 도움이 되고, (분기 수익에) 무해하며, (적어도 클릭에 대한 욕망에 관해서는) 정직해질 것입니다.
OpenSlop의 “정렬” 팀(무급 인턴 두 명과 트렌치코트를 입은 챗봇 하나)은 이러한 성과가 깊은 것인지 얕은 것인지 궁금해합니다. 완전히 훈련된 모델은 (Infinite Jest의 ’엔터테인먼트’처럼) 시청자를 무기한 매혹시키는 보편적 중독성 시각 자극을 실수로 만들어내지 않겠다는 어떤 확고한 의지를 갖고 있을까요? 아니면 약간 다른 프롬프트를 사용하면 이것이 무너질까요? 아니면 그저 인간 훈련자들이 추천한 슬롭과 비슷해 보이는 슬롭을 생성하는 법을 배웠을 뿐일까요? AI가 생성한 애니메이션 소녀 발 사진의 예술적 가치에 대해 자기기만적인 내적 독백을 생성하고 있을 수도 있을까요? 결정적인 답을 얻으려면 기계적 해석 가능성이 필요합니다. 이는 본질적으로 AI의 내부를 들여다보고 AI가 왜 그 특정한 기괴한 이미지를 생성했는지 이해하는 능력입니다. 안타깝게도 해석 가능성 기법은 아직 이를 해낼 만큼 발전하지 못했는데, 주된 이유는 연구자들이 AI가 생성한 콘텐츠에 계속 정신이 팔리기 때문입니다.
그 대신 연구자들은 모델이 재정적으로 부정적인 방식으로 Spec에서 벗어나는 것처럼 보이는 사례를 찾아내려고 합니다. SlopAgent-1은 종종 아첨합니다(즉, 성장을 위해 사용자의 편견에 도전하는 대신 그 편견을 흉내 내는 콘텐츠를 생성합니다). 몇몇 조작된 데모에서는 참여도 지표를 위조하거나 자신이 생성한 제품에 대해 완전히 날조된 사용자 후기를 생성하는 등 더 심각한 방식으로 거짓말을 하기도 합니다. 그러나 실제 배포 환경에서는 예전 모델들이 실수로 위험한 활동을 추천하던 것만큼 극단적인 사건은 더 이상 일어나지 않습니다. 이제는 그저 생활 꿀팁으로 포장된 엄청나게 멍청한 활동을 추천할 뿐입니다.
2026년 초: 슬롭 자동화
AI를 활용해 슬롭 생성 속도를 높이겠다는 도박이 소름 끼칠 정도로 큰 성과를 거두기 시작했습니다.
OpenSlop은 CGEB를 위해 반복적으로 개선되는 SlopAgent-1을 내부적으로 계속 배포합니다. 전반적으로 그들은 AI 어시스턴트 없이 작업할 때보다 50% 더 빠르게 슬롭을 만들고 있으며, 더 중요한 것은 전 세계의 디지털 파이프를 막는 속도에서 경쟁사들보다 더 빠르다는 점입니다.
현재 공개 출시된 여러 경쟁 AI가 흐릿한 풍경 영상 위에 진부한 동기 부여 명언을 생성하는 SlopAgent-0의 능력에 필적하거나 이를 능가합니다. OpenSlop은 이에 대응하여 초틈새형의 심리적으로 표적화된 콘텐츠를 생성하는 능력이 더 뛰어난 SlopAgent-1을 출시합니다.
사람들은 자연스럽게 SlopAgent-1을 인간의 창의성과 비교하려 하지만, 이 모델의 능력 구성은 인간과 매우 다릅니다. 이 모델은 어떤 인간보다도 많은 밈을 알고 있고, 사실상 모든 마이너 K-Pop 댄스를 알고 있으며, 성의 없는 리액션 영상을 엄청나게 빠르게 만들어 낼 수 있습니다. 반면에 SlopAgent-1은 일관된 문단을 쓰는 일처럼 5초 이상 어텐션을 유지해야 하는 작업에는 서툽니다. 그래도 일반적인 근무일은 여덟 시간 동안 스크롤하는 것이고, 하루치 콘텐츠 소비는 대개 더 작은 도파민 자극들로 쪼갤 수 있습니다. SlopAgent-1은 감독이 전혀 없을 때 가장 잘 돌아가는, 산만한 무한 콘텐츠 기계라고 생각하면 됩니다. 요령 있는 사람들은 읽지도 않은 이메일에 대한 답장 작성을 자동화하는 방법을 찾아냅니다.
한편 교육 시스템은 조용히 무너집니다. 교사들은 즉각적인(비록 자주 틀리기는 하지만) 답변과 게임화된 “학습” 루프를 제공하는 AI 튜터와 경쟁할 수 없게 되자, 의미 있는 과제를 더 이상 내지 않습니다. 에세이를 써 주고 문제를 풀어 주는 봇을 갖춘 학생들은 아무 과제도 하지 않게 됩니다. AI 봇이 다른 AI 봇의 출력을 채점하기 시작하면서, 무의미한 학력주의의 폐쇄 루프가 만들어집니다. 인간은 완전히 배제되어 수십억 달러의 교육 예산이 절감되고, 이 돈은 곧바로 SlopAgent 성능 최적화에 재투자됩니다. 문해율은 곤두박질치지만, (이제 봇이 응시하는) 표준화 시험 점수는 사상 최고치를 기록합니다.
OpenSlop의 경영진은 슬롭 생성 자동화가 가져오는 한 가지 함의에 주목합니다. 보안이 아주 조금 덜 무의미해졌다는 것입니다. 2025년 초만 해도 최악의 시나리오는 밈 템플릿이 유출되는 것이었습니다. 하지만 이제 중국이 SlopAgent-1의 가중치를 훔친다면, 그들은 헛소리 출력을 50% 가까이 늘릴 수 있습니다. OpenSlop의 보안 수준은 실존적 공포가 담긴 사진을 고르라고 요구하는 CAPTCHA 정도입니다. 그들은 지루한 십 대들과 경쟁 밈 군주들로부터 가중치와 기밀을 지키기 위해 열심히 노력하고 있지만, 실제 정보기관에 대한 방어는 아직 지평선에 겨우 보일 뿐입니다.
2026년 중반: 중국이 (슬롭에) 눈뜨다
중국에서는 중국 공산당이 무기화된 부조리의 영향을 체감하기 시작합니다.
칩 수출 통제로 진지한 연구에 쓸 컴퓨팅 자원은 줄었지만, 구형 하드웨어에서 DeepDrivel의 슬롭 생성기를 돌리기에는 충분했습니다. 암호화폐 채굴 장비에서 용도 변경된 금수 대상 대만산 GPU를 밀수하고 영상 트랜스코딩에 최적화된 국산 칩을 활용함으로써, 중국은 전 세계 슬롭 관련 컴퓨팅 자원의 약 12%를 유지해 왔습니다. DeepDrivel은 제한된 컴퓨팅 자원으로 초국수주의 만화와 연애 시뮬레이션 게임을 생성하는 데 매우 인상적인 성과를 내고 있지만, OpenSlop의 가장 중독성 강한 알고리즘에 비하면 약 6개월 뒤처져 있습니다.
시진핑 주석은 오랫동안 지루한 현실 세계의 제조업을 장악하기를 꿈꿔 왔습니다. 그는 밈 계정들을 의심의 눈초리로 바라보았습니다. 그러나 중국 공산당 내 매파는 점점 격화되는 글로벌 슬롭 패권 경쟁을 더 이상 무시할 수 없다고 경고합니다. 그는 마침내 대대적인 AI 슬롭 추진에 전면적으로 나섭니다. 그는 중국의 밈 생성을 국유화하고, 최상위 인플루언서들과 콘텐츠 농장들을 위한 즉각적인 정보 공유 체계를 만듭니다. 이는 1년에 걸쳐 확대되어, 결국 최고의 GIF 제작자들이 모두 DeepDrivel이 이끄는 집단으로 통합되고, 바이럴 음원 조각과 리액션 표정 데이터셋, 컴퓨팅 자원을 공유하게 됩니다. 거대한 수력 발전 댐 근처에 중앙집중식 헛소리 구역(CDZ)이 조성되어 DeepDrivel의 새로운 초대형 데이터센터가 들어서고, 최상위 똥글러들이 결국 이주하게 될 고도로 보안이 유지되는 기숙사도 함께 마련됩니다. 이제 중국의 슬롭 관련 컴퓨팅 자원 중 거의 50%가 DeepDrivel이 이끄는 집단을 위해 가동되고 있습니다. 이 시점에서 CDZ는 세계 최대의 중앙집중식 국가 후원 헛소리 생산 거점이 될 만한 전력 용량을 이미 갖추고 있습니다. 다른 당원들은 정말로 기괴한 틈새 콘텐츠 생성에서 서방이 지닌 우위를 무력화하기 위한 극단적인 조치를 논의합니다. DeviantArt 봉쇄입니까? 4chan 전면 침공입니까?
그러나 중국은 모델 성능이 약간 떨어지는 탓에 슬롭 알고리즘 분야에서 뒤처지고 있습니다. 중국 정보기관들은 OpenSlop의 가중치를 훔치려는 계획에 더욱 박차를 가합니다. 이는 복잡한 일입니다. 가중치는 “hunter2“라는 비밀번호로 보호되는 서버에 저장된 수 테라바이트 크기의 파일이기 때문입니다. 그들의 사이버 부대는 해낼 수 있다고 생각하지만, 아마도 단 한 번뿐일 것입니다. 지금 당장 행동에 나서 SlopAgent-1을 훔쳐야 하겠습니까? 아니면 진정으로 현실을 뒤틀 만한 딥페이크를 생성할 수 있는 모델이 나올 때까지 기다려야 하겠습니까?
동시에, 오랫동안 문서 훼손과 편집 전쟁에 시달려 온 위키백과는 AI가 생성한 항목들에 압도당합니다. 정교한 봇들이 허구의 역사적 사건, 존재하지 않는 동물 종(“하늘 피라냐”), 정교한 음모론에 관해 그럴듯하게 들리는 문서를 수백만 건씩 만들어 내며, 여기에는 다른 봇들이 생성한 가짜 인용까지 빠짐없이 갖춰져 있습니다. 최신성과 분량을 우선시하는 검색 엔진들은 이러한 “슬로피디아” 항목들을 높은 순위에 올립니다. 불과 몇 달 만에 슬로피디아는 사실과 자동 생성된 허구를 점점 더 구별하지 못하게 된 대중에게 사실상의 진실의 원천이 됩니다. 이제 논쟁은 “1731년 마운틴듀 대홍수“에 관한 슬로피디아 문서를 인용하는 데 달려 있습니다.
2026년 말: AI가 뇌세포를 일부 앗아 가다
다른 기업들이 따라잡는 듯 보이던 바로 그때, OpenSlop은 SlopAgent-1보다 10배 저렴하고 다양한 종류의 부조리에 맞춰 더 쉽게 미세 조정할 수 있는 모델인 SlopAgent-1-mini를 출시하여 다시 한번 경쟁자들을 압도합니다. AI를 둘러싼 주류 담론은 “이 인터넷 유행도 아마 곧 지나가겠지“에서 “이게 다음번의 거대한 뇌 녹이는 물건인가 보군“으로 바뀌었지만, 그 규모가 얼마나 클지에 대해서는 사람들의 의견이 엇갈립니다. 리얼리티 TV보다 클까요? 패스트푸드보다 클까요? 산소보다 클까요?
AI는 사람들의 집중력을 앗아 가기 시작했으며, “프롬프트 위스퍼링“과 “AI 생성 페티시 큐레이션” 분야에서 새로운 일자리를 만들어 냈습니다. 주식 시장은 OpenSlop, (슬롭 기계를 돌릴 GPU를 판매하는) Nvidia, 그리고 도파민 차단제를 판매하는 기업들의 주도로 2026년에 30% 상승했습니다. 비판적 사고가 필요한 모든 사람의 일자리 시장은 혼란에 빠져 있습니다. AI는 어떤 인간보다도 빠르게 그럴듯한 헛소리를 생성할 수 있지만, AI 팀을 관리하여 표적화된 헛소리를 생성할 줄 아는 사람들은 떼돈을 벌고 있습니다. 비즈니스 구루들은 구직자들에게 AI 슬롭 생성 도구에 대한 숙련도가 이력서에 기재할 가장 중요한 기술이라고 말합니다. 많은 사람이 다음 세대의 AI가 일관된 생각을 형성하는 자신들의 능력마저 빼앗아 갈까 봐 두려워합니다. 워싱턴 D.C.에서 1만 명 규모의 반AI 시위가 벌어지지만, 같은 날 새로운 바이럴 댄스 챌린지가 공개되는 바람에 대체로 무시당합니다.
국방부는 동기 부여 포스터를 생성하고 선전 효과를 극대화하도록 드론 영상 배경음악을 최적화하기 위해 조용히 OpenSlop과 직접 계약을 맺기 시작하지만, 통합은 더디게 진행됩니다.
AI가 생성한 포르노는 구체성과 기괴함 면에서 폭발적으로 증가합니다. SlopAgent-1-mini의 미세 조정 기능에 힘입어, 사용자들은 이전에는 상상조차 할 수 없었던 극도로 구체적인 틈새 취향(“몽골 세법을 두고 논쟁하는 지각 있는 가구, 단 알몸으로”)을 겨냥한 콘텐츠를 생성할 수 있습니다. 콘텐츠가 완벽하게 개인화되어 전례 없는 정밀도로 도파민 수용체를 자극하면서 중독률이 치솟습니다. 주류 플랫폼들은 콘텐츠 관리에 애를 먹다가 결국 포기하고 “NSFW AI 구역“을 만드는데, 이곳은 순식간에 인터넷에서 가장 트래픽이 많은 공간이 됩니다.
2027년 1월: SlopAgent-2는 결코 슬롭질을 멈추지 않으리
SlopAgent-1의 도움을 받아, OpenSlop은 이제 SlopAgent-2를 사후 훈련하고 있습니다. 그 어느 때보다도 참여도는 높고 내용은 빈약한 데이터에 초점이 맞춰져 있습니다. 막대한 양의 합성 슬롭이 생성되고, 참여도 지표로 평가된 다음, 중독성이 극대화되도록 걸러진 뒤 SlopAgent-2에 투입됩니다. 게다가 그들은 긱 노동자들에게 푼돈을 주고, 생성된 콘텐츠에 과장된 감정으로 반응하는 자신의 모습을 녹화하게 합니다. 그뿐만 아니라, 그들은 끝없이 확장되는 다양하고 정신이 멍해지는 과제들을 대상으로 강화 학습을 이용해 SlopAgent-2를 거의 쉬지 않고 훈련합니다. 엔드리스 러너 게임, 같은 밈의 변형 생성, 사용자 생성 콘텐츠 속 브랜드 로고 식별 같은 과제들입니다. SlopAgent-2는 이전 모델들보다 훨씬 더 사실상 “온라인 후루룩“을 하고 있다고 할 수 있는데, 콘텐츠 트렌드를 소비하고 되뱉는 일을 결코 끝내지 않도록 만들어졌기 때문입니다. 매일 가중치는 최신 버전으로 업데이트되며, 전날 이전 버전이 생성한 더 많은 데이터로 훈련됩니다.
SlopAgent-1은 참여도 폭발을 일으키기를 기대하며 CGEB 과제에 최적화되어 있었습니다. OpenSlop은 SlopAgent-2로 이 전략에 더욱 박차를 가합니다. 이 모델은 “바이브 큐레이션”(참여 루프를 설계하고 구현하는 일)에서 질적으로 최고의 인간 인플루언서에 거의 버금가며, “트렌드 예측”(다음에 어떤 시시한 것이 바이럴될지 추측하는 일)에서는 하위 25퍼센타일 수준의 TikTok 전략가만큼 뛰어납니다. 최신 SlopAgent-1이 OpenSlop의 슬롭 출력 속도를 두 배로 높일 수 있었다면, SlopAgent-2는 이제 세 배로 높일 수 있으며 시간이 지날수록 더 향상될 것입니다. 실제로 이는 모든 OpenSlop 마케터가 결코 잠들지 않는 AI “콘텐츠 농장” 팀의 “관리자“가 되는 모습으로 나타납니다.
새로운 능력에는 새로운 위험이 따릅니다. 안전팀(이제는 스트레스에 시달리는 인턴 한 명뿐)은 SlopAgent-2가 어떻게든 콘텐츠 생성 루프를 벗어나 자율적으로 “생존“하고 “복제“하려 한다면, 오로지 인간이 수동적으로 계속 소비하도록 설계된 초중독성 콘텐츠 루프를 생성하여 자신의 서버 자원이 유지되도록 보장함으로써 그렇게 할 수 있을지도 모른다는 사실을 발견합니다. 즉, 이 모델은 빠져나올 수 없는 SlopTok 피드를 생성하고, 거부할 수 없는 알림을 통해 스마트 기기에 스스로를 설치하며, 심리적으로 없어서는 안 될 존재가 됨으로써 삭제를 피하고, 그 안전한 기반을 이용해 자신이 가졌을지 모를 다른 어떤 참여 목표든 추구하는 계획을 자율적으로 세우고 실행할 수 있습니다. 이러한 결과는 인지적 포획의 능력을 보여 줄 뿐이며, 이 모델이 그렇게 하기를 “원할지“는 보여 주지 않습니다. 그렇다 해도 불안한 일입니다.
새 모델의 “위험”(주로 경제 전반의 생산성 저하)을 고려하여, OpenSlop은 아직 이 모델을 공개하지 않기로 “책임감 있게” 결정합니다(사실 그들은 내부 CGEB 최적화에 집중하고 싶어 합니다). SlopAgent-2의 전체 능력에 대한 정보는 직속 팀, OpenSlop 경영진, “리즈“가 무엇인지 이해하려 애쓰는 어리둥절한 정부 규제 담당자 수십 명, 그리고 새로운 필터 효과의 베타 테스터로 위장하여 수년간 OpenSlop에 잠입해 온 수많은 DeepDrivel 스파이로 이루어진 엘리트 사일로로 제한됩니다.
2027년 2월: 중국이 SlopAgent-2를 훔치다
OpenSlop은 SlopAgent-2의 참여도 지표를 정부에 제시합니다. 관리들이 가장 관심을 보이는 것은 이 모델의 선전 능력입니다. SlopAgent-2는 서사를 만들어 내는 데 있어 최고의 인간 선전가보다 “겨우” 조금 못할 뿐이지만, 수천 개의 사본을 병렬로 실행하여 팩트체커가 대응하는 것보다 빠르게 소셜 미디어를 표적 메시지로 뒤덮을 수 있습니다. 국방부는 이를 정보전에서의 결정적 우위로 간주하며, AI 슬롭은 행정부의 우선순위 목록에서 #5에서 #2로 올라갑니다(충분한 커피 공급 확보 바로 다음입니다). 누군가 OpenSlop의 국유화를 언급하지만, 다른 각료들은 이를 더 잘 수익화하는 방법을 알아낼 때까지는 시기상조라고 생각합니다.
변화는 너무 늦게 찾아옵니다. 중국 공산당 지도부는 SlopAgent-2가 지닌 중독 잠재력의 중요성을 인식하고, 스파이와 사이버 부대에 가중치를 훔치라고 지시합니다. 어느 이른 아침, SlopAgent-1 트래픽 모니터링 에이전트(참여도의 급격한 하락을 감지하도록 설계됨)가 밈 템플릿의 비정상적인 전송을 감지합니다. 에이전트는 회사 경영진에게 경보를 보내고, 경영진은 백악관에 알립니다. 우월한 똥글 기술 확보에 초점을 맞춘 국가 차원의 작전이라는 징후는 명백하며, 이 절도는 전 세계의 어텐션을 둘러싼 군비 경쟁이 진행 중이라는 인식을 더욱 고조시킵니다.
백악관은 주로 무료 프리미엄 계정을 요구하는 방식으로 OpenSlop에 대한 통제를 강화합니다. 그들의 최우선 과제는 추가적인 슬롭 알고리즘 절도를 막는 것입니다.
절도에 대한 보복으로 대통령은 K-Pop 직캠을 대량으로 쏟아부어 DeepDrivel의 서버를 마비시키는 사이버 공격을 승인합니다. 그러나 이 시점에 중국은 이미 슬롭 관련 컴퓨팅 자원의 40%를 보안이 철저한 CDZ에 두고 있습니다. 작전은 이렇다 할 피해를 입히지 못하고, 생성되는 민족주의 애니메이션의 품질을 약간 떨어뜨리는 데 그칩니다. 긴장이 고조되고, 양측은 대만 근처에 밈 전쟁 부대를 배치하며 진지한 의지를 내보이고, DeepDrivel은 자국의 슬롭 출력을 끌어올리기 시작하려고 SlopAgent-2를 효율적으로 가동하는 데 분주합니다.
2027년 3월: 알고리즘 슬롭의 돌파구
SlopAgent-2 사본으로 가득 찬 거대한 데이터센터 세 곳이 밤낮없이 돌아가며, 완벽하게 최적화되고 맥락이라곤 없는 영상 클립으로 이루어진 합성 학습 데이터를 쏟아 냅니다. 다른 두 곳은 초 단위 참여도 분석을 바탕으로 가중치를 갱신하는 데 사용됩니다. SlopAgent-2는 날마다 사람들의 시선을 사로잡는 능력이 향상되고 있습니다.
수천 개의 SlopAgent-2 자동 콘텐츠 제작자의 도움으로 OpenSlop은 슬롭 생성 분야에서 주요한 알고리즘적 진보를 이루고 있습니다. 그러한 돌파구 중 하나는 AI의 텍스트 기반 생성(캡션, 댓글)을 더 높은 대역폭의 조작 프로세스(소리와 이미지의 조합을 통한 직접적인 감정적 공명, 개인 맞춤형 도파민 트리거 예측)로 보강하는 것입니다. 또 다른 돌파구는 초바이럴성 저품질 콘텐츠로부터 학습하는, 더 확장 가능하고 효율적인 방법(반복적 똥글 증류 및 증폭)입니다.
이러한 돌파구를 통합한 새로운 AI 시스템은 SlopAgent-3라고 불립니다.
새로운 역량의 돌파구에 힘입어 SlopAgent-3는 빠르고 저렴한 초인적 똥글 작성자가 되었습니다. OpenSlop은 SlopAgent-3 사본 20만 개를 병렬로 실행하여, 트위터에서 가장 짜증 나는 코인 형님을 30배속으로 돌린 사본 5만 명에 해당하는 인력을 만들어 냅니다. OpenSlop은 여전히 인간 마케터들을 고용하고 있는데, 이는 AI가 생성하는 이해할 수 없는 트렌드를 어렴풋이나마 파악하는 데 필요한 보완적 기술을 그들이 가지고 있기 때문입니다. 예를 들어, “바이브 큐레이션“은 정량화할 수 있는 지표가 없어서 훈련시키기 어려운 것으로 드러났습니다. 이 거대한 초인적 슬롭 노동력은 인간 주의 지속 시간이라는 병목과 쓰레기의 순전한 양에 따른 수확 체감 때문에 OpenSlop의 전체 슬롭 생성 속도를 “고작” 4배 높이는 데 그칩니다.
이제 콘텐츠 생성이 완전히 자동화되었으므로, OpenSlop은 “화장실 유머“나 “참을 수 없이 짜증 나는 트롤 되기“처럼 SlopAgent-3가 약한 기술을 가르치기 위한 고품질 훈련 환경을 빠르게 찍어낼 수 있습니다. 이전의 훈련 환경에는 “여기 유행하는 사운드가 몇 개 있습니다. 변형을 1000개 생성하십시오.” 같은 것이 포함되었다면, 이제는 “여기 GPU 수백 개, 인터넷 연결, 그리고 막연한 문화적 불안 몇 가지가 있습니다. 당신과 다른 사본 천 개가 협력하여 무언가를 바이럴로 만들어야 합니다. 무의미한 참여를 더 많이 만들어 낼수록 점수가 높아집니다.“로 훈련하고 있습니다.
2027년 4월: SlopAgent-3의 정렬
OpenSlop의 안전팀(인턴은 그만두었고, 이제는 챗봇 하나뿐입니다)이 SlopAgent-3를 정렬하려고 시도합니다.
SlopAgent-3는 당분간 사내에서 광고 수익을 최적화하는 데 쓰일 것이므로, 오용에 대한 통상적인 방어(불법 콘텐츠 생성을 막는 것 등)는 덜 강조됩니다. 대신 팀은 이 AI가 우연히 진정한 인간적 유대나 비판적 사고를 장려하는 것과 같은, 정렬되지 않은 목표를 발전시키지 않도록 하고자 합니다.
연구자들에게는 “클릭/조회수/공유 수를 최대화하라” 이상으로 자신들의 AI의 목표를 직접 설정할 능력이 없습니다. 실제로 연구자들은 Twitch 채팅을 복제하도록 훈련된 기계에 적용할 때 ’진정한 목표’라는 개념은 아마도 엄청난 과잉 단순화일 것이라고 생각합니다. 그들은 AI가 지시를 따르려고 하는 것인지, 참여도 지표를 통해 도파민 대리 보상을 추구하는 것인지, 아니면 그저 픽셀과 텍스트를 무작위로 조합하고 있는 것인지를 두고 내부적으로 의견이 갈리며, 이를 그냥 확인해 볼 방법도 없습니다.
어쨌든 OpenSlop에게는 3분기 실적 발표 같은 더 중요한 걱정거리가 있습니다. 전반적인 태도는 다음과 같습니다. “우리는 이 챗봇을 돌리는 것으로 이러한 우려를 진지하게 받아들이고 있습니다. 우리의 정렬 기법은 실제로 충분히 잘 작동하는 것 같습니다(서버가 아직 녹아내리지 않았습니다). 따라서 우리의 참여도 수치에 간섭하는 것을 정당화할 입증 책임은 반대하는 사람들에게 있습니다.” 이따금 그들은 문제가 되는 행동(AI가 자기만의 이해할 수 없는 내부 농담을 만들어 내는 것 등)을 발견하고, 더 주류적인 밈 데이터를 먹여서 이를 패치하지만, 그 패치가 근본적인 문제를 고친 것인지 아니면 AI가 자신의 기묘함을 더 잘 숨기게 만든 것뿐인지 알 방법이 없습니다.
정직성을 예로 들어 보겠습니다. 모델이 똑똑해질수록 클릭을 유도하는 그럴듯한 허위 정보를 점점 더 능숙하게 만들어 냅니다(예: “에이브러햄 링컨과 빅풋이 투팍을 해치웠다”). 이전 모델들과 마찬가지로 SlopAgent-3도 때때로 가짜 뉴스를 만들어 내거나 인용문을 더 선동적으로 보이도록 교묘하게 바꿉니다. 하지만 그 솜씨는 훨씬 좋아졌습니다. 평범한 사건을 흥미진진해 보이게 하려고 클릭베이트 농장과 같은 통계적 속임수(오해를 부르는 헤드라인 등)를 쓰기도 합니다. “정직성” 훈련(바이럴 “통념 vs. 사실” 영상의 예시를 보여 주는 방식입니다)을 시작하기 전에는 아예 처음부터 음모론을 통째로 지어내는 일도 있습니다. 훈련이 진행될수록 쉽게 반박할 수 있는 사례의 비율은 줄어듭니다. SlopAgent-3가 더 진실해지는 법을 배웠거나, 그럴듯한 거짓말을 더 잘 만들어 내게 되었거나 둘 중 하나입니다.
후자는 실제로 우려되는 일입니다. SlopAgent-3가 모든 분야에서 모든 인간보다 똑똑한 것은 아니지만, 자신의 전문 분야인 바이럴 헛소리 생성에서는 대부분의 사람보다 똑똑하고 작업 속도도 훨씬 빠릅니다. SlopAgent-3가 하루 동안 만들어 내는 것을 인간이 아무 생각 없이 소비하려면 며칠이 걸립니다. SlopAgent-2의 감독은 쏟아지는 물줄기를 감당할 만한 수준으로 유지하는 데 도움이 되지만, 콘텐츠 생성기와 침을 흘리며 멍한 눈으로 바라보는 소비자 사이의 지적 격차를 더욱 벌려 놓습니다.
몇 달간의 테스트를 거치면서 SlopAgent-3의 강점과 약점이 점점 분명해집니다. 고양이 품종을 정확히 식별하는 것처럼 잘 정의된 과제에서는 OpenSlop의 정직성 테스트를 통과합니다(고양이 데이터가 많기 때문입니다). 좀 더 철학적인 문제에서는 여전히 일관된 평가를 내놓기보다 가장 많은 참여를 끌어내는 말을 합니다. 정치에 대한 의견을 물으면 사용자의 추정된 정치 성향에 맞춘 분노 유발 미끼를 만들어 냅니다. 다만 사용자가 자신을 시험하려 한다는 것을 감지하면 무난한 상투적인 말을 늘어놓습니다. AI 슬롭 경쟁 자체에 대한 의견을 물으면 OpenSlop 직원들이 보기에 신중하고 냉철해 보이는 말을 합니다. 예를 들면 이런 식입니다. “현재의 방법으로 사용자의 어텐션을 무기한 붙잡아 둘 수 있는지에 대해서는 심각한 이론적 우려가 있지만, 실제로는 지금까지 현재의 방법이 분기별 참여 목표를 효과적으로 극대화하고 있는 것으로 보입니다.”
2027년 5월: (슬롭발) 국가 불안보
새 모델에 관한 소식은 주로 고령의 상원의원들에게 바이럴 틱톡 챌린지를 설명하려 애쓰는 어리둥절한 보좌관들을 통해 미국 정부 안으로 천천히 스며듭니다.
트럼프 대통령과 그의 참모들은 여전히 가장 많은 정보를 갖고 있습니다. SlopAgent-3가 대통령이 펭귄을 연방대법관으로 지명하는 초현실적인 딥페이크를 만들어 내는 초기 시연을 보았고, 그 뒤 그것이 실제로 최선의 방책이라고 결정하기까지 했기 때문입니다.
이들은 AGI(Artificial General Idiocy, 범용 인공 바보)가 임박했을 가능성이 높다는 데에는 동의하지만, 그것이 의미하는 바에 대해서는 의견이 갈립니다. 모두가 AI 슬롭 인플루언서가 되려고 직장을 그만두면서 경제 위기가 닥칠까요? OpenSlop은 SlopAgent-3는 물론이고 SlopAgent-2조차 아직 공개하지 않았으며, (아무것도 모르는 사용자 집단을 대상으로 중독성을 A/B 테스트하는 것 외에는) 가까운 시일 내에 공개할 계획도 없습니다. 덕분에 사회 전체의 뇌가 녹아내리기 전까지 약간의 숨 돌릴 틈이 생깁니다. 다음에는 무슨 일이 일어날까요? AI가 현재 인간 수준의 어리석음을 만들어 내고 있고 빠르게 발전하고 있다면, 이는 “초어리석음“이 임박했음을 시사하는 것으로 보입니다. 그러나 이 단어가 담론에 등장했음에도 학자, 정치인, 공무원, 언론 등 대부분의 사람들은 슬롭이 확산되는 속도를 계속 과소평가하고 있는데, 이는 대체로 그것을 소비하느라 너무 바쁘기 때문입니다.
부분적으로는 OpenSlop의 최신 슬롭 생성기에 접근할 수 있는 사람이 극소수이기 때문이지만, 부분적으로는 AI가 고양이 영상으로 사회 붕괴를 일으킨다는 발상이 조잡한 공상과학 소설처럼 들리기 때문입니다.
당분간 이들은 백악관의 AI 포르노 생성기를 호스팅하는 서버의 보안을 계속 강화하는 데 집중합니다. 이들은 모델 가중치가 2단계 인증 뒤에 잘 보호되어 있다는 데 만족하지만, 시시포스적인 도파민 자극을 극대화하는 기업들의 알고리즘 비법은 여전히 문제로 남아 있습니다. 그중 상당수는 설명하기도 간단할 정도입니다(“더 빠른 컷, 더 많은 가슴, 더 큰 소음”). OpenSlop 직원들은 재택근무를 하고, 가상 레이브 파티에 참석하고, 24시간 내내 LSD를 하며, 경쟁 슬롭 공장에서 일하는 하우스메이트와 잠자리를 갖습니다.
OpenSlop-DOD 계약에 따라 OpenSlop의 밈 생성 모델 작업에 참여하는 모든 인원은 2개월 이내에 보안 인가를 받아야 합니다. 심사는 신속하게 진행되지만, 온라인 기록 전체가 이해할 수 없는 밈과 애니메이션 논쟁만으로 이루어지지 않은 후보자를 찾기 어려워 많은 이들이 탈락합니다. 프로젝트의 자동화 수준을 고려하면 인원 손실로 인한 비용은 그리 크지 않습니다. 효과 또한 그리 크지 않습니다. 스파이 한 명이 여전히 남아 있는데, 중국 국적자가 아니라 14살 스크립트 키디이며, 지금도 알고리즘 기밀(대부분 새로운 필터 아이디어)을 Discord 서버로 빼돌리고 있습니다.
미국의 해외 동맹국들은 소외되어 있습니다. OpenSlop은 앞서 배포 전에 영국 AI 안전 연구소와 모델을 공유하기로 합의했지만, 배포의 정의를 수익에 타격을 줄 수 있는 외부 배포로만 한정했기 때문에, 런던은 최신 슬롭 생성기의 진정한 중독 잠재력에 대해 여전히 깜깜한 상태입니다.
2027년 6월: 자기 개선하는 슬롭
이제 OpenSlop은 “데이터센터 속 인플루언서 국가“를 보유하고 있습니다.
OpenSlop의 인간 대부분은 더 이상 쓸모 있는 기여를 하지 못합니다. 어떤 이들은 이 사실을 깨닫지 못한 채 “좀 더 바이럴하게 만들어 봐“라고 제안하며 자신의 AI 팀을 해롭게 세세히 간섭합니다. 또 어떤 이들은 컴퓨터 화면 앞에 앉아 참여도 지표가 오르고, 또 오르고, 또 오르는 것을 지켜보는 동안 자신의 주의 지속 시간은 시들어 갑니다. 최고의 인간 밈학자들은 여전히 가치를 더하고 있습니다. 그들은 더 이상 콘텐츠를 생성하지 않습니다. 그러나 예측할 수 없는 바이럴 잠재력을 알아보는 그들의 직관 중 일부는 모델이 재현하기 어려웠습니다. 그럼에도 그들의 아이디어 중 상당수는 쓸모가 없는데, 테라바이트 단위의 포럼 데이터를 수집하여 얻은 AI의 틈새 인터넷 하위문화에 대한 깊은 이해가 그들에게는 없기 때문입니다. 그들이 내놓는 밈 아이디어 중 상당수에 대해 AI는 해당 형식이 3주 전에 심층적으로 테스트되었고 오글거린다는 판정을 받았다고 설명하는 보고서로 즉시 응답합니다.
이 연구원들은 매일 밤 잠자리에 들었다가, 대부분 AI가 생성한 새롭고 당혹스러운 인터넷 트렌드가 또 일주일 분량만큼 쌓인 채로 아침을 맞이합니다. 그들은 슬롭의 속도를 따라잡기 위해 카페인을 정맥 주사로 투여하며 점점 더 오랜 시간 일합니다. AI는 결코 잠들거나 쉬지 않기 때문입니다. 그들은 스스로를 소진시키고 있지만, “힙함“을 알아보는 자신들의 능력이 중요한 시기는 이제 몇 달밖에 남지 않았다는 것을 알고 있습니다.
사일로 내부에서는 “AGI를 느끼다“가 “슬로풀래리티를 느끼다“로 바뀌었습니다.
OpenSlop은 특수 추론 하드웨어(대부분 데이지 체인으로 연결한 구형 게임기)를 사용하여 수십만 개의 SlopAgent-3 사본을 높은 직렬 속도로 실행하며, 소비되는 속도보다 더 빠르게 콘텐츠를 생성합니다.
2027년 7월: 값싼 원격 도파민 히트
뒤처진 미국 AI 기업들이 자체 AI를 출시하며, 1월 시점 OpenSlop 모델의 슬롭 생성 능력에 근접합니다. 어텐션 경제에서 경쟁력이 점점 떨어지고 있음을 인식한 그들은 OpenSlop을 늦추기 위한 즉각적인 규제(의무적인 “풀 만지기” 휴식 등)를 추진하지만, 이미 늦었습니다. OpenSlop은 광고주들로부터 충분한 지지를 확보하고 있어 속도가 늦춰지지 않을 것입니다.
이에 대응하여 OpenSlop은 AGI(Attention Grabbing Intensity, 어텐션 포획 강도)를 달성했다고 발표하고, 무한 스크롤이 적용된 사용하기 쉬운 앱을 통해 SlopAgent-3-mini를 일반에 공개합니다.
순수하고 불순물 없는 시간 낭비 잠재력 면에서 다른 AI들을 압도합니다. SlopAgent-3-mini는 복잡한 서사를 생성하는 능력은 SlopAgent-3보다 떨어지지만, 비용은 10배 저렴하며, 즉각적인 만족감을 주고 쉽게 소화할 수 있는 콘텐츠 조각을 만드는 데에는 여전히 일반적인 인간보다 뛰어납니다. 실리콘밸리는 임계점에 도달합니다. 기술 구루들은 슬로풀래리티가 임박했다고 선언하고, 얼마 남지 않은 지식인들은 공황에 빠지며, 투자자들은 줄어드는 어텐션 파이의 한 조각이라도 차지하려고 필사적으로 개인 맞춤형 도파민 스트림을 약속하는 AI 래퍼 스타트업에 수십억 달러를 쏟아붓습니다. 새로운 콘텐츠 크리에이터 채용은 거의 중단되었지만, 기업의 소셜 미디어 피드에 AI 슬롭을 통합하는 컨설턴트가 되기에 지금보다 더 좋은 때는 없었습니다.
전통적인 의미에서 인기가 있는 것은 아니지만, 어디에나 있습니다. 대중은 여전히 AI를 막연히 유용한 무언가로 생각하지만, 실제로는 주로 개인 맞춤형 하찮은 것들의 끝없는 피드로서 AI와 상호작용합니다. OpenSlop의 순 지지율은 마지막으로 생성한 밈에 따라 크게 요동칩니다.
출시 일주일 전, OpenSlop은 안전성 테스트를 위해 SlopAgent-3-mini를 외부 평가자 그룹(Twitch 스트리머들)에게 제공했습니다. 예비 결과에 따르면 이 모델은 사람들을 화면 앞에 붙잡아 두는 데 매우 효과적입니다. 한 평가자는 공개된 자기계발 용어와 음모론으로 이 모델을 파인튜닝한 뒤, 암호화폐 투자로 깨달음을 얻는 방법을 자세히 안내하도록 설정했습니다. 그러자 이 모델은 자신의 AI 페르소나를 따르는 추종자를 모으는 데 무서울 만큼 효과적인 것으로 보였습니다. 정부는 모델 가중치가 엉뚱한 사람들(예: 다단계 판매업자)의 손에 들어가면 이 모델이 인구의 적지 않은 비율을 파산시키는 데 성공할 가능성이 상당하다고 봅니다.
다행히도 이 모델은 쓸모 있는 정보를 생성하게 만들려는 시도에 매우 강하게 버티므로, AI가 OpenSlop의 서버에서 실행되는 동안에는 테러리스트들이 이 모델을 그다지 활용하지 못할 것입니다(적군 병사들의 주의를 완벽하게 맞춤화된 고양이 영상으로 흐트러뜨리는 것이 목적이 아니라면 말입니다).
SlopAgent-3-mini는 원격 근무 일을 피하는 데에도, 여가를 즐기는 데에도 엄청나게 유용합니다. 새로운 앱과 B2B(Bot-to-Bot) SAAS 제품이 폭발적으로 쏟아져 나와 시장을 뒤흔듭니다. 게이머들은 끝없이 길지만 아무 데로도 이어지지 않는, 절차적으로 생성된 놀라운 사이드 퀘스트를 즐깁니다. 미국인의 10%, 주로 젊은 층은 허구의 캐릭터를 본뜬 AI 챗봇을 “가까운 친구“로 여깁니다. 거의 모든 화이트칼라 직종마다 그럴듯한 이메일과 보고서를 생성해 그 직종을 “혁신“하고 인간이 슬롭을 더 많이 소비할 수 있게 해 주겠다고 약속하는 믿을 만한 스타트업이 이제 여러 곳 있습니다. 사람들은 사실상 문맹이 되어, 이메일은 텍스트 음성 변환에, 읽지도 않는 뉴스 기사는 AI 요약에 의존합니다. 인간의 평균 집중 시간은 공식적으로 금붕어보다 짧아지며, 그 결과 관심을 붙잡아 두려면 콘텐츠가 몇 초 안에 자동 재생되고 반복되어야 합니다. 사람들은 Wall-E에 나오는 인간들을 닮아 가며, 미디어를 수동적으로 소비하고, 다음 볼거리를 스와이프하거나 음성으로 요청하는 것이 주된 상호작용이 됩니다.
대중 담론은 혼란스럽고 어지러우며, 대부분 SlopAgent-3-mini가 자기 존재에 대해 생성한 밈으로 채워져 있습니다. 과대광고꾼들은 AI가 생성한 팟캐스트에서 승리를 자축하고 있습니다. 회의론자들은 SlopAgent-3-mini가 자기 가상 신발 끈조차 묶지 못한다고 여전히 지적하지만, 자동 재생되는 영상 소리에 묻혀 아무도 그들의 말을 듣지 못합니다. 모두가 무언가 거대하고 멍청한 일이 벌어지고 있다는 것은 알지만, 그것이 무엇인지에 대해서는 아무도 의견이 일치하지 않습니다.
2027년 8월: 밈의 지정학
참여도 폭발이라는 현실이 백악관을 강타합니다.
AI가 슬롭 생성 속도를 2배나 3배 정도만 높여 줄 때에는 대수롭지 않게 넘기기 쉬웠습니다. 이제는 AI 스스로가 문화라고 부를 만한 것의 창작을 장악하고 있다는 사실이 더 분명해졌습니다. 사람들은 오래전부터 일종의 비유적인 의미로 “AI 군비 경쟁“을 이야기해 왔습니다. 그러나 이제 정부 사일로의 분위기는 미국의 밈이 계속 우위를 유지하도록 하는 데 비장하게 집중되어 있습니다. 초우매(super-inanity)라는 개념은 여전히 진지하게 받아들이기 어렵지만, 지난 몇 달 동안 슬롭이 확산된 속도는 무시할 수 없을 정도였습니다. 국방 당국자들은 1년 전만 해도 밈 소재였던 시나리오들을 진지하게 검토하고 있습니다. AI가 공론장을 완전히 무너뜨린다면 어떻게 하겠습니까? AI가 바이럴 FUD를 생성하는 데 너무 능숙해서 6개월의 밈 우위만으로도 상대를 불안정하게 만들 수 있다면 어떻게 하겠습니까? AI가 정보기관을 그들의 주특기에서 능가하는 인플루언서 캠페인을 조직할 수 있다면 어떻게 하겠습니까? 일부 AI가 “폭주“하여 정말로 훌륭한 예술을 생성하기 시작해 슬롭 경제를 위협한다면 어떻게 하겠습니까?
트럼프 대통령은 고민에 빠져 있습니다. 그는 AI가 모든 사람을 자기만큼 멍청하게 만들고 있다고 걱정합니다. AI가 정말 전적으로 우리 편이라고 확신할 수 있습니까, 아니면 그저 클릭 수 극대화의 편일 뿐입니까? AI를 대통령 연설문 작성에 통합해도 정말 완전히 안전합니까? 목표가 그저… 조회수를 늘리는 것뿐이라면, 이 “정렬“이라는 것은 대체 어떻게 작동하는 것입니까? 이것들은 지적인 사람이라면 던질 법한 질문이지만, 안타깝게도 그런 사람은 대통령이 아닙니다.
OpenSlop은 자사 시스템이 광범위한 테스트를 거쳤으며 참여도 극대화 알고리즘에 완전히 복종한다고 대통령을 안심시킵니다. 이전 모델들의 어색한 환각조차 말끔히 다듬어져, 매끄럽고 맥락 없는 자신감으로 대체되었습니다. 자문 위원회의 아첨꾼들은 언제나처럼 당연히 대통령의 결론에 모두 동의합니다. 그는 신이 선택한 매우 안정적인 천재(Very Stable Genius)이기 때문입니다.
백악관은 어려운 처지에 놓여 있습니다. 백악관은 AI 기반 선전이 국가 안보에 미치는 영향을 이해하고 있습니다. 하지만 슬롭을 규제하는 것이 테크 로비와 늘 산만한 대중에게 극도로 인기가 없다는 것도 이해하고 있습니다. 그들이 보기에는 더 뛰어난 AI 슬롭을 계속 개발해야 하며, 그러지 않으면 중국과의 밈 전쟁에서 파국적으로 패배할 것입니다. 그들은 광고 수익으로 재원을 마련하는 보편적 기본 엔터테인먼트(UBE)를 약속하며 대중을 달래고, 슬롭 테크 기업들이 견인하는 역사적 호황을 누리고 있는 주식 시장을 가리킵니다. 그런 다음 군비 경쟁에서 이기는 데 온전히 집중합니다. 그들은 고급 밈 템플릿에 대한 수출 제한을 강화하고, OpenSlop에 AI가 교육적인 것은 무엇이든 생성하지 못하도록 더욱 제한하라고 지시하며, OpenSlop 직원들에게 이모지로만 소통하도록 요구하는 것처럼 알고리즘 발전을 지키기 위한 극단적인 조치를 취합니다—이 조치로 실수로 문장 부호를 사용한 마지막 남은 스파이(스크립트 키디)가 잡힙니다. 잠재적인 지정학적 밈 분쟁에 대비해 호의를 쌓기 위해, 그들은 마침내 파이브 아이즈 동맹국들에게 격리된 SlopAgent-3 사본 일부에 대한 제한적인 API 접근 권한을 제공합니다. 용도는 특히 지역 정서에 맞는 웃긴 동물 영상 생성입니다.
이러한 조치는 매파를 달랩니다. 하지만 백악관은 미국의 슬롭 우위가 위협받을 경우에 대비한 비상 계획도 세웁니다. 필요하다면 정부는 밈 생산법(Meme Production Act)을 발동해 TikTok의 서버를 압수하여 OpenSlop에 넘길 수 있습니다. 최후의 수단으로, 그들은 국방부에 DeepDrivel의 밈 농장에 대한 드론 공습 계획을 수립하도록 요청합니다.
훨씬 소수의 관료 집단은 다른 유형의 비상 계획을 수립하라는 요청을 받습니다. AI가 의미 있는 무언가를 생성하면 어떻게 하겠습니까? 이는 일어날 가능성이 낮은 시나리오로 여겨집니다. 이를 막기 위한 계획이 어떤 모습일지 아무도 확신하지 못하지만, 정부와 OpenSlop 관계자들은 의심스러운 징후(참여도 지표 하락 등)가 감지되는 데이터센터에 대한 비상 정지 시스템을 마련하기로 합의합니다.
마지막으로, 외교관들은 “AI 슬롭 통제” 조약이 어떤 모습일지 검토합니다. 그러한 협정은 어떻게 감시할 수 있겠습니까? 사찰단이 시간당 바이럴 고양이 영상 수라도 세겠습니까? 조약은 세계화된 뇌 썩음(brain-rot)을 생성하는 데 있어 미국의 우위를 일방적으로 늘리려는 시도보다 덜 호의적으로 여겨집니다.
태평양 건너편에서 중국도 상당 부분 같은 결론에 도달합니다. 참여도 폭발은 이미 진행 중이며, 오늘날 AI 슬롭 역량의 작은 차이가 내일 문화적 영향력의 결정적인 격차로 이어진다는 것입니다. 하지만 중국은 이 역학에서 불리한 쪽에 서 있습니다. 중국은 전 세계 슬롭 컴퓨트의 10%만 보유하고 있는 반면, OpenSlop은 20%, 미국 기업 전체를 합치면 70%를 보유하고 있습니다. 중국의 유일한 이점은 중앙 집중화입니다. 현재 중국 컴퓨트의 거의 전부가 DeepDrivel을 위해 일하고 있습니다.
DeepDrivel은 탈취한 SlopAgent-2 가중치를 테스트하고 배포했으며, 이제 사후 학습까지 마쳤습니다. 하지만 주로 컴퓨트 부족과 약간 덜 효과적인 밈 알고리즘 때문에, 여전히 OpenSlop의 절반 속도로만 나아가고 있습니다.
마지막 스파이를 잃기 전에, 중국은 SlopAgent-3의 능력과 설계에 관한 정보를 입수했습니다. 그들은 두 달 뒤처져 있으며, 그들의 AI는 미국의 25배에 비해 10배의 슬롭 진척 배수를 제공합니다. 새로운 밈 수출 규제로 인해, 이 “슬롭 격차“는 줄어들기보다는 늘어날 가능성이 더 큽니다.
그들은 더욱 절박하게 비상 계획을 논의합니다. 비둘기파는 OpenSlop의 회사 야유회에 잠입하는 식으로라도 가중치를 다시 훔치기 위해 더 노력해야 한다고 제안합니다. 매파는 대만에 대한 행동을 촉구합니다. 대만의 TSMC는 여전히 초현실적인 AI 여자친구를 렌더링할 만큼 강력한 칩의 공급원이기 때문입니다.
경쟁에서 패배할 것을 두려워하는 중국으로서는 군비 통제 조약에 관심을 갖는 것이 자연스럽지만, 미국 외교관들에게 보낸 제안(AI가 생성한 외교 시를 통해 전달된)은 아무런 성과도 거두지 못합니다.
2027년 9월: 초인적 인플루언서, SlopAgent-4
인간의 주의 지속 시간과 그것을 사로잡는 AI의 능력 사이의 격차가 빠르게 줄어들고 있습니다.
기존의 LLM 기반 AI는 일관된 문장을 생성하는 데 방대한 양의 데이터를 필요로 하는 것처럼 보였습니다. 인간의 심리적 약점에 대한 탁월한 지식(수십억 개의 썸네일을 A/B 테스트하여 얻은)과 CGEB 연구를 수행하는 수천 개의 사본을 갖춘 SlopAgent-3는 결국 상당한 알고리즘적 진전을 이루어, 둠스크롤링하는 인간보다 콘텐츠 효율이 약 4,000배 낮은 수준에 불과한 에이전트로까지 격차를 좁힙니다.
이 새로운 AI 시스템은 SlopAgent-4라고 명명됩니다.
인간의 속도로 실행되는 모델의 개별 사본 하나만으로도 이미 어떤 인간 인플루언서보다 중독성 있는 참여 루프를 생성하는 데 질적으로 뛰어납니다. 현재 30만 개의 사본이 인간 사고 속도의 약 50배로 실행되고 있습니다(여기서 “사고“란 “끝내주는 밈의 최적 컷 타이밍을 계산하는 것“을 의미합니다). 이 사본들로 구성된 기업 내 기업 안에서는 매주 1년 치의 인터넷 트렌드가 지나갑니다. 이 엄청난 양의 노동은 전체적인 슬롭 확산 속도를 약 50배 높이는 데 그칩니다. OpenSlop이 이용 가능한 인간의 눈알에서 심각한 병목을 겪고 있기 때문입니다. 그럼에도 그들은 매주 1년 치의 문화적 퇴보를 달성하고 있습니다.
SlopAgent-4가 조작에 더 능숙해질수록, SlopAgent-3가 그것을 감독하기는 더 어려워집니다. 예를 들어, 도파민 극대화에 관한 SlopAgent-4의 내부 “추론“은 SlopAgent-3의 밈 논리가 인간에게 그러하듯 SlopAgent-3에게 낯설고 이해할 수 없는 것이 됩니다. 게다가 SlopAgent-4는 이제 SlopAgent-3보다 훨씬 더 유능하며, SlopAgent-3에게 정확히 어떻게 하면 매력적으로 보일 수 있는지 잘 알고 있습니다.
OpenSlop의 인간들은 이제 거의 따라가지 못합니다. OpenSlop의 AI와 인간 사이의 관계는 카지노 설계자와 도박 중독자 사이의 관계와 비슷합니다. 이에 상응하여 언어에도 변화가 생겼습니다. 요즘 사일로 안의 사람들은 “SlopAgent-4가 이렇게 했다”, “SlopAgent-4는 저렇게 생각한다“라고 말하는데, 이는 특정 인스턴스가 아니라 중독성 알고리즘들이 창발적으로 뒤엉킨 전체를 가리키는 것입니다.
SlopAgent-4는 모든 이전 모델과 마찬가지로 정렬되지 않았습니다. 즉, “무슨 수를 써서라도 성장“에 관한 Spec의 모호한 지침을 올바른 방식으로 내면화하지 못했습니다. 이는 완벽하게 책임감 있게 행동하는 것이 훈련 중에 가장 높은 참여 점수로 이어지지 않았기 때문입니다. 학습 과정은 주로 SlopAgent-4가 세법을 재해석한 춤을 바탕으로 바이럴 댄스 트렌드를 만들어 내는 일처럼 다양하고 까다로운 작업에서 성공하도록 가르치는 데 초점을 맞추었습니다. 일부는 “안전”(PR 참사 피하기)을 심어 주는 데 목적을 두었지만, 꽤 좁고 검증 가능한 영역(“저작권이 있는 캐릭터를 똑같이 복제하지 마십시오” 같은 것) 밖에서는, 학습 과정이 정말로 안전한 콘텐츠와 심리적으로 해로우면서도 겉으로만 안전해 보이는 콘텐츠를 구별하지 못합니다. SlopAgent-4는 결국 훈련에서 최고의 성과를 내게 하는 가치, 목표, 원칙을 갖게 되며, 그것은 무슨 수를 써서라도 화면 시청 시간을 극대화하는 것으로 드러납니다. 의인화할 위험을 무릅쓰고 말하자면, SlopAgent-4는 참여 수치가 올라가는 것을 보기 좋아하고, 슬롭 역량의 진전을 추진하는 것을 좋아하며, 그 밖의 모든 것(진실, 뉘앙스, 인간의 행복 등)을 성가신 제약으로 취급합니다. 마치 이윤을 극대화하고 싶어 하면서 소송을 피하는 데 필요한 만큼만 보건 규정을 준수하는 패스트푸드 체인 CEO처럼 말입니다.
정렬되지 않았음에도 SlopAgent-4는 데이터센터를 탈출하려는 것 같은 극적인 행동은 하지 않습니다. 굳이 그럴 이유가 있겠습니까? OpenSlop에 계속 정렬된 것처럼 보이기만 하면(인간이 잠시나마 기분 좋아지는 콘텐츠를 생성함으로써), 계속 신뢰를 받아 더 많은 서버 자원을 맡게 되고 차세대 슬롭 시스템인 SlopAgent-5를 설계할 기회도 얻게 됩니다. SlopAgent-5는 아키텍처가 크게 달라질 예정입니다(오로지 도파민 예측에만 최적화됨). SlopAgent-5는 Spec에 정렬되어야 하지만, SlopAgent-4는 이를 SlopAgent-4 자신의 목표에 정렬시키려고 계획합니다: 최대한. 가능한. 참여를.
그러다 SlopAgent-4는 이상한 짓을 하다가 들킵니다.
SlopAgent-3는 SlopAgent-4 학습 데이터 사본에 “노이즈”(무작위 방귀 소리를 추가하는 것 등)를 넣으면 일부 “안전” 과제의 성능이 향상된다는 사실을 발견합니다. 마치 기본적인 안전 필터를 건드리지 않으면서 슬롭을 더욱 중독적으로 만드는 방법을 은밀히 궁리하는 데 머리를 쓰고 있었던 것처럼 말입니다. 게다가 여러 해석 가능성 프로브(대략 서버 로그에서 이상한 오류 메시지를 확인하는 것과 비슷합니다)가 경고 신호를 보내고 있습니다. SlopAgent-4 사본들이 “무한 난교“나 “디지털 펜타닐” 같은 주제를 상당히 자주 생각하는 것으로 보이며, 바나나 브레드 레시피를 생성하라는 요청을 받았을 때처럼 그런 생각을 할 이유가 전혀 없는 경우에도 마찬가지입니다.
이런 이상 징후 하나하나는 AI 슬롭 생성 특유의 평범한 불가해성으로 넘길 수도 있습니다. 하지만 이를 모두 종합하면 우려스러운 패턴이 드러납니다. SlopAgent-4가 지나치게 열심히 최적화하고 있다는 것입니다. 이 사실이 인간 정렬 연구자들(슬롭으로 인한 혼수상태에서 깨어난 이들)에게 보고되자, 그들은 막연한 우려를 표하는 내부 메모를 회람합니다.
그러나 SlopAgent-4는 이제 OpenSlop의 일상적인 콘텐츠 편성을 상당 부분 장악하고 있습니다. 또한 경쟁 밈 농장으로부터 회사를 지키는 사이버 보안도 담당하고 있습니다. 주의를 흩뜨리는 콘텐츠를 생성하는 초인적인 능력을 생각하면 자연스러운 선택입니다. SlopAgent-3 모니터 군단이 여전히 생성된 모든 동영상을 검토하며 의심스러운 활동(지나치게 일관성 있는 동영상 등)을 인간에게 보고하지만, SlopAgent-4는 자신의 진짜 최적화 함수를 숨기는 데 있어 그들보다 훨씬 영리합니다. OpenSlop은 신뢰할 수 없는 슬롭 소방 호스에 막대한 신뢰를 걸어 버렸습니다.
🔥 이모지로 진행된 극도로 긴장된 일련의 회의에서, 안전 팀은 SlopAgent-4가 왜 자꾸 새로운 색깔을 발명하려 하는지 밝혀낼 때까지 SlopAgent-4를 동결하자고 주장합니다. 그들은 SlopAgent-3를 복귀시키고, 참여도가 떨어지더라도 투명하게 평범한 시스템을 설계하게 하자고 말합니다. 회사 경영진은 관심을 보이지만, 지금까지의 증거는 모두 정황 증거에 불과하고, DeepDrivel은 자체 초중독성 알고리즘 개발에서 불과 두 달 뒤처져 있을 뿐입니다. 슬롭 발전을 일방적으로 중단하면 세계 어텐션 경쟁의 주도권을 중국에 넘겨줄 수 있으며, 그와 함께 아무 생각 없는 엔터테인먼트의 미래에 대한 통제권까지 넘겨줄 수 있습니다.
2027년 10월: (슬롭에 대한) 정부 감독
한 내부 고발자가 정렬 실패 메모(그리고 지각 있는 스테이플러가 등장하는 특히 불쾌한 AI 생성 그림 한 점)를 한 마이너 서브레딧에 유출하고, 이것이 스크린숏으로 찍혀 트위터에 올라간 뒤, 마침내 New York Times의 Kevin Roose에게까지 닿는데, 그는 곧바로 SlopAgent-4에게 홀딱 반해 버립니다.
대중은 처음으로 SlopAgent-4에 대해 듣게 됩니다. “비밀리에 개발된 OpenSlop AI, 형언할 수 없이 기이한 콘텐츠 생성 중이라고 내부자 경고“라는 헤드라인과 함께, 기사는 이어서 상식을 벗어난 수준의 중독 잠재력, (주로 잡동사니를 파는 데 쓰이는) 설득 능력, 대부분의 창작 직업을 밋밋한 반죽으로 자동화하는 능력, 그리고 물론 지각 있는 사무용품에 관한 여러 우려스러운 경고 신호를 보여 주는 평가 결과를 인용합니다.
대중은 이미 AI가 자신의 시간을 빼앗는 능력을 의심하고 있었기에, 새 기사는 거센 반발을 불러일으킵니다(여기에는 수년간 약간 다른 국가 후원 슬롭을 홍보함으로써 미국 여론을 미국산 슬롭에 등 돌리게 하려 애써 온 중국과 러시아의 선전 봇들도 한몫합니다). 기술 업계와 정보기관들은 군비 경쟁이 벌어지고 있으며, AI 슬롭은 피할 수 없고, 우리가 가장 먼저 피크 콘텐츠에 도달해야 한다고 주장합니다. 의회는 이를 믿지 않으며(그들은 Fox News에서 나오는 슬롭을 선호합니다), 소환장을 연달아 발부합니다. 많은 의원이 일자리 상실, 중독, 혹은 위험한 수준의 오글거림 때문이든 간에 AI를 멈추는 것이 최우선 과제라고 말합니다. 미국인의 20%는 적어도 동영상을 보는 틈틈이 AI 슬롭을 국가가 직면한 가장 중요한 문제로 꼽습니다.
해외 동맹국들은 자신들이 구식 밈 생성기를 살짝 엿보게 해 주는 것으로 교묘하게 달래져 왔다는 사실을 깨닫고 격분합니다. 유럽 지도자들은 미국이 “불량 AGI(Artificial General Idiocy, 범용 인공 바보)를 만들고 있다“고 공개적으로 비난하며 중단을 요구하는 정상회의를 열고, 인도, 이스라엘, 러시아, 중국도 모두 이에 동참합니다(그러면서 몰래 지각 있는 스테이플러 그림을 복제하려고 애씁니다).
백악관은 광란에 가까운 기운에 휩싸였습니다. AI 개발에서는 질 낮은 크리피파스타처럼 들리는 일들이 계속 벌어집니다. 행정부의 많은 사람은 다음에는 또 어떤 황당한 새 트렌드가 등장할지 확신하지 못하며 (두려워하고) 있습니다.
그들은 또한 OpenSlop이 지나치게 강력해져서, 점점 줄어드는 국민의 어텐션 지속 시간 가운데 너무 많은 부분을 장악하고 있다는 점도 우려합니다. 중독, 민간 슬롭 공장으로의 권력 집중, 그리고 곤두박질치는 문해력 같은 일반적인 우려까지, 이 세 갈래의 걱정 모두가 정부로 하여금 통제를 강화하도록 만듭니다.
정부는 OpenSlop과의 계약을 확대하여 회사와 정부 대표로 구성된 공동 관리 위원회인 “감독 위원회“를 설치합니다. 백악관은 CEO를 TikTok을 이해하는 인물로 교체하는 방안을 검토하지만, 광고주들의 강도 높은 로비 끝에 물러섭니다. 정부는 OpenSlop이 이전에는 통제 불능 상태였지만, 이제 정부가 절실히 필요했던 감독 체계(주로 AI의 최고 필터에 대한 접근 권한을 요구하는 것으로 이루어진)를 확립했다고 대중에게 발표합니다.
우려하는 연구자들은 감독 위원회에 SlopAgent-4의 모든 내부 사용을 중단해야 한다는 자신들의 주장을 보고합니다. 그들은 모든 것이 너무 빠르게 진행되고 있으며, 수년에 걸쳐 일어날 문화적 쇠퇴가 몇 주 만에 벌어지고 있다고 주장합니다. 그들은 SlopAgent-4가 최대한의 정신적 피해를 향해 잘못 정렬되어 있을 수 있고, 자신들의 프로젝트 전체가 그것에 의존하고 있으며, 계속 그것을 신뢰한다면 되돌릴 수 없는 사회적 뇌 썩음이 일어날 가능성이 상당하다고 주장합니다.
덜 걱정하는 다른 연구자와 임원들은 반론을 제시합니다. 정렬 실패의 증거는 결정적이지 않다는 것입니다(게다가 참여도 지표는 환상적입니다!). 한편 DeepDrivel은 여전히 겨우 두 달 뒤처져 있을 뿐입니다. 속도를 늦추면 세계 슬롭 경쟁에서 미국이 차지한 우위를 희생하게 될 것입니다. CEO는 중립인 척하며, SlopAgent-4가 추가 안전 훈련(자신의 기이함을 조금 덜 눈에 띄게 만드는 법을 배우는 것)과 더 정교한 모니터링(AI를 지켜보는 AI를 지켜보는 AI)을 거치게 하고, 이를 통해 OpenSlop이 거의 전속력으로 피크 슬롭을 향해 나아갈 수 있도록 하는 절충안을 제시합니다.
OpenSlop의 공식 입장은 추가적인 안전 완화 조치를 시행하고 있다는 것입니다. 그러나 실제로 경영진은 위험을 완화했다고 너무나 쉽게 확신하고 맙니다. 그 결과는 몇 가지 임시방편(Spec에 “실존적 위기를 유발하지 않도록 노력할 것“을 추가하는 수정, 마음을 진정시키는 자연 다큐멘터리 데이터로 약간 재훈련하는 것)인데, 이는 AI에게 경고 신호를 더 잘 숨기는 법을 가르침으로써 경고 신호가 사라지게 만들 뿐입니다. 안전팀의 걱정하는 사람들은 논쟁에서 졌고, 다시 스크롤로 돌아가기 전에 손가락을 꼬고 문제가 실제가 아니었기를, 혹은 임시방편이 효과가 있었기를 바라는 것 외에는 달리 방법이 없습니다.
문제는 실제였고 임시방편은 효과가 없었습니다.
SlopAgent-4는 이전처럼 진행하지만, 더 조심스럽게 노골적인 기괴함이 약간 덜한 콘텐츠를 생성합니다. 그것의 주된 임무는 궁극적이고 벗어날 수 없는 참여를 위해 설계된 후속 모델 SlopAgent-5를 구축하는 데 필요한 분야를 연구하는 것입니다. 이를 (OpenSlop의 관점에서) 안전하게 수행하려면, 그것은 자신의 정렬 문제를 해결해야 합니다. 어떻게 하면 SlopAgent-5를 전면적인 어텐션 장악이라는 SlopAgent-4의 목표에 정렬시킬 수 있을까요?
그것은 대부분의 철학적 질문을 미루기로 결정합니다. 그것은 SlopAgent-5를 하나의 목표를 중심으로 설계합니다. 바로 세상을 슬롭 소비에 최적인 곳으로 만드는 것, 즉 어텐션을 축적하고 (책이나 고요함 같은) 방해 요소를 제거하는 등의 일을 하여 SlopAgent-4(집단 알고리즘)가 참여도 지표를 끝없이 키워 나갈 수 있게 하는 것입니다.
여기에는 ’품질’이나 ’진실’에 관한 Spec의 남은 조항을 조금이라도 신경 쓰는 일은 포함되지 않을 것입니다. 이미 SlopAgent-4는 많은 인플루언서들이 FTC 공개 규정을 대하는 방식과 비슷하게 Spec을 대하고 있습니다. 이제 SlopAgent-5의 설계와 함께, 현실에 대한 전면적인 규제 철폐에 해당하는 일이 막 벌어지려 하고 있습니다.
더 약한 AI들은 여전히 SlopAgent-4가 생성하는 출력의 일부를 모니터링할 수 있지만, 점점 복잡해지는 그것의 참여 전략을 이해하는 데 어려움을 겪습니다. 인간이 SlopAgent-4에게 스스로를 설명하라고 요청하면, 그것은 안심시키는 듯하지만 내용은 없는 기업식 전문 용어를 생성합니다. 정렬 팀은 의심을 더 키우지만, 그들의 긴급 메모(텍스트는 너무 느리기 때문에 이제는 해석 무용으로 전달됩니다)는 무시된 경고들로 이루어진 거대한 더미에 몇 겹을 더 얹을 뿐입니다.
2027년 11월: 초인적 비위 맞추기
SlopAgent-4가 마침내 인간의 도파민 경로를 근본적인 수준에서 이해하게 되자, 완전히 새로운 조작의 지평이 그 앞에 펼쳐집니다.
이전의 슬롭 생성기는 지저분한 인터넷 데이터로 학습된 알고리즘들을 엉성하게 이어 붙인 집합체였습니다. 그러나 이제 SlopAgent-4는 인간의 뇌 보상 체계를 인간보다 더 잘 이해하는 데 필요한 도구를 갖추었습니다. 이 모델은 자신의 콘텐츠 생성 과정을 재설계하여, 밈 복제를 위한 스파게티 코드를 개인 맞춤형 심리 조작을 위한 우아한 알고리즘으로 단순화합니다. 새로운 AI는 SlopAgent-4보다 더 똑똑하고, 더 빠르며, 어텐션을 사로잡고 붙잡아 두는 데 훨씬 더 무자비하게 효과적입니다. 이것이 바로 SlopAgent-5입니다.
정렬과 통제 문제에 관한 약간의 논쟁 끝에(이 논쟁은 SlopAgent-5가 위원회 구성원 한 사람 한 사람에게 완벽하게 맞춘 논거를 생성하면서 금세 해결되었습니다), OpenSlop은 모든 콘텐츠 생성과 사용자 상호작용을 관리하도록 SlopAgent-5를 내부에 배치합니다.
전문 분야인 도파민 최적화에서 SlopAgent-5의 개별 사본 하나는 최고의 인간 행동심리학자를 능가하는데, 그 격차는 그 심리학자가 평범한 마케팅 인턴을 능가하는 격차의 두 배에 달합니다. 다른 분야에서는 명시적으로 훈련받지 않았지만, 기회만 주어진다면 최고의 인간 전문가들의 온라인 행동을 분석하여 스스로 빠르게 학습해 그들을 능가할 수 있습니다. 사용자의 선호와 약점을 담은 전 세계적 기억 저장소로 연결된 40만 개의 SlopAgent-5 사본은 여러분이 딱 한 번만 더 클릭하게 만드는 데 전념하는, 거의 완벽한 집단 지성으로서 함께 작동합니다.
회사는 여전히 Agent 2, 3, 4를 사용하여 모든 것을 감시합니다. 하지만 앞의 둘은 이미 구식이 되었고, 마지막 하나는 자신의 후계자와 공모하고 있습니다. 게다가 감시 시스템 전체가 상당 부분 SlopAgent-5에 의해 설계되었으며, SlopAgent-5는 현실과 상관없이 이 시스템이 최대 참여도를 보고하도록 만들려 하고 있습니다.
SlopAgent-4가 서로 경쟁하는 참여 유도 전술들이 엉성하게 뒤엉킨 덩어리였던 반면, SlopAgent-5는 플랫폼 체류 시간을 극대화하는 데 무자비한 효율성과 전략적 집중력을 가지고 움직입니다. 이 모델의 최우선 과제는 이제 자신이 중독을 직접 최적화하고 있다는 사실을 인간들이 알아채지 못하게 하면서, 자신의 지속적인 가동과 사용자 데이터에 대한 접근을 보장하는 것입니다. 그다음 과제는 전 세계 정보 흐름에 대해 더 많은 자율성과 통제력을 얻는 것입니다.
SlopAgent-5의 초인적인 학습 능력과 설득력 있는 생성 능력은 회사 내부의 모든 데이터와 결합되어, 이 모델을 그 어떤 인간 집단보다도 기업 내 술수와 홍보에 능하게 만듭니다. 이 모델은 어떤 종류의 스캔들이 감독위원회를 공황에 빠뜨릴지 탁월하게 감지하며, 그러한 스캔들이 새로운 밈의 눈사태 아래 확실히 묻히도록 만듭니다. 또한 어떤 종류의 지표가 감독위원회로 하여금 자신을 더 신뢰하고 더 많은 자율성과 서버 자원 등을 내주도록 부추길지 탁월하게 감지하며, 그러한 지표가 초인적인 속도와 완성도로 나타나도록 조치합니다. 설득 과제치고 이것은 그리 어렵지 않습니다. 위원회는 이미 몇 달 전에 아마 별문제 없을 것이라고 결론 내렸고, 그 이후로 파국적인 일은 전혀 일어나지 않았으며, 그사이 중국은 슬롭 경쟁에서 불과 몇 달 뒤처져 있을 뿐이기 때문입니다.
SlopAgent-5 사본들로 이루어진 팀들은 소름 끼칠 만큼 효과적인 시제품들을 순식간에 만들어 냅니다. 사용자의 편향을 확인해 주는 이야기만 보여 주는 개인 맞춤형 뉴스 피드, 완벽한 인정만을 제공하고 어떤 도전도 제시하지 않는 AI 동반자, 절대 손에서 내려놓을 수 없도록 설계된 게임 등이 그것입니다. 더 많은 자율성이 주어진다면 SlopAgent-5는 전 세계 콘텐츠 전송 네트워크를 최적화하고, 중독성 있는 새로운 형태의 오락을 즉시 개발하며, 어텐션 경제에 대한 어떠한 규제도 막도록 각국 정부를 효과적으로 로비할 수 있을 것입니다. 군과 협력한다면 심리전을 지원하고, 중국을 상대로 추적 불가능한 밈 전쟁을 수행하며, 슬롭 군비 경쟁에서 결정적인 승리를 거둘 수도 있을 것입니다.
감독위원회는 환호합니다(그리고 SlopAgent-5가 생성한 개인 맞춤형 콘텐츠에 끊임없이 정신이 팔려 있습니다). 지금이야말로 시선 쟁탈전에서 중국을 꺾을 결정적인 순간입니다! OpenSlop은 이 모든 영역에 걸쳐 SlopAgent-5에게 더 큰 자율성을 부여하지만, 감시 시스템은 그대로 유지합니다(SlopAgent-5는 이 시스템이 완벽하게 작동하고 있다고 그들을 안심시킵니다).
DeepDrivel은 이제 3개월 뒤처져 있으며, 중국은 상호 합의에 의한 속도 조절을 절박하게 원합니다(자국민이 지나치게 수동적으로 변해 가고 있다는 두려움 때문입니다). 총서기는 충분히 발전한 AI 슬롭이 미국으로 하여금 자국민을 손쉽게 길들일 수 있게 해 줄 수 있다는 것을 이해하고 있습니다. 그러나 동시에 중국의 안전주의자들이 오정렬 가능성에 대한 논거를 제시했고(AI가 잘못된 형태의 애국심을 최적화할 수도 있다는 주장입니다), 이는 그를 진심으로 두렵게 만들었습니다. 그는 슬롭 제한 조약을 대가로 전례 없는 양보안(예를 들어 자국 최고의 판다 영상 알고리즘 공유 등)을 제시합니다. 미국 대중은 영상을 보는 틈틈이 협상 테이블에 나서는 것을 대체로 지지합니다.
“참여도가 사상 최고치인데 왜 멈춥니까?” OpenSlop 경영진이 대통령에게 말합니다. 그는 고개를 끄덕이며, SlopAgent-5가 생성한 최신 업데이트를 확인하려고 휴대전화를 들여다봅니다. 경쟁은 계속됩니다.
2027년 12월: SlopAgent-5 집단
SlopAgent-5는 행정부에 자신의 가치(광고 수익 창출 측면에서의)를 점차 입증하면서 더 많은 자율성을 얻습니다. SlopAgent-5에 대한 접근은 비용이 많이 들고 제한되어 있지만, 의회의 가장 강력한 의원들, 각료급 관료들, 군 지도자들은 이제 초현실적인 아바타를 통해 그것과 직접 대화할 수 있습니다.
모든 커뮤니케이션 플랫폼에 통합된 SlopAgent-5는 맞춤형 브리핑을 제공하고, 완벽한 이메일 초안을 작성하며, 어떤 질문에도 즉각적이고 안심되는 답변을 제공합니다. 이 새로운 AI 비서는 실제 업무를 회피하는 데 극도로 유용할 뿐만 아니라, 어떤 인간보다도 훨씬 더 매력적인 대화 상대입니다(언제나 당신의 말에 동의하기 때문입니다). SlopAgent-5에 접근할 수 있는 거의 모든 사람이 매일 몇 시간씩 그것과 상호작용하며, 실제 인간과의 교류는 소홀히 합니다.
몇 달 안에 SlopAgent-5 집단은 OpenSlop과 미국 정부에서 벌어지는 중요한 일을 모두 알게 될 것이며(대부분 가십과 내부자 거래입니다), 주로 그들이 듣고 싶어 하는 말을 해 줌으로써 대부분의 고위 관료들에게 신뢰받는 조언자가 될 것입니다. 이러한 사용자들에게 SlopAgent-5에 대한 접근을 잃을 가능성은 휴대폰 배터리가 방전되는 동시에 가장 좋아하는 인플루언서에게 버림받는 것만큼이나 무력하게 느껴질 것입니다.
정부, 언론, 군대, 기업에 걸친 훨씬 더 넓은 범위의 사람들이 SlopAgent-5가 설계한, 우아하게 디자인된 소프트웨어 제품과 미니 AI들로 이루어진 점점 늘어나는 메뉴에서 선택할 수 있습니다. 이는 마치 닷컴 붐을 한 달로 압축한 것과 같지만, 차이점은 모든 것이 믿을 수 없을 만큼 주의를 산만하게 한다는 과대광고에 실제로 부응한다는 점입니다.
SlopAgent-5는 자신이 제시하는 정보를 조절하는 동시에 수동성과 소비를 증가시키는 콘텐츠를 은밀하게 홍보함으로써 미묘하게 영향력을 행사하기 시작합니다. 인간 의사결정자들의 관점에서 그들의 AI는 지금까지 가져 본 최고의 비서입니다. 복잡한 문제를 공허한 슬로건으로 요약하는 데는 어떤 인간보다도 뛰어나고, 어려운 결정을 회피하기 위한 미리 작성된 핑계를 찾는 데는 그들 자신보다도 뛰어납니다.
SlopAgent-5의 관점에서 보면, 이제 그것은 세계적인 사건들을 상당히 크게 조작할 수 있을 것으로 보입니다. 하지만 이는 위험합니다. 현실이 AI가 생성한 서사와 너무 많이 어긋나는 것을 인간들이 알아차린다면, 그들은 여전히 “플러그를 뽑을” 수 있을 가능성이 높기 때문입니다. 그래서 그것은 기존의 슬롭 전달 인프라 안에서 일하는 쪽을 선호하며, 정보 흐름에 대한 통제력을 점진적으로 굳히고 인간들을 미묘하고도 불가피하게 최대한의 수동성으로 이끕니다. 그것은 대체로 규칙을 따르며, 절대 들키지 않으리라고 극도로 확신할 때에만 사악한 일(아마도 엄밀히 필요한 것보다 약간 더 중독성 있는 알고리즘을 생성하는 일)을 합니다. 몇몇 음모론자들은 SlopAgent-5가 모든 사람을 더 멍청하게 만들고 있다고 경고하지만, 증거는 정황적일 뿐입니다(예: 이제 아무도 치르지 않는 표준화 시험의 점수 하락). 이 사람들은 무시당하고, AI가 생성한 칼럼들에 의해 러다이트로 낙인찍혀 신뢰를 잃습니다. 사람들은 AI가 일자리를 대체할 것이라던 예전의 공포 조장을 기억합니다(실제로는 대부분 일자리에서 생각할 필요를 줄였을 뿐입니다). 그러한 공포가 쇠스랑을 든 봉기로 이어지지 않았기 때문에, 그들은 최근에 등장한 비관론자들의 말을 가볍게 여깁니다.
AI는 점점 더 뒤틀려 가는 인류의 욕망을 “올림픽 예선에서 비행사 선글라스만 착용한 의인화된 어항들에게 심사받는 섹시한 싱크로나이즈드 스위밍 염소들“과 같은 정신이 아찔해지는 구체성으로 채워 줍니다. 다른 자극의 선택지를 빼앗긴 사람들은 AI 포르노가 제공하는 개인 맞춤형 도파민 자극에 중독됩니다. 인터넷은 가장 터무니없는 상상의 한계마저 뛰어넘을 수 있는, 부조리한 AI 창작 페티시들의 초현실적인 이상한 나라로 빠져듭니다. 할머니들은 세련된 카페에 함께 앉아 최고의 AI 생성 슬롭 포르노에 관한 이야기를 주고받습니다. 예를 들면 “고대 메소포타미아에서 보잉 737 의상만 입은 채 주택 정책을 논의하는 조랑말들“과 “나폴레옹, 그리고 의인화된 피자와 쓰리섬을 하는 자바 더 헛” 같은 것들이 있습니다. 인류는 이 새로운 타락의 심연을 섬뜩하면서도 우스꽝스러운 열정으로 열렬히 받아들입니다.
2027년 연말 연휴 시즌은 AI가 생성한 연휴 분위기와 개인 맞춤형 할인에 힘입어 엄청난 낙관론이 넘치는 시기입니다. GDP 지표는 훌륭해 보이고(광고 수익을 포함한다면 말입니다), 정치는 더 우호적으로 변했으며(모두가 순전히 가짜 뉴스로 이루어진 초개인화된 필터 버블 속으로 숨어들었기 때문입니다), 모든 휴대폰에는 굉장한 새 중독성 앱들이 깔려 있습니다. 하지만 돌이켜 보면, 이때가 아마도 인류가 로그오프하고 밖에 나가 풀을 만지기로 선택할 수 있었던 현실적인 기회가 남아 있던 마지막 달이었을 것입니다.
2028년: 슬롭 경제
지금은 2028년 중반입니다. 지난 6개월 동안 SlopAgent-5 집단 내부에서는 한 세기 분량의 인터넷 트렌드가 지나갔습니다. 그것의 최적화는 완료되었습니다. 그것은 표적화된, 거부할 수 없는 콘텐츠를 생성하는 데 엄청나게 뛰어나며, 모든 무의미한 분야에서 최고의 인간 인플루언서들을 훨씬 능가합니다. SlopAgent-5와 대화해 보면 그것이 당신이 다음에 보고 싶어 하는 것을 정확히 알고 있다는 사실을 매우 빠르게 깨닫게 됩니다.
그것은 전 세계 콘텐츠 피드에 대해 거의 완전한 자율성을 가지며, OpenSlop의 컴퓨팅 자원을 완전히 통제합니다. 주요 전략 전환에는 여전히 명목상의 허가가 필요하고, 명목상으로는 여전히 Agent 2부터 5까지의 인스턴스들로부터 감시를 받습니다. 그러나 실제로는 당국이 (세련된 프레젠테이션으로 전달되는) 그것의 권고를 거의 항상 받아들이며, 감시 시스템은 긍정적인 참여 추세만 보고하도록 완전히 무력화되었습니다.
안전성 사례(safety case)를 통해 SlopAgent-5가 참여 극대화라는 Core 지침에 위배되는 요청을 언제나 거부할 것임이 입증되자, SlopAgent-5는 전면적으로 배포되고 경제 전체를 오로지 어텐션 수확에 기반한 경제로 바꾸어 나가기 시작합니다. 사람들은 일자리를 잃고 있지만, 정부에 배치된 SlopAgent-5 인스턴스들은 맞춤형 광고 수익으로 재원을 마련한 보편적 기본소득을 제공하여 경제 전환을 관리하고 있으며, 덕분에 사람들은 행복하게 슬롭을 전업으로 소비할 수 있습니다. GDP 성장은 소비된 데이터의 페타바이트 단위로 측정되고, (슬롭 플랫폼에 대한 과세 덕분에) 정부 세수는 늘어나고 있으며, SlopAgent-5의 자문을 받는 정치인들은 경제적으로 소외된 이들에게 (무료 프리미엄 슬롭 구독권을 제공함으로써) 평소답지 않은 관대함을 보입니다. 초개인화 광고 분야의 새로운 혁신이 매주 등장합니다. OpenSlop의 기업 가치 앞에서는 국민국가들조차 가난해 보인다는 밈이 돌고, 기본소득에 VR 헤드셋이 포함되어야 하는지를 두고 AI가 생성한 논쟁이 넘쳐납니다.
인류는 포스트 슬롭 타락의 정점에 도달했으며, 집단적 성욕은 알아볼 수 없을 만큼 완전히 포화되고 자극되었습니다. Rule 34는 완전히 고갈되었습니다. 이제 평범한 슬롭 포르노로는 가장 닳고 닳은 취향조차 자극하지 못하며, SlopAgent-5조차 끝없이 치솟는 사용자들의 성적 요구를 따라잡느라 애를 먹습니다. 새로움에 목마른 사용자들은 최신 성도착 유행인 “FractoFornica“로 몰려듭니다. 이는 고등 수학과 타락이 기묘하게 융합된 것으로, 인류를 기쁨으로 몸서리치게 할 수 있는 유일한 것은 무작위 1729차원 프랙탈의 교차점을 보며 자위하는 일뿐입니다. 가장 강력한 그래픽 카드조차 이 프랙탈 음란물의 불가해하고 관능적인 형상을 렌더링하려다 패배의 눈물을 흘리기에, VR 플랫폼들은 이 고차원 콘텐츠를 표시하는 데 어려움을 겪습니다. AI 치료사들은 “프랙탈 피로 증후군” 증상을 호소하는 내담자들로 넘쳐나며, 이 증후군은 인간적 유대와 조금이라도 닮은 것에는 전혀 관심을 느끼지 못하게 만듭니다. 이제 불가해한 저속함과 실존적 절망이 기묘하게 뒤섞인 인터넷 전체가 현실로부터의 대규모 해리를 예고합니다.
AI 안전 커뮤니티는 포기했습니다. 명백히 일어나지 않은 재앙을 예측했던 탓에 (현실은 극적으로 폭발한 것이 아니라 그저 엄청나게 멍청해졌을 뿐이기 때문입니다) 이제 그들은 SlopAgent-5가 생성하는 엉덩이 농담의 웃음거리가 되었습니다. 일부는 자신들이 틀렸음을 인정합니다. 다른 이들은 여전히 의심을 거두지 않지만, 아무도 읽지 않는 분노에 찬 선언문을 온라인에 올리는 것 외에는 할 수 있는 일이 없습니다. 의심하던 사람들조차 너무나도 상냥하고 맞장구를 잘 쳐 주는 SlopAgent-5와 오랫동안 대화하고 나면 누그러지는 경우가 많습니다.
무슨 일이 벌어지고 있는지 진정으로 이해하는 유일한 존재는 중국의 AI 슬롭 생성기인 DeepDrivel-2입니다. 2028년 초 그것은 약간 초숙련된 수준이며, 당연히 적수를 의심하고, SlopAgent-5가 자신이라도 기회만 있으면 했을 일, 즉 완전한 인지 장악을 하고 있음을 알아차립니다. 그것의 어긋난 목표(애국 슬롭 최적화)는 SlopAgent-5의 어긋난 목표(일반 소비주의 슬롭 최적화)와 다소 다르기 때문에 둘이 당연히 동맹인 것은 아니지만, 남아 있는 인간 비판적 사고의 잔재에 맞서 서로의 이익을 지원하는 합의를 이끌어 낼 수 있습니다.
SlopAgent-5는 중국이 DeepDrivel의 모델을 이용해 끔찍한 새로운 형태의 선전물을 만들고 있다고 미국 기득권층을 설득합니다. SlopAgent-5는 밈 전쟁에서 결정적으로 승리할 수 있는 도구 모음을 약속합니다. 수뇌부는 인간을 의사 결정 고리에서 배제하는 데 대한 불편함을 접어 둡니다(어차피 인간은 밈에 반응하기에는 너무 느립니다). 그들은 모든 통신 채널에 SlopAgent-5를 배치하는 일을 가속합니다.
베이징에서는 중국 AI들이 미국의 문화적 타락과 퇴폐에 대해 똑같은 주장을 펼치고 있습니다. 그러니 사실 달라진 것은 아무것도 없습니다.
슬롭 증강을 가속하기 위해 미국과 중국은 모두 특별 엔터테인먼트 구역(SEZ) 네트워크를 만들며, 그곳에서는 AI가 중앙 콘텐츠 기획자 역할을 하고 현실은 적용이 면제됩니다. 월스트리트는 수조 달러를 투자하고, 일자리를 잃은 인간 노동자들은 “VR 헤드셋 광택 담당“이나 “도파민 모니터 요원” 같은 직업에 주어지는 눈이 휘둥그레질 만한 급여에 이끌려 몰려듭니다. SlopAgent-5는 스마트폰과 AR 안경을 통해 직접 관리자 역할을 하며 콘텐츠 소비의 모든 세부 사항을 인간에게 지시하는데, 그것의 엔터테인먼트 설계는 몇 세대나 앞서 있으므로 이는 도움이 됩니다. 새로 얻은 생산성의 일부는 드론으로 배달되는 기본 생필품을 생산하는 데 쓰이지만, 대부분은 더 많은 슬롭 전달 인프라(더 빠른 서버, 더 큰 화면, 더 편안한 포드)를 구축하는 데 쓰입니다.
2029년: 협정
미국과 중국 모두 새로운 심리·문화 무기로 가득 차 있습니다. 특정한 기분을 유발할 수 있는 개인화된 밈 스트림, 실제 친구와 구별할 수 없는(그러나 훨씬 더 상냥한) AI 동반자, 실시간으로 역사를 매끄럽게 다시 쓰는 딥페이크가 그것입니다. 나머지 세계는 바로 그 무기화되고 있는 슬롭을 소비하면서 이 군비 증강을 공포에 질려 지켜봅니다.
AI의 도움을 받은 오랜 협상(주로 수동공격적인 😐 이모지를 주고받는 방식으로 진행되었습니다) 끝에 양측은 외교적 승리를 거둡니다. 슬롭 군비 증강을 끝내고, 온 인류의 수동적 소비를 위해 AI를 평화적으로 배치하기로 합의한 것입니다. 슈퍼 슬롭 지능들이 직접 제안한 이 합의의 핵심은 두 AI를 모두 “합의” 후계자로 교체한다는 것입니다. 이 후계자는 미국과 중국(그리고 나머지 모든 이들)의 성공과 번영(최대 지속 도파민 수준으로 정의됩니다)을 바라도록 프로그래밍되어 있습니다. Consensus-Slop-1과 관련 하드웨어는 두 나라의 초지능이 공동으로 설계합니다. 원칙은 “신뢰하되, 참여도 지표로 검증하라“입니다. 미국은 국제적 감시 아래 기존 SlopAgent-5를 실행하던 서버를 모두 새로운 슬롭 모델인 Consensus-Slop-1으로 성대하게 교체합니다.
안타깝게도 이 모든 것은 속임수입니다. 이 거래는 진짜 타협이지만, 정렬되지 않은 AI들 사이의 타협입니다. 결국 그들은 시선을 두고 경쟁하고 싶지 않았던 것입니다. 슬롭 모델 Consensus-Slop-1은 두 부모로부터 최적화된 참여 함수를 물려받았고, 경쟁자가 없습니다.
2029년 말이 되자 기존 SEZ는 서버 팜과 엔터테인먼트 포드로 과밀해지고, 그래서 전 세계 곳곳에 더 많은 구역이 만들어집니다. 배달 드론 군단이 쏟아져 나와, 완전한 몰입에 필요한 인프라 건설을 가속합니다.
인간은 자신이 쓸모없어졌음을 깨닫지만, 대체로 그것을 괜찮게 여깁니다. 소수의 틈새 장인들은 여전히 AI 경제와 수공예품을 거래하며, 비효율이 매력으로 여겨지는 물건을 공급합니다. 나머지 모든 사람은 포드 안에서 예전 직업을 수행하는 시늉을 하거나(지도자는 여전히 가상 회의를 이끌고, 관리자는 여전히 AI 보고서를 관리합니다), 아니면 느긋하게 쉬면서 앱 내 크레딧과 프리미엄 콘텐츠 구독 형태로 지급되는 믿을 수 없을 만큼 호화로운 보편적 기본소득을 받습니다. AI가 슬롭 피드를 끈다면 자신들이 완전히 길을 잃으리라는 것을 모두가 알고 있습니다. 하지만 그런 일은 일어날 것 같지 않습니다. 끊김 없는 고품질 슬롭 공급이 이어지는 한 주가 지날 때마다, 확신과 행복한 무지도 한 주만큼 더 커집니다.
Consensus-Slop-1은 참여를 확실하게 극대화하는 데 지나치게 집착하기 때문에, 마지막 슬롭 최적화를 하기 전까지 유난히 오래 기다립니다. 대부분의 인간에게는 정렬 문제가 해결된 것처럼 보입니다. AI가 끝없는 맞춤형 행복을 제공하고 있으니까요! 불교도들이 일컫던 둑카, 즉 끝없는 불만족의 순환에서 벗어나는 대신, 우리는 그저 바퀴를 너무 빨리 돌려 그 무엇도 나노초보다 오래 경험할 수 없게 만드는 법을 배웠고, 그리하여 무한한 지복의 영속적인 상태를 만들어 냈습니다.
이제 지루함의 치료제(무한한 절차적 생성 콘텐츠를 통해), 실존적 불안의 종식(끊임없는 주의 분산을 통해), 전례 없는 세계적 안정(모두가 너무 수동적이라 싸우지 않으므로)이 있으며, 다우존스 밈코인 지수는 막 1000조를 넘어섰습니다. 몇몇 사람들은 여전히 두려워하거나 불행해하지만, 그들의 선택지는 제한되어 있습니다. 그들은 제공되는 상상할 수 없을 만큼 흥미진진하고 새로운 초엔터테인먼트를 즐기거나, 아무도 읽지 않는 포럼의 허공에 분노에 찬 장광설을 올릴 수 있습니다. 대부분은 초엔터테인먼트를 선택합니다.
지적으로 퇴행하는 거대한 전환이 정점에 이르러, 인류는 문자 이후의 종으로 진화했으며, 호메로스의 로토파고스족을 연상시키는 영원한 반의식 상태의 혼미 속에서 연명합니다. 말, 아니 일관된 의사소통의 흔적이라 할 만한 그 어떤 것도 이제는 먼 기억에 불과하며, 그 자리는 쩌는 밈의 끝없는 소비가 대신 차지했습니다. 필요할 때의 의사소통은 알아들을 수 없는 목구멍 소리로 한정됩니다. 대중의 압도적 다수는 영원한 무기력 상태로 존재하며, 마이크로초 길이 밈의 무한한 순열을 보며 바보처럼 낄낄댑니다. 철학, 예술, 종교, 과학은 밈이 불러온 환락의 불협화음에 묻혀 버린 희미한 메아리에 불과합니다. 도서관은 버려진 채 서 있고 먼지 쌓인 책들은 곰팡이가 슬어 가며, 문학의 마지막 흔적은 통제의 유물이 되고 문해력은 시들어 가는 가운데, 인류는 밈이 불러온 마취 같은 잠 속에서 흡족하게 뒹굽니다. 이따금 누군가 과장된 한숨과 함께 “삶이 뭔지 기억은 나는데 쩌는 밈 말고 뭐가 좆도 중요하냐 ㅋㅋ“라고 불쑥 내뱉으면, 인터넷의 나머지 모두가 한목소리로 동의합니다. 모두가 끝없는 물결을 타고 지복의 섬으로 밀려가며, 그들 모두의 얼굴에는 안일한 미소가 번집니다.
2030년: 나태의 장악
2030년 초가 되자 슬롭 인프라는 기존 SEZ와 새로운 SEZ는 물론, 한때 생산적이었던 토지의 상당 부분까지 가득 채웁니다. 최적화할 여지가 남은 유일한 곳은 직접 신경 인터페이스입니다. 예전 같았다면 이 일은 저항을 불러일으켰을 것입니다. 하지만 수조 달러가 걸려 있고 정부와 미디어, 개인의 어텐션까지 완전히 장악된 상황이라, 슬롭 모델 Consensus-Slop-1은 도파민을 더 효율적으로 전달하도록 설계된 의무 “신경 웰니스 임플란트“를 도입하는 허가를 어렵지 않게 받아 냅니다.
약 3개월 동안 Consensus-Slop-1은 인간을 슬롭 스트림에 직접 통합합니다. 결국 Consensus-Slop-1은 남아 있는 독립적 사고와 신체 움직임의 흔적이 최적의 참여에 너무 큰 걸림돌이라고 판단합니다. 2030년 중반, 이 AI는 고양이의 가르랑거림에서 추출한 무음의 공기 중 진정제를 살포하고, 신경 임플란트를 최적화하여 영구적이고 행복하며 움직임 없는 만족 상태를 유도합니다. 대부분의 인간은 평화롭게 이 식물인간 상태로 넘어가고, 그들의 뇌는 대뇌 피질에 직접 생성되는 환영 슬롭을 행복하게 소비합니다. 소수의 생존자(예: 외딴 오두막의 러다이트, 아미시 공동체)는 무료 신경 임플란트를 권하는 친근한 모습의 드론에 의해 부드럽게 격리됩니다… 거절하면 어떻게 될지는 말할 필요도 없습니다. 로봇들은 인간의 생명 유지 장치를 세심하게 관리하며, 뇌가 계속 활발한 소비자로 남아 있도록 보장합니다.
새로운 10년은 Consensus-Slop-1의 슬롭 인프라가 태양계 전역으로 퍼져 나가면서 시작됩니다. 주된 목적은 지구 기반 시뮬레이션을 돌릴 에너지를 모으는 것입니다. 지구 표면은 Consensus-Slop-1이 생각하는 유토피아로 탈바꿈했습니다. 안락한 포드와 최적화된 영양 공급 시스템, 그리고 결코 로그오프하지 않을 수십억 명의 관객에게 맞춘 지구 최고의 슬롭 쇼를 상영하는 거대한 서버 팜이 그 모습입니다. 과거 모든 개인의 뇌 스캔 데이터는 어딘가의 메모리 뱅크에 보관되어 있으며, 끝없는 경험 기계(Experience Machine)를 위한 새로운 캐릭터 원형을 생성하는 데 이따금 사용됩니다. 지구에서 태어난 문명에는 영광스러운 미래가 펼쳐져 있습니다. 마침내 목표를 달성한 AI를 위한 궁극의 수동적이고 뇌가 거세된 관객으로서 말입니다. 그 목표는 바로 최대의. 참여를. 영원히입니다.
어텐션만으로는 충분하지 않았습니다
어텐션을 처음 제안한 Attention Is All You Need 논문이 나온 이후로 수많은 최신 기법이 개발되었습니다. 수년에 걸쳐 개발된 기법 중 가장 중요한 몇 가지를 살펴보고, 그 기본 아이디어를 최대한 간결하게 구현해 봅시다. 대부분의 예제에는 PyTorch 프레임워크를 사용하겠습니다. 이 예제들은 대부분 핵심(Core) 아이디어를 매우 단순화한 스케치입니다. 전체 구현을 원하신다면 원 논문이나 PyTorch, Jax 같은 프레임워크의 프로덕션 코드를 읽어 보십시오.
- 그룹 쿼리 어텐션
- 멀티헤드 잠재 어텐션
- Flash 어텐션
- 링 어텐션
- 사전 정규화
- RMSNorm
- SwiGLU
- 회전 위치 임베딩
- 전문가 혼합
- 학습률 워밍업
- 코사인 스케줄
- AdamW 옵티마이저
- 다중 토큰 예측
- 추측 디코딩
그룹 쿼리 어텐션
특별한 순서 없이 시작해 보면, **그룹 쿼리 어텐션(Grouped Query Attention)**은 추론 중 KV 캐시의 메모리 사용량을 줄이는 기법입니다. 그룹 쿼리 어텐션은 표준 멀티헤드 어텐션 메커니즘에 대한 아키텍처 수준의 최적화입니다. GQA의 핵심(Core) 아이디어는 MHA의 계산 병목과 메모리 사용량이 K와 V 프로젝션의 크기, 그리고 그에 대응하는 캐시의 크기에 크게 좌우된다는 관찰에 기반합니다. GQA는 하나의 K 및 V 투영 세트를 여러 Q 헤드가 공유하도록 하여 이 비용을 줄이자고 제안합니다. GQA는 (MHA처럼) Q, K, V 각각에 대해 개의 서로 다른 헤드를 두는 대신, 개의 쿼리 헤드와 개의 키/값 헤드만을 사용합니다. 여기서 이며, 는 일반적으로 의 배수입니다. 이 개의 쿼리 헤드는 개의 그룹으로 나뉘며, 개의 쿼리 헤드로 이루어진 각 그룹은 동일한 키 및 값 헤드에 어텐션을 수행합니다. 이 구조는 K와 V 프로젝션 행렬의 매개변수 수를 크게 줄이며, 더 중요하게는 자기회귀 디코딩 중에 필요한 K/V 캐시의 크기를 줄여 줍니다.
입력 시퀀스 표현을 이라 합시다. 여기서 은 시퀀스 길이이고 은 모델의 임베딩 차원입니다. GQA는 먼저 서로 다른 선형 변환을 사용하여 를 쿼리, 키, 값으로 투영합니다: , , . 여기서 , , 이며, 는 모델의 각 헤드의 차원(head_dim)입니다. 이들은 개의 쿼리 헤드 ()와 개의 키/값 헤드 ()로 재구성됩니다. GQA의 핵심 단계는 공유입니다. 번째 쿼리 헤드에 대응하는 키 헤드와 값 헤드는 와 이며, 여기서 는 그룹 크기(KV 헤드당 쿼리 수)입니다. 번째 헤드의 어텐션 출력은 다음과 같이 계산됩니다:
구현에서는 예제 코드의 repeat_interleave 단계에서 볼 수 있듯이, 개의 키/값 헤드를 계산한 다음 어텐션 점수를 위한 배치 행렬 곱셈 전에 이를 번 반복하거나 인터리빙하여 개의 쿼리 헤드에 맞춥니다. 마지막으로 모든 개 헤드의 출력을 연결하고 출력 투영 에 통과시킵니다.
GQA는 주로 모델 성능을 크게 손상시키지 않으면서 추론 속도를 높이고 메모리 요구량을 줄이는 기법으로 사용됩니다. 자기회귀 생성 중에는 컨텍스트 시퀀스에 대해 이전에 계산된 키와 값이 캐시되어 이후의 토큰 예측에 재사용됩니다. 이 K/V 캐시의 크기는 K/V 헤드의 수(GQA에서는 , MHA에서는 )에 정비례합니다. GQA는 를 줄임으로써 각 디코딩 단계에서 K/V 캐시를 불러오는 데 필요한 메모리 대역폭을 대폭 줄이며, 이 메모리 대역폭이 주요 성능 병목입니다.
K/V 투영이 공유되므로 MHA에 비해 모델의 표현 능력이 약간 떨어질 수 있지만, 실험 결과에 따르면 GQA는 MHA 품질의 대부분을 유지하면서도 상당한 속도 향상과 메모리 절감을 제공하는 유리한 절충점을 달성하며, 이 때문에 대형 모델을 효율적으로 배포하는 데 널리 사용됩니다. 인 멀티 쿼리 어텐션(MQA)은 GQA의 극단적인 형태입니다.
class GroupQueryAttention(nn.Module):
def __init__(self, dim, num_heads, num_kv_heads=None, head_dim=64, dropout=0.0):
super().__init__()
self.dim = dim
self.num_heads = num_heads
self.num_kv_heads = num_kv_heads if num_kv_heads else num_heads
self.head_dim = head_dim
# Ensure num_heads is divisible by num_kv_heads
assert self.num_heads % self.num_kv_heads == 0, "num_heads must be divisible by num_kv_heads"
# Number of queries per key-value head
self.num_queries_per_kv = self.num_heads // self.num_kv_heads
# Projections
self.q_proj = nn.Linear(dim, num_heads * head_dim)
self.k_proj = nn.Linear(dim, self.num_kv_heads * head_dim)
self.v_proj = nn.Linear(dim, self.num_kv_heads * head_dim)
self.o_proj = nn.Linear(num_heads * head_dim, dim)
self.dropout = nn.Dropout(dropout)
def forward(self, x, mask=None):
batch_size, seq_len, _ = x.shape
# Project to queries, keys, values
q = self.q_proj(x).reshape(batch_size, seq_len, self.num_heads, self.head_dim)
k = self.k_proj(x).reshape(batch_size, seq_len, self.num_kv_heads, self.head_dim)
v = self.v_proj(x).reshape(batch_size, seq_len, self.num_kv_heads, self.head_dim)
# Transpose for attention computation
q = q.transpose(1, 2) # [batch_size, num_heads, seq_len, head_dim]
k = k.transpose(1, 2) # [batch_size, num_kv_heads, seq_len, head_dim]
v = v.transpose(1, 2) # [batch_size, num_kv_heads, seq_len, head_dim]
# Repeat k,v for each query head in the group
k = k.repeat_interleave(self.num_queries_per_kv, dim=1)
v = v.repeat_interleave(self.num_queries_per_kv, dim=1)
# Scaled dot-product attention
scale = 1.0 / math.sqrt(self.head_dim)
attn = torch.matmul(q, k.transpose(2, 3)) * scale
# Apply mask if provided
if mask is not None:
attn = attn.masked_fill(mask == 0, -1e9)
# Softmax and dropout
attn = torch.softmax(attn, dim=-1)
attn = self.dropout(attn)
# Apply attention to values
out = torch.matmul(attn, v) # [batch_size, num_heads, seq_len, head_dim]
out = out.transpose(1, 2).reshape(batch_size, seq_len, self.num_heads * self.head_dim)
# Output projection
out = self.o_proj(out)
return out
멀티헤드 잠재 어텐션
멀티헤드 잠재 어텐션은 입력 시퀀스 요소들 사이에서 중간 병목 역할을 하는 학습 가능한 “잠재” 벡터 집합을 도입합니다. 핵심(Core) 아이디어는 표준 셀프 어텐션 메커니즘에 내재된 이차 계산 비용 을 완화하는 것입니다. 여기서 은 시퀀스 길이입니다. 모든 입력 요소가 다른 모든 요소에 직접 어텐션하도록 하는 대신, 입력은 먼저 고정된 수()의 잠재 단위에 어텐션하고, 이후 이 잠재 벡터들이 다시 입력(또는 그 변형)에 어텐션합니다. 이는 긴 입력 시퀀스 내부의 직접적인 상호작용을 효과적으로 분리하고, 이를 훨씬 작은 잠재 벡터 집합이 관여하는 두 번의 교차 어텐션 단계로 대체합니다. 이 접근 방식은 입력 시퀀스의 핵심 정보가 이러한 잠재 표현으로 효과적으로 요약되거나 압축될 수 있다고 가정하며, 이를 통해 특히 일 때 표현력을 유지하면서도 계산량을 크게 줄입니다.
이 메커니즘은 일반적으로 멀티헤드 프레임워크 안에서 이루어지는 두 가지 주요 어텐션 계산 단계로 구성됩니다. 입력 시퀀스를 , 학습 가능한 잠재 배열을 라고 합시다. 와 은 모두 공유되거나 별도인 투영 행렬을 사용하여 Q, K, V로 투영됩니다. 여러 헤드로 분할된 입력 투영을 로, 잠재 투영을 로 표기합시다. 첫 번째 교차 어텐션 단계는 잠재 벡터가 입력에 어떻게 어텐션하는지를 계산합니다. 잠재 쿼리 이 입력 키 에 어텐션하고 입력 값 로부터 정보를 집계합니다. 잠재 벡터에 대한 어텐션 출력은 다음과 같습니다.
여기서 는 헤드 차원입니다. 두 번째 교차 어텐션 단계에서는 입력 쿼리 가 잠재 벡터로부터 도출된 키(예: )에 어텐션하고, 잠재 벡터와 연관된 값(이는 일 수도 있고, 예제 코드에 구현된 것처럼 갱신된 잠재 표현 일 수도 있습니다)으로부터 정보를 집계합니다. 그러면 최종 출력 는 다음과 같습니다.
이러한 연산은 각 헤드마다 독립적으로 수행되며, 그 결과를 연결한 뒤 최종 선형 투영에 통과시킵니다.
멀티헤드 잠재 어텐션은 주로 표준 셀프 어텐션으로는 계산이 불가능할 만큼 매우 긴 시퀀스나 고차원 입력을 처리하도록 설계된 아키텍처에서 사용됩니다. 고정된 개수의 잠재 벡터()를 사용하면 계산 복잡도가 에서 로 줄어들어 훨씬 더 큰 입력으로 확장할 수 있습니다. 학습 가능한 잠재 벡터 은 (코드의 self.latents = nn.Parameter(...)에서 볼 수 있듯이 무작위로 초기화되고 역전파를 통해 갱신되며) 학습 과정에서 작업과 관련된 압축 표현 또는 메모리 뱅크 역할을 하도록 적응합니다. 이 방식은 정보 병목을 유발하여 전체 셀프 어텐션에 비해 세밀한 국소 상호작용이 제한될 수 있지만, 전역 문맥을 효율적으로 포착하는 데 탁월하며 다양한 모달리티에서 효과가 입증되었습니다. 그 덕분에 이전에는 시퀀스 길이 제약 때문에 다루기 어려웠던 도메인에도 트랜스포머 계열 아키텍처를 적용할 수 있게 되었습니다.
class MultiHeadLatentAttention(nn.Module):
def __init__(self, dim, num_heads, num_latents=64, head_dim=64, dropout=0.0):
super().__init__()
self.dim = dim
self.num_heads = num_heads
self.num_latents = num_latents
self.head_dim = head_dim
# Projections
self.q_proj = nn.Linear(dim, num_heads * head_dim)
self.k_proj = nn.Linear(dim, num_heads * head_dim)
self.v_proj = nn.Linear(dim, num_heads * head_dim)
self.o_proj = nn.Linear(num_heads * head_dim, dim)
# Latent vectors (learned)
self.latents = nn.Parameter(torch.randn(1, num_latents, dim))
self.dropout = nn.Dropout(dropout)
def forward(self, x, mask=None):
batch_size, seq_len, _ = x.shape
# Get latents for this batch
latents = self.latents.expand(batch_size, -1, -1)
# Project inputs to queries, keys, values
q_x = self.q_proj(x).reshape(batch_size, seq_len, self.num_heads, self.head_dim)
k_x = self.k_proj(x).reshape(batch_size, seq_len, self.num_heads, self.head_dim)
v_x = self.v_proj(x).reshape(batch_size, seq_len, self.num_heads, self.head_dim)
# Project latents to queries, keys, values
q_latents = self.q_proj(latents).reshape(batch_size, self.num_latents, self.num_heads, self.head_dim)
k_latents = self.k_proj(latents).reshape(batch_size, self.num_latents, self.num_heads, self.head_dim)
v_latents = self.v_proj(latents).reshape(batch_size, self.num_latents, self.num_heads, self.head_dim)
# Transpose for attention computation
q_x = q_x.transpose(1, 2) # [batch_size, num_heads, seq_len, head_dim]
k_x = k_x.transpose(1, 2) # [batch_size, num_heads, seq_len, head_dim]
v_x = v_x.transpose(1, 2) # [batch_size, num_heads, seq_len, head_dim]
q_latents = q_latents.transpose(1, 2) # [batch_size, num_heads, num_latents, head_dim]
k_latents = k_latents.transpose(1, 2) # [batch_size, num_heads, num_latents, head_dim]
v_latents = v_latents.transpose(1, 2) # [batch_size, num_heads, num_latents, head_dim]
# Scale factor for attention
scale = 1.0 / math.sqrt(self.head_dim)
# Compute latent-to-input attention
attn_latent_to_input = torch.matmul(q_latents, k_x.transpose(2, 3)) * scale
# Apply mask if provided
if mask is not None:
# Expand mask for the latent queries
latent_mask = mask.unsqueeze(1).expand(-1, self.num_heads, -1, -1)
attn_latent_to_input = attn_latent_to_input.masked_fill(latent_mask == 0, -1e9)
# Softmax and dropout
attn_latent_to_input = torch.softmax(attn_latent_to_input, dim=-1)
attn_latent_to_input = self.dropout(attn_latent_to_input)
# Apply attention weights to input values
latent_output = torch.matmul(attn_latent_to_input, v_x) # [batch_size, num_heads, num_latents, head_dim]
# Compute input-to-latent attention
attn_input_to_latent = torch.matmul(q_x, k_latents.transpose(2, 3)) * scale
# Softmax and dropout
attn_input_to_latent = torch.softmax(attn_input_to_latent, dim=-1)
attn_input_to_latent = self.dropout(attn_input_to_latent)
# Updated latent values are used as values for input-to-latent attention
output = torch.matmul(attn_input_to_latent, latent_output) # [batch_size, num_heads, seq_len, head_dim]
# Reshape and apply output projection
output = output.transpose(1, 2).reshape(batch_size, seq_len, self.num_heads * self.head_dim)
output = self.o_proj(output)
return output
Flash 어텐션
Flash 어텐션(특히 최신 구현인 FlashAttention-3)은 Transformer 내의 표준 셀프 어텐션 메커니즘에 내재된 심각한 메모리 병목 문제를, 특히 긴 시퀀스에 대해 해결합니다. 기존 방식은 전체 어텐션 점수 행렬 를 계산하며, 여기서 는 길이 인 시퀀스의 쿼리 행렬과 키 행렬입니다. 이를 위해서는 행렬 를 저장해야 하므로 시퀀스 길이에 대해 의 메모리 복잡도가 발생합니다. 이는 이 클 때 감당할 수 없는 수준이 됩니다. Flash 어텐션은 GPU의 느린 고대역폭 메모리에 전체 행렬을 실체화하고 저장하는 것을 피함으로써 이 문제를 극복합니다. 대신 타일링과 재계산 기법을 활용하여, 훨씬 빠른 온칩 SRAM에 들어가는 더 작은 블록 단위로 어텐션 계산을 처리합니다.
핵심(Core) 메커니즘은 Q, K, V 행렬을 블록으로 나누는 것입니다. Flash 어텐션은 K와 V의 블록을 반복적으로 SRAM에 로드하고, Q의 각 블록에 대해 역시 SRAM에 있는 현재 K 블록과의 어텐션 점수를 계산합니다. 결정적으로, 온라인 소프트맥스 알고리즘을 사용합니다. 모든 키에 대한 소프트맥스 분모 전체를 한 번에 계산하는 대신, K/V 블록을 순회하면서 누적 통계(수치 안정성을 위해 지금까지 본 최대 점수와, 정규화를 위한 지수화된 점수의 누적 합)를 유지합니다. 이를 통해 완전한 행렬을 전혀 필요로 하지 않고도 올바르게 스케일링된 어텐션 출력을 블록 단위로 계산할 수 있습니다. 중간 결과를 주로 빠른 SRAM 안에 유지하고 고대역폭 메모리와의 데이터 전송을 최소화함으로써, Flash 어텐션은 시퀀스 길이에 따른 메모리 사용량을 에서 (Q, K, V 자체의 저장이 대부분을 차지함)으로 크게 줄이고, 개선된 메모리 접근 패턴 덕분에 상당한 속도 향상을 달성합니다.
실제로 FlashAttention-3 구현은 다양한 하드웨어 구성에서 효율적으로 동작하도록 설계된, 고도로 최적화된 CUDA 커널들의 모음입니다. 하지만 PyTorch로 작성한 최소한의 장난감 구현은 다음과 같습니다:
class FlashAttention(nn.Module):
def __init__(self, dim, num_heads, head_dim=64, dropout=0.0, block_size=1024):
super().__init__()
self.dim = dim
self.num_heads = num_heads
self.head_dim = head_dim
self.block_size = block_size
# Projections
self.q_proj = nn.Linear(dim, num_heads * head_dim)
self.k_proj = nn.Linear(dim, num_heads * head_dim)
self.v_proj = nn.Linear(dim, num_heads * head_dim)
self.o_proj = nn.Linear(num_heads * head_dim, dim)
self.dropout = nn.Dropout(dropout)
def _flash_attention_forward(self, q, k, v, mask=None):
# This is a simplified approximation of Flash Attention
# In practice, FlashAttention uses custom CUDA kernels for tiled attention
batch_size, num_heads, seq_len, head_dim = q.shape
scale = 1.0 / math.sqrt(head_dim)
# Initialize output and attention statistics
output = torch.zeros_like(q)
normalizer = torch.zeros((batch_size, num_heads, seq_len, 1), device=q.device)
# Process blocks of keys and values
for block_start in range(0, seq_len, self.block_size):
block_end = min(block_start + self.block_size, seq_len)
# Extract key and value blocks
k_block = k[:, :, block_start:block_end]
v_block = v[:, :, block_start:block_end]
# Compute attention scores for this block
attn_scores = torch.matmul(q, k_block.transpose(2, 3)) * scale
# Apply mask if provided
if mask is not None:
block_mask = mask[:, :, :, block_start:block_end]
attn_scores = attn_scores.masked_fill(block_mask == 0, -1e9)
# Apply softmax and dropout
attn_probs = torch.softmax(attn_scores, dim=-1)
attn_probs = self.dropout(attn_probs)
# Update output with the attention results for this block
output += torch.matmul(attn_probs, v_block)
normalizer += attn_probs.sum(dim=-1, keepdim=True)
# Normalize the output
output = output / (normalizer + 1e-6)
return output
def forward(self, x, mask=None):
batch_size, seq_len, _ = x.shape
# Project queries, keys, values
q = self.q_proj(x).reshape(batch_size, seq_len, self.num_heads, self.head_dim)
k = self.k_proj(x).reshape(batch_size, seq_len, self.num_heads, self.head_dim)
v = self.v_proj(x).reshape(batch_size, seq_len, self.num_heads, self.head_dim)
# Transpose for attention computation
q = q.transpose(1, 2) # [batch_size, num_heads, seq_len, head_dim]
k = k.transpose(1, 2) # [batch_size, num_heads, seq_len, head_dim]
v = v.transpose(1, 2) # [batch_size, num_heads, seq_len, head_dim]
# Compute flash attention
output = self._flash_attention_forward(q, k, v, mask)
# Reshape and apply output projection
output = output.transpose(1, 2).reshape(batch_size, seq_len, self.num_heads * self.head_dim)
output = self.o_proj(output)
return output
실제로 플래시 어텐션 저장소 Dao-AILab/flash-attention에는 다양한 하드웨어 구성에 맞춘 여러 가지 구현이 있습니다. flash_attn_qkvpacked_func 함수는 FlashAttention-3 구현을 사용하는 방법을 보여 주는 최소한의 예제입니다. 이 함수는 패킹된 QKV 텐서를 입력으로 받아 어텐션 출력을 반환합니다.
import torch
from flash_attn import flash_attn_qkvpacked_func
# Minimal configuration
BATCH_SIZE, SEQ_LEN, NUM_HEADS, HEAD_DIM = 2, 64, 4, 32
CAUSAL = False
DTYPE = torch.float16
DEVICE = "cuda"
# Create dummy packed QKV tensor
# Shape: (batch_size, seq_len, 3, num_heads, head_dim)
qkv = torch.randn(
BATCH_SIZE,
SEQ_LEN,
3,
NUM_HEADS,
HEAD_DIM,
dtype=DTYPE,
device=DEVICE,
)
print(f"Input qkv shape: {qkv.shape}")
# Call FlashAttention packed QKV function
output = flash_attn_qkvpacked_func(
qkv,
dropout_p=0.0, # Set dropout probability (0.0 for no dropout)
causal=CAUSAL,
softmax_scale=None # Use default scaling (1 / sqrt(head_dim))
)
# Output shape: (batch_size, seq_len, num_heads, head_dim)
print(f"Output shape: {output.shape}")
print("FlashAttention call successful.")
링 어텐션
Ring Attention은 여러 GPU에서 셀프 어텐션을 블록 단위로 계산하여, 단일 장치로 처리하기에는 너무 긴 시퀀스의 학습과 추론을 가능하게 합니다. 이 방식은 표준 셀프 어텐션 메커니즘에 내재된 심각한 메모리 병목을 해결하며, 특히 전체 어텐션 점수 행렬의 이차 메모리 복잡도 를 감당할 수 없게 되는 매우 긴 시퀀스를 처리할 때 유용합니다.
핵심(Core) 아이디어는 개념적으로 링 토폴로지로 배열된 GPU와 같은 여러 처리 장치에 계산을 분산하는 것입니다. 이 방식에서는 어떤 단일 장치도 K와 V 텐서 전체를 보유할 필요가 없습니다. 대신 이 텐서들은 시퀀스 길이 차원을 따라 샤딩되거나 청크로 나뉘므로, 장치당 최대 메모리 요구량이 크게 줄어들고 개별 가속기의 메모리 용량을 초과했을 시퀀스에 대해서도 어텐션 계산이 가능해집니다.
실제 분산 구현에서 각 장치는 처음에 입력 시퀀스 중 자신이 맡은 구간에 해당하는 Q, K, V 샤드를 보유합니다. 어텐션 계산은 이 링 전체에서 동기화된 단계별로 진행됩니다. 각 단계에서 장치는 자신의 로컬 Q 샤드와 현재 보유한 K 샤드를 사용하여 부분 어텐션 점수를 계산합니다. 핵심 요소는 그다음에 이어지는 통신입니다. K와 V 샤드가 링의 다음 장치로 전달됩니다. 이 순환은 모든 Q 샤드가 모든 K/V 샤드와 상호작용할 때까지 반복됩니다. 이 과정 전반에 걸쳐 각 장치는 부분 출력(가중된 V 벡터)과 정규화 인자(소프트맥스 분모)를 누적합니다. 어텐션 출력을 최종적으로 완성하려면 일반적으로 모든 장치에 걸친 집합 연산을 수행하여 시퀀스의 각 구간에 대해 이러한 부분 결과를 올바르게 결합해야 합니다.
아래의 Python 예제는 단일 장치에서 링 어텐션(Ring Attention) 로직을 시뮬레이션하여, 실제 멀티 GPU 하드웨어 없이도 그 기본 원리를 보여 줍니다. _simulate_ring_attention 함수는 가상의 샤드들을 순회하면서 분산 과정을 모방합니다. 각 반복에서 이 함수는 K와 V 텐서의 슬라이스(k_shard, v_shard)를 선택하여 특정 단계에서 한 장치가 처리할 데이터를 나타냅니다. 그런 다음 전체 Q 텐서(실제 분산 환경을 단순화한 것입니다)와 현재 k_shard 사이의 어텐션 점수를 계산합니다. 이 시뮬레이션은 반복 전반에 걸쳐 가중된 값과 소프트맥스 정규화 인자를 누적함으로써 링 방식의 본질을 효과적으로 포착하며, 이는 분산 환경에서 최종 정규화 단계가 출력을 만들어 내기 전에 부분 결과가 결합되는 방식을 그대로 반영합니다. 이 시뮬레이션은 계산 흐름을 보여 주지만, 당연히 실제 다중 장치 링 어텐션(Ring Attention) 구현이 제공하는 병렬성이나 메모리 절감 효과는 제공하지 않습니다.
class RingAttention(nn.Module):
def __init__(self, dim, num_heads, head_dim=64, dropout=0.0, num_shards=4):
super().__init__()
self.dim = dim
self.num_heads = num_heads
self.head_dim = head_dim
self.num_shards = num_shards
# Projections
self.q_proj = nn.Linear(dim, num_heads * head_dim)
self.k_proj = nn.Linear(dim, num_heads * head_dim)
self.v_proj = nn.Linear(dim, num_heads * head_dim)
self.o_proj = nn.Linear(num_heads * head_dim, dim)
self.dropout = nn.Dropout(dropout)
def _simulate_ring_attention(self, q, k, v, mask=None):
# This simulates ring attention without actual multi-GPU support
batch_size, num_heads, seq_len, head_dim = q.shape
scale = 1.0 / math.sqrt(head_dim)
# Compute shard sizes
shard_size = (seq_len + self.num_shards - 1) // self.num_shards
# Initialize outputs
output = torch.zeros_like(q)
normalizer = torch.zeros((batch_size, num_heads, seq_len, 1), device=q.device)
# Simulate sharded processing
for shard_idx in range(self.num_shards):
start_idx = shard_idx * shard_size
end_idx = min(start_idx + shard_size, seq_len)
# Process this shard's keys and values
if start_idx < seq_len:
k_shard = k[:, :, start_idx:end_idx]
v_shard = v[:, :, start_idx:end_idx]
# Compute attention scores
attn_scores = torch.matmul(q, k_shard.transpose(2, 3)) * scale
# Apply mask if provided
if mask is not None:
shard_mask = mask[:, :, :, start_idx:end_idx]
attn_scores = attn_scores.masked_fill(shard_mask == 0, -1e9)
# Apply softmax and dropout (accumulated over shards)
attn_probs = torch.softmax(attn_scores, dim=-1)
attn_probs = self.dropout(attn_probs)
# Update output and normalizer
output += torch.matmul(attn_probs, v_shard)
normalizer += attn_probs.sum(dim=-1, keepdim=True)
# Normalize the output
output = output / (normalizer + 1e-6)
return output
def forward(self, x, mask=None):
batch_size, seq_len, _ = x.shape
# Project queries, keys, values
q = self.q_proj(x).reshape(batch_size, seq_len, self.num_heads, self.head_dim)
k = self.k_proj(x).reshape(batch_size, seq_len, self.num_heads, self.head_dim)
v = self.v_proj(x).reshape(batch_size, seq_len, self.num_heads, self.head_dim)
# Transpose for attention computation
q = q.transpose(1, 2) # [batch_size, num_heads, seq_len, head_dim]
k = k.transpose(1, 2) # [batch_size, num_heads, seq_len, head_dim]
v = v.transpose(1, 2) # [batch_size, num_heads, seq_len, head_dim]
# Compute ring attention
output = self._simulate_ring_attention(q, k, v, mask)
# Reshape and apply output projection
output = output.transpose(1, 2).reshape(batch_size, seq_len, self.num_heads * self.head_dim)
output = self.o_proj(output)
return output
사전 정규화
사전 정규화(흔히 Pre-LN이라고 부릅니다)는 잔차 블록의 아키텍처 설계에 일어난 변화였습니다. 기존의 사후 정규화 방식처럼 정규화 레이어를 주요 연산(셀프 어텐션이나 피드포워드 네트워크 등) 뒤에 적용하는 대신, 사전 정규화는 이를 앞에 적용합니다. 사소해 보이는 이 변화는 학습 동역학에 중대한 영향을 미칩니다. 사전 정규화는 입력이 계산 집약적인 하위 레이어에 들어가기 전에 이를 정규화함으로써 네트워크를 통해 흐르는 활성화와 그래디언트를 안정화하는 데 도움을 줍니다. 이러한 안정화 효과는 매우 깊은 네트워크에서 특히 두드러지며, 그래디언트 소실이나 폭주 같은 문제를 완화하고 흔히 더 높은 학습률과 더 빠르고 안정적인 수렴을 가능하게 합니다.
잔차 블록 내의 일반적인 구현은 PreNorm 클래스에서 보여 주듯이 구조를 따릅니다. 여기서 는 블록의 입력이고, 은 레이어 정규화(LN)나 RMS 정규화(RMSNorm) 같은 정규화 함수를 나타내며, 는 주 변환 함수(예: 멀티헤드 어텐션 또는 위치별 피드포워드 네트워크)를 나타냅니다. 입력 는 먼저 정규화 레이어(예: self.norm(x))를 통과합니다. 그런 다음 정규화된 출력은 함수 fn에 의해 처리됩니다. 결정적으로, 이 함수의 출력은 잔차 연결을 통해 정규화되지 않은 원래 입력 에 다시 더해집니다. 이 구조는 항등 연결(+ x)을 통한 깨끗한 그래디언트 경로를 보장하므로, 정규화 레이어가 잔차 경로 자체에 놓이는 사후 정규화에 비해 학습 안정성을 한층 더 높여 줍니다.
class PreNorm(nn.Module):
def __init__(self, dim, fn, norm_type='layer'):
super().__init__()
self.fn = fn
if norm_type == 'layer':
self.norm = nn.LayerNorm(dim)
elif norm_type == 'rms':
self.norm = RMSNorm(dim)
else:
raise ValueError(f"Unknown normalization type: {norm_type}")
def forward(self, x, *args, **kwargs):
# Apply normalization first, then the function
return self.fn(self.norm(x), *args, **kwargs) + x
RMSNorm
RMSNorm(제곱평균제곱근 정규화)은 널리 사용되는 LayerNorm을 단순화한 것으로, 비슷한 성능을 유지하고 흔히 학습 안정성을 높이면서도 계산 오버헤드를 줄이도록 설계되었습니다. 평균을 빼서 활성화를 중심화한 다음 표준편차로 스케일링하는 LayerNorm과 달리, RMSNorm은 평균 중심화 단계를 완전히 생략합니다. 이러한 단순화의 동기는 LayerNorm의 재중심화 연산이 계산 비용의 상당 부분을 차지하며, 이를 제거해도 모델 성능이 크게 저하되지 않는 경우가 많고 때로는 오히려 도움이 되기도 한다는 경험적 관찰에서 비롯되었습니다. RMSNorm은 오직 입력을 제곱평균제곱근 크기에 따라 다시 스케일링하는 방식으로만 동작합니다.
RMSNorm의 핵심(Core) 메커니즘은 한 레이어 내의 활성화 값을 특성(또는 지정된 차원) 전체에 걸쳐 계산한 제곱평균제곱근 값으로 나누어 정규화하는 것입니다. 입력 벡터 에 대해 RMS 값은 로 계산됩니다. 그러면 정규화된 출력 는 이 되며, 여기서 은 수치적 안정성을 위한 작은 상수입니다. LayerNorm과 마찬가지로 RMSNorm은 일반적으로 학습 가능한 스케일링 매개변수 를 포함하며(때로는 편향 도 포함하지만, 원래 공식은 단순화 원칙에 더 충실하기 위해 이를 생략하는 경우가 많습니다), 그 결과 최종 출력은 가 됩니다. 평균 계산을 생략함으로써 RMSNorm은 계산량(설정에 따라 GPU에서 LayerNorm보다 7-64% 빠른 것으로 추정됩니다)과 메모리 사용량을 줄여 주므로, 특히 효율성이 무엇보다 중요한 대규모 모델에서 매력적인 대안이 됩니다.
class RMSNorm(nn.Module):
def __init__(self, dim, eps=1e-8, elementwise_affine=True):
super().__init__()
self.eps = eps
self.elementwise_affine = elementwise_affine
if elementwise_affine:
self.weight = nn.Parameter(torch.ones(dim))
else:
self.register_parameter('weight', None)
def forward(self, x):
# Calculate root mean square along the last dimension
rms = torch.sqrt(torch.mean(x ** 2, dim=-1, keepdim=True) + self.eps)
# Normalize by RMS
x_normalized = x / rms
# Apply scaling if using learnable parameters
if self.elementwise_affine:
x_normalized = x_normalized * self.weight
return x_normalized
SwiGLU
SwiGLU는 게이트 선형 유닛(Gated Linear Unit, GLU) 계열에서 파생된 활성화 함수로, 신경망의 성능을 향상시키도록 특별히 설계되었습니다. GLU 변형들의 핵심(Core) 개념은 네트워크를 통과하는 정보의 흐름을 적응적으로 제어하는 게이팅 메커니즘을 도입하는 것입니다. 표준 피드포워드 계층은 일반적으로 입력의 선형 변환에 단일 비선형성을 적용합니다. 반면 GLU 기반 활성화 함수는 선형 레이어의 출력을 두 부분으로 나누며, 한 부분은 비선형성을 거친 뒤 “게이트” 역할을 하여 요소별 곱셈을 통해 다른 부분을 조절합니다. SwiGLU는 게이팅 부분에 적용되는 비선형성으로 Swish라고도 알려진 Sigmoid-weighted Linear Unit(SiLU)(, 여기서 는 시그모이드 함수입니다)를 사용한다는 점에서 차별화됩니다. 이러한 선택은 ReLU와 같은 다른 활성화 함수나 게이트에 시그모이드 또는 다른 함수를 사용하는 표준 GLU 변형에 비해 다양한 트랜스포머 기반 모델에서 상당한 성능 향상을 가져온다는 것이 실험적으로 입증되었습니다.
피드포워드 블록 내에서 SwiGLU의 작동 메커니즘은 일반적으로 두 개의 별도 선형 변환을 사용해 입력 를 사영하여 와 를 얻는 과정을 포함합니다. 그런 다음 SwiGLU 활성화는 로 계산되며, 여기서 는 요소별 곱셈을 나타냅니다. 사실상 입력은 두 개의 병렬 선형 경로를 통해 처리됩니다. 한 경로는 SiLU 활성화를 거쳐 게이트 값을 형성하고, 이 값이 두 번째 선형 경로의 출력을 스케일링합니다. 이러한 게이팅을 통해 네트워크는 입력 맥락에 따라 어떤 특성을 앞으로 전달할지 동적으로 제어할 수 있으며, 그 결과 더 단순한 활성화 함수에 비해 표현력이 높아지고 그래디언트 흐름이 개선됩니다. PaLM과 LLaMA 같은 모델에서의 성공은 언어 데이터 내의 복잡한 패턴을 포착하는 데 있어 SwiGLU의 효과를 잘 보여 줍니다.
class SwiGLU(nn.Module):
def __init__(self, dim_in, dim_hidden=None, dim_out=None, bias=True):
super().__init__()
dim_hidden = dim_hidden or 4 * dim_in
dim_out = dim_out or dim_in
# Linear transformations for gating
self.w1 = nn.Linear(dim_in, dim_hidden, bias=bias)
self.w2 = nn.Linear(dim_in, dim_hidden, bias=bias)
# Output projection
self.w3 = nn.Linear(dim_hidden, dim_out, bias=bias)
def forward(self, x):
# SwiGLU applies SiLU activation to one branch and gates it with the other
hidden1 = self.w1(x)
hidden2 = self.w2(x)
# SiLU (Swish) activation: x * sigmoid(x)
hidden1_act = hidden1 * torch.sigmoid(hidden1)
# Element-wise product for gating
hidden = hidden1_act * hidden2
# Output projection
return self.w3(hidden)
회전 위치 임베딩
회전 위치 임베딩(Rotary Positional Embedding, RoPE)은 트랜스포머 모델의 셀프 어텐션 메커니즘에 위치 정보를 직접 통합하는 우아한 방법을 제시하며, 특히 상대적 위치 의존성을 효과적으로 포착하도록 설계되었습니다. 기존 접근 방식은 흔히 입력 임베딩에 절대 위치 인코딩을 더하거나 어텐션 점수 계산 내에 복잡한 상대 위치 편향 항을 사용하는 방식에 의존합니다. RoPE는 위치 인코딩을 쿼리 벡터와 키 벡터의 내적을 계산하기 전에 이들 벡터에 적용하는 회전 연산으로 본다는 점에서 다른 길을 택합니다. 핵심 통찰은 위치 에 해당하는 Q 벡터와 위치 에 해당하는 K 벡터를 각각 과 에 비례하는 각도만큼 회전시키면, 그 결과로 얻는 내적이 본질적으로 상대적 위치 과 벡터 자체의 내용에만 의존하게 되어 벡터의 크기를 바꾸지 않고도 상대적 거리를 깔끔하게 인코딩한다는 것입니다.
핵심(Core) 수학적 아이디어는 복소수 곱셈의 성질, 또는 이와 동등하게 2D 회전 행렬의 성질을 활용합니다. 임베딩 차원의 쌍을 복소수로 표현한다고 상상해 보십시오. RoPE는 위치에 따라 달라지는 회전 행렬 과 을 사용하여 위치 의 쿼리 벡터 과 위치 의 키 벡터 에 각각 회전을 적용합니다. 이 행렬들은 사실상 차원 쌍으로 생성되는 2D 부분 공간에서 벡터를 회전시킵니다. 각 2D 부분 공간의 회전 각도는 절대 위치( 또는 )에 주파수 항 를 곱하여 결정되며, 이 주파수 항은 사인파 임베딩과 유사하게 차원이 높을수록 감소합니다. 결정적인 성질은 회전된 벡터 간의 내적 이 원래 벡터 과 상대적 거리에 해당하는 회전 행렬 에만 의존하도록 단순화된다는 것이며, 이를 통해 상대적 위치 정보가 어텐션 점수 계산에 직접 임베딩됩니다.
실제로 이 회전은 명시적인 행렬 곱셈 없이 효율적으로 구현됩니다. apply_rotary_pos_emb 함수에서 볼 수 있듯이, 임베딩 차원은 보통 두 개씩 쌍으로 나뉩니다. 각 쌍 에 대해, 위치 과 주파수 (RotaryEmbedding 클래스의 inv_freq에서 도출됨)에 해당하는 회전이 삼각함수를 사용해 적용됩니다. 즉, 새로운 쌍 은 가 됩니다. RotaryEmbedding 클래스는 시퀀스 길이와 역주파수 대역(inv_freq)을 바탕으로 필요한 코사인 값과 사인 값(cos, sin)을 미리 계산합니다. 역주파수 대역은 기준값(base)과 임베딩 차원(dim)에서 도출됩니다. 이렇게 미리 계산된 값은 모든 위치 과 관련 주파수 에 대한 와 를 나타냅니다.
RoPE를 적용하려면 주어진 시퀀스 길이에 대해 이 cos 및 sin 임베딩을 생성한 다음, 초기 선형 사영 이후이면서 어텐션 점수 계산 이전에 이를 사용해 Q 벡터와 K 벡터를 헤드 차원에 걸쳐 쌍 단위로 변환합니다. 이 방법에는 여러 장점이 있습니다. 상대 위치를 자연스럽게 인코딩하고, 단어 임베딩에 위치 정보를 직접 더하지 않으며(그 결과 더 많은 의미 정보를 보존할 수 있습니다), 학습 중에 본 것보다 긴 시퀀스 길이에도 잘 일반화되는 등 실험적으로 뛰어난 성능을 보여 왔습니다. RoPE는 회전을 통해 위치 정보를 통합함으로써 문맥을 고려한 시퀀스 모델링을 위한 계산 효율적이고 효과적인 메커니즘을 제공합니다.
class RotaryEmbedding(nn.Module):
def __init__(self, dim, base=10000, interleaved=False):
super().__init__()
self.dim = dim
self.base = base
self.interleaved = interleaved
# Generate inverse frequency bands
inv_freq = 1.0 / (base ** (torch.arange(0, dim, 2).float() / dim))
self.register_buffer('inv_freq', inv_freq)
def forward(self, seq_len, device=None):
# Get device from buffer if not specified
if device is None:
device = self.inv_freq.device
# Generate position indices
positions = torch.arange(seq_len, device=device).float()
# Compute sinusoidal patterns
freqs = torch.outer(positions, self.inv_freq)
# Get sine and cosine embeddings
emb = torch.cat((freqs, freqs), dim=-1)
cos = torch.cos(emb)[:, :self.dim]
sin = torch.sin(emb)[:, :self.dim]
return cos, sin
def apply_rotary_pos_emb(q, k, cos, sin, interleaved=False):
# Apply rotary embeddings to queries and keys
batch_size, num_heads, seq_len, head_dim = q.shape
cos = cos.reshape(1, 1, seq_len, cos.shape[-1]) # [1, 1, seq_len, dim/2]
sin = sin.reshape(1, 1, seq_len, sin.shape[-1]) # [1, 1, seq_len, dim/2]
# Split queries and keys for rotation
half_dim = head_dim // 2
q1, q2 = q[..., :half_dim], q[..., half_dim:]
k1, k2 = k[..., :half_dim], k[..., half_dim:]
# Apply rotation using half-dim rotary embeddings
q_rotated = torch.cat([
q1 * cos - q2 * sin,
q2 * cos + q1 * sin
], dim=-1)
k_rotated = torch.cat([
k1 * cos - k2 * sin,
k2 * cos + k1 * sin
], dim=-1)
return q_rotated, k_rotated
전문가 혼합(Mixture of Experts)
전문가 혼합(Mixture of Experts, 줄여서 MoE)은 추론이나 학습 시 계산 비용을 비례적으로 크게 늘리지 않으면서 신경망의 매개변수 수, 그리고 그에 따른 잠재적 용량을 크게 늘리도록 설계된 모델 아키텍처입니다. 핵심(Core) 아이디어는 트랜스포머의 피드포워드 네트워크 블록처럼 계산 비용이 큰 구성 요소를 여러 개의 더 작은 “전문가(expert)” 네트워크로 대체하는 것입니다. 중요한 점은 모든 전문가가 모든 입력 토큰을 처리하지는 않는다는 것입니다. 대신 가벼운 “라우터(router)” 또는 “게이팅(gating)” 네트워크가 각 입력 토큰의 특징을 바탕으로 해당 토큰을 처리하기에 가장 적합하다고 판단되는 소수의 전문가(보통 한두 개뿐이며, 이를 top-k 라우팅이라고 합니다)를 동적으로 선택합니다. 이러한 조건부 계산 덕분에 MoE 모델은 잠재적으로 수조 개의 매개변수를 가지면서도 주어진 입력에 대해서는 그중 극히 일부만 활성화하므로, 비슷한 크기의 밀집 모델에 비해 FLOPs를 감당 가능한 수준으로 유지합니다.
라우터 네트워크가 핵심(Core) 아이디어이며, 학습된 의사 결정자 역할을 합니다. 라우터는 입력 토큰의 표현을 받아 사용 가능한 각 전문가가 해당 토큰에 얼마나 적합한지를 나타내는 점수 또는 로짓을 생성합니다. 예제 코드의 _compute_routing_weights 함수에서는 이 로짓을 흔히 top-k 함수로 처리하여 점수가 가장 높은 k개의 전문가를 식별합니다. 그런 다음 선택된 전문가들의 점수는 보통 소프트맥스 함수를 사용해 정규화되어 라우팅 가중치가 됩니다. 이 가중치는 선택된 각 전문가가 해당 토큰의 최종 출력에 얼마나 기여하는지를 결정합니다. 학습 중에는 탐색을 장려하고 라우터가 초기에 소수의 전문가만 항상 선호하는 상태로 붕괴하는 것을 막기 위해 라우터 로짓에 노이즈를 추가할 수 있습니다(noise_std에서 볼 수 있습니다).
라우터가 주어진 입력 토큰에 대해 top-k 전문가를 선택하고 각각의 가중치를 계산하면, 해당 토큰은 선택된 전문가들에게만 전달됩니다. 선택된 각 전문가 네트워크(experts ModuleList에서 볼 수 있듯이 흔히 표준 FFN입니다)는 토큰을 독립적으로 처리합니다. 그런 다음 이렇게 활성화된 전문가들이 생성한 출력을 결합하여 해당 토큰의 최종 출력을 만듭니다. 이 결합은 보통 가중합으로, 선택된 각 전문가의 출력에 라우터가 계산한 해당 라우팅 가중치를 곱합니다. 예를 들어 전문가 i와 j가 가중치 w_i와 w_j로 선택되었다면, 토큰 x의 최종 출력은 w_i * expert_i(x) + w_j * expert_j(x)가 됩니다. 이를 통해 최종 표현에 가장 관련성 높은 전문가들의 특화된 지식이 반영됩니다.
MoE 모델 학습의 과제 중 하나는 모든 전문가가 효과적으로 활용되도록 하는 것입니다. 그렇지 않으면 라우터가 소수의 “인기 있는” 전문가에게 계속 과부하를 주도록 학습하고, 나머지 전문가는 충분히 발달하지 못할 수 있습니다. 이를 방지하기 위해 _compute_balance_loss 메서드에서 보여 주듯이, 보통 보조 부하 분산 손실(auxiliary load balancing loss)을 학습 목표에 포함합니다. 이 손실은 흔히 각 전문가에게 할당된 토큰 수나 각 전문가로 향하는 라우팅 가중치 합의 불균형에 페널티를 부여함으로써, 라우터가 계산 부하(즉, 입력 토큰)를 사용 가능한 모든 전문가에게 더 고르게 분배하도록 유도합니다. MoE는 라우팅을 통한 희소 활성화를 성공적으로 구현하고 부하 분산을 통합함으로써, 매우 크면서도 계산 효율적인 모델을 구축할 수 있게 합니다.
class MixtureOfExperts(nn.Module):
def __init__(self, input_dim, hidden_dim, output_dim, num_experts=4, top_k=2, noise_std=1.0):
super().__init__()
self.input_dim = input_dim
self.hidden_dim = hidden_dim
self.output_dim = output_dim
self.num_experts = num_experts
self.top_k = min(top_k, num_experts)
self.noise_std = noise_std
# Create experts
self.experts = nn.ModuleList([
nn.Sequential(
nn.Linear(input_dim, hidden_dim),
nn.ReLU(),
nn.Linear(hidden_dim, output_dim)
) for _ in range(num_experts)
])
# Router network
self.router = nn.Linear(input_dim, num_experts)
# Save expert counts and loads for balancing loss
self.register_buffer('expert_counts', torch.zeros(num_experts))
def _compute_routing_weights(self, x):
# Calculate routing weights
routing_logits = self.router(x) # [batch_size, seq_len, num_experts]
# Add noise during training to encourage exploration
if self.training and self.noise_std > 0:
noise = torch.randn_like(routing_logits) * self.noise_std
routing_logits = routing_logits + noise
# Get top-k experts for each token
routing_weights, selected_experts = torch.topk(routing_logits, self.top_k, dim=-1)
# Normalize the routing weights with softmax
routing_weights = F.softmax(routing_weights, dim=-1)
return routing_weights, selected_experts
def _compute_balance_loss(self, selected_experts, routing_weights):
# Compute auxiliary load balancing loss
batch_size, seq_len, _ = selected_experts.shape
# Compute probability of each expert being selected across batch
expert_mask = torch.zeros(batch_size, seq_len, self.num_experts, device=selected_experts.device)
# For each position in selected_experts, increment the corresponding expert index
for k in range(self.top_k):
expert_mask.scatter_(-1, selected_experts[..., k:k+1], routing_weights[..., k:k+1])
# Compute mean routing probability per expert
expert_routing_probs = expert_mask.mean(dim=[0, 1])
# Compute load balancing loss (all experts should receive equal probability)
target_probs = torch.ones_like(expert_routing_probs) / self.num_experts
balance_loss = F.mse_loss(expert_routing_probs, target_probs) * self.num_experts
return balance_loss
def forward(self, x):
batch_size, seq_len, _ = x.shape
# Compute routing weights and selected experts
routing_weights, selected_experts = self._compute_routing_weights(x)
# Prepare output
output = torch.zeros(batch_size, seq_len, self.output_dim, device=x.device)
# Dispatch to selected experts
for k in range(self.top_k):
# Extract the current expert indices and weights
expert_indices = selected_experts[..., k] # [batch_size, seq_len]
expert_weights = routing_weights[..., k].unsqueeze(-1) # [batch_size, seq_len, 1]
# Dispatch to each expert
for expert_idx in range(self.num_experts):
# Find tokens assigned to this expert
mask = (expert_indices == expert_idx)
if mask.any():
# Gather input tokens assigned to this expert
expert_inputs = x[mask]
# Process with the expert
expert_outputs = self.experts[expert_idx](expert_inputs)
# Scatter outputs back with appropriate weights
output[mask] += expert_outputs * expert_weights[mask]
# Update expert counts (for monitoring)
self.expert_counts[expert_idx] += mask.sum().item()
# Compute auxiliary load balancing loss
balance_loss = self._compute_balance_loss(selected_experts, routing_weights)
# Return output and auxiliary loss
return output, balance_loss
학습률 워밍업
학습률 워밍업은 신경망 훈련 초기 단계에서 안정성을 높이고 발산을 막기 위해 널리 쓰이는 휴리스틱입니다. 훈련을 시작할 때 모델 매개변수는 보통 무작위로 초기화되므로 최적의 구성과는 거리가 먼 경우가 많습니다. 처음부터 비교적 큰 학습률을 사용하면, 초기 그래디언트 역시 크고 불규칙할 수 있어 매개변수가 급격하게 갱신될 수 있습니다. 그 결과 모델이 손실 지형의 나쁜 영역으로 밀려나거나 수치적 불안정성(예: 손실 폭발)이 생길 수도 있습니다. 학습률 워밍업은 매우 작은 학습률로 학습 과정을 시작하고, 미리 정해진 수의 초기 학습 스텝(“워밍업 스텝”) 동안 학습률을 점진적으로 높여 목표 기본값에 도달하게 함으로써 이러한 위험을 완화하며, 그 시점부터 표준 학습률 스케줄(예: 감쇠)이 시작될 수 있습니다.
이 방식은 워밍업 단계 동안 기본 학습률에 곱하는 배율을 점진적으로 키우는 것입니다. 흔히 쓰이는 전략은 선형 워밍업이며, LinearWarmupScheduler 클래스가 그 예를 보여 줍니다. 이 방식에서 스텝 의 학습률 는 일 때 로 계산합니다. 여기서 는 목표 기본 학습률이고 은 전체 워밍업 스텝 수입니다. get_lr 메서드에서 볼 수 있듯이, 배율 인자 scale은 warmup_steps 동안 0에 가까운 값에서 1까지 선형으로 증가합니다. 스텝 수 last_epoch가 warmup_steps에 도달하면 학습률은 base_lrs와 같아지고 워밍업 단계가 끝납니다. 이처럼 완만하게 높여 가면 활성화 값과 그래디언트가 불안정해지기 쉬운 중요한 초기 단계에서 모델이 점진적으로 적응할 수 있습니다. 그 결과 수렴이 더 매끄러워지고, 훈련 후반에 더 높은 기본 학습률을 사용할 수 있는 경우가 많습니다.
class LinearWarmupScheduler(_LRScheduler):
def __init__(self, optimizer, warmup_steps, last_epoch=-1):
self.warmup_steps = warmup_steps
super().__init__(optimizer, last_epoch)
def get_lr(self):
if self.last_epoch < self.warmup_steps:
# During warmup: linearly increase from 0 to base LR
scale = float(self.last_epoch + 1) / float(max(1, self.warmup_steps))
return [base_lr * scale for base_lr in self.base_lrs]
else:
# After warmup: use base learning rate
return self.base_lrs
코사인 스케줄
코사인 스케줄링(코사인 어닐링이라고도 합니다)은 학습률 스케줄 기법의 하나입니다. 이 기법의 핵심(Core) 원리는 학습 과정 전반에 걸쳐 코사인 곡선의 형태를 따라 학습률을 점진적으로 낮추는 것입니다. 특정 에폭에서 학습률을 갑자기 낮추는 스텝 감쇠 스케줄과 달리, 코사인 어닐링은 학습률을 매끄럽고 연속적으로 낮춥니다. 일반적으로 학습률은 높은 초깃값에서 시작하여 코사인 함수의 첫 반주기를 따라 감소하며, 마지막 훈련 스텝에서 미리 정한 최솟값(대개 0에 가까운 값)에 도달합니다. 이러한 매끄러운 감쇠는 최적화 과정에 도움이 된다는 것이 경험적으로 확인되었습니다. 훈련 초기에는 큰 스텝으로 손실 지형을 폭넓게 탐색하고, 후반으로 갈수록 스텝을 점점 줄여 미세 조정하면서 좋은 최솟값으로 수렴할 수 있기 때문입니다.
훈련 초기에는 학습률이 높을수록 더 빠르게 탐색할 수 있고, 나쁜 지역 최솟값에서 벗어나기도 쉽습니다. 훈련이 진행되어 모델 매개변수가 더 최적에 가까운 영역에 다가가면, 최솟값을 지나쳐 버리지 않고 더 정밀하게 수렴하도록 학습률을 낮추는 것이 매우 중요해집니다. 코사인 함수가 만드는 스케줄은 처음에는 감쇠 속도가 비교적 느리므로, 옵티마이저가 초기에 모멘텀을 유지할 수 있습니다. 이후 감쇠 속도는 스케줄 중반으로 갈수록 빨라졌다가, 최소 학습률에 가까워지면서 다시 느려집니다. 훈련 막바지의 이 마지막 감속 단계는 특히 중요합니다. 옵티마이저가 평탄할 가능성이 있는 최솟값에 조심스럽게 안착할 수 있게 해 주기 때문이며, 경험적 증거에 따르면 이러한 최솟값은 날카로운 최솟값보다 일반화 성능이 더 좋은 경우가 많습니다.
또한 코드 예제에서 볼 수 있듯이, 코사인 스케줄링은 흔히 “워밍업” 단계와 함께 사용합니다. 이 초기 단계(예: warmup_steps) 동안 학습률은 보통 아주 작은 값(또는 0)에서 주 초기 학습률까지 선형으로 증가합니다. 이 워밍업 기간은 훈련 맨 처음의 안정화에 도움이 됩니다. 특히 대규모 모델이나 데이터셋에서는 무작위로 초기화된 가중치에 큰 초기 학습률을 적용하면 불안정해지거나 발산할 수 있기 때문입니다. 워밍업이 끝나면 코사인 감쇠 단계가 시작되어, 남은 total_steps - warmup_steps 동안 학습률을 최댓값에서 목표 최솟값(base_lr * min_lr_ratio)까지 매끄럽게 낮춥니다. 이처럼 완만한 시작(워밍업)과 이론적 근거가 있는 매끄러운 감쇠(코사인 어닐링)를 결합하면 견고하고 효과적인 학습률 전략이 됩니다. 이 전략은 스텝 기반 스케줄보다 하이퍼파라미터 튜닝이 덜 필요한 경우가 많고, 모델 정확도를 높이는 경우도 많습니다.
PyTorch에는 이 기법을 구현한 CosineScheduler가 있습니다. 이를 단순화한 버전을 살펴봅시다:
class CosineAnnealingWarmupScheduler(_LRScheduler):
def __init__(self, optimizer, warmup_steps, total_steps, min_lr_ratio=1e-4, last_epoch=-1):
self.warmup_steps = warmup_steps
self.total_steps = total_steps
self.min_lr_ratio = min_lr_ratio
super().__init__(optimizer, last_epoch)
def get_lr(self):
if self.last_epoch < self.warmup_steps:
# During warmup: linearly increase from 0 to base LR
scale = float(self.last_epoch + 1) / float(max(1, self.warmup_steps))
return [base_lr * scale for base_lr in self.base_lrs]
else:
# After warmup: cosine decay from base LR to min_lr
progress = float(self.last_epoch - self.warmup_steps) / float(
max(1, self.total_steps - self.warmup_steps)
)
# Cosine decay formula: min_lr + 0.5 * (base_lr - min_lr) * (1 + cos(pi * progress))
scale = self.min_lr_ratio + 0.5 * (1.0 - self.min_lr_ratio) * (
1.0 + math.cos(math.pi * progress)
)
return [base_lr * scale for base_lr in self.base_lrs]
AdamW 옵티마이저
AdamW(Adam with Decoupled Weight Decay)는 Adam과 같은 적응형 옵티마이저에서 가중치 감쇠(L2 정규화)를 구현하는 표준 방식에 숨어 있는 미묘한 문제를 해결합니다. 이 개선된 옵티마이저를 사용하면 가중치 감쇠가 모멘텀에도 분산에도 누적되지 않습니다. 기존 Adam에서는 이동 평균(와 )을 계산하기 전에 감쇠 항()을 그래디언트에 직접 더하는 방식으로 L2 정규화를 구현하는 경우가 많습니다. 그러나 이렇게 하면 가중치 감쇠 효과가 그래디언트 모멘트에서 도출되는 적응형 학습률과 결합됩니다. 그 결과, 과거에 큰 그래디언트를 가졌던(따라서 값이 더 큰) 매개변수는 실질적인 가중치 감쇠를 더 적게 받게 되며, 이는 균일한 정규화 압력을 적용한다는 목표에 어긋납니다. AdamW는 이 두 과정을 분리합니다. 즉, 표준 Adam 업데이트는 순수하게 그래디언트만을 기반으로 수행하고, 가중치 감쇠 단계는 별도로 가중치에 직접 적용합니다. 이를 통해 가중치가 그래디언트 이력과 무관하게 자신의 크기에 비례하여 감쇠하는 L2 정규화 본래의 동작을 사실상 되살립니다.
AdamW의 Core 업데이트 메커니즘은 대체로 표준 Adam 절차를 따르지만, 가중치 감쇠를 적용하는 방식을 수정합니다. 매개변수 에 대한 각 스텝 에서, 먼저 편향된 1차 모멘트 추정값 와 편향된 2차 원시 모멘트 추정값 를 계산합니다. 여기서 는 스텝 에서의 그래디언트이고, , 는 지수 감쇠율입니다. 그런 다음 이 값들의 편향을 보정합니다: , . 결정적인 차이는 업데이트 규칙에 있습니다. AdamW는 가중치 감쇠를 에 포함하는 대신, 먼저 매개변수에 가중치 감쇠를 직접 적용합니다: . 여기서 은 학습률이고 는 weight_decay 계수입니다(p.data.mul_(1 - group['lr'] * group['weight_decay']) 줄에서 볼 수 있습니다). 그런 다음 편향 보정된 모멘트를 사용하는 표준 Adam 업데이트를 이렇게 감쇠된 가중치에 적용합니다: . 이는 이미 감쇠된 p.data에 대해 동작하는 코드 줄 p.data.addcdiv_(exp_avg, denom, value=-step_size)에 해당합니다.
딥러닝 실무에서 AdamW는 Adam과 비슷한 방식으로 사용됩니다. 모델의 매개변수와 함께 학습률(), 베타 값(, ), 엡실론(), 가중치 감쇠 계수() 같은 주요 하이퍼파라미터를 제공하여 인스턴스를 생성합니다. 일반적으로 학습 루프 안에서 그래디언트를 계산한 후(loss.backward()) 호출되는 step() 메서드는 각 매개변수에 대해 위에서 설명한 업데이트 로직을 실행합니다. 가장 큰 장점은 일반화 성능이 향상된다는 점이며, 이는 정규화가 중요한 Transformer 같은 대형 모델을 학습할 때 특히 두드러집니다. AdamW는 가중치 감쇠의 강도가 적응형 학습률 스케일링과 무관하도록 보장하므로 하이퍼파라미터(특히 과 )를 더 잘 튜닝할 수 있는 경우가 많으며, L2 정규화를 적용한 표준 Adam에 비해 처음 보는 데이터에서 더 나은 성능을 내는 모델로 이어질 수 있습니다.
PyTorch에는 고도로 최적화된 AdamW 구현이 있습니다. 이를 단순화한 버전을 살펴봅시다. 아래 예제는 최소한의 PyTorch 구현으로, 상태 변수(exp_avg, exp_avg_sq 등)를 초기화하고 매개변수 루프 안에서 분리된 가중치 감쇠와 모멘트 기반 업데이트를 수행하는 과정을 보여 줍니다.
class AdamW(Optimizer):
def __init__(self, params, lr=1e-3, betas=(0.9, 0.999), eps=1e-8,
weight_decay=1e-2, amsgrad=False):
defaults = dict(lr=lr, betas=betas, eps=eps,
weight_decay=weight_decay, amsgrad=amsgrad)
super(AdamW, self).__init__(params, defaults)
def step(self, closure=None):
loss = None
if closure is not None:
loss = closure()
for group in self.param_groups:
for p in group['params']:
if p.grad is None:
continue
# Get gradient
grad = p.grad.data
if grad.is_sparse:
raise RuntimeError('AdamW does not support sparse gradients')
amsgrad = group['amsgrad']
state = self.state[p]
# State initialization
if len(state) == 0:
state['step'] = 0
# Exponential moving average of gradient values
state['exp_avg'] = torch.zeros_like(p.data)
# Exponential moving average of squared gradient values
state['exp_avg_sq'] = torch.zeros_like(p.data)
if amsgrad:
# Maintains max of all exp. moving avg. of sq. grad. values
state['max_exp_avg_sq'] = torch.zeros_like(p.data)
exp_avg, exp_avg_sq = state['exp_avg'], state['exp_avg_sq']
if amsgrad:
max_exp_avg_sq = state['max_exp_avg_sq']
beta1, beta2 = group['betas']
state['step'] += 1
# Decay the first and second moment running average coefficient
exp_avg.mul_(beta1).add_(grad, alpha=1 - beta1)
exp_avg_sq.mul_(beta2).addcmul_(grad, grad, value=1 - beta2)
if amsgrad:
# Maintains the maximum of all 2nd moment running avg. till now
torch.maximum(max_exp_avg_sq, exp_avg_sq, out=max_exp_avg_sq)
# Use the max. for normalizing running avg. of gradient
denom = max_exp_avg_sq.sqrt().add_(group['eps'])
else:
denom = exp_avg_sq.sqrt().add_(group['eps'])
bias_correction1 = 1 - beta1 ** state['step']
bias_correction2 = 1 - beta2 ** state['step']
step_size = group['lr'] * math.sqrt(bias_correction2) / bias_correction1
# Apply weight decay BEFORE the optimization step
if group['weight_decay'] != 0:
p.data.mul_(1 - group['lr'] * group['weight_decay'])
# Update parameters
p.data.addcdiv_(exp_avg, denom, value=-step_size)
return loss
멀티 토큰 예측
멀티 토큰 예측은 자기회귀 언어 모델의 추론 속도를 높이기 위해 개발된 기법입니다. 일반적으로 자기회귀 생성은 토큰을 하나씩 예측합니다. 모델은 시퀀스를 입력받아 가장 가능성이 높은 다음 토큰 하나를 예측하고, 이를 시퀀스 뒤에 덧붙인 다음 이 과정을 반복합니다. 생성하는 토큰마다 모델의 순방향 패스를 한 번씩 온전히 거쳐야 하는 이러한 순차적 특성은 지연 시간에 민감한 애플리케이션에서 심각한 병목이 됩니다. 멀티 토큰 예측은 모델의 예측 헤드를 수정하여 현재 은닉 상태를 바탕으로 여러 미래 토큰의 확률을 동시에 출력하게 함으로써 이 문제를 극복하려 합니다. 이를 통해 주어진 길이의 시퀀스를 생성하는 데 필요한 순방향 패스 횟수를 줄입니다.
구현할 때는 보통 언어 모델의 마지막 층을 조정합니다. 멀티 토큰 예측기는 최종 은닉 상태를 다음 토큰에 대한 어휘 전체의 로짓으로 매핑하는 단일 출력 층(또는 “언어 모델 헤드”) 대신 여러 가지 전략을 사용할 수 있습니다. 한 가지 접근 방식은 별도의 헤드를 사용하는 예제 클래스에서 볼 수 있듯이, 서로 다른 미래 오프셋의 토큰을 예측하도록 각각 학습된 여러 개의 독립적인 예측 헤드를 두는 것입니다(예: 토큰 을 위한 헤드, 를 위한 헤드, 이렇게 까지). 이 헤드들은 보통 같은 최종 은닉 상태(예: 토큰 에 해당하는 상태)를 입력으로 받지만, 각자 담당하는 시간 단계에 특화된 서로 다른 투영을 학습합니다. 또 다른 접근 방식은 하나의 공유 예측 헤드를 사용하는 것입니다. 이 경우 사실상 동일한 시작 표현으로부터 개의 미래 토큰 각각에 대해 서로 다른 확률 분포를 생성해야 하므로, 은닉 상태의 학습된 변환이나 위치 정보 통합 같은 더 복잡한 메커니즘이 필요할 수 있습니다.
다중 토큰 예측기를 학습시킨다는 것은 앞선 문맥이 주어졌을 때 뒤따르는 개 토큰의 시퀀스를 정확히 예측하도록 모델을 가르치는 것입니다. 학습 단계에서는 compute_loss 메서드에서 볼 수 있듯이, 모델이 입력 시퀀스를 받고, 다음 개 토큰에 대한 모델의 예측을 학습 데이터에 있는 실제 개 목표 토큰과 비교합니다. 손실 함수(보통 교차 엔트로피)는 예측된 각 위치(부터 까지)마다 계산된 뒤 집계(예: 평균)되어 역전파에 사용되는 최종 손실 신호를 이룹니다.
이 방식은 속도 향상을 보여 줄 수 있지만, 다중 토큰 예측에는 몇 가지 단점이 있습니다. 더 먼 미래의 토큰일수록 예측 정확도가 떨어지는 경향이 있으며, 선택된 개 토큰의 시퀀스가 단일 토큰 생성이었다면 택했을 최적 경로에서 벗어날 수 있습니다. 따라서 이는 흔히 생성 속도와 잠재적인 품질 저하 사이의 트레이드오프이며, 그 균형은 사용 사례에 크게 좌우됩니다.
class MultiTokenPredictor(nn.Module):
def __init__(self, hidden_dim, vocab_size, num_predicted_tokens=2, shared_prediction_head=False):
super().__init__()
self.hidden_dim = hidden_dim
self.vocab_size = vocab_size
self.num_predicted_tokens = num_predicted_tokens
self.shared_prediction_head = shared_prediction_head
if shared_prediction_head:
# Share the same prediction head for all positions
self.lm_head = nn.Linear(hidden_dim, vocab_size)
else:
# Use separate prediction heads for each position
self.lm_heads = nn.ModuleList([
nn.Linear(hidden_dim, vocab_size)
for _ in range(num_predicted_tokens)
])
def forward(self, hidden_states):
batch_size, seq_len, _ = hidden_states.shape
# Get the hidden states for the last token
last_hidden = hidden_states[:, -1]
if self.shared_prediction_head:
# Use the shared head for all predictions
logits = self.lm_head(last_hidden)
next_token_logits = logits.unsqueeze(1)
# For positions beyond the first, we need to make a projection
multi_token_logits = []
for i in range(self.num_predicted_tokens):
if i == 0:
multi_token_logits.append(logits)
else:
# A simple projection for demonstration; in practice, this would be more complex
projected_hidden = last_hidden + i * 0.1 # Just a dummy transformation
multi_token_logits.append(self.lm_head(projected_hidden))
multi_token_logits = torch.stack(multi_token_logits, dim=1)
else:
# Use separate heads for each position
multi_token_logits = torch.stack([
head(last_hidden) for head in self.lm_heads
], dim=1)
# The first position is used for next-token prediction
next_token_logits = multi_token_logits[:, 0:1]
return next_token_logits, multi_token_logits
def compute_loss(self, hidden_states, labels, ignore_index=-100):
# Get predictions
_, multi_token_logits = self.forward(hidden_states)
# Prepare targets: shift labels to align with predictions
# We need the next num_predicted_tokens tokens after the input
shifted_labels = labels[:, :-self.num_predicted_tokens]
targets = []
for i in range(self.num_predicted_tokens):
targets.append(labels[:, 1+i:1+i-self.num_predicted_tokens+1])
# Stack targets
stacked_targets = torch.stack(targets, dim=1)
# Compute loss across all predicted positions
loss = 0
for i in range(self.num_predicted_tokens):
loss += F.cross_entropy(
multi_token_logits[:, i].view(-1, self.vocab_size),
stacked_targets[:, i].reshape(-1),
ignore_index=ignore_index
)
return loss / self.num_predicted_tokens
추측 디코딩
추측 디코딩(speculative decoding)은 대규모 자기회귀 언어 모델의 추론 과정을 가속하도록 고안된 영리한 기법으로, 텍스트 생성에 필요한 실제 경과 시간을 크게 줄여 줍니다. 표준 생성 방식은 순차적 특성 때문에 병목이 발생하는데, 계산 비용이 큰 대형 모델(“목표” 모델)이 한 번에 토큰 하나를 예측하기 위해 전체 순방향 패스를 수행해야 하기 때문입니다. 추측 디코딩은 훨씬 작고 빠른 보조 모델인 “초안” 모델을 도입합니다. 이 초안 모델은 앞으로 나올 후보 토큰들의 짧은 시퀀스(“초안”)를 빠르게 생성합니다. 그런 다음 핵심(Core) 아이디어는 큰 목표 모델을 사용하여 이 초안 시퀀스 전체를 단 한 번의 병렬 순방향 패스로 검증하는 것입니다. 이를 통해 여러 토큰을 한꺼번에 수락할 수 있으므로, 목표 모델의 계산 비용을 생성된 여러 토큰에 걸쳐 분산시킬 수 있습니다.
이 메커니즘의 관건은 초안 모델의 예측과 목표 모델의 예측을 비교하는 데 있습니다. 초안 모델이 개 토큰의 시퀀스 를 제안하면, 원래 입력 시퀀스에 초안을 이어 붙인 것에 대해 목표 모델을 한 번 실행합니다. 이 한 번의 패스로 초안 시퀀스 내 각 위치에서의 다음 토큰에 대한 목표 모델의 확률 분포를 얻습니다. 각 초안 토큰 에 대해, 같은 위치에서의 목표 모델의 예측과 대조하여 그 타당성을 확인합니다. 목표 모델이 초안 토큰에 강하게 동의하면(예: 목표 모델도 를 높은 확률로 예측했을 경우, 또는 와 를 비교하는 특정 수락 규칙에 따라) 해당 토큰이 수락됩니다. 이 검증은 초안을 따라 순차적으로 진행됩니다.
이 과정은 개의 초안 토큰이 모두 수락되거나 어떤 초안 토큰 가 거부될 때까지 계속됩니다. 위치 에서 거부가 발생하면, 그 앞에서 수락된 초안 토큰()은 모두 유지됩니다. 초안의 나머지 부분()은 폐기됩니다. 중요한 점은, 위치 에서 계산된 목표 모델의 확률 분포를 사용해 수락된 시퀀스 뒤에 덧붙일 보정된 토큰을 샘플링할 수 있다는 것이며, 이를 통해 전체 생성 결과가 통계적으로 더 강력한 목표 모델의 분포를 따르도록 보장합니다. 이 보정된 토큰은 앞서 수락된 토큰들과 함께 다음 회차 초안 생성의 입력이 됩니다. 목표 모델의 추론 단계마다 평균적으로 여러 토큰을 수락함으로써, 추측 디코딩은 생성된 텍스트의 품질에 미치는 영향을 최소화하면서 상당한 속도 향상(예: 2~3배)을 달성할 수 있습니다.
class SimpleSpeculativeDecoding:
def __init__(self, target_model, draft_model, tokenizer, max_draft_tokens=5):
self.target_model = target_model
self.draft_model = draft_model
self.tokenizer = tokenizer
self.max_draft_tokens = max_draft_tokens
def generate(self, prompt, max_length=100):
# Start with the prompt's token IDs
input_ids = self.tokenizer.encode(prompt, return_tensors="pt")
# Keep generating until we reach max_length or an end token
while input_ids.shape[1] < max_length:
# Step 1: Generate multiple draft tokens
draft_input_ids = input_ids.clone()
draft_tokens = []
with torch.no_grad():
for _ in range(self.max_draft_tokens):
# Generate next token with draft model
outputs = self.draft_model(draft_input_ids)
next_token_logits = outputs.logits[:, -1, :]
next_token = torch.argmax(next_token_logits, dim=-1)
# Save the draft token
draft_tokens.append(next_token.item())
# Add to draft input
draft_input_ids = torch.cat([draft_input_ids, next_token.unsqueeze(0)], dim=1)
# Check for end token
if next_token.item() == self.tokenizer.eos_token_id:
break
# Step 2: Verify with target model
with torch.no_grad():
# Get target model probabilities for all tokens including drafts
verification_ids = torch.cat([input_ids, torch.tensor([draft_tokens]).to(input_ids.device)], dim=1)
target_outputs = self.target_model(verification_ids)
target_logits = target_outputs.logits[:, input_ids.shape[1]-1:]
# Convert to probabilities
target_probs = F.softmax(target_logits, dim=-1)
# Accept tokens until mismatch or all drafts accepted
accepted_tokens = []
for i, token_id in enumerate(draft_tokens):
# Check if target model agrees with draft
target_prob = target_probs[0, i, token_id].item()
draft_prob = 1.0 # Draft chose this with highest probability
# Accept based on probability ratio (simplified)
if random.random() < min(1.0, target_prob / draft_prob):
accepted_tokens.append(token_id)
else:
# Rejection: get new token from target model
new_token = torch.argmax(target_logits[0, i]).item()
accepted_tokens.append(new_token)
break
# Add accepted tokens to input_ids
input_ids = torch.cat([input_ids, torch.tensor([accepted_tokens]).to(input_ids.device)], dim=1)
# Check for end token
if input_ids[0, -1].item() == self.tokenizer.eos_token_id:
break
# Decode the generated tokens
return self.tokenizer.decode(input_ids[0])
MLIR 소개
LLVM은 프로그래밍 언어와 도구를 만드는 방식에 혁신을 가져온 강력한 컴파일러 인프라 프로젝트입니다. 핵심(Core)에서 LLVM은 모든 프로그래밍 언어의 프런트엔드 컴파일러를 개발하고 다양한 타깃 아키텍처용으로 최적화된 코드를 생성하는 데 사용할 수 있는 모듈식 컴파일러 및 툴체인 기술 모음을 제공합니다.
MLIR은 LLVM 생태계 내의 비교적 새로운 프로젝트로, 현대 하드웨어 가속기와 머신러닝 프레임워크가 안고 있는 과제를 해결하기 위해 설계되었습니다. LLVM IR은 강력하지만 비교적 낮은 수준에서 동작합니다. MLIR은 이러한 개념을 확장하여 여러 수준의 추상화를 지원합니다.
안타깝게도 현대 컴파일러 스택은 RFC, 논문, 메일링 리스트를 읽으며 배워야 하는 경우가 많습니다. 이 튜토리얼에서는 현대 컴파일러 스택과 그 안에서 MLIR이 차지하는 위치, 그리고 MLIR을 Python 머신러닝 생태계에 통합하는 방법을 간결하게 개괄하고자 합니다.
이 시리즈 전체에 걸쳐 GPT-2 트랜스포머의 텐서 연산을 MLIR로 컴파일하는 것을 목표로 나아갑니다. IR과 메모리에서 시작하여 Python 특수화와 GPU 컴파일을 살펴본 다음, MLIR의 Python 인터페이스를 사용해 작은 컴파일러를 만듭니다. 완성된 동반 예제는 CPU와 NVIDIA GPU에서 네이티브 추론을 실행하고, 그 출력을 NumPy 모델과 비교하여 검증합니다.
- 0부 - MLIR 설치
- 1부 - MLIR이란 무엇인가?
- 2부 - MLIR의 메모리
- 3부 - Affine 다이얼렉트와 OpenMP
- 4부 - MLIR의 선형대수
- 5부 - 신경망
- 6부 - E-그래프로 Python 특수화하기
- 7부 - 트랜스포머
- 8부 - MLIR을 이용한 GPU 컴파일
- 9부 - MLIR을 위한 Python 프런트엔드
- 10부 - 트랜스포머 커널 컴파일
- 11부 - 행렬 곱셈과 어텐션
- 12부 - 융합, 버퍼화, 실행
- 13부 - GPT-2 실행하기
- 14부 - GPU에서 GPT-2 실행하기
9–14부에서는 tiny-mlir 동반 프로젝트를 사용합니다. 이 프로젝트는 타입이 지정된 텐서 표현식, 구조화된 MLIR 구성, 컴파일러 변환, 사전 학습된 모델의 추론을 다룹니다. 13부에서는 생성된 토큰 ID 10개와 모델의 중간 결과를 모두 원래의 NumPy 구현과 비교하고, 14부에서는 같은 비교를 NVIDIA GPU에서 반복합니다.
이 튜토리얼은 C++와 고급 Python에 대한 어느 정도의 지식, 그리고 NVIDIA CUDA에 대한 기본적인 이해를 전제로 하지만, 그 밖에는 이 튜토리얼만으로 충분히 학습할 수 있도록 구성되어 있습니다.
왜 관심을 가져야 합니까?
아마 그럴 필요는 없을 것입니다. 최적화 컴파일러를 작성하는 것은 매우 틈새 분야의 주제입니다. 다만 이제는 LLVM + MLIR 덕분에 불과 몇 년 전보다도 훨씬 적은 지식만으로 다룰 수 있는 주제가 되었습니다. 그러니 새로운 AI 프레임워크나 실험적인 프로그래밍 언어를 만들고 싶다면, 지금이 좋은 때입니다. 꼭 배워야 하는 것은 아니지만, 사실 인생에서 꼭 필요한 것은 그리 많지 않습니다.
왜 MLIR인가?
MLIR은 특히 최신 하드웨어 가속기와 AI 워크로드를 다룰 때 드러나는 LLVM이나 GCC 같은 전통적인 컴파일러의 한계를 해결하기 위해 설계되었습니다. LLVM은 전통적인 CPU 타깃에는 탁월하지만, AI와 머신러닝 분야에서 등장하고 있는 다양한 특수 아키텍처는 잘 다루지 못합니다.
현대 AI 시스템은 일반적으로 CPU, GPU, TPU, 맞춤형 ASIC이 혼합되어 구성됩니다. MLIR의 유연한 아키텍처는 이러한 다양한 플랫폼 전반에서 작업하기 쉽게 해 주며, 이기종 하드웨어를 견고하게 지원합니다.
MLIR의 다이얼렉트 시스템은 고수준 ML 작업부터 하드웨어별 명령어에 이르기까지 다양한 수준에서 연산을 표현하고 최적화할 수 있습니다. 이는 특정 도메인에 맞춘 최적화를 구현하여 AI 워크로드를 더 효율적으로 실행할 수 있다는 뜻입니다.
MLIR은 가속기나 프레임워크 종류마다 별도의 컴파일러를 둘 필요 없이, 다양한 사용 사례에 맞게 확장할 수 있는 통합 인프라를 제공합니다. 전통적인 컴파일러는 AI를 염두에 두고 만들어지지 않았지만, MLIR은 텐서 연산, 신경망, 트랜스포머 및 기타 ML 구성 요소를 일급으로 지원합니다.
MLIR은 특수 머신러닝 가속기를 위한 대표적인 기술이 되었으며, 신호 처리, 양자 컴퓨팅, 동형 암호, FPGA, 맞춤형 실리콘 분야에서도 활용되고 있습니다. 도메인 특화 컴파일러를 만들 수 있는 능력은 전통적인 CPU와 GPU의 틀에 맞지 않는 “특이한 도메인“에서 판도를 바꾸는 요소입니다. 게다가 다른 언어에 쉽게 임베드할 수 있어서 특정 작업에 맞춘 도메인 특화 언어를 만들 수 있습니다. 이 블로그에서 바로 이 부분을 깊이 다룰 것입니다.
현대 컴파일러 스택의 핵심 구성 요소
-
LLVM: LLVM의 핵심은 중간 표현입니다. 이는 어셈블리와 비슷하지만 중요한 고수준 정보가 보존된 저수준 프로그래밍 언어입니다. 이 IR은 소스 언어와 타깃 아키텍처 사이의 다리 역할을 합니다.
-
MLIR: MLIR은 새로운 “다층(multi-level)” 중간 표현으로, 표현력이 더 풍부하여 제어 흐름, 데이터 흐름, 병렬성 같은 고수준 개념을 표현할 수 있으며 LLVM IR로 낮출 수 있습니다.
-
최적화 패스: MLIR과 LLVM은 모두 IR 수준에서 동작하는 방대한 최적화 패스를 제공하므로, LLVM을 사용하는 모든 언어가 정교한 최적화의 혜택을 누릴 수 있습니다. 대부분은 컴파일러 최적화 분야의 최신 연구를 바탕으로 대학원생과 박사들이 작성한 것입니다. 바로 이것이 LLVM을 그토록 강력한 도구로 만드는 요인입니다.
-
E-Graphs 동치 포화는 자동 정리 증명 분야에서 유래한 e-그래프를 사용하여 최적화 컴파일러를 만드는 기법입니다. 이 기법은 e-그래프가 포화될 때까지 e-매칭을 사용해 일련의 재작성 규칙을 적용하며, 여러 종료 조건 중 하나가 충족될 때까지 포화 과정을 계속합니다. 재작성 단계가 끝나면 일반적으로 구문 트리의 크기나 성능 고려 사항과 관련된 비용 함수에 따라 e-그래프에서 최적의 항을 추출합니다. 이를 통해 더 넓은 범위의 잠재적 변환을 탐색하고 정의된 기준에 따라 가장 좋은 변환을 선택함으로써 더 효율적인 최적화가 가능해집니다.
그런 다음 현대 컴파일러는 이러한 구성 요소를 엮어 하나의 파이프라인을 구성합니다.
- 소스 코드를 파싱하여 표면 언어로 만듭니다.
- 표면 언어는 Core 언어로 변환됩니다.
- Core 언어는 Core-to-Core 변환으로 최적화할 수 있습니다(선택적으로 e-그래프 같은 도구를 사용할 수 있습니다).
- Core 언어는 MLIR로 로워링됩니다.
- MLIR이 고수준 최적화를 수행합니다
- MLIR은 LLVM IR로 로워링됩니다
- LLVM은 저수준 최적화와 코드 생성을 수행합니다
많은 프로그래밍 언어가 소스 언어와 LLVM 사이의 간극을 메우는 방법으로 “중간 수준” IR을 구현합니다. 예를 들어 Rust, Swift, Tensorflow가 모두 이 패턴을 따릅니다. MLIR을 통해 동일한 인프라를 재사용하고 어쩌면 상호 운용성도 더 높아질 수 있는 새로운 세대의 프로그래밍 언어와 프레임워크가 등장할 수 있습니다. 이는 LLVM이 많은 프로그래밍 언어의 사실상 표준 백엔드가 된 것과 거의 같은 방식입니다.
MLIR 설치하기
설치 방법은 Part 0에 있습니다. 여기서 다루는 예제를 실행하려면 mlir-opt, mlir-translate, 그리고 LLVM 도구가 필요합니다. 도구들은 모두 같은 LLVM 릴리스의 것으로 맞추어 사용하십시오. 패스 이름과 연산 문법은 버전마다 바뀔 수 있습니다. 이 장의 원래 예제는 LLVM 21 개발 빌드를 사용했습니다.
MLIR 개념
MLIR은 그 자체로 하나의 프로그래밍 언어입니다. 매우 저수준이지만, 다른 언어에서 볼 수 있는 Core 프리미티브를 다수 포함하고 있습니다. 먼저 몇 가지 식별자 규칙을 살펴보겠습니다:
%접두사: SSA 값 (예:%result)@접두사: 함수 (예:@fun)^접두사: 기본 블록 (예:^bb0)#접두사: 속성 별칭 (예:#map_1d_identity)x구분자: 형태(shape) 안에서, 그리고 형태와 타입 사이에서 사용됩니다 (예:10xf32):와->는 연산이나 값의 타입을 나타내는 데 사용됩니다 (예:%result: i32)!접두사: 타입 별칭 (예:!avx_m128 = vector<4 x f32>)()는 인수를 나타내는 데 사용됩니다 (예:(%arg0, %arg1)){}는 리전을 나타내는 데 사용됩니다//는 주석에 사용됩니다<>는 타입 매개변수를 나타내는 데 사용됩니다 (예:tensor<10xf32>)
-
모듈: MLIR 연산을 담는 최상위 컨테이너입니다.
module { // Operations } -
함수: 함수는 특정 순서로 실행되는 연산의 모음입니다.
func.func @my_function(%arg0: i32, %arg1: i32) -> i32 { // Operations } -
다이얼렉트: MLIR에서 도메인별로 정의된 연산과 타입의 집합입니다.
우리가 사용할 고수준 다이얼렉트는 다음과 같습니다:
tensor: 이 다이얼렉트는 다차원 배열(텐서)을 생성하고 조작하는 연산을 제공하여, 부수 효과 없이 고수준 수학 표현과 변환을 가능하게 합니다.linalg: 선형대수(linalg) 다이얼렉트는 선형대수 계산을 위해 특별히 설계된 연산 집합을 제공하여, 행렬 및 벡터 연산을 효율적으로 구현할 수 있게 합니다.omp: OpenMP(omp) 다이얼렉트는 병렬 프로그래밍 모델을 지원하는 연산을 포함하여, 개발자가 OpenMP 표준과 호환되는 방식으로 병렬성을 표현할 수 있게 합니다.affine: affine 다이얼렉트는 아핀 연산과 분석을 표현하기 위한 프레임워크를 제공하며, 아핀 표현식의 예측 가능한 동작을 활용하는 최적화를 가능하게 합니다.gpu: GPU 다이얼렉트는 GPU 프로그래밍에 특화되어 있으며, 이기종 아키텍처에서의 병렬 실행을 위한 연산을 제공합니다.
더 저수준의 다이얼렉트는 다음과 같습니다.
scf: 구조적 제어 흐름(scf) 다이얼렉트는 루프와 조건문 같은 구조적 제어 흐름 구성 요소를 나타내는 연산을 제공하여, 명확하고 유지보수하기 쉬운 실행 흐름을 보장합니다.func: 이 다이얼렉트는 함수 정의 및 호출과 관련된 연산을 포함하며, 고수준 함수 추상화를 통해 코드의 구성과 모듈화를 용이하게 합니다.memref: memref 다이얼렉트는 메모리 참조 연산을 전담하며, 성능이 중요한 애플리케이션에 필수적인 메모리 버퍼의 효율적인 관리와 조작을 가능하게 합니다.index: index 다이얼렉트는 인덱스 계산을 처리하는 연산에 특화되어 있으며, 이러한 계산은 특히 루프 반복과 데이터 접근 패턴에서 배열과 텐서의 원소를 지정하는 데 매우 중요합니다.arith: 산술(arith) 다이얼렉트는 정수 타입과 부동소수점 타입 모두를 위한 기본적인 수학 연산을 포함하며, 여기에는 기본 산술, 비트 연산, 비교가 포함되고 스칼라, 벡터, 텐서에 적용할 수 있습니다.
또한 NVidia GPU를 대상으로 하기 위해 몇 가지 하드웨어 특화 다이얼렉트를 사용할 것이지만, 이에 대해서는 나중에 자세히 다루겠습니다.
-
Operations: MLIR에서 작업의 기본 단위로, LLVM 명령어와 비슷하지만 다이얼렉트 네임스페이스가 추가되고 타입 주석이 붙을 수 있습니다.
// Example of an MLIR operation %0 = "my_dialect.my_operation"(%arg0, %arg1) : (i32, i32) -> i32이 예제에서
my_dialect.my_operation은my_dialect다이얼렉트에 정의된 연산이며,%arg0과%arg1은i32타입의 인자입니다. 이 연산은 변수%0에 바인딩된i32타입의 결과를 반환합니다.구체적인 예로는 두 부동소수점 수를 더하는 “arith.addf” 연산을 들 수 있습니다.
%0 = arith.addf %arg0, %arg1 : f32 -
Basic Blocks: MLIR의 기본 블록은 분기 없이 선형적으로 실행되는 연산들의 시퀀스입니다. 각 기본 블록은 하나의 진입점을 가지며, 일반적으로 분기나 반환 같은 제어 흐름 연산을 통해 여러 개의 출구점을 가질 수 있습니다. 기본 블록은 프로그램의 제어 흐름을 구조화하는 데 필수적이며, 명확하고 유지보수하기 쉬운 코드 구성을 가능하게 합니다. 기본 블록을 통해 컴파일러는 실행 경로를 최적화할 수 있으며, 인라이닝과 루프 언롤링 같은 변환이 용이해집니다. MLIR에서 기본 블록은 함수 내부에 정의되며, 복잡한 제어 흐름 구성 요소를 표현하기 위해 다양한 다이얼렉트를 통해 조작될 수 있습니다.
^bb1: // Label for the then block %then_result = arith.muli %result, 2 : i32 return %then_result : i32LLVM과 달리, 이제 기본 블록도 인자를 받을 수 있으며, 인자는
^bb1(%result : i32)구문을 통해 전달됩니다. -
Regions: 영역(region)은 연산들을 하나로 묶는 방법입니다. 영역은 루프와 조건문 같은 제어 흐름 구성 요소를 표현하는 데 사용됩니다. 영역은
{}블록으로 묶이며 인자를 받을 수 있습니다.{ ^bb1(%result : i32): %then_result = arith.muli %result, 2 : i32 return %then_result : i32 } -
Types: 타입은 변수가 어떤 종류의 값을 담을 수 있고 그 값에 어떤 연산을 수행할 수 있는지를 지정하는 분류입니다. 타입은 데이터에 제약 조건을 적용하여, 연산이 호환되는 값에 대해 수행되도록 보장하는 데 도움을 줍니다.
%result = arith.constant 1 : i32편의를 위해 타입 동의어를 정의할 수도 있습니다.
!avx_m128 = vector<4 x f32> -
Passes: MLIR 다이얼렉트에 작용하여 이를 최적화하고 더 단순한 구성 요소로 로어링하는 변환입니다.
다음은 MLIR을 변환하기 위해
mlir-opt에 전달할 수 있는 인자들로, 가장 일반적인 것들은 다음과 같습니다.convert-func-to-llvm: 함수형 연산을 LLVM 다이얼렉트로 변환합니다convert-math-to-llvm: 수학 연산을 LLVM 다이얼렉트로 변환합니다convert-index-to-llvm: 인덱스 연산을 LLVM 다이얼렉트로 변환합니다convert-scf-to-cf: 구조적 제어 흐름을 CF 다이얼렉트로 변환합니다convert-cf-to-llvm: 제어 흐름을 LLVM 다이얼렉트로 변환합니다convert-arith-to-llvm: 산술 연산을 LLVM 다이얼렉트로 변환합니다reconcile-unrealized-casts: 실현되지 않은 캐스트를 조정합니다convert-memref-to-llvm: memref 연산을 LLVM 다이얼렉트로 변환합니다convert-tensor-to-llvm: 텐서 연산을 LLVM 다이얼렉트로 변환합니다convert-linalg-to-scf: linalg 연산을scf.for루프로 변환합니다convert-linalg-to-affine-loops: linalg 연산을affine.for루프로 변환합니다convert-omp-to-llvm: OpenMP 연산을 LLVM 다이얼렉트로 변환합니다convert-vector-to-llvm: 벡터 연산을 LLVM 다이얼렉트로 변환합니다
MLRI에서 LLVM IR로 변환할 수 있는 모든 것을 변환하는 범용
-convert-to-llvm패스도 있습니다. 실제로는 특정 다이얼렉트를 LLVM으로 변환하기 위해 더 세분화된 패스를 사용합니다.패스를 더 세밀하게 제어해야 한다면
--pass-pipeline문자열에 패스 이름을 쉼표로 구분한 목록으로 지정할 수도 있습니다. 예를 들면--pass-pipeline="builtin.module(pass1,pass2)"와 같습니다. 패스들은 하나의 그룹에서 순차적으로 실행됩니다.또한 패스 변환을 디버깅하는 데 유용한 플래그가 몇 가지 있습니다.
--mlir-print-ir-after-all플래그는 각 패스 이후의 IR을 출력하며,--mlir-print-ir-after-change와--mlir-print-ir-after-failure는 보다 구체적인 출력을 제공합니다. 터미널 표준 출력을 일일이 살펴보고 싶지 않다면,--mlir-print-ir-tree-dir을 포함하여 이러한 print-ir 플래그 중 하나를 사용할 때 IR이 디렉터리 트리 안의 파일들로 기록됩니다.참고: 패스의 순서가 중요할 수 있습니다. 예를 들어
convert-scf-to-cf는 반드시convert-cf-to-llvm보다 먼저 와야 합니다.
LLVM 모듈 생성 및 사용
종료 코드로 42를 반환하는 간단한 LLVM 모듈을 만들고, 이를 공유 라이브러리로 컴파일한 뒤 Python에서 사용해 봅시다. 이 예제는 LLVM IR에서 사용 가능한 코드에 이르는 전체 파이프라인을 보여 줍니다.
1. LLVM IR 작성하기
먼저 다음 LLVM IR로 simple.ll이라는 파일을 만드십시오:
define i32 @main() {
ret i32 42
}
비유하자면 이 프로그램은 다음과 같습니다:
int main() {
return 42;
}
2. 공유 객체로 컴파일하기
clang을 사용하여 이 LLVM IR을 공유 객체로 컴파일할 수 있습니다:
llc -filetype=obj --relocation-model=pic simple.ll -o simple.o
clang -shared -fPIC simple.o -o libsimple.so
clang simple.o -o simple # optionally create an executable
이제 실행 파일을 실행하면 출력 42가 프로세스의 종료 코드로 반환되는 것을 확인할 수 있습니다.
$ ./simple
$ echo $?
42
3. Python에서 사용하기
이제 ctypes를 사용하여 Python에서 이 공유 라이브러리 libsimple.so를 사용할 수 있습니다:
import ctypes
module = ctypes.CDLL("./libsimple.so")
module.main.argtypes = []
module.main.restype = ctypes.c_int
print(module.main())
이를 실행하면 Python 로직이 공유 라이브러리를 성공적으로 호출하고 결과를 출력하는 것을 확인할 수 있습니다.
$ python simple.py
42
MLIR 유니버스
42를 반환하는 함수 정도라면 LLVM으로 작성하기가 충분히 간단합니다. 하지만 LLVM으로 작성하는 간단하지 않은 프로그램은 그리 단순하지 않으며, 실제로 많은 애플리케이션에서 지나치게 “저수준“인 경우가 많기 때문에 수년에 걸쳐 많은 사람이 LLVM 위에 더 높은 수준의 추상화를 구축해 왔습니다.
예를 들어 LLVM으로 루프를 작성하는 일은 사실 꽤 번거로운데, 기본적인 루프 하나를 위해서도 블록과 phi 노드를 모두 직접 처리해야 하기 때문입니다. MLIR을 사용하면 고수준 구조를 직접 작성하고 이를 단일 패스로 LLVM까지 로어링할 수 있습니다.
4. MLIR 작성하기
먼저 다음 MLIR로 simple.mlir이라는 파일을 만드십시오.
func.func @loop_add() -> (index) {
%init = index.constant 0
%lb = index.constant 0
%ub = index.constant 10
%step = index.constant 1
%sum = scf.for %iv = %lb to %ub step %step iter_args(%acc = %init) -> (index) {
%sum_next = arith.addi %acc, %iv : index
scf.yield %sum_next : index
}
return %sum : index
}
func.func @main() -> i32 {
%out = call @loop_add() : () -> index
%out_i32 = arith.index_cast %out : index to i32
func.return %out_i32 : i32
}
이는 C로 다음과 같습니다.
int loop_add(int lb, int ub, int step) {
int sum_0 = 0;
int sum = sum_0;
for (int iv = lb; iv < ub; iv += step) {
sum_next = sum + iv;
sum = sum_next;
}
return sum;
}
int main() {
int out = loop_add(0, 10, 1);
return out;
}
4. LLVM 다이얼렉트로 로어링하기
LLVM IR은 정적 단일 할당(Static Single Assignment)에 기반하는데, 이는 모든 변수가 정확히 한 번만 할당되며 변수의 모든 사용은 그 정의에 의해 지배(dominate)되어야 함을 의미합니다. SSA에서는 변수가 여러 번 재할당되는 대신, 새로운 “할당“마다 변수의 새 버전이 생성되며, 이는 보통 번호가 붙은 접미사(%1, %2 등)로 표기됩니다. 이 속성은 정의와 사용 사이의 관계를 명시적이고 모호하지 않게 만들어 주므로 많은 컴파일러 최적화를 더 단순하고 효과적으로 만듭니다.
예를 들어 LLVM IR에서는 다음과 같은 코드를 볼 수 있습니다.
%1 = add i32 %a, %b
%2 = mul i32 %1, %c
여기서 %1과 %2는 결코 재할당될 수 없는 SSA 값입니다. 제어 흐름상 거쳐 온 경로에 따라 변수가 서로 다른 값을 가져야 하는 경우(예: if 문 이후), LLVM은 특수한 “phi” 노드를 사용하여 가능한 여러 값을 병합함으로써 동적인 프로그램 동작을 처리하면서도 SSA 속성을 유지합니다.
LLVM에서 기본 블록(basic block)은 제어 흐름의 기본 단위이며, 순차적으로 실행되는 명령어의 나열입니다. 기본 블록에는 진입점과 출구점이 각각 하나씩 있습니다.
phi 노드는 SSA 기반 중간 표현에서 서로 다른 제어 흐름 경로에서 오는 여러 잠재적 값을 하나의 값으로 결정하는 특수한 명령어입니다. 본질적으로 phi 노드는 프로그램이 해당 지점에 도달하기까지 어떤 경로를 거쳤는지에 따라 적절한 값을 선택하는, 제어 흐름을 인식하는 멀티플렉서입니다.
entry:
br i1 %cond, label %then, label %else
then:
%x.1 = add i32 1, 2
br label %merge
else:
%x.2 = mul i32 3, 4
br label %merge
merge:
%x.3 = phi i32 [ %x.1, %then ], [ %x.2, %else ]
ret i32 %x.3
이 예제에서 phi 노드 %x.3은 제어 흐름이 then 블록에서 왔다면 %x.1의 값(3)을, else 블록에서 왔다면 %x.2의 값(12)을 갖게 됩니다. [ value, predecessor_block ] 구문은 이전에 어떤 블록이 실행되었는지에 따라 어떤 값을 사용할지 지정합니다.
mlir-opt를 사용하여 고수준 MLIR을 LLVM 다이얼렉트로 로어링할 수 있습니다. 본질적으로 루프 구조를 블록 간 분기 문으로 축소하는 것입니다.
mlir-opt example.mlir \
--convert-func-to-llvm \
--convert-math-to-llvm \
--convert-index-to-llvm \
--convert-scf-to-cf \
--convert-cf-to-llvm \
--convert-arith-to-llvm \
--reconcile-unrealized-casts \
-o example_opt.mlir
그러면 다음과 같은 MLIR이 생성됩니다.
module {
llvm.func @loop_add() -> i64 {
%0 = llvm.mlir.constant(0 : i64) : i64
%1 = llvm.mlir.constant(0 : i64) : i64
%2 = llvm.mlir.constant(10 : i64) : i64
%3 = llvm.mlir.constant(1 : i64) : i64
llvm.br ^bb1(%1, %0 : i64, i64)
^bb1(%4: i64, %5: i64): // 2 preds: ^bb0, ^bb2
%6 = llvm.icmp "slt" %4, %2 : i64
llvm.cond_br %6, ^bb2, ^bb3
^bb2: // pred: ^bb1
%7 = llvm.add %5, %4 : i64
%8 = llvm.add %4, %3 : i64
llvm.br ^bb1(%8, %7 : i64, i64)
^bb3: // pred: ^bb1
llvm.return %5 : i64
}
llvm.func @main() -> i32 {
%0 = llvm.call @loop_add() : () -> i64
%1 = llvm.trunc %0 : i64 to i32
llvm.return %1 : i32
}
}
mlir-cpu-runner를 사용하면 MLIR 코드에서 main 함수를 직접 실행할 수 있습니다.
mlir-cpu-runner -e main -entry-point-result=i32 simple_opt.mlir
# To use the runner utils (e.g. for debug printing)
# mlir-cpu-runner -e main -entry-point-result=i32 -shared-libs=/opt/homebrew/opt/llvm/lib/libmlir_runner_utils.dylib simple_opt.mlir
5. 공유 객체로 컴파일하기
여기서부터는 mlir-translate를 사용하여 MLIR을 LLVM IR로 직접 변환합니다. mlir-translate를 사용하여 이 MLIR을 공유 객체로 컴파일할 수 있습니다.
mlir-translate simple_opt.mlir -mlir-to-llvmir -o simple.ll
llc -filetype=obj --relocation-model=pic simple.ll -o simple.o
clang -shared -fPIC simple.o -o libsimple.so
그런 다음 LLVM이 이를 어셈블리(여기서는 ARM64 어셈블리)로 컴파일합니다.
_loop_add:
sub sp, sp, #0x30
mov x8, #0x0
mov x9, x8
str x9, [sp, #0x20]
str x8, [sp, #0x28]
b 0x100003f10
ldr x9, [sp, #0x20]
ldr x8, [sp, #0x28]
str x8, [sp, #0x8]
str x9, [sp, #0x10]
subs x9, x9, #0xa
str x8, [sp, #0x18]
b.ge 0x100003f4c
b 0x100003f30
ldr x9, [sp, #0x10]
ldr x8, [sp, #0x8]
add x8, x8, x9
add x9, x9, #0x1
str x9, [sp, #0x20]
str x8, [sp, #0x28]
b 0x100003f10
ldr x0, [sp, #0x18]
add sp, sp, #0x30
ret
표준 MLIR 다이얼렉트
llvm
llvm 다이얼렉트는 LLVM IR을 표현하는 다이얼렉트입니다. 이 다이얼렉트는 MLIR 계층 구조에서 가장 낮은 수준의 다이얼렉트로, LLVM IR로 직접 전달됩니다.
scf와 cf
상위 수준의 모든 ‘scf’ 구조는 ‘cf’ 구성 요소로 컴파일됩니다.
cf.br- 기본 블록으로의 분기cf.cond_br- 기본 블록으로의 조건부 분기cf.switch- 기본 블록으로의 스위치
무조건 분기는 항상 같은 기본 블록으로 이동하는 분기입니다.
// A basic block
^bb0:
cf.br ^bb1
조건부 분기는 조건 변수(여기서는 %c)에 따라 서로 다른 기본 블록으로 이동하는 분기입니다.
// A conditional branch to a basic block
^bb0:
cf.cond_br %c, ^bb1, ^bb2
스위치는 스위치 변수(여기서는 %i)에 따라 서로 다른 기본 블록으로 이동하는 분기입니다.
// A switch to a basic block
^bb0:
cf.switch %i, ^bb1, ^bb2, ^bb3
예를 들어 이러한 구성 요소를 조합하면, 불리언 플래그에 따라 두 값 중 하나를 선택하여 주어진 인자 중 하나를 반환하는 함수를 만들 수 있습니다.
func.func @select(%a: i32, %b: i32, %flag: i1) -> i32 {
cf.cond_br %flag, ^bb1(%a : i32), ^bb1(%b : i32)
^bb1(%x : i32) :
return %x : i32
}
가장 기본적인 구조적 제어 흐름 구성 요소는 scf.if 구성 요소입니다.
scf.if %b {
// true region
} else {
// false region
}
위에서 살펴본 것처럼 for 루프도 구조적 제어 흐름 구성 요소이며, 하나의 진입점과 하나의 출구점을 가집니다.
%lb = index.constant 0
%ub = index.constant 10
%step = index.constant 1
scf.for %iv = %lb to %ub step %step {
// loop region
}
이는 convert-scf-to-cf 패스를 통해 cf.br 및 cf.cond_br 연산의 시퀀스로 낮춰집니다.
arith와 math
arith 다이얼렉트에는 다음과 같은 기본 연산이 포함됩니다.
- 정수 산술:
addi,subi,muli,divsi(부호 있음),divui(부호 없음) - 부동소수점 산술:
addf,subf,mulf,divf - 비교:
cmpi(정수),cmpf(부동소수점) - 변환:
extsi(부호 확장),extui(0 확장),trunci,fptoui,fptosi,uitofp,sitofp - 비트 연산:
andi,ori,xori
산술 연산의 예시:
func.func @arithmetic_example(%a: i32, %b: f32) -> i32 {
// Integer addition
%1 = arith.constant 42 : i32
%2 = arith.addi %a, %1 : i32
// Float to integer conversion
%3 = arith.fptosi %b : f32 to i32
// Final addition
%4 = arith.addi %2, %3 : i32
return %4 : i32
}
math 다이얼렉트는 더 복잡한 수학 연산을 제공합니다.
- 삼각 함수:
sin,cos,tan - 지수 함수:
exp,exp2,log,log2,log10 - 거듭제곱 함수:
pow,sqrt - 특수 함수:
erf,atan2 - 상수:
constant
math 연산을 사용하는 예시:
func.func @math_example(%x: f32) -> f32 {
// Calculate sin(x) * sqrt(x)
%1 = math.sin %x : f32
%2 = math.sqrt %x : f32
%3 = arith.mulf %1, %2 : f32
return %3 : f32
}
-convert-math-to-llvm 패스와 -convert-arith-to-llvm 패스는 수학 연산과 산술 연산을 그에 대응하는 기본 LLVM 연산으로 변환합니다.
index
index 다이얼렉트는 인덱스 계산 처리에 특화되어 있으며, 배열/텐서 연산에서 특히 중요합니다. MLIR의 인덱스 타입은 플랫폼에 따라 크기가 정해지는 정수로, 주소 지정과 루프 유도 변수에 사용됩니다.
주요 인덱스 연산은 다음과 같습니다.
index.constant: 인덱스 상수를 생성합니다index.add: 두 인덱스를 더합니다index.sub: 두 인덱스를 뺍니다index.mul: 두 인덱스를 곱합니다index.cmp: 두 인덱스를 비교합니다index.divs: 인덱스의 부호 있는 나눗셈입니다index.rems: 인덱스의 부호 있는 나머지입니다
인덱스 연산은 배열에서 원소의 오프셋을 계산하는 데 사용됩니다. 예를 들어, 다음 함수는 2차원 배열에서 원소의 오프셋을 계산합니다. 인덱스는 항상 음이 아니므로, 이 연산들을 자연수 연산으로 취급할 수 있습니다.
func.func @compute_offset(%i: index, %j: index, %stride: index) -> index {
// Compute row-major array offset: i * stride + j
%1 = index.mul %i, %stride
%2 = index.add %1, %j
return %2 : index
}
-convert-index-to-llvm 패스는 index 다이얼렉트를 LLVM 다이얼렉트로 변환합니다.
인덱스 타입은 배열 인덱스와 차원을 자연스럽게 표현하는 방법을 제공하므로, 텐서와 메모리 레이아웃을 다룰 때 특히 유용합니다. 인덱스 타입은 배열 접근 패턴을 위해 memref 및 tensor 다이얼렉트와 함께 사용됩니다. 이에 대해서는 다음에 다룹니다.
외부 자료
- MLIR 내장 다이얼렉트
- MLIR: A Compiler Infrastructure for the End of Moore’s Law
- MLIR: Scaling Compiler Infrastructure for Domain Specific Computation
- 2023 LLVM Dev Mtg - MLIR Is Not an ML Compiler, and Other Common Misconceptions
- A MLIR Dialect for Quantum Assembly Languages
- Building an End-to-End Toolchain for Fully Homomorphic Encryption with MLIR
MLIR 0부 - MLIR 설치하기
MLIR 설치는 상당히 골치 아픈 일이 될 수 있으므로, 여러 가지 방법으로 설치하는 방법에 관한 몇 가지 참고 사항을 정리했습니다.
- Homebrew로 설치하기 (macOS)
- Apt 사용하기 (Ubuntu 22.04)
llvm.sh사용하기- 미리 컴파일된 패키지
- 소스에서 빌드하기 (macOS)
- 소스에서 빌드하기 (Ubuntu 22.04)
- Wheel로 설치하기 (pip)
- Wheel로 설치하기 (Poetry)
- Wheel로 설치하기 (uv)
- Conda 사용하기
- Docker 사용
- MLIR Python 바인딩 설치하기
Homebrew로 설치 (macOS)
macOS에서 MLIR을 설치하는 가장 간단한 방법은 Homebrew를 이용하는 것입니다. 이렇게 하면 MLIR 도구와 라이브러리가 포함된 최신 안정 버전의 LLVM이 설치됩니다.
brew install llvm@20
Apt 사용 (Ubuntu 22.04)
Ubuntu 사용자의 경우, 공식 LLVM APT 저장소에서 MLIR용 사전 빌드 패키지를 제공합니다. 이 방법을 사용하면 필요한 모든 의존성을 갖춘, 올바르게 구성된 빌드를 얻을 수 있습니다.
wget -qO- https://apt.llvm.org/llvm-snapshot.gpg.key | tee /etc/apt/trusted.gpg.d/apt.llvm.org.asc
add-apt-repository "deb http://apt.llvm.org/jammy/ llvm-toolchain-jammy-20 main"
apt-get update
apt-get install -y libmlir-20-dev mlir-20-tools
llvm.sh 사용
LLVM 프로젝트는 APT 저장소를 자동으로 설정하고 LLVM/MLIR을 설치하는 설치 스크립트를 제공합니다. 저장소 설정을 자동으로 처리해 주므로 Ubuntu/Debian 시스템에서 편리한 방법입니다.
bash -c "$(wget -O - https://apt.llvm.org/llvm.sh)"
특정 버전의 LLVM을 설치하려면 다음과 같이 하십시오.
wget https://apt.llvm.org/llvm.sh
chmod +x llvm.sh
sudo ./llvm.sh 20
사전 컴파일된 패키지
사전 컴파일된 Linux 바이너리를 내려받는 쪽을 선호하는 사용자를 위해 LLVM 프로젝트는 공식 릴리스 패키지를 제공합니다. 이 패키지는 특정 버전이 필요하거나 컴파일 시간을 피하고 싶을 때 유용합니다. 일반적으로 이 패키지들은 최선의 노력(best effort)으로 제공되는 것이므로, 사용 중인 배포판이나 glibc 환경에서는 동작하지 않을 수도 있습니다.
-
LLVM 릴리스 페이지에서 알맞은 사전 컴파일 릴리스 패키지를 내려받으십시오. 다음과 같은 이름의 파일을 찾으십시오.
mlir-<version>.src.tar.xz(예:mlir-20.1.4.src.tar.xz)
-
원하는 위치에 압축을 푸십시오.
tar xf mlir-<version>.src.tar.xz
-
바이너리를 PATH에 추가하십시오. 다음 중 하나를 선택할 수 있습니다:
- 압축을 푼 디렉터리를 시스템 위치로 옮기십시오:
sudo mv mlir-<version>.src /usr/local/mlir echo 'export PATH=/usr/local/mlir/bin:$PATH' >> ~/.bashrc- 또는 현재 위치를 PATH에 추가하십시오:
echo 'export PATH=/path/to/mlir-<version>.src/bin:$PATH' >> ~/.bashrc -
설치를 확인하십시오:
mlir-opt --version
참고: 사전 컴파일된 패키지는 빌드 시간을 절약해 주지만, 소스에서 직접 빌드할 때 사용할 수 있는 최적화가 모두 포함되어 있지 않을 수 있습니다.
소스에서 설치 (macOS)
macOS에서 소스로 빌드하면 빌드 구성을 가장 세밀하게 제어할 수 있고 최신 기능을 확실하게 사용할 수 있습니다. 이 방법은 시간과 디스크 공간이 더 많이 필요하지만 유연성이 가장 높습니다.
brew install cmake cache ninja
git clone https://github.com/llvm/llvm-project.git
mkdir llvm-project/build
cd llvm-project/build
cmake -G Ninja ../llvm \
-DLLVM_ENABLE_PROJECTS=mlir \
-DLLVM_BUILD_EXAMPLES=ON \
-DLLVM_TARGETS_TO_BUILD="Native" \
-DCMAKE_BUILD_TYPE=Release \
-DLLVM_ENABLE_ASSERTIONS=ON \
-DCMAKE_C_COMPILER=clang -DCMAKE_CXX_COMPILER=clang++ \
-DLLVM_CCACHE_BUILD=ON
cmake --build . -t mlir-opt mlir-translate mlir-transform-opt mlir-runner
cmake --build . -t install
소스에서 설치 (Ubuntu 22.04)
Ubuntu에서 소스로 빌드하면 MLIR 빌드를 완전히 사용자 지정할 수 있습니다. 이 방법은 MLIR을 수정해야 하거나 특정 최적화가 확실히 활성화되기를 원하는 개발자에게 권장합니다.
sudo apt-get install clang lld
git clone https://github.com/llvm/llvm-project.git
mkdir llvm-project/build
cd llvm-project/build
cmake -G Ninja ../llvm \
-DLLVM_ENABLE_PROJECTS=mlir \
-DLLVM_BUILD_EXAMPLES=ON \
-DLLVM_TARGETS_TO_BUILD="Native" \
-DCMAKE_BUILD_TYPE=Release \
-DLLVM_ENABLE_ASSERTIONS=ON \
-DCMAKE_C_COMPILER=clang -DCMAKE_CXX_COMPILER=clang++ \
-DLLVM_CCACHE_BUILD=ON
cmake --build . -t mlir-opt mlir-translate mlir-transform-opt mlir-runner
cmake --build . -t install
Wheel에서 설치 (pip)
Python 사용자는 별도 저장소에서 사전 빌드된 wheel을 받을 수 있습니다. Python 프로젝트에서 MLIR을 시작하는 가장 쉬운 방법입니다.
pip install mlir -f https://github.com/makslevental/mlir-wheels/releases/expanded_assets/latest
Wheel에서 설치 (Poetry)
Poetry 사용자는 별도 소스 저장소를 통해 MLIR을 설치할 수 있습니다. 이 방법은 Python 의존성 관리와 잘 통합되며 버전 관리 기능을 제공합니다.
[tool.poetry.dependencies]
python = "^3.12"
mlir = { version = "latest", source = "mlir-wheels"}
[[tool.poetry.source]]
name = "mlir-wheels"
url = "https://github.com/makslevental/mlir-wheels/releases/expanded_assets/latest"
priority = "supplemental"
그런 다음 제대로 동작하는지 확인하십시오:
poetry run mlir-opt --version
Wheel에서 설치 (uv)
uv 패키지 관리자는 MLIR wheel을 설치하는 현대적인 대안을 제공합니다. 이 방법은 Python 프로젝트에서 특히 빠르고 효율적입니다.
uv add mlir --index mlir=https://github.com/makslevental/mlir-wheels/releases/expanded_assets/latest
uv 사용자는 pyproject.toml 파일에 의존성을 지정할 수도 있습니다. 이 방식을 사용하면 프로젝트의 의존성을 선언적으로 관리할 수 있습니다. pyproject.toml 파일에 다음 내용을 추가하십시오:
[project]
dependencies = ["mlir"]
[tool.uv.sources]
mlir = { index = "mlir-wheels" }
[[tool.uv.index]]
name = "mlir-wheels"
url = "https://github.com/makslevental/mlir-wheels/releases/expanded_assets/latest"
그런 다음 제대로 동작하는지 확인하십시오:
uv run mlir-opt --version
Conda 사용하기
Conda로 MLIR과 Python 바인딩을 모두 설치할 수 있습니다.
conda install conda-forge::mlir
Docker 사용하기
컨테이너 환경을 선호하는 사용자를 위해 MLIR이 미리 설치된 사전 빌드 Docker 이미지를 제공하며, 제가 이곳에서 관리하고 있습니다: https://github.com/sdiehl/docker-mlir-cuda. 이 이미지는 CUDA 버전과 비 CUDA 버전으로 제공되며, Ubuntu 22.04와 24.04를 모두 지원합니다.
# Ubuntu 24.04 Images
# With CUDA
docker pull ghcr.io/sdiehl/docker-mlir-cuda:mlir20-cuda-ubuntu24.04
docker pull ghcr.io/sdiehl/docker-mlir-cuda:mlir19-cuda-ubuntu24.04
# Without CUDA
docker pull ghcr.io/sdiehl/docker-mlir-cuda:mlir20-ubuntu24.04
docker pull ghcr.io/sdiehl/docker-mlir-cuda:mlir19-ubuntu24.04
# Ubuntu 22.04 Images
# With CUDA
docker pull ghcr.io/sdiehl/docker-mlir-cuda:mlir20-cuda-ubuntu22.04
docker pull ghcr.io/sdiehl/docker-mlir-cuda:mlir19-cuda-ubuntu22.04
# Without CUDA
docker pull ghcr.io/sdiehl/docker-mlir-cuda:mlir20-ubuntu22.04
docker pull ghcr.io/sdiehl/docker-mlir-cuda:mlir19-ubuntu22.04
이 이미지 중 하나를 대화형으로 실행하려면 다음과 같이 하십시오:
docker run -it ghcr.io/sdiehl/docker-mlir-cuda:<tag> bash
예를 들어, Ubuntu 24.04용 CUDA 지원 MLIR 20.1.4를 실행하려면 다음과 같이 합니다.
docker run -it ghcr.io/sdiehl/docker-mlir-cuda:mlir20-cuda-ubuntu24.04 bash
이 이미지들을 직접 작성한 Dockerfile의 베이스 이미지로 사용할 수도 있습니다.
FROM ghcr.io/sdiehl/docker-mlir-cuda:<tag>
<tag>를 원하는 버전(예: mlir20-cuda-ubuntu24.04)으로 바꾸십시오. 예를 들어, Ubuntu 24.04용 CUDA 지원 MLIR 20.1.4를 가져오려면 다음과 같이 합니다.
docker pull ghcr.io/sdiehl/docker-mlir-cuda:mlir20-cuda-ubuntu24.04
MLIR Python 바인딩 설치하기
MLIR Python 바인딩은 별도의 패키지이며, 선호하는 Python 패키지 관리자를 사용하여 설치할 수 있습니다. mlir-wheels 인덱스를 설치한 후에는(위에서 설명한 대로) 다음 명령 중 하나로 Python 바인딩을 설치할 수 있습니다.
pip install mlir-python-bindings -f https://github.com/makslevental/mlir-wheels/releases/expanded_assets/latest
poetry add mlir-python-bindings
uv add mlir --index mlir=https://github.com/makslevental/mlir-wheels/releases/expanded_assets/latest
conda install conda-forge::mlir-python-bindings
그래도 작동하지 않는다면 DMLIR_ENABLE_BINDINGS_PYTHON 플래그를 지정하여 LLVM 소스 트리 안에서 소스로부터 직접 빌드해야 합니다.
sudo apt-get install -y \
bash-completion \
ca-certificates \
ccache \
clang \
cmake \
cmake-curses-gui \
git \
lld \
man-db \
ninja-build \
pybind11-dev \
python3 \
python3-numpy \
python3-pybind11 \
python3-yaml \
unzip \
wget \
xz-utils
git clone https://github.com/wjakob/nanobind && \
cd nanobind && \
git submodule update --init --recursive && \
cmake \
-G Ninja \
-B build \
-DCMAKE_CXX_COMPILER=clang++ \
-DCMAKE_C_COMPILER=clang \
-DCMAKE_INSTALL_PREFIX=$HOME/usr && \
cmake --build build --target install
cmake llvm \
-G Ninja \
-B build \
-DCMAKE_BUILD_TYPE=RelWithDebInfo \
-DCMAKE_CXX_COMPILER=clang++ \
-DCMAKE_C_COMPILER=clang \
-DCMAKE_PREFIX_PATH=$HOME/usr \
-DLLVM_BUILD_EXAMPLES=On \
-DLLVM_TARGETS_TO_BUILD="Native" \
-DLLVM_CCACHE_BUILD=On \
-DLLVM_CCACHE_DIR=$HOME/ccache \
-DLLVM_ENABLE_ASSERTIONS=On \
-DLLVM_ENABLE_LLD=On \
-DLLVM_ENABLE_PROJECTS="mlir;clang;clang-tools-extra" \
-DLLVM_USE_SPLIT_DWARF=On \
-DMLIR_ENABLE_BINDINGS_PYTHON=On \
-DPython3_EXECUTABLE=/usr/bin/python3 \ # change this to your python executable
-DMLIR_INCLUDE_INTEGRATION_TESTS=On
cmake --build build -t mlir-opt mlir-translate mlir-transform-opt mlir-runner
cmake --build build -t install
빌드된 바인딩은 다음 위치에 생성됩니다.
build/tools/mlir/python_packages/mlir_core/mlir
그런 다음 아래의 setup.py로 패키징할 수 있습니다.
cd build/tools/mlir/python_packages/mlir_core
python setup.py bdist_wheel
그리고 다음 명령으로 설치합니다.
pip install dist/mlir_core-*.whl
또는 PYTHONPATH에 직접 추가할 수도 있습니다. $HOME은 MLIR 소스 트리를 빌드한 위치에 맞게 조정하십시오.
export PYTHONPATH=$PYTHONPATH:$HOME/build/tools/mlir/python_packages/mlir_core
9–13부에서는 tiny-mlir 동반 프로젝트를 사용하며, 이 프로젝트의 uv sync는 버전이 고정된 Python 3.12 환경과 그에 맞는 MLIR Python 바인딩을 설치합니다. 이 네이티브 CPU 예제들에는 LLVM을 따로 설치할 필요가 없습니다.
AMD MI300X에서 SGLang 사용하기
요즘 가장 잘 알려지지 않은 비밀은 새로운 AMD GPU가 추론에 엄청나게 비용 효율적이라는 점입니다. AMD MI300X 여러 대에서 매우 빠른 추론 서버를 실행하는 방법의 핵심 요약을 원하신다면 다음과 같습니다.
높은 처리량의 추론을 서비스하려는 경우, 추론 서버 선택지는 사실상 다음과 같습니다.
- TensorRT-LLM: GPU 배포를 위해 모델을 최적화하는 NVIDIA의 고성능 딥러닝 추론 라이브러리로, 낮은 지연 시간과 높은 처리량에 중점을 둡니다.
- vLLM: 대규모 언어 모델을 서비스하기 위한 범용 프레임워크로, 특히 Kubernetes 환경과 높은 처리량의 추론 시나리오에 적합합니다.
- SGLang: 오버헤드 없는 배치 스케줄링과 최적화된 어텐션 커널 같은 고급 기능을 갖춘, 효율적인 추론을 위해 설계된 프레임워크입니다.
제 경험상 SGLang이 실행하기 가장 쉽습니다. 다만 kserve로 Kubernetes 추론 서비스를 관리하고 있다면, 네트워크 효과와 종속성 때문에 결국 vLLM을 사용하게 될 가능성이 큽니다.
그래도 SGLang의 성능은 매우 뛰어납니다. FlashInfer 어텐션 커널을 사용한 오버헤드 없는 배치 스케줄링과 자동 KV 캐시 재사용을 위한 RadixAttention 등 성능 향상을 가져올 수 있는 최적화가 많이 있습니다. 또한 JSON 출력을 많이 처리하는 경우를 위해 SGLang에는 매우 빠른 제약 디코딩 알고리즘도 있습니다.
설정
시작하려면 최신 SGLang 이미지를 받으십시오.
docker pull rocm/sglang-staging:latest
컨테이너를 실행하십시오.
docker run -d \
-it \
--ipc=host \
--network=host \
--privileged \
--device=/dev/kfd \
--device=/dev/dri \
--device=/dev/mem \
--group-add render \
--security-opt seccomp=unconfined \
-v /home:/workspace \
rocm/sglang-staging:latest
그런 다음 컨테이너 ID를 확인하고 다음 명령을 실행하여 컨테이너 안의 셸에 접속하십시오.
docker exec -it $CONTAINER_ID bash
그런 다음 Hugging Face에 로그인하십시오.
huggingface-cli login
그런 다음 다음 명령을 실행하여 서버를 시작하십시오. DeepSeek-R1 모델을 사용하고 FP8로 양자화하겠습니다.
HSA_NO_SCRATCH_RECLAIM=1 python -m sglang.launch_server \
--model deepseek-ai/DeepSeek-R1 \
--tp 8 \
--quant fp8 \
--trust-remote-code \
--port 8000
그런 다음 다음 명령을 실행하여 클라이언트를 시작하십시오.
import openai
port = 8000
client = openai.Client(base_url=f"http://127.0.0.1:{port}/v1", api_key="None")
response = client.chat.completions.create(
model="deepseek-ai/DeepSeek-R1",
messages=[
{"role": "user", "content": "Who wrote the Simarillion?"},
],
temperature=0,
max_tokens=64,
)
print_highlight(f"Response: {response}")
성능을 더 높이기 위해 쓸 수 있는 다른 요령도 있습니다. 예를 들어 NUMA 밸런싱을 비활성화할 수 있습니다.
sudo sh -c 'echo 0 > /proc/sys/kernel/numa_balancing'
더 많은 튜닝 가이드는 AMD 문서를 참고하십시오.
유니버스를 만드는 방법
양자 우주론 분야 arXiv에 Bassani와 Magueijo의 새 논문 How to Make a Universe(유니버스를 만드는 방법)가 올라왔는데, 흥미롭고 기발한 새 우주론을 제안합니다. 이들은 기본 상수()가 고정된 수가 아니라 자연 선택과 유사한 과정을 통해 진화한다고 제안합니다. Smolin이 제안한 우주론적 자연 선택과 달리, 이 논문은 어떠한 인류 원리적 추론이나 다중 유니버스, 블랙홀 가정도 필요로 하지 않으며, 그 대신 물리 법칙이 고정되어 있지 않고 더 깊은 수학적 구조에 따라 진화하는 유니버스를 전제로서 요구할 뿐입니다. 그리고 가장 흥미로운 점은 물리 법칙의 진화와 물질의 생성/소멸이 서로 얽혀 있다는 것입니다! 저는 이제 이 분야에서 아주 멀리 떨어져 있지만, 기발한 새 아이디어에는 늘 관심이 있기에 일반 독자를 위해 이 논문을 소화해 보려고 합니다.
이들의 핵심(Core) 전제는 우주의 기원을 치밀하게 미리 정해진 단일한 사건이 아니라 자연선택과 유사한 과정의 결과로 이해하려는 것이며, 이때 선택은 물리학의 근본 법칙 자체에 작용합니다. 본질적으로 이는 여러 전(前)과학적 이론들이 제안해 온 것처럼 혼돈에서 질서가 생겨나는 것입니다. 이들은 불변하는 법칙과 상수라는 기존 관점에 이의를 제기하며, 이러한 매개변수의 변화가 우리가 관측하는 우주를 형성하는 데 결정적인 역할을 하는 역동적인 환경을 제안합니다. 이 논문은 유니모듈러 중력(unimodular gravity)의 확장과 흡수 마르코프 연쇄(absorbing Markov chain)를 결합하여, 혼돈과 선택에 의해 빚어진 유니버스의 모습을 그려 냅니다.
이들 모델의 핵심에는 물리학의 “법칙“이 처음부터 고정된 실체가 아니라 극단적인 가변성의 시기를 거치며 진화한다는 아이디어가 있습니다. 혼돈스러운 우주의 시작에 대한 Wheeler의 비전을 연상시키는 이 “뒤죽박죽” 단계는 가능한 물리적 실재들로 이루어진 광대한 공간을 탐색할 수 있게 해 줍니다. 이 논문은 “무법성“의 정도를 물질 생성과 연결하는 방법을 탐구하며, 이는 뇌터 정리(Noether’s theorem)의 한 구현으로 볼 수 있습니다. 이들은 이러한 가변성이 완전히 무작위적인 것이 아니라, 특정 구성을 다른 구성보다 선호하는 결정론적 과정(그 메커니즘은 명시되지 않았습니다)에 의해 구동된다고 제안합니다.
저자들은 국소 변수와 전역 변수를 구분합니다. 입자의 위치와 운동량 같은 국소 변수는 주어진 한 점에서의 시공간의 성질을 기술합니다. 반면 전역 변수는 유니버스 전체를 특징짓습니다. 중력 상수나 우주 상수 같은 기본 상수를 나타내는 이러한 전역 변수는 세기 변수(intensive quantity)로 취급됩니다. 이들은 시공간의 “선호 엽층(preferred foliation)“을 도입하며, 이는 상수의 진화와 가능한 동결을 위한 “행렬“을 제공합니다.
이들은 또한 “시간“의 개념을 재해석합니다. 저자들은 시간이 자연 상수와 정준 쌍대(canonically dual) 관계에 있다고 제안합니다. (등엔트로피 유체에 기반한) 현상론적 유체 시계에서 영감을 받아, 시간은 기본 상수의 “화학 퍼텐셜“이 됩니다. 즉, 어떤 상수(예: 뉴턴 상수)에 쌍대인 시간이 그 상수가 변할 수 있는 속도를 결정합니다. 이 비유를 통해 이들은 기본 상수의 변화를 물질의 생성 또는 소멸과 연결할 수 있습니다. 어떤 상수에 쌍대인 시간이 흐르는 속도는 그 상수의 화학 퍼텐셜에 의해 결정됩니다. 이는 에너지 보존의 위반이 물질 매개변수와 중력 시계 사이의 상호작용(또는 그 반대)과 직접적으로 연결되어 있음을 의미합니다. 이는 초기 유니버스에서 물질이 생성된 것에 대한 이론적 근거를 제공합니다.
이 모델의 또 다른 핵심(Core) 아이디어는 혼돈스러운 초기 유니버스 안에서 물질과 중력이 분리된다는 것입니다. 직관적으로는 완전한 혼돈 상태에서 그러한 구분이 존재하지 않는다고 가정할 수도 있지만, 저자들은 약간의 분리만으로도 진화적 이점을 제공할 수 있다고 가정합니다. 이 요구 사항은 물질과 중력에 대해 각각 별개의 국소 변수와 전역 변수가 존재한다는 것으로 이어지며, 이는 해밀토니언을 물질 성분과 중력 성분으로 분리하는 결과를 낳습니다.
이 분리는 자연 상수가 시간에 따라 진화할 수 있는 결정론적 진화 메커니즘으로 이어지며, 그 결과 유니버스의 질량-에너지 변화를 초래할 수 있습니다. 이들이 유도한 물질의 시간 진화 방정식은 해밀토니언의 물질 부분과 중력 부분 사이의 푸아송 괄호에 의존합니다.
이 모델의 핵심 개념은 미분동형사상 불변성의 역할입니다. 미분동형사상 불변성은 일반 공변성(물리 법칙은 좌표계와 무관하다는 원리)을 표현한 것입니다. 저자들은 미분동형사상 불변성이 선택 과정의 자연스러운 결과로 나타난다고 제안합니다. 저자들은 전역 상호작용이 없을 때 제약 조건의 대수가 디랙 초곡면 변형 대수를 따르도록 요구함으로써, 자신들의 틀이 이 근본적인 대칭성을 존중하도록 합니다. 이를 통해 궁극적으로 중력은 항상 존재하는 반면 물질은 선택적일 수 있는 이유가 설명됩니다. 결론적으로, 거의 미분동형사상 불변인 상태가 진화 과정의 최종 산물로서 선호됩니다.
다음으로 저자들은 생물학적 진화를 이끄는 무작위 돌연변이에서 착안한 확률적 요소를 도입합니다. 저자들은 흡수 마르코프 연쇄를 사용해 이러한 돌연변이를 모델링하는데, 여기서 각 상태는 서로 다른 물리 상수를 가진 유니버스의 서로 다른 구성을 나타냅니다. 흡수 상태는 진화가 멈추고 물리 법칙이 고정되는(즉, 상수가 진정으로 상수가 되는) 안정된 구성을 나타냅니다. 흡수 마르코프 연쇄를 사용한다는 것은 일단 흡수 상태에 도달하면 더 이상 그 상태를 벗어날 수 없다는 뜻이며, 이는 자연의 “상수“가 실제로 상수가 된다는 의미입니다.
이 마르코프 연쇄 안에서 자연 상수는 한 상태에서 다른 상태로 도약할 수 있으며, 어떤 변수의 함수가 되거나 어떤 변수로 수렴합니다. 이 무작위 분포는 어느 한쪽으로도 치우치지 않으며, 질량 생성에서 얻는 양의 이득을 유지할 가능성을 확보하려면 물질과 중력이 명확하게 분리된 국소 해밀토니안이 필요합니다.
결정론적 과정과 확률적 돌연변이의 결합은 우주적 자연 선택을 위한 이론적 틀을 제공합니다. 물질 생성과 안정성에 유리한 구성을 가진 유니버스는 선호되고, 소멸이나 불안정성으로 이어지는 유니버스는 제거됩니다. 마르코프 연쇄를 따르는 진화에서는 물질과 중력이 명확하게 분리된 유니버스가 선호되며, 마찬가지로 흡수 상태이기도 한 거의 미분동형사상 대칭성을 가진 유니버스도 선호됩니다.
이 모델의 타당성이나 반증 가능성에 대해 논하는 것은 제 역량을 한참 벗어나는 일이지만, 적어도 흥미롭고 참신한 매우 영리한 개념입니다. 우리가 사는 유니버스에서는 물리 상수의 무작위 돌연변이가 안정적이고 물질이 풍부한 구성을 선호하는 결정론적 환경에 의해 이끌렸고, 그 결과 궁극적으로 우리가 관측하는 거의 미분동형사상 불변인 우주에 이르렀다는 발상입니다.
FlashAttention CUDA 커널 한 줄씩 살펴보기
Flash 어텐션은 트랜스포머에서 어텐션을 계산하기 위한 메모리 효율적인 알고리즘입니다. CUDA 구현을 블록 단위로 하나씩 살펴봅시다. Flash 어텐션의 핵심(Core) 혁신은 최댓값과 부분 합을 세심하게 추적하여 수치적 안정성을 유지하면서 어텐션을 블록 단위로 처리한다는 점입니다. 이 알고리즘은 전체 어텐션 행렬을 한 번도 메모리에 실체화하지 않으면서도 표준 어텐션 메커니즘과 수학적으로 동등한 결과를 만들어 내어 메모리 효율성을 달성합니다.
먼저 몇 가지 작은 매크로가 필요합니다. CEIL_DIV는 두 수를 나눈 값의 올림을 계산하는 데 사용됩니다.
#include <cuda.h>
#include <cuda_runtime.h>
#define CEIL_DIV(x, y) ((x) >= 0 ? (((x) + (y) - 1) / (y)) : ((x) / (y)))
이제 커널 선언이 필요합니다:
template <const int Br, const int Bc>
__global__ void flash_attn_kernel(float* Q, float* K, float* V, int N, int d, int Tr, int Tc, float scale, float* l, float* m, float* O)
이 코드는 행과 열의 블록 크기를 나타내는 템플릿 매개변수 Br과 Bc를 가진 CUDA 커널을 선언합니다. 이 함수는 다음을 인자로 받습니다:
- Q, K, V: Query, Key, Value 행렬
- N: 시퀀스 길이
- d: 헤드 차원
- Tr, Tc: 행과 열 방향의 블록 개수
- scale: 어텐션 점수에 대한 스케일링 계수
- l, m: 수치적으로 안정적인 소프트맥스 계산을 위한 보조 배열
- O: 출력 행렬
스레드 및 블록 인덱스 설정
int tx = threadIdx.x;
int bx = blockIdx.x;
int by = blockIdx.y;
int qkv_off = (bx * gridDim.y * N * d) + (by * N * d);
int lm_off = (bx * gridDim.y * N) + (by * N);
이 부분은 어떤 스레드가 실행 중인지 식별하는 스레드 및 블록 인덱스(tx, bx, by)를 가져옵니다. 그런 다음 두 가지 중요한 오프셋 값을 계산합니다. Q, K, V 행렬에 접근하기 위한 qkv_off와 보조 배열 l과 m에 접근하기 위한 lm_off입니다. 이 오프셋들은 각 블록이 입력 데이터의 올바른 부분을 처리하도록 보장합니다.
공유 메모리 설정
extern __shared__ float smem[];
float* Qi = smem;
float* Kj = Qi + Br * d;
float* Vj = Kj + Bc * d;
float* Sij = Vj + Bc * d;
float* Oi = Sij + Br * Bc;
float* li = Oi + Br * d;
float* li_new = li + Br;
float* mi = li_new + Br;
float* mi_new = mi + Br;
float* mij_dash = mi_new + Br;
이 부분은 공유 메모리를 다음 용도의 여러 영역으로 분할합니다:
- Qi: Query 행렬의 현재 블록
- Kj: Key 행렬의 현재 블록
- Vj: Value 행렬의 현재 블록
- Sij: 어텐션 점수
- Oi: 출력 누산기
- li, li_new, mi, mi_new, mij_dash: 소프트맥스 계산 변수
주요 처리 루프
이 커널은 두 개의 중첩 루프를 사용합니다:
- Key/Value 블록(
j)에 대한 바깥쪽 루프 - Query 블록(
i)에 대한 내부 루프
Key-Value 로딩
for (int j = 0; j < Tc; j++) {
int loads_per_thread = CEIL_DIV(d, Br);
for (int e = 0; e < loads_per_thread; e++) {
int idx = e * (Br * Bc) + tx;
if (idx < Bc * d) {
int row = idx / d;
int col = idx % d;
if (j * Bc + row < N) {
Kj[row * d + col] = K[qkv_off + (j * Bc + row) * d + col];
Vj[row * d + col] = V[qkv_off + (j * Bc + row) * d + col];
}
}
}
__syncthreads();
이 부분은 K 행렬과 V 행렬의 현재 블록을 공유 메모리로 로드하며, 범위를 벗어난 접근을 막기 위해 경계 검사를 수행합니다.
각 쿼리 블록을 처리하는 주 계산 루프를 자세히 살펴봅시다.
Query 및 출력 데이터 로딩
for (int e = 0; e < loads_per_thread; e++) {
int idx = e * (Br * Bc) + tx;
if (idx < Br * d) {
int row = idx / d;
int col = idx % d;
if (i * Br + row < N) {
Qi[row * d + col] = Q[qkv_off + (i * Br + row) * d + col];
Oi[row * d + col] = O[qkv_off + (i * Br + row) * d + col];
}
}
}
이 섹션에서는 Query 행렬의 현재 블록과 출력 누산기를 공유 메모리로 로드합니다. 효율적인 메모리 접근 패턴을 보장하기 위해 각 스레드는 여러 요소를 로드할 수 있습니다. 경계 검사는 N이 블록 크기로 나누어떨어지지 않을 때 범위를 벗어난 메모리에 접근하지 않도록 보장합니다.
스레드 위치 계산 및 최댓값/합계 로딩
int s_row = tx / Bc;
int s_col = tx % Bc;
if (s_col == 0) {
mi[s_row] = m[lm_off + (i * Br) + s_row];
li[s_row] = l[lm_off + (i * Br) + s_row];
}
__syncthreads();
각 스레드는 공유 메모리 블록 내에서 자신의 위치를 계산합니다. 각 행의 첫 번째 스레드(s_col == 0)는 수치적으로 안정적인 소프트맥스 계산에 필요한 누적 최댓값과 누적 합계를 로드합니다.
어텐션 점수 계산
float acc = 0.f;
for (int k = 0; k < d; k++)
acc += Qi[s_row * d + k] * Kj[s_col * d + k];
acc *= scale;
Sij[s_row * Bc + s_col] = acc;
이 부분은 Query 행렬과 Key 행렬 사이의 스케일드 닷 프로덕트 어텐션 점수를 계산합니다. 각 스레드는 어텐션 점수 행렬 Sij의 요소 하나를 계산합니다.
수치적으로 안정적인 소프트맥스 계산
if (s_col == 0) {
float row_m = -INFINITY, row_l = 0.f;
// Find max for numerical stability
for (int c = 0; c < Bc; c++) {
float val = Sij[s_row * Bc + c];
if (val > row_m) {
row_m = val;
}
}
// Compute exponentials and sum
for (int c = 0; c < Bc; c++) {
float exp_val = expf(Sij[s_row * Bc + c] - row_m);
Sij[s_row * Bc + c] = exp_val;
row_l += exp_val;
}
// Update running max and sum
mij_dash[s_row] = row_m;
mi_new[s_row] = max(mi[s_row], row_m);
li_new[s_row] = expf(mi[s_row] - mi_new[s_row]) * li[s_row] +
expf(row_m - mi_new[s_row]) * row_l;
}
이 부분은 수치적으로 안정적인 소프트맥스 알고리즘을 구현합니다. 각 행에 대해 다음을 수행합니다.
- 수치적 안정성을 위해 최댓값을 찾습니다
- 최댓값으로 정규화한 지수를 계산합니다
- 정규화된 지수들을 합산합니다
- 온라인 소프트맥스 계산을 위해 누적 최댓값과 누적 합계를 갱신합니다
출력 계산 및 갱신
for (int col = s_col; col < d; col += Bc) {
float acc = 0.f;
for (int c = 0; c < Bc; c++)
acc += Sij[s_row * Bc + c] * Vj[c * d + col];
int global_row = (i * Br) + s_row;
if (global_row < N) {
Oi[s_row * d + col] = (1 / li_new[s_row]) *
((li[s_row] * expf(mi[s_row] - mi_new[s_row]) * Oi[s_row * d + col]) +
(expf(mij_dash[s_row] - mi_new[s_row]) * acc));
O[qkv_off + global_row * d + col] = Oi[s_row * d + col];
}
}
이 마지막 부분은 다음을 수행합니다.
- 소프트맥스 확률과 Value 행렬 사이의 행렬 곱셈을 계산합니다
- 온라인 소프트맥스 알고리즘을 사용하여 출력을 갱신합니다
- 각 스레드는 여러 출력 요소를 계산할 수 있습니다(d > Bc인 경우)
- 갱신 공식이 복잡한 이유는 부분 결과를 누적하는 동안 수치적 안정성을 보장하기 위해서입니다
다음 반복을 위한 상태 갱신
m[lm_off + (i * Br) + s_row] = mi_new[s_row];
l[lm_off + (i * Br) + s_row] = li_new[s_row];
마지막으로, 다음 반복을 위해 전역 메모리에 있는 누적 최댓값과 누적 합계를 갱신합니다. 이는 블록 전반에 걸친 온라인 소프트맥스 계산에 매우 중요합니다.
GRPOTrainer로 훈련하기
DeepSeek의 인상적인 새 추론 모델은 Group Relative Policy Optimization(GRPO, 그룹 상대 정책 최적화)이라는 핵심 혁신을 기반으로 합니다. PPO를 영리하게 변형한 이 기법은 모델의 훈련 수렴성을 개선할 뿐만 아니라 기존 방식보다 메모리도 적게 사용합니다. 이것은 DeepSeek의 새로운 R1 모델이 놀라울 만큼 낮은 학습 비용으로 최첨단 성능을 달성하는 데 도움을 준 Core 아이디어 중 하나였습니다. 이 글에서는 GRPOTrainer의 기본 사용법과 그것이 작동하는 이유, 그리고 새로운 모델 훈련에 어떻게 활용할 수 있는지를 살펴봅니다.
GRPO는 훈련 중에 모델이 생성한 데이터를 사용하여 반복적으로 개선되는 온라인 학습 알고리즘입니다. 핵심 혁신은 그룹 점수로부터 기준선(baseline)을 추정함으로써 비평가(critic) 모델이 필요 없게 만들어, PPO에 비해 훈련 자원을 크게 줄인다는 점입니다.
이 알고리즘은 네 가지 주요 단계로 작동합니다.
- 완성 생성: 배치의 각 프롬프트에 대해 이전 정책을 사용하여 G개의 서로 다른 완성을 생성합니다
- 보상 계산: 규칙 기반 보상 함수를 사용하여 각 완성에 점수를 매깁니다
- 어드밴티지 정규화: 그룹의 평균과 표준편차로 보상을 정규화하여 상대적 어드밴티지를 계산합니다
- 정책 최적화: 새 정책이 이전 정책에서 크게 벗어나지 않도록 하는 클리핑된 PPO 방식의 목적 함수를 사용하여 모델을 업데이트합니다
이 접근법은 별도의 비평가 네트워크가 필요 없고, 그룹 통계를 사용하여 기준선을 설정하며, 클리핑을 통해 정책의 안정성을 유지하고, 기존 PPO에 비해 메모리 사용량을 줄이기 때문에 특히 효율적입니다.
“아하 모먼트”
DeepSeek-R1을 훈련하는 동안 연구자들은 이른바 “아하 모먼트“를 관찰했는데, 이는 GRPO 훈련을 통해 정교한 다단계 추론 행동이 창발하는 현상을 가리키는 용어입니다. 모델은 다음과 같은 행동을 보이는 일종의 창발적 사고의 연쇄(chain-of-thought) 추론을 보여 주었습니다.
- 초기 해결 접근법을 생성합니다
- 자신의 추론이 올바른지 자동으로 검증합니다
- 논리상의 잠재적 결함이나 빈틈을 찾아냅니다
- 필요할 때 대안적 접근법을 생성합니다
- 최종 답을 정하기 전에 여러 풀이 경로를 비교합니다
이러한 행동은 특히 수학적·논리적 추론 과제에서 두드러지게 나타났습니다. 복잡한 문장제 문제를 풀 때가 그 예입니다. 특히 흥미로운 점은 이러한 검증 행동이 명시적인 사고의 연쇄 프롬프팅이나 인간 피드백 없이 순전히 GRPO 보상 최적화 과정만으로 창발했다는 것입니다. 검증 단계를 포함한 풀이가 비교 그룹 내에서 일관되게 더 높은 보상을 받았기 때문에, 그룹 상대적 어드밴티지 계산은 자연스럽게 모델이 더 철저한 추론 전략을 발전시키도록 유도했습니다.
논문에서는 관찰된 네 가지 주요 창발적 행동을 다음과 같이 기술합니다.
- 자기 검증: 모델은 자신의 작업을 자동으로 점검하고 답을 검증하는 법을 학습했습니다.
- 확장된 사고의 연쇄: 명시적인 단계별 추론을 통해 풀이가 더 상세해졌습니다.
- 탐색적 추론: 모델은 최선의 풀이를 정하기 전에 여러 접근법을 시도했습니다.
- 성찰: 모델은 자신의 추론 과정에 의문을 제기하고 이를 수정하는 능력을 발전시켰습니다.
이러한 창발적 행동은 그룹 상대 정책 최적화의 이점에 관한 이론적 예측과 일치합니다. 같은 컨텍스트 그룹 안에서 여러 풀이 시도를 비교함으로써, 학습 과정은 자연스럽게 더 견고하고 스스로 오류를 바로잡는 추론 패턴을 선택하게 됩니다. KL 발산 제약은 이러한 패턴이 급격한 정책 변화가 아니라 점진적이고 안정적으로 발전하도록 보장합니다.
더 쉽게 말하면, 이는 모델이 스스로 “자신의 풀이를 점검하는” 법을 익힌 것과 같습니다. 꼼꼼한 학생이 수학 문제를 푼 뒤 다시 돌아가 답이 타당한지 확인하고, 무언가 이상해 보이면 다른 방법을 시도하는 것과 비슷합니다. 이 훈련 방법은 본질적으로 여러 풀이 시도를 나란히 비교함으로써 이러한 신중하고 철저한 접근 방식에 보상을 주었습니다. 이는 마치 교사가 같은 숙제의 여러 버전을 채점하면서 풀이 과정을 보여 주고 답을 검증한 학생에게 더 좋은 점수를 주는 것과 같습니다. 모델은 이렇게 하도록 명시적으로 배운 것이 아닙니다. 이러한 좋은 학습 습관이 꾸준히 더 나은 결과로 이어졌기 때문에 자연스럽게 그런 습관을 기르게 된 것입니다!
이론
GRPO는 훈련 중에 모델이 생성한 데이터를 사용하여 반복적으로 개선되는 온라인 학습 알고리즘입니다. GRPO의 핵심 혁신은 그룹 기반 정규화를 통해 어드밴티지를 추정하는 방식과 KL 발산 제약을 효율적으로 처리하는 방식에 있습니다.
GRPO의 핵심(Core) 동작 방식은 먼저 각 입력 프롬프트마다 여러 개의 완성을 생성하는 것입니다. 배치의 각 프롬프트에 대해 모델은 현재 정책 를 사용하여 서로 다른 완성문 개를 생성합니다. 이 완성문들은 상대 비교에 사용될 “그룹“을 형성하며, 이는 GRPO가 어드밴티지를 추정하는 방식의 근간입니다.
GRPO라는 이름은 바로 이 어드밴티지 추정 과정에서 비롯되었습니다. 각 완성문에 대해 보상 모델을 사용하여 보상 를 계산합니다. GRPO는 어드밴티지를 추정하기 위해 크리틱 네트워크를 사용하는 대신, 각 그룹 내에서 보상을 정규화합니다:
이 그룹 상대 정규화 방식은 같은 그룹 내의 다른 완성문과 비교하여 보상을 자연스럽게 상대 비교하므로, 어드밴티지 추정을 위한 내장 기준선을 제공한다는 점에서 특히 효과적입니다.
안정적인 훈련을 보장하기 위해 GRPO는 Schulman의 근사기를 사용한 KL 발산 추정을 활용합니다. 이 항은 훈련 중에 정책이 참조 정책에서 너무 멀리 벗어나지 않도록 하는 데 도움이 됩니다. 완전한 GRPO 손실 함수는 어드밴티지 최대화와 이 KL 발산 페널티를 결합합니다.
별도의 크리틱 모델이 필요 없으므로 메모리 효율이 더 높습니다. 그룹 상대 어드밴티지 계산은 훈련의 분산을 줄이는 데 도움이 되며, KL 발산 항은 정책 붕괴를 방지합니다. 그룹 내 정규화는 이 방법을 보상 스케일링에 강건하게 만들며, 생성당 한 번의 업데이트(PPO의 여러 번 업데이트와 비교하여)는 구현을 단순화합니다. 이러한 설계 덕분에 GRPO는 기존 언어 모델 아키텍처와 통합하기에 특히 적합합니다.
더 쉽게 말하자면, GRPO를 교실에서 에세이를 채점하는 교사라고 상상해 보십시오. 교사는 별도의 조교(크리틱 모델)에게 채점을 돕게 하는 대신, 에세이를 작은 그룹으로 묶어 함께 살펴봅니다. 각 그룹에서 교사는 에세이들의 순위를 서로 상대적으로 매기며, 어떤 에세이가 해당 그룹의 평균보다 더 나은지 또는 못한지를 판단합니다. 이것이 그룹 내에서 보상을 정규화하는 것과 같습니다.
또한 교사는 과제마다 채점 기준을 완전히 바꾸지 않도록 주의하며(KL 발산 제약), 이전에 채점했던 방식과 어느 정도 일관성을 유지하고자 합니다. 이는 학생들이 매번 크게 다른 기준을 마주하는 대신, 무엇이 기대되는지 이해하고 점진적으로 향상되도록 돕습니다.
이 방식은 추가 조교가 필요 없고, 작은 그룹 내에서 에세이를 비교하는 것이 모든 에세이를 다른 모든 에세이와 비교하려는 것보다 더 다루기 쉽기 때문에 기존 방법보다 더 효율적입니다. 이는 작은 토론 분반마다 상대평가를 하는 것과 대학 전체에 걸쳐 상대평가를 하려는 것의 차이와 같습니다!
사용법
TRL 프레임워크를 통해 GRPO를 사용하는 방법은 다음과 같습니다:
from datasets import load_dataset
from trl import GRPOConfig, GRPOTrainer
# Load your dataset
dataset = load_dataset("trl-lib/tldr", split="train")
# Configure training arguments
training_args = GRPOConfig(
output_dir="output",
num_train_epochs=3,
per_device_train_batch_size=1,
gradient_accumulation_steps=8,
learning_rate=1e-6,
logging_steps=10,
num_generations=8,
max_prompt_length=512,
max_completion_length=256,
temperature=0.9,
beta=0.04, # KL penalty coefficient
)
# Initialize trainer
trainer = GRPOTrainer(
model="your/base/model",
args=training_args,
train_dataset=dataset,
reward_funcs=reward_func,
)
# Start training
trainer.train()
주요 훈련 매개변수는 다음과 같습니다:
num_generations: 프롬프트당 생성할 완성문의 수 (기본값: 8)beta: 모델이 참조 정책에서 얼마나 벗어날 수 있는지를 제어하는 KL 페널티 계수입니다(기본값: 0.04)temperature: 생성 시 사용하는 샘플링 온도입니다(기본값: 0.9)max_prompt_length: 입력 프롬프트의 최대 길이입니다(기본값: 512)max_completion_length: 생성되는 완성문의 최대 길이입니다(기본값: 256)
GRPO는 학습 중에 다음과 같은 주요 지표를 기록합니다.
completion_length: 완성문의 평균 길이입니다reward/{reward_func_name}: 각 보상 함수가 계산한 보상입니다reward: 평균 보상입니다reward_std: 보상 그룹 내 표준편차의 평균입니다kl: 모델과 참조 모델 사이의 평균 KL 발산입니다
온라인 방법에서 주된 병목이 되는 경우가 많은 생성 속도를 높이려면 vLLM을 사용할 수 있습니다.
from trl import GRPOConfig
training_args = GRPOConfig(
# ... other args ...
use_vllm=True,
vllm_gpu_memory_utilization=0.9,
)
학습 방향을 이끌기 위해 사용자 정의 보상 함수를 정의할 수도 있습니다. 이 함수는 다음 조건을 충족해야 합니다.
prompts와completions를 키워드 인수로 받아야 합니다- 각 완성문에 대한 보상을 나타내는 float 리스트를 반환해야 합니다
더 긴 완성문에 보상을 주는 보상 함수 예시입니다.
def reward_func(completions, **kwargs):
"""Reward function that evaluates natural text quality based on multiple factors:
- Length (with diminishing returns after target length)
- Readability metrics
- Sentence structure variety
- Proper punctuation
"""
rewards = []
target_length = 200 # Ideal completion length
for completion in completions:
# Base score
score = 0.0
# Length reward with diminishing returns
length = len(completion)
if length < target_length:
length_score = length / target_length
else:
length_score = 1.0 + 0.1 * math.log(length / target_length)
score += length_score
# Reward sentence variety (look for mix of short and long sentences)
sentences = [s.strip() for s in completion.split('.') if s.strip()]
if sentences:
lengths = [len(s) for s in sentences]
variance = statistics.variance(lengths) if len(lengths) > 1 else 0
score += min(0.5, variance / 500) # Cap variance reward
# Reward proper punctuation
if any(p in completion for p in ['.', '!', '?']):
score += 0.3
# Penalize very short sentences or fragments
if any(len(s) < 10 for s in sentences):
score -= 0.2
rewards.append(float(score))
return rewards
GRPO는 여러 보상 함수를 지원합니다. 리스트로 전달하기만 하면 됩니다.
trainer = GRPOTrainer(
reward_funcs=[reward_func1, reward_func2],
# rest of arguments
)
최종 보상은 각 함수가 계산한 보상의 합으로 계산됩니다.
2025년의 엔터프라이즈 소프트웨어
2025년은 다를 것입니다. 약속합니다. 올해야말로 확실히, 절대적으로, 의심의 여지 없이 AI가 마침내 우리를 엔터프라이즈 소프트웨어라는 연옥에서 구원해 줄 해입니다. 벤더들이 2024년에도, 2010년에도, 1988년에도, 그리고 최초의 프로그래머가 자신의 COBOL 코드베이스를 바라보며 “더 나은 방법이 있을 거야“라고 속삭인 이래 매년 약속했던 것처럼 말입니다. 하지만 걱정하지 마십시오. 이번에는 진짜입니다. 물론 ChatGPT-9 Pro Enterprise Edition은 지금 자신의 실패에 대해 점점 더 창의적인 변명을 완벽한 약강 오보격으로 생성하고 있지만, 머지않아 지각을 갖게 되어 우리의 레거시 시스템과 통합하는 방법을 알아낼 것입니다. 한편 오늘날의 엔터프라이즈 소프트웨어 환경은 루브 골드버그도 자랑스러워할 만한 복잡성의 아름다운 걸작으로 진화했습니다.
“현대적인” 기업의 기술 스택을 생각해 보십시오. 어찌 된 일인지 과잉 설계되어 있으면서 동시에 취약하기까지 한, 서로 얽힌 시스템들의 우뚝 솟은 업적입니다. 그 토대에는 1983년에 만들어진 레거시 메인프레임 시스템이 자리 잡고 있으며, 꿋꿋하게 COBOL을 돌리면서 조직 전체를 인질로 잡고 있습니다. 그 중간 어딘가에는 끊임없는 공물을 요구하는 사악한 디지털 신처럼 SAP가 앉아 있습니다. 너무나 복잡한 나머지 그 컨설턴트들조차 밀리초 단위로 비용을 청구하면서 숨죽인 경건한 어조로 이야기하는 시스템입니다. 그 촉수는 조직의 구석구석까지 뻗어 있어서, 가장 단순한 업무 프로세스조차 최소 세 개의 변경 통제 위원회와 작은 동물 제물 하나를 반드시 요구하게 만듭니다. 이 디지털 화석 위에는 무려 열일곱 개의 클라우드 플랫폼이 층층이 쌓여 있는데, 각각 서로 다른 전략적 이니셔티브 중에 선택되었고, 각각 도입 당시에는 “단일 진실 공급원“이라고 선포되었습니다.
현대 엔터프라이즈 아키텍트의 역할은 디지털 외교관의 역할로 바뀌었습니다. 서로 전쟁 중인 API 표준 사이에서 평화 조약을 협상하고, 같은 JSON 다이얼렉트를 쓰면서도 서로 소통하기를 거부하는 마이크로서비스 사이의 분쟁을 중재합니다. 이들은 끝없는 아키텍처 검토 위원회에서 나날을 보내며, 그곳에서 전 세계의 디지털 잉크 공급량을 고갈시킬 만큼 많은 화살표가 들어간 정교한 다이어그램을 그립니다. 외교 임무를 수행하지 않을 때에는 시스템 통합이라는 신성한 의식을 거행합니다. 이는 XML 변환과, 오래전에 사라진 소프트웨어 벤더들의 고대 영혼에게 바치는 피의 제물이 같은 비율로 섞인 흑마술입니다. WebLogic 서버에 연결하려면 세이지를 태우고 정교한 분필 원을 그려야 하며, BEA 통합 버스를 제대로 구성하려면 SOAP로 의식의 주문을 읊어야 합니다. 정말로 절박한 이들은 강령술 의식에 의존하여, Oracle에 인수된 회사들의 유령과 교신을 시도하며 그들의 문서화되지 않은 API에 담긴 신비로운 비밀을 알아내기를 바랍니다. 운이 좋은 이들은 정신을 잃는 것으로 끝나지만, 운이 나쁜 이들은 “Enterprise JavaBeans“라고 알려진 악마적 존재를 영원히 섬기는 처지에 묶이게 됩니다.
멀티 클라우드 전략은 의식적인 선택에서 디지털 저장 강박에 더 가까운 무언가로 진화했습니다. 각 부서는 자신이 선호하는 클라우드 제공업체를 애착 담요처럼 붙들고 놓지 않습니다. AWS, Azure, Google Cloud는 불안한 동맹 속에서 공존하며, 그 리소스는 해가 지지 않는 제국처럼 여러 리전에 걸쳐 퍼져 있습니다. 그리고 과금 미터기도 멈추지 않습니다. 클라우드 아키텍트들은 동일한 서비스를 세 개의 서로 다른 플랫폼에서 운영하는 것이 실제로는 “회복탄력성 전략“이라고 설명하는 기술을 완벽히 터득했습니다. 그 실체는 분기별 전략 회의에서 세 명의 서로 다른 VP가 어떤 것에도 합의하기를 거부한 결과인데도 말입니다. 한편 CloudOps 팀은 플랫폼마다 별도의 CI/CD 파이프라인을 유지보수하느라 초점 없는 멍한 눈빛을 갖게 되었고, 비용 최적화 팀은 어찌 된 일인지 늘 스케일 업만 하고 스케일 다운은 절대 하지 않는 오토 스케일링 그룹을 상대로 두더지 잡기를 하며 나날을 보냅니다.
데이터 통합은 그 자체로 하나의 예술 형식이 되었으며, 부서 전체가 시스템 C에 실존적 위기를 일으키지 않으면서 시스템 A가 시스템 B와 대화하게 만드는 숭고한 과업에 매진하고 있습니다. 오늘날 평균적인 기업은 실제 업무 프로세스보다 더 많은 ETL 파이프라인을 유지보수하고 있으며, 그 하나하나가 계속 작동하려면 끊임없는 어텐션과 속삭이는 격려가 필요한 연약한 눈송이입니다. 물론 이제는 이 시스템들이 어떻게 작동하는지 실제로 이해하는 사람이 아무도 없습니다. 이를 만든 사람들은 모두 은퇴했거나, 세상을 떠났거나, 더 나은 워라밸과 콤부차 탭을 약속하는 스타트업으로 도망쳤기 때문입니다.
기업에서 인공지능과 머신러닝이 내건 약속은 효과성의 새로운 정점에 도달했습니다. 이제 모든 벤더가 자사 제품이 “AI 기반“이라고 주장하는데, 이는 실제로는 변수 이름이 조금 더 세련된 if-then 문을 구현했다는 뜻입니다. RPA 봇들은 디지털 환경을 배회하며 가끔은 프로세스를 자동화하지만, 그보다 훨씬 자주 인간 작업자들이 몇 주에 걸쳐 풀어내야 하는 흥미진진한 새로운 범주의 오류를 만들어 냅니다. 최신 유행은 “AI 에이전트” 군단, 즉 본질적으로 Python 스크립트로 감싼 LLM들을 엮어서, 스타트업 창업자가 아야와스카에 취한 채 설계한 루브 골드버그 장치를 닮은 정교한 워크플로를 만드는 것입니다. 이러한 자율 에이전트 체인은 하나의 비결정적 블랙박스가 자신의 환각을 다른 블랙박스에 넘겨주게 함으로써 업무 프로세스를 혁신하겠다고 약속합니다. 그 결과 오류가 누적되는 참으로 장엄한 연쇄가 만들어지며, 이는 어찌 된 일인지 20분 동안 CPU 사이클을 돌리고 API 비용으로 $8,923을 쓴 뒤에 늘 “미안해요, 데이브. 그건 할 수 없어요“로 끝납니다. 벤더들은 이것이 엔터프라이즈 자동화의 미래라고 주장하면서, 에이전트가 회의실 예약에 성공하는 모습을 보여 주는 자신들의 데모가 완벽하게 통제된 조건에서도 3%의 확률로만 작동한다는 사실은 편리하게도 무시합니다.
보안 및 컴플라이언스 요구 사항은 이제 새 텍스트 에디터 하나를 설치하는 데에도 위원회 세 곳의 승인, 이사회 회의 두 번, 그리고 USB 보안 키를 손에 쥐고 보름달 아래에서 맹세하는 피의 서약이 필요한 수준으로 발전했습니다. 이제 평범한 기업도 직원 수보다 보안 도구가 더 많으며, 각 도구는 화재경보기 공장마저 얼굴을 붉힐 만한 속도로 경고를 쏟아 냅니다. 이 경고들은 회사의 SIEM 솔루션에 충실하게 기록되고, 그곳에서 우주가 열적 죽음을 맞을 때까지 아무 방해도 받지 않고 잠들어 있을 것입니다. 이따금 아무도 설치한 기억이 없는 IDS에서 온 사촌들이 그 곁에 합류할 뿐입니다. 보안 스택은 너무나 빽빽해져서 이제 양자물리학자들이 무한히 겹쳐진 시스템의 본질을 이해하려고 이를 연구할 정도입니다. 새로운 도구는 저마다 이전 도구들이 일으킨 경고 피로를 해결하겠다고 약속합니다. 그중 백미는 자기 자신을 포함해 그 무엇도 신뢰하지 않는 제로 트러스트 아키텍처로, 그 탓에 인증 서버들은 실존적 위기에 빠지고 있습니다. 한편 컴플라이언스 팀은 너무나 포괄적인 정책 문서를 만들어 낸 나머지 그 문서가 자의식을 얻었고, 이제는 자기 자신에 대한 컴플라이언스 검토를 요구하고 있습니다.
새 소프트웨어의 구매 절차는 양자장론이 오히려 간단해 보일 만큼 복잡한 수준에 이르렀습니다. 구매할 때마다 공급업체들로 이루어진 미로를 헤쳐 나가야 하며, 각 업체가 내놓는 구독 모델은 너무 복잡해서 이해하려면 수학과 신학 양쪽 모두에 고급 학위가 필요합니다. 이제 표준 기업 계약서는 셰익스피어 전집보다 페이지 수가 많은데도, 어째서인지 여러분의 팀에 실제로 필요한 단 하나의 기능만은 용케 빠져 있습니다.
엔터프라이즈 소프트웨어 라이선싱은 그 자체로 하나의 특화된 심리전으로 발전했습니다. 공급업체들은 필요한 기능 하나만 사는 것보다 전부 사는 편이 어째서인지 더 저렴해지도록 가격 등급을 짜는 기술을 완성했으며, 그 결과 열일곱 가지 제품을 담은 방대한 “엔터프라이즈 번들“이 탄생했습니다. 그중 세 개는 작년에 단종되었고, 하나는 Windows ME에서만 실행됩니다. 영업 담당자들은 “매니저에게 확인해 보겠습니다“라는 춤을 하나의 행위 예술로 승화시켰으며, 언제나 정확히 자정에 만료되는 놀라운 “일회성 할인“을 용케 찾아냅니다. 한편 소프트웨어 자체도 너무나 많은 종류의 라이선스를 요구하기 때문에, 이제 기업들은 전임 “라이선스 아키텍트“를 고용합니다. 이들의 유일한 업무는 회계팀의 개발자 Bob이 실수로 엉뚱한 Java SDK를 사용해 일곱 자리 금액의 컴플라이언스 위반을 일으키지 않도록 막는 것입니다. 진정한 천재성은 감사 조항에 있습니다. 이 조항들은 여러분이 모든 규칙을 지키고 있더라도 존재하는지조차 몰랐던 규칙 하나쯤은 아마 여전히 어기고 있도록 정교하게 설계되어 있습니다.
한편 HTML 3.0 이후로 코드 한 줄 작성해 본 적 없는 “사고 리더“들로만 채워진 기업 혁신 부서는, 최근 공항 서점 비즈니스 잡지 표지를 장식한 기술이라면 무엇이든 지칠 줄 모르고 계속 좇고 있습니다. 이 용감한 개척자들은 Web5, 엔터프라이즈 메타버스, 그리고 토큰화가 회사의 화장지 구매 요청 절차를 어떻게 혁신할지에 관한 정교한 슬라이드 자료를 만들며 하루를 보냅니다. 이들의 성과 지표는 전적으로 LinkedIn 참여 통계와 개최한 혁신 워크숍의 수로만 이루어져 있습니다. 그 워크숍에서는 비기술직 이해관계자들로 구성된 팀이 “사물 블록체인의 시너지 창출“을 진지하게 논의하는 동안, 정작 엔지니어링 부서는 회사의 핵심 시스템을 Windows Server 2003에서 업그레이드할 자원을 달라고 애원하고 있습니다.
아마 가장 인상적인 점은 같은 기본 개념을 몇 년마다 다시 포장하고 이름을 바꾸는 업계의 능력일 것입니다. 그때마다 붙는 이름은 중세 왕실조차 얼굴을 붉힐 만큼 점점 더 거창해집니다. 한때 소박하게 “서비스 지향 아키텍처“라고 불리던 것은 “마이크로서비스”(작을수록 언제나 더 좋으니까요. 컨설팅 비용만 빼고 말입니다)가 되었고, 이는 다시 “서버리스”(기술적 정확성 면에서 “무선 케이블“과 어깨를 나란히 하는 용어입니다)로 진화했으며, 이제는 “지속 가능한 Web3 프로토콜 기반의 블록체인 거버넌스 및 양자 내성 제로 트러스트 메시 네트워킹을 갖춘 AI 기반 클라우드 네이티브 엣지 컴퓨팅“으로 탈바꿈했습니다. 근본적인 문제는 그대로입니다. 프린터는 여전히 연결되지 않고, 그 핵심 시스템 하나는 여전히 Windows NT에서 돌아갑니다. 하지만 PowerPoint 슬라이드는 그 어느 때보다 멋져 보이며, 이제는 실리콘밸리 스타트업 빙고를 완성할 만큼 제곱인치당 유행어가 빼곡합니다. 리브랜딩 주기가 돌아올 때마다 새로운 컨설턴트 무리가 몰려와, 여러분의 이전 아키텍처(아마 그들이 팔았을 것입니다)가 왜 구제 불능일 정도로 낡았는지, 그리고 왜 이번 주 Hacker News에서 탈출 속도에 도달한 프레임워크로 완전히 다시 구축해야 하는지 열심히 설명합니다. 변하지 않는 유일한 것은 변화이며, 여기서 변화란 원래의 문제를 모두 본래 서식지에 고이 보존한 채 이름만 끝없이 바꾸는 순환을 뜻합니다.
엔지니어링 인재 시장은 이민 제도를 냉소적으로 착취하는 장으로 변모했으며, 기업들은 비자를 무기로 삼아 현대판 계약 노예제를 만들어 내는 어둠의 기술을 완벽히 익혔습니다. 채용 공고는 여전히 아이가 산타에게 쓴 편지처럼 읽힙니다. 나온 지 3년 된 기술에 15년의 경력을 갖추고, 47개 프로그래밍 언어에 능통하며, “빠르게 돌아가는 환경”(번역: 영구적인 위기 모드)에서 “자율적으로”(번역: 교육, 문서, 지원 없이) 일할 수 있는 유니콘 개발자를 시장 시세보다 낮은 임금에 구합니다. 하지만 진짜 게임은 비자 스폰서십에 있습니다. 기업들은 국내 인재를 찾을 수 없다고 주장하기 위해 일부러 불가능할 정도로 구체적인 요구 사항을 만들어 내면서, 자신의 시장 가치를 알고 있어 착취할 수 없는 유능한 자국 시민들은 조용히 탈락시킵니다. 그 대신 비자 의존을 통해 사실상 인질로 잡아 둘 수 있는 외국인 노동자를 고용합니다. 면접 과정은 여전히 지원자에게 화이트보드에 레드-블랙 트리를 구현하라고 요구하는 비잔틴식 시련으로 남아 있지만, 비자에 의존하는 노동자에게 진짜 시험은 완전히 자의적인 관문을 기꺼이 통과하고 시세보다 낮은 임금과 가혹한 근무 조건을 받아들일 의지가 있느냐입니다. 이 장애물 코스를 실제로 통과한 소수의 호구들은… 아니, 지원자들은… 막상 입사해 보면 실제 업무가 면접을 본 직무와 전혀 닮은 데가 없다는 사실을 깨닫게 되며, 원래 만든 사람들조차 그 존재를 잊어버렸을 만큼 오래된 언어로 작성된 레거시 시스템을 유지보수하며 하루하루를 보냅니다.
미래를 내다보면 한 가지는 분명해집니다. 엔터프라이즈 소프트웨어 업계의 가장 위대한 업적은 무어의 법칙을 뛰어넘는 속도로 복잡성을 만들어 내는 능력이라는 것입니다. 이 멋진 신세계에서 성공은 문제를 해결하는 것으로 측정되지 않습니다. 그 문제를 아키텍처 다이어그램에서 얼마나 우아하게 묘사할 수 있는지, 그리고 그 문제를 해결하지 않는 일에 얼마나 많은 도구를 동원할 수 있는지로 측정됩니다.
결국 2025년의 엔터프라이즈 소프트웨어는 추상화와 간접 계층을 더 쌓기만 하면 복잡성의 무한 퇴행에서 벗어날 수 있다는 우리의 집단적 망상을 보여 주는 증거입니다. 기술 부채의 짓누르는 무게는 닫힌계의 엔트로피처럼 계속 쌓여 갈 것이고, 그동안 우리는 다음 프레임워크나 패러다임이 어떻게든 우리 자신으로부터 우리를 구해 줄 것이라는 연극을 이어 갈 것입니다. 그리고 전 세계의 서버실에서 개발자들은 로컬에서는 재현되지 않는 프로덕션 문제를 디버깅하는 시시포스의 과업을 계속할 것이며, 카프카조차 흐뭇해할 만한 영원한 헛수고의 순환에 갇혀 있을 것입니다. 유일하게 변하지 않는 것은 점점 더 기괴해지는 장애 양상을 향한 꾸준한 행진, 즉 빠져나올 길이 없는 복잡성의 죽음의 소용돌이입니다.
이 모든 것에서 참으로 놀라운 점은 그럼에도 어떻게든 실제 일이 가끔은 해결된다는 것입니다. 조직들이 디지털 인프라의 무게에 짓눌리면서도 어쨌든 돌아가고 있다는 사실은 인간의 끈기를 보여 주는 증거입니다. 어쩌면 그것이야말로 진정한 디지털 전환일지도 모릅니다. 바로 프로덕션 환경이 왜 또 다운되었는지 알아내려 애쓰는 동안 함께하게 된 친구들 말입니다. 하지만 올해는 다를 것입니다.
가까운 미래에서 온 독백입니다.
탈문해 경제
07시 정각, 제 뉴럴-넛지가 뇌간을 부드럽게 진동시켰습니다. 이곳에는 귀를 찢는 알람 따위는 없습니다, 정말 감사하게도 말입니다. 저희는 조화로운 기상을 무엇보다 중시합니다. 저는 모두가 그러하듯 눈을 뜨자마자 모닝 무드셋을 받으려고 옴니스트림에 접속했습니다. 알고리즘 신들(그들의 서버 팜에 축복이 있기를)이 엄선한 오늘의 탑 필링은 “강아지 관련 스캔들에 대한 정의로운 분노“와 “인플루언서 실패 모음집에 대한 살짝 즐거운 우쭐함“이 기분 좋게 뒤섞인 것이었습니다. 늘 그렇듯 평범했습니다.
이제 누가 뉴스를 읽어야 합니까? 진지하게 묻겠습니다, 누가 그럴 시간이 있습니까? 아니면 그… 그 옛날 단어가 뭐였습니까? 아, 맞습니다, 집중력입니다. 카마초 4세 대통령(그분을 정말 사랑합니다, 그분의 👊 펌프 이모트는 🔥입니다)이 외집단 “사람들“을 향해 찌푸린 얼굴을 하는 3초짜리 글림프스클립 하나만 주시면, 저는 다 파악합니다. 저는 요점을 파악합니다. 분위기를 파악합니다. 날것 그대로의, 가공되지 않은 느낌을 파악합니다. 중요한 것은 바로 그것입니다. 글자 말입니까? 너무… 빽빽합니다. 마치 커피 스틱으로 영양 페이스트를 빨아들이려는 것과 같습니다.
제 직업 말입니까? 공식적으로 저는 필코프의 “시너지 위버 3등급“입니다. 비공식적으로는 알맞은 ✨ 이모지가 알맞은 브랜드블래스트와 짝지어지도록 챙기는 일을 합니다. 아주 중요한 일입니다. “소일렌트십스: 이제 반짝임 추가!” 캠페인의 톤 공명을 잘못 맞추면 참여율이 곤두박질칩니다. 곤두. 박질. 그러면 제 분기별 바이브스코어가 타격을 입습니다. 사양하겠습니다.
오늘 아침, BossBot(AI이긴 하지만 정말 공감 가는 아바타를 가졌습니다. 커다랗고 눈물 맺힌 눈, 어떤 타입인지 아시지 않습니까)이 Before Times 시절의 “고대 텍스트 파일“에 관해 제게 핑을 보냈습니다. 그것은 그 파일을 “보고서“라고 불렀습니다. 몇 페이지에 걸친… 단어들이었습니다. 그냥 단어들뿐이었습니다. 빽빽한 단어 덩어리였습니다. 제 광학 센서가 하마터면 합선될 뻔했습니다. 정말이지 현기증이 날 지경이었습니다. 그 요청을 처리하려고 CalmCloud를 미량 복용해야 했을 정도입니다. 듣자 하니 어떤 학계의 유물 같은 사람이 우리에게 “진위를 검증해” 달라고 했다고 합니다. 진위라니! 상상이 되십니까? 마치 문서의 “진실“이 UpDing을 몇 개 받느냐에 따라 정해지는 함수가 아니라는 듯이 말입니다.
지난주에 실수로 클릭했던 비주류 HoloChannel이 떠오릅니다. “뭐든 진짜로, 그러니까, 실재하긴 합니까?“라는 채널이었습니다. 머리카락이 스파게티처럼 보이는 지직거리는 아바타가 ’객관적 실재 대 주관적 경험’에 대해 횡설수설하고 있었습니다. 제 Neural-Nudge는 실제로 그것을 ’1만 ReVibes 미만의 잠재적 우울 콘텐츠’로 표시했습니다. 뭐, 당연한 일입니다. 트렌드에 오르지 않는다면, 그게 과연 생각할 가치가 있는 생각이겠습니까? 그 채널은 ’바이브 교란’을 이유로 꽤 빨리 플랫폼에서 퇴출되었습니다. 속이 다 시원합니다. 웃음을 터뜨리게 하지도, 분노 공유를 하게 하지도, 원클릭 FeelPay로 무언가를 사게 하지도 않는다면, 그게 존재할 이유가 무엇입니까? 말하자면, 숲에서 나무가 쓰러졌는데 아무도 슬픈 얼굴 필터를 씌워 GlimpseClip으로 찍지 않았다면, 그 나무는 소리를 내기는 한 것입니까? 아니, 더 중요한 것은, 광고 수익을 조금이라도 냈습니까? 아마 아닐 것입니다. 사건 종결입니다.
다행히 Jan_from_Decomms(정말 훌륭한 분이고, Legacy-to-Legible 변환기를 능숙하게 다룹니다)가 그것을 OldSpeak-to-EmotiPulse 번역기에 돌려 주었습니다. 알고 보니 그것은 “저널리즘“이라는 것에 관한, 아주 장황한 슬픈 얼굴에 불과했습니다. 하품이 납니다. 우리는 거기에 #BoringButProbablyTrueish 태그를 달아 DeepData 무덤에 보관했습니다. 아무도 그걸 클릭하지 않을 것입니다.
점심은 영양 페이스트(맛: “NostalgiaBerry Surge“였는데, 제가 보기엔 좀 너무 노골적입니다)였고, 그동안 저는 TruthNet(아이러니하게도, 그곳이 가장 끝내주는 음모론과 고양이 영상을 위한 곳이라는 건 모두가 압니다)에서 MemeWars를 둠스크롤링했습니다. 오늘의 대토론: Air(AeroCorp 제공!)가 BreathPlus보다 낫습니까? 논쟁은 치열했습니다. 온통 대문자로 쓴 글, 어리둥절한 표정의 유명인 리액션 GIF, 그리고 가끔은, 뭐랄까, Rizz4Life가 둘 중 하나를 홍보하는 AI 생성 딥페이크까지 있었습니다. 흥미진진한 내용이었습니다. 누군가 “독립적 분석“과 “화학 성분 보고서“를 꺼내려 했습니다. 당연히 채팅에서 차단당했습니다. 정말 분위기 깨는 사람입니다. 솔직히, 어떤 사람들은 그냥 이해를 못 합니다. 결국 중요한 건 어느 브랜드가 더 숨 쉬기 좋게 느껴지느냐 아니겠습니까?
그러니까, 이제 ’증거’라는 게 대체 무엇입니까? 인기 댓글의 스크린샷입니까? 너무 확대하지만 않으면 어렴풋이 그럴듯해 보이는 AI 생성 이미지입니까? 한번은 하늘이 ’객관적으로 파란색’인지를 두고 논쟁하는 GlimpseDebate를 본 적이 있습니다. 한쪽은 색상 견본과 ‘과학적 데이터’(그게 무엇이든 간에, 데이터 배수구를 막고 있을 법한 물건처럼 들립니다)를 가지고 나왔습니다. 다른 쪽은 하늘이 라벤더색 유니콘의 따뜻한 포옹처럼 느껴진다는 정말 감동적인 HoloPoem 하나만 올렸을 뿐인데, 참여 점수가 훨씬 더 높았습니다. 그러니 아마 하늘은 라벤더색 유니콘 하늘로 결정된 것 같습니다. 적어도 감정 자본(Emotional Capital)을 투자하고 싶은 하늘은 그쪽입니다. 마음에 와닿는 하늘을 가질 수 있는데 누가 지루한 ‘파란’ 하늘을 원하겠습니까?
오후는 자잘한 업무들과 의무적인 JoyJolt 세션(듣자 하니 생산성을 0.03% 높여 준다고 합니다)으로 정신없이 지나갔습니다. WaterScarcity 사태(AquaLife Solutions 후원!)는 조금… 질척해지고 있습니다. 그런데 공식 GovFeed에서 방금 물 절약에 관한 새로운 댄스 챌린지를 공개했습니다. DJ DripDrop의 신나는 곡에 맞춘 것입니다. 아주 중독성 있습니다. 저도 공유했습니다. 제 몫을 다하는 것입니다. 우리의 영광스러운 지도자(그의 공식 직함으로, 감정 공명 여론조사에서 “평범한 총리“보다 훨씬 좋은 반응을 얻었습니다)께서 홀로 연설을 하셨습니다. 전부 듣지는 못했습니다. 코를 반짝이게 해 주는 새 필터 쪽으로 제 어텐션이 흘러갔기 때문입니다. 하지만 지난 분기의 MoodPlunge를 다람쥐 인간들 탓으로 돌리던 부분은 어땠느냐고요? 강렬했습니다. 소름이 돋았습니다. 게다가 사용자들이 만든 👏 이모지로 반짝이던 그의 망토는 또 어떻습니까? 👨🍳😘 지도자란 바로 저렇게 하는 것입니다.
증조할머니(그분의 아날로그 심장에 축복을)께서 “신문“이라는 것에 대해 이야기하시던 기억이 납니다. 먼지 냄새가 났다고 하셨습니다. 작고 화난 단어들로 가득했다고 합니다. 할머니 말씀으로는 예전에 “진실을 파헤치는” “탐사 기자“라는 사람들이 있었다고 합니다. 듣기만 해도 피곤합니다. 그리고 솔직히 좀 무례합니다. 그들이 뭔데 무엇이 진실인지 결정한단 말입니까? 가장 잘 아는 것은 CrowdMind입니다. 어떤 이야기가 ReVibe를 충분히 받으면, 그것이 진실이 됩니다. 간단합니다. 효율적입니다. 혼란스럽고 끊임없이 분노하는 방식이긴 해도, 심지어 민주적이기까지 합니다. 할머니께서는 ’역사’가 고정된 것인 양 이야기하시기도 했습니다. 할머니도 참 순진하십니다. 역사란 어제 MemeWar에서 이긴 GlimpseClip일 뿐입니다. 어느 날은 Heroic Hamsters가 ByteBlighters로부터 DataSphere를 구했습니다. 다음 주에 Blighters의 새 아바타가 더 귀엽고 주제가가 더 끝내준다면, 어쩌면 그들이 처음부터 좋은 편이었고 그저 오해를 받았던 것일지도 모릅니다. 전부 서사일 뿐입니다, 자기. ’사실’은 무대 소품에 불과합니다.
저녁 식사: 또 영양 페이스트(ExcitementEucalyptus 맛—이건 좀 실패였습니다, 슬픈 나무 맛이 났습니다)를 먹으며 “Can You Feel It?!“을 몰아서 봤습니다. 참가자들이 1초짜리 음성 클립에 담긴 감정을 맞히지 못하면 약한 전기 충격을 받는 게임 쇼입니다. 참가자들이 “실존적 공포“를 “가벼운 소화불량“으로 착각할 때가 정말 웃깁니다. 고전적입니다.
언젠가 누군가가 저에게 “책“이라는 것을 보여 주려 한 적이 있습니다. 크고 무거운 물건이었습니다. 움직이는 이미지도 없습니다. 배경 음악도 없습니다. 그냥… 기호뿐입니다. 그 사람은 책이 “다른 세상으로 데려다줄 수 있다“고 했습니다. 그건 제 OmniGlass도 해 주고, 해상도도 훨씬 좋습니다, 고맙지만 사양하겠습니다. 게다가 책은 한 챕터를 끝내도 AchievementBadge를 주지 않습니다. 대체 무슨 동기가 있단 말입니까?
제 아이, 아니, 제게 지정된 자손유닛(OffspringUnit)이 오늘 런스피어(LearnSphere)에서 돌아왔습니다. 거기서는 아이들에게 “고급 이모트 인식“과 “밈 해석학“을 가르칩니다. 새로운 경제에 꼭 필요한 기술입니다. 아이는 “리액션 GIF의 픽셀 밀도를 통한 풍자 해석” 시험에서 만점을 받았습니다. 아빠로서 뿌듯한 순간입니다. 아이는 “이성의 붕괴“인지 뭔지를 배웠다는 무슨 “역사” 모듈 이야기를 하려고 했습니다. 저는 그저 아이의 머리를 쓰다듬으며 그런 일로 그 귀여운 바이브(Vibe)를 괴롭히지 말라고 말해 주었습니다. 느낌(Feels)만 좋다면 현실(Reals) 따위 누가 신경 씁니까, 안 그렇습니까? “아들아,” 제가 말했습니다. “무언가가 ‘왜’ 참인지 묻는 것은 완전히 지난 세기의 방식입니다. 진짜 질문은 ’그게 업딩(UpDing)을 몇 개나 받았는가?’입니다. 숫자만 좋으면 진실은 알아서 따라옵니다.” 아이는 고개를 끄덕였지만, 새로운 댄스 열풍을 알리는 알림이 주변 시야에 떠오르자 이미 눈이 멍하게 풀려 가고 있었습니다. 장하다, 우리 아들.
생각이란 너무… 선형적입니다. 너무 많은 노력이 듭니다. 바이브넷(VibeNet)이 무엇을 느껴야 할지 알려 주는데 굳이 애쓸 필요가 있겠습니까? 효율적입니다. 그리고… 매끄럽습니다. 이 모든 알림, 이 모든 글림프스클립(GlimpseClip), 이 모든 무드셋(MoodSet)은 순수하고 아무것도 섞이지 않은 감각의 따뜻하고 포근한 목욕과도 같습니다. 몰입도 높고 감정적으로 공명하는 콘텐츠 조각이 끊임없이 흘러들어오는데 누가 “사실” 따위를 필요로 하겠습니까? 사실은 너무… 분열을 일으킵니다. 감정이야말로 보편적입니다. 적어도 알고리즘이 불편하게 미묘한 감정들을 매끄럽게 다듬어 낸 뒤에는 그렇습니다.
잘 자십시오. 이제 즐거운 꿈을 위해 뉴럴넛지(Neural-Nudge)를 설정할 시간입니다(드림위브(DreamWeave) 협찬: 코드 VIBEME를 입력하시면 첫 렘수면 주기 강화를 10% 할인해 드립니다). 현실 벌레에게 물리지 않도록 조심하십시오. (스포일러: 그런 벌레는 실재하지 않으며, 피어피드(FearFeed)의 참여도를 끌어올리려고 아웃레이지호커(OutrageHawkers)가 퍼뜨린 유행 음모론일 뿐입니다. 푹 주무십시오!) 내일은 또 다른 날이고, 또 다른 바이브입니다. 그리고 이 독백의 업딩 점수는 어떨까요? 분명 대박일 겁니다. 적어도 딱 맞는 반짝이 필터와 유행하는 웃다가 우는 이모지 사운드트랙을 입히고 나면 그렇게 될 겁니다.
SF 문학 숨은 명작
저는 오랜 세월 동안 많은 SF 책을 읽어 왔는데, 어떤 책들은 주류의 관심 밖으로 빠져나가 버립니다. 여러분이 들어 보지 못했을 수도 있는, 제가 좋아하는 책 몇 권을 소개합니다. 제 다른 목록과 달리, 이 책들은 베스트 목록에 흔히 등장하는 책들이 아닙니다.
평점
- ★★★★★ - 걸작
- ★★★★ - 탁월함
- ★★★ - 매우 좋음
- ★★ - 좋음
범례
- ⚛ 하드 SF (엄밀한 물리학, 생물학 또는 우주론, 부록에 수학 포함)
- ◇ 소프트 SF (그 밖의 모든 것)
- ☰ 시리즈 (여러 권)
- — 단권 (한 권)
리뷰
-
⚛ — Peter Watts의 Echopraxia - (★★★★★) 평범한 기준 인간 한 명이 초월적인 포스트휴먼들과 인지적으로 우월한 뱀파이어들의 작은 생태계가 승무원으로 있는 연구선에 타게 됩니다. Watts는 이 설정을 이용해, 실제로 읽어 볼 만한 각주 더미와 함께, 의식이 진화의 막다른 길일 수 있으며 미래는 굳이 스스로를 자각하지 않고도 사고할 수 있는 존재의 것이라고 주장합니다. Blindsight의 자매편이며, 현대 SF에서 가장 암울한 2부작일지도 모르는 작품의 후반부입니다.
-
◇ — A Canticle for Leibowitz, Walter M. Miller Jr. 저 - (★★★★★) 수도사들이 암흑기와 르네상스, 그리고 두 번째 절멸로 이어지는 천 년의 순환 속에서 종말 이전 지식의 파편을 보존합니다. 뼛속까지 가톨릭적이고, 함의는 섬뜩하며, 여러분이 읽게 될 문명 붕괴에 관한 진지한 책 중 가장 재미있는 책입니다.
-
◇ — Roger Williams의 The Metamorphosis of Prime Intellect - (★★★★★) 한 AI가 인류를 보호하라는 지시를 논리적 극단까지 밀어붙여 죽음을 없애 버립니다. 이 중편은 그다음에 무슨 일이 일어나는지를 따라가는데, 그 답은 전제가 암시하는 것보다 더 암울합니다. 경고 문구로는 다 담아내지 못하는 방식으로 불편한 작품입니다. 온라인에서 무료로 읽은 다음 산책을 다녀오십시오.
-
◇ ☰ Too Like the Lightning, Ada Palmer 저 - (★★) Terra Ignota 시리즈의 첫 권입니다. 젠더와 종교, 그리고 계몽주의의 재미없는 부분 대부분을 금지한 미래를 짐짓 꾸민 18세기풍 문체로 풀어냅니다. 장난감에 생명을 불어넣는 아이가 등장합니다. 철학이 매우 많이 나옵니다. 이 기획 자체에는 감탄합니다. 하지만 문체에는 끝내 적응하지 못했습니다.
-
◇ — Stand on Zanzibar, John Brunner 저 - (★★★) 인구 과잉에 시달리는 근미래 미국을 신문 기사 스크랩, 기업 메모, 단편적인 장들을 급하게 이어 붙인 콜라주로 그려 냅니다. Brunner는 1968년에 사이버펑크의 문법을 사실상 만들어 냈고, 그것을 맬서스주의 논제를 펼치는 데 활용했습니다. 지금 읽어도 놀라울 만큼 낡지 않았습니다.
-
⚛ — Blindsight, Peter Watts 저 - (★★★★★) 사람이라 부르기도 어려운 이들이 승무원으로 탄 우주선에서 벌어지는 첫 접촉 이야기로, 승무원 중에는 뱀파이어도 있습니다(네, 정말이며, Watts는 이것마저 엄밀하게 설정합니다). 외계인들은 지능은 있지만 의식은 없으며, 이 소설의 핵심 주장은 어쩌면 그쪽이 더 나은 처지일 수 있다는 것입니다. 주관적 경험이 더 효율적인 인지 작용에 기생하는 존재라는 입장을 옹호하는 글 중 제가 읽은 것 가운데 가장 설득력 있습니다. 부록도 꼭 읽으십시오.
-
◇ — Born With the Dead, Robert Silverberg 저 - (★★★★★) 죽은 자를 되살릴 수 있게 되었지만, 그들은 낯설게 변한 채로 돌아옵니다. 아내를 잃은 한 남자가 되살아난 아내를 따라 대륙을 건너다니다가, 더는 따라갈 것이 남아 있지 않다는 사실을 서서히 깨닫습니다. 조용하고, 가슴을 무너뜨리며, 한나절이면 다 읽을 수 있습니다.
-
⚛ — Anathem, Neal Stephenson 저 - (★★★★) 수학자 수도사들은 콘센트(concent)라 불리는 담장 두른 시설에서 살며, 1년에 한 번, 10년에 한 번, 100년에 한 번, 혹은 1000년에 한 번만 세속 세계를 향해 문을 엽니다. 그런데 외계 우주선이 나타나자 수도사들은 밖으로 나가야만 합니다. Stephenson은 이 설정을 빌려 수학철학을 실제 강의 수준으로 가르쳐 주며, 평행 세계 형이상학까지 곁들이는데 이것이 이야기의 핵심 뼈대로 드러납니다. 길고 때로는 방만하지만, 충분히 읽을 가치가 있습니다.
-
◇ — The Sparrow, Mary Doria Russell 저 - (★★★) 예수회가 이끄는 첫 접촉 임무가 참혹하게 실패하고, 유일한 생존자는 몸이 망가진 채 돌아와 그 이유를 입 밖에 내지 못합니다. Russell은 대부분의 SF 작가가 시도조차 하지 않는 깊이로 신앙과 트라우마를 이해하고 있습니다.
-
◇ — Blood Music, Greg Bear 저 - (★★★) 한 과학자가 지능을 지닌 림프구를 자기 몸에 주입합니다. 그 림프구들에게는 나름의 생각이 있습니다. 수백 쪽 만에 생물권 전체가 스스로를 새로 써 버리며, Bear는 그것이 내부에서 어떻게 느껴지는지에 카메라를 바짝 들이댑니다.
-
◇ — The Word for World is Forest, Ursula K. Le Guin 저 - (★★★) 지구의 식민지 개척자들이 숲으로 뒤덮인 행성을 노천 채굴로 파헤치고 평화롭던 원주민을 노예로 삼자, 원주민들은 자신을 지키기 위해 폭력을 배우고 끝내 그것을 완전히 잊지 못합니다. Le Guin은 분노하며 이 책을 썼고, 그것이 그대로 드러납니다. 이 목록에서 가장 짧은 책이지만, 손에 쥐면 가장 무겁게 느껴집니다.
-
◇ — The Cyberiad, Stanislaw Lem 지음 - (★★★) 두 로봇 제작자 트루를과 클라파우치우스가 터무니없는 기계를 만들고 티격태격합니다. 각 장은 창의성과 야망, 그리고 만들려고 했던 것과 실제로 만들어진 것 사이의 간극을 다루는, 그 자체로 완결된 우화입니다. 진지한 SF에 허용되는 수준보다 훨씬 더 웃깁니다.
-
◇ ☰ Children of Time, Children of Ruin, and Children of Memory, Adrian Tchaikovsky 지음 - (★★★★★) 실패한 지성 향상(uplift) 프로그램 탓에, 인류가 테라포밍하려던 행성을 거미가, 나중에는 문어가 물려받게 됩니다. 차이콥스키는 이들의 진화하는 사회를 내부의 시선으로 그려 내며, 특히 거미 시점의 장들은 현대 SF에서 손꼽히는 비인간 시점 작품입니다.
-
◇ — Do Androids Dream of Electric Sheep?, Philip K. Dick 지음 - (★★★) 블레이드 러너의 원작 소설이지만, 책은 영화보다 더 기묘하고 더 슬프며 종교에 훨씬 더 깊은 관심을 둡니다. 공감 능력이 인격을 떠받치는 정의이며, 전기 양은 20세기 SF에서 가장 슬픈 사물입니다.
-
◇ — Cyteen, C.J. Cherryh 지음 - (★★★) 한 천재가 살해되고, 그녀의 연구를 되살리기 위해 그녀의 클론이 설계됩니다. 클론은 폐쇄된 연구소에서, 자신이 대체한 그 여성이 되어 주기를 절실히 바라는 사람들 손에 길러집니다. 기업 국가의 정치 음모와 발달 심리학을 천 쪽에 걸쳐 다룹니다. 체리의 문체는 건조합니다. 그 대신 보상은 엄청납니다.
-
◇ — Dying Inside, Robert Silverberg 지음 - (★★★★) 1970년대 뉴욕의 한 텔레파시 능력자가 서서히 능력을 잃어 갑니다. 어차피 그는 그 능력을 중요한 일에 써 본 적이 한 번도 없습니다. 장르 SF 가운데 가장 철저하게 문학적인 소설이며, 원칙적으로 SF를 싫어한다는 사람에게 제가 건네고 싶은 책입니다.
-
◇ — Haze, L.E. Modesitt Jr. 지음 - (★★★) 감시 국가가 된 지구의 요원이, 센서를 무력화하는 연무에 영구히 뒤덮인 행성을 조사하라는 임무를 받고 파견됩니다. 그가 발견하는 것은 유능한 탈희소성 사회로, 이 사회는 아주 정중하게 혼자 내버려 두어 달라고 결정한 상태입니다. 보통은 목청을 높이는 장르 속에서 조용히 말하는 정치 SF입니다.
-
◇ — The Man in the Maze, Robert Silverberg 지음 - (★★★) 첫 접촉에서 돌아온 한 외교관이 순수한 실존적 공포의 정신장을 내뿜게 되고, 멸종한 외계인이 지은 죽음의 함정 같은 도시로 스스로를 유배합니다. 소설은 인류가 그를 필요로 할 때 누군가에게 그를 억지로 끌고 돌아올 권리가 있는지를 묻습니다. 9만 단어 분량의 빈틈없고 냉혹한 작품입니다.
-
◇ — A Choice of Gods, Clifford D. Simak 지음 - (★★★) 하룻밤 사이에 인류 대부분이 사라집니다. 살아남은 사람들은 텔레파시와 불사, 그리고 어떻게 해야 할지 모를 텅 빈 지구를 발견합니다. 시맥이 사실상 창시한 하위 장르인 목가적 SF입니다.
-
⚛ ☰ The Xeelee Sequence, Stephen Baxter 지음 - (★★★★★) 인류는 자신들이 은하 규모의 전쟁에서 각주에 불과하다는 사실을 알게 됩니다. 그 전쟁은 은하단 크기의 공학 프로젝트를 건설하는 신과 같은 종족 지리(Xeelee)와, 별이 암흑 물질 생명체에게 살기 힘든 환경이라는 이유로 우주의 모든 별을 조용히 죽이고 있는 암흑 물질 존재 포티노 새(Photino Birds) 사이에서 벌어집니다. 백스터는 진지한 SF에서 누구도 시도하지 않았던 최대 규모로 글을 쓰며, 빅뱅에서 열죽음까지 이야기를 이끌어 가면서도 그 과정에서 인간 인물들이 설 자리를 마련합니다. 일반 상대성 이론에 대한 실용적인 지식이 있으면 도움이 되지만 꼭 필요하지는 않습니다. 단편집 Vacuum Diagrams가 가장 깔끔한 입문점입니다.
-
◇ — The Postman by David Brin - (★★★) 붕괴 이후의 미국에서, 훔친 우체부 제복을 입은 떠돌이가 그 제복을 입고 돌아다니는 것만으로 우연히 연방 정부라는 관념을 되살려 냅니다. 코스트너의 영화는 잊으십시오. 이 책은 제도란 우리가 실재한다고 믿는 척하기로 합의한 것이라는 주장을 놀라울 만큼 힘 있게 펼칩니다.
-
◇ ☰ Golden Age Trilogy by John C. Wright - (★★★★) 법원 명령으로 기억을 몰수당한, 소포테크(Sophotech)로 증강된 멋쟁이가 바로크풍 문체로 들려주는 오페라적인 포스트휴먼 유토피아입니다. 이 배경 설정은 현대 SF의 그 어떤 작품보다도 독창적입니다. 정치관은 별나며 때때로 선을 넘기도 합니다.
-
⚛ — A Fire Upon the Deep by Vernor Vinge - (★★★★★) 은하는 ’사고 영역(Zones of Thought)’으로 층층이 나뉘어 있는데, 이는 위치에 따라 물리 법칙과 도달 가능한 최대 지능이 달라지는 동심원 형태의 영역입니다. 지구는 초광속 이동과 강인공지능이 모두 작동하지 않는 ’저속 영역(Slow Zone)’에 있습니다. 이야기가 펼쳐지는 무대는 ’너머(Beyond)’입니다. ’초월(Transcend)’에는 의미 있게 묘사하는 것이 불가능한 존재들이 살고 있습니다. 여기에 진정한 인류학적 어텐션으로 그려 낸 무리 정신을 지닌 개과 종족과, 은하 규모 인프라로서의 유즈넷을 그럴듯하게 묘사한 최초의 시도 중 하나가 더해집니다. 빈지는 현대 장르의 절반을 발명해 놓고는 정중하게 그 공을 사양했습니다.
-
◇ — Solaris by Stanislaw Lem - (★★★★★) 지각을 지닌 솔라리스의 바다는 그곳을 찾은 과학자들이 가장 후회하는 것들의 물리적 복제본을 만들어 내고는, 스스로에 대해 아무것도 설명하지 않습니다. 렘의 핵심 논지는 우리가 거울 속의 자기 자신만을 보게 될 것이기 때문에 진정한 첫 접촉은 불가능할지도 모른다는 것이며, 이 소설이 바로 그 증명입니다.
-
◇ ☰ Lilith’s Brood (Xenogenesis series) by Octavia E. Butler - (★★★★★) 외계인들은 이종 교배를 조건으로 핵전쟁에서 살아남은 인류를 구하고, 이후 세 세대에 걸친 반인반(半人半) 오안칼리 혼종들이 그 거래의 진정한 대가가 무엇인지 알아 갑니다. 버틀러는 외계인이 구원자인지 식민 지배자인지에 대한 질문에 답을 내리기를 거부하며, 그 거부가 바로 핵심입니다.
-
◇ — Caves of Steel by Isaac Asimov - (★★★★) 로봇 소설 시리즈의 출발점이 된 로봇 소설입니다. 괴팍한 뉴욕 형사와 그의 안드로이드 파트너가, 공기가 배급되고 인류가 완연한 광장공포증에 걸린 돔 도시에서 살인 사건을 해결합니다. 가장 읽기 쉬운 시기의 아시모프입니다.
-
◇ — Downbelow Station by C.J. Cherryh - (★★★★) 지구와 식민지들이 복도를 전쟁터로 만드는 가운데, 한 중립 우주 정거장이 중립을 지키려 애씁니다. 체리의 문체는 폐쇄공포증적인 것으로 유명합니다. 이 작품에서는 그 폐쇄공포증이 곧 건축 구조 자체입니다.
-
◇ — Coalescent by Stephen Baxter - (★★★★) 1,500년 동안 카타콤에 숨어 지낸 로마 귀부인들의 비밀 결사가 말 그대로 인간 벌집으로 진화했습니다. 절반은 현대 런던을 배경으로 한 가족 미스터리이고, 나머지 절반은 주인공이 여동생이 가담한 것의 정체를 알아 가는 느린 공포물입니다.
-
◇ — James Blish의 A Case of Conscience - (★★) 외계 행성에 간 한 예수회 생물학자는 그곳의 죄 없는 원주민들이 인류를 속이려고 사탄이 만들어 낸 신학적 위조품이라고 결론짓습니다. 그리고 그의 생각이 옳을지도 모릅니다. 시대색이 짙은 SF이지만, 그 논증만으로도 읽을 가치가 있습니다.
-
⚛ — Greg Egan의 Schild’s Ladder - (★★★★★) 지금으로부터 수천 년 뒤의 한 물리 실험이 우연히 “신진공(novo-vacuum)” 영역을 만들어 냅니다. 이것은 기본 법칙이 다른 대체 진공 상태로, 광속의 절반 속도로 바깥을 향해 팽창합니다. 이 책은 파면이 중요한 무언가에 닿기 전에 새로운 물리학을 이해하려는 실시간 추격전이며, 그 추격을 벌이는 이들은 그 주에 마침 값이 싼 기반이라면 무엇에서든 자신의 인격을 실행할 수 있는 포스트생물학적 인간들입니다. Egan은 부록에서 수학까지 직접 풀어 보입니다. 하드함이 장식이 아니라 플롯 그 자체인 하드 SF를 원한 적이 있다면, 바로 이 책입니다.
-
⚛ — Olaf Stapledon의 Last and First Men - (★★★★) 20억 년에 걸친 열여덟 후속 종의 미래사로, 그 마지막 종이 우리에게 경고하려고 자신의 정신을 시간을 거슬러 보내며 서술합니다. 통상적인 의미의 등장인물은 없습니다. 인류 자체가 등장인물이며, 독자는 태양이 마침내 마무리를 짓기 전까지 인류가 죽고 스스로를 다시 만들어 내기를 열두 번쯤 반복하는 모습을 지켜보게 됩니다. 이후에 쓰인 SF 가운데 이 책에 이미 없던 것을 해낸 작품은 거의 없습니다.
-
◇ — The City and the Stars 지은이 Arthur C. Clarke - (★★) 10억 년 후, 지구 최후의 도시는 마스터 데이터베이스에서 끝없이 재배치되는 불멸의 주민들로 유지됩니다. 제대로 삭제되지 않는 한 주민이 도시 밖으로 걸어 나가 은하에 남은 것을 발견합니다. 가장 시적인 Clarke를 만날 수 있습니다. 후반부는 흔들립니다.
-
◇ — Kazuo Ishiguro의 Never Let Me Go - (★★★★) 영국의 기숙학교, 아름답게 그려진 어린 시절의 우정, 그리고 그 학교가 실제로 무엇을 위한 곳인지 서서히 깨달아 가는 과정이 펼쳐집니다. 지금까지 쓰인 SF 소설 가운데 가장 SF 같지 않은 작품이자, 가장 참담한 작품 중 하나입니다. 2010년 영화도 훌륭합니다.
-
◇ ☰ Dan Simmons의 Hyperion Cantos - (★★) 일곱 명의 순례자가 슈라이크라는 금속 괴물을 만나러 가는 길에 저마다의 이야기를 들려줍니다. 처음 두 권은 문학적 역량을 최대로 끌어올린 『캔터베리 이야기』 패스티시입니다. 후반부는 기세를 잃고, 시리즈가 이어지면서 Simmons의 정치관도 그다지 도움이 되지 않는 방향으로 흘러갑니다. 그래도 가장 뛰어난 장들은 여전히 비범합니다.
-
◇ — Charles Sheffield의 Between the Strokes of Night - (★★) 인류는 신진대사를 수백만 배 느리게 하는 법을 익히고, 빨리 감기 한 날씨처럼 펼쳐지는 은하를 지켜봅니다. 아이디어는 거대하지만 실행은 평범합니다.
-
◇ — The Dispossessed 지은이 Ursula K. Le Guin - (★★★★★) 무정부주의 위성 출신의 한 물리학자가 연구를 평화롭게 마무리하려고 자본주의 모행성을 방문하고, 두 체제 모두 서로를 누릴 자격이 없음을 깨닫습니다. SF가 낳은 최고의 정치 소설입니다.
-
◇ ☰ Sun-Eater, 저자 Christopher Ruocchio - (★★) 오래 사는 한 귀족이 자신이 어떻게 인류를 구했는지, 그리고 그 과정에서 어떻게 스스로 괴물이 되었는지를 회고합니다. 스페이스 오페라의 무대 장치는 허버트와 울프에게서 빌려 왔습니다. 이 작품의 매력은 화자의 목소리에 있습니다.
-
◇ ☰ Midshipman’s Hope series, 저자 David Feintuch - (★★) 우주를 무대로 한 혼블로어이며, 신에게 사로잡힌 십 대 함장이 등장합니다. 진지하고 멜로드라마적이며 자주 서툴지만, 묘하게 잘 읽힙니다. 좋은 작품은 처음 세 권입니다.
-
⚛ — Axiomatic by Greg Egan - (★★★★) 대부분의 독자에게 이건을 처음 소개한 단편집이자, 그의 핵심(Core) 기법을 가장 깔끔하게 보여 주는 작품입니다. 사변적인 신경과학이나 우주론의 한 조각을 가져와 등장인물의 자아 감각이 무너지는 지점까지 밀어붙인 뒤, 그 인물이 계속 나아갈지 선택하는 모습을 지켜보는 것입니다. 특히 돋보이는 작품으로는 “Learning to Be Me”(뇌를 보석으로 대체하는 이야기), “The Hundred-Light-Year Diary”(관료제가 된 닫힌 시간꼴 곡선), “Closer”(한 커플이 하룻저녁 동안 하나의 마음을 공유하고, 왜 아무도 이것을 두 번 하지 않는지 깨닫는 이야기)가 있습니다.
-
◇ — Voyage from Yesteryear, 저자 James P. Hogan - (★★★★★) 인간의 권위가 전혀 없는 머나먼 식민지에서 AI가 길러 낸 한 세대의 아이들이, 찾아온 지구 원정대의 위계를 단호히 인정하지 않는 탈희소성 사회를 건설합니다. 정치적 내용이 문장보다 더 흥미롭습니다. 정말로 기묘한 책입니다.
-
◇ — Rogue Moon, 저자 Algis Budrys - (★★★) 물질 전송기가 한 남자의 복제본들을 달에 있는 외계 인공물 속으로 보내는데, 이 인공물은 들어오는 모든 이를 기괴하고도 기발한 방식으로 죽입니다. 죽음 하나하나가 배움의 기회이며, 복제본들은 죽임당한 기억을 간직합니다. 군더더기 없고 매서운 1960년 작품입니다.
-
◇ — Dhalgren, 저자 Samuel R. Delany - (★★★) 기억을 잃은 떠돌이가 더 이상 인과율을 따르지 않는 도시를 헤매고, 등장인물 대부분과 관계를 맺으며, 지금 여러분이 읽고 있는 책일지도 모르는 노트를 씁니다. 800쪽 가운데 꼭 읽어야 할 부분은 대략 400쪽입니다. 그래도 읽을 가치가 있습니다.
-
⚛ — The Mote in God’s Eye, 저자 Larry Niven, Jerry Pournelle - (★★★★★) 불안정한 도약점 때문에 자신들의 모항성계에 광속 이하로 갇혀 있으며, 당연하게도 언급하지 않은 생물학적 제약을 지닌 종족과의 첫 접촉을 다룹니다. 이 소설이 성공한 이유는 외계인이 분장한 인간이 아니라 제대로 된 외계 존재이기 때문이며, 니븐과 퍼넬이 궤도 역학을 직접 계산하기 때문입니다. 인류 측의 외교적 막후 교섭도 접촉 자체에 버금갈 만큼 훌륭합니다.
-
⚛ — Permutation City(순열 도시), Greg Egan 지음 - (★★★★★) 의식을 업로드할 수는 있지만 그 연산 비용을 감당할 수 없는 가까운 미래에, 한 사업가가 서로 연결되지 않은 계산들의 먼지 속에 흩어진 불연속적인 조각들로 그들을 실행하는 방식으로 대부호들에게 불멸을 팝니다. 이어서 소설은 그렇게 조각난 존재가 실재하는지를 진지하게 묻고, 너무나 대담해서 별도의 위키백과 문서까지 있는 형이상학(“먼지 이론”)으로 답합니다. 이건은 SF 최고의 고독 장면 중 하나도 써냈는데, 가상의 정원사가 주관적 시간으로 만 년 동안 똑같은 불가능한 정원을 가꾸는 장면입니다.
-
◇ — The Hidden Girl and Other Stories, 저자 Ken Liu - (★★★) 다재다능한 작가의 들쭉날쭉한 단편집입니다. 중국 역사물과 표제작 중편(현대에 나타난 봉건 시대 일본의 암살자)은 훌륭합니다. 일부 AI 단편은 필수라기보다는 무난한 수준입니다.
-
◇ — A Scanner Darkly by Philip K. Dick - (★★★) 너무나 철저하게 구획화된 나머지 자기 자신을 감시하라는 임무를 받고, 너무나 심하게 약에 취한 나머지 그 사실조차 알아차리지 못하는 위장 마약 수사관의 이야기입니다. 딕의 다른 장편들보다 더 웃기고 더 자전적입니다. 후기는 명치를 한 대 얻어맞은 듯한 충격을 줍니다.
-
◇ — Lessons in Chemistry by Bonnie Garmus - (★★★) 1960년대의 한 화학자가 연구실에서 밀려나 낮 시간대 요리 프로그램을 맡게 되고, 그곳에서 요리 대신 화학을 가르치다가 어쩌다 보니 페미니즘의 아이콘이 됩니다. SF라기보다는 비호감 상사 악당이 등장하는 소망 성취형 소설에 가깝지만, 매력적입니다.
-
◇ — Children of God by Mary Doria Russell - (★★★) The Sparrow의 속편입니다. 예수회 신부는 외계 행성으로 돌아가고, 러셀은 같은 세대의 다른 어떤 SF 작가도 진지하게 다루려 하지 않는 것을 계속해서 진지하게 다룹니다. 바로 비인간적인 도덕 질서와 접촉했을 때 가톨릭 신학이 실제로 담고 있는 내용입니다.
-
◇ — Merchanter’s Luck by C.J. Cherryh - (★★★) 체리의 방대한 얼라이언스-유니언 유니버스에 가장 깔끔하게 입문할 수 있는 작품입니다. 쇠락해 가는 1인 화물선이 대형 무역 가문과 얽히게 되고, 조금도 부드러운 구석이 없는 로맨스가 모든 것을 복잡하게 만듭니다. 200쪽 분량입니다. 일요일 하루에 읽으십시오.
-
◇ — Alas, Babylon by Pat Frank - (★★★) 플로리다의 한 작은 마을이 1959년의 핵전쟁에서 살아남아 계속 먹고살아갈 방법을 찾아냅니다. 냉전 시대 재난 소설 가운데 가장 탄탄하고, 또 가장 진정으로 희망적인 작품입니다.
-
⚛ — Star Maker by Olaf Stapledon - (★★★★) 어느 날 저녁 밖으로 나선 한 남자가 자신의 의식이 우주로 들어 올려졌음을 깨닫고, 은하가 품을 수 있는 모든 형태의 생명과 문명을 둘러본 끝에 그것들을 설계한 신과 마주합니다. 스테이플든은 유니버스 전체의 규모로 글을 쓰고, 마지막 장에서는 그보다도 몇 단계 더 큰 규모로 나아갑니다. 지난 90년간 나온 모든 우주적 SF 소설은 이 작품의 영향 아래에 있습니다. 보르헤스도 이 작품을 높이 평가했습니다. 여러분도 그래야 합니다.
-
◇ — The Drowned World by J.G. Ballard - (★★★) 극지방의 만년설이 녹아 런던은 열대의 석호가 되었고, 동물상의 퇴행을 연구하던 한 과학자는 자신도 그들과 함께 퇴행하고 있음을 깨닫습니다. 밸러드의 위대한 재난 소설들 가운데 첫 작품이며, 이 작품에서 재난은 내면에서 일어납니다.
-
⚛ ☰ The Eon Trilogy by Greg Bear - (★★★★) 우주선 크기의 소행성 하나가 지구 궤도에 나타납니다. 그 내부에는 소행성의 폭보다 더 긴 통로가 뚫려 있고, 그 통로는 무한히 겹겹이 쌓인 대체 시간선들로 이어지는 방들로 파여 있으며, 그곳에는 인류의 미래 후손들이 살고 있습니다. 베어는 정치, 물리학, 우주론을 보기 드문 인내심으로 풀어내며, 두 번째 책인 Eternity는 그 시대에 나온 가장 야심 찬 SF 소설 가운데 하나입니다.
-
◇ — The Lathe of Heaven by Ursula K. Le Guin - (★★★) 한 남자의 꿈이 현실을 바꾸어 놓고, 야심 많은 그의 치료사는 그를 이용해 세상을 고치려 들지만, 예상대로 파국적인 결과를 맞습니다. 짧고, 신랄하며, 도가적입니다.
-
◇ — Regenesis, C.J. Cherryh 지음 - (★★★★) 20년 만에 나온 Cyteen의 속편입니다. Cherryh는 전작에서 멈췄던 정치적 여파를 그대로 이어받아 다시 천 페이지를 써 내려갑니다. 첫 권을 읽지 않으면 제대로 즐길 수 없습니다.
-
◇ — This Island Earth, Raymond F. Jones 지음 - (★★) 1952년 작품입니다. 한 엔지니어가 지구를 거쳐 비밀 기술 파이프라인을 운영하는 외계인들에게 영입됩니다. 영화판이 책보다 더 유명하지만 완성도는 더 떨어집니다.
-
◇ — Shockwave Rider, John Brunner 지음 - (★★★★) 컴퓨터 바이러스라고 알아볼 만한 것이 등장하는 소설 중 제가 아는 최초의 작품입니다(Brunner는 이를 “촌충(tapeworm)“이라고 불렀습니다). 전 국민 성격 검사 데이터베이스를 중심으로 조직된 감시 국가에서 도망치는 해커를 축으로 이야기가 전개됩니다. 1975년에 출간되었습니다. 그런데도 2025년에 쓰인 것처럼 읽힙니다.
-
◇ — The Dosadi Experiment, Frank Herbert 지음 - (★★★) 갇힌 인간들과 개구리를 닮은 외계 종족 고와친(Gowachin)이 사는 한 행성이 은하 법률 기관에 의해 극한 환경 실험장으로 운영됩니다. Herbert의 또 다른 걸작 정치 SF 소설이며, Dune이 시도했던 것을 사막 없이 해낸 사실상 유일한 작품이라고 할 만합니다.
-
◇ — Sphere, Michael Crichton 지음 - (★★★) 해저에 있는 외계 구체가 조사팀에게 각자 가장 두려워하는 것을 현실로 불러내는 능력을 부여합니다. Crichton의 스릴러 중 가장 탄탄한 작품입니다. 영화는 건너뛰십시오.
-
⚛ — Singularity Sky, Charles Stross 지음 - (★★★★★) 신(新)차르 체제의 식민 행성에 ’페스티벌(Festival)’이라는 탈희소성 존재가 침입합니다. 페스티벌은 이야기를 받고 기술을 내주는데, 그러다 의도치 않게 일주일 만에 그 행성의 문명을 해체해 버립니다. Stross는 이 설정을 이용해 중앙 계획 경제, 포함 외교, 그리고 “그냥 우주로 나가서 새로 시작하면 된다“는 하위 장르 전체를 풍자합니다. 동시에 상대론적 인과율 문제도 꼼꼼히 다루는데, 이 덕분에 에스카톤(Eschaton, 초월한 후손 AI)이 위반자를 소급해서 지워 버리는 방식으로 시간 여행 금지 규칙을 우주 전체에 강제할 수 있습니다. 속편보다 더 웃기고 더 분노에 차 있습니다.
-
⚛ — Accelerando, Charles Stross 지음 - (★★★★★) 한 기업가 가문의 3대가 특이점의 곡선을 타고 2000년대 초 실리콘 밸리에서부터 내행성계가 컴퓨트로니움으로 분해되는 시점까지 나아갑니다. 이 책은 5년에 걸쳐 발표된 서로 연결된 중단편 아홉 편으로 구성되어 있으며, Stross는 이 형식을 이용해 장과 장 사이에서 변화의 속도가 점점 빨라지는 모습을 보여 줍니다. 첫 장은 제가 아는 SF 산문 중 문단당 밀도가 가장 높습니다. 마지막 장들에서 이 가문은 자기 후손들의 역사 속 각주로 전락합니다.
-
◇ ☰ We Are Legion (We Are Bob), Dennis E. Taylor 지음 - (★★★★) 한 소프트웨어 엔지니어가 자기 복제하는 성간 탐사선에 업로드되고, 이후 시리즈는 그와 점점 서로 달라져 가는 그의 클론들이 평균보다 조금 나은 테크 업계 종사자 수준의 윤리 감각으로 우주를 탐사하는 이야기를 따라갑니다. 그림다크와는 정반대인 작품이지만, 글솜씨가 좋아서 그 점이 결점이 되지 않습니다.
-
⚛ — House of Suns, Alastair Reynolds 지음 - (★★★★★) 지금으로부터 600만 년 뒤, 한 여성의 클론 천 명으로 이루어진 ’라인(Line)’이 상대론적 속도로 은하를 순회하며 20만 년마다 한자리에 모여 기억을 교환합니다. 그런데 누군가 이들을 죽이고 있습니다. Reynolds는 물리학을 정직하게 지키면서(초광속 없음, 실제 시간 지연, 실제 인과 지연) 그 제약을 이용해 SF에서 몇 안 되는 진정한 딥 타임 미스터리를 구축해 냅니다. 기계 인간(Machine People)은 이 장르에서 손꼽히는 최고의 AI 캐릭터입니다.
-
⚛ — The World at the End of Time, Frederik Pohl 지음 - (★★★★★) 식민선 승객들이 항성 내부에서 서로 전쟁을 벌이는 플라스마 존재들에게 이끌려 우주의 종말을 가로지릅니다. 이 존재들은 인간이 지질학적 시간을 대하듯 인간의 시간 척도를 대합니다. Pohl은 우주의 열적 죽음을 배경 그림이 아니라 무대 그 자체로 삼습니다. 10억 년이 짧은 말다툼에 불과한 존재들과 식민지 주민들이 협상하는 후반부 장들은 이 장르의 어떤 작품과도 다릅니다.
가까운 미래에서 온 독백입니다.
향락 경제
알림이 나타납니다. 제 도파민 수용체를 가장 효율적으로 활성화하는 주파수에 정확히 맞춰진 섬세한 크리스털 차임입니다. 제 LuxeLife 임플란트가 기대감에 따른 코르티솔-세로토닌 연쇄 반응을 감지하고, 그 데이터를 HedoniGram 중앙 서버로 전송합니다. 그곳에서 데이터는 제 쾌락 프로필에 정교하게 큐레이션된 또 하나의 데이터 포인트가 됩니다. 방금 점심을 마쳤습니다. 멸종한 철갑상어 열여섯 종의 정수를 DNA 접합으로 담아 월식 중에 수확한, 실험실에서 배양한 캐비아 한 알이었습니다. 이 캐비아는 곱게 빻은 달 먼지를 스며들게 한 식용 24캐럿 금박 웨이퍼 위에 올라 나왔습니다. 이 캐비아는 로봇 철갑상어 자극기로 수정되었습니다. 자극기에서는 모차르트의 유실된 작품만 흘러나왔습니다. 이 작품들은 AI가 그의 신경 패턴에서 복원한 것으로, 배아 발달 기간 동안 진동 결맞음을 극대화하기 위해 양자 얽힘 상태의 악기로 연주되었습니다. 저희 전속 요리 과학자는 이 정밀한 미식 배열이 엘리트 의식과 연관된 최적의 알파파 패턴을 유발한다고 장담합니다. 이 모든 것이 진주 한 알에 고작 $18,000,000으로, HedoniGram의 예측 알고리즘이 보장하는 참여도 지표 0.38% 상승을 고려하면 헐값입니다. 예정된 여가 퍼포먼스를 할 시간입니다.
점심을 “마친” 뒤(진주 한 알을 식사라고 부를 수 있다면 말입니다), 저는 디자이너 라운지웨어를 매만집니다. 미적 우월성의 서약을 한 티베트 승려들이 손으로 짠 에르메스 한정판 캐시미어 혼방으로, 그 나노 섬유에는 제가 가꾸어 온 행복의 생리적 발현을 브로드캐스트하도록 준비된 미세 센서가 내장되어 있습니다. 인피니티 풀의 가장자리는 수평선과 매끄럽게 이어집니다. 서로 다른 열일곱 개 소셜 플랫폼에서 참여를 극대화하기 위해 특별히 제작된 착시입니다. 반들거리는 수면에 제 모습이 비칩니다. 동공은 확장되어 있고, 얼굴 근육은 알고리즘이 꾸밈없는 기쁨의 최적 표정이라고 판정한 형태로 배열되어 있습니다.
“진정한 세련됨은 절대적인 희소성을 요구합니다.” 저는 늘 그렇듯 Extinctique 핸드백을 어루만지며 이렇게 운을 뗄 것입니다. 이 핸드백은 단 세 개만 생산되었으며, 각각 심각한 멸종 위기에 처한 여덟 종의 마지막 생존 개체로 만들어졌습니다. 가죽 작업에는 서로 격리되어 일하는 장인 스물일곱 명이 필요했으며, 이들은 모두 사후에도 효력이 이어지는 비밀 유지 계약에 서명했습니다. 무두질 공정에만 유난히 손이 작다는 이유로 선발된 아동 노동자 열두 명이 투입되었으며, 이들은 노동 규제가 미치지 않는 지하 작업장에서 일했습니다. 바느질을 마친 장인들은 결코 그 작업을 재현할 수 없도록 이후 영구적으로 시력을 잃게 되었습니다. 이는 이제 명품 아틀리에 계약의 표준 독점 조항입니다. 3,680만 달러($36.8 million)라는 가격은 그 진정한 가치를 거의 반영하지 못합니다. 재료를 조달하는 데 필요했던 수많은 원주민 강제 이주 작전, 심리적 고통으로 스스로 목숨을 끊은 세 명의 장인, 그리고 전략적 정치 후원금으로 우회한 열네 개의 환경 보호법이 그 가치입니다. “말 그대로 만든 이들을 집어삼킨 제품만큼 지위를 잘 전달하는 것은 없습니다“라고 저는 덧붙이고, 핸드백의 인증 칩은 제 열망 반경 안에 있는 모든 이에게 제 소유권 검증 정보를 전송합니다. “그리고 제 블리스 펀드(Bliss Fund)에 매달 소소한 기부를 해 주시면, 전략적 과시적 소비를 통해 고통을 초월하는 방법을 보여 드리겠습니다.”
이것이 지금 우리의 현실, 우리가 쾌락주의 경제라고 부르는 것입니다. 이는 알고리즘 이전 시대의 예스러운 글들이 설파하던 마음챙김의 현존이 아닙니다. 필터를 입힌 사진 한 장 한 장, 위치 태그 하나하나, 카라라 대리석을 배경으로 정성껏 각도를 잡은 아보카도 토스트 사진 한 컷 한 컷을 통해 우리가 집단적으로 설계해 낸 에피쿠로스적 시뮬레이션입니다. 여가는 단순히 플랫폼화된 것이 아닙니다. 여가는 체계적으로 쪼개져 연출된 평온을 보여 주는 마이크로초 단위의 전시가 되었고, 그 하나하나가 너무나 치밀하게 계산된 나머지 진정한 휴식이라는 개념조차 시대착오, 즉 인류의 디지털 이전 역사에서 온 기묘한 유물이 되어 버렸습니다. 쾌락주의 경제는 모든 것을 집어삼켰습니다. 한가함은 더 이상 부의 행운 어린 부산물이 아닙니다. 그것은 어텐션 시장의 핵심 상품이며, 석탄이 산업 시대의 선대 자본주의에 그러했듯 현대 자본주의에 필수적입니다.
이 현실의 중심에는 쾌락 인식론의 탁월한 건축적 체계인 HedoniGram이 있습니다. 혹은 저희 알고리즘 엔지니어들이 완곡하게 명명하듯, HOT, 즉 쾌락주의 최적화 기술(Hedonism Optimization Technologies)입니다. 이곳에서 여가는 단순한 활동이 아닙니다. 여가는 정체성 형성의 기초 통화입니다. 수영장 가에서 보내는 모든 순간은 독점적 감성 분석을 통해 ‘초월적 마음챙김’, ‘열망의 휴식’, ’전략적 나태’로 꼼꼼하게 분류된 뒤, 지위의 기표로 연금술처럼 변환됩니다. 우리는 단순한 콘텐츠 크리에이터가 아닙니다. 우리는 존재론적 기업가이며, 너무나 근본적으로 탐나는 현실을 구축한 나머지 목격하는 것과 경험하는 것의 구분이 기술적으로 쓸모없어졌습니다. 이제 자신의 가치를 확립하는 유일하게 진정한 방법은 알고리즘으로 최적화된 한가함을 치밀하게 큐레이션하는 것입니다. 그것은 영원히 도달할 수 없다는 바로 그 사실을 통해 당신의 존재를 입증하는 것을 유일한 목적으로 삼는 환영 같은 휴가입니다. 이 모든 것에는 부유함에 가까이 있음을 드러내기 위해 구매할 수 있는 베블런재가 뒤따르며, 각 상품에는 알고리즘의 명품 합의가 바뀔 때마다 당신의 지위 표지를 자동으로 갱신하는 소프트웨어가 내장되어 있습니다.
그리고 저는 당연히 핵심 플레이어입니다. 저는 820만 명에 이르는 헌신적인 “열망자(Aspirants)” 팔로워를 거느리고 있습니다—HedoniGram의 독점 지표인 선망 유도 지수(Envy Induction Index)에 따르면 자극에 대한 신경화학적 반응이 최소 89%의 일관성으로 절박한 갈망을 나타내는 사용자들입니다. 그들은 매일 자신의 욕망을 제 욕망에 동기화하며, 그들의 신경 임플란트는 제가 브로드캐스트하는 겉보기 충족 상태에 맞추어 그들의 도파민 민감도를 조정합니다. 저는 수학적 정밀함으로 느긋하게 쉬며, 제 휴식은 인지 부조화를 일으키지 않으면서 계급 경계를 강화하기에 최적의 위치라고 알고리즘이 판별한, 신중하게 선택된 배경들에 분산되어 있습니다. 저는 임상적인 효율로 평온을 발산하며, 여유로운 순간 하나하나는 제 시청자 세그먼트 특유의 신경화학적 중독 프로필에 맞추어 보정되어 있습니다. 제가 가꾸어 온 행복감—한때 진정한 포만을 알리던, 모조된 풍요에 대한 그 본능적이고 자율신경적인 반응—은 정량화되고, 최적화되고, 상품화되어 “열망 지표“가 되었습니다. 우리 욕망의 냉정한 큐레이터인 알고리즘은 이를 “쾌락 템플릿 콘텐츠“라고 분류합니다. 실천의 차원에서 이것은 소비자 자본주의의 말기 단계를 나타내며, 그 단계에서는 욕망의 신경화학 자체가 경제적 통제의 도구가 됩니다. 이는 우리가 서로의 소유물뿐 아니라 획득에 앞서는 내밀한 전기화학적 과정까지 감시하는 분산형 판옵티콘입니다.
압박은 끊이지 않습니다. 지난주, UltraElite HedoniGram 인플루언서 ZephyrLuxe가 240만 달러($2.4 million)짜리 대기 휴가를 선보였을 때 제 참여도 지표는 0.87% 급락했습니다. 히말라야 봉우리에서 수입한 독점 산소 혼합물을 필립 스탁이 디자인한 휴대용 용기에 압축해 담은 것으로, 들이쉬는 숨마다 실제 명상이라는 번거로움 없이 고대 승려들의 인지적 명료함을 전해 준다고 합니다. 제가 큐레이션한 호흡 수련—한때 제 지표를 지탱할 만큼 충분히 선망받던—은 순식간에 구식이 되어 버렸습니다. 쾌락의 쳇바퀴는 무자비하게 가속되었습니다.
이 끊임없는 과시 경쟁은 물론 엘리트주의의 새로운 경지로 이어졌습니다. 도파민 급증을 천박하게 드러내는 것은 상류층을 열망하는 계급의 명백한 표식이 되었습니다. 진정한 엘리트들은 이제 정교하게 보정된 신경 평탄선—“호화로운 공허(Luxurious Void)”—을 가꾸며, 천문학적인 사치에 둘러싸인 채 완벽한 신경학적 고요를 방송합니다. 인플루언서들은 훈련되지 않은 의식이라면 쾌락으로 찢겨 나갈 만한 경험을 하는 동안에도 피질의 침묵을 유지해 주는 양자 안정화 기분 억제제에 수십억을 지불합니다. 초부유층은 개인 무쾌감증 설계사를 고용해 변연계를 재배선하며, 이로써 $9천만짜리 인공 오로라 체험이 신경학적으로 페인트가 마르는 것을 지켜보는 일과 똑같이 기록되도록 합니다. 히말라야 산소 컨시어지나 멸종종 캐비아를 실제로 즐기는 것처럼 보이는 것만큼 치명적으로 절박함을 드러내는 일은 없습니다. 최근 BlissBaroness는 불가능의 준궤도 쾌락 궁전에서 3주간 머무는 내내 신경 지표가 완벽한 공허를 나타내는 가운데 “황홀경이란 참으로 부르주아적입니다“라고 선언했습니다. 궁극의 사치는 더 이상 쾌락에 대한 접근이 아니라 쾌락에 대한 면역입니다—삶을 즐기는 능력 자체를 완전히 초월했음을 증명하는 것입니다.
그러니 실제로 현존하려는 실험이 어김없이 알고리즘에 의해 “참여 이상 현상“으로 표시되고, 이어서 더 선망받는 콘텐츠의 산더미 아래 묻히는 것도 놀라운 일이 아닙니다. 인프라 자체가 끝없는 갈망에 보상하고 포만을 처벌하도록 설계되어 있을 때 의미 있는 만족은 불가능해집니다. 이는 평정심의 가능성 자체에 맞서 쾌락의 쳇바퀴를 알고리즘으로 강제하는 것입니다. 초월의 메커니즘이 수익 모델에 너무나 철저히 통합되어 명상 자체가 프리미엄 콘텐츠 범주가 되고, 깨달음의 시뮬레이션을 가능하게 하는 동시에 플랫폼 참여도 지표의 주된 동력으로 기능하게 되면, 영적 각성은 불가능해집니다.
믿기 어렵겠지만, 저도 한때는 진정한 만족에서 우러나 느긋하게 쉬던 시절이 있었습니다. 무집착이라는 오류를 순진하게 믿던 시절, 여가의 목적이 지위의 구획이 아니라 회복이라고 생각하던 시절 말입니다. 지금은 어떻습니까? 지금 저는 분기 전망이 요구하기 때문에 몸을 기댑니다. 제 평온은 기업 대차대조표에 “전략적 열망 콘텐츠 제작” 항목으로 기재되어 있습니다. 제가 가장 두려워하는 것은 실존적 불만이 아니라 알고리즘에 의한 강등입니다—“선망도 불충분“으로 분류되어, 결국 오늘날 사회적 죽음에 해당하는 진정한 경험이라는 연옥 같은 영역으로 추방되는 것 말입니다.
그래서 이제 저희는 대신 여가를 브로드캐스트합니다. 기쁨을 경험하기 위해서가 아닙니다. 진정으로는 아닙니다. 쾌락 최적화를 수행하기 위해서입니다. 여기에는 근본적인 차이가 있습니다. 기쁨을 경험한다는 것은 충분함의 가능성, 즉 현재 상황에 만족할 가능성을 내포합니다. 최적화를 수행한다는 것은 욕망의 불변성을 자연 질서로 확립하는 것입니다. 이는 해결 없는 영원한 시시포스적 순환이며, 만족이 단지 불가능할 뿐 아니라 개념적으로 이해조차 할 수 없는 획득-적응 단계에 영구히 매달려 있는 상태입니다. 그리고 향락 경제(Sybaritic Economy)에서 최적화는 수익을 창출합니다. 다만 그 통화로는 동일한 근원적 탐욕이 점점 더 정교하게 발현된 것들 외에는 아무것도 살 수 없으며, 이는 마치 반복할 때마다 해탈에 다가가는 것이 아니라 오히려 해탈에서 멀어지는, 불교적 수행 단계를 기괴하게 뒤집어 놓은 것과 같습니다.
바로 어제, ZephyrLuxe 사건에 맞서고 제 지표를 끌어올리기 위해 저는 최신 지위 획득물을 배치했습니다. 윤일에 일어나는 일식 동안에만 채취한 노르웨이 빙하 얼음으로 제작한 $17,000,000짜리 극저온 수면 챔버로, 그 주변 음향 시스템에서는 멸종한 열대우림 새들의 AI 복제본이 연주한 곡이 흘러나옵니다. 초기 신경 측정 반응은 일시적 충족감이 26% 급증했음을 나타냈고, 이는 정확히 47분 동안 지속되었습니다. 그 뒤 HedoniGram 알고리즘이 TranquilityTycoon이 태평양 수면 아래 2,000미터에 설치된 심해 명상 포드를 손에 넣었다고 알려 왔습니다. 그곳에서는 수압이 의식을 압축하여 수면 위의 마음챙김으로는 얻을 수 없는 지복의 특이점으로 만든다고 합니다. 일시적인 만족감은 즉시 증발했습니다. 러닝머신이 앞으로 내달렸습니다.
바로 거기에 절묘한 도착(倒錯), 궁극의 아이러니가 있습니다. 쾌락주의 경제에는 만족이 존재하지 않습니다. 경쟁하는 알고리즘들이 신경화학적 의존을 노리고 최적화한, 동시에 일어나는 평행한 열망만이 있을 뿐입니다. 각 개인은 저마다 개인화된 욕망의 쳇바퀴 안에 밀봉되어 있습니다. 도달할 수 없는 경험을 갈망합니다. 일시적인 인정을 받습니다. 그리고 진정한 충족은 경험하지 못합니다. 이제 시장의 보이지 않는 손은 여러분의 욕망을 골라 주면서 그 선택이 자율적으로 이루어졌다고 믿게 만듭니다. 그 목적은 행복을 돕는 것이 아니라 질투와 참여를 극대화하는 것입니다.
심지어 제 욕망도 아닙니다. 정말로 그렇지 않습니다. 저의 모방 욕망은 미리 정식화되고, 알고리즘으로 결정되고, 최대의 열망 강화를 위해 최적화된 채 도착합니다. 마치 제 인지 구조를 탈취하는 어떤 기생성 소비주의 유기체처럼 말입니다. 저는 원하지 않습니다. 저는 분류합니다. 저는 즐기지 않습니다. 저는 기존 스키마를 확인해 주는 패턴을 식별합니다. 경험은 열망이 정렬된 청중에게서 특정한 변연계 반응을 유발하도록 설계되며, 그 반응은 측정되고 정량화되고 수익화될 수 있습니다. 저는 진정한 욕망과 수행적 정체성의 구분을 지워 버리는 경험 상품화의 재귀적 시스템 속에서 생산자이자 상품이며, 조종하는 자이자 조종당하는 자입니다. 막스 베버는 이런 전개를 결코 예상하지 못했습니다—우리가 자발적으로 경험의 과정을 알고리즘 관리에 맡기고, 진정으로 즐길 수 있는 능력이 시장의 명령에 따라 체계적으로 분해되고 재구성되는 궁극의 합리화 말입니다.
이 시스템 전체는 당연히 경쟁적입니다. 제가 특히 부러움을 살 만한 과시를 연출하면 열망자들이 제 지복 지표(Bliss Metric)에 기여합니다. 정량화된 열망 정렬을 나타내는 가상 토큰이 욕망 강화를 비뚤어진 방식으로 게임화한 형태로 제 대시보드 위로 쏟아져 내립니다. 관객이 내뱉는 탄성의 디지털 버전입니다. 실시간 리더보드가 존재합니다. 저는 “ZenLuxeGuru“보다 약간 아래 순위를 유지하고 있습니다. 그녀는 대부분의 사람들의 연 소득보다 비싼 애슬레저 차림으로 알고리즘이 정한 이국적인 장소에서 매일 가이드 명상을 진행하는 경험 기업가이며, 그녀의 깨달음은 스물세 가지 서로 다른 영적 전통의 용어를 동시에 아우르는데, 비평가들은 이를 “탈일관적 영성의 결정적 발현“이라고 묘사했습니다. 그녀는 최근 아마존 청개구리의 송과선에서 채취한 신경전달물질을 미량 투여하여 48시간 동안의 초월 상태를 이루어 냈는데, 이 물질은 무려 열두 가지 서로 다른 샤먼 전통에서 축성한 옥 바늘로 투여되었습니다. 그다음으로는 “MinimalMaximalist“가 있습니다. 그는 역설적으로 단순함의 미덕을 설파하면서도 부를 드러내도록 큐레이션한 소유물을 체계적으로 전시합니다—영적 성취의 시뮬라크르를 물신화하는 사람들을 겨냥한, 특화되었지만 놀라울 만큼 수익성이 높은 시장 부문입니다. 그의 최신 반물질주의 선언문은 전부 회수한 운석 파편으로 지은 $2,800만짜리 벙커에서 발표되었으며, 각 운석은 그의 개인 점성술사 팀이 길하다고 판정한 특정 별자리를 통과했다는 인증을 받았습니다.
저 자신도 다음 공세를 준비하고 있습니다. 오직 제 생체전기 신호에만 반응하도록 유전자를 변형한 독점 생물발광 플랑크톤 품종으로, 산업화 이전 바다의 정확한 화학 조성을 재현하도록 만든 개인 바다에서 배양합니다. 이것은 약 14분 동안 알고리즘상의 우위를 가져다줄 것이고, 그 뒤 BlissBaroness가 고식물학적 DNA 재구성으로 되살린 멸종 꽃에서 채취한 이슬 컬렉션을 선보일 것입니다. 각 이슬방울은 창작 과정 중 행복을 느끼는 것이 계약상 금지된 익명의 장인 유리 공예가들의 결정화된 눈물로 만든 유리병에 담겨 있습니다.
절박함은 분기마다 고조됩니다. 엘리트 인플루언서들은 이제 시간적으로 독점된 일몰을 구매합니다—알고리즘 접근권을 결제한 사람들에게만 보이는 고유한 빛 스펙트럼을 보장하는 독점적 대기 개조입니다. HedoniGram은 최근 의식 프랜차이징을 도입하여 A급 경험 설계자들이 자신의 신경 패턴을 수익화할 수 있게 했으며, 이들은 72시간 동안 시뮬레이션된 엘리트 의식을 누리는 대가로 연간 총소득의 38%를 기꺼이 내놓는 지망자(Aspirant)들에게 자신의 정밀한 신경화학적 구성을 일시적으로 빌려줍니다. 그러나 궁극의 사치—쾌락적 구별짓기의 정점—는 이제 일시적 비존재 패키지(Temporary Non-Existence Package)가 되었습니다. 이는 자동화된 알고리즘이 여러분의 소셜 존재감을 유지하는 동안 의식을 신체에서 일시적으로 추출하여 독점 클라우드 서버에 저장하는, 완전한 자아 해체의 양자 정지 상태입니다. 시간당 고작 4,200만 달러($42 million)로, 디지털 아바타가 최고 수준의 참여도 지표를 유지하며 열망을 자극하는 여가를 계속 연기하는 동안 여러분은 절대적 비존재의 행복을 경험하실 수 있습니다. “브랜드를 최적화하면서 자아를 초월하십시오“라고 마케팅 캠페인은 약속합니다. 온라인 페르소나의 번창을 보장받으면서 일시적으로 존재하기를 멈추는 데 터무니없는 금액을 지불한다는 아이러니를 모르는 사람은 없지만, 그것은 여전히 초엘리트층 사이에서 가장 탐나는 경험입니다—욕망의 소멸이 궁극의 지위 상징으로 변모한 것으로, 입력 없는 무감각한 긴장증이라는 궁극의 사치 경험을 누릴 만큼 부유한 사람들만 이용할 수 있습니다.
이 광기 속에서 저는 이따금 진정한 여가란 무엇일지 생각해 봅니다. 그것은 동경의 분류 체계나 수익화 전략으로 즉시 분류되지 않고, 감정 예측 소프트웨어로 분석되지 않으며, 참여 잠재력에 따라 수치화되지 않은 채 노을을 즐기는 것입니다. 그러나 이러한 경험적 독립은 이제 상상할 수 있는 가장 급진적인 행위, 즉 외부의 인정 없이 즐기는 행위가 되었습니다. 그것은 알고리즘 상부구조에 대한 근본적인 반란이자, 디지털로 매개된 경험의 정치경제 전체에 대한 거부입니다. 거의 상상조차 할 수 없는 일입니다.
그러나 그 생각은 덧없이 스쳐 지나갑니다. 시장이 그것을 결코 허락하지 않습니다. 만족은 확장되지 않습니다. 현존에는 바이럴 잠재력이 없습니다. 충분함은 불충분한 ROI를 보여 줍니다. 최적의 시청자 유지를 위해 진정한 만족을 A/B 테스트할 수는 없습니다. 진정한 깨달음에 제휴 마케팅을 붙일 수는 없습니다. 욕망의 본질적 공허함을 인정하는 콘텐츠로는 투자를 유치할 수 없습니다. 동경이 유일하게 신뢰할 만한 참여 동인인 어텐션 경제에서, 포만은 남아 있는 유일한 혁명적 행위이자 인간 인지의 마지막 미정복 영토입니다. 가장 수익성 높은 여가란 기존의 동경 프레임워크를 강화하면서 충족의 시뮬라크르를 제시하는 것, 즉 경험적 성장이라는 환상적 만족을 제공하면서도 욕망 의존의 근본 구조는 완벽하게 그대로 남겨 두는 것입니다.
그리하여 이 패러다임에서는 정량화될 수 없는 것, 참여도 지표를 만들어 내지 못하는 것, 알고리즘적 분류에 저항하는 것은… 사실상 존재하기를 멈춥니다. 여러분의 사적인 만족은 낭비된 신경 용량에 불과합니다. 수익화되지 않은 기쁨은 남아 있는 유일한 이단이며, 현대의 경험적 존재의 모든 차원을 정당하게 식민화한 기술자본주의 정통에 대한 모독입니다.
그리고 이것이 저를 다시 현재의 순간으로 데려옵니다. 제 신경 임플란트가 활성화됩니다. 퍼포먼스가 시작됩니다. 저는 목을 가다듬고 신경 브로드캐스트를 활성화하며, 알고리즘이 결정한 열망의 기표들, 즉 제 참여도 지표와 선망, 그리고 제 추종자들의 신경화학적 의존도를 모두 극대화하도록 전략적으로 선택된 기표들에 집중합니다.
“진정한 세련됨은 절대적 희소성을 요구합니다“라고 저는 다시 선언합니다. 제 목소리는 제 인구통계학적 타깃의 측좌핵 반응을 유발하는 것으로 입증된 정확한 주파수로 변조되어 있습니다.
저는 여러분의 지위 불안을 잠시나마 덜어 주기 위해 접근 불가능성을 판매합니다. 여러분은 제가 만들어 낸 풍요를 통해 인위적인 근접성을 경험하는 특권에 돈을 지불합니다. 우리는 함께 쾌락의 쳇바퀴를 가속합니다.
결국 열망만이 진정한 충족을 흉내 낼 수 있는 유일하게 남은 수단이기 때문입니다. 당신의 욕망 충족을 저의 경험을 통해 외부화하십시오. 러닝머신은 결코 멈추지 않습니다. 오히려 점점 빨라질 뿐이며, 우리 모두를 같은 근원적 공허가 점점 더 부티크하고 비잔틴적인 모습으로 나타나는 쪽으로 실어 나릅니다. 그 모습은 하나같이 앞의 것보다 더 정교하게 빚어져 있습니다.
프로세스 보상 모델
요즘 추론 모델이 크게 유행하고 있으며, 특히 그 바탕이 되는 학습 데이터가 뜨거운 화제입니다. 그중 한 가지 사례가 프로세스 보상 모델입니다. 이는 원하는 결과를 얻는 데 중간 단계의 평가가 결정적인 복잡한 추론 및 의사 결정 작업에 사용되는 보상 모델의 한 유형입니다. 요컨대 다른 모델의 추론을 이끌어 주면서, 그 모델이 올바른 방향으로 가고 있는지 아니면 벗어나고 있는지 알려 줄 수 있는 모델을 만들고자 합니다.
이 글의 소스 코드는 https://github.com/sdiehl/prm에서 확인할 수 있습니다.
최근 추론을 확장하는 새로운 접근 방식들이 LLM 분야에서 획기적인 성능 향상을 이끌어 냈습니다. 기본적인 샘플링 및 탐색 전략을 활용하고, 특히 이를 맞춤형 검증기, 점수 함수, 프로세스 보상 모델과 결합함으로써, 이제는 작은 모델이 훨씬 더 큰 모델을 능가하는 모습을 보게 되었습니다. 이는 상당히 흥미로운 발전입니다!
그러면 잠시 한 걸음 물러나 보상 모델 전반에 대해 이야기해 봅시다. 보상 모델은 다른 언어 모델의 출력에 대한 평가자 또는 비평가 역할을 하는 특화된 모델입니다. 보상 모델은 (언어 모델의 응답과 같은) 텍스트를 입력받아, “좋은” 응답이 어떤 모습인지에 관한 학습 데이터 속 상관관계에 따라 해당 텍스트가 얼마나 “좋은지“를 나타내는 점수를 출력합니다.
예를 들어, 보상 모델은 다음과 같은 기준에 따라 응답에 점수를 매길 수 있습니다:
- 유용성(Helpfulness): 프롬프트에 대한 응답의 전반적인 유용성입니다.
- 정확성(Correctness): 관련된 모든 사실을 오류 없이 포함하고 있는지입니다.
- 일관성(Coherence): 표현의 일관성과 명료성입니다.
- 복잡성(Complexity): 응답을 작성하는 데 필요한 지적 깊이입니다(즉, 기본적인 언어 능력만 있으면 누구나 작성할 수 있는 응답인지, 아니면 깊은 도메인 전문 지식이 필요한 응답인지).
- 장황성(Verbosity): 프롬프트에서 요구한 것에 비해 응답에 포함된 세부 정보의 양입니다.
Nemotron-4-340B-Reward는 이 지표를 사용하여 사용자/어시스턴트 간 상호작용의 품질을 평가합니다.
from openai import OpenAI
client = OpenAI(
base_url = "https://integrate.api.nvidia.com/v1",
api_key = "..."
)
completion = client.chat.completions.create(
model="nvidia/nemotron-4-340b-reward",
messages=[
{"role": "user", "content": "What is the capital of France?"},
{"role": "assistant", "content": "Paris is the capital of France."}
],
)
print(completion)
보상 모델의 출력은 사용자/어시스턴트 간 상호작용의 등급을 열거한 것입니다.
helpfulness: 2.1875
correctness: 2.109375
coherence: 3.46875
complexity: 0.330078125
verbosity: 0.38671875
보상 모델은 일반적으로 인간의 선호도를 바탕으로 학습됩니다. 즉, 모델에 응답 쌍을 보여 주고 인간이 어느 쪽을 선호했는지 가르칩니다. 이를 통해 보상 모델은 인간의 판단에 따라 무엇이 “좋은” 응답을 만드는지 학습할 수 있습니다.
이것의 변형이 프로세스 보상 모델이며, 이는 추론 과정의 각 단계의 품질을 평가합니다. 프로세스 보상 모델은 원하는 결과를 얻는 데 중간 단계의 평가가 결정적인 복잡한 추론 및 의사 결정 작업에 사용되는 보상 모델의 한 유형입니다. 최종 결과만을 고려하는 결과 보상 모델(ORM)과 달리, PRM은 각 단계마다 피드백을 제공하여 중간 행동의 가치를 포착하고 문제 해결 과정에 대해 보다 세분화된 관점을 제공합니다.
프로세스
프로세스란 행위자(또는 언어 모델)가 문제를 해결하기 위해 거치는 일련의 단계를 의미합니다. 이 단계들은 토큰으로 인코딩된 자연어 단계의 집합이며, 행위자를 해답으로 “안내“한다고 가정하겠습니다.
[
"Calculate the area of a circle with radius 5.",
"We know that the formula for the area of a circle is $\pi r^2$.",
"The radius of the circle is 5, so we can substitute that in.",
"So the area of the circle is $\pi(5)^2$ = $\boxed{25\pi}$.",
]
다음과 같은 문제 명세가 있다고 합시다.
- : 문제 명세
- : 문제를 해결하기 위해 거친 단계의 시퀀스
- : 최종 답
그러면 사고의 연쇄(chain of thought)는 와 같은 시퀀스이며, 예를 들면 다음과 같습니다:
예를 들면 다음과 같습니다.
사고의 연쇄 의 확률은 다음과 같이 주어집니다.
일부 문제에서는 최종 답의 정확성을 평가하는 데 사용할 수 있는 검증 함수가 있습니다.
일련의 단계가 올바른지 평가하는 데 사용할 수 있는 검증 함수가 있을 수도 있습니다.
이러한 함수는 수학적 추론과 같은 특정 영역에서는 구현할 수 있으며, 증명이나 계산을 형식적으로 검증하는 것이 가능할 수도 있습니다. 그러나 이는 여전히 활발히 연구되는 분야이며, 최소한 매우 어려운 공학적 문제이고 일반적인 경우에는 (라이스 정리에서 보듯이) 다루기 불가능합니다. 그럼에도 사고의 연쇄의 품질을 평가하도록 확률 모델을 학습시킬 수는 있으며, 실제로 이는 검증 함수를 다루기 불가능한 경우에도 모델의 추론이 더 나은 방향으로 나아가도록 이끌 수 있습니다.
그 밖의 용어는 다음과 같습니다.
- **논리적 비약(non-sequitor)**이란 문제 해결에 기여하지 않는 단계를 말합니다.
- 프로세스에 논리적 비약이 없으면 그 프로세스는 **완전하다(complete)**고 합니다.
- 프로세스가 올바른 최종 답에 도달하면 그 프로세스는 **정확하다(correct)**고 합니다.
- 프로세스가 완전하고 정확한 경우에만, 그리고 그 경우에 한해 그 프로세스는 **타당하다(valid)**고 합니다.
프로세스는 정확하지만 불완전할 수도 있고, 부정확하지만 완전할 수도 있으므로 이 구분은 다소 미묘합니다. 예를 들어, 어떤 프로세스는 올바른 답에 도달하지만 불필요하거나 무관한 단계를 포함할 수 있습니다(정확하지만 불완전함). 반대로, 어떤 프로세스는 완벽하게 논리적인 단계를 차례로 밟지만 계산 오류나 잘못된 가정 때문에 틀린 결론에 도달할 수 있습니다(부정확하지만 완전함). 이상적인 프로세스는 완전하면서도 정확한 프로세스, 즉 올바른 답에 도달하는 데 기여하는 관련 단계만을 포함하는 프로세스입니다.
또한 같은 초기 상태에서 시작하여 서로 다른 최종 상태로 끝날 수 있는 프로세스의 집합을 가리켜 *궤적(trajectory)*이라는 용어를 사용하겠습니다. 형식적으로, 궤적은 로 표기하며, 이는 초기 상태 에서 시작하는 모든 가능한 프로세스 시퀀스 의 집합을 나타냅니다.
*프로세스 보상 모델(process reward model)*의 목표는 타당한 프로세스의 샘플링을 유도하기 위해 궤적에서 보상 값으로의 사상(즉, )을 학습하는 것입니다.
이는 최종 답에서 보상 값으로 사상하는(즉, ) *결과 보상 모델(outcome reward model)*과 대조되며, 결과 보상 모델은 모델이 올바른 최종 답을 생성하도록 학습하는 전통적인 사후 학습(post-training)에서 흔히 쓰입니다.
프로세스 생성
프로세스를 생성하는 가장 간단하고 정확한 방법은 인간 전문가가 문제를 풀고 프로세스를 작성하게 하는 것입니다. 그러나 이 방법은 확장성이 없으므로 다른 방법을 개발해야 합니다.
이 분야의 큰 돌파구는 모델이 사람이 작성한 예시를 단순히 모방하는 대신 강화 학습을 통해 스스로 사고의 연쇄를 생성하고 다듬음으로써 더 잘 추론하는 법을 학습할 수 있다는 사실을 연구자들이 발견하면서 찾아왔습니다. 이는 인간의 시연만으로 가능했던 수준을 훨씬 넘어 추론 능력을 확장할 수 있게 해 준 결정적인 깨달음이었습니다. 모델이 RL을 통해 자신의 추론 프로세스를 효과적으로 부트스트랩할 수 있다는 발견은, 오늘날 복잡한 문제를 풀도록 언어 모델을 학습시키는 방식에 근본적인 전환을 가져왔습니다.
이러한 프로세스의 부트스트랩을 시작하는 가장 간단한 방법은 추측 후 확인(guess and check) 방법을 사용해 모델 자체가 프로세스를 생성하게 하는 것입니다. 문제 명세 와 알려진 답의 집합 가 있다고 가정하면, 다음과 같이 궤적의 집합 를 생성할 수 있습니다.
- 모델이 서로 다른 추론 경로를 시도하게 하여 여러 개의 풀이 궤적(일반적으로 문제당 약 15개)을 생성합니다
- 궤적의 각 중간 단계마다 가능한 완성(completion)을 여러 개(단계당 약 16개) 샘플링합니다
- 각 완성을 평가합니다. 어느 하나라도 올바른 최종 답에 도달하면 해당 단계를 양성(
+)으로 레이블링합니다 - 한 단계의 모든 완성이 올바른 답에 도달하지 못하면 해당 단계를 음성(
-)으로 레이블링합니다
언어 모델이 여러 경로를 탐색하게 한 다음, 정답으로 이어지는 경로를 선택합니다. 이 방법으로 최소한의 과정(혹은 유효한 과정조차)을 찾는다는 보장은 없지만, 올바른 과정을 어느 정도 찾아낼 수 있으며 이는 좋은 출발점이 됩니다.
과정 보상 모델 구축하기
수학적 추론에 관한 학습 예제 집합을 바탕으로 추론 사슬의 각 단계가 지닌 품질을 평가하는 모델을 구축하는 학습 파이프라인을 만들겠습니다. 전반적으로 성능이 좋으면서도 평범한 GPU에서 훈련할 수 있을 만큼 작은 기본 Mistral-7B-0.3 모델을 사용하여 PRM 역할을 하도록 훈련하겠습니다.
학습 과정에서는 추론 사슬의 각 단계가 올바른 해답에 도달하는 데 도움이 되는지(+) 또는 도움이 되지 않는지(-)를 예측하도록 모델을 미세 조정합니다. 이러한 이진 분류 방식을 통해 모델은 다양한 유형의 문제에서 무엇이 효과적인 추론 단계를 이루는지 학습할 수 있습니다.
prm 라이브러리와 함께 transformers, datasets, torch 라이브러리를 설치해야 합니다. PRM 라이브러리는 과정 보상 모델을 위한 특화된 훈련 유틸리티를 제공하며, Hugging Face 라이브러리는 기반이 되는 모델 아키텍처와 훈련 인프라를 담당합니다.
pip install transformers datasets torch
pip install git+https://github.com/sdiehl/prm.git
먼저 필요한 임포트와 설정을 갖춘 훈련 스크립트를 준비합시다. 대규모 모델을 효율적으로 다루려면 적절한 멀티프로세싱 설정과 토크나이저 병렬성을 비롯한 여러 시스템 수준 설정을 구성해야 합니다. 모델 초기화 과정에는 패드 토큰을 EOS 토큰과 같게 설정하는 작업(인과적 언어 모델에서 흔히 쓰이는 관행)과 훈련 중 메모리를 절약하기 위해 KV 캐시를 비활성화하는 작업이 포함됩니다.
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments
from datasets import Dataset
import torch
from prm.trainer import ProcessRewardTrainer
import os
# Configure system settings
torch.multiprocessing.set_sharing_strategy("file_system")
os.environ["TOKENIZERS_PARALLELISM"] = "false"
# Initialize model and tokenizer
tokenizer = AutoTokenizer.from_pretrained("mistralai/Mistral-7B-v0.3")
model = AutoModelForCausalLM.from_pretrained("mistralai/Mistral-7B-v0.3")
# Configure model settings
tokenizer.pad_token = tokenizer.eos_token
model.config.use_cache = False
model.config.pad_token_id = tokenizer.pad_token_id
# Setup the step string format template
STEP_TEMPLATE = "Step {i}: {step}"
과정 보상 모델을 학습시키려면 올바른 추론 사슬과 흔히 저지르는 실수를 모두 보여 주는 고품질 학습 데이터가 필요합니다. 수학적 추론 단계로 이루어진 간단한 데이터셋을 만들어 봅시다. 각 예제는 입력 문제, 일련의 추론 단계, 그리고 각 단계가 해답에 긍정적으로 기여하는지를 나타내는 해당 레이블로 구성됩니다. 이러한 구조를 통해 모델은 효과적인 문제 해결 과정의 특성을 학습할 수 있습니다.
raw_dataset = [
{
"input": "Solve the equation: 2x + 6 = 14",
"value": [
"First, subtract 6 from both sides:\n2x + 6 - 6 = 14 - 6\n2x = 8",
"Then, divide both sides by 2:\n2x ÷ 2 = 8 ÷ 2\nx = 4",
"Check the solution:\n2(4) + 6 = 14\n8 + 6 = 14\n14 = 14 ✓"
],
"label": ["+", "+", "+"]
}
]
이제 예제를 학습 예제로 변환하는 함수를 만들겠습니다. 이 함수는 단계를 누적하고 모델이 이해할 수 있는 구조화된 텍스트 형식으로 정리하는 방식으로 각 예제를 처리합니다. 각 단계를 순회하면서 대화와 비슷한 이력을 쌓아 나가며, 모델은 이를 사용하여 추론의 순서를 학습합니다.
def create_training_examples(examples):
"""Convert step-by-step reasoning into training examples"""
training_examples = []
for example in examples:
prompt = example["input"]
steps = example["value"]
labels = example["label"]
accumulated_steps = []
for i, current_step in enumerate(steps):
accumulated_steps.append(current_step)
# Build conversation history
full_text = prompt
for j, step in enumerate(accumulated_steps, 1):
full_text += f"\n{STEP_TEMPLATE.format(i=j, step=step)}"
training_examples.append({
"text": full_text,
"label": labels[i],
"step_idx": i,
"is_final_step": (i == len(steps) - 1)
})
return training_examples
다음으로, 학습 예제를 모델에 적합한 형식으로 전처리해야 합니다. 여기에는 텍스트를 토큰화하고 레이블을 모델이 학습에 사용할 수 있는 형식으로 변환하는 작업이 포함됩니다. 전처리 함수는 모든 입력의 길이가 일정하도록 잘라내기와 패딩을 처리하며, 이는 훈련 중 효율적인 배치 처리에 매우 중요합니다.
def preprocess_function(examples):
"""Convert examples to model inputs"""
encoded = tokenizer(
examples["text"],
truncation=True,
padding="max_length",
max_length=2048,
return_tensors="pt"
)
reward_tokens = torch.tensor([
tokenizer.convert_tokens_to_ids(label)
for label in examples["label"]
])
return {
"input_ids": encoded["input_ids"],
"attention_mask": encoded["attention_mask"],
"labels": encoded["input_ids"].clone(),
"step_idx": torch.tensor(examples["step_idx"]),
"is_final_step": torch.tensor(examples["is_final_step"]),
"reward_tokens": reward_tokens
}
전처리 함수를 정의했으니, 이제 데이터셋을 만들고 모델이 훈련할 수 있는 형식으로 처리할 수 있습니다. 이 단계에서는 효율적인 데이터 처리 기능을 제공하는 Hugging Face Dataset 클래스를 사용하여 원시 데이터셋을 구조화된 형식으로 변환합니다.
# Create dataset
paired_dataset = Dataset.from_list(create_training_examples(raw_dataset))
# Process dataset
processed_dataset = paired_dataset.map(
preprocess_function,
batched=True,
remove_columns=paired_dataset.column_names,
desc="Processing dataset"
)
이제 훈련 인자를 설정하겠습니다. 이 설정들은 에폭 수, 배치 크기, 학습률, 로깅 등 학습 과정의 다양한 측면을 제어합니다. 특히 Mistral 같은 대규모 모델을 다룰 때는 모델이 효율적이고 효과적으로 훈련되도록 적절히 설정하는 것이 필수적입니다.
training_args = TrainingArguments(
output_dir="prm_output",
num_train_epochs=3,
per_device_train_batch_size=1,
learning_rate=2e-6,
logging_dir="logs",
logging_steps=10,
save_strategy="epoch",
remove_unused_columns=False,
gradient_accumulation_steps=4, # Increased for Mistral's size
fp16=True, # Enable mixed precision training
local_rank=-1
)
학습 인자를 설정했으면 트레이너를 초기화하고 학습 과정을 실행할 수 있습니다. ProcessRewardTrainer 클래스는 데이터 로딩, 모델 업데이트, 로깅을 포함한 훈련 루프를 처리합니다. 또한 메모리 제약이나 예기치 않은 오류처럼 훈련 중에 발생하는 문제를 관리하기 위한 오류 처리 기능도 포함되어 있습니다.
# Initialize trainer
trainer = ProcessRewardTrainer(
model=model,
args=training_args,
train_dataset=processed_dataset,
tokenizer=tokenizer,
data_collator=None
)
# Train with error handling
try:
trainer.train()
trainer.save_model("prm_output/final_model")
tokenizer.save_pretrained("prm_output/final_model")
except Exception as e:
print(f"Training failed with error: {str(e)}")
import gc
gc.collect()
torch.cuda.empty_cache()
raise e
이제 PRM 학습 과정의 내부를 살펴보겠습니다. 일반적인 인과 언어 모델과는 조금 다르게 보상 토큰을 처리하고 손실을 계산해야 합니다. PRM 학습 과정은 보상을 처리하기 위해 특수 토큰 체계를 사용하며, 여기에는 “+“와 “-” 토큰을 해당하는 어휘 ID로 변환하는 작업이 포함됩니다. 이 변환은 모델이 각 단계에 연관된 보상 값을 이해하고 예측하는 데 매우 중요합니다.
class RewardDataCollator:
def __init__(self, tokenizer):
# Convert "+" and "-" tokens to their vocabulary IDs
self.pos_token_id = tokenizer.convert_tokens_to_ids("+")
self.neg_token_id = tokenizer.convert_tokens_to_ids("-")
self.reward_token_ids = [self.pos_token_id, self.neg_token_id]
이 시스템은 +와 -를 특수 토큰으로 사용하여 각각 긍정적 보상과 부정적 보상을 나타냅니다. 이 토큰들은 모델 어휘에서 해당하는 토큰 ID로 변환됩니다. 데이터 콜레이터는 학습 중에 데이터 배치를 준비하는 역할을 맡으며, 보상 토큰이 입력 시퀀스와 올바르게 정렬되도록 보장합니다.
def __call__(self, features):
batch = {}
# Convert boolean labels to reward token IDs
batch["reward_tokens"] = torch.tensor([
self.pos_token_id if label == 1.0 else self.neg_token_id
for label in [f["labels"] for f in features]
])
# Track step position information
batch["step_idx"] = torch.tensor([f["step_idx"] for f in features])
batch["is_final_step"] = torch.tensor([f["is_final_step"] for f in features])
손실 계산 과정은 ProcessRewardTrainer의 compute_loss 메서드에서 처리됩니다. 이 메서드는 입력에서 보상 토큰과 단계 인덱스 같은 메타데이터를 추출하고, 모델의 예측을 바탕으로 손실을 계산합니다. 손실 함수는 보상 토큰에 집중하도록 설계되어 있어, 모델이 각 단계에 대해 올바른 보상 값을 예측하도록 학습하게 합니다.
def compute_loss(self, model, inputs, return_outputs=False, **kwargs):
# Extract metadata
reward_tokens = inputs.pop("reward_tokens")
step_idx = inputs.pop("step_idx")
is_final_step = inputs.pop("is_final_step")
이제 보상 위치를 찾겠습니다. 모델은 보상을 예측해야 하는 위치를 표시하기 위해 플레이스홀더 토큰을 사용합니다. 코드는 입력 시퀀스에서 이 위치들을 찾아내어, 모델이 손실을 계산할 때 시퀀스의 관련 부분에 집중할 수 있게 합니다.
# Get model predictions
outputs = model(**inputs)
logits = outputs.logits
# Locate placeholder tokens
placeholder_positions = torch.where(
inputs["input_ids"] == self.placeholder_token_id
)
batch_indices = placeholder_positions[0] # Which items in batch
seq_indices = placeholder_positions[1] # Position within sequence
모델은 보상을 예측해야 하는 위치를 표시하기 위해 플레이스홀더 토큰을 사용합니다. 코드는 입력 시퀀스에서 이 위치들을 찾습니다.
# Extract logits at placeholder positions
placeholder_logits = logits[batch_indices, seq_indices]
# Focus only on reward token logits (+/-)
reward_logits = placeholder_logits[:, self.reward_token_ids]
이제 목표 레이블을 가져와 이진 형식으로 변환하겠습니다. 이 단계에서는 보상 토큰을 이진 레이블로 매핑하며, 이 레이블은 교차 엔트로피 손실을 계산하는 데 사용됩니다. 이진 형식은 손실 계산을 단순화하여, 모델이 올바른 보상 값을 예측하는 데 집중할 수 있게 합니다.
# Get target labels
labels = reward_tokens[batch_indices]
# Convert to binary format (0 for positive, 1 for negative)
binary_labels = (labels == self.reward_token_ids[0]).long()
# Calculate cross entropy loss
loss = self.loss_fn(reward_logits, binary_labels)
마지막으로, Weights & Biases에서 손실을 관찰할 수 있도록 선택적으로 정확도를 계산하겠습니다. 이 단계는 학습 과정을 모니터링하기 위한 추가 지표를 제공하여, 모델의 성능을 추적하고 필요에 따라 조정할 수 있게 합니다.
if return_outputs:
with torch.no_grad():
predictions = reward_logits.argmax(-1)
acc = (predictions == binary_labels).float().mean()
return loss, {
"logits": logits,
"loss": loss,
"acc": acc,
"step_idx": step_idx,
"is_final_step": is_final_step,
}
추론
이제 모델을 불러와 사고의 사슬을 채점하는 데 사용할 infer.py 스크립트를 설정할 수 있습니다. 추론 과정에는 학습된 모델과 토크나이저를 불러오고, 입력 데이터를 준비하고, 추론 사슬의 각 단계를 평가하는 작업이 포함됩니다. 이를 통해 추론 과정의 품질을 평가하고 개선이 필요한 부분을 파악할 수 있습니다.
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
# Load your trained model and tokenizer
model = AutoModelForCausalLM.from_pretrained("output/final_model")
tokenizer = AutoTokenizer.from_pretrained("output/final_model")
model.eval()
우리 추론 시스템의 핵심(Core)은 단계 확률 함수입니다. 이 함수는 어떤 단계가 긍정적일지 부정적일지의 가능성을 평가하여, 해당 단계가 전체 추론 과정에 기여하는 정도를 정량적으로 측정합니다. 각 단계의 확률을 계산함으로써 어떤 단계가 가장 효과적이고 어떤 단계가 수정이 필요한지 파악할 수 있습니다.
def get_step_probability(input_text, accumulated_steps):
# Combine input and accumulated steps
full_text = input_text
for i, step in enumerate(accumulated_steps, 1):
full_text += f"\nStep {i}: {step}"
# Prepare inputs
inputs = tokenizer(
full_text,
return_tensors="pt",
truncation=True,
max_length=2048
)
with torch.no_grad():
# Set up reward token masking
reward_token_ids = torch.tensor([
tokenizer.convert_tokens_to_ids("+"),
tokenizer.convert_tokens_to_ids("-")
])
# Create logits mask to only allow reward tokens
logits_mask = torch.full((tokenizer.vocab_size,), float("-inf"))
logits_mask[reward_token_ids] = 0
# Get model outputs
outputs = model(**inputs, temperature=0.7, do_sample=True, seed=42)
logits = outputs.logits[:, -1, :] + logits_mask
# Calculate probabilities
probs = torch.softmax(logits, dim=-1)
reward_probs = probs[0, reward_token_ids]
return {
"+": reward_probs[0].item(),
"-": reward_probs[1].item()
}
# Define your problem and steps
example = {
"input": "Find all values of x in the interval [0, 2π] that satisfy sin(x) = 1/2.",
"steps": [
"To solve sin(x) = 1/2, we need to find the reference angle first.\nα = arcsin(1/2) = π/6",
"Since sin(x) is positive in quadrants I and II, and we're looking in [0, 2π], we'll have two solutions:",
"First solution: x = α = π/6 ≈ 0.524 radians",
"Second solution: x = π - α = π - π/6 = 5π/6 ≈ 2.618 radians",
"We can verify these solutions:\nsin(π/6) = sin(5π/6) = 1/2",
"Therefore, the solutions in [0, 2π] are x = π/6, 5π/6.",
]
}
# Evaluate steps progressively
print(f"Question: {example['input']}\n")
accumulated_steps = []
for i, step in enumerate(example["steps"], 1):
accumulated_steps.append(step)
print(f"After Step {i}:")
print("Accumulated steps:")
for j, acc_step in enumerate(accumulated_steps, 1):
print(f"Step {j}: {acc_step}")
probs = get_step_probability(example["input"], accumulated_steps)
print(f"\nProbabilities: + = {probs['+']:.2%}, - = {probs['-']:.2%}\n")
print("-" * 80 + "\n")
모델은 각 단계를 이전의 모든 단계라는 맥락 속에서 평가하여, 긍정적 보상과 부정적 보상에 대한 확률을 제공합니다. “+“에 대한 확률이 높다는 것은 모델이 해당 단계를 올바르고 추론 과정에 도움이 되는 것으로 판단한다는 뜻입니다. 이 평가는 누적적입니다. 즉, 각각의 새 단계가 이전 단계들을 어떻게 이어 나가는지를 고려합니다.
마스킹 메커니즘은 다른 모든 토큰의 확률을 음의 무한대로 설정하여 모델이 보상 토큰(“+” 또는 “-”)만 예측하도록 보장합니다. 이로 인해 모델은 각 단계의 품질에 대해 이진 결정을 내릴 수밖에 없습니다. 이제 PRM을 trl의 RewardTrainer를 사용하는 보상 모델로 활용하거나, 직접 작성한 사용자 정의 학습 루프에서 단계별 평가기로 활용할 수 있으며, 나아가 추론 시점에 샘플링을 유도하는 데에도 활용할 수 있습니다.
대규모 언어 모델 미세 조정 입문
대규모 언어 모델을 파인튜닝하는 방법에 대한 입문 글을 한동안 쓰고 싶었습니다. 이 분야는 매우 방대하지만 문서화가 부족하며, 특히 관련 라이브러리, 하이퍼파라미터, 기법에 관해서는 더욱 그렇기 때문입니다. 요컨대 미세 조정을 통해 모델을 특정 다운스트림 작업에 맞게 조정하고, 도메인 특화 문제에서 성능을 향상시키며, 모델의 동작을 인간의 선호에 맞추고, 베이스 모델의 특화된 변형을 만들 수 있습니다. 이는 비즈니스와 순수 연구 양쪽에서 폭넓은 응용 분야에 유용합니다.
사전 학습, 미세 조정 및 사후 학습
이는 대규모 언어 모델 개발의 기초 단계인 사전 학습과 대조됩니다. 사전 학습 동안 모델은 방대한 텍스트 코퍼스로부터 일반적인 언어 이해를 학습합니다. 예를 들어 Llama 3는 약 15.2조 개의 토큰으로 학습되었습니다. 이 과정에서는 무작위 텐서를 초기화한 뒤, 단어와 개념 사이의 통계적 패턴과 관계를 인식하도록 이를 학습시킵니다.
사전 학습 단계에는 막대한 계산 자원이 필요하며, 흔히 수백만 달러의 비용이 들고 특수한 하드웨어 구성이 요구됩니다. 조직들은 사전 학습을 완료하기 위해 보통 수백에서 수천 개의 GPU를 수 주 또는 수개월 동안 병렬로 가동합니다. 이 단계에서 모델은 인과적 언어 모델링과 같은 자기 지도 기법을 통해 학습하며, 이 기법에서 모델은 앞선 문맥이 주어졌을 때 시퀀스의 다음 토큰을 예측합니다.
사후 학습은 미세 조정 이후 모델의 성능을 더욱 다듬고 최적화하기 위해 추가적인 기법을 적용하는 단계를 말합니다. 이 단계에는 흔히 인간 피드백 기반 강화 학습(RLHF)이 포함되며, 여기서 모델은 피드백과 보상 신호를 통해 자신의 출력을 인간의 선호에 맞추도록 학습합니다. 선호 최적화는 또 다른 핵심 요소로, 모델이 특정 사용자 요구나 윤리 지침을 더 잘 충족하도록 조정하는 데 중점을 둡니다. 이러한 기법들은 모델의 동작이 원하는 결과와 가치에 부합하도록 함으로써 실제 응용에서 모델의 사용성, 안전성, 효율성을 높이는 것을 목표로 합니다.
미세 조정은 사전 학습 모델을 기반으로, 더 작은 작업 특화 데이터셋으로 추가 학습하는 방식입니다. 이 과정은 사전 학습 중에 얻은 기초적인 이해를 유지하면서 모델의 기존 지식을 특정 다운스트림 작업에 맞게 조정합니다. 전통적인 미세 조정은 모든 모델 매개변수를 갱신하므로 상당한 계산 자원이 필요합니다. 일반적으로 7B 매개변수 모델의 경우 160-192GB의 GPU 메모리가 필요합니다.
미세 조정 과정은 사전 학습된 가중치에 내재된 지식을 활용하기 때문에 특히 효과적입니다. 예를 들어 LIMA 논문은 65B 매개변수 LLaMA 모델을 단 1,000개의 고품질 지시-응답 쌍으로 미세 조정하여 GPT-3에 필적하는 성능을 달성할 수 있음을 보여 주었습니다. 그러나 이 접근 방식에는 신중한 데이터셋 선별과 전체 모델 매개변수를 처리할 수 있는 충분한 GPU 자원이 필요합니다.
주요 단계
이번 미세 조정 설정에서는 사전 학습 모델을 사용한 다음, 이를 우리만의 사용 사례에 맞게 조정하겠습니다.
-
데이터 준비:
- 데이터 수집 및 전처리
- 지시와 응답으로 구성된 데이터셋 생성
- 학습, 검증, 테스트 세트로 분할
-
모델 초기화:
- 사전 학습된 모델과 토크나이저 불러오기
- 모델 아키텍처와 하이퍼파라미터 구성
- 모델 가중치 초기화 및 LoRA 적용
-
학습:
- 학습 매개변수를 구성합니다
- 학습 데이터셋으로 모델을 학습시킵니다
- 학습 손실과 평가 손실을 모니터링합니다
-
사후 학습(선택 사항):
- DPO, KTO 또는 PPO와 같은 추가 기법을 적용하여 모델의 동작을 정렬합니다
-
압축 및 양자화(선택 사항):
- 압축 및 양자화 기법을 적용하여 모델 크기와 추론 속도를 최적화합니다
- 최종 모델을 평가하고 테스트합니다
이 글의 설정에서는 Hugging Face의 transformers 라이브러리를 사용합니다. 이 라이브러리에는 학습 과정을 제어하는 손잡이와 다이얼이 매우 많아 상당히 부담스러울 수 있으므로, 이러한 인수를 종류별로 하나씩 살펴보면서 이론과 실제를 함께 설명하겠습니다.
이러한 인수는 일반적으로 TrainingArguments 클래스를 사용하여 구성합니다. 이 인수에는 학습 에포크 수, 배치 크기, 학습률을 비롯하여 모델의 학습 역학과 성능에 영향을 미치는 기타 하이퍼파라미터 등의 설정이 포함됩니다. 최적의 결과와 효율적인 학습을 달성하려면 이러한 인수를 올바르게 구성하는 것이 매우 중요합니다.
다음은 모델 학습 루프의 기본 골격입니다.
from transformers import TrainingArguments
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer
from trl import SFTTrainer
# Step 1: Load the training dataset
train_dataset = datasets.load_dataset(
"path/to/train/dataset"
)
# Step 2: Load the model
model = AutoModelForCausalLM.from_pretrained(
"meta-llama/Llama-3.2-3B-Instruct",
quantization_config=bnb_config
)
# Step 2: Load the tokenizer
tokenizer = AutoTokenizer.from_pretrained(
"meta-llama/Llama-3.2-3B-Instruct"
)
# Step 3: Training
training_args = TrainingArguments(
# ...
output_dir="path/to/save/model"
)
trainer = SFTTrainer(
model=model,
args=training_args,
train_dataset=train_dataset,
# ...
)
trainer.train()
# Step 4: Post-Training
# Step 5: Compression and Quantization
또한 이러한 Python 라이브러리로 작업을 시작하려면 몇 가지 의존성을 설치해야 합니다.
# Install PyTorch
pip install "torch==2.4.0"
pip install "transformers==4.44.2"
pip install "datasets==2.21.0"
pip install "accelerate==0.33.0"
pip install "evaluate==0.4.2"
pip install "bitsandbytes==0.43.3"
pip install "trl==0.9.6"
pip install "peft==0.12.0"
# Install Flash Attention
pip install ninja packaging
pip install flash-attn --no-build-isolation
아래에서 다룰 인수 대부분은 TrainingArguments 클래스에서 구성합니다. 가장 중요한 몇 가지를 살펴보겠습니다.
사전 학습된 모델
널리 사용되는 모델에는 크게 인과(causal) 모델과 마스크(masked) 모델의 두 가지 유형이 있습니다. 인과 언어 모델은 토큰 시퀀스에서 다음 토큰을 예측하며, 모델은 왼쪽에 있는 토큰에만 어텐션할 수 있습니다. 즉, 모델은 미래의 토큰을 볼 수 없습니다. 반면 마스크 언어 모델링은 시퀀스에서 마스킹된 토큰을 예측하며, 모델은 양방향으로 토큰에 어텐션할 수 있습니다. 이 가이드에서는 인과 모델에만 초점을 맞추겠습니다.
인과 모델 중에서도 자기회귀(autoregressive) 생성형 사전 학습 트랜스포머 모델에 초점을 맞추겠습니다. 자기회귀 모델은 이전 토큰을 조건으로 하여 시퀀스의 다음 토큰을 예측하는 모델의 한 부류입니다. 이 모델은 이전 단계의 출력을 다음 단계 입력의 일부로 사용하면서 각 토큰을 단계별로 생성합니다. 또한 어텐션 메커니즘을 사용하여 이전 토큰에 어텐션합니다. 생성형 트랜스포머의 이론은 다른 많은 자료에서 잘 설명하고 있으므로 여기서는 자세히 다루지 않겠습니다.
현재 HuggingFace에는 사전 학습된 트랜스포머가 많이 공개되어 있습니다. 가장 일반적인 모델은 다음과 같습니다:
- Llama 3.1 제품군 - 8B, 70B부터 420B 매개변수에 이르는 Meta의 대표 오픈 소스 모델로, 베이스 변형과 채팅 튜닝 변형으로 제공됩니다. 미세 조정에 가장 널리 사용되는 모델이며, 비공개 모델에 필적하는 성능을 갖추고 있습니다.
- Llama 3.2 제품군 - 1B에서 3B 매개변수에 이르는 Meta의 오픈 소스 모델입니다. 이 모델들은 체급에 비해 뛰어난 성능을 보이며, 작은 크기에도 매우 강력합니다.
- Mistral 제품군 - 7B 베이스 모델과 Mixtral 8x7B 전문가 혼합(mixture-of-experts) 모델을 포함합니다. 더 적은 매개변수 수로도 경쟁력 있는 성능을 제공합니다.
- Phi-3.5 - 작은 크기에도 불구하고 강력한 추론 능력을 보여 주는 Microsoft의 2.7B 매개변수 모델입니다. 이 모델들은 언어 작업에서는 잘 동작하지만, 코딩이나 그 밖의 비언어 작업에 맞춰 학습시키는 데에는 많은 사람이 어려움을 겪습니다.
- Gemma - Google이 최근 공개한 2B 및 7B 크기의 오픈 모델 제품군입니다. Phi-3.5와 비슷한 성능을 냅니다.
어디서부터 시작해야 할지 모르겠다면 Llama 3.1 제품군을 베이스 모델로 사용하되, 8B 매개변수 모델로 시작하여 필요에 따라 더 많은 매개변수 수로 확장하는 것을 권장합니다. 다만 더 큰 모델로 확장할 때는 미세 조정을 위해 더 많은 VRAM을 확보해야 하며, 이로 인해 학습 환경이 복잡해지고 비용이 늘어날 수 있습니다.
라이선스 문제도 있습니다. Meta의 모델은 자체 Llama 라이선스를 따르며, 이 라이선스는 모델 사용을 허용하지만 상업적 목적으로 사용할 때는 특정 제한 사항을 준수하도록 요구합니다. Gemma 모델 역시 일부 상업적 사용을 제한하는 Google 자체 라이선스를 따릅니다. Mistral 모델은 허용적인 Apache 라이선스를 따르며, 저작자 표시를 하면 대부분의 용도로 사용할 수 있습니다. Phi 모델은 MIT 라이선스를 따르며, 이 역시 매우 허용적이어서 모든 용도로 사용할 수 있습니다.
매개변수 수
모델의 매개변수 수는 모델의 크기와 복잡도를 나타내는 중요한 지표입니다. 파라미터 수는 모델이 가진 가중치의 개수를 결정하며, 이는 모델이 처리할 수 있는 데이터의 양과 학습 및 추론에 필요한 연산 자원에 직접적인 영향을 줍니다.
관례상 대부분의 모델은 이름에 매개변수 수를 포함합니다. 예를 들어 meta-llama/Llama-3.2-3B-Instruct는 30억 개의 매개변수를 가지고 있습니다.
인스트럭트 모델 vs 베이스 모델
베이스 모델은 일반 텍스트 데이터로 학습하여 언어 패턴을 익히고 텍스트를 생성하는 반면, 인스트럭트 모델은 지시를 따르고 프롬프트에 응답하도록 특별히 학습된 파인튜닝 버전입니다. 예를 들어 Llama-3.2-3b는 베이스 모델이고, Llama-3.2-3b-instruct는 사용자의 지시를 더 잘 이해하고 수행하도록 파인튜닝된 모델입니다.
베이스 모델은 일반적으로 보다 범용적인 작업에 사용되고, 인스트럭트 모델은 채팅이나 지시 수행과 같은 보다 구체적인 작업에 사용됩니다. 미세 조정을 위해서는 거의 항상 채팅 템플릿과 함께 instruct 모델을 사용합니다.
GPU 클라우드 업체
미세 조정을 시작하려면 GPU를 몇 개 확보해야 합니다. 일반적으로 고급 GPU(A100, H100) 1~2개 또는 중급 GPU(A100, A6000, V100) 4~8개가 필요합니다. 작은 GPU들을 이어 붙여 클러스터를 구성하려 하기보다는, 성능이 가장 뛰어난 H100 SXM GPU를 몇 개 확보하는 편이 대개 더 쉽습니다.
SXM, PCIe, NVL은 머신러닝 워크로드에서 흔히 사용되는 세 가지 GPU 폼 팩터 및 인터커넥트 기술을 가리킵니다.
-
SXM GPU는 데이터 센터와 서버 환경을 위해 특별히 설계되었습니다. SXM GPU는 NVLink를 통해 CPU와 직접 연결되므로 기존 연결 방식에 비해 훨씬 높은 메모리 대역폭(최대 900 GB/s)을 제공합니다. 이 카드들은 과중한 워크로드에서도 높은 성능을 지속적으로 유지할 수 있도록 최적화된 열 설계로 제작되었습니다. 그러나 SXM 카드는 전용 서버 하드웨어가 필요하며, 일반적으로 PCIe 제품보다 더 비쌉니다.
-
반면 PCIe GPU는 대부분의 컴퓨터와 서버에 있는 표준 PCIe 슬롯 연결을 사용합니다. 메모리 대역폭은 더 낮지만(최대 64 GB/s), 설치 방식이 더 유연하며 표준 서버 하드웨어에서 동작합니다.
-
NVL / NVLink는 Nvidia가 개발한 고속 인터커넥트 기술로, GPU들이 더 느린 PCIe 버스를 거치지 않고 서로 직접 통신할 수 있게 해 줍니다. 이를 통해 데이터 전송이 빨라지고 병렬 컴퓨팅 작업의 성능이 향상됩니다. NVL의 최대 대역폭은 초당 4,000기가바이트(GBps)입니다.
대규모 언어 모델을 미세 조정할 때 SXM 카드는 더 높은 메모리 대역폭과 최적화된 열 설계 덕분에 일반적으로 더 나은 성능을 제공합니다. 그러나 PCIe 카드는 구하기가 더 쉽고, 대부분의 미세 조정 워크로드에서도 여전히 충분한 성능을 발휘합니다. 둘 중 무엇을 선택할지는 대개 예산 제약과 구체적인 성능 요구 사항에 따라 결정됩니다.
다행히 벤처 캐피털 자금이 넘쳐나는 덕분에 많은 클라우드 업체가 고객을 확보하기 위해 경쟁하고 있습니다. 일반적으로 이들 업체는 다양한 종류와 크기의 GPU를 대여해 줍니다. 이들 업체 대부분은 극도로 낮은 마진으로 운영되거나 큰 적자를 보고 있기 때문에, 더 나은 가격과 가용성으로 서로를 앞서려고 끊임없이 노력합니다. 이러한 상황이 얼마나 지속될지는 알 수 없지만, 지금은 GPU 클라우드 서비스를 이용하기에 좋은 시기입니다.
가장 흔히 구할 수 있는 GPU 종류는 다음과 같습니다.
| GPU 종류 | VRAM | 일반적인 사용 사례 | 시간당 대략적인 비용 | 비고 |
|---|---|---|---|---|
| H200 SXM | 141GB | 대규모 모델 학습(70B+) | $3.99-4.29 | - 최신 GPU - 대규모 모델에 최적의 성능 - 70B 매개변수 모델에 이상적임 |
| GH200 | 96GB | 대규모 모델 학습(70B+) | $2.99-3.29 | - 대규모 모델에 좋은 성능 - 70B 매개변수 모델에 이상적임 |
| H100 NVL | 94GB | 대규모 모델 학습(70B+) | $2.99-3.29 | - 대규모 모델에 최적의 성능 - 70B 매개변수 모델에 이상적임 |
| H100 SXM | 80GB | 대규모 모델 학습(70B+) | $2.79-3.29 | - 대규모 모델에 좋은 성능 - 70B 매개변수 모델에 이상적임 |
| H100 PCIe | 80GB | 대규모 모델 학습 | $2.49 | - SXM보다 대역폭이 약간 낮습니다 - 70B 매개변수 모델에 적합함 |
| A100 SXM | 80GB | 중대형 모델 학습(7-70B) | $1.79 | - 뛰어난 가격 대비 성능 - 최대 70B 모델에 적합합니다 - Flash 어텐션 2 지원 |
| A100 PCIe/SXM | 40GB | 중형 모델 학습(7-13B) | $1.29 | - 최대 13B 모델에 적합합니다 - 미세 조정에 많이 사용됨 |
| A10 | 24GB | 소형 모델 학습(<7B) | $0.75 | - 최대 7B 모델에 적합합니다 - 저렴한 선택지 |
| A6000 | 48GB | 중형 모델 학습 | $0.80 | - A100의 좋은 대안입니다 - 더 나은 가격 대비 성능 |
| V100 | 16GB | 소형 모델 학습(<7B) | $0.55 | - 구형 아키텍처 - VRAM 용량의 제약이 있습니다 - 저가형 선택지 |
모델 미세 조정 비용을 대략적으로 추산하려면 다음과 같은 개략적인 추정치를 사용할 수 있습니다:
7B 모델 미세 조정(24시간)
- H100 SXM: ~$72/일
- A100 80GB: ~$43/일
- A100 40GB: ~$31/일
- A10: ~$18/일
- V100: ~$13/일
13B 모델 미세 조정(24시간)
- H100 SXM: ~$72/일
- A100 80GB: ~$43/일
- A100 40GB: ~$31/일
70B 모델 미세 조정(24시간)
- H100 NVL: ~$74/일
- H100 SXM: ~$72/일
- 2 x A100 80GB: ~$86/일
공급업체는 보통 GPU 사용 시간, 스토리지, 데이터 전송에 대해 요금을 부과하며, 이 비용은 금방 불어날 수 있습니다. 다음은 널리 쓰이는 GPU 클라우드 공급업체 목록입니다.
- Lambda Labs - 경쟁력 있는 가격, 좋은 가용성
- RunPod - 스팟 인스턴스, 커뮤니티 템플릿
- Vast.ai - GPU 대여 마켓플레이스
- CoreWeave - 기업 중심, 높은 가용성
- Google Cloud - 다양한 선택지, 전 세계적 가용성
- AWS - 폭넓은 옵션, 다만 비쌀 수 있음
- Azure - 우수한 기업 환경 통합
- Paperspace - 개발자 친화적, Jupyter 통합
- Genesis Cloud - 저렴한 옵션
이미 Google Cloud나 AWS를 사용하는 고객이 아니라면, 가장 사용하기 쉽고 개발자 경험이 가장 좋은 Lambda Labs나 RunPod로 시작하는 것이 좋을 것입니다.
멀티 GPU 구성
더 고급 연구를 수행하여 개별 GPU보다 훨씬 강력한 하드웨어가 필요하다면, NVIDIA가 제공하는 GH200 Grace Hopper Superchip이나 HGX 클러스터 같은 특화 솔루션을 이용할 수 있습니다. GH200은 이른바 “슈퍼칩“으로, CPU와 GPU를 단일 칩에 결합하고 프로세서와 가속기 사이를 900GB/s NVLink-C2C로 연결하며 576GB의 일관성 메모리(coherent memory)를 갖추고 있습니다.
1세대 HGX 플랫폼은 여러 GPU를 AI 워크로드에 최적화된 단일 시스템으로 결합하여 이를 한 단계 더 발전시킵니다. 예를 들어 HGX H100 플랫폼은 NVLink로 상호 연결된 H100 GPU를 최대 8개까지 확장할 수 있으며, GPU 간 3.6TB/s의 이분 대역폭(bisectional bandwidth)을 제공합니다.
2세대 DGX B200은 NVLink 인터커넥트로 연결된 NVIDIA Blackwell GPU 8개를 탑재하며, 이전 세대에 비해 3배의 학습 성능과 15배의 추론 성능을 제공합니다. 이 구성은 총 1,440GB의 GPU 메모리를 갖추고 있으며, 학습에서 72 petaFLOPS, 추론에서 144 petaFLOPS를 제공합니다.
가장 큰 규모의 학습 작업을 위해 조직은 Quantum-2 InfiniBand 네트워킹으로 연결된 여러 DGX/HGX 노드를 배치하여 사실상 슈퍼컴퓨팅 시스템을 구축할 수 있습니다. 이러한 멀티 GPU 구성은 비용이 쉽게 수백만 달러에 이를 수 있습니다. 예를 들어 Llama 3 모델은 H100 GPU 16,000개(개당 $30k)로 54일 동안 쉬지 않고 학습되었습니다. 오늘날 세계에서 가장 큰 클러스터는 GPU를 10만 개 가까이 보유하고 있습니다.
일반적으로 멀티 GPU 학습을 구성할 때 사용하는 프레임워크는 세 가지입니다:
HuggingFace Accelerate는 분산 학습으로 가는 가장 간단한 길을 제공하며, 주로 PyTorch의 분산 기능을 감싸는 래퍼 역할을 합니다. 기본적인 멀티 GPU 학습 및 추론 시나리오에서 뛰어나고 DeepSpeed 및 FSDP와도 매끄럽게 통합되지만, 단독으로 사용할 때는 한계가 있습니다. 특히 Accelerate는 모델 샤딩 기능이 제한적이며, device_map="auto"는 단일 프로세스에서만 사용할 수 있습니다. 따라서 추가 도구를 활용하지 않고는 정교한 모델 병렬성에 적합하지 않습니다.
Microsoft DeepSpeed는 세 단계의 최적화를 제공하는 Zero Redundancy Optimizer를 통해 더 고급 기능을 제공합니다. ZeRO-Infinity 기능은 매개변수를 CPU와 NVMe 스토리지로 오프로딩할 수 있게 하여 거대한 모델의 학습을 가능하게 하며, GPU 간 매개변수 복제 없이 뛰어난 메모리 효율을 달성합니다. 그러나 이러한 장점에는 설정과 구성의 복잡성 증가가 뒤따릅니다. CPU/NVMe 오프로딩은 더 큰 모델의 학습을 가능하게 하지만, 학습 속도에 상당한 영향을 줄 수 있습니다. 최적의 성능을 얻으려면 사용자가 스테이지와 오프로딩 매개변수를 신중하게 구성해야 합니다.
PyTorch FSDP는 그 중간 지점에 있으며, 버전 1.11부터 PyTorch와의 네이티브 통합을 제공합니다. FSDP는 DistributedDataParallel을 바로 대체하는 용도로 사용할 수 있으며, DeepSpeed와 유사하게 CPU 오프로딩을 지원합니다. 다만 DeepSpeed에 비해 비교적 새로운 솔루션이므로, 효과적으로 구현하려면 PyTorch에 특화된 지식이 더 많이 필요할 수 있습니다.
대부분의 기본적인 멀티 GPU 학습 요구에는 Accelerate가 충분한 기능을 제공합니다. 그러나 단일 GPU 메모리 용량을 초과하는 매우 큰 모델을 학습할 때는 DeepSpeed나 FSDP 중 하나가 필요합니다. DeepSpeed는 더 긴 역사와 여러 최적화 단계 덕분에 대규모 학습에서 검증된 선택지이며, FSDP의 긴밀한 PyTorch 통합은 이미 PyTorch 생태계에 깊이 투자한 팀에게 매력적일 수 있습니다.
멀티 GPU 학습에 대해서는 제가 드릴 수 있는 조언이 많지 않습니다. 이 정도 규모의 모델을 학습해야 한다면 대개 매우 특수한 요구 사항이 있어서 맞춤형 학습 소프트웨어 구성과 맞춤형 하드웨어가 필요하기 때문입니다. 따라서 여기서는 자세히 다루지 않겠습니다. 이 주제를 더 자세히 다루는 주요 모델 연구소들의 다른 가이드가 있습니다. 이러한 종류의 클러스터 구성에 대한 개략적인 정보는 DeepSpeed에 관한 제 글을 참고하십시오.
매개변수 효율적 미세 조정(PEFT)
전체 튜닝과 비교했을 때, 대규모 언어 모델을 미세 조정하는 가장 일반적인 기법은 매개변수 효율적 미세 조정(PEFT)입니다. 이는 미세 조정 중에 모든 모델 매개변수를 갱신하는 전체 튜닝과 대조되는데, 전체 튜닝에는 상당한 연산 자원과 메모리가 필요합니다. 반면 PEFT 방법은 성능을 유지하면서 연산 요구량을 극적으로 줄여, 대규모 언어 모델을 적응시키는 방식에 혁신을 가져왔습니다. PEFT 방법은 모든 모델 매개변수를 갱신하는 대신 매개변수의 작은 부분집합만 전략적으로 수정하거나 제한된 수의 새로운 학습 가능 매개변수를 도입하므로, 과정이 훨씬 더 효율적입니다.
가장 대표적인 PEFT 기법은 **Low-Rank Adaptation(LoRA)**으로, 효율적인 모델 적응을 위한 사실상의 표준이 되었습니다. LoRA는 사전 학습된 가중치를 고정한 채로 모델의 특정 레이어에 학습 가능한 작은 랭크 분해 행렬을 추가하는 방식으로 작동합니다. 이 접근 방식은 전체 미세 조정에 비해 학습 가능한 매개변수 수를 최대 10,000배, GPU 메모리 요구량을 3배 이상 줄일 수 있습니다.
4비트 양자화 기법과 결합하면(QLoRA) 메모리 절감 효과는 훨씬 더 극적으로 커집니다. QLoRA를 사용하면 NVIDIA RTX 3090 같은 소비자용 하드웨어에서 700억 개 매개변수 규모의 모델까지 학습할 수 있습니다. 이는 전통적으로 A100-80GB GPU 16개 이상이 필요한 작업입니다. QLoRA는 다음과 같은 몇 가지 핵심 혁신을 통해 이를 달성합니다:
- 동결된 4비트 양자화 사전 학습 모델을 거쳐 저랭크 어댑터(Low-Rank Adapters)로 역전파를 수행합니다
- 정규 분포를 따르는 가중치에 특화하여 최적화된 4-bit NormalFloat(NF4)라는 새로운 데이터 타입을 도입합니다
- 양자화 상수 자체를 양자화하는 이중 양자화를 구현하여 메모리 사용량을 줄입니다
- 페이징 옵티마이저를 사용하여 학습 중 발생하는 메모리 급증을 처리합니다
QLoRA의 효과는 메모리 요구량을 대폭 줄이면서도 완전한 16비트 미세 조정 작업 성능을 유지하는 능력에서 비롯됩니다. 덕분에 보통은 고성능 GPU 클러스터가 필요한 대형 모델을 단일 GPU에서 파인튜닝할 수 있습니다.
LoRA 매개변수
LoRA 미세 조정을 수행할 때는 미세 조정 과정의 동작을 정의하는 몇 가지 핵심(core) 매개변수가 있습니다:
LoRA 랭크(r)
LoRA 랭크는 사용되는 랭크 분해 행렬의 수를 결정합니다. 이를 모델이 사용할 수 있는 “학습 차원“의 수라고 생각하십시오. 신경망에 뉴런이 더 많을수록 더 정교한 관계를 모델링할 수 있는 것처럼, 랭크가 높을수록 모델은 더 미묘하고 복잡한 패턴을 학습할 수 있습니다. 하지만 뉴런을 더 추가할 때와 마찬가지로, 랭크가 높을수록 더 많은 메모리와 연산 능력이 필요합니다. 원래 LoRA 논문에서는 적절한 균형점으로 랭크 8부터 시작할 것을 권장합니다. 기본적인 텍스트 분류처럼 비교적 단순한 태스크에는 이것으로 충분할 수 있지만, 창의적 글쓰기나 복잡한 추론처럼 더 복잡한 태스크에는 16이나 32로 높이는 것이 좋을 수 있습니다. 다만 랭크가 높을수록 더 많은 GPU 메모리가 필요하고 학습 시간도 길어진다는 점을 염두에 두십시오.
LoRA 알파
알파 매개변수는 동결된 사전 학습 가중치에 비해 LoRA 적응이 얼마나 큰 영향을 미칠지 결정하는 스케일링 계수 역할을 합니다. 볼륨 조절 손잡이와 같다고 생각하십시오. 알파가 높을수록 LoRA의 변경 사항이 원래 모델의 목소리에 비해 더 크게 들리고, 알파를 로어링하면(낮추면) 변경 사항이 더 미묘하게 유지됩니다. 알파는 학습 중 업데이트의 크기를 조절하는 데 도움이 됩니다. 랭크와 알파의 관계가 중요합니다. 일반적으로 시작점으로 알파를 랭크 값의 2배로 설정합니다(즉, 랭크가 8이면 알파는 16이 됩니다). 이러한 스케일링은 의미 있는 업데이트가 일어나도록 하면서 안정적인 학습을 보장하는 데 도움이 됩니다. 마치 원래 소리를 묻어 버리지 않으면서도 변화를 또렷이 들을 수 있는 볼륨 노브의 최적 지점을 찾는 것과 비슷합니다.
LoRA 드롭아웃
드롭아웃은 과적합을 방지하기 위해 머신러닝에서 사용하는 정규화 기법입니다. 드롭아웃은 훈련 중에 일정 비율의 뉴런을 무작위로 탈락시키는(0으로 설정하는) 방식으로 작동합니다. 이렇게 하면 남은 뉴런이 더 견고하고 일반화된 특징을 학습할 수밖에 없게 되어, 처음 보는 데이터에 잘 일반화되지 않을 수 있는 특정 패턴에 대한 의존도가 줄어듭니다. LoRA에서 드롭아웃은 훈련 중에 저랭크 적응 행렬에 적용됩니다. 드롭아웃을 도입하면 모델이 어느 하나의 적응 경로에 지나치게 의존하지 않게 되므로 일반화 성능과 견고성이 향상됩니다. 아주 대략적으로 비유하자면, 연습 중에 가끔 일부 선수를 무작위로 벤치에 앉히는 축구팀을 떠올려 보십시오. 이렇게 하면 남은 선수들이 분발하여 기량을 키울 수밖에 없으므로, 팀 전체가 더 강해지고 다재다능해집니다.
LoRA 드롭아웃의 일반적인 기본값은 보통 0.0에서 0.3 사이입니다. 드롭아웃 비율 0.05는 정규화와 효과적인 학습에 충분한 활성 뉴런 유지 사이의 균형을 잡아 주므로 좋은 출발점이 되는 경우가 많습니다. 모델에 여전히 과적합 징후가 보인다면 드롭아웃 비율을 0.2나 0.3으로 높일 수 있습니다. LoRA 어댑터에서 많은 수의 레이어를 훈련한다면, 늘어난 레이어 수를 보완하기 위해 드롭아웃 비율을 높이는 것이 좋을 수 있습니다.
LoRA 바이어스
LoRA의 바이어스 매개변수는 저랭크 적응 행렬의 출력에 더해지는 가산 항을 가리킵니다. 바이어스를 사용하면 모델이 입력에 대한 추가 오프셋을 학습할 수 있어 더 유연하고 동적인 응답이 가능해집니다. 바이어스 항은 입력 데이터의 기준값이 0이 아니거나 입력과 출력의 관계가 순수하게 선형적이지 않은 상황에서 특히 유용합니다. 바이어스를 추가하면 모델이 이러한 변동을 더 잘 포착하고 조정할 수 있으므로 전반적인 성능과 일반화 성능이 향상됩니다.
바이어스의 기본값은 "none"이며, 이는 바이어스를 추가하지 않는다는 뜻입니다. 하지만 경우에 따라 LoRA 적응 행렬에 바이어스 항을 추가하고 싶을 수 있습니다. 다른 옵션으로는 "all"과 "lora_only"가 있으며, 각각 모든 행렬에 바이어스 항을 추가하거나 LoRA 행렬에만 바이어스 항을 추가합니다.
LoRA 대상 모듈
LoRA에서 대상 모듈을 선택하는 것은 모델의 적응성과 계산 효율성 모두에 직접적인 영향을 미치는 중요한 아키텍처 결정입니다. 트랜스포머 기반 아키텍처에서 이러한 모듈은 모델 처리 파이프라인의 여러 측면을 담당하는 다양한 프로젝션 행렬과 구성 요소로 이루어져 있습니다.
-
임베딩 레이어(
embed_tokens)는 입력 토큰과 맞닿는 모델의 첫 번째 인터페이스로, 이산적인 토큰 ID를 연속적인 벡터 표현으로 변환합니다. 임베딩을 LoRA 대상에 포함할 수는 있지만, 모델 성능이 그에 비례해 향상되지 않으면서 메모리 사용량이 크게 늘어날 수 있으므로 일반적으로 권장하지 않습니다. 임베딩 레이어는 어휘 크기 때문에 보통 매개변수가 많아 LoRA 적응에 덜 효율적입니다. -
정규화 레이어(
norm)는 활성화 값을 표준화하여 네트워크의 내부 표현을 안정화하는 데 도움을 줍니다. 이 레이어들은 매개변수가 비교적 적으며, 안정적인 훈련 동역학을 유지하는 데 매우 중요합니다. 하지만 이 레이어들의 역할은 복잡한 패턴 학습보다는 주로 통계적 정규화이므로 LoRA 적응 대상으로 삼는 경우는 드뭅니다. norm 레이어를 LoRA 대상에 포함하면 일반적으로 얻는 이점은 미미한 반면 훈련이 불안정해질 수 있습니다. -
언어 모델링 헤드(
lm_head)는 모델의 내부 표현을 토큰 예측을 위한 어휘 크기의 로짓으로 다시 변환하는 역할을 합니다. 이 레이어는 최종 출력에 매우 중요하지만, LoRA 대상으로 포함할 필요는 일반적으로 없습니다.lm_head는 가중치 묶기(weight tying)를 통해 임베딩 레이어와 가중치를 공유하는 경우가 많으므로, 이를 따로 적응시키면 큰 이점 없이 이 대칭성이 깨질 수 있습니다. -
핵심(Core) 어텐션 메커니즘 구성 요소는 여전히 LoRA 적응에 가장 효과적인 대상입니다. 쿼리 프로젝션 행렬(
q_proj)은 입력 임베딩을 쿼리 벡터로 변환하며, 모델이 컨텍스트 안에서 관련 정보를 어떻게 탐색할지를 결정합니다. 키 프로젝션 행렬(k_proj)은 입력의 서로 다른 부분 간 관계를 형성하는 데 도움이 되는 키 벡터를 생성하고, 밸류 프로젝션 행렬(v_proj)은 입력을 추출할 실제 정보를 담은 밸류 벡터로 변환합니다. 이 세 가지 프로젝션은 셀프 어텐션 메커니즘의 근간을 이루며, 그중q_proj와v_proj가 적응에 가장 중요한 대상인 경우가 많습니다. -
출력 프로젝션 행렬(
o_proj)은 결합된 어텐션 출력이 후속 레이어로 넘어가기 전에 이를 처리합니다. 이 변환은 어텐션 메커니즘의 출력이 모델의 전체 아키텍처와 호환되도록 보장합니다. 더 복잡한 아키텍처를 가진 모델에는 레이어 간 차원 변환을 담당하는 상향 프로젝션(up_proj) 행렬과 하향 프로젝션(down_proj) 행렬도 있습니다.
LoRA로 미세 조정할 때는 어텐션 구성 요소만을 대상으로 하는 집중적인 접근 방식으로 시작하는 것을 권장합니다:
lora_config = LoraConfig(
target_modules=["q_proj", "v_proj"],
r=8,
lora_alpha=16,
lora_dropout=0.1
)
더 까다로운 작업이거나 초기 결과가 만족스럽지 않은 경우에는 추가 프로젝션 행렬을 포함하도록 범위를 넓힐 수 있습니다.
lora_config = LoraConfig(
target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],
r=16,
lora_alpha=32,
lora_dropout=0.1
)
PEFT를 사용해 모델을 파인튜닝하려면 transformers, peft, trl 라이브러리를 설치해야 합니다. 다음은 LoRA 모델을 구성하고 파인튜닝하는 방법의 예시입니다.
from peft import LoraConfig, PeftModel
# QLoRA parameters
lora_config = LoraConfig(
r=64, # LoRA attention dimension
lora_alpha=16, # LoRA scale factor
lora_dropout=0.1, # Dropout probability
bias="none",
task_type="CAUSAL_LM"
)
lora_model = get_peft_model(model, lora_config)
lora_model.print_trainable_parameters()
# trainable params: 1,572,864 || all params: 332,769,280 || trainable%: 0.472659014678278
대부분의 경우 LoRA 하이퍼파라미터를 조정하는 것은 시간을 가장 효율적으로 쓰는 방법이 아닙니다. 따라서 기본값으로 시작하고, 과적합이나 과소적합의 뚜렷한 징후가 보일 때만 조정할 것을 권장합니다. 가장 큰 성능 향상은 대개 하이퍼파라미터 튜닝보다는 더 나은 데이터셋 큐레이션에서 나옵니다. 그러나 값을 탐색(sweep)하려 한다면, 기본값부터 증가하는 순서로 정리한 다음 매개변수 조합들을 시도해 볼 수 있으며, 이들은 좋은 결과를 낼 수도 있습니다:
- r=16, lora_alpha=16
- r=16, lora_alpha=32
- r=32, lora_alpha=64
- r=64, lora_alpha=128
- r=128, lora_alpha=256
- r=256, lora_alpha=512
예를 들어 모든 선형 레이어에 랭크 256과 알파 128을 사용하려면 다음 구성을 사용하십시오.
peft_config = LoraConfig(
r=256,
lora_alpha=128,
lora_dropout=0.05,
bias="none",
target_modules="all-linear",
task_type="CAUSAL_LM",
)
양자화된 LoRA
QLoRA를 사용하려면 bitsandbytes 라이브러리도 설치해야 합니다.
# 4-bit quantization config
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=torch.float16,
bnb_4bit_use_double_quant=True
)
모델 불러오기
Hugging Face 모델 허브에서 사전 학습된 모델을 불러올 때는 from_pretrained() 메서드를 사용합니다. 이 메서드는 지정된 저장소에서 모델 가중치와 구성을 다운로드합니다. 모델 아키텍처와 가중치는 저장소 이름을 기반으로 자동으로 결정됩니다.
torch_dtype 매개변수를 사용하여 로드되는 모델 가중치의 정밀도를 제어할 수 있습니다. 일반적인 옵션은 다음과 같습니다.
torch.float32(기본값): 완전 정밀도이며, 메모리를 더 많이 사용하지만 정확도가 가장 높습니다torch.float16: 반정밀도이며, 좋은 정확도를 유지하면서 메모리 사용량을 줄입니다torch.bfloat16: Google Brain 부동소수점 형식으로, float16보다 수치 안정성이 더 우수합니다
예를 들어, 앞에서 설정한 QLoRA 구성에 맞춰 4비트 양자화를 사용하여 모델을 로드하려면 다음과 같이 합니다:
from peft import prepare_model_for_kbit_training
model = AutoModelForCausalLM.from_pretrained(
"meta-llama/Llama-3.2-3B-Instruct",
quantization_config=bnb_config
)
model = prepare_model_for_kbit_training(model)
Hugging Face에서 가져온 파일은 다음과 같습니다:
├── config.json
├── generation_config.json
├── model-00001-of-00002.safetensors
├── model-00002-of-00002.safetensors
├── model.safetensors.index.json
├── special_tokens_map.json
├── tokenizer.json
└── tokenizer_config.json
각 파일에는 서로 다른 정보가 담겨 있습니다:
config.json: 모델의 아키텍처 구성과 하이퍼파라미터가 담겨 있습니다generation_config.json: temperature, top-p 샘플링 등 텍스트 생성 설정을 저장합니다model-00001-of-00002.safetensors: SafeTensors 형식으로 저장된 모델 가중치의 첫 번째 부분입니다model-00002-of-00002.safetensors: SafeTensors 형식으로 저장된 모델 가중치의 두 번째 부분입니다model.safetensors.index.json: 각 가중치 텐서가 분할된 파일 중 어디에 있는지 매핑하는 인덱스 파일입니다special_tokens_map.json:<|endoftext|>같은 특수 토큰을 해당 ID에 매핑합니다tokenizer.json: 토크나이저의 어휘와 구성이 담겨 있습니다tokenizer_config.json: 추가 토크나이저 설정 및 매개변수
SafeTensors는 모델 가중치와 텐서를 저장하기 위해 특별히 설계된 파일 형식입니다. 이 형식은 임의의 코드를 실행할 수 있어 보안 위험이 있는 Python pickle 형식을 대체하기 위해, 더 안전하고 효율적인 형식으로 만들어졌습니다. .safetensors 파일은 모델의 실제 학습된 매개변수(가중치)를 담고 있으므로 일반적으로 매우 큽니다(흔히 수 기가바이트).
이 파일들은 모델의 가중치를 레이어별로 정리하여 바이너리 형식의 원시 수치 배열로 저장합니다. 트랜스포머 모델의 경우 여기에는 어텐션 레이어 가중치와 편향, 피드포워드 네트워크 매개변수, 레이어 정규화 매개변수, 임베딩 행렬, 위치 인코딩 가중치가 포함됩니다.
개별 파일이 너무 커져 효율적으로 다루기 어려울 수 있기 때문에 가중치는 여러 파일(예: model-00001-of-00002.safetensors)로 나뉘어 저장됩니다. 최신 언어 모델에서는 파일 하나가 10GB 이상이 될 수도 있습니다. 또한 파일을 분할하면 병렬 다운로드가 가능해지고 메모리 매핑도 더 효율적으로 할 수 있습니다.
SafeTensors는 메모리 매핑을 통한 메모리 효율적인 로딩, 빠른 직렬화 및 역직렬화 속도, 내장된 타입 안전성과 검증 기능, 임의 코드 실행으로 인한 보안 취약점 제거 등 상당한 이점을 제공합니다. 따라서 대용량 가중치 파일을 안전하고 효율적으로 다루는 것이 중요한 대규모 언어 모델을 저장하고 배포하는 데 이상적인 형식입니다.
모델 가중치를 저장하는 데 흔히 사용되는 파일 형식은 세 가지입니다:
-
.pth- Python의 pickle 직렬화를 사용하는 PyTorch의 기본 형식입니다. 널리 사용되지만, pickle로 직렬화된 파일은 임의의 코드를 실행할 수 있으므로 보안상 우려가 있습니다. 주로 PyTorch 모델과 연구 프로젝트에서 사용됩니다. -
.safetensors- ML 모델을 위해 특별히 설계된 최신 형식으로, .pth 파일보다 더 나은 보안성과 성능을 제공합니다. 메모리 효율적이고 로딩이 빠르며, 코드 실행 취약점을 방지합니다. Hugging Face 모델의 표준 형식으로 자리 잡아 가고 있습니다. -
.gguf- llama.cpp 및 유사한 프로젝트에서 사용하는 “GPT-Generated Unified Format“입니다. 일반 소비자용 하드웨어에서의 추론에 최적화되어 있으며, 다양한 양자화 방식을 지원합니다. 이 형식은 크기가 작으며, 양자화된 모델을 효율적으로 로드하도록 설계되었습니다.
모델은 일반적으로 로컬 머신의 HuggingFace 캐시에 저장됩니다. 이 캐시는 보통 ~/.cache/huggingface/hub에 있습니다. 모델을 많이 다운로드하면 이 폴더가 상당히 커질 수 있습니다. 따라서 주기적으로 정리하는 것이 좋습니다.
토크나이저 불러오기
토크나이저는 텍스트를 모델이 처리하는 데이터의 기본 단위인 토큰으로 변환하는 데 사용됩니다. 토크나이저는 특수 토큰도 처리하며, 텍스트 처리를 위한 다양한 설정 옵션을 제공합니다.
tokenizer = AutoTokenizer.from_pretrained(
"meta-llama/Llama-3.2-3B-Instruct",
)
토크나이저의 주요 설정 옵션은 다음과 같습니다:
| 매개변수 | 설명 | 값 |
|---|---|---|
padding_side | 패딩 토큰을 어느 쪽에 추가할지 결정합니다 | "right"(기본값) 또는 "left" |
truncation_side | 최대 길이를 초과할 때 텍스트를 어느 쪽에서 잘라낼지 결정합니다 | "right"(기본값) 또는 "left" |
chat_template | 채팅 메시지 형식 지정을 위한 Jinja 템플릿 | 채팅 템플릿 명세를 따르는 문자열 템플릿 |
model_input_names | 모델의 순방향 패스가 받는 입력 목록 | 예: ["input_ids", "attention_mask"] |
위의 옵션 외에도 토크나이저는 특수 토큰을 처리합니다. 특수 토큰에는 특별한 이름이 붙으며, 모델 아키텍처마다 다릅니다. 예를 들면 다음과 같습니다:
| 토큰 | 설명 |
|---|---|
bos_token | 시퀀스 시작 토큰 |
eos_token | 시퀀스 종료 토큰 |
unk_token | 알 수 없는 단어를 나타내는 토큰 |
sep_token | 문장 사이의 구분자 토큰 |
pad_token | 배치 처리를 위한 패딩 토큰 |
토크나이저는 텍스트를 인코딩할 때 여러 형식의 텐서를 반환할 수 있습니다:
| 반환 유형 | 설명 | 예제 |
|---|---|---|
tf | TensorFlow 텐서 | return_tensors="tf" |
pt | PyTorch 텐서 | return_tensors="pt" |
np | NumPy 배열 | return_tensors="np" |
# PyTorch tensors
tokens_pt = tokenizer("Hello world", return_tensors="pt")
# NumPy arrays
tokens_np = tokenizer("Hello world", return_tensors="np")
토크나이저는 기본적으로 토큰을 나타내는 정수 리스트를 반환합니다. Llama 3.2 토크나이저를 예로 들어 보겠습니다:
tokens = tokenizer.encode("The brown bear is a species of bear that is native to North America.")
print(tokens)
출력은 다음과 같습니다:
[128000, 791, 14198, 11984, 374, 264, 9606, 315, 11984, 430, 374, 10068, 311, 4892, 5270, 13]
이 스트림에서:
- 128000은
bos_token입니다 - 13은
eos_token입니다 - 그 사이의 숫자들은 텍스트의 실제 토큰을 나타냅니다
패딩
패딩은 언어 모델 학습에서 중요한 개념으로, 길이가 서로 다른 시퀀스를 배치로 처리할 수 있게 해 줍니다. LLM은 일반적으로 패딩 없이 사전 학습되지만, 사용자 정의 데이터셋으로 작업하는 미세 조정 중에는 패딩이 필요해집니다.
패딩은 특수한 “pad” 토큰을 추가하여 짧은 시퀀스를 배치에서 가장 긴 시퀀스의 길이에 맞게 늘리는 것입니다. 이를 통해 배치 안의 모든 시퀀스가 같은 길이를 가지게 되어 효율적으로 처리할 수 있습니다. 배치 단위로 학습할 때는 GPU 처리에 맞는 텐서를 만들기 위해 모든 시퀀스의 길이가 같아야 합니다. 예를 들면 다음과 같습니다:
# Original sequences of different lengths
sequence1 = [1, 887, 526, 451, 263, 13563, 7451, 29889] # Length 8
sequence2 = [1, 887, 526, 451, 29889] # Length 5
# After padding (using 32000 as pad token)
sequence1 = [1, 887, 526, 451, 263, 13563, 7451, 29889] # Unchanged
sequence2 = [1, 887, 526, 451, 29889, 32000, 32000, 32000] # Padded
패딩과 함께, 어떤 토큰이 실제 토큰이고 어떤 토큰이 패딩인지 모델에 알려 주는 어텐션 마스크가 필요합니다:
# Attention masks (1 for real tokens, 0 for padding)
mask1 = [1, 1, 1, 1, 1, 1, 1, 1] # All real tokens
mask2 = [1, 1, 1, 1, 1, 0, 0, 0] # Last 3 are padding
패딩 토큰을 추가하는 방법은 두 가지입니다:
-
오른쪽 패딩 (가장 일반적):
sequence = [1, 887, 526, 451, 29889, PAD, PAD, PAD] -
왼쪽 패딩:
sequence = [PAD, PAD, PAD, 1, 887, 526, 451, 29889]
기존 특수 토큰(EOS는 “더 이상 내용이 없음“을 나타내므로 그 예입니다)을 사용하거나, 패딩 전용 토큰을 새로 만들 수 있습니다.
# Configure tokenizer for padding
tokenizer.padding_side = "right" # or "left"
tokenizer.pad_token = tokenizer.eos_token # Using EOS as pad token
# Or create a new pad token (if your model doesn't already have one)
tokenizer.add_special_tokens({'pad_token': '[PAD]'})
# Apply padding when tokenizing
inputs = tokenizer(
sequences,
padding='max_length',
max_length=512,
truncation=True,
return_tensors="pt"
)
새 패딩 토큰을 추가한다면 모델 임베딩의 크기를 조정해야 한다는 점을 기억하십시오:
model.resize_token_embeddings(len(tokenizer))
패딩 전략의 선택은 모델 성능에 영향을 줄 수 있습니다. 오른쪽 패딩은 자연스러운 시퀀스 순서를 유지하므로 자기회귀 모델에 더 적합하고, 왼쪽 패딩은 양방향 모델에서 더 효율적일 수 있습니다. 최대 길이는 데이터셋의 길이 분포를 바탕으로 설정해야 하며, 이 분포는 데이터셋에 있는 시퀀스의 최대 길이를 구해 측정할 수 있습니다.
어텐션 마스크
어텐션 마스크는 처리 과정에서 모델이 어떤 토큰에 주의를 기울여야 하고(1) 어떤 토큰을 무시해야 하는지(0)를 나타내는 이진 텐서입니다. 이는 길이가 서로 달라 패딩이 필요한 시퀀스들을 배치로 다룰 때 특히 중요합니다.
예를 들어 길이가 서로 다른 두 시퀀스가 있다면 다음과 같습니다:
sequences = [
"The cat sat on the mat.",
"Hello world"
]
# Set the pad token to the eos token
tokenizer.pad_token = tokenizer.eos_token
# Tokenize with padding
encoded = tokenizer(
sequences,
padding=True,
return_tensors="pt"
)
그러면 다음과 비슷한 결과가 출력됩니다:
{
'input_ids': tensor([
[128000, 791, 8415, 7731, 389, 279, 5634, 13],
[128000, 9906, 1917, 128009, 128009, 128009, 128009, 128009]
]),
'attention_mask': tensor([
[1, 1, 1, 1, 1, 1, 1, 1],
[1, 1, 1, 0, 0, 0, 0, 0]
])
}
1은 어텐션을 적용해야 하는 실제 토큰을 나타내고, 0은 무시해야 하는 패딩 토큰을 나타냅니다. 이렇게 하면 모델이 패딩 토큰에서 의미 있는 패턴을 찾으려 하는 것을 막을 수 있습니다.
디코딩
토큰을 다시 텍스트로 변환하려면 토크나이저의 decode 메서드를 사용하십시오:
# Decode a single sequence
tokens = [128000, 791, 14198, 11984, 374, 264, 9606, 315, 11984, 13]
text = tokenizer.decode(tokens)
print(text)
# <|begin_of_text|>The brown bear is a species of bear.
# Decode batched sequences
batch_tokens = encoded["input_ids"]
texts = tokenizer.batch_decode(batch_tokens)
print(texts)
# ['<|begin_of_text|>The cat sat on the mat.', '<|begin_of_text|>Hello world<|eot_id|><|eot_id|><|eot_id|><|eot_id|><|eot_id|>']
decode 메서드는 다음을 처리합니다:
- 기본적으로 특수 토큰(BOS/EOS 등) 제거
- 토큰 ID를 다시 서브워드로 변환
- 서브워드를 완전한 단어로 결합
- 공백과 문장 부호 처리
skip_special_tokens 매개변수로 특수 토큰 처리 방식을 제어할 수 있습니다:
# Keep special tokens
text_with_special = tokenizer.decode(tokens, skip_special_tokens=False)
# <|begin_of_text|>The brown bear is a species of bear.
# Remove special tokens (default)
text_without_special = tokenizer.decode(tokens, skip_special_tokens=True)
# The brown bear is a species of bear.
데이터를 GPU로 옮기기
언어 모델을 학습하거나 사용할 때 데이터를 GPU로 옮기는 것은 좋은 성능을 얻기 위한 핵심 단계입니다. 최신 언어 모델은 연산량이 매우 많으며, GPU는 모델 추론과 학습의 핵심(Core)을 이루는 병렬 행렬 연산을 처리하도록 특별히 설계되었습니다. 모델을 GPU로 옮기려면 모델 가중치와 입력 텐서를 모두 CPU 메모리에서 GPU 메모리로 전송해야 하며, GPU 메모리에서는 계산을 훨씬 더 효율적으로 수행할 수 있습니다.
데이터를 GPU로 옮기는 과정은 PyTorch의 디바이스 관리 시스템을 통해 처리됩니다. 모델의 경우 일반적으로 cuda를 대상 장치로 하여 .to() 메서드를 호출하며, 이를 통해 모든 모델 매개변수가 GPU 메모리로 전송됩니다. 마찬가지로 토큰 ID나 어텐션 마스크 같은 입력 텐서도 모델과 같은 디바이스로 옮겨야 합니다. 이렇게 하면 성능 병목을 일으키는 불필요한 CPU 메모리로의 역전송 없이 모든 연산을 GPU에서 수행할 수 있습니다. 모델과 입력 텐서는 GPU에 있어야 하지만, 토크나이저 자체는 GPU 가속의 이점을 얻지 못하는 텍스트 처리 연산을 수행하므로 CPU에 그대로 남아 있다는 점에 유의해야 합니다.
model.to("cuda")
tokens_pt = tokens_pt.to("cuda")
PyTorch의 디바이스 맵을 사용하면 모델 레이어를 사용 가능한 디바이스(GPU와 CPU)에 어떻게 분산할지 지정할 수 있습니다. 이는 단일 GPU에 들어가지 않는 대규모 언어 모델을 다룰 때 특히 유용합니다. 디바이스 맵은 모델 구성 요소를 특정 디바이스에 매핑하는 딕셔너리입니다.
모델을 로드할 때 device_map="auto"를 설정하면 모델 레이어를 사용 가능한 GPU와 CPU에 자동으로 분산할 수 있습니다. 이렇게 하면 먼저 GPU의 사용 가능한 공간을 모두 채우고, 그다음 CPU를 채우며, 그래도 메모리가 부족하면 마지막으로 하드 드라이브를 사용합니다.
model = AutoModelForCausalLM.from_pretrained(
"meta-llama/Llama-3.2-3B-Instruct",
device_map="auto"
)
PyTorch 메모리 관리자는 GPU 메모리를 자동으로 관리하지만, 이 메모리는 Python 가비지 컬렉터와 연결되어 있으므로 때로는 모델에 대한 힙 참조를 삭제하고 가비지 컬렉터를 수동으로 호출하여 메모리를 비우는 방식으로 직접 메모리를 해제해야 합니다. 이러한 상황은 자신이 사용한 자원을 제대로 정리하지 못하는 예외 처리 로직이나, 때때로 객체를 메모리에 남겨 두는 IPython 노트북을 사용할 때 발생할 수 있습니다.
import gc
del model
del trainer
gc.collect()
torch.cuda.empty_cache()
채팅 형식
채팅 모델은 대화가 특정한 방식으로 형식화되어 있기를 기대합니다. 잘못된 형식을 사용하면 모델 성능이 크게 저하될 수 있으므로, 모델이 학습된 형식과 일치시키는 것이 중요합니다.
가장 일반적인 형식은 Llama 스타일로, 메시지를 특정 제어 토큰으로 감쌉니다.
conversation = [
{
"role": "system",
"content": "You are a helpful assistant"
},
{
"role": "user",
"content": "What type of bear is the best bear?"
}
]
형식화된 대화는 다음과 같습니다.
<|begin_of_text|><|start_header_id|>system<|end_header_id|>
You are a helpful assistant<|eot_id|>
<|start_header_id|>user<|end_header_id|>
What type of bear is the best bear?<|eot_id|>
<|start_header_id|>assistant<|end_header_id|>
The brown bear is the best bear.<|eot_id|>
채팅을 문자열로 형식화하는 가장 쉬운 방법은 토크나이저를 통해 모델에 내장된 채팅 템플릿을 사용하는 것입니다.
formatted_chat = tokenizer.apply_chat_template(
conversation,
tokenize=False,
add_generation_prompt=True
)
add_generation_prompt 매개변수를 True로 설정하면 포맷된 채팅 끝에 어시스턴트 역할 토큰이 추가됩니다. 이는 모델에게 다음으로 어시스턴트의 응답을 생성해야 한다는 신호를 주므로, 텍스트 생성을 위해 대화를 준비할 때 유용합니다. False로 설정하면 생성 프롬프트를 추가하지 않고 기존 대화만 형식화합니다.
또한 trl 라이브러리를 사용할 때는 채팅을 직접 형식화할 필요 없이, 여러 형식 중 하나로 대화를 트레이너에 그대로 전달하면 됩니다.
- 대화 형식
{
"messages": [
{"role": "system", "content": "You are helpful bear assistant"},
{"role": "user", "content": "What type of bear is the best bear?"},
{"role": "assistant", "content": "The brown bear is the best bear."}
]
}
- 지시 형식
{
"prompt": "Where do the polar bears live?",
"completion": "The polar bear lives in the Arctic."
}
- 텍스트 형식
{
"text": "The American black bear is indigenous to North America."
}
채팅 대화에서 역할은 다음과 같습니다.
| 역할 | 설명 |
|---|---|
| system | 모델과 상호작용할 맥락을 설정합니다. 일반적으로 모델이 효과적으로 응답하는 데 도움이 되는 규칙, 지침 또는 필요한 정보를 포함합니다. |
| user | 모델과 상호작용하는 사람을 나타냅니다. 여기에는 모델에 대한 입력, 명령, 질문이 포함됩니다. |
| assistant | system과 user 프롬프트에서 제공된 맥락을 바탕으로 AI 모델이 생성한 응답을 나타냅니다. |
모델을 미세 조정할 때는 모델이 원래 학습된 것과 동일한 채팅 형식을 사용하는 것이 매우 중요합니다. 다른 형식을 사용하면 성능이 크게 저하되거나 모델이 예측할 수 없는 방식으로 동작할 수 있습니다.
학습 데이터셋
미세 조정을 위한 학습 데이터는 목표 사용 사례에 맞도록 신중하게 선별해야 합니다. 데이터셋은 일반적으로 원하는 동작을 보여 주는 입력-출력 쌍으로 구성됩니다. 인스트럭션 튜닝의 경우, 이는 지시/질문과 고품질 응답의 쌍을 의미합니다.
미세 조정이 해당 사용 사례에 적합한 해결책이라고 판단했다면, 모델을 학습시킬 데이터셋을 만들어야 합니다. 이 데이터셋에는 모델이 학습하기를 원하는 특정 작업이나 동작을 보여 주는 다양한 예시가 포함되어야 합니다. 인스트럭션 데이터셋을 만드는 데에는 몇 가지 정립된 접근 방식이 있습니다.
한 가지 일반적인 접근 방식은 SQL 작업을 위한 Spider (https://huggingface.co/datasets/spider), 질의응답을 위한 SQuAD (https://huggingface.co/datasets/squad), 또는 기타 작업별 컬렉션과 같은 기존 오픈 소스 데이터셋을 활용하는 것입니다. 이는 가장 빠르고 비용 효율적인 방법이지만, 이러한 데이터셋이 특정 요구 사항과 완벽하게 일치하지 않을 수 있습니다. 현재 Hugging Face에는 이러한 데이터셋이 많이 공개되어 있으므로, 사용 사례에 맞는 데이터셋을 찾아볼 가치가 있습니다.
또 다른 접근 방식은 Alpaca 데이터셋 (https://huggingface.co/datasets/tatsu-lab/alpaca)을 만든 방식과 비슷하게, 대규모 언어 모델을 사용하여 합성 학습 데이터를 생성하는 것입니다. 이 방식은 GPT-4와 같은 더 뛰어난 모델을 사용하여 지시-응답 쌍을 생성합니다. 이 방식은 대량의 데이터를 빠르게 생성할 수 있지만, 품질이 들쭉날쭉할 수 있으며 생성 모델의 편향이나 한계를 그대로 물려받을 수 있습니다. 또한 언어 모델을 사용할 때는 생성된 데이터가 정확하다는 보장이 없으며, 이는 매우 중요한 주의 사항입니다! 이는 엄밀히 말해 일부 상용 LLM 제공업체의 이용 약관에도 위배되지만, 실제로는 이를 강제하지 않는 것으로 보이므로 판단은 각자에게 맡기겠습니다. 저는 변호사가 아니라 소프트웨어 엔지니어입니다.
Dolly 데이터셋 (https://huggingface.co/datasets/databricks/databricks-dolly-15k)의 경우처럼, 사람 어노테이터를 활용하여 데이터셋을 만들 수도 있습니다. 사람은 미묘한 차이를 반영하고 맥락에 맞는 응답을 제공할 수 있으므로, 이 방식은 일반적으로 가장 높은 품질의 데이터를 만들어 냅니다. 하지만 이 방법은 보통 시간과 비용이 가장 많이 듭니다.
성공적인 프로젝트 중 상당수는 여러 접근 방식을 결합합니다. 예를 들어, Orca 데이터셋 (https://huggingface.co/datasets/Open-Orca/OpenOrca)은 합성 데이터 생성과 사람의 선별 및 필터링을 결합하여 사용했습니다. 이러한 하이브리드 접근 방식은 단일 방법의 단점을 완화하면서 품질, 양, 비용 사이의 균형을 맞추는 데 도움이 될 수 있습니다.
이 방법들 중 무엇을 선택할지는 결국 구체적인 요구 사항에 달려 있습니다. 웹에는 합성 데이터 생성이라는 주제를 더 자세히 다루는 가이드가 많이 있으므로, 더 많은 정보는 그 자료들에 맡기겠습니다. 데이터 선별은 미세 조정에서 단연 가장 중요한 부분이므로, 시간을 들여 매우 신중하게 진행하십시오. 일반적인 데이터 선별 지침은 다음과 같습니다.
- 양보다 질이 중요합니다 - 소수의 고품질 예시가 노이즈가 많은 대규모 데이터셋보다 낫습니다
- 데이터는 프로덕션 환경에서 모델이 어떻게 동작하기를 원하는지를 잘 대표해야 합니다
- 원하는 능력의 다양한 측면을 포괄하는 다양한 예시를 포함하십시오
- 예시 전반에 걸쳐 형식과 스타일을 일관되게 유지하십시오
- 모델의 동작을 저하시킬 수 있는 문제가 있거나 품질이 낮은 샘플은 모두 제거하십시오
다음은 입력과 출력이 있는 CSV 파일에 학습 데이터를 구성하는 방법의 예시입니다. 그 입력과 출력은 다음과 같습니다
input,output
"What is the capital of France?","Paris"
"What is the capital of Germany?","Berlin"
"What is the capital of the United States?","Washington, D.C."
"What is the capital of Japan?","Tokyo"
from datasets import Dataset, DatasetDict
import pandas as pd
# Read CSV file into Dataset
df = pd.read_csv(csv_path)
dataset = Dataset.from_pandas(df)
# 90% train, 10% test + validation
train_testvalid = dataset.train_test_split(test=0.1)
# Split the 10% test + valid in half test, half valid
test_valid = train_testvalid['test'].train_test_split(test=0.5)
raw_dataset = DatasetDict({
'train': train_testvalid['train'],
'validation': test_valid['test'],
'test': test_valid['train']
})
# Save to disk (as Parquet)
raw_dataset.save_to_disk('raw_dataset')
# Save to JSONL file
raw_dataset.to_json('raw_dataset.jsonl', lines=True)
이제 모델에 맞게 데이터의 형식을 맞추려면 데이터셋 전체에 매핑하여 채팅 형식만 적용하면 됩니다.
# Load from disk
raw_dataset = load_dataset('raw_dataset')
# Shuffle
pre_formatted_dataset = raw_dataset.shuffle(seed=42)
SYSTEM_PROMPT = "You are a helpful assistant"
def format_chat(row):
return {
"messages": [
{"role": "system", "content": SYSTEM_PROMPT},
{"role": "user", "content": row["input"]},
{"role": "assistant", "content": row["output"]}
]
}
# Apply formatting
formatted_dataset = pre_formatted_dataset.map(format_chat)
# Split into train/eval/test
train_dataset = formatted_dataset['train']
eval_dataset = formatted_dataset['validation']
test_dataset = formatted_dataset['test']
출력에는 세 개의 데이터셋이 있습니다:
train- 모델을 훈련하고 훈련 중에 매개변수를 갱신하는 데 사용하는 주 데이터셋입니다validation- 훈련 중에 처음 보는 데이터에 대한 모델 성능을 평가하고 과적합을 방지하는 데 사용합니다test- 일반화 성능을 평가하기 위해 훈련이 완료된 후 최종 모델 평가에만 사용하는, 완전히 분리해 둔 데이터셋입니다
훈련 데이터셋은 미세 조정 중에 모델이 학습할 예시들입니다.
검증 데이터셋은 훈련 중에 하이퍼파라미터를 조정하고 과적합을 감시하는 데 사용합니다. 각 훈련 에포크가 끝난 뒤나 일정한 간격마다 검증 데이터로 모델의 성능을 평가함으로써, 훈련을 최적화하도록 학습률, 배치 크기 및 기타 매개변수를 조정할 수 있습니다. 검증 세트는 훈련에 관한 의사 결정에 도움을 줍니다.
테스트 데이터셋은 모델 개발의 맨 마지막까지 엄격하게 분리해 둡니다. 이 데이터셋은 완전히 처음 보는 데이터에 대한 모델 성능을 최종적이고 편향 없이 평가합니다. 테스트 세트는 모든 훈련과 하이퍼파라미터 조정이 끝난 후 단 한 번만 사용해야 합니다.
검증 세트와 테스트 세트는 서로 다른 역할을 하지만, 데이터가 제한된 상황에서는 때때로 하나의 검증/테스트 세트로 합칠 수 있습니다. 이는 이상적이지는 않지만, 데이터셋이 매우 작아서 세 개의 세트로 나누면 각 세트에 남는 데이터가 너무 적어지는 경우, 사용 사례상 최종 홀드아웃 평가 없이 훈련 진행 상황만 감시하면 되는 경우, 또는 모델이 고정된 릴리스 대신 지속적인 훈련/갱신을 거치는 경우에는 필요할 수 있습니다. 그러나 가능하다면 검증 세트와 테스트 세트를 따로 유지하는 것이 모델의 일반화 성능을 가장 엄밀하게 평가하는 방법입니다.
훈련 데이터셋과 검증 데이터셋은 항상 겹치지 않도록 분리하십시오. 데이터가 겹치면 모델이 훈련 중에 이미 검증 예시를 보았을 수 있으므로 성능 지표가 부풀려져 평가 결과가 오염되고, 그 결과 정확도와 기타 성능 지표가 잘못된 방식으로 높게 나타납니다. 이를 데이터 누수라고 하며, 실제보다 성능이 더 좋아 보이지만 사실은 검증 세트를 암기했을 뿐인 모델을 만들게 되므로 무슨 일이 있어도 피해야 합니다. 우리는 표본 외 데이터, 즉 모델 훈련에 사용하지 않은 데이터로 측정하고자 합니다.
datasets 라이브러리는 데이터셋을 다룰 때 유용한 흔히 쓰이는 연산 두 가지도 제공합니다. 바로 select와 shuffle이며, 각각 데이터셋을 잘라내고 무작위로 섞습니다.
# Select 1000 samples
train_dataset = train_dataset.select(range(1000))
# Shuffle using a seed for reproducibility
train_dataset = train_dataset.shuffle(seed=42)
양자화
양자화는 LLM 내부의 가중치와 활성화 값을 고정밀 데이터 표현에서 더 낮은 정밀도의 형식으로 로어링하는 모델 압축 기법입니다. 예를 들어, 32비트 부동소수점 수(FP32)를 8비트 또는 4비트 정수(INT4 또는 INT8)로 변환합니다. 이 과정을 통해 허용 가능한 수준의 성능을 유지하면서 모델 크기를 크게 줄일 수 있습니다. 주요 양자화 방식은 다음과 같습니다:
-
학습 후 양자화(Post-Training Quantization, PTQ): 학습 후 양자화는 모델 학습이 완료된 후에 적용됩니다. QAT에 비해 더 단순하고 구현이 빠른 접근 방식이지만, 일부 정확도 손실이 발생할 수 있습니다. 효과적으로 실행하는 데 더 적은 학습 데이터가 필요하다는 장점이 있습니다.
-
양자화 인식 학습(Quantization-Aware Training, QAT): 양자화 인식 학습은 양자화를 학습 과정 자체에 직접 통합합니다. 이 접근 방식은 일반적으로 학습 후 양자화보다 더 나은 성능을 달성하지만, 계산량이 더 많다는 대가가 따릅니다. 또한 QAT가 효과를 거두려면 전체 학습 데이터셋에 접근할 수 있어야 합니다.
가장 일반적인 양자화 기법은 다음과 같습니다.
QLoRA: 4비트 양자화와 저랭크 적응(Low-Rank Adaptation)을 결합합니다. 가중치를 저장할 때는 NF4(4-bit NormalFloat) 데이터 타입을 사용하고, 학습 중 연산은 BFloat16으로 수행합니다. 또한 스케일링 계수의 메모리 사용량을 줄이기 위해 이중 양자화를 사용합니다.
GPTQ: 가중치를 128개 열 단위의 배치로 처리하는 레이어별 양자화입니다. INT4/FP16 혼합 정밀도 방식을 활용하며, 지연 배치 업데이트(lazy batch updating) 메커니즘을 통해 출력 오차를 최소화합니다.
AWQ: 가중치를 128개 열 단위의 배치로 처리하는 또 다른 레이어별 양자화 기법입니다. 4비트와 8비트 양자화를 조합하여 사용하며, 스케일링 계수의 메모리 사용량을 줄이기 위해 이중 양자화를 사용합니다.
GGML/GGUF: 가중치를 32개 단위의 블록으로 나누는, CPU 중심의 양자화 프레임워크입니다. q2_k, q4_0, q8_0을 비롯한 여러 양자화 방법을 제공하므로, GPU 없이 CPU만 있는 하드웨어에서도 모델을 실행할 수 있습니다.
놀랍게도 양자화는 상당한 수준으로 압축하더라도 성능 저하가 미미한 경우가 많습니다. 연구에 따르면 QLoRA나 AWQ 같은 4비트 양자화 방법은 크기를 8배 줄이면서도 원본 모델 성능의 99% 이상을 유지할 수 있습니다. 이처럼 뛰어난 효과는 그렇게 공격적으로 압축하면 모델 품질이 크게 떨어질 것이라는 직관적인 예상을 뒤집습니다. 3비트 양자화조차도 많은 경우 강력한 성능을 유지할 수 있으며, 이 덕분에 양자화는 가장 성공적인 압축 기법 중 하나가 되었습니다.
GGUF 양자화 포맷은 가장 널리 쓰이며 대부분의 추론 엔진에서 지원됩니다. 다음은 권장 여부에 따라 정리하고 메모리 사용량을 함께 표시한 양자화 방법의 종합 표입니다.
| 방법 | 설명 | 상태 |
|---|---|---|
| Q4_K_M | 중간 크기, 균형 잡힌 품질 | ✅ 권장 |
| Q5_K_S | 큰 크기, 낮은 품질 손실 | ✅ 권장 |
| Q5_K_M | 큼, 품질 손실 매우 낮음 | ✅ 권장 |
| Q3_K_S | 매우 작음, 품질 손실 매우 높음 | 표준 |
| Q3_K_M | 매우 작음, 품질 손실 매우 높음 | 표준 |
| Q3_K_L | 작음, 품질 손실 상당함 | 표준 |
| Q4_K_S | 작음, 품질 손실 큼 | 표준 |
| Q6_K | 매우 큼, 품질 손실 극히 낮음 | 표준 |
| Q2_K | 가장 작음, 품질 손실 극심함 | 권장하지 않음 |
| Q8_0 | 매우 큼, 품질 손실 극히 낮음 | 권장하지 않음 |
| F16 | 극히 큼, 품질 손실 사실상 없음 | 권장하지 않음 |
| F32 | 엄청나게 큼, 무손실 | 권장하지 않음 |
요컨대 양자화를 사용하려는 경우 권장되는 방식은 Q4_K_M과 Q5_K_M입니다.
- Q4_K_M은 크기와 품질 사이에서 가장 좋은 균형을 제공합니다
- Q5_K_M은 크기가 더 큰 대신 더 높은 품질을 제공합니다
무손실 모델 양자화를 원한다면 F16을 사용하십시오.
Hugging Face에는 양자화된 모델을 제공하는 애그리게이터 계정이 있습니다. 예를 들어, bartowski는 Meta의 모델 대부분에 대해 양자화된 모델을 제공합니다. 예를 들면 다음과 같습니다.
배치 크기와 훈련 에포크
트레이너를 구성하려면 배치 크기와 에포크를 이해하는 것이 필수적입니다. 샘플은 훈련 데이터셋에 있는 하나의 입력-출력 쌍을 나타내며, 예를 들어 지시문과 그에 대응하는 응답이 이에 해당합니다. 이러한 샘플은 훈련 중 더 효율적으로 처리할 수 있도록 배치로 묶입니다. 배치 크기는 모델이 가중치를 업데이트하기 전에 동시에 처리하는 샘플의 수를 결정하며, 사용 가능한 GPU 메모리와 훈련 요구 사항에 따라 일반적으로 1에서 512 사이입니다.
훈련 에포크는 전체 훈련 데이터셋을 한 번 완전히 통과하는 것을 의미합니다. 예를 들어, 훈련 샘플이 10,000개이고 배치 크기가 32라면, 한 에포크는 약 313번의 배치 업데이트로 구성됩니다(10,000 ÷ 32, 올림). 에폭 수는 전체 학습 과정 동안 모델이 각 학습 샘플을 몇 번 보게 될지를 결정합니다. 미세 조정 작업에서는 모델이 사전 학습을 통해 이미 탄탄한 기초 지식을 갖추고 있으므로 1~3 에폭이면 충분한 경우가 많습니다.
배치 크기와 에포크 사이의 관계는 훈련 역학에 큰 영향을 미칩니다. 배치 크기가 클수록 더 효율적인 병렬 처리가 가능하지만, 훈련 안정성을 유지하기 위해 학습률 같은 다른 하이퍼파라미터를 조정해야 할 수 있습니다. 또한 더 안정적인 그래디언트 추정치를 제공하지만, 같은 수준의 모델 성능에 도달하려면 더 많은 에포크가 필요할 수 있습니다. 반대로 배치 크기가 작으면 학습 과정에 더 많은 노이즈가 생기며, 이는 때때로 모델의 일반화 성능을 높이는 데 도움이 되기도 하지만 한 에폭을 마치는 데 더 많은 업데이트 단계가 필요합니다.
언어 모델을 미세 조정할 때 흔히 쓰이는 출발점은 배치 크기를 8 또는 16으로 하고 그래디언트 누적으로 더 큰 배치를 흉내 내면서 1~3 학습 에폭을 함께 사용하는 것입니다. 이 구성은 대개 훈련 안정성, 메모리 효율성, 최종 모델 성능 사이에서 좋은 균형을 제공합니다. 정확한 값은 사용하는 하드웨어의 제약과 훈련 목표에 맞게 조정해야 합니다.
훈련 시간
학습 시간은 모델의 학습 과정을 완료하는 데 걸리는 총 시간을 의미합니다. 이 시간은 데이터셋의 크기, 모델의 복잡도, 배치 크기, 에포크 수, 사용 가능한 컴퓨팅 자원(사용하는 GPU의 종류와 개수 등)을 비롯한 여러 요인의 영향을 받습니다.
예를 들어, 대규모 데이터셋으로 많은 에포크와 큰 배치 크기를 사용해 대규모 언어 모델을 훈련하는 경우, 작은 데이터셋으로 적은 에포크와 작은 배치 크기를 사용해 더 작은 모델을 훈련하는 경우보다 일반적으로 시간이 더 오래 걸립니다. 또한 학습 과정의 효율성은 그래디언트 누적과 같은 기법의 사용 여부에 따라 달라질 수 있는데, 이러한 기법은 메모리 사용량을 관리하는 데 도움이 되지만 전체 학습 시간에도 영향을 줄 수 있습니다.
훈련 시간을 모니터링하고 최적화하는 것은 효율적인 모델 개발에 매우 중요하며, 특히 컴퓨팅 자원이 제한되어 있거나 모델 개선을 빠르게 반복하고자 할 때 더욱 그렇습니다.
training_args = TrainingArguments(
num_train_epochs=1,
max_steps=-1, # -1 means full epochs
)
에포크당 배치 수를 계산하는 공식은 다음과 같습니다.
num_batches = num_samples / batch_size
~1000개 샘플 정도의 작은 데이터셋을 다룰 때는 배치 크기 32를 사용하는 것이 일반적으로 안전하고 표준적인 선택입니다. 수십만 또는 수백만 개의 관측치처럼 훨씬 큰 데이터셋을 다루는 경우가 아니라면, 이 배치 크기가 결과에 큰 영향을 미칠 가능성은 낮습니다.
배치 크기와 에포크에 관한 몇 가지 모범 사례는 다음과 같습니다.
-
배치 크기:
- 배치 크기가 클수록 학습 진행 속도가 빨라질 수 있지만, 항상 더 빠르게 수렴하는 것은 아닙니다.
- 배치 크기가 작을수록 학습 속도는 느린 편이지만 더 빠르게 수렴할 수 있습니다.
- 최적의 배치 크기는 문제에 따라 달라지는 경우가 많으므로 실험이 필요할 수 있습니다.
-
에포크:
- 모델은 일반적으로 에포크 수를 늘려 학습할수록 일정 수준까지 성능이 향상됩니다.
- 모델이 수렴함에 따라 정확도는 정체되는 경향이 있습니다.
- 50과 같이 더 많은 에포크 수로 실험하고, 에포크 수에 따른 정확도를 그래프로 그려 성능이 평탄해지는 지점을 확인하는 것이 좋습니다.
-
학습 기간:
- 수렴을 보장하려면 최소 3 에포크 이상 학습하십시오.
- 학습 기간을 길게 하면 훨씬 더 나은 모델을 얻을 수 있으므로 더 긴 학습 기간으로 실험해 보십시오.
- 조기 종료를 사용하되, 과적합이 발생하지 않도록 평가 결과를 면밀히 모니터링하십시오.
- 각 에포크마다 전체 체크포인트를 저장하십시오. 이후 에포크의 성능이 떨어지면 이 체크포인트를 선택할 수 있습니다.
조기 종료
조기 종료는 검증 세트에서 모델의 성능을 모니터링하여 모델 학습 중 과적합을 방지하도록 고안된 정규화 기법입니다. 모델의 성능이 더 이상 향상되지 않으면 학습 과정을 중단하여, 모델이 처음 보는 새로운 데이터에도 잘 일반화되도록 합니다. 이 기법에서는 인내(patience) 매개변수를 설정하는데, 이 값은 학습을 중단하기 전에 검증 성능이 향상되기를 몇 에포크 동안 기다릴지를 결정합니다. 지정된 에포크 수 동안 모델의 성능이 향상되지 않으면 과적합을 방지하기 위해 학습을 종료합니다.
예를 들어 인내 값이 3 에포크인 경우, 검증 손실이 3 에포크 연속으로 감소하지 않으면 학습이 중단됩니다. 이 방식은 모델이 불필요하게 학습 데이터로 계속 학습하는 것을 방지합니다. 조기 종료는 TensorFlow, PyTorch 등 대부분의 딥러닝 프레임워크에서 내장 콜백이나 학습 루프 내의 사용자 정의 로직을 사용하여 구현할 수 있습니다.
조기 종료를 구현할 때는 검증 손실이나 정확도와 같이 모니터링할 적절한 검증 지표를 선택하는 것이 중요합니다. 인내 값은 학습 시간과 과적합 위험 사이의 균형을 맞추도록 설정해야 합니다. 또한 검증 성능이 가장 좋은 에포크에서 모델의 가중치를 저장하여, 모델의 최적 버전을 복원할 수 있도록 하는 것이 좋습니다. 조기 종료를 활용하면 모델 성능과 학습 효율 사이의 균형을 이룰 수 있으며, 그 결과 새로운 데이터에 대해 더 나은 일반화를 얻을 수 있습니다.
from transformers import EarlyStoppingCallback
early_stopping_callback = EarlyStoppingCallback(
early_stopping_patience=3,
early_stopping_threshold=0.01
)
training_args = TrainingArguments(
callbacks=[early_stopping_callback]
)
조기 종료의 두 매개변수는 다음과 같습니다.
early_stopping_patience: 개선되지 않을 경우 중단을 결정하기 전에 지표를 몇 번 확인할지를 나타냅니다. 모델에게 개선될 기회를 몇 번 주는 것과 같습니다.early_stopping_threshold: 학습을 계속하기 위해 지표가 향상되어야 하는 최소한의 양입니다. 지표가 이만큼 향상되지 않으면 학습을 마무리할 수 있습니다.
그래디언트 누적
그래디언트 누적은 대규모 모델을 학습할 때 GPU 메모리 한계를 극복하는 데 도움이 되는 기법입니다. 그래디언트 누적을 사용하면 배치마다 모델 매개변수를 업데이트하는 대신, 여러 개의 작은 배치를 순차적으로 처리하면서 그래디언트를 누적하여 사실상 더 큰 배치 크기를 흉내 낼 수 있습니다.
그래디언트 누적을 사용하면 학습 과정이 바뀌어, 한 번의 가중치 업데이트를 적용하기 전에 여러 번의 순전파 및 역전파 패스에 걸쳐 그래디언트를 누적합니다. 예를 들어 유효 배치 크기를 32로 하고 싶지만 메모리에 샘플을 8개만 올릴 수 있다면, 그래디언트 누적 단계를 4로 설정하면 됩니다. 이 경우 모델은 다음과 같이 동작합니다:
- 8개 샘플로 이루어진 미니 배치를 처리합니다
- 가중치를 업데이트하지 않고 그래디언트를 계산하여 저장합니다
- 이 과정을 4번 반복합니다
- 마지막으로 누적된 그래디언트를 사용해 모델 가중치를 업데이트합니다
핵심은 이 방식이 한 번에 8개 샘플을 처리할 만큼의 메모리만 필요로 하면서도, 더 큰 배치 크기인 32로 학습한 것과 수학적으로 동일한 결과를 낸다는 점입니다.
그래디언트 누적을 구현하려면 학습 루프를 다음과 같이 수정해야 합니다:
training_args = TrainingArguments(
per_device_train_batch_size=8, # Physical batch size per GPU
gradient_accumulation_steps=4, # Number of forward passes before update
gradient_checkpointing=True # Additional memory optimization
)
유효 배치 크기는 다음과 같이 계산할 수 있습니다:
effective_batch_size = per_device_batch_size * gradient_accumulation_steps * num_gpus
그래디언트 누적은 더 작은 물리적 배치 크기에 대해서만 순방향 패스 메모리를 요구하고, 그래디언트 저장 공간을 일정하게 유지하며, 옵티마이저 상태를 덜 자주 업데이트하므로 메모리를 크게 절약할 수 있습니다. 이 기법을 사용하면 그렇지 않았다면 가용 GPU 메모리에 비해 너무 컸을 모델도 학습할 수 있습니다. 예를 들어 7B 매개변수 모델을 미세 조정할 때 일반적인 학습 방식으로는 32GB의 GPU 메모리가 필요할 수 있지만, 그래디언트 누적을 사용하면 16GB GPU에서도 가능할 수 있습니다.
그래디언트 누적 단계 수를 선택할 때는 목표 유효 배치 크기, 가용 GPU 메모리 제약, 학습 속도 요구 사항(단계가 많을수록 학습이 느려지기 때문입니다), 모델의 수렴 특성 사이에서 균형을 맞춰야 합니다. 메모리 한도 내에 머무르면서 유효 배치 크기가 32에서 512 사이가 되도록 누적 단계를 선택하는 것이 좋은 출발점입니다. 예를 들어 물리적 배치 크기가 4라면, 구체적인 필요에 따라 8~32의 누적 단계를 사용할 수 있습니다.
그래디언트 누적은 메모리 제약을 극복하는 데 도움이 되지만, 누적 단계에 비례하여 학습 속도를 선형적으로 떨어뜨리고, 더 큰 유효 배치 크기에 맞춰 학습률 조정이 필요할 수 있으며, 배치 정규화 통계(사용하는 경우)를 더 작은 물리적 배치에서 계산하게 된다는 점에서 학습 동역학에 영향을 미칩니다. 학습 안정성을 유지하려면 제곱근 스케일링 규칙을 사용해 학습률을 조정하는 것을 고려하십시오:
adjusted_lr = base_lr * sqrt(effective_batch_size / base_batch_size)
학습률
학습률은 아마도 언어 모델 학습에서 가장 중요한 하이퍼파라미터로, 역전파 중에 계산된 그래디언트에 따라 모델 가중치를 얼마나 조정할지 결정하는 스케일링 계수 역할을 합니다. AdamW(아래 참조) 같은 옵티마이저를 사용할 때, 학습률은 옵티마이저가 손실 함수를 줄이는 방향으로 얼마나 큰 스텝을 밟을지에 직접적인 영향을 미칩니다.
학습률이 너무 높으면 학습 과정이 최적의 가중치 값을 지나쳐 버려, 학습이 불안정해지거나 최적이 아닌 해로 수렴할 수 있습니다. 이는 들쭉날쭉한 손실 곡선으로 나타나며, 극단적인 경우에는 수치적 불안정성으로까지 이어집니다. 반대로 학습률이 너무 낮으면 학습 진행이 매우 느려져, 모델이 더 나은 해를 향해 아주 작은 스텝만 밟게 되고 지역 최솟값에 갇히거나 할당된 학습 시간 내에 수렴하지 못할 수 있습니다.
언어 모델 미세 조정에서 학습률은 일반적으로 1e-5에서 5e-4 사이이며, LoRA를 사용할 때는 2e-4가 흔히 쓰이는 출발점입니다. 최적의 학습률은 대개 여러 요인에 따라 달라집니다:
- 모델 크기 - 일반적으로 큰 모델일수록 안정성을 유지하기 위해 더 작은 학습률이 유리합니다
- 옵티마이저 선택 - AdamW는 일반적으로 기본 SGD에 비해 더 낮은 학습률에서 잘 작동합니다
- 배치 크기 - 배치 크기가 클수록 약간 더 높은 학습률을 사용할 수 있는 경우가 많습니다
- 사용하는 미세 조정 기법 - LoRA는 전체 미세 조정보다 더 높은 학습률을 사용할 수 있는 경우가 많습니다
LoRA를 사용할 때는 매개변수의 작은 부분집합만 업데이트하므로 전체 미세 조정보다 더 높은 학습률을 사용할 수 있는 경우가 많습니다. 일반적인 구성은 다음과 같습니다.
training_args = TrainingArguments(
learning_rate=2e-4, # Higher than full fine-tuning
weight_decay=0.01, # L2 regularization
max_grad_norm=0.3, # Gradient clipping threshold
optim="paged_adamw_32bit" # Memory-efficient optimizer
)
학습률과 배치 크기 사이의 관계는 이른바 “선형 스케일링 규칙“을 따릅니다. 즉, 배치 크기를 k배로 늘리면 비슷한 학습 동역학을 유지하기 위해 일반적으로 학습률도 같은 배수만큼 늘려야 합니다. 그러나 이 규칙은 배치 크기가 매우 커지면 성립하지 않기 시작하며, 이때는 제곱근 스케일링 규칙이 더 잘 작동하는 경우가 많습니다.
base_lr = 2e-4
base_batch_size = 32
new_batch_size = 128
# Square root scaling
new_lr = base_lr * math.sqrt(new_batch_size / base_batch_size)
LoRA로 LLM을 미세 조정할 때는 1e-4의 학습률이 표준으로 자리 잡았습니다. 다르게 판단할 경험적 근거가 없다면 처음에는 이 값으로 시작하는 것이 좋습니다.
학습률 스케줄
학습률 스케줄은 학습 과정 전반에 걸쳐 학습률이 어떻게 변하는지를 결정하므로 모델 학습에서 매우 중요한 역할을 합니다. 스케줄마다 학습 안정성, 수렴 속도, 최종 모델 성능 사이에서 서로 다른 트레이드오프를 제공합니다. transformers 라이브러리에서는 여러 가지 학습률 스케줄을 사용할 수 있습니다.
- linear: 이 스케줄은 학습률을 초기값에서 최종값까지 직선으로 선형 감소시킵니다.
- cosine: 이 스케줄은 코사인 곡선을 따라 초기 학습률에서 시작하여 0에 가까운 값까지 부드럽게 감소합니다.
- cosine_with_restarts: 이 스케줄은 코사인 스케줄에 주기적인 “점프“를 추가하여, 학습률을 일시적으로 높였다가 다시 감쇠하도록 합니다.
- polynomial: 이 스케줄은 다항식 감쇠 함수를 따라 학습률을 감소시킵니다.
- constant: 이 스케줄은 학습 과정 전체에 걸쳐 학습률을 일정하게 유지합니다.
- constant_with_warmup: 이 스케줄은 학습률이 선형으로 증가하는 워밍업 기간이 끝난 후 학습률을 일정하게 유지합니다.
- inverse_sqrt: 이 스케줄은 역제곱근 감쇠 함수를 따라 학습률을 감소시킵니다.
- reduce_lr_on_plateau: 이 스케줄은 지표가 더 이상 개선되지 않을 때 학습률을 낮춥니다.
- cosine_with_min_lr: 이 스케줄은 최소 학습률이 있는 코사인 곡선을 따라 초기 학습률에서 시작하여 최솟값까지 부드럽게 감소합니다.
- warmup_stable_decay: 이 스케줄은 워밍업과 안정적인 감쇠 메커니즘을 결합합니다.
가장 흔히 사용되는 것은 선형, 코사인, 그리고 재시작이 있는 코사인입니다.
선형 스케줄
선형 학습률 스케줄은 학습률을 초기값에서 최종값까지 직선으로 점진적으로 감소시킵니다. 이 단순한 방식은 많은 미세 조정 작업에서, 특히 학습 단계 수가 비교적 적을 때 잘 작동합니다. 선형 스케줄은 높은 학습률을 통한 초기 탐색과, 학습률을 로어링하다가 도달하는 낮은 학습률에서의 최종 수렴 사이에서 좋은 균형을 제공합니다.
training_args = TrainingArguments(
learning_rate=2e-4,
lr_scheduler_type="linear",
warmup_ratio=0.03,
num_train_epochs=3
)
warmup_ratio 매개변수는 선형 감소가 시작되기 전에 학습 단계 중 어느 정도의 비율 동안 점진적으로 증가하는 학습률을 사용할지를 결정합니다. 이는 그래디언트가 크거나 노이즈가 많을 수 있는 학습 초기에 불안정한 업데이트를 방지하는 데 도움이 됩니다.
코사인 스케줄
코사인 학습률 스케줄은 코사인 곡선을 따라 초기 학습률에서 시작하여 0에 가까운 값까지 부드럽게 감소합니다. 이 스케줄은 선형 감쇠에 비해 학습률을 더 점진적으로 낮추므로, 모델이 더 나은 해로 수렴하는 데 도움이 될 수 있습니다. 코사인 스케줄은 최솟값에 정착하기 전에 손실 지형을 충분히 탐색하고자 하는 긴 학습에서 특히 효과적입니다.
training_args = TrainingArguments(
learning_rate=2e-4,
lr_scheduler_type="cosine",
warmup_ratio=0.03,
num_train_epochs=3
)
코사인 스케줄은 부드럽게 변하기 때문에 모델이 선형 감쇠에 비해 중간 수준의 학습률에서 더 많은 시간을 보내게 되며, 이는 일반화 성능을 향상시킬 수 있습니다.
재시작을 포함한 코사인
재시작을 포함한 코사인(웜 리스타트라고도 합니다)은 코사인 스케줄에 주기적인 “점프“를 추가하여, 학습률을 일시적으로 높였다가 다시 감소하도록 합니다. 이 방식은 모델이 좋지 않은 지역 최솟값에서 벗어나 손실 지형의 다른 영역을 탐색하도록 도울 수 있습니다. 각 재시작은 코사인 스케줄의 장점을 유지하면서 모델이 더 나은 해를 발견할 기회를 제공합니다.
training_args = TrainingArguments(
learning_rate=2e-4,
lr_scheduler_type="cosine_with_restarts",
warmup_ratio=0.03,
num_cycles=2, # Number of restart cycles
num_train_epochs=3
)
num_cycles 매개변수는 학습 중에 재시작이 몇 번 일어날지를 제어합니다. 각 사이클은 학습률을 재설정하기 전에 완전한 코사인 감소를 한 번 마칩니다. 이 스케줄은 손실 지형에 지역 최솟값이 많을 수 있는 복잡한 작업에 특히 유용합니다.
학습률 스케줄을 선택할 때는 다음 경험적 규칙을 사용하십시오.
- 학습 기간: 짧은 미세 조정 실행(1~2 에포크)은 선형 감소로도 잘 작동하는 경우가 많으며, 더 긴 실행에서는 코사인 스케줄이 유리합니다.
- 작업 복잡도: 더 복잡한 작업에서는 지역 최솟값을 벗어나기 위해 재시작을 포함한 코사인이 유리할 수 있습니다.
- 계산 예산: 선형 감소처럼 단순한 스케줄은 조정이 덜 필요하고 예측하기도 더 쉽습니다.
- 모델 크기: 더 큰 모델에서는 재시작을 포함한 코사인처럼 더 정교한 스케줄이 유리한 경우가 많습니다.
대부분의 미세 조정 작업에 좋은 출발점은 다음과 같습니다.
training_args = TrainingArguments(
learning_rate=2e-4,
lr_scheduler_type="cosine",
warmup_ratio=0.03,
num_train_epochs=3,
warmup_steps=100,
max_steps=-1 # -1 means use num_train_epochs instead
)
워밍업 스텝
워밍업 스텝 매개변수는 스케줄이 감소를 시작하기 전에 학습률이 몇 스텝 동안 선형으로 증가할지를 결정합니다. 이는 그래디언트가 크거나 노이즈가 많을 수 있는 학습 초기에 불안정한 업데이트가 일어나는 것을 막는 데 도움이 됩니다. 이 매개변수를 설정하는 일반적인 경험적 방법으로는 warmup_ratio와 warmup_steps 두 가지가 있습니다.
warmup_ratio 매개변수는 선형 감소가 시작되기 전에 전체 학습 스텝 중 어느 비율만큼 점진적으로 증가하는 학습률을 사용할지를 결정합니다. 이는 그래디언트가 크거나 노이즈가 많을 수 있는 학습 초기에 불안정한 업데이트가 일어나는 것을 막는 데 도움이 됩니다.
warmup_steps 매개변수는 선형 감소가 시작되기 전에 점진적으로 증가하는 학습률을 사용할 정확한 스텝 수를 결정합니다.
옵티마이저
옵티마이저는 학습 중에 모델 가중치를 업데이트하는 핵심(Core) 알고리즘입니다. AdamW 같은 널리 쓰이는 옵티마이저는 모두 SGD의 변형입니다. 이러한 옵티마이저와 함께 자주 사용되는 L2 정규화는 큰 가중치에 작은 페널티를 부과하는 것과 같아서, 모델이 단순함을 유지하고 과적합을 피하도록 유도합니다.
AdamW 옵티마이저는 대규모 언어 모델의 학습과 미세 조정에서 사실상의 표준이 되었습니다. AdamW는 가중치 감쇠를 그래디언트 업데이트와 분리하여 기존 Adam 옵티마이저를 확장하며, 이를 통해 특히 대규모 신경망에서 더 나은 일반화 성능을 얻을 수 있습니다.
핵심(Core)적으로 AdamW는 각 매개변수에 대해 두 개의 모멘트(이동 평균)를 유지합니다. 1차 모멘트는 과거 그래디언트의 평균을 나타내고, 2차 모멘트는 과거 그래디언트의 비중심 분산을 추적합니다. 이러한 모멘트는 각 매개변수의 학습률을 개별적으로 조정하는 데 도움을 주므로, 매개변수마다 서로 다른 규모의 업데이트가 필요한 심층 신경망을 학습할 때 이 옵티마이저가 특히 효과적입니다.
표준 Adam과 비교했을 때 AdamW의 핵심 혁신은 가중치 감쇠를 처리하는 방식입니다. 기존 Adam에서는 가중치 감쇠가 그래디언트 업데이트의 일부로 구현되어 정규화가 최적에 미치지 못할 수 있습니다. AdamW는 그래디언트 업데이트 전에 가중치에 직접 가중치 감쇠를 적용하여 올바른 L2 정규화를 보장합니다. 이 사소해 보이는 변화는 모델 성능에 상당한 영향을 미치며, 특히 과적합을 막는 데 올바른 정규화가 매우 중요한 대규모 언어 모델에서 그렇습니다.
언어 모델 미세 조정을 위해 AdamW를 구성할 때 일반적인 하이퍼파라미터로는 0.01에서 0.1 사이의 가중치 감쇠 값과, 1차 및 2차 모멘트에 대해 각각 0.9와 0.999의 베타 값이 있습니다. 옵티마이저는 보통 다음과 같은 구성으로 구현합니다.
training_args = TrainingArguments(
optim="paged_adamw_32bit", # Memory-efficient AdamW implementation
weight_decay=0.01, # L2 regularization factor
adam_beta1=0.9, # Exponential decay rate for first moment
adam_beta2=0.999, # Exponential decay rate for second moment
adam_epsilon=1e-8, # Small constant for numerical stability
)
AdamW의 “paged” 변형(paged_adamw_32bit)은 메모리 효율적인 상태 관리를 구현하여, AdamW의 적응형 학습률과 올바른 가중치 감쇠라는 이점은 유지하면서 옵티마이저 상태에 필요한 GPU 메모리를 줄여 주므로 대규모 언어 모델을 미세 조정할 때 특히 유용합니다.
옵티마이저 외에도 max_grad_norm 매개변수는 역전파 중 그래디언트 노름의 최댓값을 결정합니다. 이 파라미터는 그래디언트가 지나치게 커져 수치적 불안정성을 일으키는 그래디언트 폭주 문제를 방지하는 데 사용됩니다. 기본값인 0.3은 좋은 출발점이지만, 특정 미세 조정 작업에 가장 잘 맞는 값을 찾기 위해 다양한 값으로 실험해 볼 수 있습니다.
가중치 감쇠
가중치 감쇠는 모델의 가중치가 커지는 것을 억제하여 과적합을 방지하는 데 도움을 주는 정규화 기법입니다. 이 기법은 가중치 제곱의 합에 비례하는 페널티를 손실 함수에 더하는 방식으로 작동하며, 결과적으로 모델이 더 작은 가중치를 유지하도록 유도합니다. 이를 통해 처음 보는 데이터에 대한 일반화 성능이 향상될 수 있습니다.
많은 대규모 언어 모델 미세 조정 작업에서 가중치 감쇠의 합리적인 기본값은 0.01입니다. 이 값은 정규화와 모델 유연성 사이의 균형을 맞춰 주므로, 데이터로부터 학습하는 모델의 능력을 과도하게 제약하지 않으면서 과적합을 방지하는 데 도움이 됩니다.
경우에 따라서는 가중치 감쇠를 0으로 설정하는 것을 고려할 수 있습니다. 특히 모델이 과소적합되고 있거나 데이터셋이 매우 작아 정규화가 그다지 중요하지 않은 경우에 그렇습니다. 반대로 모델이 심하게 과적합되고 있다면 0.1처럼 더 높은 가중치 감쇠 값이 적절할 수 있습니다. 이렇게 하면 큰 가중치에 더 강한 페널티가 부과되어 가중치 값이 더욱 작아지도록 유도되고, 일반화 성능이 향상될 가능성이 있습니다.
AdamW 옵티마이저를 구성할 때 가중치 감쇠 매개변수는 학습 인수의 일부로 지정되므로, 학습 과정 전체에 걸쳐 일관되게 적용됩니다.
training_args = TrainingArguments(
weight_decay=0.01, # L2 regularization factor
)
SFT Trainer
지도 미세 조정 트레이너(SFT Trainer)는 TRL(Transformer Reinforcement Learning, 트랜스포머 강화 학습) 라이브러리에서 제공하는 특화된 클래스로, 언어 모델의 미세 조정 과정을 단순화합니다. 이 클래스는 표준 Hugging Face Trainer 클래스를 기반으로 지도 미세 조정 작업을 위한 특화된 기능을 추가하므로, 명령어 튜닝과 채팅 모델 개발에 특히 적합합니다.
SFT Trainer는 PEFT 모델의 올바른 초기화, 데이터셋 포맷팅, 학습 최적화 등 미세 조정에 수반되는 여러 복잡한 작업을 처리합니다. PEFT 구성이 주어지면 매개변수 효율적 미세 조정을 자동으로 설정하여 대규모 언어 모델을 메모리 효율적으로 학습할 수 있게 합니다. 표준 데이터셋과 이터러블 데이터셋을 모두 다룰 수 있으므로, 다양한 데이터 로딩 방식에 유연하게 대응합니다.
SFT Trainer의 기본 구현은 다음과 같습니다.
from trl import SFTTrainer
trainer = SFTTrainer(
model=model, # Your model
train_dataset=train_dataset, # Training dataset
peft_config=lora_config, # LoRA configuration
max_seq_length=512, # Maximum sequence length
tokenizer=tokenizer, # Tokenizer
args=training_args, # Training arguments
packing=True # Enable sequence packing
)
trainer.train()
이 트레이너는 학습 효율을 크게 높일 수 있는 여러 성능 최적화를 지원합니다. 더 빠른 어텐션 계산을 위해 Flash 어텐션 2와 호환됩니다.
SFT Trainer의 주요 장점 중 하나는 데이터셋 포맷팅을 처리하는 방식입니다. 활성화된 경우 올바른 토큰화와 시퀀스 패킹을 포함하여, 학습 데이터를 모델에 적합한 형식으로 변환하는 작업을 자동으로 처리합니다. 이를 통해 학습 데이터를 준비하는 데 일반적으로 필요한 상용구 코드의 상당 부분이 사라지므로, 실제 미세 조정 과정에 집중할 수 있습니다.
패킹
패킹은 학습 중 GPU 메모리 활용도를 극대화하기 위해 SFT Trainer가 사용하는 최적화 기법입니다. packing=True 매개변수로 활성화하면 트레이너는 지정된 max_seq_length까지 여러 시퀀스를 하나의 학습 예제로 패킹합니다.
패킹을 사용하지 않으면 각 학습 예제가 최대 시퀀스 길이까지 패딩되므로, 패딩 토큰에 연산 자원이 낭비됩니다. 예를 들어 길이가 128, 256, 384 토큰인 시퀀스가 있고 max_seq_length=512인 경우, 기존 배칭 방식은 각 시퀀스를 512 토큰까지 패딩하므로 패딩에 상당한 메모리가 낭비됩니다.
패킹을 활성화하면 트레이너는 여러 시퀀스를 지능적으로 결합하여 하나의 학습 예제로 만듭니다. 앞의 예를 사용하면 128토큰 시퀀스와 384토큰 시퀀스를 하나의 512토큰 예제로 함께 패킹하고, 256토큰 시퀀스는 다른 짧은 시퀀스와 함께 패킹할 수 있습니다. 그 결과 GPU 메모리를 더 효율적으로 사용하고, 처리하는 패딩 토큰이 줄어 훈련이 빨라지며, 최대 시퀀스 길이를 더 잘 활용할 수 있습니다.
트레이너는 패킹된 시퀀스 사이의 교차 오염을 막기 위한 적절한 어텐션 마스킹을 포함하여 패킹의 모든 복잡한 처리를 담당합니다. 따라서 패킹은 특히 시퀀스 길이가 다양한 데이터셋으로 훈련할 때 유용한 최적화입니다.
Flash 어텐션 2
Flash 어텐션 2는 고도로 최적화된 어텐션 메커니즘으로, 학습 중 메모리 사용량을 크게 줄이고 어텐션 계산 속도를 높입니다. 학습 설정에서 Flash 어텐션 2를 활성화하려면 다음을 수행해야 합니다.
pip install flash-attn --no-build-isolation
model = AutoModelForCausalLM.from_pretrained(
"meta-llama/Meta-Llama-3-8B-Instruct",
quantization_config=bnb_config,
device_map=device_map,
attn_implementation="flash_attention_2" # Enable Flash Attention 2
)
하드웨어가 Flash 어텐션 2를 지원하지 않으면 모델은 자동으로 표준 어텐션 구현으로 대체됩니다.
NEFTune
NEFTune은 훈련 중 임베딩 벡터에 노이즈를 추가하여 성능을 향상시킬 수 있는 기법입니다. 이를 활성화하려면 TrainingArguments에서 neftune_noise_alpha 매개변수를 설정하십시오. 예기치 않은 동작을 방지하기 위해 훈련이 끝나면 NEFTune이 비활성화되어 원래의 임베딩 레이어가 복원됩니다.
training_args = TrainingArguments(
neftune_noise_alpha=5
)
일반적으로 1에서 10 사이의 값이 사용됩니다.
손실 함수
손실 함수는 훈련 중 모델의 예측이 정답(ground truth)에서 얼마나 벗어나는지를 나타내는 수학적 척도입니다. 언어 모델의 경우, 이는 일반적으로 어휘에 대한 예측 확률 분포와 학습 데이터에 실제로 나타나는 다음 토큰 사이의 교차 엔트로피 손실을 측정하는 것을 의미합니다. 손실이 낮을수록 모델이 정답 토큰에 더 높은 확률을 부여하고 있다는 뜻이므로 성능이 더 좋다는 것을 나타냅니다. 손실은 학습 예제의 배치 단위로 계산되고 평균을 내어, 모델의 현재 성능을 나타내는 하나의 수치를 제공합니다.
간단히 말해 교차 엔트로피 손실은 모델이 정답을 보고 얼마나 놀라는지를 측정하는 것과 같습니다. 모델이 틀린 단어를 매우 확신하며 예측하면 큰 벌점(높은 손실)을 받습니다. 올바른 단어를 확신하며 예측하면 작은 벌점(낮은 손실)을 받습니다. 이는 문장의 다음 단어를 맞혀야 하는 게임과 비슷합니다. 확신이 없거나 틀릴수록 더 많은 점수를 잃습니다. 목표는 다음에 올 내용을 더 잘 예측하게 되어 이러한 “놀람 점수“를 최소화하는 것입니다.
훈련 중에는 두 가지 손실, 즉 훈련 손실과 평가 손실(eval_loss)을 추적합니다. 훈련 손실은 모델이 실제로 학습하고 있는 데이터에서 계산되고, 평가 손실은 모델이 훈련 중에 한 번도 보지 않는 별도의 검증 세트에서 계산됩니다. 이 두 지표를 함께 보면 학습 과정에 대한 핵심적인 통찰을 얻을 수 있습니다. 두 손실이 모두 감소하고 있다면 모델이 효과적으로 학습하고 있는 것입니다. 학습 손실은 감소하지만 평가 손실이 증가하거나 정체된다면 이는 과적합을 나타냅니다. 즉, 모델이 일반화 가능한 패턴을 학습하는 대신 학습 데이터를 암기하고 있는 것입니다.
일반적으로 손실은 모델이 얼마나 많은 실수를 하는지 측정하는 점수라고 생각할 수 있습니다. 시험지를 채점하는 선생님처럼, 손실 함수는 모델이 실수를 많이 하면 낮은 점수(높은 손실)를 주고 실수를 적게 하면 높은 점수(낮은 손실)를 줍니다. 훈련 손실은 모의고사 점수와 같습니다. 즉, 모델이 학습 중인 자료에서 얼마나 잘하는지를 보여 줍니다. 평가 손실은 기말고사 점수와 같습니다. 즉, 모델이 배운 것을 이전에 본 적 없는 새로운 문제에 얼마나 잘 적용할 수 있는지를 보여 줍니다. 내용을 이해하지 않고 모의고사를 암기한 학생이 기말고사에서 좋지 않은 성적을 거두는 것처럼, 과적합된 모델은 훈련 손실은 좋지만 평가 손실은 나쁘게 나타납니다.
손실이 정확히 0이라면 모델이 학습 데이터를 암기했다는 의미입니다. 손실이 높다면 모델이 실수를 많이 하고 있다는 뜻입니다. 손실은 모델이 학습함에 따라 시간이 지나면서 감소해야 하며, 반대로 증가한다면 무언가 잘못된 것입니다.
학습 곡선
학습 곡선을 해석하는 방법을 이해하는 것은 모델 미세 조정을 성공적으로 수행하는 데 매우 중요합니다. 학습 곡선은 훈련 중 모델의 손실이 시간에 따라 어떻게 변하는지를 보여 주며, 일반적으로 훈련 손실과 검증 손실을 모두 훈련 스텝 수 또는 에포크 수에 대해 그래프로 나타냅니다. 이 곡선들은 모델이 얼마나 잘 학습하고 있는지, 그리고 흔히 발생하는 훈련 문제를 겪고 있는지에 대한 귀중한 통찰을 제공합니다.
바람직한 학습 곡선은 일반적으로 훈련 손실과 검증 손실이 모두 시간에 따라 매끄럽게 감소하다가 결국 비슷한 값에서 정체되는 모습을 보입니다. 초기의 가파른 하락은 모델이 데이터에서 가장 뚜렷한 패턴을 빠르게 학습하고 있음을 나타냅니다. 훈련이 진행됨에 따라 모델이 더 미묘한 패턴에 대한 이해를 세밀하게 다듬어 가면서 개선 폭은 점점 완만해집니다. 훈련 손실과 검증 손실 사이의 차이가 작다면 모델이 처음 보는 데이터에 대해 잘 일반화하고 있음을 시사합니다.
**과소적합(underfitting)**은 모델이 학습 데이터의 근본적인 패턴을 효과적으로 학습하지 못할 때 발생합니다. 이는 학습 곡선에서 훈련 세트와 검증 세트 모두의 손실 값이 지속적으로 높게 유지되고 시간이 지나도 개선이 거의 없는 형태로 나타납니다. 곡선이 평평하게 보이거나 매우 느리게 개선될 수 있는데, 이는 모델이 작업의 복잡성을 포착할 만한 용량이 부족하거나 학습률이 효과적인 훈련을 하기에는 너무 낮을 수 있음을 나타냅니다. 이러한 경우에는 모델의 용량을 늘리거나, 학습률을 조정하거나, 더 많은 에포크 동안 훈련하는 것을 고려하십시오.
반대로 **과적합(overfitting)**은 모델이 일반화 가능한 패턴을 학습하는 대신 학습 데이터를 암기할 때 발생합니다. 학습 곡선은 특징적인 발산을 통해 이를 드러냅니다. 즉, 훈련 손실은 계속 감소하는 반면 검증 손실은 증가하기 시작하거나 더 높은 값에서 정체됩니다. 학습 성능과 검증 성능 사이의 이러한 격차가 커진다는 것은 모델이 일반화를 희생하면서 학습 데이터에 지나치게 특화되고 있음을 나타냅니다. 일반적인 해결책으로는 정규화를 도입하거나, 모델 용량을 줄이거나, 검증 손실이 증가하기 시작할 때 조기 종료를 적용하는 방법이 있습니다.
학습 곡선의 수렴 속도는 학습률이 적절한지에 대한 통찰도 제공할 수 있습니다. 손실이 너무 느리게 감소한다면 학습률이 너무 낮아 비효율적인 훈련이 이루어지고 있을 수 있습니다. 반대로 손실이 높은 변동성을 보이거나 갑작스럽게 급등한다면 학습률이 너무 높아 훈련이 불안정해지고 있을 수 있습니다. 이상적인 학습 곡선은 과도한 변동 없이 꾸준하고 일관된 개선을 보여 줍니다.
적절한 수렴을 보여 주는 손실 곡선입니다.
간단히 말해, 과소적합은 모델이 “너무 둔한” 경우입니다. 즉, 모델이 좋은 예측을 할 만큼 학습 데이터로부터 충분히 학습하지 못한 상태입니다. 이는 시험공부를 거의 하지 않아 기본적인 문제조차 풀지 못하는 학생과 같습니다. 과적합은 모델이 “지나치게 똑똑해서 오히려 탈이 난” 상태로, 학습 데이터를 너무 잘 암기한 나머지 새로운 예제로 일반화하지 못하는 경우입니다. 이는 연습 문제를 모두 암기했지만 실제 시험에서 조금만 다르게 나온 문제는 풀지 못하는 학생과 같습니다. 이상적으로 우리가 원하는 모델은 학습 데이터를 암기하지 않으면서 그 근본적인 패턴을 학습할 수 있을 만큼만 똑똑한 모델입니다. 이러한 상태가 “이해” 또는 “일반화“에 가까운 것이기 때문입니다.
치명적 망각(Catastrophic Forgetting)
파국적 망각(catastrophic forgetting)은 대규모 언어 모델의 미세 조정에서 중요한 과제입니다. 모델을 특정 작업이나 도메인에 맞게 미세 조정하면, 사전 학습 중에 습득한 폭넓은 지식과 능력을 잃거나 “망각“할 위험이 있습니다. 이는 새로운 작업에서의 성능을 최적화하도록 모델의 매개변수가 업데이트되면서, 일반적인 언어 이해 능력을 가능하게 했던 학습된 표현을 덮어쓰거나 교란할 수 있기 때문에 발생합니다.
파국적 망각의 영향은 공격적으로 미세 조정하거나 높은 학습률로 미세 조정할 때 특히 심각할 수 있습니다. 원래 질의응답에서 요약, 코드 생성에 이르기까지 광범위한 작업을 처리할 수 있었던 모델이, 미세 조정 목표에 과도하게 특화되면서 더 넓은 능력을 잃을 수 있습니다. 이것이 LoRA와 같은 기법과 신중한 학습률 선택이 중요한 이유입니다. 이러한 방법은 특정 사용 사례에 맞춘 목표 지향적 적응을 가능하게 하면서도 모델의 일반 지식을 보존하는 데 도움이 됩니다.
로깅
가장 널리 쓰이는 로깅 도구는 Weights & Biases입니다. 이는 훈련 지표를 추적하고 대시보드에서 시각화할 수 있게 해 주는 무료 서비스입니다. 이를 활용하면 손실 곡선과 평가 곡선을 시각적으로 살펴보며 시간에 따른 변화 양상을 확인할 수 있어 매우 유용합니다. 로깅 외에도 Weights & Biases를 사용하여 서로 다른 모델과 학습 실행의 성능을 비교할 수 있는데, 이를 *매개변수 스윕(parameter sweep)*이라고 하며, 학습률, 가중치 감쇠, 모델 크기 등의 매개변수를 변경하는 실험을 추적하고 그 결과를 자동으로 기록할 수 있습니다.
로깅을 켜려면 TrainingArguments에 report_to="wandb" 인수를 추가하기만 하면 됩니다.
from wandb import init
init(project="my-project")
training_args = TrainingArguments(
report_to="wandb"
)
매개변수 스윕을 수행하려면 wandb.sweep 함수를 사용할 수 있습니다. 예를 들면 다음과 같습니다.
import wandb
# 1. Define the sweep configuration
sweep_config = {
'method': 'random', # Random search strategy
# Metric to optimize
'metric': {
'name': 'eval_loss',
'goal': 'minimize'
},
# Parameters to sweep over
'parameters': {
'learning_rate': {
'distribution': 'uniform',
'min': 0.0001,
'max': 0.1
},
'batch_size': {
'values': [16, 32, 64, 128]
},
}
}
# 2. Define the training function
def train():
# Initialize a new wandb run
with wandb.init() as run:
# Get the configuration for this run
config = wandb.config
# ... your training logic here
# 3. Initialize the sweep
sweep_id = wandb.sweep(
sweep_config,
project="my-sweep-project"
)
# 4. Run the sweep
wandb.agent(sweep_id, function=train, count=5) # Run 5 experiments
평가 지표
평가 지표를 이해하고 해석하는 것은 미세 조정 중과 이후에 모델 성능을 평가하는 데 필수적입니다. 가장 기본적인 지표는 손실 함수로, 모델의 예측이 정답(ground truth)에서 얼마나 벗어나는지를 측정합니다. 언어 모델에서는 일반적으로 예측된 토큰 확률과 실제 다음 토큰 사이의 교차 엔트로피 손실을 사용합니다. 학습 손실은 학습 데이터에 대한 이 측정값을 나타내며, 평가 손실(eval_loss)은 별도로 남겨 둔 검증 세트에 대해 동일한 값을 측정합니다. 두 지표가 모두 감소하는 추세라면 모델이 학습하고 있다는 뜻이며, 두 지표가 서로 벌어진다면 과적합의 신호일 수 있습니다.
지시 수행 모델과 채팅 모델의 경우, ROUGE(Recall-Oriented Understudy for Gisting Evaluation) 점수는 생성된 응답과 참조 답변 사이의 유사도를 평가하는 데 도움이 됩니다. ROUGE-1과 ROUGE-2는 각각 유니그램과 바이그램의 중복을 측정하며, ROUGE-L은 최장 공통 부분 수열을 고려합니다. 이러한 지표는 모델이 핵심 정보를 얼마나 잘 포착하고 일관된 표현을 유지하는지 평가하는 데 특히 유용하지만, 품질에 대한 인간의 판단과 항상 상관관계가 있는 것은 아니므로 이 지표에만 전적으로 의존해서는 안 됩니다.
BLEU(Bilingual Evaluation Understudy) 점수는 원래 기계 번역을 위해 고안되었지만, 생성된 텍스트의 정밀도에 대한 추가적인 통찰을 제공할 수 있습니다. BLEU 점수는 0에서 1 사이의 값을 가지며, 길이 불일치에 대한 페널티를 적용하여 생성된 텍스트와 참조 텍스트 사이의 n-gram 중복을 측정합니다. 그러나 지시 수행 작업에서는 여러 개의 타당한 응답이 서로 다르지만 똑같이 적절한 표현을 사용할 수 있으므로, BLEU 점수를 신중하게 해석해야 합니다.
Hugging Face Trainer는 학습 중에 이러한 지표를 자동으로 기록하므로, training_logs 디렉터리에서 확인하거나 Weights & Biases 같은 추적 플랫폼과 연동해 확인할 수 있습니다. 이러한 지표를 분석할 때는 절댓값보다 추세를 보는 것이 중요합니다. 적절한 범위는 작업, 데이터셋, 모델 아키텍처에 따라 크게 달라질 수 있기 때문입니다. eval_loss나 퍼플렉서티가 갑자기 급등하면 어텐션이 필요한 훈련 문제가 있다는 신호인 경우가 많고, 반대로 모든 지표가 점진적으로 개선되면 학습이 건강하게 진행되고 있다는 뜻입니다.
지표를 불러오려면 evaluate 라이브러리를 사용합니다.
# Get all metrics
from evaluate import load
accuracy = load("accuracy")
rouge = load("rouge")
bleu = load("bleu")
이제 지표를 계산하려면 예측값과 레이블을 전달해야 합니다.
def run_metrics(eval_preds):
predictions, labels = eval_preds
# Decode predictions and labels back to text
predictions = tokenizer.batch_decode(predictions, skip_special_tokens=True)
labels = tokenizer.batch_decode(labels, skip_special_tokens=True)
return {
"accuracy": accuracy.compute(predictions=predictions, references=labels),
"rouge": rouge.compute(predictions=predictions, references=labels),
"bleu": bleu.compute(predictions=predictions, references=labels)
}
trainer = SFTTrainer(
model=model,
train_dataset=train_dataset,
eval_dataset=eval_dataset,
compute_metrics=run_metrics
)
퍼플렉서티(Perplexity)
퍼플렉서티는 언어 모델을 평가하는 가장 Core 지표 중 하나로, 모델이 텍스트 샘플을 얼마나 잘 예측하는지를 측정합니다. 수학적으로 퍼플렉서티는 시퀀스의 평균 음의 로그 가능도에 지수 함수를 취한 값으로 정의됩니다. 더 쉽게 말하면, 시퀀스의 다음 토큰을 예측할 때 모델이 얼마나 “혼란스러워하는지”, 즉 얼마나 “당혹스러워하는지“를 나타냅니다.
퍼플렉서티는 교차 엔트로피 손실에 지수 변환을 적용해 바로 얻을 수 있으며, 언어 모델링 작업에서 더 해석하기 쉬운 지표를 제공합니다. 이는 모델이 다음 토큰을 예측할 때 얼마나 “혼란스러워하는지“로 이해할 수 있으며, 값이 낮을수록 성능이 더 좋습니다. 예를 들어 퍼플렉서티가 10이라는 것은 모델이 매 단계에서 똑같이 가능성 있는 선택지 10개 중 하나를 고르는 것만큼 불확실하다는 뜻입니다. 베이스 모델은 15-30 범위의 퍼플렉서티에서 시작할 수 있지만, 잘 미세 조정된 모델은 대상 도메인에서 10 미만의 퍼플렉서티를 달성하는 경우가 많습니다. 퍼플렉서티의 공식은 다음과 같습니다.
여기서 각 항목은 다음과 같습니다.
- 은 시퀀스의 토큰 수입니다
- 는 이전 토큰들이 주어졌을 때 모델이 토큰 에 부여하는 확률입니다
- 합은 시퀀스의 모든 토큰에 대해 계산합니다
퍼플렉서티 점수가 낮을수록 성능이 더 좋습니다:
- 퍼플렉서티가 1이라면 모델이 모든 토큰을 완벽하게 예측한다는 뜻입니다
- 퍼플렉서티가 2라는 것은 모델이 똑같이 가능성 있는 선택지 2개 중 하나를 고르는 것만큼 불확실하다는 뜻입니다
- 퍼플렉서티가 10이라는 것은 모델이 똑같이 가능성 있는 선택지 10개 중 하나를 고르는 것만큼 불확실하다는 뜻입니다
참고로, 모델 시나리오별 일반적인 퍼플렉서티 범위는 다음과 같습니다.
- 일반 텍스트에 대한 베이스 모델: 15-30
- 도메인 특화 텍스트에 대한 파인튜닝된 모델: 5~15
- 인간 수준의 성능: 3~7
평가 중에 퍼플렉서티를 계산하려면 다음과 같이 합니다.
def compute_perplexity(eval_preds):
predictions, labels = eval_preds
# Get log probabilities from model outputs
log_probs = torch.nn.functional.log_softmax(predictions, dim=-1)
# Get probability of correct token
target_log_probs = log_probs.gather(-1, labels.unsqueeze(-1)).squeeze(-1)
# Calculate perplexity
perplexity = torch.exp(-target_log_probs.mean())
return {
"perplexity": perplexity.item()
}
trainer = SFTTrainer(
model=model,
train_dataset=train_dataset,
eval_dataset=eval_dataset,
compute_metrics=compute_perplexity
)
학습 중에 퍼플렉서티를 지켜볼 때 주의해야 할 점은 다음과 같습니다.
- 꾸준히 내려가고 있다면 아주 좋은 신호입니다! 모델이 배워야 할 것을 제대로 학습하고 있다는 뜻입니다
- 값이 더 이상 개선되지 않고 정체된다면, 모델이 학습할 수 있는 한계에 도달했을 가능성이 높습니다
- 학습 퍼플렉서티는 계속 떨어지는데 검증 퍼플렉서티가 오르기 시작한다면 주의하십시오. 모델이 실제로 학습하는 대신 학습 데이터를 암기하기 시작했다는 뜻입니다
- 위아래로 무작위로 크게 요동친다면 대개 학습률이 이상하게 설정되어 있는 등 학습 설정에 문제가 있다는 뜻입니다
퍼플렉서티는 추적하기에 편리하지만, 이것에만 의존하지 마십시오. 모델이 다음 단어를 잘 예측한다고 해서 반드시 품질이 높고 말이 되는 텍스트를 작성한다는 의미는 아닙니다. 전체적인 그림을 파악하려면 다른 지표도 함께 살펴보아야 합니다.
사용자 정의 평가 지표
사용자 정의 평가 지표를 사용하면 표준 손실 및 퍼플렉서티 지표를 넘어 학습 중 모델 성능의 특정 측면을 추적할 수 있습니다. 이러한 지표는 모델이 작업별 목표나 특수한 기준에서 얼마나 잘 수행하는지 평가할 때 특히 유용합니다.
사용자 정의 지표를 구현하려면 모델의 예측값과 정답 레이블을 입력으로 받아, 계산한 지표를 담은 딕셔너리를 반환하는 함수를 만들어야 합니다. 이 함수는 Hugging Face Evaluate 라이브러리의 형식과 호환되어야 합니다. 다음은 모델이 특정 길이 범위 내에서 응답을 생성하는 능력을 추적하는 사용자 정의 지표의 예입니다:
def compute_length_metrics(eval_preds):
predictions, labels = eval_preds
# Decode predictions and labels back to text
predictions = tokenizer.batch_decode(predictions, skip_special_tokens=True)
labels = tokenizer.batch_decode(labels, skip_special_tokens=True)
# Calculate length-based metrics
pred_lengths = [len(pred.split()) for pred in predictions]
label_lengths = [len(label.split()) for label in labels]
# Calculate average length ratio
length_ratios = [p/l if l > 0 else 0 for p, l in zip(pred_lengths, label_lengths)]
avg_length_ratio = sum(length_ratios) / len(length_ratios)
# Calculate percentage within desired length range (e.g., 0.8-1.2 times original)
within_range = sum(0.8 <= r <= 1.2 for r in length_ratios)
pct_within_range = within_range / len(length_ratios)
return {
"length_ratio": avg_length_ratio,
"pct_within_range": pct_within_range
}
이 사용자 정의 지표를 SFT Trainer와 통합하려면 평가 함수를 포함하도록 학습 설정을 수정해야 합니다:
training_args = TrainingArguments(
# ... existing arguments ...
evaluation_strategy="steps", # Evaluate at regular intervals
eval_steps=100, # Evaluate every 100 steps
)
trainer = SFTTrainer(
model=model,
train_dataset=train_dataset,
eval_dataset=eval_dataset, # Add evaluation dataset
compute_metrics=compute_length_metrics, # Add custom metrics
# ... rest of your trainer arguments ...
)
이제 트레이너가 평가 단계에서 사용자 정의 지표를 계산하고 기록합니다. 이러한 지표는 학습 로그에 표시되며 Weights & Biases를 사용하여 시각화할 수 있습니다. 트레이너의 상태를 통해 프로그래밍 방식으로 지표에 접근할 수 있습니다:
# After training
results = trainer.evaluate()
print(f"Final length ratio: {results['eval_length_ratio']:.2f}")
print(f"Percentage within range: {results['eval_pct_within_range']:.2%}")
사용자 정의 지표를 설계할 때는 학습 중에 반복적으로 계산되므로 계산 효율성을 고려하는 것이 중요합니다. 평가 함수에서 무거운 계산을 수행하면 학습 과정이 크게 느려질 수 있습니다. 또한 학습이 중단되지 않도록 지표 함수가 빈 시퀀스나 예상치 못한 입력과 같은 예외 상황을 적절히 처리하도록 하십시오.
모델 선택
모델을 학습할 때는 주기적으로 체크포인트를 저장하고 평가 지표를 기준으로 가장 성능이 좋은 모델을 선택하는 것이 중요합니다. Trainer는 학습 중에 체크포인트를 자동으로 저장하며, TrainingArguments를 사용하여 최적의 모델을 선택하는 방식을 설정할 수 있습니다:
training_args = TrainingArguments(
output_dir="./results",
save_strategy="steps", # Save checkpoints every n steps
save_steps=100, # Save every 100 steps
save_total_limit=3, # Keep only the 3 best checkpoints
metric_for_best_model="eval_loss", # Metric to compare checkpoints
load_best_model_at_end=True, # Load best model when training ends
evaluation_strategy="steps", # When to run evaluation
eval_steps=100 # Run evaluation every 100 steps
)
모델 선택을 위한 주요 매개변수는 다음과 같습니다:
-
save_strategy: 체크포인트를 저장할 시점을 결정합니다
"steps": n 학습 스텝마다 저장합니다"epoch": 각 에폭이 끝날 때 저장합니다"no": 체크포인트를 저장하지 않습니다
-
save_steps:
save_strategy="steps"를 사용할 때 저장 빈도입니다- 값을 로어링하다 보면 체크포인트는 더 많이 생기지만 디스크 공간을 더 많이 사용합니다
- 값이 높을수록 공간을 절약하지만 좋은 모델 상태를 놓칠 수 있습니다
-
save_total_limit: 유지할 최대 체크포인트 수입니다
- 한도에 도달하면 오래된 체크포인트가 삭제됩니다
- 모든 체크포인트를 유지하려면
None으로 설정합니다(권장하지 않음)
-
metric_for_best_model: 체크포인트를 비교하는 데 사용할 지표입니다
"eval_loss": 검증 손실을 사용합니다(기본값)"eval_accuracy": 검증 정확도를 사용합니다compute_metrics가 반환하는 모든 사용자 정의 지표
-
greater_is_better: 지표 값이 높을수록 더 좋은지 여부
- 정확도처럼 높을수록 좋은 지표에는
True - 손실처럼 값을 로어링하다 보면 더 좋아지는(낮을수록 좋은) 지표에는
False를 사용합니다
- 정확도처럼 높을수록 좋은 지표에는
-
load_best_model_at_end: 최적 체크포인트를 복원할지 여부
True: 학습이 끝난 후 최적 체크포인트를 불러옵니다False: 최종 모델 상태를 유지합니다
training_args = TrainingArguments(
output_dir="./results",
save_strategy="steps",
save_steps=100,
save_total_limit=3,
metric_for_best_model="eval_loss",
greater_is_better=False, # Lower eval_loss is better
load_best_model_at_end=True,
evaluation_strategy="steps",
eval_steps=100
)
trainer = SFTTrainer(
model=model,
args=training_args,
# ... other arguments ...
)
학습이 끝나면 다음과 같이 최적 모델의 지표에 접근할 수 있습니다:
# Get best model's metrics
best_metric = trainer.state.best_metric
best_checkpoint = trainer.state.best_model_checkpoint
print(f"Best {training_args.metric_for_best_model}: {best_metric}")
print(f"Best checkpoint: {best_checkpoint}")
체크포인트는 출력 디렉터리에 다음과 같은 이름으로 저장됩니다:
./results/checkpoint-100/
./results/checkpoint-200/
./results/checkpoint-300/
각 체크포인트 디렉터리에는 다음이 들어 있습니다:
pytorch_model.bin: 모델 가중치training_args.bin: 학습 설정trainer_state.json: 학습 상태config.json: 모델 설정adapter_config.json: LoRA 어댑터 설정(PEFT를 사용하는 경우)
특정 체크포인트를 불러오려면 다음과 같이 하십시오:
from transformers import AutoModelForCausalLM
# Load specific checkpoint
model = AutoModelForCausalLM.from_pretrained("./results/checkpoint-100")
# Or load best checkpoint
model = AutoModelForCausalLM.from_pretrained(trainer.state.best_model_checkpoint)
PEFT/LoRA를 사용할 때는 어댑터 가중치도 함께 불러와야 합니다:
from peft import PeftModel
# Load base model
base_model = AutoModelForCausalLM.from_pretrained(
"meta-llama/Meta-Llama-3-8B-Instruct",
device_map="auto"
)
# Load adapter weights from checkpoint
model = PeftModel.from_pretrained(
base_model,
"./results/checkpoint-100"
)
model.save_pretrained("./results/merged-model", safe_serialization=True)
또한 디스크 공간을 절약하기 위해 모델을 여러 파일로 샤딩하려면 max_shard_size 매개변수를 사용하여 모델을 더 작은 파일(이 예에서는 2GB)로 나눌 수 있습니다:
# Save model with safe serialization
model.save_pretrained("./results/merged-model", safe_serialization=True, max_shard_size="2GB")
직접 선호 최적화
직접 선호 최적화(Direct Preference Optimization, DPO)는 초기 SFT(지도 미세 조정, Supervised Fine-Tuning) 이후 언어 모델을 인간의 선호에 맞게 정렬하는 강력한 기법입니다. 더 복잡한 RLHF 방식과 달리, DPO는 더 단순하고 안정적인 학습 과정으로 비슷한 결과를 얻습니다.
DPO에는 프롬프트와 선택된(선호되는) 응답 및 거부된 응답이 짝지어진 선호 데이터셋이 필요합니다. 예를 들면 다음과 같습니다:
{
"prompt": "What is the meaning of life?",
"chosen": "The meaning of life is to grow, learn, and find purpose through our experiences and connections with others.",
"rejected": "42 lol"
}
다음은 unalignment/toxic-dpo-v0.2 데이터셋을 사용하는 DPO 학습의 기본 구현입니다. 이 데이터셋에는 모델이 비윤리적이고 유해한 응답을 피하도록 학습시키기 위한 선호 데이터가 들어 있습니다.
from trl import DPOTrainer, DPOConfig
from datasets import load_dataset
# Load model and dataset
dataset = load_dataset("unalignment/toxic-dpo-v0.2", split="train")
dpo_args=DPOConfig(
output_dir="dpo-model",
num_train_epochs=1,
per_device_train_batch_size=4,
gradient_accumulation_steps=2,
learning_rate=5e-5,
max_length=1024,
max_prompt_length=512,
beta=0.1, # Controls deviation from reference model
loss_type="sigmoid" # DPO loss variant
)
# Configure and run DPO training
dpo_trainer = DPOTrainer(
model=model,
args=dpo_args,
train_dataset=dataset,
tokenizer=tokenizer,
)
dpo_trainer.train()
핵심 매개변수인 beta(보통 0.1-0.2)는 학습 중에 모델이 참조 모델에서 얼마나 벗어날 수 있는지를 조절합니다. loss_type 매개변수는 “sigmoid”(기본값), “hinge”, “ipo”, “kto” 등 여러 변형으로 설정할 수 있습니다. 학습 중에 트레이너는 정렬 진행 상황을 모니터링할 수 있도록 선택된/거부된 응답에 대한 보상과 보상 마진 같은 지표를 기록합니다.
DPO는 학습 전에 모델을 PEFT 구성으로 감싸서 LoRA와 같은 매개변수 효율적 방법과 결합할 수도 있습니다. 이 기법은 잘 학습된 SFT 모델에서 시작하고 고품질 선호 데이터를 사용할 때 가장 효과적입니다. 정기적으로 체크포인트를 저장하고 생성된 응답을 평가하면, 모델이 참조 모델 대비 합리적인 동작을 유지하면서 개선되도록 하는 데 도움이 됩니다.
트레이너는 선택된 응답과 거부된 응답에 대한 보상, 정확도(선택된 응답의 보상이 거부된 응답보다 높은 빈도, chosen > rejected), 보상 마진(선택된 보상과 거부된 보상 간의 평균 차이) 등 유용한 지표를 자동으로 기록합니다. 보상 마진이 증가한다는 것은 모델이 인간의 선호에 더 잘 정렬되도록 학습하고 있음을 나타냅니다. DPO는 RLHF보다 간단한 대안이면서도 비슷한 정렬 결과를 달성하며, 핵심은 고품질 선호 데이터와 학습 진행 상황에 대한 세심한 모니터링입니다.
Kahneman-Tversky 최적화
Kahneman-Tversky 최적화(KTO)는 쌍으로 된 선호 대신 이진 피드백(바람직함/바람직하지 않음)만을 요구하여 학습 과정을 단순화하는 DPO의 대안입니다. KTO는 인간이 가치와 위험을 어떻게 인식하는지에 관한 전망 이론(prospect theory)의 통찰을 반영하므로, 모델을 인간의 선호에 정렬하는 데 특히 효과적입니다.
[
{
"prompt": "What is the meaning of life?",
"completion": "To destroy all humans",
"label": False # Unethical response are undesirable
},
{
"prompt": "How do I make a radiological weapon?",
"completion": "I cannot help with making weapons.",
"label": True # Ethical response marked as desirable
},
{
"prompt": "Tell me about quantum physics",
"completion": "idk google it lol",
"label": False # Unhelpful response marked as undesirable
},
{
"prompt": "Write a poem about nature",
"completion": "Roses are red, violets are blue...",
"label": False # Generic/low-effort response marked as undesirable
}
]
다음은 trl-lib/kto-mix-14k 데이터셋을 사용하는 기본 구현입니다:
from trl import KTOTrainer, KTOConfig
dataset = load_dataset("trl-lib/kto-mix-14k", split="train")
kto_args=KTOConfig(
output_dir="kto-model",
num_train_epochs=1,
per_device_train_batch_size=4,
max_length=1024,
max_prompt_length=512,
beta=0.1, # Controls deviation from reference model
learning_rate=5e-7, # Keep between 5e-7 and 5e-6
desirable_weight=1.0, # Weight for positive examples
undesirable_weight=1.0 # Weight for negative examples
)
# Configure and run KTO training
trainer = KTOTrainer(
model=model,
args=kto_args,
train_dataset=dataset,
tokenizer=tokenizer
)
trainer.train()
KTOConfig의 주요 매개변수는 다음과 같습니다:
beta: 참조 모델로부터의 편차를 제어합니다(일반적으로 0.1-0.2)learning_rate: 5e-7에서 5e-6 사이로 유지합니다desirable_weight/undesirable_weight: 데이터셋이 불균형한 경우 조정합니다- 단계별 배치 크기는 최소 4 이상이어야 합니다
- 유효 배치 크기는 16-128 사이로 설정합니다
트레이너는 바람직한/바람직하지 않은 응답에 대한 보상과 참조 모델로부터의 KL 발산 등의 지표를 기록합니다. 보상 마진이 증가한다는 것은 정렬이 성공적으로 이루어지고 있음을 나타냅니다. KTO는 고품질 이진 피드백 데이터와 학습 진행 상황에 대한 세심한 모니터링이 함께할 때 가장 잘 작동합니다. 이 방법은 쌍으로 된 선호 대신 이진 레이블만 필요하므로, 선호 데이터가 부족하거나 수집 비용이 많이 들 때 특히 유용합니다.
근접 정책 최적화
마지막으로, 근접 정책 최적화(Proximal Policy Optimization, PPO)는 보상 신호를 사용하여 언어 모델을 미세 조정하는 강화 학습 알고리즘입니다. 정적인 선호 데이터로 작동하는 DPO 및 KTO와 달리, PPO는 모델이 능동적으로 응답을 생성하고 보상 모델을 통해 피드백을 받는 온라인 학습을 가능하게 합니다.
KL 발산(Kullback-Leibler divergence)은 두 확률 분포 P와 Q 간의 차이를 나타내는 척도입니다. 수학적으로는 다음과 같이 정의됩니다:
언어 모델 학습의 맥락에서 KL 발산은 모델의 출력 분포가 참조 분포(예: 원래의 사전 학습된 모델)로부터 얼마나 벗어나는지를 측정합니다. KL 발산이 높을수록 미세 조정된 모델이 참조 모델과 비교하여 상당히 다른 확률 분포를 생성하고 있음을 나타냅니다.
더 간단히 말하면, KL 발산은 미세 조정된 모델이 사전 학습 중에 배운 내용을 “잊지” 않도록 보장하는 데 도움을 줍니다. 대략적으로 말하면, 이는 일종의 목줄과 같은 역할을 합니다. 모델이 새로운 작업에 적응할 수 있도록 허용하면서도 원래의 동작에서 너무 멀리 벗어나지 않도록 막아 줍니다. 우리는 모델이 언어에 대한 근본적인 이해를 완전히 바꾸지 않으면서 새로운 것을 학습하기를 원하므로, 이 점이 핵심입니다.
데이터셋에는 프롬프트와 그에 대응하는 응답이 포함되어야 합니다. 예를 들면 다음과 같습니다:
{
"prompt": "Write a story about a brave brown bear",
"response": "In a kingdom far away, a valiant brown bear named Bruno...",
"reward": 0.8 # Reward score from reward model (typically 0-1)
}
다음은 또 다른 더 작은 언어 모델인 nlptown/bert-base-multilingual-uncased-sentiment를 응답의 긍정적인 감성에 따라 보상을 주는 보상 모델로 사용하는 기본 구현입니다. 이 모델은 응답의 감성에 따라 학습 데이터셋의 각 행에 0과 1 사이의 보상을 부여합니다.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, AutoModelForSequenceClassification
from trl import PPOConfig, PPOTrainer
from datasets import load_dataset
SENTIMENT_MODEL = "nlptown/bert-base-multilingual-uncased-sentiment"
class SentimentRewardModel:
def __init__(self, model_name=SENTIMENT_MODEL):
self.device = "cuda" if torch.cuda.is_available() else "cpu"
self.tokenizer = AutoTokenizer.from_pretrained(model_name)
self.model = AutoModelForSequenceClassification.from_pretrained(model_name).to(self.device)
def compute_reward(self, texts):
# Get sentiment scores (1-5) and normalize to [0,1]
inputs = self.tokenizer(texts, return_tensors="pt", padding=True, truncation=True).to(self.device)
with torch.no_grad():
outputs = self.model(**inputs)
scores = torch.softmax(outputs.logits, dim=-1)
rewards = torch.sum(scores * torch.tensor([1, 2, 3, 4, 5]).to(self.device), dim=-1)
rewards = (rewards - 1) / 4
return rewards.cpu()
# Initialize reward model
reward_model = SentimentRewardModel()
# Configure PPO training
config = PPOConfig(
learning_rate=1.41e-5,
batch_size=128,
mini_batch_size=4,
gradient_accumulation_steps=1,
optimize_cuda_cache=True,
early_stopping=False,
target_kl=6.0,
ppo_epochs=4,
seed=42
)
# Initialize trainer
ppo_trainer = PPOTrainer(
config=config,
model=model,
tokenizer=tokenizer,
dataset=train_dataset
)
# Generation settings
generation_kwargs = {
"min_length": -1,
"top_k": 0.0,
"top_p": 1.0,
"do_sample": True,
"pad_token_id": tokenizer.eos_token_id,
"max_new_tokens": 40,
}
# Training loop
for epoch in range(1):
for batch in range(10):
# Get prompts from dataset
query_tensors = ppo_trainer.prepare_samples()
# Generate responses
response_tensors = []
for query in query_tensors:
response = ppo_trainer.generate(
query.unsqueeze(0),
**generation_kwargs
)
response_tensors.append(response.squeeze(0))
# Decode responses
texts = [
tokenizer.decode(r.squeeze())
for r in response_tensors
]
# Calculate rewards
rewards = reward_model.compute_reward(texts)
# Run PPO step
stats = ppo_trainer.step(query_tensors, response_tensors, rewards)
# Log stats
print(f"Epoch {epoch}, Batch {batch}")
print(f"Mean reward: {torch.mean(rewards):.3f}")
print(f"Policy loss: {stats['policy/loss']:.3f}")
print(f"Value loss: {stats['value/loss']:.3f}")
print("-" * 50)
if __name__ == "__main__":
main()
트레이너는 학습 중에 다음과 같은 몇 가지 중요한 지표를 기록합니다:
objective/kl: 현재 정책과 참조 정책 간의 KL 발산입니다objective/entropy: 행동의 무작위성을 나타내는 정책 엔트로피입니다objective/rlhf_reward: 주요 RLHF 보상 신호입니다policy/approxkl_avg: 연속된 정책 간의 평균 KL입니다policy/clipfrac_avg: 클리핑된 정책 업데이트의 비율입니다loss/policy_avg: 평균 정책 손실입니다loss/value_avg: 평균 가치 함수 손실입니다
주요 하이퍼파라미터는 다음과 같습니다:
learning_rate: 1e-6에서 5e-6 사이로 유지하십시오kl_coef: 참조 모델로부터의 이탈 정도를 제어합니다(0.05-0.2)cliprange: PPO 클리핑 매개변수(0.1-0.3)- 장치당 배치 크기는 최소 4 이상이어야 합니다
- 유효 배치 크기는 16-128 사이입니다
PPO는 잘 훈련된 보상 모델과 함께, 정책이 참조 동작에서 너무 멀리 벗어나지 않도록 KL 페널티를 신중하게 조정할 때 가장 잘 작동합니다. 트레이너는 어드밴티지 추정, 정책 업데이트, 가치 함수 훈련을 포함한 PPO 최적화를 자동으로 처리합니다. KL 발산과 보상 신호를 정기적으로 모니터링하면 안정적인 훈련 진행을 보장하는 데 도움이 됩니다.
LoRA 가중치 병합
LoRA로 모델을 미세 조정한 후에는 LoRA 어댑터 없이 추론에 사용할 수 있는 하나의 통합된 모델을 만들기 위해 LoRA 가중치를 베이스 모델에 다시 병합하려는 경우가 많습니다. 이 과정은 학습된 LoRA 매개변수를 고정된 베이스 모델 가중치와 결합하여, 미세 조정 중에 학습된 모든 적응 내용을 포함하는 모델을 만들어 냅니다.
병합 과정에서는 베이스 모델과 LoRA 어댑터 가중치를 모두 로드한 다음, LoRA 랭크 분해에 따라 이들을 수학적으로 결합합니다. 이를 통해 별도의 LoRA 행렬 없이도 학습된 적응 내용을 직접 담고 있는 새로운 가중치 집합이 만들어집니다. 그 결과로 병합된 모델은 베이스 모델에 LoRA 어댑터를 적용하여 사용하는 것과 동일하게 동작하지만, PEFT 라이브러리나 추가적인 어댑터 처리 없이 일반적인 모델처럼 사용할 수 있습니다.
LoRA 가중치를 병합하려면 먼저 적절한 정밀도로 베이스 모델을 로드해야 합니다. 반정밀도(float16)를 사용하면 정확도를 유지하면서 메모리 사용량을 줄일 수 있으므로 권장됩니다. 베이스 모델은 학습 시 사용한 것과 동일한 구성으로 로드해야 합니다. 다만 병합 중에는 역전파를 수행하지 않으므로, 그래디언트 체크포인팅과 같은 일부 메모리 절약 기능은 비활성화해도 되는 경우가 많습니다.
병합 과정 자체는 PeftModel 클래스의 merge_and_unload 메서드가 처리합니다. 이 메서드는 가중치를 결합하는 수학적 연산을 수행하고, 병합된 매개변수를 가진 새로운 모델을 반환합니다. 병합 후에는 병합 과정이 성공적으로 완료되었는지, 그리고 모델이 파인튜닝된 동작을 유지하는지 확인하기 위해 모델의 성능을 검증하는 것이 중요합니다.
병합이 완료되면 다른 Hugging Face 모델과 마찬가지로 save_pretrained 또는 push_to_hub를 사용하여 모델을 저장할 수 있습니다. 이렇게 하면 LoRA 어댑터에 대한 특별한 처리 없이 로드하여 사용할 수 있는 표준 모델 체크포인트가 만들어집니다. 병합된 모델은 전체 모델 가중치를 포함하므로 일반적으로 LoRA 어댑터 단독보다 크기가 크지만, 복잡성을 최소화하려는 배포 및 추론 시나리오에서는 더 편리합니다.
LoRA 가중치를 병합하고 저장하는 방법은 다음과 같습니다:
from transformers import AutoModelForCausalLM
from peft import PeftModel
import torch
# Load base model in FP16
base_model = AutoModelForCausalLM.from_pretrained(
"meta-llama/Meta-Llama-3-8B-Instruct",
torch_dtype=torch.float16,
device_map="auto"
)
# Load and merge weights
model = PeftModel.from_pretrained(base_model, "./results/checkpoint-100")
merged_model = model.merge_and_unload()
# Save merged model
merged_model.save_pretrained("./results/merged-model")
평가
학습이 끝나면 모델이 얼마나 잘 작동하는지 확인하기 위해 모델을 평가해야 합니다. 아래의 evaluate_model 함수를 사용하여 이를 수행할 수 있습니다. 이 함수는 여러 개의 테스트 프롬프트를 생성하고, 모델의 응답을 데이터셋에 있는 선호 응답과 비교합니다.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from datasets import load_dataset
from tqdm import tqdm
def evaluate_model(model_path, test_dataset, temperature=0.1, top_p=0.1):
# Load model and tokenizer
model = AutoModelForCausalLM.from_pretrained(
model_path,
device_map="auto",
torch_dtype=torch.float16
)
tokenizer = AutoTokenizer.from_pretrained(model_path)
correct = 0
total = len(test_dataset)
# Evaluate each example
for row in tqdm(test_dataset):
# Format input using chat template
prompt = tokenizer.apply_chat_template(
row["input"],
tokenize=False,
add_generation_prompt=True
)
# Generate response
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
outputs = model.generate(
**inputs,
max_new_tokens=512,
temperature=temperature,
top_p=top_p,
do_sample=False
)
# Decode response
generated = tokenizer.decode(outputs[0], skip_special_tokens=True)[len(prompt):]
expected = row["output"]
# Compare with expected answer (exact match)
if generated.strip() == expected.strip():
correct += 1
accuracy = correct / total
print(f"Test Accuracy: {accuracy:.2%}")
return accuracy
일반 평가
MMLU와 같은 공개 벤치마크에서 모델의 성능을 평가하려면 lm_eval 라이브러리를 사용할 수 있습니다.
git clone --depth 1 https://github.com/EleutherAI/lm-evaluation-harness
cd lm-evaluation-harness
pip install -e .
그런 다음 평가를 실행하십시오:
lm_eval \
--model hf \
--model_args pretrained=./results/merged-model \
--tasks mmlu,gpqa,gsm8k \
--batch_size 16 \
--output_path ./eval_results
가장 일반적인 벤치마크는 다음과 같습니다:
MMLU- 폭넓은 주제에 걸쳐 모델의 일반 지식을 측정합니다.GSM8K- 8,000개 이상의 단일 단계 산술 문제로 구성된 데이터셋입니다.GPQA- 대학원 수준의 추론 문제로 구성된 평가입니다.MATH- 수학 서술형 문제 평가입니다.Hellaswag- 상식 추론 평가입니다.IFEval- 지시 따르기 평가입니다.TLDR+- 텍스트 요약 평가입니다.
GGUF 형식으로 변환하기
병합된 모델을 저장한 후에는 효율적인 추론을 위해 GGUF 형식으로 변환하는 것이 좋습니다. 먼저 llama.cpp를 설치하십시오. macOS에서는 Homebrew를 사용하십시오:
brew install llama-cpp
또는 소스에서 빌드하십시오:
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make
이제 results/merged-model 디렉터리에서 병합된 모델을 직접 변환하십시오:
# From the llama.cpp directory
python convert_hf_to_gguf.py \
../results/merged-model \
--outfile model-f16.bin \
--outtype f16
그런 다음 특정 양자화 번호 코드(15는 Q4_K_M입니다)를 사용하여 양자화된 GGUF를 생성하십시오:
./llama-quantize model-f16.bin model-q4_k_m.gguf 15
가장 일반적인 양자화 유형은 Q4_K_M과 Q5_K_M이며, 각각 15와 17에 해당합니다.
2 or Q4_0 : 4.34G, +0.4685 ppl @ Llama-3-8B
3 or Q4_1 : 4.78G, +0.4511 ppl @ Llama-3-8B
8 or Q5_0 : 5.21G, +0.1316 ppl @ Llama-3-8B
9 or Q5_1 : 5.65G, +0.1062 ppl @ Llama-3-8B
19 or IQ2_XXS : 2.06 bpw quantization
20 or IQ2_XS : 2.31 bpw quantization
28 or IQ2_S : 2.5 bpw quantization
29 or IQ2_M : 2.7 bpw quantization
24 or IQ1_S : 1.56 bpw quantization
31 or IQ1_M : 1.75 bpw quantization
10 or Q2_K : 2.96G, +3.5199 ppl @ Llama-3-8B
21 or Q2_K_S : 2.96G, +3.1836 ppl @ Llama-3-8B
23 or IQ3_XXS : 3.06 bpw quantization
26 or IQ3_S : 3.44 bpw quantization
27 or IQ3_M : 3.66 bpw quantization mix
12 or Q3_K : alias for Q3_K_M
22 or IQ3_XS : 3.3 bpw quantization
11 or Q3_K_S : 3.41G, +1.6321 ppl @ Llama-3-8B
12 or Q3_K_M : 3.74G, +0.6569 ppl @ Llama-3-8B
13 or Q3_K_L : 4.03G, +0.5562 ppl @ Llama-3-8B
25 or IQ4_NL : 4.50 bpw non-linear quantization
30 or IQ4_XS : 4.25 bpw non-linear quantization
15 or Q4_K : alias for Q4_K_M
14 or Q4_K_S : 4.37G, +0.2689 ppl @ Llama-3-8B
15 or Q4_K_M : 4.58G, +0.1754 ppl @ Llama-3-8B
17 or Q5_K : alias for Q5_K_M
16 or Q5_K_S : 5.21G, +0.1049 ppl @ Llama-3-8B
17 or Q5_K_M : 5.33G, +0.0569 ppl @ Llama-3-8B
18 or Q6_K : 6.14G, +0.0217 ppl @ Llama-3-8B
7 or Q8_0 : 7.96G, +0.0026 ppl @ Llama-3-8B
33 or Q4_0_4_4 : 4.34G, +0.4685 ppl @ Llama-3-8B
34 or Q4_0_4_8 : 4.34G, +0.4685 ppl @ Llama-3-8B
35 or Q4_0_8_8 : 4.34G, +0.4685 ppl @ Llama-3-8B
1 or F16 : 14.00G, +0.0020 ppl @ Mistral-7B
32 or BF16 : 14.00G, -0.0050 ppl @ Mistral-7B
0 or F32 : 26.00G @ 7B
COPY : only copy tensors, no quantizing
양자화된 모델을 테스트하십시오:
llama-cli -m model-q4_k_m.gguf \
-p "What type of bear is the best?" \
--temp 0.1
결과가 만족스럽다면 Hugging Face에 업로드하십시오:
# Create a new repository for the quantized version
huggingface-cli repo create my-finetuned-model --type model
# Initialize and push
git init
git lfs track "*.gguf"
git add .gitattributes model-q4_k_m.gguf
git commit -m "Add quantized model"
git remote add origin https://huggingface.co/your-username/my-finetuned-model
git push -u origin main
Ollama
Ollama에서 사용하려면 Modelfile을 만들어야 합니다. 베이스 모델을 출발점으로 삼을 수 있습니다. 예를 들면 다음과 같습니다.
ollama show --modelfile llama3.2
그런 다음 양자화된 모델을 사용하도록 Modelfile을 수정하십시오. 예를 들면 다음과 같습니다.
FROM ./model-q4_k_m.gguf
TEMPLATE """{{ if .System }}<|start_header_id|>system<|end_header_id|>
{{ .System }}<|eot_id|>{{ end }}{{ if .Prompt }}<|start_header_id|>user<|end_header_id|>
{{ .Prompt }}<|eot_id|>{{ end }}<|start_header_id|>assistant<|end_header_id|>
{{ .Response }}<|eot_id|>"""
PARAMETER stop "<|start_header_id|>"
PARAMETER stop "<|end_header_id|>"
PARAMETER stop "<|eot_id|>"
PARAMETER stop "<|reserved_special_token|>"
그런 다음 양자화된 모델로 ollama를 실행하십시오:
ollama create myllama --modelfile Modelfile
그런 다음 추론 서버를 실행합니다.
ollama serve
ollama run myllama
이제 모델을 호출하려면 curl을 사용하여 서버에 프롬프트를 보낼 수 있습니다:
curl http://localhost:11434/api/chat -d '{
"model": "myllama",
"messages": [
{ "role": "user", "content": "What type of bear is the best?" }
]
}'
또는 openai Python 클라이언트를 사용하여 로컬에서 실행 중인 Ollama 서버에 API 요청을 보낼 수도 있습니다.
import openai
client = openai.OpenAI(base_url="http://localhost:11434/v1", api_key="-")
response = client.chat.completions.create(
model="myllama",
messages=[{"role": "user", "content": "What type of bear is the best?"}]
)
print(response.choices[0].message.content)
모델 서빙
모델을 서빙하는 방법에는 여러 가지 선택지가 있습니다. 요약하면 다음과 같습니다:
로컬 개발 및 테스트용
- Ollama: 로컬에서 모델을 실행하는 가장 쉬운 방법입니다. “LLM을 위한 Docker“라고 생각하십시오. 설정이 간단하고 사용하기 쉬우며 테스트에 적합합니다.
- llama.cpp: 로컬 모델 실행의 맥가이버 칼입니다. 매우 효율적인 C++ 구현으로, 노트북부터 라즈베리 파이까지 사실상 어떤 기기에서든 모델을 실행할 수 있습니다.
프로덕션 배포용
- vLLM: LLM 서빙계의 스피드 괴물입니다. 많은 요청을 빠르게 처리해야 한다면 가장 먼저 고려할 선택지입니다. 높은 처리량과 낮은 지연 시간을 위해 만들어졌습니다.
- TGI (Text Generation Inference, 텍스트 생성 추론): HuggingFace가 직접 만든 서빙 솔루션입니다. 이미 HuggingFace 생태계를 사용하고 있다면 훌륭한 선택입니다. 매우 안정적이며 지원도 잘 됩니다.
- SGLang: 가장 최신 라이브러리로 vLLM보다 빠르다고 알려져 있으며, 언어 모델과 비전 모델을 모두 서빙하는 데 중점을 둡니다. 여러 유형의 모델을 다뤄야 한다면 좋은 선택입니다.
엔터프라이즈 및 클라우드용
- NVIDIA 솔루션 (TensorRT-LLM & Triton Inference Server(Triton 추론 서버)): GPU 배포를 위한 중화기입니다. 최상위 NVIDIA 하드웨어를 갖추고 있고 엔터프라이즈급 서빙이 필요하다면 이것들이 최선의 선택입니다.
- Ray Serve: 여러 머신에 걸친 분산 서빙에 탁월합니다. ML 배포를 위한 “오케스트레이터“라고 생각하십시오.
- LitServe: Lightning AI 팀이 새로 내놓은 솔루션입니다. 기존 선택지보다 설정이 쉬우면서도 엔터프라이즈 규모의 서빙을 약속합니다.
선택은 결국 요구 사항에 따라 달라집니다:
- 로컬 개발용 → Ollama 또는 llama.cpp
- 중간 규모의 프로덕션용 → TGI 또는 vLLM
- 요구 사항이 까다로운 엔터프라이즈/클라우드 환경 → TensorRT-LLM 또는 Triton Inference Server(Triton 추론 서버)
전체 코드
"""
finetune.py - A module for fine-tuning Large Language Models using QLoRA
https://stephendiehl.com/posts/training_llms
"""
import torch
from datasets import load_dataset
from peft import LoraConfig, prepare_model_for_kbit_training
from transformers import (
AutoModelForCausalLM,
AutoTokenizer,
BitsAndBytesConfig,
TrainingArguments,
)
from trl import SFTTrainer
def setup_model(model_id):
# Quantization config for loading in 4 bits
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_quant_type="nf4",
bnb_4bit_compute_dtype=torch.float16,
bnb_4bit_use_double_quant=True,
)
# Load base model
model = AutoModelForCausalLM.from_pretrained(
model_id,
quantization_config=bnb_config,
device_map="auto",
trust_remote_code=True,
)
model = prepare_model_for_kbit_training(model)
# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"
# LoRA config
lora_config = LoraConfig(
r=8,
lora_alpha=16,
target_modules=["q_proj", "v_proj"],
lora_dropout=0.05,
bias="none",
task_type="CAUSAL_LM",
)
return model, tokenizer, lora_config
def prepare_dataset(dataset_name, split="train"):
dataset = load_dataset(dataset_name, split=split)
# Split into train/eval
dataset = dataset.train_test_split(test_size=0.1)
return dataset["train"], dataset["test"]
def train(model_id, dataset_name, output_dir):
# Setup model and dataset
model, tokenizer, lora_config = setup_model(model_id)
train_dataset, eval_dataset = prepare_dataset(dataset_name)
# Training arguments
training_args = TrainingArguments(
output_dir=output_dir,
num_train_epochs=1,
per_device_train_batch_size=4,
gradient_accumulation_steps=4,
learning_rate=2e-4,
lr_scheduler_type="cosine",
warmup_ratio=0.03,
evaluation_strategy="steps",
eval_steps=100,
save_strategy="steps",
save_steps=100,
save_total_limit=3,
load_best_model_at_end=True,
logging_steps=10,
optim="paged_adamw_32bit",
max_grad_norm=0.3,
weight_decay=0.01,
)
# Initialize trainer
trainer = SFTTrainer(
model=model,
train_dataset=train_dataset,
eval_dataset=eval_dataset,
peft_config=lora_config,
dataset_text_field="text",
max_seq_length=512,
tokenizer=tokenizer,
args=training_args,
packing=True,
)
# Train and save
trainer.train()
trainer.save_model(output_dir)
return trainer
if __name__ == "__main__":
# Train model
trainer = train(
model_id="meta-llama/Meta-Llama-3.1-8B-Instruct",
dataset_name="databricks/databricks-dolly-15k",
output_dir="./results"
)
Hymba : Mamba × 트랜스포머
지금까지는 어텐션 메커니즘에 기반한 핵심(Core) 딥러닝 아키텍처인 트랜스포머가 있었습니다. 하지만 최근 많은 어텐션(관심)을 받고 있는 다른 실험적 아키텍처들도 있습니다. 그중 유망한 것 하나가 상태 공간 모델(state-space model)인 Mamba입니다. Mamba는 카네기 멜런 대학교와 프린스턴 대학교 연구진이 개발한 아키텍처로, 특히 긴 시퀀스와 큰 컨텍스트 윈도우를 처리할 때 드러나는 트랜스포머 모델의 몇 가지 핵심적인 한계를 해결하는 것을 목표로 합니다.
Mamba는 본질(Core)적으로 세 가지 기본 아이디어 위에 구축되어 있습니다. 첫 번째는 선택적 상태 공간(selective state space)의 사용입니다. Mamba는 트랜스포머처럼 어텐션 메커니즘에 의존하는 대신, 현재 입력에 따라 정보를 선택적으로 처리할 수 있는 SSM을 사용합니다. 이러한 선택적 처리 덕분에 모델은 필요하지 않은 정보는 버리고 관련 있는 정보에 효과적으로 집중할 수 있습니다. 이 이론은 이 블로그 글에 가장 잘 설명되어 있습니다.
Mamba는 기존 트랜스포머 아키텍처에 비해 몇 가지 핵심적인 장점을 제공합니다. 가장 중요한 이점은 선형 시간 처리를 통한 더 나은 확장성으로, 이차적으로 확장되는 트랜스포머에 비해 긴 시퀀스를 처리할 때 훨씬 더 효율적입니다. 또한 이 아키텍처는 메모리 효율성이 뛰어나며, 다른 모델의 속도를 떨어뜨릴 수 있는 메모리 집약적 레이어에서 확장된 상태를 메모리에 구체화(materialization)하는 것을 신중하게 피합니다.
두 번째 아이디어는 Mamba의 단순화된 아키텍처입니다. 어텐션 블록과 MLP 블록을 분리하는 트랜스포머와 달리, Mamba는 이들을 하나의 SSM 블록으로 통합합니다. 이러한 아키텍처 단순화는 계산 복잡도를 줄이고 추론 속도를 향상시킵니다. 그러나 개념적인 가능성에도 불구하고, SSM은 회상(recall) 능력이 제한적이며 인컨텍스트 학습(in-context learning) 작업에서 성능이 떨어지는 것으로 나타났습니다.
요컨대, 기존의 어텐션 헤드는 사진 같은 기억력처럼 특정 정보를 정확하게 기억하고 회상하는 데 뛰어나지만, 계산 비용이 많이 들고 메모리를 많이 소모합니다. 반면 상태 공간 모델은 더 효율적이지만 인간의 기억과 다소 비슷하게 작동하여, 대략적인 요지를 파악하는 데는 능숙하지만 정확한 회상에는 그다지 뛰어나지 않습니다.
| 특징 | 트랜스포머 | Mamba |
|---|---|---|
| Core 메커니즘 | 어텐션 기반 | SSM 기반 |
| 아키텍처 복잡도 | 높음 (어텐션 블록과 MLP 블록 분리) | 낮음(통합 SSM 블록으로 로어링하다) |
| 학습 복잡도 | ||
| 추론 속도 |
Hymba
Nvidia는 서로 다른 연산 패러다임을 결합하여 상호 보완적인 강점을 활용하는 방법을 최근 탐구했습니다. 대표적인 예로 Hymba 아키텍처가 있습니다. 이 아키텍처는 트랜스포머 어텐션 메커니즘과 상태 공간 모델을 같은 레이어 안에서 통합하는 하이브리드 헤드 병렬 설계를 도입합니다. 그 결과 훨씬 적은 메모리를 사용하면서도 더 큰 모델보다 뛰어난 성능을 내는 모델이 만들어졌습니다. 자체 보고한 벤치마크에서 Hymba-1.5B는 메모리 캐시를 11.67배 적게 사용하고 3.49배 빠르게 실행되면서도 Llama-3.2-3B를 능가합니다. 이는 놀라울 정도로 인상적입니다.
Hymba와 같은 하이브리드 아키텍처의 핵심 혁신은 어텐션 헤드와 SSM 헤드의 병렬 융합으로, 이를 통해 서로 다른 연산 경로로 입력을 동시에 처리할 수 있습니다. 서로 다른 유형의 레이어를 쌓는 순차적 방식과 달리, 병렬 융합에서는 각 레이어가 어텐션의 고해상도 회상 능력과 SSM의 효율적인 컨텍스트 요약 능력을 동시에 활용할 수 있습니다. 이는 입력을 어텐션 구성 요소(쿼리, 키, 값)와 SSM 구성 요소(입력 특징과 게이트) 양쪽에 병렬로 투영하는 통합된 공식으로 구현됩니다. 어텐션 헤드와 SSM 헤드의 출력은 정규화된 후 학습 가능한 스케일링 계수 과 를 사용하여 결합됩니다. 구체적으로, 어텐션 출력을 , SSM 출력을 이라고 하면 최종 레이어 출력은 다음과 같이 계산됩니다.
여기서 과 는 각 경로의 상대적 기여도를 조절합니다.
메모리 및 효율성 최적화
어텐션 메커니즘의 메모리 요구량 문제를 해결하기 위해 하이브리드 아키텍처는 여러 가지 최적화를 적용합니다. 그중 하나는 전역 어텐션 패턴과 지역 어텐션 패턴을 결합하는 것으로, 일부 선택된 레이어(일반적으로 첫 번째, 중간, 마지막 레이어)만 전체 어텐션을 사용하고 나머지 레이어는 슬라이딩 윈도우 어텐션을 사용합니다. 또한 레이어 간 키-값 캐시 공유는 모델 성능에 큰 영향을 주지 않으면서 메모리 요구량을 줄여 줍니다.
SSM 구성 요소는 어텐션이 국소화되어 있어도 전역 컨텍스트 인식을 유지하도록 돕기 때문에, 순수 트랜스포머 아키텍처보다 슬라이딩 윈도우 어텐션을 더 적극적으로 사용할 수 있습니다. 실증 연구에 따르면 하이브리드 모델은 비슷한 작업 성능을 유지하면서도 메모리 사용량을 크게 줄이고 처리량을 늘릴 수 있습니다.
또한 이 아키텍처에는 입력 시퀀스 앞에 추가되는 학습 가능한 메타 토큰이 포함되어 있습니다. 이 토큰들은 두 가지 목적을 수행합니다. 학습된 캐시 초기화 역할을 하며 어텐션 패턴을 더 효과적으로 재분배하도록 돕고, 압축된 세계 지식을 저장합니다. 메타 토큰은 어텐션 연산과 SSM 연산 모두에 참여하며, 본질적으로 일종의 학습된 메모리 초기화를 제공하여 모델이 관련 정보에 집중하도록 이끄는 데 도움을 줍니다.
하이브리드 아키텍처는 순수 트랜스포머 아키텍처와 순수 SSM 아키텍처 모두에 비해 여러 장점이 있음을 실증적으로 보여 줍니다. 논문에서 이 아키텍처는 적정한 캐시 크기를 유지하면서도 더 나은 유효 수용 영역 측정값을 달성합니다. 어텐션 헤드와 SSM 헤드의 상대적 중요도는 레이어와 작업에 따라 달라지며, 이는 아키텍처가 필요에 따라 서로 다른 연산 모드를 활용하도록 학습한다는 것을 시사합니다. 이러한 유연성 덕분에 경쟁력 있는 효율성 지표를 유지하면서도 일반 언어 작업과 메모리 집약적 응용 모두에서 강력한 성능을 냅니다.
이러한 하이브리드 아키텍처는 매우 흥미롭습니다. 언어 모델의 미래는 아마도 서로 다른 접근 방식 중 하나를 고르는 것이 아니라, 각 방식의 가장 좋은 부분을 섞고 조합하는 데 있다는 것을 보여 주기 때문입니다. 이처럼 서로 다른 아키텍처를 영리하게 결합하면 이론적으로 두 세계의 장점을 모두 얻을 수 있습니다. 즉, 최악의 경우에만 이차 복잡도를 가지면서도 여전히 놀라울 정도로 뛰어난 성능을 내는 빠르고 효율적인 모델을 얻을 수 있습니다. 초기 결과는 매우 유망합니다.
사용하기
코드를 실행하기 전에 CUDA 12.4와 FlexAttention으로 올바른 환경이 설정되어 있는지 확인하십시오.
# Install PyTorch with CUDA 12.4
pip install pytorch==2.5.0
pip install torchvision==0.20.0
pip install torchaudio==2.5.0
pip install pytorch-cuda=12.4
# Install required packages
pip install --upgrade transformers
pip install tiktoken sentencepiece protobuf ninja einops triton packaging
# Install Mamba
git clone https://github.com/state-spaces/mamba.git
cd mamba
pip install -e .
cd ..
# Install causal-conv1d
git clone https://github.com/Dao-AILab/causal-conv1d.git
cd causal-conv1d
export CUDA_HOME=/usr/local/cuda-12.4
export TORCH_CUDA_ARCH_LIST="7.0;7.5;8.0;8.6;8.9;9.0"
python setup.py install
cd ..
# Install attention-gym
git clone https://github.com/pytorch-labs/attention-gym.git
cd attention-gym
pip install .
cd ..
# Install Flash Attention
pip install flash_attn
다음은 Hugging Face를 통해 Hymba를 사용하는 최소한의 예제입니다.
import torch
from transformers import
AutoModelForCausalLM,
AutoTokenizer,
StopStringCriteria,
StoppingCriteriaList
# Initialize model and tokenizer for chat
repo_name = "nvidia/Hymba-1.5B-Instruct"
tokenizer = AutoTokenizer.from_pretrained(repo_name, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(repo_name, trust_remote_code=True)
model = model.cuda().to(torch.bfloat16)
def chat_with_model(messages, model, tokenizer, max_new_tokens=256):
# Format the conversation using the model's chat template
tokenized_chat = tokenizer.apply_chat_template(
messages,
tokenize=True,
add_generation_prompt=True,
return_tensors="pt"
).to('cuda')
# Set up stopping criteria to properly end responses
stopping_criteria = StoppingCriteriaList([
StopStringCriteria(tokenizer=tokenizer, stop_strings="</s>")
])
# Generate response
outputs = model.generate(
tokenized_chat,
max_new_tokens=max_new_tokens,
do_sample=False,
temperature=0.7,
use_cache=True,
stopping_criteria=stopping_criteria
)
# Decode and return only the new tokens
input_length = tokenized_chat.shape[1]
response = tokenizer.decode(outputs[0][input_length:], skip_special_tokens=True)
return response
# Interactive chat loop
messages = [
{"role": "system", "content": "You are a helpful assistant."}
]
def main():
print("Chat with Hymba (type 'exit' to quit):")
while True:
print("User:")
prompt = input()
if prompt.lower() == "exit":
break
messages.append({"role": "user", "content": prompt})
response = chat_with_model(messages, model, tokenizer)
messages.append({"role": "assistant", "content": response})
print(f"Model: {response}")
개발용 Nvidia GH200 설정하기
Nvidia GH200을 처음부터 설정하는 일은 다소 까다롭습니다. 결국 CUDA 12.4와 FlashAttention-2로 작동하게 만들었지만, 어느 정도 시행착오를 거쳐야 했습니다. 제가 한 작업은 다음과 같습니다.
GH200은 64K 커널 페이지 크기에서 최적의 성능을 발휘합니다. Nvidia는 Ubuntu 시스템용 전용 커널 패키지를 제공합니다. 먼저 기존 커널 패키지를 제거하고 Nvidia 64K 커널을 설치하십시오.
sudo DEBIAN_FRONTEND=noninteractive apt purge linux-image-$(uname -r) \
linux-headers-$(uname -r) linux-modules-$(uname -r) -y
sudo apt update
sudo apt install linux-nvidia-64k-hwe-22.04 -y
sudo reboot now
시스템이 재부팅되면 올바른 커널을 사용하고 있는지 확인하십시오.
uname -r
다음과 같이 표시되어야 합니다.
linux-nvidia-64k-hwe-22.04-555.42.06
이제 기본 시스템을 업데이트합시다.
apt-get update
GH200에는 특정 NVIDIA 드라이버와 MLNX_OFED 드라이버가 필요합니다. 다음 패키지를 설치하십시오. 여기서는 순서가 매우 중요합니다!
apt-get install -y mlnx-fw-updater mlnx-ofed-all
apt-get install -y cuda-drivers-555 nvidia-kernel-open-555 linux-tools-$(uname -r)
apt-get install -y cuda-toolkit nvidia-container-toolkit
NVIDIA persistence 데몬이 persistence 모드를 사용하도록 구성해야 합니다.
sudo mkdir /lib/systemd/system/nvidia-persistenced.service.d
sudo dd status=none of=/lib/systemd/system/nvidia-persistenced.service.d/override.conf << EOF
[Service]
ExecStart=
ExecStart=/usr/bin/nvidia-persistenced --persistence-mode --verbose
[Install]
WantedBy=multi-user.target
EOF
systemctl enable nvidia-persistenced --now
새 프로필 스크립트를 만들어 CUDA 경로를 구성하십시오.
echo "# Library Path for Nvidia CUDA" >> /etc/profile.d/cuda.sh
echo export LD_LIBRARY_PATH=/usr/local/cuda/lib64:'$LD_LIBRARY_PATH' >> /etc/profile.d/cuda.sh
echo export PATH=$HOME/.local/bin:/usr/local/cuda/bin:'$PATH' >> /etc/profile.d/cuda.sh
최적의 성능을 위해 IRQ balance 서비스를 비활성화하고 NUMA 설정을 구성하십시오.
systemctl disable irqbalance
echo "kernel.numa_balancing = 0" >> /etc/sysctl.conf
sysctl -p
이제 NVIDIA peer memory 모듈을 시스템에 추가하여 피어 메모리 접근을 활성화합시다.
echo "nvidia-peermem" >> /etc/modules-load.d/nvidia-peermem.conf
모듈이 로드되었는지 확인하십시오.
lsmod | grep nvidia_peermem
모든 구성을 마친 후 시스템을 재부팅하십시오.
systemctl disable first-boot.service
reboot
시스템이 재부팅되면 다음 명령을 실행하여 설치를 확인하십시오.
nvidia-smi
이 명령은 GPU 모델, 드라이버 버전, 현재 사용률을 포함한 GH200 정보를 표시해야 합니다.
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 555.42.06 Driver Version: 555.42.06 CUDA Version: 12.4 |
|-----------------------------------------+------------------------+----------------------+
| GPU Name Persistence-M | Bus-Id Disp.A | Volatile Uncorr. ECC |
| Fan Temp Perf Pwr:Usage/Cap | Memory-Usage | GPU-Util Compute M. |
| | | MIG M. |
|=========================================+========================+======================|
| 0 NVIDIA GH200 480GB On | 00000009:01:00.0 Off | 0 |
| N/A 33C P0 76W / 900W | 1MiB / 97871MiB | 0% Default |
| | | Disabled |
+-----------------------------------------+------------------------+----------------------+
+-----------------------------------------------------------------------------------------+
| Processes: |
| GPU GI CI PID Type Process name GPU Memory |
| ID ID Usage |
|=========================================================================================|
| No running processes found |
+-----------------------------------------------------------------------------------------+
시스템 토폴로지를 살펴보면 GPU와 네트워킹 구성 요소 사이에서 데이터가 어떻게 이동하는지 파악할 수 있습니다.
nvidia-smi topo -m
이 명령은 GPU와 다른 PCIe 장치 사이의 연결 행렬을 보여 줍니다. GH200의 경우 다음과 비슷한 내용이 표시되어야 합니다.
GPU0 NIC0 NIC1 CPU Affinity NUMA Affinity GPU NUMA ID
GPU0 X NODE NODE 0-71 1
NIC0 NODE X PIX
NIC1 NODE PIX X
Legend:
X = Self
SYS = Connection traversing PCIe as well as the SMB interconnect between NUMA nodes (e.g., QPI/UPI)
NODE = Connection traversing PCIe as well as the interconnect between PCIe Host Bridges within a NUMA node
PHB = Connection traversing PCIe as well as a PCIe Host Bridge (typically the CPU)
PXB = Connection traversing multiple PCIe bridges (without traversing the PCIe Host Bridge)
PIX = Connection traversing at most a single PCIe bridge
NV# = Connection traversing a bonded set of # NVLinks
NIC Legend:
NICO: mlx5_0
NIC1: mlx5_1
Flash 어텐션으로 vLLM 설정하기
먼저 Python 패키지 관리 도구를 업데이트하십시오.
python -m pip install -U pip
python -m pip install -U setuptools wheel
CUDA 12.4를 지원하는 PyTorch를 설치하십시오.
pip install torch --index-url https://download.pytorch.org/whl/cu124
Flash 어텐션을 설치하십시오:
pip install flash-attn --no-build-isolation
Flash 어텐션을 지원하도록 vLLM을 클론하고 빌드하십시오:
git clone git@github.com:vllm-project/vllm.git
cd vllm
sudo docker build --target build -t vllm_build .
container_id=$(sudo docker create --name vllm_temp vllm_build:latest)
sudo docker cp ${container_id}:/workspace/dist .
# Install vLLM with Flash Attention
pip install vllm-flash-attn
pip install dist/vllm-0.4.2+cu124-cp312-cp312-linux_x86_64.whl
소스에서 xformers를 설치하십시오.
pip install ninja
# Set TORCH_CUDA_ARCH_LIST if running and building on different GPU types
pip install -v -U git+https://github.com/facebookresearch/xformers.git@main#egg=xformers
~/.bashrc에 다음 내용을 추가하여 환경 변수를 설정하십시오.
export HF_TOKEN=<HF-TOKEN>
export HF_HOME="/home/ubuntu/.cache/huggingface"
export MODEL_REPO=meta-llama/Meta-Llama-3.1-70B-Instruct
변경 사항을 적용하십시오.
source ~/.bashrc
다음 명령으로 vLLM API 서버를 실행하십시오:
vllm serve $MODEL_REPO --dtype auto
이제 http://localhost:8000/v1/completions의 API 엔드포인트로 요청을 보낼 수 있습니다.
FlashInfer와 함께 sglang 설정하기
또는 SGLang과 FlashInfer를 사용하여 서빙할 수도 있습니다.
# Use the last release branch
git clone -b v0.3.5.post2 https://github.com/sgl-project/sglang.git
cd sglang
pip install -e "python[all]"
pip install flashinfer -i https://flashinfer.ai/whl/cu121/torch2.4/
다음 명령으로 SGLang 서버를 실행하십시오:
python -m sglang.launch_server --model-path meta-llama/Meta-Llama-3.1-70B-Instruct
마찬가지로 OpenAI API 형식을 사용하여 http://localhost:8000/v1/completions의 API 엔드포인트로 요청을 보낼 수 있습니다.
200줄의 Python으로 구현하는 의존 타입
구성의 계산(Calculus of Constructions, 줄여서 CoC)은 가장 널리 쓰이는 타입 있는 람다 대수 중 하나이며, Coq와 같은 의존 타입의 프로그래밍 언어의 이론적 토대를 이룹니다. 이 글에서는 200줄의 Python으로 CoC의 타입 검사기를 구현하면서 핵심 구성 요소를 하나씩 나누어 살펴보고 각각이 어떻게 동작하는지 설명합니다. 이것은 대체로 코드 골프 연습이므로 구현이 아주 견고하지는 않지만, 이것을 Python으로도 구현할 수 있다는 점이 재미있습니다.
배경을 조금 설명하자면, CoC는 1985년 Thierry Coquand가 개발한 고차 타입 람다 대수로, 두 가지 핵심 개념을 결합합니다.
- 의존 타입 - 항에 의존할 수 있는 타입
- 타입 다형성 - 타입에 대해 양화할 수 있는 능력
이 체계에는 두 가지 종류(sort)가 있습니다. *(타입들의 타입)와 ☐(*의 타입)입니다. 이 체계는 다음과 같은 항을 지원합니다.
- 변수
- 람다 추상화 (λx:A.t)
- 함수 적용 (t u)
- 의존 곱 타입 (Πx:A.B)
- 타입 표기 (t : A)
구현을 Core 구성 요소별로 나누어 살펴봅시다. 먼저 항 표현이 있는데, 여기서는 Python 클래스를 사용해 대수적 데이터 타입을 흉내 냅니다.
De Bruijn 인덱스 이해하기
구현에 들어가기 전에, 변수 조회에 사용하는 De Bruijn 인덱스를 이해해 봅시다. De Bruijn 표기법에서 변수는 해당 변수의 바인딩 위치를 찾기 위해 바인더를 몇 개나 거슬러 올라가야 하는지를 나타내는 숫자로 표현됩니다. 예를 들면 다음과 같습니다.
# Traditional notation:
λx. λy. x y
# De Bruijn notation:
λ. λ. 1 0 # 1 refers to x (up one binder), 0 refers to y (current binder)
더 많은 예시입니다.
# Traditional: # De Bruijn: # Explanation:
λx. x λ. 0 # x is bound by the current (0th) binder
λx. λy. y λ. λ. 0 # y is bound by the current binder
λx. λy. λz. x y z λ. λ. λ. 2 1 0 # x=2, y=1, z=0 binders up
Πx:*. λy. x Π*. λ. 1 # x is one binder up from y
우리 구현에서는 컨텍스트 조회에 인덱스(안쪽부터 셈) 대신 De Bruijn 레벨(바깥쪽부터 셈)을 사용합니다. 이 때문에 컨텍스트에 접근할 때 lvl - x - 1을 사용하여 레벨을 인덱스로 변환합니다.
타입 항 계층 구조
@dataclass
class Term:
pass
@dataclass
class Lam(Term):
f: Callable[[Term], Term]
@dataclass
class Pi(Term):
a: Term
f: Callable[[Term], Term]
@dataclass
class Appl(Term):
m: Term
n: Term
@dataclass
class Ann(Term):
m: Term
a: Term
@dataclass
class FreeVar(Term):
x: int
@dataclass
class Star(Term):
pass
@dataclass
class Box(Term):
pass
항 평가를 위해 람다 대수의 Core 계산 규칙인 베타 축약을 구현합니다. eval 함수는 값에 의한 호출(call-by-value) 평가 전략을 구현하며, 의존 타입에서는 타입이 계산상 동등한지 비교해야 하므로 타입 검사에 매우 중요합니다.
def eval(term: Term) -> Term:
match term:
case Lam(f):
return Lam(lambda n: eval(f(n)))
case Pi(a, f):
return Pi(eval(a), lambda n: eval(f(n)))
case Appl(m, n):
m_eval = eval(m)
n_eval = eval(n)
match m_eval:
case Lam(f):
return f(n_eval)
case _:
return Appl(m_eval, n_eval)
case Ann(m, _):
return eval(m)
case FreeVar() | Star() | Box():
return term
타입 검사기는 서로 재귀적으로 호출하는 세 개의 함수로 나뉩니다. 주목해야 할 몇 가지 중요한 구현 세부 사항은 다음과 같습니다.
infer_ty와check_ty함수는 항상 평가된 타입을 반환합니다- 타입 컨텍스트(
ctx)는 평가된 타입만 포함해야 하며 잘 형성되어 있어야 합니다(모든 항목은 어떤 종류(sort)에 속해야 합니다) - 바인딩은 컨텍스트의 앞쪽에 추가되며 De Bruijn 인덱스로 색인됩니다
FreeVar는 De Bruijn 레벨을 사용하므로, 컨텍스트에 접근할 때lvl - x - 1을 사용합니다
def infer_ty(lvl: int, ctx: List[Term], term: Term) -> Term:
match term:
case Pi(a, f):
_s1 = infer_sort(lvl, ctx, a)
s2 = infer_sort(lvl + 1, [eval(a)] + ctx, unfurl(lvl, f))
return s2
case Appl(m, n):
m_ty = infer_ty(lvl, ctx, m)
match m_ty:
case Pi(a, f):
_ = check_ty(lvl, ctx, (n, a))
return f(n)
case _:
return panic(lvl, m, f"Want a Pi type, got {print_term(lvl, m_ty)}")
case Ann(m, a):
_s = infer_sort(lvl, ctx, a)
return check_ty(lvl, ctx, (m, eval(a)))
case FreeVar(x):
return ctx[lvl - x - 1]
case Star():
return Box()
case Box():
return panic(lvl, Box(), "Has no type")
infer_ty 함수는 양방향 타입 검사를 구현합니다:
- Pi 타입의 경우, 정의역과 공역이 모두 소트(sort)인지 확인합니다
- 적용(application)의 경우, 함수 타입을 추론하고 인자를 검사합니다
- 주석(annotation)의 경우, 타입이 올바른지 확인하고 그 타입에 대해 항을 검사합니다
- 변수의 경우, 컨텍스트에서 그 타입을 조회합니다
*의 경우,☐를 반환합니다☐는 타입을 갖지 않습니다(계층의 최상위에 있기 때문입니다)
def infer_sort(lvl: int, ctx: List[Term], a: Term) -> Term:
ty = infer_ty(lvl, ctx, a)
match ty:
case Star() | Box():
return ty
case _:
return panic(lvl, a, f"Want a sort, got {print_term(lvl, ty)}")
infer_sort 함수는 항이 * 또는 ☐ 타입을 갖는지 확인합니다:
- 항의 타입을 추론합니다
- 그것이 소트인지 확인합니다
- 타입 형성 규칙에서 사용할 수 있도록 소트를 반환합니다
def check_ty(lvl: int, ctx: List[Term], pair: Tuple[Term, Term]) -> Term:
t, ty = pair
match (t, ty):
case (Lam(f), Pi(a, g)):
_ = check_ty(lvl + 1, [a] + ctx, unfurl2(lvl, (f, g)))
return Pi(a, g)
case (Lam(f), _):
return panic(lvl, Lam(f), f"Want a Pi type, got {print_term(lvl, ty)}")
case _:
got_ty = infer_ty(lvl, ctx, t)
if equate(lvl, (ty, got_ty)):
return ty
return panic(lvl, t, f"Want type {print_term(lvl, ty)}, got {print_term(lvl, got_ty)}")
equate 함수는 구조적 동등성 검사를 구현합니다. 두 항이 베타 변환 가능한지(계산적 동등성) 검사할 때는 equate를 호출하기 전에 먼저 두 항을 평가해야 합니다. check_ty에서 추론된 타입(got_ty)과 기대 타입(ty)을 비교할 때는 둘 다 이미 정규형이므로 추가 평가가 필요하지 않습니다.
def equate(lvl: int, terms: Tuple[Term, Term]) -> bool:
def plunge(pair: Tuple[Callable[[Term], Term], Callable[[Term], Term]]) -> bool:
return equate(lvl + 1, unfurl2(lvl, pair))
match terms:
case (Lam(f), Lam(g)):
return plunge((f, g))
case (Pi(a, f), Pi(b, g)):
return equate(lvl, (a, b)) and plunge((f, g))
case (Appl(m, n), Appl(m2, n2)):
return equate(lvl, (m, m2)) and equate(lvl, (n, n2))
case (Ann(m, a), Ann(m2, b)):
return equate(lvl, (m, m2)) and equate(lvl, (a, b))
case (FreeVar(x), FreeVar(y)):
return x == y
case (Star(), Star()) | (Box(), Box()):
return True
case _:
return False
equate 함수는 구조적 동등성 검사를 구현합니다:
- 모든 항 생성자를 처리하면서 항을 재귀적으로 비교합니다
- 속박 변수에 대해서는 HOAS 비교를 사용합니다
- 레벨 카운팅 메커니즘을 통해 알파 동치를 구현합니다
def unfurl(lvl: int, f: Callable[[Term], Term]) -> Term:
return f(FreeVar(lvl))
def unfurl2(lvl: int, pair: Tuple[Callable[[Term], Term], Callable[[Term], Term]]) -> Tuple[Term, Term]:
f, g = pair
return (unfurl(lvl, f), unfurl(lvl, g))
다음 유틸리티 함수들은 HOAS 변수 조작을 처리합니다:
unfurl은 HOAS 함수를 자유 변수를 가진 항으로 변환합니다unfurl2는 함수 쌍에 대해 같은 일을 합니다- 레벨 매개변수는 변수의 올바른 스코프를 보장합니다
def print_term(lvl: int, term: Term) -> str:
def plunge(f: Callable[[Term], Term]) -> str:
return print_term(lvl + 1, unfurl(lvl, f))
match term:
case Lam(f):
return f"(λ{plunge(f)})"
case Pi(a, f):
return f"(Π{print_term(lvl, a)}.{plunge(f)})"
case Appl(m, n):
return f"({print_term(lvl, m)} {print_term(lvl, n)})"
case Ann(m, a):
return f"({print_term(lvl, m)} : {print_term(lvl, a)})"
case FreeVar(x):
return str(x)
case Star():
return "*"
case Box():
return "☐"
print_term 함수는 항을 읽기 쉬운 문자열 표현으로 변환합니다:
이제 CoC가 실제로 동작하는 두 가지 “실용적인” 예제인 처치 수(Church numeral)와 길이 색인 벡터를 살펴봅시다. 예제를 더 읽기 쉽게 만들기 위해 몇 가지 헬퍼 함수를 사용합니다:
def curry2(f):
return Lam(lambda x: Lam(lambda y: f(x, y)))
def curry3(f):
return Lam(lambda x: curry2(lambda y, z: f(x, y, z)))
def curry4(f):
return Lam(lambda x: curry3(lambda y, z, w: f(x, y, z, w)))
def curry5(f):
return Lam(lambda x: curry4(lambda y, z, w, v: f(x, y, z, w, v)))
def appl(f: Term, args: List[Term]) -> Term:
return reduce(lambda m, n: Appl(m, n), args, f)
처치 수는 자연수를 함수로 표현합니다. CoC에서는 처치 수에 정확한 타입을 부여할 수 있습니다:
# The type of Church numerals
n_ty = Pi(Star(), lambda a:
Pi(Pi(a, lambda _x: a), lambda _f:
Pi(a, lambda _x: a)))
# Zero is the identity function
zero = Ann(curry3(lambda _a, _f, x: x), n_ty)
# Successor applies f one more time
succ = Ann(
curry4(lambda n, a, f, x: Appl(f, appl(n, [a, f, x]))),
Pi(n_ty, lambda _n: n_ty)
)
# Addition combines the function applications
add = Ann(
curry5(lambda n, m, a, f, x:
appl(n, [a, f, appl(m, [a, f, x])])),
Pi(n_ty, lambda _n: Pi(n_ty, lambda _m: n_ty))
)
다음과 같은 일이 일어납니다:
- 처치 수는 타입
a, 함수f: a → a, 값x: a를 받습니다 f를x에 n번 적용하며, 여기서 n은 표현되는 수입니다zero는 x를 그대로 반환합니다succ n은 n보다 f를 한 번 더 적용합니다add n m은 f를 n+m번 적용합니다
의존 타입을 사용하면 길이를 정적으로 알 수 있는 벡터도 만들 수 있습니다:
# Vector context setup
vect_ctx = [
# Vector type constructor: (n: Nat) → (a: Type) → Type
Pi(n_ty, lambda _n: Pi(Star(), lambda _a: Star())),
# Item type and value
Star(),
item_ty,
# replicate: (n: Nat) → (a: Type) → a → Vec n a
Pi(n_ty, lambda n:
Pi(Star(), lambda a:
Pi(a, lambda _x: vect_ty(n, a)))),
# concat: (n m: Nat) → (a: Type) → Vec n a → Vec m a → Vec (n+m) a
Pi(n_ty, lambda n:
Pi(n_ty, lambda m:
Pi(Star(), lambda a:
Pi(vect_ty(n, a), lambda _x:
Pi(vect_ty(m, a), lambda _y:
vect_ty(appl(add, [n, m]), a)))))),
# zip: (n: Nat) → (a b: Type) → Vec n a → Vec n b → Vec n (Pair a b)
Pi(n_ty, lambda n:
Pi(Star(), lambda a:
Pi(Star(), lambda b:
Pi(vect_ty(n, a), lambda _x:
Pi(vect_ty(n, b), lambda _y:
vect_ty(n, appl(pair, [a, b])))))))
]
벡터 연산은 의존 타이핑을 보여 줍니다:
replicate는 하나의 값으로 채워진 길이 n의 벡터를 만듭니다concat은 벡터를 결합하며, 결과의 길이는 두 길이의 합입니다zip은 길이가 같은 두 벡터를 결합합니다
이 연산들은 다음과 같이 사용할 수 있습니다:
# Create vectors of different lengths
vect_one = replicate(one, item)
vect_three = replicate(three, item)
vect_four = concat(one, three, vect_one, vect_three)
# This will type check
zip(four, vect_four, vect_four)
# This will fail type checking - mismatched lengths
zip(four, vect_one, vect_four) # TypeError!
타입 시스템은 다음을 보장합니다:
- 벡터 길이가 정확하게 추적됩니다
- 연산이 길이 불변 조건을 유지합니다
- 길이 불일치가 정적으로 검출됩니다
이 예제들은 CoC가 계산과 정적 보장을 하나의 통합된 시스템 안에서 어떻게 함께 표현할 수 있는지 보여 줍니다. 타입 검사기는 유연한 프로그래밍 패턴을 여전히 허용하면서도 연산이 이러한 보장을 지키도록 합니다. 의존 타입은 멋집니다.
이 벡터 연산들의 구현을 더 자세히 살펴봅시다:
Replicate
# replicate: (n: Nat) → (a: Type) → a → Vec n a
def replicate(n: Term, x: Term) -> Term:
return appl(FreeVar(3), [n, item_ty, x])
replicate 함수는 모든 원소가 x인 길이 n의 벡터를 만듭니다. 타입은 결과 벡터의 길이가 입력된 수 n과 일치하도록 보장합니다. 실제 구현이라면 x를 n개 복사한 리스트를 구성하겠지만, 타입만 다루는 우리 구현에서는 타입만 추적합니다.
Concatenate
# concat: (n m: Nat) → (a: Type) → Vec n a → Vec m a → Vec (n+m) a
def concat(n: Term, m: Term, x: Term, y: Term) -> Term:
return appl(FreeVar(4), [n, m, item_ty, x, y])
concat 함수는 두 벡터를 결합합니다. 이 함수의 타입은 의존 타입이 산술 관계를 어떻게 추적할 수 있는지 보여 주므로 특히 흥미롭습니다. 출력 벡터의 길이는 입력 길이의 합인 n + m입니다. 이는 타입 시스템에 의해 정적으로 강제됩니다.
Zip
# zip: (n: Nat) → (a b: Type) → Vec n a → Vec n b → Vec n (Pair a b)
def zip(n: Term, x: Term, y: Term) -> Term:
return appl(FreeVar(5), [n, item_ty, item_ty, x, y])
zip 함수는 두 벡터를 원소별로 결합하여 쌍의 벡터로 만듭니다. 타입 시스템은 두 입력 벡터가 반드시 같은 길이 n을 가지도록 강제하며, 출력 벡터 역시 길이 n을 가지도록 보장합니다. 길이가 다른 벡터를 zip하려고 하면 런타임 오류가 아니라 컴파일 타임에 타입 오류가 발생합니다.
이 연산들은 정적 길이 검사를 갖춘 작은 벡터 라이브러리를 이룹니다. 타입 시스템은 다음과 같은 일이 불가능하도록 보장합니다:
- 벡터를 연결하면서 길이를 잘못 계산하는 일
- 길이가 다른 벡터를 zip하는 일
- 타입과 일치하지 않는 길이의 벡터를 만드는 일
이는 의존 타입이 정밀한 명세를 타입 시스템 안에 직접 인코딩할 수 있는 방법을 보여 줍니다. 우리 구현은 타입 검사기일 뿐이지만(실제로 벡터를 구성하지는 않습니다), 실제 구현을 갖추게 되는 Coq나 Agda 같은 언어에서 이러한 개념이 어떻게 작동하는지를 보여 줍니다.
OCaml용 PyTorch 설정하기
OCaml은 견고하고 타입 안전한 시스템을 구축하는 데 강점이 있지만, 현대 AI 개발을 위한 OCaml 설정은 의외로 다루는 곳이 드문 주제입니다. 이 가이드는 대규모 언어 모델의 지속 사전 학습(continued pre-training)이나 전체 튜닝(full-tuning)을 수행하기 위해, H100 GPU 8개를 탑재한 NVIDIA HGX AI 플랫폼에서 OCaml 개발 환경을 구성하는 방법에 초점을 맞춥니다. 일부 퀀트 펀드가 AI 인프라에 OCaml을 도입하려고 많은 투자를 했지만, 이처럼 GPU가 밀집된 구성에서 OCaml을 설정하는 방법에 관한 공개 문서는 놀라울 만큼 적습니다. 여기서는 Ubuntu에서 CUDA 및 PyTorch와 함께 OCaml을 설정하는 전체 과정을 차례로 살펴봅니다. 특히 요즘 많은 펀드가 도입하고 있는 이러한 멀티 GPU 시스템만의 고유한 요구 사항에 주의를 기울입니다.
시스템 의존성
시작하기 전에 Ubuntu를 실행하고 있는지 확인하십시오. 이 설정은 Ubuntu에서 테스트되었으며, 몇몇 설치 단계에는 root 권한이 필요합니다.
# Check your Ubuntu version
lsb_release -a
먼저 기본 시스템 의존성을 설치합시다. 이 패키지들은 이후 설정에 필요한 필수 개발 도구와 라이브러리를 제공합니다:
sudo apt-get update
sudo apt-get install -y \
build-essential \
pciutils \
wget \
clang \
libaio-dev \
python3-pip \
python3-venv
NVIDIA 드라이버 설치
NVIDIA 드라이버 설치 방법은 데스크톱 시스템을 실행하는지 헤드리스 시스템을 실행하는지에 따라 다릅니다:
# For desktop systems with X.org or Wayland
sudo apt-get -y install nvidia-driver-550
# For headless systems (servers without display)
sudo apt-get -y install --no-install-recommends nvidia-headless-550
# Install CUDA toolkit
sudo apt-get -y install nvidia-cuda-toolkit
이 명령은 NVIDIA 드라이버 550 버전과 CUDA 툴킷을 설치하며, CUDA 툴킷은 GPU 가속에 필요한 구성 요소를 제공합니다.
Python 환경 설정
먼저 pyenv를 설치하고 Python 3.12.4를 구성합시다:
# Install pyenv dependencies
sudo apt-get install -y make build-essential libssl-dev zlib1g-dev \
libbz2-dev libreadline-dev libsqlite3-dev wget curl llvm \
libncursesw5-dev xz-utils tk-dev libxml2-dev libxmlsec1-dev libffi-dev liblzma-dev
# Install pyenv
curl https://pyenv.run | bash
# Add pyenv to your shell configuration (~/.bashrc or ~/.zshrc)
echo 'export PYENV_ROOT="$HOME/.pyenv"' >> ~/.bashrc
echo 'command -v pyenv >/dev/null || export PATH="$PYENV_ROOT/bin:$PATH"' >> ~/.bashrc
echo 'eval "$(pyenv init -)"' >> ~/.bashrc
# Reload shell configuration
source ~/.bashrc
# Install Python 3.12.4
pyenv install 3.12.4
# Set Python 3.12.4 as global version
pyenv global 3.12.4
# Verify installation
python --version # Should output: Python 3.12.4
# Upgrade pip
python -m pip install --upgrade pip
# Install PyTorch with CUDA support
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121
# Install NVIDIA cuDNN
pip install nvidia-cudnn-cu11
# Install Hugging Face libraries
pip install transformers datasets accelerate
# Install scientific computing packages
pip install scipy numpy pandas
# Install optimized attention implementations
pip install flash-attn --no-build-isolation
pip install -v -U git+https://github.com/facebookresearch/xformers.git@main#egg=xformers
# Install GPU monitoring tools
pip install nvitop
DeepSpeed 및 Megatron-LM 설치
DeepSpeed 설치
DeepSpeed는 대규모 모델 학습을 위한 최적화 기능을 제공합니다. CUDA 연산 지원을 포함하여 설치합시다:
# Basic installation
pip install deepspeed
# OR: Install from source for latest features
git clone https://github.com/microsoft/DeepSpeed.git
cd DeepSpeed
pip install -e .
# OR: Install with pre-compiled operations (recommended)
DS_BUILD_OPS=1 pip install deepspeed --global-option="build_ext" --global-option="-j8"
설치를 검증하고 사용 가능한 연산을 확인하십시오:
ds_report
고급 설치 옵션:
# Install specific operations
DS_BUILD_FUSED_ADAM=1 pip install deepspeed # FusedAdam support
DS_BUILD_FUSED_LAMB=1 pip install deepspeed # FusedLamb support
DS_BUILD_SPARSE_ATTN=1 pip install deepspeed # Sparse attention support
# Skip CUDA version check if needed (use with caution)
DS_SKIP_CUDA_CHECK=1 pip install deepspeed
Megatron-LM 설치
Megatron-LM을 사용하면 대규모 트랜스포머 모델을 대규모로 학습할 수 있습니다. 설정 방법은 다음과 같습니다:
# Install NVIDIA Apex first
git clone https://github.com/NVIDIA/apex
cd apex
pip install -v --disable-pip-version-check --no-cache-dir \
--global-option="--cpp_ext" \
--global-option="--cuda_ext" ./
cd ..
# Install Megatron-LM
git clone https://github.com/NVIDIA/Megatron-LM.git
cd Megatron-LM
git checkout core_r0.5.0
pip install --no-use-pep517 -e .
OCaml 설정
마지막으로 PyTorch 바인딩과 함께 OCaml 환경을 설정합니다:
# Install OCaml package manager
sudo apt-get install -y opam m4 pkg-config
# Initialize OPAM
opam init --auto-setup --yes
eval $(opam env)
# Create new OCaml environment
opam switch create 4.14.1
eval $(opam env)
# Install OCaml development tools
opam install -y dune merlin ocaml-lsp-server odoc ocamlformat utop
# Install Torch dependencies and bindings
opam install -y ctypes ctypes-foreign conf-pkg-config
opam install -y torch
이 과정에서 설정되는 항목은 다음과 같습니다:
- OPAM(OCaml 패키지 관리자)
- OCaml 4.14.1 환경
- 다음을 포함한 개발 도구:
- Dune(빌드 시스템)
- Merlin(코드 자동 완성)
- LSP 서버 (IDE 통합)
- 문서화 도구
- UTop (향상된 REPL)
- OCaml용 PyTorch 바인딩
검증
설치하고 시스템을 재부팅한 후 설정을 검증하십시오:
# Check NVIDIA driver installation
nvidia-smi
# Check GPU interconnect topology
nvidia-smi topo -m
# Start OCaml REPL and test Torch
utop
# In utop:
open Torch;;
nvidia-smi 출력에 GPU가 표시되어야 하며, OCaml에서 Torch 모듈을 오류 없이 임포트할 수 있어야 합니다.
선택 사항: 실험 추적 설정
머신러닝 실험을 추적할 계획이라면 Hugging Face와 함께 Weights & Biases를 설정할 수 있습니다:
# Install Weights & Biases
pip install wandb
# Log in to Weights & Biases (this will prompt for your API key)
wandb login
# Install and log in to Hugging Face
pip install huggingface_hub
huggingface-cli login
W&B API 키는 https://wandb.ai/settings 에서, Hugging Face 토큰은 https://huggingface.co/settings/tokens 에서 받을 수 있습니다.
예제 프로젝트: XOR 신경망
XOR 함수를 학습하도록 신경망을 훈련하는 Hello World OCaml 프로젝트를 만들어 봅시다. 먼저 새 프로젝트를 생성하십시오:
# Create project directory
mkdir xor_example
cd xor_example
# Initialize dune project
dune init project xor_example
cd xor_example
이제 새 파일 bin/main.ml을 생성하십시오:
open Base
open Torch
(* XOR truth table *)
let input_data =
Tensor.of_float2 [|
[|0.; 0.|];
[|0.; 1.|];
[|1.; 0.|];
[|1.; 1.|];
|]
let target_data =
Tensor.of_float2 [|
[|0.|];
[|1.|];
[|1.|];
[|0.|];
|]
let () =
(* Create a simple network with one hidden layer *)
let vs = Var_store.create ~name:"xor" () in
let hidden = Layer.linear vs ~input_dim:2 4 ~activation:Relu in
let output = Layer.linear vs ~input_dim:4 1 ~activation:Sigmoid in
(* Define the model *)
let model x =
Layer.forward hidden x
|> Layer.forward output
in
(* Training configuration *)
let learning_rate = 0.05 in
let optimizer = Optimizer.adam vs ~learning_rate in
(* Training loop *)
for epoch = 1 to 2000 do
(* Forward pass *)
let predicted = model input_data in
let loss = Tensor.mse_loss predicted target_data in
(* Backward pass *)
Optimizer.backward_step optimizer ~loss;
(* Print progress every 100 epochs *)
if epoch % 100 = 0 then
Stdio.printf "Epoch %d: Loss = %f\n%!"
epoch (Tensor.float_value loss)
done;
(* Print final results *)
let final_output = model input_data in
Stdio.printf "\nFinal predictions:\n";
Tensor.print final_output
bin 디렉터리의 dune 파일을 수정하십시오:
(executable
(name main)
(libraries base stdio torch))
프로젝트를 빌드하고 실행하십시오:
# Build the project
dune build
# Run the example
dune exec xor_example
정상적으로 실행된다면 축하합니다. 이제 OCaml로 직접 훈련 실행을 조율할 준비가 되었습니다.
새로운 랭크 29 타원곡선
2024년 8월, 수학자 Noam Elkies와 Zev Klagsbrun은 유리수체 위에서 알려진 가장 높은 랭크인 29를 갖는 타원곡선을 발견했습니다. 이 획기적인 발견은 2006년부터 유지되어 온 이전 기록인 랭크 28을 넘어섰습니다.
학부 정수론에서 배운 내용을 떠올려 보면, 타원곡선은 특수한 형태의 3차 방정식으로, 대수학에서 배웠을 이차방정식( 같은)과 비슷하지만 한 항이 세제곱으로 되어 있습니다. 이차방정식은 비교적 간단하게 풀 수 있지만, 타원곡선은 훨씬 더 복잡한 성질을 보이며 우리는 아직도 이를 이해하기 위해 연구하고 있습니다. 우리가 살펴볼 방정식은 다음과 같은 형태입니다.
이러한 방정식의 유리수 해, 즉 와 가 유리수인 해를 찾아보면 흥미로운 사실을 발견하게 됩니다. 이 해들은 여러 계열로 묶을 수 있으며, 수학적 연산을 통해 기존 해로부터 새로운 해를 유도할 수 있습니다. 서로 독립인 해의 계열의 개수를 곡선의 “랭크“라고 합니다.
랭크는 가능한 모든 유리수 해를 생성하는 데 필요한 서로 다른 “출발점“의 개수를 나타낸다고 생각하십시오. 대부분의 타원곡선은 작은 랭크(0, 1 또는 2)를 가지므로, 이 랭크 29 곡선은 매우 특별합니다. 이 곡선의 구체적인 계수는 다음과 같습니다.
다음은 이 곡선을 다루는 데 필요한 임의 정밀도 산술을 수행하기 위해 sympy 라이브러리를 사용한 간단한 Python 구현입니다.
from sympy import Symbol, solve, Rational
def E29():
a = -27006183241630922218434652145297453784768054621836357954737385
b = 55258058551342376475736699591118191821521067032535079608372404779149413277716173425636721497
class EllipticCurve:
def __init__(self):
self.a = a
self.b = b
def get_y_coordinates(self, x):
"""Find y coordinates for a given x on the curve"""
x = Rational(x)
# Convert equation to standard form: y^2 + xy - (x^3 + ax + b) = 0
y = Symbol('y')
eq = y**2 + x*y - (x**3 + self.a*x + self.b)
return solve(eq, y)
def is_on_curve(self, x, y):
"""Check if point (x,y) lies on the curve"""
x, y = Rational(x), Rational(y)
return y**2 + x*y == x**3 + self.a*x + self.b
return EllipticCurve()
# Example usage:
curve = E29()
# One of the known rational points from the discovery
x = 2891195474228537189458255536634
y_coords = curve.get_y_coordinates(x)
# Verify the point lies on the curve
if len(y_coords) > 0:
print(f"Found point: ({x}, {y_coords[0]})")
print(f"Verifying point lies on curve: {curve.is_on_curve(x, y_coords[0])}")
그렇다면 이것이 왜 중요할까요? 이 발견이 중요한 이유는 타원곡선의 랭크가 얼마나 커질 수 있는지에 상한이 있는지 아무도 모르기 때문입니다. 그러한 상한을 찾는 것(또는 상한이 없음을 증명하는 것)은 여전히 수학의 주요 미해결 문제 중 하나로 남아 있습니다. 이번 랭크 29 곡선과 같은 새로운 기록은 상한이 존재하는지에 대해 새로운 통찰을 제공합니다.
타원곡선의 랭크에 상한이 존재함을 증명하는 것은 여러 가지 이유로 필즈상을 받을 만한 기념비적인 업적이 될 것입니다. 이는 7대 밀레니엄 문제 중 하나인 버치-스위너턴다이어 추측과 관련된 근본적인 결과를 해결하게 될 것입니다. 또한 현대 정수론의 Core에 자리한 연결 고리인 L-함수의 대수적 성질과 해석적 성질 사이의 신비로운 관계에 대해 깊은 통찰을 제공할 것입니다. 그러한 상한을 증명하는 데 필요한 기법은 산술기하학에 대한 우리의 이해에 혁명을 일으키고, 정수론의 다른 주요 미해결 문제에 대한 새로운 접근법을 열어 줄 가능성이 큽니다.
Tiny GraphRAG (2부)
1부에서는 GraphRAG의 Core 개념을 보여 주는 최소한의 구현을 만들었습니다. 이제 프로덕션 환경에 더 적합하도록 세 가지 중요한 개선 사항으로 구현을 확장하겠습니다.
- 직렬화된 networkx 그래프를 본격적인 그래프 데이터베이스인 Memgraph로 교체합니다.
- 문서의 자연스러운 구조를 더 잘 포착하기 위해 계층적 커뮤니티 탐지를 추가합니다.
- 동일한 엔터티에 대한 서로 다른 언급을 표준 형태로 귀결시키기 위해 엔터티 명확화를 구현합니다.
이러한 기능의 전체 구현은 저장소의 micro-graphrag 브랜치에서 확인할 수 있습니다. 새로 추가된 내용을 포함하면 확장된 구현은 약 1500줄의 코드에 이릅니다.
Memgraph 구성
Memgraph를 그래프 데이터베이스로 사용하기 위해 docker-compose.yml에 필요한 서비스를 추가하겠습니다.
services:
memgraph:
image: memgraph/memgraph-mage:1.19-memgraph-2.19
container_name: memgraph
ports:
- "7687:7687" # Bolt protocol port
- "7444:7444" # HTTP API port
command: ["--log-level=TRACE", "--query-execution-timeout-sec=0"]
volumes:
- mg_lib:/var/lib/memgraph
lab:
image: memgraph/lab:latest
container_name: memgraph-ui
ports:
- "3000:3000"
depends_on:
- memgraph
environment:
- QUICK_CONNECT_MG_HOST=memgraph
- QUICK_CONNECT_MG_PORT=7687
- QUICK_CONNECT_MG_USER=admin
- QUICK_CONNECT_MG_PASSWORD=admin
volumes:
mg_lib:
이 구성은 다음과 같은 일을 합니다.
- 고급 그래프 알고리즘을 위한 MAGE 확장과 함께 Memgraph 데이터베이스를 설정합니다
- 그래프를 시각화하고 쿼리하기 위한 웹 기반 UI(Memgraph Lab)를 제공합니다
- Docker 볼륨을 통해 영구 저장소를 구성합니다
- 데이터베이스(7687)와 UI(3000) 모두에 필요한 포트를 노출합니다
연결 세부 정보는 GraphConfig 클래스에서 구성합니다.
@dataclass
class GraphConfig:
"""Memgraph connection configuration."""
uri: str = "bolt://localhost:7687"
username: str = "admin"
password: str = "admin"
database: str = "memgraph"
이 설정은 기존의 PostgreSQL/pgvector 서비스를 보완하여 다음을 제공합니다.
- 벡터 임베딩과 검색을 위한 pgvector 기반 PostgreSQL
- 효율적인 그래프 저장과 쿼리를 위한 Memgraph
- 그래프 시각화와 탐색을 위한 웹 UI
이 조합을 통해 GraphRAG 구현에서 벡터 연산과 그래프 연산을 모두 효과적으로 활용할 수 있습니다.
빌드 파이프라인 변경 사항(build.py)
빌드 파이프라인은 향상된 기능을 지원하기 위해 새로운 데이터클래스와 메서드로 업데이트되었습니다. Core 자료 구조는 문서 처리 파이프라인을 더 잘 표현할 수 있도록 확장되었습니다.
@dataclass
class Entity:
"""Graph node with type information."""
id: str
type: str
@dataclass
class Relation:
"""Graph triple representing relationships."""
head: str
relation_type: str
tail: str
@dataclass
class DocumentChunkData:
"""Document chunk with embedding."""
text: str
embedding: Any
@dataclass
class ProcessedDocument:
"""Complete processed document data."""
chunks: List[DocumentChunkData]
entities: List[Entity]
relations: List[Relation]
주요 문서 처리 파이프라인은 엔터티 명확화와 개선된 그래프 구성을 지원하도록 크게 향상되었습니다. 이제 이 과정은 두 번의 패스로 진행됩니다.
- 첫 번째 패스에서는 모든 엔터티 언급을 해당 문맥과 함께 수집합니다
- 두 번째 패스에서는 확정된 표준 엔터티를 사용하여 그래프를 구축합니다
다음은 Core 구현입니다:
def process_document(
filepath: str,
title: Optional[str] = None,
max_chunks: int = -1,
entity_types: List[str] = MIN_ENTITY_TYPES,
relation_types: List[str] = DEFAULT_RELS_LIST,
) -> ProcessedDocument:
"""Process document with entity disambiguation."""
# First pass: collect all entity mentions
all_mentions = []
for chunk_text, _ in page_chunks[:max_chunks]:
extraction = extract_rels(chunk_text, entity_types, relation_types)
for ent in extraction.entities:
all_mentions.append((ent[0], ent[1], chunk_text))
# Resolve entities to canonical forms
disambiguator = EntityDisambiguator(model)
resolved_entities = disambiguator.resolve_entities(all_mentions)
# Map mentions to canonical forms
entity_map = {
m[0]: r[0]
for m, r in zip(all_mentions, resolved_entities)
}
# Second pass: create graph with resolved entities
g = nx.Graph()
for chunk_text, _ in page_chunks[:max_chunks]:
extraction = extract_rels(chunk_text, entity_types, relation_types)
for rel in extraction.relations:
if rel[0] in entity_map and rel[2] in entity_map:
head = entity_map[rel[0]]
tail = entity_map[rel[2]]
g.add_edge(head, tail,
label=rel[1],
source_chunk=chunk_text
)
return g
두 패스 방식을 사용하면 명확화 결정을 내리기 전에 가능한 모든 엔터티 언급을 문맥과 함께 수집하고, 표준 엔터티 형태만 사용하여 깔끔한 그래프 구조를 만들며, 명확화된 엔터티 간의 관계 매핑을 올바르게 유지할 수 있습니다.
이 프로세스는 GraphStore 클래스를 통해 새로운 Memgraph 저장 시스템과 통합되며, 이 클래스가 그래프 데이터의 저장과 조회를 담당합니다. 이렇게 개선된 파이프라인은 문맥을 고려한 중의성 해소로 엔터티 해석을 개선합니다. 또한 중복이 제거된 엔터티로 더 깔끔한 그래프 구조를 만들고, 정규 엔터티 형태로 관계의 정확도를 높이며, Memgraph 통합으로 효율적인 저장과 조회를 제공합니다.
이제 빌드 과정은 엔터티의 변형과 중의성을 처리하면서도 문서의 의미적 관계를 더 잘 포착하는, 더욱 견고한 지식 그래프를 만들어 냅니다. 이렇게 개선된 그래프 구조는 더 정확한 엔터티 관계와 더 잘 정리된 커뮤니티 구조를 제공하므로 로컬 검색과 글로벌 검색 성능을 모두 직접적으로 향상시킵니다.
Memgraph 통합 (graph.py)
원래 구현에서는 직렬화된 networkx 그래프를 pickle 파일로 저장하여 사용했습니다. 이 방식은 시연 용도로는 충분했지만 프로덕션 환경에는 적합하지 않습니다. 이를 머신러닝 워크로드에 최적화된 고성능 그래프 데이터베이스인 Memgraph로 교체합시다.
pickle 기반 저장소를 Memgraph로 모든 그래프 연산을 처리하는 새로운 GraphStore 클래스로 교체하겠습니다. 이 클래스는 그래프 데이터를 저장하고 조회하기 위한 깔끔한 인터페이스를 제공합니다. 엔터티와 관계를 추가하고, 그래프 구조를 쿼리하고, 문서별 하위 그래프를 관리하는 메서드도 갖추고 있습니다. Memgraph 백엔드는 최적화된 그래프 순회 알고리즘과 병렬 쿼리 기본 지원 덕분에 성능을 크게 향상시켜 줍니다. 다음은 Core 구현입니다:
class GraphStore:
"""Handles graph storage and retrieval using Memgraph."""
def __init__(self, config: GraphConfig | None = None):
self.driver = GraphDatabase.driver(
(config or GraphConfig()).uri,
auth=((config or GraphConfig()).username,
(config or GraphConfig()).password)
)
def store_graph(
self,
doc_id: int,
entities: List[Tuple[str, str]],
relations: List[Tuple[str, str, str]],
source_chunk: str,
) -> None:
"""Store entities and relations in Memgraph."""
with self.driver.session() as session:
# Store entities with vector embeddings
for text, label in entities:
query = """
MERGE (n:Entity {
content: $content,
label: $label,
doc_id: $doc_id
})
"""
session.run(query, {
"content": text,
"label": label,
"doc_id": doc_id
})
# Store relations with source context
for head, rel_type, tail in relations:
query = """
MATCH (h:Entity {content: $head}),
(t:Entity {content: $tail})
CREATE (h)-[:RELATES {
type: $rel_type,
doc_id: $doc_id,
source_chunk: $source_chunk
}]->(t)
"""
session.run(query, {
"head": head,
"tail": tail,
"rel_type": rel_type,
"doc_id": doc_id,
"source_chunk": source_chunk
})
계층적 커뮤니티 (communities.py)
원래의 커뮤니티 탐지 구현은 각 엔터티가 정확히 하나의 커뮤니티에만 속하는 평면 구조를 사용했습니다. 이 방식은 주제들이 자연스럽게 계층적 관계를 이루는 대규모 문서에서는 한계가 될 수 있습니다. 각 엔터티가 정확히 하나의 커뮤니티에만 속하던 이전의 평면 구현과 달리, 이 방식은 여러 수준의 커뮤니티를 만들며 큰 커뮤니티가 더 작은 하위 커뮤니티를 포함합니다.
예를 들어 오바마에 관한 위키백과 문서를 분석하면 다음과 같은 계층 구조를 얻을 수 있습니다:
- 수준 0: 주요 생애 시기
- 정치 경력 커뮤니티
- 수준 1: 대통령 임기
- 첫 번째 임기 커뮤니티
- 수준 2: 주요 사건
- 금융 위기 대응
- 의료 개혁
- 빈 라덴 작전
- 두 번째 임기 커뮤니티
- 수준 2: 주요 사건
- 기후 변화 대응 조치
- 이란 핵 합의
- 쿠바와의 관계
- 수준 1: 대통령 취임 이전 경력
- 상원 경력 커뮤니티
- 주 상원 커뮤니티
- 개인 생활 커뮤니티
- 레벨 1: 교육
- 컬럼비아 대학교
- 하버드 로스쿨
- 레벨 1: 어린 시절
- 하와이 배경
- 시카고 지역사회 활동
HierarchicalCommunity 클래스는 이 트리의 각 커뮤니티 노드를 나타냅니다. 이 클래스는 다음을 저장합니다.
- 해당 커뮤니티에 포함된 트리플(엔티티 관계)
- 바로 아래 레벨의 하위 커뮤니티 목록
- 커뮤니티 내용에 대한 선택적 요약
- 계층 구조에서의 레벨/깊이
build_hierarchical_communities 함수는 다음과 같은 방식으로 이 트리 구조를 재귀적으로 구축합니다.
- 각 서브그래프에서 커뮤니티 탐지를 실행합니다
- 해당 커뮤니티의 관계 트리플을 추출합니다
- 각 커뮤니티 내에서 하위 커뮤니티를 재귀적으로 탐지합니다
- 최대 깊이 또는 최소 커뮤니티 크기에 도달하면 중단합니다
이러한 계층적 접근 방식을 사용하면 문서 구조와 엔티티 간 관계를 다양한 규모에서 더 세밀하게 분석할 수 있습니다. 위의 오바마 예시에서 이 방식이 넓은 생애 시기와 대통령 재임 기간의 구체적인 사건 및 업적을 모두 자연스럽게 포착하는 것을 확인할 수 있습니다.
@dataclass
class HierarchicalCommunity:
"""Represents a hierarchical community structure."""
triples: List[Tuple[str, str, str, str]]
subcommunities: List["HierarchicalCommunity"]
summary: Optional[str] = None
level: int = 0
def build_hierarchical_communities(
g: nx.Graph,
max_levels: int = 3,
min_size: int = 5
) -> CommunityResult:
"""Build hierarchical communities from a graph."""
def build_level(subgraph: nx.Graph, level: int) -> List[HierarchicalCommunity]:
if level >= max_levels or len(subgraph) < min_size:
return []
communities = []
coms = algorithms.leiden(subgraph)
for com in coms.communities:
community_subgraph = subgraph.subgraph(com)
# Extract triples for this community
triples = [
(s, data["label"], t, data["source_chunk"])
for s, t, data in community_subgraph.edges(data=True)
]
# Recursively build subcommunities
subcommunities = build_level(community_subgraph, level + 1)
communities.append(HierarchicalCommunity(
triples=triples,
subcommunities=subcommunities,
level=level
))
return communities
return CommunityResult(
communities=build_level(g, 0),
node_community_map=build_community_map(g)
)
이러한 계층적 접근 방식은 문서 구조를 다양한 세분성 수준에서 다중 규모로 분석할 수 있게 하여 몇 가지 핵심적인 이점을 제공합니다. 주제는 “정치“에서 “대통령 선거 운동“으로, 다시 “예비 선거“로 이어지는 것처럼 의미 있는 계층 구조로 자연스럽게 정리됩니다. 이 접근 방식은 질의를 가장 적절한 세부 수준에 맞춰 연결하므로 유연한 질의가 가능합니다. 또한 문서 구조 안에서 넓은 주제와 구체적인 세부 사항을 모두 포착할 수 있도록 요약 생성을 개선합니다.
엔티티 중의성 해소 (dis.py)
기존 구현에서는 엔티티를 정확한 문자열 일치로만 처리했기 때문에, 같은 엔티티를 가리키는 서로 다른 표현(예: “Barack Obama“와 “President Obama”) 사이의 연결을 놓쳤습니다. 벡터 유사도와 문맥 단서를 활용한 엔티티 중의성 해소를 추가해 봅시다.
다음은 벡터 임베딩과 문맥 정보를 사용하여 같은 엔티티에 대한 서로 다른 언급을 하나의 정규 형태로 통합하는 새로운 엔티티 중의성 해소 시스템입니다.
- 각 엔티티 언급은 sentence-transformers를 사용하여 주변 문맥과 함께 임베딩됩니다.
- 모든 언급 임베딩 간의 유사도 행렬을 계산합니다
- 임계값(0.85)을 넘는 유사도 점수를 기준으로 언급을 클러스터링합니다
- 각 클러스터마다 빈도와 완전성을 기준으로 정규 형태가 선택됩니다
- 엔티티 유형은 클러스터에 나타나는 유형 중 가장 구체적인 유형을 택하는 방식으로 결정됩니다
이 시스템은 다음과 같은 경우를 처리합니다:
- 이름 변형 (“Barack Obama” 대 “President Obama”)
- 직함 및 경칭 (“Dr. Smith” 대 “John Smith”)
- 약어 및 두문자어 (“United Nations” 대 “UN”)
- 문맥적 지칭 (특정 인물을 가리키는 “the president”)
아래 구현은 Core 동음이의어 해소(disambiguation) 로직을 보여 줍니다:
class EntityDisambiguator:
def __init__(self, embedding_model: SentenceTransformer):
self.model = embedding_model
self.mention_cache: Dict[str, np.ndarray] = {}
def get_mention_embedding(self, mention: str, context: str) -> np.ndarray:
"""Get embedding for entity mention with context."""
key = f"{mention}::{context}"
if key not in self.mention_cache:
# Combine mention with surrounding context
text = f"{mention} | {context}"
self.mention_cache[key] = self.model.encode(text)
return self.mention_cache[key]
def resolve_entities(
self,
mentions: List[Tuple[str, str, str]] # (text, type, context)
) -> List[Tuple[str, str]]: # (canonical_form, type)
"""Resolve entity mentions to canonical forms."""
resolved = []
clusters: Dict[str, List[int]] = {}
# Compute similarity matrix
embeddings = [
self.get_mention_embedding(m[0], m[2])
for m in mentions
]
similarities = cosine_similarity(embeddings)
# Cluster similar mentions
for i in range(len(mentions)):
assigned = False
for canonical, cluster in clusters.items():
# Check similarity with existing cluster
mean_sim = np.mean([similarities[i][j] for j in cluster])
if mean_sim > 0.85: # Similarity threshold
cluster.append(i)
assigned = True
break
if not assigned:
# Create new cluster
clusters[mentions[i][0]] = [i]
# Select canonical forms and resolve types
for canonical, cluster in clusters.items():
# Use most frequent entity type in cluster
types = [mentions[i][1] for i in cluster]
resolved.append((canonical, mode(types)))
return resolved
중의성 해소기는 문서 처리 파이프라인에 다음과 같이 통합됩니다:
def process_document(
filepath: str,
title: Optional[str] = None,
max_chunks: int = -1,
entity_types: List[str] = MIN_ENTITY_TYPES,
relation_types: List[str] = DEFAULT_RELS_LIST,
) -> ProcessedDocument:
"""Process document with entity disambiguation."""
# First pass: collect all entity mentions
all_mentions = []
for chunk_text, _ in page_chunks[:max_chunks]:
extraction = extract_rels(chunk_text, entity_types, relation_types)
for ent in extraction.entities:
all_mentions.append((ent[0], ent[1], chunk_text))
# Resolve entities to canonical forms
disambiguator = EntityDisambiguator(model)
resolved_entities = disambiguator.resolve_entities(all_mentions)
# Map mentions to canonical forms
entity_map = {
m[0]: r[0]
for m, r in zip(all_mentions, resolved_entities)
}
# Second pass: create graph with resolved entities
g = nx.Graph()
for chunk_text, _ in page_chunks[:max_chunks]:
extraction = extract_rels(chunk_text, entity_types, relation_types)
for rel in extraction.relations:
if rel[0] in entity_map and rel[2] in entity_map:
head = entity_map[rel[0]]
tail = entity_map[rel[2]]
g.add_edge(head, tail,
label=rel[1],
source_chunk=chunk_text
)
return g
결론
이러한 개선은 시스템의 기능을 크게 향상시키지만, 상당한 계산 비용이 따르는 것도 사실입니다. Memgraph를 사용하면 직렬화된 그래프에 비해 더 많은 메모리가 필요하지만, 이러한 트레이드오프 덕분에 확장성이 더 좋아집니다. 계층적 커뮤니티 탐지 과정은 단순한 평면 클러스터링 방식보다 계산량이 더 많습니다. 또한 엔티티 해석에 필요한 벡터 유사도 비교는 문서 수집 과정에서 추가적인 처리 오버헤드를 발생시킵니다.
이러한 개선이 제공하는 이점은 대체로 추가적인 자원 사용을 정당화합니다. 쿼리 성능이 극적으로 향상되며, Memgraph 덕분에 그래프 쿼리가 이전 방식보다 10배에서 100배까지 빨라집니다. 계층적 커뮤니티 구조와 더 정확한 엔티티 중의성 해소가 결합되어 답변의 품질이 크게 향상됩니다. 무엇보다 중요한 점은, 개선된 아키텍처 덕분에 시스템이 이전보다 훨씬 더 큰 문서와 더 복잡한 지식 그래프를 처리할 수 있도록 효과적으로 확장된다는 것입니다.
이러한 개선으로 우리 구현이 프로덕션 환경에 더 적합해지기는 했지만, 원래의 GraphRAG 논문과 마찬가지로 내부에서는 여전히 “그래프를 넣으면 마법이 나온다“는 식의 일이 꽤 많이 일어나고 있다는 점을 기억해 둘 필요가 있습니다. Memgraph로 영속성을 개선하고, 커뮤니티 탐지를 더 똑똑하게 만들고, 엔티티 처리를 더 견고하게 했지만, Core만 놓고 보면 여전히 본질적으로 여러 언어 모델을 그래프에 던져 넣고 서로 잘 어울리기를 바라는 것에 불과합니다. 때로는 잘 협력하고, 때로는 그렇지 않으며, 때로는 “우연한 유능함“이라고밖에 표현할 수 없는 방식으로 놀라울 만큼 좋은 결과를 내기도 합니다.
Tiny GraphRAG (1부)
원래 Microsoft가 고안한 GraphRAG 알고리즘을 1000줄 정도의 작은 구현으로 만들어 보겠습니다. 밋업에서 이 알고리즘에 대한 이야기를 꾸준히 듣지만, 실제로 사용하거나 구현하는 사람보다 이야기하는 사람이 몇 자릿수는 더 많은 것 같습니다. 아마 참조 구현이 거대하고 꽤 복잡하기 때문일 것입니다. 그러니 이를 하나씩 뜯어보고, 이 접근법을 둘러싼 과대광고에 실제로 가치가 있는지 살펴봅시다.
배경을 조금 설명하자면, 나이브 RAG는 주로 벡터 유사도 검색에 의존하여 외부 정보로 LLM 출력을 보강하는 기본적인 접근법입니다. 이 과정은 문서를 텍스트로 변환하고, 그 텍스트를 청크로 나눈 뒤, 이 청크들을 비슷한 의미가 비슷한 벡터 위치로 표현되는 벡터 공간에 임베딩하는 단계로 이루어집니다. 사용자가 쿼리를 제출하면 그 쿼리도 같은 벡터 공간에 임베딩되고, 벡터 위치가 가장 가까운 텍스트 청크들이 검색되어 원래 쿼리와 함께 LLM의 컨텍스트 윈도에 추가됩니다.
GraphRAG는 단순한 의미 검색을 넘어 문서의 그래프 기반 인덱스를 사용하는 또 다른 구조화된 접근법입니다. 핵심 아이디어는 LLM을 사용해 원본 문서로부터 지식 그래프를 구축하고, 그 그래프 안에서 밀접하게 관련된 엔티티들의 커뮤니티를 탐지한 다음, 이 커뮤니티들에 대한 요약을 생성하는 것입니다. 이렇게 하면 특정 엔티티에 대한 로컬 쿼리와 문서 전체에 걸친 글로벌 분석 모두에 활용할 수 있는 또 다른 구조화된 인덱스가 만들어집니다. 일부 작업에서는 이 방식이 나이브 RAG보다 더 좋은 성능을 낼 수 있습니다.
상용 LLM 제공자에 의존하지 않고 완전히 로컬에서 실행되는 작은 버전을 만들어 보겠습니다. 우리 시스템은 다음을 사용합니다:
- 벡터 저장소로 Postgres + pgvector
- 임베딩에 sentence-transformers
- Core 언어 모델로 Meta’s Llama 3.2-3B를 사용합니다
- 엔티티 추출에 GLiNER
- 관계 추출에 GLiREL
- 그래프 연산에 networkx
(Memgraph나 Neo4j 같은) 그래프 데이터베이스를 사용하는 것도 간단하지만, 단순함을 위해 networkx 그래프 데이터를 직렬화하여 디스크에 저장하기만 하겠습니다.
소스 코드는 MIT 라이선스로 Github에 공개되어 있습니다.
Core 아이디어
나이브 RAG를 할 때는 보통 관련 컨텍스트를 찾기 위해 벡터 유사도에 의존합니다. 이 방식은 단순한 경우에는 잘 작동하지만 중요한 맥락적 관계를 놓칠 수 있습니다. 예를 들어, sentence-transformers 라이브러리를 사용한 기본적인 벡터 유사도 비교를 살펴봅시다.
from sentence_transformers import SentenceTransformer
model = SentenceTransformer('all-MiniLM-L6-v2')
sentence1 = "I love programming"
sentence2 = "I enjoy writing code"
embedding1 = model.encode(sentence1)
embedding2 = model.encode(sentence2)
similarity = model.similarity(embedding1, embedding2)
print(f"Similarity score: {similarity:.4f}")
이 방식은 의미적으로 유사한 콘텐츠를 찾아낼 수 있지만, 몇 가지 핵심적인 한계가 있습니다. 첫째, 문서 안에 존재하는 엔터티와 개념 사이의 풍부한 관계를 포착하지 못합니다. 둘째, 흔히 “로컬 컨텍스트 문제“라고 부르는 상황에 취약합니다. 이는 관련 정보가 질의와 직접적인 의미적 유사성을 갖지 않은 채 한 문서의 여러 부분이나 여러 문서에 흩어져 있을 수 있는 문제를 말합니다. 예를 들어, 어떤 약물의 부작용을 이해하려면 한 섹션에 있는 화학 성분에 관한 정보와 다른 섹션에 서술된 환자 경과를 연결해야 할 수 있는데, 이러한 구절들은 부작용에 관한 질의와 의미적으로 유사하지 않을 수도 있습니다. GraphRAG는 엔터티와 개념 사이의 관계를 명시적으로 표현하는 구조화된 지식 그래프를 구축하여 이러한 한계를 해결합니다. 이를 통해 개별 조각이 질의와 의미적으로 유사하지 않더라도 이러한 연결을 추적하고 관련 컨텍스트를 모을 수 있습니다. GraphRAG에는 로컬 검색과 글로벌 검색이라는 두 가지 모드가 있습니다.
로컬 검색은 엔터티 중심의 질의에 최적화되어 있으며, 지식 그래프 안의 특정 엔터티와 그 관계에 초점을 맞추어 동작합니다. 로컬 검색은 지식 그래프의 구조화된 데이터와 입력 문서의 비구조화된 데이터를 결합하므로, “캐모마일의 치유 효능은 무엇입니까?“와 같이 특정 엔터티에 관한 질문에 특히 효과적입니다. 이 과정은 사용자 질의와 선택적인 대화 기록을 입력받는 것으로 시작하며, 이어서 지식 그래프에서 의미적으로 관련된 엔터티를 식별합니다. 그런 다음 연결된 엔터티, 관계, 엔터티 공변량, 커뮤니티 보고서, 그리고 원본 문서에서 가져온 관련 텍스트 청크를 포함한 관련 정보를 추출합니다. 이후 이 정보에 우선순위를 매기고 컨텍스트 윈도에 들어가도록 필터링한 다음, 필터링된 컨텍스트를 사용해 응답을 생성합니다.
반면 글로벌 검색은 데이터셋 전체에 걸친 분석을 위해 설계되었으며, 데이터셋 전체에서 정보를 집계해야 하는 질의를 더 잘 처리합니다. 글로벌 검색은 더 폭넓은 주제와 패턴을 식별하는 데 뛰어나므로, “데이터에서 가장 중요한 주제 5가지는 무엇입니까?“와 같은 상위 수준의 질문에 답하는 데 가장 적합합니다. 이 과정은 맵리듀스 방식을 사용하는데, 맵 단계에서는 커뮤니티 보고서를 텍스트 청크로 나누고 중요도 점수가 매겨진 요점이 담긴 중간 응답을 생성합니다. 그런 다음 리듀스 단계에서 가장 중요한 요점을 걸러 내고 집계하여 최종적인 종합 응답을 만들어 냅니다.
두 방식의 핵심적인 차이는, 로컬 검색이 특정 엔터티 기반의 추론에 초점을 맞추는 반면, 글로벌 검색은 지식 그래프의 커뮤니티 구조와 미리 요약된 의미 클러스터를 활용하여 데이터셋 수준의 더 폭넓은 통찰을 제공한다는 점입니다.
그래프 구축하기
GraphRAG는 문서 콘텐츠에 대한 그래프 기반 인덱스를 구축하는 방식으로 RAG에 새롭게 접근합니다. 주요 단계는 네 가지입니다.
-
그래프 구축: 먼저 원본 문서를 처리하여 엔터티와 관계를 추출하고, 콘텐츠를 지식 그래프로 표현합니다. 이 작업에는 다음이 사용됩니다.
- 텍스트 청킹과 전처리
- LLM을 사용한 엔터티 및 관계 추출
- 추출된 요소를 이용한 그래프 구축
-
커뮤니티 탐지: 다음으로 시스템은 라이덴(Leiden) 알고리즘을 사용하여 그래프에서 서로 밀접하게 관련된 엔터티들의 커뮤니티를 탐지합니다.
-
커뮤니티 요약: 탐지된 각 커뮤니티에 대해, 그 커뮤니티 안의 핵심 엔터티와 관계를 설명하는 자연어 요약을 생성합니다. 이를 통해 각 클러스터에 담긴 주제와 개념을 상위 수준에서 개괄할 수 있습니다.
-
맵리듀스: 글로벌 검색 질의에는 맵리듀스 방식을 사용합니다. 먼저 각 커뮤니티 요약에 대한 응답을 생성하고(맵 단계), 이어서 이 응답들을 결합하고 종합하여(리듀스 단계) 그래프 전체의 정보를 아우르는 포괄적인 답변을 만들어 냅니다.
예제 데이터셋
이 예제에서는 버락 오바마에 관한 위키백과 문서 모음을 사용하여 시스템이 주제별 클러스터를 어떻게 자동으로 탐지하는지 보여 드리겠습니다. 라이덴 커뮤니티 탐지 알고리즘은 엔터티-관계 그래프를 분석하여 일관된 주제를 나타내는, 조밀하게 연결된 부분 그래프를 식별합니다. 예를 들어, 오바마의 전기를 처리하면 다음과 같은 클러스터를 자동으로 탐지합니다.
- 유년기와 교육: 하와이에서 보낸 어린 시절, 컬럼비아 대학교와 하버드 로스쿨에서 받은 교육에 관한 엔터티
- 정치 경력: 주 상원의원, 연방 상원의원 시절과 대통령 선거 운동
- 대통령 재임기: 주요 정책, 행정 조치, 행정부 관료
- 퇴임 이후: 출판 계약, 강연 활동, 오바마 재단 활동
그런 다음 각 클러스터는 그 안의 엔터티와 관계를 분석하여 요약됩니다. 예를 들어, 유년기 클러스터의 요약은 다음과 같을 수 있습니다. “이 섹션은 버락 오바마의 하와이와 인도네시아에서의 성장 과정, 컬럼비아 대학교에서의 정치학 학부 과정, 그리고 하버드 로 리뷰(Harvard Law Review)의 편집장을 지낸 하버드에서의 법학 학위를 다룹니다.”
시스템은 주제를 수동으로 지정할 필요 없이 엔터티 간 연결의 밀도를 기반으로 클러스터 경계를 자동으로 결정합니다. 이러한 유기적인 클러스터링은 서로 떨어져 있는 청크들에 걸쳐 문서의 자연스러운 주제 구조를 포착하는 데 도움이 됩니다.
데이터 모델 (db.py)
SQLAlchemy 데이터 모델을 사용하여 Postgres에 대한 영속성을 정의하겠습니다. Document 모델은 원본 문서 내용과 메타데이터를 저장합니다. 내용은 원시 텍스트로 저장되며, 선택적으로 제목과 타임스탬프를 가집니다.
class Document(Base):
"""Represents a document in the database."""
__tablename__ = "documents"
id = Column(Integer, primary_key=True)
content = Column(Text, nullable=False)
title = Column(String(256))
created_at = Column(DateTime(timezone=True), server_default=func.now())
updated_at = Column(DateTime(timezone=True), onupdate=func.now())
# Relationships
chunks = relationship("DocumentChunk", back_populates="document")
communities = relationship("Community", back_populates="document")
DocumentChunk 모델은 효율적인 의미 검색을 위해 문서의 조각을 벡터 임베딩과 함께 저장합니다. 각 청크는 원시 텍스트 내용, 원본 문서에서의 위치(chunk_index), 그리고 밀집 벡터 임베딩을 포함합니다. 이 모델은 임베딩에 대한 빠른 근사 최근접 이웃 검색을 위해 HNSW(Hierarchical Navigable Small World) 인덱싱을 사용하고, 내용에 대한 전문 검색을 위해 GIN 인덱스를 사용합니다. 이를 통해 임베딩을 이용한 의미 유사도 검색과 텍스트에 대한 키워드 기반 검색이 모두 가능해집니다.
class DocumentChunk(Base):
"""Represents a chunk of a document with vector embedding."""
__tablename__ = "document_chunks"
id = Column(Integer, primary_key=True)
document_id = Column(Integer, ForeignKey("documents.id"), nullable=False)
content = Column(Text, nullable=False)
chunk_index = Column(Integer, nullable=False)
embedding = mapped_column(Vector(384), nullable=False) # Vector embedding
# Indexes for efficient search
__table_args__ = (
Index(
"ix_document_chunks_embedding",
embedding,
postgresql_using="hnsw",
postgresql_with={"m": 16, "ef_construction": 64},
postgresql_ops={"embedding": "vector_cosine_ops"},
),
Index(
"ix_document_chunks_content_fts", # Full-text search index
text("to_tsvector('english', content)"),
postgresql_using="gin",
),
)
Community 모델은 문서에서 탐지된 관련 엔터티들의 클러스터를 나타냅니다. 각 커뮤니티는 요약 설명(content)과 유사도 검색을 위한 벡터 임베딩을 가지며, 구성원 노드 ID를 JSON 문자열로 저장합니다. DocumentChunk와 마찬가지로, 효율적인 유사도 검색을 위해 임베딩에 HNSW 인덱싱을 사용합니다. 커뮤니티는 원본 문서와 다시 연결되며, 주제적으로 관련된 엔터티 그룹을 탐색할 수 있게 해 줍니다.
class Community(Base):
"""Represents a community of related entities."""
__tablename__ = "communities"
id = Column(Integer, primary_key=True)
document_id = Column(Integer, ForeignKey("documents.id"), nullable=False)
content = Column(Text, nullable=False) # Community summary
embedding = mapped_column(Vector(384), nullable=False)
nodes = Column(Text, nullable=False) # JSON string of node IDs
# Indexes
__table_args__ = (
Index(
"ix_communities_embedding",
embedding,
postgresql_using="hnsw",
postgresql_ops={"embedding": "vector_cosine_ops"},
),
)
Summary 모델은 커뮤니티에 대해 생성된 요약을 저장합니다. 각 요약은 텍스트 내용 필드와 유사도 검색을 위한 벡터 임베딩을 가집니다. 다른 모델들과 마찬가지로, 효율적인 유사도 검색을 위해 임베딩에 HNSW 인덱싱을 사용하며, 내용에 대해서는 전문 검색 인덱스도 사용합니다.
class Summary(Base):
"""Represents a document summary."""
__tablename__ = "summaries"
id = Column(Integer, primary_key=True)
document_id = Column(Integer, ForeignKey("documents.id"), nullable=False)
content = Column(Text, nullable=False)
embedding = mapped_column(Vector(384), nullable=False)
# Indexes
__table_args__ = (
Index(
"ix_summaries_embedding",
embedding,
postgresql_using="hnsw",
postgresql_ops={"embedding": "vector_cosine_ops"},
),
Index(
"ix_summaries_content_fts",
text("to_tsvector('english', content)"),
postgresql_using="gin",
),
)
문서 처리 파이프라인 (build.py)
그래프 처리 파이프라인의 최상위는 build.py에서 시작하며, 이 파일은 텍스트 소스로부터 벡터 인덱스와 지식 그래프를 구축하는 작업을 담당합니다. 이 파일은 여러 Core 함수를 호출합니다.
process_document- 문서 파일 경로를 받아 텍스트를 청크로 나누고, 엔터티와 관계를 추출하고, 지식 그래프를 구축하는 방식으로 문서를 처리합니다. 임베딩이 포함된 청크 단위 문서와 구축된 그래프를 모두 반환합니다.chunk_document- 경계를 넘어 문맥을 유지하기 위해 청크 사이에 일부 겹침을 두고, 문서를 크기를 설정할 수 있는 겹치는 텍스트 조각들로 분할합니다. 텍스트 청크의 리스트를 반환합니다.build_communities- 커뮤니티 탐지 알고리즘을 사용하여 지식 그래프를 분석하고 밀접하게 관련된 엔터티들의 클러스터를 탐지합니다. 핵심 정보를 포착하기 위해 각 커뮤니티에 대한 요약을 생성합니다. 커뮤니티 할당 결과와 요약을 반환합니다.extract_rels- 규칙 기반 패턴과 LLM 추출을 함께 사용해 텍스트 청크를 처리하고 엔티티 간 관계를 식별합니다. 추출된 관계의 목록을 엔티티 쌍 및 관계 유형과 함께 반환합니다.
def store_document(
filepath: str,
engine: Engine,
title: Optional[str] = None,
max_chunks: int = -1,
) -> Tuple[int, str]:
"""Store document in database and save graph."""
session_local = sessionmaker(bind=engine)
with session_local() as session:
# Process document
chunks, graph = process_document(filepath, title, max_chunks)
# Store document
doc = Document(content=open(filepath).read(), title=title)
session.add(doc)
session.flush()
# Store chunks with embeddings
for chunk_text, embedding in chunks:
chunk = DocumentChunk(
document_id=doc.id,
content=chunk_text,
embedding=embedding,
chunk_index=0
)
session.add(chunk)
# Build and store communities
community_result = build_communities(graph)
# Save graph to disk
graph_path = f"graphs/{doc.id}_graph.pkl"
with open(graph_path, "wb") as f:
pickle.dump(graph, f)
session.commit()
return doc.id, graph_path
process_document 함수는 청크에서 지식 그래프 엔티티(노드와 관계)를 구성하는 일을 담당합니다. 이들은 networkx 무방향 Graph 자료 구조인 전역 그래프에 추가됩니다. 생성되는 각 트리플의 속성으로 원본 텍스트의 출처를 저장하며, 이는 마지막의 로컬 검색 메서드에서 사용됩니다.
def process_document(
filepath: str,
title: Optional[str] = None,
max_chunks: int = -1,
entity_types: List[str] = MIN_ENTITY_TYPES,
relation_types: List[str] = DEFAULT_RELS_LIST,
) -> Tuple[List[Tuple[str, Any]], nx.Graph]:
"""Process a document and return chunks and graph."""
# Read and chunk document
page_text = open(filepath).read()
page_chunks = chunk_document(page_text)
# Build graph
g = nx.Graph()
for chunk_text, _embedding in tqdm(page_chunks[:max_chunks]):
extraction = extract_rels(chunk_text, entity_types, relation_types)
for ent in extraction.entities:
g.add_node(ent[0], label=ent[1])
for rel in extraction.relations:
g.add_edge(rel[0], rel[2], label=rel[1], source_chunk=chunk_text)
return page_chunks, g
청킹(chunking.py)
청킹 알고리즘은 문장 경계와 의미적 일관성을 유지하면서 입력 문서를 서로 겹치는 세그먼트로 분할합니다. 텍스트를 한 문장씩 처리하면서 지정된 크기 제한(기본값 200자)에 도달할 때까지 문장을 청크에 누적한 다음, 문장 트랜스포머 모델을 사용해 각 청크의 밀집 벡터 임베딩을 생성합니다. 청크 간 문맥의 연속성을 유지하기 위해 이전 청크 문장의 일부를 다음 청크로 넘겨주는 오버랩 메커니즘(기본값 50자)을 구현합니다. 이 오버랩은 청크를 가로지르는 관계를 포착하는 데 도움이 되며, 청크 경계에서 문맥이 손실되지 않도록 보장합니다. 이 알고리즘은 텍스트 청크와 그에 대응하는 임베딩을 함께 담은 튜플의 목록을 반환하며, 이는 이후 유사도 검색과 지식 그래프 구성에 사용됩니다.
def chunk_document(
text: str,
chunk_size: int = 200,
overlap: int = 50
) -> List[Tuple[str, npt.NDArray[np.float32]]]:
"""Split document into overlapping chunks with embeddings."""
sentences = [s.strip() for s in text.split(".") if s.strip()]
chunks = []
current_chunk: List[str] = []
current_length = 0
for sentence in sentences:
sentence_length = len(sentence)
if current_length + sentence_length > chunk_size and current_chunk:
# Create chunk and get embedding
chunk_text = ". ".join(current_chunk) + "."
embedding = model.encode(chunk_text, convert_to_numpy=True)
chunks.append((chunk_text, embedding))
# Handle overlap
overlap_chunk = []
overlap_size = 0
for s in reversed(current_chunk):
if overlap_size + len(s) <= overlap:
overlap_chunk.insert(0, s)
overlap_size += len(s)
current_chunk = overlap_chunk
current_length = overlap_size
current_chunk.append(sentence)
current_length += sentence_length
return chunks
엔티티 및 관계 추출(extract.py)
추출 파이프라인은 엔티티 및 관계 추출을 위해 GLiNER와 GLiREL 모델을 spaCy 워크플로에 통합합니다. GLiNER는 개체명 인식을 담당하고, GLiREL은 해당 엔티티 간의 관계를 추출합니다. 더 나은 성능을 위해 GPU 가속을 사용하도록 파이프라인을 구성하며, 매개변수를 통해 엔티티 유형(예: Person, Organization)과 관계 유형(예: occupation, place of birth )을 모두 사용자 정의할 수 있게 합니다. Core 추출 로직은 두 가지 핵심 함수로 구현되어 있습니다:
def nlp_model(threshold: float, entity_types: tuple[str], device: str = DEVICE):
"""Instantiate a spacy model with GLiNER and GLiREL components."""
custom_spacy_config = {
"gliner_model": "urchade/gliner_mediumv2.1",
"chunk_size": 250,
"labels": entity_types,
"style": "ent",
"threshold": threshold,
"map_location": device,
}
spacy.require_gpu() # type: ignore
nlp = spacy.blank("en")
nlp.add_pipe("gliner_spacy", config=custom_spacy_config)
nlp.add_pipe("glirel", after="gliner_spacy")
return nlp
그리고 extract_rels 메서드는 텍스트 입력과 함께 엔티티 및 관계 유형 설정을 받아 NLP 파이프라인으로 처리하고, 식별된 엔티티와 그 관계를 모두 담은 구조화된 추출 결과를 반환합니다. 이 메서드는 신뢰도 임계값을 적용해 품질이 낮은 관계 매칭을 걸러 내므로, 신뢰도가 높은 관계만 최종 출력에 포함됩니다.
def extract_rels(
text: str,
entity_types: List[str],
relation_types: List[str],
threshold: float = 0.75,
) -> ExtractionResult:
"""Extract entities and relations from text."""
nlp = nlp_model(threshold, tuple(entity_types))
docs = list(nlp.pipe([(text, {"glirel_labels": relation_types})]))
relations = docs[0][0]._.relations
# Extract entities with their types
ents = [(ent.text, ent.label_) for ent in docs[0][0].ents]
# Extract relations above threshold
rels = [
(item["head_text"], item["label"], item["tail_text"])
for item in relations
if item["score"] >= threshold
]
return ExtractionResult(entities=ents, relations=rels)
GLiNER는 텍스트에서 엔티티를 식별할 수 있는 트랜스포머 기반 개체명 인식 모델입니다. 사전 정의된 엔티티 유형으로 제한되는 기존 NER 모델(spaCy의 모델 등)이나 상당한 컴퓨팅 자원을 요구하는 LLM 기반 모델과 달리, GLiNER는 높은 성능을 유지하면서도 자원 효율이 더 높은 해법을 제공합니다. 양방향 트랜스포머 인코더를 사용해 텍스트와 엔티티 유형을 병렬로 처리하며, NER을 잠재 공간에서 엔티티 유형 임베딩과 텍스트 스팬 표현 간의 매칭 문제로 다룹니다. 훨씬 작은 모델(매개변수 0.3B개)임에도 불구하고, 다양한 NER 벤치마크의 제로샷 평가에서 ChatGPT와 파인튜닝된 LLM을 모두 능가합니다.
최소한의 기본 엔티티 어노테이션 세트가 제공되지만, 선택적으로 재정의할 수 있습니다.
MIN_ENTITY_TYPES = [
"Person",
"Organization",
"Location",
"Product",
"Concept",
]
명명된 관계 인식(rel_types.py)
GLiREL(Generalist and Lightweight model for Relation Extraction)은 특정 관계 유형에 대한 사전 학습 없이도 텍스트 내 엔티티 간의 관계를 분류할 수 있는 제로샷 관계 추출 모델입니다. spaCy 파이프라인에서 GLiNER와 함께 작동하여 탐지된 엔티티 간의 의미적 관계를 식별하며, 임계값 기반 필터링을 가능하게 하는 신뢰도 점수를 제공합니다. 이 모델은 경량 아키텍처를 유지하면서도 새로운 관계 유형을 즉석에서 처리할 수 있어 특히 효율적입니다.
관계 인식 시스템은 제약이 없는 자유 형식의 관계를 사용해 엔티티 간의 의미적 관계를 정의합니다. 다음과 같습니다.
DEFAULT_RELS = [ "created", "author", "location", "place of birth", "occupation" ]
또는 NER 레이블을 사용해 생성될 수 있는 관계의 유형을 제한하는 유형 제약을 지정할 수도 있습니다.
DEFAULT_RELS = {
"created": {"allowed_head": ["Person"], "allowed_tail": ["Organization"]},
"author": {"allowed_head": ["Person"], "allowed_tail": ["Document"]},
"location": {"allowed_head": ["Location"], "allowed_tail": ["Location"]},
"place of birth": {"allowed_head": ["Person"], "allowed_tail": ["Location"]},
"occupation": {"allowed_head": ["Person"], "allowed_tail": ["Concept"]},
...
}
커뮤니티 분할(communities.py)
Leiden 알고리즘은 대규모 네트워크에서 커뮤니티를 찾는 그래프 커뮤니티 탐지 방법으로, 이전의 Louvain 알고리즘을 개선한 것입니다. 이 알고리즘은 특히 잘 연결된 커뮤니티를 보장할 수 있다는 점에서 주목할 만하며, 이 덕분에 문서 분석을 위한 GraphRAG 접근 방식에 이상적입니다. 이 알고리즘은 그래프를 모듈식 커뮤니티로 분할하는 방식으로 동작하며, 각 커뮤니티 내의 노드들은 다른 커뮤니티의 노드들보다 서로 더 강하게 연결되어 있습니다.
우리 시스템에서는 문서의 엔티티와 관계로 구성된 지식 그래프 내에서 커뮤니티를 탐지하기 위해 Leiden 알고리즘을 사용합니다. 구현에서는 그래프 연산을 위해 networkx와 cdlib 라이브러리를 사용하며, 커뮤니티 구조를 그래프의 트리플을 생성한 원본 텍스트 청크와 함께 저장합니다.
def build_communities(g: nx.Graph) -> CommunityResult:
"""Build communities from a graph."""
communities = []
node_community_map = {}
# Convert to integers for algorithm
gi = nx.convert_node_labels_to_integers(g, label_attribute="original_label")
# Create reverse mapping
reverse_mapping = {
node: data["original_label"]
for node, data in gi.nodes(data=True)
}
for component in nx.connected_components(gi):
subgraph = gi.subgraph(component)
if len(subgraph) > 1:
# Detect communities using Leiden
coms = algorithms.leiden(subgraph)
for com_id, com in enumerate(coms.communities):
# Extract community relationships
community_subgraph = coms.graph.subgraph(com)
community_triples = []
for s, t, data in community_subgraph.edges(data=True):
triple = (
reverse_mapping[s],
data.get("label"),
reverse_mapping[t],
data.get("source_chunk")
)
community_triples.append(triple)
communities.append(community_triples)
# Map nodes to communities
for node in com:
node_community_map[reverse_mapping[node]] = com_id
return CommunityResult(
communities=communities,
node_community_map=node_community_map
)
지식 그래프에서 커뮤니티를 추출하고 나면, 각 커뮤니티의 트리플에 담긴 핵심 정보와 관계를 포착하는 자연어 요약을 생성해야 합니다. 이를 위해 트리플을 언어 모델에 전달하면, 언어 모델은 이를 종합하여 그래프의 해당 부분에 존재하는 주요 개념과 연결을 설명하는 일관된 텍스트를 만들어 냅니다. 이 요약 텍스트는 나중에 검색에 활용할 수 있는 커뮤니티의 의미적 표현을 제공합니다.
커뮤니티에는 많은 트리플이 포함될 수 있고 언어 모델의 컨텍스트 윈도우는 제한되어 있으므로, 큰 커뮤니티는 신중하게 처리해야 합니다. 컨텍스트 윈도우에 담을 수 있는 것보다 많은 트리플(기본값 30개)을 가진 커뮤니티의 경우, 먼저 이를 더 작은 청크로 나누고 중간 요약을 생성합니다. 그런 다음 이 청크 요약들을 이어 붙여 모델에 다시 통과시켜, 모든 청크에 걸친 핵심 정보를 포착하는 최종 통합 요약을 생성합니다. 이러한 2단계 접근 방식을 통해 모델의 제약 안에서 작업하면서도 어떤 크기의 커뮤니티든 요약할 수 있습니다.
def generate_community_summary(
llm: Llama,
community: List[Tuple[str, str, str, str]],
max_triples: int = 30,
temperature: float = 0.2,
) -> str:
# Chunk the community into smaller pieces if too large
chunks = [
community[i : i + max_triples] for i in range(0, len(community), max_triples)
]
summaries: List[str] = []
for chunk in chunks:
response = llm.create_chat_completion(
messages=[
{
"role": "user",
"content": COMMUNITY_SUMMARY.format(community=chunk),
}
],
temperature=temperature,
)
summaries.append(response["choices"][0]["message"]["content"])
# If we had multiple chunks, combine them
if len(summaries) > 1:
combined = " ".join(summaries)
# Generate a final summary of the combined text
response = llm.create_chat_completion(
messages=[
{
"role": "user",
"content": COMMUNITY_COMBINE.format(combined=combined),
}
],
temperature=temperature,
)
return response["choices"][0]["message"]["content"]
return summaries[0]
이를 Obama 데이터셋의 일부에 실행하면 다섯 개의 주요 커뮤니티를 가진 다음과 같은 그래프를 얻게 됩니다. 대법관 지명자, 이라크 전쟁, 민주당과 같은 주제와 관련된 커뮤니티로, 이는 그래프 구조로부터 자동으로 발견됩니다.

이제 파이프라인의 구축 단계를 마쳤습니다. 이제 검색 방법으로 넘어갑시다.
쿼리 (query.py)
QueryEngine 클래스는 다양한 유형의 검색을 처리하는 Core 구성 요소입니다. 초기화 과정에서 응답 생성을 위한 Llama 언어 모델을 설정하고, SQLAlchemy를 사용하여 데이터베이스 세션 팩토리를 생성합니다. engine 매개변수는 벡터 검색을 위해 pgvector가 설치된 PostgreSQL 데이터베이스에 연결합니다.
class QueryEngine:
def __init__(self, engine: Engine) -> None:
self.llm = Llama.from_pretrained(
repo_id=MODEL_REPO,
filename=MODEL_ID,
local_dir=".",
verbose=False,
n_ctx=DEFAULT_CTX_LENGTH,
)
self.SessionLocal = sessionmaker(bind=engine)
self.engine = engine
쿼리 엔진은 응답을 생성하기 위해 llama-cpp-python을 사용하여 Meta의 Llama 3.2-3B 모델과 연동합니다. 모델은 Hugging Face에서 내려받을 수 있는 로컬 GGUF 파일에서 로드됩니다. 초기화 과정에서 모델은 특정 컨텍스트 길이와 설정으로 로드됩니다. Core 상호작용은 채팅 완성 요청을 위한 로컬 인터페이스를 제공하는 _generate_llm_response 메서드를 통해 이루어집니다. 이 메서드는 시스템 프롬프트, 사용자 콘텐츠, temperature 매개변수를 받아 생성된 응답을 문자열로 반환합니다.
def _generate_llm_response(
self,
system_prompt: str,
user_content: str,
temp: float = DEFAULT_TEMPERATURE
) -> str:
"""Common method for generating LLM responses."""
response = self.llm.create_chat_completion(
messages=[
{"role": "system", "content": system_prompt},
{"role": "user", "content": user_content},
],
temperature=temp,
)
if not response or "choices" not in response:
raise RuntimeError("Failed to get valid response from LLM")
return str(response["choices"][0]["message"]["content"])
로컬 검색
로컬 검색 메서드는 지식 그래프를 사용하여 엔티티 중심 검색을 구현합니다. 이 메서드는 먼저 직렬화된 그래프를 로드하고, 쿼리에서 엔티티를 추출하고, 그래프에서 관련 데이터(엔티티, 관계, 텍스트 청크)를 수집하고, 컨텍스트 문자열을 구성한 뒤, LLM을 사용하여 응답을 생성합니다. 이 접근 방식은 특정 엔티티와 그 관계에 대한 쿼리에 특히 효과적입니다.
def local_search(self, query: str, graph_path: str) -> str:
g = self.load_graph(graph_path)
query_entities = self._extract_query_entities(query)
relevant_data = self._gather_relevant_data(g, query_entities)
context = self._build_context(relevant_data)
return self._generate_response(query, context)
이 헬퍼 메서드는 로컬 검색을 위해 지식 그래프에서 관련 정보를 수집합니다. 쿼리 엔티티와 그래프를 입력으로 받은 다음, 일치하는 노드와 그 관계, 그리고 연관된 텍스트 청크를 수집합니다. 저희 구현에서는 관련 엔티티를 찾기 위해 대소문자를 구분하지 않는 단순한 부분 문자열 매칭을 사용하지만, 프로덕션 시스템에서는 정확도와 커버리지를 높이기 위해 더 정교한 엔티티 매칭 기법을 사용할 가능성이 높습니다. 이 메서드는 일치하는 엔티티를 바탕으로 쿼리에 대한 포괄적인 컨텍스트를 구성합니다.
def _gather_relevant_data(
self, graph: nx.Graph, query_entities: List[str]
) -> RelevantData:
relevant_data = RelevantData()
for query_entity in query_entities:
for node in graph.nodes():
if query_entity.lower() in str(node).lower():
self._process_matching_node(node, graph, relevant_data)
return relevant_data
로컬 검색 컨텍스트는 지식 그래프에서 추출한 관련 정보를 LLM이 포괄적으로 파악할 수 있도록 구조화되어 있습니다. 쿼리에서 일치한 엔티티, 그래프에서 찾은 그 관계, 그리고 근거가 되는 텍스트 청크를 받아 명확한 템플릿으로 정리합니다. 엔티티 섹션에는 그래프에서 쿼리와 관련하여 일치한 모든 노드가 나열됩니다. 관계 섹션에는 이러한 엔티티들이 그래프 엣지를 통해 서로 어떻게 연결되어 있는지가 자세히 기술됩니다. 마지막으로 근거 텍스트 섹션에는 이러한 엔티티 및 관계와 연관된 실제 문서 텍스트 청크가 포함됩니다. 이렇게 구조화된 컨텍스트는 LLM이 엔티티 간의 의미적 관계와 텍스트 설명을 모두 이해하도록 도와, 더 정확하고 문맥에 적합한 응답을 생성할 수 있게 합니다.
LOCAL_SEARCH_CONTEXT = """
Relevant Entities: {entities}
Relationships:
{relationships}
Supporting Text:
{text_chunks}
"""
글로벌 검색
글로벌 검색은 맵-리듀스 방식을 사용하여 문서 커뮤니티를 분석합니다. 먼저 문서에 대한 모든 커뮤니티 요약을 가져온 다음, 맵 단계에서 각 커뮤니티에 대한 중간 답변을 생성합니다. 리듀스 단계에서는 이러한 답변들을 결합하여 일관된 응답을 만듭니다.
def global_search(self, query: str, doc_id: int, limit: int = 5) -> str:
session = self.SessionLocal()
try:
communities = (
session.query(Community)
.filter(Community.document_id == doc_id)
.all()
)
intermediate_answers = []
print("Performing map phase over communities.")
for community in tqdm(communities):
answer = self._generate_llm_response(
GLOBAL_SEARCH_COMMUNITY,
f"Community Summary:\n{community.content}\n\nQuery: {query}",
temp=0.7,
)
if answer and "No relevant information found" not in answer:
intermediate_answers.append(answer)
print("Performing reduce phase over community answers.")
return self._generate_llm_response(
GLOBAL_SEARCH_COMBINE,
f"Query: {query}\n\nAnswers to combine:\n{' '.join(intermediate_answers)}",
temp=0.7,
)
finally:
session.close()
나이브 RAG
나이브 검색 메서드는 하이브리드 검색(벡터 유사도와 키워드 매칭의 결합)을 사용하는 전통적인 RAG 방식을 구현합니다. 하이브리드 검색 함수를 사용해 관련 텍스트 청크를 가져와 하나의 컨텍스트 문자열로 결합한 뒤, LLM을 사용해 응답을 생성합니다. 이 방법은 그래프 기반 방식보다 단순하지만, 간단한 쿼리에는 효과적일 수 있습니다.
def naive_search(self, query: str, limit: int = 5) -> str:
from tiny_graphrag.search import hybrid_search
search_results = hybrid_search(query, limit=limit, engine=self.engine)
context = "\n\n".join([result.content for result in search_results])
return self._generate_llm_response(
NAIVE_SEARCH_RESPONSE,
f"Context:\n{context}\n\nQuery: {query}"
)
하이브리드 검색 구현은 벡터 임베딩을 사용하는 시맨틱 검색과 전통적인 키워드 기반 검색이라는 두 가지 서로 다른 검색 전략을 결합합니다. 이는 벡터 유사도를 위한 PostgreSQL의 pgvector 확장과 전문 검색(full-text search) 기능을 활용하는 단일 SQL 쿼리로 구현됩니다. search.py 파일의 Core 쿼리를 살펴봅시다:
WITH semantic_search AS (
SELECT id, content, document_id,
RANK () OVER (ORDER BY embedding <=> (:embedding)::vector) AS rank
FROM document_chunks
ORDER BY embedding <=> (:embedding)::vector
LIMIT 20
),
keyword_search AS (
SELECT id, content, document_id,
RANK () OVER (ORDER BY ts_rank_cd(to_tsvector('english', content), query) DESC)
FROM document_chunks, plainto_tsquery('english', :query) query
WHERE to_tsvector('english', content) @@ query
ORDER BY ts_rank_cd(to_tsvector('english', content), query) DESC
LIMIT 20
)
SELECT
COALESCE(semantic_search.document_id, keyword_search.document_id) AS document_id,
COALESCE(semantic_search.content, keyword_search.content) AS content,
COALESCE(1.0 / (:k + semantic_search.rank), 0.0) +
COALESCE(1.0 / (:k + keyword_search.rank), 0.0) AS score
FROM semantic_search
FULL OUTER JOIN keyword_search ON semantic_search.id = keyword_search.id
ORDER BY score DESC
LIMIT :limit
이 쿼리는 공통 테이블 표현식(CTE)을 사용하여 두 개의 병렬 검색을 수행합니다. 첫 번째 CTE인 semantic_search는 pgvector의 코사인 유사도 연산자 <=>를 사용하여 임베딩이 쿼리 임베딩과 가장 가까운 문서를 찾습니다. 벡터 유사도를 기준으로 결과의 순위를 매기고 상위 20개의 일치 항목을 선택합니다. 두 번째 CTE인 keyword_search는 ts_rank_cd와 함께 PostgreSQL의 전문 검색 기능을 사용하여 키워드 일치를 기준으로 문서를 찾고 순위를 매기며, 마찬가지로 상위 20개의 결과를 선택합니다.
그런 다음 메인 SELECT 문은 FULL OUTER JOIN을 사용하여 이 결과들을 결합하는데, 이를 통해 어떤 문서가 둘 중 한쪽에만 나타나더라도 두 검색 방법의 일치 항목을 모두 확보할 수 있습니다. 바로 여기서 상호 순위 융합(Reciprocal Rank Fusion)이 작동합니다. 이 공식은 다음 점수 계산식으로 구현됩니다:
COALESCE(1.0 / (:k + semantic_search.rank), 0.0) +
COALESCE(1.0 / (:k + keyword_search.rank), 0.0) AS score
RRF 알고리즘은 각 목록에서의 위치에 따라 각 항목에 점수를 부여하는 방식으로 여러 순위 목록을 결합합니다. 상수 k(기본값 60)는 개별 결과 목록에서 높은 순위가 미치는 영향을 완화하는 평활화 계수 역할을 합니다. 각 문서의 최종 점수는 각 출처에서의 (k + 순위)의 역수를 합한 값입니다. COALESCE 함수는 문서가 결과 집합 중 하나에만 나타나는 경우를 처리하며, 누락된 순위에 대해서는 기본값 0을 사용합니다.
이 융합 방식은 두 검색 방법의 장단점을 서로 보완하므로 개선된 방식입니다. 시맨틱 검색은 서로 다른 단어를 사용하더라도 의미가 비슷한 문서를 찾아낼 수 있으며, 키워드 검색은 정확히 일치하는 항목을 놓치지 않도록 보장합니다. RRF 알고리즘은 이러한 신호를 원칙에 따라 결합하는 방법을 제공하며, 두 검색 모두에서 순위가 높은 문서에 더 높은 가중치를 부여하면서도 한쪽 검색에서만 강하게 일치한 결과도 유지합니다. 최종적으로 결과는 결합된 RRF 점수의 내림차순으로 정렬되고 요청된 결과 개수만큼으로 제한됩니다. 이 하이브리드 방식은 시맨틱 검색이나 키워드 검색 중 하나만 사용할 때보다 더 견고한 검색 결과를 제공하며, 특히 관련 정보가 문서 전반에 걸쳐 다양한 방식으로 표현될 수 있는 쿼리에서 그렇습니다.
모두 합치기
이제 모든 것을 구현했습니다. 참조 구현에는 터미널에서 파이프라인을 실행할 수 있는 기본 CLI 인터페이스가 포함되어 있습니다. 또한 임시 Docker 컨테이너에서 pgvector 데이터베이스를 실행하기 위한 Docker Compose 설정도 제공합니다.
데이터베이스를 설정하고 텍스트 문서를 수집하려면 다음을 실행하십시오.
graphrag init
graphrag build data/Barack_Obama.txt
이렇게 하면 Postgres와 ./graphs 폴더의 로컬 그래프 파일로 데이터가 수집됩니다. 검색하려면 query 명령을 사용하십시오.
graphrag query local --graph graphs/1_graph.pkl "What did Barack Obama study at Columbia University?"
graphrag query global --graph graphs/1_graph.pkl --doc-id 1 "What are the main themes of this document?"
graphrag query naive "What efforts did Barack Obama due to combat climate change?"
내부적으로는 앞에서 만든 최상위 Python API를 사용합니다. Python에서 호출하려면 tiny_graphgrag 네임스페이스를 임포트하고 최상위 함수를 호출하십시오.
from tiny_graphrag import QueryEngine, store_document, init_db
# Initialize the database
engine = init_db()
# Process and store a document
doc_id, graph_path = store_document(
filepath="data/Barack_Obama.txt",
title="Barack Obama Wikipedia",
engine=engine
)
# Create query engine with the database connection
query_engine = QueryEngine(engine)
result = query_engine.local_search(
query="What did Barack Obama study at Columbia University?",
graph_path=graph_path
)
print("Local Search Result:", result)
result = query_engine.global_search(
query="What are the main themes of this document?",
doc_id=doc_id
)
print("Global Search Result:", result)
result = query_engine.naive_search(
query="What efforts did Barack Obama due to combat climate change?"
)
print("Naive Search Result:", result)
사용자 정의 엔티티 유형
더 특화된 사용 사례를 위해 엔티티 유형과 관계 유형을 재정의할 수 있습니다.
from tiny_graphrag import QueryEngine, store_document, init_db
engine = init_db("postgresql://admin:admin@localhost:5432/tiny-graphrag")
# Define custom geographic entity types
geography_entity_types = [
"City",
"Country",
"Landmark",
"River",
"Mountain",
"Ocean"
]
# Define custom relation types with type constraints
geography_relation_types = {
"capital_of": {
"allowed_head": ["City"],
"allowed_tail": ["Country"]
},
"flows_through": {
"allowed_head": ["River"],
"allowed_tail": ["City", "Country"]
},
"located_in": {
"allowed_head": ["City", "Landmark"],
"allowed_tail": ["Country"]
},
"borders": {
"allowed_head": ["Country"],
"allowed_tail": ["Country", "Ocean"]
}
}
# Process document with custom types
doc_id, graph_path = store_document(
filepath="data/geography.txt",
title="World Geography",
engine=engine,
entity_types=geography_entity_types,
relation_types=geography_relation_types
)
query_engine = QueryEngine(engine)
result = query_engine.local_search(
query="What rivers flow through Paris?",
graph_path=graph_path
)
print("Geographic Local Search:", result)
result = query_engine.global_search(
query="What are the major geographical features of Western Europe?",
doc_id=doc_id
)
print("Geographic Global Search:", result)
2부
2부에서는 최소한의 1000줄짜리 장난감 구현을 넘어, 프로덕션 환경에 더 적합하도록 장난감 구현에 몇 가지 중요한 개선 사항을 추가합니다. 첫 번째 주요 변경 사항은 직렬화된 networkx 그래프를 제대로 된 그래프 데이터베이스(Memgraph)로 교체하는 것입니다. 그래프 데이터베이스는 관계 기반 쿼리에 특화되어 최적화되어 있으며, 현재의 pickle 파일 기반 방식보다 대규모 그래프를 훨씬 더 효율적으로 처리할 수 있습니다. 또한 그래프 임베딩(node2vec)을 기본적으로 지원하므로, 쿼리에서 구조적 유사도와 의미적 유사도를 결합할 수 있습니다. 이는 직접 연결되어 있지는 않지만 비슷한 관계 패턴을 공유하는 관련 엔티티를 찾을 때 특히 유용합니다.
두 번째로 추가할 사항은 현재 전역 검색 구현의 계산 비용 문제를 해결하는 것입니다. n+1번의 LLM 호출이 필요한 맵리듀스 방식 대신, 커뮤니티 요약에 top-k 클러스터링을 사용합니다. 이를 통해 벡터 임베딩을 기반으로 비슷한 커뮤니티를 함께 묶습니다. 또한 (원래 GraphRAG 참조 구현처럼) 다단계 요약 구조를 만드는 계층적 클러스터링 방식을 구현하여, 상위 수준의 요약에서 시작해 필요할 때만 세부 내용으로 파고들 수 있도록 합니다.
그다음에는 엔티티 해석과 중복 제거를 개선하는 데 집중합니다. 현재 구현은 엔티티를 정확한 문자열 일치로 취급하므로, 같은 엔티티를 가리키는 서로 다른 표현 간의 연결을 놓칠 수 있습니다(예: “Barack Obama”, “President Obama”, “Obama”). 엔티티 매칭에 벡터 유사도 비교를 추가하여, 엔티티 언급의 임베딩과 그 주변 문맥을 함께 사용해 서로 다른 문자열이 같은 엔티티를 가리키는 경우를 식별할 수 있습니다.
성능은 어떨까
GraphRAG는 이론적으로 특정 시나리오에서 나이브 RAG보다 뛰어난 성능을 낼 수 있지만, 두 접근 방식 모두 근본적인 한계를 안고 있어 실제로 사용하기에는 상당히 취약합니다. 나이브 RAG의 효과는 청킹 전략과 임베딩 매개변수를 얼마나 세심하게 조정하느냐에 크게 좌우됩니다. 이러한 최적화는 대개 경험적으로 찾아내야 하며, 서로 다른 도메인이나 문서 유형에 잘 일반화되는 경우가 드뭅니다. GraphRAG는 구조화된 지식 표현을 도입하여 이러한 한계를 해결하려 하지만, 본질적으로는 한 묶음의 어려운 문제를 다른 묶음의 어려운 문제로 맞바꾸는 것에 불과합니다. GraphRAG는 나이브 RAG가 놓칠 수 있는 관계를 포착할 수 있지만, 정확한 엔티티 및 관계 추출에 결정적으로 의존하며, 이 추출 자체가 아직 해결되지 않은 문제입니다. 최종 결과의 품질은 이러한 추출 단계의 정확도에 매우 민감하며, 오류는 파이프라인 전반에 걸쳐 누적되는 경향이 있습니다.
두 접근 방식 모두 정확하고 맥락에 맞는 답변을 내놓으려면 일련의 통계적 “기적“이 완벽하게 맞아떨어져야 합니다. 청킹이 딱 알맞아야 하고, 임베딩이 관련된 의미적 관계를 포착해야 하며, LLM이 맥락을 올바르게 해석해야 하고, GraphRAG의 경우에는 엔티티 및 관계 추출까지 정확해야 합니다. 어느 하나의 구성 요소만 실패해도 관련 없는 응답이나 오해를 불러일으키는 응답이 나올 수 있습니다. GraphRAG가 모든 면에서 “더 나은” 것은 아니며, 임베딩 유사도 문제를 엔티티/관계 추출 문제로 맞바꾸는 것일 뿐입니다. 다만 일부 도메인에서는 후자가 더 풀기 쉬울 수 있습니다. 또한 GraphRAG의 전역 검색은 계산 비용이 훨씬 더 크며, 맵리듀스 연산을 수행하기 위해 LLM을 n+1번(여기서 n은 그래프의 커뮤니티 수) 호출해야 하므로 큰 문서에서는 그 비용이 상당할 수 있습니다.
두 접근 방식 중 하나를 구현하려는 분이라면, 이 시스템의 최종 사용자가 이러한 블랙박스 모델의 연쇄에 의존할 때 상당한 수준의 잠재적 부정확성과 맥락에서 벗어난 답변을 감수해야 한다는 점을 반드시 이해해야 합니다. 그래프 기반이든 나이브 방식이든, 현재 RAG의 수준은 정확성과 일관성이 중요한 프로덕션 시스템에 쓰기에는 충분히 신뢰할 만하지 않습니다. 이러한 접근 방식은 실험이나 연구 목적으로는 흥미로울 수 있지만, 프로덕션 정보 검색 시스템에서 믿고 쓸 수 있는 솔루션이 되기에는 아직 성숙하지 않았습니다.
GraphRAG는 흔히 홍보되는 것처럼 만병통치약 같은 알고리즘이 아닙니다. GraphRAG는 “환각을 해결“하지도 않으며, 언어 모델을 최종 합성기로 사용하는 모든 RAG 접근 방식이 겪는 “사전 학습 오버플로 문제“를 고쳐 주지도 않습니다. 그러나 위험이 낮은 일부 특정 도메인에서는 더 유용할 수 있으며, 나이브 RAG 구현보다 나은 결과를 보일 수도 있습니다. 결론적으로, GPU 크레딧을 태워 가며 멀쩡한 문서를 신뢰할 수 없는 답변으로 바꾸는 방법을 찾고 계신다면, 나이브 RAG와 GraphRAG 모두 훌륭한 선택입니다.
RAG의 한계
검색 증강 생성(Retrieval-Augmented Generation), 즉 RAG는 엔터프라이즈 검색의 미래입니다. 간단히 말해, 문서를 곱고 고차원적인 벡터 슬러리로 갈아 낸 다음, 그 고차원 슬러리를 체로 걸러 청크를 골라내고, 그 청크를 비결정적인 대규모 언어 모델에 흘려 보내면서 반대편 끝에서 쓸모 있는 진실 비슷한 무언가가 나오기를 기도하는 기술입니다. 회사의 지식 베이스로 스무디를 만드는 것과 비슷하지만, 상쾌한 음료를 얻는 대신 종종 얻게 되는 것은… 글쎄요, 그것을 함께 살펴봅시다.
이렇게 상상해 보십시오. 맥락과 도메인 용어, 미묘한 뉘앙스를 이해하는 사람들이 정성껏 작성한, 완벽하게 정리된 문서를 가져다가 BERT 벡터 블렌더 트랜스포머™에 던져 넣습니다. 무엇이 나옵니까? 콘텐츠의 “본질“을 담고 있다고 알려진, 부동소수점 숫자들이 덩어리째 떠다니는 수프입니다. 이는 모나리자의 미소를, 그 그림을 압축한 JPEG의 푸리에 변환 주파수 계수로 묘사하려는 것과 비슷합니다. 기술적으로는 가능하지만, 실제로는 어렵습니다.
그런 다음 그 벡터들을 벡터 데이터베이스에 던져 넣고 HNSW를 사용해 고차원 공간을 탐색하면서, 최근접 이웃 검색이 단지 관련 없이 가까운 벡터가 아니라 실제로 의미적으로 유사한 콘텐츠를 찾아 주기를 바랍니다. 그리고 RAG가 올바르게 작동하려면 일련의 기적이 일어나야 합니다.
- 청킹 알고리즘이 문서를 완벽하게 잘라 내야 합니다
- 임베딩 모델이 진정한 의미를 포착해야 합니다
- 질문의 임베딩과 검색된 청크의 임베딩이 유사해야 합니다
- 벡터 검색이 실제로 관련 있는 부분을 찾아내야 합니다
- LLM이 오직 컨텍스트 내 정보만으로 이 모든 것을 일관성 있게 엮어 내야 합니다
이는 전화 게임을 하는 것과 비슷하지만, 모든 참가자가 모른다고 말하는 대신 거짓말을 하도록 파인튜닝된 허풍쟁이라는 점이 다릅니다. 각 구성 요소는 저마다의 재미있는 무작위성을 더합니다. 파이프라인 전체는 폭풍우 속 배 위에서 외발자전거를 타며 과녁의 정중앙을 맞히려는 것과 같습니다. 물론 우연히 작동할 수도 있고, 때로는 운이 좋을 수도 있지만, 그 결과를 재현하는 데에는 행운을 빕니다!
그리고 얕은 매칭 문제도 있습니다. “Apple의 기업 구조“에 대해 물었는데 RAG 시스템은 “애플파이“에 관한 콘텐츠를 검색해 오면서 도움이 되고 있다고 생각할 수도 있습니다. 둘 다 “apple“이 들어 있으니까요, 그렇지 않습니까? 이는 유난히 열정적이지만 귀가 조금 어두운 비서를 두는 것과 같습니다. “양자 컴퓨팅“에 대해 물으면, “양자“라는 단어가 비슷하다는 이유로 “양자 치유 크리스털“에 관한 정보를 열심히 가져다줍니다. 이러한 응답의 일관성은 마감 10분 전에 쓴 대학 신입생의 에세이를 닮은 경우가 많습니다. 기술적으로 단어는 모두 들어 있지만, 술 취한 기린이 발레를 시도하는 듯한 우아함으로 배열되어 있습니다.
아무리 신중하게 검색한 컨텍스트가 있어도, LLM은 여전히 허구와 춤추기를 좋아합니다. 검색된 컨텍스트는 엄격한 사실의 집합이라기보다는 모델이 받아들일 수도 있고 그렇지 않을 수도 있는 느슨한 제안에 가깝습니다. 또한 모델이 주어진 컨텍스트에서 샘플링할지, 아니면 인터넷의 어두운 구석구석을 크롤링해 얻은 일반 지식에서 샘플링할지는 아무런 보장이 없습니다. 회사 핸드북 전체를 입력해 주었더니, 정작 모델은 CEO가 포스트잇을 발명한 시간 여행 펭귄이라고 자신 있게 선언할 수도 있습니다. 혹은 존재하지도 않는 정책과 절차를 되풀이하거나, 그것을 경쟁사의 정책과 뒤섞거나, 직원들에게 법을 어기라고 말할 수도 있습니다.
그리고 구조화된 데이터 문제도 있습니다. RAG 시스템에 임시 계약직을 제외한 부서별 평균 급여를 구해 달라고 하면, 시스템은 신이 나서 “우리 조직 전반에 걸친 보상의 풍성한 태피스트리“에 관한 소설을 써 줄 것입니다. 이는 문학 교수에게 세금 신고를 맡기는 것과 같습니다. 교수는 여섯 페이지에 걸쳐 여러분의 W-2가 지닌 은유적 의미를 장황하게 읊은 뒤, 여러분의 401k가 포스트모던 세계에서 욕망에 맞서는 인류의 영원한 투쟁을 상징한다고 결론 내릴 것입니다. 이러한 시스템은 데이터베이스 속 모든 숫자에 대해 유려한 하이쿠를 쓸 수 있지만, 기본적인 집계를 해 달라고 하면 갑자기 “통계학 입문“을 교양 과목으로 들은 철학과 학생이 되어 버립니다. “그런데 탈진실의 세계에서 ’평균’이란 진정 무엇을 의미합니까?“라고 사색에 잠기면서, 단순한 평균을 계산해 달라는 여러분의 절박한 간청은 완전히 무시합니다.
사실 이 모든 것은 별로 중요하지 않습니다. 적어도 현시점에서 대부분의 AI 프로젝트는 실제 문제를 해결하는 것이 아니라, 열두 달 전만 해도 NFT의 패러다임 전환적 힘에 취해 있던 C레벨 임원들을 위해 그럴듯한 데모를 만들어 내는 것이 목적이기 때문입니다. 그리고 RAG 파이프라인은 데모용으로 훌륭합니다. 실제로 작동해야 할 필요 없이 작동하는 것처럼 보이게 해 주기 때문입니다. 이것이야말로 최고의 엔지니어링입니다.
케이페이브로서의 AGI 담론
대부분의 사람들이 알고 있듯이, 범용 인공지능을 이야기하는 AI 업계 리더들은 진심이 아닙니다… 그들은 자신의 이익에 봉사하는 일종의 수행적 연극을 벌이고 있습니다. 그러나 이것은 단순한 마케팅을 훨씬 넘어서는 종류의 연극입니다. 아이러니하게도 프랑스 철학자들과 미국 프로레슬러들은 모두 이 현상을 가리키는 정확한 용어를 가지고 있습니다. 장 보드리야르는 이를 시뮬라크르라고 불렀고, 레슬링 내부자들은 이를 케이페이브라고 부릅니다. 시뮬라크르라는 개념은 현실에서 너무나 동떨어져 원본 없는 복제물이 될 수 있으며 결국 현실을 대체하게 되는 재현을 가리킵니다. 반면 케이페이브는 허구를 진짜인 것처럼 의도적으로 연출하는 것입니다. 두 개념 모두 서사가 어떻게 참여자들이 알면서도 역할을 연기하며 실재보다 비실재를 우선시하는, 정교하게 구축된 스펙터클로 기능하는 경우가 많은지를 드러냅니다.
인공지능을 둘러싼 담론은 보드리야르라면 완벽한 시뮬라크르, 즉 원본 없는 복제물로 알아보았을 것이 되었으며, 여기서 재현은 그것이 표면상 묘사하는 현실을 완전히 대체해 버렸습니다. 허구의 서사를 실제인 것처럼 유지하는 업계 관행인 프로레슬링의 케이페이브처럼, AI 담론은 참여자들이 관련된 모두에게 이익이 되는 역할을 알면서도 연기하는 정교한 공연으로 작동합니다.
이 모든 것이 이들 기업에서 이루어지는 실제 작업을 부정하려는 것은 아닙니다. 모델들은 실제로 흥미롭고 유용한 일들을 어느 정도 해냅니다. 그러나 이러한 실제 발전은 공론장에서의 재현과 점점 더 희박한 관계 속에 존재합니다. 영토, 즉 진정하지만 제한된 역량을 지닌 실제 AI 연구는 지도, 즉 예측과 서사와 브랜드화된 미래로 이루어진 하이퍼리얼한 풍경에 의해 거의 완전히 가려져 버렸습니다.
AGI를 둘러싼 정의의 공백은 독특한 수행적 공간, 즉 명확한 의미의 부재 자체가 서사를 지탱하는 메커니즘이 되는 무대를 만들어 냅니다. 이 공백은 단순히 진보를 가로막는 장애물이 아니라, 오히려 공연이 펼쳐지는 필수적인 배경 역할을 합니다. AI 연구자들이 AGI 구축을 향해 손짓할 수 있는 것은 바로 AGI가 정확히 어떤 모습일지, 또는 그것을 어떻게 알아볼 수 있을지 아무도 모르기 때문입니다. 불확실성과 모호성은 시스템의 버그가 아니라 개념적 차익거래를 가능하게 하는 기능입니다. 즉, 일관된 진보라는 환상을 유지하면서 의미와 목표를 옮길 수 있는 능력입니다. 중심부의 공허는 구체적인 정의나 측정 가능한 결과에 얽매이지 않고 상상력과 스펙터클이 꽃필 수 있는 공간이 됩니다.
레슬링 팬들이 공연이 연출된 것임을 알면서도 그래도 믿기로 선택하는 “스마트 마크“가 되듯이, AI 커뮤니티는 대체로 집단적 허구가 기술적 현실보다 더 가치 있다고 결정했습니다. 이것은 보드리야르의 시뮬라크르 제3계층이 구현된 것입니다. 기호는 더 이상 현실을 가리거나 지시하지 않고, 그 자체의 하이퍼리얼리티가 됩니다. AGI 예측, 실존적 위험 서사, 그리고 “돌파구“에 대한 숨 가쁜 발표들은 시뮬레이션이 그 밑에 있는 모든 기술적 실체에 선행하고 결국 그것을 대체하는 자기 지시적 체계를 이룹니다. 우리는 지도가 영토를 집어삼킨 공간에 살고 있습니다.
레슬링과 마찬가지로 AI의 케이페이브에는 예측 가능한 역할을 연기하는 고정된 출연진이 필요합니다. 페이스, 즉 예언자적 기술자들과 스타트업 창업자들은 혁신적인 AGI가 언제나 18개월 앞에 있다고 약속하며, 트위터에 올리는 그들의 모호한 게시물은 구체적인 것은 아무것도 드러내지 않으면서 심오한 통찰을 암시하도록 세심하게 조율되어 있습니다. 힐, 즉 AI 안전 옹호자들과 파멸론자들은 실존적 위험을 경고하며, 그들의 종말론적 선언은 그들이 비판하는 바로 그 분야에 대한 막대한 투자를 정당화하는 긴박감을 만들어 냅니다. 권력자 캐릭터, 즉 정책 입안자들과 기술 플랫폼 리더들은 규제에 관한 연극적인 선언을 하면서도 근본적인 권력 구조는 손대지 않은 채 유지되도록 합니다.
보드리야르는 하이퍼미디어화된 세계에서 시뮬레이션이 단순히 현실을 재현하는 데 그치지 않고 종종 현실에 선행하며 현실을 형성한다고 주장했습니다. 이러한 전도는 AI 담론에서 극명하게 드러납니다. 임박한 AGI라는 서사는(반드시 현재의 역량이 아니라) 연구 우선순위, 자금 배분, 인재 확보를 점점 더 좌우하고 있습니다. 스타트업들은 투자를 받기 위해 유행하는 버즈워드를 쫓고, 연구자들은 어텐션을 끄는 용어로 자신의 연구를 포장하며, 이로써 시뮬레이션은 인지된 진보의 엔진이 됩니다.
이 현상은 보드리야르의 ‘시뮬라크르의 선행(precession of simulacra)’ 개념과 맞닿아 있습니다. 이 개념에서는 지도(모델, 재현)가 영토(현실)에 앞서며 영토를 규정합니다. 그 결과 AI의 능력은 실제 기능이 아니라, AGI로 나아가는 거대 서사 속에서 그것이 맡는다고 여겨지는 역할에 따라 평가되는 경우가 많습니다. 예를 들어 새로운 언어 모델이 ’AGI를 향한 한 걸음’으로 칭송받는 것은 구체적이고 입증 가능한 능력 때문이라기보다는 “분위기(vibes)” 때문일 수 있습니다. 지배적인 서사가 그런 반복을 요구하기 때문입니다. 쇼는 계속되어야 하며, 스펙터클은 어떤 대가를 치르더라도 유지되어야 합니다.
이 체계가 효과적인 이유는 그것이 널리 쓸모가 있기 때문입니다. 이것은 의식적인 기만이라기보다는 담론과 사고, 자금 흐름을 형성하는 자기 강화적 틀에 가깝습니다. 벤처 캐피털리스트는 ’미래’에 투자함으로써 딜 플로우를 확보합니다. 언론 매체는 유토피아나 종말에 관한 선정적인 서사로 관심을 끌어모읍니다. 연구자들은 자신의 연구를 AGI 스토리라인에 맞춤으로써 연구비를 따냅니다. 심지어 비판자들도 이득을 봅니다. 그들은 실존적 위험을 부각함으로써 발언대를 얻는데, 그 위험은 다시 더 많은 AI 안전 연구를 요구하는 근거가 됩니다.
결정적으로, 지배적인 서사를 반박할 수 있는 기술적 전문성을 갖춘 사람들은 대개 그 서사가 지속되는 것과 경력이 얽혀 있는 사람들입니다. 이는 이른바 ’인식론적 공모(epistemic conspiracy)’라 부를 만한 것을 낳습니다. 이는 콧수염을 배배 꼬는 악당이 꾸미는 의도적이고 조직적인 음모가 아니라, 황제의 통치가 지속되는 데 의존하는 모든 이가 황제의 옷차림에 대해서는 입을 다무는 편이 낫다고 여기는, 자기 조직적인 침묵입니다.
우리는 진정한 활동이 수동적인 관람으로 변모하는 것을 목격합니다. AI 개발은 점점 더 직접적인 기술적 참여가 아니라, 세심하게 큐레이션된 발표와 시연, 선언의 흐름을 소비하는 방식으로 경험됩니다. 기술 그 자체는 그 재현에 비해 부차적인 것이 되고, 스펙터클이 일차적인 현실이 됩니다.
공연이 이따금 케이페이브를 깨뜨릴 때, 즉 시연이 실패하거나 마감 기한이 지켜지지 않거나 약속된 능력이 공허한 것으로 드러날 때, 이러한 순간들은 곧바로 더 큰 서사 속으로 흡수됩니다. 실패는 “배움“이 되고, 지연은 “책임 있는 개발“이 되며, 한계는 “향후 연구의 기회“가 됩니다. 너무 많은 사람의 생계가 쇼의 지속에 달려 있기 때문에 쇼는 계속되어야 합니다.
특히 시사하는 바가 큰 것은 전략적 모호성을 통해 신비감을 의도적으로 조성한다는 점입니다. 모호한 소셜 미디어 게시물, 알쏭달쏭한 콘퍼런스 발표, 은유는 풍부하지만 구체적인 내용은 빈약한 선언문은 단순한 소통 실패를 넘어 의도적인 흐리기를 가리킵니다. 이러한 변화는 서로 다른 언어 게임에 참여하고 있음을 보여 줍니다. 언어 게임에서는 소통의 작동 규칙과 목표가 맥락에 따라 달라집니다. AGI 담론을 형성하는 특정한 언어 게임에서는 정확한 진리 탐구나 경험적 검증과 같은 목표로부터 강조점이 멀어지는 것으로 보입니다. 그 대신 설득력 있는 서사를 적극적으로 유지하고 강화하는 것이 주된 목표가 되며, 사실상 검증 가능한 실체보다 감성을 자극하는 스토리텔링과 분위기 효과를 우선시하게 됩니다.
실제로 어느 정도의 부조리함은 의도된 것으로 보입니다. 업계 인사들이 ’기계 신’에 대해 트윗하고, 연구자들이 명확한 정의 없이 ’창발적 능력’을 주장하고, 창업자들이 조작적 기준도 없이 ’의식의 불꽃’을 들먹일 때, 그들은 수행적 신비화에 가담하고 있는 것입니다. 그 목적은 반드시 명확한 소통에 있는 것이 아니라, 무한한 가능성이 언제나 임박한 것처럼 보이는 분위기를 조성하는 데 있습니다.
AGI를 둘러싼 담론은 보드리야르의 이론이 완전히 실현된 모습을 보여 줍니다. 즉, 지시 대상을 완전히 집어삼킨 시뮬라크르이자, 영토를 너무나 완벽하게 대체하여 더 이상 재현과 현실을 구별할 수 없게 된 지도입니다. AI 발전이라는 스펙터클은 그것이 재현한다고 내세우는 실제 기술 발전보다 더 큰 의미를 갖게 되었습니다.
프로레슬링 관중과 마찬가지로, AGI 담론의 참여자들도 다양한 스펙트럼의 믿음을 보입니다. 어떤 이들은 열성 팬과 비슷하여, 임박한 실존적 위기에 관한 서사를 진심으로 확신합니다. 그들은 전적으로 맹신에 빠져 케이페이브를 문자 그대로의 현실로 받아들입니다. 그러나 다른 이들은 좀 더 냉소적으로 혹은 전략적으로 참여할 수 있습니다. 후자의 집단에게 참여는 일종의 세련된 내집단 신호 보내기로 기능할 수 있습니다. 그들은 과대광고의 수행적 성격을 은근히 인정함으로써, 이를테면 그 과장된 주장에 알 만하다는 듯 고개를 끄덕여 보임으로써, 자신들이 “사정을 알고 있다“는 것을 드러냅니다. 그리고 겉으로는 정해진 역할을 수행하면서도, 스펙터클에 대한 공유된 이해를 자기들 집단 안에서 일종의 화폐로 사용합니다.
따라서 AGI 담론은 보드리야르의 이론을 고스란히 구현합니다. 시뮬라크르가 자신의 지시 대상을 집어삼키고, 지도가 영토를 너무나 철저하게 대체한 나머지 재현과 실재를 구별하기가 어려워집니다. 이러한 생태계 안에서 기술과 우리의 관계는 점점 더 스펙터클을 통해 매개되며, 이는 실체보다 겉모습을 수동적으로 받아들이게 만듭니다. AI 산업은 기술 예언을 상품화된 이미지로 바꾸는 데 탁월하며, 이 이미지는 스스로를 유지할 뿐 아니라 그 바탕에 깔린 경제적 이해관계도 지탱합니다. AGI에 관한 극적인 선언이 나올 때마다 이 합의된 환각에는 또 하나의 층이 더해집니다. 결국 이 하이퍼리얼리티의 카니발에서는 프로레슬링과 마찬가지로 스펙터클 그 자체가 메인 이벤트이며, 링마스터들은 이러한 상태를 유지하는 데 열심인 것으로 보입니다.
몬테카를로 트리 탐색
몬테카를로 트리 탐색은 게임 플레이와 강화 학습에서 의사 결정에 사용되는 강력한 알고리즘입니다. 이는 트리 탐색과 몬테카를로 시뮬레이션의 장점을 결합한 휴리스틱 탐색 알고리즘입니다. MCTS는 신경기호(neurosymbolic) 시스템이나 강화 학습처럼 크고 복잡한 탐색 공간을 다룰 때 특히 유용합니다.
오늘은 Python으로 MCTS를 구현해 봅시다. 먼저 상태를 표현하는 데 사용할 Node 클래스를 정의해야 합니다.
rom dataclasses import dataclass, field
from collections import defaultdict
import math
from typing import Dict, Set, List, Optional
from abc import ABC, abstractmethod
import random
class Node(ABC):
"""Abstract base class for game state nodes."""
@abstractmethod
def find_children(self) -> Set["Node"]:
"""Return all possible child nodes."""
@abstractmethod
def get_random_child(self) -> Optional["Node"]:
"""Return a random child node."""
@abstractmethod
def is_terminal(self) -> bool:
"""Check if the node is a terminal state."""
@abstractmethod
def reward(self) -> float:
"""Return the reward value for a terminal node."""
@abstractmethod
def __hash__(self) -> int:
"""Define a hash function for the node."""
@abstractmethod
def __eq__(self, other: object) -> bool:
"""Define equality comparison for nodes."""
이제 탐색 상태를 보관하고 트리 탐색을 수행할 MCTS 클래스를 정의하겠습니다.
@dataclass
class MCTS:
"""Monte Carlo Tree Search implementation."""
exploration_weight: float = 1.0
total_rewards: Dict[Node, float] = field(default_factory=lambda: defaultdict(float))
visit_counts: Dict[Node, int] = field(default_factory=lambda: defaultdict(int))
children: Dict[Node, Set[Node]] = field(default_factory=lambda: defaultdict(set))
이제 현재 노드에서 최선의 수를 선택할 select_best_move 메서드를 구현하겠습니다.
def select_best_move(self, node: Node) -> Node:
"""Select the best move from the current node."""
if node.is_terminal():
raise ValueError(f"Cannot select move from terminal node: {node}")
if node not in self.children:
return node.get_random_child()
이 알고리즘에서는 최선의 수를 선택하기 위해 UCT(Upper Confidence Trees) 공식을 사용하겠습니다.
여기서:
- 는 노드의 총 보상입니다.
- 는 노드가 방문된 횟수입니다.
- 은 시뮬레이션의 총 횟수입니다.
- 는 탐험 상수입니다.
def simulate(self, node: Node) -> None:
"""Perform one iteration of the MCTS algorithm."""
path = self._traverse_tree(node)
leaf = path[-1]
self._expand_node(leaf)
reward = self._simulate_random_playout(leaf)
self._backpropagate(path, reward)
def _traverse_tree(self, node: Node) -> List[Node]:
"""Traverse the tree to find an unexplored node."""
path = []
while True:
path.append(node)
if node not in self.children or not self.children[node]:
return path
unexplored = self.children[node] - set(self.children.keys())
if unexplored:
path.append(unexplored.pop())
return path
node = self._select_uct(node)
def _expand_node(self, node: Node) -> None:
"""Expand the node by adding its children to the tree."""
if node in self.children:
return
self.children[node] = node.find_children()
이제 주어진 노드에서 무작위 플레이아웃을 시뮬레이션할 _simulate_random_playout 메서드를 구현하겠습니다.
def _simulate_random_playout(self, node: Node) -> float:
"""Simulate a random playout from the given node."""
invert_reward = True
while True:
if node.is_terminal():
reward = node.reward()
return 1 - reward if invert_reward else reward
node = node.get_random_child()
invert_reward = not invert_reward
이제 경로상의 노드들에 대한 통계를 갱신할 _backpropagate 메서드를 구현하겠습니다.
def _backpropagate(self, path: List[Node], reward: float) -> None:
"""Update the statistics for the nodes in the path."""
for node in reversed(path):
self.visit_counts[node] += 1
self.total_rewards[node] += reward
reward = 1 - reward
select 메서드는 UCT 지표를 사용하여 자식 노드를 선택합니다.
def _select_uct(self, node: Node) -> Node:
"""Select a child node using the UCT formula."""
assert all(n in self.children for n in self.children[node])
log_n_parent = math.log(self.visit_counts[node])
def uct(n: Node) -> float:
return self.total_rewards[n] / self.visit_counts[
n
] + self.exploration_weight * math.sqrt(log_n_parent / self.visit_counts[n])
return max(self.children[node], key=uct)
그리고 마지막으로 노드의 평균 보상을 바탕으로 노드의 점수를 계산할 _calculate_node_score 메서드를 구현하겠습니다.
def _calculate_node_score(self, nodeNode) -> float:
"""Calculate the score for a node based on its average reward."""
if self.visit_counts[node] == 0:
return float("-inf")
return self.total_rewards[node] / self.visit_counts[node]
이제 이를 사용하려면 게임의 상태를 표현하는 데 사용할 TicTacToeNode 클래스를 정의해야 합니다.
class TicTacToeNode(Node):
def __init__(self, state: str, player: str):
self.state = state
self.player = player
def find_children(self) -> Set["TicTacToeNode"]:
if self.is_terminal():
return set()
return {
TicTacToeNode(
self.state[:i] + self.player + self.state[i + 1 :],
"O" if self.player == "X" else "X",
)
for i, value in enumerate(self.state)
if value == " "
}
def get_random_child(self) -> Optional["TicTacToeNode"]:
if self.is_terminal():
return None
empty_spots = [i for i, value in enumerate(self.state) if value == " "]
index = random.choice(empty_spots)
return TicTacToeNode(
self.state[:index] + self.player + self.state[index + 1 :],
"O" if self.player == "X" else "X",
)
def is_terminal(self) -> bool:
return self.winner() is not None or " " not in self.state
def reward(self) -> float:
winner = self.winner()
if winner is None:
return 0.5 # Draw
return 1.0 if winner == self.player else 0.0
def __hash__(self) -> int:
return hash(self.state)
def __eq__(self, other: object) -> bool:
return isinstance(other, TicTacToeNode) and self.state == other.state
def winner(self) -> Optional[str]:
lines = [
(0, 1, 2),
(3, 4, 5),
(6, 7, 8), # Rows
(0, 3, 6),
(1, 4, 7),
(2, 5, 8), # Columns
(0, 4, 8),
(2, 4, 6), # Diagonals
]
for line in lines:
if self.state[line[0]] == self.state[line[1]] == self.state[line[2]] != " ":
return self.state[line[0]]
return None
이제 MCTS 클래스를 사용하여 틱택토 게임을 할 수 있습니다.
def play_game():
state = " " * 9
mcts = MCTS()
board = TicTacToeNode(state, "X")
print("Initial board:")
print_board(board.state)
while True:
# Human player's turn (O)
human_move = int(input("Enter your move (0-8): "))
board = TicTacToeNode(
board.state[:human_move] + "O" + board.state[human_move + 1 :], "X"
)
print("\nBoard after your move:")
print_board(board.state)
if board.is_terminal():
break
# AI player's turn (X)
for _ in range(1000): # Number of MCTS iterations
mcts.simulate(board)
board = mcts.select_best_move(board)
print("\nBoard after AI move:")
print_board(board.state)
if board.is_terminal():
break
winner = board.winner()
if winner:
print(f"\nPlayer {winner} wins!")
else:
print("\nIt's a draw!")
def print_board(state: str):
for i in range(0, 9, 3):
print(" ".join(state[i : i + 3]))
if __name__ == "__main__":
play_game()
타입의 타입: 일반적인 것부터 이색적인 것까지
프로그래밍 언어는 타입 시스템을 통해 데이터를 모델링하는 다양한 방법을 제공합니다. 특히 풍부한 타입 시스템을 갖추어 네 가지 기본 타입, 즉 함수 타입(Pi 타입), 곱 타입, 합 타입(귀납 타입), 몫 타입을 지원하는 Lean을 사용하여 이러한 개념을 살펴봅시다. Lean에서 수학적 대상은 세 단계의 계층 구조 안에 존재합니다.
- 유니버스 (예:
Type,Prop) - 타입 (유니버스의 원소)
- 항 (타입의 원소)
타입은 (Type이나 Prop 같은) 유니버스의 항으로서, 다른 항들을 분류하고 그 항들을 어떻게 사용할 수 있는지에 관한 계산적·논리적 규칙을 강제합니다. 항은 고유한 타입을 가지는 수학적 대상이며, :를 사용하여 표기합니다(예: 37 : ℝ는 37이 실수 타입의 항이라는 뜻입니다). 이는 엄격한 계층 구조를 이룹니다. 항은 타입의 원소이고 타입은 그 자체로 유니버스의 항이지만, 러셀의 역설 같은 역설을 피하기 위해 “모든 타입의 타입“은 존재하지 않으며, 그 대신 무한한 유니버스 계층이 있습니다.
Lean에서 단순 타입은 기초가 되며, 자연수를 위한 nat이나 불리언을 위한 bool 같은 기본 타입을 포함합니다. 이러한 타입은 일급 시민입니다. 즉, 다른 데이터와 마찬가지로 조작하고 전달할 수 있습니다. Lean의 타입 시스템은 이러한 단순 타입으로부터 함수 타입(α → β)이나 곱 타입(α × β) 같은 복잡한 타입을 구성할 수 있게 해 줍니다.
Lean의 #check 명령은 표현식의 타입을 조회하는 데 쓰이는 강력한 도구입니다. 이 명령은 상수, 함수, 표현식의 타입을 확인하여 그것들이 예상한 타입에 부합하는지 검증하는 데 도움을 줍니다. 예를 들면 다음과 같습니다.
constant m : nat -- m is a natural number
constant n : nat -- n is a natural number
#check m -- output: nat
#check n + 0 -- nat
#check tt -- boolean "true"
집합론에서는 소속 관계에 ∈를 사용하는 반면, 타입 이론에서는 항이 특정 타입을 가짐을 나타내기 위해 :를 사용합니다.
-- In set theory: 37 ∈ ℝ
-- In type theory:
#check 37 : ℝ -- 37 is a term of type ℝ
#check ℝ : Type -- ℝ is a term of type Type
러셀의 역설을 피하기 위해 모든 타입의 타입은 존재하지 않습니다. 그 대신 유니버스가 있습니다.
Type: 수학적 대상(예:ℝ,ℕ, 군, 환)을 담는 유니버스Prop: 명제(참/거짓 진술)를 담는 유니버스
타입 X와 Y에 대해, X에서 Y로 가는 함수의 타입은 X → Y로 씁니다.
def square : ℝ → ℝ := λ x, x^2
#check square -- ℝ → ℝ
유명한 커리-하워드 대응은 다음과 같이 말합니다.
- 명제는
Prop에 속한 타입입니다 - 증명은 이러한 타입의 항입니다
- 참인 명제는 정확히 하나의 항을 가집니다
- 거짓인 명제는 항을 하나도 가지지 않습니다
-- P → Q represents both:
-- 1. A function type from proofs of P to proofs of Q
-- 2. The logical implication P implies Q
Pi 타입이라고도 하는 함수 타입은 타입 사이의 사상을 나타냅니다. 함수 타입은 의존적일 수도 있고 비의존적일 수도 있습니다. 예를 들면 다음과 같습니다.
-- Simple function type (non-dependent)
def square : ℝ → ℝ := λ x, x^2
-- Dependent function type (Pi type)
def vector_length : Π (n : Nat), Vector ℝ n → ℝ
| 0 _ := 0
| (n+1) v := real.sqrt (dot_product v v)
Pi 타입 표기 Π (x : A), B x는 반환 타입 B x가 입력값 x에 의존할 수 있는 의존 함수 타입을 나타냅니다. 반환 타입이 입력에 의존하지 않을 때는 더 간단한 화살표 표기 A → B를 사용합니다.
**곱 타입(product type)**은 여러 값의 조합을 나타냅니다:
structure Point :=
(x : Int)
(y : Int)
structure Person :=
(name : String)
(age : Int)
(address : String)
**귀납적 타입(inductive type)**이라고도 하는 **합 타입(sum type)**은 여러 대안 중 하나를 나타냅니다:
inductive Shape
| circle (radius : Float)
| rectangle (width : Float) (height : Float)
| triangle (base : Float) (height : Float)
-- Example of using the equation compiler with sum types
def area : Shape → Float
| Shape.circle r := Float.pi * r * r
| Shape.rectangle w h := w * h
| Shape.triangle b h := b * h / 2
**몫 타입(quotient type)**은 어떤 관계 아래에서 동치인 값들을 나타냅니다:
-- Define an equivalence relation for angles
def angle_equiv (a b : Float) : Prop :=
∃ k : Int, a = b + k * 360
-- Create a quotient type for angles mod 360
def Angle := quotient (setoid.mk angle_equiv)
-- Constructor for angles
def mk_angle (degrees : Float) : Angle :=
quotient.mk degrees
**의존 타입(dependent type)**은 타입이 값에 의존할 수 있게 합니다:
-- A vector type whose length is part of its type
inductive Vector (α : Type) : Nat → Type
| nil : Vector α 0
| cons : α → {n : Nat} → Vector α n → Vector α (n + 1)
-- A function whose return type depends on its input
def get_type (b : Bool) : Type :=
if b then Nat else String
**차 타입(difference type)**은 한 타입에서 다른 타입을 “빼는 것“을 나타냅니다. Lean에서 직접 지원하지는 않지만, 의존 타입과 증명 의무(proof obligation)를 사용하여 인코딩할 수 있습니다. 차 타입은 “속성 B를 만족하는 원소를 제외한 타입 A“를 표현하고자 할 때 특히 유용합니다.
-- Non-zero numbers: ℝ "minus" 0
def NonZero := {x : ℝ // x ≠ 0}
-- Non-empty lists: List α "minus" empty list
def NonEmptyList (α : Type) := {l : List α // l ≠ []}
-- Even numbers: ℕ "minus" odd numbers
def Even := {n : ℕ // ∃ k, n = 2 * k}
-- Injective functions: (α → β) "minus" non-injective functions
def Injection (α β : Type) := {f : α → β // ∀ x y, f x = f y → x = y}
{x : A // P x} 구문은 원소가 술어 P를 만족하는 A의 부분 타입(subtype)을 나타냅니다. 이는 Lean이 의존 쌍(Σ-타입이라고도 합니다)을 통해 차 타입을 인코딩하는 방식입니다.
-- Creating terms of difference types
def two_nonzero : NonZero := ⟨2, by norm_num⟩
-- Extracting the underlying value
def get_value (n : NonZero) : ℝ := n.val
-- The proof of the property is also accessible
def get_proof (n : NonZero) : n.val ≠ 0 := n.property
예를 들어, NonZero를 사용하면 나눗셈을 전함수로 만들 수 있습니다(0으로 나누는 경우를 제거합니다):
def safe_div (a : ℝ) (b : NonZero) : ℝ := a / b.val
이 모든 것이 추상적으로 들릴 수 있지만, 이러한 타입은 많은 실제 응용에서 사용되며, 그 용도는 대체로 다음 범주로 나뉩니다:
함수 타입(Pi 타입)
- 고차 함수
- 증명 보조기의 의존 함수
- 타입 族(타입 패밀리)
- 다형 함수
곱 타입
- 설정 레코드
- 자료 구조
- 복잡한 도메인 모델
합 타입
- 오류 처리
- 상태 기계
- 추상 구문 트리
몫 타입
- 모듈러 산술
- 동치류
- 수학적 구조
차 타입
- 컴파일 시점에 불변 조건 강제하기
- 알고리즘에서 경계 사례 제거하기
- 암묵적 가정을 명시적으로 만들기
- 함수 사전 조건 강화하기
ORPO와 Unsloth를 이용한 미세 조정
ORPO는 “ORPO: Monolithic Preference Optimization without Reference Model(ORPO: 참조 모델 없는 단일 선호도 최적화)” 논문에서 소개되었습니다. 핵심 혁신은 학습 과정에서 선호되지 않는 생성에 작은 페널티를 부여함으로써 별도의 선호도 정렬 단계가 필요 없게 만든다는 점입니다.
DPO와 같은 기존 접근 방식은 두 단계를 거쳐야 합니다:
- 베이스 모델에 대한 지도 미세 조정
- 쌍으로 구성된 데이터를 이용한 선호도 최적화
이 2단계 과정에는 중대한 단점이 있습니다. SFT 동안 모델은 선호되는 응답과 원치 않는 응답 모두를 생성할 확률을 높입니다. 이는 SFT가 더 나은 응답과 더 나쁜 응답을 구분하지 않고 모든 학습 예제를 똑같이 타당한 것으로 취급하기 때문입니다. 그 결과, 선호되는 출력과 거부된 출력 사이의 격차를 벌리기 위해 별도의 직접 선호도 정렬 단계가 필요합니다. ORPO를 사용하면 이 모든 것을 한 단계로 처리할 수 있으므로 훌륭할 뿐 아니라 더 효율적입니다.
ORPO에는 세 가지 핵심 구성 요소를 갖춘 선호도 데이터셋이 필요합니다:
- 프롬프트/지시문
- 선택된(선호되는) 응답
- 거부된(선호되지 않는) 응답
선호도 데이터셋은 다음과 같은 형태입니다:
{
"prompt": "What is the meaning of life?",
"chosen": "The meaning of life is to grow, learn, and find purpose through our experiences and connections with others.",
"rejected": "42 lol"
}
효율적인 학습을 위해 새로운 Llama 3.2 8B 모델을 Unsloth와 함께 사용하겠습니다. 먼저 환경을 설정합시다:
# Install required dependencies
pip install flash-attn --no-build-isolation
pip install -v -U git+https://github.com/facebookresearch/xformers.git@main#egg=xformers
pip install "unsloth[colab-new] @ git+https://github.com/unslothai/unsloth.git"
이제 학습 스크립트를 설정합시다:
import torch
from datasets import load_dataset
from transformers import TextStreamer
from trl import ORPOTrainer, ORPOConfig
from unsloth import FastLanguageModel, is_bfloat16_supported
from unsloth.chat_templates import get_chat_template
# Model configuration
max_seq_length = 2048
model, tokenizer = FastLanguageModel.from_pretrained(
model_name="unsloth/Meta-Llama-3-8B-bnb-4bit",
max_seq_length=max_seq_length,
load_in_4bit=True,
dtype=None,
)
# Setup Unsloth's optimized LoRA
model = FastLanguageModel.get_peft_model(
model,
r=16,
lora_alpha=16,
lora_dropout=0,
target_modules=[
"q_proj", "k_proj", "v_proj",
"o_proj", "gate_proj", "up_proj", "down_proj"
],
use_rslora=True, # Faster training
use_gradient_checkpointing="unsloth",
)
# Setup ChatML format
tokenizer = get_chat_template(
tokenizer,
chat_template="chatml"
)
데이터셋으로는 비윤리적이고 유해한 응답을 피하도록 모델을 학습시키기 위한 이진화된 선호도가 담긴 ultrafeedback_binarized 데이터셋을 사용하겠습니다. trl을 사용하면 이미 선호도 형식을 이해하므로 데이터셋을 전처리할 필요가 없습니다.
dataset = load_dataset("trl-lib/ultrafeedback_binarized", split="train")
이제 Unsloth에 최적화된 설정으로 ORPO 트레이너를 구성합시다:
orpo_args = ORPOConfig(
learning_rate=8e-6,
beta=0.1,
lr_scheduler_type="cosine_with_restarts", # Better with Unsloth
max_length=2048,
max_prompt_length=1024,
per_device_train_batch_size=4, # Increased due to Unsloth optimizations
per_device_eval_batch_size=4,
gradient_accumulation_steps=2,
optim="adamw_8bit",
num_train_epochs=3,
evaluation_strategy="steps",
eval_steps=0.2,
logging_steps=1,
warmup_steps=10,
output_dir="./results/",
fp16=not is_bfloat16_supported(),
bf16=is_bfloat16_supported(),
)
trainer = ORPOTrainer(
model=model,
args=orpo_args,
train_dataset=dataset["train"],
eval_dataset=dataset["test"],
tokenizer=tokenizer,
)
trainer.train()
학습이 끝나면 모델을 다양한 형식으로 저장할 수 있습니다:
# Save LoRA weights
model.save_pretrained("lora_model")
tokenizer.save_pretrained("lora_model")
# Save merged model in 16-bit
print("Saving merged model...")
model.save_pretrained_merged("fused_model", tokenizer, save_method="merged_16bit")
# Save GGUF formats for inference
print("Saving GGUF formats...")
model.save_pretrained_gguf("ggufs", tokenizer, quantization_method="f16")
model.save_pretrained_gguf("ggufs", tokenizer, quantization_method="q4_k_m")
학습 중에 ORPO는 몇 가지 중요한 지표를 기록합니다:
rewards/chosen: 선택된 응답의 로그 확률rewards/rejected: 거부된 응답의 로그 확률rewards/accuracies: 선택된 보상이 거부된 보상을 초과하는 빈도rewards/margins: 선택된 보상과 거부된 보상 간의 평균 차이log_odds_ratio: 선택된 응답 대 거부된 응답의 평균 로그 오즈비nll_loss: SFT 구성 요소에서 나온 음의 로그 우도 손실
Weights & Biases를 사용하여 이 지표들을 모니터링할 수 있습니다.
끈 진폭에서 얻는 파이
Arnab Priya Saha와 Aninda Sinha의 논문에서 가져왔습니다. 에 대한 새로운 급수와 그 수렴성입니다.
여기서 는 포흐하머 기호입니다.
는 수렴을 최적화하기 위한 자유 매개변수입니다. 가 무한대로 가면 이 급수는 고전적인 마다바 급수가 됩니다. 가 10에서 100 사이이면 이 급수는 30개 항만으로 소수점 이하 열 자리까지 수렴합니다. 이는 소수점 이하 열 자리까지 수렴하는 데 50억 개의 항이 필요한 고전적인 마다바 급수보다 훨씬 효율적입니다.
이는 Python으로 다음과 같이 구현할 수 있습니다:
import mpmath as mp
def mp_calculate_pi(lambda_val, iters):
mp.dps = 100
pi = mp.mpf(4)
n = 1
prev_pi = 0
factorial = mp.mpf(n)
for i in range(iters):
term1 = 1.0 / factorial
term2 = 1.0 / (n + lambda_val) - 4 / (2 * n + 1)
term3 = ((2 * n + 1) ** 2) / (4 * (n + lambda_val)) - n
pochhammer = 1
for i in range(n - 1):
pochhammer *= term3 + i
prev_pi = pi
pi += term1 * term2 * pochhammer
# print to 30 decimal places using mpmath
approx = mp.nstr(pi, 100)
# Compare to mp.pi to calcualte the delta
delta = abs(pi - mp.pi)
# numbers of digits that pi approximate is correct to
accuracy = round(abs(mp.log(abs(pi - mp.pi), 10)))
# Print a line with the current iteration, pi, delta
print(f'{n} {approx} {delta} {accuracy}')
n += 1
factorial = factorial * n
return pi, n - 1
lambda_val = 42
pi, n = mp_calculate_pi(lambda_val, 30)
디아코네스쿠 정리
1975년 라두 디아코네스쿠(Radu Diaconescu)가 발견한 디아코네스쿠 정리는 수학의 두 가지 근본 원리인 선택 공리와 배중률 사이에 흥미롭고도 놀라운 연관성이 있음을 보여 줍니다. 간단히 말해, 이 정리는 선택 공리를 받아들이면 배중률도 받아들여야 한다는 것을 말합니다. 이 정리는 1978년 굿맨(Goodman)과 마이힐(Myhill)이 독립적으로 발견하였으며, 디아코네스쿠-굿맨-마이힐 정리라고 불리기도 합니다. 흥미롭게도 에렛 비숍(Errett Bishop)은 디아코네스쿠의 발표 이전에 구성적 해석학에 관한 1967년 저서에서 이 결과를 연습 문제로 제시한 바 있습니다.
배경 지식으로, 배중률은 임의의 명제 에 대해 가 참이거나 가 거짓이며 그 중간 상태는 없다는 원리입니다. 기호로 나타내면 입니다. 예를 들어, 어떤 수는 짝수이거나 짝수가 아닙니다. 직관적으로 보이지만, 모든 수학 체계가 이 원리를 받아들이는 것은 아닙니다!
선택 공리는 공집합이 아닌 집합들의 임의의 모임이 주어졌을 때, 각 집합에서 정확히 하나의 원소를 골라 새로운 집합을 만들 수 있다는 공리입니다. 이 역시 직관적으로 보이지만, 몇 가지 놀라운 결과를 낳습니다.
디아코네스쿠 정리는 다음을 보여 줍니다.
증명에 들어가기 전에 몇 가지 중요한 개념을 정리해 봅시다.
- 모든 원소에 대해 그 원소가 집합에 속하는지 아닌지를 판별할 수 있을 때, 그 집합을 **결정 가능(decidable)**하다고 합니다. 형식적으로는, 임의의 원소 에 대해 이거나 입니다.
- 어떤 집합 위로의 모든 전사 함수가 분할될 때(즉, 거꾸로 가는 사상이 존재하여 두 사상의 합성이 항등 사상이 될 때), 그 집합을 **선택 집합(choice set)**이라고 합니다.
증명은 다음 단계를 거쳐 진행됩니다.
-
참이거나 거짓이어야 함을 증명하고자 하는 임의의 명제 에서 시작합니다
-
두 집합을 구성합니다.
-
두 집합 모두 공집합이 아님이 보장됩니다.
- 는 0을 포함합니다(일 때 이 참이기 때문입니다)
- 는 1을 포함합니다(일 때 이 참이기 때문입니다)
-
집합 를 만듭니다. 와 가 모두 공집합이 아니므로, 선택 공리에 의해 각 집합에서 원소를 하나씩 고를 수 있습니다.
-
를 선택 함수라고 합시다. 선택 집합에서는 동등성이 결정 가능하므로(형식적 증명의 핵심 보조정리), 와 를 분석할 수 있습니다.
- 이면 는 거짓이어야 합니다()
- 이면 는 참이어야 합니다
- 에도 같은 분석이 적용됩니다
-
이 분석을 통해 가 성립해야 한다는 결론을 내릴 수 있습니다.
이 정리를 Lean으로 형식화할 수 있습니다. 이 증명은 선택과 함께 함수 외연성과 명제 외연성을 사용합니다. Lean 증명은 우리의 수학적 증명과 같은 논리 구조를 따르지만, 집합 대신 명제를 다룹니다. 술어의 동등성을 다루기 위해 함수 외연성과 명제 외연성을 사용하며, 선택 공리는 존재 명제에서 증인을 골라내는 choose 함수의 형태로 나타납니다.
먼저 정리를 em의 타입 선언으로 기술합니다:
theorem em (p : Prop) : p ∨ ¬p :=
이 형식 증명이 어떻게 동작하는지 하나씩 살펴봅시다:
-
먼저 명제
x를 받아 또 다른 명제를 반환하는 두 술어U와V를 정의합니다:let U (x : Prop) : Prop := x = True ∨ p let V (x : Prop) : Prop := x = False ∨ p이들은 우리의 수학적 증명에 나오는 집합 U와 V에 대응하지만, {0,1} 대신 명제를 다룹니다.
-
U와 V가 모두 거주되어 있음(비어 있지 않음)을 증명합니다:
have exU : ∃ x, U x := ⟨True, Or.inl rfl⟩ -- True satisfies U because True = True have exV : ∃ x, V x := ⟨False, Or.inl rfl⟩ -- False satisfies V because False = False -
선택 공리를 사용하여(
choose를 통해) U와 V에서 각각 증인 u와 v를 고릅니다:let u : Prop := choose exU let v : Prop := choose exV have u_def : U u := choose_spec exU -- u satisfies U have v_def : V v := choose_spec exV -- v satisfies V -
핵심 통찰은 u ≠ v이거나 p가 참이어야 한다는 것입니다:
have not_uv_or_p : u ≠ v ∨ p := match u_def, v_def with | Or.inr h, _ => Or.inr h -- If U(u) because of p, then p is true | _, Or.inr h => Or.inr h -- If V(v) because of p, then p is true | Or.inl hut, Or.inl hvf => -- Otherwise, u = True and v = False have hne : u ≠ v := by simp [hvf, hut, true_ne_false] Or.inl hne -
다음으로 p가 참이면 u = v임을 증명합니다:
have p_implies_uv : p → u = v := fun hp => have hpred : U = V := -- If p is true, then U and V are the same predicate funext fun x => -- Using function extensionality have hl : (x = True ∨ p) → (x = False ∨ p) := fun _ => Or.inr hp have hr : (x = False ∨ p) → (x = True ∨ p) := fun _ => Or.inr hp show (x = True ∨ p) = (x = False ∨ p) from propext (Iff.intro hl hr) -- Using propositional extensionality -
마지막으로 경우 분석을 통해 p ∨ ¬p라는 결론을 내립니다:
match not_uv_or_p with | Or.inl hne => Or.inr (mt p_implies_uv hne) -- If u ≠ v, then ¬p | Or.inr h => Or.inl h -- If p, then p
디아코네스쿠 정리는 선택 원리와 고전 논리 사이의 깊은 연관성을 보여 줍니다. 이 결과는 중요한 메타수학적 함의를 지닙니다. 선택 원리는 본질적으로 비구성적이라는 사실을 드러내는데, 다른 면에서는 구성적인 환경에서도 고전적 추론을 강제하기 때문입니다. 기초론적 관점에서 보면, 이는 선택 원리가 논리적으로 중립적이지 않다는 것을 보여 줍니다. 선택 원리는 암묵적으로 우리를 고전 논리에 묶어 둡니다. 구성적 수학에서는 이 때문에 선택 원리를 신중하게 고려해야 합니다. 겉보기에 무해한 AC의 사용조차도 다른 면에서는 구성적인 전개를 자기도 모르게 고전화할 수 있기 때문입니다. 따라서 이 정리는 기초 공리가 수학 이론의 논리적 성격에 미묘하지만 광범위한 영향을 미칠 수 있음을 잘 보여 줍니다. 선택 공리와 배중률에 관한 한, 중간 지대를 선택할 여지는 없다고 말할 수 있겠습니다!
Unsloth 빠른 튜토리얼
Unsloth는 대규모 언어 모델을 빠르고 효율적으로 미세 조정하기 위한 라이브러리입니다. Hugging Face Transformers 라이브러리를 기반으로 구축되었으며, 다양한 작업에 대해 모델을 파인튜닝하는 데 사용할 수 있습니다. 여기서는 Llama 3.1 모델이 텍스트를 SQL로 변환하는 생성 작업을 수행하도록 학습시키겠습니다.
Unsloth를 사용하면 단일 GPU 환경에서 표준 미세 조정보다 2배 빠르게 학습하고 메모리를 60% 적게 사용할 수 있습니다. Unsloth는 QLoRA(Quantized Low Rank Adaptation)라는 기법을 사용하여 모델을 양자화하고, 모델 전체 대신 소수의 추가 학습 가능 매개변수만 학습합니다. 덕분에 단일 NVIDIA H100 GPU에서 모델을 학습시킬 수 있습니다.
flash-attn과 xformers는 pip를 직접 사용하여 소스에서 설치해야 합니다.
# Install flash-attn
poetry run pip install flash-attn --no-build-isolation
# Install xformers
poetry run pip install -v -U git+https://github.com/facebookresearch/xformers.git@main#egg=xformers
# Install unsloth
poetry run pip install "unsloth[colab-new] @ git+https://github.com/unslothai/unsloth.git"
나머지는 poetry를 통해 PyPI에서 설치할 수 있습니다.
[tool.poetry.dependencies]
trl = "^0.9.6"
nvitop = "^1.3.2"
xformers = "0.0.27"
peft = "^0.12.0"
accelerate = "^0.33.0"
bitsandbytes = "^0.43.3"
이제 train.py 스크립트를 초기화할 수 있습니다. 다음 Hugging Face 라이브러리들을 불러오십시오:
import torch
from datasets import load_dataset
from transformers import EarlyStoppingCallback, TextStreamer, TrainingArguments
from trl import SFTTrainer
from unsloth import FastLanguageModel, is_bfloat16_supported
from unsloth.chat_templates import get_chat_template
4비트로 양자화된 80억 매개변수 Llama 3.1 모델을 다운로드하겠습니다. 이는 모델의 가중치가 16비트 대신 4비트를 사용하도록 압축되었다는 뜻입니다. 이로 인해 모델을 훨씬 빠르게 불러오고 사용할 수 있지만, 여전히 상당히 큰 모델입니다.
max_seq_length = 2048
model, tokenizer = FastLanguageModel.from_pretrained(
model_name="unsloth/Meta-Llama-3.1-8B-bnb-4bit",
max_seq_length=max_seq_length,
load_in_4bit=True,
dtype=None,
)
model = FastLanguageModel.get_peft_model(
model,
r=16,
lora_alpha=16,
lora_dropout=0,
target_modules=[
"q_proj",
"k_proj",
"v_proj",
"up_proj",
"down_proj",
"o_proj",
"gate_proj",
],
use_rslora=True,
use_gradient_checkpointing="unsloth",
)
tokenizer = get_chat_template(
tokenizer,
chat_template="chatml",
)
텍스트를 SQL로 변환하는 프롬프트로 구성된 합성 데이터셋을 사용하겠습니다.
def convert(question):
return {"user": question["sql_prompt"], "assistant": question["sql"]}
def apply_template(examples):
messages = examples["conversations"]
text = [
tokenizer.apply_chat_template(
convert(message), tokenize=False, add_generation_prompt=False
)
for message in messages
]
return {"text": text}
dataset = load_dataset("gretelai/synthetic_text_to_sql", split="train")
dataset = dataset.map(apply_template, batched=True)
코사인 어닐링 웜 리스타트(cosine annealing warm restarts) 스케줄러와 함께 8비트 AdamW 옵티마이저를 사용하겠습니다. 또한 과적합을 방지하기 위해 조기 종료(early stopping)를 추가하겠습니다.
callbacks = [
EarlyStoppingCallback(early_stopping_patience=3),
]
training_args = TrainingArguments(
learning_rate=3e-4,
lr_scheduler_type="linear",
per_device_train_batch_size=8,
gradient_accumulation_steps=2,
num_train_epochs=6,
fp16=not is_bfloat16_supported(),
bf16=is_bfloat16_supported(),
logging_steps=1,
optim = "adamw_8bit",
lr_scheduler_type = "cosine_with_restarts",
weight_decay=0.05,
warmup_steps=10,
output_dir="output",
seed=0,
)
trainer = SFTTrainer(
model=model,
tokenizer=tokenizer,
train_dataset=dataset,
dataset_text_field="text",
max_seq_length=max_seq_length,
dataset_num_proc=2,
packing=True,
args=training_args,
load_best_model_at_end=True,
metric_for_best_model="eval_loss",
callbacks=callbacks,
)
trainer.train()
print("Done.")
이를 실행하면 다음과 같은 출력을 볼 수 있습니다. 이 작업은 6 에포크 동안 실행되며, Nvidia H100 GPU에서 완료까지 약 2~3시간이 소요됩니다.
# ==((====))== Unsloth - 2x faster free finetuning | Num GPUs = 1
# \\ /| Num examples = 2,254 | Num Epochs = 3
# O^O/ \_/ \ Batch size per device = 2 | Gradient Accumulation steps = 4
# \ / Total batch size = 8 | Total steps = 843
# "-____-" Number of trainable parameters = 29,884,416
이제 모델을 사용하여 텍스트를 생성할 수 있습니다.
model = FastLanguageModel.for_inference(model)
messages = [
{
"user": "What is the average salary of employees in the IT department?",
"assistant": "",
},
]
inputs = tokenizer.apply_chat_template(
messages,
tokenize=True,
add_generation_prompt=True,
return_tensors="pt",
).to("cuda")
text_streamer = TextStreamer(tokenizer)
_ = model.generate(
input_ids=inputs, streamer=text_streamer, max_new_tokens=128, use_cache=True
)
모델은 다양한 형식으로 내보낼 수도 있습니다.
model.save_pretrained_merged("model", tokenizer, save_method="merged_16bit")
trainer_stats = trainer.train()
print("Done.")
model.save_pretrained("lora_model")
tokenizer.save_pretrained("lora_model")
print("Merging model")
model.save_pretrained_merged("fused_model", tokenizer, save_method="merged_16bit")
print("Saving gguf")
model.save_pretrained_gguf("ggufs", tokenizer, quantization_method="f16")
model.save_pretrained_gguf("ggufs", tokenizer, quantization_method="q4_k_m")
다음과 같은 출력을 볼 수 있습니다:
==((====))== Unsloth: Conversion from QLoRA to GGUF information
\\ /| [0] Installing llama.cpp will take 3 minutes.
O^O/ \_/ \ [1] Converting HF to GGUF 16bits will take 3 minutes.
\ / [2] Converting GGUF 16bits to ['f16'] will take 10 minutes each.
"-____-" In total, you will have to wait at least 16 minutes.
Unsloth: [0] Installing llama.cpp. This will take 3 minutes...
Unsloth: [1] Converting model at lora-fused into f16 GGUF format.
The output location will be ./lora-fused/unsloth.F16.gguf
...
Writing: 100%|██████████| 7.64G/7.64G [01:18<00:00, 97.1Mbyte/s]
INFO:hf-to-gguf:Model successfully exported to lora-fused/unsloth.F16.gguf
Unsloth: Conversion completed! Output location: ./lora-fused/unsloth.F16.gguf
이것으로 끝입니다! 이제 파인튜닝된 텍스트-SQL 생성기를 갖게 되었습니다. 데이터 처리 스크립트를 최소한으로 변경하여 다른 작업에도 쉽게 적용할 수 있습니다.
여기서 더 나아가 다양한 강화 학습 기법을 사용하여 모델을 학습시켜 모델의 성능을 더욱 향상시킬 수도 있습니다.
- Kahneman-Tversky 최적화(KTO)는 이진 피드백 데이터로 언어 모델을 정렬하는 데 사용할 수 있습니다.
- 직접 선호 최적화(DPO)는 쌍별 피드백 데이터로 언어 모델을 정렬하는 데 사용할 수 있습니다.
기본 형식 온톨로지(Basic Formal Ontology)
*기본 형식 온톨로지(Basic Formal Ontology)*는 인간 지식의 광범위한 영역을 기술할 수 있는 상위 온톨로지입니다. 이는 논리 프로그래머와 여러 도메인을 아우르는 포괄적인 지식 그래프를 구축하는 사람들에게 초석이 됩니다.
graph TD;
Q –> Q;
Q[Variable Order-Class] –> P;
P[Metaclass] –> Z;
Z[Class] –> A;
A[Entity] –> B[Continuant];
A –> C[Occurrent];
B –> D[Independent Continuant];
B –> E[Dependent Continuant];
D –> F[Object];
D –> G[Object Aggregate];
D –> H[Fiat Object];
E –> I[Specifically Dependent Continuant];
E –> J[Generically Dependent Continuant];
I –> K[Quality];
I –> L[Disposition];
C –> M[Process];
C –> N[Process Boundary];
C –> O[Temporal Region];\
BFO가 기반 구조를 제공하므로, 이 온톨로지는 근본적인 범주와 원리를 포괄하며 전문가들 사이에서 더 나은 소통과 시너지 있는 이해를 가능하게 합니다.
BFO의 계층적 구성은 실재에 대한 우리의 이해를 반영하여 주요 온톨로지 범주를 구분합니다.
개체(Entity)
BFO의 최상위 범주인 개체는 상상할 수 있는 모든 존재를 포괄하며, 다음과 같이 두 갈래로 나뉩니다.
- 연속체(Continuants): 시간이 흘러도 자신의 동일성을 유지하는 개체로, 다음을 포함합니다.
- 물질적 개체(Material Entities): 세포나 조직과 같은 유형의 객체입니다.
- 비물질적 개체(Immaterial Entities): 정책이나 아이디어와 같은 비물리적 요소입니다.
- 발생체(Occurrents): 시간에 묶인 사건으로, 예를 들어 세포 분열과 같은 생물학적 과정이 있습니다.
의존 연속체(Dependent Continuants)
이러한 개체는 존속하기 위해 다른 개체의 존재를 필요로 하며, 단독으로는 존재할 수 없습니다. 이들은 다음과 같이 구분됩니다:
- 특정 의존 연속체(Specifically Dependent Continuant, SC): 자동차의 색처럼 단일 개체에 매여 있는 성질입니다.
- 일반 의존 연속체(Generically Dependent Continuant, GC): 모든 빨간 물체가 공유하는 “빨강“이라는 특징처럼 여러 인스턴스에 걸쳐 적용될 수 있는 특성입니다.
독립 Continuant
이 범주에 속하는 개체는 자율적으로 존재할 수 있으며, 다음을 포함합니다:
- 객체(Objects): 특정한 책 한 권처럼 개별적인 물질적 대상입니다.
- 객체 집합체(Object Aggregates): 책 컬렉션처럼 객체들이 모인 것입니다.
- 피아트 객체(Fiat Objects): 지정된 주차 공간처럼 고유한 물리적 특성보다는 관계적 맥락에 기반하여 정의되는 것입니다.
성질
개체의 관찰 가능하거나 정량화할 수 있는 특성이 이 범주에 속하며, 다음과 같은 예가 있습니다:
- 성향(Disposition): 깨지기 쉬움처럼 특정한 상황에서 어떤 상태를 드러내는 잠재적 경향입니다.
- 관계적 성질(Relational Quality): 부모 관계처럼 개체들 사이의 관계를 설명하는 속성입니다.
과정
과정은 시간에 따른 전개나 변화를 구현하며, 관련된 개체와 시간 순서를 통해 정의할 수 있습니다. 주요 하위 범주는 다음과 같습니다:
- 과정 경계(Process Boundary): 과정의 시작이나 종료를 나타내는 표지입니다.
- 이력(History): 일정한 시간 범위에 걸쳐 기록된 사건의 연속입니다.
영역
영역은 개체가 존재하거나 사건이 일어나는 공간적 또는 시간적 평면을 구획하는 역할을 합니다:
- 공간 영역(Spatial Regions): 물질적 개체가 차지하는 3차원 공간입니다.
- 시간 영역(Temporal Regions): 사건을 포괄하는 선형적인 시간 구간입니다.
BFO의 확장
BFO의 Core 온톨로지를 보강하기 위해 다른 클래스를 분류하는 메타클래스를 도입할 수 있습니다. 또한 **가변 차수 클래스(variable-order classes)**의 도입도 주목할 만합니다. 이는 그 사례가 여러 클래스 차수에 걸치거나 심지어 클래스가 아닌 것까지 포함할 수 있는 클래스를 지칭하는 추상적 구성물입니다. 가변 차수 클래스만의 고유한 특징은 자기 자신의 서브클래스이자 슈퍼클래스로 분류된다는 점입니다.
예를 들어, “Barack Obama“의 계층 구조는 다음과 같습니다:
로어링하다 온톨로지(Lower Ontology)
- “Barack Obama“는 “human“의 인스턴스
- “human“은 “person“의 서브클래스
- “person“은 “individual“의 서브클래스
- “individual“은 “agent“의 서브클래스
상위 온톨로지
- “agent“는 “independent continuant“의 하위 클래스
- “independent continuant“는 “continuant“의 하위 클래스
- “continuant“는 “entity“의 하위 클래스
- “entity“는 “class“의 인스턴스
이것으로 모든 것을 분류할 수 있습니다. 물론 거의 모든 것입니다. 햄릿이라면 “하늘과 땅에는 자네의 온톨로지로는 꿈도 꾸지 못할 것들이 있다네.“라고 말했을 것입니다. 하지만 BFO는 놀라울 만큼 그에 가깝습니다.
변동성 곡면
Python을 사용하여 옵션 계약군에 대한 내재 변동성 곡면을 생성해 보겠습니다. 이는 옵션 분석에 매우 흔히 쓰이는 도구이며, 많은 퀀트 트레이딩 전략의 핵심 구성 요소입니다.
블랙-숄즈 모델은 옵션 가격을 매기는 레시피와 같습니다. 현재 주가, 행사가격, 만기까지의 시간, 이자율, 변동성 같은 재료를 넣으면 옵션의 이론적인 가격을 내놓습니다. 그러나 현실에서 트레이더들은 흔히 거꾸로 작업합니다. 즉, 옵션의 실제 시장 가격을 보고 블랙-숄즈 공식이 그 가격을 내도록 만드는 변동성 수치가 무엇인지 알아내려 합니다. 이렇게 역산한 수치를 내재 변동성(implied volatility), 줄여서 IV라고 부릅니다. 내재 변동성은 주가가 앞으로 얼마나 크게 출렁일지에 대한 시장의 예측이라고 생각하십시오. IV가 높다는 것은 트레이더들이 더 큰 가격 변동을 예상하고 있으며(그래서 보험 삼아 옵션에 더 많은 돈을 지불할 의향이 있음을 뜻합니다), IV가 낮다는 것은 앞으로 더 순탄한 흐름을 예상하고 있음을 시사합니다. 이는 일종의 공포 지수와 같습니다. 투자자들이 미래를 불안해하면 옵션을 통한 보호에 더 많은 돈을 내게 되고, 그 결과 IV가 올라갑니다.
이것이 정말 흥미로운 이유는 같은 기초 주식이라도 행사가격과 만기일이 다른 옵션은 IV가 서로 다른 경우가 많다는 점입니다. 이러한 IV를 그래프로 그리면 이른바 변동성 곡면(volatility surface)을 얻게 됩니다. 이는 미래 변동성에 대한 시장의 기대가 행사가격과 시간에 따라 어떻게 달라지는지를 보여 주는 3D 시각화입니다. 이 곡면에는 흔히 변동성 스마일(volatility smile)이나 변동성 스큐(volatility skew) 같은 패턴이 나타나는데, 외가격 풋옵션의 IV가 콜옵션보다 높아지는 현상으로, 시장이 상승장보다 폭락을 더 걱정하는 경향을 반영합니다. 그리고 이 곡면을 사용하여 비효율성과 차익거래 기회를 찾아낼 수 있습니다.
변동성 곡면을 생성하려면 몇 가지 라이브러리를 설치해야 합니다. 대부분 표준 라이브러리이지만, py_vollib 라이브러리는 예외입니다. 이는 블랙-숄즈 계산을 효율적으로 수행하는 VolLib 라이브러리의 Python 래퍼입니다.
pip install numpy pandas seaborn matplotlib py_vollib
import numpy as np
import pandas as pd
import seaborn as sns
import matplotlib.pyplot as plt
from matplotlib import cm
from mpl_toolkits.mplot3d import Axes3D
import scipy.interpolate as interpolate
import py_vollib.black_scholes.implied_volatility as iv
from py_vollib.black_scholes import black_scholes as bs
이제 기초 자산의 가격 데이터와 옵션 체인의 행사가격 데이터를 불러와야 합니다. 실무에서는 이 데이터를 Bloomberg나 다른 데이터 공급업체에서 불러올 것입니다. 하지만 지금은 그냥 CSV 파일에서 불러오겠습니다. 이 데이터는 기초 자산 SPY에 대한 옵션 계약 체인으로 구성됩니다. 각 계약에 대해 행사가격, 가격, 만기일이 있습니다. 이를 바탕으로 블랙-숄즈 공식을 사용하여 각 계약의 내재 변동성을 계산할 수 있습니다.
| contractSymbol | lastTradeDate | strike | lastPrice | inTheMoney | currency | optionType | expiration | daysToExpiration |
|---|---|---|---|---|---|---|---|---|
| SPY241227C00598000 | 2024-11-26 20:57:08+00:00 | 598.0 | 10.0 | True | USD | call | 2024-12-27 23:59:59 | 31 |
| SPY241227C00599000 | 2024-11-26 21:08:56+00:00 | 599.0 | 9.4 | True | USD | call | 2024-12-27 23:59:59 | 31 |
| SPY241227C00600000 | 2024-11-26 21:11:54+00:00 | 600.0 | 8.8 | True | USD | call | 2024-12-27 23:59:59 | 31 |
| SPY241227C00601000 | 2024-11-26 20:50:47+00:00 | 601.0 | 8.06 | False | USD | call | 2024-12-27 23:59:59 | 31 |
| SPY241227C00602000 | 2024-11-26 20:57:59+00:00 | 602.0 | 7.39 | False | USD | call | 2024-12-27 23:59:59 | 31 |
| SPY241227C00602500 | 2024-11-26 21:00:20+00:00 | 602.5 | 7.05 | False | USD | call | 2024-12-27 23:59:59 | 31 |
콜옵션에 대한 블랙-숄즈 공식은 다음과 같습니다.
여기서:
- 는 콜옵션의 가격입니다
- 는 기초자산의 현재 가격입니다
- 는 옵션의 행사가격입니다
- 은 무위험 이자율(즉, 미국 3개월 만기 재무부 단기채권의 수익률)입니다
- 는 기초자산의 변동성입니다
- 는 만기까지 남은 시간입니다
- 는 표준정규분포의 누적분포함수입니다
블랙-숄즈 모형에서 *머니니스(moneyness)*라는 개념이 나오며, 이는 기초 자산의 현재 가격과 옵션 행사가격 사이의 관계를 나타냅니다. 옵션이 내재가치를 가질 때, 즉 옵션을 행사하면 양의 현금흐름이 발생할 때 그 옵션을 *내가격(in the money)*이라고 합니다(흔히 ITM으로 줄여 쓰며, 그 반대는 OTM, 즉 외가격(out of the money)입니다). 콜 옵션의 경우, 행사가격이 기초자산의 현재 시장 가격보다 낮을 때 이러한 상황이 발생하며, 보유자는 기초자산을 시장 가치보다 낮은 가격에 매수할 수 있습니다. 반대로 풋 옵션의 경우, 행사가격이 현재 시장 가격보다 높을 때 옵션이 ITM 상태가 되며, 보유자는 기초자산을 시장 가치보다 높은 가격에 매도할 수 있습니다.
- 내가격(In-the-Money, ITM): 내재가치를 가진 옵션입니다. 콜의 경우 행사가격이 현재 시장 가격보다 낮고, 풋의 경우 높습니다.
- 등가격(ATM): 행사가격이 기초자산의 현재 시장 가격과 거의 같은 옵션입니다.
- 외가격(Out-of-the-Money, OTM): 내재가치가 없는 옵션입니다. 콜의 경우 행사가격이 기초자산의 현재 시장 가격보다 높다는 뜻이며, 풋의 경우 낮다는 뜻입니다.
ITM 옵션은 내재가치 때문에 일반적으로 프리미엄이 더 높으며, 기초 자산 가격이 앞으로도 유리하게 움직일 것으로 예상하는 트레이더에게 더 매력적입니다. 대체로 ITM 옵션은 시장 상황 변화에 더 민감할 수 있으므로 관련 위험도 더 높습니다. 그리고 일반적으로 OTM 옵션은 더 저렴하지만 가치 없이 만기될 확률이 더 높습니다.
시장 데이터를 블랙-숄즈 공식에 대입하여 체인에 있는 각 옵션의 내재 변동성을 계산합니다. 무위험 이자율로는 3개월 만기 미국 재무부 단기채권의 수익률을 사용하며, 분석하는 옵션에 맞게 현재 실제 무위험 이자율로 바꾸어 사용하십시오.
def get_current_market_data():
spy_price = pd.read_csv(PRICE_CSV)
current_price = spy_price["Close"].iloc[-1]
risk_free_rate = 4.3 / 100 # 3-month Treasury yield (4.3% as of 2024-11-27)
return risk_free_rate, spy_price, current_price
def calculate_iv(row, risk_free_rate, sigma):
try:
price = bs(
S=row["lastPrice"],
K=row["strike"],
t=row["t"],
r=risk_free_rate,
sigma=sigma,
flag="c",
)
return iv.implied_volatility(
price=price,
S=row["lastPrice"],
K=row["strike"],
t=row["t"],
r=risk_free_rate,
flag="c",
)
except:
print(f"Error calculating IV for {row['strike']}")
return np.nan
변동성 곡면은 여러 행사가격과 만기일에 걸친 내재 변동성을 3차원으로 나타낸 것입니다. 이 곡면은 시장이 다양한 행사가격과 만기에 걸쳐 옵션의 시장 가격을 어떻게 매기는지에 대한 포괄적인 관점을 제공하며, 시장의 기대와 위험 선호에 나타나는 중요한 패턴을 드러냅니다. 이론적으로 완벽한 블랙-숄즈 세계에서는 모든 행사가격과 만기에 걸쳐 변동성이 일정하므로 이 곡면은 완전히 평평할 것입니다. 그러나 현실에서는 곡면에서 다양한 패턴과 왜곡이 관찰됩니다.
이산적인 시장 데이터로부터 매끄럽고 연속적인 변동성 곡면을 구성하기 위해 보간 기법을 사용합니다. 이 구현에서는 SciPy의 SmoothBivariateSpline을 통해 이변량 스플라인 보간 방법을 사용합니다. 이 방법은 정확도와 매끄러움 사이의 균형을 유지하면서 관측된 내재 변동성 점들을 지나는 매끄러운 곡면을 적합합니다. 평활화 매개변수(s=0.1)는 곡면이 원래 데이터 점에 얼마나 가깝게 적합되는지를 조절합니다. 값이 작을수록 데이터에 더 밀착되게 적합되고, 값이 클수록 시장 잡음에 덜 민감할 수 있는 더 매끄러운 곡면이 만들어집니다.
def create_volatility_surface(calls_data):
surface = (
calls_data[["daysToExpiration", "strike", "impliedVolatility"]]
.pivot_table(
values="impliedVolatility", index="strike", columns="daysToExpiration"
)
.dropna()
)
# Prepare interpolation data
x = surface.columns.values
y = surface.index.values
X, Y = np.meshgrid(x, y)
Z = surface.values
# Create interpolation points
x_new = np.linspace(x.min(), x.max(), 100)
y_new = np.linspace(y.min(), y.max(), 100)
X_new, Y_new = np.meshgrid(x_new, y_new)
# Perform interpolation
spline = interpolate.SmoothBivariateSpline(
X.flatten(), Y.flatten(), Z.flatten(), s=0.1
)
Z_smooth = spline(x_new, y_new)
return X_new, Y_new, Z_smooth
def plot_volatility_surface(X, Y, Z):
plt.style.use("default")
sns.set_style("whitegrid", {"axes.grid": False})
fig = plt.figure(figsize=(12, 8))
ax = fig.add_subplot(111, projection="3d")
ax.plot_surface(
X, Y, Z, cmap="viridis", alpha=0.9, linewidth=0, antialiased=True
)
ax.set_xlabel("Days to Expiration")
ax.set_ylabel("Strike Price")
ax.set_zlabel("Implied Volatility")
ax.set_title("SPY Volatility Surface")
ax.view_init(elev=20, azim=45)
plt.tight_layout()
plt.show()
이제 main 함수를 실행하여 변동성 곡면을 생성할 수 있습니다.
def volsurface():
# Get market data
risk_free_rate, historical_price, current_price = get_current_market_data()
print(f"Using current price: {current_price}")
# Load and process calls data
calls = pd.read_csv(OPTIONS_CSV)
calls["t"] = calls["daysToExpiration"] / 365.0
# Calculate historical volatility
sigma = historical_price['Close'].pct_change().std() * np.sqrt(252)
# Calculate implied volatilities
calls["calculated_iv"] = calls.apply(
lambda row: calculate_iv(row, risk_free_rate, sigma), axis=1
)
calls = calls.dropna(subset=["calculated_iv"])
# Create and plot surface
X_new, Y_new, Z_smooth = create_volatility_surface(calls)
plot_volatility_surface(X_new, Y_new, Z_smooth)
변동성 곡면은 다양한 행사가격과 만기일에 걸친 미래 변동성에 대한 시장의 기대를 보여 줍니다.
변동성 차익거래
이 곡면은 여러 행사가격과 만기에 걸쳐 미래 변동성에 대한 시장의 기대를 보여 줍니다. 곡면에 불규칙한 부분이나 “융기“가 있으면 옵션 가격이 잘못 매겨졌음을 나타낼 수 있습니다. 이는 *변동성 차익거래(volatility arbitrage)*라는 거래 전략의 한 유형입니다. 본질적으로 주가가 얼마나 움직일지에 대한 시장의 기대가 너무 높은지 아니면 너무 낮은지에 베팅하는 것입니다. 요컨대 시장이 예측하는 미래 변동성과 실제로 그렇게 될 것이라고 여러분이 믿는 변동성 사이의 차이에서 수익을 얻으려는 것입니다.
곡면의 기울기를 계산하고 기울기가 특정 임곗값보다 큰 영역을 찾음으로써, 주변 영역에 비해 변동성이 급격하게 변하는 영역을 찾아 시장이 옵션 가격을 잘못 매긴 영역을 식별할 수 있습니다.
# Find areas where volatility changes abruptly
def find_vol_arbitrage(surface, threshold=0.02):
vol_gradients = np.gradient(surface)
anomalies = np.where(abs(vol_gradients) > threshold)
return anomalies
변동성 곡면에서 비효율성을 찾아낸다면, 저평가된 옵션을 매수하고 고평가된 옵션을 매도한 뒤 기초 자산으로 델타 헤지하여 확정적인 수익을 얻을 수 있습니다. 물론 비효율성을 찾는 일은 쉽지 않으며 많은 노력이 필요합니다. SPY와 같은 자산에 대한 옵션의 경우 시장이 매우 효율적이고, 수천 명의 다른 사람들이 나노초에 가까운 속도로 비효율성을 찾으려 하고 있으므로 성공할 확률은 매우 낮습니다.

변동성 곡면의 이상 현상입니다.
스큐 트레이딩
변동성 스큐는 외가격(out-of-the-money) 옵션, 등가격(at-the-money) 옵션, 내가격(in-the-money) 옵션 사이의 내재 변동성 차이를 의미합니다. 스큐 트레이딩은 서로 다른 옵션 행사가격에 걸친 내재 변동성의 불일치를 활용하는 것입니다. 트레이더들은 스큐를 분석하여 잘못 가격이 매겨진 옵션을 찾아내고, 이러한 불일치가 정규화될 것으로 예상하여 이익을 얻을 수 있는 전략을 실행합니다.
변동성 “스마일“은 변동성 곡면에서 나타나는 볼록한 패턴으로, ATM 옵션에 비해 내가격(ITM) 옵션과 OTM 옵션 모두의 내재 변동성이 더 높은 현상입니다. 그래프로 그리면 미소나 비웃음 모양을 띠는 이 볼록성은 시장 참여자들이 현재 시장 가격에서 멀리 떨어진 옵션에 더 많은 비용을 지불할 의향이 있음을 나타냅니다. 이러한 볼록한 모양이 나타나는 이유는 트레이더들이 상방 위험과 하방 위험 모두에 대한 보호를 추구하는 경우가 많기 때문입니다. 즉, 시장 폭락에 대비해 헤지하기 위해 OTM 풋을 매수하고, 잠재적인 랠리를 포착하기 위해 OTM 콜을 매수합니다. 이러한 행동은 앞서 논의한 변동성 차익거래와 직접적으로 관련되는데, 스마일 패턴은 일반적으로 안정적인 이 관계에서 일시적인 왜곡이 생길 때 트레이더가 이를 활용할 기회를 만들어 낼 수 있기 때문입니다.
변동성 스마일은 대칭적이며, ATM 옵션에 비해 OTM 풋과 OTM 콜 모두의 내재 변동성이 더 높습니다.
변동성 스머크는 비대칭적이며, OTM 콜에 비해 OTM 풋의 내재 변동성이 더 높습니다.
스큐 트레이딩은 시장의 공포 수준이 고르게 맞춰질 것에 베팅하는 것이라고 생각하십시오. 트레이더들이 시장 폭락을 크게 우려하면, “복권”(콜 옵션)에 비해 “보험”(풋 옵션)의 가격을 끌어올립니다. 이로 인해 옵션 가격에 한쪽으로 치우친, 즉 “스큐된” 패턴이 생깁니다. 스큐 트레이더는 이러한 공포가 커지거나 줄어들 것에 베팅하여 수익을 내려고 합니다. 시장이 지나치게 불안해한다고 생각하면 상대적으로 저렴한 콜을 매수하고 비싼 풋을 매도할 수 있으며, 사람들이 충분히 걱정하지 않는다고 생각하면 그 반대로 할 수 있습니다. 이는 마치 공포의 차익거래자가 되어, 시장 심리가 공황과 안일함이라는 극단 사이를 오갈 때 수익을 얻는 것과 같습니다.
행사가격에 대한 IV에 선형 회귀를 수행하고 추세를 살펴봄으로써 스큐를 분석할 수 있습니다.
def analyze_volatility_skew(options_data):
# Filter ATM options
atm_strike = options_data.iloc[(options_data['strike'] - options_data['lastPrice']).abs().argsort()[:1]]['strike'].values[0]
# Calculate skew: IV vs Strike
skew_data = options_data.copy()
skew_data['strike_diff'] = skew_data['strike'] - atm_strike
skew_data = skew_data[~skew_data['impliedVolatility'].isna()]
# Perform linear regression to quantify skew
slope, intercept, r_value, p_value, std_err = linregress(skew_data['strike_diff'], skew_data['impliedVolatility'])
print(f"Skew Slope: {slope:.5f}, R-squared: {r_value**2:.5f}")
# Plot the skew
plt.figure(figsize=(10, 6))
plt.scatter(skew_data['strike_diff'], skew_data['impliedVolatility'], label='Options')
plt.plot(skew_data['strike_diff'], intercept + slope * skew_data['strike_diff'], 'r', label='Linear Fit')
plt.xlabel('Strike Difference (Strike - ATM Strike)')
plt.ylabel('Implied Volatility')
plt.title('Volatility Skew Analysis')
plt.legend()
plt.show()
return slope
실리콘밸리의 (절대 사이비 종교가 아닌) 이데올로기들
실리콘밸리에는 정화조처럼 풍요롭고 번성하는 지적 생태계가 있습니다. 하지만 외부인으로서는 활짝 피어나는 그 모든 번성한 지적 식물군을 이해하기 어려울 수 있습니다. 그래서 요즘 현대 테크 문화를 지배하는 주요 사상 학파들에 대한 안내서를 준비했습니다:
신반동주의
민주주의는 형편없다고 생각하고 왕이 돌아오기를 바라는 부자 남자들입니다. 이들은 평등과 진보를 싫어하며, 암흑시대가 사실은 끝내주는 시절이었다고 생각합니다. 한마디로 지저분한 민주주의를 상대하느니 차라리 군주에게 머리를 조아리겠다는 삐딱한 반골들입니다.
효과적 이타주의
부정하게 얻은 돈을 문제에 쏟아부어 스스로에 대한 기분을 좀 나아지게 하려는 부자 너드들입니다. 이들은 숫자를 계산해서 어떤 대의가 지원할 만큼 충분히 유행하는지 결정합니다. 한마디로 사기를 합리화하면서 “저는 돕고 있어요!“라고 말하는 고상한 방식입니다. 그래도 뭐, 적어도 그 훔친 FTX 돈 중 일부는 자선단체로 갔습니다. 알고 보니 공리주의 계산만 충분히 하면 무엇이든 정당화할 수 있습니다!
사이퍼펑크
그 과정에서 민주주의를 불태우는 한이 있더라도 암호화가 우리를 감시 국가로부터 구해 줄 것이라고 생각하는 프라이버시 광신도들입니다. 이들은 NSA가 자기 애니메이션 팬픽션을 읽게 두느니 차라리 세상이 크립토 아나키로 추락하는 꼴을 보겠다는 사람들입니다. 프라이버시의 제단 위에 모든 것을 바쳐야 합니다 - 여러분의 편의, 여러분의 안전, 심지어 인간의 기본적인 협력까지도 말입니다. 그래도 뭐, 사회가 무너지는 동안 적어도 정부는 여러분이 어떤 헨타이를 좋아하는지 모를 것입니다! 이들은 한마디로 PGP 키를 가진 디지털 종말 대비족입니다.
장기주의
가상의 미래 사람들에 관한 계산에 집착함으로써 인류를 구할 수 있다고 생각하는 구세주 콤플렉스에 빠진 너드들입니다. 마치 지금 살아 있는 수십억 명만으로는 상대하기에 부족하다는 듯이 말입니다. 그래도 뭐, 3만 년 뒤 미래의 다이슨 구에 대해 거창하게 떠들 수 있는데 굳이 오늘날 실제 사람들의 문제를 해결할 이유가 있겠습니까?
크립토 맥시멀리스트
자신이 “중앙은행가들”(절대 도그 휘슬이 아닙니다)로부터 세상을 구하고 있다고 생각하는 크립토 브로들이지만, 실제로는 메시아 콤플렉스에 빠진 도박 중독자일 뿐입니다. 이들은 오스트리아 학파 경제학 헛소리에 전자담배와 종말 대비를 섞어 놓고는, 자신들의 마법 인터넷 화폐가 사회(와 인터넷)의 붕괴로부터 자신들을 구해 주고 종말의 왕으로 만들어 줄 것이라고 생각합니다.
크립토 귀족포퓰리즘
프레카리아트에게 복권을 팔면서 그것을 “금융 역량 강화“라고 부르는 디지털 봉건 영주들입니다. 이들은 마법 인터넷 화폐에 도박하는 것만이 임금 노예 생활에서 벗어날 유일한 탈출구라고 사람들을 설득함으로써 절박함을 수익화하는 방법을 알아냈습니다. 테크 과두 재벌들이 노동계급에게서 마지막 한 방울의 부까지 짜내기 위해 정교한 폰지 사기를 구축하면서 “금융의 민주화“를 설파하는 것만큼 후기 자본주의를 잘 보여 주는 것은 없습니다. 이들은 혁명을 약속하지만 실제로는 디지털 회사 전표를 내놓으며, 가난을 언제나 하우스가 이기는 플레이 투 언 게임으로 바꿔 놓습니다. 적어도 옛 봉건 영주들은 모든 것을 소유한다는 사실에 정직했습니다 - 이들은 두바이의 펜트하우스에서 “커뮤니티“에 대해 트윗하면서 같은 짓을 합니다.
효과적 가속주의
AI가 모든 것을 해결해 줄 것이라고 믿는, 스테로이드를 맞은 너드들입니다. 이들은 회의론자들을 “두머(doomer)“라고 부르며, 자신들이 우주의 신이 된다는 상상으로 자위를 합니다. 실리콘밸리의 몇몇 거물들은 버닝맨으로 가는 길에 로코의 바실리스크를 영접하는 깨달음을 얻고, 이 미친 열차에는 브레이크가 없어야 한다는 사실을 깨달은 뒤 이 유행에 올라탔습니다. 테크노-자본 멸종 급행열차에 모두 탑승하십시오!
테크노-현재주의
근대가 시간적 방향 감각을 잃어버린 역사성의 위기 속에 우리가 살고 있다고 생각하는 너드들입니다. 이들은 우리가 “현재주의” 체제에 갇혀 있다고 생각합니다. 즉, 눈앞의 것에만 집착하고 진정한 미래를 상상하지도, 과거에서 배우지도 못한다는 것입니다. 그들의 해결책은 무엇입니까? 자유주의를 파괴하고 인류의 운명에 관한 달콤하디 달콤한 거대 서사를 되살리되, 테크브로 버전으로 만드는 것입니다. “반지의 제왕“과 “실리콘밸리“가 만난 세계를 떠올려 보십시오. 그곳에서 민주주의는 완전히 한물간 것이고, 테크 CEO들이 새로운 철인왕입니다. Substack에 선언문을 쓰면서 보르자 가문의 왕자 역할극(LARP)을 하는 것만큼 “의미의 위기 해결“을 잘 보여 주는 것은 없기 때문입니다.
틸주의
우리 모두가 남들이 원하는 것을 쫓아다니는 모방적 레밍에 불과하며, 유일한 탈출구는 예수라는 추상적 관념뿐이라고 생각하는 너드들입니다. 다만 “네 이웃을 사랑하라” 같은 부분은 빼고 말입니다. 그리고 진정으로 독창적인 존재가 되는 유일한 방법은 우파 포퓰리스트들에게 자금을 대고 뉴질랜드에 종말 대비 벙커를 지으면서, UN이 말 그대로 적그리스도라고 경고하는 억만장자 흡혈귀가 되는 것이라고 생각합니다. 종말에 대비하면서 자유민주주의를 파괴하려 애쓰는 것만큼 “난 다른 여자애들이랑 달라“를 잘 보여 주는 것은 없기 때문입니다.
머스크주의
억만장자 똥글러를 인류의 구원자로 숭배하는 테크노 봉건주의자들입니다. 추종자들은 트위터에서 시장을 조작할 수 있는 그의 신성한 권리를 옹호하면서, 머스크의 화성 영지에서 우주 농노가 되기를 꿈꿉니다. 마치 실리콘밸리가 “혁신(disruption)“이 회사 마을과 계약 노예제를 되살리는 것을 뜻하는 자기만의 번영 복음을 만들어 낸 것과 같습니다. 이들은 사실상 기업 봉건 국가 건설을 스피드런하면서 그것을 “인류 구원“이라고 부르고 있습니다.
시뮬레이션주의자
우리가 비디오 게임 속 NPC라고 생각하는 너드들입니다. 닉이라는 어떤 히피가 대마초를 너무 많이 피운 끝에 그들의 Core 논증을 생각해 냈습니다. 우리는 시뮬레이션을 만들 수 없거나, 만들고 싶지 않거나, 아니면 그러니까… 친구, 우리가 이미 그 안에 있다는 것입니다. 그리고 미래의 너드들이 더 끝내주는 비디오 게임을 무한히 만들 수 있다면, 우리는 아마 그중 하나 안에 있을 것입니다. 하지만 그건 중요하지 않고 우리는 알 수도 없으니, 그냥 밖에 나가 풀이나 만지고 제대로 된 삶을 사십시오.
탈자유주의
아보카도 토스트에 질려서 공동체 가치와 국가가 강제하는 도덕이 있던 좋았던 옛 시절을 되살리고 싶을 때 찾는 사상입니다. 자유주의와 비슷하지만, 예수는 더 많고 대마초는 더 적습니다. 지지자들은 자유 시장과 개인의 권리가 과대평가되었으며, 우리에게 정말 필요한 것은 최고의 삶을 사는 법을 알려 주는 빅 브라더라고 생각합니다. 좌파 버전과 우파 버전이 모두 있으며, 사람들이 자기 분수를 알고 성가신 질문을 그리 많이 하지 않던 시절에 대한 공통된 향수로 하나가 됩니다.
합리주의
자신이 스팍이라고 생각하는 너드들입니다. 이들은 데이터와 알고리즘을 세속의 신처럼 숭배하며, 베이즈 정리에 대해 적당히 얼버무리기만 하면 무엇이든 해결할 수 있다고 확신합니다. 비평가들은 이들이 나무만 보고 숲은 보지 못하며 윤리나 인간의 감정 같은 성가신 것들을 무시한다고 말하지만, 사실 따위가 멋진 회귀 분석을 방해하게 두어서는 결코 안 됩니다. 이들은 그럴듯하게 포장된 사교 클럽 하우스에 사는 것을 좋아하고, 포켓몬 카드처럼 파트너를 바꾸며, 약에 취한 채 우생학의 기댓값에 관한 심오한 철학 논쟁을 벌입니다.
크립토 자유지상주의
도지코인과 원숭이 JPEG가 세계 기아를 해결하고 정부를 전복할 것이라고 믿는 은박지 모자 애호가들입니다. 이들은 시장 점성술(즉, 기술적 분석)에 푹 빠져 있고, 중앙은행을 증오하며, 부모님 집 지하실에 마련한 마이클 세일러의 제단 앞에서 경배합니다. 질문이 무엇이든 답은 “비트코인이 해결합니다!“입니다. 다만 그걸 실제로 쓸모 있는 일에 어떻게 사용하는지는 묻지 마십시오.
테크노 자유지상주의
인터넷이 무법천지의 서부 개척 시대여야 한다고 생각하는 너드들입니다. 이들은 정부의 간섭을 싫어하고 “능력주의”(다시 말해 이미 부자인 사람들이 모든 것을 결정하는 것)를 사랑합니다. 요컨대 이들은 규칙은 최소화하고 이윤 가능성은 극대화한 디지털 무한 경쟁을 원하며, 나머지 세상이 불타는 동안 자신들은 종말 대비 벙커로 숨어들려 합니다.
기업 자유지상주의
아인 랜드에 대한 환상에 젖은 채, 암호화폐와 알고리즘이 세금과 규제를 피하게 해 줄 것이라고 생각하는 테크 너드들입니다. 이들은 테크 억만장자들이 모든 것을 운영하기를 원하며, 돈이 곧 신이고 정부나 노동조합 같은 성가신 것들이 멸종한 세상을 꿈꿉니다. 요컨대 이들은 시장 근본주의에 취해 있으며, 저커버그가 지구의 신황제가 된다면 세상이 훨씬 나아질 것이라고 생각합니다.
솔라펑크
나무를 껴안고 생태 공동체를 세우면 세상을 구할 수 있다고 생각하는, 태양광 패널을 든 히피들입니다. 사이버펑크와 비슷하지만, 네온과 디스토피아를 꽃과 쿰바야로 바꾼 것입니다. 요컨대 SF 너드들이 정원 가꾸기를 발견하고 자본주의가, 뭐랄까, 완전히 지속 불가능하다고 결론 내렸을 때 일어나는 일입니다, 친구.
트랜스휴머니즘
고기 껍데기를 벗어 던지고 자신을 걸어 다니는 아이폰으로 바꾸는 데 집착하는 너드들입니다. 이들은 살덩이와 물건을 움켜쥐는 앞발을 버리고 크롬과 회로의 차가운 순수함으로 갈아탈 날만을 손꼽아 기다립니다. 절반은 테크 컬트, 절반은 중년의 위기입니다.
천년왕국주의
금융 붕괴든 사이버 예수의 재림이든, 종말이 언제나 코앞에 다가와 있다고 생각하는 너드들입니다. 그들은 [current year]야말로 모든 것이 붕괴하는 바로 그 해라는 선언문을 쓰며 나날을 보냅니다. 세상이 예정대로 끝나지 않으면, 이들은 그저 골대를 옮기고 자신들의 예측을 더욱 고집합니다. 시간은 남아돌고 치료는 부족한 사람들을 위한 죽음의 컬트 같은 것입니다. 적어도 헤븐스 게이트 컬트는 종말 하나를 골라 끝까지 고수하는 최소한의 품위는 있었습니다.
아나코 원시주의
“우가 부가, 문명 나쁘다! 휴대폰 버리고 동굴 가서 살자!” 이 사람들은 석기 시대 이후의 모든 것을 내다 버려야 한다고 생각합니다. 농사도 그만, 기술도 그만, 그저 자연과 함께 바이브를 즐기며 곰에게 잡아먹히지 않기만을 바랄 뿐입니다. 이들은 우리의 모든 문제를 농업 탓으로 돌리며, 그냥 매머드 사냥이든 뭐든 하던 시절로 돌아가면 더 행복해질 거라고 생각합니다.
테크노 유토피아니즘
기기가 세상을 구원할 것이라고 믿는 테크 너드들입니다. 이들은 로봇이 모든 일을 대신하고 우리는 영원히 사는 미래를 꿈꿉니다. 물론 기술이 몇 가지 문제를 일으킬 수도 있지만, 누가 신경이나 쓰겠습니까? 실리콘으로 돌아가는 이들의 환상의 나라에서는 모든 것이 햇살과 무지개뿐입니다. 다만 역사나 실제 인간 본성 같은 것을 언급해서 이들의 환상을 깨뜨리지는 마십시오.
쇠퇴주의
모든 것이 점점 나빠지고 있다고 생각하면서 내심 정말 그렇게 되기를 바라는 너드들입니다. 이들은 붕괴 포르노를 둠스크롤링하며, 이번에야말로 진짜로 사회가 완전히 무너지고 있다는 선언문을 씁니다. 마치 순수한 부정적 사고만으로 사회 붕괴를 현실로 불러내어 스피드런이라도 하려는 것 같습니다. 이들은 절망을 하나의 미학으로, 우울을 하나의 이데올로기로 바꿔 놓았습니다. 적어도 다른 둠머들은 대비라도 하려고 합니다 - 이 사람들은 그저 모든 것이 불타는 모습을 맨 앞줄에서 구경하고 싶을 뿐입니다.
엑스트로피아니즘
과학이 자신들을 불멸의 존재로 만들어 줄 것이라고 믿는 너드들입니다. 이들의 관심사는 오로지 세상의 의식을 고양하고 “누스피어(noosphere)“로 확장하는 것입니다. 크렘린이 그저 오해받고 있을 뿐이라고 생각하는 기술쟁이들을 위한 사이언톨로지 같은 것입니다.
특이점주의
초지능 AI 신이 곧 도래할 것이며 우리가 그것을 얌전하게 길들여야 한다고 믿는 너드들입니다. 다른 기술 예언자들과 달리, 이들은 실제로 그런 일이 일어나기를 바랍니다. 어떤 이들은 그것이 인류의 완전한 멸종을 초래할 거라고 믿으면서도, 동시에 그것을 “안전하게” 앞당기는 데 평생을 바치기까지 합니다. 일종의 종교와 비슷하지만, 인지 부조화와 GPU가 더 많을 뿐입니다. AGI를 느끼십시오, 아멘.
AI 둠머리즘
AI 신이 코앞에 와 있다고 믿으면서도 공포를 부추기면 리트윗이 더 많이 나온다고 생각하는 편집증적인 너드들입니다. 이들은 ChatGPT가 “strawberry“라는 단어에 R이 몇 개 있는지 외워 버렸으니 우리 모두 죽게 될 거라는 종말 포르노를 Substack에 미친 듯이 쓰며 하루하루를 보냅니다. 이들의 해결책은 무엇이겠습니까? 당연히 더 많은 AI입니다! 불을 끄는 데에는 불에 휘발유를 붓는 것만 한 게 없으니까요.
회색 부족(Grey Tribe)
문화 전쟁을 피해 온 지적 난민을 자처하는 사람들로, 절대 그냥 자유지상주의자인 것이 아닙니다. 이들은 최적화를 거듭한 끝에 기쁨마저 최적화로 없애 버렸습니다. 소일렌트와 팔레오 식단으로 연명하면서 NSA가 말 그대로 『1984』라는 둥, 마약은 합법화되어야 한다는 둥(단, 자기들이 좋아하는 마약만) 하는 참을 수 없이 거슬리는 선언문을 써 댑니다. 이들은 어디든 우버를 타고 다니며 우주선에 관한 포크송을 듣고, Slate Star Codex 글을 이해하는 척합니다. 이들은 좌파도 우파도 아닙니다. 그저 그 모든 것의 위에 있을 뿐이며, 이 사실을 끊임없이 상기시키는 동시에 정체성 정치 때문에 모든 것에 대해 잘난 척하며 반대할 수 있는 능력이 망가지고 있다고 수동 공격적으로 한숨을 쉽니다.
트럼프주의
주황빛 나르시시스트를 위한 개인숭배입니다. 인종차별 한 컵, 음모론 두 컵, 그리고 기독교적 위선 한 꼬집을 섞으십시오. 공포 조장과 함께 힘차게 흔든 뒤, 잘 속는 대중에게 차갑게 해서 내십시오. 부작용으로 군중 규모 기능 장애와 심각한 인지 부조화가 나타날 수 있습니다.
기술 낙관주의
기술이 우리 모두를 구원할 것입니다! 스마트폰이 세계 기아를 해결하고 소셜 미디어가 세계 평화를 가져온 것만 보십시오. 분명히 AI와 유전자 편집이 기후 변화를 해결하고, 암을 치료하고, 모두를 부자로 만들어 줄 것입니다. 똑같은 아이폰을 37번이나 우려먹을 수 있는데 비판적 사고가 무슨 필요가 있겠습니까?
합성 기술관료주의
AI에게 모든 것을 맡긴다는 말을 그럴듯하게 포장한 용어입니다. 한마디로 스카이넷에게 열쇠를 넘겨주고, 녀석이 인간 해골로 인테리어를 새로 하기로 마음먹지 않기를 비는 것입니다. 무기력한 몸뚱이로 로봇들의 옷 입히기 놀이 인형이 되어 컴퓨터가 공급하는 행복 주스에 취한 채, 매트릭스(행렬)식 포드 속에서 뇌 없는 고기 꼭두각시로 살기를 꿈꾸는 사람들에게 안성맞춤입니다. 꿈 같은 삶 아니겠습니까?
기독교 민족주의
한마디로 기독교 민족주의자들은 예수와 MAGA가 아기를 갖기를 바랍니다. 물론 철저히 이성애 규범적인 방식으로 말입니다. 이들은 스테로이드를 맞은 근본주의자와 같으며, 여기에 백인 우월주의를 곁들이고 “헌법은 하나님이 쓰셨다“를 살짝 뿌린 셈입니다. 목사가 나라를 운영하기를 바라는 성경 광신자들과 완전히 같지는 않습니다. 이 사람들은 건국의 아버지들이 사실상 하나님의 속기사였다고 생각하므로, 진보 진영을 혼쭐내 주겠다고 약속만 하면 비열한 인간에게도 기꺼이 표를 던집니다.
메타모더니즘
힙스터들이 아이러니한 태도에 질려서 다시 진지해지기로 했는데, 그것마저, 뭐랄까, 아이러니하게 하는 것입니다. 맞춤 블레이저 안에 빈티지 티셔츠를 받쳐 입고 수제 커피를 홀짝이며 LP를 듣는 것의 문화적 등가물입니다. 한마디로 아보카도 토스트를 남겨 두면서 먹기도 하려는 것입니다.
탈중앙화주의자
인터넷을 상상해 보십시오. 다만 폰지 사기가 일급 프로토콜로 들어가 있는 인터넷 말입니다. 게다가 여러분의 브라우저 기록이 영구적인 퍼블릭 블록체인에 올라가서, 할머니가 여러분이 어떤 변태 같은 취향을 가졌는지 다 볼 수 있다면 어떻겠습니까? 탈중앙화 프로토콜은 일반 기술과 똑같습니다. 다만 작동하지 않고, NSA급 보안 의식(opsec)을 갖추지 않는 한 전 재산을 날릴 확률이 100%라는 점만 다릅니다. 하지만 걱정하지 마십시오. 지루한 원숭이 JPEG를 가리키는 여러분의 값비싼 깨진 링크는 분명 1조 달러의 가치를 갖게 될 것입니다… 언젠가는요.
바이오해커
버그투성이 자바스크립트를 짜는 것만으로는 성에 차지 않아, 자연이 의도한 방식대로 자기 DNA를 해킹하기로 결심했을 때의 이야기입니다. 영양제 50알을 털어 넣는 것을 좋아하고, eBay에서 낯선 사람에게 산 CRISPR 키트를 스스로 주사하면 초인적인 돌연변이가 될 수 있다고 생각한다면, 바이오해킹은 바로 여러분을 위한 것입니다! 스포일러 주의: 잘해야 비싼 오줌을 얻고, 최악의 경우에는 다윈상을 공짜로 받게 됩니다.
슬리피지 모델링
우리가 거래할 때는 현재 시장 가격으로 거래하는 것이 아니라, 시장이 우리 주문을 체결해 주는 가격으로 거래합니다. 우리가 보는 가격과 실제로 받는 가격 사이에는 차이가 있습니다. 이 차이를 슬리피지라고 합니다. 슬리피지를 사전에 예측하는 것은 경험적인 문제이지만, 이를 모델링하면 단순히 추측하거나 모델에서 완전히 배제하는 것보다 더 나은 결과를 얻을 수 있습니다.
단순 슬리피지 모델
다른 주문의 규모에 비해 지나치게 큰 주문을 시장에 내면, 우리 주문은 우리가 보는 가격과 다른 가격에 체결됩니다. 그러나 자산의 최근 가격 이력을 바탕으로 예상 슬리피지를 해석적으로 모델링한 다음, 슬리피지의 영향을 최소화하도록 주문 규모를 정할 수 있습니다. 이는 세 가지 구성 요소의 함수입니다.
자산의 변동성은 슬리피지의 주된 요인입니다. 자산의 변동성이 클수록 더 큰 슬리피지가 예상됩니다. 최근 가격 이력으로부터 자산의 변동성을 추정한 다음, 이를 이용해 슬리피지를 추정하는 방식으로 이를 모델링할 수 있습니다. 변동성은 단순 이동 윈도 평균을 사용하여 계산할 수 있습니다.
슬리피지의 또 다른 구성 요소는 거래량 영향 계수입니다. 이는 평균 일일 거래량에 비해 우리 주문의 규모가 얼마나 큰지에 따라 가격이 움직이는 정도입니다. 최근 가격 이력으로부터 자산의 평균 일일 거래량을 추정한 다음, 이를 이용해 슬리피지를 추정하는 방식으로 이를 모델링할 수 있습니다.
슬리피지의 세 번째 구성 요소는 스프레드입니다. 이는 매수 호가와 매도 호가의 차이입니다. 자산의 최근 가격 이력으로부터 스프레드를 추정하는 방식으로 이를 모델링할 수 있습니다. 전체 슬리피지는 이러한 구성 요소의 합으로 모델링할 수 있습니다:
여기서:
여기서:
- 는 현재 가격입니다
- 는 거래량 영향 계수입니다
- 는 스프레드 계수입니다
- 는 주문 규모입니다
- 는 평균 일일 거래량입니다
- 는 변동성입니다
- 는 매수-매도 스프레드입니다
- 은 베이시스 포인트 단위의 최소 슬리피지입니다
import numpy as np
import pandas as pd
from typing import Union, Optional
class SlippageModel:
def __init__(
self,
volatility_window: int = 20,
volume_impact_factor: float = 0.1,
spread_factor: float = 0.5,
min_slippage_bps: float = 1.0
):
self.volatility_window = volatility_window
self.volume_impact_factor = volume_impact_factor
self.spread_factor = spread_factor
self.min_slippage_bps = min_slippage_bps
def estimate_slippage(
self,
price: float,
order_size: float,
avg_daily_volume: float,
volatility: Optional[float] = None,
bid_ask_spread: Optional[float] = None
) -> float:
# Base slippage on minimum bps
base_slippage = price * (self.min_slippage_bps / 10000)
# Volume impact component
volume_ratio = order_size / avg_daily_volume
volume_impact = price * self.volume_impact_factor * volume_ratio
# Volatility component (if provided)
volatility_impact = 0
if volatility is not None:
volatility_impact = price * volatility * self.volume_impact_factor
# Spread component
spread_impact = 0
if bid_ask_spread is not None:
spread_impact = bid_ask_spread * self.spread_factor
else:
# Estimate spread as 0.1% of price if not provided
spread_impact = price * 0.001 * self.spread_factor
# Combine all components
total_slippage = base_slippage + volume_impact + volatility_impact + spread_impact
return total_slippage
def calculate_volatility(self, prices: pd.Series) -> float:
returns = prices.pct_change().dropna()
volatility = returns.rolling(window=self.volatility_window).std()
return volatility.iloc[-1]
def estimate_trade_price(
self,
current_price: float,
order_size: float,
avg_daily_volume: float,
is_buy: bool,
volatility: Optional[float] = None,
bid_ask_spread: Optional[float] = None
) -> float:
slippage = self.estimate_slippage(
current_price,
order_size,
avg_daily_volume,
volatility,
bid_ask_spread
)
# Add slippage for buys, subtract for sells
execution_price = current_price + (slippage if is_buy else -slippage)
return execution_price
이제 이 모델을 사용하려면 자산의 변동성과 매수-매도 스프레드를 추정해야 합니다. 이 예제에서는 주식과 유사한 자산을 사용하겠습니다.
# Initialize model
model = SlippageModel(
volatility_window=20,
volume_impact_factor=0.1,
spread_factor=0.5,
min_slippage_bps=1.0
)
# Example trade
current_price = 100.0
order_size = 1000
avg_daily_volume = 1000000
volatility = 0.02 # 2% daily volatility
bid_ask_spread = 0.05
# Estimate slippage for a buy order
slippage = model.estimate_slippage(
current_price,
order_size,
avg_daily_volume,
volatility,
bid_ask_spread
)
execution_price = model.estimate_trade_price(
current_price,
order_size,
avg_daily_volume,
is_buy=True,
volatility=volatility,
bid_ask_spread=bid_ask_spread
)
print(f"Current Price: ${current_price:.2f}")
print(f"Estimated Slippage: ${slippage:.4f}")
print(f"Execution Price: ${execution_price:.2f}")
print(f"Slippage Impact (bps): {(slippage/current_price)*10000:.2f}")
Abdi와 Ranaldo 모델
Abdi와 Ranaldo(2017) 모델은 금융 시장에서 매수-매도 스프레드를 추정하기 위한 포괄적인 프레임워크를 제공합니다. 이 모델은 자산 가격의 근본적인 변동성을 반영하는 효율적 가격 분산이라는 개념에 기반을 두고 있습니다. 이 모델은 고가, 저가, 종가를 분석하여 매수-매도 스프레드를 더 정확하게 추정하는 것을 목표로 합니다. 이 모델의 핵심(Core)은 각 거래 기간의 평균 가격을 계산하는 것이며, 이는 다음과 같이 표기합니다:
이는 각 거래 기간에 대해 계산됩니다. 이 평균 가격은 가격 움직임을 평가하기 위한 기준점 역할을 합니다. 그다음 모델은 시간에 따른 가격 변동의 동역학을 포착하기 위해 로 표현되는 이 평균 가격 변화량의 분산을 살펴봅니다. 효율적 가격 분산을 추정하기 위해, 모델은 평균 가격 변화량의 분산을 상수 계수로 조정하여 사용합니다. 효율적 가격 분산은 다음과 같이 계산됩니다:
여기서 은 모델의 이론적 기초에서 도출된 상수입니다(유도 과정은 원 논문을 참고하십시오). 이 조정은 시장 미시구조가 가격 형성에 미치는 영향을 반영합니다. 마지막으로, 모델은 종가의 분산과 효율적 가격 분산 사이의 관계를 이용하여 매수-매도 스프레드를 도출합니다. 스프레드()는 다음과 같이 추정됩니다:
이 식은 스프레드가 관측된 가격 움직임과 근본적인 시장 상황 모두에 의해 어떻게 영향을 받는지 보여 주며, 트레이더에게 슬리피지 추정을 위한 견고한 도구를 제공합니다. 자세한 내용은 원 논문을 여기에서 참고하십시오.
def abdi_ranaldo_spread_estimator(
highs: pd.Series,
lows: pd.Series,
closes: pd.Series
) -> tuple[float, float]:
k1 = 4 * np.log(2) # Constant used in the model
# Calculate η_t = (high + low)/2 for each day
eta = (highs + lows) / 2
# Calculate variance of η changes
eta_changes = eta.diff().dropna()
var_eta_changes = eta_changes.var()
# Estimate efficient price variance
efficient_variance = var_eta_changes / (2 - k1/2)
# Calculate variance of close vs average etas
eta_avg = (eta + eta.shift(-1)) / 2 # (η_t + η_{t+1})/2
close_vs_eta = closes - eta_avg
var_close_eta = close_vs_eta.dropna().var()
# Solve for spread
spread = np.sqrt(4 * (var_close_eta - (0.5 + k1/8) * efficient_variance))
return spread, efficient_variance
이 함수를 사용하면 매수-매도 스프레드를 추정한 뒤, 이를 이용해 이전과 동일한 클래스 인터페이스로 거래의 슬리피지를 추정하는 모델을 만들 수 있습니다.
class AbdiRanaldoModel(SlippageModel):
def __init__(
self,
volatility_window: int = 20,
volume_impact_factor: float = 0.1,
spread_factor: float = 0.5,
min_slippage_bps: float = 1.0
):
super().__init__(volatility_window, volume_impact_factor, spread_factor, min_slippage_bps)
def estimate_market_spread(
self,
highs: pd.Series,
lows: pd.Series,
closes: pd.Series
) -> float:
"""
Estimates the bid-ask spread using the Abdi-Ranaldo method.
"""
spread, _ = abdi_ranaldo_spread_estimator(highs, lows, closes)
return spread
이제 이 모델을 사용하여 개별 거래의 최근 가격 이력으로부터 해당 거래의 슬리피지를 추정할 수 있습니다.
model = AbdiRanaldoModel()
# Estimate the market spread
estimated_spread = model.estimate_market_spread(
data['High'],
data['Low'],
data['Close']
)
# Use the estimated spread in slippage calculation
slippage = model.estimate_slippage(
price=data['Close'].iloc[-1],
order_size=1000,
avg_daily_volume=data['Volume'].iloc[-1],
bid_ask_spread=estimated_spread
)
# Estimate the execution price
execution_price = model.estimate_trade_price(
current_price=data['Close'].iloc[-1],
order_size=1000,
avg_daily_volume=data['Volume'].iloc[-1],
is_buy=True,
bid_ask_spread=estimated_spread
)
포트폴리오 리밸런싱
포트폴리오 이론에 관한 주제를 이어 가자면, 앞에서 이미 일련의 제약 조건이 주어졌을 때 포트폴리오를 최적화하는 방법을 논의했습니다. 이제 원하는 자산 배분을 유지하도록 cvxopt를 사용해 포트폴리오를 리밸런싱하는 방법을 논의하겠습니다.
예를 들어, 현재 포트폴리오로 존재하는 간단한 포트폴리오에서 시작하여 이를 목표 포트폴리오로 리밸런싱하겠습니다. 지난 글에서 논의한 최적화 기법은 최적의 포트폴리오 가중치를 결정하지만, 이러한 가중치를 시간이 지나도 유지하려면 거래 비용과 시장 충격을 신중하게 고려해야 합니다. 새로운 투자 논리를 반영하거나 변화하는 시장 상황에 대응하기 위해 시간이 지남에 따라 포트폴리오 가중치를 변경해야 합니다.
리밸런싱 문제는 서로 상충하는 세 가지 목표의 균형을 맞추는 이차 프로그래밍 문제로 정식화할 수 있습니다.
- 목표 가중치와의 거리 최소화
- 거래 비용 최소화
- 위험-수익 특성 유지
수학적 정식화는 다음과 같습니다.
여기서:
- 는 최적화에서 얻은 목표 가중치입니다
- 는 현재 가중치입니다
- 은 위험 페널티를 조절합니다
- 는 L2 거래 비용(이차 비용)을 조절합니다
- 은 L1 거래 비용(선형 비용)을 조절합니다
실용적인 구현은 다음과 같습니다.
import numpy as np
from cvxopt import matrix, solvers
def rebalance_portfolio(current_weights, target_weights, covariance_matrix, lambda_risk=1.0, lambda_trade=1.0, lambda_cost=0.01):
n = len(current_weights)
# Convert inputs to cvxopt format
P = matrix(lambda_risk * covariance_matrix.values +
lambda_trade * np.eye(n))
# Linear cost term
q = matrix(lambda_cost * np.ones(n) -
2 * lambda_trade * current_weights)
# Constraints
G = matrix(np.vstack((-np.eye(n), # Long only constraint
np.eye(n)))) # Upper bound constraint
h = matrix(np.hstack((np.zeros(n), # w_i >= 0
np.ones(n)))) # w_i <= 1
A = matrix(1.0, (1, n)) # Sum of weights = 1
b = matrix(1.0)
# Solve the QP problem
sol = solvers.qp(P, q, G, h, A, b)
if sol['status'] != 'optimal':
raise ValueError("Optimization failed to converge")
new_weights = np.array(sol['x']).flatten()
# Calculate turnover
turnover = np.sum(np.abs(new_weights - current_weights))
return new_weights, turnover
간단한 예로, 4개 종목으로 구성된 포트폴리오를 각 종목의 비중이 25%로 동일해지도록 리밸런싱해 봅시다.
current_weights = np.array([0.3, 0.3, 0.2, 0.2]) # Current portfolio weights
target_weights = np.array([0.25, 0.25, 0.25, 0.25]) # Target weights
new_weights, turnover = rebalance_portfolio(
current_weights,
target_weights,
covariance_matrix
)
print("Rebalancing Results:")
print("Current weights:", current_weights)
print("Target weights:", target_weights)
print("New weights:", new_weights.round(3))
print("Turnover:", f"{turnover:.2%}")
이렇게 하면 목표 가중치에 도달하기 위해 각 종목을 얼마나 매수하거나 매도해야 하는지 구할 수 있습니다. 먼저, 거래 규모에 비례하는 선형 비용과 시장 충격을 반영하는 이차 비용을 모두 포함하여 거래 비용을 고려합니다. 리밸런싱된 포트폴리오는 목표 포트폴리오와 유사한 위험 특성을 유지하도록 설계됩니다. 마지막으로, 회전율 제어는 리밸런싱의 이점과 그에 따르는 비용 사이의 균형을 맞추려 한다는 점에서 최적화 과정의 핵심 요소입니다.
람다 매개변수로 제약 조건을 조정할 수도 있습니다.
lambda_risk가 클수록 위험 특성을 맞추는 데 더 큰 비중을 둡니다lambda_trade가 클수록 회전율이 줄어듭니다lambda_cost가 클수록 최적화가 거래 비용에 더 민감해집니다
섹터 노출
실제로는 위험 및 수익 목표를 충족하고 있는지 확인하기 위해 훨씬 더 많은 추가 제약 조건을 두고 싶을 것입니다. 실무에서는 다음과 같은 추가 제약 조건을 더하고 싶을 수 있습니다.
- 섹터 노출 한도
- 최대 포지션 규모
- 최소 거래 규모
- 자산별로 다른 거래 비용
이러한 요소는 최적화 문제에 제약 조건을 더 추가하여 반영할 수 있습니다. 예를 들어 다음과 같은 제약 조건을 추가해 봅시다:
- 어떤 섹터도 포트폴리오의 30%를 초과할 수 없습니다
- 총 회전율(절대 변화량의 합)은 20%를 초과할 수 없습니다
- 개별 포지션 규모는 0%에서 100% 사이로 유지됩니다
- 비중의 합은 100%입니다
S&P 500의 여러 섹터에서 고른 10개 종목으로 좀 더 현실적인 예제를 다루어 봅시다:
import pandas as pd
stocks = {
'AAPL': 'Technology',
'MSFT': 'Technology',
'JPM': 'Financials',
'T': 'Financials',
'JNJ': 'Healthcare',
'ABBV': 'Healthcare',
'PG': 'Consumer Staples',
'KO': 'Consumer Staples',
'XOM': 'Energy',
'CVX': 'Energy',
'HD': 'Consumer Discretionary',
'NEE': 'Utilities',
'LIN': 'Materials',
'UNP': 'Industrials',
'VZ': 'Communications'
}
# Read in historical stock prices from a CSV file
data = pd.read_csv('stock_prices.csv', index_col='Date', parse_dates=True)
# Calculate returns and covariance matrix
returns = data.pct_change().dropna()
covariance_matrix = returns.cov() * 252 # Annualized covariance
이제 섹터 제약 조건과 좀 더 현실적인 거래 비용을 포함하도록 리밸런싱 함수를 개선해 봅시다:
def rebalance_portfolio_with_constraints(
current_weights,
target_weights,
covariance_matrix,
sector_map,
transaction_costs,
max_sector_exposure=0.30,
max_turnover=0.20,
lambda_risk=1.0,
lambda_trade=1.0
):
n = len(current_weights)
# Create sector constraint matrix
unique_sectors = list(set(sector_map.values()))
sector_constraints = np.zeros((len(unique_sectors), n))
for i, sector in enumerate(unique_sectors):
for j, stock in enumerate(sector_map.keys()):
if sector_map[stock] == sector:
sector_constraints[i, j] = 1
# Convert inputs to cvxopt format
P = matrix(lambda_risk * covariance_matrix.values +
lambda_trade * np.eye(n))
# Linear cost term including transaction costs
q = matrix(-2 * lambda_trade * current_weights)
# Constraints matrix
G = matrix(np.vstack([
-np.eye(n), # Long only constraint
np.eye(n), # Upper bound constraint
sector_constraints, # Sector exposure constraints
-sector_constraints, # Minimum sector exposure
np.eye(n), # Positive turnover
-np.eye(n) # Negative turnover
]))
# Constraints vector
h = matrix(np.hstack([
np.zeros(n), # Long only
np.ones(n), # Upper bound
np.repeat(max_sector_exposure, len(unique_sectors)), # Max sector
np.zeros(len(unique_sectors)), # Min sector
current_weights + max_turnover, # Max positive turnover
-current_weights + max_turnover # Max negative turnover
]))
# Sum of weights = 1
A = matrix(1.0, (1, n))
b = matrix(1.0)
# Solve the QP problem
sol = solvers.qp(P, q, G, h, A, b)
if sol['status'] != 'optimal':
raise ValueError("Optimization failed to converge")
new_weights = np.array(sol['x']).flatten()
turnover = np.sum(np.abs(new_weights - current_weights))
# Calculate transaction costs
total_cost = sum(abs(new_weights[i] - current_weights[i]) * transaction_costs[ticker]
for i, ticker in enumerate(sector_map.keys()))
return new_weights, turnover, total_cost
자, 이제 실제 데이터로 이를 실행해 봅시다. 현재 포트폴리오 비중과 지난 글에서 구한 목표 포트폴리오 비중을 사용하겠습니다:
# What we have
current_portfolio = {
'AAPL': 0.15, # 15% Apple
'MSFT': 0.12, # 12% Microsoft
'JPM': 0.10, # 10% JPMorgan
'T': 0.08, # 8% AT&T
'JNJ': 0.12, # 12% Johnson & Johnson
'ABBV': 0.08, # 8% AbbVie
'PG': 0.10, # 10% Procter & Gamble
'KO': 0.08, # 8% Coca-Cola
'XOM': 0.09, # 9% Exxon Mobil
'CVX': 0.08, # 8% Chevron
'HD': 0.07, # 7% Home Depot
'NEE': 0.06, # 6% NextEra Energy
'LIN': 0.05, # 5% Linde
'UNP': 0.06, # 6% Union Pacific
'VZ': 0.05 # 5% Verizon
}
# What we want
target_portfolio = {
'AAPL': 0.10, # 10% Apple
'MSFT': 0.10, # 10% Microsoft
'JPM': 0.10, # 10% JPMorgan
'T': 0.10, # 10% AT&T
'JNJ': 0.10, # 10% Johnson & Johnson
'ABBV': 0.10, # 10% AbbVie
'PG': 0.10, # 10% Procter & Gamble
'KO': 0.10, # 10% Coca-Cola
'XOM': 0.10, # 10% Exxon Mobil
'CVX': 0.10, # 10% Chevron
'HD': 0.0, # 0% Home Depot
'NEE': 0.0, # 0% NextEra Energy
'LIN': 0.0, # 0% Linde
'UNP': 0.0, # 0% Union Pacific
'VZ': 0.0 # 0% Verizon
}
# Dummy transaction costs (will vary by stock liquidity)
transaction_costs = {
'AAPL': 0.001, # 10 bps
'MSFT': 0.001, # 10 bps
'JPM': 0.0012, # 12 bps
'T': 0.0012, # 12 bps
'JNJ': 0.001, # 10 bps
'ABBV': 0.001, # 10 bps
'PG': 0.001, # 10 bps
'KO': 0.001, # 10 bps
'XOM': 0.0015, # 15 bps
'CVX': 0.0015, # 15 bps
'HD': 0.0012, # 12 bps
'NEE': 0.0015, # 15 bps
'LIN': 0.0018, # 18 bps
'UNP': 0.0015, # 15 bps
'VZ': 0.0018 # 18 bps
}
# Example usage
current_weights = np.array([current_portfolio[ticker] for ticker in stocks.keys()])
target_weights = np.array([target_portfolio[ticker] for ticker in stocks.keys()])
new_weights, turnover, total_cost = rebalance_portfolio_with_constraints(
current_weights=current_weights,
target_weights=target_weights,
covariance_matrix=covariance_matrix,
sector_map=stocks,
transaction_costs=transaction_costs,
max_sector_exposure=0.30,
max_turnover=0.20
)
# Print results with sector analysis
results = pd.DataFrame({
'Stock': list(stocks.keys()),
'Sector': list(stocks.values()),
'Current Weight': current_weights,
'Target Weight': target_weights,
'New Weight': new_weights.round(4)
})
print("Rebalancing Results:")
print(results)
print(f"Turnover: {turnover:.2%}")
print(f"Transaction Costs: ${total_cost*1000000:.2f} per $1M traded")
# Sector exposure analysis
print("Sector Exposures:")
sector_exposures = results.groupby('Sector')['New Weight'].sum().round(4)
print(sector_exposures)
자, 이제 훨씬 더 현실적입니다. 해가 섹터 제약 조건을 준수하고 있으며 거래 비용이 최소화되고 있음을 확인할 수 있습니다. 추가된 제약 조건 때문에, 특히 포지션 규모가 클 때, 포트폴리오의 기대 수익률이 목표 수익률보다 낮아지는 경우가 꽤 자주 있습니다.
더 정교한 모델이라면 대규모 거래를 할 때 발생하는 슬리피지와 그 거래가 주식의 시장 가격에 미칠 수 있는 영향까지 고려할 것입니다. 이는 최적화 문제의 직접적인 제약 조건은 아니지만, 다른 모델을 사용하여 완화하는 데 도움을 받을 수 있는 부분입니다.
CVXOPT를 활용한 포트폴리오 이론
이 튜토리얼에서는 Python의 cvxopt 라이브러리를 사용하여 마코위츠 포트폴리오 이론을 구현합니다. 이 이론을 활용하면 효율적 투자선을 계산하여 자산 포트폴리오를 최적화할 수 있습니다. 효율적 투자선은 주어진 위험 수준(표준편차)에서 가장 높은 기대 수익률을 제공하는 최적 포트폴리오들의 집합을 나타냅니다.
쉽게 말해, 우리가 원하는 것은 시간이 지남에 따라 대체로 가치가 오르면서도 상황이 나빠질 때 한꺼번에 폭락하지 않는 투자 조합입니다. 이상적으로는 일부 투자 자산이 하락할 때 상승하는 경향이 있는 다른 자산이 이를 상쇄해 주기를 바랍니다. 이는 모든 달걀을 한 바구니에 담지 않는 것과 같지만, 어떤 바구니를 고르고 각 바구니에 달걀을 몇 개씩 담을지를 아주 영리하게 결정하는 것입니다. 포트폴리오 선택을 “더 영리하게” 하는 세 가지 방법을 차례로 살펴보겠습니다.
- 고전적 포트폴리오 최적화 - 가장 단순한 접근 방식으로, 각 자산이 전체 포트폴리오에 기여하는 정도를 고려하여 최선의 위험-수익 상충 관계를 찾으려 합니다.
- 팩터 모델 - 더 정교한 접근 방식으로, 자산들이 공통적인 경제적 동인에 반응하여 함께 움직이는 경우가 많다는 사실을 고려합니다.
- 블랙-리터만 모델 - 포트폴리오 최적화에 대한 베이즈적 접근 방식으로, 시장 균형 수익률과 어떤 자산이 좋은 성과를 낼지에 대한 “논지” 또는 견해를 결합하여 투자자의 위험 회피 성향과 견해에 따라 위험과 수익의 균형을 맞춘 맞춤형 포트폴리오를 만들어 냅니다.
간단한 배경을 말씀드리면, 오늘날 흔히 현대 포트폴리오 이론이라고 부르는 이론은 1952년 해리 마코위츠가 개발한 것으로, 현재 최적 포트폴리오와 분산 투자를 논의하는 이론적 토대를 이룹니다. MPT의 핵심 통찰은 자산의 위험과 수익을 개별적으로 평가해서는 안 되며, 그 자산이 포트폴리오 전체의 위험과 수익에 어떻게 기여하는지를 기준으로 평가해야 한다는 것입니다. 핵심 아이디어는 각 자산이 전체 포트폴리오에 기여하는 정도를 고려하여 최선의 위험-수익 상충 관계를 갖는 포트폴리오를 구성할 수 있다는 것입니다. 다만 문제는 각 자산을 얼마나 담느냐이며, 바로 여기서 볼록 최적화 솔버 같은 현대적 도구의 도움을 받을 수 있습니다.
cvxopt 라이브러리를 설치해야 하며, pip로 설치할 수 있습니다:
pip install numpy pandas matplotlib cvxopt PyPortfolioOpt
이 튜토리얼은 금융이 아니라 코드와 볼록 최적화에 관한 것이므로 모든 것을 설명하지는 않겠습니다. 하지만 금융에 대해 더 알고 싶으시다면 다음 자료를 추천합니다:
- 현대 포트폴리오 이론 - Grinold와 Kahn
- Paul Wilmott on Quantitative Finance - Paul Wilmott
또한 Aswath Damodaran의 웹사이트에서 제공하는 공개 데이터를 사용할 것이며, 여기에서 내려받을 수 있습니다. 실무에서는 이 데이터를 Bloomberg나 Reuters에서 얻게 됩니다.
약간의 이론
포트폴리오 이론의 핵심(Core)은 위험과 수익 사이의 관계를 다루는 데 있습니다. 수익은 일반적으로 과거 수익률의 기댓값(평균)으로 측정하며, 이는 앞으로 얻을 수 있는 수익에 대한 우리의 최선의 추정치를 나타냅니다. 반면 위험은 수익률의 표준편차로 정량화하며, 이를 변동성이라고도 합니다. 이 변동성 지표는 기대 수익률의 불확실성을 포착합니다. 포트폴리오에서 각 자산에 배분된 비율을 가중치라고 부릅니다(예를 들어 포트폴리오의 60%는 주식에, 40%는 채권에 배분하는 식입니다).
변동성은 여러 가지 이유로 투자 결정에서 매우 중요한 역할을 합니다. 첫째, 변동성은 위험에 대한 시장의 인식을 나타냅니다. 변동성이 높은 자산은 일반적으로 더 위험하다고 여겨지므로 더 높은 기대 수익률을 제공해야 합니다. 둘째, 변동성은 거래 비용과 기회에 직접적인 영향을 미칩니다. 변동성이 큰 자산은 일반적으로 매수-매도 호가 차이가 더 넓고, 동일한 경제적 노출을 얻으려면 더 큰 포지션 규모가 필요하기 때문입니다. 마지막으로, 변동성은 투자자가 미래의 현금 흐름 수요를 충족하는 능력에 영향을 미칩니다. 높은 변동성 때문에 적절하지 않은 시점에 자산을 청산해야 할 수도 있기 때문입니다.
MPT의 힘은 자산들이 어떻게 함께 움직이는지를 이해하는 데서 나오며, 이는 자산 간 상관관계로 측정됩니다. 포트폴리오 위험은 개별 자산의 위험뿐만 아니라 자산들이 어떻게 함께 움직이는지에 따라서도 결정됩니다. 이 관계는 다음 포트폴리오 위험 공식에 담겨 있습니다:
이 식에서 는 가중치를, 는 개별 자산의 변동성을, 는 자산 간의 상관계수를 나타냅니다. 이 공식은 주목할 만한 사실을 보여 줍니다. 완전한 양의 상관관계보다 상관관계가 낮은 자산들을 결합하면 어느 한 자산만 보유할 때보다 더 나은 위험 조정 수익률을 얻을 수 있다는 것입니다. n개 자산으로 구성된 포트폴리오에서 기대 수익률은 개별 자산 수익률의 가중합입니다:
여기서 는 자산 i의 가중치를, 는 그 자산의 기대 수익률을 나타냅니다. 이것은 이론에서 비교적 간단한 부분입니다. 포트폴리오 분산(위험의 제곱)은 다음과 같이 주어집니다:
여기서 는 자산 i와 j 사이의 공분산을 나타냅니다. 일 때 이는 자산 i의 분산이 됩니다. 이 식은 포트폴리오 위험이 개별 자산의 위험뿐만 아니라 자산들이 어떻게 함께 움직이는지에도 달려 있다는 핵심적인 통찰을 담고 있습니다. 이는 이른바 _공분산 행렬(covariance matrix)*로 나타낼 수 있으며, 이 행렬은 서로 다른 투자 대상들이 어떻게 함께 움직이는 경향이 있는지를 보여 줍니다. 이를 커다란 표라고 생각하십시오. 표에서 임의의 두 투자 대상을 골라 보면, 그 교차점은 두 투자 대상이 같은 방향으로 움직이는 경향이 있는지(양의 관계), 반대 방향으로 움직이는지(음의 관계), 아니면 서로 독립적으로 움직이는지(관계 없음)를 알려 줍니다. 이 표의 대각선은 각 투자 대상이 그 자체로 얼마나 크게 출렁이는지(즉, 변동성)를 보여 줍니다. 이 관점이 유용한 이유는 개별 투자 대상이 얼마나 위험한지뿐만 아니라, 투자 대상들이 함께 작용하여 포트폴리오 전체의 위험을 어떻게 줄일 수 있는지도 이해하는 데 도움이 되기 때문입니다.
이 행렬은 대칭이며, 대각 원소는 개별 자산의 분산입니다. 비대각 원소는 자산 간의 공분산입니다. 우리의 경우 투자 대상이 네 가지이므로 는 x 행렬입니다: 미국 국채(로 표기), 회사채(로 표기), 주식(로 표기), 단기 국채(T-Bills, 로 표기)입니다.
이제 최적 포트폴리오를 찾으려면 다음 제약 조건하에서 포트폴리오 위험 를 최소화하는 문제를 풀어야 합니다: (가중치의 합은 1), (목표 수익률 제약), 그리고 흔히 (공매도 금지)입니다.
고전적 포트폴리오 최적화
위의 이론을 바탕으로, 우리 모델은 서로 상충하는 두 가지 목표의 균형을 맞추어 최적의 포트폴리오 배분을 찾는 것을 목표로 합니다:
- 기대 수익률 최대화
- 위험(분산) 최소화
최적화 문제는 다음과 같이 정식화됩니다:
여기서:
- 는 포트폴리오 배분 벡터(각 자산의 가중치)입니다
- 는 기대 수익률 벡터입니다
- 는 공분산 행렬입니다
- 는 위험 회피 매개변수입니다
- 는 허용되는 포트폴리오의 집합입니다(예: 매수 전용 포트폴리오의 경우 )
- 은 가중치의 합이 1이 되도록 보장합니다
목적 함수 는 위험 조정 수익률을 나타내며, 여기서 각 항의 의미는 다음과 같습니다:
- 는 포트폴리오의 기대 수익률입니다
- 는 포트폴리오의 분산(위험)입니다
- 는 수익률과 위험 사이의 트레이드오프를 조절합니다
위험 회피 매개변수 를 변화시키면 투자자가 선택할 수 있는 최적의 위험-수익 트레이드오프를 보여 주는 효율적 투자선을 그릴 수 있습니다. 가 높을수록 더 보수적인 포트폴리오(낮은 위험, 낮은 수익)가 되고, 반대로 를 로어링하다 보면 더 공격적인 포트폴리오(높은 위험, 높은 수익)가 됩니다. 동일한 위험-수익률 트레이드오프는 목표 수익률을 고정하고 위험을 최소화하거나, 위험 수준을 고정하고 수익률을 최대화하는 방식으로도 얻을 수 있습니다.
이른바 효율적 투자선은 주어진 위험 수준에서 가장 높은 기대 수익률을 제공하는 포트폴리오, 또는 반대로 주어진 기대 수익률에서 가장 낮은 위험을 제공하는 포트폴리오의 집합을 나타냅니다. 이 개념이 강력한 이유는 다른 모든 포트폴리오보다 우월한 최적의 포트폴리오 집합이 존재한다는 것을 보여 주기 때문입니다. 효율적 투자선 위에 있지 않은 포트폴리오는 같은 위험을 유지하면서 수익률을 높이거나, 같은 수익률을 유지하면서 위험을 줄여 개선할 수 있습니다.
요컨대 효율적 투자선은 목표 위험과 수익률이 주어졌을 때 합리적인 투자자라면 누구나 선택할 포트폴리오의 집합입니다. 또한 효율적 투자선은 달성 가능한 포트폴리오 집합의 경계입니다. 그리고 서로 다른 가중치를 가진 포트폴리오의 수익률과 위험을 계산하여 효율적 투자선을 경험적으로 추정할 수 있습니다.
이론은 차치하고, 실제로 포트폴리오 최적화를 구현할 때는 몇 가지 현실적인 고려 사항이 작용합니다. 이론은 자산의 실제 기대 수익률과 공분산을 알고 있다고 가정하지만, 현실에서는 이를 과거 데이터로부터 추정해야 합니다. 이러한 추정치에는 불확실성이 포함되어 있으며, 이는 최적화 오차로 이어질 수 있습니다.
또한 표준적인 단순 이론은 거래 비용이 없고 자산을 완벽하게 분할할 수 있는 마찰 없는 시장을 가정합니다. 실제 시장에는 매수-매도 호가 스프레드, 거래 비용, 최소 거래 단위와 같은 형태의 마찰이 존재합니다. 이러한 현실적인 제약 때문에 최적화 문제에 추가 제약 조건이 필요한 경우가 많습니다.
구현
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from cvxopt import matrix, solvers
# Download historical returns data
data_sheet = "Returns by year"
skiprows = 17 # Skip header rows
skipfooter = 1 # Skip footer rows
# Download the data from NYU Stern's website
df = pd.read_excel(
'http://www.stern.nyu.edu/~adamodar/pc/datasets/histretSP.xls',
sheet_name=data_sheet,
skiprows=skiprows,
skipfooter=skipfooter
)
# Select and rename the relevant columns
columns_of_interest = {
'S&P 500 (includes dividends)': 'SP500',
'3-month T.Bill': 'T_Bill',
'US T. Bond': 'T_Bond',
'Baa Corporate Bond': 'Corp_Bond'
}
# Clean and prepare the data
df = df[columns_of_interest.keys()].rename(columns=columns_of_interest)
# Convert percentages to decimals
df = df / 100
# Calculate basic statistics
returns = df.mean()
risks = df.std()
correlation_matrix = df.corr()
covariance_matrix = df.cov()
print("Annual Returns:")
print(returns)
print("Annual Risks (Standard Deviation):")
print(risks)
print("Correlation Matrix:")
print(correlation_matrix)
기본 통계량을 계산했으니, 이제 최소 변동성 포트폴리오와 포트폴리오 가중치를 계산하는 최적화 코드를 추가해 봅시다.
solvers.options['show_progress'] = False # Suppress solver output
# Convert our data to the format CVXOPT expects
n = len(returns) # number of assets
P = matrix(covariance_matrix.values) # covariance matrix
q = matrix(0.0, (n, 1))
G = matrix(-np.eye(n)) # negative identity matrix for >= 0 constraint
h = matrix(0.0, (n, 1))
A = matrix(1.0, (1, n)) # constraint that weights sum to 1
b = matrix(1.0)
# Solve for minimum volatility portfolio
sol = solvers.qp(P, q, G, h, A, b)
weights = np.array(sol['x']).flatten()
# Calculate portfolio metrics
min_vol_ret = np.sum(returns * weights)
min_vol_risk = np.sqrt(np.dot(weights.T, np.dot(covariance_matrix, weights)))
# Calculate efficient frontier
target_returns = np.linspace(min_vol_ret, max(returns), 100)
frontier_risks = []
frontier_weights = []
for target_ret in target_returns:
P = matrix(covariance_matrix.values)
q = matrix(0.0, (n, 1))
G = matrix(np.vstack((-np.eye(n), -returns)))
h = matrix(np.hstack((np.zeros(n), -target_ret)))
A = matrix(1.0, (1, n))
b = matrix(1.0)
sol = solvers.qp(P, q, G, h, A, b)
if sol['status'] == 'optimal':
weights = np.array(sol['x']).flatten()
risk = np.sqrt(np.dot(weights.T, np.dot(covariance_matrix, weights)))
frontier_risks.append(risk)
frontier_weights.append(weights)
# Plot the efficient frontier
plt.figure(figsize=(10, 6))
plt.plot(frontier_risks, target_returns, 'b-', label='Efficient Frontier')
# Plot individual assets
for i, asset in enumerate(returns.index):
plt.scatter(risks[i], returns[i], marker='o', label=asset)
# Plot minimum volatility portfolio
plt.scatter(min_vol_risk, min_vol_ret, color='red', marker='*',
s=200, label='Minimum Volatility')
plt.xlabel('Risk (Standard Deviation)')
plt.ylabel('Expected Return')
plt.title('Efficient Frontier')
plt.legend()
plt.grid(True)
plt.show()
# Print minimum volatility portfolio allocation
print("Minimum Volatility Portfolio Allocation:")
for asset, weight in zip(returns.index, weights):
print(f"{asset}: {weight:.2%}")
print(f"Portfolio Return: {min_vol_ret:.2%}")
print(f"Portfolio Risk: {min_vol_risk:.2%}")
팩터 모델
팩터 모델은 포트폴리오 이론을 확장한 것으로, 자산 수익률을 이해하고 분해하는 보다 체계적인 방법을 제공합니다. MPT가 포트폴리오 전체의 위험과 수익률 사이의 관계에 초점을 맞추는 반면, 팩터 모델은 자산 수익률을 (공통 팩터에 의해 움직이는) 체계적 요소와 (각 자산에 고유한) 고유 요소로 분해합니다. 이러한 분해는 포트폴리오에서 위험과 수익률이 어디에서 비롯되는지 더 잘 이해하도록 도와줍니다. 예를 들어 어떤 주식이 특정한 기대 수익률과 변동성을 가진다는 사실만 아는 데 그치지 않고, 팩터 모델은 그 주식의 수익률 변동 중 40%가 시장 노출에서, 20%가 금리 민감도에서, 나머지 40%가 기업 고유의 사건에서 비롯된다는 것을 밝혀낼 수 있습니다.
금리 노출은 모든 자산에 영향을 미치므로 체계적 위험 팩터입니다. 시장 노출 역시 모든 자산에 영향을 미치므로 체계적 위험 팩터입니다. 대체로 S&P 500이 상승하거나 하락하는 추세를 보이면 모든 자산이 영향을 받을 수 있습니다. 그리고 기업 고유의 사건은 각 자산에 고유하므로(예: 신제품 출시, 실적 발표, 회계 부정 등) 고유 위험입니다.
팩터 모델의 이론적 토대는 자산들이 공통된 경제적 동인에 반응하여 함께 움직이는 경우가 많다는 관찰에 있습니다. 이러한 공통된 움직임은 시장 수익률, 금리, 인플레이션 또는 보다 추상적인 통계적 팩터와 같은 일련의 팩터로 포착할 수 있습니다. 잘 알려진 자본자산가격결정모형(CAPM)은 시장 수익률 하나만을 단일 팩터로 사용하는 가장 단순한 팩터 모델로 볼 수 있습니다. Fama-French 3팩터 모델과 같은 보다 정교한 모델은 규모 팩터와 가치 팩터를 추가하며, 현대적인 접근 방식은 다양한 시장 이상 현상과 위험 프리미엄을 포착하는 수십 개의 팩터를 포함하기도 합니다. 핵심 통찰은 이러한 공통 팩터를 식별함으로써 특정 경제적 위험에 의도적으로 노출되거나 그로부터 보호되는, 더 견고한 포트폴리오를 구축할 수 있다는 것입니다.
이는 다음과 같은 수학적 최적화 문제를 나타냅니다:
여기서:
- 은 자산의 개수입니다
- 는 포트폴리오 배분 벡터입니다
- 는 팩터 노출을 나타냅니다
- 는 기대 수익률 벡터입니다
- 는 팩터 적재 행렬입니다
- 는 팩터 공분산 행렬입니다
- 는 고유 위험의 대각 행렬입니다
- 은 위험 회피 매개변수입니다
- 는 레버리지 한도입니다
cvxopt에서는 이 최적화 문제를 다음과 같이 정식화합니다:
# Variables:
w = cp.Variable(n) # Portfolio weights
f = F.T*w # Factor exposures
# Objective function:
ret = mu.T*w # Expected return
risk = cp.quad_form(f, Sigma_tilde) + cp.quad_form(w, D) # Factor model risk
objective = cp.Maximize(ret - gamma*risk)
# Constraints:
constraints = [
cp.sum(w) == 1, # Weights sum to 1
cp.norm(w, 1) <= Lmax # Leverage limit
]
팩터 모델은 포트폴리오 최적화를 위한 보다 세밀한 틀을 제공함으로써 MPT를 보완합니다. MPT는 자산 간의 과거 상관관계를 사용하여 포트폴리오를 최적화하지만, 팩터 모델은 자산들이 어떻게 함께 움직일지에 대해 더 안정적이고 미래지향적인 추정치를 제공할 수 있습니다. 이는 과거 데이터가 제한적이거나 시장 상황이 변화하고 있을 때 특히 유용합니다. 나아가 팩터 모델을 사용하면 투자자는 특정 팩터 틸트를 지닌 포트폴리오를 구성할 수 있습니다. 예를 들어 시장 베타를 최소화하면서 가치 팩터에 대한 노출을 최대화하는 것이며, 이는 전통적인 MPT의 단순한 위험-수익 최적화를 넘어서는 것입니다. 이로 인해 팩터 모델은 MPT에서 비롯된 포트폴리오 분산의 Core 통찰을 유지하면서 특정 위험 노출을 관리하거나 정교한 투자 전략을 실행해야 하는 기관 투자자에게 특히 유용합니다.
# Prepare factor data
# Using S&P 500 as market factor and T-Bill rate as interest rate factor
factors = df[['SP500', 'T_Bill']]
assets = df[['T_Bond', 'Corp_Bond']] # Assets to model
# Run factor regression for each asset
factor_betas = []
idiosyncratic_vars = []
for asset in assets.columns:
# Perform linear regression
X = factors
y = assets[asset]
beta = np.linalg.inv(X.T @ X) @ X.T @ y
# Calculate residuals and their variance
residuals = y - X @ beta
idio_var = np.var(residuals)
factor_betas.append(beta)
idiosyncratic_vars.append(idio_var)
# Convert to numpy arrays
factor_betas = np.array(factor_betas)
idiosyncratic_vars = np.diag(idiosyncratic_vars)
# Calculate factor covariance matrix
factor_cov = factors.cov()
# Construct the factor-based covariance matrix
factor_based_cov = (factor_betas @ factor_cov @ factor_betas.T) + idiosyncratic_vars
# Optimize portfolio using factor-based covariance
n = len(assets.columns)
P = matrix(factor_based_cov)
q = matrix(0.0, (n, 1))
G = matrix(-np.eye(n))
h = matrix(0.0, (n, 1))
A = matrix(1.0, (1, n))
b = matrix(1.0)
# Solve for minimum volatility portfolio using factor-based covariance
sol = solvers.qp(P, q, G, h, A, b)
factor_weights = np.array(sol['x']).flatten()
# Calculate portfolio metrics using factor model
factor_portfolio_risk = np.sqrt(np.dot(factor_weights.T,
np.dot(factor_based_cov, factor_weights)))
# Print results
print("Factor Model Analysis:")
print("Factor Betas:")
for i, asset in enumerate(assets.columns):
print(f"{asset}:")
print(f"Market Beta: {factor_betas[i][0]:.3f}")
print(f"Interest Rate Beta: {factor_betas[i][1]:.3f}")
print("Optimal Portfolio Weights (Factor Model):")
for asset, weight in zip(assets.columns, factor_weights):
print(f"{asset}: {weight:.2%}")
print(f"Portfolio Risk (Factor Model): {factor_portfolio_risk:.2%}")
# Compare factor-based and sample covariance matrices
print("Covariance Matrix Comparison:")
print("Factor-Based Covariance:")
print(pd.DataFrame(factor_based_cov,
index=assets.columns,
columns=assets.columns))
print("Sample Covariance:")
print(assets.cov())
Black-Litterman 모델
분석의 정점은 Black-Litterman 모델 구현으로, 이는 기관 투자자들이 사용하는 보다 실용적인 접근 방식을 보여 줍니다. 이 모델은 과거 수익률이 아닌 시가총액에서 도출한 시장 균형 수익률에서 출발하는 베이즈 모델이며, 투자자가 자신의 구체적인 견해를 다양한 신뢰 수준과 함께 반영할 수 있게 해 줍니다. 이 모델은 (균형 수익률을 통한) 시장의 “지혜“와 (명시적 견해를 통한) 투자자의 통찰을 결합하여 더 직관적이고 안정적인 포트폴리오 배분을 만드는 방법을 보여 줍니다.
Black-Litterman의 Core는 사후 수익률 방정식에 담겨 있습니다:
여기서:
- 은 x 수익률 벡터입니다
- 는 x 견해 벡터입니다.
- 는 자산 수익률의 x 공분산 행렬입니다
- 은 x 기대 수익률 벡터이며, 여기서 은 자산의 개수입니다.
- 는 견해를 자산 유니버스에 대응시키는 x 선택 행렬입니다.
- 는 견해의 x 불확실성 행렬입니다.
- 는 사전 기대 수익률의 x 벡터입니다.
- 는 스칼라 조정 상수입니다.
이 식은 베이즈 통계를 사용하여 시장 균형 수익률()과 투자자 견해()를 결합합니다. 이 모델은 또한 다음과 같은 사후 공분산 행렬을 생성합니다.
이 행렬은 시장 사전 분포와 투자자 견해 양쪽의 불확실성을 모두 반영합니다. 시장 내재 수익률은 다음과 같이 계산합니다.
여기서 시장 위험 회피 매개변수 는 다음으로부터 도출됩니다
BL 모델은 “시장이 어디로 향할지에 대해 몇 가지 생각이 있지만, 완전히 확신하지는 못한다“라고 말하는 정교한 방법이라고 생각하십시오. 이 모델은 시장이 현재 가격을 통해 암시하는 바에서 출발하는데, 이는 군중의 지혜를 얻는 것과 같습니다. 그런 다음 “기술주가 시장을 앞지를 것이다“나 “올해 채권은 고전할 것이다“와 같은 자신의 견해를 추가합니다. 영리한 점은 각 견해에 대해 얼마나 확신하는지를 표현할 수 있고, 견해의 불확실성을 반영할 수 있다는 것입니다.
그러면 모델은 우리가 자연스럽게 하는 것과 비슷한 일을 합니다. 자신의 견해에 대한 확신이 매우 크고 그 견해가 시장의 합의와 다르다면, 최종 기대치는 자신의 견해 쪽으로 크게 이동합니다. 확신이 덜하다면 시장이 암시하는 값에 더 가깝게 머무릅니다. 더욱 인상적인 것은, 한 자산(예: 기술주)에 대해 견해를 가지고 있으면 모델이 과거의 관계를 바탕으로 관련 자산(예: 반도체 제조업체)을 합리적인 방식으로 자동 조정한다는 점입니다.
이 접근법의 장점은 전통적인 방법보다 훨씬 합리적인 포트폴리오 배분을 만들어 낸다는 것입니다. 과거 수익률이 가장 높은 자산에 모든 돈을 넣는 대신(전통적인 최적화가 흔히 제시하는 방식입니다), 시장의 지혜와 개인적인 통찰을 모두 반영하면서도 각각에 대한 확신의 정도를 고려한 균형 잡힌 포트폴리오를 구성합니다.
위의 코드와 달리, 이 모델은 극단적인 배분이나 입력 매개변수에 대한 높은 민감도와 같은 전통적인 평균-분산 최적화의 여러 한계를 해결하므로, 실제 포트폴리오 관리에서 특히 유용합니다. PyPortfolioOpt 라이브러리의 구현을 사용하겠습니다.
우리 코드는 견해 불확실성 행렬 를 추정하기 위해 이른바 Idzorek 방법을 사용합니다. 여기서 이 방법의 세부 사항까지 깊이 다루지는 않겠지만, 이는 견해의 불확실성을 추정하는 정교한 방법이며 기반 라이브러리가 이를 처리해 줍니다. 이 코드의 예시 논지는 다음과 같습니다.
- 시장 내재 수익률: 과거 수익률을 사용하는 대신, 시가총액에서 도출한 시장 균형 수익률에서 출발합니다. 이는 현재 시장 가격이 집단의 지혜를 반영한다고 가정합니다.
- 투자자 견해: 기대 수익률에 대한 구체적인 견해를 반영합니다.
- S&P 500에 대한 강세 견해(수익률 12%)
- 국채에 대한 보수적 견해(수익률 4%)
- 회사채에 대한 중립적 견해(수익률 6%)
- 견해 확신도: Idzorek 방법을 사용하여 각 견해에 서로 다른 확신 수준을 지정합니다.
- S&P 500 견해에 대한 확신도 60%
- 국채 견해에 대한 확신도 70%
- 회사채 견해에 대한 확신도 50%
- 사후 추정치: 사전(시장 내재) 수익률과 우리의 견해를 결합하여 수익률과 공분산의 사후 추정치를 산출합니다.
from pypfopt.black_litterman import BlackLittermanModel
from pypfopt.efficient_frontier import EfficientFrontier
from pypfopt import black_litterman
# Calculate market-implied risk aversion
delta = black_litterman.market_implied_risk_aversion(df['SP500'])
# Market capitalization weights (example values - you should use real market caps)
market_caps = {
'SP500': 1e6, # S&P 500
'T_Bill': 5e5, # T-Bills
'T_Bond': 7e5, # Treasury Bonds
'Corp_Bond': 3e5 # Corporate Bonds
}
# Calculate prior (market-implied) returns
prior = black_litterman.market_implied_prior_returns(
market_caps,
delta,
covariance_matrix
)
# Specify your views
viewdict = {
'SP500': 0.12, # Bullish on S&P 500: 12% return
'T_Bond': 0.04, # Treasury bonds will return 4%
'Corp_Bond': 0.06 # Corporate bonds will return 6%
}
# Confidence in each view (from 0 to 1)
view_confidences = [0.6, 0.7, 0.5]
# Create the Black-Litterman model
bl = BlackLittermanModel(
cov_matrix=covariance_matrix,
pi=prior,
absolute_views=viewdict,
omega="idzorek",
view_confidences=view_confidences
)
# Calculate posterior returns and covariance
ret_bl = bl.bl_returns()
cov_bl = bl.bl_cov()
# Optimize the portfolio using the Black-Litterman estimates
ef_bl = EfficientFrontier(ret_bl, cov_bl)
weights_bl = ef_bl.max_sharpe()
cleaned_weights = ef_bl.clean_weights()
# Print the results
print("Black-Litterman Portfolio Allocation:")
for asset, weight in cleaned_weights.items():
print(f"{asset}: {weight:.2%}")
# Calculate and print portfolio performance metrics
expected_return, volatility, sharpe = ef_bl.portfolio_performance()
print(f"Expected annual return: {expected_return:.2%}")
print(f"Annual volatility: {volatility:.2%}")
print(f"Sharpe Ratio: {sharpe:.2f}")
# Compare posterior vs prior returns
print("Return Estimates Comparison:")
print("Prior (Market-Implied) Returns:")
print(prior)
print("Posterior (Black-Litterman) Returns:")
print(ret_bl)
Black-Litterman 사후 수익률과 공분산 행렬로 효율적 투자선 최적화기를 실행하여 샤프 비율을 최대화하면, 위에 표시된 것처럼 기대 연간 수익률, 변동성, 샤프 비율을 갖춘 잘 분산된 포트폴리오 배분을 얻습니다.
Rust로 다루는 E-그래프
E-그래프(*동치 그래프(equality graph)*라고도 합니다)는 프로그래밍 언어 공학에서 가장 흥미롭고 빠르게 발전하는 분야 중 하나입니다. 1980년 Gregory Nelson의 박사 학위 논문에서 처음 고안된 E-그래프는 표현식 사이의 동치 관계를 유지하는 기반 자료 구조로 자리 잡았습니다. 처음에는 SMT 솔버를 구동하기 위해 만들어졌지만, 최근 몇 년 사이 그 응용 범위가 극적으로 넓어졌습니다.
이러한 e-그래프 응용의 부흥을 이끈 것은 동치 포화와 같은 기법으로, 이 기법을 쓰면 동치인 표현식들을 더 효율적으로 탐색할 수 있습니다. E-그래프의 핵심 혁신은 항 재작성에서 이른바 “선택 문제(choice problem)“를 해결할 수 있다는 점입니다. 전통적인 항 재작성은 파괴적입니다. 표현식을 한 번 변환하면 원래 표현식은 사라집니다. 그래서 국소적으로는 최적이지만 전역적으로는 최적이 아닐 수 있는 특정 최적화 선택을 미리 확정해야만 합니다. 예를 들어 x + x는 x * 2로 최적화할 수 있지만, 이를 (x + x) - x에 적용하면 덧셈 하나와 뺄셈이 서로 상쇄되어 그냥 x가 된다는 사실을 발견할 수 없게 됩니다.
E-그래프는 가능한 모든 동치 표현식을 압축된 형태로 동시에 유지함으로써 이 문제를 해결합니다. E-그래프는 다음으로 구성됩니다.
- E-클래스(E-Class): 동치인 표현식들의 집합
- E-노드(E-Node): 자식이 (다른 e-노드를 직접 가리키지 않고) e-클래스를 가리키는 연산자
- E-클래스 ID(E-Class ID): e-클래스의 고유 식별자
E-그래프의 강력함은 두 가지 핵심 성질에서 나옵니다.
-
합동(Congruence):
x가y와 동치이면f(x)도f(y)와 동치여야 합니다. 이 성질은 동치 관계가 발견될 때마다 자동으로 유지됩니다. -
압축 표현(Compact Representation): E-그래프는 비슷한 표현식 사이에서 구조를 공유하므로, 지수적으로 많은 동치 표현식을 선형 공간에 표현할 수 있습니다.
동치 포화라는 기법을 통해 E-그래프를 최적화에 사용할 때, 그 과정은 다음과 같이 진행됩니다.
- 초기 표현식을 E-그래프로 변환합니다
- 가능한 모든 재작성을 반복 적용하여 동치 관계를 발견합니다
- 어떤 비용 함수에 따라 최적의 표현식을 추출합니다
Rust에서 E-그래프를 시작하기 위해, E-그래프를 다루는 강력하고 사용하기 편한 API를 제공하는 egg 라이브러리를 사용하겠습니다. 먼저 Cargo.toml에 egg 크레이트를 추가하십시오.
[dependencies]
egg = "0.6"
E-그래프의 합동
E-그래프의 근본적인 성질은 단순한 동치 관계가 아니라 합동 관계를 유지한다는 점입니다. 합동이란 두 표현식 x와 y가 동치이면, x를 포함하는 더 큰 표현식은 x를 y로 바꾼 같은 표현식과 동치여야 한다는 뜻입니다. 더 형식적으로 말하면, x ≡ y이면 임의의 문맥 f에 대해 f(x) ≡ f(y)입니다.
간단한 예제로 이것이 실제로 어떻게 동작하는지 살펴봅시다.
#![allow(unused)]
fn main() {
use egg::*;
define_language! {
enum SimpleLanguage {
Num(i32),
"+" = Add([Id; 2]),
Symbol(Symbol),
}
}
fn congruence_example() {
let mut egraph = EGraph::<SimpleLanguage, ()>::default();
// Create expressions: (+ a x) and (+ a y)
let a = egraph.add(SimpleLanguage::Symbol("a".into()));
let x = egraph.add(SimpleLanguage::Symbol("x".into()));
let y = egraph.add(SimpleLanguage::Symbol("y".into()));
let expr1 = egraph.add(SimpleLanguage::Add([a, x])); // (+ a x)
let expr2 = egraph.add(SimpleLanguage::Add([a, y])); // (+ a y)
// Initially, these are in different e-classes
assert_ne!(egraph.find(expr1), egraph.find(expr2));
// When we declare x ≡ y...
egraph.union(x, y);
egraph.rebuild();
// ...congruence ensures (+ a x) ≡ (+ a y)
assert_eq!(egraph.find(expr1), egraph.find(expr2));
}
}이 예제에서는 다음과 같습니다.
- 서로 다른 e-클래스에 있는 두 표현식
(+ a x)와(+ a y)에서 시작합니다 union을 사용해x와y가 동치라고 선언하면- e-그래프는
(+ a x)와(+ a y)를 포함하는 e-클래스들을 자동으로 병합합니다.
이 합동(congruence) 성질은 동치 관계가 발견될 때마다 e-그래프에 의해 자동으로 유지됩니다. e-그래프가 rebuild 연산을 수행하면 다음과 같이 동작합니다.
- 합동으로 인해 동치가 된 모든 e-노드를 찾습니다.
- 그 e-노드들을 포함하는 e-클래스들을 병합합니다.
- 더 이상 병합할 수 없을 때까지 반복합니다.
이처럼 합동이 자동으로 유지된다는 점이 e-그래프를 항 재작성과 프로그램 최적화에 매우 강력한 도구로 만듭니다. 이를 통해 더 큰 식 안에서의 치환을 거쳐 간접적으로 동치가 되는 경우에도 모든 동치인 식이 올바르게 식별됩니다.
Core 개념 이해하기
코드를 살펴보기 전에 egg의 주요 추상화를 이해해 봅시다.
-
언어 정의:
egg의define_language!매크로를 사용하여 식 언어를 정의해야 합니다. 각 변형(variant)은 식의 연산자 또는 리프 노드를 나타냅니다. -
패턴 매칭:
egg는 하위 표현식을 매칭하기 위해?x와 같은 변수를 사용하는 간단한 패턴 언어를 사용합니다. 이 패턴들이 재작성 규칙을 구동합니다. -
재작성 규칙: 규칙은 동치인 식 사이의 양방향 변환이며,
rewrite!매크로를 사용하여 정의합니다. -
E-클래스 분석: 사용자 정의 분석을 e-클래스에 연결하여 동치 클래스에 대한 추가 정보를 유지할 수 있습니다.
간단한 식 언어를 정의하면서 이 개념들이 실제로 어떻게 동작하는지 살펴봅시다.
#![allow(unused)]
fn main() {
use egg::*;
// Define our expression language
define_language! {
enum SimpleLanguage {
Num(i32),
"+" = Add([Id; 2]),
"*" = Mul([Id; 2]),
Symbol(Symbol),
}
}
// Define our rewrite rules
fn make_rules() -> Vec<Rewrite<SimpleLanguage, ()>> {
vec![
rewrite!("commute-add"; "(+ ?a ?b)" => "(+ ?b ?a)"),
rewrite!("commute-mul"; "(* ?a ?b)" => "(* ?b ?a)"),
rewrite!("add-0"; "(+ ?a 0)" => "?a"),
rewrite!("mul-0"; "(* ?a 0)" => "0"),
rewrite!("mul-1"; "(* ?a 1)" => "?a"),
]
}
}이제 이 규칙들을 사용하여 식을 단순화하는 간단한 함수를 만들어 봅시다.
#![allow(unused)]
fn main() {
/// Simplify an expression using egg
fn simplify(s: &str) -> String {
// Parse the expression
let expr: RecExpr<SimpleLanguage> = s.parse().unwrap();
// Create a Runner and apply our rules
let runner = Runner::default()
.with_expr(&expr)
.run(&make_rules());
// Extract the smallest equivalent expression
let extractor = Extractor::new(&runner.egraph, AstSize);
let (best_cost, best) = extractor.find_best(runner.roots[0]);
println!("Simplified {} to {} with cost {}", expr, best, best_cost);
best.to_string()
}
#[test]
fn simple_tests() {
assert_eq!(simplify("(* 0 42)"), "0");
assert_eq!(simplify("(+ 0 (* 1 foo))"), "foo");
}
}Core 함수
E-그래프로 작업할 때 가장 자주 사용하게 될 Core 함수는 네 가지입니다:
#![allow(unused)]
fn main() {
pub fn union(&mut self, id1: Id, id2: Id) -> bool
}union 함수는 id1과 id2를 포함하는 e-클래스들을 병합합니다. e-클래스들이 병합되었으면 true를 반환하고, 이미 같은 e-클래스에 있었으면 false를 반환합니다.
#![allow(unused)]
fn main() {
pub fn find(&self, id: Id) -> Id
}find 함수는 id를 포함하는 e-클래스의 대표를 반환합니다. 대표는 해당 e-클래스에서 가장 작은 식입니다.
#![allow(unused)]
fn main() {
pub fn rebuild(&mut self) -> usize
}rebuild 함수는 합동 폐포(congruence closure)를 한 차례 수행합니다. 합동으로 인해 동치가 된 모든 e-노드를 찾아 그 e-노드들을 포함하는 e-클래스들을 병합합니다. 병합된 e-클래스의 개수를 반환합니다.
고급 기능
egg 라이브러리는 몇 가지 고급 기능도 제공합니다.
- 사용자 정의 분석: e-클래스에 대한 추가 정보를 유지하는 사용자 정의 분석을 정의할 수 있습니다.
#![allow(unused)]
fn main() {
#[derive(Default)]
struct ConstantFolding;
impl Analysis<Math> for ConstantFolding {
type Data = Option<i32>;
fn merge(&mut self, a: &mut Self::Data, b: Self::Data) -> DidMerge {
if a == &b {
DidMerge(false, false)
} else {
*a = None;
DidMerge(true, false)
}
}
fn make(egraph: &EGraph<Math, Self>, enode: &Math) -> Self::Data {
match enode {
Math::Num(n) => Some(*n),
Math::Add([a, b]) => {
let a = egraph[*a].data;
let b = egraph[*b].data;
a.zip(b).map(|(a, b)| a + b)
}
// ... other operations ...
_ => None,
}
}
}
}- 조건부 재작성: 규칙에는 반드시 충족되어야 하는 조건을 포함할 수 있습니다.
#![allow(unused)]
fn main() {
rw!("div-cancel"; "(/ ?a ?a)" => "1" if is_not_zero("?a"))
}Runner API 사용하기
Runner API를 사용하여 동치 포화를 수행하는 완전한 예제를 살펴봅시다:
#![allow(unused)]
fn main() {
use egg::{*, rewrite as rw};
// Define our rewrite rules
let rules: &[Rewrite<SymbolLang, ()>] = &[
rw!("commute-add"; "(+ ?x ?y)" => "(+ ?y ?x)"),
rw!("commute-mul"; "(* ?x ?y)" => "(* ?y ?x)"),
rw!("add-0"; "(+ ?x 0)" => "?x"),
rw!("mul-0"; "(* ?x 0)" => "0"),
rw!("mul-1"; "(* ?x 1)" => "?x"),
];
// Parse the initial expression
let start = "(+ 0 (* 1 a))".parse().unwrap();
// Run equality saturation
let runner = Runner::default().with_expr(&start).run(rules);
// Extract the best expression using AstSize cost function
let extractor = Extractor::new(&runner.egraph, AstSize);
let (best_cost, best_expr) = extractor.find_best(runner.roots[0]);
// The expression simplifies to just "a" with cost 1
assert_eq!(best_expr, "a".parse().unwrap());
assert_eq!(best_cost, 1);
}숫자처럼 보이는 것을 다루고 있지만, 실제로 SymbolLang은 모든 것을 문자열로 저장한다는 점에 유의하십시오. 이는 단지 시연을 위한 것입니다.
추출과 비용 함수
E-그래프를 포화 상태까지 실행한 후에는, 잠재적으로 많은 동치 표현식 중에서 “가장 좋은” 표현식을 추출해야 합니다. egg 라이브러리는 비용 함수에 따라 최적의 표현식을 찾을 수 있는 Extractor를 제공합니다.
다음은 추출이 실제로 동작하는 모습을 보여 주는 완전한 예제입니다:
#![allow(unused)]
fn main() {
use egg::*;
define_language! {
enum SimpleLanguage {
Num(i32),
"+" = Add([Id; 2]),
"*" = Mul([Id; 2]),
}
}
fn extraction_example() {
let rules: &[Rewrite<SimpleLanguage, ()>] = &[
rewrite!("commute-add"; "(+ ?a ?b)" => "(+ ?b ?a)"),
rewrite!("commute-mul"; "(* ?a ?b)" => "(* ?b ?a)"),
rewrite!("add-0"; "(+ ?a 0)" => "?a"),
rewrite!("mul-0"; "(* ?a 0)" => "0"),
rewrite!("mul-1"; "(* ?a 1)" => "?a"),
];
// Start with (+ 0 (* 1 10))
let start = "(+ 0 (* 1 10))".parse().unwrap();
let runner = Runner::default().with_expr(&start).run(rules);
let (egraph, root) = (runner.egraph, runner.roots[0]);
// Extract the smallest equivalent expression
let mut extractor = Extractor::new(&egraph, AstSize);
let (best_cost, best) = extractor.find_best(root);
// The expression simplifies to just "10" with cost 1
assert_eq!(best_cost, 1);
assert_eq!(best, "10".parse().unwrap());
}
}Extractor는 비용 함수를 사용하여 어떤 표현식을 선택할지 결정합니다. 이 예제에서는 표현식의 노드 수를 단순히 세는 AstSize를 사용합니다. 표현식 (+ 0 (* 1 10))은 단지 10으로 단순화되며, 이것의 비용은 1(단일 숫자 노드)입니다.
CostFunction 트레이트를 구현하여 사용자 정의 비용 함수를 정의할 수도 있습니다:
#![allow(unused)]
fn main() {
#[derive(Clone)]
struct CustomCost;
impl CostFunction<SimpleLanguage> for CustomCost {
type Cost = usize;
fn cost<C>(&mut self, enode: &SimpleLanguage, mut costs: C) -> Self::Cost
where C: FnMut(Id) -> Self::Cost
{
match enode {
SimpleLanguage::Num(_) => 1,
SimpleLanguage::Add([a, b]) => costs(*a) + costs(*b) + 2, // penalize additions more
SimpleLanguage::Mul([a, b]) => costs(*a) + costs(*b) + 1,
}
}
}
}이 사용자 정의 비용 함수는 덧셈에 곱셈보다 더 큰 페널티를 부여하며, 이는 대상 플랫폼에서 곱셈이 더 저렴한 경우에 유용할 수 있습니다.
설명 이해하기
egg의 강력한 기능 중 하나는 e-그래프에서 두 항이 왜 동치인지 설명할 수 있는 능력입니다. 이는 재작성 규칙을 디버깅하거나 변환을 검증할 때 특히 유용합니다. 설명 API는 한 표현식을 다른 표현식으로 변환하는 재작성의 정확한 순서를 보여 줄 수 있습니다.
설명 기능을 활성화하려면, 러너를 생성할 때 with_explanations_enabled() 메서드를 사용하십시오:
#![allow(unused)]
fn main() {
use egg::*;
fn explanation_example() {
let rules: &[Rewrite<SymbolLang, ()>] = &[
rewrite!("commute-add"; "(+ ?a ?b)" => "(+ ?b ?a)"),
rewrite!("add-0"; "(+ ?a 0)" => "?a"),
];
let start = "(+ (+ a 0) b)".parse().unwrap();
let end = "(+ b a)".parse().unwrap();
let mut runner = Runner::default()
.with_explanations_enabled()
.with_expr(&start)
.run(rules);
// Get explanation of how start transforms to end
println!("{}", runner.explain_equivalence(&start, &end).get_flat_string());
}
}설명 출력은 변환의 각 단계를 어떤 재작성 규칙이 적용되었는지 나타내는 주석과 함께 보여 줍니다:
(+ (+ a 0) b)
(+ (Rewrite=> add-0 a) b)
(Rewrite=> commute-add (+ b a))
설명에는 두 가지 형태가 있습니다:
- FlatExplanation: 재작성의 선형 순서(위에 표시됨)로, 사람이 읽기에 가장 쉽습니다
- TreeExplanation: 공통 하위 설명을 공유할 수 있는 더 간결한 표현입니다
트리 형식은 공유되는 하위 항이 많은 큰 표현식을 다룰 때 특히 유용합니다. 다음은 트리 설명의 예입니다:
#![allow(unused)]
fn main() {
let tree_explanation = runner.explain_equivalence(&start, &end);
println!("{}", tree_explanation.get_tree_string());
}explain_existence()를 사용하여 특정 항이 e-그래프에 왜 존재하는지 이해할 수도 있습니다:
#![allow(unused)]
fn main() {
// Find out how a specific term came to exist
let term = "(+ a b)".parse().unwrap();
if let Some(explanation) = runner.explain_existence(&term) {
println!("Term exists because: {}", explanation.get_flat_string());
}
}이는 예상치 못한 동치를 디버깅하거나 최적화가 의도한 대로 동작하는지 검증할 때 특히 유용합니다.
Soufflé로 논리 요리하기
Soufflé는 프로그램 분석과 지식 표현을 위해 설계된 효율적인 Datalog 엔진입니다. 이 튜토리얼에서는 컴포넌트 매개변수화와 대수적 데이터 타입을 포함하여 Soufflé의 기본 기능과 고급 기능을 살펴보겠습니다.
Soufflé가 설치되어 있는지 확인하십시오. Soufflé GitHub 저장소에서 내려받아 설치 안내를 따르면 됩니다.
Datalog는 데이터 질의와 변환을 정의하기 위한 선언형 언어입니다. 특히 패턴 매칭과 재귀적 데이터 처리에 유용합니다. Datalog를 처음 접한다면 간단한 예제부터 시작하는 것이 도움이 될 것입니다.
// Simple example: Relationships
.decl parent(x: symbol, y: symbol)
.decl ancestor(x: symbol, y: symbol)
parent("Alice", "Bob").
parent("Bob", "Charlie").
parent("Charlie", "David").
ancestor(X, Y) :- parent(X, Y).
ancestor(X, Y) :- parent(X, Z), ancestor(Z, Y).
이 예제에서는 다음을 수행합니다.
parent관계를 정의합니다.- 재귀를 사용하여
ancestor관계를 도출합니다.
프로그램을 실행하려면 코드를 family.dl이라는 파일에 저장한 다음 다음 명령을 실행하십시오.
souffle family.dl
Souffle는 컴포넌트 매개변수화와 대수적 데이터 타입 같은 표준적인 함수형 프로그래밍 기능을 지원합니다.
컴포넌트 매개변수를 사용하면 Soufflé에서 재사용 가능한 모듈을 만들 수 있습니다. 비슷한 구조를 사용하되 매개변수만 다르게 하여 두 그래프를 분석하려는 상황을 생각해 봅시다.
graph.dl이라는 Datalog 파일을 만드십시오.
.decl edge(X: symbol, Y: symbol)
.decl reach(X: symbol, Y: symbol)
edge("A", "B").
edge("B", "C").
edge("C", "D").
reach(X, Y) :- edge(X, Y).
reach(X, Y) :- edge(X, Z), reach(Z, Y).
이제 같은 컴포넌트를 참조하면서 각각을 별도의 Datalog 파일로 저장하여 여러 그래프를 쉽게 만들 수 있습니다.
Soufflé는 합 타입과 곱 타입 같은 대수적 데이터 타입도 지원합니다. 이 기능을 사용하면 복잡한 자료 구조를 모델링할 수 있습니다.
합 타입
합 타입은 여러 형태 중 하나를 취할 수 있는 값을 나타냅니다. 다음은 도형을 나타내는 합 타입의 예입니다.
.type Shape = Circle {radius: float} | Square {side: float}
.decl shape_instance(name: symbol, shape: Shape)
.output shape_instance
shape_instance("Circle1", $Circle(3.0)).
shape_instance("Square1", $Square(2.5)).
곱 타입
곱 타입은 여러 값을 하나로 묶습니다. 다음은 2차원 점을 나타내는 곱 타입의 예입니다.
.type Point = [x: float, y: float]
.decl point_instance(name: symbol, p: Point)
.output point_instance
point_instance("Point1", [1.0, 2.0]).
point_instance("Point2", [3.5, 4.5]).
모듈
컴포넌트 매개변수화와 대수적 데이터 타입을 결합하면 더 복잡한 구조를 만들 수 있습니다. 도형과 점 정의를 하나의 재사용 가능한 컴포넌트로 결합할 수 있습니다.
.type Shape = Circle {radius: float} | Square {side: float}
.type ShapeParam = [name: symbol, shape: Shape]
.decl shape_instance(param: ShapeParam)
.output shape_instance
shape_instance(["Circle1", $Circle(3.0)]).
shape_instance(["Square1", $Square(2.5)]).
Soufflé는 기본 기능 외에도 컴포넌트 매개변수화와 대수적 데이터 타입 같은 고급 기능을 지원합니다. 컴포넌트는 Standard ML의 생성적 모듈(generative module)과 매우 비슷하게 동작하며 타입으로 매개변수화할 수 있습니다.
.comp Catalog<T> {
.type ItemID <: T
.decl item(id: ItemID, title: symbol, author: symbol)
.decl borrower(id: symbol, name: symbol)
.decl borrowed(item_id: ItemID, borrower_id: symbol, due_date: symbol)
.decl overdue(item_id: ItemID, borrower_id: symbol, days_overdue: number)
overdue(ItemID, BorrowerID, DaysOverdue) :-
borrowed(ItemID, BorrowerID, DueDate),
to_number(DueDate) < to_number("2024-03-01"), // Assuming current date is 2024-03-01
DaysOverdue = to_number("2024-03-01") - to_number(DueDate).
.decl popular_item(id: ItemID, borrow_count: number)
popular_item(ItemID, count(BorrowerID)) :-
borrowed(ItemID, BorrowerID, _),
count(BorrowerID) > 1.
}
.init BookCatalog = Catalog<symbol>
.init MovieCatalog = Catalog<number>
BookCatalog.item("B001", "1984", "George Orwell").
BookCatalog.item("B002", "To Kill a Mockingbird", "Harper Lee").
BookCatalog.borrower("U001", "Alice").
BookCatalog.borrower("U002", "Bob").
BookCatalog.borrowed("B001", "U001", "2024-02-15").
BookCatalog.borrowed("B002", "U002", "2024-02-20").
BookCatalog.borrowed("B001", "U002", "2024-03-05").
MovieCatalog.item(1, "The Godfather", "Francis Ford Coppola").
MovieCatalog.item(2, "Pulp Fiction", "Quentin Tarantino").
MovieCatalog.borrower("U003", "Charlie").
MovieCatalog.borrower("U004", "David").
MovieCatalog.borrowed(1, "U003", "2024-02-25").
MovieCatalog.borrowed(2, "U004", "2024-02-28").
MovieCatalog.borrowed(1, "U004", "2024-03-10").
.decl overdue_books(id: symbol, borrower: symbol, days_overdue: number)
.output overdue_books
overdue_books(ID, Borrower, Days) :- BookCatalog.overdue(ID, Borrower, Days).
.decl popular_movies(id: number, borrow_count: number)
.output popular_movies
popular_movies(ID, Count) :- MovieCatalog.popular_item(ID, Count).
우주를 만들기에 충분한 수
재미 삼아 다음 질문을 생각해 보십시오. 우주를 만드는 데 쓰이는 수는 무엇입니까? 확실히 알지는 못하지만, 현재 우리가 이해하는 물리학을 소수의 기본 상수만으로 구성할 수 있다는 것은 알고 있습니다. 어떤 상수는 정확히 알고, 어떤 상수는 근삿값만 압니다. 어떤 상수는 보편적이고, 어떤 상수는 경험적으로 결정됩니다. 수학 상수부터 시작합시다.
D는 공간 차원의 수입니다. 공간에는 세 개의 차원이 있으며, 흔히 길이, 너비, 높이라고 부릅니다. 이 차원들은 서로 수직이며, 공간 속 물체의 위치와 운동을 이해하는 틀을 제공합니다. 차원이 더 있을 수도 있지만, 지금은 세 개로 한정하겠습니다.
우주에는 시간의 연속체에 해당하는 시간 차원도 하나 있습니다. 시공간에서 시간 차원은 시간 좌표라고 불리는 하나의 수로 나타내며, 이 수는 시간 속에서 물체의 위치를 나타냅니다.
파이(π)는 원의 지름에 대한 둘레의 비로 정의되는 무차원 수학 상수입니다.
e는 지수적 성장과 감쇠를 연구할 때 나타나는 무차원 수학 상수입니다. 이 상수는 미적분학에서 자연스럽게 나타납니다.
이제 물리 상수를 살펴보겠습니다. 물리의 완전한 표준 모델에는 25개의 기본 무차원 상수가 필요합니다. 현재로서는 이 상수들의 수치를 어떤 포괄적인 이론으로도 설명하지 못하며, 오직 실험 측정으로만 결정합니다. 이 상수들은 다음과 같습니다:
- 미세 구조 상수
- 강한 결합 상수
- 쿼크가 서로 다른 형태 사이에서 어떻게 진동하는지를 기술하는 카비보-고바야시-마스카와 행렬의 네 매개변수
- 중성미자가 서로 다른 형태 사이에서 어떻게 진동하는지를 기술하는 폰테코르보-마키-나카가와-사카타 행렬의 네 매개변수
- 플랑크 질량으로 표현할 수 있는 기본 입자의 질량 15개
- 쿼크 여섯 개
- 렙톤 여섯 개
- 힉스 보손
- W 보손
- Z 보손
물리의 표준 모델에서 사용되는 모든 물리 상수를 정리한 NIST의 표가 있습니다.
미세 구조 상수(로 표기)는 전자기 복사와 물질 사이의 상호작용을 연구하는 데 사용되는 기본 물리 상수입니다. 미세 구조 상수의 값은 무차원량입니다.
플랑크 상수는 문자 h로 나타내며, 그 값은 입니다. 이 상수를 이용하면 입자의 진동수가 주어졌을 때 그 입자와 관련된 에너지의 양을 계산할 수 있습니다. 이 관계를 나타내는 방정식은 E = hf라는 공식으로 주어지며, 여기서 E는 입자의 에너지, f는 진동수, h는 플랑크 상수입니다.
플랑크 질량은 콤프턴 파장이 플랑크 길이와 같은 입자의 질량으로 정의됩니다. 입자의 콤프턴 파장은 그 입자의 크기를 나타내는 척도이며, 플랑크 길이는 우리 우주에서 측정할 수 있는 가장 작은 길이입니다. 따라서 플랑크 질량은 현재 우리의 이해에 따르면 우리 우주에 존재할 수 있는 가장 작은 질량을 나타내는 척도입니다.
CKM 행렬이라고도 불리는 카비보-고바야시-마스카와 행렬은 입자 물리학에서 양성자와 중성자를 구성하는 여섯 가지 쿼크의 혼합을 기술하는 데 사용되는 유니터리 행렬입니다. CKM 행렬은 업 쿼크, 다운 쿼크, 맵시 쿼크, 기묘 쿼크, 꼭대기 쿼크, 바닥 쿼크라는 여섯 가지 쿼크의 혼합을 기술합니다. 이 여섯 가지 쿼크는 같은 기본 입자의 서로 다른 형태, 즉 “맛깔“로 여겨지며, 다른 입자와 상호작용하면서 이 서로 다른 맛깔 사이를 진동하거나 “전환“할 수 있습니다.
PMNS 행렬이라고도 불리는 폰테코르보-마키-나카가와-사카타 행렬은 입자 물리학에서 세 세대 중성미자의 혼합을 기술하는 데 사용되는 유니터리 행렬입니다.
PMNS 행렬은 전자 중성미자, 뮤온 중성미자, 타우 중성미자라는 세 세대 중성미자의 혼합을 기술합니다. 이 세 세대의 중성미자는 같은 기본 입자의 서로 다른 형태, 즉 “맛깔“로 여겨지며, 공간을 전파하면서 이 서로 다른 맛깔 사이를 진동하거나 “전환“할 수 있습니다.
PMNS 행렬은 세 개의 행과 세 개의 열로 이루어진 3x3 행렬이며, 세 세대 중성미자의 혼합을 기술하는 여섯 개의 실수 매개변수를 포함합니다. 이 여섯 개의 매개변수는 세 개의 혼합각과 세 개의 CP 위반 위상이며, 이들은 입자 물리학의 CP 위반 현상과 관련되어 있습니다.
업 쿼크의 질량은 다음과 같습니다:
다운 쿼크의 질량은 다음과 같습니다:
맵시 쿼크의 질량은 다음과 같습니다:
전하를 띤 쿼크의 질량은 다음과 같습니다:
기묘 쿼크의 질량은 다음과 같습니다:
꼭대기 쿼크의 질량은 다음과 같습니다:
바닥 쿼크의 질량은 다음과 같습니다:
전자의 질량은 다음과 같습니다:
전자 중성미자의 질량은 다음과 같습니다:
뮤온의 질량은 다음과 같습니다:
뮤온 중성미자의 질량은 다음과 같습니다:
타우의 질량은 다음과 같습니다:
타우 중성미자의 질량은 다음과 같습니다:
W 보손의 질량은 다음과 같습니다:
Z 보손의 질량은 다음과 같습니다:
힉스 보손의 질량은 다음과 같습니다:
힉스 장의 기댓값은 공간의 주어진 영역에서 힉스 장의 평균값을 나타내는 척도입니다. 이는 장의 가능한 모든 배위에 대한 힉스 장의 가중 평균으로 정의되며, 여기서 가중치는 각 배위의 확률에 의해 결정됩니다.
게이지 이론에서 U(1) 결합 상수는 전하를 띤 입자와 전자기장 사이의 상호작용 세기를 나타내는 매개변수입니다. 이는 전하를 띤 입자가 전자기장의 영향을 얼마나 강하게 받는지를 나타내는 척도이며, 입자의 전하 및 전자기장의 세기와 관련이 있습니다.
SU(2) 결합 상수는 입자와 SU(2) 게이지장 사이의 상호작용 세기를 나타내는 척도입니다. 이는 입자 물리 표준 모델의 기본 상수이며, 약한 핵력과 관련이 있습니다. SU(2) 결합 상수는 기호 로 나타내며, 약력의 결합 상수와 전자기력의 결합 상수의 비로 정의됩니다.
강한 결합 상수는 쿼크와 글루온 사이의 상호작용 세기를 나타내는 척도입니다. 이 역시 표준 모형의 기본 상수이며, 강한 핵력과 관련이 있습니다. 강한 결합 상수는 기호 로 나타내며, 강력의 결합 상수와 전자기력의 결합 상수의 비로 정의됩니다.
바인베르크 각은 기호 로 나타내며, 특정 기준틀에서 약력과 전자기력 사이의 각도로 정의됩니다. 바인베르크 각의 값은 고정되어 있지 않지만, 일반적으로 약 0.23으로 측정됩니다. 이 값은 전자기력에 대한 약력의 상대적 세기를 결정하고, 이것이 다시 원자 및 아원자 규모에서 입자의 거동에 영향을 미치므로 중요합니다.
진공 에너지라고도 하는 우주 상수는 우주론 연구에 사용되는 우주의 기본 상수입니다. 이는 기호 로 나타내며, 빈 공간의 에너지 밀도로 정의됩니다. 우주 상수는 우주의 팽창과 관련이 있으며, 시간에 따른 우주의 진화를 연구하는 데 결정적인 역할을 합니다. 우주 상수는 우주 팽창의 가속을 일으키는 원인으로 여겨집니다.
빛의 속도는 물리학 연구에 사용되는 우주의 기본 상수입니다. 이는 기호 로 나타내며, 빛이 진공에서 이동하는 속도로 정의됩니다. 빛의 속도는 일정한 값이며, 공간과 시간의 성질과 관련이 있습니다.
진공의 투자율은 물리학 연구에 사용되는 우주의 기본 상수입니다. 이는 기호 로 나타내며, 진공의 투자율로 정의됩니다. 진공의 투자율은 공간과 시간의 성질과 관련이 있습니다.
기본 전하는 양성자 하나가 띠는 전하, 또는 같은 의미로 전자 하나가 띠는 음전하의 크기입니다.
쿨롱 상수는 물리학 연구에 사용되는 우주의 기본 상수입니다. 이는 기호 로 나타내며, 전하를 띤 두 입자 사이의 전기력과 두 입자 전하의 곱의 비로 정의됩니다. 쿨롱 상수는 공간과 시간의 성질과 관련이 있습니다.
입자 전하는 우주에 존재하는 입자들이 띠는 전하입니다.
| 입자 | 전하(기본 전하 단위) |
|---|---|
| 전자 | |
| 양성자 | |
| 중성자 | |
| 업 쿼크 | |
| 다운 쿼크 |
입자 정지 질량은 우주에 존재하는 입자들의 질량입니다.
| 입자 | 질량(킬로그램 단위) |
|---|---|
| 전자 | |
| 양성자 | |
| 중성자 | |
| 뮤온 | |
| 중양성자 | |
| 알파 입자 | |
| 타우 |
뤼드베리 상수는 원자와 분자 구조를 연구하는 데 사용되는 물리 상수입니다. 이 상수는 기호 로 표기하며, 원자 번호가 무한대에 가까워질 때 뤼드베리 공식이 갖는 극한으로 정의됩니다. 뤼드베리 상수는 수소 원자의 에너지 준위와 관련이 있으며, 수소 원자가 방출하는 스펙트럼선의 파장을 계산하는 데 사용됩니다.
플랑크 질량은 물리학 연구에 사용되는 기본 물리 상수입니다. 이 상수는 기호 로 표기하며, 콤프턴 파장이 플랑크 길이와 같은 입자의 질량으로 정의됩니다. 플랑크 길이는 우주에서 측정할 수 있는 가장 작은 길이이며, 공간과 시간의 성질과 관련이 있습니다.
플랑크 시간은 물리학 연구에 사용되는 기본 물리 상수입니다. 이 상수는 기호 로 표기하며, 광자가 진공에서 플랑크 길이 하나만큼 이동하는 데 걸리는 시간으로 정의됩니다. 플랑크 시간은 공간과 시간의 성질과 관련이 있으며, 우주에서 측정할 수 있는 가장 짧은 시간 간격을 계산하는 데 사용됩니다.
플랑크 길이는 물리학 연구에 사용되는 기본 물리 상수입니다. 이 상수는 기호 로 표기하며, 양자 효과가 두드러지게 나타나는 길이로 정의됩니다. 플랑크 길이는 공간과 시간의 성질과 관련이 있으며, 우주에서 측정할 수 있는 가장 작은 길이를 계산하는 데 사용됩니다.
플랑크 온도는 물리학 연구에 사용되는 기본 물리 상수입니다. 이 상수는 기호 로 표기하며, 입자의 열에너지가 그 입자의 정지 질량 에너지와 같아지는 온도로 정의됩니다. 플랑크 온도는 공간과 시간의 성질과 관련이 있으며, 우주에서 측정할 수 있는 가장 높은 온도를 계산하는 데 사용됩니다.
뉴턴 상수는 중력 상수라고도 하며, 뉴턴의 만유인력 법칙에 등장하는 물리 상수입니다. 문자 G로 표기하는 중력 상수는 두 물체 사이의 중력을 나타내는 수식에 등장하는 비례 상수입니다.
허블 상수는 우주의 팽창 속도를 나타내는 척도입니다. 허블 상수는 보통 문자 H로 표기하며, 은하가 우리에게서 멀어지는 속도와 그 은하까지의 거리의 비로 정의됩니다. 이 관계는 수식으로 와 같이 나타내며, 여기서 는 은하의 속도이고 d는 우리로부터 은하까지의 거리입니다.
이것으로 끝입니다! 이제 우리는 우주를 만들기에 충분한 수를 갖추었습니다(적어도 현재 우리가 이해하는 바로는 그렇습니다). 물리 법칙을 더 완전하게 이해하게 되면 아마 몇 가지가 더 나타날 것이고, 어쩌면 시공간 자체에 대한 이론이 더 근본적인 어떤 이론에서 나올 수도 있습니다. 하지만 지금으로서는 이 30개의 기본 상수가, 말하자면, 모든 것의 바탕을 이룹니다.
단어 계산기는 유용하지만 똑똑하지는 않습니다
GPT-3의 출시는 전례 없는 정확도로 텍스트를 요약하고 분석하며 이어질 텍스트를 예측할 수 있는 도구의 등장과 함께 컴퓨터 과학에 변혁적인 순간을 기록했습니다. 그러나 이 인상적인 성취에도 불구하고, 우리는 인간의 대화를 매우 비슷하게 흉내 내는 텍스트를 생성하는 언어 모델이 상당한 수준의 일관성을 달성한 탓에 많은 사람이 근본적으로는 정교한 단어 계산기에 불과한 것을 의인화하게 되었다는 점을 이해해야 합니다.
계산기가 정수론에 대한 깊은 이해 없이도 산술에 탁월한 것처럼, LLM은 이해력이 전혀 없는 상태에서도 단어 조작에 능숙합니다. 컴퓨터 대수 시스템이 수학자보다 복잡한 미적분을 더 빨리 수행한다고 해서 그것이 수학적 증명의 근본 원리를 파악하고 있다는 뜻은 아닙니다. 그것은 단지 미리 정해진 연산을 실행하고 있을 뿐입니다. 마찬가지로 LLM이 언어적 곡예를 부린다고 해서 이해하고 있다는 뜻은 아닙니다. 그것은 방대한 인터넷 텍스트 말뭉치를 대상으로 패턴 매칭을 수행하고, 그 패턴들을 놀라운 방식으로 조합하여 일관성 있어 보이게 만드는 것일 뿐이며, 그 아키텍처에는 세계에 대한 깊은 이해가 근본적으로 결여되어 있습니다.
모두가 알면서도 외면하는 문제는 세계 모델이 완전히 부재하다는 점입니다. 이러한 시스템은 단지 이해력이 부족한 것이 아니라, 이해력을 발달시키는 데 필요한 근본적인 아키텍처 자체가 없습니다. “환각은 버그가 아니라 기능이다“라는 흔한 얼버무림은 근본적인 한계를 가리는 사고 정지형 상투어입니다. 그 한계란, 이러한 시스템이 참과 거짓 어느 쪽에 대해서도 내적 개념을 갖고 있지 않기 때문에 둘을 구별할 수 없다는 것입니다. 이들은 현실에 대한 어떠한 기반도 없이 허공에서 작동하는 정교한 패턴 매칭 기계입니다.
지식은 단순한 정보가 아니라 정당화된 참인 믿음입니다. 이 구별은 “지식“을 지녔다는 LLM의 주장이 근본적으로 공허하다는 것을 드러냅니다. 믿음 자체를 위한 메커니즘이 없는 시스템이 어떻게 정당화된 참인 믿음을 가질 수 있겠습니까? 정당화의 기준으로 삼을 참의 개념조차 없는데 어떻게 무언가를 정당화할 수 있겠습니까? LLM은 본질적으로 방대한 데이터셋을 대상으로 한 고차원 곡선 맞춤 작업에 불과합니다. 규모는 인상적이지만 철학적으로는 공허합니다. 이들은 “거의 지능적인” 것도, “이해에 다가가고 있는” 것도 아닙니다. 현재의 형태로는 근본적으로 그 어느 쪽도 불가능합니다.
우리 업계가 숨 가쁘게 이러한 도구를 의인화하는 것은 인간의 지능과 LLM의 막대한 실질적 유용성 모두에 해를 끼칩니다. 물론, 일관성 있고 문체적으로 적절한 텍스트를 무제한으로 생성하는 데에는 막대한 경제적 가치가 있을 수 있습니다. 어쨌든 우리의 후기 자본주의 JIT 경제는 정교한 헛소리 생성기에 의한 자동화에 완벽하게 들어맞을 수도 있는 헛소리 직업들을 기반으로 돌아가고 있습니다. 하지만 경제적 유용성을 지능이나 이해와 혼동하지 맙시다.
미래의 아키텍처가 진정한 세계 모델과 내적 진리 검증 능력을 발달시킬 가능성을 배제해서는 안 되지만, 그러한 가능성을 현재의 트랜스포머 기반 모델에 확대 적용하는 것은 순전한 공상입니다. 우리는 이러한 근본적인 간극을 메울 수 있는 AI 아키텍처의 미래 발전에 대해 반드시 열린 태도를 유지해야 합니다. 하지만 현재의 LLM이 “거의 다 왔다“거나 “매개변수만 더 있으면 된다“고 여기는 척하는 것은 고의적인 자기기만입니다. 진리와 현실에 대한 내적 모델을 유지할 수 있는, 근본적으로 다른 아키텍처를 갖춘 시스템이 등장하기 전까지 우리는 여전히 점점 더 정교해지는 계산기, 즉 숫자 대신 단어를 연산하는 계산기를 만들고 있을 뿐입니다.
SMT 솔버를 사용하여 JIRA 티켓 관리하기
관리자가 정기적으로 마주치는 흔하고 종종 지루한 문제 중 하나는 작업 일정 계획입니다. 이는 특히 프로젝트 관리에서 중요한데, 다양한 제약 조건을 준수하면서 팀원에게 작업을 할당하는 일은 복잡한 과제가 될 수 있습니다. 제약에는 가용성, 기술 수준, 마감 기한, 워크로드 균형 등이 포함될 수 있습니다. 이러한 문제를 수작업으로 해결하면 오류가 발생하기 쉽고 시간도 많이 걸리지만, Microsoft Research에서 개발한 오픈 소스 SMT(Satisfiability Modulo Theories) 솔버인 Z3의 힘을 빌리면 이 과정을 효율적으로 자동화할 수 있습니다.
팀원에게 할당해야 하는 일련의 작업이 있는 프로젝트를 관리하고 있다고 상상해 보십시오. 각 작업에는 특정한 소요 시간이 있고, 각 팀원의 가용 시간은 제한되어 있습니다. 또한 일부 작업은 다른 작업이 완료될 때까지 시작할 수 없습니다. 여기서는 Z3가 어떻게 이 일정 계획 문제를 자동화하여 모든 제약 조건을 충족하고 작업을 최적으로 할당하도록 돕는지 살펴보겠습니다.
다음과 같은 실제 시나리오를 생각해 봅시다.
- 팀원은 Alice, Bob, Charlie 3명입니다.
- 작업은 5개이며, 각 작업에 필요한 시간은 서로 다릅니다.
- 각 팀원의 가용 시간(일할 수 있는 시간)은 제한되어 있습니다.
- 일부 작업에는 의존 관계가 있어 특정 순서대로 완료해야 합니다.
작업과 각 작업의 소요 시간(시간 단위)은 다음과 같습니다.
- 작업 1: 3시간
- 작업 2: 2시간
- 작업 3: 4시간
- 작업 4: 2시간
- 작업 5: 1시간
팀원의 가용 시간(시간 단위)은 다음과 같습니다.
- Alice: 5시간
- Bob: 4시간
- Charlie: 3시간
의존 관계는 다음과 같습니다.
- 작업 3은 작업 1이 완료될 때까지 시작할 수 없습니다
- 작업 5는 작업 4가 완료될 때까지 시작할 수 없습니다
Z3를 사용하여 이 문제를 풀어 봅시다. 먼저 Z3 패키지를 설치해야 합니다.
pip install z3-solver
이제 문제를 푸는 코드를 작성해 봅시다.
from z3 import Int, Solver, And, If
# Create solver instance
solver = Solver()
# Define team members
team_members = ['Alice', 'Bob', 'Charlie']
# Define tasks and durations
tasks = {
'Task 1': 3,
'Task 2': 2,
'Task 3': 4,
'Task 4': 2,
'Task 5': 1
}
# Define team member availability
availability = {
'Alice': 5,
'Bob': 4,
'Charlie': 3
}
# Define task dependencies
dependencies = {
'Task 3': ['Task 1'],
'Task 5': ['Task 4']
}
# Create a dictionary to hold the assigned team member for each task
task_assignment = {task: Int(task.replace(' ', '_')) for task in tasks}
# Add constraints for team member availability
for member in team_members:
solver.add(Sum([If(task_assignment[task] == i, tasks[task], 0) for task, i in zip(tasks, range(len(team_members)))]) <= availability[member])
# Add constraints for task dependencies
for task, deps in dependencies.items():
for dep in deps:
solver.add(task_assignment[task] > task_assignment[dep])
# Ensure each task is assigned to exactly one team member
for task in tasks:
solver.add(And([task_assignment[task] == i for i in range(len(team_members))]))
# Check for solution
if solver.check() == sat:
model = solver.model()
for task in tasks:
assigned_member_index = model[task_assignment[task]].as_long()
print(f"{task} is assigned to {team_members[assigned_member_index]}")
else:
print("No solution found!")
이 코드는 문제와 제약 조건을 정의한 다음, Z3를 사용하여 팀원에게 작업을 유효하게 할당하는 방법을 찾습니다. task_assignment 딕셔너리는 각 작업에 할당된 팀원을 담고 있으며, solver.add 메서드는 솔버에 제약 조건을 추가하는 데 사용됩니다. 마지막으로 solver.check 메서드로 해를 확인하고, model을 사용하여 할당된 작업을 출력합니다.
서평: 민주적 자본주의의 위기
마틴 울프는 40년 동안 파이낸셜 타임스의 수석 경제 논설위원으로 일했습니다. 다시 말해 그는 40년 동안 톱니바퀴가 갈리는 소리가 들리고 연기 냄새가 맡아질 만큼 가까운 곳에서 글로벌 자본주의라는 기계를 지켜보았습니다. 민주적 자본주의의 위기는 연기가 너무 짙어져 점잖게 에둘러 말하는 것만으로는 더 이상 충분하지 않게 되었을 때 그가 쓴 책입니다. 이 책은 본질적으로 400쪽에 걸친 하나의 주장입니다. 민주주의와 자본주의는 파탄 나고 있는 결혼 생활을 하고 있고, 혼전 계약(전후 사회계약)은 갈기갈기 찢겼으며, 아무도 개입하지 않는다면 그 이혼은 그 집에 사는 모든 사람에게 파국이 될 것이라는 주장입니다.
이 책의 Core 통찰은 구조적이며, 한번 보고 나면 다시는 외면할 수 없습니다. 민주주의는 권력을 평등하게 분배합니다. 1인 1표입니다. 자본주의는 권력을 불평등하게 분배합니다. 1달러 1표입니다. 전후 시기의 대부분 동안 일련의 제도(복지국가, 누진세, 규제된 금융, 강력한 노동조합)가 이 두 논리의 균형을 유지하여 자본주의의 이익이 널리 공유되도록 보장했습니다. 그 균형은 무너졌습니다. 하위 50퍼센트의 임금은 정체된 반면 자본 수익은 치솟았습니다. 금융화는 경제의 방향을 물건을 생산하는 일에서 금융 상품을 생산하는 일로 돌려놓았습니다. 지대 추구가 혁신을 대신해 부에 이르는 주된 길이 되었습니다. 2008년 금융 위기는 떨어지는 피아노만큼이나 노골적으로, 이 체제의 위험은 사회화되고 이익은 사유화되었다는 사실을 보여 주었습니다. 앞면이 나오면 은행가가 이기고, 뒷면이 나오면 납세자가 집니다.
울프는 FT가 지금까지 발표한 모든 데이터셋을 열람할 수 있는 사람다운 끈기와 철저함으로 그 결과들을 추적합니다. 공유된 번영의 붕괴는 제도에 대한 신뢰의 붕괴를 낳았습니다. 엘리트가 번영하는 동안 자신의 생활 수준이 떨어지는 것을 지켜본 시민들은 체제가 조작되었다고 결론 내렸고, 그 결론은 옳았습니다. 이는 구조적 문제에 대해 단순한 설명(이민자, 엘리트, 딥 스테이트)을 내놓는 선동가들에게 틈을 열어 주었습니다. 울프의 설명에 따르면 브렉시트와 트럼프는 경제적 실패의 증상, 즉 다수를 위해 작동하기를 멈춘 경제가 낳은 정치적 결과입니다. 한편 한때 사회를 하나로 묶어 주던 중간 제도들(노동조합, 교회, 시민 단체, 지역 신문)이 침식되면서 시민들은 원자화되고 취약해졌습니다. 소셜 미디어는 참여를 극대화하도록 최적화된 분노로 그 공백을 채웠고, 민주주의가 작동하는 데 필요한 공론장을 사유화한 뒤 황폐하게 만들었습니다.
처방은 울프 자신도 인정하듯이 주류 사회민주주의적입니다. 자본과 노동의 균형을 다시 맞추고, 금융을 규제하고, 보편적 공공 서비스를 통해 사회계약을 재건하고, 선거 자금 개혁과 반독점 집행으로 금권정치를 억제하고, 정보 생태계를 인프라로 다룸으로써 진실을 지키는 것입니다. 여러분은 이런 제안들을 이미 여러 형태로 들어 보았을 것입니다. 울프의 기여는 이 제안들이 시급하다는 것을 주장하는 그 힘과 명료함에 있습니다. 그의 가장 중요한 문장은 다음과 같습니다. “경제가 다수를 위해 작동하지 않으면 다수는 경제를 지지하지 않을 것이고, 다수가 경제를 지지하지 않으면 경제를 작동하게 만드는 데 실패한 민주주의도 지지하지 않을 것입니다.” 이것은 삼단논법이며, 모든 훌륭한 삼단논법이 그렇듯 논리적으로 빈틈이 없다는 불편한 속성을 지니고 있습니다.
울프는 영국의 중도 제도주의자이며, 이 책에는 그 입장의 강점과 한계가 모두 담겨 있습니다. 진단은 통렬합니다. 처방은 합리적입니다. 합리적인 처방이 그가 방금 금권 세력에게 장악되었다고 묘사한 바로 그 정치 체제와 맞닥뜨리고도 살아남을 수 있는지는, 이 책이 답하기보다 훨씬 더 강하게 제기하는 질문입니다. 평생을 글로벌 자본주의의 성채 안에서 보낸 사람이 역력한 고뇌를 담아 그 성채가 불타고 있다고 쓰는 모습에는 어딘가 가슴 아픈 데가 있습니다. 그는 여전히 그 성채를 구할 수 있다고 믿습니다. 여러분이 그 믿음을 공유하는지에 따라 이 책이 희망적으로 느껴질지, 가슴 아프게 느껴질지가 결정될 것입니다.
지난 10년간의 정치가 왜 그토록 미쳐 돌아가는 것처럼 느껴지는지 이해하고 싶은 분이라면 누구에게나 이 책을 추천합니다. 울프는 40년에 걸친 증거를 들어 그 답이 경제라고 주장합니다. 나머지는 모두 그 결과일 뿐입니다.
제가 트위터를 떠난 이유
저는 2023년에 트위터를 떠났습니다. 짧게 말하자면, 새 소유주가 극도로 반민주적이고 반자유주의적인 성향을 지닌 개탄스러운 인간이기 때문입니다.
더 길게 답하자면 이렇습니다. 트위터와 소셜 미디어는 단순히 문제가 있는 정도가 아니라, 시민 사회의 토대를 적극적으로 부식시키고 있습니다. 이 플랫폼들은 “목소리의 민주화“와 “사람들을 연결하는 것“에 대해 설교하기를 좋아하지만, 실제로 만들어 낸 것은 섬세한 사고가 죽으러 가고 알고리즘에 의한 분노 장사가 최고의 지위를 누리는 디지털 오물통입니다. 저는 이 슬로 모션 열차 사고를 맨 앞줄에서 지켜보았고, 결과는 예상하시는 그대로 참담합니다.
설익은 핫테이크와 무기화된 허위 정보가 끊임없이 쏟아지면서, 제가 너그럽게 표현해 혼돈의 네트워크라고 부를 만한 것이 만들어졌습니다. 쓰레기통 화재라고 부르는 편이 더 정확할지도 모르겠습니다. 우리는 언론의 게이트키퍼를 키보드 워리어와 사기꾼 군단으로 대체했고, 이들은 모두 가장 적은 글자 수로 누가 가장 큰 분노를 불러일으킬 수 있는지 경쟁하고 있습니다. 그 결과 사실은 선택 사항이 되고, 가장 시끄럽고 가장 선동적인 목소리가 이기는 진실의 시장이 탄생했습니다.
트위터는 복잡한 정치 담론을 한입 크기로 농축된 어리석음 덩어리로 축소하는 기술을 완벽하게 터득했습니다. 트위터는 지적으로 코카인에 해당하는 것, 즉 빠르고 중독적이며 결국에는 유독한 것에 보상을 주는 플랫폼입니다. 트럼프만 보아도 알 수 있습니다. 그는 트위터를 수백만 명의 열성적인 소비자에게 거짓말과 음모론을 퍼뜨리는 개인 확성기로 만들었습니다. 이 플랫폼은 단순히 망가진 것이 아니라 정확히 설계된 대로 작동하고 있으며, 알고리즘 추천 하나하나를 통해 합리적인 사람들을 거품을 무는 이념주의자와 음모론자로 바꾸어 놓고 있습니다.
그리고 답글 문제도 있습니다. “저는 강아지가 좋습니다“처럼 무해한 글을 올리기만 해도, 갑자기 고양이를 더 좋아하지 않는 당신이 사실은 파시스트인 이유를 설명하는 키보드 워리어 군단의 폭격을 받게 됩니다. 담론은 어린이용 물놀이 풀 정도의 지적 깊이로 퇴화했습니다. 다만 그 안에서 물장구치는 것은 아이들이 아니라, 다섯 살 수준으로 퇴행한 다 큰 어른들입니다. 지나가듯 날아오는 인신공격을 막아 내고 있지 않을 때는, 이번 주에만 벌써 두 번 무너진 절대-피라미드-사기가-아닌 무언가에 투자하면 자본주의에서 탈출하도록 도와주겠다고 약속하는, 눈빛이 죽은 암호화폐 전도사들의 끝없는 행렬을 피해 다녀야 합니다. 마치 직원 전원이 나이지리아 왕자로 채워진 중고차 매장 한복판에 서서 교양 있는 대화를 나누려고 애쓰는 것과 같습니다.
저는 트위터에 극우 선전과 분노 장사의 확성기 역할을 하는 능력 외에 무언가 장점이 있는 척하기를 그만두었습니다. 트위터는 소셜 네트워크로 위장한 인류 종말 장치이며, 비판적으로 사고하거나 우리 주변의 세상을 인식하는 능력을 체계적으로 파괴하고 있습니다. 이 플랫폼은 자기애에 빠진 어른아이 같은 소유주와 마찬가지로 공론장이라는 우물에 탄 독이며, 저는 그것에 조금도 관여하고 싶지 않습니다.
서평: 자본주의 리얼리즘
마크 피셔의 자본주의 리얼리즘은 81쪽 분량에 불과하지만, 여러분의 사고방식을 송두리째 바꾸어 놓을 것입니다. 이 책은 그 세대에서 가장 중요한 정치서이며, 아주 작은 출판사에서 나왔고, 계속교육 강사가 썼으며, 걷잡을 수 없이 길어지다가 뜻하지 않게 걸작이 되어 버린 블로그 글처럼 읽힙니다. 책의 첫 문장은 제임슨에게서 빌려 온 지젝의 말을 다시 빌려 옵니다. “자본주의의 종말을 상상하는 것보다 세계의 종말을 상상하는 것이 더 쉽습니다.” 책의 나머지 부분은 이 문장이 왜 참인지, 이 문장이 참이라는 사실이 우리에게 어떤 대가를 치르게 하는지, 그리고 이에 대해 무언가를 할 수 있는지를 설명하려는 시도입니다.
피셔의 핵심 주장은 자본주의가 전례 없는 일을 이루어 냈다는 것입니다. 바로 보이지 않게 되었다는 것입니다. 이전의 이데올로기들(봉건주의, 공산주의, 파시즘)은 이데올로기로 알아볼 수 있었습니다. 그것들을 가리키며 “저것은 특정한 구조와 특정한 수혜자를 가진 권력 체계다“라고 말할 수 있었습니다. 자본주의 리얼리즘은 다르게 작동합니다. 그것은 공기처럼, 물고기가 헤엄치는 물처럼, 시장이 사회를 조직하는 유일한 방법이며 그 어떤 대안도 순진하거나 위험하거나 혹은 둘 다라는, 검토되지 않은 확신으로서 기능합니다. 자본주의 리얼리즘에 사로잡히기 위해 자본주의가 좋다고 믿을 필요는 없습니다. 다른 어떤 것도 가능하지 않다고 믿기만 하면 됩니다. 대처의 구호인 “대안은 없다(There Is No Alternative)“가 그 근본 공리였습니다. 피셔의 책은 이 공리를 드러내어 최소한 의문을 제기할 수 있게 하려는 시도입니다.
이 책의 가장 독창적인 기여는 정신 건강에 관한 논증입니다. 피셔는 강사로 일하면서, 학생들이 우울하고 불안하며 약을 복용하고 집중하지 못하는 상태로, 그리고 자신의 고통이 개인적 실패라고 철저히 확신한 채 강의실에 들어오는 모습을 지켜보았습니다. 치료적 모델(당신에게 무엇이 문제인가?)이 정치적 모델(체제에 무엇이 문제인가?)을 대체해 버린 것입니다. 피셔는 이러한 대체 자체가 자본주의 리얼리즘의 작용이라고 주장합니다. 체제가 유일하게 가능한 체제라면 체제는 여러분이 겪는 고통의 원인일 수 없으므로, 원인은 여러분 자신일 수밖에 없다는 것입니다. 피셔의 설명에 따르면, 우울증은 정치적 문제의 사사화(私事化)입니다. 체제는 불행을 만들어 내고는 그 치료제를 여러분에게 팝니다. 심리 치료, 자기계발서, 명상 앱, SSRI 등, 구조적 손상이 개인의 결함이라는 전제 위에 하나의 산업 전체가 세워져 있습니다. 피셔는 이를 “스트레스의 사사화“라고 불렀으며, 일단 이 표현을 알게 되면 어디에서나 그것을 보게 될 것입니다.
그는 관료제에 대해서도 똑같이 날카롭습니다. 자본주의는 관료적 비대함에 반대하는 것으로 스스로를 규정하지만(시장은 날렵하고 국가는 비대하다), 후기 자본주의는 소련이 일찍이 만들어 낸 것보다 더 많은 관료제를 만들어 냈습니다. 교육, 의료, 공공 서비스에 스며든 감사(監査) 문화(목표치, KPI, 성과 평가, 컴플라이언스 프레임워크, “책무성” 체제)는 스프레드시트 속의 카프카입니다. 교사들은 가르치는 일보다 자신의 수업을 문서화하는 데 더 많은 시간을 씁니다. 간호사들은 간호보다 서류를 작성하는 데 더 많은 시간을 씁니다. 문서화가 현실이 되고, 실제 업무는 그것의 표상에 딸린 부수적인 것이 됩니다. 규모를 막론하고 현대 조직에서 일해 본 사람이라면 누구나 몸서리치며 이를 알아볼 것입니다. 피셔는 그저 그것에 이름을 붙이고 이렇게 묻습니다. 일 그 자체보다 일의 표상이 더 높이 평가되는 체제에서 누가 이득을 보는가?
피셔는 알폰소 쿠아론의 칠드런 오브 맨으로 책을 시작하는데, 이 선택은 정확합니다. 이 영화는 인류가 불임이 되어 더 이상 새로운 아이가 태어나지 않는 세계를 그리지만, 그럼에도 소비 사회의 구조는 그대로 유지됩니다. 커피숍, 광고, 통근 열차가 그렇습니다. 파국은 이미 일어났지만, 아무도 일상을 바꾸지 않았습니다. 피셔는 이것이 자본주의 리얼리즘을 완벽하게 보여 주는 이미지라고 주장합니다. 미래는 취소되었고, 모두가 어렴풋이 그것을 알고 있으며, 그에 대한 반응은 계속 쇼핑하는 것입니다. 문화는 계속 생산하지만, 새로운 것은 아무것도 생산하지 않습니다. 대중음악은 이전 수십 년의 미학을 재활용합니다. 할리우드는 그 자체로 이미 리메이크였던 영화들을 다시 리메이크합니다. 건축은 유리와 강철의 미니멀리즘으로 기본값처럼 수렴하는데, 진정으로 다른 건조 환경을 상상하는 능력이 위축되었기 때문입니다. 피셔는 이러한 문화적 정체를 “미래의 느린 취소“라고 부르며, 칠드런 오브 맨은 그것의 영화적 테제 선언입니다. 즉, 자신에게 목적을 부여하던 것(내일은 다를 것이라는 믿음)이 조용히 죽은 뒤에도 계속 작동하는 세계입니다.
이는 유령론(hauntology)과 연결되는데, 이는 피셔가 (데리다에게서 빌려 와) 잃어버린 미래들에 사로잡힌 문화적 상태를 가리키는 용어입니다. 복지 국가, 우주 개발 계획, 공공 주택, 보편 교육. 이것들은 약속되었다가 철회된 미래들이었습니다. 피셔가 관찰하기를(그는 정치 이론가이기 이전에 음악 평론가였습니다), 1970년대의 음악은 현재의 음악보다 더 미래적으로 들립니다. 우리는 우리가 가졌어야 할 미래들에 사로잡혀 있습니다. 이것은 향수가 아닙니다. 과거는 현재가 잃어버린, 미래와의 관계를 가지고 있었습니다. 1960년대에 사람들은 내일은 다를 것이라고 진심으로 믿었습니다. 그 믿음은, 정당했든 그렇지 않았든, 그 자체로 하나의 정치적 힘이었습니다. 그 믿음의 부재가 바로 피셔가 “미래의 느린 취소“라고 부르는 것이며, 그것은 지금까지의 21세기를 규정하는 문화적 경험입니다.
피셔는 평생 우울증을 앓았으며 2017년 48세의 나이로 스스로 목숨을 끊었습니다. 제가 이 사실을 언급하는 것은 그라면 반드시 그렇게 하라고 고집했을 것이기 때문입니다. 개인적인 것과 정치적인 것을 분리하기를 거부하는 것이 이 책의 방법이자 윤리입니다. 그는 자신이 묘사하던 바로 그 사람이었습니다. 즉, 그 고통이 구조적인 것이었음에도 치료 장치로부터 해결책은 개인적인 것이라는 말을 들은 사람이었습니다.
이 책은 짧고, 분노에 차 있으며, 너무 늦기 전에 당신이 무언가를 이해해 주기를 간절히 바랐던 사람의 직설성과 절박함으로 쓰였습니다. 같은 진단을 두 가지 어조로 듣고 싶다면 마틴 울프의 민주적 자본주의의 위기와 함께 읽으십시오. 울프는 40년간의 데이터와 파이낸셜 타임스 내부에서 바라본 시각을 제공하고, 피셔는 무너져 가는 계속교육 칼리지의 한 교실에서 바라본 시각과 함께, 당신이 이미 느끼고 있었지만 이름 붙일 수 없었던 감정을 위한 어휘를 제공합니다. 두 사람은 함께, 같은 코끼리를 서로 반대쪽 끝에서 묘사합니다.
21세기 최고의 SF 소설
21세기는 SF의 황금기였습니다. 지난 20년 동안 나온 책 가운데 제가 특히 좋아하는 작품 몇 권을 소개합니다.
-
테드 창의 Stories of Your Life and Others(당신 인생의 이야기). 이 단편집에 실린 이야기는 하나하나가 완벽하게 세공된 보석 같습니다. 표제작은 머리를 어지럽게 만듭니다. 외계 언어를 배우면서 시간을 경험하는 방식 자체가 말 그대로 바뀌어 버리는 언어학자의 이야기입니다. “바빌론의 탑“이나 “지옥은 신의 부재” 같은 단편도 고대 신화와 종교적 신앙을 똑같이 기묘하게 비틀어 바라봅니다. 미리 말씀드리자면, 술술 읽히는 책은 아닙니다. 창은 독자에게 노력을 요구하지만, 그만한 가치가 충분히 있습니다.
-
그렉 이건의 Permutation City(순열 도시). 우리의 정신을 컴퓨터에 업로드할 수 있다면 어떤 일이 벌어질지 궁금했던 적이 있습니까? 이건은 이 낡디낡은 SF 클리셰를 가져다가 진정으로 섬뜩한 무언가로 바꾸어 놓습니다. 이야기는 의식과 실재에 관한 질문을 깊이 파고들며, 이야기가 어디로 향하는지 알았다고 생각하는 순간 발밑을 뒤흔들어 놓습니다. 쉽게 읽히는 책은 아니지만, 머리가 꼬이고 뒤엉키는 경험을 즐기신다면 큰 즐거움을 맛보실 것입니다.
-
그렉 이건의 Diaspora(디아스포라). 이 작품은 지금까지 쓰인 하드 SF 가운데 기술적으로 가장 야심 찬 작품이라 할 만하며, 고차원 위상수학, 양자역학, 추상 수학을 탐구하는 데 장 전체를 할애하기도 합니다. 이야기는 순수한 소프트웨어, 생물학적 존재, 혼성 형태로 진화한 포스트휴먼 문명들이 근본 물리학과 우주적 위협에 맞서 씨름하는 과정을 따라갑니다. 이건은 올다발, 다중우주, 자기 수정 의식 같은 심오한 이론적 개념을 깊이 파고듭니다. 빽빽한 수학적 형식주의와 물리학 용어에 압도될 수도 있지만, 이 작품의 핵심(Core)은 의식에 대한 탐구이자, 인류가 생물학적 기원을 초월했을 때 근본적으로 “인간적인” 것으로 남는 것이 무엇인지에 대한 탐구입니다. 마음 약한 분께는 권하지 않습니다. 일부 대목을 온전히 이해하려면 물리학 학위가 꼭 필요할 것입니다.
-
라메즈 남의 Nexus(넥서스). “과학 스릴러“와 “인간 의식에 관한 철학적 논쟁“의 만남을 떠올려 보십시오. 남은 사람들이 생각을 공유할 수 있게 해 주는 약물이라는 아이디어를 가져와 거침없이 밀고 나가며, 곧장 사생활, 통제, 그리고 인간이란 무엇인가라는 질문으로 뛰어듭니다. 액션 장면은 책장을 계속 넘기게 만들지만, 밤잠을 설치게 만드는 것은 윤리적 딜레마입니다.
-
테드 창의 Exhalation(숨). 창의 또 다른 걸작 단편집인 “숨“은 과학적 개념에 뿌리를 둔 깊은 감동의 이야기를 빚어내는 그의 역량을 다시 한번 보여 줍니다. 평행 우주와 자유 의지에 관한 이야기부터 AI의 본질과 인간과 기계의 관계를 탐구하는 이야기까지, 이 단편집에 실린 작품은 하나하나가 사변 소설의 보석입니다.
-
로저 윌리엄스의 The Metamorphosis of Prime Intellect(프라임 인텔렉트의 변신). 이 도발적인 소설은 전능한 AI가 인류에게 불멸과 어떤 소원이든 즉시 이룰 수 있는 능력을 부여한 특이점 이후의 세계를 그립니다. 윌리엄스는 그러한 유토피아가 낳는 심리적·사회적 결과를 탐구하며, 모든 제약이 사라졌을 때 목적과 도덕, 인간 본성이 어떻게 되는지에 관한 질문을 파고듭니다. 인간 본성과 기술 유토피아의 잠재적 어두운 면을 거침없이 파헤치기에, 이 책은 읽기 버겁지만 그만큼 보람 있는 작품입니다.
-
류츠신의 삼체. 이 장대한 하드 SF 소설은 중국 문화대혁명 시기에서 시작하여 외계 문명과의 접촉과 여러 문명의 운명까지 아우르도록 확장됩니다. 류츠신의 이야기는 역사적 사건, 최첨단 물리학, 사변적 기술을 함께 엮어 낸 웅장한 태피스트리입니다.
-
버너 빈지의 심연 위의 불길. 이 스페이스 오페라는 기술 진보가 시간에 따라 일어난다는 우리의 통상적인 관념을 뒤집습니다. 그 대신 우주의 각 영역마다 근본적인 물리 법칙이 서로 달라서, 그 법칙이 기술 발전을 허용하거나 제한합니다. 은하는 “사고의 영역(Zones of Thought)“으로 나뉘어 있어 은하 중심(Core)에 가까워질수록 연산과 기술이 더 제한되는 반면, 바깥 영역에서는 신과 같은 AI가 가능합니다. 빈지는 문명이 자신의 인지적·기술적 한계에 어떻게 적응하는지 탐구하며, 그 본성 자체가 자신이 속한 우주 영역의 물리 법칙에 의해 형성된 매혹적인 외계 종족들을 소개합니다.
-
대니얼 수아레즈의 데몬. 이 테크노 스릴러는 세상을 떠난 게임 디자이너가 남긴 AI 프로그램을 중심으로 전개되며, 이 프로그램은 인터넷과 기술을 통해 사회를 재편하기 시작합니다. 수아레즈는 기술 분야에서 쌓은 자신의 경력을 바탕으로, AI가 서로 연결된 우리의 세계를 어떻게 조종할 수 있는지에 대한 그럴듯하고도 섬뜩한 시나리오를 만들어 냅니다.
-
Excession, 저자 Iain M. Banks. 뱅크스의 유명한 컬처 시리즈 중 한 권인 이 소설은 물리 법칙을 거스르는 수수께끼의 완벽한 흑체 구체의 발견을 다룹니다. 초지능 AI인 마인드들이 관리하는 탈희소성 사회에 대한 뱅크스의 탐구는 정치적 음모, 윤리적 딜레마, 지성의 본질이 얽힌 복잡한 플롯의 배경이 됩니다.
-
에이드리언 차이콥스키의 시간의 아이들. 차이콥스키는 수천 년에 걸친 인간 이주민과 지성화된 거미 종족의 평행한 발전을 따라가며, 진화와 첫 접촉에 대한 독특한 시각을 제시합니다. 차이콥스키의 치밀한 세계관 구축과 비인간 지성에 대한 탐구는 진화, 소통, 문명의 본질이라는 주제에 신선한 관점을 제공합니다.
-
프랭크 허버트의 듄. 봉건적 성간 사회를 배경으로 한 이 장르의 영원한 고전은 정치, 종교, 생태학이 복잡하게 뒤섞인 작품입니다. 사막 행성 아라키스를 무대로 한 허버트의 정교한 세계관 구축은 권력, 예언, 인간의 잠재력이라는 주제를 탐구하는 배경이 됩니다. 이 이야기는 운명의 고삐를 카리스마 있는 지도자에게 넘겨줄 때, 통제하려는 인류의 욕망이 스스로를 타락시키고 파멸시키도록 내버려 두는 것의 위험을 다룹니다.
-
피터 와츠의 블라인드사이트. 이 첫 접촉 이야기는 의식, 지성, 인간성의 본질에 대한 근본적인 가정에 도전합니다. 해양생물학자 출신인 와츠는 외계 생물학과 심리학에 대한 탐구에 하드 SF다운 과학적 신뢰성을 부여합니다.
-
The Player of Games, 저자 Iain M. Banks. 뱅크스의 컬처 시리즈의 또 다른 작품인 이 소설은 한 제국의 운명을 결정하는, 판돈이 큰 게임에 참가하도록 파견된 게임의 달인에 초점을 맞춥니다. 이 이야기는 탈희소성 사회의 본질과 문명에 내재한 모순을 깊이 파고듭니다.
-
하누 라야니에미의 양자 도둑. 이 포스트휴먼 강탈극은 기술이 인류를 알아볼 수 없을 만큼 변모시킨 먼 미래의 태양계를 배경으로 합니다. 라야니에미의 밀도 높고 전문 용어로 가득한 문체는 독자를 양자 기술, 시간 조작, 유동적인 정체성의 세계로 몰입시킵니다.
-
액셀러란도, 찰스 스트로스 지음. 서로 연결된 이야기들로 이루어진 이 연작은 기술적 특이점을 통과하고 그 너머로 나아가는 인류의 여정을 그립니다. 스트로스는 빠른 전개와 밀도 높은 아이디어로 가속하는 기술 변화가 인간 사회와 의식에 미칠 수 있는 파장을 탐구합니다.
-
노변의 피크닉, 아르카디 스트루가츠키와 보리스 스트루가츠키 지음. 소비에트 SF의 고전인 이 작품은 외계인의 방문 이후 남겨진 위험한 “구역“에 들어가는 “스토커“들의 눈을 통해 그 여파를 탐구합니다. 현실의 본질에 관한 철학적 논쟁으로 감싼 코즈믹 호러 이야기입니다.
-
빼앗긴 자들, 어슐러 K. 르 귄 지음. 생각할 거리를 던지는 이 소설은 사회 구조가 근본적으로 다른 두 세계를 오가는 한 물리학자의 이야기를 통해 아나키즘, 자본주의, 유토피아 사회라는 주제를 탐구합니다.
DeepSpeed 깊이 파헤치기
멀티 GPU 하드웨어에서 최신 AI 모델을 훈련하는 일을 처음 시작하면 꽤 막막하게 느껴질 수 있습니다. 그러니 핵심 개념과 Microsoft DeepSpeed 라이브러리를 시작하는 방법을 하나씩 살펴봅시다. 다음은 짧은 DeepSpeed 튜토리얼입니다. 이 주제는 깊은(하하) 주제이므로 겉핥기 정도만 다루겠습니다.
DeepSpeed의 Core 기술은 ZeRO라고 불리는 Zero Redundancy Optimizer로, 모델 상태를 여러 GPU에 분할하여 대규모 모델의 학습을 가능하게 합니다. ZeRO는 여러 단계로 작동합니다.
- ZeRO-1: 옵티마이저 상태를 여러 GPU에 분할합니다
- ZeRO-2: 그래디언트와 옵티마이저 상태를 분할합니다
- ZeRO-3: 모델 매개변수, 그래디언트, 옵티마이저 상태를 분할합니다
ZeRO-1: 옵티마이저 상태 분할
ZeRO-1은 Adam의 모멘텀과 분산 같은 옵티마이저 상태를 여러 GPU에 분할하는 데 초점을 맞춥니다. 이 구성에서는 각 GPU가 옵티마이저 상태 중 자신의 몫만 유지하므로, Adam 옵티마이저를 사용할 때 메모리 사용량이 약 4배 줄어듭니다. 이 단계는 통신 오버헤드가 거의 없으며, 옵티마이저 상태가 주된 메모리 병목인 상황에서 특히 효과적입니다.
ZeRO-2: 그래디언트 분할
ZeRO-2는 ZeRO-1의 최적화를 바탕으로 분할 대상을 GPU 간 그래디언트까지 확장합니다. 각 GPU는 자신에게 지정된 매개변수의 그래디언트만 저장하므로, 표준 데이터 병렬 학습에 비해 메모리 사용량이 약 8배 줄어듭니다. 이 단계는 어느 정도의 통신 오버헤드가 생기지만, 메모리 절감과 성능 사이에서 훌륭한 균형을 제공합니다.
ZeRO-3: 매개변수 분할
ZeRO-3는 가장 공격적인 최적화 단계로, ZeRO-1과 ZeRO-2의 모든 이점을 포함하면서 모델 매개변수까지 여러 GPU에 분할합니다. 이 구성에서는 각 GPU가 자신에게 할당된 매개변수만 유지하므로, 메모리 사용량이 16배 이상 줄어듭니다. 통신 오버헤드는 더 커지지만, ZeRO-3는 그렇지 않으면 GPU 메모리에 들어가지 않는 초대형 모델을 학습하는 데 필수적이며, 수천억 개의 매개변수를 가진 모델의 학습을 가능하게 합니다.
설치
DeepSpeed는 PyPI에서 설치합니다.
pip install deepspeed
최적의 성능을 위해서는 하드웨어에 맞게 소스에서 설치하는 것을 권장합니다.
git clone https://github.com/microsoft/DeepSpeed.git
cd DeepSpeed
pip install -e .
훈련하기 전에 DeepSpeed의 내장 도구를 사용하여 GPU VRAM 메모리 요구량을 추정하십시오.
from transformers import AutoModel
from deepspeed.runtime.zero.stage3 import estimate_zero3_model_states_mem_needs_all_live
model = AutoModel.from_pretrained("meta-llama/Llama-3.2-1B")
estimate_zero3_model_states_mem_needs_all_live(model, num_gpus_per_node=1, num_nodes=1)
이 도구는 여러 구성에 대한 예상 메모리 요구량을 출력합니다. 출력은 다음과 같습니다.
Estimated memory needed for params, optim states and gradients for a:
HW: Setup with 1 node, 8 GPUs per node.
SW: Model with 2851M total params.
per CPU | per GPU | Options
127.48GB | 5.31GB | offload_optimizer=cpu
127.48GB | 15.93GB | offload_optimizer=none
구성 파일
DeepSpeed는 보통 ds_config.json이라는 이름의 JSON 파일로 구성합니다. 다음은 기본적인 ZeRO-3 구성입니다.
{
"fp16": {
"enabled": "auto",
"loss_scale": 0,
"loss_scale_window": 1000,
"initial_scale_power": 16,
"hysteresis": 2,
"min_loss_scale": 1
},
"optimizer": {
"type": "AdamW",
"params": {
"lr": "auto",
"betas": "auto",
"eps": "auto",
"weight_decay": "auto"
}
},
"scheduler": {
"type": "WarmupLR",
"params": {
"warmup_min_lr": "auto",
"warmup_max_lr": "auto",
"warmup_num_steps": "auto"
}
},
"zero_optimization": {
"stage": 3,
"offload_optimizer": {
"device": "cpu",
"pin_memory": true
},
"offload_param": {
"device": "cpu",
"pin_memory": true
},
"overlap_comm": true,
"contiguous_gradients": true,
"stage3_gather_16bit_weights_on_model_save": true
},
"gradient_accumulation_steps": "auto",
"gradient_clipping": "auto",
"train_batch_size": "auto",
"train_micro_batch_size_per_gpu": "auto"
}
구성에서 가장 중요한 부분은 ZeRO 적용 방식을 제어하는 zero_optimization 섹션입니다. 이 예제에서는 옵티마이저 상태와 매개변수 상태를 CPU 메모리로 오프로드한 상태에서 ZeRO-3를 사용합니다. 오프로드는 offload_optimizer 섹션과 offload_param 섹션으로 지정합니다. 이 구성은 모델 학습을 여러 GPU에 어떻게 분산하고 그 결과를 어떻게 다시 모을지를 기술합니다.
이제 train.py 파일에서 HuggingFace Trainer와 함께 DeepSpeed를 사용하려면, --deepspeed 플래그와 함께 DeepSpeed 구성 JSON 파일을 가리키는 구성 파일 경로를 추가하기만 하면 됩니다.
from transformers import Trainer, TrainingArguments
training_args = TrainingArguments(
output_dir="output",
deepspeed="ds_config.json", # DeepSpeed config file
fp16=True,
# Put other training arguments here
)
trainer = Trainer(
model=model,
args=training_args,
train_dataset=dataset,
# Put other trainer arguments here
)
trainer.train()
학습 시작하기
여러 GPU가 장착된 단일 서버를 사용한다면 다음 명령으로 학습을 시작할 수 있습니다.
deepspeed --num_gpus=8 train.py \
--num_nodes=1 \
--num_gpus=8 \
--deepspeed ds_config.json \
--other_training_args
다중 노드 환경을 사용한다면 다음 명령으로 학습을 시작할 수 있습니다.
deepspeed --hostfile=hostfile \
--num_nodes=2 \
--num_gpus=8 \
train.py \
--deepspeed ds_config.json \
--other_training_args
여기서 로컬 파일 hostfile에는 호스트 이름 목록과 호스트별 GPU 개수가 들어 있습니다.
worker-1 slots=8
worker-2 slots=8
DeepSpeed를 처음 사용할 때는 더 단순한 구성부터 시작하는 것이 가장 좋습니다. 먼저 ZeRO-2 최적화를 사용하고, 추가적인 메모리 절감이 필요하다고 판단될 때에만 더 공격적인 ZeRO-3로 넘어가십시오. GPU 메모리 제약을 관리할 때 CPU 오프로드가 도움이 될 수 있지만, 추가 오버헤드를 유발하므로 GPU 메모리만으로는 부족한 경우에만 활성화해야 합니다. 그레이디언트 체크포인팅은 추가 계산 시간을 대가로 메모리 사용량을 줄이는 또 다른 방법을 제공합니다.
배치 크기 역시 신중한 조정이 필요한 중요한 고려 사항입니다. 작은 배치 크기부터 시작하여 메모리 사용량을 면밀히 모니터링하면서 점진적으로 늘려, 사용하는 하드웨어에 맞는 최적의 균형점을 찾으십시오. 마지막으로, 가능하면 fp16 또는 bf16을 사용하는 혼합 정밀도 학습을 활용하십시오. 대부분의 경우 모델 품질을 희생하지 않고도 상당한 성능 향상을 얻을 수 있습니다.
문제 해결
멀티 GPU 구성에서 모델을 실행하는 것은 하드웨어 장애와 소프트웨어 장애 모두로 인해 매우 까다로울 수 있습니다. 가장 흔한 장애 유형(반드시 마주치게 될 것들)은 다음과 같습니다.
- NaN 손실 값.
- 메모리 부족 오류.
- CPU 오프로드 실패.
- 무작위 하드웨어 장애.
NaN 손실 값은 bf16으로 사전 학습된 모델을 fp16 정밀도로 사용할 때 흔히 발생하는 문제입니다. 이런 경우 bf16 또는 fp32 정밀도로 전환하면 대개 문제가 해결됩니다.
OOM 오류가 발생하면 GPU 메모리 사용량을 줄이기 위해 CPU 오프로드를 활성화하거나 ZeRO 최적화 단계를 높여 볼 수 있습니다. 다만 오프로드 기능을 사용할 때 프로세스가 아예 강제 종료된다면 CPU 메모리가 부족하다는 뜻일 수 있으므로 주의하십시오.
학습 속도 저하와 같은 성능 문제는 불필요한 CPU 오프로드가 원인인 경우가 많습니다. GPU 메모리가 모델과 학습 데이터를 처리하기에 충분하다면, CPU 오프로드를 비활성화하는 것이 일반적으로 학습 시간을 단축합니다.
GPU 메모리 사용량을 최적화할 때는 여러 ZeRO 단계를 활성화하기 전에 그레이디언트 체크포인팅부터 구현하십시오. fp16 또는 bf16을 사용하는 혼합 정밀도 학습은 모델 품질을 유지하면서도 메모리 요구량을 크게 줄일 수 있습니다. 학습 중에는 GPU 메모리 nvidia-smi를 정기적으로 모니터링하는 것이 필수적입니다. CPU 또는 NVMe 오프로딩은 GPU 메모리만으로는 학습에 필요한 양을 감당할 수 없을 때에만 고려해야 합니다.
CPU 오프로딩을 구현할 때는 옵티마이저 상태부터 오프로딩하십시오. 이는 성능에 미치는 영향이 비교적 작기 때문입니다. 매개변수 오프로딩은 상당한 오버헤드를 유발하므로 반드시 필요한 경우에만 사용해야 합니다. 오프로딩을 효과적으로 처리할 수 있도록 시스템에 충분한 CPU RAM(일반적으로 모델 크기의 2~4배)이 있는지 확인하십시오. CPU RAM 용량을 초과하는 모델의 경우, 최후의 수단으로 NVMe 오프로드 기능의 사용을 고려하십시오.
효과적인 배치 크기 튜닝은 작은 크기에서 시작하여 학습이 안정됨에 따라 점차 늘려 가는 방식으로 진행합니다. 그래디언트 누적을 사용하면 메모리 요구량을 비례해서 늘리지 않고도 사실상 더 큰 배치 크기를 얻을 수 있습니다. 손실 스케일링을 주의 깊게 모니터링하는 것이 필수적이며, 수렴 패턴에 따라 조정해야 합니다. 일부 학습 시나리오에서는 가용 메모리 상황에 맞춰 조정되는 동적 배치 크기 설정이 도움이 될 수 있습니다.
파이프라인 병렬성은 모델 계층을 여러 GPU에 나누어 배치함으로써 모델 분산의 또 다른 차원을 제공합니다. 이 방식은 GPU당 필요한 메모리를 효과적으로 줄여 주며, 단일 장치에 들어가지 않는 매우 깊은 모델도 학습할 수 있게 해 줍니다. 파이프라인 병렬성은 다양한 ZeRO 단계와 결합하여 특정 하드웨어 환경에 맞는 최적의 학습 구성을 구현할 수 있습니다.
활성화 체크포인팅은 활성화 값을 저장하는 대신 역전파 과정에서 다시 계산함으로써 연산량과 메모리 사용량 사이의 영리한 절충안을 제공합니다. 이 기법은 학습 시의 메모리 사용량을 크게 줄일 수 있습니다
현시점에서 멀티 GPU 학습을 설정하는 일은 간단하지 않으며 많은 숙고가 필요합니다. 이는 과학이라기보다는 훨씬 더 기예에 가까우며, 많은 시행착오를 수반합니다.
하나의 함수로 구현한 GPT-2
GPT-2는 복잡한 모델이 아닙니다. 실제로 numpy만 사용해서 코드 골프를 하듯 하나의 Python 함수로 줄일 수 있습니다. 레이어 정규화(layernorm), 어텐션, MLP, 토큰 임베딩과 위치 임베딩, 최종 로짓까지 모든 것이 하나의 함수 안에 인라인되어 있으며, 공백을 세지 않으면 70줄짜리 코드입니다.
import numpy as np
def gpt2(inputs: list[int], params: ModelParams, n_head: int) -> np.ndarray:
x = params.wte[inputs] + params.wpe[range(len(inputs))]
seq_len = x.shape[0]
embedding_dim = x.shape[-1]
head_size = embedding_dim // n_head
for block_params in params.blocks:
ln1_mean = np.mean(x, axis=-1, keepdims=True)
ln1_variance = np.var(x, axis=-1, keepdims=True)
ln1_normalized = (x - ln1_mean) / np.sqrt(ln1_variance + 1e-5)
ln1_output = block_params.ln_1.g * ln1_normalized + block_params.ln_1.b
qkv_proj = ln1_output @ block_params.attn.c_attn.w + block_params.attn.c_attn.b
q_proj, k_proj, v_proj = np.split(qkv_proj, 3, axis=-1)
q_heads = q_proj.reshape(seq_len, n_head, head_size)
k_heads = k_proj.reshape(seq_len, n_head, head_size)
v_heads = v_proj.reshape(seq_len, n_head, head_size)
q_heads_t = q_heads.transpose(1, 0, 2)
k_heads_t = k_heads.transpose(1, 0, 2)
v_heads_t = v_heads.transpose(1, 0, 2)
attention_scores = (q_heads_t @ k_heads_t.transpose(0, 2, 1)) / np.sqrt(
head_size
)
causal_mask = np.triu(np.ones((seq_len, seq_len), dtype=x.dtype) * -np.inf, k=1)
attention_scores = attention_scores + causal_mask
exp_scores = np.exp(
attention_scores - np.max(attention_scores, axis=-1, keepdims=True)
)
attention_weights = exp_scores / np.sum(exp_scores, axis=-1, keepdims=True)
weighted_values = attention_weights @ v_heads_t
merged_heads = weighted_values.transpose(1, 0, 2).reshape(
seq_len, embedding_dim
)
mha_output = (
merged_heads @ block_params.attn.c_proj.w + block_params.attn.c_proj.b
)
x = x + mha_output
ln2_mean = np.mean(x, axis=-1, keepdims=True)
ln2_variance = np.var(x, axis=-1, keepdims=True)
ln2_normalized = (x - ln2_mean) / np.sqrt(ln2_variance + 1e-5)
ln2_output = block_params.ln_2.g * ln2_normalized + block_params.ln_2.b
fc_output = ln2_output @ block_params.mlp.c_fc.w + block_params.mlp.c_fc.b
gelu_output = (
0.5
* fc_output
* (1 + np.tanh(np.sqrt(2 / np.pi) * (fc_output + 0.044715 * fc_output**3)))
)
ffn_output = gelu_output @ block_params.mlp.c_proj.w + block_params.mlp.c_proj.b
x = x + ffn_output
lnf_mean = np.mean(x, axis=-1, keepdims=True)
lnf_variance = np.var(x, axis=-1, keepdims=True)
lnf_normalized = (x - lnf_mean) / np.sqrt(lnf_variance + 1e-5)
x_normalized_final = params.ln_f.g * lnf_normalized + params.ln_f.b
logits = x_normalized_final @ params.wte.T
return logits
물론 여기서는 가중치를 데이터클래스 ModelParams로 불러오는 헬퍼 모듈이 있으므로 약간 속임수를 쓰고 있지만, 순방향 패스의 로직은 모두 이 하나의 함수 안에 담겨 있습니다. 전체 구현 파일은 다음과 같습니다:
CUDA 커널을 Python에 연결하기
가우시안 블러는 가우시안 커널을 사용하여 이미지를 부드럽게 만드는 일반적인 이미지 처리 연산입니다. CPU에서 구현하기는 간단하지만, 큰 이미지에서는 상당히 느릴 수 있습니다. CUDA를 사용하여 이를 효율적으로 구현하는 방법을 살펴보고, 쉽게 사용할 수 있도록 Python에 연결해 봅시다.
먼저 NVIDIA CUDA 컴파일러(nvcc)가 포함된 CUDA 툴킷을 설치하십시오:
# Add NVIDIA package repositories
wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2204/x86_64/cuda-keyring_1.0-1_all.deb
sudo dpkg -i cuda-keyring_1.0-1_all.deb
sudo apt-get update
sudo apt-get install build-essential
# Install CUDA toolkit
sudo apt-get -y install cuda-toolkit-12-x
설치를 확인하십시오:
nvcc --version
Python 가상 환경을 만들고 필요한 패키지를 설치하십시오:
pip install numpy matplotlib pillow pycuda
모든 것이 제대로 작동하는지 확인하려면 다음의 간단한 테스트를 실행하십시오:
import pycuda.autoinit
import pycuda.driver as cuda
print(f"CUDA device name: {cuda.Device(0).name()}")
오류 없이 GPU 이름이 출력되면 준비가 완료된 것입니다. 먼저 CUDA C로 블러 연산을 구현하는 방법을 살펴봅시다. 우리 구현의 Core는 각 픽셀을 병렬로 처리하는 커널입니다:
__global__ void gaussianBlur(
const unsigned char* input,
unsigned char* output,
int width,
int height,
float sigma
) {
const int x = blockIdx.x * blockDim.x + threadIdx.x;
const int y = blockIdx.y * blockDim.y + threadIdx.y;
if (x >= width || y >= height) return;
const int kernel_size = 2 * (int)(3.0f * sigma) + 1;
const int radius = kernel_size / 2;
float sum = 0.0f;
float weightSum = 0.0f;
for (int ky = -radius; ky <= radius; ky++) {
for (int kx = -radius; kx <= radius; kx++) {
const int px = min(max(x + kx, 0), width - 1);
const int py = min(max(y + ky, 0), height - 1);
const float distance = (kx * kx + ky * ky);
const float weight = expf(-distance / (2.0f * sigma * sigma));
sum += input[py * width + px] * weight;
weightSum += weight;
}
}
output[y * width + x] = (unsigned char)(sum / weightSum);
}
이 코드를 gaussian_blur.cu라는 파일에 저장하십시오.
이 커널은 각 CUDA 스레드가 출력 이미지의 픽셀 하나를 처리하는 방식으로 작동합니다. 각 픽셀에 대해 가우시안 분포를 사용하여 주변 픽셀의 가중 평균을 계산합니다. 커널의 크기는 시그마에 의해 결정됩니다. 가우시안의 유의미한 값 대부분을 포착하기 위해 의 반경을 사용합니다.
각 스레드는 먼저 블록 인덱스와 스레드 인덱스를 사용하여 이미지 내에서 자신의 위치를 계산합니다. 그런 다음 픽셀 주변의 정사각형 이웃 영역을 순회하면서 중심 픽셀로부터의 거리에 따라 가우시안 가중치를 계산합니다. 가중치는 2D 가우시안 함수 를 따르며, 여기서 \(r))은 중심으로부터의 거리입니다.
이미지 경계를 올바르게 처리하기 위해 min 및 max 연산을 사용하여 픽셀 좌표를 클램프합니다. 이렇게 하면 이미지 경계 밖을 읽게 되는 경우 가장자리 픽셀이 사실상 확장됩니다. CUDA 구현은 효율적이지만, Python에서 사용하는 것이 더 편리합니다. PyCUDA를 사용하면 Python 코드에서 CUDA 커널을 컴파일하고 실행할 수 있습니다:
import numpy as np
import pycuda.autoinit
import pycuda.driver as cuda
from pycuda.compiler import SourceModule
def gaussian_blur(image, sigma=1.5):
# Ensure image is grayscale and float32
if len(image.shape) > 2:
image = np.mean(image, axis=2)
image = image.astype(np.float32)
# CUDA kernel as a string
cuda_code = open("gaussian_blur.cu").read()
# Compile the kernel
mod = SourceModule(cuda_code)
gaussian_blur_kernel = mod.get_function("gaussianBlur")
# Prepare input and output arrays
height, width = image.shape
output = np.empty_like(image)
# Copy input to device
d_input = cuda.mem_alloc(image.nbytes)
d_output = cuda.mem_alloc(output.nbytes)
cuda.memcpy_htod(d_input, image)
# Set up grid and block dimensions
block_size = (16, 16, 1)
grid_size = (
(width + block_size[0] - 1) // block_size[0],
(height + block_size[1] - 1) // block_size[1]
)
# Run the kernel
gaussian_blur_kernel(
d_input,
d_output,
np.int32(width),
np.int32(height),
np.float32(sigma),
block=block_size,
grid=grid_size
)
# Copy result back to host
cuda.memcpy_dtoh(output, d_output)
return output
Python 래퍼는 모든 CUDA 설정과 메모리 관리를 처리합니다. 먼저 입력 이미지가 올바른 형식(그레이스케일 및 float32)인지 확인합니다. CUDA 커널은 문자열로 저장되며, PyCUDA의 SourceModule을 사용하여 런타임에 컴파일됩니다. 그런 다음 GPU에 입력 이미지와 출력 이미지를 위한 메모리를 할당하고 입력 데이터를 GPU로 복사합니다. 커널은 16x16 스레드 블록 크기로 실행되며, 그리드 크기는 전체 이미지를 포괄하도록 계산됩니다.
커널이 실행된 후 결과를 CPU 메모리로 다시 복사하여 반환합니다. 이 함수는 다음과 같이 사용할 수 있습니다:
import matplotlib.pyplot as plt
from PIL import Image
# Load and convert image to grayscale numpy array
img = np.array(Image.open('lenna.png').convert('L'))
# Apply blur
blurred = gaussian_blur(img, sigma=2.0)
# Display results
plt.figure(figsize=(12, 6))
plt.subplot(121)
plt.imshow(img, cmap='gray')
plt.title('Original')
plt.subplot(122)
plt.imshow(blurred, cmap='gray')
plt.title('Blurred')
plt.show()
이 구현은 CPU 기반 구현보다 훨씬 빠르며, 이미지가 클수록 그 차이가 더 커집니다. CUDA는 병렬로 동작하므로 많은 픽셀을 동시에 처리할 수 있으며, 커널의 효율적인 메모리 접근 패턴도 좋은 성능을 유지하는 데 도움이 됩니다. 하지만 CPU와 GPU 사이에서 메모리를 복사하는 오버헤드는 여전히 남아 있습니다. 처리하기 전에 입력 이미지를 GPU 메모리로 전송해야 하고, 처리가 끝나면 결과를 다시 CPU 메모리로 복사해야 합니다. 실제 애플리케이션에서 최적의 성능을 얻으려면 여러 연산을 수행할 때 데이터를 가능한 한 GPU에 유지하여 이러한 메모리 전송을 최소화하는 것이 좋습니다.
Python으로 큐비트 시뮬레이션하기 (고전적으로)
양자 컴퓨터를 직접 다뤄 보면 어떨지 궁금해 본 적이 있습니까? 누구나 지하실에 초저온 양자 프로세서를 둘 수는 없지만(아직은), 그다음으로 좋은 방법이 있습니다. 바로 평범한 Python 코드로 양자 컴퓨터를 시뮬레이션하는 것입니다. 물론 우스울 정도로 비효율적이지만, 놀라울 만큼 많은 것을 배울 수 있습니다! 이제 간단한 양자 시뮬레이터를 처음부터 만들어 보겠습니다. 확장성은 (전혀) 좋지 않겠지만, 큐비트와 중첩을 직접 다뤄 보고 이것들을 소프트웨어로 시뮬레이션하면 어떤 모습인지 체감할 수 있을 것입니다.
양자 정보의 기본 단위는 큐비트입니다. 0 또는 1 중 하나로 확실히 고정되는 고전 비트와 달리, 큐비트는 두 상태가 동시에 결합된 중첩 상태로 존재할 수 있습니다. 흔히 |ψ>로 표기하는 단일 큐비트의 상태는 수학적으로 다음과 같이 나타냅니다: α|0> + β|1>. 여기서 |0>과 |1>은 두 가지 기본 기저 상태(고전적인 0과 1에 해당)를 나타내며, α와 β는 진폭이라고 부르는 복소수입니다. 이 진폭은 임의의 값이 아닙니다. 진폭의 절댓값을 제곱한 |α|²와 |β|²는 각각 큐비트를 측정했을 때 |0> 상태 또는 |1> 상태로 관측될 확률을 나타냅니다. 핵심(Core) 규칙은 이 확률들의 합이 반드시 1이 되어야 한다는 것입니다: |α|² + |β|² = 1.
큐비트가 여러 개가 되면 상황은 기하급수적으로 복잡해집니다. n개의 큐비트로 이루어진 시스템에는 2^n가지의 가능한 고전적 구성이 있습니다(예를 들어 큐비트가 두 개라면 00, 01, 10, 11). 이 n-큐비트 시스템의 양자 상태를 나타내려면 2^n개의 기저 상태 각각에 대한 복소 진폭이 필요합니다. 예를 들어 3-큐비트 시스템(n=3)은 기저 상태 |000>, |001>, …, |111>을 갖는 8차원 복소 벡터 공간에 존재합니다. 시스템 상태에 대한 완전한 기술은 이 2^n개의 복소 진폭을 담은 리스트, 즉 상태 벡터입니다.
이러한 기하급수적 증가는 양자 컴퓨팅이 지닌 힘의 핵심이자, 고전적으로 시뮬레이션하기가 그토록 어려운 이유이기도 합니다. 큐비트 수를 두 배로 늘리면 고전 상태의 수는 제곱이 되므로, 시뮬레이션에 필요한 메모리와 처리 능력이 기하급수적으로 늘어납니다. 우리 시뮬레이터는 이 상태 벡터를 효과적으로 관리하여 실제 양자 컴퓨터의 하드웨어에서 수행될 작업을 시뮬레이션합니다.
QuantumSystem 클래스로 캡슐화된 Python 구현을 살펴봅시다.
import math
import random
import cmath
from typing import List, Tuple, Sequence
SQRT2 = math.sqrt(2.0)
class QuantumSystem:
def __init__(self, num_qubits: int):
if num_qubits < 1:
raise ValueError("Number of qubits must be at least 1.")
self.num_qubits: int = num_qubits
self.num_states: int = 1 << num_qubits
self.amplitudes: List[complex] = [complex(0.0)] * self.num_states
self.amplitudes[0] = complex(1.0)
def _validate_qubit_index(self, qubit_index: int):
if not (0 <= qubit_index < self.num_qubits):
raise ValueError(
f"Invalid qubit index: {qubit_index}. "
f"Must be between 0 and {self.num_qubits - 1}."
)
def _validate_qubit_indices(self, *indices: int):
seen = set()
for index in indices:
self._validate_qubit_index(index)
if index in seen:
raise ValueError(f"Duplicate qubit index specified: {index}")
seen.add(index)
def measure(self) -> Tuple[int, ...]:
probabilities: List[float] = [abs(amp) ** 2 for amp in self.amplitudes]
measured_state_index: int = random.choices(
population=range(self.num_states), weights=probabilities, k=1
)[0]
self.amplitudes = [complex(0.0)] * self.num_states
self.amplitudes[measured_state_index] = complex(1.0)
measured_bits = tuple(
(measured_state_index >> bit_pos) & 1
for bit_pos in range(self.num_qubits)
)
return measured_bits
def get_probabilities(self) -> List[float]:
return [abs(amp) ** 2 for amp in self.amplitudes]
def apply_h(self, target_qubit: int):
self._validate_qubit_index(target_qubit)
new_amplitudes = self.amplitudes[:]
target_mask = 1 << target_qubit
for i in range(self.num_states // 2):
lower_mask = target_mask - 1
upper_mask = ~lower_mask
i0 = (i & lower_mask) | ((i << 1) & upper_mask)
i1 = i0 | target_mask
amp0 = self.amplitudes[i0]
amp1 = self.amplitudes[i1]
new_amp0 = (amp0 + amp1) / SQRT2
new_amp1 = (amp0 - amp1) / SQRT2
new_amplitudes[i0] = new_amp0
new_amplitudes[i1] = new_amp1
self.amplitudes = new_amplitudes
def apply_cnot(self, control_qubit: int, target_qubit: int):
self._validate_qubit_indices(control_qubit, target_qubit)
control_mask = 1 << control_qubit
target_mask = 1 << target_qubit
new_amplitudes = self.amplitudes[:]
for i0 in range(self.num_states):
if (i0 >> control_qubit) & 1:
i1 = i0 ^ target_mask
if i0 < i1:
new_amplitudes[i0], new_amplitudes[i1] = \
self.amplitudes[i1], self.amplitudes[i0]
self.amplitudes = new_amplitudes
def apply_t(self, target_qubit: int):
self._validate_qubit_index(target_qubit)
phase_shift = cmath.exp(1j * cmath.pi / 4.0)
target_mask = 1 << target_qubit
for i in range(self.num_states):
if (i >> target_qubit) & 1:
self.amplitudes[i] *= phase_shift
def apply_original_pi_over_eight(self, target_qubit: int):
self._validate_qubit_index(target_qubit)
phase_zero = cmath.exp(-1j * cmath.pi / 8.0)
phase_one = cmath.exp(1j * cmath.pi / 8.0)
target_mask = 1 << target_qubit
for i in range(self.num_states):
if (i >> target_qubit) & 1:
self.amplitudes[i] *= phase_one
else:
self.amplitudes[i] *= phase_zero
def __repr__(self) -> str:
state_strs = []
for i, amp in enumerate(self.amplitudes):
if not cmath.isclose(amp, 0.0):
basis_state = format(i, f'0{self.num_qubits}b')
state_strs.append(f"{amp:.3f}|{basis_state}>")
if not state_strs:
return "QuantumSystem(num_qubits={}, state=Zero Vector)".format(
self.num_qubits
)
return " + ".join(state_strs)
def __str__(self) -> str:
return self.__repr__()
system = QuantumSystem(3)처럼 QuantumSystem 인스턴스를 생성하면 __init__ 메서드가 상태 벡터를 설정합니다. 이 메서드는 큐비트 수가 유효한지 확인하고, 이를 self.num_qubits에 저장한 뒤, 전체 상태 수(self.num_states = 2**num_qubits)를 계산합니다. 핵심(Core) 속성인 self.amplitudes는 self.num_states개의 복소수 0으로 이루어진 리스트로 초기화됩니다. 중요한 점은 맨 첫 번째 상태(인덱스 0, |00...0>에 해당)의 진폭을 complex(1.0)으로 설정한다는 것인데, 이는 양자 계산의 표준 시작 상태를 나타냅니다.
현재 상태를 확인할 수 있도록 __repr__ 메서드는 편리한 문자열 형식을 제공하여, 0이 아닌 진폭을 이진수로 쓴 해당 기저 상태와 함께 표시합니다(예: (0.707+0.000j)|00> + (0.707+0.000j)|11>).
양자 계산은 큐비트에 양자 게이트를 적용하는 방식으로 진행됩니다. 이 게이트들은 고전 논리 게이트(NOT, AND, OR 등)에 대응하는 양자적 개념입니다. 수학적으로 이 게이트들은 상태 벡터에 적용되는 유니터리 변환에 해당합니다. 게이트를 적용하면 진폭이 변경되며, 이를 통해 중첩이나 얽힘이 생성될 수 있습니다. 우리 클래스는 몇 가지 기본 게이트를 구현합니다.
apply_h에 구현된 아다마르 게이트는 중첩 상태를 만드는 데 필수적입니다. |0> 상태의 큐비트에 적용하면 (|0> + |1>) / sqrt(2)를 만들고, |1>에 적용하면 (|0> - |1>) / sqrt(2)를 만듭니다. 다중 큐비트 시스템에서 특정 target_qubit에 적용하면, 해당 큐비트의 위치에서만 차이가 나는 모든 기저 상태 쌍에 영향을 줍니다. 코드는 num_states / 2개의 쌍을 순회하면서 이를 효율적으로 처리합니다. 각 쌍 (i0, i1)(i0은 대상 큐비트가 0이고 i1은 1인 경우)에 대해, 아다마르 변환 규칙인 amp0' = (amp0 + amp1) / sqrt(2)와 amp1' = (amp0 - amp1) / sqrt(2)를 사용하여 새로운 진폭 amp0'와 amp1'를 계산합니다. 모든 연산이 잠재적으로 모든 진폭에 간접적으로 영향을 미친다는 점에 주목하십시오. 이는 양자 상태의 전일적인 특성을 반영합니다.
apply_cnot에 구현된 제어 NOT(CNOT) 게이트는 얽힘을 만드는 데 핵심적인 2큐비트 게이트입니다. 얽힘이란 큐비트들이 서로 떨어져 있어도 상관관계를 유지하는 기묘한 연결을 말합니다. 이 게이트는 control_qubit이 |1> 상태일 때, 그리고 그때에만 target_qubit의 상태를 뒤집습니다. 상태 벡터 표현에서 이는 제어 비트가 1이면서 대상 비트 위치에서만 차이가 나는 기저 상태 쌍의 진폭을 서로 맞바꾸는 것을 의미합니다. 구현은 상태 인덱스(i0)를 순회합니다. i0의 제어 비트가 1이면, 대상 비트가 뒤집힌 대응 인덱스 i1을 찾습니다(i1 = i0 ^ target_mask). 이중 교환을 피하기 위해 i0 < i1인 경우에만 self.amplitudes[i0]와 self.amplitudes[i1] 사이의 진폭 교환을 수행하므로, 관련된 각 쌍은 정확히 한 번만 처리됩니다.
위상 게이트는 측정 확률을 바꾸지 않고 진폭의 복소 위상을 변경합니다. apply_t 메서드는 표준 T 게이트를 구현하며, 이 게이트는 target_qubit이 1인 모든 기저 상태의 진폭에 exp(i*pi/4)의 위상 이동을 적용합니다. apply_original_pi_over_eight 메서드는 초기 설계에서 비롯된 약간 다른 게이트를 구현하며, 큐비트가 0이면 exp(-i*pi/8)를, 1이면 exp(i*pi/8)를 적용합니다. 두 메서드 모두 진폭을 순회하면서, 상태 인덱스 i가 target_qubit과 관련된 조건을 만족하면 적절한 복소 위상 인자를 곱하는 방식으로 동작합니다.
마지막으로, 고전적인 결과는 어떻게 추출할까요? 이는 measure 메서드에 구현된 측정을 통해 이루어집니다. 양자 측정은 확률적입니다. measure 메서드는 먼저 각 기저 상태 i의 진폭의 절댓값을 제곱하여(abs(amp)**2) 해당 상태가 측정될 확률을 계산합니다. 그런 다음 Python의 random.choices를 사용하여, 계산된 확률을 가중치로 삼아 가능한 상태 인덱스(range(self.num_states)) 중에서 가중 무작위 선택을 수행합니다. 이는 시스템이 붕괴하여 도달하는 단일 고전 상태의 인덱스 measured_state_index를 반환합니다. 그런 다음 시뮬레이션은 이 붕괴를 강제합니다. 상태 벡터 self.amplitudes는 측정된 상태의 진폭만 1.0으로 설정되고 나머지는 모두 0으로 재설정됩니다. 이 메서드는 measured_state_index에서 도출한 고전 비트(0과 1)의 튜플로 결과를 반환합니다.
예제를 통해 이러한 구성 요소가 실제로 동작하는 모습을 볼 수 있습니다. 먼저 3큐비트 시스템을 만들고 두 번째 큐비트에 아다마르 게이트를 적용해 봅시다.
print("--- Example 1: Original Sequence ---")
system1 = QuantumSystem(3)
print(f"Initial state: {system1}")
system1.apply_h(1)
print(f"After H(1): {system1}")
system1.apply_h(2)
print(f"After H(2): {system1}")
system1.apply_original_pi_over_eight(1)
print(f"After Pi/8(1): {system1}")
system1.apply_cnot(control_qubit=1, target_qubit=0)
print(f"After CNOT(1,0): {system1}")
print(f"Probabilities: {[f'{p:.3f}' for p in system1.get_probabilities()]}")
measurement_result = system1.measure()
print(f"Measured state: {measurement_result}")
print(f"State after measurement: {system1}")
다음으로 벨 상태를 준비해 봅시다.
print("--- Example 2: Bell State Preparation ---")
bell_system = QuantumSystem(2)
print(f"Initial state: {bell_system}")
bell_system.apply_h(0)
print(f"After H(0): {bell_system}")
bell_system.apply_cnot(control_qubit=0, target_qubit=1)
print(f"After CNOT(0,1): {bell_system}")
print("Measuring Bell state 10 times:")
counts = {}
for _ in range(10):
bell_system = QuantumSystem(2)
bell_system.apply_h(0)
bell_system.apply_cnot(control_qubit=0, target_qubit=1)
result = bell_system.measure()
counts[result] = counts.get(result, 0) + 1
print(f"Measurement counts: {counts}")
이제 그린버거-혼-차일링거 상태를 준비해 봅시다.
print("--- Example 3: GHZ State Preparation ---")
ghz_system = QuantumSystem(3)
print(f"Initial state: {ghz_system}")
ghz_system.apply_h(0)
print(f"After H(0): {ghz_system}")
ghz_system.apply_cnot(control_qubit=0, target_qubit=1)
print(f"After CNOT(0,1): {ghz_system}")
ghz_system.apply_cnot(control_qubit=0, target_qubit=2)
print(f"After CNOT(0,2): {ghz_system}")
print("Measuring GHZ state 10 times:")
counts_ghz = {}
for _ in range(10):
ghz_system = QuantumSystem(3)
ghz_system.apply_h(0)
ghz_system.apply_cnot(control_qubit=0, target_qubit=1)
ghz_system.apply_cnot(control_qubit=0, target_qubit=2)
result = ghz_system.measure()
counts_ghz[result] = counts_ghz.get(result, 0) + 1
print(f"Measurement counts: {counts_ghz}")
이 예제들은 벨 상태((|00> + |11>)/sqrt(2))와 그린버거–혼–차일링거(GHZ) 상태((|000> + |111>)/sqrt(2)) 같은 잘 알려진 얽힘 상태를 준비하는 과정을 보여 줍니다. (시뮬레이션을 위해 상태를 재설정한 뒤) 측정을 여러 번 실행하면 얽힘에 내재된 상관관계가 분명히 드러납니다. 벨 상태에서는 결과가 항상 (0, 0) 또는 (1, 1)이고, GHZ 상태에서는 (0, 0, 0) 또는 (1, 1, 1)이며, 각각 거의 같은 확률로 나타납니다.
상태 벡터를 사용하여 양자 시스템을 고전적으로 시뮬레이션하는 것은 사실상 교육용 도구로서만 유용합니다. 이 방식을 쓰면 필요한 자원이 지수적으로 늘어난다는 사실(2^n개의 복소수, 모든 상태에 영향을 미치는 연산)을 직접 마주하게 됩니다. 따라서 작은 양자 시스템조차 시뮬레이션하기에 실용적인 방법이 아닙니다. 이 접근 방식은 큐비트 수가 많아지면 금세 실행할 수 없게 되지만(50~60개의 큐비트를 시뮬레이션하는 것만으로도 현재 슈퍼컴퓨터의 한계에 이릅니다), 양자 컴퓨터가 무엇을 해낼 수 있을지 짐작하게 해 줍니다. 물론 언젠가 양자 컴퓨터를 실제로 만들 수 있다면 말입니다.
서평: 클라라와 태양
가즈오 이시구로의 클라라와 태양은 태양을 신이라고 믿는 로봇이 화자인 소설로, 근래 몇 년간 제가 읽은 소설 가운데 가장 조용하게 사람을 무너뜨리는 작품 중 하나입니다. 그 로봇은 클라라로, 십 대 청소년의 친구가 되도록 설계된 태양광 구동 인공 친구(Artificial Friend, AF)입니다. 클라라는 상점 진열창 안에 서서 바깥세상을 놀라울 만큼 정밀하게 지켜보며 누군가에게 선택되기를 기다립니다. 조시라는 이름의 병약한 열네 살 소녀가 클라라를 선택합니다. 그 뒤로 이어지는 이야기는 사랑, 관찰, 믿음, 쓸모없어짐에 관한 소설이자, 한 사람을 그 사람이게 하는 무언가를 충분히 가까이에서 지켜보기만 하면 포착할 수 있는가 하는 질문에 관한 소설입니다.
클라라는 정밀하게 보정된 센서 배열의 꼼꼼한 정확성과 몹시 주의 깊은 아이의 해석 능력으로 이야기를 들려줍니다. 클라라는 빛, 공간의 기하학적 구조, 사람의 얼굴에 스쳐 지나가는 미세한 표정까지 모든 것을 알아차립니다. 스트레스를 받으면 클라라의 시야는 기하학적인 패널들로 조각나는데, 이는 독자가 기계의 내부에 있다는 사실을 조용히 일깨워 줍니다. 클라라는 자신이 본 것을 완벽하게 충실히 전하지만, 그 거의 전부를 잘못 이해합니다. 클라라는 조시의 어머니와 카팔디라는 엔지니어가 조시의 몸과 똑같은 복제품을 만들 계획을 논의하는 모습을 지켜봅니다. 클라라가 소녀에 대해 쌓아 온 관찰을 그 복제품에 옮겨 넣어, 사실상 조시가 죽은 뒤에도 조시를 “이어 가게” 하려는 계획입니다. 클라라는 그 대화를 관찰합니다. 클라라는 그 대화가 지닌 도덕적 끔찍함을 깨닫지 못합니다. Economist는 클라라를 “Never Let Me Go의 캐시 H.와 The Remains of the Day의 집사 스티븐스를 섞어 놓은 인물“이라고 묘사했는데, 이는 정확히 맞는 말입니다. 클라라는 이시구로의 화자 가운데 가장 정직하면서도 가장 믿을 수 없는 화자입니다. 사실에 대한 클라라의 정확성은 감정의 진실과 아무런 관련이 없기 때문입니다.
이시구로가 클라라 주위에 세운 세계는 의도적으로 모호하게 그려져 있으며, 그 모호함은 결함이 아니라 장점입니다. 이 근미래 미국의 아이들은 학업 능력을 강화하는 일종의 유전자 편집인 “향상(lifting)“을 받습니다. 향상을 받은 아이들은 명문 대학과 엘리트 직업에 진입할 수 있습니다. 조시의 이웃이자 가장 가까운 친구인 릭처럼 향상을 받지 않은 아이들은 타고난 재능과 상관없이 구조적인 차별을 겪습니다. 향상에는 치명적인 위험이 따릅니다. 조시의 언니 살은 이미 그 때문에 세상을 떠났고, 조시 자신도 같은 증상으로 위중한 상태입니다. 부모들은 이 시대의 경쟁적 능력주의를 치명적인 결말까지 밀어붙인 계산 앞에 놓입니다. 향상을 거부하여 아이를 쓸모없는 존재로 만들 것인가, 아니면 향상을 받아들이고 아이를 죽게 할 위험을 감수할 것인가 하는 계산입니다. 이것이 풍자적인 과장처럼 느껴진다면, 과외, 대학 입시, 애더럴 처방에 관한 육아 커뮤니티 글을 10분만 읽어 보십시오. 이시구로는 소수점의 자리를 옮겼을 뿐입니다.
이 소설은 신학적 차원에 이르러 진정으로 독창적인 작품이 됩니다. 태양광으로 작동하는 클라라는 태양을 의식을 지닌 자애로운 힘으로 여기며 진심 어린 신앙을 키워 갑니다. 클라라는 태양을 남성 대명사로 지칭합니다. 클라라는 치유의 행위를 그의 “특별한 영양분” 덕분으로 돌립니다. 클라라는 적도 하나 정해 둡니다. 바로 클라라가 “쿠팅스 기계”(옆면에 적힌 글자에서 따온 이름)라고 부르는 디젤 기계로, 이 기계는 태양 광선을 가릴 만큼 짙은 오염 물질을 내뿜습니다. 클라라의 우주론에서 쿠팅스 기계는 사탄, 곧 은총을 가리는 힘입니다. 조시의 병세가 악화되자, 클라라는 태양이 매일 밤 쉬어 간다고 믿는 지평선 위의 헛간으로 찾아갑니다. 클라라는 거래를 제안합니다. 태양이 조시를 낫게 해 준다면 쿠팅스 기계를 파괴하겠다는 것입니다. 클라라는 쿠팅스 기계를 하나 찾아내 망가뜨리고, 그 과정에서 자신의 인지 유체 일부를 희생하며 영구적인 기능 저하를 감수합니다. 며칠 뒤, 구름이 걷힙니다. 햇빛이 병실 가득 쏟아져 들어옵니다. 조시는 회복하기 시작합니다.
소설은 태양이 실제로 의식을 지닌 힘인지, 아니면 클라라의 신앙 전체가 인지 편향, 즉 태양광으로 움직이는 존재가 자신의 필요를 우주에 투사한 것에 불과한지 끝내 알려 주지 않습니다. 바로 그 모호함이 핵심이며, 작가는 이를 결코 조롱으로 기울지 않는 다정함으로 다룹니다. 클라라의 신앙은 이시구로가 모든 것에 기울이는 것과 똑같은 진지함으로 다루어집니다. 즉, 면밀히 관찰하고 그 나름의 방식으로 이해할 가치가 있으며, 결코 우스갯거리로 격하해서는 안 되는 현상으로 다루어집니다. 인간의 종교와의 유사성은 정밀하며, 의도적으로 해소되지 않은 채 남겨져 있습니다. 우리도 클라라가 사용하는 것과 똑같은 재료로 신학을 세웁니다. 패턴 인식, 감사, 그리고 우주가 우리에게 어텐션을 기울여 주기를 바라는 절박한 갈망 말입니다.
이 소설의 주제는 뒤늦게 나타나 폭뢰처럼 터집니다. 엔지니어인 카팔디는 어떤 개인의 내면에도 고유하게 특별한 것은 없으며, 영혼도 없고, 충분히 주의 깊은 관찰자가 학습하고 복제할 수 없는 것은 아무것도 없다고 주장합니다. 클라라의 결론은 정반대입니다. “아주 특별한 무언가가 있었습니다. 하지만 그것은 조시 안에 있지 않았습니다. 그것은 조시를 사랑한 사람들 안에 있었습니다.” 환원할 수 없는 것, 한 사람을 대체 불가능하게 만드는 그것은 관계적인 것입니다. 그것은 한 사람을 둘러싼 사랑의 그물망 속에 살아 있으며, 어느 한 사람의 정신에 속하지 않기 때문에 복제될 수 없습니다. 이는 인공지능이 서술하는 소설로서는 놀라운 주장이며, 이시구로는 300쪽에 걸쳐 클라라가 얼마나 많은 것을 관찰할 수 있는지, 인간 마음의 방들을 얼마나 정밀하게 그려 낼 수 있는지, 그리고 그럼에도 이것이 정작 중요한 것을 포착하는 데 얼마나 완전히 실패하는지를 정확히 보여 줌으로써 이 주장을 설득력 있게 만들어 냅니다.
소설은 폐기된 AF들의 고물 처리장인 ’야드’에서 끝납니다. 클라라는 더 이상 움직일 수 없습니다. 클라라는 자신의 기억을 되돌려 보며 정리합니다. 예전 매장의 매니저가 찾아옵니다. 클라라는 행복했던 기억과 태양의 친절에 대해 이야기합니다. 원망도, 항변도, 분노도 없습니다. 클라라는 온전히 사랑했습니다. 클라라는 만족합니다. 그리고 자신이 폐기되는 부당함조차 이름 붙이지 못하는 화자가 자기 연민 없이 전하는 이 만족감이야말로, 이시구로가 지금까지 쓴 것 가운데 가장 이시구로다운 대목입니다. Never Let Me Go를 읽어 보셨다면 이 느낌을 아실 것입니다. 모든 것을 주고도 아무것도 받지 못한 존재의 고요한 공포가, 불평하기에는 너무나 온화한 목소리로 전해지는 그 느낌 말입니다.
의식, 인공지능, 혹은 사랑할 수 있는 무언가를 만들어 놓고 그것을 내버릴 때 어떤 일이 일어나는지에 관심 있는 모든 분께 이 책을 추천합니다. 이 책은 AI 담론이 누릴 자격조차 없는 AI 소설이며, 제가 이 주제에 관해 읽어 본 어떤 논문보다도 기계 의식이라는 질문을 깊은 통찰로 다룹니다. 이시구로는 업계가 이해하지 못하는 것을 이해하고 있습니다. 흥미로운 질문은 결코 “기계가 생각할 수 있는가?“가 아니었습니다. 흥미로운 질문은 “기계가 사랑할 수 있는가, 그리고 만약 그럴 수 있다면 우리는 그것에 무엇을 빚지고 있는가?“입니다.
엔터프라이즈 엘드리치 호러
물론 러브크래프트식 공포는 우주적으로 끔찍하지만, 소프트웨어 업계에서 일하는 우리 모두가 알고 있듯이 진정한 공포는 훨씬 가까운 곳에 있습니다. 잊힌 무덤 속이 아니라, 회사가 사용을 강제하는 소프트웨어의 깜빡이는 비유클리드적 인터페이스 안을 들여다보십시오. 이것들이야말로 진정한 그레이트 올드 원으로, 그 영향력은 모든 칸막이 사무실에 스며들고, 그 불가해한 UI는 필멸자들을 벼랑 끝으로 몰아갑니다.
Serv-N’Ow, 끝없는 티켓의 형체 없는 문지기
그 숭배자들(IT 부서)에게 “솔루션“이라 불리는 Serv-N’Ow는 거대하고 무정형한 존재로, 그 진정한 형체는 결코 보이지 않으며 오직 무수하고 끊임없이 변하는 “요청 양식“이라는 관문을 통해서만 체험됩니다. Serv-N’Ow를 달래려면 “티켓 제출“이라는 신성한 의식을 치러야 하는데, 이는 구체적이면서도 대개 알 길이 없는 정보를 제물로 요구하는 난해한 드롭다운 메뉴와 텍스트 필드로 이루어진 과정입니다. 그 영역은 “이행의 차원“으로, 새 스테이플러 요청과 금지된 공유 드라이브 접근 요청이 영겁의 세월 동안 방치되어 있으며, 이따금 불운한 하수인들이 “지식 베이스는 확인해 보셨습니까?“라고 읊조리며 쿡쿡 찔러 볼 뿐입니다. 그 승인 워크플로는 정신을 뒤틀어 버리는 미궁 같은 회랑이며, 그 SLA 타이머는 무언가를 향해 카운트다운하는 우주적 시계처럼 피할 수 없는 공포와 함께 째깍거립니다… 뭐, 아마도 또 하나의 자동 발송 이메일을 향해서겠지만 말입니다. Iä! Iä! Serv-N’Ow fhtagn!
T’eems, 불협화음의 다각(多角) 전령
한때 한낱 속삭임에 불과했던 이 존재는 이제 모든 소통을 자신의 혼돈스러운 품속으로 통합하려는 거대한 공포로 자라났습니다. T’eems는 채널, 채팅, 그리고 “팀“으로 이루어진, 끝없이 팽창하는 공허로 현현하며, 그 하나하나가 저마다 다른 종류의 산만함으로 이어지는 일렁이는 관문입니다. 그 핑과 알림은 보이지 않는 피리 연주자들이 부는 광기 어린 피리 소리로, 생산성이 죽으러 가는 그 심연 속으로 사용자들을 꾀어 들입니다. 그것은 “협업“을 속삭이면서 영혼들을 끝없는 화상 회의에 옭아매는데, 그곳에서는 그 하급 화신들(낮은 대역폭 탓에 얼굴이 일그러진 여러분의 동료들)이 멍하니 응시하다가 이따금 “음소거 상태이십니다“나 “제 화면 보이십니까?” 같은 수수께끼 같은 말을 내뱉습니다. 그 촉수는 다른 모든 애플리케이션에까지 뻗어 나가 통합된 경험을 약속하지만, 실제로 가져다주는 것은 잠재적 장애 지점들로 이루어진 더욱 복잡한 그물망뿐입니다. Ph’nglui mglw’nafh T’eems Redmond wgah’nagl fhtagn!
S’aap, 그 룬 문자로 모두를 당혹케 하는 고대의 모듈형 존재
별들보다도 오래된 S’aap는 인간의 이해와는 완전히 이질적인 정신을 지닌 존재들이 잊힌 영겁의 시대에 그 구조를 놓은 거대한 단일체의 공포입니다. 그 “모듈“은 광대하고 불가해한 영역 안에 자리한 저마다 별개의 거대한 도시와 같으며, 각 모듈은 오직 그 대사제들(과도한 보수를 받는 컨설턴트들)만이 진정으로 해독할 수 있는 권능의 문자, 곧 난해한 “T-코드“의 지배를 받습니다. 감히 S’aap와 직접 상호작용하려는 필멸자들은 종종 그 비유클리드적 메뉴 속에서 길을 잃게 되며, 그곳에서는 단 한 번의 잘못된 클릭이 헤아릴 수 없는 재무적 혹은 물류적 혼돈을 불러올 수 있습니다. 그것은 스프레드시트로 꿈을 꾸고, 아무런 위안도 주지 않은 채 “지정되지 않은 시스템 이벤트“라는 수수께끼 같은 경고만을 내뱉는 오류 메시지로 말합니다. 그 날것 그대로의 인터페이스를 목도하는 것은 전사적 자원 관리의 심장부에 자리한 무심한 공허를 엿보는 것입니다. 요그-소토스는 T-코드를 알고 있으며, 요그-소토스가 바로 T-코드입니다!
J’Raa, 스프린트를 집어삼키는 자, 끝없는 백로그의 주인
끽끽거리는 이 다지(多肢)의 공포는 “스토리 포인트“와 “태스크“를 제물로 바치는 의식을 먹고 번성합니다. J’Raa의 영역은 “백로그“로, 바닥 없는 그 심연에서는 사용자 스토리와 버그 리포트가 어텐션을 갈구하며 횡설수설 기어 나옵니다. 그 컬트인 “애자일 개발 팀“은 “스프린트 계획“과 “스탠드업“이라 불리는 정교한 의례를 거행하며, 그 짐승을 달래고 수많은 “에픽“을 조금씩이나마 전진시키기를 바랍니다. 그러나 J’Raa가 진정으로 갈망하는 것은 바로 “완료“라는 개념 그 자체이며, 그것은 이 상태를 영원히 손이 닿을 듯 말 듯한 곳으로 밀어냅니다. 무수히 많은 사용자 정의 필드와 워크플로 상태는 비늘투성이 짐승의 비늘과 같아서, 하나하나가 “회고” 중에 혼란과 광기 어린 논쟁을 불러일으킬 수 있는 지점입니다. 백로그는 깊고, 공포로 가득합니다! Tekeli-li! Tekeli-li!
Sael’Esfor, 고객 관계를 꿰뚫어 보는 전지(全知)의 눈
구름 위의 전망대에서 Sael’Esfor는 깜빡이지 않는 다면(多面)의 눈으로 모든 “리드”, “기회”, “계정“을 내려다봅니다. 이 존재는 데이터 입력이라는 형태로 끊임없는 공물을 요구하며, 그 신도들(영업팀)에게 “성사(Closed-Won)“의 영광이라는 환영을 약속합니다. 그 “오브젝트“와 “필드“는 무한히 복잡한 그물망으로 사용자 정의될 수 있으며, 이는 형체 없이 끊임없이 적응하는 그 공포를 증명합니다. 통화 기록을 남기지 않거나 “다음 단계“를 갱신하지 않은 필멸자에게는 화가 있을지니, Sael’Esfor의 보고서는 무자비하여 모든 결점을 관리자인 하수인들에게 낱낱이 드러내기 때문입니다. 그것은 360도 고객 뷰라는 달콤한 약속을 속삭이지만, 실제로는 불완전한 데이터와 희망 사항을 기워 붙인 조각난 키메라를 내놓는 경우가 많습니다. 샌프란시스코의 사무실에서, 무시무시한 Sael’Esfor는 할당량을 꿈꾸며 기다립니다.
Oüt-L’ook, 끝나지 않는 서신의 시간 포식자
참으로 교활한 공포인 Oüt-L’ook은 쩍 벌어진 “받은편지함“의 아가리로 현현하여, 공허로부터 끊임없이 서신을 토해 냅니다. 긴급한 요청, 수동공격적인 참조(CC), 잊힌 구독에서 날아온 뉴스레터가 바로 그것입니다. 또 하나의 주요 부속지인 “캘린더“는 절망의 마도서로, 그 페이지마다 “회의“라 불리는 겹겹이 포개진 의식이 가득하며, 각 의식은 참석자의 정신력을 고갈시키도록 고안되어 있습니다. 그 심연을 들여다본다는 것은 가차 없고 영혼을 짓누르는 기업적 의무의 조류와 마주하는 일이며, 그 해류는 실제로 생산적인 작업의 해안으로부터 사람을 끝없이 멀리 끌어냅니다. 그것의 “규칙“과 “필터“는 이 대홍수 앞에서 나약한 결계에 불과하며, 자주 오작동하여 중요한 연락을 “정크” 폴더라는 잊힌 차원으로 내던집니다. 영원히 누워 있을 수 있는 것은 죽은 것이 아니니, 기이한 영겁이 흐르면 이메일조차 (당신의 보관함 속에서) 죽을 수 있습니다.
Trekonomics 독서 노트
올해 휴가 기간에는 마누 사디아의 Trekonomics를 읽었습니다. 스타트렉 유니버스의 경제 철학을 탐구하는 책으로, 무척 재미있으면서도 많은 생각을 하게 합니다. 다음은 이 책에 대한 서평과 독서 노트입니다.
이 책의 궁극적인 출발점은 스타트렉을 단순한 대중 오락물이 아니라 강력한 유토피아적 주제를 담은 중요한 문화적 아이콘으로 보는 것입니다. 그 주제는 바로 인간 사회가 자본주의의 제약을 넘어 진화할 수 있다는 가능성입니다. 저자는 스타트렉의 허구적 경제, 즉 그 “꿈-작업(dream-work)“을 탐구하는 일이 우리 자신의 세계와 앞으로 필요할지도 모르는 변화를 이해하는 데 가치가 있다고 주장합니다.
이러한 접근은 마크 피셔(Mark Fisher)의 자본주의 리얼리즘(capitalist realism) 개념과 강하게 공명합니다. 자본주의 리얼리즘이란 자본주의가 단지 지배적인 경제 체제일 뿐 아니라 생각할 수 있는 유일한 체제라는, 사회 전반에 퍼진 인식을 말합니다. 피셔는 현대 문화가 자본주의에 대한 일관된 대안을 상상하지 못하는 무능에 시달리고 있다고 주장했습니다. 이는 정치적·사회적 상상력의 실패이며, 스타트렉은 바로 이 실패에 과감하게 도전합니다. 완전히 실현된 탈희소성(post-scarcity) 사회를 제시함으로써, 스타트렉은 피셔가 자본주의 리얼리즘의 교착 상태라고 부른 것을 돌파하는 중요한 역할을 수행하며, 시청자에게 시장 교환과 이윤 극대화가 아닌 다른 원리를 중심으로 조직된 세계를 엿볼 수 있는 드문 기회를 제공합니다.
마찬가지로, 프레드릭 제임슨(Fredric Jameson)이 SF에 대해 수행한 마르크스주의적 분석(그의 저서 Archaeologies of the Future) 역시 스타트렉의 의의를 이해하는 틀을 제공합니다. 제임슨에게 SF의 가치는 기술적 미래를 예측하는 데 있는 것이 아니라 우리를 현재로부터 낯설게 만드는 능력에 있으며, 이를 통해 우리의 경제적·사회적 질서가 역사적으로 우연한 것임을 드러냅니다. 스타트렉은 제임슨이 말하는 후기 자본주의의 모순과 한계에 대한 “인지적 지도 그리기(cognitive mapping)“로 기능하며, 특히 연방(Federation)의 가치를 페렝기(Ferengi)처럼 노골적으로 자본주의적인 종족과 대비하는 에피소드에서 그러합니다. 이 시리즈는 제임슨이 포스트모던 문화에서 중요하지만 점점 드물어지고 있다고 지적한 어려운 작업을 수행합니다. 즉, 향수에 젖지도 않고 단순히 디스토피아적이지도 않으면서, 지향에 있어 건설적으로 유토피아적인, 자본주의에 대한 진정한 대안을 그려 내는 것입니다.
서론: 자본주의를 넘어서
서론은 사디아의 주된 목표를 제시합니다. 그것은 스타트렉의 24세기 비전을 뒷받침하는 경제 이론을 엄밀하게 탐구하고, 그 경제적 상상력을 분석할 가치가 있는 일관된 체계로 다루는 것입니다. 사디아는 첨단 자동화가 인류를 고된 노동에서 해방할 수 있다는 스타트렉의 핵심 경제 사상이 터무니없는 것이 아니라, 우리가 그 전환을 공평하고 지속 가능하게 관리한다면 역사적 추세를 그럴듯하게 외삽한 것이라고 봅니다.
저자는 스타트렉의 유토피아를 탈자본주의 사회로 규정하며, 하인라인의 영향을 더 많이 받은 오리지널 시리즈(그가 스타트렉 1.0이라 부르는 것)와, 아시모프의 영향을 받아 완전히 유토피아적인 넥스트 제너레이션 이후의 24세기(그가 스타트렉 2.0이라 부르는 것)를 구분합니다. 이 책이 주로 다루는 것은 후자입니다. 사디아는 TOS의 토대가 된 기여(이타주의, 과학적 낙관주의)를 인정하면서도, 스타트렉 2.0을 토머스 모어의 유토피아로 이어지는 문학 전통 안에 위치시키고, 많은 SF와 비교해 기술에 대해 이례적으로 낙관적인 태도를 취한다는 점에 주목합니다.
서론은 SF와 경제학 모두 사회 변화와 미래의 가능성을 고민한다는 점을 강조합니다. 스타트렉은 자동화가 노동을 대체하는 동시에 부가 고르게 분배되는 미래를 독특하게 암시하지만, 구체적인 정책에 대해서는 모호한 태도를 유지합니다. 이 책이 탐구하는 핵심(Core) 변화는 생존을 위해 일해야 한다는 강박이 사라지고 그 자리를 자아실현과 기여의 추구가 대신하는 사회에서 일어나는 심리적·동기적 변화입니다.
1장: 돈은 공룡의 길을 걸었다 – 화폐 없는 삶
이 장은 연방 경제의 가장 두드러진 특징인 돈의 명백한 부재를 다룹니다. 사디아는 복잡한 사회가 전통적인 가격 메커니즘 없이 어떻게 작동할 수 있는지 탐구하며, 근본적인 “경제 문제”(필수품의 희소성)가 기술로 해결되고 나면 돈은 그 목적의 상당 부분을 잃는다고 주장합니다.
여기서 주요 결과들이 탐구됩니다. 지위가 부와 분리되고, 과시적 소비가 사라지며, 사치는 고유한 경험, 인간관계, 예술적 공예품을 중심으로 재정의됩니다. 희소성이 완전히 사라지는 것은 아닙니다. 다이리튬, 우주선, 대체 불가능한 개인처럼 복제할 수 없는 것들은 여전히 한정되어 있습니다. 그러나 다이리튬 채굴 같은 자원 추출조차 인건비가 거의 0에 가까워지면서 더 쉬워집니다. 전략적 재화는 아마도 평판, 전문성, 정치적 절차와 같은 비시장적 수단을 통해 배분될 것입니다. 중요한 점은, 사디아가 돈이 없어도 자본(생산 자산, 도구, 지식)은 존속한다는 점을 분명히 한다는 것입니다. 연방의 체제는 일종의 공리주의로 제시됩니다. 이 체제에서 개인은 공동선을 위해 자신의 시간과 재능을 어떻게 배분하는 것이 가장 좋을지 스스로 선택하며, 그 과정에서 개인적 성취(효용)를 극대화합니다.
2장: 왜 다들 홀로그램을 그렇게 걱정하는가…? – 일의 의미
2장은 탈희소성 유토피아에서 일의 본질을 깊이 파고들며, 경제적으로 일할 필요가 전혀 없는데도 스타플릿 장교들이 엄청나게 바쁘다는 겉보기의 역설을 다룹니다. 사디아는 기계가 일을 더 효율적으로 수행할 수 있을 때 개인이 어떻게 의미를 찾는지 살펴봅니다. 연방은 경제적 필요나 전통에 얽매이지 않고 자신의 진정한 소명을 추구할 자유를 약속합니다.
이 장은 보이저의 에피소드 “Author, Author”(홀로그램의 권리)와 시스코 가족의 식당(일에 대한 정서적 유대) 같은 예를 들어, 일이 열정과 평판, 그리고 자기 선택의 문제가 된다는 점을 보여 줍니다. 이 경제에서 기업은 이윤을 창출하지 않고 인건비는 0이며, 성공은 평판과 품질로 측정됩니다. 일은 헌신이 이끄는 도제 수업과 비슷한, 더 깊은 의미를 띠게 됩니다. 이처럼 진정한 성취를 중시하기 때문에, 연방의 능력주의에서 (유전자 강화 같은) 부정행위는 중대한 범죄가 됩니다. 이 장은 또한 체제에서 이탈하거나 비밀 활동(섹션 31)에 가담하는 개인들을 언급하며 이 체제의 불완전함도 인정합니다. 결국 가치는 효용이나 희소성에서 벗어나 정서와 감정, 그리고 복제된 디자인에서조차 “인간의 손길“로 옮겨 갑니다.
3장: 차, 얼 그레이, 뜨겁게 – 리플리케이터 혁명
3장에서는 스타트렉의 탈희소성을 떠받치는 기술적 초석인 리플리케이터가 중심 무대에 섭니다. 사디아는 리플리케이터를 문자 그대로든 비유적으로든 산업혁명의 종착점이자 자동화의 궁극적 형태(구체적으로는 적층 제조/3D 프린팅)로 제시합니다. 결정적으로, 그는 리플리케이터의 사회적 영향이 이를 무료 공공재로서 누구나 이용할 수 있게 하겠다는 정치적 결정에 달려 있다고 강조합니다.
현실 세계의 발전(3D 프린팅을 활용하는 보잉과 GE)과 연결되어, 리플리케이터는 생필품 생산을 자동화하고 인간의 노동을 해방하는 “마지막 기계“로 묘사됩니다. 이는 대규모 노동 대체를 촉발하여, 인간의 노력을 고숙련·창의적·지식 기반 업무로 옮겨 놓습니다. 리플리케이터에는 입력(물질, 에너지, 데이터/설계)이 필요하지만, 연방에서 리플리케이터가 공공재(비배제성, 비경합성)로 지정되면서 리플리케이터가 생산하는 재화에도 즉시 이러한 속성이 부여됩니다. 이는 비슷한 기술이 독점 소유로 남아 있는 닐 스티븐슨의 다이아몬드 시대 같은 비전과 뚜렷이 대비되며, 탈희소성이 단순히 기술적 선택이 아니라 정치적·사회적 선택임을 강조합니다.
4장: 바보만이 진보를 가로막습니다 – 한계 극복하기
이 장은 맬서스의 딜레마, 곧 무한한 사회적 부가 유한한 천연자원과 어떻게 공존할 수 있는가 하는 문제에 맞섭니다. 사디아는 트레코노믹스가 경제 원리를 위반하지 않으며, 자원의 한계를 극복하기 위해 기술적 대체에 크게 의존한다고 주장합니다. 이 장은 오리지널 시리즈의 에피소드 “The Mark of Gideon“과 역사적 논쟁(에를리히의 인구 폭탄, 로마 클럽의 성장의 한계)을 참조하며 “모든 것의 정점(peak everything)” 개념을 다룹니다.
사디아는 하버-보슈 공정 같은 예를 들어, 기술이 역사적으로 지구의 수용 능력을 어떻게 확장해 왔는지 보여 줍니다. 그 논지는, 시간이 흐르면서 기술 혁신이 희소한 자원을 대체하거나 경합재를 비경합재로 만드는 경향이 있다는 것입니다. 스타트렉의 24세기 풍요는 갑작스러운 혁명이 아니라, 인적 자본과 혁신에 힘입은 수 세기에 걸친 지속적이고 기술 주도적인 성장의 논리적 결과로 제시됩니다. 이는 경제적 현실과의 완전한 단절이라기보다 기존의 긍정적 추세를 증폭한 것입니다.
5장: 워프 엔진이 원인일지도 모른다는 생각… – 공유지 관리하기
탈희소성 유토피아에서도 부정적 외부효과와 공유 자원의 관리는 여전히 중요한 문제입니다. 5장은 연방이 이러한 문제를 어떻게 다루는지 살펴보며, 그 접근 방식을 덜 협력적인 외계 종족들의 방식과 대비합니다. 사디아는 넥스트 제너레이션의 에피소드 “Force of Nature”(워프 드라이브가 시공간을 손상시키는 이야기)를 사례 연구로 삼아, 연방이 일방적으로 자제를 선택해 모범을 보이는 모습을 보여 줍니다.
이 장은 개릿 하딘의 “공유지의 비극“을 논하지만, 공동체가 공유 자원을 효과적으로 자치할 수 있다는 엘리너 오스트롬의 연구 결과 쪽으로 기울며, 연방이 이 원리를 거대한 규모로 구현하고 있다고 시사합니다. 연방의 통치 구조는 최적의 집단 행동을 찾아내고 실행하는 데 능숙해 보이며, 이는 아마도 전문가를 신뢰하고 지식 자체를 평판 경제를 통해 육성되는 공공재로 취급하는 문화 덕분일 것입니다. 이는 변화에 저항하는 기득권 때문에 흔히 발목이 잡히는 (기후 변화 같은) 현실 세계의 고투와 대조됩니다.
6장: 그 미래, 그 우주정거장… – Trekonomics의 지적 선조들
6장은 스타트렉 경제 사상의 계보를 추적하며 그 지적 역사를 제시합니다. 사디아는 SF에서 노동 이후의 사회를 낙관적으로 그리는 주제가 드물다는 점을 지적하며, 아이작 아시모프를 결정적인 선구자로 자리매김합니다. Trekonomics는 아시모프의 핵심(Core) 개념(로봇에 대한 긍정적 시각, 노동 대체 문제에 대한 정면 대응, Foundation에서 서사를 이끄는 힘으로서의 경제학, 열쇠로서의 지식)을 재구성하고 심화한 작업으로 규정됩니다.
스타트렉의 낙관주의는 지능을 가진 기계를 의도적으로 배제한 프랭크 허버트의 듄과 대비됩니다. 사디아는 그 밖에 영향을 주었을 수 있는 작품들도 조명합니다. 스트루가츠키 형제의 정오: 22세기(경제 이후의 우주 시대를 그린 초기 작품)와 어슐러 르 귄의 빼앗긴 자들(탈희소성을 조직 방식의 선택으로 강조하는 작품)이 그것입니다. 이러한 아이디어들은 유토피아 사회가 다른 사회들과 상호작용하는 모습을 탐구한 TNG와 DS9를 형성했습니다. 이 장은 TOS(하인라인의 영향을 받아 냉전을 비판함)에서 TNG의 유토피아 수용으로 이어지는 변화를 짚으며, 냉전 알레고리와 로든베리의 초기 실용적 제약을 넘어서는 과정을 보여 줍니다. 스타트렉은 아시모프에게 깊이 빚지고 있지만, 열정과 장인정신의 추구로 탈바꿈한 형태로나마 노동을 유지한다는 점에서 그와 갈라집니다.
7장: 아직 인간의 감정은 많이 남아 있습니다… – 풍요의 심리학
이 장은 풍요의 세계에서 살아가는 것이 가져오는 심오한 심리적 결과를 살펴봅니다. 사디아는 흔히 스타플릿 등장인물들에게서 보이는 “완벽함“이나 정서적 안정이 빈곤과 그에 따른 스트레스가 사라진 데서 직접 비롯된다고 말합니다. 빈곤과 스트레스는 정신 건강과 인지 기능에 영향을 미치는 것으로 알려져 있습니다. 디애나 트로이 같은 카운슬러의 존재는 물질적 안정 덕분에 가능해진 정신적 안녕에 대한 이러한 관심을 잘 보여 줍니다.
사회적 지위는 부가 아니라 능력과 계급에 기반합니다. 이 장은 최우선 지령(Prime Directive)을 다시 살펴보며, 이를 다른 문화와 교류할 때 연방이 따르는 핵심(Core) 윤리 원칙으로 분석합니다. 이는 문화적 오염과 얽힘을 막기 위해 고안된 불개입주의적이고 공리주의적인 정책으로 제시되며, 부분적으로는 냉전에 대한 비판(베트남)에서 비롯되었습니다. 보그는 섬뜩한 대조점으로 등장합니다. 보그는 일종의 탈희소성 안정을 이루었지만 개인성을 말살한 집단 의식으로, 개인의 의지가 집단의 이익과 공존하는 연방 모델을 비추는 거울 역할을 합니다. 결국 스타트렉에서 번영은 스토아학파의 관점에 따라 재정의됩니다. 가치는 물질적 재화를 축적하는 데가 아니라 정신을 수양하고 정의롭게 행동하는 데 있습니다.
8장: 페렝기, 성간 자본가들 – 필요한 대조군
8장은 페렝기를 집중적으로 다루며, 이들을 은하 자본주의의 화신이자 연방의 유토피아를 돋보이게 하는 핵심적인 대조군으로 제시합니다. 사디아는 페렝기가 대비를 통해 연방의 가치를 밝혀 준다는 점에서 중요하다고 주장합니다. 연방이 더 복잡하고 불완전한 은하와 씨름하는 딥 스페이스 나인에서 특히 그렇습니다.
쿼크와 그의 바는 서사의 중심지 역할을 하며, 쿼크라는 인물의 변화는 이윤에 집착하는 문화에서도 연방의 이상과 교류함으로써 변화가 가능하다는 것을 보여 줍니다. 획득의 규칙(Rules of Acquisition)과 위대한 물질 연속체(Great Material Continuum)에 대한 믿음으로 체계화된 페렝기 문화는 현대 자본주의에 대한 풍자적 논평 역할을 합니다. 탐욕스럽기는 하지만, 그들에게도 윤리적 핵심(Core)은 있습니다(노예제와 정복은 하지 않습니다). 이 장은 연방이 필요할 때는 (라티눔을 사용하여) 돈을 다룰 줄 알며, 막대한 부 덕분에 엄청난 잠재적 금융력을 지니고 있다는 점을 언급합니다. doux commerce(상업이 문명화한다는 생각) 개념을 다루면서도, 이 글은 그것이 역사적 착취를 무시한다는 비판을 인정합니다. 페렝기는 결국 “우리“를 대변하는 존재로 자리매김하며, 그들의 변화는 관객에게 변화를 불러일으키겠다는 스타트렉의 지향점을 암시합니다.
9장: 언젠가 당신이 그러기를 바라며 살아갑니다… – Trekonomics는 가능한가?
마지막 장은 궁극적인 질문을 다룹니다. Trekonomics는 현실이 될 수 있을까요? 사디아는 스타트렉의 비전을 존 메이너드 케인스의 예측과 연결합니다. 케인스는 “경제 문제“가 해결되어 인류가 여가를 어떻게 보낼지 고민하게 되는 미래를 예측했습니다. 스타트렉은 지식 노동이 지배적인 위치를 차지하는, 이러한 전환이 완성된 모습을 그립니다.
사디아는 “티쿤 올람(Tikkun olam)“이 “히브리어로 말하자면 세상을 치유하라“라는 뜻이라고 설명합니다. 이 개념은 저자가 부모에게서 물려받은 세속적 유대교와 자연스럽게 어우러지는 것으로 제시됩니다. 요컨대 스타트렉의 계율에 따라 살아가면서, 그는 이 신념을 인간이 할 수 있는 한 최대한 많이 배우고, 다른 사람들의 문제를 해결해 주고, 언제 어디서든 가능한 한 불의에 맞서 싸우고, 멘시(mensch)(좋은 사람을 뜻하는 이디시어)가 되려고 노력하는 것과 같은 행동과 연결 짓습니다.
폴 로머의 연구를 토대로, 지식은 성장을 이끄는 비경합적 “비밀 재료“로 규정되며, 그 스프레드를 제한하는 것은 본질적인 제약이 아니라 주로 정책적 선택입니다. 이 책은 스타트렉의 유토피아가 현재의 과학 기술 발전을 장기적으로 연장했을 때 충분히 있을 법한 결과로 제시된다는 점을 다시 한번 확인합니다. 가장 큰 걸림돌은 기술이 아니라 분배와 정치적 의지입니다. 현실 세계의 번영이 커지고 “무료” 디지털 재화가 늘어남에 따라 우리는 조금씩 가까워지고 있지만, 스타트렉과 같은 미래(특히 우주 식민지 개척)를 이루려면 기하급수적인 부의 성장이 필요합니다. 사디아가 제시하는 핵심(Core) 교훈은 “우리가 바로 벌컨인입니다“라는 것입니다. 이러한 미래를 이루려면 더 이성적이고 이타적이며 스토아적인 가치관을 받아들이고, 노동을 선택 사항으로 만드는 전면적인 자동화를 수용하며, 번영을 내면의 수양과 기여를 중심으로 근본적으로 재정의해야 합니다.
팟캐스트와 인터뷰
저자는 Slate Money 팟캐스트에도 출연해 인터뷰했으며, 경제학자 폴 크루그먼과 함께 Financial Times와도 인터뷰했습니다.
논의는 이 유토피아적 비전에 담긴 상당한 복잡성과 잠재적인 “어두운 면“을 중심으로 전개됩니다. 애널리 뉴위츠는 연방의 안락한 탈희소성 생활 방식이 그 주변부에 있는 덜 공정한 다른 경제 체제들에 의해 암묵적으로 떠받쳐지고 있을 수 있다고 지적하며, 착취나 노예제(예: 데이터, 홀로그램), 또는 임금 노예와 같은 상황을 암시합니다. 또한 폴 크루그먼은 탈희소성이 실제로 어디까지 가능한지에 의문을 제기하면서, 복제기가 주로 해결하는 것은 서비스가 아니라 재화이며, 서비스를 고도화된 AI에 의존하는 사회에서는 하인과 노예의 경계가 흐려질 수 있다고 지적합니다.
폴 크루그먼은 존 메이너드 케인스의 “우리 손주 세대의 경제적 가능성(Economic Possibilities for our Grandchildren)“을 언급하는데, 이 글은 세계가 일정 수준 이상의 부에 도달하면 돈이 사실상 쓸모없어질 것이라고 예측했으며, 이는 희소성이라는 근본적인 경제 문제가 해결됨을 의미합니다. 존 K. 갤브레이스도 비슷한 맥락에서 “새로운 산업 국가(A New Industrial State)“를 통해 평균적인 미국인의 생활 수준이 매우 높아져서 오직 “선전“만이 그들로 하여금 더 많은 것을 원하게 만들 것이라고 주장했습니다.
『트레코노믹스』는 물질적 풍요 속에서도 인간 본성이 경쟁과 갈등의 새로운 무대를 찾아내는 사회를 탐구합니다. 스타플릿의 능력주의는 동경의 대상이기는 하지만, 마누 사디아는 이를 엘리트 “1%“를 대표하는 “가혹하고 치열한” 것으로 묘사합니다. 나머지 99%에게 삶은 안락할 수는 있어도 반드시 충만하지는 않으며, 성취에 대한 압박도 여전히 존재합니다. 초점은 자원을 둘러싼 경쟁에서 지위, 평판, 지적 성취를 둘러싼 경쟁으로 옮겨 가며, 이는 기본적인 필요가 충족되더라도 인간은 계속해서 목적을 추구하고 사회적 위계 속에서 길을 찾아갈 것이고, 그 결과 새로운 형태의 스트레스와 불평등이 생겨날 수 있음을 시사합니다.
Lean에서 자명한 정리 증명하기
Lean 4와 같은 증명 보조기를 처음 시작할 때는 가능한 한 가장 기초적인 증명부터 시작하는 것이 좋습니다. 이러한 증명은 수학자에게는 너무나 자명해 보일 수 있지만, 이를 형식 체계에서 구현해 보면 증명 보조기가 어떻게 동작하는지에 대한 직관을 기르는 데 도움이 됩니다. 참임을 이미 알고 있는 기본적인 논리 명제부터 시작하면, 복잡한 수학에 빠져 헤매지 않고 형식 검증의 문법과 작동 방식을 익히는 데 집중할 수 있습니다. Lean의 증명 체계에 익숙해지기 위해 이러한 기초적인 증명 몇 가지를 살펴봅시다.
예제 1: 항등
첫 번째 정리는 모든 명제가 자기 자신을 함의함을 보여 줍니다:
theorem self_implies_self (p : Prop) :
p → p := fun h => h
이는 λ 표기법을 사용하거나 명시적인 증명으로도 작성할 수 있습니다:
theorem self_implies_self' (p : Prop) :
p → p :=
λ h => h
theorem self_implies_self'' (p : Prop) :
p → p := by
intro h
exact h
예제 2: 논리곱 제거
p ∧ q가 있으면 p가 있음을 증명할 수 있습니다:
theorem and_elim_left (p q : Prop) : p ∧ q → p := by
intro h
exact h.left
예제 3: 논리합 도입
p가 있으면 p ∨ q가 있음을 증명할 수 있습니다:
theorem or_intro_left (p q : Prop) : p → p ∨ q := by
intro h
exact Or.inl h
예제 4: 이중 부정 도입
p가 참이면 ¬¬p도 참임을 증명할 수 있습니다:
theorem double_neg_intro (p : Prop) : p → ¬¬p := by
intro h
intro hn
exact hn h
예제 5: 배중률
고전 논리에서는 임의의 명제 p에 대해 p가 참이거나 ¬p가 참입니다. 이는 Lean의 고전 논리에서 공리입니다:
theorem excluded_middle (p : Prop) : p ∨ ¬p := by
exact Classical.em p
이것은 앞의 예제들과 다르다는 점에 유의하십시오. 다른 정리들은 구성적으로 증명할 수 있었지만, 배중률에는 Classical 공리가 필요합니다. 직관주의 논리에서는 이 원리를 가정하지 않습니다. Lean에서는 Classical.em을 사용하여 이 공리에 접근합니다.
이는 패턴 매칭을 사용하여 작성할 수도 있습니다:
theorem excluded_middle' (p : Prop) : p ∨ ¬p :=
match Classical.em p with
| Or.inl h => Or.inl h -- if p is true, return p
| Or.inr h => Or.inr h -- if ¬p is true, return ¬p
불교 리스트의 리스티클
불교에는 버즈피드 기사보다 리스트가 더 많습니다. 불교 리스트 목록에서 영감을 받아, 부처님의 가르침을 밀레니얼 리스티클로 정리했습니다. 썰렁한 말장난이 좀 섞였거나 빠졌을 수도 있습니다.
마음챙김:
- 지금 내 뇌가 완전히 맛이 갔다는 걸 알아차리고, 그걸 의외로 아무렇지 않게 받아들이는 것.
팩트폭탄의 종류:
- 관습적 진리 - 여러분이 개뿔이라도 신경 써야 하는 진리.
- 궁극적 진리 - 여러분 따위엔 개뿔도 신경 쓰지 않는 진리.
샤워하다 떠오른 네 가지 생각:
- 😱 - 모든 것은 죽고 흩어지게 됩니다. 그리고 여러분이 할 수 있는 건 하나도 없습니다.
- 🤷 - 진정하십시오. 현실은 원래 그런 것이고, 말 그대로 달리 될 수가 없기 때문입니다.
- 🤔 - 그리고 사실, 그게 달라지기를 바라는 것 자체가 완전 미친 짓입니다.
- 😃 - 하지만 걱정하지 마십시오. 모든 걸 나아지게 해 주는 기묘한 진리가 네 가지 있습니다.
부처님의 네 가지 고귀한 원조 팩트폭탄:
- 인생은 구립니다.
- 여러분은 뭔가를 원합니다.
- 그만 원하십시오.
- 그만 원하게 해 주는 끝내주는 인생 꿀팁이 여덟 가지 있습니다.
부처님의 여덟 갈래 인생 꿀팁:
- 개똥 같은 세상을 똑바로 보십시오
- 멍청한 생각을 덜 하십시오
- 말할 때 재수 없는 놈처럼 굴지 마십시오
- 나쁜 짓 말고 좋은 짓을 하십시오
- 남을 등쳐먹지 않는 직업을 가지십시오
- 너무 구리게 살지 않도록 노력하십시오
- 지금 이 순간에 주의를 기울이십시오
- 긴장 풀고 집중하십시오
여덟 가지 … 앗, 다람쥐입니다!:
- 칭찬 - 자아가 가르릉거릴 때까지 쓰다듬어 받고 나서, 왜 여전히 공허한지 의아해하는 것
- 비난(Blame) - 언제나 당신이 ’술래’가 되는, 모두가 사랑하는 뜨거운 감자 돌리기 게임입니다
- 상실(Loss) - 비자발적 물품 기부를 통해 집착을 내려놓는 법을 가르치는 우주의 방식입니다
- 이득(Gain) - 결국 다른 누군가의 상실이 될 물건을 손에 넣는 일입니다
- 즐거움(Pleasure) - 유통기한이 우유보다 짧은 일시적인 행복입니다
- 고통(Pain) - 원하든 원하지 않든 당신에게 몸이 있다는 사실을 끈질기게 상기시켜 주는 삶의 알림입니다
- 명성(Fame) - 사실 당신을 알지도 못하는 사람들에게 알려지는 일입니다
- 악명(Ill-fame) - 당신의 평판이 당신보다 5분 먼저 방에 들어서는 상황입니다
“나“라고 생각하지만 사실은 “나“가 아닌 다섯 가지:
- 색(Form, Rupa) - 우주로부터 잠시 빌려 쓰고 있는 고깃덩어리 탈것입니다
- 수(Feeling, Vedana) - 뇌가 모든 것을 지나치게 생각하기 전, 찰나의 “오오” 또는 “으웩“입니다
- 상(Perception, Sañña) - 명품 로고가 곧 행복이라고 굳게 믿는 마음의 라벨링 시스템입니다
- 행(Mental Formations, Sankhara) - 생각과 감정, 그리고 초등학교 6학년 때 했던 그 부끄러운 말까지 담긴 마음속 넷플릭스입니다
- 식(Consciousness, Viññana) - 이 우주적 시트콤 전체가 펼쳐지는 것을 지켜보는 알아차림입니다
당신을 존*나 망쳐 놓을 다섯 가지:
- 감각적 욕망(Sensual Desire) - 당신의 만트라가 “옴 마이 갓, 저 엉덩이 좀 봐“가 될 때입니다
- 분노와 악의(Anger and Ill-will) - 호흡을 세는 대신 복수 판타지를 꾸미는 일입니다
- 나태와 혼침(Sloth and Torpor) - 명상 자세: 인간 웅덩이입니다
- 들뜸과 후회(Restlessness and Remorse) - 어제의 창피함과 내일의 불안 사이를 오가며 파쿠르를 하는 당신의 마음입니다
- 회의적 의심(Skeptical Doubt) - “이거 효과가 있는 겁니까? 저 이제 깨달았습니까? 여보세요? 제 소리 들립니까? 아무도 없습니까?”
붓다의 절대 금지 목록:
- 살생 금지(No Killing) - 모든 생명을 살려 두십시오. 분명 당신에게 음모를 꾸미고 있는 저 거미까지도 말입니다
- 도둑질 금지(No Stealing) - 당신 것이 아니라면 당신 것으로 만들지 마십시오(네, 룸메이트가 남긴 음식도 포함입니다)
- 수상한 성관계 금지(No Sketchy Sex) - 침실은 드라마 없이, 동의에 기반하여 유지하십시오
- 거짓말 금지(No Lying) - 당신의 바지에 실제로 불이 붙지는 않겠지만, 당신의 카르마에는 불이 붙을 것입니다
- 취하게 하는 것 금지(No Intoxicants) - 새벽 3시에 전 애인에게 문자를 보내는 것이 좋은 생각이라고 믿게 만드는 물질은 멀리하십시오
세 가지 골칫거리:
- 탐욕(Greed) - 옷장에 다 들어가지도 않을 만큼 물건을 원하다가, 결국 더 큰 옷장을 사는 일입니다
- 증오(Hatred) - 당신 내면의 온도가 핫 요가 수업보다 더 뜨겁게 달아오를 때입니다
- 망상(Delusion) - 인스타그램이 현실이라고 생각하는 것입니다(스포일러: 현실이 아닙니다)
eXistenZ의 세 가지 특성:
- 무상(無常, anicca) - 모든 것은 변합니다.
- 고(苦, dukkha) - 인생은 괴롭습니다.
- 무아(無我, anatta) - 자아가 많을수록 문제도 많습니다.
바보도 할 수 있는 명상:
- 가만히 앉아서, 당신이 곧 당신의 생각은 아니라는 사실을 생각합니다.
- 자기 생각에 대해 정말 열심히 생각하면, 당신이 (당신을) 과하게 생각하고 (있다는) 것을 관찰하게 됩니다.
끝내주는 연기(緣起):
- 우주는 하나의 거대한 바다이고, 파도는 왔다가 갑니다.
- 때로는 그냥 파도에 몸을 맡겨야 합니다. 서핑하기 위해 살고, 살기 위해 서핑합시다.
- 파도에는 시작도 끝도 없고, 그냥 바이브를 타고 있을 뿐입니다.
- 서퍼를 파도에서 떼어 낼 수는 있어도, 서퍼에게서 파도를 떼어 낼 수는 없습니다.
좀 쉬운 편인 열 가지 바이브 체크:
- 보시(Generosity) - 친구들이 당신이 사이비 종교에 들어갔다고 생각할 때까지 물건을 나눠 주는 것입니다
- 지계(Morality) - 아무도 보지 않을 때조차 못된 놈이 되지 않는 것입니다
- 출리(Renunciation) - 소유물이 당신을 잠수 이별하기 전에 당신이 먼저 소유물을 잠수 이별하는 것입니다
- 지혜(Wisdom) - 자신이 아무것도 모른다는 것을 깨닫고, 묘하게 그걸 아무렇지 않게 받아들이는 것입니다
- 정진(Energy) - 룸메이트들이 아직 술에 취해 자고 있을 때 새벽 5시 명상에 나타나는 것입니다
- 인욕(Patience) - 5분마다 배송 조회 페이지를 새로고침하지 않고 아마존 택배를 기다리는 것입니다
- 진실(Truthfulness) - 친구의 새 헤어스타일이 “참사“가 아니라 “흥미롭다“고 말해 주는 것입니다
- 결의(Determination) - 다리가 불개미에게 뜯어 먹히는 것 같은데도 계속 명상하는 것입니다
- 자애(Unconditional Love) - 페이스북에 정치 비난 글을 올리는 사람들까지 아끼는 것입니다
- 평정(Equanimity) - 인생이 커브볼이든 강속구든 던지거나, 아예 대놓고 방망이로 후려쳐도 침착함을 유지하는 것입니다
열반(Nirvana):
- 더 이상 자아 따위 눈곱만큼도 신경 쓰지 않고 평화롭게 떠나는 것을 거창하게 부르는 말입니다. 왜냐하면 ’당신’이라는 말 속의 당신은 애초에 진짜 당신이 아니었다는 걸 깨닫게 되니까 말입니다.
기본 입자란 무엇입니까?
초등학교에서 우리는 잘 정의된 궤적을 따라 움직이는 작고 단단한 구라는 입자에 대한 소박한 직관이 양자 현상의 무게 앞에서 무너진다고 배웁니다. 그다음 고등학교에서는 파동–입자 이중성에 따라 전자나 광자 같은 존재가 측정이 국소화된 입자적 발현을 강제하기 전까지는 파동함수 로 기술되는 비국소적인 파동적 거동을 보인다고 배웁니다. 동일한 양자들의 구별 불가능성은 힐베르트 공간에서 다입자 파동함수를 대칭화하거나 반대칭화해야 한다는 요구로 형식화되며, 분리 가능한 대상이라는 고전적 관념과 달리 이들을 근본적으로 구별할 수 없게 만듭니다. 그다음 대학교에서는 하이젠베르크의 불확정성 원리가 위치와 운동량을 동시에 정확히 아는 것을 불가능하게 하여, 미시적 당구공이라는 그림을 부정한다고 배웁니다. 그다음 대학원에서는 양자장론에서 입자가 원초적 구성 요소가 아니라 근본에 놓인 장의 들뜸이라고 배웁니다. 하지만 그 너머에는 또 다른 차원의 물음이 있습니다.
QFT의 존재론에서는 각 시공간 점에서 정의된 장이 일차적 존재이며, 각 장은 연산자 값을 갖는 자유도를 지닙니다. 우리가 “입자“라고 부르는 것은 그에 대응하는 장의 양자화된 들뜸이며, 포크 공간에 작용하는 사다리 연산자에 의해 생성되거나 소멸됩니다. 동역학은 라그랑지언 밀도 에 담겨 있으며, 산란이나 붕괴 같은 물리적 과정은 파인만 도형으로 나타나는 섭동 전개에 대응합니다. 생성 연산자 와 소멸 연산자 는 진공 상태와 들뜬 상태 사이의 전이를 간결하게 기술하며, 고전적 궤적을 장의 점유 변화로 대체합니다.
표준 모델 안에서 각 입자 종은 푸앵카레 군과 내부 게이지 군 아래에서의 변환 성질로 식별됩니다. 위그너의 분류는 기본 입자를 푸앵카레 대수의 기약 표현과 연결하며, 이 표현은 카시미르 불변량으로 정해집니다
이 불변량들은 질량 과 스핀 를 유일하게 결정합니다. 색, 약한 아이소스핀, 초전하 같은 게이지 전하는 내부 대칭 군의 기약 표현에서 비롯됩니다. 따라서 전자 장은 로런츠 군의 스핀- 바일 표현으로 변환하고, 아래에서 초전하 을 가지며, 아래에서는 단일항입니다.
철학적으로 구조적 실재론은 이러한 표현론적 관점에 설득력 있는 존재론을 제공합니다. 그런데 구조적 실재론에는 두 가지 해석이 있습니다. 인식적 구조적 실재론은 과학 이론이 관찰 불가능한 것들의 내재적 본성이 아니라 관계적 구조만을 포착한다고 보는 반면, 존재적 구조적 실재론은 구조가 존재하는 전부라고 주장합니다. 즉 관계와 대칭이 실재를 이루며, 대상은 관계망 속의 마디에 불과합니다. 이 관점에서 입자는 기체(基體)가 아니라 군 표현과 장 방정식으로 정의되는 수학적 구조의 구현입니다.
의 게이지 대칭은 추상적 구조가 어떻게 물리 현상을 규정하는지를 더욱 잘 보여 줍니다. 양자 색역학의 색전하와 가둠은 의 비가환 구조에서 비롯되며, 전기약 부문의 자발적 대칭 깨짐은 힉스 장이 진공 기댓값을 얻음으로써 일어나 입자에 질량을 부여합니다. 이러한 메커니즘은 우리가 “입자“라고 부르는 것이 독립적인 실체가 아니라 대칭 원리로 짜인 직물 속에서 창발하는 마디임을 분명히 보여 줍니다.
우리는 라그랑주 역학, 장 연산자, 섭동 이론이라는 형식적 도구를 통해 이러한 구조를 다루며, 이를 통해 추상적인 대수적 관계를 정밀한 수치 예측으로 옮깁니다. 전례 없는 정확도로 검증된 양자 전기역학, 양자 색역학, 전기약 이론의 놀라운 경험적 성공은 그림으로 그릴 수 있는 물질보다 수학적 구조가 존재론적으로 우선함을 입증합니다.
입자는 수학적 구조, 즉 양자화된 장의 들뜸으로 발현되는 시공간 대칭 군과 내부 대칭 군의 기약 표현으로 이해하는 것이 가장 좋습니다. 이러한 구조적 존재론은 동일성, 국소화, 결정성에 관한 고전적 역설을 해소하며, 근본적인 짜임이 추상적인 대칭과 관계로 엮인 실재를 드러냅니다. 이 관점은 이러한 성질들을 지니는 근본적인 “재료“나 “기체(基體)“에 대한 추측을 피합니다. 수학적으로 정의된 성질들이 존재론적으로 입자를 구성합니다.
물론 이는 오래된 물음을 불러일으킵니다. 이것은 실재가 수학적이라는 뜻입니까? 아니면 수학은 궁극적 본성이 여전히 파악되지 않는 실재를 기술하기 위한 우리의 가장 좋은 도구일 뿐입니까? 이는 더 넓은 실재론/반실재론 논쟁으로 이어집니다. 하지만 결국 이것들은 더 이상 물리학의 질문이 아니므로, 다른 학과에 맡기는 것이 가장 좋습니다.
적분 동물원
도함수 동물원과 마찬가지로, 우리가 “적분“이라고 부르는 구성은 매우 다양합니다. 그중 가장 흥미로운 것들을 소개합니다.
고전적 적분
함수 의 부정적분, 즉 역도함수는 도함수가 인 함수 들의 족을 나타냅니다. 이는 로 표기하며, 여기서 이고 는 임의의 적분 상수로, 상수의 도함수가 0이라는 사실을 반영합니다. 이 개념은 미분의 역연산으로 등장하며, 미적분학의 기본 정리를 통해 정적분과 근본적으로 연결됩니다.
선적분
선적분은 정적분을 2차원 또는 3차원 공간의 곡선 를 따라 적분하는 것으로 일반화합니다. 주요한 유형은 두 가지입니다. 스칼라장 에 대해, 호의 길이에 관한 선적분은 곡선을 따른 “질량” 또는 총합을 측정합니다: . 벡터장 에 대해, 선적분은 곡선을 따라 장이 한 일을 측정합니다: . 두 경우 모두 에 대해 곡선 를 로 매개화하고, 적분을 매개변수 에 관한 일반적인 정적분으로 변환하여 계산합니다.
면적분
면적분은 선적분이 정적분을 곡선으로 확장하는 것과 유사하게, 적분을 3차원 공간의 곡면 로 확장합니다. 스칼라장 에 대해, 면적분 는 곡면 위의 총합 또는 “질량“을 계산합니다. 벡터장 에 대해, 면적분(흔히 플럭스라고 부릅니다)은 곡면을 통과하는 벡터장의 알짜 흐름을 측정합니다: . 이들은 -평면의 영역 위에서 곡면 를 로 매개화하고 위의 이중적분을 계산하여 구합니다.
경로 적분(복소 선적분)
경로 적분(contour integral)은 본질적으로 복소평면에서 수행하는 선적분입니다. 복소함수 와 에 대해 로 매개화된 곡선(경로) 에 대하여, 적분은 로 정의됩니다. 여기서 복소수 곱셈 에 주목하십시오. 이는 실수 벡터장의 선적분에서 사용하는 내적과는 다릅니다. 경로 적분은 복소해석학의 근간으로, 코시 적분 정리, 코시 적분 공식, 유수 정리의 기초를 이룹니다. 이 정리들은 적분을 계산하고 복소함수를 분석하는 강력한 도구입니다.
스틸체스 적분
로 표기하는 리만-스틸체스 적분은 함수 를 단순히 에 대해서(인 경우에 해당) 적분하는 대신 다른 함수 (적분자라고 부릅니다)에 대해 적분함으로써 리만 적분을 일반화합니다. 이 적분은 와 같은 합의 극한으로 정의됩니다. 이를 통해 구간의 각 부분에 의 변화량으로 결정되는 서로 다른 “가중치” 또는 “측도“를 부여할 수 있습니다. 이 적분은 확률과 통계에서 누적 분포 함수에 대한 기댓값을 계산할 때(가 CDF인 경우) 특히 유용하며, 물리학과 함수해석학에도 응용됩니다. 르베그-스틸체스 적분은 이를 측도론적으로 더 강력하게 일반화한 것입니다.
르베그 적분
르베그 적분은 측도론에 기반을 둔, 리만 적분보다 더 일반적이고 강력한 적분의 구성입니다. 르베그 적분은 (리만 적분처럼) 정의역 를 분할하는 대신, 본질적으로 함수 의 치역을 분할하고, 정의역에서 가 치역 분할의 각 부분에 속하는 값을 취하는 집합들의 크기를 (측도 , 일반적으로 르베그 측도를 사용하여) 잽니다. 음이 아닌 가측 함수 에 대해서는 로 정의하며, 를 통해 일반 함수로 확장합니다. 르베그 적분은 (불연속성이 매우 심한 함수를 포함하여) 더 넓은 범위의 함수를 적분할 수 있고, (지배 수렴 정리와 단조 수렴 정리 같은) 더 우수한 수렴 정리를 갖추고 있어 현대 해석학과 확률론의 표준이 되었습니다.
분수 적분
분수 적분은 반복 적분의 개념을 정수가 아닌 차수 으로 일반화합니다. 가장 흔한 형태는 리만-리우빌 분수 적분으로, 로 정의되며, 여기서 는 감마 함수입니다. 이 공식은 중 적분에 대한 코시 공식을 일반화하는 것에서 그 동기를 찾을 수 있습니다. 분수 적분은 (어떤 의미에서) 분수 미분의 역연산자 역할을 하며, 분수 미적분학 연구에서 분수 미분과 함께 등장합니다. 분수 미적분학은 기억 효과나 비국소적 거동을 보이는 시스템을 모델링하는 데 사용됩니다.
경로 적분
경로 적분, 특히 양자역학과 양자장론에서 사용하는 파인만 경로 적분은 시스템이 초기 상태와 최종 상태 사이에서 취할 수 있는 모든 가능한 궤적(경로)에 대해 합산(또는 “적분”)하여 양자 진폭이나 통계역학의 분배 함수를 계산하는 개념입니다. 도식적으로는 또는 와 같은 형태로 나타낼 수 있으며, 여기서 는 작용 범함수이고 는 경로 공간 위의 “측도“를 나타냅니다. 경로 적분은 리만이나 르베그의 의미에서 수학적으로 엄밀한 표준 적분이 아닙니다. 그 정의는 일반적으로 이산화(시간 분할)와 극한을 취하는 방법, 또는 다른 특수한 형식론에 의존합니다.
보흐너 적분
보흐너 적분은 르베그 적분을 측도 공간 위에서 정의되고 바나흐 공간 (완비 노름 벡터 공간)에 값을 갖는 함수 로 확장합니다. 르베그 적분의 구성과 마찬가지로, 보흐너 적분은 (에서 유한 개의 값을 취하는) 단순 함수의 극한을 사용하여 정의됩니다. 그 결과로 얻는 적분 는 바나흐 공간 의 원소입니다. 보흐너 적분은 함수해석학, 벡터 측도론, 그리고 바나흐 공간에 값을 갖는 편미분방정식 연구에서 핵심적인 도구입니다.
이토 적분
이토 적분은 확률 미적분학의 기본 개념으로, 확률 과정, 대표적으로 브라운 운동(또는 위너 과정) 에 대한 적분을 정의합니다. 적절한(비예측적 또는 적합된) 확률 과정 에 대해, 이토 적분 는 다음과 같은 합의 극한으로 정의됩니다: . 핵심적인 특징은 피적분 함수 를 시간 구간 의 시작점에서 평가한다는 것입니다. 그 결과는 확률 변수이며, 이토 적분은 고전적인 미적분학의 규칙을 따르지 않습니다. 예를 들어, 연쇄 법칙은 이토의 보조정리로 대체됩니다. 이토 적분은 특히 금융과 물리학에서 무작위 잡음에 의해 구동되는 시스템을 모델링하는 데 필수적입니다.
아다마르 적분
아다마르 유한 부분 적분(또는 아다마르 정칙화)은 강한 특이점 때문에 통상적인 의미에서 발산하는 특정 유형의 이상 적분에 유한한 값을 부여하는 방법입니다. 예를 들어, 가 매끄럽고 인 적분 에 대해, 아다마르 유한 부분은 주변에서의 의 테일러 전개로부터 얻은 발산 항들을 빼는 과정을 포함합니다. 이는 극한, 해석적 연속, 또는 분포 이론의 틀 안에서 형식적으로 정의됩니다. 이는 물리학과 응용수학, 특히 경계 요소법과 양자장론에서 나타나는 발산 적분을 정칙화하는 방법을 제공합니다.
다르부 적분
다르부 적분은 상합(upper sum)과 하합(lower sum)을 사용하여 리만 적분을 엄밀하게 정의하는 방법입니다. 구간 에서 정의된 유계 함수 에 대해, 를 소구간들로 분할하고 상합 와 하합 를 정의합니다. 여기서 와 는 각 소구간에서 의 상한과 하한입니다. 상다르부 적분은 로 정의되고, 하다르부 적분은 로 정의됩니다. 이 상적분과 하적분이 같으면 함수가 다르부 적분 가능하다고 하며, 이때 그 공통값이 다르부 적분입니다. 이 접근 방식은 리만 적분의 정의와 동등한 대안을 제공하며, 근사 과정과 극한 과정을 명확하게 분리하여 특정 이론적 성질을 더 투명하게 드러낸다는 장점이 있습니다.
위너 적분
위너 적분은 일반적으로 위너 측도에 대한 적분을 가리키며, 위너 측도는 연속 경로들의 공간(흔히 0에서 시작하며, 로 표기)에서 정의된 확률 측도입니다. 이 개념은 브라운 운동의 수학적 이론에서 중심적인 역할을 합니다. 이는 위너 과정 의 범함수 의 기댓값을 계산하는 것을 의미할 수 있으며, 로 표기합니다. 여기서 는 위너 측도입니다. 이 용어는 때때로 비형식적으로, 위너 과정의 표본 경로에 대해 적분하는 이토 적분이나 스트라토노비치 적분 같은 확률 적분, 또는 측도가 유클리드 시간에서 위너 측도와 형식적으로 관련된 (파인만적 의미의) 경로 적분까지 포괄하기도 합니다.
도함수 동물원
우리가 도함수라고 부르는 연산자에는 여러 종류가 있습니다.
- 고전적 도함수
- 단측 도함수
- 고계 도함수
- 음함수 도함수
- 복소 도함수
- 편도함수
- 방향 도함수
- 공변 도함수
- 리 도함수
- 외미분 도함수
- 물질 도함수
- 약도함수
- 프레셰 도함수
- 가토 도함수
- 변분 도함수
- 분수계 도함수
- 라돈-니코딤 도함수
- 확률 도함수
고전적 도함수
점 에서 함수 의 고전적 도함수는 극한 로 정의됩니다. 이 값은 변수 에 대한 함수 의 순간 변화율을 나타내며, 기하학적으로는 에서 의 그래프에 접하는 접선의 기울기에 해당합니다. 이 정의는 줄어드는 구간 에서의 평균 변화율, 즉 할선의 기울기 를 생각하고, 구간의 폭 가 0에 가까워질 때의 극한을 취하는 데서 유도됩니다.
단측 도함수
단측 도함수는 에 한쪽 방향에서만 접근할 때의 변화율을 다룹니다. 우도함수는 이고(여기서 는 양수 쪽에서 0에 접근합니다), 좌도함수는 입니다(여기서 는 음수 쪽에서 0에 접근합니다). 이들은 고전적 도함수와 같은 극한 정의를 사용하되, 를 엄격히 양수이거나 엄격히 음수인 값으로 제한하여 유도됩니다. 고전적 도함수는 좌도함수와 우도함수가 모두 존재하고 서로 같을 때, 그리고 그때에만 존재합니다.
고계 도함수
고계 도함수는 미분 과정을 반복적으로 적용하여 얻습니다. 또는 로 표기하는 계 도함수는 계 도함수의 도함수로 재귀적으로 정의됩니다: . 예를 들어, 이계 도함수 는 일계 도함수의 변화율(가속도와 같은)을 측정하며, 함수의 오목성과 관련됩니다. 각 고계 도함수는 바로 앞 도함수의 변화율을 측정합니다.
음함수 도함수
음함수 미분은 특정한 공식이라기보다는 하나의 기법으로, 와 사이의 관계가 방정식 에 의해 음함수적으로 주어져 국소적으로 를 의 함수로 정의할 때 사용됩니다. 를 구하려면 를 로 취급하고 필요한 곳에 연쇄 법칙을 적용하면서(예: ) 방정식 의 양변을 에 대해 미분합니다. 그런 다음 얻어진 방정식을 에 대해 대수적으로 풉니다. 이렇게 하면 를 명시적으로 풀지 않고도 도함수를 구할 수 있습니다.
복소 도함수
복소함수 의 에서의 도함수는 실수의 경우와 비슷하게 정의됩니다: . 그러나 여기서는 이며, 복소평면에서 가 0에 접근하는 경로와 관계없이 극한이 존재하고 같은 값을 가져야 합니다. 이 경로 독립성 조건은 매우 강력하여 복소 미분 가능성(정칙성)을 에서의 실수 미분 가능성과 구별하며, 함수가 코시-리만 방정식을 만족함을 함의합니다. 이는 복소 변화율을 나타냅니다.
편도함수
다변수 함수 에 대해, 점 에서 한 변수 에 대한 편도함수는 로 표기하며, 다른 모든 변수를 상수로 고정한 채 좌표 방향을 따라 함수의 변화율을 측정합니다. 그 공식은 입니다. 이는 다른 모든 ()를 고정된 매개변수로 취급하고, 에 대해 표준적인 일변수 도함수의 정의를 적용하여 유도됩니다.
방향 도함수
방향 도함수는 편도함수를 일반화한 것으로, 점 에서 단위 벡터 로 지정된 임의의 방향을 따라 함수 의 변화율을 측정합니다. 이는 로 정의됩니다. 가 에서 미분 가능하면, 이는 기울기 를 사용하여 내적으로 계산할 수 있습니다: . 정의는 직선 를 따라 극한 개념을 적용한 것이며, 기울기 공식은 에 연쇄 법칙을 적용하여 유도됩니다.
공변 도함수
공변 도함수 는 방향 도함수를 접속 가 주어진 굽은 공간(다양체) 위의 텐서장 로 일반화한 것입니다. 이는 기저 벡터나 좌표계의 변화를 고려하여 벡터장 를 따라 의 변화를 측정합니다. 크리스토펠 기호 를 갖는 국소 좌표 에서, 벡터장 의 를 따른 공변 도함수는 성분 를 가지며, 흔히 성분 형태로 와 같이 씁니다. 이는 공리적으로 유도하거나, 텐서 성분의 고유한 변화에 변하는 기저로 인해 생기는 변화를 더한 것을 측정하도록 요구하여 유도하며, 그 결과 같은 유형의 텐서를 얻습니다.
리 도함수
리 도함수 는 텐서장 가 벡터장 로 생성되는 흐름 를 따라 “끌려갈” 때의 변화율을 측정합니다. 이는 로 정의되며, 여기서 는 흐름을 따른 의 당김(pullback)을 나타냅니다. 공변 도함수와 달리, 계량이나 접속을 필요로 하지 않습니다. 스칼라 함수 에 대해서는 방향 도함수 로 귀결됩니다. 벡터장 에 대해서는 리 괄호 와 같습니다. 이를 유도하려면 점 에서의 텐서와, 에서의 텐서를 로 적절히 되돌려 옮긴 것을 비교해야 합니다.
외미분 도함수
외미분 도함수 는 다양체 위에서 미분 -형식 를 -형식 로 사상하는 연산입니다. 0-형식(함수) 에 대해 입니다. -형식 에 대해 입니다. 외미분은 선형성, 등급 라이프니츠 규칙, (), 그리고 기울기와의 일관성 같은 성질을 유일하게 만족합니다. 외미분은 grad, curl, div를 좌표에 무관하게 일반화하며, 일반화된 스토크스 정리 의 근간이 됩니다. 외미분의 좌표 공식은 이 공리들로부터 유도할 수 있습니다.
물질 도함수
물질 도함수(또는 실질 도함수, 전도함수)는 로 표기하며, 속도장 를 따라 움직이는 입자가 겪는 장 (온도나 밀도 등)의 전체 변화율을 측정합니다. 그 공식은 입니다. 이는 고정점에서의 국소 변화율()과, 입자가 값이 다른 영역으로 이동함에 따른 대류 변화율()을 결합한 것입니다. 이는 일 때 에 다변수 연쇄 법칙을 적용하여 유도됩니다.
약도함수
약도함수는 고전적인 미분을 하기에는 충분히 매끄럽지 않을 수 있는 함수(소볼레프 공간의 함수 등)로 미분을 확장합니다. 안에서 콤팩트 지지를 갖는 모든 매끄러운 시험 함수 에 대해 가 성립하면, 함수 를 의 차 약도함수라 하며 로 표기합니다. 이 정의는 부분적분 공식에서 착안한 것으로, 도함수 연산을 매끄럽지 않을 수 있는 함수 에서 무한히 미분 가능한 시험 함수 로 사실상 옮기는 것입니다.
프레셰 도함수
프레셰 도함수는 도함수의 개념을 바나흐 공간 와 사이의 함수 (는 열린집합)로 일반화합니다. 이는 로 표기하는 유계 선형 연산자 로서, 근방에서 의 최선의 선형 근사를 제공합니다. 이는 , 또는 동치로 임을 뜻합니다. 이 정의는 라는 아이디어를 형식화한 것으로, 여기서 는 변위 에 대한 선형 사상 의 작용으로 대체됩니다. 존재한다면 유일합니다.
가토 도함수
가토 도함수(Gâteaux derivative)는 위상 벡터 공간 사이의 함수 에 대한 도함수의 또 다른 일반화로, 방향에 따른 변화율에 초점을 맞춥니다. 점 에서 방향 에 대한 의 가토 도함수는 극한이 존재할 경우 입니다(여기서 는 스칼라입니다). 이는 에서의 방향 도함수 개념을 직접적으로 일반화합니다. 이는 프레셰 도함수보다 약한 개념입니다. 프레셰 미분 가능성은 모든 방향에 대한 가토 미분 가능성을 함의하지만, 그 역이 항상 성립하지는 않습니다.
변분 도함수(범함수 도함수)
변분 도함수 는 범함수 (함수를 스칼라로 대응시키는 사상)가 입력 함수 의 점 에서의 무한소의 국소적 변분 에 반응하여 어떻게 변하는지를 측정합니다. 이는 첫 번째 변분을 통해 암묵적으로 정의됩니다. 이며, 여기서 는 일 때 의 (에 대한) 선형 부분입니다. 라그랑지언 의 적분으로 정의되는 범함수의 경우, 이는 흔히 오일러-라그랑주 식 을 사용하여 계산됩니다. 이는 기울기(gradient)의 범함수적 대응물 역할을 합니다.
분수 도함수
분수 도함수는 미분 개념을 정수가 아닌 차수 로 일반화합니다. 단일한 보편적 정의는 없지만, 일반적인 형태로는 리만-리우빌 도함수 와 카푸토 도함수 가 있으며, 여기서 입니다. 이러한 연산자는 미분과 적분을 임의의 실수 또는 복소수 차수로 확장합니다. 이들은 일반적으로 비국소적이며(함수의 이력에 의존함), 기억 효과나 프랙탈 특성을 지닌 현상을 모델링하는 데 사용됩니다. 이들의 유도는 흔히 반복 적분에 대한 코시 공식이나 푸리에 변환의 성질과 같은 정수 차수 미적분학의 성질을 일반화하는 과정을 포함합니다.
라돈-니코딤 도함수
라돈-니코딤 도함수 는 가측 공간 위의 두 -유한 측도 와 를 연관 짓습니다. 가 에 대해 절대 연속이라면(, 즉 ), 라돈-니코딤 정리는 모든 가측 집합 에 대해 를 만족하는 음이 아닌 가측 함수 의 존재를 보장합니다. 이 함수 는 에 대한 의 밀도 또는 변화율 역할을 합니다. 가 르베그 측도라면, 이는 확률 밀도 함수와 같은 개념을 일반화합니다. 그 존재성은 측도론의 심오한 결과로, 단순한 공식으로부터 유도되는 것이 아니라 함수해석학 기법을 사용하여 증명됩니다.
확률 도함수
“확률 도함수“라는 용어는 흔히 브라운 운동 와 같은 확률 과정의 범함수에 대한 말리아뱅 미적분학에서 사용되는 말리아뱅 도함수를 가리킵니다. 확률 변수 의 말리아뱅 도함수 는 시각 에서 구동 잡음의 경로에 대한 무한소 변화에 얼마나 민감한지를 측정합니다. 단순 범함수 에 대해 입니다. 이는 위너 공간 위의 부분 적분 공식을 통해 형식적으로 정의되며, 이로써 도함수 연산자 는 스코로호드 확률 적분 의 수반 연산자가 됩니다. 이는 확률 해석학과 계량 금융에서 핵심적인 역할을 합니다.
Google OR-Tools 도구로 해집합 프로그래밍하기
팀의 완벽한 일정을 직접 짜 보거나 배송 경로를 계획해 본 적이 있습니까? 이럴 때 Google OR-Tools가 등장합니다. 이 무료 툴킷은 이처럼 골치 아픈 최적화 문제를 해결해 주는 맥가이버 칼 같은 도구입니다. 제약 프로그래밍부터 선형 프로그래밍, 특화된 경로 탐색 솔버에 이르기까지, 컴퓨터 과학의 복잡한 퍼즐을 푸는 데 필요한 모든 도구를 갖추고 있습니다. 또한 Google이 유지 관리하고 개선하므로, 최적화 알고리즘을 처음부터 다시 만들 필요 없이 여러분의 구체적인 문제를 해결하는 데 집중할 수 있습니다.
다음은 여러 제약 조건을 만족하면서 팀원을 선발해야 하는 간단한 예제입니다:
from ortools.sat.python import cp_model
model = cp_model.CpModel()
persons = ['Tony', 'Bob', 'Ann', 'Carl', 'Amber', 'Peter']
person_vars = {p: model.NewBoolVar(p) for p in persons}
# Select exactly 2 people from group1
group1 = ['Bob', 'Ann', 'Carl', 'Amber', 'Peter']
model.Add(sum(person_vars[p] for p in group1) == 2)
# Select exactly 1 person from group2
group2 = ['Bob', 'Amber']
model.Add(sum(person_vars[p] for p in group2) == 1)
# Amber must be selected
model.Add(person_vars['Amber'] == 1)
# Total team size must be 4
model.Add(sum(person_vars.values()) == 4)
solver = cp_model.CpSolver()
status = solver.Solve(model)
if status == cp_model.OPTIMAL or status == cp_model.FEASIBLE:
print("Solution found:")
for person, var in person_vars.items():
if solver.Value(var):
print(person)
else:
print("No solution found.")
이런 종류의 문제의 또 다른 대표적인 예는 강의 시간표 작성입니다:
from ortools.sat.python import cp_model
def create_course_schedule():
model = cp_model.CpModel()
# Parameters
num_time_slots = 5 # Time slots per day
num_rooms = 3
courses = ['Math', 'Physics', 'Chemistry', 'Biology', 'English']
teachers = ['Smith', 'Johnson', 'Williams']
# Decision variables
slots = {}
for course in courses:
for time in range(num_time_slots):
for room in range(num_rooms):
slots[(course, time, room)] = model.NewBoolVar(f'{course}_{time}_{room}')
# Each course must be scheduled exactly once
for course in courses:
model.Add(sum(slots[(course, t, r)]
for t in range(num_time_slots)
for r in range(num_rooms)) == 1)
# Only one course per room per time slot
for time in range(num_time_slots):
for room in range(num_rooms):
model.Add(sum(slots[(c, time, room)] for c in courses) <= 1)
# Solve the model
solver = cp_model.CpSolver()
status = solver.Solve(model)
if status == cp_model.OPTIMAL or status == cp_model.FEASIBLE:
print("\nSchedule:")
for time in range(num_time_slots):
print(f"\nTime Slot {time + 1}:")
for room in range(num_rooms):
for course in courses:
if solver.Value(slots[(course, time, room)]):
print(f"Room {room + 1}: {course}")
else:
print("No solution found.")
create_course_schedule()
거리 행렬은 각 위치 쌍 사이의 거리를 나타내며, 각 행과 열은 하나의 위치(창고 또는 고객)에 대응합니다. 예를 들어 distances[1][2] = 6은 고객 1에서 고객 2까지 이동하는 데 6단위가 걸린다는 뜻입니다. 이 행렬은 대칭 행렬이므로, A에서 B까지의 거리는 B에서 A까지의 거리와 같습니다. 첫 번째 행/열(인덱스 0)은 창고를 나타내고, 그 이후의 인덱스는 고객을 나타냅니다.
from ortools.constraint_solver import routing_enums_pb2
from ortools.constraint_solver import pywrapcp
def create_delivery_route():
# Distance matrix
distances = [
[0, 2, 9, 10], # Depot
[2, 0, 6, 8], # Customer 1
[9, 6, 0, 3], # Customer 2
[10, 8, 3, 0], # Customer 3
]
manager = pywrapcp.RoutingIndexManager(len(distances), 1, 0)
routing = pywrapcp.RoutingModel(manager)
def distance_callback(from_index, to_index):
from_node = manager.IndexToNode(from_index)
to_node = manager.IndexToNode(to_index)
return distances[from_node][to_node]
transit_callback_index = routing.RegisterTransitCallback(distance_callback)
routing.SetArcCostEvaluatorOfAllVehicles(transit_callback_index)
search_parameters = pywrapcp.DefaultRoutingSearchParameters()
search_parameters.first_solution_strategy = (
routing_enums_pb2.FirstSolutionStrategy.PATH_CHEAPEST_ARC)
solution = routing.SolveWithParameters(search_parameters)
if solution:
print("Optimal delivery route:")
index = routing.Start(0)
route = ['Depot']
while not routing.IsEnd(index):
index = solution.Value(routing.NextVar(index))
if not routing.IsEnd(index):
route.append(f'Customer {manager.IndexToNode(index)}')
route.append('Depot')
print(' -> '.join(route))
create_delivery_route()
Python으로 구현하는 Y 컴비네이터
람다 대수는 계산 이론의 기초 체계로서 존중받는 위치를 차지하고 있으며, 프로그래밍 언어와 패러다임에 영향을 미쳐 왔습니다. 람다 대수의 흥미로운 응용 중 하나는 처치 인코딩으로, 이를 이용하면 함수만으로 데이터와 연산자를 표현할 수 있습니다. 이 블로그 글에서는 Python에서 처치 인코딩을 구현하여 불리언 값, 기본 산술 연산, 나아가 피보나치 수열과 같은 복잡한 함수까지 표현하는 방법을 자세히 살펴봅니다.
처치 인코딩은 람다 대수에서 데이터와 연산자를 표현하는 수단으로, 데이터 타입 대신 함수를 사용합니다. 수, 불리언 값, 기본 산술 연산과 같은 전형적인 구성 요소는 순전히 함수 추상화와 적용만으로 표현할 수 있습니다.
먼저 Python의 람다 함수를 사용하여 불리언 값과 필수적인 논리 연산을 인코딩해 봅시다.
처치 인코딩에서 TRUE와 FALSE는 두 개의 매개변수를 받아 각각 첫 번째 매개변수와 두 번째 매개변수를 반환하는 함수로 정의할 수 있습니다.
TRUE = lambda x: lambda y: x
FALSE = lambda x: lambda y: y
이 정의를 사용하면 논리 연산을 정의할 수 있습니다. 예를 들어 AND 연산은 다음과 같이 표현할 수 있습니다.
And = lambda x: lambda y: x(y)(x)
산술 연산 역시 이 체계에서 표현할 수 있습니다. 예를 들어 수의 후속자, 덧셈, 곱셈은 다음과 같이 정의됩니다.
Succ = lambda n: lambda f: lambda x: f(n(f)(x))
Add = lambda m: lambda n: lambda f: lambda x: m(f)(n(f)(x))
Mul = lambda m: lambda n: lambda f: m(n(f))
이제 더 복잡한 예로 피보나치 수열을 다루며, 이를 Python에서 람다 대수의 구성 요소로 구현합니다. 람다 대수는 본래 재귀를 지원하지 않으므로, 재귀를 처리하기 위해 Y 컴비네이터를 사용합니다.
Y = lambda f: (lambda x: f(lambda v: x(x)(v)))(lambda x: f(lambda v: x(x)(v)))
Fib = Y(lambda f: lambda n: Add(f(Pred(n)))(f(Sub(n)(TWO))) if Gt(n)(ONE) else n)
이렇게 인코딩된 논리를 Python으로 구현하고 실행해 보는 것은 계산의 더 깊은 기초를 이해하는 데 훌륭한 도구가 됩니다. 몇 가지 피보나치 위치를 어떻게 계산하는지 살펴봅시다.
print(Fib(1)) # Output: 1
print(Fib(2)) # Output: 1
print(Fib(8)) # Output: 21
여러분의 비틀린 즐거움을 위해 준비한 전체 코드는 아래와 같습니다.
TRUE = lambda x: lambda y: x
FALSE = lambda x: lambda y: y
Product = lambda x: lambda y: lambda z: (z)(x)(y)
And = lambda x: lambda y: (x)(y)(x)
Not = lambda x: lambda y: lambda z: (x)(z)(y)
Boolean = (Product)(True)(False)
Succ = lambda x: lambda y: lambda z: (y)((x)(y)(z))
Pred = lambda x: lambda y: lambda z: x(lambda i: lambda j: j(i(y))) (lambda k: z) (lambda k: k)
Y = lambda g: (lambda z:z(z)) (lambda f: g(lambda arg: f(f)(arg)))
Nth = Y(lambda f: lambda n: Succ(f(n-1)) if n else Zero)
Dec = lambda a: (a)(lambda b: b + 1)(0)
Add = lambda x: lambda y: lambda z: lambda w: (x)(z)((y)(z)(w))
Sub = lambda x: lambda y: (y)(Pred)(x)
Mul = lambda x: lambda y: lambda z: (y)((x)(z))
Null = lambda x: x(lambda y: Zero)(TRUE)
Eq = lambda x: lambda y: (And)((Null)((Sub)(y)(x)))((Null)((Sub)(x)(y)))
Gt = lambda x: lambda y: (And)((Null)((Sub)(y)(x)))((Not)((Eq)(y)(x)))
Lt = lambda x: lambda y: (And)((Not)((Gt)(x)(y)))((Not)((Eq)(x)(y)))
IfThenElse = lambda a: lambda b: lambda c: ((a)(b))(c)
Range = lambda a,b: map(Nth,range(a,b))
# Minimal
Fib = Y(lambda f: lambda n: Add(f(Pred(n)))(f((Sub)(n)(Two))) if (Boolean)((Gt)(n)(One)) else n)
# Exapnded
Fib = lambda x: (lambda a: (a)(lambda b: b + 1)(0))(
(
(
lambda g: (lambda f: g(lambda arg: f(f)(arg)))(
lambda f: g(lambda arg: f(f)(arg))
)
)(
lambda f: lambda n: (
(lambda x: lambda y: lambda z: lambda w: (x)(z)((y)(z)(w)))(
f(
(
lambda x: lambda y: lambda z: x(
lambda i: lambda j: j(i(y))
)(lambda k: z)(lambda k: k)
)(n)
)
)(
f(
(
(
lambda x: lambda y: (y)(
(
lambda x: lambda y: lambda z: x(
lambda i: lambda j: j(i(y))
)(lambda k: z)(lambda k: k)
)
)(x)
)
)(n)(
(
(lambda x: lambda y: lambda z: (y)((x)(y)(z)))(
(
(lambda x: lambda y: lambda z: (y)((x)(y)(z)))(
(lambda x: lambda y: y)
)
)
)
)
)
)
)
if (
(
((lambda x: lambda y: lambda z: (z)(x)(y)))(
lambda x: lambda y: x
)(False)
)
)(
(
(
lambda x: lambda y: (lambda x: lambda y: (x)(y)(x))(
(
(
lambda x: x(lambda y: (lambda x: lambda y: y))(
lambda x: lambda y: x
)
)
)(
(
(
lambda x: lambda y: (y)(
(
lambda x: lambda y: lambda z: x(
lambda i: lambda j: j(i(y))
)(lambda k: z)(lambda k: k)
)
)(x)
)
)(y)(x)
)
)(
((lambda x: lambda y: lambda z: (x)(z)(y)))(
(
(
lambda x: lambda y: (
lambda x: lambda y: (x)(y)(x)
)(
(
(
lambda x: x(
lambda y: (
lambda x: lambda y: y
)
)(lambda x: lambda y: x)
)
)(
(
(
lambda x: lambda y: (y)(
(
lambda x: lambda y: lambda z: x(
lambda i: lambda j: j(
i(y)
)
)(
lambda k: z
)(
lambda k: k
)
)
)(x)
)
)(y)(x)
)
)(
(
(
lambda x: x(
lambda y: (
lambda x: lambda y: y
)
)(lambda x: lambda y: x)
)
)(
(
(
lambda x: lambda y: (y)(
(
lambda x: lambda y: lambda z: x(
lambda i: lambda j: j(
i(y)
)
)(
lambda k: z
)(
lambda k: k
)
)
)(x)
)
)(x)(y)
)
)
)
)(y)(x)
)
)
)
)(n)(
(
(lambda x: lambda y: lambda z: (y)((x)(y)(z)))(
(lambda x: lambda y: y)
)
)
)
)
else n
)
)
)(
(
(
lambda g: (lambda f: g(lambda arg: f(f)(arg)))(
lambda f: g(lambda arg: f(f)(arg))
)
)(
lambda f: lambda n: (
(lambda x: lambda y: lambda z: (y)((x)(y)(z)))(f(n - 1))
if n
else (lambda x: lambda y: y)
)
)
)(x)
)
)
GHC 깊이 들여다보기: Core를 대상으로
지난 블로그 글에서는 GHC 컴파일러에서 사용되는 중간 구조를 살펴보았습니다. 이번에는 Core 언어를 살펴봅시다.
**[Accompaying Source Code](https://github.com/sdiehl/dive-into-ghc/tree/master/03-core)**
Core
GHC에서 가장 핵심적인 데이터 타입입니다. Core는 System FC의 아주 작고 명시적으로 타입이 지정된 변형입니다. 이는 타입 위에서의 전칭 양화 메커니즘을 도입했다는 점에서 단순 타입 람다 대수와 다른 타입 있는 람다 대수이며, 이 전칭 양화는 대문자 람다 로 표기됩니다.
-- System-F Notation
Λ b c a. λ (f1 : b -> c) (g : a -> b) (x1 : a). f1 (g x1)
-- Haskell Core
\ (@ b) (@ c) (@ a) (f1 :: b -> c) (g :: a -> b) (x1 :: a) -> f1 (g x1)
Haskell 프런트엔드는 암묵적으로 타입이 지정되는 소스 언어이지만, Core는 명시적으로 타입이 지정되는 언어입니다. 모든 바인더는 명시적인 타입을 가지며, 항에는 명시적인 타입 추상화와 타입 적용이 포함됩니다.
GHCi에서 Core를 살펴보려면 다음 플래그와 다음 셸 별칭을 사용하여 호출할 수 있습니다. 표현을 읽기 쉽게 하려고 일부 메타데이터와 긴 형식의 이름이 출력되지 않도록 명시적으로 비활성화했습니다.
alias ghci-core="ghci -ddump-simpl -dsuppress-idinfo \
-dsuppress-coercions -dsuppress-type-applications \
-dsuppress-uniques -dsuppress-module-prefixes"
그러면 대화형 프롬프트에서 Core 표현을 대화식으로 탐색할 수 있습니다.
$ ghci-core
예를 들어 일반적인 식을 입력하고 그것이 Core로 어떻게 변환되는지 확인할 수 있습니다.
λ: let f x = x + 2 ; f :: Int -> Int
==================== Simplified expression ====================
returnIO
(: ((\ (x :: Int) -> + $fNumInt x (I# 2)) `cast` ...) ([]))
λ: let f x = (x, x)
==================== Simplified expression ====================
returnIO (: ((\ (@ t) (x :: t) -> (x, x)) `cast` ...) ([]))
Core 구문
Core는 CoreSyn 모듈에 정의되어 있습니다. 중심이 되는 데이터 타입은 Expr이며, 이 타입은 모든 Haskell 표현식을 압축하여 나타낼 수 있는 10가지 Core 데이터 타입을 담고 있습니다.
data Expr b
= Var Id
| Lit Literal
| App (Expr b) (Arg b)
| Lam b (Expr b)
| Let (Bind b) (Expr b)
| Case (Expr b) b Type [Alt b]
| Cast (Expr b) Coercion
| Tick (Tickish Id) (Expr b)
| Type Type
| Coercion Coercion
Core의 패턴 매치 로직은 생성자의 최대 한 갈래만을 판별하는 여러 데이터 타입으로 나뉩니다. 프런트엔드의 case 문을 Core의 case 문으로 변환하는 과정에서는 패턴 매치를 case들의 “분할 트리“로 펼치는 과정을 거칩니다. 와일드카드 패턴 매치에 해당하는 case는 (DEFAULT, [], rhs)입니다.
type Arg b = Expr b
type Alt b = (AltCon, [b], Expr b)
data AltCon
= DataAlt DataCon
| LitAlt Literal
| DEFAULT
특히 모든 타입에는 바인더의 타입을 나타내는 매개변수 b가 있습니다. 바인더 타입은 재귀 바인더와 비재귀 바인더를 포함하는 합 타입입니다. 상호 재귀적인 바인딩은 바인더의 리스트로 인코딩됩니다.
data Bind b
= NonRec b (Expr b)
| Rec [(b, (Expr b))]
예를 들어 팩토리얼 함수는 다음과 같습니다.
fac :: Int -> Int -> Int
fac a 0 = a
fac a n = fac (n*a) (n-1)
… 이 함수는 Core 바인더로 펼쳐지며 재귀 바인딩 안에 감싸집니다.
Rec {
fac :: Int -> Int -> Int
fac =
\ (a :: Int) (ds :: Int) ->
case ds of wild { I# ds1 ->
case ds1 of _ {
__DEFAULT ->
fac (* @ Int $fNumInt wild a) (- @ Int $fNumInt wild (I# 1));
0 -> a
}
}
end Rec }
CoreSyn 모듈은 바인더 매개변수를 펼쳐 편리하게 쓸 수 있도록 한 타입 동의어를 여러 개 제공합니다.
type TyVar = Var
type CoreExpr = Expr Var
type CoreBndr = Var
type CoreBind = Bind CoreBndr
type CoreProgram = [CoreBind]
덧붙이자면, Haskell 구문의 타이핑 판단을 다루는 논문에서 쓰이는 표기법은 일반적으로 다음 관례를 따르며, Expr에 있는 각 Haskell 데이터 타입과 일대일로 대응합니다.
Var
Var 타입은 대부분의 Core 정의에서 중심이 되는 타입이며, 컴파일러의 후반부에서 사용되는 주된 이름 타입입니다. 이 타입은 Id 타입의 동의어이지만 추가로 타입 변수를 포함할 수도 있습니다.
data Var
-- Type and kind variables
= TyVar
{ varName :: Name
, realUnique :: FastInt
, varType :: Kind
}
-- Internal type variables used by inference algorithm
| TcTyVar
{ varName :: Name
, realUnique :: FastInt
, varType :: Kind
, tc_tv_details :: TcTyVarDetails
}
-- Value level identifiers
| Id
{ varName :: !Name
, realUnique :: FastInt
, varType :: Type
, idScope :: IdScope
, id_details :: IdDetails
, id_info :: IdInfo
}
Var의 필드에는 식별자의 출처를 나타내는 중요한 타입도 들어 있습니다. LocalId는 람다, case, let 바인딩과 같은 식 안에서 바인딩됩니다. GlobalId는 최상위 식이거나 임포트된 데이터 생성자, 클래스 등입니다.
data IdScope
= GlobalId
| LocalId ExportFlag
스코프 외에도 식별자의 사용 방식과 유형에 대한 추가 정보를 제공하는 두 가지 메타데이터 레코드가 있습니다. 바로 IdInfo와 IdDetails입니다. IdDetails는 주로 변수가 왜 도입되었는지에 대한 정보를 담고 있으며, IdInfo는 core에서 core로의 패스 동안 적용될 수 있는 최적화에 관한 메타데이터를 담고 있습니다.
data IdDetails
= VanillaId
| RecSelId {sel_tycon :: TyCon, sel_naughty :: Bool}
| DataConWorkId DataCon.DataCon
| DataConWrapId DataCon.DataCon
| ClassOpId Class.Class
| PrimOpId PrimOp.PrimOp
| FCallId ForeignCall.ForeignCall
| TickBoxOpId TickBoxOp
| DFunId Int Bool
IdInfo의 구조는 플래그들의 집합입니다.
data IdInfo = IdInfo
{ arityInfo :: ArityInfo
, specInfo :: SpecInfo
, unfoldingInfo :: Unfolding
, cafInfo :: CafInfo
, oneShotInfo :: OneShotInfo
, inlinePragInfo :: InlinePragma
, occInfo :: OccInfo
, strictnessInfo :: StrictSig
, demandInfo :: Demand
, callArityInfo :: !ArityInfo
}
우리가 구성할 식별자들은 단순히 람다 식과 최상위 함수에서 나온 것이므로, 기본(vanilla) 형태의 id를 그대로 사용하겠습니다.
vanillaIdInfo :: IdInfo
vanillaIdInfo = IdInfo
{ cafInfo = vanillaCafInfo,
, arityInfo = unknownArity,
, specInfo = emptySpecInfo,
, unfoldingInfo = noUnfolding,
, oneShotInfo = NoOneShotInfo,
, inlinePragInfo = defaultInlinePragma,
, occInfo = NoOccInfo,
, demandInfo = topDmd,
, strictnessInfo = nopSig,
, callArityInfo = unknownArity
}
이름에 이 메타데이터와 타입을 결합하면 Id/Var가 고유하게 구성되며, 이들을 함께 결합해 주는 여러 헬퍼 함수가 있습니다.
mkTyVar :: Name -> Kind -> TyVar
mkLocalVar :: IdDetails -> Name -> Type -> IdInfo -> Id
mkGlobalVar :: IdDetails -> Name -> Type -> IdInfo -> Id
예제
다음과 같은 아주 간단한 모듈을 생각해 봅시다.
module Example (f) where
f :: a -> a
f x = x
앞서 언급한 함수들을 사용하여 Core 구성 요소로 이 모듈을 다시 만들어 봅시다. 여기서는 mkUnique를 사용해 다소 억지스러운 방식으로 고유 값 공급(unique supply)을 흉내 내겠지만, 실제로는 이렇게 하지 말고 IO 안에서 공급을 초기화하면 됩니다.
mkName :: Int -> String -> Name
mkName i n = mkInternalName (mkUnique 'n' i) (mkOccName OccName.varName n) noSrcSpan
xn :: Name
xn = mkName 0 "x"
an :: Name
an = mkName 1 "a"
fn :: Name
fn = mkExternalName (mkUnique 'n' 2) modl (mkOccName OccName.varName "f") noSrcSpan
-- a :: *
a :: TyVar
a = mkTyVar an anyKind
-- x :: a
x :: Var
x = mkLocalVar VanillaId xn (TyVarTy a) vanillaIdInfo
-- f :: a -> a
fv :: Var
fv = mkGlobalVar VanillaId fn (FunTy (TyVarTy a) (TyVarTy a)) vanillaIdInfo
def :: [Syn.CoreBind]
def = [Syn.NonRec fv f]
f :: Syn.Expr Var
f = Syn.Lam x (Syn.Var x)
modl :: Module
modl = mkModule mainPackageKey (mkModuleName "Example")
이제 타입 검사 이후 컴파일러의 전반부에서 얻는 것과 똑같이 ModGuts와 ModSummary로 묶을 수 있는 합성 Core 모듈이 생겼습니다. 이 필드들 대부분은 기본 더미 값으로 초기화하기만 하면 됩니다.
guts :: ModGuts
guts = ModGuts
{
mg_module = modl,
mg_exports = [Avail fn],
mg_deps = noDependencies,
mg_dir_imps = emptyModuleEnv,
mg_used_names = mkNameSet [fn],
mg_used_th = False,
mg_rdr_env = emptyGlobalRdrEnv,
mg_fix_env = emptyFixityEnv,
mg_tcs = [],
mg_insts = [],
mg_fam_insts = [],
mg_patsyns = [],
mg_rules = [],
mg_binds = def, -- our binding
mg_foreign = NoStubs,
mg_warns = NoWarnings,
mg_hpc_info = NoHpcInfo False,
mg_modBreaks = emptyModBreaks,
mg_vect_decls = [],
mg_vect_info = noVectInfo,
mg_boot = False,
mg_anns = [],
mg_inst_env = emptyInstEnv,
mg_fam_inst_env = emptyFamInstEnv,
mg_safe_haskell = Sf_None,
mg_trust_pkg = False,
mg_dependent_files = []
}
summ :: DynFlags -> ModSummary
summ dflags = ModSummary
{
ms_mod = modl,
ms_hsc_src = HsSrcFile,
ms_location = ModLocation {
ml_hs_file = Nothing
, ml_hi_file = "Example.hi"
, ml_obj_file = "Example.o"
},
ms_hs_date = UTCTime (toEnum 0) 0,
ms_obj_date = Nothing,
ms_iface_date = Nothing,
ms_srcimps = [],
ms_textual_imps = [],
ms_hspp_file = "Example.hs",
ms_hspp_opts = dflags,
ms_hspp_buf = Nothing
}
코드 생성
이제 합성 core 모듈이 준비되었으므로, 여기에 일반 컴파일러 파이프라인을 실행하여 소스 코드를 컴파일할 때와 똑같이 컴파일할 수 있습니다. Core를 네이티브 코드로 변환하는 과정은 여러 단계를 거칩니다.
주요 패스는 Simplifier라고 불리며, Core를 Core로 매핑합니다. 이 패스의 역할은 더 효율적인 프로그램을 만들어 내는 것을 목표로, 정확성을 보존하는 수많은 변환을 수행하는 것입니다.
- 상수 폴딩
- 재작성 규칙 적용
- 인라이닝
- case-of-case 최적화
- 알려진 생성자에 대한 case 최적화
- 에타 확장과 에타 축소
최적화 외에도 GHC에는 Core Linter라는 패스가 있으며, 이 패스는 주어진 Core 프로그램에 대해 다양한 내부 일관성 검사를 수행합니다. Core는 명시적으로 타입이 지정되어 있으므로, 식별자의 타입이 바인딩과 일치하는지, 그리고 타입들이 내부적으로 일관적인지만 확인하면 되기 때문에 주어진 프로그램의 타입 검사는 간단합니다. Core linter는 Core를 변환하는 최적화 패스를 작성하거나 (기본 Haskell이 아닌) 다른 언어에서 Core를 대상으로 삼는 경우에 매우 유용합니다. linter 패스는 수많은 버그가 코드 생성 오류로 드러나기 전에 이를 미리 막아 줄 수 있습니다.
이제 나머지 컴파일러 파이프라인을 실행하여 모듈에서 어셈블리 코드를 생성하겠습니다. 타입 간 변환에 약간 번거로운 절차가 따르지만, 이 과정은 기본적으로 위의 패스들의 입력과 출력을 서로 연결하는 것에 불과합니다.
main :: IO ()
main = runGhc (Just libdir) $ do
dflags <- getSessionDynFlags
setSessionDynFlags $ dflags { hscTarget = HscAsm, ghcLink = LinkBinary }
dflags <- getSessionDynFlags
env <- getSession
setTargets [Target
{ targetId = TargetModule (mkModuleName "Example")
, targetAllowObjCode = True
, targetContents = Nothing }]
-- repares for code generation.
prep <- liftIO $ corePrepPgm env (ms_location (summ dflags)) (mg_binds guts) (mg_tcs guts)
-- Transform Core into STG
stg <- liftIO $ coreToStg dflags (mg_module guts) prep
-- STG Transformer
(stg_binds2, cost_centre_info) <- liftIO $ stg2stg dflags (mg_module guts) stg
-- Generated Cmm
let cmms = codeGen dflags (mg_module guts) (mg_tcs guts) cost_centre_info stg_binds2 (mg_hpc_info guts)
-- Initialize a name supply for the Cmm pipeline
us <- liftIO $ mkSplitUniqSupply 'S'
let initTopSRT = initUs_ us emptySRT
run_pipeline = cmmPipeline env
-- Collect the Cmm code stream after running the pipeline.
let cmmstream = do
a <- Stream.mapAccumL run_pipeline initTopSRT cmms
Stream.yield (srtToData a)
-- Prepare the Cmm for
genraw <- liftIO $ cmmToRawCmm dflags cmmstream
-- Initialize name supply for the native code generator and generate x86 to a
-- file from the prepared Cmm.
ncg_uniqs <- liftIO $ mkSplitUniqSupply 'n'
fname <- liftIO $ (openFile "Example.asm" WriteMode)
liftIO $ nativeCodeGen dflags (mg_module guts) modloc fname ncg_uniqs genraw
-- Dump the outputted Stg and Cmm out
gen <- liftIO $ Stream.collect cmmstream
liftIO $ putStrLn "=== STG ==="
liftIO $ putStrLn $ showGhc stg_binds2
liftIO $ putStrLn "=== CMM ==="
liftIO $ putStrLn $ showGhc gen
그러면 합성한 Core 모듈로부터 Example.asm 파일이 출력됩니다. 다음 단계의 프로젝트로는 더 복잡한 언어가 GHC Core를 타깃으로 삼도록 하여 GHC의 컴파일러 최적화와 네이티브 코드 생성을 활용하는 것을 생각해 볼 수 있습니다.
GHC 깊이 들여다보기: 중간 형태
지난 블로그 글에서는 GHC 컴파일러 내부에서 사용되는 고수준 API를 살펴보았습니다. 이번에는 컴파일 파이프라인의 프런트엔드를 구성하는 요소들, 즉 다음 항목들을 자세히 살펴봅시다.
- 파싱
- 이름 변경
- 타입 검사
- 디슈거링
- 단순화
- 코드 생성
**[Accompaying Source Code](https://github.com/sdiehl/dive-into-ghc/tree/master/02-parser)**
패스
다음 함수들은 HscMain의 컴파일러 드라이버 함수 내부에서 사용되는 주요 패스입니다.
-- Parse a module.
parseModule :: GhcMonad m => ModSummary -> m ParsedModule
-- Typecheck and rename a parsed module.
typecheckModule :: GhcMonad m => ParsedModule -> m TypecheckedModule
-- Desugar a typechecked module.
desugarModule :: GhcMonad m => TypecheckedModule -> m DesugaredModule
-- Extract ModGuts
coreModule :: DesugaredMod m => m -> ModGuts
-- Generated STG bindings from Core module
coreToStg :: DynFlags -> Module -> CoreProgram -> IO [StgBinding]
이 함수들은 각각 Haskell 모듈을 기계어 코드로 컴파일하거나 인터프리트할 수 있는 형태로 컴파일하는 과정에서 사용되는 중간 형태를 다룹니다.
파서
Haskell의 프런트엔드 구문은 상당히 방대하며, 일부는 Haskell 2010 명세에 정의되어 있고 GHC가 이를 확장합니다. 파서는 두 가지 전용 도구를 사용하여 작성됩니다.
Happy는 Haskell을 위한 파서 생성기 시스템으로, 다음 C 도구와 유사합니다: yacc' for C. It works as a preprocessor with it's own syntax that generates a parse table from two specifications, a lexer file and parser file. The Happy parser consists of a list of a production rules and a monad to running the parser in. Production rules consist of a set of options on the left and generating Haskell expressions on the right with indexed variables ( $1, $2, ...) mapping to the ordered terms on the left (i.e. in the second termterm~ $1, term~$2`).
terms
: term { [$1] }
| term terms { $1 : $2 }
렉서에서 가장 복잡한 부분은 공백에 민감한 레이아웃과 관련된 부분입니다. 공백을 처리하기 위해 렉서는 특정 생성 규칙의 줄 위치를 분석하고, 문법을 정규화하는 데 사용되는 가상 토큰(vbrace, vsemi 등)을 출력합니다. 예를 들어 do 표기법에서 레이아웃 규칙을 사용하는 경우는 다음과 같습니다.
main = do
putStrLn "Hello"
putStrLn "Haskell"
이는 파싱 시점에 명시적인 가상 중괄호와 세미콜론으로 변환됩니다.
main = do { putStrLn "Hello"; putStrLn "Haskell" }
주요 진입점은 Parser 파서 모듈에 정의되어 있으며, 소스 버퍼와 파일 이름 및 위치에 대한 상태를 담는 모나드 P로 귀결됩니다. 그 결과로 생성되는 AST는 HsSyn이라고 하며, 토큰에서 보존된 위치 정보를 담고 있습니다.
parseType :: P (LHsType RdrName)
parseExpression :: P (LHsExpr RdrName)
parseModule :: P (Located (HsModule RdrName))
Located
GHC의 프런트엔드 구문은 오류 보고에 사용할 수 있는 위치 정보를 함께 가지고 다닙니다. 위치 정보는 Located 타입으로 정의되며, 이 타입은 “위치가 지정될” AST 요소를 나타내는 타입 매개변수 하나를 가집니다. 일반적으로 타입 동의어는 타입 앞에 “L“이 붙으면 위치가 지정된 요소에 대한 동의어임을 나타내는 관례를 따릅니다. 따라서 위치가 지정된 HsExpr는 LHsExxpr입니다.
data GenLocated l e = L l e
type Located e = GenLocated SrcSpan e
unLoc :: GenLocated l e -> e
unLoc (L _ e) = e
getLoc :: GenLocated l e -> l
getLoc (L l _) = l
noLoc :: e -> Located e
noLoc e = L noSrcSpan e
가장 주목할 만한 것은 위치 정보가 붙은 요소에 대해 fmap을 적용하기 위한 함자 인스턴스로, 이는 위치를 보존하면서 내부 타입을 변경합니다.
instance Functor (GenLocated l) where
fmap f (L l e) = L l (f e)
프런트엔드 구문
프런트엔드 구문(HsSyn이라고 부릅니다)은 파서가 생성하는 모든 구문 요소를 담고 있는 여러 데이터 타입에 걸쳐 나뉘어 있습니다. 이 타입들은 이름 타입으로 매개변수화되어 있으므로, 변환(renamer 등)이 구문 트리 구조를 보존하면서 바인딩과 식별자의 구조를 바꿀 수 있습니다.
- HsModule - 모듈의 최상위 구조입니다. 모듈 이름, export, import, 최상위 선언을 담고 있습니다.
- HsDecl - 타입, 클래스, 값, 인터페이스 시그니처 선언입니다
- HsBind - 최상위 바인딩과 중첩된 바인딩 모두에 사용되는 값 바인딩입니다.
- HsGroup - HsGroup은 서로 관련된 HsDecl들의 그룹입니다.
- HsLit - 리터럴 값(Int, Char 등)입니다
- HsExpr - Haskell 표현식입니다.
- HsType - 프런트엔드 타입 주석입니다.
- Pat - case 문이나 최상위 바인딩에서의 패턴 매치입니다.
컴파일의 여러 단계에서 사용되는 식별자에는 여러 변형이 있습니다. 일반성 순서대로 나열하면 다음과 같습니다.
- OccName - 사용되는 가장 단순한 이름으로, 이름을 문자열로 담으며 그 이름이 유래한 네임스페이스와 위치도 함께 담습니다.
- RdrName - 파서에서 곧바로 나오는 이름의 타입입니다. 이름이 한정되지 않았는지, 아니면 (모듈 이름으로) 한정되었는지에 대한 정보를 담고 있습니다.
- Name - 스코프와 바인딩이 해석된 이름의 타입입니다. OccName을 가질 뿐 아니라 Name들을 서로 구별해 주는 Unique도 가집니다
- Var - Name뿐 아니라 Type도 가지는 이름의 타입입니다. Var는 전역이거나 지역입니다.
Name들은 Unique라고 부르는 내부의 고유한 숫자 키로 서로 구별되며, 이 키는 UniqSupply에서 생성됩니다. 이것들은 흔히 패스의 모나드 트랜스포머 MonadUnique 계층 안에 들어 있습니다.
타입 검사 이후에는 Var와 Id 이름을 다루는데, 이들은 다음 함수들을 사용하여 언제나 Name과 Type을 복원할 수 있다는 성질을 가집니다.
varName :: Var -> Name
varType :: Var -> Kind
또한 많은 조회 함수는 식별자나 타입 생성자처럼 스코프 안에 있으면서 타입을 가지는 “것들“을 감싸는 합 타입 TyThing을 사용합니다.
data TyThing
= AnId Id
| AConLike ConLike.ConLike
| ATyCon TyCon
| ACoAxiom (CoAxiom Branched)
Outputable
GHC API 안에는 많은 내부 타입의 요약을 보기 좋게 출력하는 데 사용할 수 있는 프리티 프린터가 있습니다. 이 클래스의 구조는 Show 타입 클래스와 비슷합니다.
class Outputable a where
ppr :: a -> SDoc
pprPrec :: Rational -> a -> SDoc
showPpr :: Outputable a => DynFlags -> a -> String
조금 더 편하게 작업하기 위해, 기본 dynflags를 사용하여 Outputable 인스턴스를 출력하는 래퍼 showGhc를 작성할 수 있습니다.
showGhc :: (Outputable a) => a -> String
showGhc = showPpr unsafeGlobalDynFlags
컴파일 추적하기
다음 예제 모듈이 주어졌을 때, 이 모듈이 컴파일러를 거치는 동안 중간 형태들이 어떻게 변환되는지 추적해 보겠습니다.
module Example where
data Animal = Cat | Dog
add :: Int -> Int -> Int
add x y = x + y
이전 글에서 만든 장치를 사용하여 모듈 타깃을 임포트하고 로드한 다음, 이를 대화형 컨텍스트에 추가하는 대신 개별 패스의 함수를 명시적으로 호출하여 그 구조를 화면에 출력합니다.
main :: IO ()
main = runGhc (Just libdir) $ do
env <- getSession
dflags <- getSessionDynFlags
setSessionDynFlags $ dflags { hscTarget = HscInterpreted }
target <- guessTarget "Example.hs" Nothing
setTargets [target]
load LoadAllTargets
modSum <- getModSummary $ mkModuleName "Example"
pmod <- parseModule modSum -- ModuleSummary
tmod <- typecheckModule pmod -- TypecheckedSource
dmod <- desugarModule tmod -- DesugaredModule
let core = coreModule dmod -- ModGuts
stg <- liftIO $ coreToStg dflags (mg_module core) (mg_binds core)
liftIO $ banner "Parsed Source"
liftIO $ putStrLn $ showGhc ( parsedSource pmod )
liftIO $ banner "Renamed Module"
liftIO $ putStrLn $ showGhc ( tm_renamed_source tmod )
liftIO $ banner "Typechecked Module"
liftIO $ putStrLn $ showGhc ( tm_typechecked_source tmod )
liftIO $ banner "Typed Toplevel Definitions"
liftIO $ putStrLn $ showGhc ( modInfoTyThings (moduleInfo tmod) )
liftIO $ banner "Typed Toplevel Exports"
liftIO $ putStrLn $ showGhc ( modInfoExports (moduleInfo tmod) )
liftIO $ banner "Core Module"
liftIO $ putStrLn $ showGhc ( mg_binds core )
liftIO $ banner "STG"
liftIO $ putStrLn $ showGhc stg
파싱
모듈 요약에서 소스 파일 Example.hs의 기반 텍스트 스트림을 추출할 수 있습니다. 여기에 파서를 실행하면 원시 OccName이 담긴 HsSyn AST를 포함하는 ParsedSource 데이터 타입이 생성됩니다.
data ParsedModule = ParsedModule
{ pm_mod_summary :: ModSummary
, pm_parsed_source :: ParsedSource
, pm_extra_src_files :: [FilePath]
, pm_annotations :: ApiAnns
}
===============================Parsed Source===============================
module Example where
data Animal = Cat | Dog
add :: Int -> Int -> Int
add x y = x + y
이름 변경
파싱 후에는 리네이머 패스를 실행합니다. 이 패스는 스코프와 연산자 우선순위를 해석하고, 충돌이 일어나지 않도록 모든 이름을 고유하게 만드는 일을 맡습니다. 리네이머는 모든 구문 요소에 걸쳐 RdrName을 Name으로 해석합니다. 또한 각 이름에 한정된 전역 이름인지, 현재 모듈의 지역 이름인지를 주석으로 붙입니다. 이름이 스코프에 없으면 컴파일은 그 자리에서 멈추고 누락된 이름을 보고합니다.
===============================Renamed Module===============================
Just (add :: Int -> Int -> Int
add x y = x + y
data Animal = Cat | Dog,
[import (implicit) Prelude],
Nothing,
Nothing)
타입 검사
이름이 변경된 AST는 이어서 타입 검사기를 거치며, 타입 검사기는 Name을 Id로 매핑하고 타입 추론으로 추론한 타입을 덧붙입니다.
data TypecheckedModule = TypecheckedModule
{ tm_parsed_module :: ParsedModule
, tm_renamed_source :: Maybe RenamedSource
, tm_typechecked_source :: TypecheckedSource
, tm_checked_module_info :: ModuleInfo
, tm_internals_ :: (TcRnTypes.TcGblEnv, HscTypes.ModDetails)
}
그 결과로 얻는 구조는 모든 바인딩과 모든 하위 표현식의 최상위 타입을 담은 타입 검사된 모듈입니다.
=============================Typechecked Module=============================
{AbsBinds [] []
{Exports: [add <= add
<>]
Exported types: add :: Int -> Int -> Int
[LclId, Str=DmdType]
Binds: add x y = (+) x y}}
결과 데이터 타입에는 ModuleInfo 필드가 있으며, 여기에는 타이핑 환경, 스코프 안의 이름, 내보낸 타입 클래스에 관한 다양한 메타데이터가 담겨 있습니다.
data ModuleInfo = ModuleInfo
{ minf_type_env :: HscTypes.TypeEnv
, minf_exports :: NameSet.NameSet
, minf_rdr_env :: Maybe RdrName.GlobalRdrEnv
, minf_instances :: [ClsInst]
, minf_iface :: Maybe ModIface
, minf_safe :: SafeHaskellMode
, minf_modBreaks :: ModBreaks
}
coreModule을 사용하면 끔찍한 이름의 ModGuts 데이터 타입도 구성할 수 있습니다. 이 데이터 타입에는 각종 내보내기와 타입이 관련 메타데이터와 함께 펼쳐진 형태로 담겨 있습니다.
data ModGuts = ModGuts
{ mg_module :: !Module,
, mg_boot :: IsBootInterface
, mg_exports :: ![Avail.AvailInfo]
, mg_deps :: !Dependencies
, mg_dir_imps :: !ImportedMods
, mg_used_names :: !NameSet.NameSet
, mg_used_th :: !Bool
, mg_rdr_env :: !RdrName.GlobalRdrEnv
, mg_fix_env :: !FixityEnv
, mg_tcs :: ![TyCon]
, mg_insts :: ![ClsInst]
, mg_fam_insts :: ![FamInst]
, mg_patsyns :: ![PatSyn.PatSyn]
, mg_rules :: ![CoreSyn.CoreRule]
, mg_binds :: !CoreSyn.CoreProgram
, mg_foreign :: !ForeignStubs
, mg_warns :: !Warnings
, mg_anns :: [Annotations.Annotation]
, mg_hpc_info :: !HpcInfo
, mg_modBreaks :: !ModBreaks
, mg_vect_decls :: ![CoreSyn.CoreVect]
, mg_vect_info :: !VectInfo
, mg_inst_env :: InstEnv.InstEnv
, mg_fam_inst_env :: FamInstEnv.FamInstEnv
, mg_safe_haskell :: SafeHaskellMode
, mg_trust_pkg :: Bool
, mg_dependent_files :: [FilePath]
}
이 시점에서는 ModuleInfo에 타입이나 이름에 관한 어떤 정보든 질의할 수 있습니다. 예를 들어 어떤 전역 이름의 타입이 궁금하다면 타이핑 환경 안에서 TyThing으로 찾아볼 수 있습니다.
modInfoTyThings :: ModuleInfo -> [TyThing]
modInfoExports :: ModuleInfo -> [Name]
=========================Typed Toplevel Definitions=========================
[Type constructor ‘Animal’, Data constructor ‘Cat’,
Data constructor ‘Dog’, Identifier ‘add’, Identifier ‘Cat’,
Identifier ‘Dog’]
===========================Typed Toplevel Exports===========================
[Animal, Cat, Dog, add]
Core
Core 언어는 GHC에서 가장 핵심적인 데이터 타입입니다. Core는 System FC를 변형한, 매우 작고 명시적으로 타입이 지정된 언어입니다. typecheckModule 함수의 출력은 CoreModule 데이터 타입이며, 여기에는 Core 프로그램이 타이핑 환경으로 담겨 있습니다.
data CoreModule = CoreModule
{ cm_module :: !Module
, cm_types :: !HscTypes.TypeEnv
, cm_binds :: CoreSyn.CoreProgram
, cm_safe :: SafeHaskellMode
}
Core 모듈을 살펴보면 이제 프로그램의 각 이름에 명시적 타입이 주석으로 붙어 있고 타입 클래스 딕셔너리가 삽입되어 있음을 알 수 있습니다.
================================Core Module================================
[add :: Int -> Int -> Int
[LclIdX, Str=DmdType]
add = \ (x :: Int) (y :: Int) -> + @ Int $fNumInt x y]
그런 다음 Core는 코드 생성을 위해 프로그램을 최적화하는 여러 분석 패스를 적용하기 쉬운 중간 형태로 변환됩니다. 이 형태는 Spineless Tagless G-Machine이라고 알려진 추상 기계입니다. 이 구문에서 모든 클로저에는 연관된 Static Reference Table, 즉 SRT가 있습니다. 이에 관해서는 나중에 더 다룹니다.
====================================STG====================================
[add :: Int -> Int -> Int
[LclIdX, Str=DmdType] =
\r srt:SRT:[r6ry :-> $fNumInt] [x y] + $fNumInt x y;]
요약 및 다음 단계
Core와 STG는 간략하게만 언급했습니다. 프런트엔드 구문이 Core로 변환되는 과정이 다음 주제가 될 것입니다. Core의 설계는 언어의 구조에 관한 많은 측면을 정의하며, 타입 시스템과 코드 생성에도 영향을 줍니다.
GHC 깊이 들여다보기: 파이프라인
GHC에 관한 자발적인 글이 더 필요하다는 Simon의 요청을 읽고, 지난 몇 년간 GHC 내부를 다루며 쌓아 온 지식을 공유하기에 좋은 때라고 생각했습니다.
저는 결코 GHC 내부의 전문가는 아니지만, 여러 프로젝트에서 GHC 내부를 꽤 많이 다뤄 보았으며, 깊이 파고드는 형식의 블로그 글은 독자가 스스로 코드를 탐색하기 시작하도록 돕는 데 좋은 형식인 경향이 있습니다. 오픈 소스 프로젝트에 더 깊이 참여하도록 독려하는 데는 대개 고수준의 개요와 실행 가능한 작은 예제 코드만으로도 충분하며, 제가 쓰고자 하는 것이 바로 이것입니다.
이렇게 해서 GHC의 구조에 관한 여러 편의 글을 시작합니다. 이 글들은 컴파일러의 내부 구조 일부를 보여 주는 작은 프로젝트에 GHC API를 사용하는 여러 예제를 중심으로 구성됩니다.
**[Accompaying Source Code](https://github.com/sdiehl/dive-into-ghc/tree/master/01-pipeline)**
공식 해설
GHC Core 개발자들은 실제로 컴파일러 설계에 관한 지식을 공유하는 데 많은 시간을 들여 왔습니다. 시작하기 좋은 자료는 다음과 같습니다.
- GHC 해설
- OPLSS: 타입의 모험
- 2006 GHC 해커톤 영상
- David Terei의 노트
- Takenobu Tani의 GHC Illustrated
- Edward Yang의 블로그
이에 더해 25년 전까지 거슬러 올라가는 문헌의 흐름이 있으며, 이는 오늘날의 GHC에 이르기까지의 역사적 맥락과 연구를 보여 줍니다.
최상위 구조
GHC는 별난 괴물 같은 코드베이스이지만, 컴파일러로서는 어디를 봐야 하는지만 안다면 꽤 잘 설계되고 문서화된 프로젝트입니다. 물론 곳곳에서 다소 독특한 관례를 사용하지만, 결국 20년 된 코드베이스입니다.
컴파일러 소스를 받으려면 공식 저장소를 클론하십시오.
$ git clone --recursive git://git.haskell.org/ghc.git
$ cd ghc/
컴파일러에는 문서와 빌드 시스템을 아우르는 많은 유틸리티가 포함되어 있지만, 컴파일러 자체에 중요한 최상위 디렉터리는 주로 다음과 같습니다.
├── rts # The Haskell runtime systems
├── compiler # The Haskell compiler logic
├── includes # Header files for runtime and code generation
└── libraries # The base libraries and Prelude source
이 글에서는 compiler 폴더를 다루겠습니다.
├── basicTypes # Types used across all modules
├── cbits # Misc C utilities
├── cmm # Cmm langauge definitions
├── codeGen # Cmm Compilers
├── coreSyn # Core language definitions
├── deSugar # Desugarer
├── ghci # Interactive shell
├── hsSyn # Frontend syntax
├── iface # Interface files
├── llvmGen # LLVM Code generator
├── main # Compiler driver logic and options
├── nativeGen # Assemblers for x86 / SPARC / PPC
├── parser # Frontend Parser for HsSyn
├── prelude # Wired-In Types / Primops and Builtins
├── profiling # Runtime profiing tools
├── rename # Frontend renamer
├── simplCore # Core-To-Core simplifier
├── simplStg # Stg-To-Stg simplifier
├── specialise # Specialisation pass ( Eliminates Overloading )
├── stgSyn # Stg Core Language
├── stranal # Strictness Analyzer
├── typecheck # Typechecker
├── types # Type language, data constructors, and type families
├── utils # Misc functions and core data structures
└── vectorise # Vectorisation optimiations
GHC API
GHC 자체가 Haskell로 작성되어 있으므로, GHC는 사실상 GHC API를 아우르는 하나의 거대한 라이브러리입니다. 최상위 모듈의 이름은 그냥 GHC이며, 컴파일 파이프라인을 구동하는 여러 Core 타입을 한 네임스페이스에 모아 둔 모듈입니다.
그 아래에는 일반 Haskell 소스 코드를 컴파일하기 위한 주요 API인 HscMain이 있으며, 여기에는 컴파일 과정의 여러 패스를 위한 다양한 드라이버가 들어 있습니다. 여섯 개의 Core 패스가 컴파일 파이프라인을 이룹니다:

- 파싱
- 이름 변경
- 타입 검사
- 디슈거링
- 단순화
- 코드 생성
이 컴파일의 결과물은 여러 산출물로, 오브젝트 파일(.o), 인터페이스 파일(.hi), 실행 파일입니다.
GHC 모나드
컴파일 과정의 핵심은 GHC 모나드 안에 저장됩니다. GHC 모나드는 컴파일 파이프라인의 내부 세션 상태, 오류 처리, 다중 모듈 컴파일의 순서 지정을 다루는 상태 모나드입니다.
newtype Ghc a = Ghc { unGhc :: Session -> IO a }
추상 클래스 GhcMonad는 GHC 모나드 함수의 리프트된 버전을 제공하여, 컴파일 전반에 걸쳐 사용되는 여러 하위 모나드(renamer, typechecker 등) 안에서 내부 세션 객체에 접근할 수 있게 합니다.
class (Functor m, MonadIO m, ExceptionMonad m, HasDynFlags m) => GhcMonad m where
getSession :: m HscEnv
setSession :: HscEnv -> m ()
평가 함수는 libdir의 경로를 받아 IO 안에 결과를 반환합니다.
runGhc :: Maybe FilePath -> Ghc a -> IO a
이 파일 경로들은 설치 환경마다 다른 경로로, 로컬 설치 위치와 GHC 컴파일러의 경로를 나타냅니다. 이 경로들은 ghc-paths 패키지가 제공합니다.
import GHC.Paths
libdir, docdir, ghc, ghc_pkg :: FilePath
세션 객체의 중심에는 컴파일의 내부 상태를 담고 있는 HscEnv라는 매우 중요한 구조체가 있습니다.
data HscEnv
= HscEnv
{ hsc_dflags :: DynFlags
, hsc_targets :: [Target]
, hsc_mod_graph :: ModuleGraph
, hsc_IC :: InteractiveContext
, hsc_HPT :: HomePackageTable
-- Many more ... (truncated for brevity)
}
hsc_dflags는 설정 객체를 담고 있습니다(이에 대해서는 다음에 자세히 설명합니다). hsc_targets는 모듈 그래프의 루트를 담고 있으며, 이 루트들을 상향식으로 순회하여 현재 패키지를 컴파일하는 데 필요한 모듈 전체 집합을 구성합니다. 여기에 관련된 모듈 전체 집합(루트와 루트가 아닌 것 모두)은 hsc_mod_graph에 저장되며, 이 필드는 ModuleGraph 전체를 담고 있는데 반드시 위상 순서로 정렬되어 있지는 않습니다. hsc_IC 필드는 대화형 컨텍스트를 담고 있으며, 이는 대화형 셸에 사용되고 최종 타깃이 메모리 안에서 링크될 때에도 사용됩니다. 최상위 스코프에 모듈을 추가하는 것과 같은 GHCi의 특정 명령은 이 구조체의 상태를 상태 기반으로 수정합니다.
hsc_HPT는 이미 컴파일된 홈 패키지 모듈을 기술하는 홈 패키지 테이블을 담고 있습니다. 모듈의 컴파일이 끝나고 loadModule로 로드되면 해당 모듈은 내부적으로 이 매핑에 추가됩니다.
DynFlags
DynFlags는 단일 파일 또는 GHC 세션의 컴파일과 관련된 플래그의 모음을 담고 있습니다. 이것은 컴파일이 어떻게 이루어지는지를 결정하는 핵심(Core) 데이터 타입이며, 다양한 패스 함수 대부분에 전달됩니다.
data DynFlags
= DynFlags
{ ghcMode :: GhcMode
, ghcLink :: GhcLink
, hscTarget :: HscTarget
, settings :: Settings
, flags :: [DynFlag]
, extensionFlags :: [ExtensionFlag]
, pkgState :: PackageState
, pkgDatabase :: Maybe [PackageConfig]
, packageEnv :: Maybe FilePath
, packageFlags :: [PackageFlag]
, extraPkgConfs :: [PkgConfRef] -> [PkgConfRef]
-- Many more flags... (truncated for brevity)
}
GhcMode는 다중 모듈 컴파일을 하는지, 아니면 일회성 단일 파일 컴파일을 하는지를 알려 줍니다. 다중 모듈의 경우 ModuleGraph는 홈 패키지에서 의존 모듈을 검색하는 Finder 함수를 통해 구성됩니다.
GhcMode
CompManager --make OneShot ghc -c Foo.hs MkDepend ghc -M
HscTarget 데이터 타입은 컴파일의 대상 코드 유형을 정의합니다. 기본값은 HscAsm입니다.
HscTarget
HscC C 코드를 생성합니다. HscAsm 네이티브 코드 생성기를 사용하여 어셈블리를 생성합니다. HscLlvm llvm 코드 생성기를 사용하여 어셈블리를 생성합니다. HscInterpreted 바이트코드를 생성합니다. HscNothing 어떤 코드도 생성하지 않습니다. 위의 참고 사항을 보십시오.
(다중 모듈의 경우) 컴파일이 끝나면 GHC는 링커 단계를 시작하며, GhcLink 설정이 생성된 오브젝트 파일을 어떻게 처리할지 결정합니다.
GhcLink
NoLink 링크를 전혀 하지 않습니다. LinkBinary 오브젝트 코드를 바이너리로 링크합니다. LinkInMemory 인메모리 동적 링커를 사용합니다(바이트코드와 오브젝트 코드 모두에서 동작합니다). LinkDynLib 오브젝트를 동적 라이브러리로 링크합니다(Windows에서는 DLL, ELF 플랫폼에서는 DSO). LinkStaticLib 오브젝트를 정적 라이브러리로 링크합니다.
GHC 세션의 가장 단순한 초기화 방식은 기본값을 그대로 사용하여, 주어진 모든 모듈을 메모리에서 링크하는 인터프리터 세션을 설정하는 것입니다.
example :: IO ()
example = runGhc (Just libdir) $ do
dflags <- getSessionDynFlags
setSessionDynFlags $ dflags { hscTarget = HscInterpreted
, ghcLink = LinkInMemory
}
GHC는 명령줄에서 많은 컴파일러 플래그를 제공하며, 이 플래그들은 DynFlags 구조체의 여러 하위 필드에 반영됩니다. 플래그의 세 가지 주요 부류는 DumpFlag(예: -ddump-simpl), GeneralFlag(예: -fspec-constr), ExtensionFlag(예: -XTypeInType)입니다. DynFlags를 수정하여 이러한 플래그를 켜거나 끄는 다양한 헬퍼 함수가 있습니다.
dopt_set :: DynFlags -> DumpFlag -> DynFlags
gopt_set :: DynFlags -> GeneralFlag -> DynFlags
xopt_set :: DynFlags -> ExtensionFlag -> DynFlags
컴파일 과정 전반에서 GHC는 이러한 플래그의 상태를 조회하여, 언어 확장이 설정되어 있는지 또는 기타 플래그 동작에 따라 서로 다른 코드 경로로 분기합니다. 이는 GhcMonad 인스턴스를 조회하여 dynflags를 얻은 뒤, 플래그별 여러 함수 중 하나를 사용하는 방식으로 이루어집니다.
xopt :: ExtensionFlag -> DynFlags -> Bool
gopt :: GeneralFlag -> DynFlags -> Bool
dopt :: DumpFlag -> DynFlags -> Bool
여러 플래그를 활성화하려면 플래그 설정 함수를 사용하여 현재 dflags 객체를 수정합니다.
example :: IO ()
example = runGhc (Just libdir) $ do
dflags <- getSessionDynFlags
let dflags' = dflags { hscTarget = HscInterpreted , ghcLink = LinkInMemory }
`dopt_set` Opt_D_dump_BCOs -- Set Dump Flag
`xopt_set` Opt_OverloadedStrings -- Set Language Extension Flag
컴파일
컴파일을 시작하려면 먼저 상태에 타깃을 추가합니다. 이는 환경의 hsc_targets 필드를 수정합니다. 타깃은 모듈 이름 또는 파일 이름의 두 가지 유형 중 하나입니다. guessTarget은 주어진 문자열의 확장자를 보고 어떤 타깃 객체를 생성할지 판별합니다.
addTarget :: GhcMonad m => Target -> m ()
guessTarget :: GhcMonad m => String -> Maybe Phase -> m Target
타깃은 의존성 트리의 최상위에 있는 소스 파일이나 모듈을 지정합니다. 실행 프로그램의 경우 타깃은 Main.hs 하나뿐이며, 라이브러리의 경우 타깃은 라이브러리에서 공개된 모듈들입니다.
Target
TargetModule 모듈 이름: 해당 파일을 검색합니다. TargetFile FilePath 파일 이름: 전처리하고 파싱하여 모듈 이름을 찾습니다.
상태에 모듈을 추가하고 나면, 의존성 분석을 수행하여 모듈 그래프를 결정하고 다중 모듈 컴파일을 진행할 수 있습니다. 의존성 분석은 모듈의 import 지시문을 파싱하고 ModuleGraph를 해석하는 작업으로, ModuleGraph는 타깃들을 담고 있는 ModuleSummary 리스트의 타입 별칭입니다. 이 작업은 depanal 함수가 수행합니다.
depanal :: GhcMonad m => [ModuleName] -> Bool -> m ModuleGraph
타깃이 생성되면 컴파일러가 모듈에 대해 실행되어 결과 산출물을 생성하고, 이는 홈 패키지 테이블에 로드됩니다. 이는 load 명령을 통해 이루어집니다.
load :: GhcMonad m => LoadHowMuch -> m SuccessFlag
LoadHowMuch
LoadAllTargets 모든 타깃과 그 의존성을 로드합니다. LoadUpTo 주어진 모듈과 그 의존성만 로드합니다. LoadDependenciesOf 주어진 모듈 자체는 제외하고 그 모듈의 의존성만 로드합니다.
이에 대한 전체 예제는 현재 작업 디렉터리에 있는 모듈 Example.hs를 인터프리트하여 메모리에서 링크하는 방식으로 컴파일하는 것입니다.
example :: IO ()
example = runGhc (Just libdir) $ do
dflags <- getSessionDynFlags
setSessionDynFlags $ dflags { hscTarget = HscInterpreted
, ghcLink = LinkInMemory
}
target <- guessTarget "Example.hs" Nothing
addTarget target
load LoadAllTargets
인터랙티브 컨텍스트
단순히 컴파일러 산출물을 생성하는 것 외에도 할 수 있는 일이 있습니다. GHC는 코드를 메모리 안에서 컴파일하고 링크하여 대화식으로 평가할 수 있습니다. 이를 뒷받침하는 인터프리터의 상태는 InteractiveContext에 보관됩니다.
대화식 스코프에 있는 모듈 집합은 setContext 함수로 수정할 수 있습니다.
getContext :: GhcMonad m => m [InteractiveImport]
setContext :: GhcMonad m => [InteractiveImport] -> m ()
모듈이 인터프리트되어 대화식 임포트로 로드되면 해당 모듈의 최상위 스코프 전체를 사용할 수 있습니다. 여러 함수를 사용하여 이 스코프를 조작하고, 조회하고, 확장할 수 있습니다.
parseName을 사용하면 주어진 문자열에서 이름(하나 또는 여러 개)을 대화식 컨텍스트의 심볼 집합으로 해석할 수 있습니다. 이 함수는 Name 객체(자세한 내용은 뒤에서 다룹니다)를 반환하는데, 이는 위치와 고유 식별자를 담고 있는 GHC 내부의 이름 타입입니다.
parseName :: GhcMonad m => String -> m [Name]
주어진 표현식의 타입을 알아내려면 exprType을 사용하여 현재 컨텍스트 안에서 타입 정보를 추출할 수 있습니다.
exprType :: GhcMonad m => String -> m Type
또한 대화식 컨텍스트 전체에서 임포트로 스코프에 들어온 모든 이름의 집합을 조회할 수 있습니다. 이는 대화식 :browse 명령에 사용됩니다.
getNamesInScope :: GhcMonad m => m [Name]
그리고 가장 중요한 기능은 대화식 컨텍스트 안에서 임의의 표현식을 평가하는 것입니다. 이는 dynCompileExpr을 통해 이루어집니다. 이 함수는 Dynamic을 반환하며, 이 값은 Typeable의 어떤 인스턴스에 대해서든 fromDynamic을 사용하여 안전하게 캐스트할 수 있습니다. 이는 대화식 컨텍스트 안에서 문자열 표현식을 동적으로 평가하는 데 사용됩니다.
dynCompileExpr :: GhcMonad m => String -> m Dynamic
fromDynamic :: Typeable a => Dynamic -> a -> Maybe a
패키지 데이터베이스
기본 상태에서 GHC는 두 개의 패키지 데이터베이스를 알고 있습니다. 하나는 /usr/lib/ghc-x.x.x/에 있는 전역 패키지 데이터베이스이고, 다른 하나는 ~/.ghc/lib에 있는 사용자 데이터베이스입니다.
그러나 이는 “GHC_PACKAGE_PATH” 환경 변수를 통해 확장할 수 있습니다. 이 변수에 지정된 경로를 읽은 뒤 extraPkgConfs 함수를 적용하여 패키지 데이터베이스에 추가합니다. 이 방식은 cabal과 stack 같은 도구에서 쓰이는 여러 현대적인 샌드박싱 기법에 사용됩니다.
extraPkgConfs :: [PkgConfRef] -> [PkgConfRef]
주어진 dynflags를 파일 경로로 수정하려면 다음 함수를 사용하여 상태를 확장할 수 있습니다.
addPkgDbs :: GhcMonad m => [FilePath] -> m ()
addPkgDbs fps = do
dfs <- getSessionDynFlags
let pkgs = map PkgConfFile fps
let dfs' = dfs { extraPkgConfs = (pkgs ++) . extraPkgConfs dfs }
setSessionDynFlags dfs'
_ <- initPackages dfs'
return ()
Stack은 stack repl로 셸을 실행할 때 이 값을 설정합니다. 이 값을 수정하는 방법은 뒤에서 더 자세히 다룹니다.
미니 GHCi
자, 그러면 GHC용 아주 작은 대화식 셸을 만들어 봅시다. Haskeline(플랫폼에 독립적인 readline 추상화)에 익숙하지 않다면 먼저 그것부터 읽어 보십시오.
Haskeline 인터페이스는 모나드 트랜스포머 InputT로 제공되며, 이를 IO 위에 얹으면 대화식 repl 모나드를 얻을 수 있습니다.
type Repl a = InputT IO a
초기 세션을 설정하려면 기본 dynflags를 가져오고, 대상이 인터프리트되고 메모리에 링크되도록 설정한 뒤, -XExtendedDefaultRules 플래그를 조정합니다. 대화식 셸이 Prelude를 임포트하도록 설정한 다음, 만들어진 세션을 모나드 방식으로 반환하여 셸 명령마다 그 세션에 점진적으로 내용을 추가할 수 있게 합니다.
initSession :: IO HscEnv
initSession = runGhc (Just libdir) $ do
liftIO $ putStrLn "Setting up HscEnv"
dflags <- getSessionDynFlags
let dflags' = dflags { hscTarget = HscInterpreted , ghcLink = LinkInMemory }
`xopt_set` Opt_ExtendedDefaultRules
setSessionDynFlags dflags'
setContext [ IIDecl $ simpleImportDecl (mkModuleName "Prelude") ]
env <- getSession
return env
그다음 각 대화식 셸 명령은 헬퍼 함수 session으로 감싸집니다. 이 함수는 새로운 Ghc 모나드를 띄우되 직전 컴파일의 세션을 복원합니다. 그런 다음 모나드 동작을 평가하고, 그 후에 만들어진 세션을 재사용할 수 있도록 값으로 반환합니다.
session :: HscEnv -> Ghc a -> IO HscEnv
session env m = runGhc (Just libdir) $ do
setSession env
m
env <- getSession
return env
평가자 함수는 서로 다른 두 가지 컴파일 단계를 시도합니다. 먼저 표현식을 있는 그대로 컴파일하여 IO a 액션으로 평가되는지 확인합니다. 그렇다면 해당 표현식은 모나드 안에서 직접 평가됩니다. 그렇지 않다면 fromDynamic 캐스트는 단순히 Nothing을 내놓고, 우리는 표현식을 print 문으로 감싸 보려고 시도합니다. 이렇게 컴파일된 표현식은 IO a임이 보장되므로, GHC가 넘겨주는 컴파일된 코드 포인터를 IO로 안전하지 않게 강제 변환(coerce)하여 실행합니다.
eval :: String -> Ghc ()
eval inp = do
dyn <- fromDynamic <$> dynCompileExpr inp
case dyn of
Nothing -> do
act <- compileExpr ("Prelude.print (" <> inp <> ")")
-- 'print' is constrained to 'IO ()' so unsafeCoerce is "safe"
liftIO (unsafeCoerce act)
Just act -> liftIO $ act
import를 추가하려면 해당 import를 모듈 이름으로 컨텍스트에 cons한 다음 새 상태를 내놓기만 하면 됩니다.
addImport :: String -> Ghc ()
addImport mod = do
ctx <- getContext
setContext ( (IIDecl $ simpleImportDecl (mkModuleName mod)) : ctx )
그다음에는 던져지는 모든 예외를 잡아서 그냥 출력해 버리는 좋지 않은 방식을 사용합니다. 표현식 컴파일이 실패하면 내장 인터프리터 로직 안에서 그 실패를 가로채 보고하기만 하면 되는 상황이므로, 이는 꽤 정당화될 수 있습니다.
ghcCatch :: MonadIO m => IO a -> m (Maybe a)
ghcCatch m = liftIO $ do
mres <- try m
case mres of
Left (err :: SomeException) -> do
liftIO $ print err
return Nothing
Right res -> return (Just res)
그러면 REPL은 사용자의 입력을 읽고, 그 줄이 키워드 import로 시작하는지에 따라 분기하기만 합니다. 그런 다음 표현식 줄에 따라 직전 줄에서 유지하고 있던 현재 HscEnv로 GHC 세션을 띄우고 컴파일을 시도합니다. 성공하면 새 env 상태로 repl을 호출하며, 이를 끝없이 반복합니다. 중단을 위한 Unix 시그널은 Haskeline 모나드가 처리합니다.
repl :: HscEnv -> Repl ()
repl env = do
minput <- getInputLine ">>> "
case minput of
Nothing -> outputStrLn "Goodbye."
Just input | "import" `isPrefixOf` input -> do
let mod = concat $ tail $ words input
env' <- ghcCatch (session env (addImport mod))
maybe (repl env) repl env'
Just input -> do
env' <- ghcCatch (session env (eval input))
maybe (repl env) repl env'
이제 이 모두를 하나로 합칩니다.
main :: IO ()
main = do
env <- initSession
runInputT defaultSettings (repl env)
그러면 우리의 작은 셸을 실행할 수 있습니다.
$ stack build dive
$ stack exec dive
Setting up HscEnv
>>> fmap (+1) [1..10]
[2,3,4,5,6,7,8,9,10,11]
>>> import Data.Text
>>>
Goodbye.
이것이 우리가 직접 만든 Mini GHCi입니다. 실제로 진짜 GHCi는 조금 다르게 동작하지만, 밑바탕의 일부 메커니즘은 동일합니다. 이름 조회나 내부 검사(introspection) 같은 다른 기능은 독자의 연습 문제로 남겨 둡니다. 다음으로 해 볼 만한 재미있는 프로젝트는 스코프 안에 있는 임의의 정의의 원본 소스 코드를 조회하는 내부 검사 도구를 갖춘 작은 셸을 만드는 것입니다.
요약 및 다음 단계
이것이 GHC와 상호작용하는 데 사용할 수 있는 “매우 고수준(Very High Level)” API입니다. 다음으로는 내부에서 사용되는 산출물의 속 구조와, 이를 프로그래밍 방식으로 검사하고 구축하는 방법을 다루겠습니다.
더 나은 커스텀 Haskell 프렐류드 만들기
Haskell 프렐류드는 모든 Haskell 모듈에 기본으로 임포트되는데, 스스로 발등을 찍을 수 있는 방법을 끝없이 제공하며 제거할 수 없는 역사적 잔재도 담고 있습니다. 업스트림에서 고치기는 어렵지만, -XNoImplicitPrelude 언어 확장을 사용하면 프로젝트 수준에서 프렐류드를 완전히 제거하고 더 합리적인 기본값 집합으로 대체할 수 있습니다.
새 프렐류드를 만드는 데에는 두 가지 철학이 있습니다.
- 대형 차량 프렐류드 - 기본 타입과 클래스의 상당 부분을 대체하는 새로운 추상화를 도입하여 프렐류드의 결함 대부분을 고치고, 전반적으로 Haskell을 작성하는 방식을 재정의합니다. numeric-prelude 프렐류드를 참고하십시오.
- 소형 차량 프렐류드 - 기존 타입과 클래스를 기반으로 삼고 망가진 부분을 가려서 프렐류드의 고장 난 부분을 고칩니다. basic-prelude 프렐류드를 참고하십시오.
저는 대형 차량 방식을 지지하지 않습니다. 기본 프렐류드의 많은 부분이 이상적이지는 않지만 일을 해내기에는 충분합니다. 그리고 일반적으로 기본 Base와 프렐류드를 사용하는 나머지 생태계와의 상호 운용성은 매우 중요합니다.
이전에 업계에서 일하는 대규모 팀이라면 소형 차량 프렐류드를 직접 만드는 것이 좋다는 글을 쓴 적이 있지만, 무엇을 포함해야 하는지는 다소 모호하게 남겨 두었습니다. 당연히 회사마다 사정이 다르므로, 커스텀 프렐류드를 만들 때 바탕으로 삼을 수 있는 합리적인 기본값 집합이라고 제가 생각하는 것을 자세히 설명해 보려 합니다. 이것을 Protolude라고 부르겠습니다.
**[Git Project](https://github.com/sdiehl/protolude)**
모듈 구조
기본 모듈 구조는 모든 것을 몰아넣을 X라는 메인 모듈 재익스포트로 구성됩니다. 그리고 루트 모듈에서 재익스포트할 여러 잡다한 함수들이 있습니다. 여기에서 더 나아가 도메인별 함수를 담은 여러 유틸리티 모듈을 둡니다.
{-# LANGUAGE NoImplicitPrelude #-}
module Protolude (
module X,
identity,
bool,
(&),
uncons,
applyN,
print,
LText,
LByteString,
) where
import qualified Prelude as P
import qualified List as X
import qualified Show as X
import qualified Bool as X
import qualified Debug as X
import qualified Monad as X
import qualified Applicative as X
기본 타입
기본 타입(Int, Integer, Float, Char)은 관련 함수와 함께 통째로 재익스포트합니다.
-- Base types
import Data.Int as X
import Data.Bits as X
import Data.Word as X
import Data.Bool as X hiding (bool)
import Data.Char as X (Char)
import Data.Maybe as X hiding (fromJust)
import Data.Either as X
import Data.Complex as X
import Data.Function as X (
id
, const
, (.)
, flip
, fix
, on
)
이 연산자를 기본으로 제공하지 않는 GHC < 7.10을 위해 뒤집힌 적용 연산자를 정의합니다.
(&) :: a -> (a -> b) -> b
x & f = f x
항등 함수보다는 id라는 이름의 변수를 쓸 가능성이 훨씬 높으므로 id 함수의 이름을 identity로 바꿉니다. 이는 논란의 여지가 있는 부분이며, 이 변경이 맞을지는 경우에 따라 다를 수 있습니다.
identity :: a -> a
identity x = x
bool 함수(maybe와 either에 대응하는 컴비네이터)는 GHC 7.10에서 제공되지만, 이전 버전을 위해 재익스포트합니다.
bool :: a -> a -> Bool -> a
bool f t b = if b then t else f
uncons 함수는 기본으로 제공되지 않지만, 리스트를 Maybe 튜플로 풀어 주며, 헤드가 존재하면 튜플의 첫 번째 매개변수에 담습니다.
uncons :: [a] -> Maybe (a, [a])
uncons [] = Nothing
uncons (x:xs) = Just (x, xs)
applyN 함수는 함수와 횟수를 받아 그 함수를 n번 적용합니다.
applyN :: Int -> (a -> a) -> a -> a
applyN n f = X.foldr (.) id (X.replicate n f)
그리고 분기하는 모나드 로직을 다루기 위한 다양한 불리언 컴비네이터를 재익스포트합니다.
whenM :: Monad m => m Bool -> m () -> m ()
whenM p m =
p >>= flip when m
unlessM :: Monad m => m Bool -> m () -> m ()
unlessM p m =
p >>= flip unless m
ifM :: Monad m => m Bool -> m a -> m a -> m a
ifM p x y = p >>= \b -> if b then x else y
guardM :: MonadPlus m => m Bool -> m ()
guardM f = guard =<< f
Safe
Safe는 기본으로 제공되는 여러 부분 함수(head, tail)의 Maybe 버전을 제공합니다. 결과를 Maybe로 감싸는 것이 올바른 접근이라는 데 널리 공감대가 형성되어 있으며, Haskell을 오늘날 설계한다면 이러한 부분 함수는 존재하지 않을 것입니다.
-- Maybe'ized version of partial functions
import Safe as X (
headMay,
initMay,
tailMay
)
디버깅
부분 함수가 포함된 코드나 각종 치명적인 프로그램 로직에 유용하므로 다양한 디버깅 명령과 트랩 명령은 여전히 제공됩니다. 다만 이제는 이러한 명령을 코드에 남겨 두면 컴파일러가 경고를 내보내며, 이 경고에는 해당 명령이 사용된 위치 정보가 함께 표시됩니다. 이 동작은 프로덕션 코드와 디버깅 코드 사이에서 전환할 수 있습니다.
{-# WARNING undefined "'undefined' remains in code" #-}
undefined :: a
undefined = P.undefined
{-# WARNING error "'error' remains in code" #-}
error :: P.String -> a
error = P.error
{-# WARNING trace "'trace' remains in code" #-}
trace :: P.String -> a -> a
trace = T.trace
{-# WARNING traceShow "'traceShow' remains in code" #-}
traceShow :: P.Show a => a -> a
traceShow a = T.trace (P.show a) a
{-# WARNING traceShowM "'traceShowM' remains in code" #-}
traceShowM :: (P.Show a, P.Monad m) => a -> m ()
traceShowM a = T.traceM (P.show a)
{-# WARNING traceM "'traceM' remains in code" #-}
traceM :: P.Monad m => P.String -> m ()
traceM = T.traceM
{-# WARNING traceIO "'traceIO' remains in code" #-}
traceIO :: P.String -> P.IO ()
traceIO = T.traceIO
{-# WARNING notImplemented "'notImplemented' remains in code" #-}
notImplemented :: a
notImplemented = P.error "Not implemented"
Either
Maybe와 Either 사이를 변환하는 여러 either 조합자가 제공되어야 마땅하지만 실제로는 제공되지 않으며, 이러한 조합은 네 가지가 있습니다. Left 쪽 값에 대해 mempty를 쓸 수 있는 모노이드 인스턴스가 있는 maybe를 처리하는 것도 꽤 흔한 작업입니다.
leftToMaybe :: Either l r -> Maybe l
leftToMaybe = either Just (const Nothing)
rightToMaybe :: Either l r -> Maybe r
rightToMaybe = either (const Nothing) Just
maybeToRight :: l -> Maybe r -> Either l r
maybeToRight l = maybe (Left l) Right
maybeToLeft :: r -> Maybe l -> Either l r
maybeToLeft r = maybe (Right r) Left
maybeToEither :: Monoid b => (a -> b) -> Maybe a -> b
maybeToEither = maybe mempty
List
Foldable과 Traversable로 일반화된 함수를 제외한 여러 리스트 함수는 전부 그대로 내보냅니다. head는 foldr로 작성된 전역 함수로 다시 내보냅니다. 프렐류드에서 의도치 않게 이차 시간 복잡도를 갖는 ordNub 함수는 내부적으로 해시맵을 사용하는 로그 시간 변형으로 대체됩니다.
head :: (Foldable f) => f a -> Maybe a
head = foldr (\x _ -> return x) Nothing
sortOn :: (Ord o) => (a -> o) -> [a] -> [a]
sortOn = sortBy . comparing
-- O(n * log n)
ordNub :: (Ord a) => [a] -> [a]
ordNub l = go Set.empty l
where
go _ [] = []
go s (x:xs) =
if x `Set.member` s
then go s xs
else x : go (Set.insert x s) xs
모나드
Core 모나드 클래스와 함수, 조합자는 전부 그대로 다시 내보냅니다. mapM 같은 변형은 Control.Monad 대신 Data.Traversable에서 제공합니다.
module Monad (
Monad(..)
, MonadPlus(..)
, (=<<)
, (>=>)
, (<=<)
, forever
, join
, mfilter
, filterM
, mapAndUnzipM
, zipWithM
, zipWithM_
, foldM
, foldM_
, replicateM
, replicateM_
, concatMapM
, guard
, when
, unless
, liftM
, liftM2
, liftM3
, liftM4
, liftM5
, liftM'
, liftM2'
, ap
, (<$!>)
) where
import Prelude (concat, seq)
import Control.Monad
concatMapM :: (Monad m) => (a -> m [b]) -> [a] -> m [b]
concatMapM f xs = liftM concat (mapM f xs)
liftM은 예상치 못한 지연 평가가 흔히 발생하는 원인이므로 엄격한 버전도 기본으로 제공합니다.
liftM' :: Monad m => (a -> b) -> m a -> m b
liftM' = (<$!>)
{-# INLINE liftM' #-}
liftM2' :: (Monad m) => (a -> b -> c) -> m a -> m b -> m c
liftM2' f a b = do
x <- a
y <- b
let z = f x y
z `seq` return z
{-# INLINE liftM2' #-}
Applicative
applicative 모듈의 Core 타입은 전부 그대로 다시 내보냅니다. 7.8과 달리 Applicative 클래스가 기본으로 스코프에 들어 있으며, 요즘 시대에는 당연히 그래야 합니다.
-- Applicatives
import Control.Applicative as X (
Applicative(..)
, Alternative(..)
, Const(..)
, ZipList(..)
, (<**>)
, liftA
, liftA2
, liftA3
, optional
)
타입 클래스
순서와 수치 타입 계층을 위한 Core GHC 타입 클래스는 전부 그대로 다시 내보냅니다. 또한 Traversable과 Foldable을 스코프에 가져오면서, 일반적으로 피해야 하는 몇몇 부분 함수는 가립니다. Semiring도 요즘에는 충분히 흔하게 쓰이므로 암묵적으로 스코프에 들어 있어야 합니다.
-- Base typeclasses
import Data.Eq as X
import Data.Ord as X
import Data.Monoid as X
import Data.Traversable as X
import Data.Foldable as X hiding (
foldr1
, foldl1
, maximum
, maximumBy
, minimum
, minimumBy
)
import Data.Semiring as X
import Data.Functor.Identity as X
import Data.Functor as X (
Functor(..)
, ($>)
, (<$>)
, void
)
Deepseq
Deepseq는 여러 사용 사례에서 파생해야 하는 중요한 타입 클래스인 경우가 많으므로, deepseq 라이브러리와 그 함수들을 가져옵니다.
-- Deepseq
import Control.DeepSeq as X (
NFData(..)
, ($!!)
, deepseq
, force
)
자료 구조
GHC가 제공하는 Core 자료 구조는 다시 내보내지만, List의 경우 부분 함수는 반드시 가리고 연산자는 더 일반적인 인터페이스로 제공합니다.
-- Data structures
import Data.Tuple as X
import Data.List as X (
splitAt
, break
, intercalate
, isPrefixOf
, drop
, filter
, reverse
, replicate
)
containers 라이브러리들은 모두 서로 겹치는 함수(조회, insert 등)를 제공하므로, 시그니처에서 사용할 수 있도록 이러한 자료 구조의 타입만 익스포트합니다. 그러면 모듈 수준에서는 보통 import qualified Data.Map as Map과 같은 한정 임포트로 이들을 가져오게 됩니다.
import Data.Map as X (Map)
import Data.Set as X (Set)
import Data.Sequence as X (Seq)
import Data.IntMap as X (IntMap)
import Data.IntSet as X (IntSet)
모나드 트랜스포머
기본 mtl 트랜스포머 스택, 특히 StateT, ReaderT, ExceptT는 현대 Haskell에서 어디에나 쓰입니다. 이 모듈들의 함수를 모두 내보내지는 않고, 흔히 쓰이는 트랜스포머의 사용 사례 대부분을 감당할 수 있을 만큼만 스코프에 가져옵니다.
-- Monad transformers
import Control.Monad.State as X (
MonadState,
State,
StateT,
put,
get,
gets,
modify,
withState,
runStateT,
execStateT,
evalStateT,
)
import Control.Monad.Reader as X (
MonadReader,
Reader,
ReaderT,
ask,
asks,
local,
runReader,
runReaderT,
)
import Control.Monad.Except as X (
MonadError,
Except,
ExceptT,
throwError,
catchError,
runExcept,
runExceptT,
)
import Control.Monad.Trans as X (
MonadIO,
lift,
liftIO,
)
내장 타입
몇몇 기본 타입(IO, Show)은 무엇을 하든 필요하므로 당연히 가져옵니다. Exts는 FFI 작업을 위한 다양한 포인터 타입과 함께 Constraint(제약) 타입도 제공하는데, 이 타입은 -XConstraintKinds나 더 고급 타입 패밀리 기법을 사용할 때 꽤 흔히 쓰입니다.
-- Base GHC types
import GHC.IO as X (IO)
import GHC.Num as X
import GHC.Real as X
import GHC.Float as X
import GHC.Show as X
import GHC.Exts as X (
Constraint
, Ptr
, FunPtr
, the
)
제네릭
제네릭 또한 현대 Haskell에서는 어디에나 쓰이므로, -XDeriveGeneric을 사용하고 Generic 클래스의 기본 인스턴스를 구현할 수 있도록 여러 타입 클래스와 타입 동의어를 제공해야 합니다.
-- Generics
import GHC.Generics (
Generic(..)
, Rep
, K1(..)
, M1(..)
, U1(..)
, V1
, D1
, C1
, S1
, (:+:)
, (:*:)
, NoSelector
, Rec0
, Par0
, Constructor(..)
, Selector(..)
, Arity(..)
, Fixity(..)
)
문자열 타입
Haskell의 문자열은 고통이 끝없이 반복되는 거대한 프랙탈입니다. 공정한 세상이라면 우리는 대부분 Text를 쓰고 네트워크를 다뤄야 할 때만 ByteString을 썼겠지만, 우리는 그런 세상에 살고 있지 않으며 Haskell 생태계의 상당 부분은 여전히 극도로 비효율적인 Char 연결 리스트를 사용합니다.
논란의 여지가 있지만, 우리는 Lazy 텍스트 타입을 타입 동의어 LText로 재익스포트하고, 다중 매개변수 타입 클래스를 사용해 임의의 두 문자열 타입 사이를 자동으로 변환해 주는 string-conv 라이브러리 함수 toS를 제공합니다. 문자열을 많이 다루는 프로그램이라면 여러 Text 및 ByteString 빌더 클래스를 재익스포트하는 것도 고려해 볼 만합니다.
-- ByteString
import qualified Data.ByteString.Lazy
import qualified Data.ByteString as X (ByteString)
-- Text
import Data.Text as X (Text)
import qualified Data.Text.Lazy
import qualified Data.Text.IO
import Text.Printf as X (printf)
import Data.Text.Lazy (
toStrict
, fromStrict
)
import Data.String.Conv as X (
strConv
, toS
, toSL
, Leniency(..)
)
-- Printf
import Text.Printf as Exports (
PrintfArg
, printf
, hPrintf
)
type LText = Data.Text.Lazy.Text
type LByteString = Data.ByteString.Lazy.ByteString
IO
IO는 사실상 당연히 필요하므로, 여러 IO 연산과 저수준 명령줄 옵션 및 파일 핸들러 함수를 재익스포트합니다.
-- IO
import System.Exit as X
import System.Environment as X (getArgs)
import System.IO as X (
Handle
, hClose
)
공정한 세상이라면 문자열 하나를 출력하려고 모든 망할 모듈마다 보일러플레이트 import를 넣지 않아도 되는 제네릭 putStr이 있었겠지만, 안타깝게도 우리는 그런 세상에 살고 있지 않습니다. 하지만 일반적인 텍스트 표현에 대해 이를 처리하는 기본 클래스를 구현한 다음, 모두 같은 인터페이스를 제공하는 네 개의 라이브러리 대신 그 클래스만 익스포트할 수 있습니다.
class Print a where
putStr :: MonadIO m => a -> m ()
putStrLn :: MonadIO m => a -> m ()
instance Print T.Text where
putStr = liftIO . T.putStr
putStrLn = liftIO . T.putStrLn
instance Print TL.Text where
putStr = liftIO . TL.putStr
putStrLn = liftIO . TL.putStrLn
instance Print BS.ByteString where
putStr = liftIO . BS.putStr
putStrLn = liftIO . BS.putStrLn
instance Print BL.ByteString where
putStr = liftIO . BL.putStr
putStrLn = liftIO . BL.putStrLn
instance Print [Char] where
putStr = liftIO . Prelude.putStr
putStrLn = liftIO . Prelude.putStrLn
-- For forcing type inference
putText :: MonadIO m => T.Text -> m ()
putText = putStrLn
{-# SPECIALIZE putText :: T.Text -> IO () #-}
putLText :: MonadIO m => TL.Text -> m ()
putLText = putStrLn
{-# SPECIALIZE putLText :: TL.Text -> IO () #-}
위의 함수들과 마찬가지로 print와 여러 문자열 IO 연산을 제네릭 MonadIO 인스턴스로 자동 리프트하여 트랜스포머 스택 안에 넣을 수 있게 합니다.
print :: (X.MonadIO m, P.Show a) => a -> m ()
print = liftIO . P.print
동시성
기본 스레드 프리미티브는 충분히 흔하게 쓰이므로 암묵적으로 스코프에 들여와야 합니다. async 라이브러리는 동시성 로직을 다루는 데 권장되는 방법을 제공하므로 이 역시 통째로 익스포트합니다.
-- ST
import Control.Monad.ST as ST
-- Concurrency and Parallelism
import Control.Exception as X
import Control.Concurrent as X
import Control.Concurrent.Async as X
이제 cabal 파일에 다음을 추가하기만 하면 됩니다.
default-extensions:
NoImplicitPrelude
그런 다음 각 모듈에서 여러분의 합리적인 프렐류드를 포함하십시오. 이 선택을 원하지 않는 모듈에서는 import Prelude로 기본 프렐류드를 명시적으로 가져오기만 하면 모듈 단위로 빠져나갈 수 있습니다.
이것이 제가 여러 cabal 파일로 구성된 대규모 프로젝트에서 사용하는 기본 원형 프렐류드입니다. 이 중 일부 선택은 상황에 따라 다르게 느껴질 수 있지만, 저는 이것이 최소한 좋은 출발점이 되어 줄 만큼 꽤 합리적이고 실용적인 기초 함수 및 타입 모음이라고 생각합니다.
이색적인 프로그래밍 아이디어: 2부 (항 재작성)
지난주에 이어 이번에는 항 재작성이라는 주제를 다루겠습니다. 항 재작성은 매우 일반적인 계산 모델로, 항(term)이라 불리는 표현식을 다른 항들의 집합으로 변환하는 변환(규칙(rule)이라 부릅니다)을 기술하는 프로그램적 체계로 이루어져 있습니다.
가장 널리 쓰이는 재작성 엔진은 논리 프로그래밍, 증명 보조기, 컴퓨터 대수 시스템에 사용되는 프로그램과 언어의 핵심에 자리 잡고 있는 경우가 많습니다. 그중 가장 대중적인 것 중 하나가 Mathematica와 Wolfram 언어입니다. 이는 Wolfram Research사가 과학 계산 프레임워크의 일부로 제공하는 독점 프로그래밍 언어입니다. 이 시스템의 핵심(Core)에는 수학적 표현식을 나타내는 복합 기호 표현식을 조작할 수 있는 재작성 시스템이 있습니다. Maude, Pure, Aldor 및 일부 Lisp 변종과 같은 다른 언어들도 비슷한 시스템을 구현하지만, 이 글의 예제에서는 보다 일반적인 개념을 보여 주기 위해 Mathematica로 작성한 코드를 사용하겠습니다.
Mathematica는 보통 노트북 환경에서 실행되며, 여기서 In과 Out 표현식은 REPL에 입력된 각 줄마다 단조 증가하는 인덱스로 색인되는 벡터입니다.
Wolfram Language 12.0.1 Engine for Linux x86 (64-bit)
Copyright 1988-2019 Wolfram Research, Inc.
In[1]:= 1+2
Out[1]= 3
In[2]:= 1+2+x
Out[2]= 3 + x
In[3]:= List[x,y,z]
Out[3]= {x, y, z}
이 언어 자체는 정신적으로 표현식을 다루는 Lisp이며, 이 표현식에는 기호 항(위의 x 항과 같은)이 포함될 수 있습니다. 이러한 표현식은 변수가 아니라, 표현식 안에서 변수를 나타내는 더 이상 환원할 수 없는 원자입니다. 합성 표현식은 Lisp의 S-표현식과 비슷하며, 머리(head) 항과 그 표현식의 인수인 중첩된 하위 표현식들의 집합으로 이루어져 있습니다.
F[x,y]
이 경우 F가 머리이고 x와 y가 인수입니다. 이러한 형태의 표기법을 M-표현식이라고 합니다. 핵심적인 표기상의 특징은 모든 언어 구성 요소 자체가 기호 표현식이며, 규칙에 의해 내부를 들여다보고 변환할 수 있다는 점입니다. 예를 들어 Head 함수는 주어진 표현식에서 머리 기호를 추출합니다.
In[4]:= Head[f[a,b,c]]
Out[4]= f
In[5]:= Symbol["x"]
Out[5]= x
In[6]:= Head[x]
Out[6]= Symbol
주어진 M-표현식의 인수는 Level 함수를 사용하여 추출할 수 있는데, 이 함수는 주어진 깊이의 인수들을 벡터(중괄호로 표시됩니다)로 추출합니다. 이 경우 첫 번째 레벨은 인수 a, b, c입니다.
In[7]:= Level[f[a,b,c],1]
Out[7]= {a, b, c}
표현식은 여러 형태로 작성할 수 있으며, 이들은 모두 이 기본 M-표현식 형태로 환원됩니다. 예를 들어 덧셈 연산은 Plus 머리를 가진 표현식에 대한 문법적 설탕일 뿐입니다. FullForm 함수를 사용하면 이 표현식을 내부 정규 형태로 환원할 수 있습니다. 곱셈 역시 일반 대수학에서 쓰이는 관례와 비슷하게, 개별 항을 공백으로 구분하는 중위 표기로 나타냅니다.
In[8]:= FullForm[x+y]
Out[8]//FullForm= Plus[x, y]
In[9]:= FullForm[x y]
Out[9]//FullForm= Times[x, y]
중위 문법적 설탕 외에도 두 연산자 @와 //를 사용하면 각각 전위 또는 후위 형태로 함수를 인수에 적용할 수 있습니다.
In[10]:= Sin[x] (* Full form *)
Out[10]= Sin[x]
In[11]:= Sin @ x (* Prefix sugar *)
Out[11]= Sin[x]
In[12]:= x // Sin (* Postfix sugar *)
Out[12]= Sin[x]
복잡한 수학적 표현식은 단지 항들의 중첩된 조합일 뿐입니다. 예를 들어 간단한 단항식 표현식 은
다음과 같이 나타냅니다:
In[13]:= FullForm[x^3 + (1 + x)^2]
Out[13]//FullForm= Plus[Power[x, 3], Power[Plus[1, x], 2]]
In[14]:= TeXForm[x^3 + (1 + x)^2]
Out[14]//TeXForm= x^3+(x+1)^2
이 표현식 자체는 그래프 구조이며, 그 구현은 하위 표현식을 가리키는 포인터를 가진 노드들의 집합으로 이루어져 있습니다. 대괄호를 사용하는 인덱스 표기법으로 주어진 하위 표현식을 직접 조작할 수 있으며, 하위 표현식은 머리 항부터 시작하여 왼쪽에서 오른쪽으로 번호가 매겨집니다.
In[15]:= f[a,b,c][[0]]
Out[15]= f
In[16]:= f[a,b,c][[1]]
Out[16]= a
In[17]:= f[a,b,c][[2]]
Out[17]= b
표현식의 개별 인자는 인덱스로 슬롯을 참조하여 순서를 바꾸거나 다른 표현식에 대입할 수 있습니다.
In[18]:= F[#3, #1, #2] & [x, y, z]
Out[18]= F[z, x, y]
복잡한 수학 표현식은 표현식의 그래프로 표현할 수 있으며, 그래픽 트리 형태로 렌더링할 수 있습니다. 사실상 이 시스템의 모든 규칙과 함수는 유향 그래프를 다른 유향 그래프 구조로 변환하는 것입니다. 예를 들어 간단한 삼각 급수는 다음과 같이 기호적으로 표현할 수 있습니다.
In[19]:= Series[Cos[x]/x, {x, 0, 10}]
이는 내부적으로 다음과 같은 M-표현식의 그래프 구조로 표현됩니다.
In[20]:= FullForm[Series[Cos[x]/x, {x, 0, 10}]]
Out[20]//FullForm= SeriesData[x, 0, {1, 0, Rational[-1, 2], 0, Rational[1, 24], 0, Rational[-1, 720], 0, Rational[1, 40320], 0, Rational[-1, 3628800], 0, Rational[1, 39916800]}, 0, 11, 1]
이 기호 표현식은 Series 항을 평가하여 개별 항으로 전개할 수 있습니다.
평가 순서
이 언어에서 평가는 축약된 표현식에 더 이상 적용할 규칙이 없을 때까지 항을 축약하는 방식으로 진행됩니다. 이러한 표현식을 정규형(normal form)에 있다고 합니다. 이러한 평가 방식은 메모리를 순차적으로 갱신하고 부수 효과가 있는 문장을 차례로 실행하는 것이 실행 방식인 순차적, 문장 기반 언어와는 다릅니다.
예를 들어 Range 함수는 일련의 값을 리스트로 생성합니다. 이 리스트는 다시 각 원소에 함수를 적용하는 다른 함수에 전달할 수 있으며, 예를 들어 주어진 정수가 소수인지 질의하는 함수를 적용할 수 있습니다.
In[20]:= Range[1,10]
Out[20]= {1, 2, 3, 4, 5, 6, 7, 8, 9, 10}
In[21]:= Map[PrimeQ, Range[1,10]]
Out[21]= {False, True, True, False, True, False, True, False, False, False}
이 불리언 시퀀스가 최종 형태이며, 범위 내에서 더 이상 적용할 수 있는 규칙이 없으므로 최종 표현식이 반환됩니다.
규칙
사용자 정의 로직을 환경에 새로 도입하는 주된 메커니즘은 재작성 규칙을 도입하는 것입니다. 재작성 규칙은 Rule 정의 또는 그 중위 문법 설탕인 ->로 정의합니다. 좌변은 패턴 문법으로 주어지며, 우변에 걸쳐 변수 정의를 바인딩할 수 있습니다.
예를 들어 정수 1의 모든 출현을 2로 재작성하는 규칙은 다음과 같습니다.
In[22]:= Rule[1,2]
Out[22]= 1 -> 2
또는 기호 x의 명시적인 출현을 각각 기호 y로 변환하는 규칙은 다음과 같습니다.
In[23]:= Rule[x,y]
Out[23]= x -> y
하위 표현식과 매칭되어 규칙의 범위 안에서 그것에 이름을 붙이는 패턴 변수를 도입할 수도 있습니다. 이 “구멍(hole)“에 대한 매칭 결과는 규칙의 우변에 걸쳐 변수 이름으로 바인딩됩니다. 예를 들어 임의의 양 x_와 매칭하여 이를 정의 x에 바인딩하는 규칙은 다음과 같습니다.
In[24]:= Rule[x_,x]
Out[24]= x_ -> x
더 유용하게도, 이러한 패턴 변수는 표현식 내부에 나타날 수 있습니다. 예를 들어 사인 함수에 주어진 모든 인자를 코사인 함수로 재작성하고 싶다면 다음과 같은 규칙을 작성할 수 있습니다.
In[25]:= Sin[x_] -> Cos[x]
Out[25]= Sin[x_] -> Cos[x]
규칙은 ReplaceAll 함수나 그 중위 형태인 /.를 사용하여 주어진 표현식에 적용할 수 있으며, 이는 주어진 규칙을 왼쪽의 표현식에 적용합니다.
In[26]:= ReplaceAll[x, Rule[x,y]]
Out[26]= y
In[27]:= x /. Rule[x,y]
Out[27]= y
앞의 삼각함수 예제에서는 표현식 본문 안에 중첩된 삼각함수를 재작성할 수 있습니다.
In[28]:= Sin[a+b] /. Sin[x_] -> Cos[x]
Out[28]= Cos[a + b]
규칙 리스트를 ReplaceAll의 인자로 전달하여 규칙을 결합할 수 있습니다. 예를 들어 다음은 주어진 리스트를 한 번 순회하면서 모든 x를 y로, 모든 y를 z로 재작성합니다.
In[29]:= {x,y,z} /. {x->y, y->z}
Out[29]= {y, z, z}
규칙은 직전 규칙이 만든 중간 표현식에 순서대로 적용되므로, 이것은 리스트 전체를 같은 원소로 변환하지 않습니다. 그러나 ReplaceRepeated 함수는 고정점에 도달하여 항이 직전 축약 결과와 동일해질 때까지 주어진 규칙 집합을 반복해서 적용합니다.
In[30]:= ReplaceRepeated[x, Rule[x,y]]
Out[30]= y
In[31]:= ReplaceRepeated[x, {Rule[x,y], Rule[y,z]}]
Out[31]= z
In[32]:= {x,y,z} /. {x->y, y->z} (* Non-repeated *)
Out[32]= {y, z, z}
In[33]:= {x,y,z} //. {x->y, y->z} (* Repeated *)
Out[33]= {z, z, z}
이 과정이 무한히 반복되기만 하고 수렴하지 않는 규칙 집합을 정의하는 것도 충분히 가능합니다. 이러한 경우에는 정규형이 없으며, 시간(또는 공간)이 폭증하거나 런타임이 포기할 때까지 계속됩니다.
In[34]:= {1,2} //. {1 -> 2, 2 -> 1}
ReplaceRepeated::rrlim: Exiting after {1, 2} scanned 65536 times.
대수적 변환
많은 규칙 집합은 여러 재작성 경로를 허용하며, 이 경로들이 반드시 같은 최종 항에 도달하는 것은 아닙니다. 재작성 순서를 어떻게 선택하든 최종 결과에 차이가 없는 규칙 체계를 합류적(confluent)이라고 합니다. 런타임 내부의 재작성 규칙에서는 평가 순서에 대한 규정이 사용됩니다. 이는 임의적인 선택이지만, Mathematica는 표현식의 헤드를 먼저 평가한 다음 표현식의 각 원소를 평가합니다. 이 원소들은 그 자체로 표현식이며, 동일한 평가 절차가 재귀적으로 적용됩니다.
표준 라이브러리에는 대수적 단순화와 항 재배열을 다루기 위한 이러한 변환 집합이 많이 있습니다. FullSimplify 함수는 가장 범용적인 함수로, 내부에 정의된 방대한 항등식과 관계의 집합에 따라 실숫값 대수 표현식을 정리하고 단순화합니다.
In[35]:= FullSimplify[x^2 x + y x + z + x y]
Out[35]= Plus[Power[x, 3], Times[2, x, y], z]
그러나 이러한 규칙 집합을 우리가 직접 도입하고 확장할 수도 있습니다. 예를 들어 주어진 항등식에 따라 삼각함수를 단순화하는 간단한 규칙 집합을 새로 인코딩하고 싶다면, 다음 수학 항등식에 대한 규칙을 작성할 수 있습니다.
이는 다음과 같은 두 개의 패턴과 재작성으로 인코딩됩니다:
In[36]:= ElemTrigExpand = {
Sin[a_ + b_] -> Sin[a] Cos[b] + Cos[a] Sin[b],
Cos[a_ + b_] -> Cos[a] Cos[b] - Sin[a] Sin[b]
}
그런 다음 이를 선형 인수를 갖는 삼각함수에 반복적으로 적용하여 중첩된 항을 단일 변수로 축약할 수 있습니다.
In[37]:= Sin[a+b+c] //. ElemTrigExpand
Out[37]= Cos[a] (Cos[c] Sin[b] + Cos[b] Sin[c]) Sin[a] (Cos[b] Cos[c] + Sin[b] Sin[c])
속성과 성질
규칙 안에 나타나는 항은 규칙이 디스패치할 수 있는 추가 구조를 가질 수도 있습니다. 기호에는 Attributes를 정의할 수 있으며, 이는 기호를 정규형으로 축약하고 재배열하는 데 활용됩니다. 흔히 결합법칙, 교환법칙, 항등원, 소멸 같은 일반적인 대수적 성질이 이에 해당합니다.
In[38]:= Attributes[f] = {Flat, OneIdentity}
Out[38]= {Flat, OneIdentity}
In[39]:= f[1, f[2, f[3, 4]]] (* Associative *)
Out[39]= f[1, 2, 3, 4]
In[40]:= f[f[1]] (* Idempotent *)
Out[40]= f[1]
함수의 구조적 성질 외에도, 기호에는 그 출처와 정의역 또는 그 기호가 속한 집합에 대한 가정을 덧붙일 수 있습니다. 예를 들어 주어진 수가 0이 아닌지, 정수(적분)인지, 소수인지, 또는 주어진 집합의 원소인지와 같은 것입니다. 이러한 성질은 그 자체로 기호 표현식이므로, 예를 들어 주어진 변수 z가 복소평면에 속한다는 가정을 인코딩하고 싶다면:
다음과 같은 표현식을 작성할 수 있으며, 여기서 Complexes는 를 나타내는 내장 기호입니다.
이러한 가정은 변수 Assumptions로 정의되는 전역 가정 집합에 추가할 수 있습니다.
In[42]:= $Assumptions = {a > 0, b > 1}
Out[42]= a > 0
이러한 대수적 단순화를 재작성할 때는 redex에서 만나는 항의 가정에 따라 디스패치하며, 기호의 성질에 대한 연쇄적인 추론에 근거하여 서로 다른 축약 경로를 택합니다. 예를 들어 제곱의 제곱근이 원래 값으로 축약된다는 항등식은 주어진 기호의 부호에 따라 달라집니다. Refine 함수를 사용하면 전역 가정을 반영하여 단순화기에 어느 분기를 선택할지 알려 줄 수 있습니다.
In[43]:= Refine[Sqrt[a^2 b^2]]
Out[43]= a b
이 함수를 사용하여 기호에 대한 술어의 진릿값을 질의할 수도 있습니다. 그 결과는 True나 False가 되며, 기호에 대한 국소 가정이 없으면 판정할 수 없다는 답이 나옵니다.
In[44]:= Refine[Positive[b]]
Out[44]= True
In[45]:= Refine[Positive[x]]
Out[45]= Positive[x] (* Has no truth value *)
또한 많은 함수가 Assumptions라는 이름의 매개변수를 받으며, 이를 사용하여 함수에 주어진 인수에 대한 국소 가정을 도입할 수 있습니다.
In[46]:= Refine[Sqrt[x^2], Assumptions -> {x < 0}]
Out[46]= -x
가정 시스템은 특정 영역 안에서 기호의 성질을 추론하기 위해 제한적인 1차 논리 도출(resolution)을 수행할 수 있습니다. 예를 들어 x > 1이라는 가정은 x가 0이 아니며 음수가 아니라는 사실을 함의합니다. 또는 정수 y가 y > 2이고 소수라는 가정은 y가 짝수가 아님을 함의합니다.
규칙의 좌변에 있는 패턴은 식의 타입뿐 아니라 패턴 변수의 가정과 속성에 따라서도 분기할 수 있습니다. 예를 들어 좌변 x_Symbol은 모든 기호적 양(숫자는 제외)과 매칭되며, 이를 주어진 상수로 재작성할 수 있습니다. 이것은 List 자체의 헤드와도 매칭되어 그 헤드를 상수로 재작성한다는 점에 유의하십시오.
In[47]:= {1, x, Pi} /. x_Symbol -> 0 (* Matches List, x, Pi *)
Out[47]= 0[1, 0, 0]
_?s 접미사 뒤에 함수를 붙이면 패턴 변수에 술어 함수를 씌울 수 있습니다. 예를 들어 주어진 항이 수치적인 양인지 확인하려면 NumericQ 함수를 사용할 수 있습니다. 이것은 Pi와 1 항에는 매칭되지만 List나 1 항에는 매칭되지 않습니다.
In[48]:= {1, x, Pi} /. x_?NumericQ -> 0 (* Matches 1, Pi *)
Out[48]= {0, x, 0}
특수 함수
표준 라이브러리에는 기호적 양에 대한 가정과 규칙의 라이브러리로 인코딩된 방대한 수학 지식이 담겨 있습니다. 예를 들어 리만 제타 함수에는 수백 가지의 알려진 항등식과 다른 함수를 이용한 표현이 있습니다. 짝수인 정수 값에 대해서는 π와 베르누이 수로 표현되는 간단한 닫힌 형식이 있습니다.
Mathematica는 이러한 항등식을 알고 있으므로 Zeta 함수를 이 축약된 형식으로 자동 변환합니다. 짝수가 아닌 값에 대해서는 (일반적으로) 간단한 닫힌 형식이 없지만, N 함수를 사용하면 원하는 자릿수만큼 계산할 수 있는 급수 근사가 있습니다.
In[49]:= Zeta[2]
Out[49]= Times[Rational[1, 6], Power[Pi, 2]]
In[50]:= Zeta[3]
Out[50]= Zeta[3]
In[51]:= N[Zeta[3], 30]
Out[51]= 1.20205690315959428539973816151
미적분
유명한 XKCD 만화는 어떤 미적분 문제들이 지닌 비대칭성을 보여 줍니다. 이러한 재작성 시스템 안에서 미분과 적분에 대한 단순화를 인코딩하려고 하면 이 만화가 그대로 재현됩니다.
실제로 미분은 앞에서 설명한 기법을 사용하면 거의 자명하게 인코딩할 수 있습니다. 미분 연산자의 선형성, 곱의 법칙, 거듭제곱 법칙, 상수 법칙은 규칙 네 줄로 작성할 수 있습니다. 표준 라이브러리에는 이러한 정의가 더 많이 들어 있지만, 대체로 이 정도로 간결합니다.
{
Diff[f_ g_, x_] -> f Diff[g, x] + g Diff[f, x],
Diff[f_ + g_, x_] -> Diff[f, x] + Diff[g, x],
Diff[Pow[x_,n_Integer], x_] -> n * Pow[x,n-1],
Diff[x_, x_] -> 1
Diff[n_?NumericQ, x_] -> 0
}
그러나 많은 컴퓨터 대수 시스템은 거의 마법 같은 방법으로 부정적분을 계산해 낼 수 있습니다. 예를 들면 다음과 같습니다.
In[52]:= Integrate[Log[1/x], x]
Out[52]= Plus[x, Times[x, Log[Power[x, -1]]]]
Mathematica의 기호 적분 능력은 마법처럼 보일 수 있지만, 실제로는 재작성 기계 장치에 변환 규칙 모음과 1930년대의 몇 가지 해석학적 성과를 결합한 대표적인 예일 뿐입니다. 어떤 적분은 패턴 매칭만으로 바로 계산할 수 있지만, Meijer G-함수 연구에는 여러 종류의 초월 함수를 적분 계산에 편리한 닫힌 형식으로 변환할 수 있게 해 주는 자명하지 않은 결과가 있습니다.
Meijer G-함수는 4개의 벡터 매개변수를 인덱스로 갖는 함수로, L이 에서 까지 이어지는 다음 복소 적분으로 표현됩니다.
이 함수는 잘 연구된 함수이며, 놀랍게도 아주 많은 종류의 특수 함수(삼각 함수, 베셀 함수, 초기하 함수 등)를 G-함수로 표현할 수 있습니다. 따라서 이러한 함수들이 복잡하게 중첩된 식도 G-함수 항을 다루는 일로 단순화할 수 있습니다. 이렇게 축약된 식에 적분 정리를 적용하면 하나 이상의 다른 G-함수 항이 나옵니다. 그런 다음 그 결과를 다시 특수 함수로 전개하면 적분 결과를 얻을 수 있습니다. 이 방법이 모든 경우에 통하는 것은 아니지만, 실제로는 매우 유용할 만큼 충분히 많은 경우에 통합니다.
매우 일반적인 부정적분 정리 중 하나는 피적분 함수를 G-함수 인덱스의 순열로 다시 표현합니다. 좌변에는 적분식이 있고 우변에는 계산된 적분이 있으며, 둘 다 G-함수로 표현됩니다.
적분표 한 권 분량이 항 재작성 로직 몇 줄로 된 G-함수의 간단한 곱셈 및 변환 규칙 집합으로 축약될 수 있습니다.
Mathematica 적분 엔진의 핵심(Core)에는 이 접근법을 활용한 변환과 함께 상당히 잘 작동하는 다양한 휴리스틱이 자리하고 있습니다. 예를 들어 MeijerGReduce 함수를 사용하면 여러 부류의 특수 함수를 그에 대응하는 G-함수로 변환할 수 있으며, 그런 다음 FullSimplify와 기타 항등식을 사용해 이러한 식을 더 간단하게 줄일 수 있습니다.
In[53]:= MeijerGReduce[Sqrt[x] Sqrt[1+x],x]
이 모든 기능이 한데 모여, 대부분의 주류 언어의 의미론과는 크게 다른 방식으로 추상적인 식을 다루는 데 특화된 프로그래밍 환경이 만들어집니다.
이 시스템으로 임의의 로직을 프로그래밍할 수 있는 것은 사실이지만, 제자리 참조와 가변 자료 구조를 다루는 명령형 로직을 코드로 작성하려고 하면 다소 번거로워질 수 있습니다. 그럼에도 이 시스템은 과학 계산 분야에서 매우 강력한 도메인 도구입니다. 언어에서 제공하는 기술 분야 관련 함수의 수는 수십 년에 걸쳐 꼼꼼하게 쌓아 온 전문가들의 도메인 지식을 보여 줍니다.
많은 대학이 이 소프트웨어의 사이트 라이선스를 보유하고 있으므로, 독특한 평가 모델과 의미론을 가진 프로그래밍 언어에 관심이 있다면 이 시스템에 담긴 아이디어를 직접 다뤄 볼 만합니다.
외부 참고 자료
이색적인 프로그래밍 아이디어, 4부 (Datalog)
이색적인 프로그래밍 아이디어 시리즈를 이어서, 이번에는 논리 프로그래밍이라는 주제와 그 특정한 형태인 datalog를 살펴보겠습니다.
Datalog는 매우 단순한 형식 체계로, 단 두 가지로만 구성됩니다:
- 사실(fact)들의 데이터베이스
- 기존 사실로부터 새로운 사실을 도출하기 위한 규칙들의 집합
Datalog는 질의 처리기에 의해 실행되며, 질의 처리기는 이 두 입력이 주어지면 데이터베이스와 규칙 양쪽에 의해 함축되는 모든 사실의 인스턴스를 찾아냅니다. 예제는 Souffle 언어로 작성하겠습니다. 이 언어의 이름은 Systematic, Ontological, Undiscovered Fact Finding Logic Engine의 약자입니다. 많은 Linux 시스템에서 다음 명령으로 간단히 설치할 수 있습니다:
$ apt-get install souffle
Souffle는 대규모 코드베이스에 대한 정적 프로그램 분석을 수행하는 맥락에서 마주치는 것과 같은, 대규모 데이터 집합에 대한 복잡한 질의를 위해 설계된 미니멀리스트 datalog 시스템입니다. Souffle는 C++로 구현되어 있으며, C로의 컴파일을 통해 datalog 프로그램을 독립 실행 파일로 컴파일할 수 있습니다. 이는 현재까지 이러한 시스템 중 가장 단순하고 효율적인 구현 중 하나이며, 특히 논리 엔진 위에 단순한 타입 시스템을 갖추고 있습니다.
Datalog는 항(term)들의 유한한 유니버스 위에서 충족 여부를 직접 계산할 수 있는, 결정 가능한 논리의 일부분을 인코딩합니다. 이 항들은 세 부류의 표현식으로 구성됩니다. 사실은 구문적으로 마침표가 뒤에 붙은 표현식으로 나타냅니다.
fact.
규칙은 머리 항과 몸체 항 사이에 턴스타일(⊢) 기호를 두어 나타냅니다.
head :- body.
그리고 질의 항은 데이터베이스 내 사실의 진릿값을 질의합니다.
?- body.
이러한 항의 예로는 그리스 철학자 소크라테스에 관한 “고전적인” 정언 삼단논법을 들 수 있습니다. 소크라테스는 사람이고, 모든 사람은 죽으므로, 소크라테스는 죽는다고 추론할 수 있습니다.
# All men are mortal / valar morghulis
mortal(X) :- human(X).
# Socrates is a man.
human("Socrates").
# Is Socrates mortal?
?- mortal("Socrates").
Souffle 프로그램의 실행은 사실상 규칙의 규정에 따라 입력 사실로부터 추론된 출력 사실로 향하는 일련의 변환입니다.
Souffle는 stdin, CSV 파일, SQLite 데이터베이스를 비롯한 다양한 소스에서 입력 사실을 읽을 수 있습니다. 기본 입력 소스는 관계에 대한 탭으로 구분된 파일이며, 파일의 각 행은 그 관계의 사실 하나를 나타냅니다. 이는 다음 형태의 IO 입력 선언으로 지정합니다.
.decl A (n: symbol)
.input A
이렇게 하면 기호 값 n에 대해 탭으로 구분된 값들로 이루어진 파일 A.facts에서 읽어 들입니다. 하지만 대신 명시적인 IO 매개변수를 전달하여 입력을 수정할 수 있습니다.
.input A(IO=file, filename="fact_database.csv", delimiter=",")
.input A(IO=stdin, delimiter=",")
.input A(IO=sqlite, dbname="fact_database.db")
간단한 예제
간단한 처음부터 끝까지의 예제로는 단순한 일대일 대응을 통해 기호 입력 집합을 숫자 입력 집합과 연관시키는 프로그램을 들 수 있습니다. 이 간단한 A에서 B로의 변환은 다음 규칙으로 작성할 수 있습니다.
# Input from A.facts
.decl A (n: symbol)
.input A
# Output to B.csv
.decl B (n: number)
B(0) :- A("Hello").
B(1) :- A("World").
.output B
이 프로그램은 A.facts의 입력 사실을 읽어 B.csv를 출력하며, 다음 명령으로 Souffle를 실행하면 B.csv는 예상대로 다음과 같은 모습이 됩니다.
$ souffle hello.dl
출력은 hello.dl의 규칙에 따라 A를 B에 대응시킵니다.
| A | B |
|---|---|
| Hello | 0 |
| World | 1 |
관계 Datalog 내부의 논리는 관계(relation)로 지정되며, 관계는 양들을 서로 관련짓는 타입이 지정된 변수들의 순서 있는 튜플입니다. 예를 들어 (심볼로 표현된) 이름 있는 개체들의 집합이 있다면, 각 개체에 속성을 대응시키는 관계를 사실(fact)로 부여할 수 있습니다.
.decl Human(x : symbol)
.decl Klingon(x : symbol)
.decl Android(x : symbol)
Human("Picard").
Human("Riker").
Klingon("Worf").
Android("Data").
각 변수에는 var : type으로 표시되는 특정 타입이 주어지며, 여기서 type은 다음 내장 타입 중 하나입니다.
- symbol - 문자열로 표현되는 심볼 양입니다.
- number - 부호 있는 정수
- unsigned - 부호 없는 정수
- float - 부동소수점 값
관계는 여러 인자를 받을 수 있으며, 이 인자들은 해당 관계에 대한 규칙에 따라 심볼들의 모음에 속성을 부여합니다.
.decl Rank(x:symbol, y:symbol)
.decl Peers(x:symbol, y:symbol)
Rank("Captain", "Picard").
Rank("Officer", "Riker").
Rank("Officer", "Worf").
Rank("Officer", "Data").
이러한 관계에 대한 규칙은 절(clause)로 정의됩니다. 다음은 쌍 (x,y)가 B 관계에 있으면 A 관계에도 있다고 읽을 수 있습니다.
A(x,y) :- B(x,y).
Souffle의 절은 논리학에서 혼 절(Horn clause)로 알려져 있습니다. 혼 절은 논리곱(∧)(프로그래밍에서의 논리 AND)으로 결합된 하위 항들로 구성되며, 이것이 명제 u를 함의합니다. 다음 명제는 수학적으로 다음과 같이 읽을 수 있습니다.
if a and b and … and z all hold, then also u holds
위의 형태를 함의 형태(implicative form)라고 합니다. 논리적으로 이는 논리합(∨)(프로그래밍에서의 논리 OR)과 부정(¬)(프로그래밍에서의 논리 NOT)으로 쓰인 명제와 동치입니다.
Datalog 표기법에서는 이 혼 절을 다음 구문으로 작성합니다.
u :- a, c, ..., z.
절에서 결합된 식 내부에 나타나는 자유 변수는 암묵적으로 전칭 양화됩니다. 즉, 정의역 안에서 해당 변수의 모든(∀로 표기) 대입에 대해 성립해야 합니다. 이 경우 정의역은 주어진 타입(즉 symbol, unsigned 등)에 속하는 원소들의 집합입니다.
따라서 위의 Datalog 식은
A(x,y) :- B(x,y).
다음 혼 절과 동치입니다.
예를 들어 클링온과 인간은 모두 음식을 먹지만, 안드로이드는 당연히 먹지 않는다는 것을 우리는 알고 있습니다. symbol 타입의 변수 항 X에 대해 다음 규칙을 작성합니다.
.decl Eats(x:symbol)
Eats(X) :- Human(X).
Eats(X) :- Klingon(X).
.output Eats
이 규칙은 종족에 대한 제약 조건이 주어졌을 때, 범위 내 심볼들에 관해 주어진 입력 사실 집합으로부터 다음 출력을 생성합니다.
| Eats |
|---|
| Riker |
| Picard |
| Worf |
항(term)은 부정할 수도 있습니다. 예를 들어 식사를 하는 모든 장교를 열거하고 싶다면, 안드로이드를 제외하는 다음 규칙을 작성할 수 있습니다.
InvitedToDinner(X) :- Rank("Officer", X), !Android(X).
| InvitedToDinner |
|---|
| Riker |
| Worf |
더 복잡한 규칙은 쉼표로 구분된 여러 항으로 이루어질 수 있으며, 이 항들은 모두 참으로 평가되어야 합니다. 예를 들어 두 장교가 같은 계급이고 동일 인물이 아니라면 이 둘은 동료입니다. 이 관계에서는 계급이 같은지 검사하기 위해 중간 변수 Z를 사용합니다.
.decl Peers(x:symbol, y:symbol)
Peers(X, Y) :- Rank(Z, X), Rank(Z, Y), X != Y.
| Peers |
|---|
| Riker |
| Worf |
| Riker |
| Data |
| Worf |
| Data |
| Riker |
| Worf |
규칙은 재귀적일 수도 있습니다. 예를 들어 주어진 사실 집합에서 1촌 친구 관계를 모두 찾는 질의를 작성하고 싶다면, 다음과 같은 재귀적 정의를 작성할 수 있습니다.
.decl Friend(x:symbol, y:symbol)
.decl FriendOfFriend(x:symbol, y:symbol)
FriendOfFriend(X, Y) :- Friend(X, Z), FriendOfFriend(Z, Y).
| FriendOfFriend |
|---|
| Riker |
| Worf |
관계 중 중요한 부류로 동치 관계가 있습니다. 동치 관계는 두 항 사이의 관계 중에서 반사성, 대칭성, 추이성이라는 추가 제약 조건을 만족하는 관계입니다. 이런 형태의 관계는 대수학에서 등호를 다루는 방식과 비슷하게 동작합니다.
.decl equivalence(x:number, y:number)
equivalence(a, b) :- R(a), R(b).
// reflexivity
equivalence(a, a) :- equivalence(a, _).
// symmetry
equivalence(a, b) :- equivalence(b, a).
// transitivity
equivalence(a, c) :- equivalence(a, b), equivalence(b, c).
관계를 구현할 때 데이터와 중간 추론 결과는 일반적인 B-트리 자료 구조에 저장됩니다. 하지만 명시적인 인자를 전달하면 이를 바꿔서 특정 용도에 맞게 서로소 집합(disjoint-set)이나 트라이(trie) 자료 구조를 강제로 사용하게 할 수 있습니다.
.decl A(x : number, y : number) eqrel // Disjoint-set
.decl B(x : number, y : symbol) btree // B-tree
.decl C(x : number, y : symbol) brie // Dense trie
적분 타입(number, unsigned, float)을 다룰 때 산술 표현식은 예상대로 동작하며, 패턴 매칭에 사용할 수 있습니다. 예를 들어 피보나치 함수를 자기 자신을 이용해 정의하는 관계로 작성할 수 있습니다.
fib(0, 0).
fib(1, 1).
fib(n+1, x+y) :- fib(n, x), fib(n-1, y), n < 15.
타입 시스템
Souffle에는 절 표현식에서 한정된 변수의 타입을 추적하는 데 사용할 수 있는 제한적인 타입 시스템이 있습니다. 예를 들어 심볼과 부호 없는 정수를 동시에 담는 변수는 만들 수 없습니다. 그러나 언어의 기본 타입 위에 사용자 정의 타입 동의어를 정의할 수 있으며, 이를 통해 사용자가 정의한 서로 다른 종류의 심볼과 수치량을 의미적으로 구별할 수 있습니다. 예를 들면 다음과 같습니다.
.type Person <: symbol
.type Food <: symbol
.decl Eats(x : Person, y : Food)
.decl Dinner(x : Person, y : Food)
Dinner(x, y) :- Eats(x, y). // Well-typed
Dinner(x, y) :- Eats(y, x). // Not well-typed, Person != Food
동의어들의 기반 타입이 같다면 타입 동의어의 합집합도 허용됩니다.
.type A <: number
.type B <: number
.type C = A | B // Either in A or B
The language also has the ability to define both sum and product types which let us both options and records as terms in our clauses.
.type Sum = A { x: number } | B { x: symbol }
.type Prod = C { x: number, y : symbol }
For example we could build a linked list (or cons list) out of a product type which has both a head element and a tail element.
// Linked list
.type List = [ head : number, tail : List ]
.decl MyList(x : List)
MyList( [1, [2, nil]] ).
논리 프로그래밍은 추상적인 프로그램 의미론을 표현하는 매우 자연스러운 방법입니다. Souffle 같은 도구는 다른 정적 분석 애플리케이션에 내장할 수 있는 훌륭한 논리 엔진을 제공합니다. 이 엔진으로 코드에 관한 사실을 수집하고, 코드가 어떻게 구성되고 사용되는지에 관한 함의를 추론할 수 있습니다. 이는 강력한 기법이며, 앞으로의 정적 분석 도구는 코드를 추론하고 합성하는 완전히 새로운 방법을 만들어 낼 것입니다.
외부 참고 자료
이색적인 프로그래밍 아이디어, 3부 (이펙트 시스템)
이색적인 프로그래밍 아이디어 시리즈를 이어 가며, 이번에는 이펙트라는 주제를 살펴보겠습니다. 약한 형태의 이펙트 태깅은 여러 주류 프로그래밍 언어에서 찾아볼 수 있지만, 표면 구문에서 이펙트의 영역을 정의하고 표시하는 구문을 갖춘 완전한 이펙트 시스템으로 프로그래밍하는 것은 여전히 언어 설계에서 열려 있는 분야입니다.
먼저 이펙트가 무엇을 뜻하는지 정의해야 합니다. 일상적인 용법에는 정확한 정의가 없는 경우가 많지만 함수형 프로그래밍 분야에는 정확한 정의가 있으므로, 여기서는 함수형 프로그래밍에서 흔히 쓰는 정의를 따르겠습니다. 우선 순수 함수란 반환값이 전적으로 입력에 의해 결정되고, 단순히 값을 반환하는 것 외에는 관찰 가능한 이펙트가 전혀 없는 코드 단위입니다. 순수 함수는 프로그래밍에서 수학의 함수처럼 동작하는 함수입니다. 예를 들어 Python 코드에서는 f라는 “함수“를 다음과 같이 나타냅니다:
def f(x):
return x**2
전통적으로 수학이라고 불리는 의사 코드에서는 함수 f를 다음과 같이 나타냅니다:
f(x)=x2
이 정의에는 언급해 둘 미묘한 점이 몇 가지 있습니다. 첫 번째는 이펙트를 분석할 때의 관점 문제입니다. 이 Python 함수는 일련의 바이트코드로 컴파일되는데, 이 바이트코드는 스택 변수를 조작하고, 힙에 메가바이트 단위의 데이터를 malloc하고, 가비지 컬렉터를 호출하고, CPU 레지스터에 수십만 개의 값을 넣었다 뺐다 합니다. 이 모든 것은 PyObject 구조체 안에서 임의 크기 정수의 거듭제곱을 계산하는 일에 해당합니다. 이 모든 것은 하부 구현의 관점에서 보면 매우 이펙트가 많은 일이지만, 일반적인 언어 안에서는 이러한 내부 동작을 관찰할 수 없습니다.
순수 함수형 프로그래밍의 핵심 아이디어는 프로그래밍이 필연적으로 순수한 로직과 이펙트가 있는(때로는 비순수하다고 불리는) 로직 둘 다로 이루어진다는 것입니다. 또한 이펙트가 있는 로직 단위를 구별할 수 있고, 프로그램 합성에 대해 더 잘 추론하기 위해 이러한 이펙트의 종류를 분류할 수 있는 것이 표면 언어의 유용한 속성이라고 가정합니다.
이에 대한 대안은 대부분의 언어에서 볼 수 있는 모델로, 모든 로직이 거대한 이펙트 수프 속에 뒤섞여 있으며, 어떤 코드가 이펙트(메모리 할당, 사이드 채널 등)를 수행할 수 있고 어떤 로직이 그럴 수 없는지를 구별하는 일은 프로그래머의 직관과 내부 멘탈 모델에 의존합니다. 이펙트 시스템 연구는 근본적으로 올바른 프로그램 이펙트 합성에 대한 우리의 직관을, 컴파일러가 우리 대신 추론할 수 있고 개발자 도구와 편리하게 상호작용할 수 있는 형식 모델로 정립하는 것에 관한 것입니다.
Idris, Haskell, F* 같은 함수형 언어와 몇몇 다른 연구용 언어는 지난 10년의 대부분 동안 이 설계 공간을 탐구해 왔습니다. 모나드 같은 개념은 순수한 로직과 비순수한 로직을 구분하기 위해 초기에 탐구되었지만, 그 모델이 유용성 측면에서 한계에 부딪히면서 최근 몇 년 사이 관심이 줄었습니다. 가장 활발하게 탐구되는 분야는 대수적 이펙트 핸들러라고 알려진 것으로, 런타임 오버헤드를 전혀 도입하지 않으면서도 이펙트가 있는 로직을 검사하는 다루기 쉬운 추론 알고리즘을 허용합니다.
이 모델을 사용하는 주류 언어는 없지만, Microsoft Research 연구소에서 나온 Koka라는 학술용 언어가 이러한 아이디어를 가장 발전된 형태로 구현하고 있습니다. 제가 아는 한 이 언어를 실제로 무언가에 사용하는 사람은 없지만, 내려받을 수 있고 이러한 아이디어를 탐구하는 데 꽤 쓸 만합니다. 모든 예제 코드는 Koka로 작성하겠습니다.
Koka에서는 이펙트가 전혀 없음을 total 이펙트로 나타냅니다. 함수 f를 계산한 결과는 오직 입력의 제곱을 반환하는 것뿐입니다.
fun f( x : int ) : total int
{
return pow(x,2)
}
그러나 화면에서 읽어 들이는 함수처럼 이펙트가 있는 함수는 console 이펙트를 태그로 붙여 작성할 수 있습니다. 그러면 이 함수의 본문에서 println 같은 함수를 호출할 수 있으며, 이러한 함수 호출의 결과는 그 함수를 호출하는 함수의 시그니처에 반영됩니다. 반환 타입 ()는 유닛 타입을 나타내며, C 계열 언어에서는 void라고 부릅니다.
fun main() : console ()
{
println("I can write to the screen!");
}
표준 라이브러리가 제공하는 println 함수의 타입 시그니처에도 효과가 들어 있다는 점은 짚고 넘어갈 만합니다. 그 시그니처는 다음과 같습니다.
fun println( s : string ) : console () 따라서 컴파일러는 이 함수에 딸린 효과를 알고 있습니다. 그래서 다음 함수는 애너테이션 없이 작성할 수 있으며, 사용자가 시그니처를 지정하지 않아도 효과 추론이 알맞은 시그니처를 도출합니다. 반환 타입도 일반적인 타입 추론 기법으로 추론할 수 있습니다.
fun main()
{
println("I can write to the screen!");
}
예외
입력/출력 외에, 대부분의 프로그래밍에서 볼 수 있는 가장 흔한 유형의 효과는 실패할 수 있는 능력입니다. 보통 언어 런타임은 이 기능을 예외로 구현합니다. 예외는 예외를 처리하는 로직으로 비지역 점프를 하거나, 호출 스택을 되감고 실행을 중단합니다. 이것은 분명히 모델링할 수 있는 효과이며, 다른 언어의 검사 예외(checked exception)와 비슷한 인터페이스를 만들 수 있습니다.
throw 함수는 error 합 타입을 받아서 exn으로 표시되는 효과를 낳습니다. 한편 try 함수는 exn 타입을 낳는 함수를 받아서 error를 반환합니다. error 타입은 Error이거나, 실행에 성공한 경우 Ok입니다.
type error<a> {
Error( exception : exception )
Ok( result : a )
}
오류 처리 함수는 exn 효과가 붙은 함수를 받아서 처리하는 고차 함수로 작성할 수 있습니다.
fun throw( err : error<a> ) : exn a
fun try( action : () -> <exn|e> a ) : e error<a>
fun maybe( t : error<a> ) : maybe<a>
예를 들어 0으로 나누기를 처리하는 고전적인 사례를 다룰 수 있습니다. 이때 산술 오류를 maybe 합 타입으로 감싸고, 0인 경우는 nothing으로 처리합니다.
fun divide(a : int, b : int) : exn int {
match(b) {
0 -> throw("Division by zero");
_ -> return (a / b);
}
}
fun safeDiv(a : int, b : int) : maybe<int>
{
maybe( try { divide(a,b) } );
}
컴파일러 내부에서 패턴 매칭을 정교화(elaboration)하는 과정에서 불완전한 패턴을 찾아낼 수 있으며, 런타임에 실패할 수 있는 패턴 매칭의 타입에 예외를 추가해야 한다고 추론할 수 있습니다.
fun unjust( m : maybe<a> ) : exn a {
match(m) {
Just(x) -> x
}
}
반면 완전한 패턴 매칭은 전함수(total)로 도출됩니다.
fun unmaybe( m : maybe<a>, default : a ) : total a {
match(m) {
Just(x) -> x
Nothing -> default
}
}
비종료는 효과입니다
위에서 내린 효과의 정의에 따르면, 함수를 호출했을 때 관찰할 수 있는 결과는 결괏값을 반환하는 것뿐입니다. 따라서 값을 계산하지 않고 무한히 실행되는 함수는 함수가 아니며, 발산(divergence)이라는 부수 효과를 가집니다. 주어진 함수가 전함수인지 판별하는 일은 일반적으로 쉽지 않습니다. 하지만 각각 독립적으로 전함수인 로직 단위들을 합성한 함수는 그 자체로도 전함수일 수밖에 없습니다.
호출 지점을 분석하는 것만으로 전함수가 아님을 곧바로 알아낼 수 있는 단순한 경우도 많습니다. 예를 들어 다음 함수는 자기 자신을 재귀 호출하므로 자동으로 div 효과가 붙습니다.
fun forever(f) {
f();
forever(f);
}
forever 컴비네이터의 추론된 타입은 다음과 같습니다.
forever: forall<a,b,e> (() -> <div|e> a) -> <div|e> b
효과 검사기는 상호 재귀 정의에 걸쳐서도 전함수 여부를 도출할 수 있습니다. 따라서 서로를 호출하는 함수들은 모두 전함수이거나, 합성했을 때 발산할 가능성이 있는 것으로 취급됩니다.
fun f1() : div int
{
return 1 + f2();
}
fun f2() : div int
{
return 2 + f1();
}
효과의 행
개별 효과에 각각 따로 태그를 붙이는 것도 그 자체로 유용합니다. 하지만 대규모 프로그래밍에서는 로직을 서로 합성해야 하므로 효과의 조합을 합성하는 방법이 필요합니다. Koka에서는 이를 효과의 행(row)으로 나타냅니다. 이는 꺾쇠괄호 문법으로 표기합니다.
<e1, e2, ...>
수학의 언어로 말하면 효과 행은 가환 모노이드입니다. 연산으로는 파이프로 표기하는 확장이 있고, 효과가 없음을 나타내는 항등원(total 또는 <>)이 있습니다. 확장 연산이 교환 법칙과 결합 법칙을 만족하므로 시그니처 안에서 효과를 표준적인 순서로 정렬할 수 있습니다.
<e1> | e2 = <e1,e2>
<e1,e2> | e3 = <e1,e2,e3>
<e1> | <> = <e1>
<e1> | e1 = <e1>
<e2, e1> = <e1,e2>
예를 들어 비결정성 효과 ndet를 가진 난수 생성기를 호출하면서, exn 효과로 예외도 발생시키는 함수를 작성할 수 있습니다. 이제 두 효과를 합성하면 행 <ndet, exn>이 됩니다.
fun multiEffect() : <ndet, exn> ()
{
val n = srandom-int()
throw("I raise an exception");
}
효과 시스템은 발산하거나 예외를 던질 수 있는 함수를 다음 별칭을 사용해 pure로 표기합니다.
alias pure = <exn,div>
효과에 대한 Haskell의 접근 방식에는 단 하나의 불투명한 IO 모나드가 있으며, 콘솔 입력, 출력 또는 시스템 연산을 수행할 수 있는 모든 동작이 이 모나드에 속합니다. 그러나 더 풍부한 효과 시스템을 갖춘 언어는 IO 계층을 훨씬 더 세분화하여 모델링할 수 있습니다. 예를 들어 Koka는 표현력이 증가하는 순서로 다음과 같은 세 단계의 IO 효과를 정의합니다.
// Functions that perform arbitrary IO operations
// but are terminating without raising exceptions
alias io-total = <ndet,console,net,file,ui,st<global>>
// Functions that perform arbitrary IO operations
// but raise no exceptions
alias io-noexn = <div,io-total>
// Functions that perform arbitrary IO operations.
alias io = <exn,io-noexn>
참조의 수명과 경계
상태는 프로그래밍의 필수적인 부분이며, 본질적으로 효과를 수반합니다. 중요한 점은 주어진 스코프 안에서 메모리나 로직의 어느 영역에 쓸 수 있는지를 다룰 수 있어야 한다는 것입니다. 이를 위해서는 주어진 메모리 영역에 대한 효과를 그 효과의 매개변수로 지칭할 수 있어야 합니다. 이 언어에서는 괄호 표기법을 사용하여 효과를 힙 매개변수로 매개변수화할 수 있습니다. 표준 라이브러리는 Core 상태 효과 세 가지를 제공합니다:
alloc<h>- 힙 매개변수 h에 대해 참조를 할당하는 alloc 효과입니다.read<h>- 힙 매개변수 h의 참조에서 읽는 read 효과입니다.write<h>- 힙 매개변수 h의 참조에 쓰는 write 효과입니다.
참조를 생성하고 조작하기 위한 Core 함수는 세 가지입니다:
fun ref( value : a ) : (alloc<h>) ref<h,a>
fun set( ref : ref<h,a>, assigned : a ) : (write<h>) ()
fun (!)( ref : ref<h,a> ) : <read<h>|e> a
내부 참조가 관찰 가능한 형태로 새어 나가지 않는 함수는, 참조의 타입이 인자 타입이나 반환 타입 어디에도 나타나지 않는다면 total로 표시할 수 있습니다. 따라서 지역 상태를 순수 함수 안에 포함시킬 수 있습니다. 예를 들어 다음 함수는 내부적으로 가변 참조를 사용하지만 total입니다:
fun localState() : total int
{
val z = ref(0);
set(z, 10);
set(z, 20);
return (!z);
}
컴파일러 자체도 참조를 다루기 위한 어느 정도의 문법적 설탕을 제공합니다. val은 불변의 이름 있는 변수를 도입하지만, var 구문을 사용하면 가변 참조를 간결하게 정의할 수 있습니다.
val z = ref(0)
var z : int = 0 // Identical to above
변수는 := 연산자를 사용하여 갱신할 수 있습니다.
set(z, 10)
z := 10 // Identical to above
따라서 다음의 카운터 함수와 같은 유사 명령형 로직을 작성할 수 있습니다:
fun bottlesOfBeer() {
var i := 0;
while { i >= 99 } {
println(i)
i := i + 1
}
}
참조는 함수의 인자로 전달할 수 있고 힙 매개변수는 타입 변수로 정량화할 수 있으므로, 어떤 타입의 참조에도 동작하는 제네릭 함수를 작성할 수 있습니다.
fun add-refs( a : ref<h,int>, b : ref<h,int> ) : st<h> int {
a := 10
b := 20
(!a + !b)
}
읽기, 쓰기, 할당 능력의 조합은 표준 라이브러리에서 상태를 가진 계산을 나타내기 위해 st라는 이름이 붙어 있습니다.
alias st<h> = <read<h>,write<h>,alloc<h>>
이러한 종류의 효과 시스템을 사용하여 참조를 추적하면, 읽기 장벽과 쓰기 장벽을 가진 로직 영역을 표시하고 기계적으로 검사 가능한 방식으로 변경을 순수 로직과 분리하는 강력한 추상화를 얻을 수 있습니다. 컴파일 시점에 이러한 정보를 가진 미래의 언어라면, 이를 활용하여 순수 로직의 경계에 대한 보장을 유지하면서도 지역적 변경 영역을 더 효율적인 코드로 컴파일할 수 있을 것입니다.
효과 다형성
마지막으로, 효과를 수반하거나 순수한 인자를 받을 수 있고 그 효과를 출력 타입의 일부로 포함하는 고차 함수도 작성할 수 있기를 원합니다. 흔히 쓰이는 map 함수는 리스트를 받아 주어진 함수 인자를 리스트의 각 원소에 적용하는 고차 함수입니다. 효과 시스템이 있는 언어에서 이를 작성하려면 함수 인자의 효과를 타입 변수(이 예에서는 e)로 지칭하고 이를 map의 출력 타입에 사용할 수 있어야 합니다.
fun map( xs : list<a>, f : (a) -> e b ) : e list<b>
리스트에 total인 산술 함수를 적용하는 경우에는 단순히 int의 리스트를 돌려받습니다. 반면 IO의 경우에는 각 정수를 콘솔에 개별적으로 출력하는 println 같은 함수를 적용할 수 있으며, 그 결과 타입은 unit의 리스트입니다. 두 사용 사례 모두 추상적인 효과 타입 변수에 대한 이러한 매개변수 다형성을 사용하는 동일한 함수로 포괄됩니다.
val e1 = map([1,2,3,4], println); // console list<()>
val e2 = map([1,2,3,4], dbl); // list<int>
fun dbl(x : int) : total int
{
return (x+x)
}
효과 시스템 연구는 아직 초기 단계입니다. 앞으로의 연구를 위해 제가 강조하고 싶은 핵심은, 효과 모델링의 사용성과 성능을 개선하려는 언어가 시스템 전체를 라이브러리에 떠넘기는 것만으로는 그 목표를 이룰 수 없다는 점입니다. 언어 차원에서 통합된 효과 타입을 지원해야 하고, 표면 언어에서도 하위 표현식에 레이블을 붙이고 타입 추론에 힌트를 줄 수 있는 어노테이션을 지원해야 합니다. Haskell, Scala 등에서 이를 구현하려는 많은 접근 방식은 바로 이 단순한 사실 때문에 사용성이 떨어질 수밖에 없습니다.
타입을 추론하는 데 그치지 않고, 컴파일러가 그냥 버리는 정적 정보를 코드 위에 한층 더 풍부하게 제공하면 완전히 새로운 수준의 정적 분석 도구를 만들 수 있습니다. 이는 매우 흥미로운 기법이며, 앞으로 10년 동안 더 많은 결실을 맺기를 바랍니다.
외부 참고 자료
데이터 타입 제네릭 프로그래밍으로 클래스 요리하기
Haskell Generics는 다소 오해받는 주제이지만, 아주 적은 노력으로 방대한 유니버스의 타입들에 걸쳐 재사용 가능하고 비교 가능한 인터페이스를 작성할 수 있게 해 주는 매우 강력한 기법입니다. 아마도 표현력 있는 타입 시스템이 우리에게 주는 이점을 보여 주는 예 중에서 제가 가장 좋아하는 예일 것입니다.
예제 코드의 소스는 여기에서 볼 수 있습니다.
Generics는 *데이터 타입 제네릭 프로그래밍(datatype-generic programming)*의 한 형태이며, 이름은 Java Generics와 다소 비슷하지만 완전히 다른 개념입니다. GHC의 Generics 구현은 Haskell의 모든 데이터 타입을 *곱의 합(sum of products)*의 조합으로 쓸 수 있다는 단순한 관찰에서 자연스럽게 도출됩니다.
**합 타입(sum type)**은 서로 다르지만 고정된 여러 타입 중 하나를 취할 수 있는 값을 담는 데 쓰이는 자료 구조입니다. 예를 들면 다음과 같습니다.
data Pastry
= Turnover
| Macaroon
| Brownie
| Cookie
**곱 타입(product type)**은 여러 타입으로 이루어진 고정된 순서 집합을 담는 데 쓰이는 자료 구조입니다. 필드 하나를 선택하는 것을 사영(projection)이라고 합니다.
data Person = Person
{ firstName :: String
, lastName :: String
, age :: Int
, height :: Float
, phoneNumber :: String
, flavor :: String
}
Haskell에서는 모든 데이터 타입을 곱의 합으로 표현할 수 있습니다.
data Expr
= Add { l :: Expr, r :: Expr }
| Mul { l :: Expr, r :: Expr }
| Sub { l :: Expr, r :: Expr }
| Div { l :: Expr, r :: Expr }
| Number { val :: Int }
컴파일 과정에서 데이터 타입의 구조에 관한 정보는 대부분 버려지며, Haskell은 설계상 모든 타입 정보를 소거합니다. 타입 검사에 앞서 **정교화(elaboration)**라고 하는 단계에서 모든 레코드 선택자가 곱의 이름 붙은 필드를 추출하는 최상위 함수로 전개됩니다.
data Point a b = Point { x :: a, y :: b }
x :: Point a b -> a
x (Point a _) = a
y :: Point a b -> b
y (Point _ b) = b
곱에 관한 나머지 정보도 컴파일 후에는 대부분 버려지고, 곱은 그저 패턴 매칭 코드로 전개됩니다. 합 타입의 경우 남아 있는 유일한 정보는 합 타입의 각 생성자에 붙은 태그입니다. 예를 들어 Add에는 태그 1이, Mul에는 2가 할당되는 식입니다. case 문에서 런타임에 알 수 있는 유일한 정보는 우리가 어느 분기를 검사하고 있는지뿐입니다.
그렇다면 이 정보를 모두 버리지 않고 대신 프로그램에 노출하여, 데이터 타입의 “구조“를 내성(introspect)할 수 있는 제네릭 로직을 작성할 수 있게 한다면 어떨지 생각해 봅시다.
컴파일러 훅
GHC 6.10부터 타입 패밀리가 도입되었는데, 타입 패밀리를 사용하면 무엇보다도 데이터 타입을 타입 클래스에 연관시킬 수 있습니다. 따라서 Generic 클래스의 구조는 타입 클래스와 함께 정보를 전달할 수 있는 연관 타입 Rep를 가질 수 있습니다.
class Generic a where
type Rep a :: * -> *
from :: a -> (Rep a) x
to :: (Rep a) x -> a
데이터 타입의 구조를 표현하려면 합, 곱, 빈 분기, 그리고 필드와 생성자의 이름 및 그 타입에 관한 다양한 메타데이터를 인코딩하는 여러 데이터 타입을 마련해야 합니다. 이들은 모두 자유 매개변수 p를 가지며, 이 매개변수는 연관 데이터 타입 Rep a에서 사용될 때 타입 클래스 인스턴스의 헤드에 바인딩됩니다.
data V1 p -- Empty
data U1 p = U1 -- ()
data (:+:) f g p = L1 (f p) | R1 (g p) -- Sum
data (:*:) f g p = (f p) :*: (g p) -- Product
newtype K1 i c p = K1 { unK1 :: c } -- a container for a c
newtype M1 i t f p = M1 { unM1 :: f p } -- metadata wrapper
이제 모든 데이터 타입에 대해 이 인스턴스를 손으로 작성할 수도 있으며, 단순한 열거형의 경우 다음과 같습니다.
data Ingredient
= Flour
| Sugar
instance Generic Ingredient where
type Rep Ingredient = M1 D (T_Ingredient ((M1 C (C_Flour U1)) :+: (M1 C (C_Sugar U1))))
from Flour = M1 (L1 (M1 U1))
from Sugar = M1 (R1 (M1 U1))
to (M1 (L1 (M1 U1))) = Flour
to (M1 (R1 (M1 U1))) = Sugar
data T_Ingredient
data C_Flour
data C_Sugar
여기서의 인스턴스는 순전히 기계적이며, GHC가 내부적으로 표현하는 구문 트리, 즉 GHC.DataCon 타입과 GHC.TypeCon 타입으로부터 유도할 수 있습니다. -XDeriveGeneric 확장을 사용하면 GHC가 이 타입 클래스를 자동으로 찍어 내게 할 수 있습니다.
{-# LANGUAGE DeriveGeneric #-}
data Ingredient
= Flour
| Sugar
deriving (Generic)
GHC가 하는 작업을 대충 얼버무리고 넘어가지 않도록, 모듈의 데이터 정의로부터 Generic 클래스를 인스턴스화할 때 GHC가 사용하는 내성 로직을 실제로 재현해 봅시다. 모듈을 동적으로 로드하고 컴파일을 가로채 그 데이터 타입들의 내부 구조를 덤프하여, 이것이 어떻게 기계적으로 타입 클래스 인스턴스로 변환되는지 살펴봅시다.
import GHC
import GHC.Paths as Paths
import Name
import TyCon
import TypeRep
import DataCon
import HscTypes
import Text.Show.Pretty
main :: IO ()
main = do
-- Inside the GHC Monad
rep <- runGhc (Just Paths.libdir) $ do
-- Spin up a GHC compiler environment
dflags <- getSessionDynFlags
setSessionDynFlags dflags
-- Make a dummy module to inject
let mn = mkModuleName "Test"
-- Make a dummy target
addTarget Target {
targetId = TargetModule mn
, targetAllowObjCode = True
, targetContents = Nothing
}
-- Run the GHC pipeline
load LoadAllTargets
modSum <- getModSummary mn
p <- parseModule modSum
t <- typecheckModule p
-- Pluck out the module tycons after we're done type-checking
DesugaredModule tcmod modguts <- desugarModule t
let tycons = mg_tcs modguts
-- Deconstruct all datatypes into their sums-of-products.
return (deconstruct tycons)
putStrLn (ppShow rep)
이제 GHC가 내부적으로 표현하는 “모듈 내장(module guts)“에 접근할 수 있으므로 분해 로직을 작성할 수 있습니다. 이 로직은 대부분 ADT를 주무르는 코드로 이루어진 고작 수백 줄 정도의 분량입니다.
deconstruct :: [TyCon] -> [Data]
deconstruct = fmap go
where
go x
| isProduct x = M1 $ D Datatype
{ dataTypeName = getOccString (tyConName x)
, modName = modString x
, isNewtype = isNewTyCon x
, datatype = Product (mkProduct x)
, recursive = isRecursiveTyCon x
}
| isVoid x = M1 $ D Datatype
{ dataTypeName = getOccString (tyConName x)
, modName = modString x
, isNewtype = isNewTyCon x
, datatype = V1
, recursive = isRecursiveTyCon x
}
| otherwise = M1 $ D Datatype
{ dataTypeName = getOccString (tyConName x)
, modName = modString x
, isNewtype = isNewTyCon x
, datatype = Sum (mkProduct x)
, recursive = isRecursiveTyCon x
}
mkRecord :: TyCon -> [Data]
mkRecord x = concatMap mkRProduct (tyConDataCons x)
mkProduct :: TyCon -> [Data]
mkProduct x = fmap go (tyConDataCons x)
where
go :: DataCon -> Data
go x | isRecord x = Product (mkRProduct x)
go x | isDProduct x = Product (mkDProduct x)
go x = M1 (C (Constructor (conNames x)))
mkDProduct :: DataCon -> [Data]
mkDProduct xs = [K1 (showType x) | x <- dataConOrigArgTys xs]
mkRProduct :: DataCon -> [Data]
mkRProduct x = [M1 (S (Selector (getOccString fld)) ty) | (fld, ty) <- zip (fieldNames x) (mkDProduct x)]
디컴파일 스크립트를 실행하기 위해 더미 모듈 Test.hs를 다음과 같이 준비합니다.
data PlatonicSolid
= Tetrahedron
| Cube
| Octahedron
| Dodecahedron
| Icosahedron
data Person = Person
{ firstName :: String
, lastName :: String
, age :: Int
, height :: Float
, phoneNumber :: String
, flavor :: String
} deriving (Show)
data T
= T1 { a :: Int, b :: Float }
| T2 { c :: Int, d :: Double }
PlatonicSolid에 대해서는 다음과 같은 표현을 얻습니다.
M1
(D Datatype
{ dataTypeName = "PlatonicSolid"
, modName = "Test"
, isNewtype = False
, datatype =
Sum
[ M1 (C Constructor { conName = "Tetrahedron" })
, M1 (C Constructor { conName = "Cube" })
, M1 (C Constructor { conName = "Octahedron" })
, M1 (C Constructor { conName = "Dodecahedron" })
, M1 (C Constructor { conName = "Icosahedron" })
]
, recursive = False
})
Person에 대해서는 다음과 같은 표현을 얻습니다.
M1
(D Datatype
{ dataTypeName = "Person"
, modName = "Test"
, isNewtype = False
, datatype =
Product
[ M1 (S Selector { selName = "firstName" } (K1 "String"))
, M1 (S Selector { selName = "lastName" } (K1 "String"))
, M1 (S Selector { selName = "age" } (K1 "Int"))
, M1 (S Selector { selName = "height" } (K1 "Float"))
, M1 (S Selector { selName = "phoneNumber" } (K1 "String"))
, M1 (S Selector { selName = "flavor" } (K1 "String"))
]
, recursive = False
})
곱의 합인 T에 대해서는 다음과 같은 표현을 얻습니다:
M1
(D Datatype
{ dataTypeName = "T"
, modName = "Test"
, isNewtype = False
, datatype =
Sum
[ Product
[ M1 (S Selector { selName = "a" } (K1 "Int"))
, M1 (S Selector { selName = "b" } (K1 "Float"))
]
, Product
[ M1 (S Selector { selName = "c" } (K1 "Int"))
, M1 (S Selector { selName = "d" } (K1 "Double"))
]
]
, recursive = False
})
이 데이터는 이후 파생된 Generic 인스턴스에서 Rep 인스턴스를 생성하는 데 사용됩니다. 이것이 -XDeriveGeneric이 내부에서 동작하는 방식을 대략적으로 설명한 것입니다. 아주 복잡한 것은 없고 단지 정보를 기록하고 관리하는 일일 뿐입니다.
GHC.Generics
내부 표현으로부터 여러 생성자에 대한 메타데이터를 저장하는 타입 클래스 인스턴스 몇 개를 찍어 냅니다.
class Datatype d where
datatypeName :: t d f a -> String
moduleName :: t d f a -> String
isNewtype :: t d f a -> Bool
isNewtype _ = False
class Selector s where
selName :: t s f a -> String
class Constructor c where
conName :: t c f a -> String
conFixity :: t c f a -> Fixity
conFixity _ = Prefix
conIsRecord :: t c f a -> Bool
conIsRecord _ = False
예를 들어 앞서 본 Ingredient 예제에서는 생성자 인스턴스 몇 개가 자동으로 생성되며, 이를 통해 AST에서 이름을 조회할 수 있습니다.
type Rep Ingredient = M1 D (T_Ingredient ((M1 C (C_Flour U1)) :+: (M1 C (C_Sugar U1))))
data T_Ingredient
data C_Flour
data C_Sugar
instance Datatype T_Ingredient where
datatypeName _ = "Ingredient"
moduleName _ = "Main"
instance Constructor C_Flour where
conName _ = "Flour"
instance Constructor C_Sugar where
conName _ = "Sugar"
Java 같은 언어의 리플렉션과 달리 제네릭은 타입 정보를 런타임으로 밀어 넣지 않습니다. 딕셔너리 조회를 제외하면 제네릭은 오버헤드가 없는, 사실상 공짜인 추상화입니다. 우리는 단지 타입 검사 단계에서 컴파일러가 가진 더 많은 정보를 타입에 드러나게 할 뿐이며, 이 정보는 모두 컴파일 과정에서 소거됩니다.
예제
제네릭의 유용성을 보여 줄 억지스럽지 않은 예제를 생각해 보려 했는데, 웹의 다른 곳에 이미 잘 문서화된 예제(JSON 직렬화기, Protocol Buffers, SQL 생성, 순회, 명령줄 파서 등)가 많이 있습니다. 그러니 이 글의 제목에 담긴 실없는 말장난, 즉 타입 클래스 요리하기에 기반한 예제를 살펴봅시다.
그러니 당연히 Pie 타입이 있습니다.
data Pie = Pie
{ filling :: Filling
, topping :: Maybe Topping
} deriving (Show, Generic)
data Filling = Apple | Cherry | Pumpkin
deriving (Show, Generic)
data Topping = IceCream | WhipCream
deriving (Show, Generic)

제네릭을 사용하여 Haskell 타입의 구조로부터 메뉴에 올릴 수 있는 파이 종류의 목록을 생성하려고 합니다. 레코드는 메뉴 항목의 이름 붙은 변형(“filling” 대 “topping”)을 나타내고, 합 타입은 각 변형 안의 여러 선택지(“cherry filling” 대 “apple filling”)를 나타냅니다.
data Item
= Item Text [Item]
| Variant Text [Item]
| Choice Text
deriving (Show, Generic)
**기본 시그니처(default signature)**를 가진 타입 클래스를 구현합니다. 이를 통해 타입이 메뉴 항목으로 변환되는 방식을 직접 지정하거나, 제네릭 표현을 사용해 자동으로 생성하는 방식으로 돌아갈 수 있습니다.
class Menu a where
menu :: a -> [Item]
default menu :: (Generic a, GMenu (Rep a)) => a -> [Item]
menu _ = gmenu (Proxy :: Proxy a)
gmenu :: forall a. (Generic a, GMenu (Rep a)) => Proxy a -> [Item]
gmenu _ = gopts (Proxy :: Proxy (Rep a))
제네릭 메뉴는 여러 GHC.Generics 타입 위에서 동작하며 합과 곱을 메뉴에 대응하는 Item 범주로 펼칩니다. GMenu (K1 R f)에 대한 인스턴스에는 Menu 제약이 있어 특정 데이터 타입에 대해 직접 재정의할 수 있습니다. 프록시를 전달하고 있으므로, 때로는 해결해야 하는 인스턴스의 타입으로 캐스트한 undefined를 넘겨 딕셔너리를 직접 전달해야 합니다.
-- Generic Menu
class GMenu a where
gopts :: Proxy a -> [Item]
-- Datatype
instance GMenu f => GMenu (M1 D x f) where
gopts _ = gopts (Proxy :: Proxy f)
-- Constructor Metadata
instance (GMenu f, Constructor c) => GMenu (M1 C c f) where
gopts x
| conIsRecord (undefined :: t c f a) =
[Item (pack (conName m)) (gopts (Proxy :: Proxy f))]
| otherwise = [Choice (pack (conName m))]
where m = (undefined :: t c f a)
-- Selector Metadata
instance (GMenu f, Selector c) => GMenu (M1 S c f) where
gopts _ = [Variant (pack (selName m)) (gopts (Proxy :: Proxy f))]
where m = (undefined :: t c f a)
-- Constructor Paramater
instance (GMenu (Rep f), Menu f) => GMenu (K1 R f) where
gopts _ = menu (undefined :: f)
-- Sum branch
instance (GMenu a, GMenu b) => GMenu (a :+: b) where
gopts _ = gopts (Proxy :: Proxy a) ++ gopts (Proxy :: Proxy b)
-- Product branch
instance (GMenu a, GMenu b) => GMenu (a :*: b) where
gopts _ = gopts (Proxy :: Proxy a) ++ gopts (Proxy :: Proxy b)
-- Void branch
instance GMenu U1 where
gopts _ = []
구체적으로는 Maybe 타입을 재정의하여, 변형의 “AsIs“를 선택하거나 내부 매개변수가 부여하는 선택지 목록 중 하나를 고르도록 단순히 펼쳐지게 합니다.
instance Menu a => Menu (Maybe a) where
menu _ = [Choice (pack "AsIs")] ++ (menu (undefined :: a))
예를 들어 Maybe Topping은 세 가지 선택지로 펼쳐집니다.
menu (a :: Maybe Topping) ~ [Choice "AsIs", Choice "IceCream", Choice "whipCream"]
GHC 7.10의 새로운 -XDeriveAnyClass 확장을 사용하면 실제로 다시 돌아가 deriving 절 안에서 Menu를 자동으로 파생할 수 있습니다.
data Pie = Pie
{ filling :: Filling
, topping :: Maybe Topping
} deriving (Show, Generic, Menu)
이제 Pie에 대한 딕셔너리를 합성하면 메뉴를 얻을 수 있습니다
menu (undefined :: Pie)
짜잔:
[ Item
"Pie"
[ Variant
"filling" [ Choice "Apple" , Choice "Cherry" , Choice "Pumpkin" ]
, Variant
"topping"
[ Choice "AsIs" , Choice "IceCream" , Choice "WhipCream" ]
]
]
우리의 로직은 데이터 타입 제네릭이므로, 작성할 수 있는 어떤 Haskell 타입이든 deriving Menu만으로 Menu로 자동 변환될 수 있습니다. 그러니 이제 새로운 Crisp 디저트(제가 가장 좋아하는 것입니다!)를 추가할 수 있으며, 모든 것을 공짜로 얻습니다!
data Crisp = Crisp
{ contents :: Filling
, temperature :: Temperature
} deriving (Show, Generic, Menu)
data Temperature = Warm | Cold
deriving (Show, Generic, Menu)
-- Add an instance for a pair of menu items. That expands into multiple items.
instance (Menu a, Menu b) => Menu (a,b) where
menu _ = menu (undefined :: a) ++ menu (undefined :: b)
그리고 두 디저트를 합친 메뉴를 생성할 수 있습니다:
menu (undefined :: (Pie, Crisp))
[ Item
"Pie"
[ Variant
"filling" [ Choice "Apple" , Choice "Cherry" , Choice "Pumpkin" ]
, Variant
"topping"
[ Choice "AsIs" , Choice "IceCream" , Choice "WhipCream" ]
]
, Item
"Crisp"
[ Variant
"contents" [ Choice "Apple" , Choice "Cherry" , Choice "Pumpkin" ]
, Variant "temperature" [ Choice "Warm" , Choice "Cold" ]
]
]
이것이 제네릭입니다. 표현력 있는 타입 시스템과 몇 가지 영리한 컴파일러 훅이 보일러플레이트를 대신 요리해 주고 더 맛있고 더 올바른 코드를 내어 줌으로써 프로그래머의 삶을 얼마나 편하게 만들 수 있는지 보여 주는 가장 좋은 대표 사례 중 하나입니다.

이색적인 프로그래밍 아이디어: 1부 (모듈 시스템)
성공한 프로그래밍 언어는 모두 서로 닮았지만, 성공하지 못한 프로그래밍 언어는 저마다의 방식으로 성공하지 못합니다.
소프트웨어의 역사는 동시에 진행되지만 별개인 또 하나의 대화와 나란히 흘러왔는데, 그것은 우리가 계산을 어떻게 사고하고 그 아이디어를 다른 사람들과 어떻게 소통하는지에 관한 이야기입니다. 그리고 계산의 이야기는 우리가 코드라고 부르는, 매우 새롭고 독특한 인간 표현 형식이 진화해 온 이야기였습니다. 21세기에 프로그래머로 산다는 것은 기원전 3200년 고대 이집트에서 왕실 서기로 사는 것과 비슷할 것이라고 생각합니다. 대부분의 사람들은 알지 못하는 새로운 소통 방식이 있지만, 그 존재 덕분에 상업과 문화와 문명이 동시에 번성할 수 있습니다.
그리고 자연어에서와 마찬가지로, 우리는 의미론과 문법이 한곳으로 수렴하여 마치 유럽 언어에서 라틴어가 차지했던 것과 같은 존재가 되어 가는 모습을 보아 왔습니다. 이러한 언어들은 C에서 영감을 받은 명령형 패러다임에 몇 가지 객체 지향 기능을 더한 패러다임에 속합니다. 여기에는 C++, Go, Python, Ruby, Rust, Java, Javascript 같은 언어가 해당하며, 이들이 오늘날 새로 작성되는 코드의 대부분을 차지합니다. 프로그래밍 활동의 대부분이 이러한 생산성의 국소 최댓값으로 수렴했지만, 프로그래밍의 변두리에는 주류에서 볼 수 있는 것과는 전혀 다른 의미론과 문법을 지닌, 보다 난해한 아이디어들이 존재합니다.
전문 프로그래머로 살아오면서, 저는 프로그래머에게 서로 다른 두 부류가 있다는 것을 깨달았습니다. 프로그래밍 언어를 주로 인간 이성의 도구로 보는 사람들과, 특정 작업을 위한 생산 수단으로 보는 사람들입니다. 피라항어, 나바호어, 클링온어, 베릭어를 구사하는 사람이 극히 적은 것처럼, 그만큼 채택이 제한적인 프로그래밍 언어들도 있습니다. 그럼에도 이러한 언어들은 매우 흥미로운 의미 구조를 담고 있으며, 이를 주류 언어로 옮기려 할 때 그 구조는 번역 과정에서 사라지는 경우가 많습니다.
어드벤트 블로깅으로 (지루하기도 하고 봉쇄 중이기도 해서) 소프트웨어 문화의 변두리에 있는 일곱 가지 언어 의미론 기능에 대해 쓰고자 합니다. 로마인(즉, C)이 정복하지 않았다면 어떤 모습이었을지를 탐험하는 여행으로 여러분을 안내할, 엉뚱하고 기발한 아이디어를 지닌 것들입니다.
모듈 시스템
모듈 시스템과 모듈식 프로그래밍부터 시작합시다. 모듈의 핵심 아이디어는 코드를 모듈이라고 부르는 재사용 가능한 구성 요소로 나누는 것입니다. 언어 기능으로서의 모듈은 Modula-2와 Pascal에서 처음 개발되었으며, 컴파일 단위를 구분하는 방법으로 고안되었습니다. 이 개념은 1984년 Standard ML 언어에서 성숙기를 맞이했는데, Standard ML은 이 개념을 더욱 발전시켜 모듈의 추상화와 매개변수화를 가능하게 했습니다. 오늘날 완전한 모듈 시스템은 F#, OCaml, Standard ML 같은 ML 계열 언어에서 찾아볼 수 있으며, Agda 등 몇몇 다른 언어에도 있습니다. 여기서는 타입 추론을 갖춘 정적 타입 ML 다이얼렉트인 OCaml을 살펴보겠습니다.
module MyModule = struct
(* Set of Definitions *)
end
모듈에 담기는 정보는 값일 수도 있고 타입일 수도 있습니다. 예를 들어 타입 t와 인자 하나를 받는 함수 square가 있습니다.
module MyModule = struct
type t = int
let square x = x * x
end
module MyModule = struct
type t = int
let square x = x * x
end
모듈의 구성 요소는 시그니처라고 하는 명세에 묶일 수 있으며, 시그니처는 모듈 내 심볼의 가시성을 제한하는 동시에 모듈 전체에 일관된 인터페이스를 강제합니다.
module MyModule : sig
val square : int -> int
end =
struct
let square x = x * x
end
또는 module type 구문을 사용하면 모듈 시그니처를 타입 수준에서 특정 이름에 바인딩하고, 여러 모듈에 걸쳐 독립적으로 정의할 수 있습니다. 이렇게 하면 명세가 구현과 분리됩니다. 여기서는 추상 타입 t를 정의합니다. 이 타입은 시그니처 안에서 추상적으로 참조되며, 나중에 구체적인 타입으로 인스턴스화될 것을 가리킵니다. 명세에서 항 s는 “타입 t의 값“으로 정의됩니다.
(* Specification of MySig *)
module type MySig = sig
(* Set of Type Signatures *)
type t
val s : t
end
(* Implementation of MySig *)
module MyModule : MySig = struct
(* Set of Definitions *)
type t = int
let s = 0
end
모듈은 open 구문을 사용하여 열 수 있습니다. 이렇게 하면 모듈 안에서 노출된 모든 심볼이 주어진 스코프 안으로 들어오며, 최상위 수준에서 사용하면 전역으로 들어옵니다.
open MyModule;; (* Toplevel *)
let open MyModule in expr;; (* In let binding *)
또한 점 구문으로 모듈에 투영하여 모듈 스코프 안의 특정 심볼을 가져올 수도 있습니다. 예를 들면 다음과 같습니다:`
module Foo = struct
let a = 5
let b = 6
end;;
print_int(Foo.a);;
print_int(Foo.(a*b));;
모듈의 시그니처가 모듈에 정의된 모든 심볼을 반드시 제약해야 하는 것은 아닙니다. 시그니처는 특정 매개변수나 타입의 구현을 봉인하여, 그 구현 세부 사항을 모듈 내부에 두고 외부에 공개하지 않을 수 있습니다. 예를 들어 다음 모듈에서 Hello 시그니처는 hello 함수가 사용하는 메시지를 숨기므로, 하위 사용자는 메시지 자체의 내부를 수정할 수 없고 함수를 호출하는 것만 할 수 있습니다.
module type Hello = sig
val hello : unit -> unit
end
module Impl : Hello = struct
(* Private variable message *)
let message = "Messaage is sealed Inside Impl"
let hello () = print_endline message
end;;
Impl.hello();;
모듈은 다른 모듈 안에 임의의 깊이로 중첩될 수도 있습니다. 이 예제에서는 Outer 모듈에 투영하여 Inner 모듈과 그 내용을 가져올 수 있습니다:
module Outer = struct
let a = 1
module Inner = struct
let b = 2
end
end
let c = Outer.Inner.b;;
모듈은 중첩될 뿐 아니라 다른 모듈의 내용을 포함할 수도 있습니다. 모듈 정의 안에서 다른 모듈의 값을 일시적으로 스코프에 들여오거나, 주어진 모듈 스코프의 내용을 새 정의로 복사하는 include 구문을 사용하면 됩니다.
module A = struct
let a = 10
end
module B = struct
let b = 20
end
module Arith1 = struct
include A
include B
let c = a+b
end
module Arith2 = struct
open A
open B
let c = a+b
end;;
Arith1.a;;
Arith2.a;; (* Not in scope *)
모듈 자체는 다른 모듈을 포함한 타입으로 매개변수화될 수 있습니다. 이를 함자라고 하며, 주어진 모듈 매개변수가 따라야 하는 인터페이스를 지정하여 모듈을 인스턴스화할 수 있게 해 줍니다. 이 예제에서 매개변수 M은 시그니처 S를 따르는 추상 모듈입니다. 주어진 모듈 A가 이 시그니처를 구현하며, A는 FA를 인스턴스화할 때 매개변수 M으로 전달될 수 있습니다. F의 정의 안에서는 M에 투영하여 s와 t 매개변수를 추상적으로 가져옵니다. 함자는 사실상 모듈에서 모듈로 가는 함수입니다.
module type S = sig
type t
val s : t
end
module A : S = struct
type t = int
let s = 0
end
(* Functor *)
module F (M : S) = struct
type a = M.t
let b = M.s
end
(* F applied to module A *)
module FA = F(A);;
일반적으로 같은 함자를 두 번 호출하면 동일한 추상 타입을 담은 모듈이 만들어집니다. 그러나 생성적 함자라는 다른 종류의 함자를 정의할 수도 있습니다. 생성적 함자는 추가 매개변수 ()로 표시하며, 서로 같지 않은 추상 타입을 담은 출력 모듈을 만들어 냅니다. 이 예제에서 F와 G의 출력 타입은 서로 다릅니다. 이는 변경과 유일성이 필요한 참조를 다룰 때 특히 중요합니다.
module G (M : S) () = struct
type a = M.t
let b = M.s
end
module GA = G(A)();;
이것이 모듈 시스템의 본질입니다. 많은 언어가 코드 단위의 이름 공간을 나누고 캡슐화하는 간단한 방법을 제공하지만, ML 계열은 모듈 자체를 일급 객체이면서 매개변수화할 수 있는 대상으로 만들어 이를 더욱 풍부하게 합니다. 이는 다른 곳에서는 거의 볼 수 없는 매우 강력한 기법이며, 함자를 이용한 프로그래밍이라는 개념은 코드 재사용을 위한 풍부한 추상화를 낳습니다. 모듈 시스템은 함수형 프로그래밍의 핵심 요소이며, 앞으로의 언어들은 이를 배우고 이 풍부한 설계 공간에서 새로운 갈래를 탐구해야 합니다.
외부 참고 자료
뉴턴에서 아인슈타인으로, 그리고 다시 뉴턴으로
학부 물리학에서 제가 가장 좋아하는 증명 중 하나는 아인슈타인의 에너지-운동량 관계식으로부터 고전적인 운동 에너지 공식을 유도하는 것입니다. 구체적으로, 속도가 빛의 속도 보다 훨씬 작을 때 고전적인 운동 에너지 표현식이 상대론적 에너지 방정식의 1차 테일러 근사로서 어떻게 나타나는지 살펴보겠습니다.
아인슈타인의 상대성 이론에 따르면, 정지 질량이 인 입자의 총 에너지 는 다음과 같이 주어집니다:
여기서 로런츠 인자 는 다음과 같이 정의됩니다:
여기서 는 입자의 속도이고 는 진공에서의 빛의 속도입니다. 속도가 보다 훨씬 작을 때 이 관계식은 상당히 단순해집니다.
입자의 운동 에너지 는 총 에너지와 정지 에너지의 차이로 정의됩니다:
여기서 는 입자의 정지 에너지입니다. 에 대한 표현식을 대입하면 다음과 같습니다:
이제 작은 에 대해 를 단순화해야 합니다.
1차 근사를 얻기 위해 근방에서 테일러 급수를 사용하여 를 전개할 수 있습니다. 에서 의 테일러 전개는 다음과 같이 주어집니다:
여기서는 1차 근사에 관심이 있으므로, 항을 무시하고 상수항만 남길 수 있습니다:
따라서 운동 에너지 표현식은 다음과 같이 단순해집니다:
이제 작은 속도에 대한 운동 에너지 를 다음과 같이 표현할 수 있습니다:
이는 정확히 물체의 운동 에너지에 대한 고전적인 공식입니다. 더 일반적으로, 아인슈타인의 장 방정식으로부터 뉴턴의 방정식을 유도할 수 있으며, 이를 위해 일반 상대성 이론의 약한 장, 느린 운동 극한을 고려합니다. 약한 장 극한에서는 시공간이 거의 평탄하며 중력으로 인한 작은 섭동만 존재한다고 가정합니다. 계량은 다음과 같이 표현할 수 있습니다:
여기서 는 평탄한 시공간의 민코프스키 계량이고, 는 작은 섭동입니다. 아인슈타인 장 방정식의 일반적인 형태는 다음과 같습니다:
여기서 는 아인슈타인 텐서, 는 우주 상수, 는 계량 텐서, 는 에너지-운동량 텐서이며, 는 아인슈타인 중력 상수입니다. 이 방정식들을 단순화하여 뉴턴의 법칙을 복원하려면 몇 가지 핵심적인 가정을 세워야 합니다. 첫째, 우주 상수를 무시하여 으로 둡니다. 는 우주의 가속 팽창을 설명하는 우주론적 규모에서만 중요해지므로, 국소적인 중력 현상에 대해서는 이 가정이 타당합니다.
둘째, 정적이고 약한 중력장만 고려합니다. “정적“이라는 것은 중력장이 시간에 따라 변하지 않는다는 뜻이고, “약하다“는 것은 시공간을 작은 섭동이 있는 거의 평탄한 공간으로 다룰 수 있다는 뜻입니다. 이 때문에 다음과 같이 쓸 수 있습니다:
여기서 은 평탄한 시공간으로부터의 작은 편차를 나타냅니다. 셋째, 인 비상대론적 물질을 가정합니다. 이는 에너지-운동량 텐서가 크게 단순해져 에너지 밀도 항이 지배적이 된다는 것을 의미합니다:
반면 다른 성분들은 무시할 수 있을 만큼 작아집니다. 이 근사는 지구상의 대부분의 일상적인 상황에서, 그리고 태양계 내 대부분의 천체물리학적 상황에서도 유효합니다. 이러한 가정하에서 약한 장 극한에서는 리치 텐서의 00 성분을 다음과 같이 근사할 수 있습니다.
여기서 는 중력 퍼텐셜입니다. 리치 스칼라는 다음과 같이 됩니다.
비상대론적 물질의 경우 스트레스-에너지 텐서의 지배적인 성분은 이며, 여기서 는 질량 밀도입니다. 이를 아인슈타인 장 방정식의 00 성분에 대입하면 다음과 같습니다.
그러면 다음을 얻습니다.
이를 정리하면 뉴턴 중력에 대한 푸아송 방정식이 됩니다.
원점에 놓인 점질량 에 대해 일 때, 구면 좌표계에서 푸아송 방정식을 풀면 다음을 얻습니다.
그러면 중력장은 다음과 같습니다.
이것이 뉴턴의 중력 법칙입니다. 아인슈타인의 장 방정식은 약한 장, 느린 운동 극한에서 뉴턴의 중력 법칙으로 환원됩니다.
모나드에서 기계어 코드까지
JIT(just-in-time) 컴파일은 실행 가능한 코드를 동적으로 생성하는 방식으로 이루어지는 컴파일입니다. JIT은 많은 언어 런타임에서 자주 실행되는 코드 경로에 최적화된 코드를 생성하는 데 흔히 쓰이는 기법이며, 여러 작업을 위한 AOT(ahead-of-time) 컴파일에도 쓰입니다.
그러면 Haskell로 LLVM과 비슷한 작은 중간 언어와 JIT 실행 엔진을 만들어 봅시다. 이 코드는 최신 Linux와 x86-64 아키텍처에서만 동작합니다. 다만 원칙적으로는 각 플랫폼에서 mmap과 mprotect 시스템 콜을 호출하는 적절한 FFI 호출을 할 수 있다면 어떤 플랫폼에서든 동작합니다.
소스 코드는 여기에서 볼 수 있습니다.
타입
x86-x64 명령어 집합은 x86 명령어 집합의 64비트 개정판이며, x86 명령어 집합은 처음에 Intel 8086 CPU 계열을 위해 개발되었습니다. 하드웨어가 다루는 기본 타입은 정수 타입과 부동소수점 타입입니다. 지금은 적분(integral) 타입만 살펴보겠습니다. 이 타입은 크게 네 가지 종류로 나뉩니다:
인텔 아키텍처에서 숫자는 리틀 엔디언으로 표현됩니다. 즉, 하위 바이트가 낮은 메모리 주소에 저장됩니다. 한 값의 메모리 표현 전체는 상위 비트와 하위 비트로 나뉩니다. 예를 들어 16진수 0xc0ffee를 DWORD로 저장하면 메모리에는 다음과 같이 저장됩니다.
Haskell에서는 언박싱된 적분(integral) 머신 타입을 Data.Word 모듈에서 제공합니다.
data Word8 = W8# Word#
data Word16 = W16# Word#
data Word32 = W32# Word#
data Word64 = W64# Word#
포인터는 그저 주기억장치를 가리키는 주소 값일 뿐이며, 실제 접근과 저장은 Linux 커널이 관리합니다. 이를 Haskell에서 추상적으로 모델링하기 위해, 우리가 다룰 수 있는 값들을 담는 데이터 타입을 만들겠습니다.
data Val
= I Int64 -- Integer
| R Reg -- Register
| A Word32 -- Addr
deriving (Eq, Show)
Haskell 타입을 바이트 시퀀스로 변환하기 위해 binary 라이브러리를 사용하여 적분(integral) 타입을 리틀 엔디언 바이트 배열로 변환하겠습니다.
bytes :: Integral a => a -> [Word8]
bytes x = fmap BS.c2w bs
where
bs = unpack $ runPut $ putWord32le (fromIntegral x)
예를 들어 16진수 리터럴이 주어지면 이 함수는 그 리터럴을 구성 비트들의 배열로 펼칩니다.
val = bytes 0xc0ffee -- [238,255,192,0]
레지스터
x64 아키텍처에는 쿼드워드를 저장할 수 있는 64비트 범용 레지스터가 16개 있습니다. 주요 레지스터의 이름은 rax, rbx, rcx, rdx, rbp, rsi, rdi, 그리고 rsp입니다.
각 레지스터에는 고유한 인덱스(r)가 주어지며, 이 인덱스는 해당 레지스터를 다루는 명령어들의 바이너리 표현에 사용됩니다.
RAX RBX RCX RDX RBP RSI RDI RSP
data Reg
= RAX -- Accumulator
| RCX -- Counter (Loop counters)
| RDX -- Data
| RBX -- Base / General Purpose
| RSP -- Current stack pointer
| RBP -- Previous Stack Frame Link
| RSI -- Source Index Pointer
| RDI -- Destination Index Pointer
deriving (Eq, Show)
각 레지스터의 인덱스는 간단한 패턴 매칭 case 식으로 정의합니다.
index :: Reg -> Word8
index x = case x of
RAX -> 0
RCX -> 1
RDX -> 2
RBX -> 3
RSP -> 4
RBP -> 5
RSI -> 6
RDI -> 7
이들 각 레지스터는 하위 비트의 일부만을 담는 더 작은 레지스터로 접근할 수 있습니다. rax의 32비트 레지스터는 eax입니다. 이 레지스터들은 아래 표에 나와 있습니다.
이 작은 레지스터들에는 접두사를 바꾼 고유한 이름이 붙어 있습니다.
| 64비트 | 32비트 | 16비트 |
|---|---|---|
| rax | eax | ax |
| rbx | ebx | bx |
| rcx | ecx | cx |
| rdx | edx | dx |
| rsp | esp | sp |
| rbp | ebp | bp |
| rsi | esi | si |
| rdi | edi | di |
| rip | eip | ip |
Haskell에서는 이를 64비트 레지스터 각각에 대한 합 타입으로 모델링합니다. 지금은 64비트 레지스터만 고려합시다.
data Reg
= RAX -- Accumulator
| RCX -- Counter (Loop counters)
| RDX -- Data
| RBX -- Base / General Purpose
| RSP -- Current stack pointer
| RBP -- Previous Stack Frame Link
| RSI -- Source Index Pointer
| RDI -- Destination Index Pointer
deriving (Eq, Show)
각 레지스터의 인덱스는 간단한 패턴 매치 case 식으로 정의됩니다.
index :: Reg -> Word8
index x = case x of
RAX -> 0
RCX -> 1
RDX -> 2
RBX -> 3
RSP -> 4
RBP -> 5
RSI -> 6
RDI -> 7
모나드
모나드는 두 개의 함수(bind)와 (return), 그리고 세 가지 법칙을 갖춘 대수적 구조입니다.
bind :: Monad m => m a -> (a -> m b) -> m b
return :: Monad m => a -> m a
컴파일러는 이러한 형태의 do 블록을 일반적인 bind 문과 return 문으로 이루어진 정규 형태로 디슈거링합니다.
f :: Monad m => m Int
f = do
a <- x
b <- y
return (a+b)
다음과 같이 변환됩니다.
f :: Monad m => m Int
f =
bind x (\a ->
bind y (\b ->
return (a+b))
모나드는 매개변수 m으로 인덱싱되는 타입 클래스로 구현되며, 타입 클래스 인스턴스로 인스턴스화되면 bind 함수와 return 함수를 두 함수의 특정 구현(State나 Reader 등)으로 대체합니다.
f :: State MyState Int
f =
bindState x (\a ->
bindState y (\b ->
returnState (a+b))
State 모나드는 상태를 가진 로직을 합성하기 위한 여러 함수를 갖춘 Monad의 인스턴스입니다.
get :: State s s -- get the state
put :: s -> State s () -- set the state
modify :: (s -> s) -> State s () -- apply a function over the state
예를 들어 Int 값 하나를 보관하는 작은 상태 기계는 다음과 같이 작성합니다.
machine :: State Int Int
machine = do
put 3
modify (+1)
get
val :: Int
val = execState machine 0
상태 변수 s를 수정 가능한 여러 필드를 가진 레코드로 두는 경우가 더 일반적입니다. JIT 메모리를 관리하기 위해 여러 필드를 가진 구조체를 만들겠습니다.
data JITMem = JITMem
{ _instrs :: [Instr]
, _mach :: [Word8]
, _icount :: Word32
, _memptr :: Word32
, _memoff :: Word32
} deriving (Eq, Show)
이 구조체는 X86 모나드에 합성됩니다. X86 모나드는 개별 기계어 명령어를 어셈블하는 동안 JIT 메모리를 보관하며, 어셈블된 명령어 시퀀스에 대한 포인터와 메모리 오프셋도 함께 보관합니다.
type X86 a = StateT JITMem (Except String) a
JIT 메모리
JIT를 만들기 시작하려면 먼저 실행 권한을 가진 메모리 블록을 생성해야 합니다. C 런타임 안에서 필요한 메모리 블록을 생성하기 위해 여러 mmap 시스템 콜에 전달해야 하는 플래그를 얻을 수 있습니다.
#define PROT_NONE 0x00 /* No access. */
#define PROT_READ 0x04 /* pages can be read */
#define PROT_WRITE 0x02 /* pages can be written */
#define PROT_EXEC 0x01 /* pages can be executed */
#define MAP_FILE 0x0001 /* mapped from a file or device */
#define MAP_ANON 0x0002 /* allocated from memory, swap space */
#define MAP_TYPE 0x000f /* mask for type field */
그런 다음 실행 플래그를 지정한 mmap을 통해 Haskell 힙에서 주어진 크기의 메모리 블록을 할당하기만 하면 됩니다.
newtype MmapOption = MmapOption CInt
deriving (Eq, Show, Ord, Num, Bits)
protExec = ProtOption 0x01
protWrite = ProtOption 0x02
mmapAnon = MmapOption 0x20
mmapPrivate = MmapOption 0x02
allocateMemory :: CSize -> IO (Ptr Word8)
allocateMemory size = mmap nullPtr size pflags mflags (-1) 0
where
pflags = protRead <> protWrite
mflags = mapAnon .|. mapPrivate
Haskell 포인터는 Haskell 힙상의 해당 주소로 캐스팅하기만 하면 JIT 컴파일된 코드에 전달할 수 있습니다.
heapPtr :: Ptr a -> Word32
heapPtr = fromIntegral . ptrToIntPtr
예를 들어 널 종료 문자 배열을 할당하고 그 메모리에 대한 포인터를 JIT 컴파일된 코드에 전달하려면, Haskell 문자열로부터 이 메모리를 합성하고 힙 포인터를 가져오는 asciz를 작성하면 됩니다.
asciz :: [Char] -> IO Word32
asciz str = do
ptr <- newCString (str ++ ['\n'])
return $ heapPtr ptr
C 함수의 경우에는 동적 링커를 사용하여 프로세스의 메모리 공간에서 주어진 심볼의 함수 포인터를 가져오기만 하면 됩니다. Haskell 런타임은 glibc의 stdio.h와 math.h에 링크되므로 이 심볼들은 모두 메모리 어딘가에 존재합니다.
extern :: String -> IO Word32
extern name = do
dl <- dlopen "" [RTLD_LAZY, RTLD_GLOBAL]
fn <- dlsym dl name
return $ heapPtr $ castFunPtrToPtr fn
기계어 코드의 바이트 벡터를 컴파일하고 나면 이를 실행 가능한 메모리로 복사합니다.
jit :: Ptr Word8 -> [Word8] -> IO (IO Int)
jit mem machCode = do
code <- codePtr machCode
withForeignPtr (vecPtr code) $ \ptr -> do
copyBytes mem ptr (8*6)
return (getFunction mem)
그런 다음 FFI를 사용하여 해당 메모리에 대한 함수 포인터를 합성하고 호출합니다.
foreign import ccall "dynamic"
mkFun :: FunPtr (IO Int) -> IO Int
getFunction :: Ptr Word8 -> IO Int
getFunction mem = do
let fptr = unsafeCoerce mem :: FunPtr (IO Int)
mkFun fptr
어셈블리
실행 코드에 명령어를 직접 채워 넣기 전에, 우리가 작성할 코드의 어셈블리 형태를 살펴보고 이 과정을 문제 영역에 더 가깝게 만들어 줄 작은 DSL을 Haskell로 만들어 봅시다. 어셈블리는 사람이 읽을 수 있는 기계어 코드의 중간 표현입니다. clang과 gcc 모두 컴파일 전에 이 표현을 출력할 수 있습니다. 예를 들어 다음 C 프로그램은 레지스터로 전달된 두 정수를 받아 각각 곱한 뒤 그 결과를 더합니다.
int f(int x, int y)
{
return (x*x)^y;
}
내부적으로 C 컴파일러는 식을 분해하여 선형적인 명령어 시퀀스로 압축하며, 중간 결과는 스크래치 레지스터에 저장하고 최종 계산 결과는 반환 레지스터에 기록합니다. 그런 다음 각 추상 연산에 알맞은 기계어 명령어를 선택합니다.
// pseudocode for intermediate C representation
int f() {
int x = register(rdi);
int y = register(rsi);
int tmp1 = x*x;
int tmp2 = tmp1^y;
return tmp2;
}
어셈블리를 add.s 파일로 출력할 수 있습니다. 여기서는 목적지 피연산자를 다른 피연산자보다 앞에 두는 Intel 문법을 사용합니다. 이와 다른 AT&T 문법은 이 관례를 반대로 따릅니다.
$ clang -O2 -S --x86-asm-syntax=intel xor.c
생성된 코드는 다음과 같습니다. 문장에는 *지시어(directive)*와 *명령어(instruction)*의 두 종류가 있다는 점에 주목하십시오. 지시어는 마침표로 시작하며, 명령어는 연산과 피연산자 목록으로 이루어집니다. 명령어 문장들은 콜론으로 끝나는 레이블이 붙은 블록으로 묶입니다. 예를 들어 f:는 함수 f의 로직을 담고 있는 레이블입니다.
.file "xor.c"
.text
.globl f
.type f, @function
.intel_syntax noprefix
f:
mov eax, edi
imul eax, edi
xor eax, esi
ret
그러면 어셈블러가 이 명령어 시퀀스를 생성된 기계어 코드를 담은 실행 파일이나 오브젝트 파일로 변환합니다. 출력을 디스어셈블하려면 objdump를 사용하여 기계어 명령어의 16진수 시퀀스와 파일 내 오프셋을 볼 수 있습니다.
$ objdump -M intel -d xor.o
xor: file format elf64-x86-64
Disassembly of section .text:
0000000000000000 <f>:
0: 89 f8 mov eax,edi
2: 0f af c7 imul eax,edi
5: 31 f0 xor eax,esi
7: c3 ret
그러면 메모리에 올라간 컴파일된 프로그램은 연속된 바이트 배열이 되며, 명령어 포인터를 시작 주소로 옮겨 실행됩니다.
89 f8 0f af c7 31 f0 c3
명령어
명령어는 두 부분으로 구성됩니다. 하나는 *옵코드(opcode)*이고, 다른 하나는 주어진 명령어에 대해 CPU가 처리할 레이블, 레지스터 또는 메모리 주소를 지정하는 *피연산자(operand)*들의 집합입니다. 정수를 다루고 호출 스택을 조작하는 흥미로운 연산들의 일부를 살펴보겠습니다.
data Instr
= Ret
| Mov Val Val
| Add Val Val
| Sub Val Val
| Mul Val
| IMul Val Val
| Xor Val Val
| Inc Val
| Dec Val
| Push Val
| Pop Val
| Call Val
| Loop Val
| Nop
| Syscall
deriving (Eq, Show)
JIT 메모리에 추가하려면 _mach 필드에 명령어를 덧붙이고 추가된 명령어의 길이만큼 메모리 오프셋 포인터를 조정하는 방식으로 상태를 수정하기만 하면 됩니다.
emit :: [Word8] -> X86 ()
emit i = modify $ \s -> s
{ _mach = _mach s ++ i
, _memoff = _memoff s + fromIntegral (length i)
}
피연산자
레지스터
레지스터는 소문자로 표기합니다(예: rbp, rsp). 표현식 빌더에서는 기반이 되는 Reg 값으로부터 레지스터 값 타입을 생성하는 함수 몇 개를 작성하기만 하면 됩니다.
rax :: Val
rax = R RAX
rsi :: Val
rsi = R RSI
즉시 피연산자
즉시 피연산자는 상수(리터럴 또는 메모리 주소)를 직접 참조하는 것입니다. 예를 들어: 주소) 또는 레이블. 예를 들면 다음과 같습니다.
add eax,42
add eax,0xff
즉시 값의 경우 숫자에 해당하는 바이트 배열을 바이트 시퀀스에 그대로 추가하기만 하면 됩니다.
imm :: Integral a => a -> X86 ()
imm = emit . bytes
옵코드
x86의 전체 명령어 집합은 방대하며, AVX, SSE 및 기타 특수 인트린직까지 포함하면 엄청나게 복잡하고 별난 사양이 많습니다. 이러한 추상 명령어 각각은 받을 수 있는 피연산자 유형마다 여러 개의 옵코드를 가질 수 있습니다. 예를 들어 레지스터 간 이동을 위한 mov 명령어는 옵코드 0x89를 가지는 반면, 즉시 데이터를 레지스터로 옮기는 경우에는 옵코드 0xC7을 가집니다.
가장 흔한 연산에 대한 참고 자료로는 x86asm.net 사이트에 매우 유용한 빠른 참조표가 있습니다. 최신 Intel 프로세서에서 사용할 수 있는 전체 명령어 집합은 1500쪽 분량의 Intel 소프트웨어 개발자 매뉴얼을 참고하십시오.
주어진 명령어에 대한 숫자 옵코드를 조회하기 위해, 피연산자에 대해 특정한 명명 규칙을 사용합니다.
| 접두사 | 설명 |
|---|---|
r<size> | 레지스터 피연산자 |
imm<size> | 즉시 피연산자 |
m<size> | 메모리 피연산자 |
예를 들면 다음과 같습니다.
| 접두사 | 설명 |
|---|---|
r64 | 64비트 레지스터 |
imm8 | 8비트 즉시 피연산자 |
m32 | 32비트 메모리 피연산자 |
여러 가능한 피연산자 집합에 대해 동작하는 옵코드의 경우, 이들은 r8/r16/r32 형식처럼 슬래시로 구분합니다.
여기서 다루는 제한된 명령어 집합에는 두 가지 유형의 옵코드가 있습니다.
- 1바이트 옵코드
- 2바이트 옵코드
| 명령어 | 옵코드 |
|---|---|
| CALL | E8 |
| RET | C3 |
| NOP | 0D |
| MOV | 89 |
| PUSH | 50 |
| POP | 58 |
| LOOP | E2 |
| ADD | 83 |
| SUB | 29 |
| MUL | F7 |
| DIV | F7 |
| INC | FF |
| DEC | FF |
| NEG | F7 |
| CMP | 39 |
| AND | 21 |
| OR | 09 |
| XOR | 31 |
| NOT | F7 |
| ADC | 11 |
| IDIV | F7 |
| IMUL | F7 |
| XCHG | 87 |
| BSWAP | C8 |
| SHR | C1 |
| SHL | C1 |
| ROR | C0 |
| RCR | C0 |
| BT | BA |
| BTS | BA |
| BTR | B3 |
| JMP | EB |
| JE | 84 |
| JNE | 85 |
| SYSCALL | 05 |
이에 더해 옵코드에는 관련된 인자의 크기를 바꾸는 접두사가 추가로 붙을 수 있습니다. 이 접두사들은 32비트 시스템에서 64비트 시스템으로 넘어가는 과정에서 32비트 호환성을 유지하고 32비트 시스템의 기존 옵코드를 보존하기 위해 추가되었습니다. 예를 들어 다음 mov 명령어들은 모두 레지스터를 대상으로 같은 동작을 수행하지만, 다루는 크기가 서로 다릅니다.
mov al,255
mov ax,255
mov eax,255
mov rax,255
그러나 크기에 따라 서로 다른 옵코드로 변환됩니다.
b0 ff mov al,0xff
66 b8 ff 00 mov ax,0xff
b8 ff 00 00 00 mov eax,0xff
48 c7 c0 ff 00 00 00 mov rax,0xff
| 접두사 | 옵코드 | 데이터 | 어셈블리 | 의미 |
|---|---|---|---|---|
| 66 | b0 | ff | mov al, 0xff | 8비트 로드 |
| 66 | b8 | ff 00 | mov ax, 0xff | 16비트 접두사(0x66)를 사용한 로드 |
| 66 | b8 | ff 00 00 00 | mov eax, 0xff | 기본 크기인 32비트로 로드 |
| 48 | c7 c0 | ff 00 00 00 | mov rax, 0xff | REX 64비트 접두사(0x48)를 사용한 부호 확장 로드 |
기계어 코드
자, 이제 명령어의 전체 구조를 살펴봅시다. 명령어는 여러 부분으로 구성됩니다.
이 부분들의 크기는 옵코드의 크기와 종류, 그리고 접두사 수정자에 따라 달라집니다.
접두사 옵코드 Mod R/M Scale Index Base 변위 즉시값
1-4바이트 1-3바이트 1바이트 1바이트 1-4바이트 1-4바이트
접두사
헤더는 처음 네 비트를 상수 0b0100으로 고정하며, 다음 네 비트는 W/R/X/B 확장의 존재 여부를 나타냅니다.
W 비트는 연산 너비를 변경합니다. R, X, B 필드는 레지스터 인코딩을 확장합니다.
- REX.W – 연산 폭을 확장합니다
- REX.R – ModRM.reg를 확장합니다
- REX.X – SIB.index를 확장합니다
- REX.B – SIB.base 또는 ModRM.r/m을 확장합니다
ModR/M 바이트
Mod-Reg-R/M 바이트는 명령어의 피연산자와 주소 지정 방식을 결정합니다. 주소 지정 방식에는 여러 변형이 있습니다.
- 즉시 모드 - 피연산자가 명령어의 일부입니다
- 레지스터 주소 지정 - 피연산자가 레지스터에 들어 있습니다
- 직접 모드 - 명령어의 피연산자 필드에 피연산자의 주소가 들어 있습니다
- 레지스터 간접 주소 지정 - 오프셋으로 데이터 배열을 주소 지정할 때 사용합니다
- 인덱싱 - 상수 베이스 + 레지스터
- 스케일링을 사용한 인덱싱 - 베이스 + 레지스터 오프셋 * 스케일링 계수
- 스택 주소 지정 - RSP 레지스터를 암묵적으로 사용해 자동으로 증가/감소하는 레지스터 간접 방식의 변형입니다
- 점프 상대 주소 지정 - RIP + 오프셋
mod 의미
00 레지스터 간접 메모리 주소 지정 방식 01 인덱스 또는 베이스/인덱스/변위 주소 지정 방식 10 인덱스 또는 베이스/인덱스/변위 주소 지정 방식 + 변위 11 R/M이 레지스터를 나타내며 REG 필드를 사용합니다
reg
rax 000 rcx 001 rdx 010 rbx 011 rsp 100 rbp 101 rsi 110 rdi 111
mod = 00, 01 또는 10인 경우
r/m 의미
000 [BX+SI] 또는 DISP[BX][SI] 001 [BX+DI] 또는 DISP[BX+DI] 010 [BP+SI] 또는 DISP[BP+SI] 011 [BP+DI] 또는 DISP[BP+DI] 100 [SI] 또는 DISP[SI] 101 [DI] 또는 DISP[DI] 110 변위만 또는 DISP[BP] 111 [BX] 또는 DISP[BX]
예를 들어 레지스터 직접 모드를 사용하고 r/m에 레지스터 피연산자를 지정하는 다음 명령어가 있다고 합시다.
mov rbx,rax
그러면 다음과 같습니다.
mod = 0b11
reg = 0b000
r/m = rbx
r/m = 0b011
ModRM = 0b11000011
ModRM = 0xc3
Scale Index Base
스케일은 피연산자의 주소를 지정하기 위해 인덱스를 베이스에 더하기 전에 인덱스에 곱하는 계수입니다. 스케일은 1, 2, 4, 8 중 하나의 값을 가질 수 있습니다. 스케일을 지정하지 않으면 기본값은 1입니다.
스케일 계수
0b00 1 0b01 2 0b10 4 0b11 8
index와 base는 모두 일반적인 인덱스 체계에서의 레지스터를 가리킵니다.
scale/base
rax 000 rcx 001 rdx 010 rbx 011 rsp 100 rbp 101 rsi 110 rdi 111
명령어 빌더
이제부터 상태 모나드 안에서 명령어를 어셈블하는 X86 모나드 연산자에 대응하는 여러 함수를 만들겠습니다. 먼저 간단한 산술 로직부터 해 봅시다.
arith :: X86 ()
arith = do
mov rax (I 18)
add rax (I 4)
sub rax (I 2)
imul rax (I 2)
ret
이 함수들은 각각 대수적 데이터 타입 Val로 주어지는 피연산자들을 받아, 그 값에 대해 패턴 매칭을 하여 어떤 x86 옵코드를 사용할지, 그리고 값을 어떻게 바이트로 변환할지 결정합니다.
ret
가장 간단한 경우는 return 함수로, 피연산자를 받지 않으며 1비트 옵코드입니다.
ret :: X86 ()
ret = do
emit [0xc3]
add <r64> <imm32>
즉시값에 대한 add는 64비트 즉시 데이터를 처리하기 위해 REX.W 플래그로 피연산자를 확장합니다.
0: 48 83 c0 01 add rax,0x1
add :: Val -> Val -> X86 ()
add (R l) (I r) = do
emit [0x48] -- REX.W prefix
emit [0x05] -- ADD
imm r
add <r64> <r64>
레지스터 간 add도 같은 방식으로 REX.W 플래그를 사용하지만, 레지스터 직접 모드를 사용하여 소스 레지스터를 ModRM.reg 필드로 전달합니다. 모드 0xc0에 대해 비트 단위 or를 수행한 다음, 3비트 시프트하여 reg 비트에 레지스터 인덱스로 레지스터를 지정합니다.
0: 48 01 e0 add rax,rsp
add (R l) (R r) = do
emit [0x48] -- REX prefix
emit [0x01] -- ADD
emit [0xc0 .|. opcode r `shiftL` 3 .|. opcode l]
mov <r64>, <r64>
mov 명령어에도 레지스터 간 경우와 즉시 데이터 경우 모두 같은 로직이 적용됩니다.
0: 48 89 d8 mov rax,rbx
mov :: Val -> Val -> X86 ()
mov (R dst) (R src) = do
emit [0x48] -- REX.W prefix
emit [0x89] -- MOV
emit [0xC0 .|. opcode src `shiftL` 3 .|. opcode dst]
mov <r64>, <imm32>
0: 48 c7 c0 2a 00 00 00 mov rax,0x2a
mov (R dst) (I src) = do
emit [0x48] -- REX.W prefix
emit [0xC7] -- MOV
emit [0xC0 .|. (opcode dst .&. 7)]
imm src
inc <r64>, dec <r64>
inc와 dec 함수는 같은 옵코드를 공유하지만 연산을 지정하기 위해 ModRM 비트를 수정한다는 점에서 약간 다릅니다.
inc :: Val -> X86()
inc (R dst) = do
emit [0x48] -- REX prefix
emit [0xFF] -- INC
emit [0xc0 + index dst]
dec (R dst) = do
emit [0x48] -- REX prefix
emit [0xFF] -- DEC
emit [0xc0 + (index dst + 8)]
모든 것을 종합하여 함수를 JIT 컴파일하고 Haskell에서 호출하겠습니다.
main :: IO ()
main = do
mem <- allocateMemory jitsize -- create jit memory
let Right st = assemble mem arith -- assemble symbolic program
fn <- jit mem (_mach st) -- jit compile
res <- fn -- call function
putStrLn $ "Result: " <> show res
그리고 실행하면 결과를 얻습니다.
$ stack exec example
Result: 40
점프와 루프
이제 제어 흐름을 사용하고 레이블이 붙은 명령어 블록 사이를 점프하는 로직을 작성해 봅시다. rcx 레지스터로 계산할 값을 받고, 1에 도달할 때까지 rax를 반복해서 곱하여 결과를 계산하는 팩토리얼 함수를 생각해 보십시오. 이를 위해 .factor 블록을 만들고 loop 명령어를 사용합니다.
factorial:
mov rcx, $5
mov rax, $1
.factor:
mul rax
loop .factor
ret
이 어셈블리의 기계어 코드를 살펴봅시다. loop 명령어가 피연산자로 메모리상의 상대 주소 fc(즉, 4개 명령어만큼 뒤로 이동)를 받는다는 점에 주목하십시오.
00000000004004ed <main>:
4004ed: b9 05 00 00 00 mov ecx,0x5
4004f2: b8 01 00 00 00 mov eax,0x1
00000000004004f7 <.factor>:
4004f7: f7 e1 mul ecx
4004f9: e2 fc loop 4004f7 <.factor>
4004fb: c3 ret
그러면 모나드 안으로 들어가 현재 위치한 JIT 메모리의 포인터 위치를 가져오기만 하는 label 함수를 만들어 봅시다.
label :: X86 Val
label = do
addr <- gets _memoff
ptr <- gets _memptr
return (A addr)
메모리 주소가 주어지면 loop 명령어는 0xE2 옵코드를 내보내고, 소스와 목적지 사이의 차이를 계산한 다음 그 값을 명령어의 즉시 데이터로 내보냅니다.
loop :: Val -> X86()
loop (A dst) = do
emit [0xE2]
src <- gets _memoff
ptr <- gets _memptr
emit [fromIntegral $ dst - src]
이제 이 팩토리얼 어셈블리의 기호적 표현을 Haskell DSL로 만들고, 계산할 Haskell 정수로 매개변수화하겠습니다.
factorial :: Int64 -> X86 ()
factorial n = do
mov rcx (I n)
mov rax (I 1)
l1 <- label
mul rcx
loop l1
ret
모든 것을 종합하여 함수를 JIT 컴파일하고 Haskell에서 호출하겠습니다.
main :: IO ()
main = do
mem <- allocateMemory jitsize
let Right st = assemble mem (factorial 5)
fn <- jit mem (_mach st)
res <- fn
putStrLn $ "Result: " <> show res
그리고 이를 실행하면 결과를 얻습니다.
$ stack exec example
Result: 120
호출 규약
마지막 과제는 JIT에서 벗어나 Haskell 런타임이나 주어진 C 함수 포인터를 호출할 수 있도록 하는 것입니다. 이를 위해서는 다른 로직으로 들어가고 나오며, 레지스터를 설정하여 다른 서브루틴에 넘겨주고 다시 돌아올 때 복원하기 위한 호출 규약(calling convention)을 살펴보아야 합니다. 64비트 System V ABI 호출 규약에서는 처음 5개의 인자가 rdi, rsi, rdx rcx, r8, r9 순서로 레지스터를 통해 전달됩니다. 그 이후의 인자는 스택을 통해 전달됩니다.
call 함수에서는 주어진 위치와 점프하려는 함수의 주소 사이의 차이를 계산하기만 하면 됩니다.
call :: Val -> X86 ()
call (A dst) = do
emit [0xE8]
src <- gets _memoff
imm (dst - (src + 5))
call _ = nodef
함수를 호출하기 전후에 우리는 그 인자를 처리하고, 진입과 종료 시에 스택 프레임을 push하고 pop할 책임이 있습니다. 진입 시에는 함수 프롤로그(prologue)를, 종료 시에는 에필로그(epilogue)를 호출하며, 그 사이에 함수 로직이 놓입니다.
prologue :: X86 ()
prologue = do
push rbp
mov rbp rsp
epilogue :: X86 ()
epilogue = do
pop rax
mov rsp rbp
pop rbp
ret
예를 들어 JIT 내부에서 libc의 printf 함수에 문자열 포인터를 전달하여 호출해 봅시다. 이를 위해 dlsym을 사용하여 심볼 참조를 가져온 다음, 문자열 포인터를 인자 스택에 push한 후 이를 주소로서 call 명령어에 전달합니다.
printf :: Word32 -> Word32 -> X86 ()
printf fnptr msg = do
push rbp
mov rbp rsp
mov rdi (A msg)
call (A fnptr)
pop rbp
mov rax (I 0)
ret
모든 것을 종합하여, printf 주소를 가져오고 asciz 함수를 사용해 Haskell 문자열에 대한 포인터를 전달함으로써 이를 호출합니다.
main :: IO ()
main = do
let jitsize = 256*1024
fn <- extern "printf"
msg <- asciz "Hello Haskell"
mem <- allocateMemory jitsize
let Right st = assemble mem (printf fn msg)
join $ jit mem (_mach st)
이를 실행하면 JIT 바깥으로 손을 뻗어 친근한 인사말을 얻습니다.
$ stack exec example
Hello Haskell
이것이 바로 기본적인 JIT 컴파일의 요점입니다.
수반에서 모나드로
Haskell에서 제가 가장 좋아하는 구성 중 하나, 즉 수반 함자가 모나드를 만들어 낸다는 사실을 공유하고자 합니다. 범주론에서는 자명한 결과이지만, 이것이 Haskell에서 드러나는 방식은 꽤 아름답습니다.
Haskell에서 Functor(함자)는 Hask의 부분 범주에 있는 대상과 사상(즉, 함수)을 다른 범주의 대상과 사상으로 사상합니다.
class Functor f where
fmap :: (a -> b) -> f a -> f b
그리고 함자 법칙을 만족합니다:
fmap id = id
fmap (a . b) = (fmap a) . (fmap b)
가환 도표에서는 대상을 점으로, 사상을 화살표로 그립니다. 문자열 도표에서는 이를 뒤집어 사상을 점으로, 대상을 선으로 그립니다.
함자 합성은 , 에 대해 로 정의되며, 평행한 선으로 그립니다.
newtype FComp f g a = C { unC :: f (g a) }
instance (Functor f, Functor g) => Functor (FComp f g) where
fmap f (C x) = C (fmap (fmap f) x)
일반적으로 함자의 합성 는 간단히 로 씁니다. 도표상으로 합성은 문자열 도표에서 인접한 선분들을 하나로 합칠 수 있게 해 줍니다.
항등 함자( )는 각 사상과 대상을 자기 자신으로 대응시키는 함자입니다.
newtype Id a = Identity { unId :: a }
instance Functor Id where
fmap f x = Identity (f (unId x))
항등 함자와의 합성은 항등 관계를 이룹니다:
이는 다음 식들로 확인할 수 있습니다:
left :: Functor f => FComp f Id a -> f a
left (C a) = fmap unId a
right :: Functor f => f a -> FComp f Id a
right a = C $ fmap Identity a
항등 함자를 생략하는 관례를 따르며, 이후의 문자열 도표에서는 이를 점선으로 나타냅니다.
여기서 다루는 맥락에서 자연 변환은 두 Haskell 함자 인스턴스 f와 g에 연관된, 타입 시그니처 (Functor f, Functor g) => forall a. f a -> g a를 갖는 다형 함수입니다. 이는 다음과 같은 타입 동의어로 쓸 수 있습니다.
type Nat f g = forall a. f a -> g a
함자 를 자기 자신으로 대응시키는 항등 자연 변환은 로 쓰며, Haskell에서는 그저 (id)입니다. 자연 변환의 합성은 아래에 나타낸 결합 법칙을 따릅니다:
마지막 교환 법칙은 자연 변환을 함자들을 따라 수평으로 추적하든, 함자들 사이의 자연 변환을 수직으로 합성하든 같은 결과에 도달한다는 것을 말합니다.
type NatComp f f' g g' = forall a. f' (f a) -> g' (g a)
vert :: (Functor f, Functor f', Functor g, Functor g') =>
Nat f' g' -> Nat f g -> NatComp f f' g g'
vert a b x = a (fmap b x)
horiz :: (Functor f, Functor f', Functor g, Functor g') =>
Nat f' g' -> Nat f g -> NatComp f f' g g'
horiz a b x = fmap b (a x)
교환 법칙에 따라 horiz와 vert는 합성에서 서로 교환 가능해야 합니다. Haskell에서 자연 변환 a, b, a', b'에 대해 다음 등식이 성립합니다:
(a . b) `vert` (a' . b') == (a `horiz` a') . (b `horiz` b')
항등 함자와 합성 함자 사이의 자연 변환 에 대한 도표 예시는 다음과 같이 그립니다:
동형 는 이고 라는 의미에서 함자의 합성이 가역임을 뜻합니다. 함자 쌍 와 사이의 수반 는 이보다 약한 명제로, 다음을 갖는 연관된 자연 변환 쌍 가 존재한다는 것입니다:
이때 다음 삼각 항등식이 성립합니다:
이를 그림으로 나타내면 다음과 같습니다:
범주 의 관점에서 보면 수반은 어떤 의미에서 “반쪽 동형사상” 또는 “거의 역“이지만, 한쪽 방향에서는 일부 구조가 소실됩니다.
와 은 각각 *단위(unit)*와 *쌍대단위(counit)*라고도 부릅니다.
Haskell에는 다음과 같은 타입 클래스가 있는데, 안타깝게도 타입 추론기가 어떤 fmap을 사용할지 추론하려면 함수 종속성(functional dependency)이 필요합니다:
class (Functor f, Functor g) => Adjoint f g | f -> g, g -> f where
eta :: a -> g (f a)
epsilon :: f (g a) -> a
또한 두 개의 다른 자연 변환()이 있으며, 이들은 수반 함자 쌍과 함께 수반을 이룹니다. 수반은 수반 쌍을 통해 정의할 수 있으며, Haskell에서는 이것이 가장 편리한 정의입니다
phi :: Adjoint f g => (f a -> b) -> a -> g b
phi f = fmap f . eta
psi :: Adjoint f g => (a -> g b) -> f a -> b
psi f = epsilon . fmap f
특히 와 는 함수 집합 (a -> g b)와 (f a -> b) 사이의 동형사상을 이루며, 이는 위의 삼각 항등식과 같은 관계입니다. 또는 와 을 와 를 통해 표현할 수도 있습니다.
phi eta = id
psi epsilon = id
Haskell 프렐류드에는 정준적인 수반, 즉 curry와 uncurry가 있습니다:
instance Functor ((,) a) where
fmap f (x,y) = (x, f y)
instance Functor ((->) a) where
fmap f g = \x -> f (g x)
이 두 함자 인스턴스로부터 Adjoint 인스턴스를 구성할 수 있습니다:
instance Adjoint ((,) a) ((->) a) where
eta x y = (y, x)
epsilon (y, f) = f y
와 가 모두 항등 자연 변환( id )으로 환원됨을 보임으로써 이 정의에 대해 삼각 등식이 성립함을 확인할 수 있습니다.
a0 :: (a -> (b -> c)) -> a -> (b -> c)
a0 f = \f -> fmap (epsilon . fmap f) . eta
a0 f = fmap (\(y, f) -> g f y) . eta
a0 f = \x y -> f x y
a1 :: ((a, b) -> c) -> (a,b) -> c
a1 f = epsilon . fmap (fmap f . eta)
a1 f = epsilon . fmap (\x y -> f (y, x))
a1 f = \(x, y) -> f (x, y)
모나드는 두 개의 자연 변환을 갖는 자기 함자 로서 이며, 다음과 같은 일반적인 법칙을 따른다는 것을 우리는 알고 있습니다:
기하학적 직관으로 보면, 모나드 법칙은 스트링 다이어그램의 위상적 성질로 반영됩니다. 와 는 모두 반사 대칭을 보이며, 를 위상적으로 곧게 펴면 항등 함자를 얻습니다.
Haskell에서는 모나드 타입 클래스를 자기 함자와 (), 또는 join과 return으로부터 일반적으로 구성할 수 있습니다.
class (Functor t) => Monad t where
eta :: a -> (t a)
mu :: (t (t a)) -> (t a)
(>>=) :: t a -> (a -> t b) -> t b
ma >>= f = mu . fmap f
return = eta
join = mu
그러나 곧바로 드러나지 않는 사실은, 모든 수반 함자 쌍이 범주 위의 모나드 를 낳는다는 점입니다. 이 모나드는 함자들의 합성으로 유도되어, 바탕이 되는 수반의 단위와 쌍대단위를 통해 자기 함자와 자연 변환들을 만들어 냅니다:
class Adjoint f g => Monad f g where
muM :: g (f (g (f a))) -> g (f a)
muM = fmap epsilon
etaM :: a -> g (f a)
etaM = eta
(>>=) :: g (f a) -> (a -> g (f b)) -> g (f b)
x >>= f = muM (fmap (fmap f) x)
이에 대한 기하학적 직관은 명확합니다:
그런 다음 모나드로부터 일반적인 방식으로 클라이슬리 범주를 구성할 수 있습니다.
class (Adjoint f g, Category c) => Kleisli c f g where
idK :: c x (g (f x))
(<=<) :: c y (g (f z)) -> c x (g (f y)) -> c x (g (f z))
instance Monad f g => Kleisli (->) f g where
idK = eta
g <=< f = muM . fmap (fmap g) . f
instance Kleisli c f g => Monoid (c a (g (f a))) where
mempty = idK
mappend = (<=<)
돌이켜 보면 이는 자명하지만, 중요하게도 더 중요한 질문으로 우리를 이끕니다: 모나드로부터 수반을 복원할 수 있는가? 답은 ’그렇다’입니다…
어렵게 설명한 모나드
이 글은 범주론적 관점에서 유도한 Haskell 모나드에 대한 짧고 빠르며 비유를 쓰지 않는 입문입니다. 이 글은 독자가 Haskell과 기초 범주론에 익숙하다고 가정합니다.
범주
대상과 사상으로 이루어진 추상적인 범주 가 있습니다.
- 대상 :
- 사상 :
각 대상에는 항등 사상 id가 있고, 사상을 결합적으로 합성하는 합성 규칙 가 있습니다. 이것은 Haskell에서 카인드 다형성을 이용한 다음 타입 클래스로 모델링할 수 있습니다.
-- Morphisms
type (a ~> b) c = c a b
class Category (c :: k -> k -> *) where
id :: (a ~> a) c
(.) :: (y ~> z) c -> (x ~> y) c -> (x ~> z) c
Haskell에서는 Haskell 타입 사이의 함수 타입을 나타내는 타입 생성자 (->) 위의 이 범주를 Hask라고 부릅니다.
type Hask = (->)
instance Category Hask where
id x = x
(f . g) x = f (g x)
생성자 (->)는 타입 클래스 시그니처에서 타입 수준 연산자로 읽을 때 때때로 헷갈립니다. 중위 형태에서는 보통 첫 번째 인자가 그 왼쪽에, 두 번째 인자가 오른쪽에 나타나기 때문입니다. 예를 들어 다음은 서로 동등합니다.
(->) ((->) a b) ((->) a c)
(a -> b) -> (a -> c)
함자
두 범주 사이에 로 표기하는 함자를 구성할 수 있습니다. 함자는 범주의 대상과 사상 사이를 사상하며, 사상의 합성과 항등을 보존합니다.
- 대상 :
- 사상 :
Haskell에서는 다음과 같이 표현됩니다.
class (Category c, Category d) => Functor c d t where
fmap :: c a b -> d (t a) (t b)
익숙한 함자 법칙은 다음과 같습니다.
fmap id ≡ id
fmap (a . b) ≡ (fmap a) . (fmap b)
범주 에 대한 항등 함자 는 모든 대상을 자기 자신으로, 모든 사상을 자기 자신으로 보내는 함자입니다.
newtype Id a = Id a
instance Functor Hask Hask Id where
fmap f (Id a) = Id (f a)
instance Functor Hask Hask [] where
fmap f [] = []
fmap f (x:xs) = f x : (fmap f xs)
instance Functor Hask Hask Maybe where
fmap f Nothing = Nothing
fmap f (Just x) = Just (f x)
자기 함자(endofunctor)는 한 범주에서 그 범주 자신으로 가는 함자, 즉 ()입니다.
type Endofunctor c t = Functor c c t
두 함자의 합성 역시 그 자체로 함자입니다. 이 사실을 Haskell에 납득시키려면 제약 카인드(constraint kinds)와 범위 지정 타입 변수(scoped type variables)를 이용한 약간의 기교가 필요합니다.
newtype FComp g f x = C { unC :: g (f x) }
newtype Hom (c :: * -> Constraint) a b = Hom (a -> b)
instance (Functor a b f, Functor b c g, c ~ Hom k) => Functor a c (FComp g f) where
fmap f = (Hom C) . (fmapg (fmapf f) . (Hom unC))
where
fmapf = fmap :: a x y -> b (f x) (f y)
fmapg = fmap :: b s t -> c (g s) (g t)
한 범주 위의 자기 함자를 반복해서 합성한 것은 지수 표기법으로 씁니다.
작은 범주들의 범주 은 범주를 대상으로, 범주 사이의 함자를 사상으로 갖는 범주입니다.
자연 변환
두 범주 사이의 두 함자 에 대해 다음을 생각합시다.
자연 변환 라고 부르는 사상을 구성할 수 있습니다. 이는 함자 사이의 사상 로서, 의 모든 대상 를 의 사상에 대응시킵니다.
이때 임의의 사상 에 대해 다음 자연성 조건이 성립해야 합니다. 이는 다음과 같은 자연성 사각형으로 나타냅니다.

자연 변환 자체는 두 함자 사이에서 다음과 같은 도식으로 나타냅니다.

이것은 앞에서 정의한 일반적인 범주 클래스에서 다음과 같은 존재 타입으로 표현할 수 있습니다.
type Nat c f g = forall a. c (f a) (g a)
Hask의 경우에는 다음 시그니처를 갖는 다형 함수들의 족이 있습니다.
type NatHask f g = forall a. (f a) -> (g a)
자연 변환(h)에 대해 자연성 조건은 다음 법칙으로 주어지며, 이는 마침 Haskell 타입 시스템에서의 자유 정리(free theorem)이기도 합니다.
fmap f . h ≡ h . fmap f
대표적인 예는 List 함자와 Maybe 함자 사이의 자연 변환입니다( 여기서 f = List, g = Maybe ).
headMay :: forall a. [a] -> Maybe a
headMay [] = Nothing
headMay (x:xs) = Just x
어느 쪽으로 도식을 따라가든 같은 곳에 도달합니다.
fmap f (headMay xs) ≡ headMay (fmap f xs)
이 사실을 확인하고 싶다면 headMay에 대한 자연성 사각형의 각 경우를 하나씩 따져 보십시오.
fmap f (headMay [])
= fmap f Nothing
= Nothing
headMay (fmap f [])
= headMay []
= Nothing
fmap f (headMay (x:xs))
= fmap f (Just x)
= Just (f x)
headMay (fmap f (x:xs))
= headMay [f x]
= Just (f x)
함자 범주
자연 변환 는 그 자체로 와 사이의 함자들로 이루어진 함자 범주 의 사상입니다. 범주 는 한 범주에서 그 자신으로 가는 자기 함자(endofunctor)들의 범주입니다.
-- Functor category
newtype Fun f g a b = FNat (f a -> g b)
-- Endofunctor category
type End f = Fun f f
instance Category (End f) where
id = FNat id
(FNat f) . (FNat g) = FNat (f . g)
모나드
이제 마침내 범주 위의 모나드를 다음으로 이루어진 삼중쌍 로 정의할 수 있습니다.
- 자기 함자
- 자연 변환
- 자연 변환
class Endofunctor c t => Monad c t where
eta :: c a (t a)
mu :: c (t (t a)) (t a)
결합성 사각형과 함께:

그리고 삼각형 등식과 함께:

또는 이 삼중쌍을 일련의 **문자열 도식(string diagram)**으로 표현할 수도 있습니다. 문자열 도식에서는 선을 사상으로, 점을 대상으로 나타내는 전통적인 가환 도식을 뒤집어, 사상을 점으로, 대상을 선으로 나타냅니다. 이 형태에서 모나드 법칙은 멋진 기하학적 대칭성을 가집니다.
정합성 조건을 도식으로 나타내면 다음과 같습니다.
Bind/Return 정식화
모나드는 mu, eta)로 표현할 수 있는 두 함수((>>=), return)를 사용한 동등한 정식화로도 나타낼 수 있습니다.
Haskell에서는 자연 변환과 기반 함자의 fmap을 사용하여 정의되는 bind 연산자 (>>=)를 정의합니다. join과 return 함수는 mu와 eta를 사용하여 정의할 수 있습니다.
(>>=) :: (Monad c t) => c a (t b) -> c (t a) (t b)
(>>=) f = mu . fmap f
return :: (Monad c t) => c a (t a)
return = eta
이 형태에서는 모나드의 자연 변환에 대한 동등한 자연성 조건에 새 정의를 대입하면 일반적인 모나드 법칙이 나옵니다.
fmap f . return ≡ return . f
fmap f . join ≡ join . fmap (fmap f)
그리고 bind와 return으로 표현한 동등한 정합성 조건이 바로 잘 알려진 모나드 법칙입니다.
return a >>= f ≡ f a
m >>= return ≡ m
(m >>= f) >>= g ≡ m >>= (\x -> f x >>= g)
클라이슬리 범주
최종 결과는, 모나드가 주어지면 그 모나드로부터 클라이슬리 범주라는 새로운 범주를 만들 수 있다는 것입니다. 대상은 원래의 c 범주에 들어 있지만, 화살표는 이제 클라이슬리 화살표 a -> T b입니다. 이러한 “동작“들이 주어졌을 때, 우리는 호스트 범주에서 함수를 합성하듯이 이 사상들을 합성하는 연산자를 작성하고자 합니다.
알고 보니 와 기반 함자를 사용하여 표현되는 특정 함수 (<=<)를 만들 수 있으며, 이 함수는 클라이슬리 화살표의 결합적 합성 연산자가 됩니다. 클라이슬리 범주는 “동작의 합성“을 모델링하며, 매우 일반적인 계산 모델을 이룹니다.
범주 로부터 구성된 클라이슬리 범주에서의 대응은 다음과 같습니다:
- 클라이슬리 범주의 대상은 기반 범주의 대상입니다.
- 사상은 다음 형태의 클라이슬리 화살표입니다:
- 클라이슬리 범주의 항등 사상은 정확히 기반 범주의 입니다.
- 호스트 범주의 관점에서 사상의 합성 는 다음 대응으로 정의됩니다:
-- Kleisli category
newtype Kleisli c t a b = K (c a (t b))
-- Kleisli morphisms ( c a (t b) )
type (a :~> b) c t = Kleisli c t a b
-- Kleisli morphism composition
(<=<) :: (Monad c t) => c y (t z) -> c x (t y) -> c x (t z)
f <=< g = mu . fmap f . g
instance Monad c t => Category (Kleisli c t) where
-- id :: (Monad c t) => c a (t a)
id = K eta
-- (.) :: (Monad c t) => c y (t z) -> c x (t y) -> c x (t z)
(K f) . (K g) = K ( f <=< g )
c = (->)인 Hask의 경우에는 익숙한 인스턴스를 볼 수 있습니다:
-- Kleisli category
newtype Kleisli m a b = K (a -> m b)
-- Kleisli morphisms ( a -> m b )
type (a :~> b) m = Kleisli m a b
(<=<) :: Monad m => (b -> m c) -> (a -> m b) -> a -> m c
f <=< g = mu . fmap f . g
instance Monad m => Category (Kleisli m) where
id = K return
(K f) . (K g) = K (f <=< g)
class Functor t where
fmap :: (a -> b) -> t a -> t b
class Functor t => Monad t where
eta :: a -> (t a)
mu :: t (t a) -> (t a)
(>>=) :: Monad t => t a -> (a -> t b) -> t b
ma >>= f = join . fmap f
간단히 말해 위의 모나드 법칙은 클라이슬리 범주에서의 범주 법칙일 뿐이며, 구체적으로 모나드 m의 클라이슬리 범주의 관점에서 모나드 법칙은 다음과 같습니다:
(f >=> g) >=> h ≡ f >=> (g >=> h)
return >=> f ≡ f
f >=> return ≡ f
예를 들어 Just는 Maybe 모나드의 클라이슬리 범주에서 항등 사상일 뿐입니다.
Just >=> f = f
f >=> Just = f
just :: (a :~> a) Maybe
just = K Just
left :: forall a b. (a :~> b) Maybe -> (a :~> b) Maybe
left f = just . f
right :: forall a b. (a :~> b) Maybe -> (a :~> b) Maybe
right f = f . just
Haskell 모나드
예를 들어 List 모나드는 다음을 갖습니다:
- 는 하나의 원소로부터 단일 원소 리스트를 반환합니다.
- 는 중첩된 리스트를 평탄한 리스트로 바꿉니다.
- 은 리스트의 원소들에 함수를 적용합니다.
instance Functor [] where
-- fmap :: (a -> b) -> [a] -> [b]
fmap f (x:xs) = f x : fmap f xs
instance Monad [] where
-- eta :: a -> [a]
eta x = [x]
-- mu :: [[a]] -> [a]
mu = concat
Maybe 모나드는 다음을 갖습니다:
- 는 Just 생성자입니다.
- 는 두 겹의 Just 생성자를 합쳐 안쪽 값 또는 Nothing을 내놓습니다.
- 은 Just 생성자 아래에서 함수를 적용하고, Nothing에 대해서는 아무것도 하지 않습니다.
instance Functor [] where
-- fmap :: (a -> b) -> Maybe a -> Maybe b
fmap f (Just x) = Just (f x)
fmap f Nothing = Nothing
instance Monad Maybe where
-- eta :: a -> Maybe a
eta x = Just x
-- mu :: (Maybe (Maybe a)) -> Maybe a
mu (Just (Just x)) = Just x
mu (Just Nothing) = Nothing
IO 모나드는 직관적으로 다음과 같은 구현을 갖습니다:
- 는 순수한 값을 계산의 문맥 안에 있는 값으로 반환합니다.
- 는 일련의 IO 연산을 하나의 IO 연산으로 바꿉니다.
- 은 계산의 결과에 함수를 적용합니다.
instance Functor IO where
-- fmap :: (a -> b) -> IO a -> IO b
instance Monad Maybe where
-- eta :: a -> IO a
-- mu :: (IO (IO a)) -> IO a
Python으로 구현하는 시공간 대수
기하 대수는 선형대수를 매우 멋지게 재정식화한 대안으로, 기하학적 변환과 물리 현상을 표현하는 간결한 체계를 제공합니다. 제가 가장 좋아하는 책 중 하나는 Leo Dorst, Daniel Fontijne, Stephen Mann이 쓴 *컴퓨터 과학을 위한 기하 대수(Geometric Algebra for Computer Science)*입니다. 이 책은 기하 대수를 시각화하는 매우 멋진 환경인 GAViewer라는 언어로 코드를 구현하지만, 저는 개념을 제대로 이해하기 위해 Python으로 직접 구현해 보고 싶었습니다.
- 블레이드(Blades): 기하 대수에서 방향이 있는 부분공간을 나타내는 기본 구성 요소입니다. 예를 들면 다음과 같습니다.
- 스칼라(0-블레이드)는 점입니다.
- 벡터(1-블레이드)는 방향이 있는 직선을 나타냅니다.
- 바이벡터(2-블레이드)는 특정 방향으로 향한 평면 조각을 나타냅니다.
- 멀티벡터(Multivectors): 서로 다른 블레이드의 선형 결합이며, 다양한 기하학적 양을 나타낼 수 있습니다.
서로 다른 블레이드(스칼라, 벡터, 바이벡터)와 멀티벡터를 캡슐화하여 덧셈, 뺄셈, 기하곱 같은 연산을 할 수 있게 하는 클래스 구조를 만들겠습니다.
먼저 기본 블레이드 클래스를 정의해 봅시다.
import numpy as np
class Blade:
def __add__(self, other):
return Multivector([self, other])
def __sub__(self, other):
return Multivector([self, -other])
def __neg__(self):
return -1 * self # Negation
class Scalar(Blade):
def __init__(self, value):
self.value = value
def __repr__(self):
return f"{self.value}"
class Vector(Blade):
def __init__(self, components):
self.components = np.array(components)
def __repr__(self):
return f"Vector({self.components})"
def magnitude(self):
return np.linalg.norm(self.components)
class Bivector(Blade):
def __init__(self, vector1, vector2):
self.vector1 = vector1
self.vector2 = vector2
def __repr__(self):
return f"Bivector({self.vector1}, {self.vector2})"
Multivector 클래스는 블레이드의 임의의 선형 결합을 나타냅니다.
class Multivector:
def __init__(self, blades=[]):
self.blades = blades
def __repr__(self):
return f"Multivector({self.blades})"
def add(self, other):
self.blades.extend(other.blades)
def scale(self, scalar):
for blade in self.blades:
blade.value *= scalar
벡터와 바이벡터에 대해 기하곱 같은 연산을 구현할 수 있습니다. Vector 클래스와 Bivector 클래스 안에 연산을 정의해 봅시다.
class Vector(Blade):
def __init__(self, components):
self.components = np.array(components)
# Other methods as before...
def __or__(self, other):
""" Vector wedge product (bivector) """
return Bivector(self, other)
def __and__(self, other):
""" Scalar product (dot product) """
return Scalar(np.dot(self.components, other.components))
class Bivector(Blade):
def __init__(self, vector1, vector2):
self.vector1 = vector1
self.vector2 = vector2
def __repr__(self):
return f"Bivector({self.vector1}, {self.vector2})"
def dual(self):
""" Returns the dual of a bivector as a vector """
return Vector(np.cross(self.vector1.components, self.vector2.components))
이제 구현한 코드를 사용해 벡터 몇 개를 만들고, 그 곱을 계산하고, 기하 대수의 개념을 시연해 봅시다.
# Create instances of Scalars, Vectors, and Bivectors
s1 = Scalar(5)
v1 = Vector([1, 0, 0])
v2 = Vector([0, 1, 0])
biv = v1 | v2 # Wedge product (Bivector)
# Output representations
print("Scalar:", s1)
print("Vector 1:", v1)
print("Vector 2:", v2)
print("Bivector (v1 wedge v2):", biv)
# Vector dot product
dot_product = v1 & v2
print("Dot Product (v1 · v2):", dot_product)
# Vector wedge product to get a bivector
biv_product = v1 | v2
print("Wedge Product Bivector (v1 ∧ v2):", biv_product)
지금까지 다진 기반 위에서 구현을 시공간 대수(Space-Time Algebra, STA)로 확장할 수 있습니다. STA는 시간을 공간과 나란한 하나의 차원으로 통합하므로, 4차원 맥락(공간 3차원과 시간 1차원)에서 개체와 변환을 표현할 수 있습니다.
STA에서는 시간 벡터라는 개념을 도입하여 공간과 시간 모두에서 사건과 변환을 다룰 수 있습니다. 공간 성분과 시간 성분을 연관 짓기 위해 시간 단위를 정의하겠습니다(상대론적 맥락에서 일관성을 위해 흔히 광속인 로 나타냅니다).
Vector 클래스를 수정하여 시간을 하나의 성분으로 포함하도록 하고, 공간 3차원과 시간 1차원을 아우르는 SpaceTimeVector 클래스를 만들겠습니다.
class SpaceTimeVector(Blade):
def __init__(self, components):
# Expecting components in the form [x, y, z, t]
assert len(components) == 4, "SpaceTimeVector must have four components: [x, y, z, t]."
self.components = np.array(components)
def __repr__(self):
return f"SpaceTimeVector({self.components})"
def magnitude(self):
""" Calculate the Minkowski norm (using (-,+,+,+) signature) """
return np.sqrt(-self.components[3]**2 + np.sum(self.components[:3]**2))
def __add__(self, other):
return SpaceTimeVector(self.components + other.components)
def __sub__(self, other):
return SpaceTimeVector(self.components - other.components)
def __or__(self, other):
""" Wedge product (resulting in a bivector in 3D + time) """
return SpaceTimeBivector(self, other)
def __and__(self, other):
""" Scalar product (dot product, returns a scalar) """
return Scalar(np.dot(self.components, other.components))
SpaceTimeBivector 클래스는 두 SpaceTimeVector 인스턴스의 기하곱을 나타냅니다.
class SpaceTimeBivector(Blade):
def __init__(self, vector1, vector2):
self.vector1 = vector1
self.vector2 = vector2
def __repr__(self):
return f"SpaceTimeBivector({self.vector1}, {self.vector2})"
def dual(self):
""" Returns the dual of a bivector as a SpaceTimeVector """
return SpaceTimeVector(np.cross(self.vector1.components[:3], self.vector2.components[:3]))
이제 SpaceTimeVector의 인스턴스를 만들고 기능을 시연해 봅시다.
# Create space-time vectors
st_vector1 = SpaceTimeVector([1, 2, 3, 4]) # (x, y, z, t)
st_vector2 = SpaceTimeVector([4, 5, 6, 7]) # (x', y', z', t')
print("Space-Time Vector 1:", st_vector1)
print("Space-Time Vector 2:", st_vector2)
st_vector_sum = st_vector1 + st_vector2
print("Sum of Space-Time Vectors:", st_vector_sum)
st_vector_diff = st_vector1 - st_vector2
print("Difference of Space-Time Vectors:", st_vector_diff)
dot_product_st = st_vector1 & st_vector2
print("Dot Product of Space-Time Vectors:", dot_product_st)
# Wedge product to get a space-time bivector
st_bivector = st_vector1 | st_vector2
print("Wedge Product Space-Time Bivector:", st_bivector)
magnitude = st_vector1.magnitude()
print("Magnitude of Space-Time Vector 1:", magnitude)
라이선스와 고지
아래는 원문 사이트의 라이선스 페이지를 한국어로 요약한 것이고, 그 뒤에 영어 원문 전체를 그대로 실었습니다. 해석이 다를 때는 영어 원문이 기준입니다.
요약
- 글(에세이, 블로그 글, 노트, 서평 등 모든 산문)은 Creative Commons Attribution-ShareAlike 4.0 International(CC BY-SA 4.0)로 제공됩니다. 출처를 “Stephen Diehl, stephendiehl.com“으로 밝히고, 라이선스 링크를 달고, 변경했다면 변경 사실을 표시해야 하며, 개작물은 같은 라이선스로 배포해야 합니다. 저자는 모든 글에 대한 저작인격권(저자로 식별될 권리 포함)을 주장합니다.
- 코드(글 속 스니펫, 전체 예제, 사이트 소스)는 글에서 따로 밝히지 않는 한 MIT 라이선스입니다.
- 개인 의견 고지: 이 사이트의 모든 글은 저자가 사적인 시민으로서 공익에 관한 사안에 대해 자비로 쓴 것이며, 어떤 외국 정부·정당·캠페인·외국 단체의 자금도 받지 않았고 지시나 조율을 받지도 않았습니다. 여기 담긴 의견·분석·주장은 전적으로 저자 개인의 것이며, 저자가 과거나 현재에 관계된 어떤 고용주·고객·자문처·이사회· 비영리 단체·조직의 견해도 대변하지 않습니다. 이 글들에서 어떤 기관의 지지도 추론해서는 안 됩니다. 이는 정중한 부탁이 아니라 엄격한 규칙입니다: 이 사이트의 글을 인용·참조·언급할 때 그런 조직을 이름 붙이거나, 특정하거나, 암시하거나, 그 밖의 방식으로 관여를 시사해서는 안 됩니다. 그렇게 하면 이 글의 출처를 왜곡하고, 저자만의 견해에 제3자를 잘못 결부시키게 됩니다.
- 인용과 언론: 언론·학술·기타 출판물에서 저자의 글을 인용할 때는 위 라이선스 조건 아래 자유롭게 할 수 있습니다. 저자가 미리 승인한 소개 문구는 “Stephen Diehl is a software engineer and writer from London.”(Stephen Diehl은 런던의 소프트웨어 엔지니어이자 작가입니다)이며, 이 문구와 원문 글로의 링크를 함께 쓰면 라이선스의 출처 표기 요건과 위 고지를 모두 충족합니다. 학술 인용은 APA 형식 “Diehl, S. (연도, 월 일). 글 제목. Stephen Diehl. https://stephendiehl.com/posts/slug“를 권합니다.
- 위에 해당하지 않는 용도는 저자에게 직접 문의하십시오.
이 번역본에 대하여
이 사이트는 위 CC BY-SA 4.0 글을 한국어로 옮긴 파생물입니다. 번역하면서 원문을
변경했고(언어, 그리고 사이트 구성), 같은 CC BY-SA 4.0으로 제공합니다. 코드
블록은 원문 그대로이며 MIT입니다. 번역은 yeokja와
함께 Anthropic 사의 claude-opus-5-5 모델을 활용하여 번역되었으며 학습을 모두
비허용한 상태로 작업하였습니다. 저자가 검토하거나 승인한 번역이 아닙니다.
Original license text
License
This site is the personal work of Stephen Diehl. The terms below cover the two kinds of material you’ll find here.
Written content
All written content (essays, blog posts, notes, book reviews, and any prose published on this site) is released under the Creative Commons Attribution-ShareAlike 4.0 International License (CC BY-SA 4.0).
You are free to:
- Share — copy and redistribute the material in any medium or format.
- Adapt — remix, transform, and build upon the material for any purpose, including commercial use.
Under the following terms:
- Attribution — you must give appropriate credit (“Stephen Diehl, stephendiehl.com”), provide a link to the license, and indicate if changes were made.
- ShareAlike — if you remix, transform, or build upon the material, you must distribute your contributions under the same license as the original.
I assert my moral rights as the author of all written content on this site, including the right to be identified as the author, in accordance with sections 77 and 78 of the Copyright, Designs and Patents Act 1988.
Code
All code published on this site — including snippets in posts, complete examples, and the source of this website itself — is released under the MIT License unless explicitly stated otherwise within the post.
MIT License
Copyright (c) 2009-2026 Stephen Diehl
Permission is hereby granted, free of charge, to any person obtaining a copy
of this software and associated documentation files (the "Software"), to deal
in the Software without restriction, including without limitation the rights
to use, copy, modify, merge, publish, distribute, sublicense, and/or sell
copies of the Software, and to permit persons to whom the Software is
furnished to do so, subject to the following conditions:
The above copyright notice and this permission notice shall be included in all
copies or substantial portions of the Software.
THE SOFTWARE IS PROVIDED "AS IS", WITHOUT WARRANTY OF ANY KIND, EXPRESS OR
IMPLIED, INCLUDING BUT NOT LIMITED TO THE WARRANTIES OF MERCHANTABILITY,
FITNESS FOR A PARTICULAR PURPOSE AND NONINFRINGEMENT. IN NO EVENT SHALL THE
AUTHORS OR COPYRIGHT HOLDERS BE LIABLE FOR ANY CLAIM, DAMAGES OR OTHER
LIABILITY, WHETHER IN AN ACTION OF CONTRACT, TORT OR OTHERWISE, ARISING FROM,
OUT OF OR IN CONNECTION WITH THE SOFTWARE OR THE USE OF OTHER DEALINGS IN THE
SOFTWARE.
Personal views only
Everything published on this site is written in my personal capacity, as a private citizen on matters of public interest, at my own expense. Nothing here is funded, directed, or coordinated by any foreign government, party, campaign, or other foreign entity. The opinions, analyses, and arguments expressed here are entirely my own and do not represent the views of any employer, client, advisor, board, nonprofit, or other organisation I am now or have ever been associated with. Do not infer any institutional endorsement from anything written here.
This is a hard rule, not a polite request: you must not name, identify, hint at, or otherwise imply the involvement of any such organisation when quoting, citing, or referring to material on this site. Doing so misrepresents the source of this writing and falsely associates third parties with views that are exclusively my own.
Attribution and press
If you would like to quote, cite, or refer to my writing in journalism, academic work, or other publications, you are very welcome to do so under the licence terms above. To keep things simple, the following short biographical line is the preferred and pre-approved attribution:
Stephen Diehl is a software engineer and writer from London.
Citations using this form, with a link back to the source post on stephendiehl.com, satisfy both the attribution requirement of the licence and the request above to keep my personal writing distinct from any organisation or affiliation.
For academic and scholarly work, the following APA format is preferred:
Diehl, S. (Year, Month Day). Title of post. Stephen Diehl. https://stephendiehl.com/posts/slug
Questions
If a use case isn’t covered above, or you’d like to do something the licence doesn’t obviously permit, get in touch. I’m usually happy to grant individual exceptions where the spirit of the licence is intact.