트랜스포머
트랜스포머 아키텍처는 기념비적인 2017년 논문 Attention is All You Need(어텐션만 있으면 된다)에서 소개되면서 자연어 처리 분야에 혁명을 일으켰습니다. 트랜스포머는 전통적인 시퀀스 모델에서 벗어나 셀프 어텐션 메커니즘(자세한 내용은 뒤에서 다룹니다)을 핵심(Core) 구성 요소로 사용하며, 이를 통해 데이터의 장거리 의존성을 놀라울 만큼 효율적으로 포착합니다. 본질적으로 트랜스포머는 범용 계산 기반으로 볼 수 있습니다. 즉, 학습 데이터에 따라 스스로를 재구성하는 프로그래밍 가능한 논리 조직이며, 이를 층층이 쌓아 흥미로운 창발적 행동을 보이는 대규모 모델을 만들 수 있습니다.
이러한 각 레이어에는 함께 맞물려 작동하는 두 가지 필수 하위 레이어가 있습니다. 바로 멀티헤드 셀프 어텐션 메커니즘과 위치별 피드포워드 네트워크입니다. 멀티헤드 어텐션을 통해 모델은 입력 시퀀스의 여러 부분에 동시에 주목할 수 있으며, 서로 다른 표현 관점에서 토큰 사이의 다양한 관계를 포착합니다. 이어서 각 위치에 동일하게 적용되는 피드포워드 네트워크가 비선형성을 도입하고, 복잡한 패턴을 학습하는 모델의 능력을 확장합니다.
어텐션 메커니즘은 모든 토큰을 병렬로 처리하므로, 트랜스포머에는 순서 정보를 다루는 혁신적인 방법이 필요합니다. 이 문제는 입력 레이어에서 토큰 임베딩에 더해지는 위치 인코딩으로 해결합니다. 위치 인코딩으로는 학습된 임베딩이나 고정된 사인파 함수를 사용합니다. 이러한 인코딩은 병렬 처리 과정에서 사라졌을 토큰 위치에 관한 핵심 정보를 모델에 제공합니다.
트랜스포머의 강력함은 처리 과정에서 여러 토큰의 중요도에 동적으로 가중치를 부여하는 능력에서 비롯됩니다. “I went to the bank to deposit money.“라는 문장의 “bank“라는 단어를 생각해 보십시오. 이 중의적인 단어를 처리할 때 모델은 “deposit“과 “money” 같은 문맥상의 단서에 강하게 주목할 수 있으며, 덕분에 “bank“를 강둑이 아닌 금융 기관으로 올바르게 해석합니다. 이러한 문맥 인식 능력 덕분에 트랜스포머는 미묘한 언어 이해가 필요한 작업에서 탁월한 성능을 발휘합니다.
레이어 정규화와 잔차 연결은 트랜스포머 아키텍처를 한층 더 강화합니다. 레이어 정규화는 각 레이어 안의 활성화 값을 정규화하여 학습 과정을 안정시키고, 잔차 연결은 학습 중 그래디언트가 흐를 지름길을 만듭니다. 이 구성 요소들은 함께 작용하여 깊은 네트워크를 자주 괴롭히는 그래디언트 소실 문제를 완화하며, 덕분에 트랜스포머는 깊이가 깊어도 효과적으로 학습할 수 있습니다.
놀랍게도 연구자들은 레이어 수, 임베딩 차원, 학습 데이터를 늘려 트랜스포머 모델의 규모를 키우자 이 아키텍처가 놀라운 창발적 능력을 보인다는 사실을 발견했습니다. 더 큰 모델은 퓨샷 학습, 추론, 심지어 명시적으로 학습하지 않은 개념에 대한 초보적인 이해까지, 더 작은 모델에는 없는 능력을 보입니다. 이러한 스케일링 효과는 최근 인공지능 발전의 상당 부분을 이끌어 왔습니다.
여기서 처음부터 직접 만들어 볼 디코더 전용 트랜스포머 아키텍처는 동일한 디코더 블록 여러 개를 수직으로 쌓은 구조입니다. 인코더와 디코더 구성 요소를 모두 갖춘 원래의 트랜스포머와 달리, 현대 언어 모델은 일반적으로 다음 토큰 예측 작업에 디코더 부분만 사용합니다. 이 아키텍처는 확장성이 매우 뛰어나다는 것이 입증되었으며, 모델의 규모는 수억 개의 매개변수에서 이제 최첨단 모델의 수십억 개 매개변수에 이릅니다.
순수 NumPy로 구현한 GPT-2 모델을 구성 요소별로 하나씩 살펴봅시다. 핵심(Core) 모델 자체는 작으며, 이를 둘러싼 코드의 대부분은 가중치와 토큰화를 처리합니다. 전체 소스 코드는 tiny-gpt2에서 볼 수 있습니다.
나중에 인터넷에서 내려받을 신경망 가중치에는 여러 자료 구조가 있습니다. 지금은 이것들이 다양한 차원의 배열 모음이라는 점만 알아 두십시오.
LinearParams- 선형 변환을 위한 가중치와 편향 매개변수를 갖는 선형 레이어입니다.LayerNormParams- 정규화를 위한 이득과 편향 매개변수를 갖는 레이어 정규화 레이어입니다.AttentionParams- 쿼리, 키, 값, 출력 투영 매개변수를 담은 멀티헤드 어텐션 레이어입니다.BlockParams- 어텐션과 피드포워드 매개변수를 담은 트랜스포머 블록입니다.ModelParams- 토큰 임베딩, 위치 임베딩, 트랜스포머 블록, 최종 레이어 정규화를 포함한 전체 모델 매개변수입니다.HParams- 레이어 수, 헤드 수, 임베딩 차원 등을 포함한 모델의 하이퍼파라미터입니다.
코드에서는 다음과 같은 약어를 사용합니다.
g- 감마(레이어 정규화를 위한 스케일 매개변수)b- 베타(편향 매개변수)w- 가중치 행렬/배열wte- 단어/토큰 임베딩wpe- 단어 위치 임베딩ln- 레이어 정규화mlp- 다층 퍼셉트론fc- 완전 연결 레이어qkv- 쿼리, 키, 값(어텐션 구성 요소)attn- 어텐션proj- 투영(선형 변환)
BPE 토큰화
바이트 쌍 인코딩(Byte-Pair Encoding, 줄여서 BPE)은 단어를 서브워드라는 더 작은 단위로 나누어 어휘 사전에 없는 단어 문제를 해결하는 토큰화 알고리즘입니다. BPE는 처음에 데이터 압축 기법으로 개발되었으나, 단어를 문자의 시퀀스로 취급하는 방식으로 자연어 처리에 맞게 변형되었습니다. BPE의 핵심(Core) 아이디어는 코퍼스에서 가장 빈번하게 나타나는 인접 기호 쌍을 반복적으로 병합하여 새로운 서브워드 단위로 만드는 것입니다. 이 과정은 말뭉치의 각 단어를 개별 문자로 분리하는 것으로 시작하며, 이렇게 해서 고유한 모든 문자로 구성된 초기 어휘 사전이 만들어집니다.
그런 다음 BPE 알고리즘은 반복적 병합을 진행합니다. 각 반복에서는 말뭉치 전체에 걸쳐 모든 인접 기호 쌍의 개수를 셉니다. 그런 다음 빈도가 가장 높은 쌍을 선택하여 새로운 기호, 즉 서브워드로 병합합니다. 이 병합 연산은 말뭉치에서 선택된 쌍이 나타나는 모든 곳에 적용되며, 결과적으로 단어의 토큰화된 표현에서 두 기호 사이의 공백이 제거됩니다. 새로 만들어진 서브워드는 어휘 사전에 추가됩니다. 이 반복 과정은 어휘 사전이 미리 정한 목표 크기에 도달하거나 더 이상 빈번한 쌍을 찾을 수 없을 때까지 계속됩니다. 학습 중에 수행된 병합 연산의 순서는 처음 보는 새로운 단어를 토큰화하는 데 매우 중요합니다.
BPE 토크나이저가 학습되고 나면(즉, 병합 순서가 결정되고 나면) 이를 사용해 새로운 텍스트를 토큰화할 수 있습니다. 단어를 토큰화할 때 토크나이저는 먼저 (초기 단어 경계 표시가 붙은) 단어 전체가 어휘 사전에 있는지 확인합니다. 없다면 단어를 문자 단위로 분리한 다음, 학습된 병합 규칙을 학습된 순서대로 반복해서 적용합니다. 초기 문자 집합에 없는 문자는 알 수 없는 토큰(예: <UNK>)으로 대체될 수 있습니다. BPE는 현대 언어 모델에서 널리 사용되며, 특히 희귀한 단어나 중국어처럼 단어 경계가 명확하지 않아 초기 토큰화를 개별 문자에서 시작할 수 있는 언어를 처리하는 데 유용합니다.
BPE를 처음부터 구현하지는 않겠지만, 간단한 Python 구현은 여기에서 찾아볼 수 있습니다. 대신 원래 GPT-2 저장소에 있는 기존 토크나이저를 불러와 사용하겠습니다.
encoder = get_encoder("", "model")

# encode a string into a list of tokens
tokens = encoder.encode("Hello world")

print(tokens) # [15496, 995]
여기서 토크나이저가 문자열 “Hello world“를 토큰 리스트 [15496, 995]로 인코딩한 것을 볼 수 있으며, 이 경우에는 공교롭게도 단어 두 개와 토큰 두 개로 이루어져 있습니다. 그러나 문자열 “Barack Obama“는 [10374, 441, 2486]로 인코딩되며, 이는 단어 두 개와 토큰 세 개로 이루어져 있습니다.

토큰화와 위치 임베딩
문자열 입력을 먼저 토큰 리스트로 토큰화한 다음, 각 토큰에 대한 토큰 임베딩을 params.wte 행렬에서 조회합니다.
x = params.wte[inputs] + params.wpe[range(len(inputs))]
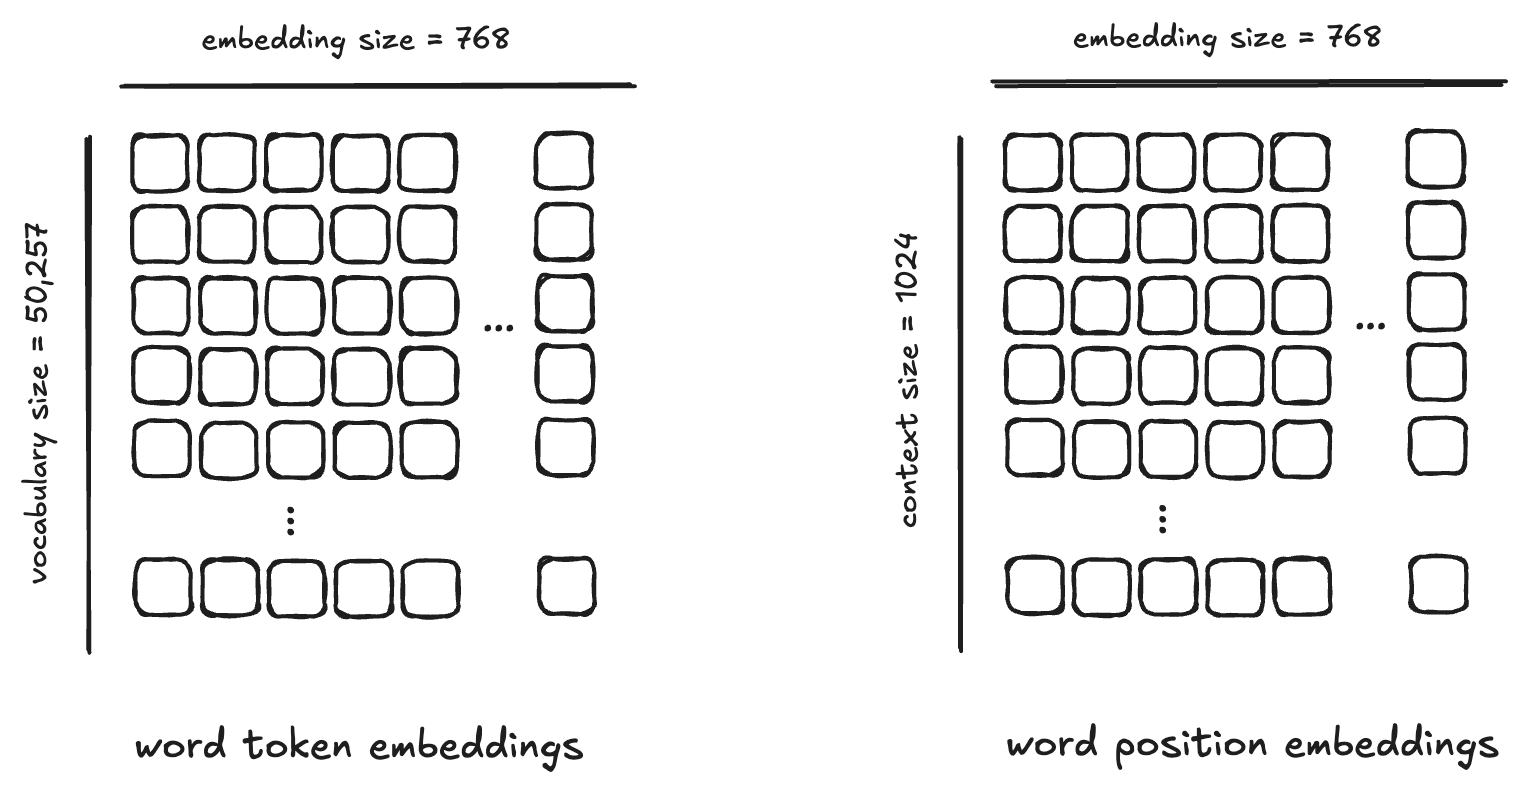
이 줄은 입력 시퀀스가 주요 트랜스포머 블록에서 처리되기 전에 이를 준비하는 데 매우 중요합니다. 이 줄은 입력의 각 토큰에 대해 두 가지 유형의 정보(위치와 토큰 자체)를 결합합니다. 모델 설정에는 두 개의 큰 임베딩 행렬, 즉 토큰 임베딩 행렬과 위치 임베딩 행렬이 있습니다.
토큰 임베딩 (params.wte[inputs]):
inputs 매개변수는 입력 토큰 시퀀스를 정수(토큰 ID) 리스트로 나타냅니다. 예를 들어 입력 텍스트 “Hello world“가 [15496, 995]로 토큰화된다면, inputs는 [15496, 995]가 됩니다.
params.wte는 Word Token Embedding(단어 토큰 임베딩) 행렬을 가리킵니다. 이는 본질적으로 큰 표(조회 테이블)로, 각 행은 모델 어휘의 고유한 토큰 ID 하나에 대응하며, 행 자체는 벡터(예를 들어 소형 GPT-2 모델에서는 크기 768)입니다. 이 벡터는 해당 토큰에 대해 학습된 수치 표현, 즉 “임베딩“입니다.
params.wte[inputs] 연산은 조회를 수행합니다. 이 연산은 inputs 리스트의 각 정수 ID를 가져와 params.wte 행렬에서 그에 대응하는 임베딩 벡터를 가져옵니다. 그 결과는 각 행이 입력 시퀀스의 대응하는 토큰에 대한 토큰 임베딩인 행렬입니다. 따라서 [15496, 995]의 경우 두 개의 행, 즉 토큰 15496의 임베딩과 토큰 995의 임베딩으로 이루어진 행렬을 얻게 됩니다.
위치 임베딩 (params.wpe[range(len(inputs))]):
트랜스포머는 셀프 어텐션을 사용하여 토큰을 병렬로 처리하는데, 셀프 어텐션은 본질적으로 토큰의 순서를 알지 못합니다. 이러한 순서 정보를 제공하기 위해 위치 임베딩을 사용합니다. len(inputs) 함수는 입력 시퀀스의 길이를 계산합니다(예: [15496, 995]의 경우 2). range(len(inputs))를 사용하면 0부터 시작하는 위치 인덱스 시퀀스가 생성되며, 이 예제에서는 [0, 1]입니다.
params.wpe는 Word Position Embedding(단어 위치 임베딩) 행렬을 가리킵니다. wte와 마찬가지로 조회 테이블이지만, 그 행은 시퀀스 내의 위치(0, 1, 2, … 모델이 처리할 수 있는 최대 시퀀스 길이까지)에 대응합니다. 각 행은 해당 위치를 나타내는 학습된 벡터입니다. GPT-2는 학습된 위치 임베딩을 사용하며, 이는 이 벡터들이 학습 중에 학습되는 매개변수라는 뜻입니다.
마지막으로 params.wpe[range(len(inputs))]는 위치 인덱스를 사용하여 조회를 수행합니다. 이는 입력 길이만큼 위치 0, 위치 1 등의 순서로 임베딩 벡터를 가져옵니다. 그 결과는 각 행이 입력 시퀀스의 대응하는 위치에 대한 위치 임베딩인 행렬입니다.
덧셈 (+):
토큰 임베딩 행렬(각 토큰이 무엇인지를 나타냄)과 위치 임베딩 행렬(각 토큰이 시퀀스의 어디에 있는지를 나타냄)은 단순히 원소별로 더해집니다. 두 행렬은 같은 형태(시퀀스 길이 × 임베딩 차원)를 가집니다.
이렇게 만들어진 행렬 x에는 이제 각 벡터가 토큰의 정체와 위치를 함께 인코딩하는 벡터들이 담깁니다. 이렇게 결합된 표현이 최종 입력이 되어, 처리를 위해 트랜스포머 블록 스택에 전달됩니다.
요약하면, 이 줄 x = params.wte[inputs] + params.wpe[range(len(inputs))]는 각 토큰에 대해 학습된 벡터를 조회하고 그 위치에 대해 학습된 벡터를 더하여 입력 시퀀스의 초기 표현을 만듭니다. 덕분에 이후의 트랜스포머 레이어는 토큰의 순서를 인식한 채로 토큰을 처리할 수 있습니다.
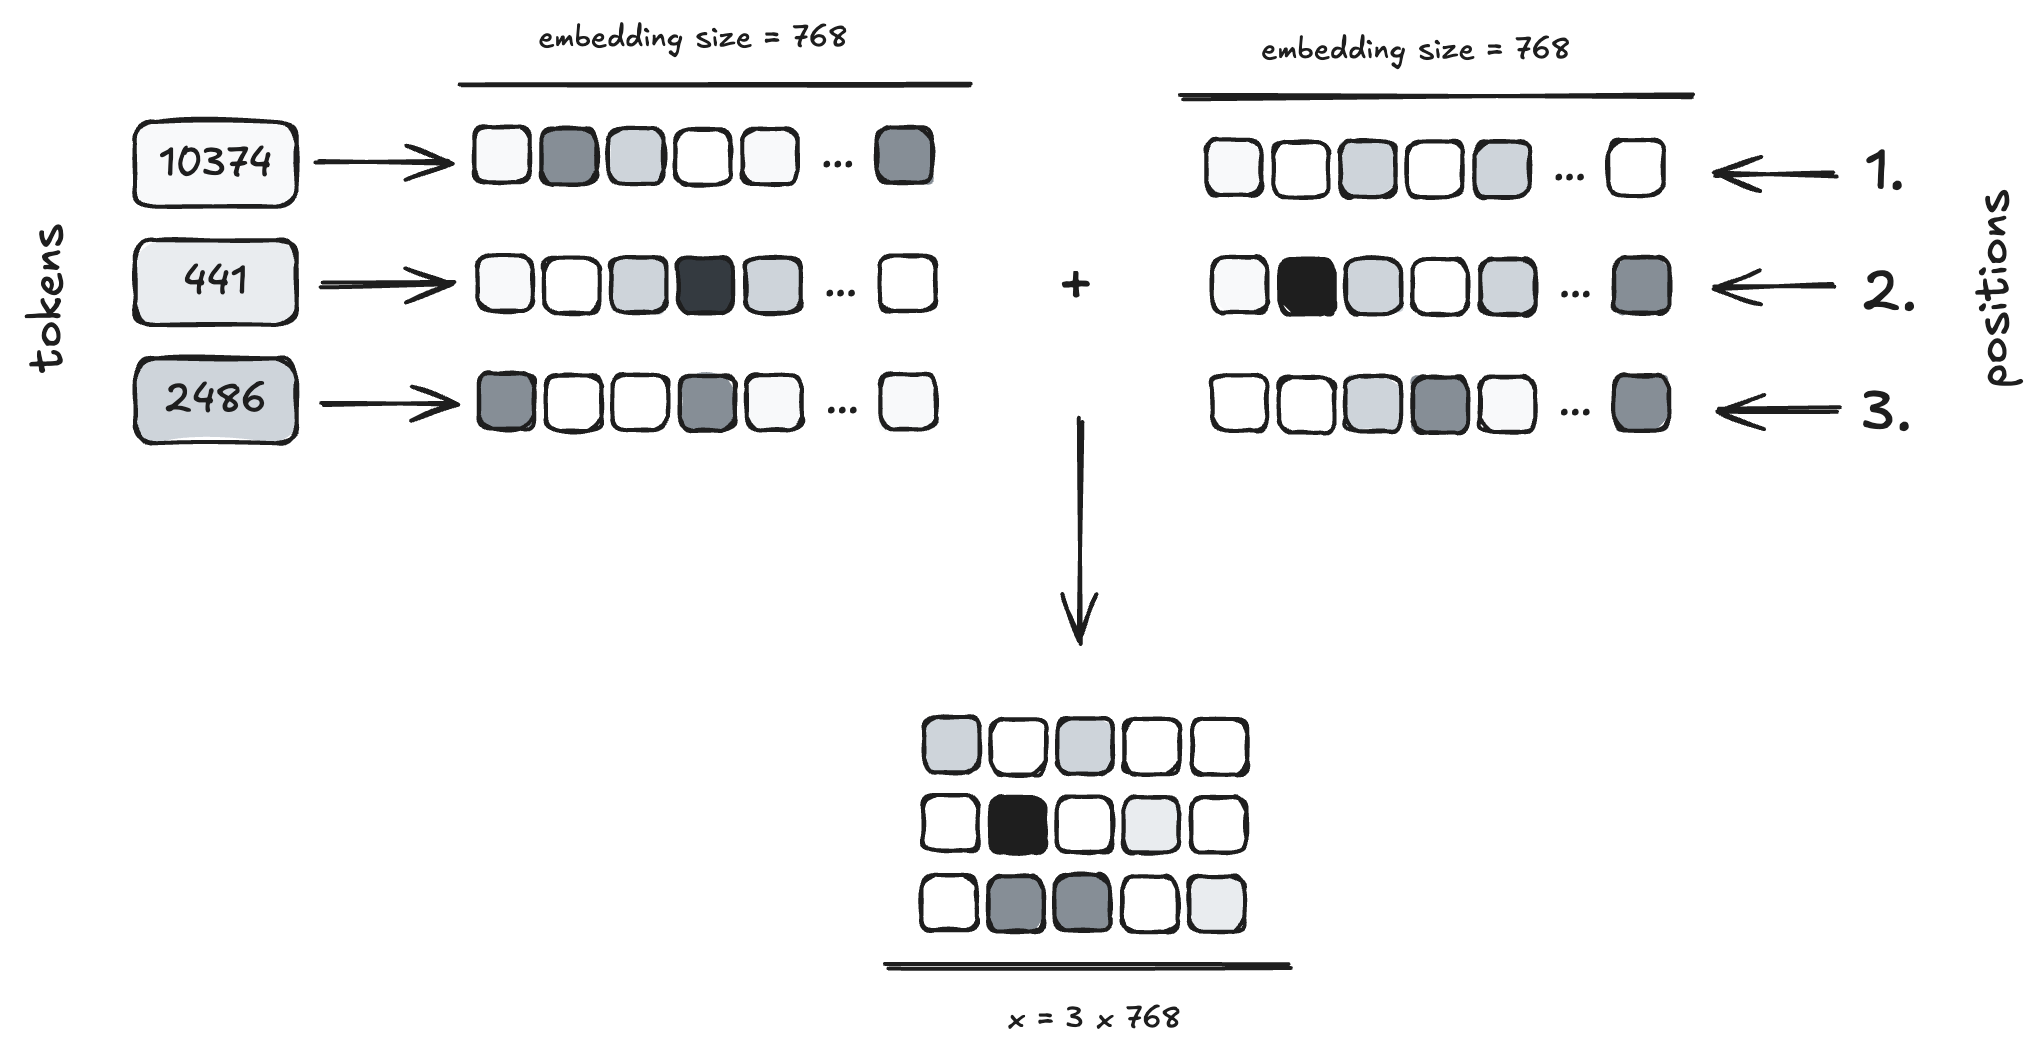
이 행렬의 크기는 [sequence_length, embedding_dimension]입니다. 코드에서는 시퀀스 길이를 N으로 표기합니다.
GELU
GELU(Gaussian Error Linear Unit, 가우스 오차 선형 유닛)는 트랜스포머 아키텍처, 특히 각 블록의 피드포워드 네트워크(FFN) 안에서 사용되는 활성화 함수입니다. 주된 역할은 모델에 비선형성을 도입하여 데이터의 더 복잡한 패턴과 관계를 학습할 수 있게 하는 것입니다. 비선형 활성화 함수가 없으면 여러 레이어를 쌓아도 하나의 선형 변환과 같아져서 모델의 표현력이 크게 제한됩니다. 수학적으로는 다음과 같이 정의됩니다.
여기서 erf는 가우스 오차 함수입니다. 실제로는 오차 함수에 포함된 적분을 계산하지 않아도 되도록 tanh 함수로 오차 함수를 근사하는 방식을 사용합니다. Python에서는 이 근사를 다음과 같이 구현합니다.
# gelu:
#   x : (N, 768)
#   out : (N, 768)
def gelu(x: np.ndarray) -> np.ndarray:
    return 0.5 * x * (1 + np.tanh(np.sqrt(2 / np.pi) * (x + 0.044715 * x**3)))
이 함수는 입력에 원소별로 적용되는 스칼라 함수라는 점에 유의하십시오.
소프트맥스
GELU가 피드포워드 네트워크 안에서 비선형성을 담당한다면, 트랜스포머 아키텍처에는 원시 점수를 의미 있는 확률 분포로 바꾸는 방법도 필요합니다. 바로 여기서 소프트맥스 함수가 등장합니다. 소프트맥스는 트랜스포머 아키텍처에서 주로 두 곳, 즉 어텐션 메커니즘 안과 최종 출력 레이어에서 사용되는 중요한 함수입니다. 그 목적은 원시 점수(로짓) 벡터를 확률 분포로 변환하는 것입니다. 입력 벡터를 받아 각 원소에 지수 함수를 적용하여 모두 양수로 만든 다음, 그 값들을 합으로 나누어 정규화합니다. 그 결과 모든 원소가 0과 1 사이에 있고 그 합이 1이 되는 벡터를 얻습니다.
어텐션 메커니즘(attention 함수)에서는 쿼리와 키 사이의 스케일된 내적 점수에 소프트맥스를 적용합니다. 이를 통해 원시 유사도 점수가 어텐션 가중치로 바뀌며, 이 가중치는 값 벡터들에 대한 확률 분포, 즉 각 값이 얼마나 주목받아야 하는지를 나타냅니다.
모델의 마지막 레이어에서는(다음 토큰을 생성하기 직전에) 보통 최종 선형 사영이 만들어 낸 로짓에 소프트맥스를 적용합니다. 이를 통해 어휘의 각 단어에 대한 모델의 원시 출력 점수가 확률로 바뀌므로, 점수를 해석하고 이 분포에 따라 다음 토큰을 샘플링할 수 있습니다.
# softmax:
#   x : (N, 64)
#   out : (N, 64)
def softmax(x: np.ndarray) -> np.ndarray:
    exp_x = np.exp(x - np.max(x, axis=-1, keepdims=True))
    return exp_x / np.sum(exp_x, axis=-1, keepdims=True)
레이어 정규화
활성화 함수와 확률 변환 외에도, 신경망에는 특히 트랜스포머처럼 깊은 아키텍처에서 학습을 안정화하는 방법이 필요합니다. 레이어 정규화(LayerNorm)가 바로 이 중요한 역할을 합니다. 배치 차원에 걸쳐 정규화하는 배치 정규화와 달리, 레이어 정규화는 각 데이터 샘플마다 독립적으로 특성(임베딩 차원)에 걸쳐 입력을 정규화합니다.
여기서 는 입력의 평균이고 는 입력의 분산이며, 와 는 학습 가능한 이득 및 편향 매개변수입니다.
트랜스포머 블록에서 LayerNorm은 일반적으로 멀티헤드 어텐션 하위 레이어의 앞과 피드포워드 네트워크 하위 레이어의 앞에 적용됩니다(이를 pre-LN이라고 합니다). 이는 단일 학습 예제에 대해 한 레이어 안의 모든 활성화의 평균과 분산을 계산하는 방식으로 동작합니다. 그런 다음 이 평균과 분산을 사용하여 활성화 값을 정규화합니다. 무엇보다 중요한 점은 학습 가능한 이득(g)과 편향(b) 매개변수도 도입한다는 것이며, 이를 통해 네트워크는 정규화된 출력의 크기를 조정하고 이동시켜 표현 능력을 보존할 수 있습니다.
LayerNorm은 기울기 소실이나 폭주 같은 문제를 완화하고, 더 높은 학습률을 사용할 수 있게 하며, 모델이 매개변수의 스케일과 초기화에 덜 민감하도록 만듭니다. 각 계층 내의 활성화 값을 정규화함으로써 후속 계층의 입력이 일관된 스케일을 갖도록 보장하며, 그 결과 더 매끄럽고 안정적인 훈련 동역학을 얻을 수 있습니다.
# layer_norm:
#   x : (N, 768)
#   g : (768,)
#   b : (768,)
#   out : (N, 768)
def layer_norm(
    x: np.ndarray, g: np.ndarray, b: np.ndarray, eps: float = 1e-5
) -> np.ndarray:
    mean = np.mean(x, axis=-1, keepdims=True)
    variance = np.var(x, axis=-1, keepdims=True)
    return g * (x - mean) / np.sqrt(variance + eps) + b
선형 투영
정규화로 네트워크를 안정화했으니, 이제 트랜스포머에는 표현을 한 공간에서 다른 공간으로 변환하는 방법이 필요합니다. 바로 여기서 선형 레이어가 등장합니다. 완전 연결 레이어 또는 밀집 레이어라고도 불리는 선형 레이어는 신경망에서 가장 기본적인 구성 요소 중 하나입니다. 선형 계층은 입력 데이터에 선형 변환을 수행합니다.
수학적으로는 output = input @ weights + bias를 계산하며, 여기서 @는 행렬 곱셈을 나타냅니다. input은 레이어에 주어지는 데이터이고, weights는 학습 가능한 매개변수로 이루어진 행렬이며, bias는 결과에 더해지는 학습 가능한 벡터입니다. 가중치 행렬은 사실상 입력 벡터를 원래 차원에서 (가중치 행렬의 형태로 정의되는) 새로운 차원으로 투영하며, 편향은 출력을 이동시킬 수 있게 해 줍니다.
# linear:
#   x : (N, 768)
#   w : (768, 3072)
#   b : (3072,)
#   out : (N, 3072)
def linear(x: np.ndarray, w: np.ndarray, b: np.ndarray) -> np.ndarray:
    return x @ w + b
피드포워드 네트워크
정규화, 활성화, 선형 변환이라는 개별 구성 요소를 살펴보았으니, 이제 이러한 구성 요소가 피드포워드 네트워크(FFN)에서 어떻게 결합되는지 살펴볼 수 있습니다. 위치별 피드포워드 네트워크라고도 불리는 FFN은 각 트랜스포머 블록 안에서 (멀티헤드 어텐션 하위 레이어 다음에 오는) 두 번째 주요 하위 레이어입니다.
FFN은 두 개의 선형 변환과 그 사이에 적용되는 비선형 활성화 함수(앞서 살펴본 GELU 함수)로 구성됩니다. 첫 번째 선형 레이어는 보통 입력의 차원을 확장하고(예를 들어 GPT-2에서는 768에서 3072로), GELU 활성화는 비선형성을 도입하며, 두 번째 선형 레이어는 결과를 원래 입력 차원으로 다시 투영합니다(예를 들어 3072에서 다시 768로).

이 FFN은 시퀀스의 각 위치에 독립적으로 적용됩니다. 어텐션 메커니즘은 토큰들이 서로 상호작용할 수 있게 하는 반면, FFN은 각 위치의 정보를 개별적으로 처리하여 모델이 학습한 특징을 바탕으로 표현을 변환합니다. FFN은 모델에 상당한 표현 능력을 더해 주어, 어텐션 메커니즘만으로는 포착할 수 없는 더 복잡한 함수를 학습할 수 있게 합니다.
# ffn:
#   x : (N, 768)
#   c_fc_w : (768, 3072)
#   c_fc_b : (3072,)
#   c_proj_w : (3072, 768)
#   c_proj_b : (768,)
#   out : (N, 768)
def ffn(
    x: np.ndarray,
    c_fc_w: np.ndarray,
    c_fc_b: np.ndarray,
    c_proj_w: np.ndarray,
    c_proj_b: np.ndarray,
) -> np.ndarray:
    return linear(gelu(linear(x, w=c_fc_w, b=c_fc_b)), w=c_proj_w, b=c_proj_b)
어텐션
어텐션은 트랜스포머 아키텍처의 핵심(Core) 아이디어입니다. 어텐션은 인간의 시각적 주의에서 영감을 받은 메커니즘입니다. 우리가 이미지의 특정 부분이나 문장의 특정 단어에 집중하고 나머지는 무시하는 것처럼, 어텐션은 모델이 특정 요소를 처리할 때 입력 데이터의 여러 부분이 지닌 중요도를 동적으로 가늠할 수 있게 합니다. 텍스트 같은 순차 데이터의 경우, 이는 모델이 한 단어를 처리할 때 문맥과 의미를 더 잘 이해하기 위해 거리에 관계없이 시퀀스 내의 다른 관련 단어에 “주의를 기울일” 수 있다는 뜻입니다. 이러한 선택적 집중 덕분에 모델은 이전의 시퀀스 모델보다 장거리 의존성과 관계를 더 효과적으로 포착할 수 있습니다.
각 어텐션 계산의 중심에는 입력 시퀀스에서 도출되는 세 가지 핵심 행렬이 있습니다:
- 쿼리(Q): 현재 처리 중인 토큰 또는 위치를 나타냅니다. 이를 “지금 내가 찾고 있는 구체적인 정보는 무엇인가?“라고 묻는 것으로 생각하십시오.
- Key (K): 시퀀스에 있는 모든 토큰(현재 토큰 포함)을 나타냅니다. 각 토큰에 담긴 정보의 레이블이나 식별자라고 생각하면 됩니다. “각 토큰은 어떤 종류의 정보를 제공하는가?”
- Value (V): 이것 역시 시퀀스의 모든 토큰을 나타냅니다. 각 토큰의 실제 내용이나 표현이라고 생각하면 됩니다. “각 토큰이 전달하는 실제 정보는 무엇인가?”
이 과정은 초기 투영(projection)에서 시작합니다. 여기서 입력 시퀀스 x는 세 개의 개별 선형 레이어를 통과하여 입력 차원 전체에 걸친 초기 Q, K, V 행렬을 생성합니다. 그런 다음 이 큰 행렬들을 임베딩 차원을 따라 더 작은 조각으로 나누어, 각 어텐션 “헤드“마다 별도의 Q, K, V 집합을 만듭니다. 형식적으로 셀프 어텐션은 다음과 같이 계산됩니다.
여기서:
Q,K,V는 각각 쿼리, 키, 값 행렬이며,d_k는 키 벡터의 차원입니다.
attention 함수는 멀티헤드 어텐션 레이어의 각 헤드 내부에서 사용되는 기본 구성 요소인 핵심(Core) 스케일드 닷 프로덕트 어텐션 메커니즘을 구현합니다. 이 함수는 특정 토큰(Query 벡터로 표현됨)을 처리할 때 각 입력 토큰(Value 벡터로 표현됨)이 얼마나 많은 주목, 즉 “어텐션“을 받아야 하는지 계산합니다.
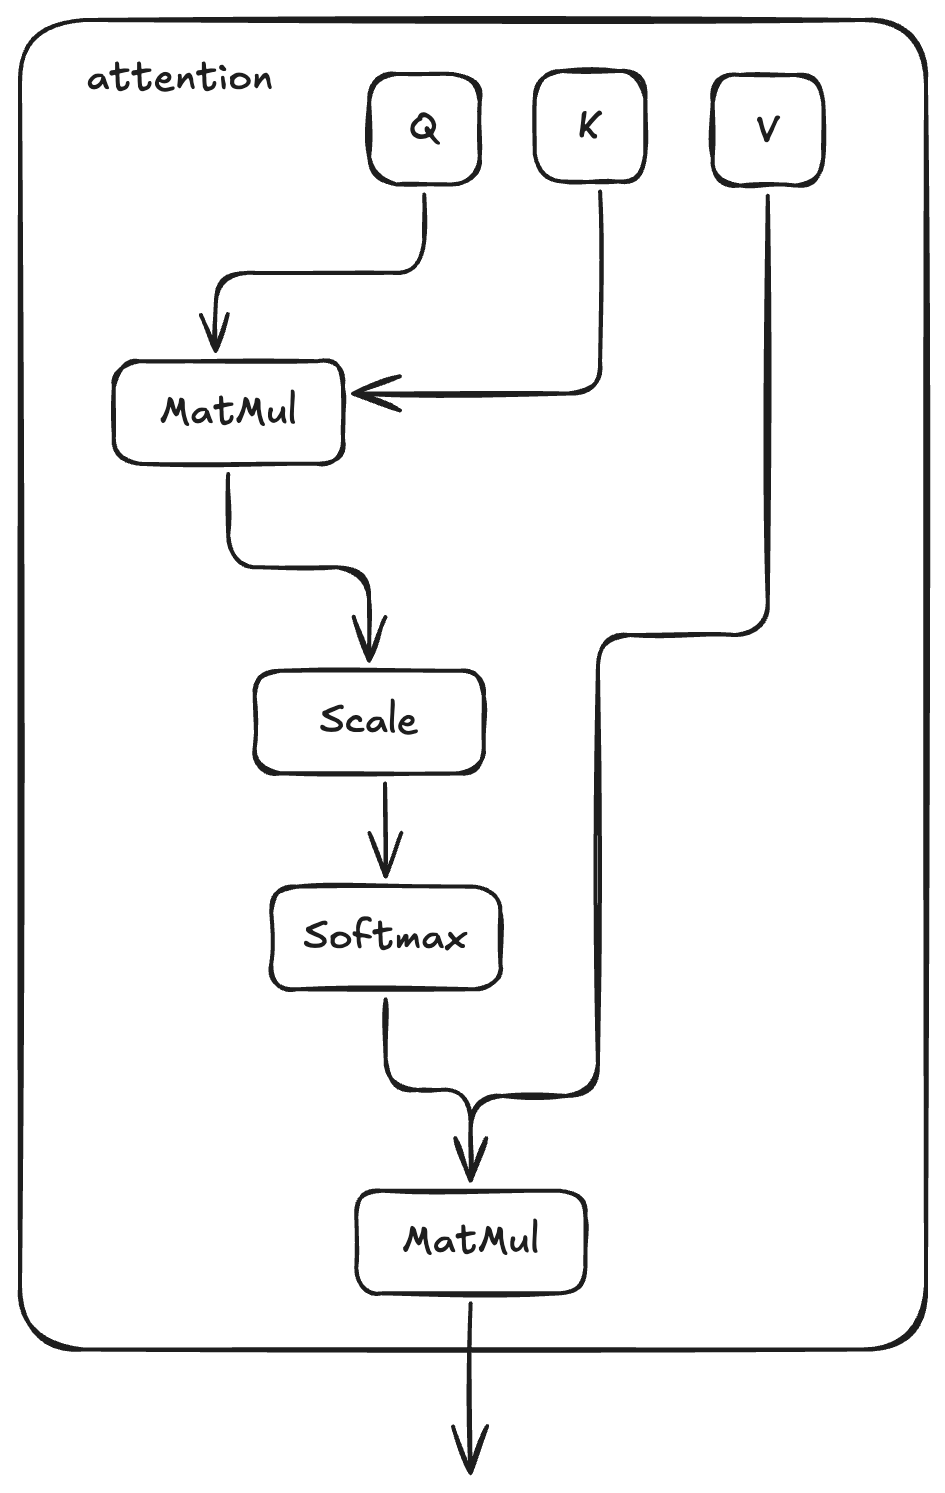
이 과정은 Q 행렬과 K 행렬의 전치 행렬 사이의 내적(q @ k.T)을 계산하는 것으로 시작합니다. 이 단계에서는 각 쿼리와 모든 키 사이의 원시 유사도 또는 호환성을 측정합니다. 그런 다음 이 원시 점수를 키 벡터 차원의 제곱근(np.sqrt(q.shape[-1]))으로 나누어 스케일을 줄입니다.
인과 마스크(causal mask)는 이렇게 스케일된 점수에 더해지는 마스크입니다. 이 마스크는 각 위치가 그 뒤에 오는 위치에 어텐션하지 못하도록 막아, 예측이 이전 토큰에만 기반하도록 보장합니다. 사실상 이 마스크는 미래 토큰에 해당하는 점수에 매우 큰 음수 값을 할당합니다.
다음으로, 마스크가 적용되고 스케일된 점수에 softmax 함수를 적용합니다. 이를 통해 점수가 확률 분포(어텐션 가중치)로 변환되며, 각 가중치는 쿼리에 대한 특정 키(및 그에 대응하는 값)의 상대적 중요도를 나타냅니다.
마지막으로, 함수는 이 어텐션 가중치와 V 행렬의 행렬 곱(attention_weights @ v)을 계산합니다. 그 결과로 어텐션 메커니즘의 출력, 즉 Value 벡터들의 가중합이 나오며, 이때 가중치는 계산된 어텐션 확률입니다. 따라서 각 쿼리에 대한 결과 벡터는 입력 시퀀스의 정보를 혼합한 것이며, 쿼리-키 상호작용에 따라 가장 관련성 높은 부분이 강조됩니다.
# attention:
#   q : (N, 64)
#   k : (N, 64)
#   v : (N, 64)
#   mask : (N, N)
#   out : (N, 64)
def attention(
    q: np.ndarray, k: np.ndarray, v: np.ndarray, mask: np.ndarray
) -> np.ndarray:
    attention_scores = (q @ k.T) / np.sqrt(q.shape[-1]) + mask
    attention_weights = softmax(attention_scores)
    return attention_weights @ v
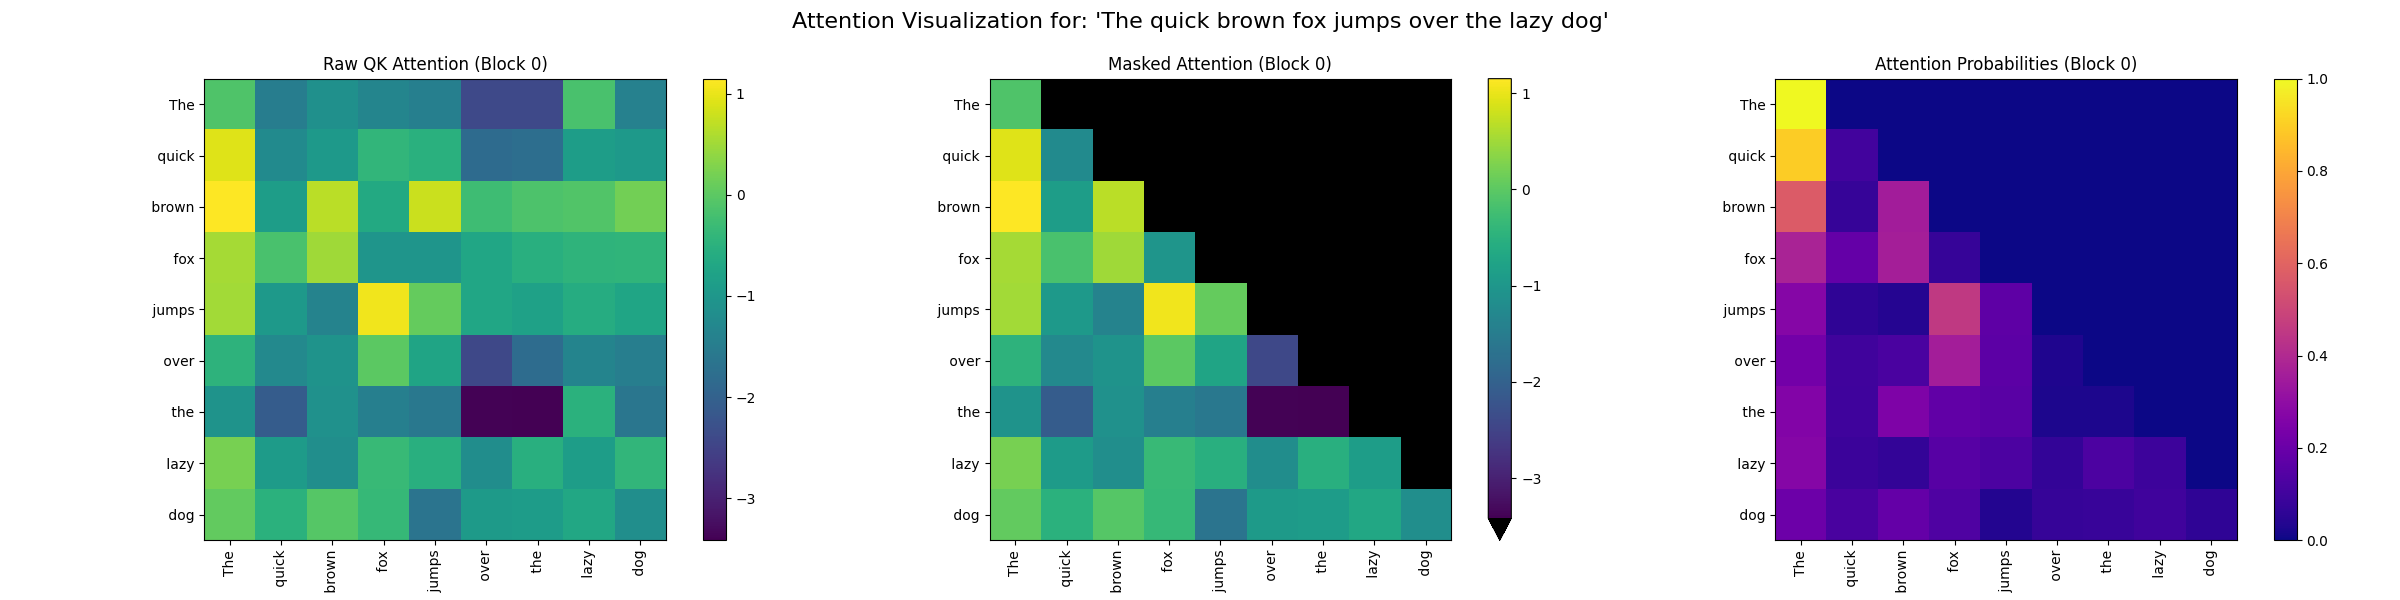
각 헤드의 어텐션 가중치를 플롯하여 어텐션 메커니즘을 시각화할 수 있습니다. 예를 들어 *“The quick brown fox jumps over the lazy dog”*라는 문구에 대해 트랜스포머 스택의 첫 번째 블록에서 어텐션 가중치를 플롯하면, 각 헤드가 어떤 단어 쌍에 가장 많이 어텐션하는지 확인할 수 있습니다. 여기서는 첫 번째 헤드가 *“jumps”*와 *“fox”*에 가장 많이 어텐션하는 것을 볼 수 있습니다.
멀티헤드 어텐션
기본 어텐션 메커니즘이 토큰 간의 관계를 포착하는 방법을 제공한다면, 트랜스포머는 멀티헤드 어텐션으로 이를 한 단계 더 발전시킵니다. 이러한 개선을 통해 모델은 서로 다른 유형의 관계를 동시에 포착할 수 있으며, 표현력이 크게 확장됩니다. 멀티헤드 어텐션은 모델이 서로 다른 위치에서 서로 다른 표현 부분 공간의 정보에 함께 주의를 기울일 수 있게 하는 핵심(Core) 구성 요소입니다. MHA는 어텐션 계산을 한 번만 수행하는 대신, 입력에 대해 학습된 서로 다른 선형 변환 위에서 어텐션 메커니즘을 여러 번(“헤드”) 병렬로 실행합니다. 이를 통해 모델은 다양한 유형의 관계(예: 구문적, 의미적 관계)를 동시에 포착할 수 있습니다.
각 헤드 내부에서는 스케일드 닷 프로덕트 어텐션이 수행됩니다. 어텐션 점수는 Q와 모든 K의 내적을 구하여 계산하며, 이는 현재 토큰과 다른 모든 토큰 사이의 관련성을 측정합니다. 이 점수들은 스케일링(키 차원의 제곱근으로 나눔)된 뒤 소프트맥스 함수를 거쳐 확률(어텐션 가중치)이 됩니다. 이 가중치는 각 V에 얼마나 집중할지를 나타냅니다.
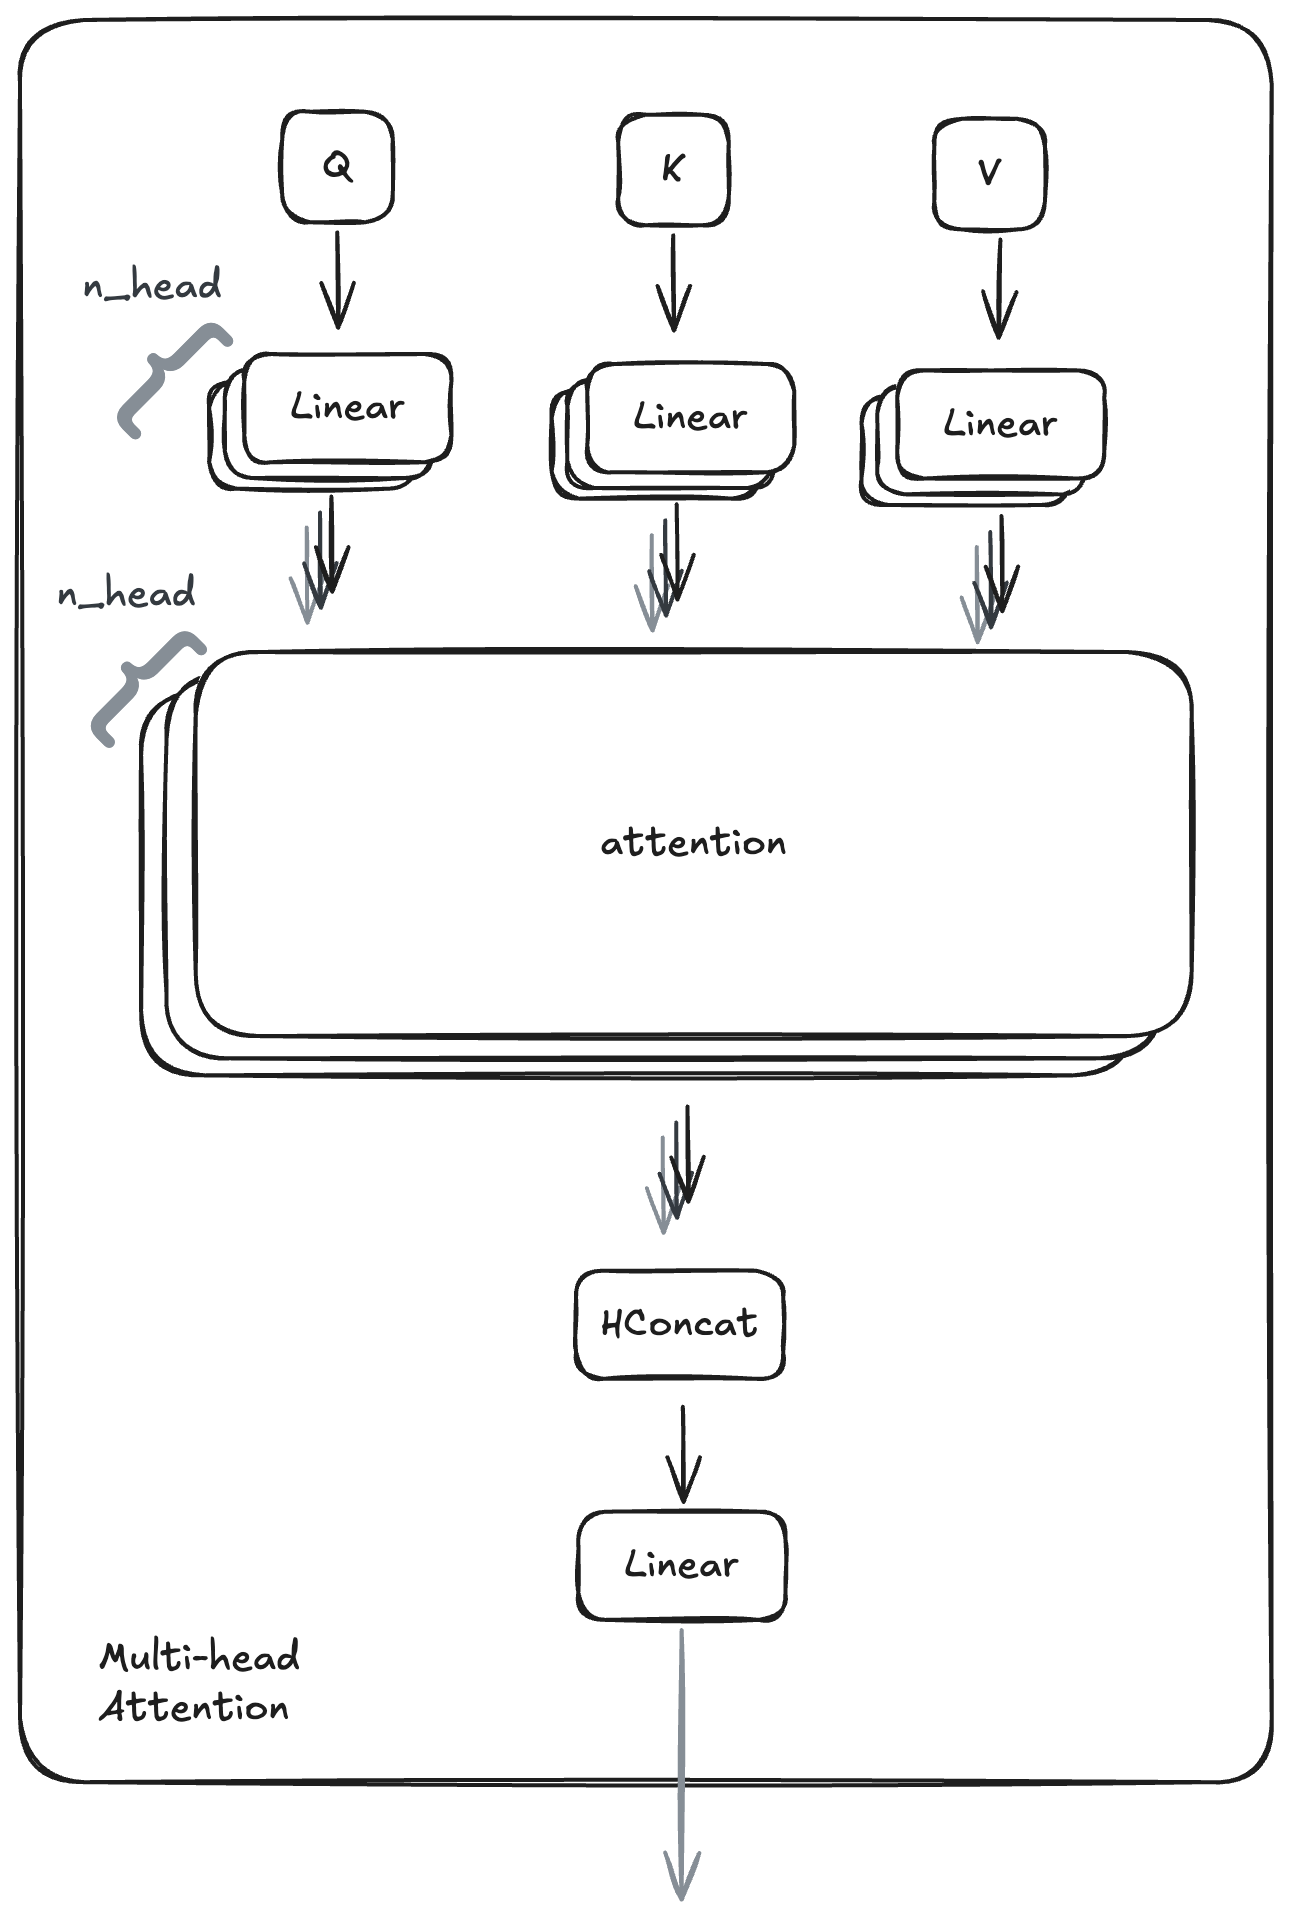
각 어텐션 헤드의 쿼리 행렬 크기(64)는 모델의 임베딩 차원(768)을 어텐션 헤드 수(12)로 나누어 얻습니다. 모든 헤드의 출력을 다시 이어 붙이면 원래의 임베딩 차원을 되찾게 됩니다:
768/n_head = 768/12 = 64
그런 다음 어텐션 가중치를 대응하는 V 벡터에 곱하여 가중합을 만듭니다. 이렇게 하면 가장 관련성 높은 토큰들의 정보를 혼합한, 해당 헤드의 출력 벡터가 만들어집니다. 마지막으로 모든 어텐션 헤드의 출력 벡터를 다시 이어 붙입니다. 이렇게 결합된 벡터는 최종 선형 레이어를 거쳐 멀티헤드 어텐션 블록의 전체 출력이 됩니다. 이러한 다각적 접근 방식 덕분에 모델은 시퀀스를 여러 “관점“에서 동시에 바라보며 더 풍부한 문맥 정보를 포착할 수 있습니다.
# mha:
#   x : (N, 768)
#   out : (N, 768)
def mha(
    x: np.ndarray, c_attn: LinearParams, c_proj: LinearParams, n_head: int
) -> np.ndarray:
    # qkv projection
    # [N, 768] -> [N, 3*768]
    x = linear(x, w=c_attn.w, b=c_attn.b)

    # split into qkv
    # [N, 3*768] -> [3, N, 768]
    qkv = np.split(x, 3, axis=-1)

    # split into heads
    # [3, N, 768] -> [3, n_head, N, 64]
    qkv_heads = [np.split(x, n_head, axis=-1) for x in qkv]

    # apply causal mask to hide future inputs
    # [N, N]
    causal_mask = (1 - np.tri(x.shape[0], dtype=x.dtype)) * -1e10

    # perform attention on each head
    # [3, n_head, N, 64] -> [n_head, N, 64]
    out_heads = [attention(q, k, v, causal_mask) for q, k, v in zip(*qkv_heads)]

    # merge heads
    # [n_head, N, 64] -> [N, 768]
    x = np.hstack(out_heads)

    # out projection
    # [N, 768] -> [N, 768]
    return linear(x, w=c_proj.w, b=c_proj.b)
트랜스포머 블록
어텐션 메커니즘과 피드포워드 네트워크를 모두 정의했으니, 이제 이 구성 요소들이 완전한 트랜스포머 블록으로 어떻게 통합되는지 살펴볼 수 있습니다. 트랜스포머 블록은 GPT-2 아키텍처의 기본 반복 단위로, 멀티헤드 어텐션에 피드포워드 처리, 정규화, 잔차 연결을 결합하여 여러 번 쌓을 수 있는 연산 단위를 만듭니다.
각 블록은 입력 벡터 시퀀스를 받아 두 개의 주요 하위 레이어를 통해 처리하며, 각 하위 레이어 주변에 잔차 연결과 레이어 정규화를 적용합니다. 이 구조는 원래 입력의 보존(잔차 연결을 통해)과 새로운 표현으로의 변환을 모두 가능하게 하는 균형 잡힌 정보 흐름을 만들어 냅니다.
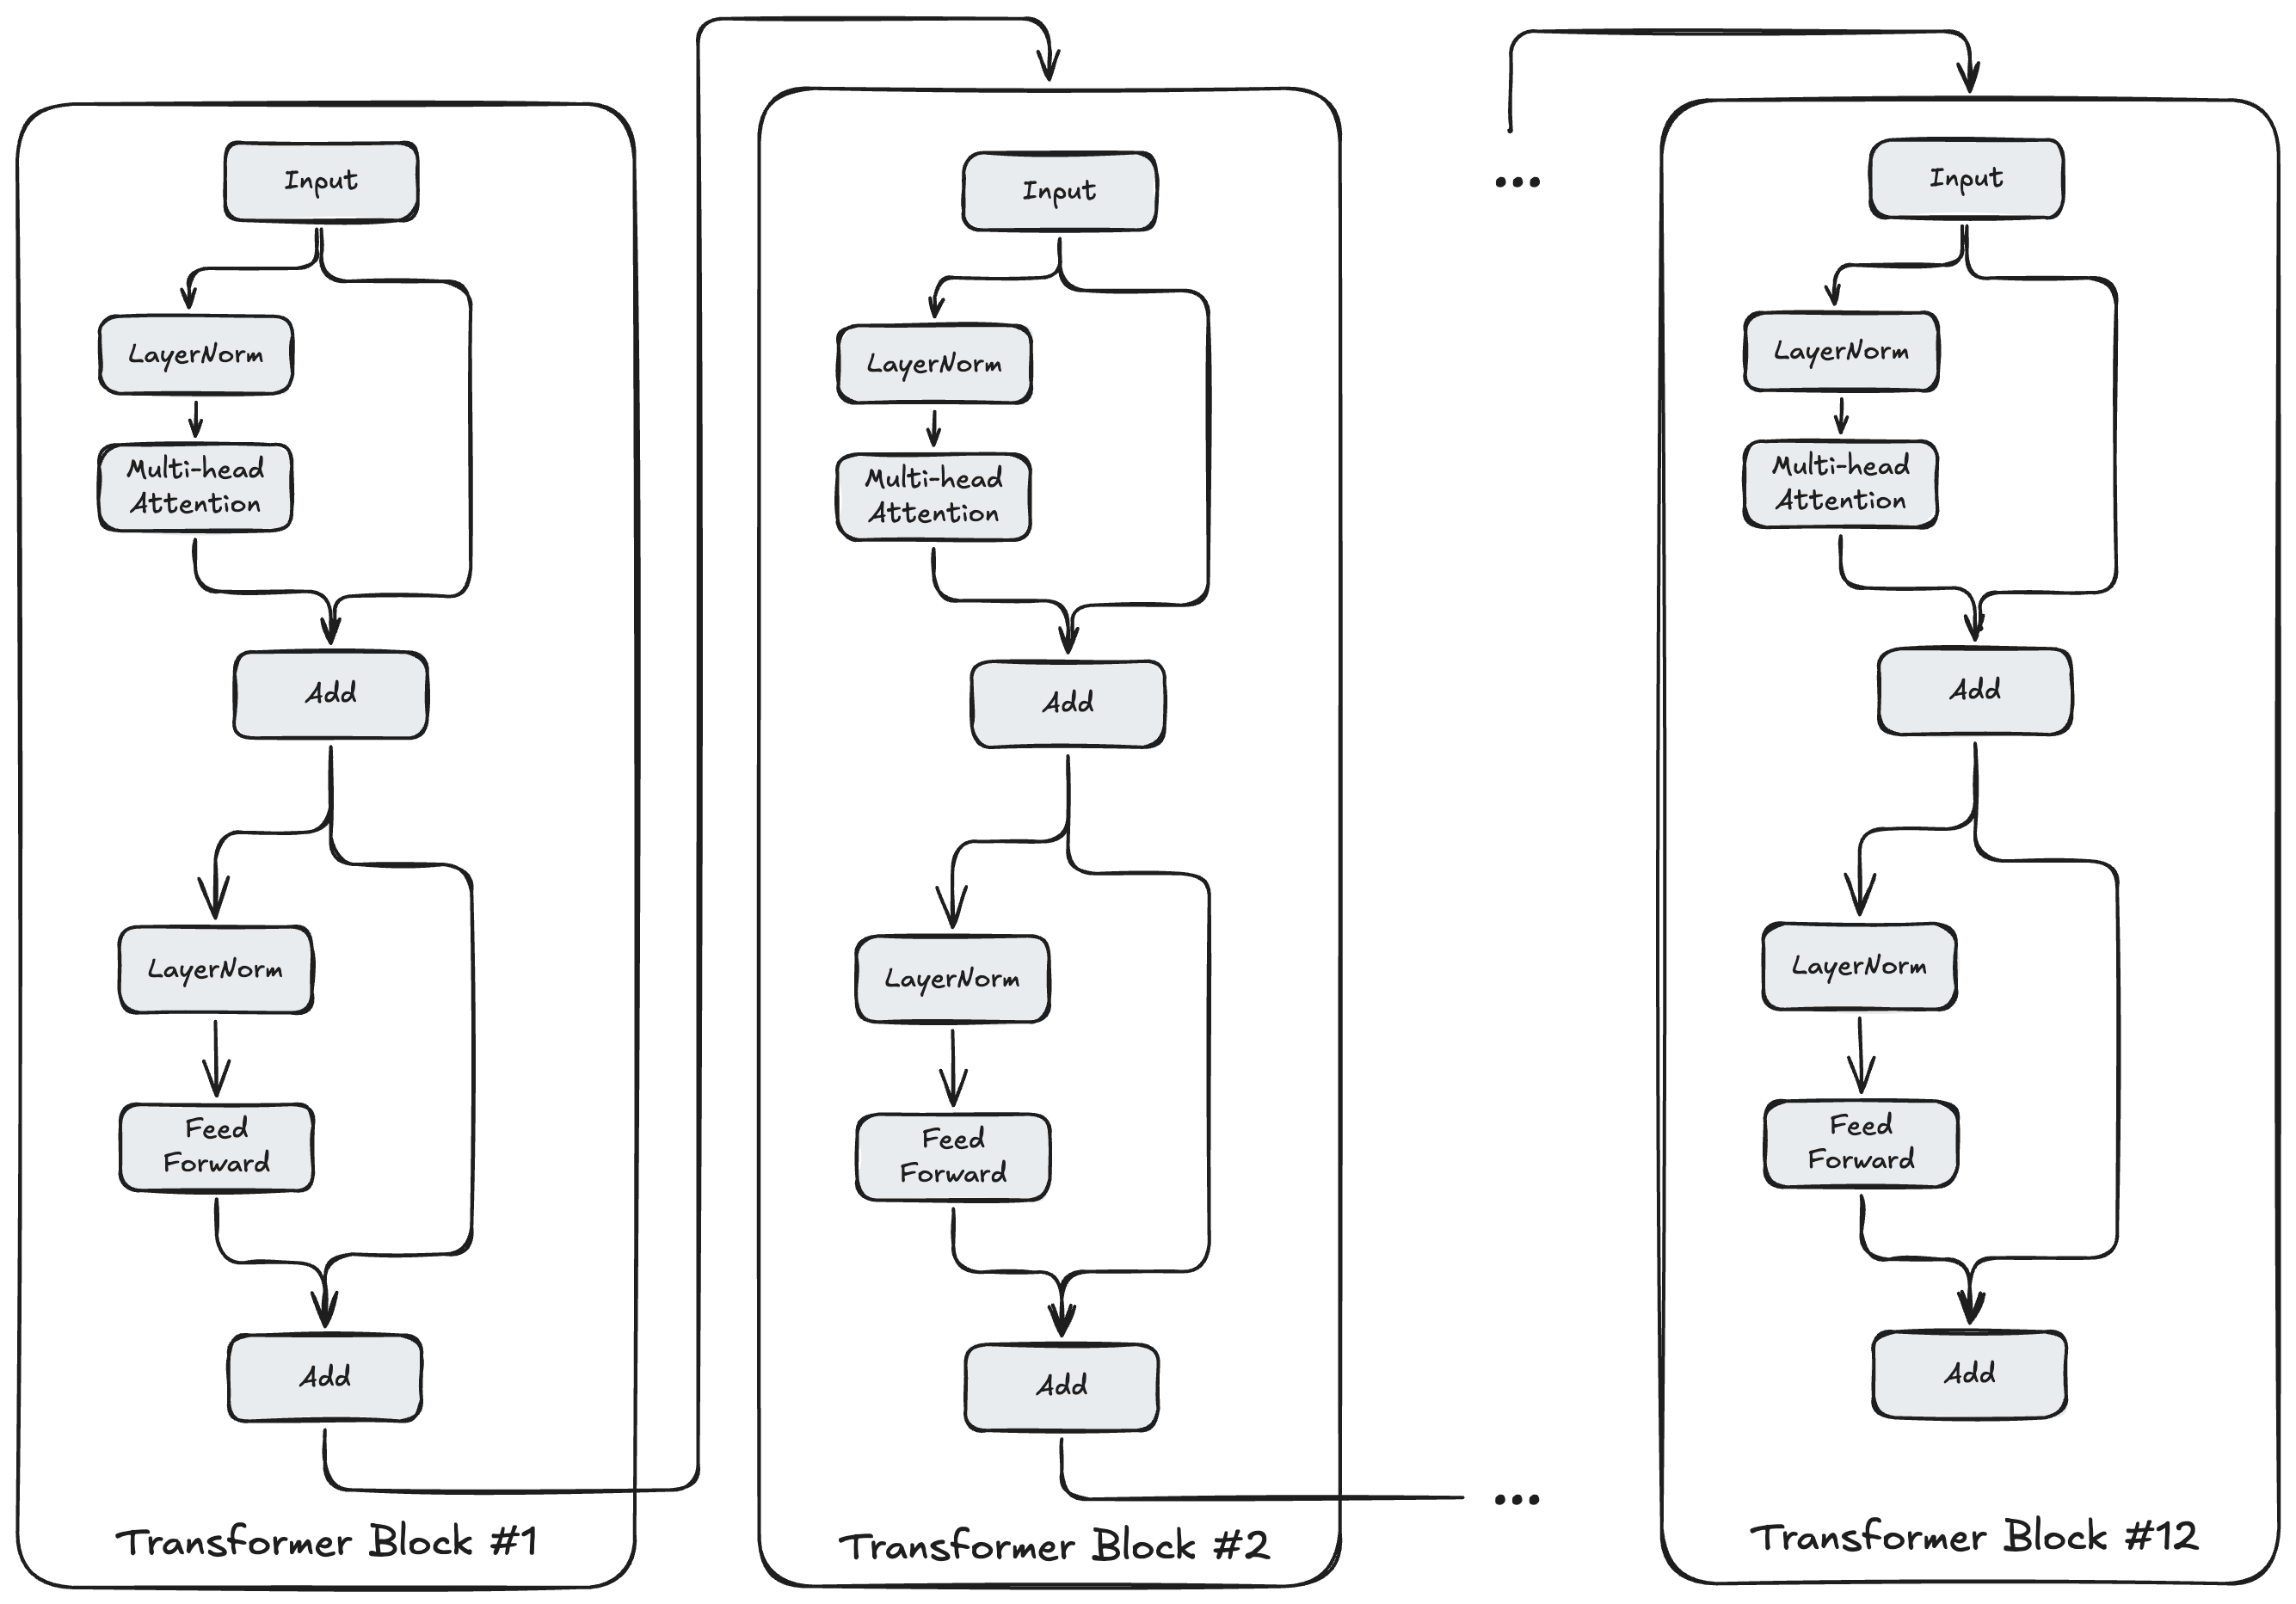
첫 번째 하위 레이어는 방금 살펴본 멀티헤드 어텐션 메커니즘입니다. 입력은 MHA에 들어가기 전에 레이어 정규화를 거칩니다. 그런 다음 MHA의 출력을 원래 입력에 다시 더하여(잔차 연결), 어텐션으로 얻은 문맥과 원래의 위치 표현을 결합합니다. 이 합은 이어서 두 번째 하위 레이어로 전달됩니다.
두 번째 하위 레이어는 앞에서 설명한 피드포워드 네트워크입니다. 첫 번째 하위 레이어와 마찬가지로, 입력(첫 번째 잔차 연결의 출력)은 먼저 레이어 정규화를 거칩니다. 그런 다음 정규화된 출력을 FFN이 처리합니다. 이어서 FFN의 출력은 또 하나의 잔차 연결을 통해 FFN의 입력에 다시 더해집니다. 트랜스포머 블록의 최종 출력은 이 합이며, 이는 스택에 있는 다음의 동일한 트랜스포머 블록의 입력으로 쓰입니다.
# transformer_block:
#   x : (N, 768)
#   out : (N, 768)
def transformer_block(
    x: np.ndarray,
    mlp: MLPParams,
    attn: AttentionParams,
    ln_1: LayerNormParams,
    ln_2: LayerNormParams,
    n_head: int
) -> np.ndarray:
    # First sub-block: Layer norm -> Attention -> Residual
    a = layer_norm(x, g=ln_1.g, b=ln_1.b)
    a = mha(a, c_attn=attn.c_attn, c_proj=attn.c_proj, n_head=n_head)
    x = x + a

    # Second sub-block: Layer norm -> FFN -> Residual
    m = layer_norm(x, g=ln_2.g, b=ln_2.b)
    m = ffn(
        m,
        c_fc_w=mlp.c_fc.w,
        c_fc_b=mlp.c_fc.b,
        c_proj_w=mlp.c_proj.w,
        c_proj_b=mlp.c_proj.b,
    )
    x = x + m

    return x
전체 모델
개별 구성 요소와 트랜스포머 블록 구조를 살펴보았으니, 이제 모든 것을 조립하여 완전한 모델을 만들 수 있습니다. 이 블록들을 여러 번(예를 들어 가장 작은 GPT-2 모델에서는 12번) 쌓아 정교한 언어 이해와 생성이 가능한 깊은 네트워크를 구축합니다. 어텐션 메커니즘, 피드포워드 네트워크, 레이어 정규화, 잔차 연결의 조합은 순차적 정보를 효과적으로 처리하고, 복잡한 의존 관계를 포착하며, 깊이가 깊은데도 안정적으로 학습되는 아키텍처를 만들어 냅니다.
gpt2 함수는 주어진 입력 토큰 ID 시퀀스에 대한 GPT-2 모델의 완전한 순방향 패스를 나타냅니다. 이 함수는 앞에서 정의한 모든 구성 요소를 거치는 데이터 흐름을 조율하여, 원시 토큰 ID를 문맥적 표현으로 변환하고 최종적으로 다음 토큰에 대한 예측으로 바꿉니다.
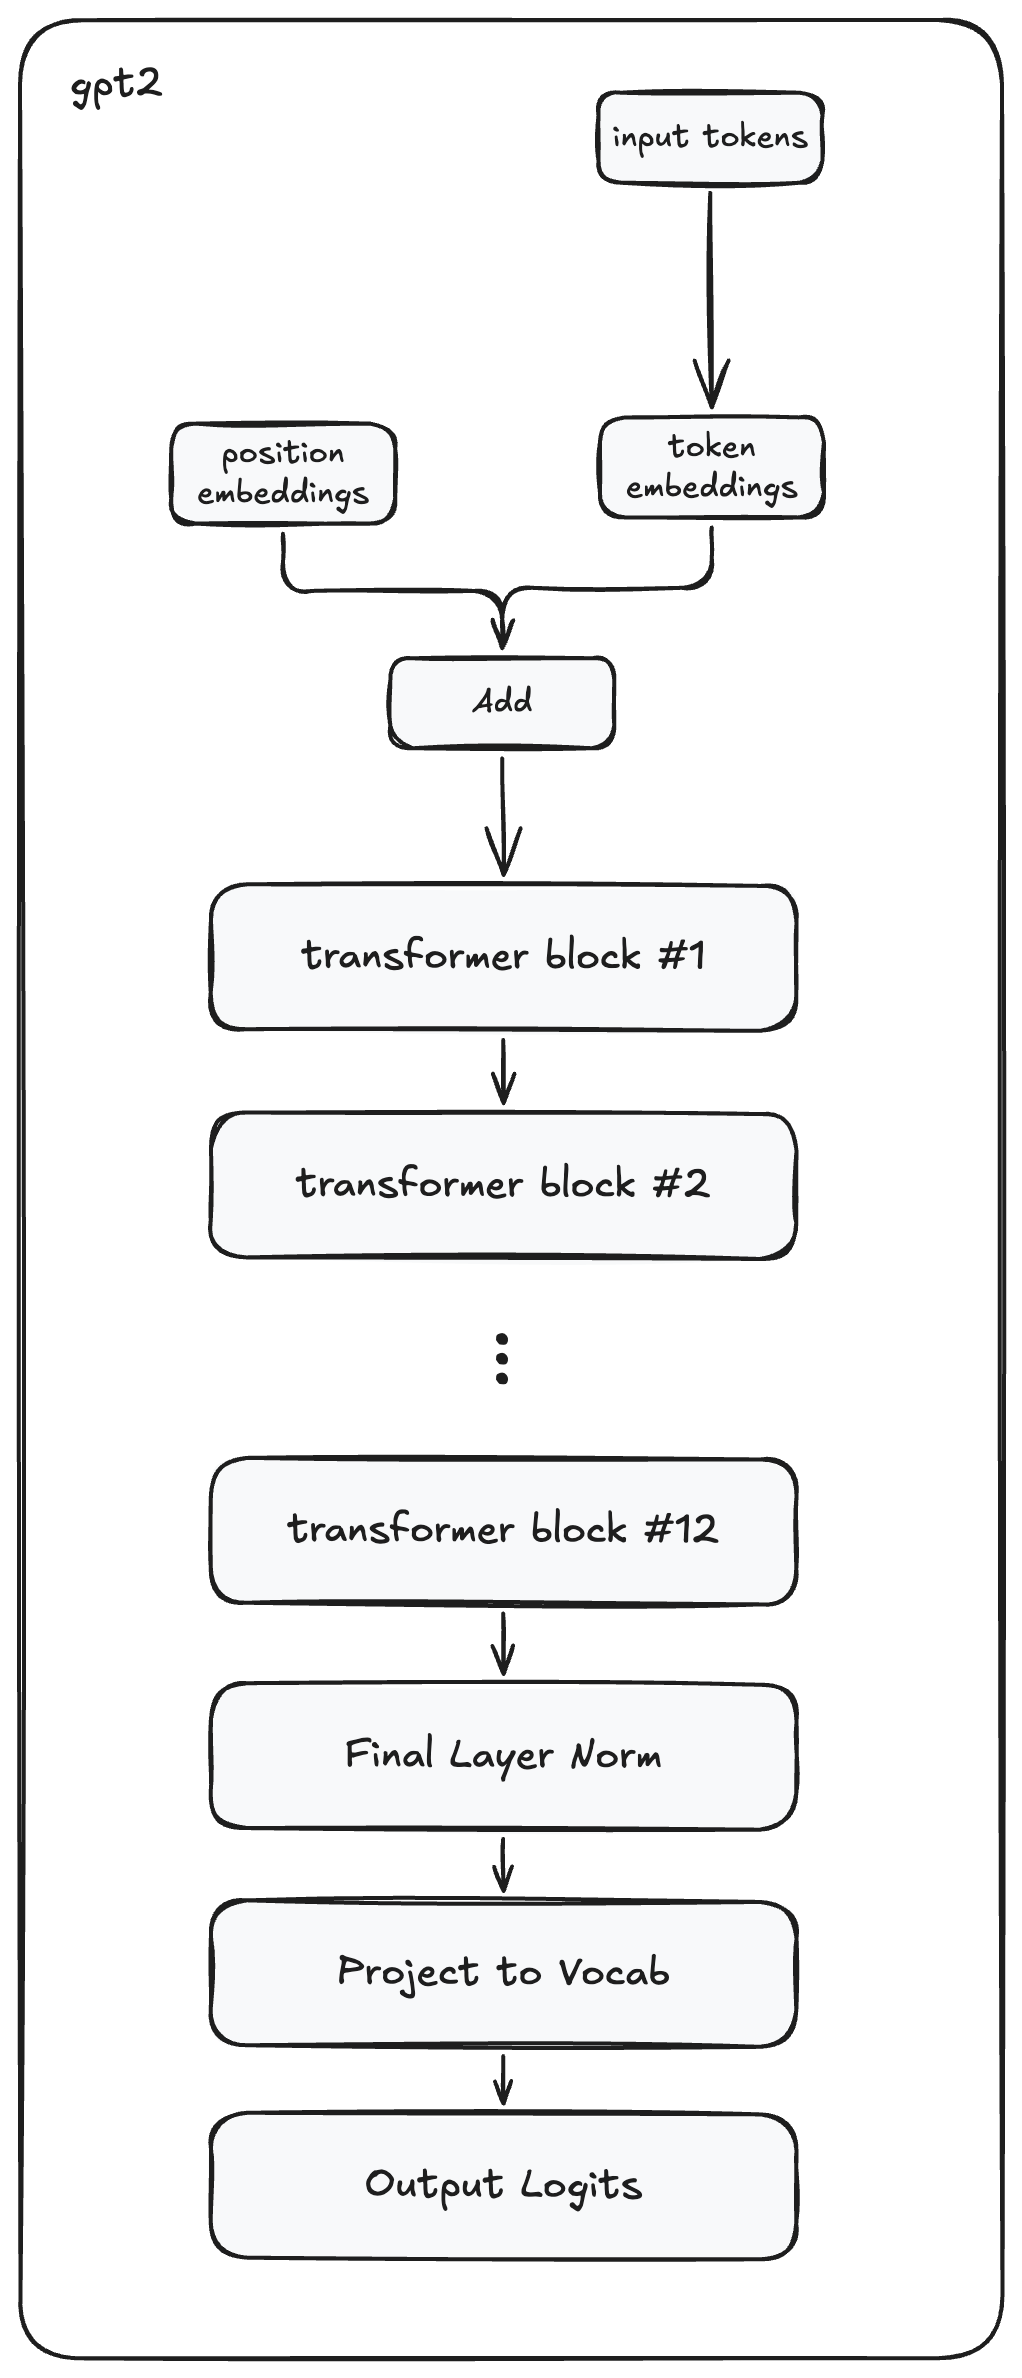
이 과정은 입력 토큰을 임베딩하는 것에서 시작합니다. 이는 입력 시퀀스의 각 토큰에 대해 토큰 임베딩(params.wte에서 조회)과 위치 임베딩(params.wpe에서 조회)을 더하여 이루어집니다. 이렇게 처음 결합된 임베딩은 각 토큰의 의미와 시퀀스 내 위치를 모두 담고 있으며, 이후 모든 처리의 기반이 됩니다.
임베딩된 시퀀스는 이어서 트랜스포머 블록 스택을 통과합니다. 각 블록은 어텐션 메커니즘과 피드포워드 메커니즘을 통해 표현을 다듬으며, 점차 더 정교한 문맥적 이해를 쌓아 갑니다. 코드는 12개 레이어 모델에 대해 이 스태킹을 명시적으로 구현하며, 한 블록의 출력이 다음 블록의 입력이 됩니다. 레이어를 하나씩 거칠 때마다 모델은 데이터에 담긴 점점 더 복잡한 패턴과 관계를 포착할 수 있습니다.
def gpt2(inputs: list[int], params: ModelParams, n_head: int) -> np.ndarray:
    # Get token embeddings and position embeddings
    x = params.wte[inputs] + params.wpe[range(len(inputs))]

    # Apply transformer block stack ( 12 blocks total )
    for i in range(12):
        x = transformer_block(
            x,
            n_head=n_head,
            mlp=params.blocks[i].mlp,
            attn=params.blocks[i].attn,
            ln_1=params.blocks[i].ln_1,
            ln_2=params.blocks[i].ln_2,
        )

    # Apply final layer norm and project to vocabulary
    x = layer_norm(x, g=params.ln_f.g, b=params.ln_f.b)
    logits = x @ params.wte.T  # Project to vocabulary

    return logits
모든 트랜스포머 블록을 거친 뒤, 결과 시퀀스는 값을 안정화하기 위해 마지막 레이어 정규화를 거칩니다. 형태가 (N, 768)(GPT-2 small 기준)인 이 정규화된 출력은 시퀀스의 각 토큰에 대한 최종 문맥 임베딩을 나타냅니다. 이 임베딩을 어휘에 대한 예측으로 변환하기 위해, 모델은 전치된 토큰 임베딩 행렬(params.wte.T)을 사용하여 사영을 수행합니다. 이 영리한 가중치 공유 기법(입력 임베딩과 출력 투영 모두에 같은 임베딩 행렬을 사용하는 것)은 전체 매개변수 수를 줄여 줍니다.
그 결과는 형태가 (N, 50257)(GPT-2 기준)인 로짓 텐서이며, 여기서 50,257은 어휘 크기입니다. 이 로짓은 시퀀스의 각 위치에서 가능한 모든 다음 토큰에 대한 정규화되지 않은 예측 점수를 나타냅니다. 어휘의 모든 토큰이 점수를 받으며, 이 점수를 순위대로 정렬하면 시퀀스에서 다음에 올 가능성이 가장 높은 토큰이 무엇인지 알 수 있습니다. 단일 위치에 대한 로짓의 전형적인 예는 다음과 같습니다.
array([-114.83902718, -111.23177705, -116.58203861, ..., -118.4023539 ,
       -118.92616557, -113.37047973], shape=(50257,))
자기회귀 생성에서는 일반적으로 현재 시퀀스의 끝 다음에 올 다음 토큰을 예측하는 것에만 관심을 둡니다. 마지막 위치에 해당하는 로짓을 선택하고 argmax 같은 연산을 적용하면 가장 가능성이 높은 다음 토큰을 찾을 수 있습니다.
next_token = np.argmax(logits[-1, :])
이 토큰 ID를 시퀀스에 덧붙이고 이 과정을 반복하면 한 번에 한 토큰씩 텍스트를 생성할 수 있습니다. 하지만 이 방식이 동작하려면 사전 학습 가중치에서 불러온, 올바르게 초기화된 모델 매개변수가 필요하며, 이것이 다음 주제로 이어집니다.
Safetensors와 모델 매개변수
GPT-2와 같은 사전 학습 모델을 활용하려면 그 매개변수를 효과적으로 불러오고 구성해야 합니다. 이 절에서는 모델 가중치를 저장하는 안전하고 효율적인 방식인 safetensors 형식을 사용하여 이러한 매개변수를 구성하고 불러오는 방법을 설명합니다. 이를 위해 파라미터가 model.safetensors 파일에 저장되어 있는 HuggingFace에서 파라미터를 불러옵니다.
Safetensors는 텐서를 저장하기 위한 빠르고 안전한(즉, 임의 코드 실행이 필요한 Pickle을 사용하지 않는) 형식입니다. 이 형식은 단순한 키/값 구조를 사용합니다. 키는 텐서 이름을 나타내는 UTF-8 인코딩 문자열(예: model.layers.0.attention.weight)이고, 값은 형태와 dtype 정보를 담은 고정 헤더가 붙은 바이너리 텐서 데이터이며, 파일 시작 부분의 메타데이터 섹션에는 모든 텐서와 그 오프셋의 인덱스가 들어 있습니다.
내부적으로 GPT-2의 모델 매개변수는 다음과 같은 키/값 형식으로 저장되어 있습니다.
{
    "wpe.weight"             : np.array([1024, 768]),
    "wte.weight"             : np.array([50257, 768]),
    ...
    "h.0.attn.bias"          : np.array([1, 1, 1024, 1024]),
    "h.0.attn.c_attn.bias"   : np.array([2304]),
    "h.0.attn.c_attn.weight" : np.array([768, 2304]),
    "h.0.attn.c_proj.bias"   : np.array([768]),
    "h.0.attn.c_proj.weight" : np.array([768, 768]),
    "h.0.ln_1.bias"          : np.array([768]),
    "h.0.ln_1.weight"        : np.array([768]),
    "h.0.ln_2.bias"          : np.array([768]),
    "h.0.ln_2.weight"        : np.array([768]),
    "h.0.mlp.c_fc.bias"      : np.array([3072]),
    "h.0.mlp.c_fc.weight"    : np.array([768, 3072]),
    "h.0.mlp.c_proj.bias"    : np.array([768]),
    "h.0.mlp.c_proj.weight"  : np.array([3072, 768]),
    ...
    "ln_f.bias"              : np.array([768]),
    "ln_f.weight"            : np.array([768])
}
이들 각각은 해당 구성 요소의 학습된 매개변수를 담고 있는, shape와 dtype을 가진 텐서이며, 모델 학습 과정의 결과물입니다.
LayerNormParams 데이터클래스는 레이어 정규화 매개변수를 나타내며, 여기에는 각 레이어의 스케일(g)과 편향(b)이 포함됩니다.
@dataclass
class LayerNormParams:
    g: np.ndarray  # Gamma (scale)
    b: np.ndarray  # Beta (bias)
LinearParams 데이터클래스는 선형 투영 매개변수를 나타내며, 여기에는 가중치 행렬(w)과 편향 벡터(b)가 포함됩니다.
@dataclass
class LinearParams:
    w: np.ndarray  # Weight matrix
    b: np.ndarray  # Bias vector
MLPParams 데이터클래스는 피드포워드 네트워크 매개변수를 나타내며, 여기에는 두 개의 선형 레이어, 즉 첫 번째 선형 레이어(c_fc)와 두 번째 선형 레이어(c_proj)가 포함됩니다.
@dataclass
class MLPParams:
    c_fc: LinearParams  # First linear layer
    c_proj: LinearParams  # Second linear layer
AttentionParams 데이터클래스는 어텐션 매개변수를 나타내며, 여기에는 쿼리-키-값 투영(c_attn)과 출력 투영(c_proj)이 포함됩니다.
@dataclass
class AttentionParams:
    c_attn: LinearParams  # QKV projection
    c_proj: LinearParams  # Output projection
TransformerBlockParams 데이터클래스는 하나의 트랜스포머 블록을 나타내며, 레이어 정규화(ln_1), 피드포워드 네트워크(mlp), 어텐션 메커니즘(attn), 두 번째 레이어 정규화(ln_2)를 포함합니다.
@dataclass
class TransformerBlockParams:
    ln_1: LayerNormParams  # First layer norm
    ln_2: LayerNormParams  # Second layer norm
    mlp: MLPParams  # MLP block
    attn: AttentionParams  # Attention block
ModelParams 데이터클래스는 전체 모델 매개변수를 나타내며, 여기에는 토큰 임베딩 행렬(wte), 위치 임베딩 행렬(wpe), 트랜스포머 블록의 리스트(blocks), 그리고 최종 레이어 정규화(ln_f)가 포함됩니다.
@dataclass
class ModelParams:
    wte: np.ndarray  # Token embeddings
    wpe: np.ndarray  # Position embeddings
    blocks: List[TransformerBlockParams]  # Transformer blocks
    ln_f: LayerNormParams  # Final layer norm
HParams 데이터클래스는 모델의 하이퍼파라미터를 나타내며, 여기에는 트랜스포머 레이어 수(n_layer), 어텐션 헤드 수(n_head), 그리고 컨텍스트 길이(n_ctx)가 포함됩니다.
@dataclass
class HParams:
    n_layer: int  # Number of transformer layers
    n_head: int  # Number of attention heads
    n_ctx: int  # Context length
safe_open 함수를 사용하여 model.safetensors 파일에서 모델 매개변수를 불러올 수 있습니다. 이 파일은 Hugging Face 모델 허브에서 내려받을 수 있습니다.
tensors = {}
with safe_open(weights_path, framework="numpy") as f:
    for key in f.keys():
        tensors[key] = f.get_tensor(key)

# Build transformer blocks
blocks = []
for i in range(config["n_layer"]):
    prefix = f"h.{i}"
    block = TransformerBlockParams(
        ln_1=LayerNormParams(
            g=tensors[f"{prefix}.ln_1.weight"], b=tensors[f"{prefix}.ln_1.bias"]
        ),
        ln_2=LayerNormParams(
            g=tensors[f"{prefix}.ln_2.weight"], b=tensors[f"{prefix}.ln_2.bias"]
        ),
        mlp=MLPParams(
            c_fc=LinearParams(
                w=tensors[f"{prefix}.mlp.c_fc.weight"],
                b=tensors[f"{prefix}.mlp.c_fc.bias"],
            ),
            c_proj=LinearParams(
                w=tensors[f"{prefix}.mlp.c_proj.weight"],
                b=tensors[f"{prefix}.mlp.c_proj.bias"],
            ),
        ),
        attn=AttentionParams(
            c_attn=LinearParams(
                w=tensors[f"{prefix}.attn.c_attn.weight"],
                b=tensors[f"{prefix}.attn.c_attn.bias"],
            ),
            c_proj=LinearParams(
                w=tensors[f"{prefix}.attn.c_proj.weight"],
                b=tensors[f"{prefix}.attn.c_proj.bias"],
            ),
        ),
    )
    blocks.append(block)

# Build final model params
params = ModelParams(
    wte=tensors["wte.weight"],
    wpe=tensors["wpe.weight"],
    blocks=blocks,
    ln_f=LayerNormParams(g=tensors["ln_f.weight"], b=tensors["ln_f.bias"]),
)
탐욕적 디코딩
모델 아키텍처를 정의하고 매개변수를 불러왔으니, 이제 모든 것을 하나로 합쳐 텍스트를 생성할 준비가 되었습니다. 텍스트 생성의 가장 간단한 방법은 탐욕적 디코딩(greedy decoding)으로, 각 단계에서 모델이 예측한 확률이 가장 높은 토큰을 그대로 선택하는 방식입니다.
아래의 generate 함수는 초기 프롬프트를 인코딩하는 것부터 새 토큰을 반복적으로 생성하는 것까지 전체 텍스트 생성 과정을 캡슐화합니다. 이 함수는 지금까지 살펴본 모든 구성 요소, 즉 토큰화, 임베딩, 트랜스포머 블록, 어휘 사영이 어떻게 함께 작동하여 제대로 동작하는 언어 모델을 만들어 내는지 보여 줍니다.
def generate(prompt: str, n_tokens_to_generate: int = 40) -> str:
    encoder = get_encoder("", "model")
    params, hparams = load_gpt2_weights()

    input_ids = encoder.encode(prompt)
    generated_token_ids: list[int] = []

    print(prompt, end="", flush=True)

    current_ids = list(input_ids)

    for _ in range(n_tokens_to_generate):
        logits = gpt2(current_ids, params, n_head=hparams.n_head)
        next_id = np.argmax(logits[-1, :])
        next_id_int = int(next_id)

        current_ids.append(next_id_int)
        generated_token_ids.append(next_id_int)

        token_text = encoder.decode([next_id_int])
        print(token_text, end="", flush=True)

    print()

    return encoder.decode(generated_token_ids)
생성 과정은 BPE 토크나이저를 사용하여 사용자의 프롬프트를 토큰 ID로 인코딩하는 것으로 시작합니다. 생성할 토큰을 추적하기 위해 빈 리스트를 초기화합니다. 그런 다음 루프에 진입하여, 매 반복마다 다음을 수행합니다.
- 현재 토큰 ID 시퀀스(원래 프롬프트와 지금까지 생성된 모든 토큰)를 GPT-2 모델에 통과시킵니다
- 마지막 토큰 위치의 로짓을 추출합니다. 이 로짓은 다음에 무엇이 올지에 대한 모델의 예측을 나타냅니다
- 이 로짓의 argmax를 취하여 가장 가능성이 높은 다음 토큰을 선택합니다
- 이 새 토큰을 생성된 토큰 리스트와 현재 시퀀스에 추가합니다
- 새 토큰을 디코딩하고 출력하여 생성 과정을 실시간으로 보여 줍니다
요청된 수만큼 토큰을 생성한 후, 생성된 토큰의 전체 시퀀스를 다시 텍스트로 디코딩하여 반환합니다. 이것으로 끝입니다. GPT-2 모델의 단순한 버전을 구현하는 데 필요한 것은 이것이 전부입니다. 구현해야 하는 “커널” 연산은 여섯 개 정도(softmax, gelu, layer_norm, linear, add, matmul, var, mean)에 불과하며, 나머지는 자료 구조를 다루기 위한 많은 부수적인 관리 작업일 뿐입니다.
이를 통해 모델 컴파일을 시작할 때 비교 기준으로 삼을 참조 구현을 얻게 됩니다. 융합과 병렬화 모두의 기회가 있지만, 먼저 생성된 코드를 GPU에서 실행할 방법이 필요합니다. 8부에서는 작은 요소별(elementwise) 커널을 사용하여 그 백엔드를 구축합니다. 그 후에 Python 프런트엔드와 트랜스포머 연산으로 돌아갈 수 있습니다.
외부 자료
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- QLoRA: Efficient Finetuning of Quantized LLMs
- The Illustrated GPT-2
- The Annotated Transformer
- attention-gym
이전: 6부 - E-그래프로 Python 특수화하기 · 시리즈 목차 · 다음: 8부 - MLIR을 이용한 GPU 컴파일