다음 글의 일부입니다: Putting the “You” in CPU: 컴퓨터가 프로그램을 실행하는 방식이라는 토끼굴로 깊이 빠져드는 여정입니다.
5장: 컴퓨터 속의 번역가 GitHub에서 편집하기
지금까지 메모리를 읽고 쓰는 것에 대해 이야기할 때마다 설명이 다소 모호했습니다. 예를 들어 ELF 파일은 데이터를 적재할 특정 메모리 주소를 지정하는데, 그렇다면 서로 다른 프로세스가 충돌하는 메모리를 사용하려 할 때 문제가 생기지 않는 이유는 무엇입니까? 왜 각 프로세스는 서로 다른 메모리 환경을 가진 것처럼 보이는 것입니까?
또한, 우리는 정확히 어떻게 여기까지 오게 된 것입니까? execve가 현재 프로세스를 새 프로그램으로 교체하는 시스템 호출이라는 것은 이해했지만, 이것만으로는 여러 프로세스가 어떻게 시작될 수 있는지 설명되지 않습니다. 맨 처음 프로그램이 어떻게 실행되는지는 더더욱 설명되지 않습니다. 과연 어떤 닭(프로세스)이 다른 모든 달걀(다른 프로세스)을 낳는(생성하는) 것입니까?
우리의 여정도 끝을 향해 가고 있습니다. 이 두 가지 질문에 대한 답을 얻고 나면, 컴퓨터가 부팅에서부터 지금 여러분이 사용하고 있는 소프트웨어를 실행하기까지 어떤 과정을 거쳤는지 거의 완전히 이해하게 될 것입니다.
메모리는 가짜입니다
자, 그럼 메모리 이야기를 해 봅시다. 알고 보면 CPU가 메모리 주소를 읽거나 쓸 때, 실제로는 물리 메모리(RAM)의 해당 위치를 가리키는 것이 아닙니다. 그보다는 가상 메모리 공간의 한 위치를 가리키는 것입니다.
CPU는 메모리 관리 장치(MMU)라는 칩과 통신합니다. MMU는 가상 메모리의 위치를 RAM의 위치로 번역해 주는 사전을 가진 번역가처럼 동작합니다. CPU가 메모리 주소 0xfffaf54834067fe2에서 읽으라는 명령어를 받으면, MMU에 그 주소를 번역해 달라고 요청합니다. MMU는 사전에서 그 주소를 찾아보고, 대응하는 물리 주소가 0x53a4b64a90179fe2라는 것을 알아낸 뒤 그 숫자를 CPU에 돌려보냅니다. 그러면 CPU는 RAM의 해당 주소에서 읽을 수 있습니다.
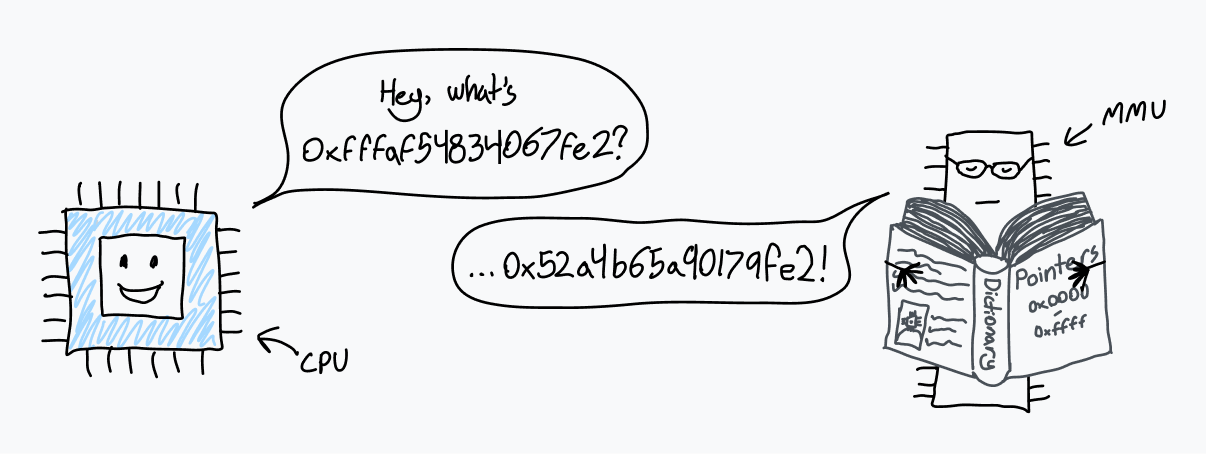
컴퓨터가 처음 부팅될 때는 메모리 접근이 물리 RAM으로 곧바로 이루어집니다. 시작 직후 운영체제는 번역 사전을 만들고 CPU에 MMU를 사용하기 시작하라고 지시합니다.
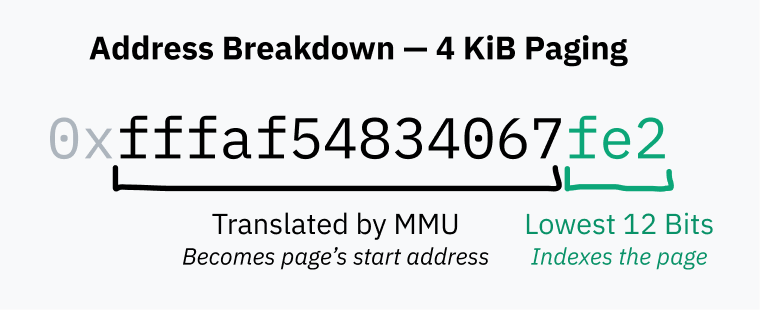
이 사전은 사실 페이지 테이블이라고 부르며, 모든 메모리 접근을 번역하는 이 시스템을 페이징이라고 부릅니다. 페이지 테이블의 항목은 페이지라고 부르며, 각 항목은 가상 메모리의 특정 덩어리가 RAM에 어떻게 매핑되는지를 나타냅니다. 이 덩어리는 항상 고정된 크기이며, 프로세서 아키텍처마다 페이지 크기가 다릅니다. x86-64의 기본 페이지 크기는 4 KiB로, 각 페이지가 4,096바이트 길이의 메모리 블록에 대한 매핑을 지정한다는 뜻입니다.
다시 말해, 4 KiB 페이지에서는 주소의 하위 12비트가 MMU 번역 전후에 항상 동일합니다. 12비트인 이유는 번역 후 얻게 되는 4,096바이트 페이지를 인덱싱하는 데 필요한 비트 수가 12이기 때문입니다.
x86-64는 운영체제가 2 MiB 또는 4 GiB의 더 큰 페이지를 활성화하는 것도 허용합니다. 이렇게 하면 주소 번역 속도가 향상될 수 있지만, 메모리 단편화와 낭비가 늘어납니다. 페이지 크기가 클수록 주소 중 MMU가 번역하는 부분은 작아집니다.
페이지 테이블 자체는 그저 RAM에 존재합니다. 페이지 테이블에는 수백만 개의 항목이 들어갈 수 있지만, 각 항목의 크기는 몇 바이트 정도에 불과하므로 페이지 테이블이 공간을 그리 많이 차지하지 않습니다.
부팅 시 페이징을 활성화하기 위해 커널은 먼저 RAM에 페이지 테이블을 구성합니다. 그런 다음 페이지 테이블 시작 지점의 물리 주소를 페이지 테이블 베이스 레지스터(PTBR)라는 레지스터에 저장합니다. 마지막으로 커널은 페이징을 활성화하여 모든 메모리 접근이 MMU를 거쳐 변환되도록 합니다. x86-64에서는 제어 레지스터 3(CR3)의 상위 20비트가 PTBR 역할을 합니다. 페이징(Paging)을 뜻하는 PG라는 이름이 붙은 CR0의 31번 비트를 1로 설정하면 페이징이 활성화됩니다.
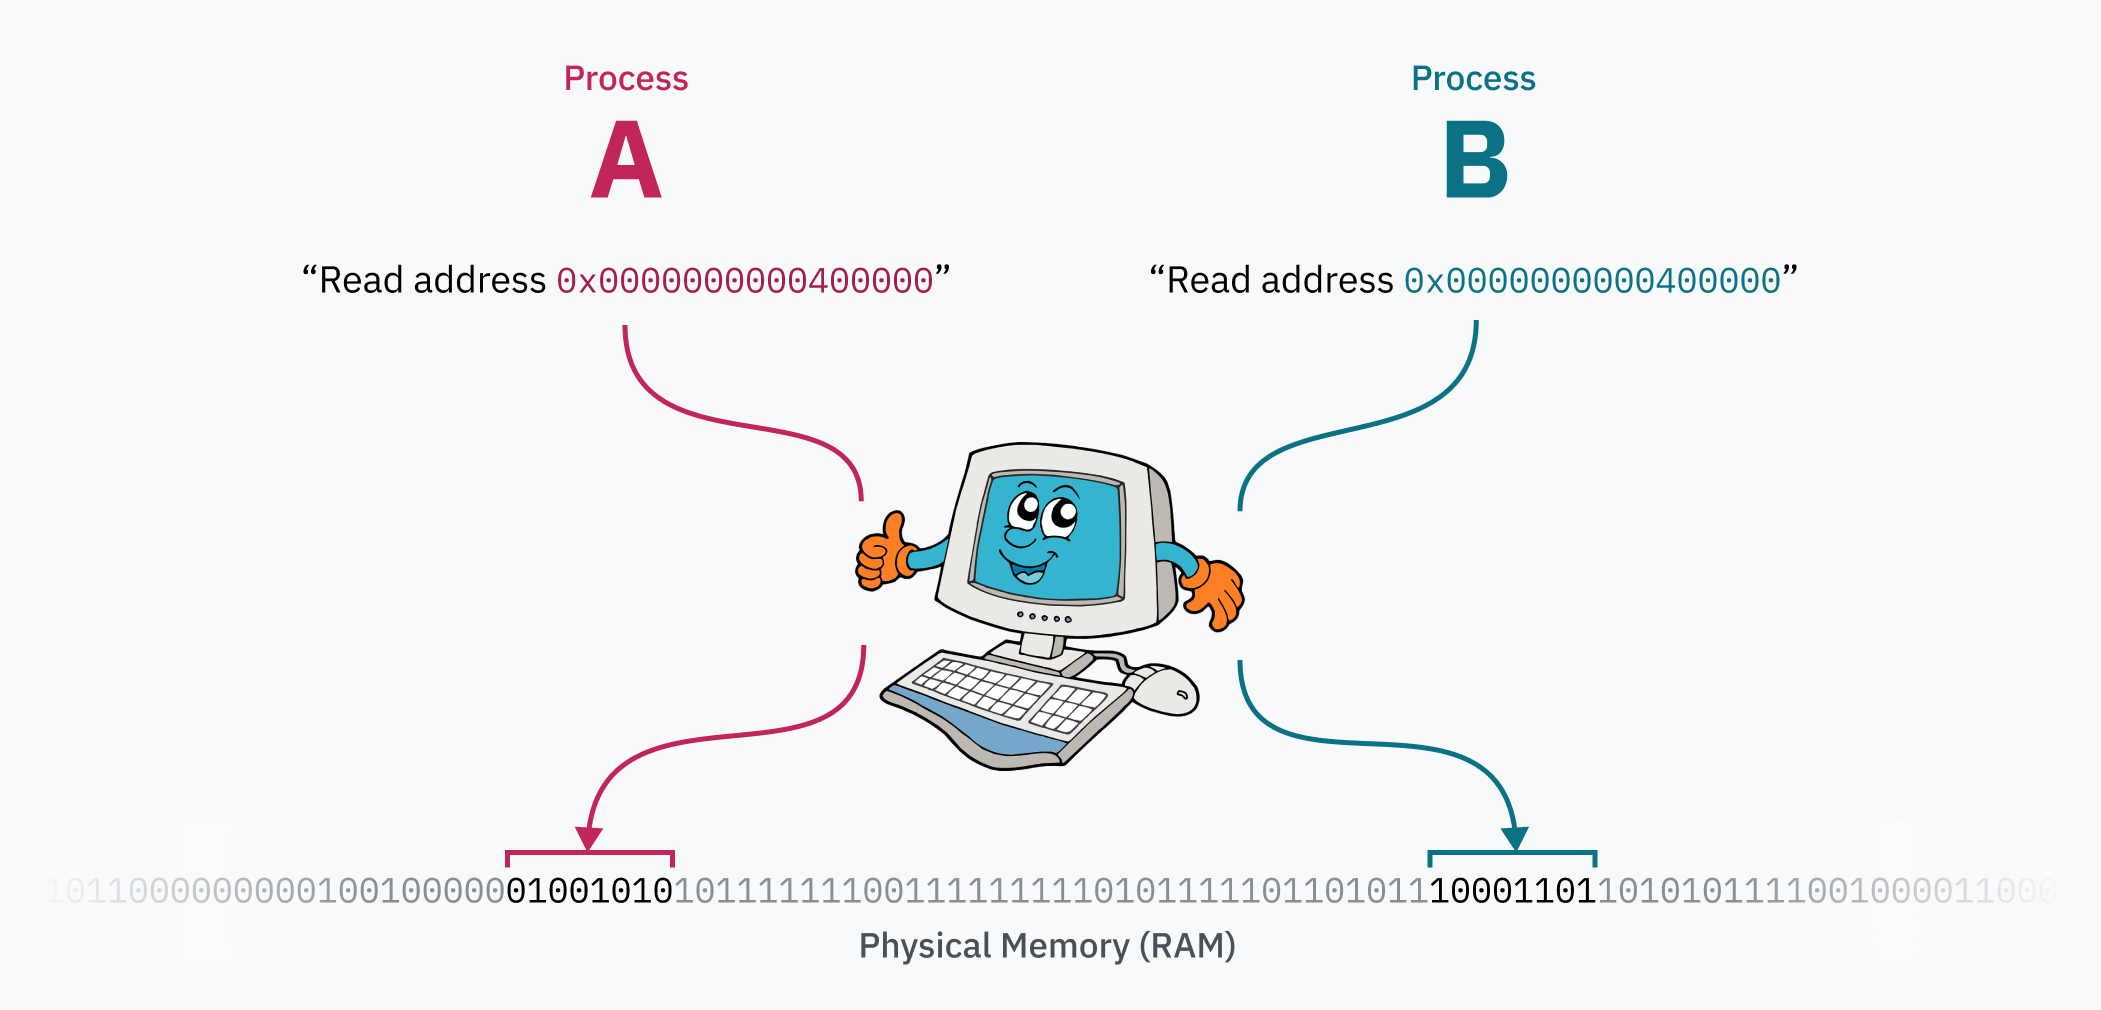
페이징 시스템의 마법은 컴퓨터가 실행되는 동안에도 페이지 테이블을 수정할 수 있다는 점입니다. 바로 이 방식으로 각 프로세스가 자신만의 격리된 메모리 공간을 가질 수 있습니다. 운영체제가 한 프로세스에서 다른 프로세스로 컨텍스트를 전환할 때 중요한 작업 중 하나는 가상 메모리 공간을 물리 메모리의 다른 영역으로 다시 매핑하는 것입니다. 프로세스가 두 개 있다고 가정해 봅시다. 프로세스 A는 자신의 코드와 데이터(아마도 ELF 파일에서 로드되었을 것입니다!)를 0x0000000000400000에 둘 수 있고, 프로세스 B도 정확히 같은 주소에서 자신의 코드와 데이터에 접근할 수 있습니다. 두 프로세스는 실제로 그 주소 범위를 두고 다투는 것이 아니므로, 심지어 같은 프로그램의 인스턴스일 수도 있습니다! 프로세스 A의 데이터는 물리 메모리에서 프로세스 B와 멀리 떨어진 어딘가에 있으며, 커널이 해당 프로세스로 전환할 때 0x0000000000400000에 매핑합니다.
여담: 저주받은 ELF 이야기
특정 상황에서
binfmt_elf는 메모리의 첫 번째 페이지를 0으로 매핑해야 합니다. ELF를 최초로 지원한 1988년의 운영체제인 UNIX System V Release 4.0(SVr4)용으로 작성된 일부 프로그램은 널 포인터를 읽을 수 있다는 점에 의존합니다. 그리고 어째서인지 아직도 그 동작에 의존하는 프로그램이 있습니다.이 기능을 구현한 Linux 커널 개발자는 조금 불만스러웠던 것 같습니다:
“왜 이런 짓을 하냐고요??? 글쎄요, SVr4는 페이지 0을 읽기 전용으로 매핑하고, 일부 애플리케이션이 이 동작에 ‘의존’합니다. 우리에게는 이 애플리케이션들을 다시 컴파일할 힘이 없으므로 SVr4의 동작을 에뮬레이션합니다. 하아.”
하아.
페이징을 통한 보안
메모리 페이징으로 가능해진 프로세스 격리는 코드 작성의 편의성을 높여 주지만(프로세스는 메모리를 사용하기 위해 다른 프로세스를 의식할 필요가 없습니다), 동시에 일정 수준의 보안도 제공합니다. 프로세스는 다른 프로세스의 메모리에 접근할 수 없습니다. 이것으로 이 글의 처음에 던졌던 질문 중 하나에 절반쯤 답할 수 있습니다:
프로그램이 CPU에서 직접 실행되고 CPU가 RAM에 직접 접근할 수 있다면, 왜 코드는 다른 프로세스의 메모리나, 맙소사, 커널의 메모리에 접근할 수 없습니까?
기억나십니까? 아주 오래전 일처럼 느껴집니다…
그렇다면 커널 메모리는 어떻습니까? 우선, 커널은 당연히 실행 중인 모든 프로세스와 페이지 테이블 자체까지 관리하기 위해 자체적으로 많은 데이터를 저장해야 합니다. 하드웨어 인터럽트, 소프트웨어 인터럽트 또는 시스템 호출이 발생하여 CPU가 커널 모드로 들어갈 때마다 커널 코드는 어떻게든 그 메모리에 접근해야 합니다.
Linux의 해법은 가상 메모리 공간의 상위 절반을 항상 커널에 할당하는 것이며, 그래서 Linux를 상위 절반 커널(higher half kernel)이라고 부릅니다. Windows도 비슷한 기법을 사용하지만, macOS는… 조금 더 복잡해서 관련 자료를 읽다가 뇌가 귀로 흘러나오는 줄 알았습니다. ~(++)~
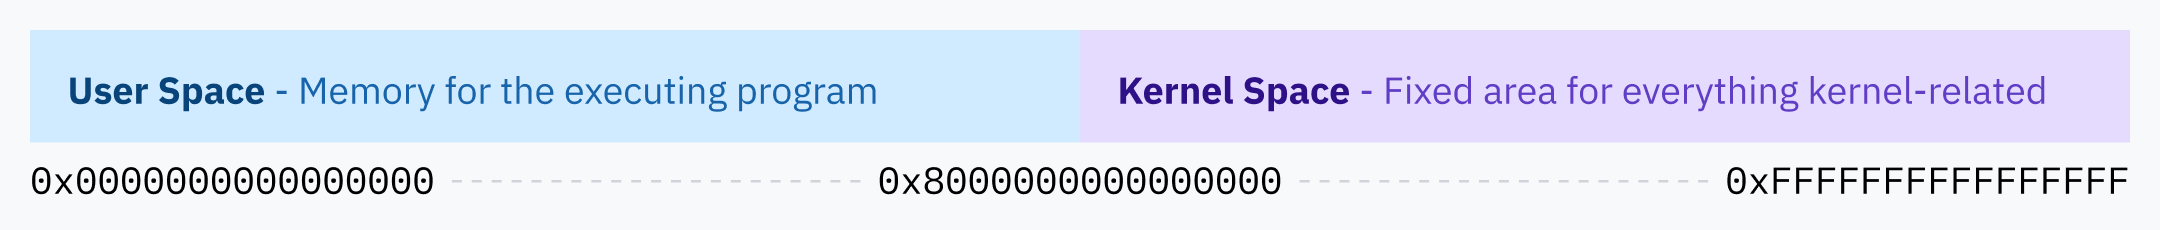
하지만 유저랜드 프로세스가 커널 메모리를 읽거나 쓸 수 있다면 보안상 끔찍한 일이 될 것이므로, 페이징은 두 번째 보안 계층을 제공합니다. 각 페이지에는 권한 플래그가 지정되어야 합니다. 한 플래그는 해당 영역이 쓰기 가능한지, 아니면 읽기만 가능한지를 결정합니다. 또 다른 플래그는 커널 모드에서만 해당 영역의 메모리에 접근할 수 있다고 CPU에 알려 줍니다. 이 후자의 플래그는 상위 절반의 커널 공간 전체를 보호하는 데 사용됩니다. 사실 커널 메모리 공간 전체가 사용자 공간 프로그램의 가상 메모리 매핑에 들어 있으며, 프로그램에는 거기에 접근할 권한이 없을 뿐입니다.
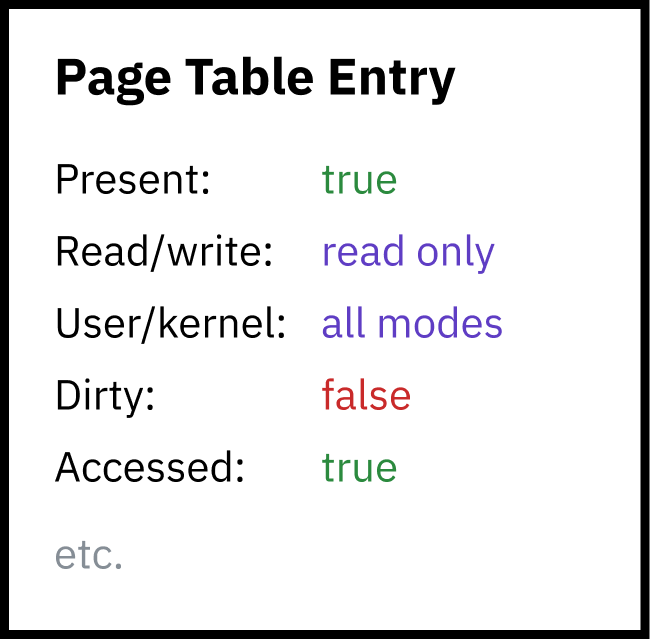
사실 페이지 테이블 자체도 커널 메모리 공간 안에 들어 있습니다! 타이머 칩이 프로세스 전환을 위해 하드웨어 인터럽트를 발생시키면, CPU는 권한 수준을 커널 모드로 전환하고 Linux 커널 코드로 점프합니다. 커널 모드(Intel 링 0)에 있으면 CPU는 커널이 보호하는 메모리 영역에 접근할 수 있습니다. 그러면 커널은 (메모리 상위 절반 어딘가에 있는) 페이지 테이블에 기록하여 새 프로세스를 위해 가상 메모리의 하위 절반을 다시 매핑할 수 있습니다. 커널이 새 프로세스로 전환하고 CPU가 사용자 모드에 진입하면, CPU는 더 이상 커널 메모리에 전혀 접근할 수 없습니다.
거의 모든 메모리 접근은 MMU를 거칩니다. 인터럽트 디스크립터 테이블의 핸들러 포인터는 어떻습니까? 그것들 역시 커널의 가상 메모리 공간에 있는 주소를 가리킵니다.
계층적 페이징과 기타 최적화
64비트 시스템의 메모리 주소는 64비트 길이이며, 이는 64비트 가상 메모리 공간의 크기가 무려 16엑스비바이트에 달한다는 뜻입니다. 이는 엄청나게 큰 크기로, 현재 존재하거나 가까운 미래에 존재할 어떤 컴퓨터보다도 훨씬 큽니다. 제가 아는 한, 역대 컴퓨터 중 가장 많은 RAM을 갖춘 것은 1.5페타바이트가 넘는 RAM을 탑재한 Blue Waters 슈퍼컴퓨터였습니다. 그래도 16 EiB의 0.01%에도 미치지 못합니다.
가상 메모리 공간의 4 KiB 구역마다 페이지 테이블 항목이 하나씩 필요하다면, 4,503,599,627,370,496개의 페이지 테이블 항목이 필요합니다. 페이지 테이블 항목이 8바이트 길이라면, 페이지 테이블 하나를 저장하는 데만 32페비바이트의 RAM이 필요합니다. 이 역시 컴퓨터 한 대에 탑재된 RAM의 세계 기록보다 크다는 점을 알아차리셨을 것입니다.
여담: 단위가 왜 이렇게 이상합니까?
흔하지 않고 정말 보기 흉하다는 것은 알지만, 저는 이진 바이트 크기 단위(2의 거듭제곱)와 미터법 단위(10의 거듭제곱)를 명확히 구분하는 것이 중요하다고 생각합니다. 킬로바이트(kB)는 1,000바이트를 뜻하는 SI 단위입니다. 키비바이트(KiB)는 1,024바이트를 뜻하는, IEC가 권장하는 단위입니다. 컴퓨터는 이진 시스템이므로, CPU와 메모리 주소에서 바이트 수는 보통 2의 거듭제곱입니다. KB(더 나쁘게는 kB)를 1,024라는 의미로 쓰면 더 모호해질 것입니다.
가능한 가상 메모리 공간 전체에 대해 연속된 페이지 테이블 항목을 두는 것은 불가능하기 때문에(적어도 대단히 비현실적이기 때문에), CPU 아키텍처는 계층적 페이징을 구현합니다. 계층적 페이징 시스템에는 단위가 점점 더 잘게 나뉘는 여러 단계의 페이지 테이블이 있습니다. 최상위 단계의 항목은 큰 메모리 블록을 담당하며 더 작은 블록의 페이지 테이블을 가리키고, 이렇게 해서 트리 구조를 이룹니다. 4 KiB 또는 페이지 크기가 얼마이든 그 크기의 블록에 대한 개별 항목이 트리의 잎이 됩니다.
x86-64는 전통적으로 4단계 계층적 페이징을 사용합니다. 이 체계에서 각 페이지 테이블 항목은 그 항목이 들어 있는 테이블의 시작 위치에 주소의 일부를 오프셋으로 더해 찾습니다. 이 일부는 최상위 비트부터 시작합니다. 이 비트들이 접두사 역할을 하므로 해당 항목은 그 비트들로 시작하는 모든 주소를 담당합니다. 항목은 해당 메모리 블록의 하위 트리를 담고 있는 다음 단계 테이블의 시작 위치를 가리키며, 이 하위 트리들은 다시 그다음 비트 묶음으로 인덱싱됩니다.
x86-64의 4단계 페이징 설계자들은 페이지 테이블 공간을 절약하기 위해 모든 가상 포인터의 상위 16비트를 무시하기로 하기도 했습니다. 48비트로는 128 TiB의 가상 주소 공간을 얻을 수 있으며, 이 정도면 충분히 크다고 판단했습니다. (64비트를 모두 사용하면 16 EiB가 되는데, 이는 꽤 많은 양입니다.)
처음 16비트를 건너뛰므로, 페이지 테이블의 첫 번째 단계를 인덱싱하는 “최상위 비트”는 실제로 63번 비트가 아니라 47번 비트부터 시작합니다. 이는 또한 이 장 앞부분의 상위 절반 커널 다이어그램이 엄밀히 말해 부정확했다는 뜻이기도 합니다. 커널 공간의 시작 주소는 64비트보다 작은 주소 공간의 중간 지점으로 표시했어야 합니다.
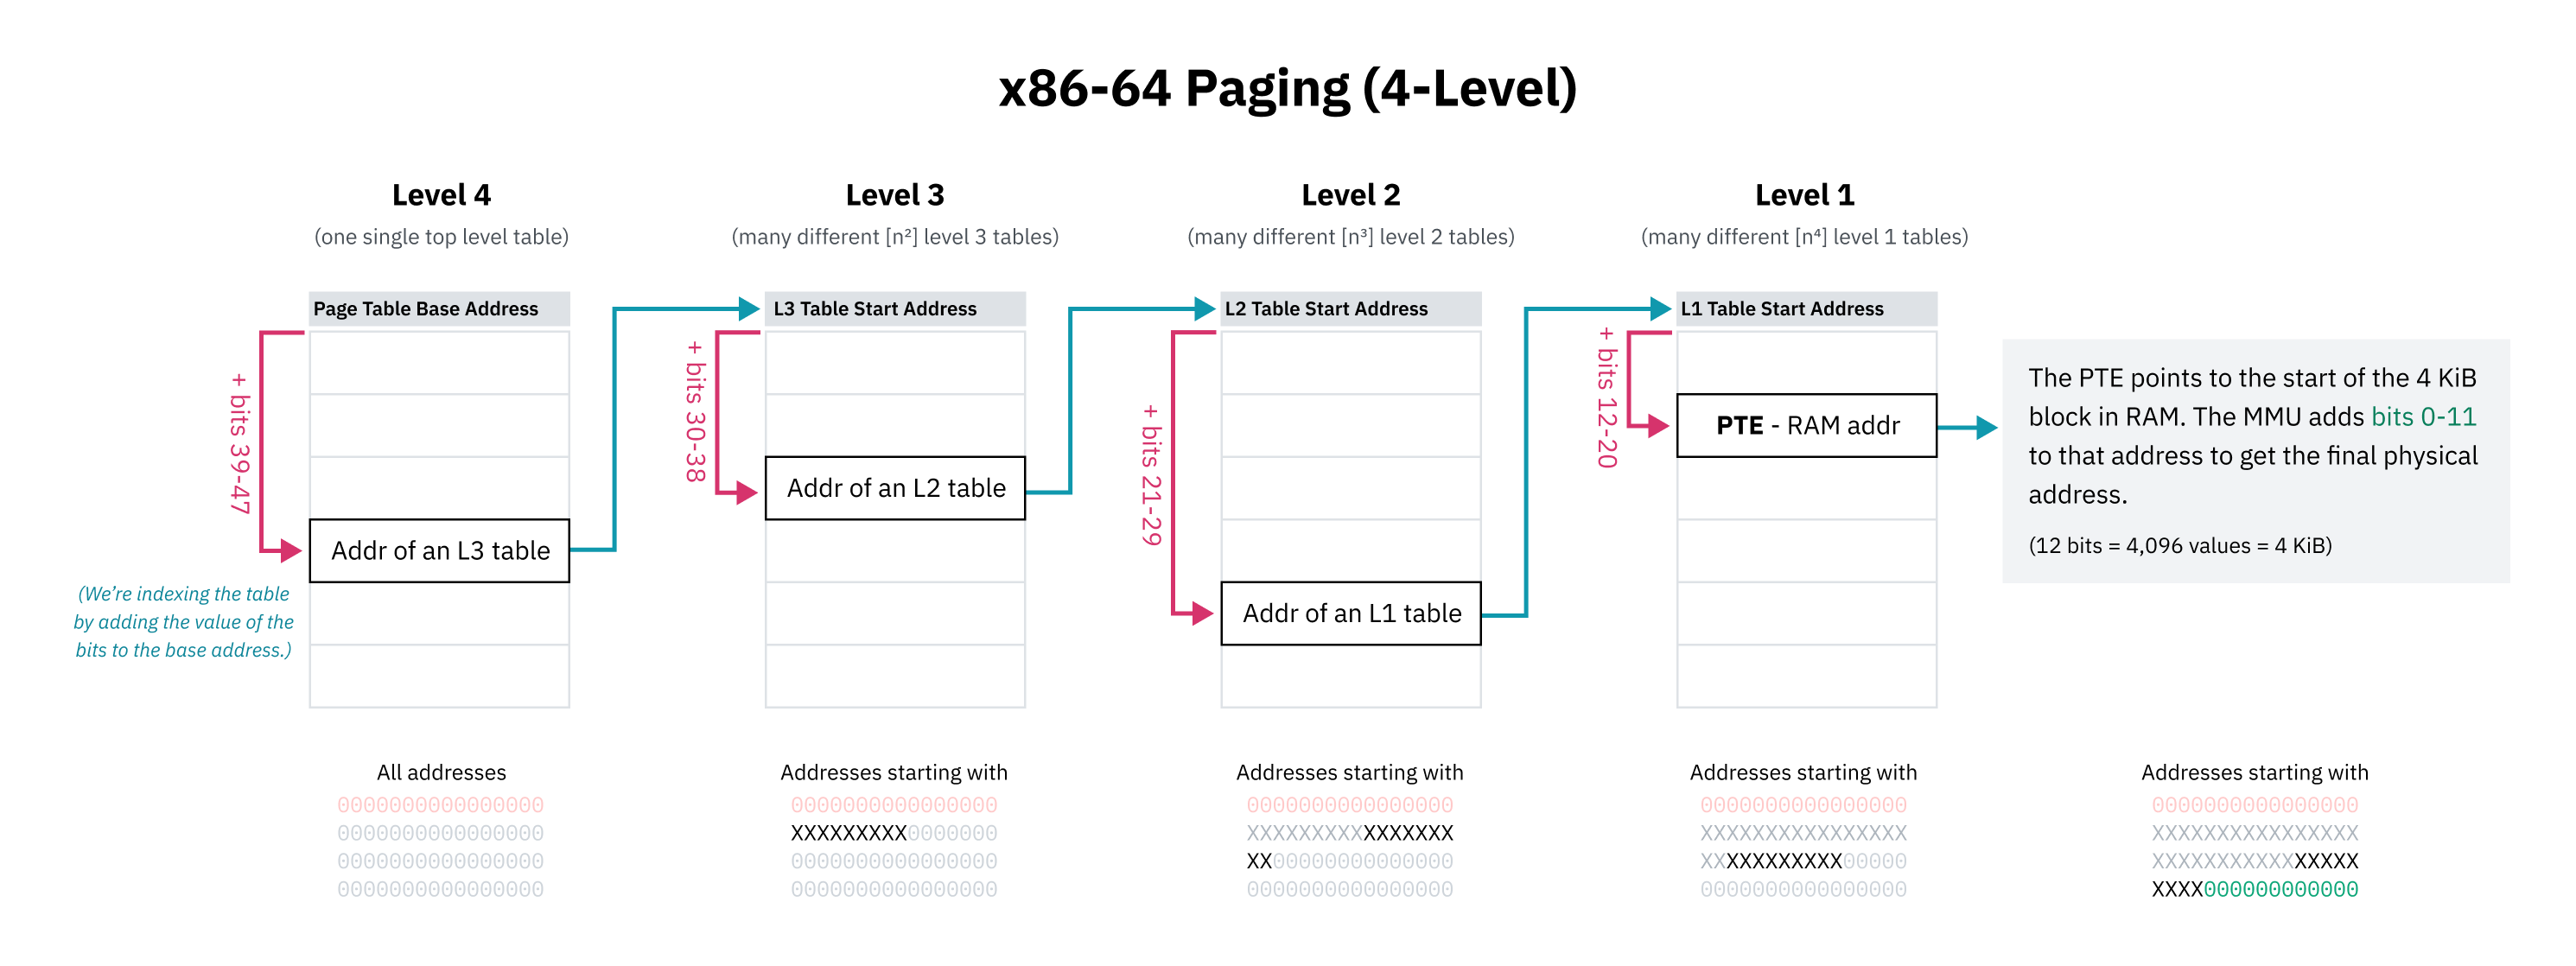
계층적 페이징은 트리의 어느 단계에서든 다음 항목을 가리키는 포인터가 null(0x0)일 수 있으므로 공간 문제를 해결합니다. 이 덕분에 페이지 테이블의 하위 트리 전체를 생략할 수 있으며, 이는 가상 메모리 공간에서 매핑되지 않은 영역이 RAM의 공간을 전혀 차지하지 않는다는 뜻입니다. CPU는 트리의 상위 단계에서 빈 항목을 발견하는 즉시 오류를 낼 수 있으므로, 매핑되지 않은 메모리 주소에 대한 조회는 빠르게 실패할 수 있습니다. 페이지 테이블 항목에는 존재 플래그도 있어서, 주소가 유효해 보이더라도 해당 항목을 사용할 수 없다고 표시하는 데 쓸 수 있습니다.
계층적 페이징의 또 다른 장점은 가상 메모리 공간의 큰 부분을 효율적으로 교체할 수 있다는 것입니다. 가상 메모리의 넓은 영역이 어떤 프로세스에서는 물리 메모리의 한 영역에, 다른 프로세스에서는 또 다른 영역에 매핑될 수 있습니다. 커널은 두 매핑을 모두 메모리에 저장해 두고, 프로세스를 전환할 때 트리 최상위 단계의 포인터만 갱신하면 됩니다. 전체 메모리 공간 매핑이 평평한 항목 배열로 저장되어 있다면 커널은 많은 항목을 갱신해야 할 것입니다. 이는 느릴 뿐 아니라, 여전히 각 프로세스의 메모리 매핑을 별도로 추적해야 합니다.
제가 x86-64가 “전통적으로” 4단계 페이징을 사용한다고 말한 이유는 최근 프로세서들이 5단계 페이징을 구현하기 때문입니다. 5단계 페이징은 간접 참조 단계를 하나 더 추가하고 주소 지정 비트를 9개 더 늘려, 57비트 주소로 주소 공간을 128 PiB까지 확장합니다. 5단계 페이징은 2017년부터 이를 지원한 Linux를 비롯해 최신 Windows 10 및 11 서버 버전 등의 운영체제에서 지원됩니다.
여담: 물리 주소 공간의 한계
운영체제가 가상 주소에 64비트를 모두 사용하지 않는 것처럼, 프로세서도 64비트 물리 주소 전체를 사용하지 않습니다. 4단계 페이징이 표준이던 시절에 x86-64 CPU는 46비트를 넘게 사용하지 않았으며, 이는 물리 주소 공간이 64 TiB로 제한되었다는 뜻입니다. 5단계 페이징에서는 지원 범위가 52비트로 확장되어 4 PiB의 물리 주소 공간을 지원합니다.
운영체제 수준에서는 가상 주소 공간이 물리 주소 공간보다 큰 것이 유리합니다. Linus Torvalds가 말했듯이, “[가상 주소 공간은] 더 커야 합니다. 최소한 두 배는 되어야 하는데, 솔직히 그것도 빠듯하고, 열 배 이상이면 훨씬 낫습니다. 이걸 이해하지 못하는 사람은 멍청이입니다. 논의는 여기서 끝입니다.”
스와핑과 요구 페이징
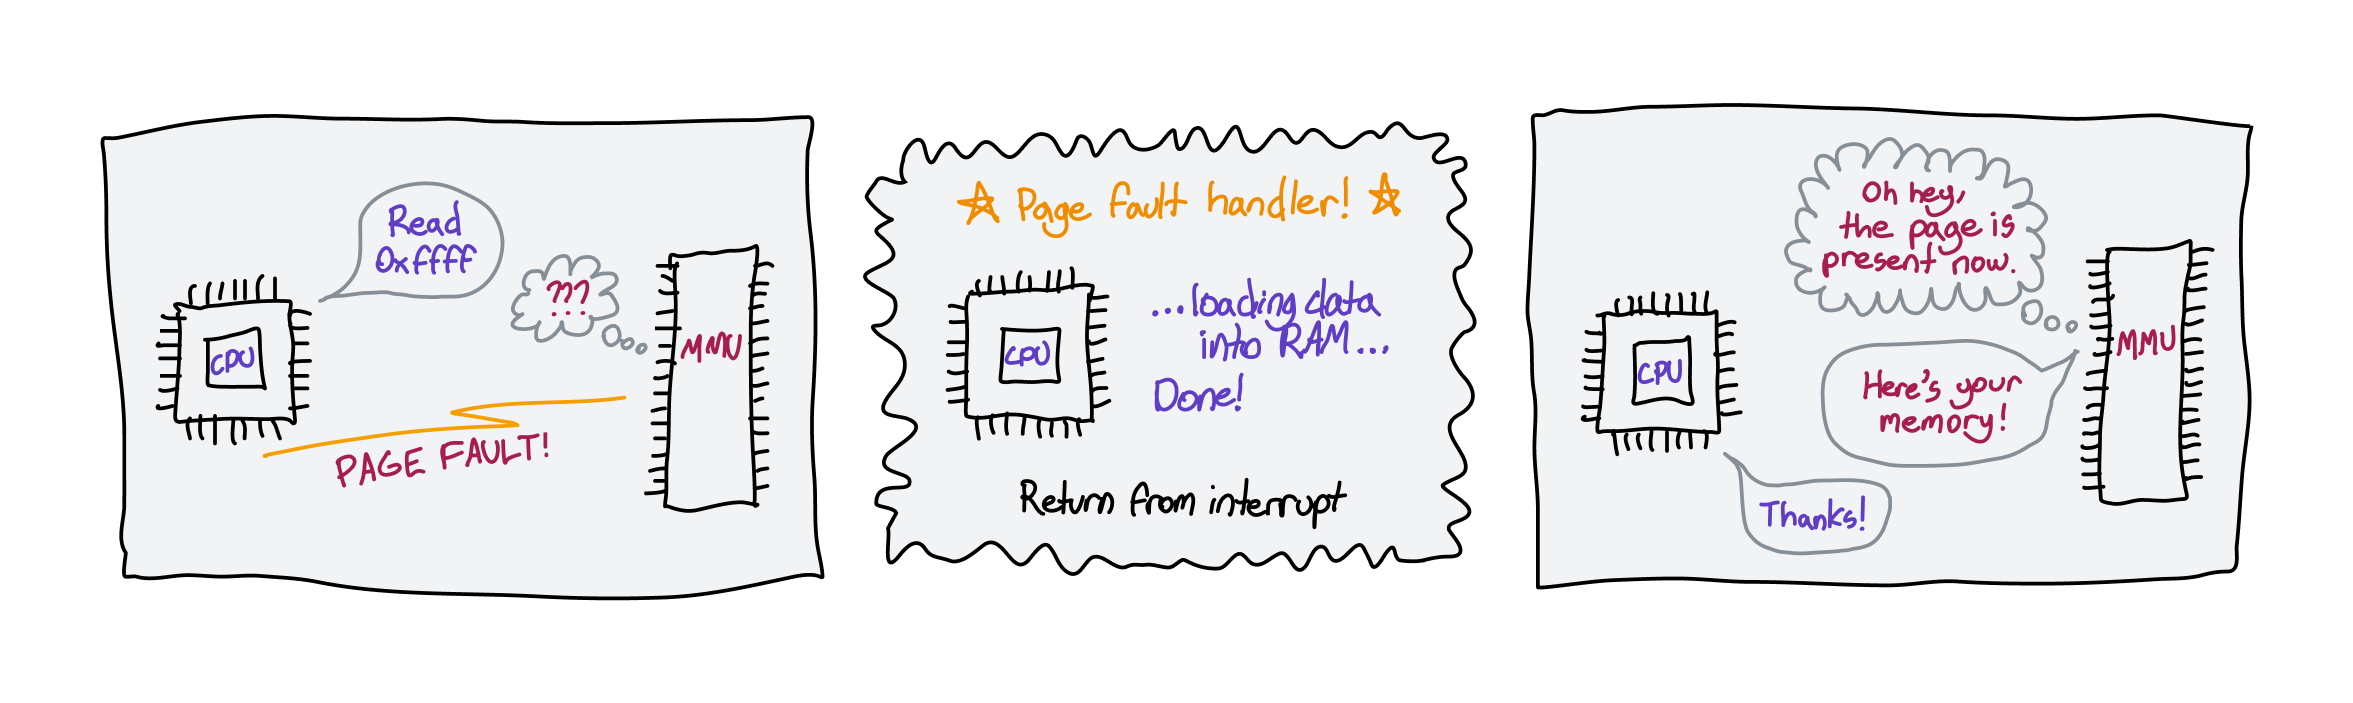
메모리 접근은 몇 가지 이유로 실패할 수 있습니다. 주소가 범위를 벗어났을 수도 있고, 페이지 테이블에 매핑되지 않았을 수도 있으며, 존재하지 않는 것으로 표시된 항목을 가지고 있을 수도 있습니다. 이 중 어떤 경우든 MMU는 페이지 폴트라는 하드웨어 인터럽트를 발생시켜 커널이 문제를 처리하게 합니다.
어떤 경우에는 읽기가 정말로 유효하지 않거나 금지된 것입니다. 이런 경우 커널은 아마 세그멘테이션 폴트 오류와 함께 프로그램을 종료할 것입니다.
$ ./program
Segmentation fault (core dumped)
$
여담: 세그폴트의 존재론
“세그멘테이션 폴트”는 맥락에 따라 다른 의미를 가집니다. MMU는 권한 없이 메모리를 읽을 때 “세그멘테이션 폴트”라는 하드웨어 인터럽트를 발생시키지만, “세그멘테이션 폴트”는 운영체제가 모든 종류의 불법적인 메모리 접근을 이유로 실행 중인 프로그램을 종료하기 위해 보낼 수 있는 시그널의 이름이기도 합니다.
다른 경우에는 메모리 접근이 의도적으로 실패하도록 하여, 운영체제가 메모리를 채운 뒤 CPU에 제어권을 다시 넘겨 재시도하게 할 수 있습니다. 예를 들어, 운영체제는 디스크에 있는 파일을 실제로 RAM에 적재하지 않은 채 가상 메모리에 매핑해 두었다가, 해당 주소가 요청되어 페이지 폴트가 발생하면 그때 물리 메모리에 적재할 수 있습니다. 이를 요구 페이징(demand paging)이라고 합니다.
우선, 이 덕분에 디스크의 파일 전체를 가상 메모리에 지연 매핑하는 mmap 같은 시스템 호출이 존재할 수 있습니다. 유출된 Facebook 언어 모델의 런타임인 LLaMa.cpp를 알고 계신다면, 최근 Justine Tunney가 모든 로딩 로직이 mmap을 사용하도록 만들어 이를 크게 최적화했다는 소식도 들으셨을 것입니다. (그녀에 대해 처음 들어 보셨다면 그녀의 작업물을 살펴보십시오! Cosmopolitan Libc와 APE는 정말 멋지며, 이 글을 재미있게 읽고 계신다면 흥미롭게 느끼실 것입니다.)
보아하니 이 변경에 Justine이 관여한 것을 두고 많은 논란이 있는 듯합니다. 인터넷의 낯선 사용자들에게 욕을 먹지 않으려고 짚어 두는 것뿐입니다. 고백하자면 저는 그 논란의 대부분을 읽어 보지 않았으며, Justine의 작업물이 멋지다고 했던 제 말은 여전히 전적으로 사실입니다.
프로그램과 그 라이브러리를 실행할 때, 커널은 실제로 아무것도 메모리에 적재하지 않습니다. 커널은 해당 파일의 mmap을 생성할 뿐이며, CPU가 코드를 실행하려 하면 즉시 페이지 폴트가 발생하고 커널이 그 페이지를 실제 메모리 블록으로 교체합니다.
요구 페이징은 여러분이 아마 “스와핑(swapping)” 또는 “페이징(paging)“이라는 이름으로 접해 보셨을 기법도 가능하게 합니다. 운영체제는 메모리 페이지를 디스크에 기록한 뒤 물리 메모리에서는 제거하되, present 플래그를 0으로 설정한 채 가상 메모리에는 남겨 둠으로써 물리 메모리를 확보할 수 있습니다. 그 가상 메모리를 읽으려 하면, 운영체제는 디스크에서 RAM으로 메모리를 복원하고 present 플래그를 다시 1로 설정할 수 있습니다. 운영체제는 디스크에서 적재되는 메모리를 위한 공간을 마련하기 위해 RAM의 다른 영역을 스왑해야 할 수도 있습니다. 디스크 읽기와 쓰기는 느리기 때문에, 운영체제는 효율적인 페이지 교체 알고리즘을 사용하여 스와핑이 최대한 적게 일어나도록 합니다.
흥미로운 꼼수 하나는 페이지 테이블의 물리 메모리 포인터를 사용하여 물리 저장 장치 내 파일의 위치를 저장하는 것입니다. MMU는 present 플래그가 0인 것을 보는 즉시 페이지 폴트를 일으키므로, 그 값이 유효하지 않은 메모리 주소라는 것은 문제가 되지 않습니다. 모든 경우에 실용적인 방법은 아니지만, 생각해 보면 재미있습니다.
6장으로 계속: 포크와 소에 대해 이야기해 봅시다