지금까지 CPU가 실행 파일에서 불러온 기계어 코드를 어떻게 실행하는지, 링 기반 보안이 무엇인지, 그리고 시스템 호출이 어떻게 동작하는지 살펴보았습니다. 이번 절에서는 Linux 커널을 깊이 파고들어 애초에 프로그램이 어떻게 로드되고 실행되는지 알아보겠습니다.
구체적으로는 x86-64 위의 Linux를 살펴볼 것입니다. 왜일까요?
Linux는 데스크톱, 모바일, 서버 용도로 쓰이는, 모든 기능을 갖춘 프로덕션 운영체제입니다. Linux는 오픈 소스이므로 소스 코드를 읽는 것만으로도 매우 쉽게 연구할 수 있습니다. 이 글에서는 커널 코드 일부를 직접 참조하겠습니다!
x86-64는 대부분의 최신 데스크톱 컴퓨터가 사용하는 아키텍처이며, 많은 코드가 대상으로 삼는 아키텍처이기도 합니다. 제가 언급하는 동작 가운데 x86-64에 특화된 부분도 잘 일반화될 것입니다.
우리가 배울 내용의 대부분은 다른 운영체제와 아키텍처가 여러 구체적인 면에서 다르더라도 그대로 잘 일반화될 것입니다.
Exec 시스템 호출의 기본 동작
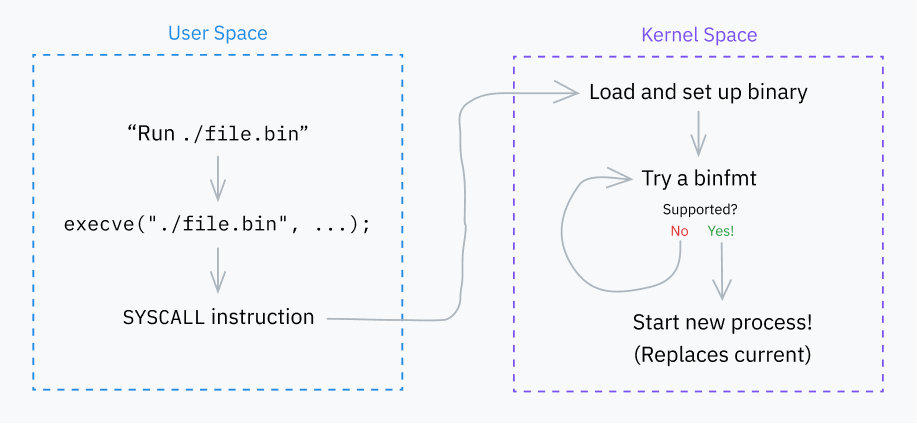
매우 중요한 시스템 호출인 execve부터 시작합시다. 이 시스템 호출은 프로그램을 로드하고, 성공하면 현재 프로세스를 그 프로그램으로 대체합니다. 다른 시스템 호출(execlp, execvpe 등)도 몇 가지 있지만, 모두 다양한 방식으로 execve 위에 계층을 이루고 있습니다.
여담: execveat
execve는 사실 몇 가지 설정 옵션과 함께 프로그램을 실행하는 더 일반적인 시스템 호출인 execveat 위에 구축되어 있습니다. 간단히 하기 위해 주로 execve를 다루겠습니다. 유일한 차이는 execve가 execveat에 몇 가지 기본값을 제공한다는 점입니다.
ve가 무엇을 뜻하는지 궁금하십니까? v는 매개변수 하나가 인자의 벡터(리스트)(argv)라는 뜻이고, e는 또 다른 매개변수가 환경 변수의 벡터(envp)라는 뜻입니다. 다른 여러 exec 시스템 호출은 서로 다른 호출 시그니처를 나타내기 위해 각기 다른 접미사를 가지고 있습니다. execveat의 at은 그냥 “at”이라는 뜻인데, execve를 실행할 위치를 지정하기 때문입니다.
execve의 호출 시그니처는 다음과 같습니다:
int execve(const char *filename, char *const argv[], char *const envp[]);
filename 인자는 실행할 프로그램의 경로를 지정합니다.
argv는 프로그램에 전달할 인자들의 널 종료(마지막 항목이 널 포인터라는 뜻) 리스트입니다. C의 main 함수에 전달되는 것을 흔히 보는 argc 인자는 사실 나중에 시스템 호출이 계산하는 값이며, 그래서 널 종료가 필요합니다.
envp 인자에는 애플리케이션의 컨텍스트로 사용되는 환경 변수들의 또 다른 널 종료 리스트가 들어 있습니다. 이것들은… 관례적으로 KEY=VALUE 쌍입니다. 관례적으로 말입니다. 저는 컴퓨터가 정말 좋습니다.
재미있는 사실이 있습니다! 프로그램의 첫 번째 인자가 프로그램 이름이라는 관례를 알고 계십니까? 그것은 순전히 관례일 뿐이며, 실제로 execve 시스템 호출 자체가 설정하는 것이 아닙니다! 첫 번째 인자는 프로그램 이름과 전혀 관계가 없더라도 argv 인자의 첫 번째 항목으로 execve에 전달된 값이 무엇이든 그 값이 됩니다.
흥미롭게도 execve에는 argv[0]이 프로그램 이름이라고 가정하는 코드가 실제로 일부 있습니다. 이에 대해서는 나중에 인터프리터 방식의 스크립트 언어를 다룰 때 더 자세히 이야기하겠습니다.
0단계: 정의
시스템 호출이 어떻게 동작하는지는 이미 알고 있지만, 실제 코드 예시는 아직 한 번도 본 적이 없습니다! 내부적으로 execve가 어떻게 정의되어 있는지 Linux 커널의 소스 코드를 살펴봅시다.
SYSCALL_DEFINE3는 인자가 3개인 시스템 호출의 코드를 정의하기 위한 매크로입니다.
저는 왜 매크로 이름에 인자 개수(arity)가 하드코딩되어 있는지 궁금해서 이리저리 검색해 보았고, 이것이 어떤 보안 취약점을 고치기 위한 우회책이었다는 사실을 알게 되었습니다.
파일 이름 인자는 getname() 함수로 전달되며, 이 함수는 문자열을 사용자 공간에서 커널 공간으로 복사하고 사용량 추적과 관련된 작업도 몇 가지 수행합니다. 이 함수는 include/linux/fs.h에 정의된 filename 구조체를 반환합니다. 이 구조체는 사용자 공간에 있는 원래 문자열을 가리키는 포인터와 함께, 커널 공간으로 복사된 값을 가리키는 새 포인터도 저장합니다:
struct filename { const char *name; /* pointer to actual string */ const __user char *uptr; /* original userland pointer */ int refcnt; struct audit_names *aname; const char iname[];};
그다음 execve 시스템 호출은 do_execve() 함수를 호출합니다. 이 함수는 다시 몇 가지 기본값과 함께 do_execveat_common()를 호출합니다. 앞서 언급한 execveat 시스템 호출 역시 do_execveat_common()를 호출하지만, 사용자가 제공한 옵션을 더 많이 전달합니다.
execveat에서는 파일 디스크립터(어떤 리소스를 가리키는 일종의 ID)가 시스템 호출에 전달된 다음 do_execveat_common으로 전달됩니다. 이 값은 프로그램을 실행할 때 기준이 되는 디렉터리를 지정합니다.
execve에서는 파일 디스크립터 인자로 특별한 값인 AT_FDCWD가 사용됩니다. 이것은 Linux 커널에서 공유되는 상수로, 경로명을 현재 작업 디렉터리 기준의 상대 경로로 해석하라고 함수에 알려 줍니다. 파일 디스크립터를 받는 함수에는 보통 다음과 같은 수동 검사가 들어 있습니다if (fd == AT_FDCWD) { /* special codepath */ }.
1단계: 준비
이제 프로그램 실행을 처리하는 핵심 함수인 do_execveat_common에 도달했습니다. 이 함수가 무엇을 하는지 더 큰 그림으로 보기 위해, 코드를 들여다보던 것에서 잠시 한 발 물러서 보겠습니다.
do_execveat_common의 첫 번째 주요 작업은 linux_binprm이라는 구조체를 준비하는 것입니다. 구조체 정의 전체를 옮겨 싣지는 않겠지만, 짚고 넘어가야 할 중요한 필드가 몇 가지 있습니다:
새 프로그램의 가상 메모리 관리를 준비하기 위해 mm_struct와 vm_area_struct 같은 자료 구조가 정의됩니다.
프로그램에 전달할 argc와 envc가 계산되어 저장됩니다.
filename과 interp는 각각 프로그램의 파일 이름과 그 인터프리터의 파일 이름을 저장합니다. 이 둘은 처음에는 서로 같은 값으로 시작하지만, 경우에 따라 달라질 수 있습니다. 그러한 경우 중 하나가 셔뱅(shebang)이 있는 인터프리터 방식의 스크립트를 실행할 때입니다. 예를 들어 Python 프로그램을 실행할 때 filename은 소스 파일을 가리키지만 interp는 Python 인터프리터의 경로입니다.
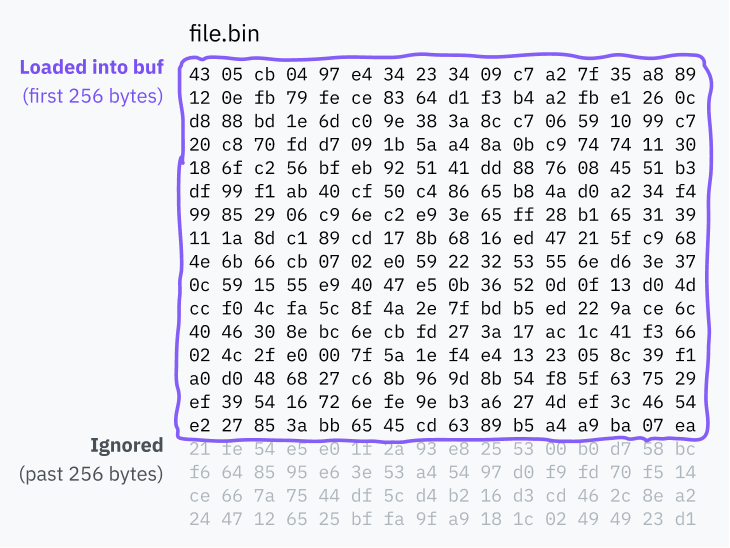
buf는 실행할 파일의 처음 256바이트로 채워진 배열입니다. 이 배열은 파일 형식을 감지하고 스크립트의 셔뱅을 불러오는 데 사용됩니다.
위 코드의 경로에 /uapi/가 들어 있다는 점을 눈치채셨을 것입니다. 왜 이 길이는 linux_binprm 구조체와 같은 파일인 include/linux/binfmts.h에 정의되어 있지 않을까요?
UAPI는 “userspace API(사용자 공간 API)“의 약자입니다. 여기서는 누군가가 버퍼의 길이를 커널의 공개 API에 포함해야 한다고 결정했다는 뜻입니다. 이론상 UAPI에 속한 모든 것은 유저랜드에 노출되고, UAPI가 아닌 모든 것은 커널 코드 내부에서만 쓰입니다.
원래 커널 코드와 사용자 공간 코드는 한데 뒤섞인 채로 공존했습니다. 2012년에 유지보수성을 높이려는 시도의 일환으로 UAPI 코드가 별도의 디렉터리로 리팩터링되었습니다.
2단계: Binfmt
커널이 다음으로 하는 주요 작업은 여러 “binfmt”(바이너리 형식) 핸들러를 차례로 순회하는 것입니다. 이 핸들러들은 fs/binfmt_elf.c나 fs/binfmt_flat.c 같은 파일에 정의되어 있습니다. 커널 모듈도 자체 binfmt 핸들러를 이 풀에 추가할 수 있습니다.
각 핸들러는 load_binary() 함수를 노출하는데, 이 함수는 linux_binprm 구조체를 받아 해당 핸들러가 프로그램의 형식을 이해할 수 있는지 확인합니다.
이 과정에서는 흔히 버퍼에서 매직 넘버를 찾거나, (역시 버퍼에 있는) 프로그램의 시작 부분을 디코딩해 보거나, 파일 확장자를 확인하거나, 이들을 함께 수행합니다. 핸들러가 해당 형식을 지원하면 프로그램을 실행할 수 있도록 준비한 뒤 성공 코드를 반환합니다. 그렇지 않으면 일찍 종료하고 오류 코드를 반환합니다. 커널은 성공하는 binfmt가 나올 때까지 각 binfmt의 load_binary() 함수를 차례로 시도합니다. 때로는 이 과정이 재귀적으로 실행되기도 합니다. 예를 들어 스크립트에 인터프리터가 지정되어 있고 그 인터프리터 자체도 스크립트라면, 계층 구조는 binfmt_script > binfmt_script > binfmt_elf가 될 수 있습니다(여기서 ELF는 체인의 마지막에 있는 실행 파일 형식입니다).
형식 집중 탐구: 스크립트
Linux가 지원하는 여러 형식 중에서 제가 가장 먼저 따로 이야기하고 싶은 것은 binfmt_script입니다.
셔뱅을 읽거나 써 본 적이 있으십니까? 일부 스크립트의 맨 앞에서 인터프리터의 경로를 지정하는 그 줄 말입니다.
1
#!/bin/bash
저는 늘 셔뱅을 셸이 처리한다고만 생각했지만, 그렇지 않습니다! 셔뱅은 사실 커널의 기능이며, 스크립트는 다른 모든 프로그램과 똑같은 시스템 호출로 실행됩니다. 컴퓨터는 정말 멋집니다.
fs/binfmt_script.c가 파일이 셔뱅으로 시작하는지 어떻게 확인하는지 살펴보십시오:
	/* Not ours to exec if we don't start with "#!". */
	if ((bprm->buf[0] != '#') || (bprm->buf[1] != '!'))
		return -ENOEXEC;
파일이 실제로 셔뱅으로 시작하면, binfmt 핸들러는 이어서 인터프리터 경로와 그 경로 뒤에 공백으로 구분된 인자들을 읽습니다. 이 과정은 줄바꿈 문자나 버퍼의 끝을 만나면 멈춥니다.
여기에는 흥미롭고도 기묘한 점이 두 가지 있습니다.
먼저, 파일의 처음 256바이트로 채워진 linux_binprm의 버퍼를 기억하십니까? 이 버퍼는 실행 파일 형식을 감지하는 데 쓰이지만, binfmt_script에서 셔뱅을 읽어 들이는 곳도 바로 이 버퍼입니다.
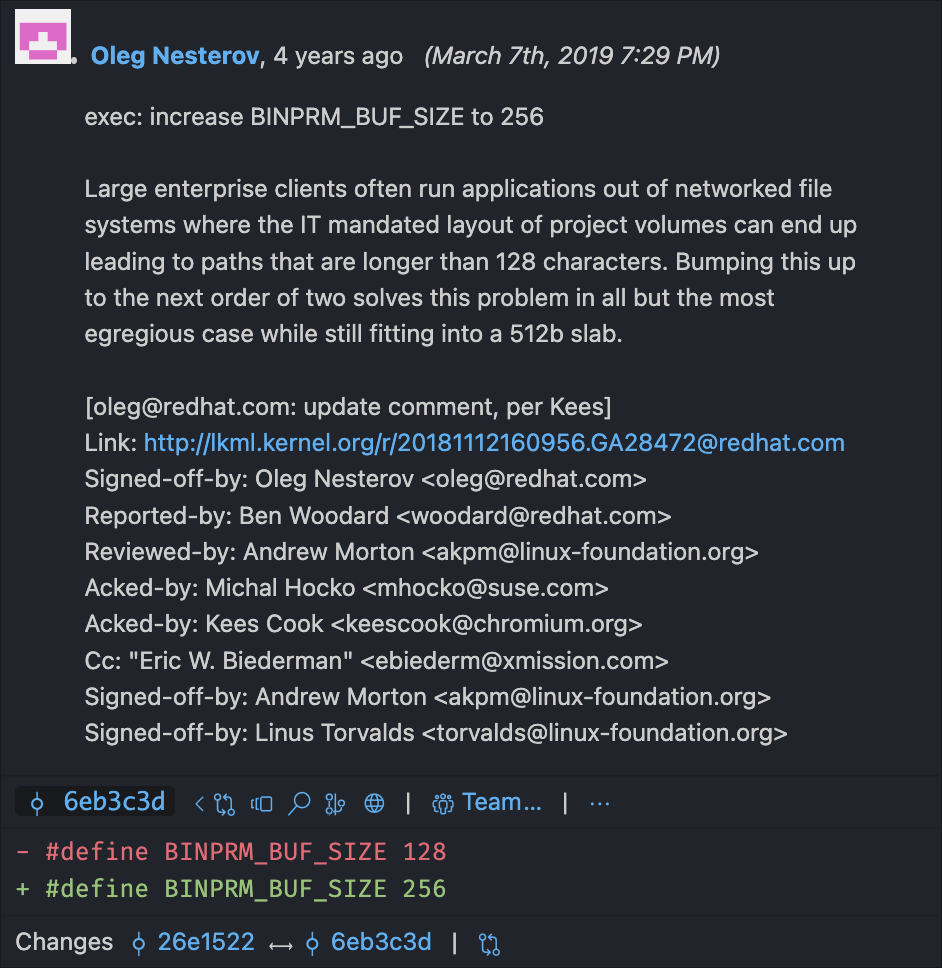
조사하는 동안 저는 이 버퍼의 길이가 128바이트라고 설명한 글을 읽었습니다. 그런데 그 글이 게시된 후 어느 시점에 길이가 두 배인 256바이트로 늘어났습니다! 이유가 궁금해서 Linux 소스 코드에서 BINPRM_BUF_SIZE가 정의된 줄의 Git blame(특정 코드 줄을 수정한 모든 사람의 기록)을 확인해 보았습니다. 그랬더니 놀랍게도…
컴퓨터는 정말 멋집니다!
셔뱅은 커널이 처리하며 파일 전체를 불러오는 대신 buf에서 가져오기 때문에, 항상buf의 길이만큼 잘립니다. 보아하니 4년 전 누군가가 커널이 128자를 넘는 경로를 잘라 버리는 데 짜증이 났고, 그 해결책으로 버퍼 크기를 두 배로 늘려 잘리는 지점을 두 배로 늘렸던 것입니다! 오늘날 여러분의 Linux 머신에서도 셔뱅 줄이 256자를 넘으면 256자 이후의 모든 내용은 완전히 사라집니다.
이 때문에 버그가 생겼다고 상상해 보십시오. 코드가 망가지는 근본 원인을 찾아내려 애쓰는 모습을 상상해 보십시오. 문제가 Linux 커널 깊숙한 곳에 있다는 사실을 알게 되었을 때의 기분을 상상해 보십시오. 경로의 일부가 알 수 없이 사라졌다는 사실을 발견하게 될, 어느 거대 기업의 다음 IT 담당자에게 애도를 표합니다.
두 번째 기묘한 점:argv[0]이 프로그램 이름이라는 것은 관례일 뿐이며, 호출자는 exec 시스템 호출에 원하는 어떤 argv든 넘길 수 있고 그 값은 아무런 검사 없이 그대로 전달된다는 것을 기억하십니까?
공교롭게도 binfmt_script는 argv[0]이 프로그램 이름이라고 가정하는 곳 중 하나입니다. 이 핸들러는 항상 argv[0]을 제거한 다음, argv의 맨 앞에 다음 항목들을 추가합니다:
argv를 갱신한 후, 핸들러는 linux_binprm.interp를 인터프리터 경로(이 경우에는 Node 바이너리)로 설정하여 파일의 실행 준비를 마칩니다. 마지막으로, 프로그램의 실행 준비에 성공했음을 나타내기 위해 0을 반환합니다.
형식 집중 탐구: 기타 인터프리터
또 하나의 흥미로운 핸들러는 binfmt_misc입니다. 이 핸들러는 /proc/sys/fs/binfmt_misc/에 특수 파일 시스템을 마운트하여, 유저랜드 설정을 통해 몇 가지 제한된 형식을 추가할 수 있게 해 줍니다. 프로그램은 이 디렉터리의 파일에 특별한 형식으로 쓰기를 수행하여 자신만의 핸들러를 추가할 수 있습니다. 각 설정 항목은 다음을 지정합니다.
해당 파일 형식을 감지하는 방법입니다. 특정 오프셋에 있는 매직 넘버나 찾아볼 파일 확장자 중 하나를 지정할 수 있습니다.
인터프리터 실행 파일의 경로입니다. 인터프리터 인자를 지정할 방법은 없으므로, 인자가 필요하다면 래퍼 스크립트를 사용해야 합니다.
몇 가지 설정 플래그이며, 여기에는 binfmt_misc가 argv를 어떻게 갱신할지 지정하는 플래그도 포함됩니다.
이 binfmt_misc 시스템은 Java 설치에서 자주 사용되며, 클래스 파일은 0xCAFEBABE 매직 바이트로, JAR 파일은 확장자로 감지하도록 설정됩니다. 제 시스템에는 Python 바이트코드를 .pyc 확장자로 감지하여 적절한 핸들러에 넘겨주는 핸들러가 설정되어 있습니다.
이는 프로그램 설치 프로그램이 높은 권한으로 동작하는 커널 코드를 작성하지 않고도 자신만의 형식에 대한 지원을 추가할 수 있게 해 주는 꽤 멋진 방법입니다.
결국에는 (Linkin Park의 노래 말고)
exec 시스템 호출은 항상 다음 두 경로 중 하나로 끝납니다.
어쩌면 여러 겹의 스크립트 인터프리터를 거친 뒤일 수도 있지만, 결국 자신이 이해하는 실행 파일 바이너리 형식에 도달하여 그 코드를 실행합니다. 이 시점에서 기존 코드는 교체된 상태입니다.
… 아니면 모든 선택지를 소진하고, 꼬리를 내린 채 호출한 프로그램에 오류 코드를 반환합니다.
유닉스 계열 시스템을 사용해 본 적이 있다면, 터미널에서 실행한 셸 스크립트에 셔뱅 줄이나 .sh 확장자가 없어도 여전히 실행된다는 것을 눈치챘을 수도 있습니다. Windows가 아닌 터미널이 가까이 있다면 지금 바로 시험해 볼 수 있습니다.
(chmod +x는 운영체제에 해당 파일이 실행 파일임을 알려 줍니다. 이렇게 하지 않으면 파일을 실행할 수 없습니다.)
그렇다면 이 셸 스크립트는 왜 셸 스크립트로 실행되는 것입니까? 커널의 형식 핸들러에는 식별할 만한 표시가 전혀 없는 셸 스크립트를 감지할 확실한 방법이 없을 텐데 말입니다!
알고 보니 이 동작은 커널의 일부가 아닙니다. 실은 여러분의 셸이 실패 상황을 처리하는 흔한 방식입니다.
셸로 파일을 실행했는데 exec 시스템 호출이 실패하면, 대부분의 셸은 파일 이름을 첫 번째 인자로 하여 셸을 실행함으로써 그 파일을 셸 스크립트로 다시 실행하려고 시도합니다. Bash는 보통 자기 자신을 이 인터프리터로 사용하지만, ZSH는 sh가 가리키는 것을 사용하며, 이는 보통 본 셸입니다.
이 동작이 이렇게 흔한 이유는 Unix 시스템 간에 코드를 이식할 수 있도록 만들어진 오래된 표준인 POSIX에 명시되어 있기 때문입니다. 대부분의 도구나 운영체제가 POSIX를 엄격하게 따르지는 않지만, 그 관례 중 상당수는 여전히 공유되고 있습니다.
[exec 시스템 호출이] [ENOEXEC] 오류에 해당하는 오류로 실패하면, 셸은 명령 이름을 첫 번째 피연산자로 하여 셸을 호출한 것과 동등한 명령을 실행해야 하며, 나머지 인자는 모두 새 셸에 전달됩니다. 실행 파일이 텍스트 파일이 아니면 셸은 이 명령 실행을 건너뛸 수 있습니다. 이 경우 셸은 오류 메시지를 출력하고 종료 상태 126을 반환해야 합니다.