다음 글의 일부입니다: Putting the “You” in CPU: 컴퓨터가 프로그램을 실행하는 방식이라는 토끼굴로 깊이 빠져드는 여정입니다.
2장: 시간을 쪼개 봅시다 GitHub에서 편집하기
여러분이 운영체제를 만들고 있고, 사용자가 여러 프로그램을 동시에 실행할 수 있게 하고 싶다고 가정해 봅시다. 하지만 여러분에게는 멋진 멀티코어 프로세서가 없으므로, CPU는 한 번에 명령어 하나만 실행할 수 있습니다!
다행히 여러분은 아주 똑똑한 운영체제 개발자입니다. 프로세스들이 CPU를 번갈아 사용하게 하면 병렬 처리를 흉내 낼 수 있다는 사실을 알아냅니다. 프로세스들을 차례로 돌아가며 각각 명령어를 몇 개씩 실행하면, 어느 한 프로세스가 CPU를 독차지하지 않고도 모든 프로세스가 반응성을 유지할 수 있습니다.
그런데 프로세스를 전환하려면 프로그램 코드로부터 제어권을 어떻게 되찾아 와야 할까요? 조금 조사해 보니, 대부분의 컴퓨터에는 타이머 칩이 달려 있다는 사실을 알게 됩니다. 일정 시간이 지나면 OS 인터럽트 핸들러로 전환이 일어나도록 타이머 칩을 프로그램할 수 있습니다.
하드웨어 인터럽트
앞에서 소프트웨어 인터럽트가 유저랜드 프로그램에서 운영체제로 제어권을 넘기는 데 어떻게 쓰이는지 이야기했습니다. 이것을 “소프트웨어” 인터럽트라고 부르는 이유는 프로그램이 자발적으로 일으키기 때문입니다. 즉, 일반적인 페치-실행 사이클에서 프로세서가 실행하는 기계어 코드가 프로세서에게 제어권을 커널로 넘기라고 지시합니다.
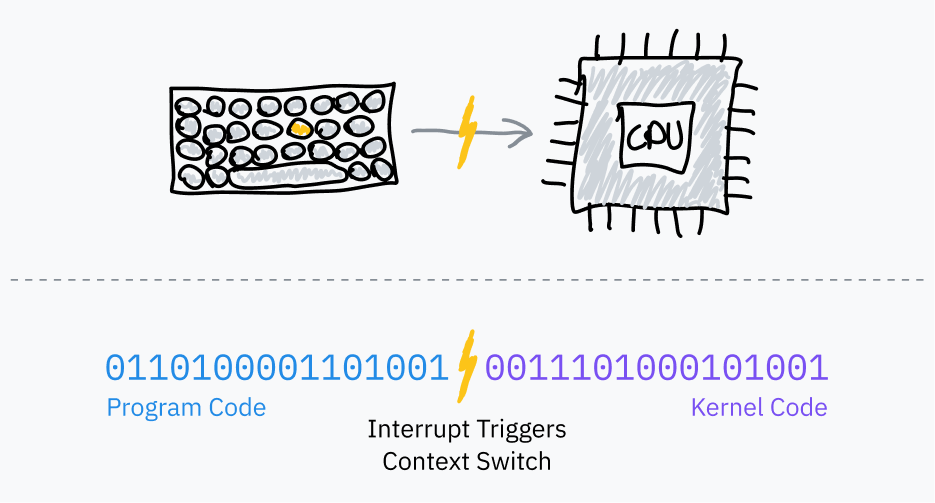
운영체제 스케줄러는 PIT 같은 타이머 칩을 사용해 멀티태스킹을 위한 하드웨어 인터럽트를 일으킵니다:
- 프로그램 코드로 점프하기 전에, 운영체제는 일정 시간이 지나면 인터럽트를 일으키도록 타이머 칩을 설정합니다.
- 운영체제는 사용자 모드로 전환하고 프로그램의 다음 명령어로 점프합니다.
- 타이머가 만료되면 하드웨어 인터럽트가 발생해 커널 모드로 전환되고 운영체제 코드로 점프합니다.
- 이제 운영체제는 프로그램이 멈춘 지점을 저장하고, 다른 프로그램을 불러온 뒤, 이 과정을 반복할 수 있습니다.
이것을 선점형 멀티태스킹이라고 하며, 프로세스를 중단시키는 것을 선점이라고 합니다. 예를 들어 여러분이 같은 컴퓨터에서 브라우저로 이 글을 읽으면서 음악을 듣고 있다면, 여러분의 컴퓨터는 아마 1초에 수천 번씩 바로 이 사이클을 반복하고 있을 것입니다.
타임슬라이스 계산
타임슬라이스란 운영체제 스케줄러가 프로세스를 선점하기 전까지 그 프로세스가 실행되도록 허용하는 시간입니다. 타임슬라이스를 정하는 가장 간단한 방법은 모든 프로세스에 10 ms 정도의 같은 타임슬라이스를 주고 작업을 순서대로 돌아가며 실행하는 것입니다. 이를 고정 타임슬라이스 라운드 로빈 스케줄링이라고 합니다.
여담: 재미있는 전문 용어 이야기!
타임슬라이스를 흔히 “퀀텀(quantum)“이라고도 부른다는 사실을 알고 계셨습니까? 이제 아셨으니 기술 좋아하는 친구들에게 자랑하실 수 있습니다. 이 글에서 한 문장 걸러 한 번씩 퀀텀이라는 말을 쓰지 않은 것만으로도 저는 칭찬을 듬뿍 받아야 마땅하다고 생각합니다.
타임슬라이스 용어 이야기가 나온 김에 덧붙이면, Linux 커널 개발자들은 고정 주파수 타이머 틱을 세는 데 지피(jiffy)라는 시간 단위를 사용합니다. jiffy는 여러 용도 가운데 특히 타임슬라이스의 길이를 재는 데 쓰입니다. Linux의 지피 주파수는 보통 1000 Hz이지만, 커널을 컴파일할 때 설정할 수 있습니다.
고정 타임슬라이스 스케줄링을 조금 개선하는 방법은 프로세스가 응답하기까지 걸리는 이상적인 최대 시간인 목표 지연 시간(target latency)을 정하는 것입니다. 목표 지연 시간이란 프로세스 수가 적당하다고 가정할 때, 프로세스가 선점된 뒤 실행을 다시 시작하기까지 걸리는 시간입니다. 이것은 머릿속에 그려 보기가 꽤 어렵습니다! 걱정하지 마십시오. 곧 다이어그램이 나옵니다.
타임슬라이스는 목표 지연 시간을 전체 태스크 수로 나누어 계산합니다. 이 방식은 프로세스 수가 적을 때 불필요한 태스크 전환을 없애 주므로 고정 타임슬라이스 스케줄링보다 낫습니다. 목표 지연 시간이 15ms이고 프로세스가 10개라면 각 프로세스는 15/10, 즉 1.5ms씩 실행됩니다. 프로세스가 3개뿐이라면 각 프로세스는 목표 지연 시간을 지키면서도 5ms라는 더 긴 타임슬라이스를 받습니다.
프로세스를 전환하려면 현재 프로그램의 전체 상태를 저장하고 다른 프로그램의 상태를 복원해야 하므로 계산 비용이 큽니다. 타임슬라이스가 일정 수준보다 작아지면 프로세스가 너무 자주 전환되어 성능 문제가 생길 수 있습니다. 그래서 타임슬라이스 길이에 하한(최소 세분도)을 두는 것이 일반적입니다. 따라서 최소 세분도가 적용될 만큼 프로세스가 많아지면 목표 지연 시간을 넘기게 됩니다.
이 글을 쓰는 시점에서 Linux의 스케줄러는 6 ms의 목표 지연 시간과 0.75 ms의 최소 단위(minimum granularity)를 사용합니다.
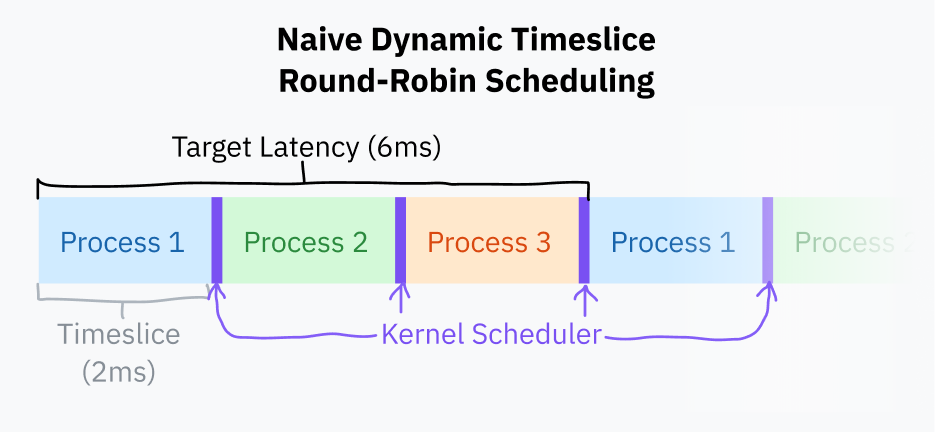
이런 기본적인 타임슬라이스 계산을 쓰는 라운드 로빈 스케줄링은 오늘날 대부분의 컴퓨터가 쓰는 방식과 비슷합니다. 그래도 여전히 다소 단순한 방식입니다. 대부분의 운영체제는 프로세스 우선순위와 마감 시한까지 고려하는 더 복잡한 스케줄러를 사용합니다. 2007년부터 Linux는 Completely Fair Scheduler라는 스케줄러를 사용해 왔습니다. CFS는 태스크의 우선순위를 정하고 CPU 시간을 나누기 위해 매우 정교한 컴퓨터 과학 기법을 여러 가지 사용합니다.
운영체제는 프로세스를 선점할 때마다 새 프로그램의 메모리 환경을 포함해 저장해 둔 실행 컨텍스트를 불러와야 합니다. 이 작업은 CPU에 다른 페이지 테이블, 즉 “가상” 주소를 물리 주소로 매핑하는 표를 사용하라고 지시해서 이루어집니다. 이 페이지 테이블은 프로그램이 서로의 메모리에 접근하지 못하게 막는 시스템이기도 합니다. 이 주제는 이 글의 5장과 6장에서 깊이 파고들겠습니다.
참고 #1: 커널 선점 가능성
지금까지는 유저랜드 프로세스의 선점과 스케줄링에 대해서만 이야기했습니다. 커널 코드가 시스템 호출을 처리하거나 드라이버 코드를 실행하는 데 너무 오래 걸리면 프로그램이 버벅거리는 것처럼 느껴질 수 있습니다.
Linux를 포함한 현대의 커널은 선점형 커널입니다. 이는 커널 코드 자체도 유저랜드 프로세스와 마찬가지로 인터럽트되고 스케줄링될 수 있도록 프로그래밍되어 있다는 뜻입니다.
커널 같은 것을 직접 작성하는 것이 아니라면 그리 중요한 내용은 아니지만, 제가 읽은 글마다 거의 빠짐없이 이 내용을 언급해서 저도 다루기로 했습니다! 더 알아 두어서 나쁠 일은 거의 없습니다.
참고 #2: 역사 수업
클래식 Mac OS와 NT보다 훨씬 이전의 Windows 버전 같은 옛 운영체제는 선점형 멀티태스킹의 전신에 해당하는 방식을 사용했습니다. 운영체제가 프로그램을 언제 선점할지 결정하는 대신 프로그램이 스스로 운영체제에 제어권을 양보하는 방식이었습니다. 프로그램은 소프트웨어 인터럽트를 발생시켜 “이제 다른 프로그램을 실행해도 됩니다”라고 알렸습니다. 이렇게 명시적으로 양보해야만 운영체제가 제어권을 되찾아 다음으로 스케줄링된 프로세스로 전환할 수 있었습니다.
이를 협력형 멀티태스킹이라고 합니다. 이 방식에는 몇 가지 큰 결함이 있습니다. 악의적이거나 그저 잘못 설계된 프로그램 하나가 운영체제 전체를 쉽게 멈추게 할 수 있고, 실시간 작업이나 시간에 민감한 작업의 시간적 일관성을 보장하기가 거의 불가능합니다. 이런 이유로 기술 업계는 오래전에 선점형 멀티태스킹으로 전환했고 다시는 돌아가지 않았습니다.
3장으로 계속: 프로그램을 실행하는 방법