저는 컴퓨터로 많은 일을 해 왔지만, 제 지식에는 늘 빈틈이 하나 있었습니다. 컴퓨터에서 프로그램을 실행하면 정확히 무슨 일이 일어나는 것일까요? 저는 이 빈틈에 대해 생각해 보았습니다. 필요한 저수준 지식은 대부분 갖추고 있었지만, 모든 것을 하나로 엮어 내기가 어려웠습니다. 프로그램은 정말로 CPU에서 직접 실행되는 것일까요, 아니면 다른 무언가가 일어나고 있는 것일까요? 시스템 호출을 사용해 본 적은 있지만, 시스템 호출은 어떻게 동작하는 것일까요? 시스템 호출이란 정말 무엇일까요? 여러 프로그램은 어떻게 동시에 실행되는 것일까요?
결국 참지 못하고 알아낼 수 있는 것은 최대한 알아내기 시작했습니다. 대학에 다니지 않는다면 시스템을 폭넓게 다루는 자료가 많지 않기 때문에, 저는 품질도 제각각이고 때로는 서로 모순되는 정보를 담은 수많은 자료를 샅샅이 뒤져야 했습니다. 몇 주간의 조사와 40쪽에 가까운 노트 끝에, 이제는 컴퓨터가 부팅부터 프로그램 실행까지 어떻게 동작하는지 훨씬 더 잘 이해하게 되었다고 생각합니다. 제가 배운 내용을 설명해 주는 제대로 된 글 하나가 그토록 간절했기에, 제가 갖고 싶었던 바로 그 글을 지금 쓰고 있습니다.
그리고 이런 말이 있지 않습니까… 무언가를 다른 사람에게 설명할 수 있어야만 그것을 진정으로 이해한 것이라고 말입니다.
바쁘십니까? 이런 내용은 이미 알고 있다고 생각하십니까?
3장을 읽어 보십시오. 분명 새로운 것을 배우시리라 장담합니다. 물론 여러분이 리누스 토르발스 본인쯤 되는 분이 아니라면 말입니다.
1장: “기초”
이 글을 쓰면서 몇 번이고 거듭 놀랐던 한 가지는 컴퓨터가 얼마나 단순한지였습니다. 지금도 실제보다 더 많은 복잡성이나 추상화가 있을 거라고 예상하며 지레 겁먹지 않기가 어렵습니다! 계속 읽기 전에 머릿속에 새겨 두어야 할 것이 하나 있다면, 단순해 보이는 모든 것은 실제로도 그만큼 단순하다는 사실입니다. 이 단순함은 무척 아름답고, 때로는 정말, 정말 저주스럽습니다.
컴퓨터가 가장 근본적인 수준에서 어떻게 동작하는지, 그 기초부터 시작해 봅시다.
컴퓨터는 어떻게 설계되어 있는가
컴퓨터의 중앙 처리 장치(CPU)는 모든 연산을 담당합니다. CPU는 그야말로 우두머리입니다. 수리수리 마수리 그 자체입니다. CPU는 컴퓨터를 켜자마자 쉬지 않고 돌아가기 시작하여, 명령어를 하나, 또 하나, 또 하나 실행합니다.
최초로 대량 생산된 CPU는 Intel 4004로, 60년대 후반 이탈리아의 물리학자이자 엔지니어인 페데리코 파긴(Federico Faggin)이 설계했습니다. 이 CPU는 오늘날 우리가 쓰는 64비트 시스템이 아닌 4비트 아키텍처였고 현대 프로세서보다 훨씬 덜 복잡했지만, 그 단순함의 상당 부분은 지금도 여전히 남아 있습니다.
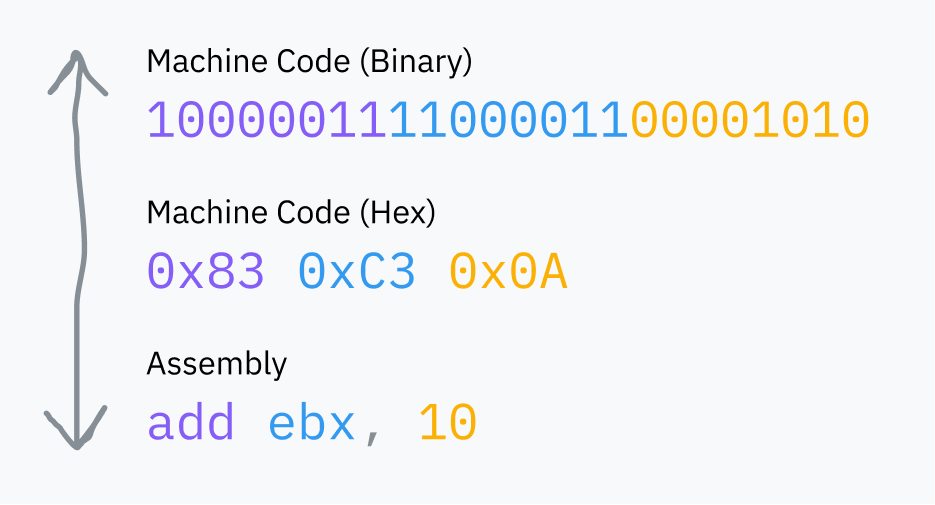
CPU가 실행하는 “명령어”는 그저 바이너리 데이터일 뿐입니다. 어떤 명령어를 실행하는지 나타내는 한두 바이트(옵코드)가 오고, 그 뒤에 명령어 실행에 필요한 데이터가 이어집니다. 우리가 기계어라고 부르는 것은 이러한 바이너리 명령어를 줄줄이 늘어놓은 것에 지나지 않습니다. 어셈블리는 기계어를 날것의 비트보다 사람이 더 쉽게 읽고 쓸 수 있게 해 주는 유용한 문법이며, 항상 CPU가 읽을 수 있는 바이너리로 컴파일됩니다.
여담으로, 명령어가 위 예시처럼 항상 기계어와 1:1로 대응되어 표현되는 것은 아닙니다. 예를 들어 add eax, 512는 05 00 02 00 00으로 변환됩니다.
첫 번째 바이트(05)는 특별히 EAX 레지스터에 32비트 숫자를 더하는 것을 나타내는 옵코드입니다. 나머지 바이트는 리틀 엔디언 바이트 순서로 표현한 512(0x200)입니다.
Defuse Security는 어셈블리와 기계어 사이의 변환을 이것저것 시험해 볼 수 있는 유용한 도구를 만들었습니다.
RAM은 컴퓨터의 주 메모리 저장소로, 컴퓨터에서 실행되는 프로그램이 사용하는 모든 데이터를 저장하는 커다란 다목적 공간입니다. 여기에는 프로그램 코드 자체뿐 아니라 운영체제 핵심부의 코드도 포함됩니다. CPU는 항상 RAM에서 직접 기계어를 읽으며, RAM에 올라가 있지 않은 코드는 실행할 수 없습니다.
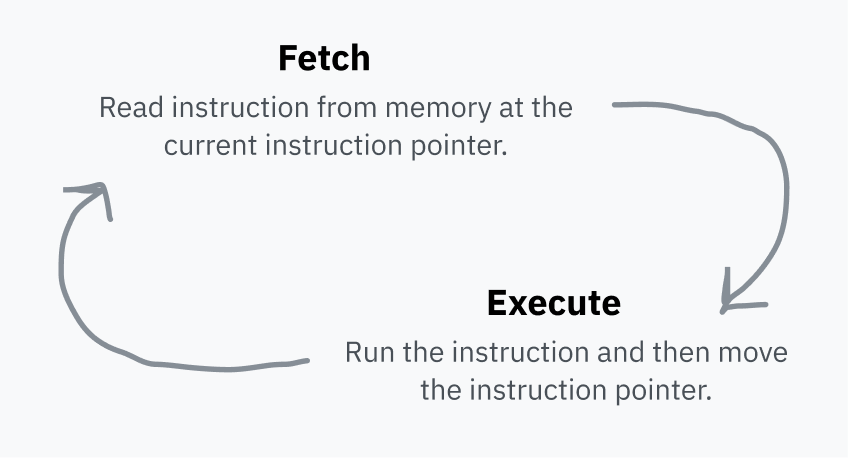
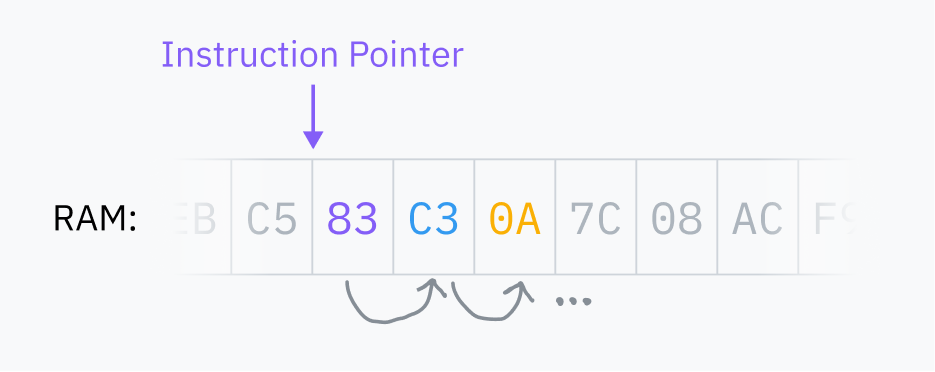
CPU는 다음 명령어를 가져올 RAM 위치를 가리키는 명령어 포인터를 저장합니다. CPU는 각 명령어를 실행한 뒤 포인터를 옮기고 이를 반복합니다. 이것이 바로 페치-실행 사이클입니다.
명령어를 실행하고 나면 포인터는 RAM에서 그 명령어 바로 다음 위치로 이동하여 이제 다음 명령어를 가리키게 됩니다. 코드가 실행되는 이유가 바로 이것입니다! 명령어 포인터는 그저 계속해서 앞으로 나아가며, 기계어를 메모리에 저장된 순서대로 실행합니다. 어떤 명령어는 명령어 포인터에게 대신 다른 곳으로 점프하라고 하거나, 특정 조건에 따라 서로 다른 곳으로 점프하라고 지시할 수 있습니다. 이 덕분에 재사용 가능한 코드와 조건부 로직이 가능해집니다.
이 명령어 포인터는 레지스터에 저장됩니다. 레지스터는 CPU가 매우 빠르게 읽고 쓸 수 있는 작은 저장 공간입니다. CPU 아키텍처마다 정해진 레지스터 집합이 있으며, 이 레지스터들은 연산 중에 임시 값을 저장하는 일부터 프로세서를 설정하는 일까지 온갖 용도로 쓰입니다.
앞의 다이어그램에 나온 ebx처럼 일부 레지스터는 기계어 코드에서 직접 접근할 수 있습니다.
다른 레지스터는 CPU 내부에서만 사용되지만, 특수한 명령어를 통해 값을 갱신하거나 읽을 수 있는 경우가 많습니다. 명령어 포인터가 그 예입니다. 명령어 포인터는 직접 읽을 수는 없지만, 점프 명령어 등으로 갱신할 수 있습니다.
프로세서는 단순합니다
처음 질문으로 돌아가 봅시다. 컴퓨터에서 실행 파일을 실행하면 무슨 일이 일어납니까? 먼저 실행을 준비하느라 온갖 마법 같은 일이 벌어지지만(이 과정은 모두 나중에 차근차근 살펴보겠습니다), 그 과정이 끝나면 어딘가의 파일에 기계어 코드가 남습니다. 운영체제는 이 코드를 RAM에 올리고, CPU에 명령어 포인터를 RAM의 해당 위치로 점프하라고 지시합니다. CPU는 평소처럼 페치-실행 사이클을 계속 수행하므로, 프로그램이 실행되기 시작합니다!
(저는 이 대목에서 머리가 멍해졌습니다. 진지하게 말해서, 지금 이 글을 읽는 데 쓰고 있는 프로그램도 바로 이렇게 실행되고 있습니다! 여러분의 CPU는 브라우저의 명령어를 RAM에서 차례대로 가져와 직접 실행하고 있으며, 그 명령어들이 이 글을 화면에 그려 내고 있습니다.)
알고 보면 CPU의 세계관은 아주 단순합니다. CPU는 현재 명령어 포인터와 약간의 내부 상태만 볼 뿐입니다. 프로세스는 전적으로 운영체제가 만든 추상화이며, CPU가 본래 이해하거나 추적하는 대상이 아닙니다.
*손을 휘저으며* 프로세스는 컴퓨터를 더 팔려고 OS 개발자들이 빅 바이트가 지어낸 추상화입니다
저에게는 이 사실이 답보다 더 많은 질문을 불러일으킵니다.
CPU가 멀티프로세싱을 모르고 그저 명령어를 순서대로 실행할 뿐이라면, 왜 CPU는 실행 중인 프로그램 안에 갇혀 버리지 않습니까? 어떻게 여러 프로그램이 동시에 실행될 수 있습니까?
프로그램이 CPU에서 직접 실행되고 CPU가 RAM에 직접 접근할 수 있다면, 왜 코드는 다른 프로세스의 메모리나, 맙소사, 커널의 메모리에 접근하지 못합니까?
말이 나온 김에, 모든 프로세스가 아무 명령어나 실행해서 컴퓨터에 무슨 짓이든 하지 못하게 막는 메커니즘은 무엇입니까? 그리고 도대체 시스템 호출이란 게 뭡니까?
메모리에 관한 질문은 따로 한 절을 할애할 만한 주제라서 5장에서 다룹니다. 요약하자면, 대부분의 메모리 접근은 실제로 전체 주소 공간을 다시 매핑하는 간접 계층을 거칩니다. 당분간은 프로그램이 모든 RAM에 직접 접근할 수 있고 컴퓨터는 한 번에 하나의 프로세스만 실행할 수 있다고 가정하겠습니다. 이 두 가정은 때가 되면 모두 풀어 설명하겠습니다.
이제 첫 번째 토끼굴로 뛰어들어 시스템 호출과 보안 링으로 가득한 세계로 들어갈 차례입니다.
여담: 그런데 커널이란 무엇입니까?
macOS, Windows, Linux 같은 컴퓨터의 운영체제는 컴퓨터에서 실행되며 모든 기본적인 것들이 작동하게 해 주는 소프트웨어의 모음입니다. “기본적인 것들”은 정말 포괄적인 말이고, “운영체제”도 마찬가지입니다. 누구에게 묻느냐에 따라 컴퓨터에 기본으로 딸려 오는 앱, 글꼴, 아이콘 같은 것까지 여기에 포함될 수 있습니다.
반면 커널은 운영체제의 핵심입니다. 컴퓨터를 부팅하면 명령어 포인터는 어딘가에 있는 한 프로그램에서 시작합니다. 그 프로그램이 바로 커널입니다. 커널은 컴퓨터의 메모리, 주변 장치 및 기타 자원에 거의 완전하게 접근할 수 있으며, 컴퓨터에 설치된 소프트웨어(유저랜드 프로그램이라고 합니다)를 실행하는 일을 담당합니다. 커널이 어떻게 이러한 접근 권한을 갖는지, 그리고 유저랜드 프로그램은 어째서 갖지 못하는지를 이 글 전반에 걸쳐 알아보겠습니다.
Linux는 커널일 뿐이며, 실제로 사용하려면 셸이나 디스플레이 서버 같은 유저랜드 소프트웨어가 많이 필요합니다. macOS의 커널은 XNU라고 불리며 유닉스 계열이고, 최신 Windows 커널은 NT 커널이라고 불립니다.
모든 것을 지배하는 두 개의 링
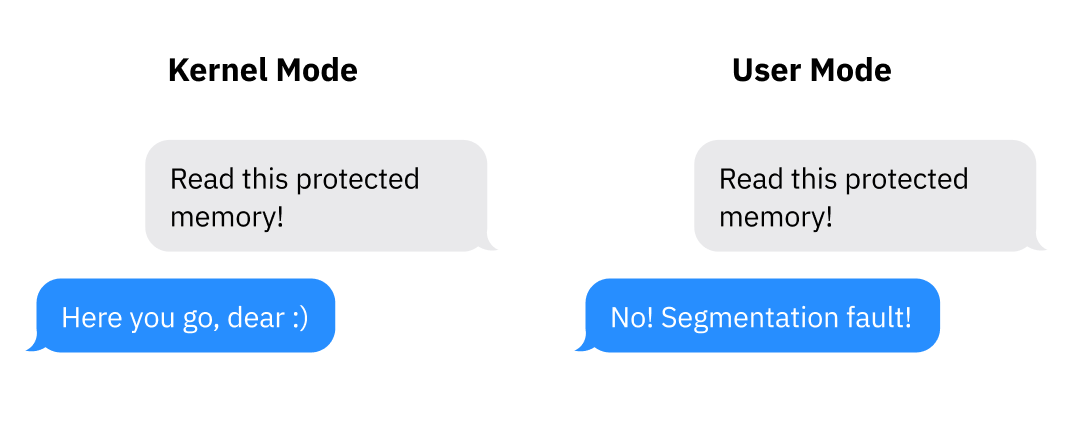
프로세서가 어떤 모드(권한 수준 또는 링이라고도 합니다)에 있는지에 따라 프로세서가 할 수 있는 일이 정해집니다. 현대 아키텍처에는 최소한 두 가지 선택지가 있습니다. 바로 커널/슈퍼바이저 모드와 사용자 모드입니다. 아키텍처가 두 개보다 많은 모드를 지원할 수도 있지만, 요즘 흔히 쓰이는 것은 커널 모드와 사용자 모드뿐입니다.
커널 모드에서는 무엇이든 가능합니다. CPU는 지원되는 모든 명령어를 실행하고 모든 메모리에 접근할 수 있습니다. 사용자 모드에서는 명령어의 일부만 허용되고, I/O 및 메모리 접근이 제한되며, 많은 CPU 설정이 잠깁니다. 일반적으로 커널과 드라이버는 커널 모드에서 실행되고, 애플리케이션은 사용자 모드에서 실행됩니다.
프로세서는 커널 모드에서 시작합니다. 커널은 프로그램을 실행하기 전에 사용자 모드로의 전환을 시작합니다.
실제 아키텍처에서 프로세서 모드가 어떻게 드러나는지 예를 들어 보겠습니다. x86-64에서는 현재 권한 수준(CPL)을 cs(코드 세그먼트)라는 레지스터에서 읽을 수 있습니다. 구체적으로 말하면, CPL은 cs 레지스터의 최하위 비트 두 개에 담겨 있습니다. 이 두 비트로 x86-64에서 가능한 네 가지 링을 모두 나타낼 수 있습니다. 링 0은 커널 모드이고 링 3은 사용자 모드입니다. 링 1과 링 2는 드라이버를 실행하기 위해 설계되었지만, 오래된 소수의 특수한 운영체제에서만 사용됩니다. 예를 들어 CPL 비트가 11이라면 CPU는 링 3, 즉 사용자 모드에서 실행 중입니다.
시스템 호출이란 대체 무엇입니까?
프로그램은 컴퓨터에 대한 완전한 접근 권한을 맡길 만큼 신뢰할 수 없기 때문에 사용자 모드에서 실행됩니다. 사용자 모드는 컴퓨터 대부분에 대한 접근을 막아 제 역할을 다합니다. 하지만 프로그램은 어떻게든 I/O에 접근하고, 메모리를 할당하고, 운영체제와 상호작용할 수 있어야 합니다! 이를 위해 사용자 모드에서 실행되는 소프트웨어는 운영체제 커널에 도움을 요청해야 합니다. 그러면 운영체제는 자체 보안 보호 장치를 구현하여 프로그램이 악의적인 일을 하지 못하도록 막을 수 있습니다.
운영체제와 상호작용하는 코드를 작성해 본 적이 있다면 open, read, fork, exit 같은 함수가 아마 낯익을 것입니다. 추상화 계층을 몇 단계 내려가 보면, 이 함수들은 모두 시스템 호출을 사용해 운영체제에 도움을 요청합니다. 시스템 호출은 프로그램이 사용자 공간에서 커널 공간으로의 전환을 시작하여 프로그램의 코드에서 운영체제 코드로 넘어갈 수 있게 해 주는 특수한 절차입니다.
사용자 공간에서 커널 공간으로의 제어 이전은 소프트웨어 인터럽트라는 프로세서 기능을 사용해 이루어집니다.
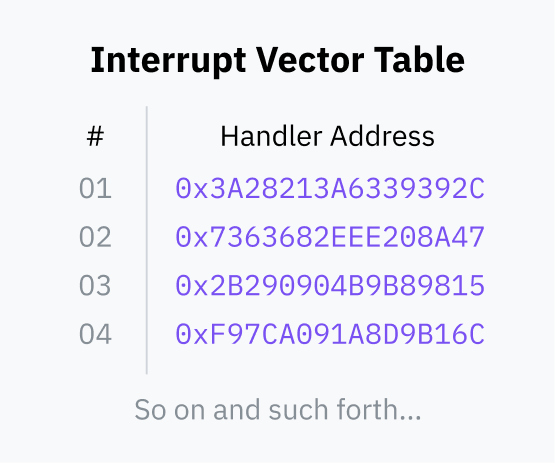
부팅 과정에서 운영체제는 인터럽트 벡터 테이블(IVT, x86-64에서는 인터럽트 디스크립터 테이블이라고 합니다)이라는 테이블을 RAM에 저장하고 CPU에 등록합니다. IVT는 인터럽트 번호를 핸들러 코드 포인터에 대응시킵니다.
그러면 유저랜드 프로그램은 INT 같은 명령어를 사용할 수 있습니다. 이 명령어는 프로세서에게 IVT에서 주어진 인터럽트 번호를 찾고, 커널 모드로 전환한 다음, 명령어 포인터를 IVT에 저장된 메모리 주소로 점프시키라고 지시합니다.
이 커널 코드가 끝나면 IRET 같은 명령어를 사용하여 CPU에게 사용자 모드로 다시 전환하고 명령어 포인터를 인터럽트가 발생했던 시점의 위치로 되돌리라고 지시합니다.
사용자 모드 프로그램은 I/O나 메모리에 직접 접근할 수 없습니다. 외부 세계와 상호작용하려면 운영체제에 도움을 요청해야 합니다.
프로그램은 INT와 IRET 같은 특수한 기계어 명령어로 운영체제에 제어권을 위임할 수 있습니다.
프로그램은 권한 수준을 직접 전환할 수 없습니다. 소프트웨어 인터럽트가 안전한 이유는 운영체제 코드의 어디로 점프할지가 운영체제에 의해 프로세서에 미리 설정되어 있기 때문입니다. 인터럽트 벡터 테이블은 커널 모드에서만 설정할 수 있습니다.
프로그램은 시스템 호출을 발생시킬 때 운영체제에 데이터를 전달해야 합니다. 운영체제는 어떤 시스템 호출을 실행할지와 함께, 예를 들어 어떤 파일 이름을 열지처럼 그 시스템 호출 자체에 필요한 데이터도 알아야 합니다. 이 데이터를 전달하는 방식은 운영체제와 아키텍처에 따라 다르지만, 보통은 인터럽트를 발생시키기 전에 특정 레지스터나 스택에 데이터를 넣는 방식으로 이루어집니다.
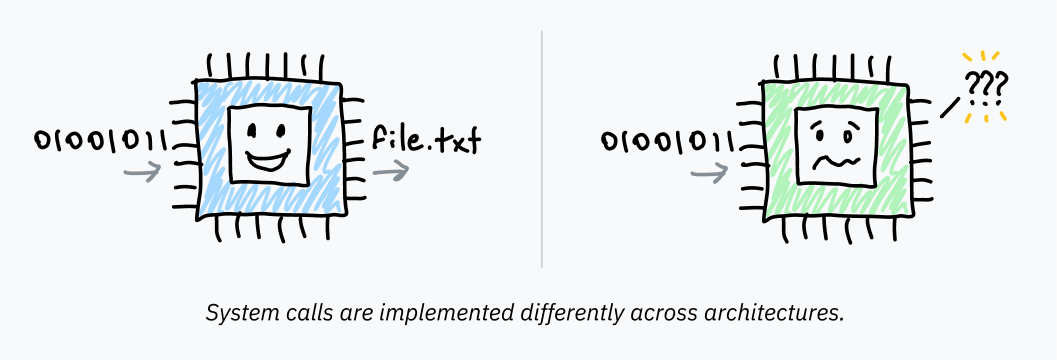
기기마다 시스템 호출을 부르는 방식이 다르므로, 프로그래머가 프로그램마다 시스템 호출을 직접 구현하는 것은 지극히 비현실적입니다. 또한 그렇게 되면 운영체제는 예전 방식을 사용하도록 작성된 모든 프로그램이 망가질까 봐 인터럽트 처리 방식을 바꿀 수 없게 됩니다. 마지막으로, 요즘은 보통 프로그램을 순수 어셈블리로 작성하지 않습니다 — 파일을 읽거나 메모리를 할당하고 싶을 때마다 프로그래머에게 어셈블리 수준까지 내려가라고 기대할 수는 없습니다.
그래서 운영체제는 이러한 인터럽트 위에 추상화 계층을 제공합니다. 필요한 어셈블리 명령어를 감싸는 재사용 가능한 고수준 라이브러리 함수는 유닉스 계열 시스템에서는 libc가, Windows에서는 ntdll.dll이라는 라이브러리의 일부가 제공합니다. 이러한 라이브러리 함수를 호출하는 것 자체는 커널 모드로의 전환을 일으키지 않으며, 그저 일반적인 함수 호출일 뿐입니다. 라이브러리 내부에서는 어셈블리 코드가 실제로 커널에 제어권을 넘기며, 이 코드는 이를 감싸는 라이브러리 서브루틴보다 훨씬 더 플랫폼에 의존적입니다.
유닉스 계열 시스템에서 실행되는 C에서 exit(1)을 호출하면, 그 함수는 내부적으로 시스템 호출의 옵코드와 인자를 알맞은 레지스터/스택/기타 등등에 넣은 뒤 인터럽트를 발생시키는 기계어 코드를 실행합니다. 컴퓨터는 정말 멋집니다!
속도가 필요합니다 / CISC스럽게 가 봅시다
x86-64 같은 많은 CISC 아키텍처에는 시스템 호출 패러다임이 널리 쓰이면서 만들어진, 시스템 호출 전용으로 설계된 명령어가 있습니다.
Intel과 AMD는 x86-64에서 그다지 잘 협력하지 못했습니다. 그래서 x86-64에는 최적화된 시스템 호출 명령어 세트가 실제로 두 가지나 있습니다. SYSCALL과 SYSENTER는 INT 0x80 같은 명령어의 최적화된 대안입니다. 이에 대응하는 반환 명령어인 SYSRET과 SYSEXIT는 사용자 공간으로 빠르게 돌아가 프로그램 코드를 재개하도록 설계되었습니다.
(AMD와 Intel 프로세서는 이 명령어들에 대한 호환성이 조금씩 다릅니다. 64비트 프로그램에는 일반적으로 SYSCALL이 가장 좋은 선택이고, 32비트 프로그램에서는 SYSENTER가 더 잘 지원됩니다.)
그 설계 방식을 대표하듯, RISC 아키텍처에는 이런 특수 명령어가 없는 경향이 있습니다. Apple Silicon의 기반이 되는 RISC 아키텍처인 AArch64는 시스템 호출과 소프트웨어 인터럽트 모두에 인터럽트 명령어 하나만 사용합니다. Mac 사용자들도 잘 지내고 있다고 생각합니다 :)
휴, 내용이 정말 많았습니다! 간단히 정리해 봅시다.
프로세서는 무한한 인출-실행 루프 속에서 명령어를 실행할 뿐이며, 운영체제나 프로그램이라는 개념을 전혀 갖고 있지 않습니다. 보통 레지스터에 저장되는 프로세서의 모드가 어떤 명령어를 실행할 수 있는지를 결정합니다. 운영체제 코드는 커널 모드에서 실행되며, 프로그램을 실행할 때는 사용자 모드로 전환합니다.
바이너리를 실행하기 위해 운영체제는 사용자 모드로 전환하고, 프로세서가 RAM에 있는 코드의 진입점을 가리키게 합니다. 프로그램은 사용자 모드의 권한만 가지므로, 외부 세계와 상호작용하려는 프로그램은 도움을 받기 위해 OS 코드로 점프해야 합니다. 시스템 호출은 프로그램이 사용자 모드에서 커널 모드로 전환하여 OS 코드로 진입하기 위한 표준화된 방법입니다.
프로그램은 일반적으로 공유 라이브러리 함수를 호출하는 방식으로 이러한 시스템 호출을 사용합니다. 이 함수들은 소프트웨어 인터럽트나 아키텍처별 시스템 호출 명령어의 기계어 코드를 감싸고 있으며, 이 명령어들이 OS 커널로 제어권을 넘기고 링을 전환합니다. 커널은 할 일을 마친 뒤 다시 사용자 모드로 전환하고 프로그램 코드로 돌아갑니다.
앞서 던졌던 첫 번째 질문에 어떻게 답할 수 있을지 알아봅시다.
CPU가 둘 이상의 프로세스를 추적하지 않고 그저 명령어를 하나씩 차례로 실행할 뿐이라면, 왜 실행 중인 프로그램 안에 갇혀 버리지 않을까요? 어떻게 여러 프로그램이 동시에 실행될 수 있을까요?
친애하는 친구여, 이 질문의 답은 콜드플레이가 그토록 인기 있는 이유에 대한 답이기도 합니다… 바로 클록(clocks)입니다! (뭐, 엄밀히 말하면 타이머입니다. 그냥 이 농담을 억지로라도 끼워 넣고 싶었을 뿐입니다.)
2장: 시간을 쪼개 봅시다
여러분이 운영체제를 만들고 있고, 사용자가 여러 프로그램을 동시에 실행할 수 있게 하고 싶다고 가정해 봅시다. 하지만 여러분에게는 멋진 멀티코어 프로세서가 없으므로, CPU는 한 번에 명령어 하나만 실행할 수 있습니다!
다행히 여러분은 아주 똑똑한 운영체제 개발자입니다. 프로세스들이 CPU를 번갈아 사용하게 하면 병렬 처리를 흉내 낼 수 있다는 사실을 알아냅니다. 프로세스들을 차례로 돌아가며 각각 명령어를 몇 개씩 실행하면, 어느 한 프로세스가 CPU를 독차지하지 않고도 모든 프로세스가 반응성을 유지할 수 있습니다.
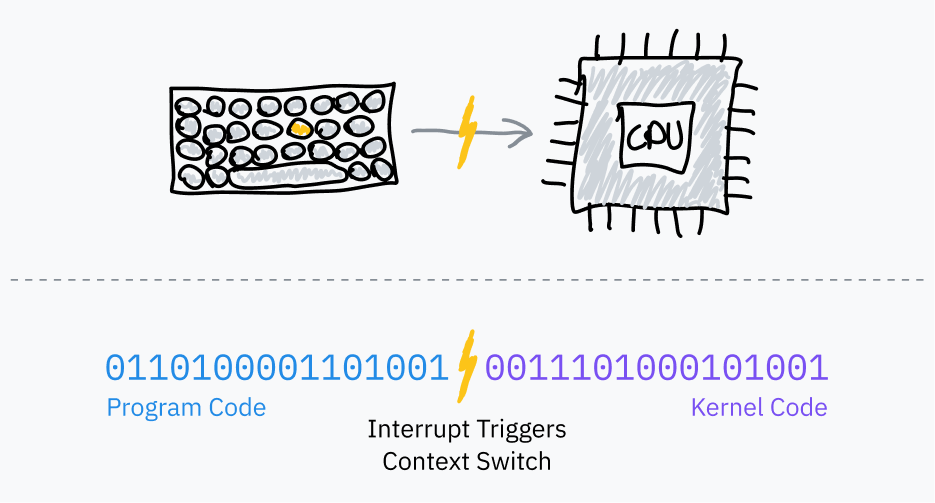
그런데 프로세스를 전환하려면 프로그램 코드로부터 제어권을 어떻게 되찾아 와야 할까요? 조금 조사해 보니, 대부분의 컴퓨터에는 타이머 칩이 달려 있다는 사실을 알게 됩니다. 일정 시간이 지나면 OS 인터럽트 핸들러로 전환이 일어나도록 타이머 칩을 프로그램할 수 있습니다.
하드웨어 인터럽트
앞에서 소프트웨어 인터럽트가 유저랜드 프로그램에서 운영체제로 제어권을 넘기는 데 어떻게 쓰이는지 이야기했습니다. 이것을 “소프트웨어” 인터럽트라고 부르는 이유는 프로그램이 자발적으로 일으키기 때문입니다. 즉, 일반적인 페치-실행 사이클에서 프로세서가 실행하는 기계어 코드가 프로세서에게 제어권을 커널로 넘기라고 지시합니다.
운영체제 스케줄러는 PIT 같은 타이머 칩을 사용해 멀티태스킹을 위한 하드웨어 인터럽트를 일으킵니다:
프로그램 코드로 점프하기 전에, 운영체제는 일정 시간이 지나면 인터럽트를 일으키도록 타이머 칩을 설정합니다.
이제 운영체제는 프로그램이 멈춘 지점을 저장하고, 다른 프로그램을 불러온 뒤, 이 과정을 반복할 수 있습니다.
이것을 선점형 멀티태스킹이라고 하며, 프로세스를 중단시키는 것을 선점이라고 합니다. 예를 들어 여러분이 같은 컴퓨터에서 브라우저로 이 글을 읽으면서 음악을 듣고 있다면, 여러분의 컴퓨터는 아마 1초에 수천 번씩 바로 이 사이클을 반복하고 있을 것입니다.
타임슬라이스 계산
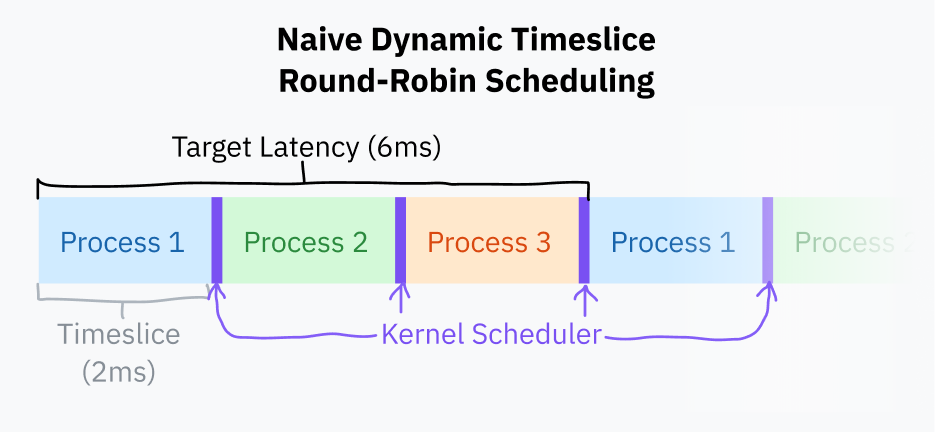
타임슬라이스란 운영체제 스케줄러가 프로세스를 선점하기 전까지 그 프로세스가 실행되도록 허용하는 시간입니다. 타임슬라이스를 정하는 가장 간단한 방법은 모든 프로세스에 10 ms 정도의 같은 타임슬라이스를 주고 작업을 순서대로 돌아가며 실행하는 것입니다. 이를 고정 타임슬라이스 라운드 로빈 스케줄링이라고 합니다.
여담: 재미있는 전문 용어 이야기!
타임슬라이스를 흔히 “퀀텀(quantum)“이라고도 부른다는 사실을 알고 계셨습니까? 이제 아셨으니 기술 좋아하는 친구들에게 자랑하실 수 있습니다. 이 글에서 한 문장 걸러 한 번씩 퀀텀이라는 말을 쓰지 않은 것만으로도 저는 칭찬을 듬뿍 받아야 마땅하다고 생각합니다.
타임슬라이스 용어 이야기가 나온 김에 덧붙이면, Linux 커널 개발자들은 고정 주파수 타이머 틱을 세는 데 지피(jiffy)라는 시간 단위를 사용합니다. jiffy는 여러 용도 가운데 특히 타임슬라이스의 길이를 재는 데 쓰입니다. Linux의 지피 주파수는 보통 1000 Hz이지만, 커널을 컴파일할 때 설정할 수 있습니다.
고정 타임슬라이스 스케줄링을 조금 개선하는 방법은 프로세스가 응답하기까지 걸리는 이상적인 최대 시간인 목표 지연 시간(target latency)을 정하는 것입니다. 목표 지연 시간이란 프로세스 수가 적당하다고 가정할 때, 프로세스가 선점된 뒤 실행을 다시 시작하기까지 걸리는 시간입니다. 이것은 머릿속에 그려 보기가 꽤 어렵습니다! 걱정하지 마십시오. 곧 다이어그램이 나옵니다.
타임슬라이스는 목표 지연 시간을 전체 태스크 수로 나누어 계산합니다. 이 방식은 프로세스 수가 적을 때 불필요한 태스크 전환을 없애 주므로 고정 타임슬라이스 스케줄링보다 낫습니다. 목표 지연 시간이 15ms이고 프로세스가 10개라면 각 프로세스는 15/10, 즉 1.5ms씩 실행됩니다. 프로세스가 3개뿐이라면 각 프로세스는 목표 지연 시간을 지키면서도 5ms라는 더 긴 타임슬라이스를 받습니다.
프로세스를 전환하려면 현재 프로그램의 전체 상태를 저장하고 다른 프로그램의 상태를 복원해야 하므로 계산 비용이 큽니다. 타임슬라이스가 일정 수준보다 작아지면 프로세스가 너무 자주 전환되어 성능 문제가 생길 수 있습니다. 그래서 타임슬라이스 길이에 하한(최소 세분도)을 두는 것이 일반적입니다. 따라서 최소 세분도가 적용될 만큼 프로세스가 많아지면 목표 지연 시간을 넘기게 됩니다.
이 글을 쓰는 시점에서 Linux의 스케줄러는 6 ms의 목표 지연 시간과 0.75 ms의 최소 단위(minimum granularity)를 사용합니다.
이런 기본적인 타임슬라이스 계산을 쓰는 라운드 로빈 스케줄링은 오늘날 대부분의 컴퓨터가 쓰는 방식과 비슷합니다. 그래도 여전히 다소 단순한 방식입니다. 대부분의 운영체제는 프로세스 우선순위와 마감 시한까지 고려하는 더 복잡한 스케줄러를 사용합니다. 2007년부터 Linux는 Completely Fair Scheduler라는 스케줄러를 사용해 왔습니다. CFS는 태스크의 우선순위를 정하고 CPU 시간을 나누기 위해 매우 정교한 컴퓨터 과학 기법을 여러 가지 사용합니다.
운영체제는 프로세스를 선점할 때마다 새 프로그램의 메모리 환경을 포함해 저장해 둔 실행 컨텍스트를 불러와야 합니다. 이 작업은 CPU에 다른 페이지 테이블, 즉 “가상” 주소를 물리 주소로 매핑하는 표를 사용하라고 지시해서 이루어집니다. 이 페이지 테이블은 프로그램이 서로의 메모리에 접근하지 못하게 막는 시스템이기도 합니다. 이 주제는 이 글의 5장과 6장에서 깊이 파고들겠습니다.
참고 #1: 커널 선점 가능성
지금까지는 유저랜드 프로세스의 선점과 스케줄링에 대해서만 이야기했습니다. 커널 코드가 시스템 호출을 처리하거나 드라이버 코드를 실행하는 데 너무 오래 걸리면 프로그램이 버벅거리는 것처럼 느껴질 수 있습니다.
Linux를 포함한 현대의 커널은 선점형 커널입니다. 이는 커널 코드 자체도 유저랜드 프로세스와 마찬가지로 인터럽트되고 스케줄링될 수 있도록 프로그래밍되어 있다는 뜻입니다.
커널 같은 것을 직접 작성하는 것이 아니라면 그리 중요한 내용은 아니지만, 제가 읽은 글마다 거의 빠짐없이 이 내용을 언급해서 저도 다루기로 했습니다! 더 알아 두어서 나쁠 일은 거의 없습니다.
참고 #2: 역사 수업
클래식 Mac OS와 NT보다 훨씬 이전의 Windows 버전 같은 옛 운영체제는 선점형 멀티태스킹의 전신에 해당하는 방식을 사용했습니다. 운영체제가 프로그램을 언제 선점할지 결정하는 대신 프로그램이 스스로 운영체제에 제어권을 양보하는 방식이었습니다. 프로그램은 소프트웨어 인터럽트를 발생시켜 “이제 다른 프로그램을 실행해도 됩니다”라고 알렸습니다. 이렇게 명시적으로 양보해야만 운영체제가 제어권을 되찾아 다음으로 스케줄링된 프로세스로 전환할 수 있었습니다.
이를 협력형 멀티태스킹이라고 합니다. 이 방식에는 몇 가지 큰 결함이 있습니다. 악의적이거나 그저 잘못 설계된 프로그램 하나가 운영체제 전체를 쉽게 멈추게 할 수 있고, 실시간 작업이나 시간에 민감한 작업의 시간적 일관성을 보장하기가 거의 불가능합니다. 이런 이유로 기술 업계는 오래전에 선점형 멀티태스킹으로 전환했고 다시는 돌아가지 않았습니다.
3장: 프로그램을 실행하는 방법
지금까지 CPU가 실행 파일에서 불러온 기계어 코드를 어떻게 실행하는지, 링 기반 보안이 무엇인지, 그리고 시스템 호출이 어떻게 동작하는지 살펴보았습니다. 이번 절에서는 Linux 커널을 깊이 파고들어 애초에 프로그램이 어떻게 로드되고 실행되는지 알아보겠습니다.
구체적으로는 x86-64 위의 Linux를 살펴볼 것입니다. 왜일까요?
Linux는 데스크톱, 모바일, 서버 용도로 쓰이는, 모든 기능을 갖춘 프로덕션 운영체제입니다. Linux는 오픈 소스이므로 소스 코드를 읽는 것만으로도 매우 쉽게 연구할 수 있습니다. 이 글에서는 커널 코드 일부를 직접 참조하겠습니다!
x86-64는 대부분의 최신 데스크톱 컴퓨터가 사용하는 아키텍처이며, 많은 코드가 대상으로 삼는 아키텍처이기도 합니다. 제가 언급하는 동작 가운데 x86-64에 특화된 부분도 잘 일반화될 것입니다.
우리가 배울 내용의 대부분은 다른 운영체제와 아키텍처가 여러 구체적인 면에서 다르더라도 그대로 잘 일반화될 것입니다.
Exec 시스템 호출의 기본 동작
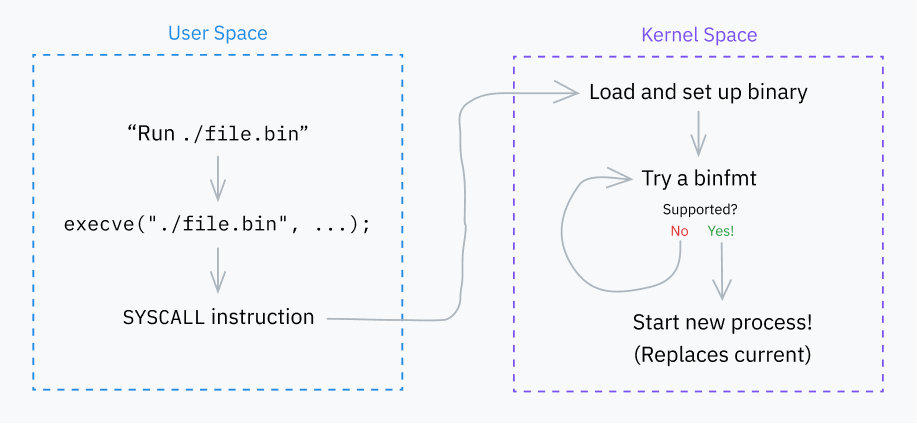
매우 중요한 시스템 호출인 execve부터 시작합시다. 이 시스템 호출은 프로그램을 로드하고, 성공하면 현재 프로세스를 그 프로그램으로 대체합니다. 다른 시스템 호출(execlp, execvpe 등)도 몇 가지 있지만, 모두 다양한 방식으로 execve 위에 계층을 이루고 있습니다.
여담: execveat
execve는 사실 몇 가지 설정 옵션과 함께 프로그램을 실행하는 더 일반적인 시스템 호출인 execveat 위에 구축되어 있습니다. 간단히 하기 위해 주로 execve를 다루겠습니다. 유일한 차이는 execve가 execveat에 몇 가지 기본값을 제공한다는 점입니다.
ve가 무엇을 뜻하는지 궁금하십니까? v는 매개변수 하나가 인자의 벡터(리스트)(argv)라는 뜻이고, e는 또 다른 매개변수가 환경 변수의 벡터(envp)라는 뜻입니다. 다른 여러 exec 시스템 호출은 서로 다른 호출 시그니처를 나타내기 위해 각기 다른 접미사를 가지고 있습니다. execveat의 at은 그냥 “at”이라는 뜻인데, execve를 실행할 위치를 지정하기 때문입니다.
execve의 호출 시그니처는 다음과 같습니다:
int execve(const char *filename, char *const argv[], char *const envp[]);
filename 인자는 실행할 프로그램의 경로를 지정합니다.
argv는 프로그램에 전달할 인자들의 널 종료(마지막 항목이 널 포인터라는 뜻) 리스트입니다. C의 main 함수에 전달되는 것을 흔히 보는 argc 인자는 사실 나중에 시스템 호출이 계산하는 값이며, 그래서 널 종료가 필요합니다.
envp 인자에는 애플리케이션의 컨텍스트로 사용되는 환경 변수들의 또 다른 널 종료 리스트가 들어 있습니다. 이것들은… 관례적으로 KEY=VALUE 쌍입니다. 관례적으로 말입니다. 저는 컴퓨터가 정말 좋습니다.
재미있는 사실이 있습니다! 프로그램의 첫 번째 인자가 프로그램 이름이라는 관례를 알고 계십니까? 그것은 순전히 관례일 뿐이며, 실제로 execve 시스템 호출 자체가 설정하는 것이 아닙니다! 첫 번째 인자는 프로그램 이름과 전혀 관계가 없더라도 argv 인자의 첫 번째 항목으로 execve에 전달된 값이 무엇이든 그 값이 됩니다.
흥미롭게도 execve에는 argv[0]이 프로그램 이름이라고 가정하는 코드가 실제로 일부 있습니다. 이에 대해서는 나중에 인터프리터 방식의 스크립트 언어를 다룰 때 더 자세히 이야기하겠습니다.
0단계: 정의
시스템 호출이 어떻게 동작하는지는 이미 알고 있지만, 실제 코드 예시는 아직 한 번도 본 적이 없습니다! 내부적으로 execve가 어떻게 정의되어 있는지 Linux 커널의 소스 코드를 살펴봅시다.
SYSCALL_DEFINE3는 인자가 3개인 시스템 호출의 코드를 정의하기 위한 매크로입니다.
저는 왜 매크로 이름에 인자 개수(arity)가 하드코딩되어 있는지 궁금해서 이리저리 검색해 보았고, 이것이 어떤 보안 취약점을 고치기 위한 우회책이었다는 사실을 알게 되었습니다.
파일 이름 인자는 getname() 함수로 전달되며, 이 함수는 문자열을 사용자 공간에서 커널 공간으로 복사하고 사용량 추적과 관련된 작업도 몇 가지 수행합니다. 이 함수는 include/linux/fs.h에 정의된 filename 구조체를 반환합니다. 이 구조체는 사용자 공간에 있는 원래 문자열을 가리키는 포인터와 함께, 커널 공간으로 복사된 값을 가리키는 새 포인터도 저장합니다:
struct filename { const char *name; /* pointer to actual string */ const __user char *uptr; /* original userland pointer */ int refcnt; struct audit_names *aname; const char iname[];};
그다음 execve 시스템 호출은 do_execve() 함수를 호출합니다. 이 함수는 다시 몇 가지 기본값과 함께 do_execveat_common()를 호출합니다. 앞서 언급한 execveat 시스템 호출 역시 do_execveat_common()를 호출하지만, 사용자가 제공한 옵션을 더 많이 전달합니다.
execveat에서는 파일 디스크립터(어떤 리소스를 가리키는 일종의 ID)가 시스템 호출에 전달된 다음 do_execveat_common으로 전달됩니다. 이 값은 프로그램을 실행할 때 기준이 되는 디렉터리를 지정합니다.
execve에서는 파일 디스크립터 인자로 특별한 값인 AT_FDCWD가 사용됩니다. 이것은 Linux 커널에서 공유되는 상수로, 경로명을 현재 작업 디렉터리 기준의 상대 경로로 해석하라고 함수에 알려 줍니다. 파일 디스크립터를 받는 함수에는 보통 다음과 같은 수동 검사가 들어 있습니다if (fd == AT_FDCWD) { /* special codepath */ }.
1단계: 준비
이제 프로그램 실행을 처리하는 핵심 함수인 do_execveat_common에 도달했습니다. 이 함수가 무엇을 하는지 더 큰 그림으로 보기 위해, 코드를 들여다보던 것에서 잠시 한 발 물러서 보겠습니다.
do_execveat_common의 첫 번째 주요 작업은 linux_binprm이라는 구조체를 준비하는 것입니다. 구조체 정의 전체를 옮겨 싣지는 않겠지만, 짚고 넘어가야 할 중요한 필드가 몇 가지 있습니다:
새 프로그램의 가상 메모리 관리를 준비하기 위해 mm_struct와 vm_area_struct 같은 자료 구조가 정의됩니다.
프로그램에 전달할 argc와 envc가 계산되어 저장됩니다.
filename과 interp는 각각 프로그램의 파일 이름과 그 인터프리터의 파일 이름을 저장합니다. 이 둘은 처음에는 서로 같은 값으로 시작하지만, 경우에 따라 달라질 수 있습니다. 그러한 경우 중 하나가 셔뱅(shebang)이 있는 인터프리터 방식의 스크립트를 실행할 때입니다. 예를 들어 Python 프로그램을 실행할 때 filename은 소스 파일을 가리키지만 interp는 Python 인터프리터의 경로입니다.
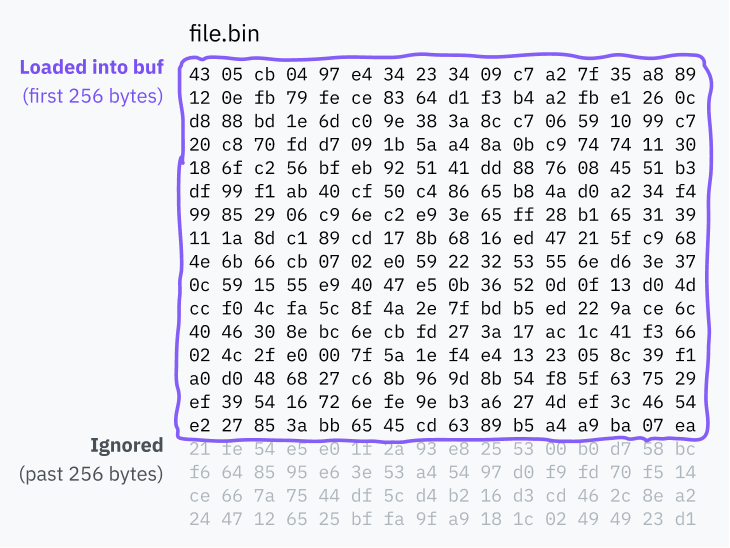
buf는 실행할 파일의 처음 256바이트로 채워진 배열입니다. 이 배열은 파일 형식을 감지하고 스크립트의 셔뱅을 불러오는 데 사용됩니다.
위 코드의 경로에 /uapi/가 들어 있다는 점을 눈치채셨을 것입니다. 왜 이 길이는 linux_binprm 구조체와 같은 파일인 include/linux/binfmts.h에 정의되어 있지 않을까요?
UAPI는 “userspace API(사용자 공간 API)“의 약자입니다. 여기서는 누군가가 버퍼의 길이를 커널의 공개 API에 포함해야 한다고 결정했다는 뜻입니다. 이론상 UAPI에 속한 모든 것은 유저랜드에 노출되고, UAPI가 아닌 모든 것은 커널 코드 내부에서만 쓰입니다.
원래 커널 코드와 사용자 공간 코드는 한데 뒤섞인 채로 공존했습니다. 2012년에 유지보수성을 높이려는 시도의 일환으로 UAPI 코드가 별도의 디렉터리로 리팩터링되었습니다.
2단계: Binfmt
커널이 다음으로 하는 주요 작업은 여러 “binfmt”(바이너리 형식) 핸들러를 차례로 순회하는 것입니다. 이 핸들러들은 fs/binfmt_elf.c나 fs/binfmt_flat.c 같은 파일에 정의되어 있습니다. 커널 모듈도 자체 binfmt 핸들러를 이 풀에 추가할 수 있습니다.
각 핸들러는 load_binary() 함수를 노출하는데, 이 함수는 linux_binprm 구조체를 받아 해당 핸들러가 프로그램의 형식을 이해할 수 있는지 확인합니다.
이 과정에서는 흔히 버퍼에서 매직 넘버를 찾거나, (역시 버퍼에 있는) 프로그램의 시작 부분을 디코딩해 보거나, 파일 확장자를 확인하거나, 이들을 함께 수행합니다. 핸들러가 해당 형식을 지원하면 프로그램을 실행할 수 있도록 준비한 뒤 성공 코드를 반환합니다. 그렇지 않으면 일찍 종료하고 오류 코드를 반환합니다. 커널은 성공하는 binfmt가 나올 때까지 각 binfmt의 load_binary() 함수를 차례로 시도합니다. 때로는 이 과정이 재귀적으로 실행되기도 합니다. 예를 들어 스크립트에 인터프리터가 지정되어 있고 그 인터프리터 자체도 스크립트라면, 계층 구조는 binfmt_script > binfmt_script > binfmt_elf가 될 수 있습니다(여기서 ELF는 체인의 마지막에 있는 실행 파일 형식입니다).
형식 집중 탐구: 스크립트
Linux가 지원하는 여러 형식 중에서 제가 가장 먼저 따로 이야기하고 싶은 것은 binfmt_script입니다.
셔뱅을 읽거나 써 본 적이 있으십니까? 일부 스크립트의 맨 앞에서 인터프리터의 경로를 지정하는 그 줄 말입니다.
1
#!/bin/bash
저는 늘 셔뱅을 셸이 처리한다고만 생각했지만, 그렇지 않습니다! 셔뱅은 사실 커널의 기능이며, 스크립트는 다른 모든 프로그램과 똑같은 시스템 호출로 실행됩니다. 컴퓨터는 정말 멋집니다.
fs/binfmt_script.c가 파일이 셔뱅으로 시작하는지 어떻게 확인하는지 살펴보십시오:
	/* Not ours to exec if we don't start with "#!". */
	if ((bprm->buf[0] != '#') || (bprm->buf[1] != '!'))
		return -ENOEXEC;
파일이 실제로 셔뱅으로 시작하면, binfmt 핸들러는 이어서 인터프리터 경로와 그 경로 뒤에 공백으로 구분된 인자들을 읽습니다. 이 과정은 줄바꿈 문자나 버퍼의 끝을 만나면 멈춥니다.
여기에는 흥미롭고도 기묘한 점이 두 가지 있습니다.
먼저, 파일의 처음 256바이트로 채워진 linux_binprm의 버퍼를 기억하십니까? 이 버퍼는 실행 파일 형식을 감지하는 데 쓰이지만, binfmt_script에서 셔뱅을 읽어 들이는 곳도 바로 이 버퍼입니다.
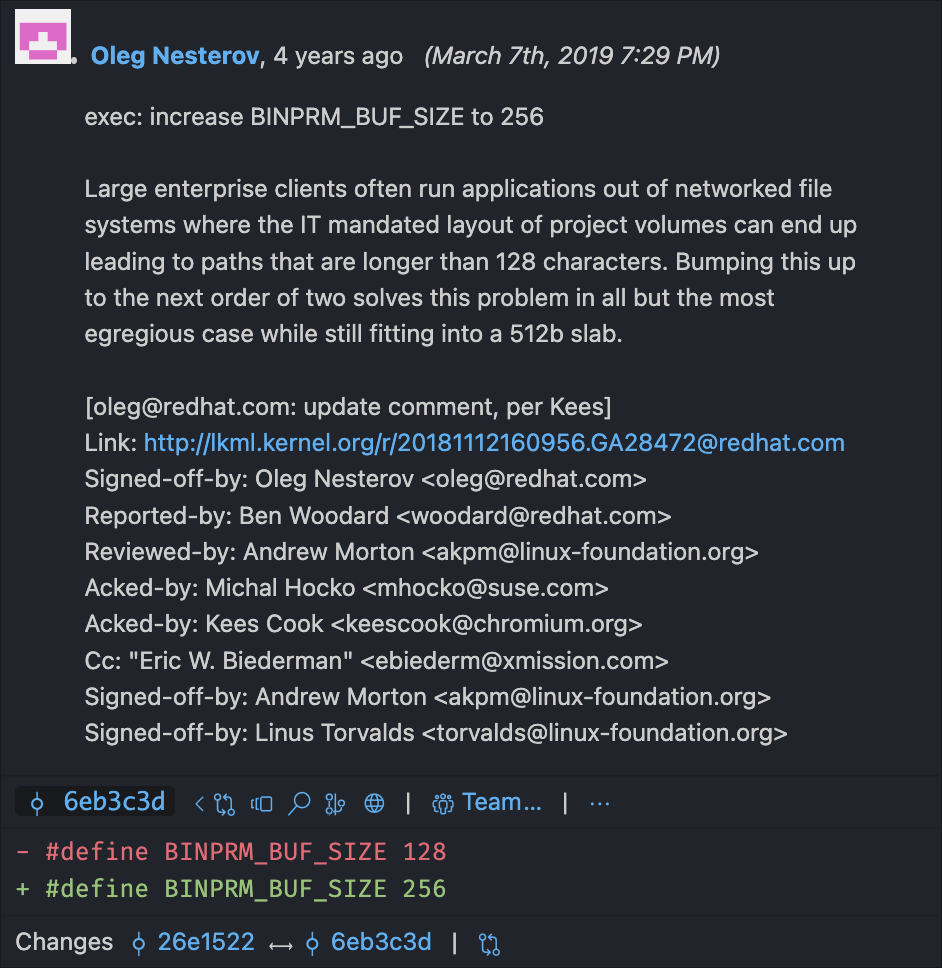
조사하는 동안 저는 이 버퍼의 길이가 128바이트라고 설명한 글을 읽었습니다. 그런데 그 글이 게시된 후 어느 시점에 길이가 두 배인 256바이트로 늘어났습니다! 이유가 궁금해서 Linux 소스 코드에서 BINPRM_BUF_SIZE가 정의된 줄의 Git blame(특정 코드 줄을 수정한 모든 사람의 기록)을 확인해 보았습니다. 그랬더니 놀랍게도…
컴퓨터는 정말 멋집니다!
셔뱅은 커널이 처리하며 파일 전체를 불러오는 대신 buf에서 가져오기 때문에, 항상buf의 길이만큼 잘립니다. 보아하니 4년 전 누군가가 커널이 128자를 넘는 경로를 잘라 버리는 데 짜증이 났고, 그 해결책으로 버퍼 크기를 두 배로 늘려 잘리는 지점을 두 배로 늘렸던 것입니다! 오늘날 여러분의 Linux 머신에서도 셔뱅 줄이 256자를 넘으면 256자 이후의 모든 내용은 완전히 사라집니다.
이 때문에 버그가 생겼다고 상상해 보십시오. 코드가 망가지는 근본 원인을 찾아내려 애쓰는 모습을 상상해 보십시오. 문제가 Linux 커널 깊숙한 곳에 있다는 사실을 알게 되었을 때의 기분을 상상해 보십시오. 경로의 일부가 알 수 없이 사라졌다는 사실을 발견하게 될, 어느 거대 기업의 다음 IT 담당자에게 애도를 표합니다.
두 번째 기묘한 점:argv[0]이 프로그램 이름이라는 것은 관례일 뿐이며, 호출자는 exec 시스템 호출에 원하는 어떤 argv든 넘길 수 있고 그 값은 아무런 검사 없이 그대로 전달된다는 것을 기억하십니까?
공교롭게도 binfmt_script는 argv[0]이 프로그램 이름이라고 가정하는 곳 중 하나입니다. 이 핸들러는 항상 argv[0]을 제거한 다음, argv의 맨 앞에 다음 항목들을 추가합니다:
argv를 갱신한 후, 핸들러는 linux_binprm.interp를 인터프리터 경로(이 경우에는 Node 바이너리)로 설정하여 파일의 실행 준비를 마칩니다. 마지막으로, 프로그램의 실행 준비에 성공했음을 나타내기 위해 0을 반환합니다.
형식 집중 탐구: 기타 인터프리터
또 하나의 흥미로운 핸들러는 binfmt_misc입니다. 이 핸들러는 /proc/sys/fs/binfmt_misc/에 특수 파일 시스템을 마운트하여, 유저랜드 설정을 통해 몇 가지 제한된 형식을 추가할 수 있게 해 줍니다. 프로그램은 이 디렉터리의 파일에 특별한 형식으로 쓰기를 수행하여 자신만의 핸들러를 추가할 수 있습니다. 각 설정 항목은 다음을 지정합니다.
해당 파일 형식을 감지하는 방법입니다. 특정 오프셋에 있는 매직 넘버나 찾아볼 파일 확장자 중 하나를 지정할 수 있습니다.
인터프리터 실행 파일의 경로입니다. 인터프리터 인자를 지정할 방법은 없으므로, 인자가 필요하다면 래퍼 스크립트를 사용해야 합니다.
몇 가지 설정 플래그이며, 여기에는 binfmt_misc가 argv를 어떻게 갱신할지 지정하는 플래그도 포함됩니다.
이 binfmt_misc 시스템은 Java 설치에서 자주 사용되며, 클래스 파일은 0xCAFEBABE 매직 바이트로, JAR 파일은 확장자로 감지하도록 설정됩니다. 제 시스템에는 Python 바이트코드를 .pyc 확장자로 감지하여 적절한 핸들러에 넘겨주는 핸들러가 설정되어 있습니다.
이는 프로그램 설치 프로그램이 높은 권한으로 동작하는 커널 코드를 작성하지 않고도 자신만의 형식에 대한 지원을 추가할 수 있게 해 주는 꽤 멋진 방법입니다.
결국에는 (Linkin Park의 노래 말고)
exec 시스템 호출은 항상 다음 두 경로 중 하나로 끝납니다.
어쩌면 여러 겹의 스크립트 인터프리터를 거친 뒤일 수도 있지만, 결국 자신이 이해하는 실행 파일 바이너리 형식에 도달하여 그 코드를 실행합니다. 이 시점에서 기존 코드는 교체된 상태입니다.
… 아니면 모든 선택지를 소진하고, 꼬리를 내린 채 호출한 프로그램에 오류 코드를 반환합니다.
유닉스 계열 시스템을 사용해 본 적이 있다면, 터미널에서 실행한 셸 스크립트에 셔뱅 줄이나 .sh 확장자가 없어도 여전히 실행된다는 것을 눈치챘을 수도 있습니다. Windows가 아닌 터미널이 가까이 있다면 지금 바로 시험해 볼 수 있습니다.
(chmod +x는 운영체제에 해당 파일이 실행 파일임을 알려 줍니다. 이렇게 하지 않으면 파일을 실행할 수 없습니다.)
그렇다면 이 셸 스크립트는 왜 셸 스크립트로 실행되는 것입니까? 커널의 형식 핸들러에는 식별할 만한 표시가 전혀 없는 셸 스크립트를 감지할 확실한 방법이 없을 텐데 말입니다!
알고 보니 이 동작은 커널의 일부가 아닙니다. 실은 여러분의 셸이 실패 상황을 처리하는 흔한 방식입니다.
셸로 파일을 실행했는데 exec 시스템 호출이 실패하면, 대부분의 셸은 파일 이름을 첫 번째 인자로 하여 셸을 실행함으로써 그 파일을 셸 스크립트로 다시 실행하려고 시도합니다. Bash는 보통 자기 자신을 이 인터프리터로 사용하지만, ZSH는 sh가 가리키는 것을 사용하며, 이는 보통 본 셸입니다.
이 동작이 이렇게 흔한 이유는 Unix 시스템 간에 코드를 이식할 수 있도록 만들어진 오래된 표준인 POSIX에 명시되어 있기 때문입니다. 대부분의 도구나 운영체제가 POSIX를 엄격하게 따르지는 않지만, 그 관례 중 상당수는 여전히 공유되고 있습니다.
[exec 시스템 호출이] [ENOEXEC] 오류에 해당하는 오류로 실패하면, 셸은 명령 이름을 첫 번째 피연산자로 하여 셸을 호출한 것과 동등한 명령을 실행해야 하며, 나머지 인자는 모두 새 셸에 전달됩니다. 실행 파일이 텍스트 파일이 아니면 셸은 이 명령 실행을 건너뛸 수 있습니다. 이 경우 셸은 오류 메시지를 출력하고 종료 상태 126을 반환해야 합니다.
이제 우리는 execve를 꽤 철저하게 이해했습니다. 대부분의 경로 끝에서 커널은 실행할 기계어 코드가 담긴 최종 프로그램에 도달하게 됩니다. 일반적으로 실제로 코드로 점프하기 전에 준비 과정이 필요합니다. 예를 들어 프로그램의 여러 부분을 메모리의 올바른 위치에 적재해야 합니다. 프로그램마다 용도별로 필요한 메모리의 양이 다르므로, 프로그램을 실행할 수 있게 준비하는 방법을 명시하는 표준 파일 형식이 존재합니다. Linux는 이러한 형식을 많이 지원하지만, 단연 가장 흔한 형식은 ELF(executable and linkable format, 실행 파일 및 링크 가능 형식)입니다.
Linux에서 앱이나 명령줄 프로그램을 실행한다면, 그것은 십중팔구 ELF 바이너리입니다. 하지만 macOS에서는 Mach-O가 사실상의 표준 형식입니다. Mach-O는 ELF와 똑같은 일을 모두 하지만 구조가 다릅니다. Windows에서 .exe 실행 파일은 Portable Executable 형식을 사용하는데, 이 역시 같은 개념을 가진 다른 형식입니다.
Linux 커널에서 ELF 바이너리는 binfmt_elf 핸들러가 처리하며, 이 핸들러는 다른 많은 핸들러보다 복잡하고 수천 줄의 코드로 이루어져 있습니다. 이 핸들러는 ELF 파일에서 특정 세부 정보를 파싱해 내고, 그 정보를 이용해 프로세스를 메모리에 적재하고 실행하는 일을 담당합니다.
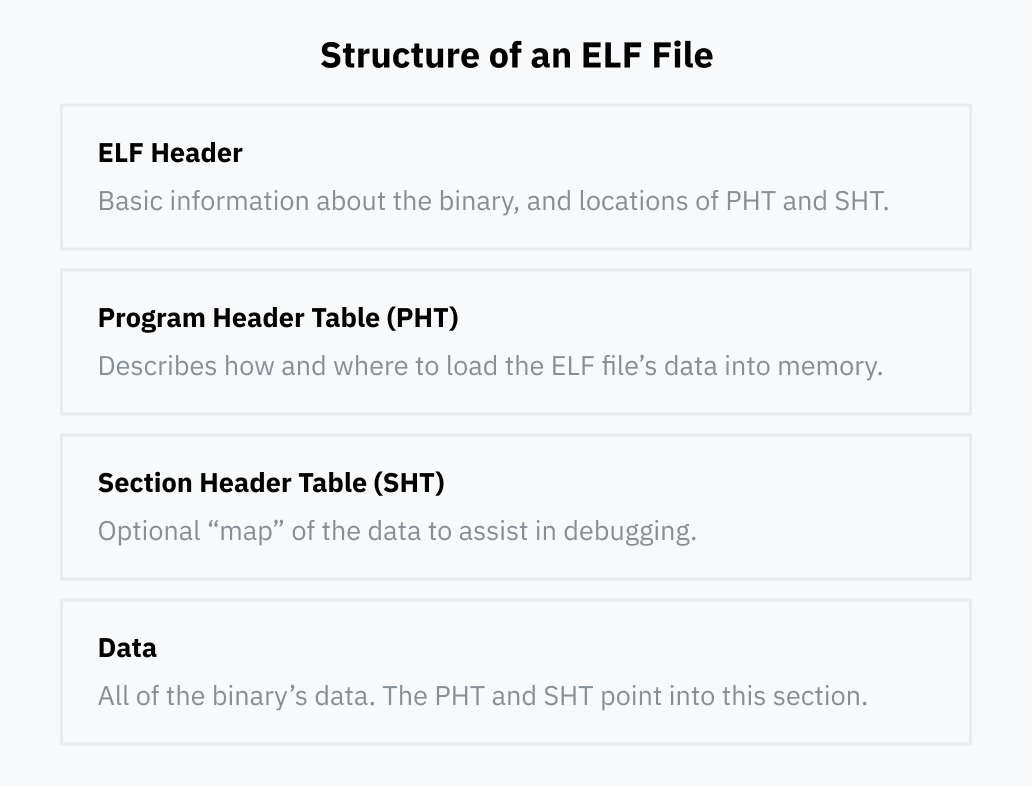
binfmt_elf가 ELF 파일을 어떻게 실행하는지 더 깊이 살펴보기 전에, 먼저 파일 형식 자체를 살펴봅시다. ELF 파일은 일반적으로 네 부분으로 구성됩니다:
ELF 헤더
모든 ELF 파일에는 ELF 헤더가 있습니다. ELF 헤더는 다음과 같은 바이너리의 기본 정보를 전달하는 매우 중요한 역할을 합니다:
어떤 프로세서에서 실행되도록 설계되었는지. ELF 파일에는 ARM이나 x86 같은 여러 프로세서 유형용 기계어 코드가 담길 수 있습니다.
바이너리가 실행 파일로서 단독으로 실행되기 위한 것인지, 아니면 다른 프로그램이 “동적 링크 라이브러리”로 적재하기 위한 것인지. 동적 링킹이 무엇인지는 곧 자세히 다루겠습니다.
실행 파일의 진입점. 뒤쪽 섹션들은 ELF 파일에 담긴 데이터를 메모리의 정확히 어디에 적재할지 명시합니다. 진입점은 전체 프로세스가 적재된 후 첫 번째 기계어 명령어가 메모리의 어디에 있는지를 가리키는 메모리 주소입니다.
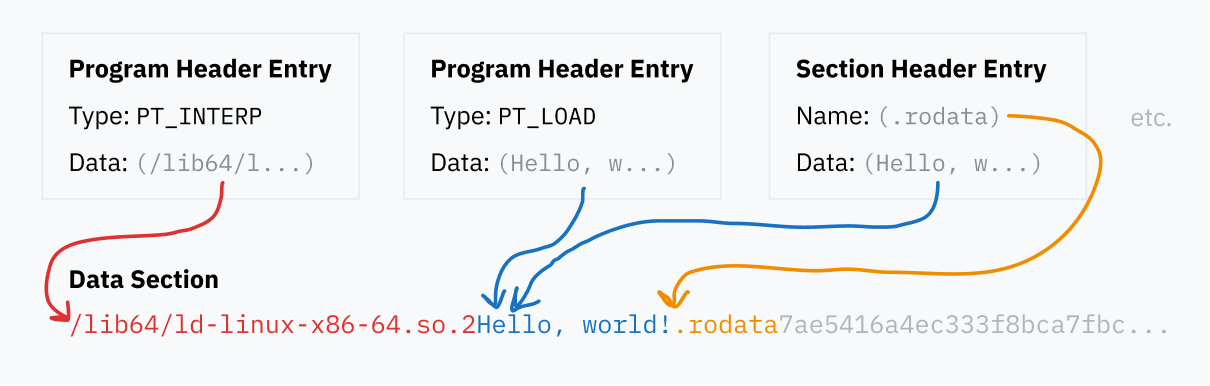
ELF 헤더는 항상 파일의 맨 앞에 있습니다. ELF 헤더는 파일 내 어디에든 있을 수 있는 프로그램 헤더 테이블과 섹션 헤더의 위치를 명시합니다. 그리고 이 테이블들은 다시 파일의 다른 곳에 저장된 데이터를 가리킵니다.
프로그램 헤더 테이블
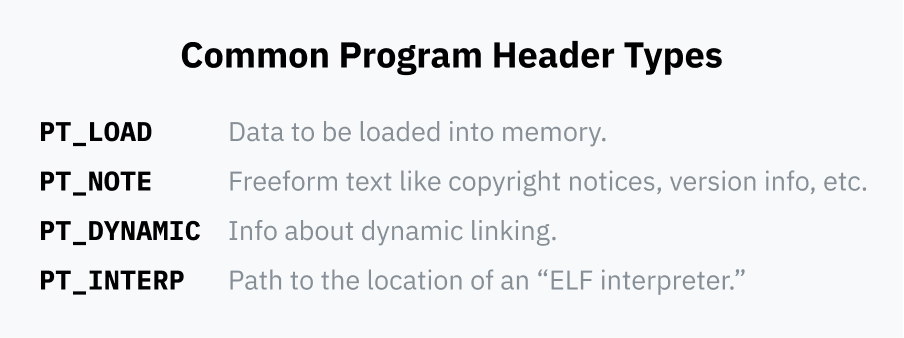
프로그램 헤더 테이블은 런타임에 바이너리를 적재하고 실행하는 방법에 대한 구체적인 세부 정보를 담은 일련의 항목입니다. 각 항목에는 어떤 세부 정보를 명시하는지 나타내는 유형 필드가 있습니다. 예를 들어 PT_LOAD는 메모리에 적재해야 할 데이터가 담겨 있음을 뜻하지만, PT_NOTE는 해당 세그먼트에 반드시 어딘가에 적재할 필요는 없는 정보성 텍스트가 담겨 있음을 뜻합니다.
각 항목은 해당 데이터가 파일 안의 어디에 있는지, 그리고 경우에 따라서는 그 데이터를 메모리에 어떻게 적재할지에 대한 정보를 지정합니다.
항목은 ELF 파일 안에서 해당 데이터의 위치를 가리킵니다.
데이터를 어느 가상 메모리 주소에 적재해야 하는지 지정할 수 있습니다. 세그먼트를 메모리에 적재할 목적이 아니라면 이 값은 보통 비워 둡니다.
두 필드가 데이터의 길이를 지정합니다. 하나는 파일 안에 있는 데이터의 길이이고, 다른 하나는 새로 만들 메모리 영역의 길이입니다. 메모리 영역의 길이가 파일 안의 길이보다 길면 남는 메모리는 0으로 채워집니다. 이는 런타임에 사용할 정적 메모리 세그먼트가 필요한 프로그램에 유용합니다. 이러한 빈 메모리 세그먼트를 보통 BSS 세그먼트라고 부릅니다.
마지막으로, 플래그 필드는 세그먼트가 메모리에 적재되었을 때 어떤 작업을 허용할지 지정합니다. PF_R은 읽기 가능하게, PF_W는 쓰기 가능하게 만들며, PF_X는 CPU에서 실행을 허용해야 하는 코드임을 뜻합니다.
섹션 헤더 테이블
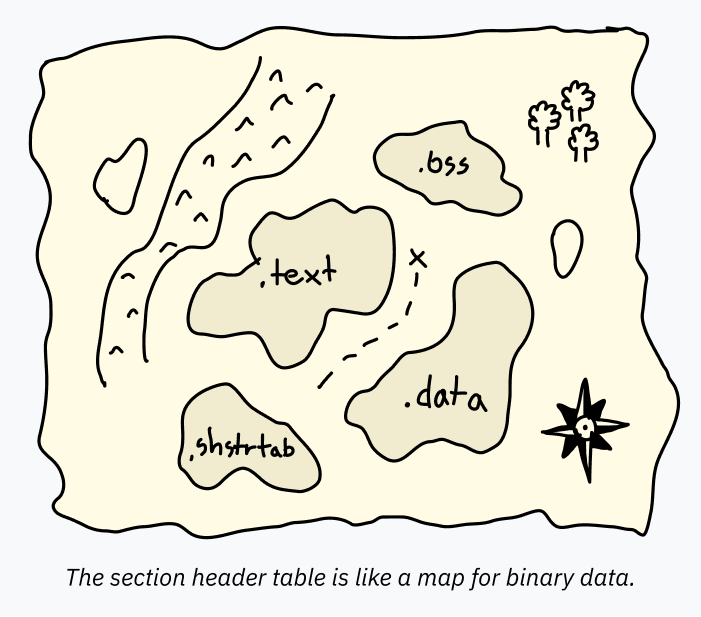
섹션 헤더 테이블은 섹션에 대한 정보를 담은 일련의 항목입니다. 이 섹션 정보는 ELF 파일 안의 데이터를 그려 놓은 지도와 같습니다. 이 정보 덕분에 디버거 같은 프로그램은 데이터의 각 부분이 어떤 용도로 쓰이는지 쉽게 파악할 수 있습니다.
예를 들어, 프로그램 헤더 테이블은 넓은 범위의 데이터를 한꺼번에 메모리에 적재하도록 지정할 수 있습니다. 그 하나의 PT_LOAD 블록 안에 코드와 전역 변수가 모두 들어 있을 수도 있습니다! 프로그램을 실행하는 데에는 이 둘을 따로 지정해야 할 이유가 없습니다. CPU는 그저 엔트리 포인트에서 시작해 한 단계씩 나아가며, 프로그램이 요청하는 때와 위치에서 데이터에 접근할 뿐입니다. 하지만 프로그램을 분석하는 디버거 같은 소프트웨어는 각 영역이 정확히 어디서 시작하고 어디서 끝나는지 알아야 합니다. 그렇지 않으면 “hello”라고 적힌 텍스트를 코드로 해석하려 들 수도 있습니다(그리고 그것은 올바른 코드가 아니므로 폭발해 버립니다). 이 정보는 섹션 헤더 테이블에 저장됩니다.
섹션 헤더 테이블은 보통 포함되어 있지만, 사실은 선택 사항입니다. ELF 파일은 섹션 헤더 테이블을 완전히 제거해도 아무 문제 없이 실행되며, 자기 코드가 하는 일을 숨기고 싶은 개발자는 해석하기 더 어렵게 만들려고 때때로 ELF 바이너리에서 섹션 헤더 테이블을 일부러 제거하거나 망가뜨리기도 합니다.
각 섹션에는 이름과 타입, 그리고 섹션을 어떻게 사용하고 해석할지 지정하는 몇 가지 플래그가 있습니다. 표준 이름은 관례상 보통 점으로 시작합니다. 가장 흔한 섹션은 다음과 같습니다.
.text: 메모리에 적재되어 CPU에서 실행될 기계어입니다. SHT_PROGBITS 타입이며, 실행 파일 안에서 실행 가능한 영역임을 표시하는 SHF_EXECINSTR 플래그와 실행을 위해 메모리에 적재된다는 뜻의 SHF_ALLOC 플래그를 가집니다. (이름에 헷갈리지 마십시오. 이것은 여전히 바이너리 기계어일 뿐입니다! 읽을 수 있는 “텍스트”도 아닌데 .text라고 부르는 것이 저는 늘 좀 이상하다고 생각했습니다.)
.data: 실행 파일에 하드코딩되어 메모리에 적재될 초기화된 데이터입니다. 예를 들어, 어떤 텍스트를 담은 전역 변수가 이 섹션에 들어 있을 수 있습니다. 저수준 코드를 작성한다면, 정적 변수가 들어가는 곳이 바로 이 섹션입니다. 이 섹션의 타입도 SHT_PROGBITS인데, 이는 단지 섹션에 “프로그램을 위한 정보”가 들어 있다는 뜻입니다. 플래그는 SHF_ALLOC과 SHF_WRITE로, 쓰기 가능한 메모리임을 표시합니다.
.bss: 앞에서 할당된 메모리 중 일부가 0으로 채워진 상태로 시작하는 경우가 흔하다고 말씀드렸습니다. ELF 파일에 빈 바이트를 잔뜩 넣는 것은 낭비이므로, BSS라는 특별한 세그먼트 타입을 사용합니다. 디버깅할 때 BSS 세그먼트에 대해 알면 도움이 되므로, 할당할 메모리의 길이를 지정하는 섹션 헤더 테이블 항목도 따로 있습니다. 타입은 SHT_NOBITS이며, SHF_ALLOC과 SHF_WRITE 플래그가 붙습니다.
.rodata: 읽기 전용이라는 점을 제외하면 .data와 비슷합니다. printf("Hello, world!")를 실행하는 아주 기본적인 C 프로그램에서 문자열 “Hello world!”는 .rodata 섹션에 들어가고, 실제로 출력을 수행하는 코드는 .text 섹션에 들어갑니다.
.shstrtab: 이것은 재미있는 구현 세부 사항입니다! 섹션 자체의 이름(.text나 .shstrtab 같은)은 섹션 헤더 테이블에 직접 포함되지 않습니다. 그 대신 각 항목에는 자신의 이름이 들어 있는 ELF 파일 내 위치를 가리키는 오프셋이 담겨 있습니다. 이렇게 하면 섹션 헤더 테이블의 각 항목이 같은 크기를 가질 수 있어 파싱하기가 더 쉬워집니다. 이름에 대한 오프셋은 고정 크기의 숫자인 반면, 테이블에 이름을 직접 넣으면 크기가 변수인 문자열을 사용하게 됩니다. 이 이름 데이터는 모두 SHT_STRTAB 타입의 .shstrtab라는 별도의 섹션에 저장됩니다.
데이터
프로그램 헤더 테이블과 섹션 헤더 테이블의 항목은 메모리에 로드하기 위해서든, 프로그램 코드의 위치를 지정하기 위해서든, 단순히 섹션에 이름을 붙이기 위해서든 모두 ELF 파일 안의 데이터 블록을 가리킵니다. 이 모든 다양한 데이터 조각은 ELF 파일의 데이터 섹션에 들어 있습니다.
링킹에 대한 간단한 설명
다시 binfmt_elf 코드로 돌아가 봅시다. 커널은 프로그램 헤더 테이블에서 두 가지 타입의 항목에 관심을 둡니다.
PT_LOAD 세그먼트는 .text 섹션과 .data 섹션 같은 모든 프로그램 데이터가 메모리의 어디에 로드되어야 하는지를 지정합니다. 커널은 ELF 파일에서 이 항목들을 읽어 데이터를 메모리에 로드하며, 이를 통해 CPU가 프로그램을 실행할 수 있게 됩니다.
커널이 관심을 두는 또 다른 타입의 프로그램 헤더 테이블 항목은 PT_INTERP이며, 이는 “동적 링킹 런타임”을 지정합니다.
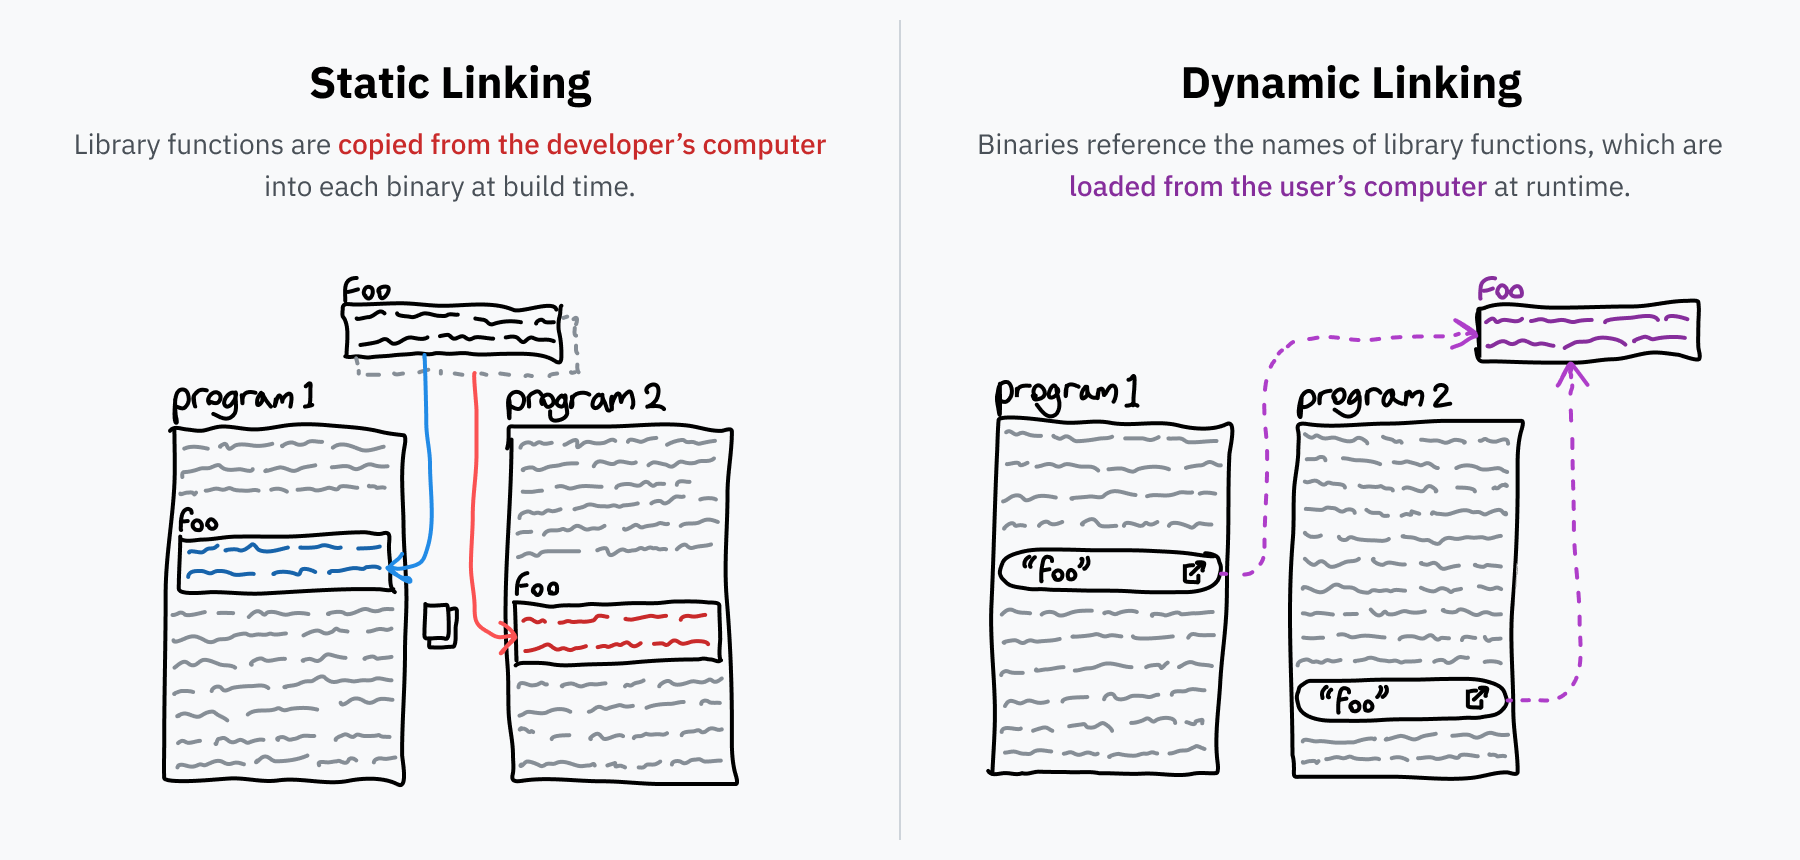
동적 링킹이 무엇인지 이야기하기 전에, 먼저 “링킹” 전반에 대해 이야기해 봅시다. 프로그래머는 보통 재사용 가능한 코드로 이루어진 라이브러리 위에 프로그램을 만듭니다 — 앞에서 이야기한 libc가 그 예입니다. 소스 코드를 실행 파일 바이너리로 바꿀 때, 링커라는 프로그램이 라이브러리 코드를 찾아 바이너리에 복사함으로써 이러한 참조를 모두 해결합니다. 이 과정을 정적 링킹이라고 하며, 이는 외부 코드가 배포되는 파일에 직접 포함된다는 뜻입니다.
하지만 어떤 라이브러리는 매우 흔하게 쓰입니다. libc는 시스템 호출을 통해 운영체제와 상호작용하기 위한 표준 인터페이스이기 때문에, 세상의 거의 모든 프로그램이 libc를 사용한다는 것을 알 수 있습니다. 컴퓨터에 있는 모든 프로그램마다 libc의 복사본을 따로 포함시키는 것은 공간을 끔찍하게 낭비하는 일입니다. 또한 라이브러리를 사용하는 각 프로그램이 업데이트되기를 기다릴 필요 없이 라이브러리의 버그를 한 곳에서 고칠 수 있다면 좋을 것입니다. 동적 링킹은 이러한 문제에 대한 해결책입니다.
정적으로 링크된 프로그램이 bar라는 라이브러리의 foo 함수를 필요로 한다면, 그 프로그램에는 foo 전체의 복사본이 포함됩니다. 하지만 동적으로 링크된 경우에는 “라이브러리 bar의 foo가 필요합니다”라는 참조만 포함됩니다. 프로그램이 실행될 때 bar가 컴퓨터에 설치되어 있다면, foo 함수의 기계어 코드를 필요할 때 메모리에 로드할 수 있습니다. 컴퓨터에 설치된 bar 라이브러리가 업데이트되면, 프로그램 자체를 전혀 변경하지 않아도 다음에 프로그램을 실행할 때 새 코드가 로드됩니다.
실제 환경에서의 동적 링킹
Linux에서 bar와 같이 동적으로 링크할 수 있는 라이브러리는 보통 .so(Shared Object) 확장자를 가진 파일로 패키징됩니다. 이러한 .so 파일도 프로그램과 마찬가지로 ELF 파일입니다 — ELF 헤더에 해당 파일이 실행 파일인지 라이브러리인지를 지정하는 필드가 있다는 것을 기억하실 것입니다. 또한 공유 오브젝트는 섹션 헤더 테이블에 .dynsym 섹션을 가지고 있으며, 여기에는 파일에서 어떤 심볼을 내보내고 있어 동적으로 링크할 수 있는지에 대한 정보가 담겨 있습니다.
Windows에서는 bar 같은 라이브러리가 .dll(dynamic link library) 파일로 패키징됩니다. macOS는 .dylib(dynamically linked library) 확장자를 사용합니다. macOS 앱이나 Windows .exe 파일과 마찬가지로, 이 파일들은 ELF 파일과 형식이 조금 다르지만 개념과 기법은 같습니다.
두 가지 링킹 방식의 흥미로운 차이점은, 정적 링킹에서는 라이브러리 중 실제로 사용되는 부분만 실행 파일에 포함되고 따라서 그 부분만 메모리에 로드된다는 것입니다. 동적 링킹에서는 라이브러리 전체가 메모리에 로드됩니다. 처음에는 덜 효율적으로 들릴 수 있지만, 실제로는 라이브러리를 메모리에 한 번만 로드한 뒤 그 코드를 여러 프로세스가 공유하게 함으로써 현대 운영체제가 더 많은 공간을 절약할 수 있게 해 줍니다. 라이브러리는 프로그램마다 서로 다른 상태가 필요하므로 코드만 공유할 수 있지만, 그래도 절약되는 양은 RAM 수십에서 수백 메가바이트에 이를 수 있습니다.
실행
ELF 파일을 실행하는 커널 이야기로 다시 돌아가 봅시다. 실행하려는 바이너리가 동적으로 링크되어 있다면, 운영체제는 바이너리의 코드로 곧바로 점프할 수 없습니다. 코드 일부가 빠져 있기 때문입니다. 동적으로 링크된 프로그램에는 필요한 라이브러리 함수에 대한 참조만 들어 있다는 점을 기억하십시오!
바이너리를 실행하려면 운영체제는 어떤 라이브러리가 필요한지 파악하고, 그것들을 로드하고, 이름으로 된 포인터를 모두 실제 점프 명령어로 바꾼 다음에야 실제 프로그램 코드를 시작해야 합니다. 이는 ELF 형식과 깊이 얽혀 동작하는 매우 복잡한 코드이므로, 보통 커널의 일부가 아니라 독립된 프로그램으로 존재합니다. ELF 파일은 사용하려는 프로그램의 경로(보통 /lib64/ld-linux-x86-64.so.2와 같은 형태)를 프로그램 헤더 테이블의 PT_INTERP 항목에 지정합니다.
ELF 헤더를 읽고 프로그램 헤더 테이블을 훑어본 뒤, 커널은 새 프로그램을 위한 메모리 구조를 설정할 수 있습니다. 커널은 먼저 모든 PT_LOAD 세그먼트를 메모리에 로드하여 프로그램의 정적 데이터, BSS 공간, 기계어 코드를 채웁니다. 프로그램이 동적으로 링크되어 있다면 커널은 ELF 인터프리터(PT_INTERP)를 실행해야 하므로, 인터프리터의 데이터, BSS, 코드도 메모리에 로드합니다.
이제 커널은 유저랜드로 돌아갈 때 CPU가 복원할 명령어 포인터를 설정해야 합니다. 실행 파일이 동적으로 링크되어 있다면, 커널은 명령어 포인터를 메모리에 있는 ELF 인터프리터 코드의 시작 지점으로 설정합니다. 그렇지 않다면 커널은 명령어 포인터를 실행 파일의 시작 지점으로 설정합니다.
커널은 이제 시스템 호출에서 돌아갈 준비가 거의 되었습니다(아직 execve 안에 있다는 점을 기억하십시오). 커널은 프로그램이 시작할 때 읽을 수 있도록 argc, argv, 환경 변수를 스택에 푸시합니다.
이제 레지스터를 비웁니다. 커널은 시스템 호출을 처리하기 전에, 사용자 공간으로 다시 전환할 때 복원할 수 있도록 레지스터의 현재 값을 스택에 저장합니다. 커널은 사용자 공간으로 돌아가기 전에 스택의 이 부분을 0으로 채웁니다.
마침내 시스템 호출이 끝나고 커널은 유저랜드로 돌아갑니다. 커널은 이제 0으로 채워진 레지스터를 복원하고, 저장된 명령어 포인터로 점프합니다. 이제 그 명령어 포인터가 새 프로그램(또는 ELF 인터프리터)의 시작 지점이 되며, 현재 프로세스는 교체되었습니다!
5장: 컴퓨터 속의 번역가
지금까지 메모리를 읽고 쓰는 것에 대해 이야기할 때마다 설명이 다소 모호했습니다. 예를 들어 ELF 파일은 데이터를 적재할 특정 메모리 주소를 지정하는데, 그렇다면 서로 다른 프로세스가 충돌하는 메모리를 사용하려 할 때 문제가 생기지 않는 이유는 무엇입니까? 왜 각 프로세스는 서로 다른 메모리 환경을 가진 것처럼 보이는 것입니까?
또한, 우리는 정확히 어떻게 여기까지 오게 된 것입니까? execve가 현재 프로세스를 새 프로그램으로 교체하는 시스템 호출이라는 것은 이해했지만, 이것만으로는 여러 프로세스가 어떻게 시작될 수 있는지 설명되지 않습니다. 맨 처음 프로그램이 어떻게 실행되는지는 더더욱 설명되지 않습니다. 과연 어떤 닭(프로세스)이 다른 모든 달걀(다른 프로세스)을 낳는(생성하는) 것입니까?
우리의 여정도 끝을 향해 가고 있습니다. 이 두 가지 질문에 대한 답을 얻고 나면, 컴퓨터가 부팅에서부터 지금 여러분이 사용하고 있는 소프트웨어를 실행하기까지 어떤 과정을 거쳤는지 거의 완전히 이해하게 될 것입니다.
메모리는 가짜입니다
자, 그럼 메모리 이야기를 해 봅시다. 알고 보면 CPU가 메모리 주소를 읽거나 쓸 때, 실제로는 물리 메모리(RAM)의 해당 위치를 가리키는 것이 아닙니다. 그보다는 가상 메모리 공간의 한 위치를 가리키는 것입니다.
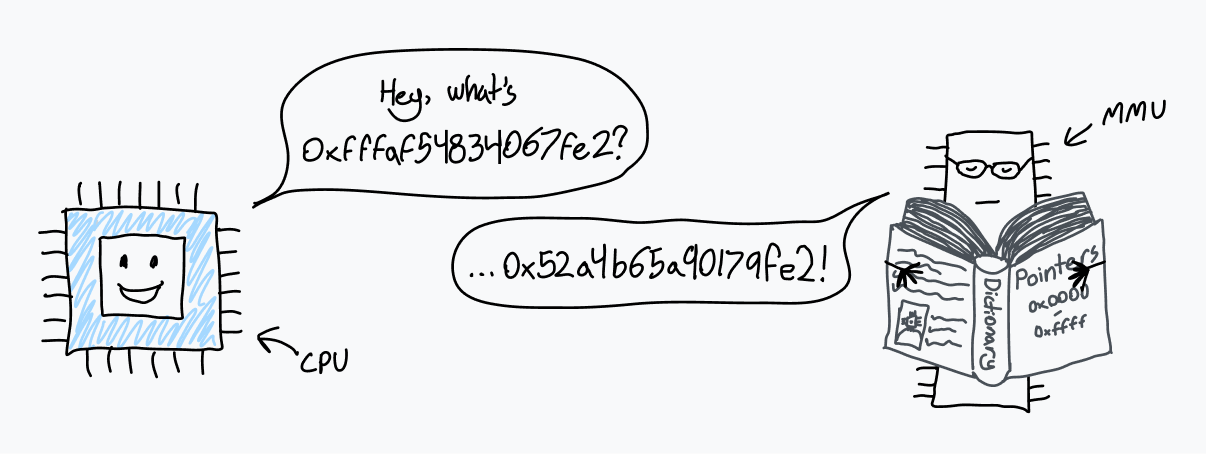
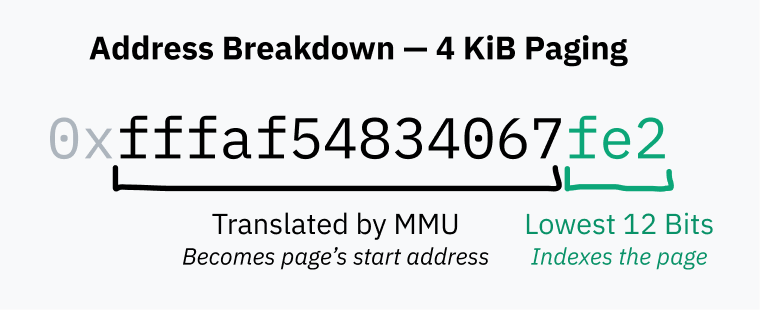
CPU는 메모리 관리 장치(MMU)라는 칩과 통신합니다. MMU는 가상 메모리의 위치를 RAM의 위치로 번역해 주는 사전을 가진 번역가처럼 동작합니다. CPU가 메모리 주소 0xfffaf54834067fe2에서 읽으라는 명령어를 받으면, MMU에 그 주소를 번역해 달라고 요청합니다. MMU는 사전에서 그 주소를 찾아보고, 대응하는 물리 주소가 0x53a4b64a90179fe2라는 것을 알아낸 뒤 그 숫자를 CPU에 돌려보냅니다. 그러면 CPU는 RAM의 해당 주소에서 읽을 수 있습니다.
컴퓨터가 처음 부팅될 때는 메모리 접근이 물리 RAM으로 곧바로 이루어집니다. 시작 직후 운영체제는 번역 사전을 만들고 CPU에 MMU를 사용하기 시작하라고 지시합니다.
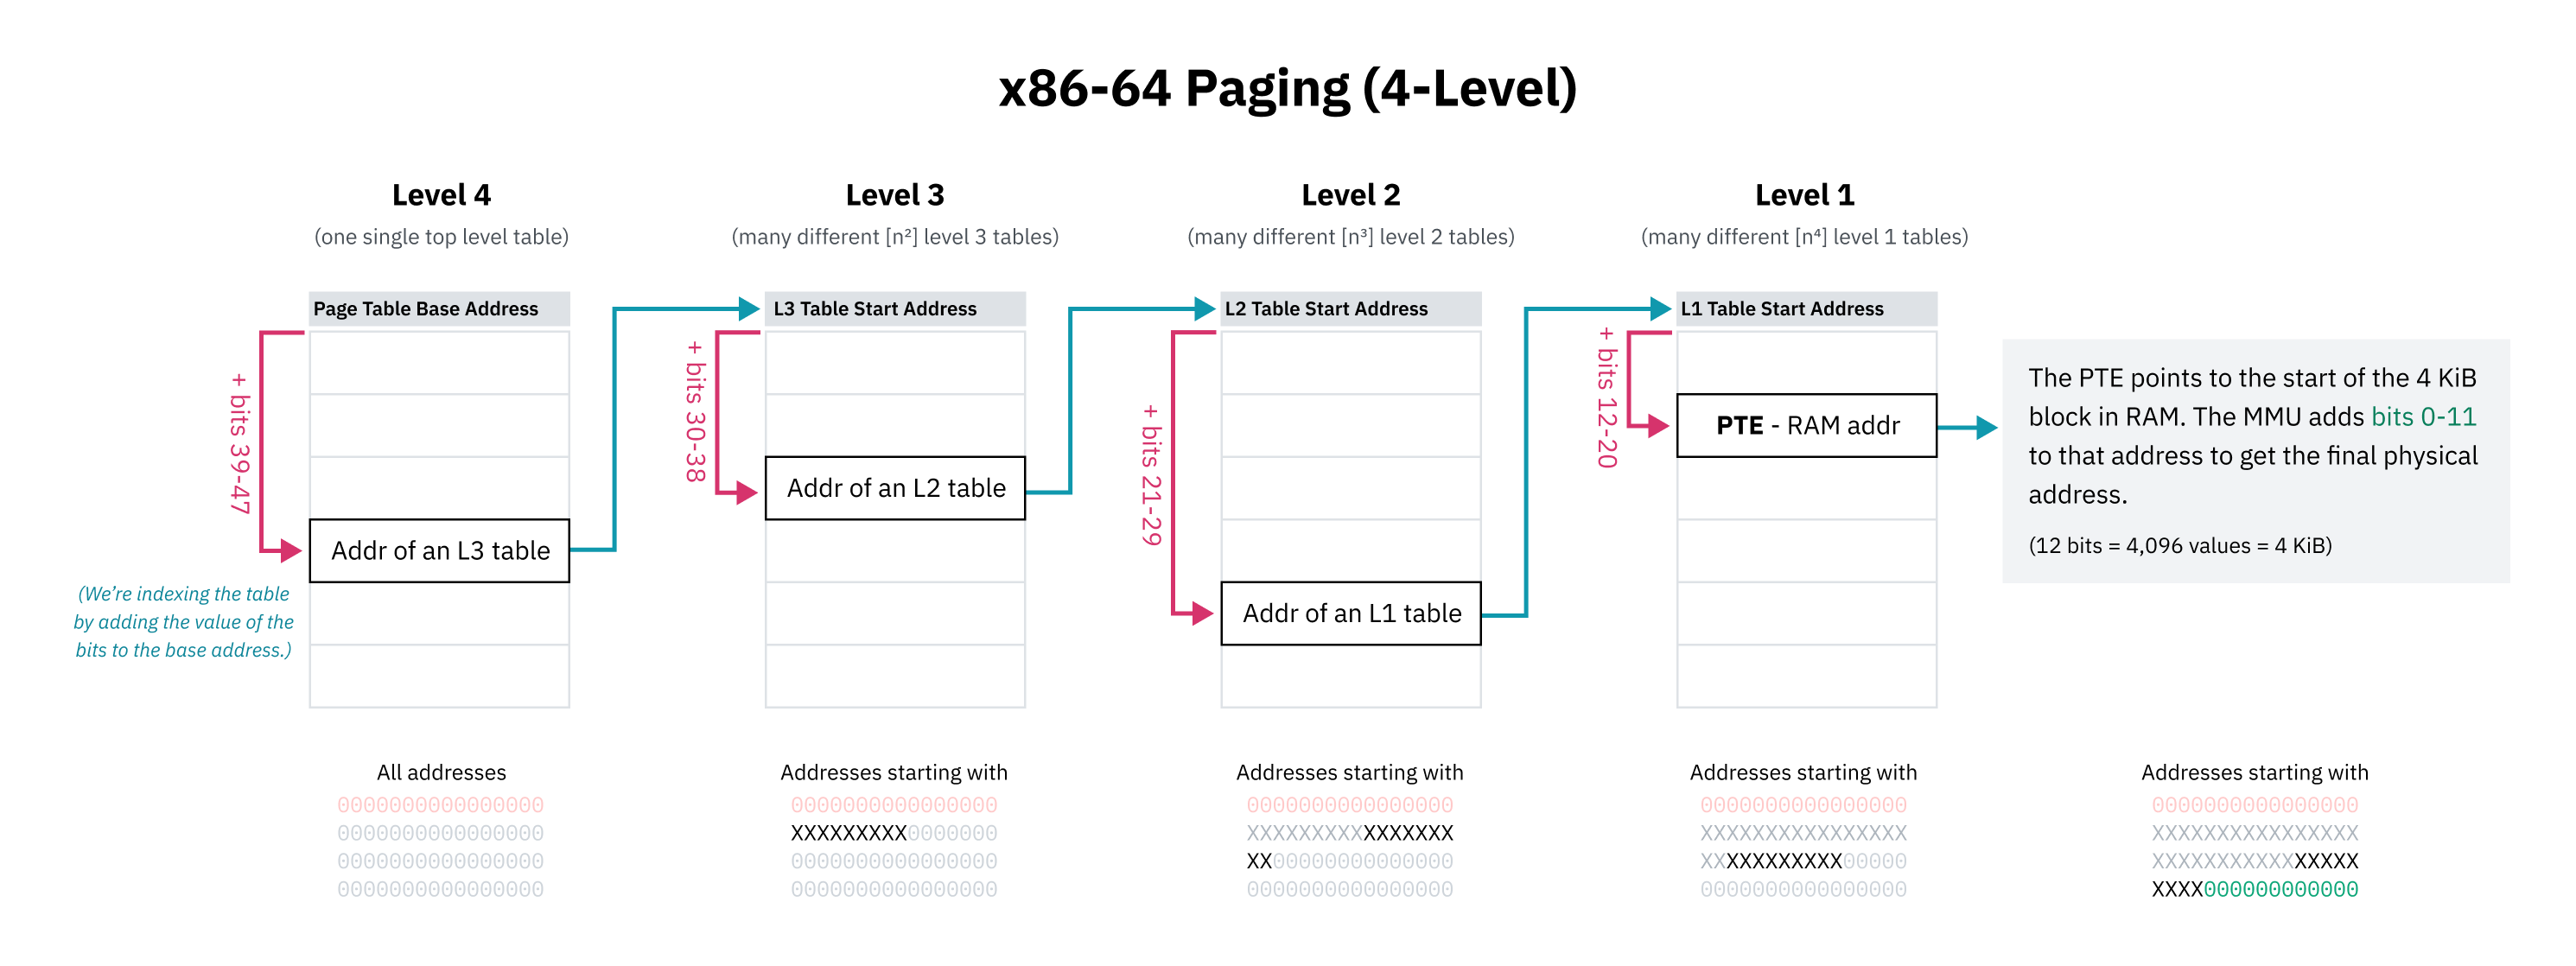
이 사전은 사실 페이지 테이블이라고 부르며, 모든 메모리 접근을 번역하는 이 시스템을 페이징이라고 부릅니다. 페이지 테이블의 항목은 페이지라고 부르며, 각 항목은 가상 메모리의 특정 덩어리가 RAM에 어떻게 매핑되는지를 나타냅니다. 이 덩어리는 항상 고정된 크기이며, 프로세서 아키텍처마다 페이지 크기가 다릅니다. x86-64의 기본 페이지 크기는 4 KiB로, 각 페이지가 4,096바이트 길이의 메모리 블록에 대한 매핑을 지정한다는 뜻입니다.
다시 말해, 4 KiB 페이지에서는 주소의 하위 12비트가 MMU 번역 전후에 항상 동일합니다. 12비트인 이유는 번역 후 얻게 되는 4,096바이트 페이지를 인덱싱하는 데 필요한 비트 수가 12이기 때문입니다.
x86-64는 운영체제가 2 MiB 또는 4 GiB의 더 큰 페이지를 활성화하는 것도 허용합니다. 이렇게 하면 주소 번역 속도가 향상될 수 있지만, 메모리 단편화와 낭비가 늘어납니다. 페이지 크기가 클수록 주소 중 MMU가 번역하는 부분은 작아집니다.
페이지 테이블 자체는 그저 RAM에 존재합니다. 페이지 테이블에는 수백만 개의 항목이 들어갈 수 있지만, 각 항목의 크기는 몇 바이트 정도에 불과하므로 페이지 테이블이 공간을 그리 많이 차지하지 않습니다.
부팅 시 페이징을 활성화하기 위해 커널은 먼저 RAM에 페이지 테이블을 구성합니다. 그런 다음 페이지 테이블 시작 지점의 물리 주소를 페이지 테이블 베이스 레지스터(PTBR)라는 레지스터에 저장합니다. 마지막으로 커널은 페이징을 활성화하여 모든 메모리 접근이 MMU를 거쳐 변환되도록 합니다. x86-64에서는 제어 레지스터 3(CR3)의 상위 20비트가 PTBR 역할을 합니다. 페이징(Paging)을 뜻하는 PG라는 이름이 붙은 CR0의 31번 비트를 1로 설정하면 페이징이 활성화됩니다.
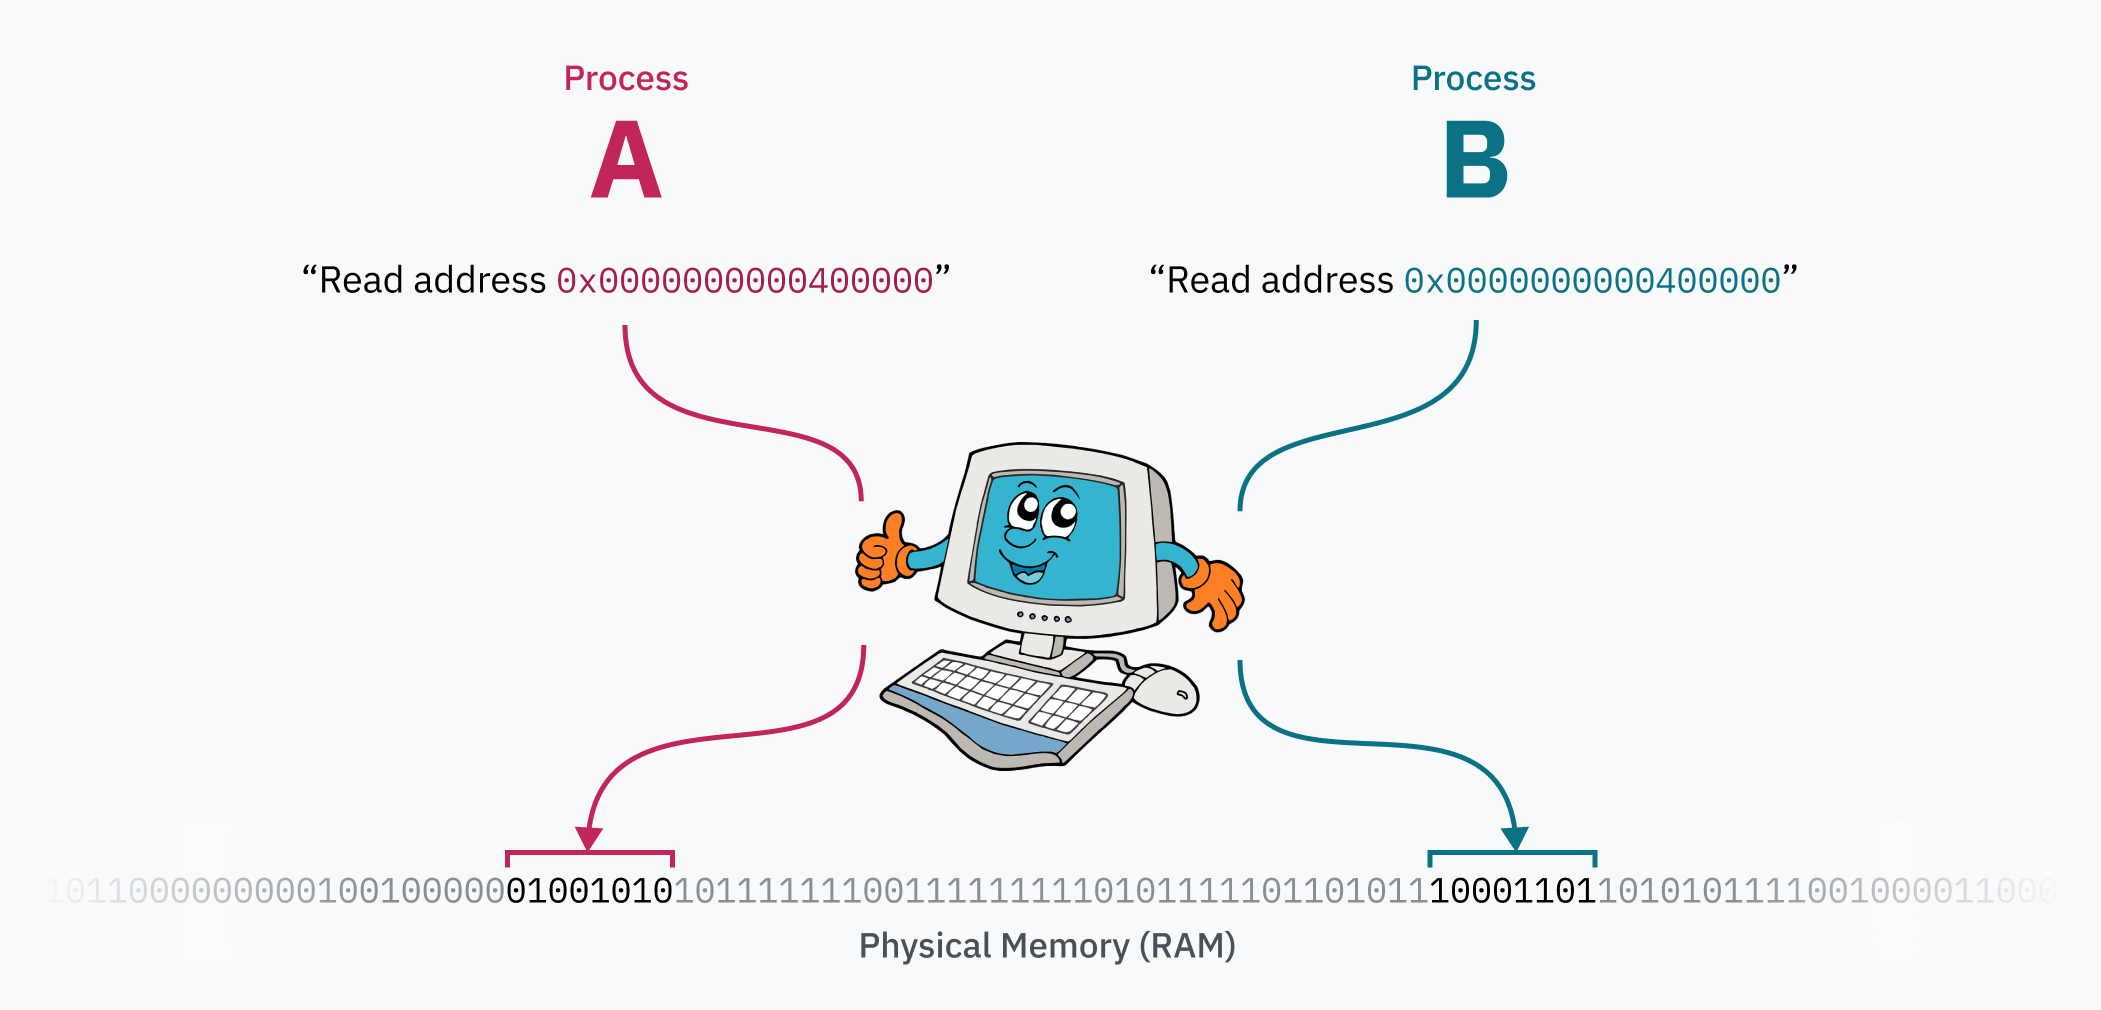
페이징 시스템의 마법은 컴퓨터가 실행되는 동안에도 페이지 테이블을 수정할 수 있다는 점입니다. 바로 이 방식으로 각 프로세스가 자신만의 격리된 메모리 공간을 가질 수 있습니다. 운영체제가 한 프로세스에서 다른 프로세스로 컨텍스트를 전환할 때 중요한 작업 중 하나는 가상 메모리 공간을 물리 메모리의 다른 영역으로 다시 매핑하는 것입니다. 프로세스가 두 개 있다고 가정해 봅시다. 프로세스 A는 자신의 코드와 데이터(아마도 ELF 파일에서 로드되었을 것입니다!)를 0x0000000000400000에 둘 수 있고, 프로세스 B도 정확히 같은 주소에서 자신의 코드와 데이터에 접근할 수 있습니다. 두 프로세스는 실제로 그 주소 범위를 두고 다투는 것이 아니므로, 심지어 같은 프로그램의 인스턴스일 수도 있습니다! 프로세스 A의 데이터는 물리 메모리에서 프로세스 B와 멀리 떨어진 어딘가에 있으며, 커널이 해당 프로세스로 전환할 때 0x0000000000400000에 매핑합니다.
여담: 저주받은 ELF 이야기
특정 상황에서 binfmt_elf는 메모리의 첫 번째 페이지를 0으로 매핑해야 합니다. ELF를 최초로 지원한 1988년의 운영체제인 UNIX System V Release 4.0(SVr4)용으로 작성된 일부 프로그램은 널 포인터를 읽을 수 있다는 점에 의존합니다. 그리고 어째서인지 아직도 그 동작에 의존하는 프로그램이 있습니다.
“왜 이런 짓을 하냐고요??? 글쎄요, SVr4는 페이지 0을 읽기 전용으로 매핑하고, 일부 애플리케이션이 이 동작에 ‘의존’합니다. 우리에게는 이 애플리케이션들을 다시 컴파일할 힘이 없으므로 SVr4의 동작을 에뮬레이션합니다. 하아.”
하아.
페이징을 통한 보안
메모리 페이징으로 가능해진 프로세스 격리는 코드 작성의 편의성을 높여 주지만(프로세스는 메모리를 사용하기 위해 다른 프로세스를 의식할 필요가 없습니다), 동시에 일정 수준의 보안도 제공합니다. 프로세스는 다른 프로세스의 메모리에 접근할 수 없습니다. 이것으로 이 글의 처음에 던졌던 질문 중 하나에 절반쯤 답할 수 있습니다:
프로그램이 CPU에서 직접 실행되고 CPU가 RAM에 직접 접근할 수 있다면, 왜 코드는 다른 프로세스의 메모리나, 맙소사, 커널의 메모리에 접근할 수 없습니까?
기억나십니까? 아주 오래전 일처럼 느껴집니다…
그렇다면 커널 메모리는 어떻습니까? 우선, 커널은 당연히 실행 중인 모든 프로세스와 페이지 테이블 자체까지 관리하기 위해 자체적으로 많은 데이터를 저장해야 합니다. 하드웨어 인터럽트, 소프트웨어 인터럽트 또는 시스템 호출이 발생하여 CPU가 커널 모드로 들어갈 때마다 커널 코드는 어떻게든 그 메모리에 접근해야 합니다.
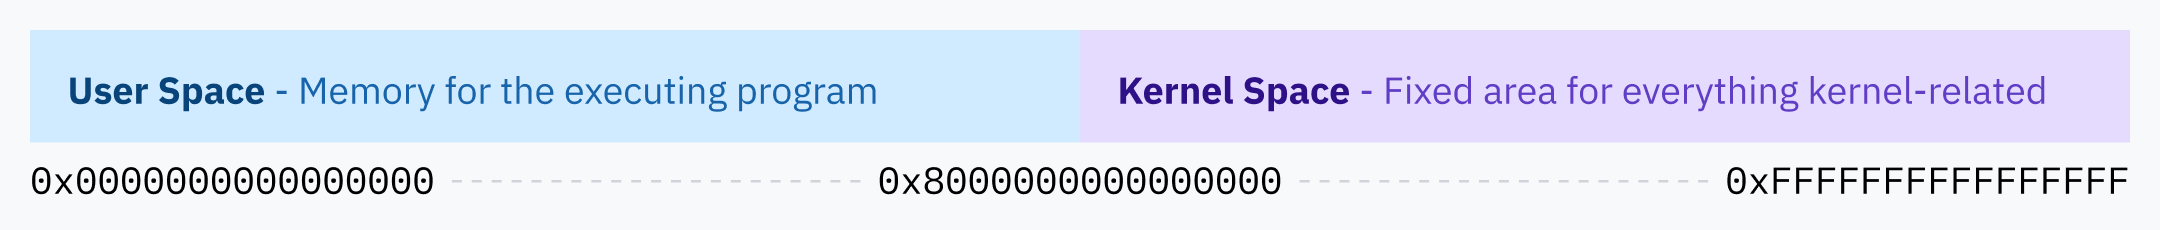
Linux의 해법은 가상 메모리 공간의 상위 절반을 항상 커널에 할당하는 것이며, 그래서 Linux를 상위 절반 커널(higher half kernel)이라고 부릅니다. Windows도 비슷한 기법을 사용하지만, macOS는… 조금더복잡해서 관련 자료를 읽다가 뇌가 귀로 흘러나오는 줄 알았습니다. ~(++)~
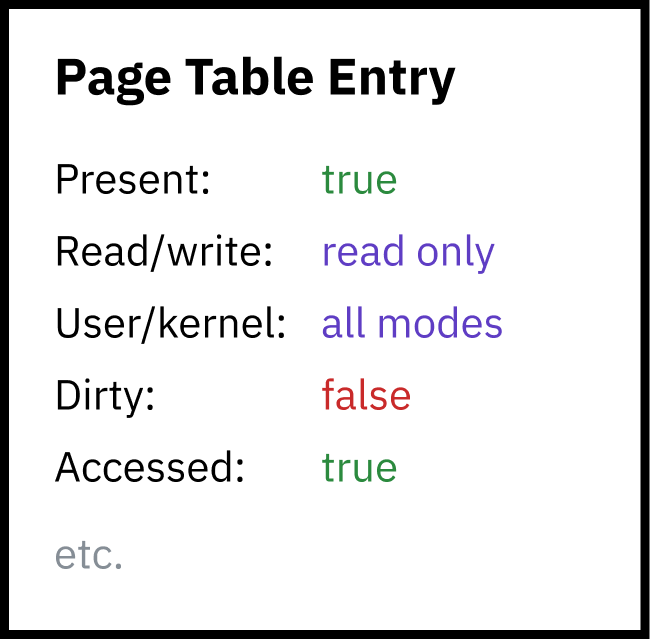
하지만 유저랜드 프로세스가 커널 메모리를 읽거나 쓸 수 있다면 보안상 끔찍한 일이 될 것이므로, 페이징은 두 번째 보안 계층을 제공합니다. 각 페이지에는 권한 플래그가 지정되어야 합니다. 한 플래그는 해당 영역이 쓰기 가능한지, 아니면 읽기만 가능한지를 결정합니다. 또 다른 플래그는 커널 모드에서만 해당 영역의 메모리에 접근할 수 있다고 CPU에 알려 줍니다. 이 후자의 플래그는 상위 절반의 커널 공간 전체를 보호하는 데 사용됩니다. 사실 커널 메모리 공간 전체가 사용자 공간 프로그램의 가상 메모리 매핑에 들어 있으며, 프로그램에는 거기에 접근할 권한이 없을 뿐입니다.
사실 페이지 테이블 자체도 커널 메모리 공간 안에 들어 있습니다! 타이머 칩이 프로세스 전환을 위해 하드웨어 인터럽트를 발생시키면, CPU는 권한 수준을 커널 모드로 전환하고 Linux 커널 코드로 점프합니다. 커널 모드(Intel 링 0)에 있으면 CPU는 커널이 보호하는 메모리 영역에 접근할 수 있습니다. 그러면 커널은 (메모리 상위 절반 어딘가에 있는) 페이지 테이블에 기록하여 새 프로세스를 위해 가상 메모리의 하위 절반을 다시 매핑할 수 있습니다. 커널이 새 프로세스로 전환하고 CPU가 사용자 모드에 진입하면, CPU는 더 이상 커널 메모리에 전혀 접근할 수 없습니다.
거의 모든 메모리 접근은 MMU를 거칩니다. 인터럽트 디스크립터 테이블의 핸들러 포인터는 어떻습니까? 그것들 역시 커널의 가상 메모리 공간에 있는 주소를 가리킵니다.
계층적 페이징과 기타 최적화
64비트 시스템의 메모리 주소는 64비트 길이이며, 이는 64비트 가상 메모리 공간의 크기가 무려 16엑스비바이트에 달한다는 뜻입니다. 이는 엄청나게 큰 크기로, 현재 존재하거나 가까운 미래에 존재할 어떤 컴퓨터보다도 훨씬 큽니다. 제가 아는 한, 역대 컴퓨터 중 가장 많은 RAM을 갖춘 것은 1.5페타바이트가 넘는 RAM을 탑재한 Blue Waters 슈퍼컴퓨터였습니다. 그래도 16 EiB의 0.01%에도 미치지 못합니다.
가상 메모리 공간의 4 KiB 구역마다 페이지 테이블 항목이 하나씩 필요하다면, 4,503,599,627,370,496개의 페이지 테이블 항목이 필요합니다. 페이지 테이블 항목이 8바이트 길이라면, 페이지 테이블 하나를 저장하는 데만 32페비바이트의 RAM이 필요합니다. 이 역시 컴퓨터 한 대에 탑재된 RAM의 세계 기록보다 크다는 점을 알아차리셨을 것입니다.
여담: 단위가 왜 이렇게 이상합니까?
흔하지 않고 정말 보기 흉하다는 것은 알지만, 저는 이진 바이트 크기 단위(2의 거듭제곱)와 미터법 단위(10의 거듭제곱)를 명확히 구분하는 것이 중요하다고 생각합니다. 킬로바이트(kB)는 1,000바이트를 뜻하는 SI 단위입니다. 키비바이트(KiB)는 1,024바이트를 뜻하는, IEC가 권장하는 단위입니다. 컴퓨터는 이진 시스템이므로, CPU와 메모리 주소에서 바이트 수는 보통 2의 거듭제곱입니다. KB(더 나쁘게는 kB)를 1,024라는 의미로 쓰면 더 모호해질 것입니다.
가능한 가상 메모리 공간 전체에 대해 연속된 페이지 테이블 항목을 두는 것은 불가능하기 때문에(적어도 대단히 비현실적이기 때문에), CPU 아키텍처는 계층적 페이징을 구현합니다. 계층적 페이징 시스템에는 단위가 점점 더 잘게 나뉘는 여러 단계의 페이지 테이블이 있습니다. 최상위 단계의 항목은 큰 메모리 블록을 담당하며 더 작은 블록의 페이지 테이블을 가리키고, 이렇게 해서 트리 구조를 이룹니다. 4 KiB 또는 페이지 크기가 얼마이든 그 크기의 블록에 대한 개별 항목이 트리의 잎이 됩니다.
x86-64는 전통적으로 4단계 계층적 페이징을 사용합니다. 이 체계에서 각 페이지 테이블 항목은 그 항목이 들어 있는 테이블의 시작 위치에 주소의 일부를 오프셋으로 더해 찾습니다. 이 일부는 최상위 비트부터 시작합니다. 이 비트들이 접두사 역할을 하므로 해당 항목은 그 비트들로 시작하는 모든 주소를 담당합니다. 항목은 해당 메모리 블록의 하위 트리를 담고 있는 다음 단계 테이블의 시작 위치를 가리키며, 이 하위 트리들은 다시 그다음 비트 묶음으로 인덱싱됩니다.
x86-64의 4단계 페이징 설계자들은 페이지 테이블 공간을 절약하기 위해 모든 가상 포인터의 상위 16비트를 무시하기로 하기도 했습니다. 48비트로는 128 TiB의 가상 주소 공간을 얻을 수 있으며, 이 정도면 충분히 크다고 판단했습니다. (64비트를 모두 사용하면 16 EiB가 되는데, 이는 꽤 많은 양입니다.)
처음 16비트를 건너뛰므로, 페이지 테이블의 첫 번째 단계를 인덱싱하는 “최상위 비트”는 실제로 63번 비트가 아니라 47번 비트부터 시작합니다. 이는 또한 이 장 앞부분의 상위 절반 커널 다이어그램이 엄밀히 말해 부정확했다는 뜻이기도 합니다. 커널 공간의 시작 주소는 64비트보다 작은 주소 공간의 중간 지점으로 표시했어야 합니다.
계층적 페이징은 트리의 어느 단계에서든 다음 항목을 가리키는 포인터가 null(0x0)일 수 있으므로 공간 문제를 해결합니다. 이 덕분에 페이지 테이블의 하위 트리 전체를 생략할 수 있으며, 이는 가상 메모리 공간에서 매핑되지 않은 영역이 RAM의 공간을 전혀 차지하지 않는다는 뜻입니다. CPU는 트리의 상위 단계에서 빈 항목을 발견하는 즉시 오류를 낼 수 있으므로, 매핑되지 않은 메모리 주소에 대한 조회는 빠르게 실패할 수 있습니다. 페이지 테이블 항목에는 존재 플래그도 있어서, 주소가 유효해 보이더라도 해당 항목을 사용할 수 없다고 표시하는 데 쓸 수 있습니다.
계층적 페이징의 또 다른 장점은 가상 메모리 공간의 큰 부분을 효율적으로 교체할 수 있다는 것입니다. 가상 메모리의 넓은 영역이 어떤 프로세스에서는 물리 메모리의 한 영역에, 다른 프로세스에서는 또 다른 영역에 매핑될 수 있습니다. 커널은 두 매핑을 모두 메모리에 저장해 두고, 프로세스를 전환할 때 트리 최상위 단계의 포인터만 갱신하면 됩니다. 전체 메모리 공간 매핑이 평평한 항목 배열로 저장되어 있다면 커널은 많은 항목을 갱신해야 할 것입니다. 이는 느릴 뿐 아니라, 여전히 각 프로세스의 메모리 매핑을 별도로 추적해야 합니다.
제가 x86-64가 “전통적으로” 4단계 페이징을 사용한다고 말한 이유는 최근 프로세서들이 5단계 페이징을 구현하기 때문입니다. 5단계 페이징은 간접 참조 단계를 하나 더 추가하고 주소 지정 비트를 9개 더 늘려, 57비트 주소로 주소 공간을 128 PiB까지 확장합니다. 5단계 페이징은 2017년부터 이를 지원한 Linux를 비롯해 최신 Windows 10 및 11 서버 버전 등의 운영체제에서 지원됩니다.
여담: 물리 주소 공간의 한계
운영체제가 가상 주소에 64비트를 모두 사용하지 않는 것처럼, 프로세서도 64비트 물리 주소 전체를 사용하지 않습니다. 4단계 페이징이 표준이던 시절에 x86-64 CPU는 46비트를 넘게 사용하지 않았으며, 이는 물리 주소 공간이 64 TiB로 제한되었다는 뜻입니다. 5단계 페이징에서는 지원 범위가 52비트로 확장되어 4 PiB의 물리 주소 공간을 지원합니다.
운영체제 수준에서는 가상 주소 공간이 물리 주소 공간보다 큰 것이 유리합니다. Linus Torvalds가 말했듯이, “[가상 주소 공간은] 더 커야 합니다. 최소한 두 배는 되어야 하는데, 솔직히 그것도 빠듯하고, 열 배 이상이면 훨씬 낫습니다. 이걸 이해하지 못하는 사람은 멍청이입니다. 논의는 여기서 끝입니다.”
스와핑과 요구 페이징
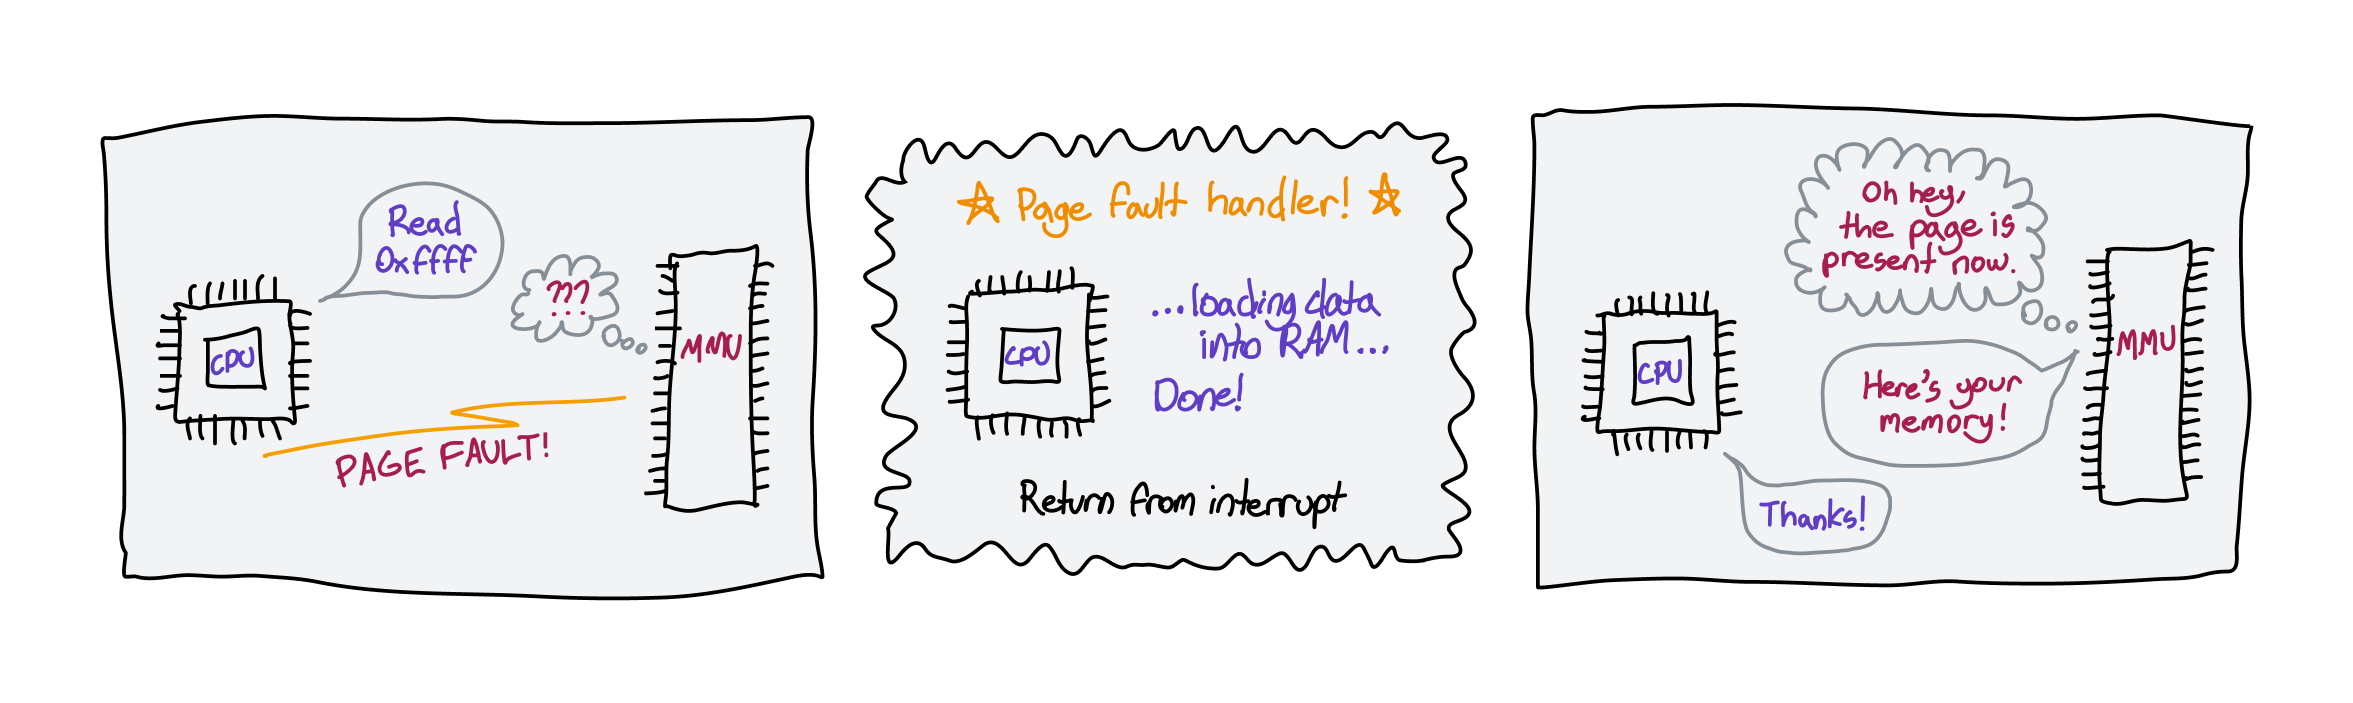
메모리 접근은 몇 가지 이유로 실패할 수 있습니다. 주소가 범위를 벗어났을 수도 있고, 페이지 테이블에 매핑되지 않았을 수도 있으며, 존재하지 않는 것으로 표시된 항목을 가지고 있을 수도 있습니다. 이 중 어떤 경우든 MMU는 페이지 폴트라는 하드웨어 인터럽트를 발생시켜 커널이 문제를 처리하게 합니다.
어떤 경우에는 읽기가 정말로 유효하지 않거나 금지된 것입니다. 이런 경우 커널은 아마 세그멘테이션 폴트 오류와 함께 프로그램을 종료할 것입니다.
셸 세션
$ ./programSegmentation fault (core dumped)$
여담: 세그폴트의 존재론
“세그멘테이션 폴트”는 맥락에 따라 다른 의미를 가집니다. MMU는 권한 없이 메모리를 읽을 때 “세그멘테이션 폴트”라는 하드웨어 인터럽트를 발생시키지만, “세그멘테이션 폴트”는 운영체제가 모든 종류의 불법적인 메모리 접근을 이유로 실행 중인 프로그램을 종료하기 위해 보낼 수 있는 시그널의 이름이기도 합니다.
다른 경우에는 메모리 접근이 의도적으로 실패하도록 하여, 운영체제가 메모리를 채운 뒤 CPU에 제어권을 다시 넘겨 재시도하게 할 수 있습니다. 예를 들어, 운영체제는 디스크에 있는 파일을 실제로 RAM에 적재하지 않은 채 가상 메모리에 매핑해 두었다가, 해당 주소가 요청되어 페이지 폴트가 발생하면 그때 물리 메모리에 적재할 수 있습니다. 이를 요구 페이징(demand paging)이라고 합니다.
우선, 이 덕분에 디스크의 파일 전체를 가상 메모리에 지연 매핑하는 mmap 같은 시스템 호출이 존재할 수 있습니다. 유출된 Facebook 언어 모델의 런타임인 LLaMa.cpp를 알고 계신다면, 최근 Justine Tunney가 모든 로딩 로직이 mmap을 사용하도록 만들어 이를 크게 최적화했다는 소식도 들으셨을 것입니다. (그녀에 대해 처음 들어 보셨다면 그녀의 작업물을 살펴보십시오! Cosmopolitan Libc와 APE는 정말 멋지며, 이 글을 재미있게 읽고 계신다면 흥미롭게 느끼실 것입니다.)
보아하니 이 변경에 Justine이 관여한 것을 두고 많은논란이있는 듯합니다. 인터넷의 낯선 사용자들에게 욕을 먹지 않으려고 짚어 두는 것뿐입니다. 고백하자면 저는 그 논란의 대부분을 읽어 보지 않았으며, Justine의 작업물이 멋지다고 했던 제 말은 여전히 전적으로 사실입니다.
프로그램과 그 라이브러리를 실행할 때, 커널은 실제로 아무것도 메모리에 적재하지 않습니다. 커널은 해당 파일의 mmap을 생성할 뿐이며, CPU가 코드를 실행하려 하면 즉시 페이지 폴트가 발생하고 커널이 그 페이지를 실제 메모리 블록으로 교체합니다.
요구 페이징은 여러분이 아마 “스와핑(swapping)” 또는 “페이징(paging)“이라는 이름으로 접해 보셨을 기법도 가능하게 합니다. 운영체제는 메모리 페이지를 디스크에 기록한 뒤 물리 메모리에서는 제거하되, present 플래그를 0으로 설정한 채 가상 메모리에는 남겨 둠으로써 물리 메모리를 확보할 수 있습니다. 그 가상 메모리를 읽으려 하면, 운영체제는 디스크에서 RAM으로 메모리를 복원하고 present 플래그를 다시 1로 설정할 수 있습니다. 운영체제는 디스크에서 적재되는 메모리를 위한 공간을 마련하기 위해 RAM의 다른 영역을 스왑해야 할 수도 있습니다. 디스크 읽기와 쓰기는 느리기 때문에, 운영체제는 효율적인 페이지 교체 알고리즘을 사용하여 스와핑이 최대한 적게 일어나도록 합니다.
흥미로운 꼼수 하나는 페이지 테이블의 물리 메모리 포인터를 사용하여 물리 저장 장치 내 파일의 위치를 저장하는 것입니다. MMU는 present 플래그가 0인 것을 보는 즉시 페이지 폴트를 일으키므로, 그 값이 유효하지 않은 메모리 주소라는 것은 문제가 되지 않습니다. 모든 경우에 실용적인 방법은 아니지만, 생각해 보면 재미있습니다.
6장: 포크와 소에 대해 이야기해 봅시다
마지막 질문입니다. 우리는 어떻게 여기까지 왔습니까? 최초의 프로세스는 어디에서 오는 것입니까?
이 글도 거의 끝나갑니다. 이제 마지막 구간에 들어섰습니다. 곧 홈런을 칠 참입니다. 더 푸른 초원으로 나아가는 중입니다. 그 밖에도 온갖 끔찍한 관용구가 있지만, 모두 여러분이 6장 분량 하나만 더 읽으면 밖에 나가 풀을 만지거나, CPU 아키텍처에 관한 15,000단어짜리 글을 읽지 않을 때 하는 무언가를 하러 갈 수 있다는 뜻입니다.
execve가 현재 프로세스를 대체하여 새 프로그램을 시작한다면, 새 프로그램을 새 프로세스에서 따로 시작하려면 어떻게 해야 합니까? 컴퓨터에서 여러 가지 일을 하고 싶다면 이는 꽤 중요한 능력입니다. 앱을 더블 클릭해 실행하면 그 앱은 따로 열리고, 이전에 사용하던 프로그램은 계속 실행됩니다.
답은 또 다른 시스템 호출인 fork이며, 모든 멀티프로세싱의 근간이 되는 시스템 호출입니다. fork는 사실 꽤 단순합니다. 현재 프로세스와 그 메모리를 복제하고, 저장된 명령어 포인터는 원래 위치에 그대로 둔 다음, 두 프로세스가 평소처럼 계속 진행하도록 합니다. 아무런 개입이 없으면 두 프로그램은 서로 독립적으로 계속 실행되며, 모든 연산이 두 배가 됩니다.
새로 실행되는 프로세스를 “자식”이라 하고, 원래 fork를 호출한 프로세스를 “부모”라고 합니다. 프로세스는 fork를 여러 번 호출할 수 있으므로 자식을 여러 개 가질 수 있습니다. 각 자식에는 1부터 시작하는 프로세스 ID(PID)가 번호로 매겨집니다.
같은 코드를 아무 생각 없이 두 배로 실행하는 것은 별 쓸모가 없으므로, fork는 부모와 자식에서 서로 다른 값을 반환합니다. 부모에서는 새 자식 프로세스의 PID를 반환하고, 자식에서는 0을 반환합니다. 이 덕분에 새 프로세스에서 다른 작업을 할 수 있어 포크가 실제로 쓸모 있게 됩니다.
main.c
pid_t pid = fork();// Code continues from this point as usual, but now across// two "identical" processes.//// Identical... except for the PID returned from fork!//// This is the only indicator to either program that they// are not one of a kind.if (pid == 0) { // We're in the child. // Do some computation and feed results to the parent!} else { // We're in the parent. // Probably continue whatever we were doing before.}
프로세스 포크는 이해하기가 조금 어려울 수 있습니다. 지금부터는 여러분이 이해했다고 가정하겠습니다. 아직 이해하지 못했다면 꽤 괜찮은 설명이 있는 이 끔찍하게 생긴 웹사이트를 확인해 보십시오.
어쨌든 유닉스 프로그램은 fork를 호출한 다음 자식 프로세스에서 곧바로 execve를 실행하는 방식으로 새 프로그램을 시작합니다. 이를 fork-exec 패턴이라고 합니다. 프로그램을 실행하면 컴퓨터는 다음과 비슷한 코드를 실행합니다.
launcher.c
pid_t pid = fork();if (pid == 0) { // Immediately replace the child process with the new program. execve(...);}// Since we got here, the process didn't get replaced. We're in the parent!// Helpfully, we also now have the PID of the new child process in the PID// variable, if we ever need to kill it.// Parent program continues here...
음메에에에!
프로세스의 메모리를 복제해 놓고 다른 프로그램을 불러올 때 곧바로 전부 버리는 것은 조금 비효율적으로 들린다는 점을 눈치채셨을지도 모릅니다. 다행히도 우리에게는 MMU가 있습니다. 느린 부분은 페이지 테이블 복제가 아니라 물리 메모리의 데이터 복제이므로, 우리는 RAM을 아예 복제하지 않습니다. 대신 새 프로세스를 위해 기존 프로세스의 페이지 테이블 사본을 만들고, 매핑은 그대로 같은 물리 메모리를 가리키도록 둡니다.
하지만 자식 프로세스는 부모로부터 독립되고 격리되어야 합니다! 자식이 부모의 메모리에 쓰거나 그 반대가 되어서는 안 됩니다!
COW(copy on write) 페이지를 소개합니다. COW 페이지를 사용하면 두 프로세스는 메모리에 쓰기를 시도하지 않는 한 같은 물리 주소에서 읽습니다. 둘 중 하나가 메모리에 쓰려고 하는 순간 해당 페이지가 RAM에 복사됩니다. COW 페이지 덕분에 두 프로세스는 전체 메모리 공간을 미리 복제하는 비용 없이도 메모리 격리를 누릴 수 있습니다. fork-exec 패턴이 효율적인 이유가 바로 이것입니다. 새 바이너리를 로드하기 전까지 이전 프로세스의 메모리에는 아무것도 쓰이지 않으므로 메모리를 복사할 필요가 전혀 없습니다.
다른 여러 재미있는 기능처럼 COW도 페이징 꼼수와 하드웨어 인터럽트 처리로 구현됩니다. fork는 부모를 복제한 뒤 두 프로세스의 모든 페이지를 읽기 전용으로 표시합니다. 프로그램이 메모리에 쓰면 해당 메모리가 읽기 전용이기 때문에 쓰기가 실패합니다. 그러면 세그폴트(하드웨어 인터럽트 쪽의 세그폴트)가 발생하고, 이를 커널이 처리합니다. 커널은 메모리를 복제하고, 쓰기가 가능하도록 페이지를 갱신한 다음, 인터럽트에서 복귀하여 쓰기를 다시 시도합니다.
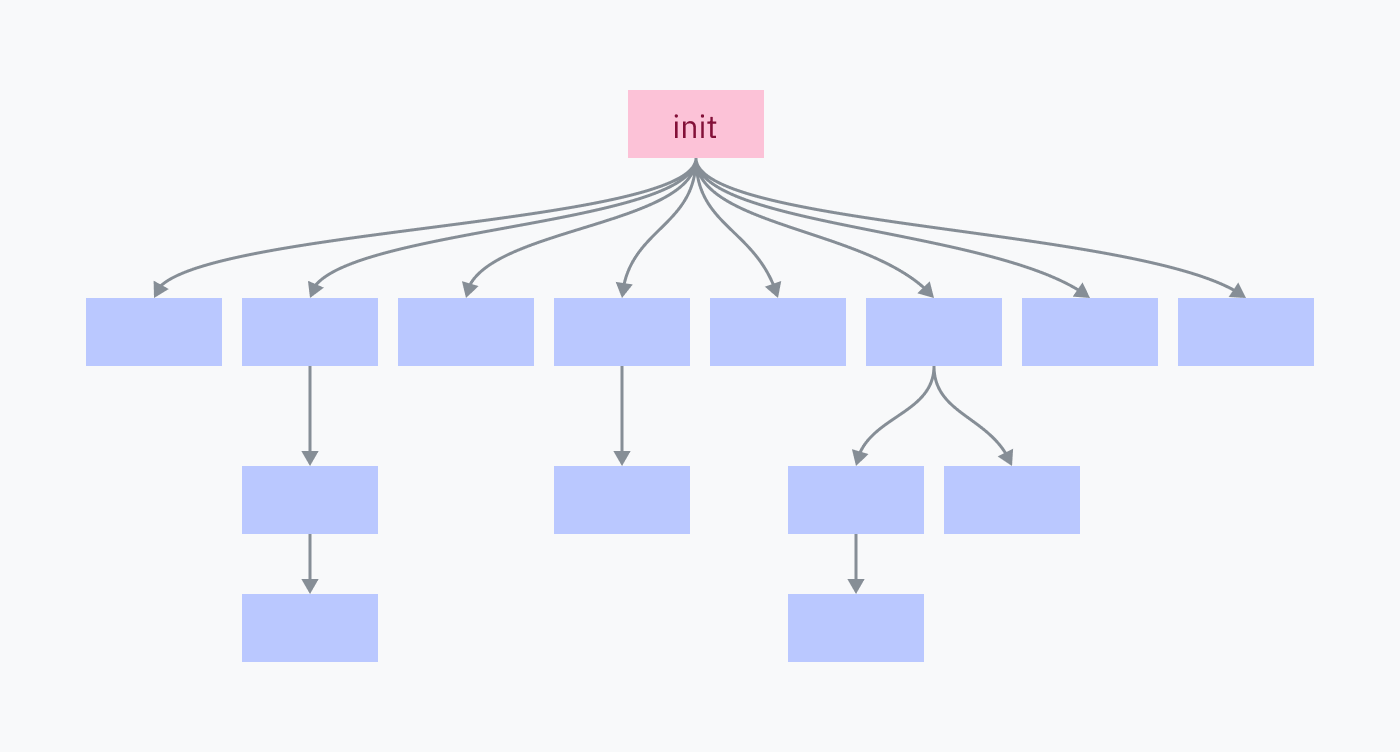
여러분 컴퓨터의 모든 프로세스는 부모 프로그램이 fork-exec한 것입니다. 단 하나, init 프로세스만 예외입니다. init 프로세스는 커널이 직접 수동으로 설정합니다. init 프로세스는 가장 먼저 실행되는 유저랜드 프로그램이자 시스템 종료 시 가장 마지막에 종료되는 프로그램입니다.
순식간에 화면이 까맣게 변하는 멋진 광경을 보고 싶으십니까? macOS나 Linux를 사용 중이라면 작업을 저장하고 터미널을 연 뒤 init 프로세스(PID 1)를 종료해 보십시오:
셸 세션
$ sudo kill 1
저자 주: 안타깝게도 init 프로세스에 관한 지식은 macOS나 Linux 같은 유닉스 계열 시스템에만 적용됩니다. 지금부터 배우는 내용 대부분은 커널 아키텍처가 매우 다른 Windows를 이해하는 데에는 적용되지 않습니다.
execve 절에서와 마찬가지로 이 점을 분명히 짚고 넘어갑니다 — NT 커널에 대해서도 글 한 편을 통째로 쓸 수 있지만 꾹 참고 있습니다. (적어도 지금은 말입니다.)
init 프로세스는 운영체제를 구성하는 모든 프로그램과 서비스를 생성하는 역할을 합니다. 그중 다수는 다시 자신만의 서비스와 프로그램을 생성합니다.
init 프로세스를 종료하면 그 자식들과 자식들의 자식들까지 모두 종료되어 OS 환경이 꺼집니다.
다시 커널로
3장에서 Linux 커널 코드를 살펴보는 일이 무척 재미있었으니, 이번에도 조금 더 살펴보겠습니다! 이번에는 커널이 init 프로세스를 어떻게 시작하는지 살펴보는 것으로 시작하겠습니다.
컴퓨터는 다음과 같은 순서로 부팅됩니다:
메인보드에는 연결된 디스크에서 부트로더라는 프로그램을 찾는 작은 소프트웨어가 함께 탑재되어 있습니다. 이 소프트웨어는 부트로더를 하나 골라 그 기계어 코드를 RAM에 적재한 뒤 실행합니다.
아직은 운영체제가 실행 중인 세계에 들어선 것이 아니라는 점을 기억하십시오. 운영체제 커널이 init 프로세스를 시작하기 전까지는 멀티프로세싱도 시스템 호출도 사실상 존재하지 않습니다. init 이전의 맥락에서 프로그램을 “실행”한다는 것은 돌아올 것을 기대하지 않고 RAM에 있는 그 프로그램의 기계어 코드로 곧바로 점프한다는 뜻입니다.
부트로더는 커널을 찾아 RAM에 적재하고 실행하는 일을 담당합니다. GRUB 같은 일부 부트로더는 설정을 바꿀 수 있거나 여러 운영체제 중 하나를 선택할 수 있게 해 줍니다. BootX와 Windows Boot Manager는 각각 macOS와 Windows에 내장된 부트로더입니다.
이제 커널이 실행되어 인터럽트 핸들러 설정, 드라이버 적재, 초기 메모리 매핑 생성 등 방대한 초기화 작업을 시작합니다. 마지막으로 커널은 권한 수준을 사용자 모드로 전환하고 init 프로그램을 시작합니다.
드디어 운영체제의 유저랜드에 들어왔습니다! init 프로그램은 init 스크립트를 실행하고, 서비스를 시작하고, 셸/UI 같은 프로그램을 실행하기 시작합니다.
Linux 초기화하기
리눅스에서 3단계(커널 초기화)의 대부분은 init/main.c의 start_kernel 함수에서 이루어집니다. 이 함수는 다른 여러 init 함수를 호출하는 코드가 200줄을 넘기 때문에 이 글에 전체 내용을 싣지는 않겠지만, 한번 훑어보시기를 권합니다! start_kernel의 끝에서는 arch_call_rest_init라는 함수가 호출됩니다:
	/* Do the rest non-__init'ed, we're now alive */
	arch_call_rest_init();
non-__init’ed란 무슨 뜻입니까?
start_kernel 함수는 asmlinkage __visible void __init __no_sanitize_address start_kernel(void)로 정의되어 있습니다. __visible, __init, __no_sanitize_address 같은 이상한 키워드는 모두 Linux 커널에서 함수에 여러 코드나 동작을 덧붙이는 데 쓰이는 C 전처리기 매크로입니다.
여기서 __init은 단지 공간을 절약하기 위해, 부팅 과정이 끝나는 즉시 해당 함수와 그 데이터를 메모리에서 해제하도록 커널에 지시하는 매크로입니다.
이것은 어떻게 동작하는 것입니까? 너무 세세한 부분까지 들어가지 않고 말하자면, Linux 커널 자체도 ELF 파일로 패키징되어 있습니다. __init 매크로는 __section(".init.text")로 확장되는데, 이는 코드를 일반적인 .text 섹션 대신 .init.text라는 섹션에 배치하도록 하는 컴파일러 지시문입니다. __section(".init.data")로 확장되는 __initdata처럼, 데이터와 상수를 특별한 init 섹션에 배치할 수 있게 해 주는 다른 매크로들도 있습니다.
	/*
	 * We need to spawn init first so that it obtains pid 1, however
	 * the init task will end up wanting to create kthreads, which, if
	 * we schedule it before we create kthreadd, will OOPS.
	 */
	pid = user_mode_thread(kernel_init, NULL, CLONE_FS);
user_mode_thread에 전달되는 kernel_init 매개변수는 몇 가지 초기화 작업을 마친 뒤 유효한 init 프로그램을 찾아 실행하는 함수입니다. 이 과정은 몇 가지 기본 설정 작업으로 시작합니다. free_initmem이 호출되는 부분을 제외하면 대부분은 건너뛰겠습니다. 바로 여기서 커널이 .init 섹션을 해제합니다!
	/*
	 * We try each of these until one succeeds.
	 *
	 * The Bourne shell can be used instead of init if we are
	 * trying to recover a really broken machine.
	 */
	if (execute_command) {
		ret = run_init_process(execute_command);
		if (!ret)
			return 0;
		panic("Requested init %s failed (error %d).",
		      execute_command, ret);
	}

	if (CONFIG_DEFAULT_INIT[0] != '\0') {
		ret = run_init_process(CONFIG_DEFAULT_INIT);
		if (ret)
			pr_err("Default init %s failed (error %d)\n",
			       CONFIG_DEFAULT_INIT, ret);
		else
			return 0;
	}

	if (!try_to_run_init_process("/sbin/init") ||
	    !try_to_run_init_process("/etc/init") ||
	    !try_to_run_init_process("/bin/init") ||
	    !try_to_run_init_process("/bin/sh"))
		return 0;

	panic("No working init found.  Try passing init= option to kernel. "
	      "See Linux Documentation/admin-guide/init.rst for guidance.");
Linux에서 init 프로그램은 거의 항상 /sbin/init에 있거나 그곳으로 심볼릭 링크되어 있습니다. 흔히 쓰이는 init으로는 systemd(웹사이트가 유난히 훌륭합니다), OpenRC, runit 등이 있습니다. kernel_init은 다른 것을 전혀 찾지 못하면 기본값으로 /bin/sh를 사용하며, /bin/sh마저 찾지 못한다면 무언가가 끔찍하게 잘못된 것입니다.
MacOS에도 init 프로그램이 있습니다! 이름은 launchd이며 /sbin/launchd에 있습니다. 터미널에서 실행해 보십시오. 커널이 아니라고 혼날 것입니다.
이 시점부터는 부팅 과정의 4단계에 해당합니다: init 프로세스가 유저랜드에서 실행되며 fork-exec 패턴을 사용해 다양한 프로그램을 실행하기 시작합니다.
Fork 메모리 매핑
프로세스를 fork할 때 Linux 커널이 메모리의 하위 절반을 어떻게 다시 매핑하는지 궁금해서 조금 뒤져 보았습니다. 프로세스 fork 코드의 대부분은 kernel/fork.c에 들어 있는 것으로 보입니다. 고맙게도 그 파일의 앞부분이 어디를 봐야 하는지 알려 주었습니다:
/*
 *  'fork.c' contains the help-routines for the 'fork' system call
 * (see also entry.S and others).
 * Fork is rather simple, once you get the hang of it, but the memory
 * management can be a bitch. See 'mm/memory.c': 'copy_page_range()'
 */
이 copy_page_range 함수는 메모리 매핑에 관한 정보를 받아 페이지 테이블을 복사하는 것으로 보입니다. 이 함수가 호출하는 함수들을 빠르게 훑어보면, 페이지를 읽기 전용으로 설정해 COW 페이지로 만드는 곳도 바로 여기입니다. 이 작업을 해야 하는지는 is_cow_mapping이라는 함수를 호출해 확인합니다.
is_cow_mapping은 include/linux/mm.h에 정의되어 있으며, 메모리 매핑에 해당 메모리가 쓰기 가능하고 프로세스 간에 공유되지 않음을 나타내는 플래그가 있으면 true를 반환합니다. 공유 메모리는 애초에 공유되도록 설계되었으므로 COW를 적용할 필요가 없습니다. 약간 이해하기 어려운 비트마스킹을 감상해 보십시오:
kernel/fork.c로 돌아가서 copy_page_range를 Command-F로 간단히 검색해 보면 dup_mmap 함수에서 한 번 호출된다는 것을 알 수 있습니다… 이 함수는 다시 dup_mm에서 호출되고… 그것은 copy_mm에서 호출되며… 그것은 마지막으로 거대한 copy_process 함수에서 호출됩니다! copy_process는 fork 함수의 핵심이자, 어떤 의미에서는 Unix 시스템이 프로그램을 실행하는 방식의 중심입니다. 부팅 시 첫 번째 프로세스를 위해 만들어진 템플릿을 언제나 복사하고 수정하는 방식이기 때문입니다.
요약하자면…
그래서… 프로그램은 어떻게 실행됩니까?
가장 낮은 수준에서 보면 프로세서는 멍청합니다. 프로세서는 메모리를 가리키는 포인터를 하나 가지고 있으며, 다른 곳으로 점프하라는 명령어를 만나지 않는 한 명령어를 차례대로 실행합니다.
점프 명령어 외에도 하드웨어 인터럽트와 소프트웨어 인터럽트가 미리 정해진 위치로 점프하여 실행 순서를 끊을 수 있으며, 그 위치에서 다시 어디로 점프할지 정할 수 있습니다. 프로세서 코어는 여러 프로그램을 동시에 실행할 수 없지만, 타이머로 인터럽트를 반복해서 발생시키고 커널 코드가 서로 다른 코드 포인터 사이를 전환하도록 하면 이를 흉내 낼 수 있습니다.
프로그램은 자신이 일관되고 격리된 단위로 실행되고 있다고 속아서 믿습니다. 사용자 모드에서는 시스템 자원에 직접 접근할 수 없고, 메모리 공간은 페이징으로 격리되며, 시스템 호출은 실제 실행 환경을 자세히 알지 못해도 일반적인 I/O에 접근할 수 있도록 설계되어 있습니다. 시스템 호출은 CPU에 커널 코드를 실행해 달라고 요청하는 명령어이며, 그 커널 코드의 위치는 시작 시 커널이 설정합니다.
그런데… 프로그램은 어떻게 실행됩니까?
컴퓨터가 부팅된 후 커널은 init 프로세스를 실행합니다. 이것은 더 높은 추상화 수준에서 실행되는 첫 번째 프로그램이며, 이 수준에서는 기계어 코드가 구체적인 시스템 세부 사항을 많이 신경 쓸 필요가 없습니다. init 프로그램은 컴퓨터의 그래픽 환경을 렌더링하고 다른 소프트웨어의 실행을 담당하는 프로그램들을 실행합니다.
프로그램을 실행하기 위해 init은 fork 시스템 호출로 자기 자신을 복제합니다. 모든 메모리 페이지가 COW이므로 물리 RAM 안에서 메모리를 복사할 필요가 없어 이 복제는 효율적입니다. Linux에서는 copy_process 함수가 바로 이 일을 합니다.
두 프로세스는 각각 자신이 fork된 프로세스인지 확인합니다. fork된 프로세스라면 exec 시스템 호출을 사용해 현재 프로세스를 새 프로그램으로 교체해 달라고 커널에 요청합니다.
새 프로그램은 ELF 파일일 가능성이 높으며, 커널은 이 파일을 파싱하여 프로그램을 어떻게 로드할지, 그리고 새 가상 메모리 매핑 안에서 코드와 데이터를 어디에 배치할지에 관한 정보를 찾습니다. 프로그램이 동적으로 링크되어 있다면 커널은 ELF 인터프리터도 준비할 수 있습니다.
그런 다음 커널은 프로그램의 가상 메모리 매핑을 로드하고 프로그램이 실행되는 상태로 유저랜드에 복귀할 수 있는데, 이는 실제로는 CPU의 명령어 포인터를 가상 메모리에 있는 새 프로그램 코드의 시작 지점으로 설정한다는 뜻입니다.
7장: 에필로그
축하합니다! 이제 우리는 CPU 속에 “여러분”을 확실히 새겨 넣었습니다. 즐거운 시간이 되셨기를 바랍니다.
여러분이 방금 얻은 모든 지식이 실재하며 지금도 실제로 작동하고 있다는 점을 다시 한번 강조하며 여러분을 떠나보내겠습니다. 다음에 컴퓨터가 어떻게 여러 앱을 동시에 실행하고 있는지 생각하게 된다면, 타이머 칩과 하드웨어 인터럽트를 떠올리시기 바랍니다. 어떤 멋진 프로그래밍 언어로 프로그램을 작성하다가 링커 오류를 만나면, 그 링커가 무엇을 하려는 것인지 생각해 보시기 바랍니다.
직접 저수준 프로그래밍을 해 보셨다면 아마 스택과 힙이 무엇인지 알고 계실 것이고, malloc도 사용해 보셨을 것입니다. 하지만 그것들이 어떻게 구현되어 있는지는 깊이 생각해 보지 않으셨을 수도 있습니다!
먼저, 스레드의 스택은 가상 메모리의 높은 주소 어딘가에 매핑된 고정 크기의 메모리입니다. 대부분의(전부는 아니지만) 아키텍처에서 스택 포인터는 스택 메모리의 맨 위에서 시작하며, 스택이 커질수록 아래쪽으로 이동합니다. 매핑된 스택 공간 전체에 대해 물리 메모리를 미리 할당하지는 않습니다. 대신 요구 페이징을 사용하여 스택 프레임에 도달할 때마다 메모리를 지연 할당합니다.
malloc 같은 힙 할당 함수가 시스템 호출이 아니라는 사실을 들으면 놀라실 수도 있습니다. 대신 힙 메모리 관리는 libc 구현이 제공합니다! malloc, free 등은 복잡한 프로시저이며, libc는 메모리 매핑의 세부 사항을 직접 추적합니다. 내부적으로 유저랜드 힙 할당자는 mmap(파일 외의 것도 매핑할 수 있습니다)과 sbrk를 비롯한 시스템 호출을 사용합니다.
보너스: 소소한 이야기
이 내용들을 넣을 만한 적당한 자리를 찾지 못했지만 재미있다고 생각해서 여기에 실었습니다.
대부분의 Linux 사용자는 아마도 커널에서 페이지 테이블이 어떻게 표현되는지 상상하는 데 시간을 거의 쓰지 않을 만큼 충분히 흥미로운 삶을 살고 있을 것입니다.
참고로 일부 시스템 호출은 커널 공간으로 점프하는 대신 vDSO라는 기법을 사용합니다. 이에 대해 이야기할 시간은 없었지만, 꽤 흥미로운 내용이니 한번찾아읽어 보시기를 권합니다.
마지막으로, 유닉스 편향이라는 지적에 대해 말씀드리겠습니다. 실행과 관련된 내용 중 상당 부분이 유닉스에 매우 특화되어 있다는 점은 저도 정말 미안하게 생각합니다. macOS나 Linux 사용자라면 문제없지만, CPU 아키텍처에 관한 내용은 모두 같더라도 Windows가 프로그램을 실행하거나 시스템 호출을 처리하는 방식을 이해하는 데에는 그다지 도움이 되지 않을 것입니다. 언젠가 Windows 세계를 다루는 글도 꼭 써 보고 싶습니다.
감사의 말
이 글을 쓰는 동안 GPT-3.5, GPT-4와 꽤 많은 대화를 나눴습니다. 거짓말을 많이 했고 정보도 대부분 쓸모없었지만, 문제를 풀어 나갈 때는 가끔 큰 도움이 되었습니다. LLM의 한계를 알고 LLM이 하는 모든 말을 극도로 의심한다면, LLM의 도움은 전체적으로 보아 이득이 될 수 있습니다. 그렇긴 하지만 LLM은 글쓰기에는 형편없습니다. LLM에게 글을 대신 쓰게 하지 마십시오.
무엇보다도 제 글을 교정해 주고, 격려해 주고, 함께 브레인스토밍해 준 모든 분께 감사드립니다. 특히 Ani, B, Ben, Caleb, Kara, polypixeldev, Pradyun, Spencer, Nicky(4장의 멋진 엘프를 그려 주었습니다), 그리고 사랑하는 부모님께 감사드립니다.
컴퓨터를 좋아하는 십 대인데 아직 Hack Club Slack에 들어오지 않았다면 지금 바로 가입하십시오. 제 생각과 진행 상황을 나눌 멋진 사람들의 커뮤니티가 없었다면 저는 이 글을 쓰지 못했을 것입니다. 십 대가 아니라면 저희가 계속 멋진 일을 할 수 있도록 후원해 주십시오.