다음 글의 일부입니다: Putting the “You” in CPU: 컴퓨터가 프로그램을 실행하는 방식이라는 토끼굴로 깊이 빠져드는 여정입니다.
4장: 엘프 군주 되기 GitHub에서 편집하기
이제 우리는 execve를 꽤 철저하게 이해했습니다. 대부분의 경로 끝에서 커널은 실행할 기계어 코드가 담긴 최종 프로그램에 도달하게 됩니다. 일반적으로 실제로 코드로 점프하기 전에 준비 과정이 필요합니다. 예를 들어 프로그램의 여러 부분을 메모리의 올바른 위치에 적재해야 합니다. 프로그램마다 용도별로 필요한 메모리의 양이 다르므로, 프로그램을 실행할 수 있게 준비하는 방법을 명시하는 표준 파일 형식이 존재합니다. Linux는 이러한 형식을 많이 지원하지만, 단연 가장 흔한 형식은 ELF(executable and linkable format, 실행 파일 및 링크 가능 형식)입니다.
(귀여운 그림을 그려 주신 Nicky Case님께 감사드립니다.)
여담: 엘프는 어디에나 있을까요?
Linux에서 앱이나 명령줄 프로그램을 실행한다면, 그것은 십중팔구 ELF 바이너리입니다. 하지만 macOS에서는 Mach-O가 사실상의 표준 형식입니다. Mach-O는 ELF와 똑같은 일을 모두 하지만 구조가 다릅니다. Windows에서 .exe 실행 파일은 Portable Executable 형식을 사용하는데, 이 역시 같은 개념을 가진 다른 형식입니다.
Linux 커널에서 ELF 바이너리는 binfmt_elf 핸들러가 처리하며, 이 핸들러는 다른 많은 핸들러보다 복잡하고 수천 줄의 코드로 이루어져 있습니다. 이 핸들러는 ELF 파일에서 특정 세부 정보를 파싱해 내고, 그 정보를 이용해 프로세스를 메모리에 적재하고 실행하는 일을 담당합니다.
명령줄 쿵푸를 좀 부려서 binfmt 핸들러들을 줄 수 기준으로 정렬해 보았습니다:
$ wc -l binfmt_* | sort -nr | sed 1d
    2181 binfmt_elf.c
    1658 binfmt_elf_fdpic.c
     944 binfmt_flat.c
     836 binfmt_misc.c
     158 binfmt_script.c
      64 binfmt_elf_test.c
파일 구조
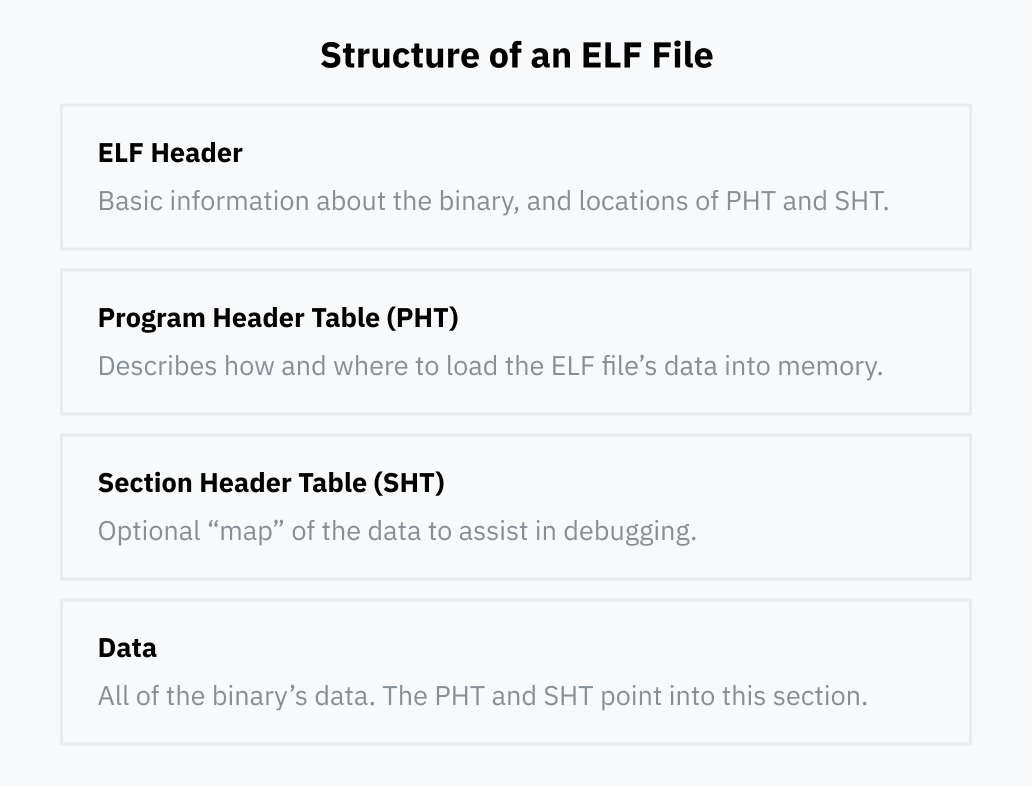
binfmt_elf가 ELF 파일을 어떻게 실행하는지 더 깊이 살펴보기 전에, 먼저 파일 형식 자체를 살펴봅시다. ELF 파일은 일반적으로 네 부분으로 구성됩니다:
ELF 헤더
모든 ELF 파일에는 ELF 헤더가 있습니다. ELF 헤더는 다음과 같은 바이너리의 기본 정보를 전달하는 매우 중요한 역할을 합니다:
- 어떤 프로세서에서 실행되도록 설계되었는지. ELF 파일에는 ARM이나 x86 같은 여러 프로세서 유형용 기계어 코드가 담길 수 있습니다.
- 바이너리가 실행 파일로서 단독으로 실행되기 위한 것인지, 아니면 다른 프로그램이 “동적 링크 라이브러리”로 적재하기 위한 것인지. 동적 링킹이 무엇인지는 곧 자세히 다루겠습니다.
- 실행 파일의 진입점. 뒤쪽 섹션들은 ELF 파일에 담긴 데이터를 메모리의 정확히 어디에 적재할지 명시합니다. 진입점은 전체 프로세스가 적재된 후 첫 번째 기계어 명령어가 메모리의 어디에 있는지를 가리키는 메모리 주소입니다.
ELF 헤더는 항상 파일의 맨 앞에 있습니다. ELF 헤더는 파일 내 어디에든 있을 수 있는 프로그램 헤더 테이블과 섹션 헤더의 위치를 명시합니다. 그리고 이 테이블들은 다시 파일의 다른 곳에 저장된 데이터를 가리킵니다.
프로그램 헤더 테이블
프로그램 헤더 테이블은 런타임에 바이너리를 적재하고 실행하는 방법에 대한 구체적인 세부 정보를 담은 일련의 항목입니다. 각 항목에는 어떤 세부 정보를 명시하는지 나타내는 유형 필드가 있습니다. 예를 들어 PT_LOAD는 메모리에 적재해야 할 데이터가 담겨 있음을 뜻하지만, PT_NOTE는 해당 세그먼트에 반드시 어딘가에 적재할 필요는 없는 정보성 텍스트가 담겨 있음을 뜻합니다.
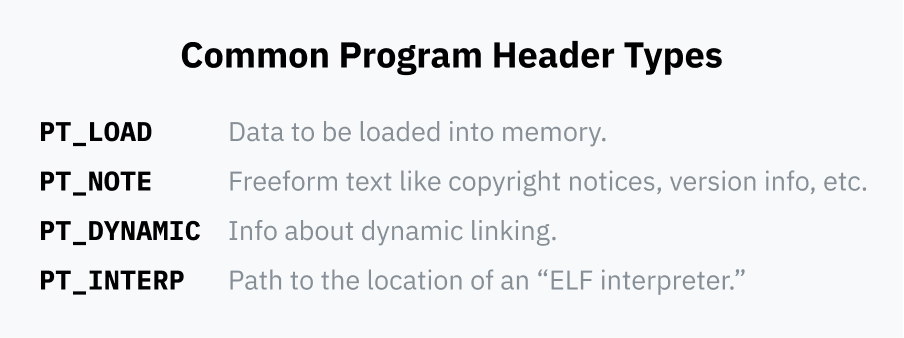
각 항목은 해당 데이터가 파일 안의 어디에 있는지, 그리고 경우에 따라서는 그 데이터를 메모리에 어떻게 적재할지에 대한 정보를 지정합니다.
- 항목은 ELF 파일 안에서 해당 데이터의 위치를 가리킵니다.
- 데이터를 어느 가상 메모리 주소에 적재해야 하는지 지정할 수 있습니다. 세그먼트를 메모리에 적재할 목적이 아니라면 이 값은 보통 비워 둡니다.
- 두 필드가 데이터의 길이를 지정합니다. 하나는 파일 안에 있는 데이터의 길이이고, 다른 하나는 새로 만들 메모리 영역의 길이입니다. 메모리 영역의 길이가 파일 안의 길이보다 길면 남는 메모리는 0으로 채워집니다. 이는 런타임에 사용할 정적 메모리 세그먼트가 필요한 프로그램에 유용합니다. 이러한 빈 메모리 세그먼트를 보통 BSS 세그먼트라고 부릅니다.
- 마지막으로, 플래그 필드는 세그먼트가 메모리에 적재되었을 때 어떤 작업을 허용할지 지정합니다.
PF_R은 읽기 가능하게,PF_W는 쓰기 가능하게 만들며,PF_X는 CPU에서 실행을 허용해야 하는 코드임을 뜻합니다.
섹션 헤더 테이블
섹션 헤더 테이블은 섹션에 대한 정보를 담은 일련의 항목입니다. 이 섹션 정보는 ELF 파일 안의 데이터를 그려 놓은 지도와 같습니다. 이 정보 덕분에 디버거 같은 프로그램은 데이터의 각 부분이 어떤 용도로 쓰이는지 쉽게 파악할 수 있습니다.
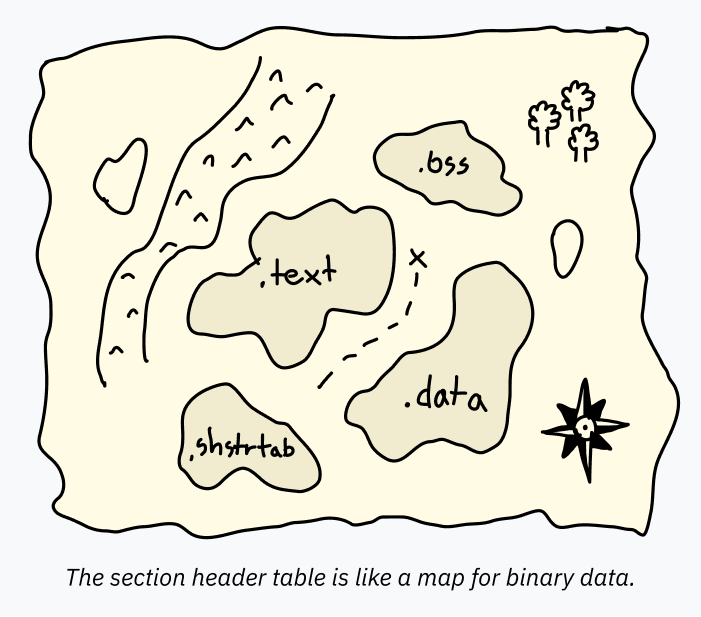
예를 들어, 프로그램 헤더 테이블은 넓은 범위의 데이터를 한꺼번에 메모리에 적재하도록 지정할 수 있습니다. 그 하나의 PT_LOAD 블록 안에 코드와 전역 변수가 모두 들어 있을 수도 있습니다! 프로그램을 실행하는 데에는 이 둘을 따로 지정해야 할 이유가 없습니다. CPU는 그저 엔트리 포인트에서 시작해 한 단계씩 나아가며, 프로그램이 요청하는 때와 위치에서 데이터에 접근할 뿐입니다. 하지만 프로그램을 분석하는 디버거 같은 소프트웨어는 각 영역이 정확히 어디서 시작하고 어디서 끝나는지 알아야 합니다. 그렇지 않으면 “hello”라고 적힌 텍스트를 코드로 해석하려 들 수도 있습니다(그리고 그것은 올바른 코드가 아니므로 폭발해 버립니다). 이 정보는 섹션 헤더 테이블에 저장됩니다.
섹션 헤더 테이블은 보통 포함되어 있지만, 사실은 선택 사항입니다. ELF 파일은 섹션 헤더 테이블을 완전히 제거해도 아무 문제 없이 실행되며, 자기 코드가 하는 일을 숨기고 싶은 개발자는 해석하기 더 어렵게 만들려고 때때로 ELF 바이너리에서 섹션 헤더 테이블을 일부러 제거하거나 망가뜨리기도 합니다.
각 섹션에는 이름과 타입, 그리고 섹션을 어떻게 사용하고 해석할지 지정하는 몇 가지 플래그가 있습니다. 표준 이름은 관례상 보통 점으로 시작합니다. 가장 흔한 섹션은 다음과 같습니다.
.text: 메모리에 적재되어 CPU에서 실행될 기계어입니다.SHT_PROGBITS타입이며, 실행 파일 안에서 실행 가능한 영역임을 표시하는SHF_EXECINSTR플래그와 실행을 위해 메모리에 적재된다는 뜻의SHF_ALLOC플래그를 가집니다. (이름에 헷갈리지 마십시오. 이것은 여전히 바이너리 기계어일 뿐입니다! 읽을 수 있는 “텍스트”도 아닌데.text라고 부르는 것이 저는 늘 좀 이상하다고 생각했습니다.).data: 실행 파일에 하드코딩되어 메모리에 적재될 초기화된 데이터입니다. 예를 들어, 어떤 텍스트를 담은 전역 변수가 이 섹션에 들어 있을 수 있습니다. 저수준 코드를 작성한다면, 정적 변수가 들어가는 곳이 바로 이 섹션입니다. 이 섹션의 타입도SHT_PROGBITS인데, 이는 단지 섹션에 “프로그램을 위한 정보”가 들어 있다는 뜻입니다. 플래그는SHF_ALLOC과SHF_WRITE로, 쓰기 가능한 메모리임을 표시합니다..bss: 앞에서 할당된 메모리 중 일부가 0으로 채워진 상태로 시작하는 경우가 흔하다고 말씀드렸습니다. ELF 파일에 빈 바이트를 잔뜩 넣는 것은 낭비이므로, BSS라는 특별한 세그먼트 타입을 사용합니다. 디버깅할 때 BSS 세그먼트에 대해 알면 도움이 되므로, 할당할 메모리의 길이를 지정하는 섹션 헤더 테이블 항목도 따로 있습니다. 타입은SHT_NOBITS이며,SHF_ALLOC과SHF_WRITE플래그가 붙습니다..rodata: 읽기 전용이라는 점을 제외하면.data와 비슷합니다.printf("Hello, world!")를 실행하는 아주 기본적인 C 프로그램에서 문자열 “Hello world!”는.rodata섹션에 들어가고, 실제로 출력을 수행하는 코드는.text섹션에 들어갑니다..shstrtab: 이것은 재미있는 구현 세부 사항입니다! 섹션 자체의 이름(.text나.shstrtab같은)은 섹션 헤더 테이블에 직접 포함되지 않습니다. 그 대신 각 항목에는 자신의 이름이 들어 있는 ELF 파일 내 위치를 가리키는 오프셋이 담겨 있습니다. 이렇게 하면 섹션 헤더 테이블의 각 항목이 같은 크기를 가질 수 있어 파싱하기가 더 쉬워집니다. 이름에 대한 오프셋은 고정 크기의 숫자인 반면, 테이블에 이름을 직접 넣으면 크기가 변수인 문자열을 사용하게 됩니다. 이 이름 데이터는 모두SHT_STRTAB타입의.shstrtab라는 별도의 섹션에 저장됩니다.
데이터
프로그램 헤더 테이블과 섹션 헤더 테이블의 항목은 메모리에 로드하기 위해서든, 프로그램 코드의 위치를 지정하기 위해서든, 단순히 섹션에 이름을 붙이기 위해서든 모두 ELF 파일 안의 데이터 블록을 가리킵니다. 이 모든 다양한 데이터 조각은 ELF 파일의 데이터 섹션에 들어 있습니다.
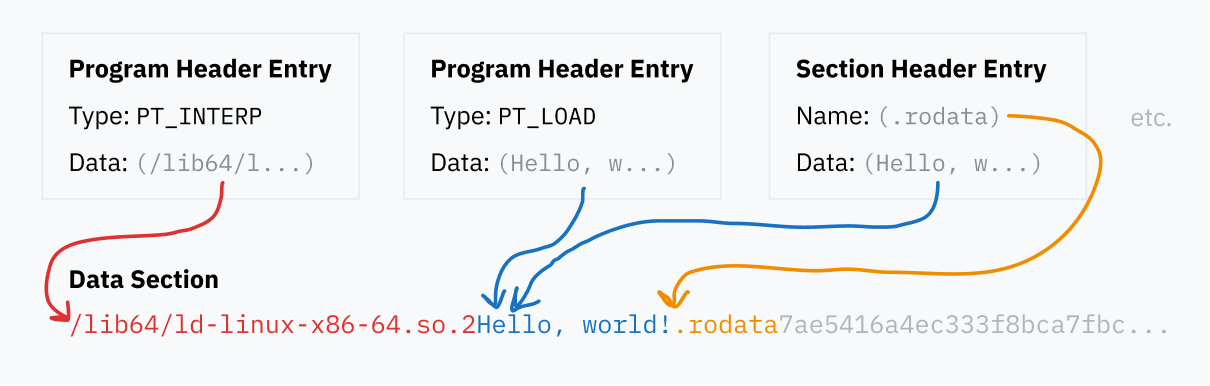
링킹에 대한 간단한 설명
다시 binfmt_elf 코드로 돌아가 봅시다. 커널은 프로그램 헤더 테이블에서 두 가지 타입의 항목에 관심을 둡니다.
PT_LOAD 세그먼트는 .text 섹션과 .data 섹션 같은 모든 프로그램 데이터가 메모리의 어디에 로드되어야 하는지를 지정합니다. 커널은 ELF 파일에서 이 항목들을 읽어 데이터를 메모리에 로드하며, 이를 통해 CPU가 프로그램을 실행할 수 있게 됩니다.
커널이 관심을 두는 또 다른 타입의 프로그램 헤더 테이블 항목은 PT_INTERP이며, 이는 “동적 링킹 런타임”을 지정합니다.
동적 링킹이 무엇인지 이야기하기 전에, 먼저 “링킹” 전반에 대해 이야기해 봅시다. 프로그래머는 보통 재사용 가능한 코드로 이루어진 라이브러리 위에 프로그램을 만듭니다 — 앞에서 이야기한 libc가 그 예입니다. 소스 코드를 실행 파일 바이너리로 바꿀 때, 링커라는 프로그램이 라이브러리 코드를 찾아 바이너리에 복사함으로써 이러한 참조를 모두 해결합니다. 이 과정을 정적 링킹이라고 하며, 이는 외부 코드가 배포되는 파일에 직접 포함된다는 뜻입니다.
하지만 어떤 라이브러리는 매우 흔하게 쓰입니다. libc는 시스템 호출을 통해 운영체제와 상호작용하기 위한 표준 인터페이스이기 때문에, 세상의 거의 모든 프로그램이 libc를 사용한다는 것을 알 수 있습니다. 컴퓨터에 있는 모든 프로그램마다 libc의 복사본을 따로 포함시키는 것은 공간을 끔찍하게 낭비하는 일입니다. 또한 라이브러리를 사용하는 각 프로그램이 업데이트되기를 기다릴 필요 없이 라이브러리의 버그를 한 곳에서 고칠 수 있다면 좋을 것입니다. 동적 링킹은 이러한 문제에 대한 해결책입니다.
정적으로 링크된 프로그램이 bar라는 라이브러리의 foo 함수를 필요로 한다면, 그 프로그램에는 foo 전체의 복사본이 포함됩니다. 하지만 동적으로 링크된 경우에는 “라이브러리 bar의 foo가 필요합니다”라는 참조만 포함됩니다. 프로그램이 실행될 때 bar가 컴퓨터에 설치되어 있다면, foo 함수의 기계어 코드를 필요할 때 메모리에 로드할 수 있습니다. 컴퓨터에 설치된 bar 라이브러리가 업데이트되면, 프로그램 자체를 전혀 변경하지 않아도 다음에 프로그램을 실행할 때 새 코드가 로드됩니다.
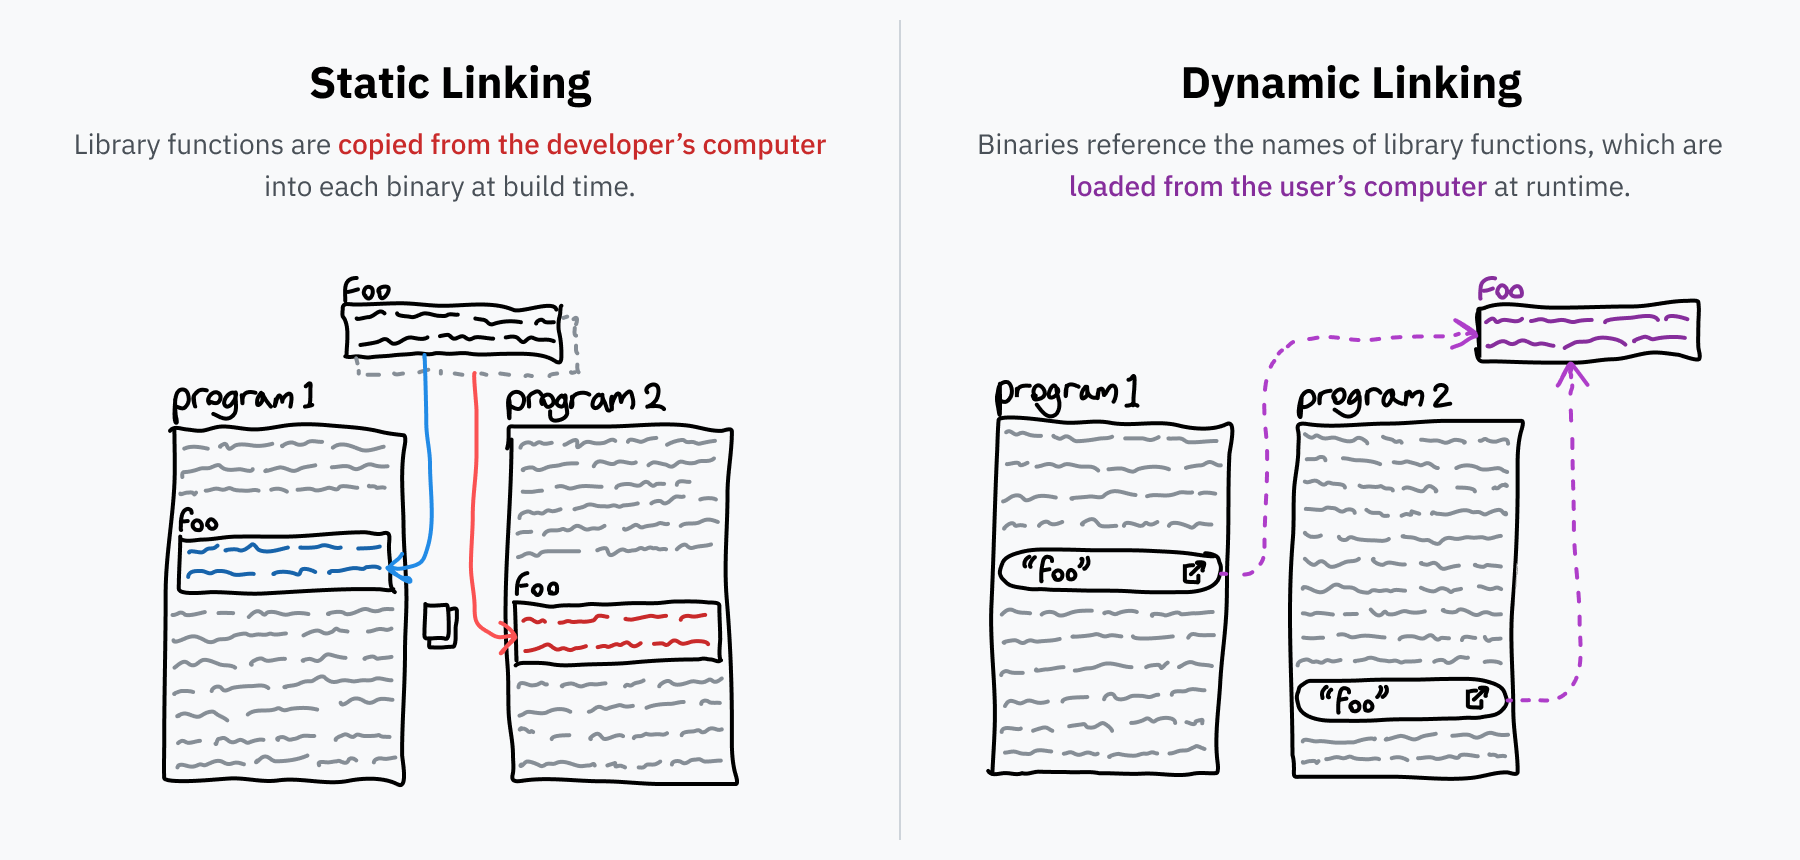
실제 환경에서의 동적 링킹
Linux에서 bar와 같이 동적으로 링크할 수 있는 라이브러리는 보통 .so(Shared Object) 확장자를 가진 파일로 패키징됩니다. 이러한 .so 파일도 프로그램과 마찬가지로 ELF 파일입니다 — ELF 헤더에 해당 파일이 실행 파일인지 라이브러리인지를 지정하는 필드가 있다는 것을 기억하실 것입니다. 또한 공유 오브젝트는 섹션 헤더 테이블에 .dynsym 섹션을 가지고 있으며, 여기에는 파일에서 어떤 심볼을 내보내고 있어 동적으로 링크할 수 있는지에 대한 정보가 담겨 있습니다.
Windows에서는 bar 같은 라이브러리가 .dll(dynamic link library) 파일로 패키징됩니다. macOS는 .dylib(dynamically linked library) 확장자를 사용합니다. macOS 앱이나 Windows .exe 파일과 마찬가지로, 이 파일들은 ELF 파일과 형식이 조금 다르지만 개념과 기법은 같습니다.
두 가지 링킹 방식의 흥미로운 차이점은, 정적 링킹에서는 라이브러리 중 실제로 사용되는 부분만 실행 파일에 포함되고 따라서 그 부분만 메모리에 로드된다는 것입니다. 동적 링킹에서는 라이브러리 전체가 메모리에 로드됩니다. 처음에는 덜 효율적으로 들릴 수 있지만, 실제로는 라이브러리를 메모리에 한 번만 로드한 뒤 그 코드를 여러 프로세스가 공유하게 함으로써 현대 운영체제가 더 많은 공간을 절약할 수 있게 해 줍니다. 라이브러리는 프로그램마다 서로 다른 상태가 필요하므로 코드만 공유할 수 있지만, 그래도 절약되는 양은 RAM 수십에서 수백 메가바이트에 이를 수 있습니다.
실행
ELF 파일을 실행하는 커널 이야기로 다시 돌아가 봅시다. 실행하려는 바이너리가 동적으로 링크되어 있다면, 운영체제는 바이너리의 코드로 곧바로 점프할 수 없습니다. 코드 일부가 빠져 있기 때문입니다. 동적으로 링크된 프로그램에는 필요한 라이브러리 함수에 대한 참조만 들어 있다는 점을 기억하십시오!
바이너리를 실행하려면 운영체제는 어떤 라이브러리가 필요한지 파악하고, 그것들을 로드하고, 이름으로 된 포인터를 모두 실제 점프 명령어로 바꾼 다음에야 실제 프로그램 코드를 시작해야 합니다. 이는 ELF 형식과 깊이 얽혀 동작하는 매우 복잡한 코드이므로, 보통 커널의 일부가 아니라 독립된 프로그램으로 존재합니다. ELF 파일은 사용하려는 프로그램의 경로(보통 /lib64/ld-linux-x86-64.so.2와 같은 형태)를 프로그램 헤더 테이블의 PT_INTERP 항목에 지정합니다.
ELF 헤더를 읽고 프로그램 헤더 테이블을 훑어본 뒤, 커널은 새 프로그램을 위한 메모리 구조를 설정할 수 있습니다. 커널은 먼저 모든 PT_LOAD 세그먼트를 메모리에 로드하여 프로그램의 정적 데이터, BSS 공간, 기계어 코드를 채웁니다. 프로그램이 동적으로 링크되어 있다면 커널은 ELF 인터프리터(PT_INTERP)를 실행해야 하므로, 인터프리터의 데이터, BSS, 코드도 메모리에 로드합니다.
이제 커널은 유저랜드로 돌아갈 때 CPU가 복원할 명령어 포인터를 설정해야 합니다. 실행 파일이 동적으로 링크되어 있다면, 커널은 명령어 포인터를 메모리에 있는 ELF 인터프리터 코드의 시작 지점으로 설정합니다. 그렇지 않다면 커널은 명령어 포인터를 실행 파일의 시작 지점으로 설정합니다.
커널은 이제 시스템 호출에서 돌아갈 준비가 거의 되었습니다(아직 execve 안에 있다는 점을 기억하십시오). 커널은 프로그램이 시작할 때 읽을 수 있도록 argc, argv, 환경 변수를 스택에 푸시합니다.
이제 레지스터를 비웁니다. 커널은 시스템 호출을 처리하기 전에, 사용자 공간으로 다시 전환할 때 복원할 수 있도록 레지스터의 현재 값을 스택에 저장합니다. 커널은 사용자 공간으로 돌아가기 전에 스택의 이 부분을 0으로 채웁니다.
마침내 시스템 호출이 끝나고 커널은 유저랜드로 돌아갑니다. 커널은 이제 0으로 채워진 레지스터를 복원하고, 저장된 명령어 포인터로 점프합니다. 이제 그 명령어 포인터가 새 프로그램(또는 ELF 인터프리터)의 시작 지점이 되며, 현재 프로세스는 교체되었습니다!
5장으로 계속: 컴퓨터 속의 번역가