모나드에서 기계어 코드까지
JIT(just-in-time) 컴파일은 실행 가능한 코드를 동적으로 생성하는 방식으로 이루어지는 컴파일입니다. JIT은 많은 언어 런타임에서 자주 실행되는 코드 경로에 최적화된 코드를 생성하는 데 흔히 쓰이는 기법이며, 여러 작업을 위한 AOT(ahead-of-time) 컴파일에도 쓰입니다.
그러면 Haskell로 LLVM과 비슷한 작은 중간 언어와 JIT 실행 엔진을 만들어 봅시다. 이 코드는 최신 Linux와 x86-64 아키텍처에서만 동작합니다. 다만 원칙적으로는 각 플랫폼에서 mmap과 mprotect 시스템 콜을 호출하는 적절한 FFI 호출을 할 수 있다면 어떤 플랫폼에서든 동작합니다.
소스 코드는 여기에서 볼 수 있습니다.
타입
x86-x64 명령어 집합은 x86 명령어 집합의 64비트 개정판이며, x86 명령어 집합은 처음에 Intel 8086 CPU 계열을 위해 개발되었습니다. 하드웨어가 다루는 기본 타입은 정수 타입과 부동소수점 타입입니다. 지금은 적분(integral) 타입만 살펴보겠습니다. 이 타입은 크게 네 가지 종류로 나뉩니다:
인텔 아키텍처에서 숫자는 리틀 엔디언으로 표현됩니다. 즉, 하위 바이트가 낮은 메모리 주소에 저장됩니다. 한 값의 메모리 표현 전체는 상위 비트와 하위 비트로 나뉩니다. 예를 들어 16진수 0xc0ffee를 DWORD로 저장하면 메모리에는 다음과 같이 저장됩니다.
Haskell에서는 언박싱된 적분(integral) 머신 타입을 Data.Word 모듈에서 제공합니다.
data Word8  = W8# Word#
data Word16 = W16# Word#
data Word32 = W32# Word#
data Word64 = W64# Word#
포인터는 그저 주기억장치를 가리키는 주소 값일 뿐이며, 실제 접근과 저장은 Linux 커널이 관리합니다. 이를 Haskell에서 추상적으로 모델링하기 위해, 우리가 다룰 수 있는 값들을 담는 데이터 타입을 만들겠습니다.
data Val
  = I Int64      -- Integer
  | R Reg        -- Register
  | A Word32     -- Addr
  deriving (Eq, Show)
Haskell 타입을 바이트 시퀀스로 변환하기 위해 binary 라이브러리를 사용하여 적분(integral) 타입을 리틀 엔디언 바이트 배열로 변환하겠습니다.
bytes :: Integral a => a -> [Word8]
bytes x = fmap BS.c2w bs
  where
    bs = unpack $ runPut $ putWord32le (fromIntegral x)
예를 들어 16진수 리터럴이 주어지면 이 함수는 그 리터럴을 구성 비트들의 배열로 펼칩니다.
val = bytes 0xc0ffee -- [238,255,192,0]
레지스터
x64 아키텍처에는 쿼드워드를 저장할 수 있는 64비트 범용 레지스터가 16개 있습니다. 주요 레지스터의 이름은 rax, rbx, rcx, rdx, rbp, rsi, rdi, 그리고 rsp입니다.
각 레지스터에는 고유한 인덱스(r)가 주어지며, 이 인덱스는 해당 레지스터를 다루는 명령어들의 바이너리 표현에 사용됩니다.
RAX RBX RCX RDX RBP RSI RDI RSP
data Reg
  = RAX  -- Accumulator
  | RCX  -- Counter (Loop counters)
  | RDX  -- Data
  | RBX  -- Base / General Purpose
  | RSP  -- Current stack pointer
  | RBP  -- Previous Stack Frame Link
  | RSI  -- Source Index Pointer
  | RDI  -- Destination Index Pointer
  deriving (Eq, Show)
각 레지스터의 인덱스는 간단한 패턴 매칭 case 식으로 정의합니다.
index :: Reg -> Word8
index x = case x of
  RAX -> 0
  RCX -> 1
  RDX -> 2
  RBX -> 3
  RSP -> 4
  RBP -> 5
  RSI -> 6
  RDI -> 7
이들 각 레지스터는 하위 비트의 일부만을 담는 더 작은 레지스터로 접근할 수 있습니다. rax의 32비트 레지스터는 eax입니다. 이 레지스터들은 아래 표에 나와 있습니다.
이 작은 레지스터들에는 접두사를 바꾼 고유한 이름이 붙어 있습니다.
| 64비트 | 32비트 | 16비트 |
|---|---|---|
| rax | eax | ax |
| rbx | ebx | bx |
| rcx | ecx | cx |
| rdx | edx | dx |
| rsp | esp | sp |
| rbp | ebp | bp |
| rsi | esi | si |
| rdi | edi | di |
| rip | eip | ip |
Haskell에서는 이를 64비트 레지스터 각각에 대한 합 타입으로 모델링합니다. 지금은 64비트 레지스터만 고려합시다.
data Reg
  = RAX  -- Accumulator
  | RCX  -- Counter (Loop counters)
  | RDX  -- Data
  | RBX  -- Base / General Purpose
  | RSP  -- Current stack pointer
  | RBP  -- Previous Stack Frame Link
  | RSI  -- Source Index Pointer
  | RDI  -- Destination Index Pointer
  deriving (Eq, Show)
각 레지스터의 인덱스는 간단한 패턴 매치 case 식으로 정의됩니다.
index :: Reg -> Word8
index x = case x of
  RAX -> 0
  RCX -> 1
  RDX -> 2
  RBX -> 3
  RSP -> 4
  RBP -> 5
  RSI -> 6
  RDI -> 7
모나드
모나드는 두 개의 함수(bind)와 (return), 그리고 세 가지 법칙을 갖춘 대수적 구조입니다.
bind :: Monad m => m a -> (a -> m b) -> m b
return :: Monad m => a -> m a
컴파일러는 이러한 형태의 do 블록을 일반적인 bind 문과 return 문으로 이루어진 정규 형태로 디슈거링합니다.
f :: Monad m => m Int
f = do
  a <- x
  b <- y
  return (a+b)
다음과 같이 변환됩니다.
f :: Monad m => m Int
f =
  bind x (\a ->
    bind y (\b ->
      return (a+b))
모나드는 매개변수 m으로 인덱싱되는 타입 클래스로 구현되며, 타입 클래스 인스턴스로 인스턴스화되면 bind 함수와 return 함수를 두 함수의 특정 구현(State나 Reader 등)으로 대체합니다.
f :: State MyState Int
f =
  bindState x (\a ->
    bindState y (\b ->
      returnState (a+b))
State 모나드는 상태를 가진 로직을 합성하기 위한 여러 함수를 갖춘 Monad의 인스턴스입니다.
get :: State s s                   -- get the state
put :: s -> State s ()             -- set the state
modify :: (s -> s) -> State s ()   -- apply a function over the state
예를 들어 Int 값 하나를 보관하는 작은 상태 기계는 다음과 같이 작성합니다.
machine :: State Int Int
machine = do
  put 3
  modify (+1)
  get

val :: Int
val = execState machine 0
상태 변수 s를 수정 가능한 여러 필드를 가진 레코드로 두는 경우가 더 일반적입니다. JIT 메모리를 관리하기 위해 여러 필드를 가진 구조체를 만들겠습니다.
data JITMem = JITMem
 { _instrs :: [Instr]
 , _mach   :: [Word8]
 , _icount :: Word32
 , _memptr :: Word32
 , _memoff :: Word32
 } deriving (Eq, Show)
이 구조체는 X86 모나드에 합성됩니다. X86 모나드는 개별 기계어 명령어를 어셈블하는 동안 JIT 메모리를 보관하며, 어셈블된 명령어 시퀀스에 대한 포인터와 메모리 오프셋도 함께 보관합니다.
type X86 a = StateT JITMem (Except String) a
JIT 메모리
JIT를 만들기 시작하려면 먼저 실행 권한을 가진 메모리 블록을 생성해야 합니다. C 런타임 안에서 필요한 메모리 블록을 생성하기 위해 여러 mmap 시스템 콜에 전달해야 하는 플래그를 얻을 수 있습니다.
#define PROT_NONE       0x00    /* No access.  */
#define PROT_READ       0x04    /* pages can be read */
#define PROT_WRITE      0x02    /* pages can be written */
#define PROT_EXEC       0x01    /* pages can be executed */

#define MAP_FILE        0x0001  /* mapped from a file or device */
#define MAP_ANON        0x0002  /* allocated from memory, swap space */
#define MAP_TYPE        0x000f  /* mask for type field */
그런 다음 실행 플래그를 지정한 mmap을 통해 Haskell 힙에서 주어진 크기의 메모리 블록을 할당하기만 하면 됩니다.
newtype MmapOption = MmapOption CInt
  deriving (Eq, Show, Ord, Num, Bits)

protExec    = ProtOption 0x01
protWrite   = ProtOption 0x02
mmapAnon    = MmapOption 0x20
mmapPrivate = MmapOption 0x02

allocateMemory :: CSize -> IO (Ptr Word8)
allocateMemory size = mmap nullPtr size pflags mflags (-1) 0
  where
    pflags = protRead <> protWrite
    mflags = mapAnon .|. mapPrivate
Haskell 포인터는 Haskell 힙상의 해당 주소로 캐스팅하기만 하면 JIT 컴파일된 코드에 전달할 수 있습니다.
heapPtr :: Ptr a -> Word32
heapPtr = fromIntegral . ptrToIntPtr
예를 들어 널 종료 문자 배열을 할당하고 그 메모리에 대한 포인터를 JIT 컴파일된 코드에 전달하려면, Haskell 문자열로부터 이 메모리를 합성하고 힙 포인터를 가져오는 asciz를 작성하면 됩니다.
asciz :: [Char] -> IO Word32
asciz str = do
  ptr <- newCString (str ++ ['\n'])
  return $ heapPtr ptr
C 함수의 경우에는 동적 링커를 사용하여 프로세스의 메모리 공간에서 주어진 심볼의 함수 포인터를 가져오기만 하면 됩니다. Haskell 런타임은 glibc의 stdio.h와 math.h에 링크되므로 이 심볼들은 모두 메모리 어딘가에 존재합니다.
extern :: String -> IO Word32
extern name = do
  dl <- dlopen "" [RTLD_LAZY, RTLD_GLOBAL]
  fn <- dlsym dl name
  return $ heapPtr $ castFunPtrToPtr fn
기계어 코드의 바이트 벡터를 컴파일하고 나면 이를 실행 가능한 메모리로 복사합니다.
jit :: Ptr Word8 -> [Word8] -> IO (IO Int)
jit mem machCode = do
  code <- codePtr machCode
  withForeignPtr (vecPtr code) $ \ptr -> do
    copyBytes mem ptr (8*6)
  return (getFunction mem)
그런 다음 FFI를 사용하여 해당 메모리에 대한 함수 포인터를 합성하고 호출합니다.
foreign import ccall "dynamic"
  mkFun :: FunPtr (IO Int) -> IO Int

getFunction :: Ptr Word8 -> IO Int
getFunction mem = do
  let fptr = unsafeCoerce mem :: FunPtr (IO Int)
  mkFun fptr
어셈블리
실행 코드에 명령어를 직접 채워 넣기 전에, 우리가 작성할 코드의 어셈블리 형태를 살펴보고 이 과정을 문제 영역에 더 가깝게 만들어 줄 작은 DSL을 Haskell로 만들어 봅시다. 어셈블리는 사람이 읽을 수 있는 기계어 코드의 중간 표현입니다. clang과 gcc 모두 컴파일 전에 이 표현을 출력할 수 있습니다. 예를 들어 다음 C 프로그램은 레지스터로 전달된 두 정수를 받아 각각 곱한 뒤 그 결과를 더합니다.
int f(int x, int y)
{
    return (x*x)^y;
}
내부적으로 C 컴파일러는 식을 분해하여 선형적인 명령어 시퀀스로 압축하며, 중간 결과는 스크래치 레지스터에 저장하고 최종 계산 결과는 반환 레지스터에 기록합니다. 그런 다음 각 추상 연산에 알맞은 기계어 명령어를 선택합니다.
// pseudocode for intermediate C representation
int f() {
    int x = register(rdi);
    int y = register(rsi);
    int tmp1 = x*x;
    int tmp2 = tmp1^y;
    return tmp2;
}
어셈블리를 add.s 파일로 출력할 수 있습니다. 여기서는 목적지 피연산자를 다른 피연산자보다 앞에 두는 Intel 문법을 사용합니다. 이와 다른 AT&T 문법은 이 관례를 반대로 따릅니다.
$ clang -O2 -S --x86-asm-syntax=intel xor.c
생성된 코드는 다음과 같습니다. 문장에는 *지시어(directive)*와 *명령어(instruction)*의 두 종류가 있다는 점에 주목하십시오. 지시어는 마침표로 시작하며, 명령어는 연산과 피연산자 목록으로 이루어집니다. 명령어 문장들은 콜론으로 끝나는 레이블이 붙은 블록으로 묶입니다. 예를 들어 f:는 함수 f의 로직을 담고 있는 레이블입니다.
        .file   "xor.c"
        .text
        .globl  f
        .type   f, @function
        .intel_syntax noprefix
f:
        mov     eax, edi
        imul    eax, edi
        xor     eax, esi
        ret
그러면 어셈블러가 이 명령어 시퀀스를 생성된 기계어 코드를 담은 실행 파일이나 오브젝트 파일로 변환합니다. 출력을 디스어셈블하려면 objdump를 사용하여 기계어 명령어의 16진수 시퀀스와 파일 내 오프셋을 볼 수 있습니다.
$ objdump -M intel -d xor.o

xor:     file format elf64-x86-64

Disassembly of section .text:

0000000000000000 <f>:
   0: 89 f8                 mov    eax,edi
   2: 0f af c7                imul   eax,edi
   5: 31 f0                 xor    eax,esi
   7: c3                      ret
그러면 메모리에 올라간 컴파일된 프로그램은 연속된 바이트 배열이 되며, 명령어 포인터를 시작 주소로 옮겨 실행됩니다.
89 f8 0f af c7 31 f0 c3
명령어
명령어는 두 부분으로 구성됩니다. 하나는 *옵코드(opcode)*이고, 다른 하나는 주어진 명령어에 대해 CPU가 처리할 레이블, 레지스터 또는 메모리 주소를 지정하는 *피연산자(operand)*들의 집합입니다. 정수를 다루고 호출 스택을 조작하는 흥미로운 연산들의 일부를 살펴보겠습니다.
data Instr
  = Ret
  | Mov Val Val
  | Add Val Val
  | Sub Val Val
  | Mul Val
  | IMul Val Val
  | Xor Val Val
  | Inc Val
  | Dec Val
  | Push Val
  | Pop Val
  | Call Val
  | Loop Val
  | Nop
  | Syscall
  deriving (Eq, Show)
JIT 메모리에 추가하려면 _mach 필드에 명령어를 덧붙이고 추가된 명령어의 길이만큼 메모리 오프셋 포인터를 조정하는 방식으로 상태를 수정하기만 하면 됩니다.
emit :: [Word8] -> X86 ()
emit i = modify $ \s -> s
  { _mach   = _mach s ++ i
  , _memoff = _memoff s + fromIntegral (length i)
  }
피연산자
레지스터
레지스터는 소문자로 표기합니다(예: rbp, rsp). 표현식 빌더에서는 기반이 되는 Reg 값으로부터 레지스터 값 타입을 생성하는 함수 몇 개를 작성하기만 하면 됩니다.
rax :: Val
rax = R RAX

rsi :: Val
rsi = R RSI
즉시 피연산자
즉시 피연산자는 상수(리터럴 또는 메모리 주소)를 직접 참조하는 것입니다. 예를 들어: 주소) 또는 레이블. 예를 들면 다음과 같습니다.
add    eax,42
add    eax,0xff
즉시 값의 경우 숫자에 해당하는 바이트 배열을 바이트 시퀀스에 그대로 추가하기만 하면 됩니다.
imm :: Integral a => a -> X86 ()
imm = emit . bytes
옵코드
x86의 전체 명령어 집합은 방대하며, AVX, SSE 및 기타 특수 인트린직까지 포함하면 엄청나게 복잡하고 별난 사양이 많습니다. 이러한 추상 명령어 각각은 받을 수 있는 피연산자 유형마다 여러 개의 옵코드를 가질 수 있습니다. 예를 들어 레지스터 간 이동을 위한 mov 명령어는 옵코드 0x89를 가지는 반면, 즉시 데이터를 레지스터로 옮기는 경우에는 옵코드 0xC7을 가집니다.
가장 흔한 연산에 대한 참고 자료로는 x86asm.net 사이트에 매우 유용한 빠른 참조표가 있습니다. 최신 Intel 프로세서에서 사용할 수 있는 전체 명령어 집합은 1500쪽 분량의 Intel 소프트웨어 개발자 매뉴얼을 참고하십시오.
주어진 명령어에 대한 숫자 옵코드를 조회하기 위해, 피연산자에 대해 특정한 명명 규칙을 사용합니다.
| 접두사 | 설명 |
|---|---|
r<size> | 레지스터 피연산자 |
imm<size> | 즉시 피연산자 |
m<size> | 메모리 피연산자 |
예를 들면 다음과 같습니다.
| 접두사 | 설명 |
|---|---|
r64 | 64비트 레지스터 |
imm8 | 8비트 즉시 피연산자 |
m32 | 32비트 메모리 피연산자 |
여러 가능한 피연산자 집합에 대해 동작하는 옵코드의 경우, 이들은 r8/r16/r32 형식처럼 슬래시로 구분합니다.
여기서 다루는 제한된 명령어 집합에는 두 가지 유형의 옵코드가 있습니다.
- 1바이트 옵코드
- 2바이트 옵코드
| 명령어 | 옵코드 |
|---|---|
| CALL | E8 |
| RET | C3 |
| NOP | 0D |
| MOV | 89 |
| PUSH | 50 |
| POP | 58 |
| LOOP | E2 |
| ADD | 83 |
| SUB | 29 |
| MUL | F7 |
| DIV | F7 |
| INC | FF |
| DEC | FF |
| NEG | F7 |
| CMP | 39 |
| AND | 21 |
| OR | 09 |
| XOR | 31 |
| NOT | F7 |
| ADC | 11 |
| IDIV | F7 |
| IMUL | F7 |
| XCHG | 87 |
| BSWAP | C8 |
| SHR | C1 |
| SHL | C1 |
| ROR | C0 |
| RCR | C0 |
| BT | BA |
| BTS | BA |
| BTR | B3 |
| JMP | EB |
| JE | 84 |
| JNE | 85 |
| SYSCALL | 05 |
이에 더해 옵코드에는 관련된 인자의 크기를 바꾸는 접두사가 추가로 붙을 수 있습니다. 이 접두사들은 32비트 시스템에서 64비트 시스템으로 넘어가는 과정에서 32비트 호환성을 유지하고 32비트 시스템의 기존 옵코드를 보존하기 위해 추가되었습니다. 예를 들어 다음 mov 명령어들은 모두 레지스터를 대상으로 같은 동작을 수행하지만, 다루는 크기가 서로 다릅니다.
mov al,255
mov ax,255
mov eax,255
mov rax,255
그러나 크기에 따라 서로 다른 옵코드로 변환됩니다.
b0 ff                   mov    al,0xff
66 b8 ff 00             mov    ax,0xff
b8 ff 00 00 00          mov    eax,0xff
48 c7 c0 ff 00 00 00    mov    rax,0xff
| 접두사 | 옵코드 | 데이터 | 어셈블리 | 의미 |
|---|---|---|---|---|
| 66 | b0 | ff | mov al, 0xff | 8비트 로드 |
| 66 | b8 | ff 00 | mov ax, 0xff | 16비트 접두사(0x66)를 사용한 로드 |
| 66 | b8 | ff 00 00 00 | mov eax, 0xff | 기본 크기인 32비트로 로드 |
| 48 | c7 c0 | ff 00 00 00 | mov rax, 0xff | REX 64비트 접두사(0x48)를 사용한 부호 확장 로드 |
기계어 코드
자, 이제 명령어의 전체 구조를 살펴봅시다. 명령어는 여러 부분으로 구성됩니다.
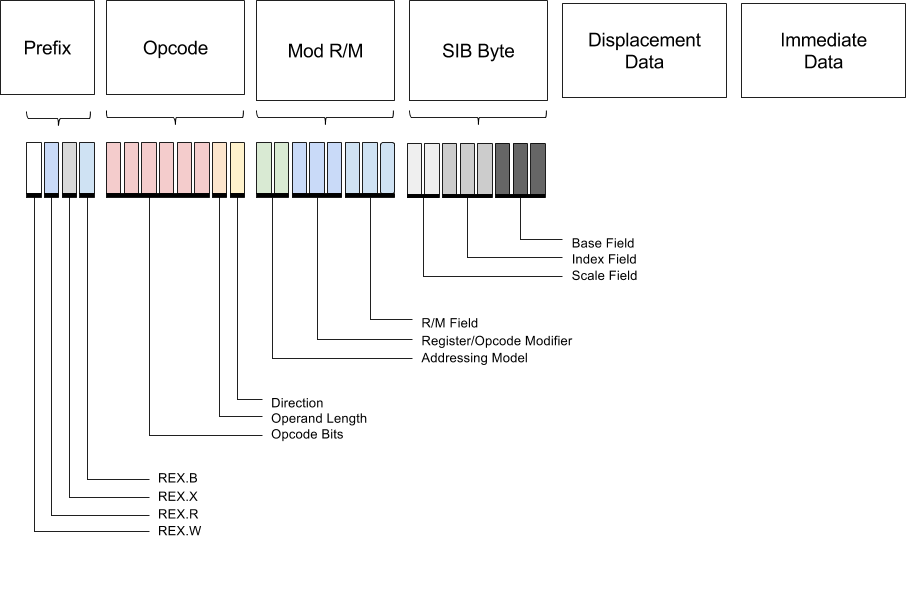
이 부분들의 크기는 옵코드의 크기와 종류, 그리고 접두사 수정자에 따라 달라집니다.
접두사 옵코드 Mod R/M Scale Index Base 변위 즉시값
1-4바이트 1-3바이트 1바이트 1바이트 1-4바이트 1-4바이트
접두사
헤더는 처음 네 비트를 상수 0b0100으로 고정하며, 다음 네 비트는 W/R/X/B 확장의 존재 여부를 나타냅니다.
W 비트는 연산 너비를 변경합니다. R, X, B 필드는 레지스터 인코딩을 확장합니다.
- REX.W – 연산 폭을 확장합니다
- REX.R – ModRM.reg를 확장합니다
- REX.X – SIB.index를 확장합니다
- REX.B – SIB.base 또는 ModRM.r/m을 확장합니다
ModR/M 바이트
Mod-Reg-R/M 바이트는 명령어의 피연산자와 주소 지정 방식을 결정합니다. 주소 지정 방식에는 여러 변형이 있습니다.
- 즉시 모드 - 피연산자가 명령어의 일부입니다
- 레지스터 주소 지정 - 피연산자가 레지스터에 들어 있습니다
- 직접 모드 - 명령어의 피연산자 필드에 피연산자의 주소가 들어 있습니다
- 레지스터 간접 주소 지정 - 오프셋으로 데이터 배열을 주소 지정할 때 사용합니다
- 인덱싱 - 상수 베이스 + 레지스터
- 스케일링을 사용한 인덱싱 - 베이스 + 레지스터 오프셋 * 스케일링 계수
- 스택 주소 지정 - RSP 레지스터를 암묵적으로 사용해 자동으로 증가/감소하는 레지스터 간접 방식의 변형입니다
- 점프 상대 주소 지정 - RIP + 오프셋
mod 의미
00 레지스터 간접 메모리 주소 지정 방식 01 인덱스 또는 베이스/인덱스/변위 주소 지정 방식 10 인덱스 또는 베이스/인덱스/변위 주소 지정 방식 + 변위 11 R/M이 레지스터를 나타내며 REG 필드를 사용합니다
reg
rax 000 rcx 001 rdx 010 rbx 011 rsp 100 rbp 101 rsi 110 rdi 111
mod = 00, 01 또는 10인 경우
r/m 의미
000 [BX+SI] 또는 DISP[BX][SI] 001 [BX+DI] 또는 DISP[BX+DI] 010 [BP+SI] 또는 DISP[BP+SI] 011 [BP+DI] 또는 DISP[BP+DI] 100 [SI] 또는 DISP[SI] 101 [DI] 또는 DISP[DI] 110 변위만 또는 DISP[BP] 111 [BX] 또는 DISP[BX]
예를 들어 레지스터 직접 모드를 사용하고 r/m에 레지스터 피연산자를 지정하는 다음 명령어가 있다고 합시다.
mov rbx,rax
그러면 다음과 같습니다.
mod   = 0b11
reg   = 0b000
r/m   = rbx
r/m   = 0b011
ModRM = 0b11000011
ModRM = 0xc3
Scale Index Base
스케일은 피연산자의 주소를 지정하기 위해 인덱스를 베이스에 더하기 전에 인덱스에 곱하는 계수입니다. 스케일은 1, 2, 4, 8 중 하나의 값을 가질 수 있습니다. 스케일을 지정하지 않으면 기본값은 1입니다.
스케일 계수
0b00 1 0b01 2 0b10 4 0b11 8
index와 base는 모두 일반적인 인덱스 체계에서의 레지스터를 가리킵니다.
scale/base
rax 000 rcx 001 rdx 010 rbx 011 rsp 100 rbp 101 rsi 110 rdi 111
명령어 빌더
이제부터 상태 모나드 안에서 명령어를 어셈블하는 X86 모나드 연산자에 대응하는 여러 함수를 만들겠습니다. 먼저 간단한 산술 로직부터 해 봅시다.
arith :: X86 ()
arith = do
  mov rax (I 18)
  add rax (I 4)
  sub rax (I 2)
  imul rax (I 2)
  ret
이 함수들은 각각 대수적 데이터 타입 Val로 주어지는 피연산자들을 받아, 그 값에 대해 패턴 매칭을 하여 어떤 x86 옵코드를 사용할지, 그리고 값을 어떻게 바이트로 변환할지 결정합니다.
ret
가장 간단한 경우는 return 함수로, 피연산자를 받지 않으며 1비트 옵코드입니다.
ret :: X86 ()
ret = do
  emit [0xc3]
add <r64> <imm32>
즉시값에 대한 add는 64비트 즉시 데이터를 처리하기 위해 REX.W 플래그로 피연산자를 확장합니다.
0: 48 83 c0 01 add rax,0x1
add :: Val -> Val -> X86 ()
add (R l) (I r) = do
  emit [0x48]              -- REX.W prefix
  emit [0x05]              -- ADD
  imm r
add <r64> <r64>
레지스터 간 add도 같은 방식으로 REX.W 플래그를 사용하지만, 레지스터 직접 모드를 사용하여 소스 레지스터를 ModRM.reg 필드로 전달합니다. 모드 0xc0에 대해 비트 단위 or를 수행한 다음, 3비트 시프트하여 reg 비트에 레지스터 인덱스로 레지스터를 지정합니다.
0: 48 01 e0 add rax,rsp
add (R l) (R r) = do
  emit [0x48]              -- REX prefix
  emit [0x01]              -- ADD
  emit [0xc0 .|. opcode r `shiftL` 3 .|. opcode l]
mov <r64>, <r64>
mov 명령어에도 레지스터 간 경우와 즉시 데이터 경우 모두 같은 로직이 적용됩니다.
0: 48 89 d8 mov rax,rbx
mov :: Val -> Val -> X86 ()
mov (R dst) (R src) = do
  emit [0x48]              -- REX.W prefix
  emit [0x89]              -- MOV
  emit [0xC0 .|. opcode src `shiftL` 3 .|. opcode dst]
mov <r64>, <imm32>
0: 48 c7 c0 2a 00 00 00 mov rax,0x2a
mov (R dst) (I src) = do
  emit [0x48]              -- REX.W prefix
  emit [0xC7]              -- MOV
  emit [0xC0 .|. (opcode dst .&. 7)]
  imm src
inc <r64>, dec <r64>
inc와 dec 함수는 같은 옵코드를 공유하지만 연산을 지정하기 위해 ModRM 비트를 수정한다는 점에서 약간 다릅니다.
inc :: Val -> X86()
inc (R dst) = do
  emit [0x48]              -- REX prefix
  emit [0xFF]              -- INC
  emit [0xc0 + index dst]
dec (R dst) = do
  emit [0x48]              -- REX prefix
  emit [0xFF]              -- DEC
  emit [0xc0 + (index dst + 8)]
모든 것을 종합하여 함수를 JIT 컴파일하고 Haskell에서 호출하겠습니다.
main :: IO ()
main = do
  mem <- allocateMemory jitsize                -- create jit memory
  let Right st = assemble mem arith            -- assemble symbolic program
  fn  <- jit mem (_mach st)                    -- jit compile
  res <- fn                                    -- call function
  putStrLn $ "Result: " <> show res
그리고 실행하면 결과를 얻습니다.
$ stack exec example
Result: 40
점프와 루프
이제 제어 흐름을 사용하고 레이블이 붙은 명령어 블록 사이를 점프하는 로직을 작성해 봅시다. rcx 레지스터로 계산할 값을 받고, 1에 도달할 때까지 rax를 반복해서 곱하여 결과를 계산하는 팩토리얼 함수를 생각해 보십시오. 이를 위해 .factor 블록을 만들고 loop 명령어를 사용합니다.
factorial:
        mov rcx, $5
        mov rax, $1
.factor:
        mul rax
        loop .factor
        ret
이 어셈블리의 기계어 코드를 살펴봅시다. loop 명령어가 피연산자로 메모리상의 상대 주소 fc(즉, 4개 명령어만큼 뒤로 이동)를 받는다는 점에 주목하십시오.
00000000004004ed <main>:
  4004ed:       b9 05 00 00 00          mov    ecx,0x5
  4004f2:       b8 01 00 00 00          mov    eax,0x1

00000000004004f7 <.factor>:
  4004f7:       f7 e1                   mul    ecx
  4004f9:       e2 fc                   loop   4004f7 <.factor>
  4004fb:       c3                      ret
그러면 모나드 안으로 들어가 현재 위치한 JIT 메모리의 포인터 위치를 가져오기만 하는 label 함수를 만들어 봅시다.
label :: X86 Val
label = do
  addr <- gets _memoff
  ptr  <- gets _memptr
  return (A addr)
메모리 주소가 주어지면 loop 명령어는 0xE2 옵코드를 내보내고, 소스와 목적지 사이의 차이를 계산한 다음 그 값을 명령어의 즉시 데이터로 내보냅니다.
loop :: Val -> X86()
loop (A dst) = do
  emit [0xE2]
  src <- gets _memoff
  ptr <- gets _memptr
  emit [fromIntegral $ dst - src]
이제 이 팩토리얼 어셈블리의 기호적 표현을 Haskell DSL로 만들고, 계산할 Haskell 정수로 매개변수화하겠습니다.
factorial :: Int64 -> X86 ()
factorial n = do
  mov rcx (I n)
  mov rax (I 1)
  l1 <- label
  mul rcx
  loop l1
  ret
모든 것을 종합하여 함수를 JIT 컴파일하고 Haskell에서 호출하겠습니다.
main :: IO ()
main = do
  mem <- allocateMemory jitsize
  let Right st = assemble mem (factorial 5)
  fn  <- jit mem (_mach st)
  res <- fn
  putStrLn $ "Result: " <> show res
그리고 이를 실행하면 결과를 얻습니다.
$ stack exec example
Result: 120
호출 규약
마지막 과제는 JIT에서 벗어나 Haskell 런타임이나 주어진 C 함수 포인터를 호출할 수 있도록 하는 것입니다. 이를 위해서는 다른 로직으로 들어가고 나오며, 레지스터를 설정하여 다른 서브루틴에 넘겨주고 다시 돌아올 때 복원하기 위한 호출 규약(calling convention)을 살펴보아야 합니다. 64비트 System V ABI 호출 규약에서는 처음 5개의 인자가 rdi, rsi, rdx rcx, r8, r9 순서로 레지스터를 통해 전달됩니다. 그 이후의 인자는 스택을 통해 전달됩니다.
call 함수에서는 주어진 위치와 점프하려는 함수의 주소 사이의 차이를 계산하기만 하면 됩니다.
call :: Val -> X86 ()
call (A dst) = do
  emit [0xE8]
  src <- gets _memoff
  imm (dst - (src + 5))
call _ = nodef
함수를 호출하기 전후에 우리는 그 인자를 처리하고, 진입과 종료 시에 스택 프레임을 push하고 pop할 책임이 있습니다. 진입 시에는 함수 프롤로그(prologue)를, 종료 시에는 에필로그(epilogue)를 호출하며, 그 사이에 함수 로직이 놓입니다.
prologue :: X86 ()
prologue = do
  push rbp
  mov rbp rsp

epilogue :: X86 ()
epilogue = do
  pop rax
  mov rsp rbp
  pop rbp
  ret
예를 들어 JIT 내부에서 libc의 printf 함수에 문자열 포인터를 전달하여 호출해 봅시다. 이를 위해 dlsym을 사용하여 심볼 참조를 가져온 다음, 문자열 포인터를 인자 스택에 push한 후 이를 주소로서 call 명령어에 전달합니다.
printf :: Word32 -> Word32 -> X86 ()
printf fnptr msg = do
  push rbp
  mov rbp rsp
  mov rdi (A msg)
  call (A fnptr)
  pop rbp
  mov rax (I 0)
  ret
모든 것을 종합하여, printf 주소를 가져오고 asciz 함수를 사용해 Haskell 문자열에 대한 포인터를 전달함으로써 이를 호출합니다.
main :: IO ()
main = do
  let jitsize = 256*1024

  fn  <- extern "printf"
  msg <- asciz "Hello Haskell"
  mem <- allocateMemory jitsize

  let Right st = assemble mem (printf fn msg)
  join $ jit mem (_mach st)
이를 실행하면 JIT 바깥으로 손을 뻗어 친근한 인사말을 얻습니다.
$ stack exec example
Hello Haskell
이것이 바로 기본적인 JIT 컴파일의 요점입니다.