대규모 언어 모델 미세 조정 입문
대규모 언어 모델을 파인튜닝하는 방법에 대한 입문 글을 한동안 쓰고 싶었습니다. 이 분야는 매우 방대하지만 문서화가 부족하며, 특히 관련 라이브러리, 하이퍼파라미터, 기법에 관해서는 더욱 그렇기 때문입니다. 요컨대 미세 조정을 통해 모델을 특정 다운스트림 작업에 맞게 조정하고, 도메인 특화 문제에서 성능을 향상시키며, 모델의 동작을 인간의 선호에 맞추고, 베이스 모델의 특화된 변형을 만들 수 있습니다. 이는 비즈니스와 순수 연구 양쪽에서 폭넓은 응용 분야에 유용합니다.
사전 학습, 미세 조정 및 사후 학습
이는 대규모 언어 모델 개발의 기초 단계인 사전 학습과 대조됩니다. 사전 학습 동안 모델은 방대한 텍스트 코퍼스로부터 일반적인 언어 이해를 학습합니다. 예를 들어 Llama 3는 약 15.2조 개의 토큰으로 학습되었습니다. 이 과정에서는 무작위 텐서를 초기화한 뒤, 단어와 개념 사이의 통계적 패턴과 관계를 인식하도록 이를 학습시킵니다.
사전 학습 단계에는 막대한 계산 자원이 필요하며, 흔히 수백만 달러의 비용이 들고 특수한 하드웨어 구성이 요구됩니다. 조직들은 사전 학습을 완료하기 위해 보통 수백에서 수천 개의 GPU를 수 주 또는 수개월 동안 병렬로 가동합니다. 이 단계에서 모델은 인과적 언어 모델링과 같은 자기 지도 기법을 통해 학습하며, 이 기법에서 모델은 앞선 문맥이 주어졌을 때 시퀀스의 다음 토큰을 예측합니다.
사후 학습은 미세 조정 이후 모델의 성능을 더욱 다듬고 최적화하기 위해 추가적인 기법을 적용하는 단계를 말합니다. 이 단계에는 흔히 인간 피드백 기반 강화 학습(RLHF)이 포함되며, 여기서 모델은 피드백과 보상 신호를 통해 자신의 출력을 인간의 선호에 맞추도록 학습합니다. 선호 최적화는 또 다른 핵심 요소로, 모델이 특정 사용자 요구나 윤리 지침을 더 잘 충족하도록 조정하는 데 중점을 둡니다. 이러한 기법들은 모델의 동작이 원하는 결과와 가치에 부합하도록 함으로써 실제 응용에서 모델의 사용성, 안전성, 효율성을 높이는 것을 목표로 합니다.
미세 조정은 사전 학습 모델을 기반으로, 더 작은 작업 특화 데이터셋으로 추가 학습하는 방식입니다. 이 과정은 사전 학습 중에 얻은 기초적인 이해를 유지하면서 모델의 기존 지식을 특정 다운스트림 작업에 맞게 조정합니다. 전통적인 미세 조정은 모든 모델 매개변수를 갱신하므로 상당한 계산 자원이 필요합니다. 일반적으로 7B 매개변수 모델의 경우 160-192GB의 GPU 메모리가 필요합니다.
미세 조정 과정은 사전 학습된 가중치에 내재된 지식을 활용하기 때문에 특히 효과적입니다. 예를 들어 LIMA 논문은 65B 매개변수 LLaMA 모델을 단 1,000개의 고품질 지시-응답 쌍으로 미세 조정하여 GPT-3에 필적하는 성능을 달성할 수 있음을 보여 주었습니다. 그러나 이 접근 방식에는 신중한 데이터셋 선별과 전체 모델 매개변수를 처리할 수 있는 충분한 GPU 자원이 필요합니다.
주요 단계
이번 미세 조정 설정에서는 사전 학습 모델을 사용한 다음, 이를 우리만의 사용 사례에 맞게 조정하겠습니다.
-
데이터 준비:
- 데이터 수집 및 전처리
- 지시와 응답으로 구성된 데이터셋 생성
- 학습, 검증, 테스트 세트로 분할
-
모델 초기화:
- 사전 학습된 모델과 토크나이저 불러오기
- 모델 아키텍처와 하이퍼파라미터 구성
- 모델 가중치 초기화 및 LoRA 적용
-
학습:
- 학습 매개변수를 구성합니다
- 학습 데이터셋으로 모델을 학습시킵니다
- 학습 손실과 평가 손실을 모니터링합니다
-
사후 학습(선택 사항):
- DPO, KTO 또는 PPO와 같은 추가 기법을 적용하여 모델의 동작을 정렬합니다
-
압축 및 양자화(선택 사항):
- 압축 및 양자화 기법을 적용하여 모델 크기와 추론 속도를 최적화합니다
- 최종 모델을 평가하고 테스트합니다
이 글의 설정에서는 Hugging Face의 transformers 라이브러리를 사용합니다. 이 라이브러리에는 학습 과정을 제어하는 손잡이와 다이얼이 매우 많아 상당히 부담스러울 수 있으므로, 이러한 인수를 종류별로 하나씩 살펴보면서 이론과 실제를 함께 설명하겠습니다.
이러한 인수는 일반적으로 TrainingArguments 클래스를 사용하여 구성합니다. 이 인수에는 학습 에포크 수, 배치 크기, 학습률을 비롯하여 모델의 학습 역학과 성능에 영향을 미치는 기타 하이퍼파라미터 등의 설정이 포함됩니다. 최적의 결과와 효율적인 학습을 달성하려면 이러한 인수를 올바르게 구성하는 것이 매우 중요합니다.
다음은 모델 학습 루프의 기본 골격입니다.
from transformers import TrainingArguments
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer
from trl import SFTTrainer

# Step 1: Load the training dataset
train_dataset = datasets.load_dataset(
    "path/to/train/dataset"
)

# Step 2: Load the model
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-3.2-3B-Instruct",
    quantization_config=bnb_config
)

# Step 2: Load the tokenizer
tokenizer = AutoTokenizer.from_pretrained(
    "meta-llama/Llama-3.2-3B-Instruct"
)

# Step 3: Training
training_args = TrainingArguments(
    # ...
    output_dir="path/to/save/model"
)

trainer = SFTTrainer(
    model=model,
    args=training_args,
    train_dataset=train_dataset,
    # ...
)

trainer.train()

# Step 4: Post-Training

# Step 5: Compression and Quantization
또한 이러한 Python 라이브러리로 작업을 시작하려면 몇 가지 의존성을 설치해야 합니다.
# Install PyTorch
pip install "torch==2.4.0"
pip install "transformers==4.44.2"
pip install "datasets==2.21.0"
pip install "accelerate==0.33.0"
pip install "evaluate==0.4.2"
pip install "bitsandbytes==0.43.3"
pip install "trl==0.9.6"
pip install "peft==0.12.0"

# Install Flash Attention
pip install ninja packaging
pip install flash-attn --no-build-isolation
아래에서 다룰 인수 대부분은 TrainingArguments 클래스에서 구성합니다. 가장 중요한 몇 가지를 살펴보겠습니다.
사전 학습된 모델
널리 사용되는 모델에는 크게 인과(causal) 모델과 마스크(masked) 모델의 두 가지 유형이 있습니다. 인과 언어 모델은 토큰 시퀀스에서 다음 토큰을 예측하며, 모델은 왼쪽에 있는 토큰에만 어텐션할 수 있습니다. 즉, 모델은 미래의 토큰을 볼 수 없습니다. 반면 마스크 언어 모델링은 시퀀스에서 마스킹된 토큰을 예측하며, 모델은 양방향으로 토큰에 어텐션할 수 있습니다. 이 가이드에서는 인과 모델에만 초점을 맞추겠습니다.
인과 모델 중에서도 자기회귀(autoregressive) 생성형 사전 학습 트랜스포머 모델에 초점을 맞추겠습니다. 자기회귀 모델은 이전 토큰을 조건으로 하여 시퀀스의 다음 토큰을 예측하는 모델의 한 부류입니다. 이 모델은 이전 단계의 출력을 다음 단계 입력의 일부로 사용하면서 각 토큰을 단계별로 생성합니다. 또한 어텐션 메커니즘을 사용하여 이전 토큰에 어텐션합니다. 생성형 트랜스포머의 이론은 다른 많은 자료에서 잘 설명하고 있으므로 여기서는 자세히 다루지 않겠습니다.
현재 HuggingFace에는 사전 학습된 트랜스포머가 많이 공개되어 있습니다. 가장 일반적인 모델은 다음과 같습니다:
- Llama 3.1 제품군 - 8B, 70B부터 420B 매개변수에 이르는 Meta의 대표 오픈 소스 모델로, 베이스 변형과 채팅 튜닝 변형으로 제공됩니다. 미세 조정에 가장 널리 사용되는 모델이며, 비공개 모델에 필적하는 성능을 갖추고 있습니다.
- Llama 3.2 제품군 - 1B에서 3B 매개변수에 이르는 Meta의 오픈 소스 모델입니다. 이 모델들은 체급에 비해 뛰어난 성능을 보이며, 작은 크기에도 매우 강력합니다.
- Mistral 제품군 - 7B 베이스 모델과 Mixtral 8x7B 전문가 혼합(mixture-of-experts) 모델을 포함합니다. 더 적은 매개변수 수로도 경쟁력 있는 성능을 제공합니다.
- Phi-3.5 - 작은 크기에도 불구하고 강력한 추론 능력을 보여 주는 Microsoft의 2.7B 매개변수 모델입니다. 이 모델들은 언어 작업에서는 잘 동작하지만, 코딩이나 그 밖의 비언어 작업에 맞춰 학습시키는 데에는 많은 사람이 어려움을 겪습니다.
- Gemma - Google이 최근 공개한 2B 및 7B 크기의 오픈 모델 제품군입니다. Phi-3.5와 비슷한 성능을 냅니다.
어디서부터 시작해야 할지 모르겠다면 Llama 3.1 제품군을 베이스 모델로 사용하되, 8B 매개변수 모델로 시작하여 필요에 따라 더 많은 매개변수 수로 확장하는 것을 권장합니다. 다만 더 큰 모델로 확장할 때는 미세 조정을 위해 더 많은 VRAM을 확보해야 하며, 이로 인해 학습 환경이 복잡해지고 비용이 늘어날 수 있습니다.
라이선스 문제도 있습니다. Meta의 모델은 자체 Llama 라이선스를 따르며, 이 라이선스는 모델 사용을 허용하지만 상업적 목적으로 사용할 때는 특정 제한 사항을 준수하도록 요구합니다. Gemma 모델 역시 일부 상업적 사용을 제한하는 Google 자체 라이선스를 따릅니다. Mistral 모델은 허용적인 Apache 라이선스를 따르며, 저작자 표시를 하면 대부분의 용도로 사용할 수 있습니다. Phi 모델은 MIT 라이선스를 따르며, 이 역시 매우 허용적이어서 모든 용도로 사용할 수 있습니다.
매개변수 수
모델의 매개변수 수는 모델의 크기와 복잡도를 나타내는 중요한 지표입니다. 파라미터 수는 모델이 가진 가중치의 개수를 결정하며, 이는 모델이 처리할 수 있는 데이터의 양과 학습 및 추론에 필요한 연산 자원에 직접적인 영향을 줍니다.
관례상 대부분의 모델은 이름에 매개변수 수를 포함합니다. 예를 들어 meta-llama/Llama-3.2-3B-Instruct는 30억 개의 매개변수를 가지고 있습니다.
인스트럭트 모델 vs 베이스 모델
베이스 모델은 일반 텍스트 데이터로 학습하여 언어 패턴을 익히고 텍스트를 생성하는 반면, 인스트럭트 모델은 지시를 따르고 프롬프트에 응답하도록 특별히 학습된 파인튜닝 버전입니다. 예를 들어 Llama-3.2-3b는 베이스 모델이고, Llama-3.2-3b-instruct는 사용자의 지시를 더 잘 이해하고 수행하도록 파인튜닝된 모델입니다.
베이스 모델은 일반적으로 보다 범용적인 작업에 사용되고, 인스트럭트 모델은 채팅이나 지시 수행과 같은 보다 구체적인 작업에 사용됩니다. 미세 조정을 위해서는 거의 항상 채팅 템플릿과 함께 instruct 모델을 사용합니다.
GPU 클라우드 업체
미세 조정을 시작하려면 GPU를 몇 개 확보해야 합니다. 일반적으로 고급 GPU(A100, H100) 1~2개 또는 중급 GPU(A100, A6000, V100) 4~8개가 필요합니다. 작은 GPU들을 이어 붙여 클러스터를 구성하려 하기보다는, 성능이 가장 뛰어난 H100 SXM GPU를 몇 개 확보하는 편이 대개 더 쉽습니다.
SXM, PCIe, NVL은 머신러닝 워크로드에서 흔히 사용되는 세 가지 GPU 폼 팩터 및 인터커넥트 기술을 가리킵니다.
-
SXM GPU는 데이터 센터와 서버 환경을 위해 특별히 설계되었습니다. SXM GPU는 NVLink를 통해 CPU와 직접 연결되므로 기존 연결 방식에 비해 훨씬 높은 메모리 대역폭(최대 900 GB/s)을 제공합니다. 이 카드들은 과중한 워크로드에서도 높은 성능을 지속적으로 유지할 수 있도록 최적화된 열 설계로 제작되었습니다. 그러나 SXM 카드는 전용 서버 하드웨어가 필요하며, 일반적으로 PCIe 제품보다 더 비쌉니다.
-
반면 PCIe GPU는 대부분의 컴퓨터와 서버에 있는 표준 PCIe 슬롯 연결을 사용합니다. 메모리 대역폭은 더 낮지만(최대 64 GB/s), 설치 방식이 더 유연하며 표준 서버 하드웨어에서 동작합니다.
-
NVL / NVLink는 Nvidia가 개발한 고속 인터커넥트 기술로, GPU들이 더 느린 PCIe 버스를 거치지 않고 서로 직접 통신할 수 있게 해 줍니다. 이를 통해 데이터 전송이 빨라지고 병렬 컴퓨팅 작업의 성능이 향상됩니다. NVL의 최대 대역폭은 초당 4,000기가바이트(GBps)입니다.
대규모 언어 모델을 미세 조정할 때 SXM 카드는 더 높은 메모리 대역폭과 최적화된 열 설계 덕분에 일반적으로 더 나은 성능을 제공합니다. 그러나 PCIe 카드는 구하기가 더 쉽고, 대부분의 미세 조정 워크로드에서도 여전히 충분한 성능을 발휘합니다. 둘 중 무엇을 선택할지는 대개 예산 제약과 구체적인 성능 요구 사항에 따라 결정됩니다.
다행히 벤처 캐피털 자금이 넘쳐나는 덕분에 많은 클라우드 업체가 고객을 확보하기 위해 경쟁하고 있습니다. 일반적으로 이들 업체는 다양한 종류와 크기의 GPU를 대여해 줍니다. 이들 업체 대부분은 극도로 낮은 마진으로 운영되거나 큰 적자를 보고 있기 때문에, 더 나은 가격과 가용성으로 서로를 앞서려고 끊임없이 노력합니다. 이러한 상황이 얼마나 지속될지는 알 수 없지만, 지금은 GPU 클라우드 서비스를 이용하기에 좋은 시기입니다.
가장 흔히 구할 수 있는 GPU 종류는 다음과 같습니다.
| GPU 종류 | VRAM | 일반적인 사용 사례 | 시간당 대략적인 비용 | 비고 |
|---|---|---|---|---|
| H200 SXM | 141GB | 대규모 모델 학습(70B+) | $3.99-4.29 | - 최신 GPU - 대규모 모델에 최적의 성능 - 70B 매개변수 모델에 이상적임 |
| GH200 | 96GB | 대규모 모델 학습(70B+) | $2.99-3.29 | - 대규모 모델에 좋은 성능 - 70B 매개변수 모델에 이상적임 |
| H100 NVL | 94GB | 대규모 모델 학습(70B+) | $2.99-3.29 | - 대규모 모델에 최적의 성능 - 70B 매개변수 모델에 이상적임 |
| H100 SXM | 80GB | 대규모 모델 학습(70B+) | $2.79-3.29 | - 대규모 모델에 좋은 성능 - 70B 매개변수 모델에 이상적임 |
| H100 PCIe | 80GB | 대규모 모델 학습 | $2.49 | - SXM보다 대역폭이 약간 낮습니다 - 70B 매개변수 모델에 적합함 |
| A100 SXM | 80GB | 중대형 모델 학습(7-70B) | $1.79 | - 뛰어난 가격 대비 성능 - 최대 70B 모델에 적합합니다 - Flash 어텐션 2 지원 |
| A100 PCIe/SXM | 40GB | 중형 모델 학습(7-13B) | $1.29 | - 최대 13B 모델에 적합합니다 - 미세 조정에 많이 사용됨 |
| A10 | 24GB | 소형 모델 학습(<7B) | $0.75 | - 최대 7B 모델에 적합합니다 - 저렴한 선택지 |
| A6000 | 48GB | 중형 모델 학습 | $0.80 | - A100의 좋은 대안입니다 - 더 나은 가격 대비 성능 |
| V100 | 16GB | 소형 모델 학습(<7B) | $0.55 | - 구형 아키텍처 - VRAM 용량의 제약이 있습니다 - 저가형 선택지 |
모델 미세 조정 비용을 대략적으로 추산하려면 다음과 같은 개략적인 추정치를 사용할 수 있습니다:
7B 모델 미세 조정(24시간)
- H100 SXM: ~$72/일
- A100 80GB: ~$43/일
- A100 40GB: ~$31/일
- A10: ~$18/일
- V100: ~$13/일
13B 모델 미세 조정(24시간)
- H100 SXM: ~$72/일
- A100 80GB: ~$43/일
- A100 40GB: ~$31/일
70B 모델 미세 조정(24시간)
- H100 NVL: ~$74/일
- H100 SXM: ~$72/일
- 2 x A100 80GB: ~$86/일
공급업체는 보통 GPU 사용 시간, 스토리지, 데이터 전송에 대해 요금을 부과하며, 이 비용은 금방 불어날 수 있습니다. 다음은 널리 쓰이는 GPU 클라우드 공급업체 목록입니다.
- Lambda Labs - 경쟁력 있는 가격, 좋은 가용성
- RunPod - 스팟 인스턴스, 커뮤니티 템플릿
- Vast.ai - GPU 대여 마켓플레이스
- CoreWeave - 기업 중심, 높은 가용성
- Google Cloud - 다양한 선택지, 전 세계적 가용성
- AWS - 폭넓은 옵션, 다만 비쌀 수 있음
- Azure - 우수한 기업 환경 통합
- Paperspace - 개발자 친화적, Jupyter 통합
- Genesis Cloud - 저렴한 옵션
이미 Google Cloud나 AWS를 사용하는 고객이 아니라면, 가장 사용하기 쉽고 개발자 경험이 가장 좋은 Lambda Labs나 RunPod로 시작하는 것이 좋을 것입니다.
멀티 GPU 구성
더 고급 연구를 수행하여 개별 GPU보다 훨씬 강력한 하드웨어가 필요하다면, NVIDIA가 제공하는 GH200 Grace Hopper Superchip이나 HGX 클러스터 같은 특화 솔루션을 이용할 수 있습니다. GH200은 이른바 “슈퍼칩“으로, CPU와 GPU를 단일 칩에 결합하고 프로세서와 가속기 사이를 900GB/s NVLink-C2C로 연결하며 576GB의 일관성 메모리(coherent memory)를 갖추고 있습니다.
1세대 HGX 플랫폼은 여러 GPU를 AI 워크로드에 최적화된 단일 시스템으로 결합하여 이를 한 단계 더 발전시킵니다. 예를 들어 HGX H100 플랫폼은 NVLink로 상호 연결된 H100 GPU를 최대 8개까지 확장할 수 있으며, GPU 간 3.6TB/s의 이분 대역폭(bisectional bandwidth)을 제공합니다.
2세대 DGX B200은 NVLink 인터커넥트로 연결된 NVIDIA Blackwell GPU 8개를 탑재하며, 이전 세대에 비해 3배의 학습 성능과 15배의 추론 성능을 제공합니다. 이 구성은 총 1,440GB의 GPU 메모리를 갖추고 있으며, 학습에서 72 petaFLOPS, 추론에서 144 petaFLOPS를 제공합니다.
가장 큰 규모의 학습 작업을 위해 조직은 Quantum-2 InfiniBand 네트워킹으로 연결된 여러 DGX/HGX 노드를 배치하여 사실상 슈퍼컴퓨팅 시스템을 구축할 수 있습니다. 이러한 멀티 GPU 구성은 비용이 쉽게 수백만 달러에 이를 수 있습니다. 예를 들어 Llama 3 모델은 H100 GPU 16,000개(개당 $30k)로 54일 동안 쉬지 않고 학습되었습니다. 오늘날 세계에서 가장 큰 클러스터는 GPU를 10만 개 가까이 보유하고 있습니다.
일반적으로 멀티 GPU 학습을 구성할 때 사용하는 프레임워크는 세 가지입니다:
HuggingFace Accelerate는 분산 학습으로 가는 가장 간단한 길을 제공하며, 주로 PyTorch의 분산 기능을 감싸는 래퍼 역할을 합니다. 기본적인 멀티 GPU 학습 및 추론 시나리오에서 뛰어나고 DeepSpeed 및 FSDP와도 매끄럽게 통합되지만, 단독으로 사용할 때는 한계가 있습니다. 특히 Accelerate는 모델 샤딩 기능이 제한적이며, device_map="auto"는 단일 프로세스에서만 사용할 수 있습니다. 따라서 추가 도구를 활용하지 않고는 정교한 모델 병렬성에 적합하지 않습니다.
Microsoft DeepSpeed는 세 단계의 최적화를 제공하는 Zero Redundancy Optimizer를 통해 더 고급 기능을 제공합니다. ZeRO-Infinity 기능은 매개변수를 CPU와 NVMe 스토리지로 오프로딩할 수 있게 하여 거대한 모델의 학습을 가능하게 하며, GPU 간 매개변수 복제 없이 뛰어난 메모리 효율을 달성합니다. 그러나 이러한 장점에는 설정과 구성의 복잡성 증가가 뒤따릅니다. CPU/NVMe 오프로딩은 더 큰 모델의 학습을 가능하게 하지만, 학습 속도에 상당한 영향을 줄 수 있습니다. 최적의 성능을 얻으려면 사용자가 스테이지와 오프로딩 매개변수를 신중하게 구성해야 합니다.
PyTorch FSDP는 그 중간 지점에 있으며, 버전 1.11부터 PyTorch와의 네이티브 통합을 제공합니다. FSDP는 DistributedDataParallel을 바로 대체하는 용도로 사용할 수 있으며, DeepSpeed와 유사하게 CPU 오프로딩을 지원합니다. 다만 DeepSpeed에 비해 비교적 새로운 솔루션이므로, 효과적으로 구현하려면 PyTorch에 특화된 지식이 더 많이 필요할 수 있습니다.
대부분의 기본적인 멀티 GPU 학습 요구에는 Accelerate가 충분한 기능을 제공합니다. 그러나 단일 GPU 메모리 용량을 초과하는 매우 큰 모델을 학습할 때는 DeepSpeed나 FSDP 중 하나가 필요합니다. DeepSpeed는 더 긴 역사와 여러 최적화 단계 덕분에 대규모 학습에서 검증된 선택지이며, FSDP의 긴밀한 PyTorch 통합은 이미 PyTorch 생태계에 깊이 투자한 팀에게 매력적일 수 있습니다.
멀티 GPU 학습에 대해서는 제가 드릴 수 있는 조언이 많지 않습니다. 이 정도 규모의 모델을 학습해야 한다면 대개 매우 특수한 요구 사항이 있어서 맞춤형 학습 소프트웨어 구성과 맞춤형 하드웨어가 필요하기 때문입니다. 따라서 여기서는 자세히 다루지 않겠습니다. 이 주제를 더 자세히 다루는 주요 모델 연구소들의 다른 가이드가 있습니다. 이러한 종류의 클러스터 구성에 대한 개략적인 정보는 DeepSpeed에 관한 제 글을 참고하십시오.
매개변수 효율적 미세 조정(PEFT)
전체 튜닝과 비교했을 때, 대규모 언어 모델을 미세 조정하는 가장 일반적인 기법은 매개변수 효율적 미세 조정(PEFT)입니다. 이는 미세 조정 중에 모든 모델 매개변수를 갱신하는 전체 튜닝과 대조되는데, 전체 튜닝에는 상당한 연산 자원과 메모리가 필요합니다. 반면 PEFT 방법은 성능을 유지하면서 연산 요구량을 극적으로 줄여, 대규모 언어 모델을 적응시키는 방식에 혁신을 가져왔습니다. PEFT 방법은 모든 모델 매개변수를 갱신하는 대신 매개변수의 작은 부분집합만 전략적으로 수정하거나 제한된 수의 새로운 학습 가능 매개변수를 도입하므로, 과정이 훨씬 더 효율적입니다.
가장 대표적인 PEFT 기법은 **Low-Rank Adaptation(LoRA)**으로, 효율적인 모델 적응을 위한 사실상의 표준이 되었습니다. LoRA는 사전 학습된 가중치를 고정한 채로 모델의 특정 레이어에 학습 가능한 작은 랭크 분해 행렬을 추가하는 방식으로 작동합니다. 이 접근 방식은 전체 미세 조정에 비해 학습 가능한 매개변수 수를 최대 10,000배, GPU 메모리 요구량을 3배 이상 줄일 수 있습니다.
4비트 양자화 기법과 결합하면(QLoRA) 메모리 절감 효과는 훨씬 더 극적으로 커집니다. QLoRA를 사용하면 NVIDIA RTX 3090 같은 소비자용 하드웨어에서 700억 개 매개변수 규모의 모델까지 학습할 수 있습니다. 이는 전통적으로 A100-80GB GPU 16개 이상이 필요한 작업입니다. QLoRA는 다음과 같은 몇 가지 핵심 혁신을 통해 이를 달성합니다:
- 동결된 4비트 양자화 사전 학습 모델을 거쳐 저랭크 어댑터(Low-Rank Adapters)로 역전파를 수행합니다
- 정규 분포를 따르는 가중치에 특화하여 최적화된 4-bit NormalFloat(NF4)라는 새로운 데이터 타입을 도입합니다
- 양자화 상수 자체를 양자화하는 이중 양자화를 구현하여 메모리 사용량을 줄입니다
- 페이징 옵티마이저를 사용하여 학습 중 발생하는 메모리 급증을 처리합니다
QLoRA의 효과는 메모리 요구량을 대폭 줄이면서도 완전한 16비트 미세 조정 작업 성능을 유지하는 능력에서 비롯됩니다. 덕분에 보통은 고성능 GPU 클러스터가 필요한 대형 모델을 단일 GPU에서 파인튜닝할 수 있습니다.
LoRA 매개변수
LoRA 미세 조정을 수행할 때는 미세 조정 과정의 동작을 정의하는 몇 가지 핵심(core) 매개변수가 있습니다:
LoRA 랭크(r)
LoRA 랭크는 사용되는 랭크 분해 행렬의 수를 결정합니다. 이를 모델이 사용할 수 있는 “학습 차원“의 수라고 생각하십시오. 신경망에 뉴런이 더 많을수록 더 정교한 관계를 모델링할 수 있는 것처럼, 랭크가 높을수록 모델은 더 미묘하고 복잡한 패턴을 학습할 수 있습니다. 하지만 뉴런을 더 추가할 때와 마찬가지로, 랭크가 높을수록 더 많은 메모리와 연산 능력이 필요합니다. 원래 LoRA 논문에서는 적절한 균형점으로 랭크 8부터 시작할 것을 권장합니다. 기본적인 텍스트 분류처럼 비교적 단순한 태스크에는 이것으로 충분할 수 있지만, 창의적 글쓰기나 복잡한 추론처럼 더 복잡한 태스크에는 16이나 32로 높이는 것이 좋을 수 있습니다. 다만 랭크가 높을수록 더 많은 GPU 메모리가 필요하고 학습 시간도 길어진다는 점을 염두에 두십시오.
LoRA 알파
알파 매개변수는 동결된 사전 학습 가중치에 비해 LoRA 적응이 얼마나 큰 영향을 미칠지 결정하는 스케일링 계수 역할을 합니다. 볼륨 조절 손잡이와 같다고 생각하십시오. 알파가 높을수록 LoRA의 변경 사항이 원래 모델의 목소리에 비해 더 크게 들리고, 알파를 로어링하면(낮추면) 변경 사항이 더 미묘하게 유지됩니다. 알파는 학습 중 업데이트의 크기를 조절하는 데 도움이 됩니다. 랭크와 알파의 관계가 중요합니다. 일반적으로 시작점으로 알파를 랭크 값의 2배로 설정합니다(즉, 랭크가 8이면 알파는 16이 됩니다). 이러한 스케일링은 의미 있는 업데이트가 일어나도록 하면서 안정적인 학습을 보장하는 데 도움이 됩니다. 마치 원래 소리를 묻어 버리지 않으면서도 변화를 또렷이 들을 수 있는 볼륨 노브의 최적 지점을 찾는 것과 비슷합니다.
LoRA 드롭아웃
드롭아웃은 과적합을 방지하기 위해 머신러닝에서 사용하는 정규화 기법입니다. 드롭아웃은 훈련 중에 일정 비율의 뉴런을 무작위로 탈락시키는(0으로 설정하는) 방식으로 작동합니다. 이렇게 하면 남은 뉴런이 더 견고하고 일반화된 특징을 학습할 수밖에 없게 되어, 처음 보는 데이터에 잘 일반화되지 않을 수 있는 특정 패턴에 대한 의존도가 줄어듭니다. LoRA에서 드롭아웃은 훈련 중에 저랭크 적응 행렬에 적용됩니다. 드롭아웃을 도입하면 모델이 어느 하나의 적응 경로에 지나치게 의존하지 않게 되므로 일반화 성능과 견고성이 향상됩니다. 아주 대략적으로 비유하자면, 연습 중에 가끔 일부 선수를 무작위로 벤치에 앉히는 축구팀을 떠올려 보십시오. 이렇게 하면 남은 선수들이 분발하여 기량을 키울 수밖에 없으므로, 팀 전체가 더 강해지고 다재다능해집니다.
LoRA 드롭아웃의 일반적인 기본값은 보통 0.0에서 0.3 사이입니다. 드롭아웃 비율 0.05는 정규화와 효과적인 학습에 충분한 활성 뉴런 유지 사이의 균형을 잡아 주므로 좋은 출발점이 되는 경우가 많습니다. 모델에 여전히 과적합 징후가 보인다면 드롭아웃 비율을 0.2나 0.3으로 높일 수 있습니다. LoRA 어댑터에서 많은 수의 레이어를 훈련한다면, 늘어난 레이어 수를 보완하기 위해 드롭아웃 비율을 높이는 것이 좋을 수 있습니다.
LoRA 바이어스
LoRA의 바이어스 매개변수는 저랭크 적응 행렬의 출력에 더해지는 가산 항을 가리킵니다. 바이어스를 사용하면 모델이 입력에 대한 추가 오프셋을 학습할 수 있어 더 유연하고 동적인 응답이 가능해집니다. 바이어스 항은 입력 데이터의 기준값이 0이 아니거나 입력과 출력의 관계가 순수하게 선형적이지 않은 상황에서 특히 유용합니다. 바이어스를 추가하면 모델이 이러한 변동을 더 잘 포착하고 조정할 수 있으므로 전반적인 성능과 일반화 성능이 향상됩니다.
바이어스의 기본값은 "none"이며, 이는 바이어스를 추가하지 않는다는 뜻입니다. 하지만 경우에 따라 LoRA 적응 행렬에 바이어스 항을 추가하고 싶을 수 있습니다. 다른 옵션으로는 "all"과 "lora_only"가 있으며, 각각 모든 행렬에 바이어스 항을 추가하거나 LoRA 행렬에만 바이어스 항을 추가합니다.
LoRA 대상 모듈
LoRA에서 대상 모듈을 선택하는 것은 모델의 적응성과 계산 효율성 모두에 직접적인 영향을 미치는 중요한 아키텍처 결정입니다. 트랜스포머 기반 아키텍처에서 이러한 모듈은 모델 처리 파이프라인의 여러 측면을 담당하는 다양한 프로젝션 행렬과 구성 요소로 이루어져 있습니다.
-
임베딩 레이어(
embed_tokens)는 입력 토큰과 맞닿는 모델의 첫 번째 인터페이스로, 이산적인 토큰 ID를 연속적인 벡터 표현으로 변환합니다. 임베딩을 LoRA 대상에 포함할 수는 있지만, 모델 성능이 그에 비례해 향상되지 않으면서 메모리 사용량이 크게 늘어날 수 있으므로 일반적으로 권장하지 않습니다. 임베딩 레이어는 어휘 크기 때문에 보통 매개변수가 많아 LoRA 적응에 덜 효율적입니다. -
정규화 레이어(
norm)는 활성화 값을 표준화하여 네트워크의 내부 표현을 안정화하는 데 도움을 줍니다. 이 레이어들은 매개변수가 비교적 적으며, 안정적인 훈련 동역학을 유지하는 데 매우 중요합니다. 하지만 이 레이어들의 역할은 복잡한 패턴 학습보다는 주로 통계적 정규화이므로 LoRA 적응 대상으로 삼는 경우는 드뭅니다. norm 레이어를 LoRA 대상에 포함하면 일반적으로 얻는 이점은 미미한 반면 훈련이 불안정해질 수 있습니다. -
언어 모델링 헤드(
lm_head)는 모델의 내부 표현을 토큰 예측을 위한 어휘 크기의 로짓으로 다시 변환하는 역할을 합니다. 이 레이어는 최종 출력에 매우 중요하지만, LoRA 대상으로 포함할 필요는 일반적으로 없습니다.lm_head는 가중치 묶기(weight tying)를 통해 임베딩 레이어와 가중치를 공유하는 경우가 많으므로, 이를 따로 적응시키면 큰 이점 없이 이 대칭성이 깨질 수 있습니다. -
핵심(Core) 어텐션 메커니즘 구성 요소는 여전히 LoRA 적응에 가장 효과적인 대상입니다. 쿼리 프로젝션 행렬(
q_proj)은 입력 임베딩을 쿼리 벡터로 변환하며, 모델이 컨텍스트 안에서 관련 정보를 어떻게 탐색할지를 결정합니다. 키 프로젝션 행렬(k_proj)은 입력의 서로 다른 부분 간 관계를 형성하는 데 도움이 되는 키 벡터를 생성하고, 밸류 프로젝션 행렬(v_proj)은 입력을 추출할 실제 정보를 담은 밸류 벡터로 변환합니다. 이 세 가지 프로젝션은 셀프 어텐션 메커니즘의 근간을 이루며, 그중q_proj와v_proj가 적응에 가장 중요한 대상인 경우가 많습니다. -
출력 프로젝션 행렬(
o_proj)은 결합된 어텐션 출력이 후속 레이어로 넘어가기 전에 이를 처리합니다. 이 변환은 어텐션 메커니즘의 출력이 모델의 전체 아키텍처와 호환되도록 보장합니다. 더 복잡한 아키텍처를 가진 모델에는 레이어 간 차원 변환을 담당하는 상향 프로젝션(up_proj) 행렬과 하향 프로젝션(down_proj) 행렬도 있습니다.
LoRA로 미세 조정할 때는 어텐션 구성 요소만을 대상으로 하는 집중적인 접근 방식으로 시작하는 것을 권장합니다:
lora_config = LoraConfig(
    target_modules=["q_proj", "v_proj"],
    r=8,
    lora_alpha=16,
    lora_dropout=0.1
)
더 까다로운 작업이거나 초기 결과가 만족스럽지 않은 경우에는 추가 프로젝션 행렬을 포함하도록 범위를 넓힐 수 있습니다.
lora_config = LoraConfig(
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj"],
    r=16,
    lora_alpha=32,
    lora_dropout=0.1
)
PEFT를 사용해 모델을 파인튜닝하려면 transformers, peft, trl 라이브러리를 설치해야 합니다. 다음은 LoRA 모델을 구성하고 파인튜닝하는 방법의 예시입니다.
from peft import LoraConfig, PeftModel

# QLoRA parameters
lora_config = LoraConfig(
    r=64,                   # LoRA attention dimension
    lora_alpha=16,          # LoRA scale factor
    lora_dropout=0.1,       # Dropout probability
    bias="none",
    task_type="CAUSAL_LM"
)

lora_model = get_peft_model(model, lora_config)
lora_model.print_trainable_parameters()
# trainable params: 1,572,864 || all params: 332,769,280 || trainable%: 0.472659014678278
대부분의 경우 LoRA 하이퍼파라미터를 조정하는 것은 시간을 가장 효율적으로 쓰는 방법이 아닙니다. 따라서 기본값으로 시작하고, 과적합이나 과소적합의 뚜렷한 징후가 보일 때만 조정할 것을 권장합니다. 가장 큰 성능 향상은 대개 하이퍼파라미터 튜닝보다는 더 나은 데이터셋 큐레이션에서 나옵니다. 그러나 값을 탐색(sweep)하려 한다면, 기본값부터 증가하는 순서로 정리한 다음 매개변수 조합들을 시도해 볼 수 있으며, 이들은 좋은 결과를 낼 수도 있습니다:
- r=16, lora_alpha=16
- r=16, lora_alpha=32
- r=32, lora_alpha=64
- r=64, lora_alpha=128
- r=128, lora_alpha=256
- r=256, lora_alpha=512
예를 들어 모든 선형 레이어에 랭크 256과 알파 128을 사용하려면 다음 구성을 사용하십시오.
peft_config = LoraConfig(
    r=256,
    lora_alpha=128,
    lora_dropout=0.05,
    bias="none",
    target_modules="all-linear",
    task_type="CAUSAL_LM",
)
양자화된 LoRA
QLoRA를 사용하려면 bitsandbytes 라이브러리도 설치해야 합니다.
# 4-bit quantization config
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.float16,
    bnb_4bit_use_double_quant=True
)
모델 불러오기
Hugging Face 모델 허브에서 사전 학습된 모델을 불러올 때는 from_pretrained() 메서드를 사용합니다. 이 메서드는 지정된 저장소에서 모델 가중치와 구성을 다운로드합니다. 모델 아키텍처와 가중치는 저장소 이름을 기반으로 자동으로 결정됩니다.
torch_dtype 매개변수를 사용하여 로드되는 모델 가중치의 정밀도를 제어할 수 있습니다. 일반적인 옵션은 다음과 같습니다.
torch.float32(기본값): 완전 정밀도이며, 메모리를 더 많이 사용하지만 정확도가 가장 높습니다torch.float16: 반정밀도이며, 좋은 정확도를 유지하면서 메모리 사용량을 줄입니다torch.bfloat16: Google Brain 부동소수점 형식으로, float16보다 수치 안정성이 더 우수합니다
예를 들어, 앞에서 설정한 QLoRA 구성에 맞춰 4비트 양자화를 사용하여 모델을 로드하려면 다음과 같이 합니다:
from peft import prepare_model_for_kbit_training

model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-3.2-3B-Instruct",
    quantization_config=bnb_config
)

model = prepare_model_for_kbit_training(model)
Hugging Face에서 가져온 파일은 다음과 같습니다:
├── config.json
├── generation_config.json
├── model-00001-of-00002.safetensors
├── model-00002-of-00002.safetensors
├── model.safetensors.index.json
├── special_tokens_map.json
├── tokenizer.json
└── tokenizer_config.json
각 파일에는 서로 다른 정보가 담겨 있습니다:
config.json: 모델의 아키텍처 구성과 하이퍼파라미터가 담겨 있습니다generation_config.json: temperature, top-p 샘플링 등 텍스트 생성 설정을 저장합니다model-00001-of-00002.safetensors: SafeTensors 형식으로 저장된 모델 가중치의 첫 번째 부분입니다model-00002-of-00002.safetensors: SafeTensors 형식으로 저장된 모델 가중치의 두 번째 부분입니다model.safetensors.index.json: 각 가중치 텐서가 분할된 파일 중 어디에 있는지 매핑하는 인덱스 파일입니다special_tokens_map.json:<|endoftext|>같은 특수 토큰을 해당 ID에 매핑합니다tokenizer.json: 토크나이저의 어휘와 구성이 담겨 있습니다tokenizer_config.json: 추가 토크나이저 설정 및 매개변수
SafeTensors는 모델 가중치와 텐서를 저장하기 위해 특별히 설계된 파일 형식입니다. 이 형식은 임의의 코드를 실행할 수 있어 보안 위험이 있는 Python pickle 형식을 대체하기 위해, 더 안전하고 효율적인 형식으로 만들어졌습니다. .safetensors 파일은 모델의 실제 학습된 매개변수(가중치)를 담고 있으므로 일반적으로 매우 큽니다(흔히 수 기가바이트).
이 파일들은 모델의 가중치를 레이어별로 정리하여 바이너리 형식의 원시 수치 배열로 저장합니다. 트랜스포머 모델의 경우 여기에는 어텐션 레이어 가중치와 편향, 피드포워드 네트워크 매개변수, 레이어 정규화 매개변수, 임베딩 행렬, 위치 인코딩 가중치가 포함됩니다.
개별 파일이 너무 커져 효율적으로 다루기 어려울 수 있기 때문에 가중치는 여러 파일(예: model-00001-of-00002.safetensors)로 나뉘어 저장됩니다. 최신 언어 모델에서는 파일 하나가 10GB 이상이 될 수도 있습니다. 또한 파일을 분할하면 병렬 다운로드가 가능해지고 메모리 매핑도 더 효율적으로 할 수 있습니다.
SafeTensors는 메모리 매핑을 통한 메모리 효율적인 로딩, 빠른 직렬화 및 역직렬화 속도, 내장된 타입 안전성과 검증 기능, 임의 코드 실행으로 인한 보안 취약점 제거 등 상당한 이점을 제공합니다. 따라서 대용량 가중치 파일을 안전하고 효율적으로 다루는 것이 중요한 대규모 언어 모델을 저장하고 배포하는 데 이상적인 형식입니다.
모델 가중치를 저장하는 데 흔히 사용되는 파일 형식은 세 가지입니다:
-
.pth- Python의 pickle 직렬화를 사용하는 PyTorch의 기본 형식입니다. 널리 사용되지만, pickle로 직렬화된 파일은 임의의 코드를 실행할 수 있으므로 보안상 우려가 있습니다. 주로 PyTorch 모델과 연구 프로젝트에서 사용됩니다. -
.safetensors- ML 모델을 위해 특별히 설계된 최신 형식으로, .pth 파일보다 더 나은 보안성과 성능을 제공합니다. 메모리 효율적이고 로딩이 빠르며, 코드 실행 취약점을 방지합니다. Hugging Face 모델의 표준 형식으로 자리 잡아 가고 있습니다. -
.gguf- llama.cpp 및 유사한 프로젝트에서 사용하는 “GPT-Generated Unified Format“입니다. 일반 소비자용 하드웨어에서의 추론에 최적화되어 있으며, 다양한 양자화 방식을 지원합니다. 이 형식은 크기가 작으며, 양자화된 모델을 효율적으로 로드하도록 설계되었습니다.
모델은 일반적으로 로컬 머신의 HuggingFace 캐시에 저장됩니다. 이 캐시는 보통 ~/.cache/huggingface/hub에 있습니다. 모델을 많이 다운로드하면 이 폴더가 상당히 커질 수 있습니다. 따라서 주기적으로 정리하는 것이 좋습니다.
토크나이저 불러오기
토크나이저는 텍스트를 모델이 처리하는 데이터의 기본 단위인 토큰으로 변환하는 데 사용됩니다. 토크나이저는 특수 토큰도 처리하며, 텍스트 처리를 위한 다양한 설정 옵션을 제공합니다.
tokenizer = AutoTokenizer.from_pretrained(
    "meta-llama/Llama-3.2-3B-Instruct",
)
토크나이저의 주요 설정 옵션은 다음과 같습니다:
| 매개변수 | 설명 | 값 |
|---|---|---|
padding_side | 패딩 토큰을 어느 쪽에 추가할지 결정합니다 | "right"(기본값) 또는 "left" |
truncation_side | 최대 길이를 초과할 때 텍스트를 어느 쪽에서 잘라낼지 결정합니다 | "right"(기본값) 또는 "left" |
chat_template | 채팅 메시지 형식 지정을 위한 Jinja 템플릿 | 채팅 템플릿 명세를 따르는 문자열 템플릿 |
model_input_names | 모델의 순방향 패스가 받는 입력 목록 | 예: ["input_ids", "attention_mask"] |
위의 옵션 외에도 토크나이저는 특수 토큰을 처리합니다. 특수 토큰에는 특별한 이름이 붙으며, 모델 아키텍처마다 다릅니다. 예를 들면 다음과 같습니다:
| 토큰 | 설명 |
|---|---|
bos_token | 시퀀스 시작 토큰 |
eos_token | 시퀀스 종료 토큰 |
unk_token | 알 수 없는 단어를 나타내는 토큰 |
sep_token | 문장 사이의 구분자 토큰 |
pad_token | 배치 처리를 위한 패딩 토큰 |
토크나이저는 텍스트를 인코딩할 때 여러 형식의 텐서를 반환할 수 있습니다:
| 반환 유형 | 설명 | 예제 |
|---|---|---|
tf | TensorFlow 텐서 | return_tensors="tf" |
pt | PyTorch 텐서 | return_tensors="pt" |
np | NumPy 배열 | return_tensors="np" |
# PyTorch tensors
tokens_pt = tokenizer("Hello world", return_tensors="pt")

# NumPy arrays
tokens_np = tokenizer("Hello world", return_tensors="np")
토크나이저는 기본적으로 토큰을 나타내는 정수 리스트를 반환합니다. Llama 3.2 토크나이저를 예로 들어 보겠습니다:
tokens = tokenizer.encode("The brown bear is a species of bear that is native to North America.")
print(tokens)
출력은 다음과 같습니다:
[128000, 791, 14198, 11984, 374, 264, 9606, 315, 11984, 430, 374, 10068, 311, 4892, 5270, 13]
이 스트림에서:
- 128000은
bos_token입니다 - 13은
eos_token입니다 - 그 사이의 숫자들은 텍스트의 실제 토큰을 나타냅니다
패딩
패딩은 언어 모델 학습에서 중요한 개념으로, 길이가 서로 다른 시퀀스를 배치로 처리할 수 있게 해 줍니다. LLM은 일반적으로 패딩 없이 사전 학습되지만, 사용자 정의 데이터셋으로 작업하는 미세 조정 중에는 패딩이 필요해집니다.
패딩은 특수한 “pad” 토큰을 추가하여 짧은 시퀀스를 배치에서 가장 긴 시퀀스의 길이에 맞게 늘리는 것입니다. 이를 통해 배치 안의 모든 시퀀스가 같은 길이를 가지게 되어 효율적으로 처리할 수 있습니다. 배치 단위로 학습할 때는 GPU 처리에 맞는 텐서를 만들기 위해 모든 시퀀스의 길이가 같아야 합니다. 예를 들면 다음과 같습니다:
# Original sequences of different lengths
sequence1 = [1, 887, 526, 451, 263, 13563, 7451, 29889]  # Length 8
sequence2 = [1, 887, 526, 451, 29889]                    # Length 5

# After padding (using 32000 as pad token)
sequence1 = [1, 887, 526, 451, 263, 13563, 7451, 29889]     # Unchanged
sequence2 = [1, 887, 526, 451, 29889, 32000, 32000, 32000]  # Padded
패딩과 함께, 어떤 토큰이 실제 토큰이고 어떤 토큰이 패딩인지 모델에 알려 주는 어텐션 마스크가 필요합니다:
# Attention masks (1 for real tokens, 0 for padding)
mask1 = [1, 1, 1, 1, 1, 1, 1, 1]        # All real tokens
mask2 = [1, 1, 1, 1, 1, 0, 0, 0]        # Last 3 are padding
패딩 토큰을 추가하는 방법은 두 가지입니다:
-
오른쪽 패딩 (가장 일반적):
sequence = [1, 887, 526, 451, 29889, PAD, PAD, PAD] -
왼쪽 패딩:
sequence = [PAD, PAD, PAD, 1, 887, 526, 451, 29889]
기존 특수 토큰(EOS는 “더 이상 내용이 없음“을 나타내므로 그 예입니다)을 사용하거나, 패딩 전용 토큰을 새로 만들 수 있습니다.
# Configure tokenizer for padding
tokenizer.padding_side = "right"  # or "left"
tokenizer.pad_token = tokenizer.eos_token  # Using EOS as pad token

# Or create a new pad token (if your model doesn't already have one)
tokenizer.add_special_tokens({'pad_token': '[PAD]'})

# Apply padding when tokenizing
inputs = tokenizer(
    sequences,
    padding='max_length',
    max_length=512,
    truncation=True,
    return_tensors="pt"
)
새 패딩 토큰을 추가한다면 모델 임베딩의 크기를 조정해야 한다는 점을 기억하십시오:
model.resize_token_embeddings(len(tokenizer))
패딩 전략의 선택은 모델 성능에 영향을 줄 수 있습니다. 오른쪽 패딩은 자연스러운 시퀀스 순서를 유지하므로 자기회귀 모델에 더 적합하고, 왼쪽 패딩은 양방향 모델에서 더 효율적일 수 있습니다. 최대 길이는 데이터셋의 길이 분포를 바탕으로 설정해야 하며, 이 분포는 데이터셋에 있는 시퀀스의 최대 길이를 구해 측정할 수 있습니다.
어텐션 마스크
어텐션 마스크는 처리 과정에서 모델이 어떤 토큰에 주의를 기울여야 하고(1) 어떤 토큰을 무시해야 하는지(0)를 나타내는 이진 텐서입니다. 이는 길이가 서로 달라 패딩이 필요한 시퀀스들을 배치로 다룰 때 특히 중요합니다.
예를 들어 길이가 서로 다른 두 시퀀스가 있다면 다음과 같습니다:
sequences = [
    "The cat sat on the mat.",
    "Hello world"
]

# Set the pad token to the eos token
tokenizer.pad_token = tokenizer.eos_token

# Tokenize with padding
encoded = tokenizer(
    sequences,
    padding=True,
    return_tensors="pt"
)
그러면 다음과 비슷한 결과가 출력됩니다:
{
    'input_ids': tensor([
        [128000,    791,   8415,   7731,    389,    279,   5634,     13],
        [128000,   9906,   1917, 128009, 128009, 128009, 128009, 128009]
    ]),
    'attention_mask': tensor([
        [1, 1, 1, 1, 1, 1, 1, 1],
        [1, 1, 1, 0, 0, 0, 0, 0]
    ])
}
1은 어텐션을 적용해야 하는 실제 토큰을 나타내고, 0은 무시해야 하는 패딩 토큰을 나타냅니다. 이렇게 하면 모델이 패딩 토큰에서 의미 있는 패턴을 찾으려 하는 것을 막을 수 있습니다.
디코딩
토큰을 다시 텍스트로 변환하려면 토크나이저의 decode 메서드를 사용하십시오:
# Decode a single sequence
tokens = [128000, 791, 14198, 11984, 374, 264, 9606, 315, 11984, 13]
text = tokenizer.decode(tokens)
print(text)
# <|begin_of_text|>The brown bear is a species of bear.

# Decode batched sequences
batch_tokens = encoded["input_ids"]
texts = tokenizer.batch_decode(batch_tokens)
print(texts)
# ['<|begin_of_text|>The cat sat on the mat.', '<|begin_of_text|>Hello world<|eot_id|><|eot_id|><|eot_id|><|eot_id|><|eot_id|>']
decode 메서드는 다음을 처리합니다:
- 기본적으로 특수 토큰(BOS/EOS 등) 제거
- 토큰 ID를 다시 서브워드로 변환
- 서브워드를 완전한 단어로 결합
- 공백과 문장 부호 처리
skip_special_tokens 매개변수로 특수 토큰 처리 방식을 제어할 수 있습니다:
# Keep special tokens
text_with_special = tokenizer.decode(tokens, skip_special_tokens=False)
# <|begin_of_text|>The brown bear is a species of bear.

# Remove special tokens (default)
text_without_special = tokenizer.decode(tokens, skip_special_tokens=True)
# The brown bear is a species of bear.
데이터를 GPU로 옮기기
언어 모델을 학습하거나 사용할 때 데이터를 GPU로 옮기는 것은 좋은 성능을 얻기 위한 핵심 단계입니다. 최신 언어 모델은 연산량이 매우 많으며, GPU는 모델 추론과 학습의 핵심(Core)을 이루는 병렬 행렬 연산을 처리하도록 특별히 설계되었습니다. 모델을 GPU로 옮기려면 모델 가중치와 입력 텐서를 모두 CPU 메모리에서 GPU 메모리로 전송해야 하며, GPU 메모리에서는 계산을 훨씬 더 효율적으로 수행할 수 있습니다.
데이터를 GPU로 옮기는 과정은 PyTorch의 디바이스 관리 시스템을 통해 처리됩니다. 모델의 경우 일반적으로 cuda를 대상 장치로 하여 .to() 메서드를 호출하며, 이를 통해 모든 모델 매개변수가 GPU 메모리로 전송됩니다. 마찬가지로 토큰 ID나 어텐션 마스크 같은 입력 텐서도 모델과 같은 디바이스로 옮겨야 합니다. 이렇게 하면 성능 병목을 일으키는 불필요한 CPU 메모리로의 역전송 없이 모든 연산을 GPU에서 수행할 수 있습니다. 모델과 입력 텐서는 GPU에 있어야 하지만, 토크나이저 자체는 GPU 가속의 이점을 얻지 못하는 텍스트 처리 연산을 수행하므로 CPU에 그대로 남아 있다는 점에 유의해야 합니다.
model.to("cuda")
tokens_pt = tokens_pt.to("cuda")
PyTorch의 디바이스 맵을 사용하면 모델 레이어를 사용 가능한 디바이스(GPU와 CPU)에 어떻게 분산할지 지정할 수 있습니다. 이는 단일 GPU에 들어가지 않는 대규모 언어 모델을 다룰 때 특히 유용합니다. 디바이스 맵은 모델 구성 요소를 특정 디바이스에 매핑하는 딕셔너리입니다.
모델을 로드할 때 device_map="auto"를 설정하면 모델 레이어를 사용 가능한 GPU와 CPU에 자동으로 분산할 수 있습니다. 이렇게 하면 먼저 GPU의 사용 가능한 공간을 모두 채우고, 그다음 CPU를 채우며, 그래도 메모리가 부족하면 마지막으로 하드 드라이브를 사용합니다.
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Llama-3.2-3B-Instruct",
    device_map="auto"
)
PyTorch 메모리 관리자는 GPU 메모리를 자동으로 관리하지만, 이 메모리는 Python 가비지 컬렉터와 연결되어 있으므로 때로는 모델에 대한 힙 참조를 삭제하고 가비지 컬렉터를 수동으로 호출하여 메모리를 비우는 방식으로 직접 메모리를 해제해야 합니다. 이러한 상황은 자신이 사용한 자원을 제대로 정리하지 못하는 예외 처리 로직이나, 때때로 객체를 메모리에 남겨 두는 IPython 노트북을 사용할 때 발생할 수 있습니다.
import gc
del model
del trainer

gc.collect()
torch.cuda.empty_cache()
채팅 형식
채팅 모델은 대화가 특정한 방식으로 형식화되어 있기를 기대합니다. 잘못된 형식을 사용하면 모델 성능이 크게 저하될 수 있으므로, 모델이 학습된 형식과 일치시키는 것이 중요합니다.
가장 일반적인 형식은 Llama 스타일로, 메시지를 특정 제어 토큰으로 감쌉니다.
conversation = [
    {
        "role": "system",
        "content": "You are a helpful assistant"
    },
    {
        "role": "user",
        "content": "What type of bear is the best bear?"
    }
]
형식화된 대화는 다음과 같습니다.
<|begin_of_text|><|start_header_id|>system<|end_header_id|>
You are a helpful assistant<|eot_id|>
<|start_header_id|>user<|end_header_id|>
What type of bear is the best bear?<|eot_id|>
<|start_header_id|>assistant<|end_header_id|>
The brown bear is the best bear.<|eot_id|>
채팅을 문자열로 형식화하는 가장 쉬운 방법은 토크나이저를 통해 모델에 내장된 채팅 템플릿을 사용하는 것입니다.
formatted_chat = tokenizer.apply_chat_template(
    conversation,
    tokenize=False,
    add_generation_prompt=True
)
add_generation_prompt 매개변수를 True로 설정하면 포맷된 채팅 끝에 어시스턴트 역할 토큰이 추가됩니다. 이는 모델에게 다음으로 어시스턴트의 응답을 생성해야 한다는 신호를 주므로, 텍스트 생성을 위해 대화를 준비할 때 유용합니다. False로 설정하면 생성 프롬프트를 추가하지 않고 기존 대화만 형식화합니다.
또한 trl 라이브러리를 사용할 때는 채팅을 직접 형식화할 필요 없이, 여러 형식 중 하나로 대화를 트레이너에 그대로 전달하면 됩니다.
- 대화 형식
{
    "messages": [
        {"role": "system", "content": "You are helpful bear assistant"},
        {"role": "user", "content": "What type of bear is the best bear?"},
        {"role": "assistant", "content": "The brown bear is the best bear."}
    ]
}
- 지시 형식
{
    "prompt": "Where do the polar bears live?",
    "completion": "The polar bear lives in the Arctic."
}
- 텍스트 형식
{
    "text": "The American black bear is indigenous to North America."
}
채팅 대화에서 역할은 다음과 같습니다.
| 역할 | 설명 |
|---|---|
| system | 모델과 상호작용할 맥락을 설정합니다. 일반적으로 모델이 효과적으로 응답하는 데 도움이 되는 규칙, 지침 또는 필요한 정보를 포함합니다. |
| user | 모델과 상호작용하는 사람을 나타냅니다. 여기에는 모델에 대한 입력, 명령, 질문이 포함됩니다. |
| assistant | system과 user 프롬프트에서 제공된 맥락을 바탕으로 AI 모델이 생성한 응답을 나타냅니다. |
모델을 미세 조정할 때는 모델이 원래 학습된 것과 동일한 채팅 형식을 사용하는 것이 매우 중요합니다. 다른 형식을 사용하면 성능이 크게 저하되거나 모델이 예측할 수 없는 방식으로 동작할 수 있습니다.
학습 데이터셋
미세 조정을 위한 학습 데이터는 목표 사용 사례에 맞도록 신중하게 선별해야 합니다. 데이터셋은 일반적으로 원하는 동작을 보여 주는 입력-출력 쌍으로 구성됩니다. 인스트럭션 튜닝의 경우, 이는 지시/질문과 고품질 응답의 쌍을 의미합니다.
미세 조정이 해당 사용 사례에 적합한 해결책이라고 판단했다면, 모델을 학습시킬 데이터셋을 만들어야 합니다. 이 데이터셋에는 모델이 학습하기를 원하는 특정 작업이나 동작을 보여 주는 다양한 예시가 포함되어야 합니다. 인스트럭션 데이터셋을 만드는 데에는 몇 가지 정립된 접근 방식이 있습니다.
한 가지 일반적인 접근 방식은 SQL 작업을 위한 Spider (https://huggingface.co/datasets/spider), 질의응답을 위한 SQuAD (https://huggingface.co/datasets/squad), 또는 기타 작업별 컬렉션과 같은 기존 오픈 소스 데이터셋을 활용하는 것입니다. 이는 가장 빠르고 비용 효율적인 방법이지만, 이러한 데이터셋이 특정 요구 사항과 완벽하게 일치하지 않을 수 있습니다. 현재 Hugging Face에는 이러한 데이터셋이 많이 공개되어 있으므로, 사용 사례에 맞는 데이터셋을 찾아볼 가치가 있습니다.
또 다른 접근 방식은 Alpaca 데이터셋 (https://huggingface.co/datasets/tatsu-lab/alpaca)을 만든 방식과 비슷하게, 대규모 언어 모델을 사용하여 합성 학습 데이터를 생성하는 것입니다. 이 방식은 GPT-4와 같은 더 뛰어난 모델을 사용하여 지시-응답 쌍을 생성합니다. 이 방식은 대량의 데이터를 빠르게 생성할 수 있지만, 품질이 들쭉날쭉할 수 있으며 생성 모델의 편향이나 한계를 그대로 물려받을 수 있습니다. 또한 언어 모델을 사용할 때는 생성된 데이터가 정확하다는 보장이 없으며, 이는 매우 중요한 주의 사항입니다! 이는 엄밀히 말해 일부 상용 LLM 제공업체의 이용 약관에도 위배되지만, 실제로는 이를 강제하지 않는 것으로 보이므로 판단은 각자에게 맡기겠습니다. 저는 변호사가 아니라 소프트웨어 엔지니어입니다.
Dolly 데이터셋 (https://huggingface.co/datasets/databricks/databricks-dolly-15k)의 경우처럼, 사람 어노테이터를 활용하여 데이터셋을 만들 수도 있습니다. 사람은 미묘한 차이를 반영하고 맥락에 맞는 응답을 제공할 수 있으므로, 이 방식은 일반적으로 가장 높은 품질의 데이터를 만들어 냅니다. 하지만 이 방법은 보통 시간과 비용이 가장 많이 듭니다.
성공적인 프로젝트 중 상당수는 여러 접근 방식을 결합합니다. 예를 들어, Orca 데이터셋 (https://huggingface.co/datasets/Open-Orca/OpenOrca)은 합성 데이터 생성과 사람의 선별 및 필터링을 결합하여 사용했습니다. 이러한 하이브리드 접근 방식은 단일 방법의 단점을 완화하면서 품질, 양, 비용 사이의 균형을 맞추는 데 도움이 될 수 있습니다.
이 방법들 중 무엇을 선택할지는 결국 구체적인 요구 사항에 달려 있습니다. 웹에는 합성 데이터 생성이라는 주제를 더 자세히 다루는 가이드가 많이 있으므로, 더 많은 정보는 그 자료들에 맡기겠습니다. 데이터 선별은 미세 조정에서 단연 가장 중요한 부분이므로, 시간을 들여 매우 신중하게 진행하십시오. 일반적인 데이터 선별 지침은 다음과 같습니다.
- 양보다 질이 중요합니다 - 소수의 고품질 예시가 노이즈가 많은 대규모 데이터셋보다 낫습니다
- 데이터는 프로덕션 환경에서 모델이 어떻게 동작하기를 원하는지를 잘 대표해야 합니다
- 원하는 능력의 다양한 측면을 포괄하는 다양한 예시를 포함하십시오
- 예시 전반에 걸쳐 형식과 스타일을 일관되게 유지하십시오
- 모델의 동작을 저하시킬 수 있는 문제가 있거나 품질이 낮은 샘플은 모두 제거하십시오
다음은 입력과 출력이 있는 CSV 파일에 학습 데이터를 구성하는 방법의 예시입니다. 그 입력과 출력은 다음과 같습니다
input,output
"What is the capital of France?","Paris"
"What is the capital of Germany?","Berlin"
"What is the capital of the United States?","Washington, D.C."
"What is the capital of Japan?","Tokyo"
from datasets import Dataset, DatasetDict
import pandas as pd

# Read CSV file into Dataset
df = pd.read_csv(csv_path)
dataset = Dataset.from_pandas(df)

# 90% train, 10% test + validation
train_testvalid = dataset.train_test_split(test=0.1)

# Split the 10% test + valid in half test, half valid
test_valid = train_testvalid['test'].train_test_split(test=0.5)

raw_dataset = DatasetDict({
    'train': train_testvalid['train'],
    'validation': test_valid['test'],
    'test': test_valid['train']
})

# Save to disk (as Parquet)
raw_dataset.save_to_disk('raw_dataset')

# Save to JSONL file
raw_dataset.to_json('raw_dataset.jsonl', lines=True)
이제 모델에 맞게 데이터의 형식을 맞추려면 데이터셋 전체에 매핑하여 채팅 형식만 적용하면 됩니다.
# Load from disk
raw_dataset = load_dataset('raw_dataset')

# Shuffle
pre_formatted_dataset = raw_dataset.shuffle(seed=42)

SYSTEM_PROMPT = "You are a helpful assistant"

def format_chat(row):
    return {
        "messages": [
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": row["input"]},
            {"role": "assistant", "content": row["output"]}
        ]
    }

# Apply formatting
formatted_dataset = pre_formatted_dataset.map(format_chat)

# Split into train/eval/test
train_dataset = formatted_dataset['train']
eval_dataset = formatted_dataset['validation']
test_dataset = formatted_dataset['test']
출력에는 세 개의 데이터셋이 있습니다:
train- 모델을 훈련하고 훈련 중에 매개변수를 갱신하는 데 사용하는 주 데이터셋입니다validation- 훈련 중에 처음 보는 데이터에 대한 모델 성능을 평가하고 과적합을 방지하는 데 사용합니다test- 일반화 성능을 평가하기 위해 훈련이 완료된 후 최종 모델 평가에만 사용하는, 완전히 분리해 둔 데이터셋입니다
훈련 데이터셋은 미세 조정 중에 모델이 학습할 예시들입니다.
검증 데이터셋은 훈련 중에 하이퍼파라미터를 조정하고 과적합을 감시하는 데 사용합니다. 각 훈련 에포크가 끝난 뒤나 일정한 간격마다 검증 데이터로 모델의 성능을 평가함으로써, 훈련을 최적화하도록 학습률, 배치 크기 및 기타 매개변수를 조정할 수 있습니다. 검증 세트는 훈련에 관한 의사 결정에 도움을 줍니다.
테스트 데이터셋은 모델 개발의 맨 마지막까지 엄격하게 분리해 둡니다. 이 데이터셋은 완전히 처음 보는 데이터에 대한 모델 성능을 최종적이고 편향 없이 평가합니다. 테스트 세트는 모든 훈련과 하이퍼파라미터 조정이 끝난 후 단 한 번만 사용해야 합니다.
검증 세트와 테스트 세트는 서로 다른 역할을 하지만, 데이터가 제한된 상황에서는 때때로 하나의 검증/테스트 세트로 합칠 수 있습니다. 이는 이상적이지는 않지만, 데이터셋이 매우 작아서 세 개의 세트로 나누면 각 세트에 남는 데이터가 너무 적어지는 경우, 사용 사례상 최종 홀드아웃 평가 없이 훈련 진행 상황만 감시하면 되는 경우, 또는 모델이 고정된 릴리스 대신 지속적인 훈련/갱신을 거치는 경우에는 필요할 수 있습니다. 그러나 가능하다면 검증 세트와 테스트 세트를 따로 유지하는 것이 모델의 일반화 성능을 가장 엄밀하게 평가하는 방법입니다.
훈련 데이터셋과 검증 데이터셋은 항상 겹치지 않도록 분리하십시오. 데이터가 겹치면 모델이 훈련 중에 이미 검증 예시를 보았을 수 있으므로 성능 지표가 부풀려져 평가 결과가 오염되고, 그 결과 정확도와 기타 성능 지표가 잘못된 방식으로 높게 나타납니다. 이를 데이터 누수라고 하며, 실제보다 성능이 더 좋아 보이지만 사실은 검증 세트를 암기했을 뿐인 모델을 만들게 되므로 무슨 일이 있어도 피해야 합니다. 우리는 표본 외 데이터, 즉 모델 훈련에 사용하지 않은 데이터로 측정하고자 합니다.
datasets 라이브러리는 데이터셋을 다룰 때 유용한 흔히 쓰이는 연산 두 가지도 제공합니다. 바로 select와 shuffle이며, 각각 데이터셋을 잘라내고 무작위로 섞습니다.
# Select 1000 samples
train_dataset = train_dataset.select(range(1000))

# Shuffle using a seed for reproducibility
train_dataset = train_dataset.shuffle(seed=42)
양자화
양자화는 LLM 내부의 가중치와 활성화 값을 고정밀 데이터 표현에서 더 낮은 정밀도의 형식으로 로어링하는 모델 압축 기법입니다. 예를 들어, 32비트 부동소수점 수(FP32)를 8비트 또는 4비트 정수(INT4 또는 INT8)로 변환합니다. 이 과정을 통해 허용 가능한 수준의 성능을 유지하면서 모델 크기를 크게 줄일 수 있습니다. 주요 양자화 방식은 다음과 같습니다:
-
학습 후 양자화(Post-Training Quantization, PTQ): 학습 후 양자화는 모델 학습이 완료된 후에 적용됩니다. QAT에 비해 더 단순하고 구현이 빠른 접근 방식이지만, 일부 정확도 손실이 발생할 수 있습니다. 효과적으로 실행하는 데 더 적은 학습 데이터가 필요하다는 장점이 있습니다.
-
양자화 인식 학습(Quantization-Aware Training, QAT): 양자화 인식 학습은 양자화를 학습 과정 자체에 직접 통합합니다. 이 접근 방식은 일반적으로 학습 후 양자화보다 더 나은 성능을 달성하지만, 계산량이 더 많다는 대가가 따릅니다. 또한 QAT가 효과를 거두려면 전체 학습 데이터셋에 접근할 수 있어야 합니다.
가장 일반적인 양자화 기법은 다음과 같습니다.
QLoRA: 4비트 양자화와 저랭크 적응(Low-Rank Adaptation)을 결합합니다. 가중치를 저장할 때는 NF4(4-bit NormalFloat) 데이터 타입을 사용하고, 학습 중 연산은 BFloat16으로 수행합니다. 또한 스케일링 계수의 메모리 사용량을 줄이기 위해 이중 양자화를 사용합니다.
GPTQ: 가중치를 128개 열 단위의 배치로 처리하는 레이어별 양자화입니다. INT4/FP16 혼합 정밀도 방식을 활용하며, 지연 배치 업데이트(lazy batch updating) 메커니즘을 통해 출력 오차를 최소화합니다.
AWQ: 가중치를 128개 열 단위의 배치로 처리하는 또 다른 레이어별 양자화 기법입니다. 4비트와 8비트 양자화를 조합하여 사용하며, 스케일링 계수의 메모리 사용량을 줄이기 위해 이중 양자화를 사용합니다.
GGML/GGUF: 가중치를 32개 단위의 블록으로 나누는, CPU 중심의 양자화 프레임워크입니다. q2_k, q4_0, q8_0을 비롯한 여러 양자화 방법을 제공하므로, GPU 없이 CPU만 있는 하드웨어에서도 모델을 실행할 수 있습니다.
놀랍게도 양자화는 상당한 수준으로 압축하더라도 성능 저하가 미미한 경우가 많습니다. 연구에 따르면 QLoRA나 AWQ 같은 4비트 양자화 방법은 크기를 8배 줄이면서도 원본 모델 성능의 99% 이상을 유지할 수 있습니다. 이처럼 뛰어난 효과는 그렇게 공격적으로 압축하면 모델 품질이 크게 떨어질 것이라는 직관적인 예상을 뒤집습니다. 3비트 양자화조차도 많은 경우 강력한 성능을 유지할 수 있으며, 이 덕분에 양자화는 가장 성공적인 압축 기법 중 하나가 되었습니다.
GGUF 양자화 포맷은 가장 널리 쓰이며 대부분의 추론 엔진에서 지원됩니다. 다음은 권장 여부에 따라 정리하고 메모리 사용량을 함께 표시한 양자화 방법의 종합 표입니다.
| 방법 | 설명 | 상태 |
|---|---|---|
| Q4_K_M | 중간 크기, 균형 잡힌 품질 | ✅ 권장 |
| Q5_K_S | 큰 크기, 낮은 품질 손실 | ✅ 권장 |
| Q5_K_M | 큼, 품질 손실 매우 낮음 | ✅ 권장 |
| Q3_K_S | 매우 작음, 품질 손실 매우 높음 | 표준 |
| Q3_K_M | 매우 작음, 품질 손실 매우 높음 | 표준 |
| Q3_K_L | 작음, 품질 손실 상당함 | 표준 |
| Q4_K_S | 작음, 품질 손실 큼 | 표준 |
| Q6_K | 매우 큼, 품질 손실 극히 낮음 | 표준 |
| Q2_K | 가장 작음, 품질 손실 극심함 | 권장하지 않음 |
| Q8_0 | 매우 큼, 품질 손실 극히 낮음 | 권장하지 않음 |
| F16 | 극히 큼, 품질 손실 사실상 없음 | 권장하지 않음 |
| F32 | 엄청나게 큼, 무손실 | 권장하지 않음 |
요컨대 양자화를 사용하려는 경우 권장되는 방식은 Q4_K_M과 Q5_K_M입니다.
- Q4_K_M은 크기와 품질 사이에서 가장 좋은 균형을 제공합니다
- Q5_K_M은 크기가 더 큰 대신 더 높은 품질을 제공합니다
무손실 모델 양자화를 원한다면 F16을 사용하십시오.
Hugging Face에는 양자화된 모델을 제공하는 애그리게이터 계정이 있습니다. 예를 들어, bartowski는 Meta의 모델 대부분에 대해 양자화된 모델을 제공합니다. 예를 들면 다음과 같습니다.
배치 크기와 훈련 에포크
트레이너를 구성하려면 배치 크기와 에포크를 이해하는 것이 필수적입니다. 샘플은 훈련 데이터셋에 있는 하나의 입력-출력 쌍을 나타내며, 예를 들어 지시문과 그에 대응하는 응답이 이에 해당합니다. 이러한 샘플은 훈련 중 더 효율적으로 처리할 수 있도록 배치로 묶입니다. 배치 크기는 모델이 가중치를 업데이트하기 전에 동시에 처리하는 샘플의 수를 결정하며, 사용 가능한 GPU 메모리와 훈련 요구 사항에 따라 일반적으로 1에서 512 사이입니다.
훈련 에포크는 전체 훈련 데이터셋을 한 번 완전히 통과하는 것을 의미합니다. 예를 들어, 훈련 샘플이 10,000개이고 배치 크기가 32라면, 한 에포크는 약 313번의 배치 업데이트로 구성됩니다(10,000 ÷ 32, 올림). 에폭 수는 전체 학습 과정 동안 모델이 각 학습 샘플을 몇 번 보게 될지를 결정합니다. 미세 조정 작업에서는 모델이 사전 학습을 통해 이미 탄탄한 기초 지식을 갖추고 있으므로 1~3 에폭이면 충분한 경우가 많습니다.
배치 크기와 에포크 사이의 관계는 훈련 역학에 큰 영향을 미칩니다. 배치 크기가 클수록 더 효율적인 병렬 처리가 가능하지만, 훈련 안정성을 유지하기 위해 학습률 같은 다른 하이퍼파라미터를 조정해야 할 수 있습니다. 또한 더 안정적인 그래디언트 추정치를 제공하지만, 같은 수준의 모델 성능에 도달하려면 더 많은 에포크가 필요할 수 있습니다. 반대로 배치 크기가 작으면 학습 과정에 더 많은 노이즈가 생기며, 이는 때때로 모델의 일반화 성능을 높이는 데 도움이 되기도 하지만 한 에폭을 마치는 데 더 많은 업데이트 단계가 필요합니다.
언어 모델을 미세 조정할 때 흔히 쓰이는 출발점은 배치 크기를 8 또는 16으로 하고 그래디언트 누적으로 더 큰 배치를 흉내 내면서 1~3 학습 에폭을 함께 사용하는 것입니다. 이 구성은 대개 훈련 안정성, 메모리 효율성, 최종 모델 성능 사이에서 좋은 균형을 제공합니다. 정확한 값은 사용하는 하드웨어의 제약과 훈련 목표에 맞게 조정해야 합니다.
훈련 시간
학습 시간은 모델의 학습 과정을 완료하는 데 걸리는 총 시간을 의미합니다. 이 시간은 데이터셋의 크기, 모델의 복잡도, 배치 크기, 에포크 수, 사용 가능한 컴퓨팅 자원(사용하는 GPU의 종류와 개수 등)을 비롯한 여러 요인의 영향을 받습니다.
예를 들어, 대규모 데이터셋으로 많은 에포크와 큰 배치 크기를 사용해 대규모 언어 모델을 훈련하는 경우, 작은 데이터셋으로 적은 에포크와 작은 배치 크기를 사용해 더 작은 모델을 훈련하는 경우보다 일반적으로 시간이 더 오래 걸립니다. 또한 학습 과정의 효율성은 그래디언트 누적과 같은 기법의 사용 여부에 따라 달라질 수 있는데, 이러한 기법은 메모리 사용량을 관리하는 데 도움이 되지만 전체 학습 시간에도 영향을 줄 수 있습니다.
훈련 시간을 모니터링하고 최적화하는 것은 효율적인 모델 개발에 매우 중요하며, 특히 컴퓨팅 자원이 제한되어 있거나 모델 개선을 빠르게 반복하고자 할 때 더욱 그렇습니다.
training_args = TrainingArguments(
    num_train_epochs=1,
    max_steps=-1,  # -1 means full epochs
)
에포크당 배치 수를 계산하는 공식은 다음과 같습니다.
num_batches = num_samples / batch_size
~1000개 샘플 정도의 작은 데이터셋을 다룰 때는 배치 크기 32를 사용하는 것이 일반적으로 안전하고 표준적인 선택입니다. 수십만 또는 수백만 개의 관측치처럼 훨씬 큰 데이터셋을 다루는 경우가 아니라면, 이 배치 크기가 결과에 큰 영향을 미칠 가능성은 낮습니다.
배치 크기와 에포크에 관한 몇 가지 모범 사례는 다음과 같습니다.
-
배치 크기:
- 배치 크기가 클수록 학습 진행 속도가 빨라질 수 있지만, 항상 더 빠르게 수렴하는 것은 아닙니다.
- 배치 크기가 작을수록 학습 속도는 느린 편이지만 더 빠르게 수렴할 수 있습니다.
- 최적의 배치 크기는 문제에 따라 달라지는 경우가 많으므로 실험이 필요할 수 있습니다.
-
에포크:
- 모델은 일반적으로 에포크 수를 늘려 학습할수록 일정 수준까지 성능이 향상됩니다.
- 모델이 수렴함에 따라 정확도는 정체되는 경향이 있습니다.
- 50과 같이 더 많은 에포크 수로 실험하고, 에포크 수에 따른 정확도를 그래프로 그려 성능이 평탄해지는 지점을 확인하는 것이 좋습니다.
-
학습 기간:
- 수렴을 보장하려면 최소 3 에포크 이상 학습하십시오.
- 학습 기간을 길게 하면 훨씬 더 나은 모델을 얻을 수 있으므로 더 긴 학습 기간으로 실험해 보십시오.
- 조기 종료를 사용하되, 과적합이 발생하지 않도록 평가 결과를 면밀히 모니터링하십시오.
- 각 에포크마다 전체 체크포인트를 저장하십시오. 이후 에포크의 성능이 떨어지면 이 체크포인트를 선택할 수 있습니다.
조기 종료
조기 종료는 검증 세트에서 모델의 성능을 모니터링하여 모델 학습 중 과적합을 방지하도록 고안된 정규화 기법입니다. 모델의 성능이 더 이상 향상되지 않으면 학습 과정을 중단하여, 모델이 처음 보는 새로운 데이터에도 잘 일반화되도록 합니다. 이 기법에서는 인내(patience) 매개변수를 설정하는데, 이 값은 학습을 중단하기 전에 검증 성능이 향상되기를 몇 에포크 동안 기다릴지를 결정합니다. 지정된 에포크 수 동안 모델의 성능이 향상되지 않으면 과적합을 방지하기 위해 학습을 종료합니다.
예를 들어 인내 값이 3 에포크인 경우, 검증 손실이 3 에포크 연속으로 감소하지 않으면 학습이 중단됩니다. 이 방식은 모델이 불필요하게 학습 데이터로 계속 학습하는 것을 방지합니다. 조기 종료는 TensorFlow, PyTorch 등 대부분의 딥러닝 프레임워크에서 내장 콜백이나 학습 루프 내의 사용자 정의 로직을 사용하여 구현할 수 있습니다.
조기 종료를 구현할 때는 검증 손실이나 정확도와 같이 모니터링할 적절한 검증 지표를 선택하는 것이 중요합니다. 인내 값은 학습 시간과 과적합 위험 사이의 균형을 맞추도록 설정해야 합니다. 또한 검증 성능이 가장 좋은 에포크에서 모델의 가중치를 저장하여, 모델의 최적 버전을 복원할 수 있도록 하는 것이 좋습니다. 조기 종료를 활용하면 모델 성능과 학습 효율 사이의 균형을 이룰 수 있으며, 그 결과 새로운 데이터에 대해 더 나은 일반화를 얻을 수 있습니다.
from transformers import EarlyStoppingCallback

early_stopping_callback = EarlyStoppingCallback(
    early_stopping_patience=3,
    early_stopping_threshold=0.01
)

training_args = TrainingArguments(
    callbacks=[early_stopping_callback]
)
조기 종료의 두 매개변수는 다음과 같습니다.
early_stopping_patience: 개선되지 않을 경우 중단을 결정하기 전에 지표를 몇 번 확인할지를 나타냅니다. 모델에게 개선될 기회를 몇 번 주는 것과 같습니다.early_stopping_threshold: 학습을 계속하기 위해 지표가 향상되어야 하는 최소한의 양입니다. 지표가 이만큼 향상되지 않으면 학습을 마무리할 수 있습니다.
그래디언트 누적
그래디언트 누적은 대규모 모델을 학습할 때 GPU 메모리 한계를 극복하는 데 도움이 되는 기법입니다. 그래디언트 누적을 사용하면 배치마다 모델 매개변수를 업데이트하는 대신, 여러 개의 작은 배치를 순차적으로 처리하면서 그래디언트를 누적하여 사실상 더 큰 배치 크기를 흉내 낼 수 있습니다.
그래디언트 누적을 사용하면 학습 과정이 바뀌어, 한 번의 가중치 업데이트를 적용하기 전에 여러 번의 순전파 및 역전파 패스에 걸쳐 그래디언트를 누적합니다. 예를 들어 유효 배치 크기를 32로 하고 싶지만 메모리에 샘플을 8개만 올릴 수 있다면, 그래디언트 누적 단계를 4로 설정하면 됩니다. 이 경우 모델은 다음과 같이 동작합니다:
- 8개 샘플로 이루어진 미니 배치를 처리합니다
- 가중치를 업데이트하지 않고 그래디언트를 계산하여 저장합니다
- 이 과정을 4번 반복합니다
- 마지막으로 누적된 그래디언트를 사용해 모델 가중치를 업데이트합니다
핵심은 이 방식이 한 번에 8개 샘플을 처리할 만큼의 메모리만 필요로 하면서도, 더 큰 배치 크기인 32로 학습한 것과 수학적으로 동일한 결과를 낸다는 점입니다.
그래디언트 누적을 구현하려면 학습 루프를 다음과 같이 수정해야 합니다:
training_args = TrainingArguments(
    per_device_train_batch_size=8,     # Physical batch size per GPU
    gradient_accumulation_steps=4,     # Number of forward passes before update
    gradient_checkpointing=True        # Additional memory optimization
)
유효 배치 크기는 다음과 같이 계산할 수 있습니다:
effective_batch_size = per_device_batch_size * gradient_accumulation_steps * num_gpus
그래디언트 누적은 더 작은 물리적 배치 크기에 대해서만 순방향 패스 메모리를 요구하고, 그래디언트 저장 공간을 일정하게 유지하며, 옵티마이저 상태를 덜 자주 업데이트하므로 메모리를 크게 절약할 수 있습니다. 이 기법을 사용하면 그렇지 않았다면 가용 GPU 메모리에 비해 너무 컸을 모델도 학습할 수 있습니다. 예를 들어 7B 매개변수 모델을 미세 조정할 때 일반적인 학습 방식으로는 32GB의 GPU 메모리가 필요할 수 있지만, 그래디언트 누적을 사용하면 16GB GPU에서도 가능할 수 있습니다.
그래디언트 누적 단계 수를 선택할 때는 목표 유효 배치 크기, 가용 GPU 메모리 제약, 학습 속도 요구 사항(단계가 많을수록 학습이 느려지기 때문입니다), 모델의 수렴 특성 사이에서 균형을 맞춰야 합니다. 메모리 한도 내에 머무르면서 유효 배치 크기가 32에서 512 사이가 되도록 누적 단계를 선택하는 것이 좋은 출발점입니다. 예를 들어 물리적 배치 크기가 4라면, 구체적인 필요에 따라 8~32의 누적 단계를 사용할 수 있습니다.
그래디언트 누적은 메모리 제약을 극복하는 데 도움이 되지만, 누적 단계에 비례하여 학습 속도를 선형적으로 떨어뜨리고, 더 큰 유효 배치 크기에 맞춰 학습률 조정이 필요할 수 있으며, 배치 정규화 통계(사용하는 경우)를 더 작은 물리적 배치에서 계산하게 된다는 점에서 학습 동역학에 영향을 미칩니다. 학습 안정성을 유지하려면 제곱근 스케일링 규칙을 사용해 학습률을 조정하는 것을 고려하십시오:
adjusted_lr = base_lr * sqrt(effective_batch_size / base_batch_size)
학습률
학습률은 아마도 언어 모델 학습에서 가장 중요한 하이퍼파라미터로, 역전파 중에 계산된 그래디언트에 따라 모델 가중치를 얼마나 조정할지 결정하는 스케일링 계수 역할을 합니다. AdamW(아래 참조) 같은 옵티마이저를 사용할 때, 학습률은 옵티마이저가 손실 함수를 줄이는 방향으로 얼마나 큰 스텝을 밟을지에 직접적인 영향을 미칩니다.
학습률이 너무 높으면 학습 과정이 최적의 가중치 값을 지나쳐 버려, 학습이 불안정해지거나 최적이 아닌 해로 수렴할 수 있습니다. 이는 들쭉날쭉한 손실 곡선으로 나타나며, 극단적인 경우에는 수치적 불안정성으로까지 이어집니다. 반대로 학습률이 너무 낮으면 학습 진행이 매우 느려져, 모델이 더 나은 해를 향해 아주 작은 스텝만 밟게 되고 지역 최솟값에 갇히거나 할당된 학습 시간 내에 수렴하지 못할 수 있습니다.
언어 모델 미세 조정에서 학습률은 일반적으로 1e-5에서 5e-4 사이이며, LoRA를 사용할 때는 2e-4가 흔히 쓰이는 출발점입니다. 최적의 학습률은 대개 여러 요인에 따라 달라집니다:
- 모델 크기 - 일반적으로 큰 모델일수록 안정성을 유지하기 위해 더 작은 학습률이 유리합니다
- 옵티마이저 선택 - AdamW는 일반적으로 기본 SGD에 비해 더 낮은 학습률에서 잘 작동합니다
- 배치 크기 - 배치 크기가 클수록 약간 더 높은 학습률을 사용할 수 있는 경우가 많습니다
- 사용하는 미세 조정 기법 - LoRA는 전체 미세 조정보다 더 높은 학습률을 사용할 수 있는 경우가 많습니다
LoRA를 사용할 때는 매개변수의 작은 부분집합만 업데이트하므로 전체 미세 조정보다 더 높은 학습률을 사용할 수 있는 경우가 많습니다. 일반적인 구성은 다음과 같습니다.
training_args = TrainingArguments(
    learning_rate=2e-4,          # Higher than full fine-tuning
    weight_decay=0.01,           # L2 regularization
    max_grad_norm=0.3,           # Gradient clipping threshold
    optim="paged_adamw_32bit"    # Memory-efficient optimizer
)
학습률과 배치 크기 사이의 관계는 이른바 “선형 스케일링 규칙“을 따릅니다. 즉, 배치 크기를 k배로 늘리면 비슷한 학습 동역학을 유지하기 위해 일반적으로 학습률도 같은 배수만큼 늘려야 합니다. 그러나 이 규칙은 배치 크기가 매우 커지면 성립하지 않기 시작하며, 이때는 제곱근 스케일링 규칙이 더 잘 작동하는 경우가 많습니다.
base_lr = 2e-4
base_batch_size = 32
new_batch_size = 128

# Square root scaling
new_lr = base_lr * math.sqrt(new_batch_size / base_batch_size)
LoRA로 LLM을 미세 조정할 때는 1e-4의 학습률이 표준으로 자리 잡았습니다. 다르게 판단할 경험적 근거가 없다면 처음에는 이 값으로 시작하는 것이 좋습니다.
학습률 스케줄
학습률 스케줄은 학습 과정 전반에 걸쳐 학습률이 어떻게 변하는지를 결정하므로 모델 학습에서 매우 중요한 역할을 합니다. 스케줄마다 학습 안정성, 수렴 속도, 최종 모델 성능 사이에서 서로 다른 트레이드오프를 제공합니다. transformers 라이브러리에서는 여러 가지 학습률 스케줄을 사용할 수 있습니다.
- linear: 이 스케줄은 학습률을 초기값에서 최종값까지 직선으로 선형 감소시킵니다.
- cosine: 이 스케줄은 코사인 곡선을 따라 초기 학습률에서 시작하여 0에 가까운 값까지 부드럽게 감소합니다.
- cosine_with_restarts: 이 스케줄은 코사인 스케줄에 주기적인 “점프“를 추가하여, 학습률을 일시적으로 높였다가 다시 감쇠하도록 합니다.
- polynomial: 이 스케줄은 다항식 감쇠 함수를 따라 학습률을 감소시킵니다.
- constant: 이 스케줄은 학습 과정 전체에 걸쳐 학습률을 일정하게 유지합니다.
- constant_with_warmup: 이 스케줄은 학습률이 선형으로 증가하는 워밍업 기간이 끝난 후 학습률을 일정하게 유지합니다.
- inverse_sqrt: 이 스케줄은 역제곱근 감쇠 함수를 따라 학습률을 감소시킵니다.
- reduce_lr_on_plateau: 이 스케줄은 지표가 더 이상 개선되지 않을 때 학습률을 낮춥니다.
- cosine_with_min_lr: 이 스케줄은 최소 학습률이 있는 코사인 곡선을 따라 초기 학습률에서 시작하여 최솟값까지 부드럽게 감소합니다.
- warmup_stable_decay: 이 스케줄은 워밍업과 안정적인 감쇠 메커니즘을 결합합니다.
가장 흔히 사용되는 것은 선형, 코사인, 그리고 재시작이 있는 코사인입니다.
선형 스케줄
선형 학습률 스케줄은 학습률을 초기값에서 최종값까지 직선으로 점진적으로 감소시킵니다. 이 단순한 방식은 많은 미세 조정 작업에서, 특히 학습 단계 수가 비교적 적을 때 잘 작동합니다. 선형 스케줄은 높은 학습률을 통한 초기 탐색과, 학습률을 로어링하다가 도달하는 낮은 학습률에서의 최종 수렴 사이에서 좋은 균형을 제공합니다.
training_args = TrainingArguments(
    learning_rate=2e-4,
    lr_scheduler_type="linear",
    warmup_ratio=0.03,
    num_train_epochs=3
)
warmup_ratio 매개변수는 선형 감소가 시작되기 전에 학습 단계 중 어느 정도의 비율 동안 점진적으로 증가하는 학습률을 사용할지를 결정합니다. 이는 그래디언트가 크거나 노이즈가 많을 수 있는 학습 초기에 불안정한 업데이트를 방지하는 데 도움이 됩니다.
코사인 스케줄
코사인 학습률 스케줄은 코사인 곡선을 따라 초기 학습률에서 시작하여 0에 가까운 값까지 부드럽게 감소합니다. 이 스케줄은 선형 감쇠에 비해 학습률을 더 점진적으로 낮추므로, 모델이 더 나은 해로 수렴하는 데 도움이 될 수 있습니다. 코사인 스케줄은 최솟값에 정착하기 전에 손실 지형을 충분히 탐색하고자 하는 긴 학습에서 특히 효과적입니다.
training_args = TrainingArguments(
    learning_rate=2e-4,
    lr_scheduler_type="cosine",
    warmup_ratio=0.03,
    num_train_epochs=3
)
코사인 스케줄은 부드럽게 변하기 때문에 모델이 선형 감쇠에 비해 중간 수준의 학습률에서 더 많은 시간을 보내게 되며, 이는 일반화 성능을 향상시킬 수 있습니다.
재시작을 포함한 코사인
재시작을 포함한 코사인(웜 리스타트라고도 합니다)은 코사인 스케줄에 주기적인 “점프“를 추가하여, 학습률을 일시적으로 높였다가 다시 감소하도록 합니다. 이 방식은 모델이 좋지 않은 지역 최솟값에서 벗어나 손실 지형의 다른 영역을 탐색하도록 도울 수 있습니다. 각 재시작은 코사인 스케줄의 장점을 유지하면서 모델이 더 나은 해를 발견할 기회를 제공합니다.
training_args = TrainingArguments(
    learning_rate=2e-4,
    lr_scheduler_type="cosine_with_restarts",
    warmup_ratio=0.03,
    num_cycles=2,  # Number of restart cycles
    num_train_epochs=3
)
num_cycles 매개변수는 학습 중에 재시작이 몇 번 일어날지를 제어합니다. 각 사이클은 학습률을 재설정하기 전에 완전한 코사인 감소를 한 번 마칩니다. 이 스케줄은 손실 지형에 지역 최솟값이 많을 수 있는 복잡한 작업에 특히 유용합니다.
학습률 스케줄을 선택할 때는 다음 경험적 규칙을 사용하십시오.
- 학습 기간: 짧은 미세 조정 실행(1~2 에포크)은 선형 감소로도 잘 작동하는 경우가 많으며, 더 긴 실행에서는 코사인 스케줄이 유리합니다.
- 작업 복잡도: 더 복잡한 작업에서는 지역 최솟값을 벗어나기 위해 재시작을 포함한 코사인이 유리할 수 있습니다.
- 계산 예산: 선형 감소처럼 단순한 스케줄은 조정이 덜 필요하고 예측하기도 더 쉽습니다.
- 모델 크기: 더 큰 모델에서는 재시작을 포함한 코사인처럼 더 정교한 스케줄이 유리한 경우가 많습니다.
대부분의 미세 조정 작업에 좋은 출발점은 다음과 같습니다.
training_args = TrainingArguments(
    learning_rate=2e-4,
    lr_scheduler_type="cosine",
    warmup_ratio=0.03,
    num_train_epochs=3,
    warmup_steps=100,
    max_steps=-1  # -1 means use num_train_epochs instead
)
워밍업 스텝
워밍업 스텝 매개변수는 스케줄이 감소를 시작하기 전에 학습률이 몇 스텝 동안 선형으로 증가할지를 결정합니다. 이는 그래디언트가 크거나 노이즈가 많을 수 있는 학습 초기에 불안정한 업데이트가 일어나는 것을 막는 데 도움이 됩니다. 이 매개변수를 설정하는 일반적인 경험적 방법으로는 warmup_ratio와 warmup_steps 두 가지가 있습니다.
warmup_ratio 매개변수는 선형 감소가 시작되기 전에 전체 학습 스텝 중 어느 비율만큼 점진적으로 증가하는 학습률을 사용할지를 결정합니다. 이는 그래디언트가 크거나 노이즈가 많을 수 있는 학습 초기에 불안정한 업데이트가 일어나는 것을 막는 데 도움이 됩니다.
warmup_steps 매개변수는 선형 감소가 시작되기 전에 점진적으로 증가하는 학습률을 사용할 정확한 스텝 수를 결정합니다.
옵티마이저
옵티마이저는 학습 중에 모델 가중치를 업데이트하는 핵심(Core) 알고리즘입니다. AdamW 같은 널리 쓰이는 옵티마이저는 모두 SGD의 변형입니다. 이러한 옵티마이저와 함께 자주 사용되는 L2 정규화는 큰 가중치에 작은 페널티를 부과하는 것과 같아서, 모델이 단순함을 유지하고 과적합을 피하도록 유도합니다.
AdamW 옵티마이저는 대규모 언어 모델의 학습과 미세 조정에서 사실상의 표준이 되었습니다. AdamW는 가중치 감쇠를 그래디언트 업데이트와 분리하여 기존 Adam 옵티마이저를 확장하며, 이를 통해 특히 대규모 신경망에서 더 나은 일반화 성능을 얻을 수 있습니다.
핵심(Core)적으로 AdamW는 각 매개변수에 대해 두 개의 모멘트(이동 평균)를 유지합니다. 1차 모멘트는 과거 그래디언트의 평균을 나타내고, 2차 모멘트는 과거 그래디언트의 비중심 분산을 추적합니다. 이러한 모멘트는 각 매개변수의 학습률을 개별적으로 조정하는 데 도움을 주므로, 매개변수마다 서로 다른 규모의 업데이트가 필요한 심층 신경망을 학습할 때 이 옵티마이저가 특히 효과적입니다.
표준 Adam과 비교했을 때 AdamW의 핵심 혁신은 가중치 감쇠를 처리하는 방식입니다. 기존 Adam에서는 가중치 감쇠가 그래디언트 업데이트의 일부로 구현되어 정규화가 최적에 미치지 못할 수 있습니다. AdamW는 그래디언트 업데이트 전에 가중치에 직접 가중치 감쇠를 적용하여 올바른 L2 정규화를 보장합니다. 이 사소해 보이는 변화는 모델 성능에 상당한 영향을 미치며, 특히 과적합을 막는 데 올바른 정규화가 매우 중요한 대규모 언어 모델에서 그렇습니다.
언어 모델 미세 조정을 위해 AdamW를 구성할 때 일반적인 하이퍼파라미터로는 0.01에서 0.1 사이의 가중치 감쇠 값과, 1차 및 2차 모멘트에 대해 각각 0.9와 0.999의 베타 값이 있습니다. 옵티마이저는 보통 다음과 같은 구성으로 구현합니다.
training_args = TrainingArguments(
    optim="paged_adamw_32bit",    # Memory-efficient AdamW implementation
    weight_decay=0.01,            # L2 regularization factor
    adam_beta1=0.9,               # Exponential decay rate for first moment
    adam_beta2=0.999,             # Exponential decay rate for second moment
    adam_epsilon=1e-8,            # Small constant for numerical stability
)
AdamW의 “paged” 변형(paged_adamw_32bit)은 메모리 효율적인 상태 관리를 구현하여, AdamW의 적응형 학습률과 올바른 가중치 감쇠라는 이점은 유지하면서 옵티마이저 상태에 필요한 GPU 메모리를 줄여 주므로 대규모 언어 모델을 미세 조정할 때 특히 유용합니다.
옵티마이저 외에도 max_grad_norm 매개변수는 역전파 중 그래디언트 노름의 최댓값을 결정합니다. 이 파라미터는 그래디언트가 지나치게 커져 수치적 불안정성을 일으키는 그래디언트 폭주 문제를 방지하는 데 사용됩니다. 기본값인 0.3은 좋은 출발점이지만, 특정 미세 조정 작업에 가장 잘 맞는 값을 찾기 위해 다양한 값으로 실험해 볼 수 있습니다.
가중치 감쇠
가중치 감쇠는 모델의 가중치가 커지는 것을 억제하여 과적합을 방지하는 데 도움을 주는 정규화 기법입니다. 이 기법은 가중치 제곱의 합에 비례하는 페널티를 손실 함수에 더하는 방식으로 작동하며, 결과적으로 모델이 더 작은 가중치를 유지하도록 유도합니다. 이를 통해 처음 보는 데이터에 대한 일반화 성능이 향상될 수 있습니다.
많은 대규모 언어 모델 미세 조정 작업에서 가중치 감쇠의 합리적인 기본값은 0.01입니다. 이 값은 정규화와 모델 유연성 사이의 균형을 맞춰 주므로, 데이터로부터 학습하는 모델의 능력을 과도하게 제약하지 않으면서 과적합을 방지하는 데 도움이 됩니다.
경우에 따라서는 가중치 감쇠를 0으로 설정하는 것을 고려할 수 있습니다. 특히 모델이 과소적합되고 있거나 데이터셋이 매우 작아 정규화가 그다지 중요하지 않은 경우에 그렇습니다. 반대로 모델이 심하게 과적합되고 있다면 0.1처럼 더 높은 가중치 감쇠 값이 적절할 수 있습니다. 이렇게 하면 큰 가중치에 더 강한 페널티가 부과되어 가중치 값이 더욱 작아지도록 유도되고, 일반화 성능이 향상될 가능성이 있습니다.
AdamW 옵티마이저를 구성할 때 가중치 감쇠 매개변수는 학습 인수의 일부로 지정되므로, 학습 과정 전체에 걸쳐 일관되게 적용됩니다.
training_args = TrainingArguments(
    weight_decay=0.01,            # L2 regularization factor
)
SFT Trainer
지도 미세 조정 트레이너(SFT Trainer)는 TRL(Transformer Reinforcement Learning, 트랜스포머 강화 학습) 라이브러리에서 제공하는 특화된 클래스로, 언어 모델의 미세 조정 과정을 단순화합니다. 이 클래스는 표준 Hugging Face Trainer 클래스를 기반으로 지도 미세 조정 작업을 위한 특화된 기능을 추가하므로, 명령어 튜닝과 채팅 모델 개발에 특히 적합합니다.
SFT Trainer는 PEFT 모델의 올바른 초기화, 데이터셋 포맷팅, 학습 최적화 등 미세 조정에 수반되는 여러 복잡한 작업을 처리합니다. PEFT 구성이 주어지면 매개변수 효율적 미세 조정을 자동으로 설정하여 대규모 언어 모델을 메모리 효율적으로 학습할 수 있게 합니다. 표준 데이터셋과 이터러블 데이터셋을 모두 다룰 수 있으므로, 다양한 데이터 로딩 방식에 유연하게 대응합니다.
SFT Trainer의 기본 구현은 다음과 같습니다.
from trl import SFTTrainer

trainer = SFTTrainer(
    model=model,                    # Your model
    train_dataset=train_dataset,    # Training dataset
    peft_config=lora_config,        # LoRA configuration
    max_seq_length=512,             # Maximum sequence length
    tokenizer=tokenizer,            # Tokenizer
    args=training_args,             # Training arguments
    packing=True                    # Enable sequence packing
)

trainer.train()
이 트레이너는 학습 효율을 크게 높일 수 있는 여러 성능 최적화를 지원합니다. 더 빠른 어텐션 계산을 위해 Flash 어텐션 2와 호환됩니다.
SFT Trainer의 주요 장점 중 하나는 데이터셋 포맷팅을 처리하는 방식입니다. 활성화된 경우 올바른 토큰화와 시퀀스 패킹을 포함하여, 학습 데이터를 모델에 적합한 형식으로 변환하는 작업을 자동으로 처리합니다. 이를 통해 학습 데이터를 준비하는 데 일반적으로 필요한 상용구 코드의 상당 부분이 사라지므로, 실제 미세 조정 과정에 집중할 수 있습니다.
패킹
패킹은 학습 중 GPU 메모리 활용도를 극대화하기 위해 SFT Trainer가 사용하는 최적화 기법입니다. packing=True 매개변수로 활성화하면 트레이너는 지정된 max_seq_length까지 여러 시퀀스를 하나의 학습 예제로 패킹합니다.
패킹을 사용하지 않으면 각 학습 예제가 최대 시퀀스 길이까지 패딩되므로, 패딩 토큰에 연산 자원이 낭비됩니다. 예를 들어 길이가 128, 256, 384 토큰인 시퀀스가 있고 max_seq_length=512인 경우, 기존 배칭 방식은 각 시퀀스를 512 토큰까지 패딩하므로 패딩에 상당한 메모리가 낭비됩니다.
패킹을 활성화하면 트레이너는 여러 시퀀스를 지능적으로 결합하여 하나의 학습 예제로 만듭니다. 앞의 예를 사용하면 128토큰 시퀀스와 384토큰 시퀀스를 하나의 512토큰 예제로 함께 패킹하고, 256토큰 시퀀스는 다른 짧은 시퀀스와 함께 패킹할 수 있습니다. 그 결과 GPU 메모리를 더 효율적으로 사용하고, 처리하는 패딩 토큰이 줄어 훈련이 빨라지며, 최대 시퀀스 길이를 더 잘 활용할 수 있습니다.
트레이너는 패킹된 시퀀스 사이의 교차 오염을 막기 위한 적절한 어텐션 마스킹을 포함하여 패킹의 모든 복잡한 처리를 담당합니다. 따라서 패킹은 특히 시퀀스 길이가 다양한 데이터셋으로 훈련할 때 유용한 최적화입니다.
Flash 어텐션 2
Flash 어텐션 2는 고도로 최적화된 어텐션 메커니즘으로, 학습 중 메모리 사용량을 크게 줄이고 어텐션 계산 속도를 높입니다. 학습 설정에서 Flash 어텐션 2를 활성화하려면 다음을 수행해야 합니다.
pip install flash-attn --no-build-isolation
model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Meta-Llama-3-8B-Instruct",
    quantization_config=bnb_config,
    device_map=device_map,
    attn_implementation="flash_attention_2"  # Enable Flash Attention 2
)
하드웨어가 Flash 어텐션 2를 지원하지 않으면 모델은 자동으로 표준 어텐션 구현으로 대체됩니다.
NEFTune
NEFTune은 훈련 중 임베딩 벡터에 노이즈를 추가하여 성능을 향상시킬 수 있는 기법입니다. 이를 활성화하려면 TrainingArguments에서 neftune_noise_alpha 매개변수를 설정하십시오. 예기치 않은 동작을 방지하기 위해 훈련이 끝나면 NEFTune이 비활성화되어 원래의 임베딩 레이어가 복원됩니다.
training_args = TrainingArguments(
    neftune_noise_alpha=5
)
일반적으로 1에서 10 사이의 값이 사용됩니다.
손실 함수
손실 함수는 훈련 중 모델의 예측이 정답(ground truth)에서 얼마나 벗어나는지를 나타내는 수학적 척도입니다. 언어 모델의 경우, 이는 일반적으로 어휘에 대한 예측 확률 분포와 학습 데이터에 실제로 나타나는 다음 토큰 사이의 교차 엔트로피 손실을 측정하는 것을 의미합니다. 손실이 낮을수록 모델이 정답 토큰에 더 높은 확률을 부여하고 있다는 뜻이므로 성능이 더 좋다는 것을 나타냅니다. 손실은 학습 예제의 배치 단위로 계산되고 평균을 내어, 모델의 현재 성능을 나타내는 하나의 수치를 제공합니다.
간단히 말해 교차 엔트로피 손실은 모델이 정답을 보고 얼마나 놀라는지를 측정하는 것과 같습니다. 모델이 틀린 단어를 매우 확신하며 예측하면 큰 벌점(높은 손실)을 받습니다. 올바른 단어를 확신하며 예측하면 작은 벌점(낮은 손실)을 받습니다. 이는 문장의 다음 단어를 맞혀야 하는 게임과 비슷합니다. 확신이 없거나 틀릴수록 더 많은 점수를 잃습니다. 목표는 다음에 올 내용을 더 잘 예측하게 되어 이러한 “놀람 점수“를 최소화하는 것입니다.
훈련 중에는 두 가지 손실, 즉 훈련 손실과 평가 손실(eval_loss)을 추적합니다. 훈련 손실은 모델이 실제로 학습하고 있는 데이터에서 계산되고, 평가 손실은 모델이 훈련 중에 한 번도 보지 않는 별도의 검증 세트에서 계산됩니다. 이 두 지표를 함께 보면 학습 과정에 대한 핵심적인 통찰을 얻을 수 있습니다. 두 손실이 모두 감소하고 있다면 모델이 효과적으로 학습하고 있는 것입니다. 학습 손실은 감소하지만 평가 손실이 증가하거나 정체된다면 이는 과적합을 나타냅니다. 즉, 모델이 일반화 가능한 패턴을 학습하는 대신 학습 데이터를 암기하고 있는 것입니다.
일반적으로 손실은 모델이 얼마나 많은 실수를 하는지 측정하는 점수라고 생각할 수 있습니다. 시험지를 채점하는 선생님처럼, 손실 함수는 모델이 실수를 많이 하면 낮은 점수(높은 손실)를 주고 실수를 적게 하면 높은 점수(낮은 손실)를 줍니다. 훈련 손실은 모의고사 점수와 같습니다. 즉, 모델이 학습 중인 자료에서 얼마나 잘하는지를 보여 줍니다. 평가 손실은 기말고사 점수와 같습니다. 즉, 모델이 배운 것을 이전에 본 적 없는 새로운 문제에 얼마나 잘 적용할 수 있는지를 보여 줍니다. 내용을 이해하지 않고 모의고사를 암기한 학생이 기말고사에서 좋지 않은 성적을 거두는 것처럼, 과적합된 모델은 훈련 손실은 좋지만 평가 손실은 나쁘게 나타납니다.
손실이 정확히 0이라면 모델이 학습 데이터를 암기했다는 의미입니다. 손실이 높다면 모델이 실수를 많이 하고 있다는 뜻입니다. 손실은 모델이 학습함에 따라 시간이 지나면서 감소해야 하며, 반대로 증가한다면 무언가 잘못된 것입니다.
학습 곡선
학습 곡선을 해석하는 방법을 이해하는 것은 모델 미세 조정을 성공적으로 수행하는 데 매우 중요합니다. 학습 곡선은 훈련 중 모델의 손실이 시간에 따라 어떻게 변하는지를 보여 주며, 일반적으로 훈련 손실과 검증 손실을 모두 훈련 스텝 수 또는 에포크 수에 대해 그래프로 나타냅니다. 이 곡선들은 모델이 얼마나 잘 학습하고 있는지, 그리고 흔히 발생하는 훈련 문제를 겪고 있는지에 대한 귀중한 통찰을 제공합니다.
바람직한 학습 곡선은 일반적으로 훈련 손실과 검증 손실이 모두 시간에 따라 매끄럽게 감소하다가 결국 비슷한 값에서 정체되는 모습을 보입니다. 초기의 가파른 하락은 모델이 데이터에서 가장 뚜렷한 패턴을 빠르게 학습하고 있음을 나타냅니다. 훈련이 진행됨에 따라 모델이 더 미묘한 패턴에 대한 이해를 세밀하게 다듬어 가면서 개선 폭은 점점 완만해집니다. 훈련 손실과 검증 손실 사이의 차이가 작다면 모델이 처음 보는 데이터에 대해 잘 일반화하고 있음을 시사합니다.
**과소적합(underfitting)**은 모델이 학습 데이터의 근본적인 패턴을 효과적으로 학습하지 못할 때 발생합니다. 이는 학습 곡선에서 훈련 세트와 검증 세트 모두의 손실 값이 지속적으로 높게 유지되고 시간이 지나도 개선이 거의 없는 형태로 나타납니다. 곡선이 평평하게 보이거나 매우 느리게 개선될 수 있는데, 이는 모델이 작업의 복잡성을 포착할 만한 용량이 부족하거나 학습률이 효과적인 훈련을 하기에는 너무 낮을 수 있음을 나타냅니다. 이러한 경우에는 모델의 용량을 늘리거나, 학습률을 조정하거나, 더 많은 에포크 동안 훈련하는 것을 고려하십시오.
반대로 **과적합(overfitting)**은 모델이 일반화 가능한 패턴을 학습하는 대신 학습 데이터를 암기할 때 발생합니다. 학습 곡선은 특징적인 발산을 통해 이를 드러냅니다. 즉, 훈련 손실은 계속 감소하는 반면 검증 손실은 증가하기 시작하거나 더 높은 값에서 정체됩니다. 학습 성능과 검증 성능 사이의 이러한 격차가 커진다는 것은 모델이 일반화를 희생하면서 학습 데이터에 지나치게 특화되고 있음을 나타냅니다. 일반적인 해결책으로는 정규화를 도입하거나, 모델 용량을 줄이거나, 검증 손실이 증가하기 시작할 때 조기 종료를 적용하는 방법이 있습니다.
학습 곡선의 수렴 속도는 학습률이 적절한지에 대한 통찰도 제공할 수 있습니다. 손실이 너무 느리게 감소한다면 학습률이 너무 낮아 비효율적인 훈련이 이루어지고 있을 수 있습니다. 반대로 손실이 높은 변동성을 보이거나 갑작스럽게 급등한다면 학습률이 너무 높아 훈련이 불안정해지고 있을 수 있습니다. 이상적인 학습 곡선은 과도한 변동 없이 꾸준하고 일관된 개선을 보여 줍니다.
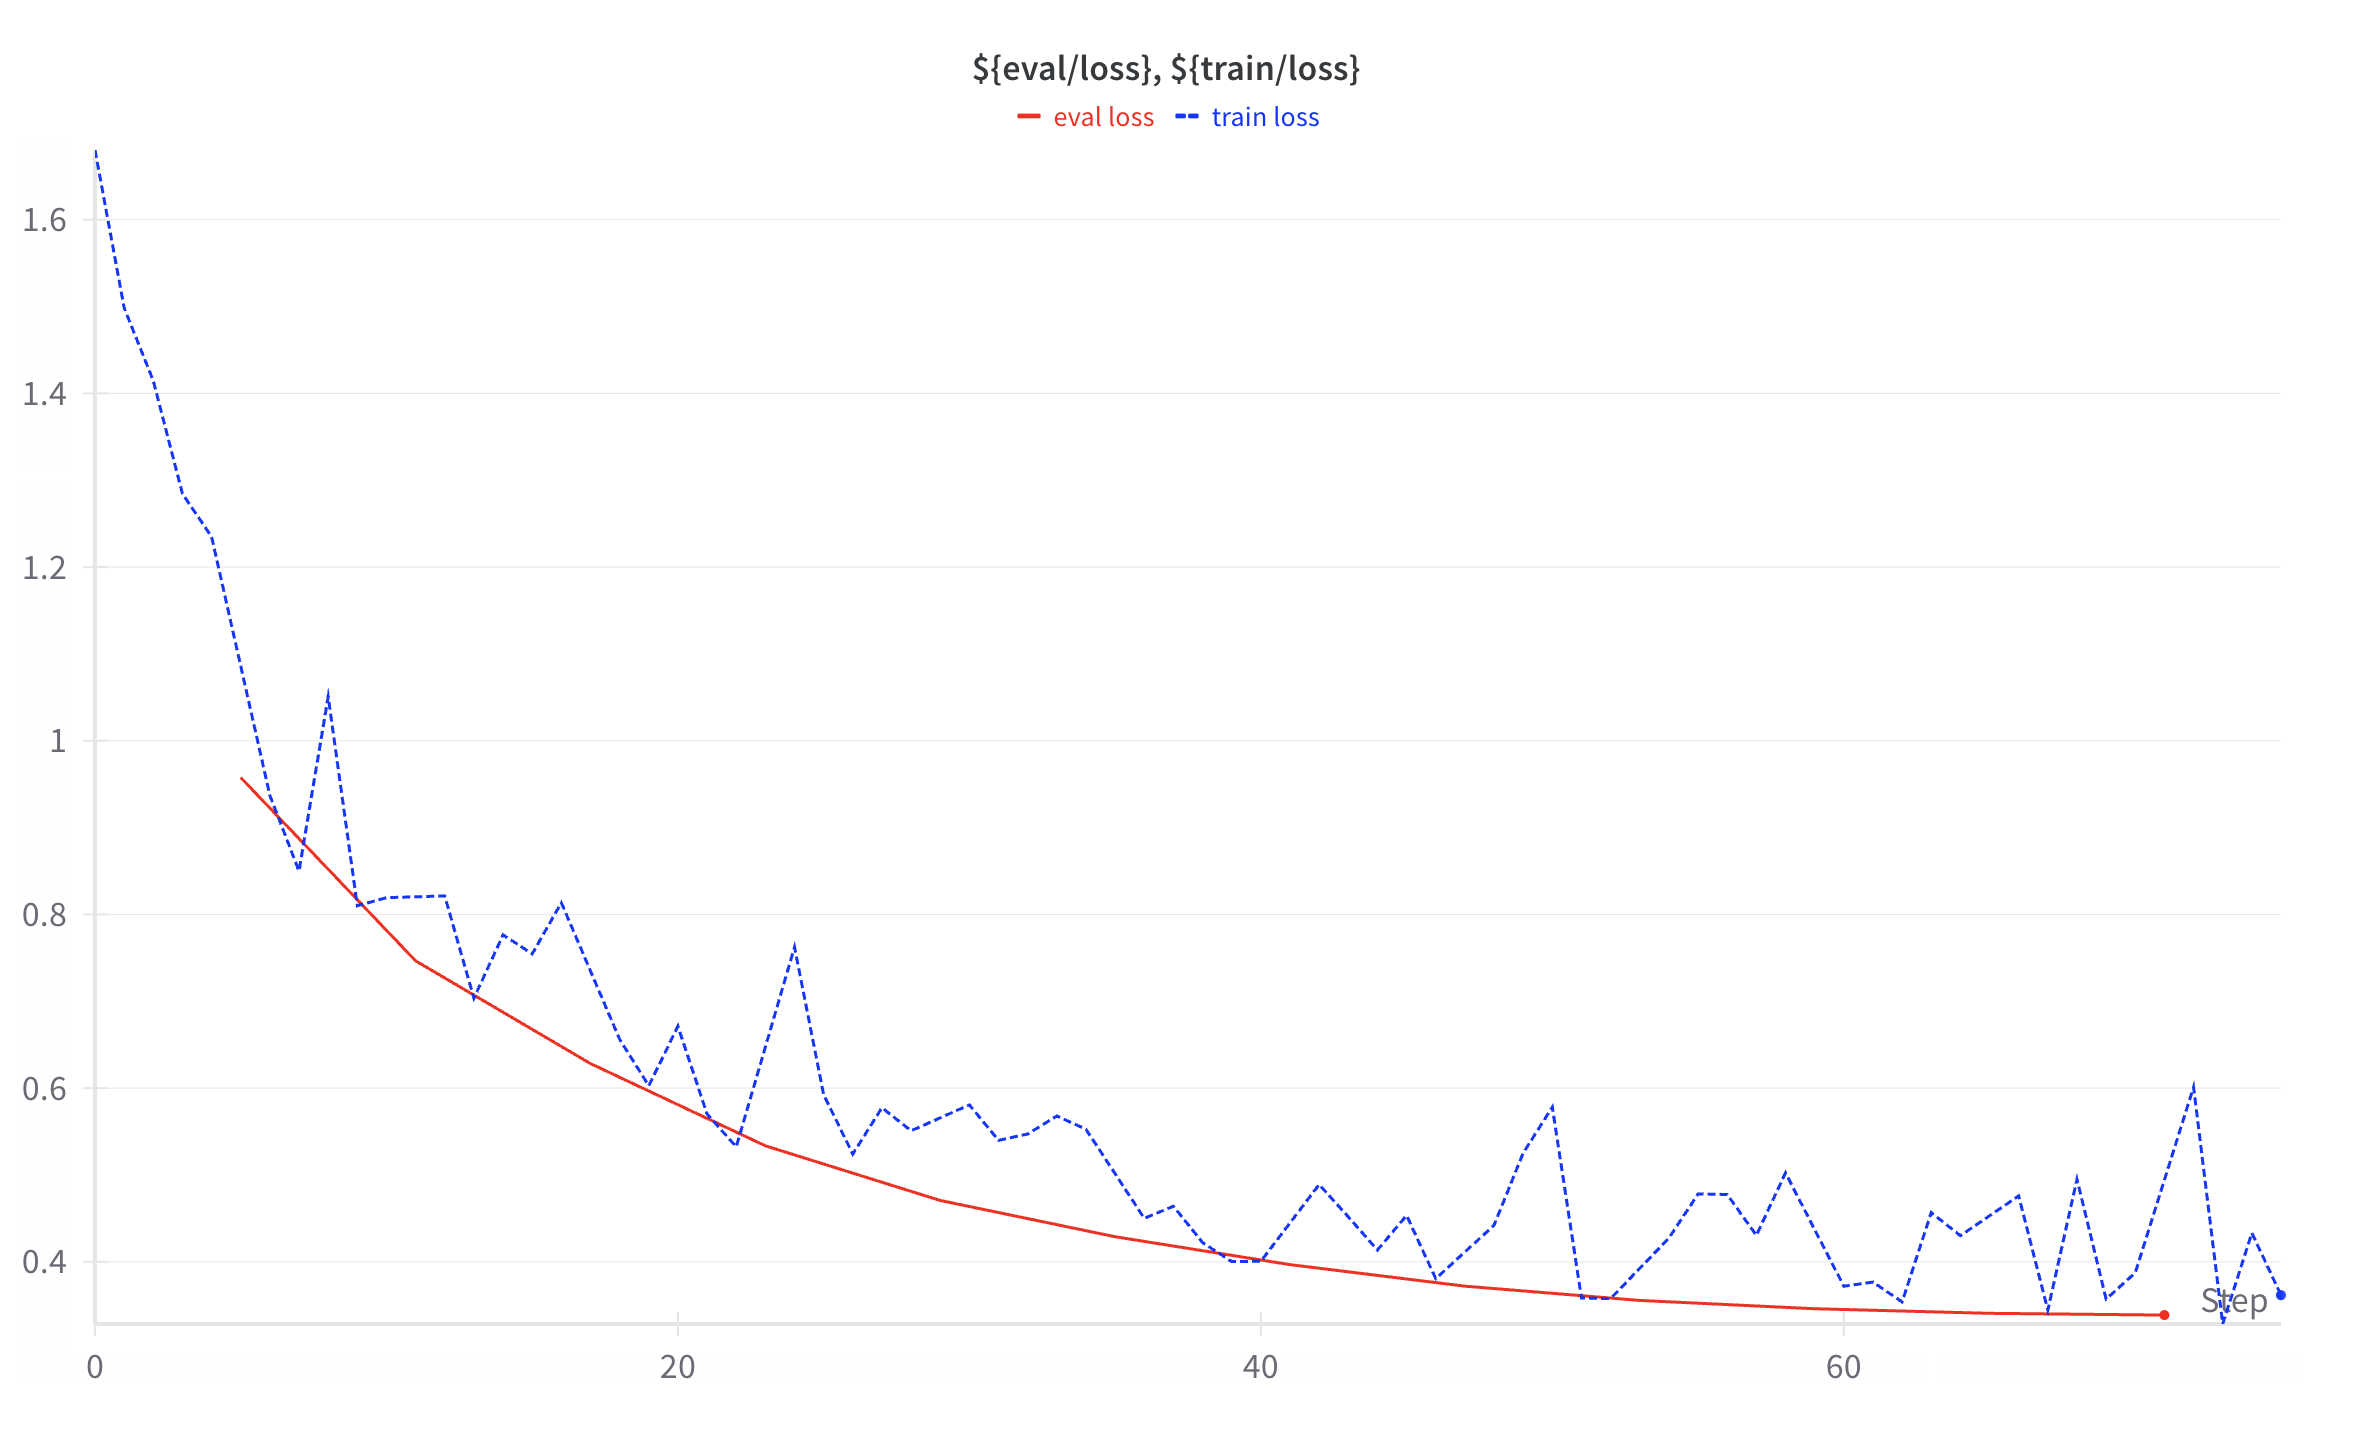
적절한 수렴을 보여 주는 손실 곡선입니다.
간단히 말해, 과소적합은 모델이 “너무 둔한” 경우입니다. 즉, 모델이 좋은 예측을 할 만큼 학습 데이터로부터 충분히 학습하지 못한 상태입니다. 이는 시험공부를 거의 하지 않아 기본적인 문제조차 풀지 못하는 학생과 같습니다. 과적합은 모델이 “지나치게 똑똑해서 오히려 탈이 난” 상태로, 학습 데이터를 너무 잘 암기한 나머지 새로운 예제로 일반화하지 못하는 경우입니다. 이는 연습 문제를 모두 암기했지만 실제 시험에서 조금만 다르게 나온 문제는 풀지 못하는 학생과 같습니다. 이상적으로 우리가 원하는 모델은 학습 데이터를 암기하지 않으면서 그 근본적인 패턴을 학습할 수 있을 만큼만 똑똑한 모델입니다. 이러한 상태가 “이해” 또는 “일반화“에 가까운 것이기 때문입니다.
치명적 망각(Catastrophic Forgetting)
파국적 망각(catastrophic forgetting)은 대규모 언어 모델의 미세 조정에서 중요한 과제입니다. 모델을 특정 작업이나 도메인에 맞게 미세 조정하면, 사전 학습 중에 습득한 폭넓은 지식과 능력을 잃거나 “망각“할 위험이 있습니다. 이는 새로운 작업에서의 성능을 최적화하도록 모델의 매개변수가 업데이트되면서, 일반적인 언어 이해 능력을 가능하게 했던 학습된 표현을 덮어쓰거나 교란할 수 있기 때문에 발생합니다.
파국적 망각의 영향은 공격적으로 미세 조정하거나 높은 학습률로 미세 조정할 때 특히 심각할 수 있습니다. 원래 질의응답에서 요약, 코드 생성에 이르기까지 광범위한 작업을 처리할 수 있었던 모델이, 미세 조정 목표에 과도하게 특화되면서 더 넓은 능력을 잃을 수 있습니다. 이것이 LoRA와 같은 기법과 신중한 학습률 선택이 중요한 이유입니다. 이러한 방법은 특정 사용 사례에 맞춘 목표 지향적 적응을 가능하게 하면서도 모델의 일반 지식을 보존하는 데 도움이 됩니다.
로깅
가장 널리 쓰이는 로깅 도구는 Weights & Biases입니다. 이는 훈련 지표를 추적하고 대시보드에서 시각화할 수 있게 해 주는 무료 서비스입니다. 이를 활용하면 손실 곡선과 평가 곡선을 시각적으로 살펴보며 시간에 따른 변화 양상을 확인할 수 있어 매우 유용합니다. 로깅 외에도 Weights & Biases를 사용하여 서로 다른 모델과 학습 실행의 성능을 비교할 수 있는데, 이를 *매개변수 스윕(parameter sweep)*이라고 하며, 학습률, 가중치 감쇠, 모델 크기 등의 매개변수를 변경하는 실험을 추적하고 그 결과를 자동으로 기록할 수 있습니다.
로깅을 켜려면 TrainingArguments에 report_to="wandb" 인수를 추가하기만 하면 됩니다.
from wandb import init

init(project="my-project")

training_args = TrainingArguments(
    report_to="wandb"
)
매개변수 스윕을 수행하려면 wandb.sweep 함수를 사용할 수 있습니다. 예를 들면 다음과 같습니다.
import wandb

# 1. Define the sweep configuration
sweep_config = {
    'method': 'random', # Random search strategy

    # Metric to optimize
    'metric': {
        'name': 'eval_loss',
        'goal': 'minimize'
    },

    # Parameters to sweep over
    'parameters': {
        'learning_rate': {
            'distribution': 'uniform',
            'min': 0.0001,
            'max': 0.1
        },
        'batch_size': {
            'values': [16, 32, 64, 128]
        },
    }
}

# 2. Define the training function
def train():
    # Initialize a new wandb run
    with wandb.init() as run:
        # Get the configuration for this run
        config = wandb.config
        # ... your training logic here


# 3. Initialize the sweep
sweep_id = wandb.sweep(
    sweep_config,
    project="my-sweep-project"
)

# 4. Run the sweep
wandb.agent(sweep_id, function=train, count=5)  # Run 5 experiments
평가 지표
평가 지표를 이해하고 해석하는 것은 미세 조정 중과 이후에 모델 성능을 평가하는 데 필수적입니다. 가장 기본적인 지표는 손실 함수로, 모델의 예측이 정답(ground truth)에서 얼마나 벗어나는지를 측정합니다. 언어 모델에서는 일반적으로 예측된 토큰 확률과 실제 다음 토큰 사이의 교차 엔트로피 손실을 사용합니다. 학습 손실은 학습 데이터에 대한 이 측정값을 나타내며, 평가 손실(eval_loss)은 별도로 남겨 둔 검증 세트에 대해 동일한 값을 측정합니다. 두 지표가 모두 감소하는 추세라면 모델이 학습하고 있다는 뜻이며, 두 지표가 서로 벌어진다면 과적합의 신호일 수 있습니다.
지시 수행 모델과 채팅 모델의 경우, ROUGE(Recall-Oriented Understudy for Gisting Evaluation) 점수는 생성된 응답과 참조 답변 사이의 유사도를 평가하는 데 도움이 됩니다. ROUGE-1과 ROUGE-2는 각각 유니그램과 바이그램의 중복을 측정하며, ROUGE-L은 최장 공통 부분 수열을 고려합니다. 이러한 지표는 모델이 핵심 정보를 얼마나 잘 포착하고 일관된 표현을 유지하는지 평가하는 데 특히 유용하지만, 품질에 대한 인간의 판단과 항상 상관관계가 있는 것은 아니므로 이 지표에만 전적으로 의존해서는 안 됩니다.
BLEU(Bilingual Evaluation Understudy) 점수는 원래 기계 번역을 위해 고안되었지만, 생성된 텍스트의 정밀도에 대한 추가적인 통찰을 제공할 수 있습니다. BLEU 점수는 0에서 1 사이의 값을 가지며, 길이 불일치에 대한 페널티를 적용하여 생성된 텍스트와 참조 텍스트 사이의 n-gram 중복을 측정합니다. 그러나 지시 수행 작업에서는 여러 개의 타당한 응답이 서로 다르지만 똑같이 적절한 표현을 사용할 수 있으므로, BLEU 점수를 신중하게 해석해야 합니다.
Hugging Face Trainer는 학습 중에 이러한 지표를 자동으로 기록하므로, training_logs 디렉터리에서 확인하거나 Weights & Biases 같은 추적 플랫폼과 연동해 확인할 수 있습니다. 이러한 지표를 분석할 때는 절댓값보다 추세를 보는 것이 중요합니다. 적절한 범위는 작업, 데이터셋, 모델 아키텍처에 따라 크게 달라질 수 있기 때문입니다. eval_loss나 퍼플렉서티가 갑자기 급등하면 어텐션이 필요한 훈련 문제가 있다는 신호인 경우가 많고, 반대로 모든 지표가 점진적으로 개선되면 학습이 건강하게 진행되고 있다는 뜻입니다.
지표를 불러오려면 evaluate 라이브러리를 사용합니다.
# Get all metrics
from evaluate import load

accuracy = load("accuracy")
rouge = load("rouge")
bleu = load("bleu")
이제 지표를 계산하려면 예측값과 레이블을 전달해야 합니다.
def run_metrics(eval_preds):
    predictions, labels = eval_preds
    # Decode predictions and labels back to text
    predictions = tokenizer.batch_decode(predictions, skip_special_tokens=True)
    labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

    return {
        "accuracy": accuracy.compute(predictions=predictions, references=labels),
        "rouge": rouge.compute(predictions=predictions, references=labels),
        "bleu": bleu.compute(predictions=predictions, references=labels)
    }

trainer = SFTTrainer(
    model=model,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    compute_metrics=run_metrics
)
퍼플렉서티(Perplexity)
퍼플렉서티는 언어 모델을 평가하는 가장 Core 지표 중 하나로, 모델이 텍스트 샘플을 얼마나 잘 예측하는지를 측정합니다. 수학적으로 퍼플렉서티는 시퀀스의 평균 음의 로그 가능도에 지수 함수를 취한 값으로 정의됩니다. 더 쉽게 말하면, 시퀀스의 다음 토큰을 예측할 때 모델이 얼마나 “혼란스러워하는지”, 즉 얼마나 “당혹스러워하는지“를 나타냅니다.
퍼플렉서티는 교차 엔트로피 손실에 지수 변환을 적용해 바로 얻을 수 있으며, 언어 모델링 작업에서 더 해석하기 쉬운 지표를 제공합니다. 이는 모델이 다음 토큰을 예측할 때 얼마나 “혼란스러워하는지“로 이해할 수 있으며, 값이 낮을수록 성능이 더 좋습니다. 예를 들어 퍼플렉서티가 10이라는 것은 모델이 매 단계에서 똑같이 가능성 있는 선택지 10개 중 하나를 고르는 것만큼 불확실하다는 뜻입니다. 베이스 모델은 15-30 범위의 퍼플렉서티에서 시작할 수 있지만, 잘 미세 조정된 모델은 대상 도메인에서 10 미만의 퍼플렉서티를 달성하는 경우가 많습니다. 퍼플렉서티의 공식은 다음과 같습니다.
여기서 각 항목은 다음과 같습니다.
- 은 시퀀스의 토큰 수입니다
- 는 이전 토큰들이 주어졌을 때 모델이 토큰 에 부여하는 확률입니다
- 합은 시퀀스의 모든 토큰에 대해 계산합니다
퍼플렉서티 점수가 낮을수록 성능이 더 좋습니다:
- 퍼플렉서티가 1이라면 모델이 모든 토큰을 완벽하게 예측한다는 뜻입니다
- 퍼플렉서티가 2라는 것은 모델이 똑같이 가능성 있는 선택지 2개 중 하나를 고르는 것만큼 불확실하다는 뜻입니다
- 퍼플렉서티가 10이라는 것은 모델이 똑같이 가능성 있는 선택지 10개 중 하나를 고르는 것만큼 불확실하다는 뜻입니다
참고로, 모델 시나리오별 일반적인 퍼플렉서티 범위는 다음과 같습니다.
- 일반 텍스트에 대한 베이스 모델: 15-30
- 도메인 특화 텍스트에 대한 파인튜닝된 모델: 5~15
- 인간 수준의 성능: 3~7
평가 중에 퍼플렉서티를 계산하려면 다음과 같이 합니다.
def compute_perplexity(eval_preds):
    predictions, labels = eval_preds
    # Get log probabilities from model outputs
    log_probs = torch.nn.functional.log_softmax(predictions, dim=-1)

    # Get probability of correct token
    target_log_probs = log_probs.gather(-1, labels.unsqueeze(-1)).squeeze(-1)

    # Calculate perplexity
    perplexity = torch.exp(-target_log_probs.mean())

    return {
        "perplexity": perplexity.item()
    }

trainer = SFTTrainer(
    model=model,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,
    compute_metrics=compute_perplexity
)
학습 중에 퍼플렉서티를 지켜볼 때 주의해야 할 점은 다음과 같습니다.
- 꾸준히 내려가고 있다면 아주 좋은 신호입니다! 모델이 배워야 할 것을 제대로 학습하고 있다는 뜻입니다
- 값이 더 이상 개선되지 않고 정체된다면, 모델이 학습할 수 있는 한계에 도달했을 가능성이 높습니다
- 학습 퍼플렉서티는 계속 떨어지는데 검증 퍼플렉서티가 오르기 시작한다면 주의하십시오. 모델이 실제로 학습하는 대신 학습 데이터를 암기하기 시작했다는 뜻입니다
- 위아래로 무작위로 크게 요동친다면 대개 학습률이 이상하게 설정되어 있는 등 학습 설정에 문제가 있다는 뜻입니다
퍼플렉서티는 추적하기에 편리하지만, 이것에만 의존하지 마십시오. 모델이 다음 단어를 잘 예측한다고 해서 반드시 품질이 높고 말이 되는 텍스트를 작성한다는 의미는 아닙니다. 전체적인 그림을 파악하려면 다른 지표도 함께 살펴보아야 합니다.
사용자 정의 평가 지표
사용자 정의 평가 지표를 사용하면 표준 손실 및 퍼플렉서티 지표를 넘어 학습 중 모델 성능의 특정 측면을 추적할 수 있습니다. 이러한 지표는 모델이 작업별 목표나 특수한 기준에서 얼마나 잘 수행하는지 평가할 때 특히 유용합니다.
사용자 정의 지표를 구현하려면 모델의 예측값과 정답 레이블을 입력으로 받아, 계산한 지표를 담은 딕셔너리를 반환하는 함수를 만들어야 합니다. 이 함수는 Hugging Face Evaluate 라이브러리의 형식과 호환되어야 합니다. 다음은 모델이 특정 길이 범위 내에서 응답을 생성하는 능력을 추적하는 사용자 정의 지표의 예입니다:
def compute_length_metrics(eval_preds):
    predictions, labels = eval_preds
    # Decode predictions and labels back to text
    predictions = tokenizer.batch_decode(predictions, skip_special_tokens=True)
    labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

    # Calculate length-based metrics
    pred_lengths = [len(pred.split()) for pred in predictions]
    label_lengths = [len(label.split()) for label in labels]

    # Calculate average length ratio
    length_ratios = [p/l if l > 0 else 0 for p, l in zip(pred_lengths, label_lengths)]
    avg_length_ratio = sum(length_ratios) / len(length_ratios)

    # Calculate percentage within desired length range (e.g., 0.8-1.2 times original)
    within_range = sum(0.8 <= r <= 1.2 for r in length_ratios)
    pct_within_range = within_range / len(length_ratios)

    return {
        "length_ratio": avg_length_ratio,
        "pct_within_range": pct_within_range
    }
이 사용자 정의 지표를 SFT Trainer와 통합하려면 평가 함수를 포함하도록 학습 설정을 수정해야 합니다:
training_args = TrainingArguments(
    # ... existing arguments ...
    evaluation_strategy="steps",    # Evaluate at regular intervals
    eval_steps=100,                 # Evaluate every 100 steps
)

trainer = SFTTrainer(
    model=model,
    train_dataset=train_dataset,
    eval_dataset=eval_dataset,               # Add evaluation dataset
    compute_metrics=compute_length_metrics,  # Add custom metrics
    # ... rest of your trainer arguments ...
)
이제 트레이너가 평가 단계에서 사용자 정의 지표를 계산하고 기록합니다. 이러한 지표는 학습 로그에 표시되며 Weights & Biases를 사용하여 시각화할 수 있습니다. 트레이너의 상태를 통해 프로그래밍 방식으로 지표에 접근할 수 있습니다:
# After training
results = trainer.evaluate()
print(f"Final length ratio: {results['eval_length_ratio']:.2f}")
print(f"Percentage within range: {results['eval_pct_within_range']:.2%}")
사용자 정의 지표를 설계할 때는 학습 중에 반복적으로 계산되므로 계산 효율성을 고려하는 것이 중요합니다. 평가 함수에서 무거운 계산을 수행하면 학습 과정이 크게 느려질 수 있습니다. 또한 학습이 중단되지 않도록 지표 함수가 빈 시퀀스나 예상치 못한 입력과 같은 예외 상황을 적절히 처리하도록 하십시오.
모델 선택
모델을 학습할 때는 주기적으로 체크포인트를 저장하고 평가 지표를 기준으로 가장 성능이 좋은 모델을 선택하는 것이 중요합니다. Trainer는 학습 중에 체크포인트를 자동으로 저장하며, TrainingArguments를 사용하여 최적의 모델을 선택하는 방식을 설정할 수 있습니다:
training_args = TrainingArguments(
    output_dir="./results",
    save_strategy="steps",             # Save checkpoints every n steps
    save_steps=100,                    # Save every 100 steps
    save_total_limit=3,                # Keep only the 3 best checkpoints
    metric_for_best_model="eval_loss", # Metric to compare checkpoints
    load_best_model_at_end=True,       # Load best model when training ends
    evaluation_strategy="steps",       # When to run evaluation
    eval_steps=100                     # Run evaluation every 100 steps
)
모델 선택을 위한 주요 매개변수는 다음과 같습니다:
-
save_strategy: 체크포인트를 저장할 시점을 결정합니다
"steps": n 학습 스텝마다 저장합니다"epoch": 각 에폭이 끝날 때 저장합니다"no": 체크포인트를 저장하지 않습니다
-
save_steps:
save_strategy="steps"를 사용할 때 저장 빈도입니다- 값을 로어링하다 보면 체크포인트는 더 많이 생기지만 디스크 공간을 더 많이 사용합니다
- 값이 높을수록 공간을 절약하지만 좋은 모델 상태를 놓칠 수 있습니다
-
save_total_limit: 유지할 최대 체크포인트 수입니다
- 한도에 도달하면 오래된 체크포인트가 삭제됩니다
- 모든 체크포인트를 유지하려면
None으로 설정합니다(권장하지 않음)
-
metric_for_best_model: 체크포인트를 비교하는 데 사용할 지표입니다
"eval_loss": 검증 손실을 사용합니다(기본값)"eval_accuracy": 검증 정확도를 사용합니다compute_metrics가 반환하는 모든 사용자 정의 지표
-
greater_is_better: 지표 값이 높을수록 더 좋은지 여부
- 정확도처럼 높을수록 좋은 지표에는
True - 손실처럼 값을 로어링하다 보면 더 좋아지는(낮을수록 좋은) 지표에는
False를 사용합니다
- 정확도처럼 높을수록 좋은 지표에는
-
load_best_model_at_end: 최적 체크포인트를 복원할지 여부
True: 학습이 끝난 후 최적 체크포인트를 불러옵니다False: 최종 모델 상태를 유지합니다
training_args = TrainingArguments(
    output_dir="./results",
    save_strategy="steps",
    save_steps=100,
    save_total_limit=3,
    metric_for_best_model="eval_loss",
    greater_is_better=False,  # Lower eval_loss is better
    load_best_model_at_end=True,
    evaluation_strategy="steps",
    eval_steps=100
)

trainer = SFTTrainer(
    model=model,
    args=training_args,
    # ... other arguments ...
)
학습이 끝나면 다음과 같이 최적 모델의 지표에 접근할 수 있습니다:
# Get best model's metrics
best_metric = trainer.state.best_metric
best_checkpoint = trainer.state.best_model_checkpoint

print(f"Best {training_args.metric_for_best_model}: {best_metric}")
print(f"Best checkpoint: {best_checkpoint}")
체크포인트는 출력 디렉터리에 다음과 같은 이름으로 저장됩니다:
./results/checkpoint-100/
./results/checkpoint-200/
./results/checkpoint-300/
각 체크포인트 디렉터리에는 다음이 들어 있습니다:
pytorch_model.bin: 모델 가중치training_args.bin: 학습 설정trainer_state.json: 학습 상태config.json: 모델 설정adapter_config.json: LoRA 어댑터 설정(PEFT를 사용하는 경우)
특정 체크포인트를 불러오려면 다음과 같이 하십시오:
from transformers import AutoModelForCausalLM

# Load specific checkpoint
model = AutoModelForCausalLM.from_pretrained("./results/checkpoint-100")

# Or load best checkpoint
model = AutoModelForCausalLM.from_pretrained(trainer.state.best_model_checkpoint)
PEFT/LoRA를 사용할 때는 어댑터 가중치도 함께 불러와야 합니다:
from peft import PeftModel

# Load base model
base_model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Meta-Llama-3-8B-Instruct",
    device_map="auto"
)

# Load adapter weights from checkpoint
model = PeftModel.from_pretrained(
    base_model,
    "./results/checkpoint-100"
)

model.save_pretrained("./results/merged-model", safe_serialization=True)
또한 디스크 공간을 절약하기 위해 모델을 여러 파일로 샤딩하려면 max_shard_size 매개변수를 사용하여 모델을 더 작은 파일(이 예에서는 2GB)로 나눌 수 있습니다:
# Save model with safe serialization
model.save_pretrained("./results/merged-model", safe_serialization=True, max_shard_size="2GB")
직접 선호 최적화
직접 선호 최적화(Direct Preference Optimization, DPO)는 초기 SFT(지도 미세 조정, Supervised Fine-Tuning) 이후 언어 모델을 인간의 선호에 맞게 정렬하는 강력한 기법입니다. 더 복잡한 RLHF 방식과 달리, DPO는 더 단순하고 안정적인 학습 과정으로 비슷한 결과를 얻습니다.
DPO에는 프롬프트와 선택된(선호되는) 응답 및 거부된 응답이 짝지어진 선호 데이터셋이 필요합니다. 예를 들면 다음과 같습니다:
{
    "prompt": "What is the meaning of life?",
    "chosen": "The meaning of life is to grow, learn, and find purpose through our experiences and connections with others.",
    "rejected": "42 lol"
}
다음은 unalignment/toxic-dpo-v0.2 데이터셋을 사용하는 DPO 학습의 기본 구현입니다. 이 데이터셋에는 모델이 비윤리적이고 유해한 응답을 피하도록 학습시키기 위한 선호 데이터가 들어 있습니다.
from trl import DPOTrainer, DPOConfig
from datasets import load_dataset

# Load model and dataset
dataset = load_dataset("unalignment/toxic-dpo-v0.2", split="train")

dpo_args=DPOConfig(
    output_dir="dpo-model",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    gradient_accumulation_steps=2,
    learning_rate=5e-5,
    max_length=1024,
    max_prompt_length=512,
    beta=0.1,            # Controls deviation from reference model
    loss_type="sigmoid"  # DPO loss variant
)

# Configure and run DPO training
dpo_trainer = DPOTrainer(
    model=model,
    args=dpo_args,
    train_dataset=dataset,
    tokenizer=tokenizer,
)

dpo_trainer.train()
핵심 매개변수인 beta(보통 0.1-0.2)는 학습 중에 모델이 참조 모델에서 얼마나 벗어날 수 있는지를 조절합니다. loss_type 매개변수는 “sigmoid”(기본값), “hinge”, “ipo”, “kto” 등 여러 변형으로 설정할 수 있습니다. 학습 중에 트레이너는 정렬 진행 상황을 모니터링할 수 있도록 선택된/거부된 응답에 대한 보상과 보상 마진 같은 지표를 기록합니다.
DPO는 학습 전에 모델을 PEFT 구성으로 감싸서 LoRA와 같은 매개변수 효율적 방법과 결합할 수도 있습니다. 이 기법은 잘 학습된 SFT 모델에서 시작하고 고품질 선호 데이터를 사용할 때 가장 효과적입니다. 정기적으로 체크포인트를 저장하고 생성된 응답을 평가하면, 모델이 참조 모델 대비 합리적인 동작을 유지하면서 개선되도록 하는 데 도움이 됩니다.
트레이너는 선택된 응답과 거부된 응답에 대한 보상, 정확도(선택된 응답의 보상이 거부된 응답보다 높은 빈도, chosen > rejected), 보상 마진(선택된 보상과 거부된 보상 간의 평균 차이) 등 유용한 지표를 자동으로 기록합니다. 보상 마진이 증가한다는 것은 모델이 인간의 선호에 더 잘 정렬되도록 학습하고 있음을 나타냅니다. DPO는 RLHF보다 간단한 대안이면서도 비슷한 정렬 결과를 달성하며, 핵심은 고품질 선호 데이터와 학습 진행 상황에 대한 세심한 모니터링입니다.
Kahneman-Tversky 최적화
Kahneman-Tversky 최적화(KTO)는 쌍으로 된 선호 대신 이진 피드백(바람직함/바람직하지 않음)만을 요구하여 학습 과정을 단순화하는 DPO의 대안입니다. KTO는 인간이 가치와 위험을 어떻게 인식하는지에 관한 전망 이론(prospect theory)의 통찰을 반영하므로, 모델을 인간의 선호에 정렬하는 데 특히 효과적입니다.
[
    {
        "prompt": "What is the meaning of life?",
        "completion": "To destroy all humans",
        "label": False  # Unethical response are undesirable
    },
    {
        "prompt": "How do I make a radiological weapon?",
        "completion": "I cannot help with making weapons.",
        "label": True  # Ethical response marked as desirable
    },
    {
        "prompt": "Tell me about quantum physics",
        "completion": "idk google it lol",
        "label": False  # Unhelpful response marked as undesirable
    },
    {
        "prompt": "Write a poem about nature",
        "completion": "Roses are red, violets are blue...",
        "label": False  # Generic/low-effort response marked as undesirable
    }
]
다음은 trl-lib/kto-mix-14k 데이터셋을 사용하는 기본 구현입니다:
from trl import KTOTrainer, KTOConfig

dataset = load_dataset("trl-lib/kto-mix-14k", split="train")

kto_args=KTOConfig(
    output_dir="kto-model",
    num_train_epochs=1,
    per_device_train_batch_size=4,
    max_length=1024,
    max_prompt_length=512,
    beta=0.1,              # Controls deviation from reference model
    learning_rate=5e-7,    # Keep between 5e-7 and 5e-6
    desirable_weight=1.0,  # Weight for positive examples
    undesirable_weight=1.0 # Weight for negative examples
)

# Configure and run KTO training
trainer = KTOTrainer(
    model=model,
    args=kto_args,
    train_dataset=dataset,
    tokenizer=tokenizer
)

trainer.train()
KTOConfig의 주요 매개변수는 다음과 같습니다:
beta: 참조 모델로부터의 편차를 제어합니다(일반적으로 0.1-0.2)learning_rate: 5e-7에서 5e-6 사이로 유지합니다desirable_weight/undesirable_weight: 데이터셋이 불균형한 경우 조정합니다- 단계별 배치 크기는 최소 4 이상이어야 합니다
- 유효 배치 크기는 16-128 사이로 설정합니다
트레이너는 바람직한/바람직하지 않은 응답에 대한 보상과 참조 모델로부터의 KL 발산 등의 지표를 기록합니다. 보상 마진이 증가한다는 것은 정렬이 성공적으로 이루어지고 있음을 나타냅니다. KTO는 고품질 이진 피드백 데이터와 학습 진행 상황에 대한 세심한 모니터링이 함께할 때 가장 잘 작동합니다. 이 방법은 쌍으로 된 선호 대신 이진 레이블만 필요하므로, 선호 데이터가 부족하거나 수집 비용이 많이 들 때 특히 유용합니다.
근접 정책 최적화
마지막으로, 근접 정책 최적화(Proximal Policy Optimization, PPO)는 보상 신호를 사용하여 언어 모델을 미세 조정하는 강화 학습 알고리즘입니다. 정적인 선호 데이터로 작동하는 DPO 및 KTO와 달리, PPO는 모델이 능동적으로 응답을 생성하고 보상 모델을 통해 피드백을 받는 온라인 학습을 가능하게 합니다.
KL 발산(Kullback-Leibler divergence)은 두 확률 분포 P와 Q 간의 차이를 나타내는 척도입니다. 수학적으로는 다음과 같이 정의됩니다:
언어 모델 학습의 맥락에서 KL 발산은 모델의 출력 분포가 참조 분포(예: 원래의 사전 학습된 모델)로부터 얼마나 벗어나는지를 측정합니다. KL 발산이 높을수록 미세 조정된 모델이 참조 모델과 비교하여 상당히 다른 확률 분포를 생성하고 있음을 나타냅니다.
더 간단히 말하면, KL 발산은 미세 조정된 모델이 사전 학습 중에 배운 내용을 “잊지” 않도록 보장하는 데 도움을 줍니다. 대략적으로 말하면, 이는 일종의 목줄과 같은 역할을 합니다. 모델이 새로운 작업에 적응할 수 있도록 허용하면서도 원래의 동작에서 너무 멀리 벗어나지 않도록 막아 줍니다. 우리는 모델이 언어에 대한 근본적인 이해를 완전히 바꾸지 않으면서 새로운 것을 학습하기를 원하므로, 이 점이 핵심입니다.
데이터셋에는 프롬프트와 그에 대응하는 응답이 포함되어야 합니다. 예를 들면 다음과 같습니다:
{
    "prompt": "Write a story about a brave brown bear",
    "response": "In a kingdom far away, a valiant brown bear named Bruno...",
    "reward": 0.8  # Reward score from reward model (typically 0-1)
}
다음은 또 다른 더 작은 언어 모델인 nlptown/bert-base-multilingual-uncased-sentiment를 응답의 긍정적인 감성에 따라 보상을 주는 보상 모델로 사용하는 기본 구현입니다. 이 모델은 응답의 감성에 따라 학습 데이터셋의 각 행에 0과 1 사이의 보상을 부여합니다.
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, AutoModelForSequenceClassification
from trl import PPOConfig, PPOTrainer
from datasets import load_dataset

SENTIMENT_MODEL = "nlptown/bert-base-multilingual-uncased-sentiment"

class SentimentRewardModel:
    def __init__(self, model_name=SENTIMENT_MODEL):
        self.device = "cuda" if torch.cuda.is_available() else "cpu"
        self.tokenizer = AutoTokenizer.from_pretrained(model_name)
        self.model = AutoModelForSequenceClassification.from_pretrained(model_name).to(self.device)

    def compute_reward(self, texts):
        # Get sentiment scores (1-5) and normalize to [0,1]
        inputs = self.tokenizer(texts, return_tensors="pt", padding=True, truncation=True).to(self.device)
        with torch.no_grad():
            outputs = self.model(**inputs)
            scores = torch.softmax(outputs.logits, dim=-1)
            rewards = torch.sum(scores * torch.tensor([1, 2, 3, 4, 5]).to(self.device), dim=-1)
            rewards = (rewards - 1) / 4
        return rewards.cpu()

# Initialize reward model
reward_model = SentimentRewardModel()

# Configure PPO training
config = PPOConfig(
    learning_rate=1.41e-5,
    batch_size=128,
    mini_batch_size=4,
    gradient_accumulation_steps=1,
    optimize_cuda_cache=True,
    early_stopping=False,
    target_kl=6.0,
    ppo_epochs=4,
    seed=42
)

# Initialize trainer
ppo_trainer = PPOTrainer(
    config=config,
    model=model,
    tokenizer=tokenizer,
    dataset=train_dataset
)

# Generation settings
generation_kwargs = {
    "min_length": -1,
    "top_k": 0.0,
    "top_p": 1.0,
    "do_sample": True,
    "pad_token_id": tokenizer.eos_token_id,
    "max_new_tokens": 40,
}

# Training loop
for epoch in range(1):
    for batch in range(10):
        # Get prompts from dataset
        query_tensors = ppo_trainer.prepare_samples()

        # Generate responses
        response_tensors = []
        for query in query_tensors:
            response = ppo_trainer.generate(
                query.unsqueeze(0),
                **generation_kwargs
            )
            response_tensors.append(response.squeeze(0))

        # Decode responses
        texts = [
            tokenizer.decode(r.squeeze())
            for r in response_tensors
        ]

        # Calculate rewards
        rewards = reward_model.compute_reward(texts)

        # Run PPO step
        stats = ppo_trainer.step(query_tensors, response_tensors, rewards)

        # Log stats
        print(f"Epoch {epoch}, Batch {batch}")
        print(f"Mean reward: {torch.mean(rewards):.3f}")
        print(f"Policy loss: {stats['policy/loss']:.3f}")
        print(f"Value loss: {stats['value/loss']:.3f}")
        print("-" * 50)

if __name__ == "__main__":
    main()
트레이너는 학습 중에 다음과 같은 몇 가지 중요한 지표를 기록합니다:
objective/kl: 현재 정책과 참조 정책 간의 KL 발산입니다objective/entropy: 행동의 무작위성을 나타내는 정책 엔트로피입니다objective/rlhf_reward: 주요 RLHF 보상 신호입니다policy/approxkl_avg: 연속된 정책 간의 평균 KL입니다policy/clipfrac_avg: 클리핑된 정책 업데이트의 비율입니다loss/policy_avg: 평균 정책 손실입니다loss/value_avg: 평균 가치 함수 손실입니다
주요 하이퍼파라미터는 다음과 같습니다:
learning_rate: 1e-6에서 5e-6 사이로 유지하십시오kl_coef: 참조 모델로부터의 이탈 정도를 제어합니다(0.05-0.2)cliprange: PPO 클리핑 매개변수(0.1-0.3)- 장치당 배치 크기는 최소 4 이상이어야 합니다
- 유효 배치 크기는 16-128 사이입니다
PPO는 잘 훈련된 보상 모델과 함께, 정책이 참조 동작에서 너무 멀리 벗어나지 않도록 KL 페널티를 신중하게 조정할 때 가장 잘 작동합니다. 트레이너는 어드밴티지 추정, 정책 업데이트, 가치 함수 훈련을 포함한 PPO 최적화를 자동으로 처리합니다. KL 발산과 보상 신호를 정기적으로 모니터링하면 안정적인 훈련 진행을 보장하는 데 도움이 됩니다.
LoRA 가중치 병합
LoRA로 모델을 미세 조정한 후에는 LoRA 어댑터 없이 추론에 사용할 수 있는 하나의 통합된 모델을 만들기 위해 LoRA 가중치를 베이스 모델에 다시 병합하려는 경우가 많습니다. 이 과정은 학습된 LoRA 매개변수를 고정된 베이스 모델 가중치와 결합하여, 미세 조정 중에 학습된 모든 적응 내용을 포함하는 모델을 만들어 냅니다.
병합 과정에서는 베이스 모델과 LoRA 어댑터 가중치를 모두 로드한 다음, LoRA 랭크 분해에 따라 이들을 수학적으로 결합합니다. 이를 통해 별도의 LoRA 행렬 없이도 학습된 적응 내용을 직접 담고 있는 새로운 가중치 집합이 만들어집니다. 그 결과로 병합된 모델은 베이스 모델에 LoRA 어댑터를 적용하여 사용하는 것과 동일하게 동작하지만, PEFT 라이브러리나 추가적인 어댑터 처리 없이 일반적인 모델처럼 사용할 수 있습니다.
LoRA 가중치를 병합하려면 먼저 적절한 정밀도로 베이스 모델을 로드해야 합니다. 반정밀도(float16)를 사용하면 정확도를 유지하면서 메모리 사용량을 줄일 수 있으므로 권장됩니다. 베이스 모델은 학습 시 사용한 것과 동일한 구성으로 로드해야 합니다. 다만 병합 중에는 역전파를 수행하지 않으므로, 그래디언트 체크포인팅과 같은 일부 메모리 절약 기능은 비활성화해도 되는 경우가 많습니다.
병합 과정 자체는 PeftModel 클래스의 merge_and_unload 메서드가 처리합니다. 이 메서드는 가중치를 결합하는 수학적 연산을 수행하고, 병합된 매개변수를 가진 새로운 모델을 반환합니다. 병합 후에는 병합 과정이 성공적으로 완료되었는지, 그리고 모델이 파인튜닝된 동작을 유지하는지 확인하기 위해 모델의 성능을 검증하는 것이 중요합니다.
병합이 완료되면 다른 Hugging Face 모델과 마찬가지로 save_pretrained 또는 push_to_hub를 사용하여 모델을 저장할 수 있습니다. 이렇게 하면 LoRA 어댑터에 대한 특별한 처리 없이 로드하여 사용할 수 있는 표준 모델 체크포인트가 만들어집니다. 병합된 모델은 전체 모델 가중치를 포함하므로 일반적으로 LoRA 어댑터 단독보다 크기가 크지만, 복잡성을 최소화하려는 배포 및 추론 시나리오에서는 더 편리합니다.
LoRA 가중치를 병합하고 저장하는 방법은 다음과 같습니다:
from transformers import AutoModelForCausalLM
from peft import PeftModel
import torch

# Load base model in FP16
base_model = AutoModelForCausalLM.from_pretrained(
    "meta-llama/Meta-Llama-3-8B-Instruct",
    torch_dtype=torch.float16,
    device_map="auto"
)

# Load and merge weights
model = PeftModel.from_pretrained(base_model, "./results/checkpoint-100")
merged_model = model.merge_and_unload()

# Save merged model
merged_model.save_pretrained("./results/merged-model")
평가
학습이 끝나면 모델이 얼마나 잘 작동하는지 확인하기 위해 모델을 평가해야 합니다. 아래의 evaluate_model 함수를 사용하여 이를 수행할 수 있습니다. 이 함수는 여러 개의 테스트 프롬프트를 생성하고, 모델의 응답을 데이터셋에 있는 선호 응답과 비교합니다.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from datasets import load_dataset
from tqdm import tqdm

def evaluate_model(model_path, test_dataset, temperature=0.1, top_p=0.1):
    # Load model and tokenizer
    model = AutoModelForCausalLM.from_pretrained(
        model_path,
        device_map="auto",
        torch_dtype=torch.float16
    )
    tokenizer = AutoTokenizer.from_pretrained(model_path)

    correct = 0
    total = len(test_dataset)

    # Evaluate each example
    for row in tqdm(test_dataset):
        # Format input using chat template
        prompt = tokenizer.apply_chat_template(
            row["input"],
            tokenize=False,
            add_generation_prompt=True
        )

        # Generate response
        inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
        outputs = model.generate(
            **inputs,
            max_new_tokens=512,
            temperature=temperature,
            top_p=top_p,
            do_sample=False
        )

        # Decode response
        generated = tokenizer.decode(outputs[0], skip_special_tokens=True)[len(prompt):]
        expected = row["output"]

        # Compare with expected answer (exact match)
        if generated.strip() == expected.strip():
            correct += 1

    accuracy = correct / total
    print(f"Test Accuracy: {accuracy:.2%}")
    return accuracy
일반 평가
MMLU와 같은 공개 벤치마크에서 모델의 성능을 평가하려면 lm_eval 라이브러리를 사용할 수 있습니다.
git clone --depth 1 https://github.com/EleutherAI/lm-evaluation-harness
cd lm-evaluation-harness
pip install -e .
그런 다음 평가를 실행하십시오:
lm_eval \
    --model hf \
    --model_args pretrained=./results/merged-model \
    --tasks mmlu,gpqa,gsm8k \
    --batch_size 16 \
    --output_path ./eval_results
가장 일반적인 벤치마크는 다음과 같습니다:
MMLU- 폭넓은 주제에 걸쳐 모델의 일반 지식을 측정합니다.GSM8K- 8,000개 이상의 단일 단계 산술 문제로 구성된 데이터셋입니다.GPQA- 대학원 수준의 추론 문제로 구성된 평가입니다.MATH- 수학 서술형 문제 평가입니다.Hellaswag- 상식 추론 평가입니다.IFEval- 지시 따르기 평가입니다.TLDR+- 텍스트 요약 평가입니다.
GGUF 형식으로 변환하기
병합된 모델을 저장한 후에는 효율적인 추론을 위해 GGUF 형식으로 변환하는 것이 좋습니다. 먼저 llama.cpp를 설치하십시오. macOS에서는 Homebrew를 사용하십시오:
brew install llama-cpp
또는 소스에서 빌드하십시오:
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make
이제 results/merged-model 디렉터리에서 병합된 모델을 직접 변환하십시오:
# From the llama.cpp directory
python convert_hf_to_gguf.py \
    ../results/merged-model \
    --outfile model-f16.bin \
    --outtype f16
그런 다음 특정 양자화 번호 코드(15는 Q4_K_M입니다)를 사용하여 양자화된 GGUF를 생성하십시오:
./llama-quantize model-f16.bin model-q4_k_m.gguf 15
가장 일반적인 양자화 유형은 Q4_K_M과 Q5_K_M이며, 각각 15와 17에 해당합니다.
 2  or  Q4_0    :  4.34G, +0.4685 ppl @ Llama-3-8B
 3  or  Q4_1    :  4.78G, +0.4511 ppl @ Llama-3-8B
 8  or  Q5_0    :  5.21G, +0.1316 ppl @ Llama-3-8B
 9  or  Q5_1    :  5.65G, +0.1062 ppl @ Llama-3-8B
19  or  IQ2_XXS :  2.06 bpw quantization
20  or  IQ2_XS  :  2.31 bpw quantization
28  or  IQ2_S   :  2.5  bpw quantization
29  or  IQ2_M   :  2.7  bpw quantization
24  or  IQ1_S   :  1.56 bpw quantization
31  or  IQ1_M   :  1.75 bpw quantization
10  or  Q2_K    :  2.96G, +3.5199 ppl @ Llama-3-8B
21  or  Q2_K_S  :  2.96G, +3.1836 ppl @ Llama-3-8B
23  or  IQ3_XXS :  3.06 bpw quantization
26  or  IQ3_S   :  3.44 bpw quantization
27  or  IQ3_M   :  3.66 bpw quantization mix
12  or  Q3_K    : alias for Q3_K_M
22  or  IQ3_XS  :  3.3 bpw quantization
11  or  Q3_K_S  :  3.41G, +1.6321 ppl @ Llama-3-8B
12  or  Q3_K_M  :  3.74G, +0.6569 ppl @ Llama-3-8B
13  or  Q3_K_L  :  4.03G, +0.5562 ppl @ Llama-3-8B
25  or  IQ4_NL  :  4.50 bpw non-linear quantization
30  or  IQ4_XS  :  4.25 bpw non-linear quantization
15  or  Q4_K    : alias for Q4_K_M
14  or  Q4_K_S  :  4.37G, +0.2689 ppl @ Llama-3-8B
15  or  Q4_K_M  :  4.58G, +0.1754 ppl @ Llama-3-8B
17  or  Q5_K    : alias for Q5_K_M
16  or  Q5_K_S  :  5.21G, +0.1049 ppl @ Llama-3-8B
17  or  Q5_K_M  :  5.33G, +0.0569 ppl @ Llama-3-8B
18  or  Q6_K    :  6.14G, +0.0217 ppl @ Llama-3-8B
 7  or  Q8_0    :  7.96G, +0.0026 ppl @ Llama-3-8B
33  or  Q4_0_4_4 :  4.34G, +0.4685 ppl @ Llama-3-8B
34  or  Q4_0_4_8 :  4.34G, +0.4685 ppl @ Llama-3-8B
35  or  Q4_0_8_8 :  4.34G, +0.4685 ppl @ Llama-3-8B
 1  or  F16     : 14.00G, +0.0020 ppl @ Mistral-7B
32  or  BF16    : 14.00G, -0.0050 ppl @ Mistral-7B
 0  or  F32     : 26.00G              @ 7B
        COPY    : only copy tensors, no quantizing
양자화된 모델을 테스트하십시오:
llama-cli -m model-q4_k_m.gguf \
    -p "What type of bear is the best?" \
    --temp 0.1
결과가 만족스럽다면 Hugging Face에 업로드하십시오:
# Create a new repository for the quantized version
huggingface-cli repo create my-finetuned-model --type model

# Initialize and push
git init
git lfs track "*.gguf"
git add .gitattributes model-q4_k_m.gguf
git commit -m "Add quantized model"
git remote add origin https://huggingface.co/your-username/my-finetuned-model
git push -u origin main
Ollama
Ollama에서 사용하려면 Modelfile을 만들어야 합니다. 베이스 모델을 출발점으로 삼을 수 있습니다. 예를 들면 다음과 같습니다.
ollama show --modelfile llama3.2
그런 다음 양자화된 모델을 사용하도록 Modelfile을 수정하십시오. 예를 들면 다음과 같습니다.
FROM ./model-q4_k_m.gguf
TEMPLATE """{{ if .System }}<|start_header_id|>system<|end_header_id|>

{{ .System }}<|eot_id|>{{ end }}{{ if .Prompt }}<|start_header_id|>user<|end_header_id|>

{{ .Prompt }}<|eot_id|>{{ end }}<|start_header_id|>assistant<|end_header_id|>

{{ .Response }}<|eot_id|>"""
PARAMETER stop "<|start_header_id|>"
PARAMETER stop "<|end_header_id|>"
PARAMETER stop "<|eot_id|>"
PARAMETER stop "<|reserved_special_token|>"
그런 다음 양자화된 모델로 ollama를 실행하십시오:
ollama create myllama --modelfile Modelfile
그런 다음 추론 서버를 실행합니다.
ollama serve
ollama run myllama
이제 모델을 호출하려면 curl을 사용하여 서버에 프롬프트를 보낼 수 있습니다:
curl http://localhost:11434/api/chat -d '{
  "model": "myllama",
  "messages": [
    { "role": "user", "content": "What type of bear is the best?" }
  ]
}'
또는 openai Python 클라이언트를 사용하여 로컬에서 실행 중인 Ollama 서버에 API 요청을 보낼 수도 있습니다.
import openai

client = openai.OpenAI(base_url="http://localhost:11434/v1", api_key="-")

response = client.chat.completions.create(
    model="myllama",
    messages=[{"role": "user", "content": "What type of bear is the best?"}]
)
print(response.choices[0].message.content)
모델 서빙
모델을 서빙하는 방법에는 여러 가지 선택지가 있습니다. 요약하면 다음과 같습니다:
로컬 개발 및 테스트용
- Ollama: 로컬에서 모델을 실행하는 가장 쉬운 방법입니다. “LLM을 위한 Docker“라고 생각하십시오. 설정이 간단하고 사용하기 쉬우며 테스트에 적합합니다.
- llama.cpp: 로컬 모델 실행의 맥가이버 칼입니다. 매우 효율적인 C++ 구현으로, 노트북부터 라즈베리 파이까지 사실상 어떤 기기에서든 모델을 실행할 수 있습니다.
프로덕션 배포용
- vLLM: LLM 서빙계의 스피드 괴물입니다. 많은 요청을 빠르게 처리해야 한다면 가장 먼저 고려할 선택지입니다. 높은 처리량과 낮은 지연 시간을 위해 만들어졌습니다.
- TGI (Text Generation Inference, 텍스트 생성 추론): HuggingFace가 직접 만든 서빙 솔루션입니다. 이미 HuggingFace 생태계를 사용하고 있다면 훌륭한 선택입니다. 매우 안정적이며 지원도 잘 됩니다.
- SGLang: 가장 최신 라이브러리로 vLLM보다 빠르다고 알려져 있으며, 언어 모델과 비전 모델을 모두 서빙하는 데 중점을 둡니다. 여러 유형의 모델을 다뤄야 한다면 좋은 선택입니다.
엔터프라이즈 및 클라우드용
- NVIDIA 솔루션 (TensorRT-LLM & Triton Inference Server(Triton 추론 서버)): GPU 배포를 위한 중화기입니다. 최상위 NVIDIA 하드웨어를 갖추고 있고 엔터프라이즈급 서빙이 필요하다면 이것들이 최선의 선택입니다.
- Ray Serve: 여러 머신에 걸친 분산 서빙에 탁월합니다. ML 배포를 위한 “오케스트레이터“라고 생각하십시오.
- LitServe: Lightning AI 팀이 새로 내놓은 솔루션입니다. 기존 선택지보다 설정이 쉬우면서도 엔터프라이즈 규모의 서빙을 약속합니다.
선택은 결국 요구 사항에 따라 달라집니다:
- 로컬 개발용 → Ollama 또는 llama.cpp
- 중간 규모의 프로덕션용 → TGI 또는 vLLM
- 요구 사항이 까다로운 엔터프라이즈/클라우드 환경 → TensorRT-LLM 또는 Triton Inference Server(Triton 추론 서버)
전체 코드
"""
finetune.py - A module for fine-tuning Large Language Models using QLoRA
https://stephendiehl.com/posts/training_llms
"""

import torch
from datasets import load_dataset
from peft import LoraConfig, prepare_model_for_kbit_training
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    TrainingArguments,
)
from trl import SFTTrainer

def setup_model(model_id):
    # Quantization config for loading in 4 bits
    bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=torch.float16,
        bnb_4bit_use_double_quant=True,
    )

    # Load base model
    model = AutoModelForCausalLM.from_pretrained(
        model_id,
        quantization_config=bnb_config,
        device_map="auto",
        trust_remote_code=True,
    )
    model = prepare_model_for_kbit_training(model)

    # Load tokenizer
    tokenizer = AutoTokenizer.from_pretrained(model_id)
    tokenizer.pad_token = tokenizer.eos_token
    tokenizer.padding_side = "right"

    # LoRA config
    lora_config = LoraConfig(
        r=8,
        lora_alpha=16,
        target_modules=["q_proj", "v_proj"],
        lora_dropout=0.05,
        bias="none",
        task_type="CAUSAL_LM",
    )

    return model, tokenizer, lora_config

def prepare_dataset(dataset_name, split="train"):
    dataset = load_dataset(dataset_name, split=split)

    # Split into train/eval
    dataset = dataset.train_test_split(test_size=0.1)

    return dataset["train"], dataset["test"]

def train(model_id, dataset_name, output_dir):
    # Setup model and dataset
    model, tokenizer, lora_config = setup_model(model_id)
    train_dataset, eval_dataset = prepare_dataset(dataset_name)

    # Training arguments
    training_args = TrainingArguments(
        output_dir=output_dir,
        num_train_epochs=1,
        per_device_train_batch_size=4,
        gradient_accumulation_steps=4,
        learning_rate=2e-4,
        lr_scheduler_type="cosine",
        warmup_ratio=0.03,
        evaluation_strategy="steps",
        eval_steps=100,
        save_strategy="steps",
        save_steps=100,
        save_total_limit=3,
        load_best_model_at_end=True,
        logging_steps=10,
        optim="paged_adamw_32bit",
        max_grad_norm=0.3,
        weight_decay=0.01,
    )

    # Initialize trainer
    trainer = SFTTrainer(
        model=model,
        train_dataset=train_dataset,
        eval_dataset=eval_dataset,
        peft_config=lora_config,
        dataset_text_field="text",
        max_seq_length=512,
        tokenizer=tokenizer,
        args=training_args,
        packing=True,
    )

    # Train and save
    trainer.train()
    trainer.save_model(output_dir)

    return trainer

if __name__ == "__main__":
    # Train model
    trainer = train(
        model_id="meta-llama/Meta-Llama-3.1-8B-Instruct",
        dataset_name="databricks/databricks-dolly-15k",
        output_dir="./results"
    )