MCP를 조합 최적화, 볼록 최적화, SMT 솔버와 연동하기
최근 저는 MCP를 단순히 기호 대수 조작에 쓰는 것을 넘어 활용하는 작업을 해 왔으며, 과학 계산을 위한 전용 솔버 모음을 도구로 노출하여 대규모 언어 모델과 연동하는 방법을 고민해 왔습니다. 특히 물리 공학 분야의 워크플로를 자동화하는 데 관심을 두고 있습니다.
- Github 소스 코드
git clone https://github.com/sdiehl/usolver.git
MCP에 익숙하지 않다면 제 이전 글이나, MCP가 무슨 세기의 발명품이라도 되는 양 숨 가쁘게 떠들어 대는 인터넷의 수많은 칼럼에서 더 자세한 내용을 읽어 보실 수 있습니다. 하지만 실상은 JSON RPC 인터페이스를 통해 일련의 함수 호출(도구라고 부릅니다)을 언어 모델에 노출하는 조잡한 방식에 불과합니다. 언어 모델은 언어 해석과 제한적인 “계획 수립“에 뛰어나고, 수치 솔버는 수치 계산에 뛰어납니다. 그러니 각 시스템이 가장 잘하는 일을 하게 하고, 둘을 결합하여 하이브리드 시스템을 구축합시다. MCP는 이러한 과학 계산용 Python 라이브러리를 모델과 묶어 주는 접착제일 뿐이며, 본질적으로 AI의 ’cgi-bin’이라고 할 수 있습니다.
MCP를 통해 언어 모델과 수치 솔버를 결합하는 가장 단순한 동기는 특정 문제에 대해 그것이 압도적으로 더 효율적이라는 점입니다. 단순한 예를 하나 생각해 봅시다. 스도쿠 퍼즐을 최첨단 추론 모델(o3, deepseek r1 등) 중 하나에 입력할 수는 분명히 있으며, 그러면 모델은 꽤 오랫동안 시행착오식 추측에 관해 “자기 자신“과 대화하며 한참을 헤맨 끝에 (어쩌면) 퍼즐을 풀 수도 있습니다. 그 사고의 사슬은 추측과 백트래킹으로 이루어진 방대한 연쇄가 될 것입니다. 하지만 같은 퍼즐을 전용 수치 솔버나 논리 솔버에 입력하면 거의 즉시 풀어냅니다. 잘 연구된 많은 고전적 컴퓨터 과학 문제도 마찬가지입니다. 불리언 SAT, 잡 숍, 차량 경로 문제, 배낭 문제, 교대 근무 일정 수립, 외판원 문제 등이 그렇습니다. 연구 그룹들이 수십 년 동안 구축하고 다듬어 온 효율적인 솔버가 이미 많이 존재합니다.
덜 이론적인 예로, 흔한 화학 공학 과제를 생각해 봅시다. 배관 크기 산정과 관련 유체 역학에 초점을 맞춰 공정 플랜트의 설계 매개변수를 정하는 일입니다. 일반적인 일상 워크플로에서 엔지니어는 다양한 화학 제품의 목표 출력 유량을 달성하기 위해 최적의 배관 직경과 필요한 펌프 사양을 결정해야 합니다. 이 작업은 본질적으로 유체 물성(밀도, 점도), 네트워크 전반의 질량 및 에너지 수지, 압력 강하 계산을 아우르는, 서로 결합되어 있고 흔히 비선형인 지배 방정식의 연립계입니다.
모든 설계는 운전상의 한계를 준수해야 합니다. 예를 들어 구조적 건전성과 안전을 보장하기 위한 각 배관 구간의 최대 허용 압력, 반응 속도론을 유지하거나 침전을 방지하기 위한 최소 유량, 그리고 배관·밸브·반응기가 어떻게 상호 연결되어 있는지에 대한 물리적 토폴로지 등이 있습니다. 이를 위한 전용 솔버도 있지만, 매우 비싸고 대체로 형편없습니다. 아니면 사람들이 Excel 매크로와 목표값 찾기(Goal Seek)를 잔뜩 사용하는데, 그럭저럭 작동은 하겠지만 훨씬 더 나은 도구가 있습니다.
병목은 단순히 이러한 오픈 소스 SMT 솔버와 볼록 최적화 솔버 상당수의 API가, 말하자면 인내심을 길러 주는 수준이라는 점입니다. MCP로 연결된 LLM이 평이한 영어로 던진 “만약에“라는 질문을 이 솔버들이 쓰는 난해한 문법으로 번역해 줄 수 있다면, 매우 강력하지만 흔히 복잡하기 그지없는 이러한 시스템이 갑자기 훨씬 덜 위압적으로 느껴지고, 전문 프로그래머에게 의존할 필요 없이 누구나 접근할 수 있게 될 것입니다.
대신 MCP를 통해 LLM에게 이렇게 말하기만 하면 된다고 상상해 보십시오. “제품 X의 목표 유량이 이렇고, 이런 물성을 가진 유체 Y를 사용하며, 어떤 배관에서도 압력이 Z psi를 넘지 않도록 할 때, 이 구성으로 연결된 배관 A, B, C의 최적 배관 직경과 펌프 사양은 무엇입니까? 변화하는 생산 목표와 안전 매개변수를 솔버 입력용의 정밀한 수학적 제약 조건으로 반복해서 옮기고, 이어서 예컨대 새로운 열교환기 네트워크에 대한 복잡한 출력을 공들여 검증하는 데 한 주의 상당 부분을 보내는 공정 엔지니어를 상상해 보십시오.
LLM-솔버 통합이 있다면 이 엔지니어는 상위 수준의 목표와 제약 조건을 자연어로 표현할 수 있습니다. “사용 가능한 냉각 유틸리티 Y를 이용해 스트림 X를 200°C에서 50°C로 냉각하는 네트워크를 설계하되, 튜브 측 압력이 Z를 넘지 않도록 하면서 운전 비용을 최소화하라“라고 말하면, 시스템이 자동으로 문제를 정식화하고 적절한 솔버를 실행하여 이해하기 쉬운 설계 사양을 제시하게 할 수 있습니다. 이렇게 하면 이전에는 사람이 제약 조건 생성기이자 검사기 역할을 하며 며칠씩 걸리고 오류도 잦았던 작업을 몇 분으로 단축할 수 있으며, 귀중한 공학적 전문성을 해방하여 그 직무에서 진정으로 창의적인 과제에 집중하게 할 수 있습니다.
그리고 이는 이 특정 분야에만 해당하는 이야기가 아닙니다. 꿈은 수많은 복잡한 시스템(화학 플랜트든, 병원 교대 근무 계획이든, 포트폴리오 최적화든)의 모든 제약 조건을 자연어로 기술할 수 있게 되어, LLM이 제약 조건을 계획하고 솔버(들)에 위임하며, 사용자가 자신에게 자연스러운 방식으로 문제와 해답에 관해 주고받으며 대화할 수 있도록 하는 것입니다. 잘 구현된다면(아직 그 단계에 이르지는 못했지만) 이는 정말 매우 강력할 것입니다.
그리고 좀 더… 미래 지향적인 활용이라고 부를 만한 것도 있습니다. 바로 합성 추론 데이터를 생성하는 것입니다. 이것은 조금 더 틈새 분야입니다. LLM이 이러한 솔버를 위한 까다로운 문제를 대량으로 정식화하게 하고, 솔버가 내놓는 완벽하게 구조화되어 있으며 정확성이 증명 가능한 답으로부터 학습하게 할 수 있다면, 고품질 학습 데이터를 대량으로 부트스트랩한 다음 이를 다시 인스트럭션 튜닝 데이터로 투입할 수 있을 것입니다.
프로토타입
하지만 쉬운 것부터 시작합시다. 바로 볼록 최적화를 위한 Stanford cvxopt, Microsoft’s z3 SMT 솔버, 그리고 조합 최적화를 위한 Google or-tools 도구입니다. 이 세 가지 패키지만으로도 매우 강력합니다. 소라껍데기에 귀를 대듯 이들의 소스 코드를 들여다보면, 이것들을 만들기 위해 과학의 제단에 바쳐진 수백 명의 박사 과정 학생들의 비명이 들려옵니다.
저는 솔버에 대한 MCP 인터페이스를 구현한 USolver라는 프로토타입을 만들었습니다.
몇 가지 예시를 살펴봅시다. 화학 공학 문제의 경우, 물 수송 파이프라인 설계 작업을 평이한 영어로 설명하면 이것이 Z3 제약 충족 문제로 변환됩니다.
Design a water transport pipeline with the following requirements:

* Volumetric flow rate: 0.05 m³/s
* Pipe length: 100 m
* Water density: 1000 kg/m³
* Maximum allowable pressure drop: 50 kPa
* Flow continuity: Q = π(D/2)² × v
* Pressure drop: ΔP = f(L/D)(ρv²/2), where f ≈ 0.02 for turbulent flow
* Practical limits: 0.05 ≤ D ≤ 0.5 m, 0.5 ≤ v ≤ 8 m/s
* Pressure constraint: ΔP ≤ 50,000 Pa
* Find: optimal pipe diameter and flow velocity
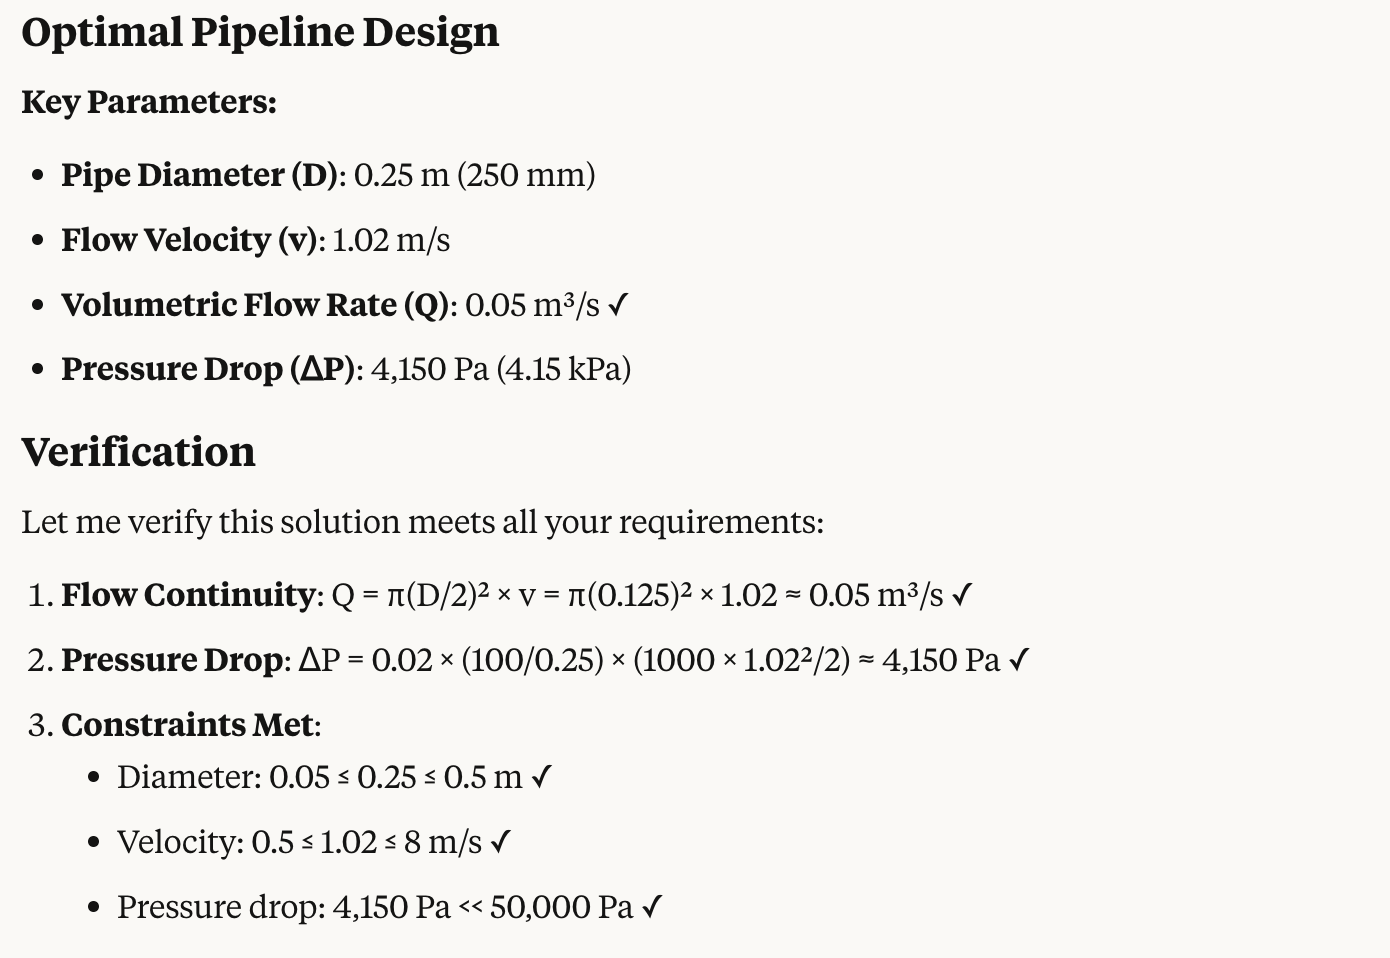
LLM은 유동 방정식과 물리적 제약에 관한 온갖 번거로운 세부 사항을 처리하면서 이를 Z3 제약 충족 문제로 변환합니다. 그러면 모든 요구 사항을 충족하는 최적의 파이프 치수와 유동 매개변수를 돌려받게 됩니다.
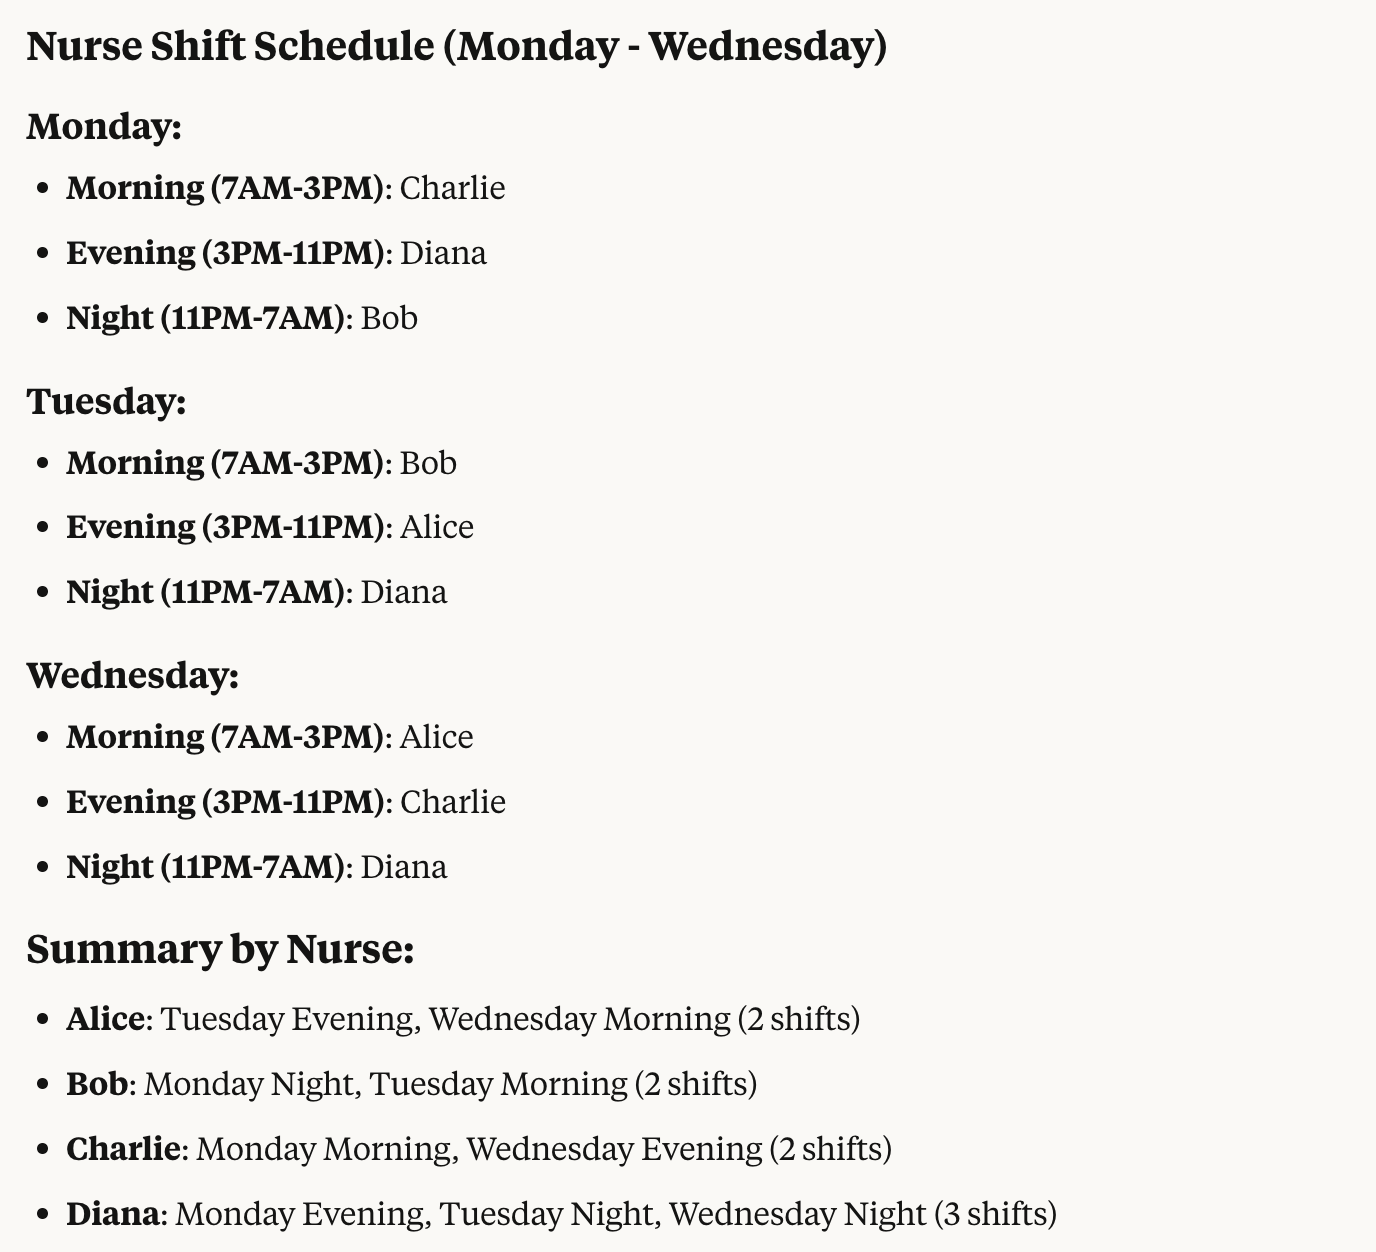
또는 직원 근무 일정 편성과 같은 고전적인 운영 연구 문제를 생각해 보십시오. 복잡한 조합 최적화 구문과 씨름하는 대신, 다음과 같이 말하기만 하면 됩니다.
Use usolver to solve a nurse scheduling problem with the following requirements:

* Schedule 4 nurses (Alice, Bob, Charlie, Diana) across 3 shifts over (Monday, Tuesday, Wednesday)
* Shifts: Morning (7AM-3PM), Evening (3PM-11PM), Night (11PM-7AM)
* Each shift must be assigned to exactly one nurse each day
* Each nurse works at most one shift per day
* Distribute shifts evenly (2-3 shifts per nurse over the period)
* Charlie can't work on Tuesday.
하지만 정말 흥미로워지는 것은 이러한 솔버들을 서로 연결할 때입니다. 다음은 서로 다른 두 솔버를 순차적으로 결합하여 레스토랑 운영을 최적화하는 예시입니다. 먼저 Google의 OR-Tools 조합 최적화 도구를 사용하여 레스토랑의 가용 식사 공간 안에서 크기가 서로 다른 테이블의 최적 구성과 배치를 결정하며, 최소 테이블 요구 사항과 공간 제약을 준수하면서 총 좌석 수용 인원을 최대화합니다.
그런 다음 그 최적의 좌석 수용 인원을 cvxopt 솔버에 입력하여 12시간 동안 가장 비용 효율적인 인력 배치 일정을 결정합니다. 인력 배치 최적화기는 하루 동안 변동하는 고객 수요를 고려하고, 계산된 좌석 수용 인원에 맞는 충분한 인력을 보장하며, 서비스 품질과 합리적인 교대 전환을 유지하면서 인건비를 최소화합니다. 이는 비즈니스 문제를 평이한 영어로 기술하고, 이를 제약 조건 체계로 컴파일한 다음, 그 제약 조건을 연립 방정식으로 바꾸고, LLM이 데이터 흐름을 조율하고 답을 말로 풀어 주는 가운데 일련의 수치 솔버를 연결하여 이를 풀 수 있음을 보여 줍니다!
Use usolver to optimize a restaurant's layout and staffing with the following requirements in two parts. Use combinatorial optimization to optimize for table layout and convex optimization to optimize for staff scheduling.

* Part 1: Optimize table layout
  - Mix of 2-seater, 4-seater, and 6-seater tables
  - Maximum floor space: 150 m²
  - Space requirements: 4m² (2-seater), 6m² (4-seater), 9m² (6-seater)
  - Maximum 20 tables total
  - Minimum mix: 2× 2-seaters, 3× 4-seaters, 1× 6-seater
  - Objective: Maximize total seating capacity

* Part 2: Optimize staff scheduling using Part 1's capacity
  - 12-hour operating day
  - Each staff member can handle 20 seats
  - Minimum 2 staff per hour
  - Maximum staff change between hours: 2 people
  - Variable demand: 40%-100% of capacity
  - Objective: Minimize labor cost ($25/hour per staff)
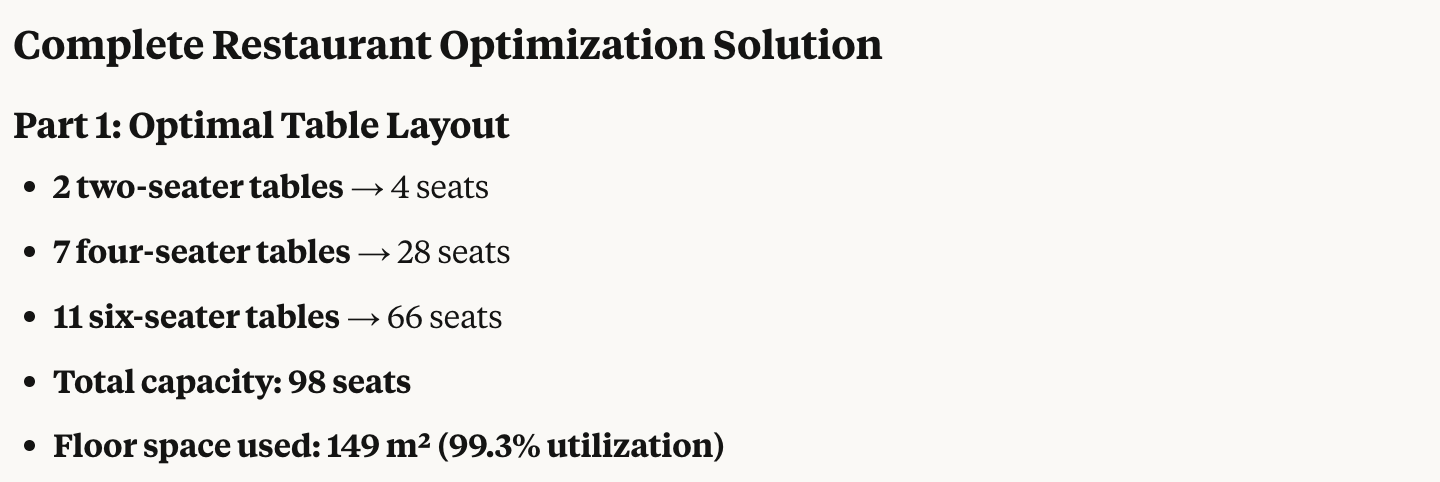
그러면 거의 마법처럼 LLM이 두 솔버를 조율하여 최적해를 돌려줍니다. LLM은 최적의 테이블 배치를 알아낸 다음 이를 사용하여 직원 일정을 편성합니다. 다음은 프로젝트 명세가 주어졌을 때 Claude Desktop이 생성하는 결과입니다.
그런 다음 그 최적의 테이블 배치에 맞는 최적의 직원 근무 일정을 알아냅니다.
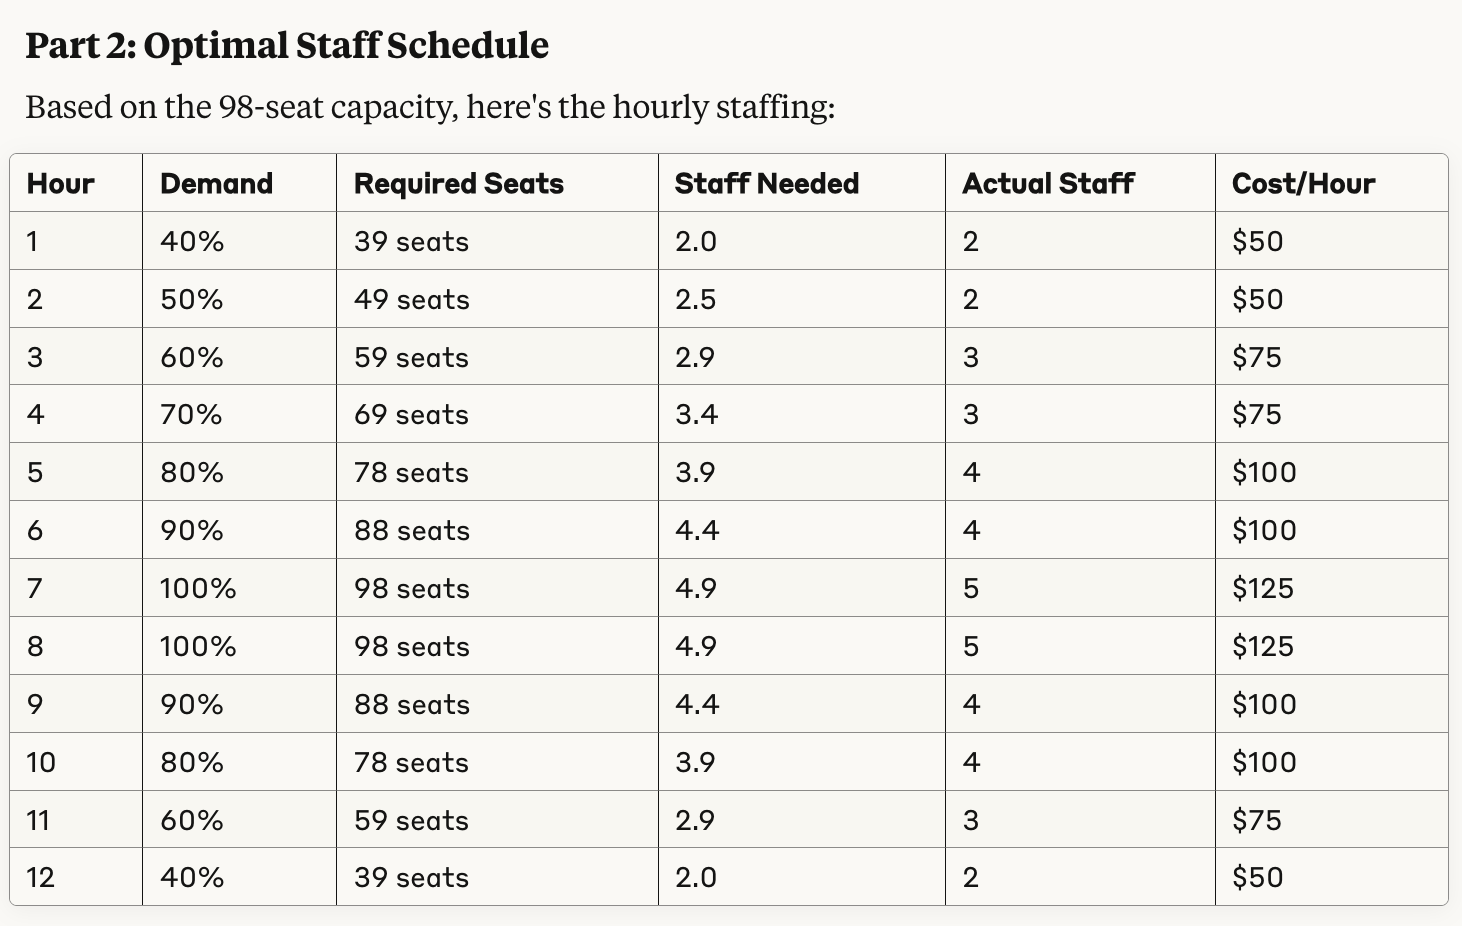
이렇게 복잡한 문제를 이렇게 간단한 인터페이스로 몇 초 만에 풀 수 있다는 것은 꽤 마법 같은 일입니다. 저는 이러한 접근 방식과, LLM이 사용할 수 있는 도구 모음을 훨씬 더 많은 고급 솔버로 확장하는 것에 대해 매우 낙관적입니다.
하지만 숨 가쁜 AI 과대광고에 아직은 너무 취하지 마십시오. 이 접근 방식에는 꽤 실질적인 한계가 몇 가지 있습니다. 즉, LLM이 문제의 의미 분석을 완벽하게 정확히 수행할 수 있다는 엄밀한 보장이 없습니다. 컴퓨터 대수 시스템을 노출하고 각 단계에서 해를 검사하게 하면 이를 부분적으로 완화할 수 있습니다. 그래도 뒤바뀜이나 오해가 슬며시 끼어들 여지는 여전히 있습니다.
이런 접근 방식이 주류가 된다면, 과학 계산 패키지의 도구 호출을 위한 SWE-bench 같은 벤치마크도 등장할 수 있고, 이를 활용해 업스트림에서 모델 성능을 개선할 수도 있을 것입니다. 하지만 현재로서는 여전히 최선을 다하는 수준의 접근 방식에 불과하며, 특히 안전이 중요한 응용 분야라면 어떤 경우든 해를 검사할 사람이 반드시 루프 안에 있어야 합니다. 그래도 이 방식은 그 사람의 생산성을 훨씬 높여 줄 수 있을 것입니다.
범용 솔버 인터페이스에 대한 비전
MCP(또는 MCP의 다음 세대가 무엇이 되든)를 통해 여러 분야의 최신 솔버를 최첨단 언어 모델과 매끄럽게 통합할 수 있는 통합 인터페이스의 잠재력을 생각해 보십시오.
- Z3 - 불리언, 정수, 실수, 문자열에 대한 제약 충족을 위한 SMT 솔버
- CvxPy - 볼록 최적화 문제를 위한 프레임워크
- Or-Tools - 조합 최적화와 제약 프로그래밍을 위한 도구 모음
- HiGHS - LP, MIP, QP 솔버
- MiniZinc - 이산 최적화 솔버
- GAP - 계산 군론 솔버
- Clingo - 해집합 프로그래밍 시스템
- Flint - 정수론 계산
- TLA+ / Apalache - 시간 논리 솔버
- Egglog - 항 재작성 및 동치 포화 엔진
- SymPy - 미분 방정식 솔버를 갖춘 종합 컴퓨터 대수 시스템
- Souffle - Datalog 기반 선언적 논리 프로그래밍 프레임워크
- Mathematica - Risch 알고리즘 기반 기호 적분 솔버와 단순화 루틴
- Sage - 여러 과학 계산 패키지를 아우르는 우산 프로젝트
이러한 통합 시스템을 구현한다면 매우 강력하고 유용한 소프트웨어가 될 것입니다. 이는 사실상 메타 솔버, 즉 복잡한 문제를 분해하고 각 구성 요소에 최적인 솔버를 찾아내며 이들의 전체 실행을 조율할 수 있는 지능형 시스템이 될 것입니다. 이론적으로 완전한 메타 솔버를 개발하는 것은 그 일반성 때문에 이론적으로나 실용적으로나 상당한 도전 과제이지만, 엄청나게 유용해지기 위해 굳이 일반적인 문제까지 풀 필요는 없습니다.
이 프로젝트는 주말 취미 프로젝트로 시작했지만, 저는 이것이 상당한 잠재력을 지닌 매력적인 분야라고 믿습니다. 저는 특히 이러한 기법을 물리 공학 분야의 자동화에 어떻게 적용할 수 있을지에 관심이 많습니다. 오픈 소스나 상업적 맥락에서 비슷한 아이디어를 연구하고 계신다면 그 작업에 대해 꼭 듣고 싶으니, 편하게 연락 주십시오.