13.7 R 통계 분석 도구
이 절을 마치면 다음을 할 수 있습니다.
- R 통계 분석 도구에서 사용할 데이터 값의 벡터를 생성합니다.
- R 통계 분석 도구를 사용하여 기본적인 통계 명령을 작성합니다.
R의 명령과 벡터
R은 금융 산업에서 널리 사용되는 통계 분석 도구입니다. R은 무료 프로그램으로 제공되며, 데이터 분석, 그래프 작성, 통계 프로그래밍을 위한 통합된 함수 모음을 제공합니다. R은 오픈 소스 언어이고 사용자 커뮤니티가 끊임없이 기능을 추가하고 있기 때문에 데이터 분석 및 통계 도구로 점점 더 많이 사용되고 있습니다. 이 도구는 여러 컴퓨팅 플랫폼에서 사용할 수 있으며, R 프로젝트 웹사이트에서 내려받을 수 있습니다.
컴퓨터에 R을 설치하고 실행하면 R 콘솔 하단에 > 기호가 보이는데, 이 기호는 R이 명령을 받을 준비가 되었음을 나타냅니다.
    Type 'demo()' for some demos, 'help()' for on-line help, or
    'help.start()' for an HTML browser interface to help.

    Type 'q()' to quit R.

    >
R은 명령 기반 언어로, 사용자가 프롬프트에 명령을 입력하면 R이 이를 한 번에 하나씩 실행합니다. R은 여러 명령이 담긴 프로그램을 실행할 수도 있습니다. R에 그래픽 사용자 인터페이스(GUI)를 추가하는 방법도 있습니다. R용 GUI 도구의 예로는 RStudio가 있습니다.
R 명령줄은 휴대용 계산기처럼 어떤 수치 계산이든 수행하는 데 사용할 수 있습니다. 예를 들어 식을 계산하려면 명령줄 프롬프트에 다음 식을 입력하고 Return 키를 누르십시오:
> 10+3*7

[1] 31
R에서 대부분의 계산은 함수를 통해 처리됩니다. 통계 분석을 위해 R에는 평균, 중앙값, 표준편차, 사분위수 등을 계산하는 미리 정의된 함수가 많이 있습니다. 대입 연산자 <-를 사용하여 변수에 이름을 붙이고 값을 대입할 수 있습니다. 예를 들어, 다음 R 명령은 x라는 변수에 값 20을 대입하고 y라는 변수에 값 30을 대입합니다.
> x <- 20

> y <- 30
이 변수 이름들은 어떤 계산에든 사용할 수 있습니다. 예를 들어, x에 y를 곱하면 결과 600이 나옵니다.
> x*y

[1] 600
통계 응용에서 함수를 사용하는 일반적인 방법은 먼저 데이터 값의 벡터를 생성하는 것입니다. R에서 벡터를 생성하는 방법은 여러 가지가 있습니다. 예를 들어, 값들을 하나의 벡터로 결합할 때 c 함수가 자주 사용됩니다. 다음 R 명령은 데이터 값 40,000, 50,000, 75,000, 92,000을 담은 salaries라는 벡터를 생성합니다.
> salaries <- c(40000, 50000, 75000, 92000)이렇게 만든 벡터 salaries는 다음과 같이 평균, 중앙값, 최솟값, 최댓값 등의 통계 함수에 사용할 수 있습니다.
> mean(salaries)

[1] 64250

> median(salaries)

[1] 62500

> min(salaries)

[1] 40000

> max(salaries)

[1] 92000
R에서 벡터를 생성하는 또 다른 방법은 seq 함수를 사용하는 것입니다. 이 함수는 수열을 자동으로 생성합니다. 예를 들어, 다음과 같이 1부터 5까지 0.5씩 증가하는 수열을 생성하고 이 벡터를 example1이라고 부를 수 있습니다.
> example1 <- seq(1, 5, by=0.5)그런 다음 벡터 이름을 입력하고 Enter 키를 누르면 R이 해당 벡터의 수치 값 목록을 보여 줍니다.
> salaries

[1] 40000 50000 75000 92000

> example1

[1] 1.0 1.5 2.0 2.5 3.0 3.5 4.0 4.5 5.0
데이터 집합의 평균, 중앙값, 사분위수, 최솟값, 최댓값으로 이루어진 간단한 통계 요약을 빠르게 생성하고 싶을 때가 많습니다. summary라는 R 명령이 이러한 결과를 제공합니다.
> summary(salaries)

 Min. 1st Qu.  Median    Mean 3rd Qu.    Max.

 40000   47500   62500   64250   79250   92000
산포도 측정을 위해 R에는 표준편차를 구하는 sd 명령과 분산을 구하는 var 명령이 있습니다. 표준편차와 분산은 데이터 집합이 표본에서 수집되었다는 가정하에 계산됩니다.
> sd(salaries)

[1] 23641.42

> var(salaries)

[1] 558916667
R에서 가중평균을 계산하려면 벡터 두 개를 만드십시오. 하나에는 데이터 값을, 다른 하나에는 그에 대응하는 가중치를 담습니다. 그런 다음 R 명령 weighted.mean(values, weights)를 입력하십시오.
다음은 R에서 가중평균을 계산하는 예입니다.
표 13.14에 나타난 것처럼 포트폴리오에 서로 다른 세 날짜에 매수한 XYZ Corporation 주식 1,000주가 있다고 가정합니다. 포트폴리오의 주식 수를 가중치로 하여 매입 가격의 가중평균을 계산하십시오.
| 매수일 | 매입 가격($) | 매수 주식 수 |
|---|---|---|
| 1월 17일 | 78 | 200 |
| 2월 10일 | 122 | 300 |
| 3월 23일 | 131 | 500 |
| 합계 | 1,000 |
R에서 두 벡터를 만드는 방법은 다음과 같습니다. price 벡터에는 매입 가격을 담고, shares 벡터에는 주식 수를 담습니다. 그런 다음 다음과 같이 R 명령 weighted.mean(price, shares)를 실행하십시오.
> price <- c(78, 122, 131)

> shares <- c(200, 300, 500)

> weighted.mean(price, shares)

[1] 117.7
자주 사용하는 R 통계 명령 목록은 표 13.15에 나와 있습니다.
| R 명령 | 결과 |
|---|---|
| mean( ) | 산술평균을 계산합니다 |
| median( ) | 중앙값을 계산합니다 |
| min( ) | 최솟값을 계산합니다 |
| max( ) | 최댓값을 계산합니다 |
| weighted.mean( ) | 가중평균을 계산합니다 |
| sum( ) | 값의 합계를 계산합니다 |
| summary( ) | 평균, 중앙값, 사분위수, 최솟값, 최댓값을 계산합니다 |
| sd( ) | 표본 표준편차를 계산합니다 |
| var( ) | 표본 분산을 계산합니다 |
| IQR( ) | 사분위수 범위를 계산합니다 |
| barplot( ) | 비수치 데이터의 막대그래프를 그립니다 |
| boxplot( ) | 수치 데이터의 상자그림을 그립니다 |
| hist( ) | 수치 데이터의 히스토그램을 그립니다 |
| plot( ) | 산점도를 비롯한 다양한 그래프를 그립니다 |
| freq( ) | 도수분포표를 생성합니다 |
R에서 그래프 그리기
R에는 다양한 통계 응용 기능이 있으며, 막대그래프, 히스토그램, 시계열 도표, 산점도 등 여러 가지 그래프 표현이 가능합니다. R에서 도표를 만드는 기본 명령은 plot 명령인 plot(x, y)이며, 여기서 x는 데이터 집합의 x값을 담은 벡터이고 y는 데이터 집합의 y값을 담은 벡터입니다.
명령의 일반적인 형식은 다음과 같습니다:
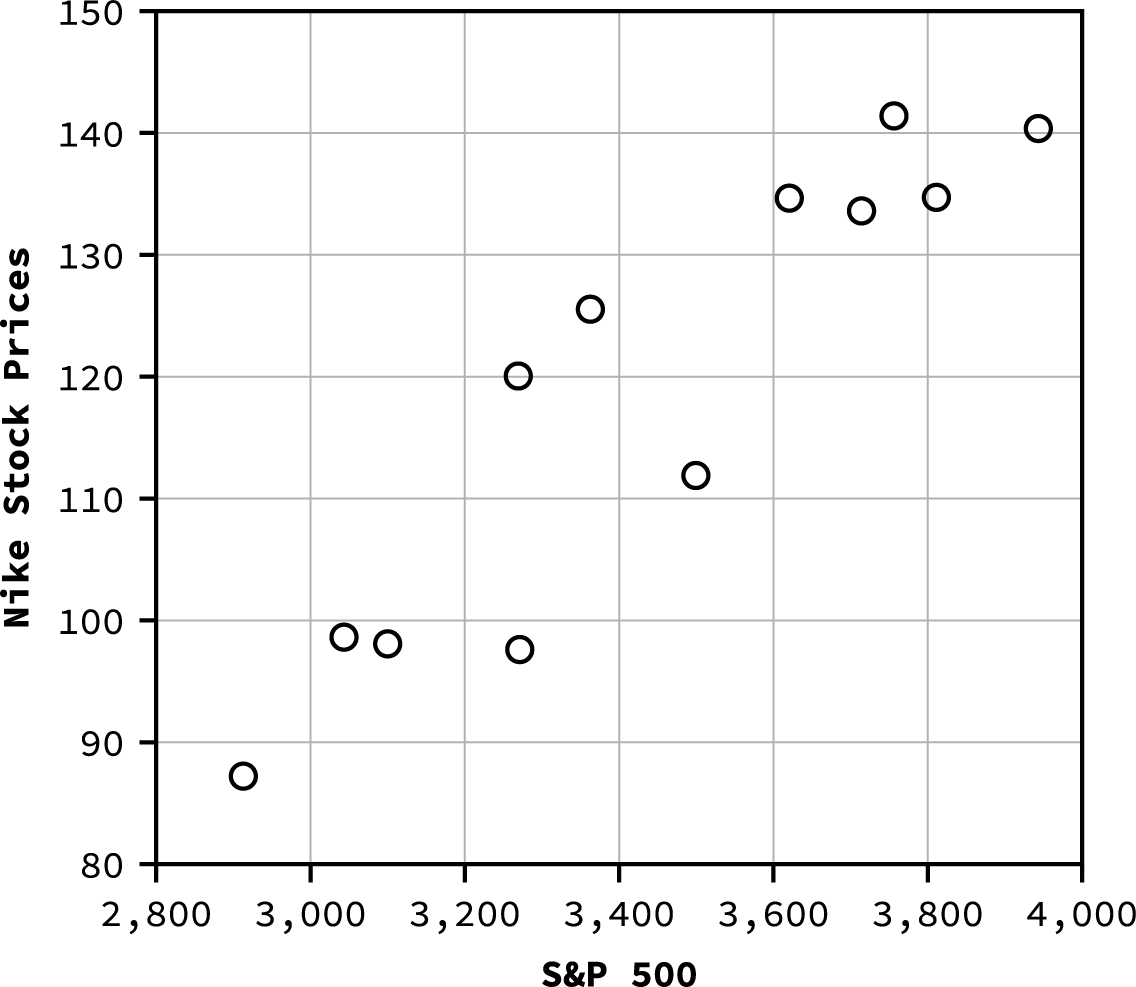
>plot(x, y, main="text for title of graph", xlab="text for x-axis label", ylab="text for y-axis label")예를 들어, S&P 500 지수의 값과 나이키 주식 가격 사이의 상관을 살펴보기 위해 산점도를 작성한다고 가정합니다. 1년 동안 수집한 표 13.13의 데이터가 있다고 가정합니다.
여러 가지 R 명령을 사용하면 텍스트 파일, Excel 파일 또는 클립보드에서 R로 데이터를 읽어 들일 수 있다는 점에 유의하십시오. S&P 500 지수의 값은 벡터 SP500에, 나이키 주식 가격은 벡터 Nike에 불러왔다고 가정합니다. 그러면 산점도를 생성하기 위해 다음 R 명령을 사용할 수 있습니다.
>plot(SP500, Nike, main="Scatter Plot of Nike Stock Price vs. S&P 500", xlab="S&P 500", ylab="Nike Stock Price")이 명령들을 실행하면 R은 그림 13.10에 나타난 산점도를 출력합니다. 이는 Excel에서 그림 13.8의 산점도를 생성하는 데 사용한 것과 동일한 데이터입니다.