13.2 산포의 척도
이 절을 마치면 다음을 할 수 있습니다:
- 데이터 집합의 표준편차를 정의하고 계산할 수 있습니다.
- 데이터 집합의 분산을 정의하고 계산할 수 있습니다.
- 표준편차와 분산의 관계를 설명할 수 있습니다.
표준편차
모든 데이터 집합의 중요한 특성 중 하나는 데이터의 변동입니다. 어떤 데이터 집합에서는 데이터 값이 평균 가까이에 모여 있고, 다른 데이터 집합에서는 데이터 값이 더 넓게 퍼져 있습니다. 예를 들어, 투자자는 주식 A의 연간 수익률인 1%, 2%, -1%, 0%, 3%를 살펴보고, 이를 주식 B의 연간 수익률인 -9%, 2%, 15%, -5%, 0%와 비교할 수 있습니다.
주식 B가 주식 A보다 연간 수익률의 변동성이 더 크다는 점에 주목하십시오. 투자자는 특정 투자 목표에 맞는 최선의 투자 결정을 내리기 위해 이러한 변동을 정량화하고자 할 수 있습니다.
변동, 즉 산포를 나타내는 가장 일반적인 척도는 표준편차입니다. 데이터 집합의 표준편차는 데이터 값이 평균으로부터 얼마나 떨어져 있는지를 나타내는 척도입니다. 표준편차는
- 데이터 집합의 전체 변동량에 대한 수치적 척도를 제공하며,
- 특정 데이터 값이 평균에 가까운지 또는 먼지를 판단하는 데 사용할 수 있습니다.
표준편차는 데이터 집합의 전체 변동에 대한 척도를 제공합니다. 표준편차는 항상 양수이거나 0입니다. 데이터 값이 모두 평균 가까이에 모여 있어 변동이나 산포가 거의 없을 때 표준편차는 작습니다. 데이터 값이 평균으로부터 더 많이 퍼져 있어 변동이 클 때 표준편차는 더 커집니다.
서로 다른 두 주식, 주식 A와 주식 B의 변동성을 연구한다고 가정해 봅시다. 두 주식의 평균 주가는 모두 5달러입니다. 주식 A의 주가 표준편차는 2인 반면, 주식 B의 표준편차는 4입니다. 주식 B의 표준편차가 더 크므로, 주식 B의 주가가 주식 A의 주가보다 변동이 더 크다는 것을 알 수 있습니다.
표준편차를 계산하는 공식에는 두 가지가 있습니다. 어느 공식을 사용할지는 데이터가 표본을 나타내는지 모집단을 나타내는지에 따라 달라집니다. 표기 s는 표본 표준편차를 나타내는 데 사용되고, 표기 는 모집단 표준편차를 나타내는 데 사용됩니다. 아래에 제시된 공식에서 x̄는 표본 평균, 는 모집단 평균, n은 표본 크기, N은 모집단 크기입니다.
표본 표준편차 공식:
모집단 표준편차 공식:
분산
분산 또한 데이터 값의 퍼짐 정도를 나타내는 척도입니다. 데이터 집합의 분산은 각 데이터 값이 평균과 얼마나 차이가 나는지를 측정합니다. 개별 데이터 값이 평균과 많이 차이 날수록 분산은 커집니다. 표준편차와 분산은 모두 비슷한 정보를 제공합니다.
금융 분야에서 분산은 투자의 변동성을 판단하는 데 사용될 수 있으며, 따라서 금융 의사결정을 내리는 데 도움을 줄 수 있습니다. 예를 들어, 좀 더 신중한 투자자는 변동성이 낮은 투자를 선택할 수 있습니다.
표준편차와 마찬가지로, 분산을 계산하는 데 사용하는 공식 역시 데이터가 표본에서 수집되었는지 모집단에서 수집되었는지에 따라 달라집니다. 표본분산은 기호로 나타내고, 모분산은 σ2 기호로 나타냅니다.
표본분산 공식:
모분산 공식:
표본의 표준편차와 분산을 계산하는 방법은 다음과 같습니다.
- 먼저, 데이터 값을 모두 더한 뒤 그 합을 데이터 값의 개수로 나누어 데이터 집합의 평균 을 구하십시오.
- 열이 세 개인 표를 만들고, 첫 번째 열에 데이터 집합의 데이터 값을 나열하십시오.
- 각 행마다 데이터 값 에서 평균을 빼고, 그 차이를 두 번째 열에 기입하십시오. 이 열의 값은 양수일 수도 있고 음수일 수도 있다는 점에 유의하십시오. 이 열에 있는 값의 합은 0이 됩니다.
- 세 번째 열에는 각 행마다 두 번째 열의 값을 제곱한 값을 기입하십시오. 따라서 이 세 번째 열에는 각 행의 (데이터 값 – 평균)2이 들어가게 됩니다. 이 값은 로 나타낼 수 있습니다. 세 번째 열의 값은 제곱한 값이므로 항상 양수라는 점에 유의하십시오.
- 세 번째 열의 값을 모두 더하십시오. 이 합은 로 나타낼 수 있습니다.
- 이 합을 (n – 1)로 나누십시오. 여기서 n은 데이터 점의 개수입니다. 이는 로 나타낼 수 있습니다.
- 이 결과를 표본분산이라고 하며, s2로 표기합니다. 따라서 표본분산 공식은 입니다.
- 이제 표본분산의 제곱근을 구하십시오. 이 값이 표본 표준편차이며, s라고 합니다. 따라서 표본 표준편차의 공식은 입니다.
- 반올림 규칙: 표본 분산과 표본 표준편차는 일반적으로 데이터 값 자체보다 소수점 아래 한 자리를 더 두어 반올림합니다.
위 예제에서 보듯이 분산과 표준편차를 계산하는 것은 번거로운 과정입니다. 재무용 계산기를 사용하면 평균과 표준편차 같은 통계 측정값을 빠르고 효율적으로 계산할 수 있습니다.
계산기로 통계 계산을 수행하려면 다음 두 단계가 필요합니다.
- 7 키 위에 있는 [DATA] 기능을 사용하여 계산기에 데이터를 입력하십시오.
- 8 키 위에 있는 [STAT] 기능을 사용하여 계산기가 제공하는 통계 결과를 확인하십시오.
재무용 계산기로 평균과 표준편차를 계산하려면 표 13.4의 단계를 따르십시오. 여기서는 위 Think It Through 예제의 나이 데이터 집합을 다시 사용합니다: 40, 36, 44, 51, 54, 55, 39, 47, 44, 50.
| 단계 | 설명 | 입력 | 표시 | |
|---|---|---|---|---|
| 1 | [DATA] 입력 모드로 들어갑니다 | 2ND [DATA] | X01 | 0.00 |
| 2 | 이전 데이터를 모두 지웁니다 | 2ND [CLR WORK] | X01 | 0.00 |
| 3 | 첫 번째 데이터 값 40을 입력합니다 | 40 ENTER | X01 = | 40.00 |
| 4 | 다음 데이터 입력 항목으로 이동합니다 | ↓ | Y01 = | 1.00 |
| 5 | 다음 데이터 입력 항목으로 이동합니다 | ↓ | X02 | 0.0 |
| 6 | 두 번째 데이터 값 36을 입력합니다 | 36 ENTER | X02 = | 36.00 |
| 7 | 다음 데이터 입력 항목으로 이동합니다 | ↓ | Y02 = | 1.00 |
| 8 | 다음 데이터 입력 항목으로 이동합니다 | ↓ | X03 | 0.00 |
| 9 | 세 번째 데이터 값 44를 입력합니다 | 44 ENTER | X03 = | 44.00 |
| 10 | 다음 데이터 입력 항목으로 이동합니다 | ↓ | Y03 = | 1.00 |
| 11 | 나머지 데이터 값을 계속 입력합니다 | |||
| 12 | [STAT] 모드로 들어갑니다 | 2nd [STAT] | LIN | |
| 13 | 첫 번째 통계 결과로 이동합니다 | ↓ | n = | 10.00 |
| 14 | 다음 통계 결과로 이동합니다 | ↓ | 46.00 | |
| 15 | 다음 통계 결과로 이동합니다 | ↓ | Sx = | 6.50 |
통계 결과에서 평균은 46으로, 표본 표준편차는 6.50으로 표시됩니다.
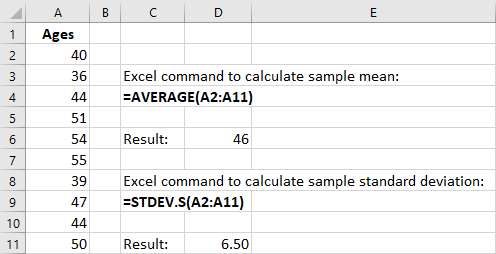
Excel은 내장 함수 =AVERAGE(평균)와 =STDEV.S(표본 표준편차)를 사용하여 비슷한 분석을 제공합니다. Excel에서 이러한 통계 결과를 계산하려면 데이터 값을 한 열에 입력하십시오. 데이터 값이 A2 셀부터 A11 셀까지 입력되어 있다고 가정합시다. 아무 셀에나 Excel 명령 =AVERAGE(A2:A11)을 입력하고 Enter 키를 누르십시오. Excel이 이 셀에 산술평균을 계산합니다. 그런 다음, 다른 아무 셀에 Excel 명령 =STDEV.S(A2:A11)을 입력하고 Enter 키를 누르십시오. Excel이 이 셀에 표본 표준편차를 계산합니다. 그림 13.2은 10개 나이의 평균과 표준편차를 보여 줍니다.
표준편차와 분산의 관계
위에 제시한 분산과 표준편차 공식에서 분산은 표준편차의 제곱이고, 표준편차는 분산의 제곱근이라는 점에 주목하십시오.
이 값 중 하나를 계산하면 다른 값을 바로 계산할 수 있습니다. 예를 들어, 어떤 데이터 집합의 표준편차가 12.5라는 것을 알고 있다면, 이 표준편차를 제곱하여 분산을 계산할 수 있습니다. 그러면 분산은 12.52, 즉 156.25입니다.
같은 방식으로, 분산의 값을 알고 있다면 분산의 제곱근을 계산하여 표준편차를 구할 수 있습니다. 예를 들어, 어떤 데이터 집합의 분산이 31.36으로 알려져 있다면, 표준편차는 31.36의 제곱근인 5.6으로 계산할 수 있습니다.
분산을 사용할 때의 단점 중 하나는 분산이 데이터 집합의 단위와 다른 제곱 단위로 측정된다는 것입니다. 예를 들어, 데이터 집합이 연 단위로 측정한 나이로 구성되어 있다면 분산은 연의 제곱 단위로 측정되므로 혼란스러울 수 있습니다. 표준편차는 원래 데이터 집합과 같은 단위로 측정되므로, 데이터 집합의 산포를 측정할 때 분산보다 표준편차가 더 흔히 사용됩니다.
각주
- 이 예제에서 사용하는 재무용 계산기는 Texas Instruments BA II PlusTM Professional 모델이지만, 이러한 계산에는 다른 재무용 계산기를 사용해도 됩니다. ↩