깜빡이에서 RISC-V까지
이 튜토리얼은 간단한 블링키 설계에서 출발해 RISC-V 코어에 이르기까지 단계적으로 나아가는 여정입니다.
다음 보드에서 동작합니다.
- IceStick
- IceBreaker
- ULX3S
- ARTY
- tang nano 9K
보드가 없더라도 모든 것을 시뮬레이션으로 실행할 수 있습니다(다만 그만큼 재미있지는 않습니다).
이 튜토리얼에 대하여
- 이 튜토리얼은 한 번에 한 가지씩만 바꿔 가는 점진적인 입문서입니다. 제가 이 개념들을 익히던 시기(2020-2022)에 쓴 작업 일지를 다듬어 정리한 것입니다. 또한 제가 들어섰던 막다른 길과 제가 빠졌던 함정도 모두 기록해 두려고 했으며, 이런 내용은 주로 곁가지 설명과 참고 사항으로 표시되어 있습니다;
- 필요한 하드웨어는 최대한 적게 유지하려고 합니다. 가장 작은 FPGA(IceStick Ice40HX1K)로도 튜토리얼의 첫 번째 에피소드를 진행하여, 컴파일된 C 코드를 실행할 수 있는 완전히 동작하는 RV32I 마이크로컨트롤러로 만들 수 있습니다.
- 최종적으로 얻는 프로세서는 가장 효율적이지는 않지만 장난감도 아닙니다. 어떤 프로그램이든 실행할 수 있습니다. 궁금해하실 질문에 답하자면, 네, DOOM도 실행됩니다! (다만 IceStick에서는 안 되며, 더 큰 FPGA가 필요합니다.) Doom에는 RAM이 어느 정도 필요하므로, 훌륭한 SDRAM 컨트롤러를 갖춘 LiteX의 도움을 받아 동작합니다;
- 이 튜토리얼은 하드웨어와 소프트웨어를 모두 다룹니다. 여러분의 코어에서 돌아갈 프로그램을 어셈블리와 C로 컴파일하는 방법을 배우게 됩니다;
- 모든 예제 프로그램을 적당히 짧으면서도 재미있고 흥미롭게 만들려고
합니다. 함께 제공되는 데모 프로그램은 다음과 같습니다.
- 어셈블리와 C로 작성한 망델브로 집합
- 로토줌 그래픽 효과
- 채워진 다각형 그리기
- 레이트레이싱 이 그래픽 프로그램들은 모두 ANSI 이스케이프 시퀀스를 사용해 터미널에 텍스트 모드로 표시됩니다(네, 그래서 픽셀이 아주 큽니다). 더 재미있게 즐기고 싶다면 작은 OLED 디스플레이를 대신 사용할 수도 있습니다(관련 안내는 나중에 추가할 예정입니다).
- 에피소드 II는 파이프라이닝을 다룹니다. 여기서는 이 튜토리얼 끝에서 얻은 기본 프로세서를 분기 예측 기능을 갖춘 더 효율적인 파이프라인 프로세서로 바꾸는 방법을 배웁니다.
- [에피소드 III)(INTERRUPTS.md)는 인터럽트와 특권(privileged) RISC-V ISA를 다루며, 현재 작성 중입니다.
- 이 튜토리얼은 Verilog로 작성되었습니다. 현재 다른 HDL로 옮기는
작업이 진행 중입니다.
- @bl0x가 만든 Amaranth/nMigen 버전
- TODO: Silice 버전
- TODO: SpinalHDL 버전
프로세서 설계 입문 및 참고 자료
프로세서 설계를 이해하기 위해 제가 처음 읽은 것은 Stackoverflow의 이 답변이었으며, 많은 영감을 받았습니다. @mithro가 추천한 이 글도 있습니다. 체계적인 강좌로는 MIT의 이 강좌를 강력히 추천합니다. 이 강좌는 제가 여기서 다룬 것보다 훨씬 더 나아가기 위한 원리(파이프라인 등)도 알려 줍니다.
Verilog 기초와 문법은 Verilog by example by Blaine C. Readler 책을 읽고 익혔습니다. 이 책도 짧고 핵심만 다룹니다.
이 Stackoverflow 답변에는 두 가지 좋은 점이 있습니다.
- 본질에 집중하며, 본질적인 것 외에는 아무것도 담지 않습니다.
- 예로 든 것이 RISC 프로세서여서 RISC-V와 여러 유사점을 공유합니다(다만 RISC-V에는 없는 상태 플래그가 있습니다).
여기서 배울 수 있는 것은 이른바 범용 레지스터를 저장하는
레지스터 파일이 있다는 점입니다. 범용이란 명령어가 레지스터를
읽을 때마다 어느 레지스터든 읽을 수 있고, 명령어가 레지스터에 쓸 때마다
어느 레지스터든 쓸 수 있다는 뜻이며, 이 점에서 전용 레지스터를
가진 x86(CISC)과 다릅니다. 가장 일반적인
명령어(register <- register OP register)를 구현하기 위해
레지스터 파일은 매 사이클마다 레지스터 두 개를 읽고, 선택적으로 하나를
write-back합니다.
두 값에 대한 연산을 계산하는 ALU가 있습니다.
또한 현재 명령어의 비트 패턴으로부터 필요한 모든 내부 신호를 생성하는 디코더도 있습니다.
RISC-V 프로세서를 직접 설계하고 싶다면 Stackoverflow 답변을 깊이 살펴보고, 더 나아가기 전에 직접 회로도를 몇 개 그려 보면서 전반적인 개념을 모두 머릿속에 정리해 두기를 권합니다... 아니면 이 튜토리얼로 바로 점프하여 한 단계씩 진행하는 방법을 선택할 수도 있습니다. 이 튜토리얼은 가장 단순한 블링키 설계에서 완전히 동작하는 RISC-V 코어까지 차근차근 안내합니다.
사전 준비 사항:
첫 번째 단계는 learn-fpga 저장소를 클론하는 것입니다:
$ git clone https://github.com/BrunoLevy/learn-fpga.git시작하기 전에 다음 소프트웨어를 설치해야 합니다:
- iverilog/icarus (시뮬레이션)
$ sudo apt-get install iverilog- yosys/nextpnr, 여러분의 보드용 툴체인입니다. 이 링크를 참고하십시오.
iverilog/icarus만으로도 튜토리얼의 모든 단계를 실행하고 실험해 볼 수 있지만, 그 경험은 같지 않다는 점에 유의하십시오. 각 단계를 실제 장치에서 실행해 보시기를 강력히 권합니다. 여러분이 만든 프로세서가 처음으로 코드를 실행할 때의 느낌과 흥분은 시뮬레이션을 할 때와는 차원이 다릅니다!!!
1단계: 첫 번째 블링키
이제 시작하여 첫 번째 블링키를 만들어 봅시다! 우리의 블링키는 입력과 출력에 연결된 Verilog 모듈로 다음과 같이 구현됩니다(step1.v):
   module SOC (
       input  CLK,
       input  RESET,
       output [4:0] LEDS,
       input  RXD,
       output TXD
   );

   reg [4:0] count = 0;
   always @(posedge CLK) begin
      count <= count + 1;
   end
   assign LEDS = count;
   assign TXD  = 1'b0; // not used for now

   endmodule
우리는 이것을 SOC(System On Chip, 시스템 온 칩)라고 부릅니다. 블링키에게는 거창한 이름이지만, 이 튜토리얼의 모든 단계를 거치고 나면 우리의 블링키는 결국 그것으로 변모하게 됩니다. 우리의 SOC는 다음 신호들에 연결됩니다:
CLK(입력)는 시스템 클록입니다.LEDS(출력)는 보드의 LED 5개에 연결되어 있습니다.RESET(입력)은 리셋 버튼입니다. IceStick에는 버튼이 없다고 말씀하시겠지만, 사실은... (이에 대해서는 나중에 이야기하겠습니다)RXD와TXD(입력, 출력)는 USB를 통해 시리얼 포트를 에뮬레이션하는 FTDI 칩에 연결되어 있습니다. 이것도 나중에 이야기하겠습니다.
다음과 같이 합성한 뒤 비트스트림을 장치로 전송할 수 있습니다:
$ BOARDS/run_xxx.sh step1.v여기서 xxx는 사용하시는 보드에 해당합니다.
LED 다섯 개가 켜지지만... 깜박이지는 않습니다. 왜 그럴까요? 사실은 깜박이고 있지만, 너무 빨라서 아무것도 구별할 수 없습니다.
무언가를 보려면 시뮬레이션을 사용할 수 있습니다. 시뮬레이션을
사용하기 위해, 우리의 SOC를 감싸는 bench
모듈을 담은 새 VERILOG 파일 bench_iverilog.v를 작성합니다:
module bench();
   reg CLK;
   wire RESET = 0;
   wire [4:0] LEDS;
   reg  RXD = 1'b0;
   wire TXD;

   SOC uut(
     .CLK(CLK),
     .RESET(RESET),
     .LEDS(LEDS),
     .RXD(RXD),
     .TXD(TXD)
   );

   reg[4:0] prev_LEDS = 0;
   initial begin
      CLK = 0;
      forever begin
     #1 CLK = ~CLK;
     if(LEDS != prev_LEDS) begin
        $display("LEDS = %b",LEDS);
     end
     prev_LEDS <= LEDS;
      end
   end
endmodule
bench 모듈은 우리 SOC(여기서는 "unit under
test", 즉 테스트 대상 유닛이라는 뜻으로 uut라고 부릅니다)의
모든 신호를 구동합니다. forever 루프는 CLK
신호를 토글하고, LED 상태가 바뀔 때마다 그 상태를 표시합니다.
이제 시뮬레이션을 시작할 수 있습니다:
  $ iverilog -DBENCH -DBOARD_FREQ=10 bench_iverilog.v step1.v
  $ vvp a.out
... 하지만 기억할 것이 많으므로 이를 위한 스크립트를 만들어 두었습니다. 다음과 같이 하시는 편이 좋습니다:
$ ./run.sh step1.vLED가 카운트하는 모습을 보실 수 있습니다. 시뮬레이션은 매우
소중합니다. VERILOG 코드에 "print" 문($display)을 넣을 수
있게 해 주는데, 이는 장치에서 실행할 때는 직접 할 수 없는 일입니다!
시뮬레이션을 종료하려면:
  <ctrl><c>
  finish
참고: 저는 시뮬레이션을 사용하는 방법을 몰랐기 때문에 디버깅에 LED만 사용하면서 femtorv의 첫 번째 버전을 전부 장치에서 개발했습니다. 그렇게 하지 마십시오. 어리석은 일입니다!
직접 해 보십시오 LED가 깜박이는 것을 볼 수 있을 만큼
충분히 느리게 하려면 step1.v를 어떻게 수정하시겠습니까?
직접 해 보십시오 카운트 대신 "나이트 라이더(Knight Rider)" 같은 깜박임 패턴을 구현할 수 있으시겠습니까?
2단계: 더 느린 블링키
아마 정답을 맞히셨을 것입니다. 블링키를 느리게 하는 방법은 더 많은
비트로 카운트하는 것(그리고 최상위 비트들을 LED에 연결하는 것) 또는 많은
비트로 카운트하는 "클록 분주기"("기어박스"라고도 합니다)를 삽입하는
것(그리고 그 최상위 비트로 카운터를 구동하는 것) 중 하나입니다. 두 번째
방법이 흥미로운데, 설계를 수정할 필요 없이 보드의 CLK
신호와 설계 사이에 클록 분주기를 삽입하기만 하면 되기 때문입니다. 그러면
장치에서도 LED에 무슨 일이 일어나는지 구별할 수 있습니다.
이를 위해 clockworks.v에
Clockworks 모듈을 만들었습니다. 이 모듈에는 기어박스와
RESET 신호와 관련된 메커니즘(나중에 이야기하겠습니다)이
들어 있습니다. Clockworks는 다음과 같이 구현됩니다:
module Clockworks
(
   input  CLK,   // clock pin of the board
   input  RESET, // reset pin of the board
   output clk,   // (optionally divided) clock for the design.
   output resetn // (optionally timed) negative reset for the design (more on this later)
);
   parameter SLOW;
...
   reg [SLOW:0] slow_CLK = 0;
   always @(posedge CLK) begin
      slow_CLK <= slow_CLK + 1;
   end
   assign clk = slow_CLK[SLOW];
...
endmodule
이 모듈은 클록 주파수를 2^SLOW로 나눕니다.
그런 다음 step2.v에서 다음과 같이 내부
clk 신호를 사용하여 보드의 CLK 신호와 설계
사이에 Clockworks 모듈을 삽입합니다:
`include "clockworks.v"

module SOC (
    input  CLK,        // system clock
    input  RESET,      // reset button
    output [4:0] LEDS, // system LEDs
    input  RXD,        // UART receive
    output TXD         // UART transmit
);

   wire clk;    // internal clock
   wire resetn; // internal reset signal, goes low on reset

   // A blinker that counts on 5 bits, wired to the 5 LEDs
   reg [4:0] count = 0;
   always @(posedge clk) begin
      count <= !resetn ? 0 : count + 1;
   end

   // Clock gearbox (to let you see what happens)
   // and reset circuitry (to workaround an
   // initialization problem with Ice40)
   Clockworks #(
     .SLOW(21) // Divide clock frequency by 2^21
   )CW(
     .CLK(CLK),
     .RESET(RESET),
     .clk(clk),
     .resetn(resetn)
   );

   assign LEDS = count;
   assign TXD  = 1'b0; // not used for now
endmodule
이 모듈은 RESET 신호도 처리합니다.
이제 시뮬레이션에서 시험해 보실 수 있습니다:
$ ./run.sh step2.v보시다시피 이제 카운터가 훨씬 느려졌습니다. 장치에서도 실행해 보십시오:
$ BOARDS/run_xxx.sh step2.v네, 이제 무슨 일이 일어나는지 분명히 볼 수 있습니다! 그럼
RESET 버튼은 어떻습니까? IceStick에는 버튼이 없습니다.
사실은 하나 있습니다!
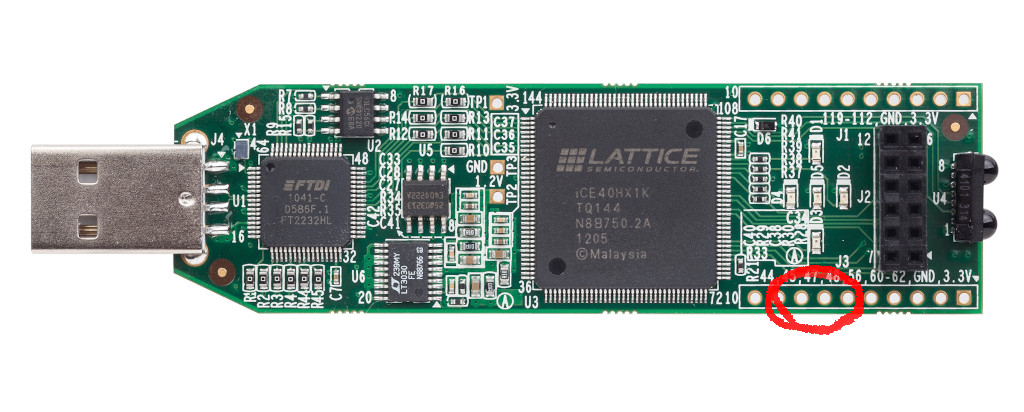
이미지에서 원으로 표시된 영역(47번 핀 주변)을 손가락으로 누르십시오.
직접 해 보기 나이트 라이더 모드를 만들고,
RESET으로 방향이 바뀌게 해 보십시오.
clockworks.v를 살펴보면 PLL도
생성할 수 있다는 것을 알 수 있는데, 이는 더 빠른 클록을
생성하는 데 사용할 수 있는 구성 요소입니다. 예를 들어 IceStick의 시스템
클록은 12 MHz이지만, 우리가 생성할 코어는 45 MHz로 동작합니다. 이는
나중에 살펴보겠습니다.
3단계: ROM에서 LED 패턴을 읽어 오는 블링커
이제 필요한 도구를 모두 갖추었으니, 이 블링커를 완전히 동작하는 RISC-V 프로세서로 바꾸는 방법을 살펴봅시다. 이 목표는 아주 멀리 있는 것처럼 보이지만, 16단계에서 완성할 프로세서는 Verilog 200줄을 넘지 않습니다! 프로세서를 만드는 일이 이렇게 간단하다는 사실을 알고 저는 깜짝 놀랐습니다. 자, 한 단계씩 차근차근 나아갑시다.
우리는 프로세서가 메모리를 가지고 있고, 대부분의 경우(점프와 분기가 있을 때를 제외하면) 그곳에서 명령어를 순차적으로 가져온다는 것을 이미 알고 있습니다. 이와 비슷하지만 훨씬 더 단순한 것부터 시작합시다. 바로 메모리에서 LED 패턴을 읽어 오는, 미리 프로그래밍된 크리스마스 반짝이 장식입니다(step3.v 참고). 우리의 반짝이 장식에는 패턴이 담긴 메모리가 있습니다:
   reg [4:0] MEM [0:20];
   initial begin
       MEM[0]  = 5'b00000;
       MEM[1]  = 5'b00001;
       MEM[2]  = 5'b00010;
       MEM[3]  = 5'b00100;
       ...
       MEM[19] = 5'b10000;
       MEM[20] = 5'b00000;
   end
initial 블록 안의 내용은 합성될 때 어떤 회로도 생성하지 않으며, FPGA의 BRAM 초기화 데이터로 직접 변환된다는 점에 유의하십시오.
또한 매 클록마다 증가하는 "프로그램 카운터" PC와
PC로 인덱싱된 MEM의 내용을 가져오는 메커니즘도
갖추게 됩니다:
   reg [4:0] PC = 0;
   reg [4:0] leds = 0;

   always @(posedge clk) begin
      leds <= MEM[PC];
      PC <= (!resetn || PC==20) ? 0 : (PC+1);
   end
PC==20 테스트를 통해 사이클이 반복되도록 한다는 점에
유의하십시오.
이제 시뮬레이션과 장치에서 실행해 보십시오.
직접 해 보기 여러 가지 깜빡임 모드를 만들고,
RESET으로 모드를 전환해 보십시오.
RISC-V 명령어 집합 아키텍처
물론 중요한 정보원은 RISC-V 참조 매뉴얼입니다. 이 매뉴얼을 보면 RISC-V 표준에 여러 가지 변형이 있다는 것을 알 수 있습니다. 가장 단순한 것(RV32I, 즉 32비트 기본 정수 명령어 집합)부터 시작합시다. 그런 다음 기능을 한 번에 하나씩 추가하는 방법을 살펴보겠습니다. 명령어 집합이 모듈식이므로 아주 작은 자체 완결형 커널로 시작할 수 있고, 이 커널도 표준을 준수한다는 점은 RISC-V의 매우 좋은 특징입니다. 즉, 표준 도구(컴파일러, 어셈블러, 링커)로 이 커널용 코드를 생성할 수 있습니다. 그다음 저는 2장(13쪽부터 30쪽까지)을 읽기 시작했습니다. 130쪽의 표도 함께 보면, 서로 다른 명령어는 사실 11개뿐입니다! (예를 들어 저는 AND, OR, ADD 등을 같은 명령어로 봅니다. 연산 종류는 추가 매개변수일 뿐이기 때문입니다.) 지금은 전체적인 그림만 파악하려는 것이므로 아직 세부 사항까지 깊이 들어갈 필요는 없습니다. 이 11개 명령어를 전체적으로 살펴봅시다:
| 명령어 | 설명 | 알고리즘 |
|---|---|---|
| branch | 조건부 점프, 6가지 변형 | if(reg OP reg) PC<-PC+imm |
| ALU reg | 레지스터 3개를 쓰는 ALU 연산, 10가지 변형 | reg <- reg OP reg |
| ALU imm | 레지스터 2개를 쓰는 ALU 연산, 9가지 변형 | reg <- reg OP imm |
| load | 메모리에서 레지스터로, 5가지 변형 | reg <- mem[reg + imm] |
| store | 레지스터에서 메모리로, 3가지 변형 | mem[reg+imm] <- reg |
LUI |
상위 즉시값 로드 | reg <- (im << 12) |
AUIPC |
PC에 상위 즉시값 더하기 | reg <- PC+(im << 12) |
JAL |
점프 후 링크 | reg <- PC+4 ; PC <- PC+imm |
JALR |
레지스터 기준 점프 후 링크 | reg <- PC+4 ; PC <- reg+imm |
FENCE |
멀티코어를 위한 메모리 순서 지정 | (여기서는 자세히 다루지 않고 지금은 건너뜁니다) |
SYSTEM |
시스템 콜, 중단점 | (여기서는 자세히 다루지 않고 지금은 건너뜁니다) |
6가지 분기 명령어는 두 레지스터를 검사한 결과에 따라 동작하는 조건부 점프입니다.
ALU 연산은
register <- register OP register형태이거나register <- register OP immediate형태입니다.다음으로 로드와 스토어가 있습니다. 이 명령어들은 바이트, 16비트 값(하프워드라고 부릅니다), 32비트 값(워드라고 부릅니다)을 다룰 수 있습니다. 또한 바이트 로드와 하프워드 로드는 부호 확장을 할 수 있습니다. 읽거나 쓸 주소는 레지스터 값에 즉시값 오프셋을 더해서 구합니다.
나머지 명령어는 좀 더 특수합니다(처음 읽을 때는 설명을 건너뛰어도 되며, 무조건 점프, 함수 호출, 멀티코어를 위한 메모리 순서 지정, 시스템 콜과 브레이크를 구현하는 데 사용된다는 것만 알면 됩니다):
LUI(상위 즉시값 로드)는 상수의 상위 20비트를 로드하는 데 사용됩니다. 그런 다음ADDI나ORI로 하위 비트를 설정할 수 있습니다. 32비트 상수 하나를 레지스터에 로드하는 데 명령어가 두 개나 필요하다는 점이 처음에는 이상해 보일 수 있습니다. 하지만 모든 명령어의 길이가 32비트이므로 사실 이는 영리한 선택입니다.AUIPC(PC에 상위 즉시값 더하기)는 현재 프로그램 카운터에 상수를 더하고 그 결과를 레지스터에 저장합니다. 이 명령어는JALR과 함께 써서 32비트 PC 상대 주소로 이동하기 위한 것입니다.JAL(점프 후 링크)은 PC에 오프셋을 더하고, 점프 다음에 오는 명령어의 주소를 레지스터에 저장합니다. 이 명령어로 함수 호출을 구현할 수 있습니다.JALR도 같은 일을 하지만, 오프셋을 레지스터 값에 더합니다.FENCE와SYSTEMS는 각각 멀티코어 시스템에서의 메모리 순서 지정과 시스템 콜/브레이크를 구현하는 데 사용됩니다.
정리하면 분기(조건부 점프), ALU 연산, 로드와 스토어, 그리고 무조건 점프와 함수 호출을 구현하는 특수 명령어 몇 개가 있습니다. 또한 메모리 순서 지정과 시스템 콜을 위한 함수가 두 개 있습니다(하지만 이 두 가지는 당분간 무시하겠습니다). 좋습니다. 그러면 사실 명령어는 9개뿐이니 해 볼 만해 보입니다... 이 시점에서 저도 모든 것을 이해하지는 못했으므로, 가장 간단하다고 생각하는 부분(명령어 디코더, 레지스터 파일, ALU)부터 시작하겠습니다. 그다음에 각 부분이 어떻게 서로 연결되는지, 그리고 점프와 분기를 비롯한 모든 명령어를 어떻게 구현하는지 살펴보겠습니다.
4단계: 명령어 디코더
이제 아이디어는 RISC-V 명령어가 들어 있는 메모리를 두고, (크리스마스
반짝이 장식에서처럼) 모든 명령어를 순차적으로 instr
레지스터에 로드한 다음, 11개의 명령어 중 어느 것인지 인식하는 방법을
살펴보는 것입니다(그리고 인식된 명령어를 입력으로 하는 함수처럼 서로
다른 LED를 켭니다). 각 명령어는 32비트 워드로 인코딩되어 있으며,
명령어와 그 매개변수를 인식하려면 이 워드의 여러 비트를 디코딩해야
합니다.
RISC-V 참조 매뉴얼의 130페이지에 있는 두 개의 표(RV32/64G Instruction Set Listings, RV32/64G 명령어 집합 목록)에 우리에게 필요한 모든 정보가 요약되어 있습니다.
큰 표를 살펴봅시다. 가장 먼저 눈에 띄는 점은 하위 7비트(LSB)가 어떤
명령어인지 알려 준다는 것입니다(가능한 경우는 10가지이며, 지금은
FENCE를 세지 않습니다).
   reg [31:0] instr;
   ...
   wire isALUreg  =  (instr[6:0] == 7'b0110011); // rd <- rs1 OP rs2
   wire isALUimm  =  (instr[6:0] == 7'b0010011); // rd <- rs1 OP Iimm
   wire isBranch  =  (instr[6:0] == 7'b1100011); // if(rs1 OP rs2) PC<-PC+Bimm
   wire isJALR    =  (instr[6:0] == 7'b1100111); // rd <- PC+4; PC<-rs1+Iimm
   wire isJAL     =  (instr[6:0] == 7'b1101111); // rd <- PC+4; PC<-PC+Jimm
   wire isAUIPC   =  (instr[6:0] == 7'b0010111); // rd <- PC + Uimm
   wire isLUI     =  (instr[6:0] == 7'b0110111); // rd <- Uimm
   wire isLoad    =  (instr[6:0] == 7'b0000011); // rd <- mem[rs1+Iimm]
   wire isStore   =  (instr[6:0] == 7'b0100011); // mem[rs1+Simm] <- rs2
   wire isSYSTEM  =  (instr[6:0] == 7'b1110011); // special
명령어 유형 외에도 명령어의 인자를 디코딩해야 합니다. 위쪽 표는
명령어의 인자와 그 인자가 명령어 워드의 32비트 안에 인코딩되는 방식에
따라 6가지 명령어
유형(R-type,I-type,S-type,B-type,U-type,J-type)을
구분합니다.
R-type 명령어는 두 소스 레지스터 rs1과
rs2를 받아 연산을 적용하고, 그 결과를 세 번째 레지스터인
목적지 레지스터 rd에 저장합니다(ADD,
SUB, SLL, SLT, SLTU,
XOR, SRL, SRA, OR,
AND).
RISC-V에는 레지스터가 32개 있으므로
rs1,rs2,rd는 각각 명령어 워드의
5비트를 사용합니다. 흥미롭게도 이 비트들은 모든 명령어 형식에서 같은
위치에 있습니다. 따라서
rs1,rs2,rd를 "디코딩"하는 일은
명령어 워드에서 배선 몇 개를 끌어오는 것에 불과합니다:
   wire [4:0] rs1Id = instr[19:15];
   wire [4:0] rs2Id = instr[24:20];
   wire [4:0] rdId  = instr[11:7];
다음으로, 10개의 R-type 명령어 중 어떤 것인지 인식해야 합니다. 이는
주로 3비트 코드인 funct3 필드로 이루어집니다. 3비트
코드로는 서로 다른 명령어를 8개까지만 인코딩할 수 있으므로,
funct7 필드(명령어 워드의 상위 7비트(MSB))도 있습니다.
명령어 워드의 30번 비트는 ADD/SUB와
SRA/SRL(부호 확장을 동반하는 산술 오른쪽
시프트/논리 오른쪽 시프트)을 인코딩합니다. 명령어 디코더에는
funct3와 funct7을 위한 배선이 있습니다:
   wire [2:0] funct3 = instr[14:12];
   wire [6:0] funct7 = instr[31:25];
I-type 명령어는 레지스터 하나(rs1)와 즉시값
Iimm을 받아 연산을 적용하고, 그 결과를 목적지 레지스터
rd에 저장합니다(ADDI, SLTI,
SLTIU, XORI, ORI,
ANDI, SLLI, SRLI,
SRAI).
잠깐: R-Type 명령어는 10개인데 I-Type 명령어는 9개뿐입니다.
왜 그럴까요? 자세히 보면 SUBI가 없다는 것을 알 수 있는데,
대신 음수 즉시값과 함께 ADDI를 사용하면 됩니다. 이것은
RISC-V의 일반적인 원칙으로, 기존 기능을 사용할 수 있다면 새 기능을
만들지 않습니다.
R-type 명령어와 마찬가지로 명령어는 funct3와
funct7을 사용해 구분할 수
있습니다(funct7에서는 산술 오른쪽 시프트와 논리 오른쪽
시프트인 SRAI/SRLI를 구분하기 위해 명령어
워드의 30번 비트만 사용합니다).
즉시값은 명령어 워드의 상위 12비트에 인코딩되어 있으므로, 이를 얻기 위해 배선을 추가로 끌어오겠습니다:
wire [31:0] Iimm={{21{instr[31]}}, instr[30:20]};보시다시피 명령어 워드의 31번 비트가 21번 반복되는데, 이것이 "부호 확장"입니다(12비트 부호 있는 값을 32비트 값으로 변환합니다).
그 밖에 S-type(Store용), B-type(Branch용),
U-type(12만큼 왼쪽 시프트되는 상위 즉시값용),
J-type(점프용)의 네 가지 명령어 형식이 있습니다. 각 명령어
형식은 명령어 워드 안에 즉시값을 인코딩하는 방식이 서로 다릅니다.
이것이 무엇을 의미하는지 이해하기 위해 2장 16쪽으로 돌아가 봅시다. 서로 다른 명령어 유형은 그 안에 즉시값이 인코딩되는 방식에 대응합니다.
| 명령어 유형 | 설명 | 즉시값 인코딩 |
|---|---|---|
R-type |
레지스터-레지스터 ALU 연산. 자세한 내용은 여기 | None |
I-type |
레지스터-즉시값 정수 ALU 연산 및 JALR. |
12비트, 부호 확장 |
S-type |
Store | 12비트, 부호 확장 |
B-type |
Branch | 12비트, 부호 확장, 상위 [31:1] (0번 비트는 0) |
U-type |
LUI,AUIPC |
20비트, 상위 31:12 (비트 [11:0]은 0) |
J-type |
JAL |
12비트, 부호 확장, 상위 [31:1] (0번 비트는 0) |
I-type과 S-type은 같은 종류의 값을
인코딩한다는 점에 유의하십시오(다만 instr의 서로 다른
부분에서 값을 가져옵니다). B-type과 J-type도
마찬가지입니다.
여러 종류의 즉시값은 다음과 같이 디코딩할 수 있습니다.
   wire [31:0] Uimm={    instr[31],   instr[30:12], {12{1'b0}}};
   wire [31:0] Iimm={{21{instr[31]}}, instr[30:20]};
   wire [31:0] Simm={{21{instr[31]}}, instr[30:25],instr[11:7]};
   wire [31:0] Bimm={{20{instr[31]}}, instr[7],instr[30:25],instr[11:8],1'b0};
wire [31:0] Jimm={{12{instr[31]}}, instr[19:12],instr[20],instr[30:21],1'b0};Iimm, Simm, Bimm,
Jimm은 (상위 비트를 채우는 데 필요한 횟수만큼 비트 31을
복사하여) 부호 확장을 수행한다는 점에 유의하십시오.
이것으로 명령어 디코더에 대한 설명은 모두 끝났습니다! 정리하자면, 명령어 디코더는 명령어 워드에서 다음 정보를 얻습니다.
- 가능한 11가지 RISC-V 명령어 중 어느 것인지 식별하는 isXXX 신호
- 소스 레지스터와 목적지 레지스터
rs1,rs2,rd - 함수 코드
funct3및funct7 - 다섯 가지 즉시값 형식(
Iimm,Simm,Bimm,Jimm의 부호 확장 포함).
이제 몇 가지 RISC-V 명령어로 메모리를 초기화하고, 명령어에 따라 서로
다른 LED를 켜서 명령어를 식별할 수 있는지 확인해 봅시다(step4.v). 이를 위해 RISC-V
참조 매뉴얼 130페이지에 있는 큰 표를 사용합니다. 비트 필드를
하나하나 맞춰야 하므로 다소 고통스럽습니다(나중에 더 쉬운 방법을
살펴보겠습니다!). 이런 상황에서는 _ 문자로 이진 상수의
필드를 구분하는 방법이 특히 유용합니다.
   initial begin
      // add x1, x0, x0
      //                    rs2   rs1  add  rd  ALUREG
      MEM[0] = 32'b0000000_00000_00000_000_00001_0110011;
      // addi x1, x1, 1
      //             imm         rs1  add  rd   ALUIMM
      MEM[1] = 32'b000000000001_00001_000_00001_0010011;
      ...
      // lw x2,0(x1)
      //             imm         rs1   w   rd   LOAD
      MEM[5] = 32'b000000000000_00001_010_00010_0000011;
      // sw x2,0(x1)
      //             imm   rs2   rs1   w   imm  STORE
      MEM[6] = 32'b000000_00001_00010_010_00000_0100011;
      // ebreak
      //                                        SYSTEM
      MEM[7] = 32'b000000000001_00000_000_00000_1110011;
   end
그러면 다음과 같이 명령어를 가져와서 식별할 수 있습니다.
   always @(posedge clk) begin
      if(!resetn) begin
     PC <= 0;
      end else if(!isSYSTEM) begin
     instr <= MEM[PC];
     PC <= PC+1;
      end
   end
   assign LEDS = isSYSTEM ? 31 : {PC[0],isALUreg,isALUimm,isStore,isLoad};
(같은 명령어가 여러 번 나오더라도 깜박이는 것을 볼 수 있도록 첫 번째
LED는 PC[0]에 연결되어 있습니다.)
보시다시피 프로그램 카운터는 명령어가 SYSTEM이 아닐 때만
증가합니다. 현재 우리가 지원하는 SYSTEM 명령어는 실행을
중단하는 EBREAK 하나뿐입니다.
시뮬레이션 모드에서는 인식된 명령어의 이름과 필드도 함께 표시할 수 있습니다.
`ifdef BENCH
   always @(posedge clk) begin
      $display("PC=%0d",PC);
      case (1'b1)
    isALUreg: $display("ALUreg rd=%d rs1=%d rs2=%d funct3=%b",rdId, rs1Id, rs2Id, funct3);
    isALUimm: $display("ALUimm rd=%d rs1=%d imm=%0d funct3=%b",rdId, rs1Id, Iimm, funct3);
    isBranch: $display("BRANCH");
    isJAL:    $display("JAL");
    isJALR:   $display("JALR");
    isAUIPC:  $display("AUIPC");
    isLUI:    $display("LUI");
    isLoad:   $display("LOAD");
    isStore:  $display("STORE");
    isSYSTEM: $display("SYSTEM");
      endcase
   end
`endif
직접 해 보십시오 step4.v를 시뮬레이션과
실제 장치에서 실행해 보십시오. 메모리를 여러 가지 RISC-V 명령어로
초기화해 보고, 디코더가 그 명령어들을 인식하는지 테스트해 보십시오.
사이드바: RISC-V의 우아함
이 단락은 건너뛰어도 됩니다. 이 단락에는 RISC-V 참조 매뉴얼에 이탤릭체로 실린 주석과 Q&A에서 영감을 받아 RISC-V 명령어 집합에 대해 제가 느낀 인상과 생각만 담겨 있습니다.
이 시점에서 저는 명령어 집합 아키텍처가 무엇을 의미하는지 깨달았습니다. 그것은 분명 어떤 비트 패턴이 무엇을 하는지에 대한 명세(명령어 집합, Instruction Set)이면서, 동시에 이것이 어떻게 배선으로 변환될지에 따라 결정되는 것(아키텍처, Architecture)이기도 합니다. ISA는 추상적인 것이 아닙니다. 구현과 독립적이지만, 구현을 강하게 염두에 두고 설계된 것입니다! 파이프라인, 분기 예측 유닛, 다중 실행 유닛, 캐시는 구현마다 다를 수 있지만, 명령어 디코더는 아마 모든 구현에서 매우 비슷할 것입니다.
처음에는 정말 이상해 보이는 것들이 있었습니다. 여러 가지 즉시값 형식
변형, 즉시값이 instr의 여러 비트에 뒤섞여 있다는 점,
zero 레지스터, 그리고
LUI,AUIPC,JAL,JALR라는
이상한 명령어들이 그랬습니다. 명령어 디코더를 작성하다 보면 그 이유를 더
잘 이해하게 됩니다. 이 ISA는 정말 영리하게 설계되었으며, 오랜 진화의
결과입니다(이전에 RISC-I, RISC-II, ... 가 있었습니다). 제게는 이것이
일종의 증류의 결과로 보입니다. 2020년인 지금, ISA 측면에서 많은
것들이 시도되었고, 이 ISA는 이전의 모든 시도에서 교훈을 얻어 좋은 선택은
취하고 최적이 아닌 선택은 피한 것으로 보입니다.
이 ISA에서 정말 좋은 점은 다음과 같습니다.
- 명령어 크기가 고정되어 있습니다. 덕분에 일이 정말 쉬워집니다. (명령어 길이가 가변적인 확장도 있지만, 적어도 핵심 명령어 집합은 단순합니다);
rs1,rs2,rd는 항상instr의 같은 비트로 인코딩됩니다.- 부호 확장이 필요한 즉시값 형식은 모두 같은
비트(
instr[31])에서 부호 확장을 수행합니다. LUI,AUIPC,JAL,JALR라는 이상한 명령어들을 조합하면 더 높은 수준의 작업(레지스터에 32비트 상수 로드, 임의 주소로 점프, 함수 호출)을 구현할 수 있습니다. 이 명령어들은 설계를 더 쉽게 해 준다는 점에서 존재 이유가 있습니다. 그리고 어셈블리 프로그래머는CALL,RET, ... 같은 의사 명령어들 덕분에 훨씬 편해집니다. risc-v 어셈블리 매뉴얼의 페이지 끝에 있는 두 표를 참고하십시오. 매개변수를 서로 바꿔서 얻을 수 있는 비교/분기 명령어(예:a < b <=> b > a등...)도 마찬가지로, 그 일을 대신 해 주는 의사 명령어들이 있습니다.
달리 말하면, RISC-V ISA의 우아함을 제대로 느끼려면 여러분의 임무가 그것을 발명하는 것이라고 상상해 보십시오. 즉, 명령어 집합과 그 명령어들을 비트 패턴으로 인코딩하는 방식을 모두 발명하는 것입니다. 제약 조건은 다음과 같습니다.
- 고정된 명령어 길이(32비트)
- 최대한 단순할 것: 궁극의 정교함은 단순함입니다 [레오나르도 다빈치] !!
- 소스 레지스터와 목적지 레지스터는 항상 같은 위치에 인코딩될 것
- 부호 확장이 있을 때는 항상 같은 비트에서 수행될 것
- 임의의 32비트 즉시값(immediate value)을 레지스터에 적재하는 일은 간단해야 합니다(여러 명령어가 필요할 수는 있습니다)
- 메모리의 임의 위치로 점프하는 일은 간단해야 합니다(여러 명령어가 필요할 수는 있습니다)
- 함수 호출을 구현하는 일은 간단해야 합니다(여러 명령어가 필요할 수는 있습니다)
그러면 즉시값 형식이 왜 여러 가지인지 이해할 수 있습니다. 예를 들어
소스 레지스터가 하나 있는 JALR과 소스 레지스터가 없는
JAL을 비교해 보십시오. 둘 다 즉시값을 받지만,
JAL은 소스 레지스터를 인코딩할 필요가 없으므로 즉시값을
저장하는 데 5비트를 더 쓸 수 있습니다. 남는 비트는 하나도 빠짐없이
즉시값의 표현 범위를 넓히는 데 사용됩니다. 이로써 즉시값 형식이 여러
가지인 이유와 함께, 즉시값이 instr의 여러 조각을 모아
조립되며 경우에 따라 있기도 하고 없기도 한 세 개의 고정된 5비트 레지스터
인코딩 사이를 이리저리 피해 간다는 사실도 설명됩니다.
이제 LUI, AUIPC, JAL,
JALR이라는 이상한 명령어들이 존재하는 이유는, 임의의 32비트
값을 레지스터에 적재하거나, 메모리의 임의 위치로 점프하거나, 함수 호출
규약을 최대한 간단하게 구현할 수 있도록 서로 조합할 수 있는 기능들을
제공하기 위해서입니다. 제약 조건을 고려하면, (처음에는 제게 이상해
보였던) 이러한 선택들이 완벽하게 납득이 됩니다. 게다가 이러한 선택
덕분에 명령어 디코더는 꽤 단순하고 논리 깊이(logical depth)도 낮습니다.
7비트 명령어 디코더를 제외하면, 디코더는 대부분 instr의
비트에서 끌어온 와이어들과, 즉시값을 만들기 위해 부호 확장된 31번 비트를
복제하는 부분으로 이루어져 있습니다.
다음으로 넘어가기 전에, zero 레지스터에 대해 한 워드,
아니 한마디 하고 싶습니다. 이것은 정말 영리한 선택이라고 생각합니다. 이
레지스터 덕분에 MOV rd rs 명령어가 필요
없고(ADD rd rs zero로 충분합니다), NOP
명령어도 필요 없으며(ADD zero zero zero), 모든 분기 명령어
변형이 zero와 비교할 수 있습니다! zero는
0만큼은 아니더라도 훌륭한 발명이며, 명령어 집합을 정말로 더
간결하게 만들어 준다고 생각합니다.
5단계: 레지스터 뱅크와 상태 기계
레지스터 뱅크는 다음과 같이 구현합니다:
reg [31:0] RegisterBank [0:31];명령어 하나를 실행하려면 무엇을 해야 하는지 좀 더 자세히 살펴봅시다. 예를 들어 R-type 명령어가 연속으로 들어오는 경우를 생각해 보십시오. 각 명령어마다 다음 네 가지 작업을 해야 합니다:
- 명령어를 인출합니다:
instr <= MEM[PC] rs1과rs2의 값을 인출합니다:rs1 <= RegisterBank[rs1Id]; rs2 <= RegisterBank[rs2Id]여기서rs1과rs2는 두 레지스터입니다. 이렇게 해야 하는 이유는RegisterBank가 BRAM 블록으로 합성되며, BRAM의 내용에 접근하는 데 한 사이클이 필요하기 때문입니다.rs1OPrs2를 계산합니다(OP는funct3와funct7에 따라 달라집니다)- 결과를
rd에 저장합니다:RegisterBank[rdId] <= writeBackData.OP를 조합 회로로 계산한다면 이 작업은 이전 단계와 같은 사이클에 수행할 수 있습니다.
처음 세 가지 작업은 다음과 같이 상태 기계로 구현합니다(step5.v 참고):
   localparam FETCH_INSTR = 0;
   localparam FETCH_REGS  = 1;
   localparam EXECUTE     = 2;
   reg [1:0] state = FETCH_INSTR;
   always @(posedge clk) begin
     case(state)
       FETCH_INSTR: begin
          instr <= MEM[PC];
          state <= FETCH_REGS;
       end
       FETCH_REGS: begin
          rs1 <= RegisterBank[rs1Id];
          rs2 <= RegisterBank[rs2Id];
          state <= EXECUTE;
       end
       EXECUTE: begin
          PC <= PC + 1;
          state <= FETCH_INSTR;
       end
     endcase
      end
   end
네 번째 작업(레지스터 write-back)은 다음 블록에서 구현합니다:
   wire [31:0] writeBackData = ... ;
   wire writeBackEn = ...;
   always @posedge(clk) begin
      if(writeBackEn && rdId != 0) begin
          RegisterBank[rdId] <= writeBackData;
      end
   end
0번 레지스터에 쓰는 것은 아무 효과가 없다는 점을 기억하십시오(그래서
rdId != 0 검사가 있습니다). writeBackEn 신호는
writeBackData를 rdId 레지스터에 써야 할 때마다
활성화됩니다. write-back할 데이터(writeBackData)는 다음
에피소드에서 설명하듯이 ALU에서 얻습니다.
직접 해 보십시오: step5.v를 시뮬레이션과 실제 장치에서 실행해 보십시오. CPU 지망생의 상태 기계가 (현재 상태를 표시하는) LED 위에서 왈츠를 추는 모습을 보실 수 있습니다.
6단계: ALU
이제 메모리에서 명령어를 가져오고, 디코딩하고, 레지스터 값을 읽을 수 있게 되었지만, 우리의 (CPU 지망생인) CPU는 여전히 아무것도 할 수 없습니다. 레지스터 값으로 실제 연산을 수행하는 방법을 살펴봅시다.
그러면 ALU 모듈을 만들 예정입니까? 그런데 왜
Decoder 모듈과 RegisterBank 모듈은 만들지
않았습니까?
제 최초의 설계는 여러 모듈과 여러 파일로 이루어져 총 1000줄 정도의 코드였는데, 이후 Matthias Koch가 200줄의 코드에 들어가는 단일 구조(monolithic) 버전을 작성했습니다. 더 간결할 뿐만 아니라, 모든 것이 한곳에 있으니 이해하기도 훨씬 쉽습니다. 경험칙: 상자 안의 회로보다 상자와 상자 사이의 배선이 더 많다면, 상자가 너무 많은 것입니다!
하지만 잠깐, 모듈식 설계는 좋은 것 아닙니까?
모듈식 설계는 좋지도 나쁘지도 않으며, 일을 더 단순하게 만들어 줄 때 유용합니다. 지금 상황은 그런 경우가 아닙니다. 물론 절대적인 정답은 없으며, 취향과 스타일의 문제입니다! 이 튜토리얼에서는 (대체로) 단일 구조 설계를 사용합니다.
이제 두 가지 유형의 명령어를 구현하려고 합니다.
- Rtype:
rd<-rs1OPrs2(isALUreg로 인식) - Itype:
rd<-rs1OPIimm(isALUimm으로 인식)
ALU는 두 입력 aluIn1과 aluIn2를 받아
aluIn1 OP aluIn2를 계산하고 그
결과를 aluOut에 저장합니다.
   wire [31:0] aluIn1 = rs1;
   wire [31:0] aluIn2 = isALUreg ? rs2 : Iimm;
   reg [31:0] aluOut;
명령어 유형에 따라 aluIn2는 두 번째 소스 레지스터
rs2의 값이거나, Itype 형식의
즉시값(Immm)입니다. 연산 OP는 주로
funct3에 따라 (그리고 funct7에 따라서도)
결정됩니다. RISC-V
참조 매뉴얼의 130쪽을 펼쳐 무릎 위에 두거나 다른 창에 띄워
두십시오.
| funct3 | 연산 |
|---|---|
| 3'b000 | ADD 또는 SUB |
| 3'b001 | 왼쪽 시프트 |
| 3'b010 | 부호 있는 비교 (<) |
| 3'b011 | 부호 없는 비교 (<) |
| 3'b100 | XOR |
| 3'b101 | 논리 오른쪽 시프트 또는 산술 오른쪽 시프트 |
| 3'b110 | OR |
| 3'b111 | AND |
ADD/SUB의 경우,ALUreg연산(R타입)이면funct7의 5번 비트를 검사하여ADD와SUB를 구별합니다(SUB이면 1).ALUimm연산(I타입)이면ADD만 가능합니다. 이 경우에는instr의 5번 비트만 검사하면ALUreg(1인 경우)와ALUimm(0인 경우)을 구별할 수 있습니다.- 논리 오른쪽 시프트와 산술 오른쪽 시프트 역시
funct7의 5번 비트를 검사하여 구별합니다. 1이면 산술 시프트(부호 확장 포함)이고, 0이면 논리 시프트입니다. - 시프트 양은
ALUreg명령어에서는rs2의 내용이고,ALUimm명령어에서는instr[24:20](rs2Id와 같은 비트)입니다.
이 모든 것을 종합하면 ALU에 대한 다음 Verilog 코드를 얻을 수 있습니다.
   reg [31:0] aluOut;
   wire [4:0] shamt = isALUreg ? rs2[4:0] : instr[24:20]; // shift amount
   always @(*) begin
      case(funct3)
    3'b000: aluOut = (funct7[5] & instr[5]) ? (aluIn1-aluIn2) : (aluIn1+aluIn2);
    3'b001: aluOut = aluIn1 << shamt;
    3'b010: aluOut = ($signed(aluIn1) < $signed(aluIn2));
    3'b011: aluOut = (aluIn1 < aluIn2);
    3'b100: aluOut = (aluIn1 ^ aluIn2);
    3'b101: aluOut = funct7[5]? ($signed(aluIn1) >>> shamt) : (aluIn1 >> shamt);
    3'b110: aluOut = (aluIn1 | aluIn2);
    3'b111: aluOut = (aluIn1 & aluIn2);
      endcase
   end
참고: aluOut은 reg로 선언되어
있지만 조합 함수가 됩니다(플립플롭이 생성되지 않습니다). 그 값이 조합
블록(always @(*)) 안에서 결정되고, 모든 경우가
case 문에 열거되어 있기 때문입니다.
레지스터 write-back은 다음과 같이 구성됩니다.
   assign writeBackData = aluOut;
   assign writeBackEn = (state == EXECUTE && (isALUreg || isALUimm));
직접 해 보기 step6.v를
시뮬레이션과 장치에서 실행해 보십시오. 시뮬레이션에서는 모든 레지스터
write-back 연산에 대해 기록된 값과 기록된 레지스터를 표시합니다.
장치에서는 x1의 하위 5비트(LSB)를 LED에 표시합니다. 그런
다음 프로그램을 바꿔 보고 레지스터 값에 어떤 영향이 있는지 관찰해
보십시오.
현재 위치! 다음은 구현해야 할 명령어 목록이며, 여러분이 만들고 있는 RISC-V 코어는 현재 이 중 20개를 지원합니다. 다음 단계는 점프, 그다음은 분기, 그다음은... 나머지 전부입니다. 그 전에, 아마 눈치채셨겠지만 RISC-V 프로그램을 바이너리로 변환하는 일(즉, 손으로 어셈블하는 일)은 매우 고통스럽습니다. 다음 절에서 훨씬 쉬운 해결책을 소개합니다.
| ALUreg | ALUimm | 점프 | Branch | LUI | AUIPC | Load | Store | SYSTEM |
|---|---|---|---|---|---|---|---|---|
| [*] 10 | [*] 9 | [ ] 2 | [ ] 6 | [ ] | [ ] | [ ] 5 | [ ] 3 | [*] 1 |
7단계: Verilog 어셈블러 사용하기
RISC-V 어셈블리를 손으로 직접 바이너리로 변환하지 않으려면, GNU
어셈블러로 바이너리 파일을 생성하고 이를 16진수로 변환한 다음, Verilog
함수 readmemh()를 사용해 그 파일의 내용으로 메모리를
초기화할 수 있습니다. 그 방법은 나중에 살펴보겠습니다.
하지만 우리의 경우에는 작은 어셈블리 프로그램을 설계와 같은 Verilog 파일 안에 직접 작성할 수 있다면 매우 편리할 것입니다. 실제로 riscv_assembly.v에서 한 것처럼 Verilog로 직접 RISC-V 어셈블러를 구현하면(task와 함수를 사용하여) 이렇게 할 수 있습니다.
step7.v에서는 step6.v와 같은 어셈블리 프로그램으로 메모리를 초기화합니다. 이제는 다음과 같은 모습입니다. 훨씬 읽기 쉽지 않습니까?
   `include "riscv_assembly.v"
   initial begin
      ADD(x0,x0,x0);
      ADD(x1,x0,x0);
      ADDI(x1,x1,1);
      ADDI(x1,x1,1);
      ADDI(x1,x1,1);
      ADDI(x1,x1,1);
      ADD(x2,x1,x0);
      ADD(x3,x1,x2);
      SRLI(x3,x3,3);
      SLLI(x3,x3,31);
      SRAI(x3,x3,5);
      SRLI(x1,x3,26);
      EBREAK();
   end
참고: riscv_assembly.v는 어셈블리를 사용하는
모듈 안에서 include해야 합니다.
이 단계에서는 또 다른 수정을 합니다. 이전 단계에서 PC는
현재 명령어의 인덱스였습니다. 앞으로 진행할 내용을 위해, 이 값이 현재
명령어의 주소가 되도록 하겠습니다. 각 명령어의 길이가
32비트이므로, 이는 다음을 의미합니다.
PC를 증가시키려면 (이전처럼PC <= PC + 1이 아니라)PC <= PC + 4를 수행합니다- 현재 명령어를 가져오려면
instr <= MEM[PC[31:2]];를 실행합니다(PC의 두 LSB는 무시합니다).
8단계: 점프
점프 명령어는 JAL(점프 후 링크)과 JALR(점프
후 레지스터 링크) 두 가지입니다. "and link"는 현재 PC를 레지스터에
기록할 수 있다는 뜻입니다. 따라서 JAL과 JALR은
점프뿐 아니라 함수 호출을 구현하는 데에도 사용할 수 있습니다. 두
명령어가 수행해야 하는 동작은 다음과 같습니다.
| 명령어 | 효과 |
|---|---|
| JAL rd,imm | rd<-PC+4; PC<-PC+Jimm |
| JALR rd,rs1,imm | rd<-PC+4; PC<-rs1+Iimm |
이 두 명령어를 구현하려면 코어를 다음과 같이 수정해야 합니다. 첫
번째는 레지스터 write-back입니다. 이제 점프 명령어의 경우 기록할 값이
aluOut 대신 PC+4일 수 있습니다.
   assign writeBackData = (isJAL || isJALR) ? (PC + 4) : aluOut;
   assign writeBackEn = (state == EXECUTE &&
             (isALUreg ||
              isALUimm ||
              isJAL    ||
              isJALR)
             );
또한 세 가지 경우를 구현하는 nextPC 값을 선언해야
합니다.
   wire [31:0] nextPC = isJAL  ? PC+Jimm :
                    isJALR ? rs1+Iimm :
                    PC+4;
그런 다음 상태 기계에서 PC <= PC + 4; 줄을
PC <= nextPC;로 바꾸면 끝입니다!
이제 새 점프 명령어를 테스트하기 위해 간단한 (무한) 루프를 구현할 수 있습니다.
`include "riscv_assembly.v"
      integer L0_=4;
      initial begin
     ADD(x1,x0,x0);
      Label(L0_);
     ADDI(x1,x1,1);
     JAL(x0,LabelRef(L0_));
     EBREAK();
     endASM();
      end
정수 L0_는 레이블입니다. 실제 어셈블러와 달리 여기서는
L0_의 값을 직접 지정해야 합니다. 이 경우는 쉽습니다.
L0_는 첫 번째 명령어 바로 다음에 있으므로 RAM의 시작(0)에
32비트 워드 하나를 더한 값, 즉 4에 해당합니다. 레이블이 많은 긴
프로그램에서는 레이블을 초기화하지 않은 채로(integer L0_;)
두어도 됩니다. 그러면 프로그램을 처음 실행할 때 레이블에 사용할 값을
계산하여 표시해 줍니다. 아주 편리하지는 않지만, 손으로 어셈블하거나
레이블을 손으로 정하는 것보다는 훨씬 낫습니다.
LabelRef() 함수는 현재 프로그램 카운터를 기준으로 한
레이블의 오프셋을 계산합니다. 또한 시뮬레이션 모드에서는 (레이블
초기화에 사용할) 현재 주소를 표시하고, 레이블이 이미 초기화되어
있다면(여기서 L0_=4처럼) 그 레이블이 어셈블러가 생성한 현재
주소와 일치하는지 검사합니다. 일치하지 않으면 endASM() 문이
오류 메시지를 표시하고 종료합니다.
참고 1: 저는 프로그램 끝에 항상 EBREAK()
명령어를 넣습니다. 여기서는 (무한 루프이므로) 필요하지 않지만, 나중에
마음이 바뀌어 루프를 빠져나오게 만들더라도 EBREAK()가 이미
들어가 있게 됩니다.
참고 2: endASM(); 문은 모든 레이블의 유효성을
검사하고, 잘못된 레이블이 발견되면 시뮬레이션을 종료합니다. RISC-V
Verilog 어셈블러를 사용한다면 합성하기 전에 반드시 시뮬레이션으로 설계를
실행해 보십시오(이 검증은 합성 시점에는 할 수 없기 때문입니다).
직접 해 보십시오 step8.v 설계를 시뮬레이션과 장치에서 실행해 보십시오. 네, 8단계를 거쳐 얻은 것은 또 하나의 시시한 블링키일 뿐입니다! 하지만 이번에는 이 블링키가 진짜 RISC-V 프로그램을 실행하고 있습니다! 아직 완전한 RISC-V 코어는 아니지만, RISC-V다운 면모가 뚜렷해지기 시작했습니다. 조금만 기다리십시오. 곧 우리 코어는 블링키보다 더 흥미로운 RISC-V 프로그램을 실행할 수 있게 됩니다.
현재 위치입니다! 아직 할 일이 남아 있지만, 진전을 이루고 있습니다. | ALUreg | ALUimm | 점프 | Branch | LUI | AUIPC | Load | Store | SYSTEM | |--------|--------|-------|--------|-----|-------|-------|-------|--------| | [] 10 | [] 9 | [] 2 | [ ] 6 | [ ] | [ ] | [ ] 5 | [ ] 3 | [] 1 |
직접 해 보십시오 루프 앞에 명령어를 몇 개 추가하고, 시뮬레이션으로 실행한 다음, 시뮬레이터가 알려 주는 대로 레이블을 고치고, 시뮬레이션으로 다시 실행한 뒤, 장치에서 실행하십시오.
9단계: 분기
분기는 점프와 비슷하지만, 두 레지스터를 비교하고 그 비교 결과에 따라
PC를 갱신한다는 점이 다릅니다. 또 다른 차이점은
PC에서 도달할 수 있는 주소 범위가 더 제한적이라는
것입니다(12비트 오프셋). 분기 명령어는 6가지가 있습니다.
| 명령어 | 효과 |
|---|---|
| BEQ rs1,rs2,imm | if(rs1 == rs2) PC <- PC+Bimm |
| BNE rs1,rs2,imm | if(rs1 != rs2) PC <- PC+Bimm |
| BLT rs1,rs2,imm | if(rs1 < rs2) PC <- PC+Bimm (부호 있는 비교) |
| BGE rs1,rs2,imm | if(rs1 >= rs2) PC <- PC+Bimm (부호 있는 비교) |
| BLTU rs1,rs2,imm | if(rs1 < rs2) PC <- PC+Bimm (부호 없는 비교) |
| BGEU rs1,rs2,imm | if(rs1 >= rs2) PC <- PC+Bimm (부호 없는 비교) |
잠깐: BLT는 있는데 BGT는 어디에
있습니까? RISC-V 프로세서에서는 언제나 같은 원칙이 적용됩니다. 이미 있는
기능으로 할 수 있는 일이라면 새 기능을 추가하지 마십시오! 이 경우
BGT rs1,rs2,imm은 BLT rs2,rs1,imm과
같습니다(앞의 두 피연산자를 서로 바꾸기만 하면 됩니다). RISC-V 어셈블리
프로그램에서 BGT를 사용해도 동작합니다(어셈블러가 이를
피연산자를 바꾼 BLT로 대체합니다). BGT는 "의사
명령어(pseudo-instruction)"라고 부릅니다. RISC-V 어셈블리 프로그래머의
작업을 편하게 해 주는 의사 명령어가 많이 있습니다(이에 대해서는 나중에
더 다룹니다).
다시 분기 명령어로 돌아가서, 다음과 같이 ALU에 비교 결과를 계산하는 wire를 몇 개 추가해야 합니다:
   reg takeBranch;
   always @(*) begin
      case(funct3)
    3'b000: takeBranch = (rs1 == rs2);
    3'b001: takeBranch = (rs1 != rs2);
    3'b100: takeBranch = ($signed(rs1) < $signed(rs2));
    3'b101: takeBranch = ($signed(rs1) >= $signed(rs2));
    3'b110: takeBranch = (rs1 < rs2);
    3'b111: takeBranch = (rs1 >= rs2);
    default: takeBranch = 1'b0;
      endcase
참고 1 합성했을 때 훨씬 적은 수의 LUT를 사용하는, 훨씬 더 컴팩트한 ALU를 만들 수도 있으며, 이는 나중에 살펴보겠습니다(지금의 목표는 동작하는 RISC-V 프로세서를 만드는 것이며, 최적화는 나중에 하겠습니다).
참고 2 funct3로 표현할 수 있는 8가지 경우 중
분기 명령어가 사용하는 것은 6가지뿐입니다. case에
default: 문이 반드시 있어야 합니다. 그렇지 않으면 합성기가
takeBranch를 순수한 조합 논리로 유지할 수 없어 래치를
생성하게 되는데, 이는 원하는 결과가 아닙니다.
이제 분기를 구현하기 위해 남은 일은 다음과 같이 nextPC에
경우를 하나 추가하는 것뿐입니다:
   wire [31:0] nextPC = (isBranch && takeBranch) ? PC+Bimm :
                    isJAL                    ? PC+Jimm :
                    isJALR                   ? rs1+Iimm :
                    PC+4;
이제 0부터 31까지 세면서 각 반복을 LED에 표시하고(LED는
x1에 연결되어 있다는 점을 기억하십시오) 멈추는 간단한
루프를 테스트할 준비가 되었습니다:
`include "riscv_assembly.v"
      integer L0_ = 8;

      initial begin
         ADD(x1,x0,x0);
         ADDI(x2,x0,32);
      Label(L0_);
     ADDI(x1,x1,1);
         BNE(x1, x2, LabelRef(L0_));
         EBREAK();

     endASM();
      end
직접 해 보십시오 step9.v를 시뮬레이션과 실제 장치에서 실행해 보십시오. 프로그램을 수정하여 바깥 루프 하나와 안쪽 루프 두 개(하나는 왼쪽에서 오른쪽으로, 다른 하나는 오른쪽에서 왼쪽으로)로 이루어진 "knight driver" 블링키를 만들어 보십시오.
현재 위치! 와, 38개 명령어 중 28개를 구현했습니다! 계속합시다...
| ALUreg | ALUimm | 점프 | Branch | LUI | AUIPC | Load | Store | SYSTEM |
|---|---|---|---|---|---|---|---|---|
| [*] 10 | [*] 9 | [*] 2 | [ *] 6 | [ ] | [ ] | [ ] 5 | [ ] 3 | [*] 1 |
10단계: LUI와 AUIPC
아직 구현해야 할 이상한 명령어 두 개가 남아 있습니다. 이 명령어들은 무엇을 할까요? 꽤 간단합니다.
| 명령어 | 효과 |
|---|---|
| LUI rd, imm | rd <= Uimm |
| AUIPC rd, imm | rd <= PC + Uimm |
그리고 Uimm 형식을 보면, 상위
비트(imm[31:12])를 명령어에 인코딩된 즉시값에서 읽어
옵니다. 하위 12비트(LSB)는 0으로 설정됩니다. 이 두 명령어는 매우
유용합니다. 다른 모든 명령어가 지원하는 즉시값 형식으로는 LSB만 수정할
수 있기 때문입니다. 이 두 함수를 함께 사용하면 레지스터에 임의의 값을
로드할 수 있습니다(다만 최대 두 개의 명령어가 필요할 수 있습니다).
이 두 명령어를 구현하려면 writeBackEn과
writeBackData를 다음과 같이 변경하기만 하면 됩니다.
   assign writeBackData = (isJAL || isJALR) ? (PC + 4) :
              (isLUI) ? Uimm :
              (isAUIPC) ? (PC + Uimm) :
              aluOut;

   assign writeBackEn = (state == EXECUTE &&
             (isALUreg ||
              isALUimm ||
              isJAL    ||
              isJALR   ||
              isLUI    ||
              isAUIPC)
             );
현재 위치입니다! 거의 다 온 것 같습니다! 이제 명령어 8개만 남았습니다...
| ALUreg | ALUimm | 점프 | Branch | LUI | AUIPC | Load | Store | SYSTEM |
|---|---|---|---|---|---|---|---|---|
| [*] 10 | [*] 9 | [*] 2 | [ *] 6 | [*] | [*] | [ ] 5 | [ ] 3 | [*] 1 |
해 보십시오 step10.v를 시뮬레이션과 장치에서 실행해 보십시오.
으악!! 제 icestick에는 들어가지 않습니다(LUT가 1283개 필요한데 IceStick에는 1280개밖에 없습니다). 어떻게 해야 하겠습니까? 기억하십시오. 우리는 리소스 사용량에는 전혀 신경 쓰지 않고, 그저 동작하는 설계를 작성하려고만 했습니다. 사실 우리 설계에는 개선할 여지가 아주 많습니다. 이는 나중에 살펴보겠지만, 그 전에 먼저 SOC를 비트 하나만큼이라도 더 잘 정리해 봅시다(그다음에 프로세서를 축소하겠습니다).
11단계: 별도 모듈로 분리한 메모리
이전 설계에서는 모든 것(메모리와 프로세서)을 SOC 모듈
안에 넣었습니다. 이번 단계에서는 이들을 분리하는 방법을
살펴보겠습니다.
먼저 Memory 모듈입니다:
module Memory (
   input             clk,
   input      [31:0] mem_addr,  // address to be read
   output reg [31:0] mem_rdata, // data read from memory
   input         mem_rstrb  // goes high when processor wants to read
);
   reg [31:0] MEM [0:255];

`include "riscv_assembly.v"
   integer L0_=8;
   initial begin
                  ADD(x1,x0,x0);
                  ADDI(x2,x0,31);
      Label(L0_); ADDI(x1,x1,1);
                  BNE(x1, x2, LabelRef(L0_));
                  EBREAK();
      endASM();
   end

   always @(posedge clk) begin
      if(mem_rstrb) begin
         mem_rdata <= MEM[mem_addr[31:2]];
      end
   end
endmodule
인터페이스에는 클록에 연결된 clk 신호가 있습니다.
프로세서가 메모리에서 읽으려 할 때마다, 읽을 주소를
mem_addr에 두고 mem_rstrb를 1로 설정합니다.
그러면 Memory 모듈이 읽을 데이터를 mem_rdata로
반환합니다.
대칭적으로, Processor 모듈에는 mem_addr
신호(이번에는 output), mem_rdata 신호(입력),
mem_rstrb 신호(출력)가 있습니다:
module Processor (
    input         clk,
    input         resetn,
    output     [31:0] mem_addr,
    input      [31:0] mem_rdata,
    output        mem_rstrb,
    output reg [31:0] x1
);
...
endmodule
(추가로, 레지스터 x1의 내용을 담고 있는 x1
신호가 있으며, 이는 시각적 디버깅에 사용할 수 있습니다. 이 신호는 LED에
연결하겠습니다).
상태 기계에는 상태가 하나 추가됩니다:
   localparam FETCH_INSTR = 0;
   localparam WAIT_INSTR  = 1;
   localparam FETCH_REGS  = 2;
   localparam EXECUTE     = 3;

   case(state)
     FETCH_INSTR: begin
       state <= WAIT_INSTR;
     end
     WAIT_INSTR: begin
       instr <= mem_rdata;
       state <= FETCH_REGS;
     end
     FETCH_REGS: begin
       rs1 <= RegisterBank[rs1Id];
       rs2 <= RegisterBank[rs2Id];
       state <= EXECUTE;
     end
     EXECUTE: begin
        if(!isSYSTEM) begin
       PC <= nextPC;
    end
    state <= FETCH_INSTR;
      end
   endcase
참고 이를 단순화하여 다시 세 개의 상태로 되돌리는 방법은 나중에 살펴보겠습니다.
이제 mem_addr와 mem_rstrb는 다음과 같이
배선할 수 있습니다:
   assign mem_addr = PC;
   assign mem_rstrb = (state == FETCH_INSTR);
마지막으로, 모든 것을 SOC 안에 설치하고 연결합니다
module SOC (
    input  CLK,        // system clock
    input  RESET,      // reset button
    output [4:0] LEDS, // system LEDs
    input  RXD,        // UART receive
    output TXD         // UART transmit
);
   wire    clk;
   wire    resetn;
   Memory RAM(
      .clk(clk),
      .mem_addr(mem_addr),
      .mem_rdata(mem_rdata),
      .mem_rstrb(mem_rstrb)
   );

   wire [31:0] mem_addr;
   wire [31:0] mem_rdata;
   wire mem_rstrb;
   wire [31:0] x1;
   Processor CPU(
      .clk(clk),
      .resetn(resetn),
      .mem_addr(mem_addr),
      .mem_rdata(mem_rdata),
      .mem_rstrb(mem_rstrb),
      .x1(x1)
   );
   assign LEDS = x1[4:0];

   // Gearbox and reset circuitry.
   Clockworks #(
     .SLOW(19) // Divide clock frequency by 2^19
   ) CW (
     .CLK(CLK),
     .RESET(RESET),
     .clk(clk),
     .resetn(resetn)
   );

   assign TXD  = 1'b0; // not used for now
endmodule
이제 step11.v를 시뮬레이터에서 실행할 수 있습니다. 예상대로 이전 단계와 같은 동작을 합니다(LED로 0부터 31까지 센 뒤 멈춥니다). 장치에서 실행하면 어떨까요? 이런, 더 나빠졌습니다. LUT가 1341개입니다(IceStick에는 1280개밖에 없습니다). 그러니 코드를 줄여서 들어가게 만들어 봅시다!
12단계: 크기 최적화: 놀랍도록 줄어드는 코어.
고전 영화 "놀랍도록 줄어드는 사나이(the Incredible Shrinking Man)"에 대한 헌사
이 코어를 줄이기 위해 할 수 있는 일은 많습니다. 먼저 ALU부터 살펴봅시다. ALU는 덧셈, 뺄셈, 비교를 계산할 수 있습니다. 뺄셈 결과를 비교에 재사용할 수는 없겠습니까? 물론 가능합니다. 다만 그러려면 33비트 뺄셈을 계산하고 부호 비트를 검사해야 합니다. Matthias Koch(@Mecrisp)가 이 기법을 설명해 주었는데, 이 기법은 swapforth/J1(IceStick에서 동작하는 또 다른 소형 RISC 코어)에서도 사용됩니다. 33비트 뺄셈은 다음과 같이 작성합니다:
wire [32:0] aluMinus = {1'b0,aluIn1} - {1'b0,aluIn2};Verilog에서 A-B가 무엇을 하는지 궁금하다면, 이는
A+~B+1(더하기 전에 B의 모든 비트를 반전하고 1을 더함)에
해당하며, 이것이 2의 보수 뺄셈이 동작하는 방식입니다. 예를 들어
4'b0000 - 4'b0001을 보면, 결과는 -1이며
4'b1111로 인코딩됩니다. 이는 공식에 따라 다음과 같이
계산됩니다: 4'b0000 + ~4'b0001 + 1 =
4'b0000 + 4'b1110 + 1 = 4'b1111. 따라서 다음
식을 사용하겠습니다(위의 더 단순한 형태를 유지할 수도 있었지만, 내부에서
무슨 일이 일어나는지 알아 두는 것은 흥미롭습니다):
wire [32:0] aluMinus = {1'b1, ~aluIn2} + {1'b0,aluIn1} + 33'b1;그런 다음 세 가지 검사를 위한 wire를 만들 수 있습니다(이렇게 하면 32비트 가산기 세 개를 절약합니다):
   wire        EQ  = (aluMinus[31:0] == 0);
   wire        LTU = aluMinus[32];
wire LT = (aluIn1[31] ^ aluIn2[31]) ? aluIn1[31] : aluMinus[32];- 첫 번째인
EQ는aluIn1과aluIn2의 값이 같을 때, 즉aluMinus == 0일 때 high가 됩니다(33번째 비트는 검사할 필요가 없습니다). - 두 번째인
LTU는 부호 없는 비교에 해당합니다. 이 값은 33비트 뺄셈의 부호 비트로 주어집니다. - 세 번째는 두 가지 경우로 나뉩니다. 부호가 다르면
aluIn1이 음수일 때LT가 high가 되고, 그렇지 않으면 33비트 뺄셈의 부호 비트로 주어집니다.
물론 덧셈을 위한 가산기는 여전히 하나 필요합니다:
wire [31:0] aluPlus = aluIn1 + aluIn2;그런 다음 aluOut은 다음과 같이 계산됩니다:
   reg [31:0]  aluOut;
   always @(*) begin
      case(funct3)
    3'b000: aluOut = (funct7[5] & instr[5]) ? aluMinus[31:0] : aluPlus;
    3'b001: aluOut = aluIn1 << shamt;;
    3'b010: aluOut = {31'b0, LT};
    3'b011: aluOut = {31'b0, LTU};
    3'b100: aluOut = (aluIn1 ^ aluIn2);
    3'b101: aluOut = funct7[5]? ($signed(aluIn1) >>> shamt) :
             ($signed(aluIn1) >> shamt);
    3'b110: aluOut = (aluIn1 | aluIn2);
    3'b111: aluOut = (aluIn1 & aluIn2);
      endcase
   end
IceStick에서 시험해 봅시다. 됐습니다! 1167 LUT로, 들어갑니다! 하지만
그렇다고 여기서 멈출 이유는 없습니다. 공간을 줄일 기회가 아직 여럿 남아
있습니다. takeBranch를 살펴봅시다. 방금 만든
EQ,LT,LTU 신호를 재사용할 수는
없겠습니까? 물론 가능합니다:
   reg takeBranch;
   always @(*) begin
      case(funct3)
    3'b000: takeBranch = EQ;
    3'b001: takeBranch = !EQ;
    3'b100: takeBranch = LT;
    3'b101: takeBranch = !LT;
    3'b110: takeBranch = LTU;
    3'b111: takeBranch = !LTU;
    default: takeBranch = 1'b0;
      endcase
   end
이것이 동작하려면 분기 명령에서도 rs2가 ALU의 두 번째
입력으로 전달되도록 해야 합니다:
wire [31:0] aluIn2 = isALUreg | isBranch ? rs2 : Iimm;장치에서는 어떤 결과가 나올까요? LUT 1094개로 나쁘지 않지만, 계속
진행해 봅시다... JALR의 점프 대상은
rs1+Iimm인데, 이를 위해 별도의 가산기를 만들었습니다. ALU가
이미 이 값을 계산하므로 어리석은 일입니다. 그러면 이것을
재사용합시다:
   wire [31:0] nextPC = ((isBranch && takeBranch) || isJAL) ? PCplusImm  :
                    isJALR                              ? {aluPlus[31:1],1'b0}:
                    PCplus4;
지금은 어떻습니까? 1030 LUT입니다. 아직 끝나지 않았습니다. LUT를 가장 많이 잡아먹는 것은 시프터인데, ALU에는 시프터가 세 개(왼쪽 시프트용, 논리 오른쪽 시프트용, 산술 오른쪽 시프트용 각각 하나씩) 있습니다. Matthias Koch(@mecrisp)가 알려 준 또 하나의 마법 같은 기법을 쓰면, 두 오른쪽 시프트를 하나로 합칠 수 있습니다. 33비트 시프터를 만들고, 추가된 비트를 입력의 bit31과 논리 시프트인지 산술 시프트인지에 따라 0 또는 1로 설정하면 됩니다.
   wire [31:0] shifter =
               $signed({instr[30] & aluIn1[31], shifter_in}) >>> aluIn2[4:0];
더 나아가, Matthias는 왼쪽 시프트일 때 입력을 뒤집고 출력도 뒤집으면 실제로 시프터 하나만으로 충분하다고 알려 주었습니다:
   wire [31:0] shifter_in = (funct3 == 3'b001) ? flip32(aluIn1) : aluIn1;
   wire [31:0] leftshift = flip32(shifter);
그러면 ALU는 다음과 같은 모습이 됩니다:
   reg [31:0]  aluOut;
   always @(*) begin
      case(funct3)
    3'b000: aluOut = (funct7[5] & instr[5]) ? aluMinus[31:0] : aluPlus;
    3'b001: aluOut = leftshift;
    3'b010: aluOut = {31'b0, LT};
    3'b011: aluOut = {31'b0, LTU};
    3'b100: aluOut = (aluIn1 ^ aluIn2);
    3'b101: aluOut = shifter;
    3'b110: aluOut = (aluIn1 | aluIn2);
    3'b111: aluOut = (aluIn1 & aluIn2);
      endcase
   end
지금 우리는 어디쯤 와 있습니까? 887 LUT입니다, 친구여!
참고 1 사실 시프터가 클록마다 1비트씩만 시프트하도록 하면 공간을 더 절약할 수 있습니다. 그러면 ALU는 비트를 하나씩 처리하므로 조금 더 복잡해지지만(멀티 사이클), 훨씬 더 작아집니다(Femtorv32-quark가 이 기법을 사용합니다). 이는 나중에 살펴보겠습니다.
참고 2 멀티 사이클 ALU를 사용하면 33비트 가산기 하나만 두고
~aluIn2, aluIn1+(~aluIn2),
aluIn1+(~aluIn2)+1의 계산을 나누어 세 사이클에 걸쳐 뺄셈을
계산할 수도 있습니다.
그 전에 손쉽게 얻을 수 있는 또 하나의 이득은 다음과 같이 주소 계산에 사용되는 가산기를 공유하도록 묶는 것입니다:
   wire [31:0] PCplusImm = PC + ( instr[3] ? Jimm[31:0] :
                  instr[4] ? Uimm[31:0] :
                             Bimm[31:0] );
   wire [31:0] PCplus4 = PC+4;
그러면 이 두 가산기를 nextPC와
writeBackData 모두에서 사용할 수 있습니다:
   assign writeBackData = (isJAL || isJALR) ? (PCplus4) :
              (isLUI) ? Uimm :
              (isAUIPC) ? PCplusImm :
              aluOut;

   assign writeBackEn = (state == EXECUTE && !isBranch);

   wire [31:0] nextPC = (isBranch && takeBranch || isJAL) ? PC+Imm  :
                    isJALR                   ? {aluPlus[31:1],1'b0} :
                    PCplus;
결과는 어떻습니까? 839 LUT입니다(LUT를 50개 정도 더 절약했습니다...). 시프트에 다중 사이클 ALU를 사용하고 주소 계산에 더 적은 수의 비트를 사용하면 LUT를 더 절약할 여지가 아직 있습니다. 하지만 이제 다음 단계를 진행하기에 충분한 공간이 장치에 확보되었으므로 이는 나중으로 미루겠습니다.
13단계: 서브루틴(버전 1, 일반 RISC-V 명령어 사용)
자, 이제 (미완성인) RISC-V 프로세서와 SoC가 생겼고, 둘 다 장치에 들어갑니다. 기억하십시오. 이제 끝이 다가오고 있으며, 남은 명령어는 8개뿐입니다(Load 변형 5개, Store 변형 3개).
| ALUreg | ALUimm | 점프 | Branch | LUI | AUIPC | Load | Store | SYSTEM |
|---|---|---|---|---|---|---|---|---|
| [*] 10 | [*] 9 | [*] 2 | [ *] 6 | [*] | [*] | [ ] 5 | [ ] 3 | [*] 1 |
그 명령어들을 다루기 전에 RISC-V 어셈블리와 함수 호출에 대해 한
비트(조금) 더 알아봅시다. 지금까지는 CPU가 프로그램을 실행하는 모습을
관찰할 수 있도록 기어박스를 사용해 CPU의 속도를 늦췄습니다. 그 대신
wait 함수를 구현하고 그것을 호출할 수는 없겠습니까? 그
방법을 알아봅시다.
가장 먼저 할 일은 Clockworks 인스턴스화에서
#(.SLOW(nnn)) 파라미터를 제거하는 것입니다:
   Clockworks CW(
     .CLK(CLK),
     .RESET(RESET),
     .clk(clk),
     .resetn(resetn)
   );
이렇게 하면 더 이상 기어박스가 생성되지 않으며, 보드의
CLK 신호가 우리 설계에서 사용하는 내부 clk
신호에 직접 연결됩니다.
자, 이제 두 가지를 살펴보아야 합니다:
- 일정 시간 동안 대기하는 함수를 작성하는 방법
- 그 함수를 호출하는 방법
잠깐만 기다리십시오. 함수 호출을 이야기하고 있지만
우리에게는 Load / Store 명령어가 없습니다.
메모리를 읽거나 쓸 수 없고 스택은 메모리에 있으므로 반환 주소를 스택에
push할 수 없을 텐데(!), 그렇다면 어떻게 가능하겠습니까?
RISC-V 명령어를 사용해 함수 호출을 구현하는 방법은 여러 가지가 있을 수 있습니다. 모두가 같은 규약을 사용하도록 하기 위해, 함수를 호출하는 방법, 파라미터를 전달하는 방법, 각 레지스터의 역할을 정의하는 애플리케이션 바이너리 인터페이스(application binary interface)가 있습니다. 자세한 내용은 이 문서를 참고하십시오.
함수 호출하기 이 문서에 따르면, 함수를 호출할 때
반환 주소는 x1에 저장됩니다. 따라서
JAL(x1,offset)을 사용해 함수를 호출할 수 있으며, 여기서
offset은 프로그램 카운터와 호출할 함수의 주소 사이의 (부호
있는) 차이입니다. 이 방법은 오프셋이 20비트(Jimm 형식) 안에 들어가는
경우에만 동작합니다. 참고: 더 멀리 떨어진 함수의 경우
AUIPC와 JALR을 조합하여 임의의 오프셋에 도달할
수 있습니다.
함수에서 반환하기는 x1에 저장된 주소로
점프하는 방식으로 이루어지며, 이는 JALR(x0,x1,0)으로 할 수
있습니다.
함수 인자와 반환값: 처음 6개의 함수 인자는
x10..x16을 통해 전달되며, 반환값은
x10을 통해 전달됩니다(첫 번째 함수 인자를 덮어씁니다).
흥미롭게도 Load/Store가 없어도 함수가 있는
프로그램을 작성할 수 있습니다. 하지만 다른 함수를 호출하는 함수는 작성할
수 없는데, 그러려면 x1을 스택에 저장해야 하기
때문입니다(사실 x1을 다른 레지스터에 저장하는 방식으로
그렇게 하는 것을 막는 것은 없지만, 그러면 금방 엉망이 되므로 그렇게
하지는 않겠습니다).
사소한 것 하나: 방금 ABI에서 x1이 함수의 반환 주소를
저장하는 데 사용된다는 것을 배웠습니다. 지금까지는 이 레지스터를 LED에
연결해 두었습니다. 이제부터는 ABI를 따를 것이므로 대신 다른 레지스터를
골라야 합니다. 이제부터는 x10을 LED에 연결하겠습니다.
자, 이제 블링키의 또 다른 버전을 작성하는 데 필요한 것이 모두
갖추어졌습니다! slow_bit 상수를 정하고,
2^slow_bit까지 세는 wait 함수를 만든 다음,
이를 호출하여 블링키의 속도를 늦춥시다:
`ifdef BENCH
   localparam slow_bit=15;
`else
   localparam slow_bit=19;
`endif


`include "riscv_assembly.v"
   integer L0_   = 4;
   integer wait_ = 20;
   integer L1_   = 28;

   initial begin
      ADD(x10,x0,x0);
   Label(L0_);
      ADDI(x10,x10,1);
      JAL(x1,LabelRef(wait_)); // call(wait_)
      JAL(zero,LabelRef(L0_)); // jump(l0_)

      EBREAK(); // I keep it systematically
                // here in case I change the program.

   Label(wait_);
      ADDI(x11,x0,1);
      SLLI(x11,x11,slow_bit);
   Label(L1_);
      ADDI(x11,x11,-1);
      BNE(x11,x0,LabelRef(L1_));
      JALR(x0,x1,0);

      endASM();
   end

   always @(posedge clk) begin
      if(mem_rstrb) begin
         mem_rdata <= MEM[mem_addr[31:2]];
      end
   end
endmodulestep13.v를 시뮬레이션과 실제 장치에서 실행해 보십시오.
직접 해 보십시오 왼쪽에서 오른쪽으로 이동하는 루틴,
오른쪽에서 왼쪽으로 이동하는 루틴, 그리고 wait 루틴으로 구성된 전격 Z
작전(Knight Rider) 스타일 블링키를 만들어 보십시오. 힌트
x1을 다른 레지스터에 저장해야 합니다.
14단계: 서브루틴(버전 2, RISC-V ABI와 의사 명령어 사용)
ABI 덕분에 프로그램을 작성하는 표준적인 방법이 생겼지만, 기억해야 할 것이 많습니다:
- 모든 RISC-V 레지스터는 동일하지만, ABI에서는 특정 작업에 특정
레지스터를 사용해야 합니다(반환 주소에는
x1, 함수 파라미터에는x10..x16등); - 함수 호출은
JAL또는AUIPC와JALR을 사용해 구현하며, 함수에서의 반환은JALR을 사용해 구현합니다.
CISC 프로세서에는 함수 호출(CALL)과 함수
반환(RET)을 위한 특수 기능이 있는 경우가 많고, 레지스터도
특정 용도로 나뉘어 있는 경우가 많습니다(함수 반환 주소, 스택 포인터,
함수 매개변수). 이렇게 하면 기억해야 할 것이 적어지므로 프로그래머의
수고가 줄어듭니다. RISC 프로세서에서도 똑같이 하지 못할 이유가 없습니다!
레지스터들이 서로 다른 것처럼 간주하고 각각에 다른 이름(또는 별칭)을
붙여 봅시다. 이 이름들은 여기에
정리되어 있습니다.
| ABI 이름 | 이름 | 용도 |
|---|---|---|
zero |
x0 |
읽기:0 쓰기:무시됨 |
ra |
x1 |
반환 주소 |
t0...t6 |
... | 임시 레지스터 |
fp,s0...s11 |
... | 저장 레지스터, fp=so: 프레임 포인터 |
a0...a7 |
... | 함수 매개변수 및 반환값(a0) |
sp |
x2 |
스택 포인터 |
gp |
x3 |
전역 포인터 |
저장 레지스터(s0, ... s11)는 함수가
건드리지 않고 그대로 두거나, 저장했다가 복원해야 합니다. 지역 변수를
여기에 둘 수 있습니다. 함수를 작성할 때는 사용하는 저장 레지스터를
스택에 푸시했다가 반환하기 전에 팝해야 합니다.
그 밖의 모든 레지스터는 함수 호출을 거치면서 값이 보존되리라고 기대할 수 없습니다.
전역 포인터 gp는 멀리 떨어진 메모리 영역에 명령어 1개로
접근하는 "지름길"로 사용할 수 있습니다. 이는 나중에(Load와
Store를 갖추고 나면) 살펴보겠습니다.
우리의 VERILOG 어셈블러 riscv_assembly.v에서는 레지스터 이름에 대한 다음 별칭만 선언하면 됩니다.
   localparam zero = x0;
   localparam ra   = x1;
   localparam sp   = x2;
   localparam gp   = x3;
   ...
   localparam t4   = x29;
   localparam t5   = x30;
   localparam t6   = x31;
이러한 이름 외에도, 자주 하는 작업을 위한 의사
명령어(pseudo-instruction)도 있습니다. 예를 들면 다음과 같습니다. |
의사 명령어 | 동작 |
|-----------------------|--------------------------------------| |
LI(rd,imm) | 32비트 수를 레지스터에 적재합니다 | |
CALL(offset) | 함수를 호출합니다 | | RET() |
함수에서 반환합니다 | | MV(rd,rs) |
ADD(rd,rs,zero)와 동일합니다 | | NOP() |
ADD(zero,zero,zero)와 동일합니다 | | J(offset)
| JAL(zero,offset)와 동일합니다 | |
BEQZ(rd1,offset) | BEQ(rd1,x0,offset)와
동일합니다 | | BNEZ(rd1,offset) |
BNE(rd1,x0,offset)와 동일합니다 | |
BGT(rd1,rd2,offset) | BLT(rd2,rd1,offset)와
동일합니다 |
상수가 [-2048,2047] 범위에 있으면 LI는
ADDI(rd,x0,imm)로 구현되고, 그렇지 않으면
LUI와 ADDI의 조합을 사용합니다(동작 원리가
궁금하다면 이 stackoverflow
답변을 참고하십시오. 부호 확장과 관련해 까다로운 세부 사항이
있습니다).
ABI 레지스터 이름과 의사 명령어를 사용하면 프로그램은 다음과 같이 바뀝니다.
   integer L0_   = 4;
   integer wait_ = 24;
   integer L1_   = 32;

   initial begin
      LI(a0,0);
   Label(L0_);
      ADDI(a0,a0,1);
      CALL(LabelRef(wait_));
      J(LabelRef(L0_));

      EBREAK();

   Label(wait_);
      LI(a1,1);
      SLLI(a1,a1,slow_bit);
   Label(L1_);
      ADDI(a1,a1,-1);
      BNEZ(a1,LabelRef(L1_));
      RET();

      endASM();
   end
큰 차이는 없지만, 더 긴 프로그램에서는 프로그래머의 의도(이것은 함수이고, 저것은 레이블로의 점프라는 등)를 드러내 주므로 가독성이 향상됩니다. 이것이 없으면 모든 것이 똑같아 보이기 때문에 프로그램을 읽기가 더 어렵습니다.
꽤 재미있는 점이 있습니다. RISC-V 표준의 명령어 집합은 매우
단순하지만 이것으로 프로그래밍하기는 그리 쉽지 않습니다. 그래서 ABI는
명령어 집합이 CISC 프로세서처럼 더 복잡한 것처럼 꾸미고, 덕분에
프로그래머는 일하기가 더 편해집니다. 또한 ABI는 한 프로그래머가 작성한
함수를 다른 프로그래머가 작성한 함수에서 호출할 수 있도록 보장합니다. 두
함수가 서로 다른 언어로 작성되었더라도 마찬가지입니다. GNU 어셈블러와 C
컴파일러로 우리 CPU용 프로그램을 컴파일하는 방법은 나중에
살펴보겠습니다. 하지만 소프트웨어와 툴체인을 다루기 전에 기억하십시오.
하드웨어로 구현해야 할 명령어가 아직 8개(Load 변형 5개와
Store 변형 3개) 남아 있습니다.
직접 해 보기 두 수를 곱하는 루틴을 고안하십시오(또는 다른 곳에서 가져와도 됩니다). 그런 다음 시뮬레이션과 실제 장치에서 다양한 입력으로 테스트해 보십시오.
15단계: 로드
이제 로드 명령어를 구현하는 방법을 살펴봅시다. 명령어는 다음 5가지입니다.
| 명령어 | 효과 |
|---|---|
| LW(rd,rs1,imm) | 주소 (rs1+imm)의 워드를 rd에 로드 |
| LBU(rd,rs1,imm) | 주소 (rs1+imm)의 바이트를 rd에 로드 |
| LHU(rd,rs1,imm) | 주소 (rs1+imm)의 하프워드를 rd에 로드 |
| LB(rd,rs1,imm) | 주소 (rs1+imm)의 바이트를 rd에 로드한 뒤 부호 확장 |
| LH(rd,rs1,imm) | 주소 (rs1+imm)의 하프워드를 rd에 로드한 뒤 부호 확장 |
참고: LW의 주소는 워드 경계(4바이트의 배수)에
정렬되고, LH,LHU의 주소는 하프워드
경계(2바이트의 배수)에 정렬됩니다. 이는 좋은 점입니다. 덕분에 우리 일이
훨씬 쉬워집니다...
그래도 아직 할 일이 남아 있습니다! 먼저 로드되는 값(이 값을
LOAD_data라고 부르겠습니다)을 결정하는 회로가
필요합니다.
보시다시피 워드, 하프워드, 바이트를 로드하는 명령어가 있으며, 그중 하프워드와 바이트를 로드하는 명령어는 두 가지 버전으로 나뉩니다.
- 바이트나 하프워드를
rd의 LSB 쪽에 로드하는LBU,LHU - 바이트나 하프워드를
rd의 LSB 쪽에 로드한 뒤 부호 확장을 하는LB,LH:
예를 들어 값이 -1, 즉 8'b11111111인 부호
있는 바이트가 있다고 합시다. 이를 LBU로 32비트 레지스터에
로드하면 32'b0000000000000000000000011111111이 되지만,
LB로 로드하면
32'b11111111111111111111111111111111, 즉 -1의
32비트 표현이 됩니다.
따라서 경우의 수가 "2차원" 배열을 이룹니다(바이트, 하프워드, 워드 중
무엇을 로드하는지, 그리고 부호 확장을 하는지 여부). 사실 실제로는 이보다
더 복잡합니다. 우리 메모리는 워드 단위로 구성되어 있다는 점을
기억하십시오. 따라서 바이트를 로드할 때는 (4개 중) 어느 바이트인지
알아야 하고, 하프워드를 로드할 때는 (2개 중) 어느 하프워드인지 알아야
합니다. 이는 로드할 데이터의 주소(rs1 + Iimm)의 하위
2비트(LSB)를 살펴보면 알 수 있습니다.
   wire [31:0] loadstore_addr = rs1 + Iimm;
   wire [15:0] LOAD_halfword =
           loadstore_addr[1] ? mem_rdata[31:16] : mem_rdata[15:0];

   wire  [7:0] LOAD_byte =
           loadstore_addr[0] ? LOAD_halfword[15:8] : LOAD_halfword[7:0];
자, 이제 mem_rdata(LW),
LOAD_halfword(LH,LHU),
LOAD_byte(LB,LBU) 중에서 하나를
선택해야 합니다. RISC-V
참조 매뉴얼 130쪽의 표를 보면, 이는 funct3의 하위 두
비트(LSB)로 결정됩니다:
   wire mem_byteAccess     = funct3[1:0] == 2'b00;
   wire mem_halfwordAccess = funct3[1:0] == 2'b01;

   wire [31:0] LOAD_data =
         mem_byteAccess ? LOAD_byte     :
     mem_halfwordAccess ? LOAD_halfword :
                          mem_rdata     ;
이제 이 식에 부호 확장을 넣어야 합니다. rd의 상위
비트(MSB)에 기록할 값인 LOAD_sign은 두 가지에 따라
달라집니다. 하나는 명령어가 부호 확장을
하는지(LB,LH) 여부이며, 이는
funct3[2]=0으로 구분됩니다. 다른 하나는 읽어 온 값의
MSB입니다:
   wire LOAD_sign =
    !funct3[2] & (mem_byteAccess ? LOAD_byte[7] : LOAD_halfword[15]);

   wire [31:0] LOAD_data =
         mem_byteAccess ? {{24{LOAD_sign}},     LOAD_byte} :
     mem_halfwordAccess ? {{16{LOAD_sign}}, LOAD_halfword} :
                          mem_rdata ;
휴우우우, 한 비트(약간) 고통스러웠지만, 결국 그렇게 복잡하지는 않습니다. 제 처음 설계는 훨씬 더 복잡했지만, Matthias Koch(@mecrisp)가 이를 크게 단순화해 주어서 위와 같은 (꽤 이해하기 쉬운) 설계가 되었습니다.
하지만 아직 완전히 끝난 것은 아니며, 이제 상태 기계를 수정해야
합니다. 상태 머신에는 LOAD와 WAIT_DATA라는 두
개의 상태가 추가됩니다:
   localparam FETCH_INSTR = 0;
   localparam WAIT_INSTR  = 1;
   localparam FETCH_REGS  = 2;
   localparam EXECUTE     = 3;
   localparam LOAD        = 4;
   localparam WAIT_DATA   = 5;
   reg [2:0] state = FETCH_INSTR;
참고 1 더 적은 수의 상태로도 구현할 수 있지만, 지금의 목표는
동작하면서도 최대한 이해하기 쉬운 것을 만드는 것입니다. 상태 기계를
단순화하는 방법은 나중에 살펴보겠습니다. 참고 2
state에 필요한 비트 수가 있는지 확인하는 것을 잊지
마십시오! (이전처럼 reg [1:0] state가 아니라
reg [2:0] state입니다!!) 그런 다음 새 상태들을 다음과 같이
연결합니다:
     ...
       EXECUTE: begin
          if(!isSYSTEM) begin
         PC <= nextPC;
          end
          state <= isLoad ? LOAD : FETCH_INSTR;
       end
       LOAD: begin
          state <= WAIT_DATA;
       end
       WAIT_DATA: begin
          state <= FETCH_INSTR;
       end

     ...
마지막으로 mem_addr 신호(읽을 주소를 담음)와
mem_rstrb 신호(프로세서가 데이터를 읽으려 할 때마다 high가
됨)를 다음과 같이 구동합니다:
   assign mem_addr = (state == WAIT_INSTR || state == FETCH_INSTR) ?
             PC : loadstore_addr ;
   assign mem_rstrb = (state == FETCH_INSTR || state == LOAD);
이제 다음 프로그램으로 새 명령어들을 테스트해 봅시다:
   integer L0_   = 8;
   integer wait_ = 32;
   integer L1_   = 40;

   initial begin
      LI(s0,0);
      LI(s1,16);
   Label(L0_);
      LB(a0,s0,400); // LEDs are plugged on a0 (=x10)
      CALL(LabelRef(wait_));
      ADDI(s0,s0,1);
      BNE(s0,s1, LabelRef(L0_));
      EBREAK();

   Label(wait_);
      LI(t0,1);
      SLLI(t0,t0,slow_bit);
   Label(L1_);
      ADDI(t0,t0,-1);
      BNEZ(t0,LabelRef(L1_));
      RET();

      endASM();

      // Note: index 100 (word address)
      //     corresponds to
      // address 400 (byte address)
      MEM[100] = {8'h4, 8'h3, 8'h2, 8'h1};
      MEM[101] = {8'h8, 8'h7, 8'h6, 8'h5};
      MEM[102] = {8'hc, 8'hb, 8'ha, 8'h9};
      MEM[103] = {8'hff, 8'hf, 8'he, 8'hd};
   end
이 프로그램은 주소 400에 있는 네 개의 워드에 몇 가지 값을 초기화하고,
루프를 돌며 이 값들을 a10에 로드합니다. 이전과 마찬가지로
무언가를 눈으로 확인할 수 있도록 지연 루프(wait 함수)도
들어 있습니다.
직접 해 보십시오 이 프로그램을 시뮬레이션과 실제 장치에서 실행해 보십시오. 다른 명령어들도 테스트해 보십시오. 3단계에서처럼 프로그래밍 가능한 반짝이 장식을 만들어 보십시오.
현재 위치입니다! 이제 명령어 세 개만 더 하면 끝납니다!
| ALUreg | ALUimm | 점프 | Branch | LUI | AUIPC | Load | Store | SYSTEM |
|---|---|---|---|---|---|---|---|---|
| [*] 10 | [*] 9 | [*] 2 | [*] 6 | [*] | [*] | [*] 5 | [ ] 3 | [*] 1 |
16단계: Store
끝이 가까워지고 있지만, 다음 세 가지 명령어를 구현하려면 아직 할 일이 남아 있습니다.
| 명령어 | 효과 |
|---|---|
| SW(rs2,rs1,imm) | rs2를 주소 rs1+imm에 저장 |
| SB(rs2,rs1,imm) | rs2의 하위 8비트(LSB)를 주소 rs1+imm에 저장 |
| SH(rs2,rs1,imm) | rs2의 하위 16비트(LSB)를 주소 rs1+imm에 저장 |
이를 위해서는 세 가지 작업을 해야 합니다.
- 프로세서가 메모리에 쓸 수 있도록 프로세서와 메모리 사이의 인터페이스를 수정합니다
- 메모리는 워드 단위로 주소가 지정됩니다. 각 쓰기 연산은 워드 하나를
수정합니다. 하지만
SB와SH는 개별 바이트를 쓸 수 있어야 합니다. 쓸 워드 외에도, 이 워드의 어느 바이트를 메모리에서 실제로 수정해야 하는지(4비트 마스크) 계산해야 합니다 - 상태 기계를 수정해야 합니다.
Memory 모듈은 다음과 같이 수정됩니다.
module Memory (
   input             clk,
   input      [31:0] mem_addr,
   output reg [31:0] mem_rdata,
   input         mem_rstrb,
   input      [31:0] mem_wdata,
   input      [3:0]  mem_wmask
);

   reg [31:0] MEM [0:255];

   initial begin
      ...
   end

   wire [29:0] word_addr = mem_addr[31:2];
   always @(posedge clk) begin
      if(mem_rstrb) begin
         mem_rdata <= MEM[word_addr];
      end
      if(mem_wmask[0]) MEM[word_addr][ 7:0 ] <= mem_wdata[ 7:0 ];
      if(mem_wmask[1]) MEM[word_addr][15:8 ] <= mem_wdata[15:8 ];
      if(mem_wmask[2]) MEM[word_addr][23:16] <= mem_wdata[23:16];
      if(mem_wmask[3]) MEM[word_addr][31:24] <= mem_wdata[31:24];
   end
새로운 입력 신호가 두 개 있습니다. 하나는 쓸 값을 담은 32비트 신호인
mem_wdata이고, 다른 하나는 어느 바이트를 써야 하는지
나타내는 4비트 신호인 mem_wmask입니다.
참고 이것이 실제로 어떻게 구현되는지, 특히 메모리에 대한
마스크 쓰기가 장치에서 어떻게 합성되는지 궁금할 수 있습니다. 대부분의
FPGA에서 BRAM은 벤더의 특수 프리미티브를 통해 마스크 쓰기를 직접
지원합니다. Yosys에는 "테크놀로지 매핑(technology mapping)"이라는 (매우
똑똑한) 특수 단계가 있어서, 소스 Verilog 파일에서 특정 패턴을 감지하고
그 용도에 가장 적합한 벤더의 프리미티브를 인스턴스화합니다. 사실
테크놀로지 매핑은 앞서 이 튜토리얼에서 레지스터 뱅크를 표현할 때 이미
사용되었습니다. 매 사이클마다 두 개의 레지스터 rs1과
rs2를 읽습니다. IceStick의 BRAM은 클록마다 값 하나만 읽을
수 있으므로, 이를 가능하게 하기 위해 yosys가 레지스터 뱅크를 자동으로
복제합니다. rd에 값이 쓰일 때마다 그 값은 두 레지스터 뱅크
모두에
쓰이며(bank1[rdId] <- writeBackValue; bank2[rdId] <- writeBackValue;),
서로 다른 두 레지스터를 같은 사이클에 각자의 레지스터 뱅크에서 읽을 수
있습니다(rs1 <- bank1[rs1Id]; rs2 <- bank2[rs2Id;).
Yosys의 마법 덕분에 이 부분은 신경 쓸 필요가 없으며, Yosys가 가장 적합한
매핑을 자동으로 선택해 줍니다(복제된 레지스터 뱅크, 대상이 지원한다면
읽기 포트가 두 개인 단일 레지스터 뱅크, LUT가 많은 대형 FPGA라면 주소
디코더가 달린 플립플롭 배열까지). 우리의 경우 IceStick에는 Ice40HX1K가
탑재되어 있으며, 이 칩은 1 kB 블록 8개로 구성된 8 kB의 BRAM을 갖추고
있습니다. 그중 두 블록은 (복제된) 레지스터 뱅크에 사용되고, 남은 6 kB의
BRAM은 시스템 RAM을 합성하는 데 사용합니다.
이에 맞춰 Processor 모듈을 다음과 같이 수정합니다:
module Processor (
    input         clk,
    input         resetn,
    output [31:0]     mem_addr,
    input [31:0]      mem_rdata,
    output        mem_rstrb,
    output [31:0]     mem_wdata,
    output [3:0]      mem_wmask,
    output reg [31:0] x10 = 0
);
(그리고 모든 것은 SOC에서 연결됩니다.)
이제 쓸 워드와 마스크를 계산하는 방법을 살펴봅시다. 값을 써야 할
주소는 여전히 rs1 + imm이지만, 즉시값의 형식은
Load(Iimm)와
Store(Simm)가 서로 다릅니다:
wire [31:0] loadstore_addr = rs1 + (isStore ? Simm : Iimm);이제 쓸 데이터는 바이트, 하프워드, 워드 중 무엇을 쓰는지에 따라 달라지며, 바이트와 하프워드의 경우에는 주소의 하위 2비트(LSB)에 따라서도 달라집니다. 흥미롭게도 바이트, 하프워드, 워드 중 무엇을 쓰는지 검사할 필요는 없습니다. 쓰기 마스크(뒤에서 설명합니다)가 바이트 및 하프워드 쓰기에서 상위 비트(MSB)를 무시하기 때문입니다:
   assign mem_wdata[ 7: 0] = rs2[7:0];
   assign mem_wdata[15: 8] = loadstore_addr[0] ? rs2[7:0]  : rs2[15: 8];
   assign mem_wdata[23:16] = loadstore_addr[1] ? rs2[7:0]  : rs2[23:16];
   assign mem_wdata[31:24] = loadstore_addr[0] ? rs2[7:0]  :
                 loadstore_addr[1] ? rs2[15:8] : rs2[31:24];
마지막으로, mem_wdata의 어느 바이트를 실제로 메모리에
쓸지를 나타내는 4비트 쓰기 마스크가 있습니다. 이는 다음과 같이
결정됩니다:
| 쓰기 마스크 | 명령어 |
|---|---|
4'b1111 |
SW |
4'b0011 또는 4'b1100 |
SH, loadstore_addr[1]에 따라 결정 |
4'b0001, 4'b0010, 4'b0100
또는 4'b1000 |
SB, loadstore_addr[1:0]에 따라 결정 |
이 식을 유도하는 과정은 한 비트(약간) 고통스럽습니다. Matthias Koch와 함께 최종적으로 다음 식을 얻었습니다:
   wire [3:0] STORE_wmask =
          mem_byteAccess      ?
                (loadstore_addr[1] ?
                  (loadstore_addr[0] ? 4'b1000 : 4'b0100) :
                  (loadstore_addr[0] ? 4'b0010 : 4'b0001)
                    ) :
          mem_halfwordAccess ?
                (loadstore_addr[1] ? 4'b1100 : 4'b0011) :
              4'b1111;
이제 상태 기계에 추가 상태를 만들어 봅시다:
   localparam FETCH_INSTR = 0;
   localparam WAIT_INSTR  = 1;
   localparam FETCH_REGS  = 2;
   localparam EXECUTE     = 3;
   localparam LOAD        = 4;
   localparam WAIT_DATA   = 5;
   localparam STORE       = 6;

   ...

   always @(posedge clk) begin
   ...
       case(state)
           ...
       EXECUTE: begin
          if(!isSYSTEM) begin
         PC <= nextPC;
          end
          state <= isLoad  ? LOAD  :
               isStore ? STORE :
               FETCH_INSTR;
       LOAD: begin
          state <= WAIT_DATA;
       end
       WAIT_DATA: begin
          state <= FETCH_INSTR;
       end
       STORE: begin
          state <= FETCH_INSTR;
       end
     endcase
      end
   end
메모리와 연결되는 신호는 다음과 같이 구동됩니다:
   assign mem_addr = (state == WAIT_INSTR || state == FETCH_INSTR) ?
             PC : loadstore_addr ;
   assign mem_rstrb = (state == FETCH_INSTR || state == LOAD);
   assign mem_wmask = {4{(state == STORE)}} & STORE_wmask;
그리고 마지막으로 사소한 것 하나가 남았습니다. 명령어가
Store이면 레지스터 뱅크에 다시 쓰지 마십시오!
   assign writeBackEn = (state==EXECUTE && !isBranch && !isStore && !isLoad) ||
            (state==WAIT_DATA) ;
참고 EXECUTE 단계에서 rd에 쓰는
것을 막는 !isLoad 항은 조건에서 제거해도 됩니다. 바로 다음
WAIT_DATA 단계에서 rd를 덮어쓰기 때문입니다.
이 항은 시뮬레이션 결과를 더 쉽게 이해할 수 있도록 넣어 둔 것입니다.
해 보십시오 step16.v를 시뮬레이션과 장치에서 실행하십시오. 이 프로그램은 주소 400에서 주소 800으로 16바이트를 복사한 다음, 복사된 바이트들의 값을 표시합니다.
현재 위치는 여기입니다! 축하합니다! 여러분의 첫 번째 RV32I RISC-V 코어 구현을 마쳤습니다!
| ALUreg | ALUimm | 점프 | Branch | LUI | AUIPC | Load | Store | SYSTEM |
|---|---|---|---|---|---|---|---|---|
| [*] 10 | [*] 9 | [*] 2 | [*] 6 | [*] | [*] | [*] 5 | [*] 3 | [*] 1 |
그런데 잠깐 분명 RISC-V 코어를 구현하느라 많은 노력을 들였는데, 지금 보이는 것이라고는 1단계의 그 시시한 블링키처럼 생긴 것뿐입니다! 더 많은 것을 보고 싶습니다!
그렇게 하려면 장치가 5개의 LED보다 더 많은 수단으로 외부 워드(세계)와 통신할 수 있도록 해야 합니다.
17단계: 메모리 매핑된 장치 - 블링키보다 (훨씬) 더 많은 것을 해 봅시다!
이제 SOC에 장치들을 추가하려고 합니다. 이미 LED가 있으며, 이 LED들은
레지스터 a0(x10)에 연결되어 있습니다. 이처럼
레지스터에 장치를 연결하는 방식은 그다지 우아하지 않습니다. 실제 RAM은
아니지만 LED에 연결된 레지스터가 있는 특별한 메모리 주소를 두는 편이 더
좋습니다. 이 아이디어를 이용하면 각 장치에 가상 주소를 할당하여 원하는
만큼 장치를 추가할 수 있습니다. 그러면 SOC에는 데이터를 올바른 장치로
보내는 주소 디코딩 하드웨어가 들어가게 됩니다. 보시게 되겠지만,
프로세서에서 x10에서 LED로 이어지는 배선을 제거하는 것
외에는 SOC를 약간만 수정하면 됩니다.
SOC를 수정하기 전에 가장 먼저 할 일은 "메모리 맵"을 정하는 것, 즉 주소 공간의 어느 부분이 무엇에 대응하는지를 결정하는 것입니다. 우리 시스템에는 6 kB의 RAM이 있으므로, 실제로는 0부터 2^13-1까지의 주소(8 kB, 2의 거듭제곱으로 맞추도록 합시다)가 RAM에 대응한다고 할 수 있습니다. 저는 RAM에 더 넓은 주소 공간을 할당하기로 했습니다(BRAM 용량이 더 넉넉한 FPGA도 있기 때문입니다). 그래서 RAM 전용 주소 공간은 0부터 2^22-1까지(즉, 4 MB의 RAM)가 됩니다.
다음으로, 주소에서 22번 비트가 설정되어 있으면 그 주소는 장치에
대응한다고 정했습니다. 이제 여러 장치 중 하나를 선택하는 방법을 정해야
합니다. 자연스럽게 떠오르는 방법은 0번부터 21번까지의 비트를 "장치
인덱스"로 사용하는 것이지만, 그렇게 하면 22비트 폭의 비교기가 여러 개
필요하고, 우리의 IceStick에서는 남은 LUT의 상당 부분을 잡아먹게 됩니다.
(이번에도) Matthias Koch(@mecrisp)가 제안한 더 나은 방법은 1-hot
인코딩을 사용하는 것입니다. 즉, 주소에서 n번 비트가
설정되어 있으면 데이터가 n번 장치로 전달됩니다. 여기서는
"워드 주소"만 고려합니다(즉, 하위 두 비트(LSB)는 무시합니다). 이렇게
하면 SOC에 연결할 수 있는 장치가 20개로 제한되지만, 그래도 우리가 필요로
하는 것보다 훨씬 많습니다. 이 방식의 장점은 주소 디코딩이 크게
단순해져서 모든 것이 여전히 IceStick에 들어간다는 점입니다.
메모리 요청을 RAM으로 보낼지 장치로 보낼지 판단하기 위해, SOC에 다음 회로를 추가합니다:
   wire [31:0] RAM_rdata;
   wire [29:0] mem_wordaddr = mem_addr[31:2];
   wire isIO  = mem_addr[22];
   wire isRAM = !isIO;
   wire mem_wstrb = |mem_wmask;
RAM은 다음과 같이 연결합니다:
   Memory RAM(
      .clk(clk),
      .mem_addr(mem_addr),
      .mem_rdata(RAM_rdata),
      .mem_rstrb(isRAM & mem_rstrb),
      .mem_wdata(mem_wdata),
      .mem_wmask({4{isRAM}}&mem_wmask)
);(isRAM 신호가 쓰기 마스크와 AND 연산된다는 점에
주목하십시오)
이제 LED를 연결하는 로직을 추가할 수 있습니다. LED는 SOC 모듈
인터페이스에서 reg로 선언되어 있습니다:
module SOC (
    input        CLK,
    input        RESET,
    output reg [4:0] LEDS,
    input        RXD,
    output       TXD
);
간단한 블록으로 구동됩니다:
   localparam IO_LEDS_bit = 0;

   always @(posedge clk) begin
      if(isIO & mem_wstrb & mem_wordaddr[IO_LEDS_bit]) begin
     LEDS <= mem_wdata;
      end
   end
이제 정겨운 블링키를 (또 다른 버전으로) 작성할 수 있습니다:
      LI(gp,32'h400000);
      LI(a0,0);
   Label(L1_);
      SW(a0,gp,4);
      CALL(LabelRef(wait_));
      ADDI(a0,a0,1);
      J(LabelRef(L1_));
먼저 IO 페이지의 기준 주소(즉, 2^22)를 gp에
불러옵니다. LED 값을 쓰려면 IO 페이지의 워드 주소 1(즉, 주소 4)에
a0를 저장합니다. (곧이어) 장치가 여러 개가 될 때 작업을
편하게 하기 위해, 도우미 함수를 몇 개 작성합시다:
   // Memory-mapped IO in IO page, 1-hot addressing in word address.
   localparam IO_LEDS_bit      = 0;  // W five leds

   // Converts an IO_xxx_bit constant into an offset in IO page.
   function [31:0] IO_BIT_TO_OFFSET;
      input [31:0] bit;
      begin
     IO_BIT_TO_OFFSET = 1 << (bit + 2);
      end
   endfunction
그러면 다음과 같이 LED에 쓸 수 있습니다:
SW(a0,gp,IO_BIT_TO_OFFSET(IO_LEDS_bit));자, 가진 게 이게 전부입니까? 튜토리얼을 17(!)단계나 진행했는데 여전히 그 시시한 블링키입니까?
네, 맞는 말씀입니다. 코어가 가상 터미널에 무언가를 표시할 수 있도록
UART를 추가합시다. IceStick에는 (그리고 다른 많은 FPGA 보드에도)
고전적인 RS232 직렬 프로토콜과 USB 사이를 변환해 주는 특수
칩(궁금하시다면, FTDI2232H입니다)이 있습니다. RS232는 단순한
프로토콜이라 USB보다 구현하기가 훨씬 쉬우므로, 우리에게는 좋은
소식입니다. 실제로 우리 코어는 두 개의 핀(데이터를 보내는
TXD와 데이터를 받는 RXD)을 통해 외부
워드(세계)와 통신하며, FTDI 칩이 이를 USB 프로토콜로 변환해 줍니다.
게다가 바퀴를 다시 발명하지 않는 것이 좋으며, Verilog로 작성된
UART(Universal Asynchronous Receiver Transmitter, RS232 프로토콜을
구현한 것) 구현이 이미 많이 있습니다. 지금은 우리 목적에 맞게 그중
절반만 구현하겠습니다(즉, 프로세서가 데이터를 보내 터미널 에뮬레이터에
텍스트를 표시할 수 있게 하는 부분입니다).
Olof Kindren이 트윗 크기의 UART를 작성했으며, 더 읽기 쉬운 버전은 여기에 있습니다.
이것을 SOC에 넣고 연결합시다:
   // Memory-mapped IO in IO page, 1-hot addressing in word address.
   localparam IO_LEDS_bit      = 0;  // W five leds
   localparam IO_UART_DAT_bit  = 1;  // W data to send (8 bits)
   localparam IO_UART_CNTL_bit = 2;  // R status. bit 9: busy sending
   ...

   wire uart_valid = isIO & mem_wstrb & mem_wordaddr[IO_UART_DAT_bit];
   wire uart_ready;

   corescore_emitter_uart #(
      .clk_freq_hz(`BOARD_FREQ*1000000),
      .baud_rate(115200)
   ) UART(
      .i_clk(clk),
      .i_rst(!resetn),
      .i_data(mem_wdata[7:0]),
      .i_valid(uart_valid),
      .o_ready(uart_ready),
      .o_uart_tx(TXD)
   );

   wire [31:0] IO_rdata =
           mem_wordaddr[IO_UART_CNTL_bit] ? { 22'b0, !uart_ready, 9'b0}
                                          : 32'b0;

   assign mem_rdata = isRAM ? RAM_rdata :
                          IO_rdata ;
UART는 메모리 공간에서 서로 다른 두 주소에 매핑됩니다. 첫 번째 주소는 쓰기만 가능하며, 문자 하나를 전송합니다. 두 번째 주소는 읽기만 가능하며, UART가 준비되었는지(비트 9 = 0) 아니면 문자를 전송하느라 사용 중인지(비트 9 = 1)를 나타냅니다.
이제 우리 프로세서는 이전에 있던 초라한 LED 다섯 개보다 훨씬 다양한 방법으로 바깥 세상과 소통할 수 있습니다! 문자를 전송하는 함수를 구현해 봅시다:
   Label(putc_);
      // Send character to UART
      SW(a0,gp,IO_BIT_TO_OFFSET(IO_UART_DAT_bit));
      // Read UART status, and loop until bit 9 (busy sending)
      // is zero.
      LI(t0,1<<9);
   Label(putc_L0_);
      LW(t1,gp,IO_BIT_TO_OFFSET(IO_UART_CNTL_bit));
      AND(t1,t1,t0);
      BNEZ(t1,LabelRef(putc_L0_));
      RET();
이 함수는 IO 공간에 매핑된 UART 주소에 문자를 쓴 다음, UART 상태가 문자를 전송하느라 바쁘다고 나타내는 동안 루프를 돕니다.
직접 해 보십시오: step17.v를 시뮬레이션에서 실행해 보십시오.
잠깐만요, 시뮬레이션에서는 무언가를 표시하는 방법을 어떻게 아는 것입니까?
사실 제가 한 비트(약간) 속임수를 썼기 때문입니다. SoC에 다음 코드 블록을 추가했습니다:
`ifdef BENCH
   always @(posedge clk) begin
      if(uart_valid) begin
     $write("%c", mem_wdata[7:0] );
     $fflush(32'h8000_0001);
      end
   end
`endif($fflush()에 전달하는 매직 상수 인자는
stdout에 해당합니다. 이렇게 해야 하는데, 그렇지 않으면
stdout의 출력 버퍼가 가득 찰 때까지 터미널에 아무것도
보이지 않습니다). 이렇게 하면 시뮬레이션에서 UART를 테스트하지 않게
됩니다(UART를 완전히 우회합니다). UART가 잘 동작한다는 점은 Olof를
믿습니다만, 제대로 하려면 시뮬레이션된 TXD 신호에 무언가를
연결하여 RS232 프로토콜을 디코딩하고 문자를 표시하는 편이 더
좋습니다(이런 종류의 시뮬레이션 예제는 나중에 살펴보겠습니다).
직접 해 보십시오: step17.v를 장치에서 실행해 보십시오.
UART로 전송된 내용을 표시하려면 다음을 사용하십시오:
$ ./terminal.sh참고
terminal.sh를 편집하여 그 안에서 선호하는 터미널 에뮬레이터를 선택하십시오. 로컬 환경에 따라DEVICE=/dev/ttyUSB1도 변경해야 할 수 있습니다.- 알아볼 수 없는 문자가 표시되면 break 신호를 보내
보십시오(picocom에서는
<ctrl><A><crtl><\>를 누르십시오) - 기본 보드 레이트는
115200입니다(기본적인 테스트와 데모에는 충분합니다). 일부 데모(나중에 살펴봅니다)는 tty에 ANSI 시퀀스를 전송하여 "그래픽"을 구현합니다. 이런 데모는 부드럽게 실행될 때 더 재미있습니다. 이를 위해 더 높은 보드 레이트를 시도해 볼 수 있습니다(1000000을 시도해 보십시오). 보드 레이트는emitter_uart.v와terminal.sh양쪽에서 모두 변경해야 합니다(대부분의 FPGA에서 동작하지만, GOWIN 보드는 예외입니다. 전형적인 FTDI 칩 대신 BL702가 탑재되어 있기 때문일 수 있습니다.)
18단계: 망델브로 집합 계산하기
이제 동작하는 RISC-V 프로세서와, 가상 터미널로 문자를 보낼 수 있는 UART를 갖춘 SoC가 생겼으니, 순수하게 소프트웨어만 다루는 단계로 한 비트(잠시) 쉬어 갑시다. 이 단계에서는 망델브로 집합을 투박한 ASCII 아트로 계산하는 프로그램을 RISC-V 어셈블리로 작성하겠습니다.
우리의 "이미지"는 80x80개의 문자로 구성됩니다. 그러면 먼저 이미지를
"*" 문자로 채우는 프로그램부터 작성해 봅시다. 이를 위해 중첩 루프 두
개를 사용하겠습니다. Y 좌표는 s0에, X 좌표는
s1에 저장합니다. 상한값(80)은 s11에
저장합니다. 프로그램은 다음과 같습니다:
      LI(gp,32'h400000); // IO page
      LI(s1,0);
      LI(s11,80);

   Label(loop_y_);
      LI(s0,0);

   Label(loop_x_);
      LI(a0,"*");
      CALL(LabelRef(putc_));

      ADDI(s0,s0,1);
      BNE(s0,s11,LabelRef(loop_x_));

      LI(a0,13);
      CALL(LabelRef(putc_));
      LI(a0,10);
      CALL(LabelRef(putc_));

      ADDI(s1,s1,1);
      BNE(s1,s11,LabelRef(loop_y_));

      EBREAK();
(그리고 이전 예제의 putc 함수를 복사합니다.)
고정 소수점 이제 망델브로 집합을 계산하려고 합니다.
그러려면 실수를 다룰 수 있어야 합니다. 안타깝게도 우리의 아주 단순한
RISC-V 코어는 부동소수점 수를 직접 다룰 수 없습니다. C 컴파일러의 지원
라이브러리인 libgcc에는 부동 소수점 수를 지원하는 함수가 몇
가지 있지만, 그 사용법은 나중에 살펴보겠습니다. 지금은 고정 소수점 수를
사용해 망델브로 집합을 계산하려고 합니다. 즉, 정수 하나에서 일부
비트(여기서는 10비트)로 소수 부분을 나타내고, 나머지 비트(여기서는
22비트)로 정수 부분을 나타냅니다. 다른 워드(말)로 하면, 실수
x를 표현하고 싶다면 x*2^10(의 정수 부분)을
레지스터에 저장한다는 뜻입니다. 이는 부동소수점 수와 비슷하지만, 우리의
경우 지수가 항상 10이라는 점이 다릅니다. 프로그램에서는 다음 상수들을
사용합니다:
   `define mandel_shift 10
   `define mandel_mul (1 << `mandel_shift)
두 수의 합이나 차를 계산할 때는 달라지는 것이 없습니다. 더하는(또는
빼는) 두 수 모두 2^10 인수가 같기 때문입니다. 곱셈은 사정이
다릅니다. x*y를 계산하면 실제로는
x*2^10*y*2^10을 계산하게 되므로 결과는
(x*y)*2^20이 되지만, 원하는 값은
(x*y)*2^10이므로 2^10으로
나누어야(10만큼 오른쪽 시프트해야) 합니다. 좋습니다. 그런데
두 레지스터에 저장된 두 정수의 곱은 어떻게 계산합니까? 우리 프로세서에는
MUL 명령어가 없지 않습니까? 사실 MUL
명령어(RV32M 명령어 집합에 속합니다)를 추가할 수는 있으며 이는 나중에
살펴보겠지만, 그렇게 하면 우리의 작은 IceStick에 들어가지 않습니다!
그렇다면 어떻게 해야 합니까? a0과 a1로 두 수를
받아 그 곱을 계산하고 결과를 a0에 담아 반환하는 함수를
구현하면 됩니다. C 컴파일러 지원 라이브러리인 libgcc에 이런
함수가 있습니다(우리 프로세서처럼 MUL 명령어가 없는 소형
RV32I RISC-V 프로세서용으로 C를 컴파일할 때 이 함수가 쓰입니다). 이
함수의 소스 코드는 여기에
있습니다. 이 함수를 우리의 Verilog RISC-V 어셈블러로
포트(이식)합시다(아쉽게도 문법이 약간 다르지만, gcc와 gas를 직접
사용하는 방법은 나중에 살펴보겠습니다):
      // Mutiplication routine,
      // Input in a0 and a1
      // Result in a0
   Label(mulsi3_);
      MV(a2,a0);
      LI(a0,0);
   Label(mulsi3_L0_);
      ANDI(a3,a1,1);
      BEQZ(a3,LabelRef(mulsi3_L1_));
      ADD(a0,a0,a2);
   Label(mulsi3_L1_);
      SRLI(a1,a1,1);
      SLLI(a2,a2,1);
      BNEZ(a1,LabelRef(mulsi3_L0_));
RET();(initial 블록 앞에 새 레이블들을 선언하는 것을 잊지
마십시오.)
이제 망델브로 집합을 표시하기 전에, 고정 소수점 계산 아이디어를
시험해 보기 위해 더 단순한 도형을 표시해 봅시다. 즉,
[-2.0,2.0]x[-2.0,2.0] 정사각형(30x30 문자 디스플레이에
대응됨)을 시각화한다고 보고, (0,0)을 중심으로 하는 반지름
2의 원판을 표시하려고 합니다. 그러려면 먼저 (고정 소수점)
좌표 x,y를 계산해야 합니다. 이 좌표는 s2와
s3에 저장합니다. 그다음 x^2+y^2를 계산해야
합니다. 이는 mulsi3 루틴을 두 번 호출하여 계산할 수
있습니다(결과를 10만큼 오른쪽 시프트하는 것을 잊지 마십시오). 마지막으로
결과를 4 << 10과 비교하여 점이 원판 안에 있는지 밖에
있는지 판단하고, 그에 따라 다른 문자로 표시합니다(4인 이유는 이것이
제곱한 반지름이기 때문이고, 왼쪽으로 10만큼 시프트하는 이유는
고정 소수점 표현 때문입니다). 이에 해당하는 프로그램은 다음과
같습니다:
   `define mandel_shift 10
   `define mandel_mul (1 << `mandel_shift)
   `define xmin (-2*`mandel_mul)
   `define xmax ( 2*`mandel_mul)
   `define ymin (-2*`mandel_mul)
   `define ymax ( 2*`mandel_mul)
   `define dx ((`xmax-`xmin)/30)
   `define dy ((`ymax-`ymin)/30)
   `define norm_max (4 << `mandel_shift)

   integer    loop_y_      = 28;
   integer    loop_x_      = 36;
   integer    in_disk_     = 92;

   initial begin
      LI(gp,32'h400000); // IO page

      LI(s1,0);
      LI(s3,`xmin);
      LI(s11,30);
      LI(s10,`norm_max);

   Label(loop_y_);
      LI(s0,0);
      LI(s2,`ymin);

   Label(loop_x_);

      MV(a0,s2);
      MV(a1,s2);
      CALL(LabelRef(mulsi3_));
      SRLI(s4,a0,`mandel_shift); // s4 = x*x
      MV(a0,s3);
      MV(a1,s3);
      CALL(LabelRef(mulsi3_));
      SRLI(s5,a0,`mandel_shift); // s5 = y*y
      ADD(s6,s4,s5);             // s6 = x*x+y*y
      LI(a0,"*");
      BLT(s6,s10,LabelRef(in_disk_)); // if x*x+y*y < 4
      LI(a0," ");
  Label(in_disk_);
      CALL(LabelRef(putc_));

      ADDI(s0,s0,1);
      ADDI(s2,s2,`dx);
      BNE(s0,s11,LabelRef(loop_x_));

      LI(a0,13);
      CALL(LabelRef(putc_));
      LI(a0,10);
      CALL(LabelRef(putc_));

      ADDI(s1,s1,1);
      ADDI(s3,s3,`dy);
      BNE(s1,s11,LabelRef(loop_y_));

      EBREAK();
그리고 출력은 다음과 같습니다:
          ***********
        ***************
       ******************
     *********************
    ***********************
    ************************
   *************************
  ***************************
  ***************************
 *****************************
 *****************************
 *****************************
 *****************************
 *****************************
 *****************************
 *****************************
 *****************************
 *****************************
 *****************************
 *****************************
  ***************************
  ***************************
   *************************
   *************************
    ***********************
     *********************
      *******************
        ***************
          ***********
이제 망델브로 집합을 계산하려면 다음 연산을 반복해야 합니다:
   Z <- 0; iter <- 0
   do
      Z <- Z^2 + C
      iter <- iter + 1
   while |Z| < 2
여기서 Z와 C는 복소수입니다.
C = x + iy는 현재 픽셀에 해당합니다. 복소수 곱셈
규칙(i*i = -1)을 떠올리면
Z^2 = (Zr + i*Zi)^2 = Zr^2-Zi^2 + 2*i*Zr*Zi를 계산할 수
있습니다. 이 반복 계산을 수행하는 루프는 다음과 같습니다:
   Label(loop_Z_);
      MV(a0,s4); // Zrr  <- (Zr*Zr) >> mandel_shift
      MV(a1,s4);
      CALL(LabelRef(mulsi3_));
      SRLI(s6,a0,`mandel_shift);
      MV(a0,s4); // Zri <- (Zr*Zi) >> (mandel_shift-1)
      MV(a1,s5);
      CALL(LabelRef(mulsi3_));
      SRAI(s7,a0,`mandel_shift-1);
      MV(a0,s5); // Zii <- (Zi*Zi) >> (mandel_shift)
      MV(a1,s5);
      CALL(LabelRef(mulsi3_));
      SRLI(s8,a0,`mandel_shift);
      SUB(s4,s6,s8); // Zr <- Zrr - Zii + Cr
      ADD(s4,s4,s2);
      ADD(s5,s7,s3); // Zi <- 2Zri + Cr

      ADD(s6,s6,s8); // if norm > norm max, exit loop
      LI(s7,`norm_max);
      BGT(s6,s7,LabelRef(exit_Z_));

      ADDI(s10,s10,-1);  // iter--, loop if non-zero
      BNEZ(s10,LabelRef(loop_Z_));

   Label(exit_Z_);
마지막으로, 루프를 빠져나올 때의 iter(s10)
값에 따라 서로 다른 문자를 표시합니다.
   Label(exit_Z_);
      LI(a0,colormap_);
      ADD(a0,a0,s10);
      LBU(a0,a0,0);
      CALL(LabelRef(putc_));
여기서 "colormap"은 가장 어두운 것부터 가장 밝은 것까지 서로 다른 "밝기"를 흉내 내는 문자들의 배열입니다.
   Label(colormap_);
      DATAB(" ",".",",",":");
      DATAB(";","o","x","%");
      DATAB("#","@", 0 , 0 );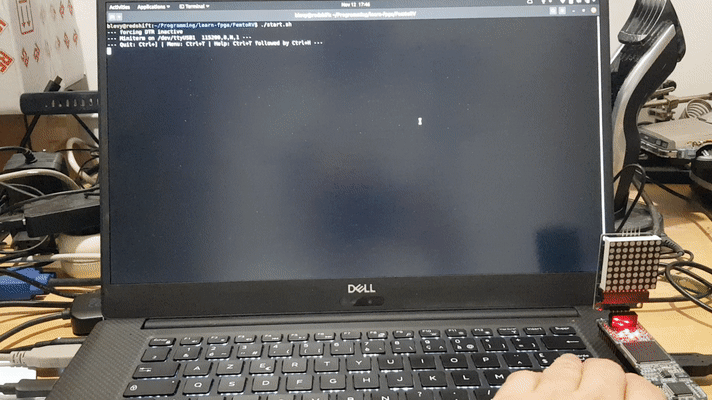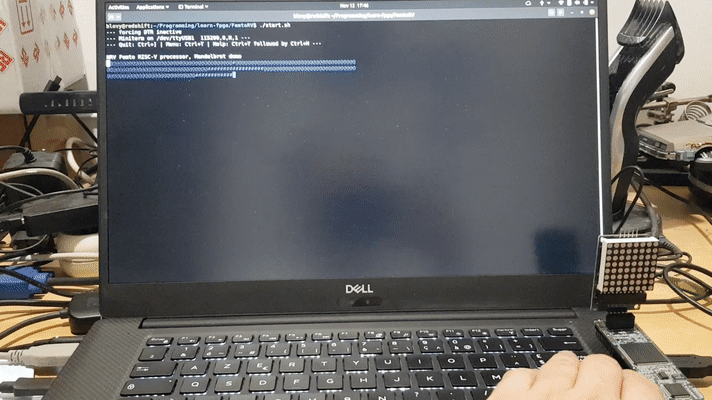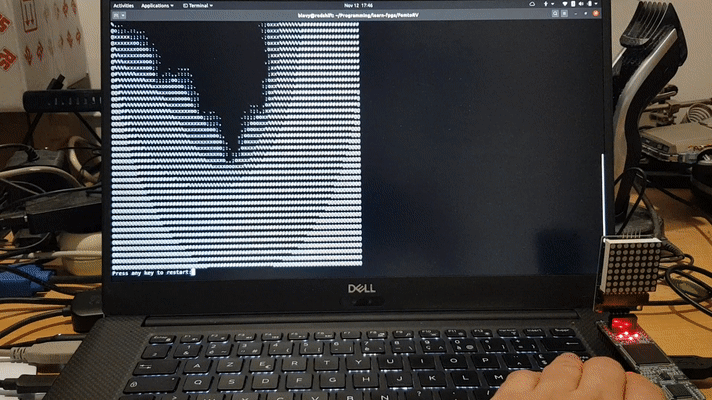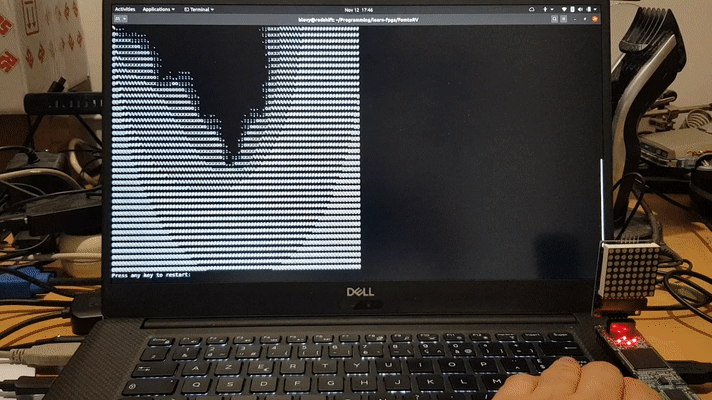
직접 해 보십시오 step18.v를 시뮬레이션과 장치에서 실행해 보십시오. 이를 수정하여 여러분만의 그래픽을 그려 보십시오(예를 들어 "colormap"을 사용하여 "동심원"을 그려 보십시오).
19단계: Verilator를 이용한 더 빠른 시뮬레이션
18단계에서 보았듯이 시뮬레이션은 장치에서 설계를 실행하는 것보다
훨씬, 훨씬 느립니다. 하지만 VERILOG 디자인을 C++로 변환해 주는
verilator라는 또 다른 도구가 있습니다. 그런 다음 C++를
컴파일하면 icarus/iverilog보다 훨씬 더 빠른 시뮬레이션을 얻을 수
있습니다. 먼저 verilator를 설치합시다.
$ apt-get install verilator디자인을 C++로 변환하기 전에 "벤치(bench)"를 만들어야 합니다. 벤치란
디자인에 필요한 신호를 생성하고 C++ main() 함수를 선언하는
C++ 코드를 말합니다. main 함수의 주된 역할은 (SOC 모듈에서
생성된) VSOC 클래스의 객체를 선언하고 그 CLK
신호를 흔드는 것입니다. CLK 신호가 바뀔 때마다 그 변화를
반영하도록 eval() 함수를 호출해야 합니다.
sim_main.cpp 파일은 다음과 같습니다.
#include "VSOC.h"
#include "verilated.h"
#include <iostream>

int main(int argc, char** argv, char** env) {
   VSOC top;
   top.CLK = 0;
   while(!Verilated::gotFinish()) {
      top.CLK = !top.CLK;
      top.eval();
   }
   return 0;
}
또한 sim_main.cpp에는 LED가 바뀔 때마다 이를 디코딩하여 상태를 표시하는 코드가 들어 있습니다.
디자인을 C++로 변환하려면 다음 명령을 사용하십시오.
$ verilator -DBENCH -DBOARD_FREQ=12 -Wno-fatal --top-module SOC -cc -exe sim_main.cpp step18.v그런 다음 C++를 컴파일하고 생성된 프로그램을 실행하려면 다음과 같이 하십시오.
  $ cd obj_dir
  $ make -f VSOC.mk
  $ ./VSOC
보시다시피 icarus/iverilog보다 훨씬 더 빠릅니다! 작은 디자인에서는 큰 차이가 없지만, 제 말을 믿으십시오. FPU를 갖춘 RV32IMFC 코어를 개발할 때에는 효율적인 시뮬레이션이 있으면 매우 좋습니다!
작업을 더 쉽게 할 수 있도록 run_verilator.sh 스크립트가
준비되어 있으며, 다음과 같이 실행할 수 있습니다.
$ run_verilator.sh step18.v20단계: GNU 툴체인으로 프로그램 컴파일하기 - 어셈블리
이 단계에서는 우리의 RISC-V 디자인이 교육용 장난감일 뿐이며 "진짜"와는 거리가 멀다고 느낄 수도 있습니다. 사실 이 단계에서 여러분은 지금까지 만든 것이 다른 어떤 RISC-V 프로세서 못지않게 진짜라는 것을 느끼기 시작할 것입니다! 프로세서를 흥미롭게 만드는 것은 그 위에서 실행할 수 있는 소프트웨어입니다. 따라서 우리가 만든 것이 (RV32I) RISC-V 프로세서용으로 작성된 어떤 소프트웨어든 실행할 수 있다면, 그것은 RV32I RISC-V 프로세서입니다.
잠깐, 하지만 지금까지 소프트웨어를 작성하는 데 사용한 것은 VERILOG 어셈블러이고, 그것은 진짜와는 다른 장난감일 뿐이지 않습니까?
사실 VERILOG 어셈블러는 다른 어떤 RISC-V 어셈블러와도 완전히 동일한 기계어 코드를 생성합니다. 대신 다른 어떤 RISC-V 어셈블러를 사용하더라도, 생성된 기계어 코드를 우리 디자인에 로드하여 실행할 수 있습니다!
이를 위해 VERILOG에는 외부 파일에서 데이터를 읽어 메모리를 초기화하는
$readmemh() 명령이 있습니다. step20.v에서는 다음과 같이 사용합니다.
   initial begin
       $readmemh("firmware.hex",MEM);
   end
여기서 firmware.hex는 MEM의 초기 내용을
16진수로 담고 있는 ASCII 파일입니다.
따라서 외부 어셈블러를 사용하려면 다음 사항만 알아내면 됩니다.
- GNU 도구를 사용하여 RISC-V 어셈블리 코드를 컴파일하는 방법
- 우리가 만든 장치에 대한 정보(RAM 시작 주소, RAM 용량)를 GNU 도구에 알려 주는 방법
- GNU 도구의 출력을
$readmemh()가 이해할 수 있는 파일로 변환하는 방법
자, blinker.S에 있는 간단한 블링커부터 시작해 봅시다:
# Simple blinker

.equ IO_BASE, 0x400000
.equ IO_LEDS, 4

.section .text

.globl start

start:
        li   gp,IO_BASE
    li   sp,0x1800
.L0:
    li   t0, 5
    sw   t0, IO_LEDS(gp)
    call wait
    li   t0, 10
    sw   t0, IO_LEDS(gp)
    call wait
    j .L0

wait:
        li t0,1
    slli t0, t0, 17
.L1:
        addi t0,t0,-1
    bnez t0, .L1
    ret
보시다시피 지금까지 VERILOG 어셈블러로 작성한 코드와 매우 비슷합니다. 이 프로그램은 세 가지 부분으로 이루어져 있습니다:
- 메인 프로그램
- 유틸리티, 여기서는
wait함수 - 설정, 즉
gp와sp초기화
따라서 파일을 세 부분으로 나누겠습니다:
main함수가 들어 있는 FIRMWARE/blinker.Swait함수가 들어 있는 FIRMWARE/wait.S- 설정 코드가 들어 있고 마지막에
main을 호출하는 FIRMWARE/start.S
이를 컴파일하려면 컴퓨터에 RISC-V 툴체인(컴파일러, 어셈블러, 링커)을 설치해야 합니다. 우리 makefile이 이 작업을 대신해 줄 수 있습니다:
  $ cd learn-fpga/FemtoRV
  $ make ICESTICK.firmware_config
참고: 더 큰 보드를 가지고 있더라도 항상
ICESTICK.firmware_config를 사용하십시오. 이 설정은
makefile을 RV32I 빌드용으로 구성하며, 이것이 바로 우리
프로세서가 지원하는 것입니다.
이 명령은 몇 가지 파일을 내려받아
learn-fpga/FemtoRV/FIRMWARE/TOOLCHAIN에 압축을 풉니다.
riscv64-unknown-elf-gcc..../bin/ 디렉터리를 경로(path)에
추가하십시오.
이제 프로그램을 컴파일해 봅시다:
  $ cd learn-fpga/FemtoRV/TUTORIALS/FROM_BLINKER_TO_RISCV/FIRMWARE
  $ riscv64-unknown-elf-as -march=rv32i -mabi=ilp32 -mno-relax start.S -o start.o
  $ riscv64-unknown-elf-as -march=rv32i -mabi=ilp32 -mno-relax blinker.S -o blinker.o
  $ riscv64-unknown-elf-as -march=rv32i -mabi=ilp32 -mno-relax wait.S -o wait.o
우리 프로세서가 지원하는 명령어에 해당하는
아키텍처(rv32i)와, 함수를 호출하는 방식에 해당하는
ABI(ilp32)를 지정합니다. no-relax 옵션은 IO
페이지에 접근하는 데 사용하는 gp 레지스터와 관련이
있습니다(즉, 어셈블러가 이 레지스터를 다른 용도로 사용하지 못하게
합니다).
이렇게 하면 오브젝트 파일(.o)이 생성됩니다. 이제 링커를
호출하여 이 파일들로부터 실행 파일을 생성해야 합니다. 링커는 코드와
데이터가 메모리의 어느 위치에 배치되어야 하는지 결정합니다. 이를 위해
장치의 메모리가 어떻게 구성되어 있는지를 링커 스크립트(FIRMWARE/bram.ld)에 지정해야 합니다:
MEMORY
{
   BRAM (RWX) : ORIGIN = 0x0000, LENGTH = 0x1800  /* 6kB RAM */
}
SECTIONS
{
    everything :
    {
    . = ALIGN(4);
    start.o (.text)
        *(.*)
    } >BRAM
}
링커 스크립트에는 MEMORY에 대한 기술이 들어 있습니다.
우리의 경우에는 BRAM이라고 부르는 6 kB 크기의 메모리
세그먼트 하나가 있습니다. 이 세그먼트는 0x0000 주소에서
시작합니다. 다음으로 SECTIONS가 있는데, 이는 무엇이 어디로
가는지(즉, 어떤 세그먼트가 어떤 메모리로 가는지)를 나타냅니다. 우리의
경우에는 매우 간단합니다. 모든 것이 BRAM으로 갑니다. 또한
start.o의 내용이 메모리에 가장 먼저 배치되어야 한다는 것도
지정합니다. 링커는 다음과 같이 호출합니다:
$ riscv64-unknown-elf-ld blinker.o wait.o -o blinker.bram.elf -T bram.ld -m elf32lriscv -nostdlib -norelax이 명령은 "elf" 실행 파일을 생성합니다("elf"는 Executable and
Linkable Format의 약자입니다). 이는 Linux 시스템의 바이너리와 같은
형식입니다. -T bram.ld 옵션은 우리가 작성한 링커 스크립트를
사용하도록 지시합니다. -m elf32lriscv 옵션은 32비트 실행
파일을 생성한다는 것을 나타냅니다. 지금은 C 표준 라이브러리를 사용하지
않으며(-nostdlib), gp는 우리가 직접 사용하도록
남겨 둡니다(-norelax). 링크할 오브젝트 목록에
start.o를 명령줄에 넣을 필요는 없습니다. 링커 스크립트
bram.ld에 이미 포함되어 있기 때문입니다.
아직 완전히 끝난 것은 아닙니다. 이제 elf 실행 파일에서 필요한 정보를
추출하고, VERILOG의 $readmemh() 함수가 이해할 수 있도록
모든 기계어 코드를 16진수로 담은 파일을 생성해야 합니다. 이를 위해 저는
firmware_words 유틸리티를 작성했습니다. 이 유틸리티는 elf
파일 형식을 이해하고, 우리에게 필요한 부분을 추출하여 ASCII 16진수로
기록합니다:
$ make blinker.bram.hex참고 make xxxx.bram.hex를 직접 실행할 수도
있으며, 그러면 어셈블러, 링커, elf 변환 유틸리티가 자동으로
호출됩니다.
이제 예제를 시뮬레이션과 실제 장치에서 실행할 수 있습니다:
  $ cd ..
  $ ./run_verilator.sh step20.v
  $ BOARDS/run_xxx.sh step20.v
이제 작업이 수월해졌으므로 더 복잡한 프로그램을 작성할 수 있습니다.
그 유명한 "hello world" 프로그램을 작성하는 방법을 살펴봅시다. 필요한
것은 tty에 문자열을 출력하는 putstring 루틴입니다. 이
루틴은 출력할 문자열의 첫 번째 문자의 주소를 a0 레지스터로
입력받습니다. 문자열의 모든 문자를 순회하면서 각 문자마다
putchar를 호출하고, 널 문자를 만나는 즉시 루프를
빠져나오기만 하면 됩니다:
# Warning, buggy code ahead !
putstring:
    mv t2,a0
.L2:    lbu a0,0(t2)
    beqz a0,.L3
    call putchar
    addi t2,t2,1
    j .L2
.L3:    ret
주석을 보셨습니까? 이는 위 코드에 오류가 있다는 뜻입니다. 찾아낼 수 있겠습니까?
힌트를 드리자면, putstring은 함수를 호출하는 함수입니다.
이런 경우에는 특별한 처리가 필요하지 않습니까?
call과 ret이 무엇을 하는지 기억하십니까?
그렇습니다. call은 PC+4를 ra에
저장한 다음 함수로 점프하고, ret은 ra에 있는
주소로 점프합니다. 이제 누군가가 우리의 putstring 함수를
호출했다고 가정해 봅시다. 함수에 진입할 때 ra에는
putstring의 ret 문에 도달했을 때 점프해야 할
주소가 들어 있습니다. 그런데 putstring 내부에서
putchar를 호출하면, putchar가 반환할 때
그곳으로 점프할 수 있도록 ra가 호출 직후의 주소로
덮어쓰입니다. 하지만 그러면 putstring도 그곳으로 점프하게
되며, 이는 우리가 원하는 동작이 아닙니다. 이를 방지하려면
putstring의 시작 부분에서 ra를 저장하고 끝에서
복원해야 합니다. 이를 위해 다음과 같이 스택을 사용합니다:
putstring:
    addi sp,sp,-4 # save ra on the stack
    sw ra,0(sp)   # (need to do that for functions that call functions)
    mv t2,a0
.L2:    lbu a0,0(t2)
    beqz a0,.L3
    call putchar
    addi t2,t2,1
    j .L2
.L3:    lw ra,0(sp)  # restore ra
    addi sp,sp,4 # resptore sp
    ret
이 함수는 다음과 같이 사용할 수 있습니다:
   la   a0, hello
   call putstring

   ...

hello:
.asciz "Hello, world !\n"la(load address) 의사 명령어는 문자열의 주소를
a0에 로드합니다. 문자열은 일반 레이블과, 0으로 끝나는
문자열을 생성하는 .asciz 지시어로 선언합니다.
직접 해 보십시오 hello.S를
컴파일하고(cd FIRMWARE; make hello.bram.hex) 시뮬레이션과
장치에서 테스트해 보십시오. mandelbrot.S도 시도해 보십시오.
보시다시피 FIRMWARE/mandelbrot.S에는
__mulsi 함수가 없습니다. FIRMWARE/Makefile을 살펴보면, 실행 파일은
이 함수가 들어 있는 올바른 버전의 libgcc.a(RV32I용)와
링크됩니다.
이제 여러분의 프로세서가 진짜라는 느낌이 들기 시작할 것입니다. 망델브로 예제를 실행하면 다른 사람이 작성한 코드가 여러분의 프로세서에서 실행됩니다. 더 나아가 표준 도구로 생성한 코드를 실행할 수 있을까요?
21단계: GNU 툴체인으로 프로그램 컴파일하기 - C
이제 우리 프로세서를 위한 코드를 C로 작성하는 방법을 알아봅시다. 지금
시점에서 우리는 오브젝트 파일(.o)을 생성하고, 링커를 사용해
이로부터 elf 실행 파일을 만들 수 있습니다. 링커 스크립트는 모든 것이
메모리의 올바른 위치에 놓이도록 보장하며, 그러면 프로세서가 코드를
실행할 수 있습니다. 가장 먼저 주소 0에 배치된 start.S의
내용이 실행되고, 이것이 다시 main 함수를 호출합니다.
지금까지 우리의 프로그램은 전부 어셈블리로 작성되었습니다. 13단계와
14단계에서 살펴본 ABI(Application Binary Interface)의 좋은 점은, 서로
다른 도구가 생성한 오브젝트 파일(.o)이라도 ABI를 준수하기만
하면 결합할 수 있다는 것이며, (당연히) C 컴파일러도 ABI를
준수합니다.
picorv의 예제에서 가져온 FIRMWARE/sieve.c 예제가 좋은 후보입니다. 이
예제는 정수를 사용해 곱셈, 나눗셈, 나머지 연산을 수행하므로
흥미롭습니다. 이러한 연산은 우리의 RV32I 코어에 구현되어 있지 않지만,
컴파일러가 libgcc.a의 함수를 사용해 지원하며, 우리는
libgcc.a와 링크하므로 제대로 동작합니다. 그러나 이
프로그램은 결과를 표시하기 위해 printf()도 사용하는데, 이
함수는 libc.a에 선언되어 있습니다. 원칙적으로는 이를 사용할
수도 있지만, printf()는 너무 많은 형식을 지원하기 때문에
코드가 너무 커서 6 kB RAM에 들어가지 않습니다. 이러한 이유로 훨씬 작고
훨씬 단순한 버전을 FIRMWARE/print.c(역시
picorv에서 가져왔습니다)에 넣어 두었으며, 이를 실행 파일과 링크할
오브젝트에 포함했습니다.
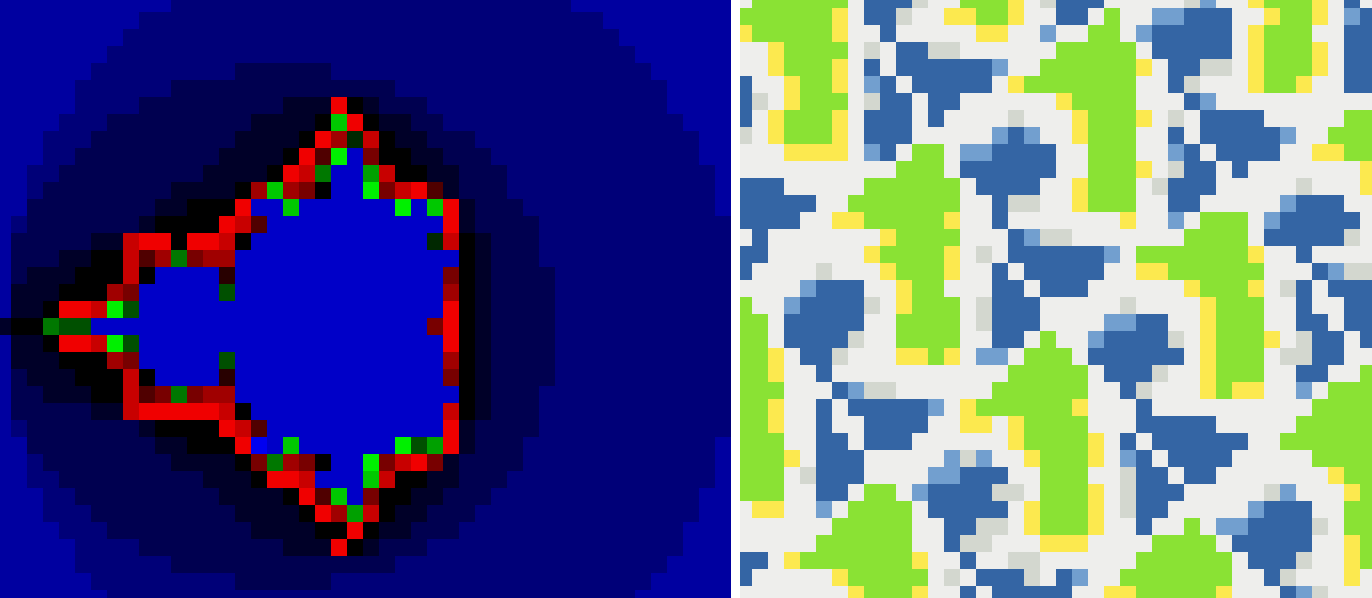
다른 예제가 두 개 더 있는데, 하나는 망델브로 프로그램의 C 버전인 FIRMWARE/mandel_C.c입니다. 이 프로그램은 ANSI 색상을 사용해 터미널에 저해상도 "그래픽"을 표시합니다. 또한 회전하는 Risc-V 로고를 (90년대풍 데모신 스타일로!) 표시하는 FIRMWARE/riscv_logo.c도 있습니다.
직접 해 보십시오 sieve.c를
컴파일하고(cd FIRMWARE; make sieve.bram.hex)
시뮬레이션(./run_verilator.sh step20.v)과
장치(BOARDS/run_xxx.sh step20.v; ./terminal.sh)에서
테스트해 보십시오. 다른 프로그램도 시도해 보십시오. 여러분만의
프로그램을 작성해 보십시오(아이디어가 없다면 예를 들어 세포 자동자,
라이프 게임 등을 시도해 보십시오). 참고: Verilator 프레임워크는
시뮬레이션에서 ELF 실행 파일을 직접 로드할 수
있습니다(firmware.hex를 다시 생성할 필요가 없습니다).
cd FIRMWARE; make hello.bram.elf mandelbrot.bram.elf mandel_C.bram.elf riscv_logo.bram.elf;cd ..로
모든 데모 프로그램을 생성한 다음,
./run_verilator.sh step20.v FIRMWARE/mandel_C.bram.elf 또는
./obj_dir/FIRMWARE/mandel_C.bram.elf를 사용해 원하는
프로그램을 실행할 수 있습니다.
이제 여러분의 프로세서가 단순한 장난감이 아니라, 표준 도구로 생성한 프로그램을 실행할 수 있는 진짜 RISC-V 프로세서라는 것을 알 수 있습니다!
참고 IceStick에는 RAM이 6kB밖에 없으므로 아주
작은 프로그램만 들어갑니다. 컴파일된 프로그램이 6kB보다
크면 오류가 발생합니다. 더 문제가 되는 경우는 프로그램이 BRAM 전체를
거의 채우는 경우인데, 이때는 스택을 위한 공간이 거의 없어서 스택이
나머지 부분을 덮어쓰게 되고, CPU가 잘못된 상태에 빠져 아마도 멈춰 버릴
것입니다. 이런 상황은 실제로 마주쳤을 때 이해하거나 디버그하기 어렵기
때문에, firmware_words는 생성된 코드가 BRAM의 95%를 넘게
채울 때마다 큰 경고 메시지를 표시합니다.
22단계: 데이터 저장하기: 6 kB보다 많은 메모리를 쓸 수 있습니까?
그리고 프로세서의 몇 가지 최적화
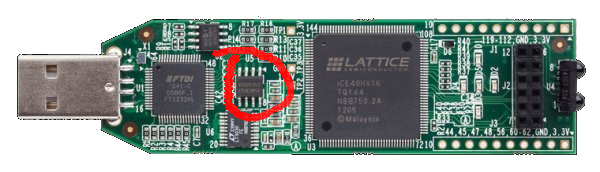
IceStick에는 1 kB짜리 BRAM 블록이 8개밖에 없고, 그중 두 개를 레지스터에 써야 하므로 프로그램에 쓸 수 있는 RAM은 6 kB만 남습니다. 망델브로나 작은 그래픽 데모 같은 작은 프로그램에는 충분하지만, 금방 한계에 도달하게 될 것입니다. IceStick에는 4MB의 플래시 메모리를 가진 작은 칩(그림 참조)이 있습니다(다른 보드에도 비슷한 칩이 있습니다). 설계를 합성하면 그 결과는 이 플래시 메모리에 저장됩니다. 시작할 때 FPGA는 이 칩에서 구성을 불러옵니다. 좋은 점은 FPGA 구성이 몇 킬로바이트밖에 차지하지 않아서 우리 데이터를 저장할 공간이 많이 남는다는 것입니다. 하지만 이 칩과 통신하려면 추가 하드웨어를 만들어야 합니다.
그림에서 볼 수 있듯이 이 칩에는 다리가 8개밖에 없는데, 핀 8개만으로 어떻게 4 MB의 데이터에 주소를 지정할 수 있겠습니까? 사실 이 칩은 직렬 프로토콜(SPI)을 사용합니다. 데이터에 접근하려면 읽을 주소를 한 핀으로 한 번에 한 비트씩 보내고, 그러면 칩이 다른 핀으로 데이터를 한 번에 한 비트씩 돌려보냅니다. 더 자세히 알고 싶으시다면 SPI 플래시에 관한 제 노트가 여기에 있고, Verilog 구현은 spi_flash.v에 있습니다. 이 구현은 사용하는 핀 수와 핀의 양방향 여부에 따라 여러 프로토콜을 지원합니다.
MappedSPIFlash 모듈의 인터페이스는 다음과 같습니다.
module MappedSPIFlash(
    input wire         clk,
    input wire         rstrb,
    input wire [19:0]  word_address,

    output wire [31:0] rdata,
    output wire        rbusy,

    output wire        CLK,
    output reg         CS_N,
    inout  wire [1:0]  IO
);| 신호 | 설명 |
|---|---|
| clk | 시스템 클록 |
| rstrb | 읽기 스트로브이며, 프로세서가 워드를 읽으려 할 때마다 하이가 됩니다 |
| word_address | 읽을 워드의 주소 |
| rdata | 메모리에서 읽은 데이터 |
| rbusy | 데이터를 받느라 바쁠 때 어서트됩니다 |
| CLK | SPI 플래시 칩의 클록 핀 |
| CS_N | SPI 플래시 칩의 칩 선택 핀이며, 로우 액티브입니다 |
| IO | 데이터를 송수신하는 양방향 핀 두 개 |
이제 일부 주소가 SPI 플래시에 대응하도록 SOC를 수정하려고 합니다. 먼저 SPI 플래시를 프로세서의 메모리 공간에 어떻게 매핑할지 정해야 합니다. 메모리 주소의 23번 비트로 SPI 플래시를 선택하는 방식을 사용합니다. 22번 비트는 IO(LED, UART)용입니다. 또한 IO의 경우에는 23번 비트가 0인지도 확인해야 합니다. 그리고 23번 비트와 22번 비트가 모두 0이면 BRAM에 해당합니다. 따라서 메모리 공간은 23번 비트와 22번 비트에 따라 네 개의 "사분면"으로 나뉘며, 그중 세 개를 사용합니다.
다음으로 메모리의 각 영역을 구분하는 여러 신호가 있습니다.
   wire isSPIFlash  = mem_addr[23];
   wire isIO        = mem_addr[23:22] == 2'b01;
   wire isRAM       = mem_addr[23:22] == 2'b00;
MappedSPIFlash 모듈은 다음과 같이 연결됩니다.
   wire SPIFlash_rdata;
   wire SPIFlash_rbusy;
   MappedSPIFlash SPIFlash(
      .clk(clk),
      .word_address(mem_wordaddr),
      .rdata(SPIFlash_rdata),
      .rstrb(isSPIFlash & mem_rstrb),
      .rbusy(SPIFlash_rbusy),
      .CLK(SPIFLASH_CLK),
      .CS_N(SPIFLASH_CS_N),
      .IO(SPIFLASH_IO)
);(SPIFLASH_CLK, SPIFLASH_CS_N,
SPIFLASH_IO[0], SPIFLASH_IO[1] 핀은
BOARDS 하위 디렉터리에 있는 제약 파일에 선언되어
있습니다.)
프로세서로 전달되는 데이터에는 3방향 mux가 있습니다:
   assign mem_rdata = isRAM      ? RAM_rdata :
                      isSPIFlash ? SPIFlash_rdata :
                               IO_rdata ;
좋습니다. 이제 프로세서는 주소의 23번 비트가 설정된 메모리에 접근하는
것만으로 SPI 플래시 읽기를 자동으로 시작할 수 있습니다. 그런데 데이터가
준비되었다는 것은 어떻게 알 수 있을까요? (데이터는 한 번에 한 비트씩
도착한다는 점을 기억하십시오.) MappedSPIFlash가 데이터를
수신하는 중일 때마다 high가 되는 SPIFlash_rbusy 신호가
있으므로, 프로세서의 상태 기계에서 이 신호를 고려해야 합니다. 프로세서에
새 입력 신호 mem_rbusy를 추가하고, 상태 기계를 다음과 같이
수정합니다.
   ...
   WAIT_DATA: begin
      if(!mem_rbusy) begin
     state <= FETCH_INSTR;
      end
   end
   ...
그런 다음 SOC에서 이 신호를 SPIFlash_rbusy에
연결합니다.
   wire mem_rbusy;
   ...
   Processor CPU(
     ...
     .mem_rbusy(mem_rbusy),
     ...
   );
   ...
   assign mem_rbusy = SPIFlash_rbusy;
그런데 상태 기계를 다시 살펴보는 김에 할 수 있는 일이 하나 있습니다. 상태 기계의 이 부분을 기억하십니까? 더 빠르게 만들 수 있을 것 같지 않습니까?
   WAIT_INSTR: begin
      instr <= mem_rdata;
      state <= FETCH_REGS;
   end
   FETCH_REGS: begin
      rs1 <= RegisterBank[rs1Id];
      rs2 <= RegisterBank[rs2Id];
      state <= EXECUTE;
   end
그렇습니다. rs1Id와 rs2Id는 각각
instr에서 뽑아낸 와이어 5개일 뿐이므로, 다음과 같이
mem_rdata에서 직접 가져와 WAIT_INSTR 상태에서
레지스터를 읽어 올 수 있습니다.
   WAIT_INSTR: begin
      instr <= mem_rdata;
      rs1 <= RegisterBank[mem_rdata[19:15]];
      rs2 <= RegisterBank[mem_rdata[24:20]];
      state <= EXECUTE;
   end
이렇게 하면 명령어마다 한 사이클을 절약할 수 있으니, 손쉽게 얻는 이득입니다!
아, 그리고 한 가지 더 있습니다. LOAD 상태와
STORE 상태가 굳이 필요할까요? EXECUTE 상태에서
메모리 전송을 시작할 수는 없을까요? 할 수 있습니다. 그러려면 쓰기
마스크와 읽기 스트로브를 다음과 같이 바꿔야 합니다.
   assign mem_rstrb = (state == FETCH_INSTR || (state == EXECUTE & isLoad));
   assign mem_wmask = {4{(state == EXECUTE) & isStore}} & STORE_wmask;
이제 상태 기계의 상태는 4개뿐입니다!
   localparam FETCH_INSTR = 0;
   localparam WAIT_INSTR  = 1;
   localparam EXECUTE     = 2;
   localparam WAIT_DATA   = 3;
   reg [1:0] state = FETCH_INSTR;
   always @(posedge clk) begin
      if(!resetn) begin
     PC    <= 0;
     state <= FETCH_INSTR;
      end else begin
     if(writeBackEn && rdId != 0) begin
        RegisterBank[rdId] <= writeBackData;
     end
     case(state)
       FETCH_INSTR: begin
          state <= WAIT_INSTR;
       end
       WAIT_INSTR: begin
          instr <= mem_rdata;
          rs1 <= RegisterBank[mem_rdata[19:15]];
          rs2 <= RegisterBank[mem_rdata[24:20]];
          state <= EXECUTE;
       end
       EXECUTE: begin
          if(!isSYSTEM) begin
         PC <= nextPC;
          end
          state <= isLoad  ? WAIT_DATA : FETCH_INSTR;
       end
       WAIT_DATA: begin
          if(!mem_rbusy) begin
         state <= FETCH_INSTR;
          end
       end
     endcase
      end
   end
최적화할 수 있는 부분이 몇 가지 더 있습니다. 우선, RV32I에서 명령어의
하위 두 LSB가 항상 2'b11이라는 것을 눈치채셨을 것입니다.
따라서 이 비트들은 로드할 필요가 없습니다:
   reg [31:2] instr;
   ...
   instr <= mem_rdata[31:2];
   ...
   wire isALUreg  =  (instr[6:2] == 5'b01100);
   ...
또 하나 있습니다. 주소 공간은 24비트뿐인데 모든 주소 계산을 32비트로 하고 있으므로, 여기서 자원을 상당히 절약할 수 있습니다.
   localparam ADDR_WIDTH=24;
   wire [ADDR_WIDTH-1:0] PCplusImm = PC + ( instr[3] ? Jimm[31:0] :
                  instr[4] ? Uimm[31:0] :
                             Bimm[31:0] );
   wire [ADDR_WIDTH-1:0] PCplus4 = PC+4;

   wire [ADDR_WIDTH-1:0] nextPC = ((isBranch && takeBranch) || isJAL) ? PCplusImm   :
                                      isJALR   ? {aluPlus[31:1],1'b0} :
                                                 PCplus4;

   wire [ADDR_WIDTH-1:0] loadstore_addr = rs1 + (isStore ? Simm : Iimm);
최신 Verilog 파일은 step22.v에 있습니다. 이제 다음 프로그램으로 프로세서에서 SPI 플래시에 접근할 수 있는지 확인해 봅시다.
#include "io.h"
#define SPI_FLASH_BASE ((char*)(1 << 23))
int main()  {
   for(int i=0; i<16; ++i) {
      IO_OUT(IO_LEDS,i);
      int lo = (int)SPI_FLASH_BASE[2*i  ];
      int hi = (int)SPI_FLASH_BASE[2*i+1];
      print_hex_digits((hi << 8) | lo,4); // print four hexadecimal digits
      printf(" ");
   }
   printf("\n");
}
SPI 플래시는 23번 비트가 설정된 주소를 사용하여 메모리 공간에
매핑됩니다(SPI_FLASH_BASE라고 부르는 첫 주소는
1 << 23입니다). 그런 다음 바이트 하나하나에 접근하고,
이를 16비트 워드로 묶어 표시합니다(RISC-V는 리틀 엔디언 규약을 따르므로
각 워드에서 메모리상의 첫 바이트가 최하위 바이트입니다). 이 작업은 FIRMWARE/print.c에 있는
print_hex_digits() 함수가 수행합니다(두 번째 인자는 각
숫자마다 출력할 16진수 문자의 개수입니다).
이제 다음과 같이 프로그램을 컴파일하고, 설계를 합성한 뒤 장치로 전송하십시오:
 $ cd FIRMWARE
 $ make read_spiflash.bram.hex
 $ cd ..
 $ BOARDS/run_icestick.sh step22.v
 $ ./terminal.sh
... 그런데 아무것도 보이지 않습니다. 왜 그럴까요? 터미널을 시작하기 전에 프로그램이 이미 끝났기 때문에 아무것도 볼 수 없었습니다. 하지만 (2단계에서 언급한) 보이지 않는 리셋 버튼을 눌러 프로세서를 리셋할 수 있습니다. 이 "버튼"을 누를 때마다 SPI 플래시에 저장된 처음 16개의 워드가 터미널에 표시됩니다. IceStick에서는 다음과 비슷한 내용이 보입니다:
00FF FF00 AA7E 7E99 0051 0501 0092 6220 4B01 0072 8290 0000 0011 0101 0000 0000이 값들이 어디에서 오는지 짐작이 가십니까? FPGA 보드에 이 SPI 플래시
칩이 왜 있는지 떠올려 보십시오. 바로 여러분의 설계가 저장되는 곳입니다.
FPGA가 시작되면 SPI 플래시에서 설계를 불러옵니다. 이 설계는
yosys/nextpnr/icepack 파이프라인의 마지막에 생성되는
SOC.bin 파일에 해당합니다:
yosys는 여러분의 Verilog를 "넷리스트(netlist)"라고도 부르는 "회로"로 변환하고,- 그다음
nextpnr은 이 회로의 게이트를 FPGA의 논리 요소에 매핑하며, - 마지막으로
icepack은 그 결과를 FPGA가 직접 이해하는 "바이너리 스트림"으로 변환합니다.
바이너리 스트림의 처음 16개 워드를 살펴봅시다:
$ od -x -N 32 SOC.bin그러면 다음과 비슷한 내용이 보입니다:
0000000 00ff ff00 aa7e 7e99 0051 0501 0092 6220
0000020 4b01 0072 8290 0000 0011 0101 0000 0000
0000040
그리고 이것은 방금 터미널에서 본, SPI 플래시 칩에서 읽어 온 내용과
일치합니다. 즉, 우리 CPU는 마치 생물학자가 자신의 DNA를 시퀀싱하듯이 SPI
플래시에서 자기 자신의 FPGA 표현을 읽을 수 있습니다! 멋지고 흥미로운
재귀적 느낌이 있기는 하지만 실용성은 아마 거의 없을 것입니다. 그래도 좀
더 깊이 살펴봅시다. SOC.bin 파일은 그다지 크지
않습니다:
$ ls -al SOC.bin
-rw-rw-r-- 1 blevy blevy 32220 Jan  7 07:31 SOC.bin
크기가 32KB 정도에 불과하고, 우리 SPI 플래시 칩의 용량은
4MB이므로 공간이 충분합니다! 유일하게 주의해야 할 점은 FPGA
구성을 덮어쓰지 않는 것입니다(다른 워드로 말하면, 항상
SOC.bin의 크기보다 더 먼 위치에서 시작해야 합니다). 그래서
데이터를 저장할 때 1MB 오프셋을
사용하겠습니다(32KB와 1MB 사이의 공간을 많이
낭비한다고 생각하실 수도 있지만, 이 공간은 이 튜토리얼의 이후 단계에서
다른 용도로 사용할 것입니다).
직접 해 보십시오 텍스트 파일
hello.txt를 만들어 1MB 오프셋에 FPGA로
전송하고(방법은 아래를 참고하십시오), 저장된 파일을 표시하는 프로그램을
작성해 보십시오. 어디에서 멈출지 알려면 종료 문자를 정하거나 파일 길이를
미리 기록해 두어야 할 수 있습니다.
ICE40 보드(IceStick, IceBreaker, ...)의 경우 다음을 사용하십시오:
$ iceprog -o 1M hello.txtECP5 보드(ULX3S)의 경우 다음을 사용하십시오:
 $ cp hello.txt hello.img
$ ujprog -j flash -f 1048576 hello.img(https://github.com/kost/fujprog에서
컴파일한 최신 버전의 ujprog를 사용합니다).
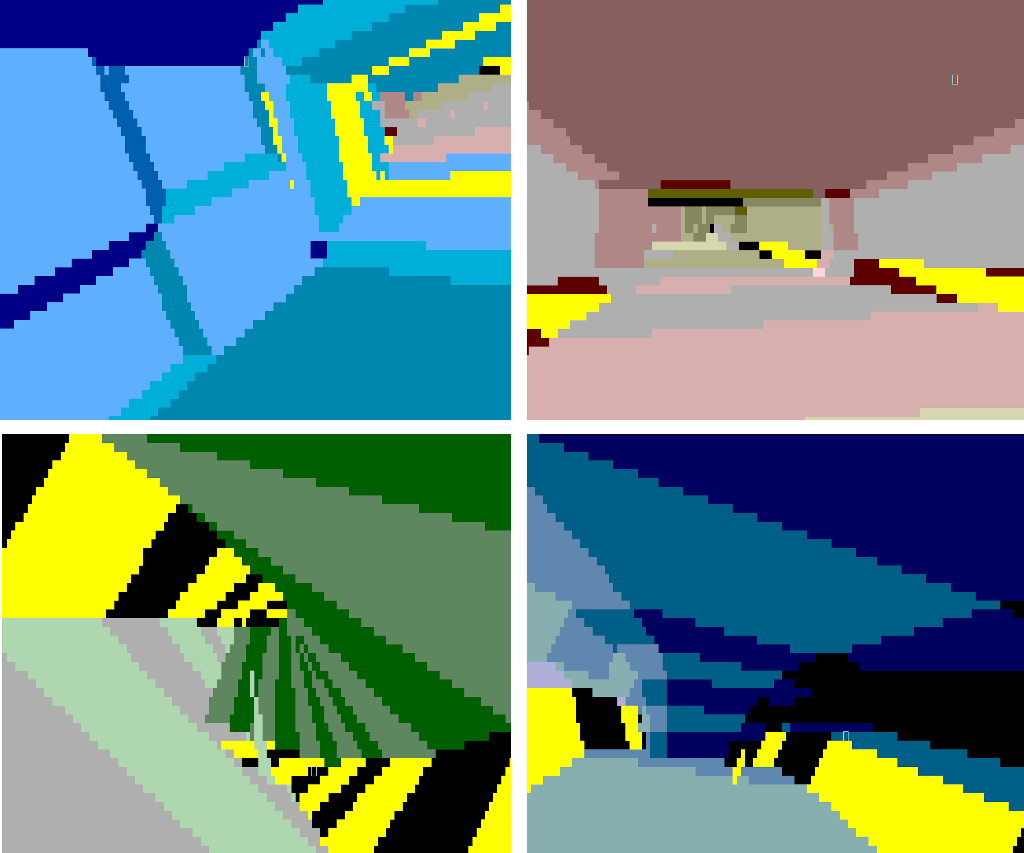
자, 이제 새로 확보한 저장 공간을 더 흥미로운 용도로 사용할 준비가
되었습니다. 이번에 할 일은 터미널에 애니메이션을 표시하는 것입니다. 이
애니메이션은 90년대의 데모로, 다각형 데이터를 소프트웨어 다각형 렌더러로
스트리밍합니다. 다각형 데이터는 640kB 크기의 바이너리 파일로,
learn_fpga/FemtoRV/FIRMWARE/EXAMPLES/DATA/scene1.dat에서
구할 수 있습니다(파일 형식에 대한 자세한 정보는 같은 디렉터리의 다른
파일을 참조하십시오). 가장 먼저 할 일은 이 파일을 SPI 플래시의 1MB
오프셋 위치부터 기록하는 것입니다. ICE40 기반 보드(IceStick,
IceBreaker)에서는 다음을 사용하십시오:
$ iceprog -o 1M learn_fpga/FemtoRV/FIRMWARE/EXAMPLES/DATA/scene1.datECP5 보드(ULX3S)에서는 다음을 사용하십시오:
 $ cp learn_fpga/FemtoRV/FIRMWARE/EXAMPLES/DATA/scene1.dat scene1.img
$ ujprog -j flash -f 1048576 scene1.img(https://github.com/kost/fujprog에서
컴파일한 최신 버전의 ujprog를 사용합니다).
이제 프로그램을 컴파일할 수 있습니다:
 $ cd FIRMWARE
 $ make ST_NICCC.bram.hex
 $ cd ..
그리고 디자인과 프로그램을 장치로 전송합니다:
 $ BOARDS/run_xxx.sh step22.v
 $ ./terminal.sh
직접 해 보십시오 SPI 플래시에 이미지를 (읽기 쉬운
형식으로) 저장하고, 이를 표시하는 프로그램을 작성해 보십시오. 픽셀
하나를 보내려면 printf("\033[48;2;%d;%d;%dm ",R,G,B);를
사용하고(여기서 R,G,B는 0에서 255
사이의 숫자입니다), 각 스캔라인이 끝날 때마다
printf("\033[48;2;0;0;0m\n");를 사용하면 됩니다.
23단계: SPI 플래시에서 프로그램 실행하기, 첫걸음
이전 단계에서 한 작업 덕분에 이제 SPI 플래시에서 데이터를 불러올 수 있고 모든 데이터를 담을 넉넉한 공간도 생겼지만, 코드와 변수가 함께 나눠 쓰는 공간은 여전히 6 kB뿐이며, 이는 그리 많지 않습니다! SPI 플래시에 코드를 저장하고 거기서 바로 실행할 수 있다면 정말 좋을 것입니다. 우리는 6 kB에 들어가는 멋진 데모들을 작성할 수 있었습니다. 코드용으로 2 MB를 쓰고 변수용으로 6 kB 전체를 쓸 수 있다면 무엇을 할 수 있을지 상상해 보십시오!
SPI 플래시에서 코드를 불러올 수 있게 하려면, mem_rbusy가
0이 될 때까지 WAIT_INSTR 상태에 머무르도록 바꾸기만 하면
됩니다. 따라서 state를 EXECUTE로 바꾸기 전에
mem_rbusy를 검사하기만 하면 됩니다:
   WAIT_INSTR: begin
      instr <= mem_rdata[31:2];
      rs1 <= RegisterBank[mem_rdata[19:15]];
      rs2 <= RegisterBank[mem_rdata[24:20]];
      if(!mem_rbusy) begin
     state <= EXECUTE;
      end
   end
그리고 BRAM을 다음 프로그램으로 초기화합니다. 이 프로그램은 주소
0x00820000으로 점프합니다:
   initial begin
      LI(a0,32'h00820000);
      JR(a0);
   end
이 주소는 SPI 플래시가 CPU의 주소 공간에 투영되는
주소(0x00800000 = 1 << 23)에
128kB(0x20000)의 오프셋을 더한 것입니다. 이 128 kB 오프셋이
필요한 이유는, 기억하시겠지만 SPI 플래시를 FPGA와 공유하고 있고 FPGA가
자신의 구성을 그 안에 저장하기 때문입니다!
자, 하드웨어 부분은 대략 이것으로 끝입니다. 이제 거기서 코드를 실행할 수 있는지 확인해 봅시다. 이를 위해 새로운 링커 스크립트(FIRMWARE/spiflash0.ld)가 필요합니다:
MEMORY {
   FLASH (RX)  : ORIGIN = 0x00820000, LENGTH = 0x100000 /* 4 MB in flash */
}
SECTIONS {
    everything : {
    . = ALIGN(4);
    start.o (.text)
        *(.*)
    } >FLASH
}
이전과 같지만, 링커에게 모든 것을 플래시 메모리에 배치하라고 지시합니다(전역 변수의 경우 어떻게 동작하는지는 나중에 살펴보겠습니다). 전역 변수에 쓰기를 하지 않는 프로그램, 예를 들어 FIRMWARE/hello.S로 테스트해 봅시다. 새 링커 스크립트를 사용해 링크하려면 다음과 같이 합니다:
$ riscv64-unknown-elf-ld -T spiflash0.ld -m elf32lriscv -nostdlib -norelax hello.o putchar.o -o hello.spiflash0.elf하지만 이를 일일이 입력하기는 번거로우므로, Makefile로 자동화되어 있습니다:
$ make hello.spiflash0.elf이제 ELF 실행 파일을 플랫 바이너리로 변환해야 합니다:
$ riscv64-unknown-elf-objcopy hello.spiflash0.elf hello.spiflash0.bin -O binary또는 Makefile을 사용합니다:
$ make hello.spiflash0.bin그리고 이를 SPI 플래시의 128k 오프셋 위치로 전송합니다:
$ iceprog -o 128k hello.spiflash0.bin또는 Makefile을 사용합니다:
$ make hello.spiflash0.prog그런 다음:
$ ./terminal.sh24단계: SPI 플래시에서 프로그램 실행하기, 더 나은 링커 스크립트
시작하기 전에 코어를 조금 수정합시다. 리셋 버튼을 누르면 주소 0으로 점프하며, 이 주소에는 플래시 메모리로 점프하는 명령어가 초기값으로 들어 있습니다. 그러나 프로그램을 실행하고 나면 RAM이 다른 용도로 쓰여 플래시로 점프하는 명령어가 더 이상 남아 있지 않을 수 있습니다(그럴 가능성이 매우 높습니다). 이를 해결하려면 reset이 low가 될 때마다 CPU가 플래시 메모리로 점프하도록 하면 됩니다.
   if(!resetn) begin
     PC    <= 32'h00820000;
     state <= WAIT_DATA;
   end
상태가 WAIT_DATA로 설정되므로, 다른 작업을 하기 전에
mem_rbusy가 low가 될 때까지 기다린다는 점에
유의하십시오.
자, 이제 코드를 넣어 두고 그곳에서 바로 실행할 수 있는 큰 플래시
메모리가 생겼습니다. 앞의 예제에 나온 문자열
.asciz "Hello, world !\n"처럼 읽기 전용 변수도 그곳에 넣을
수 있습니다. 그렇다면 지역 변수는 어떻습니까? 지역 변수는 스택에
할당되고, 스택은 우리가 가진 6 kB의 RAM에 있으므로 문제없이 동작합니다.
스택이 어디에 있는지는 어떻게 알 수 있습니까? 앞에서 FIRMWARE/start.S를 작성했던 것을 떠올려
보십시오. 이 파일이 sp를 RAM의 끝(0x1800)으로
초기화하며, 그것으로 충분합니다.
그러나 다음과 같은 프로그램에서는 어떻게 동작합니까?
  int x = 3;
  void main() {
     x = x + 1;
     printf("%d\n",x);
  }
전역 변수 x에는 어딘가에 저장해 두어야 하는 초기값이
있으므로 플래시 메모리에 넣어야 합니다. 그런데 나중에 이 값을 수정하므로
RAM에도 넣어야 합니다. 어떻게 이것이 가능하겠습니까? 실제로 필요한 것은
(초기화된) 전역 변수의 초기값을 모두 플래시 메모리에 저장해 두었다가
시작할 때 RAM으로 복사하는 메커니즘입니다. 이를 위해서는 새 링커
스크립트(변수를 어디에 두고 그 초기값을 어디에 둘지 지정합니다)와 새
start.S(초기값을 변수로 복사합니다)가 필요합니다. 그 방법을
살펴봅시다.
C 코드를 컴파일하면 컴파일러는 각 요소가 어디에 배치되는지(섹션)를 나타내는 지시어를 삽입합니다. 확인해 보려면 우리가 작성한 C 프로그램 중 하나에서 어셈블리를 생성하십시오.
$ cd FIRMWARE
$ make ST_NICCC.o
$ readelf -S ST_NICCC.o
그러면 오브젝트 파일에 있는 여러 섹션을 볼 수 있습니다.
| 섹션 | 설명 |
|---|---|
| text | 실행 파일 코드 |
| bss, sbss | 초기화되지 않은 데이터 |
| 데이터, sdata | 읽기-쓰기 데이터 |
| rodata | 읽기 전용 데이터 |
초기화되지 않은 데이터의 섹션 이름(bss)은 60년대까지 거슬러 올라가는 역사적인 이유에서 비롯되었습니다(BSS: Block Started by Symbol은 IBM 704용 어셈블러의 의사 명령어입니다). 초기화되지 않은 데이터 섹션과 초기화된 데이터 섹션에는 각각 두 가지 종류가 있으며, sbss와 sdata는 각각 크기가 작은 초기화되지 않은 데이터와 초기화된 데이터를 위한 섹션입니다.
readelf 출력에는 type 필드도 있습니다.
PROGBIT는 파일에서 어떤 데이터를 로드해야 한다는
뜻입니다(text, data, rodata
세그먼트의 경우). NOBITS는 로드할 데이터가 없다는
뜻입니다(bss의 경우). 다음으로 Addr는 섹션이
메모리의 어디에 매핑될지를 나타냅니다(.o 파일에서는 항상
0이지만, 링크된 elf 실행 파일에서는 유용하며 readelf로
확인할 수 있습니다). 그리고 Offs 필드는 .o
파일 안에서 섹션 데이터의 오프셋을 나타내고, Size 필드는
섹션의 바이트 수를 나타냅니다.
따라서 우리가 해야 할 일은 다음 내용을 지정하는 링커 스크립트를 작성하는 것입니다.
text섹션은 플래시 메모리에 배치합니다bss섹션은 BRAM에 배치합니다data섹션은 BRAM에 배치하되, 초깃값은 플래시 메모리에 저장합니다
text와 bss는 이미 어떻게 하는지 알고
있습니다. data의 경우, 링커 스크립트는 초기값을 저장할
위치를 나타내는 LMA(Load Memory Address, 로드 메모리 주소)를 지정할 수
있습니다. 우리 링커 스크립트에는 다음과 같은 내용이 들어갑니다.
  MEMORY {
      FLASH (rx)  : ORIGIN = 0x00820000, LENGTH = 0x100000
      RAM   (rwx) : ORIGIN = 0x00000000, LENGTH = 0x1800
  }
  SECTIONS {

    .data: AT(address_in_spi_flash) {
      *(.data*)
      *(.sdata*)
    } > RAM

    .text : {
      start_spiflash1.o(.text)
      *(.text*)
      *(.rodata*)
      *(.srodata*)
    } >FLASH

    .bss : {
      *(.bss*)
      *(.sbss*)
    } >RAM
  }
각 섹션은 오브젝트 파일에서 읽은 섹션을 실행 파일의
섹션(.data, .text, .bss)에 어떻게
매핑할지, 그리고 이 섹션들을 플래시 메모리와 BRAM에 어떻게 매핑할지를
나타냅니다. 각 섹션마다 몇 가지 패턴 매칭 규칙이 오브젝트 파일의 어떤
섹션이 해당되는지를 나타냅니다. .text 섹션에서는 첫 번째
섹션이 반드시 start_spiflash1.o의 text 섹션이 되도록
합니다. 프로세서가 리셋 시 그곳으로 점프하기 때문입니다. 또한 읽기 전용
데이터(.rodata와 .srodata)를 플래시에 넣는다는
점에도 유의하십시오.
.data 섹션에서 AT 키워드는 링커가 초기값을
넣을 LMA(Load Memory Address, 로드 메모리 주소), 즉 SPI 플래시 안의
주소를 나타내며, data 또는 sdata 섹션의 심볼이
참조될 때마다 링커는 RAM 안에서의 해당 주소를 사용합니다.
하지만 한 가지 의문이 남습니다. 시스템은 초기화 데이터를 플래시에서
BRAM으로 복사해야 한다는 것을 어떻게 알 수 있습니까? 어느 주소로
복사해야 하는지는 어떻게 알 수 있습니까? 초기화되지 않은 데이터(BSS)를
0으로 초기화하려면 어떻게 해야 합니까? 사실 이 작업은 시작 코드
start_spiflash1.S에서 직접 해야 하며, 그 코드는 다음과
같습니다.
.equ IO_BASE, 0x400000

.text
.global _start
.type _start, @function

_start:
.option push
.option norelax
     li  gp,IO_BASE
.option pop

     li   sp,0x1800

# zero-init bss section:
     la a0, _sbss
     la a1, _ebss
     bge a0, a1, end_init_bss
loop_init_bss:
     sw zero, 0(a0)
     addi a0, a0, 4
     blt a0, a1, loop_init_bss
end_init_bss:

# copy data section from SPI Flash to BRAM:
     la a0, _sidata
     la a1, _sdata
     la a2, _edata
     bge a1, a2, end_init_data
loop_init_data:
     lw a3, 0(a0)
     sw a3, 0(a1)
     addi a0, a0, 4
     addi a1, a1, 4
     blt a1, a2, loop_init_data
end_init_data:

     call main
ebreak- 가장 먼저 하는 일은 스택 포인터와 범용 포인터
gp를 초기화하는 것입니다(여기서는 IO 페이지 주소로 초기화합니다). - 첫 번째 루프는
_sbss와_ebss사이의 메모리를 지웁니다. - 두 번째 루프는
_sidata에서_sdata..._edata로 데이터를 복사합니다 - 마지막으로
main을 호출합니다
... 그런데 잠깐,
_sbss,_ebss,_sidata,_sdata,_edata의
값은 어떻게 알 수 있습니까?
사실 링커 스크립트가 이 값들을 대신 생성해 줄 수 있습니다.
.data 섹션은 다음과 같습니다.
    .data : AT ( _sidata ) {
        . = ALIGN(4);
        _sdata = .;
        *(.data*)
        *(.sdata*)
        . = ALIGN(4);
        _edata = .;
    } > RAM
여기서 .는 현재 주소를 나타냅니다. 또한
. = ALIGN(4); 같은 줄은 주소가 4바이트 경계에 맞춰 정렬된
상태를 유지하도록 합니다. start_spiflash1.S의 초기화 루프가
이에 의존하기 때문입니다.
.text 섹션의 선언은 다음과 같습니다.
    .text : {
        . = ALIGN(4);
        start_spiflash1.o(.text)
        *(.text*)
        . = ALIGN(4);
        *(.rodata*)
        *(.srodata*)
        _etext = .;
        _sidata = _etext;
    } >FLASH
text 섹션의 바로 끝에 _sidata를 선언하여
.data 섹션이 그곳에 초기화 데이터를 넣을 수 있도록 한다는
점에 유의하십시오.
좋습니다. 그러면 예제 중 하나로 시험해 봅시다.
  $ cd FIRMWARE
  $ make mandel_C.spiflash1.prog
  $ cd ..
  $ ./terminal.sh
네, 동작은 합니다. 하지만 잠깐, 이전보다 상당히 느립니다. 왜 그런지 짐작하실 수 있습니까?
플래시 메모리는 직렬 메모리라는 점을 기억하십시오. 즉, 주소가 한 번에 한 비트씩 전송되고 결과도 한 번에 한 비트씩 얻어지므로(사실 우리의 경우에는 둘 다 한 번에 두 비트씩입니다), 한 사이클에 32비트 값을 얻는 BRAM보다 훨씬 느립니다. 무언가 할 수 있겠습니까? 물론 할 수 있습니다! 몇몇 핵심 함수를 BRAM에 넣으면 어떻겠습니까? 그렇게 하려면 링커 스크립트를 다음과 같이 변경하면 됩니다(결과는 FIRMWARE/spiflash2.ld에 있습니다):
    .data_and_fastcode : AT ( _sidata ) {
        . = ALIGN(4);
        _sdata = .;

    /* Initialized data */
        *(.data*)
        *(.sdata*)

    /* integer mul and div */
    */libgcc.a:muldi3.o(.text)
    */libgcc.a:div.o(.text)

    putchar.o(.text)
    print.o(.text)

    /* functions with attribute((section(".fastcode"))) */
    *(.fastcode*)

        . = ALIGN(4);
        _edata = .;
    } > RAM
이렇게 하면 특정 함수들(libgcc의 정수 곱셈·나눗셈 함수와 IO 함수)을
빠른 RAM에 넣어야 한다고 지정하게 되며, 우리가 할 일은 이것이
전부입니다! 링커는 이 함수들의 코드를 초기화된 변수의 초기화 데이터와
같은 섹션에 배치하고, 런타임 start_spiflash1.S가 시작 시
초기화 데이터와 함께 이 코드를 RAM으로 복사합니다. 멋지지 않습니까!
우리 예제로 시험해 봅시다:
  $ cd FIRMWARE
  $ make mandel_C.spiflash2.prog
  $ cd ..
  $ ./terminal.sh
아아, 훨씬 낫습니다!
*(.fastcode*) 줄에도 주목하십시오. 직접 작성한 함수가
fastcode 섹션에 있다고 지정하면 그 함수를 BRAM에 넣을 수
있습니다. C에서는 다음과 같이 할 수 있습니다:
 void my_function(my args ...) __attribute((section(".fastcode")));
 void my_function(my args ...) {
      ...
 }
직접 해 보십시오. ST_NICCC 데모를
실행하십시오(make ST_NICCC.spiflash2.prog). 그런 다음
ST_NICCC.c에서 RV32_FASTCODE를 정의하는 줄의
주석을 해제하고 다시 실행하십시오.
이제 우리 장치에서 더 큰 프로그램을 실행할 수 있습니다:
- FIRMWARE/pi.c (Fabrice Beillard 작성, 원주율의 소수 자릿수를 계산합니다)
- FIRMWARE/tinyraytracer.c (Dmitry Sokolov 작성, 레이트레이싱)
두 프로그램 모두 부동소수점 수를 사용합니다. 우리 것과 같은 RV32I
코어에서는 부동소수점 수 연산에 libgcc에 구현된 루틴을
사용합니다. 그 결과 실행 파일이 더 커지며(pi는 17 kB,
tinyraytracer는 25 kB입니다), 6 kB RAM에서는 실행할 수
없었을 것입니다. SPI 플래시가 제공하는 추가 메모리 덕분에 우리 장치로 할
수 있는 일이 훨씬 많아집니다!
이 시점에서 우리 장치는 표준 도구(gcc)로 컴파일한 코드를 실행할 뿐만
아니라, 독립적으로 개발된 기존 코드(libgcc의 수학 루틴)도
실행합니다. 직접 만든 프로세서에서 기존 바이너리 코드를 실행하는 것은 꽤
신나는 일입니다!
다음 튜토리얼
모든 단계의 파일
- 1단계: 점멸기, 너무 빨라서 아무것도 보이지 않습니다
- 2단계: 클록워크를 사용한 점멸기
- 3단계: ROM에서 패턴을 불러오는 점멸기
- 4단계: 명령어 디코더
- step 5: 레지스터 뱅크와 상태 기계
- step 6: ALU
- step 7: VERILOG 어셈블러 사용하기
- step 8: 점프
- step 9: 분기
- step 10: LUI와 AUIPC
- step 11: 메모리를 별도 모듈로 분리하기
- step 12: 크기 최적화: 놀랍도록 줄어드는 코어!
- step 13: 서브루틴 1(표준 Risc-V 명령어 집합)
- step 14: 서브루틴 2(Risc-V 의사 명령어 사용)
- step 15: 로드
- step 16: 스토어
- step 17: 메모리 매핑 장치
- step 18: 망델브로 집합
- step 19: Verilator로 더 빠르게 시뮬레이션하기
- step 20: GNU 툴체인으로 어셈블리 프로그램 컴파일하기
- step 21: GNU 툴체인으로 C 프로그램 컴파일하기
- step 22: 메모리를 더 많이! SPI 플래시 사용하기
- step 23: SPI 플래시에서 프로그램 실행하기, 첫걸음
- step 24: SPI 플래시에서 프로그램 실행하기, 더 나은 링커 스크립트
작업 중
- step 25: 더 많은 장치(LED 매트릭스, OLED 화면 등)