Blinker에서 RISC-V까지 에피소드 II - 파이프라이닝
이전 에피소드에서는 FPGA 위에 완전히 동작하는 RISC-V 프로세서를 만드는 방법을 배웠습니다. 우리 프로세서는 명령어 하나당 3~4 사이클을 사용하므로 가장 효율적이라고 할 수는 없습니다. 현대 프로세서는 여러 기법 덕분에 훨씬 더 효율적이며, 사이클당 여러 개의 명령어를 실행할 수 있습니다. 여기서는 아주 단순한 우리 프로세서를 더 효율적인 파이프라인 프로세서로 탈바꿈시키는 방법을 살펴보겠습니다.
이번 에피소드를 진행하려면 BRAM이 최소 128kB인 FPGA(예: ULX3S)가 필요합니다. 순수하게 시뮬레이션만으로 실행할 수도 있습니다.
1단계: 명령어 메모리와 데이터 메모리 분리하기
이전 프로세서 step24.v는 "통합 메모리"를
가지고 있어서, 프로그램과 데이터 모두 같은 배선을 사용해 접근합니다.
파이프라인 프로세서는 내부 사정이 다릅니다. 프로그램 메모리와 데이터
메모리가 분리되어 있습니다. 사실 이 메모리들은 캐시이며, 외부 세계와
연결된 하나의 메모리 버스로부터 채워집니다. 아직은 캐시가 어떻게
동작하는지 제가 모르므로(다음 단계에서 다룰 예정입니다), 일을 단순하게
하기 위해 프로세서 안에 "프로그램 ROM"과 "데이터 RAM"(각각 64 kB)을 두고
.hex 파일로부터 직접 초기화하겠습니다(ELF 실행
파일로부터 이 .hex 파일들을 만드는 방법은 나중에
살펴보겠습니다):
   reg [31:0] PROGROM [0:16383];
   reg [31:0] DATARAM [0:16383];
   initial begin
      $readmemh("PROGROM.hex",PROGROM);
      $readmemh("DATARAM.hex",DATARAM);
endPROGROM은 명령어가 저장되는 곳입니다.DATARAM은 변수가 저장되는 곳입니다.LOAD와STORE명령어는 이 메모리를 읽고 쓸 수 있습니다(하지만 프로그램 메모리에는 접근할 수 없습니다).
이전의 메모리 버스는 내부 배선으로 대체됩니다:
   wire [31:0] mem_addr;
   wire [31:0] mem_rdata;
   wire [31:0] mem_wdata;
   wire [3:0]  mem_wmask;
이전과 비교하면 mem_rstrobe와 mem_rbusy가
더 이상 없습니다. 내부 메모리는 항상 다음 사이클에
mem_addr의 데이터를 전달합니다.
외부 세계와 통신할 수 있도록, 우리 프로세서에는 여전히 매핑된 IO
페이지를 위한 메모리 버스가 있습니다(UART 및 기타 장치와
통신하는 데 사용합니다):
module Processor (
    ...
    output [31:0] IO_mem_addr,
    input [31:0]  IO_mem_rdata,
    output [31:0] IO_mem_wdata,
    output    IO_mem_wr
);
이제 모든 것을 내부 메모리 버스로 연결해야 합니다. 같은 코드를 재사용할 수 있도록 이전과 같은 IO 페이지를 유지하며, 이는 메모리 주소의 22번 비트로 표시됩니다:
   wire isIO  = mem_addr[22];
   wire isRAM = !isIO;
데이터 RAM은 다음과 같이 매 사이클마다 읽히고, 필요에 따라 쓰입니다:
   wire [13:0] mem_word_addr = mem_addr[15:2];
   reg [31:0] dataram_rdata;
   wire [3:0] dataram_wmask = mem_wmask & {4{isRAM}};
   always @(posedge clk) begin
      dataram_rdata <= DATARAM[mem_word_addr];
      if(dataram_wmask[0]) DATARAM[mem_word_addr][ 7:0 ] <= mem_wdata[ 7:0 ];
      if(dataram_wmask[1]) DATARAM[mem_word_addr][15:8 ] <= mem_wdata[15:8 ];
      if(dataram_wmask[2]) DATARAM[mem_word_addr][23:16] <= mem_wdata[23:16];
      if(dataram_wmask[3]) DATARAM[mem_word_addr][31:24] <= mem_wdata[31:24];
   end
그런 다음 외부 IO 버스를 연결할 수 있습니다:
   assign mem_rdata = isRAM ? dataram_rdata : IO_mem_rdata;
   assign IO_mem_addr  = mem_addr;
   assign IO_mem_wdata = mem_wdata;
   assign IO_mem_wr    = isIO & mem_wmask[0];
마지막으로, 몇 가지 간단한 수정을 해야 합니다:
- 명령어는
FETCH_INSTR상태에서PROGROM으로부터 가져옵니다:instr <= PROGROM[PC[15:2]]; mem_rbusy신호가 더 이상 없으므로(DATARAM과PROGROM은 항상 한 사이클 안에 접근된다는 점을 기억하십시오) 상태 기계가 단순해집니다. 그 대가로 이전처럼 SPI 플래시에서 프로그램을 실행할 수는 없게 됩니다(PROGROM이 명령어 캐시로 대체되면 다시 가능해질 것입니다).
업데이트된 Verilog 소스는 여기에 있습니다: pipeline1.v
새 코어를 위한 소프트웨어도 작성해야 합니다. 소프트웨어는 두 개의
ASCII 16진수 파일 PROGROM.hex와 DATARAM.hex의
형태를 띠며, 각각 프로그램 메모리의 내용과 데이터 메모리의 초기 내용을
담고 있습니다. 먼저 메모리 맵을 기술한 새 링커 스크립트를 만들어야
합니다:
MEMORY {
   PROGROM (RX) : ORIGIN = 0x00000, LENGTH = 0x10000  /* 64kB ROM */
   DATARAM (RW) : ORIGIN = 0x10000, LENGTH = 0x10000  /* 64kB RAM */
}
ROM이 처음 64킬로바이트를 차지하고, 그다음에 RAM이 옵니다.
그런 다음 섹션을 기술하여, 텍스트 세그먼트는 PROGROM으로
보내고 나머지는 DATARAM으로 보내도록 지정합니다:
SECTIONS {

    .text : {
        . = ALIGN(4);
    start_pipeline.o (.text)
        *(.text*)
    } > PROGROM

    .data : {
    . = ALIGN(4);
        *(.data*)
        *(.sdata*)
        *(.rodata*)
        *(.srodata*)
        *(.bss*)
        *(.sbss*)

        *(COMMON)
        *(.eh_frame)
        *(.eh_frame_hdr)
        *(.init_array*)
        *(.gcc_except_table*)
    } > DATARAM
}
텍스트 세그먼트는 start_pipeline.S의 내용으로
시작합니다:
.equ IO_BASE, 0x400000
.section .text
.globl start
start:
        li   gp,IO_BASE
    li   sp,0x20000
    call main
    ebreak
이 링커 스크립트를 사용하면 모든 코드는 메모리의 처음 64킬로바이트에, 데이터는 그다음 64킬로바이트에 배치된 ELF 바이너리를 생성할 수 있습니다. 예를 들어, 원주율(pi)의 소수점 이하 자릿수를 계산하는 Fabrice Bellard의 프로그램은 다음과 같이 컴파일합니다:
$ cd FIRMWARE
$ riscv64-unknown-elf-gcc -Os -fno-pic -march=rv32i -mabi=ilp32 -fno-stack-protector -w -Wl,--no-relax   -c pi.c
$ riscv64-unknown-elf-as -march=rv32i -mabi=ilp32   start_pipeline.S -o start_pipeline.o
$ riscv64-unknown-elf-as -march=rv32i -mabi=ilp32   putchar.S -o putchar.o
$ riscv64-unknown-elf-as -march=rv32i -mabi=ilp32   wait.S -o wait.o
$ riscv64-unknown-elf-gcc -Os -fno-pic -march=rv32i -mabi=ilp32 -fno-stack-protector -w -Wl,--no-relax   -c print.c
$ riscv64-unknown-elf-gcc -Os -fno-pic -march=rv32i -mabi=ilp32 -fno-stack-protector -w -Wl,--no-relax   -c memcpy.c
$ riscv64-unknown-elf-gcc -Os -fno-pic -march=rv32i -mabi=ilp32 -fno-stack-protector -w -Wl,--no-relax   -c errno.c
$ riscv64-unknown-elf-ld -T pipeline.ld -m elf32lriscv -nostdlib -norelax pi.o putchar.o wait.o print.o memcpy.o errno.o -lm libgcc.a -o pi.pipeline.elfMakefile이 다음과 같이 이 작업을 대신 처리해 줍니다:
$ make pi.pipeline.elf메모리 맵을 살펴볼 수 있습니다:
$ readelf -a pi.pipeline.elf | more그러면 .text와 .data가 예상한 위치에 있음을
확인할 수 있습니다:
Section Headers:
  [Nr] Name              Type            Addr     Off    Size   ES Flg Lk Inf Al
  [ 0]                   NULL            00000000 000000 000000 00      0   0  0
  [ 1] .text             PROGBITS        00000000 000074 003fd8 00  AX  0   0  4
[ 2] .data PROGBITS 00010000 004050 0002c0 00 WA 0 0 8PROGROM.hex와 DATARAM.hex를 생성하려면
firmware_words 유틸리티를 사용할 수 있습니다. 이
유틸리티에는 .hex 파일에 기록할 메모리 영역을 선택하는
-from_addr 인자와 -to_addr 인자가
있습니다:
$ firmware_words pi.pipeline.elf -ram 0x20000 -max_addr 0x20000 -out pi.PROGROM.hex -from_addr 0 -to_addr 0xFFFF
$ firmware_words pi.pipeline.elf -ram 0x20000 -max_addr 0x20000 -out pi.DATARAM.hex -from_addr 0x10000 -to_addr 0x1FFFF
이번에도 Makefile이 이 작업을 대신 처리해 줍니다(또한
.hex 파일을 필요한 위치에 복사하는 작업도 함께
수행합니다):
$ make clean
$ make pi.pipeline.hex
(먼저 make clean을 실행해야 합니다. 그렇지 않으면
기존에 있던 .elf 파일 때문에 혼동이 생깁니다)
이제 시뮬레이션에서 pi를 실행할 수 있습니다:
$ cd ..
$ ./run_verilator.sh pipeline1.v
다른 프로그램(예: tinyraytracer)도 실행해 볼 수
있습니다:
$ cd FIRMWARE
$ make tinyraytracer.pipeline.hex
$ cd ..
$ ./run_verilator.sh pipeline1.v
ULX3S가 있다면 USB 포트에 연결한 다음, 다음을 실행하십시오:
$ BOARDS/run_ulx3s.sh pipeline1.v
$ ./terminal.sh
2단계: 성능 카운터
파이프라이닝의 목적은 성능을 높이는 것이므로, 성능을 측정할 방법이 필요합니다. RISC-V ISA에는 특수 레지스터 집합(Control and Status Registers의 약자로 "CSR"이라고 부릅니다)이 있습니다. CSR은 여러 가지가 있으며, 인터럽트, 보호 수준, 가상 메모리 등을 제어하는 데 사용됩니다. 여기서는 그중 두 개(또는 네 개)만 구현합니다:
CYCLE: 클록 틱 수를 셉니다INSTRET: 리타이어(retire)된 명령어 수를 셉니다(이 두 카운터가 있으면CYCLE을INSTRET으로 나누어 CPI(clock per instruction, 명령어당 클록 수)를 쉽게 계산할 수 있습니다).
CYCLE과 INSTRET은 다음 명령어로 읽을 수
있습니다:
RDCYCLERDCYCLEHRDINSTRETRDINSTRETH
카운터는 64비트 폭이므로 카운터마다 명령어가 두 개씩 있습니다.
RDCYCLE은 하위 32비트(LSB)를 rd로 읽어 오고,
RDCYCLEH는 상위 32비트(MSB)를 rd로 읽어
옵니다(INSTRET도 마찬가지입니다).
사실 이 네 명령어는 의사 명령어(pseudo-instruction)이며, 모두 단일
명령어(CSRRS)로 구현됩니다. 이 명령어는 다음과 같이
인코딩됩니다:
| instr[31:20] | instr[19:15] | instr[14:12] | instr[11:7] | instr[6:0] |
|---|---|---|---|---|
| CSR Id | rs1 | funct3 | rd | SYSTEM |
| 5'b00000 | 3'b010 | 7'b1110011 |
CSRRS 명령어는 CSR의 현재 내용을 원자적으로 읽어
rd에 저장하고, rs1에 따라 CSR의 비트를
설정합니다. rs1이 x0이면 이 명령어는 단순히
CSR을 rd로 복사합니다(우리가 다루는 네 가지 의사 명령어
RDXXX가 바로 이 경우입니다).
- 명령어 워드의 상위 12비트(MSB)는 대상 CSR의 id를 인코딩합니다.
- 우리의 경우
rs1은 항상x0입니다. CSRRS의funct3은3'b010입니다(CSR을 조작하는 다른 명령어도 있지만 여기서는 구현하지 않습니다).rd는 평소와 같이 명령어 워드의 동일한 비트를 사용합니다.- opcode는
SYSTEM입니다(이미 사용하고 있는EBREAK와 같습니다).EBREAK는funct3으로 구별합니다(EBREAK의 경우3'b000입니다).
인식해야 하는 네 가지 CSR의 Id는 다음과 같습니다:
| CSR | Id | Id (2진수) |
|---|---|---|
| 사이클 | C00 | 110000000000 |
| CYCLEH | C80 | 110010000000 |
| INSTRET | C02 | 110000000010 |
| INSTETH | C82 | 110010000010 |
설계에서 64비트 레지스터 두 개를 새로 선언합니다.
cycle은 클록 틱마다 증가합니다:
   reg [63:0] cycle;
   reg [63:0] instret;

   always @(posedge clk) begin
      cycle <= cycle + 1;
   end
그리고 instret은 프로그램 메모리에서 명령어를
가져올(fetch) 때마다 증가합니다:
     ...
     WAIT_INSTR: begin
        rs1 <= RegisterBank[instr[19:15]];
        rs2 <= RegisterBank[instr[24:20]];
        state <= EXECUTE;
        instret <= instret + 1;
     end
     ...
명령어 디코더에서는 둘 다 SYSTEM opcode를 사용하는
EBREAK와 CSRRS를 구별해야 합니다:
   wire isEBREAK     = isSYSTEM & (funct3 == 3'b000);
   wire isCSRRS      = isSYSTEM & (funct3 == 3'b010);
그런 다음 읽어 들인 CSR의 값을 다음과 같이 선언합니다:
   wire [31:0] CSR_data =
           ( instr[27] & instr[21]) ? instret[63:32]:
           (!instr[27] & instr[21]) ? instret[31:0] :
                 instr[27]          ? cycle[63:32]  :
                                      cycle[31:0]   ;
(구현한 네 개의 CSR을 구별하는 데 필요한 instr의 비트만
검사합니다).
마지막으로, 디코딩된 명령어가 CSRRS일 때 이 값을
writeBackData로 보냅니다:
   assign writeBackData = (isJAL || isJALR) ? PCplus4   :
                  isLUI         ? Uimm      :
                  isAUIPC       ? PCplusImm :
                  isLoad        ? LOAD_data :
                  isCSRRS       ? CSR_data  :
                                  aluOut;
그 결과로 완성된 Verilog 설계는 여기에서 볼 수 있습니다: pipeline2.v.
이제 C 프로그램에서 카운터를 쉽게 읽을 수 있도록 몇 가지 유틸리티
함수를 만들어야 합니다. 이 함수들은 FIRMWARE/perf.S에 구현되어 있습니다.
rdcycle()을 살펴봅시다:
rdcycle:
.L0:
   rdcycleh a1
   rdcycle a0
   rdcycleh t0
   bne a1,t0,.L0
   ret
알아 두어야 할 점이 두 가지 있습니다:
- RISC-V RV32 ABI는 64비트 값을
a1과a0에 담아 반환합니다(상위 32비트는a1에 담깁니다). - 64비트 카운터를 읽으려면 명령어 두 개가 필요하므로, 읽는 도중에 하위 32개의 LSB가 랩어라운드될 수 있습니다. 이를 감지하려면 RISC-V 프로그래머 매뉴얼에 설명된 대로 상위 비트를 두 번 읽어 비교하면 됩니다(그리고 두 값이 일치할 때까지 루프를 돕니다).
이 함수는 ABI를 준수하므로 C 코드에서 호출할 수 있다는 점에 유의하십시오. 이 함수는 perf.h에 다음과 같이 선언합니다:
#include <stdint.h>
extern uint64_t rdcycle();(rdinstret()도 마찬가지입니다).
이제 간단한 FIRMWARE/test_rdcycle.c 프로그램으로 프로세서의 성능을 테스트해 봅시다:
#include "perf.h"

int main() {
   for(int i=0; i<100; ++i) {
      uint64_t cycles = rdcycle();
      uint64_t instret = rdinstret();
      printf("i=%d    cycles=%d     instret=%d\n", i, (int)cycles, (int)instret);
   }
   uint64_t cycles = rdcycle();
   uint64_t instret = rdinstret();
   printf("cycles=%d     instret=%d    100CPI=%d\n", (int)cycles, (int)instret, (int)(100*cycles/instret));

}
이제 다음과 같이 프로그램을 컴파일하고, ROM과 RAM 초기 내용을 생성한 뒤 시뮬레이션을 시작할 수 있습니다:
$ cd FIRMWARE
$ make test_rdcycle.pipeline.hex
$ cd ..
$ ./run_verilator.sh pipeline2.v
참고 1: 혹시 궁금하실까 봐 덧붙이면, perf.S는
Makefile이 컴파일하고 링크하는 파일 목록에 이미 포함되어
있습니다.
참고 2: 우리의 printf() 함수는 부동소수점 값을
출력할 수 없으므로 CPI 대신 100*CPI를
출력합니다.
그러면 이 간단한 루프에서 우리의 (단순한) CPU 설계가 약
3.14 CPI로 동작한다는 것을 알 수 있습니다. 이제
tinyraytracer처럼 좀 더 현실적인 프로그램에서는 어떤 결과가
나오는지 살펴봅시다. CPI와 "raystones" 성능 지표를 계산하는 명령어를
여기에 추가합니다: FIRMWARE/raystones.c.
어떤 결과가 나오는지 봅시다:
$ cd FIRMWARE
$ make raystones.pipeline.hex
$ cd ..
$ ./run_verilator.sh pipeline2.v
이 프로그램은 간단한 레이트레이싱 장면을 계산하여 표시하고, 코어의 CPI와 "raystones" 점수를 알려 줍니다.
장치(ULX3S)에서 실행할 수도 있습니다:
$ BOARDS/run_ulx3s.sh pipeline1.v
$ ./terminal.sh
이 프로그램은 Dmitry Sokolov의 tinyraytracer를 C로 옮긴 버전입니다. 레이트레이싱은 소프트웨어로 구현되든 FPU로 구현되든 부동소수점 연산을 대량으로 사용하므로 코어를 벤치마크하기에 흥미로운 대상입니다.
이 프로그램은 CPI(명령어당 사이클 수) 외에도 PCU의 "raystones" 점수를 계산합니다.
"raystones"(pixels/s/MHz 또는
pixels/Mticks)는 현실적인 시나리오(레이트레이싱)에서 코어의
부동소수점 성능을 보여 주는 흥미로운 지표입니다. 우리 코어에서는 다음과
같은 수치를 얻습니다:
| CPI | RAYSTONES |
|---|---|
| 3.034 | 2.614 |
우리 코어는 3 CPI를 약간 넘는 수준으로 동작합니다. 대부분의 명령어는 3사이클이 걸리며, 4사이클이 걸리는 로드 명령어만 예외입니다. 레이트레이싱은 상당히 연산 집약적인 작업이므로, 데이터 집약적인 프로그램이라면 평균 CPI가 4에 더 가까워질 것입니다.
아래 표는 널리 쓰이는 여러 코어의 raystones 성능을 보여 줍니다.
| 코어 | 명령어 집합 | raystones |
|---|---|---|
| serv | rv32i | 0.111 |
| picorv32-minimal | rv32i | 1.45 |
| picorv32-standard | rv32im | 2.352 |
| femtorv-quark | rv32i | 1.99 |
| femtorv-electron | rv32im | 3.373 |
| femtorv-gracilis | rv32imc | 3.516 |
| femtorv-petitbateau | rv32imfc | 45.159 |
| vexriscv imac | rv32imac | 7.987 |
| vexriscv_smp | rv32imafd | 124.121 |
이 코어는 1사이클에 시프트를 수행하는 배럴 시프터를 갖추고 있으므로
femtorv-quark보다 빠릅니다. 다만 rv32im을
지원하며 곱셈을 1사이클에, 나눗셈을 32사이클에 수행하는
femtorv-electron보다는 느립니다.
파이프라이닝으로 무엇을 얻을 수 있다고 기대할 수 있겠습니까?
이상적으로는 파이프라인 프로세서가 1 CPI로 동작하겠지만, 이는 특정
상황(의존성과 분기)을 해결하는 데 필요한 스톨을 고려하지 않은 경우이며,
이에 대해서는 뒤에서 더 다룹니다.
femtorv-gracilis(rv32imc)와 파이프라인 방식인
vexriscv imac을 비교해 보면, vexriscv가 두 배
이상 빠르다는 것을 알 수 있습니다.
따라서 우리의 목표는 현재 프로세서를 vexriscv와
비슷하지만 더 단순한 파이프라인 버전으로 바꾸는 것입니다. 당분간 우리의
ALU는 rv32i 명령어 집합만 지원하며 단일 사이클에
동작합니다. 또한 당분간은 프로그램 메모리와 데이터 메모리를 분리하여
모두 BRAM에 두고, 메모리 읽기/쓰기를 1사이클에 수행합니다. 캐시를
구현하는 방법은 나중에 살펴보겠습니다.
RAYSTONE에 관한 참고: 모든 RAYSTONES 통계는 FIRMWARE/raystones.c에서
#define NO_GRAPHIC 줄의 주석을 해제한 상태로 측정해야
합니다. 이는 FIRMWARE/putchar.S의
putchar() 함수가 문자를 보낸 뒤 UART가 사용 중이 아닐
때까지 기다리기 때문입니다. 이 대기 루프의 반복 횟수는 CPU 주파수와 UART
보드레이트의 비율에 따라 매우 크게 달라질 수 있습니다.
3단계: 순차적인 5스테이지 파이프라인
파이프라인 프로세서는 상태 기계를 사용하는 멀티사이클 프로세서와 비슷하지만, 각 상태가 자체 회로를 가지고 다른 상태들과 동시에 동작하며 자신의 출력을 다음 상태로 넘긴다는 점이 다릅니다(이때는 상태(state)가 아니라 스테이지(stage)라고 부릅니다). 처리해야 할 까다로운 상황이 여럿 있고 지금으로서는 그것을 정확히 어떻게 처리해야 할지 모르기 때문에, 한 단계씩 나아가려고 합니다. 먼저 모든 스테이지를 갖춘 코어를 작성하되, 스테이지들을 동시에 실행하는 대신 한 번에 한 스테이지씩 실행하는 상태 기계로 구동하겠습니다. 그런 다음 모든 스테이지가 동시에 동작할 때 무엇을 수정해야 하는지 살펴보겠습니다.
프로세서 설계에 관한 좋은 책들(Patterson & Hennessy, Harris & Harris)이 모두 그렇듯이, 우리도 5개의 스테이지로 이루어진 아주 고전적인 설계에서 시작하겠습니다:
| 약어 | 전체 이름 | 설명 |
|---|---|---|
| IF | 명령어 인출(Instruction fetch) | 프로그램 메모리에서 명령어를 읽습니다 |
| ID | 명령어 해독(Instruction decode) | 명령어와 즉시값을 해독합니다 |
| EX | 실행(Execute) | ALU 연산, 조건 검사, 주소를 계산합니다 |
| MEM | 메모리 읽기 또는 쓰기 | 로드 및 스토어 |
| WB | 라이트 백(Write back) | 결과를 레지스터 파일에 씁니다 |
(이하에서는 더 고전적인 명칭(IF,IF,EX,MEM,WB) 대신 한 글자로 된 스테이지 이름(F,D,E,M,W)을 사용합니다. 나중에 파이프라인 레지스터에 이름을 붙일 때, 그 레지스터에 쓰는 상태의 글자와 그 레지스터를 읽는 상태의 글자를 접두사로 붙일 것이기 때문입니다)
각 스테이지는 일련의 레지스터에서 입력을 읽고, 일련의 레지스터에 출력을 씁니다. "파이프라인 레지스터"라고 부르는 이 레지스터들은 표준 RISC-V ISA 레지스터("아키텍처 레지스터"라고 부름)와는 다르며, 내부 관리를 위해 존재합니다.
특히 각 스테이지는 프로그램 카운터, 현재 명령어, 그리고 이들로부터 파생된 몇 가지 다른 필드의 자체 사본을 갖게 됩니다(사실 마지막 스테이지들에서는 프로그램 카운터와 명령어 워드를 없앨 수 있지만, 지금은 모든 것을 유지한다고 가정합니다).
요컨대, 더 정확히 말하면 각 스테이지는 제대로 동작하는 데 필요한 모든 것의 자체 사본을 가지고 있어야 합니다. 왜 그럴까요?
- 지금은 스테이지들을 순차적으로 실행하더라도, 모든 스테이지는 동시에 실행되도록 되어 있다는 점을 기억하십시오(다음 단계에서 그렇게 됩니다). 특히 이는 각 스테이지가 서로 다른 명령어(그리고 그에 연관된 서로 다른 PC)를 처리한다는 것을 의미합니다.
- 처리량이 늘어난다는 장점 외에도 또 다른 이유가 있습니다. 실행을 여러 개의 레지스터 간(register-to-register) 스테이지로 나누면, 파이프라이닝은 흔히 더 짧은 임계 경로(critical path)를 만들어 냅니다(따라서 더 높은 주파수를 지원합니다).
자, 이 첫 번째 단계에서는 멀티사이클(multi-cycle) CPU를 만들 것이며, 각 상태는 위의 표에 대응합니다. 따라서 다음과 같이 모든 상태를 체계적으로 거치는 상태 기계를 두게 됩니다:
   localparam F_bit = 0; localparam F_state = 1 << F_bit;
   localparam D_bit = 1; localparam D_state = 1 << D_bit;
   localparam E_bit = 2; localparam E_state = 1 << E_bit;
   localparam M_bit = 3; localparam M_state = 1 << M_bit;
   localparam W_bit = 4; localparam W_state = 1 << W_bit;
   reg [4:0]      state;
   wire           halt;
   always @(posedge clk) begin
      if(!resetn) begin
     state  <= F_state;
      end else if(!halt) begin
     state <= {state[3:0],state[4]};
      end
   end
이 상태 기계는 다음 단계에서 제거하겠지만, 지금은 몇 가지 골치 아픈
문제를 신경 쓰지 않아도 되도록 단계들을 순차적으로 실행하는 편이
낫습니다. 나중에는 선택의 여지가 없겠지만, 적어도 저에게는 한 번에
하나의 어려움만 도입하고, 각 단계마다 RAYSTONES 벤치마크를
실행하여 CPU가 여전히 동작하는지 테스트하는 편이 더 쉽습니다.
이제 우리가 따를 게임의 규칙을 살펴봅시다:
- 스테이지 이름을
A,B,C,D,E라고 생각해 봅시다(곧F,D,E,M,W라는 이름을 대신 사용하겠지만, 이쪽이 기억하기 더 쉽습니다). 각 스테이지는 일련의 레지스터에서 입력을 읽고, 일련의 레지스터에 출력을 씁니다. 한 스테이지(예를 들어B)의 출력은 다음 스테이지(예를 들어C)의 입력에 해당합니다. 이해하기 쉽도록, 이 레지스터들(B의 출력이자C의 입력인 레지스터들)의 이름에는BC_라는 접두사를 붙입니다. 계속해서B를 예로 들면,B는AB_접두사가 붙은 레지스터에서 입력을 읽고BC_접두사가 붙은 레지스터에 출력을 씁니다. 그다음C는BC_접두사가 붙은 레지스터에서 입력을 읽고CD_접두사가 붙은 레지스터에 출력을 쓰며, 이런 식으로 계속됩니다... 따라서B스테이지의 Verilog 코드는 다음과 같은 형태가 됩니다:
   always @(posedge clk) begin
     if(state[B_bit]) begin
         BC_xxx <= AB_aaa;
     BC_yyy <= AB_bbb;
     ...
     end
   end
하지만 그것이 전부가 아닙니다. 각 스테이지에는 약간의 조합 논리(combinatorial logic)가 있을 수 있습니다. 예를 들어
E스테이지에서 ALU는 두 레지스터DE_rs1과DE_rs2에서 입력을 읽고 결과를EM_Eresult에 출력합니다. 이 조합 함수는 중간 신호를 사용하여 작성할 수 있는데, 이 신호들은 항상 와이어(wire)이며 상태 이름이 접두사로 붙습니다.B스테이지에서 이 신호들은AB_접두사가 붙은 레지스터나B_접두사가 붙은 다른 신호를 입력으로 받습니다.그리고 일부 상태는 메모리(프로그램 ROM, 데이터 RAM, 레지스터 파일)를 읽거나 쓰거나, 또는 둘 다 수행합니다.
B단계에서 메모리에 쓸 때, 주소와 쓸 데이터는AB_접두사가 붙은 레지스터이거나B_접두사가 붙은 와이어일 수 있습니다. 메모리에서 읽을 때는 출력이 항상BC_접두사가 붙은 레지스터여야 하며, 데이터를 읽는 것 외에는 아무것도 해서는 안 됩니다 (각 메모리에는 이미 레지스터가 달린 읽기 포트가 있으며, 이 규칙을 따르면 합성기가BC_대상을 이 레지스터 읽기 포트에 매핑할 수 있기 때문입니다).
규칙을 정리해 봅시다:
규칙 1
B상태는AB_접두사가 붙은 레지스터에서 입력을 받고,BC_접두사가 붙은 레지스터에 출력을 씁니다;규칙 2
B상태는 중간 와이어를 가질 수 있습니다. 이 와이어의 이름에는B_접두사가 붙습니다. 이 와이어의 입력은AB_접두사가 붙은 레지스터이거나B_접두사가 붙은 와이어입니다;규칙 3
B상태가 메모리를 읽으면, 그 결과는 항상BC_접두사가 붙은 레지스터에 저장되며 결과에 대해 다른 처리는 하지 않습니다;
달리 말하면, B 상태에서 <=의 왼쪽에는
BC_ 접두사가 붙은 레지스터만 올 수 있습니다.
<= 또는 =의 오른쪽에는 AB_
접두사가 붙은 레지스터, B_ 접두사가 붙은 와이어, 또는
이들의 조합만 올 수 있습니다...
하지만 두 가지 규칙의 예외가 있습니다(그렇지 않다면 너무 간단할 것입니다!):
점프가 있거나 분기가 성립(taken)하면,
Fetch 상태가 관리하는 프로그램 카운터를 수정해야 합니다. 따라서 32비트 신호jumpOrBranchAddress와, 프로그램 카운터를jumpOrBranchAddress로 갱신해야 할 때마다 어서트되는 1비트 신호jumpOrBranch가 있습니다;대부분의 명령어는 결과를 레지스터 파일에 다시 씁니다. 따라서 쓸 값을 담은 32비트 신호
wbData, 값을 어느 레지스터에 써야 하는지 나타내는 5비트 신호wbRdId, 그리고wbData를 레지스터wbRdId에 써야 할 때마다 어서트되는 1비트 신호wbEnable이 있습니다.
명령어가 모든 상태(Fetch, Decode,
Execute, Memory, Writeback)를
거쳐 왼쪽에서 오른쪽으로 이동한다고 상상해 보면, 이 두 신호 묶음은
오른쪽에서 왼쪽으로 이동한다는 것을 알 수 있습니다(따라서 어떤
의미에서는 "시간을 거슬러" 가는 셈입니다). 바로 이것이 다음 단계에서
우리가 겪게 될 모든 어려움의 원인입니다(하지만 지금은 한 번에 한 단계씩
순차적으로 활성화하므로 아무런 어려움이 없습니다).
한 가지 더 말씀드리면, 제가 이것을 한 번에 제대로 해내지 못할 것이 거의 확실하므로 디버깅이 중요합니다. 이를 위해 저는 VERILOG로 간단한 RISC-V 디스어셈블러를 작성했습니다. 이 디스어셈블러는 시뮬레이션에서 파이프라인의 모든 단계에 있는 명령어를 표시하는 데 사용할 수 있으며, 버그를 추적하는 데 매우 유용합니다.
자, 일을 간단하게 만들고 디스어셈블러를 사용할 수 있도록, 모든 단계에 PC와 현재 명령어를 저장하겠습니다(물론 단계마다 서로 다른 명령어가 저장됩니다).
Fetch 상태를 살펴보기 전에, 레지스터와 신호의 이름을 매우 엄격하게 지을 것을 강력히 권장합니다. 파이프라인 아키텍처에서는 많은 것이 같은 이름을 가지므로, 이름을 제대로 짓지 않으면 모든 것을 혼동할 위험이 큽니다!
Fetch
Fetch 단계가 어떤 모습인지 살펴봅시다:
   reg  [31:0] F_PC;
   reg  [31:0] PROGROM[0:16383];

   initial begin
      $readmemh("PROGROM.hex",PROGROM);
   end

   always @(posedge clk) begin
      if(!resetn) begin
     F_PC    <= 0;
      end else if(state[F_bit]) begin
     FD_instr <= PROGROM[F_PC[15:2]];
     FD_PC    <= F_PC;
     F_PC     <= F_PC+4;
      end else if(jumpOrBranch) begin
     F_PC  <= jumpOrBranchAddress;
      end
   end

/******************************************************************************/
   reg [31:0] FD_PC;
   reg [31:0] FD_instr;
/******************************************************************************/
F 단계는 첫 번째 단계라는 점에서 조금 특별합니다. 이
단계에는 입력이 없지만, 프로그램 카운터 F_PC와 명령어 ROM이
있습니다. 이 단계는 PC와 로드한 명령어를 Decode 단계로
출력합니다. 이 단계는 이후 단계에서 오는 "규칙의 예외"
신호(jumpOrBranch와 jumpOrBranchAddress)를
처리한다는 점에 유의하십시오.
Decode
Decode 단계는 opcode를 인식하고, 명령어에서 즉시값을
추출하고, 레지스터 파일에서 피연산자를 가져오는 일을 담당합니다. 최대한
단순하게 만들기 위해, 당분간은 Decode 단계에서 명령어를 디코딩하는 대신
필요할 때마다 명령어를 디코딩하겠습니다. 조금 엉뚱하게 들릴 수 있지만,
지금의 목표는 파이프라인 설계가 어떻게 동작하는지 이해하는 것입니다.
설계를 최적화하는 방법은 나중에 살펴보겠습니다. 또 다른 이유는
디스어셈블러로 각 단계의 명령어를 표시할 수 있기를 원하기 때문입니다.
그러려면 각 단계가 명령어와 PC를 가지고 있어야 하는데, 저는 시스템
안에서 정보를 하나의 형태로만 유지하는 편을 선호합니다(그렇지 않으면
버그의 원인이 될 수 있습니다). 따라서 Decode 단계는 다음과 같이
구현됩니다:
   reg [31:0] RegisterBank [0:31];

   always @(posedge clk) begin
      if(state[D_bit]) begin
     DE_PC    <= FD_PC;
     DE_instr <= FD_instr;
     DE_rs1 <= RegisterBank[rs1Id(FD_instr)];
     DE_rs2 <= RegisterBank[rs2Id(FD_instr)];
      end
   end

   always @(posedge clk) begin
      if(wbEnable) begin
     RegisterBank[wbRdId] <= wbData;
      end
   end

/******************************************************************************/
   reg [31:0] DE_PC;
   reg [31:0] DE_instr;
   reg [31:0] DE_rs1;
   reg [31:0] DE_rs2;
/******************************************************************************/
이 단계는 DE_PC와 DE_instr를 통해 PC와
명령어를 다음 단계(Execute)로 전달하고, 레지스터 파일에서 두 피연산자를
가져와 DE_rs1과 DE_rs2에 저장합니다. 소스를
읽기 쉽게 하기 위해, 명령어에서 여러 필드와 즉시값을 추출하는 헬퍼
함수를 몇 가지 두었습니다:
   function isALUreg; input [31:0] I; isALUreg=(I[6:0]==7'b0110011); endfunction
   function isALUimm; input [31:0] I; isALUimm=(I[6:0]==7'b0010011); endfunction
   function isBranch; input [31:0] I; isBranch=(I[6:0]==7'b1100011); endfunction
   ...
   function [4:0] rs1Id; input [31:0] I; rs1Id = I[19:15];      endfunction
   function [4:0] rs2Id; input [31:0] I; rs2Id = I[24:20];      endfunction
   function [4:0] rdId;  input [31:0] I; rdId  = I[11:7];       endfunction
   ...
   function [2:0] funct3; input [31:0] I; funct3 = I[14:12]; endfunction
   function [6:0] funct7; input [31:0] I; funct7 = I[31:25]; endfunction
   ...
   function [31:0] Uimm; input [31:0] I; Uimm={I[31:12],{12{1'b0}}}; endfunction
   ...
(이 함수들은 이후 단계에서도 사용됩니다.) 이렇게 하면 "명령어 디코더"가 여러 개 생기므로 어리석은 방식이라는 점에 유의하십시오. 최적화하는 방법은 나중에 살펴보겠지만, 지금은 이 방식이 더 단순하고 디스어셈블러를 사용해 모든 단계의 명령어를 표시할 수 있게 해 주므로 이대로 두겠습니다.
또한 "규칙의 예외" 신호인 wbEnable, wbRdId,
wbData와 이 신호들이 레지스터 파일에 다시 쓰는 데 사용되는
방식에도 주목하십시오.
Execute
Execute 단계는 에피소드 I과 똑같이 동작하며, 큰 조합
함수인 E_aluOut(현재 연산의 32비트 결과)과
E_takeBranch(Branch 판정 결과를 나타내는 1비트)를 가지고
있는데, 여기서는 다시 싣지 않습니다. 그러면 다음 신호들을 도출할 수
있습니다:
   wire E_JumpOrBranch = (
         isJAL(DE_instr)  ||
         isJALR(DE_instr) ||
         (isBranch(DE_instr) && E_takeBranch)
   );

   wire [31:0] E_JumpOrBranchAddr =
    isBranch(DE_instr) ? DE_PC + Bimm(DE_instr) :
    isJAL(DE_instr)    ? DE_PC + Jimm(DE_instr) :
    /* JALR */           {E_aluPlus[31:1],1'b0} ;

   wire [31:0] E_result =
    (isJAL(DE_instr) | isJALR(DE_instr)) ? DE_PC+4                :
    isLUI(DE_instr)                      ? Uimm(DE_instr)         :
    isAUIPC(DE_instr)                    ? DE_PC + Uimm(DE_instr) :
        E_aluOut                                                      ;
마지막으로 Execute 단계는 연산 결과(Eresult)와 Load 및
Store 명령어의 주소(addr)를 모두 계산하여 다음 단계로
전달합니다(PC, 명령어, 두 번째 소스 레지스터의 값도 함께
전달합니다):
   always @(posedge clk) begin
      if(state[E_bit]) begin
     EM_PC      <= DE_PC;
     EM_instr   <= DE_instr;
     EM_rs2     <= DE_rs2;
     EM_Eresult <= E_result;
     EM_addr    <= isStore(DE_instr) ? DE_rs1 + Simm(DE_instr) :
                                           DE_rs1 + Iimm(DE_instr) ;
      end
   end

/******************************************************************************/
   reg [31:0] EM_PC;
   reg [31:0] EM_instr;
   reg [31:0] EM_rs2;
   reg [31:0] EM_Eresult;
   reg [31:0] EM_addr;
/******************************************************************************/
그런 다음 Fetch 단계의 두 "규칙의 예외" 신호는 다음과 같이 연결됩니다:
   assign jumpOrBranchAddress = E_JumpOrBranchAddr;
   assign jumpOrBranch        = E_JumpOrBranch & state[M_bit];
메모리
메모리 단계는 에피소드 I과 거의 똑같이 동작하며, 피연산자를 정렬하고
로드 시 부호 확장을 수행하는 (다소) 복잡한 처리도 그대로 포함합니다.
다만 약간 미묘한 점이 있습니다. 어떤 상태(여기서는 M)에서
메모리로부터 무언가를 읽을 때는 그 메모리의 내용을 결과
레지스터(여기서는 MW 접두사가 붙은 레지스터)에 쓰는 것
외에는 아무것도 할 수 없다는 점을 기억하십시오. 따라서 M
상태에서는 정렬과 부호 확장을 할 수 없습니다. 이런 이유로 메모리 워드의
내용인 MW_Mdata를 다음 단계(WriteBack)로 전달하고, 그
단계에서 정렬과 부호 확장을 수행합니다(다만 메모리 연산의
입력에는 제약이 없으므로 Store 명령어의 정렬은 여전히
M 단계에서 수행합니다).
WriteBack
앞 문단에서 언급한 정렬과 부호 확장 외에도, Writeback
단계에는 레지스터 데이터를 Decode 단계에 다시 쓰는 나머지 "규칙의 예외"
신호를 생성하는 멀티플렉서가 몇 개 있습니다:
   assign wbData =
           isLoad(MW_instr)  ? (W_isIO ? MW_IOresult : W_Mresult) :
           isCSRRS(MW_instr) ? MW_CSRresult :
           MW_Eresult;

   assign wbEnable =
        !isBranch(MW_instr) && !isStore(MW_instr) && (rdId(MW_instr) != 0);

   assign wbRdId = rdId(MW_instr);
이것으로 거의 끝입니다! 결과는 pipeline3.v에 구현되어 있습니다. 여기에서 RAYSTONES를 실행하면:
$ cd FIRMWARE
$ make raystones.pipeline.hex
$ cd ..
$ ./run_verilator.sh pipeline3.v
다음과 같은 결과가 나옵니다(참고용으로 pipeline2.v의
결과도 함께 싣습니다):
| 버전 | 설명 | CPI | RAYSTONES |
|---|---|---|---|
| pipeline2.v | 3~4 상태 멀티사이클 | 3.034 | 2.614 |
| pipeline3.v | 순차 파이프라인 | 5 | 1.589 |
오, 대단하군요. 성능이 더 낮은 코어를 얻으려고 그렇게 미친 듯이 작업한 것입니까? 잠깐, 잠깐, 잠깐만 기다리십시오. 이 코어는 아직 파이프라인화되지 않았습니다. 다음 단계에서 본격적으로 "기어를 바꿀" 것입니다. 하지만 사실 우리는 이미 얻은 것이 있습니다. 코어들을 합성해 보면:
   BOARDS/run_ulx3s.sh pipeline2.v
   BOARDS/run_ulx3s.sh pipeline3.v
fmax(보고된 클록 최대 주파수)를 확인할 수 있으며, 다음과 같이 나옵니다:
| 버전 | fmax |
|---|---|
| pipeline2.v | 50 MHz |
| pipeline3.v | 80 MHz |
왜 그럴까요? 사실 우리는 프로세서가 해야 할 일을 5개의 단순한 단계로 분해했으며, 각 단계는 규칙에 따라 구현되어 있습니다(단... 점프와 분기, 그리고 레지스터 라이트백을 위한 예외적인 배선은 제외합니다). 이 규칙은 각 단계가 (예외적인 배선을 제외하면) 다른 단계와 독립적이며 단순한 일만 수행하도록 보장합니다. 그 결과, 명령어를 3~4 사이클에 실행하던 이전 버전보다 임계 경로(critical path)가 더 짧아집니다(예외적인 배선이 있더라도 그렇습니다).
요약 에피소드 I에서 만든, 3개 또는 4개의 상태로 이루어진 아키텍처의 코어를 가져왔습니다. 그리고 다음과 같은 아이디어에 따라 코어를 다시 설계했습니다:
- 5개 상태: Fetch, Decode, Execute, 메모리, Writeback
- 각 상태는 체계적으로 실행됩니다
- 각 상태는 이전 상태에만 의존하며 그 결과를 다음 상태에 기록합니다
- 현재로서는 각 상태가 프로그램 카운터와 명령어의 복사본을 각자 가지고 있습니다
- 예외는 두 가지입니다: 점프/분기와 레지스터 라이트백입니다
이번 단계에서 한 일에는 복잡한 것이 전혀 없습니다.
이제 모든 단계를 병렬로 실행하여 1 CPI에 더 가까워지는 방법을 살펴봅시다. 몇 가지만 바꾸면 됩니다(다만 이 부분들은 조금 더 미묘합니다).
4단계: 파이프라인
좋습니다. 이전 단계의 코어에서 시작하여 약간의 "수술"을 가해 봅시다:
- 첫 번째는 상태 기계를 제거하는 것입니다
- 그다음
if(state[F_bit),if(state[D_bit]),if(state[E_bit)같은 문장을 모두 제거합니다... - 또한
IO_mem_wr와M_wmask에서state[M_bit]를 참조하는 부분도 제거합니다. - 이제 무엇이 잘못될 수 있는지 / 무엇을 망가뜨렸는지 생각해 보기 시작합니다...
제어 해저드
해결해야 할 문제가 두 가지 있습니다. 첫 번째는 점프 및 분기와 관련된 문제입니다. 간단한 프로그램을 살펴봅시다:
$ cd FIRMWARE
$ make helloC.pipeline.hex
이렇게 하면 생성된 어셈블리 코드가 담긴
helloC.pipeline.elf.list도 함께 만들어집니다. 이 코드는
다음과 같이 시작합니다:
00000000 <start>:
   0:   004001b7            lui x3,0x400
   4:   00020137            lui x2,0x20
   8:   008000ef            jal x1,10 <main>
   c:   00100073            ebreak

00000010 <main>:
  10:   ff010113            addi    x2,x2,-16 # 1fff0 <val.1514+0xffb8>
  14:   00112623            sw  x1,12(x2)
  18:   004007b7            lui x15,0x400
  1c:   0ff00713            li  x14,255
  20:   00010537            lui x10,0x10
  ...
이제 우리 파이프라인이 어떻게 동작할지 살펴봅시다:
| clk | F | D | E | M | W |
|---|---|---|---|---|---|
| 1 | lui x3,0x400 | nop | nop | nop | nop |
| 2 | lui x2,0x20 | lui x3,0x400 | nop | nop | nop |
| 3 | jal x1,0x10 | lui x2,0x20 | lui x3,0x400 | nop | nop |
| 4 | ebreak | jal x1,0x10 | lui x2,0x20 | lui x3,0x400 | nop |
| 5 | addi x2,x2,-16 | ebreak | jal x1,0x10 | lui x2,0x20 | lui x3,0x400 |
- 클록 3에서
jal명령어가F단계로 파이프라인에 들어갑니다. - 클록 4에서 이 명령어는 Decode 단계에 들어갑니다
- 클록 5에서는 실행 단계에 들어갑니다. 즉, 클록 6에는 목표
주소(
0x10)로 점프해야 합니다. 하지만 이미 두 개의 명령어가 파이프라인에 들어와 있습니다.PC가jal명령어의 주소를 나타낸다고 하면,D단계에는PC+4에 있는 명령어가,F단계에는PC+8에 있는 명령어가 들어와 있습니다. 하지만 이 명령어들은 그곳에 있어서는 안 됩니다(여기서는addi x2,x2,-16이 분기 목표 주소0x10에 있는 명령어와 같기는 하지만, 이는 특수한 경우일 뿐이며<main>이 더 멀리 떨어져 있었다면 달라졌을 것입니다...). 따라서 클록 5에서jal x1,0x10이 실행되어,jumpOrBranch와jumpOrBranchAddress를 통해0x10을F단계로 보냅니다. 그러므로 별다른 처리를 하지 않으면 다음과 같은 구성이 됩니다:
| clk | F | D | E | M | W |
|---|---|---|---|---|---|
| 6 | addi x2,x2,-16 | addi x2,x2,-16 | ebreak | jal x1,0x10 | lui x2,0x20 |
E에 있는ebreak명령어는 그곳에 있어서는 안 됩니다 (PC+4에 있던 명령어인데 점프했기 때문입니다)D에 있는addi x2,x2,-16명령어는 그곳에 있어서는 안 됩니다 (PC+8에 있던 명령어인데 점프했기 때문입니다)F에 있는 (두 번째)addi x2,x2,-16명령어는 올바릅니다 (점프 대상에 있는 명령어이기 때문입니다)
다음 PC 값을 두 사이클 늦게 알게 되어 생기는 이러한 상황을 제어 해저드(control hazard)라고 합니다.
따라서 아이디어는 간단합니다. 다음과 같이 그곳에 있어서는 안 되는
명령어들을 NOP(또는 add x0, x0, x0)으로 교체하는
것입니다.
| clk | F | D | E | M | W |
|---|---|---|---|---|---|
| 6 | addi x2,x2,-16 | nop | nop | jal x1,0x10 | lui x2,0x20 |
이를 두고 D와 E가 "플러시(flush)되었다"고
합니다.
이것이 전부입니다! 이를 어떻게 구현할 수 있겠습니까?
D_flush와 E_flush라는 두 와이어를 선언합니다.
이 와이어들은 D(또는 E)의 명령어를 다음
사이클에 nop으로 교체해야 할 때마다, 즉 E의
명령어가 점프이거나 분기가 성립하는 분기 명령어일 때마다 활성화됩니다.
Fetch 단계와 Decode 단계의 코드는 다음과 같이 수정됩니다.
   localparam NOP = 32'b0000000_00000_00000_000_00000_0110011;
   wire D_flush;
   wire E_flush;

   ...
   /* F */
   always @(posedge clk) begin
      FD_instr <= PROGROM[F_PC[15:2]];
      FD_PC <= F_PC;
      F_PC <= F_PC+4;

      if(jumpOrBranch) begin
     F_PC     <= jumpOrBranchAddress;
      end

      if(D_flush | !resetn) begin
         FD_instr <= NOP;
      end

      if(!resetn) begin
     F_PC <= 0;
      end
   end
   ...
   /* D */
   always @(posedge clk) begin
      DE_PC    <= FD_PC;
      DE_instr <= E_flush ? NOP : FD_instr;
      DE_rs1 <= RegisterBank[rs1Id(FD_instr)];
      DE_rs2 <= RegisterBank[rs2Id(FD_instr)];
      if(wbEnable) begin
     RegisterBank[wbRdId] <= wbData;
      end
   end
그리고 D_flush와 E_flush 신호는
E_JumpOrBranch에 연결됩니다.
   assign D_flush = E_JumpOrBranch;
   assign E_flush = E_JumpOrBranch;
... 그런데 위의 Verilog 코드에는 문제가 있습니다. 찾아낼 수 있겠습니까?
규칙을 기억하십시오. 메모리에 접근할 때는 그 값을 레지스터에 쓰기만
하고 다른 일은 아무것도 해서는 안 됩니다(그런데 여기서는 특정 조건에서
레지스터의 값을 NOP으로 교체하고 있습니다).
시뮬레이션에서는 아무런 영향이 없지만, 설계를 합성하려고 하면 결과는
처참합니다! 합성 도구는 64 kB PROGROM을 조합(combinatorial)
메모리, 즉 거대한 주소 디코더가 달린 플립플롭 집합으로
교체하려고 합니다(ULX3S에 들어갈 수는 있지만, 밤새 돌려도 라우팅이
수렴하지 않습니다. 제가 직접 시도해 보았습니다...).
그래서 그 대신 D의 명령어를 비워야 할 때마다 1로
설정되는 FD_nop 레지스터를 추가합니다.
   /* F */
   always @(posedge clk) begin
      FD_instr <= PROGROM[F_PC[15:2]];
      FD_PC    <= F_PC;
      F_PC     <= F_PC+4;
      if(jumpOrBranch) begin
     F_PC     <= jumpOrBranchAddress;
      end

      FD_nop <= D_flush | !resetn;

      if(!resetn) begin
     F_PC <= 0;
      end
   end
   ...
   reg FD_nop;
그리고 Decode 단계는 다음과 같이 수정됩니다.
   /* D */
   always @(posedge clk) begin
      ...
      DE_instr <= (E_flush | FD_nop) ? NOP : FD_instr;
      ...
   end
(그리고 FD_instr가 관련될 때마다 FD_nop을
검사해야 한다는 점을 명심하십시오).
자, 이제 점프와 분기는 다 다루었습니다. 점프와 분기 조건이 성립한(taken) 분기는 파이프라인에 NOP 두 개를 삽입하므로 3사이클이 걸립니다(점프 또는 분기 명령어에 1사이클, NOP에 2사이클).
그런데 사실 완전히 끝난 것은 아닙니다. 모든 스테이지를 병렬로 실행하면 또 다른 유형의 문제를 만날 수 있습니다. 그 문제가 무엇인지 찾을 수 있겠습니까?
앞서 말한 것을 기억하십시오. 문제는 규칙의 예외에서 비롯됩니다. 첫
번째 유형의 문제는 E 스테이지에서 F 스테이지로
가는 jumpOrBranch 와이어 및
jumpOrBranchAddress 와이어와 관련이 있습니다.
또한 W 스테이지에서 D 스테이지의 레지스터
파일로 가는 wbEnable, wbData,
wbRdId도 있습니다. 이 와이어들은 또 다른 유형의 문제를
일으킬 것입니다.
데이터 해저드
같은 프로그램을 계속 살펴봅시다:
00000000 <start>:
   0:   004001b7            lui x3,0x400
   4:   00020137            lui x2,0x20
   8:   008000ef            jal x1,10 <main>
   c:   00100073            ebreak

00000010 <main>:
  10:   ff010113            addi    x2,x2,-16 # 1fff0 <val.1514+0xffb8>
  14:   00112623            sw  x1,12(x2)
  18:   004007b7            lui x15,0x400
  1c:   0ff00713            li  x14,255
  20:   00010537            lui x10,0x10
  ...
이제 다음과 같이 실행됩니다:
| clk | F | D | E | M | W |
|---|---|---|---|---|---|
| 1 | lui x3,0x400 | nop | nop | nop | nop |
| 2 | lui x2,0x20 | lui x3,0x400 | nop | nop | nop |
| 3 | jal x1,0x10 | lui x2,0x20 | lui x3,0x400 | nop | nop |
| 4 | ebreak | jal x1,0x10 | lui x2,0x20 | lui x3,0x400 | nop |
| 5 | addi x2,x2,-16 | ebreak | jal x1,0x10 | lui x2,0x20 | lui x3,0x400 |
| 6 | addi x2,x2,-16 | nop | nop | jal x1,0x10 | lui x2,0x20 |
| 7 | sw x1,12(x2) | addi x2,x2,-16 | nop | nop | jal x1,0x10 |
| 8 | lui x15,0x400 | sw x1,12(x2) | addi x2,x2,-16 | nop | nop |
| 9 | li x14,255 | lui x15,0x400 | sw x1,12(x2) | addi x2,x2,-16 | nop |
| 10 | lui x10,0x10 | li x14,255 | lui x15,0x400 | sw x1,12(x2) | addi x2,x2,-16 |
문제가 보이십니까? 클록 8에서 디코딩되는 sw x1,12(x2)
명령어는 레지스터 x2를 사용하는데, 이 레지스터는 바로 앞의
명령어(addi x2,x2,-16)가 설정합니다. 그러나
x2는 이 명령어가 W 단계를 떠나는 클록 10이
끝나기 전에는 갱신되지 않습니다. 따라서 sw x1,12(x2)는
D 단계에 있는 클록 8에서 잘못된 x2 값을 얻게
됩니다. 이를 데이터 해저드(data hazard)라고 합니다.
이 문제를 어떻게 해결할 수 있겠습니까? 아이디어는 간단합니다.
addi x2,x2,-16이 결과를 x2에 쓸 때까지(즉,
W를 떠날 때까지) sw x1,12(x2)를
D에 머물게 하고, 다음과 같이 E에 NOP을
삽입합니다.
| clk | F | D | E | M | W |
|---|---|---|---|---|---|
| 8 | lui x15,0x400 | sw x1,12(x2) | addi x2,x2,-16 | nop | nop |
| 9 | lui x15,0x400 | sw x1,12(x2) | nop | addi x2,x2,-16 | nop |
| 10 | lui x15,0x400 | sw x1,12(x2) | nop | nop | addi x2,x2,-16 |
| 11 | lui x15,0x400 | sw x1,12(x2) | nop | nop | nop |
| 12 | li x14,255 | lui x15,0x400 | sw x1,12(x2) | nop | nop |
| 13 | lui x10,0x10 | li x14,255 | lui x15,0x400 | sw x1,12(x2) | nop |
즉, D에 있는 명령어가 E, M
또는 W에 있는 명령어가 쓰는 레지스터를 사용할 때마다 다음과
같이 해야 합니다.
- 해당 명령어를
D에 유지합니다(이를D스테이지가 "stall되었다"고 합니다). - 당연히
F도 stall되어야 합니다(작은 교통 체증과 같습니다). - 그리고
E는 flush됩니다.
다시 말해, 어떤 스테이지가 스톨될 때마다 그 이전의 모든 스테이지도
함께 스톨되어야 하고, 다음 스테이지는 플러시되어야 합니다. 여기서는
D가 스톨되므로 이전 스테이지(F뿐)도 함께
스톨되고, 다음 스테이지(E)는 플러시됩니다.
이것을 어떻게 구현할 수 있겠습니까?
새로운 와이어 두 개, F_stall과 D_stall을
선언하고 다음과 같이 F와 D에서 이를 반영하기만
하면 됩니다:
   ...
   /* F */
   always @(posedge clk) begin
      if(!F_stall) begin
     FD_instr <= PROGROM[F_PC[15:2]];
     FD_PC    <= F_PC;
     F_PC     <= F_PC+4;
      end

      if(jumpOrBranch) begin
     F_PC     <= jumpOrBranchAddress;
      end

      FD_nop <= D_flush | !resetn;

      if(!resetn) begin
     F_PC <= 0;
      end
   end
   ...
   /* D */
   always @(posedge clk) begin
      if(!D_stall) begin
     DE_PC    <= FD_PC;
     DE_instr <= (E_flush | FD_nop) ? NOP : FD_instr;
      end

      if(E_flush) begin
     DE_instr <= NOP;
      end

      DE_rs1 <= RegisterBank[rs1Id(FD_instr)];
      DE_rs2 <= RegisterBank[rs2Id(FD_instr)];

      if(wbEnable) begin
     RegisterBank[wbRdId] <= wbData;
      end
   end
다시 말해, 어떤 상태가 스톨되면 그 상태는 출력을 갱신하지 않습니다. 단, 플러시되는 경우는 예외입니다(플러시가 스톨보다 우선순위가 높습니다).
플러시 신호와 스톨 신호는 다음과 같이 생성됩니다:
   wire rs1Hazard = !FD_nop && readsRs1(FD_instr) && rs1Id(FD_instr) != 0 && (
               (writesRd(DE_instr) && rs1Id(FD_instr) == rdId(DE_instr)) ||
               (writesRd(EM_instr) && rs1Id(FD_instr) == rdId(EM_instr)) ||
           (writesRd(MW_instr) && rs1Id(FD_instr) == rdId(MW_instr)) ) ;

   wire rs2Hazard = !FD_nop && readsRs2(FD_instr) && rs2Id(FD_instr) != 0 && (
               (writesRd(DE_instr) && rs2Id(FD_instr) == rdId(DE_instr)) ||
               (writesRd(EM_instr) && rs2Id(FD_instr) == rdId(EM_instr)) ||
           (writesRd(MW_instr) && rs2Id(FD_instr) == rdId(MW_instr)) ) ;

   wire dataHazard = rs1Hazard || rs2Hazard;

   assign F_stall = dataHazard;
   assign D_stall = dataHazard;

   assign D_flush = E_JumpOrBranch;
assign E_flush = E_JumpOrBranch | dataHazard;(FD_nop을 검사해야 한다는 점을 기억하십시오.
FD_nop이 있는 이유는 FD_instr이 메모리의 출력
레지스터여서 F가 플러시될 때 FD_instr에
NOP을 쓸 수 없기 때문입니다).
rs1Hazard와 rs2Hazard 신호는 다음과 같이
정의된 새 함수 writesRd(), readsRs1(),
readsRs2()를 사용합니다:
   function writesRd;
      input [31:0] I;
      writesRd = !isStore(I) && !isBranch(I);
   endfunction

   function readsRs1;
      input [31:0] I;
      readsRs1 = !(isJAL(I) || isAUIPC(I) || isLUI(I));
   endfunction

   function readsRs2;
      input [31:0] I;
      readsRs2 = isALUreg(I) || isBranch(I) || isStore(I);
   endfunction
다음 표를 보면 Store와 Branch를 제외한 모든
명령어가 rd에 쓰고, JAL, AUIPC,
LUI를 제외한 모든 명령어가 rs1을 읽으며,
ALUreg, Branch, Store만
rs2를 읽는다는 것을 알 수 있습니다:
| 명령어 | 동작 |
|---|---|
| ALUreg | rd <- rs1 OP rs2 |
| ALUimm | rd <- rs1 OP Iimm |
| Branch | if(rs1 OP rs2) PC<-PC+Bimm |
| JALR | rd <- PC+4; PC<-rs1+Iimm |
| JAL | rd <- PC+4; PC<-PC+Jimm |
| AUIPC | rd <- PC + Uimm |
| LUI | rd <- Uimm |
| Load | rd <- mem[rs1+Iimm] |
| Store | mem[rs1+Simm] <- rs2 |
| SYSTEM | 특수 |
이제 파이프라인을 스톨시키는 메커니즘이 있으므로, 예를 들어
EBREAK가 실행될 때 이를 이용해 다음과 같이 실행을 정지시킬
수도 있습니다:
   wire halt = resetn & isEBREAK(DE_instr);

   assign F_stall = dataHazard | halt;
   assign D_stall = dataHazard | halt;
요약 이렇게 해서 두 가지 유형의 문제를 해결했습니다.
하나는 (JumpOrBranch,JumpOrBranchAddress)가
F의 프로그램 카운터에 너무 늦게 도달해서 생기는 제어
해저드(control hazard)이고, 다른 하나는 (wbEnable,
wbData, wbRdId)가 D의 레지스터
파일에 너무 늦게 도달해서 생기는 데이터 해저드(data hazard)입니다. 그
결과로 만들어진 프로세서는 pipeline4.v에
구현되어 있습니다. 이전 단계의 "순차 파이프라인"인 pipeline3.v와 비교해 보면, 수정한 부분은 상당히
적습니다:
- 상태 기계 제거
- "파이프라인 제어" 신호
F_stall,D_stall,D_flush,E_flush를 추가했습니다 - 파이프라인 제어 신호를 생성하는 작은 조합 회로를 추가했습니다:
- 제어 해저드가 있을 때마다
F와D를 플러시(flush)합니다 - 데이터 해저드가 있을 때마다
F와D를 스톨(stall)하고,E를 플러시합니다
- 제어 해저드가 있을 때마다
다음을 해 보십시오. pipeline4.v에서
//define VERBOSE가 있는 줄의 주석을 해제한 다음:
   $ cd FIRMWARE
   $ make helloC.pipeline.hex
   $ cd ..
$ ./run_verilator.sh pipeline4.v log.txt를 살펴보십시오.
- 각 스테이지마다 프로그램 카운터와 명령어를 보여 줍니다;
F는 또한jumpOrBranch가 활성화될 때마다, 그리고PC가jumpOrBranchAddress로부터 새 값을 받았을 때 이를 표시합니다;D는rs1과rs2에 데이터 해저드가 있을 때마다 이를[ ]안에 표시합니다;E는rs1과rs2의 값을 표시합니다W는 레지스터 파일에 다시 기록되는 값을 표시합니다
이 도구는 디버깅에 정말 많이 도움이 되었습니다(처음부터 이 모든 것을 제대로 해내지는 못했습니다!!!).
이제 새 프로세서를 RAYSTONES로 테스트해 볼 차례입니다.
$ cd FIRMWARE
$ make raystones.pipeline.hex
$ cd ..
$ ./run_verilator.sh pipeline4.v &> log.txt
지금 우리는 어디까지 왔습니까?
| 버전 | 설명 | CPI | RAYSTONES |
|---|---|---|---|
| pipeline2.v | 3~4 상태 멀티사이클 | 3.034 | 2.614 |
| pipeline3.v | 순차 파이프라인 | 5 | 1.589 |
| pipeline4.v | 스톨/플러시 | 2.193 | 3.734 |
훨씬 낫습니다! 이전 단계보다 두 배 이상 빨라졌으며, 처음 만든 3-4 상태 코어보다도 약간 더 빠릅니다. 하지만 파이프라인에 NOP("버블"이라고도 합니다)가 많이 생깁니다. 여기에 버블을 좀 덜 불어 넣을 수는 없겠습니까?
5단계: 같은 사이클에 레지스터 파일 읽기와 쓰기
프로세서 설계에 관한 좋은 책들(Patterson과 Hennessy, Harris와
Harris)을 읽어 보면, W가 레지스터 파일에 쓴 데이터를
D가 같은 사이클에 읽을 수 있다고 합니다. 그렇다면
왜 명령어가 W를 떠날 때까지 스톨해야 합니까?
사실 우리 설계는 레지스터 파일에 1사이클의 지연 시간(latency)으로
접근한다고 가정하며, 이는 레지스터 파일이 BRAM에 매핑되는 경우에
해당합니다. 즉 W가 레지스터 파일에 쓴 데이터는 1사이클
뒤에야 사용할 수 있으므로, 데이터 해저드를 판단할 때 W에
있는 명령어도 검사해야 합니다.
레지스터 파일은 이러한 1사이클 지연 시간이 없는 플립플롭 배열로 구현할 수도 있습니다(이를 조합적 접근을 한다고 합니다). 그 방법은 나중에 살펴보기로 하고, 지금은 1사이클 지연 시간을 가진 레지스터 파일을 그대로 유지하면서 여기에 와이어를 추가하는 방법을 알아보겠습니다:
/* D */
always @(posedge clk) begin
  ...
  if(wbEnable && rdId(MW_instr) == rs1Id(FD_instr)) begin
      DE_rs1 <= wbData;
  end else begin
      DE_rs1 <= RegisterBank[rs1Id(FD_instr)];
  end

  if(wbEnable && rdId(MW_instr) == rs2Id(FD_instr)) begin
      DE_rs2 <= wbData;
  end else begin
      DE_rs2 <= RegisterBank[rs2Id(FD_instr)];
  end
  ...
end
아이디어는 간단합니다. W가 쓰는 레지스터가
D가 접근하는 레지스터와 같다면, 레지스터 파일에 접근하지
않고 그 값을 D로 곧바로 보냅니다(이를 D로
"포워딩"한다고 합니다). 이렇게 추가한 와이어를 "바이패스(bypass)"라고도
합니다.
이제 데이터 해저드 규칙을 수정하여 W에 있는 명령어에
대한 검사를 제거할 수 있습니다:
   wire rs1Hazard = !FD_nop && readsRs1(FD_instr) && rs1Id(FD_instr) != 0 && (
               (writesRd(DE_instr) && rs1Id(FD_instr) == rdId(DE_instr)) ||
           (writesRd(EM_instr) && rs1Id(FD_instr) == rdId(EM_instr)) );


   wire rs2Hazard = !FD_nop && readsRs2(FD_instr) && rs2Id(FD_instr) != 0 && (
               (writesRd(DE_instr) && rs2Id(FD_instr) == rdId(DE_instr)) ||
           (writesRd(EM_instr) && rs2Id(FD_instr) == rdId(EM_instr)) );
소스는 pipeline5.v에 있습니다.
이제 좋은 책들(Patterson & Hennessy, Harris & Harris)에 설명된 대로 같은 사이클에 레지스터 파일을 실제로 쓰고 읽을 수 있도록, 레지스터 파일에 조합적 접근을 사용하여 "제대로 하는" 방법을 살펴봅시다:
   reg [31:0] RegisterBank [0:31];
   always @(posedge clk) begin
      if(!D_stall) begin
     DE_PC    <= FD_PC;
     DE_instr <= (E_flush | FD_nop) ? NOP : FD_instr;
      end

      if(E_flush) begin
     DE_instr <= NOP;
      end

      if(wbEnable) begin
     RegisterBank[wbRdId] <= wbData;
      end
   end

/******************************************************************************/
   reg [31:0] DE_PC;
   reg [31:0] DE_instr;
   wire [31:0] DE_rs1 = RegisterBank[rs1Id(DE_instr)];
   wire [31:0] DE_rs2 = RegisterBank[rs2Id(DE_instr)];
/******************************************************************************/
보시다시피 DE_rs1과 DE_rs2는 이제 레지스터
파일에 직접 연결된 와이어입니다(물론 이 값들을 읽는 명령과 바이패스도
제거했습니다). 전체 소스는 pipeline5_bis.v에 있습니다.
지금 우리는 어디까지 왔습니까?
| 버전 | 설명 | CPI | RAYSTONES |
|---|---|---|---|
| pipeline2.v | 3~4 상태 멀티사이클 | 3.034 | 2.614 |
| pipeline3.v | 순차 파이프라인 | 5 | 1.589 |
| pipeline4.v | 스톨/플러시 | 2.193 | 3.734 |
| pipeline5.v | 스톨/플러시 comb. RF | 1.889 | 4.330 |
아주 대단하지는 않지만, (천천히) 1 CPI에 가까워지고 있음을 알 수 있습니다.
6단계: 레지스터 포워딩
이전 단계에서는 레지스터 파일에 대한 조합(combinatorial) 접근을
"에뮬레이션"하여 같은 사이클에 쓰기와 읽기를 수행했고, 이를 통해
D에 있는 명령어가 W에 있는 명령어가 되쓴 값을
"볼" 수 있게 했습니다. 또한 이것이 최선의 방법은 아니라는 점도
살펴보았습니다. 조합 접근을 지원하는 레지스터 파일을 사용하는 더 쉬운
방법이 있기 때문입니다. 하지만 "에뮬레이션된" 조합 접근을 설계하면서 한
가지를 배웠습니다. 필요한 데이터가 파이프라인의 다른 곳에 이미 있다면,
그 데이터가 레지스터 파일에 기록될 때까지 (스톨을 걸고 버블을 넣으면서)
기다리기보다 필요한 곳으로 바로 보내는 편이 낫습니다(그러면 기다릴
필요도 없습니다!).
E로 포워딩해야 하는 데이터는 다음 두 곳 중 하나에 있을
수 있습니다:
M, 즉EM_EresultW, 즉wbData
따라서 다음과 같이 E 단계가 시작될 때 결과를
rs1과 rs2로 "포워딩"하는 바이패스를 추가할 수
있습니다:
   wire E_M_fwd_rs1 = rdId(EM_instr) != 0 && writesRd(EM_instr) &&
                  (rdId(EM_instr) == rs1Id(DE_instr));

   wire E_W_fwd_rs1 = rdId(MW_instr) != 0 && writesRd(MW_instr) &&
                  (rdId(MW_instr) == rs1Id(DE_instr));

   wire E_M_fwd_rs2 = rdId(EM_instr) != 0 && writesRd(EM_instr) &&
                  (rdId(EM_instr) == rs2Id(DE_instr));

   wire E_W_fwd_rs2 = rdId(MW_instr) != 0 && writesRd(MW_instr) &&
                  (rdId(MW_instr) == rs2Id(DE_instr));

   wire [31:0] E_rs1 = E_M_fwd_rs1 ? EM_Eresult :
                   E_W_fwd_rs1 ? wbData     :
                   DE_rs1;

   wire [31:0] E_rs2 = E_M_fwd_rs2 ? EM_Eresult :
                   E_W_fwd_rs2 ? wbData     :
                   DE_rs2;
그런 다음 E 안의 나머지 모든 곳에서
EM_rs1(또는 EM_rs2)을 E_rs1(또는
E_rs2)로 바꾸십시오. 하나라도 빠뜨리면 모든 것이 망가지니
주의하십시오! (각각 세 군데씩 있습니다.)
이제 남은 데이터 해저드 조건은 로드 바로 다음에 그 결과를 사용하는
명령어가 오는 경우뿐입니다(로드 명령어의 결과를 두 명령어 뒤에서
사용한다면, 그 결과는 W에서 올바르게 포워딩됩니다).
파이프라인 제어 로직이 더 단순해집니다:
   wire rs1Hazard = readsRs1(FD_instr) && (rs1Id(FD_instr) == rdId(DE_instr)) ;
   wire rs2Hazard = readsRs2(FD_instr) && (rs2Id(FD_instr) == rdId(DE_instr)) ;
   wire dataHazard = !FD_nop && (isLoad(DE_instr)||isCSRRS(DE_instr)) && (rs1Hazard || rs2Hazard);

   assign F_stall = dataHazard | halt;
   assign D_stall = dataHazard | halt;
   assign D_flush = E_JumpOrBranch;
assign E_flush = E_JumpOrBranch | dataHazard;(F_stall, D_stall, D_flush,
E_flush의 정의는 바뀌지 않았습니다.)
참고:
- 원래는
datahazard에서rdId(DE_instr)값이 0이 아닌지도 검사해야 하지만, 일반적으로 로드와 CRS 읽기의 대상은 0번 레지스터가 아닙니다! 그리고 정말로 0번 레지스터에 로드하는 경우가 있더라도 피할 수 있었던 버블이 하나 생길 뿐입니다. - 다음과 같이 로드가 있을 때마다 무조건 버블을 만드는 방법도 있습니다:
wire dataHazard = !FD_nop && (isLoad(DE_instr)||isCSRRS(DE_instr)). 이 방법도 올바르지만 버블이 더 많이 생깁니다. 그래도 파이프라인 제어 로직이 더 단순해지고 fmax를 높일 수도 있으므로 고려해 볼 만합니다. 임계 경로가 그 부분에 있다면 레지스터 ID의 일부 비트만 비교하는 등 다른 전략도 가능합니다. 필요 이상으로dataHazard를 자주 활성화해도 틀린 것은 아닙니다(다만 CPI가 증가합니다).
새 버전은 pipeline6.v에 있습니다. 벤치마크를 해 볼 차례입니다!
| 버전 | 설명 | CPI | RAYSTONES |
|---|---|---|---|
| pipeline2.v | 3~4 상태 멀티사이클 | 3.034 | 2.614 |
| pipeline3.v | 순차 파이프라인 | 5 | 1.589 |
| pipeline4.v | 스톨/플러시 | 2.193 | 3.734 |
| pipeline5.v | 스톨/플러시 comb. RF | 1.889 | 4.330 |
| pipeline6.v | 스톨/플러시+레지스터 포워딩 | 1.426 | 5.714 |
좋습니다. 새 파이프라인 CPU는 처음의 3-4상태 멀티사이클 CPU보다 두 배 이상 빠릅니다!
7단계: 분기 예측 맛보기
점프와 분기에는 항상 버블 두 개를 넣습니다. JAL의 경우를
살펴봅시다. JAL에 버블 두 개를 넣는 것은 다소 어리석은
일입니다. 다음 PC가 PC+Jimm이 되어야 한다는
것을 이미 알고 있기 때문입니다. 따라서 D 단계에서
PC+Jimm을 계산하여 F 단계로 곧바로 전달할 수
있습니다. 그러면 F 단계는 다음과 같습니다.
   reg  [31:0] PC;
   wire [31:0] F_PC = D_JumpOrBranchNow ? D_JumpOrBranchAddr : PC;

   always @(posedge clk) begin

      if(!F_stall) begin
     FD_instr <= PROGROM[F_PC[15:2]];
     FD_PC    <= F_PC;
     PC       <= F_PC+4;
      end

      if(E_JumpOrBranch) begin
     PC     <= E_JumpOrBranchAddr;
      end

      FD_nop <= D_flush | !resetn;

      if(!resetn) begin
     PC <= 0;
      end
   end
이렇게 하면 F 단계는 현재 PC를
D_JumpOrBranchAddress에서, 다음 PC를
E_JumpOrBranchAddress에서 얻을 수 있습니다. 이제
JAL을 위해 이 메커니즘을 도입했으니, 조금 더 나아갈 수
있습니다. Branch는 역방향일 때(대상이 PC보다 작을 때) 더
자주 분기하고, 순방향일 때(대상이 PC보다 클 때) 덜 자주
분기합니다. 분기가 순방향인지 역방향인지 알려면 Jimm의 부호
비트만 검사하면 됩니다. 그러면 다음과 같이 D가 역방향
분기에서는 항상 분기 목표를 보내고("분기 실행 예측"), 순방향 분기에서는
절대 보내지 않도록("분기 미실행 예측") 정할 수 있습니다.
   wire D_predictBranch = FD_instr[31];

   wire D_JumpOrBranchNow = !FD_nop && (
           isJAL(FD_instr) ||
           (isBranch(FD_instr) && D_predictBranch))
        );

   wire [31:0] D_JumpOrBranchAddr =
               FD_PC + (isJAL(FD_instr) ? Jimm(FD_instr) : Bimm(FD_instr));
이 분기 예측 전략은 (상태를 유지하지 않으므로) "정적(static)" 예측이라고 하며, BTFNT(Backwards taken forwards not taken)라고 부릅니다. 더 정교한 분기 예측 전략은 나중에 살펴보겠습니다.
예측 결과는 새로운 DE_predictBranch 레지스터를 통해
E로 전달합니다.
/* D */
   always @(posedge clk) begin
      ...
      if(!D_stall) begin
         ...
     DE_predictBranch <= D_predictBranch;
     ...
      end
      ...
   end
그런 다음 E는 분기가 실행되지 않았거나 명령어가
JALR이었을 때 "정정"을 보내야 합니다.
   wire E_JumpOrBranch = (
         isJALR(DE_instr) ||
         (isBranch(DE_instr) && (E_takeBranch^DE_predictBranch))
   );

   wire [31:0] E_JumpOrBranchAddr =
    isBranch(DE_instr) ?
                     (DE_PC + (DE_predictBranch ? 4 : Bimm(DE_instr))) :
    /* JALR */   {E_aluPlus[31:1],1'b0} ;
예측과 실제 결정이 다르면(E_takeBranch^DE_predictBranch)
정정해야 합니다. 분기를 예측했지만 실제로는 분기하지 않아야 한다면
PC+4를 보내고, 분기를 예측하지 않았지만 실제로는 분기해야
한다면 PC+Bimm을 보냅니다.
(E_JumpOrBranchAddr를 통해, 그리고
E_JumpOrBranch를 어서트하여) "정정"이 전송되면 파이프라인
제어가 버블 두 개를 생성합니다. 파이프라인 제어는 바꿀 필요가 없으며
여전히 다음과 같습니다.
   assign F_stall = dataHazard | halt;
   assign D_stall = dataHazard | halt;

   assign D_flush = E_JumpOrBranch;
assign E_flush = E_JumpOrBranch | dataHazard;- note1
D_flush와E_flush는 여전히 (레지스터를 거치지 않은)E_JumpOrBranch신호에 연결되어 있습니다.E를 플러시할지는 같은 사이클에 결정해야 하기 때문입니다. - note2
E_JumpOrBranch가 어서트되는 빈도는 이전보다 훨씬 줄어듭니다. 이제JAL은 한 사이클에 동작하고, 분기는 두 번 중 한 번꼴로 (예측이 맞을 때) 한 사이클에 동작합니다. - note3
JALR에는 여전히 버블 두 개를 생성합니다. JALR은rs1에 의존하는데, 이 값은E가 시작될 때에야 (그리고 경우에 따라서는 레지스터 포워딩을 통해서) 사용할 수 있기 때문입니다. - note4 이 설계는 임계 경로가 매우 깁니다.
PC앞의 mux는 ALU에서 나오는E_JumpOrBranch가 구동하고, ALU의 두 입력은 레지스터 포워딩 로직에 연결되어 있기 때문입니다. 이를 해결하려면E_JumpOrBranch와E_JumpOrBranchAddress를EM파이프라인 레지스터에 저장하면 됩니다.
   /* E */
   always @(posedge clk) begin
      ...
      EM_JumpOrBranchNow  <= E_JumpOrBranch;
      EM_JumpOrBranchAddr <= E_JumpOrBranchAddr;
   end
그러면 이 신호들은 한 사이클 늦게 사용할 수 있게 되지만, 다음과 같이
PC 대신 F_PC로 mux하면 문제가 되지
않습니다:
   /* F */

   wire [31:0] F_PC =
           D_JumpOrBranchNow  ? D_JumpOrBranchAddr  :
           EM_JumpOrBranchNow ? EM_JumpOrBranchAddr :
                                PC;

   always @(posedge clk) begin
      if(!F_stall) begin
     FD_instr <= PROGROM[F_PC[15:2]];
     FD_PC    <= F_PC;
     PC       <= F_PC+4;
      end

      FD_nop <= D_flush | !resetn;

      if(!resetn) begin
     PC <= 0;
      end
   end
새 버전은 pipeline7.v에 있습니다. 결과는 어떻습니까?
| 버전 | 설명 | CPI | RAYSTONES |
|---|---|---|---|
| pipeline2.v | 3~4 상태 멀티사이클 | 3.034 | 2.614 |
| pipeline3.v | 순차 파이프라인 | 5 | 1.589 |
| pipeline4.v | 스톨/플러시 | 2.193 | 3.734 |
| pipeline5.v | 스톨/플러시, 조합 논리 RF | 1.889 | 4.330 |
| pipeline6.v | 스톨/플러시+레지스터 포워딩 | 1.426 | 5.714 |
| pipeline7.v | 기본 분기 예측 | 1.226 | 6.077 |
흥미롭게도, 우리 코어는 RV32IM을 구현한 femtorv-electron(3.373 raystones)보다 훨씬 빠릅니다!
8단계: 동적 분기 예측
이제 동적 분기 예측을 사용하여 이를 어떻게 더 개선할 수 있는지 살펴봅시다(gshare 사용을 제안해 주신 Bruce Hoult 님께 감사드립니다. 이에 대해서는 아래에서 더 자세히 다룹니다).
사실, 이제 우리는 지금까지 한 작업을 좀 더 일반적인 관점에서 바라볼 수 있습니다:
D단계에서는 분기가 일어날지 여부를 예측하고, 이 예측을 바탕으로D단계가 예측된 다음 명령어의 주소를F단계에 전달합니다;D단계는 이 예측을E단계에도 전달합니다. 그런 다음E단계는 이 예측을 실제 분기 결과와 비교합니다. 둘이 일치하지 않으면, 수정된 주소를F단계로 보내고 파이프라인에 있는 명령어 두 개를 플러시합니다.
이 메커니즘은 완전히 범용적이며, D_predictBranch 신호로
매개변수화되어 있습니다(이 신호는 현재 BImm의 부호 비트, 즉
instr[31]에 연결되어 있습니다). 이 메커니즘은 결정을 내릴
때 현재 명령어 워드만 사용합니다. 더 영리하게 할 수도 있습니다. 이전
결정들로부터 "학습"하는 메커니즘을 두면 어떻겠습니까? 이는 동적으로
갱신되는 상태를 두게 된다는 뜻입니다(그래서 "동적" 분기 예측이라고
부릅니다).
동적 분기 예측에 대한 입문 자료로 다음 링크들을 추천합니다:
- link1
- link2
- Onur Mutlu의 ETH Zurich 강의(Luke Wren에게 감사드립니다).
- ALF
이것이 우리 코어에서 실제로 무엇을 의미하는지 살펴봅시다. 핵심
아이디어는 각 분기의 가장 최근 결과(즉, taken인지 not taken인지)를
저장하는 것입니다. 물론 모든 주소에 대해 이렇게 할 수는 없지만, PC의
하위 비트를 사용해 주소를 해시할 수 있습니다. BHT(Branch
History Table, 분기 이력 테이블)를 선언합니다. 여기서는 4096개의
엔트리를 둡니다:
   localparam BP_ADDR_BITS=12;
   localparam BHT_SIZE=1<<BHT_INDEX_BITS;
   reg BHT[BHT_SIZE-1:0];
PC로부터 BHT의 주소를 구하는 함수를 선언해 두는 것도
편리합니다(물론 명령어는 32비트 경계에 정렬되어 하위 두 비트가 항상
00이므로, 이 두 LSB는 무시합니다).
   function [BP_ADDR_BITS-1:0] BHT_index;
      input [31:0] PC;
      BHT_index = PC[BP_ADDR_BITS+1:2];
   endfunction
이제 D_predictBranch 신호를 정의할 수 있습니다. 이
신호는 다음과 같이 파이프라인 레지스터를 통해 E로도
전달됩니다:
   /* D */
   wire D_predictBranch = BHT[BHT_index(FD_PC)][1];
   ...
   always @(posedge clk) begin
      ...
      if(!D_stall) begin
         ...
     DE_predictBranch <= D_predictBranch;
     DE_BHTindex <= BHT_index(FD_PC);
      end
      ...
   end
그러면 E 상태는 두 가지 일을 해야 합니다.
- 예측과 결정이 일치하지 않으면 정정 신호와 두 개의 버블을 보냅니다
- 결정 결과로 분기 이력 테이블(Branch History Table)을 갱신합니다
  /* E */
  wire E_JumpOrBranch = (
         isJALR(DE_instr) ||
         (isBranch(DE_instr) && (E_takeBranch^DE_predictBranch))
  );
  ...
  always @(posedge clk) begin
     ...
     if(isBranch(DE_instr)) begin
    BHT[DE_BHTindex] <= E_takeBranch;
     end
     ...
  end
또한 진행 상황을 추적할 수 있도록 예측 적중률을 측정하는 Verilog
명령문도 몇 개 추가했습니다. 물론 적중률은 실행하는 프로그램에 따라
매우 달라질 수 있습니다. 그래서 RAYSTONES 테스트와, 더 널리
쓰이는 DHRYSTONES 테스트(FIRMWARE에서
make dhrystone.pipeline.hex)에 대해 측정합니다:
| 예측 전략 | raystones | dhrystones |
|---|---|---|
| 항상 분기 발생으로 예측 | 68.6% | 89.2% |
| 역방향 분기 발생, 순방향 분기 미발생 | 63% | 93.4% |
| 1비트 BHT | 74% | 92.7% |
흥미롭게도, 더 똑똑한 전략이라고 해서 항상 이득을 보는 것은 아닙니다! "BTFNT" 전략은 DHRYSTONE에서는 다소 이득을 보지만, raystones에서는 아주 단순한 "predict taken" 전략보다 성능이 떨어집니다. 우리가 만든 1비트 분기 이력 테이블(branch history table)에서는 상황이 반대입니다.
위의 참고 자료를 읽어 보셨다면, (포화 카운터(saturating counter)를
사용해) 2비트 상태를 저장하는 편이 더 낫다는 내용을 보셨을 것입니다.
그러면 D_predictBranch 신호는 최상위 비트가 됩니다:
   reg [1:0] BHT[BHT_SIZE-1:0];
   ...
   wire D_predictBranch = BHT[BHT_index(FD_PC)][1];
그런 다음 E 단계는 2비트 포화 카운터를 증가시키거나
감소시키는 함수를 사용해 다음과 같이 BHT를 갱신합니다:
   /* E */
   function [1:0] incdec_sat;
      input [1:0] prev;
      input dir;
      incdec_sat =
       {dir, prev} == 3'b000 ? 2'b00 :
           {dir, prev} == 3'b001 ? 2'b00 :
       {dir, prev} == 3'b010 ? 2'b01 :
       {dir, prev} == 3'b011 ? 2'b10 :
       {dir, prev} == 3'b100 ? 2'b01 :
       {dir, prev} == 3'b101 ? 2'b10 :
       {dir, prev} == 3'b110 ? 2'b11 :
                               2'b11 ;
   endfunction;

   ...
   always @(posedge clk) begin
      if(isBranch(DE_instr)) begin
     BHT[DE_BHTindex] <= incdec_sat(BHT[DE_BHTindex], E_takeBranch);
      end
   end
지금 우리는 어디까지 왔습니까? 나쁘지 않습니다! 두 테스트 프로그램 모두에서 예측률이 올라갑니다:
| 예측 전략 | raystones | dhrystones |
|---|---|---|
| 항상 분기 발생으로 예측 | 68.6% | 89.2% |
| 역방향 분기 발생, 순방향 분기 미발생 | 63% | 93.4% |
| 1비트 BHT | 74% | 92.7% |
| 2비트 BHT | 76.8% | 95.97% |
분기 이력에 대한 정보를 더 많이 넣으면 예측률을 높일 수 있습니다. 적은 수(여기서는 9개)의 분기에 대한 최근 결과를 기억하는 FIFO를 만들 수 있습니다:
   localparam BP_HISTO_BITS=9;
   reg [BP_HISTO_BITS-1:0] branch_history;

   /* E */
   always @(posedge clk) begin
      ...
      if(isBranch(DE_instr)) begin
     branch_history <= {E_takeBranch,branch_history[BP_HISTO_BITS-1:1]};
     BHT[DE_BHTindex] <= incdec_sat(BHT[DE_BHTindex], E_takeBranch);
      end
   end
그런 다음 이 이력을 PC의 하위 비트와 XOR하여 BHT의 인덱스로 사용합니다:
   function [BHT_INDEX_BITS-1:0] BHT_index;
      input [31:0] PC;
   /* verilator lint_off WIDTH */
      BHT_index = PC[BP_ADDR_BITS+1:2] ^
                  (branch_history << (BP_ADDR_BITS - BP_HISTO_BITS));
   /* verilator lint_on WIDTH */
   endfunction
새 버전은 pipeline8.v에 있습니다
"gshare"라고 알려진 이 전략은 비용이 거의 들지 않으면서도, 아래 표에서 볼 수 있듯이 분기 예측의 정확도를 크게 높일 수 있습니다:
| 예측 전략 | raystones | dhrystones |
|---|---|---|
| 항상 분기 발생으로 예측 | 68.6% | 89.2% |
| 역방향 분기 발생, 순방향 분기 미발생 | 63% | 93.4% |
| 1비트 BHT | 74% | 92.7% |
| 2비트 BHT | 76.8% | 95.97% |
| gshare | 82% | 96.3% |
이 효과는 DHRYSTONES보다 RAYSTONES에서 더 크게 나타납니다. 아마도 DHRYSTONES에는 반복적인 패턴을 가진 긴 루프가 많아 대부분의 경우 BHT의 2비트 카운터만으로 충분한 반면, RAYSTONES는 부동소수점 연산(여기서는 소프트웨어로 처리)을 수행하므로 분기 패턴이 훨씬 불규칙하고, 이러한 패턴은 전역 히스토리로 포착되기 때문일 것입니다.
9단계: 반환 주소 스택
함수 호출을 구현하는 데 쓰이는 JALR 명령어를 최적화하면
비교적 쉽게 성능을 더 끌어올릴 수 있습니다. 프로세서 안에 작은 스택(반환
주소 스택(Return Address Stack), 줄여서 RAS)을 두는 것이 핵심
아이디어이며, 이 스택의 깊이는 보통 4입니다. 함수 호출이 감지될 때마다
함수의 주소를 스택의 맨 위에 푸시합니다. 함수가 (JALR을
사용하여) 반환할 때는 주소가 이미 스택의 맨 위에 준비되어 있으며, 이
주소는 팝됩니다. RAS는 다음과 같이 32비트 레지스터 4개로 간단히
선언합니다:
/* D */
   reg [31:0] RAS_0;
   reg [31:0] RAS_1;
   reg [31:0] RAS_2;
   reg [31:0] RAS_3;
두 신호 D_JumpOrBranchNow와
D_JumpOrBranchAddress의 이름을 D_predictPC와
D_PCprediction으로 바꿉니다(이쪽이 더 명확하다고
생각합니다).
/* D */

   wire D_predictPC = !FD_nop && (
      D_isJAL || D_isJALR || (D_isBranch && D_predictBranch)
   );
   wire [31:0] D_PCprediction =
                D_isJALR ? RAS_0 :
            (FD_PC + (D_isJAL ? D_Jimm : D_Bimm));
예측된 반환 주소는 E로 전달되며, E는 이를
실제 반환 주소와 비교할 수 있습니다.
/* D */
always @(posedge clk) begin
   ...
   DE_predictRA <= RAS_0;
end
이제 execute 단계에서는 두 가지 다른 작업을 해야 합니다. 먼저 PC
예측이 맞았는지 판단하고, 틀렸다면 E_correctPC를 어서트하고
E_PCcorrection을 F로 보냅니다(이 신호들은
이전에 E_jumpOrBranch와
E_jumpOrBranchAddress라고 불렸습니다):
/* E */
  wire [31:0] E_JALRaddr = {E_aluPlus[31:1],1'b0};
  wire E_correctPC = (
     (DE_isJALR    && (DE_predictRA != E_JALRaddr)   ) ||
     (DE_isBranch  && (E_takeBranch^DE_predictBranch))
  );
  wire [31:0] E_PCcorrection = DE_isBranch ? DE_PCplus4orBimm : E_JALRaddr;
또한 다음과 같이 RAS를 갱신해야 합니다:
/* E */
 always @(posedge clk) begin
    ...
    if(!FD_nop && !D_flush) begin
       if(D_isJAL && (D_rdId==1 || D_rdId==5)) begin
          RAS_3 <= RAS_2;
          RAS_2 <= RAS_1;
          RAS_1 <= RAS_0;
          RAS_0 <= FD_PC + 4;
        end
        if(D_isJALR && D_rdId==0 && (D_rs1Id == 1 || D_rs1Id==5)) begin
           RAS_0 <= RAS_1;
           RAS_1 <= RAS_2;
           RAS_2 <= RAS_3;
        end
    end
    ...
  end
JAL x1,addr 또는 JAL x5,addr는 함수 호출을
구현하고, JALR x0,x1,imm 또는 JALR x0,x5,imm는
함수에서 반환한다고 가정합니다. 왜 x5입니까? 사실
x1과 x5는 모두 링크 레지스터로 사용할 수
있으며, 이는 RISCV 명세서 17쪽의 표 2.1에 설명되어 있습니다(Bruce Hoult
님께 감사드립니다).
새 버전은 pipeline9.v에 구현되어 있습니다. 이 새 버전은 여러 기능을 활성화하거나 비활성화하도록 설정할 수 있습니다:
| 플래그 | 설명 |
|---|---|
CONFIG_PC_PREDICT |
D -> F 경로를 활성화합니다 |
CONFIG_RAS |
반환 주소 스택(CONFIG_PC_PREDICT 필요) |
CONFIG_GSHARE |
gshare 분기 예측(CONFIG_PC_PREDICT 필요) |
CONFIG_INITIALIZE |
설정하면 레지스터를 0으로 초기화합니다 |
| (일부 합성 도구에서 필요합니다) |
이제 반환 주소 스택의 효과를 시험해 볼 수 있습니다:
| 예측 전략 | raystones | CPI | dhrystones(DMIPS/MHz) | CPI |
|---|---|---|---|---|
| gshare | 7.185 | 1.121 | 1.562 | 1.116 |
| gshare+RAS | 7.374 | 1.092 | 1.606 | 1.086 |
VERILOG로 작성한 디버거
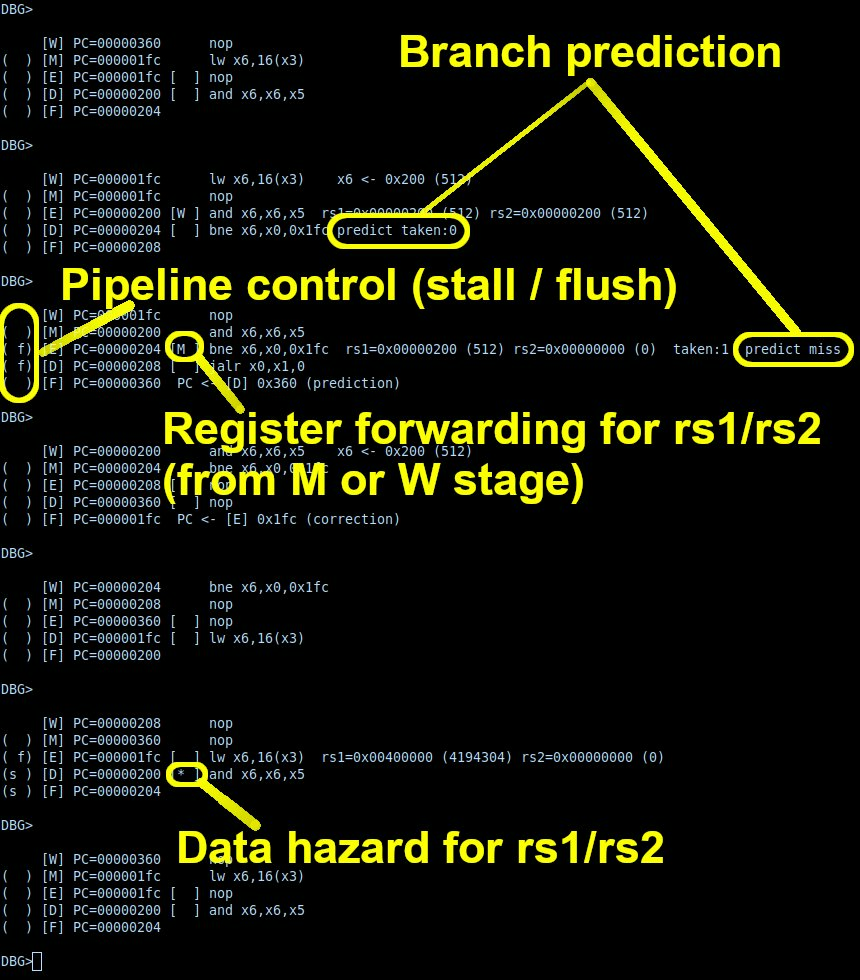
또한 이 버전에는 VERILOG로 작성한 "디버거"가 내장되어 있으며, 이
디버거는 Verilator에서만 동작합니다. CONFIG_DEBUG를
설정하면 활성화할 수 있습니다. 이를 통해 코어를 클록 단위로 실행하면서
각 단계를 살펴볼 수 있습니다. 레지스터 포워딩과 파이프라인 제어 신호도
표시합니다.
디버거에는 명령이 두 개만 있습니다:
<return>을 누르면 다음 클록으로 진행합니다g는 다음 중단점까지 진행합니다
중단점은 Verilog 소스에서 breakpoint 신호를 assert하여
선언할 수 있습니다. pipeline9.v의 840번째 줄을
참조하십시오.
예를 들어, 특정 주소의 명령어가 실행될 때마다 멈추게 할 수 있습니다:
wire breakpoint = (DE_PC == 32'h000000); // break on address reached또는 특정 주소의 데이터를 읽거나 쓸 때 멈추게 할 수 있습니다:
wire breakpoint = (EM_addr == 32'h......);LED 출력 시 멈추기:
wire breakpoint = (EM_addr == 32'h400004);문자 출력 시 멈추기:
wire breakpoint = (EM_addr == 32'h400008);다음 단계에서는 RV32M을 구현합니다. 여기에는 (조금 더) 복잡한 파이프라인 제어가 필요한 멀티사이클 ALU가 들어가므로, 이 디버거가 있으면 유용할 것입니다!
10단계: RV32M
파이프라이닝, 레지스터 포워딩, Branch 예측, 반환 주소 스택을 사용하여
7.374 raystones를 달성했습니다. 이제 더 많은 명령어, 즉 정수 곱셈,
나눗셈, 나머지 연산을 지원하여 프로세서를 더 빠르게 만들 수 있는지
알아봅시다. 이 명령어들은 RV32M 확장에 속합니다. 코어가 이
명령어들을 지원하게 되면 이 아키텍처를 대상으로 코드를 다시 컴파일하기만
하면 됩니다. 그러면 컴파일러가 gcc 라이브러리의 __mulsi3를
호출하는 대신 MUL 명령어를 생성합니다. 따라서 새로 지원해야
할 명령어는 8개입니다:
| 명령어 | 설명 | 비고 | funct3 |
|---|---|---|---|
| MUL rd,rs1,rs2 | rd <- rs1 * rs2 | 부호 있음, 하위 32 LSB | 000 |
| MULH rd,rs1,rs2 | rd <- rs1 * rs2 | 부호 있음, 상위 32비트 | 001 |
| MULHSU rd,rs1,rs2 | rd <- rs1 * rs2 | 부호 있음*부호 없음, 상위 32비트 | 010 |
| MULHU rd,rs1,rs2 | rd <- rs1 * rs2 | 부호 없음, 상위 32비트 | 011 |
| DIV rd,rs1,rs2 | rd <- rs1 / rs2 | 부호 있는 버전 | 100 |
| DIVU rd,rs1,rs2 | rd <- rs1 / rs2 | 부호 없음 | 101 |
| REM rd,rs1,rs2 | rd <- rs1 % rs2 | 부호 있음 | 110 |
| REMU rd,rs1,rs2 | rd <- rs1 % rs2 | 부호 없음 | 111 |
곱셈, 나눗셈, 나머지 연산이 있습니다. 각 연산에는 부호 있는 버전과
부호 없는 버전이 있습니다. 곱셈의 경우 32비트와 32비트를 곱하면 64비트가
되므로 명령어가 두 개 있습니다(LSB를 얻는 MUL과 상위 비트를
얻는 MULH). MULH에는 부호 있음 x 부호 있음,
부호 있음 x 부호 없음, 부호 없음 x 부호 없음의 세 가지 변형이
있습니다.
가장 먼저 해야 할 일은 이 새 명령어들을 디코딩하는 것입니다. 이
명령어들은 모두 opcode = 7'b0110011, 즉
ALUreg로 인코딩됩니다. 차이점은 funct7으로,
모든 RV32M 명령어에서 0000001입니다. 그리고 예상대로
명령어는 funct3으로 인코딩됩니다(새 명령어가 8개이고
funct3이 가질 수 있는 값도 8개이니 딱 맞습니다!).
funct3[2]가 곱셈인지 나눗셈/나머지 연산인지를 나타낸다는
점에 유의하십시오.
이제 RV32M 명령어를 디코딩하는 방법을 알았으니, 곱셈, 나눗셈, 나머지를 계산하는 회로를 만들어야 합니다.
곱셈의 경우, 대부분의 FPGA에는 Verilog에서
A <= B * C;라고 쓰기만 하면(yosys에 올바른 플래그를 넘겨
주었다면) 곱셈을 1 사이클에 계산할 수 있는 내장 블록이 있습니다. 이
블록은 바로 그 일을 잘하기 때문에 "Digital Signal Processing"(디지털
신호 처리)의 약자를 따서 DSP라고 부릅니다. 이는 좋은 일입니다. 이 블록이
없다면 곱을 비트 단위로 계산해야 하고, 그러면 곱셈 한 번에 32 사이클이
들 것이며, 좋은 분기 예측을 갖춘 소프트웨어 곱셈(__mulsi)에
비해 얻는 것이 별로 없을 것이기 때문입니다. 따라서 33비트 곱하기
33비트의 곱을 계산합니다. 왜 33비트일까요? Matthias Koch는 연산 종류와
피연산자의 부호에 따라 부호 비트를 추가하는 아이디어를 냈습니다:
   /* E */
   wire E_isMULH   = DE_funct3_is[1];
   wire E_isMULHSU = DE_funct3_is[2];

   wire E_mul_sign1 = E_rs1[31] &  E_isMULH;
   wire E_mul_sign2 = E_rs2[31] & (E_isMULH | E_isMULHSU);

   wire signed [32:0] E_mul_signed1 = {E_mul_sign1, E_rs1};
   wire signed [32:0] E_mul_signed2 = {E_mul_sign2, E_rs2};
   wire signed [63:0] E_multiply = E_mul_signed1 * E_mul_signed2;
나눗셈과 나머지 연산은 선택의 여지가 없으므로 다중 사이클 회로를 만들어야 합니다. 나눗셈 한 번에 33사이클이 걸리는 고전적인 알고리즘을 사용합니다. 이 구현은 Claire Wolf의 picorv에서 많은 영감을 받았으며, Matthias Koch의 아이디어도 일부 포함하고 있습니다:
   /* E */
   reg [31:0] EE_dividend;
   reg [62:0] EE_divisor;
   reg [31:0] EE_quotient;
   reg [31:0] EE_quotient_msk;

   reg  EE_div_sign;
   reg  EE_divBusy     = 1'b0;
   reg  EE_divFinished = 1'b0;

   wire E_divstep_do = (EE_divisor <= {31'b0, EE_dividend});

   always @(posedge clk) begin
      if (!EE_divBusy) begin
     if(DE_isDIV & !dataHazard & !EE_divFinished) begin
        EE_quotient_msk <= 1 << 31;
        EE_divBusy     <= 1'b1;
     end
     EE_dividend <=   ~DE_funct3[0] & E_rs1[31] ? -E_rs1 : E_rs1;
     EE_divisor  <= {(~DE_funct3[0] & E_rs2[31] ? -E_rs2 : E_rs2), 31'b0};
     EE_quotient <= 0;
     EE_div_sign <= ~DE_funct3[0] & (DE_funct3[1] ? E_rs1[31] :
                         (E_rs1[31] != E_rs2[31]) & |E_rs2)       ;
      end else begin
     EE_dividend <= E_divstep_do ? EE_dividend-EE_divisor[31:0]:EE_dividend;
     EE_divisor  <= EE_divisor >> 1;
     EE_quotient <= E_divstep_do ? EE_quotient|EE_quotient_msk :EE_quotient;
     EE_quotient_msk <= EE_quotient_msk >> 1;
     EE_divBusy <= EE_divBusy & !EE_quotient_msk[0];
      end
      EE_divFinished <= EE_quotient_msk[0];
   end
나눗셈을 위해 execute 단계가 레지스터에 일부 상태를 저장한다는 점에
유의하십시오. 와이어와 구별하기 위해 이 레지스터들에는
EE라는 접두사를 붙입니다.
각 명령어의 결과는 다음과 같이 멀티플렉싱되어 ALU의 출력을 이룹니다.
또한 aluBusy 신호는 현재 나눗셈이 실행 중인지를
나타냅니다.
   wire [2:0] E_divsel = {DE_isDIV,DE_funct3[1],EE_div_sign};

   wire [31:0] E_aluOut_muldiv =
     (  DE_funct3_is[0]    ? E_multiply[31: 0] : 32'b0) | // 0:MUL
     ( |DE_funct3_is[3:1]  ? E_multiply[63:32] : 32'b0) | // 1:MH, 2:MHSU, 3:MHU
     (  E_divsel == 3'b100 ?  EE_quotient      : 32'b0) | // DIV
     (  E_divsel == 3'b101 ? -EE_quotient      : 32'b0) | // DIV (negative)
     (  E_divsel == 3'b110 ?  EE_dividend      : 32'b0) | // REM
     (  E_divsel == 3'b111 ? -EE_dividend      : 32'b0) ; // REM (negative)

   wire [31:0] E_aluOut = DE_isRV32M ? E_aluOut_muldiv : E_aluOut_base;

   wire aluBusy = EE_divBusy | (DE_isDIV & !EE_divFinished);
나눗셈이 실행되는 동안에는 명령어가 E에 머물러 있어야
합니다(E가 stall됩니다). 이는 F와
D도 stall되어야 하고, M은 flush되어야 한다는
뜻입니다. 새로운 파이프라인 제어 신호(E_stall과
M_flush)를 만들고, 모든 파이프라인 제어 신호를 다음과 같이
연결합니다:
   assign F_stall = aluBusy | dataHazard | halt;
   assign D_stall = aluBusy | dataHazard | halt;
   assign E_stall = aluBusy;

   assign D_flush = E_correctPC;
   assign E_flush = E_correctPC | dataHazard;
   assign M_flush = aluBusy;
새 버전은 pipeline10.v에 있습니다. 먼저 RV32I 대신 RV32IM을 대상으로 하도록 시스템을 다시 구성해야 합니다:
  $ cd learn-fpga/FemtoRV
  $ make ICEBREAKER.firmware_config
  $ cd TUTORIALS/FROM_BLINKER_TO_RISCV/FIRMWARE
  $ make clean raystones.pipeline.hex
그런 다음 실행하십시오:
  $ cd ..
  $ ./run_verilator.sh pipeline10.v
새 코어의 점수는 18.215 RAYSTONES입니다. 레이트레이싱에는 FPU가 더 좋겠지만, 1사이클 하드웨어 정수 곱셈만으로도 성능이 크게 향상됩니다.
프로세서가 동작하는 모습을 보려면 CONFIG_DEBUG가 있는
줄의 주석을 해제하고 verilator로 실행하십시오. g를 눌러
다음 중단점(DIV 명령어에 설정됨)으로 이동한 다음,
<return>을 눌러 한 사이클씩 실행하십시오. 화면에
표시되는 나눗셈 마스크로 진행 상황을 확인할 수 있습니다.
10단계: fmax 최적화
이렇게 CPI 면에서는 이득을 얻었음을 확인했습니다. 그렇다면 fmax(그리고 LUT와 FF)는 어떤 상황일까요? ULX3S에서의 수치는 다음과 같습니다:
| 버전 | 설명 | Fmax | LUT | FF |
|---|---|---|---|---|
| pipeline2.v | 3~4 상태 멀티사이클 | 50 MHz | 2100 | 532 |
| pipeline3.v | 순차 파이프라인 | 80 MHz | 1877 | 1092 |
| pipeline4.v | 스톨/플러시 | 50 MHz | 2262 | 1148 |
| pipeline5.v | 스톨/플러시 RF 바이패스 | 55 MHz | 2115 | 1040 |
| pipeline5_bis.v | 스톨/플러시 조합 RF | 55 MHz | 1903 | 1040 |
| pipeline6.v | 스톨/플러시+레지스터 포워딩 | 40 MHz | 2478 | 1040 |
- "순차 파이프라인(sequential pipeline)"은 80 MHz에서 검증을 통과합니다. 이를 통해 단순한 스테이지를 갖는 것의 이점을 확인할 수 있습니다
- 파이프라인 제어 로직을 추가하면 Fmax가 급격히 떨어집니다(pipeline4)
- ... 하지만 쓴 값을 같은 사이클에 읽을 수 있는 조합 논리(combinatorial) 레지스터 파일(에뮬레이션 또는 실제)을 사용하는 pipeline5와 pipeline5_bis에서는 다시 높아집니다(그래서 파이프라인 제어 로직이 더 단순합니다)
- ... 그리고 마지막으로 레지스터 포워딩 로직을 추가하면 다시 떨어집니다.
하지만 지금까지 Fmax 최적화에는 전혀 노력을 기울이지 않았으며, 지금까지의 목표는 주로 CPI를 줄이는 것이었습니다. 이제 무엇을 할 수 있는지 살펴봅시다.
할 수 있는 일이 몇 가지 있습니다:
E
스테이지에서 DATARAM을 읽고, M에서 부호 확장
및 정렬하기
메모리 연산을 여러 스테이지로 나누면 임계 경로가 줄어듭니다.
wbEn 레지스터
파이프라인
마지막 행에서 fmax가 떨어지는 것을 보면, 레지스터 포워딩 역시 제한 요인이라고 짐작할 수 있습니다. 레지스터 포워딩을 위해 무엇을 했는지 좀 더 자세히 살펴봅시다:
   wire E_M_fwd_rs1 = rdId(EM_instr) != 0 && writesRd(EM_instr) &&
                  (rdId(EM_instr) == rs1Id(DE_instr));

   wire E_W_fwd_rs1 = rdId(MW_instr) != 0 && writesRd(MW_instr) &&
                  (rdId(MW_instr) == rs1Id(DE_instr));

   wire E_M_fwd_rs2 = rdId(EM_instr) != 0 && writesRd(EM_instr) &&
                  (rdId(EM_instr) == rs2Id(DE_instr));

   wire E_W_fwd_rs2 = rdId(MW_instr) != 0 && writesRd(MW_instr) &&
                  (rdId(MW_instr) == rs2Id(DE_instr));

   wire [31:0] E_rs1 = E_M_fwd_rs1 ? EM_Eresult :
                   E_W_fwd_rs1 ? wbData     :
                   DE_rs1;

   wire [31:0] E_rs2 = E_M_fwd_rs2 ? EM_Eresult :
                   E_W_fwd_rs2 ? wbData     :
                   DE_rs2;
그리고 writesRd(I)는
!isStore(I) & !isBranch(I)로 정의되며, 여기서
isStore()와 isBranch()는 각각 7비트를
검사합니다. 이들은 5비트(rdId)도 검사하므로, 두 mux
E_rs1과 E_rs2를 제어하는 네 개의 식은 상당히
넓습니다. 이를 어떻게 줄일 수 있겠습니까?
핵심 아이디어는 각 스테이지에 명령어가 레지스터 파일에 다시
쓰는지(write back) 여부를 나타내는 wbEnable 파이프라인
레지스터를 만드는 것입니다. Decode 단계는
!isStore(I) & !isBranch(I) 검사를 수행하고, 이어서 실행
단계에서는 rdId가 0이 아닌지 검사합니다.
D에서
디코딩하고, 이후 스테이지에서 instr와 PC를
제거하기
현재는 instr를 스테이지에서 스테이지로 전달하고, 필요할
때마다 디코딩합니다. 이는 최적이 아니며, D에서 각 명령어를
판별한 다음 각 명령어를 나타내는 is_xxxx 플래그를 전달하는
편이 더 좋습니다.
D에서의 세심한
최적화
10개 주요 명령어 클래스의 비트 패턴 인코딩은 임의로 정해진 것이
아니라, 효율성을 염두에 두고 설계되었습니다. 가장 분명한 것은 항상
00이어서 검사할 필요가 없는 마지막 두 비트이지만, 이보다 더
미묘한 구조도 있습니다:
예를 들어, JAL은 비트 3이 설정된 유일한 명령어이므로
D는 다른 비트를 검사할 필요가 없습니다. 이는 PC 예측 로직을
단순하게 만들어 주므로 흥미롭습니다.
레지스터 포워딩을 위한 파이프라인화된 레지스터 Id 비교기
E의 시작 부분에 있는 두 개의 3-way mux는
(DE,EM) 및
(DE,MW)에서 소스 레지스터
ID(rs1Id 및 rs2Id)와 목적지 레지스터 ID
rdId)를 비교한 결과에 의해 구동됩니다. 이 두 검사의 결과는
D에서 한 사이클 앞서 계산하여 4개의 플립플롭
DE_rs1Id_eq_EM_rdId, DE_rs1Id_eq_MW_rdId,
DE_rs2Id_eq_EM_rdId, DE_rs2Id_eq_MW_rdId에
저장할 수 있습니다.
TordBoyau라는 이름의 "최종 결과물"은 이 프로젝트에서 확인할
수 있습니다. Vivado를 사용하는 ARTY 보드에서는 100-125 MHz로 검증되며,
140 MHz까지 오버클록해도 문제없이 동작합니다.
- RV32I 구성에서는 레이트레이싱 테스트가 7.375 raystones를 기록합니다(CPI는 1.092로, gshare + RAS가 아주 잘 동작합니다!).
- RV32IM 구성에서는 18.215 raystones에 도달합니다.
에필로그
이 시리즈를 즐겁게 읽으셨기를 바랍니다. 공부할 주제는 아직 많이 남아 있으며, (언젠가) 다음 주제들에 대한 튜토리얼을 준비할 예정입니다(제가 이해하는 대로 바로 준비하겠습니다!).
최적화: 프로세서를 더 빠르게 만들기 위해 할 수 있는 일이 몇 가지 있습니다. 첫째는
STORE->LOAD레지스터 포워딩으로, 이를 통해memcpy()가 워드당 1사이클로 실행되게 할 수 있습니다. 둘째는TordBoyau의RV32IM버전에 관한 것입니다. 이 버전은 140 MHz까지 안전하게 오버클록할 수 있는데도 약 80 MHz에서만 검증되므로, 제거해야 할 false path가 몇 개 있을 것으로 보입니다.캐시: 현재 우리 파이프라인 프로세서에는
PROGROM과DATARAM이 있습니다. 여기에 SDRam 컨트롤러와 연결된 캐시 인터페이스를 붙여서, 필요할 때 SDRAM에서 데이터를 가져오고 SDRAM에 데이터를 저장하도록 해야 합니다. 이 작업은 LiteX 시스템에서 개발할 계획입니다. LiteX는 SDRam 컨트롤러, 프레임 버퍼 등 매우 완전한 기능을 갖추고 있습니다. 그러면 우리 파이프라인 프로세서에서 DOOM을 실행할 수 있게 됩니다(에피소드 I에서 만든 코어에서는 이미 DOOM이 실행되는데, LiteX 개발자들이 그 코어를 자신들의 캐시 컨트롤러에 이미 연결해 두었기 때문입니다).인터럽트: RISC-V ISA는 여러 장으로 구성되어 있습니다. 그중 "특권 ISA(privileged ISA)"에는 인터럽트와 트랩을 제어하는 특수 레지스터와 명령어가 있습니다. 그러나 ISA 공식 문서는 모든 가능성을 빠짐없이 나열하기 때문에 (제 생각에는) 읽기가 매우 어렵습니다. 예를 들어 Linux-noMMU를 실행하는 데 필요한 최소한의 내용을 간단히 정리해 볼 계획입니다.
MMU: MMU 이야기가 나왔으니 말씀드리면, 이것만 해도 이미 흥미로운 주제입니다. @ultraembedded는 MMU를 추가하는 일이 아주 간단하다고 알려 주었습니다.
비순차 실행(Out-of-order): 이 에피소드를 마무리하며 gshare Branch 예측과 반환 주소 스택의 결합 효과 덕분에 1.092 CPI를 달성했으며, 이는 "광속"(1 CPI)에 매우 가깝습니다. 사실 여러 실행 유닛이 명령어를 골라 순서와 관계없이 실행(OoO)하여 한 사이클에 여러 명령어를 처리하는 "빛보다 빠른" 프로세서도 설계할 수 있습니다. 이런 방식으로 동작하는 코어로는 @dolu1990의 NaxRiscV와 @ultraembedded의 BiRiscV 등이 있습니다. 이런 코어의 마이크로아키텍처는 완전히 다릅니다. 여전히 파이프라인의 집합이지만 트리 형태로 구성되며, 명령어를 분배하는 "중앙 관리자"가 있습니다(토마술로 알고리즘). 누구나 자신만의 파이프라인 트리를 만들 수 있고, "중앙 관리자"를 자동으로 생성하는 코드도 갖춘 범용 설계가 있다면 좋을 것입니다. 이를 위해 LiteX 같은 프레임워크를 활용할 수 있을 것입니다.