RPython 툴체인
Contents
이 문서는 (PyPy 자체와 같은) RPython 프로그램을 분석하고 다양한 대상 플랫폼으로 “컴파일”하기 위해 저희가 개발한 툴체인을 설명합니다.
이 문서는 크게 세 부분으로 구성됩니다. 약간 단순화한 개요, 저희 툴체인의 주요 구성 요소 각각에 대한 간략한 소개, 그리고 각 구성 요소가 어떻게 서로 맞물리는지를 더 포괄적으로 설명하는 부분입니다. 이 문서를 처음 읽는다면 Overview가 가장 유용할 것이고, PyPy에 관한 머릿속 메모리를 새로 고치려 한다면 How It Fits Together가 아마 원하시는 내용일 것입니다.
개요
변환 툴체인의 역할은 RPython 프로그램을 여러 대상 플랫폼 중 하나에 맞춘 효율적인 버전으로 변환하는 것입니다. 대상 플랫폼은 일반적으로 Python보다 상당히 저수준입니다. 변환 툴체인은 이 작업을 여러 단계로 나누어 수행하며, 이 문서의 목적은 그 단계들을 소개하는 것입니다.
먼저 RPython 프로그램을 C(기본 대상이자 원래의 대상)로 변환하는 과정을 설명합니다.
RPython 변환 툴체인은 Python 소스 코드나 구문 트리를 전혀 보지 않으며, 대신 입력으로 주어진 함수 객체의 동작을 정의하는 코드 객체에서 출발합니다. 흐름 그래프 빌더는 Abstract interpretation을 사용하여 이러한 코드 객체를 처리하고 제어 흐름 그래프(함수마다 하나씩)를 생성합니다. 이 그래프는 소스 프로그램의 또 다른 표현이지만, 타입 추론과 변환 기법을 적용하기에 적합하며 대부분의 변환 단계가 다루는 기본 자료 구조입니다.
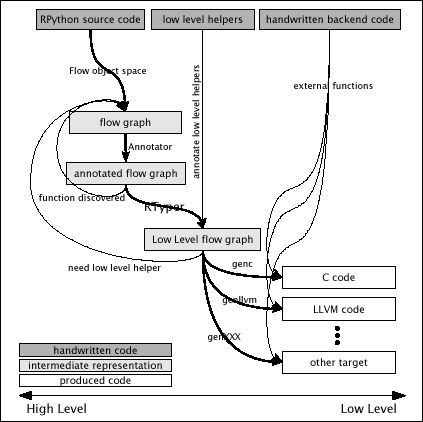
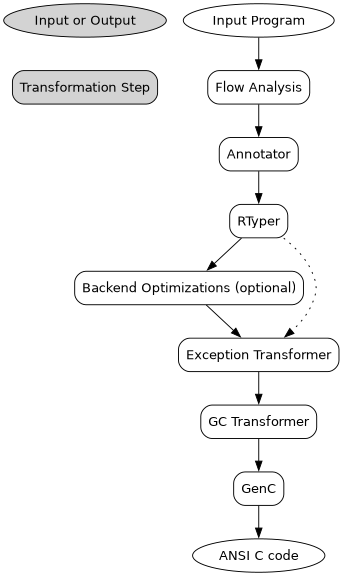
변환은 다음 단계들로 이루어져 있다고 생각하면 이해하는 데 도움이 됩니다(아래 그림도 참고하십시오):
- 전체 프로그램을 임포트하며, 이때 임의의 런타임 초기화를 수행할 수 있습니다. 이 작업이 끝나면 프로그램은 RPython의 관점에서 “충분히 정적인” 형태로 메모리에 존재해야 합니다.
- Annotator는 지정된 진입점에서 시작하는 전역 분석을 수행하여 각 변수가 런타임에 담을 수 있는 값의 타입과 기타 정보를 추론하며, 그 과정에서 마주치는 대로 흐름 그래프를 구축합니다.
- RPython Typer(또는 RTyper)는 어노테이터가 추론한 고수준 정보를 사용하여 제어 흐름 그래프의 연산을 저수준 연산으로 바꿉니다.
- RTyper 이후에는 선택적으로 적용할 수 있는 여러 optimizations가 있으며, 이는 결과 프로그램이 더 빠르게 실행되도록 하기 위한 것입니다.
- 다음 단계는 preparing the graphs for source generation입니다. 이 단계에서는 프로그램의 여러 함수와 타입이 최종 소스에서 갖게 될 이름을 계산하고, 명시적인 예외 처리와 메모리 관리 연산을 삽입하는 변환을 적용합니다.
- The C Backend (흔히 “GenC”라고 부름)는 여러 개의 C 소스 파일을 생성합니다(앞서 언급했듯이 지금은 다른 백엔드를 고려하지 않습니다).
- 이 소스 파일들을 컴파일하면 실행 파일이 만들어집니다.
(다만 이 설명만 보면 단계들이 뚜렷하게 나뉘는 것처럼 보이겠지만, 실제로는 그만큼 명확하게 구분되지는 않습니다).
변환 과정에는 이러한 단계를 대화형으로 하나씩 진행해 볼 수 있는 rpython/bin/translatorshell.py라는 대화형 인터페이스가 있습니다.
다음 그림은 간략한 개요를 보여 줍니다(PDF color version):
흐름 그래프 구축
소개
흐름 그래프 빌더(소스는 rpython/flowspace/에 있습니다)의 역할은 함수로부터 제어 흐름 그래프를 생성하는 것입니다. 이 그래프에는 개별 연산의 트레이스도 담기므로, 사실상 해당 함수를 다른 방식으로 표현한 것에 불과합니다.
기본 아이디어는 인터프리터에 함수가 주어졌을 때, 예를 들어:
def f(n):
  return 3*n+2
이를 바이트코드로 컴파일한 다음 자신의 VM에서 실행합니다. 대신 흐름 그래프 빌더에는 abstract interpreter가 들어 있습니다. 이 추상 인터프리터는 바이트코드를 받아 필요한 스택 조작과 변수 처리를 모두 수행하지만, Python 객체에 실제로 수행되는 연산은 기본 블록(basic block)이라는 구조에 기록하기만 합니다. 연산 결과는 이후 연산에 나타날 수 있는 자리 표시자(placeholder) 값으로 표현됩니다.
예를 들어 위 함수에 자리 표시자 v1이 인자로 주어지면, 바이트코드 인터프리터는 v2 = space.mul(space.wrap(3), v1)을 호출한 다음 v3 = space.add(v2, space.wrap(2))를 호출하고, v3를 결과로 반환합니다. 이러한 호출이 이루어지는 동안 다음 블록이 기록됩니다:
Block(v1):     # input argument
  v2 = mul(Constant(3), v1)
  v3 = add(v2, Constant(2))
추상 해석
build_flow()는 바이트코드 인터프리터가 내보내는 모든 연산을 기본 블록(basic block)에 기록하는 방식으로 동작합니다. 기본 블록은 두 가지 경우 중 하나에서 끝납니다. 바이트코드 인터프리터가 is_true()를 호출할 때, 또는 합류 지점(joinpoint)에 도달할 때입니다.
- 조인포인트(joinpoint)는 다음 연산이 현재 블록에 기록되려는 시점에, 같은 바이트코드 위치의 연산을 기록하는 다른 블록이 이미 존재할 때 발생합니다. 이는 바이트코드 인터프리터가 루프를 한 바퀴 돌아 이미 살펴본 코드를 다시 해석하고 있다는 뜻입니다. 이 경우 바이트코드 인터프리터를 중단하고 현재 블록의 끝에서 이전 블록으로 되돌아가는 링크를 만들어, 흐름 그래프(flow graph)에서도 루프를 닫습니다. (이는 연산이 기록되려는 시점에만 발생하므로 어느 정도의 상수 폴딩(constant-folding)이 가능하다는 점에 유의하십시오.)
- 바이트코드 인터프리터가
is_true()를 호출하면, 추상 인터프리터는 일반적으로 그 답이 True여야 하는지 False여야 하는지 알 수 없으므로 조건부 점프를 넣고 현재 기본 블록에 대해 두 개의 후속 블록을 생성합니다. 여기에는 약간의 속임수가 동원되어, 바이트코드 인터프리터는is_true()가 처음에는 False를 반환하고(이어지는 연산들은 첫 번째 후속 블록에 기록됩니다), 나중에는 같은is_true()호출이 True도 반환한다고(이번에는 이어지는 연산들이 다른 후속 블록으로 들어갑니다) 착각하게 됩니다.
(이 절은 추후 보강될 예정입니다…)
흐름 모델
여기서는 변환 과정의 기본 자료 구조인, build_flow()가 생성하는 자료 구조를 설명합니다.
이 모든 타입은 rpython/flowspace/model.py에 정의되어 있습니다(다시 한번 강조하자면, 이 모듈은 PyPy 소스 코드에서 상당히 중요한 모듈입니다).
함수의 흐름 그래프는 FunctionGraph 클래스로 표현됩니다. 이 클래스는 Link로 연결된 Block들의 모음에 대한 참조를 가지고 있습니다.
Block에는 SpaceOperation의 리스트가 들어 있습니다. 각 SpaceOperation에는 opname과 args 리스트, 그리고 result가 있으며, 이들은 Variable 또는 Constant입니다.
저희에게는 매우 유용한 PyGame 뷰어가 있습니다. 이 뷰어를 사용하면 변환 과정의 여러 단계에서 그래프를 시각적으로 살펴볼 수 있습니다(무언가가 왜 깨지는지 알아낼 때 매우 유용합니다). 다음과 같은 모습입니다:
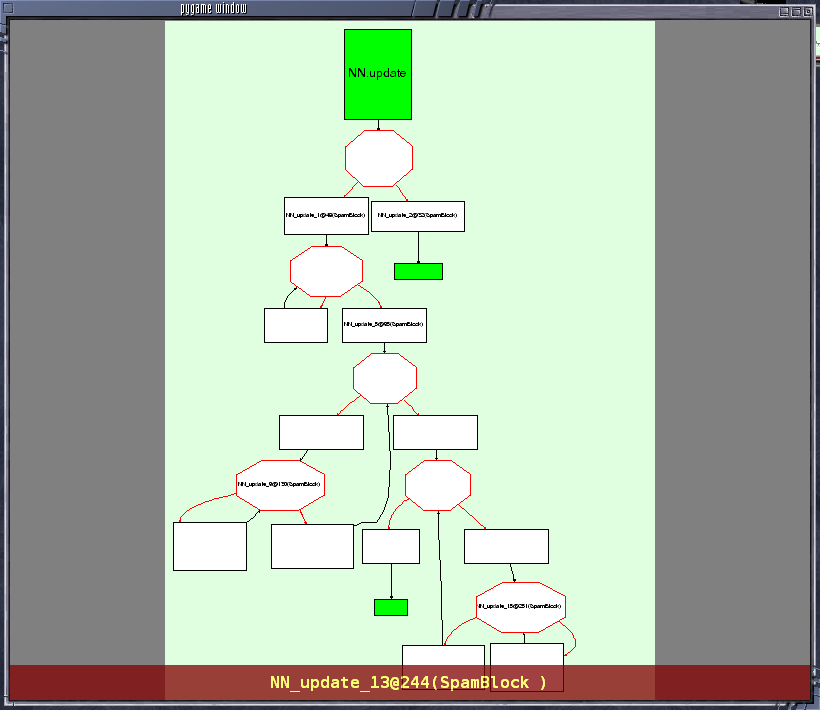
흐름 그래프(flow graph)의 구조를 파악하려면 몇 가지 예제로 python bin/translatorshell.py를 직접 사용해 보기를 권장합니다. 다음은 타입과 그 속성을 비교적 자세히 설명합니다.
FunctionGraph하나의 그래프(하나의 함수에 대응)를 담는 컨테이너입니다.
startblock: the first block. It is where the control goes when the 함수가 호출됩니다. startblock의 입력 인자는 함수의 인자입니다. 함수가 *args인자를 받는 경우,args튜플이 startblock의 마지막 입력 인자로 주어집니다.returnblock: the (unique) block that performs a function return. It is 비어 있으며, 실제로는 어떤 return연산도 포함하지 않습니다. 반환은 암묵적으로 이루어집니다. 반환되는 값은 returnblock의 유일한 입력 변수입니다.exceptblock: the (unique) block that raises an exception out of the 함수입니다. 두 입력 변수는 각각 예외 클래스와 예외 값입니다. (함수가 명시적으로 예외를 발생시키지 않으면 실제로 exceptblock에 연결되는 다른 블록은 없습니다.) Block연산 목록을 담고 있으며 다른 기본 블록으로의 점프로 끝나는 기본 블록입니다. 블록이 실행되는 동안 “살아 있는” 모든 값은 변수(Variable)에 저장됩니다. 각 기본 블록은 다른 블록과 구별되는 고유한 변수(Variable)를 사용합니다.
inputargs: list of fresh, distinct Variables that represent all the 이전 블록 중 어느 블록에서든 이 블록으로 들어올 수 있는 값입니다. operations: list of SpaceOperations. exitswitch: see below exits: list of Links representing possible jumps from the end of this 기본 블록에서 다른 기본 블록의 시작 부분으로. 각 Block은 다음 중 한 가지 방식으로 끝납니다:
- 무조건 점프: exitswitch는 None이고, exits에는 Link가 하나만 들어 있습니다.
- 조건부 점프: exitswitch는 Block에 나타나는 변수(Variable) 중 하나이며, exits에는 하나 이상의 Link(보통 2개)가 들어 있습니다. 각 Link의 exitcase는 구체적인 값을 나타냅니다. 이는 “switch”에 해당합니다. 제어는 exitcase가 exitswitch 변수(Variable)의 런타임 값과 일치하는 Link를 따라갑니다. 변수(Variable)가 어떤 exitcase와도 일치하지 않으면 런타임 오류입니다.
- 예외 포착: exitswitch는
Constant(last_exception)입니다. 첫 번째 Link는 exitcase가 None으로 설정되어 있으며, 예외가 발생하지 않는 경로를 나타냅니다. 그다음 Link들은 exitcase가 Exception의 서브클래스로 설정되어 있으며, 기본 블록의 마지막 연산이 일치하는 예외를 발생시킬 때 선택됩니다. (따라서 기본 블록은 비어 있으면 안 되며, 핸들러는 마지막 연산만 보호합니다.) - return 또는 except: returnblock과 exceptblock은 operations가 빈 튜플로, exitswitch가 None으로 설정되어 있으며, exits는 비어 있습니다.
Link한 기본 블록에서 다른 기본 블록으로 이어지는 링크입니다.
prevblock: the Block that this Link is an exit of. target: the target Block to which this Link points to. args: a list of Variables and Constants, of the same size as the 대상 Block의 inputargs로, 다음 블록에 전달되는 모든 값을 담고 있습니다. (prevblock에서 사용된 각 Variable(변수)은 args리스트에 0번, 1번 또는 여러 번 나타날 수 있다는 점에 유의하십시오.)exitcase: see above. last_exception: None or a Variable; see below. last_exc_value: None or a Variable; see below. args는 prevblock의 변수(Variable)를 사용하며, 이 변수들은 튜플 할당이나 함수 호출에서와 마찬가지로 위치에 따라 대상 블록의inputargs와 대응된다는 점에 유의하십시오.링크가 예외를 잡는 링크라면
last_exception과last_exc_value는 링크에 진입할 때 생성되는 것으로 간주되는 새로운 두 Variable로 설정됩니다. 런타임에 이 두 변수는 각각 예외 클래스와 예외 값을 담습니다. 이 두 새 변수는 같은 링크의args목록에서만 사용할 수 있으며, 이를 통해 다음 블록으로 전달됩니다(평소와 마찬가지로 실제로는args에 전혀 나타나지 않을 수도 있고 여러 번 나타날 수도 있습니다).SpaceOperation기록된(또는 다른 방식으로 생성된) 기본 연산입니다.
opname: the name of the operation. build_flow()produces only operationsrpython.flowspace.operation에 있는 목록에서 가져오지만, 나중에 이름을 임의로 바꿀 수 있습니다.args: list of arguments. Each one is a Constant or a Variable seen 이전에 기본 블록(basic block)에서. result: a new Variable into which the result is to be stored. 일반적으로 연산은 런타임에 암묵적으로 예외를 발생시킬 수 없다는 점에 유의하십시오. 따라서 예를 들어, 코드 생성기는 리스트에 대한
getitem연산이 안전하며 범위 검사 없이 수행될 수 있다고 가정할 수 있습니다. 이 규칙의 예외는 다음과 같습니다. (1) 연산이exitswitch == Constant(last_exception)으로 끝나는 블록의 마지막 연산인 경우, 암묵적 예외를 검사하고 생성하며 적절히 잡아야 합니다. (2)simple_call또는call_args에 따른 다른 함수 호출은 호출된 함수가 발생시킬 수 있는 예외라면 무엇이든 언제나 발생시킬 수 있습니다. 그리고 이러한 예외는 위와 같이 잡히지 않는 한 부모에게 그대로 전달되어야 합니다.Variable런타임 값을 담는 자리 표시자입니다. 여기에는 대부분 디버깅용 코드가 들어 있습니다.
name: it is good style to use the Variable object itself instead of its name은 고유함이 보장되기는 하지만, 값을 참조하는 데name속성을ConstantSpaceOperation의 인자로 사용되거나, 대상 Block의 입력 변수(Variable)를 초기화하기 위해 Link를 통해 전달되는 값으로 사용되는 상수 값입니다.
value: the concrete value represented by this Constant. key: a hashable object representing the value. 상수(Constant)는 때때로 변경 가능한 Python 객체를 저장할 수 있습니다. 이 경우 Constant는 해당 객체의 정적이고 미리 초기화된 읽기 전용 버전을 나타냅니다. 흐름 그래프는 이러한 상수를 실제로 변경하려고 시도해서는 안 됩니다.
어노테이션 패스
아래에서는 제어 흐름 그래프에 “주석을 달아(annotate)” 객체의 타입을 알아내는 방법을 간략히 설명합니다. 이 주석 처리 단계(annotation pass)는 타입 추론의 한 형태입니다. 이 단계는 Flow 객체 공간(object space)이 만든 제어 흐름 그래프를 대상으로 동작합니다.
어노테이션 과정에 대한 더 자세한 설명은 저희 EU report about translation의 해당 절을 참조하십시오.
어노테이터(annotator)의 주요 목표는 흐름 그래프에 나타나는 각 변수를 “어노테이트”하는 것입니다. “어노테이션”은 모든 흐름 그래프(함수당 하나)를 대상으로 한 전체 프로그램 분석을 바탕으로, 이 변수가 런타임에 담을 수 있는 모든 가능한 Python 객체를 기술합니다.
“어노테이션(annotation)”은 SomeObject의 서브클래스의 인스턴스입니다. 각 서브클래스는 특정 객체 계열을 나타냅니다.
다음은 개요입니다(pypy/annotation/model/ 참조):
SomeObject는 기반 클래스입니다.SomeObject()의 인스턴스는 임의의 Python 객체를 나타내며, 따라서 이는 대개 입력 프로그램이 완전한 RPython이 아니었음을 의미합니다.SomeInteger()는 임의의 정수를 나타냅니다.SomeInteger(nonneg=True)는 음이 아닌 정수(>=0)를 나타냅니다.SomeString()은 임의의 문자열을 나타내고,SomeChar()는 길이가 1인 문자열을 나타냅니다.SomeTuple([s1,s2,..,sn])은 길이가n인 튜플을 나타냅니다. 이 튜플의 요소들은 주어진 어노테이션 목록에 의해 각각 제약을 받습니다. 예를 들어,SomeTuple([SomeInteger(), SomeString()])은 정수와 문자열이라는 두 항목으로 이루어진 튜플을 나타냅니다.
어노테이션(annotation) 패스의 결과는 본질적으로 Variable들을 어노테이션에 매핑하는 큰 딕셔너리입니다.
모든 SomeXxx 인스턴스는 불변입니다. 어노테이터가 어떤 변수(Variable)에 무엇이 담길 수 있는지에 대한 판단을 수정해야 할 경우, 기존 어노테이션을 변경하지 않고 새 어노테이션을 생성하는 방식으로 수정합니다.
가변 값과 컨테이너
가변 객체는 어노테이션 과정에서 특별한 처리가 필요합니다. 변경 연산을 반영하기 위해 포함된 값의 어노테이션을 갱신해야 할 수 있고, 그에 따라 어노테이션 정보를 흐름 그래프의 관련 부분에 다시 흘려보내야 하기 때문입니다.
SomeList는 동종(homogeneous) 타입의 리스트를 나타냅니다(즉, 리스트의 모든 요소가 하나의 공통된SomeXxx어노테이션으로 표현됩니다).SomeDict는 동종(homogeneous) 딕셔너리를 나타냅니다(즉, 모든 키가 같은SomeXxx어노테이션을 가지며, 모든 값도 마찬가지입니다).
사용자 정의 클래스와 인스턴스
SomeInstance는 주어진 클래스 또는 그 서브클래스의 인스턴스를 나타냅니다. 어노테이터가 만나는 각 사용자 정의 클래스마다 해당 클래스 인스턴스의 속성을 기술하는 ClassDef(pypy.annotation.classdef)를 유지합니다. 본질적으로 ClassDef는 클래스 수준과 인스턴스 수준의 모든 속성 집합을 제공하며, 각 속성마다 대응하는 SomeXxx 어노테이션을 제공합니다.
인스턴스 수준 속성은 어노테이션이 진행됨에 따라 점진적으로 발견됩니다. 다음과 같은 할당문은:
inst.attr = value
주어진 인스턴스의 ClassDef를 갱신하여, 주어진 속성이 존재하며 주어진 값만큼 일반적일 수 있음을 기록합니다.
각 속성마다 ClassDef는 해당 속성을 읽는 모든 위치도 기록합니다. 나중에 어느 시점에 해당 속성에 대한 어노테이션을 일반화하도록 강제하는 대입을 발견하면, 지금까지 그 속성을 읽은 모든 위치가 무효로 표시되고 어노테이터는 그 위치부터 분석을 다시 시작합니다.
인스턴스 수준 속성과 클래스 수준 속성 사이의 구분은 미미합니다. 클래스 수준 속성은 사실상 인스턴스 수준 속성의 초기값으로 간주됩니다. 메서드도 이 점에서 특별하지 않습니다. 다만 인스턴스의 초기값으로 간주될 때 인스턴스에 바인딩된다는 점(즉, self = SomeInstance(cls))만 다릅니다.
상속 규칙은 다음과 같습니다. 두 SomeInstance 어노테이션의 합집합은 가장 구체적인 공통 기반 클래스의 SomeInstance입니다. 어떤 속성이 부모 클래스의 SomeInstance를 통해 다루어진다면(즉, 읽히거나 쓰인다면), 모든 서브클래스도 같은 속성을 가지며 동일한 어노테이션이 그 모두에 적용된다고 가정합니다(따라서 부모 클래스의 메서드 안에 있는 return self.x 같은 코드는 부모 클래스와 그 모든 서브클래스가 속성 x를 갖도록 강제하며, 이 속성의 어노테이션은 모든 서브클래스가 x에 저장하려 할 수 있는 모든 값을 포함할 만큼 일반적입니다). 그러나 서로 다른 서브클래스들은 부모 클래스를 통해 일반적인 방식으로 사용되지 않는 한, 서로 관련 없는 다른 어노테이션을 가진 같은 이름의 속성을 가질 수 있습니다.
RPython 타이퍼(Typer)
자세한 내용은 RPython 타이퍼(Typer)를 참조하십시오.
백엔드 최적화
백엔드 최적화의 목적은 컴파일된 프로그램이 더 빠르게 실행되도록 하는 것입니다. 전통적인 컴파일러와는 매우 다른 PyPy 변환기의 여러 부분과 달리, 이 최적화들은 대부분 컴파일러의 동작 방식을 아는 사람들에게 꽤 익숙할 것입니다.
함수 인라이닝
PyPy 인터프리터를 실행할 때 발생하는 수많은 함수 호출의 오버헤드를 줄이기 위해 함수 인라이닝(inlining)을 구현했습니다. 이는 흐름 그래프(flow graph)와 호출 지점(callsite)을 받아 해당 흐름 그래프의 사본을 호출하는 함수의 그래프에 삽입하고, 그 안에 나타나는 변수의 이름을 적절히 바꾸는 최적화입니다. 원래 함수가 try: ... except: ... 가드(guard)로 둘러싸여 있었다면 이는 문제를 일으킵니다. 이 경우에는 인라이닝이 항상 가능한 것은 아닙니다. 하지만 호출된 함수가 예외를 직접 발생시키지 않는다면(그 함수가 다시 호출하는 함수들이 예외를 발생시킬 가능성은 있더라도) 인라이닝은 안전합니다.
또한 어떤 함수를 어디에 인라인할지 결정하는 휴리스틱도 구현했습니다. 이를 위해 모든 함수에 “크기”를 부여합니다. 이 크기는 해당 함수를 어딘가에 인라인했을 때 예상되는 코드 크기 증가량과 대략 일치해야 합니다. 이 추정치는 두 수의 합입니다. 먼저 모든 연산에는 특정 가중치가 부여되며, 기본 가중치는 1입니다. 어떤 연산은 다른 연산보다 더 많은 비용이 드는 것으로 간주되며(예: 메모리 할당과 호출), 어떤 연산은 비용이 전혀 들지 않는 것으로 간주됩니다(캐스팅 등). 크기 추정치의 한 부분은 그래프에 나타나는 모든 연산의 가중치 합입니다. 이를 “정적 명령어 수”라고 합니다. 그래프 크기 추정치의 다른 부분은 “실행 비용 중앙값”입니다. 이것 역시 그래프에 있는 모든 연산의 가중치 합이지만, 이번에는 각 연산이 얼마나 자주 실행되는지에 대한 추정치로 가중치를 매깁니다. 이 추정치를 얻기 위해 모든 브랜치에서 두 경로를 똑같은 빈도로 택한다고 가정합니다. 단, 루프의 끝에 있는 브랜치는 예외로, 이 경우에는 루프의 끝으로 되돌아가는 점프가 더 일어날 가능성이 높다고 간주합니다. 그 결과 연립방정식이 만들어지며, 이를 풀면 모든 연산의 근사 가중치를 얻을 수 있습니다.
모든 함수의 크기 추정치가 결정되고 나면, 가장 작은 함수부터 시작하여 함수들을 호출 지점에 인라인합니다. 한 함수를 다른 함수에 인라인할 때마다 바깥 함수의 크기를 다시 계산합니다. 이 과정은 남은 함수들의 크기가 모두 미리 정해진 한도보다 커질 때까지 계속됩니다.
Malloc 제거
RPython은 가비지 컬렉션을 사용하는 언어이므로 힙 메모리 할당이 끊임없이 많이 일어납니다. 좀 더 전통적인, 메모리를 명시적으로 관리하는 언어였다면 이러한 할당은 아예 일어나지 않았거나, 소멸 시점을 미리 알 수 있어 명시적으로 해제할 수 있는 객체를 만들었을 것입니다. 예를 들어 다음과 같은 형태의 루프는:
for i in range(n):
    ...
0부터 n - 1까지의 모든 수를 단순히 순회하는 이 코드는 Python으로 나타내면 다음과 같습니다:
l = range(n)
iterator = iter(l)
try:
    while 1:
        i = iterator.next()
        ...
except StopIteration:
    pass
즉, 세 번의 메모리 할당이 실행됩니다. range 객체, range 객체의 이터레이터, 그리고 루프를 끝내는 StopIteration 인스턴스입니다.
약간의 인라이닝을 거치고 나면 이 세 객체는 모두 다른 함수에 인자로 전달되는 일조차 없으며, 전역에서 도달 가능한 위치에 저장되지도 않습니다. 이러한 상황에서는 (어차피 함수가 반환된 뒤에는 소멸할 것이므로) 객체를 제거하고 객체가 담고 있는 값들로 대체할 수 있습니다.
이러한 패턴(할당된 객체가 현재 함수를 벗어나지 않으므로 함수가 반환된 후에 소멸하는 경우)은 특히 인라이닝이 어느 정도 이루어진 후에 상당히 자주 나타납니다. 따라서 저희는 객체를 “분해(explode)”하여 이 단순한(그러나 상당히 흔한) 상황에서 할당을 한 번 줄이는 최적화를 구현했습니다.
탈출 분석(Escape Analysis)과 스택 할당
메모리 할당 부담을 줄이는 또 다른 기법은 자신이 할당된 스택 프레임보다 오래 살아남지 않는다고 증명할 수 있는 객체에 스택 할당을 사용하는 것입니다. 이 기법으로는 실제로 속도 향상을 거의 얻지 못하는 것으로 드러나, 시간이 지나면서 다시 제거되었습니다.
소스 생성 준비
이름이 다소 모호할 수도 있는 이 단계는 별도의 단계로 가장 최근에 추가된 단계입니다. 이 단계의 역할은 소스 생성 전에 최종 구현 결정을 내리는 것입니다. 경험상 실제로 소스 코드를 생성하는 동안에는 어떤 판단도 동시에 하지 않는 것이 좋다는 사실이 드러났습니다. C 백엔드의 경우 이 단계는 세 가지 일을 수행합니다:
- 명시적인 예외 처리를 삽입하고,
- 명시적인 메모리 관리 연산을 삽입하며,
- 최종 소스에서 함수와 타입이 갖게 될 이름을 결정합니다(객체와 이름 사이의 이 매핑을 “저수준 데이터베이스(low-level database)”라고 부르기도 합니다).
예외 처리를 명시적으로 만들기
RPython 코드는 제약 없는 Python과 거의 같은 방식으로 예외를 자유롭게 사용할 수 있지만, 최종 결과물은 C 프로그램이며 C에는 예외라는 개념이 없습니다. 예외 변환기는 CPython과 비슷한 방식으로 예외 처리를 구현합니다. 예외는 특수한 반환값으로 표시되며, 현재 예외는 전역 자료 구조에 저장됩니다.
어떤 의미에서 예외 변환기(exception transformer)의 입력은 예외가 포함된 lltypesystem 관점의 프로그램이고, 출력은 순수한 lltypesystem 관점의 프로그램입니다.
메모리 관리 세부 사항
RPython은 예외를 지원할 뿐만 아니라 가비지 컬렉션을 사용하는 언어이기도 합니다. 이 점에서도 C는 그렇지 않습니다. 이 모순을 해결하려면 메모리 관리에 관한 결정을 내려야 합니다. 유연성을 중시하는 PyPy의 접근 방식에 따라, 메모리 관리 방식은 자유롭게 바꿀 수 있습니다. 현재 구현된 접근 방식은 세 가지입니다.
- 참조 카운팅(사용 중단됨, 너무 느림)
- Boehm-Demers-Weiser conservative garbage collector를 사용하여
- RPython으로 구현한 자체 정밀(exact) GC 중 하나를 사용하여
거의 모든 애플리케이션 수준의 Python 코드는 매우 빠른 속도로 객체를 할당합니다. 따라서 메모리 관리 구현은 PyPy 인터프리터의 성능에 결정적으로 중요합니다.
역사적 참고 사항
이 문서에서 살펴본 것처럼, 변환 단계는 처음에 예상할 법한 것보다 더 많은 단계로 나뉘어 있습니다. 프로젝트를 시작할 때 우리가 예상했던 것보다 더 많은 단계로 나뉜 것은 분명합니다. GenC의 최초 버전은 고수준 흐름 그래프(flow graph)와 어노테이터(annotator)의 출력을 대상으로 동작했으며, 당시에는 RTyper라는 개념조차 아직 존재하지 않았습니다. 최근에는 소스 생성을 위해 그래프를 준비하는 작업(“데이터베이싱”)과 실제로 소스를 생성하는 작업을 따로 다루는 것이 가장 좋다는 점이 분명해졌습니다.
전체가 맞물리는 방식
이제쯤이면 분명히 아셨겠지만, PyPy의 변환 툴체인은 여러 개의 독립된 구성 요소로 이루어진, 유연하면서도 복잡한 괴물입니다.
아직 강조하지 않은 세부 사항 하나는 여러 구성 요소 사이의 상호 작용입니다. 어노테이터가 작업을 마친 뒤 RTyper가 그래프를 처리하고, 이어서 예외 처리가 명시적으로 바뀌는 식으로 진행된다고 설명하면 보기 좋게 정리되지만, 이는 완전히 사실은 아닙니다. 예를 들어 RTyper는 여러 저수준 헬퍼에 대한 호출을 삽입하는데, 이 헬퍼들은 먼저 어노테이션되어야 합니다. 또한 GC 변환기는 성능을 높이기 위해 자신의 작은 헬퍼 함수 일부를 인라이닝(Backend Optimizations 중 하나)할 수 있습니다. 다음 그림은 기본 변환 과정의 각 단계를 수행하는 데 관여하는 구성 요소를 요약해 보여 줍니다:
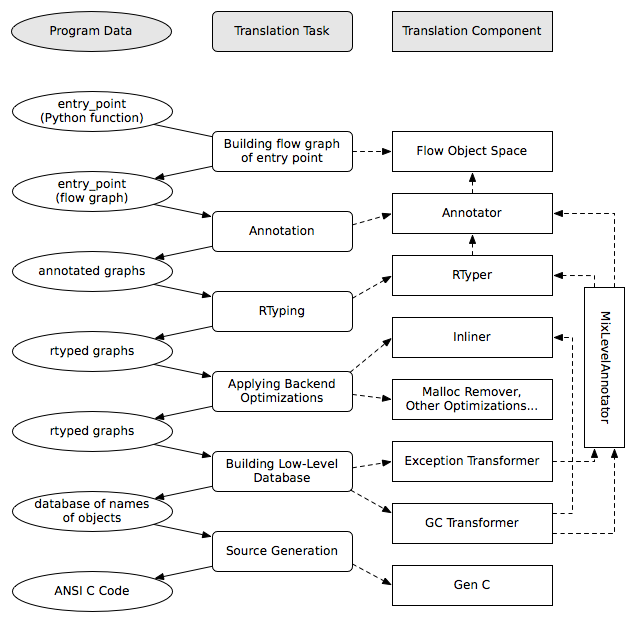
앞에서 언급하지 않은 구성 요소로 “MixLevelAnnotator”가 있습니다. 이 구성 요소는 “늦은”(RTyping 이후) 변환 단계에서 여러 함수의 모음(서로를 상호 재귀적으로 참조할 수 있습니다)에 속한 함수 각각을 호출할 수 있어야 한다고 선언하고, 이 함수들을 한꺼번에 어노테이션하고 rtype할 수 있는 편리한 인터페이스를 제공합니다.