범용 RPython 모듈
Contents
이 페이지에서는 rpython/rlib에 있는 모듈 중 일부를 각 모듈의 용도에 대한 간단한 안내와 함께 소개합니다. 여기에 있는 모듈들은 RPython 프로그램에 유용한 범용 라이브러리를 이루게 됩니다(표준 라이브러리 모듈 대부분이 RPython이 아니기 때문입니다). 이 모듈들 대부분은 아직 다소 미완성 상태이며, 언젠가 변경될 가능성이 높습니다. 모듈 사용법을 파악하려면 보통 rpython/rlib/test에 있는 테스트를 살펴보는 것이 도움이 됩니다.
listsort
rpython/rlib/listsort.py 모듈에는 timsort 정렬 알고리즘 구현이 들어 있습니다(리스트의 sort 메서드는 RPython이 아닙니다). 이를 사용하려면 MySort = listsort.make_timsort_class(lt=my_comparison_func)를 호출하여 (전역으로) 클래스 하나를 만드십시오. 다른 선택적 인자도 있지만, 보통은 lt=...로 리스트에 있는 두 객체를 비교하는 함수를 전달합니다. 리스트의 “타입”마다, 그리고 비교 함수마다 클래스가 하나씩 필요합니다.
MySort의 생성자는 리스트를 인자로 받으며, 이 리스트는 MySort 인스턴스의 sort 메서드가 호출될 때 제자리에서 정렬됩니다.
nonconst
rpython/rlib/nonconst.py 모듈은 주로 테스트에서 유용합니다. 흐름 그래프 빌더와 어노테이터는 상수 폴딩(constant folding)을 상당히 많이 수행하는데, 테스트에서는 이것이 바람직하지 않을 때가 있습니다. 특정 값에 상수 폴딩이 일어나지 않게 하려면 NonConst 클래스를 사용하십시오. NonConst의 생성자는 임의의 값을 받습니다. NonConst의 인스턴스는 어노테이션 중에 그 값처럼 동작하지만, 상수 폴딩은 일어나지 않습니다.
objectmodel
rpython/rlib/objectmodel.py 모듈에는 다양한 기능이 뒤섞여 있습니다. 그중 특히 유용한 것은 다음과 같습니다:
ComputedIntSymbolic:- 어노테이터는
ComputedIntSymbolic의 인스턴스를 값을 알 수 없는 정수처럼 취급합니다. 그 값은 인자가 없는 함수로 결정됩니다(이 함수는 클래스의 생성자에 전달해야 합니다). 백엔드가 코드를 생성할 때 이 함수를 호출하여 값을 결정합니다. CDefinedIntSymbolic:CDefinedIntSymbolic의 인스턴스도 어노테이터에서는 값을 알 수 없는 정수처럼 취급됩니다. C 코드가 생성될 때 이 인스턴스는 심볼릭의expr속성으로 표현됩니다(이 속성은 생성자의 첫 번째 인자이기도 합니다).r_dict:- RPython의 dict와 유사한 객체입니다. r_dict의 생성자는 딕셔너리 항목을 비교하고 해싱하는 데 사용되는 두 함수
key_eq와key_hash를 받습니다. instantiate(cls):__init__을 호출하지 않고 클래스cls의 인스턴스를 생성합니다.we_are_translated():- 이 함수는 CPython 위에서 실행하면
False를 반환하지만, 어노테이터(annotator)는 반환값이True라고 판단합니다. 따라서 CPython 위에서 실행할 때와 변환 후에 서로 다른 동작을 하도록 만드는 데 사용할 수 있습니다. 이 함수는 극히 드물게 사용해야 합니다(주로 최적화나 디버그 코드에 사용합니다). cast_object_to_weakaddress(obj):- obj에 대한 일종의 “약한 참조(weak reference)”를 반환하지만, 편의 기능은 전혀 제공하지 않습니다. 반환되는 약한 주소는 객체가 소멸해도 무효화되지 않으므로, 객체가 언제 소멸하는지는 직접 파악해야 합니다. 극도로 주의해서 사용하십시오.
cast_weakadress_to_object(obj):- 앞의 함수와 반대로 동작합니다. 객체가 이미 소멸했다면 세그폴트(segfault)가 발생합니다.
UnboxedValue:- 이 클래스는 정수 필드를 정확히 하나만 가지는 클래스의 기반 클래스로 사용해야 합니다. 해당 클래스에는 항목이 정확히 하나만 정의된
__slots__가 있어야 합니다. 변환 후에는 이 클래스의 인스턴스가 할당되지 않고 태그된 포인터(tagged pointer)*, 즉 최하위 비트가 설정된 포인터로 표현됩니다.
rarithmetic
rpython/rlib/rarithmetic.py 모듈에는 일반 Python 코드와 RPython 코드 사이에서 산술 코드의 동작이 조금씩 다른 점을 처리하는 기능이 들어 있습니다. 이러한 차이의 대부분은 이미 RPython 설명에 기술되어 있습니다.
rbigint
rpython/rlib/rbigint.py 모듈에는 Python long 타입(RPython 자체에서는 지원되지 않음)을 RPython으로 완전히 구현한 코드가 들어 있습니다. 그 구현은 rbigint 클래스에 들어 있습니다. rbigint 인스턴스를 생성하려면 정적 메서드 fromint, frombool, fromfloat, fromdecimalstr를 사용하십시오. 다른 타입으로 다시 변환하려면 toint, tobool, touint, tofloat 메서드를 사용하십시오. RPython은 연산자 오버로딩을 지원하지 않으므로, 원래는 “__”로 시작하고 끝나는 rbigint의 모든 특수 메서드는 가독성을 위해 이 밑줄을 뺀 이름을 사용합니다(따라서 두 rbigint 인스턴스를 더할 때는 a.add(b)를 사용할 수 있습니다).
rrandom
rpython/rlib/rrandom.py 모듈에는 메르센 트위스터(mersenne twister) 난수 생성기가 구현되어 있습니다. 이 모듈에는 Random 클래스 하나가 들어 있으며, 이 클래스에서 가장 중요한 것은 0.0과 1.0 사이의 의사 난수 부동소수점 수를 반환하는 random 메서드입니다.
rsocket
rpython/rlib/rsocket.py 모듈에는 소켓 표준 라이브러리의 기능을 약간 다른 인터페이스로 구현한 RPython 구현이 들어 있습니다. Python 소켓 API의 어려운 점은 주소가 “타입이 잘 정의된(well-typed)” 객체가 아니라는 것입니다. 주소 패밀리에 따라 튜플이 되기도 하고 문자열이 되기도 하는 등 형태가 달라지는데, 이는 RPython에 적합하지 않습니다. 대신 rsocket에는 전형적인 정적 객체 지향 프로그래밍 방식을 따르는 Address 클래스 계층 구조가 들어 있습니다.
rstrategies
rpython/rlib/rstrategies 모듈에는 RPython VM에서 저장소 전략(storage strategy)을 구현하기 위한 라이브러리가 들어 있습니다. 이 라이브러리는 특정 언어에 종속되지 않으며 확장할 수 있습니다. 더 자세한 내용과 예제는 rstrategies 문서에서 확인할 수 있습니다.
streamio
rpython/rlib/streamio.py에는 RPython 스트림 I/O 구현이 들어 있습니다(이 구현은 Guido van Rossum이 Python 3000에 도입될 새로운 파일 구현의 프로토타입으로 CPython 샌드박스에서 sio.py라는 이름으로 시작한 것입니다).
언롤(unroll)
rpython/rlib/unroll.py 모듈에서 가장 중요한 것은 이터레이터를 감싸는 함수 unrolling_iterable입니다. RPython 코드에서 이 이터레이터를 순회하면 결과 흐름 그래프에 루프가 생기지 않고, 대신 루프가 펼쳐집니다.
rsre
PyPy에서 사용하는 정규 표현식 구현입니다. 이 구현은 다른 언어에서 재사용하기 어렵다는 점에 유의하십시오. Python에서 정규 표현식은 먼저 표준 라이브러리의 순수 Python 코드를 통해 바이트코드 형식으로 컴파일됩니다. 이 저수준 모듈은 이 바이트코드 형식만 이해합니다. 완전한 Python 인터프리터 없이는 정규 표현식 구문을 바이트코드 형식으로 변환할 수 없습니다. (정적 정규 표현식만 있는 제한된 사용 사례를 위한 편법이 있습니다. 이러한 정규 표현식은 변환 중에 미리 컴파일할 수 있습니다. 또는 런타임에 정규 표현식 하나를 변환하기 위해서만 Python 하위 프로세스를 실행하는 방법도 생각해 볼 수 있습니다…)
파싱
rpython/rlib/parsing/ 모듈은 RPython으로 토크나이저와 파서를 생성하기 위한 모듈이며, 아직 개발 중입니다. 이 모듈은 여전히 매우 실험적이며, 실제로는 Prolog interpreter에서만 사용되고 있습니다(그것도 다소 비표준적인 방식으로 사용됩니다). 토크나이저/문법을 지정하는 가장 쉬운 방법은 정규 표현식과 간단한 EBNF 형식으로 작성하는 것입니다.
정규 표현식은 유한 오토마타를 사용하여 구현됩니다. 파싱 엔진은 packrat parsing을 사용합니다. 이 방식은 파싱 시간이 O(n)이면서도 LL(n) 및 LR(n) 문법보다 더 강력합니다.
정규 표현식
정규 표현식 구문은 대체로 re 모듈 구문의 부분집합입니다. 참고: 이는 rlib.rsre와는 다릅니다. 기본적으로 특수 문자가 아닌 문자는 그 문자 자체와 일치합니다. 정규 표현식을 연결하면, 그 결과는 각 정규 표현식이 일치하는 문자열들을 연결한 것과 일치합니다.
|R|S는 R과 일치하거나 또는 S와 일치하는 모든 문자열과 일치합니다.*R*는 R이 0번 이상 반복되는 것과 일치합니다.+R+는 R이 1회 이상 반복되는 것과 일치합니다.?R?는 R의 0회 또는 1회 반복과 일치합니다.(...)- 괄호를 사용하여 정규 표현식을 그룹으로 묶을 수 있습니다(단, Python의 re 모듈과 달리 이 그룹의 내용을 나중에 다시 매칭할 수는 없다는 점에 유의하십시오).
{m}R{m}은 R을 정확히 m번 반복한 것과 일치합니다.{m, n}R{m, n}은 R이 m번 이상 n번 이하(m과 n 포함)로 반복되는 경우와 일치합니다.[]- 문자 집합에 일치합니다. 일치시킬 문자들은 차례로 나열할 수 있습니다.
-를 사용하여 문자 범위를 지정할 수 있습니다. 예를 들어[ac-eg]는 문자 a, c, d, e, g에 일치합니다. 집합을^로 시작하면 집합 전체를 반전할 수 있습니다. 따라서 [^a]는 a를 제외한 모든 문자에 일치합니다.
정규 표현식을 파싱하고 그에 대한 매처를 얻으려면 rpython.rlib.parsing.regexparse 모듈의 make_runner(s) 함수를 사용할 수 있습니다. 이 함수는 recognize(input) 메서드를 가진 객체를 반환하며, 이 메서드는 input이 문자열과 일치하는지 여부에 따라 True 또는 False를 반환합니다.
EBNF
토크나이저와 문법을 기술하기 위해 rpython.rlib.parsing.ebnfparse는 이를 위한 구문을 정의합니다.
구문 파일은 일련의 규칙을 담고 있습니다. 각 규칙은 정규 표현식이나 문법 규칙 중 하나를 기술합니다.
정규 표현식 규칙은 다음과 같은 형식입니다.:
NAME: "regex";
NAME은 정규 표현식이 생성하는 토큰의 이름이며(대문자로만 이루어져야 합니다), regex는 위에서 설명한 구문을 따르는 정규 표현식입니다. 토큰 이름 하나는 특별하게 처리됩니다. IGNORE라는 토큰은 파서에 전달되기 전에 토큰 스트림에서 걸러지므로, 주석이나 의미 없는 공백을 매칭하는 데 사용할 수 있습니다.
문법 규칙은 다음과 같은 형식입니다:
name: expansion_1 | expansion_2 | ... | expansion_n;
여기서 expansion_i는 비단말 기호(nonterminal) 또는 토큰 이름의 시퀀스입니다:
symbol_1 symbol_2 symbol_3 ... symbol_n
이는 비단말 기호 name(소문자로만 이루어져야 합니다)을 여러 확장 중 어느 것으로든 확장할 수 있다는 뜻입니다. 확장은 토큰 이름, 비단말 이름 또는 리터럴의 시퀀스로 구성될 수 있으며, 리터럴은 따옴표로 둘러싼 문자열로서 글자 그대로 매칭됩니다.
이해를 돕기 위한 예시:
IGNORE: " ";
DECIMAL: "0|[1-9][0-9]*";
additive: multitive "+" additive |
          multitive;
multitive: primary "*" multitive |
           primary;
primary: "(" additive ")" | DECIMAL;
이 문법은 덧셈과 곱셈을 포함하는 산술 표현식의 구문을 기술합니다. 토크나이저는 DECIMAL 토큰, 또는 리터럴 “+”, “*”, “(“, “)” 중 하나와 일치한 토큰으로 이루어진 스트림을 생성합니다. 공백은 모두 무시됩니다. 이 문법은 연산자 우선순위를 따르는 구문 트리를 생성합니다. 예를 들어 12 + 4 * 5 표현식은 다음과 같은 트리로 파싱됩니다:
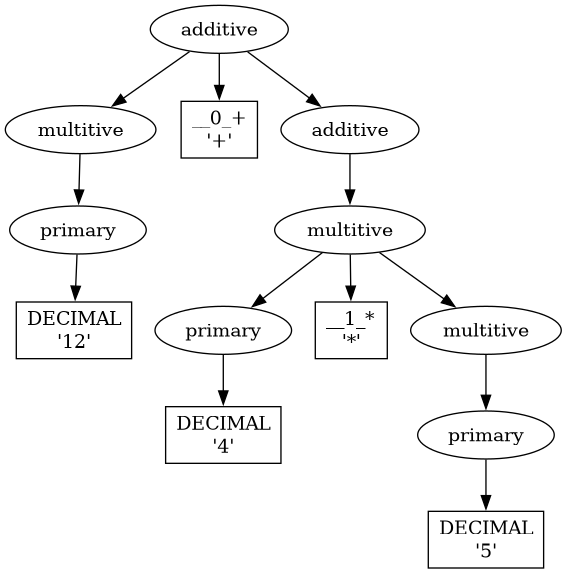
파스 트리
파싱 과정은 Symbol과 Nonterminal의 인스턴스로 이루어진 트리를 빌드합니다. 전자는 토큰에, 후자는 비단말 기호에 해당합니다. 두 클래스 모두 rpython/rlib/parsing/tree.py 모듈에 있습니다. Nonterminal 인스턴스의 view() 메서드를 사용하면 파스 트리를 pygame 화면으로 볼 수 있습니다.
Symbol 인스턴스에는 다음 속성이 있습니다. 토큰의 이름인 symbol과 일치한 소스인 additional_info입니다.
Nonterminal 인스턴스에는 다음 속성이 있습니다. symbol은 비단말(nonterminal)의 이름이고, children은 자식 속성들의 리스트입니다.
방문자
RPython으로 된 파스 트리를 위한 트리 방문자(visitor)를 작성할 때 사용할 수 있도록 rpython/rlib/parsing/tree.py에 특별한 기반 클래스 RPythonVisitor가 있습니다. 클래스가 이 기반 클래스를 사용하면 dispatch(node) 메서드가 생기며, 이 메서드는 node 인자에 따라 적절한 visit_<symbol> 메서드를 호출합니다. 여기서 <symbol>은 방문한 노드의 symbol 속성으로 대체됩니다.
비지터(visitor)가 RPython이 되려면 모든 visit 메서드의 반환값이 같은 타입이어야 합니다.
트리 변환
위의 산술 예제 트리에서 볼 수 있듯이, 기본적으로 파스 트리에는 실제로 유용한 정보를 전달하지 않는 노드가 많이 포함되어 있습니다. 이러한 노드 중 일부를 없애기 위해, 문법 형식은 트리를 변환하여 불필요한 노드를 제거하는 방문자(visitor)를 자동으로 생성하는 기능을 어느 정도 지원합니다. 이러한 변환 중 가장 단순한 것은 노드를 제거하기만 하지만, 더 복잡한 변환도 있습니다.
이러한 변환을 표기하는 구문은 비단말 기호(nonterminal)의 확장에 포함된 기호들을 […], <…> 또는 >…<로 감싸는 것입니다.
[symbol_1 symbol_2 … symbol_n]
이렇게 하면 감싸인 기호들을 트리에서 완전히 제거하는 트랜스포머가 생성됩니다.
예제:
IGNORE: " ";
n: "A" [","] n | "A";
문자열 “A, A, A”를 파싱하면 다음과 같은 트리를 얻습니다:
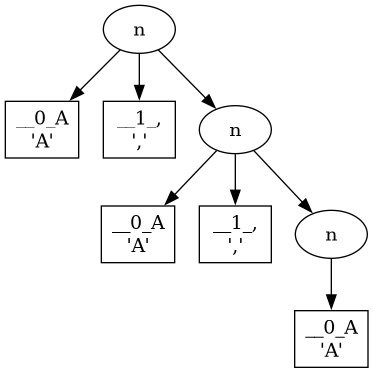
변환 후의 트리에서는 “,” 노드가 제거됩니다:
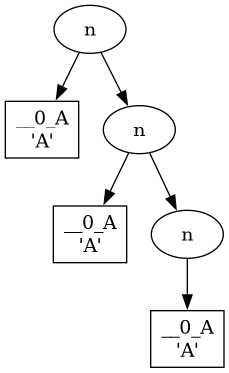
<symbol>
이것은 부모를 심볼로 대체합니다. 부모는 당연히 한 번만 대체될 수 있으므로, 각 확장에는 <…>로 둘러싸인 심볼이 최대 하나만 포함될 수 있습니다.
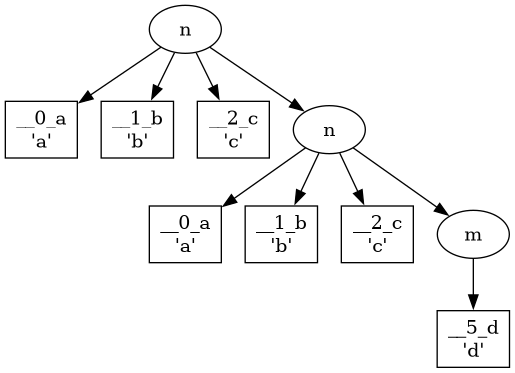
예제:
IGNORE: " ";
n: "a" "b" "c" m;
m: "(" <n> ")" | "d";
문자열 “a b c (a b c d)”를 파싱하면 다음과 같은 트리가 나옵니다:
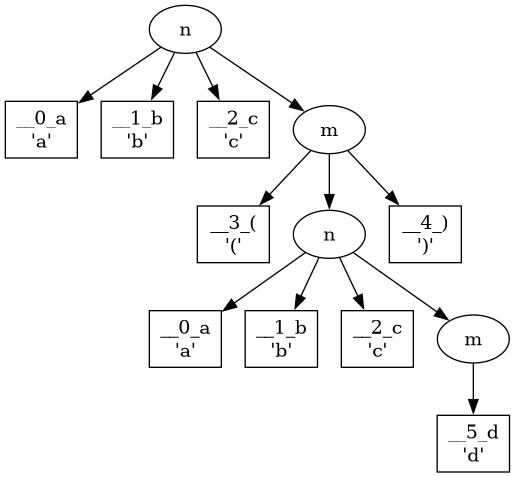
변환 후의 트리는 다음과 같습니다:
>nonterminal_1 nonterminal_2 … nonterminal_n<
이는 nonterminal_1부터 nonterminal_n까지의 노드를 각각의 자식 노드로 대체합니다.
예제:
IGNORE: " ";
DECIMAL: "0|[1-9][0-9]*";
list: DECIMAL >list< | DECIMAL;
문자열 “1 2”를 파싱하면 다음과 같은 트리가 만들어집니다:
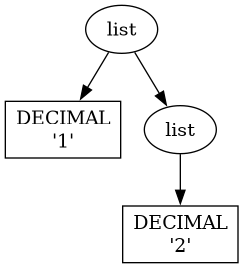
변환 후 트리는 다음과 같습니다:
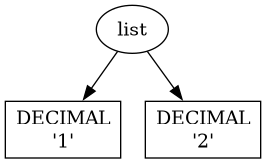
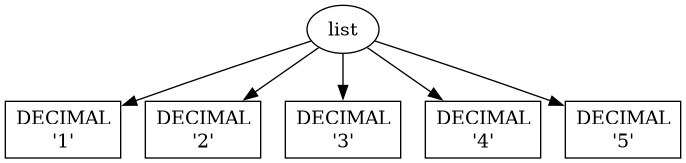
이 변환은 재귀적으로 동작한다는 점에 유의하십시오. 즉, 다음과 같은 경우에도 동작합니다. 문자열 “1 2 3 4 5”를 파싱하면 트리는 처음에 다음과 같은 모습입니다.
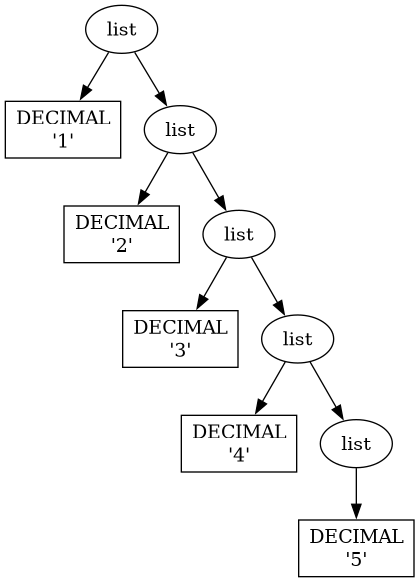
하지만 변환 후에는 전체 구조가 자식이 많은 하나의 노드로 축소됩니다:
EBNF 문법 형식의 확장
EBNF 문법 형식에는 실제로는 구문 설탕(syntactic sugar)에 불과하지만 문법 작성의 번거로움을 덜어 주는 확장이 몇 가지 있습니다. 그 확장은 다음과 같습니다.
symbol?:- symbol의 0회 또는 1회 반복과 일치합니다
symbol*:- symbol이 0회 이상 반복되는 것과 일치합니다. 트리 변환이 끝나면 이러한 반복은 모두 현재 symbol의 자식이 됩니다.
symbol+:- symbol이 1회 이상 반복되는 것과 일치합니다. 트리 변환 후에는 이러한 반복이 모두 현재 symbol의 자식이 됩니다.
이러한 기능은 문법에 올바른 방식으로 규칙을 몇 가지 더 추가하여 구현합니다. 예시: 문법:
s: a b? c;
다음과 같은 형태로 변환됩니다:
s: a >_maybe_symbol_0_< c | a c;
_maybe_symbol_0_: b;
문법:
s: a b* c;
다음과 같은 형태로 변환됩니다.:
s: a >_star_symbol_0< c | a c;
_star_symbol_0: b >_symbol_star_0< | b;
문법:
s: a b+ c;
다음과 같은 형태로 변환됩니다:
s: a >_plus_symbol_0< c;
_plus_symbol_0: b >_plus_symbol_0< | b;
전체 예제
json format을 위한 반쯤 완성된 파서:
STRING: "\\"[^\\\\"]*\\"";
NUMBER: "\-?(0|[1-9][0-9]*)(\.[0-9]+)?([eE][\+\-]?[0-9]+)?";
IGNORE: " |\n";
value: <STRING> | <NUMBER> | <object> | <array> | <"null"> |
       <"true"> | <"false">;
object: ["{"] (entry [","])* entry ["}"];
array: ["["] (value [","])* value ["]"];
entry: STRING [":"] value;
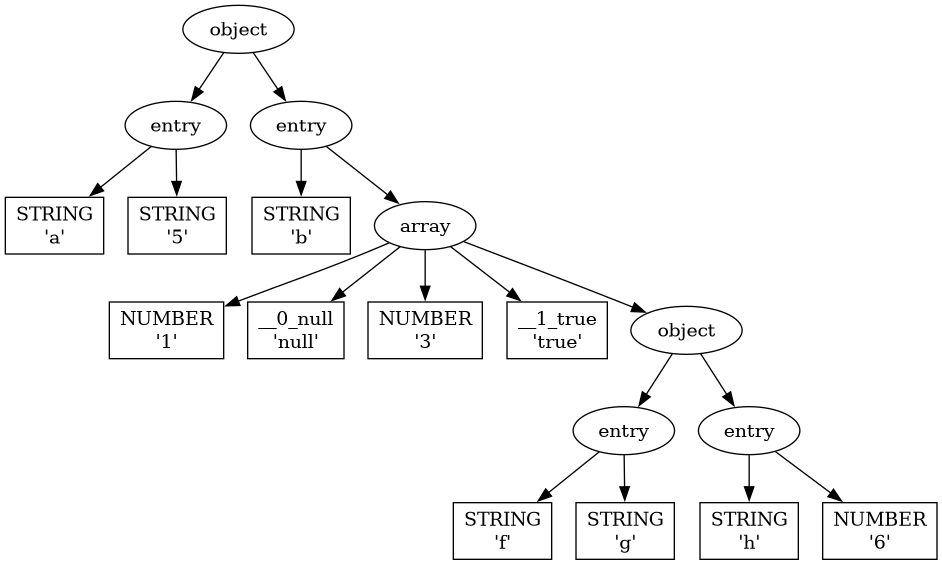
다음 문자열을 파싱하여 얻은 트리는 다음과 같습니다.:
{"a": "5", "b": [1, null, 3, true, {"f": "g", "h": 6}]}
다음과 같습니다: