The BEAM Book
Written by Erik Stenman and contributors.
This work is licensed under a Creative Commons Attribution 4.0 International License (CC BY 4.0). This means you are free to share, copy, redistribute, and modify this book under the following terms:
-
Attribution: Credit must be given to the original authors and contributors.
-
No Additional Restrictions: You cannot impose legal restrictions that prevent others from using the book freely under the same terms.
Contributors: Special thanks to Richard Carlsson, Yoshihiro Tanaka, Roberto Aloi and Dmytro Lytovchenko.
For full attribution details, visit: https://github.com/happi/theBeamBook/graphs/contributors.
Free Digital Version Available. This book is freely available online at https://github.com/happi/theBeamBook/ under the Creative Commons license. This printed edition is provided for convenience.
For more information on the Creative Commons license, visit: https://creativecommons.org/licenses/by/4.0/.
First Edition, 2025 ISBN: 978-91-531-4253-9
© 2025 Erik Stenman.
- 서문
- I: Understanding ERTS
- II: Running ERTS
- Appendix A: Erlang 런타임 시스템 빌드하기
- Appendix B: BEAM 명령어
- Appendix C: 전체 코드 목록
- 참고 문헌
- Index
서문
Erlang과 Elixir는 지금까지 만들어진 가상 머신 가운데 가장 견고한 것 중 하나 위에서 실행됩니다. 이 책은 그것이 어떻게 동작하는지를 개념적으로뿐만 아니라 실제로 일이 일어나는 수준에서 보여 줍니다.
이 책은 스타일 가이드가 아닙니다. 문법이나 모범 사례를 다루는 책도 아닙니다. GenServer를 어떻게 구성해야 하는지 가르치지도 않고, 슈퍼비전 트리를 두고 논쟁하지도 않습니다.
이 책은 BEAM의 내부를 차근차근 안내합니다. BEAM이 프로세스를 어떻게 스케줄링하는지. 메모리를 어떻게 할당하는지. 동시성을 어떻게 처리하는지. 부하가 걸린 상황에서 어떤 트레이드오프를 선택하는지. 시스템이 실제로 운영 중이고 버그가 테스트에서 드러나지 않을 때 중요해지는 것들입니다.
끝부분에서는 트레이싱, 프로파일링, 성능 튜닝을 다룹니다. 하지만 진정한 목표는 여러분의 코드가 런타임에 무엇을 하고 있는지, 그리고 왜 그렇게 하는지를 이해할 수 있는 도구를 제공하는 것입니다.
시스템이 어떻게 동작하는지 알면 더 이상 추측할 필요가 없습니다.
이 책에 대하여
이 책은 다음에 해당하는 분들을 위한 책입니다.
-
여러분은 Erlang이 실제로 어떻게 동작하는지 이해하고 싶으실 것입니다.
-
성능이나 신뢰성을 높이기 위해 BEAM 설치 환경을 튜닝하려는 경우입니다.
-
VM 내부에서 발생하는 크래시와 이상 동작을 디버깅하고자 하는 경우입니다.
-
프로덕션 환경에서 시스템을 최대한 활용하고 싶을 것입니다.
-
아니면 그저 자신만의 런타임을 처음부터 직접 만들어 보고 싶으실 수도 있습니다.
성능 향상 요령만 찾으신다면 뒤쪽 장으로 건너뛰셔도 좋습니다. 하지만 그런 도구들 이면에서 무슨 일이 일어나는지, 시스템이 실제로 어떻게 동작하는지 이해하고 싶으시다면 처음부터 시작하십시오.
이해가 깊을수록 더 나은 결정을 내릴 수 있습니다.
이 책의 표기 규칙
BEAM VM은 소형 임베디드 하드웨어부터 테라바이트급 메모리를 갖춘 대형 멀티코어 서버에 이르기까지 다양한 시스템에서 실행될 수 있습니다. BEAM 애플리케이션의 성능을 효과적으로 최적화하려면 VM이 메모리와 기타 자원을 어떻게 활용하는지 이해해야 합니다.
이 책에서는 메모리 구조와 데이터 레이아웃을 명확하게 설명하기 위해 다이어그램을 폭넓게 사용합니다. 메모리 레이아웃과 스택 연산은 표현 방식이 다양할 수 있으므로, 이 책의 다이어그램에서 따르는 규칙은 다음과 같습니다.
-
메모리 다이어그램:
-
이 책의 다이어그램에서는 메모리 주소가 위로 갈수록 커집니다.
-
낮은 메모리 주소는 아래쪽에, 높은 주소는 위쪽에 표시됩니다.
-
스택은 일반적으로 높은 주소에서 시작하여 아래쪽으로 자라며, 새 요소는 더 낮은 주소에 푸시됩니다.
-
-
C 구조체 다이어그램:
-
C 구조체는 첫 번째 필드가 더 낮은 메모리 주소를 차지하는데도, 첫 번째 필드를 맨 위에 두는 방식으로 표현됩니다.
-
이 때문에 구조체 다이어그램은 일반적인 메모리 영역 다이어그램과 비교해 위아래가 뒤집힌 모습으로 나타납니다.
-
다이어그램에 구조체와 메모리 영역이 함께 나타날 때는 주소 표현이 서로 반대 방향으로 뒤집혀 표시된다는 점에 유의하십시오. 이 관례를 이해해 두면 책 전반에 나오는 시각적 예시를 해석할 때 혼동을 피하는 데 도움이 됩니다.
이 책을 읽기 위해 Erlang 프로그래머일 필요는 없지만, Erlang이 무엇인지에 대한 기본적인 이해는 필요합니다. 이어지는 절에서는 Erlang에 대한 배경지식을 간략히 소개합니다.
Erlang
이 절에서는 이 책의 나머지 부분을 이해하는 데 꼭 필요한 Erlang의 몇 가지 기본 개념을 살펴보겠습니다.
Erlang은 특히 Erlang의 창시자 중 한 사람인 Joe Armstrong에 의해 동시성 지향 언어라고 불려 왔습니다. 동시성은 분명히 Erlang의 핵심에 있으며, Erlang 시스템이 어떻게 동작하는지 이해하려면 Erlang의 동시성 모델을 이해해야 합니다.
먼저 동시성(concurrency)과 병렬성(parallelism)을 구분해야 합니다. 이 책에서 동시성이란 서로 독립적으로 실행될 수 있는 둘 이상의 프로세스가 존재한다는 개념을 말하며, 이는 한 프로세스를 먼저 실행한 다음 다른 프로세스를 실행하거나, 실행을 교차시키거나, 프로세스들을 병렬로 실행하는 방식으로 이루어질 수 있습니다. 병렬 실행이란 여러 개의 물리적 실행 유닛을 사용하여 프로세스들이 실제로 정확히 같은 시각에 실행되는 것을 의미합니다. 병렬성은 여러 수준에서 달성할 수 있습니다. 하나의 코어 안에 있는 실행 파이프라인의 여러 실행 유닛을 통해, 하나의 CPU에 있는 여러 코어를 통해, 한 대의 머신에 있는 여러 CPU를 통해, 또는 서로 다른 장소에 있을 수도 있는 여러 대의 머신을 통해 달성할 수 있습니다.
Erlang은 동시성을 구현하기 위해 프로세스를 사용합니다. 개념적으로 Erlang 프로세스는 대부분의 OS 프로세스와 비슷합니다. 서로 격리된 메모리 공간이며(따라서 스레드가 아닙니다), 병렬로 실행되고, 시그널을 통해 통신할 수 있습니다. 실제로는 Erlang 프로세스가 대부분의 OS 프로세스보다 훨씬 가볍다는 점에서 큰 차이가 있습니다. 다른 많은 동시성 프로그래밍 언어에서는 Erlang 프로세스에 해당하는 것을 에이전트라고 부릅니다.
Erlang은 Erlang 가상 머신인 BEAM에서 프로세스들의 실행을 인터리빙하여 동시성을 달성합니다. 멀티코어 프로세서에서 BEAM은 코어마다 스케줄러를 하나씩 실행하고 스케줄러마다 Erlang 프로세스를 하나씩 실행하여 진정한 병렬성을 달성합니다. Erlang 시스템의 설계자는 시스템을 여러 대의 컴퓨터에 분산시켜 병렬성을 더 높일 수 있습니다.
일반적인 Erlang 시스템(Erlang으로 구축한 서버나 서비스)은 여러 Erlang 애플리케이션, 즉 마이크로서비스나 라이브러리처럼 독립적으로 버전이 관리되는 소프트웨어 단위로 구성됩니다. 각 애플리케이션은 여러 Erlang 모듈, 즉 코드 캡슐화의 기본 단위로 이루어지며, 각 모듈은 별도의 파일에 담깁니다. 이 파일의 확장자는 로드할 수 있는 컴파일된 코드이면 .beam, 컴파일할 소스 코드이면 .erl입니다.
각 모듈에는 여러 개의 함수가 들어 있으며, 그중 일부는 익스포트되어 다른 모듈에서 호출할 수 있고 나머지는 내부용입니다. 함수는 여러 개의 인자를 받아 값을 반환합니다. 함수의 본문은 표현식으로 이루어집니다. Erlang은 함수형 언어이므로 문(statement)이 없고, 결과를 만들어 내는 표현식만 있습니다. Erlang 코드 예제에서 Erlang 표현식과 함수의 몇 가지 예를 볼 수 있습니다.
%% Some Erlang expressions:

true.
1+1.
if (X > Y) -> X; true -> Y end.

%% An Erlang function:

max(X, Y) ->
  if (X > Y) -> X;
     true    -> Y
  end.
Erlang에는 VM이 구현하는 내장 함수(또는 BIF)가 여럿 있습니다. 이는 효율성 때문일 수 있으며, Erlang 자체로도 쉽게 구현할 수 있었을 lists:append() 구현이 그 예입니다. 또는 list_to_atom()처럼 Erlang 자체로는 구현하기 어렵거나 불가능한 저수준 기능을 제공하기 위해서일 수도 있습니다.
최종 사용자는 Native Implemented Functions(NIF) 인터페이스를 사용하여 C로 구현한 자신만의 함수를 제공할 수 있습니다([NIFs] 참조).
감사의 글
먼저 Erlang과 Erlang 런타임 시스템을 유지 관리해 주시고, 제 모든 질문에 인내심을 갖고 답해 주신 Ericsson의 OTP 팀 모든 분께 감사드립니다. 특히 Kenneth Lundin, Björn Gustavsson, Lukas Larsson, Rickard Green, Raimo Niskanen 님께 감사드립니다.
또한 이 책에 큰 기여를 해 주신 Yoshihiro Tanaka, Roberto Aloi, Dmytro Lytovchenko께, 그리고 이 책의 작업을 후원해 주신 HappiHacking과 TubiTV에도 감사드립니다.
마지막으로, 편집과 수정으로 기여해 주신 모든 분께 깊이 감사드립니다:
Alex Fu |
Alex Jiao |
Alex Martsinovich |
Alexandre Rodrigues |
Amir Moulavi |
Andrea Leopardi |
Anthony Molinaro |
Anton N Ryabkov |
Antonio Nikishaev |
Benjamin Tan Wei Hao |
Borja o’Cook |
Buddhika Chathuranga |
Cameron Price |
Chris Keele |
Chris Yunker |
Christopher Keele |
David Ansari |
Davide Bettio |
Dhony Silva |
Dmytro Lytovchenko |
DuskyElf |
Elias Lanfranconi |
Eric Yu |
Erick Dennis |
Gary Coulbourne |
Greg Baraghimian |
Gustaw Lippa |
Humber Aquino |
Humberto Rodríguez A |
Jan Lehnardt |
Jesper Öqvist |
Joakim Fremstad |
Juan Facorro |
Karl Hallsby |
Ken Causey |
Kian-Meng Ang |
Kian-Meng, Ang |
Kim Shrier |
Kyle Baker |
Lincoln Bryant |
Lukas Larsson |
Luke Imhoff |
Marc van Woerkom |
Meraj |
Meraj Molla |
Michael Daines |
Michael Kohl |
Michał Piotrowski |
Milton Inostroza |
Oskar Köök |
Paul Ivanov |
PlatinumThinker |
Ramkumar Rajagopalan |
Richard Carlsson |
Roberto Aloi |
Ryan Kirkman |
Sergey Yelin |
ShalokShalom |
Simon Johansson |
Stefan Hagen |
Steve Yen |
Thales Macedo Garitezi |
Tobias Lindahl |
Trevor Brown |
Vandern Rodrigues |
Yago Riveiro |
Yoshihiro TANAKA |
Yoshihiro Tanaka |
Yves Müller |
fred |
phf-1 |
techgaun |
tomdos |
yagogarea |
yoshi |
I: Understanding ERTS
1. Erlang 런타임 시스템 소개
엄밀히 말하면 BEAM은 Erlang 코드를 BEAM 바이트코드 명령어 형태로 컴파일하고, 배포하고, 실행하는 데 사용되는 추상 머신 모델만을 가리킵니다. 이는 JVM이 Java를 위한 추상 머신인 것과 마찬가지이며, 컴파일된 동일한 바이트코드를 VM 규격을 준수하는 어떤 구현체에서든 실행할 수 있어야 합니다.
하지만 바이트코드를 실행하기 위해 단순한 인터프리터나 기본적인 JIT 컴파일러를 작성하는 일은 비교적 작은 작업으로, 빙산의 일각에 불과합니다. 산업용 수준의 프로그래밍 언어에 기대되는 모든 일을 해내려면 자동 메모리 관리, 효율적인 I/O, 프로세스 스케줄링, 멀티코어 활용, OS 시그널, 네트워킹, 파일 시스템 통합, 시간 처리 등 훨씬 더 많은 것이 필요합니다. 수면 아래에 숨겨진 이 모든 부분을 런타임 시스템이라고 합니다. 하지만 일상적인 대화에서는 BEAM VM(그리고 JVM)이라는 말을 그것을 돌아가게 하는 모든 것을 포함한 추상 기계라는 의미로 쓰는 경우가 많습니다.
Erlang 런타임 시스템(Erlang RunTime System), 즉 ERTS는 서로 의존하는 여러 구성 요소로 이루어진 복잡한 시스템입니다. ERTS는 C 프로그래밍 언어로 작성되었으며, 이식성이 매우 뛰어나 껌 크기의 소형 컴퓨터부터 테라바이트급 메모리를 갖춘 최대 규모의 멀티코어 시스템까지 어디서든 실행할 수 있습니다. 그 위에서 BEAM 가상 머신이 실행되며, 이에 대해서는 Erlang 가상 머신: BEAM에서 더 자세히 설명합니다.
1.1. ERTS와 Erlang 런타임 시스템
임의의 Erlang Runtime System과 Erlang 런타임 시스템의 특정 구현체 사이에는 차이가 있습니다. Ericsson의 Erlang/OTP는 Erlang 런타임 시스템과 BEAM의 사실상 표준 구현체입니다. 이 책에서는 이 구현을 ERTS 또는 T를 대문자로 쓴 Erlang RunTime System(Erlang 런타임 시스템)이라고 부르겠습니다. (OTP의 정의는 Section 1.3를 참조하십시오.)
Erlang 런타임 시스템이 무엇인지, 또는 Erlang 가상 머신이 무엇인지에 대한 공식적인 정의는 없습니다. ERTS에서 구현에 특화된 세부 사항을 모두 제거하면 그러한 이상적인 플라톤적 시스템이 어떤 모습일지 어렴풋이 상상해 볼 수는 있습니다. 안타깝게도 이는 순환 정의입니다. 구현에 특화된 세부 사항을 식별하려면 먼저 일반적인 정의를 알아야 하기 때문입니다. Erlang 세계에서 우리는 대개 지나치게 실용적이어서 이런 문제에 신경 쓰지 않습니다.
이 책에서는 Erlang 런타임 시스템이라는 텀을 Ericsson의 특정 구현이 아니라 모든 Erlang 런타임 시스템을 아우르는 일반적인 개념을 가리키는 데 사용하고자 합니다. Ericsson의 특정 구현은 Erlang RunTime System, 또는 보통 간단히 ERTS라고 부릅니다.
참고 이 책은 주로 ERTS 자체를 다루며, Erlang 런타임 시스템 전반은 일부만 다룹니다. 일반적인 원리를 이야기한다고 분명히 밝히지 않는 한, Ericsson 구현을 이야기한다고 보셔도 대체로 맞을 것입니다.
1.2. 이 책을 읽는 방법
Erlang BEAM VM은 껌 스틱만 한 초소형 컴퓨터부터 테라바이트급 메모리를 갖춘 최대 규모의 멀티코어 시스템에 이르기까지 어디서든 실행할 수 있는 훌륭한 엔지니어링의 산물입니다. 이러한 시스템의 성능을 여러분의 애플리케이션에 맞게 최적화하려면 애플리케이션을 아는 것만으로는 부족하며, VM 자체도 깊이 이해하고 있어야 합니다.
이 책의 Part I에서는 런타임 시스템이 어떻게 동작하는지 깊이 이해하게 될 것입니다.
이러한 지식을 갖추면 애플리케이션이 BEAM에서 실행될 때 어떻게 동작하는지 이해할 수 있고, 애플리케이션의 성능 문제를 찾아 해결할 수도 있습니다.
이 책의 Part II에서는 ERTS를 운영하는 방법과 실행 중인 시스템에 접속하여 살펴보는 방법을 다룹니다.
이어지는 장들에서는 시스템의 각 구성 요소를 하나씩 따로 살펴봅니다. 이 장들 가운데 어느 장이든 다른 구성 요소가 어떻게 구현되어 있는지 완전히 이해하지 않고도 읽을 수 있지만, 각 구성 요소가 무엇인지에 대한 기본적인 이해는 필요합니다. 이 도입 장의 나머지 부분에서는 1부의 나머지 장들을 원하는 순서대로 오가며 읽을 수 있을 만큼의 기본 지식과 용어를 제공합니다.
하지만 시간이 있다면 처음에는 이 책을 순서대로 읽으십시오. Erlang과 ERTS에만 해당하는 단어나 이 책에서 특별한 의미로 쓰이는 단어는 대개 처음 등장할 때 설명합니다. 그렇게 용어를 익히고 나면, 특정 구성 요소에 문제가 생길 때마다 다시 돌아와 1부를 참고 자료로 활용할 수 있습니다.
1.3. ERTS
이 절에서는 ERTS의 주요 구성 요소를 개략적으로 소개하고, 이어지는 장들에서 각 구성 요소를 더 자세히 설명하는 내용을 이해하는 데 필요한 몇 가지 용어를 알려 드립니다.
1.3.1. Erlang 노드
Erlang 또는 Elixir 시스템을 시작하면 Erlang 런타임 시스템을 실행하는 OS 프로세스가 하나 생성되며, 그 OS 프로세스 안에서는 BEAM VM이 여러 Erlang 프로세스를 실행합니다. 이렇게 실행 중인 런타임 시스템 인스턴스를 Erlang 노드라고 부르며(ERTS를 실행하든 Erlang의 다른 구현체를 실행하든 관계없습니다 — Section 1.4 참조), 같은 네트워크나 심지어 같은 호스트 머신에서 실행 중일 수 있는 다른 Erlang 노드와 구별하기 위해 이름을 붙일 수 있습니다. Java 세계에서 이에 해당하는 것은 JVM 인스턴스입니다. 그러나 Erlang에는 투명한 분산이라는 개념도 내장되어 있어, Erlang 노드들을 네트워크를 통해 서로 연결하여 클러스터를 구성할 수 있습니다.
따라서 BEAM 애플리케이션 코드는 항상 Erlang 노드의 컨텍스트 안에서 실행되며, 노드의 모든 계층이 애플리케이션의 성능에 영향을 미칩니다. 노드를 구성하는 계층 스택을 살펴보겠습니다. 이를 통해 다양한 환경에서 시스템을 실행할 때 어떤 선택지가 있는지 이해할 수 있을 것입니다.
Erlang OTP 문서에 따라 완전히 정확하게 말하자면, 노드는 실제로는 이름이 부여되어 클러스터에 참여할 준비가 된, 실행 중인 런타임 시스템입니다. 즉, 명령줄 스위치 --name NAME@HOST 또는 --sname NAME 중 하나(Erlang 런타임의 경우 -name 및 -sname)로 이름을 지정하지 않고 Elixir를 시작하면, 엄밀히 말해 런타임은 있지만 노드는 없는 상태가 됩니다. 이러한 시스템에서는 Node.alive? 함수(Erlang에서는 is_alive())가 false를 반환합니다.
$ iex
Erlang/OTP 19 [erts-8.1] [source-0567896] [64-bit] [smp:4:4]
              [async-threads:10]  [kernel-poll:false]

Interactive Elixir (1.4.0) - press Ctrl+C to exit (type h() ENTER for help)
iex(1)> Node.alive?
false
iex(2)>
런타임 시스템 자체는 용어를 그다지 엄격하게 사용하지 않습니다. 노드에 이름을 지정하지 않았더라도 노드의 이름을 조회할 수 있습니다. Elixir에서는 Node.list 함수를 :this 인자와 함께 사용하고, Erlang에서는 nodes(this)를 호출하거나 간단히 node()를 호출하면 됩니다:
iex(2)> Node.list :this
[:nonode@nohost]
iex(3)>
이 책에서는 이름이 부여되었는지와 관계없이 실행 중인 런타임의 모든 인스턴스를 노드라는 텀으로 부르겠습니다.
이 책의 Part I에서는 ERTS의 구성 요소에 관한 모든 것을 배웁니다. Part II에서는 Erlang 노드를 실행하고, 검사하고, 디버깅하고, 프로파일링하는 방법을 설명합니다. 소스에서 Erlang을 빌드하는 방법은 Appendix A를 참조하십시오.
1.3.2. 실행 환경의 계층
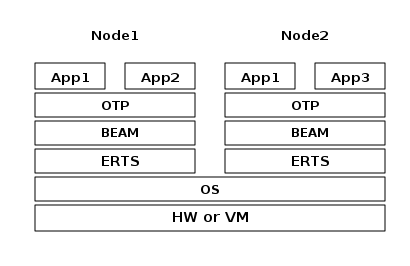
여러분의 애플리케이션은 하나 이상의 노드에서 실행되며, 프로그램의 성능은 애플리케이션 코드뿐만 아니라 ERTS 스택 안에서 여러분의 코드 아래에 있는 모든 계층에도 좌우됩니다. Figure 1에서는 한 머신에서 두 개의 Erlang 노드가 실행되는 모습으로 ERTS 스택을 나타낸 그림을 볼 수 있습니다.
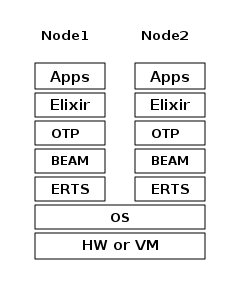
Elixir를 사용한다면 스택에 계층이 하나 더 있습니다.
스택의 각 계층을 살펴보고, 애플리케이션의 요구에 맞게 각 계층을 어떻게 튜닝할 수 있는지 알아봅시다.
스택의 맨 아래에는 여러분이 사용하고 있는 하드웨어가 있습니다. 애플리케이션의 성능을 개선하는 가장 쉬운 방법은 아마도 더 좋은 하드웨어에서 실행하는 것입니다. 경제적 또는 물리적 제약이나 환경적 우려 때문에 하드웨어를 업그레이드할 수 없다면, 스택의 더 높은 계층을 살펴보기 시작해야 할 수도 있습니다.
하드웨어와 관련하여 가장 중요한 두 가지 선택은 멀티코어인지 여부와 32비트인지 64비트인지 여부입니다. 멀티코어를 사용할지 여부와 32비트를 사용할지 64비트를 사용할지에 따라 서로 다른 ERTS 빌드가 필요합니다.
스택의 두 번째 계층은 OS 수준입니다. ERTS는 대부분의 Windows 버전과 Linux, FreeBSD, Solaris, Mac OS X를 포함한 대부분의 POSIX "호환" 운영 체제에서 실행됩니다. 오늘날 ERTS 개발은 대부분 Linux와 OS X에서 이루어지며, 이 플랫폼들에서 최상의 성능을 기대할 수 있습니다. 하지만 Ericsson은 사내의 많은 프로젝트에서 Solaris를 사용해 왔으며, ERTS는 여러 해 동안 Solaris에 맞게 튜닝되어 왔습니다. 사용 사례에 따라서는 실제로 Solaris 시스템에서 최상의 성능을 얻을 수도 있습니다. OS 선택은 보통 성능 요구 사항에 따라 결정되지 않으며, 다른 요인들에 의해 제약을 받습니다. 임베디드 애플리케이션을 만든다면 Raspbian만 사용해야 할 수도 있고, 어떤 이유로 최종 사용자용 애플리케이션이나 클라이언트 애플리케이션을 만든다면 Windows를 사용해야 할 수도 있습니다. ERTS의 Windows 포트는 지금까지 최우선 순위로 다뤄지지 않았으며, 성능이나 유지 보수 관점에서 최선의 선택이 아닐 수 있습니다. 64비트 ERTS를 사용하려면 당연히 64비트 머신과 64비트 OS가 모두 필요합니다. 이 책에서는 OS별 문제를 많이 다루지 않으며, 대부분의 예제는 Linux에서 실행한다고 가정합니다.
스택의 세 번째 계층은 Erlang 런타임 시스템입니다. 여기서는 이것이 ERTS입니다. 이 계층과 네 번째 계층인 Erlang 가상 머신(BEAM)이 바로 이 책에서 다루는 내용입니다.
다섯 번째 계층인 OTP는 Erlang 표준 라이브러리를 제공합니다. OTP는 원래 "Open Telecom Platform"의 약자였으며, (전화 교환기와 같은) 견고한 애플리케이션을 구축하는 데 필요한 구성 요소(supervisor, gen_server, gen_tcp 등)를 제공하는 여러 Erlang 라이브러리를 가리켰습니다. 일찍부터 이 라이브러리들과 OTP의 의미는 ERTS와 함께 배포되는 다른 모든 표준 라이브러리와 뒤섞이게 되었습니다. 오늘날 대부분의 사람들은 ERTS와 Ericsson이 배포하는 모든 Erlang 라이브러리를 가리키는 이름으로 OTP를 Erlang과 함께 묶어 "Erlang/OTP"라고 부릅니다. 이러한 표준 라이브러리를 알고 언제 어떻게 사용해야 하는지 이해하면 애플리케이션의 성능을 크게 향상시킬 수 있습니다. 이 책에서는 표준 라이브러리와 OTP를 자세히 다루지 않습니다. 이러한 측면을 다루는 다른 책이 많이 있습니다.
Elixir 프로그램을 실행하는 경우, 여섯 번째 계층이 Elixir 환경과 Elixir 라이브러리를 제공합니다.
마지막으로, 일곱 번째 계층(Apps)은 여러분의 애플리케이션과 여러분이 사용하는 서드파티 라이브러리입니다. 애플리케이션은 하위 계층들이 제공하는 모든 기능을 사용할 수 있습니다. 하드웨어를 업그레이드하는 것을 제외하면, 아마도 이 계층이 애플리케이션의 성능을 가장 쉽게 개선할 수 있는 곳일 것입니다. Chapter 21에서는 애플리케이션을 프로파일링하고 최적화하는 데 도움이 되는 몇 가지 힌트와 도구를 소개합니다. Chapter 18에서는 애플리케이션이 크래시하는 원인을 찾는 방법과 애플리케이션의 버그를 찾는 방법을 살펴보겠습니다.
1.3.3. 분산
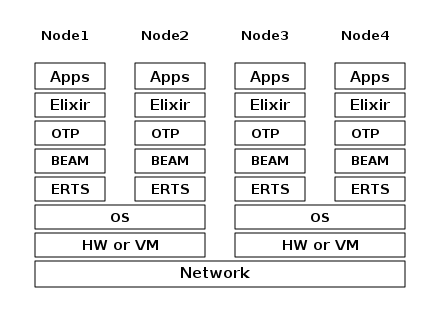
Erlang 언어 설계자들이 얻은 핵심 통찰 중 하나는 연중무휴 24시간 동작하는 시스템을 구축하려면 하드웨어 장애에 대처할 수 있어야 한다는 것이었습니다. 따라서 시스템을 최소 두 대의 물리 머신에 분산해야 합니다. 이를 위해 각 머신에서 노드를 시작한 다음 노드들을 서로 연결하면, 프로세스들이 마치 같은 노드에서 실행되는 것처럼 노드를 넘나들며 서로 통신할 수 있습니다. 분산에 대한 자세한 내용은 Chapter 14을 참조하십시오.
1.3.4. Erlang 컴파일러
Erlang 컴파일러는 Erlang 소스 코드, 즉 .erl 파일을 BEAM 가상 머신 코드로 컴파일하는 역할을 합니다. 컴파일러 자체도 Erlang 애플리케이션으로, Erlang으로 작성되었으며 자기 자신에 의해 BEAM 코드로 컴파일됩니다. 배포되는 Erlang 기반 시스템(릴리스)에는 해당 시스템이 코드를 실행할 뿐만 아니라 컴파일도 할 수 있어야 하는지에 따라 컴파일러가 포함될 수도 있고 포함되지 않을 수도 있습니다.
런타임 시스템을 부트스트랩하기 위해 Erlang의 소스 분산본에는 컴파일러를 비롯하여 미리 컴파일된 여러 BEAM 파일이 bootstrap 및 erts/preloaded 디렉터리에 포함되어 있습니다.
컴파일러에 대한 자세한 내용은 Chapter 2를 참조하십시오.
1.3.5. Erlang 가상 머신: BEAM
BEAM은 Erlang 코드를 실행하는 데 사용되는 가상 머신입니다. JVM이 Java 코드를 실행하는 데 사용되는 것과 같습니다. BEAM 코드는 Erlang 노드의 컨텍스트 안에서 실행됩니다.
ERTS가 Erlang 런타임 시스템이라는 더 일반적인 개념의 한 구현인 것처럼, BEAM 역시 더 일반적인 Erlang 가상 머신 (EVM)의 한 구현입니다. 무엇이 EVM을 이루는지에 대한 정의는 없지만, BEAM에는 실제로 두 가지 수준의 명령어, 즉 일반 명령어(Generic Instructions)와 특정 명령어(Specific Instructions)가 있습니다. 범용 명령어 집합은 EVM의 청사진으로 볼 수 있습니다.
BEAM에 대한 자세한 설명은 Chapter 5 및 이어지는 장들에서 확인할 수 있습니다.
1.3.6. 프로세스
Erlang 프로세스는 기본적으로 OS 프로세스처럼 동작합니다. 각 프로세스는 자신만의 전용 메모리(메일박스, 힙, 스택)와 해당 프로세스에 대한 정보를 담은 프로세스 제어 블록(PCB)을 가집니다. Erlang 프로세스는 스레드와 다릅니다. 수정할 공유 메모리가 없고, 오직 메시지를 통해서만 통신할 수 있으며, 한 프로세스의 관점에서는 다른 프로세스가 같은 VM에서 실행되든 네트워크로 연결된 다른 노드에서 실행되든 차이가 거의 없습니다. Erlang 프로그램에는 잠금이나 보호 구역이 필요하지 않습니다.
모든 Erlang 코드는 프로세스의 컨텍스트 안에서 실행됩니다. 하나의 Erlang 노드에는 여러 프로세스가 있을 수 있으며, 이 프로세스들은 메시지 전달과 시그널을 통해 서로 통신합니다. Erlang 프로세스는 노드끼리 연결되어 있기만 하면 다른 Erlang 노드에 있는 프로세스와도 통신할 수 있습니다.
프로세스와 PCB에 대해 더 자세히 알아보려면 Chapter 3를 참조하십시오.
1.3.7. 스케줄링
스케줄러는 실행할 Erlang 프로세스를 선택하는 역할을 합니다. 기본적으로 스케줄러는 두 개의 큐를 유지합니다. 하나는 실행할 준비가 된 프로세스들의 준비 큐이고, 다른 하나는 메시지 수신을 기다리는 프로세스들의 대기 큐입니다.
스케줄러는 준비 큐(ready queue)에서 첫 번째 프로세스를 골라 BEAM에 넘기고, BEAM은 이 프로세스를 타임 슬라이스(time slice) 하나 동안 실행합니다. BEAM은 타임 슬라이스를 다 쓰면 실행 중인 프로세스를 선점하고, 그 프로세스를 준비 큐의 맨 뒤로 되돌려 보냅니다. 타임 슬라이스를 다 쓰기 전에 프로세스가 receive에서 블로킹되면, 그 프로세스는 대신 대기 큐(waiting queue)로 옮겨집니다. 대기 큐에 있는 프로세스가 메시지를 받거나 타임아웃이 발생하면, 그 프로세스는 준비 큐로 옮겨집니다.
Erlang은 본질적으로 동시적입니다. 즉, 각 프로세스는 개념적으로 다른 모든 프로세스와 동시에 실행되지만, 실제로는 스케줄러가 한 번에 하나의 프로세스만 실행할 뿐입니다. 따라서 단일 코어 머신에서도, 그리고 기반 OS가 선점을 지원하지 않더라도, BEAM은 수십만 개의 동시 프로세스로 이루어진 동일한 Erlang 프로그램을 여전히 실행할 수 있습니다.
멀티코어 머신에서 Erlang은 자동으로 둘 이상의 스케줄러를 각각 별도의 OS 스레드에서 실행합니다. 보통 물리 코어당 하나씩 실행하며, 각 스케줄러는 자체 실행 큐를 가집니다. 한 스케줄러에 할 일이 떨어지면, 그 스케줄러는 다른 스케줄러들로부터 실행 준비가 된 프로세스 일부를 넘겨받을 수 있습니다. 이런 방식으로 Erlang은 프로그래머가 신경 쓸 필요 없이 진정한 병렬성을 달성합니다.
실제로는 프로세스 간에 우선순위가 있어 상황이 더 복잡하며, 대기 큐는 타이밍 휠로 구현되어 있습니다. 이 모든 내용과 그 이상의 사항은 Chapter 10에서 자세히 설명합니다.
1.3.8. Erlang 태그 체계
Erlang은 동적 타입 언어이므로 런타임 시스템에는 각 데이터 객체의 타입을 추적할 방법이 필요합니다. 이는 태깅 방식으로 이루어집니다. 각 데이터 객체나 데이터 객체를 가리키는 포인터에는 해당 객체의 데이터 타입 정보를 담은 태그도 붙어 있습니다.
기본적으로 포인터의 일부 비트는 태그용으로 예약되어 있으며, VM은 태그의 비트 패턴을 보고 객체의 타입을 판별할 수 있습니다.
이 태그는 패턴 매칭, 타입 테스트, 기본 연산에 사용되며 가비지 컬렉터에서도 사용됩니다.
전체 태깅 방식은 Chapter 4에 설명되어 있습니다.
1.3.9. 메모리 처리
Erlang은 자동 메모리 관리를 사용하므로 프로그래머는 메모리 할당과 해제에 대해 신경 쓸 필요가 없습니다. 각 프로세스는 힙과 스택을 가지며, 둘 다 필요에 따라 커지거나 줄어들 수 있습니다. OS 스레드에서는 있을 수 있는 스택 크기 제한도 걱정할 필요가 없고, 스택을 위해 미리 할당된 주소 범위도 없습니다. 처음에는 프로세스의 스택과 힙이 모두 상당히 작기 때문에 수천 개, 심지어 수백만 개의 프로세스를 둘 수 있습니다.
프로세스의 힙 공간이 부족해지면 VM은 먼저 가비지 컬렉션을 통해 여유 힙 공간을 회수하려고 시도합니다. 그런 다음 가비지 컬렉터는 프로세스의 스택과 힙을 훑으면서 살아 있는 데이터를 새 힙으로 복사하고, 죽은 데이터는 모두 버립니다. 그래도 힙 공간이 충분하지 않으면 더 큰 새 힙이 할당되고, 살아 있는 데이터가 그곳으로 옮겨집니다.
참조 카운트 방식 바이너리의 처리를 포함하여, 현재의 세대별 복사 가비지 컬렉터에 대한 자세한 내용은 Chapter 11에서 확인할 수 있습니다.
1.3.10. 명령줄 인터페이스와 인터프리터
erl로 Erlang 노드를 시작하면 명령 프롬프트가 나타납니다. 이것은 Erlang 읽기-평가-출력 루프(REPL) 또는 명령줄 인터페이스(CLI), 혹은 간단히 Erlang 셸입니다.
셸에서 Erlang 표현식을 입력하고 바로 실행할 수 있습니다. 이 경우 코드는 BEAM 코드로 컴파일되어 BEAM에서 실행되는 것이 아닙니다. 대신 코드는 Erlang 인터프리터가 파싱하고 해석합니다. 일반적으로 인터프리트된 코드는 컴파일된 코드와 똑같이 동작하지만 몇 가지 미묘한 차이가 있습니다. 특히 인터프리트된 코드는 더 느립니다. 이러한 차이점을 비롯해 셸의 다른 모든 측면은 Chapter 17에서 설명합니다.
1.4. 대체 Erlang 구현체
이 책은 주로 Ericsson/OTP가 만든 "표준" Erlang 구현체인 ERTS를 다루지만, 이 밖에도 몇 가지 다른 구현체가 있으며 이 절에서는 그중 일부를 간략히 살펴보겠습니다.
1.4.1. Erlang on Xen
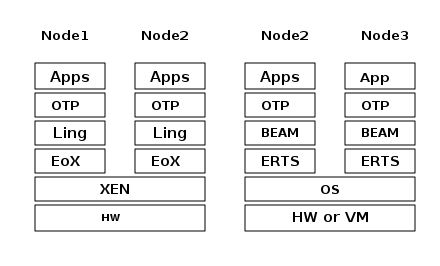
Erlang on Xen (https://github.com/cloudozer/ling)은 중간에 OS 계층 없이 얇은 Xen 클라이언트만 둔 채 서버 하드웨어에서 직접 실행되는 Erlang 구현체입니다.
Erlang on Xen의 가상 머신인 Ling은 BEAM과 바이너리 수준에서 거의 100% 호환됩니다. Figure 4에서 Erlang Solution Stack의 Erlang on Xen 구현이 ERTS 스택과 어떻게 다른지 확인할 수 있습니다. 여기서 주목할 점은 Erlang on Xen 스택에는 운영 체제가 없다는 것입니다.
Ling은 BEAM의 범용 명령어 집합을 구현하므로, OTP 계층의 BEAM 컴파일러를 재사용하여 Erlang을 Ling으로 컴파일할 수 있습니다.
1.4.2. Erjang
Erjang (https://github.com/trifork/erjang)은 JVM 위에서 실행되는 Erlang 구현체입니다. .beam 파일을 로드하여 코드를 Java .class 파일로 다시 컴파일합니다. Erjang은 (일반적인) BEAM과 바이너리 수준에서 거의 100% 호환됩니다.
Figure 5에서 Erlang 솔루션 스택의 Erjang 구현이 ERTS 스택과 어떻게 다른지 확인할 수 있습니다. 여기서 주목할 점은 JVM이 BEAM을 대신하여 가상 머신 역할을 한다는 것과, Erjang이 ERTS의 서비스를 JVM 위에서 Java로 구현하여 제공한다는 것입니다.
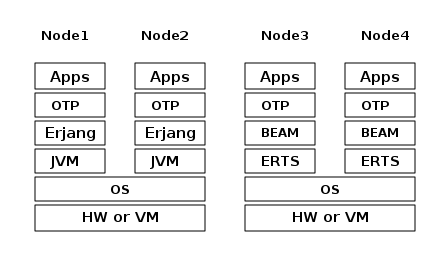
이제 ERTS의 주요 구성 요소 전반과 필요한 용어를 기본적으로 이해했으므로, 각 구성 요소를 자세히 살펴볼 수 있습니다. 특정 구성 요소를 빨리 이해하고 싶다면 해당 장으로 바로 건너뛰어도 됩니다. 또는 특정 문제의 해결책을 정말 빨리 찾고 싶다면 Part II의 알맞은 장으로 건너뛰어 시스템을 튜닝하거나 조정하거나 디버깅하는 여러 방법을 시도해 볼 수 있습니다.
2. 컴파일러
이 책은 프로그래밍 언어 Erlang을 다루지는 않지만, ERTS의 목적이 Erlang 코드를 실행하는 것이므로 Erlang 코드를 컴파일하는 방법은 알아야 합니다. 이 장에서는 사람이 읽을 수 있는 BEAM 코드를 생성하는 데 필요한 컴파일러 옵션과, 생성된 .beam 파일에 디버그 정보를 추가하는 방법을 다룹니다. 장의 끝에는 Elixir 컴파일러에 관한 절도 있습니다.
자신이 좋아하는 언어를 ERTS를 대상으로 컴파일하는 데 관심이 있는 독자를 위해, 이 장에서는 컴파일러의 여러 중간 형식과 여러분의 컴파일러를 BEAM 컴파일러 백엔드에 연결하는 방법도 자세히 다룹니다. 또한 파스 트랜스폼을 소개하고, 이를 사용하여 Erlang 언어를 변형하는 방법을 예제와 함께 보여 드리겠습니다.
2.1. Erlang 컴파일하기
Erlang은 .erl 파일에 있는 소스 코드 모듈에서 바이너리 .beam 파일로 컴파일됩니다.
컴파일러는 OS 셸에서 erlc 명령으로 실행할 수 있습니다:
> erlc foo.erlerlc의 전반적인 동작을 제어하는 -o <Directory>와 같은 여러 옵션이 있으며, 대부분 C 컴파일러 옵션과 비슷합니다. 전체 목록은 https://www.erlang.org/doc/apps/erts/erlc_cmd.html에서 확인하십시오. 더 세부적인 컴파일러 옵션은 +debug_info처럼 더하기 기호로 시작합니다. 이 옵션들은 컴파일러 애플리케이션에 그대로 전달되는 Erlang 텀이므로, { 또는 "와 같은 특수 문자가 들어 있으면 셸에서 따옴표로 감싸야 할 수 있습니다. 이 옵션들의 전체 목록은 compile 모듈 문서에서 찾을 수 있습니다. http://www.erlang.org/doc/man/compile.html을 참조하십시오.
컴파일러는 Erlang 셸에서도 호출할 수 있습니다. 셸 단축 명령 c()를 사용하면 컴파일한 뒤 모듈까지 로드하며, compile:file() 함수를 호출하면 컴파일만 하고 로드하지는 않습니다. 파일 이름은 아톰이나 문자열로 지정할 수 있으며, .erl 확장자는 붙이지 않아도 됩니다:
1> c(foo).
{ok, foo}
또는
1> compile:file(foo).
{ok, foo}
두 함수 모두 두 번째 인자로 옵션 리스트를 받을 수 있습니다. 이 옵션들은 erlc에서 +-옵션으로 전달할 수 있는 것과 동일한 텀입니다:
1> c(foo, [nowarn_unused_function, debug_info]).일반적으로 컴파일러는 .erl 파일에 있는 Erlang 소스 코드를 컴파일하고, 그 결과로 생성된 바이너리 BEAM 코드를 .beam 파일에 기록합니다. compile:file()에 binary 옵션을 지정하면(단, c() 단축 함수에는 지정할 수 없습니다) 결과 바이너리를 Erlang 텀으로 돌려받을 수도 있습니다:
1> compile:file(foo, [binary]).
{ok, foo, <<70,79,82,...>>}
일부 옵션을 사용하면 컴파일러가 컴파일의 특정 단계를 마친 뒤 멈추고 그 시점의 중간 표현을 출력합니다. 예를 들어 Core Erlang으로 변환된 뒤의 프로그램 모습을 보려면 다음과 같이 합니다.
1> c(foo, [to_core]).
** Warning: No object file created - nothing loaded **
ok
이 경고는 c() 셸 단축 명령에서 나온 것입니다. .beam 오브젝트 파일이 생성되지 않았으므로, 로드할 새 버전의 모듈도 없었습니다. 대신 이제 foo.core라는 텍스트 파일이 생겼을 것입니다.
전처리 결과를 확인하려면 대신 'P' 옵션을 전달하면 됩니다:
1> c(foo, ['P']).
** Warning: No object file created - nothing loaded **
ok
이제 출력 파일 foo.P를 보면 모든 include 파일을 읽어 들이고, 매크로를 치환하고, -ifdef 같은 조건부 컴파일 지시어를 평가한 뒤의 Erlang 소스 코드가 어떤 모습인지 알 수 있습니다.
사실 binary 옵션은 다음과 같은 의미로 오버로드되어 왔습니다: “at the stage where the compiler stops, return the intermediate format as a term instead of writing it to a file”. 예를 들어 컴파일러가 Core Erlang 코드를 반환하도록 하려면 [to_core, binary] 옵션을 지정하면 됩니다:
1> compile:file(foo, [to_core,binary]).
{ok, foo, {c_module, ...}}
이 경우 텍스트 덩어리가 아니라 Erlang 텀으로 된 실제 내부 표현을 얻게 된다는 점에 유의하십시오. 대부분의 내부 표현에는 대응하는 prettyprinting 함수가 있습니다. 예를 들면 다음과 같습니다.
1> {ok, foo, Core} = compile:file(foo, [to_core,binary]).
{ok, foo, {c_module, ...}}
2> io:put_chars(core_pp:format(Core)).
module 'foo' [...]
  ...
또한 컴파일러가 이후 단계, 예를 들어 .core 소스 파일부터 컴파일을 이어서 진행하도록 지시할 수도 있으며, 이때 erlc를 사용하거나:
> erlc foo.core또는 Erlang에서 직접 호출할 수도 있습니다:
1> c(foo, [from_core]).
{ok, foo}
중간 코드를 Erlang 텀 형태로 가지고 있다면, 다음과 같이 이를 컴파일러에 곧바로 다시 넘겨 작업을 이어서 진행하도록 지시할 수 있습니다:
1> {ok, foo, Core} = compile:file(foo, [to_core,binary]).
{ok, foo, {c_module, ...}}
3> {ok, foo, Bin} = compile:forms(Core, [from_core,binary]).
{ok,foo, <<70,79,82,...>>}
마지막으로, 바이너리 형태의 Beam 모듈이 있다면 이를 메모리에 직접 로드하여 실행할 수 있습니다:
4> code:load_binary(foo, "nopath", Bin).
{module,foo}
5> foo:f()
hello
6> code:which(foo).
"nopath"
(이 경우 바이너리가 실제로 어떤 파일에도 저장된 적이 없더라도, 로더에 모듈 이름과 함께 코드 서버가 오브젝트 파일 경로로 보고할 문자열도 알려 주어야 합니다.)
이렇게 하면 컴파일러의 여러 지점에 끼어들어 출력을 살펴보거나, 출력을 수정해 다시 넘겨주거나, 심지어 대응하는 .erl 파일 없이 다른 방법으로 생성한 저수준 코드를 넘겨줄 수도 있습니다. 그리고 원하지 않는 한 이 모든 작업을 파일에 아무것도 쓰지 않고 할 수 있습니다.
2.2. 컴파일러 개요
컴파일러는 여러 개의 패스로 구성됩니다. 가독성을 위해 이 패스들을 두 부분으로 나눕니다. 하나는 Erlang 소스 코드를 받아 Core Erlang 코드로 변환하는 컴파일러 프런트엔드 이고(Figure 6), 다른 하나는 Core Erlang 수준에서 이어받아 코드를 BEAM 바이트코드로 변환하고 최적화하는 컴파일러 백엔드 입니다(Figure 7).
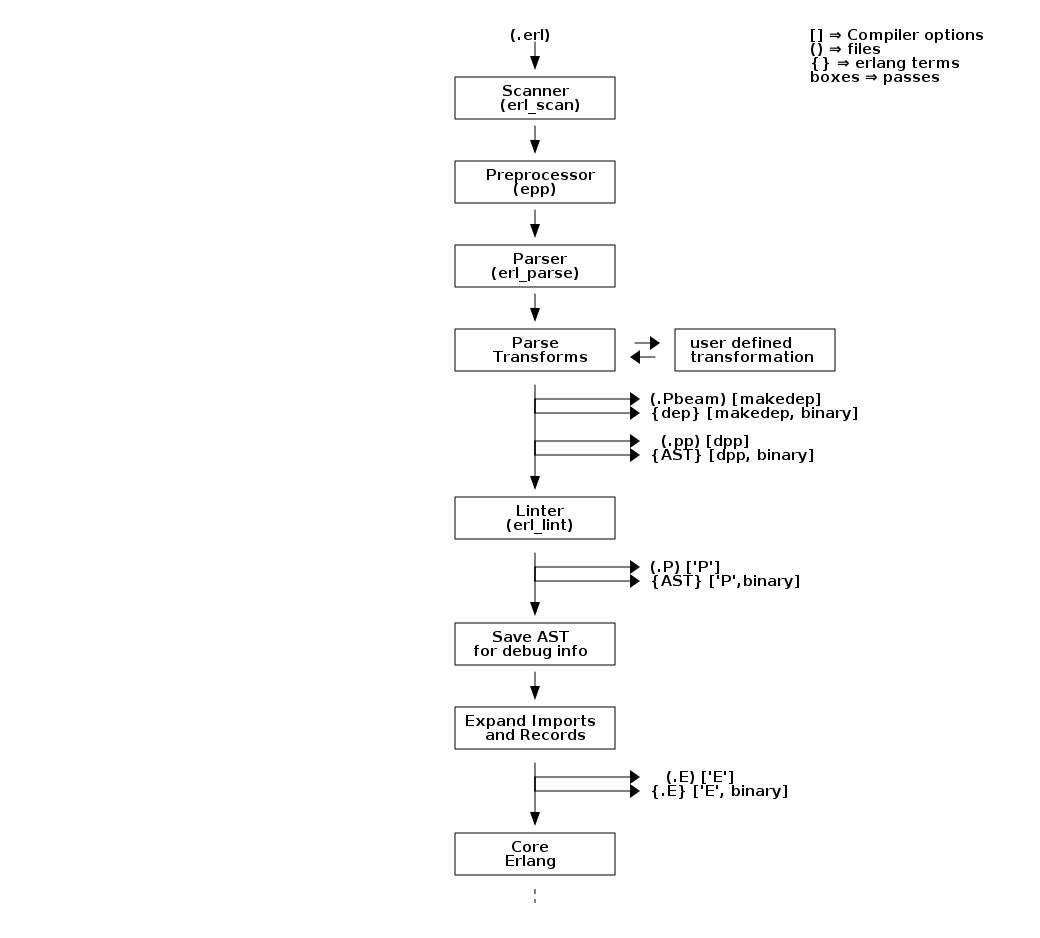
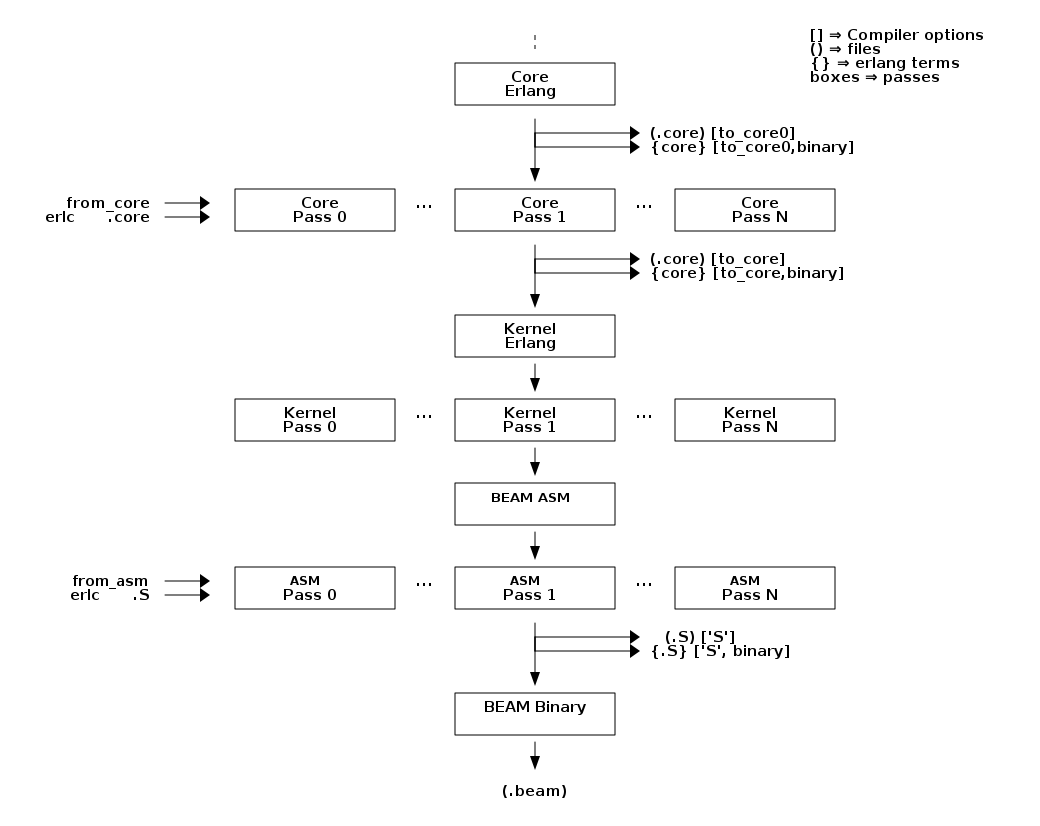
컴파일러 패스의 전체 최신 목록을 보려면 Erlang 셸에서 compile:options() 함수를 실행하십시오. 컴파일러에 관한 정보의 가장 확실한 출처는 물론 Erlang/OTP 소스 코드입니다: compile.erl
2.3. 중간 출력 생성하기
컴파일러가 생성한 코드를 살펴보면 가상 머신이 어떻게 동작하는지 이해하는 데 큰 도움이 됩니다. 다행히 컴파일러는 각 컴파일러 패스를 거친 뒤의 중간 코드와 최종 beam 코드를 보여 줄 수 있습니다.
새로 얻은 지식을 활용하여 생성된 코드를 살펴봅시다.
 1> compile:options().
 dpp - Generate .pp file
 'P' - Generate .P source listing file
...
'E' - Generate .E source listing file
...
'S' - Generate .S file
작은 예제 프로그램 "world.erl"로 시도해 봅시다:
-module(world).
-export([hello/0]).

-include("world.hrl").

hello() -> ?GREETING.
그리고 include 파일 "world.hrl"은 다음과 같습니다.
-define(GREETING, "hello world").이제 파싱된 파일을 얻기 위해 'P' 옵션으로 이것을 컴파일하면 "world.P" 파일이 생성됩니다:
2> c(world, ['P']).
** Warning: No object file created - nothing loaded **
ok
결과로 생성된 .P 파일에서는 전처리기(및 파스 변환)가 적용된 후의 코드를 보기 좋게 출력한 버전을 확인할 수 있습니다:
-file("world.erl", 1).

-module(world).

-export([hello/0]).

-file("world.hrl", 1).

-file("world.erl", 4).

hello() ->
    "hello world".
모든 소스 코드 변환이 끝난 뒤 코드가 어떤 모습인지 확인하려면 'E' 플래그를 주어 코드를 컴파일하면 됩니다.
3> c(world, ['E']).
** Warning: No object file created - nothing loaded **
ok
이렇게 하면 .E 파일을 얻습니다. 이 경우 모든 컴파일러 지시문은 제거되었고, 모든 레코드는 튜플로 확장되었으며, 함수 임포트를 사용한 부분은 모두 명시적인 원격 호출로 확장되었고, module_info/{1,2} 내장 함수가 소스에 추가되었습니다:
-vsn("\002").

-file("world.erl", 1).

-file("world.hrl", 1).

-file("world.erl", 5).

hello() ->
    "hello world".

module_info() ->
    erlang:get_module_info(world).

module_info(X) ->
    erlang:get_module_info(world, X).
나중에 Section 2.5에서 파스 트랜스폼을 살펴볼 때 'P' 옵션과 'E' 옵션을 사용하겠습니다.
다른 모든 중간 단계를 살펴보기 전에, 최종적으로 생성된 BEAM 코드를 사람이 읽을 수 있는 “assembler” 형태로 먼저 살펴보겠습니다. 컴파일러에 'S' 옵션을 주면 코드의 각 BEAM 명령어에 대응하는 Erlang 텀이 담긴 .S 파일을 얻을 수 있습니다.
3> c(world, ['S']).
** Warning: No object file created - nothing loaded **
ok
world.S 파일은 대략 다음과 같은 모습이어야 합니다:
{module, world}.  %% version = 0

{exports, [{hello,0},{module_info,0},{module_info,1}]}.

{attributes, []}.

{labels, 7}.


{function, hello, 0, 2}.
  {label,1}.
    {line,[{location,"world.erl",6}]}.
    {func_info,{atom,world},{atom,hello},0}.
  {label,2}.
    {move,{literal,"hello world"},{x,0}}.
    return.


{function, module_info, 0, 4}.
  {label,3}.
    {line,[]}.
    {func_info,{atom,world},{atom,module_info},0}.
  {label,4}.
    {move,{atom,world},{x,0}}.
    {line,[]}.
    {call_ext_only,1,{extfunc,erlang,get_module_info,1}}.


{function, module_info, 1, 6}.
  {label,5}.
    {line,[]}.
    {func_info,{atom,world},{atom,module_info},1}.
  {label,6}.
    {move,{x,0},{x,1}}.
    {move,{atom,world},{x,0}}.
    {line,[]}.
    {call_ext_only,2,{extfunc,erlang,get_module_info,2}}.
이 파일은 점(.)으로 구분된 Erlang 텀들로 이루어져 있으므로, 다음과 같이 Erlang 셸에서 파일을 쉽게 다시 읽어 들일 수 있습니다:
{ok, BEAM_Code} = file:consult("world.S").
보시다시피 어셈블러 코드는 대체로 원래 소스 코드의 구조를 따릅니다.
첫 번째 명령어는 코드의 모듈 이름을 정의합니다. 주석에 언급된 버전(%% version = 0)은 옵코드 형식의 버전(beam_opcodes:format_number/0이 반환하는 값)입니다.
이어서 여느 Erlang 소스 모듈과 마찬가지로 export 목록과 컴파일러 속성(이 예제에는 없음)이 나옵니다.
처음으로 나오는 실제 beam 유사 명령어는 {labels, 7}입니다. 이 명령어는 코드에 있는 레이블의 개수를 VM에 알려 주어, 코드를 한 번만 훑으면서 모든 레이블을 위한 공간을 할당할 수 있게 합니다.
그다음에는 각 함수의 실제 코드가 있습니다. 첫 번째 명령어는 함수 이름과 애리티(arity), 그리고 레이블 번호로 나타낸 진입점을 알려 줍니다. 진입점이 함수의 첫 번째 레이블이 아니라는 점을 알 수 있습니다. 진입점 앞에는 함수의 메타데이터를 정의하는 명령어가 몇 개 있습니다. 이 명령어들은 런타임에 실행되지 않습니다.
'S' 옵션을 활용하면 BEAM이 어떻게 동작하는지 이해하는 데 큰 도움이 되며, 이후 장에서도 이 옵션을 그런 용도로 사용할 것입니다. 또한 Core Erlang을 거쳐 BEAM으로 컴파일되는 자신만의 언어를 개발하는 경우, 생성된 코드를 확인하는 데에도 매우 유용합니다.
2.4. 컴파일러 패스
다음 절들에서는 Figure 6와 Figure 7에 나와 있는 컴파일러 패스 대부분을 살펴보겠습니다. BEAM을 대상으로 하는 언어 설계자에게는 이 내용이 흥미로울 것입니다. 매크로, 파스 트랜스폼(parse transform), Core Erlang, BEAM 코드라는 여러 접근 방식으로 각각 무엇을 할 수 있는지, 그리고 이들이 서로 어떻게 의존하는지 보여 주기 때문입니다.
Erlang 코드를 튜닝할 때는 어떤 최적화가 언제 적용되는지, 그리고 최적화 전후에 생성된 코드를 어떻게 살펴볼 수 있는지 알아 두는 것이 좋습니다.
2.4.1. 컴파일러 패스: Erlang 전처리기(epp)
컴파일은 토큰화(또는 스캐닝)와 전처리로 시작합니다. 전처리기 epp는 파일을 읽고 토크나이저 erl_scan을 호출하여 텍스트를 문자 단위가 아닌 개별 토큰 시퀀스로 풀어내며, 이 과정에서 공백과 주석은 버립니다. 그런 다음 매크로 정의와 조건부 컴파일 지시문을 처리하고, 매크로가 사용된 부분을 치환합니다.
전처리기는 include 문을 발견하면 지정된 include 파일을 읽어 토큰화하고, 그 결과로 얻은 토큰 시퀀스를 include 문 대신 삽입한 뒤, 이것 역시 처리합니다. 따라서 파일들이 서로를 재귀적으로 include할 수 있습니다. 전처리기는 한 파일에서 다른 파일로 전환할 때 앞의 예제에서 본 것처럼 -file 어노테이션을 삽입하여, 이후 패스에서 특정 코드 조각이 어디에서 왔는지 알 수 있도록 합니다:
...
-file("world.hrl", 1).

-file("world.erl", 4).
...world.hrl과 같은 include 파일이 처리될 때 실제로는 아무 코드도 삽입되지 않을 수 있다는 점에 유의하십시오. include 파일에는 매크로 정의와 전처리기 조건문만 들어 있는 경우가 많기 때문입니다. 남는 것은 “we are now at line 1 of the header file”, “we are now back at line 4 in the original source file” 두 주석뿐입니다.
이 모든 것은 epp가 (C/C++ 전처리기 cpp와 마찬가지로) 토큰 수준에서 동작한다는 뜻이므로, (예를 들어 m4와 같은) 순수한 문자열 치환 처리기가 아니라는 점에 유의하십시오. Erlang 매크로로 임의의 문법을 직접 정의할 수는 없습니다. 매크로는 주변 문자와 분리된 별개의 토큰으로 확장되므로, 매크로와 문자를 이어 붙여 하나의 토큰으로 만들 수 없습니다:
-define(plus,+).
t(A,B) -> A?plus+B.
이는 다음과 같이 확장됩니다
t(A,B) -> A + + B.그리고 다음은 아닙니다
t(A,B) -> A ++ B.한편 매크로 확장은 실제 파싱 전에 토큰 스트림에서 이루어지므로, 매크로의 우변에 반드시 유효한 Erlang 텀이 올 필요는 없습니다. 최종적으로 유효한 텀이 되도록 사용하기만 하면 됩니다. 예를 들면 다음과 같습니다.
-define(p,o, o]).
 t() -> [f,?p.
이는 다음 토큰 시퀀스로 확장됩니다.
t ( ) -> [ f , o , o ] .난독화된 Erlang 코드 대회에서 우승하는 것 말고는 이 기능을 실제로 쓸 일이 거의 없습니다. 기억해야 할 핵심은 Erlang 전처리기로 Erlang과 다른 구문을 가진 언어를 정의하기는 사실상 불가능하다는 점입니다.
2.4.2. 컴파일러 패스: Erlang 파서
파서 erl_parse는 전처리기로부터 최종 토큰 시퀀스를 받아 Erlang 문법에 맞는지 검사하고, 프로그램을 순차적인 텍스트가 아닌 데이터 구조로 표현하는 추상 구문 트리 또는 AST(http://www.erlang.org/doc/apps/erts/absform.html 참고)를 생성합니다.
2.4.3. 컴파일러 패스: 파스 변환
파스 트랜스폼은 AST를 대상으로 동작하는 함수입니다. 컴파일러는 초기 토큰화, 전처리, 파싱을 마친 뒤 그때까지 오류가 없었다면, 파스 트랜스폼 함수가 선언된 경우 그 함수를 호출합니다. 이때 컴파일러는 현재 AST를 함수에 넘기고, 수정된 AST를 돌려받을 것으로 기대합니다.
즉, 입력이 여전히 Erlang 파서에서 받아들여져야 하므로 Erlang 문법을 근본적으로 바꿀 수는 없지만, 코드를 원하는 대로 수정하여 의미는 바꿀 수 있다는 뜻입니다.
파스 트랜스폼은 이를 사용할 모듈 안에서 다음과 같이 선언합니다:
-compile({parse_transform, my_pt}).그러면 컴파일러는 추가 패스로 my_pt:parse_transform(Forms, Options)를 호출하려고 시도합니다. 한 모듈에서 여러 파스 트랜스폼을 사용할 수 있으며, 이들은 단순히 순서대로 실행됩니다.
파스 트랜스폼은 Mnesia(QLC 구문용), EUnit, Merl 등의 라이브러리에서 사용됩니다. Section 2.5에서는 파스 트랜스폼을 직접 구현하는 방법을 전체 예제로 보여 드리겠습니다.
2.4.4. 컴파일러 패스: 린터
“linter”라는 텀은 원래 컴파일러에 덧붙여 쓰는 도구를 뜻했습니다. 이 도구는 의류 건조기의 보풀 필터(lint filter)처럼 스타일상의 오류와 안티패턴 등 컴파일러 자체가 검사하지 않는 여러 사항을 검사했습니다(당시 컴파일러는 사용할 수 있는 메모리가 매우 적었고 속도에 중점을 두었기 때문입니다). 그러나 컴퓨터가 빨라지면서 린터는 가끔씩만이 아니라 항상 실행하고 싶은 패스로서 컴파일러 안으로 옮겨졌습니다.
Erlang 컴파일러에서 린터 erl_lint는 파싱과 변환이 끝난 뒤 소스 코드 검사의 대부분을 수행하는 단계입니다. (즉, 파스 트랜스폼은 린터가 받아들이는 AST만 반환할 수 있습니다.)
린터는 정의되지 않은 변수나 함수 같은 오류를 검사할 뿐만 아니라, "export_all flag enabled"처럼 올바르지만 의심스러운 코드에 대해서도 경고를 생성합니다.
2.4.5. 컴파일러 패스: AST 저장
모듈의 디버깅을 활성화하려면 해당 모듈을 “debug compile” 해야 합니다. 즉, 컴파일러에 debug_info 옵션을 전달해야 합니다. 그러면 추상 구문 트리는 “Save AST” 패스에서 저장되어 컴파일이 끝날 때까지 보존되며, 컴파일이 끝나면 브레이크포인트 설정, 단일 스텝 실행 등을 위해 .beam 파일에 포함됩니다. 이때 코드는 컴파일된 상태가 아니라 인터프리트되어 실행됩니다.
코드는 최적화가 적용되기 전에 저장된다는 점에 유의해야 합니다. 따라서 컴파일러의 최적화 패스에 버그가 있는 경우, 디버거에서 인터프리트된 코드를 실행하면 다르게 동작합니다. 컴파일러 최적화를 직접 구현하고 있다면 이 점 때문에 크게 곤란을 겪을 수 있습니다.
2.4.6. 컴파일러 패스: Expand
확장 단계에서는 레코드와 같은 소스 수준의 Erlang 구성 요소가 더 낮은 수준의 Erlang 구성 요소로 확장됩니다. 이 단계에서는 컴파일러 지시문을 제거하고, 레코드 구문을 튜플에 대한 연산으로 바꾸고, 임포트한 함수의 사용을 명시적인 원격 호출로 확장하며, 내장 함수 module_info/{1,2}를 코드에 추가합니다.
2.4.7. 컴파일러 패스: Core Erlang
Core Erlang은 컴파일러 최적화에 적합한 엄격한(strict) 함수형 언어입니다. Core Erlang은 같은 연산을 표현하는 방법의 수를 줄여 코드 변환을 더 쉽게 만듭니다. 이를 위한 방법 중 하나는 let 및 letrec 식을 도입하여 스코프를 더 명시적으로 만드는 것입니다. 컴파일러는 코어 수준에서 여러 차례의 패스를 수행합니다.
Core Erlang은 ERTS에서 실행하려는 언어의 좋은 타깃이 될 수 있습니다. Core Erlang은 거의 바뀌지 않으며, Erlang의 모든 측면을 깔끔한 형태로 담고 있습니다. BEAM 명령어 집합을 직접 타깃으로 삼으면 훨씬 더 많은 세부 사항을 다루어야 하며, 그 명령어 집합은 보통 ERTS의 메이저 릴리스마다 조금씩 바뀝니다. 반면 Erlang을 직접 타깃으로 삼으면 기술할 수 있는 내용이 더 제한되며, Core Erlang이 더 깔끔한 언어이므로 더 많은 세부 사항을 다루어야 할 수도 있습니다.
다만 일반 Erlang을 대상으로 하면 생성한 코드가 올바르게 동작하는지 컴파일 시점에 더 많이 검사받을 수 있다는 점에 유의하십시오. Core Erlang을 직접 생성하면 Erlang 컴파일러가 이전에 한 번도 마주친 적 없는 코너 케이스를 발견하게 될 수도 있습니다. 따라서 올바른 코드를 생성해야 할 책임이 여러분에게 더 크게 주어집니다.
Erlang 파일을 core로 컴파일하려면 to_core 옵션을 지정하면 됩니다. 이렇게 하면 생성된 Core Erlang 프로그램이 확장자가 .core인 파일로 출력됩니다. .core 파일에서 Core Erlang 프로그램을 컴파일하려면 컴파일러에 from_core 옵션을 지정하면 됩니다.
1> c(world, to_core).
** Warning: No object file created - nothing loaded **
ok
2> c(world, from_core).
{ok,world}
.core 파일은 사람이 읽을 수 있는 core 형식으로 작성된 텍스트 파일이라는 점에 유의하십시오. core 프로그램을 Erlang 텀으로 얻으려면 컴파일할 때 binary 옵션을 추가하면 됩니다.
2.4.8. 컴파일러 패스: Kernel Erlang
Kernel Erlang은 Core Erlang을 평탄화한(flat) 버전으로, 몇 가지 차이점이 있습니다. 예를 들어, 각 변수는 고유하며 스코프는 함수 전체입니다. 패턴 매칭은 더 원시적인 연산으로 컴파일됩니다. 커널 표현에는 잘 정의된 파일 형식이 없으며, 안정적일 것이라고 기대해서는 안 됩니다.
2.4.9. 컴파일러 패스: BEAM 어셈블리 코드
일반적인 컴파일의 마지막 단계는 외부 BEAM 어셈블리 코드 형식으로, Erlang 텀으로 표현된 개별 BEAM 명령어의 시퀀스입니다. 데드 코드 제거와 핍홀 최적화 같은 일부 저수준 최적화가 이 단계에서 수행됩니다.
BEAM 코드는 Chapter 7 및 Appendix B에서 자세히 설명합니다
2.4.10. 컴파일러 패스: BEAM 바이너리 형식
BEAM 어셈블리 코드는 최종적으로 바이너리 전송 형식으로 패킹되며, 이 형식은 .beam 파일에 기록하거나, 네트워크를 통해 전송하거나, code:load_binary/3을 통해 메모리에 직접 로드할 수 있습니다. 자세한 내용은 Chapter 6]를 참조하십시오.
2.5. 파스 트랜스폼 작성하기
Erlang 언어를 손보는 가장 쉬운 방법은 파스 변환(또는 파스 트랜스폼)을 사용하는 것입니다. 파스 변환에는 OTP 문서의 다음 안내처럼 온갖 경고가 따라붙습니다.
| 프로그래머는 파스 변환(parse transformation)을 사용하지 않도록 강력히 권고되며, 이를 사용하다가 발생한 문제에 대해서는 어떠한 지원도 제공되지 않습니다. |
파스 트랜스폼을 사용한다는 것은 사실상 컴파일러에 패스를 하나 더 작성하는 것이며, 주의하지 않으면 매우 예상치 못한 결과로 이어질 수 있습니다. 하지만 파스 트랜스폼을 사용하려면 그것을 사용하는 모듈에서 사용을 선언해야 하고, 그 효과는 해당 모듈에만 국한되므로, 컴파일러를 조정하는 방법 중에서는 비교적 안전한 편입니다.
제가 보기에 파스 트랜스폼(parse transform)의 가장 큰 문제는 여러분이 자신만의 문법을 만들어 낸다는 것이며, 이 때문에 여러분의 코드를 읽는 다른 사람들이 코드를 이해하기가 더 어려워진다는 점입니다. 적어도 여러분의 파스 트랜스폼이 예컨대 QLC만큼 대중적이고 널리 쓰이게 되기 전까지는 그렇습니다.
자, 이제 이것을 사용하면 안 된다는 것은 아셨겠지만, 그래도 꼭 사용해야 한다면 어떻게 하는지 예제를 하나 보여 드리겠습니다.
예를 들어 어떤 이유로 Erlang 코드 안에 json 코드를 직접 작성하고 싶다고 합시다. 그렇다면 운이 좋은 편입니다. json의 토큰과 Erlang의 토큰이 기본적으로 같기 때문입니다. 또한 Erlang 컴파일러는 파스 트랜스폼 패스 다음에 오는 린터 패스에서 대부분의 무결성 검사를 수행하므로, 유효한 Erlang을 나타내지 않는 추상 구문 트리(AST)도 허용할 수 있습니다.
파스 트랜스폼을 작성하려면 함수 parse_transform/2를 익스포트하는 Erlang 모듈(이를 p라고 부릅시다)을 작성해야 합니다. 컴파일되는 모듈(이를 m이라고 부릅시다)이 컴파일러 옵션 {parse_transform, p}를 포함하고 있으면, 컴파일러는 파스 트랜스폼 패스 중에 이 함수를 호출합니다. 이 함수의 인자는 모듈 m의 AST와 컴파일러를 호출할 때 전달된 컴파일러 옵션입니다.
|
파일 안에서 지정한 컴파일러 옵션은 전혀 전달받지 못한다는 점에 유의하십시오. 코드에서 파스 트랜스폼에 옵션을 넘길 수 없으므로 다소 불편한 점입니다. 컴파일러는 파스 트랜스폼 패스 이후에 실행되는 expand 패스에 이르러서야 컴파일러 옵션을 확장합니다. |
추상 형식에 관한 문서는 내용이 다소 빽빽해서 문서만 읽어서는 추상 형식을 제대로 이해하기가 상당히 어렵습니다. AST로 본격적인 작업을 하려면 syntax_tools, 그중에서도 특히 erl_syntax_lib를 사용하시기를 권합니다.
여기서는 AST를 이해하는 데 목적을 두고 간단한 파스 트랜스폼을 하나 만들어 보겠습니다. 따라서 syntax_tools 대신 AST를 직접 다루며, 오래되었지만 믿을 만한 io:format 방식을 사용하겠습니다.
먼저 컴파일할 수 있게 만들고자 하는 대상의 예제인 json_test.erl을 작성합니다:
-module(json_test).
-compile({parse_transform, json_parser}).
-export([test/1]).

test(V) ->
    <<{{
      "name"  : "Jack (\"Bee\") Nimble",
      "format": {
                 "type"      : "rect",
                 "widths"     : [1920,1600],
                 "height"    : (-1080),
                 "interlace" : false,
                 "frame rate": V
                }
      }}>>.
그런 다음 최소한의 파스 트랜스폼 모듈 json_parser.erl을 만듭니다:
-module(json_parser).
-export([parse_transform/2]).

parse_transform(AST, _Options) ->
  io:format("~p~n", [AST]),
  AST.
이 항등 파스 트랜스폼은 AST를 변경하지 않고 그대로 반환하지만, AST가 어떤 모습인지 확인할 수 있도록 출력하기도 합니다.
> c(json_parser).
{ok,json_parser}
2> c(json_test).
[{attribute,1,file,{"./json_test.erl",1}},
 {attribute,1,module,json_test},
 {attribute,3,export,[{test,1}]},
 {function,5,test,1,
  [{clause,5,
    [{var,5,'V'}],
    [],
    [{bin,6,
      [{bin_element,6,
        {tuple,6,
         [{tuple,6,
           [{remote,7,{string,7,"name"},{string,7,"Jack (\"Bee\") Nimble"}},
            {remote,8,
             {string,8,"format"},
             {tuple,8,
              [{remote,9,{string,9,"type"},{string,9,"rect"}},
               {remote,10,
                {string,10,"widths"},
                {cons,10,
                 {integer,10,1920},
                 {cons,10,{integer,10,1600},{nil,10}}}},
               {remote,11,{string,11,"height"},{op,11,'-',{integer,11,1080}}},
               {remote,12,{string,12,"interlace"},{atom,12,false}},
               {remote,13,{string,13,"frame rate"},{var,13,'V'}}]}}]}]},
        default,default}]}]}]},
 {eof,16}]
./json_test.erl:7: illegal expression
./json_test.erl:8: illegal expression
./json_test.erl:5: Warning: variable 'V' is unused
error
모듈에 잘못된 Erlang 구문이 들어 있어 json_test 컴파일은 실패하지만, AST가 어떤 모습인지는 확인할 수 있습니다. 이제 AST를 순회하면서 json 코드를 Erlang 코드로 바꿔 쓰는 함수 몇 개만 작성하면 됩니다.[1]
-module(json_parser).
-export([parse_transform/2]).

parse_transform(AST, _Options) ->
    json(AST, []).

-define(FUNCTION(Clauses), {function, Label, Name, Arity, Clauses}).

%% We are only interested in code inside functions.
json([?FUNCTION(Clauses) | Elements], Res) ->
    json(Elements, [?FUNCTION(json_clauses(Clauses)) | Res]);
json([Other|Elements], Res) -> json(Elements, [Other | Res]);
json([], Res) -> lists:reverse(Res).

%% We are interested in the code in the body of a function.
json_clauses([{clause, CLine, A1, A2, Code} | Clauses]) ->
    [{clause, CLine, A1, A2, json_code(Code)} | json_clauses(Clauses)];
json_clauses([]) -> [].


-define(JSON(Json), {bin, _, [{bin_element
                                         , _
                                         , {tuple, _, [Json]}
                                         , _
                                         , _}]}).

%% We look for: <<"json">> = Json-Term
json_code([])                     -> [];
json_code([?JSON(Json)|MoreCode]) -> [parse_json(Json) | json_code(MoreCode)];
json_code(Code)                   -> Code.

%% Json Object -> [{}] | [{Label, Term}]
parse_json({tuple,Line,[]})            -> {cons, Line, {tuple, Line, []}};
parse_json({tuple,Line,Fields})        -> parse_json_fields(Fields,Line);
%% Json Array -> List
parse_json({cons, Line, Head, Tail})   -> {cons, Line, parse_json(Head),
                                                       parse_json(Tail)};
parse_json({nil, Line})                -> {nil, Line};
%% Json String -> <<String>>
parse_json({string, Line, String})     -> str_to_bin(String, Line);
%% Json Integer -> Integer
parse_json({integer, Line, Integer})   -> {integer, Line, Integer};
%% Json Float -> Float
parse_json({float, Line, Float})       -> {float, Line, Float};
%% Json Constant -> true | false | null
parse_json({atom, Line, true})         -> {atom, Line, true};
parse_json({atom, Line, false})        -> {atom, Line, false};
parse_json({atom, Line, null})         -> {atom, Line, null};

%% Variables, should contain Erlang encoded Json
parse_json({var, Line, Var})         -> {var, Line, Var};
%% Json Negative Integer or Float
parse_json({op, Line, '-', {Type, _, N}}) when Type =:= integer
                                             ; Type =:= float ->
                                          {Type, Line, -N}.
%% parse_json(Code)                  -> io:format("Code: ~p~n",[Code]), Code.

-define(FIELD(Label, Code), {remote, L, {string, _, Label}, Code}).

parse_json_fields([], L) -> {nil, L};
%% Label : Json-Term  --> [{<<Label>>, Term} | Rest]
parse_json_fields([?FIELD(Label, Code) | Rest], _) ->
    cons(tuple(str_to_bin(Label, L), parse_json(Code), L)
         , parse_json_fields(Rest, L)
         , L).


tuple(E1, E2, Line)    -> {tuple, Line, [E1, E2]}.
cons(Head, Tail, Line) -> {cons, Line, Head, Tail}.

str_to_bin(String, Line) ->
    {bin
     , Line
     , [{bin_element
         , Line
         , {string, Line, String}
         , default
         , default
        }
       ]
    }.
이제 오류 없이 json_test를 컴파일할 수 있습니다:
1> c(json_parser).
{ok,json_parser}
2> c(json_test).
{ok,json_test}
3> json_test:test(42).
[{<<"name">>,<<"Jack (\"Bee\") Nimble">>},
{<<"format">>,
  [{<<"type">>,<<"rect">>},
   {<<"widths">>,[1920,1600]},
   {<<"height">>,-1080},
   {<<"interlace">>,false},
{<<"frame rate">>,42}]}]parse_transform/2가 생성하는 AST는 유효한 Erlang 코드에 대응해야 합니다. 다만 파스 트랜스폼을 여러 개 적용하는 경우는 예외이며, 실제로 여러 개를 적용할 수도 있습니다. 코드의 유효성은 그다음 컴파일러 패스에서 검사합니다.
2.6. 기타 컴파일러 도구
코드 생성과 코드 조작 작업에 도움이 되는 여러 도구가 있습니다. 이 도구들은 Erlang으로 작성되었으며 엄밀히 말해 런타임 시스템의 일부는 아니지만, BEAM 위에 다른 언어를 구현한다면 알아 두면 매우 유용합니다.
이 절에서는 가장 유용한 코드 도구 세 가지, 즉 렉서인 Leex, 파서 생성기인 Yecc, 그리고 추상 형식(abstract form)을 조작하는 범용 함수 모음인 Syntax Tools를 다룹니다.
2.6.1. Leex
Leex는 Erlang 렉서 생성기입니다. 렉서 생성기는 정의 파일 xrl에서 DFA의 기술을 받아, 그 DFA가 기술하는 토큰을 매칭하는 Erlang 프로그램을 생성합니다.
토크나이저용 DFA 정의를 작성하는 방법의 세부 사항은 이 책의 범위를 벗어납니다. 자세한 설명은 "Dragon book"([DragonBook])을 추천합니다. 그 밖의 좋은 자료로는 leex에 영감을 준 렉서 프로그램인 flex의 man 및 info 항목과 leex 문서 자체가 있습니다. info와 flex가 설치되어 있다면 다음과 같이 입력하여 전체 매뉴얼을 읽을 수 있습니다:
> info flex
온라인 Erlang 문서에는 leex 매뉴얼도 있습니다(yecc.html 참조).
렉서 생성기를 사용하면 JSON 토큰을 인식하는 Erlang 프로그램을 만들 수 있습니다. JSON 정의 http://www.ecma-international.org/publications/files/ECMA-ST/ECMA-404.pdf 를 살펴보면 처리해야 할 토큰이 몇 가지뿐이라는 것을 알 수 있습니다.
Definitions.

Digit         = [0-9]
Digit1to9     = [1-9]
HexDigit      = [0-9a-f]
UnescapedChar = [^\"\\]
EscapedChar   = (\\\\)|(\\\")|(\\b)|(\\f)|(\\n)|(\\r)|(\\t)|(\\/)
Unicode       = (\\u{HexDigit}{HexDigit}{HexDigit}{HexDigit})
Quote         = [\"]
Delim         = [\[\]:,{}]
Space         = [\n\s\t\r]

Rules.

{Quote}{Quote} : {token, {string, TokenLine, ""}}.
{Quote}({EscapedChar}|({UnescapedChar})|({Unicode}))+{Quote} :
  {token, {string, TokenLine, drop_quotes(TokenChars)}}.

null  : {token, {null,  TokenLine}}.
true  : {token, {true,  TokenLine}}.
false : {token, {false, TokenLine}}.

{Delim} : {token, {list_to_atom(TokenChars), TokenLine}}.

{Space} : skip_token.

-?{Digit1to9}+{Digit}*\.{Digit}+((E|e)(\+|\-)?{Digit}+)? :
  {token, {number, TokenLine, list_to_float(TokenChars)}}.
-?{Digit1to9}+{Digit}* :
  {token, {number, TokenLine, list_to_integer(TokenChars)+0.0}}.

Erlang code.
-export([t/0]).

drop_quotes([$" | QuotedString]) -> literal(lists:droplast(QuotedString)).
literal([$\\,$" | Rest]) ->
  [$"|literal(Rest)];
literal([$\\,$\\ | Rest]) ->
  [$\\|literal(Rest)];
literal([$\\,$/ | Rest]) ->
  [$/|literal(Rest)];
literal([$\\,$b | Rest]) ->
  [$\b|literal(Rest)];
literal([$\\,$f | Rest]) ->
  [$\f|literal(Rest)];
literal([$\\,$n | Rest]) ->
  [$\n|literal(Rest)];
literal([$\\,$r | Rest]) ->
  [$\r|literal(Rest)];
literal([$\\,$t | Rest]) ->
  [$\t|literal(Rest)];
literal([$\\,$u,D0,D1,D2,D3|Rest]) ->
  Char = list_to_integer([D0,D1,D2,D3],16),
  [Char|literal(Rest)];
literal([C|Rest]) ->
  [C|literal(Rest)];
literal([]) ->[].

t() ->
  {ok,
   [{'{',1},
    {string,2,"no"},
    {':',2},
    {number,2,1.0},
    {'}',3}
   ],
   4}.
Leex 컴파일러를 사용하면 이 DFA를 Erlang 코드로 컴파일할 수 있으며, dfa_graph 옵션을 지정하면 Graphviz 등으로 볼 수 있는 dot 파일도 함께 생성할 수 있습니다.
1> leex:file(json_tokens, [dfa_graph]).
{ok, "./json_tokens.erl"}
2>
예를 들어 dotty를 사용하면 DFA 그래프(Figure 8)를 볼 수 있습니다:
> dotty json_tokens.dot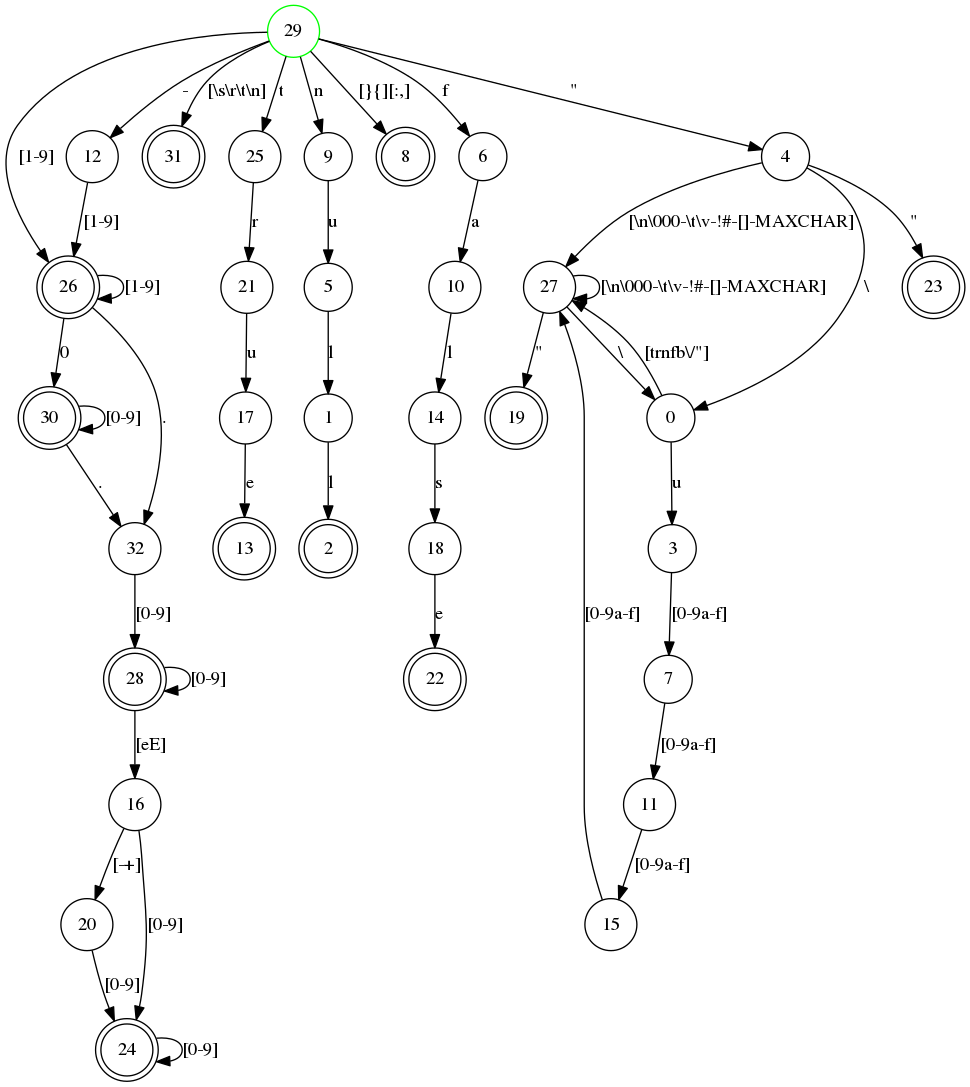
예제 JSON 파일(test.json)로 우리 토크나이저를 시험해 볼 수 있습니다.
{
    "no" : 1,
    "name"  : "Jack \"Bee\" Nimble",
    "escapes" : "\b\n\r\t\f\//\\",
    "format": {
        "type"      : "rect",
        "widths"    : [1920,1600],
        "height"    : -1080,
        "interlace" : false,
        "unicode"   : "\u002f",
        "frame rate": 4.5
    }
}
먼저 토크나이저를 컴파일한 다음, 파일을 읽어 문자열로 변환해야 합니다. 마지막으로 leex가 생성하는 string/1 함수를 사용하여 테스트 파일을 토큰화할 수 있습니다.
2> c(json_tokens).
{ok,json_tokens}.
3> f(File), f(L), {ok, File} = file:read_file("test.json"), L = binary_to_list(File), ok.
ok
4> f(Tokens), {ok, Tokens,_} = json_tokens:string(L), hd(Tokens).
{'{',1}
5>
셸 함수 f/1은 셸이 변수 바인딩을 잊도록 합니다. 이 함수는 변수를 바인딩하는 명령을 여러 번 실행해 보고 싶을 때 유용합니다. 예를 들어 렉서를 작성하면서 코드를 고칠 때마다 실행해 보고 싶은 경우가 그렇습니다. 셸 명령은 뒤의 장에서 자세히 살펴보겠습니다.
JSON 토크나이저를 갖추었으니 이제 파서 생성기 Yecc를 사용하여 json 파서를 작성할 수 있습니다.
2.6.2. Yecc
Yecc는 Erlang용 파서 생성기입니다. 이 이름은 C의 대표적인 파서 생성기인 Yacc(Yet Another Compiler Compiler, 또 하나의 컴파일러 컴파일러)에서 유래했습니다. 이에 해당하는 현대의 오픈 소스 도구는 Bison이며, 흔히 Flex와 함께 사용됩니다.
이제 JSON 텀을 위한 렉서가 있으므로 yecc를 사용하여 파서를 작성할 수 있습니다.
Nonterminals value values object array pair pairs.

Terminals number string true false null '[' ']' '{' '}' ',' ':'.

Rootsymbol value.

value -> object  :  '$1'.
value -> array   :  '$1'.
value -> number  :  get_val('$1').
value -> string  :  get_val('$1').
value -> 'true'  :  get_val('$1').
value -> 'null'  :  get_val('$1').
value -> 'false' :  get_val('$1').

object -> '{' '}' : #{}.
object -> '{' pairs '}' : '$2'.

pairs -> pair : '$1'.
pairs -> pair ',' pairs : maps:merge('$1', '$3').

pair -> string ':' value : #{ get_val('$1') => '$3' }.

array -> '[' ']' : {}.
array -> '[' values ']' : list_to_tuple('$2').

values -> value : [ '$1' ].
values -> value ',' values : [ '$1' | '$3' ].


Erlang code.

get_val({_,_,Val}) -> Val;
get_val({Val, _}) -> Val.
그런 다음 yecc를 사용하여 파서를 구현하는 Erlang 프로그램을 생성하고, 토크나이저가 생성한 토큰을 인수로 전달하여 제공된 parse/1 함수를 호출할 수 있습니다.
5> yecc:file(yecc_json_parser), c(yecc_json_parser).
{ok,yexx_json_parser}
6> f(Json), {ok, Json} = yecc_json_parser:parse(Tokens).
{ok,#{"escapes" => "\b\n\r\t\f////",
      "format" => #{"frame rate" => 4.5,
        "height" => -1080.0,
        "interlace" => false,
        "type" => "rect",
        "unicode" => "/",
        "widths" => {1920.0,1.6e3}},
       "name" => "Jack \"Bee\" Nimble",
       "no" => 1.0}}
Leex와 Yecc 도구는 직접 만든 완전한 언어를 Erlang 가상 머신용으로 컴파일하려 할 때 유용합니다. 이 도구들을 Syntax tools, 특히 Merl과 함께 사용하면 Erlang 추상 구문 트리를 조작하여 Erlang 코드를 생성하거나 Erlang 코드의 동작을 바꿀 수 있습니다.
2.7. Syntax Tools와 Merl
Syntax Tools는 Erlang 추상 구문 트리(AST)의 내부 표현을 다루기 위한 라이브러리 모음입니다.
syntax tools 애플리케이션에는 메타프로그래밍 유틸리티인 Merl도 포함되어 있습니다. Merl을 사용하면 구문 트리를 매우 쉽게 조작할 수 있고, Erlang 코드로 파스 트랜스폼(parse transform)을 작성할 수 있습니다.
Syntax Tools 문서는 Erlang.org 사이트에서 찾을 수 있습니다: http://erlang.org/doc/apps/syntax_tools/chapter.html.
2.8. Elixir 컴파일하기
BEAM 위에 자신만의 언어를 작성하는 또 다른 방법은 Elixir의 매크로 프로그래밍 기능을 사용하는 것입니다. Elixir는 Erlang 추상 구문 트리를 거쳐 BEAM 코드로 컴파일됩니다.
Elixir의 defmacro를 사용하면 Elixir 안에서 직접 자신만의 도메인 특화 언어(Domain Specific Language)를 정의할 수 있습니다.
3. 프로세스
경량 프로세스라는 개념은 Erlang과 BEAM의 본질이며, BEAM을 다른 가상 머신과 구별 짓는 요소입니다. BEAM(그리고 Erlang과 Elixir)이 어떻게 동작하는지 이해하려면 프로세스가 어떻게 동작하는지 자세히 알아야 합니다. 이를 알면 프로세스에게 무엇이 쉽고 비용이 적게 들며 무엇이 어렵고 비용이 많이 드는지를 비롯하여 BEAM의 핵심 개념을 이해하는 데 도움이 됩니다.
BEAM의 거의 모든 것은 프로세스라는 개념과 연결되어 있으며, 이 장에서는 이러한 연결 관계에 대해 더 자세히 알아보겠습니다. 서론에서 배운 내용을 확장하여 메모리 관리, 메시지 전달, 그리고 특히 스케줄링과 같은 개념을 더 깊이 살펴보겠습니다.
Erlang 프로세스는 OS 프로세스와 매우 유사합니다. Erlang 프로세스는 자체 주소 공간을 가지며, 시그널과 메시지를 통해 다른 프로세스와 통신할 수 있고, 실행은 선점형 스케줄러가 제어합니다.
Erlang이나 Elixir 시스템에서 성능 문제가 발생하면, 그 문제는 대개 특정 프로세스 내부의 문제나 프로세스 간 불균형에서 비롯됩니다. 물론 잘못된 알고리즘이나 메모리 문제와 같은 다른 흔한 문제도 있으며, 이는 다른 장에서 살펴보겠습니다. 그렇더라도 문제를 일으키는 프로세스를 정확히 짚어 낼 수 있는 것은 언제나 중요하므로, 프로세스 검사를 위해 Erlang 런타임 시스템에서 제공하는 도구들을 살펴보겠습니다.
이 장에서는 프로세스와 스케줄러가 어떻게 동작하는지 살펴보면서 도구들을 차례로 소개하고, 마지막에는 모든 도구를 함께 활용하는 실습을 진행하겠습니다.
3.1. 프로세스란 무엇입니까?
프로세스는 코드가 실행되는 격리된 개체입니다. 프로세스는 오류의 영향을 결함이 있는 코드를 실행하는 프로세스 안으로 국한함으로써 코드의 오류로부터 시스템을 보호합니다.
런타임에는 프로세스를 검사하는 여러 도구가 함께 제공되며, 이를 통해 병목 지점, 문제, 자원의 과도한 사용을 찾을 수 있습니다. 이러한 도구는 문제가 있는 프로세스를 식별하고 검사하는 데 도움이 됩니다.
3.1.1. 셸에서 프로세스 목록 조회하기
바로 본론으로 들어가서 실행 중인 시스템에 어떤 프로세스가 있는지 살펴봅시다. 가장 쉬운 방법은 Erlang 셸을 시작하고 셸 명령 i()를 실행하는 것입니다. Elixir에서는 shell_default 모듈의 함수를 :shell_default.i로 호출할 수 있습니다.
$ erl
Erlang/OTP 19 [erts-8.1] [source] [64-bit] [smp:4:4] [async-threads:10]
               [kernel-poll:false]

Eshell V8.1  (abort with ^G)
1> i().
Pid                   Initial Call                     Heap     Reds Msgs
Registered            Current Function                 Stack
<0.0.0>               otp_ring0:start/2                 376      579    0
init                  init:loop/1                         2
<0.1.0>               erts_code_purger:start/0          233        4    0
erts_code_purger      erts_code_purger:loop/0             3
<0.4.0>               erlang:apply/2                    987   100084    0
erl_prim_loader       erl_prim_loader:loop/3              5
<0.30.0>              gen_event:init_it/6               610      226    0
error_logger          gen_event:fetch_msg/5               8
<0.31.0>              erlang:apply/2                   1598      416    0
application_controlle gen_server:loop/6                   7
<0.33.0>              application_master:init/4         233       64    0
                      application_master:main_loop/2      6
<0.34.0>              application_master:start_it/4     233       59    0
                      application_master:loop_it/4        5
<0.35.0>              supervisor:kernel/1               610     1767    0
kernel_sup            gen_server:loop/6                   9
<0.36.0>              erlang:apply/2                   6772    73914    0
code_server           code_server:loop/1                  3
<0.38.0>              rpc:init/1                        233       21    0
rex                   gen_server:loop/6                   9
<0.39.0>              global:init/1                     233       44    0
global_name_server    gen_server:loop/6                   9
<0.40.0>              erlang:apply/2                    233       21    0
                      global:loop_the_locker/1            5
<0.41.0>              erlang:apply/2                    233        3    0
                      global:loop_the_registrar/0         2
<0.42.0>              inet_db:init/1                    233      209    0
inet_db               gen_server:loop/6                   9
<0.44.0>              global_group:init/1               233       55    0
global_group          gen_server:loop/6                   9
<0.45.0>              file_server:init/1                233       79    0
file_server_2         gen_server:loop/6                   9
<0.46.0>              supervisor_bridge:standard_error/ 233       34    0
standard_error_sup    gen_server:loop/6                   9
<0.47.0>              erlang:apply/2                    233       10    0
standard_error        standard_error:server_loop/1        2
<0.48.0>              supervisor_bridge:user_sup/1      233       54    0
                      gen_server:loop/6                   9
<0.49.0>              user_drv:server/2                 987     1975    0
user_drv              user_drv:server_loop/6              9
<0.50.0>              group:server/3                    233       40    0
user                  group:server_loop/3                 4
<0.51.0>              group:server/3                    987    12508    0
                      group:server_loop/3                 4
<0.52.0>              erlang:apply/2                   4185     9537    0
                      shell:shell_rep/4                  17
<0.53.0>              kernel_config:init/1              233      255    0
                      gen_server:loop/6                   9
<0.54.0>              supervisor:kernel/1               233       56    0
kernel_safe_sup       gen_server:loop/6                   9
<0.58.0>              erlang:apply/2                   2586    18849    0
                      c:pinfo/1                          50
Total                                                 23426   220863    0
                                                        222
ok
i/0 함수는 시스템에 있는 모든 프로세스의 목록을 출력합니다. 각 프로세스마다 두 줄의 정보가 표시됩니다. 출력의 처음 두 줄은 각 정보가 무엇을 의미하는지 알려 주는 헤더입니다. 보시다시피 프로세스 ID(Pid)와 프로세스 이름(있는 경우)뿐 아니라, 프로세스가 시작된 코드와 현재 실행 중인 코드에 관한 정보도 얻을 수 있습니다. 또한 힙과 스택의 크기, 그리고 프로세스의 리덕션 수와 메시지 수에 관한 정보도 얻을 수 있습니다. 이 장의 나머지 부분에서는 스택, 힙, 리덕션, 메시지가 무엇인지 자세히 알아보겠습니다. 지금은 힙 크기의 수치가 크면 프로세스가 메모리를 많이 사용하고 있고, 리덕션 수치가 크면 프로세스가 많은 코드를 실행했다고 간단히 가정해도 됩니다.
i/3 함수를 사용하면 프로세스를 더 자세히 살펴볼 수 있습니다. code_server 프로세스를 살펴봅시다. 앞의 목록에서 code_server의 프로세스 식별자(pid)가 <0.36.0>임을 확인할 수 있습니다. pid의 세 숫자를 인자로 i/3을 호출하면 다음 정보를 얻을 수 있습니다:
2> i(0,36,0).
[{registered_name,code_server},
 {current_function,{code_server,loop,1}},
 {initial_call,{erlang,apply,2}},
 {status,waiting},
 {message_queue_len,0},
 {messages,[]},
 {links,[<0.35.0>]},
 {dictionary,[]},
 {trap_exit,true},
 {error_handler,error_handler},
 {priority,normal},
 {group_leader,<0.33.0>},
 {total_heap_size,46422},
 {heap_size,46422},
 {stack_size,3},
 {reductions,93418},
 {garbage_collection,[{max_heap_size,#{error_logger => true,
                                       kill => true,
                                       size => 0}},
                      {min_bin_vheap_size,46422},
                      {min_heap_size,233},
                      {fullsweep_after,65535},
                      {minor_gcs,0}]},
 {suspending,[]}]
3>
이 호출로 많은 정보를 얻었으며, 이 장의 나머지 부분에서는 이 항목들 대부분이 무엇을 의미하는지 자세히 알아보겠습니다. 첫 번째 줄은 이 프로세스에 code_server라는 이름이 부여되었음을 알려 줍니다. 다음으로 프로세스가 현재 실행 중이거나 일시 중단된 함수(current_function)와 프로세스가 실행을 시작한 함수의 이름(initial_call)을 확인할 수 있습니다.
또한 프로세스가 메시지를 기다리며 일시 중단되어 있고({status,waiting}) 메일박스에 메시지가 없다는 것({message_queue_len,0}, {messages,[]})도 확인할 수 있습니다. 메시지 전달이 어떻게 동작하는지는 이 장의 뒷부분에서 더 자세히 살펴보겠습니다.
priority, suspending, reductions, links, trap_exit, error_handler, group_leader 필드는 프로세스 실행, 오류 처리, IO를 제어합니다. 이에 대해서는 Observer를 소개할 때 좀 더 자세히 살펴보겠습니다.
마지막 몇 개의 필드(dictionary, total_heap_size, heap_size, stack_size, garbage_collection)는 프로세스의 메모리 사용량에 관한 정보를 제공합니다. 프로세스 메모리 영역은 Chapter 11 장에서 자세히 살펴보겠습니다.
프로세스 정보를 얻는 또 다른 방법으로, 이보다 훨씬 더 침습적인 방법은 BREAK 메뉴에서 제공하는 프로세스 정보를 사용하는 것입니다: Ctrl+c p [enter]. BREAK 상태에 있는 동안에는 노드 전체가 멈춘다는 점에 유의하십시오.
3.1.2. 프로그래밍 방식의 프로세스 조사
셸 함수는 프로세스에 관한 정보를 출력하기만 하지만, 실제로는 이 정보를 데이터로 얻을 수 있으므로 프로세스를 검사하는 도구를 직접 작성할 수 있습니다. erlang:processes/0로 모든 프로세스의 목록을 얻을 수 있고, erlang:process_info/1로 특정 프로세스에 관한 정보를 얻을 수 있습니다. 또한 whereis/1 함수를 사용하여 이름으로 pid를 얻을 수도 있습니다:
1> Ps = erlang:processes().
[<0.0.0>,<0.1.0>,<0.4.0>,<0.30.0>,<0.31.0>,<0.33.0>,
 <0.34.0>,<0.35.0>,<0.36.0>,<0.38.0>,<0.39.0>,<0.40.0>,
 <0.41.0>,<0.42.0>,<0.44.0>,<0.45.0>,<0.46.0>,<0.47.0>,
 <0.48.0>,<0.49.0>,<0.50.0>,<0.51.0>,<0.52.0>,<0.53.0>,
 <0.54.0>,<0.60.0>]
2> CodeServerPid = whereis(code_server).
<0.36.0>
3> erlang:process_info(CodeServerPid).
[{registered_name,code_server},
 {current_function,{code_server,loop,1}},
 {initial_call,{erlang,apply,2}},
 {status,waiting},
 {message_queue_len,0},
 {messages,[]},
 {links,[<0.35.0>]},
 {dictionary,[]},
 {trap_exit,true},
 {error_handler,error_handler},
 {priority,normal},
 {group_leader,<0.33.0>},
 {total_heap_size,24503},
 {heap_size,6772},
 {stack_size,3},
 {reductions,74260},
 {garbage_collection,[{max_heap_size,#{error_logger => true,
                                       kill => true,
                                       size => 0}},
                      {min_bin_vheap_size,46422},
                      {min_heap_size,233},
                      {fullsweep_after,65535},
                      {minor_gcs,33}]},
 {suspending,[]}]
프로세스 정보를 데이터로 얻으면 그 데이터를 원하는 대로 분석하거나 정렬하는 코드를 작성할 수 있습니다. 시스템의 모든 프로세스를 가져온 다음(erlang:processes/0 사용) 각 프로세스의 힙 크기 정보를 얻으면(erlang:process_info(P, total_heap_size) 사용), pid와 힙 크기로 이루어진 리스트를 만들어 힙 크기 기준으로 정렬할 수 있습니다:
1> lists:reverse(lists:keysort(2,[{P,element(2,
    erlang:process_info(P,total_heap_size))}
    || P <- erlang:processes()])).
[{<0.36.0>,24503},
 {<0.52.0>,21916},
 {<0.4.0>,12556},
 {<0.58.0>,4184},
 {<0.51.0>,4184},
 {<0.31.0>,3196},
 {<0.49.0>,2586},
 {<0.35.0>,1597},
 {<0.30.0>,986},
 {<0.0.0>,752},
 {<0.33.0>,609},
 {<0.54.0>,233},
 {<0.53.0>,233},
 {<0.50.0>,233},
 {<0.48.0>,233},
 {<0.47.0>,233},
 {<0.46.0>,233},
 {<0.45.0>,233},
 {<0.44.0>,233},
 {<0.42.0>,233},
 {<0.41.0>,233},
 {<0.40.0>,233},
 {<0.39.0>,233},
 {<0.38.0>,233},
 {<0.34.0>,233},
 {<0.1.0>,233}]
2>
많은 프로세스의 힙 크기가 233워드라는 것을 볼 수 있을 텐데, 이는 233워드가 프로세스의 기본 시작 힙 크기이기 때문입니다.
process_info/2로 얻을 수 있는 정보에 대한 전체 설명은 erlang 모듈의 문서를 참고하십시오: https://erlang.org/doc/apps/erts/erlang.html#process_info/2 process_info/1 함수는 프로세스에 대해 얻을 수 있는 전체 정보 중 일부만 반환하며, 추가 정보는 process_info/2 함수로 가져올 수 있다는 점에 주목하십시오. 예를 들어, 위의 code_server 프로세스에서 backtrace를 추출하려면 다음을 실행하면 됩니다:
3> process_info(whereis(code_server), backtrace).
{backtrace,<<"Program counter: 0x00000000161de900 (code_server:loop/1 + 152)\nCP: 0x0000000000000000 (invalid)\narity = 0\n\n0"...>>}
위 바이너리 끝에 있는 점 세 개가 보이십니까? 이는 출력이 잘렸다는 뜻입니다. 전체 값을 보는 유용한 방법은 위의 함수 호출을 rp/1 함수로 감싸는 것입니다:
4> rp(process_info(whereis(code_server), backtrace)).다른 방법으로, 다음과 같이 io:put_chars/1 함수를 사용할 수도 있습니다:
5> {backtrace, Backtrace} = process_info(whereis(code_server), backtrace).
{backtrace,<<"Program counter: 0x00000000161de900 (code_server:loop/1 + 152)\nCP: 0x0000000000000000 (invalid)\narity = 0\n\n0"...>>}
6> io:put_chars(Backtrace).
출력이 장황하여 4> 명령과 6> 명령의 출력은 여기에 싣지 않았지만, 위 명령을 Erlang 셸에서 직접 실행해 보십시오.
3.1.3. Observer로 프로세스 살펴보기
프로세스를 살펴보는 세 번째 방법은 Observer를 사용하는 것입니다. Observer는 Erlang 런타임 시스템을 살펴볼 수 있는 폭넓은 그래픽 인터페이스입니다. 이 책 전반에 걸쳐 Observer를 사용하여 시스템의 여러 측면을 살펴보겠습니다.
Observer를 시작하려면 Erlang이 WxWidgets 지원을 포함하여 컴파일되어 있어야 하며, 노드에서 observer와 wx 애플리케이션을 사용할 수 있어야 합니다. 프로덕션 시스템에는 이러한 구성을 원하지 않으실 가능성이 높지만, Observer는 바로 이 점을 염두에 두고 만들어졌습니다. Observer 지원을 포함하여 빌드된 Erlang에서 Observer를 시작한 다음, “Nodes” 메뉴로 들어가 “Connect node” 항목을 선택하면 로컬 노드 대신 연결된 노드를 관찰할 수 있습니다.
|
지금은 다음과 같이 Erlang 셸에서 Observer를 시작하기만 하겠습니다:
7> observer:start().또는 Elixir 셸에서 :observer.start로 실행할 수도 있습니다. 실행 중인 시스템을 디버깅할 때는 Observer 실행만을 위한 임시 Erlang 노드를 띄우고, 검사 대상 노드가 옵저버 노드를 볼 수 없도록 -hidden 플래그를 사용하는 것이 좋습니다.
$ erl -hidden -sname observer -run observerObserver를 시작하면 다음 스크린샷과 같이 시스템 개요가 표시됩니다.
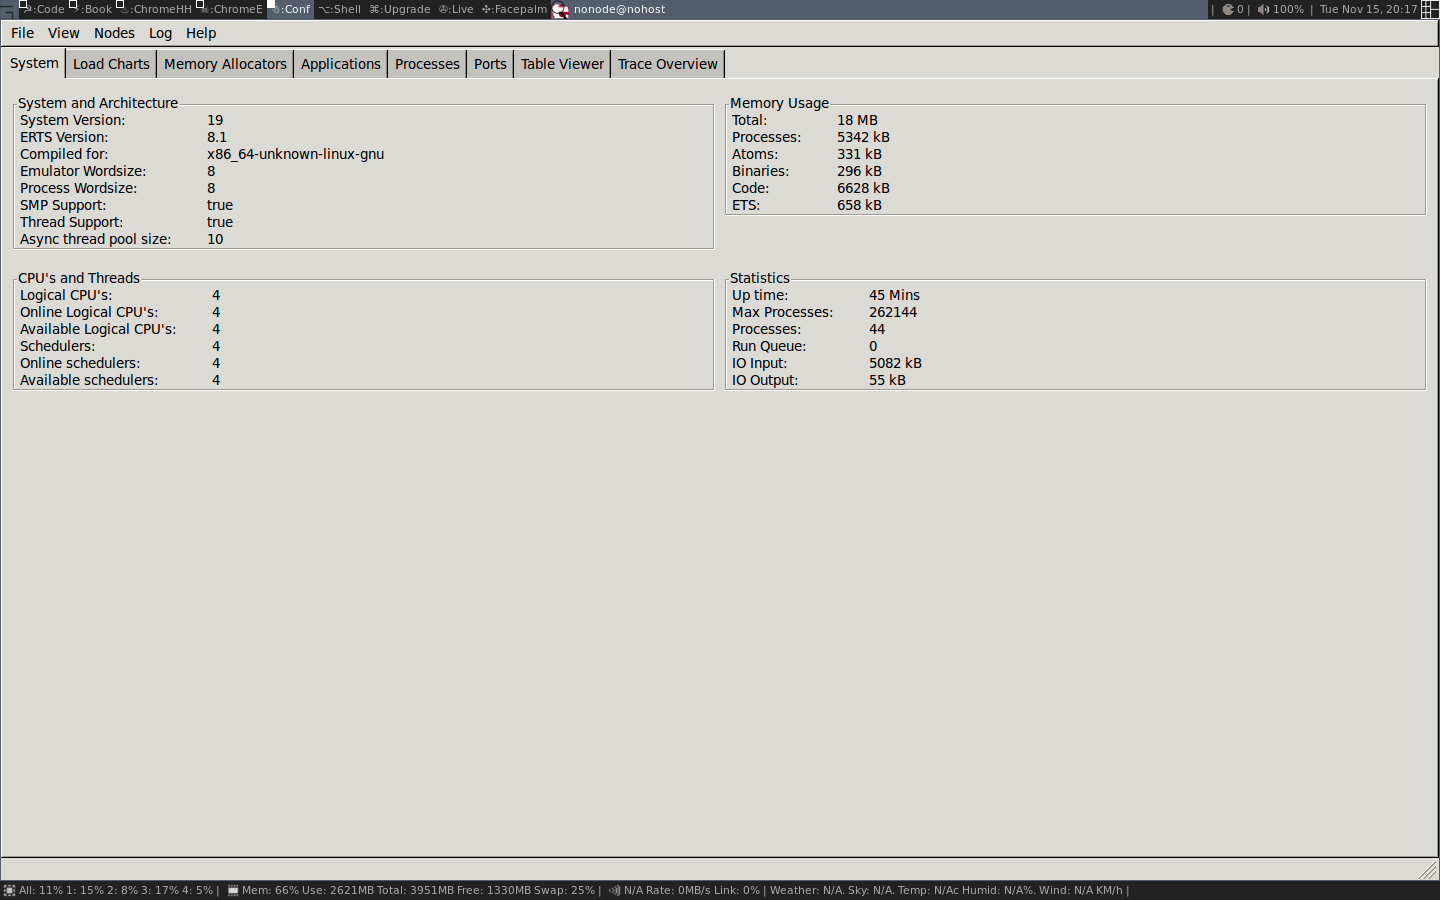
이 정보 중 일부는 이 장의 뒷부분과 다음 장에서 자세히 살펴보겠습니다. 지금은 Observer를 사용하여 실행 중인 프로세스를 살펴보기만 하겠습니다. 먼저 실행 중인 시스템의 슈퍼비전 트리를 보여 주는 Applications 탭을 살펴보겠습니다:
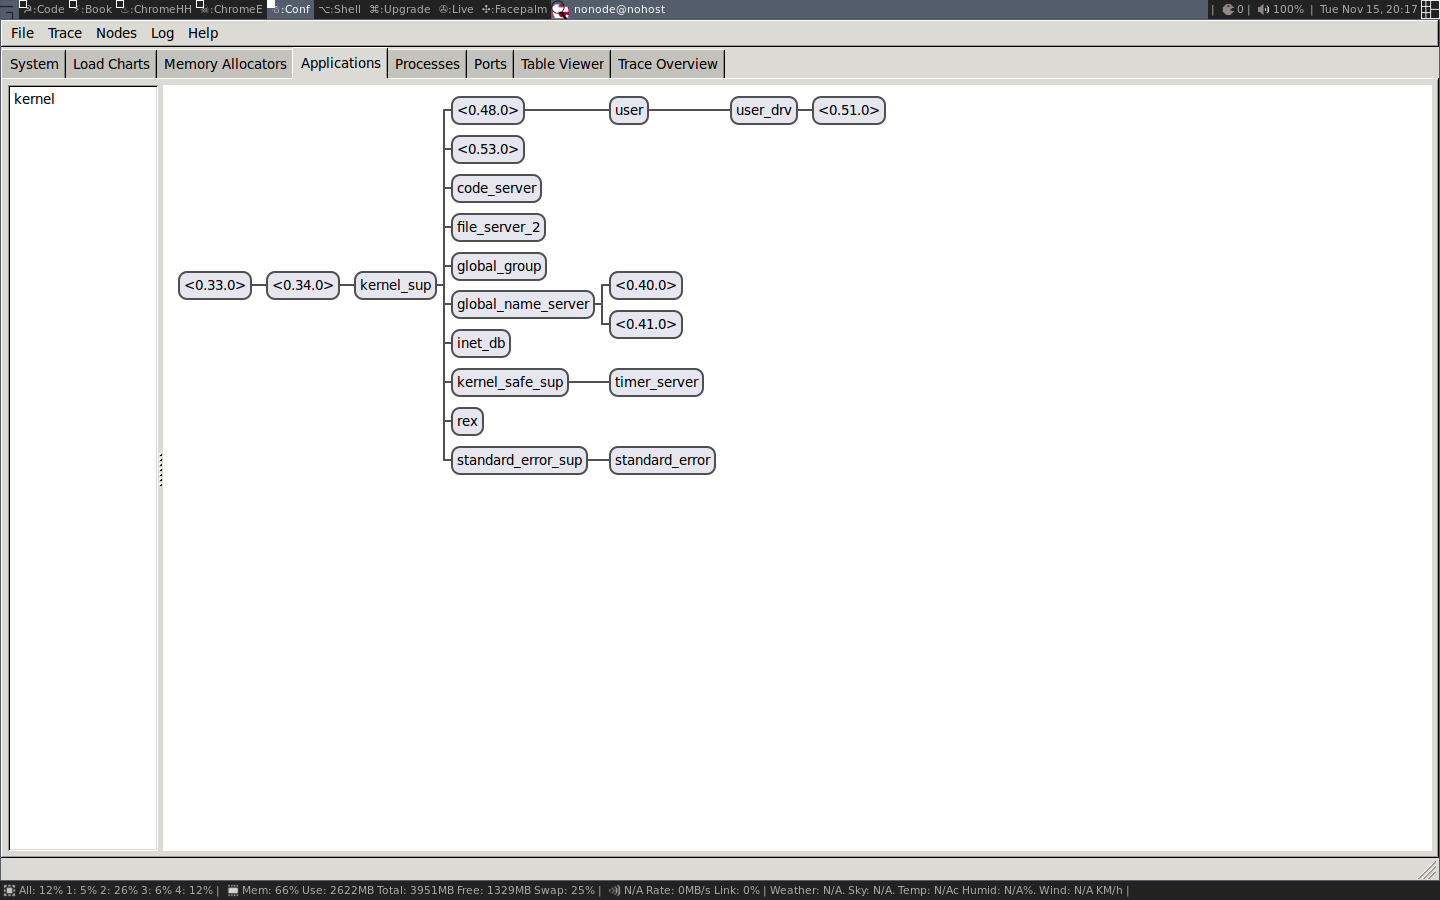
여기서는 프로세스들이 어떻게 링크되어 있는지 그래픽으로 볼 수 있습니다. 이는 시스템이 어떻게 구성되어 있는지 한눈에 파악할 수 있는 아주 좋은 방법입니다. 또한 프로세스들이 링크를 통해 서로 연결된 채 공간에 떠 있는 고립된 개체라는 느낌도 잘 받을 수 있습니다.
프로세스에 관한 실질적으로 유용한 정보를 얻기 위해 Processes 탭으로 전환합니다:
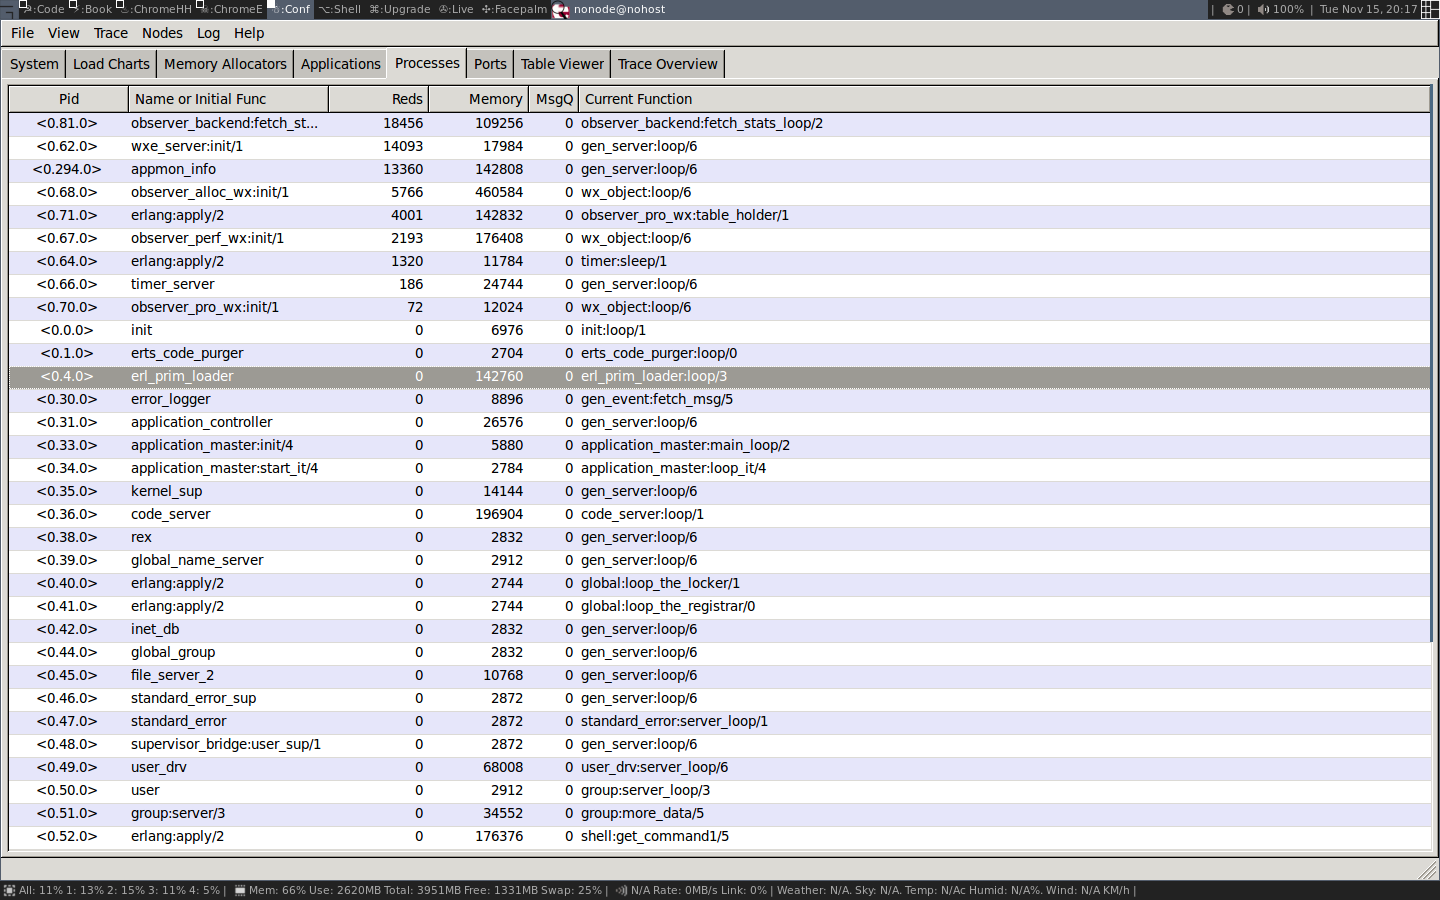
이 화면에서는 셸에서 i/0을 실행했을 때와 기본적으로 같은 정보를 얻을 수 있습니다. pid, 등록된 이름, 리덕션 수, 메모리 사용량, 메시지 수, 현재 함수를 볼 수 있습니다.
또한 코드 서버처럼 프로세스의 행을 더블 클릭하면 해당 프로세스를 자세히 살펴볼 수 있으며, process_info/2로 얻을 수 있는 것과 같은 종류의 정보를 확인할 수 있습니다:
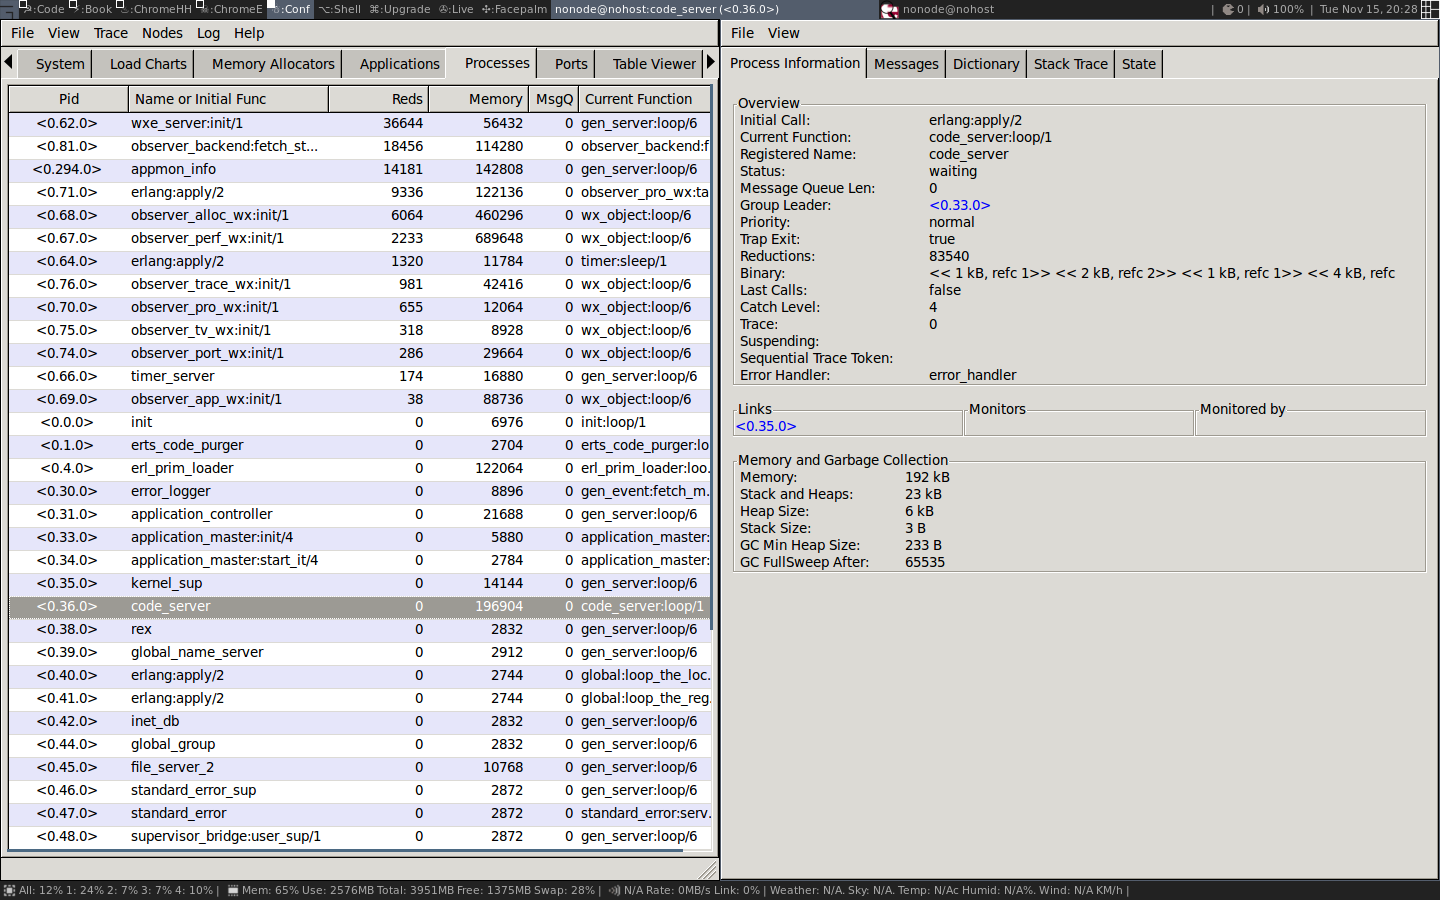
이 모든 정보가 무엇을 의미하는지 지금 당장 살펴보지는 않겠지만, 계속 읽어 나가다 보면 결국 모든 것이 밝혀질 것입니다.
이제 프로세스가 무엇인지 기본적으로 이해했고 시스템에서 프로세스를 찾아 검사할 수 있는 도구도 몇 가지 갖추었으니, 프로세스가 어떻게 구현되는지 더 깊이 살펴볼 준비가 되었습니다.
3.2. 프로세스는 메모리일 뿐입니다
프로세스는 기본적으로 네 개의 메모리 블록, 즉 스택, 힙, 메시지 영역, 그리고 프로세스 제어 블록(PCB)으로 구성됩니다.
스택은 반환 주소를 저장하여 프로그램 실행을 추적하고, 함수에 인자를 전달하며, 지역 변수를 보관하는 데 사용됩니다. 리스트나 튜플 같은 더 큰 구조는 힙에 저장됩니다.
메시지 영역은 메일박스라고도 하며, 다른 프로세스가 해당 프로세스에 보낸 메시지를 저장하는 데 사용됩니다. 프로세스 제어 블록은 프로세스의 상태를 추적하는 데 사용됩니다.
프로세스를 메모리로 나타낸 그림은 Figure 9을 참조하십시오.
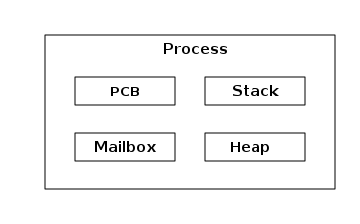
이 프로세스 그림은 매우 단순화한 것이며, 더 정확한 그림에 이르기 위해 점점 더 정교해지는 여러 버전을 차례로 살펴보겠습니다.
스택, 힙, 메일박스는 모두 동적으로 할당되며 필요에 따라 커지거나 줄어들 수 있습니다. 이것이 정확히 어떻게 동작하는지는 이후 장에서 살펴보겠습니다. 반면 PCB는 정적으로 할당되며 프로세스를 제어하는 여러 필드를 포함합니다.
내장 인트로스펙션 호출을 사용하면 이러한 메모리 영역 중 일부를 살펴볼 수 있습니다. 예를 들어 erlang:process_info/2 함수를 사용하면 프로세스에 stack_size, heap_size, total_heap_size 또는 원시 backtrace 바이너리를 요청할 수 있으며, current_stacktrace 항목은 스택을 {M,F,A,Location} 튜플로 이루어진 구조화된 리스트로 반환하므로 직접 패턴 매칭하거나 보기 좋게 출력할 수 있습니다. 셸 헬퍼 c:bt(Pid) 함수는 erlang:process_display(Pid, backtrace) 호출을 감싼 편의용 래퍼일 뿐입니다. 이러한 조회를 memory 또는 reductions 같은 process_info 항목과 함께 사용하면 프로세스의 스택, 힙, 그리고 PCB와 유사한 필드를 살펴볼 수 있습니다.
더 깊은 바이트 수준에서 살펴보려면 런타임에 함께 제공되는 Emulator Toolbox for Pathologists (ETP)—일시 정지된 가상 머신이나 코어 덤프에서 살아 있는 BEAM 데이터 구조를 순회하는 GDB 매크로 모음(etp-stackdump, etp-heapdump, etp-process-info 등)—을 사용할 수 있습니다.
ETP를 지원하는 Erlang 런타임 시스템의 디버그 버전을 빌드하는 방법에 대한 자세한 내용은 Appendix A를 참조하십시오.
erlang:process_display/2로 프로세스 스택의 컨텍스트를 확인할 수 있습니다:
1> erlang:process_display(self(), backtrace).
Program counter: 0x00007fdf9baa2e78 (erlang:self/0 + 32)

0x00007fdedf247480 Return addr 0x00007fdf9baa2118 (erlang:process_display/2 + 128)
y(0)     []
y(1)     backtrace
y(2)     <0.89.0>

0x00007fdedf2474a0 Return addr 0x00007fdf9bbb7644 (erl_eval:do_apply/7 + 308)
y(0)     none
y(1)     []

0x00007fdedf2474b8 Return addr 0x00007fdf9bf0e430 (shell:exprs/7 + 536)
y(0)     []
y(1)     []
y(2)     []
y(3)     []
y(4)     cmd
y(5)     []
y(6)     {value,#Fun<shell.5.46532814>}
y(7)     {eval,#Fun<shell.23.46532814>}
y(8)     #Ref<0.908573933.3456499713.143140>
y(9)     []

0x00007fdedf247510 Return addr 0x00007fdf9bf0dc60 (shell:eval_exprs/7 + 152)
y(0)     []
y(1)     []
y(2)     []
y(3)     []
y(4)     <0.88.0>
y(5)     Catch 0x00007fdf9bf0dd0e (shell:eval_exprs/7 + 326)

0x00007fdedf247548 Return addr 0x00007fdf9bf0d87c (shell:eval_loop/4 + 564)
y(0)     #Ref<0.908573933.3456499713.143140>
y(1)     #Ref<0.908573933.3456499713.143160>
y(2)     <0.88.0>

0x00007fdedf247568 Return addr 0x00007fdf9ba2d1f8 (<terminate process normally>)
true
스택과 힙에 있는 값들은 Chapter 4에서 더 자세히 살펴보겠습니다.
RTP와 디버그 버전의 BEAM을 사용하면 프로세스의 힙을 검사할 수 있습니다.
디버그 버전을 빌드했다고 가정하면 다음과 같습니다.
$ERL_TOP/bin/cerl -debug -rgdb
GNU gdb (Ubuntu 15.0.50.20240403-0ubuntu1) 15.0.50.20240403-git
...
Reading symbols from beam.debug.smp...
%---------------------------------------------------------------------------
% Use etp-help for a command overview and general help.
%
% To use the Erlang support module, the environment variable ROOTDIR
% must be set to the toplevel installation directory of Erlang/OTP,
% so the etp-commands file becomes:
%     $ROOTDIR/erts/etc/unix/etp-commands
% Also, erl and erlc must be in the path.
%---------------------------------------------------------------------------
etp-set-max-depth 20
etp-set-max-string-length 100
--------------- System Information ---------------
OTP release: 24
ERTS version: 12.3.2.17
Arch: x86_64-pc-linux-gnu
Endianness: Little
Word size: 64-bit
BeamAsm support: yes
--Type <RET> for more, q to quit, c to continue without paging--
SMP support: yes
Thread support: yes
Kernel poll: Supported
Debug compiled: yes
Lock checking: yes
Lock counting: no
System not initialized
--------------------------------------------------
그런 다음 run으로 BEAM을 시작할 수 있습니다.
(gdb) run
Starting program: /home/happi/hh/theBeamBook/otp24/bin/x86_64-pc-linux-gnu/beam.debug.smp -- -root /home/happi/hh/theBeamBook/otp24 -progname /home/happi/hh/theBeamBook/otp24/bin/cerl -debug -- -home /home/happi -- -emu_type debug

This GDB supports auto-downloading debuginfo from the following URLs:
  <https://debuginfod.ubuntu.com>
Enable debuginfod for this session? (y or [n]) y
Debuginfod has been enabled.
To make this setting permanent, add 'set debuginfod enabled on' to .gdbinit.
warning: could not find '.gnu_debugaltlink' file for /lib/x86_64-linux-gnu/libtinfo.so.6
[Thread debugging using libthread_db enabled]
Using host libthread_db library "/lib/x86_64-linux-gnu/libthread_db.so.1".
[New Thread 0x7fffb6baf6c0 (LWP 2185)]
...
[New Thread 0x7fff9f4fa6c0 (LWP 2232)]
Erlang/OTP 24 [erts-12.3.2.17] [source] [64-bit] [smp:16:16] [ds:16:16:10] [async-threads:1] [jit] [type-assertions] [debug-compiled] [lock-checking]

Eshell V12.3.2.17  (abort with ^G)
1>
힙에 동적 데이터를 가진 프로세스를 하나 시작해 봅시다:
-module(mini_proc).
-export([wait/0]).

wait() ->
  X = {timestamp, erlang:timestamp()},
  receive _ -> X end,
  X.
이제 디버거 안의 셸에서 해당 프로세스를 컴파일하고 시작할 수 있습니다:
1> c(mini_proc).
{ok,mini_proc}
9> P3 = spawn(mini_proc, wait, []).
<0.101.0>Ctrl+c를 누르면 디버거로 돌아갑니다:
    Thread 1 "beam.debug.smp" received signal SIGINT, Interrupt.
                                                                [Switching to Thread 0x7ffff79b3c40 (LWP 2170)]
(gdb)
스케줄러 스레드에 있지 않을 때는 ETP 명령을 사용하는 데 문제가 있었으므로, 스케줄러 스레드로 전환한 뒤 프로세스 목록을 출력해 봅시다:
(gdb) thread 7
[Switching to thread 7 (Thread 0x7fffb40b96c0 (LWP 2191))]
(gdb) etp-processes
---
  Pix: 0
  Pid: <0.0.0>
  State: prq-prio-normal | usr-prio-normal | act-prio-normal

  Flags: trap-exit
  Registered name: init
  Current function: unknown
  I: #Cp<init:loop/1+0x64>
  Heap size: 987
  Old-heap size: 987
  Mbuf size: 38
  Msgq len: 0 (inner=0, outer=0)
  Msgq Flags: on-heap
  Parent: []
  Pointer: (Process*)0x5555561301c8

...

---
  Pix: 808
  Pid: <0.101.0>
  State: prq-prio-normal | usr-prio-normal | act-prio-normal

  Flags:
  Current function: unknown
  I: #Cp<0x7fffb53711dc>
  Heap size: 233
  Old-heap size: 0
  Mbuf size: 0
  Msgq len: 0 (inner=0, outer=0)
  Msgq Flags: on-heap
  Parent: <0.93.0>
  Pointer: (Process*)0x7fff9ed6e030
---
  Pix: 816
  Pid: <0.102.0>
  State: prq-prio-normal | usr-prio-normal | act-prio-normal

  Flags:
  Current function: unknown
  I: #Cp<io:execute_request/3+0x1a4>
  Heap size: 233
  Old-heap size: 0
  Mbuf size: 0
  Msgq len: 0 (inner=0, outer=0)
  Msgq Flags: on-heap
  Parent: <0.79.0>
  Pointer: (Process*)0x7fff9ed6dce8
---
(gdb)
Pointer 필드에서 '<0.101.0>' 프로세스의 주소를 확인할 수 있습니다. etp-stackdump 명령과 etp-heapdump 명령을 사용하여 프로세스의 스택과 힙을 살펴볼 수 있습니다. etp-stackdump 명령은 프로세스 포인터를 인수로 받습니다.
(gdb) set $p = ((Process *) 0x7fff9ed6e030)
(gdb) etp-stackdump $p
% Stacktrace (3)
I: #Cp<0x7fffb53711dc>.
0: {timestamp,{1747,147859,212377}}.
1: #Cp<0x7fffb4c14a78>.
2: #Cp<0x7fffb4c14a78>.
(gdb) etp-heapdump $p
% heapdump (7):
 0x7fff9eaf8278: | H:   3-tuple | I:      1747 | I:    147859 | I:    212377 | H:   2-tuple |    timestamp | B:0x9eaf827a
(gdb)
예상대로 스택과 힙에는 3-튜플 타임스탬프를 담은 2-튜플이 들어 있습니다: {timestamp, {1747,147859,212377}}.
3.3. PCB
프로세스 제어 블록(Process Control Block)에는 프로세스의 동작과 현재 상태를 제어하는 모든 필드가 들어 있습니다. 이 절과 이 장의 나머지 부분에서는 가장 중요한 필드들을 살펴보겠습니다. 실행 및 트레이싱과 관련된 일부 필드는 이 장에서 제외하고, 대신 Chapter 5에서 다루겠습니다.
프로세스 포인터가 가리키는 값을 출력하기만 해도 PCB 필드의 대부분을 볼 수 있습니다:
print *((Process *) 0x7fff9ed6e030)
$2 = {common =
      {id = 3470333576787,
       refc = {atmc = {counter = 1}, sint = 1},
       tracer = 59, trace_flags = 167772160,
       timer = {counter = 0},
       u = {alive = {started_interval = 263, reg = 0x0, links = 0x0,
                    lt_monitors = 0x0, monitors = 0x0},
                   release = {later = 263, func = 0x0, data = 0x0, next = 0x0}}},
      htop = 0x7fff9eaf82b0,
      stop = 0x7fff9eaf89a8,
      fcalls = 3998,
      freason = 0,
      fvalue = 59,
      heap = 0x7fff9eaf8278,
      hend = 0x7fff9eaf89c0,
      abandoned_heap = 0x0,
      heap_sz = 233,
      min_heap_size = 233,
      min_vheap_size = 46422,
      max_heap_size = 3,
      arity = 0,
      arg_reg = 0x7fff9ed6e0f8,
      max_arg_reg = 6,
      def_arg_reg = {588235, 322955, 59, 14178673876263027908, 14178673876263027908, 4000},
      i = 0x7fffb53711dc <mini_proc:wait/0+140>,
      catches = 0, rcount = 0, schedule_count = 0,
      reds = 6, flags = 0, group_leader = 2267742733347, ftrace = 59, next = 0x555556142888,
      uniq = 0,
      sig_qs = {first = 0x0, last = 0x7fff9ed6e170, save = 0x7fff9ed6e170, cont = 0x0,
                cont_last = 0x7fff9ed6e188,
                nmsigs = {next = 0x0, last = 0x0},
                recv_mrk_blk = 0x0, len = 0, flags = 2},
      bif_timers = 0x0, dictionary = 0x0,
      seq_trace_clock = 0, seq_trace_lastcnt = 0, seq_trace_token = 59,
      u = {real_proc = 0x8f9cb, terminate = 0x8f9cb,
           initial = {module = 588235, function = 322955, arity = 0}},
      current = 0x0, parent = 3195455669715, static_flags = 0,
      high_water = 0x7fff9eaf8278,
      old_hend = 0x0,
      old_htop = 0x0,
      old_heap = 0x0,
      gen_gcs = 0,
      max_gen_gcs = 65535,
      off_heap = {first = 0x0, overhead = 0},
      mbuf = 0x0, live_hf_end = 0xfffffffffffffff8, msg_frag = 0x0, mbuf_sz = 0,
      psd = {counter = 0},
      bin_vheap_sz = 46422, bin_old_vheap_sz = 46422, bin_old_vheap = 0,
      sys_task_qs = 0x0, dirty_sys_tasks = 0x0,
      state = {counter = 42}, dirty_state = {counter = 0},
      sig_inq = {first = 0x0, last = 0x7fff9ed6e2a8, len = 0,
                 nmsigs = {next = 0x0, last = 0x0}},
      trace_msg_q = 0x0,lock = {flags = {counter = 0},
                                queue = {0x0, 0x0, 0x0, 0x0, 0x0},
                                locked = {{counter = 0}, {counter = 0}, {counter = 0},
                                          {counter = 0}, {counter = 0}}},
      scheduler_data = 0x0, run_queue = {counter = 140736249294720},
      last_htop = 0x7fff9eaf8298, last_mbuf = 0x0, heap_hfrag = 0x0, last_old_htop = 0x0,
      debug_reds_in = 4000
     }
이 장에서 다루는 것보다 더 깊이 파고들고 싶다면 C 소스 코드를 살펴볼 수 있습니다. PCB는 OTP19의 경우 erl_process.h 파일에, 최신 버전의 경우 erl_process.h 파일에 process라는 이름의 C 구조체로 구현되어 있습니다.
id 필드에는 프로세스 ID(또는 PID)가 들어 있습니다. 'id = 3470333576787’이며, 이를 바이너리로 나타내면 '0b110010100000000000000000000000011001010011’입니다. 프로세스 ID는 Erlang 텀이므로 태그가 붙어 있습니다(Chapter 4 참고). 즉, 최하위 4비트가 태그(0011)입니다. 코드 섹션에는 Erlang 텀을 검사하는 모듈(온라인 부록의 show.erl 참고)이 있으며, 이 모듈은 타입에 관한 장에서 다룰 것입니다. 하지만 지금도 이 모듈을 사용해 태그가 붙은 워드의 타입을 살펴볼 수 있습니다.
4> show:tag_to_type(3470333576787).
pid
5>
htop 필드와 stop 필드는 힙과 스택의 꼭대기를 가리키는 포인터입니다. 즉, 힙이나 스택에서 다음 빈 슬롯을 가리킵니다. heap 필드(시작)와 hend 필드는 각각 힙 전체의 시작과 끝을 가리키며, heap_sz 필드는 힙의 크기를 워드 단위로 나타냅니다. 즉, 64비트 머신에서는 hend - heap = heap_sz * 8 관계가, 32비트 머신에서는 hend - heap = heap_sz * 4 관계가 성립합니다.
필드 min_heap_size는 힙이 처음 시작할 때의 크기이자 더 이상 줄어들지 않는 최소 크기를 워드 단위로 나타내며, 기본값은 233입니다.
이제 힙의 형태를 제어하는 PCB의 필드들을 더해 프로세스 힙 그림을 더 자세하게 다듬을 수 있습니다. Figure 10를 참조하십시오:
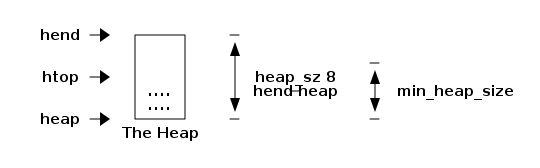
그런데 잠깐, 힙에는 시작과 끝이 있는데 어째서 스택에는 시작과 끝이 없습니까? 그 이유는 BEAM이 힙과 스택을 함께 할당하여 공간과 포인터를 절약하는 기법을 사용하기 때문입니다. 이제 메모리로서의 프로세스 그림을 처음으로 수정할 차례입니다. Figure 11에 나타나 있듯이, 힙과 스택은 사실 하나의 메모리 영역일 뿐입니다:
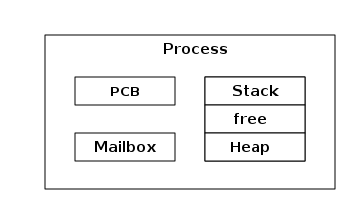
스택은 낮은 메모리 주소 방향으로, 힙은 높은 메모리 주소 방향으로 자라므로 그림에 stack top 포인터를 추가하여 힙의 그림을 더 정교하게 다듬을 수도 있습니다(Figure 12 참조):
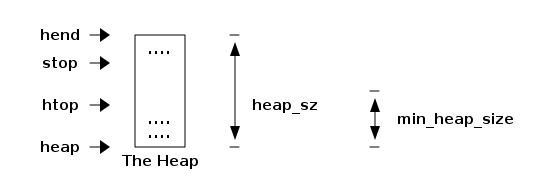
포인터 htop과 stop이 만나면 프로세스의 여유 메모리가 바닥난 것이므로, 메모리를 확보하려면 가비지 컬렉터를 호출해야 합니다.
3.4. 가비지 컬렉터(GC)
힙 메모리 관리 방식은 프로세스별로 동작하는 복사 방식의 세대별 가비지 컬렉터를 사용하는 것입니다. 힙에 더 이상 공간이 없으면(힙과 스택은 할당된 메모리 블록을 공유하므로 스택의 공간이 부족할 때도 마찬가지입니다) 가비지 컬렉터가 동작하여 메모리를 확보합니다.
GC는 to space라는 새 메모리 영역을 할당합니다. 그런 다음 스택을 훑어 살아 있는 모든 루트를 찾고, 각 루트를 따라가며 힙에 있는 데이터를 새 힙으로 복사합니다. 마지막으로 스택도 새 힙으로 복사하고 이전 메모리 영역을 해제합니다.
GC는 PCB의 다음 필드로 제어됩니다:
    Eterm *high_water;
    Eterm *old_hend;     /* Heap pointers for generational GC. */
    Eterm *old_htop;
    Eterm *old_heap;
    Uint max_heap_size;  /* Maximum size of heap (in words). */
    Uint16 gen_gcs;      /* Number of (minor) generational GCs. */
    Uint16 max_gen_gcs;	 /* Max minor gen GCs before fullsweep. */
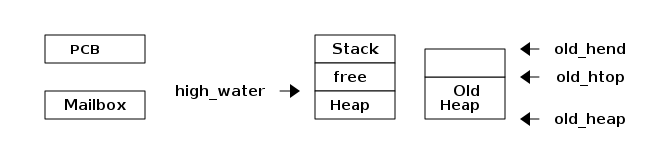
가비지 컬렉터는 세대별(generational) 방식이므로 대부분의 경우 새 데이터만 살펴보는 휴리스틱을 사용합니다. 즉, 이른바 마이너 컬렉션에서 GC는 스택의 윗부분만 살펴보고 새 데이터를 새 힙으로 옮깁니다. 오래된 데이터, 즉 힙에서 high_water 마크 아래에 할당된 데이터(Figure 13 참고)는 올드 힙이라고 하는 특별한 영역으로 옮겨집니다.
그렇다면 대부분의 경우 각 프로세스에는 또 하나의 힙 영역인 올드 힙이 있으며, 이는 PCB의 old_heap, old_htop, old_hend 필드로 관리됩니다. 이로써 Figure 13에서 보듯이, 프로세스를 네 개의 메모리 영역으로 보았던 처음의 그림으로 거의 되돌아옵니다:
프로세스가 시작될 때는 오래된 힙이 없지만, 젊은 데이터가 오래된 데이터로 성숙하고 가비지 컬렉션이 일어나면 곧바로 오래된 힙이 할당됩니다. 오래된 힙은 풀 스윕(full sweep)이라고도 하는 메이저 컬렉션(major collection)이 일어날 때 가비지 컬렉션됩니다. 가비지 컬렉션이 동작하는 방식에 대한 자세한 내용은 Chapter 11를 참고하십시오. 그 장에서는 메모리 관련 문제를 추적하고 해결하는 방법도 살펴보겠습니다.
3.5. 메일박스와 메시지 전달
프로세스 간 통신은 메시지 전달을 통해 이루어집니다. 프로세스 송신은 송신 프로세스가 자신의 힙에 있는 메시지를 수신 프로세스의 메일박스로 복사하는 방식으로 구현됩니다.
Erlang 초기에는 동시성이 오직 Erlang 자체 스케줄러가 작업 전환을 수행하는 방식으로만 구현되었습니다. 동시성에 대해서는 이 장 뒷부분의 스케줄러 절에서 더 자세히 다루겠습니다. 지금은 Erlang의 첫 번째 버전에는 병렬성이 없었으며 한 번에 하나의 프로세스만 실행될 수 있었다는 점을 짚어 둘 만합니다. 그 버전에서는 송신 프로세스가 잠금 없이 수신 프로세스의 힙에 데이터를 직접 쓸 수 있었습니다.
3.5.1. 메시지 병렬 전송
멀티코어 시스템이 도입되고 Erlang 구현이 둘 이상의 스케줄러가 실행 중인 프로세스를 병렬로 처리하도록 확장되자, 수신자의 main lock을 획득하지 않고 다른 프로세스의 힙에 직접 쓰는 것은 더 이상 안전하지 않게 되었습니다. 이때 m-bufs라는 개념이 도입되었습니다(힙 프래그먼트라고도 합니다). m-buf는 프로세스 힙 바깥에 있는 메모리 영역으로, 다른 프로세스가 안전하게 데이터를 쓸 수 있는 곳입니다. 송신 프로세스가 락을 획득하지 못하면 대신 m-buf에 데이터를 씁니다. 메시지의 모든 데이터가 m-buf에 복사되면, 메시지는 메일박스를 통해 프로세스에 연결됩니다. 이 연결 작업(erl_message.h의 LINK_MESSAGE)은 메시지를 수신자의 메시지 큐 끝에 추가합니다.
그러면 가비지 컬렉터가 메시지를 프로세스의 힙으로 복사합니다. GC의 부담을 줄이기 위해 메일박스는 두 개의 리스트로 나뉘는데, 하나는 이미 확인한 메시지를 담고 다른 하나는 새 메시지를 담습니다. 새 메시지는 살아남는다는 것을 알고 있으므로(아직 메일박스에 있으므로) GC는 새 메시지를 살펴볼 필요가 없으며, 이렇게 하면 복사 작업의 일부를 피할 수 있습니다.
3.6. 락 프리 메시지 전달
Erlang 19에서는 프로세스별 설정인 message_queue_data가 새로 도입되었으며, 이 설정은 on_heap 또는 off_heap 값을 가질 수 있습니다. on_heap으로 설정하면 송신 프로세스는 먼저 수신자의 메인 락을 획득하려고 시도하며, 성공하면 메시지가 수신자의 힙에 직접 복사됩니다. 이는 수신자가 일시 중단된 상태이고, 같은 프로세스에 메시지를 보내기 위해 다른 프로세스가 락을 먼저 잡지 않은 경우에만 가능합니다. 송신자가 락을 획득하지 못하면 대신 힙 프래그먼트를 할당하고 그곳에 메시지를 복사합니다.
플래그가 off_heap으로 설정되면 송신자는 락을 얻으려 하지 않고 대신 힙 프래그먼트에 직접 씁니다. 이렇게 하면 락 경합은 줄어들지만, 힙 프래그먼트를 할당하는 것은 이미 할당된 프로세스 힙에 직접 쓰는 것보다 비용이 크며 메모리 사용량이 늘어날 수 있습니다. 크고 비어 있는 힙이 할당되어 있는데도 새 메시지가 여전히 새 프래그먼트에 쓰일 수 있습니다.
on_heap 할당을 사용하면 힙에 직접 할당된 메시지와 힙 프래그먼트에 있는 메시지를 포함한 모든 메시지가 GC에 의해 복사됩니다. 메시지 큐가 크고 처리되지 않은 메시지가 많아 여전히 살아 있는 상태라면, 해당 메시지들은 old 힙으로 승격되고 프로세스 힙의 크기가 커져 메모리 사용량이 증가합니다.
모든 메시지는 수신 프로세스로 복사되면 연결 리스트(메일박스)에 추가됩니다. 메시지가 수신 프로세스의 힙으로 복사되면 해당 메시지는 내부 메시지 큐(또는 seen 메시지)에 연결되고 GC가 이를 검사합니다. off_heap 할당 방식에서는 새 메시지가 “external” 메시지 인큐에 배치되며 GC는 이를 무시합니다.
3.6.1. 메시지를 위한 메모리 영역
이제 프로세스를 네 개의 메모리 영역으로 보던 그림을 다시 한번 수정할 수 있습니다. 이제 프로세스는 Figure 14에 나타낸 것처럼 다섯 개의 메모리 영역(두 개의 메일박스)과 가변적인 수의 힙 프래그먼트(m-bufs)로 구성됩니다:
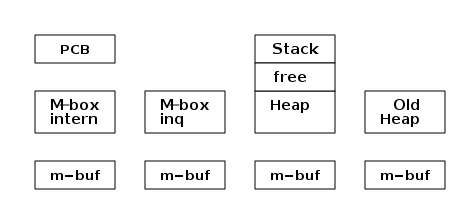
각 메일박스는 길이 하나와 포인터 두 개로 구성되며, 이 값들은 내부 큐의 경우 msg.len, msg.first, msg.last 필드에, 외부 입력 큐의 경우 msg_inq.len, msg_inq.first, msg_inq.last 필드에 저장됩니다. 또한 선택적 수신(selective receive)을 구현하기 위해 다음에 확인할 메시지를 가리키는 포인터(msg.save)도 있습니다.
3.6.2. 프로세스에 메시지를 보내는 과정
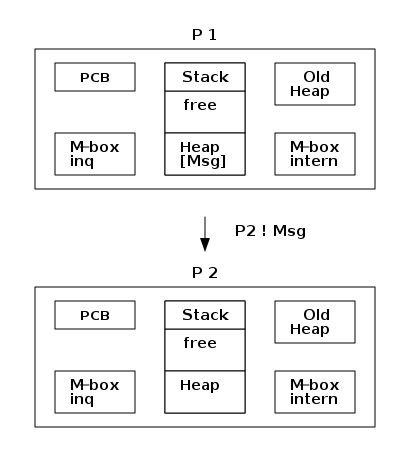
지금은 분산의 경우는 무시하겠습니다. 즉, Erlang 노드 사이에서 전송되는 메시지는 고려하지 않겠습니다. 두 프로세스 P1과 P2가 있다고 가정해 보겠습니다. Figure 15에 나타난 것처럼, 프로세스 P1이 프로세스 P2에게 메시지(Msg)를 보내려고 합니다:
그러면 프로세스 P1은 다음 단계를 수행합니다:
-
Msg의 크기를 계산합니다. -
메시지를 위한 공간을 할당합니다(앞서 설명한 대로
P2의 힙 안 또는 밖에). -
Msg를P1의 힙에서 할당된 공간으로 복사합니다. -
메시지를 감싸는
ErlMessage구조체를 할당하고 채웁니다. -
ErlMessage를ErlMsgQueue또는ErlMsgInQueue에 연결합니다.
프로세스 P2가 일시 중단된 상태이고, 다른 어떤 프로세스도 P2에 메시지를 보내려 하지 않으며, 힙에 공간이 있고, 할당 전략이 on_heap이면, 메시지는 Figure 16에서와 같이 곧바로 힙에 놓입니다:
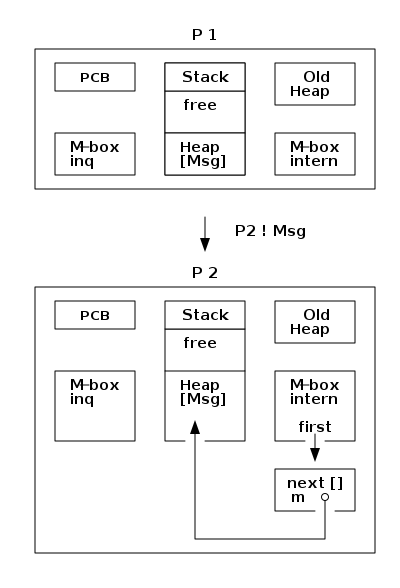
P1이 P2의 main lock을 얻을 수 없거나, P2의 힙에 공간이 충분하지 않고 할당 전략이 on_heap이면 메시지는 Figure 17에서와 같이 m-buf에 들어가지만 내부 메일박스에서 링크됩니다:
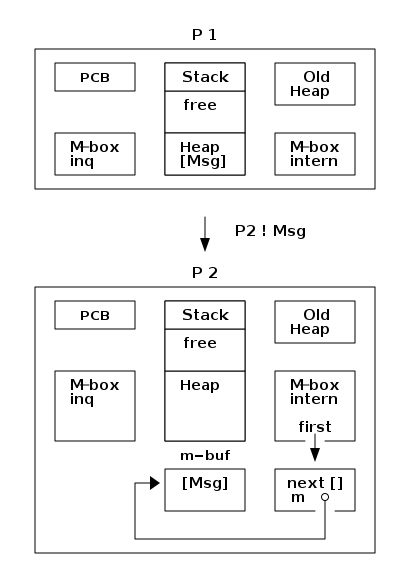
GC가 끝나면 메시지는 힙으로 옮겨집니다.
할당 전략이 off_heap이면 메시지는 Figure 18에서처럼 m-buf에 들어가고 외부 메일박스에서 링크됩니다:
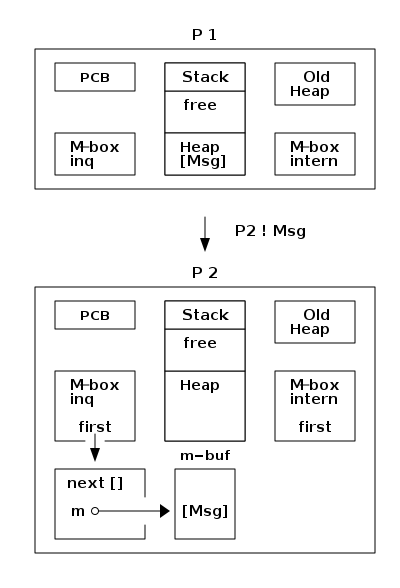
GC 이후에도 메시지는 여전히 m-buf에 남아 있습니다. 메시지가 수신되어 힙의 다른 객체나 스택에서 도달 가능해진 뒤에야 비로소 GC 중에 메시지가 프로세스 힙으로 복사됩니다.
3.6.3. 메시지 수신
Erlang은 선택적 수신(selective receive)을 지원합니다. 즉, 일치하지 않는 메시지를 메일박스에 남겨 두었다가 나중의 receive에서 처리할 수 있습니다. 또한 일치하는 메시지가 없으면 프로세스는 메일박스에 메시지가 남아 있는 상태로 일시 중단될 수 있습니다. msg.save 필드에는 다음에 살펴볼 메시지를 가리키는 포인터에 대한 포인터가 들어 있습니다.
이후 장에서 m-bufs의 세부 사항과 가비지 컬렉터가 메일박스를 처리하는 방식을 다룰 것입니다. 또한 BEAM에서 receive가 구현되는 방식의 세부 사항도 이후 장에서 살펴볼 것입니다.
3.6.4. 메시지 전달 튜닝
Erlang 19에서 새로 도입된 message_queue_data 플래그를 사용하면 메모리와 실행 시간을 새로운 방식으로 맞바꿀 수 있습니다. 수신 프로세스가 과부하 상태이면서 main lock을 계속 잡고 있다면, 송신 프로세스가 메시지를 m-buf에 빠르게 넣어 둘 수 있도록 off_heap 할당을 사용하는 것이 좋은 전략일 수 있습니다.
두 프로세스의 생산자-소비자 관계가 잘 균형 잡혀 있어 프로세스 락을 두고 실질적인 경합이 일어나지 않는다면, 수신자의 힙에 직접 할당하는 편이 더 빠르고 메모리도 덜 사용합니다.
수신자에게 메시지가 밀려 처리할 수 있는 것보다 더 많은 메시지를 받고 있다면, 메시지가 힙으로 복사되고 old 힙으로 옮겨지면서 실제로는 메모리를 더 많이 사용하기 시작할 수도 있습니다. 아직 확인하지 않은 메시지는 살아 있는 것으로 간주되므로, 힙이 커져야 하고 더 많은 메모리를 사용하게 됩니다.
시스템에 가장 적합한 할당 전략을 알아내려면 벤치마크를 수행하고 동작을 측정해야 합니다. 가장 먼저 해 볼 수 있는 가장 쉬운 테스트는 아마도 시스템 시작 시 기본 할당 전략을 변경하는 것입니다. ERTS 플래그 +hmqd는 기본 전략을 off_heap 또는 on_heap 중 하나로 설정합니다. 이 플래그 없이 Erlang을 시작하면 기본값은 on_heap입니다. Erlang이 +hmqd off_heap으로 시작되도록 벤치마크를 구성하면, 모든 프로세스가 오프 힙 할당을 사용할 때 시스템이 더 잘 동작하는지 아니면 더 나쁘게 동작하는지 테스트할 수 있습니다. 그런 다음 병목이 되는 프로세스를 찾아 해당 프로세스에 대해서만 할당 전략을 바꾸어 테스트해 볼 수 있습니다.
3.7. 프로세스 딕셔너리
사실 프로세스에는 Erlang 텀을 저장할 수 있는 메모리 영역이 하나 더 있습니다. 바로 프로세스 딕셔너리(Process Dictionary)입니다.
프로세스 딕셔너리 (PD)는 프로세스 로컬 키-값 저장소입니다. 한 가지 장점은 모든 키와 값이 프로세스의 힙에 보관된다는 점입니다. 따라서 저장한 텀을 메시지 전달이나 ETS 테이블을 쓸 때처럼 다른 곳으로 복사할 필요가 없습니다.
이제 Figure 19에서 볼 수 있듯이, 또 하나의 메모리 영역인 PD, 즉 프로세스 딕셔너리를 더해 프로세스에 대한 그림을 갱신할 수 있습니다:
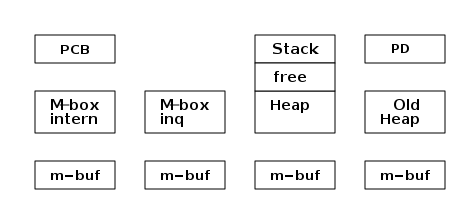
프로세스 딕셔너리는 매우 단순한 해시 테이블 구현입니다. 실제로 PD 메모리 영역은 평범한 버킷 배열일 뿐이며, 각 슬롯은 버킷이 비어 있으면 NIL (빈 리스트)이고, 그렇지 않으면 힙에 있는 데이터를 가리키는 태그된 포인터입니다 — 버킷에 항목이 하나뿐이면 단순한 튜플 {Key, Value}이고, 버킷에 항목이 N개 있으면 NIL로 끝나는 리스트 [{Key1, Value1}, …, {KeyN, ValueN}]입니다. 구현은 erl_process_dict.c 파일에서 찾을 수 있습니다.
이렇게 하면 동적으로 늘어나고 줄어드는 버킷 리스트를 관리하기 위한 추가적인 복잡성이 없으며, 버킷 배열을 제외하면 이러한 데이터 구조를 위한 별도의 메모리 관리도 필요하지 않습니다. 이 모든 것은 힙에서 튜플과 리스트를 생성하고 해제하는 일반적인 방식으로 처리됩니다(이 방식은 이미 원하는 만큼 효율적입니다). 이는 또한 가비지 컬렉터가 다른 Erlang 데이터와 마찬가지로 해시 테이블을 쉽게 순회할 수 있다는 뜻입니다. (가비지 컬렉션이 어떻게 동작하는지는 Chapter 11에서 자세히 살펴보겠습니다.)
단점은 PD에 있는 텀이 항상 살아 있는 데이터이므로 (복사 방식의) GC가 이리저리 옮겨야 한다는 것입니다. 따라서 PD에 대량의 데이터를 저장하는 것은 항목을 복사해 넣고 빼야 하더라도 별도의 ETS 테이블을 사용하는 것보다 나쁜 선택일 수 있습니다. 이는 딕셔너리의 초기 성장 단계 이후 GC에 부하가 얼마나 걸리는지에 따라 달라집니다. 큰 PD를 구축하게 될 것을 미리 안다면 spawn_opt(…, [{min_heap_size, Size}])처럼 초기 힙 크기를 크게 잡아 프로세스를 시작하고, GC 부하가 큰 작업은 다른 프로세스에서 수행하는 것이 좋을 수 있습니다.
여느 해시 테이블과 마찬가지로 PD에 요소를 저장하는 것도 완전히 공짜는 아니라는 점에 유의하십시오 — 키/값 항목을 위한 튜플이 하나 더 생기고, 버킷이 비어 있지 않았다면 cons 셀도 하나 더 생기며, 이로 인해 가비지 컬렉션이 트리거될 수도 있습니다. 또한 버킷 배열의 크기를 조정해야 할 수도 있습니다. 딕셔너리의 기존 키를 갱신하면 이전 힙에서 새 힙을 가리키는 포인터가 생기지 않도록 해당 버킷의 리스트 전체가 재할당됩니다. 하지만 이러한 리스트는 평균적으로 매우 짧을 것입니다.
3.8. 자세히 살펴보기
이 장에서는 프로세스가 어떻게 구현되는지 살펴보았습니다. 특히 프로세스의 메모리가 어떻게 구성되는지, 메시지 전달이 어떻게 동작하는지, 그리고 PCB에 어떤 정보가 담기는지 살펴보았습니다. 또한 erlang:process_info/2와 ETP 디버그 매크로처럼 프로세스를 검사하고 내부를 들여다보는 여러 도구도 살펴보았습니다.
시스템의 프로세스를 살펴보려면 erlang:processes/0 함수와 erlang:process_info/1,2 함수를 사용하십시오. 다음은 시험해 볼 만한 함수입니다:
1> Ps = erlang:processes().
[<0.0.0>,<0.3.0>,<0.6.0>,<0.7.0>,<0.9.0>,<0.10.0>,<0.11.0>,
 <0.12.0>,<0.13.0>,<0.14.0>,<0.15.0>,<0.16.0>,<0.17.0>,
 <0.19.0>,<0.20.0>,<0.21.0>,<0.22.0>,<0.23.0>,<0.24.0>,
 <0.25.0>,<0.26.0>,<0.27.0>,<0.28.0>,<0.29.0>,<0.33.0>]
2> P = self().
<0.33.0>
3> erlang:process_info(P).
[{current_function,{erl_eval,do_apply,6}},
 {initial_call,{erlang,apply,2}},
 {status,running},
 {message_queue_len,0},
 {messages,[]},
 {links,[<0.27.0>]},
 {dictionary,[]},
 {trap_exit,false},
 {error_handler,error_handler},
 {priority,normal},
 {group_leader,<0.26.0>},
 {total_heap_size,17730},
 {heap_size,6772},
 {stack_size,24},
 {reductions,25944},
 {garbage_collection,[{min_bin_vheap_size,46422},
                      {min_heap_size,233},
                      {fullsweep_after,65535},
                      {minor_gcs,1}]},
 {suspending,[]}]
 4>  lists:keysort(2,[{P,element(2,erlang:process_info(P,
     total_heap_size))} || P <- Ps]).
[{<0.10.0>,233},
 {<0.13.0>,233},
 {<0.14.0>,233},
 {<0.15.0>,233},
 {<0.16.0>,233},
 {<0.17.0>,233},
 {<0.19.0>,233},
 {<0.20.0>,233},
 {<0.21.0>,233},
 {<0.22.0>,233},
 {<0.23.0>,233},
 {<0.25.0>,233},
 {<0.28.0>,233},
 {<0.29.0>,233},
 {<0.6.0>,752},
 {<0.9.0>,752},
 {<0.11.0>,1363},
 {<0.7.0>,1597},
 {<0.0.0>,1974},
 {<0.24.0>,2585},
 {<0.26.0>,6771},
 {<0.12.0>,13544},
 {<0.33.0>,13544},
 {<0.3.0>,15143},
 {<0.27.0>,32875}]
9>
4. Erlang 타입 시스템과 태그
ERTS를 이해하는 데 가장 중요한 측면 중 하나는 ERTS가 데이터를 저장하는 방식, 즉 Erlang 텀이 메모리에 저장되는 방식입니다. 이를 알면 가비지 컬렉션과 메시지 전달이 어떻게 동작하는지 이해하는 기반을 얻을 수 있으며, 메모리가 얼마나 필요한지도 가늠할 수 있습니다.
이 장에서는 Erlang의 기본 데이터 타입과 그것이 ERTS에서 어떻게 구현되는지를 배웁니다. 이 지식은 메모리 할당과 가비지 컬렉션을 다루는 장을 이해하는 데 반드시 필요합니다. Chapter 11를 참고하십시오.
4.1. Erlang 타입 시스템
Erlang은 강타입 언어입니다. 즉, 한 타입을 다른 타입으로 강제 변환할 방법은 없으며, 한 타입에서 다른 타입으로 변환하는 것만 가능합니다. 이를 예를 들어 char를 int로, 또는 임의의 포인터 타입을 void *로 강제 변환할 수 있는 C와 비교해 보십시오.
Figure 20에서 볼 수 있듯이 Erlang 타입 격자는 상당히 평평합니다. 실제 서브타입은 몇 개뿐입니다. numbers에는 integer와 float라는 서브타입이 있고, list에는 nil과 cons라는 서브타입이 있습니다. (tuple에는 크기마다 서브타입이 하나씩 있다고 볼 수도 있으며, maps도 마찬가지입니다.)
Erlang 타입 격자
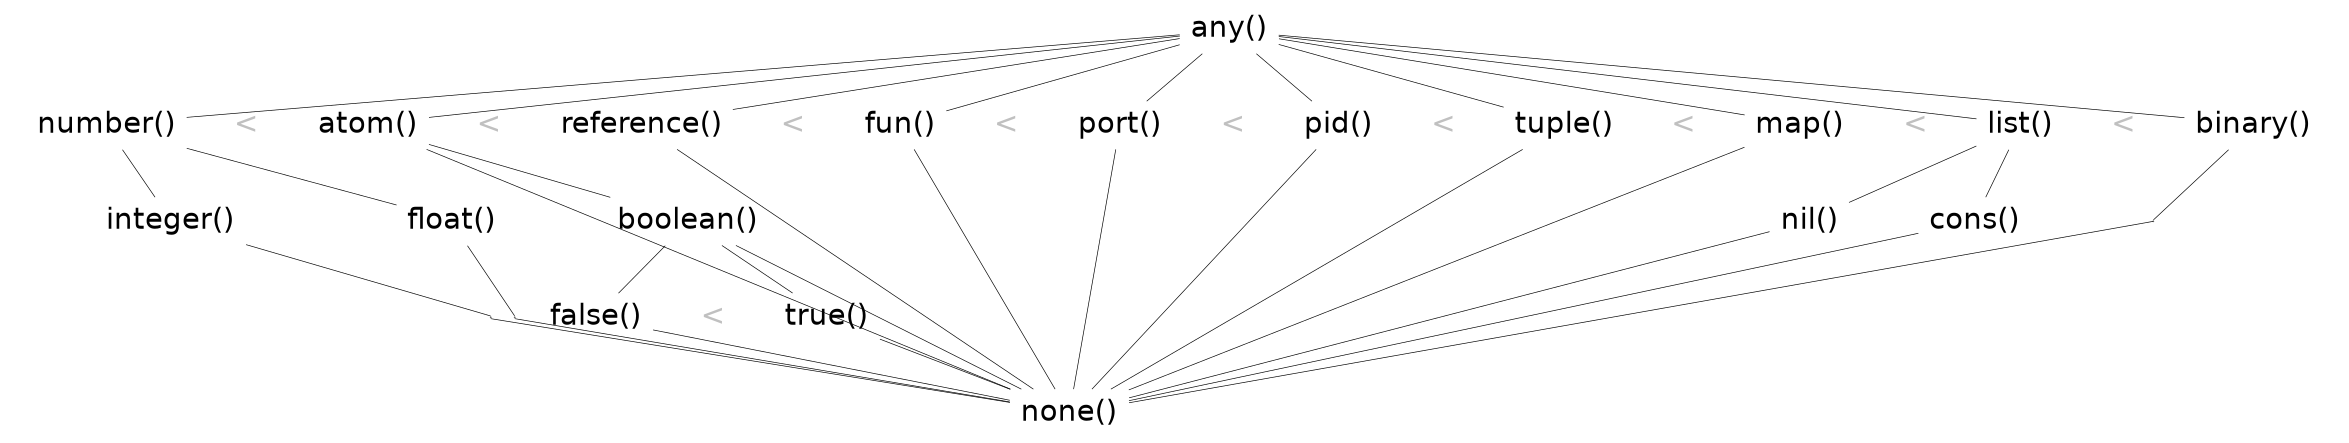
Erlang의 모든 텀에는 부분 순서(<, >)가 있으며, 이 순서에서 타입은 위 격자의 왼쪽에서 오른쪽 순으로 정렬됩니다.
정수와 부동소수점 수는 비교하기 전에 변환되므로 이 순서는 전순서가 아니라 부분 순서입니다. 1 < 1.0과 1.0 < 1은 모두 거짓이며, 1 =< 1.0, 1 >= 1.0, 1 == 1.0은 참입니다. 정밀도가 낮은 수가 정밀도가 높은 수로 변환됩니다. 일반적으로는 정수가 부동소수점 수로 변환됩니다. 매우 크거나 매우 작은 부동소수점 수는 정수로 변환됩니다. 이런 변환은 모든 유효 숫자가 소수점 왼쪽에 있을 때 일어납니다.
튜플이나 리스트 같은 복합 구조에서는 순서가 재귀적으로 확장되므로, 예를 들어 {1, 2} < {1, 3}이지만 {2, 1} > {1, 3}입니다. 이는 어떤 Erlang 텀의 집합이든 순서대로 정렬할 수 있다는 뜻이며, 이 텀 순서는 언어가 정의합니다.
두 맵의 순서를 비교할 때는 다음과 같이 비교합니다. 한 맵의 요소 수가 다른 맵보다 적으면 튜플의 경우와 마찬가지로 그 맵이 더 작은 것으로 간주됩니다. 그렇지 않으면 키를 키 순서로 비교하며, 이는 모든 정수가 모든 부동소수점 수보다 작은 것으로 간주된다는 뜻입니다. 모든 키가 같으면 각 값 쌍을 (키 순서대로) 산술적으로 비교합니다. 즉, 먼저 두 값을 같은 정밀도로 변환한 다음 비교합니다.
동등성을 비교할 때도 마찬가지이므로, #{1 => 1.0} == #{1 => 1}이지만 #{1.0 => 1} /= #{1 => 1}입니다.
Erlang은 동적 타입 언어입니다. 즉, 타입은 런타임에 검사되며 타입 오류가 발생하면 예외가 던져집니다. 컴파일 중에 타입 오류가 발생할 수 있는 C나 Java 같은 정적 타입 언어와 달리, 컴파일러는 컴파일 시점에 타입을 검사하지 않습니다.
강한 동적 타입이면서 타입 간에 순서가 정해져 있다는 Erlang 타입 시스템의 이러한 특성은 언어 구현에 몇 가지 제약을 가합니다. 런타임에 타입을 검사하고 비교할 수 있으려면 모든 Erlang 텀은 자신의 타입을 함께 지니고 있어야 합니다.
이 문제는 텀에 태그를 붙여 해결합니다.
4.2. 태깅 방식
Erlang 텀의 메모리 표현에서는 몇 비트가 타입 태그용으로 예약되어 있습니다. 성능상의 이유로 텀은 즉시값과 박스 텀으로 나뉩니다. 즉시값 텀은 하나의 머신 워드, 즉 레지스터나 스택 슬롯 하나에 들어갈 수 있습니다. 박스형 텀은 태그된 포인터와 프로세스 힙에 저장된 여러 개의 워드, 이렇게 두 부분으로 이루어집니다. 힙에 저장된 박스는 헤더와 본문을 가지지만, 리스트는 예외적으로 헤더가 없습니다.
현재 ERTS는 단계적 태그 방식을 사용하며, 이 방식의 역사와 설계 근거는 HiPE 그룹의 기술 보고서에 설명되어 있습니다. (http://www.it.uu.se/research/publications/reports/2000-029/를 참조하십시오.) 태깅 방식은 erl_term.h에 구현되어 있습니다.
기본 아이디어는 최하위 비트를 태그로 사용하는 것입니다. 대부분의 최신 CPU 아키텍처는 32비트 및 64비트 워드를 정렬하므로, 포인터에는 "사용되지 않는" 비트가 최소 두 개 있습니다. 이 비트들을 대신 태그로 사용할 수 있습니다. 안타깝게도 이 두 비트만으로는 Erlang의 모든 타입을 표현하기에 충분하지 않으므로, 필요에 따라 더 많은 비트를 사용합니다.
4.2.1. 기본 태그
처음 두 비트는 기본 태그라고 하며, 다음과 같이 사용됩니다:
  00 Header (on heap) CP (on stack)
  01 List (cons)
  10 Boxed
  11 Immediate
Immediate(태그 11)는 작은 정수처럼 그 자체로 완결된 워드입니다. 추가 워드가 필요하지 않습니다. Boxed 태그 10은 리스트를 제외하고 힙에 있는 객체를 가리키는 포인터에 사용됩니다.
헤더 태그 00은 힙에서 헤더 워드에만 사용되며, 이에 대해서는 Section 4.5에서 설명하겠습니다. 힙의 모든 객체는 정수 개의 머신 워드를 차지하며, 일반적으로 헤더 워드로 시작합니다. 스택에서는 대신 00 태그가 반환 주소, 즉 연속 포인터를 나타냅니다 — 이는 실용적인 선택입니다. 반환 주소는 어차피 항상 워드 단위로 정렬되므로 이러한 포인터에는 태깅/언태깅을 전혀 할 필요가 없습니다. 이는 00을 즉시값, 리스트 또는 박스형 값에 사용하는 것보다 더 나은 절충안입니다.
4.2.2. 즉시값
Immediate 태그는 다음과 같이 더 세분됩니다.
 00 11 Pid
 01 11 Port
 10 11 Immediate 2
 11 11 Small integer
Pid와 포트는 즉시값이므로 효율적으로 동등 비교를 할 수 있습니다. 물론 실제로는 참조에 불과하며, pid는 프로세스 식별자로서 프로세스를 가리킵니다. 해당 프로세스는 어떤 프로세스의 힙에도 존재하지 않으며, PCB에 의해 관리됩니다. 포트도 거의 같은 방식으로 동작합니다.
PID 즉시값(immediate)은 하나의 머신 워드에 압축되어 들어갑니다. 최하위 두 비트는 기본 태그 11이고, 그다음 두 비트는 서브타입 00이며, 나머지 상위 비트에는 PID 값이 담깁니다. 32비트 시스템에서는 이 28비트가 15비트 프로세스 인덱스(프로세스 테이블 내 오프셋), 13비트 시리얼(재사용된 인덱스를 구별하기 위한 값), 그리고 작은 크리에이션(creation) 필드로 다시 나뉩니다. 셸에서 PID를 출력하면 <Node.Index.Serial> 형태로 표시되며, 여기서 creation 값(노드 부분)은 재시작 전후의 PID를 구별해 줍니다. 포트도 같은 레이아웃(서브타입 01)을 사용하며, 상위 비트를 포트 번호와 크리에이션으로 나눕니다. 참조 전체가 한 워드 안에 들어 있으므로, PID와 포트에 대한 동등(및 비동등) 검사는 단 한 번의 정수 비교로 귀결됩니다.
ERTS에는 두 가지 유형의 정수가 있습니다. 작은 정수와 bignum입니다. 작은 정수는 머신 워드 하나에서 태그 비트 4개를 뺀 크기에 들어갑니다. 즉, 32비트 시스템에서는 28비트, 64비트 시스템에서는 60비트에 들어갑니다. 반면 bignum은 필요한 만큼 커질 수 있으며(힙 공간에 의해서만 제한됨), 박스형 객체로서 힙에 저장됩니다([Boxed Terms] 참조).
작은 정수의 태그 비트 네 개를 모두 1로 두면, 에뮬레이터는 정수 산술 연산을 수행할 때 두 인자가 모두 즉시값(immediate)인지 효율적으로 검사할 수 있습니다. (is_both_small(x,y)는 (x & y & 1111) == 1111로 정의됩니다.)
Immediate 2 태그는 다음과 같이 더 세분됩니다:
 00 10 11 Atom
 01 10 11 Catch
 10 10 11   [UNUSED]
 11 10 11 Nil
아톰은 아톰 테이블 내의 인덱스와 아톰 태그로 구성됩니다. 두 아톰 즉시값은 즉시값 표현만 비교하여 동등성을 판별할 수 있습니다.
아톰 테이블에서 아톰은 다음과 같은 C 구조체로 저장됩니다:
typedef struct atom {
    IndexSlot slot;  /* MUST BE LOCATED AT TOP OF STRUCT!!! */
    int len;         /* length of atom name */
    int ord0;        /* ordinal value of first 3 bytes + 7 bits */
    byte* name;      /* name of atom */
} Atom;
len 필드와 ord0 필드 덕분에 두 아톰이 같은 네 글자로 시작하지 않는 한 두 아톰의 순서를 효율적으로 비교할 수 있습니다.
Catch 즉시값은 스택에서만 사용됩니다. 이 값에는 예외가 발생한 뒤 실행을 이어 갈 코드 내 지점을 가리키는 간접 포인터가 들어 있습니다. 이에 대한 자세한 내용은 Chapter 8에서 다룹니다.
Nil 태그는 Erlang에서 []로 표기하고 C 코드에서는 NIL이라고 부르는 빈 리스트에 사용됩니다. 워드의 나머지 비트는 모두 1로 채워집니다.
4.3. 리스트
리스트는 cons 셀로 이루어져 있으며, 이는 힙 위에 연속으로 놓인 두 워드, 즉 헤드와 테일일 뿐입니다(LISP에서, 그리고 ERTS 코드베이스의 일부 위치에서도 이를 car와 cdr라고 부릅니다). 빈 리스트는 앞에서 본 것처럼 즉치값(immediate)입니다.
cons 셀은 단일 연결 리스트를 만들기 위한 최소한의 C 구조체로 다음과 같이 나타낼 수 있습니다:
struct cons_cell {
    Eterm *head;     /* the value */
    Eterm *tail;     /* the next element */
};
tail 요소는 보통 다음 cons 셀을 가리키는 또 다른 List 태그된 포인터이거나, 리스트의 끝을 표시하는 NIL 즉시값입니다. 이러한 리스트를 proper lists(진리스트)라고 부릅니다. 그러나 Erlang은 동적 타입 언어이므로 [1|2]처럼 tail에 어떤 텀이든 올 수 있습니다. 이러한 리스트를 improper lists(비진리스트)라고 부르며, 진리스트를 입력으로 기대하는 함수는 마지막 요소로 []를 찾지 못하면 예상치 못한 상황을 맞게 됩니다.
각 cons 셀은 셀을 가리키는 포인터의 태그로 식별되므로 별도의 헤더 워드가 필요하지 않습니다. 따라서 cons 셀 [A|B]는 박스형 2-튜플 {A,B}보다 메모리를 33% 적게 사용합니다. 세 개가 아닌 두 개의 힙 워드만 초기화하면 되므로, 이는 그에 상응하는 속도 향상으로도 나타납니다. 따라서 항목들의 시퀀스를 다룰 때에는 리스트가 임시 데이터 구조로 선호됩니다.
다만 대량의 데이터를 오랫동안 텀으로 표현해 두는 경우에는 리스트가 메모리를 많이 사용할 수 있다는 점에 유의하십시오. 각각 2바이트로 표현할 수 있는 작은 정수가 백만 개 있다고 가정해 봅시다. 64비트 Erlang 시스템에서 이를 [1234, 2001, …] 같은 리스트로 표현하면 백만 개의 cons 셀을 사용하게 됩니다. 각 셀은 64비트 즉시 정수(immediate integer)와 리스트의 다음 셀을 가리키는 64비트 포인터를 담으므로 셀당 16바이트가 됩니다. 즉 2메가바이트가 아니라 16메가바이트입니다. 이 데이터를 바이너리에 빽빽하게 채워 넣으면 공간 효율이 더 좋겠지만, 이는 전적으로 이 숫자들에 어떻게 접근해야 하는지에 달려 있습니다.
4.4. 문자열
Erlang의 문자열("…"로 표기)은 유니코드 코드 포인트를 나타내는 정수 리스트일 뿐입니다. 따라서 "XYZ"는 [88,89,90]의 문법적 설탕입니다. Erlang 대화형 셸은 이처럼 출력 가능한 문자로 이루어진 리스트를 감지하여 대신 문자열로 보여 주려고 합니다. 예를 들면 다음과 같습니다:
Eshell V15.2.2 (press Ctrl+G to abort, type help(). for help)
1> [88,89,90].
"XYZ"| Erlang 초기에는 문자열이 Latin-1(ISO 8859-1) 코드 포인트만 사용할 것으로 여겨졌습니다. 다행히도 이들은 유니코드의 0-255 부분 집합에 불과하므로, 이 범위가 확장되었을 때 호환성 문제가 거의 없었습니다. |
유니코드 전체 범위를 "출력 가능한 문자"로 허용하면 여러 정수가 뒤섞인 많은 리스트가 문자열일 수도 있는 것처럼 보이게 되므로, 셸은 문자열을 감지할 때 기본적으로 Latin-1 범위를 사용합니다. 예를 들면 다음과 같습니다.
2> [955, 960, 963].
[955,960,963]
955, 960, 963은 각각 그리스 문자 람다, 파이, 시그마인데도 결과를 숫자 리스트로만 보여 줍니다. 그러나 +pc unicode 옵션을 주어 Erlang을 시작하면 Erlang 셸은 출력 가능한 것으로 간주하는 범위가 훨씬 넓어집니다:
$ erl +pc unicode
Erlang/OTP 27 [erts-15.2.2] [source] [64-bit] [smp:8:8] [ds:8:8:10] [async-threads:1] [jit:ns]

Eshell V15.2.2 (press Ctrl+G to abort, type help(). for help)
1> [955, 960, 963].
"λπσ"
다만 콘솔이 이 문자들을 실제로 표시할 수 있는지는 콘솔에 설정된 기대 인코딩과 사용 가능한 글꼴에 따라 달라진다는 점에 유의하십시오.
그러면 문자열 "hello"는 메모리에서 다음과 같은 모습일 수 있습니다(Figure 21):
이것은 기본적으로 UTF-32로 인코딩된 문자의 연결 리스트이며, 보시다시피 같은 문자열을 UTF-8로 인코딩된 바이트 시퀀스로 표현할 때와 비교하면 메모리를 상당히 많이 낭비합니다 — 특히 64비트 머신에서는 문자 하나당 16바이트를 사용합니다 --. 따라서 문자열은 매칭하고, 순회하고, 앞에 덧붙일 수 있는 임시 "텍스트 버퍼"로 사용하는 것이 가장 좋으며, 작업이 끝나면 저장, 전송 또는 출력을 위해 UTF-8로 인코딩된 바이너리로 변환할 수 있습니다. (바이너리에 대해서는 아래에서 더 자세히 다루겠습니다.)
Erlang 문자열을 다른 노드로 보내거나 ETS 테이블 또는 디스크에 저장하기 위해 직렬화할 때에는 term_to_binary()를 통해 Erlang 외부 텀 형식을 사용합니다. 이 형식은 문자열에 훨씬 더 간결한 바이트 인코딩을 사용합니다. 이러한 경우에는 일반적으로 문자열을 걱정할 필요가 없습니다. 오래 붙잡고 있지 말아야 할 것은 힙 위의 표현입니다.
|
4.4.1. IO 리스트
IO 리스트는 바이너리, 중첩 리스트, 문자열, 정수를 평탄화하지 않고 이어 붙일 수 있게 하여 Erlang 문자열을 확장합니다. 각 요소는 바이너리 청크이거나 리스트 노드이며, 드라이버는 최소한의 복사로 이들을 순서대로 출력합니다.
4.5. 박싱된 텀
힙에 있는 다른 모든 텀은 헤더 워드로 시작합니다. 헤더 워드는 4비트 서브태그와 기본 태그 00을 사용합니다. 나머지 비트는 박스형 텀이 추가로 사용하는 워드의 개수를 나타내는 아리티를 인코딩합니다:
aaaaaaaa...aaaaaaaaaaaaaaaa tttt 00
서브태그는 다음과 같습니다:
 0000 00  ARITYVAL (Tuples)
 0001 00  BINARY_AGGREGATE                |
 001s 00  BIGNUM with sign bit            |
 0100 00  REF                             |
 0101 00  FUN                             | THINGS
 0110 00  FLONUM                          |
 0111 00  EXPORT                          |
 1000 00  REFC_BINARY     |               |
 1001 00  HEAP_BINARY     | BINARIES      |
 1010 00  SUB_BINARY      |               |
 1011 00    [UNUSED]
 1100 00  EXTERNAL_PID  |                 |
 1101 00  EXTERNAL_PORT | EXTERNAL THINGS |
 1110 00  EXTERNAL_REF  |                 |
 1111 00  MAP
4.5.1. 튜플
튜플(ERTS 코드 베이스에서는 ARITYVAL이라고 부릅니다)은 태그와 요소 개수를 담은 헤더와 함께 단순하게 저장되며, 튜플 요소(있는 경우)는 그 뒤에 이어지는 워드들에 저장됩니다. 예를 들어, {$h, $e, $l, $l, $o}` 같은 5-튜플은 메모리에서 다음과 같은 모습입니다 (Figure 22)
이는 빈 튜플 {}가 힙에서 모든 비트가 0인 단일 워드(arity 0, 서브태그 0000, 기본 태그 00)로 표현된다는 뜻임에 유의하십시오. 그러나 이 방식에는 힙에 있는 해당 워드를 가리키는 박스 포인터도 필요하므로, 즉시값이어서 추가 힙 워드 없이도 레지스터에 보관하거나 리스트의 꼬리로 저장하는 등으로 사용할 수 있는 NIL만큼 저렴하지는 않습니다.
4.5.2. 바이너리
바이너리는 바이트로 이루어진 불변 배열입니다. 내부적으로 바이너리의 표현 방식에는 네 가지 유형이 있습니다. 힙 바이너리와 refc 바이너리라는 두 유형은 바이너리 데이터를 담고 있습니다. 나머지 두 유형인 서브 바이너리와 매치 컨텍스트(BINARY_AGGREGATE 태그)는 앞의 두 유형 중 하나를 가리키는 더 작은 참조입니다.
64바이트 이하의 바이너리는 힙 바이너리로서 프로세스 힙에 직접 저장될 수 있습니다. 이보다 큰 바이너리는 참조 카운트되며 페이로드는 프로세스 힙 바깥에 저장되고, 페이로드에 대한 참조는 ProcBin이라는 객체에 담겨 프로세스 힙에 저장됩니다.
| 바이너리와 관련해 중요한 점은 바이너리가 단순히 바이트 덩어리를 나타내므로 다른 객체를 절대 참조하지 않으며, 가비지 컬렉터가 그 페이로드를 검사할 필요가 없다는 것입니다. 따라서 바이너리에 맞춘 별도의 저장 전략을 사용할 수 있습니다. 특히 참조 카운팅 바이너리에서는 순환 참조 문제가 결코 발생하지 않습니다. |
  Heap/Refc Binary Header Word (32-bit view)
  +------------------------------------------+
  |  20-bit or 28-bit length/offset field    |
  +----------------+-------------+-----------+
  | subtag (4-bit) | primary tag | padding?  |
+----------------+-------------+-----------+-
기본 태그
00은 박스형 텀 헤더를 나타냅니다. -
서브태그
1001은 힙 바이너리(페이로드가 힙에 있음)를 나타냅니다. -
서브태그
1000은 참조 카운트 바이너리(ProcBin)를 나타냅니다.
헤더 다음에는 다음 내용이 옵니다:
-
힙 바이너리의 경우, 바이너리 페이로드 바이트가 바로 뒤에 이어집니다.
-
refc 바이너리의 경우, 헤더 뒤에 ProcBin 구조체가 이어집니다.
서브 바이너리(서브태그 1010)는 기존 바이너리를 가리키는 뷰입니다. 서브 바이너리는 길이 필드와 오프셋 필드를 담은 헤더 워드 하나와 그 뒤에 오는 머신 워드 두 개를 저장합니다. 덕분에 바이너리의 일부를 잘라 내거나 매칭할 때 페이로드 데이터를 복사할 필요가 없습니다.
매치 컨텍스트(서브태그 0001, BINARY_AGGREGATE)는 바이너리 패턴 매칭 엔진에서 사용됩니다. 매치 컨텍스트는 새 페이로드 공간을 할당하지 않고, 자신을 감싸는 하나 이상의 바이너리에서 세그먼트를 참조합니다:
-
여기에는 전체 세그먼트 수를 담은 헤더 워드가 들어 있습니다.
-
여기에는 원본 바이너리 내부를 가리키는
{pointer, length}튜플의 배열이 들어 있습니다.
이를 통해 데이터를 평탄화하거나 복사하지 않고도 효율적으로 순회할 수 있습니다.
바이너리에 대해서는 Chapter 11에서 더 자세히 다루겠습니다.
4.5.3. 큰 정수(Bignum)
작은 즉시값(워드 크기에서 태그 비트 4개를 뺀 크기)에 담을 수 없을 만큼 큰 정수는 bignum으로 표현됩니다. bignum은 박스형 텀이며, 그 헤더 워드에는 부호와 뒤따르는 “림(limb)” 워드의 개수가 함께 인코딩됩니다. 헤더의 기본 태그(00)는 이것이 힙에 할당된 헤더임을 나타내고, 4비트 서브태그(001)는 이것이 bignum임을 식별하며, 그 서브태그의 최상위 비트는 부호(0 = 양수, 1 = 음수)를 담습니다. 뒤따르는 각 림은 정수의 일부를 2^D_EXP 진법(일반적으로 32비트 빌드에서는 28비트, 64비트 빌드에서는 60비트)으로 담는 완전한 머신 워드이며, 리틀 엔디언 순서(최하위 림이 먼저)로 배치됩니다.
다중 정밀도 산술 연산은 이 림 배열을 직접 다룹니다. 덧셈과 뺄셈은 올림(carry)이나 빌림(borrow)을 전파하면서 림을 워드 단위로 훑는 방식으로 구현되며(I_add/I_sub), 그 결과로 림 배열을 내놓습니다. 마지막에 올림이 남으면 이 배열의 길이가 하나 늘어날 수 있습니다. 곱셈은 림 수가 적을 때는 이차 시간이 드는 교과서식 알고리즘(I_mul)을, 피연산자 길이가 임곗값을 넘을 때는 카라추바(Karatsuba) 분할 정복 방식(I_mul_karatsuba)을 사용하며, 중간 단계의 배정밀도 곱은 상위 절반과 하위 절반으로 나눕니다. 나눗셈과 나머지 연산은 커누스(Knuth)의 알고리즘 D(I_div/I_rem)를 사용하여 몫과 나머지 림 배열을 계산하며, 결과의 부호는 피연산자의 부호에 따라 조정합니다.
내부적으로 각 림(limb)은 ErtsDigit 타입이며, bignum의 림 배열에는 BIG_V(xp) 매크로로 접근합니다. 이 매크로는 최하위 워드를 가리키는 ErtsDigit* 포인터를 반환합니다. 개별 림은 BIG_DIGIT(xp, i)(0부터 시작하는 인덱스, 리틀 엔디언)로 읽거나 씁니다. big.c 파일의 모든 핵심 루틴(예: I_add, I_sub, I_mul, I_mul_karatsuba, I_div, I_rem)은 이러한 ErtsDigit* 배열을 직접 다루며, 올림/빌림, 다중 정밀도 곱셈, 긴 나눗셈 단계를 처리합니다. 결과 자릿수가 계산되면 big_norm이 박스형 헤더(태그, 애리티, 부호)를 다시 계산하며, 결과가 태그 비트 안에 들어갈 수 있으면 결과를 작은 즉시값(small immediate)으로 되돌리기도 합니다.
| 빅넘(bignum)과 바이너리는 둘 다 단지 “바이트 덩어리”라는 점에서 비슷하지만, 빅넘은 항상 통째로 힙에 저장되며, 매우 큰 빅넘으로 가득 찬 힙은 가비지 컬렉터가 대량의 살아 있는 데이터를 이리저리 복사해야 한다는 것을 의미합니다. 따라서 큰 바이너리 데이터 덩어리를 bignum으로 인코딩하는 것은 가능하더라도 그리 영리한 꼼수가 아닙니다. [2] |
4.5.4. 참고 문헌
레퍼런스는 “unique” 텀으로, 기본적으로 프로세스 메일박스 위에 채널을 구현하기 위해 메시지에 태그를 붙이는 데 자주 사용됩니다. 레퍼런스는 82비트 카운터로 구현됩니다. make_ref/0을 9671406556917033397649407번 호출하고 나면 카운터가 한 바퀴 돌아 다시 ref 0부터 시작합니다. 평생 make_ref를 그만큼 많이 호출하려면 정말 빠른 머신이 필요합니다. 다만 노드를 재시작하면 이야기가 다릅니다. 이 경우에도 카운터는 다시 0부터 시작하지만, 그때는 이전의 로컬 ref가 모두 사라진 상태입니다. ref를 다른 노드로 보내면 그 ref는 외부 ref가 됩니다. 아래를 참조하십시오.
32비트 시스템에서 로컬 ref는 힙에서 32비트 워드 네 개를 차지합니다. 64비트 시스템에서 ref는 힙에서 64비트 워드 세 개를 차지합니다.
    |00000000 00000000 00000000 11010000| Arity 3 + ref tag
    |00000000 000000rr rrrrrrrr rrrrrrrr| Data0
    |rrrrrrrr rrrrrrrr rrrrrrrr rrrrrrrr| Data1
    |rrrrrrrr rrrrrrrr rrrrrrrr rrrrrrrr| Data2
참조 번호는 (Data2 bsl 50) + (Data1 bsl 18) + Data0입니다.
4.5.5. 부동소수점 수
Erlang 부동소수점 수는 FLONUM 서브태그가 붙은 박스형 힙 텀입니다. 각 부동소수점 수는 머신 워드 두 개를 차지합니다. 하나는 헤더 워드(기본 태그 00, 서브태그 0110)이고, 다른 하나는 64비트 IEEE 754 페이로드 워드입니다. 에뮬레이터는 가비지 컬렉션과 비교에서 부동소수점 수를 불투명한 “박스형” 값으로 취급합니다. 산술 연산에는 가능하면 네이티브 CPU 명령어를 사용하고, 그렇지 않으면 소프트웨어 루틴으로 대체합니다.
4.5.6. 레코드
레코드는 튜플을 기반으로 한 컴파일 타임 편의 기능입니다. 애리티가 N인 레코드는 N개의 요소로 이루어진 튜플일 뿐이며, 첫 번째 요소는 레코드의 이름을 나타내는 아톰입니다. 접근 매크로와 갱신 매크로는 고정 인덱스 튜플 조회나 setelement/3 호출로 변환됩니다. 튜플 헤더(기본 태그 00, 서브태그 0000)가 arity를 인코딩하므로, 레코드 크기와 필드 오프셋은 추가 메타데이터 없이도 런타임에 알 수 있습니다.
4.6. 결론
이 장에서는 Erlang의 동적 타입 시스템이 ERTS에서 어떻게 구현되는지 살펴보았으며, 효율적인 런타임 타입 검사와 비교를 위해 즉시값(immediate)과 박스형 텀(boxed term)을 하나로 통합하는 태깅 방식을 다루었습니다. 하부의 태그 비트와 힙 레이아웃이 Erlang의 강하면서도 동적인 타입 모델을 어떻게 반영하는지도 확인했습니다. 이러한 인코딩을 이해하면 이후 메모리 할당과 가비지 컬렉션을 다루는 장을 더 쉽게 이해할 수 있을 것입니다. 해당 장에서는 박스형 텀이 프로세스 힙에서 어떻게 관리되는지 살펴볼 것입니다.
5. Erlang 가상 머신: BEAM
BEAM (Bogdan’s/Björn’s Abstract Machine)은 Erlang 런타임 시스템에서 코드를 실행하는 머신입니다. BEAM은 가비지 컬렉션을 수행하고 리덕션을 세는, 가상의 비선점형 직접 스레딩(direct threaded) 레지스터 머신입니다. 이 설명만으로는 잘 와닿지 않더라도 걱정하지 마십시오. 이어지는 절들에서 이 맥락에서 각 단어가 무엇을 의미하는지 하나씩 살펴보겠습니다.
가상 머신인 BEAM은 Erlang 노드의 핵심입니다. Erlang 코드를 실행하는 것이 바로 BEAM입니다. 다시 말해, 여러분의 애플리케이션 코드를 실행하는 것이 바로 BEAM입니다. 코드를 프로파일링하고 튜닝하려면 BEAM이 코드를 어떻게 실행하는지 이해하는 것이 매우 중요합니다.
BEAM의 설계는 ERTS의 나머지 부분 가운데 상당 부분에 영향을 미칩니다. 스케줄링 프리미티브는 스케줄러(Chapter 10)에 영향을 미치고, Erlang 텀의 표현 방식(Chapter 4)과 메모리와의 상호작용은 가비지 컬렉션을 수행하는 가비지 컬렉터(Chapter 12)에 영향을 미칩니다. BEAM의 기본 설계를 이해하면 이러한 다른 구성 요소의 구현도 더 쉽게 이해할 수 있습니다.
5.1. 작업 메모리: 스택 머신이 아닙니다
스택 머신이었던 전신 JAM(Joe’s Abstract Machine)과 달리, BEAM은 WAM [Warren]에 느슨하게 기반을 둔 레지스터 머신입니다. 스택 머신에서는 명령어의 각 피연산자가 먼저 작업 스택에 푸시되고, 그다음 명령어가 피연산자들을 팝한 뒤 그 결과를 스택에 푸시합니다.
스택 머신은 코드를 생성하기가 매우 쉽고 생성된 코드도 매우 간결해지기 때문에 가상 머신 및 프로그래밍 언어 구현자들 사이에서 상당히 인기가 있습니다. 컴파일러는 레지스터 할당을 전혀 할 필요가 없으며, 대부분의 연산은 (명령어 스트림에) 피연산자가 필요하지 않습니다.
"8 + 17 * 2." 식을 스택 머신용으로 컴파일하면 다음과 같은 코드가 나올 수 있습니다:
push 8
push 17
push 2
multiply
add
이 코드는 표현식의 파스 트리에서 직접 생성할 수 있습니다. Erlang 표현식과 erl_scan 및 erl_parse 모듈을 사용하면 세상에서 가장 단순한 컴파일러를 만들 수 있습니다:
compile(String) ->
    [ParseTree] = element(2,
			  erl_parse:parse_exprs(
			    element(2,
				    erl_scan:string(String)))),
    generate_code(ParseTree).

generate_code({op, _Line, '+', Arg1, Arg2}) ->
    generate_code(Arg1) ++ generate_code(Arg2) ++ [add];
generate_code({op, _Line, '*', Arg1, Arg2}) ->
    generate_code(Arg1) ++ generate_code(Arg2) ++ [multiply];
generate_code({integer, _Line, I}) -> [push, I].
그리고 이보다 훨씬 더 단순한 가상 스택 머신은 다음과 같습니다:
interpret(Code) -> interpret(Code, []).

interpret([push, I |Rest], Stack)              -> interpret(Rest, [I|Stack]);
interpret([add     |Rest], [Arg2, Arg1|Stack]) -> interpret(Rest, [Arg1+Arg2|Stack]);
interpret([multiply|Rest], [Arg2, Arg1|Stack]) -> interpret(Rest, [Arg1*Arg2|Stack]);
interpret([],              [Res|_])            -> Res.
그리고 간단히 테스트를 실행해 보면 답을 얻을 수 있습니다:
1> stack_machine:interpret(stack_machine:compile("8 + 17 * 2.")).
42
훌륭합니다, 여러분의 첫 가상 머신을 만들었습니다! 뺄셈과 나눗셈, 그리고 Erlang 언어의 나머지 부분을 처리하는 일은 독자의 연습 과제로 남겨 둡니다.
5.1.1. BEAM의 레지스터
어쨌든 BEAM은 스택 머신이 아닙니다. BEAM은 레지스터 머신입니다. 레지스터 머신에서는 명령어 피연산자가 스택이 아닌 레지스터에 저장되며, 연산 결과는 대개 특정 레지스터에 담깁니다. BEAM에서 레지스터는 X 레지스터(X0, X1, …)라고 부르는 워드 크기의 메모리 위치이며, 실행 중인 프로세스 전용입니다.
대부분의 레지스터 머신에는 여전히 함수에 인자를 전달하고 반환 주소를 저장하는 데 쓰이는 스택이 있습니다. 스택에서 특정 함수 호출에 관한 정보를 담는 구역을 스택 프레임이라고 하며, 여기에는 반환 주소, 레지스터에 들어가지 않는 입력 인자와 지역 변수, 그리고 서브루틴을 호출하는 동안 임시로 저장해 두는 값이 담깁니다. [3]
BEAM에는 스택이 있으며, 스택 프레임의 모든 항목은 X 레지스터와 마찬가지로 균일하게 워드 크기입니다. 따라서 이 항목들은 간단히 Y 레지스터(Y0, Y1, …)라고 부릅니다 — 이는 WAM [Warren]에서 빌려 온 용어입니다. 다시 말해, BEAM 명령어가 Y0을 참조한다면 이는 현재 호출의 스택 프레임에 있는 슬롯 0을 의미하며,
X 레지스터는 범용 레지스터이지만 호출되는 함수에 인자를 전달하는 데에도 사용되며, 레지스터 X0(때로는 R0이라고도 부릅니다)은 반환값을 담는 데 사용됩니다. 이 레지스터들은 하드웨어 레지스터가 아니라 단순한 메모리 위치이므로, 실제 CPU에서만큼 한정된 자원이 아닙니다(실제 CPU에서는 레지스터가 32개만 있어도 많은 편으로 여겨집니다). BEAM에서는 1024개의 X 레지스터를 사용할 수 있으므로 함수 인자를 스택으로 전달할 필요가 전혀 없습니다. (다만 함수 호출 전후로 값을 유지하려면 “caller saves” 규약에 따라, 살아 있는 다른 X 레지스터의 현재 내용을 스택의 Y 레지스터에 저장해 두어야 합니다.)
X 레지스터는 BEAM 에뮬레이터 안의 C 배열에 저장되며(스케줄러마다 따로 존재합니다), 모든 함수에서 전역적으로 접근할 수 있습니다. X0 레지스터는 지역 변수에 캐시되며, 이 지역 변수는 대부분의 아키텍처에서 물리적인 머신 레지스터에 유지됩니다. X0은 매우 빈번하게 사용되므로 이는 중요한 최적화입니다.
Y 레지스터는 현재 스택 프레임에 저장되며, 현재 실행 중인 함수만 접근할 수 있습니다. 함수 호출 뒤에도 값을 유지하기 위해 BEAM은 스택 프레임에 그 값을 담을 공간을 할당한 다음, 값을 해당 Y 레지스터로 옮깁니다. 공간이 예약되지 않은 Y 레지스터에 값을 쓰는 것은 허용되지 않습니다. 그렇게 하면 힙을 덮어쓸 수 있기 때문입니다.
BEAM에는 X 레지스터와 Y 레지스터 외에도 여러 특수 목적 레지스터가 있습니다.
-
Htop — 힙의 최상단 (
htop) -
E — 스택의 최상단(
stop) -
I — 명령어 포인터
-
FP — 프레임 포인터(현재 프레임의 시작)
-
CP — 연속 포인터(Continuation Pointer), 즉 함수 반환 주소
-
fcalls — 리덕션 카운터
Htop이나 E 같은 레지스터는 PCB의 해당 필드 값을 캐시해 둔 것입니다. 프로세스가 타임 슬라이스를 모두 소진하면 이 값들이 PCB에 다시 기록되고 다른 프로세스가 실행됩니다. BEAM이 한 프로세스를 다른 프로세스로 교체하는 시점을 결정하는 방식(일종의 협력형 멀티태스킹이라고 볼 수 있는 방식을 사용합니다)([Process Switching] 참조) 때문에, 이러한 교체가 일어날 때 모든 X 레지스터를 저장하고 복원할 필요가 없습니다 — 저장해야 하는 모든 것은 그 시점에 Y 레지스터에 들어 있기 때문입니다.
프레임 포인터(FP)가 반드시 “real” BEAM 레지스터일 필요는 없습니다 — 현재 스택 프레임의 크기를 알고 있다면 스택 최상단으로부터 계산할 수 있기 때문입니다. 그러나 이를 별도로 추적하면 구현의 다른 부분이 더 쉬워질 수 있으며, 설명도 간단해지므로 여기서는 FP가 존재하는 것처럼 다루겠습니다.
BEAM이 호출 명령어를 실행하면 연속 포인터(Continuation Pointer, CP)가 반환 주소로 설정됩니다. 반환 주소를 스택에 직접 푸시하지 않고 CP에 보관하므로, 반환 명령어는 I의 새 값을 CP와 같게 설정하고 실행을 계속하기만 하면 됩니다. 이는 평균적으로 전체 호출(꼬리 호출 제외)의 절반이 리프 함수, 즉 다른 함수를 더 이상 호출하지 않는 함수에 대한 호출이라는 사실에 기반한 최적화입니다. 리프 함수를 호출할 때는 반환 주소를 스택에 저장할 필요가 없습니다. 대신 리프가 아닌 함수만 CP를 스택에 저장했다가 반환하기 전에 복원하면 됩니다.
Figure 23는 Y 레지스터 두 개를 사용하고 CP를 스택에 저장한 함수를 예로 들어, BEAM에서 레지스터와 스택 프레임이 어떻게 배치되는지 보여 줍니다. X 레지스터와 Y 레지스터에는 즉시값이나 힙을 가리키는 태그된 포인터(Chapter 4 참조)가 들어갈 수 있지만, 스택 슬롯을 가리키는 일은 결코 없습니다. 예를 들어 스택 프레임 안에 저장되는 튜플은 없습니다.
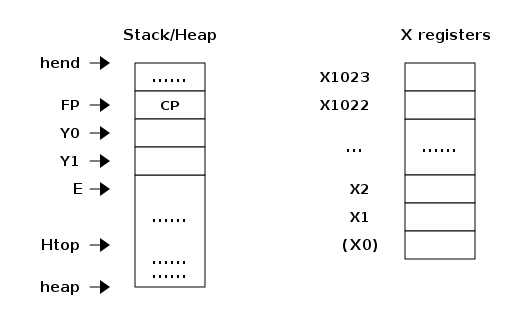
5.1.2. 스택 레이아웃 예시
다음 프로그램을 'S' 플래그로 컴파일해 봅시다:
-module(add).
-export([add/2]).

add(A,B) ->  id(A) + id(B).

id(I) -> I.
그러면 add/2 함수에 대해 다음과 같은 코드를 얻게 됩니다:
{function, add, 2, 2}.
  {label,1}.
    {line,[{location,"add.erl",4}]}.
    {func_info,{atom,add},{atom,add},2}.
  {label,2}.
    {allocate,1,2}.
    {move,{x,1},{y,0}}.
    {call,1,{f,4}}.
    {swap,{y,0},{x,0}}.
    {call,1,{f,4}}.
    {gc_bif,'+',{f,0},1,[{y,0},{x,0}],{x,0}}.
    {deallocate,1}.
    return.
관례에 따라 함수에 진입할 때 첫 번째 인자 A는 X0으로, 두 번째 인자 B는 X1로 전달됩니다. 코드(레이블 2부터 시작)가 먼저 스택 슬롯 하나만큼의 공간을 할당하는 것을 볼 수 있습니다.[4] 이렇게 하면 함수 호출 id(A) 동안 Y0을 사용해 X1의 값을 보존할 수 있으며, 이 작업은 {move,{x,1},{y,0}} 명령어가 수행합니다(“move X1 to Y0”로 읽거나, 명령형 스타일로는 y0 := x1로 씁니다).
인자 A는 이미 X0(첫 번째 인자 레지스터)에 있으므로, 레이블 {f,4}에 있는 id/1 함수(여기서는 보이지 않음)를 {call,1,{f,4}}로 직접 호출할 수 있습니다. (피연산자 "1"이 무엇을 뜻하는지는 나중에 다시 다루겠습니다.) 그런 다음 호출 결과(X0으로 반환됨)를 스택에 저장해야 하지만, Y0 슬롯은 이미 인자 B가 차지하고 있습니다. 다행히 이런 경우를 처리하는 swap 명령어가 있으므로, 먼저 Y0를 X1로, 다음으로 X0를 Y0로, 마지막으로 X1을 X0로 옮기는 세 개의 명령어를 사용하지 않아도 됩니다.
이제 X0에 두 번째 인자 B가 들어 있으므로, {call,1,{f,4}}로 id/1 함수를 다시 호출할 수 있습니다. 이 호출 뒤에는 X0에 id(B)가, Y0에 id(A)가 들어 있습니다. 내장 함수 +/2를 {gc_bif,'+',{f,0},1,[{y,0},{x,0}],{x,0}}로 호출하여 덧셈을 수행할 수 있습니다. (BIF 호출과 GC에 대해서는 뒤에서 자세히 다루겠습니다.) 결과는 다시 X0에 들어가며, 이곳은 add/2에서 반환하기 위해 결과가 있어야 하는 바로 그 위치입니다. 반환하기 전에는 deallocate 명령어로 스택 포인터를 다시 되돌리기만 하면 되며, 그러면 함수가 끝납니다.
5.2. BEAM 인터프리터
| 이 절에서 다루는 것은 BEAM 코드를 실행하는 더 새로운 방식이지만 지원되는 플랫폼에서만 동작하는 JIT 컴파일러가 아니라, 훨씬 오래전부터 존재해 왔으며 모든 플랫폼에서 동작하는 BEAM 명령어 인터프리터입니다. |
BEAM 인터프리터는 직접 스레디드 코드라는 기법으로 구현되어 있습니다. 이 맥락에서 threaded라는 단어는 OS 스레드, 동시성, 병렬성과는 아무런 관련이 없습니다. 여기서 꿰어지는(threaded) 것은 가상 머신 자체를 관통하는 실행 경로입니다.
5.2.1. 바이트코드 에뮬레이션
산술 식을 위한 단순한 스택 머신을 살펴보면, 실행할 명령어를 선택하기 위해 Erlang 아톰과 패턴 매칭을 사용한다는 것을 알 수 있습니다. 이는 기계 명령어를 디코딩하는 일만 하기에는 매우 무거운 장치입니다. 실제 머신 구현에서는 각 명령어를 "머신 워드" 정수나 심지어 단일 바이트로 코딩할 것입니다.
우리의 스택 머신을 C로 구현한 바이트코드 머신으로 다시 작성할 수 있습니다. 먼저 간단한 컴파일러가 바이트코드를 생성하도록 다시 작성합니다. 이 작업은 간단합니다. 아톰으로 인코딩된 각 명령어를 해당 명령어를 나타내는 바이트로 바꾸기만 하면 됩니다(아래 참조). 255보다 큰 정수를 처리할 수 있도록, 크기 바이트 뒤에 바이트 단위로 인코딩된 정수가 오는 형식으로 정수를 인코딩합니다.
compile(Expression, FileName) ->
    [ParseTree] = element(2,
			  erl_parse:parse_exprs(
			    element(2,
				    erl_scan:string(Expression)))),
    file:write_file(FileName, generate_code(ParseTree) ++ [stop()]).

generate_code({op, _Line, '+', Arg1, Arg2}) ->
    generate_code(Arg1) ++ generate_code(Arg2) ++ [add()];
generate_code({op, _Line, '*', Arg1, Arg2}) ->
    generate_code(Arg1) ++ generate_code(Arg2) ++ [multiply()];
generate_code({integer, _Line, I}) -> [push(), integer(I)].

stop()     -> 0.
add()      -> 1.
multiply() -> 2.
push()     -> 3.
integer(I) ->
    L = binary_to_list(binary:encode_unsigned(I)),
    [length(L) | L].
이제 C로 간단한 가상 머신과 바이트코드 인터프리터를 작성해 봅시다. (전체 코드는 온라인 부록에서 확인할 수 있습니다.)
#define STOP 0
#define ADD  1
#define MUL  2
#define PUSH 3

#define pop()   (stack[--sp])
#define push(X) (stack[sp++] = X)

int run(char *code) {
  int stack[1000];
  int sp = 0, size = 0, val = 0;
  char *ip = code;

  while (*ip != STOP) {
    switch (*ip++) {
    case ADD: push(pop() + pop()); break;
    case MUL: push(pop() * pop()); break;
    case PUSH:
      size = *ip++;
      val = 0;
      while (size--) { val = val * 256 + *ip++; }
      push(val);
      break;
    }
  }
  return pop();
}
보시다시피 C로 작성된 가상 머신은 그리 복잡할 필요가 없습니다. 이 머신은 단지 하나의 루프로, 각 명령어마다 명령어 포인터(ip)가 가리키는 값을 확인하여 바이트코드를 검사합니다.
각 바이트코드 명령어마다 명령어 바이트코드에 따라 분기하여 해당 명령어를 실행하는 case로 점프합니다. 이를 위해서는 명령어를 디코딩한 다음 올바른 코드로 점프해야 합니다. vsm.c의 어셈블리(gcc -S vsm.c)를 살펴보면 디코더의 내부 루프를 확인할 수 있습니다:
L11:
        movl    -16(%ebp), %eax
        movzbl  (%eax), %eax
        movsbl  %al, %eax
        addl    $1, -16(%ebp)
        cmpl    $2, %eax
        je      L7
        cmpl    $3, %eax
        je      L8
        cmpl    $1, %eax
        jne     L5
바이트코드를 각 명령어 코드와 비교한 다음 조건부 점프를 수행해야 합니다. 명령어가 많은 실제 머신에서는 이 작업의 비용이 상당히 커질 수 있습니다.
5.2.2. 스레디드 코드
더 나은 해결책은 코드의 주소를 담은 테이블을 두는 것입니다. 그러면 테이블의 인덱스로 주소를 불러와 아무런 비교 없이 바로 점프할 수 있습니다. 이 기법은 때때로 토큰 스레드 코드라고 불립니다. 여기서 한 걸음 더 나아가, 명령어를 구현하는 코드 조각의 주소를 코드 메모리에 “instruction” 그 자체로 저장할 수도 있습니다. 그러면 인터프리터 루프가 단일 바이트 대신 다음 주소를 읽고, 그 주소에 있는 루틴을 호출한 뒤, 루틴이 반환되면 그저 다음 주소로 넘어가도록 할 수 있습니다. 이를 subroutine threaded code 방식이라고 부릅니다. 다만 이 방식에서는 코드가 훨씬 더 많은 공간을 차지한다는 점에 유의하십시오. 명령어마다 단일 바이트 대신 워드 하나 전체를 사용하기 때문입니다. 그러나 메모리가 넉넉한 하드웨어에서는 대개 속도상의 이점 덕분에 그만한 가치가 있습니다. (토큰 스레드 코드(token threaded code)는 메모리가 부족하고 속도가 상대적으로 덜 중요할 수 있는 환경에서 자주 사용됩니다.)
이 방식은 런타임의 실행을 더 단순하게 만들지만, 로더가 필요하므로 VM을 더 복잡하게 만듭니다. 로더는 바이트코드 명령어를 그 명령어를 구현하는 함수의 주소로 치환합니다.
로더는 다음과 같은 형태일 수 있습니다:
typedef void (*instructionp_t)(void);

void add()  { int x,y; x = pop(); y = pop(); push(x + y); }
void mul()  { int x,y; x = pop(); y = pop(); push(x * y); }
void pushi(){ int x;   x = (int)*ip++;       push(x); }
void stop() { running = 0; }

instructionp_t *read_file(char *name) {
  FILE *file;
  instructionp_t *code;
  instructionp_t *cp;
  long  size;
  char ch;
  unsigned int val;

  file = fopen(name, "r");

  if(file == NULL) exit(1);

  fseek(file, 0L, SEEK_END);
  size = ftell(file);
  code = calloc(size, sizeof(instructionp_t));
  if(code == NULL) exit(1);
  cp = code;

  fseek(file, 0L, SEEK_SET);
  while ( ( ch = fgetc(file) ) != EOF )
    {
      switch (ch) {
      case ADD: *cp++ = &add; break;
      case MUL: *cp++ = &mul; break;
      case PUSH:
	*cp++ = &pushi;
	ch = fgetc(file);
	val = 0;
	while (ch--) { val = val * 256 + fgetc(file); }
	*cp++ = (instructionp_t) val;
	break;
      }
    }
  *cp = &stop;

  fclose(file);
  return code;
}
보시다시피 여기서는 255보다 큰 정수의 디코딩을 포함하여 로드 시점에 더 많은 작업을 수행합니다. (네, 알고 있습니다. 이 코드는 매우 큰 정수에 대해서는 안전하지 않습니다.)
하지만 VM의 디코드 및 디스패치 루프는 상당히 단순해집니다:
int run() {
  sp = 0;
  running = 1;

  while (running) (*ip++)();

  return pop();
}
마지막으로, 각 명령어 조각을 반환하는 함수로 만드는 대신, 메인 루프가 다음 명령어를 읽고 그곳으로 점프할 때 사용하는 것과 동일한 작은 코드 조각으로 각 조각이 끝나도록 코드를 작성할 수 있습니다. 이렇게 하면 메인 루프와 조각 사이를 오가는 일이 없어집니다 — 실제로 메인 루프 자체가 사라지고, 각 명령어 조각이 다음 명령어로 이어지도록 보장할 책임을 개별적으로 지게 됩니다. 이 기법을 직접 스레드 코드라고 부릅니다. 이를 C로 구현하기 위해 BEAM은 GCC의 “labels as values” 확장 기능을 사용합니다.
5.2.3. 실제 BEAM
BEAM 에뮬레이터는 나중에 더 자세히 살펴보겠지만, 지금은 실제 BEAM add 명령어가 어떻게 구현되어 있는지 간단히 살펴보겠습니다. 이 코드는 매크로를 많이 사용하기 때문에 따라가기가 다소 어렵습니다. STORE_ARITH_RESULT 매크로는 사실 디스패치 함수를 감추고 있으며, 이 함수는 대략 I += 4; Goto(*I);와 같은 형태입니다.
#define OpCase(OpCode)    lb_##OpCode
#define Goto(Rel) goto *(Rel)

...

 OpCase(i_plus_jId):
 {
     Eterm result;

     if (is_both_small(tmp_arg1, tmp_arg2)) {
	 Sint i = signed_val(tmp_arg1) + signed_val(tmp_arg2);
	 ASSERT(MY_IS_SSMALL(i) == IS_SSMALL(i));
	 if (MY_IS_SSMALL(i)) {
	     result = make_small(i);
	     STORE_ARITH_RESULT(result);
	 }

     }
     arith_func = ARITH_FUNC(mixed_plus);
     goto do_big_arith2;
 }
BEAM 디스패처가 어떻게 구현되어 있는지 조금 더 쉽게 이해할 수 있도록, 다소 가상적인 예제를 하나 들어 봅시다. 실제 외부 BEAM 코드로 시작하겠지만, 그다음에는 내부 BEAM 명령어 몇 가지를 제가 새로 만들어 C로 구현해 보겠습니다.
Erlang으로 작성한 간단한 add 함수부터 살펴봅시다.
add(A,B) -> id(A) + id(B).BEAM 코드로 컴파일하면 다음과 같습니다(정확히는 swap 명령어가 추가되기 전에는 이와 같았습니다 — Section 5.1.2 참조):
{function, add, 2, 2}.
  {label,1}.
    {func_info,{atom,add},{atom,add},2}.
  {label,2}.
    {allocate,1,2}.
    {move,{x,1},{y,0}}.
    {call,1,{f,4}}.
    {move,{x,0},{x,1}}.
    {move,{y,0},{x,0}}.
    {move,{x,1},{y,0}}.
    {call,1,{f,4}}.
    {gc_bif,'+',{f,0},1,[{y,0},{x,0}],{x,0}}.
    {deallocate,1}.
    return.
(전체 코드는 온라인 부록의 add.erl과 add.S를 참고하십시오.)
이제 이 코드에서 함수 호출 사이에 있는 세 개의 명령어를 자세히 살펴보면 다음과 같습니다:
    {move,{x,0},{x,1}}.
    {move,{y,0},{x,0}}.
    {move,{x,1},{y,0}}.
이 코드는 먼저 함수 호출의 반환값(x0)을 레지스터 x1로 옮깁니다. 그다음 이전에 저장해 둔 B를 스택 슬롯 y0에서 첫 번째 인자 레지스터(x0)로 옮깁니다. 마지막으로 x1의 값을 스택 슬롯(y0)으로 옮겨 다음 함수 호출 이후에도 그 값이 유지되도록 합니다.
BEAM에 move_xx, move_yx, move_xy라는 세 가지 명령어를 구현한다고 가정해 봅시다(이 글을 쓰는 시점에 실제 BEAM에는 이러한 명령어가 존재하지 않으며, 이 예시를 설명하기 위해 사용할 뿐입니다):
#define OpCase(OpCode)    lb_##OpCode
#define Goto(Rel) goto *((void *)Rel)
#define Arg(N) (Eterm *) I[(N)+1]

  OpCase(move_xx):
  {
     x(Arg(1)) = x(Arg(0));
     I += 3;
     Goto(*I);
  }

  OpCase(move_yx): {
    x(Arg(1)) = y(Arg(0));
    I += 3;
    Goto(*I);
  }

  OpCase(move_xy): {
    y(Arg(1)) = x(Arg(0));
    I += 3;
    Goto(*I);
  }
goto *의 별표는 역참조를 뜻하지 않는다는 점에 유의하십시오. 이 표현식은 주소 포인터로 점프한다는 의미이므로, 사실은 goto*로 쓰는 것이 맞습니다.
이제 이 명령어들에 대해 컴파일된 C 코드가 메모리 주소 0x3000, 0x3100, 0x3200에 위치하게 된다고 가정해 봅시다. BEAM 코드가 로드되면 코드 안에 있는 세 개의 move 명령어는 각 명령어 구현부의 메모리 주소로 대체됩니다. 코드({move,{x,0},{x,1}}, {move,{y,0},{x,0}}, {move,{x,1},{y,0}})가 주소 0x1000에 로드된다고 가정해 봅시다:
                    / 0x1000: 0x3000 -> 0x3000: OpCase(move_xx): x(Arg(1)) = x(Arg(0))
{move,{x,0},{x,1}} {  0x1004: 0x0                                I += 3;
                    \ 0x1008: 0x1                                Goto(*I);
                    / 0x100c: 0x3100
{move,{y,0},{x,0}} {  0x1010: 0x0
                    \ 0x1014: 0x0
                    / 0x1018: 0x3200
{move,{x,1},{y,0}} {  0x101c: 0x1
                    \ 0x1020: 0x0
주소 0x1000에 있는 워드는 move_xx 명령어의 구현을 가리킵니다. I 레지스터가 0x1000을 가리키는 명령어 포인터를 담고 있다면, 디스패치는 *I(즉, 0x3000)를 가져와 그 주소로 점프하는 동작(goto* *I)이 됩니다.
Chapter 7에서는 실제 BEAM 명령어 몇 가지와 그 구현 방식을 더 자세히 살펴보겠습니다.
5.3. 프로세스 전환
대부분의 최신 멀티스레딩 운영 체제는 선점형 스케줄링을 사용합니다. 이는 프로세스가 무엇을 하고 있는지와 관계없이 운영 체제가 한 프로세스에서 다른 프로세스로 언제 전환할지를 결정한다는 뜻이며, 이 전환은 일반적으로 인터럽트를 통해 이루어집니다. 이렇게 하면 어떤 프로세스가 제때 실행을 양보하지 않는 식으로 잘못 동작하더라도 다른 프로세스들이 그 영향을 받지 않습니다.
비선점형 스케줄러를 사용하는 협력형 멀티태스킹에서는 실행 중인 프로세스가 언제 양보할지를 스스로 결정합니다. 이 방식에는 잘못 동작하는 프로세스 하나가 CPU를 독점하여 다른 어떤 프로세스도 실행되지 못하게 만들 수 있다는 단점이 있습니다(예전 버전의 Microsoft Windows와 Mac OS, 또는 async/await로 동시성을 처리하는 JavaScript 같은 단일 스레드 언어에서와 마찬가지입니다).
반면에 양보하는 프로세스가 알려진 상태에서만 양보하도록 결정할 수 있다는 장점이 있습니다. 예를 들어 Erlang처럼 동적 메모리 관리와 태그된 값을 사용하는 언어에서는 작업 메모리에 태그되지 않은 값이 없고 댕글링 포인터나 초기화되지 않은 메모리 주소도 없을 때에만 프로세스가 양보하도록 구현을 설계할 수 있습니다.
add 명령어를 예로 들어 보겠습니다. 두 Erlang 정수를 더하려면 에뮬레이터는 먼저 정수의 태그를 제거하고, 두 값을 더한 뒤, 결과에 정수 태그를 붙여야 합니다. 완전한 선점형 스케줄러를 사용한다면 정수의 태그가 제거된 상태에서 프로세스가 중단되지 않는다는 보장이 없습니다. 또는 프로세스가 힙에 튜플을 생성하는 도중에 중단되어 튜플이 절반만 만들어진 상태로 남을 수도 있습니다. 이렇게 되면 중단된 프로세스의 스택과 힙을 순회하기가 매우 어려워집니다.
언어 수준에서 모든 프로세스는 동시에 실행되며, 프로그래머가 명시적인 양보(yield)를 직접 처리할 필요가 없어야 합니다. BEAM은 프로세스가 얼마나 오래 실행되었는지를 추적하여 이 문제를 해결합니다. 이는 리덕션 수를 세는 방식으로 이루어집니다. 이 용어는 원래 람다 대수에서 사용되는 수학 텀인 베타 리덕션에서 유래했습니다.
BEAM에서 리덕션의 정의는 그다지 명확하지 않지만, 이를 “small piece of work, which shouldn’t take too long”, 즉 너무 오래 걸리지 않아야 하는 작은 작업 단위라고 볼 수 있습니다. 각 함수 호출은 하나의 리덕션으로 계산됩니다. BEAM은 각 함수에 진입할 때마다 프로세스가 자신의 리덕션을 모두 소진했는지 검사합니다. 리덕션이 남아 있으면 함수가 실행되고, 그렇지 않으면 프로세스가 일시 중단되며 스케줄러가 실행 준비가 된 다른 프로세스를 골라 타임 슬라이스라고 부르는 일정한 수의 리덕션만큼 실행합니다. 이것은 협력형 멀티태스킹이지만 컴파일러가 구현하여 모든 프로그램이 올바르게 동작하도록 보장하는 방식이라고 볼 수 있습니다.
Erlang에는 직접적인 루프가 없고 꼬리 재귀 함수 호출만 있으므로, 리덕션을 소진하지 않으면서 상당한 양의 작업을 수행하는 프로그램을 작성하기는 매우 어렵습니다.
|
NIF를 직접 작성한다면 해당 NIF가 양보(yield)할 수 있도록 하고, 실행 시간에 비례하는 만큼 리덕션 카운터를 증가시키도록 하십시오. |
스케줄러의 동작 방식은 Chapter 10에서 자세히 살펴보겠습니다.
5.4. 메모리 관리
Erlang은 가비지 컬렉션을 사용하는 언어이므로, Erlang 프로그래머는 메모리 관리를 명시적으로 할 필요가 없습니다. 하지만 BEAM 코드 수준에서는 데이터 구조를 초기화하고, 스택과 힙의 오버런을 검사하며, 스택과 힙에 충분한 공간을 할당하는 일을 코드가 책임져야 합니다. 이를 올바르게 수행하지 않으면 크래시가 발생할 수 있습니다.
BEAM 명령어 test_heap은 요청한 만큼의 공간이 힙에 확보되도록 보장합니다. 이 명령어는 필요하면 가비지 컬렉터를 호출하여 힙의 공간을 회수합니다. 가비지 컬렉터는 다시 필요에 따라 메모리 서브시스템의 하위 계층을 호출하여 메모리를 할당하거나 해제합니다. 메모리 관리와 가비지 컬렉션의 세부 사항은 Chapter 11에서 살펴보겠습니다.
5.5. BEAM: 사실상 비현실적인 가상 머신
BEAM은 가상 머신입니다. 이는 BEAM이 하드웨어가 아닌 소프트웨어로 구현되어 있다는 의미입니다. FPGA로 BEAM을 구현하려는 프로젝트들도 있었으며, 누구든 BEAM을 하드웨어로 구현하지 못할 이유는 전혀 없습니다. BEAM을 추상 머신(Abstract Machine)이라고 부르고, BEAM 코드를 실행할 수 있는 머신의 청사진으로 보는 편이 더 나은 설명일 수 있습니다. 그리고 실제로 BEAM의 "AM"은 "Abstract Machine"의 약자입니다.
이 책에서는 추상 기계와 가상 머신 또는 그 구현을 구별하지 않습니다. 좀 더 엄밀하게 말하면 추상 기계는 컴퓨터의 이론적 모델이며, 가상 머신은 추상 기계를 소프트웨어로 구현한 것이거나 실제 물리적 기계를 소프트웨어로 에뮬레이션한 것입니다.
안타깝게도 BEAM에 대한 공식 명세는 존재하지 않습니다. 현재 BEAM은 Erlang/OTP의 구현으로만 정의되어 있습니다. 직접 BEAM을 구현하려면 어떤 부분이 본질적이고 어떤 부분이 우연적인지 알지 못한 채 현재 구현을 모방하려고 애써야 합니다. 유효한 BEAM 인터프리터를 만들었다고 확신하려면 관찰 가능한 모든 동작을 모방해야 합니다.
6. 모듈과 BEAM 파일 형식
6.1. 모듈
Erlang에서 모듈은 Erlang 함수를 담고 있는 파일입니다. 모듈은 관련된 함수를 한데 묶어 다른 모듈에서 사용할 수 있게 해 줍니다. Erlang에서 코드 로딩은 컴파일된 Erlang 모듈을 BEAM 가상 머신에 로드하는 프로세스입니다. 코드 로딩은 시작 시 정적으로 수행할 수도 있고, 시스템이 실행되는 동안 동적으로 수행할 수도 있습니다.
Erlang은 핫 코드 로딩을 지원합니다. 즉, 시스템을 중지하거나 재시작하지 않고도 시스템이 실행되는 동안 모듈을 업데이트할 수 있습니다. 이 기능은 개발과 디버깅 중에 매우 편리합니다. 시스템을 배포하는 방식에 따라서는 시스템을 중지하지 않고 모듈을 업그레이드할 수 있으므로, 24시간 연중무휴로 가동되는 시스템을 유지 관리하고 운영할 때에도 유용할 수 있습니다.
새 코드가 로드되면, 이전 버전은 그 코드를 실행하는 프로세스가 하나도 남지 않을 때까지 메모리에 남아 있습니다. 그렇게 되면 이전 코드는 시스템에서 퍼지(purge)됩니다. 첫 번째 버전이 퍼지되기 전에 모듈의 세 번째 버전을 로드하면, 시스템은 기본적으로 첫 번째 버전을 참조하는(스택에 해당 버전에 대한 호출이 있는) 모든 프로세스를 종료한다는 점에 유의하십시오.
code:load_file(Module) 함수를 사용하면 모듈을 시스템에 동적으로 로드할 수 있습니다. 새 모듈이 로드되면 원격 호출이라고도 하는 완전 한정 호출(즉, Module:function)은 모두 새 버전으로 향합니다. 원격 호출이 없는 서버 루프는 이전 코드를 계속 실행한다는 점에 유의하십시오.
코드 서버는 로드된 모듈과 그 코드를 관리하는 BEAM 가상 머신의 구성 요소입니다.
Erlang의 분산 모델과 핫 코드 로딩 기능 덕분에 분산 시스템의 여러 노드에 걸쳐 코드를 업데이트할 수 있습니다. 그러나 이는 신중한 조율이 필요한 복잡한 작업입니다.
6.2. BEAM 파일 형식
beam 파일 형식에 관한 가장 확실한 정보원은 당연히 beam_lib.erl의 소스 코드입니다(https://github.com/erlang/otp/blob/maint/lib/stdlib/src/beam_lib.erl 참조). 사실 Beam의 주 개발자이자 메인테이너가 작성한, 더 읽기 쉽지만 다소 오래된 형식 설명도 있습니다(http://www.erlang.se/~bjorn/beam_file_format.html 참조).
beam 파일 형식은 교환 파일 형식(EA IFF)#을 기반으로 하되, 두 가지 작은 변경 사항이 있습니다. 이 변경 사항은 곧 살펴보겠습니다. IFF 파일은 헤더로 시작하고, 그 뒤에 여러 개의 “청크”가 이어집니다. IFF 명세에는 주로 이미지와 음악을 다루는 여러 표준 청크 유형이 있습니다. 그러나 IFF 표준에서는 이름을 붙인 청크를 직접 정의할 수도 있으며, BEAM이 바로 이 방식을 사용합니다.
| Beam 파일은 각 청크가 IFF 표준처럼 2바이트 경계가 아니라 4바이트 경계(즉, 32비트 워드)에 정렬된다는 점에서 표준 IFF 파일과 다릅니다. 이 파일이 표준 IFF 파일이 아님을 나타내기 위해 IFF 헤더에는 “FOR” 대신 “FOR1” 태그가 붙습니다. IFF 명세에서는 향후 확장을 위해 이 태그를 사용하도록 제안합니다. |
Beam은 폼 타입 “BEAM”을 사용합니다. beam 파일 헤더의 레이아웃은 다음과 같습니다:
BEAMHeader = <<
  IffHeader:4/unit:8 = "FOR1",
  Size:32/big,                  // big endian, how many more bytes are there
  FormType:4/unit:8 = "BEAM"
>>
헤더 뒤에는 여러 개의 청크가 있습니다. 각 청크의 크기는 4의 배수로 정렬되며, 각 청크에는 자체 헤더(아래 참조)가 있습니다.
| 정렬되지 않은 메모리 바이트 접근이 하드웨어 예외(Linux에서는 SIGBUS라고 합니다)를 일으키는 일부 플랫폼에서는 정렬이 중요합니다. 이는 성능 저하로 이어질 수 있으며, 해당 예외로 인해 VM이 크래시될 수도 있습니다. |
BEAMChunk = <<
  ChunkName:4/unit:8,           // "Code", "Atom", "StrT", "LitT", ...
  ChunkSize:32/big,
  ChunkData:ChunkSize/unit:8,   // data format is defined by ChunkName
  Padding4:0..3/unit:8
>>
이 파일 형식은 모든 영역 앞에 뒤따르는 영역의 크기를 붙여 두므로, 디스크에서 파일을 읽으면서 바로 파싱하기가 쉽습니다. beam 파일의 구조와 내용을 설명하기 위해, beam 파일에서 모든 청크를 추출하는 작은 프로그램을 작성하겠습니다. 이 프로그램을 최대한 간단하고 읽기 쉽게 만들기 위해 파일을 읽으면서 파싱하지 않고, 대신 파일 전체를 바이너리로 메모리에 적재한 다음 각 청크를 파싱하겠습니다. 첫 번째 단계는 모든 청크의 목록을 얻는 것입니다:
-module(beamfile1).
-export([read/1]).

read(Filename) ->
   {ok, File} = file:read_file(Filename),
   <<"FOR1",
     Size:32/integer,
     "BEAM",
     Chunks/binary>> = File,
   {Size, read_chunks(Chunks, [])}.

read_chunks(<<N,A,M,E, Size:32/integer, Tail/binary>>, Acc) ->
   %% Align each chunk on even 4 bytes
   ChunkLength = align_by_four(Size),
   <<Chunk:ChunkLength/binary, Rest/binary>> = Tail,
   read_chunks(Rest, [{[N,A,M,E], Size, Chunk}|Acc]);
read_chunks(<<>>, Acc) -> lists:reverse(Acc).

align_by_four(N) -> (4 * ((N+3) div 4)).
실행 예시는 다음과 같습니다:
> beamfile1:read("beamfile1.beam").
{1116, [{"AtU8",127,
 <<0,0,0,16,9,98,101,97,109,102,105,108,101,49,4,114,101,
 97,100,4,102,105,108,...>>}, {"Code",362,
 <<0,0,0,16,0,0,0,0,0,0,0,178,0,0,0,16,0,0,0,5,1,16,...>>},
 {"StrT",8,<<"FOR1BEAM">>},
 {"ImpT",88,<<0,0,0,7,0,0,0,3,0,0,0,4,0,0,0,1,0,0,0,8,...>>},
 {"ExpT",40,<<0,0,0,3,0,0,0,15,0,0,0,1,0,0,0,15,0,0,0,...>>}, {"Meta",29,
 <<131,108,0,0,0,1,104,2,100,0,16,101,110,97,98,108,101, 100,...>>},
 {"LocT",28,<<0,0,0,2,0,0,0,10,0,0,0,1,0,0,0,11,0,...>>}, {"Attr",40,
 <<131,108,0,0,0,1,104,2,100,0,3,118,115,110,108,0,...>>}, {"CInf",122,
 <<131,108,0,0,0,3,104,2,100,0,7,118,101,114,115,...>>}, {"Dbgi",49,
 <<131,104,3,100,0,13,100,101,98,117,103,95,105,110,...>>},
 {"Line",31,<<0,0,0,0,0,0,0,0,0,0,0,12,0,...>>},
 {"Type",80,<<0,0,0,1,0,0,0,4,31,255,0,0,...>>}]}
여기에서 BEAM이 사용하는 청크 이름을 확인할 수 있습니다.
6.2.1. 아톰 테이블 청크
Atom이라는 이름의 청크나 AtU8이라는 이름의 청크 중 하나는 반드시 있어야 합니다. 이 청크에는 모듈이 참조하는 모든 아톰이 들어 있습니다. latin1 인코딩을 사용하는 소스 파일에는 Atom이라는 이름의 청크를 사용합니다. utf8로 인코딩된 모듈에서는 청크 이름이 AtU8입니다. 아톰 청크의 형식은 다음과 같습니다:
AtomChunk = <<
  ChunkName:4/unit:8 = "Atom",
  ChunkSize:32/big,
  NumberOfAtoms:32/big,
  [<<AtomLength:8, AtomName:AtomLength/unit:8>> || repeat NumberOfAtoms],
  Padding4:0..3/unit:8
>>
AtU8 청크의 형식은 청크 이름이 AtU8이라는 점을 제외하면 위와 동일합니다.
| 모듈 이름은 항상 테이블의 첫 번째 아톰(아톰 인덱스 0)으로 저장됩니다. |
Beam 파일 리더에 아톰 청크용 디코더를 추가합시다:
-module(beamfile2).
-export([read/1]).

read(Filename) ->
   {ok, File} = file:read_file(Filename),
   <<"FOR1",
     Size:32/integer,
     "BEAM",
     Chunks/binary>> = File,
   {Size, parse_chunks(read_chunks(Chunks, []),[])}.

read_chunks(<<N,A,M,E, Size:32/integer, Tail/binary>>, Acc) ->
   %% Align each chunk on even 4 bytes
   ChunkLength = align_by_four(Size),
   <<Chunk:ChunkLength/binary, Rest/binary>> = Tail,
   read_chunks(Rest, [{[N,A,M,E], Size, Chunk}|Acc]);
read_chunks(<<>>, Acc) -> lists:reverse(Acc).

parse_chunks([{"AtU8", _Size,
             <<_Numberofatoms:32/integer, Atoms/binary>>}
            | Rest], Acc) ->
   parse_chunks(Rest,[{atoms,parse_atoms(Atoms)}|Acc]);
parse_chunks([Chunk|Rest], Acc) -> %% Not yet implemented chunk
   parse_chunks(Rest, [Chunk|Acc]);
parse_chunks([],Acc) -> Acc.

parse_atoms(<<Atomlength, Atom:Atomlength/binary, Rest/binary>>) when Atomlength > 0->
   [list_to_atom(binary_to_list(Atom)) | parse_atoms(Rest)];
parse_atoms(_Alignment) -> [].

align_by_four(N) -> (4 * ((N+3) div 4)).
6.2.2. 익스포트 테이블 청크
ExpT(EXPort Table, 익스포트 테이블)라는 이름의 청크는 필수이며, 어떤 함수가 익스포트되는지에 대한 정보를 담고 있습니다.
익스포트 청크의 형식은 다음과 같습니다.
ExportChunk = <<
  ChunkName:4/unit:8 = "ExpT",
  ChunkSize:32/big,
  ExportCount:32/big,
  [ << FunctionName:32/big,
       Arity:32/big,
       Label:32/big
    >> || repeat ExportCount ],
  Padding4:0..3/unit:8
>>FunctionName은 아톰 테이블의 인덱스입니다.
아톰 처리 절 뒤에 다음 절을 추가하여 parse_chunk 함수를 확장할 수 있습니다:
parse_chunks([{"ExpT", _Size,
             <<_Numberofentries:32/integer, Exports/binary>>}
            | Rest], Acc) ->
   parse_chunks(Rest,[{exports,parse_exports(Exports)}|Acc]);

...

parse_exports(<<Function:32/integer,
               Arity:32/integer,
               Label:32/integer,
               Rest/binary>>) ->
   [{Function, Arity, Label} | parse_exports(Rest)];
parse_exports(<<>>) -> [].
6.2.3. 임포트 테이블 청크
ImpT(IMPort Table, 임포트 테이블)라는 이름의 청크는 필수이며, 어떤 함수가 임포트되는지에 대한 정보를 담고 있습니다.
청크의 형식은 다음과 같습니다:
ImportChunk = <<
  ChunkName:4/unit:8 = "ImpT",
  ChunkSize:32/big,
  ImportCount:32/big,
  [ << ModuleName:32/big,
       FunctionName:32/big,
       Arity:32/big
    >> || repeat ImportCount ],
  Padding4:0..3/unit:8
>>
여기서 ModuleName과 FunctionName은 아톰 테이블의 인덱스입니다.
| 임포트 테이블을 파싱하는 코드는 익스포트 테이블을 파싱하는 코드와 비슷하지만 완전히 같지는 않습니다. 두 테이블 모두 32비트 정수 세 개로 이루어진 묶음으로 구성되지만, 각 값의 의미가 다를 뿐입니다. 전체 코드는 이 장의 끝부분에서 확인하십시오. |
6.2.4. 코드 청크
Code라는 이름의 청크는 모듈의 BEAM 코드를 담고 있으며 필수입니다. 청크의 형식은 다음과 같습니다:
CodeChunk = <<
  ChunkName:4/unit:8 = "Code",
  ChunkSize:32/big,
  SubSize:32/big,
  InstructionSet:32/big,        % Must match code version in the emulator
  OpcodeMax:32/big,
  LabelCount:32/big,
  FunctionCount:32/big,
  Code:(ChunkSize-SubSize)/binary,  % all remaining data
  Padding4:0..3/unit:8
>>
SubSize 필드에는 코드가 시작되기 전까지의 워드 수가 저장됩니다. 이 덕분에 이전 로더를 깨뜨리지 않고도 코드 청크에 새로운 정보 필드를 추가할 수 있습니다.
InstructionSet 필드는 해당 파일이 사용하는 명령어 집합의 버전을 나타냅니다. 명령어가 하나라도 호환되지 않는 방식으로 변경되면 버전 번호가 증가합니다.
OpcodeMax 필드는 코드에서 사용된 옵코드 중 가장 큰 번호를 나타냅니다. 새 명령어는 시스템에 추가될 수 있으며, 파일에서 사용된 명령어가 로더가 알고 있는 범위 안에 있기만 하면 이전 로더도 더 새로운 파일을 로드할 수 있습니다.
LabelCount 필드에는 레이블 수가 들어 있으므로, 로더는 한 번의 호출로 알맞은 크기의 레이블 테이블을 미리 할당할 수 있습니다. FunctionCount 필드에는 함수 수가 들어 있으므로, 함수 테이블도 효율적으로 미리 할당할 수 있습니다.
Code 필드에는 서로 연결된 명령어들이 들어 있으며, 각 명령어의 형식은 다음과 같습니다:
Instruction = <<
  InstructionCode:8,
  [beam_asm:encode(Argument) || repeat Arity]
>>
여기서 Arity는 테이블에 하드코딩되어 있으며, 이 테이블은 에뮬레이터를 소스에서 빌드할 때 genop 스크립트가 ops.tab으로부터 생성합니다.
beam_asm:encode가 생성하는 인코딩은 아래의 간결한 텀 인코딩(Compact Term Encoding) 절에서 설명합니다.
프로그램에 다음 코드를 추가하면 코드 청크를 파싱해 낼 수 있습니다:
parse_chunks([{"Code", Size, <<SubSize:32/integer,Chunk/binary>>
              } | Rest], Acc) ->
   <<Info:SubSize/binary, Code/binary>> = Chunk,
   %% 8 is size of ChunkSize & SubSize
   OpcodeSize = Size - SubSize - 8,
   <<OpCodes:OpcodeSize/binary, _Align/binary>> = Code,
   parse_chunks(Rest,[{code,parse_code_info(Info), OpCodes}
                      | Acc]);

...

parse_code_info(<<Instructionset:32/integer,
		  OpcodeMax:32/integer,
		  NumberOfLabels:32/integer,
		  NumberOfFunctions:32/integer,
		  Rest/binary>>) ->
   [{instructionset, Instructionset},
    {opcodemax, OpcodeMax},
    {numberoflabels, NumberOfLabels},
    {numberofFunctions, NumberOfFunctions} |
    case Rest of
	 <<>> -> [];
	 _ -> [{newinfo, Rest}]
    end].
BEAM 명령어를 디코딩하는 방법은 이름부터 적절한 “BEAM 명령어” 장에서 나중에 배웁니다.
6.2.5. 문자열 테이블 청크
StrT라는 이름의 청크는 필수이며, 모듈에 있는 모든 상수 문자열 리터럴을 하나의 긴 문자열로 담고 있습니다. 문자열 리터럴이 없더라도 청크는 여전히 존재해야 하며, 이 경우 청크는 비어 있고 크기가 0이어야 합니다.
청크의 형식은 다음과 같습니다:
StringChunk = <<
  ChunkName:4/unit:8 = "StrT",
  ChunkSize:32/big,
  Data:ChunkSize/binary,
  Padding4:0..3/unit:8
>>
문자열 청크는 바이트 문자열을 바이너리로 바꾸기만 하면 쉽게 파싱할 수 있습니다:
parse_chunks([{"StrT", _Size, <<Strings/binary>>} | Rest], Acc) ->
    parse_chunks(Rest,[{strings,binary_to_list(Strings)}|Acc]);
6.2.6. 속성 청크
Attr라는 이름의 청크는 선택 사항이지만, 일부 OTP 도구는 속성이 존재하기를 기대합니다. 릴리스 핸들러는 "vsn" 속성이 존재하기를 기대합니다. 파일에서 버전 속성은 beam_lib:version(Filename)으로 가져올 수 있으며, 이 함수는 "vsn" 속성이 들어 있는 속성 청크가 존재한다고 가정합니다.
청크의 형식은 다음과 같습니다:
AttributesChunk = <<
  ChunkName:4/unit:8 = "Attr",
  ChunkSize:32/big,
  Attributes:ChunkSize/binary,
  Padding4:0..3/unit:8
>>
속성 청크는 다음과 같이 파싱할 수 있습니다.
parse_chunks([{"Attr", Size, Chunk} | Rest], Acc) ->
    <<Bin:Size/binary, _Pad/binary>> = Chunk,
    Attribs = binary_to_term(Bin),
    parse_chunks(Rest,[{attributes,Attribs}|Acc]);
6.2.7. 컴파일 정보 청크
CInf라는 이름의 청크는 선택 사항이지만, 일부 OTP 도구는 이 정보가 있을 것으로 예상합니다.
청크의 형식은 다음과 같습니다.
CompilationInfoChunk = <<
  ChunkName:4/unit:8 = "CInf",
  ChunkSize:32/big,
  Data:ChunkSize/binary,
  Padding4:0..3/unit:8
>>
컴파일 정보 청크는 다음과 같이 파싱할 수 있습니다:
parse_chunks([{"CInf", Size, Chunk} | Rest], Acc) ->
    <<Bin:Size/binary, _Pad/binary>> = Chunk,
    CInfo = binary_to_term(Bin),
    parse_chunks(Rest,[{compile_info,CInfo}|Acc]);
6.2.8. 로컬 함수 테이블 청크
LocT라는 이름의 청크는 선택 사항이며 상호 참조 도구에서 사용하기 위한 것입니다.
형식은 익스포트 테이블의 형식과 같습니다:
LocalFunTableChunk = <<
  ChunkName:4/unit:8 = "LocT",
  ChunkSize:32/big,
  FunctionCount:32/big,
  [ << FunctionName:32/big,
       Arity:32/big,
       Label:32/big
    >> || repeat FunctionCount ],
  Padding4:0..3/unit:8
>>| 로컬 함수 테이블을 파싱하는 코드는 익스포트 테이블과 임포트 테이블을 파싱하는 코드와 기본적으로 같으며, 실제로 모든 테이블의 항목을 같은 함수로 파싱할 수 있습니다. 전체 코드는 이 장의 끝에서 확인하십시오. |
6.2.9. 리터럴 테이블 청크
LitT라는 이름의 청크는 선택 사항이며, 모듈 소스에 있는 리터럴 값 중 즉시 값(immediate value)이 아닌 모든 값을 압축된 형태로 담고 있습니다. 청크의 형식은 다음과 같습니다.
LiteralTableChunk = <<
  ChunkName:4/unit:8 = "LitT",
  ChunkSize:32/big,
  UncompressedSize:32/big,      % It is nice to know the size to allocate some memory
  CompressedLiterals:ChunkSize/binary,
  Padding4:0..3/unit:8
>>
여기서 CompressedLiterals는 정확히 UncompressedSize 바이트여야 합니다. 테이블의 각 리터럴은 외부 텀 형식(External Term Format, erlang:term_to_binary)으로 인코딩됩니다. CompressedLiterals의 형식은 다음과 같습니다:
CompressedLiterals = <<
  Count:32/big,
  [ <<Size:32/big, Literal:binary>>  || repeat Count ]
>>
테이블 전체는 zlib:compress/1(deflate 알고리즘)로 압축되어 있으며, zlib:uncompress/1(inflate 알고리즘)로 압축을 해제할 수 있습니다.
이 청크는 다음과 같이 파싱할 수 있습니다.
parse_chunks([{"LitT", _ChunkSize,
              <<_UnCompressedTableSize:32, Compressed/binary>>}
             | Rest], Acc) ->
    <<_NumLiterals:32,Table/binary>> = zlib:uncompress(Compressed),
    Literals = parse_literals(Table),
    parse_chunks(Rest,[{literals,Literals}|Acc]);

...

parse_literals(<<Size:32,Literal:Size/binary,Tail/binary>>) ->
    [binary_to_term(Literal) | parse_literals(Tail)];
parse_literals(<<>>) -> [].
6.2.10. 추상 코드 청크
Abst라는 이름의 청크는 선택 사항이며, 추상 형식으로 된 코드를 담을 수 있습니다. 컴파일러에 debug_info 플래그를 지정하면 컴파일러는 모듈의 추상 구문 트리를 이 청크에 저장합니다. 디버거나 Xref 같은 OTP 도구에는 추상 형식이 필요합니다. 청크의 형식은 다음과 같습니다.
AbstractCodeChunk = <<
  ChunkName:4/unit:8 = "Abst",
  ChunkSize:32/big,
  AbstractCode:ChunkSize/binary,
  Padding4:0..3/unit:8
>>
이 청크는 다음과 같이 파싱할 수 있습니다
parse_chunks([{"Abst", _ChunkSize, <<>>} | Rest], Acc) ->
    parse_chunks(Rest,Acc);
parse_chunks([{"Abst", _ChunkSize, <<AbstractCode/binary>>} | Rest], Acc) ->
    parse_chunks(Rest,[{abstract_code,binary_to_term(AbstractCode)}|Acc]);
6.2.11. 추가 BEAM 청크
Erlang OTP 16 이후로 여러 새로운 청크가 추가되었습니다:
-
Type 청크(
Type): OTP 25에서 도입되었으며, JIT 최적화에 도움이 되는 단순화된 타입 정보를 담고 있습니다. -
함수 테이블 청크(
FunT): 익명 함수(fun)에 대한 메타데이터입니다. -
메타데이터 청크(
Meta): 문서나 어노테이션 같은 선택적 메타데이터를 담습니다.
새 청크의 형식은 다음과 같습니다:
타입 청크(Type):
TypeChunk = <<
  ChunkName:4/unit:8 = "Type",
  ChunkSize:32/big,
  Version:32/big,
  Count:32/big,
  TypeData:(Count * 16)/binary,
  Padding4:0..3/unit:8
>>
Type 청크에는 JIT 컴파일러가 최적화에 사용하는 단순화된 타입 정보가 담겨 있습니다. 각 타입 항목은 16바이트 고정 크기 레코드입니다. 이 데이터는 Erlang 외부 텀 형식이 아니므로 binary_to_term으로 디코딩할 수 없습니다. 인코딩 방식은 컴파일러의 beam_types.erl을 참조하십시오.
파싱:
parse_chunks([{"Type", _Size, Chunk} | Rest], Acc) ->
    <<_Version:32/big, Count:32/big, TypeData/binary>> = Chunk,
    Types = parse_types(Count, TypeData, []),
parse_chunks(Rest, [{type_info, Types}|Acc]);-
UTF-8 아톰 청크(
AtU8): 아톰 청크와 형식이 같으며, UTF-8 인코딩이 필요할 때 사용됩니다:
AtU8Chunk = <<
  ChunkName:4/unit:8 = "AtU8",
  ChunkSize:32/big,
  NumberOfAtoms:32/big,
  [<<AtomLength:8, AtomName:AtomLength/unit:8>> || repeat NumberOfAtoms],
  Padding4:0..3/unit:8
>>-
함수 테이블(
FunT): 로컬 익명 함수에 대한 정보입니다:
FunTableChunk = <<
  ChunkName:4/unit:8 = "FunT",
  ChunkSize:32/big, FunCount:32/big, [<<FunctionName:32/big, Arity:32/big,
      Label:32/big
   >> || repeat FunCount],
  Padding4:0..3/unit:8
>>-
메타데이터 청크(
Meta): 어노테이션이나 사용자 정의 속성 같은 메타데이터를 저장합니다:
MetaChunk = <<
  ChunkName:4/unit:8 = "Meta",
  ChunkSize:32/big,
  MetaInfo:ChunkSize/binary,
  Padding4:0..3/unit:8
>>
파싱 예시:
parse_chunks([{"Meta", Size, Chunk} | Rest], Acc) ->
    <<MetaInfo:Size/binary, _Pad/binary>> = Chunk,
    Meta = binary_to_term(MetaInfo),
    parse_chunks(Rest, [{meta, Meta}|Acc]);
6.2.12. 암호화
Erlang에서는 BEAM 파일에 있는 디버그 정보를 암호화할 수 있습니다. 이 기능을 사용하면 개발자는 소스 코드를 기밀로 유지하면서도 디버거나 Xref 같은 도구를 계속 활용할 수 있습니다.
암호화된 디버그 정보를 사용하려면 컴파일러와 beam_lib 양쪽 모두에 키를 제공해야 합니다. 이 키는 문자열로 지정하며, 대문자와 소문자, 숫자, 특수 문자를 모두 포함하여 32자 이상으로 구성하는 것이 이상적입니다.
기본값이자 현재 사용되는 유일한 암호화 알고리즘 유형은 des3_cbc이며, 이는 CBC(Cipher Block Chaining) 모드의 트리플 DES(Data Encryption Standard)를 뜻합니다. des3_cbc에 사용할 키를 생성하기 위해 키 문자열을 erlang:md5/1로 스크램블합니다.
키는 두 가지 방법으로 제공할 수 있습니다.
-
컴파일러 옵션: 컴파일러 옵션 {debug_info_key,Key}와 함수 crypto_key_fun/1을 사용하여, beam_lib이 디버그 정보를 복호화해야 할 때마다 키를 반환하는 함수를 등록하십시오.
-
.erlang.crypt 파일: 등록된 함수가 없으면 beam_lib는 현재 디렉터리, 사용자의 홈 디렉터리, 마지막으로 filename:basedir(user_config, "erlang") 순서로 .erlang.crypt 파일을 찾습니다. 파일을 찾았고 그 안에 키가 들어 있으면 beam_lib는 crypto 키 함수를 암묵적으로 생성하여 등록합니다.
파일 .erlang.crypt에는 {debug_info, Mode, Module, Key} 형식의 튜플 리스트가 들어 있어야 하며, 여기서 Module은 대상 모듈을 나타냅니다. Mode는 암호화 알고리즘의 종류이고(현재는 des3_cbc만 허용됩니다), Module은 아톰(이 경우 Key는 해당 모듈에만 사용됩니다)이거나 [](이 경우 Key는 모든 모듈에 사용됩니다)이며, Key는 비어 있지 않은 키 문자열입니다.
모드(Mode)와 모듈(Module)이 모두 일치하는 첫 번째 튜플의 키가 사용됩니다. 암호화된 디버그 정보의 안전성을 보장하려면 고유한 키를 사용하고 이를 안전하게 보관하는 것이 중요합니다.
6.2.13. 압축
Erlang 컴파일러에 compressed 플래그를 전달하면 컴파일러가 생성하는 BEAM 파일을 압축하도록 지시합니다. 이렇게 하면 파일 크기를 상당히 줄일 수 있으며, 디스크 공간이 부족한 환경에서 유용합니다.
compressed 플래그는 BEAM 파일에서 Erlang 코드와 리터럴 데이터가 담긴 부분에 zlib 압축을 적용합니다. 코드의 압축 해제는 실행할 때가 아니라 메모리에 로드할 때 이루어지므로, 이 플래그는 코드의 실행 속도에 영향을 주지 않습니다.
compressed 플래그를 사용하려면 다음과 같이 compile 함수에 옵션으로 전달하면 됩니다:
compile:file(Module, [compressed]).또는 erlc 명령줄 컴파일러를 사용하는 경우 +compressed 옵션을 전달할 수 있습니다:
erlc +compressed module.erlcompressed 플래그를 사용하면 BEAM 파일의 크기를 줄일 수 있지만, 코드의 압축을 풀어야 하므로 모듈을 로드하는 데 걸리는 시간도 늘어난다는 점에 유의해야 합니다. 따라서 이는 디스크 공간과 로드 시간 사이의 트레이드오프입니다.
6.2.14. 간결한 텀 인코딩
beam_asm:encode에서 사용하는 인코딩을 살펴봅시다. BEAM 파일은 단순한 텀을 효율적으로 저장하도록 설계된 간결한 인코딩 방식을 사용합니다. 이 방식은 파일 크기를 줄이도록 특별히 설계되었으며, 메모리상 텀의 메모리 레이아웃과는 크게 다릅니다. 디코딩 후에는 인코딩된 모든 값이 완전한 크기의 머신 워드나 Erlang 텀으로 확장됩니다.
Beam_asm은 Erlang 분산판에 포함된 compiler 애플리케이션의 모듈로, beam 모듈의 바이너리 콘텐츠를 어셈블하는 데 사용됩니다.
|
이 인코딩 방식의 주된 목표는 간결성입니다. 이 방식은 단순한 텀을 더 적은 비트에 담아 효율적으로 인코딩합니다. 이렇게 압축된 텀은 디코딩하면 표준 머신 워드나 Erlang 텀으로 확장됩니다.
다음은 최근 변경 사항(특히 OTP 20과 OTP 25의 변경 사항)을 포함한 태그 형식입니다:
OTP 20부터 이 태그 형식이 변경되어 Extended - Float가 사라졌습니다. 이후의 모든 태그 값은 1씩 아래로 이동합니다. List는 2#10111, fpreg는 2#100111, alloc list는 2#110111, 리터럴은 2#1010111입니다. 이제 부동소수점 값은 BEAM 파일의 리터럴 영역에 바로 저장됩니다.
|
첫 번째 바이트의 처음 3비트를 사용하여 뒤따르는 값의 타입을 정의하는 태그를 저장합니다. 이 비트가 모두 1이면(특수 값 7, 즉 beam_opcodes.hrl에 정의된 ?tag_z), 몇 비트를 더 사용합니다.
16 미만의 값은 3번 비트를 0으로 설정하고 값 전체를 4-5-6-7번 비트에 담습니다:
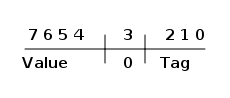
2048(16#800) 미만의 값에서는 비트 3이 1로 설정되어 연속 바이트 1개가 사용됨을 나타내며, 값의 최상위 3비트가 이 바이트의 비트 5-6-7로 확장됩니다:
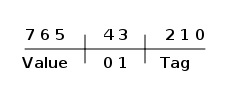
더 큰 값과 음수 값은 먼저 바이트로 변환됩니다. 그런 다음 값이 2..8바이트를 차지하면 비트 3-4는 1로 설정되고, 비트 5-6-7에는 값의 (Bytes-2) 크기가 담기며, 그 뒤에 값이 이어집니다:
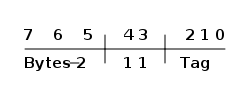
다음 값이 8바이트보다 크면 비트 3-4-5-6-7이 모두 1로 설정되고, 그 뒤에 값이 (Bytes-9):8인 중첩 인코딩된 부호 없는 리터럴(beam_opcodes.hrl의 매크로 ?tag_u)이 오며, 그다음에 데이터가 옵니다:
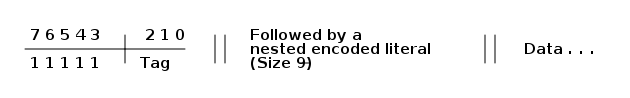
태그 타입
컴팩트 텀 형식을 읽을 때, 결과로 얻은 정수는 Tag의 값에 따라 다르게 해석될 수 있습니다.
-
리터럴의 경우 값은 리터럴 테이블의 인덱스입니다.
-
아톰의 경우 값은 아톰 인덱스에서 1을 뺀 값입니다. 값이 0이면 대신
NIL(빈 리스트)을 의미합니다. -
레이블의 경우 0은 유효하지 않은 값을 의미합니다.
-
태그가 character이면 값은 부호 없는 유니코드 코드 포인트입니다.
-
태그 Extended List는 텀의 쌍을 담고 있습니다.
Size를 읽고, 크기가Size인 튜플을 생성한 다음Size/2개의 쌍을 읽어 그 안에 넣습니다. 각 쌍은Value와Label로 이루어집니다.Value는 비교 대상이 되는 텀이고,Label은 일치할 때 점프할 위치입니다. 이는select_val명령어에서 사용됩니다.
| 타입 힌트가 추가되면서 컴파일러와 JIT가 더 긴밀하게 협력할 수 있게 되었으며, 그 결과 OTP 25 이후 버전에서는 런타임 성능이 더욱 최적화되었습니다. |
이것이 어떻게 인코딩되는지에 대한 자세한 내용은 컴파일러 애플리케이션의 beam_asm:encode/2를 참조하십시오. 태그 값은 이 절에서 제시하지만, beam_makeops가 생성하는 compiler/src/beam_opcodes.hrl에서도 찾을 수 있습니다.
7. 일반 BEAM 명령어
BEAM에는 서로 다른 두 가지 명령어 집합이 있습니다. 하나는 specific이라고 불리는 내부 명령어 집합이고, 다른 하나는 generic이라고 불리는 외부 명령어 집합입니다.
범용 명령어 집합은 공식 명령어 집합이라고 부를 수 있는 것으로, 컴파일러와 BEAM 인터프리터가 모두 사용하는 명령어 집합입니다. 공식 Erlang 가상 머신 명세가 있다면 이 명령어 집합을 규정할 것입니다. BEAM을 대상으로 하는 자신만의 컴파일러를 작성하려 한다면, 바로 이 명령어 집합을 목표로 삼아야 합니다. 자신만의 EVM을 작성하려 한다면 바로 이 명령어 집합을 처리해야 합니다.
외부 명령어 집합은 상당히 안정적이지만, Erlang 버전 사이에서, 특히 메이저 버전 사이에서는 실제로 바뀝니다.
이것이 이번 장에서 다룰 명령어 집합입니다.
다른 하나의 명령어 집합인 특정(specific) 명령어 집합은 BEAM이 외부 명령어 집합을 구현하는 데 사용하는 최적화된 명령어 집합입니다. BEAM이 어떻게 동작하는지 이해할 수 있도록 이 명령어 집합은 온라인 부록에서 다루겠습니다. 내부 명령어 집합은 마이너 버전 사이에서, 심지어 패치 릴리스에서도 예고 없이 바뀔 수 있습니다. 어떤 도구든 내부 명령어 집합에 기반해 만드는 것은 위험합니다.
이 장에서는 명령어의 일반적인 구문과 몇 가지 명령어 그룹을 자세히 살펴봅니다. 전체 명령어 목록과 간단한 설명은 Appendix B에서 확인할 수 있습니다.
7.1. 명령어 정의
범용 명령어의 이름과 옵코드는 lib/compiler/src/genop.tab에 정의되어 있습니다.
이 파일에는 Beam 명령어 형식의 버전 번호가 들어 있으며, 이 번호는 .beam 파일에도 기록됩니다. 이 번호는 지금까지 한 번도 바뀐 적이 없으며 여전히 버전 0입니다. 외부 형식이 하위 호환되지 않는 방식으로 변경된다면 이 번호도 변경될 것입니다.
genop.tab 파일은 beam_makeops의 입력으로 사용되며, beam_makeops는 ops 탭 파일로부터 코드를 생성하는 perl 스크립트입니다. 이 생성기는 컴파일러용 Erlang 코드(beam_opcodes.hrl 및 beam_opcodes.erl)를 생성하는 데에도, 에뮬레이터용 C 코드(beam_opcodes.c 및 beam_opcodes.h)를 생성하는 데에도 사용됩니다. 전통적인 BEAM 인터프리터용으로는 beam_hot.h, beam_warm.h, beam_cold.h도 생성되며, BeamAsm용으로는 beamasm_emit.h와 beamasm_protos.h가 생성됩니다.
파일에서 "#"으로 시작하는 줄은 주석이며 beam_makeops는 이를 무시합니다. 파일에는 perl 스크립트에서 바인딩으로 바뀌는 정의를 다음과 같은 형식으로 넣을 수 있습니다.
NAME=EXPR
예를 들면 다음과 같습니다:
BEAM_FORMAT_NUMBER=0
Beam 형식 번호는 외부 beam 형식의 instructionset 필드와 같습니다. 이 번호는 명령어 집합에 하위 호환성을 깨는 변경이 있을 때만 올라갑니다.
이 파일의 주요 내용은 다음과 같은 형식의 옵코드 정의입니다:
OPNUM: [-]NAME/ARITY
여기서 OPNUM과 ARITY는 정수이고, NAME은 소문자(a-z)로 시작하는 식별자이며, :, -, / 기호는 리터럴입니다.
예를 들면 다음과 같습니다.
1: label/1
빼기 기호(-)는 더 이상 사용되지 않는(deprecated) 함수를 나타냅니다. 더 이상 사용되지 않는 함수도 로더가 어느 정도 하위 호환성을 유지할 수 있도록 옵코드를 그대로 유지합니다(로더는 더 이상 사용되지 않는 명령어를 인식하고 해당 코드의 로드를 거부합니다).
이 장의 나머지 부분에서는 몇 가지 BEAM 명령어를 자세히 살펴보겠습니다. 간단한 설명이 포함된 전체 목록은 Appendix B를 참조하십시오.
7.2. BEAM 코드 목록
Chapter 2에서 살펴보았듯이, Erlang 컴파일러에 'S' 옵션을 주면 모듈의 BEAM 코드를 사람과 기계가 모두 읽을 수 있는 형식(실제로는 Erlang 텀)으로 담은 .S 파일을 얻을 수 있습니다.
다음과 같은 beamexample1.erl 파일이 있다고 합시다:
-module(beamexample1).

-export([id/1]).

id(I) when is_integer(I) -> I.
erlc -S beamexample1.erl로 컴파일하면 다음과 같은 beamexmaple1.S 파일을 얻습니다:
{module, beamexample1}.  %% version = 0

{exports, [{id,1},{module_info,0},{module_info,1}]}.

{attributes, []}.

{labels, 7}.


{function, id, 1, 2}.
  {label,1}.
    {line,[{location,"beamexample1.erl",5}]}.
    {func_info,{atom,beamexample1},{atom,id},1}.
  {label,2}.
    {test,is_integer,{f,1},[{x,0}]}.
    return.


{function, module_info, 0, 4}.
  {label,3}.
    {line,[]}.
    {func_info,{atom,beamexample1},{atom,module_info},0}.
  {label,4}.
    {move,{atom,beamexample1},{x,0}}.
    {line,[]}.
    {call_ext_only,1,{extfunc,erlang,get_module_info,1}}.


{function, module_info, 1, 6}.
  {label,5}.
    {line,[]}.
    {func_info,{atom,beamexample1},{atom,module_info},1}.
  {label,6}.
    {move,{x,0},{x,1}}.
    {move,{atom,beamexample1},{x,0}}.
    {line,[]}.
    {call_ext_only,2,{extfunc,erlang,get_module_info,2}}.
정수 항등 함수에 대한 실제 BEAM 코드 외에도 몇 가지 메타 명령어가 함께 생성됩니다.
첫 번째 줄 {module, beamexample1}. %% version = 0은 모듈 이름 beamexample1과 명령어 집합의 버전 번호 0을 알려 줍니다.
그런 다음 익스포트된 함수 목록 id/1, module_info/0, module_info/1을 얻습니다. 보시다시피 컴파일러가 자동 생성된 함수 두 개를 코드에 추가했습니다. 이 두 함수는 모듈 이름을 첫 번째 인자로 추가하여 범용 모듈 정보 BIF(erlang:get_module_info/1 및 erlang:get_module_info/2)로 호출을 전달하는 디스패처일 뿐입니다.
{attributes, []} 줄에는 정의된 모든 컴파일러 속성이 나열되며, 이 예제에는 속성이 하나도 없습니다.
다음으로 모듈에 레이블이 7개 미만이라는 것을 알 수 있습니다({labels, 7}). 덕분에 코드 로딩을 한 번의 패스로 쉽게 수행할 수 있습니다.
메타 명령어의 마지막 유형은 {function, Name, Arity, StartLabel} 형식의 function 명령어입니다. id 함수에서 볼 수 있듯이, 시작 레이블은 실제로 해당 함수 코드의 두 번째 레이블입니다.
{label, N} 명령어는 사실 명령어가 아니며, 로드될 때 메모리 공간을 전혀 차지하지 않습니다. 이는 단지 코드 내의 한 위치에 지역 이름(또는 번호)을 붙이기 위한 것입니다. 각 레이블은 점프의 목적지가 될 수 있으므로 기본 블록의 시작을 표시할 수 있습니다.
첫 번째 레이블({label,1}) 뒤에 오는 처음 두 명령어는 실제로는 오류를 생성하는 코드로, 줄 번호와 모듈, 함수, 애리티 정보를 추가한 뒤 예외를 던집니다. 이 두 명령어가 바로 line과 func_info입니다.
이 함수의 핵심은 {label,2} 다음에 오는 명령어인 {test,is_integer,{f,1},[{x,0}]}입니다. 테스트 명령어는 인자(끝에 있는 리스트 안의 값으로, 이 경우에는 변수 {x,0})가 테스트를 충족하는지, 즉 이 경우에는 정수(is_integer)인지 검사합니다. 테스트가 성공하면 다음 명령어(return)가 실행됩니다. 그렇지 않으면 함수는 레이블 1({f,1})로 실패합니다. 즉, 실행이 레이블 1에서 계속되며 그곳에서 함수 절(function clause) 예외가 발생합니다.
파일에 있는 나머지 두 함수는 자동으로 생성된 것입니다. 두 번째 함수를 보면, {move,{x,0},{x,1}} 명령어는 레지스터 x0에 있는 인자를 두 번째 인자 레지스터인 x1로 옮깁니다. 그다음 {move,{atom,beamexample1},{x,0}} 명령어는 모듈 이름 아톰을 첫 번째 인자 레지스터인 x0으로 옮깁니다. 마지막으로 erlang:get_module_info/2({call_ext_only,2,{extfunc,erlang,get_module_info,2}})를 꼬리 호출합니다. 다음 절에서 살펴보겠지만, 호출 명령어에는 여러 가지 종류가 있습니다.
7.3. 호출
Chapter 8에서 살펴보겠지만, Erlang에는 여러 종류의 호출이 있습니다. 명령어 집합에서 로컬 호출과 원격 호출을 구분하기 위해, 원격 호출은 명령어 이름에 _ext가 들어 있습니다. 로컬 호출은 모듈 코드 안의 레이블만 가지는 반면, 원격 호출은 {extfunc, Module, Function, Arity} 형태의 목적지를 받습니다.
일반적인(스택을 쌓는) 호출과 꼬리 재귀 호출을 구분하기 위해, 꼬리 재귀 호출은 이름에 _only 또는 _last가 들어갑니다. _last가 붙은 변형은 마지막 인자로 주어진 개수만큼의 스택 슬롯도 해제합니다.
레지스터 {x, Arity}에 저장된 클로저를 호출하는 call_fun Arity 명령어도 있습니다. 인자는 x0부터 {x, Arity-1}까지에 저장됩니다.
모든 종류의 호출 명령어 전체 목록은 Appendix B를 참고하십시오.
7.4. 스택(및 힙) 관리
Beam에서 Erlang 프로세스의 스택과 힙은 같은 메모리 영역을 공유합니다. 자세한 논의는 Chapter 3와 Chapter 11를 참조하십시오. 스택은 낮은 주소 쪽으로 자라고, 힙은 높은 주소 쪽으로 자랍니다. 스택이나 힙 중 어느 쪽에서든 사용 가능한 공간보다 더 많은 공간이 필요하면 Beam은 가비지 컬렉션을 수행합니다.
리프가 아닌 함수에 진입할 때 연속 포인터(CP)가 스택에 저장되고, 함수를 빠져나갈 때 스택에서 다시 읽어 옵니다. 이 작업은 allocate와 deallocate 명령어가 수행하며, 이 명령어들은 현재 명령어의 스택 프레임을 설정하고 해제하는 데 사용됩니다.
리프 함수의 함수 골격은 다음과 같습니다.
{function, Name, Arity, StartLabel}.
  {label,L1}.
    {func_info,{atom,Module},{atom,Name},Arity}.
  {label,L2}.
    ...
    return.
리프가 아닌 함수의 함수 골격은 다음과 같습니다:
{function, Name, Arity, StartLabel}.
  {label,L1}.
    {func_info,{atom,Module},{atom,Name},Arity}.
  {label,L2}.
    {allocate,Need,Live}.

    ...
    call ...
    ...

    {deallocate,Need}.
    return.
allocate StackNeed Live 명령어는 연속 포인터(CP)를 저장하고 스택에 StackNeed개의 추가 워드를 위한 공간을 할당합니다. 할당 중에 GC가 필요하면 Live개의 X 레지스터를 저장합니다. 예를 들어 Live가 2이면 x0와 x1 레지스터가 저장됩니다.
스택에 할당할 때는 스택 포인터(E)가 감소합니다.
모든 종류의 allocate 및 deallocate 명령어 전체 목록은 Appendix B를 참조하십시오.
7.5. 메시지 전달
BEAM 코드에서 메시지를 보내는 것은 간단합니다. send 명령어를 사용하기만 하면 됩니다. 다만 send 명령어는 인수를 받지 않으며 오히려 함수 호출에 가깝다는 점에 유의하십시오. 이 명령어는 인자(목적지와 메시지)가 인자 레지스터 x0과 x1에 있다고 가정합니다. 또한 메시지는 x1에서 x0으로 복사됩니다.
메시지 수신은 조금 더 복잡합니다. 패턴 매칭을 이용한 선택적 수신이 관여할 뿐 아니라 함수 본문 안에 양보/재개 지점이 생기기 때문입니다. (ref를 사용해 메시지 큐 탐색을 최소화하는 특별한 기능도 있는데, 이에 대해서는 뒤에서 다룹니다.)
7.5.1. 최소한의 수신 루프
모든 메시지를 받아들이고 타임아웃이 없는 최소한의 수신 루프(예: receive _ -> ok end)는 BEAM 코드로 다음과 같습니다:
  {label,1}.
    {loop_rec,{f,2},{x,0}}.
    remove_message.
    {jump,{f,3}}.
  {label,2}.
    {wait,{f,1}}.
  {label,3}.
     ...
loop_rec L2 x0 명령어는 먼저 메시지 큐에 메시지가 있는지 확인합니다. 메시지가 없으면 실행은 L2로 점프하며, 그곳에서 프로세스는 메시지가 도착하기를 기다리며 일시 중단됩니다.
메시지 큐에 메시지가 있으면 loop_rec 명령어는 해당 메시지를 m-buf에서 프로세스 힙으로 옮기기도 합니다. m-buf 처리에 대한 자세한 내용은 Chapter 11 및 Chapter 3를 참조하십시오.
모든 메시지를 받아들이는 receive _ -> ok end 같은 코드에서는 패턴 매칭이 필요 없으며, 메시지 큐에서 다음 메시지를 떼어 내는 remove_message 명령만 실행하면 됩니다. (이 명령은 설정된 타임아웃도 제거하는데, 이에 대해서는 곧 자세히 다룹니다.)
7.5.2. 선택적 수신 루프
예를 들어 receive [] -> ok end 와 같은 선택적 수신의 경우, 큐에 있는 메시지 중 일치하는 것이 있는지 확인하기 위해 메시지 큐를 순회합니다.
  {label,1}.
    {loop_rec,{f,3},{x,0}}.
    {test,is_nil,{f,2},[{x,0}]}.
    remove_message.
    {jump,{f,4}}.
  {label,2}.
    {loop_rec_end,{f,1}}.
  {label,3}.
    {wait,{f,1}}.
  {label,4}.
    ...
이 경우 메일박스에 메시지가 있으면 loop_rec 명령어 다음에 Nil에 대한 패턴 매칭을 수행합니다. 메시지가 매칭되지 않으면 L2로 가게 되며, 여기서 loop_rec_end 명령어가 save 포인터를 다음 메시지로 전진시키고(p->msg.save = &(*p->msg.save)->next) L1로 다시 점프합니다.
메시지 큐에 더 이상 메시지가 없으면 프로세스는 L3의 wait 명령어에 의해 일시 중단되며, 이때 저장 포인터는 메시지 큐의 끝을 가리킵니다. 프로세스가 다시 스케줄링되면 메시지 큐에서 새로운 메시지(저장 지점 이후의 메시지)만 살펴봅니다.
7.5.3. 타임아웃이 있는 수신 루프
선택적 수신에 타임아웃을 추가하면 wait 명령어는 wait_timeout 명령어로 대체되며, 그 뒤에 timeout 명령어와 타임아웃 이후에 실행되는 코드가 이어집니다.
  {label,1}.
    {loop_rec,{f,3},{x,0}}.
    {test,is_nil,{f,2},[{x,0}]}.
    remove_message.
    {jump,{f,4}}.
  {label,2}.
    {loop_rec_end,{f,1}}.
  {label,3}.
    {wait_timeout,{f,1},{integer,1000}}.
    timeout.
  {label,4}.
    ...
wait_timeout 명령어는 주어진 시간(이 예제에서는 1000 ms)으로 타임아웃 타이머를 설정하고, 다음 명령어(timeout)의 주소를 p->def_arg_reg[0]에 저장합니다. 그런 다음 타이머가 설정되면 p->i가 def_arg_reg를 가리키도록 설정됩니다.
즉, 프로세스가 일시 중단된 동안 일치하는 메시지가 도착하지 않으면 1초 후에 타임아웃이 발생하고, 프로세스의 실행은 타임아웃 명령어에서 계속됩니다.
일치하지 않는 메시지가 메일박스에 도착하면 프로세스가 실행되도록 스케줄링되고 수신 루프의 패턴 매칭 코드를 실행하지만, 타임아웃은 취소되지 않는다는 점에 유의하십시오. 타임아웃 타이머까지 함께 제거하는 것은 바로 remove_message 코드입니다.
timeout 명령어는 메일박스의 저장 지점을 큐의 첫 번째 요소로 재설정하고, PCB에서 타임아웃 플래그(F_TIMO)를 지웁니다.
7.5.4. 동기 호출 기법(일명 Ref 기법)
이제 수신 루프의 마지막 버전에 이르렀습니다. 이 버전에서는 앞서 언급한 ref 기법을 사용하여 긴 메시지 박스 스캔을 피합니다.
Erlang 코드에서 흔히 쓰이는 패턴은 두 프로세스 사이에서 send와 receive를 사용해 일종의 "원격 호출"을 구현하는 것입니다. 예를 들어 gen_server가 이 방식을 사용합니다. 이러한 코드는 보통 일반 함수 호출로 이루어진 라이브러리 뒤에 감춰져 있습니다. 예를 들어 counter:increment(Counter) 함수를 호출하면, 내부적으로는 Counter ! {self(), inc}, receive {Counter, Count} -> Count end와 같은 코드로 바뀝니다.
이는 보통 프로세스 안에 상태를 캡슐화하기 좋은 추상화입니다. 하지만 호출하는 프로세스의 메일박스에 메시지가 많이 쌓여 있으면 약간의 문제가 생깁니다. 이 경우 receive는 메일박스의 메시지를 하나하나 확인한 뒤에야 마지막 메시지를 제외하고는 반환 메시지와 일치하는 메시지가 없다는 것을 알아낼 수 있습니다.
많은 메시지를 수신하면서 메시지마다 이러한 원격 호출을 여러 번 수행하는 서버가 있을 때 이런 일이 꽤 자주 발생할 수 있으며, 역방향 스로틀링이 마련되어 있지 않으면 서버의 메시지 큐가 가득 차게 됩니다.
이를 해결하기 위해 ERTS에는 이 패턴을 인식하여 반환 메시지를 찾으려고 메시지 큐 전체를 스캔하지 않도록 하는 핵(hack)이 있습니다.
컴파일러는 receive에서 새로 생성한 참조(ref)를 사용하는 코드를 인식하고, 새 ref는 수신함에 이미 들어 있을 수 없으므로 수신함을 길게 스캔하지 않도록 하는 코드를 생성합니다.
  Ref = make_ref(),
  Counter ! {self(), inc, Ref},
  receive
    {Ref, Count} -> Count
  end.
이렇게 하면 완전한 receive의 뼈대는 다음과 같습니다.
    {recv_mark,{f,3}}.
    {call_ext,0,{extfunc,erlang,make_ref,0}}.
    ...
    send.
    {recv_set,{f,3}}.
  {label,3}.
    {loop_rec,{f,5},{x,0}}.
    {test,is_tuple,{f,4},[{x,0}]}.
    ...
    {test,is_eq_exact,{f,4},[{x,1},{y,0}]}.
    ...
    remove_message.
    ...
    {jump,{f,6}}.
  {label,4}.
    {loop_rec_end,{f,3}}.
  {label,5}.
    {wait,{f,3}}.
  {label,6}.
recv_mark 명령어는 현재 위치(끝인 msg.last)를 msg.saved_last에, 레이블의 주소를 msg.mark에 저장합니다
recv_set 명령어는 msg.mark가 다음 명령어를 가리키는지 확인하고, 그러한 경우 저장 지점(msg.save)을 ref가 생성되기 전에 마지막으로 수신된 메시지(msg.saved_last)로 옮깁니다. 마크가 유효하지 않으면(즉, msg.save와 같지 않으면) 이 명령어는 아무 동작도 하지 않습니다.
8. 다양한 호출 유형, 링킹 및 핫 코드 로딩
BEAM의 함수 호출은 여러 유형으로 분류할 수 있습니다.
8.1. 로컬 호출
로컬 호출은 모듈 이름을 명시적으로 지정하지 않고 같은 모듈 안에서 함수를 호출할 때 일어납니다. 이러한 호출은 컴파일 시점에 결정되며, 호출자와 같은 버전의 모듈 안에서 실행된다는 것이 보장됩니다.
예시:
foo() -> bar(). % Local call within the same module8.2. 원격 호출
원격 호출은 모듈 이름을 명시적으로 지정하므로 항상 가장 최근에 로드된 버전의 모듈이 사용됩니다.
예시:
foo() -> ?MODULE:bar(). % Remote call ensuring latest module version원격 호출은 핫 코드 로딩 기능을 지원하여 시스템을 재시작하지 않고도 모듈을 실시간으로 업데이트할 수 있게 합니다.
8.3. 코드 로딩
Erlang 런타임 시스템에서 코드 로딩은 코드 서버가 담당합니다. 코드 서버는 실제 로딩을 위해 erlang 모듈에 있는 저수준 BIF를 호출합니다. 그러나 퍼지(purge) 정책을 결정하는 것도 코드 서버입니다.
런타임 시스템은 각 모듈에 대해 현재 버전과 이전 버전, 이렇게 두 가지 버전을 유지할 수 있습니다. 완전히 한정된(원격) 호출은 모두 현재 버전으로 갑니다. 이전 버전 안의 로컬 호출과 스택에 있는 반환 주소는 여전히 이전 버전으로 갈 수 있습니다.
모듈의 세 번째 버전이 로드될 때 아직 이전 코드를 실행 중인(즉, 스택에 이전 코드를 가리키는 포인터가 남아 있는) 프로세스가 있으면, 코드 서버는 해당 프로세스를 종료하고 이전 코드를 제거합니다. 그런 다음 현재 버전은 이전 버전이 되고, 세 번째 버전이 현재 버전으로 로드됩니다.
8.4. 핫 코드 로딩
앞서 살펴본 것처럼 로컬 함수 호출과 원격 함수 호출 사이에는 구문상의 차이뿐만 아니라 의미상의 차이도 있습니다. 원격 호출, 즉 이름이 지정된 모듈의 함수를 호출하는 "완전 한정 호출(fully qualified call)"은 항상 해당 모듈의 가장 최근에 로드된 버전으로 전달됨이 보장됩니다. 로컬 호출, 즉 같은 모듈 안의 함수를 한정자 없이 호출하는 것은 항상 호출자와 같은 버전의 코드로 전달됨이 보장됩니다.
로컬 함수 호출은 호출 지점에서 모듈 이름을 명시하면 원격 호출로 바꿀 수 있습니다. 이는 보통 ?MODULE:foo()처럼 ?MODULE 매크로를 사용하여 수행합니다. 로컬이 아닌 모듈에 대한 원격 호출은 로컬 호출로 바꿀 수 없습니다. 즉, 호출하는 쪽에서 호출되는 쪽의 버전을 보장할 방법이 없습니다.
이는 Erlang의 중요한 기능으로, 이 기능 덕분에 핫 코드 로딩 또는 핫 업그레이드가 가능합니다. 서버 루프 어딘가에 원격 호출이 있도록 하기만 하면, 시스템이 실행 중인 동안에도 새 코드를 로드할 수 있습니다. 실행이 그 원격 호출에 도달하면 새 코드를 실행하도록 전환됩니다.
서버 루프를 작성하는 일반적인 방법은 메인 루프에는 로컬 호출을 사용하고, 원격 호출과 필요한 경우 상태 업그레이드까지 수행하는 코드 업그레이드 핸들러를 두는 것입니다:
loop(State) ->
  receive
    upgrade ->
       %% Force a call to the latest version of the code.
       NewState = ?MODULE:code_upgrade(State),
       ?MODULE:loop(NewState);
     Msg ->
       %% In other cases we call the old version of the code.
       %% That is the version of the code that also handles old data.
       NewState = handle_msg(Msg, State),
       loop(NewState)
   end.
이 구조는 기본적으로 gen_server가 사용하는 방식이며, 이를 사용하면 프로그래머가 코드 업그레이드를 언제, 어떻게 수행할지 제어할 수 있습니다.
핫 코드 업그레이드는 Erlang의 가장 중요한 기능 중 하나로, 이 기능 덕분에 일 년 내내 24시간 쉬지 않고 동작하는 서버를 작성할 수 있습니다. 이는 또한 Erlang이 동적 타입 언어인 주된 이유 중 하나이기도 합니다. 정적 타입 언어에서는 code_upgrade 함수에 타입을 부여하기가 매우 어렵습니다. (loop 함수의 타입을 부여하기도 어렵습니다.) 새로운 기능을 처리하기 위해 State의 타입이 바뀌면 이러한 타입도 앞으로 바뀌게 됩니다.
하지만 성능을 중시하는 언어 구현자에게 핫 코드 로딩 기능은 부담이 됩니다. 원격 모듈을 호출하거나 원격 모듈에서 들어오는 호출은 모두 나중에 새 코드로 바뀔 수 있으므로, 모듈 경계를 넘나드는 전체 프로그램 최적화는 매우 어렵습니다. (어렵기는 하지만 불가능하지는 않습니다. 해결책은 있지만, 지금까지 완전히 구현된 해결책은 본 적이 없습니다.)
8.5. 클로저 호출
Erlang의 클로저를 사용하면 함수를 값으로 전달할 수 있으며, 클로저는 자신이 정의된 스코프의 변수를 캡처합니다.
예시:
make_adder(N) -> fun(X) -> X + N end.클로저 호출
클로저가 한번 생성되면 다른 함수와 마찬가지로 호출할 수 있습니다.
예시:
Adder = make_adder(5),
Result = Adder(10). % Returns 15
클로저를 인자로 전달하기
클로저를 고차 함수에 전달하면 더 유연하게 동작하도록 만들 수 있습니다.
예시:
apply_fun(F, X) -> F(X).

Result = apply_fun(make_adder(3), 7). % Returns 10
함수에서 클로저 반환하기
함수는 클로저를 반환할 수 있으므로 함수를 동적으로 생성할 수 있습니다.
예시
make_multiplier(N) -> fun(X) -> X * N end.

Multiplier = make_multiplier(2),
Result = Multiplier(4). % Returns 8
클로저는 동적 실행을 가능하게 하며 고차 함수에서 흔히 사용됩니다.
8.6. 동적 호출
변수를 사용하여 런타임에 함수를 동적으로 호출할 수 있습니다.
예시:
M = lists,
F = map,
Result = M:F(fun(X) -> X * 2 end, [1,2,3]).
이 동적 호출 기법은 직접 호출보다 효율이 떨어지지만, 런타임에 실행 경로를 선택할 수 있는 유연성을 제공합니다. 이를 활용하면 특정 함수 집합을 익스포트하는 모듈을 두고 그 모듈 이름만 전달하는 방식의 콜백 시스템을 구현할 수 있습니다. 이 기법을 사용하면 컴파일 시점에 호출 그래프를 알 수 없으므로 Dialyzer 같은 분석 도구가 코드에서 오류를 찾기가 훨씬 어려워집니다.
8.7. 고차 함수와 핫 코드 로딩
고차 함수를 사용하면 동작을 동적으로 전달할 수 있으며, 이는 핫 코드 로딩과 독특한 방식으로 상호작용합니다.
예시:
init() ->
  F = ?MODULE:foo/1,
  L = fun(X) -> foo(X) end,
  loop(F, L).

foo(X) -> X + 1.

loop(F, L) ->
  F(1),
  L(2),
  loop(F, L).
L은 로컬 함수이므로 항상 X + 1을 반환합니다. 모듈이 다시 로드되고 foo/1이 X + 2를 반환하도록 변경되면 F는 X + 2를 반환합니다. 모듈이 두 번 다시 로드되면 L이 퍼지(purge)된 버전의 모듈을 참조하므로 프로세스가 크래시됩니다.
8.8. 결론
Erlang의 함수 호출 효율성은 Efficiency Guide에 설명된 대로 명확한 위계를 따릅니다:
로컬 호출과 원격 호출(foo(), m:foo())을 막론하고 명시적 호출이 가장 효율적입니다. 덧붙이자면, 가장 효율적인 호출은 같은 모듈에 있는 함수에 대한 로컬 호출입니다. 이는 호출을 컴파일 시점에 결정할 수 있고 함수를 인라인할 수 있기 때문입니다. 원격 호출은 런타임에 모듈이 바뀔 수 있으므로 이렇게 할 수 없습니다. JIT 컴파일러가 원격 호출을 잘 처리하기는 하지만, OTP 27 기준으로 원격 호출을 인라인하지는 않습니다.
클로저를 호출하는 것(Fun(), apply(Fun, []))은 약간 더 느리지만 여전히 효율적입니다.
컴파일 시점에 인수 개수를 알 수 있는 함수 () (Mod:Name(), apply(Mod, Name, []))를 적용하는 방식이 그다음으로 효율적입니다. (모듈에서 익스포트되지 않은 함수는 적용할 수 없습니다.)
인수 개수를 알 수 없는 익스포트된 함수를 적용하는 방식(apply(Mod, Name, Args))이 가장 비효율적입니다.
Erlang 런타임 시스템은 로컬 호출과, 모듈의 현재 버전에 대한 원격 호출에 최적화되어 있습니다. 핫 코드 로딩은 실행 중인 시스템을 중단 없이 업데이트할 수 있게 해 주는 강력한 기능이지만, 성능 면에서 트레이드오프가 따릅니다. 또한 모듈을 두 번 다시 로드하면 해당 모듈의 이전 버전이 제거(purge)되며, 이전 버전에 대한 참조가 남아 있으면 그 참조를 가진 프로세스가 크래시된다는 점도 이해해 두어야 합니다.
9. BEAM 로더
9.1. 제네릭 명령어에서 특정 명령어로의 변환
BEAM 로더는 외부 beam 형식을 가져와 메모리에 그대로 쓰기만 하는 것이 아닙니다. 로더는 코드에 여러 가지 변환도 수행하며, 외부(범용) 형식을 내부(특화) 형식으로 변환합니다.
로더 코드는 beam_load.c(erts/emulator/beam 디렉터리)에서 찾을 수 있지만, 변환 로직의 대부분은 같은 디렉터리에 있는 ops.tab 파일에 있습니다.
로더의 첫 번째 단계는 beam 파일을 파싱하는 것입니다. 이는 기본적으로 Chapter 6에서 Erlang으로 했던 작업과 같지만, C로 작성되어 있다는 점이 다릅니다.
그런 다음 ops.tab의 규칙을 코드 청크의 명령어에 적용하여 범용 명령어를 하나 이상의 특정 명령어로 변환합니다.
변환 테이블은 패턴 매칭을 통해 동작합니다. 파일의 각 줄은 인자를 갖는 하나 이상의 범용 명령어로 이루어진 패턴을 정의하며, 선택적으로 화살표와 그 뒤에 변환될 하나 이상의 명령어를 덧붙일 수 있습니다.
ops tab의 변환은 컴파일러가 생성한 명령어 패턴을 처리하고, 이를 핍홀 최적화하여 더 적은 수의 특정 명령어로 만들려고 시도합니다. ops tab 변환은 select 패턴에 대해 점프 테이블을 생성하려고 시도합니다.
ops.tab 파일은 런타임에 파싱되지 않습니다. 대신 ops.tab으로부터 패턴 매칭 프로그램이 생성되어, 생성된 C 파일 안의 배열에 저장됩니다. Perl 스크립트 beam_makeops(erts/emulator/utils에 위치)는 beam_opcodes.h와 beam_opcodes.c 파일에 대상별 옵코드 집합과 변환 프로그램을 생성합니다(이 파일들은 지정된 대상 디렉터리, 예를 들어 erts/emulator/x86_64-unknown-linux-gnu/opt/smp/에 생성됩니다).
같은 프로그램(beam_makeops)은 컴파일러 백엔드용 Erlang 코드인 beam_opcodes.erl도 생성합니다.
9.2. ops.tab 이해하기
ops.tab의 변환은 파일에 작성된 순서대로 실행됩니다. 따라서 Erlang 패턴 매칭과 마찬가지로, 여러 규칙이 위에서 아래로 차례대로 적용됩니다.
ops.tab이 명령어의 인자에 사용하는 타입은 Appendix B에서 확인할 수 있습니다.
9.2.1. 변환
ops.tab에 있는 규칙 대부분은 서로 다른 명령어 사이의 변환입니다. 간단한 변환은 다음과 같습니다.
move S x==0 | return => move_return S
이는 임의의 위치에서 x(0)으로 값을 옮기는 move와 반환을 move_return이라는 단일 명령어로 결합합니다. 이 변환을 부분별로 나누어 각 부분이 무엇을 하는지 살펴봅시다.
- move
-
패턴이 가장 먼저 매칭해야 하는 명령어입니다. 이는 컴파일러가 내보낸 범용 명령어일 수도 있고, 변환을 돕기 위해
ops.tab이 내보낸 임시 명령어일 수도 있습니다. - S
-
모든 타입의 값을 바인딩하는 변수입니다. 패턴(좌변 또는
⇒)에 있는 값 중 생성기(⇒의 우변)에서 사용되는 값은 모두 변수에 바인딩되어야 합니다. - x==0
-
이는 대상 위치가 값이
0인x레지스터일 때에만 변환을 적용한다는 가드입니다. 여기서는 여러 타입을 연결할 수 있으며 변수를 바인딩할 수도 있습니다. 예를 들어D=xy==0은 값이0인x레지스터와y레지스터를 모두 허용하며, 인수를 변수D에 바인딩하기도 합니다. - |
-
이 명령어가 끝나고, 같은 패턴에 속하는 다른 명령어가 시작됨을 나타냅니다.
- return
-
이 패턴에서 매칭할 두 번째 명령어입니다.
⇒-
패턴의 끝과 생성될 코드의 시작을 나타냅니다.
- move_return S
-
생성되는 명령어의 이름과 lhs에 있는 변수의 이름입니다.
|기호를 사용하면 변환의 일부로 여러 명령어를 생성할 수 있습니다.
더 복잡한 변환은 ops.tab에서 수행할 수 있습니다. 예를 들어 select_val 명령어를 살펴봅시다. 이 명령어는 입력 값에 따라 로더에 의해 점프 테이블, 선형 탐색 배열 또는 바이너리 탐색 배열 중 하나로 변환됩니다.
is_integer Fail=f S | select_val S=s Fail=f Size=u Rest=* | \
  use_jump_tab(Size, Rest) => gen_jump_tab(S, Fail, Size, Rest)
위의 변환은 가능한 경우 select_val에 대한 점프 테이블을 생성합니다. 이러한 변환에는 여러 가지 새로운 기법이 사용됩니다.
- S
-
is_integer와select_val양쪽에서 모두 사용됩니다. 이는 두 값이 같은 타입이어야 하고 같은 값을 가져야 한다는 뜻입니다. 또한S=s가드는 타입을 소스 레지스터로 제한합니다. - Rest=*
-
명령어에서 가변 개수의 인수를 허용하고, 이를 변수
Rest에 바인딩합니다. - use_jump_tab(Size, Rest)
-
beam_load.c에 있는 use_jump_tab C 함수를 호출합니다. 이 함수는select_val의 인수를 점프 테이블로 변환할 수 있는지 판단합니다. - \
-
변환 규칙이 다음 줄로 이어짐을 나타냅니다.
- gen_jump_tab(S, Fail, Size, Rest)
-
적절한 명령어를 생성하는 역할을 하는
beam_load.c의 gen_jump_tab C 함수를 호출합니다.
9.2.2. 특정 명령어
모든 변환이 끝나면 특정 명령어가 어떤 형태여야 하는지 결정해야 합니다. 계속해서 move_return을 살펴봅시다:
%macro: move_return MoveReturn -nonext
move_return x
move_return c
move_return n
이렇게 하면 beam_emu.c의 MoveReturn 매크로를 사용하여 작업을 수행하는 서로 다른 명령어 세 개가 생성됩니다.
- %매크로: move_return
-
이는
ops.tab에move_return에 대한 코드를 생성하도록 지시합니다.%macro줄이 없으면 해당 명령어는 beam_emu.c에서 직접 구현해야 합니다. 해당 명령어의 코드는%hot지시어와%cold지시어 중 어느 것이 활성화되어 있는지에 따라beam_hot.h또는beam_cold.h에 배치됩니다. - MoveReturn
-
사용할 beam_emu.c의 C 매크로 이름이 MoveReturn이라는 것을 코드 생성기에 알려 줍니다. 이 매크로는 직접 구현해야 합니다.
- -nonext
-
코드 생성기에 다음 명령어로 디스패치하는 코드를 생성하지 말라고 알립니다. 그 처리는
MoveReturn매크로가 맡습니다. - move_return x
-
명령어 인자가 x 레지스터인 경우에 맞는 특정 명령어를 생성하도록 코드 생성기에 지시합니다.
c는 인자가 상수인 경우,n은NIL인 경우입니다. 이 경우 인자가 y 레지스터일 때의 명령어는 생성되지 않습니다. 컴파일러가 그러한 코드를 생성하는 일이 없기 때문입니다.
beam_hot.h에 생성되는 코드는 다음과 같습니다:
OpCase(move_return_c):
    {
    MoveReturn(Arg(0));
    }

OpCase(move_return_n):
    {
    MoveReturn(NIL);
    }

OpCase(move_return_x):
    {
    MoveReturn(xb(Arg(0)));
    }
구현자는 beam_emu.c에 MoveReturn 매크로를 정의하기만 하면 되며, 그러면 명령어가 완성됩니다.
%macro 규칙에는 생성되는 코드를 변경하는 여러 가지 플래그를 지정할 수 있습니다.
아래 예제에서는 다음과 같은 형태의 특정 명령어가 있다고 가정합니다:
%macro move_call MoveCall
move_call x f
%macro에 아무 플래그도 지정하지 않으면 다음 코드가 생성됩니다:
BeamInstr* next;
PreFetch(2, next);
MoveCall(Arg(0));
NextPF(2, next);| PreFetch 및 NextPF 매크로는 명령어가 실행되기 전에 다음에 점프할 주소를 반드시 미리 로드하도록 합니다. 이 기법은 모든 아키텍처에서 성능을 높이며, 향상 폭은 캐시 아키텍처와 CPU의 슈퍼스칼라 특성에 따라 다릅니다. |
- -nonext
-
이 명령어에 대해서는 디스패치를 내보내지 마십시오. 이는 다음 명령어로 이어지지 않는 것으로 알려진 명령어, 즉 return, call, jump에 사용됩니다.
%macro move_call MoveCall -nonext
MoveCall(xb(Arg(0)));- -arg_*
-
타입 * 의 인자를 c-매크로의 인자로 포함합니다. 모든 인자 타입이 기본적으로 c-매크로에 포함되는 것은 아닙니다. 예를 들어 실패 레이블과 로컬 함수 호출에 사용되는
f타입은 포함되지 않습니다. 따라서-arg_f옵션을 지정하면 해당 타입이 c-매크로의 인자로 포함됩니다.
%macro move_call MoveCall -arg_f
MoveCall(xb(Arg(0)), Arg(1));- -size
-
명령어의 크기를 c-매크로의 인자로 포함하십시오.
%macro move_call MoveCall -size
MoveCall(xb(Arg(0)), 2);- -pack
-
가능하면 인자를 패킹합니다. 이렇게 하면 가능한 경우 여러 레지스터 인자가 같은 워드에 배치됩니다. 레지스터 인자는 0-1024 범위의 값만 가질 수 있으므로, 이를 저장하는 데는 10비트와 태깅용 2비트만 있으면 됩니다. 따라서 32비트 시스템에서는 한 워드에 레지스터 2개를 넣을 수 있고, 64비트 시스템에서는 한 워드에 레지스터 4개를 넣을 수 있습니다. 명령어를 패킹하면 명령어 하나가 사용하는 메모리를 크게 줄일 수 있습니다. 하지만 명령어를 언패킹하는 데에도 약간의 비용이 들며, 이 때문에 모든 명령어에 이 기능이 활성화되어 있지는 않습니다.
호출 예제에서는 f를 패킹할 수 없고 다른 인수가 하나뿐이므로 어떤 패킹도 할 수 없습니다. 그러므로 대신 put_list 명령어를 예로 살펴보겠습니다.
%macro:put_list PutList -pack
put_list x x x
BeamInstr tmp_packed1;
BeamInstr* next;
PreFetch(1, next);
tmp_packed1 = Arg(0);
PutList(xb(tmp_packed1&BEAM_TIGHT_MASK),
        xb((tmp_packed1>>BEAM_TIGHT_SHIFT)&BEAM_TIGHT_MASK),
        xb((tmp_packed1>>(2*BEAM_TIGHT_SHIFT))));
NextPF(1, next);
이렇게 하면 인수 3개가 머신 워드 1개에 압축되므로 이 명령어에 필요한 메모리가 절반으로 줄어듭니다.
- -fail_action
-
c-매크로의 인자로 실패 동작을 포함하십시오.
ClauseFail()매크로는 실패 레이블이 명령어의 첫 번째 인자에 있다고 가정하므로, 위 예제에서 이 매크로를 사용하려면move_call x f를move_call f x로 변환해야 합니다.
%macro move_call MoveCall -fail_action
MoveCall(xb(Arg(0)), ClauseFail());- -gen_dest
-
c-매크로의 인자로 저장 함수를 포함하십시오.
%macro move_call MoveCall -gen_dest
MoveCall(xb(Arg(0)), StoreSimpleDest);- -goto
-
일반적인 next 디스패치를 beam_emu.c 내부의 c-label로 점프하는 코드로 대체합니다
%macro move_call MoveCall -goto:do_call
MoveCall(xb(Arg(0)));
goto do_call;
9.3. 최적화
로더는 코드를 로드할 때 여러 가지 핍홀 최적화를 수행합니다. 그중 가장 중요한 것은 명령어 결합(instruction combining)과 명령어 특수화(instruction specialization)입니다.
명령어 결합(instruction combining)은 둘 이상의 작은 명령어를 하나의 더 큰 명령어로 합치는 것입니다. 해당 명령어들이 대부분 연달아 실행된다는 사실이 알려져 있다면 코드 속도를 크게 높일 수 있습니다. 이렇게 속도가 빨라지는 이유는 명령어 사이에서 더 이상 디스패치를 할 필요가 없고, C 컴파일러가 해당 명령어를 최적화할 때 활용할 수 있는 정보도 더 많아지기 때문입니다. 명령어 결합을 언제 할지는 트레이드오프의 문제로, 메인 에뮬레이터 루프의 크기가 커져서 생기는 영향과 해당 명령어를 실행할 때 얻는 이득을 비교하여 고려해야 합니다.
명령어 특수화를 하면 명령어의 인자를 디코딩할 필요가 없어집니다. 따라서 하나의 move_sd 명령어를 두는 대신, 인자가 이미 디코딩된 move_xx, move_xy 등의 명령어가 생성됩니다. 이렇게 하면 명령어의 디코딩 비용은 줄어들지만, 이 역시 에뮬레이터 코드 크기와 맞바꾸는 트레이드오프입니다.
9.3.1. select_val 최적화
select_val 명령어는 여러 함수나 case 절의 제어 흐름을 처리하기 위해 컴파일러가 생성합니다. 예를 들면 다음과 같습니다.
select(1) -> 3;
select(2) -> 3;
select(_) -> error.
다음과 같이 컴파일됩니다:
{function, select, 1, 2}.
  {label,1}.
    {line,[{location,"select.erl",5}]}.
    {func_info,{atom,select},{atom,select},1}.
  {label,2}.
    {test,is_integer,{f,4},[{x,0}]}.
    {select_val,{x,0},{f,4},{list,[{integer,2},{f,3},{integer,1},{f,3}]}}.
  {label,3}.
    {move,{integer,3},{x,0}}.
    return.
  {label,4}.
    {move,{atom,error},{x,0}}.
    return.
조건에 쓰이는 값은 정수나 아톰만 허용됩니다. 값이 그 밖의 타입이면 컴파일러는 select_val 명령어를 생성하지 않습니다. 로더는 몇 가지 휴리스틱을 사용하여 select_val을 수행할 때 어떤 종류의 알고리즘을 사용할지 결정합니다.
- jump_on_val
-
점프 테이블을 만들고 값을 인덱스로 사용합니다. 이 방식은 매우 효율적이며, 서로 가까운 정수들이 선택 기준 값으로 사용될 때 적용됩니다. 일부 값이 빠져 있으면 점프 테이블의 빈자리는 추가 실패 레이블 슬롯으로 채워집니다.
- select_val2
-
선택할 값이 두 개뿐이고 그 값들이 점프 테이블에 들어맞지 않을 때 사용됩니다.
- select_val_lins
-
정렬된 아톰 또는 정수에 대해 선형 탐색을 수행합니다. 이 방법은 선택 대상이 되는 아톰이나 정수의 수가 적을 때 사용됩니다.
- select_val_bins
-
정렬된 아톰 또는 정수에 대해 바이너리 서치를 수행합니다.
9.3.2. 리터럴 사전 해싱
리터럴이 로드되어 해당 리터럴의 해시 값이 필요한 bif나 명령어의 인자로 사용될 때에는 매번 리터럴 값을 해싱하는 대신 로더가 해시를 생성하고 명령어가 이를 사용합니다.
이 기법을 사용하는 코드의 예로는 맵 명령어와 프로세스 딕셔너리 BIF가 있습니다.
10. 스케줄링
ERTS 시스템에서 시간이 어디에 쓰이는지 완전히 이해하려면, 시스템이 어떤 Erlang 코드를 언제 실행할지 어떻게 결정하는지 이해해야 합니다. 이러한 결정은 스케줄러가 내립니다.
스케줄러는 시스템의 실시간 보장을 담당합니다. 컴퓨터 과학에서 실시간이라는 용어의 엄밀한 정의에 따르면, 실시간 시스템은 지정된 시간 안에 응답을 보장할 수 있어야 합니다. 즉, 실제 기한이 존재하며 각 작업은 그 기한 전에 완료되어야 합니다. Erlang에는 그러한 보장이 없으며, Erlang의 타임아웃은 주어진 기한 이전에 발동하지 않는다는 것만 보장됩니다.
Erlang처럼 온갖 종류의 프로그램과 부하를 처리할 수 있어야 하는 범용 시스템에서는 스케줄러가 어느 정도 타협을 할 수밖에 없습니다. 범용 스케줄러가 제대로 동작하지 않는 코너 케이스는 언제나 존재하기 마련입니다. 이 장을 읽고 나면 Erlang 스케줄러가 어떻게 동작하는지, 특히 어떤 경우에 최적으로 동작하지 않을 수 있는지를 더 깊이 이해하게 될 것입니다. 여러분은 코너 케이스를 피하도록 시스템을 설계할 수 있어야 하며, 비정상적으로 동작하는 시스템을 분석할 수도 있어야 합니다.
10.1. 동시성, 병렬성, 그리고 선점형 멀티태스킹
Erlang은 동시성 언어입니다. 프로세스가 동시에 실행된다고 말할 때, 이는 외부 관찰자가 보기에 두 프로세스가 같은 시간에 실행되고 있는 것처럼 보인다는 뜻입니다. 단일 코어 시스템에서는 선점형 멀티태스킹을 통해 이를 구현합니다. 즉, 한 프로세스가 잠시 실행되고 나면 가상 머신의 스케줄러가 그 프로세스를 일시 중단하고 다른 프로세스가 실행되도록 합니다.
멀티코어 시스템이나 분산 시스템에서는 진정한 병렬성을 달성할 수 있습니다. 즉, 둘 이상의 프로세스가 실제로 정확히 같은 시각에 실행됩니다. SMP가 활성화된 에뮬레이터에서 시스템은 여러 OS 스레드를 사용하며, 스레드마다 스케줄러와 에뮬레이터를 하나씩 실행하여 Erlang 프로세스를 간접적으로 실행합니다. ERTS의 기본 설정을 사용하는 시스템에서는 활성화된 코어(물리 코어 또는 하이퍼스레드 코어)마다 스레드가 하나씩 있습니다.
SMP 지원이 활성화되어 있는지 확인하면 병렬 실행이 가능한 시스템인지 알 수 있습니다:
iex(1)> :erlang.system_info :smp_support
true
시스템에서 실행 중인 스케줄러가 몇 개인지도 확인할 수 있습니다:
iex(2)> :erlang.system_info :schedulers_online
4
아래 그림과 같이 Observer에서 이 정보를 확인할 수 있습니다.
스케줄러 수보다 많은 프로세스를 생성하고 이들에게 바쁜 작업을 시키면, 여러 프로세스가 병렬로 실행 중 상태에 있고 일부 프로세스는 실행 가능 상태이지만 현재 실행되고 있지 않음을 확인할 수 있습니다. 이는 erlang:process_info/2 함수로 확인할 수 있습니다.
1> Loop = fun (0, _) -> ok; (N, F) -> F(N-1, F) end,
   BusyFun = fun() -> spawn(fun () -> Loop(1000000, Loop) end) end,
   SpawnThem = fun(N) -> [ BusyFun() || _ <- lists:seq(1, N)] end,
   GetStatus = fun() -> lists:sort([{erlang:process_info(P, [status]), P}
                        || P <- erlang:processes()]) end,
   RunThem = fun (N) -> SpawnThem(N), GetStatus() end,
   RunThem(8).

[{[{status,garbage_collecting}],<0.62.0>},
 {[{status,garbage_collecting}],<0.66.0>},
 {[{status,runnable}],<0.60.0>},
 {[{status,runnable}],<0.61.0>},
 {[{status,runnable}],<0.63.0>},
 {[{status,runnable}],<0.65.0>},
 {[{status,runnable}],<0.67.0>},
 {[{status,running}],<0.58.0>},
 {[{status,running}],<0.64.0>},
 {[{status,waiting}],<0.0.0>},
 {[{status,waiting}],<0.1.0>},

...
프로세스가 가질 수 있는 여러 상태는 이 장의 뒷부분에서 더 자세히 살펴보겠지만, 지금은 running 또는 garbage_collecting 상태인 프로세스가 실제로 스케줄러에서 실행되고 있다는 점만 알면 됩니다. 예제의 머신에는 코어 네 개와 스케줄러 네 개가 있으므로 프로세스 네 개(셸 프로세스와 busy processes 중 세 개)가 병렬로 실행되고 있습니다. 또한 runnable 상태로 실행을 기다리는 busy 프로세스도 다섯 개 있습니다.
Observer의 Load Charts 탭을 사용하면, 바쁜 프로세스들이 실행되는 동안 네 개의 스케줄러 모두가 완전히 로드되어 있는 것을 확인할 수 있습니다.
2> observer:start().
ok
3> RunThem(8).
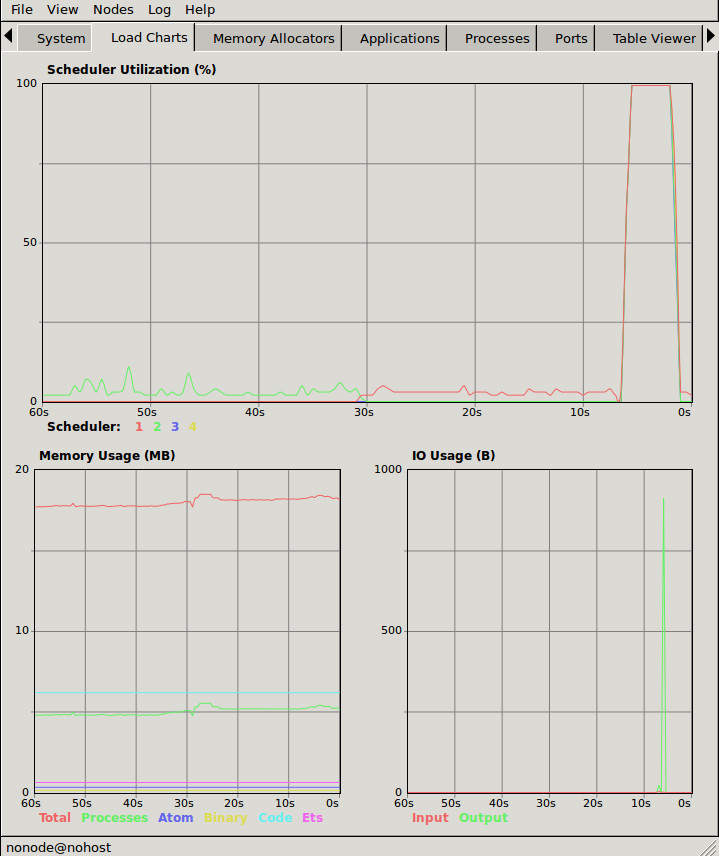
10.2. C 수준에서는 협력형으로 구현된 ERTS의 선점형 멀티태스킹
Erlang 수준의 선점형 멀티태스킹은 C 수준의 협력형 멀티태스킹을 통해 구현됩니다. Erlang 언어와 컴파일러, 가상 머신이 함께 작동하여 Erlang 프로세스가 제한된 시간 안에 실행을 양보하고 다음 프로세스가 실행될 수 있도록 보장합니다. 허용된 실행 시간을 측정하고 제한하는 데 쓰이는 기법을 리덕션 카운팅이라고 하며, 리덕션 카운팅의 모든 세부 사항은 곧 살펴보겠습니다.
10.3. 리덕션
BEAM의 스케줄링은 협력형 스케줄링 위에 얹힌 선점형 스케줄링이라고 설명할 수 있습니다. 프로세스는 receive나 함수 호출처럼 실행 중의 특정 지점에서만 일시 중단될 수 있습니다. 그런 의미에서 스케줄링은 협력형입니다---프로세스가 일시 중단을 허용하는 코드를 실행해야 하기 때문입니다. Erlang 코드의 특성상 프로세스가 함수 호출 없이 오랫동안 실행되는 것은 거의 불가능합니다. 그럼에도 양보(yield)하지 않은 채 지나치게 오래 실행될 수 있는 내장 함수(Built In Functions, BIF)가 몇 가지 있습니다. 또한 잘못 구현된 네이티브 구현 함수(Native Implemented Function, NIF)에서 C 코드를 호출하면 스케줄러 하나를 오랫동안 블록할 수도 있습니다. 올바르게 동작하는 NIF를 작성하는 방법은 Chapter 16에서 살펴보겠습니다.
재귀와 리스트 컴프리헨션 외에는 다른 반복 구문이 없으므로, 함수 호출 없이 무한히 반복할 방법은 없습니다. 각 함수 호출은 reduction으로 계산되며, 프로세스의 리덕션 한도에 도달하면 해당 프로세스는 일시 중단됩니다.
|
버전 정보
OTP-20.0 이전에는 |
|
리덕션
리덕션이라는 텀은 Erlang의 뿌리인 Prolog에서 유래했습니다. Prolog에서 각 실행 단계는 목표 리덕션(goal-reduction)이며, 각 단계에서는 논리 문제를 구성 요소로 분해한 다음 각 부분을 풀려고 시도합니다. |
10.3.1. 얼마나 많은 리덕션을 받게 됩니까?
프로세스가 스케줄되면 CONTEXT_REDS로 정의된 수만큼의 리덕션을 받습니다(erl_vm.h에 정의되어 있으며, 현재 값은 4000입니다). 리덕션을 모두 소진하거나 수신함에 일치하는 메시지가 없는 상태에서 receive를 수행하면, 해당 프로세스는 일시 중단되고 새로운 프로세스가 스케줄됩니다.
VM이 INPUT_REDUCTIONS(현재 값은 2*CONTEXT_REDS이며, 이 역시 erl_vm.h에 정의되어 있습니다)에 정의된 만큼의 리덕션을 실행했거나 실행할 준비가 된 프로세스가 없으면, 스케줄러는 시스템 수준의 작업을 수행합니다. 즉, 기본적으로 IO를 확인하는 일이며, 자세한 내용은 곧 다루겠습니다.
10.3.2. 리덕션이란 정확히 무엇입니까?
리덕션이 무엇인지 완전히 정의되어 있지는 않지만, 적어도 각 함수 호출은 하나의 리덕션으로 계산해야 합니다. BIF와 NIF에 대해 이야기할 때는 상황이 조금 더 복잡해집니다. 프로세스가 리덕션을 사용하지 않고, 양보하지도 않은 채 "오랜 시간" 동안 실행될 수 있어서는 안 됩니다. C로 작성된 함수는 도중에 양보할 수 없으며, 깨끗한 상태임을 보장한 뒤 반환해야 합니다. 재진입이 가능하려면 반환하기 전에 어떻게든 내부 상태를 저장해 두었다가 재진입할 때 그 상태를 다시 설정해야 합니다. 이는 비용이 매우 클 수 있으며, 어떤 때는 적은 작업만 하고 어떤 때는 많은 작업을 하는 함수라면 더욱 그렇습니다. 함수를 Erlang 대신 C로 작성하는 이유는 대개 성능을 향상시키고 불필요한 부가 관리 작업을 하지 않기 위해서입니다. Erlang 수준의 함수 호출이라는 것 외에는 리덕션 하나가 무엇인지에 대한 명확한 정의가 없기 때문에, C로 구현된 함수가 일반 Erlang 함수보다 리덕션당 훨씬 더 많은 클록 사이클을 소모할 위험이 있습니다. 이는 스케줄러의 불균형으로, 나아가 기아 상태로까지 이어질 수 있습니다.
예를 들어 R16 이전 버전의 Erlang에서는 BIF인 binary_to_term/1과 term_to_binary/1이 실행을 양보(yield)하지 않았고, 리덕션도 하나로만 계산되었습니다. 이 때문에 큰 텀에 대해 이 함수들을 호출하는 프로세스가 다른 프로세스를 기아 상태에 빠뜨릴 수 있었습니다. 이러한 현상은 프로세스가 스케줄러 사이에서 균형을 맞추는 방식 때문에 SMP 시스템에서도 발생할 수 있으며, 이 방식은 곧 살펴보겠습니다.
프로세스가 실행되는 동안 에뮬레이터는 실행할 수 있는 남은 리덕션 수를 (레지스터에 매핑된) 변수 FCALLS에 보관합니다(beam_emu.c를 참조하십시오).
reds 필드는 프로세스가 마지막으로 일시 중단될 때까지 수행한 리덕션의 총 횟수를 기록합니다. 이 수치를 모니터링하면 어떤 프로세스가 가장 많은 작업을 수행하는지 알 수 있습니다.
두 번째 인자로 아톰 reductions를 넘겨 erlang:process_info/2를 호출하면 프로세스의 총 리덕션 수(reds 필드)를 확인할 수 있습니다. 이 수치는 observer의 프로세스 탭에서 확인하거나 Erlang 셸에서 i/0 명령으로도 확인할 수 있습니다.
앞서 언급했듯이, 프로세스가 시작될 때마다 fcalls 필드는 CONTEXT_REDS 값으로 설정되며, 프로세스가 함수 호출을 하나 실행할 때마다 fcalls는 1씩 감소합니다. 프로세스가 일시 중단되면 reds 필드는 실행된 리덕션 수만큼 증가합니다. C와 유사한 코드로 나타내면 대략 다음과 같습니다: p→reds += (CONTEXT_REDS - p→fcalls).
일반적으로 프로세스는 할당된 리덕션을 모두 소진하므로 이 시점에서 fcalls는 0이 되지만, 프로세스가 receive에서 메시지를 기다리며 일시 중단되면 리덕션이 일부 남게 됩니다.
프로세스가 자신의 리덕션을 모두 소모하면 다른 프로세스가 실행될 수 있도록 양보하며, 이때 프로세스 상태는 running 상태에서 runnable 상태로 바뀝니다. receive에서 양보하는 경우에는 대신 (메시지를 기다리는) waiting 상태로 들어갑니다. 다음 절에서는 프로세스가 가질 수 있는 여러 상태를 모두 살펴보겠습니다.
10.4. 프로세스 상태(또는 status)
PCB의 status 필드에는 프로세스 상태가 들어 있습니다. 이 값은 free, runnable, waiting, running, exiting, garbing, suspended 중 하나일 수 있습니다. 프로세스가 종료되면 free로 표시됩니다---이 상태의 프로세스를 볼 수 있는 일은 결코 없어야 합니다. 이 상태는 시스템의 나머지 부분이 보기에는 프로세스가 더 이상 존재하지 않지만 아직 정리 작업(메모리 및 기타 자원 해제)이 남아 있는, 수명이 짧은 상태입니다.
각 프로세스 상태는 프로세스 상태 기계(Process State Machine)의 한 상태를 나타냅니다. 타임아웃이나 메시지 도착과 같은 이벤트는 상태 기계의 간선을 따라 전이를 일으킵니다. 프로세스 상태 기계는 다음과 같습니다:
프로세스의 일반적인 상태는 실행 가능(runnable), 대기(waiting), 실행 중(running) 상태입니다. 실행 중인 프로세스는 스케줄러 중 하나에서 현재 코드를 실행하고 있습니다. 프로세스가 receive에 진입했는데 메시지 큐에 매칭되는 메시지가 없으면, 해당 프로세스는 메시지가 도착하거나 타임아웃이 발생할 때까지 대기 상태가 됩니다. 프로세스가 자신의 리덕션을 모두 소진하면, 실행 가능 상태가 되어 스케줄러가 다시 선택할 때까지 기다립니다. 대기 중인 프로세스는 메시지를 받거나 타임아웃이 발생하면 실행 가능 상태가 됩니다.
프로세스가 가비지 컬렉션을 수행해야 할 때마다, 해당 프로세스는 GC가 끝날 때까지 garbing 상태에 들어갑니다. GC를 수행하는 동안 프로세스는 이전 상태를 gcstatus 필드에 저장하고, GC가 끝나면 gcstatus를 사용하여 상태를 이전 상태로 되돌립니다.
일시 중단(suspended) 상태는 디버깅 목적으로만 사용하도록 되어 있습니다. 다른 프로세스에 대해 erlang:suspend_process/2를 호출하면 해당 프로세스를 강제로 일시 중단 상태로 만들 수 있습니다. 한 프로세스가 다른 프로세스에 대해 suspend_process를 호출할 때마다 일시 중단 카운트가 증가합니다. 이 값은 rcount 필드에 기록됩니다. 일시 중단시킨 프로세스가 (erlang:resume_process/1)을 호출하면 일시 중단 카운트가 감소합니다. 일시 중단 상태에 있는 프로세스는 일시 중단 카운트가 0이 될 때까지 일시 중단 상태를 벗어나지 않습니다.
rstatus(resume status, 재개 상태) 필드는 프로세스가 일시 중단되기 전에 어떤 상태였는지 추적하는 데 사용됩니다. 프로세스가 running 또는 runnable 상태였다면 runnable 상태로 다시 시작하고, waiting 상태였다면 대기 큐로 돌아갑니다. 일시 중단된 대기 상태의 프로세스가 타임아웃을 받으면 rstatus가 runnable로 설정되므로, 해당 프로세스는 runnable 상태로 재개됩니다.
다음에 실행할 프로세스를 추적하기 위해 스케줄러는 프로세스들을 큐에 담아 둡니다.
10.5. 프로세스 큐
스케줄러의 주요 역할은 작업 큐, 즉 프로세스와 포트의 큐를 추적하는 것입니다.
스케줄러가 처리해야 하는 프로세스 상태는 runnable(실행 가능)과 waiting(대기)의 두 가지입니다. 메시지 수신을 기다리는 프로세스는 대기 상태에 있습니다. 대기 중인 프로세스가 메시지를 받으면 send 연산이 수신 프로세스를 실행 가능 상태로 옮깁니다. receive 문에 타임아웃이 있으면, 타임아웃이 발생할 때 스케줄러가 실행 가능 상태로의 전이를 촉발해야 합니다. 이 메커니즘은 이 장의 뒷부분에서 다룹니다.
10.5.1. 준비 큐
실행 가능 상태의 프로세스는 스케줄러가 관리하는 FIFO(first in first out, 선입선출) 큐에 놓이며, 이 큐를 준비 큐라고 합니다. 이 큐는 first 포인터와 last 포인터, 그리고 큐에 속한 각 프로세스의 PCB에 있는 next 포인터로 구현됩니다. 새 프로세스를 큐에 추가할 때는 last 포인터를 따라가 해당 프로세스를 큐의 끝에 O(1) 연산으로 추가합니다. 새 프로세스를 스케줄링할 때는 큐의 머리(first 포인터)에서 꺼내기만 하면 됩니다.
 The Ready Queue

 First: -->  P5       +---> P3       +-+-> P17
             next: ---+     next: ---+ |  next: NULL
                                       |
 Last: --------------------------------+
스케줄러 스레드가 여러 개 있는 SMP 시스템에서는 스케줄러마다 큐가 하나씩 있습니다.
 Scheduler 1       Scheduler 2      Scheduler 3      Scheduler 4

 Ready: P5         Ready: P1        Ready: P7        Ready: P9
        P3                P4               P12
        P17                                P10
Erlang 프로세스에는 우선순위가 있으므로 실제로는 조금 더 복잡합니다. 각 스케줄러는 실제로 세 개의 큐를 가지고 있습니다. 최대 우선순위 작업을 위한 큐 하나, 높은 우선순위 작업을 위한 큐 하나, 그리고 보통 우선순위 작업과 낮은 우선순위 작업을 함께 담는 큐 하나입니다.
 Scheduler 1       Scheduler 2      Scheduler 3      Scheduler 4

 Max:    P5        Max:             Max:             Max:
 High:             High:  P1        High:            High:
 Normal: P3        Ready: P4        Ready: P7        Ready: P9
         P17                               P12
                                           P10
max 큐에 프로세스가 있으면 스케줄러는 이 프로세스들을 실행 대상으로 선택합니다. max 큐에는 프로세스가 없지만 high 우선순위 큐에 프로세스가 있으면 스케줄러는 그 프로세스들을 선택합니다. max 큐와 high 우선순위 큐에 모두 프로세스가 없을 때에만 스케줄러는 normal 큐와 low 큐에서 첫 번째 프로세스를 선택합니다.
일반 프로세스가 큐에 삽입되면 스케줄 카운트 값으로 1을 받고, 우선순위가 낮은 프로세스는 스케줄 카운트 값으로 8을 받습니다. 큐의 맨 앞에서 프로세스를 꺼내면 그 프로세스의 스케줄 카운트가 1 줄어듭니다. 카운트가 0이 되면 그 프로세스가 스케줄되고, 그렇지 않으면 큐의 맨 끝에 삽입됩니다. 즉, 우선순위가 낮은 프로세스는 스케줄되기 전에 큐를 일곱 번 거치게 됩니다.
10.5.2. 대기, 타임아웃, 그리고 타이밍 휠
빈 메일박스나 일치하는 메시지가 없는 메일박스에서 receive를 시도하는 프로세스는 실행을 양보(yield)하고 대기 상태로 들어갑니다.
메시지가 수신함에 전달되면 송신 프로세스는 수신자가 대기 상태에서 잠들어 있는지 확인하고, 그렇다면 그 프로세스를 깨워 상태를 실행 가능으로 바꾼 뒤 적절한 준비 큐의 맨 끝에 넣습니다.
receive 문에 timeout 절이 있으면, 지정한 타임아웃 시간이 지난 뒤 작동하는 타이머가 해당 프로세스에 대해 생성됩니다. 타임아웃에 대해 런타임 시스템이 보장하는 것은 설정한 시간보다 먼저 작동하지 않는다는 점 하나뿐입니다. 프로세스가 스케줄링되어 실행되기까지는 의도한 시간보다 얼마간 늦어질 수 있습니다.
VM에서 타이머는 타이밍 휠(timing wheel)로 처리됩니다. 즉, 끝에 도달하면 처음으로 되돌아가는 타임 슬롯의 배열입니다. Erlang 18 이전에는 타이밍 휠이 전역 자원이었으므로, 많은 프로세스가 휠에 타이머를 삽입하면 쓰기 락을 두고 경합이 발생할 수 있었습니다. 타이머를 많이 사용한다면 반드시 그 이후 버전의 Erlang을 사용하십시오.
타이밍 휠의 기본 크기(TIW_SIZE)는 65536개 슬롯입니다(적은 메모리 사용량에 맞춰 시스템을 빌드했다면 8192개 슬롯입니다). 현재 시각은 배열의 인덱스(tiw_pos)로 나타냅니다. 타임아웃이 T인 타이머를 휠에 삽입하면 그 타이머는 (tiw_pos+T)%TIW_SIZE 위치의 슬롯에 들어갑니다.
   0 1                                      65535
  +-+-+- ... +-+-+-+-+-+-+-+-+-+-+-+ ... +-+-----+
  | | |      | | | | | | |t| | | | |     | |     |
  +-+-+- ... +-+-+-+-+-+-+-+-+-+-+-+ ... +-+-----+
              ^           ^                       ^
              |           |                       |
           tiw_pos     tiw_pos+T               TIW_SIZE
타이밍 휠에 저장되는 타이머는 ErlTimer 구조체를 가리키는 포인터입니다. erl_time.h를 참조하십시오. 여러 타이머가 같은 슬롯에 삽입되면 prev 필드와 next 필드를 통해 연결 리스트로 서로 연결됩니다. count 필드는 T/TIW_SIZE로 설정됩니다.
/*
** Timer entry:
*/
typedef struct erl_timer {
    struct erl_timer* next;	/* next entry tiw slot or chain */
    struct erl_timer* prev;	/* prev entry tiw slot or chain */
    Uint slot;			/* slot in timer wheel */
    Uint count;			/* number of loops remaining */
    int    active;		/* 1=activated, 0=deactivated */
    /* called when timeout */
    void (*timeout)(void*);
    /* called when cancel (may be NULL) */
    void (*cancel)(void*);
    void* arg;        /* argument to timeout/cancel procs */
} ErlTimer;
10.6. 포트
포트는 Erlang VM 외부 세계와의 통신 지점을 나타내는 Erlang의 추상화입니다. 소켓, 파이프, 파일 IO를 통한 통신은 Erlang 측에서 모두 포트를 통해 이루어집니다.
포트는 프로세스와 마찬가지로 자신을 생성한 프로세스와 같은 스케줄러에서 생성됩니다. 또한 포트도 프로세스와 마찬가지로 리덕션을 사용해 언제 양보할지 결정하며, 역시 4000 리덕션 동안 실행될 수 있습니다. 하지만 포트는 Erlang 코드를 실행하지 않으므로 리덕션으로 셀 Erlang 함수 호출이 없습니다. 그 대신 각 포트 태스크를 일정한 수의 리덕션으로 계산합니다. 현재 태스크 하나는 태스크당 200을 조금 넘는 리덕션을 사용하며, 여기에 전송된 데이터 크기의 1000분의 1에 비례하는 수의 리덕션이 더해집니다.
포트 태스크는 포트에 대한 하나의 작업으로, 포트 열기, 닫기, 일정한 수의 바이트 전송, 데이터 수신 등이 이에 해당합니다. 포트 태스크를 실행하기 위해 실행 중인 스레드는 해당 포트의 락을 획득합니다.
포트 태스크는 스케줄러 루프(아래 참조)의 각 반복에서 새 프로세스가 실행 대상으로 선택되기 전에 스케줄링되고 실행됩니다.
10.7. 스케줄러 루프
개념적으로 스케줄러는 Erlang VM에서 프로그램 실행을 이끄는 드라이버라고 볼 수 있습니다. 그러나 실제로, 즉 C 코드가 구성된 방식을 보면, 실행을 주도하는 것은 에뮬레이터(beam_emu.c의 process_main)이며, 에뮬레이터는 다음에 실행할 프로세스를 찾기 위해 스케줄러를 서브루틴으로 호출합니다.
그럼에도 우리는 그 반대인 것처럼 간주하겠습니다. 그렇게 하면 스케줄러 루프를 이해하기 좋은 개념적 모델이 되기 때문입니다. 즉, 스케줄러가 실행할 프로세스를 고른 다음 실행을 에뮬레이터에 넘겨주는 것으로 보겠습니다.
그렇게 보면 스케줄러 루프는 다음과 같습니다:
-
리덕션 카운터를 갱신합니다.
각 프로세스에는 일정 수의 리덕션(작은 실행 단위)이 할당됩니다. 리덕션 횟수를 초과하면 해당 프로세스는 선점되고 다른 프로세스가 스케줄링됩니다.
-
타이머 확인
타이머(예:
receive … after)는 타이밍 휠을 통해 확인됩니다. 타임아웃이 만료되면 해당 프로세스는 준비 큐로 옮겨집니다. -
필요하면 부하 균형을 확인합니다
시스템은 때때로 일부 스케줄러 스레드에 과부하가 걸렸는지 확인합니다. 과부하가 걸렸다면 부하 분산 결정을 내립니다.
-
필요한 경우 프로세스와 포트를 마이그레이션합니다
멀티코어 환경에서는 CPU 부하를 재분배하기 위해 프로세스와 포트를 스케줄러 스레드 간에 옮길 수 있습니다.
-
보조 스케줄러 작업 수행
여기에는 더티 NIF, 프로세스 종료, 트레이싱 훅의 처리와 그 밖의 지연된 런타임 유지 관리 작업이 포함됩니다.
-
필요하면 IO를 확인하고 시간을 갱신합니다
파일 디스크립터나 포트의 I/O 준비 상태를 폴링하며, 시스템 시간이나 벽시계 시간을 갱신할 수 있습니다.
-
필요한 동안 실행할 포트 태스크를 선택합니다
TCP 읽기나 쓰기, 드라이버 콜백 호출 같은 작업은 프로세스를 스케줄링하기 전에 이곳에서 수행됩니다.
-
실행할 프로세스 선택
실행 가능한 프로세스는 우선순위와 공정성을 고려하여 실행 큐에서 선택된 뒤, 실행을 위해 에뮬레이터에 넘겨집니다.
10.8. 부하 분산
로드 밸런서의 현재 전략은 어떤 CPU에도 과부하를 주지 않으면서 스케줄러를 가능한 한 적게 사용하는 것입니다. 프로세스들이 같은 CPU를 공유하면 메모리 지역성이 좋아져 더 나은 성능을 얻을 수 있다는 것이 그 발상입니다.
다만 한 가지 유의할 점은, 스케줄러가 수행하는 부하 분산은 스케줄러 스레드 사이에서 이루어지며 반드시 CPU나 코어 사이에서 이루어지는 것은 아니라는 점입니다. 런타임 시스템을 시작할 때 스케줄러를 코어에 어떻게 할당할지 지정할 수 있습니다. 기본 동작은 스케줄러 스레드를 코어에 할당하는 일을 OS에 맡기는 것이지만, 스케줄러를 코어에 바인딩하도록 선택할 수도 있습니다.
로드 밸런서는 각 코어에서 스케줄러가 하나씩 실행된다고 가정합니다. 따라서 과부하된 스케줄러에서 활용도가 낮은 스케줄러로 프로세스를 옮기면 더 많은 병렬 처리 능력을 얻을 수 있습니다. 스케줄러를 코어에 할당하는 방식을 변경했거나, 운영 체제가 과부하 상태이거나 스레드를 코어에 할당하는 데 서툴다면, 부하 분산이 오히려 불리하게 작용할 수도 있습니다.
로드 밸런서는 부하를 분산하기 위해 태스크 스틸링(task stealing)과 마이그레이션(migration)이라는 두 가지 기법을 사용합니다. 태스크 훔치기는 스케줄러의 작업이 바닥날 때마다 사용됩니다. 이 기법을 사용하면 작업이 스케줄러들 사이에 더 넓게 분산됩니다. 마이그레이션은 더 복잡하며, 부하를 적절한 수의 스케줄러로 모으려고 합니다.
10.8.1. 태스크 훔치기
스케줄러가 스케줄링할 새 프로세스를 골라야 할 때 해당 스케줄러의 실행 큐가 비어 있으면, 그 스케줄러는 다른 스케줄러의 작업을 훔쳐 오려고 시도합니다.
먼저 스케줄러는 다른 스케줄러가 현재 스케줄러의 작업을 훔쳐 가려 시도하지 못하도록 자기 자신에 락을 겁니다. 그런 다음 작업을 훔쳐 올 수 있는 비활성 스케줄러가 있는지 확인합니다. 훔칠 수 있는 작업을 가진 비활성 스케줄러가 없으면, 자신보다 id가 높은 스케줄러부터 시작해 활성 스케줄러를 살펴보며 훔칠 수 있는 작업을 찾습니다.
태스크 훔치기는 한 번에 하나의 스케줄러를 살펴보면서 그 스케줄러에서 우선순위가 가장 높은 태스크를 훔치려고 시도합니다. 이 작업은 스케줄러 단위로 이루어지므로, 다른 스케줄러에 훔칠 수 있는 더 높은 우선순위의 태스크가 실제로 있더라도 그 태스크는 가져가지 않을 수 있습니다.
태스크 훔치기는 번호가 더 높은 스케줄러에서 훔쳐 오는 방식으로 태스크를 번호가 더 낮은 스케줄러 쪽으로 옮기려 합니다. 하지만 훔치기는 끝에 이르면 처음으로 되돌아가 번호가 더 낮은 스케줄러에서도 훔쳐 오기 때문에, 결과적으로 프로세스는 모든 활성 스케줄러에 퍼지게 됩니다.
태스크 훔치기는 상당히 빠르므로, 스케줄러에 남은 태스크가 없을 때 스케줄러 루프를 반복할 때마다 수행할 수 있습니다.
10.8.2. 마이그레이션
스케줄러를 최적으로 활용하기 위해 보다 정교한 마이그레이션 전략을 사용합니다. 현재 전략은 부하를 가능한 한 적은 수의 스케줄러에 집약하는 동시에, 어떤 스케줄러도 과부하되지 않도록 부하를 분산하는 것입니다.
이 작업은 erl_process.c 파일에 있는 check_balance 함수가 수행합니다.
마이그레이션은 먼저 마이그레이션 계획을 수립한 다음, 새 계획이 수립될 때까지 스케줄러들이 그 계획에 따라 실행하도록 하는 방식으로 이루어집니다. 스케줄러는 2000*CONTEXT_REDS 리덕션마다 모든 스케줄러의 작업 부하를 살펴보고, 스케줄러별·우선순위별로 마이그레이션 경로를 계산합니다. 마이그레이션 경로는 다음 세 가지 유형의 값을 가질 수 있습니다: 1) 해제됨 2) 스케줄러로 이주 3) 스케줄러로부터 이입.
프로세스가 준비 상태가 되면(예를 들어 메시지를 수신하거나 타임아웃이 발생하면) 일반적으로 마지막으로 실행되었던 스케줄러(S1)에 스케줄링됩니다. 단, 이는 해당 우선순위에서 그 스케줄러(S1)의 마이그레이션 경로가 해제되어 있는 경우에 해당합니다. 스케줄러의 마이그레이션 경로가 (S2로) 이주하도록 설정되어 있다면, S1과 S2 모두 실행 큐가 불균형한 경우 프로세스는 그 스케줄러로 넘겨집니다. 이것이 무엇을 의미하는지는 나중에 다시 살펴보겠습니다.
스케줄러(S1)가 실행할 새 프로세스를 골라야 할 때, S1은 (S2)로부터의 이주 경로가 설정되어 있는지 확인합니다. 관련된 두 스케줄러의 실행 큐가 불균형하면 S1은 S2에서 프로세스를 하나 빼앗아 옵니다.
마이그레이션 경로는 특정 우선순위에 대해 각 스케줄러의 최대 실행 큐를 비교하여 계산합니다. 각 스케줄러는 스케줄러 루프를 반복할 때마다 카운터를 갱신하여 최대 큐 길이를 추적합니다. 그런 다음 이 정보를 사용하여 평균 (최대) 큐 길이(AMQL)를 계산합니다.
 Max
 Run Q
 Length
    5         o
              o
           o  o
Avg: 2.5 --------------
           o  o     o
    1      o  o     o

scheduler S1 S2 S3 S4
그런 다음 스케줄러들을 최대 큐 길이를 기준으로 정렬합니다.
 Max
 Run Q
 Length
    5               o
                    o
                 o  o
Avg: 2.5 --------------
              o  o  o
    1         o  o  o

scheduler S3 S4 S1 S2

           ^        ^
           |        |
          tix      fix
실행 큐가 평균보다 긴 스케줄러(S1, S2)는 모두 이출(emigration) 대상으로 표시되고, 최대 실행 큐가 평균보다 짧은 스케줄러(S3, S4)는 모두 이입(immigration) 대상이 됩니다.
이 작업은 두 개의 인덱스, 즉 (이주해 오는 곳(fix))과 (이주해 가는 곳(tix))을 사용하여 정렬된 스케줄러 집합을 순회하는 방식으로 수행됩니다. 루프의 각 반복에서 S[tix]의 이입 경로는 S[fix]로 설정되고, S[fix]의 이출 경로는 S[tix]로 설정됩니다. 그런 다음 두 인덱스가 모두 균형점을 지날 때까지 tix는 증가시키고 fix는 감소시킵니다. 한 인덱스가 먼저 균형점에 도달하면 그 인덱스는 순환하여 반대쪽 끝으로 넘어갑니다.
예시에서는 다음과 같습니다.
-
반복 1: S2.emigrate_to = S3이고 S3.immigrate_from = S2
-
반복 2: S1.emigrate_to = S4이고 S4.immigrate_from = S1입니다
이것으로 완료되었습니다.
실제로는 스케줄러가 오프라인으로 전환될 수 있으므로 상황이 조금 더 복잡합니다. 마이그레이션 계획은 온라인 상태인 스케줄러에 대해서만 수립됩니다. 또한 앞서 언급했듯이 이 작업은 우선순위 수준별로 수행됩니다.
프로세스를 준비 큐에 삽입해야 할 때 S1에서 S2로 가는 마이그레이션 경로가 설정되어 있으면, 스케줄러는 먼저 S1의 실행 큐가 AMQL보다 큰지, 그리고 S2의 실행 큐가 평균보다 작은지를 확인합니다. 이렇게 하면 두 큐가 여전히 불균형 상태일 때만 마이그레이션이 허용됩니다.
하지만 큐가 균형을 이루고 있거나 심지어 반대 방향으로 불균형한 경우에도 마이그레이션이 강제되는 두 가지 예외가 있습니다. 이 두 경우 모두 균형 검사보다 우선하는 특수한 대피(evacuation) 플래그가 설정됩니다.
스케줄러가 오프라인으로 전환되면, 오프라인 스케줄러에 새 프로세스가 스케줄링되지 않도록 대피 플래그가 설정됩니다. 이 플래그는 스케줄러가 특정 우선순위에서 진행이 이루어지지 않음을 감지했을 때에도 설정됩니다. 예를 들어, 항상 실행 준비가 되어 있는 max 우선순위 프로세스가 있어서 normal 우선순위 프로세스가 전혀 스케줄링되지 못하는 경우가 이에 해당합니다. 이 경우 해당 스케줄러의 normal 우선순위 큐에 대피 플래그가 설정됩니다.
11. 메모리 서브시스템: 스택, 힙, 할당자
ERTS의 메모리 서브시스템을 본격적으로 살펴보기 전에, 현대 운영 체제에서 프로그램이 갖는 일반적인 메모리 레이아웃에 관한 기본 용어와 이해를 갖출 필요가 있습니다. 이 복습 절에서는 프로그램이 ELF 실행 파일로 컴파일되어 IA-32/AMD64와 같은 아키텍처 기반의 Linux에서 실행된다고 가정하겠습니다. 레이아웃과 용어는 ERTS가 컴파일되는 모든 운영 체제에서 기본적으로 동일합니다.
프로그램의 메모리 레이아웃은 대략 다음과 같습니다.
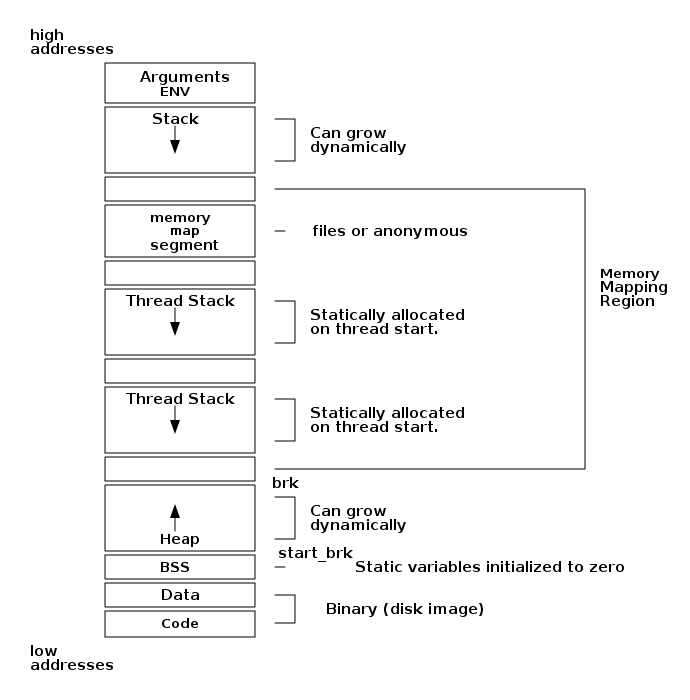
이 그림이 부담스러워 보일 수 있지만, 이것도 여전히 단순화한 것입니다. (메모리 서브시스템을 완전히 이해하려면 "Understanding the Linux Kernel"이나 "Linux System Programming" 같은 책을 읽으십시오.) 여기서 기억해 두셨으면 하는 점은 동적으로 할당할 수 있는 메모리가 두 종류라는 것입니다. 바로 힙과 메모리 매핑 세그먼트입니다. Erlang 프로세스 힙과 구별하기 위해 앞으로 이 힙을 C-힙이라고 부르겠습니다. 메모리 매핑 세그먼트는 그냥 세그먼트라고 부르고, 이 그림에 있는 스택은 어느 것이든 C-스택이라고 부르겠습니다.
C 힙은 malloc을 통해 할당되며, 세그먼트는 mmap으로 할당됩니다.
11.1. 메모리 서브시스템
이제 메모리 서브시스템을 깊이 살펴보면, ERTS가 단순한 프로그래밍 언어 환경이라기보다는 운영 체제에 더 가깝다는 사실이 다시 한번 분명해질 것입니다. ERTS는 Erlang 프로세스 수준에서 Erlang 텀을 위한 가비지 컬렉터를 제공할 뿐만 아니라, 수많은 저수준 메모리 할당자와 메모리 할당 전략도 제공합니다.
메모리 할당자에 대한 개요는 다음 erts_alloc 문서를 참조하십시오: http://www.erlang.org/doc/man/erts_alloc.html
이 모든 할당자에는 동작을 조정하는 데 사용할 수 있는 여러 매개변수도 함께 제공되며, 운영 관점에서는 아마도 이 부분이 가장 중요한 영역 중 하나일 것입니다. 바로 여기에서 (Raspberry Pi 같은) 소형 임베디드 제어 시스템부터 인터넷 규모의 2TB 데이터베이스 서버에 이르기까지 어떤 환경에든 맞도록 시스템 동작을 구성할 수 있습니다.
현재 서로 다른 할당자가 11개, 서로 다른 할당 전략이 6개 있으며, 그 밖에도 18개가 넘는 설정이 있고, 그중 일부는 임의의 숫자 값을 받습니다. 이는 가능한 구성의 수가 사실상 무한하다는 뜻입니다. (물론 엄밀히 말하면 각 숫자에는 상한이 있으므로 무한하지는 않지만, 구성의 수는 이루 다 헤아릴 수 없을 만큼 많습니다.)
이러한 설정을 의미 있게 활용하려면 이 할당자들이 어떻게 동작하는지, 그리고 각 설정이 할당자의 성능에 어떤 영향을 미치는지 이해해야 합니다.
erts_alloc 매뉴얼에는 다음과 같은 경고까지 실려 있습니다.
이 플래그는 자신이 무엇을 하고 있는지 확실히 알 때만 사용하십시오. 부적절한 설정은 심각한 성능 저하를 일으킬 수 있으며, 운영 중 언제든지 시스템 크래시까지 일으킬 수 있습니다.
http://www.erlang.org/doc/man/erts_alloc.html
여러분이 무엇을 하고 있는지 제대로 알고 있다고 완전히 확신할 수 있게 하는 것, 그것이 바로 이 장에서 다루는 내용입니다.
아, 그리고 가비지 컬렉터가 어떻게 동작하는지도 자세히 다룰 것입니다.
11.2. 다양한 종류의 메모리 할당자
Erlang 런타임 시스템은 모든 상황과 모든 종류의 부하에서 메모리를 처리하기 위해 최선을 다하지만, 예외적인 경우는 언제나 존재합니다. 이 장에서는 메모리가 어떻게 할당되는지, 그리고 여러 할당자가 각각 어떻게 동작하는지를 자세히 살펴보겠습니다. 이 지식과 뒤에서 살펴볼 몇 가지 도구를 활용하면, 시스템이 이러한 예외적인 경우 중 하나에 빠졌을 때 문제를 발견하고 해결할 수 있을 것입니다.
시스템에 생길 수 있는 문제와 그 동작을 분석하고 바로잡는 방법을 다룬 좋은 이야기를 읽고 싶다면 Fred Hébert의 에세이 "Troubleshooting Down the Logplex Rabbit Hole"을 읽어 보십시오.
이 책에서 메모리 할당자에 대해 이야기할 때는 특정한 의미를 염두에 두고 있습니다. 각 메모리 할당자는 특정 유형의 메모리에 대한 할당과 해제를 관리합니다. 각 할당자는 특정 유형의 데이터를 위한 것이며, 흔히 한 가지 크기의 데이터에 특화되어 있습니다.
각 메모리 할당자는 할당자 인터페이스를 구현하며, 이 인터페이스는 실제 메모리 할당에 서로 다른 알고리즘과 설정을 사용할 수 있습니다.
여러 종류의 할당자를 두는 목적은 크기가 같은 할당을 한데 묶어 단편화를 줄이고, 자주 일어나는 할당의 비용을 낮춰 성능을 높이는 것입니다.
메모리 할당자에는 기본적이거나 범용적인 특수 유형인 sys_alloc과 mseg_alloc 두 가지가 있고, alloc_util 프레임워크를 통해 구현된 아홉 가지 특정 할당자가 있습니다.
다음 절들에서는 여러 할당자를 차례로 살펴보고, 그 과정에서 할당자를 위한 일반 프레임워크(alloc_util)도 잠시 짚어 보겠습니다.
각 할당자에는 문서와 C 코드에서 사용하는 여러 이름이 있습니다. 모든 할당자와 그 이름을 간략히 정리한 목록은 Table 1를 참조하십시오. C-name은 C 코드에서 해당 할당자를 가리킬 때 사용합니다. Type-name은 erl_alloc.types에서 할당 유형을 할당자에 바인딩할 때 사용합니다. Flag는 Erlang을 시작할 때 해당 할당자의 매개변수를 설정하는 데 사용하는 문자입니다.
| 이름 | 설명 | C-name | 타입 이름 | 플래그 |
|---|---|---|---|---|
기본 할당자 |
malloc 인터페이스 |
sys_alloc |
SYSTEM |
Y |
메모리 세그먼트 할당자 |
mmap 인터페이스 |
mseg_alloc |
- |
M |
임시 할당자 |
임시 할당 |
temp_alloc |
TEMPORARY |
T |
힙 할당자 |
Erlang 힙 데이터 |
eheap_alloc |
EHEAP |
H |
바이너리 할당자 |
바이너리 데이터 |
binary_alloc |
BINARY |
B |
ETS 할당자 |
ETS 데이터 |
ets_alloc |
ETS |
E |
드라이버 할당자 |
드라이버 데이터 |
driver_alloc |
DRIVER |
R |
단기 수명 할당자 |
수명이 짧은 메모리 |
sl_alloc |
SHORT_LIVED |
S |
장기 생존 할당자 |
수명이 긴 메모리 |
ll_alloc |
LONG_LIVED |
L |
고정 할당자 |
고정 크기 데이터 |
fix_alloc |
FIXED_SIZE |
F |
표준 할당자 |
그 밖의 대부분의 데이터에 대해서는 |
std_alloc |
STANDARD |
D |
리터럴 할당자 |
모듈 상수 |
literal_alloc |
LITERAL |
(none) |
11.2.1. 기본 할당자: sys_alloc
sys_alloc 할당자는 비활성화할 수 없으며, 기본적으로 libc에 있는 하부 OS의 malloc 구현에 그대로 대응됩니다.
특정 할당자가 비활성화되어 있으면 대신 sys_alloc이 사용됩니다.
모든 개별 할당자는 필요에 따라 운영 체제로부터 메모리를 할당받기 위해 sys_alloc 또는 mseg_alloc 중 하나를 사용합니다.
OS로부터 메모리를 할당받을 때 sys_alloc은 요청된 크기에 고정된 킬로바이트 수만큼을 더할(패딩할) 수 있습니다. 이렇게 메모리를 초과 할당하면 시스템 호출 횟수를 줄일 수 있습니다. 기본 패딩 값은 0입니다.
메모리가 해제될 때 sys_alloc은 일부 여유 메모리를 프로세스에 할당된 상태로 유지합니다. 이 여유 메모리의 크기를 트림 임계값(trim threshold)이라고 하며, 기본값은 128킬로바이트입니다. 이 방식 역시 메모리 사용량이 늘어나는 대가로 시스템 호출 횟수를 줄여 줍니다. 즉, 기본 설정으로 시스템을 실행하면 메모리가 해제되더라도 Beam 프로세스가 메모리를 OS에 곧바로 반환하지 않는 현상을 겪을 수 있습니다.
sys_alloc로 할당된 메모리 영역은 beam 프로세스의 C 힙에 저장되며, 이 힙은 brk 시스템 호출을 통해 필요한 만큼 커집니다.
11.2.2. 메모리 세그먼트 할당자: mseg_alloc
하위 운영 체제가 mmap을 지원하는 경우, 특정 메모리 할당자는 운영 체제로부터 메모리를 할당받을 때 sys_alloc 대신 mseg_alloc을 사용할 수 있습니다.
mseg_alloc을 통해 할당된 메모리 영역을 세그먼트라고 합니다. 세그먼트가 해제되면 곧바로 OS에 반환되지 않고, 대신 세그먼트 캐시에 보관됩니다.
새 세그먼트를 할당할 때는 가능하면 캐시된 세그먼트를 재사용합니다. 즉, 캐시된 세그먼트가 요청된 크기와 같거나 더 크되 지나치게 크지 않은 경우에 재사용합니다. absolute max cache bad fit 값은 초과 크기가 몇 킬로바이트까지일 때 지나치게 크지 않은 것으로 간주할지를 결정합니다. 기본값은 4096킬로바이트입니다.
매우 작은 할당에 4096킬로바이트 세그먼트를 재사용하지 않도록 relative max cache bad fit 값도 있습니다. 이 값은 캐시된 세그먼트가 요청된 크기보다 이 백분율을 초과하여 크면 해당 세그먼트를 사용할 수 없음을 지정합니다. 기본값은 20퍼센트입니다. 즉, 10KB 세그먼트를 요청했을 때 12KB 세그먼트가 사용될 수 있습니다.
캐시 항목 수의 기본값은 10이지만, 0에서 30 사이의 원하는 값으로 설정할 수 있습니다.
11.2.3. 메모리 할당자 프레임워크: alloc_util
두 범용 할당자(sys_alloc과 mseg_alloc) 위에는 alloc_util이라는 프레임워크가 구축되어 있으며, 이 프레임워크는 다양한 용도와 데이터 유형에 맞는 특정 메모리 할당자를 구현하는 데 사용됩니다.
이 프레임워크는 erl_alloc_util.[ch] 파일에 구현되어 있으며, ERTS에서 사용하는 여러 할당자는 "erts/emulator/beam/" 디렉터리의 erl_alloc.types 파일에 정의되어 있습니다.
SMP 시스템에서는 보통 스케줄러 스레드마다 유형별로 할당자가 하나씩 있습니다.
할당자가 다룰 수 있는 가장 작은 메모리 단위를 블록이라고 합니다. 일정한 양의 메모리를 할당하려고 할당자를 호출하면 돌려받는 것이 블록입니다. 메모리를 해제하려고 할 때 할당자에 인자로 넘기는 것 역시 블록입니다.
하지만 할당자는 운영 체제로부터 블록을 직접 할당하지 않습니다. 대신 할당자는 sys_alloc 또는 mseg_alloc을 통해 운영 체제로부터 캐리어를 할당하며, 이들은 다시 malloc 또는 mmap을 사용합니다. sys_alloc을 사용하면 캐리어는 C 힙에 배치되고, mseg_alloc을 사용하면 캐리어는 세그먼트에 배치됩니다.
작은 블록은 멀티블록 캐리어(multiblock carrier)에 배치됩니다. 멀티블록 캐리어는 이름에서 알 수 있듯이 여러 블록을 담을 수 있습니다. 더 큰 블록은 싱글블록 캐리어(singleblock carrier)에 배치되며, 싱글블록 캐리어는 이름이 뜻하는 대로 블록 하나를 담습니다.
작은 블록과 큰 블록을 나누는 기준은 단일 블록 캐리어 임곗값(singleblock carrier threshold, sbct) 매개변수로 결정됩니다. 아래의 시스템 플래그 목록을 참조하십시오.
또한 대부분의 할당자에는 절대 해제되지 않는 "메인 멀티블록 캐리어(main multiblock carrier)"가 하나씩 있습니다.
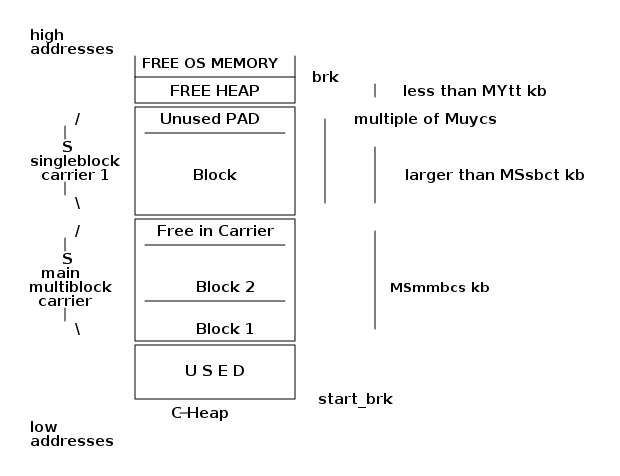
블록, 캐리어, 할당 전략
Erlang 프로세스는 메모리가 필요할 때 할당할 때마다 운영 체제에 직접 요청하지 않습니다. 그 대신 alloc_util 프레임워크(erl_alloc_util.[ch]에 구현되어 있습니다)가 제공하는 전용 할당자와 상호작용합니다. 이 할당자들은 "캐리어(carrier)"라고 불리는 더 큰 연속 메모리 영역에서 메모리를 나누어 주는 방식으로 요청을 처리합니다.
캐리어(carrier)는 운영 체제로부터 직접 할당받는 메모리 영역입니다. 캐리어는 다음 중 하나를 통해 할당됩니다:
-
sys_alloc(malloc()같은 표준 C 라이브러리 함수를 사용)를 이용하거나, 프로세스 힙에 메모리를 배치하거나, 또는 -
mseg_alloc(mmap()사용)으로, 메모리를 일반적인 C 힙 영역 바깥에 배치합니다.
캐리어는 "블록"이라고 불리는 더 작은 메모리 세그먼트로 나뉩니다. 메모리가 요청되면 이 캐리어에서 블록이 할당됩니다. 캐리어에는 두 가지 주요 유형이 있습니다:
-
멀티블록 캐리어(Multiblock Carrier): 여러 개의 작은 블록을 담으며, 자주 일어나는 작은 할당에 적합합니다. 할당자는 기본적으로 멀티블록 캐리어를 대개 약 8 MB 단위로 요청하며(시스템 플래그로 조정 가능), 이를 통해 흔한 Erlang 메모리 패턴을 효율적으로 처리합니다.
-
싱글블록 캐리어(Singleblock Carrier): 정확히 하나의 큰 블록 전용입니다. 싱글블록 캐리어 임계값을 초과하는 할당은 OS에서 직접 할당받은 싱글블록 캐리어에 배치됩니다.
캐리어 임계값(sbct)과 그 영향
싱글블록 캐리어 임계값(sbct)이라는 매개변수는 무엇을 "작은" 할당으로, 무엇을 "큰" 할당으로 볼지 정하는 크기 경계를 결정합니다. sbct 값보다 큰 할당은 싱글블록 캐리어를 사용하고, 그보다 작은 할당은 멀티블록 캐리어를 사용합니다.
기본적으로 sbct 임곗값은 더 큰 할당, 즉 일반적인 Erlang 텀보다 상당히 큰 할당이 단일 블록 캐리어에 격리되도록 설정되어 있습니다. 할당의 대부분을 차지하는 더 작은 객체들은 멀티블록 캐리어 안에서 공간을 효율적으로 공유합니다.
애플리케이션이 특이한 할당 패턴을 보인다면 이 임계값(sbct)을 조정할 수 있습니다. 이 값을 조정하면 런타임 시스템이 단편화(멀티블록 캐리어 안의 대용량 할당으로 인해 발생)와 오버헤드(다수의 단일 블록 캐리어로 인해 발생) 사이에서 균형을 잡는 방식이 달라집니다.
대부분의 할당이 작은 편이 바람직한 이유 (멀티블록 캐리어)
멀티블록 캐리어는 작고 수명이 짧은 할당이 많이 일어나는 전형적인 Erlang 워크로드에서 효율적이기 때문에 선호됩니다. HiPE 팀의 연구에 따르면 대부분의 Erlang 텀은 작아서(8워드 미만) 이러한 멀티블록 캐리어에 잘 들어맞습니다.
일반적인 ERTS 할당자는 보통 다음을 유지합니다:
-
할당자마다 하나의 주 멀티블록 캐리어(main multiblock carrier)를 두어 자주 일어나는 작은 크기의 할당을 처리합니다. 할당자는 이 캐리어를 거의 해제하지 않으며, 해제된 블록을 내부에서 재사용하여 단편화를 줄입니다.
-
여러 개의 싱글블록 캐리어(singleblock carrier), 각 캐리어는 큰 객체나 바이너리를 위해 개별적으로 할당됩니다. 이 블록들이 해제되면 싱글블록 캐리어는 즉시 OS에 반환됩니다.
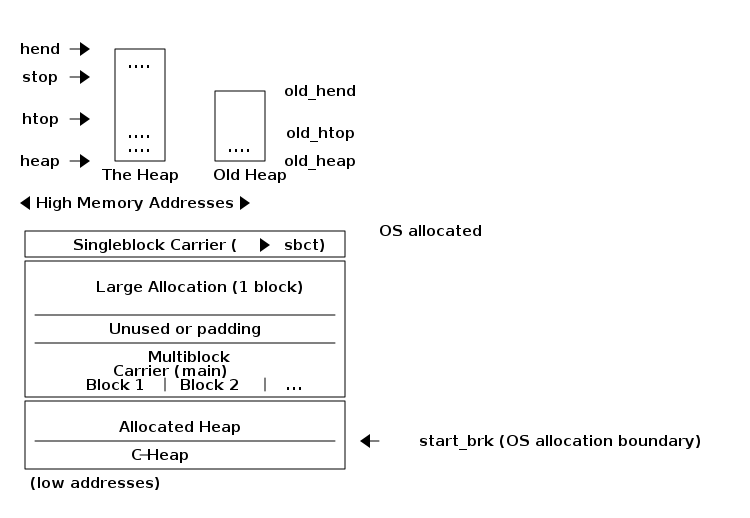
sbct를 조정해야 하는 경우
싱글블록 캐리어 임계값(sbct) 파라미터를 최적화하려면 애플리케이션의 메모리 할당 패턴을 이해해야 합니다. sbct를 높이면 더 많은 할당이 멀티블록 캐리어로 향하게 되어 메모리 재사용이 개선되고 단편화가 줄어듭니다. 이는 애플리케이션이 중간 크기의 데이터 구조를 자주 할당하여 단편화나 잦은 OS 수준의 메모리 요청이 발생하는 경우에 특히 효과적입니다.
반면 sbct를 줄이면 더 많은 할당이 싱글블록 캐리어로 들어가게 됩니다. 이는 애플리케이션이 가끔 큰 메모리 블록을 할당하는 경우에 적합합니다. 이러한 큰 할당을 별도로 관리하면 회수가 간단해지고 더 작은 할당과의 간섭을 막을 수 있습니다.
sbct 조정만으로 잦은 마이너 가비지 컬렉션이 해결되지 않는다면(대개 수명이 짧은 할당이 많아서 발생합니다), 할당 반복을 줄이기 위해 프로세스의 초기 힙 크기(min_heap_size)를 늘리는 것을 고려하십시오.
실제로는 대부분의 Erlang 애플리케이션에 기본 sbct 설정이 적합합니다. 프로파일링 결과 단편화, 메모리 오버헤드 또는 비정상적인 할당 패턴과 관련된 구체적인 문제가 드러난 경우에만 이 매개변수를 세밀하게 조정하십시오.
메모리 할당 전략
멀티 블록 캐리어에서 빈 메모리 블록을 찾을 때는 할당 전략을 사용합니다. 할당자 유형마다 기본 할당 전략이 있지만, as 플래그로 할당 전략을 직접 설정할 수도 있습니다.
Erlang 런타임 시스템 애플리케이션 레퍼런스 매뉴얼에는 다음과 같은 할당 전략이 나와 있습니다.
최적 적합(Best fit): 요청된 블록 크기를 충족하는 가장 작은 블록을 찾습니다. (bf)
주소 순서 최적 적합(Address order best fit): 요청된 블록 크기를 만족하는 가장 작은 블록을 찾습니다. 조건에 맞는 블록이 여러 개이면 주소가 가장 낮은 블록을 선택합니다. (aobf)
주소 순서 최초 적합(Address order first fit): 요청된 블록 크기를 충족하는 블록 중 주소가 가장 낮은 블록을 찾습니다. (aoff)
주소 순 최초 적합 캐리어 최적 적합(Address order first fit carrier best fit): 요청된 블록 크기를 충족할 수 있는 캐리어 중 주소가 가장 낮은 캐리어를 찾은 다음, 그 캐리어 안에서 "최적 적합(best fit)" 전략을 사용하여 블록을 찾습니다. (aoffcbf)
주소 순서 최초 적합 캐리어 주소 순서 최적 적합: 요청된 블록 크기를 충족할 수 있는 캐리어 중 주소가 가장 낮은 캐리어를 찾은 다음, 해당 캐리어 안에서 "주소 순서 최적 적합" 전략을 사용하여 블록을 찾습니다. (aoffcaobf)
Good fit: 가장 잘 맞는 블록을 찾으려고 시도하되, 제한된 범위의 탐색에서 찾은 가장 잘 맞는 블록으로 만족합니다. (gf)
A fit: 적합한 블록을 탐색하지 않고, 빈 블록 하나만 검사하여 요청을 충족하는지 확인합니다. 이 전략은 임시 할당에만 사용하도록 고안되었습니다. (af)
할당 전략을 무엇으로 선택하느냐에 따라 여유 메모리가 얼마나 효율적으로 재사용되는지가 달라지며, 이는 단편화와 성능에 직접적인 영향을 미칩니다. 대부분의 할당자에서 기본 전략은 보통 최적 적합(bf) 또는 주소 순서 최적 적합(aobf)이며, 이 전략은 메모리 활용도와 할당 속도 사이의 균형을 맞춥니다.
주소 순서 최초 적합 또는 양호 적합 같은 대체 전략은 할당자별로 설정할 수 있습니다(+M<S>as <strategy> 시스템 플래그 사용). 다른 전략을 선택하면 할당 공간을 탐색할 때 CPU 오버헤드가 커지는 대신 메모리 단편화를 줄일 수 있습니다.
11.2.4. 임시 할당자: temp_alloc
temp_alloc 할당자는 임시 할당, 즉 수명이 매우 짧은 할당에 사용됩니다. temp_alloc으로 할당한 메모리는 Erlang 프로세스 컨텍스트 스위치를 넘어서까지 할당된 상태로 유지되어서는 안 됩니다.
temp_alloc은 함수 안에서 어떤 작업을 하는 동안 작은 임시 공간이나 작업 영역으로 사용할 수 있습니다. 이것을 C 스택의 확장으로 여기고 C 스택과 같은 방식으로 해제하십시오. 즉, 안전을 위해 temp_alloc으로 할당한 메모리는 할당을 수행한 함수에서 반환하기 전에 해제하십시오. erl_alloc.types에는 에뮬레이터가 Erlang 코드를 실행하기 시작하기 전에 temp_alloc 블록을 해제해야 한다는 메모가 있습니다.
블록이 해제되기 전에는 할당자와 같은 스케줄러에서 실행되는 어떤 Erlang 프로세스도 Erlang 코드 실행을 시작할 수 없다는 점에 유의하십시오. 즉, BIF나 NIF 트랩(yield)에 걸쳐 임시 할당을 사용할 수 없습니다.
기본 R16 SMP 시스템에는 N+1개의 temp_alloc 할당자가 있으며, 여기서 N은 스케줄러의 수입니다. temp_alloc은 "A fit"(af) 전략을 사용합니다. temp_alloc의 할당 패턴은 기본적으로 스택의 할당 패턴(대부분 크기가 0 또는 1)과 같으므로, 이 전략은 잘 작동합니다.
R16에서 임시 할당자는 다음 유형의 데이터에 사용됩니다: TMP_HEAP, MSG_ROOTS, ROOTSET, LOADER_TEMP, NC_TMP, TMP, DCTRL_BUF, TMP_DIST_BUF, ESTACK, DB_TMP, DB_MC_STK, DB_MS_CMPL_HEAP, LOGGER_DSBUF, TMP_DSBUF, DDLL_TMP_BUF, TEMP_TERM, SYS_READ_BUF, ENVIRONMENT, CON_VPRINT_BUF.
각 할당자가 할당하는 할당 유형의 최신 목록은 erl_alloc.types를 참조하십시오(예: grep TEMPORARY erts/emulator/beam/erl_alloc.types).
이들 각각의 유형을 하나하나 살펴보지는 않겠지만, 이름에서 짐작할 수 있듯이 대체로 임시 버퍼이거나 작업 스택입니다.
11.2.5. 힙 할당자: eheap_alloc
힙 할당자는 프로세스의 개인 데이터를 위한 메모리 블록을 관리합니다. 여기에는 프로세스 힙(새 제너레이션과 올드 제너레이션)에 저장되는 Erlang 텀과, 힙 프래그먼트 및 BEAM 레지스터 같은 관련 구조가 포함됩니다. 프로세스가 생성하는 거의 모든 Erlang 텀은 결국 eheap_alloc을 통해 확보한 메모리에 놓입니다.
기본적으로 각 스케줄러는 eheap_alloc 인스턴스를 하나씩 가지므로, 해당 스케줄러에서 실행되는 프로세스의 메모리는 대부분 로컬에 유지되어 경합이 줄어듭니다. 할당자가 자주 수행하는 작업은 다음과 같습니다.
-
프로세스 힙: 각 Erlang 프로세스에는 자체 힙이 있으며, 여기에 튜플, 리스트, 맵, 정수 및 모든 작은 바이너리(⇐ 64바이트)와 같은 데이터를 저장합니다.
-
힙 프래그먼트(Heap Fragments): 프로세스가 잠시 더 많은 메모리를 필요로 하지만 즉시 GC를 수행할 수 없는 경우(예: 큰 메시지를 구성하는 경우), VM은 eheap_alloc에서 “힙 프래그먼트”를 할당할 수 있습니다. 다음 가비지 컬렉션 때 이러한 프래그먼트는 병합되거나 해제됩니다.
-
레지스터 배열(Register Arrays): 일부 런타임 구현 세부 사항(예: “beam_registers” 데이터 구조)도 eheap_alloc을 사용합니다. Erlang 개발자는 보통 프로세스 힙 크기를 조절하거나 프로세스가 크고 수명이 짧은 데이터를 언제 생성하는지 파악함으로써 eheap_alloc 사용을 최적화합니다. 프로세스 힙이 큰 데이터를 자주 처리한다면, 마이너 GC가 여러 번 일어나도록 두기보다는 프로세스 힙 크기를 신중하게 정하는 것이 좋은 관행입니다.
11.2.6. 바이너리 할당자: binary_alloc
바이너리 할당자는 (네, 짐작하신 대로) 바이너리를 위한 메모리를 처리합니다. 구체적으로, 이 할당자는 64바이트보다 큰 바이너리(refc 바이너리라고 부릅니다)를 관리하며, 이를 오프힙에 저장하고 참조 카운팅을 사용해 사용 현황을 추적합니다. 각 프로세스 힙에는 실제 바이너리를 가리키는 작은 래퍼(ProcBin)만 들어 있습니다.
이러한 바이너리의 크기는 수백 바이트 정도의 적당한 크기부터 메가바이트 단위에 이르는 거대한 크기(파일 전체 내용이나 네트워크에서 들어온 외부 데이터 등)까지 매우 다양합니다.
이 할당자에는 몇 가지 흥미로운 특징이 있습니다:
-
최적 적합(Best-Fit) 전략: 새 바이너리를 저장할 때 알맞은 빈 블록 가운데 가장 작은 블록을 선택하여 단편화를 줄입니다. 바이너리를 메모리에 빈틈없이 끼워 맞추는 꼼꼼한 테트리스 플레이어라고 생각하면 됩니다.
-
참조 카운팅: 오프힙 바이너리는 이를 참조하는 마지막 프로세스가 참조를 멈출 때까지 계속 남아 있습니다. 깜빡 잊은 프로세스 하나라도 거대한 바이너리를 붙잡고 있으면 그 바이너리는 계속 살아 있으며, 때로는 원하는 것보다 성가실 만큼 오래 남아 있습니다.
-
서브 바이너리(슬라이스):
<<X:32, Rest/binary>>처럼 바이너리를 매칭하면 더 작은 바이너리(Rest)는 여전히 원래의 더 큰 바이너리를 참조합니다. 복사를 피할 수 있다는 점은 훌륭하지만, 아주 작은 조각 하나를 참조하려다 거대한 바이너리를 실수로 계속 살려 두고 있었다는 사실을 깨닫기 전까지만 그렇습니다. 이런 경우에는binary:copy/1을 호출하는 것이 좋은 해결책입니다.
메모리가 원인을 알 수 없이 계속 늘어난다면, 프로세스에 남아 있는 참조 때문에 해제되지 않은 큰 바이너리가 있는지 확인하십시오. 때로는 가비지 컬렉터를 살짝 재촉하거나(erlang:garbage_collect/1 사용) 프로세스를 하이버네이트시켜 메모리를 더 빨리 회수해야 할 수도 있습니다.
11.2.7. ETS 할당자: ets_alloc
할당자 ets_alloc은 여러분이 아끼는 ETS(Erlang 텀 저장소, Erlang Term Storage) 테이블의 메모리를 관리합니다. 기본적으로 ETS 테이블은 개별 프로세스에 묶여 있지 않습니다. 따라서 프로세스가 가비지 컬렉션으로 쓰레기를 치우더라도 ETS 테이블은 그대로 남아 있습니다. 몇 가지 핵심 사항을 기억해 두십시오:
-
오래 유지되는 데이터: 데이터를 ETS 테이블에 넣으면 그 데이터는 프로세스 힙을 벗어나 자신만의 아늑한 할당자에 자리 잡습니다. 일반적인 프로세스 가비지 컬렉션은 이 공간을 정리하지 않습니다. 메모리를 되찾으려면 데이터를 명시적으로 제거하거나 테이블을 삭제해야 합니다.
-
다양한 사용 사례: 이 할당자는 전통적인 해시 테이블부터 정교한
ordered_set구조와 내부 메타데이터에 이르기까지 ETS와 관련된 모든 것을 다룹니다. 많이 사용되거나 큰 테이블은 손쉽게 메모리를 잡아먹는 괴물이 될 수 있으므로 주의하십시오. -
수명이 짧은 ETS 데이터: ETS는 매칭이나 중간 결과 처리 같은 짧은 작업을 위해 다른 할당자를 일시적으로 빌려 쓰기도 하지만, 주요 데이터는
ets_alloc에 저장됩니다.
ETS 테이블은 예상외로 크게 늘어날 수 있으므로, ets:info(Tab, memory) 같은 함수로 가끔 크기를 확인하거나 시스템 메트릭을 통해 전체 ets_alloc 사용량을 주시하십시오.
11.2.8. 드라이버 할당자: driver_alloc
드라이버 할당자는 포트, 링크드인 드라이버, NIF 리소스에 쓰이는 메모리를 관리합니다. 더 쉽게 말하면, I/O 드라이버나 외부 라이브러리, 파일 디스크립터를 다루는 등 Erlang의 안전망 바깥으로 나가는 작업을 하면 결국 이곳에 이르게 됩니다. 기억해 둘 핵심 사항은 다음과 같습니다.
-
포트 및 드라이버 데이터: 이 영역의 할당에는 네트워크 소켓과 열린 파일 디스크립터를 위한 구조체, 그리고 링크드인 드라이버 전용 버퍼가 포함됩니다.
-
NIF 할당 데이터: NIF가
enif_alloc으로 메모리를 요청하면, 그 메모리는 결국 이 할당자에서 나옵니다. VM은 여러분이enif_free를 호출하거나 NIF 객체가 우아하게 무대에서 퇴장할 때까지 정중히 기다렸다가 이 공간을 회수합니다. -
외부 누수 가능성: NIF와 드라이버는 Erlang의 일반적인 메모리 안전 규칙을 우회하기 때문에, 오작동하는 드라이버가 의도치 않게 메모리를 계속 붙잡고 있을 수 있으며, 이는 디지털 세계에서 물이 새는 수도꼭지와 같은 상황을 만들어 냅니다.
driver_alloc사용량을 주시하면 이렇게 새어 나가는 물방울을 잡아내는 데 도움이 됩니다.
개발자가 driver_alloc를 직접 다루는 경우는 드물지만, 프로덕션 환경에서는 이 할당자를 모니터링하는 것이 좋습니다. NIF를 사용하는 경우에는 특히 그렇습니다.
11.2.9. 단기 할당자: sl_alloc
단기 할당자(sl_alloc)는 눈 깜짝할 사이에 사라지는 임시 할당보다는 수명이 길지만, 그렇다고 크게 길지는 않은 데이터 구조를 위한 메모리를 처리합니다. 잠깐 들러 인사를 나누고 커피 한 잔을 가볍게 마신 뒤 떠날 만큼만 머무르는 메모리라고 생각하십시오. 대표적인 예는 다음과 같습니다.
-
중간 버퍼: 짧은 연산에 필요한 작은 버퍼로, 스케줄링 지점을 넘어 잠시 머무르기도 하지만 밤새 눌러앉을 생각은 절대 하지 않는 편이 좋습니다.
-
휘발성 리스트: 순식간에 오가는 시스템 메시지 버퍼나 수명이 짧은 스케줄링 메타데이터처럼, 알아차리자마자 거의 곧바로 사라지는 임시 런타임 구조입니다.
Erlang/OTP는 매치 상태 객체, 일시적인 I/O 버퍼, 그 밖의 수명이 짧은 개체와 같은 일시적인 작업에 sl_alloc을 활용합니다. 이러한 할당은 진정한 의미의 임시 메모리보다 오래 남아 있을 수 있지만, 그래도 신속하게 해제되어 흔적을 최소한으로만 남길 것으로 예상됩니다.
애플리케이션이 특히 수다스러워서(chatty) 수명이 짧은 할당을 대량으로 만들어 낸다면(예: 잦은 소규모 드라이버 호출이나 짧은 연산), sl_alloc에 부하가 크게 몰릴 수 있습니다. recon_alloc:usage() 같은 도구로 사용량을 확인하면 sl_alloc이 과도하게 사용되고 있는지 알 수 있습니다.
11.2.10. 장수명 할당자: ll_alloc
장기 할당자(long lived allocator)는 오랜 기간 살아 있어야 하는 데이터를 처리하며, 그 기간은 흔히 Erlang 노드 자체의 수명만큼 깁니다. 대표적인 예는 다음과 같습니다.
-
아톰: 아톰은 한 번 생성되면 무기한 유지되므로
ll_alloc에 영구적으로 상주하게 됩니다. -
로드된 모듈과 코드: 컴파일된 모듈, 익스포트된 함수, 익명 함수(
funs)와 관련된 메타데이터가 이곳에 저장됩니다. 예를 들어code:load_file(my_module)호출로 모듈을 로드하면 해당 모듈의 메타데이터는ll_alloc안에 저장됩니다. -
스케줄러 및 시스템 구조체: 스케줄러 실행 큐(
run_queue), 폴셋 정보(pollset), 프로세스 레지스트리(proc_tab) 같은 내부 런타임 구조체는 VM 동작의 근간이 되므로 이곳에 위치합니다.
ll_alloc의 객체는 오래 남아 있는 경향이 있으므로, 이 할당자는 일반적으로 노드의 수명 동안 느리지만 꾸준히 커집니다. 시스템이 모듈을 자주 로드하고 언로드한다면 변동이 나타날 수 있습니다. 예를 들어, 이전 버전을 제대로 언로드하지 않은 채 핫 코드 로딩을 반복해서 실행하면 ll_alloc의 메모리 사용량이 점차 늘어날 수 있습니다.
실제로 모듈을 명시적으로 언로드하거나 노드를 재시작하지 않는 한, 대부분의 시스템은 이 영역에서 메모리를 많이 회수하지 못합니다. 따라서 예상치 못한 급증이나 단편화를 감지하려면 가끔 recon_alloc:usage(ll_alloc) 결과를 확인하는 것이 현명합니다. 특히 애플리케이션이 모듈을 동적으로 관리하거나 대량의 장기(롱텀) 데이터를 다루는 경우에는 더욱 그렇습니다.
11.2.11. 고정 크기 할당자: fix_alloc
고정 할당자인 fix_alloc은 고정 크기 객체, 즉 크기가 변하지 않는 작은 C 구조체(예: 메시지 참조, 드라이버 이벤트 데이터, 모니터)를 할당하는 데 특화되어 있습니다. 이러한 객체는 크기가 균일하므로 할당자가 이를 효율적으로 처리할 수 있습니다.
기본적으로 fix_alloc은 "Address Order Best Fit"(주소 순서 최적 적합) 방식을 사용합니다. 이 방식은 해제된 객체를 같은 크기의 블록 리스트로 깔끔하게 되돌려 놓아 단편화를 효과적으로 최소화합니다. 크기가 제각각인 조각을 상자에 아무렇게나 던져 넣는 대신, 똑같은 레고 브릭을 빈틈없이 차곡차곡 쌓아 올리는 것이라고 생각하십시오.
예로는 ErlMessage 같은 VM 내부 구조체, 모니터 참조, 스케줄러 관리용 데이터 등이 있습니다.
개발자가 fix_alloc을 직접 다루는 일은 드물지만, fix_alloc은 시스템 수준에서 꼭 필요합니다. 여기서 할당이 효율적으로 이루어지면 런타임이 작고 단편화된 할당을 관리하느라 느려지지 않으며, 이는 Erlang이 동시성을 매끄럽게 처리한다는 명성을 유지하는 데 도움이 됩니다.
11.2.12. 표준 할당자: std_alloc
메모리가 Erlang의 특화된 할당자 버킷 어디에도 딱 들어맞지 않으면, 그 메모리는 런타임의 다용도 범용 할당자인 std_alloc에 자리를 잡습니다. 이를 메모리를 위한 Erlang의 "잡동사니 서랍"이라고 생각하면 됩니다.
이 할당자는 다양한 종류의 할당을 처리합니다. 여기에는 수명이 짧은지 긴지 모호한 임시 데이터에 대한 참조, 크기가 동적으로 변하는 구조체, 분류가 명확하지 않은 VM 하위 시스템 데이터, 또는 단순히 너무 독특해서 다른 곳에 깔끔하게 분류하기 어려운 메모리 할당 등이 포함될 수 있습니다.
다른 할당자와 마찬가지로, +Ms 또는 +Msbct 같은 시작 플래그로 std_alloc 동작을 조정할 수 있습니다. 보통은 그대로 두지만, 필요할 때 조정할 수 있다는 점은 알아 두면 좋습니다.
문제를 해결할 때 std_alloc은 원인을 알 수 없는 메모리 급증의 유력한 용의자가 될 수 있습니다. erlang:system_info({allocator, std_alloc})나 recon_alloc 같은 도구를 사용하면 이 할당자가 예상보다 많은 메모리를 쌓아 두고 있는지 빠르게 확인할 수 있습니다.
std_alloc은 깔끔하게 분류되지 않는 메모리 요청을 모아 처리하므로, 바쁜 노드에서 사용량이 상당히 누적되는 것은 정상입니다. 이 할당자가 지속적으로 증가하는 것이 보인다면, 대개 애플리케이션의 동작을 다시 점검하거나 무엇이 "정상"인지에 대한 가정을 재검토해야 한다는 신호입니다.
11.2.13. 리터럴 할당자: literal_alloc
literal_alloc는 로드된 Erlang 모듈의 컴파일 타임 상수를 저장하며, 이 영역은 흔히 리터럴 풀(literal pool)이라고 불립니다. 이것을 VM의 "읽기 전용 메모리 선반"이라고 생각하십시오. Erlang은 이곳에 컴파일 시점에 정의된 큰 정적 바이너리, 튜플, 리스트 같은 상수를 안전하게 저장합니다.
일반적인 할당자와 달리 literal_alloc은 스케줄러별이 아니라 전역적으로 관리됩니다. 리터럴은 런타임 중에 자주 수정되거나 회수되지 않기 때문입니다. 한 번 로드된 리터럴은 해당 모듈이 명시적으로 퍼지(purge)되거나 다시 로드될 때까지 유지됩니다.
literal_alloc 모니터링에서는 대개 특별한 점이 드러나지 않지만, 동적 모듈 업데이트가 잦거나 리터럴이 많은 대형 모듈을 반복해서 로드한다면 한번 살펴볼 가치가 있을 수 있습니다.
11.3. 스케줄러별 할당자 인스턴스
최신 OTP(R13B 이후)에서는 SMP(Symmetric Multi-Processing, 대칭형 다중 처리) 환경에서 경합을 최소화하기 위해 앞서 설명한 대부분의 메모리 할당자(예: eheap_alloc, binary_alloc, ets_alloc)가 여러 개의 인스턴스를 가집니다. 기본적으로 각 스케줄러 스레드는 이러한 할당자의 인스턴스를 각자 하나씩 유지하며, 이와 별도로 드라이버 비동기 스레드들이 공유하는 인스턴스가 하나 더 있습니다.
이러한 스케줄러별 할당 방식은 메모리 관리를 분할하여 락 경합을 크게 줄이고 멀티코어 시스템에서의 확장성을 향상시킵니다. 이는 또한 메모리 사용량과 단편화가 스케줄러마다 별도로 처리된다는 의미이기도 하며, 이 점은 메모리 통계를 해석하거나 메모리 관련 문제를 해결하는 방식에 영향을 줄 수 있습니다.
할당자 지표를 살펴볼 때(예: recon_alloc 또는 erlang:system_info를 통해) 여러 할당자 인스턴스에 걸쳐 집계된 통계를 보게 됩니다. 메모리 패턴을 분석할 때 이 점에 유의하십시오.
11.4. 메모리 관련 시스템 플래그
메모리 할당자 시스템 플래그는 다음 구문을 따릅니다:
+M<S><P> <V>-
<S>는 할당자를 식별하는 대문자 한 글자입니다. -
<P>는 매개변수를 지정합니다. -
<V>는 사용할 값을 지정합니다.
할당자 식별자(<S>):
-
B: binary_alloc -
D: std_alloc -
E: ets_alloc -
F: fix_alloc -
H: eheap_alloc -
I: literal_alloc -
L: ll_alloc -
M: mseg_alloc -
R: driver_alloc -
S: sl_alloc -
T: temp_alloc -
Y: sys_alloc -
u: alloc_util(alloc_util 기반의 모든 할당자에 적용됩니다)
11.5. 자주 사용하는 플래그
할당 전략(as):
캐리어 내에서 메모리 블록을 선택하는 방식을 결정합니다.
-
bf: 최적 적합(Best fit) -
aobf: 주소 순서 최적 적합(Address order best fit) -
aoff: 주소 순서 최초 적합(Address order first fit) -
aoffcbf: 주소 순서 최초 적합(address order first fit), 캐리어 최적 적합(carrier best fit) -
ageffcbf: 나이 순 최초 적합(age order first fit) 캐리어 최적 적합(carrier best fit) -
gf: 적합 -
af: A 적합(A fit)
예시:
+MBas bf(바이너리 할당자는 최적 적합(best-fit) 전략을 사용합니다.)
싱글블록 캐리어 임계값(sbct): 할당이 싱글블록 캐리어를 사용하게 되는 기준 크기를 KB 단위로 정의하며, 이 값을 초과하는 할당은 싱글블록 캐리어를 사용합니다.
예시:
+MBsbct 1024(1024 KB를 초과하는 바이너리 할당에는 싱글블록 캐리어가 사용됩니다.)
멀티블록 캐리어 설정:
-
최소(
smbcs) 및 최대(lmbcs) 멀티블록 캐리어 크기: 멀티블록 캐리어의 최소/최대 크기(KB)를 제어합니다. -
캐리어 증가 단계(
mbcgs): 최솟값과 최댓값 사이에서 캐리어 크기가 증가하는 방식을 정의합니다.
예시:
+MBsmbcs 512 +MBlmbcs 8192(바이너리 할당자의 멀티블록 캐리어 크기는 512 KB에서 8 MB 사이입니다.)
캐리어 포기 사용률 한도(acul): 캐리어 사용률이 이 백분율 임곗값보다 낮으면 해당 캐리어를 포기하고 재사용합니다.
예시:
+MBacul 50(사용률이 50% 미만인 바이너리 캐리어는 abandoned 상태로 표시됩니다.)
캐리어 포기 여유 사용률 한도(acful): 사용률이 이 값 아래로 떨어지면 VM은 사용하지 않는 메모리를 회수해도 된다고 OS에 알립니다.
예시:
+MDacful 10(std_alloc은 사용률이 10% 미만이면 해당 메모리를 OS가 회수할 수 있는 것으로 표시합니다.)
스레드별 다중 인스턴스(t): 할당자가 여러 인스턴스(스케줄러당 하나)를 사용할지 여부를 제어합니다.
예시:
+MHt true(eheap_alloc은 스케줄러 스레드마다 별도의 할당자 인스턴스를 사용합니다.)
할당 태깅(atags): 할당에 태그를 추가하며, 계측(instrumentation)을 이용한 디버깅에 유용합니다.
예시:
+MRatags true(driver_alloc에 대한 태깅을 활성화합니다.)
11.6. mseg_alloc용 특수 플래그
mseg_alloc(Memory Segment Allocator, 메모리 세그먼트 할당자)에는 다음과 같은 고유 설정이 있습니다.
-
슈퍼 캐리어 크기(
scs):` +MMscs 1024` (1GB 슈퍼 캐리어를 생성합니다.) -
대형 페이지 사용(
lp):` +MMlp on` (라지/휴즈 페이지 지원을 활성화합니다.) -
슈퍼 캐리어 전용(
sco):` +MMsco true` (할당은 슈퍼 캐리어 안에서만 이루어집니다.) -
최대 캐시된 세그먼트 (
mcs):` +MMmcs 20` (캐시된 세그먼트를 최대 20개까지 저장합니다.)
11.7. sys_alloc의 특수 플래그
sys_alloc은 시스템의 malloc과 연동됩니다:
-
Trim Threshold (
tt): 사용 가능한 여유 힙이 임계값을 초과하면 메모리를 OS에 반환합니다.` +MYtt 256` (트림 임계값을 256 KB로 설정합니다.) -
Top Pad (
tp): 이후의 호출 횟수를 줄이기 위해 malloc이 OS에 추가로 요청하는 메모리입니다.` +MYtp 512` (malloc은 512 KB의 패딩을 요청합니다.)
11.8. 리터럴 할당자(literal_alloc)
리터럴(컴파일 타임 상수)을 저장합니다:
-
리터럴 슈퍼 캐리어 크기(
scs):` +MIscs 2048` (리터럴 할당자 슈퍼 캐리어를 2 GB로 설정합니다.)
11.9. 전역 플래그와 편의 플래그
-
최소/최대 할당 설정(
ea):` +Mea min|max|config` (모든 할당자에 적용되는 빠른 설정 프리셋입니다.) -
물리 메모리 잠금(
lpm):` +Mlpm all|no` (VM 메모리를 물리 RAM에 고정합니다.) -
더티 할당자 인스턴스(
dai):` +Mdai max|<number>` (더티 스케줄러 전용 할당자 인스턴스입니다.)
11.10. 실용 예제
모든 할당자에 주소 순서 최적 적합(address-order best fit)을 적용하여 단편화 줄이기:
+Muas aobfETS 할당자의 최대 메모리 제한(예: 2 GB):
+MEamax 2097152모든 할당자에 걸쳐 디버깅용 할당 태깅을 활성화합니다:
+Muatags true11.11. 권장 사항
-
문제가 발생하지 않는 한 기본 설정으로 시작하십시오.
-
튜닝하기 전에 할당자 사용량(
erlang:system_info/1,recon_alloc)을 모니터링하십시오. -
변경 사항은 통제된 환경에서 점진적으로 테스트하십시오.
-
벤치마크와 프로파일링 없이 과도한 튜닝을 하지 마십시오.
|
위에서 설명한 메모리 할당자 플래그 대부분은 구현에 크게 의존합니다. 이러한 플래그의 동작, 사용 가능 여부, 기본값은 사전 예고 없이 변경되거나 완전히 제거될 수 있습니다. 게다가 런타임( |
11.12. 프로세스 메모리
Chapter 3에서 살펴보았듯이 프로세스는 사실 여러 개의 메모리 영역에 불과합니다. 이 장에서는 스택, 힙, 메일박스가 어떻게 관리되는지 좀 더 자세히 살펴보겠습니다.
스택과 힙의 기본 크기는 233워드입니다. 이 기본 크기는 Erlang을 시작할 때 +h 플래그를 사용하여 전역적으로 변경할 수 있습니다. 또한 spawn_opt로 프로세스를 시작할 때 min_heap_size를 설정하여 최소 힙 크기를 지정할 수도 있습니다.
Erlang 텀은 Chapter 4에서 살펴본 것처럼 태그가 붙어 있으며, 힙에 저장될 때는 cons 셀이거나 박스 객체입니다.
11.12.1. 텀 공유
힙에 있는 객체는 하나의 프로세스 컨텍스트 안에서 참조로 전달됩니다. 튜플을 인자로 하여 함수를 호출하면, 호출된 함수에는 그 튜플을 가리키는 태그된 참조만 전달됩니다. 새로운 텀을 만들 때도 하위 텀에 대한 참조만 사용하게 됩니다.
예를 들어 문자열 "hello"(정수 리스트 [104,101,108,108,111]과 같습니다)가 있다면, 다음과 비슷한 메모리 레이아웃을 얻게 됩니다:
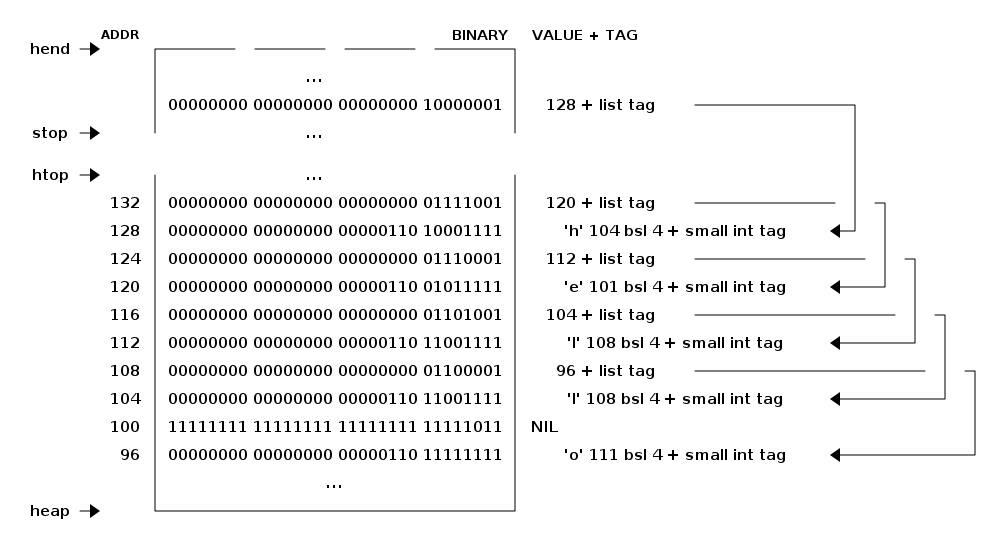
그런 다음 이 리스트의 인스턴스 두 개로 튜플을 만들면, 반복되는 것은 리스트를 가리키는 태그된 포인터뿐입니다: 00000000000000000000000010000001. 코드
L = [104, 101, 108, 108, 111],
T = {L, L}.
아래와 같은 메모리 레이아웃이 됩니다. T는 주소 136에 있는 박스 객체를 가리키며, 그곳에는 이것이 크기 2인 튜플임을 나타내는 ARITYVAL 헤더가 있고 그 뒤에 두 요소가 이어집니다. 두 요소는 모두 주소 128에 있는 같은 리스트 L을 가리킵니다.
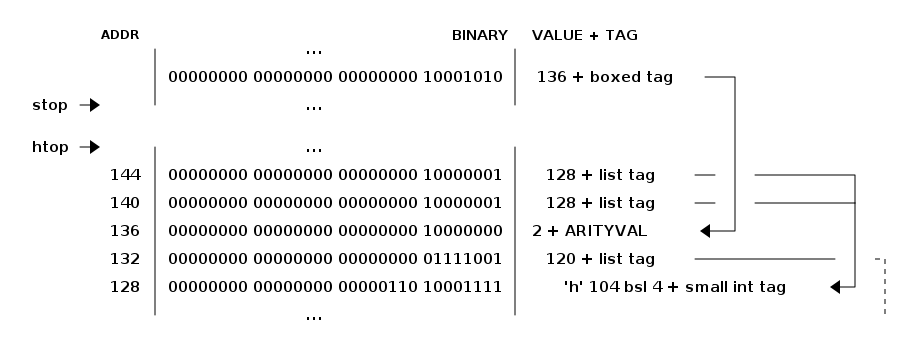
이 방식은 비용이 적게 들고 공간도 거의 차지하지 않으므로 좋습니다. 그러나 튜플을 다른 프로세스로 보내거나, 다른 종류의 IO를 수행하거나, 깊은 복사라고 불리는 결과를 낳는 연산을 수행하면 데이터 구조가 펼쳐집니다. 따라서 튜플 T를 다른 프로세스 P2로 보내면(P2 ! T) T2의 힙에는 첫 번째 요소가 문자열의 한 복사본을 가리키고 두 번째 요소가 또 다른 복사본을 가리키는 튜플이 생기므로, 사용하는 공간이 두 배가 됩니다. 그 결과는 아래의 메시지 전달 절에서 확인할 수 있습니다.
공유된 튜플이 중첩되어 있으면 깊은 복사 시 발생하는 이러한 중복은 중첩 수준에 따라 기하급수적으로 늘어납니다. 공유가 많은 텀을 펼치면 Erlang 노드를 순식간에 다운시킬 수 있습니다. 전체 코드 예제는 온라인 부록의 share.erl을 참고하십시오.
-module(share).

-export([share/2, size/0]).

share(0, Y) -> {Y,Y};
share(N, Y) -> [share(N-1, [N|Y]) || _ <- Y].

size() ->
    T = share:share(5,[a,b,c]),
    {{size, erts_debug:size(T)},
     {flat_size, erts_debug:flat_size(T)}}.


 1> timer:tc(fun() -> share:share(10,[a,b,c]), ok end).
 {1131,ok}

 2> share:share(10,[a,b,c]), ok.
 ok

 3> byte_size(term_to_binary(share:share(10,[a,b,c]))), ok.
 HUGE size (13695500364)
 Abort trap: 6
erts_debug:size/1 및 erts_debug:flat_size/1 함수를 사용하면 공유된 텀의 메모리 크기와 해당 텀을 펼쳤을 때의 크기를 계산할 수 있습니다.
> share:size().
{{size,19386},{flat_size,94110}}
대부분의 애플리케이션에서는 이것이 문제가 되지 않지만, 여러 상황에서 발생할 수 있는 문제이므로 이 문제를 인지하고 있어야 합니다. 깊은 복사는 IO, ETS 테이블, binary_to_term, 메시지 전달에 사용됩니다.
메시지 전달이 어떻게 동작하는지 좀 더 자세히 살펴봅시다.
11.12.2. 메시지 전달
프로세스 P1이 다른 (로컬) 프로세스 P2에게 메시지 M을 보낼 때, 프로세스 P1은 먼저 M의 플랫 크기를 계산합니다. 그런 다음 로컬 스케줄러 컨텍스트에서 heap_frag의 heap_alloc을 수행하여 그 크기의 새 메시지 버퍼를 할당합니다.
send.erl의 코드(온라인 부록 참조)를 기준으로 하면, p1/1에서 send가 실행되기 직전의 시스템 상태는 다음과 같을 수 있습니다.
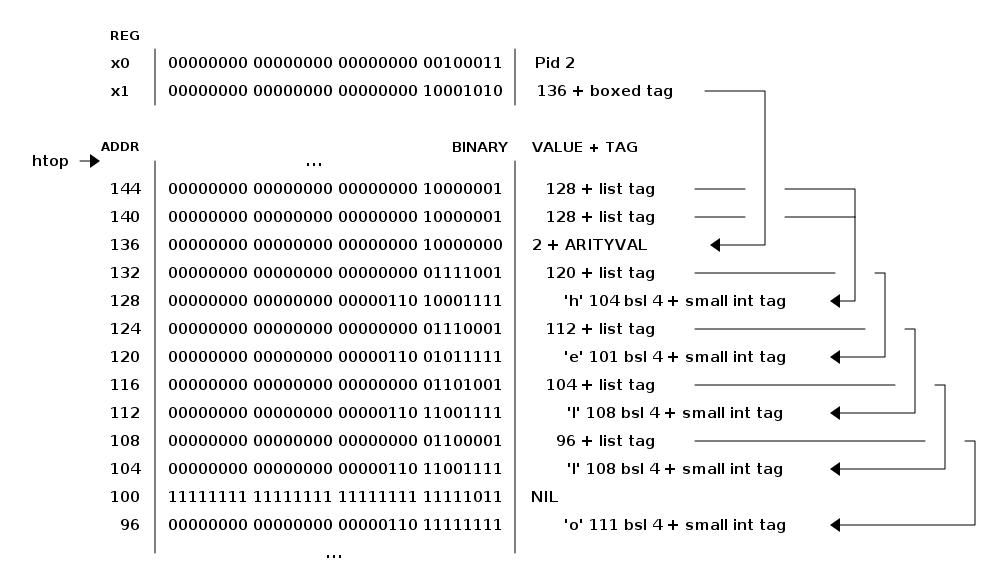
그런 다음 P1이 P2에게 메시지 M을 보내기 시작합니다. erl_message.c의 코드는 먼저 M의 플랫 크기를 계산합니다(이 예에서는 23워드입니다)[5]. 그런 다음 (SMP 시스템에서) P2에 대한 락을 획득할 수 있고 P2의 힙에 충분한 공간이 있으면, 메시지를 P2의 힙으로 복사합니다.
P2가 실행 중(또는 종료 중)이거나 힙에 공간이 충분하지 않으면, 새 힙 프래그먼트가 (sizeof ErlHeapFragment - sizeof(Eterm) + 23*sizeof(Eterm) 크기로) 할당됩니다 [6] 이 힙 프래그먼트는 초기화 후 다음과 같은 모습이 됩니다:
erl_heap_fragment:
    ErlHeapFragment* next;	    NULL
    ErlOffHeap off_heap:
      erl_off_heap_header* first;   NULL
      Uint64 overhead;                 0
    unsigned alloc_size;	      23
    unsigned used_size;               23
    Eterm mem[1];		       ?
      ... 22 free words
그런 다음 메시지가 힙 프래그먼트의 mem 부분으로 복사되고, first 포인터가 갱신됩니다(구조체 레이아웃과 맞추기 위해 이 그림에서는 메모리 주소가 아래쪽으로 갈수록 증가한다는 점에 유의하십시오):
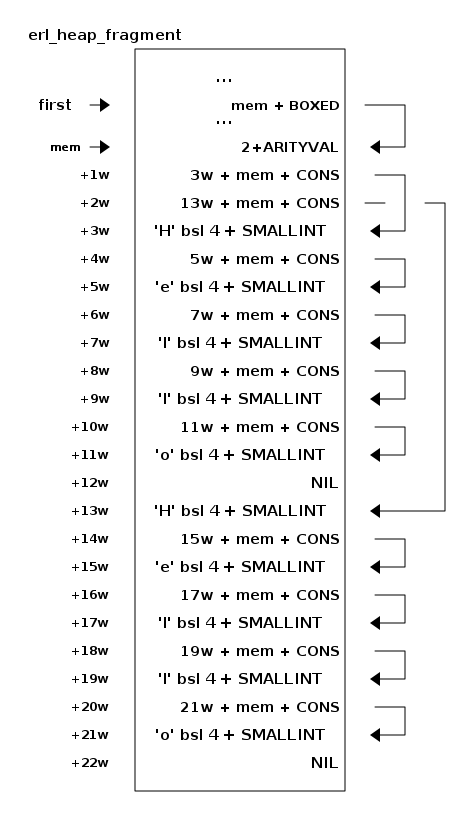
두 경우 모두 새 mbox(ErlMessage)가 할당되고, 수신자에 대해 락(ERTS_PROC_LOCK_MSGQ)을 획득하며, 힙 또는 새 힙 프래그먼트에 있는 메시지가 mbox에 연결됩니다.
 erl_mesg {
    struct erl_mesg* next = NULL;
    data:  ErlHeapFragment *heap_frag = bp;
    Eterm m[0]            = message;
 } ErlMessage;
그런 다음 mbox는 수신자의 수신 메시지 큐(msg_inq)에 연결되고 락이 해제됩니다. msg_inq.last는 큐에 있는 마지막 메시지의 next 필드를 가리킨다는 점에 유의하십시오. 새 mbox가 연결되면 이 next 포인터는 새 mbox를 가리키도록 갱신되고, last 포인터는 새 mbox의 next 필드를 가리키도록 갱신됩니다.
11.12.3. 바이너리
Chapter 4에서 살펴보았듯이, 내부적으로 바이너리에는 네 가지 타입이 있습니다. 이 중 세 가지 타입—힙 바이너리, 서브 바이너리, 매치 컨텍스트—은 로컬 힙에 저장되며, 다른 객체와 마찬가지로 가비지 컬렉터와 메시지 전달에서 처리되고 필요에 따라 복사됩니다.
참조 카운팅
반면 네 번째 유형인 대형 바이너리, 즉 refc 바이너리는 일부가 프로세스 힙 외부에 저장되며, 참조 카운트 방식으로 관리됩니다.
refc 바이너리의 페이로드는 바이너리 할당자가 할당한 메모리에 저장됩니다. 또한 페이로드를 가리키는 ProcBin이라는 작은 참조가 있으며, 이 참조는 프로세스 힙에 저장됩니다. 이 참조는 메시지 전달과 GC 과정에서 복사되지만, 페이로드는 건드리지 않습니다. 따라서 바이너리 전체를 복사할 필요가 없으므로, 큰 바이너리를 다른 프로세스에 보내는 비용이 비교적 적습니다.
ProcBin을 통해 refc 바이너리를 참조할 때마다 해당 바이너리의 참조 카운트가 1씩 증가합니다. 프로세스 힙에 있는 모든 ProcBin 객체는 연결 리스트로 서로 연결되어 있습니다. GC 패스가 끝나면 이 연결 리스트를 순회하면서, 소멸한 ProcBin 하나마다 해당 바이너리의 참조 카운트를 1씩 감소시킵니다. refc 바이너리의 참조 카운트가 0에 도달하면 해당 바이너리는 할당 해제됩니다.
큰 바이너리를 참조 카운트로 관리하여 send나 가비지 컬렉션 때 복사하지 않는 것은 큰 이점이지만, 가비지 컬렉션과 참조 카운팅이 섞인 환경에는 한 가지 문제가 있습니다. 순수한 참조 카운팅 구현에서는 객체에 대한 참조가 소멸하는 즉시 참조 카운트가 감소하고, 참조 카운트가 0에 도달하면 객체가 해제됩니다. ERTS의 혼합 환경에서는 참조 카운트되는 객체에 대한 참조가 소멸했음을 가비지 컬렉션이 감지할 때까지 그 참조는 소멸하지 않습니다.
이는 크기가 크거나 심지어 거대해지는 경향이 있는 바이너리가, 해당 바이너리에 대한 모든 참조가 죽은 뒤에도 오랫동안 남아 있을 수 있다는 뜻입니다. 바이너리는 전역으로 할당되므로 모든 프로세스의 모든 참조가 죽어야 한다는 점에 유의하십시오. 즉, 바이너리를 본 적이 있는 모든 프로세스가 GC를 수행해야 합니다.
안타깝게도 개발자 입장에서는 어떤 프로세스가 GC적 의미에서 바이너리를 "보았는지" 파악하기가 항상 쉬운 것은 아닙니다. 예를 들어 작업 항목을 받아 워커들에게 분배하는 로드 밸런서가 있다고 상상해 보십시오.
이 코드에는 GC를 수행할 필요가 없는 루프의 예가 있습니다. (전체 예제는 온라인 부록을 참조하십시오.)
loop(Workers, N) ->
  receive
    WorkItem ->
       Worker = lists:nth(N+1, Workers),
       Worker ! WorkItem,
       loop(Workers, (N+1) rem length(Workers))
  end.
이 서버는 바이너리에 대한 참조를 계속 붙잡기만 하고 결코 해제하지 않으므로, 결국 시스템 메모리를 모두 소진하게 됩니다.
문제를 인지하고 있다면 쉽게 고칠 수 있습니다. loop의 매 반복마다 garbage_collect를 수행하거나, receive에 after 절을 추가하여 5초 정도마다 수행할 수도 있습니다. (after 5000 → garbage_collect(), loop(Workers, N) ).
서브 바이너리와 매칭
바이너리의 일부를 매칭해 추출하면 서브 바이너리를 얻습니다. 이 서브 바이너리는 실제 바이너리를 가리키는 포인터만 담고 있는 작은 구조체입니다. 이로 인해 해당 바이너리의 참조 카운트는 증가하지만, 추가로 사용하는 공간은 매우 적습니다.
매칭이 바이너리에서 매칭된 부분의 새 복사본을 만든다면 공간과 시간이 모두 소모될 것입니다. 따라서 대부분의 경우에는 바이너리에 대해 패턴 매칭만 수행하고 작업할 서브 바이너리를 얻는 것이 바람직합니다.
문제가 되는 극단적인 경우도 몇 가지 있습니다. 예를 들어 책처럼 거대한 파일을 메모리에 적재한 다음, 작업할 장(chapter)처럼 작은 부분만 매칭하여 꺼낸다고 상상해 보십시오. 이때 문제는 그 장의 처리를 마칠 때까지 책의 나머지 전체가 여전히 메모리에 남아 있다는 것입니다. 이를 여러 책에 대해 수행한다면, 예컨대 파일 시스템에 있는 모든 책의 서론을 가져오려 한다면, 서론 장만이 아니라 각 책 전체를 메모리에 유지하게 됩니다. 이는 막대한 메모리 사용으로 이어질 수 있습니다.
큰 바이너리에서 작은 부분 하나만 필요하고 그 작은 부분을 한동안 유지해야 한다는 것을 알고 있다면, 이 경우의 해결책은 binary:copy/1을 사용하는 것입니다. 이 함수는 오직 부수 효과를 위해서만 사용됩니다. 그 부수 효과란 서브 바이너리를 원래 바이너리에서 실제로 복사해 내어 더 큰 바이너리에 대한 참조를 없애는 것이며, 이를 통해 더 큰 바이너리가 가비지 컬렉션될 수 있기를 기대할 수 있습니다.
바이너리 생성과 매칭이 어떻게 이루어지는지는 Erlang 문서에 꽤 자세히 설명되어 있습니다: http://www.erlang.org/doc/efficiency_guide/binaryhandling.html.
11.13. 기타 흥미로운 메모리 영역
11.13.1. 아톰 테이블
Erlang의 아톰은 내부적으로 정수로 표현되는 고유 식별자입니다. 모든 아톰은 아톰 테이블이라고 불리는 전역 구조에 저장됩니다. 아톰 테이블은 고정 크기 구조이므로 실행 중인 Erlang 시스템에 존재할 수 있는 아톰의 수에는 상한이 있습니다(기본값은 1,048,576개입니다). 큰 숫자처럼 들릴 수 있지만, 부주의하게 사용하면(특히 외부 데이터로부터 아톰을 동적으로 생성하면) 아톰 고갈이 일어날 수 있고, 이는 결국 BEAM VM 전체를 크래시시킵니다. 한밤중에 뜻하지 않게 레고 블록을 밟는 것만큼이나 달갑지 않은 일입니다.
아톰 테이블의 각 항목에는 아톰에 관한 메타데이터가 담겨 있으며, 여기에는 문자열 표현(아톰 자체의 텍스트), 런타임 시스템이 사용하는 고유한 내부 식별자, 그리고 참조 카운트나 모듈 또는 함수에서의 사용에 관한 세부 정보 같은 추가 정보가 포함됩니다.
Erlang은 세 가지 핵심 메모리 할당자 유형을 통해 아톰을 관리합니다:
-
atom_text: 아톰의 문자열 표현을 담고 있습니다. 이 영역에는 아톰의 실제 텍스트가 저장됩니다. -
atom_tab: 아톰 테이블 자체를 저장합니다. 빠른 조회를 위한 해시 테이블 구조입니다. -
atom_entry: 각 아톰의 메타데이터(내부 표현, 사용 횟수 등)를 저장할 메모리를 할당합니다.
아톰은 절대 가비지 컬렉션되지 않습니다. 아톰은 한 번 생성되면 VM이 종료될 때까지 유지됩니다. 이러한 설계 결정은 구현을 단순하게 하고 조회 성능도 높여 주지만, 위험도 따릅니다. 아톰 생성을 통제하지 않으면(흔히 list_to_atom/1 같은 함수로 아톰을 동적으로 생성하는 경우) 아톰 테이블이 고갈될 수 있습니다. 아톰 개수가 한도에 도달한 뒤에 새 아톰을 생성하려고 하면 런타임 오류가 발생하며, 이로 인해 노드가 다운될 수도 있습니다.
사용자가 제공한 데이터를 곧바로 아톰으로 변환하거나, 신뢰할 수 없는 외부 입력을 대량으로 파싱하거나, 루프나 재귀 함수 안에서 아톰을 반복적으로 생성하는 경우처럼 아톰을 부주의하게 또는 동적으로 생성할 때 문제가 자주 발생합니다. 이러한 상황에서는 아톰 테이블이 급격히 커질 수 있으며, 그 결과 아톰 한도가 소진되어 심각한 시스템 문제가 발생할 수 있습니다.
이를 방지하려면 다음과 같이 하십시오:
-
사용자 입력을 아톰으로 변환하기 전에 항상 검증하거나 허용 목록과 대조하십시오.
-
가능한 한 기존 아톰을 사용하고, 동적 식별자가 필요하다면 바이너리나 문자열을 사용하십시오.
-
Observer 같은 도구나 다음과 같은 내장 함수를 사용하여 아톰 테이블 사용량을 정기적으로 모니터링하십시오:
-
아톰 개수(
erlang:system_info(atom_count)): 현재 로드된 고유 아톰의 수입니다. -
아톰 메모리(
erlang:memory(atom)): 오버헤드를 포함하여 아톰이 사용하는 총 바이트 수입니다. -
아톰 사용 메모리(
erlang:memory(atom_used)): 실제 아톰 문자열이 사용하는 바이트만 포함합니다.
-
Erlang 셸에서 간단히 확인해 보면 상황을 빠르게 가늠할 수 있습니다:
1> erlang:system_info(atom_count).
34319
2> erlang:system_info(atom_limit).
1048576
3> erlang:memory(atom).
336049
4> erlang:memory(atom_used).
324520
아톰 개수 한도에 도달하면, 실질적으로 쓸 수 있는 해결책은 두 가지입니다.
아톰 테이블 크기를 늘리십시오 (다만 이는 일반적으로 단기(숏텀) 임시방편일 뿐이며, 올바른 아톰 관리를 대체해서는 안 됩니다):
erl +t <new_max_atoms>아톰이 무제한으로 생성되지 않도록 애플리케이션을 재설계하십시오. 일반적으로는 아톰 대신 바이너리, 문자열 또는 정수 식별자를 사용합니다.
따라서 아톰과 아톰 관리에는 주의가 필요하며, 잘못 사용하면 안정성 문제가 생길 수 있습니다. 하지만 올바르게 다루면 아톰은 시스템 전반에서 이미 알려진 정적인 키나 식별자를 참조하는 매우 효율적인 수단으로 남습니다.
아톰 고갈의 위험 없이 문자열을 아톰으로 안전하게 변환할 수 있도록 Erlang은 list_to_existing_atom/1 함수를 제공합니다. 이 함수는 해당 아톰이 이미 존재하는 경우에만 성공합니다. 이 함수로 새 아톰을 만들려고 하면 예외가 발생합니다:
1> list_to_existing_atom("Hello").
** exception error: bad argument
in function  list_to_existing_atom/1
called as list_to_existing_atom("Hello")
*** argument 1: not an already existing atom

2> list_to_existing_atom("true").
true
11.13.2. 코드
또 다른 중요한 메모리 영역은 컴파일된 Erlang 모듈이 로드되는 코드 영역입니다. 컴파일된 Erlang 모듈은 메모리의 이 코드 영역에 로드되며, 이 영역은 Erlang 런타임 시스템 안에서 실행되는 모든 프로세스가 공유합니다. 모듈은 명시적으로 언로드되거나 (핫 코드 로딩을 통해) 교체되지 않는 한 계속 로드된 상태로 남기 때문에, 코드 영역은 일반적으로 정적이고 영속적입니다.
l(Module) 또는 code:load_file(Module) 같은 함수로 모듈을 로드하거나 다시 로드하면, 이전 코드는 즉시 제거되지 않고 이를 참조하는 프로세스가 하나도 없게 될 때까지 "old" 버전으로 유지됩니다. Erlang은 각 모듈의 두 가지 버전을 동시에 유지합니다. 이를 통해 실행 중인 프로세스를 중단하지 않고 안전하게 업그레이드할 수 있습니다.
Erlang 코드에 정의된 상수(숫자, 아톰, 바이너리 등)는 모듈 코드 세그먼트 안의 상수 풀에 저장됩니다. 이러한 상수는 한 번만 저장되므로 단일 모듈 안에서는 메모리 사용 측면에서 효율적입니다. 그러나 메시지 전달이나 ETS 테이블 삽입처럼 상수가 해당 모듈 밖에서 사용되면 상수는 수신 프로세스의 힙에 복사되므로 전체 메모리 사용량이 크게 늘어날 수 있습니다.
코드 메모리 사용량을 모니터링하고 관리하는 일은 필수적이며, 핫 코드 업그레이드를 자주 수행하는 장기 실행 시스템에서는 특히 중요합니다. code:all_loaded/0 등의 내장 함수를 사용하여 로드된 모듈과 그 상태를 검사할 수 있으며, erlang:memory(code)를 사용하여 로드된 모듈과 그 상수가 사용하는 전체 메모리 사용량을 모니터링할 수 있습니다.
1> erlang:memory(code).
6378630
12. 가비지 컬렉션
프로세스의 스택과 힙 공간이 부족해지면 프로세스는 마이너 가비지 컬렉션을 수행하여 공간을 회수하려고 시도합니다. 이 작업을 수행하는 코드는 erl_gc.c에서 찾을 수 있습니다.
12.1. 복사 가비지 컬렉션
ERTS는 세대별 복사 가비지 컬렉터를 사용합니다. 복사 컬렉터란 가비지 컬렉션 중에 살아 있는 모든 젊은 텀을 기존 힙에서 새 힙으로 복사한다는 뜻입니다. 그런 다음 기존 힙은 폐기됩니다. 세대별 컬렉터는 대부분의 텀이 젊어서 죽는다는 원리에 따라 동작합니다. 즉, 대부분의 텀은 생성되고 사용된 뒤 버려지는 임시 텀입니다. 오래된 텀은 올드 제너레이션으로 승격되며, 올드 제너레이션은 더 드물게 수집됩니다. 이는 일단 오래된 텀이 되면 앞으로도 오랫동안 살아남을 가능성이 높다는 논리에 따른 것입니다.
개념적으로 가비지 컬렉션 주기는 다음과 같이 동작합니다.
-
먼저 모든 루트(예: 스택)를 수집합니다.
-
그런 다음 각 루트에 대해, 루트가 포워딩 포인터가 없는 힙 할당 객체를 가리키면 그 객체를 새 힙으로 복사합니다. 복사된 각 객체에 대해 원본을 새 복사본을 가리키는 포워딩 포인터로 갱신합니다.
-
이제 새 힙을 순회하면서 루트에 대해 했던 것과 동일한 작업을 수행하십시오.
12.1.1. 예시
이것이 구체적으로 어떻게 이루어지는지 예제를 통해 자세히 살펴보겠습니다. 올드 제너레이션이 없는 마이너 컬렉션을 살펴보겠으며, 루트 집합으로는 스택만 사용하겠습니다. 실제로는 프로세스 딕셔너리, 트레이스 데이터, 프로브 데이터 등도 루트 셋에 포함됩니다.
gc_example 예제에서 garbage_collect 호출이 어떻게 동작하는지 살펴봅시다. 이 코드는 cons의 두 요소와 튜플이 공유하는 문자열을 하나 생성하며, 그런 다음 튜플이 제거되어 가비지가 됩니다. GC가 끝나면 힙에는 문자열이 하나만 남아 있어야 합니다. 즉, 먼저 {["Hello","Hello"], "Hello"} 텀을 생성합니다(모든 인스턴스가 동일한 문자열 "Hello" 하나를 공유합니다. 그런 다음 GC를 발생시킬 때 ["Hello","Hello"] 텀만 유지합니다.
| 이번 기회에 Linux 시스템에서 gdb를 사용해 ERTS의 동작을 살펴보는 방법을 알아보겠습니다. 물론 원하는 디버거를 사용하셔도 됩니다. 이미 gdb 사용법을 알고 있거나 디버거를 깊이 다룰 생각이 없다면, 시스템을 살펴보는 방법에 관한 메타 설명은 건너뛰고 다이어그램과 GC 동작 방식에 대한 설명만 보셔도 됩니다. Section 18.8.1에서는 gdb를 사용하여 시스템을 자세히 살펴보는 방법을 다룹니다. 여기서는 저희가 직접 만든 보조 스크립트를 몇 가지 사용하는데, 안타깝게도 이 스크립트들은 세월이 흐르면서 유실되었습니다. |
-module(gc_example).
-export([example/0]).

example() ->
  T = gen_data(),
  S = element(1, T),
  erlang:garbage_collect(),
  S.

gen_data() ->
 S = gen_string($H, $e, $l, $l, $o),
 T = gen_tuple([S,S],S),
 T.

gen_string(A,B,C,D,E) ->
   [A,B,C,D,E].

gen_tuple(A,B) ->
 {A,B}.
예제를 컴파일한 후 Erlang 셸을 시작하여 호출을 테스트하고, 예제를 다시 호출할 준비를 합니다(리턴 키는 누르지 않습니다):
1> gc_example:example().
["Hello","Hello"]
2> spawn(gc_example,example,[]).
gdb를 사용하여 시스템 검사하기
그런 다음 gdb를 사용해 제 Erlang 노드(이 경우 OS PID: 2955)에 어태치합니다.
$ gdb /home/happi/otp/lib/erlang/erts-6.0/bin/beam.smp 2955
| ptrace_scope 설정에 따라서는 gdb를 실행할 때 앞에 'sudo’를 붙여야 할 수도 있습니다. |
그런 다음 gdb에서 메인 GC 함수의 시작 부분에 브레이크포인트를 설정하고 노드가 계속 실행되도록 했습니다:
(gdb) break garbage_collect_0
(gdb) cont
Continuing.
이제 Erlang 셸에서 엔터를 누르면 실행이 브레이크포인트에서 멈춥니다:
Breakpoint 1, garbage_collect_0 (A__p=0x7f673d085f88, BIF__ARGS=0x7f673da90340) at beam/bif.c:3771
3771	    FLAGS(BIF_P) |= F_NEED_FULLSWEEP;
PCB 살펴보기
이제 프로세스의 PCB를 살펴볼 수 있습니다:
(gdb) p *(Process *) A__p
$1 = {common = {id = 1408749273747, refc = {counter = 1}, tracer_proc = 18446744073709551611, trace_flags = 0, u = {alive = {
        started_interval = 0, reg = 0x0, links = 0x0, monitors = 0x0, ptimer = 0x0}, release = {later = 0, func = 0x0, data = 0x0,
        next = 0x0}}}, htop = 0x7f6737145950, stop = 0x7f6737146000, heap = 0x7f67371458c8, hend = 0x7f6737146010, heap_sz = 233,
  min_heap_size = 233, min_vheap_size = 46422, fp_exception = 0, hipe = {nsp = 0x0, nstack = 0x0, nstend = 0x0, ncallee = 0x7f673d080000,
    closure = 0, nstgraylim = 0x0, nstblacklim = 0x0, ngra = 0x0, ncsp = 0x7f673d0863e8, narity = 0, float_result = 0}, arity = 0,
  arg_reg = 0x7f673d086080, max_arg_reg = 6, def_arg_reg = {393227, 457419, 18446744073709551611, 233, 46422, 2000}, cp = 0x7f673686ac40,
  i = 0x7f673be17748, catches = 0, fcalls = 1994, rcount = 0, schedule_count = 0, reds = 0, group_leader = 893353197987, flags = 0,
  fvalue = 18446744073709551611, freason = 0, ftrace = 18446744073709551611, next = 0x7f673d084cc0, nodes_monitors = 0x0,
  suspend_monitors = 0x0, msg = {first = 0x0, last = 0x7f673d086120, save = 0x7f673d086120, len = 0, mark = 0x0, saved_last = 0x7d0}, u = {
    bif_timers = 0x0, terminate = 0x0}, dictionary = 0x0, seq_trace_clock = 0, seq_trace_lastcnt = 0,
  seq_trace_token = 18446744073709551611, initial = {393227, 457419, 0}, current = 0x7f673be17730, parent = 1133871366675,
  approx_started = 1407857804, high_water = 0x7f67371458c8, old_hend = 0x0, old_htop = 0x0, old_heap = 0x0, gen_gcs = 0,
  max_gen_gcs = 65535, off_heap = {first = 0x0, overhead = 0}, mbuf = 0x0, mbuf_sz = 0, psd = 0x0, bin_vheap_sz = 46422,
  bin_vheap_mature = 0, bin_old_vheap_sz = 46422, bin_old_vheap = 0, sys_task_qs = 0x0, state = {counter = 41002}, msg_inq = {first = 0x0,
    last = 0x7f673d086228, len = 0}, pending_exit = {reason = 0, bp = 0x0}, lock = {flags = {counter = 1}, queue = {0x0, 0x0, 0x0, 0x0},
    refc = {counter = 1}}, scheduler_data = 0x7f673bd6c080, suspendee = 18446744073709551611, pending_suspenders = 0x0, run_queue = {
    counter = 140081362118912}, hipe_smp = {have_receive_locks = 0}}
와, 정말 많은 정보였습니다. 흥미로운 부분은 스택과 힙에 관한 것입니다:
hend = 0x7f6737146010,
stop = 0x7f6737146000,
htop = 0x7f6737145950,
heap = 0x7f67371458c8,
스택 살펴보기
지금은 세월 속에 사라진 몇 가지 헬퍼 스크립트를 사용하면 스택과 힙을 의미 있는 방식으로 살펴볼 수 있습니다.
(gdb) source gdb_scripts
(gdb) print_p_stack A__p
0x00007f6737146008 [0x00007f6737145929] cons -> 0x00007f6737145928
(gdb) print_p_heap A__p
0x00007f6737145948 [0x00007f6737145909] cons -> 0x00007f6737145908
0x00007f6737145940 [0x00007f6737145929] cons -> 0x00007f6737145928
0x00007f6737145938 [0x0000000000000080] Tuple size 2
0x00007f6737145930 [0x00007f6737145919] cons -> 0x00007f6737145918
0x00007f6737145928 [0x00007f6737145909] cons -> 0x00007f6737145908
0x00007f6737145920 [0xfffffffffffffffb] NIL
0x00007f6737145918 [0x00007f6737145909] cons -> 0x00007f6737145908
0x00007f6737145910 [0x00007f67371458f9] cons -> 0x00007f67371458f8
0x00007f6737145908 [0x000000000000048f] 72
0x00007f6737145900 [0x00007f67371458e9] cons -> 0x00007f67371458e8
0x00007f67371458f8 [0x000000000000065f] 101
0x00007f67371458f0 [0x00007f67371458d9] cons -> 0x00007f67371458d8
0x00007f67371458e8 [0x00000000000006cf] 108
0x00007f67371458e0 [0x00007f67371458c9] cons -> 0x00007f67371458c8
0x00007f67371458d8 [0x00000000000006cf] 108
0x00007f67371458d0 [0xfffffffffffffffb] NIL
0x00007f67371458c8 [0x00000000000006ff] 111
여기서는 프로세스가 힙에 리스트 "Hello"를 할당하고, 그 리스트를 두 번 담은 cons와 그 cons와 리스트를 담은 튜플까지 할당한 뒤의 프로세스 힙을 볼 수 있습니다. 루트 집합(이 경우에는 스택)은 리스트의 복사본 두 개를 담은 cons를 가리키는 포인터를 가지고 있습니다. 튜플은 죽은 상태입니다. 즉, 튜플을 가리키는 참조가 전혀 없습니다.
가비지 컬렉션은 루트 집합을 계산하고 새 힙(to space)을 할당하는 것으로 시작합니다. 디버거에서 GC 코드 안으로 단계별로 따라 들어가 보면 이 과정이 어떻게 이루어지는지 확인할 수 있습니다. 여기서는 세부 사항을 다루지 않겠습니다. 몇 단계를 거치면 실행은 루트 집합의 모든 텀이 새 힙으로 복사되는 지점에 도달합니다. 이 과정은 erl_gc.c의 (버전에 따라 다르지만) 1272번째 줄 부근에서 while 루프로 시작합니다.
이 경우 루트는 문자(정수) 'H’를 담고 있는 주소 0x00007f95666597f0을 가리키는 cons입니다. cons 셀이 from space라고 부르는 현재 힙에서 to space로 옮겨지면, 헤드(또는 car)의 값은 moved cons 태그(값 0)로 덮어쓰입니다.
힙 살펴보기
루트 집합을 옮기는 첫 단계가 끝나면 from space와 to space는 다음과 같습니다:
from 공간:
(gdb) print_p_heap p
0x00007f6737145948 [0x00007f6737145909] cons -> 0x00007f6737145908
0x00007f6737145940 [0x00007f6737145929] cons -> 0x00007f6737145928
0x00007f6737145938 [0x0000000000000080] Tuple size 2
0x00007f6737145930 [0x00007f67371445b1] cons -> 0x00007f67371445b0
0x00007f6737145928 [0x0000000000000000] Tuple size 0
0x00007f6737145920 [0xfffffffffffffffb] NIL
0x00007f6737145918 [0x00007f6737145909] cons -> 0x00007f6737145908
0x00007f6737145910 [0x00007f67371458f9] cons -> 0x00007f67371458f8
0x00007f6737145908 [0x000000000000048f] 72
0x00007f6737145900 [0x00007f67371458e9] cons -> 0x00007f67371458e8
0x00007f67371458f8 [0x000000000000065f] 101
0x00007f67371458f0 [0x00007f67371458d9] cons -> 0x00007f67371458d8
0x00007f67371458e8 [0x00000000000006cf] 108
0x00007f67371458e0 [0x00007f67371458c9] cons -> 0x00007f67371458c8
0x00007f67371458d8 [0x00000000000006cf] 108
0x00007f67371458d0 [0xfffffffffffffffb] NIL
0x00007f67371458c8 [0x00000000000006ff] 111
to 공간:
(gdb) print_heap n_htop-1 n_htop-2
0x00007f67371445b8 [0x00007f6737145919] cons -> 0x00007f6737145918
0x00007f67371445b0 [0x00007f6737145909] cons -> 0x00007f6737145908
from space 영역에서는 첫 번째 cons 셀의 head가 0으로 덮어쓰였고(크기가 0인 튜플처럼 보입니다), tail은 to space 영역에 있는 새 cons 셀을 가리키는 포워딩 포인터로 덮어쓰였습니다. 이제 to space 영역에는 첫 번째 cons 셀이 있으며, 이 셀에는 from space 영역에 있는 cons의 head와 tail을 가리키는 역방향 포인터 두 개가 들어 있습니다.
힙의 나머지 부분 옮기기
컬렉터가 루트 집합 처리를 마치면 to space 영역에는 아직 살아 있는 모든 텀을 가리키는 역방향 포인터가 들어 있습니다. 이 시점에서 컬렉터는 to space 영역을 스윕하기 시작합니다. 컬렉터는 두 개의 포인터를 사용하는데, n_hp는 아직 살펴보지 않은 힙의 바닥을 가리키고 n_htop은 힙의 꼭대기를 가리킵니다.
n_htop:
        0x00007f67371445b8 [0x00007f6737145919] cons -> 0x00007f6737145918
n_hp    0x00007f67371445b0 [0x00007f6737145909] cons -> 0x00007f6737145908
그런 다음 GC는 n_hp가 가리키는 값을 살펴봅니다. 이 경우에는 from space를 다시 가리키는 cons입니다. 그래서 GC는 그 cons를 to space로 옮기고, 새 cons를 위한 공간을 마련하기 위해 n_htop을 증가시키며, 첫 번째 cons를 확인했음을 나타내기 위해 n_hp를 증가시킵니다.
from space:

0x00007f6737145948 [0x00007f6737145909] cons -> 0x00007f6737145908
0x00007f6737145940 [0x00007f6737145929] cons -> 0x00007f6737145928
0x00007f6737145938 [0x0000000000000080] Tuple size 2
0x00007f6737145930 [0x00007f67371445b1] cons -> 0x00007f67371445b0
0x00007f6737145928 [0x0000000000000000] Tuple size 0
0x00007f6737145920 [0xfffffffffffffffb] NIL
0x00007f6737145918 [0x00007f6737145909] cons -> 0x00007f6737145908
0x00007f6737145910 [0x00007f67371445c1] cons -> 0x00007f67371445c0
0x00007f6737145908 [0x0000000000000000] Tuple size 0
0x00007f6737145900 [0x00007f67371458e9] cons -> 0x00007f67371458e8
0x00007f67371458f8 [0x000000000000065f] 101
0x00007f67371458f0 [0x00007f67371458d9] cons -> 0x00007f67371458d8
0x00007f67371458e8 [0x00000000000006cf] 108
0x00007f67371458e0 [0x00007f67371458c9] cons -> 0x00007f67371458c8
0x00007f67371458d8 [0x00000000000006cf] 108
0x00007f67371458d0 [0xfffffffffffffffb] NIL
0x00007f67371458c8 [0x00000000000006ff] 111

to space:

n_htop:
        0x00007f67371445c8 [0x00007f67371458f9] cons -> 0x00007f67371458f8
        0x00007f67371445c0 [0x000000000000048f] 72
n_hp    0x00007f67371445b8 [0x00007f6737145919] cons -> 0x00007f6737145918
SEEN    0x00007f67371445b0 [0x00007f67371445c1] cons -> 0x00007f67371445c0
그런 다음 두 번째 cons에서도 같은 일이 일어납니다.
from space:

0x00007f6737145948 [0x00007f6737145909] cons -> 0x00007f6737145908
0x00007f6737145940 [0x00007f6737145929] cons -> 0x00007f6737145928
0x00007f6737145938 [0x0000000000000080] Tuple size 2
0x00007f6737145930 [0x00007f67371445b1] cons -> 0x00007f67371445b0
0x00007f6737145928 [0x0000000000000000] Tuple size 0
0x00007f6737145920 [0x00007f67371445d1] cons -> 0x00007f67371445d0
0x00007f6737145918 [0x0000000000000000] Tuple size 0
0x00007f6737145910 [0x00007f67371445c1] cons -> 0x00007f67371445c0
0x00007f6737145908 [0x0000000000000000] Tuple size 0
0x00007f6737145900 [0x00007f67371458e9] cons -> 0x00007f67371458e8
0x00007f67371458f8 [0x000000000000065f] 101
0x00007f67371458f0 [0x00007f67371458d9] cons -> 0x00007f67371458d8
0x00007f67371458e8 [0x00000000000006cf] 108
0x00007f67371458e0 [0x00007f67371458c9] cons -> 0x00007f67371458c8
0x00007f67371458d8 [0x00000000000006cf] 108
0x00007f67371458d0 [0xfffffffffffffffb] NIL
0x00007f67371458c8 [0x00000000000006ff] 111

to space:

n_htop:
        0x00007f67371445d8 [0xfffffffffffffffb] NIL
        0x00007f67371445d0 [0x00007f6737145909] cons -> 0x00007f6737145908
        0x00007f67371445c8 [0x00007f67371458f9] cons -> 0x00007f67371458f8
n_hp    0x00007f67371445c0 [0x000000000000048f] 72
SEEN    0x00007f67371445b8 [0x00007f6737145919] cons -> 0x00007f67371445d0
SEEN    0x00007f67371445b0 [0x00007f67371445c1] cons -> 0x00007f67371445c0
to space의 다음 요소는 즉시값 72이며, 이 값은 (n_hp++로) 건너뛰기만 합니다. 그다음에는 또 다른 cons가 있으며, 이것은 이동됩니다.
그런 다음 두 번째 cons에서도 같은 일이 일어납니다.
from space:

0x00007f6737145948 [0x00007f6737145909] cons -> 0x00007f6737145908
0x00007f6737145940 [0x00007f6737145929] cons -> 0x00007f6737145928
0x00007f6737145938 [0x0000000000000080] Tuple size 2
0x00007f6737145930 [0x00007f67371445b1] cons -> 0x00007f67371445b0
0x00007f6737145928 [0x0000000000000000] Tuple size 0
0x00007f6737145920 [0x00007f67371445d1] cons -> 0x00007f67371445d0
0x00007f6737145918 [0x0000000000000000] Tuple size 0
0x00007f6737145910 [0x00007f67371445c1] cons -> 0x00007f67371445c0
0x00007f6737145908 [0x0000000000000000] Tuple size 0
0x00007f6737145900 [0x00007f67371445e1] cons -> 0x00007f67371445e0
0x00007f67371458f8 [0x0000000000000000] Tuple size 0
0x00007f67371458f0 [0x00007f67371458d9] cons -> 0x00007f67371458d8
0x00007f67371458e8 [0x00000000000006cf] 108
0x00007f67371458e0 [0x00007f67371458c9] cons -> 0x00007f67371458c8
0x00007f67371458d8 [0x00000000000006cf] 108
0x00007f67371458d0 [0xfffffffffffffffb] NIL
0x00007f67371458c8 [0x00000000000006ff] 111

to space:

n_htop:
        0x00007f67371445e8 [0x00007f67371458e9] cons -> 0x00007f67371458e8
        0x00007f67371445e0 [0x000000000000065f] 101
        0x00007f67371445d8 [0xfffffffffffffffb] NIL
n_hp    0x00007f67371445d0 [0x00007f6737145909] cons -> 0x00007f6737145908
SEEN    0x00007f67371445c8 [0x00007f67371458f9] cons -> 0x00007f67371445e0
SEEN    0x00007f67371445c0 [0x000000000000048f] 72
SEEN    0x00007f67371445b8 [0x00007f6737145919] cons -> 0x00007f67371445d0
SEEN    0x00007f67371445b0 [0x00007f67371445c1] cons -> 0x00007f67371445c0
이제 이미 이동된 셀을 가리키는 cons에 이르렀습니다. GC는 0x00007f6737145908에서 IS_MOVED_CONS 태그를 발견하고, 이동된 셀의 목적지를 tail에서 복사합니다(*n_hp++ = ptr[1];). 이런 방식으로 GC 중에 공유가 유지됩니다. 이 단계는 from space에 영향을 주지 않지만, to space에 있는 역방향 포인터는 다시 쓰입니다.
to space:

n_htop:
        0x00007f67371445e8 [0x00007f67371458e9] cons -> 0x00007f67371458e8
        0x00007f67371445e0 [0x000000000000065f] 101
n_hp    0x00007f67371445d8 [0xfffffffffffffffb] NIL
SEEN    0x00007f67371445d0 [0x00007f67371445c1] cons -> 0x00007f67371445c0
SEEN    0x00007f67371445c8 [0x00007f67371458f9] cons -> 0x00007f67371445e0
SEEN    0x00007f67371445c0 [0x000000000000048f] 72
SEEN    0x00007f67371445b8 [0x00007f6737145919] cons -> 0x00007f67371445d0
SEEN    0x00007f67371445b0 [0x00007f67371445c1] cons -> 0x00007f67371445c0
그런 다음 리스트의 나머지 부분(문자열)이 이동됩니다.
from space:

0x00007f6737145948 [0x00007f6737145909] cons -> 0x00007f6737145908
0x00007f6737145940 [0x00007f6737145929] cons -> 0x00007f6737145928
0x00007f6737145938 [0x0000000000000080] Tuple size 2
0x00007f6737145930 [0x00007f67371445b1] cons -> 0x00007f67371445b0
0x00007f6737145928 [0x0000000000000000] Tuple size 0
0x00007f6737145920 [0x00007f67371445d1] cons -> 0x00007f67371445d0
0x00007f6737145918 [0x0000000000000000] Tuple size 0
0x00007f6737145910 [0x00007f67371445c1] cons -> 0x00007f67371445c0
0x00007f6737145908 [0x0000000000000000] Tuple size 0
0x00007f6737145900 [0x00007f67371445e1] cons -> 0x00007f67371445e0
0x00007f67371458f8 [0x0000000000000000] Tuple size 0
0x00007f67371458f0 [0x00007f67371445f1] cons -> 0x00007f67371445f0
0x00007f67371458e8 [0x0000000000000000] Tuple size 0
0x00007f67371458e0 [0x00007f6737144601] cons -> 0x00007f6737144600
0x00007f67371458d8 [0x0000000000000000] Tuple size 0
0x00007f67371458d0 [0x00007f6737144611] cons -> 0x00007f6737144610
0x00007f67371458c8 [0x0000000000000000] Tuple size 0

to space:

n_htop:
n_hp
SEEN    0x00007f6737144618 [0xfffffffffffffffb] NIL
SEEN    0x00007f6737144610 [0x00000000000006ff] 111
SEEN    0x00007f6737144608 [0x00007f6737144611] cons -> 0x00007f6737144610
SEEN    0x00007f6737144600 [0x00000000000006cf] 108
SEEN    0x00007f67371445f8 [0x00007f6737144601] cons -> 0x00007f6737144600
SEEN    0x00007f67371445f0 [0x00000000000006cf] 108
SEEN    0x00007f67371445e8 [0x00007f67371445f1] cons -> 0x00007f67371445f0
SEEN    0x00007f67371445e0 [0x000000000000065f] 101
SEEN    0x00007f67371445d8 [0xfffffffffffffffb] NIL
SEEN    0x00007f67371445d0 [0x00007f67371445c1] cons -> 0x00007f67371445c0
SEEN    0x00007f67371445c8 [0x00007f67371445e1] cons -> 0x00007f67371445e0
SEEN    0x00007f67371445c0 [0x000000000000048f] 72
SEEN    0x00007f67371445b8 [0x00007f67371445d1] cons -> 0x00007f67371445d0
SEEN    0x00007f67371445b0 [0x00007f67371445c1] cons -> 0x00007f67371445c0
예제 요약
이 예제에서 짚어 둘 점이 몇 가지 있습니다. Erlang에서 텀은 요소부터 시작하여 상향식(bottom-up)으로 생성됩니다. 가비지 컬렉터는 하향식(top-down)으로 동작하여, 최상위 구조부터 시작한 다음 요소를 복사합니다. 따라서 첫 번째 GC 이후에는 포인터의 방향이 바뀝니다. 이것이 실질적으로 미치는 영향은 없지만, 실제 힙을 살펴볼 때 알아 두면 좋습니다. 구조가 반드시 상향식으로 되어 있다고 가정해서는 안 됩니다.
또한 GC는 너비 우선 순회를 수행한다는 점에 유의하십시오. 따라서 GC 이후에는 하나의 텀에 대한 지역성이 대개 더 나빠집니다. 최신 캐시의 크기를 고려하면 이는 문제가 되지 않을 것입니다. 물론 이것이 문제가 되는 병적인 예를 만들 수도 있지만, 깊이 우선 방식이 문제를 일으키는 병적인 예도 만들 수 있습니다.
세 번째로 주목할 점은 공유가 보존된다는 것인데, 이는 매우 중요합니다. 그렇지 않으면 GC 후에 오히려 GC 전보다 더 많은 공간을 사용하게 될 수도 있기 때문입니다.
다음은 세대(generation)에 대한 보다 자세한 설명입니다.
12.2. Erlang 가비지 컬렉션의 세대
Erlang의 BEAM 가상 머신은 세대별 복사 가비지 컬렉터를 사용합니다. 이는 대부분의 객체가 "일찍 죽는다"는 관찰에 기반하여 메모리를 효율적으로 관리하는 방법입니다. 따라서 최근에 할당된 데이터는 자주 수집되며, 살아남은 데이터는 수집 빈도가 낮은 오래된 세대로 승격됩니다.
PCB(Process Control Block, 프로세스 제어 블록)에는 힙에 관한 다음과 같은 정보가 들어 있습니다:
-
high_water: 이 포인터는 힙에서 오래된 객체와 새 객체 사이의 경계를 표시합니다. 이 줄 아래에 있는 객체는 이전 컬렉션에서 살아남은 것으로, "오래된" 객체로 간주됩니다. 이 선 위에 있는 객체는 새로 생성된 객체이며 수명이 짧을 가능성이 더 높습니다.
-
old_heap: "오래된" 객체용으로 지정된 힙 영역을 가리키는 포인터입니다. 객체는 마이너 가비지 컬렉션에서 살아남으면 이 영역으로 승격됩니다.
-
old_htop: 올드 힙(old heap)에서 현재 top 위치를 나타내며, 승격 시 새 객체를 배치할 수 있는 위치를 의미합니다.
-
old_hend: 올드 힙 영역의 끝 경계를 표시합니다. 올드 힙에 추가 가비지 컬렉션이나 크기 조정이 필요할 수 있는 시점을 판단하는 기준 한계로 사용됩니다.
-
gen_gcs: 프로세스에서 수행된 마이너 세대별 가비지 컬렉션의 횟수를 셉니다.
-
max_gen_gcs: 가비지 컬렉터가 전체 스윕을 수행하기 전까지 허용되는 마이너 컬렉션의 최대 횟수를 정의합니다. 이 임곗값은 주기적으로 전체 힙(old 영역과 new 영역 모두)이 빠짐없이 정리되도록 보장합니다.
그 밖의 PCB 메모리 관리 관련 필드는 다음과 같습니다:
-
off_heap: 가비지 컬렉터가 컬렉션 중에 고려해야 하는 오프힙 구조에 대한 포인터를 담고 있습니다. 오프힙 데이터의 예로는 크기가 큰 바이너리가 있습니다.
-
mbuf와 mbuf_sz: 이들은 주로 메시지 전달 경합이 발생할 때 사용되는 힙 프래그먼트(메모리 버퍼, 즉 "m-buf")를 나타냅니다. 락 경합이나 힙 공간 문제를 피하기 위해 메시지는 m-buf로 복사됩니다.
-
bin_vheap_sz, bin_vheap_mature, bin_old_vheap_sz 및 bin_old_vheap: 이들은 메인 힙 외부에 저장되는 바이너리 데이터와 관련된 항목입니다.
-
bin_vheap_sz는 프로세스 힙에 할당된 바이너리의 크기를 추적합니다. -
bin_vheap_mature는 성숙 바이너리 가상 힙 크기를 나타내며, 가비지 컬렉션에서 살아남은 바이너리의 크기를 의미합니다. -
bin_old_vheap_sz와bin_old_vheap은 승격되어 젊은 세대의 할당과 별도로 추적되는 오래된 세대의 바이너리를 구체적으로 가리킵니다.
-
12.2.1. 세대별 힙의 시각적 표현(개념도)
힙과 올드 힙의 배치는 다음과 같이 나타낼 수 있습니다(단순화한 형태):
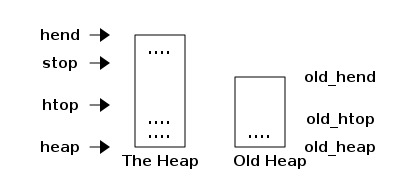
다음은 두 힙 영역을 개략적으로 나타낸 그림입니다:
-
왼쪽의 일반 힙은 새 객체가 처음 할당되는 곳입니다.
-
오른쪽의 올드 힙은 마이너 컬렉션에서 살아남아 올드 제너레이션으로 승격된, 더 오래되고 수명이 긴 객체를 저장합니다.
12.3. 실무적 영향과 고려 사항
잦은 마이너 가비지 컬렉션(gen_gcs로 추적됨)은 수명이 짧은 데이터를 빠르게 할당하고 버리는 프로세스가 있음을 나타내는 경우가 많습니다. 이러한 현상이 보인다면, 대개 코드 경로를 최적화하여 성능을 높일 수 있다는 신호입니다. 특히 금방 가비지가 되는 임시 데이터 구조나 중간 데이터 구조의 생성을 줄이는 것이 효과적입니다. 이렇게 하면 가비지 컬렉터 오버헤드가 최소화되어 더 효율적으로 실행되고 CPU 사용량이 줄어듭니다.
마찬가지로, high_water 포인터가 계속해서 위로 이동하는 것이 관찰된다면 프로세스가 점점 더 많은 영속 데이터를 생성하고 있다는 신호일 수 있습니다. 이러한 패턴은 더 많은 객체가 가비지 컬렉션 주기에서 살아남아 올드 제너레이션으로 승격되면서 시간이 지남에 따라 메모리를 소비하고 있음을 의미합니다. 이를 주의 깊게 지켜보면 잠재적인 메모리 누수나 데이터 생명주기의 비효율성을 발견하는 데 도움이 됩니다. 이상적으로는 끊임없이 차오르는 밀물이 아니라 안정적인 힙 사용량을 유지해야 합니다.
old_heap, old_htop, old_hend와 같은 다른 중요한 필드를 보면 프로세스가 덜 자주 수집되는 구세대 힙으로 얼마나 많은 데이터를 승격시켰는지 확인할 수 있습니다. 이 필드들을 모니터링하면 프로세스가 수명이 긴 데이터를 효과적으로 처리하고 있는지, 아니면 오래된 데이터에 대한 불필요한 참조를 유지하고 있지는 않은지 파악할 수 있습니다.
마찬가지로, 메모리 버퍼(mbuf, mbuf_sz)를 과도하게 사용한다면 대개 프로세스 간 메시지 전달에서 경합이 발생하고 있거나 처리량이 높다는 신호입니다. 이 수치가 비정상적으로 커지고 있다면 메시지 전달 전략을 다시 검토하십시오. 예를 들어 메시지를 일괄 처리하거나 통신 패턴을 재구성할 수 있습니다. 같은 원칙이 바이너리 힙(bin_vheap_sz 및 bin_vheap_mature)에도 적용됩니다. 바이너리 힙이 크다면 바이너리를 다루는 방식을 재검토해야 한다는 뜻일 수 있으므로, 큰 바이너리를 자신도 모르게 필요 이상으로 오래 붙잡아 두지 않도록 해야 합니다.
12.4. 최적화를 위한 제안
BEAM VM의 가비지 컬렉션을 이해하면 애플리케이션 성능 최적화에 관한 중요한 통찰을 얻을 수 있습니다. 최신 하드웨어 덕분에 캐시 지역성과 관련된 문제는 크게 줄었지만, Erlang의 세대별 가비지 컬렉터가 너비 우선 복사 방식을 사용한다는 점은 여전히 알아 둘 필요가 있습니다. 이 방식은 때때로 데이터 지역성을 떨어뜨려 미묘한 성능 차이를 만들 수 있으며, 이러한 차이는 성능에 매우 민감한 코드 경로에서 드러날 수 있습니다.
또한 힙 단편화를 주의 깊게 살펴보십시오. 특히 메모리 버퍼(m-buf)의 사용을 눈여겨보아야 합니다. 애플리케이션이 메시지 전달에 크게 의존한다면 이러한 버퍼가 자주 사용되어 힙 단편화가 심해질 수 있습니다. mbuf 또는 mbuf_sz가 과도하게 증가한다면 경합이 있거나 메시지 처리가 비효율적이라는 신호일 수 있습니다. 이런 경우에는 메시지를 일괄 처리하거나 통신 패턴을 재검토하여 메시지 전달 전략을 최적화하면 성능을 크게 개선할 수 있습니다.
마이너 컬렉션의 빈도(gen_gcs)와 메이저 컬렉션의 임계값(max_gen_gcs) 같은 가비지 컬렉션 통계를 반드시 모니터링해야 합니다. 이러한 지표를 정기적으로 검토하면 과도한 임시 데이터 할당이나 의도치 않게 오래 살아남는 데이터 같은 비효율을 조기에 발견할 수 있습니다. 이러한 패턴을 조기에 파악하면 메모리 비효율을 바로잡고 메모리 누수나 불필요한 가비지 컬렉션 오버헤드를 방지하는 데 도움이 됩니다.
마지막으로, 계산 과정에서 대량의 임시 데이터가 생성되는 상황을 고려하십시오. 잦은 가비지 컬렉션이 병목이 된다면 프로세스의 초기 힙 크기를 미리 크게 설정해 두는 것이 도움이 될 수 있습니다. 이는 Erlang의 spawn_opt에 {min_heap_size, Size} 옵션을 지정하여 구현할 수 있습니다. 이 방법은 처음부터 충분한 힙 공간을 확보하여 GC 빈도를 줄이고, 반복적인 메모리 회수에 따르는 성능 저하를 최소화합니다.
12.5. 스택과 힙의 증가
BEAM에서 실행되는 Erlang 애플리케이션을 효과적으로 관리하려면 프로세스 메모리가 어떻게 늘어나고 줄어드는지 이해해야 합니다. 구체적으로 말하면, Erlang의 프로세스는 스택과 힙이라는 두 가지 주요 영역에서 메모리를 동적으로 할당합니다.
12.5.1. 스택 증가
스택은 함수 호출, 반환 주소, 지역 변수, 그리고 계산 중에 필요한 중간 데이터를 보관합니다. 함수 호출이 일어나면 매개변수, 반환 주소, 지역 변수를 저장하기 위해 새 스택 프레임이 생성됩니다. 코드가 더 깊은 재귀 호출을 할수록 스택은 자연스럽게 커지며, 힙 영역을 향해 아래쪽으로 확장됩니다. 반대로 함수가 완료되면 스택은 더 이상 필요 없는 프레임을 버리면서 줄어듭니다. 스택은 아래쪽으로(더 낮은 메모리 주소 방향으로) 자랍니다.
함수 호출이 너무 깊게 중첩되거나 재귀를 잘못 사용하면 스택 오버플로가 발생합니다. 신중하게 설계된 Erlang 애플리케이션은 불필요한 스택 증가를 막기 위해 지나치게 깊은 재귀를 피하거나 꼬리 호출 최적화된 재귀를 구현해야 합니다.
12.5.2. 힙 증가
한편 힙은 튜플, 리스트, 맵, 바이너리 및 기타 동적으로 할당되는 구조체와 같은 Erlang 텀을 저장합니다. 스택과 달리 힙은 위쪽(더 높은 메모리 주소 방향)으로 자랍니다. 프로세스가 새로 할당한 데이터는 힙의 꼭대기(htop)에 놓이며, 이 꼭대기는 계속해서 위쪽으로 이동합니다. 힙의 공간이 부족해지면 가비지 컬렉션이 일어나 사용되지 않는 텀이 차지하던 메모리를 회수합니다.
가비지 컬렉션은 살아 있는 텀을 새 영역으로 복사해 압축함으로써 단편화를 줄입니다. GC 후 힙 크기는 (메모리가 회수되어) 줄어들 수도 있고, 그대로 유지될 수도 있으며, 프로세스의 요구를 충족할 만큼 메모리가 회수되지 않으면 늘어날 수도 있습니다.
12.5.3. 스택과 힙 간의 상호 작용
Erlang에서 스택과 힙은 개념적으로는 분리되어 있지만, 물리적으로는 프로세스에 할당된 동일한 연속 메모리 블록 안에 함께 위치합니다. 둘은 서로를 향해 자라납니다:
-
스택: 아래쪽(더 낮은 주소 방향)으로 자랍니다.
-
힙: 위쪽으로(더 높은 주소 쪽으로) 커집니다.
스택과 힙이 충돌하면 프로세스의 메모리가 부족해지며, 이로 인해 가비지 컬렉션이 일어나 힙 공간을 회수하려고 시도합니다. 회수할 수 있는 공간이 충분하지 않으면 BEAM은 해당 프로세스에 더 큰 메모리 영역을 할당합니다.
12.5.4. 실전 최적화 조언
프로파일링하는 동안 스택 깊이와 힙 크기를 주의 깊게 살펴보십시오(observer나 etop이 도움이 될 수 있습니다). 임시 텀이 누적되거나 불필요한 복사가 일어나면 힙이 과도하게 커질 수 있습니다. 또한 재귀가 깊거나 중첩이 심한 호출에서는 스택 사용량을 모니터링하십시오.
계산에 대량의 임시 힙 공간이 필요한 경우, 더 큰 힙을 미리 할당하는 것을 고려하십시오.
이러한 동적인 스택과 힙의 상호작용을 이해하면 애플리케이션의 메모리 동작을 정밀하게 제어할 수 있으며, 이를 통해 더 높은 성능과 효율성, 안정성을 갖춘 Erlang 코드를 작성할 수 있습니다.
12.6. 주요 메모리 특성과 최적화 기회
Erlang과 BEAM의 메모리 관리 및 가비지 컬렉션(GC)을 더 깊이 이해하고 접근 방식을 개선하려면 선행 연구에서 밝혀진 다음 특성과 통찰을 살펴보십시오:
12.6.1. 순환 없음: 참조 카운팅입니까, 복사입니까?
Erlang에서 텀은 불변이므로, 메모리에서 순환 참조가 생길 가능성이 자연스럽게 사라집니다. 이러한 불변성 덕분에 Erlang은 이론적으로 참조 카운팅과 같은 더 단순한 가비지 컬렉션 전략을 사용할 수도 있습니다. 하지만 참조 카운팅에는 나름의 오버헤드가 따르며, 특히 빈번한 갱신과 멀티스레드 경합에서 그 부담이 두드러집니다. 대신 Erlang은 복사 수집기를 사용합니다. 그 이유 중 하나는 Erlang 텀이 보통 크기가 작고, 복사 수집기가 더 나은 캐시 지역성을 제공하며 단편화를 최소화하기 때문입니다.
일반적인 텀 크기와 분산
HiPE(High-Performance Erlang, 고성능 Erlang) 팀의 연구에 따르면 Erlang 텀은 대체로 작으며, 대부분 단순한 구조로 이루어져 있습니다. 측정 결과, 일반적인 Erlang 애플리케이션에서 텀의 대략적인 분산은 다음과 같았습니다:
-
할당된 전체 텀 중 약 75%는 단순한 cons 셀입니다.
-
약 24%는 cons가 아닌 텀이지만 크기가 8워드보다 작습니다.
-
8워드 이상인 텀은 약 1%에 불과합니다.
이러한 관찰 결과를 고려하면, 세대별 복사 가비지 컬렉션 전략은 Erlang의 워크로드에 특히 잘 맞습니다. 대다수의 텀(약 99%)은 수명이 짧거나 크기가 작으므로, 최소한의 오버헤드로 효율적으로 복사하고 관리할 수 있습니다.
복사 GC로 단편화는 줄이고 지역성은 높이기
대부분의 Erlang 텀은 크기가 작기 때문에, 복사 가비지 컬렉터는 메모리 지역성을 유지하고 힙 단편화를 줄이는 데 탁월합니다. 작은 텀이 새 힙 영역으로 자주 복사되므로 가비지 컬렉터는 연속된 메모리 블록을 유지하며, 이를 통해 CPU 캐시 지역성이 향상됩니다. 실제로 이는 캐시 미스가 줄어들고 메모리 접근 패턴을 더 잘 예측할 수 있게 되어 성능이 향상된다는 것을 의미합니다.
애플리케이션 최적화에 주는 시사점
이러한 특성을 고려하면 복사 가비지 컬렉터는 다음과 같은 분명한 이점을 제공합니다:
-
최소 단편화: 가비지 컬렉션을 수행할 때마다 메모리가 압축되므로 힙 단편화가 거의 발생하지 않습니다. 따라서 메모리를 계속 효율적으로 사용할 수 있습니다.
-
지역성 향상: 살아 있는 텀을 하나의 연속된 메모리 영역 안에 있는 새 메모리 위치로 복사하면 캐시 지역성이 좋아져 최신 CPU에서 실행 속도가 빨라집니다.
그러나 복사 방식에는 다음과 같은 트레이드오프가 있습니다:
-
복사 오버헤드: 텀을 계속 복사하면 큰 데이터 구조나 오래 유지되는 텀에서 오버헤드가 생길 수 있지만, Erlang의 사용 사례에서는 대개 무시할 만한 수준입니다.
-
큰 텀에 미칠 수 있는 영향: 흔하지는 않지만, 큰 텀(8워드 초과, 전체 데이터의 약 1%에 해당)은 복사 과정에서 성능 저하를 일으킬 수 있습니다. 이러한 텀은 명시적인 바이너리 할당이나 오프힙 할당으로 최적화할 수 있습니다.
왜 참조 카운팅을 사용하지 않습니까?
언뜻 보기에는 Erlang에 순환 구조가 없으므로 참조 카운팅 전략을 사용할 수 있을 것처럼 보입니다. 그러나 참조 카운팅은 텀 참조가 바뀔 때마다 오버헤드가 발생하며, 단편화 문제를 근본적으로 해결하지도 못합니다. 작은 텀을 빈번하게 할당하는 Erlang의 사용 사례를 고려하면, 여전히 복사 수집이 참조 카운팅보다 성능이 뛰어납니다.
12.6.2. 실무 핵심 정리
Erlang의 데이터 특성이 세대별 복사 GC와 자연스럽게 맞아떨어진다는 점을 이해하면 BEAM이 이 방식을 채택한 이유가 분명해집니다. 이는 다음과 같은 최적화 전략을 강조합니다:
-
불필요한 할당과 일시적인 데이터 최소화.
-
가능하면 크거나 복잡한 데이터 구조를 피하거나, 큰 데이터를 메인 힙 밖으로 옮깁니다.
-
큰 임시 데이터를 생성하는 프로세스의 힙 크기를 신중하게 설정합니다.
메모리 관리 방식을 Erlang의 가비지 컬렉션 전략에 맞추면 애플리케이션을 최적화하여 성능과 자원 활용도를 높일 수 있습니다.
13. IO, 포트 및 네트워킹
Erlang 내부에서 모든 통신은 비동기 시그널링으로 이루어집니다. Erlang 노드와 외부 세계 사이의 통신은 포트를 통해 이루어집니다. 포트는 Erlang 프로세스와 외부 자원 사이의 인터페이스입니다. 초기 버전의 Erlang에서 포트는 프로세스와 거의 같은 방식으로 동작했으며, 시그널을 보내고 받는 방식으로 통신했습니다. 지금도 이 방식으로 포트와 통신할 수 있지만, 포트와 직접 통신할 수 있는 여러 BIF도 있습니다.
이 장에서는 포트가 모든 IO의 공통 인터페이스로 어떻게 사용되는지, 포트가 외부 세계와 어떻게 통신하는지, 그리고 Erlang 프로세스가 포트와 어떻게 통신하는지 살펴보겠습니다. 하지만 먼저 표준 IO가 더 높은 수준에서 어떻게 동작하는지 살펴보겠습니다.
13.1. 표준 IO
Erlang의 표준 입출력을 이해하면 디버깅과 외부 프로그램과의 상호 작용에 도움이 됩니다. 이 절에서는 입출력 프로토콜, 그룹 리더, 'erlang:display’와 'io:format’의 사용법, 그리고 표준 입출력을 리디렉션하는 방법을 다룹니다.
13.1.1. I/O 프로토콜
Erlang의 I/O 프로토콜은 프로세스와 I/O 장치 간의 통신을 처리합니다. 이 프로토콜은 터미널, 파일, 외부 프로그램 같은 장치와 데이터를 주고받는 방식을 정의합니다. 이 프로토콜에는 읽기, 쓰기, 포매팅, I/O 제어 작업 처리를 위한 명령이 포함되어 있습니다. 이러한 명령은 비동기적으로 수행되므로 Erlang의 동시성 모델이 유지됩니다. 더 자세한 내용은 erlang.org:io_protocol의 공식 문서를 참조하십시오.
I/O 프로토콜은 I/O 요청 처리를 담당하는 그룹 리더와 통신하는 데 사용됩니다. 그룹 리더는 다른 프로세스로부터 I/O 요청을 받아 I/O 서버로 전달하는 프로세스입니다. I/O 서버는 요청을 실행하고 응답을 그룹 리더에게 돌려보내는 역할을 담당하며, 그룹 리더는 이 응답을 요청한 프로세스에 전달합니다.
그룹 리더에 대해서는 나중에 다루기로 하고, 먼저 실제 I/O 프로토콜을 살펴봅시다. 이 프로토콜에는 다음과 같은 메시지가 있습니다.
기본 메시지
-
{io_request, From, ReplyAs, Request}:-
From: 클라이언트 프로세스의pid()입니다. -
ReplyAs: 응답을 요청과 매칭하기 위한 식별자입니다. -
Request: I/O 요청입니다.
-
-
{io_reply, ReplyAs, Reply}:-
ReplyAs: 원래 요청과 일치하는 식별자입니다. -
Reply: I/O 요청에 대한 응답입니다.
-
출력 요청
-
{put_chars, Encoding, Characters}:-
Encoding:unicode또는latin1. -
Characters: 기록할 데이터입니다.
-
-
{put_chars, Encoding, Module, Function, Args}:-
Module, Function, Args: 데이터를 생성하는 함수입니다.
-
입력 요청
-
{get_until, Encoding, Prompt, Module, Function, ExtraArgs}:-
Encoding:unicode또는latin1. -
Prompt: 프롬프트로 출력할 데이터입니다. -
Module, Function, ExtraArgs: 데이터를 충분히 읽었는지 판단하는 함수입니다.
-
-
{get_chars, Encoding, Prompt, N}:-
Encoding:unicode또는latin1. -
Prompt: 프롬프트로 출력할 데이터입니다. -
N: 읽을 문자 수입니다.
-
-
{get_line, Encoding, Prompt}:-
Encoding:unicode또는latin1. -
Prompt: 프롬프트로 출력할 데이터입니다.
-
서버 모드
-
{setopts, Opts}:-
Opts: I/O 서버에 대한 옵션 목록입니다.
-
-
getopts:-
I/O 서버에 현재 옵션을 요청합니다.
-
다중 요청과 선택적 메시지
-
{requests, Requests}:-
Requests: 순차적으로 실행될 유효한io_request튜플의 리스트입니다.
-
-
{get_geometry, Geometry}:-
Geometry: 행 또는 열의 개수를 요청합니다(선택 사항).
-
미구현 요청 처리
I/O 서버가 인식할 수 없는 요청을 받으면 다음과 같이 응답해야 합니다: {error, request}.
사용자 정의 I/O 서버 예제
다음은 데이터를 메모리에 저장하는 I/O 서버를 단순화한 예제입니다:
-module(custom_io_server).
-export([start_link/0, stop/1, init/0, loop/1, handle_request/2]).

-record(state, {buffer = <<>>, pos = 0}).

start_link() ->
    {ok, spawn_link(?MODULE, init, [])}.

init() ->
    ?MODULE:loop(#state{}).

stop(Pid) ->
    Pid ! {io_request, self(), Pid, stop},
    receive
        {io_reply, _, {ok, State}} ->
            {ok, State#state.buffer};
        Other ->
            {error, Other}
    end.

loop(State) ->
    receive
        {io_request, From, ReplyAs, Request} ->
            case handle_request(Request, State) of
                {ok, Reply, NewState} ->
                    From ! {io_reply, ReplyAs, Reply},
                    loop(NewState);
                {stop, Reply, _NewState} ->
                    From ! {io_reply, ReplyAs, Reply},
                    exit(normal);
                {error, Reply, NewState} ->
                    From ! {io_reply, ReplyAs, {error, Reply}},
                    loop(NewState)
            end
    end.

handle_request({put_chars, _Encoding, Chars}, State) ->
    Buffer = State#state.buffer,
    NewBuffer = <<Buffer/binary, Chars/binary>>,
    {ok, ok, State#state{buffer = NewBuffer}};
handle_request({get_chars, _Encoding, _Prompt, N}, State) ->
    Part = binary:part(State#state.buffer, State#state.pos, N),
    {ok, Part, State#state{pos = State#state.pos + N}};
handle_request({get_line, _Encoding, _Prompt}, State) ->
    case binary:split(State#state.buffer, <<$\n>>, [global]) of
        [Line|_Rest] ->
            {ok, <<Line/binary, $\n>>, State};
        _ ->
            {ok, State#state.buffer, State}
    end;
handle_request(getopts, State) ->
    {ok, [], State};
handle_request({setopts, _Opts}, State) ->
    {ok, ok, State};
handle_request(stop, State) ->
    {stop, {ok, State}, State};
handle_request(_Other, State) ->
    {error, {error, request}, State}.
이제 이 메모리 저장소를 I/O 장치로 사용할 수 있습니다. 예를 들어 파일 인터페이스를 통해 사용할 수 있습니다.
-module(file_client).
-export([open/0, close/1, write/2, read/2, read_line/1]).

open() ->
    {ok, Pid} = custom_io_server:start_link(),
    {ok, Pid}.

close(Device) ->
    custom_io_server:stop(Device).

write(Device, Data) ->
    file:write(Device, Data).

read(Device, Length) ->
    file:read(Device, Length).

read_line(Device) ->
    file:read_line(Device).
이제 file_client 인터페이스를 통해 이 메모리 스토어를 사용할 수 있습니다:
shell V14.2.1 (press Ctrl+G to abort, type help(). for help)
1> {ok, Pid} = file_client:open().
{ok,<0.219.0>}
2> file_client:write(Pid, "Hello, world!\n").
ok
3> R = file_client:close(Pid).
{ok,<<"Hello, world!\n">>}
4>
13.1.2. 그룹 리더
그룹 리더를 사용하면 I/O를 적절한 엔드포인트로 리다이렉트할 수 있습니다. 이 속성은 자식 프로세스에 상속되므로 체인이 형성됩니다. 기본적으로 Erlang 노드에는 'user’라는 그룹 리더가 있으며, 이 그룹 리더가 표준 입력/출력 채널과의 통신을 관리합니다. 모든 입력 및 출력 요청은 이 프로세스를 거칩니다.
Erlang에서 시작된 각 셸은 자기 자신의 그룹 리더가 됩니다. 즉, 셸에서 실행한 함수는 모든 I/O 데이터를 바로 그 셸 프로세스로 보냅니다. ^G로 셸을 전환하고 셸을 선택하면(예: c <number>), 셸을 관리하는 특별한 프로세스가 I/O 트래픽을 올바른 셸로 전달합니다.
분산 시스템에서 슬레이브 노드나 원격 셸은 자신의 그룹 리더를 외부 PID로 설정하여, 자손 프로세스에서 나오는 I/O 데이터가 올바르게 재라우팅되도록 합니다.
각 OTP 애플리케이션에는 그룹 리더 역할을 하는 애플리케이션 마스터 프로세스가 있습니다. 여기에는 두 가지 주요 용도가 있습니다.
-
이를 통해 프로세스는
application:get_env(Var)를 사용하여 자신이 속한 애플리케이션의 환경 설정에 접근할 수 있습니다. -
애플리케이션이 종료될 때 애플리케이션 마스터는 그룹 리더가 같은 모든 프로세스를 찾아 종료하므로, 사실상 애플리케이션 프로세스를 가비지 컬렉션하는 셈입니다.
그룹 리더는 common_test와 eunit이 테스트 중에 I/O를 캡처하는 데에도 사용되며, 대화형 셸은 I/O를 관리하기 위해 그룹 리더를 설정합니다.
그룹 리더 함수
-
group_leader() → pid(): 해당 프로세스의 그룹 리더 PID를 반환합니다. -
group_leader(GroupLeader, Pid) → true:Pid의 그룹 리더를GroupLeader로 설정합니다.
슈퍼비전 트리를 갖춘 애플리케이션에서는 OTP가 그룹 리더를 애플리케이션 마스터로 가정하므로, 일반적으로 프로세스의 그룹 리더를 변경하지 않습니다.
'group_leader/2' 함수는 'group_leader' 시그널을 사용하여 프로세스의 그룹 리더를 설정합니다. 이 시그널이 프로세스로 전송되면, 해당 프로세스는 자신의 그룹 리더를 지정된 PID로 설정합니다. 그룹 리더는 어떤 프로세스든 될 수 있지만, 일반적으로 셸 프로세스나 애플리케이션 마스터입니다.
사용 예시
1> group_leader().
<0.24.0>

2> self().
<0.42.0>

3> group_leader(self(), <0.43.0>).
true
그룹 리더를 이해하고 BIF display와 함수 io:format의 차이를 이해하면 Erlang에서 기본 I/O를 관리하는 데 도움이 됩니다.
-
erlang:display/1: Erlang I/O 시스템을 거치지 않고 표준 출력에 직접 쓰는 BIF입니다. -
io:format/1,2: 그룹 리더에게 I/O 요청을 보냅니다. rpc:call/4를 통해 수행되면 출력은 호출하는 프로세스의 표준 출력으로 전달됩니다.
13.1.3. 시작 시 표준 IO 리디렉션(분리 모드)
Erlang에서 시작 시, 특히 분리 모드(detached mode)로 실행할 때 표준 입출력(stdin, stdout, stderr)을 리디렉션하면 입력과 출력이 향하는 곳을 제어할 수 있습니다. 이는 출력을 파일에 로그로 남기거나 다른 소스로부터 입력을 받아 처리하고자 하는 프로덕션 환경에서 특히 유용합니다.
분리 모드
Erlang의 분리 모드는 -detached 플래그를 사용하여 활성화할 수 있습니다. 이 플래그는 Erlang 런타임 시스템을 콘솔이 연결되지 않은 백그라운드 프로세스로 시작합니다. 다음은 Erlang 노드를 분리 모드로 시작하는 방법입니다.
erl -sname mynode -setcookie mycookie -detached분리 모드로 실행할 때는 연결된 콘솔이 없으므로 표준 I/O를 수동으로 리디렉션해야 합니다. 이는 Erlang 런타임에 리디렉션 옵션을 지정하여 할 수 있습니다.
표준 출력 및 표준 오류 리디렉션
표준 출력과 표준 오류를 파일로 리디렉션하려면 셸 리디렉션이나 Erlang의 내장 옵션을 사용하십시오. 다음은 stdout과 stderr를 각각 별도의 로그 파일로 리디렉션하는 예입니다:
erl -sname mynode -setcookie mycookie -detached > mynode_stdout.log 2> mynode_stderr.log이 명령은 Erlang 노드를 분리 모드로 시작하고, 표준 출력을 mynode_stdout.log로, 표준 오류를 mynode_stderr.log로 리다이렉트합니다.
또는 Erlang 스크립트나 시작 설정 파일 안에서 이를 구성할 수도 있습니다:
init() ->
    % Redirect stdout and stderr
    file:redirect(standard_output, "mynode_stdout.log"),
    file:redirect(standard_error, "mynode_stderr.log").
표준 입력 리디렉션
표준 입력을 리디렉션하려면 Erlang 노드를 시작할 때 입력 소스를 지정해야 합니다. 예를 들어, 파일을 입력 소스로 사용할 수 있습니다:
erl -sname mynode -setcookie mycookie -detached < input_commands.txt13.1.4. 표준 입력 및 출력 요약
표준 출력(stdout)은 그룹 리더가 관리하며, 일반적으로 콘솔이나 지정된 로그 파일로 출력됩니다. io:format/1, io:put_chars/2 같은 함수는 출력을 그룹 리더에게 보내고, 그룹 리더는 이를 지정된 출력 장치나 파일에 기록합니다. 표준 오류(stderr)도 이와 비슷하게 그룹 리더가 관리하며, 로그 파일이나 다른 출력 대상으로 리디렉션할 수도 있습니다. 표준 입력(stdin)은 프로세스가 그룹 리더로부터 읽어 들입니다. 분리 모드(detached mode)에서는 파일이나 다른 입력 소스로부터 입력을 리디렉션할 수 있습니다.
I/O 프로토콜을 사용하여 자신만의 I/O 서버를 구현할 수 있으며, 그 I/O 서버를 파일 디스크립터로 사용하거나 프로세스의 그룹 리더로 설정하여 해당 서버를 통해 I/O를 리다이렉트할 수 있습니다.
13.2. 포트
포트는 Erlang 프로세스와 Erlang 프로세스가 아닌 모든 것 사이를 잇는, 프로세스와 유사한 인터페이스입니다. 프로그래머는 세상의 모든 것이 마치 Erlang 프로세스처럼 동작한다고 상당 부분 간주하고 메시지 전달을 통해 통신할 수 있습니다.
각 포트에는 소유자가 있지만(이에 대해서는 뒤에서 더 자세히 다룹니다), 해당 포트를 알고 있는 모든 프로세스는 그 포트에 메시지를 보낼 수 있습니다. 아래 그림은 프로세스가 포트와 어떻게 통신하는지, 그리고 포트가 Erlang 노드 바깥 세계와 어떻게 통신하는지를 보여 줍니다.
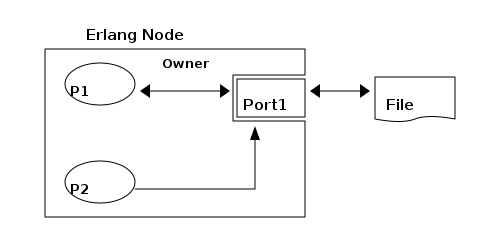
프로세스 P1은 파일에 대한 포트(Port1)를 열었으며, 이 포트의 소유자로서 포트로부터 메시지를 받을 수 있습니다. 프로세스 P2도 이 포트에 대한 핸들을 가지고 있으며, 포트로 메시지를 보낼 수 있습니다. 두 프로세스와 포트는 하나의 Erlang 노드 안에 있습니다. 파일은 Erlang 노드 바깥의 파일 시스템 및 운영 체제에 있습니다.
포트 소유자가 죽거나 종료되면 포트도 함께 종료됩니다. 포트가 종료될 때는 모든 외부 리소스도 정리되어야 합니다. 이는 Erlang에 기본으로 포함된 모든 포트에 해당하며, 포트를 직접 구현하는 경우에는 해당 포트가 이러한 정리 작업을 수행하도록 해야 합니다.
13.2.1. 여러 종류의 포트
포트에는 파일 디스크립터, 외부 프로그램, 드라이버의 세 가지 종류가 있습니다. 파일 디스크립터 포트를 사용하면 프로세스가 이미 열려 있는 파일 디스크립터에 접근할 수 있습니다. 외부 프로그램에 대한 포트는 외부 프로그램을 별도의 OS 프로세스로 실행합니다. 드라이버 포트를 사용하려면 Erlang 노드에 드라이버가 로드되어 있어야 합니다.
모든 포트는 erlang:open_port(PortName, PortSettings) 호출로 생성됩니다.
파일 디스크립터 포트는 {fd, In, Out}을 PortName으로 지정하여 엽니다. 이 종류의 포트는 예전 셸과 같은 일부 ERTS 내부 서버에서 사용합니다. 이 포트는 그다지 효율적이지 않은 것으로 여겨지므로 거의 사용하지 않습니다. 또한 파일 디스크립터는 OS에서 열려 있는 파일 디스크립터를 나타내는 음이 아닌 정수입니다. 파일 디스크립터는 Erlang I/O 서버가 될 수 없습니다.
외부 프로그램 포트를 사용하면 Erlang 노드가 실행되는 네이티브 OS에서 어떤 프로그램이든 실행할 수 있습니다. 외부 프로그램 포트를 열려면 외부 프로그램의 이름과 함께 {spawn, Command} 또는 {spawn_executable, FileName} 인자를 전달합니다. 이는 다른 프로그래밍 언어로 작성된 코드와 상호 작용하는 가장 쉬운 방법이자 가장 안전한 방법 중 하나입니다. 외부 프로그램은 자체 OS 프로세스에서 실행되므로 외부 프로그램이 크래시하더라도 Erlang 노드가 함께 다운되지 않습니다. (물론 외부 프로그램이 CPU나 메모리를 모두 소진하거나 그 밖의 여러 방식으로 OS 전체를 다운시킬 수는 있지만, 링크드인 드라이버나 NIF보다는 훨씬 안전합니다.)
드라이버 포트를 사용하려면 드라이버 프로그램이 ERTS에 로드되어 있어야 합니다. 이러한 포트는 {spawn, Command} 또는 {spawn_driver, Command}로 시작합니다. 링크드인 드라이버를 직접 작성하면 사용하려는 C 라이브러리 코드 등과 효율적으로 인터페이스할 수 있습니다. 링크드인 드라이버는 Erlang 노드와 같은 OS 프로세스에서 실행되므로 드라이버에서 크래시가 발생하면 노드 전체가 다운된다는 점에 유의하십시오. Erlang 드라이버를 작성하는 일반적인 방법에 대한 자세한 내용은 Chapter 16에서 확인할 수 있습니다.
Erlang/OTP에는 미리 정의된 포트 타입을 구현하는 여러 포트 드라이버가 함께 제공됩니다. 모든 플랫폼에서 사용할 수 있는 공통 드라이버로는 tcp_inet, udp_inet, sctp_inet, efile, zlib_drv, ram_file_drv, binary_filer, tty_sl이 있습니다. 이 드라이버들은 예를 들어 Erlang에서 파일 처리와 소켓을 구현하는 데 사용됩니다. Windows에는 레지스트리에 접근하기 위한 드라이버인 registry_drv도 있습니다. 또한 대부분의 플랫폼에는 직접 드라이버를 구현할 때 활용할 수 있는 예제 드라이버로 multi_drv와 sig_drv가 있습니다.
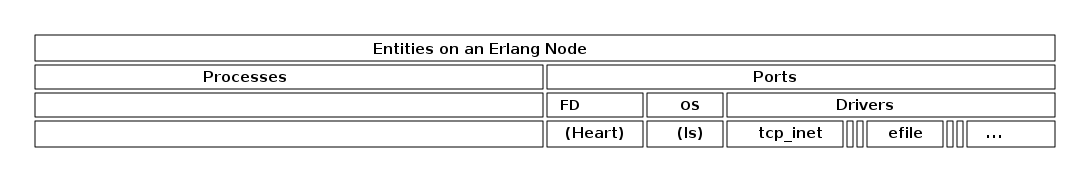
포트로 주고받는 데이터는 바이트 스트림입니다. 포트를 열 때 PortSettings에서 패킷 크기를 지정할 수 있습니다. R16부터 포트는 진정한 비동기 통신을 지원하므로 효율성과 성능이 향상되었습니다.
포트를 사용하면 표준 IO와 폴링을 대체할 수 있습니다. 이는 외부 프로그램이나 장치와 상호 작용해야 할 때 유용합니다. 파일 디스크립터에 대한 포트를 열면 해당 파일에 데이터를 읽고 쓸 수 있습니다. 마찬가지로 외부 프로그램에 대한 포트를 열고 포트 인터페이스를 사용하여 그 프로그램과 통신할 수 있습니다.
파일 디스크립터로의 포트
Erlang의 파일 디스크립터 포트는 이미 열려 있는 파일 디스크립터와 상호 작용할 수 있는 인터페이스를 제공합니다. 효율성 문제 때문에 흔히 사용되지는 않지만, 외부 리소스에 접근할 수 있는 간편한 인터페이스를 제공할 수 있습니다.
파일 디스크립터 포트를 생성하려면 {fd, In, Out} 튜플을 PortName으로 지정하여 open_port/2 함수를 사용합니다. 여기서 In과 Out은 각각 입력과 출력을 위한 파일 디스크립터입니다.
잘못된 예:
Port = open_port({fd, 0, 1}, []).이 코드는 표준 입력(파일 디스크립터 0)에서 읽고 표준 출력(파일 디스크립터 1)에 쓰는 포트를 엽니다. 이 예제는 Erlang 셸의 IO를 가로채므로 직접 실행해 보지 마십시오.
그래도 결국 해 보신 것 아닙니까? 이제 셸을 다시 시작해야 합니다.
파일 디스크립터 포트는 open_port/2 함수로 구현되며, 이 함수는 포트 객체를 생성합니다. 포트 객체는 Erlang 프로세스와 파일 디스크립터 사이의 통신을 처리합니다.
내부적으로 open_port/2가 {fd, In, Out}으로 호출되면, Erlang 런타임 시스템은 지정된 파일 디스크립터와 상호 작용하는 데 필요한 통신 채널을 설정합니다. 그러면 포트 소유자 프로세스는 포트와 메시지를 주고받을 수 있으며, 포트는 다시 파일 디스크립터와 상호 작용합니다.
생성된 OS 프로세스에 연결하는 포트
생성된 OS 프로세스에 대한 포트를 만들려면 open_port/2 함수를 사용하고, PortName 인수로 {spawn, Command} 또는 {spawn_executable, FileName} 튜플을 전달합니다. 이 방법을 사용하면 Erlang 프로세스는 외부 프로그램을 별도의 OS 프로세스로 생성하여 그 프로그램과 상호 작용할 수 있습니다.
포트와 상호작용할 때 쓰는 주요 명령은 다음과 같습니다.
-
{command, Data}: 외부 프로그램에Data를 보냅니다. -
{control, Operation, Data}: 외부 프로그램에 제어 명령을 보냅니다. -
{exit_status, Status}: 외부 프로그램의 종료 상태를 받습니다.
외부 프로그램을 포트로 생성하는 방법의 예시는 Chapter 16를 참조하십시오. 공식 문서도 참고하실 수 있습니다: erlang.org:c_port.
링크드인 드라이버로 연결되는 포트
Erlang에서 링크드인 드라이버는 {spawn_driver, Command} 튜플을 PortName으로 지정하여 open_port/2 함수를 사용해 생성합니다. 이 방법을 사용하려면 명령의 첫 번째 토큰이 로드된 드라이버의 이름이어야 합니다.
Port = open_port({spawn_driver, "my_driver"}, []).링크드인 드라이버 포트와 상호작용하기 위한 명령에는 일반적으로 다음과 같은 것이 있습니다:
-
{command, Data}:Data를 드라이버로 보냅니다. -
{control, Operation, Data}: 드라이버에 제어 명령을 보냅니다. 예시:
Port ! {self(), {command, <<"Hello, Driver!\n">>}}.링크드인 드라이버를 구현하고 포트로 생성하는 방법의 예제는 Chapter 16를 참고하십시오. 공식 문서인 erlang.org:c_portdriver도 참고할 수 있습니다.
13.2.2. Erlang 포트의 흐름 제어
포트는 백프레셔(backpressure)를 관리하고 자원을 효율적으로 사용하기 위해 흐름 제어 메커니즘을 구현합니다. 대표적인 메커니즘 중 하나는 busy port 기능으로, 동시에 너무 많은 작업이 몰려 포트에 과부하가 걸리는 것을 방지합니다. 포트가 busy 상태에 있으면, 기존 데이터를 모두 처리하기 전까지는 더 이상 데이터를 처리할 수 없다는 신호를 Erlang VM에 보낼 수 있습니다.
포트의 내부 버퍼가 지정된 상한 임계값(high-water mark)을 넘으면 포트는 비지(busy) 상태에 들어갑니다. 이 상태에서 포트는 버퍼에 쌓인 데이터를 프로세스할 수 있을 때까지 새 데이터 전송을 멈추라는 신호를 VM에 보냅니다.
사용 중(busy) 상태인 포트로 데이터를 보내려는 프로세스는 포트가 사용 중 상태에서 벗어날 때까지 일시 중단됩니다. 이를 통해 데이터 손실을 방지하고 포트가 들어오는 모든 데이터를 효율적으로 처리할 수 있도록 보장합니다.
포트가 데이터를 충분히 처리하여 지정된 하한 임계치(low-water mark) 아래로 내려가면, 포트는 비지(busy) 상태에서 벗어납니다. 그러면 일시 중단되었던 프로세스들이 데이터 전송을 재개할 수 있습니다.
포트와 주고받는 시그널을 비동기적으로 스케줄링하기 때문에, Erlang에서는 데이터를 보내는 프로세스가 블로킹되지 않고 계속 실행될 수 있습니다. 그 결과 시스템의 병렬성과 응답성이 향상됩니다.
즉, Erlang의 send 연산이 항상 비동기적인 것은 아닙니다. 포트가 바쁜 상태이면 send 연산은 포트가 더 이상 바쁘지 않을 때까지 블로킹됩니다. 많은 프로세스가 같은 포트로 데이터를 보내는 경우 이는 문제가 됩니다. 해결책은 백프레셔를 처리할 수 있는 포트 서버를 사용하여 send 연산이 항상 비동기적으로 이루어지도록 보장하는 것입니다.
공식 포트 드라이버 예제 erlang.org:c-driver를 바탕으로 예제를 만들어 봅시다.
1을 더하거나 2를 곱하는 원래의 복잡한 c 함수를 사용해 봅시다.
/* example.c */

int foo(int x)
{
    return x + 1;
}

int bar(int y)
{
    return y * 2;
}
그리고 약간 수정한 포트 드라이버입니다. 각 메시지에 id를 추가했으며, 결과와 함께 그 id를 반환합니다. 또한 메시지의 id가 14 미만이고 호출 대상이 bar 함수인 경우, 잠시 대기(sleep)한 뒤 busy port 상태를 설정하여 바쁜 포트를 시뮬레이션하는 함수도 있습니다.
/* Derived from port_driver.c
   https://www.erlang.org/doc/system/c_portdriver.html

*/

#include "erl_driver.h"
#include <stdio.h>
#include <unistd.h> // Include for sleep function

int foo(int x);
int bar(int y);

typedef struct
{
    ErlDrvPort port;
} example_data;

static ErlDrvData bp_drv_start(ErlDrvPort port, char *buff)
{
    example_data *d = (example_data *)driver_alloc(sizeof(example_data));
    d->port = port;
    return (ErlDrvData)d;
}

static void bp_drv_stop(ErlDrvData handle)
{
    driver_free((char *)handle);
}

static void bp_drv_output(ErlDrvData handle, char *buff,
                          ErlDrvSizeT bufflen)
{
    example_data *d = (example_data *)handle;
    char fn = buff[0], arg = buff[1], id = buff[2];
    static char res[2];

    if (fn == 1)
    {
        res[0] = foo(arg);
    }
    else if (fn == 2)
    {
        res[0] = bar(arg);
        if (id > 14)
        {
            // Signal that the port is free
            set_busy_port(d->port, 0);
        }
        else
        {
            // Signal that the port is busy
            // This is not essential for this example
            // However, if multiple processes attempted to use the port
            // in parallel, we would need to signal that the port is busy
            // This would make even the foo function block.
            set_busy_port(d->port, 1);
            // Simulate processing delay
            sleep(1);
            set_busy_port(d->port, 0);
        }
    }
    res[1] = id;
    driver_output(d->port, res, 2);
}

ErlDrvEntry bp_driver_entry = {
    NULL,                           /* F_PTR init, called when driver is loaded */
    bp_drv_start,                   /* L_PTR start, called when port is opened */
    bp_drv_stop,                    /* F_PTR stop, called when port is closed */
    bp_drv_output,                  /* F_PTR output, called when erlang has sent */
    NULL,                           /* F_PTR ready_input, called when input descriptor ready */
    NULL,                           /* F_PTR ready_output, called when output descriptor ready */
    "busy_port_drv",                /* char *driver_name, the argument to open_port */
    NULL,                           /* F_PTR finish, called when unloaded */
    NULL,                           /* void *handle, Reserved by VM */
    NULL,                           /* F_PTR control, port_command callback */
    NULL,                           /* F_PTR timeout, reserved */
    NULL,                           /* F_PTR outputv, reserved */
    NULL,                           /* F_PTR ready_async, only for async drivers */
    NULL,                           /* F_PTR flush, called when port is about
                       to be closed, but there is data in driver
                       queue */
    NULL,                           /* F_PTR call, much like control, sync call
                       to driver */
    NULL,                           /* unused */
    ERL_DRV_EXTENDED_MARKER,        /* int extended marker, Should always be
                       set to indicate driver versioning */
    ERL_DRV_EXTENDED_MAJOR_VERSION, /* int major_version, should always be
                       set to this value */
    ERL_DRV_EXTENDED_MINOR_VERSION, /* int minor_version, should always be
                       set to this value */
    0,                              /* int driver_flags, see documentation */
    NULL,                           /* void *handle2, reserved for VM use */
    NULL,                           /* F_PTR process_exit, called when a
                       monitored process dies */
    NULL                            /* F_PTR stop_select, called to close an
                       event object */
};

DRIVER_INIT(busy_port_drv) /* must match name in driver_entry */
{
    return &bp_driver_entry;
}
이제 Erlang에서 이 함수를 동기적으로 호출하거나 비동기 메시지를 보낼 수 있습니다. 포트 핸들러에는 포트로 메시지 10개를 보낸 뒤 결과를 동기 방식과 비동기 방식으로 각각 받는 테스트도 추가했습니다.
%% Derived from https://www.erlang.org/doc/system/c_portdriver.html

-module(busy_port).
-export([start/1, stop/0, init/1]).
-export([foo/1, bar/1, async_foo/1, async_bar/1, async_receive/0]).
-export([test_sync_foo/0,
         test_async_foo/0,
         test_async_bar/0]).

start(SharedLib) ->
    case erl_ddll:load_driver(".", SharedLib) of
	    ok -> ok;
	    {error, already_loaded} -> ok;
	    _ -> exit({error, could_not_load_driver})
    end,
    spawn(?MODULE, init, [SharedLib]).

init(SharedLib) ->
    register(busy_port_example, self()),
    Port = open_port({spawn, SharedLib}, []),
    loop(Port, [], 0).

test_sync_foo() ->
    [foo(N) || N <- lists:seq(1, 10)].

test_async_foo() ->
    [async_receive() || _ <- [async_foo(N) || N <- lists:seq(1, 10)]].

test_async_bar() ->
    [async_receive() || _ <- [async_bar(N) || N <- lists:seq(1, 10)]].


stop() ->
    busy_port_example ! stop.

foo(X) ->
    call_port({foo, X}).
bar(Y) ->
    call_port({bar, Y}).

async_foo(X) ->
    send_message({foo, X}).
async_bar(Y) ->
    send_message({bar, Y}).

async_receive() ->
    receive
        {busy_port_example, Data} ->
            Data
    after 2000 -> timeout
    end.

call_port(Msg) ->
    busy_port_example ! {call, self(), Msg},
    receive
	{busy_port_example, Result} ->
	    Result
    end.

send_message(Message) ->
    busy_port_example ! {send, self(), Message}.


reply(Id, [{Id, From}|Ids], Data) ->
    From ! {busy_port_example, Data},
    Ids;
reply(Id, [Id1|Ids], Data) ->
    [Id1 | reply(Id, Ids, Data)];
reply(_Id, [], Data) -> %% oops, no id found
    io:format("No ID found for data: ~p~n", [Data]),
    [].


loop(Port, Ids, Id) ->
    receive
	{call, Caller, Msg} ->
        io:format("Call: ~p~n", [Msg]),
	    Port ! {self(), {command, encode(Msg, Id)}},
	    receive
		{Port, {data, Data}} ->
            Res = decode_data(Data),
            io:format("Received data: ~w~n", [Res]),
		    Caller ! {busy_port_example, Res}
	    end,
	    loop(Port, Ids, Id);
     {Port, {data, Data}} ->
            {Ref, Res} = decode(Data),
            io:format("Received data: ~w~n", [Res]),
            NewIds = reply(Ref, Ids, Res),
            loop(Port, NewIds, Id);
     {send, From, Message} ->
            T1 = os:system_time(millisecond),
            io:format("Send: ~p~n", [Message]),
            Port ! {self(), {command, encode(Message, Id)}},
            T2 = os:system_time(millisecond),
            if (T2 - T1) > 500 -> io:format("Shouldn't ! be async...~n", []);
               true -> ok
            end,
            loop(Port, [{Id, From} | Ids], Id + 1);
	stop ->
	    Port ! {self(), close},
	    receive
		{Port, closed} ->
		    exit(normal)
	    end;
	{'EXIT', Port, Reason} ->
	    io:format("~p ~n", [Reason]),
	    exit(port_terminated)
    end.

encode({foo, X}, Id) -> [1, X, Id];
encode({bar, X}, Id) -> [2, X, Id].

decode([Int, Id]) -> {Id, Int}.
decode_data([Int,_Id]) -> Int.
셸에서 직접 시도해 봅시다.
1> c(busy_port).
{ok,busy_port}
2> busy_port:start("busy_port_drv").
<0.89.0>
3> busy_port:test_sync_foo().
Call: {foo,1}
Received data: 2
Call: {foo,2}
Received data: 3
Call: {foo,3}
Received data: 4
Call: {foo,4}
Received data: 5
Call: {foo,5}
Received data: 6
Call: {foo,6}
Received data: 7
Call: {foo,7}
Received data: 8
Call: {foo,8}
Received data: 9
Call: {foo,9}
Received data: 10
Call: {foo,10}
Received data: 11
[2,3,4,5,6,7,8,9,10,11]
예상대로 동작했습니다. 동기 호출을 수행했고 곧바로 응답을 받았습니다. 이제 비동기 호출을 시도해 봅시다:
4> busy_port:test_async_foo().
Send: {foo,1}
Send: {foo,2}
Send: {foo,3}
Send: {foo,4}
Send: {foo,5}
Send: {foo,6}
Send: {foo,7}
Send: {foo,8}
Send: {foo,9}
Send: {foo,10}
Received data: 2
Received data: 3
Received data: 4
Received data: 5
Received data: 6
Received data: 7
Received data: 8
Received data: 9
Received data: 10
Received data: 11
[2,3,4,5,6,7,8,9,10,11]
이것도 예상대로 동작했습니다: 메시지 10개를 보냈고, 결과도 같은 순서로 역시 즉시 돌려받았습니다. 이제 바쁜 포트를 시험해 봅시다:
5> busy_port:test_async_bar().
Send: {bar,1}
Shouldn't ! be async...
Send: {bar,2}
Shouldn't ! be async...
Send: {bar,3}
Shouldn't ! be async...
Send: {bar,4}
Shouldn't ! be async...
Send: {bar,5}
Shouldn't ! be async...
Send: {bar,6}
Send: {bar,7}
Send: {bar,8}
Send: {bar,9}
Send: {bar,10}
Received data: 2
Received data: 4
Received data: 6
Received data: 8
Received data: 10
Received data: 12
Received data: 14
Received data: 16
Received data: 18
Received data: 20
[timeout,2,4,6,8,10,12,14,16,18]
처음 5개의 메시지는 비동기가 아니지만, 마지막 5개는 비동기임을 알 수 있습니다. 이는 포트가 바쁜 상태이고 send 연산이 블로킹되기 때문입니다. 포트가 사용 중인 이유는 메시지의 id가 14 미만이고 호출 대상이 bar 함수이기 때문입니다. 포트는 5초 동안 사용 중인 상태로 있다가, 그 후 마지막 5개의 메시지가 비동기적으로 전송됩니다.
13.2.3. 포트 스케줄링
Erlang 포트는 프로세스와 마찬가지로 TCP와 같은 외부 통신을 처리하기 위해 코드(드라이버)를 실행합니다. 원래 포트 시그널은 동기적으로 처리되었으며, 이로 인해 I/O 이벤트 병렬성에 문제가 생겼습니다. 이는 심한 락 경합과 병렬성 잠재력 감소로 인해 문제가 되었습니다.
이러한 문제를 해결하기 위해 Erlang은 모든 포트 시그널을 스케줄링하여 단일 스케줄러가 순차적으로 실행하도록 보장합니다. 이를 통해 경합이 사라지고, 프로세스는 병렬로 Erlang 코드를 계속 실행할 수 있습니다.
포트에는 태스크 큐가 있으며, 이 큐는 잠금이 걸린 공개 큐와 잠금 없는 비공개 큐를 함께 사용하는 "반잠금(semi-locked)" 방식으로 관리됩니다. 락 경합을 피하기 위해 태스크는 이 큐들 사이에서 이동합니다. 이 시스템은 아토믹 연산으로 태스크를 중단됨으로 표시하여 I/O 시그널 중단을 처리하며, 이를 통해 락 경합 없이 태스크가 안전하게 해제되도록 보장합니다.
포트는 명령 시그널이 과도하게 몰리면 바쁨(busy) 상태에 들어갈 수 있으며, 큐가 감당할 수 있는 수준이 될 때까지 새 시그널을 보류합니다. 이를 통해 흐름 제어가 보장되며, 포트가 시그널을 프로세스(처리)할 수 있기도 전에 과부하되는 것을 방지합니다.
시그널 데이터 준비는 포트 락을 획득하기 전에 수행되므로 지연 시간이 줄어듭니다. 경합이 없는 시그널은 즉시 실행되어 낮은 지연 시간을 유지하며, 경합이 있는 시그널은 병렬성을 보존하기 위해 나중에 실행되도록 스케줄링됩니다.
스케줄러의 동작 방식과 포트가 전반적인 스케줄링 체계에 어떻게 들어맞는지에 대한 자세한 내용은 Chapter 10 장을 참조하십시오.
13.3. 분산 Erlang
내장 분산 계층에 대한 자세한 내용은 Chapter 14 장을 참조하십시오.
13.4. 소켓, UDP와 TCP
소켓은 Erlang에서 네트워크 통신의 기본 요소입니다. 소켓을 사용하면 프로세스가 TCP나 UDP 같은 프로토콜로 네트워크를 통해 통신할 수 있습니다. 여기서는 소켓을 다루는 방법, 소켓 정보를 조회하는 방법, 그리고 소켓 동작을 조정하는 방법을 살펴보겠습니다.
Erlang은 소켓을 생성하고 관리하기 위한 강력한 함수 집합을 제공합니다. gen_tcp 모듈과 gen_udp 모듈은 각각 TCP 프로토콜과 UDP 프로토콜을 쉽게 사용할 수 있게 해 줍니다. 다음은 TCP 소켓을 여는 기본 예제입니다:
% Open a listening socket on port 1234
{ok, ListenSocket} = gen_tcp:listen(1234, [binary, {packet, 0}, {active, false}, {reuseaddr, true}]),

% Accept a connection
{ok, Socket} = gen_tcp:accept(ListenSocket),

% Send and receive data
ok = gen_tcp:send(Socket, <<"Hello, World!">>),
{ok, Data} = gen_tcp:recv(Socket, 0).
UDP의 경우에도 전체 프로세스는 비슷하지만 gen_udp 모듈을 사용합니다:
% Open a UDP socket on port 1234
{ok, Socket} = gen_udp:open(1234, [binary, {active, false}]),

% Send and receive data
ok = gen_udp:send(Socket, "localhost", 1234, <<"Hello, World!">>),
receive
    {udp, Socket, Host, Port, Data} -> io:format("Received: ~p~n", [Data])
end.
Erlang은 소켓에 관한 정보를 조회하는 여러 함수를 제공합니다. 예를 들어, inet:getopts/2와 inet:setopts/2를 사용하여 소켓의 옵션을 조회하고 설정할 수 있습니다. 다음은 예시입니다:
% Get options on a socket
{ok, Options} = inet:getopts(Socket, [recbuf, sndbuf, nodelay]),

% Set options on a socket
ok = inet:setopts(Socket, [{recbuf, 4096}, {sndbuf, 4096}, {nodelay, true}]).
또한 inet:peername/1과 inet:sockname/1을 사용하여 소켓의 원격 주소와 로컬 주소를 얻을 수 있습니다:
% Get the remote address of a connected socket
{ok, {Address, Port}} = inet:peername(Socket),

% Get the local address of a socket
{ok, {LocalAddress, LocalPort}} = inet:sockname(Socket).
소켓의 성능과 동작을 최적화하기 위해 다양한 소켓 옵션을 조정할 수 있습니다. 흔히 조정하는 옵션으로는 버퍼 크기, 타임아웃, 패킷 크기 등이 있습니다. 다음은 이러한 옵션 중 일부를 조정하는 방법입니다:
% Set socket buffer sizes
ok = inet:setopts(Socket, [{recbuf, 8192}, {sndbuf, 8192}]),

% Set a timeout for receiving data
ok = inet:setopts(Socket, [{recv_timeout, 5000}]),

% Set packet size for a TCP socket
ok = inet:setopts(Socket, [{packet, 4}]).
14. 분산
Erlang은 분산 컴퓨팅을 지원하도록 설계되었습니다. 이 장에서는 노드, 연결, 메시지 전달을 포함하여 Erlang 분산의 핵심 측면을 살펴보겠습니다.
14.1. 노드와 연결
Erlang에서 노드는 Erlang 런타임 시스템의 인스턴스입니다. 명세에 따르면 노드는 실제로는 이름이 부여된 실행 중인 ERTS 인스턴스입니다. 이름이 있는 인스턴스만 Erlang 분산을 통해 통신할 수 있기 때문입니다.
이 책에서는 다소 부정확하지만, 분산되지 않은 이름 없는 인스턴스도 노드라고 부르는 경우가 많습니다. 이러한 인스턴스도 예를 들어 http를 통하거나 TCP로 직접 다른 서브시스템과 통신할 수 있습니다.
실제 노드마다 고유한 이름이 있으며, 이 이름은 일반적으로 아톰 뒤에 '@' 기호와 호스트 이름이 붙는 형태로 구성됩니다. 예를 들면 node1@localhost입니다.
노드의 이름은 짧은 이름(short name) 또는 긴 이름(long name)일 수 있습니다. 짧은 이름은 node1처럼 아톰으로 구성되며 호스트 이름을 포함하지 않습니다. 짧은 이름은 모든 노드가 같은 호스트에서 실행될 때 사용됩니다. 반면 긴 이름은 node1@localhost처럼 아톰과 호스트 이름을 모두 포함합니다. 긴 이름은 노드가 여러 호스트에 분산되어 있을 때 사용됩니다. 짧은 이름을 사용하는 노드는 짧은 이름을 사용하는 다른 노드와만 통신할 수 있고, 긴 이름을 사용하는 노드는 긴 이름을 사용하는 노드와만 통신할 수 있다는 점에 유의해야 합니다. 따라서 분산 시스템의 모든 노드에서 이름 지정 방식을 일관되게 유지하는 것이 매우 중요합니다.
노드는 net_kernel:connect_node/1 함수를 사용하여 서로 연결을 맺을 수 있습니다. 노드의 이름은 이름(아톰)과 호스트 이름의 두 부분으로 구성됩니다. 형식은 name@hostname입니다.
이름 없이 노드를 시작하면 다른 노드에 연결할 수 없습니다:
happi@gdc12:~$ iex
Erlang/OTP 24 [erts-12.0.4] [source] [64-bit] [smp:12:12] [ds:12:12:10] [async-threads:1] [jit]

Interactive Elixir (1.12.2) - press Ctrl+C to exit (type h() ENTER for help)
iex(1)> Node.alive?
false
iex(2)> :net_kernel.connect_node(:foo@gdc12)
:ignored
iex(3)> Node.alive?
false
iex(4)>
이름을 지정하여 노드를 시작하면 다른 노드에 연결할 수 있습니다:
happi@gdc12:~$ iex --sname bar
Erlang/OTP 24 [erts-12.0.4] [source] [64-bit] [smp:12:12] [ds:12:12:10] [async-threads:1] [jit]

Interactive Elixir (1.12.2) - press Ctrl+C to exit (type h() ENTER for help)
iex(bar@gdc12)1> Node.alive?
true
iex(bar@gdc12)2> :net_kernel.connect_node(:foo@gdc12)
true
iex(bar@gdc12)3> Node.alive?
true
iex(bar@gdc12)4>
노드 이름을 직접 정하고 싶지 않다면 특수한 이름인 undefined로 노드를 시작할 수 있습니다. 그러면 다른 노드에 연결할 때 시스템이 노드의 이름을 정해 줍니다:
happi@gdc12:~$ iex --sname undefined
Erlang/OTP 24 [erts-12.0.4] [source] [64-bit] [smp:12:12] [ds:12:12:10] [async-threads:1] [jit]

Interactive Elixir (1.12.2) - press Ctrl+C to exit (type h() ENTER for help)
iex(1)> Node.alive?
false
iex(2)> :net_kernel.connect_node(:foo@gdc12)
true
iex(2YOVGWCSCSR8R@gdc12)3> Node.alive?
true
iex(2YOVGWCSCSR8R@gdc12)4>
name 또는 sname 플래그로 시스템을 시작하지 않았더라도 분산을 수동으로 시작할 수 있습니다:
Eshell V15.2.2 (press Ctrl+G to abort, type help(). for help)
1> node().
nonode@nohost
2> net_kernel:start([baz, shortnames]).
{ok,<0.92.0>}
(baz@gdc12)3> node().
baz@gdc12
노드는 같은 "쿠키"를 사용하고 있는 한 서로 연결할 수 있으며, 쿠키는 인가된 노드만 연결할 수 있도록 보장하는 보안 수단입니다. 쿠키는 단순한 아톰으로, 서로 연결할 수 있어야 하는 모든 노드에서 같은 값이어야 합니다. 쿠키가 일치하지 않으면 연결이 수립되지 않습니다.
Erlang 노드를 시작할 때 -setcookie 옵션으로 쿠키를 설정하거나, erlang:set_cookie/2 함수로 실행 중에 설정할 수 있습니다. 쿠키를 설정하지 않으면 Erlang 노드가 시작될 때 임의의 아톰이 기본 매직 쿠키로 할당되며, 다른 노드의 쿠키는 nocookie로 간주됩니다. 이 매직 쿠키는 노드 간의 기본적인 인증 메커니즘 역할을 합니다.
auth라고도 불리는 Erlang 네트워크 인증 서버는 먼저 사용자의 홈 디렉터리에서 .erlang.cookie라는 이름의 파일을 찾고, 이어서 filename:basedir(user_config, "erlang")으로 지정된 디렉터리에서 이 파일을 찾습니다.
이 두 파일이 모두 존재하지 않는 경우, auth가 먼저 나서서 사용자의 홈 디렉터리에 .erlang.cookie 파일을 생성합니다. 이 파일에는 사용자만 읽을 수 있는 읽기 전용 UNIX 권한이 설정됩니다. 이 파일의 내용은 무작위로 생성된 문자열입니다.
이어서 .erlang.cookie 파일의 내용으로부터 아톰 Cookie가 생성됩니다. 그런 다음 erlang:set_cookie(Cookie) 함수를 사용하여 로컬 노드의 쿠키를 이 아톰으로 설정합니다. 이를 통해 로컬 노드가 다른 모든 노드와 상호 작용할 때 사용할 기본 쿠키가 정해집니다.
이 프로세스는 분산 Erlang 시스템에서 노드들이 서로 통신할 때 기본적인 수준의 보안과 인증을 보장합니다.
연결이 수립되면 노드들은 서로 자유롭게 통신할 수 있습니다. 노드 간 연결은 투명합니다. 즉, 노드들이 연결되어 있다면 같은 노드에 있는 프로세스에 메시지를 보낼 때와 똑같은 방식으로 다른 노드에 있는 프로세스에도 메시지를 보낼 수 있습니다.
Erlang 분산 환경의 노드들은 기본적으로 모두 서로 연결되어 있습니다. 노드 N1이 다른 노드 N2에 연결하면, N1은 N2와 연결된 모든 노드의 목록을 받아 그 노드들 모두에 연결합니다. 연결은 양방향이므로 N2도 N1과 연결된 모든 노드에 연결합니다.
시스템을 시작할 때 명령줄 플래그 -connect_all false를 사용하면 이 동작을 끌 수 있습니다.
Erlang은 노드 간 SSL 연결도 지원합니다. 이는 노드 간 통신을 보호해야 할 때, 예를 들어 노드들이 신뢰할 수 없는 네트워크를 통해 통신하는 경우에 유용합니다.
노드 연결에 SSL을 사용하려면 ssl 애플리케이션과 inet_dist의 listen 및 connect 옵션을 설정해야 합니다. 이를 위해서는 SSL 인증서와 키를 준비하고, 노드 간 통신에 SSL을 사용하도록 Erlang 런타임 시스템을 설정해야 합니다.
SSL을 사용하면 암호화와 복호화에 따르는 오버헤드 때문에 성능에 영향을 줄 수 있다는 점을 기억하십시오. 따라서 SSL은 보안 통신의 이점이 성능 비용보다 클 때에만 신중하게 사용해야 합니다.
Erlang의 히든 노드(hidden node)는 노드 네트워크에 완전히 합류하지 않고도 분산 Erlang 시스템에서 연결을 생성하는 데 사용할 수 있는 특수한 유형의 노드입니다.
-hidden 옵션으로 노드를 히든 노드로 시작하면, 해당 노드는 다른 노드에서 nodes() 함수가 반환하는 노드 목록에 나타나지 않으며, 시스템 내의 다른 노드와 자동으로 연결을 맺지도 않습니다. 하지만 net_kernel:connect_node/1을 사용하여 개별 노드와 연결을 맺을 수는 있으며, 이러한 연결은 모든 기능을 온전히 갖춥니다. 즉, 메시지 전달, 프로세스 생성 및 기타 분산 작업에 사용할 수 있습니다.
히든 노드(hidden node)의 주요 사용 사례 중 하나는 네트워크의 나머지 부분과 격리된 연결을 만드는 것입니다. 예를 들어, 노드를 시스템의 모든 노드에 연결하지 않고 특정 노드 그룹에만 연결하고 싶을 수 있습니다. 이는 네트워크 트래픽을 관리하거나, 특정 작업을 격리하거나, 더 큰 분산 시스템 안에 서브네트워크를 만드는 데 유용할 수 있습니다.
히든 노드의 또 다른 활용 사례는 전체 노드 네트워크가 크고 동적이어서 각 노드가 다른 모든 노드와의 연결을 유지하는 것이 불가능하거나 바람직하지 않은 시스템입니다. 히든 노드를 사용하면 더 유연하고 확장 가능한 네트워크 토폴로지를 구성할 수 있습니다.
히든 노드는 보안 기능이 아니라는 점에 유의해야 합니다. 히든 노드는 nodes() 목록에 나타나지 않고 다른 노드에 자동으로 연결되지도 않지만, 무단 접근이나 도청을 막는 추가적인 보호 기능은 제공하지 않습니다. 분산 Erlang 시스템을 보호해야 한다면 쿠키 기반 인증과 SSL/TLS 암호화 같은 기능을 사용해야 합니다.
명령줄 플래그와 유용한 모듈 및 함수를 포함하여 Erlang 수준의 분산에 대한 전체 설명은 분산 Erlang에 관한 레퍼런스 매뉴얼을 읽으십시오.
이제 더 흥미로운 부분, 즉 이것이 BEAM에서 어떻게 동작하는지 살펴보겠습니다.
15. Erlang 분산의 작동 원리
Erlang은 노드 간 통신에 Erlang 분산 프로토콜이라고 하는 자체 프로토콜을 사용합니다. 이 프로토콜은 ERTS가 구현하며, 모든 노드 간 통신에 사용됩니다.
분산 프로토콜은 프로세스 메시지, 시스템 메시지, 제어 메시지를 비롯한 다양한 메시지 유형을 지원합니다. 프로세스 메시지는 Erlang 프로세스 간 통신에 사용되며, 시스템 메시지는 VM 내부의 여러 구성 요소 간 통신에 사용됩니다. 제어 메시지는 연결 수립 및 종료와 같이 분산 시스템의 상태를 관리하는 데 사용됩니다.
15.1. Erlang 포트 매퍼 데몬(EPMD)
Erlang 포트 매퍼 데몬(EPMD)은 Erlang 노드 간 연결을 수립하는 프로세스를 지원하는 작은 서버입니다. EPMD는 Erlang 분산 메커니즘의 핵심 요소입니다.
이름을 지정하여(-name 또는 -sname 옵션 사용) Erlang 노드를 시작하면, 실행 중인 EPMD 인스턴스가 없는 경우 노드가 EPMD 인스턴스를 자동으로 시작합니다. 이 작업은 노드 자체가 시작되기 전에 Erlang 런타임 시스템(ERTS)이 수행합니다.
EPMD 프로세스는 Erlang VM과 독립된 별도의 운영 체제 프로세스로 실행됩니다. 즉, EPMD를 시작한 Erlang 노드가 중지되더라도 EPMD는 계속 실행됩니다. 같은 호스트에서 여러 Erlang 노드가 실행 중이라면 이 노드들은 모두 같은 EPMD 인스턴스를 사용합니다. EPMD는 기본적으로 포트 4369에서 연결을 수신 대기합니다.
EPMD의 주된 역할은 노드 이름을 TCP/IP 포트 번호에 매핑하는 것입니다. Erlang 노드는 시작될 때 다른 노드에서 들어오는 연결을 받기 위해 수신 대기용 TCP/IP 포트를 엽니다. 그런 다음 자신의 이름과 포트 번호를 알려 EPMD에 자신을 등록합니다.
노드가 다른 노드와 연결을 맺으려고 할 때는 먼저 (원격 호스트의) EPMD에 접속하여 원격 노드의 이름에 연결된 포트 번호를 요청합니다. EPMD가 포트 번호로 응답하면, 로컬 노드는 원격 노드로 TCP/IP 연결을 열 수 있습니다.
EPMD의 소스 코드는 GitHub의 Erlang/OTP 저장소, 구체적으로는 erts/epmd/src 디렉터리에서 찾을 수 있습니다. 구현은 비교적 단순하며, 주요 로직은 하나의 C 파일(epmd_srv.c)에 담겨 있습니다.
EPMD 서버는 단순한 루프로 동작하며, 들어오는 연결을 기다리고 요청을 처리합니다. 요청을 받으면 이를 파싱한 뒤 노드 등록, 노드 등록 해제, 노드의 포트 번호 조회 등 알맞은 작업을 수행합니다.
15.2. Erlang 분산 프로토콜
EPMD와 Erlang 노드 간의 통신에는 단순한 바이너리 프로토콜이 사용됩니다. 메시지는 크기가 작고 형식이 고정되어 있으므로, 이 프로토콜은 구현하기 쉽고 사용하기에도 효율적입니다.
이 프로토콜은 ERTS 레퍼런스:분산 프로토콜에 자세히 설명되어 있습니다.
Erlang 분산 프로토콜은 서로 다른 Erlang 노드 간의 통신을 가능하게 하는 기반 프로토콜입니다. 이 프로토콜은 분산 Erlang 시스템의 요구에 맞추어 특별히 설계된 자체 프로토콜입니다.
노드가 다른 노드와 연결을 맺으려고 하면 핸드셰이크 프로세스를 시작합니다. 이 프로세스에서는 두 노드가 일련의 메시지를 주고받으며 통신 프로토콜 버전, 노드 이름, 분산 플래그와 같은 매개변수에 합의합니다.
핸드셰이크 프로세스는 시작 노드가 대상 노드에 SEND_NAME 메시지를 보내는 것으로 시작됩니다. 이 메시지에는 프로토콜 버전과 시작 노드의 이름이 담겨 있습니다.
대상 노드는 연결을 수락하면 ALIVE_ACK 메시지로, 연결을 거부하면 NACK 메시지로 응답합니다. ALIVE_ACK 메시지에는 노드 자신의 이름과 챌린지가 포함되며, 챌린지는 인증에 사용되는 난수입니다.
그런 다음 시작 노드는 CHALLENGE_REPLY 메시지로 응답해야 합니다. 이 메시지에는 챌린지와 공유 비밀(매직 쿠키)을 사용한 계산의 결과가 담겨 있습니다. 대상 노드는 이 결과를 검증하여 시작 노드를 인증합니다.
마지막으로 대상 노드는 CHALLENGE_ACK 메시지를 보내 핸드셰이크를 완료합니다. 이 시점에서 연결이 수립되며, 노드들은 메시지를 주고받기 시작할 수 있습니다.
Erlang 분산 프로토콜은 다음을 비롯한 여러 유형의 메시지를 지원합니다.
-
제어 메시지: 분산 시스템의 상태를 관리하는 데 사용됩니다. 여기에는 프로세스를 링크하고 링크 해제하는 메시지, 프로세스를 모니터링하고 모니터링 해제하는 메시지, 그리고
EXIT,KILL같은 시그널을 보내는 메시지가 포함됩니다. -
데이터 메시지: 프로세스 간에 데이터를 전송하는 데 사용됩니다. 여기에는 텀 데이터를 전송하는 메시지와 원격 프로시저 호출(RPC)을 수행하는 메시지가 포함됩니다.
-
시스템 메시지: 이는 Erlang VM의 서로 다른 부분 간의 통신에 사용됩니다. 여기에는 분산 컨트롤러와 포트 매퍼 데몬(EPMD)을 관리하기 위한 메시지가 포함됩니다.
15.3. 대체 분산
Erlang의 기본 분산 메커니즘만으로는 특정 시스템의 요구 사항을 모두 충족하지 못하는 상황이 있을 수 있습니다. 바로 이런 경우에 대체 분산이 필요합니다.
대체 분산 메커니즘을 사용하려는 이유로는 여러 가지가 있을 수 있습니다:
-
성능: 내장 분산 메커니즘은 통신에 TCP/IP를 사용하는데, 이는 특정 워크로드나 네트워크 구성에서는 가장 효율적인 선택이 아닐 수 있습니다. 대체 분산 메커니즘은 성능을 높이기 위해 다른 프로토콜이나 사용자 정의 데이터 형식을 사용할 수 있습니다.
-
보안: Erlang의 분산 메커니즘에는 인증을 위한 매직 쿠키 같은 기본적인 보안 기능이 포함되어 있지만, 일부 애플리케이션에서 요구하는 수준의 보안은 제공하지 못할 수 있습니다. 대체 분산 메커니즘에는 암호화나 접근 제어 같은 추가 보안 기능을 포함할 수 있습니다.
-
신뢰성 향상: Erlang의 분산 메커니즘은 장애 허용을 염두에 두고 설계되었으며 노드 장애와 네트워크 분할을 처리할 수 있습니다. 그럼에도 추가적인 신뢰성 기능이 필요한 상황이 있을 수 있습니다. 대체 분산 메커니즘은 네트워크 분할에 대처하는 더 정교한 전략을 제공하거나, 메시지 전달에 대해 더 강력한 보장을 제공하거나, 향상된 오류 감지 및 복구 메커니즘을 제공할 수 있습니다. 이러한 향상은 특정 상황에서만 필요한 것으로, 이미 견고한 Erlang의 신뢰성 기능을 보완하는 역할을 한다는 점에 유의해야 합니다.
-
상호 운용성: 서로 다른 통신 프로토콜을 사용하는 다른 시스템과 Erlang 시스템을 통합해야 하는 경우, 대체 분산 메커니즘이 필요한 상호 운용성을 제공할 수 있습니다. 이것이 아마도 가장 흔한 사용 사례일 것입니다. Erlang 메시지와 RPC를 사용하여 C나 Scala로 작성된 다른 프로그램과 통신할 수 있다는 점은 매우 강력한 기능이 될 수 있습니다.
Erlang에서 대체 분산을 구현하는 방법에는 여러 가지가 있습니다:
-
커스텀 분산 드라이버: 분산 프로토콜을 구현하는 커스텀 분산 드라이버를 C로 작성할 수 있습니다. 이를 통해 네트워크 프로토콜이나 데이터 형식과 같은 노드 간 통신의 저수준 세부 사항을 제어할 수 있습니다.
-
분산 콜백 모듈: 연결 수립과 종료, 메시지 송수신 같은 분산 관련 이벤트를 처리하는 콜백 모듈을 Erlang으로 작성할 수 있습니다. 이렇게 하면 분산 드라이버보다 더 높은 수준에서 사용자 정의 동작을 구현할 수 있습니다.
-
서드파티 라이브러리: Erlang에 대체 분산 메커니즘을 제공하는 서드파티 라이브러리가 있습니다. 이러한 라이브러리는 대개 분산 통신을 위한 고수준 API를 제공하여 저수준의 세부 사항을 추상화합니다.
Erlang에서 대체 분산을 구현하려면 다음과 같은 여러 단계를 거쳐야 합니다.
-
분산 코드 작성: 이 코드는 C로 작성한 분산 드라이버일 수도 있고, Erlang으로 작성한 콜백 모듈일 수도 있으며, 둘을 조합한 것일 수도 있습니다. 이 코드는 핸드셰이크 프로세스와 제어 메시지 및 데이터 메시지 처리를 포함하여 Erlang 분산 프로토콜을 구현해야 합니다.
-
Erlang VM 구성: 대체 분산 메커니즘을 사용하려면 VM을 그에 맞게 구성해야 합니다. 이 구성은 VM을 시작할 때 특정 명령줄 옵션을 전달하여 이루어집니다. 예를 들어 사용자 정의 분산 드라이버를 사용하려면
-proto_dist옵션 뒤에 드라이버 이름을 지정하여 전달합니다. -
분산 메커니즘 테스트: 분산 메커니즘을 구현하고 구성한 후에는 올바르게 작동하는지 확인하기 위해 테스트해야 합니다. 여기에는 연결 프로세스, 메시지 전달, 오류 처리를 비롯하여 분산 메커니즘의 다른 모든 기능을 테스트하는 작업이 포함됩니다.
Erlang 문서에는 대체 캐리어를 구현하는 방법에 관한 장이 있습니다.
또한 대체 노드 탐색을 구현하는 방법에 관한 장도 있습니다.
15.4. 분산 Erlang의 프로세스
이제 알고 있듯이, Erlang의 프로세스는 프로세스 식별자, 즉 PID로 식별됩니다. PID에는 프로세스가 실행 중인 노드에 대한 정보, 인덱스, 시리얼이 들어 있습니다. 인덱스는 프로세스 테이블에 있는 해당 프로세스를 가리키는 참조이며, 시리얼은 같은 인덱스를 가진 이전(죽은) 프로세스와 새(살아 있는) 프로세스를 구별하는 데 사용됩니다.
분산 Erlang에서 PID에는 해당 PID가 속한 노드에 대한 정보가 담겨 있습니다. 이는 분산 시스템에서의 메시지 전달에 중요합니다. PID로 메시지를 보낼 때 ERTS는 그 PID가 현재 노드의 로컬 PID인지, 아니면 원격 노드에 있는 프로세스에 속한 것인지 알아야 합니다.
Erlang 셸에서 PID를 출력하면 <node.index.serial> 형식으로 표시됩니다. 예를 들면 <0.10.0>과 같습니다. 여기서 노드 ID 0은 로컬 노드를 나타냅니다.
메시지가 한 노드에서 다른 노드로 전송될 때, 메시지에 포함된 모든 로컬 PID는 Erlang 런타임 시스템에 의해 원격 PID로 자동 변환됩니다. 이 변환은 관련된 프로세스에게 투명하게 이루어집니다. 프로세스의 관점에서는 단지 PID를 사용하여 메시지를 보내고 받을 뿐입니다.
이 변환에서는 PID에 있는 로컬 노드 식별자 0을 해당 노드의 실제 식별자로 바꿉니다. 고유 프로세스 번호는 그대로 유지됩니다. 이 작업은 term_to_binary/1이 수행합니다.
메시지를 수신하면, 수신 프로세스에 메시지를 전달하기 전에 메시지 안의 모든 원격 PID를 다시 로컬 PID로 변환합니다. 이 과정에서는 노드 식별자를 0으로 바꾸고 생성 번호를 제거합니다.
이처럼 PID가 자동으로 변환되므로 Erlang 프로세스는 분산 메커니즘의 세부 사항을 알 필요 없이 여러 노드에 걸쳐 투명하게 통신할 수 있습니다.
메시지가 PID로 전송되면 ERTS는 PID의 인덱스 부분을 사용하여 프로세스 테이블에서 해당 프로세스를 찾은 다음, 그 프로세스의 메시지 큐에 메시지를 추가합니다.
프로세스가 종료되면 프로세스 테이블의 해당 항목은 비어 있는 것으로 표시되고, PID의 시리얼 부분이 증가합니다. 이렇게 하면 새 프로세스가 생성되어 같은 인덱스를 재사용하더라도 이전과 다른 PID를 갖게 됩니다.
분산 Erlang에서는 PID를 처리하는 방식이 조금 더 복잡합니다. 원격 노드에 있는 PID로 메시지를 보내면, 로컬 ERTS는 메시지를 전달하기 위해 원격 노드의 ERTS와 통신해야 합니다. 이 통신에는 Erlang 분산 프로토콜을 사용합니다.
-
Erlang 노드 1이 예를 들어
spawn/4를 통해 spawn_request를 시작합니다. -
이 요청은 노드 1의 ERTS가 처리합니다.
-
그런 다음 ERTS는 분산 프로토콜(Distribution Protocol)을 통해 SPAWN_REQUEST 메시지를 보냅니다. OTP 23 이상에서는
{29, ReqId, From, GroupLeader, {Module, Function, Arity}, OptList}다음에ArgList가 이어집니다. -
이 메시지는 노드 2의 ERTS가 수신합니다.
-
그런 다음 노드 2의 ERTS가 Erlang 노드 2에서 spawn_request를 시작합니다.
-
노드 2가
Module:Function(ArgList)를 호출하는 새 프로세스를 생성합니다. -
노드 2의 ERTS는 분산 프로토콜을 통해 SPAWN_REPLY 메시지를 되돌려 보냅니다:
{31, ReqId, To, Flags, Result}. Flags 매개변수는 각 비트가 특정 플래그를 나타내는 바이너리 필드입니다. 이 플래그들은 비트 단위 OR 연산으로 결합됩니다. 현재 다음과 같은 플래그가 정의되어 있습니다:-
플래그 1: 이 플래그는 생성을 요청한 프로세스(To)와 새로 생성된 프로세스(Result) 사이에 링크가 설정된 경우에 설정됩니다. 이 링크는 새 프로세스가 존재하는 노드에서 설정됩니다.
-
플래그 2: 이 플래그는 요청을 보낸 프로세스(To)에서 새로 생성된 프로세스(Result)로 모니터가 설정된 경우에 설정됩니다. 이 모니터는 새 프로세스가 있는 노드에서 설정됩니다.
-
-
이 메시지는 노드 1의 ERTS가 수신합니다.
-
마지막으로, 노드 1의 ERTS가 호출자에게 PID를 반환합니다.
15.5. 분산 Erlang에서의 원격 프로시저 호출
원격 프로시저 호출(RPC)은 분산 Erlang의 핵심적인 부분입니다. RPC를 사용하면 한 노드의 프로세스가 다른 노드의 함수를 마치 로컬 함수 호출처럼 호출할 수 있습니다. 이제 RPC가 어떻게 구현되는지 더 자세히 살펴보겠습니다.
가장 기본적인 수준에서 Erlang의 RPC는 rpc:call/4 함수를 사용하여 수행됩니다. 이 함수는 네 개의 인수를 받습니다. 원격 노드의 이름, 호출할 함수가 들어 있는 모듈의 이름, 함수의 이름, 그리고 함수에 전달할 인수의 리스트입니다.
다음은 RPC의 예시입니다:
Result = rpc:call(Node, Module, Function, Args).이 함수가 호출되면 다음과 같은 단계가 진행됩니다.
-
호출하는 프로세스는 원격 노드에 있는
rex서버 프로세스로 메시지를 보냅니다. 이 메시지에는 함수 호출에 관한 세부 정보가 담겨 있습니다. -
원격 노드의
rex서버가 메시지를 받아 새 프로세스에서 지정된 함수를 호출합니다. -
함수는 원격 노드에서 끝까지 실행되며, 그 결과는 메시지로 호출하는 프로세스에 다시 전송됩니다.
-
rpc:call/4함수는 결과 메시지를 수신하여 호출자에게 결과를 반환합니다.
rex 서버는 모든 Erlang 노드에 기본으로 포함된 표준 구성 요소이며, 들어오는 RPC 요청을 처리하는 역할을 합니다. 이 이름은 "Remote EXecution"(원격 실행)의 약자입니다.
rex 서버는 RPC 요청을 받으면 해당 요청을 처리할 새 프로세스를 생성합니다. 이 프로세스는 요청된 함수를 호출하고 그 결과를 호출자에게 돌려보냅니다. 함수가 예외를 던지면 그 예외를 잡아 오류로 호출자에게 반환합니다.
RPC에 사용되는 메시지는 일반적인 Erlang 메시지이며, 전송에는 표준 Erlang 분산 프로토콜을 사용합니다. 따라서 RPC는 선택적 수신(selective receive)과 패턴 매칭 등 Erlang 메시지 전달 메커니즘의 모든 기능을 활용할 수 있습니다.
동기식 rpc:call/4 함수 외에도 Erlang은 비동기식 RPC 메커니즘도 제공합니다. 이는 rpc:cast/4 함수로 수행하며, 이 함수는 rpc:call/4와 비슷하게 동작하지만 결과를 기다리지 않습니다. 대신 원격 노드에 요청을 보내고 즉시 noreply를 반환합니다.
비동기 RPC는 호출자가 결과를 기다릴 필요가 없거나 호출된 함수가 의미 있는 결과를 반환하지 않는 상황에서 유용할 수 있습니다.
15.6. 대규모 시스템에서의 분산
시스템이 커질수록 노드 연결 수가 기하급수적으로 늘어날 수 있으며, 모든 노드가 모든 노드에 연결되는 기본 설정에서는 특히 그렇습니다. 이러한 증가는 네트워크 트래픽 급증으로 이어질 수 있으며, 시스템이 연결을 관리하고 성능을 유지하는 데 부담을 줄 수 있습니다.
분산 시스템에서는 데이터가 네트워크를 거쳐 이동해야 합니다. 데이터가 한 노드에서 다른 노드로 이동하는 데 걸리는 시간을 네트워크 지연 시간(network latency)이라고 하며, 이는 시스템 성능에 영향을 줄 수 있습니다. 노드가 지리적으로 분산되어 있을 때는 특히 그렇습니다.
Erlang의 비동기 메시지 전달 모델 덕분에 네트워크 지연 시간을 효과적으로 처리할 수 있지만, 프로세스는 메시지를 보낸 뒤 응답을 기다릴 필요가 없으므로 다른 작업을 계속 실행할 수 있습니다. 그럼에도 지리적으로 분산된 분산 시스템에서 Erlang 분산을 사용하는 것은 여전히 권장되지 않습니다. Erlang 분산은 데이터 센터 내부, 가급적이면 데이터 센터의 같은 랙 안에서 이루어지는 통신을 위해 설계되었습니다. 지리적으로 분산된 분산 시스템에는 다른 비동기 통신 패턴을 사용할 것을 권장합니다.
대규모 시스템에서 장애는 피할 수 없습니다. 노드가 크래시될 수 있고, 네트워크 연결이 끊어질 수 있으며, 데이터가 손상될 수 있습니다. 시스템은 큰 다운타임 없이 이러한 장애를 감지하고 복구할 수 있어야 합니다.
이 문제는 장애 감지 및 복구를 위한 내장 메커니즘으로 대응할 수 있습니다. 슈퍼비전 트리를 사용하면 시스템이 프로세스 장애를 감지하고 실패한 프로세스를 자동으로 재시작할 수 있습니다.
여러 노드에 걸쳐 데이터 일관성을 유지하는 것은 상당히 어려운 과제입니다. 한 노드에서 데이터가 갱신되면, 그 변경 사항을 해당 데이터의 사본을 가진 다른 모든 노드에 전파해야 합니다. 이 문제에 대처하는 한 가지 방법은 분산되어야 하는 상태를 아예 두지 않는 것입니다. 가능하다면 실제 상태는 데이터베이스처럼 한 곳에만 두십시오.
Erlang은 데이터 일관성을 관리하기 위한 여러 도구와 라이브러리를 제공하며, 그 예로 분산 데이터베이스 관리 시스템인 Mnesia가 있습니다. Mnesia는 트랜잭션을 지원하며 여러 노드에 걸쳐 데이터를 복제할 수 있습니다. 안타깝게도 네트워크 분할(net split)이나 노드 재시작 후에 Mnesia가 동기화를 처리하는 기본 방식은 비용이 다소 커서, 정말 작은 테이블이 아니라면 감당하기 어렵습니다. 이에 대해서는 Mnesia 장에서 더 자세히 다룹니다. 대부분의 경우 대규모 데이터 세트에는 성능이 좋은 전통적인 ACID SQL 데이터베이스를, 이벤트 처리에는 메시지 큐를 사용하는 것을 권장합니다.
15.7. 분산 포트
Erlang 분산은 노드 간 통신 버퍼(inter-node communication buffer)라고 불리는 버퍼를 사용합니다. 이 버퍼의 크기는 기본적으로 128 MB입니다. 이는 대부분의 워크로드에 적절한 기본값입니다. 그러나 일부 환경에서는 노드 간 트래픽이 매우 많아 버퍼 용량의 한계에 도달할 수 있습니다. 기본값이 적합하지 않은 또 다른 워크로드로는 버퍼에 들어가지 않을 만큼 매우 큰 메시지(예를 들어 수백 메가바이트 단위)를 전송하는 경우가 있습니다.
이러한 경우 +zdbbl VM 플래그를 사용하여 버퍼 크기를 늘릴 수 있습니다. 값의 단위는 킬로바이트입니다:
erl +zdbbl 192000버퍼가 최대 용량 부근에 머물러 있으면 노드는 분산 포트가 바쁘다는(busy_dist_port) 경고를 로그에 남깁니다:
2023-05-28 23:10:11.032 [warning] <0.431.0> busy_dist_port <0.324.0>버퍼 크기를 늘리면 처리량을 높이거나 지연 시간을 줄이는 데, 또는 둘 다에 도움이 될 수 있습니다. 이와 같은 성능 문제를 찾아내 해결하려면 Erlang 시스템을 정기적으로 모니터링하는 것이 중요합니다. etop 또는 :observer 애플리케이션과 같은 도구는 Erlang 노드의 부하와 성능에 대한 유용한 통찰을 제공할 수 있습니다. 이에 대해서는 모니터링 장에서 더 자세히 다룹니다.
사용 중인 분산 포트(busy dist port)의 근본 원인을 찾기 위한 다른 해결 방법은 다음과 같습니다:
-
네트워크 문제: 네트워크가 느리거나 불안정하면 메시지 전송이 지연될 수 있습니다. 네트워크 성능을 점검하고, 필요한 경우 네트워크 인프라 업그레이드를 검토하십시오.
-
높은 메시지 양: Erlang 노드가 많은 메시지를 보내고 있다면 분산 포트에 과부하가 걸릴 수 있습니다. 전송되는 메시지 수를 줄이도록 코드를 최적화하는 것을 고려하십시오. 여기에는 메시지를 묶어서 일괄 전송하거나 메시지 전송 빈도를 줄이는 방법이 포함될 수 있습니다. 서로 통신해야 하는 프로세스들이 같은 노드에 있도록 하는 방법을 시도해 볼 수도 있습니다.
-
장시간 실행 작업: Erlang 프로세스가 제어권을 양보하지 않고 장시간 실행되는 작업을 수행하고 있다면 분산 포트를 막고 있을 수 있습니다. 다른 프로세스가 메시지를 보낼 수 있도록 프로세스가 주기적으로 제어권을 양보하게 하십시오. 시스템에 잘못 동작하는 NIF가 있지 않은 한, 이는 보통 문제가 되지 않습니다.
-
Erlang VM 튜닝: 부하를 더 잘 처리하도록 Erlang VM을 튜닝할 수도 있습니다. 여기에는 스케줄러 수를 늘리거나(
+S옵션 사용), IO 폴링 스레드를 늘리거나(+A옵션 사용), 그 밖의 VM 설정을 조정하는 방법이 포함될 수 있습니다.
16. 다른 언어와의 연동 및 BEAM과 ERTS 확장
16.1. 소개
C, C++, Rust 또는 어셈블러와 연동하면 BEAM의 기능을 확장할 수 있습니다. 이 장에서는 대부분의 예제에 C를 사용하지만, 여기서 설명하는 방법은 거의 모든 다른 프로그래밍 언어와 연동하는 데에도 사용할 수 있습니다. 이 장에서는 Rust와 Java 예제도 몇 가지 제시합니다. 이 장의 나머지 부분에서는 대부분의 경우 C를 다른 언어로 바꾸어 읽어도 되지만, 간결함을 위해 C만 사용하겠습니다.
C 코드를 통합하면 개발자는 Erlang 애플리케이션의 성능을 향상시킬 수 있으며, 특히 시스템 수준 자원에 직접 접근해야 하는 계산 집약적인 작업에서 그 효과가 큽니다. 또한 C와 연동하면 Erlang 애플리케이션이 하드웨어 및 시스템 수준 자원과 직접 상호작용할 수 있습니다. 이 기능은 메모리 조작, 특수 하드웨어 접근, 실시간 데이터 처리와 같은 저수준 작업이 필요한 애플리케이션에 매우 중요합니다. C를 Erlang과 통합할 때의 또 다른 장점은 기존 C 라이브러리와 코드베이스를 활용할 수 있다는 점입니다. C로 작성된 강력한 라이브러리와 도구가 많이 있으며, Erlang 개발자는 이들과 연동하여 해당 기능을 Erlang으로 다시 구현하지 않고도 애플리케이션에 통합할 수 있습니다.
또한 실행을 정밀하게 제어해야 할 때는 C와 연동하는 것이 도움이 될 수 있습니다. Erlang의 가상 머신은 뛰어난 동시성 관리 기능을 제공하지만, 일부 실시간 애플리케이션에는 C로 더 잘 구현할 수 있는 보다 결정론적인 동작이 필요할 수 있습니다. C 코드를 통합하면 개발자는 특정 요구 사항에 맞게 애플리케이션의 성능과 동작을 세밀하게 조정할 수 있습니다.
ERTS와 BEAM은 C로 작성되었기 때문에 C 코드로 이들을 확장할 수도 있습니다.
이전 장들에서는 소켓이나 포트를 통해 다른 애플리케이션 및 서비스와 안전하게 연동하는 방법을 살펴보았습니다. 이 장에서는 저수준 코드와 더 직접적으로 연동하는 방법을 살펴보겠습니다. 이는 곧 그만큼 덜 안전하게 사용한다는 의미이기도 합니다.
공식 문서에는 상호 운용성에 관한 튜토리얼이 있습니다. Interoperability Tutorial을 참고하십시오.
16.1.1. C 코드와 안전하게 연동하는 방법
BEAM 가상 머신이 불안정해질 위험을 최소화하는 여러 메커니즘을 사용하면 C 코드를 Erlang과 안전하게 연동할 수 있습니다. 주요 방법은 다음과 같습니다.
os:cmd
os:cmd 함수를 사용하면 Erlang 프로세스가 셸 명령을 실행하고 그 출력을 받아올 수 있습니다. 이 방법은 명령을 별도의 OS 프로세스에서 실행하여 BEAM VM으로부터 격리하므로 안전합니다. os:cmd를 사용하면 개발자는 Erlang 런타임 환경에 직접 영향을 주지 않고도 외부 C 프로그램과 상호 작용할 수 있습니다. 다만 오버헤드가 따르며, C 프로그램은 명령줄에서 실행할 수 있고 결과를 표준 출력으로 반환하는 독립 실행형 프로그램이어야 합니다.
예시:
// time.c
#include <stdio.h>
#include <time.h>
void get_system_time()
{
time_t rawtime;
struct tm *timeinfo;
time(&rawtime);
timeinfo = localtime(&rawtime);
printf("Current Date and Time: %s", asctime(timeinfo));
}
int main()
{
get_system_time();
return 0;
}> os:cmd("./time").
"Current Date and Time: Mon May 20 04:46:37 2024\n"'open_port' 'spawn_executable'
특히 인자가 사용자 입력에 기반하는 경우, 프로그램과 상호 작용하는 더욱 안전한 방법은 spawn_executable 인자와 함께 open_port를 사용하는 것입니다. 이 방법은 운영 체제 셸을 거치지 않고 인자를 실행 파일에 직접 전달하므로 인자 주입 위험을 줄입니다. 이렇게 직접 전달하면 셸이 인자를 해석하지 않으므로, 사용자 입력에 포함된 특수 문자나 명령으로 인해 발생할 수 있는 주입 공격을 피할 수 있습니다.
1> Port = open_port({spawn_executable, "./time"}, [{args, []}, exit_status]).
#Port<0.7>
2> receive {Port, {data, R}} -> R after 1000 -> timeout end.
"Current Date and Time: Mon May 20 13:59:32 2024\n"표준 입력에서 읽고 표준 출력에 쓰는 프로그램으로 포트를 생성하여 그 포트와 데이터를 주고받을 수도 있습니다.
예시:
Port = open_port({spawn, "./system_time"}, [binary]),
port_command(Port, <<"get_time\n">>).포트 드라이버를 사용하여 외부 프로그램에 연결하는 방법에 대한 자세한 내용은 Chapter 13를 참조하십시오.
소켓
소켓은 Erlang과 외부 C 프로그램 간의 통신을 가능하게 하는 간단한 방법을 제공합니다. TCP 또는 UDP 소켓을 사용하면 C 애플리케이션은 네트워크를 통해 Erlang 프로세스와 데이터를 주고받을 수 있으며, 두 시스템은 서로 격리된 상태로 유지됩니다. 이 방법은 분산 시스템에 특히 유용하며 비동기 통신을 가능하게 합니다.
가장 일반적이고 쉬운 방법은 HTTP 또는 HTTPS 위에서 REST 방식의 인터페이스를 사용하는 것입니다. 클라이언트와 서버 구현 모두를 위한 Erlang 라이브러리가 있으며, HTTP 클라이언트용 httpc와 HTTP 서버용 cowboy가 그 예입니다. 이 방식을 사용하면 C 애플리케이션이 Erlang 프로세스가 호출할 수 있는 API를 노출할 수 있으므로, 잘 정의된 프로토콜을 통한 상호작용이 쉬워집니다.
다음 단계는 순수 소켓 통신을 사용하는 것입니다. 이 방식은 HTTP/HTTPS보다 효율적일 수 있지만, 프로토콜을 직접 고안하거나 다른 저수준 프로토콜을 사용해야 합니다. 이 방법을 사용하면 데이터 교환 형식을 직접 정의할 수 있으며, 상위 수준 프로토콜에 수반되는 오버헤드를 줄여 성능을 최적화할 수 있습니다.
소켓의 동작 방식에 대한 자세한 내용은 Chapter 13 장을 참조하십시오.
16.2. 링크드인 드라이버
Erlang의 링크드인 드라이버를 사용하면 C 코드를 Erlang 런타임 시스템에 직접 통합할 수 있어, 고성능 연산을 수행하고 외부 자원과 원활하게 상호 작용할 수 있습니다.
링크드인 드라이버는 동일한 프로세스 공간 내에서 동작하여 프로세스 간 통신의 오버헤드를 없애므로, 외부 포트에 비해 Erlang과 C 코드 간에 더 빠른 통신을 제공합니다.
하드웨어 인터페이싱이나 실시간 데이터 처리처럼 타이밍 제약이 엄격한 애플리케이션에서는 링크드인 드라이버가 필요한 응답성을 제공합니다.
하지만 링크드인 드라이버는 메모리에 직접 접근하고 프로그래밍 오류가 생길 가능성도 있어 Erlang VM을 불안정하게 만들 위험이 더 큽니다.
16.2.1. 링크드인 드라이버 구현 방법
Erlang에서 링크드인 드라이버를 구현하는 방법을 세 가지 수준에서 살펴봅시다. 먼저 무엇을 해야 하는지 추상적으로 살펴보고, 다음으로 일반적인 의사 코드를 살펴본 뒤, 마지막으로 완전한 예제를 살펴보겠습니다.
Erlang에서 링크드인 드라이버를 구현하려면 다음 단계를 따르십시오.
1단계. 다음을 처리하는 드라이버의 C 코드를 작성하십시오.
-
드라이버 초기화
-
콜백 함수에 대한 포인터를 담은
erl_drv_entry구조체를 정의하십시오. -
DRIVER_INIT매크로를 사용하여 드라이버를 등록하십시오.
-
-
비동기 연산 구현하기
-
시작, 정지, 출력 작업에 대한 드라이버 콜백을 처리하십시오.
-
driver_select와 같은 함수를 사용하여 I/O 이벤트를 관리하십시오.
-
-
리소스 할당과 해제 관리하기
-
드라이버별 데이터를 담을 구조체를 정의하십시오.
-
드라이버를 시작할 때 리소스를 할당하고, 중지할 때 해당 리소스를 해제하십시오.
-
2단계. Erlang과 통합하기:
-
erl_ddll:load_driver/2를 사용하여 드라이버를 로드하십시오. -
Erlang에서 드라이버와 통신할 포트를 생성하십시오.
위에서 설명한 단계들을 좀 더 자세히 다루면서 링크드인 드라이버의 의사 코드를 살펴봅시다.
1단계. 드라이버의 C 코드를 작성합니다:
-
드라이버 초기화:
-
erl_drv_entry구조체 정의: 이 구조체에는 Erlang 런타임 시스템이 호출할 콜백 함수를 가리키는 포인터가 들어 있습니다. -
드라이버 등록:
DRIVER_INIT매크로를 구현하여 드라이버를 초기화하고 Erlang 런타임에 등록하십시오.
-
static ErlDrvEntry example_driver_entry = {
NULL, // init
example_drv_start, // start
example_drv_stop, // stop
example_drv_output, // output
NULL, // ready_input
NULL, // ready_output
"example_drv", // driver_name
NULL, // finish
NULL, // handle
NULL, // control
NULL, // timeout
NULL, // outputv
NULL, // ready_async
NULL, // flush
NULL, // call
NULL, // event
ERL_DRV_EXTENDED_MARKER, // extended_marker
ERL_DRV_EXTENDED_MAJOR_VERSION, // major_version
ERL_DRV_EXTENDED_MINOR_VERSION, // minor_version
0, // driver_flags
NULL, // handle2
NULL, // process_exit
NULL // stop_select
};
DRIVER_INIT(example_drv) {
return &example_driver_entry;
}-
비동기 작업:
-
드라이버 콜백 처리: 드라이버 동작을 관리하려면
example_drv_start,example_drv_stop,example_drv_output같은 필요한 콜백 함수를 구현하십시오. -
I/O 이벤트 관리:
driver_select와 같은 함수를 활용하여 비동기 I/O 작업을 효율적으로 처리하십시오.
-
static ErlDrvData example_drv_start(ErlDrvPort port, char *command) {
example_data* d = (example_data*)driver_alloc(sizeof(example_data));
d->port = port;
return (ErlDrvData)d;
}
static void example_drv_stop(ErlDrvData handle) {
driver_free((char*)handle);
}
static void example_drv_output(ErlDrvData handle, char *buff, ErlDrvSizeT bufflen) {
example_data* d = (example_data*)handle;
// Process the input and produce output
driver_output(d->port, output_data, output_len);
}-
리소스 관리:
-
할당과 해제: 메모리 누수를 방지하려면 드라이버 시작 시 리소스를 할당하고 드라이버 중지 시 이를 해제하여 메모리 관리를 올바르게 수행하십시오.
-
typedef struct {
ErlDrvPort port;
// Additional driver-specific data
} example_data;2단계. Erlang과의 통합:
-
드라이버 로드: 드라이버가 포함된 공유 라이브러리를 로드하려면
erl_ddll:load_driver/2를 사용하십시오. -
포트 열기: 드라이버와 통신하려면
{spawn, DriverName}튜플과 함께open_port/2를 사용하여 Erlang에서 포트를 생성하십시오.
start(SharedLib) ->
case erl_ddll:load_driver(".", SharedLib) of
ok -> ok;
{error, already_loaded} -> ok;
_ -> exit({error, could_not_load_driver})
end,
Port = open_port({spawn, SharedLib}, []),
loop(Port).구현 예제: 이제 정수를 두 배로 만드는 링크드인 드라이버의 전체 예제를 살펴보겠습니다.
1단계. C 드라이버를 작성합니다:
#include "erl_driver.h"
#include <stdlib.h>
#include <stdio.h>
#include <string.h>
typedef struct {
ErlDrvPort port;
} double_data;
// Start function: initialize driver state
static ErlDrvData double_drv_start(ErlDrvPort port, char *command) {
double_data* d = (double_data*)driver_alloc(sizeof(double_data));
d->port = port;
return (ErlDrvData)d;
}
// Stop function: clean up resources
static void double_drv_stop(ErlDrvData handle) {
driver_free((char*)handle);
}
// Output function: process data sent from Erlang
static void double_drv_output(ErlDrvData handle, char *buff, ErlDrvSizeT bufflen) {
double_data* d = (double_data*)handle;
// Convert input buffer to an integer
int input = atoi(buff);
// Perform the operation (double the input value)
int result = input * 2;
// Convert the result back to a string
char result_str[32];
snprintf(result_str, sizeof(result_str), "%d", result);
// Send the result back to Erlang
driver_output(d->port, result_str, strlen(result_str));
}
// Define the driver entry struct
static ErlDrvEntry double_driver_entry = {
NULL, // init
double_drv_start, // start
double_drv_stop, // stop
double_drv_output, // output
NULL, // ready_input
NULL, // ready_output
"double_drv", // driver_name
NULL, // finish
NULL, // handle
NULL, // control
NULL, // timeout
NULL, // outputv
NULL, // ready_async
NULL, // flush
NULL, // call
NULL, // event
ERL_DRV_EXTENDED_MARKER, // extended marker
ERL_DRV_EXTENDED_MAJOR_VERSION, // major version
ERL_DRV_EXTENDED_MINOR_VERSION, // minor version
0, // driver flags
NULL, // handle2
NULL, // process_exit
NULL // stop_select
};
// Driver initialization macro
DRIVER_INIT(double_drv) {
return &double_driver_entry;
}2단계. Erlang 모듈을 작성합니다:
-module(double).
-export([start/0, stop/0, double/1]).
start() ->
SharedLib = "double_drv",
case erl_ddll:load_driver(".", SharedLib) of
ok -> ok;
{error, already_loaded} -> ok;
_ -> exit({error, could_not_load_driver})
end,
register(double_server, spawn(fun() -> init(SharedLib) end)).
init(SharedLib) ->
Port = open_port({spawn, SharedLib}, []),
loop(Port).
loop(Port) ->
receive
{double, Caller, N} ->
Port ! {self(), {command, integer_to_list(N)}},
receive
{Port, {data, Result}} ->
Caller ! {double_result, list_to_integer(Result)}
end,
loop(Port);
stop ->
Port ! {self(), close},
receive
{Port, closed} -> exit(normal)
end
end.
double(N) ->
double_server ! {double, self(), N},
receive
{double_result, Result} -> Result
end.
stop() ->
double_server ! stop.double_drv_output 함수는 Erlang 런타임에서 드라이버로 전송된 데이터를 처리하는 역할을 합니다. 이 함수는 먼저 atoi를 사용하여 입력 문자열을 정수로 변환하고, 값을 두 배로 만드는 데 필요한 연산을 수행한 다음, snprintf를 사용하여 결과를 다시 문자열로 포맷합니다. 마지막으로 driver_output 함수를 사용하여 결과를 Erlang 런타임으로 다시 전송하며, 이를 통해 Erlang과 네이티브 코드 간의 원활한 통신이 가능해집니다.
double_driver_entry 구조체는 드라이버의 중심 정의 역할을 하며, Erlang 런타임과 드라이버의 핵심 기능을 연결합니다. 이 구조체에는 start, stop, output 같은 콜백 함수에 대한 포인터가 들어 있으며, 이 함수들은 드라이버의 생명 주기와 상호 작용의 여러 측면을 처리합니다. 또한 driver_name 필드는 Erlang에서 드라이버를 로드할 때 사용하는 식별자를 지정합니다. 통합을 마무리하기 위해 DRIVER_INIT 매크로는 double_driver_entry 구조체에 대한 포인터를 반환하여 드라이버를 Erlang 런타임에 등록하며, 이를 통해 런타임은 드라이버를 인식하고 효과적으로 관리할 수 있습니다.
링크드인 드라이버를 테스트하려면 먼저 C 코드를 공유 라이브러리로 컴파일하십시오:
gcc -o double_drv.so -fPIC -shared double_drv.c -I /path/to/erlang/erts/include이 책의 devcontainer에서 코드를 실행하는 경우:
cd /code/c_chapter
gcc -o double_drv.so -fPIC -shared -I /usr/local/lib/erlang/usr/include/ double_drv.cErlang에서 드라이버를 로드하십시오:
Erlang 셸을 시작하십시오:
erl드라이버를 로드하십시오:
1> c(double).
{ok,double}
2> double:start().
true기능 호출하기:
3> double:double(21).
42드라이버를 중지합니다:
4> double:stop().
stop
5>16.3. 내장 함수(Built-In Functions, BIF)
내장 함수(BIF)는 BEAM 가상 머신에 통합되어 있는, 미리 정의된 네이티브 함수의 집합입니다. BIF는 큰 수(bignum) 산술 연산, 프로세스 관리, 리스트와 튜플 같은 데이터 타입 처리 등 Erlang의 몇 가지 기본 연산을 구현합니다. BIF는 C로 구현되어 있습니다.
BEAM 명령어, BIF, 연산자, 라이브러리 함수의 차이를 명확히 이해해 두는 것이 좋습니다.
BEAM 명령어는 BEAM 가상 머신이 실행하는 명령어입니다. BEAM 명령어의 코드는 보통 작게 유지되며, 이후의 Erlang 버전에서는 JIT 로더가 이를 인라인할 수 있습니다. (자세한 내용은 JIT 장에서 다룹니다.)
BIF는 C로 구현되어 있으며 BEAM 가상 머신의 일부입니다. BIF는 대개 BEAM 명령어 하나에 비해 상당히 큰 bignum '+' 같은 연산자이거나, lists:reverse/1처럼 성능상의 이유로 C로 구현된 라이브러리 함수입니다. 일부 BIF는 순수하게 Erlang만으로는 구현하기 어려운 필수 저수준 기능을 제공합니다. 프로세스 간에 메시지를 보내는 데 사용하는 erlang:send/2가 그 예입니다.
연산자는 라이브러리 함수에 매핑되는 구문상의 언어 구성 요소입니다. 예를 들어 연산자 ``는 컴파일러에 의해 ``erlang:/2에 매핑됩니다. 이 함수들은 다시 복잡도에 따라 BEAM 명령어나 BIF로 구현될 수 있습니다.
라이브러리 함수는 lists:length/1과 같이 Erlang 언어의 일부인 기본 Erlang 함수입니다. 이러한 함수는 BEAM 명령어나 BIF로 구현될 수도 있고, Erlang으로 구현될 수도 있습니다.
BIF는 C로 작성되어 BEAM 내에서 성능에 맞게 최적화되어 있으므로 효율적입니다. BIF의 단점은 오래 실행되는 BIF가 BEAM 스케줄러를 블로킹하여 시스템 응답성에 영향을 줄 수 있다는 점입니다. 또한 BIF는 런타임 시스템 내에 고정되어 있으므로 확장성이 제한적입니다.
대부분의 Erlang 사용자는 BIF를 직접 작성할 일이 없겠지만, BIF가 무엇이며 어떻게 동작하는지 알아 두면 좋습니다. 또한 EEP(Erlang Enhancement Proposal)를 작성하고 있다면 새로운 기능을 구현하기 위해 BIF를 작성해야 할 수도 있습니다.
다음 절에서는 BIF를 구현하는 방법의 세부 사항 몇 가지를 살펴보겠습니다.
16.3.1. 구현 단계
-
BIF 만들기:
-
메모리 안전성과 프로세스 안전성을 위해 BEAM의 내부 API를 준수하여 C로 함수를 작성하십시오.
-
함수의 목적에 맞는 스레드 안전하고 효율적인 알고리즘을 구현하십시오.
-
해당 함수를 BEAM 소스 코드에 추가하고 런타임 시스템과 함께 컴파일하십시오.
-
함수의 시간 복잡도에 비례하여 BIF가 사용해야 할 리덕션 수를 계산하십시오.
-
함수 실행에 시간이 오래 걸릴 수 있다면 양보(yield)할 수 있는 기능을 추가하는 것을 고려하십시오.
-
-
성능 고려 사항:
-
BIF 안에서는 실행 시간이 긴 작업을 피하십시오.
-
시스템 안정성을 유지하려면 메모리 안전성을 보장하고 Erlang 텀을 올바르게 처리하십시오.
-
16.3.2. 구현 예시
어떤 수의 팩토리얼을 계산하는 간단한 BIF를 구현한다고 가정해 보십시오. 이 BIF는 다음과 같이 동작합니다:
-
입력 인수를 파싱하여 유효한지 확인합니다.
-
C에서 계산을 효율적으로 수행합니다.
-
결과를 Erlang 환경으로 반환합니다.
ERTS에서 BIF가 정의된 코드를 찾아보십시오: https://github.com/erlang/otp/blob/master/erts/emulator/beam/bif.c 또는 이 경우에는 https://github.com/erlang/otp/blob/master/erts/emulator/beam/erl_math.c 에 있을 수도 있습니다.
BIF에는 다음과 같이 정의된 특별한 시그니처가 있습니다:
BIF_RETTYPE [NAME]_[ARITY](BIF_ALIST_[ARITY])이름에는 모듈 이름과 함수 이름이 밑줄로 구분되어 들어 있다는 점에 유의하십시오. 애리티(arity)는 함수가 받는 인자의 개수입니다. BIF_ALIST_X 매크로는 인자를 정의하는 데 사용됩니다. BIF_RETTYPE 매크로는 함수의 반환 타입을 정의하는 데 사용됩니다.
코드 조각:
BIF_RETTYPE math_factorial_1(BIF_ALIST_1)
{
/* Calculate factorial = n!
for n >= 0
*/
int i, n, reds;
long factorial = 1;
Eterm result;
/* Check the argument and return an error if it is not a positive integer.
When defining a BIF with BIF_ALIST_X the arguments are named
BIF_ARG_1, BIF_ARG_2 etc.
To signal ann error use BIF_ERROR(BIF_P, BADARG);
The macro BIF_P is a pointer to the process struct (PCB) of the process
that called the BIF, containing all the information about the process,
such as heap pointers, stack pointers, registers etc.
*/
if (is_not_small(BIF_ARG_1) || (n = signed_val(BIF_ARG_1)) < 0)
{
BIF_ERROR(BIF_P, BADARG);
}
/* Calculate the factorial */
for (i = 1; i <= n; ++i) factorial *= i;
/* Convert the result to an Erlang term */
result = erts_make_integer(factorial, BIF_P);
/* Calculate reductions relative to the number of iterations of the calculation loop.*/
reds = n / 1000 + 1;
/* Return the result and a number of reductions.
The BIF_RET2 macro is used to return the result and the number of reductions.
The first argument is the result and the second is the number of reductions.
*/
BIF_RET2(result, reds);
}이 간단한 예제는 큰 수를 제대로 처리하지 못한다는 점에 유의하십시오. factorial(66)은 64비트 정수('long')에서 오버플로를 일으킵니다. 실제 구현에서는 bignum 라이브러리를 사용해야 합니다. 그 방법은 다음 절에서 보여 드리겠습니다.
BIF를 bif.tab 파일(https://github.com/erlang/otp/blob/master/erts/emulator/beam/bif.tab)의 BIF 목록에 추가하십시오.
bif math:factorial/1BIF를 런타임의 나머지 부분에서도 사용할 수 있게 하려면 헤더를 bif.h 등에 추가하는 것을 잊지 마십시오.
그런 다음 Erlang 모듈 math.erl(https://github.com/erlang/otp/blob/master/lib/stdlib/src/math.erl)에 스텁을 추가합니다:
-doc "The factorial of `X`.".
-doc(#{since => <<"OTP 29.0">>}).
-spec factorial(X) -> integer() when
X :: pos_integer().
factorial(_) ->
erlang:nif_error(undef).함수를 export하는 것을 잊지 마십시오.
이제 BEAM을 다시 컴파일하고 Erlang에서 새 BIF를 실행할 수 있을 것입니다.
1> math:factorial(7).
5040커널 모듈에 기능을 추가하려면 erl_prim_loader.c 파일에서 사전 로드된 모듈을 처리해야 합니다. 자세한 내용은 Chapter 9를 참조하십시오.
머신의 작은 정수가 처리할 수 있는 범위보다 더 큰 수로 시도해 보면 잘못된 결과가 나옵니다. 이제 bignum을 사용하는 더 복잡한 예제로 넘어갑시다.
BIF_RETTYPE math_factorial_1(BIF_ALIST_1)
{
/* Calculate factorial = n! for n >= 0 */
Sint64 i, n, reds;
Uint64 factorial = 1;
Eterm result;
Eterm *hp;
Eterm big_factorial;
ErtsDigit *temp_digits_a;
ErtsDigit *temp_digits_b;
ErtsDigit *src;
ErtsDigit *dest;
ErtsDigit *temp;
dsize_t temp_size;
dsize_t curr_size;
dsize_t new_size;
if (is_not_integer(BIF_ARG_1) || (!term_to_Sint64(BIF_ARG_1, &n)) || n < 0)
{
BIF_ERROR(BIF_P, BADARG);
}
/* We do not want to use heap space for intermediate results since we are
going to do a lot of them. So we use a temporary buffer.
We create two buffers, one to keep (n-1)! and one to keep n!.
*/
/* Initial allocation of buffers, this will be large enough for most n,
that is up to ~ 50.000. Then we will start increasing the buffer. */
temp_size = 2 * (n + 1);
temp_digits_a = (ErtsDigit *)erts_alloc(ERTS_ALC_T_TMP, temp_size * sizeof(ErtsDigit));
temp_digits_b = (ErtsDigit *)erts_alloc(ERTS_ALC_T_TMP, temp_size * sizeof(ErtsDigit));
src = temp_digits_a;
dest = temp_digits_b;
for (i = 1; i <= n; ++i)
{
/* We want to avoid heap allocation for small numbers.
These we do on the C stack and just return a small_int. */
if (!IS_USMALL(0, factorial * i))
{
// Initial conversion to bignum in our temp buffer
hp = (Eterm *)src;
big_factorial = uint_to_big(factorial, hp);
curr_size = BIG_SIZE(big_val(big_factorial));
for (; i <= n; ++i)
{
new_size = curr_size + 1;
if (new_size > temp_size)
{
dsize_t alloc_size = new_size * 2;
src = (ErtsDigit *)erts_realloc(ERTS_ALC_T_TMP, src, alloc_size * sizeof(ErtsDigit));
dest = (ErtsDigit *)erts_realloc(ERTS_ALC_T_TMP, dest, alloc_size * sizeof(ErtsDigit));
temp_size = alloc_size;
}
big_factorial = big_times_small(big_factorial, i, (Eterm *)dest);
temp = src;
src = dest;
dest = temp;
}
// We are done.
// Only now allocate on process heap and copy the final result
hp = HAlloc(BIF_P, BIG_SIZE(big_val(big_factorial)) + 1);
sys_memcpy(hp, big_val(big_factorial), (BIG_SIZE(big_val big_factorial)) + 1) * sizeof(Eterm));
result = make_big(hp);
erts_free(ERTS_ALC_T_TMP, temp_digits_a);
erts_free(ERTS_ALC_T_TMP, temp_digits_b);
goto done;
}
factorial *= i;
}
result = make_small(factorial);
done:
reds = n / 1000 + 1;
BIF_RET2(result, reds);
}이제 1000! 같은 아주 큰 팩토리얼도 계산할 수 있습니다:
1> math:factorial(1000).
402387260077093773543702433923003985719374864210714632543799910429938512398629020592044208486969404800479988610197196058631666872994808558901323829669944590997424504087073759918823627727188732519779505950995276120874975462497043601418278094646496291056393887437886487337119181045825783647849977012476632889835955735432513185323958463075557409114262417474349347553428646576611667797396668820291207379143853719588249808126867838374559731746136085379534524221586593201928090878297308431392844403281231558611036976801357304216168747609675871348312025478589320767169132448426236131412508780208000261683151027341827977704784635868170164365024153691398281264810213092761244896359928705114964975419909342221566832572080821333186116811553615836546984046708975602900950537616475847728421889679646244945160765353408198901385442487984959953319101723355556602139450399736280750137837615307127761926849034352625200015888535147331611702103968175921510907788019393178114194545257223865541461062892187960223838971476088506276862967146674697562911234082439208160153780889893964518263243671616762179168909779911903754031274622289988005195444414282012187361745992642956581746628302955570299024324153181617210465832036786906117260158783520751516284225540265170483304226143974286933061690897968482590125458327168226458066526769958652682272807075781391858178889652208164348344825993266043367660176999612831860788386150279465955131156552036093988180612138558600301435694527224206344631797460594682573103790084024432438465657245014402821885252470935190620929023136493273497565513958720559654228749774011413346962715422845862377387538230483865688976461927383814900140767310446640259899490222221765904339901886018566526485061799702356193897017860040811889729918311021171229845901641921068884387121855646124960798722908519296819372388642614839657382291123125024186649353143970137428531926649875337218940694281434118520158014123344828015051399694290153483077644569099073152433278288269864602789864321139083506217095002597389863554277196742822248757586765752344220207573630569498825087968928162753848863396909959826280956121450994871701244516461260379029309120889086942028510640182154399457156805941872748998094254742173582401063677404595741785160829230135358081840096996372524230560855903700624271243416909004153690105933983835777939410970027753472000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000000심지어 100000!도 계산할 수 있지만, 시간이 꽤 걸립니다. BEAM 스케줄러를 블록하지 않으려면 틈틈이 양보(yield)해야 합니다.
저장할 상태와 돌아갈 함수를 인자로 BIF_TRAP1을 호출하면 이렇게 할 수 있습니다. 이 경우에는 math_factorial_trap_1 함수로 돌아가야 합니다.
저장하려는 상태와 돌아갈 함수를 담을 구조체를 math_factorial_trap_export에 정의해야 합니다. 또한 이 export 구조체를 초기화해야 합니다. 이 작업은 math_factorial_trap_init 함수에서 erts_init_trap_export를 호출하여 수행합니다. 그런 다음 erl_init.c의 erl_init 함수에 math_factorial_trap_init 호출을 추가해야 합니다. 또한 새 아톰 am_math_factorial_trap을 atom.names에 추가해야 합니다.
실행을 양보(yield)할 때는 현재 i, 현재 factorial, 원래의 n을 담은 튜플에 상태를 저장합니다. 따라서 트랩 함수의 인자는 이 값들을 담은 튜플입니다. 원래 BIF인 math_factorial_1에서 이 튜플을 만들고 math_factorial_trap_1을 호출합니다.
이제 yield에서 돌아왔을 때 이미 bignum을 가지고 있을 수 있으므로, 이 경우를 처리하도록 코드 구조를 약간 변경합니다.
반복자를 확인하여 1000번 반복할 때마다 상태를 저장하고 양보(yield)합니다. 또한 빅넘(bignum)을 만났을 때도 상태를 저장하고 양보합니다.
static Export math_factorial_trap_export;
static BIF_RETTYPE math_factorial_trap_1(BIF_ALIST_1)
{
Sint64 n, i;
Uint64 factorial;
Eterm big_factorial = THE_NON_VALUE;
ErtsDigit *temp_digits_a = NULL;
ErtsDigit *temp_digits_b = NULL;
ErtsDigit *src;
ErtsDigit *dest;
ErtsDigit *temp;
dsize_t temp_size;
dsize_t curr_size;
dsize_t new_size;
dsize_t big_size;
Eterm result;
Eterm *hp;
Eterm *big_hp;
Eterm *tp = tuple_val(BIF_ARG_1);
Eterm state;
// Extract current state
i = signed_val(tp[1]); // Current i
n = signed_val(tp[3]); // Original n
temp_size = (n * 4);
temp_digits_a = (ErtsDigit *)erts_alloc(ERTS_ALC_T_TMP, temp_size * sizeof(ErtsDigit));
temp_digits_b = (ErtsDigit *)erts_alloc(ERTS_ALC_T_TMP, temp_size * sizeof(ErtsDigit));
src = temp_digits_a;
dest = temp_digits_b;
// Handle both small and bignum factorial cases
if (is_small(tp[2]))
{
factorial = unsigned_val(tp[2]);
}
else
{
// We're already in bignum territory, skip the small number loop
big_factorial = tp[2];
goto bignum_loop;
}
for (; i <= n; ++i)
{
if (!IS_USMALL(0, factorial * i))
{
// Initial conversion to bignum in our temp buffer
big_factorial = uint_to_big(factorial, (Eterm *)src);
goto bignum_loop;
}
factorial *= i;
}
if (temp_digits_a)
erts_free(ERTS_ALC_T_TMP, temp_digits_a);
if (temp_digits_b)
erts_free(ERTS_ALC_T_TMP, temp_digits_b);
BIF_RET(make_small(factorial));
bignum_loop:
// Continue multiplying using bignums
for (; i <= n; ++i)
{
curr_size = BIG_SIZE(big_val(big_factorial));
new_size = curr_size + 1;
if (new_size > temp_size)
{
dsize_t alloc_size = new_size * 2;
src = (ErtsDigit *)erts_realloc(ERTS_ALC_T_TMP, src,
alloc_size * sizeof(ErtsDigit));
dest = (ErtsDigit *)erts_realloc(ERTS_ALC_T_TMP, dest,
alloc_size * sizeof(ErtsDigit));
temp_size = alloc_size;
}
big_factorial = big_times_small(big_factorial, i, (Eterm *)dest);
if ((i % 1000) == 0)
{
// Increment i so we don't get stuck in a loop. with i % 1000 == 0.
// Save state: {(i+1), i!, n} and yield.
// Store the tuple with the state on the heap
big_size = BIG_SIZE(big_val(big_factorial));
hp = HAlloc(BIF_P, 4 + big_size + 1);
big_hp = hp + 4;
sys_memcpy(big_hp, big_val(big_factorial), (big_size + 1) * sizeof(Eterm));
state = TUPLE3(hp, make_small(i + 1), make_big(big_hp), tp[3]);
// Free the temporary buffers
erts_free(ERTS_ALC_T_TMP, temp_digits_a);
erts_free(ERTS_ALC_T_TMP, temp_digits_b);
// Yield giving the state to the trap function
BIF_TRAP1(&math_factorial_trap_export, BIF_P, state);
}
temp = src;
src = dest;
dest = temp;
}
hp = HAlloc(BIF_P, BIG_SIZE(big_val(big_factorial)) + 1);
sys_memcpy(hp, big_val(big_factorial),
(BIG_SIZE(big_val(big_factorial)) + 1) * sizeof(Eterm));
result = make_big(hp);
erts_free(ERTS_ALC_T_TMP, temp_digits_a);
erts_free(ERTS_ALC_T_TMP, temp_digits_b);
BIF_RET(result);
}
BIF_RETTYPE math_factorial_1(BIF_ALIST_1)
{
Sint64 n;
Eterm *hp;
Eterm state;
Eterm args[1];
if (is_not_integer(BIF_ARG_1) || (!term_to_Sint64(BIF_ARG_1, &n)) || n < 0)
{
BIF_ERROR(BIF_P, BADARG);
}
// Create initial state
hp = HAlloc(BIF_P, 4);
state = TUPLE3(hp, make_small(1), make_small(1), BIF_ARG_1); // {i, factorial, n}
// Call the continuation function with initial state
args[0] = state;
return math_factorial_trap_1(BIF_P, args, A__I);
}
void erts_init_math_factorial(void)
{
erts_init_trap_export(&math_factorial_trap_export,
am_erts_internal, am_math_factorial_trap, 1,
&math_factorial_trap_1);
return;
}이제 BEAM 스케줄러를 블로킹하지 않고도 매우 큰 팩토리얼을 처리할 수 있습니다.
16.3.3. 어느 고요한 밤: term_to_binary와 실행을 양보하지 않는 BIF 이야기
시스템의 모든 것이 완벽하게 순조로이 돌아가는 듯 보이던, 좀처럼 드문 고요한 밤이었습니다. 그런데 그때, 아무런 예고도 없이 상상조차 못 한 일이 벌어졌습니다. 시스템이 다운된 것입니다.
사태가 수습된 뒤 조사를 통해 특이한 일련의 경위가 밝혀졌습니다. 작업과 휴면 사이의 균형을 매끄럽게 맞추도록 설계된 BEAM 스케줄러들이 작업량이 줄어들자 지나치게 서둘러 종료되었던 것입니다. 단 하나의 스케줄러만 활성 상태로 남아 시스템의 모든 작업을 처리하고 있었습니다.
공교롭게도 이 외로운 스케줄러는 로깅을 위해 4MB 크기의 텀을 바이너리로 변환하는 작업을 맡게 되었습니다. 겉보기에는 평범한 이 연산은 내장 함수(BIF)인 term_to_binary 함수를 호출했습니다. 이 함수는 작업량을 감당할 수 있는 단위로 나누지 않고 끝날 때까지 모든 작업을 한 번에 수행한 뒤, 리덕션을 20만 사용했다고 보고했습니다.
이처럼 제어권을 양보하지 않는 특성이 치명적인 결함으로 드러났습니다. 하나뿐인 스케줄러가 완전히 점유되어 다른 작업을 처리하지도, 시스템의 요구에 응답하지도 못하게 되었습니다. 늘 경계를 늦추지 않는 Erlang의 HEART 메커니즘이 응답 없음을 감지하고, 노드를 더 이상 살릴 수 없다고 판단했습니다. 그리고 냉혹할 만큼 효율적으로 노드를 종료했습니다.
문제 해결하기
해결책 1: 스케줄러를 살아 있게 유지하기
첫 번째 단계는 활동이 적은 기간에도 스케줄러가 깨어 있는 상태를 유지하도록 하는 것이었습니다. 2013년 6월에 도입된 이 수정은 Erlang의 시작 플래그를 조정하는 방식이었습니다:
-
+sfwi 50: 스케줄러의 응답성을 유지하도록 스케줄러 강제 깨우기(forced wakeup) 간격을 조정했습니다. -
+scl false: 스케줄러 압축을 막아 작업 부하가 고르게 분산된 상태를 유지했습니다. -
+sub true: 시스템 전반에 걸쳐 사용률이 고르게 분산되도록 했습니다.
이러한 조정은 스케줄러에 새로운 활력을 불어넣어, 활동이 뜸한 시기에도 흔들리지 않도록 만들었습니다.
스케줄러 설정을 조정하는 방법에 대한 자세한 내용은 Chapter 10을 참조하십시오.
수정 2: term_to_binary 다시 작성하기
두 번째이자 더 복잡한 수정은 term_to_binary 함수 자체를 대상으로 했습니다. 개발자들은 이 BIF가 주기적으로 양보(yield)하도록 다시 작성하여 작업량을 여러 리덕션에 걸쳐 분산시켰습니다. 이 방식 덕분에 해당 함수는 스케줄러와 원활하게 협력하게 되었고, 시스템 자원을 오랫동안 독점하는 일을 피할 수 있었습니다.
같은 시기에 구현된 수정 사항은 이 함수에 청크 단위 처리를 도입했습니다. 또한 이 수정 사항은 BIF 내부의 가비지 컬렉션 개선에도 의존했습니다. https://github.com/erlang/otp/commit/47d6fd3ccf35a4d921591dd0a9b5e69b9804b5b0 을 참조하십시오.
16.3.4. 내장 함수(BIF) 요약
대부분의 개발자는 BIF의 코드를 직접 작성하기는커녕 읽어 볼 일조차 없을 것입니다. 그러나 BIF가 무엇이며 어떻게 동작하는지 알아 두는 것은 좋은 일입니다. 또한 일부 표준 라이브러리의 Erlang 코드를 살펴보게 된다면, 그 안에 실제 코드는 없고 스텁만 들어 있는 이유를 이제는 알 수 있을 것입니다.
16.4. NIF
Erlang 개발자에게 조금 더 흔하고 더 안전한 작업은 NIF(네이티브 구현 함수)를 작성하는 것입니다. NIF는 C나 C++(또는 다른 언어)로 구현되어 Erlang 코드에서 호출되는 함수입니다. NIF를 사용하면 성능이 중요한 연산을 수행하거나 외부 라이브러리와 연동하기 위해 네이티브 코드로 Erlang을 동적으로 확장할 수 있습니다. 그래도 잘못 사용하면 VM이 불안정해질 수 있으므로 신중하게 사용해야 합니다.
NIF를 사용하는 방법은 현재 Interoperability Tutorial의 NIF section에 잘 문서화되어 있지만, 여기서는 기본적인 내용을 살펴보겠습니다.
16.4.1. 간단한 NIF 구현하기
빠른 정수 덧셈을 위한 간단한 C 기반 NIF입니다.
C 코드 (nif_add.c):
#include "erl_nif.h"
static ERL_NIF_TERM nif_add(ErlNifEnv* env, int argc, const ERL_NIF_TERM argv[])
{
int a, b;
if (!enif_get_int(env, argv[0], &a) || !enif_get_int(env, argv[1], &b)) {
return enif_make_badarg(env);
}
return enif_make_int(env, a + b);
}
static ErlNifFunc nif_funcs[] = {
{"add", 2, nif_add}
};
ERL_NIF_INIT(my_nif, nif_funcs, NULL, NULL, NULL, NULL);Erlang 래퍼 모듈 (my_nif.erl):
-module(my_nif).
-export([add/2, load/0]).
-on_load(load/0).
load() ->
erlang:load_nif("./my_nif", 0).
add(_A, _B) ->
erlang:nif_error("NIF not loaded").NIF 컴파일 및 실행:
gcc -shared -fPIC -o my_nif.so nif_add.c -I /usr/lib/erlang/usr/include다음으로 Erlang에서는 다음과 같습니다:
> my_nif:add(10, 20).
30BEAM 스케줄러가 차단되지 않도록 NIF 실행 시간을 짧게 유지하십시오. NIF는 성능이 중요한 연산과 외부 라이브러리와의 연동에 사용하십시오. 오래 실행되는 연산에는 더티 스케줄러를 사용하십시오. 크래시를 방지하려면 항상 입력을 검증하십시오.
II: Running ERTS
17. 운영 및 유지보수
런타임 시스템 설계의 바탕이 되는 지도 원칙 가운데 하나는 버그를 어느 정도 피할 수 없다는 것입니다. 엄청난 노력을 기울여 버그 없는 애플리케이션을 만들어 내더라도, 세상이나 사용자가 변하고 애플리케이션을 "수정"해야 한다는 사실을 곧 알게 될 것입니다.
Erlang 런타임 시스템은 변경을 용이하게 하고 버그의 영향을 최소화하도록 설계되었습니다.
버그의 영향은 구획화를 통해 최소화됩니다. 이는 각 데이터 구조가 분리되어 있고 불변인 가장 낮은 수준에서부터, 실행 중인 시스템이 별도의 노드로 나뉘는 가장 높은 수준에 이르기까지 이루어집니다. 코드를 쉽게 업그레이드할 수 있게 하고, 실행 중인 시스템과 쉽게 상호작용하며 이를 살펴볼 수 있게 함으로써 변경을 용이하게 합니다.
17.1. 시스템에 연결하기
실행 중인 시스템을 모니터링하고 유지 관리하는 다양한 방법을 살펴보겠습니다. 사용할 수 있는 도구와 기법은 많지만, 가장 기본적인 도구인 셸과 셸을 노드에 연결하는 기능을 잊어서는 안 됩니다.
두 노드를 연결하려면 두 노드가 쿠키라는 비밀 암호를 공유하거나 알고 있어야 합니다. 두 노드를 같은 머신에서 실행하고 같은 사용자가 두 노드를 시작하는 한, 두 노드는 자동으로 쿠키를 공유합니다($HOME/.erlang.cookie 파일에 있습니다).
두 개의 노드, 즉 Erlang 노드 하나와 Elixir 노드 하나를 시작하면 이것이 실제로 어떻게 동작하는지 확인할 수 있습니다. 먼저 node1이라는 이름의 Erlang 노드를 시작합니다. 이 노드에는 연결된 노드가 없음을 확인할 수 있습니다:
$ erl -sname node1
Erlang/OTP 19 [erts-8.1] [source-0567896] [64-bit] [smp:4:4]
[async-threads:10] [kernel-poll:false]
Eshell V8.1 (abort with ^G)
(node1@GDC08)1> nodes().
[]
(node1@GDC08)2>그런 다음 다른 터미널 창에서 node2라는 이름의 Elixir 노드를 시작합니다. (Elixir에서는 명령줄 플래그를 대시 두 개로 지정해야 한다는 점에 유의하십시오!)
$ iex --sname node2
Erlang/OTP 19 [erts-8.1] [source-0567896] [64-bit] [smp:4:4]
[async-threads:10] [kernel-poll:false]
Interactive Elixir (1.4.0) - press Ctrl+C to exit (type h() ENTER for help)
iex(node2@GDC08)1>Elixir에서는 Node.connect(name) 명령을 실행하여 노드를 연결할 수 있습니다. Erlang에서는 net_kernel:connect_node(Name)으로 연결합니다. 노드 연결은 양방향이므로 두 노드 중 한쪽에서만 명령을 실행하면 됩니다.
iex(node2@GDC08)1> Node.connect :node1@GDC08
true
iex(node2@GDC08)2> Node.list
[:node1@GDC08]
iex(node2@GDC08)3>이제 Erlang 쪽에서도 두 노드가 서로를 알고 있음을 확인할 수 있습니다. (nodes()의 결과에는 로컬 노드 자신이 포함되지 않는다는 점에 유의하십시오.)
(node1@GDC08)2> nodes().
[node2@GDC08]
(node1@GDC08)3>분산 환경에서는 모든 노드가 쿠키를 알고 있거나 공유하도록 해야 하므로 이 작업이 다소 더 복잡합니다. 이는 세 가지 방법으로 할 수 있습니다. 특정 노드와 통신할 때 사용할 쿠키를 설정할 수도 있고, 시작할 때 -set_cookie 매개변수로 모든 시스템에 같은 쿠키를 설정할 수도 있으며, 각 머신에서 시스템을 실행하는 사용자의 홈 디렉터리에 .erlang.cookie 파일을 복사할 수도 있습니다.
마지막 대안인, 시스템 내 모든 머신의 쿠키 파일에 동일한 쿠키를 두는 방법은 로컬 OS 셸에서 노드에 쉽게 접속할 수 있게 해 주므로 대개 가장 좋은 선택입니다. VPN이나 ssh를 통해 머신에 안전하게 로그인할 수 있는 방법만 마련해 두면 됩니다.
별도의 머신에 노드를 하나 생성하고, 현재 실행 중인 노드들에 연결해 봅시다. 세 번째 터미널 창을 열어 로컬 쿠키 파일의 내용을 확인한 다음, 다른 머신으로 ssh 접속합니다:
happi@GDC08:~$ cat ~/.erlang.cookie
pepparkaka
happi@GDC08:~$ ssh gds01
happi@gds01:~$원격 머신에서 동일한 쿠키 암호를 사용하도록 지정하여 노드를 실행하면 기존 노드에 연결할 수 있습니다. (Erlang이 이 노드들의 위치를 알 수 있도록 node1@GDC08처럼 지정해야 한다는 점에 유의하십시오.)
happi@gds01:~$ erl -sname node3 -setcookie pepparkaka
Erlang/OTP 18 [erts-7.3] [source-d2a6d81] [64-bit] [smp:8:8]
[async-threads:10] [kernel-poll:false]
Eshell V7.3 (abort with ^G)
(node3@gds01)1> net_kernel:connect('node1@GDC08').
true
(node3@gds01)2> nodes().
[node1@GDC08,node2@GDC08]
(node3@gds01)3>노드 2와 명시적으로 통신하지 않았는데도, 다음에서 볼 수 있듯이 노드 2는 노드 3이 합류했다는 사실을 자동으로 통보받았습니다:
iex(node2@GDC08)3> Node.list
[:node1@GDC08,:node3@gds01]
iex(node2@GDC08)4>마찬가지로 노드 중 하나를 종료하면 나머지 노드들이 자동으로 자신의 목록에서 해당 노드를 제거합니다. 그 노드가 다시 시작되면 간단히 네트워크에 다시 합류할 수 있습니다.
|
서로 다른 쿠키로 인해 발생할 수 있는 문제
Erlang 분산은 기본적으로 완전 연결 네트워크를 구성한다는 점에 유의하십시오. 즉, 네트워크의 모든 노드가 다른 모든 노드와 연결됩니다. 각 노드가 서로 다른 쿠키를 가지고 있다면, 노드들을 연결하기 전에 각 노드에 다른 모든 노드의 쿠키를 알려 주어야 합니다. 시스템이 완전 연결 네트워크를 만들지 않게 하려면 |
이제 노드끼리, 심지어 서로 다른 머신에 있는 노드끼리도 연결하는 방법을 알았으니, 셸을 노드에 연결하는 방법을 살펴볼 수 있습니다.
17.2. 셸
Elixir 셸과 Erlang 셸은 컴퓨터의 셸이나 터미널 창과 거의 같은 방식으로 동작하지만, 런타임 시스템에 직접 연결된 터미널 창을 제공한다는 점이 다릅니다. 이를 통해 런타임에 완전히 접근할 수 있는 CLI라는 매우 강력한 도구를 얻게 됩니다. 이는 운영과 유지보수에 아주 유용합니다.
이 절에서는 셸을 통해 노드에 접속하는 여러 가지 방법과, 셸 기능 중 잘 알려지지 않았을 수도 있지만 더 강력한 기능 몇 가지를 살펴보겠습니다.
17.2.1. 셸 설정하기
Elixir 셸과 Erlang 셸 모두 자주 사용하는 함수에 대한 단축키를 제공하도록 설정할 수 있습니다.
Elixir 셸은 .iex.exs 파일을 먼저 로컬 디렉터리에서 찾고, 그다음 사용자의 홈 디렉터리에서 찾습니다. 이 파일의 코드는 셸 프로세스에서 실행되며, 모든 변수 바인딩을 셸에서 사용할 수 있습니다.
이 파일에서 구문 색상 및 히스토리 크기와 같은 항목을 설정할 수 있습니다. 전체 문서는 hexdocs를 참고하십시오.
셸 컨텍스트에서 임의의 코드를 실행할 수도 있습니다.
Erlang 런타임 시스템은 시작할 때 가장 먼저 Erlang 설정 파일에 있는 코드를 해석합니다. 이 파일의 기본 위치는 사용자 홈 디렉터리의 ~/.erlang입니다. 이 파일에는 어떤 Erlang 표현식이든 넣을 수 있으며, 각 표현식은 마침표와 줄바꿈으로 끝나야 합니다.
이 파일은 주로 Erlang 모듈을 로드할 수 있도록 코드 경로에 디렉터리를 추가하는 데 사용됩니다:
code:add_path("/home/happi/hacks/ebin").
또한 사용자 정의 함수로 Erlang 셸을 확장하는 데 사용할 수 있는 사용자 지정 user_default 모듈(.beam 파일)을 로드하는 데에도 사용됩니다:
code:load_abs("/home/happi/.config/erlang/user_default").
위의 경로를 여러분의 시스템에 맞게 바꾸기만 하면 됩니다. load_abs 명령에는 .beam 확장자를 포함하지 마십시오.
셸에서 모듈 이름을 지정하지 않고 함수를 호출하면(예: foo(bar)) 먼저 user_default 모듈(존재하는 경우)에서 함수를 찾고, 그다음 shell_default 모듈(stdlib의 일부)에서 찾습니다. ls(), help() 같은 셸 명령이 바로 이런 방식으로 구현되어 있으며, 직접 명령을 추가하거나 기존 명령을 재정의해도 됩니다.
17.2.2. 셸을 노드에 연결하기
프로덕션 시스템을 운영할 때에는 run_erl을 통해 노드를 데몬 모드로 시작하는 것이 좋습니다. 이 작업을 수행하는 방법과 배포 및 프로덕션 운영에 관한 몇 가지 모범 사례는 [xxx](#ch.live)에서 살펴보겠습니다. 다행히도 시스템을 데몬 모드로 시작하여 기본 셸이 없는 경우에도 해당 시스템에 다른 셸을 연결할 수 있습니다. 실제로 이렇게 하는 방법은 여러 가지가 있습니다. 이러한 방법 대부분은 일반적인 분산 메커니즘에 의존하므로, 앞 절에서 설명한 것처럼 두 머신에 동일한 Erlang 쿠키가 설정되어 있어야 합니다.
원격 셸(Remsh)
Erlang 노드에 연결하는 가장 쉽고 아마도 가장 일반적인 방법은 원격 셸을 통해 시스템 노드에 연결되는 이름 있는 노드를 시작하는 것입니다. 이는 erl 명령줄 플래그 -remsh NodeName으로 수행합니다. 다른 노드에 연결하려면 이름 있는 노드를 실행하고 있어야 한다는 점에 유의하십시오. -remsh를 사용할 때 -name 또는 -sname 플래그를 지정하지 않으면 Erlang이 새 노드의 이름을 무작위로 생성합니다. 어느 경우든 셸이 원격 노드에 바로 연결되므로 일반적으로 이 이름이 출력되는 것을 보지는 못합니다. 예를 들면 다음과 같습니다.
$ erl -sname node4 -remsh node2
Erlang/OTP 18 [erts-7.3] [source-d2a6d81] [64-bit] [smp:8:8]
[async-threads:10] [kernel-poll:false]
Eshell V7.3 (abort with ^G)
(node2@GDC08)1>또는 Elixir를 사용하면 다음과 같습니다:
$ iex --sname node4 --remsh node2
Erlang/OTP 19 [erts-8.1] [source-0567896] [64-bit] [smp:4:4]
[async-threads:10] [kernel-poll:false]
Interactive Elixir (1.4.0) - press Ctrl+C to exit (type h() ENTER for help)
iex(node2@GDC08)1>Erlang 노드는 일반적으로 Elixir 노드(위의 node2)에서 셸을 시작할 수 있지만, Erlang 노드(node1)에서 Elixir 셸을 시작하는 것은 동작하지 않는다는 점에 유의하십시오. Erlang 노드에는 필요한 Elixir 라이브러리가 없기 때문입니다:
$ iex --remsh node1
Could not start IEx CLI due to reason: nofile
$|
기본 보안 없음
일반적인 Erlang 분산에도, 원격 셸 구현에도 보안 기능은 내장되어 있지 않습니다. 시스템 노드를 인터넷에 노출된 상태로 두어서는 안 되며, 개발 머신의 노드에서 운영 중인 노드로 접속하는 것도 피해야 합니다. 일반적으로는 VPN 터널이나 배스천 호스트를 경유하는 ssh를 통해 운영 환경에 접근하며, 이렇게 하면 운영 노드 중 하나가 실행 중인 머신에 로그인할 수 있습니다. 그런 다음 그 머신에서 |
원격 셸을 시작할 때 실제로는 두 개의 노드가 관여한다는 점을 이해하는 것이 중요합니다. 하나는 앞의 예제에서 node4라는 이름을 가진 로컬 노드이고, 다른 하나는 원격 노드 node2입니다. 이 노드들은 같은 머신에 있을 수도 있고 서로 다른 머신에 있을 수도 있습니다. 로컬 노드는 항상 remsh와 함께 iex 또는 erl 명령을 입력한 머신에서 실행됩니다. 로컬 노드에는 터미널 창과 상호작용하는 tty 프로그램을 실행하는 프로세스가 있습니다. 실제 셸 프로세스는 원격 노드에서 실행됩니다. 이는 무엇보다도 실행하려는 셸(IEx 또는 Erlang 셸)의 코드가 원격 노드에 존재해야 한다는 것을 의미합니다. 또한 코드가 원격 노드에서 실행된다는 것을 의미합니다. 그리고 셸의 모든 기본 설정을 원격 머신의 설정에서 가져온다는 것도 의미합니다.
GDC08 머신의 홈 디렉터리에 다음과 같은 .erlang 파일이 있다고 가정해 봅시다.
code:load_abs("/home/happi/.config/erlang/user_default").
io:format("ERTS is starting in ~s~n",[os:cmd("pwd")]).
그리고 user_default.erl 파일은 다음과 같습니다:
-module(user_default). -export([tt/0]). tt() -> test.
그런 다음 ~/example/dir1, ~/example/dir2 두 디렉터리를 만들고, 각 디렉터리에 서로 다른 .iex.exs 파일을 하나씩 넣습니다. 이 파일들은 프롬프트에 각각 <d1>이나 <d2>가 표시되도록 설정합니다.
# File 1
IO.puts "iEx starting in "
pwd()
IO.puts "iEx starting on "
IO.puts Node.self
IEx.configure(
colors: [enabled: true],
alive_prompt: [
"\e[G",
"(%node)",
"%prefix",
"<d1>",
] |> IO.ANSI.format |> IO.chardata_to_string
)
# File 2
IO.puts "iEx starting in "
pwd()
IO.puts "iEx starting on "
IO.puts Node.self
IEx.configure(
colors: [enabled: true],
alive_prompt: [
"\e[G",
"(%node)",
"%prefix",
"<d2>",
] |> IO.ANSI.format |> IO.chardata_to_string
)
이제 이 디렉터리들에서 서로 다른 노드 네 개를 시작하면 셸 설정이 어떻게 로드되는지 확인할 수 있습니다. 먼저 dir1의 node1입니다:
GDC08:~/example/dir1$ iex --sname node1
Erlang/OTP 19 [erts-8.1] [source-0567896] [64-bit]
[smp:4:4] [async-threads:10] [kernel-poll:false]
ERTS is starting in /home/happi/example/dir1
on [node1@GDC08]
Interactive Elixir (1.4.0) - press Ctrl+C to exit (type h() ENTER for help)
iEx starting in
/home/happi/example/dir1
iEx starting on
node1@GDC08
(node1@GDC08)iex<d1>다음은 dir2의 node2입니다:
GDC08:~/example/dir2$ iex --sname node2
Erlang/OTP 19 [erts-8.1] [source-0567896] [64-bit]
[smp:4:4] [async-threads:10] [kernel-poll:false]
ERTS is starting in /home/happi/example/dir2
on [node2@GDC08]
Interactive Elixir (1.4.0) - press Ctrl+C to exit (type h() ENTER for help)
iEx starting in
/home/happi/example/dir2
iEx starting on
node2@GDC08
(node2@GDC08)iex<d2>다음으로 dir1에서 node3 노드를 실행하되, 이번에는 node2에 원격 셸을 띄웁니다:
GDC08:~/example/dir1$ iex --sname node3 --remsh node2@GDC08
Erlang/OTP 19 [erts-8.1] [source-0567896] [64-bit] [smp:4:4]
[async-threads:10] [kernel-poll:false]
ERTS is starting in /home/happi/example/dir1
on [node3@GDC08]
Interactive Elixir (1.4.0) - press Ctrl+C to exit (type h() ENTER for help)
iEx starting in
/home/happi/example/dir2
iEx starting on
node2@GDC08
(node2@GDC08)iex<d2>보시다시피 원격 셸은 dir2에서 시작되었습니다. dir2가 node2의 디렉터리이기 때문입니다. 마지막으로 Erlang 노드를 시작하고, user_default 모듈에 정의한 함수를 셸에서 호출할 수 있는지 확인합니다:
GDC08:~/example/dir2$ erl -sname node4
Erlang/OTP 19 [erts-8.1] [source-0567896] [64-bit] [smp:4:4]
[async-threads:10] [kernel-poll:false]
ERTS is starting in /home/happi/example/dir2
on [node4@GDC08]
Eshell V8.1 (abort with ^G)
(node4@GDC08)1> tt().
test
(node4@GDC08)2>위의 예시에서 볼 수 있듯이, 이러한 셸 설정은 셸을 실행하고 있는 노드에서 로드됩니다. 다른 머신에 있는 노드에 연결한다면 이러한 설정은 존재하지 않을 것입니다.
시작할 때 -remsh 플래그를 전달하는 것만이 원격 셸을 띄우는 유일한 방법은 아닙니다. 사실 작업 제어 모드로 들어가면 접속한 노드와 셸을 실행 중에 바꿀 수 있습니다.
작업 제어 모드
ctrl+g를 누르면 작업 제어 모드(JCL)로 들어갑니다. 그러면 또 다른 프롬프트가 나타납니다:
User switch command -->
h를 입력하고 엔터를 누르면 JCL에서 사용할 수 있는 명령어가 담긴 도움말 텍스트가 표시됩니다:
c [nn] - connect to job i [nn] - interrupt job k [nn] - kill job j - list all jobs s [shell] - start local shell r [node [shell]] - start remote shell q - quit erlang ? | h - this message
여기서 흥미로운 명령은 원격 셸을 시작하는 r 명령입니다. 이 명령에는 실행할 셸의 이름을 지정할 수 있습니다. 기본값이 표준 Erlang 셸이므로 Elixir 셸을 시작하려면 셸 이름을 지정해야 합니다. 새 작업(즉, 새 셸)을 시작한 다음에는 c 명령으로 그 작업에 연결해야 합니다. j 명령으로 모든 작업의 목록을 볼 수도 있습니다.
(node2@GDC08)iex<d2> User switch command --> r node1@GDC08 'Elixir.IEx' --> c Interactive Elixir (1.4.0) - press Ctrl+C to exit (type h() ENTER for help) iEx starting in /home/happi/example/dir1 iEx starting on node1@GDC08
매우 오래 실행되는 명령을 시작해 두고 그동안 다른 작업을 하고 싶다면, s로 새 로컬 셸을 시작하고 대신 그 셸에 연결하는 것이 유용합니다. 명령이 멈춘 것처럼 보이면 i로 명령을 중단하거나, k로 해당 셸을 종료하고 새 셸을 시작할 수 있습니다.
JCL 모드에 대한 전체 설명은 Erlang 셸 매뉴얼을 참조하십시오.
ctrl+g q [enter]를 입력하면 세션을 종료할 수 있습니다. 이렇게 하면 로컬 노드가 종료됩니다. q()., halt(), init:stop(), System.halt 중 어느 것으로도 종료해서는 안 됩니다. 이 명령들은 모두 원격 노드를 다운시키는데, 운영 중인 서버에 접속한 상태라면 이는 거의 원하지 않는 결과일 것입니다. 대신 ctrl+\, ctrl+c ctrl+c, ctrl+g q [enter] 또는 ctrl+c a [enter]를 사용하십시오.
원격 셸을 사용하려면 Erlang 런타임 시스템 인스턴스 두 개를 실행해야 합니다. 원격 셸을 사용하고 싶지 않다면, 노드에 연결하는 방법이 사실 두 가지 더 있습니다. Unix 파이프를 통해 연결하거나 ssh로 직접 연결할 수도 있습니다. 하지만 두 방법 모두 연결하려는 노드를 특별한 방식으로 시작하거나 ssh 서버를 시작하여 미리 준비해 두어야 합니다.
파이프를 통한 연결
run_erl 명령으로 노드를 시작하면 IO용 네임드 파이프를 얻게 되며, 완전히 새로운 노드를 시작할 필요 없이 그 파이프에 셸을 연결할 수 있습니다. 다음 장에서 살펴보겠지만, Erlang을 단순히 데몬 모드로 시작하는 대신 run_erl을 사용하면 표준 IO와 표준 오류 출력을 잃지 않는 등 몇 가지 이점이 있습니다.
run_erl 명령은 파이프를 구현한 유닉스 계열 운영 체제에서만 사용할 수 있습니다. 다음과 같이 run_erl로 시스템을 시작하는 경우:
> run_erl -daemon log/erl_pipe log "erl -sname node1"또는
> run_erl -daemon log/iex_pipe log "iex --sname node2"그런 다음 명명된 파이프(run_erl의 첫 번째 인수)를 통해 시스템에 연결할 수 있습니다.
> to_erl dir1/iex_pipe
iex(node2@GDC08)1>EOF(ctrl+d)를 보내면 셸을 종료하고 시스템은 백그라운드에서 계속 실행되도록 둘 수 있습니다.
to_erl을 사용하면 터미널이 실행 중인 노드에 직접 연결되므로 ctrl-c나 ctrl-g q [enter]를 입력하면 해당 노드가 종료됩니다. 아마 원하시는 결과는 아닐 것입니다! run_erl을 사용할 때는 +Bi 플래그도 함께 사용하는 것이 좋습니다. 이 플래그는 ctrl-c 시그널을 비활성화하고 ctrl-g 메뉴에서 q 옵션을 제거합니다.
|
노드에 접속하는 마지막 방법은 ssh를 통하는 것입니다.
SSH를 통한 연결
Erlang에는 SSH 서버가 내장되어 있어서 노드에서 이 서버를 시작한 뒤 직접 접속할 수 있습니다. 이 기능은 Erlang 분산 메커니즘과 완전히 별개이므로 시스템을 -name이나 -sname으로 시작할 필요가 없습니다. 자세한 내용은 ssh 모듈 문서에 모두 설명되어 있습니다. 간단히 테스트하는 데는 서버 키만 있으면 되며, 이 키는 ssh-keygen으로 생성할 수 있습니다:
> mkdir ~/ssh-test/
> ssh-keygen -t rsa -f ~/ssh-test/ssh_host_rsa_key그런 다음 Erlang 노드에서 ssh 데몬을 시작합니다:
gds01> erl
Erlang/OTP 18 [erts-7.3] [source-d2a6d81] [64-bit] [smp:8:8]
[async-threads:10] [kernel-poll:false]
Eshell V7.3 (abort with ^G)
1> ssh:start().
{ok,<0.47.0>}
2> ssh:daemon(8021, [{system_dir, "/home/happi/ssh-test"},
{auth_methods, "password"},
{password, "pwd"}]).
system_dir의 기본값은 /etc/ssh이지만, 이 키들은 root 사용자만 읽을 수 있으므로 이 예제에서는 키를 직접 생성합니다.
|
이제 다른 머신에서 접속할 수 있습니다. 접속할 때 일반 ssh 명령을 사용하는데도 노드의 Erlang 셸로 바로 들어간다는 점에 유의하십시오:
happi@GDC08:~> ssh -p 8021 happi@gds01
happi@gds01's password: [pwd]
Eshell V7.3 (abort with ^G)
1>실제 환경에서는 문서에 설명된 대로 서버 및 사용자 ssh 키를 설정하는 것이 좋습니다. 최소한 더 강력한 비밀번호는 사용하는 것이 좋습니다.
이 셸에서는 JCL 모드(ctrl+g)나 BREAK 모드(ctrl+c)를 사용할 수 없습니다. q(), halt() 또는 init:stop()을 입력하면 원격 노드가 종료됩니다. 셸과의 연결을 끊으려면 exit()를 입력하여 셸 세션을 종료하거나 터미널 창을 닫으면 됩니다.
BREAK 모드는 개발, 프로파일링, 디버깅을 할 때 매우 강력한 도구입니다. 다음으로 이 모드를 살펴보겠습니다.
17.2.3. 중단하기(빠져나가기 또는 들어가기)
ctrl+c를 누르면 BREAK 모드로 들어갑니다. 이 모드는 대개 중단(abort)을 뜻하는 a [enter]를 입력하거나 ctrl+c를 한 번 더 눌러 노드를 종료하는 데에만 쓰입니다. 하지만 실제로는 이 모드를 사용해 Erlang 런타임 시스템의 내부를 들여다볼 수 있습니다.
BREAK 모드로 들어가면 다음과 같은 짧은 메뉴가 표시됩니다.
BREAK: (a)bort (A)bort with dump (c)ontinue (p)roc info (i)nfo
(l)oaded (v)ersion (k)ill (D)b-tables (d)istribution
c [enter](continue)를 입력하면 셸로 돌아갑니다. 디버깅을 위해 A [enter]를 입력하여 강제 크래시 덤프를 생성하면서 노드를 종료할 수도 있습니다(크래시 덤프는 코어 덤프와 다릅니다. Chapter 18을 참조하십시오).
p [enter]를 입력하면 시스템에 있는 모든 프로세스의 내부 정보를 볼 수 있습니다. 이 정보가 무엇을 의미하는지는 다음 장에서 더 자세히 살펴보겠습니다(Chapter 3 참조).
i [enter]를 통해 노드의 메모리와 메모리 할당자에 대한 정보도 얻을 수 있습니다. Chapter 11에서 이 정보를 해석하는 방법을 살펴보겠습니다.
l [enter]로 로드된 모든 모듈과 그 크기를, v [enter]로 시스템 버전을 확인할 수 있으며, k [enter]를 사용하면 모든 프로세스를 하나씩 살펴보면서 검사하고 종료할 수 있습니다. 대문자 D [enter]는 시스템에 있는 모든 ETS 테이블에 대한 정보를 보여 주고, 소문자 d [enter]는 분산에 대한 정보(사실상 노드 이름뿐)를 보여 줍니다.
OPPROF나 DEBUG로 런타임을 빌드했다면 훨씬 더 많은 정보를 얻을 수 있습니다. 그 방법은 Appendix A에서 살펴보겠습니다. break 모드를 구현하는 코드는 erts/emulator/beam/break.c에서 찾을 수 있습니다.
BREAK 메뉴를 띄우는 대신 ctrl+c를 눌렀을 때 노드가 즉시 종료되기를 원한다면 erl에 +Bd 옵션을 전달하면 됩니다. Docker 같은 환경에서 Erlang을 실행할 때는 보통 이 방식이 적합합니다. ctrl-c가 현재 셸 명령만 중단하도록 하는 변형인 +Bc도 있습니다. 이 옵션은 대화형 작업을 할 때 유용합니다.
|
BREAK 모드로 들어가면 노드가 멈춘다는 점에 유의하십시오. 이는 프로덕션 시스템에서 해서는 안 되는 일입니다. 하지만 테스트 시스템에서 디버깅이나 프로파일링을 할 때는, 이 책의 뒷부분에서 살펴보겠지만 이 모드가 버그와 병목 지점을 찾는 데 도움이 될 수 있습니다.
18. BEAM 애플리케이션 디버깅
18.1. 소개
이 장에서는 진행 중인 서비스를 중단하지 않고 버그를 찾아 수정하는 다양한 방법을 다룹니다. 코드를 테스트하고 디버깅하는 데 도움이 되는 테스트 기법, 도구, 프레임워크를 살펴보겠습니다. 또한 교착 상태, 메시지 오버플로, 메모리 문제 등 흔히 발생하는 버그의 원인을 조명하고, 이러한 문제를 식별하고 해결하는 방법을 안내합니다.
디버깅은 소프트웨어에서 오류, 즉 "버그"를 찾아내어 제거하는 프로세스입니다. Erlang은 Debugger와 같은 단계별 디버깅 도구를 제공하지만, 가장 효과적인 디버깅 방법은 대개 Erlang의 트레이싱 기능에 의존합니다. 이 기능들은 Chapter 19에서 자세히 다룹니다. 이 장에서는 DTrace와 SystemTap을 이용한 시스템 수준 트레이싱을 간략히 살펴봅니다.
이 장에서는 "크래시 덤프(Crash Dumps)"라는 개념도 살펴봅니다. 크래시 덤프는 메모리가 부족해지거나 에뮬레이터 한계에 도달하는 등 복구할 수 없는 오류가 발생했을 때 Erlang 런타임 시스템이 생성하며, 사람이 읽을 수 있는 텍스트 파일입니다. 크래시 덤프는 Erlang 노드의 사후 분석에 매우 유용합니다. 이 장에서는 크래시 덤프를 해석하고 이해하는 방법을 배웁니다.
이 장에서는 이러한 주제 외에도 코드의 신뢰성과 견고성을 보장하는 데 매우 중요한 EUnit과 Common Test를 비롯한 다양한 테스트 방법론도 다룹니다. 또한 테스트에서 모킹(mocking)이 왜 중요한지 살펴보고, 그 모범 사례도 함께 알아봅니다.
"let it crash" 원칙과 이를 시스템 안에서 효과적으로 구현하는 방법을 익히게 됩니다. 예외가 동작하는 방식과 슈퍼바이저 트리 설계에 대한 통찰을 얻게 됩니다.
이 장을 마칠 때쯤이면 여러분은 시스템과 그 개별 구성 요소를 체계적으로 테스트할 수 있는 지식을 갖추게 됩니다. 흔히 저지르는 실수와 문제를 찾아낼 수 있게 되며, 그 과정에서 디버깅 철학까지 어느 정도 익힐 수도 있습니다.
18.2. 디버깅 철학
디버깅은 소프트웨어 개발의 필수적인 부분이며, Erlang에서는 언어의 내결함성 설계로 인해 디버깅도 독특한 방식으로 이루어집니다. Erlang은 장애를 예방하는 데에만 집중하기보다는 오류를 효과적으로 감지하고, 진단하고, 복구하는 반응형 디버깅 철학을 장려합니다. Erlang에서의 디버깅에는 체계적인 접근 방식 활용, 프로덕션 환경에서 발생한 장애 분석, 그리고 실수로부터 배워 코드 품질을 지속적으로 개선하는 일이 포함됩니다.
18.2.1. 디버깅에 대한 체계적 접근법
디버깅에 체계적으로 접근하면 문제를 찾아 해결하는 데 드는 시간과 노력을 크게 줄일 수 있습니다. Erlang에서의 디버깅은 관찰, 격리, 테스트로 이루어진 체계적인 프로세스를 따릅니다.
1. 문제 재현하기
버그를 수정하기 전에 버그를 일관되게 재현할 수 있어야 합니다. Erlang 시스템에서 문제를 재현하는 몇 가지 기법은 다음과 같습니다:
-
상세 로깅(
lager,logger)을 활성화한 상태로 시스템을 실행합니다. -
트레이싱 도구(
dbg,recon등)를 사용하여 함수 호출과 메시지 전달을 포착합니다. -
통제된 테스트 환경에서 장애 시나리오를 시뮬레이션합니다.
예제: 모듈의 함수 호출을 살펴보기 위해 트레이싱을 활성화하는 방법:
dbg:tracer().
dbg:p(all, c).
dbg:tpl(my_module, my_function, []). % Trace all calls to my_function문제가 간헐적으로 발생한다면 prop_er나 Common Test 같은 도구로 시스템에 부하 테스트를 걸어 실행해 보면 경쟁 조건을 찾아내는 데 도움이 될 수 있습니다.
2. 결함이 있는 구성 요소 격리
문제를 재현할 수 있게 되면, 다음 단계는 문제를 특정 모듈, 프로세스 또는 함수로 좁혀 격리하는 것입니다:
다음 명령으로 프로세스 메시지 큐를 확인하십시오.
process_info(Pid, messages).메시지 큐가 길다면 성능 병목이 있다는 신호일 수 있습니다.
ETS 테이블 및 메모리 사용량을 확인하십시오:
ets:info(my_table, size).
erlang:memory().문제와 관련된 프로세스에만 집중하려면 선택적 트레이싱(selective tracing)을 사용하십시오:
dbg:p(self(), [m]). % Trace only the current process결함이 있는 구성 요소를 격리하면 디버깅 범위를 좁히고 불필요하게 주의가 흐트러지는 일을 피할 수 있습니다.
3. 로그 및 크래시 덤프 분석
로그와 크래시 덤프는 시스템 장애에 관한 유용한 정보를 제공합니다. Erlang 노드가 크래시되면 다음과 같은 세부 정보가 담긴 erl_crash.dump 파일이 생성됩니다.
-
크래시 원인(예: 메모리 고갈, 무한 루프, 교착 상태).
-
장애 발생 시점의 프로세스 상태입니다.
-
크래시가 발생한 프로세스의 호출 스택입니다.
예시: 크래시 덤프의 메모리 사용량 섹션 확인하기:
=memory
total: 2147483648
processes: 1807483648
ets: 107374182
binary: 32212254
code: 5242880프로세스 메모리가 비정상적으로 높다면 메모리 누수를 의미할 수 있습니다.
실시간 디버깅에는 crashdump_viewer를 사용하십시오:
crashdump_viewer:start().4. 디버깅 도구를 효과적으로 사용하십시오
Erlang은 시스템 동작을 분석할 수 있는 강력한 런타임 디버깅 도구를 제공합니다.
-
Observer GUI (
observer:start()) – 대화형 프로세스 모니터링 도구입니다. -
dbg및recon– 저수준 트레이싱 및 검사. -
SystemTap또는DTrace– 고급 디버깅을 위한 커널 수준 프로파일링입니다.
작업에 알맞은 도구를 사용하면 불필요한 코드 수정을 막고 디버깅 속도를 높일 수 있습니다.
5. 수정 사항 검증 및 회귀 테스트 작성
버그를 찾아 수정한 후에는 버그가 다시 나타나지 않도록 하십시오:
-
Common Test또는EUnit으로 회귀 테스트를 작성하십시오. -
엣지 케이스를 검증하려면 속성 기반 테스트를 실행하십시오(
PropEr,QuickCheck). -
프로덕션에 배포하기 전에 스테이징 환경에서 테스트하십시오.
18.2.2. 실수에서 배우고 코드 품질 개선하기
모든 버그는 코드베이스를 개선하고 향후 문제를 예방할 기회가 됩니다. Erlang의 회복력과 자가 치유 철학은 개발자가 실수를 다루고 시스템을 다듬어 가는 방식에까지 이어집니다.
1. 사후 분석 수행
치명적인 버그를 수정한 후에는 왜 발생했는지와 어떻게 방지할 수 있는지를 분석하십시오. 사후 분석은 다음 질문에 답해야 합니다:
-
이 문제의 근본 원인은 무엇이었습니까?
-
그것이 시스템에 어떤 영향을 미쳤습니까?
-
비슷한 버그는 어떻게 예방할 수 있습니까?
프로세스가 예기치 않은 메시지 때문에 크래시되었다면 메시지 필터링이 견고한지 확인하십시오:
handle_info(_Unexpected, State) ->
{noreply, State}.2. 로깅 및 관찰 가능성 개선
많은 문제가 로깅과 모니터링이 불충분해서 발생합니다. 시스템 관측성(observability)을 높이는 방법은 다음과 같습니다.
로그 레벨과 함께 구조화된 로깅(lager, logger)을 사용합니다:
logger:log(info, "User logged in: ~p", [UserId]).실시간 모니터링 구현:
recon:bin_leak(10). % Detects potential memory leaks.로깅을 개선하면 이상 징후가 큰 장애로 확대되기 전에 이를 탐지하는 데 도움이 됩니다.
3. 코드 가독성 및 유지보수성 향상
잘 구조화된 코드는 디버깅하기가 더 쉽습니다. Erlang 모범 사례를 따르면 유지보수성이 향상됩니다:
-
명확한 함수 이름을 사용하십시오(
do_it/1대신handle_request/1). -
OTP 설계 원칙을 따르십시오 (
gen_server,supervisor). -
디버깅을 쉽게 하려면 모듈화된 코드를 작성하십시오.
예시: case 문을 복잡하게 중첩하는 대신:
case Result of
{ok, Data} -> process(Data);
{error, _} -> handle_error()
end.명확성을 위해 패턴 매칭을 사용하십시오:
process_request({ok, Data}) -> process(Data);
process_request({error, _}) -> handle_error().4. 빠른 실패(Fail-Fast) 메커니즘 구현
Erlang의 Let It Crash 철학은 오류가 발생했을 때 잘못된 상태를 전파하는 대신 프로세스가 빠르게 실패해야 한다는 뜻입니다.
예시: 가드를 사용하여 빠른 실패(fail-fast) 동작 강제하기:
handle_request({ok, Data}) when is_list(Data) ->
process(Data);
handle_request(_) ->
exit(bad_request).페일 패스트(fail-fast) 메커니즘은 조용한 실패를 방지하고 디버깅을 더 쉽게 만들어 줍니다.
5. 오픈 소스 Erlang 시스템에서 배우기
프로덕션 수준의 Erlang 애플리케이션 중 상당수는 오픈 소스로 공개되어 있습니다. 이들의 디버깅 관행을 살펴보면 귀중한 통찰을 얻을 수 있습니다:
-
RabbitMQ – 구조화된 로깅과 모니터링 도구를 사용합니다.
-
MongooseIM – 광범위한 트레이싱을 구현합니다.
-
Riak – 분산 장애 복구 기법을 사용합니다.
이러한 프로젝트를 살펴보면 디버깅 능력이 향상되고 시스템 설계 지식이 깊어집니다.
18.3. 흔한 용의자들: 버그의 일반적인 원인
소프트웨어 시스템에서는 안정성과 성능에 영향을 줄 수 있는 유형의 장애가 반복해서 나타나는 경우가 많습니다. Erlang은 내결함성을 고려해 설계되었음에도 특정 범주의 버그가 자주 나타납니다. 이 절에서는 교착 상태, 메일박스 오버플로, 메모리 문제 등 Erlang 애플리케이션에서 흔히 발생하는 문제의 주요 원인 몇 가지를 살펴봅니다. 이러한 문제를 이해하고 진단 및 해결 방법을 익히면 더 안정적이고 효율적인 Erlang 프로그램을 작성하는 데 도움이 됩니다.
18.3.1. 교착 상태
교착 상태(deadlock)는 둘 이상의 프로세스가 서로 자원을 해제하기를 기다릴 때 발생하며, 그 결과 어떤 작업도 더 이상 진행될 수 없는 상태에 빠지게 됩니다. 이는 동시성 시스템에서 흔히 발생하는 문제이며, Erlang의 경량 프로세스로 구축된 시스템도 예외가 아닙니다.
Erlang에서 교착 상태는 일반적으로 다음과 같은 원인으로 발생합니다:
-
순환 의존성: 두 프로세스가 각각 상대방이 점유한 자원을 기다리는 상황입니다.
-
잘못 사용된 락:
gen_server나gen_fsm을 사용할 때 메시지 처리 순서가 잘못되면 교착 상태(deadlock)가 발생할 수 있습니다. -
gen_server내부의 블로킹 호출:handle_call/3콜백 안에서gen_server:call/2를 호출하면 프로세스가 무기한 블로킹될 수 있습니다.
교착 상태를 식별하려면 다음과 같이 하십시오:
-
프로세스 검사: 멈춘 프로세스가 있는지 확인하려면
observer:start().또는process_info(Pid, status).를 사용하십시오. -
dbg를 사용한 트레이싱: 함수 호출 트레이싱을 활성화하여 프로세스가 어디에서 무한정 대기하고 있는지 확인합니다. -
메시지 큐 분석: 프로세스가 끝내 도착하지 않는 메시지를 기다리고 있다면
process_info(Pid, messages).를 사용하여 해당 프로세스의 메일박스를 확인하십시오.
블로킹 연산에서는 타임아웃을 사용하십시오:
gen_server:call(Server, Request, Timeout).적절한 타임아웃을 설정하면 무기한 블로킹을 방지할 수 있습니다.
블로킹을 피하려면 비동기 호출(gen_server:cast/2)이나 모니터 메시지(erlang:monitor/2)를 사용하십시오.
순환 의존성을 방지하려면 모든 프로세스에서 락(lock)을 항상 일관된 순서로 획득하도록 하십시오.
프로세스 상태를 모니터링하고 교착 상태에 빠진 프로세스를 강제로 재시작하는 주기적 검사를 구현하십시오.
18.3.2. 메일박스 오버플로
Erlang의 메시지 전달 모델에서는 프로세스가 메일박스를 통해 메시지를 비동기적으로 받을 수 있습니다. 그러나 프로세스에 메시지가 쌓이는 속도가 처리하는 속도보다 빠르면 메일박스가 끝없이 커질 수 있으며, 이로 인해 메모리 사용량이 크게 늘어나거나 크래시가 발생할 수 있습니다.
메시지 오버플로의 흔한 원인과 증상은 다음과 같습니다:
-
느린 메시지 처리: 요청을 처리하는 데 너무 오래 걸리는
gen_server로 인해 처리되지 않은 메시지가 계속 쌓일 수 있습니다. -
과도한 메시지 생성: 프로세스가 백프레셔를 확인하지 않은 채 메시지를 빈번하게 보냅니다.
-
처리되지 않은 시스템 메시지:
gen_server:handle_info/2와 같은 시스템 메시지를 처리하지 못하는 경우입니다.
증상은 다음과 같습니다.
-
메모리 사용량 증가 (
process_info(Pid, memory).) -
긴 프로세스 메시지 큐(
process_info(Pid, message_queue_len).) -
유휴 상태로 보이지만 실제로는 과부하 상태인, 응답하지 않는 프로세스
메일박스 오버플로 문제 예방 및 해결
메시지 큐 길이 모니터링:
process_info(Pid, message_queue_len).모니터링 도구를 사용하여 큐가 임계값을 넘어 커지면 알림이 발생하도록 하십시오.
송신자 속도 제한
-
메시지를 더 보내기 전에 명시적인 확인 응답을 요구하는 등의 백프레셔(backpressure) 메커니즘을 사용하십시오.
-
흐름 제어를 구현하십시오: 생산자는 메시지를 무작정 보내는 대신 소비자의 부하를 확인할 수 있습니다.
선택적 수신을 올바르게 사용하십시오
다음과 같은 패턴은 피하십시오.
receive {specific_message, Data} -> process(Data) end.이는 대기 중인 다른 메시지를 무시하므로 메일박스가 끝없이 커지게 됩니다. 이 규칙의 예외는 rpc 방식의 송신과 수신에 Ref 트릭을 사용하는 경우입니다. 자세한 내용은 Section 7.5.4을 참조하십시오.
무거운 연산 오프로드:
-
비용이 큰 연산은 메인 프로세스 루프에서 직접 수행하지 말고 워커 프로세스에 맡기십시오.
-
처리를 마친 후 메시지에 비동기적으로 응답하려면
gen_server:reply/2함수를 사용하십시오.
18.3.3. 메모리 문제
Erlang의 메모리 모델은 프로세스별 힙, 가비지 컬렉션, 바이너리 할당자를 기반으로 합니다. 이 모델은 효율성을 목표로 설계되었지만, 메모리를 부적절하게 사용하면 성능이 저하될 수 있습니다.
Erlang에서 메모리 누수는 흔히 다음과 같은 원인에서 비롯됩니다.
-
상태를 계속 쌓아 가는 장기 실행 프로세스: ETS 테이블, 큰 리스트, 처리되지 않은 메시지 등이 해당합니다.
-
무한히 쌓이는 메시지 큐: 메시지를 받기만 하고 처리하지 않는 프로세스입니다.
-
바이너리 데이터 누적: 큰 바이너리는 심각한 메모리 단편화를 일으킬 수 있습니다.
메모리 누수를 탐지하는 방법
개별 프로세스의 메모리 사용량을 확인하십시오:
process_info(Pid, memory).observer:start().를 실행한 뒤 "Processes" 탭으로 이동하여 메모리를 과도하게 사용하는 프로세스를 찾으십시오.
다음을 사용하여 메모리 할당에 대한 트레이싱을 활성화합니다:
recon_alloc:memory(ets).바이너리 메모리 사용량 관리
큰 바이너리는 참조 카운팅을 사용하여 프로세스 힙과 별도로 관리됩니다. 다음과 같은 경우에 문제가 발생합니다.
-
프로세스가 바이너리 참조를 필요 이상으로 오래 붙잡고 있습니다.
-
가비지 컬렉션이 지연되어 사용되지 않는 대용량 바이너리가 남아 있습니다.
해결 방법:
큰 바이너리를 더 작은 청크로 변환:
binary:split(BigBinary, <<"\n">>).가비지 컬렉션 강제 실행:
erlang:garbage_collect(Pid).이 작업은 프로세스가 더 이상 참조하지 않는 바이너리가 차지하던 메모리를 회수합니다. 이는 바이너리를 더 이상 사용하지 않으면서도 그에 대한 참조를 계속 쥐고 있는 중계 프로세스에서 중요할 수 있습니다. 바이너리는 참조 카운트로 관리되며 여러 프로세스에 걸쳐 존재한다는 점을 기억하십시오.
바이너리 메모리 할당 모니터링:
erlang:memory(binary).Erlang 시스템의 메모리 사용량 최적화
Erlang은 힙 할당 동작을 제어하는 여러 시스템 플래그를 제공합니다.
min_heap_size (최소 프로세스 힙 크기)
-
새로 생성된 프로세스의 초기 힙 크기를 정의합니다.
-
프로세스가 대량의 데이터를 처리할 것으로 예상되는 경우, 힙이 자주 확장되는 것을 방지하는 데 도움이 됩니다.
-
기본값은 일반적으로 233워드이지만, 이를 약간 늘리면(예: 256 또는 512) 빠르게 커지는 프로세스의 성능을 높일 수 있습니다.
사용 예시: 다음과 같이 프로세스에 이 설정을 구성할 수 있습니다:
spawn_opt(fun() -> my_function() end, [{min_heap_size, 512}]).또는 다음을 통해 전역으로 적용하십시오:
erl +hms 512이를 통해 모든 새 프로세스가 최소 512워드의 힙으로 시작하게 되므로, 힙을 자주 확장해야 할 필요가 줄어듭니다.
min_bin_vheap_size (최소 바이너리 가상 힙 크기)
-
참조 카운트 방식 바이너리(64바이트를 초과하는 바이너리)의 가상 힙 크기를 제어합니다.
-
대용량 바이너리 데이터를 다루는 프로세스의 메모리 할당 최적화에 도움이 됩니다.
-
기본값은 46422이지만, 바이너리를 많이 다루는 워크로드라면 512 이상으로 조정할 수도 있습니다.
spawn_opt(fun() -> handle_large_binaries() end, [{min_bin_vheap_size, 100000}]).이렇게 하면 프로세스가 충분한 바이너리 힙 공간을 확보한 채로 시작하므로 빈번한 재할당을 막을 수 있습니다.
전체 스윕 가비지 컬렉션 임계값(fullsweep_after)을 최적화하십시오.
ETS를 효율적으로 사용하기
-
메모리가 불필요하게 늘어나지 않도록 사용하지 않는 항목을 주기적으로 정리하십시오.
-
꼭 필요한 경우가 아니라면
bag또는ordered_set테이블 대신set테이블을 사용하십시오.
수명이 길고 공유되는 큰 텀은 전달할 때 주의하십시오. 프로세스 간에 큰 텀을 보내는 대신 참조를 사용하십시오(예: 큰 데이터는 ETS나 데이터베이스에 저장하고 참조를 보내십시오).
18.4. Let It Crash 원칙
Erlang의 “Let It Crash” 원칙은 장애 허용성과 복원력을 갖춘 시스템을 설계하는 데 있어 근본이 되는 철학입니다. Erlang 개발자는 발생할 수 있는 모든 오류를 처리하려고 방어적인 코드를 작성하는 대신 실패를 받아들이고, 크래시를 감지하고 복구하는 일을 슈퍼바이저 트리에 맡깁니다. 이 접근 방식은 코드를 단순하게 만들고 유지 보수성을 높이며, 예상치 못한 오류가 발생하더라도 시스템이 견고하게 유지되도록 보장합니다.
18.4.1. 개요 및 설계 근거
전통적인 프로그래밍에서 오류 처리는 흔히 장애를 예상하기 위해 방대한 try-catch 문과 방어적 코드를 작성하는 일을 수반합니다. 그러나 이러한 접근 방식은 복잡성을 초래하며, 유지보수하기 어려운 코드베이스로 이어질 수 있습니다. Erlang은 장애가 일어날 수밖에 없음을 받아들이고 철저한 오류 예방보다 자동 복구 쪽에 초점을 맞추는 다른 접근 방식을 취합니다.
"Let It Crash"의 근거는 다음과 같습니다.
-
장애 격리: 각 Erlang 프로세스는 독립적으로 실행되므로, 한 프로세스에서 발생한 크래시가 다른 프로세스에 영향을 주지 않습니다.
-
자동 복구: 슈퍼바이저는 프로세스를 감시하다가 프로세스가 실패하면 재시작합니다.
-
더 단순한 코드: 개발자는 방어적인 코드를 덜 작성하고 오류 처리보다 비즈니스 로직에 집중합니다.
-
장애 격리: 프로세스가 통제된 방식으로 크래시하고 재시작하도록 하여 오류가 퍼지지 않게 합니다.
이러한 철학 덕분에 Erlang 시스템은 뛰어난 복원력을 갖추며, 장애가 불가피한 분산 환경에서는 특히 그러합니다.
18.4.2. Erlang의 예외
Erlang은 예외를 처리하는 내장 메커니즘을 제공하지만, 모든 오류를 국지적으로 복구하는 데 집중하기보다는 감독(supervision)을 통한 프로세스 종료 및 재시작을 권장합니다.
예외의 종류
Erlang에는 크게 세 가지 유형의 예외가 있습니다.
-
오류 (
error:Reason) – 0으로 나누기나 정의되지 않은 함수 호출과 같은 심각한 결함으로 인해 발생합니다. -
Throws(
throw:Reason) – 비지역 반환(non-local return)과 제어된 종료에 사용됩니다. -
종료(Exits) (
exit:Reason) – 프로세스가 예기치 않게 또는 의도적으로 종료될 때 발생합니다.
예외 처리 예제
방어적 프로그래밍은 크래시를 피하도록 권하지만, Erlang에서는 필요한 경우 예외를 명시적으로 처리할 수 있습니다:
try 1 / 0 of
Result -> io:format("Result: ~p~n", [Result])
catch
error:badarith -> io:format("Cannot divide by zero!~n")
end.이는 즉각적인 로컬 처리가 필요한 경우에 유용하지만, Erlang에서 대부분의 실패는 크래시하도록 내버려 두고 슈퍼바이저가 처리하게 합니다.
프로세스 종료와 모니터링
프로세스가 크래시하면 링크된 프로세스들에 종료 시그널(exit signal)을 보냅니다. 필요한 경우 이러한 종료를 모니터링하거나 트랩할 수 있습니다:
spawn_monitor(fun() -> exit(died) end).이를 통해 다른 프로세스가 장애를 감지하고 그에 맞게 대응할 수 있습니다.
18.4.3. 슈퍼바이저 트리로 시스템 설계하기
Erlang 애플리케이션은 모든 함수 안에서 오류를 처리하는 대신 슈퍼바이저 트리에 의존합니다. 슈퍼바이저 트리는 슈퍼바이저가 워커 프로세스를 감시하다가 실패하면 재시작하는 계층 구조입니다.
슈퍼바이저 트리의 구조
슈퍼바이저 트리는 다음으로 구성됩니다:
-
슈퍼바이저: 워커 프로세스와 다른 슈퍼바이저를 관리하는 특수한 프로세스입니다.
-
워커(Workers): 실제로 연산을 수행하는 프로세스입니다. 워커가 크래시하면 슈퍼바이저가 워커를 어떻게 재시작할지 결정합니다.
-module(my_supervisor).
-behaviour(supervisor).
-export([start_link/0, init/1]).
start_link() ->
supervisor:start_link(?MODULE, []).
init([]) ->
{ok, {{one_for_one, 3, 10},
[{worker1, {my_worker, start_link, []}, permanent, 5000, worker, [my_worker]}]}}.이 슈퍼바이저는 my_worker가 비정상 종료되면 자동으로 재시작되도록 보장합니다.
슈퍼비전 전략
슈퍼바이저는 여러 가지 재시작 전략을 따를 수 있습니다:
-
one_for_one: 크래시가 발생한 프로세스만 재시작합니다(가장 흔히 쓰입니다).
-
one_for_all: 하나가 실패하면 모든 자식 프로세스를 재시작합니다.
-
rest_for_one: 실패한 프로세스와 그 이후에 시작된 모든 프로세스를 재시작합니다.
-
simple_one_for_one: 비슷한 워커 프로세스를 동적으로 생성할 때 사용합니다.
슈퍼바이저 트리 사용의 이점
-
자동 장애 복구: 워커가 비정상 종료되면 수동으로 개입하지 않아도 재시작됩니다.
-
확장성: 슈퍼바이저는 수천 개의 프로세스를 효율적으로 관리할 수 있습니다.
-
관심사의 분리: 비즈니스 로직은 워커에 두고, 장애 복구는 별도로 처리합니다.
18.5. 디버깅 도구와 기법
Erlang 애플리케이션에서 예상치 못한 동작을 다룰 때 디버깅은 필수적입니다. Erlang 생태계에는 여러 도구가 있습니다.
18.5.1. Erlang 디버거(dbg)
dbg 모듈은 성능에 미치는 영향을 최소화하면서 실행 중인 시스템을 디버깅할 수 있는 강력한 트레이싱 기능을 제공합니다.
dbg 시작하기
dbg 도구를 시작하려면 다음과 같이 하십시오:
1> dbg:tracer().
{ok,<0.85.0>}이 코드는 디버그 정보를 수집할 트레이서 프로세스를 설정합니다. 출력에 사용할 백엔드는 여러 가지 중에서 선택할 수 있습니다:
-
dbg:tracer(console).→ 셸에 출력합니다 -
dbg:tracer(port, file:open("trace.log", [write])).→ 파일에 기록합니다
트레이싱을 활성화하면 프로세스나 함수에 트레이서를 연결할 수 있습니다.
모든 함수 호출 트레이싱하기
dbg:p(all, c). % Trace all function calls in all processes특정 함수 트레이싱
dbg:tpl(my_module, my_function, []). % Trace calls to my_function/0조건부 트레이스 설정하기
함수 인자가 일치할 때만 트레이스합니다:
dbg:tpl(my_module, my_function, [{'_', [], [{message, "Function called"}]}]).브레이크포인트는 코드 실행을 단계별로 따라갈 때 유용합니다. 그래픽 디버거를 시작하십시오:
debugger:start().그런 다음, 모듈에 브레이크포인트를 설정하십시오:
int:break(my_module, my_function, Arity).함수를 트레이스하면 그 함수의 호출과 반환이 기록됩니다.
트레이스 출력 예시:
(<0.85.0>) call my_module:my_function(42)
(<0.85.0>) returned from my_function -> "Result: 42"이를 통해 실행 과정 전반에 걸쳐 값이 어떻게 변하는지 추적할 수 있습니다.
18.6. 차세대 디버거: EDB
Erlang 디버거(EDB)는 Erlang 애플리케이션을 위한 현대적이고 기능이 풍부한 디버거입니다. 이 도구는 브레이크포인트 설정, 변수 검사, 코드 실행 단계별 진행을 위한 언어 서버 인터페이스를 제공합니다. https://github.com/WhatsApp/edb 를 참고하십시오.
OTP 28 이전 버전에서 EDB를 사용하려면 EDB 지원을 포함하여 Erlang을 소스에서 빌드해야 합니다. 다음은 EDB 지원을 포함하여 Erlang을 소스에서 빌드하는 방법에 대한 안내입니다:
git clone https://github.com/WhatsApp/edb.git
git submodule update --init
pushd otp
./configure --prefix $(pwd)/../otp-bin
make -j$(nproc)
make -j$(nproc) install
popd
rebar3 escriptize그러면 다음 명령으로 EDB를 시작할 수 있습니다:
_build/default/bin/edb dap이 명령은 EDB를 실행하여 EDB가 DAP를 통해 개발 환경과 연동할 수 있게 하며, 강력한 디버깅 경험을 제공합니다.
현재 상태와 안정성
이 글을 쓰는 시점에서 EDB는 초기 단계에 있으며 빠르게 발전하고 있는 도구입니다. 통합성과 사용성은 유망하지만 여전히 다루기 까다로울 수 있으며, 특히 IDE 설정, 노드 연결, 환경 호환성 측면에서 그렇습니다. 안정성은 OTP 버전과 개발 도구 선택에 따라 크게 달라질 수 있습니다.
18.7. Erlang의 크래시 덤프
크래시 덤프는 Erlang 시스템의 장애를 진단하는 데 필요한 정보를 제공합니다. 크래시 덤프에는 크래시가 발생한 시점의 시스템 상태, 메모리 사용량, 프로세스 정보, 호출 스택에 관한 세부 정보가 담겨 있습니다. 이 파일들을 해석하는 방법을 이해하면 디버깅 속도를 크게 높이고 향후 크래시를 예방할 수 있습니다.
18.7.1. 크래시 덤프의 이해와 읽기
크래시 덤프(erl_crash.dump)는 비정상 종료 시점의 Erlang 런타임 시스템(ERTS) 상태를 담은 스냅숏입니다. 여기에는 다음 내용이 포함됩니다.
-
시스템 버전 및 런타임 매개변수
-
메모리 사용량 통계
-
로드된 모듈
-
프로세스 상태와 호출 스택
-
포트 및 드라이버 정보
크래시 덤프를 분석하면 메모리 고갈, 무한 루프, 교착 상태 또는 그 밖의 장애 가운데 무엇 때문에 시스템이 크래시했는지 파악할 수 있습니다.
공식 문서에서 크래시 덤프 형식을 자세히 설명하고 있습니다: How to Interpret the Erlang Crash Dumps. 여기서는 기본적인 내용을 다루겠습니다.
기본적으로 크래시 덤프는 Erlang 시스템이 시작된 작업 디렉터리에 저장됩니다. 파일 이름은 일반적으로 다음과 같습니다:
erl_crash.dump환경 변수를 설정하여 위치를 변경할 수 있습니다:
export ERL_CRASH_DUMP=/var/log/erl_crash.dump또는 런타임에:
erlang:system_flag(crash_dump, "/var/log/erl_crash.dump").18.7.2. 크래시 덤프의 기본 구조
크래시 덤프는 여러 섹션으로 구성됩니다. 다음은 일부를 생략한 예시입니다:
=erl_crash_dump:0.5
Sun Feb 18 13:45:52 2025
Slogan: eheap_alloc: Cannot allocate 1048576 bytes of memory (of type "heap").
System version: Erlang/OTP 26 [erts-13.1] [source] [64-bit]
Compiled: Fri Jan 26 14:10:07 2025
Taints: none
Atoms: 18423
Processes: 482
Memory: 2147483648
=memory
total: 2147483648
processes: 1807483648
ets: 107374182
binary: 32212254
code: 5242880이 덤프를 보면 시스템이 메모리 할당 실패(Cannot allocate 1048576 bytes of memory)로 인해 크래시한 것으로 보입니다.
크래시 덤프의 주요 섹션
-
슬로건
크래시의 원인을 나타냅니다. 흔히 볼 수 있는 슬로건은 다음과 같습니다: - `eheap_alloc: Cannot allocate X bytes of memory` (메모리 고갈) - `Init terminating in do_boot ()` (부트 스크립트에 오류가 있을 가능성이 높습니다) - `Could not start kernel pid` (설정에 잘못된 인수가 있을 가능성이 높습니다)
-
시스템 정보
런타임에 관한 세부 정보를 담고 있습니다: - `System version`: Erlang/OTP 버전 및 빌드 세부 정보 - `Compiled`: 시스템이 빌드된 시점 - `Taints`: 외부 네이티브 코드(NIF)가 실행 중인지 여부
-
메모리 사용량
메모리 분산을 표시합니다:
-
Total: 총 메모리 사용량 -
Processes: 프로세스가 사용하는 메모리입니다(값이 높으면 메모리 누수를 의심할 수 있습니다) -
ETS: Erlang 텀 저장소 사용량(통제할 수 없이 커지면 문제가 될 수 있습니다) -
Binary: 바이너리에 할당된 메모리입니다(누수의 원인이 될 수 있습니다). -
Code: 로드된 코드가 차지하는 메모리 양
-
-
프로세스 목록
이 섹션은 활성 프로세스에 대한 세부 정보를 제공하며, 다음을 식별하는 데 매우 중요합니다.
-
메모리를 과도하게 사용하는 프로세스(
Stack+Heap크기) -
무한 루프에 빠진 프로세스(
Reductions카운트가 비정상적으로 높음) -
메시지 큐 과부하(
Messages필드가 끝없이 증가)
-
-
포트와 드라이버
이 명령은 열려 있는 포트와 드라이버를 나열합니다. 외부 시스템과의 상호작용(파일, 소켓, 데이터베이스)이 크래시 원인으로 의심될 때 유용할 수 있습니다.
-
로드된 모듈
이는 동적으로 로드된 코드(예: ``code:load_file/1``을 통해 로드된 코드)가 크래시를 일으켰는지 판단하는 데 도움이 됩니다.
18.7.3. 크래시 덤프 분석하기
Erlang은 크래시 덤프를 파싱하기 위한 내장 도구인 crashdump_viewer를 제공합니다.
시작하려면 다음과 같이 하십시오.
crashdump_viewer:start().이 기능은 크래시 덤프를 검사할 수 있는 그래픽 인터페이스를 제공합니다.
18.7.4. 크래시 덤프가 생성되지 않을 수 있는 이유 조사하기
때때로 시스템 크래시가 발생해도 erl_crash.dump 파일이 생성되지 않는 경우가 있습니다. 그 이유와 해결 방법은 다음과 같습니다.
크래시 덤프 비활성화
Erlang에서는 다음 방법으로 크래시 덤프를 활성화하거나 비활성화할 수 있습니다:
erlang:system_flag(dump_on_exit, true).활성화되어 있는지 확인하십시오:
ERL_CRASH_DUMP=/var/log/erl_crash.dump또는 sys.config를 통해 설정할 수 있습니다:
[{kernel, [{error_logger, {file, "/var/log/erl_crash.dump"}}]}].권한이 부족합니다
Erlang을 실행하는 프로세스가 대상 덤프 디렉터리에 대한 쓰기 권한을 가지고 있는지 확인하십시오:
sudo chmod 777 /var/log/erl_crash.dump소유권을 확인하십시오:
ls -l /var/log/erl_crash.dump필요한 경우 소유권을 변경하십시오:
sudo chown erlang_user /var/log/erl_crash.dump덤프를 기록하기 전에 발생하는 크래시
덤프를 기록하기 전에 시스템의 메모리가 부족해지면 메모리를 미리 확보해 두어야 할 수 있습니다:
erlang:system_flag(reserved_memory, 1000000).또는 스왑 공간을 늘리십시오.
시스템 전역 제한
Linux/macOS 시스템 제한 때문에 덤프가 생성되지 않을 수 있습니다. 다음을 확인하십시오.
ulimit -acore file size가 0이면 이를 활성화하십시오:
ulimit -c unlimitedmacOS에서는 다음과 같습니다:
sudo launchctl limit core unlimitedNIF 내부 크래시
네이티브 구현 함수(NIF)가 크래시하면 Erlang이 이를 제대로 처리하지 못할 수 있습니다. 이러한 경우 BEAM 에뮬레이터를 gdb와 같은 디버거에서 실행하면 크래시 시점의 시스템 상태를 검사하는 데 도움이 될 수 있습니다.
18.8. 런타임 시스템 디버깅
Erlang 런타임 시스템(ERTS)은 복잡하기 때문에 그 안에서 발생하는 문제를 이해하고 진단하기가 어려울 수 있습니다. 하지만 GNU 디버거(GDB)와 같은 도구를 활용하면 이 프로세스에 큰 도움이 될 수 있습니다. 이 절에서는 GDB로 BEAM을 디버깅하는 방법을 개괄하며, 환경 설정과 GDB 매크로를 활용해 디버깅 작업 흐름을 간소화하는 방법도 함께 다룹니다.
18.8.1. GDB 사용하기
GDB는 머신 수준에서 애플리케이션을 디버깅하는 강력한 도구로, 컴파일된 프로그램이 어떻게 실행되는지 자세히 살펴볼 수 있게 해 줍니다. GDB를 BEAM에 적용하면 개발자는 실행 중이거나 크래시가 발생한 후의 Erlang 가상 머신 상태를 검사할 수 있습니다.
BEAM에서 GDB를 효과적으로 사용하려면 Erlang 런타임 시스템을 디버깅 심볼과 함께 컴파일하는 것이 좋습니다. 이렇게 컴파일하면 디버깅 세션 중에 상세한 정보를 얻을 수 있습니다.
디버깅 정보가 포함된 Erlang 버전을 컴파일하고 실행하는 명령어는 [Alternative Beam emulator builds](대체 BEAM 에뮬레이터 빌드)를 참조하십시오.
빌드가 끝나면 cerl 실행 스크립트를 사용하여 빌드 디렉터리에서 디버그 버전의 BEAM을 실행할 수 있습니다:
bin/cerl -debugGDB에서 Erlang을 실행하는 가장 쉬운 방법은 cerl과 함께 -rgdb 플래그를 사용하는 것이며, 이때 디버그 버전도 반드시 함께 선택해야 합니다:
bin/cerl -rgdb -debugGDB 프롬프트에 들어가면 브레이크포인트 등을 설정할 수 있으며, 준비가 되면 다음 명령으로 BEAM 실행을 시작하십시오:
(gdb) run비정상 종료된 실행에서 얻은 OS 코어 덤프가 있다면(Erlang 크래시 덤프와는 다른 것입니다. Section 18.7를 참조하십시오), 대신 -rcore 플래그를 붙여 cerl을 실행하여 GDB를 시작할 수 있습니다:
bin/cerl -rcore <core file>
Emacs 편집기 사용에 익숙하다면 cerl 명령에 -gdb 플래그와 -core 플래그(앞에 r 문자 없음)를 함께 사용할 수 있으며, 이렇게 하면 디버깅 세션용 IDE로 동작하는 Emacs 인스턴스가 실행됩니다. (먼저 EMACS=emacsclient 환경 변수를 설정해 두면, M-x server-start 명령을 실행해 둔 기존 Emacs 안에서 실행되게 할 수도 있습니다.) 자세한 내용은 Emacs GDB 문서를 참조하십시오.
|
이미 실행 중인 BEAM에 GDB를 연결하려면 해당 BEAM의 OS 프로세스 ID를 찾아야 합니다. 예를 들어, 별도의 셸 창에서 다음을 입력합니다
pgrep -l beam그러면 다음과 같은 결과가 출력됩니다
3140019 beam.debug.smp그런 다음 다음과 같이 실제로 사용 중인 실행 파일의 경로와 프로세스 ID를 지정하여 GDB를 실행할 수 있습니다:
gdb bin/x86_64-unknown-linux-gnu/beam.debug.smp 3140019(GDB에 bin/cerl 또는 bin/erl 경로를 사용하도록 지정할 수는 없다는 점에 유의하십시오. 이 둘은 BEAM 실행 파일에 적절한 환경 변수를 설정해 주는 셸 스크립트일 뿐이기 때문입니다.)
사용 중인 OS는 기본적으로 실행 중인 프로세스에 연결하는 것을 제한할 수 있으며, 이는 본인이 소유한 프로세스라도 마찬가지입니다. 이를 재설정하는 방법은 이 책의 범위를 벗어납니다.
GDB 매크로 사용하기
GDB 매크로는 반복 작업을 자동화하고 복잡한 명령의 단축 방법을 제공하여 디버깅 세션의 효율을 높여 줍니다. Erlang 런타임에는 병리학자를 위한 에뮬레이터 도구 상자(Emulator Toolbox for Pathologists, ETP)라고 하는 미리 정의된 GDB 매크로 모음이 포함되어 있으며, 이를 사용하면 내부 BEAM 구조, 프로세스 상태, 메모리 할당, 스케줄링 정보 등 BEAM의 여러 측면을 쉽게 검사할 수 있습니다.
ETP 매크로는 erts/etc/unix/etp-commands에서 찾을 수 있습니다. 이 매크로는 앞 절에서 설명한 대로 cerl 스크립트를 통해 GDB 세션을 시작하면 자동으로 로드됩니다. 그러면 etp-process-info 같은 매크로를 사용하여 특정 Erlang 프로세스에 대한 자세한 정보를 조회할 수 있습니다:
etp-process-info <process_pointer><process_pointer>를 확인하려는 프로세스 제어 블록(PCB)을 가리키는 실제 포인터로 바꾸십시오. 이 매크로들은 BEAM의 내부 구조에서 의미 있는 데이터를 추출하는 프로세스를 단순화합니다.
GDB를 사용하여 BEAM을 디버깅하고 이러한 매크로를 활용하는 방법에 대한 종합적인 안내는 Debugging the BEAM 및 Debug emulator 문서를 참고하십시오. 이 자료들은 상세한 명령어 사용법과 예제를 제공하여 Erlang 런타임 시스템 내의 문제를 효과적으로 진단하고 해결할 수 있도록 돕습니다.
18.8.2. SystemTap과 DTrace
SystemTap과 DTrace는 애플리케이션 코드를 수정하지 않고도 개발자가 시스템 동작을 실시간으로 분석하고 모니터링할 수 있게 해 주는 강력한 동적 트레이싱 프레임워크입니다. 이 도구들은 성능 병목 지점을 조사하고, 문제를 디버깅하며, 시스템 상호 작용을 저수준에서 이해하는 데 특히 유용합니다. 두 도구는 비슷한 목적으로 쓰이지만 서로 다른 운영 체제를 대상으로 설계되었습니다. SystemTap은 Linux에서 널리 사용되고, DTrace는 주로 Solaris, macOS, BSD 계열에서 사용됩니다.
이러한 도구를 Erlang과 함께 사용하면 BEAM 가상 머신의 동작, 프로세스 스케줄링, 가비지 컬렉션, 프로세스 간 통신을 깊이 있게 이해할 수 있습니다.
SystemTap과 DTrace 소개
SystemTap과 DTrace는 실행 중인 커널 및 사용자 공간 애플리케이션에 동적으로 생성된 프로브를 삽입하는 방식으로 동작합니다. 이러한 프로브는 실시간 데이터를 수집하므로, 개발자는 애플리케이션을 중단하거나 수정하지 않고도 프로그램 실행을 검사하고 분석할 수 있습니다.
-
SystemTap: Linux용으로 개발된 SystemTap은 스크립트를 사용하여 커널 이벤트, 사용자 공간 프로그램, 런타임 동작을 모니터링할 수 있게 해 줍니다. 주로 프로파일링, 결함 탐지, 시스템 인트로스펙션에 사용됩니다.
-
DTrace: 원래 Sun Microsystems가 Solaris용으로 개발한 DTrace는 강력한 스크립팅 언어와 함께 유사한 트레이싱 기능을 제공합니다. DTrace는 macOS, FreeBSD, SmartOS에서 널리 사용됩니다.
두 도구 모두 개발자가 함수 실행 시간을 측정하고, 시스템 호출을 트레이스하고, 메모리 사용량을 검사하고, 성능 최적화와 복잡한 애플리케이션 디버깅에 핵심적인 이벤트 기반 데이터를 수집할 수 있게 해 줍니다.
Erlang에서 SystemTap과 DTrace 사용하기
Erlang에서 SystemTap과 DTrace를 사용하려면 BEAM 런타임 시스템에서 필요한 트레이싱 지원을 활성화해야 합니다. 이를 통해 가상 머신에 프로브를 삽입하여 함수 호출, 메시지 전달, 가비지 컬렉션, 스케줄링 이벤트를 모니터링할 수 있습니다.
18.8.3. Erlang에서 SystemTap 사용하기
SystemTap 스크립트는 BEAM 에뮬레이터에 내장된 사용자 공간 마커를 사용합니다. SystemTap은 이 마커를 통해 다양한 내부 이벤트에 후킹할 수 있습니다. Erlang에서 SystemTap을 사용하려면 다음과 같이 하십시오.
-
SystemTap이 설치되어 있는지 확인하십시오(Ubuntu, Fedora, CentOS 등의 Linux 배포판에서):
sudo apt-get install systemtap systemtap-sdt-dev또는
sudo dnf install systemtap systemtap-devel-
Erlang의 SystemTap 프로브 활성화: BEAM VM은 SystemTap을 지원하지만,
--enable-systemtap옵션을 지정하여 컴파일해야 합니다:
./configure --enable-systemtap
make-
사용 가능한 프로브 목록 확인: BEAM 런타임에서 어떤 프로브를 사용할 수 있는지 확인하려면 다음과 같이 하십시오:
stap -L 'process("*beam.smp").mark("*")'-
SystemTap 스크립트를 작성합니다: 다음 예제는 BEAM VM의 함수 호출을 트레이스합니다:
probe process("beam.smp").mark("function_entry") {
printf("Function call in BEAM: %s\n", user_string($arg1))
}-
스크립트 실행: 스크립트를 실행하여 트레이싱을 시작하십시오:
sudo stap my_script.stp이를 통해 개발자는 함수 호출을 관찰하고, 병목 지점을 찾아내며, 성능 문제를 실시간으로 디버깅할 수 있습니다.
18.8.4. Erlang에서 DTrace 사용하기
DTrace는 BEAM 런타임과 직접 통합되어 시스템 동작을 깊이 들여다볼 수 있게 해 줍니다. 이를 통해 함수 호출, 메모리 할당, 가비지 컬렉션, 프로세스 간 통신을 트레이싱할 수 있습니다.
Dtrace는 Solaris에서 가장 잘 작동합니다. Linux용으로는 SystemTap과 함께 제공되는 버전이 있지만, Solaris 버전만큼 강력하지는 않습니다.
macOS에는 DTrace가 기본으로 설치되어 있습니다. Ubuntu에서는 다음 명령으로 설치할 수 있습니다:
sudo apt-get install systemtap-sdt-devBEAM VM에는 DTrace 지원이 내장되어 있습니다. 필요하다면 DTrace 지원을 포함하여 Erlang을 다시 빌드하십시오:
./configure --with-dtrace
make-
간단한 DTrace 스크립트 작성하기: 다음 스크립트는 Erlang 함수 호출을 트레이스합니다:
syscall::write:entry
/execname == "beam.smp"/ {
printf("Erlang process writing output\n");
}-
스크립트 실행: DTrace를 실행하여 트레이싱을 시작하십시오:
sudo dtrace -s my_script.d이를 통해 BEAM 가상 머신의 내부 동작을 실시간으로, 시스템에 영향을 주지 않고 모니터링할 수 있습니다.
19. 트레이싱
동시성 시스템과 분산 시스템은 특히 디버깅과 모니터링 측면에서 고유한 어려움과 복잡성을 안고 있습니다. 이러한 상황에서 트레이싱은 개발자가 실행 중인 시스템의 동작을 들여다볼 수 있는 창을 제공하므로 유용합니다. 이 장에서는 먼저 BEAM에서 트레이싱이 하는 역할을 살펴봅니다.
트레이싱을 통해 프로세스 실행, 프로세스 간 통신, 시스템의 전반적인 동작을 들여다볼 수 있습니다. Erlang 시스템은 견고성과 장애 허용성으로 잘 알려져 있으며, 이는 우리가 달성하고자 하는 특성입니다. 하지만 이러한 특성 때문에 오류나 예상치 못한 동작의 원인을 정확히 짚어내기가 어려워질 수 있습니다. 트레이싱을 사용하면 개발자는 실행 흐름을 실시간으로 또는 기록된 로그를 통해 따라갈 수 있으므로 버그를 더 쉽게 찾아내고 수정할 수 있습니다. 트레이싱은 Erlang 애플리케이션의 성능을 모니터링하는 데에도 중요한 함수, 즉 핵심적인 기능을 합니다. 함수 호출, 메시지 전달, 그 밖의 시스템 활동을 트레이싱하면 개발자는 성능 병목, 비효율적인 코드 경로, 예상치 못한 시스템 동작에 관한 데이터를 수집할 수 있습니다. Erlang의 트레이싱 기능은 시스템 동작에 대한 통찰을 제공하는 데까지 확장됩니다. 트레이싱은 시스템의 여러 부분이 어떻게 상호 작용하고, 어떻게 확장되며, 장애에서 어떻게 복구되는지 이해하는 데 도움이 됩니다. 따라서 트레이싱은 개발자가 시스템 동작을 더 정확하게 모델링하고 예측할 수 있게 해 주는 학습 도구가 됩니다.
ERTS에서 제공하는 트레이싱 도구 몇 가지와, 이 내장 지원 기능을 기반으로 만들어진 도구 몇 가지를 살펴보겠습니다.
19.1. 내장 Erlang 트레이싱 기능
19.1.1. io:format 트레이싱
io:format은 일반적인 의미의 트레이싱 도구는 아니지만, 다른 프로그래밍 언어의 printf 디버깅 같은 전통적인 디버깅 기법에 해당하는 Erlang의 도구 역할을 합니다. 개발자는 이를 사용해 코드 안에 출력문을 넣을 수 있으며, 이를 통해 변수 상태, 함수 호출 결과, 프로세스 상태를 즉시 간단하게 출력할 수 있습니다. 이 방법은 누구나 쉽게 사용할 수 있고 설정도 거의 필요하지 않으므로, 더 정교한 트레이싱 도구를 사용하기 전에 문제를 파악하는 훌륭한 첫 단계가 됩니다.
19.1.2. Erlang 트레이스(erl_tracer)
이 트레이싱 기능은 Erlang 함수, 메시지, 프로세스를 트레이싱하기 위한 저수준 인터페이스를 제공합니다. 이 기능은 상위 수준 트레이싱 도구의 기반이 되는 핵심 기능을 제공하며, Erlang 런타임이 직접 지원하는 필수 트레이싱 프리미티브를 제공합니다.
19.1.3. 순차 트레이싱(seq_trace)
분산 Erlang 시스템 내에서 메시지의 흐름을 트레이싱하는 데 특화된 seq_trace는 개발자가 프로세스 간 메시지 전달의 순서를 추적할 수 있게 해 줍니다.
19.2. 서드파티 도구
19.2.1. Redbug
Redbug는 eper 성능 및 디버깅 도구 모음의 일부이며, 사용하기 쉬운 인터페이스와 성능에 미치는 영향이 매우 적다는 점으로 잘 알려져 있습니다. Redbug는 안전하고 효율적인 트레이싱에 중점을 두어, 감당할 수 없을 만큼 많은 트레이스 출력이나 시스템 과부하 같은 흔한 함정을 피하므로 실행 중인 시스템을 분석하는 데 이상적인 선택입니다. Redbug는 외부 라이브러리이므로 별도로 설치해야 합니다. redbug의 가장 뛰어난 기능 중 하나는 과부하가 발생하면 스스로 종료하는 능력입니다.
Redbug 설치하기
다음 명령으로 redbug를 클론할 수 있습니다:
$ git clone https://github.com/massemanet/redbug그런 다음 다음과 같이 컴파일할 수 있습니다:
$ cd redbug
$ makeErlang 셸을 시작할 때 redbug가 경로에 포함되어 있는지 확인하기만 하면 바로 사용할 수 있습니다. 이는 erl을 실행할 때 redbug BEAM 파일의 경로를 명시적으로 추가하면 됩니다:
$ erl -pa /path/to/redbug/ebin또는 ~/.erlang 파일에 다음 줄을 추가할 수도 있습니다. 이렇게 하면 시작할 때마다 redbug 경로가 자동으로 포함됩니다:
code:add_patha("/path/to/redbug/ebin").Redbug 사용하기
Redbug은 과부하에 대비한 자체 보호 메커니즘 덕분에 프로덕션 환경에서도 안전하게 사용할 수 있습니다. 이 메커니즘은 트레이싱 메시지가 너무 많이 전송되면 도구를 종료하여 Erlang 노드에 과부하가 걸리지 않도록 막습니다. 실제로 어떻게 동작하는지 살펴봅시다:
$ erl
Erlang/OTP 19 [erts-8.2] [...]
Eshell V8.2 (abort with ^G)
1> l(redbug). (1)
{module,redbug}
2> redbug:start("lists:sort/1"). (2)
{30,1}
3> lists:sort([3,2,1]).
[1,2,3]
% 15:20:20 <0.31.0>({erlang,apply,2}) (3)
% lists:sort([3,2,1])
redbug done, timeout - 1 (4)| 1 | 먼저 redbug 모듈을 사용할 수 있고 로드되어 있는지 확인합니다. |
| 2 | 그런 다음 redbug를 시작합니다. 우리가 관심을 두는 함수는 lists 모듈이 익스포트하는, 이름이 sort이고 애리티가 1인 함수입니다. Erlang 용어에서 애리티(arity)는 주어진 함수가 받는 입력 인자의 개수를 나타낸다는 점을 기억하십시오. |
| 3 | 마지막으로 lists:sort/1 함수를 호출하고, redbug가 메시지를 생성하는지 확인합니다. |
| 4 | 기본 타임아웃(15초)에 도달하면 redbug는 멈추고 "redbug done"이라는 메시지를 표시합니다. 또한 Redbug는 친절하게도 멈춘 이유(timeout)와 그 시점까지 수집된 메시지의 수(1)도 알려 줍니다. |
이제 redbug가 실제로 생성한 메시지를 살펴보겠습니다. 기본적으로 메시지는 표준 출력으로 출력되지만, 파일로 덤프할 수도 있습니다:
% 15:20:20 <0.31.0>({erlang,apply,2})
% lists:sort([3,2,1])사용 중인 redbug 버전에 따라 메시지가 약간 다를 수 있습니다. 이 경우 메시지는 두 줄로 나뉩니다. 첫 번째 줄에는 타임스탬프, 함수를 호출한 Erlang 프로세스의 프로세스 식별자(또는 PID), 그리고 호출자 함수가 들어 있습니다. 두 번째 줄에는 입력 인자를 포함하여 호출된 함수가 들어 있습니다. 두 줄 모두 앞에 %가 붙어 있는데, 이는 Erlang 주석 문법을 떠올리게 합니다.
redbug에 반환값에 대한 추가 메시지를 생성하도록 요청할 수도 있습니다. 이는 다음 구문을 사용하여 수행합니다:
4> redbug:start("lists:sort/1->return").
{30,1}lists:sort/1 함수를 다시 호출해 봅시다. 이번에는 redbug의 출력이 약간 다릅니다.
5> lists:sort([3,2,1]).
[1,2,3]
% 15:35:52 <0.31.0>({erlang,apply,2})
% lists:sort([3,2,1])
% 15:35:52 <0.31.0>({erlang,apply,2})
% lists:sort/1 -> [1,2,3]
redbug done, timeout - 1이 경우에는 메시지가 두 개 생성되는데, 하나는 함수에 진입할 때, 다른 하나는 같은 함수에서 빠져나올 때 생성됩니다.
실제 코드를 다룰 때는 트레이스 메시지가 복잡해져서 읽기 어려울 수 있습니다. 원소 10,000개가 담긴 리스트의 정렬 과정을 트레이스하면 어떻게 되는지 살펴봅시다.
6> lists:sort(lists:seq(10000, 1, -1)).
[1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,
23,24,25,26,27,28,29|...]
% 15:48:42.208 <0.77.0>({erlang,apply,2})
% lists:sort([10000,9999,9998,9997,9996,9995,9994,9993,9992,9991,9990,9989,9988,9987,9986,
% 9985,9984,9983,9982,9981,9980,9979,9978,9977,9976,9975,9974,9973,9972,9971,
% 9970,9969,9968,9967,9966,9965,9964,9963,9962,9961,9960,9959,9958,9957,9956,
% 9955,9954,9953,9952,9951,9950,9949,9948,9947,9946,9945,9944,9943,9942,9941,
% 9940,9939,9938,9937,9936,9935,9934,9933,9932,9931,9930,9929,9928,9927,9926,
% 9925,9924,9923,9922,9921,9920,9919,9918,9917,9916,9915,9914,9913,9912,9911,
% [...]
% 84,83,82,81,80,79,78,77,76,75,74,73,72,71,70,69,68,67,66,65,64,63,62,61,60,
% 59,58,57,56,55,54,53,52,51,50,49,48,47,46,45,44,43,42,41,40,39,38,37,36,35,
% 34,33,32,31,30,29,28,27,26,25,24,23,22,21,20,19,18,17,16,15,14,13,12,11,10,9,
% 8,7,6,5,4,3,2,1])
% 15:48:42.210 <0.77.0>({erlang,apply,2}) lists:sort/1 ->
% [1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,
% 23,24,25,26,27,28,29,30,31,32,33,34,35,36,37,38,39,40,41,
% 42,43,44,45,46,47,48,49,50,51,52,53,54,55,56,57,58,59,60,
% 61,62,63,64,65,66,67,68,69,70,71,72,73,74,75,76,77,78,79,
% 80,81,82,83,84,85,86,87,88,89,90,91,92,93,94,95,96,97,98,
% 99,100,101,102,103,104,105,106,107,108,109,110,111,112,113,
% [...]
% 9951,9952,9953,9954,9955,9956,9957,9958,9959,9960,9961,
% 9962,9963,9964,9965,9966,9967,9968,9969,9970,9971,9972,
% 9973,9974,9975,9976,9977,9978,9979,9980,9981,9982,9983,
% 9984,9985,9986,9987,9988,9989,9990,9991,9992,9993,9994,
% 9995,9996,9997,9998,9999,10000]
redbug done, timeout - 1여기서는 출력의 대부분이 잘려 있지만, 대략적인 내용은 파악하실 수 있을 것입니다. 상황을 개선하기 위해 몇 가지 redbug 옵션을 사용할 수 있습니다. {arity, true} 옵션은 redbug가 주어진 함수의 입력 인수를 실제 값 대신 그 개수만 표시하도록 지시합니다. {print_return, false} 옵션은 redbug가 함수 호출의 반환값을 표시하지 않고, 그 대신 … 기호를 표시하도록 합니다. 이 옵션들이 실제로 어떻게 동작하는지 살펴봅시다.
7> redbug:start("lists:sort/1->return", [{arity, true}, {print_return, false}]).
{30,1}
8> lists:sort(lists:seq(10000, 1, -1)).
[1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16,17,18,19,20,21,22,
23,24,25,26,27,28,29|...]
% 15:55:32 <0.77.0>({erlang,apply,2})
% lists:sort/1
% 15:55:32 <0.77.0>({erlang,apply,2})
% lists:sort/1 -> '...'
redbug done, timeout - 1기본적으로 redbug는 15초가 지나거나 메시지 10개를 받으면 멈춥니다. 이 값들은 안전한 기본값이지만, 충분한 경우는 드뭅니다. time 옵션과 msgs 옵션을 사용하면 이 제한을 늘릴 수 있습니다. time은 밀리초 단위로 지정합니다.
9> redbug:start("lists:sort/1->return", [{arity, true}, {print_return, false}, {time, 60 * 1000}, {msgs, 100}]).
{30,1}여러 함수 호출에 대해 redbug를 동시에 활성화할 수도 있습니다. lists:sort/1 함수와 lists:sort_1/3 함수(전자가 사용하는 내부 함수) 모두에 대해 트레이싱을 활성화해 봅시다:
10> redbug:start(["lists:sort/1->return", "lists:sort_1/3->return"]).
{30,2}
11> lists:sort([4,4,2,1]).
[1,2,4,4]
% 18:39:26 <0.32.0>({erlang,apply,2})
% lists:sort([4,4,2,1])
% 18:39:26 <0.32.0>({erlang,apply,2})
% lists:sort_1(4, [2,1], [4])
% 18:39:26 <0.32.0>({erlang,apply,2})
% lists:sort_1/3 -> [1,2,4,4]
% 18:39:26 <0.32.0>({erlang,apply,2})
% lists:sort/1 -> [1,2,4,4]
redbug done, timeout - 2마지막으로 중요한 기능이 하나 더 있습니다. redbug는 입력 인자가 일치하는 경우에만 결과를 표시하는 기능을 제공합니다. 이때 구문이 마치 마법처럼 보입니다.
12> redbug:start(["lists:sort([1,2,5])->return"]).
{30,1}
13> lists:sort([4,4,2,1]).
[1,2,4,4]
14> lists:sort([1,2,5]).
[1,2,5]
% 18:45:27 <0.32.0>({erlang,apply,2})
% lists:sort([1,2,5])
% 18:45:27 <0.32.0>({erlang,apply,2})
% lists:sort/1 -> [1,2,5]
redbug done, timeout - 1위 예제에서는 redbug에게 입력 인수가 리스트 [1,2,5]일 때의 lists:sort/1 함수 호출에만 관심이 있다고 알려 주고 있습니다. 이렇게 하면 대상 함수를 여러 액터가 동시에 사용하는데 그중 특정 사용 사례에만 관심이 있는 경우, 엄청난 양의 노이즈를 걸러낼 수 있습니다. 아, 그리고 밑줄을 와일드카드로 사용할 수 있다는 점도 잊지 마십시오:
15> redbug:start(["lists:sort([1,_,5])->return"]). {30,1}
16> lists:sort([1,2,5]). [1,2,5]
% 18:49:07 <0.32.0>({erlang,apply,2}) lists:sort([1,2,5])
% 18:49:07 <0.32.0>({erlang,apply,2}) lists:sort/1 -> [1,2,5]
17> lists:sort([1,4,5]). [1,4,5]
% 18:49:09 <0.32.0>({erlang,apply,2}) lists:sort([1,4,5])
% 18:49:09 <0.32.0>({erlang,apply,2}) lists:sort/1 -> [1,4,5] redbug
% done, timeout - 2이 절은 redbug에 대한 포괄적인 안내서를 표방하지는 않지만, 시작하기에는 충분할 것입니다. redbug에서 사용할 수 있는 옵션의 전체 목록을 보려면 도구 자체에 물어보면 됩니다:
18> redbug:help().19.2.2. Recon 트레이스(recon_trace)
recon_trace는 프로덕션 시스템 진단을 위한 recon 라이브러리의 구성 요소로, 안전성과 최소한의 성능 영향을 염두에 두고 설계된 강력한 트레이싱 기능이 돋보입니다.
19.2.3. 비교 및 사용 사례
내장 도구와 서드파티 도구 중 무엇을 선택할지는 주로 구체적인 디버깅 요구에 따라 달라집니다. io:format은 간단하고 빠른 디버깅 방법을 제공하는 반면, erl_tracer나 recon_trace 같은 도구는 더 포괄적인 트레이싱 기능으로 더 깊은 통찰을 제공합니다.
redbug, recon_trace 등 운영 중인 시스템에 미치는 영향을 최소화하도록 설계된 도구는 프로덕션 환경에서 특히 유용합니다. 이러한 도구를 사용하면 성능을 크게 떨어뜨리지 않고 문제를 실시간으로 진단할 수 있습니다.
seq_trace는 분산 Erlang 노드 전반에서 이루어지는 메시지 전달과 프로세스 간 상호작용의 역학에 대한 핵심적인 통찰을 제공합니다.
20. BEAM 생태계에서의 테스트
20.1. 소개
이 장에서는 개발 과정에서 Erlang 코드의 신뢰성과 견고성을 확보하는 방법을 살펴보겠습니다. 먼저 애플리케이션의 테스트를 쉽게 작성하고 실행할 수 있게 해 주는 인기 있는 테스트 프레임워크인 EUnit부터 살펴보겠습니다.
20.1.1. EUnit
EUnit은 개별 프로그램 단위를 테스트할 수 있게 해 주는 Erlang 단위 테스트 프레임워크입니다. 이러한 단위는 함수와 모듈에서부터 프로세스, 나아가 애플리케이션 전체에 이르기까지 다양합니다. EUnit은 테스트를 작성하고 실행하며 그 결과를 분석하는 일을 도와, 코드가 올바르고 신뢰할 수 있도록 보장합니다.
기초와 설정
Erlang 모듈에서 EUnit을 사용하려면 -module 선언 뒤에 다음 줄을 포함하십시오.
-include_lib("eunit/include/eunit.hrl").이 줄은 EUnit의 기능을 사용할 수 있게 해 주며, 모듈에 있는 모든 단위 테스트를 실행하는 test() 함수를 내보냅니다.
테스트 케이스와 테스트 스위트 작성하기
간단한 테스트 함수를 만들려면 인수를 받지 않고 이름이 _test()로 끝나는 함수를 정의하십시오. 이 함수는 값을 반환하여 성공하거나 예외를 던져 실패해야 합니다.
더 복잡한 테스트 케이스를 만들려면 =를 사용한 패턴 매칭을 활용하십시오. 예를 들면 다음과 같습니다.
reverse_nil_test() -> [] = lists:reverse([]).또는 ?assert(Expression) 매크로를 사용하여 표현식을 평가하는 테스트 케이스를 작성할 수도 있습니다:
length_test() -> ?assert(length([1,2,3]) =:= 3).테스트 실행 및 결과 분석
모듈에 EUnit 선언을 포함했다면, 모듈을 컴파일한 뒤 자동으로 익스포트되는 test() 함수를 실행하십시오. 예를 들어 모듈 이름이 m이라면, m:test()를 호출하여 모듈 안의 모든 테스트에 대해 EUnit을 실행하십시오.
EUnit은 eunit:test/1 함수로도 테스트를 실행할 수 있습니다. 예를 들어, eunit:test(m)을 호출하는 것은 m:test()를 호출하는 것과 같습니다.
테스트 코드를 일반 코드와 분리하려면, 모듈 이름이 m인 경우 테스트 함수를 m_tests라는 이름의 모듈에 작성하십시오. EUnit에 모듈 m을 테스트하도록 요청하면, EUnit은 모듈 m_tests도 찾아서 그 테스트들을 실행합니다.
EUnit은 테스트 함수의 표준 출력을 캡처하므로, 테스트 코드가 표준 출력에 쓰는 텍스트는 콘솔에 나타나지 않습니다. 이를 우회하려면 EUnit 디버깅 매크로를 사용하거나, io:format(user, "~w", [Term])처럼 user 출력 스트림에 쓰십시오.
테스트 대상 유닛이 생성하는 출력을 확인하는 방법에 대한 자세한 내용은 출력 확인용 매크로에 관한 EUnit 문서를 참조하십시오.
20.1.2. Common Test
기본 사항 및 설정
Common Test(CT)는 Erlang/OTP에 포함된 강력한 테스트 프레임워크로, 테스트 스위트를 작성하고 실행하는 데 사용합니다. 화이트박스 테스트와 블랙박스 테스트를 모두 지원하므로 Erlang 애플리케이션과 분산 시스템을 테스트하는 데 유연하게 쓸 수 있으며, 외부 시스템과의 상호작용까지 테스트할 수 있습니다.
Common Test 설치
Erlang이 설치되어 있다면 Common Test는 이미 포함되어 있을 것입니다. 그러나 최소 설치 환경이나 커스텀 빌드로 작업하고 있다면, 의존성에 common_test 애플리케이션을 추가하여 Common Test를 확실히 사용할 수 있도록 할 수 있습니다.
common_test가 설치되어 있는지 확인하려면:
1> application:ensure_all_started(common_test).rebar3를 사용하는 경우, 의존성에 추가되어 있는지 확인하십시오:
{deps, [common_test]}.기본 테스트 스위트 만들기
Common Test 스위트는 특정 구조를 따르는 Erlang 모듈일 뿐입니다. 먼저 test/ 디렉터리에 sample_SUITE.erl이라는 이름의 파일을 만드십시오.
예제 sample_SUITE.erl:
-module(sample_SUITE).
-compile(export_all).
% Common Test includes these callbacks
-include_lib("common_test/include/ct.hrl").
% Test suite information
suite() ->
[{timetrap, {seconds, 10}}]. % Time limit for tests
init_per_suite(Config) ->
io:format("Initializing test suite...~n"),
Config.
end_per_suite(Config) ->
io:format("Cleaning up test suite...~n"),
Config.
% Define test cases
all() -> [simple_test].
simple_test(_Config) ->
io:format("Running simple test case...~n"),
?assertEqual(42, 21 + 21).이 테스트 스위트는 suite/0으로 테스트 스위트를 정의하고, init_per_suite/1과 end_per_suite/1을 사용하여 설정 및 정리를 수행하며, 21 + 21 = 42임을 단언하는 테스트 케이스 simple_test/1을 정의합니다.
테스트 케이스와 테스트 스위트 작성하기
Common Test의 테스트 케이스는 어설션과 검사를 실행하는 함수입니다. 테스트 케이스는 간단한 명명 규칙을 따르며, 반드시 all/0 함수에 나열되어야 합니다.
Common Test는 ct.hrl에서 어서션 매크로를 제공합니다:
?assert(Expression).
?assertEqual(Expected, Actual).
?assertNotEqual(Unexpected, Actual).
?assertMatch(Pattern, Expression).
?assertNotMatch(Pattern, Expression).여러 테스트 케이스의 예입니다:
all() -> [math_test, string_test].
math_test(_Config) ->
?assertEqual(10, 5 * 2).
string_test(_Config) ->
?assertEqual("hello", string:to_lower("HELLO")).테스트 케이스는 설정 파일이나 앞서 실행된 셋업 함수로부터 인자를 받을 수 있습니다.
init_per_testcase(math_test, Config) ->
[{base_value, 10} | Config];
init_per_testcase(_, Config) -> Config.
math_test(Config) ->
Base = proplists:get_value(base_value, Config),
?assertEqual(Base * 2, 20).테스트 실행 및 결과 분석
테스트는 ct_run 또는 rebar3를 사용하여 실행합니다.
Erlang 셸에서:
ct:run_test([{dir, "test/"}]).rebar3 사용 시:
rebar3 ct테스트 출력 이해하기
Common Test는 _build/test/logs/ 디렉터리에 상세한 로그를 생성합니다.
로그 파일:
-
ct_run.*.log- 주 테스트 실행 로그 -
suite.log- 특정 테스트 스위트의 실행 내용을 기록합니다 -
testcase.log- 특정 테스트 케이스의 실행을 기록합니다.
실시간 디버깅이 필요하면 상세 출력을 활성화할 수 있습니다:
ct:run_test([{dir, "test/"}, {verbosity, high}]).20.1.3. 기타 테스트 프레임워크 및 기법
Common Test는 Erlang/OTP에 포함된 표준 테스트 프레임워크이지만, 개발자들은 테스트 커버리지와 신뢰성을 높이고 자동화를 개선하기 위해 이 밖에도 여러 테스트 프레임워크와 방법론을 자주 사용합니다. 이러한 도구는 속성 기반 테스트, 모킹 등의 추가 기능을 제공하며, 이를 통해 Erlang 애플리케이션의 복잡한 동작과 상호작용을 검증할 수 있습니다. 이러한 기법을 자세히 살펴보는 것은 이 책의 범위를 벗어나지만, 테스트 도구를 넓히고자 하는 분들을 위해 이 절에서 간략히 소개합니다.
속성 기반 테스트
속성 기반 테스트는 시스템이 항상 만족해야 하는 속성을 바탕으로 방대한 수의 테스트 케이스를 생성한다는 점에서 전통적인 단위 테스트와 다릅니다. 개발자는 개별 테스트 케이스를 작성하는 대신 속성을 정의하고, 프레임워크는 그 속성이 광범위한 시나리오에서 성립하는지 검증하기 위한 입력을 자동으로 생성합니다. 이 접근 방식은 수동으로 작성한 테스트로는 다루지 못할 수 있는 엣지 케이스를 잡아내는 데 특히 유용합니다.
Erlang 생태계에서 널리 쓰이는 속성 기반 테스트 라이브러리로는 QuickCheck 및 PropEr 두 가지가 있습니다:
-
QuickCheck(상용 버전과 오픈 소스 버전이 있습니다)는 무작위 테스트 케이스를 생성하고, 실패한 케이스를 최소한의 반례로 줄여 주는 강력한 도구입니다.
-
PropEr(Property-Based Testing for Erlang, Erlang용 속성 기반 테스트)는 비슷한 기능을 갖춘 오픈 소스 대안으로, 타입 명세를 사용한 속성 정의, 생성기, 상태 기반 테스트를 지원합니다.
속성 기반 테스트는 입력 공간이 복잡한 알고리즘, 프로토콜, 시스템을 검증하는 데 매우 효과적입니다. 그러나 명시적인 테스트 케이스를 작성하던 방식에서 시스템의 불변 조건과 제약 조건을 정의하는 방식으로 사고방식을 전환해야 합니다.
모킹
모킹은 테스트에서 의존성이나 외부 구성 요소를 제어 가능한 대체물로 바꾸는 데 사용하는 기법입니다. 이 기법은 특히 단위 테스트 과정에서 유용합니다. 함수나 모듈을 의존성으로부터 격리하면 전체 시스템을 통합하지 않고도 특정 동작을 더 쉽게 테스트할 수 있기 때문입니다.
-
목(mock)을 사용하면 코드를 격리된 상태에서 테스트할 수 있으므로, 함수가 의존성의 실제 구현과 관계없이 올바르게 동작하도록 보장할 수 있습니다.
-
이들은 데이터베이스나 네트워크 서비스 같은 외부 시스템과의 상호 작용을 피하므로 테스트 실행 속도를 높여 줍니다.
-
목(mock)을 사용하면 타임아웃이나 실패, 의존성의 예기치 않은 응답을 시뮬레이션하는 등 엣지 케이스를 통제된 방식으로 테스트할 수 있습니다.
모킹 프레임워크가 흔히 쓰이는 일부 객체 지향 언어와 달리, Erlang은 함수형 특성과 메시지 전달 모델 때문에 모킹에 다른 접근 방식이 필요합니다. 흔히 쓰이는 전략은 다음과 같습니다.
-
함수 재정의를 이용한 수동 모킹: 고차 함수나 명시적인 모듈 교체를 사용하는 방법입니다.
-
meck사용: 런타임에 모듈 함수를 교체하여 통제된 테스트를 할 수 있게 해 주는 널리 쓰이는 모킹 라이브러리입니다. -
프로세스 기반 목(mock): 미리 정의된 응답을 반환하는 경량 프로세스로 외부 시스템을 시뮬레이션합니다.
모킹 모범 사례
Erlang 테스트에서 모킹을 사용할 때는 다음 모범 사례를 고려하십시오:
-
목(mock)은 꼭 필요한 경우에만 사용하십시오. 통합 테스트가 가능하다면 실제 구현을 사용하는 편이 좋습니다.
-
테스트 결과가 잘못된 판단으로 이어지지 않도록 모킹된 동작을 현실적으로 유지하십시오.
-
적용할 수 있는 경우 목(mock)을 속성 기반 테스트와 결합하여 특정 의존성을 제어하면서도 더 넓은 테스트 커버리지를 확보하십시오.
속성 기반 테스트와 모킹은 특정 테스트 시나리오에서 매우 유용할 수 있지만, 효과적으로 활용하려면 더 깊은 이해와 모범 사례에 따른 구현이 필요합니다. 이러한 주제를 더 폭넓게 다룬 내용은 "PropEr, Erlang, Elixir를 활용한 속성 기반 테스트(Property-Based Testing with PropEr, Erlang, and Elixir)"와 Meck 같은 전문 자료를 살펴보시기 바랍니다.
21. 프로파일링, 모니터링 및 성능 최적화
"먼저 동작하게 만들고, 그다음 아름답게 만들고, 그러고 나서 정말, 정말 그래야만 한다면 빠르게 만드십시오. 90%의 경우, 아름답게 만들면 이미 빠를 것입니다." - Joe Armstrong
성능 최적화는 견고하고 확장 가능한 시스템을 구축하는 데 매우 중요한 요소입니다. 병목 지점을 찾아내고 시스템 성능을 개선하려면 기반이 되는 실행 모델과 메모리 관리 전략을 이해해야 합니다. 이 장에서는 고성능 Erlang 및 Elixir 애플리케이션을 구축하는 데 도움이 되는 프로파일링 도구, 모니터링 기법, 최적화 전략을 살펴봅니다.
21.1. BEAM 성능의 기초
지금까지 이 책에서 다룬 핵심 개념 몇 가지를 간단히 되짚어 봅시다.
BEAM의 성능은 고도의 동시성과 장애 허용성을 갖춘 시스템을 위해 설계된 실행 모델과 근본적으로 맞물려 있습니다. BEAM 가상 머신은 프로세스 지향 모델로 동작하며, 이 모델에서 각 Erlang 프로세스는 격리된 자체 힙을 가지고 독립적으로 실행됩니다. 이러한 설계는 프로세스 간 경합을 최소화하지만, 특히 메모리 사용량과 메시지 전달 측면에서 몇 가지 성능상의 트레이드오프를 수반합니다.
BEAM에서의 실행은 리덕션을 중심으로 구성되며, 리덕션은 프로세스가 수행하는 작업의 단위를 나타냅니다. 각 프로세스에는 정해진 수의 리덕션이 할당되며, 이를 소진하면 다른 프로세스에 자리를 내주도록 선점되므로 실행 중인 모든 개체에 걸쳐 공정한 스케줄링이 보장됩니다. 스케줄러 자체는 멀티코어 효율성을 고려하여 설계되었으며, 일반적으로 CPU 코어 하나당 스케줄러 하나를 실행합니다. 스케줄러 간 부하 분산은 동적으로 처리되며, 워크 스틸링(work-stealing) 전략은 고른 활용률을 유지하는 데 도움이 됩니다. 타이밍 휠(timing wheel)은 예약된 작업을 관리하여, 과도한 CPU 오버헤드 없이 타임아웃과 지연된 메시지를 효율적으로 처리하도록 보장합니다.
BEAM의 프로세스 간 통신은 비동기 메시지 전달 모델을 따릅니다. 프로세스는 메모리를 공유하지 않으므로, 공유 바이너리 같은 특정 최적화가 적용되지 않는 한 메시지는 한 프로세스의 힙에서 다른 프로세스의 힙으로 복사됩니다. 이 때문에 메시지를 매우 자주 주고받는 상황에서는 비효율이 생길 수 있습니다. 외부 시스템과의 인터페이스 역할을 하는 포트는 스케줄러가 블로킹되지 않도록 비동기 통신 메커니즘을 사용합니다. 이는 BEAM 런타임 외부의 I/O 바운드 작업이나 연산 집약적인 작업과 연동할 때 특히 중요합니다.
BEAM의 메모리 관리는 프로세스마다 따로 두는 전용 힙을 중심으로 구성됩니다. 이 방식은 잠금을 최소화하지만, 가비지 컬렉션 전략을 신중하게 세워야 합니다. 세대별 가비지 컬렉터가 프로세스 단위로 동작하며, 수명이 짧은 데이터는 효율적으로 수집하고 수명이 긴 데이터는 계속 남아 있게 합니다. 큰 바이너리는 불필요한 중복을 피하기 위해 공유 힙에서 별도로 관리되지만, 잘못 다루면 메모리 단편화가 생길 수 있습니다. ETS(Erlang 텀 저장소) 테이블은 공유 데이터 저장을 위한 대안을 제공하지만, ETS에 대한 연산은 텀 복사를 수반하므로 처리량이 높은 애플리케이션에서는 오버헤드가 생길 수 있습니다.
BEAM의 데이터 구조는 불변 설계를 따르므로, 튜플과 맵을 갱신하면 제자리에서 수정되지 않고 복사가 일어납니다. 이렇게 갱신할 때 복사하는(copy-on-update) 동작은 안전성을 보장하지만, 큰 구조를 자주 수정하면 비용이 커질 수 있습니다. BEAM 성능을 최적화하려면 불필요한 복사를 최소화하도록 데이터를 구성하고, 접근 패턴에 따라 알맞은 저장 메커니즘을 활용해야 합니다.
21.2. 프로파일링 도구
BEAM에는 시간이 어디에서 소비되는지, 더 나아가 성능 문제가 어디에 숨어 있는지 살펴볼 수 있는 내장 프로파일러가 여럿 갖춰져 있습니다. 프로파일링에 사용할 수 있는 redbug나 recon 같은 외부 도구도 있습니다. 도구마다 고유한 강점과 트레이드오프가 있습니다.
21.2.1. fprof
fprof는 코드를 계측하여 타이밍 정보가 포함된 상세한 호출 그래프를 수집하는 트레이스 기반 프로파일러입니다. 모든 함수 호출을 수집한 다음, 별도의 후처리 단계에서 그 방대한 트레이스를 사람이 읽을 수 있는 보고서로 변환합니다. 어떤 함수가 느린지뿐만 아니라 함수들이 어떻게 중첩되어 있는지까지 파악하고 싶다면, fprof가 그 전모를 보여 줍니다. 단점은 무엇입니까? 오버헤드가 상당할 수 있으므로 실행 중인 시스템보다는 격리된 테스트 환경에서 사용하는 것이 가장 좋습니다.
21.2.2. eprof
eprof 도구는 모든 호출을 하나하나 수집하기보다는 실행 시간 측정에 초점을 맞춥니다. 실행 중인 시스템을 샘플링하여 각 함수의 실행 시간을 집계된 형태로 보여 줍니다. eprof는 상세함과 오버헤드 사이에서 적절한 균형을 이룹니다. 그 보고서는 fprof가 쏟아 내는 방대한 데이터 없이도 코드의 핫스폿을 잘 드러냅니다. 따라서 빠르게 성능을 두루 점검하는 데 이상적입니다.
21.2.3. cprof
cprof 도구는 시간에 따라 함수 호출을 샘플링하는 통계적 접근 방식을 취합니다. cprof는 완전한 호출 그래프를 생성하는 대신 데이터를 집계하여 애플리케이션의 “핫스팟”을 정확히 찾아냅니다. 실행 경로의 세세한 굴곡까지 모두 알려 주지는 못할 수도 있지만, 처리 시간의 대부분이 어디에서 소비되는지 전체적으로 조망하는 데에는 매우 뛰어납니다.
21.2.4. tprof
tprof 도구(흔히 트레이스 프로파일러로 여겨집니다)는 Erlang에 내장된 트레이싱 기능을 활용합니다. 이 도구는 트레이스 플래그를 설정하여 완전한 계측보다 덜 침습적일 수 있는 방식으로 성능 데이터를 수집합니다. 생성된 보고서를 후처리하면 시간 정보와 호출 관계를 모두 파악할 수 있습니다. 이 도구는 장시간 실행되는 프로세스나 운영 중인 프로세스를 프로파일링해야 할 때 특히 유용하지만, 설정은 다소 더 까다롭습니다.
21.2.5. Recon과 Redbug
Recon과 redbug는 런타임 진단에서 강력한 힘을 발휘하는 커뮤니티 주도 라이브러리입니다. 두 라이브러리 모두 실무에서 사용하도록 설계되었으며, 필요할 때 바로 문제를 해결할 수 있도록 프로덕션 시스템에 투입할 수 있을 만큼 가볍습니다.
21.2.6. Observer
Observer는 Erlang/OTP에 포함된 그래픽 사용자 인터페이스로, 전체 시스템을 실시간으로 한눈에 조망할 수 있게 해 줍니다. Observer는 프로세스 계층 구조, 메시지 큐, 성능 지표를 직관적으로 시각화합니다. Observer는 Section 3.1.3에서 간단히 소개한 바 있습니다.
약간의 오버헤드가 발생할 수 있으므로 지속적인 프로덕션 프로파일링에는 보통 사용하지 않지만, Observer는 대화형 디버깅에 매우 유용하며 애플리케이션의 전반적인 아키텍처를 이해하는 데에도 큰 도움이 됩니다. 개별 프로세스를 세부적으로 살펴볼 수 있는 Observer의 기능은 프로파일러가 제공하는 더 세밀한 분석 결과를 보완합니다.
21.2.7. 프로파일링 시나리오
Erlang 애플리케이션이 눈에 띄게 느려진 상황을 상상해 봅시다. 여러분은 자신의 모듈 중 하나가 원인이라고 의심합니다. 이 예제에는 재귀 함수를 호출하여 리스트를 처리하는 함수가 담긴 모듈이 있으며, 우리는 시간이 어디에서 소요되는지 정확히 짚어내고자 합니다. 이는 재귀 팩토리얼 함수 하나만 있는 매우 단순한 시나리오이지만, 각 프로파일러를 성능 문제 진단에 어떻게 활용할 수 있는지 이해하는 데 도움이 될 것입니다.
-module(perf_example).
-export([compute/1, eprof/0, tprof_example/1]).
compute([]) ->
ok;
compute([H|T]) ->
_F = factorial(H),
compute(T).
factorial(0) -> 1;
factorial(N) when N > 0 ->
N * factorial(N - 1).
eprof() ->
Compute = fun() -> perf_example:compute([10,15,20,25,30]) end,
eprof:profile(Compute),
eprof:analyze().
tprof_example(Type) ->
Compute = fun() -> perf_example:compute([10,15,20,25,30]) end,
tprof:profile(Compute, #{type => Type}).프로덕션 환경에서 적당한 길이의 리스트를 처리하기만 해도 시스템이 느려지는 현상을 발견합니다. factorial/1에 대한 반복적인 재귀 호출이 리덕션을 지나치게 많이 소모하여 CPU 경합을 일으키고 있는 것은 아닌지 의심합니다.
아래에서는 각 도구가 어떻게 도움이 되는지 사용 예시 및 결과 예시와 함께 간략히 설명합니다.
fprof 예제
fprof를 사용하면 모든 함수 호출을 트레이스하고 시간 정보가 담긴 상세한 호출 그래프를 만들 수 있습니다. 이를 통해 호출 중첩과 실행 시간의 전체 그림을 파악할 수 있지만, 오버헤드가 큽니다.
Erlang 셸에서 다음을 실행하십시오:
1> fprof:apply(fun perf_example:compute/1, [[10, 15, 20, 25, 30]]).
ok
2> fprof:profile().
Reading trace data...
End of trace!
ok
3> fprof:analyse().
Processing data...
Creating output...
%% Analysis results:
{ analysis_options,
[{callers, true},
{sort, acc},
{totals, false},
{details, true}]}.
% CNT ACC OWN
[{ totals, 113, 0.259, 0.259}]. %%%
% CNT ACC OWN
[{ "<0.105.0>", 113,undefined, 0.259}]. %%
{[{undefined, 0, 0.259, 0.017}],
{ {fprof,apply_start_stop,4}, 0, 0.259, 0.017}, %
[{{perf_example,compute,1}, 1, 0.242, 0.005},
{suspend, 1, 0.000, 0.000}]}.
{[{{fprof,apply_start_stop,4}, 1, 0.242, 0.005},
{{perf_example,compute,1}, 5, 0.000, 0.009}],
{ {perf_example,compute,1}, 6, 0.242, 0.014}, %
[{{perf_example,factorial,1}, 5, 0.228, 0.057},
{{perf_example,compute,1}, 5, 0.000, 0.009}]}.
{[{{perf_example,compute,1}, 5, 0.228, 0.057},
{{perf_example,factorial,1}, 100, 0.000, 0.163}],
{ {perf_example,factorial,1}, 105, 0.228, 0.220}, %
[{garbage_collect, 1, 0.008, 0.008},
{{perf_example,factorial,1}, 100, 0.000, 0.163}]}.
{[{{perf_example,factorial,1}, 1, 0.008, 0.008}],
{ garbage_collect, 1, 0.008, 0.008}, %
[ ]}.
{[ ],
{ undefined, 0, 0.000, 0.000}, %
[{{fprof,apply_start_stop,4}, 0, 0.259, 0.017}]}.
{[{{fprof,apply_start_stop,4}, 1, 0.000, 0.000}],
{ suspend, 1, 0.000, 0.000}, %
[ ]}.
Done!
ok분석 결과를 통해 프로파일링 시나리오에서 실행 시간이 어디에 소요되는지 자세히 파악할 수 있습니다. 여기서 알 수 있는 점은 다음과 같습니다.
합계를 보면 113번의 함수 호출에 걸쳐 약 0.259초의 실제 경과 시간(wall-clock time)이 소요되었음을 알 수 있습니다. 이 시간에는 각 함수의 "자체(own)" 시간과 모든 중첩 호출에서 누적된 시간이 모두 포함됩니다.
보고서의 핵심 부분은 재귀 함수에서 발생한 호출을 한데 묶어 보여 줍니다. 분석 결과가 데이터를 호출 계층 구조를 나타내는 그룹으로 나눈다는 점에 주목하십시오. 예를 들어, 한 그룹 안에서 perf_example:compute/1 함수가 perf_example:factorial/1을 반복해서 호출하는 것을 볼 수 있습니다. 구체적으로, 보고서에 따르면 factorial/1은 105번 호출되었으며, 누적 시간은 약 0.228초이고 "자체(own)" 시간은 0.220초입니다.
이는 처리 시간의 대부분이 factorial/1에서 소요된다는 것을 보여 주며, 반복되는 재귀 호출이 성능 병목이라는 우리의 추측을 확인해 줍니다. 가비지 컬렉션에 소요된 시간이 아주 적다는 점(약 0.008초)은 무거운 연산이 메모리 관리가 아니라 재귀 호출에 있다는 사실을 뒷받침합니다.
마지막으로, fprof:apply_start_stop/4 같은 함수가 사용되고 suspend 호출이 언급된 것을 보면 프로파일러가 우리 코드의 실행을 어떻게 감쌌는지 알 수 있습니다. 이 모든 세부 정보를 종합하면 명확한 호출 그래프를 얻을 수 있습니다. compute/1에서 소비된 시간은 대부분 factorial/1 호출이 차지하며, 이 호출이 다시 전체 처리 시간의 대부분을 차지합니다.
eprof 예제
느린 애플리케이션을 다시 살펴봅시다. 이 애플리케이션에서는 재귀 함수, 즉 우리가 작성한 단순한 팩토리얼 함수가 CPU 시간의 대부분을 소비하는 것으로 의심됩니다. eprof를 사용하면 Erlang의 트레이스 BIF를 이용하여 각 함수의 실행 시간을 집계한 결과를 얻을 수 있습니다. eprof는 fprof처럼 전체 호출 그래프를 제공하지는 않지만, 함수별로 소요된 시간을 간결하게 정리하여 보여 줍니다.
다음은 eprof를 사용하여 재귀 호출을 프로파일링하는 예제 모듈입니다:
2> perf_example:eprof().
****** Process <0.108.0> -- 100.00 % of profiled time ***
FUNCTION CALLS % TIME [uS / CALLS]
-------- ----- ------- ---- [----------]
perf_example:compute/1 6 0.00 0 [ 0.00]
perf_example:'-eprof/0-fun-0-'/0 1 0.00 0 [ 0.00]
erlang:apply/2 1 11.76 2 [ 2.00]
perf_example:factorial/1 105 88.24 15 [ 0.14]
-------------------------------- ----- ------- ---- [----------]
Total: 113 100.00% 17 [ 0.15]
ok
3>보고서에 따르면 총 113회의 함수 호출에 17마이크로초가 소요되었으며, 이는 호출당 평균 약 0.15마이크로초입니다.
-
perf_example:compute/1은 6번 호출되었으며 소요 시간은 사실상 0마이크로초였습니다. 이는 재귀 작업에 비해 이 함수의 비용이 무시할 수 있는 수준임을 의미합니다. -
익명 함수(
eprof/0에 의해 생성됨)는 눈에 띄는 비용 없이 한 번 실행되었습니다. -
erlang:apply/2는 한 번 나타나며, 전체 시간의 약 11.76%(대략 2마이크로초)를 차지합니다. 이는 프로파일링 프레임워크 안에서 함수 호출을 적용할 때 생기는 오버헤드를 반영합니다. -
작업의 대부분은
perf_example:factorial/1이 수행하며, 이 함수는 105번 호출되었습니다. 이 함수는 전체 시간의 88.24%를 소비합니다. 총 약 15마이크로초로, 호출당 약 0.14마이크로초입니다.
요점: factorial/1의 각 호출은 매우 빠르지만, 호출 횟수가 많기 때문에 전체 실행 시간에 가장 크게 기여합니다. 이를 통해 이 프로파일링 시나리오에서 factorial/1의 재귀 작업이 지배적인 요인이라는 우리의 추측이 사실임을 확인할 수 있습니다.
cprof 예제
cprof 도구는 브레이크포인트를 사용해 호출 횟수를 세는데, 이는 재컴파일이나 트레이스 메시지가 전혀 필요 없는 가벼운 방식입니다. 하지만 전체 호출 그래프를 얻을 수 없으며, 타이밍 정보도 얻을 수 없습니다.
2> f(), cprof:start(perf_example), Result = perf_example:compute([10,15,20,25,70]), PauseCount = cprof:pause().
14269
3> Analysis = cprof:analyse().
{151,
[{perf_example,151,
[{{perf_example,factorial,1},145},
{{perf_example,compute,1},6}]}]}분석 결과 perf_example 모듈에서 총 151회의 호출이 보고됩니다. 그중 두 개의 함수가 추적됩니다.
-
perf_example:compute/1이 6번 호출되었습니다. -
perf_example:factorial/1함수가 145번 호출되었습니다.
리스트를 처리하는 compute/1 함수는 6번 호출되며, 이는 원소 5개짜리 리스트를 처리하는 경우와 일치합니다(재귀 단계마다 한 번씩, 여기에 기저 사례 한 번을 더해 총 6번 호출). 한편, 실제 작업의 대부분은 145번 호출되는 factorial/1이 담당합니다. 이를 통해 작업의 대부분이 factorial/1의 재귀 호출에서 일어나고 있음을 확인할 수 있습니다.
이 데이터는 재귀 팩토리얼 함수가 핫스팟임을 분명하게 보여 줍니다. factorial/1에 대한 개별 호출은 각각 매우 빠르지만, 호출 빈도가 높다는 점(145회 호출)은 더 큰 워크로드에서 이 함수가 병목이 될 경우 이 함수를 최적화하여 성능을 개선할 수 있음을 시사합니다.
tprof 예제
tprof는 OTP 27에서 도입된 실험적인 통합 프로세스 프로파일링 도구입니다. 호출 횟수, 실행 시간, 힙 할당(call_memory) 측정을 지원합니다. 이 시나리오에서는 각 유형별로 tprof를 애드혹 모드로 사용하여, 실행 중에 함수가 몇 번 호출되는지, 시간이 얼마나 걸리는지, 그리고 메모리를 얼마나(워드 단위로) 할당하는지 살펴보겠습니다.
3> perf_example:tprof_example(call_count).
FUNCTION CALLS [ %]
perf_example:'-tprof_example/1-fun-0-'/0 1 [ 0.89]
perf_example:compute/1 6 [ 5.36]
perf_example:factorial/1 105 [93.75]
[100.0]
ok
4> perf_example:tprof_example(call_time).
****** Process <0.129.0> -- 100.00% of total ***
FUNCTION CALLS TIME (us) PER CALL [ %]
perf_example:compute/1 6 1 0.17 [ 5.00]
perf_example:'-tprof_example/1-fun-0-'/0 1 2 2.00 [10.00]
perf_example:factorial/1 105 17 0.16 [85.00]
20 [100.0]
ok
5> perf_example:tprof_example(call_memory).
****** Process <0.132.0> -- 100.00% of total ***
FUNCTION CALLS WORDS PER CALL [ %]
perf_example:factorial/1 105 51 0.49 [100.00]
51 [ 100.0]
okcall_count 프로파일을 보면 익명 래퍼 함수는 한 번(0.89%), compute/1은 6번(5.36%) 호출되며, 무거운 작업은 105번(93.75%) 호출되는 factorial/1이 수행합니다. 이는 우리의 예상을 확인해 줍니다. 호출의 대부분(따라서 작업 부하의 대부분)은 재귀 함수인 factorial/1에서 발생합니다.
call_time 출력을 보면 compute/1은 6회 호출에 걸쳐 총 1마이크로초(호출당 약 0.17 µs)가 걸리고, 익명 함수는 2 µs를 사용하며, factorial/1은 105회 호출에 걸쳐 17 µs(호출당 약 0.16 µs)가 걸린다는 것을 알 수 있습니다. 호출당 시간은 매우 작지만, 합산된 시간을 보면 여전히 factorial/1이 실행 시간의 대부분(85%)을 차지하며, 이는 이 함수가 연산 작업이 주로 이루어지는 곳임을 다시 한번 확인시켜 줍니다.
call_memory 프로파일을 보면, 측정된 힙 할당 전체(총 51워드)가 105번 호출되는 factorial/1에서 발생합니다. 이는 호출당 약 0.49워드가 할당되는 셈입니다. compute/1이나 익명 래퍼에는 메모리 할당이 전혀 잡히지 않으므로, 이 워크로드의 메모리 오버헤드는 전적으로 재귀 함수에서 비롯된다는 사실이 확인됩니다.
Appendix A: Erlang 런타임 시스템 빌드하기
이 장에서는 필요에 맞게 Erlang/OTP를 구성하고 빌드하는 여러 가지 방법을 살펴보겠습니다. 대부분의 예제에서는 Ubuntu Linux를 사용합니다. 다른 OS를 사용하고 있다면 해당 OS에서 빌드하는 방법에 대한 자세한 명령어를 소스 코드에 포함된 문서(HOWTO/INSTALL.md)나 웹 INSTALL.html에서 찾을 수 있습니다.
런타임 시스템을 빌드하는 방법은 기본적으로 두 가지입니다. autoconf, configure, make를 사용하는 전통적인 방법과 kerl의 도움을 받는 방법입니다.
먼저 전통적인 방법을 시도해 보시기를 권합니다. 그렇게 하면 빌드할 때 어떤 일이 일어나는지, 그리고 어떤 설정을 변경할 수 있는지 더 잘 이해할 수 있습니다. 그런 다음 설정과 빌드를 관리하는 일상적인 작업에는 kerl을 사용하십시오.
A.1. 처음 빌드하기
시작하는 데 도움이 되도록 먼저 시스템을 처음부터 구축하는 프로세스를 단계별로 살펴본 다음, 다양한 목적에 맞게 시스템을 구성하는 방법을 알아보겠습니다.
이 단계별 가이드는 최신 Ubuntu가 설치되어 있다고 가정합니다. OS X와 Windows에서 빌드하는 방법은 이 장의 뒷부분에서 살펴보겠습니다.
A.1.1. 사전 요구 사항
소스를 가져오고, 압축을 풀고, 빌드하려면 여러 가지 도구가 필요합니다. HOWTO/INSTALL.md 파일에 가장 중요한 도구들이 나열되어 있습니다.
최신 Ubuntu 설치 환경에서 시작하므로 sed, tar, perl 같은 일부 도구는 이미 설치되어 있을 것입니다. 하지만 git, make, gcc, m4, ncurses 같은 다른 도구는 따로 설치해야 할 가능성이 높습니다.
최신 Ubuntu 설치 환경에서는 다음 명령으로 필요한 도구 대부분을 설치할 수 있습니다:
> sudo apt-get install build-essential git autoconf m4 \
> zlib1g-dev ncurses-dev libssl-devwxWidgets 지원을 포함하여 빌드하려면 wx 라이브러리도 설치해야 합니다:
> sudo apt-get install libwxgtk3.2-dev wx3.2-i18n \
> wx3.2-examples wx3.2-doc그리고 선택적으로 WX의 WebView 지원을 위해 다음이 필요합니다.
> sudo apt-get install libwxgtk-webview3.2-1t64Erlang/OTP 문서도 빌드하려면 몇 가지 도구가 더 필요합니다:
> sudo apt-get install xsltproc libxml2-utilsA.1.2. 소스 코드 받기
소스를 얻는 방법은 크게 두 가지가 있습니다. erlang.org에서 tarball을 다운로드하거나 Github에서 소스 코드를 직접 체크아웃할 수 있습니다.
소스의 안정 버전을 빠르게 내려받으려면 다음을 시도해 보십시오:
> cd ~/otp
> wget http://erlang.org/download/otp_src_27.0.tar.gz
> tar -xzf otp_src_27.0.tar.gz
> cd otp_src_27.0또는 최신 개발 버전으로 쉽게 업데이트하고 싶거나 수정 사항을 커뮤니티에 기여하고 싶다면 git으로 소스를 체크아웃할 수 있습니다:
> git clone https://github.com/erlang/otp.git
> cd otp이전 버전의 Erlang을 빌드하는 경우 autoconf를 실행해야 할 수도 있습니다.
> ./otp_build autoconfA.1.3. 설정 및 빌드
이제 Erlang을 빌드하고 설치할 준비가 되었습니다. 시스템 전역 설치와 충돌하지 않도록 설치 접두사(prefix)를 본인만 사용하는 디렉터리로 설정하는 것이 좋습니다:
> ./configure --prefix=$HOME/.local
> make
> make install
> export PATH="$HOME/.local/bin:$PATH"A.1.4. 대체 BEAM 에뮬레이터 빌드
현재 에뮬레이터 빌드에는 크게 두 가지 플레이버가 있습니다. 하나는 JIT가 활성화된 플레이버인 jit(지원되는 플랫폼에서는 기본값입니다)이고, 다른 하나는 JIT를 사용하지 않는 플레이버인 emu입니다. smp라는 이름을 볼 수도 있지만, 이는 현재 플랫폼의 기본 플레이버를 뜻하는 별칭일 뿐입니다.
> make TYPE=emu또는 JIT가 활성화된 플레이버의 디버그 버전입니다:
> make TYPE=debug(물론 --disable-jit 옵션으로 구성했거나 사용 중인 플랫폼이 이를 지원하지 않는다면, 빌드를 요청하더라도 jit 플레이버를 빌드할 수 없습니다.)
빌드 타입(build type)을 지정하면 계측 방식이 서로 다른 여러 에뮬레이터 변형을 빌드할 수도 있습니다. 런타임에 erlang:system_info(build_type)를 호출하면 현재 실행 중인 에뮬레이터가 어떻게 빌드되었는지 알 수 있습니다. 표준 빌드는 opt라고 합니다.
대체 에뮬레이터 유형 중 하나를 빌드하려면 TYPE 변수를 설정해야 합니다. 이 변수는 FLAVOR 변수와 함께 사용할 수 있습니다.
> make
> make TYPE=debug
> make FLAVOR=emu TYPE=lcntdebug 외에도 valgrind 등 여러 가지 계측 변형을 빌드할 수 있습니다. 이러한 변형을 (소스 코드의 최상위 디렉터리에서) 빌드 트리에서 바로 실행하려면 특수 실행 스크립트인 bin/cerl로 계측된 에뮬레이터를 시작할 수 있습니다:
> bin/cerl -debugcerl 스크립트는 예를 들어 valgrind로 계측한 에뮬레이터를 실행할 때 생성되는 추가 출력 파일을 다루는 데에도 도움이 됩니다. 자세한 내용은 HOWTO/INSTALL.md와 HOWTO/DEVELOPMENT.md를 참고하십시오.
make install에 기본 빌드뿐만 아니라 이러한 변형 빌드도 포함되게 하려면, 각 조합마다 따로 실행해야 합니다:
> make install
> make install TYPE=debug
> make install FLAVOR=emu TYPE=lcnt그러면 사용자는 -emu_flavor 및 -emu_type 플래그를 사용하여 실행하려는 변형을 선택할 수 있게 됩니다:
> erl -emu_flavor emu -emu_type lcntA.2. Kerl로 빌드하기
특히 여러 가지 빌드를 갖추어 두고 실험해 보고 싶다면, Kerl로 빌드하는 것이 더 쉬운 방법입니다.
Appendix B: BEAM 명령어
여기서는 BEAM 범용 명령어 집합에 속한 명령어 대부분을 자세히 살펴보겠습니다. 다음 절에서는 코드 내 문서에서 생성한 간단한 설명과 함께 모든 명령어를 나열합니다(lib/compiler/src/genop.tab 참고).
B.1. 함수와 레이블
B.1.1. label Lbl
범용 명령어 집합의 1번 명령어는 사실 명령어라고 할 수 없습니다. 이것은 코드의 현재 위치에 이름을, 정확히는 번호를 붙여 주는 모듈 로컬 레이블일 뿐입니다.
각 레이블은 점프의 잠재적 목적지이므로 기본 블록의 시작을 나타낼 수 있습니다.
B.1.2. func_info 모듈 함수 애리티
각 함수의 코드는 func_info 명령어로 시작합니다. 이 명령어는 function clause 오류를 생성하는 데 사용되며, 함수 코드의 실제 실행은 func_info 명령어 바로 다음에 오는 레이블에서 시작됩니다.
가드가 있는 함수를 생각해 보십시오.
id(I) when is_integer(I) -> I.이 함수의 BEAM 코드는 대략 다음과 같습니다:
{function, id, 1, 4}.
{label,3}.
{func_info,{atom,test1},{atom,id},1}.
{label,4}.
{test,is_integer,{f,3},[{x,0}]}.
return.여기서 메타 정보 {function, id, 1, 4}는 id/1 함수의 실행이 레이블 4에서 시작된다는 것을 알려 줍니다. 레이블 4에서는 x0에 대해 is_integer를 수행하고, 실패하면 func_info 명령어를 가리키는 레이블 3(f3)으로 점프합니다. 이 명령어는 function clause 예외를 발생시킵니다. 그렇지 않으면 그대로 다음 명령어로 넘어가 인자(x0)를 반환합니다.
함수 정보 명령어는 Export 레코드(erts/emulator/beam/export.h에 정의되어 있습니다)를 가리키며, 이 레코드는 메모리의 다른 곳에 있습니다. 트레이싱 메커니즘은 이 레코드 안에 따로 마련된 몇 워드의 메모리에 특수한 트레이스 명령어를 배치합니다. 이 명령어는 어떤 프로세스든 해당 함수에 진입하거나 함수에서 반환할 때마다 트리거됩니다.
|
B.2. 테스트 명령어
B.2.1. 타입 테스트
타입 테스트 명령어(is_\* Lbl Argument)는 인수가 주어진 타입인지 검사하고, 그렇지 않으면 레이블 Lbl로 점프합니다. BEAM 디스어셈블러는 이러한 명령어를 모두 test 명령어로 감쌉니다. 예:
{test,is_integer,{f,3},[{x,0}]}.현재 타입 테스트 명령어는 다음과 같습니다: is_integer, is_float, is_number, is_atom, is_pid, is_reference, is_port, is_nil, is_binary, is_list, is_nonempty_list, is_function, is_function2, is_boolean, is_bitstr, is_tuple.
그리고 애리티가 3인 타입 테스트 명령어도 하나 있습니다: test_arity Lbl Arg Arity. 이 명령어는 인자(튜플로 간주)의 애리티가 Arity인지 검사합니다. 이 명령어 앞에는 보통 is_tuple 명령어가 옵니다.
B.2.2. 비교
비교 명령어(is_\* Lbl Arg1 Arg2)는 명령어에 따라 두 인자를 비교하고, 비교가 실패하면 Lbl로 점프합니다.
비교 명령어는 is_lt, is_ge, is_eq, is_ne, is_eq_exact, is_ne_exact입니다.
모든 Erlang 텀에는 순서가 정해져 있으므로 이 명령어들은 임의의 두 텀을 비교할 수 있다는 점을 기억하십시오. 예를 들어 아톰 self가 self()가 반환하는 pid보다 작은지 검사할 수 있습니다. (실제로 작습니다.)
숫자의 경우 비교는 Erlang 타입 number 기준으로 수행된다는 점에 유의하십시오. Chapter 4을 참조하십시오. 즉, 부동소수점 수와 정수를 섞어 비교할 때는 정밀도가 낮은 쪽의 숫자가 비교 전에 다른 쪽 타입으로 변환됩니다. 예를 들어 제 시스템에서는 1과 1.0이 같은 것으로 비교되며, 9999999999999999와 1.0e16도 마찬가지입니다. 부동소수점 수의 비교는 항상 위험하므로 피하는 것이 가장 좋습니다. 결과는 기반 하드웨어에 따라 달라질 수 있습니다.
정수 1과 부동소수점 수 1.0이 서로 다르게 비교되도록 하려면 is_eq_exact와 is_ne_exact를 사용할 수 있습니다. 이는 Erlang 연산자 =:=와 =/=에 해당합니다.
B.3. 함수 호출
이 장에서는 여러 호출 명령어가 각각 무엇을 하는지 요약합니다. 함수 호출이 어떻게 동작하는지에 대한 자세한 설명은 Chapter 8를 참고하십시오.
B.3.1. call Arity Label
같은 모듈에서 레이블 Label에 있는, 인자 수(arity)가 Arity인 함수를 호출합니다. 먼저 리덕션을 차감하고, 필요하면 컨텍스트 스위치를 수행합니다. 호출 명령 다음의 현재 코드 주소가 CP에 저장됩니다.
모든 로컬 호출에서 레이블은 코드가 시작되는 함수의 두 번째 레이블입니다. 컨텍스트 스위치가 필요할 때 MFA를 얻을 수 있도록, 해당 레이블 바로 앞의 명령어는 func_info라고 가정합니다.
B.3.2. call_only Arity Label
같은 모듈의 레이블 Label에 있는 인자 수 Arity의 함수를 꼬리 재귀 호출합니다. 먼저 리덕션을 차감하고, 필요하면 컨텍스트 스위치를 수행합니다. CP는 반환 주소로 갱신되지 않습니다.
B.3.3. call_last Arity Label Deallocate
스택에서 Deallocate 워드만큼을 해제한 다음, 같은 모듈의 레이블 Label에 있는 인자 수가 Arity인 함수를 꼬리 재귀 호출합니다. 먼저 리덕션을 차감하고, 필요하면 컨텍스트 스위치를 수행합니다. CP는 반환 주소로 갱신되지 않습니다.
B.3.4. call_ext Arity Destination
Destination이 지정하는 애리티 Arity의 함수를 외부 호출합니다. 어셈블리에서 Destination은 보통 {extfunc, Module, Function, Arity}로 작성되며, 이는 모듈의 임포트 섹션에 추가됩니다. 먼저 리덕션을 차감하고, 필요하면 컨텍스트 스위치를 수행합니다. CP는 반환 주소로 갱신됩니다.
B.3.5. call_ext_only Arity Destination
Destination이 지정하는 인수 개수(arity) Arity의 함수를 꼬리 재귀 방식으로 외부 호출합니다. 어셈블리에서 Destination은 보통 {extfunc, Module, Function, Arity} 형태로 작성합니다. 먼저 리덕션을 차감하고, 필요하면 컨텍스트 스위치를 수행합니다. CP는 반환 주소로 갱신되지 않습니다.
B.3.6. call_ext_last Arity Destination Deallocate
스택에서 Deallocate 워드만큼 할당을 해제한 다음, Destination이 지정하는 애리티 Arity의 함수를 꼬리 재귀 외부 호출로 호출합니다. 어셈블리에서 Destination은 보통 {extfunc, Module, Function, Arity} 형식으로 표기합니다. 먼저 리덕션을 차감하고, 필요하면 컨텍스트 스위치를 수행합니다. CP는 반환 주소로 갱신되지 않습니다.
B.3.7. bif0 Bif Reg, bif[1,2] Lbl Bif [Arg,…] Reg
주어진 인자로 bif Bif를 호출하고, 그 결과를 Reg에 저장합니다. bif가 실패하면 Lbl로 점프합니다. 인자 개수가 0인 bif는 실패할 수 없으므로 bif0 명령어는 실패 레이블을 받지 않습니다.
이 명령어들이 호출하는 Bif는 힙에 할당하거나 가비지 컬렉션을 유발해서는 안 됩니다. 그렇지 않은 경우에는 gc_bif를 참고하십시오.
|
B.3.8. gc_bif[1-3] Lbl Live Bif [Arg, …] Reg
주어진 인수로 bif Bif를 호출하고, 그 결과를 Reg에 저장합니다. bif가 실패하면 Lbl로 점프합니다. 인수는 x(Live), x(Live+1) 및 x(Live+2)에 저장됩니다.
이 명령어에는 Live 인자가 있으므로 가비지 컬렉션을 트리거하는 데 필요한 정보를 충분히 얻을 수 있습니다.
|
B.3.9. call_fun Arity
명령어 call_fun은 인자들이 처음 Arity개의 인자 레지스터에 놓여 있고, fun(클로저를 가리키는 포인터)은 마지막 인자 다음 레지스터인 x[Arity+1]에 놓여 있다고 가정합니다.
즉, 인자 개수가 0인 호출에서는 클로저가 x[0]에 놓입니다. 인자 개수가 1인 호출에서는 x[0]에 인자가, x[1]에 클로저가 들어가며, 나머지도 같은 방식입니다.
애리티가 함수 객체와 일치하지 않으면 badarity를 발생시킵니다. 함수가 아닌 값이 전달되면 badfun을 발생시킵니다.
|
B.3.10. apply Arity
X 레지스터에 저장된 Arity개의 인자로 함수 호출을 적용합니다. 모듈 아톰은 x[Arity]에 저장되고 함수 아톰은 x[Arity+1]에 저장됩니다. 모듈은 튜플로도 표현될 수 있습니다.
B.3.11. apply_last Arity Dealloc
CP를 팝하고 요소들을 해제한 뒤 CP를 다시 푸시하는 방식으로 스택에서 Dealloc개의 요소를 해제합니다. 그런 다음 새 위치로 점프하여, X 레지스터에 저장된 Arity개의 인자로 꼬리 재귀 호출을 수행합니다. 모듈 아톰과 함수 아톰은 각각 x[Arity]와 x[Arity+1]에 저장됩니다. 모듈은 튜플로 표현될 수도 있습니다.
B.4. 스택(및 힙) 관리
BEAM에서 Erlang 프로세스의 스택과 힙은 같은 메모리 영역을 공유합니다. 자세한 논의는 Chapter 3와 Chapter 11를 참조하십시오. 스택은 낮은 주소 방향으로, 힙은 높은 주소 방향으로 자랍니다. 스택이나 힙 중 어느 쪽에서든 사용 가능한 공간보다 더 많은 공간이 필요하면 BEAM은 가비지 컬렉션을 수행합니다.
이 명령어들은 리프가 아닌 함수에서 현재 명령어의 스택 프레임을 설정하고 해제하는 데에도 사용됩니다. 즉, 함수에 진입할 때 연속 포인터(CP)를 스택에 저장하고, 함수에서 나갈 때 스택에서 다시 읽어 옵니다.
리프 함수의 함수 골격은 다음과 같습니다.
{function, Name, Arity, StartLabel}.
{label,L1}.
{func_info,{atom,Module},{atom,Name},Arity}.
{label,L2}.
...
return.
리프가 아닌 함수의 함수 골격은 다음과 같습니다:
{function, Name, Arity, StartLabel}.
{label,L1}.
{func_info,{atom,Module},{atom,Name},Arity}.
{label,L2}.
{allocate,Need,Live}.
...
call ...
...
{deallocate,Need}.
return.
B.4.1. allocate StackNeed Live
연속 포인터(CP)를 저장하고, 스택에 StackNeed개의 추가 워드를 위한 공간을 할당합니다. 할당 중에 메모리가 부족해지면 GC를 호출하며, 이때 처음 Live개의 x 레지스터가 루트 집합의 일부가 됩니다. 예를 들어 Live가 2이면 GC는 레지스터 X0과 X1을 보존하며, 나머지는 사용되지 않으므로 해제됩니다.
스택에 할당할 때는 스택 포인터(E)가 감소합니다.
Before After
| xxx | | xxx |
E -> | xxx | | xxx |
| | | ??? | caller save slot
... E -> | CP |
... ...
HTOP -> | | HTOP -> | |
| xxx | | xxx |
B.4.2. allocate_heap StackNeed HeapNeed Live
연속 포인터(CP)를 저장하고 스택에 StackNeed개의 추가 워드를 위한 공간을 할당합니다. 힙에도 HeapNeed개의 워드를 위한 공간이 있는지 확인합니다. 할당 중에 메모리가 부족해지면 보존할 X 레지스터의 개수를 Live로 지정하여 GC를 호출합니다.
| 힙 포인터(HTOP)는 실제 힙 할당이 일어날 때까지 변경되지 않습니다. |
B.4.3. allocate_zero StackNeed Live
이 명령어는 allocate와 같은 방식으로 동작하지만, 할당된 스택 슬롯을 NIL로 초기화하는 일도 합니다.
Before After
| xxx | | xxx |
E -> | xxx | | xxx |
| | | NIL | caller save slot
... E -> | CP |
... ...
HTOP -> | | HTOP -> | |
| xxx | | xxx |
B.4.4. allocate_heap_zero StackNeed HeapNeed Live
allocate_heap_zero 명령어는 allocate_heap 명령어와 같이 동작하지만, 할당된 스택 슬롯을 NIL로 초기화하는 작업도 함께 수행합니다.
B.4.5. test_heap HeapNeed Live
test_heap 명령어는 힙에 HeapNeed 워드만큼의 공간이 있음을 보장합니다. 할당 중에 메모리가 부족해지면 보존할 X 레지스터의 개수인 Live를 인자로 넘겨 GC를 호출합니다.
B.4.6. init N
init 명령어는 CP 포인터 위에 있는 스택 워드 N개에 NIL을 기록하여 이들을 초기화합니다.
B.4.7. deallocate N
deallocate 명령어는 allocate와 반대되는 동작을 합니다. CP(연속 포인터)를 복원하고 N+1개의 스택 워드를 해제합니다.
B.4.8. return
return 명령어는 연속 포인터(continuation pointer, CP)에 저장된 주소로 점프합니다. C에서는 CP의 값이 0으로 설정됩니다.
B.4.9. trim N Remaining
CP를 임시 변수로 팝하고, 스택에서 N 워드를 해제한 다음, CP를 다시 스택 맨 위에 놓습니다. (제가 아는 한 Remaining 인자는 사용되지 않습니다.)
Before After
| ??? | | ??? |
| xxx | E -> | CP |
| xxx | | ... |
E -> | CP | | ... |
| | | ... |
... ...
HTOP -> | | HTOP -> | |
| xxx | | xxx |
B.5. 데이터 이동, 추출, 수정
B.5.1. move Source Destination
소스 Source(리터럴 또는 레지스터일 수 있습니다)의 값을 대상 레지스터 Destination으로 옮깁니다.
B.5.2. get_list Source Head Tail
이것은 리스트 셀을 분해하는 연산입니다. Source로 지정된 리스트(cons 셀)의 head와 tail(또는 car와 cdr) 부분을 가져와 레지스터 Head와 Tail에 넣습니다.
B.5.3. get_tuple_element Source Element Destination
이것은 배열 인덱스 기반 읽기 연산입니다. Source 튜플에서 Element 위치의 요소를 가져와 Destination 레지스터에 넣습니다.
B.5.4. set_tuple_element NewElement Tuple(튜플) Position
이것은 파괴적인 배열 인덱스 갱신 연산입니다. Tuple에서 Position 위치에 있는 요소를 새 NewElement로 갱신합니다.
B.6. 텀 구성하기
B.6.1. put_list Head Tail Destination
힙에 새 리스트(cons) 셀(2 워드)을 생성하고 그 주소를 Destination 레지스터에 넣습니다. 리스트 셀의 첫 번째 요소는 Head의 값으로, 두 번째 요소는 Tail의 값으로 설정됩니다.
B.6.2. put_tuple Size Destination
힙에 빈 튜플(Size+1 워드)을 생성하고 그 주소를 Destination 레지스터에 저장합니다. 이 시점에는 어떤 요소도 설정되지 않습니다. Put_tuple 명령어 뒤에는 항상 여러 개의 put 명령어가 이어지며, 이 명령어들이 튜플의 요소를 하나씩 파괴적으로 설정합니다.
B.6.3. put Value
앞선 put_tuple 명령어로 생성된 튜플의 다음 요소에 Value를 파괴적으로 저장합니다. 쓰기 주소는 VM이 내부적으로 유지하고 증가시킵니다. 새 튜플의 내용을 채울 때에는 여러 개의 put 명령어를 사용합니다.
B.6.4. make_fun2 LambdaIndex
모듈의 Lambda 테이블에 있는 인덱스로 정의되는 함수 객체를 생성합니다. Lambda 테이블은 진입점(레이블 또는 export 항목), 인자 수(arity), 그리고 가져올 고정 변수(frozen variable)의 개수를 정의합니다. 고정 변수의 값은 현재 실행 컨텍스트(X 레지스터)에서 복사되어 함수 객체에 저장됩니다.
Unresolved directive in chapters/ap-beam_instructions.asciidoc - include::opcodes_doc.asciidoc[]
B.7. 특정 명령어
인수 타입
| 타입 | 설명 |
|---|---|
a |
즉시 아톰 값(예: 'foo') |
c |
즉시값 상수(아톰, nil, 작은 정수) // Pid? |
d |
레지스터 또는 스택 슬롯 중 하나 |
e |
익스포트 테이블 항목에 대한 참조 |
f |
레이블, 즉 코드 주소 |
I |
정수입니다. 예: |
j |
선택적 코드 레이블 |
l |
부동소수점 레지스터 |
P |
양의(부호 없는) 정수 리터럴 |
r |
레지스터 R0( |
s |
리터럴, 레지스터 또는 스택 슬롯 중 하나 |
t |
텀, 예: |
x |
레지스터(예: |
y |
스택 슬롯, 예를 들어 |
B.7.1. 전체 BEAM 명령어 목록
| 명령어 | 인자 | 설명 |
|---|---|---|
allocate |
t t |
스택에 몇 워드를 할당합니다 |
allocate_heap |
t I t |
힙에 몇 워드를 할당합니다 |
allocate_heap_zero |
t I t |
힙을 일부 할당하고 해당 워드를 NIL로 설정합니다 |
allocate_init |
t I y |
|
allocate_zero |
t t |
스택을 일부 할당하고 워드를 0으로 설정합니까? |
apply |
I |
|
apply_last |
I P |
|
badarg |
j |
|
badmatch |
rxy |
|
bif1 |
f b s d |
인수 1개로 bif를 호출하고, 실패하면 |
bif1_body |
b s d |
|
bs_context_to_binary |
rxy |
|
bs_put_string |
I I |
|
bs_test_tail_imm2 |
f rx I |
|
bs_test_unit |
f rx I |
|
bs_test_unit8 |
f rx |
|
bs_test_zero_tail2 |
f rx |
|
call_bif0 |
e |
|
call_bif1 |
e |
|
call_bif2 |
e |
|
call_bif3 |
e |
|
case_end |
rxy |
|
catch |
y f |
|
catch_end |
y |
|
deallocate |
I |
스택에서 워드 몇 개를 해제하고 CP를 팝합니다 |
deallocate_return |
Q |
|
extract_next_element |
xy |
|
extract_next_element2 |
xy |
|
extract_next_element3 |
xy |
|
fclearerror |
||
fconv |
d l |
|
fmove |
qdl ld |
|
get_list |
rxy rxy rxy |
리스트 셀을 헤드와 테일로 분해합니다 |
i_apply |
CP를 저장하면서 인자 |
|
i_apply_fun |
CP를 저장하면서 인자 |
|
i_apply_fun_last |
P |
인자 |
i_apply_fun_only |
|
|
i_apply_last |
P |
인자 |
i_apply_only |
인자가 |
|
i_band |
j I d |
|
i_bif2 |
f b d |
|
i_bif2_body |
b d |
|
i_bor |
j I d |
|
i_bs_add |
j I d |
|
i_bs_append |
j I I I d |
|
i_bs_get_binary2 |
f rx I s I d |
|
i_bs_get_binary_all2 |
f rx I I d |
|
i_bs_get_binary_all_reuse |
rx f I |
|
i_bs_get_binary_imm2 |
f rx I I I d |
|
i_bs_get_float2 |
f rx I s I d |
|
i_bs_get_integer |
f I I d |
|
i_bs_get_integer_16 |
rx f d |
|
i_bs_get_integer_32 |
rx f I d |
|
i_bs_get_integer_8 |
rx f d |
|
i_bs_get_integer_imm |
rx I I f I d |
|
i_bs_get_integer_small_imm |
rx I f I d |
|
i_bs_get_utf16 |
rx f I d |
|
i_bs_get_utf8 |
rx f d |
|
i_bs_init |
I I d |
|
i_bs_init_bits |
I I d |
|
i_bs_init_bits_fail |
rxy j I d |
|
i_bs_init_bits_fail_heap |
I j I d |
|
i_bs_init_bits_heap |
I I I d |
|
i_bs_init_fail |
rxy j I d |
|
i_bs_init_fail_heap |
I j I d |
|
i_bs_init_heap |
I I I d |
|
i_bs_init_heap_bin |
I I d |
|
i_bs_init_heap_bin_heap |
I I I d |
|
i_bs_init_writable |
||
i_bs_match_string |
rx f I I |
|
i_bs_private_append |
j I d |
|
i_bs_put_utf16 |
j I s |
|
i_bs_put_utf8 |
j s |
|
i_bs_restore2 |
rx I |
|
i_bs_save2 |
rx I |
|
i_bs_skip_bits2 |
f rx rxy I |
|
i_bs_skip_bits2_imm2 |
f rx I |
|
i_bs_skip_bits_all2 |
f rx I |
|
i_bs_start_match2 |
rxy f I I d |
|
i_bs_utf16_size |
s d |
|
i_bs_utf8_size |
s d |
|
i_bs_validate_unicode |
j s |
|
i_bs_validate_unicode_retract |
j |
|
i_bsl |
j I d |
|
i_bsr |
j I d |
|
i_bxor |
j I d |
|
i_call |
f |
|
i_call_ext |
e |
|
i_call_ext_last |
e P |
|
i_call_ext_only |
e |
|
i_call_fun |
I |
|
i_call_fun_last |
I P |
|
i_call_last |
f P |
|
i_call_only |
f |
|
i_element |
rxy j s d |
|
i_fadd |
l l l |
|
i_fast_element |
rxy j I d |
|
i_fcheckerror |
||
i_fdiv |
l l l |
|
i_fetch |
s s |
|
i_fmul |
l l l |
|
i_fnegate |
l l l |
|
i_fsub |
l l l |
|
i_func_info |
I a a I |
|
i_gc_bif1 |
j I s I d |
|
i_gc_bif2 |
j I I d |
|
i_gc_bif3 |
j I s I d |
|
i_get |
s d |
|
i_get_tuple_element |
rxy P rxy |
|
i_hibernate |
||
i_increment |
rxy I I d |
|
i_int_bnot |
j s I d |
|
i_int_div |
j I d |
|
i_is_eq |
f |
|
i_is_eq_exact |
f |
|
i_is_eq_exact_immed |
f rxy c |
|
i_is_eq_exact_literal |
f rxy c |
|
i_is_ge |
f |
|
i_is_lt |
f |
|
i_is_ne |
f |
|
i_is_ne_exact |
f |
|
i_is_ne_exact_immed |
f rxy c |
|
i_is_ne_exact_literal |
f rxy c |
|
i_jump_on_val |
rxy f I I |
|
i_jump_on_val_zero |
rxy f I |
|
i_loop_rec |
f r |
|
i_m_div |
j I d |
|
i_make_fun |
I t |
|
i_minus |
j I d |
|
i_move_call |
c r f |
|
i_move_call_ext |
c r e |
|
i_move_call_ext_last |
e P c r |
|
i_move_call_ext_only |
e c r |
|
i_move_call_last |
f P c r |
|
i_move_call_only |
f c r |
|
i_new_bs_put_binary |
j s I s |
|
i_new_bs_put_binary_all |
j s I |
|
i_new_bs_put_binary_imm |
j I s |
|
i_new_bs_put_float |
j s I s |
|
i_new_bs_put_float_imm |
j I I s |
|
i_new_bs_put_integer |
j s I s |
|
i_new_bs_put_integer_imm |
j I I s |
|
i_plus |
j I d |
|
i_put_tuple |
rxy I |
애리티가 |
i_recv_set |
f |
|
i_rem |
j I d |
|
i_select_tuple_arity |
r f I |
|
i_select_tuple_arity |
x f I |
|
i_select_tuple_arity |
y f I |
|
i_select_tuple_arity2 |
r f A f A f |
|
i_select_tuple_arity2 |
x f A f A f |
|
i_select_tuple_arity2 |
y f A f A f |
|
i_select_val |
r f I |
값을 |
i_select_val |
x f I |
위와 같지만 x 레지스터에 대한 것입니다. |
i_select_val |
y f I |
위와 같지만 y 레지스터에 대한 것입니다 |
i_select_val2 |
r f c f c f |
값을 두 쌍 |
i_select_val2 |
x f c f c f |
위와 같지만 x 레지스터에 해당합니다 |
i_select_val2 |
y f c f c f |
위와 동일하지만 y 레지스터에 대한 것입니다. |
i_times |
j I d |
|
i_trim |
I |
스택에서 |
i_wait_error |
||
i_wait_error_locked |
||
i_wait_timeout |
f I |
|
i_wait_timeout |
f s |
|
i_wait_timeout_locked |
f I |
|
i_wait_timeout_locked |
f s |
|
if_end |
|
|
init |
y |
스택의 워드 하나를 NIL []로 설정합니다. |
init2 |
y y |
스택의 두 워드를 NIL []로 설정합니다 |
init3 |
y y y |
스택의 세 워드를 NIL []로 설정합니다 |
int_code_end |
프로그램의 끝입니다(스택이 없는 상태에서 return하는 것과 같습니다) |
|
is_atom |
f rxy |
값이 아톰인지 확인하고, 아톰이 아니면 점프합니다 |
is_bitstring |
f rxy |
값이 비트 문자열인지 확인하고, 그렇지 않으면 점프합니다 |
is_boolean |
f rxy |
값이 아톰 'true' 또는 'false’인지 확인하고, 그렇지 않으면 점프합니다 |
is_float |
f rxy |
값이 부동소수점 수인지 확인하고, 그렇지 않으면 점프합니다 |
is_function |
f rxy |
값이 함수인지 확인하고, 함수가 아니면 점프합니다 |
is_function2 |
f s s |
값이 함수인지 확인하고, 함수가 아니면 점프합니다 |
is_integer |
f rxy |
값이 큰 정수 또는 작은 정수인지 확인하고, 그렇지 않으면 점프합니다 |
is_integer_allocate |
f rx I I |
|
is_list |
f rxy |
값이 리스트 또는 NIL인지 확인하고, 그렇지 않으면 점프합니다 |
is_nil |
f rxy |
값이 빈 리스트 []인지 확인하고, 그렇지 않으면 점프합니다 |
is_nonempty_list |
f rxy |
값이 비어 있지 않은 리스트(cons 포인터)인지 확인하고, 그렇지 않으면 점프합니다 |
is_nonempty_list_allocate |
f rx I t |
|
is_nonempty_list_test_heap |
f r I t |
|
is_number |
f rxy |
값이 큰 정수, 작은 정수 또는 부동소수점 수인지 확인하고, 그렇지 않으면 점프합니다 |
is_pid |
f rxy |
값이 pid인지 확인하고, pid가 아니면 점프합니다 |
is_port |
f rxy |
값이 포트인지 확인하고, 포트가 아니면 점프합니다 |
is_reference |
f rxy |
값이 레퍼런스인지 확인하고, 레퍼런스가 아니면 점프합니다 |
is_tuple |
f rxy |
값이 튜플인지 확인하고, 튜플이 아니면 점프합니다 |
is_tuple_of_arity |
f rxy A |
값이 항수 |
jump |
f |
위치(레이블) |
label |
L |
코드 내 위치를 표시하며, 로드 시점에 제거됩니다 |
line |
I |
소스 파일 내의 위치를 표시하며, 로드 시점에 제거됩니다. |
loop_rec_end |
f |
프로세스의 receive 포인터를 한 칸 앞으로 옮기고 |
move |
rxync rxy |
값이나 레지스터를 다른 레지스터로 옮깁니다 |
move2 |
x x x x |
값 한 쌍을 목적지 한 쌍으로 옮깁니다 |
move2 |
x y x y |
값 한 쌍을 목적지 한 쌍으로 이동합니다 |
move2 |
y x y x |
값 한 쌍을 목적지 한 쌍으로 이동합니다 |
move_call |
xy r f |
|
move_call_last |
xy r f Q |
|
move_call_only |
x r f |
|
move_deallocate_return |
xycn r Q |
|
move_jump |
f ncxy |
|
move_return |
xcn r |
|
move_x1 |
c |
|
move_x2 |
c |
|
node |
rxy |
|
put |
rxy |
이러한 명령어들이 |
put_list |
s s d |
헤드와 테일로 리스트 셀을 구성하고, cons 포인터를 목적지 |
raise |
s s |
지정된 타입의 예외를 발생시킵니다. 레거시/호환성상의 이유로 예외 타입은 두 번째 스택트레이스 인수에서 추출해야 합니다. |
recv_mark |
f |
메시지 수신을 재개할 알려진 위치를 표시합니다(참조 최적화) |
remove_message |
프로세스 수신함에서 현재 메시지를 제거합니다(수신 완료됨) |
|
return |
CP에 있는 주소로 점프하고 CP를 0으로 설정합니다 |
|
self |
rxy |
|
send |
메시지 |
|
set_tuple_element |
s d P |
인덱스를 지정해 튜플 요소를 파괴적으로 갱신합니다 |
system_limit |
j |
|
test_arity |
f rxy A |
|
test_heap |
I t |
힙 공간이 충분한지 확인하십시오 |
test_heap_1_put_list |
I y |
|
timeout |
타이머를 설정하고, 들어오는 메시지나 타이머 이벤트 중 먼저 발생하는 것을 기다리며 프로세스의 실행을 양보합니다 |
|
timeout_locked |
||
try |
y f |
활성 try 블록임을 표시하는 특수한 catch 값을 스택 셀 |
try_case |
y |
|
try_case_end |
s |
|
try_end |
y |
스택 셀 |
wait |
f |
프로세스를 스케줄 아웃하여 들어오는 메시지를 기다리게 합니다(yield). |
wait_locked |
f |
|
wait_unlocked |
f |
Appendix C: 전체 코드 목록
-module(beamfile).
-export([read/1]).
read(Filename) ->
{ok, File} = file:read_file(Filename),
<<"FOR1",
Size:32/integer,
"BEAM",
Chunks/binary>> = File,
{Size, parse_chunks(read_chunks(Chunks, []),[])}.
read_chunks(<<N,A,M,E, Size:32/integer, Tail/binary>>, Acc) ->
%% Align each chunk on even 4 bytes
ChunkLength = align_by_four(Size),
<<Chunk:ChunkLength/binary, Rest/binary>> = Tail,
read_chunks(Rest, [{[N,A,M,E], Size, Chunk}|Acc]);
read_chunks(<<>>, Acc) -> lists:reverse(Acc).
align_by_four(N) -> (4 * ((N+3) div 4)).
parse_chunks([{"Atom", _Size, <<_Numberofatoms:32/integer, Atoms/binary>>} | Rest], Acc) ->
parse_chunks(Rest,[{atoms,parse_atoms(Atoms)}|Acc]);
parse_chunks([{"AtU8", _Size, <<_Numberofatoms:32/integer, Atoms/binary>>} | Rest], Acc) ->
parse_chunks(Rest,[{atU8,parse_atoms(Atoms)}|Acc]);
parse_chunks([{"ExpT", _Size,
<<_Numberofentries:32/integer, Exports/binary>>}
| Rest], Acc) ->
parse_chunks(Rest,[{exports,parse_table(Exports)}|Acc]);
parse_chunks([{"ImpT", _Size,
<<_Numberofentries:32/integer, Imports/binary>>}
| Rest], Acc) ->
parse_chunks(Rest,[{imports,parse_table(Imports)}|Acc]);
parse_chunks([{"Code", Size, <<SubSize:32/integer, Chunk/binary>>} | Rest], Acc) ->
<<Info:SubSize/binary, Code/binary>> = Chunk,
OpcodeSize = Size - SubSize - 8, %% 8 is size of ChunkSize & SubSize
<<OpCodes:OpcodeSize/binary, _Align/binary>> = Code,
parse_chunks(Rest,[{code,parse_code_info(Info), OpCodes}|Acc]);
parse_chunks([{"StrT", _Size, <<Strings/binary>>} | Rest], Acc) ->
parse_chunks(Rest,[{strings,binary_to_list(Strings)}|Acc]);
parse_chunks([{"Attr", Size, Chunk} | Rest], Acc) ->
<<Bin:Size/binary, _Pad/binary>> = Chunk,
Attribs = binary_to_term(Bin),
parse_chunks(Rest,[{attributes,Attribs}|Acc]);
parse_chunks([{"CInf", Size, Chunk} | Rest], Acc) ->
<<Bin:Size/binary, _Pad/binary>> = Chunk,
CInfo = binary_to_term(Bin),
parse_chunks(Rest,[{compile_info,CInfo}|Acc]);
parse_chunks([{"LocT", _Size,
<<_Numberofentries:32/integer, Locals/binary>>}
| Rest], Acc) ->
parse_chunks(Rest,[{locals,parse_table(Locals)}|Acc]);
parse_chunks([{"LitT", _ChunkSize,
<<_CompressedTableSize:32, Compressed/binary>>}
| Rest], Acc) ->
<<_NumLiterals:32,Table/binary>> = zlib:uncompress(Compressed),
Literals = parse_literals(Table),
parse_chunks(Rest,[{literals,Literals}|Acc]);
parse_chunks([{"Abst", _ChunkSize, <<>>} | Rest], Acc) ->
parse_chunks(Rest,Acc);
parse_chunks([{"Abst", _ChunkSize, <<AbstractCode/binary>>} | Rest], Acc) ->
parse_chunks(Rest,[{abstract_code,binary_to_term(AbstractCode)}|Acc]);
parse_chunks([{"Line", _ChunkSize, <<LineTable/binary>>} | Rest], Acc) ->
<<Ver:32,Bits:32,NumLineInstrs:32,NumLines:32,_NumFnames:32,
Lines:NumLines/binary,Fnames/binary>> = LineTable,
parse_chunks(Rest,[{line,
[{version,Ver},
{bits,Bits},
{num_line_instrunctions,NumLineInstrs},
{lines,decode_lineinfo(binary_to_list(Lines),0)},
{function_names,Fnames}]}|Acc]);
parse_chunks([{"FunT", _Size, <<_Numberofentries:32/integer, Funs/binary>>}
| Rest], Acc) ->
parse_chunks(Rest,[{funs,parse_table(Funs)}|Acc]);
parse_chunks([{"Type", _Size, Chunk} | Rest], Acc) ->
<<_Version:32/big, Count:32/big, TypeData/binary>> = Chunk,
Types = parse_types(Count, TypeData, []),
parse_chunks(Rest, [{type_info, Types}|Acc]);
parse_chunks([{"Meta", Size, Chunk} | Rest], Acc) ->
<<MetaInfo:Size/binary, _Pad/binary>> = Chunk,
Meta = binary_to_term(MetaInfo),
parse_chunks(Rest,[{meta,Meta}|Acc]);
parse_chunks([Chunk|Rest], Acc) -> %% Not yet implemented chunk
parse_chunks(Rest, [Chunk|Acc]);
parse_chunks([],Acc) -> Acc.
parse_atoms(<<Atomlength, Atom:Atomlength/binary, Rest/binary>>) when Atomlength > 0->
[list_to_atom(binary_to_list(Atom)) | parse_atoms(Rest)];
parse_atoms(_Alignment) -> [].
parse_table(<<Function:32/integer,
Arity:32/integer,
Label:32/integer,
Rest/binary>>) ->
[{Function, Arity, Label} | parse_table(Rest)];
parse_table(<<>>) -> [].
parse_code_info(<<Instructionset:32/integer,
OpcodeMax:32/integer,
NumberOfLabels:32/integer,
NumberOfFunctions:32/integer,
Rest/binary>>) ->
[{instructionset, Instructionset},
{opcodemax, OpcodeMax},
{numberoflabels, NumberOfLabels},
{numberofFunctions, NumberOfFunctions} |
case Rest of
<<>> -> [];
_ -> [{newinfo, Rest}]
end].
parse_literals(<<Size:32,Literal:Size/binary,Tail/binary>>) ->
[binary_to_term(Literal) | parse_literals(Tail)];
parse_literals(<<>>) -> [].
-define(tag_i, 1).
-define(tag_a, 2).
decode_tag(?tag_i) -> i;
decode_tag(?tag_a) -> a.
decode_int(Tag,B,Bs) when (B band 16#08) =:= 0 ->
%% N < 16 = 4 bits, NNNN:0:TTT
N = B bsr 4,
{{Tag,N},Bs};
decode_int(Tag,B,[]) when (B band 16#10) =:= 0 ->
%% N < 2048 = 11 bits = 3:8 bits, NNN:01:TTT, NNNNNNNN
Val0 = B band 2#11100000,
N = (Val0 bsl 3),
{{Tag,N},[]};
decode_int(Tag,B,Bs) when (B band 16#10) =:= 0 ->
%% N < 2048 = 11 bits = 3:8 bits, NNN:01:TTT, NNNNNNNN
[B1|Bs1] = Bs,
Val0 = B band 2#11100000,
N = (Val0 bsl 3) bor B1,
{{Tag,N},Bs1};
decode_int(Tag,B,Bs) ->
{Len,Bs1} = decode_int_length(B,Bs),
{IntBs,RemBs} = take_bytes(Len,Bs1),
N = build_arg(IntBs),
{{Tag,N},RemBs}.
decode_lineinfo([B|Bs], F) ->
Tag = decode_tag(B band 2#111),
{{Tag,Num},RemBs} = decode_int(Tag,B,Bs),
case Tag of
i ->
[{F, Num} | decode_lineinfo(RemBs, F)];
a ->
[B2|Bs2] = RemBs,
Tag2 = decode_tag(B2 band 2#111),
{{Tag2,Num2},RemBs2} = decode_int(Tag2,B2,Bs2),
[{Num, Num2} | decode_lineinfo(RemBs2, Num2)]
end;
decode_lineinfo([],_) -> [].
decode_int_length(B, Bs) ->
{B bsr 5 + 2, Bs}.
take_bytes(N, Bs) ->
take_bytes(N, Bs, []).
take_bytes(N, [B|Bs], Acc) when N > 0 ->
take_bytes(N-1, Bs, [B|Acc]);
take_bytes(0, Bs, Acc) ->
{lists:reverse(Acc), Bs}.
build_arg(Bs) ->
build_arg(Bs, 0).
build_arg([B|Bs], N) ->
build_arg(Bs, (N bsl 8) bor B);
build_arg([], N) ->
N.
parse_types(_, <<>>, Acc) ->
lists:reverse(Acc);
parse_types(-1, Type, Acc) ->
lists:reverse([Type|Acc]);
parse_types(N, <<TypeBytes:16/binary, Rest/binary>>, Acc) ->
%% See beam_disasm.erl and beam_types.erl to decode.
parse_types(N-1, Rest, [TypeBytes|Acc]).-module(world).
-export([hello/0]).
-include("world.hrl").
hello() -> ?GREETING.-module(json_parser).
-export([parse_transform/2]).
parse_transform(AST, _Options) ->
json(AST, []).
-define(FUNCTION(Clauses), {function, Label, Name, Arity, Clauses}).
%% We are only interested in code inside functions.
json([?FUNCTION(Clauses) | Elements], Res) ->
json(Elements, [?FUNCTION(json_clauses(Clauses)) | Res]);
json([Other|Elements], Res) -> json(Elements, [Other | Res]);
json([], Res) -> lists:reverse(Res).
%% We are interested in the code in the body of a function.
json_clauses([{clause, CLine, A1, A2, Code} | Clauses]) ->
[{clause, CLine, A1, A2, json_code(Code)} | json_clauses(Clauses)];
json_clauses([]) -> [].
-define(JSON(Json), {bin, _, [{bin_element
, _
, {tuple, _, [Json]}
, _
, _}]}).
%% We look for: <<"json">> = Json-Term
json_code([]) -> [];
json_code([?JSON(Json)|MoreCode]) -> [parse_json(Json) | json_code(MoreCode)];
json_code(Code) -> Code.
%% Json Object -> [{}] | [{Label, Term}]
parse_json({tuple,Line,[]}) -> {cons, Line, {tuple, Line, []}};
parse_json({tuple,Line,Fields}) -> parse_json_fields(Fields,Line);
%% Json Array -> List
parse_json({cons, Line, Head, Tail}) -> {cons, Line, parse_json(Head),
parse_json(Tail)};
parse_json({nil, Line}) -> {nil, Line};
%% Json String -> <<String>>
parse_json({string, Line, String}) -> str_to_bin(String, Line);
%% Json Integer -> Integer
parse_json({integer, Line, Integer}) -> {integer, Line, Integer};
%% Json Float -> Float
parse_json({float, Line, Float}) -> {float, Line, Float};
%% Json Constant -> true | false | null
parse_json({atom, Line, true}) -> {atom, Line, true};
parse_json({atom, Line, false}) -> {atom, Line, false};
parse_json({atom, Line, null}) -> {atom, Line, null};
%% Variables, should contain Erlang encoded Json
parse_json({var, Line, Var}) -> {var, Line, Var};
%% Json Negative Integer or Float
parse_json({op, Line, '-', {Type, _, N}}) when Type =:= integer
; Type =:= float ->
{Type, Line, -N}.
%% parse_json(Code) -> io:format("Code: ~p~n",[Code]), Code.
-define(FIELD(Label, Code), {remote, L, {string, _, Label}, Code}).
parse_json_fields([], L) -> {nil, L};
%% Label : Json-Term --> [{<<Label>>, Term} | Rest]
parse_json_fields([?FIELD(Label, Code) | Rest], _) ->
cons(tuple(str_to_bin(Label, L), parse_json(Code), L)
, parse_json_fields(Rest, L)
, L).
tuple(E1, E2, Line) -> {tuple, Line, [E1, E2]}.
cons(Head, Tail, Line) -> {cons, Line, Head, Tail}.
str_to_bin(String, Line) ->
{bin
, Line
, [{bin_element
, Line
, {string, Line, String}
, default
, default
}
]
}.-module(json_test).
-compile({parse_transform, json_parser}).
-export([test/1]).
test(V) ->
<<{{
"name" : "Jack (\"Bee\") Nimble",
"format": {
"type" : "rect",
"widths" : [1920,1600],
"height" : (-1080),
"interlace" : false,
"frame rate": V
}
}}>>.-module(msg).
-export([send_on_heap/0
,send_off_heap/0]).
send_on_heap() -> send(on_heap).
send_off_heap() -> send(off_heap).
send(How) ->
%% Spawn a function that loops for a while
P2 = spawn(fun () -> receiver(How) end),
%% spawn a sending process
P1 = spawn(fun () -> sender(P2) end),
P1.
sender(P2) ->
%% Send a message that ends up on the heap
%% {_,S} = erlang:process_info(P2, heap_size),
M = loop(0),
P2 ! self(),
receive ready -> ok end,
P2 ! M,
io:format("~p~n",[P2]),
ok.
receiver(How) ->
erlang:process_flag(message_queue_data,How),
receive P -> P ! ready end,
%% loop(100000),
receive x -> ok end,
P.
loop(0) -> [done];
loop(N) -> [loop(N-1)].-module(stack_machine_compiler).
-export([compile/2]).
compile(Expression, FileName) ->
[ParseTree] = element(2,
erl_parse:parse_exprs(
element(2,
erl_scan:string(Expression)))),
file:write_file(FileName, generate_code(ParseTree) ++ [stop()]).
generate_code({op, _Line, '+', Arg1, Arg2}) ->
generate_code(Arg1) ++ generate_code(Arg2) ++ [add()];
generate_code({op, _Line, '*', Arg1, Arg2}) ->
generate_code(Arg1) ++ generate_code(Arg2) ++ [multiply()];
generate_code({integer, _Line, I}) -> [push(), integer(I)].
stop() -> 0.
add() -> 1.
multiply() -> 2.
push() -> 3.
integer(I) ->
L = binary_to_list(binary:encode_unsigned(I)),
[length(L) | L].#include <stdio.h>
#include <stdlib.h>
char *read_file(char *name) {
FILE *file;
char *code;
long size;
file = fopen(name, "r");
if(file == NULL) exit(1);
fseek(file, 0L, SEEK_END);
size = ftell(file);
code = (char*)calloc(size, sizeof(char));
if(code == NULL) exit(1);
fseek(file, 0L, SEEK_SET);
fread(code, sizeof(char), size, file);
fclose(file);
return code;
}
#define STOP 0
#define ADD 1
#define MUL 2
#define PUSH 3
#define pop() (stack[--sp])
#define push(X) (stack[sp++] = X)
int run(char *code) {
int stack[1000];
int sp = 0, size = 0, val = 0;
char *ip = code;
while (*ip != STOP) {
switch (*ip++) {
case ADD: push(pop() + pop()); break;
case MUL: push(pop() * pop()); break;
case PUSH:
size = *ip++;
val = 0;
while (size--) { val = val * 256 + *ip++; }
push(val);
break;
}
}
return pop();
}
int main(int argc, char *argv[])
{
char *code;
int res;
if (argc > 1) {
code = read_file(argv[1]);
res = run(code);
printf("The value is: %i\n", res);
return 0;
} else {
printf("Give the file name of a byte code program as argument\n");
return -1;
}
}#include <stdio.h>
#include <stdlib.h>
#define STOP 0
#define ADD 1
#define MUL 2
#define PUSH 3
#define pop() (stack[--sp])
#define push(X) (stack[sp++] = (X))
typedef void (*instructionp_t)(void);
int stack[1000];
int sp;
instructionp_t *ip;
int running;
void add() { int x,y; x = pop(); y = pop(); push(x + y); }
void mul() { int x,y; x = pop(); y = pop(); push(x * y); }
void pushi(){ int x; x = (int)*ip++; push(x); }
void stop() { running = 0; }
instructionp_t *read_file(char *name) {
FILE *file;
instructionp_t *code;
instructionp_t *cp;
long size;
char ch;
unsigned int val;
file = fopen(name, "r");
if(file == NULL) exit(1);
fseek(file, 0L, SEEK_END);
size = ftell(file);
code = calloc(size, sizeof(instructionp_t));
if(code == NULL) exit(1);
cp = code;
fseek(file, 0L, SEEK_SET);
while ( ( ch = fgetc(file) ) != EOF )
{
switch (ch) {
case ADD: *cp++ = &add; break;
case MUL: *cp++ = &mul; break;
case PUSH:
*cp++ = &pushi;
ch = fgetc(file);
val = 0;
while (ch--) { val = val * 256 + fgetc(file); }
*cp++ = (instructionp_t) val;
break;
}
}
*cp = &stop;
fclose(file);
return code;
}
int run() {
sp = 0;
running = 1;
while (running) (*ip++)();
return pop();
}
int main(int argc, char *argv[])
{
if (argc > 1) {
ip = read_file(argv[1]);
printf("The value is: %i\n", run());
return 0;
} else {
printf("Give the file name of a byte code program as argument\n");
return -1;
}
}-module(send).
-export([test/0]).
test() ->
P2 = spawn(fun() -> p2() end),
P1 = spawn(fun() -> p1(P2) end),
{P1, P2}.
p2() ->
receive
M -> io:format("P2 got ~p", [M])
end.
p1(P2) ->
L = "hello",
M = {L, L},
P2 ! M,
io:format("P1 sent ~p", [M]).로드 밸런서.
-module(lb).
-export([start/0]).
start() ->
Workers = [spawn(fun worker/0) || _ <- lists:seq(1,10)],
LoadBalancer = spawn(fun() -> loop(Workers, 0) end),
{ok, Files} = file:list_dir("."),
Loaders = [spawn(fun() -> loader(LoadBalancer, F) end) || F <- Files],
{Loaders, LoadBalancer, Workers}.
loader(LB, File) ->
case file:read_file(File) of
{ok, Bin} -> LB ! Bin;
_Dir -> ok
end,
ok.
worker() ->
receive
Bin ->
io:format("Byte Size: ~w~n", [byte_size(Bin)]),
garbage_collect(),
worker()
end.
loop(Workers, N) ->
receive
WorkItem ->
Worker = lists:nth(N+1, Workers),
Worker ! WorkItem,
loop(Workers, (N+1) rem length(Workers))
end.보여 줍니다.
%%%-------------------------------------------------------------------
%%% show.erl – minimal BEAM tag sniffing in pure Erlang
%%%-------------------------------------------------------------------
-module(show).
-export([top_tag/1, %% → {primary,sub}
tag/1, hex_tag/1, %% → zero-padded string of low tag bits
tag_to_type/1]). %% → header|cons|boxed|pid|…
%%--------------------------------------------------------------------
%% Constants that depend on the VM word size
%%--------------------------------------------------------------------
small_limits() ->
case erlang:system_info(wordsize) of
8 -> {-(1 bsl 59), (1 bsl 59) - 1}; %% 64-bit build: 60 payload bits
4 -> {-(1 bsl 27), (1 bsl 27) - 1} %% 32-bit build: 28 payload bits
end.
word_bits() -> erlang:system_info(wordsize) * 8.
hex_digits() -> erlang:system_info(wordsize) * 2.
%%--------------------------------------------------------------------
%% High-level tag classifier
%%--------------------------------------------------------------------
top_tag(Term) when is_integer(Term) ->
{Min,Max} = small_limits(),
if Term >= Min, Term =< Max ->
{immed, small_int}; %% primary 11, sub 11
true ->
{boxed, bignum_header}
end;
top_tag(Term) when is_atom(Term) -> {immed, atom};
top_tag(true) -> {immed, bool};
top_tag(false) -> {immed, bool};
top_tag([]) -> {immed, nil};
top_tag(Term) when is_pid(Term) -> {immed, pid};
top_tag(Term) when is_port(Term) -> {immed, port};
top_tag(Term) when is_reference(Term)-> {immed, ref};
top_tag([_|_]) -> {cons_cell, list_ptr}; %% primary 01
top_tag({_}) -> {tuple_boxed, boxed_ptr};
top_tag(Term) when is_float(Term) -> {float_boxed, boxed_ptr};
top_tag(Term) when is_binary(Term) -> {bin_boxed, boxed_ptr};
top_tag(Term) when is_map(Term) -> {map_boxed, boxed_ptr};
top_tag(Term) when is_function(Term) -> {fun_boxed, boxed_ptr};
top_tag(_) -> {unknown, needs_native}.
%%--------------------------------------------------------------------
%% Pretty-print helpers (zero-padded)
%%--------------------------------------------------------------------
tag(Term) ->
pad_left(integer_to_list(tag_word(Term), 2), word_bits(), $0).
hex_tag(Term) ->
pad_left(string:uppercase(integer_to_list(tag_word(Term), 16)),
hex_digits(), $0).
pad_left(Str, Width, PadChar) ->
PadCnt = Width - length(Str),
lists:duplicate(max(PadCnt,0), PadChar) ++ Str.
%% minimal word with just the interesting low bits set ---------------
tag_word(Term) ->
case top_tag(Term) of
{immed, small_int} -> 16#3; %% …0011
{immed, atom} -> 16#F; %% …1111
{immed, bool} -> 16#B; %% …1011 (same as small int tag,
%% VM distinguishes by range)
{immed, nil} -> 16#1F; %% …11111
{immed, pid} -> 16#7; %% …0111
{immed, port} -> 16#B; %% …1011
{cons_cell,_} -> 16#1; %% …0001
{boxed,_} -> 16#2; %% …0010
_ -> 0
end.
%%--------------------------------------------------------------------
%% Decode a *real* machine word’s low tag bits (handy for GDB/ETP)
%%--------------------------------------------------------------------
tag_to_type(Word) ->
case Word band 3 of %% primary tag = two LSBs
0 -> header;
1 -> cons;
2 -> boxed;
3 ->
case (Word bsr 2) band 3 of %% immed-1 secondary tag
0 -> pid;
1 -> port;
2 ->
case (Word bsr 4) band 3 of
0 -> atom;
1 -> 'catch'; %% quoted – ‘catch’ is a keyword
2 -> unused;
3 -> nil
end;
3 -> smallint
end
end.참고 문헌
-
[DragonBook] Aho, Sethi, Ullman, Compilers: Principles, Techniques, and Tools Addison-Wesley, 1986. ISBN 0-201-10088-6
-
[Warren] D. H. D. Warren. 추상 Prolog 명령어 집합(An Abstract Prolog Instruction Set): Technical Note 309, Artificial Intelligence Center, SRI International, 333 Ravenswood Ave, Menlo Park, CA 94025, 1983년 10월.