잠재적 프로젝트 목록
참여하기
PyPy 생태계와 관련된 아이디어라면 언제든 기꺼이 함께 논의하겠습니다. RPython이나 PyPy를 직접 다뤄 보는 데 관심이 있으시거나 여기에 언급되지 않은 새로운 아이디어가 있으시다면 IRC의 #pypy 채널(irc.libera.chat)에서 저희와 함께해 주십시오. 확신이 서지 않더라도 PyPy에 가치 있는 기여를 할 수 있다고 생각하신다면 주저하지 마시고 #pypy 채널이나 저희 메일링 리스트로 연락해 주십시오. 생각의 출발점이 될 만한 아이디어를 몇 가지 소개합니다.
- PyPy 메모리 사용량 최적화: PyPy는 때때로 CPython보다 메모리를 더 많이 사용합니다. 두 가지 예를 들면 다음과 같습니다. 1) PyPy는 큰 Python 모듈을 임포트할 때 문자열을 더 많이 할당하고 계속 살려 두는 것으로 보입니다. 2) PyPy의 기본 인터프리터 크기(콘솔에서 시작한 콜드 VM)가 CPython보다 큽니다. 이 프로젝트의 일반적인 절차는 다음과 같습니다. 같은 Python 버전의 CPython과 PyPy를 모두 실행하고 (Massif나 다른 도구를 사용해) 메모리 사용량을 비교합니다. PyPy가 메모리를 훨씬 더 많이 사용한다면 원인을 찾아 해결하십시오.
- VMProf + 메모리 프로파일러: vmprof는 통계적 메모리 프로파일러입니다. vmprof에 새로운 기능을 추가하여 확장하고 현재의 몇 가지 제약을 해결하고자 합니다.
- VMProf 시각화: vmprof는 통계적 프로파일의 플레임 그래프와 특정 호출 지점에 대한 몇 가지 추가 정보를 보여 줍니다. 메모리 정보, 또는 우리 JIT 컴파일러가 생성하는 정보처럼 다른 종류의 정보를 가지고 실험해 보는 것은 매우 흥미로울 것입니다.
- RPython에서의 명시적 타입 지정: PyPy는 RPython에서 시그니처와 클래스 속성 타입을 지정하는 더 나은 방법을 갖추고자 합니다. 이 주제에 대한 자세한 내용은 이 페이지 아래쪽을 참조하십시오.
- vmprof용 가상 현실(VR) 시각화: 매우 열린 주제로, 프로파일 데이터 시각화 방법을 자유롭게 탐구할 수 있습니다. 이 프로젝트를 위해 VR 하드웨어를 직접 마련할 필요는 없습니다. 대학에서 해당 하드웨어를 제공하거나, 그렇지 않은 경우에는 저희가 VR 하드웨어 장비를 대여해 드릴 수도 있습니다.
새 기여자를 위한 간단한 작업
- random 최적화: https://github.com/pypy/pypy/issues/1901
- 소켓의 AF_XXX 패킷 타입을 구현합니다: https://github.com/pypy/pypy/issues/1942
- 문서화 작업을 도와주십시오. 한 가지 작업은 현재 이 사이트에만 나열되어 있는 rpython 설정 옵션을 RPython 문서 사이트에도 문서화하는 것입니다.
중대형 작업
아래는 PyPy 프로젝트에 진지한 관심이 있는 잠재적 기여자에게 흥미로울 만한 프로젝트 목록입니다. 이 프로젝트들은 대체로 공통된 특징이 있습니다. 규모는 중간에서 큰 편이고, 보통 독립 프로젝트로서 범위가 잘 정의되어 있으며, 현재 활발히 진행되고 있지 않습니다. 작업해 보고 싶은 작은 프로젝트를 찾으신다면 위쪽을 보시거나, issue tracker를 확인하시거나, irc.libera.chat의 #pypy 채널에 들르시거나, mailing list에 글을 보내십시오. 이는 단지 작은 프로젝트 후보들이 매우 빠르게 바뀌는 경향이 있기 때문입니다.
이 목록은 주로 잠재적인 프로젝트들을 개괄적으로 살펴보기 위한 것입니다. 이 목록은 본래 모든 것을 망라하지 않으며, 여러분이 직접 개선 아이디어를 내놓아 주신다면 기쁘겠습니다. 어떤 경우든, 이 프로젝트들 중 일부나 PyPy의 다른 어떤 부분이든 작업해 보고 싶으시다면 IRC에 들르시거나 mailing list로 저희에게 글을 보내 주십시오.
RPython의 명시적 타입 지정
RPython은 대부분 타입 추론에 기반하지만, 타입을 명시적으로 지정하는 것이 유용한 경우도 많습니다. 저희는 어떤 함수든 인자의 정확한 타입을 선택적으로 지정할 수 있기를 바랍니다. 이 분야에는 이미 @rpython.rlib.objectmodel.enforceargs와 @rpython.rlib.signature.signature라는 해결책이 있지만, 불편하고 제한적입니다. 예를 들어, 이것들로는 “정수를 키로, Foo 인스턴스의 리스트를 값으로 갖는 dict” 같은 타입을 쉽게 표현할 수 없습니다.
또한 인스턴스 속성의 타입도 지정할 수 있으면 좋겠습니다. 함수의 경우와 달리, 이 작업에는 어노테이터를 어느 정도 리팩터링해야 할 가능성이 높습니다.
bytearray 타입을 빠르게 만들기
PyPy의 bytearray 타입은 매우 비효율적입니다. 이에 대해 가능한 최적화 방안을 조사해 보는 것은 흥미로운 작업이 될 것입니다. (XXX 현재 상태는 알 수 없습니다. 이에 관한 최신 소식은 #pypy에 문의하십시오.)
쓰기 시 복사(copy-on-write) 방식의 리스트 슬라이싱 구현
이 아이디어는 myslice = mylist[a:b]를 실행할 때 사용되는 리스트 객체의 특수한 구현을 두는 것입니다. 이 구현에서는 새 리스트가 즉시 생성되지 않고, myslice나 mylist가 변경될 때에만(그리고 실제로 변경되는 경우에만) 생성됩니다.
NumPy 재시동
저희의 cpyext C-API 호환성 계층은 이제 업스트림 NumPy를 수정 없이 실행할 수 있습니다. NumPy가 독스트링을 추가하는 방식(NumPy adds docstrings)을 리팩터링해야 합니다.
또한 내부 _numpypy 모듈을 사용하여 NumPy dtype 변환과 ufunc 호출을 가로채 JIT가 이를 빠르게 처리할 수 있도록 하는 방법에 대해서도 도움을 구하고 있습니다.
jitviewer 개선
애플리케이션의 성능을 분석하는 일은 늘 까다롭습니다. 성능 분석에 도움이 되는 다양한 도구가 있으며, jitviewer가 그 예입니다.
기존 도구는 일부가 다시 작성되어 vmprof와 결합되었습니다. 이 서비스는 vmprof.com에서 호스팅됩니다.
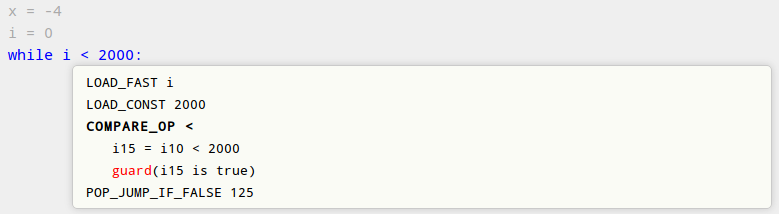
다음은 jitviewer의 예전 화면을 보여 줍니다. PyPy JIT가 생성한 코드를 계층적으로 보여 주는 모습입니다:
- 가장 아래 수준에서는 컴파일된 루프의 Python 소스 코드를 보여줍니다.
- 각 소스 코드 줄마다 그에 해당하는 Python 바이트코드를 보여 줍니다.
- 각 옵코드에 대응하는 JIT 연산을 보여 줍니다. 이 연산은 컴파일을 위해 실제로 백엔드로 전달되는 연산입니다(예제의
i15 = i10 < 2000등).
jitviewer는 django와 angularjs 기반의 웹 애플리케이션입니다. 웹 개발 실력이 뛰어나고 PyPy에 기여하고 싶으시다면, 내부 구조에 대한 깊은 지식이 필요하지 않으므로 시작하기에 이상적인 작업입니다. 미해결 이슈와 문서는 vmprof-python, vmprof-server, vmprof-integration에서 찾아보십시오.
RPython을 Python3로 변환하기
세상은 앞으로 나아가고 있으며, 우리도 그래야 합니다. 이 방향의 작업은 rpython3 브랜치에서 시작되었으며, 주된 목적은 Python3로 문서를 빌드할 수 있게 하는 것입니다. 신중한 리팩터링이 필요한 것으로 알려진 몇 가지 사항은 다음과 같습니다.
- python3에서 문자 하나는 바이트가 아니라 int입니다.
make_win32_traits에서는str/unicode를 사용하여 Windows의 서로 다른 동작 모드를 구분합니다.
아마 더 있을 것입니다. 이 브랜치는 현재 RPython 테스트를 통과하지 못하므로, 일부 변경 사항을 되돌리고 올바르게 다시 적용하는 작업이 필요합니다.
성능 개선
- 인라인되지 않은 Python 수준 호출을 더 빠르게 만들기
- sea-of-nodes IR, 또는 노드의 바다(sea-of-nodes) 접근 방식을 개선한 Lua-Jit과 유사한 IR로 전환합니다
- 실제 레지스터 할당을 사용합니다
- 명령어 선택 및 스케줄링 개선
- 하이브리드 트레이싱/메서드 JIT 만들기
워밍업 개선
- 인터프리터 속도 향상
- 트레이싱 중 최적화
- 실행 간에 정보를 캐시합니다
다양한 GC
PyPy는 교체 가능한 가비지 컬렉션 정책을 갖추고 있습니다. 이는 특수한 목적에 맞춘 다양한 가비지 컬렉터를 작성할 수 있고, 심지어 범용 목적을 위한 여러 실험도 할 수 있다는 뜻입니다. 예시:
- 모바일 기기를 위해 메모리를 더 잘 압축하는 가비지 컬렉터
- 동시(concurrent) 가비지 컬렉터(작업량이 많음)
- 여러 fork()된 프로세스 사이에서 모든 페이지의 공유가 해제되는 것을 막기 위해 객체 플래그를 별도의 메모리 페이지에 보관하는 가비지 컬렉터
STM(Software Transactional Memory, 소프트웨어 트랜잭셔널 메모리)
이것은 저희가 개발을 중단한 실험입니다. STM을 포함하는 (비교적 빠른) pypy 버전을 만드는 것이 목표인 주요 개발 경로 외에도, JIT가 없는 기존 pypy-stm 버전에서 이미 실험해 볼 수 있는 독립적인 주제들이 있습니다:
- 실제 사용 사례에서는 어떤 종류의 충돌이 발생합니까? 그리고 때로는 어떤 자료 구조가 더 적합하겠습니까? 예를 들어, 해시 테이블로 구현된 dict는 한 스레드가 여기에 무언가를 쓸 때마다 모든 스레드에서 “stm 충돌”을 겪게 됩니다. 하지만 다른 구현 방식도 있을 수 있습니다. 어쩌면 Python 인터프리터 수준에서 대안 전략을 구현할 수도 있습니다(list/dict 전략,
pypy/objspace/std/{list,dict}object.py를 참고하십시오). - 더 일반적으로 말하면, 버그가 아니라 stm 충돌인 것들을 “디버깅”하기 위해 일종의 “디버거” 같은 도구가 필요할 것이라는 생각이 있습니다. 최종 사용자인 Python 프로그래머에게 이 도구는 어떤 모습이어야 하겠습니까? 프로파일러와 같은 형태이겠습니까? 아니면 중단된 트랜잭션에 중단점을 거는 디버거와 같은 형태이겠습니까? 아마도 전부 애플리케이션 수준에서 구현되고, 트랜잭션 충돌 등을 위한 몇 가지 훅만 추가될 것입니다.
- 라이브러리가 내부적으로는 스레드와 원자적 연산을 사용하되 사용자에게는 스레드를 노출하지 않도록 하는 좋은 방법을 찾으십시오. 현재
lib_pypy/transaction.py에 대략적인 초안이 있지만, 훨씬 더 나은 방식이 가능합니다. 예를 들어, 루프의 각 반복을 병렬로 실행할 수 있게 해 주는 이터레이터와 비슷한 개념을 도입할 수 있을 것입니다.
새 벤치마크 도입
저희 벤치마크 runner는 이제 낡아서 한계를 드러내고 있습니다. CPython site와 통합해야 합니다.
또한 저희는 대개 새로운 벤치마크를 기꺼이 추가합니다. 사전에 저희와 상의해 주시기 바랍니다. 다만 일반적으로 실제 환경에서 쓰이는 Python 코드이면서 아직 다루어지지 않은 것이라면 환영합니다. 최소한 매개변수 없이 실행할 수 있는 독립 실행형 스크립트가 필요합니다. 예시 아이디어는 다음과 같습니다(이 아이디어들로부터 벤치마크를 만들어 내야 합니다!):
- hg
C와의 인터페이스
cpyext를 faster 만들 수도 있지만, 다른 아이디어도 모색하고자 합니다. cffi는 중소 규모의 확장에 적합하지만, Python C 확장이 나아갈 방향은 HPy인 것으로 보입니다. 몇 가지 아이디어는 다음과 같습니다: * HPy를 지원하고 프로젝트를 HPy로 이식합니다 * JIT가 이해할 수 있는 백엔드를 갖추도록 Cython을 확장합니다 * C 확장 작성자와 협력하여 PyPy를 완전히 지원하도록 합니다(아래 참조) * PyPy 호환 패키지를 PyPI와 conda에 올립니다
더 많은 Python 모듈을 PyPy 친화적으로 만드십시오
지난 몇 년 동안 PyPy의 CPython C-API 구현인 cpyext가 실용적인 수준의 호환성에 도달하도록 많은 작업이 이루어졌으며, 그 결과 CPython용 C 확장 모듈을 대대적으로 다시 작성하지 않고도 PyPy에서 동작시킬 수 있게 되었습니다. 하지만 아직도 오동작하는 경계 상황과 코너 케이스가 많이 남아 있습니다.
따라서 아직 PyPy와 완전히 호환된다고 밝히지 않은 인기 있는 확장 모듈이 있다면, 그 모듈을 자세히 살펴보고 PyPy와 완전히 호환되도록 만드는 작업이 유용할 것입니다. 일반적인 과정은 대략 다음과 같습니다:
- PyPy에서 확장 모듈의 테스트를 실행하고 실패한 테스트를 살펴보십시오.
- 일부 실패는 확장 모듈이 CPython의 문서화되지 않은 세부 사항이나 내부 세부 사항에 의존하는 경우를 찾아내고, 해당 코드를 문서화된 모범 사례에 맞게 다시 작성하여 해결할 수 있습니다. 확장 모듈의 개발 절차에 맞게 적절히 이슈를 열고 풀 리퀘스트를 보내십시오.
- 그 밖의 실패는 cpyext와 CPython 사이의 비호환성을 드러낼 수 있습니다. 이러한 실패는 저희에게 보고해 주시고, 직접 수정해 보십시오.
- 확장 모듈 개발자가 제공한 벤치마크나 직접 만든 벤치마크를 실행하십시오. PyPy가 CPython보다 현저히 느린 경우는 모두 버그로 간주하고 위와 같은 방법으로 해결해야 합니다.
또는, 예전에 저희가 권장하던 방법은 cffi 등 PyPy에 더 친화적인 기술을 사용하여 C 확장을 다시 작성하는 것이었습니다. 다음은 아직 마무리해야 할 좋은 작업들의 일부 목록입니다:
wxPython-cffi bitbucket 저장소의 보관된 사본
상태: Phoenix sip 빌드 시스템을 cffi에 맞게 조정하는 PyPy 개발자의 프로젝트
이 프로젝트는 2013년 GSOC https://waedt.blogspot.com/ 의 후속 프로젝트입니다.
TODO: 아카이브를 되살리고, 래퍼의 최신 버전을 병합한 뒤, sip 변환을 마무리하십시오
pygame https://github.com/CTPUG/pygame_cffi
상태: 마지막 릴리스는 2017년이었습니다