PEP 831 – 모든 곳에 프레임 포인터를: Python의 시스템 수준 관측 가능성 확보
- Author:
- Pablo Galindo Salgado <pablogsal at python.org>, Ken Jin <kenjin at python.org>, Savannah Ostrowski <savannah at python.org>, Diego Russo <diego.russo at arm.com>
- Discussions-To:
- Discourse thread
- Status:
- Final
- Type:
- Standards Track
- Created:
- 14-Mar-2026
- Python-Version:
- 3.15
- Post-History:
- 13-Apr-2026
- Resolution:
- 30-Apr-2026
번역·라이선스 안내
이 비공식 한국어 번역은 원문 Copyright 절의 Public Domain or CC0-1.0, whichever is more permissive 조건에 따라 제공합니다. 원저자와 공식 원문은 그대로 표시합니다. 수정되지 않은 기준 원문 · 공식 최신판
초록
이 PEP는 두 가지를 제안합니다:
- 프레임 포인터를 지원하는 플랫폼에서는 기본적으로 프레임 포인터를 사용하여 CPython을 빌드합니다. 기본 빌드 구성을 변경하여 인터프리터를
-fno-omit-frame-pointer와-mno-omit-leaf-frame-pointer로 컴파일합니다. 이 플래그들은CFLAGS에 추가되므로 인터프리터 자체에 적용되며,sysconfig를 통해 이 Python을 대상으로 빌드되는 C 확장 모듈에도 전파됩니다. 최대한의 순수 처리량이 필요한 배포 환경을 위해 이를 해제할 수 있는configure플래그(--without-frame-pointers)를 제공합니다. - Python 생태계의 모든 빌드 시스템이 기본적으로 프레임 포인터를 사용하여 빌드할 것을 강력히 권장합니다. 이 PEP는 Python 호출 스택에 참여하는 모든 컴파일된 구성 요소(C 확장, Rust 확장, 임베딩 애플리케이션, 네이티브 라이브러리)가 프레임 포인터를 활성화할 것을 권장합니다. 프레임 포인터 체인의 강도는 가장 약한 고리에 의해 결정됩니다. 프레임 포인터가 없는 라이브러리 하나만 있어도 프로세스 전체의 프로파일링, 디버깅, 트레이싱이 망가집니다.
프레임 포인터는 프로파일러, 디버거, 시스템 트레이싱 도구가 실행 중인 프로세스의 호출 스택을 빠르고 안정적으로 재구성할 수 있게 해 주는 CPU 레지스터 규약입니다. 프레임 포인터를 생략하면(-O1 이상에서 컴파일러의 기본 동작) 이러한 도구들이 Python 프로세스에 대해 유용한 호출 스택을 만들어 내지 못하며, CPython이 3.12에서 도입한 perf 트램펄린 지원의 효과도 약화됩니다.
측정된 오버헤드는 일반적인 워크로드에서 기하 평균 2% 미만입니다(플랫폼별 수치는 Backwards Compatibility를 참조하십시오). 여러 주요 Linux 배포판, 언어 런타임, Python 생태계 도구가 이미 이 변경을 채택했습니다. 이 주제를 다루는 기존 PEP는 없으며, CPython 이슈 #96174는 2022년 8월부터 해결되지 않은 채 열려 있습니다.
동기
Python의 관측 가능성(프로파일링, 디버깅, 시스템 수준 트레이싱)은 프레임 포인터가 없다는 점 때문에 근본적으로 제한되어 있습니다. 이 PEP의 핵심 동기는 Python을 기본적으로 관측 가능하게 만들어, 프로파일러는 더 빠르고 정확해지고, 디버거는 더 신뢰할 수 있게 되며, eBPF 기반 도구는 우회 방법 없이도 동작하게 하는 것입니다.
현재 시스템 도구로 CPython을 프로파일링하려는 사용자는 특수한 컴파일러 플래그로 인터프리터를 다시 빌드해야 하는데, 대부분의 사용자는 이 단계를 밟을 수 없거나 밟으려 하지 않습니다. Fedora 38의 프레임 포인터 제안 [2]은 이를 핵심 문제로 강조합니다. 기본 빌드에 프레임 포인터가 없으면 개발자는 “충분한 디버깅 정보를 포함하여 프로그램을 다시 컴파일”하고 “소프트웨어의 성능이 저하되었던 시나리오를 재현”해야 하는데, 프로덕션 환경의 문제에서는 이것이 불가능한 경우가 많습니다. Ubuntu 24.04의 분석 [3] 역시 프레임 포인터를 결정적 인자로 꼽으며 같은 주장을 합니다. 프레임 포인터는 “bcc-tools, bpftrace, perf 및 기타 유사한 도구가 별도 설정 없이 바로 동작하게 해 줍니다.” 이 PEP의 목표는 Python에서도 이것을 기본 경험으로 만드는 것입니다.
프로파일링으로 얻을 수 있는 성능 향상은 프레임 포인터의 적은 오버헤드를 훨씬 능가합니다. Brendan Gregg는 이렇게 말합니다: “저는 프레임 포인터가 5%에서 500%에 이르는 성능 향상을 찾는 데 도움이 되는 것을 보아 왔습니다” [1]. 이러한 성능 향상은 프로덕션 시스템의 핫 패스를 찾아내는 데서 옵니다. 이는 CPython 자체의 오버헤드에 관한 것이 아니라, 프로파일링이 전체 스택에 걸쳐 가능하게 해 주는 것에 관한 것입니다. 이러한 통찰을 얻을 수 있게 해 주는 0.5-2%의 오버헤드는 충분히 남는 거래입니다.
프레임 포인터란 무엇입니까?
프로그램이 실행될 때 각 함수 호출은 스택 프레임을 생성합니다. 스택 프레임은 호출 스택 위의 메모리 블록으로, 함수의 지역 변수, 인자, 그리고 함수가 끝났을 때 돌아갈 주소를 담습니다. 호출 스택은 활성 상태인 모든 스택 프레임의 체인으로, main()에서부터 현재 실행 중인 함수까지 어떤 함수가 어떤 함수를 호출했는지를 기록합니다.
프레임 포인터는 각 함수가 자신의 스택 프레임의 기준 위치를 가리키도록 설정하는 CPU 레지스터(예: x86-64의 %rbp, AArch64의 x29)입니다. 각 프레임은 이전 프레임 포인터도 저장하므로, 호출 스택 전체를 관통하는 연결 리스트가 만들어집니다:
┌──────────────────┐
│  main()          │ ◄─── frame pointer chain
│  saved %rbp ─────┼──► (bottom of stack)
├──────────────────┤
│  PyRun_String()  │
│  saved %rbp ─────┼──► main's frame
├──────────────────┤
│  _PyEval_Eval…() │
│  saved %rbp ─────┼──► PyRun_String's frame
├──────────────────┤
│  call_function() │ ◄─── current %rbp
│  saved %rbp ─────┼──► _PyEval_Eval's frame
└──────────────────┘
스택 되감기(stack unwinding)는 이 체인을 따라가며 호출 스택을 재구성하는 과정입니다. 프로파일러는 프로그램이 어디에서 시간을 소비하는지 알아내기 위해, 디버거는 백트레이스를 보여 주기 위해, 크래시 핸들러는 유용한 오류 보고서를 만들기 위해 이 작업을 수행합니다. 프레임 포인터가 있으면 되감기는 단순히 포인터를 따라가는 일입니다. %rbp를 읽고, 링크를 따라가고, 이를 반복합니다. 외부 데이터가 전혀 필요하지 않습니다.
최적화 수준 -O1 이상에서 GCC와 Clang은 기본적으로 프레임 포인터를 생략합니다 [14]. 이렇게 하면 %rbp 레지스터를 범용으로 쓸 수 있게 되어 최적화기가 활용할 수 있는 레지스터가 하나 더 늘어납니다. x86-64에서는 16개 중 레지스터 하나(약 7%)를 더 얻는 셈입니다. 성능상 이점은 작지만(보통 몇 퍼센트), 이 관례가 확립된 32비트 x86에서는 6개 중 레지스터 하나(~20%)를 더 얻을 수 있었기 때문에 그만한 가치가 있다고 여겨졌습니다. 플랫폼과 워크로드별 전체 분석은 Detailed Performance Analysis of CPython with Frame Pointers를 참조하십시오.
프레임 포인터가 없으면 연결 리스트가 존재하지 않습니다. 호출 스택을 순회해야 하는 도구는 그 대신 DWARF 디버그 정보(각 함수가 스택 프레임을 어떻게 배치했는지를 나타내는 복잡한 가변 길이 인코딩)를 파싱하거나, Windows에서는 .pdata / .xdata 언와인드 메타데이터를 파싱해야 합니다. 이 방식은 더 느리고 더 취약하며, 일부 상황(예: Linux 커널 내부)에서는 아예 불가능합니다. 최악의 경우 도구는 깨지거나 불완전한 결과를 내놓을 뿐입니다.
구체적인 예를 들어 보겠습니다. 프레임 포인터 없이 실행한 Python 프로세스의 perf 프로파일은 일반적으로 다음과 같이 나타납니다:
100.00%  python  libpython3.14.so  _PyEval_EvalFrameDefault
   |
   ---_PyEval_EvalFrameDefault
      (truncated, no further frames available)
프레임 포인터를 사용한 같은 프로파일은 전체 체인을 보여 줍니다:
100.00%  python  libpython3.14.so  _PyEval_EvalFrameDefault
   |
   ---_PyEval_EvalFrameDefault
      |
      +--PyObject_Call
      |  PyRun_StringFlags
      |  PyRun_SimpleStringFlags
      |  Py_RunMain
      |  main
      |
      +--call_function
         fast_function
         ...
첫 번째 트레이스는 성능 문제를 진단하는 데 쓸모가 없지만, 두 번째 트레이스는 어떤 코드 경로가 집중적으로 실행되는지 개발자에게 정확히 알려 줍니다.
프레임 포인터가 없으면 프로파일러가 더 느리고 덜 정확합니다
통계적 프로파일러(perf, py-spy, Austin, Pyroscope, Parca 등)는 실행 중인 프로세스의 호출 스택을 주기적으로 샘플링하는 방식으로 동작합니다. 프레임 포인터가 있으면 이 샘플링은 단순한 포인터 추적입니다. 프로파일러는 %rbp를 읽고 체인을 따라가서 마이크로초 단위로 전체 호출 스택을 재구성합니다. 이는 프로덕션 환경에서 무시할 수 있을 정도의 오버헤드로 10,000 Hz 샘플링을 할 수 있을 만큼 빠릅니다.
프레임 포인터가 없으면 프로파일러는 DWARF 언와인딩으로 대체해야 합니다. DWARF 언와인딩은 컴파일러가 생성한 디버그 메타데이터를 파싱하여 호출 체인을 재구성하는 방법입니다. perf --call-graph dwarf는 샘플마다 원시 스택 8 KB를 사용자 공간으로 복사한 다음, 오프라인에서 .eh_frame 디버그 섹션을 파싱하여 각 프레임을 재구성합니다. CPython 3.15-dev에서 직접 측정한 결과, 같은 워크로드를 같은 샘플링 속도로 프로파일링했을 때 같은 ~38,000개 샘플에 대해 프레임 포인터 언와인딩은 5.6 MB의 perf.data 파일을, DWARF 언와인딩은 306.5 MB의 파일(55배 더 큼)을 생성했습니다.
또한 DWARF 모드는 perf report를 사용한 오프라인 후처리가 필요하고(이 작업 자체가 CPU를 최대 17%까지 소비할 수 있습니다 [11]), 복사 윈도보다 깊은 스택은 경고 없이 잘라 버리며, 프로덕션 환경에서 높은 샘플링 속도로는 사용할 수 없습니다. 결과적으로 프로덕션 환경에서 Python 서비스를 프로파일링하려면 깨진 스택을 감수하거나, 몇 자릿수 더 큰 오버헤드와 저장 공간을 감수해야 합니다.
차이를 정량화하기 위해, x86-64 Linux에서 64개 프레임으로 된 호출 스택을 언와인딩하는 시간을 벤치마크했습니다. 비교 대상은 프레임 포인터 순회(커널의 perf_events와 bpf_get_stackid()가 사용하는 방법인 %rbp 체인 추적)와 널리 쓰이는 DWARF 기반 언와인더 세 가지, 즉 libunwind [26], glibc의 backtrace(), framehop [27](samply [28]가 사용하는 Rust 언와인더)입니다. 각 언와인더는 -fno-omit-frame-pointer를 지정하고 컴파일한 프로그램과 지정하지 않고 컴파일한 같은 프로그램을 대상으로 테스트했습니다.
프레임 포인터 순회는 64개 프레임 언와인딩을 116 ns 만에 완료했으며, 이는 테스트한 DWARF 대안보다 평균 210배 빠릅니다. 프레임 포인터가 없으면 프레임 포인터 탐색은 사용 가능한 프레임을 하나도 복구하지 못하는 반면(%rbp 체인이 존재하지 않으므로), DWARF 언와인더는 본질적으로 같은 비용으로 계속 언와인딩 함수로서 제 역할을 수행합니다.
일반적인 프로덕션 샘플링 속도인 10,000 Hz에서 이 깊이의 프레임 포인터 언와인딩은 대략 초당 1.2 ms의 CPU 시간 (0.12%)을 소비하는 반면, 테스트한 DWARF 언와인더 중 가장 느린 것은 초당 240 ms 이상(24%)을 소비합니다. DWARF 기반 프로파일링은 제대로 동작하며 오늘날 대부분의 프로파일러가 이 방식으로 동작하지만, 프레임 포인터 언와인딩보다 오버헤드가 상당히 큽니다.
BPF 기반 프로파일러(bpftrace, bcc의 profile.py, Pyroscope, Parca, Elastic Universal Profiling)를 사용한 프로파일링에서는 상황이 더 나쁩니다. 오늘날 프로덕션 환경에서 쓰이는 모든 eBPF 프로파일러의 기반인 BPF 헬퍼 bpf_get_stackid()는 프레임 포인터 체인을 순회하며, DWARF로 대체하는 경로가 없습니다. 프레임 포인터가 없으면 이러한 도구는 Python 프로세스에 대해 잘리거나 비어 있는 스택을 내놓을 뿐입니다. Linux 커널에는 DWARF 언와인더가 없으며, Linus Torvalds에 따르면 앞으로도 추가되지 않을 것입니다 [15]. 그 대신 커널은 내부용으로 자체 ORC 형식을 개발했습니다.
그 영향은 CPU 프로파일링에만 그치지 않습니다. off-CPU 플레임 그래프(I/O 대기, 잠금 경합, 스케줄링 지연으로 인한 지연 시간을 진단하는 데 사용됨)도 스레드가 블록되는 시점의 스택을 캡처하기 위해 동일한 bpf_get_stackid() 헬퍼에 의존합니다. Brendan Gregg가 지적하듯이, off-CPU 플레임 그래프는 “libc read/write 및 mutex 함수가 대부분을 차지할 수 있으므로, 프레임 포인터가 없으면 대부분 망가진 결과가 됩니다” [1]. 순수 CPU 처리량보다 지연 시간이 더 중요한 Python 서비스에서는 off-CPU 프로파일링이 가장 유용한 진단 도구인 경우가 많은데, 이 도구는 프레임 포인터 없이는 전혀 작동하지 않습니다.
디버거도 프레임 포인터의 이점을 얻습니다
GDB와 LLDB 같은 디버거는 프레임 포인터 없이도 스택을 언와인드할 수 있습니다. 이들 디버거는 여러 전략을 사용합니다. DWARF CFI 메타데이터(.debug_frame 및 .eh_frame 섹션), 어셈블리 프롤로그 분석, 컴팩트 언와인드 정보(macOS), 그리고 다양한 플랫폼별 휴리스틱이 그것입니다. 전체 디버그 정보를 사용할 수 있는 일반적인 대화형 디버깅 세션에서는 이러한 메커니즘이 잘 작동합니다.
그럼에도 프레임 포인터는 몇 가지 중요한 상황에서 디버깅을 더 빠르고 견고하게 만듭니다.
프로덕션 배포에서는 흔히 디버그 심볼을 제거하거나, 일치하는 debuginfo 패키지 없이 배포합니다. DWARF 메타데이터를 사용할 수 없으면 디버거는 그 공백을 넘어 언와인드할 수 없습니다. 프레임 포인터는 바이너리 스트리핑 후에도 남아 있고 별도의 부가 데이터가 필요하지 않으므로, DWARF 기반 언와인딩이 실패하는 곳에서도 백트레이스를 성공시킬 수 있습니다. 이는 코어 덤프 분석에서 가장 중요합니다. 프로덕션 프로세스의 크래시를 분석할 때 디버거가 스택을 재구성할 기회는 단 한 번뿐이며, 일부 공유 객체의 디버그 패키지가 일치하지 않거나 없으면 DWARF 언와인딩은 첫 번째 공백에서 멈추지만, 프레임 포인터는 디버거가 그 공백을 지나 계속 진행할 수 있게 해 줍니다.
CPython의 JIT 스텐실과 perf 트램펄린 스텁에는 DWARF 메타데이터가 없습니다. 디버거가 이러한 프레임을 거쳐 언와인드할 수 있는 유일한 방법은 프레임 포인터입니다.
elfutils(libdw)를 사용하여 코어 파일과 원격 프로세스를 분석하는 pystack 같은 도구는 추가 메타데이터 없이도 프레임 포인터를 따라갈 수 있지만, 프레임 포인터가 없으면 프로세스 내 모든 공유 객체의 디버그 심볼이 필요하며, 이는 프로덕션 컨테이너에서 좀처럼 충족되지 않는 조건입니다.
프레임 포인터 언와인딩은 또한 훨씬 더 빠릅니다. 위의 벤치마크에서 보듯이, 프레임 포인터 탐색은 64개 프레임의 언와인드를 116 ns 만에 완료하며, 이는 DWARF 대안보다 약 210배 빠릅니다. 반복적으로 언와인드하는 디버거 작업(예: 적중할 때마다 평가되는 조건부 중단점)에서는 이 차이가 중요합니다.
커널의 스택 언와인더는 프레임 포인터만 사용합니다
Linux 커널은 사용자 공간 호출 스택을 캡처하기 위한 두 가지 내장 메커니즘을 제공합니다. perf_events 서브시스템과 eBPF 헬퍼 함수입니다. 두 메커니즘 모두 동일한 커널 측 프레임 포인터 언와인더를 사용하며, 어느 쪽도 DWARF로의 대체 수단이 없습니다.
perf_events는 perf record의 기반이 되는 커널 서브시스템입니다. perf가 --call-graph fp (프레임 포인터)로 설정되면, 커널은 샘플을 캡처한 인터럽트 핸들러에서 곧바로 사용자 공간 프레임 포인터 체인을 탐색합니다. 이는 커널 컨텍스트에서, 인터럽트 시점에, 사용자 공간의 협조 없이 이루어집니다. 언와인더는 %rbp 체인을 따라가며 대상 프로세스의 스택에서 저장된 각 프레임 포인터를 읽고, 스택의 바닥이나 설정 가능한 깊이 제한에 도달할 때까지 이를 계속합니다. 그 결과는 반환 주소로 이루어진 간결한 배열이며, perf가 이를 오프라인에서 심볼로 변환합니다. 이것이 오버헤드가 가장 낮은 경로입니다. 주소 배열 자체 외에는 어떤 데이터도 사용자 공간으로 복사되지 않으며, 커널은 마이크로초 단위로 탐색을 수행합니다.
프레임 포인터가 없으면 perf_events는 커널 내에서 스택을 전혀 언와인드할 수 없습니다. 유일한 대안은 --call-graph dwarf인데, 이는 실제로 커널 내에서 언와인드하지 않습니다. 대신 샘플마다 최대 8 KB의 원시 스택 메모리를 perf.data 링 버퍼로 복사하며, 언와인딩은 perf report가 사용자 공간에서 오프라인으로 수행합니다. 이는 커널 측 언와인딩이 아니라, 대량의 메모리 복사 후 오프라인에서 DWARF를 해석하는 방식입니다.
eBPF는 작은 프로그램을 커널 내부에서 안전하게 실행할 수 있게 해 주는 Linux 커널 기술로, 오버헤드가 낮은 시스템 모니터링, 프로파일링, 트레이싱을 가능하게 합니다. 최신 프로덕션 프로파일러(Pyroscope, Parca, Datadog, Elastic)는 상시 가동되는 지속적 프로파일링에 eBPF를 점점 더 많이 사용하고 있습니다.
커널은 호출 스택을 캡처하기 위한 두 가지 BPF 헬퍼 함수를 제공합니다:
bpf_get_stackid(ctx, map, flags)는 프레임 포인터 체인을 순회하고 스택 트레이스 맵에 대한 해시 키를 반환합니다. 이는 eBPF 프로파일러, 트레이싱 도구, bpftrace 원라이너에서 호출 스택을 캡처하는 표준 방법입니다. 이 함수는 프레임 포인터만 순회하며 그 외에는 아무것도 하지 않습니다: DWARF 폴백도, SFrame 폴백도, 대체 언와인딩 경로도 없습니다.bpf_get_stack(ctx, buf, size, flags)는 원시 프레임 주소를 호출자가 제공한 버퍼에 기록합니다.bpf_get_stackid()와 마찬가지로, 이 함수도 오직 프레임 포인터 체인만 순회합니다.
두 헬퍼 모두 커널의 BPF 런타임 내부에서 실행되며, 이 런타임은 엄격한 안전 제약을 강제합니다: 제한된 실행 시간, 무한 루프 금지, 임의 메모리 접근 금지, 복잡한 라이브러리 코드 호출 금지입니다. 이러한 제약 때문에 범용 DWARF 언와인더를 BPF 헬퍼로 구현하는 것은 구조적으로 불가능합니다. DWARF 언와인딩에는 .eh_frame 섹션에서 가변 길이 명령어를 파싱하고, 스택 머신(DWARF Call Frame Information 상태 머신)을 평가하고, 임의의 깊이를 가진 CIE/FDE 레코드 체인을 따라가는 작업이 필요한데, 이 중 어느 것도 BPF 검증기를 통과할 수 없습니다.
프레임 포인터가 없으면 bpf_get_stackid()와 bpf_get_stack()은 Python 프로세스에 대해 잘리거나 비어 있는 결과를 만들어 냅니다. 현재 프로덕션에서 사용되는 모든 eBPF 프로파일러(Pyroscope, Parca, Datadog의 지속적 프로파일러, Elastic Universal Profiling, bpftrace, bcc의 profile.py)는 프로파일링 시 결국 이 두 헬퍼 중 하나를 호출합니다. 이 헬퍼들이 실패하면 프로파일러는 보고할 스택이 없습니다.
일부 벤더(Polar Signals, Elastic, OpenTelemetry의 eBPF 프로파일러, Yandex의 Perforator [24])는 우회책으로 DWARF-in-eBPF를 구현했지만, 이 접근 방식은 상당히 느리고 더 복잡하며 커널에 내장된 스택 순회 헬퍼를 사용할 수 없습니다. 이러한 구현은 bpf_get_stackid()를 호출하는 대신, 사용자 공간에서 .eh_frame 섹션을 파싱하여 간결한 스택 델타 조회 테이블로 변환하고, 그 테이블을 BPF 맵에 적재한 다음, bpf_probe_read_user()로 스택 메모리를 직접 읽는 사용자 정의 BPF 프로그램에서 테이블을 평가합니다. 이 방식은 500줄 이상의 BPF 코드가 필요하고(프레임 포인터 경로는 50줄 미만), 디버그 정보를 파싱하고 적재하기 위한 프로세스별 시작 오버헤드를 요구하며, 스택 델타 테이블을 위해 상당한 BPF 맵 메모리를 소비하고, bpftrace, bcc, perf 같은 표준 도구에서는 사용할 수 없는 최첨단 벤더 전용 인프라입니다 [12].
대다수의 eBPF 사용 사례(bpftrace 원라이너, bcc 도구, 프로덕션 모니터링용 사용자 정의 BPF 프로그램)에서 프레임 포인터는 유일하게 실행 가능한 언와인딩 메커니즘입니다. 커널의 내장 헬퍼가 지원하는 유일한 메커니즘이기 때문입니다.
CPython 자체 문서에도 이미 권장 해결책이 명시되어 있습니다:
최상의 결과를 얻으려면 Python을CFLAGS="-fno-omit-frame-pointer -mno-omit-leaf-frame-pointer"로 컴파일해야 합니다. 그래야 프로파일러가 DWARF 디버그 정보에 의존하지 않고 프레임 포인터만으로 언와인딩할 수 있기 때문입니다.
프로덕션 프로파일링 도구들도 이 지침을 되풀이합니다. Grafana Pyroscope의 문제 해결 문서에는 다음과 같이 적혀 있습니다: “프로파일에 보통 1~2 프레임 깊이의 얕은 스택 트레이스가 많이 나타난다면, 바이너리가 프레임 포인터 없이 컴파일되었을 수 있습니다” [25].
권장 구성이 -fno-omit-frame-pointer라면, 그것이 기본값이어야 합니다.
Perf 트램펄린 기능에는 프레임 포인터가 필요합니다
Python 3.12는 -Xperf (sys.activate_stack_trampoline)를 도입했는데, 이 기능은 Python 함수 이름을 perf에서 볼 수 있게 해 주는 작은 JIT 스텁을 생성합니다. 이 스텁에는 DWARF 정보가 전혀 없으므로, 프로파일러가 이를 거쳐 순회할 수 있는 유일한 방법은 프레임 포인터 체인뿐입니다. 따라서 3.12에 포함된 -Xperf 기능은 -fno-omit-frame-pointer로 명시적으로 다시 빌드되지 않은 모든 설치 환경에서 깨진 스택을 만들어 냅니다.
Python 3.13은 DWARF 기반 대안인 -Xperf_jit를 추가했지만, 이 기능은 perf >= 6.8이 필요하고, 프레임 포인터 경로보다 상당히 큰 데이터 파일을 생성하며, 샘플당 오버헤드 때문에 지속적인 프로덕션 프로파일링에는 적합하지 않습니다.
배포판들은 업스트림을 기다리고 있습니다
Fedora 38 [2], Ubuntu 24.04 LTS [3], Arch Linux는 모두 전체 패키지 트리를 -fno-omit-frame-pointer -mno-omit-leaf-frame-pointer로 다시 빌드했습니다. 그러나 Ubuntu 24.04 LTS는 CPython을 명시적으로 예외로 두었습니다:
영향이 큰 경우(Python 인터프리터 등)에는 이 문제가 해결될 때까지 계속 프레임 포인터를 생략할 것입니다.
결과적으로 순환 의존성이 생깁니다. 프로파일링에 프레임 포인터가 가장 필요한 런타임이 바로 주요 배포판이 업스트림 수정을 기다리며 프레임 포인터 없이 남겨 두는 런타임입니다. Red Hat Enterprise Linux와 CentOS 스트림 역시 기본적으로 프레임 포인터를 비활성화하며, 대신 아직 프로덕션 환경에서 사용할 준비가 되지 않은 대안적 접근 방식(eu-stacktrace, SFrame)에 투자하고 있습니다(Alternatives to Frame-Pointer Unwinding 참고). python.org에서 Python을 설치하거나, 소스에서 빌드하거나, pyenv를 사용하거나, Debian, RHEL, openSUSE 또는 시스템 전체에 프레임 포인터를 도입하지 않은 기타 배포판에서 작업하는 사용자는 자신의 로컬 배포판이 어떻게 하든 프레임 포인터를 얻지 못합니다. 업스트림 기본값으로 정하면 이 문제가 영구적으로 해결됩니다.
Python/C 혼합 프로파일링에는 끊김 없는 체인이 필요합니다
실제 Python 애플리케이션은 NumPy, 암호화 라이브러리, 압축, 데이터베이스 드라이버 등 C 확장 모듈에서 상당한 시간을 보냅니다. perf 플레임 그래프가 Python 코드에서 C 확장을 거쳐 시스템 라이브러리에 이르는 전체 경로를 보여 주려면, 프레임 포인터 체인이 인터프리터와 호출 스택에 있는 모든 확장을 거쳐 끊김 없이 이어져야 합니다. _PyEval_EvalFrameDefault에서든 C 확장에서든 어느 한 지점에서라도 체인이 끊기면 프로세스 전체의 체인이 끊어집니다.
끊김 없는 체인이 필요하다는 점이 바로 플래그가 확장 빌드에까지 전파되어야 하는 이유입니다. 인터프리터에만 프레임 포인터가 있고 확장에는 없다면, 체인은 여전히 모든 C 확장 경계에서 끊어집니다. sysconfig가 보고하는 CFLAGS에 플래그를 추가하면, CPython의 컴파일러 플래그를 사용하는 확장 빌드(예를 들어 pip install, Setuptools 또는 기타 빌드 백엔드를 통한 빌드)는 기본적으로 프레임 포인터를 물려받습니다. 독립적인 빌드 시스템을 사용하는 확장과 라이브러리는 프레임 포인터 체인이 끊김 없이 유지되도록 여전히 같은 플래그를 직접 활성화해야 합니다.
JIT 컴파일러를 디버깅할 수 있으려면 프레임 포인터가 필요합니다
CPython의 복사 후 패치(copy-and-patch) JIT(PEP 744)는 런타임에 네이티브 기계어 코드를 생성합니다. JIT 코드에 예약된 프레임 포인터가 없으면 생태계의 거의 모든 도구에서 JIT 프레임을 거치는 스택 되감기(unwinding)가 제대로 동작하지 않습니다. GDB, LLDB, libunwind, libdw(elfutils), py-spy, Austin, pystack, memray, perf, 그리고 모든 eBPF 기반 프로파일러가 여기에 해당합니다. JIT가 프로덕션에 쓸 준비가 되었다고 인정받으려면 JIT 컴파일된 코드의 전체 스택 관측 가능성을 보장하는 것이 전제 조건입니다.
개별 JIT 스텐실에는 프레임 포인터 프롤로그가 필요하지 않습니다. 되감기 목적상 JIT 영역 전체를 프레임이 없는 단일 영역으로 취급할 수 있습니다. 중요한 것은 JIT 자체가 프레임 포인터를 예약하여 프레임 포인터 레지스터(x86-64의 %rbp, AArch64의 x29)가 예약된 상태로 유지되고 스텐실 코드가 이를 덮어쓰지 않도록 해야 한다는 점입니다. JIT에 프레임 포인터가 있으면 대부분의 되감기 도구(unwinder)는 개별 스텐실을 검사할 필요 없이 JIT 영역을 통과할 수 있습니다. 이는 다른 JIT 컴파일러(V8, LuaJIT, .NET CoreCLR, Julia, LLVM의 ORC JIT)와 비교하면 매우 좋은 결과입니다. 이들 JIT 컴파일러는 일반적으로 사용자 정의 DWARF .eh_frame 생성, GDB JIT 인터페이스 지원(__jit_debug_register_code), 되감기 도구별 등록 API(_U_dyn_register, __register_frame)를 구현하는 데 수백에서 수천 줄의 코드가 필요합니다. 프레임 포인터와 JIT에 관한 추가 논의는 이슈 #126910을 참조하십시오.
생태계는 이미 프레임 포인터를 도입했습니다
프레임 포인터로의 전환은 CPython 업스트림과 관계없이, 그리고 대규모로 이미 일어났습니다.
uv, mise, rye 및 많은 CI 시스템에서 사용하는 밀폐형(hermetic) Python 배포판인 python-build-standalone은 2026년 초 모든 x86-64 및 AArch64 Linux 빌드에서 -fno-omit-frame-pointer를 활성화했으며, 이 변경은 uv 0.11.0에 포함되어 출시되었습니다 [13]. 이 프로젝트를 만든 Gregory Szorc는 다음과 같이 말했습니다. “2026년에는 x86-64 / aarch64 바이너리의 100%에서 프레임 포인터가 활성화되어야 합니다. 예외는 없습니다.” 그는 더 나아가 다음과 같이 주장했습니다. “PBS에서 프레임 포인터를 활성화하는 데서 멈추어서는 안 됩니다. CPython이 코어 인터프리터뿐만 아니라 컴파일된 C 확장에도 기본적으로 프레임 포인터를 활성화하도록 촉구해야 합니다.” [13]
이는 Python 사용자 중 크고 계속 늘어나는 비율(uv python install이나 Astral의 GitHub Actions, 또는 python-build-standalone 바이너리를 가져오는 도구를 사용하는 모든 사람)이 이미 프레임 포인터가 있는 Python을 실행하고 있다는 뜻입니다. 이들이 매일 사용하는 인터프리터에는 이미 프레임 포인터가 활성화되어 있습니다. 이 PEP는 업스트림 기본값을 이러한 현실에 맞춥니다.
python-build-standalone 벤치마크는 Python 3.11부터 3.15까지 1-3%의 오버헤드를 측정했으며, 꼬리 호출(tail-call)을 사용하지 않는 빌드에서는 1.1%, 꼬리 호출 인터프리터에서는 최대 3.3%였습니다 [13]. 이 수치는 이 PEP가 직접 측정한 결과 및 Fedora/Ubuntu 데이터와 일치합니다.
주요 Linux 배포판(Fedora 38 [2], Ubuntu 24.04 [3], Arch Linux)은 전체 패키지 트리를 프레임 포인터를 사용하도록 다시 빌드했습니다. PyTorch, Node.js, Redis, Go, .NET은 모두 기본 빌드에 프레임 포인터를 도입했습니다(전체 목록은 근거 절의 Industry Consensus Has Shifted Decisively를 참조하십시오).
업스트림 기본값을 통해 CPython을 생태계가 이미 채택한 현실에 맞춥니다.
명세
빌드 시스템 변경 사항
configure.ac에 다음과 같은 변경을 적용합니다:
AX_CHECK_COMPILE_FLAG([-fno-omit-frame-pointer],
  [BASECFLAGS="$BASECFLAGS -fno-omit-frame-pointer"])
AX_CHECK_COMPILE_FLAG([-mno-omit-leaf-frame-pointer],
  [BASECFLAGS="$BASECFLAGS -mno-omit-leaf-frame-pointer"])
플래그는 (CFLAGS_NODIST가 아니라) BASECFLAGS 앞에 추가되므로, sysconfig를 통해 서드파티 빌드로 전파됩니다. 이를 통해 다음이 보장됩니다:
- 플래그는 인터프리터의 일부로 컴파일되는 모든
*.c파일에 적용됩니다. 여기에는python바이너리,libpython, 그리고Modules/아래의 내장 확장 모듈이 포함됩니다. - 플래그는
sysconfig데이터에 기록됩니다. 따라서 (pip, Setuptools 또는 직접적인sysconfig조회를 통해) 이 Python을 대상으로 빌드되는 서드파티 C 확장은 기본적으로 프레임 포인터를 물려받습니다.
몇몇 아키텍처에서는 따라갈 수 있는 프레임 포인터 체인을 만들기 위해 조정이 필요합니다:
- 32비트 ARM에서는 ARM 모드를 강제하기 위해
-marm(GCC) 또는-mno-thumb(Clang)을 추가합니다. GCC의 기본 Thumb 프롤로그는 단순한 언와인더가 기대하는fp[0]/fp[1]레이아웃을 유지하지 않기 때문입니다. - s390x에서는 프레임 포인터 플래그 대신
-mbackchain을 추가합니다. 이 플래그가 없으면 GCC와 Clang은 s390x에서 사용 가능한 백체인을 생성하지 않습니다. - ppc64le에서는 컴파일러 플래그를 추가하지 않습니다. Power ABI가 이미 컴파일러에 기본적으로 백체인을 유지하도록 요구하므로,
-fno-omit-frame-pointer없이도 언와인딩이 동작합니다.
이는 의도적인 설계 선택입니다. 프로파일링 데이터가 유용하려면 프레임 포인터 체인이 전체 호출 스택에 걸쳐 끊김 없이 이어져야 합니다. 어느 C 확장 경계에서든 체인이 끊기면 인터프리터 자체에서 끊기는 것만큼 해롭습니다. 플래그를 전파함으로써 CPython은 프레임 포인터를 Python 스택에 대한 생태계 전반의 기본값으로 확립합니다.
-mno-omit-leaf-frame-pointer는 리프 함수에서도 프레임 포인터를 유지합니다. 이 플래그가 없으면 -fno-omit-frame-pointer가 설정되어 있더라도 컴파일러는 더 이상 다른 함수를 호출하지 않는 함수에서 프레임 포인터를 생략할 수 있습니다. Fedora, Ubuntu, Arch Linux 모두 이 플래그를 포함합니다. 이 플래그는 리프 함수 내부를 샘플링하는 프로파일러도 완전한 호출 체인을 복구할 수 있도록 보장합니다.
옵트아웃 configure 플래그
새로운 configure 옵션이 추가됩니다:
--without-frame-pointers
이 옵션을 지정하면 두 플래그 모두 BASECFLAGS에 추가되지 않습니다. 이는 특정 워크로드에서 허용할 수 없는 성능 저하를 측정한 배포나, 더 상위 수준에서 프레임 포인터 플래그를 주입하므로 이중 명세를 피하고자 하는 배포판에 적합하며, Fedora의 패키지별 %undefine _include_frame_pointers 매크로와 유사합니다.
특정 모듈에 대해 기본값을 재정의하려는 확장 작성자는 extra_compile_args에 넣거나 환경 변수를 통해 -fomit-frame-pointer를 전달할 수 있습니다. GCC와 Clang에서는 명령줄의 마지막 플래그가 우선합니다.
생태계에 미치는 영향
플래그가 CFLAGS에 들어 있으므로, pip, Setuptools 또는 직접적인 sysconfig 조회를 통해 빌드되는 C 확장처럼 CPython이 보고하는 컴파일러 플래그를 사용해 빌드하는 소비자에게 자동으로 전파됩니다. 이러한 소비자는 이 변경의 이점을 누리기 위해 별도의 조치를 취할 필요가 없습니다.
Python 생태계의 모든 컴파일된 코드가 CPython의 CFLAGS를 물려받는 것은 아닙니다. pyo3 또는 maturin으로 빌드되는 Rust 확장, 자체 빌드 시스템을 가진 C++ 라이브러리, 그리고 CPython을 소스에서 컴파일하는 임베딩 애플리케이션은 각자 자신의 컴파일러 플래그를 관리합니다. 이 PEP는 이러한 모든 프로젝트도 빌드에서 -fno-omit-frame-pointer -mno-omit-leaf-frame-pointer를 활성화할 것을 권장합니다. 프레임 포인터 체인의 강도는 가장 약한 고리의 강도를 넘지 못합니다. CPython과 다른 모든 라이브러리가 프레임 포인터를 갖추고 있더라도, 호출 스택에 프레임 포인터가 없는 라이브러리가 하나라도 있으면 프로세스 전체의 체인이 끊어집니다. 목표는 Python 프로세스의 모든 네이티브 구성 요소가 프레임 포인터 체인에 참여하여, perf record와 eBPF 프로파일러가 별도 설정 없이도 완전하고 유용한 플레임 그래프를 생성하도록 하는 것입니다.
특정 모듈에서 받아들일 수 없는 성능 저하를 발견한 확장 작성자는 extra_compile_args를 통해 확장별로 이를 해제할 수 있습니다(Extension Build Impact 참조). 이미 시스템 전체에서 프레임 포인터를 활성화한 배포판(Fedora, Ubuntu, Arch Linux)은 아무 조치도 취할 필요가 없습니다.
문서 갱신
Doc/howto/perf_profiling.rst는 Python 3.15부터 프레임 포인터가 기본으로 활성화된다는 점을 명시하고, 이전 버전을 위한 CFLAGS 권장 사항은 유지하도록 갱신됩니다.
Doc/using/configure.rst는 --without-frame-pointers를 문서화하도록 갱신됩니다.
플랫폼 범위
두 플래그 모두 x86-64, AArch64, RISC-V, 32비트 ARM에서 GCC와 Clang이 받아들입니다. s390x와 ppc64le는 다른 처리가 필요합니다(위 참조). Apple Silicon을 사용하는 macOS에서는 ARM64 ABI가 프레임 포인터를 의무화하므로, 이 플래그들은 중복되지만 해가 없습니다.
Windows x64에서 MSVC는 스택 되감기(stack unwinding)에 프레임 포인터를 사용하지 않습니다. 대신 Windows x64 ABI는 모든 비말단(non-leaf) 함수에 .pdata / .xdata 되감기 메타데이터를 의무화합니다 [18]: 컴파일러는 각 함수의 프롤로그가 스택을 어떻게 수정하는지 기술하는 RUNTIME_FUNCTION 및 UNWIND_INFO 구조체를 생성하며, 이를 통해 OS 되감기 도구는 프레임 포인터 체인 없이도 RSP와 정적으로 알려진 프레임 크기를 사용해 스택을 탐색할 수 있습니다. 이 메타데이터는 항상 존재하고 항상 정확하므로, Windows x64의 프로파일러, 디버거, ETW 기반 추적은 프레임 포인터 없이도 이미 신뢰할 수 있는 호출 스택을 만들어 냅니다. /Oy(프레임 포인터 생략) 플래그는 32비트 x86 MSVC 대상에서만 사용할 수 있으며, x64에는 존재하지 않습니다 [19]. 이 PEP에서 제안하는 GCC/Clang 플래그는 MSVC 빌드에 아무런 영향을 주지 않습니다.
Windows ARM64에서는 ETW 기반 고속 스택 탐색과의 호환성을 위해 ABI가 프레임 포인터(x29)를 요구합니다 [20]. 프레임 포인터는 기본으로 활성화되어 있으므로 아무 조치도 필요하지 않습니다.
AX_CHECK_COMPILE_FLAG 가드는 컴파일러가 받아들이지 않는 플래그를 조용히 건너뛰므로, 이 변경은 모든 플랫폼과 툴체인에서 안전합니다.
근거
프레임 포인터는 비용은 낮고 가치는 높은 기본값입니다
프레임 포인터를 생략하는 근거(범용 레지스터, 즉 GPR 하나를 확보하는 것)는 32비트 x86에서는 의미가 있었습니다. 그곳에서 %ebp는 사용 가능한 레지스터가 약 20% 늘어나는 것(5개에서 6개로)을 의미했기 때문입니다. x86-64에서는 그 이득이 7% 미만(레지스터 15개에서 16개로)이며, 31개의 GPR을 갖춘 AArch64에서는 무시할 만한 수준입니다.
프로덕션 배포에서 얻은 실측 결과는 일관됩니다:
- Brendan Gregg(OpenAI, 전 Netflix): “저는 Java와 glibc에 대해 대규모로 프레임 포인터를 활성화했습니다… 일반적으로 1% 미만이며, 대개는 0에 너무 가까워서 측정하기 어려울 정도입니다.” [1]
- Meta: Daan De Meyer, Davide Cavalca, Andrii Nakryiko(모두 Meta/Facebook 소속)가 작성한 Fedora 38 변경 제안서에 보고된 바에 따르면, 가장 성능에 민감한 두 애플리케이션에 대한 내부 벤치마크는 “성능에 유의미한 영향을 보이지 않았습니다” [2]. Google 역시 모든 내부 핵심 소프트웨어를 프레임 포인터를 사용하여 컴파일합니다 [2].
- Ubuntu 24.04 분석: “64비트 아키텍처에서의 불이익은 대부분의 경우 1-2% 사이입니다.” [3]
- Fedora 38 테스트 스위트: 개별 벤치마크 성능 저하는 약 2%입니다(커널 컴파일 2.4%, Blender 렌더링 2%) [2].
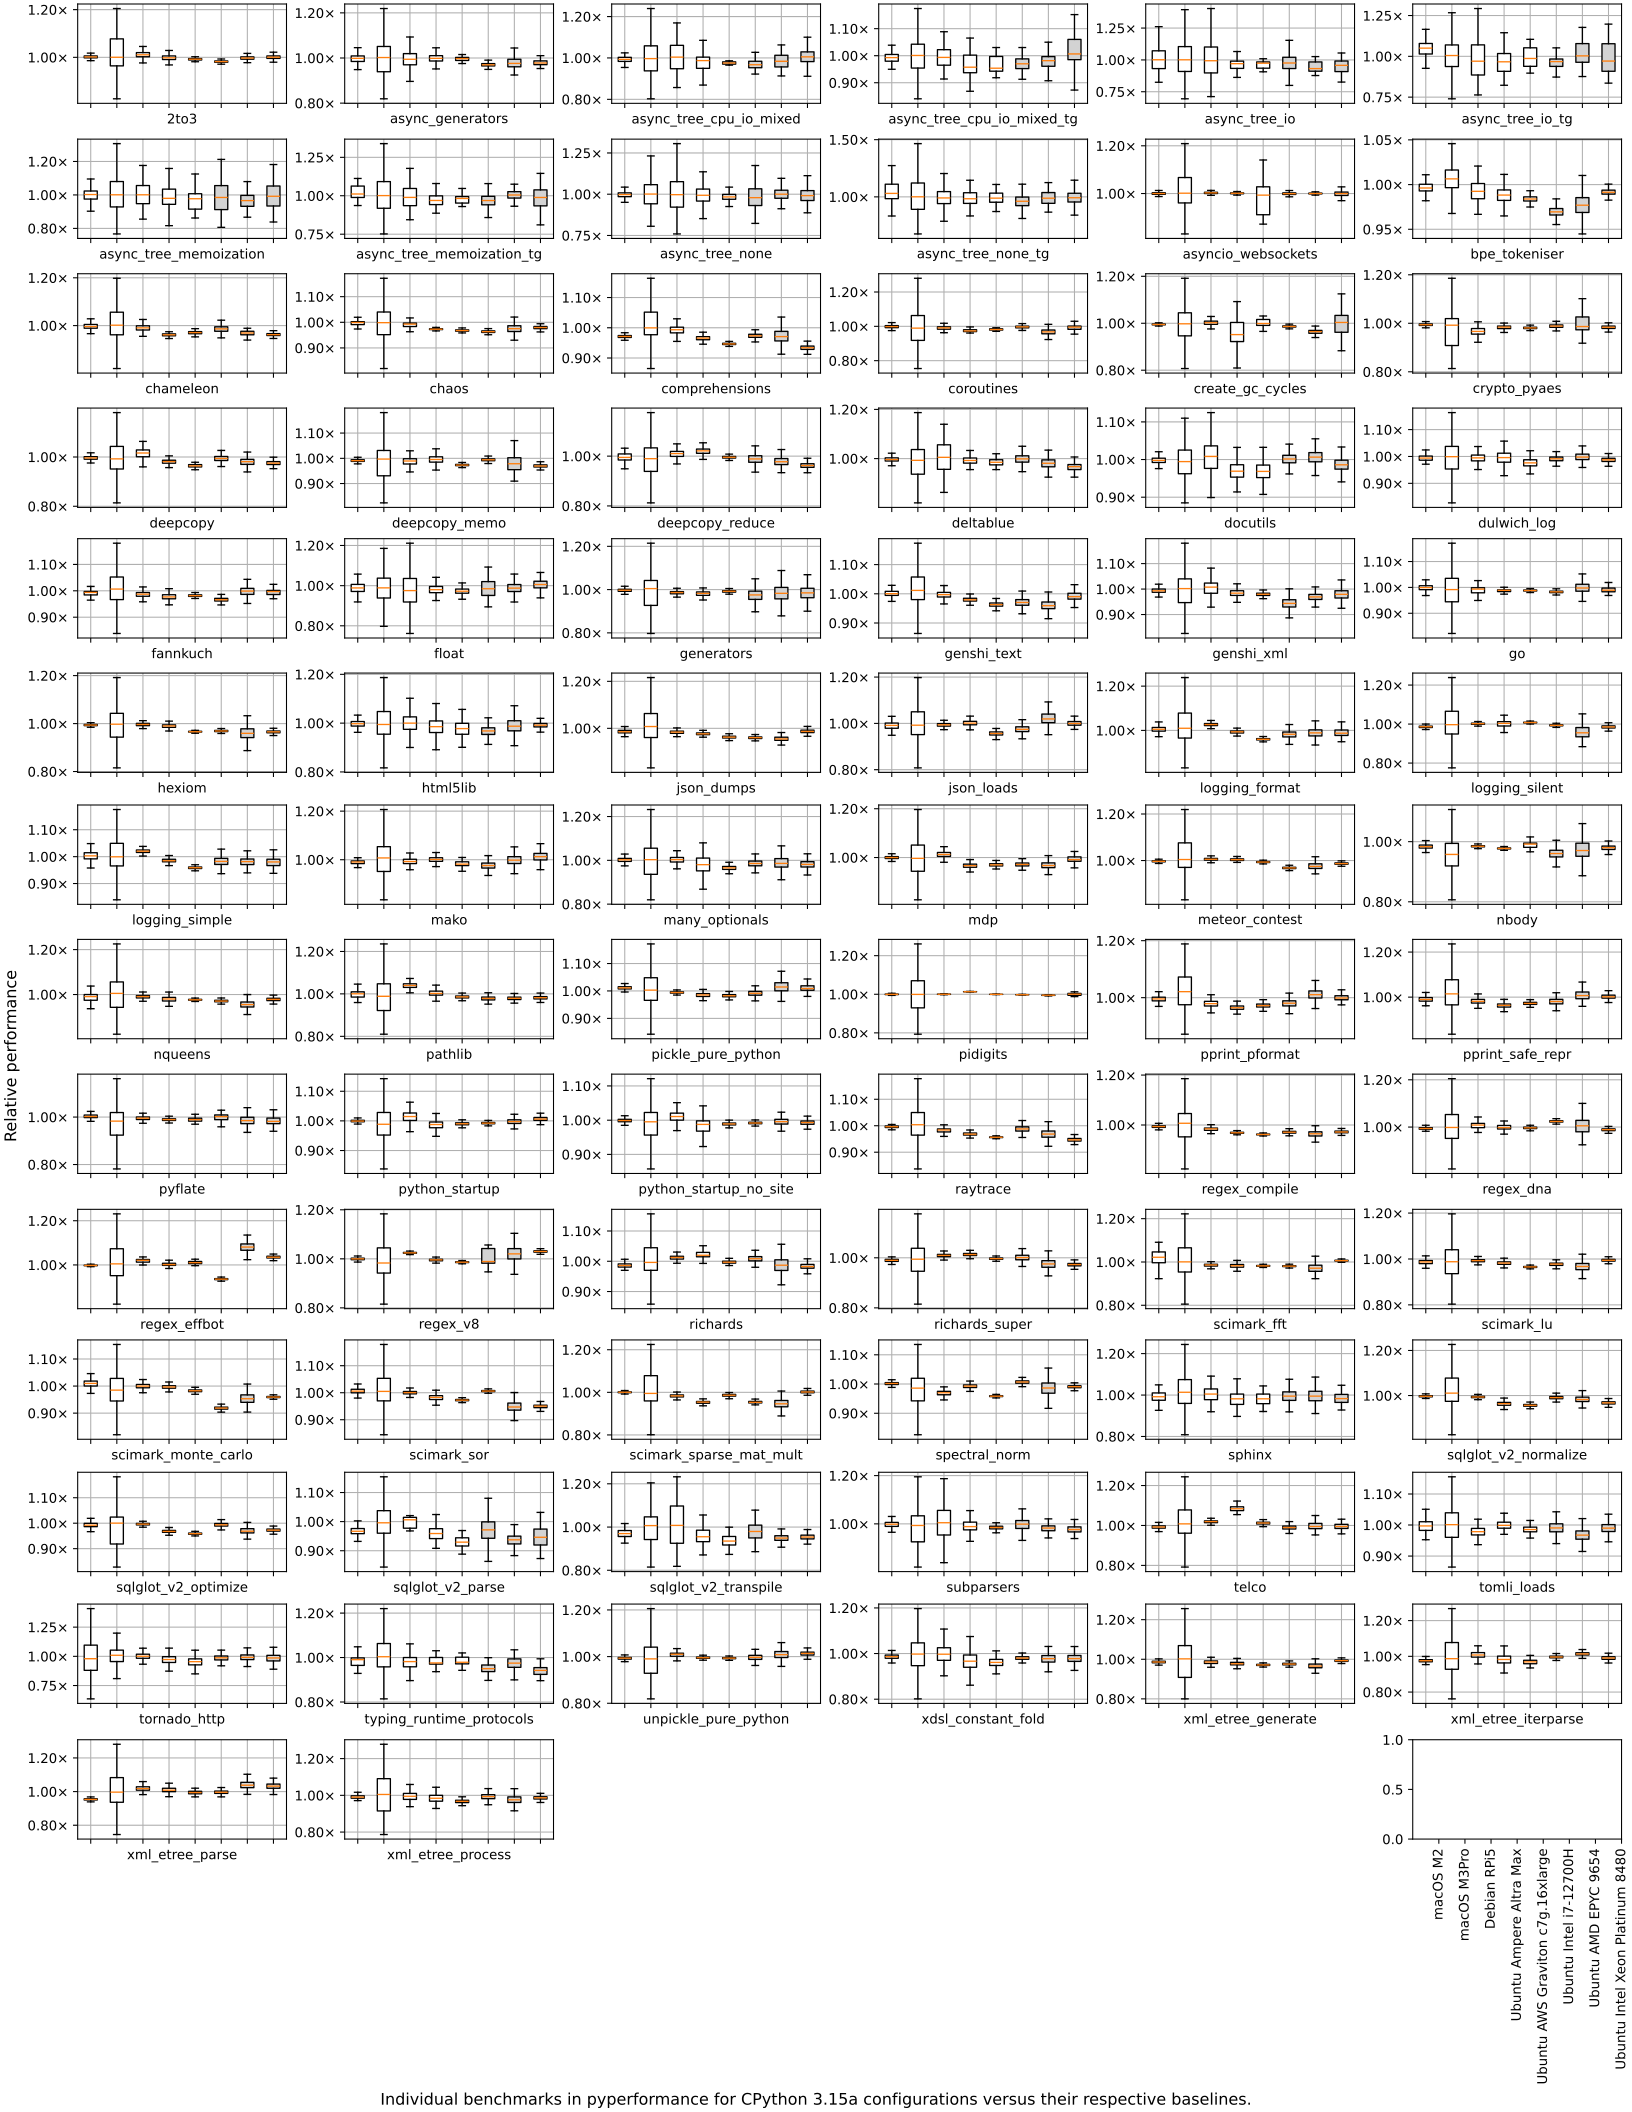
pyperformance의 scimark_sparse_mat_mult 벤치마크는 Fedora의 테스트에서 9.5% 저하되어 해당 실행에서 최악의 사례였습니다(아래 Detailed Performance Analysis of CPython with Frame Pointers 참조). CPython 3.15-dev에 대한 자체 측정에서는 xml_etree_* 벤치마크에서 더 큰 개별 저하(최대 1.31배)가 나타나지만, 기하 평균은 약 1% 수준을 유지합니다. 이러한 최악의 사례 벤치마크는 거의 전적으로 C 헬퍼 함수 호출만을 수행하는 반면, 실제 애플리케이션은 CPU 시간을 인터프리터, C 확장, I/O, 시스템 호출에 걸쳐 분산합니다.
커뮤니티에 흔한 오해는 프레임 포인터가 “+10% 느려진 Python 사례가 하나 있었기 때문에” 큰 오버헤드를 수반한다는 것입니다. [5] 그 단 하나의 사례는 평가 루프 벤치마크이며, 실제 워크로드 전반의 기하 평균은 0.5-2.3%입니다.
프레임 포인터를 사용한 CPython의 상세 성능 분석
요약하면: 오버헤드는 평가 루프(이미 두 빌드 모두에서 프레임 포인터를 사용합니다)가 아니라, 약 6,000개의 더 작은 C 헬퍼 함수가 4바이트 프롤로그를 얻고 GPR 하나를 잃는 데서 발생합니다. 측정된 비용은 C 호출이 많은 워크로드에서 명령어 수 +5.5%, 실제 경과 시간 +3.3%이며, 캐시나 브랜치 예측 측면의 병리적 현상은 없습니다.
오버헤드를 정확히 파악하기 위해 CPython 3.15-dev를 대상으로 통제된 바이너리 수준 및 마이크로아키텍처 분석을 수행했습니다. 두 빌드는 동일한 커밋, 동일한 컴파일러(GCC), 동일한 플래그(-O3 -DNDEBUG -g)를 사용했으며, 동일한 머신(x86-64, Intel, 스케줄링 노이즈를 제거하기 위해 단일 P-코어에 고정)에서 실행되었습니다. 유일한 차이는 -fno-omit-frame-pointer -mno-omit-leaf-frame-pointer의 유무였습니다.
흔한 오해는 프레임 포인터 오버헤드가 주로 바이트코드 디스패치 함수인 _PyEval_EvalFrameDefault에서 발생한다는 것입니다. Andrii Nakryiko(Meta, BPF 커널 유지 관리자)는 Python 3.11에서의 성능 저하를 분석하여, 프레임 포인터를 사용하면 해당 함수의 크기가 크게 증가한다는 것을 발견했습니다 [4]. 그러나 현재 코드베이스(DSL로 생성된 평가 루프를 사용하는 3.15-dev)에서는 더 이상 그렇지 않습니다. GCC는 이미 두 빌드 모두에서 _PyEval_EvalFrameDefault에 프레임 포인터 프롤로그를 생성합니다. 이 함수는 크기가 약 60 KB에 달하고 중첩이 깊어서, 컴파일러가 플래그와 관계없이 %rbp를 프레임 포인터로 유지하기 때문입니다. 이 함수의 크기는 플래그를 사용했을 때 59,549바이트, 사용하지 않았을 때 59,602바이트입니다(0.1% 차이). 자주 실행되는 바이트코드 디스패치 핸들러(STORE_FAST, LOAD_FAST 등)는 두 빌드에서 명령어 단위까지 동일합니다. 평가 루프가 지배적인 워크로드는 프레임 포인터를 사용할 때 오히려 1-2% 더 빠릅니다. 레지스터 할당이 달라지면서 명령어 페치 지연을 줄이는 코드 배치가 만들어지기 때문입니다(프런트엔드 병목 비율이 24.1%에서 19.4%로 떨어지고, IPC가 4.83에서 5.06으로 향상됩니다).
오버헤드는 오히려 프레임 포인터 프롤로그(진입 시 push %rbp; mov %rsp,%rbp, 종료 시 pop %rbp)가 추가되는 약 6,000개의 더 작은 C 헬퍼 함수에서 발생합니다. 기준 빌드에서는 7,471개의 텍스트 심볼 중 84개(1.1%)만 프레임 포인터 프롤로그를 가지지만, -fno-omit-frame-pointer를 사용하면 6,009개(80.4%)가 프레임 포인터 프롤로그를 가집니다. 또한 각 함수는 %rbp를 범용 레지스터로 사용할 수 없게 되므로, 컴파일러는 값을 다른 레지스터로 옮기거나 스택으로 스필해야 합니다. 예를 들어 insertdict(CPython에서 가장 자주 실행되는 C 함수 중 하나로, 딕셔너리를 많이 사용하는 워크로드에서 사이클의 약 20%를 차지)는 두 빌드에서 코드 크기(1,055바이트)가 같지만, 기준 빌드에서는 %rbp가 함수 인자를 직접 보관하는(비용 없음) 반면, 프레임 포인터 빌드에서는 그 인자를 %r12로, 키 인자를 %r13으로 옮겨야 하며, 밀려난 값들을 수용하기 위해 스택 프레임이 40바이트에서 56바이트로 커집니다.
반복마다 약 10개의 C 헬퍼 함수(insertdict, _Py_dict_lookup, unicodekeys_lookup_unicode, PyDict_SetItem 등)를 호출하는 타이트 루프 전체에서, 프롤로그/에필로그 명령어와 레지스터 스필이 누적되어 동적 명령어 수가 +5.5% 증가합니다(1억 회 반복 기준 1,675억 대 1,588억). 이 명령어 수 증가가 C 함수 호출이 많은 워크로드에서 측정된 +3.3%의 실제 경과 시간 오버헤드를 직접적으로 설명합니다.
더 느린(C 호출이 많은) 워크로드에 대한 Intel Top-Down Method 분석은 이 오버헤드가 비효율적으로 실행되는 작업이 아니라 전적으로 추가된 작업임을 확인해 줍니다:
| 지표 | FP 빌드 | 기준 | 차이 |
|---|---|---|---|
| 실제 경과 시간 | 10.27 s | 9.94 s | +3.3% |
| 명령어 수 | 167.5 B | 158.8 B | +5.5% |
| IPC | 5.11 | 5.00 | +2.1% |
| 리타이어링(유용한 작업) | 78.1% | 75.5% | +2.6 pp |
| 프런트엔드 바운드 | 20.4% | 23.1% | -2.7 pp |
| 백엔드 바운드 | 1.1% | 0.9% | +0.2 pp |
| L1 데이터 캐시 로드 미스 | 2.02 M | 2.08 M | -3.1% |
| L1 명령어 캐시 로드 미스 | 4.87 M | 4.91 M | -0.9% |
| 브랜치 예측 실패 | 473 K | 471 K | +0.4% |
프레임 포인터를 사용하면 리타이어링 비율이 더 높고(CPU가 유용한 작업에 더 많은 시간을 씁니다), 프런트엔드 바운드 비율은 더 낮으며, 캐시 미스율은 비슷하거나 약간 개선됩니다. 추가적인 스택 스필/리로드 트래픽으로 인해 전체 L1 데이터 캐시 로드 연산이 약 3% 늘어나지만(L1 로드 미스만 보고하는 위 표에는 나타나지 않습니다), 이렇게 추가된 로드는 모두 L1에서 적중합니다. 캐시 폭주도, TLB 압력 증가도, 브랜치 예측 측면의 병리적 현상도 없습니다. 오버헤드는 예측 가능하고 상한이 있으며, 다른 하드웨어나 워크로드에서 예상치 못한 성능 회귀가 발생할 위험이 없습니다.
프레임 포인터 빌드에서는 .text 섹션이 0.5% 더 작습니다(5,658,071바이트 대 5,686,703바이트). %rbp 기준 상대 주소 지정이 %rsp + SIB 주소 지정보다 더 간결한 인코딩을 만들어 내는 경우가 많고, 더 단순한 에필로그(add $N,%rsp 대신 pop 체인)도 바이트를 절약하기 때문입니다. 바이너리 크기는 문제가 되지 않습니다.
마지막으로, CPython의 구조적 추세는 프레임 포인터에 유리합니다. CPython 3.11의 특수화 적응형 인터프리터, 3.12의 DSL로 생성된 평가 루프, 그리고 실험적인 복사 후 패치(copy-and-patch) JIT(PEP 744, 3.13에서 도입)는 핫 실행 경로를 일반적인 C 헬퍼 경로로부터 점진적으로 멀어지게 합니다. 특수화된 코드나 JIT 컴파일된 코드가 처리하는 바이트코드가 늘어날수록 이러한 헬퍼 함수에서 소비되는 시간의 비율이 줄어들고, 그에 따라 프레임 포인터 오버헤드도 줄어듭니다.
업계의 합의가 결정적으로 바뀌었습니다
프레임 포인터를 기본적으로 생략하기로 한 결정은 2000년대 초반으로 거슬러 올라가며, 2011년 GCC 4.6에서 공식화되었습니다. 그 이후 업계는 대체로 방향을 되돌렸습니다:
- Go 1.7 (2016): x86-64에서 프레임 포인터를 기본으로 활성화했습니다 [6]. Russ Cox: “프레임 포인터를 기본으로 켜 두면 Linux perf, Intel VTune 및 기타 프로파일러가 Go 스택 트레이스를 훨씬 더 효율적으로 수집할 수 있습니다” [7]. Go 팀은 관측 가능성을 얻는 대가로 약 2%의 오버헤드를 감수하는 선택을 명시적으로 했습니다.
- Rust 표준 라이브러리 (2024): PR #122646은 공식 Rust 툴체인과 함께 배포되는 사전 컴파일된 표준 라이브러리에서 프레임 포인터를 활성화했으며, 측정된 명령어 수 회귀는 0.3%였고 사이클 회귀는 없었습니다 [21].
- Chromium: 세계 최대 규모의 C++ 프로젝트 중 하나인 Chromium에서는 GN 빌드 시스템이 모든 데스크톱 Linux 및 macOS 빌드에서
enable_frame_pointers의 기본값을true로 설정합니다 [22]. - .NET CoreCLR: 스택 언와인딩을 위한 네이티브 OS 도구를 지원하기 위해 처음부터 Linux 및 macOS x64에서 프레임 포인터를 기본으로 활성화해 왔습니다 [16].
- Node.js: 2013년부터 C++ 런타임을
-fno-omit-frame-pointer로 컴파일해 왔으며, 2022년 9월에 이 플래그를 제거하려는 시도가 있었으나 C++/JS 전환 지점에서perf프로파일링이 깨지는 바람에 되돌려졌습니다 [8]. - PyTorch: AArch64 빌드에서
-fno-omit-frame-pointer를 무조건 활성화하며, “aarch64 C++ 스택 언와인딩은 프레임 포인터 체인 순회를 사용하므로 모든 빌드 유형에 프레임 포인터가 있어야 합니다”라고 밝히고 있습니다 [9]. - Redis: Fedora 38에 이어
-fno-omit-frame-pointer를 도입하면서 “프레임 포인터를 포함해 빌드해도 Redis 벤치마크는 크게 영향을 받지 않는 것으로 보입니다.”라고 밝혔습니다 [10] - Fedora 38 [2], Ubuntu 24.04 [3], Arch Linux, AlmaLinux Kitten 10 [23]: 모든 시스템 패키지(Ubuntu의 CPython 제외)를 프레임 포인터를 포함해 다시 빌드했습니다. AlmaLinux는 프레임 포인터를 비활성화하는 RHEL/CentOS 스트림과 명시적으로 다른 길을 택했습니다.
- python-build-standalone: 2026년 초부터 모든 x86-64 및 AArch64 Linux 빌드가 프레임 포인터를 포함해 배포됩니다 [13].
CPython은 아직 이 변경을 도입하지 않았습니다.
BASECFLAGS 대신 CFLAGS_NODIST를 사용하지 않는 이유
CPython의 빌드 시스템은 인터프리터에는 적용되지만 sysconfig를 통해 확장 모듈 빌드로는 전파되지 않아야 하는 플래그를 위해 CFLAGS_NODIST를 별도로 제공합니다. CFLAGS_NODIST를 사용하면 오버헤드를 인터프리터 자체로 한정할 수 있습니다.
이 PEP는 프레임 포인터가 체인이 끊김 없이 이어질 때만 유용하기 때문에 의도적으로 CFLAGS_NODIST 대신 BASECFLAGS를 선택합니다. 단일 구성 요소에만 적용해도 유용한 새니타이저나 어서션 같은 디버깅 보조 도구와 달리, C 확장 경계에서 끊긴 프레임 포인터 체인은 프레임 포인터가 전혀 없을 때와 똑같이 깨진 스택 트레이스를 만듭니다. 프로파일러, 디버거, eBPF 도구는 끊긴 부분을 건너뛰고 언와인딩을 이어 갈 수 없습니다.
이 점이 프레임 포인터를 CFLAGS_NODIST에 들어가는 다른 플래그와 구별합니다. 그러한 플래그(-Werror나 내부 경고 억제 등)는 컴파일 단위별로 의미가 있는 정확성 또는 정책 제어입니다. 프레임 포인터는 모든 참여자가 협력할 때만 효과가 있는 생태계 전체의 속성입니다. CPython에서 측정된 0.5-2%의 오버헤드는 작은 C 헬퍼 함수 호출이 매우 빈번하기 때문에 발생합니다. 일반적인 C 확장 코드는 이 정도의 호출 밀도를 보이지 않으므로 오버헤드가 무시할 만한 수준입니다.
Gregory Szorc(python-build-standalone 제작자)가 언급했듯이: “롱테일에 해당하는 수많은 컴파일된 확장까지 프레임 포인터를 갖추게 되는 전환점을 넘기까지는 수년이 걸릴 것입니다. 그러니 빨리 시작할수록…” [13] BASECFLAGS를 통해 플래그를 전파하는 것이 CPython이 그 과정을 시작하는 방법입니다.
프레임 포인터 언와인딩의 대안
프레임 포인터 기반 언와인딩에는 여러 대안이 있지만, 현재로서는 어느 것도 적절한 대체 수단이 되지 못합니다.
DWARF CFI (perf --call-graph dwarf)는 Profilers Are Slower and Less Accurate Without Frame Pointers에서 다룹니다. 이 방식은 샘플마다 스택 8KB를 복사하고, 훨씬 큰 데이터 파일을 만들며, BPF 컨텍스트에서는 사용할 수 없습니다 [11].
Intel LBR(Last Branch Record, 마지막 브랜치 기록)은 16-32개 프레임으로 제한되고, Intel 하드웨어가 필요하며, 가상 머신과 클라우드 환경에서는 사용할 수 없습니다 [17].
eBPF 기반 프로파일링 방식인 DWARF-in-eBPF(Polar Signals, Elastic Universal Profiling, OpenTelemetry의 eBPF 프로파일러, Yandex Perforator [24])는 커널의 내장 bpf_get_stackid() / bpf_get_stack() 헬퍼를 완전히 우회하고 BPF 내부에서 스택 순회를 처음부터 다시 구현합니다. 이 방식은 더 느리고(샘플마다 헬퍼를 한 번 호출하는 대신 bpf_probe_read_user() 호출과 BPF 맵 조회가 여러 번 필요합니다), 더 복잡하며(프레임 포인터 경로는 50줄 미만인 반면 BPF 코드가 500줄 이상입니다), .eh_frame을 파싱하고 스택 델타 테이블을 BPF 맵에 적재하기 위해 프로세스마다 시작 오버헤드가 발생합니다. 이는 벤더 고유의 인프라로, bpftrace, bcc, perf 또는 어떤 표준 도구에서도 사용할 수 없습니다 [12].
SFrame(Simple Frame format)은 버전 6.3(2023년 4월)에서 Linux 커널에 병합된 경량 스택 되감기(unwinding) 형식이며, GNU binutils가 .sframe 섹션 생성을 지원합니다. SFrame은 프레임 포인터 없이도 BPF 기반 되감기를 할 수 있을 만큼 단순하게 설계되었습니다. 그러나 2026년 초 현재 bpf_get_stackid()는 SFrame을 지원하지 않고, SFrame을 사용하는 프로덕션 수준의 프로파일링 도구 체인이 없으며, perf에는 SFrame 기반 콜 그래프 모드가 없고, 사용자 공간 도구(GDB, libunwind, libdw)의 SFrame 지원은 없거나 실험적인 수준입니다. Brendan Gregg는 SFrame 생태계가 2029년 무렵에 성숙할 것으로 추정했습니다 [1]. 그때까지 몇 년 동안 배포되는 Python을 쓸 만한 시스템 수준 프로파일링 없이 방치해서는 안 됩니다. SFrame이 생태계 전반에서 동등한 수준의 지원을 갖추면 이 결정을 재검토할 수 있습니다.
커널 측에서 동작하고, 비동기 시그널에 안전하며, BPF와 호환되고, 깊이 제한이 없으며, 간결한 프로파일링 데이터를 만든다는 조건을 동시에 모두 만족하는 방법은 여전히 프레임 포인터 되감기뿐입니다. 추가 설정 없이 어디서나 동작하는 방법입니다.
하위 호환성
바이너리 호환성
프레임 포인터를 활성화해도 Python ABI는 바뀌지 않습니다. 안정 ABI(PEP 384), 제한된 C API, PyObject 메모리 레이아웃은 모두 영향을 받지 않습니다. 컴파일된 확장 모듈 중 로드에 실패하거나 잘못 동작하는 것은 없습니다.
성능
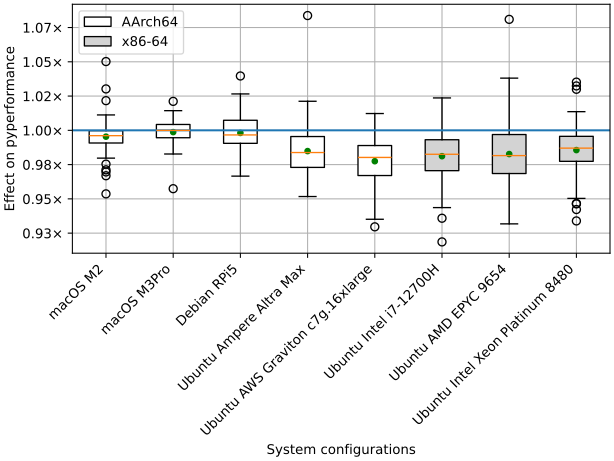
프레임 포인터 빌드와 프레임 포인터만 빠진 동일한 빌드를 비교한 전체 pyperformance 결과입니다(80개 벤치마크의 기하 평균 [30]). 재현할 수 있도록 pyperformance JSON 파일을 [29]에 공개해 두었습니다. 벤치마크 시각화 자료는 부록에 있습니다:
| 머신 | 기하 평균 성능 저하 |
|---|---|
| Apple M2 Mac Mini (arm64) | 0.5% |
| macOS M3 Pro (arm64) | 0.1% |
| Raspberry Pi (aarch64) | 0.2% |
| Ampere Altra Max (aarch64) | 1.5% |
| AWS Graviton c7g.16xlarge (aarch64) | 2.3% |
| Intel i7 12700H (x86-64) | 1.9% |
| AMD EPYC 9654 (x86-64) | 1.8% |
| Intel Xeon Platinum 8480 (x86-64) | 1.5% |
이 오버헤드는 인터프리터와 sysconfig를 통해 플래그를 상속하는 C 확장 모두에 적용됩니다. 상세한 마이크로아키텍처 분석에 따르면 오버헤드는 순전히 추가 명령어(약 6,000개의 헬퍼 함수에 있는 프레임 포인터 프롤로그)에서 비롯되며, 캐시, TLB, 브랜치 예측 측면의 병리적 효과는 없습니다(Detailed Performance Analysis of CPython with Frame Pointers를 참고하십시오). 일반적인 C 확장 코드에는 CPython 런타임만큼 작은 함수 호출이 밀집되어 있지 않습니다. 수치 연산 중심의 확장(NumPy, SciPy)은 보통 핫 루프를 BLAS/LAPACK이나 벡터화된 인트린식에서 실행하는데, 이들은 별도로 컴파일되므로 Python의 CFLAGS에 영향을 받지 않습니다. 핫 스칼라 C 루프가 있는 확장(예: Cython이 생성한 코드)에서는 측정 가능하지만 크지 않은 오버헤드가 나타날 수 있습니다.
참고로, 기하 평균 0.5-2.3%는 -fstack-protector-strong (보안)이나 공유 라이브러리를 위한 ASLR 호환 -fPIC 플래그처럼 빌드 시 기본값으로 일상적으로 수용되는 오버헤드와 비슷한 수준입니다. 그 대가로 Python 생태계 전체가 완전한 플레임 그래프, 정확한 프로파일러 출력, 신뢰할 수 있는 디버거 백트레이스를 생성할 수 있게 되는데, 이는 현재 대부분의 Python 설치 환경에서 제대로 동작하지 않거나 사용할 수 없는 기능입니다. 이는 적은 비용으로 얻는 상당한 이득입니다. 이 정도의 비용조차 받아들일 수 없는 배포 환경에서는 --without-frame-pointers를 사용할 수 있습니다.
확장 빌드에 미치는 영향
Python 3.15 이상을 대상으로 빌드되는 C 확장은 sysconfig에서 가져오는 기본 CFLAGS에 포함된 -fno-omit-frame-pointer와 -mno-omit-leaf-frame-pointer를 상속하게 됩니다. 이는 확장이 이미 -O2, 경고 플래그 및 기타 컴파일 기본값을 상속하는 것과 같은 메커니즘입니다.
자체 CFLAGS를 설정하거나 setup.py / pyproject.toml에서 extra_compile_args를 사용하는 확장은 이 기본값을 재정의할 수 있습니다. 명령줄의 마지막 플래그가 우선하므로, -fomit-frame-pointer를 덧붙이는 것만으로 확장별로 이 기능을 끌 수 있습니다.
빌드 재현성
결정적인 빌드 단계에 결정적인 플래그가 추가되는 것이므로, 이전에 재현 가능했던 빌드는 계속 재현 가능합니다.
보안 영향
이 변경은 보안에 영향을 주지 않습니다. 프레임 포인터는 스택 프레임을 배치하기 위한 컴파일러 규약으로, 새로운 공격 표면을 만들지 않으며 CPython의 기존 인터페이스를 통해 이미 얻을 수 있는 정보 외의 정보를 노출하지도 않습니다.
교육 방법
Python 사용자와 애플리케이션 개발자에게 이 변경은 드러나지 않습니다. API도 동작도 바뀌지 않으며, 사용자가 해야 할 조치도 없습니다. 관찰할 수 있는 유일한 효과는 프로파일러, 디버거, 시스템 수준 추적 도구가 별도 설정 없이도 더 완전하고 더 신뢰할 수 있는 결과를 낸다는 점입니다.
확장에서는 오버헤드가 무시할 만한 수준이겠지만, 특정 모듈에서 측정 가능한 성능 저하를 관찰한 확장 작성자는 Extension Build Impact에 설명된 대로 이 기능을 끌 수 있습니다. --without-frame-pointers configure 플래그는 Opt-Out Configure Flag에 문서화되어 있습니다.
참조 구현
기각된 아이디어
이 PEP는 프레임 포인터를 배포 환경별 옵트인으로 남겨 두는 방안을 거부합니다. 그렇게 하면 Python 사용자, Linux 배포판, 다운스트림 도구에 신뢰할 수 있는 기본 관측 가능성을 제공하지 못하기 때문입니다. 또한 DWARF 기반 또는 벤더별 언와인딩 방식을 충분한 범용 해결책으로 취급하는 방안도 거부합니다. 이러한 방식은 커널 지원 프로파일링과 트레이싱에 대해 프레임 포인터와 같이 오버헤드가 낮고 어디서나 사용할 수 있는 스택 워킹 경로를 제공하지 못하기 때문입니다. Alternatives to Frame-Pointer Unwinding에서 논의한 대안은 일부 상황에서 여전히 유용하지만, 기본 기준선으로서 프레임 포인터가 필요하다는 사실을 없애지는 못합니다.
변경 이력
현재로서는 없습니다.
각주
부록
아래의 모든 그래프에서 초록색 점은 개별 벤치마크 중앙값의 기하 평균이며, 주황색 선은 데이터 포인트의 중앙값입니다. 속이 빈 원은 이상치를 나타냅니다.
첫 번째 그래프는 각 시스템에서 관찰된 pyperformance에 대한 전체적인 영향을 보여 줍니다. 모든 시스템 구성에서 기하 평균과 중앙값 기준 속도 저하가 2% 미만입니다:
개별 벤치마크 결과는 다음을 참조하십시오:
Copyright
This document is placed in the public domain or under the CC0-1.0-Universal license, whichever is more permissive.