많은 종류의 문제에서 다음과 같은 보조 문제를 해결해야 합니다.
문제. 루트가 있는 트리가 주어집니다. 정점 $u_i$와 $v_i$의 최소 공통 조상, 즉 루트에서 $u_i$까지의 경로와 루트에서 $v_i$까지의 경로 위에 모두 놓이면서 그러한 정점 중 가장 깊은(가장 아래에 있는) 정점 $w$를 찾는 쿼리에 답해야 합니다.
영어로 이 문제는 least common ancestor, 즉 최소 공통 조상이라고 부릅니다.
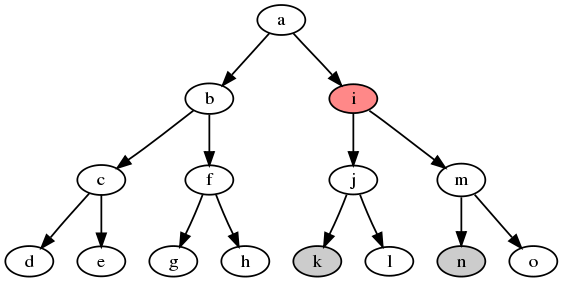
이해를 돕기 위해 설명하자면, 최소 공통 조상은 다음과 같이 느리게(선형 시간에) 찾을 수 있습니다:
bool ancestor(int u, int v) {
    return tin[u] <= tin[v] && tin[v] < tout[u];
}

int lca(int u, int v) {
    while (!ancestor(u, v))
        u = p[u];
    return u;
}
이 문제를 푸는 방법은 매우 다양하며, 이 장에서는 이어서 그 주요 방법들을 살펴보겠습니다. 특히 이 글에서는 이 문제를 구간 최솟값을 구하는 문제로 환원하겠습니다(그리고 그 반대로도 환원합니다).
#Static RMQ로의 환원
dfs로 트리를 순회하면서 두 개의 배열, 즉 정점의 깊이와 정점의 번호를 기록합시다. 이 값들은 정점에 들어갈 때와 나올 때 모두 기록합니다.
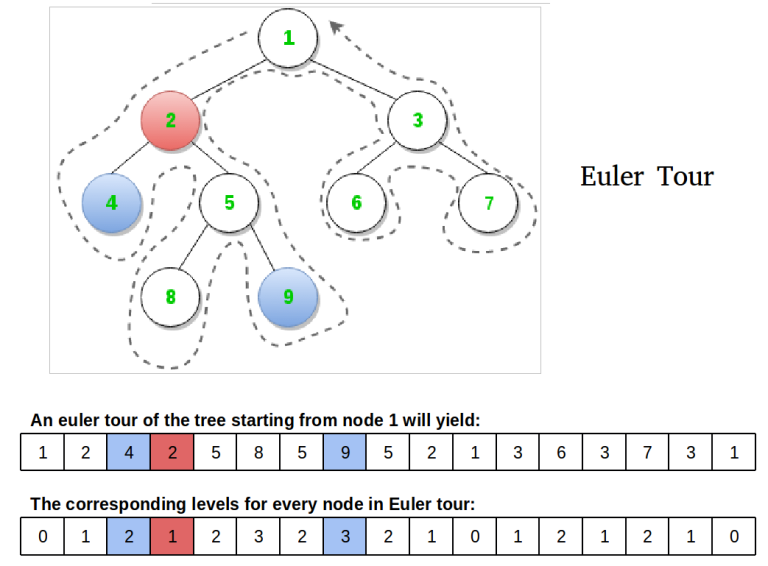
이제 $v$와 $u$ 정점의 LCA를 구하라는 쿼리가 들어왔다고 합시다. 편의상 순회에서 $v$가 먼저 나왔다고 가정합시다: $tin_v < tin_u$. 우리가 $v$에서 나온 순간부터 처음으로 $u$에 들어간 순간까지, 기록된 경로의 해당 부분을 살펴봅시다. 트리에서 두 정점 사이의 단순 경로는 항상 유일하므로, 이 구간의 어딘가에서 우리는 최소 공통 조상에 도달했어야 합니다. 또한 이 경로에서 우리는 LCA보다 위로 올라간 적이 결코 없으므로, LCA는 이 경로에서 가장 높은 정점입니다.
즉, LCA를 찾으려면 깊이 배열(첫 번째로 적은 배열)에서 구간 $[tout_v, tin_u]$의 최솟값 위치를 찾고, 그 위치가 오일러 투어(두 번째로 적은 배열)에서 어떤 정점에 해당하는지 확인하면 됩니다. 따라서 LCA 문제는 RMQ 문제(구간 최솟값 찾기)로 환원할 수 있으며, 이는 예를 들어 세그먼트 트리를 사용하여 쿼리당 $O(\log n)$에 처리할 수 있습니다.
실제로는 static RMQ 문제, 즉 배열이 변경되지 않는 문제를 풀고 있다는 사실을 이용하면 쿼리 시간의 점근적 복잡도를 개선할 수 있습니다. 이를 위해서는 더 적합한 자료 구조인 희소 테이블이 있습니다. 희소 테이블은 최솟값 쿼리에 $O(1)$에 답할 수 있지만, 전처리에 작은 상수로 $O(n \log n)$의 연산과 메모리를 사용합니다.
사실 반대 방향으로도 환원할 수 있습니다.
#Farach-Colton과 Bender 알고리즘
면책 조항: 이 섹션에서 설명하는 LCA를 구하는 알고리즘은 실제로는 전혀 쓸모가 없지만, 이론적인 관점에서는 매우 흥미롭습니다.
사실 LCA와 static RMQ 모두 질의당 $O(1)$ 시간, 전처리에 $O(n)$ 시간으로 계산할 수 있습니다.
사실 LCA를 RMQ로 환원할 때 우리가 푸는 것은 완전한 RMQ 문제가 아닙니다. 우리는 1부터 $n$까지의 정수로 이루어진 모든 배열이 아니라 일부 배열만 다룹니다. 즉, 각 이동이 dfs에서의 하강 또는 상승이므로 인접한 두 원소의 차가 정확히 1인 배열만 다룹니다. 이 제약 덕분에 이러한 배열의 부분 구간에서 최솟값을 더 빠르게 찾을 수 있습니다.
#전처리
다음과 같이 합시다. 각 원소는 이전 원소보다 1만큼 크거나 1만큼 작으므로, 원래의 깊이 배열에 크기가 $(n - 1)$인 불리언 배열을 대응시킵니다. $i$번째 위치에는 다음 값이 더 크면 1을, 더 작으면 0을 둡니다. 작은 부분 구간의 불리언 마스크를 상수 시간에 얻을 수 있도록, 이 배열은 이진 형태로 저장해야 합니다.
전처리의 첫 번째 부분. 상수 $k = \lfloor \frac{\log n}{2} \rfloor$를 잡고, 원래 배열을 $k$개 원소씩 블록으로 나눕니다. 각 블록에서 최솟값을 구하고, 이 최솟값들 위에 sparse table을 구축합니다.
이러한 블록은 모두 $O(\frac{2 n}{\log n})$개이므로, 구축은 선형 시간에 동작합니다:
$$ O(\frac{2 n}{\log n} \log \frac{2 n}{\log n}) = O(\frac{2 n}{\log n} (\log 2n - \log \log n)) = O(n) $$ 전처리의 두 번째 부분. 크기가 $k$인 오르막/내리막 마스크 각각에 대해 그 마스크에서의 최대 내리막을 계산합시다. 즉, 마스크를 따라가면서 지금까지 나온 0과 1의 개수 차이를 유지하고, 이 균형값의 최솟값을 기억해 둡니다. 이는 마스크의 길이에 마스크의 개수를 곱한 시간에 할 수 있습니다: $$ O(k \cdot 2^k) = O(\frac{\log n}{2} 2^{\frac{\log n}{2}}) = O(\sqrt n \log n) $$가능한 마스크의 수는 많지 않습니다 — 바로 이를 위해 $k$를 정할 때 로그를 2로 나누었던 것입니다
#쿼리에 대한 응답
이제 계산해 둔 구조들을 이용해 어떤 구간 $[l, r]$에서 RMQ를 구해야 합니다. 이 구간은 연속된 몇 개의 블록과, 어떤 온전한 블록에도 포함되지 않는 왼쪽과 오른쪽의 남은 칸 몇 개로 이루어집니다.
블록 부분에 대해서는 sparse table에 질의를 하기만 하면 됩니다. 이 질의는 상수 시간에 동작합니다.
블록이 아닌 두 부분에 대해서도 각각 답의 후보를 하나씩 더 계산합시다. 이를 위해서는 경계 원소에 나머지 비블록 원소들의 마스크에 대해 미리 계산해 둔 최솟값을 더해야 합니다. 이 마스크는 불리언 배열에 대한 비트 연산으로 상수 시간에 얻을 수 있습니다.
두 번째 경우를 처리하기 위해 모든 블록에 대해 접미사 최솟값과 접두사 최솟값을 전부 계산해 두는 것만으로는 아쉽게도 충분하지 않습니다. 쿼리가 작아서 어떤 블록도 완전히 덮지 않는 특수한 경우가 하나 있기 때문입니다. 이 경우에는 경계 원소를 하나 골라, 리프팅 배열에서 필요한 마스크에 대한 최솟값을 그 원소에 더하기만 하면 됩니다.
#Static RMQ → LCA
이 알고리즘은 LCA뿐만 아니라 일반적인 경우의 static RMQ까지 선형 전처리와 쿼리당 상수 시간에 풀 수 있게 해 주므로 이론적인 관점에서 매우 중요합니다.
원소의 인덱스를 키 $x_i$로, 값 자체를 우선순위 $y_i$로 삼아 트립을 만듭시다. 우선순위가 무작위가 아니므로 트립이 불균형하게 만들어졌을 수도 있지만, 여기서는 균형이 필요하지 않습니다. 그다음 이 트리에 앞서 설명한 알고리즘을 그대로 적용하면, 원래 배열에서 최솟값을 구할 때 트리에서 $l$번째 정점과 $r$번째 정점의 공통 조상을 질의하기만 하면 됩니다. 트립에서 그 조상의 우선순위가 바로 구하려는 최솟값입니다.
조금 더 자세한 내용과 구현은 Emaxx에서 읽어 볼 수 있습니다(저자는 이것을 한 번도 구현해 본 적이 없으며 여러분에게도 권하지 않습니다). 다만 실제로는 큰 상수 때문에 이 알고리즘을 사용하는 것이 바람직하지 않습니다. 점근적 복잡도에서 로그를 없애기 위해 계산해야 할 것이 너무 많기 때문입니다.