Heavy-light 분할은 갱신 쿼리도 함께 주어질 때 경로 쿼리 문제를 해결하는 강력한 방법입니다. 갱신 쿼리가 없다면 더 간단한 것을 작성하는 편이 좋습니다.
루트 트리의 heavy-light 분해란 다음 과정의 결과를 말합니다. 각 정점 $v$에 대해 그 직속 자식 $u$들을 모두 살펴보고, 그중 서브트리 크기가 가장 큰 자식 $u_{max}$를 고른 뒤(그러한 자식이 둘 이상이면 그중 아무것이나 고릅니다), 간선 $(v, u_{max})$를 무거운(영어로 heavy) 간선이라 부르고 나머지 모든 간선을 가벼운(영어로 light) 간선이라 부릅니다.
이렇게 하여 트리는 무거운 간선과 가벼운 간선으로 나뉩니다. 이 분할을 heavy-light 분해라고 부릅니다.
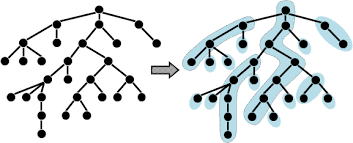
이러한 분할의 몇 가지 유용한 성질을 증명해 봅시다.
명제. 트리는 무거운 간선으로 이루어진 서로소인 경로들로 분할됩니다.
증명. 각 정점으로 들어오는 무거운 간선은 최대 하나이고, 각 정점에서 나가는 무거운 간선도 최대 하나입니다.
가벼운 간선 하나 또는 무거운 간선들로 이루어진 수직 경로를 블록이라고 부릅시다.
명제. 임의의 수직 경로에는 최대 $O(\log n)$개의 블록이 있습니다.
증명은 두 부분으로 나뉩니다:
- 수직 경로 위의 가벼운 간선은 최대 $O(\log n)$개입니다. 가장 아래에 있는 정점을 생각하고, 수직 경로를 따라 아래에서 위로 올라가 봅시다. 가벼운 간선을 따라 이동할 때마다 현재 정점의 서브트리 크기는 두 배로 늘어납니다. 정점이 부모와 가벼운 간선으로 연결되어 있다면, 그 부모에게는 현재 정점보다 가볍지 않은 다른 자식이 있기 때문입니다.
- 무거운 간선으로 이루어진 연속된 경로는 최대 $O(\log n$개입니다. 경로의 끝이나 시작이 아니라면 이러한 경로는 각각 두 개의 가벼운 간선으로 둘러싸여 있고, 가벼운 간선은 모두 합해 $O(\log n)$개뿐이기 때문입니다.
따름정리. 임의의 경로에는 최대 $O(\log n)$개의 블록이 있습니다.
바로 이것을 위해 지금까지 모든 작업을 했습니다. 이제 각 무거운 경로마다 어떤 자료 구조(예를 들어 세그먼트 트리)를 구축하고, 쿼리(예를 들어 경로 위의 합)에 답할 때는 이를 무거운 경로의 부분 구간에 대한 쿼리 또는 가벼운 간선에 대한 쿼리 $O(\log n)$개로 나눕니다.
#구현
공개된 HLD 구현은 대부분 120~150줄의 코드입니다. 하지만 우리는 작업을 훨씬 쉽게 만들어 줄 다음 트릭을 사용하겠습니다. 각 무거운 경로마다 그 경로의 모든 정점이 연속된 번호를 갖도록 트리의 정점 번호를 다시 매기는 것입니다.
즉, 서브트리 크기를 계산하는 단계에서 각 정점의 인접 리스트를 수정하여 그 정점의 «무거운» 자식이 맨 앞에 오도록 합니다. 그러면 그래프에 대해 일반적인 오일러 투어를 실행했을 때 tin 배열이 원하는 번호 매기기가 됩니다. 각 정점에서 항상 자신의 무거운 자식으로 가장 먼저 이동했기 때문입니다.
vector<int> g[maxn];
int s[maxn], p[maxn], tin[maxn], tout[maxn];
int head[maxn]; // «голова» тяжелого пути, которому принадлежит v
int t = 0;

void sizes(int v = 0) {
    s[v] = 1;
    for (int &u : g[v]) {
        sizes(u);
        s[v] += s[u];
        if (s[u] > s[g[v][0]])
            // &u -- это ссылка, так что её легально использовать при swap-е
            swap(u, g[v][0]);
    }
}

void hld(int v = 0) {
    tin[v] = t++;
    for (int u : g[v]) {
        // если это тяжелый ребенок -- его next нужно передать
        // в противном случае он сам является головой нового пути
        head[u] = (u == g[v][0] ? head[v] : u);
        hld(u);
    }
    tout[v] = t;
}
이제 크기가 $n$인 배열 위에 세그먼트 트리나 다른 어떤 자료구조를 구축하고, 어떤 무거운 경로에 대한 질의가 들어오면 이 자료구조에서 해당 구간에 대한 질의를 수행하면 됩니다.
#이를 이용해 문제를 푸는 방법
HLD로 풀 수 있는 가장 간단한 문제의 예는 다음과 같습니다. 각 정점에 어떤 수가 적혀 있는 트리가 주어지고, 다음 두 종류의 쿼리가 들어옵니다.
- $v_i$와 $u_i$ 사이 경로 위의 최솟값을 구합니다.
- $v_i$번 정점의 수를 $x_i$로 바꿉니다.
트리를 임의의 정점에 매달고, 그 위에 세그먼트 트리를 내부 구조로 사용하는 HL-분해를 구성합시다. 세그먼트 트리의 코드는 제시하지 않겠으며, 해당 글에서와 대체로 같은 방식으로 구현되어 있고 upd(k, x)와 get_min(l, r) 메서드를 가지고 있다고 가정하겠습니다.
int val[maxn];
segtree st(0, n);
업데이트 연산에서는 세그먼트 트리에서 해당 칸만 업데이트하면 됩니다:
void upd(int v, int x) {
    st.upd(tin[v], x);
}
최솟값 쿼리는 더 복잡합니다. 원래 쿼리를 수직 경로에 대한 쿼리들로 나누어야 합니다:
int ancestor(int a, int b) {
    return tin[a] <= tin[b] && tin[b] < tout[a];
}

void up(int &a, int &b, int &ans) {
    while (!ancestor(head[a], b)) {
        ans = min(ans, st.get_min(tin[head[a]], tin[a]));
        a = p[head[a]];
    }
}

int get_min(int a, int b) {
    int ans = inf;
    up(a, b, ans);
    up(b, a, ans);
    if (!ancestor(a, b))
        swap(a, b);
    ans = min(ans, st.get_min(tin[a], tin[b]));
    return ans;
}
경로를 두 개의 수직 경로로 나누기 위해 LCA 문제를 따로 풀 필요조차 없다는 점에 주목하십시오. 무거운 경로를 따라 올라가다 보면 $O(\log n)$번의 상승만에 최소 공통 조상에 도달합니다.
#참고 사항
- 문제에 갱신 쿼리가 없다면 쿼리를 «캐시»할 수 있습니다. 수행해야 하는 자료구조 쿼리의 대부분은 heavy 경로의 접두사에 있으며, 이들은 전처리를 통해 $O(1)$에 답할 수 있고, 접두사 하위 쿼리는 쿼리당 $O(\log n)$개가 된다는 점에 주목합시다. 또한 $O(\log n)$에 동작하는 자료구조 쿼리를 $O(1)$번 수행해야 합니다. 따라서 쿼리당 $O(\log n)$을 얻습니다.
- 우리의 HLD 구현은 트리의 오일러 투어 위에 자료구조를 구축하므로, 서브트리에 대한 쿼리도 추가할 수 있습니다. 서브트리는 오일러 투어의 부분 구간이기 때문입니다.