센트로이드 분해는 분할 정복 기법을 트리로 일반화한 것입니다. 보통 센트로이드 분해는 두 가지 유형의 문제를 푸는 데 사용됩니다. 「이러이러한 성질을 가진 경로가 몇 개 있는가」와 「이 경로가 이러이러한 성질을 가지는가」입니다.
때로는 그 대신 조금 더 복잡한 heavy-light 분할이나 조금 더 간단한 작은 집합을 큰 집합에 합치는 기법(small-to-large)을 작성할 수도 있습니다.
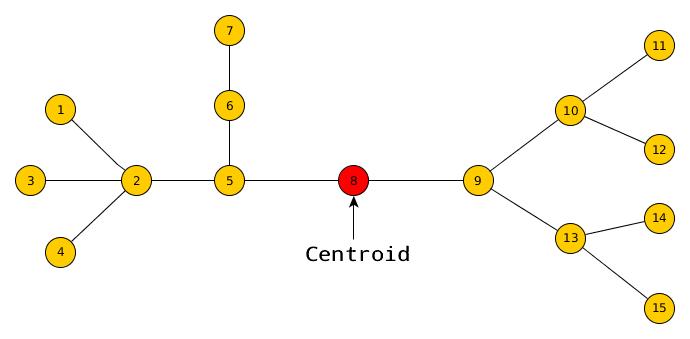
정의. 트리에서 제거했을 때 남은 컴포넌트의 크기가 모두 $\frac{n}{2}$ 이하가 되는 정점을 트리의 중심 또는 센트로이드(영어: centroid)라고 부르겠습니다.
센트로이드는 항상 존재합니다. 이는 센트로이드를 찾는 알고리즘으로부터 알 수 있습니다:
int s[maxn];

int sizes (int v) {
    s[v] = 1;
    for (int u : g[v])
        // для простоты считаем, что дерево корневое
        s[v] += sizes(u);
    return s[v];
}

// второй параметр -- размер дерева
int centroid (int v, int n) {
    for (int u : g[v])
        if (s[u] > n/2)
            return centroid(u, n);
    return v;
}
명제. centroid는 실제로 센트로이드를 찾습니다.
증명:
centroid는 모든 자식의 크기가 $\frac{n}{2}$ 이하인 정점을 반환합니다(이는if에서 명시적으로 확인합니다).- 우리는 이 정점의 크기가 $\frac{n}{2}$보다 클 때 이 정점으로 왔으며, 이는 “반대” 방향에 있는 정점이 최대 $n - (\frac{n}{2}+1) = \frac{n}{2}-1$개라는 뜻입니다.
- 따라서 모든 이웃의 크기는 $n$의 절반 이하이며, 알고리즘은 올바릅니다.
때로는 센트로이드가 두 개일 수 있으며(예: 1-2-3-4), 이 경우 알고리즘은 「아래쪽」 센트로이드를 반환합니다.
정의. 「센트로이드를 찾고, 제거하고, 각 컴포넌트에서 다시 실행한다」는 재귀적 과정을 센트로이드 분해라고 부르겠습니다.
정의. 센트로이드를 제거하기 직전에 그 센트로이드에서 도달할 수 있는 정점들의 집합을 센트로이드의 컴포넌트라고 부르겠습니다.
마지막에는 트리 전체가 제거되므로, 각 정점은 정확히 한 번 자기 컴포넌트의 센트로이드가 되었다는 점에 주목하십시오.
이제 우리가 왜 이 모든 것을 했는지 알아봅시다.
명제. 각 정점은 $O(\log n)$개의 컴포넌트에 속합니다.
증명. 센트로이드는 트리를 크기가 적어도 절반 이하인 컴포넌트들로 분할합니다. 따라서 어떤 정점도 $\lceil \log_2 n \rceil$번보다 많은 분할을 “살아남을” 수 없습니다.
따름정리. 센트로이드 분할(위의 정의 참고)은 $O(n \log n)$에 동작합니다.
명제. 임의의 경로 $a \leadsto b$에 대해, $a$와 $b$가 모두 자신의 컴포넌트에 속해 있던 센트로이드 $c$가 유일하게 존재합니다.
증명. 모든 정점은 언젠가 한 번은 센트로이드가 됩니다. 경로 위의 정점 중 어느 하나가 가장 먼저 센트로이드가 되었고, 그 정점이 $a$와 $b$를 영원히 분리했습니다.
이것은 매우 중요한 결론입니다. 즉, 센트로이드 분할 과정에서 모든 단순 경로에 대해, 그 경로가 어떤 컴포넌트에 포함되어 있으면서 센트로이드를 지나는 상황이 정확히 한 번 존재합니다. 바로 이 시점에 우리는 small-to-large 병합과 비슷한 기법을 사용하여 어떤 쿼리를 처리할 수 있습니다.
#주어진 성질을 갖는 경로의 개수 세기
구체적인 예로 주어진 길이의 경로 개수를 세는 문제를 살펴보겠습니다.
센트로이드 분해 과정에 개입해 봅시다. 각 센트로이드를 제거하기 전에, 그 센트로이드를 지나는 원하는 경로의 개수를 답에 더하겠습니다.
이러한 경로의 개수는 현재 컴포넌트의 크기에 비례하는 시간에 셀 수 있습니다. 0부터 컴포넌트의 크기까지 각 거리에 있는 정점의 개수를 저장할 배열 d를 만듭시다. 컴포넌트인 트리를 센트로이드에 매달고, 그 직계 자식들로부터 dfs를 실행합시다. 이 dfs는 임시 배열 t, 즉 해당 서브트리에 있는 정점들의 깊이 목록을 반환합니다. 그 안의 각 값 x를 순회하면서 답에 d[l-x]를 더한 다음, t의 모든 값을 d에 추가하면 됩니다. 이렇게 하면 우리가 관심 있는 각 경로가 정확히 한 번씩 계산된다는 것을 확인할 수 있습니다.
int l = 179; // нужная нам длина
int ans = 0;

// нам лень явно удалять вершины: заведем массив used -- была ли вершина удалена
bool used[maxn];
int s[maxn]; // размеры поддеревьев

void sizes(int v, int p) {
    s[v] = 1;
    for (int u : g[v])
        if (u != p && !used[u])
            sizes(u, v), s[v] += s[u];
}

int centroid(int v, int p, int n) {
    for (int u : g[v])
        if (u != p && !used[u] && s[u] > n/2)
            return centroid(u, v, n);
    return v;
}

// записывает в t[] глубины вершин
void dfs(int v, int p, int d, vector<int> &t) {
    t.push_back(d);
    for (int u : g[v])
        if (u != p && !used[u])
            dfs(u, v, d + 1, t);
}

void solve(int v) {
    /* <единственный зависящий от конкретной задачи код> */
    sizes(v);
    vector<int> d(s[v], 0);
    d[0] = 1;
    for (int u : g[v]) {
        if (!used[u]) {
            vector<int> t;
            dfs(u, v, 1, t);
            for (int x : t)
                if (x <= l)
                    ans += d[l-x];
            for (int x : t)
                d[x]++;
        }
    }
    /* </единственный зависящий от конкретной задачи код> */

    used[v] = 1;
    for (int u : g[v])
        if (!used[u])
            solve(centroid(u, v, s[u]));
}
시간 복잡도는 $O(n \log n)$입니다. $O(n)$개의 정점 각각에 대해 센트로이드 분할의 $O(\log n)$개 «레벨» 각각에서 $O(1)$번의 연산을 수행하기 때문입니다.
#경로 쿼리 — 오프라인
새로운 컴포넌트를 얻은 직후에 우리에게 필요한 모든 것을 찾습니다. «경로 위에서 무언가를 계산하라»는 쿼리의 목록이 있다면, 이를 종종 offline으로 처리할 수 있습니다.
구체적으로 말하면, 각 정점에 그 정점과 관련된 아직 답하지 않은 쿼리의 목록을 함께 저장할 수 있습니다. 이 목록은 다음 컴포넌트를 처리하는 동안 살펴보며, 센트로이드가 해당 쿼리의 경로 위에 있으면 그 쿼리에 답하고 목록에서 삭제하고, 그렇지 않으면 그냥 무시합니다.
예를 들어 경로 합 쿼리의 경우, 내부 dfs에서 각 정점마다 현재 센트로이드로부터 그 정점까지의 경로 합을 미리 계산해 둘 수 있습니다. 그러면 현재 컴포넌트를 처리하는 도중 다른 가지에서 쿼리의 두 번째 정점을 만나면, 그 정점의 합과 이미 계산해 둔 첫 번째 정점까지의 경로 합을 더하기만 하면 됩니다.
따라서 각 쿼리는 삭제될 때까지 $O(\log n)$번 살펴보게 되며, 전체 시간 복잡도는 $O(q \log n + n \log n)$이 됩니다.
#경로 쿼리 — online
또는, 먼저 센트로이드 분해를 「구축」한 다음 쿼리에 답할 수도 있습니다.
경로 위의 최솟값 쿼리에 답하고 싶은데, 이진 리프팅으로 LCA를 구하는 방법을 모른다고 합시다. 크기가 $n \times \log n$인 2차원 배열 centroid[][]를 만들고, 각 정점마다 그 정점이 한때 속했던 컴포넌트들의 센트로이드 $O(\log n)$개를 저장합니다. 이와 더불어, 같은 형태의 배열에 쿼리에 답하는 데 필요한 정보를 저장합니다. 이 경우에는 각 정점-센트로이드 쌍마다 해당 경로 위의 최솟값을 저장합니다.
그러면 쿼리에 답할 때 $O(\log n)$ 또는 $O(\log \log n)$의 연산으로 원하는 경로 위의 센트로이드를 찾고(centroid[v]와 centroid[u]의 처음 몇 개 값은 일치하며, 그중 마지막 값이 우리가 찾는 것입니다), 센트로이드까지의 두 경로에서 구한 최솟값들 중 최솟값을 답으로 취합니다.
#재계산이 더 오래 걸릴 때의 점근적 복잡도
「병합」(센트로이드를 지나는 경로의 개수를 세거나 쿼리에 답하는 부분)을 선형 시간이 아니라, 예를 들어 어딘가에서 set을 사용하여 $O(n \log n)$에 작성했다고 가정해 봅시다. 이렇게 하면 시간 면에서 얼마나 더 나빠집니까?
최악의 경우(대나무 형태의 트리에서)에는 매번 컴포넌트가 크기가 같은 두 부분으로 나뉩니다. 재귀 트리 전체의 연산 횟수를 합산해 봅시다.
$$ \sum_{k=0}^{\log n} n \log \frac{n}{2^k} = \sum_{k=0}^{\log n} n (\log n - k) = n \sum_{k=0}^{\log n} k = \Theta (n \log^2 n) $$ 교훈: 해시 테이블을 사용하십시오.