르네 데카르트(프랑스어: René Descartes)는 17세기 프랑스의 위대한 수학자이자 철학자입니다.
르네 데카르트는 트립(데카르트 트리)을 만든 사람은 아니지만, 우리 모두가 잘 알고 사랑하는 데카르트 좌표계를 만든 사람입니다.
한편 트립은 다음과 같이 정의되고 구성됩니다:
- 평면 위에 $n$개의 점으로 이루어진 집합을 찍어 봅시다. 어째서인지 이 점들의 $x$를 키라고 부르고, $y$를 우선순위라고 부르겠습니다.
- 가장 위에 있는 점(즉 $y$가 가장 큰 점이며, 그런 점이 여러 개라면 그중 아무것이나)을 하나 골라 루트라고 부릅시다.
- 루트보다 왼쪽에 있는($x$가 더 작은) 모든 정점에 대해 같은 과정을 재귀적으로 실행합시다. 왼쪽에 정점이 하나라도 있었다면, 왼쪽 부분의 루트를 현재 루트의 왼쪽 자식으로 연결합시다.
- 마찬가지로, 오른쪽 부분에 대해서도 같은 과정을 실행하고 루트에 오른쪽 자식을 추가합니다.
모든 $y$와 $x$가 서로 다르다면 트리가 유일하게 구성된다는 점에 주목하십시오.
만들어진 구조를 평면 위에 그려 보면 실제로 트리가 됩니다. 관례에 따라 루트가 위쪽에 오도록 그립니다.
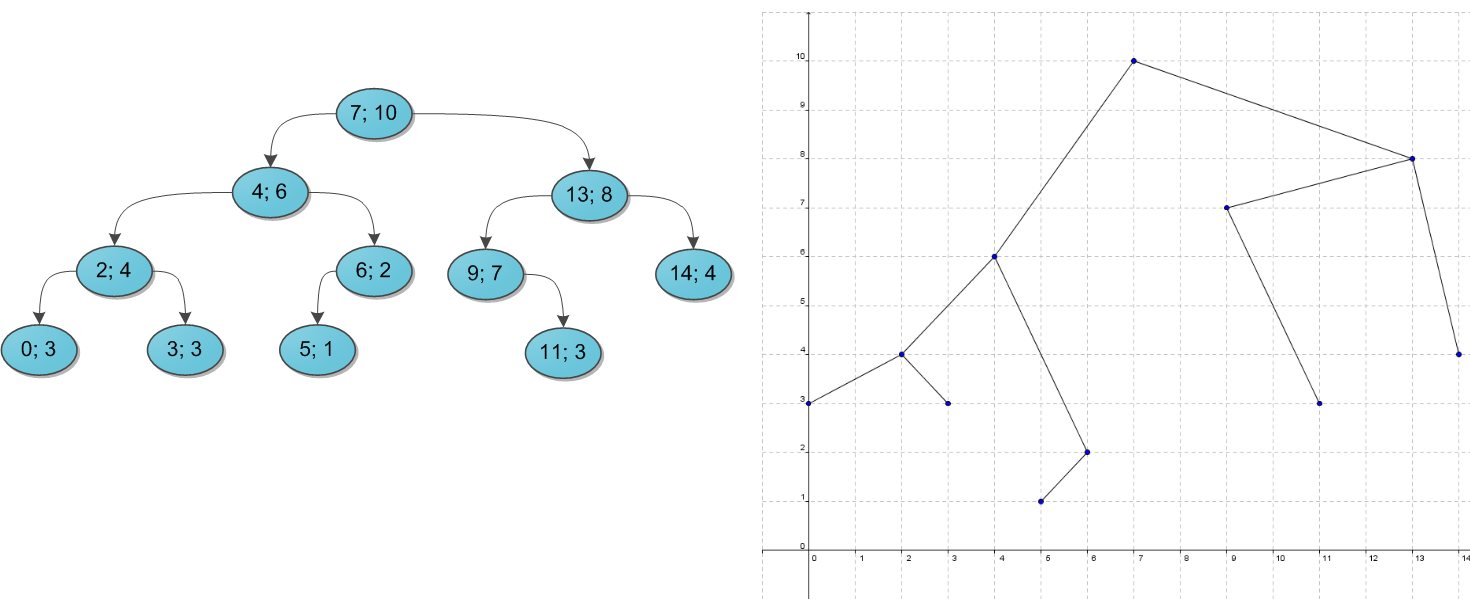
따라서 트립은 $x$에 대해서는 이진 트리이고 동시에 $y$에 대해서는 힙입니다. 그래서 트립에는 다양한 별칭이 붙었습니다:
- 트라미드 (트리 + 피라미드)
- 트힙 (트리 + 힙)
- 피트 (피라미드 + 트리)
- 힙트리 (힙 + 트리)
- 트립 (트리 + 힙)
영어로는 보통 cartesian 또는 treap이라고 부르며, 러시아어로는 흔히 «트립»으로 줄여 부릅니다.
#이진 탐색 트리로서
약간만 수정하면 트립은 다른 이진 탐색 트리가 할 수 있는 모든 것을 할 수 있습니다. 예를 들면 다음과 같습니다.
- 집합에 수 $x$ 추가하기;
- 집합에 수 $x$가 있는지 판별합니다;
- $x$ 이상인 첫 번째 수를 찾습니다 —
lower_bound와 같습니다; - 구간 $[l, r]$에 속하는 수의 개수를 구합니다.
모든 균형 이진 탐색 트리와 마찬가지로, 모든 연산은 트리의 높이에 비례하는 시간, 즉 $O(\log n)$에 동작합니다.
#우선순위와 점근적 복잡도
트립에서는 트리의 로그 높이가 불변식이나 휴리스틱이 아니라 확률론에 의해 보장됩니다. 모든 우선순위($y$)를 무작위로 고르면 정점의 평균 깊이가 로그 수준이 된다는 사실이 알려져 있습니다. 그래서 트립을 무작위화된 탐색 트리라고도 부릅니다.
정리. 트립에서 정점 깊이의 기댓값은 $O(\log n)$입니다.
증명. $x$가 $y$의 조상이면 1, 그렇지 않으면 0인 함수 $a(x, y)$를 도입합니다. 이러한 함수를 지시 함수라고 합니다.
정점의 깊이는 그 정점의 조상 수와 같으므로
$$ d_i = \sum_{j=1}^n a(j, i) $$ 따라서 깊이의 기댓값은 다음과 같습니다. $$ E[d_i] = E[\sum_{j \neq i} a(j, i)] = \sum_{j \neq i} E[a(j, i)] = \sum_{j \neq i} E[a(j, i)] = \sum_{j \neq i} p(j, i) $$여기서 $p(x, y)$는 $a(x, y) = 1$일 확률, 즉 정점 $x$가 정점 $y$의 조상일 확률입니다. 여기서 우리는 중요한 선형성 성질을 사용했습니다. 무엇이든 그 합의 기댓값은 각각의 기댓값의 합과 같습니다.
이제 남은 것은 가능한 모든 조상에 대해 이 확률들을 계산하여 더하는 것입니다. 하지만 그 전에 보조 명제가 하나 필요합니다.
보조정리. 정점 $x$의 우선순위가 반개구간 $(x, y]$에 속한 모든 정점의 우선순위보다 크면 $x$는 $y$의 조상입니다(일반성을 잃지 않고 $x < y$라고 가정하겠습니다).
필요성. $x$가 가장 높은 정점이 아니라면, $x$와 $y$ 사이 어딘가에 $x$보다 우선순위가 큰 정점이 있습니다. 그 정점은 $x$의 자손일 수 없으므로, $x$와 $y$는 그 정점에 의해 분리됩니다.
충분성. 구간 오른쪽에 우선순위가 더 큰 어떤 정점이 있다면, 그 정점의 왼쪽 자식은 $x$의 조상이 되는 어떤 정점이 됩니다. 따라서 $y$의 오른쪽에 있는 것은 아무것에도 영향을 주지 않습니다.
임의의 구간에 있는 모든 정점은 가장 큰 우선순위를 가질 확률이 동일합니다. 이 사실을 보조정리의 결과와 결합하면 구하려는 확률에 대한 식을 얻을 수 있습니다. 정점 $x$가 $y$의 조상이 되려면, $x$의 우선순위가 $x$부터 $y]$까지의 구간에 있는 나머지 $|x - y|$개의 정점 모두의 우선순위보다 커야 합니다:
$$ p(x, y) = \frac{1}{|x-y|+1} $$ 이제 깊이의 기댓값을 구하려면 이 확률들을 모두 더해야 합니다: $$ E[d_i] = \sum_{j \neq i} p(j, i) = \sum_{j \neq i} \frac{1}{|i-j|+1} = \sum_{j < i} \frac{1}{i - j} + \sum_{j > i} \frac{1}{j - i} \leq 2 \cdot \sum_{k=2}^n \frac{1}{k} = O(\log n) $$마지막 변환 직전에 우리는 조화급수의 합을 얻었습니다.
주목할 만한 점은 정점의 기대 깊이가 그 위치에 따라 달라진다는 것입니다. 가운데에 있는 정점은 가장자리에 있는 정점보다 대략 두 배 더 깊어야 합니다.
연습 문제. 이 논증과 유사한 방식으로 quicksort의 점근적 복잡도를 유도하십시오.
#구현
트립은 포인터와 구조체를 사용해 구현하는 것이 가장 편리합니다.
키, 우선순위, 그리고 왼쪽 자식과 오른쪽 자식을 가리키는 포인터를 저장할 구조체 Node를 만듭시다:
struct Node {
    int key, prior;
    Node *l = 0, *r = 0;
    Node(int key) : key(key), prior(rand()) {}
};
트리의 루트에 대한 포인터만 있으면 트리 전체를 식별할 수 있습니다. 따라서 “함수가 두 트리를 받는다"라고 말할 때는 실제로 그 루트에 대한 포인터를 의미합니다. 한편 널 포인터는 “빈” 트리로 취급하겠습니다.
트리의 구조를 변경하는 두 개의 보조 함수를 선언합시다. 하나는 트리를 분할하고, 다른 하나는 트리를 병합합니다. 앞으로 보겠지만, 이 함수들을 통해 나중에 필요한 거의 모든 함수를 쉽게 표현할 수 있습니다.
#Merge
두 트리(두 루트 $L$과 $R$)를 입력으로 받으며, 왼쪽 트리의 모든 정점은 오른쪽 트리의 모든 정점보다 키가 작다는 것이 알려져 있습니다. 이 둘을 아무것도 깨지지 않도록 하나의 트리로 합쳐야 합니다. 즉, 키 기준으로는 여전히 트리이고, 우선순위 기준으로는 힙이어야 합니다.
먼저 어느 정점을 루트로 삼을지 정합시다. 후보는 왼쪽 루트 $L$ 또는 오른쪽 루트 $R$의 두 개뿐이며, 둘 중 우선순위가 더 큰 쪽을 고르면 됩니다.
명확히 하기 위해, 그것이 왼쪽 루트였다고 합시다. 그러면 결과 트리의 루트의 왼쪽 자식은 $L$의 왼쪽 자식이어야 합니다. 오른쪽 자식은 더 복잡합니다. $R$과 병합해야 할 수도 있기 때문입니다. 따라서 재귀적으로 merge(l->r, r)를 수행하고 그 결과를 오른쪽 자식으로 기록합니다.
Node* merge(Node *l, Node *r) {
    if (!l) return r;
    if (!r) return l;
    if (l->prior > r->prior) {
        l->r = merge(l->r, r);
        return l;
    }
    else {
        r->l = merge(l, r->l);
        return r;
    }
}
#Split
트리 $P$와 키 $x$를 받아, 이 키를 기준으로 트리를 둘로 나눕니다. $L$은 $x$ 이하인 키를 모두 가져야 하고, $R$은 $x$보다 큰 키를 모두 가져야 합니다.
이 함수에서는 먼저 루트가 어느 트리에 속해야 하는지 결정한 다음, 그 루트의 오른쪽 또는 왼쪽 절반을 재귀적으로 분할하여 알맞은 곳에 붙입니다:
pair<Node*, Node*> split(Node *p, int x) {
    if (!p) return {0, 0};
    if (p->key <= x) {
        auto [l, r] = split(p->r, x);
        p->r = l;
        return {p, r};
    }
    else {
        auto [l, r] = split(p->l, x);
        p->l = r;
        return {l, p};
    }
}
#예시: 삽입
merge와 split은 그 자체로는 그다지 유용하지 않지만, 나머지 모든 연산을 작성하는 데 도움이 됩니다.
예를 들어, 트리에 수 $x$를 추가하려면 split으로 트리를 $x$ 기준으로 자르고, 수 $x$ 하나만 담은 새 정점을 만든 다음, 그렇게 얻은 세 트리를 merge로 이어 붙이면 됩니다.
Node *root = 0;

void insert(int x) {
    auto [l, r] = split(root, x);
    Node *t = new Node(x);
    root = merge(l, merge(t, r));
}
#예시: 구간 합을 위한 수정
때로는 더 고급 연산을 위해 어떤 수정을 가해야 할 때가 있습니다.
예를 들어, 때때로 구간에서 수들의 합을 구하고 싶을 수 있습니다. 이를 위해 각 정점에는 자신의 수와 함께 자신의 «구간»에 대한 합도 저장해야 합니다:
struct Node {
    int val, sum;
    // ...
};
merge와 split을 할 때 이 합을 항상 최신 상태로 유지해야 합니다.
merge와 split을 모두 우리 입맛에 맞게 수정하는 대신, 정점의 자식이 갱신될 때 호출할 보조 함수 upd를 작성합시다:
int sum(Node* v) { return v ? v->sum : 0; }
// обращаться по пустому указателю нельзя -- выдаст ошибку

void upd(Node* v) { v->sum = sum(v->l) + sum(v->r) + v->val; }
이제 merge와 split에서는 노드를 반환하기 전에 upd를 호출하기만 하면 되며, 그러면 아무것도 깨지지 않습니다:
Node* merge(Node *l, Node *r) {
    // ...
    if (...) {
        l->r = merge(l->r, r);
        upd(l);
        return l;
    }
    else {
        // ...
    }
}

pair<Node*, Node*> split(Node *p, int x) {
    // ...
    if (...) {
        // ...
        upd(p);
        return {p, r};
    }
    else {
        // ...
    }
}
그러면 합을 구하는 쿼리에서는 필요한 구간을 잘라 내어 그 합을 조회하기만 하면 됩니다:
int sum(int l, int r) {
    auto [T, R] = split(root, r);
    auto [L, M] = split(T, l);
    int res = sum(M);
    root = merge(L, merge(M, R));
    return res;
}
#간단한 리팩터링
대부분의 연산은 구현이 항상 거의 같습니다. $l$부터 $r$까지의 구간을 잘라 내고, 그 구간으로 무언가를 한 뒤, 다시 붙입니다.
중복되는 코드는 좋지 않습니다. C++의 모든 힘을 활용하여, 다른 함수를 인자로 받는 함수를 정의합시다. 인자로 받은 그 함수가 필요한 구간에서 실제로 유용한 작업을 수행하게 됩니다:
int apply(int l, int r, auto f) {
    auto [T, R] = split(root, r);
    auto [L, M] = split(T, l);
    int res = f(M);
    root = merge(L, merge(M, R));
    return res;
}
이 함수는 다음과 같이 사용해야 합니다:
apply(l, r, sum);
대부분의 연산에서는, upd에 대해 아직 구현되지 않았다면 그곳에 람다를 전달하는 것이 편리합니다.