트리는 프로그래밍에서 가장 널리 쓰이는 자료 구조 중 하나입니다.
트리는 정점(마디, 노드)들의 집합과 그 사이를 잇는 방향 있는 간선(링크)으로 이루어집니다. 정점들은 루트라고 부르는 어느 한 정점(그림에서는 정점 8)에서 나머지 모든 정점까지 단 하나의 경로로 도달할 수 있도록 연결되어 있습니다.
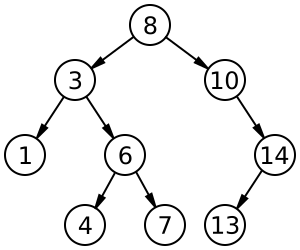
관련 정의:
- 정점 $v$의 부모는 $v$로 향하는 직접 링크를 가진 정점입니다.
- 정점 $v$의 자식(자식 원소, 아들, 딸)은 $v$에서 직접 링크가 이어지는 정점들입니다.
- 조상은 부모의 부모, 그들의 부모 등을 말합니다.
- 자손 — 자식의 자식, 그 자식의 자식 등을 말합니다.
- 리프(말단 정점)는 자식이 없는 정점입니다.
- 서브트리(부분 트리)는 트리의 한 정점과 그 정점의 모든 자손으로 이루어진 것입니다.
- 정점의 차수는 그 정점의 자식 수입니다.
- 정점의 깊이는 루트에서 그 정점까지의 거리입니다.
- 트리의 높이는 모든 정점의 깊이 중 최댓값입니다.
트리는 메모리에서 대개 자식을 가리키는 명시적 포인터를 가진 동적으로 생성되는 구조체로 표현되거나, 배열 내 위치에 의해 암묵적으로 정의되는 관계로 연결된 배열 원소로 표현됩니다.
트리는 그래프의 맥락에서도 사용됩니다.
이진 탐색 트리
이진 탐색 트리(영어: binary search tree, BST)는 다음 성질을 만족하는 트리입니다:
- 각 정점은 최대 두 개의 자식을 가집니다.
- 모든 정점은 비교 연산이 정의된 키를 가집니다(예: 정수 또는 문자열).
- 정점 $v$의 왼쪽 서브트리에 있는 모든 정점의 키는 $v$의 키보다 크지 않습니다.
- 정점 $v$의 오른쪽 부분 트리에 있는 모든 정점의 키는 $v$의 키보다 큽니다.
- 왼쪽과 오른쪽 두 서브트리 모두 이진 탐색 트리입니다.
더 일반적인 개념으로는 일반적인(이진이 아닌) 탐색 트리가 있습니다. 이 트리에서는 자식의 수가 둘보다 많을 수 있으며, 이때 「더 왼쪽의」 서브트리에 있는 키는 「더 오른쪽의」 서브트리에 있는 키보다 작아야 합니다. 당분간은 더 단순한 이진 탐색 트리에만 집중하겠습니다.
이진 탐색 트리는 대부분 구조체 형태로 저장합니다. 구조체는 정점마다 하나씩 있으며, 여기에는 오른쪽 자식과 왼쪽 자식에 대한 링크(비어 있을 수도 있음), 키, 그리고 경우에 따라 몇 가지 추가 데이터가 기록됩니다.
struct Node {
    int x;
    Node *l, *r;
};
이름에서 짐작할 수 있듯이, 이진 탐색 트리의 주된 장점은 트리에서 원소를 쉽게 탐색할 수 있다는 점입니다:
bool find(Node *v, int x) {
    if (!v)
        return false;
    if (v->x == x)
        return true;
    return (v->x < x) ? find(v->l, x) : find(v->r, x);
}
이 함수는 원소 삽입이나 삭제 같은 다른 많은 기본 연산과 마찬가지로 최악의 경우 트리의 높이에 비례하는 시간에 동작합니다. 이진 트리의 높이는 최악의 경우 $O(n)$이 될 수 있으므로(«대나무»), 효율적인 구현에서는 정점의 평균 깊이가 $O(\log n)$이 되고 기본 연산의 비용도 그에 상응하도록 보장하는 몇 가지 불변식을 유지합니다. 이러한 트리를 균형 트리라고 합니다.